Share
Embed
Transcript
86 slides
-
2 今日は何の話? • libcでもっとも良く使われる関数、mallocと freeの実装の解説 • もっと一般的に言うと、プロセスのアドレス空 間のうち、heap領域とよばれる、場所を操作 する関数の説明 •
解説というと聞こえはいいが、そんな大層なも のじゃない -
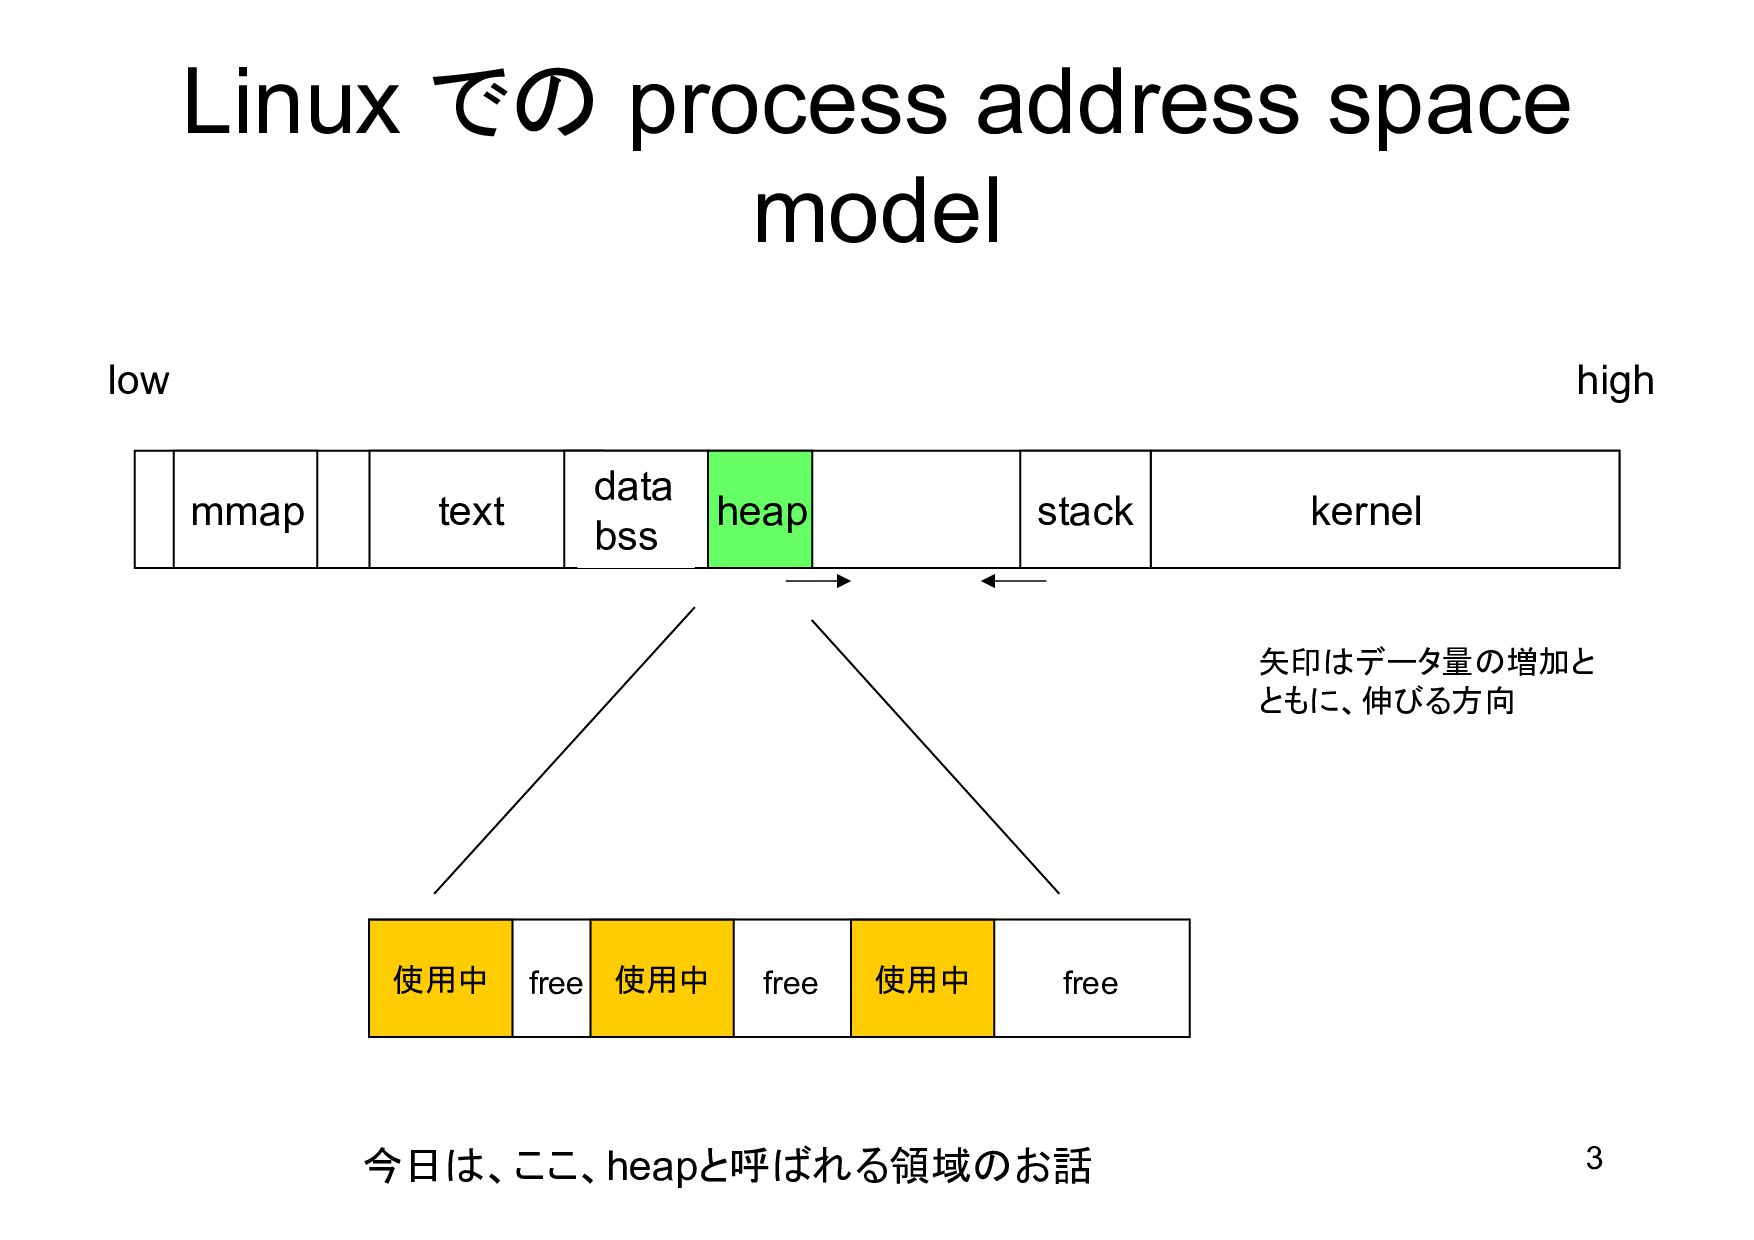
3 Linux での process address space model kernel stack text
mmap data bss heap 矢印はデータ量の増加と ともに、伸びる方向 使用中 使用中 使用中 今日は、ここ、heapと呼ばれる領域のお話 low high free free free -
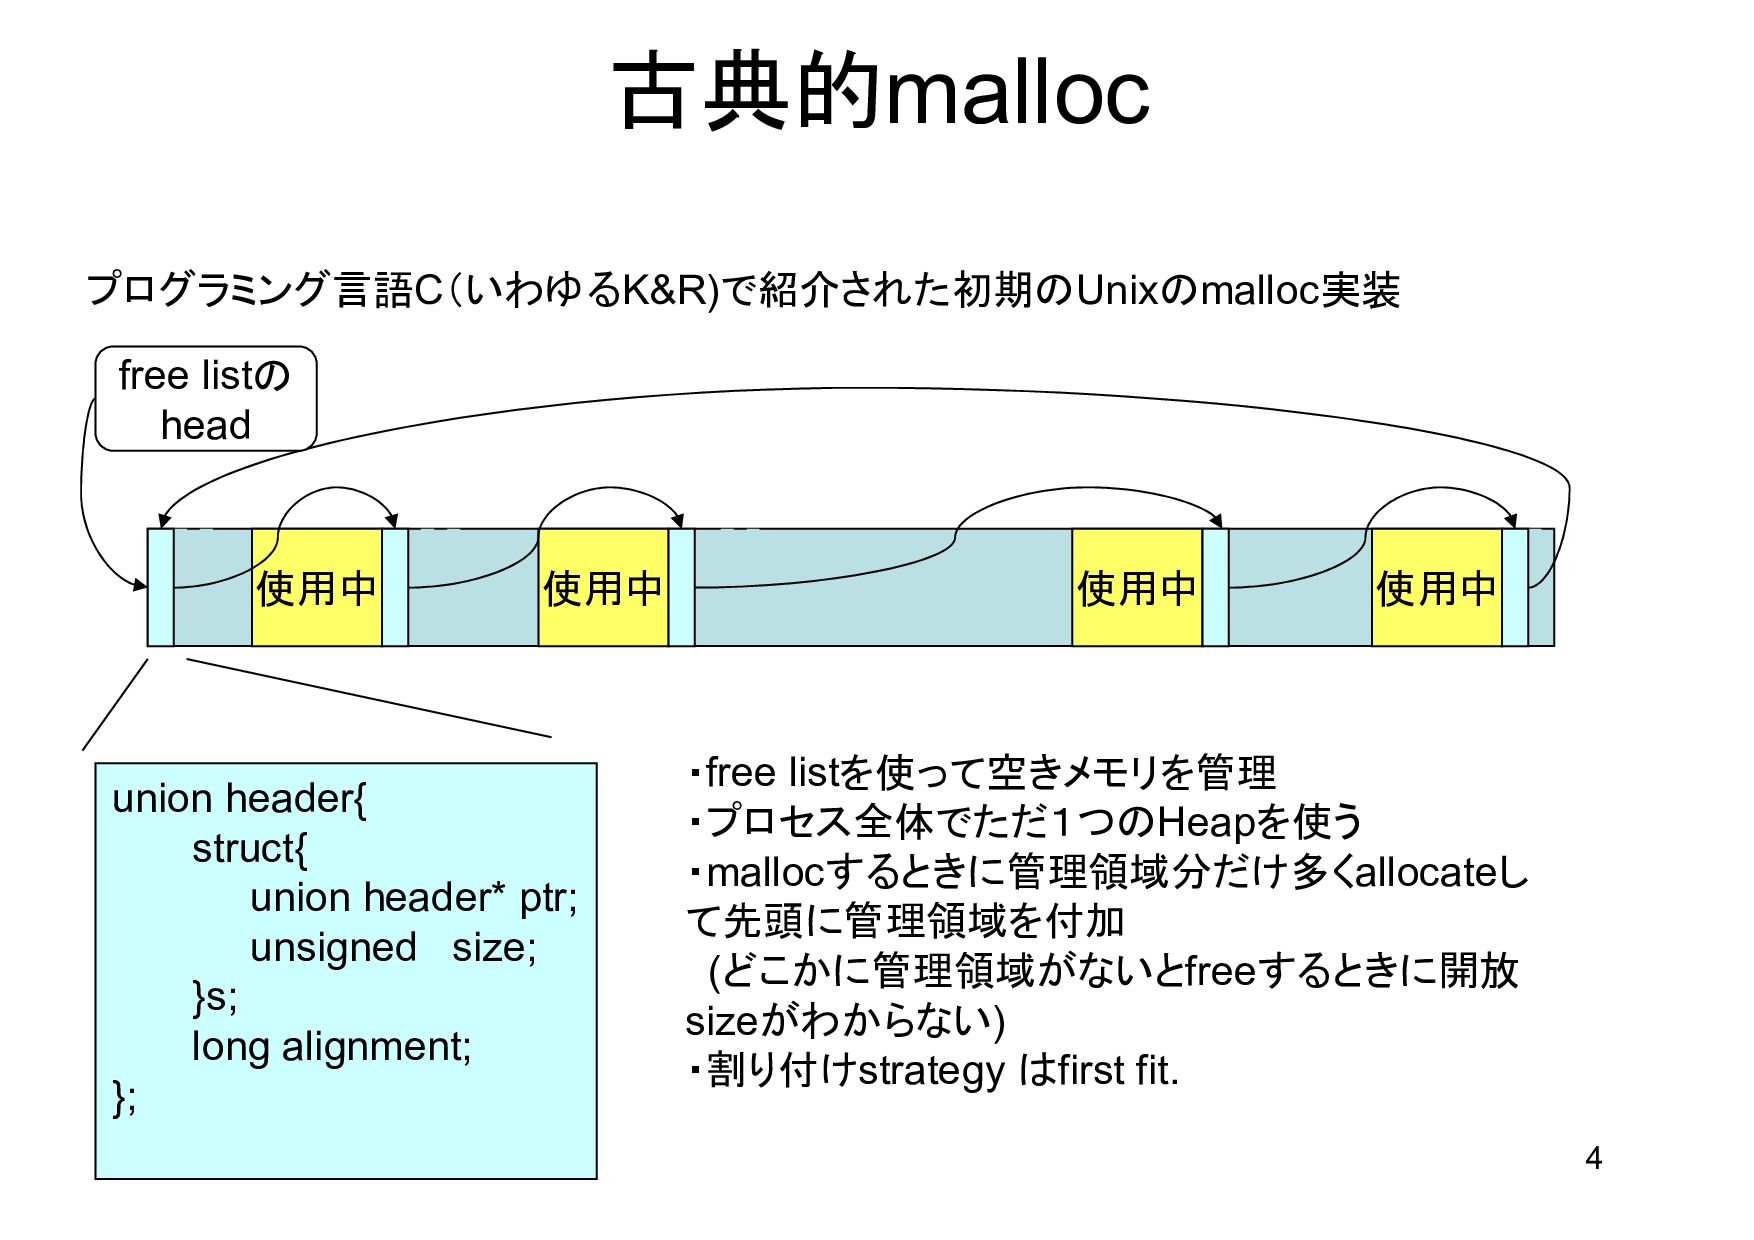
4 古典的malloc プログラミング言語C(いわゆるK&R)で紹介された初期のUnixのmalloc実装 使用中 使用中 使用中 free listの head 使用中
・free listを使って空きメモリを管理 ・プロセス全体でただ1つのHeapを使う ・mallocするときに管理領域分だけ多くallocateし て先頭に管理領域を付加 (どこかに管理領域がないとfreeするときに開放 sizeがわからない) ・割り付けstrategy はfirst fit. union header{ struct{ union header* ptr; unsigned size; }s; long alignment; }; -
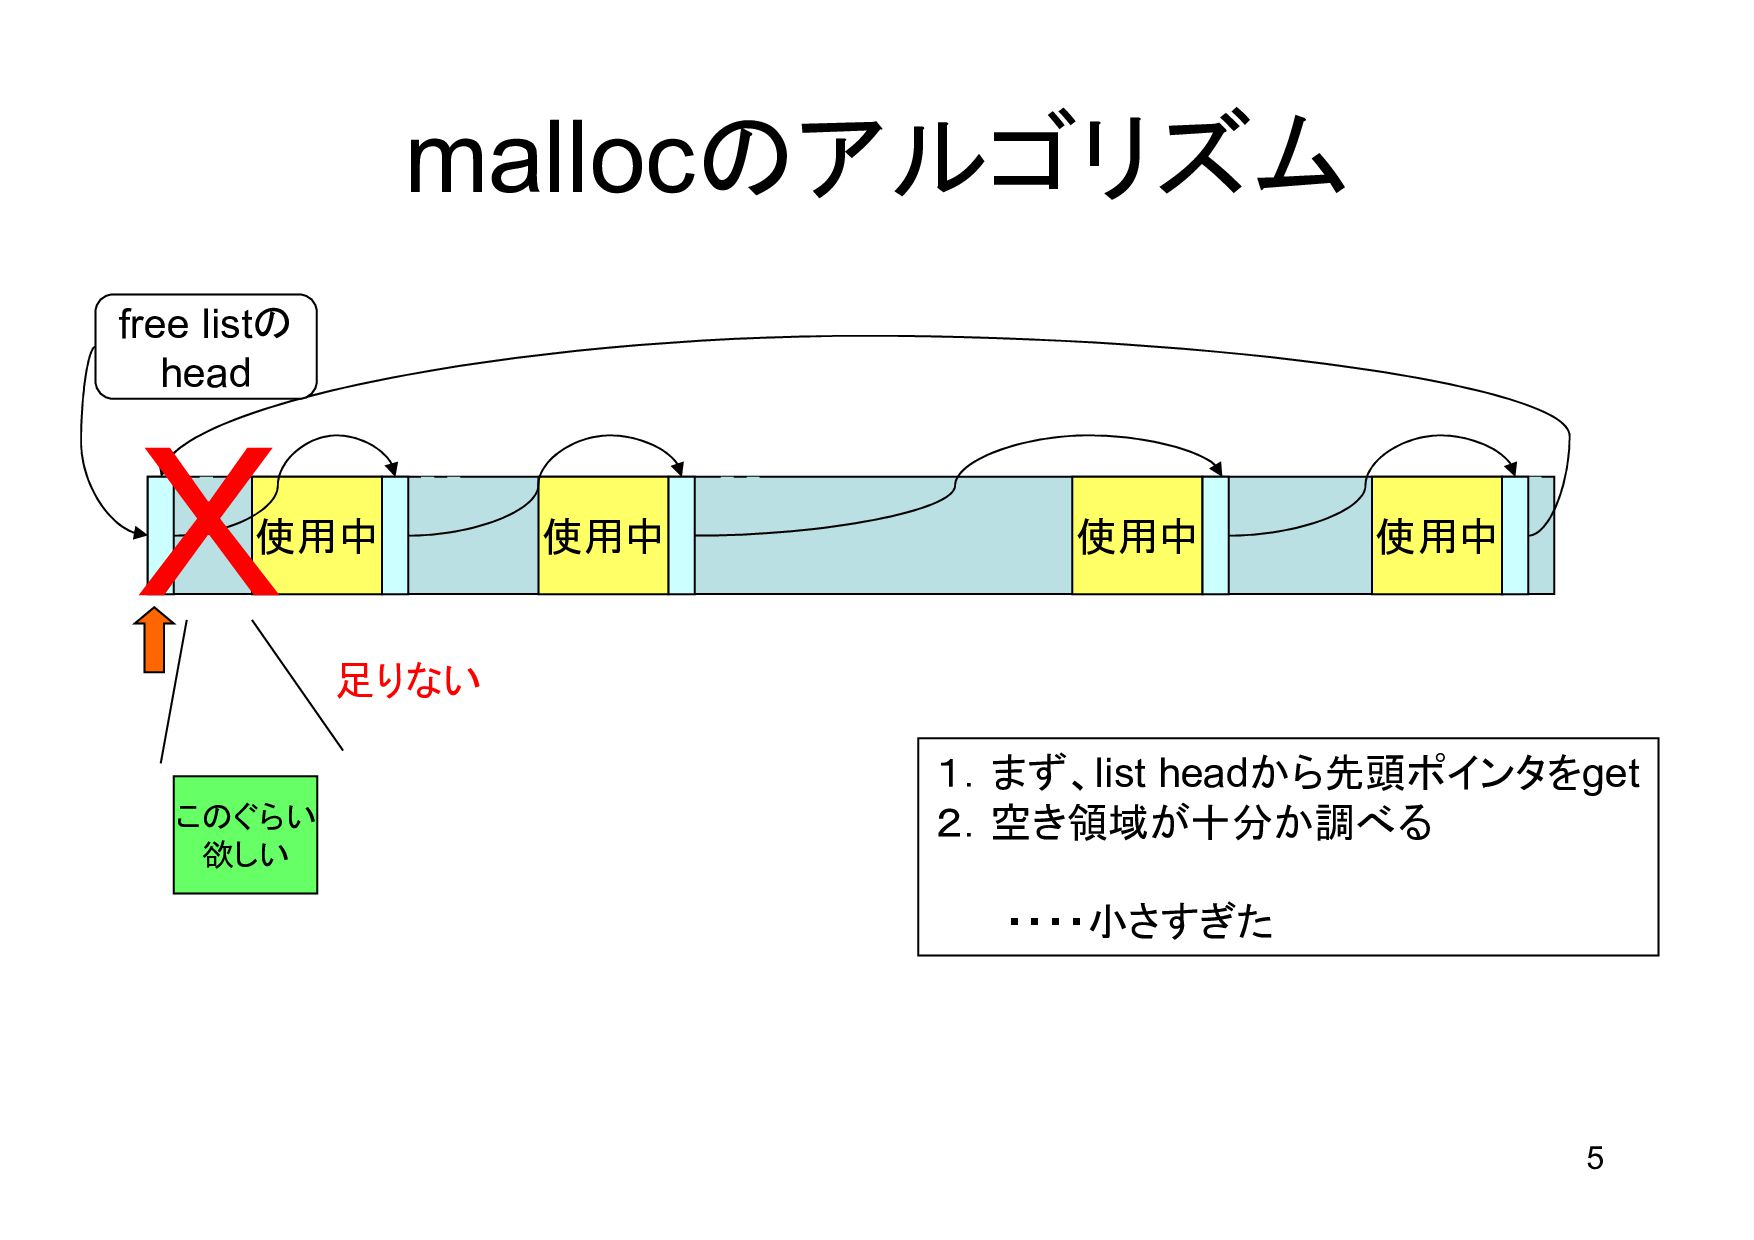
5 mallocのアルゴリズム 使用中 使用中 使用中 free listの head 使用中 このぐらい
欲しい 足りない 1.まず、list headから先頭ポインタをget 2.空き領域が十分か調べる ・・・・小さすぎた -
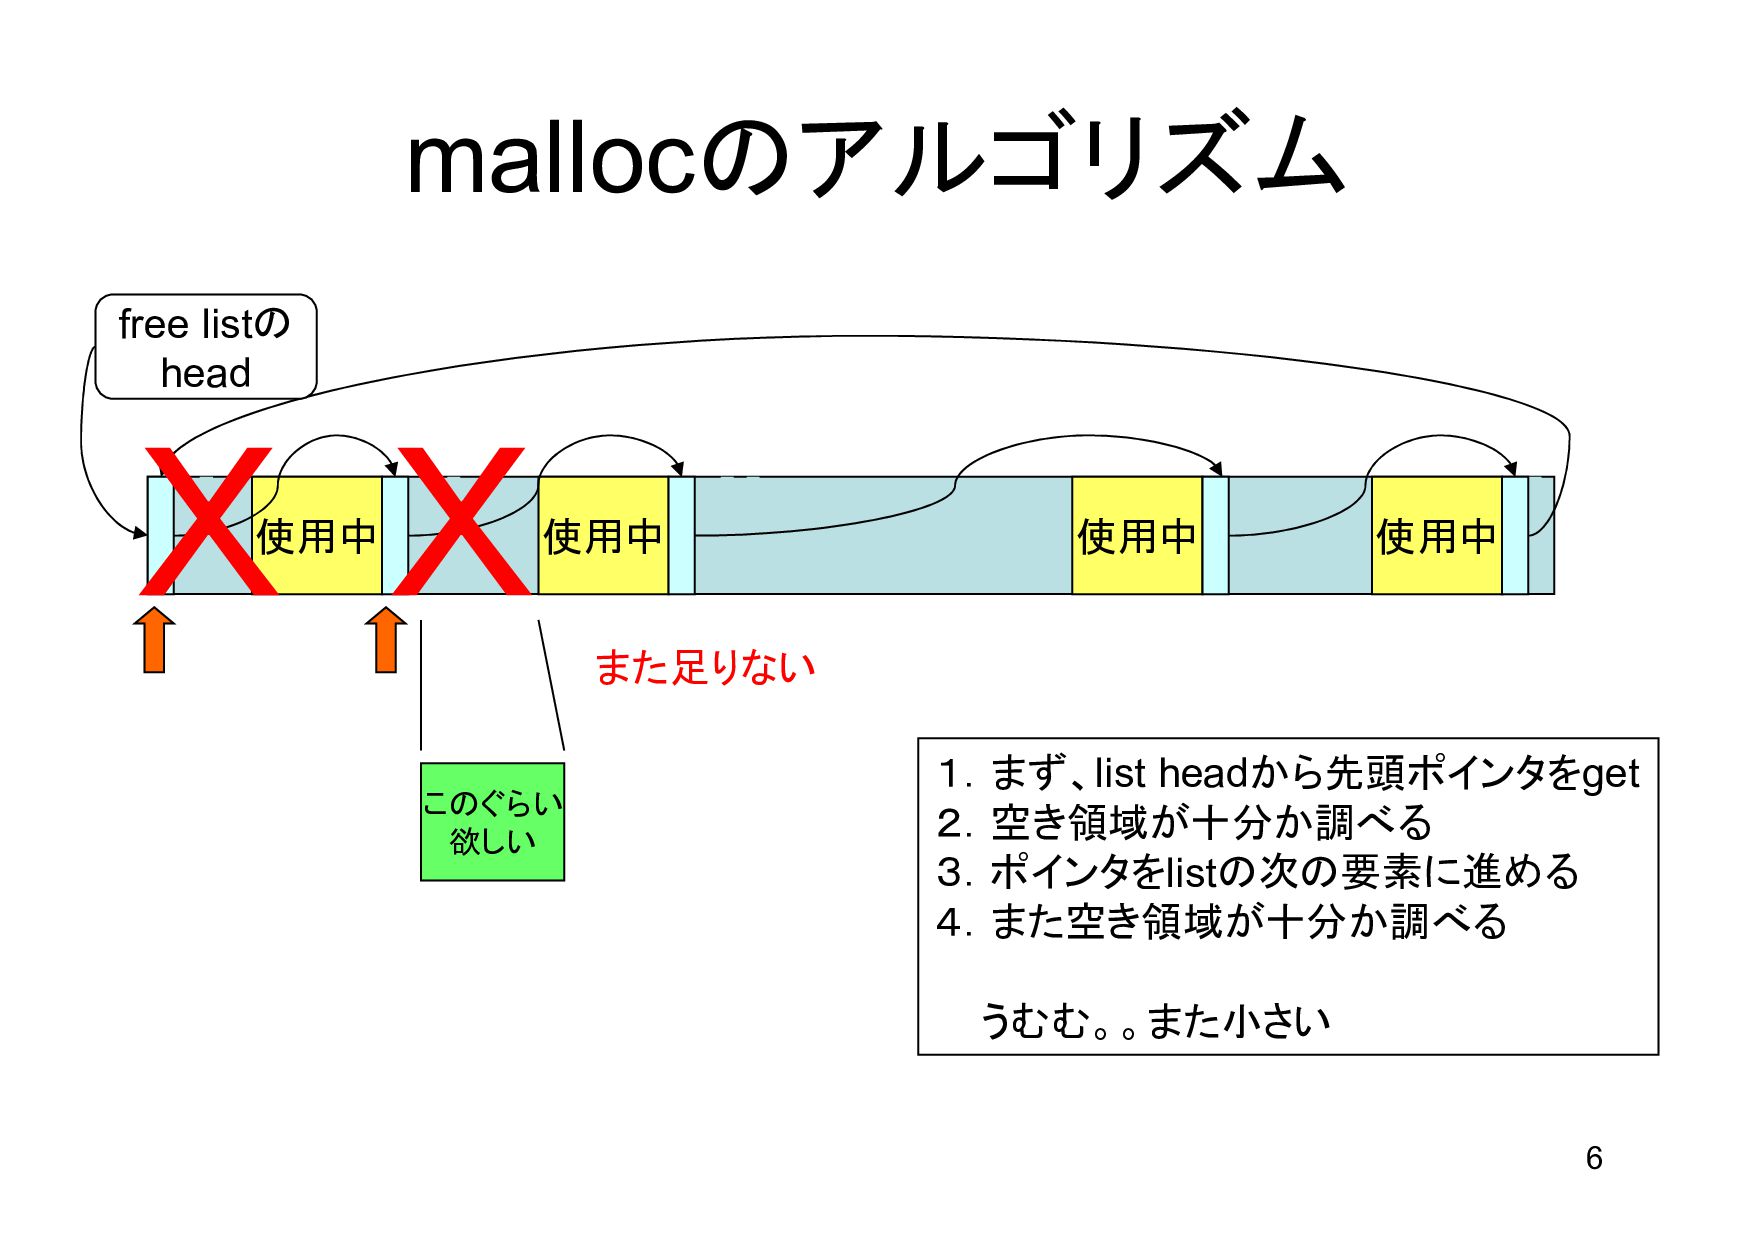
6 mallocのアルゴリズム 使用中 使用中 使用中 free listの head 使用中 また足りない
このぐらい 欲しい 1.まず、list headから先頭ポインタをget 2.空き領域が十分か調べる 3.ポインタをlistの次の要素に進める 4.また空き領域が十分か調べる うむむ。。また小さい -
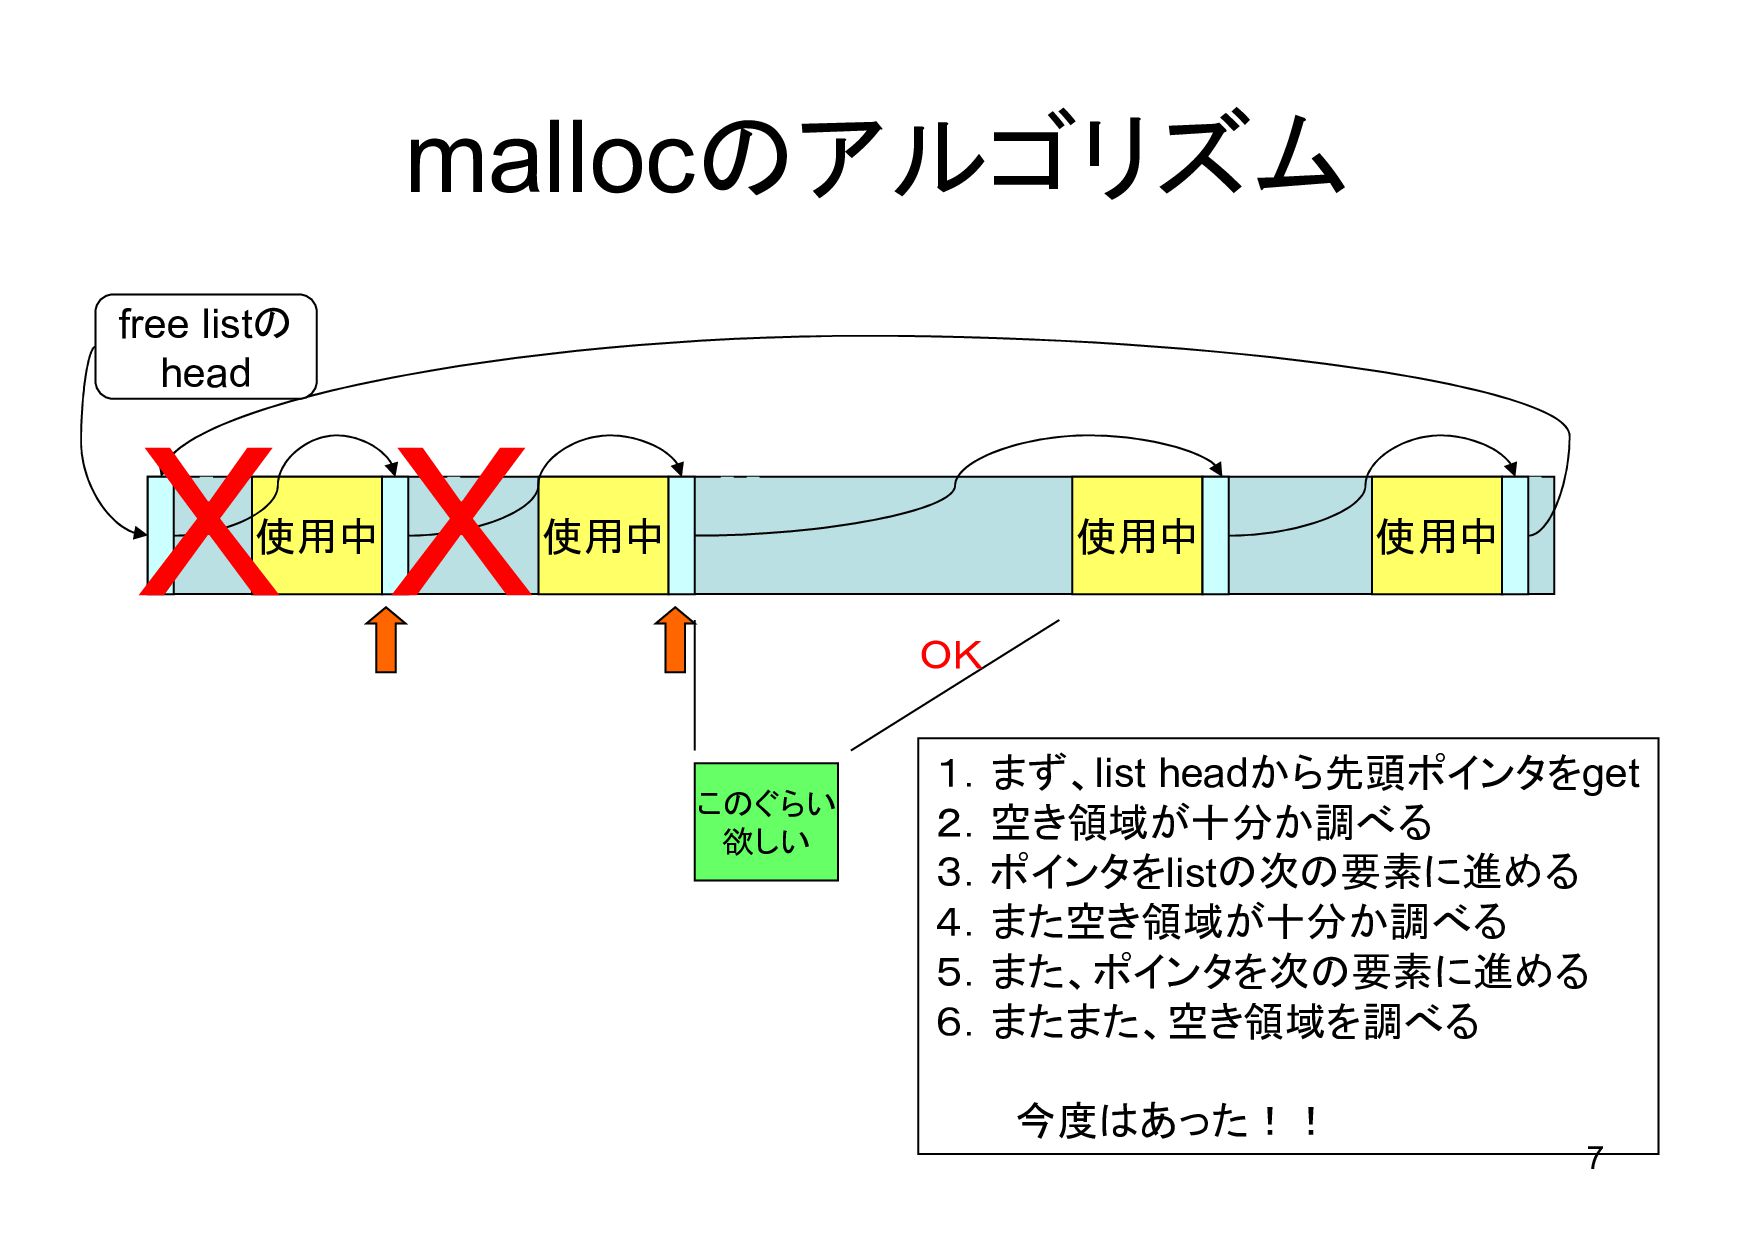
7 mallocのアルゴリズム 使用中 使用中 使用中 free listの head 使用中 1.まず、list
headから先頭ポインタをget 2.空き領域が十分か調べる 3.ポインタをlistの次の要素に進める 4.また空き領域が十分か調べる 5.また、ポインタを次の要素に進める 6.またまた、空き領域を調べる 今度はあった!! OK このぐらい 欲しい -
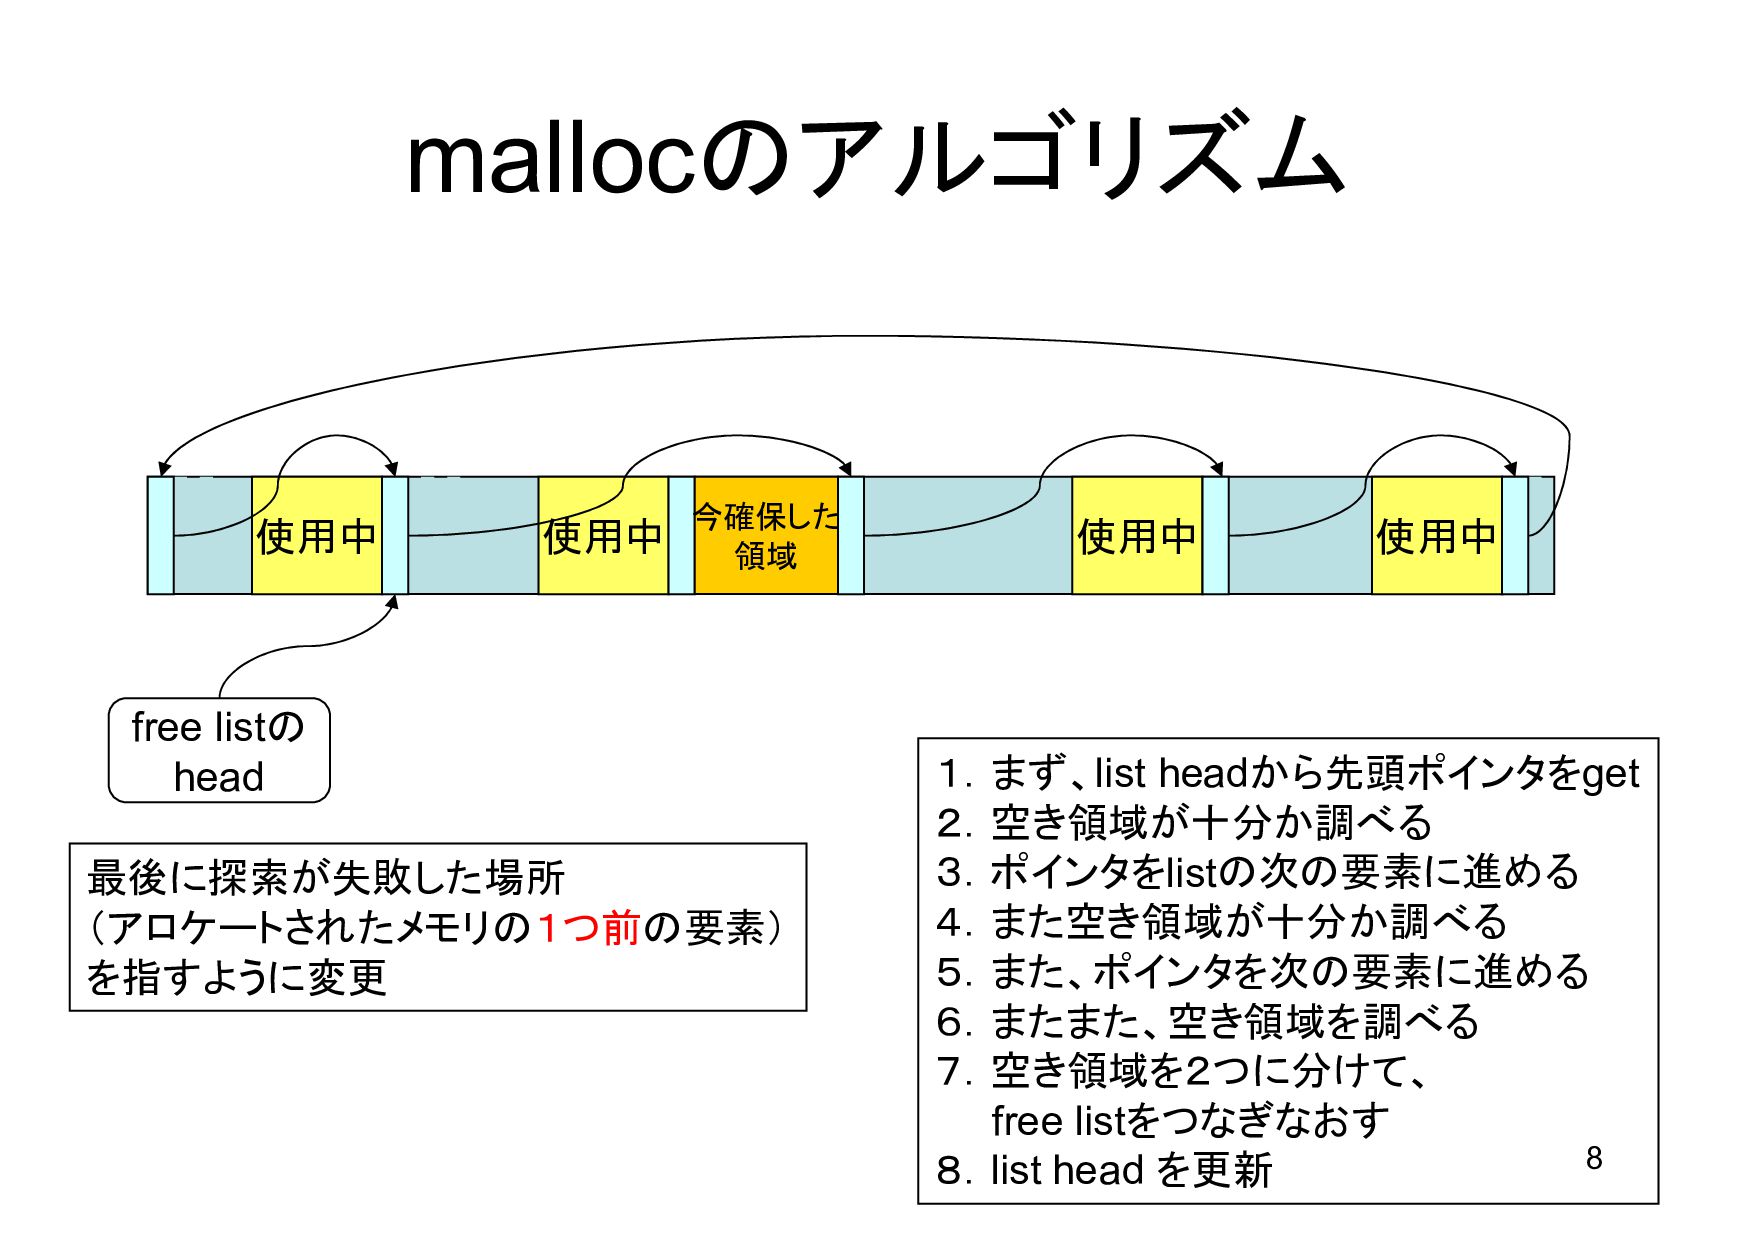
8 mallocのアルゴリズム 使用中 使用中 使用中 free listの head 使用中 1.まず、list
headから先頭ポインタをget 2.空き領域が十分か調べる 3.ポインタをlistの次の要素に進める 4.また空き領域が十分か調べる 5.また、ポインタを次の要素に進める 6.またまた、空き領域を調べる 7.空き領域を2つに分けて、 free listをつなぎなおす 8.list head を更新 今確保した 領域 最後に探索が失敗した場所 (アロケートされたメモリの1つ前の要素) を指すように変更 -
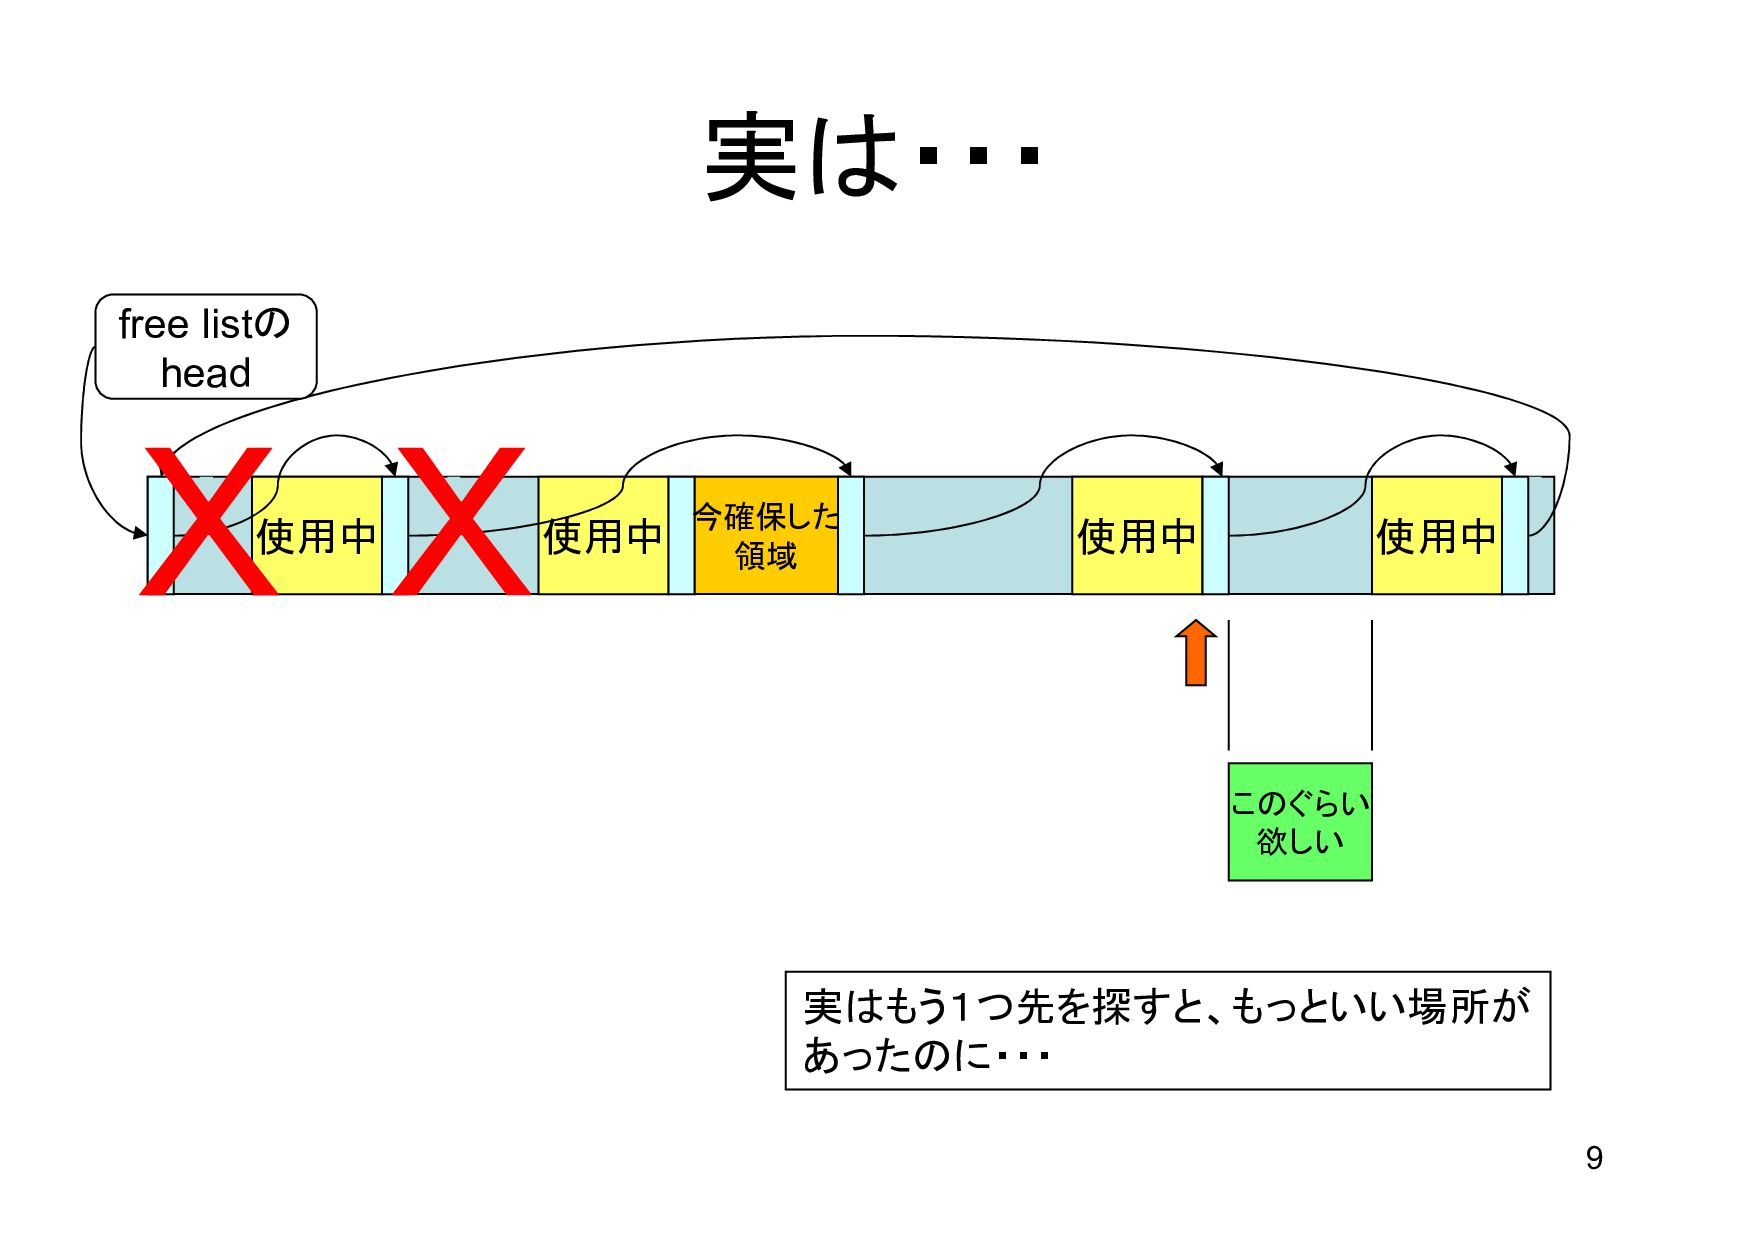
9 実は・・・ 使用中 使用中 使用中 free listの head 使用中 実はもう1つ先を探すと、もっといい場所が
あったのに・・・ このぐらい 欲しい 今確保した 領域 -
10 freeのアルゴリズム 使用中 使用中 使用中 free listの head 使用中 freeしたい
領域 1.free list headから最初のポインタをゲット 2.最初の要素の、さらに次のポインタもゲット (next = p->s.ptr) 3.p < bp < next が成立しないので次へ bp p next -
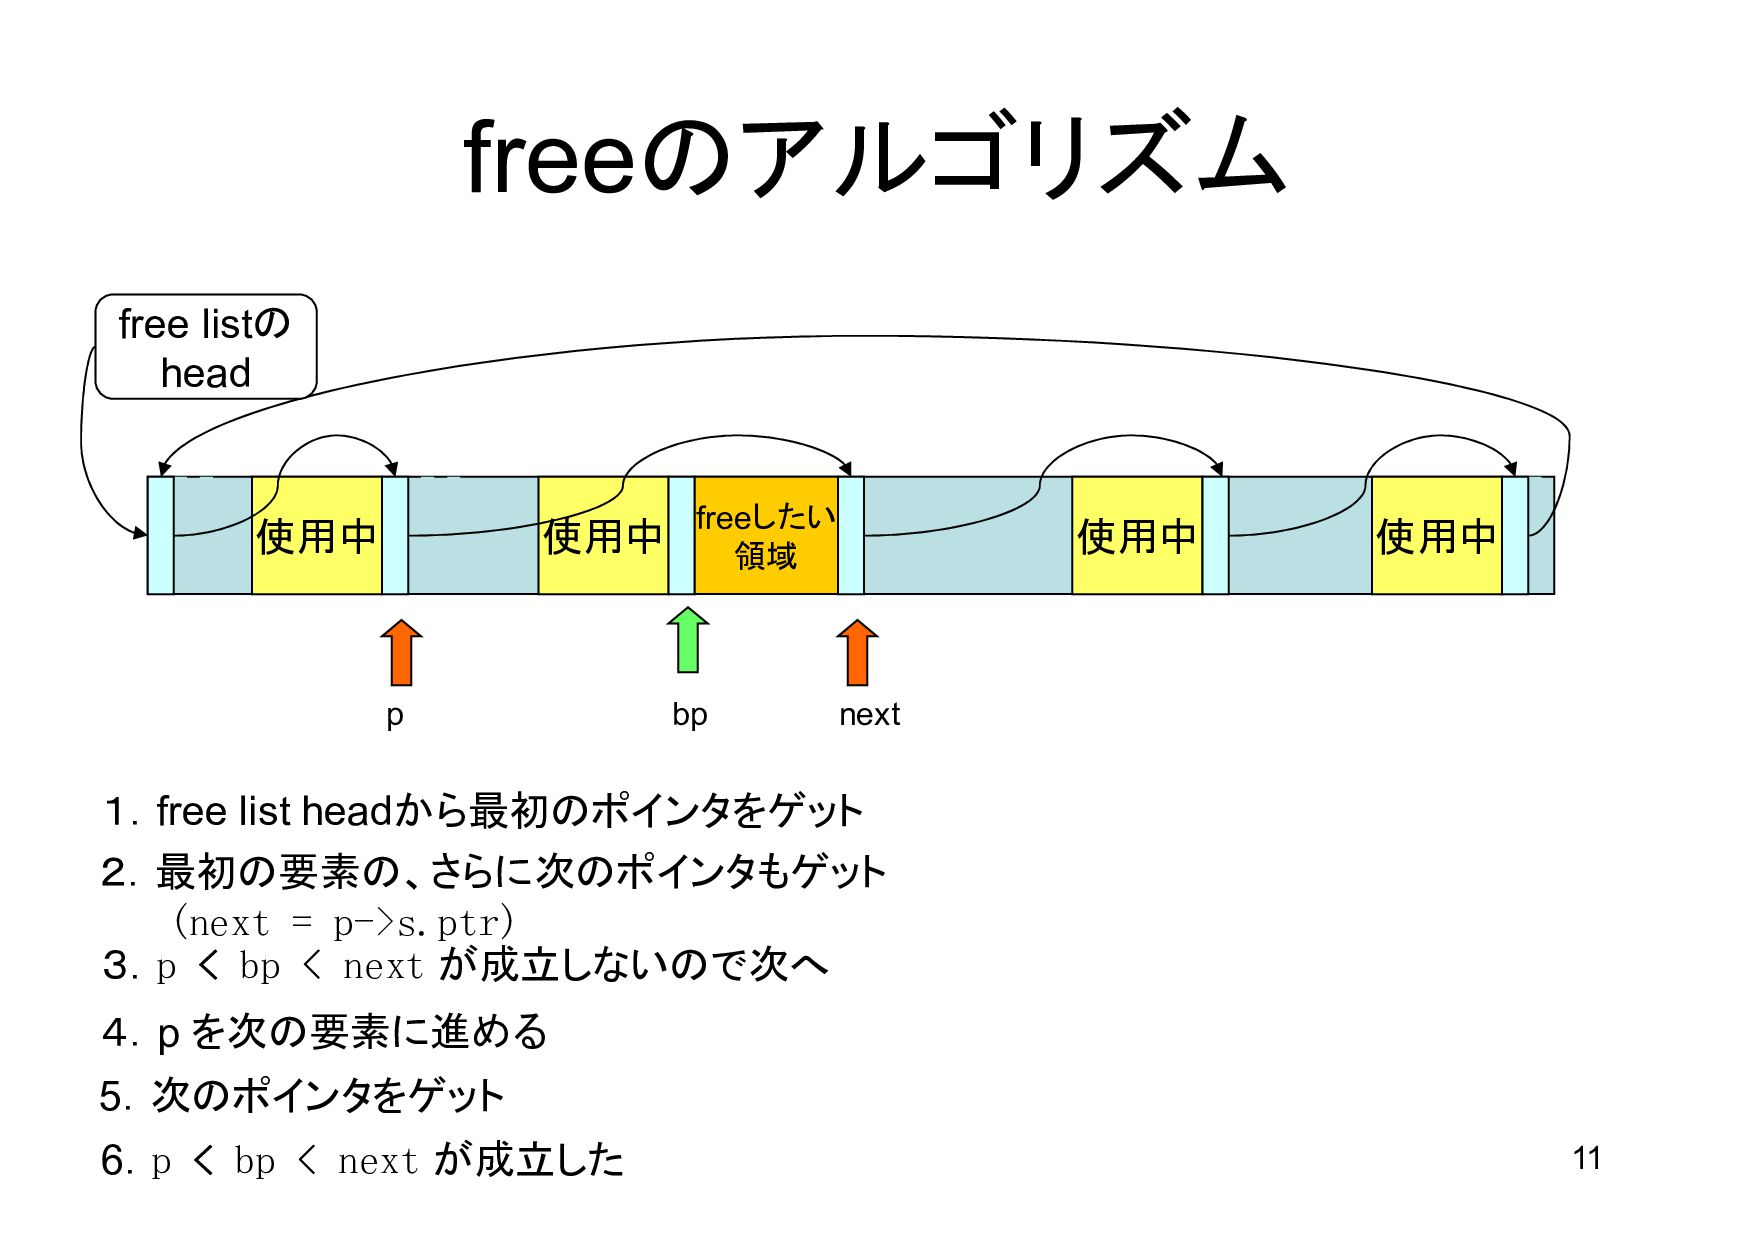
11 freeのアルゴリズム 使用中 使用中 使用中 free listの head 使用中 freeしたい
領域 bp p next 1.free list headから最初のポインタをゲット 2.最初の要素の、さらに次のポインタもゲット (next = p->s.ptr) 3.p < bp < next が成立しないので次へ 4.p を次の要素に進める 5.次のポインタをゲット 6.p < bp < next が成立した -
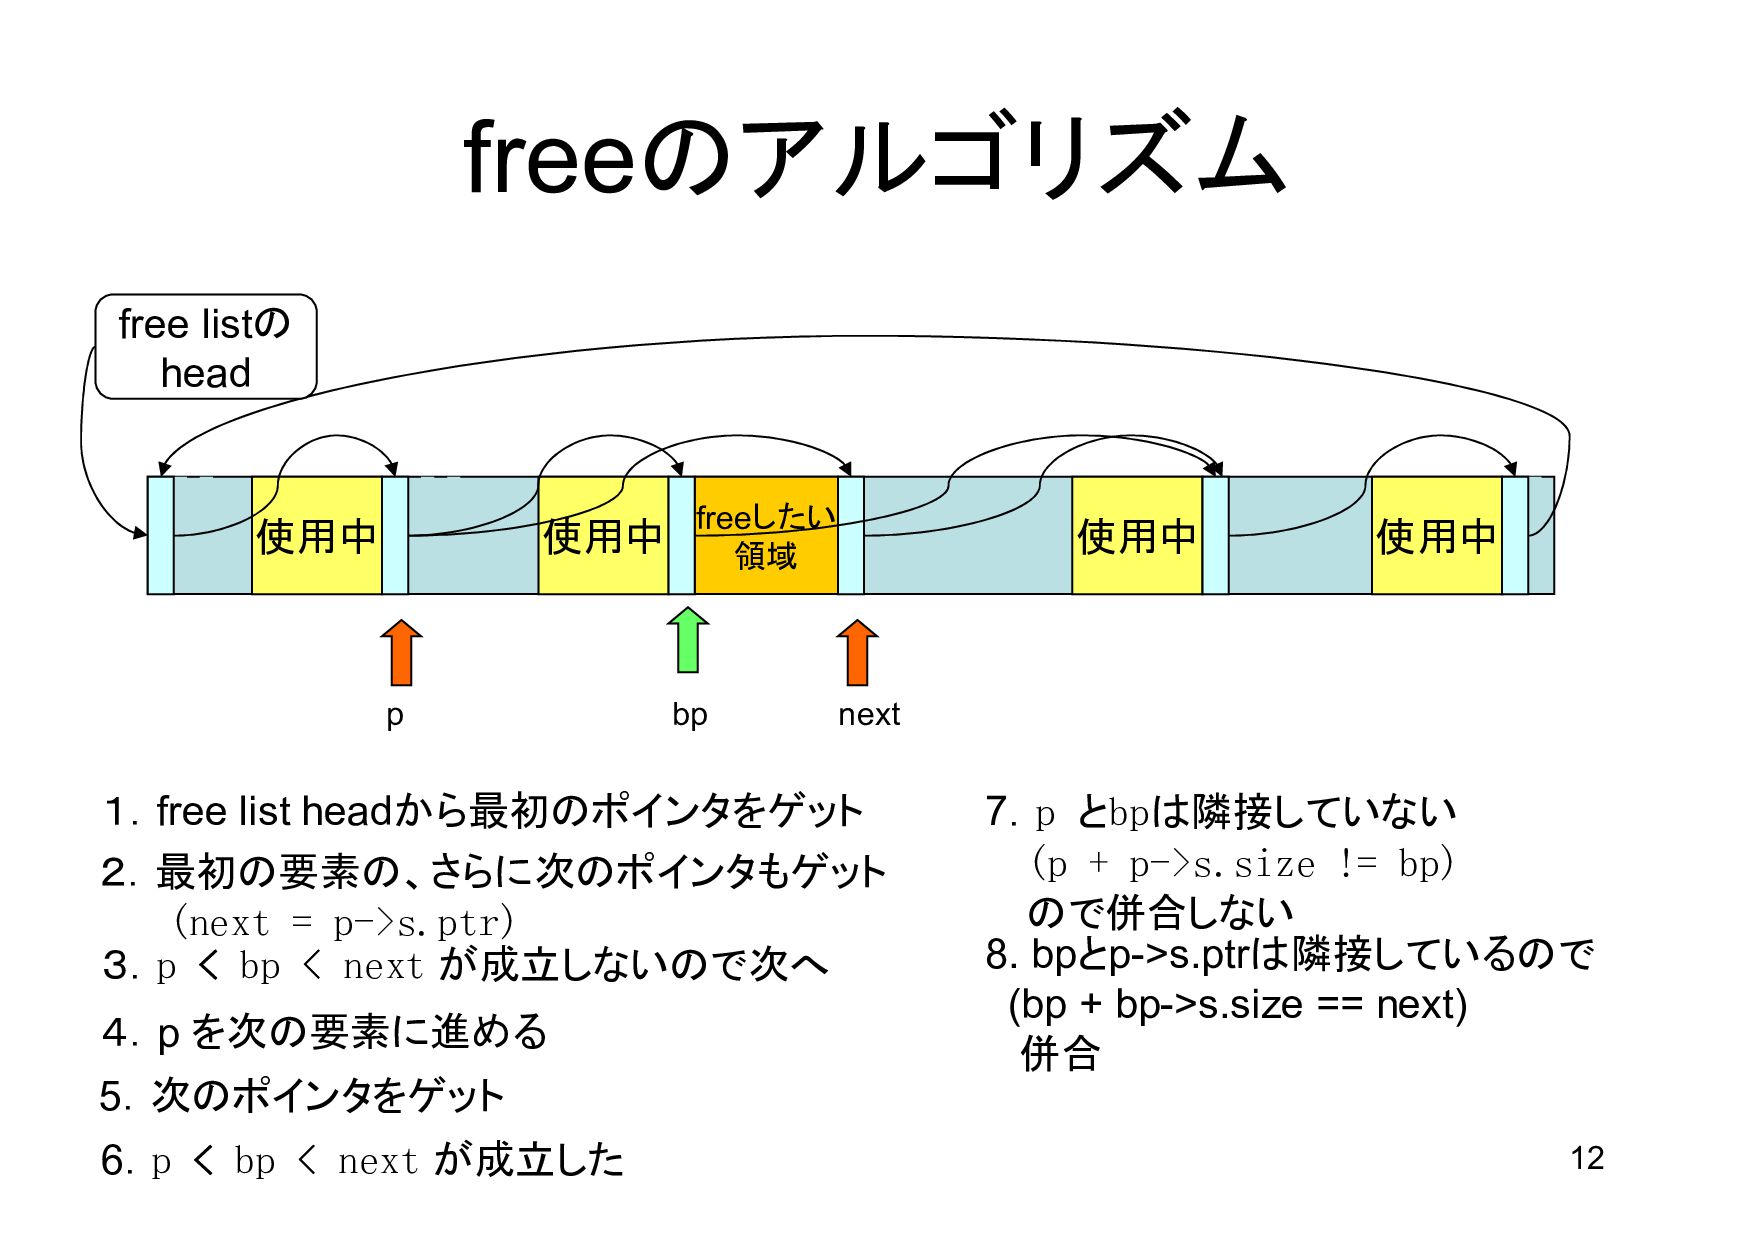
12 freeのアルゴリズム 使用中 使用中 使用中 free listの head 使用中 bp
p 7.p とbpは隣接していない (p + p->s.size != bp) ので併合しない next 1.free list headから最初のポインタをゲット 2.最初の要素の、さらに次のポインタもゲット (next = p->s.ptr) 3.p < bp < next が成立しないので次へ 4.p を次の要素に進める 5.次のポインタをゲット 6.p < bp < next が成立した 8. bpとp->s.ptrは隣接しているので (bp + bp->s.size == next) 併合 freeしたい 領域 -
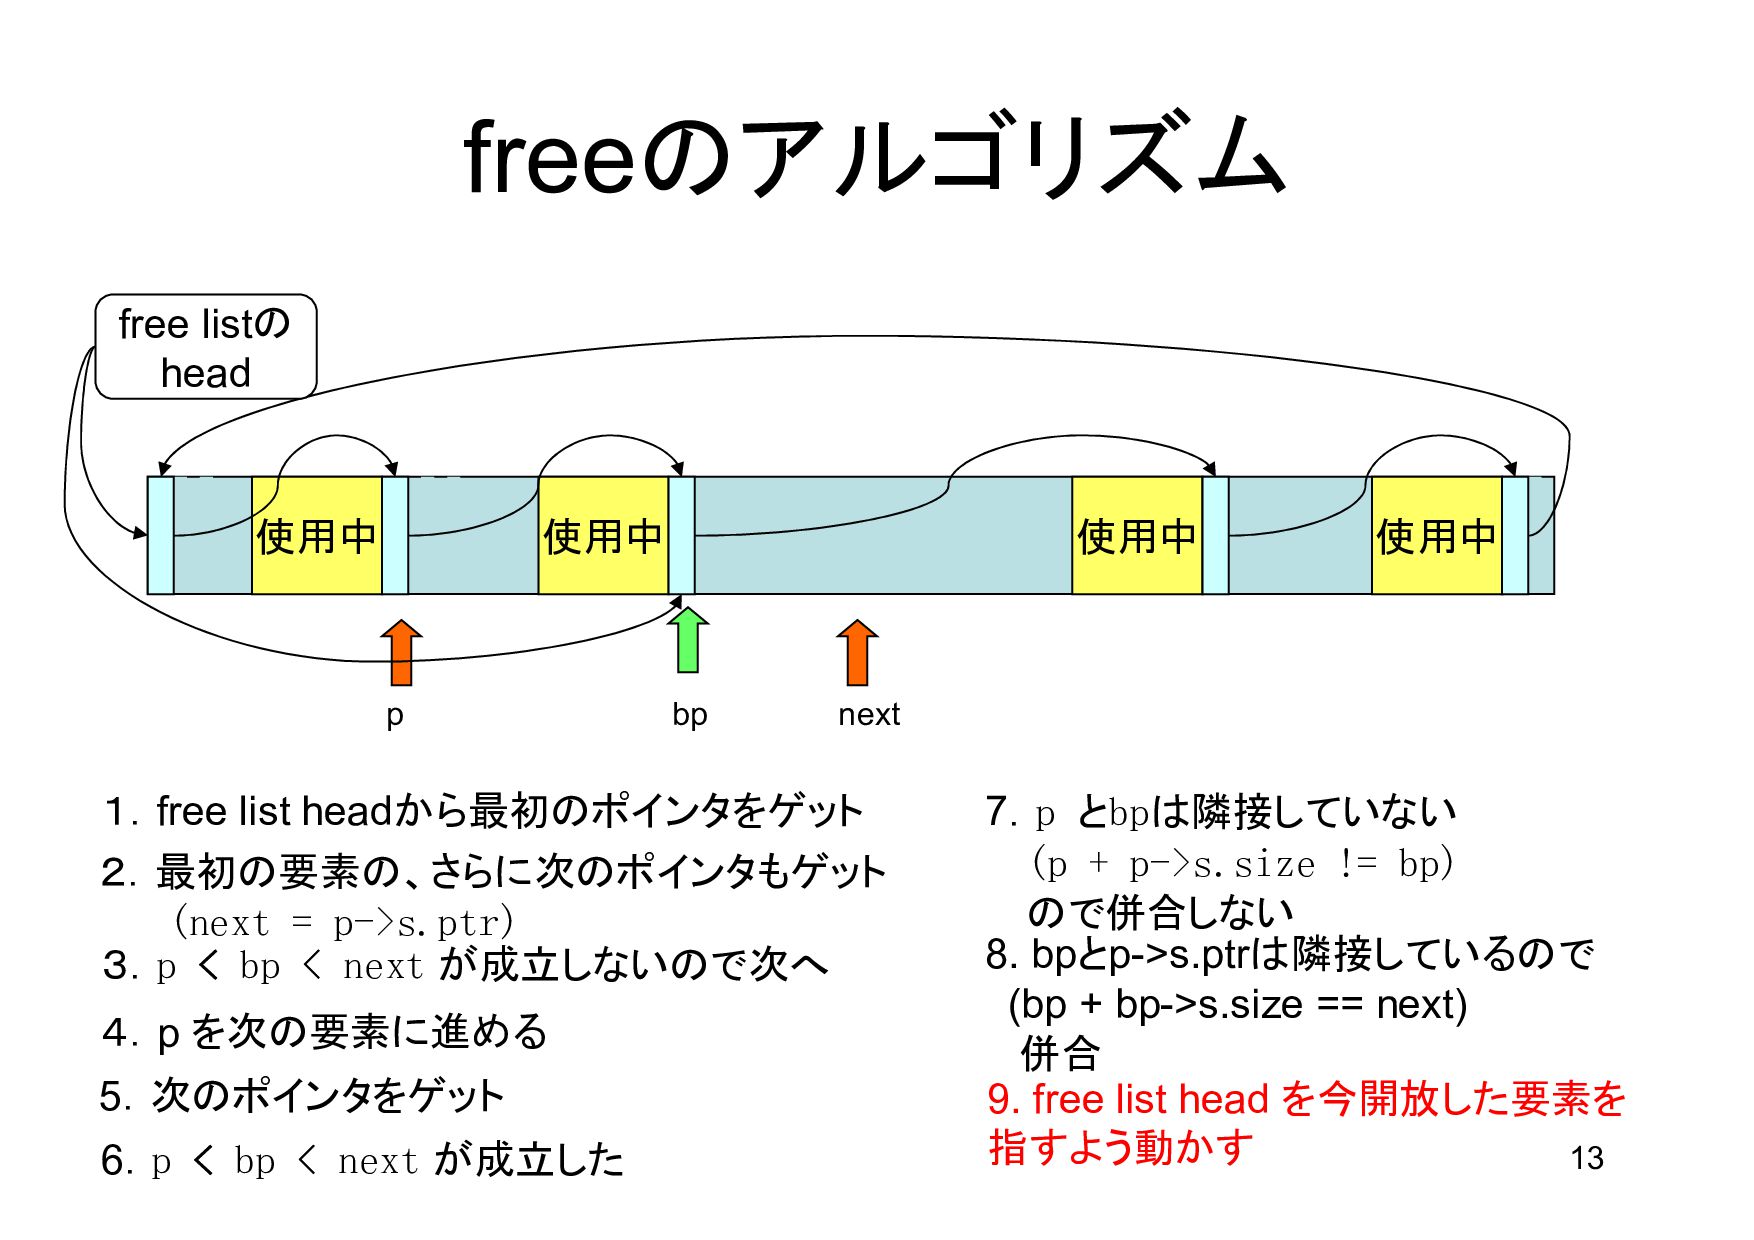
13 freeのアルゴリズム 使用中 使用中 使用中 free listの head 使用中 bp
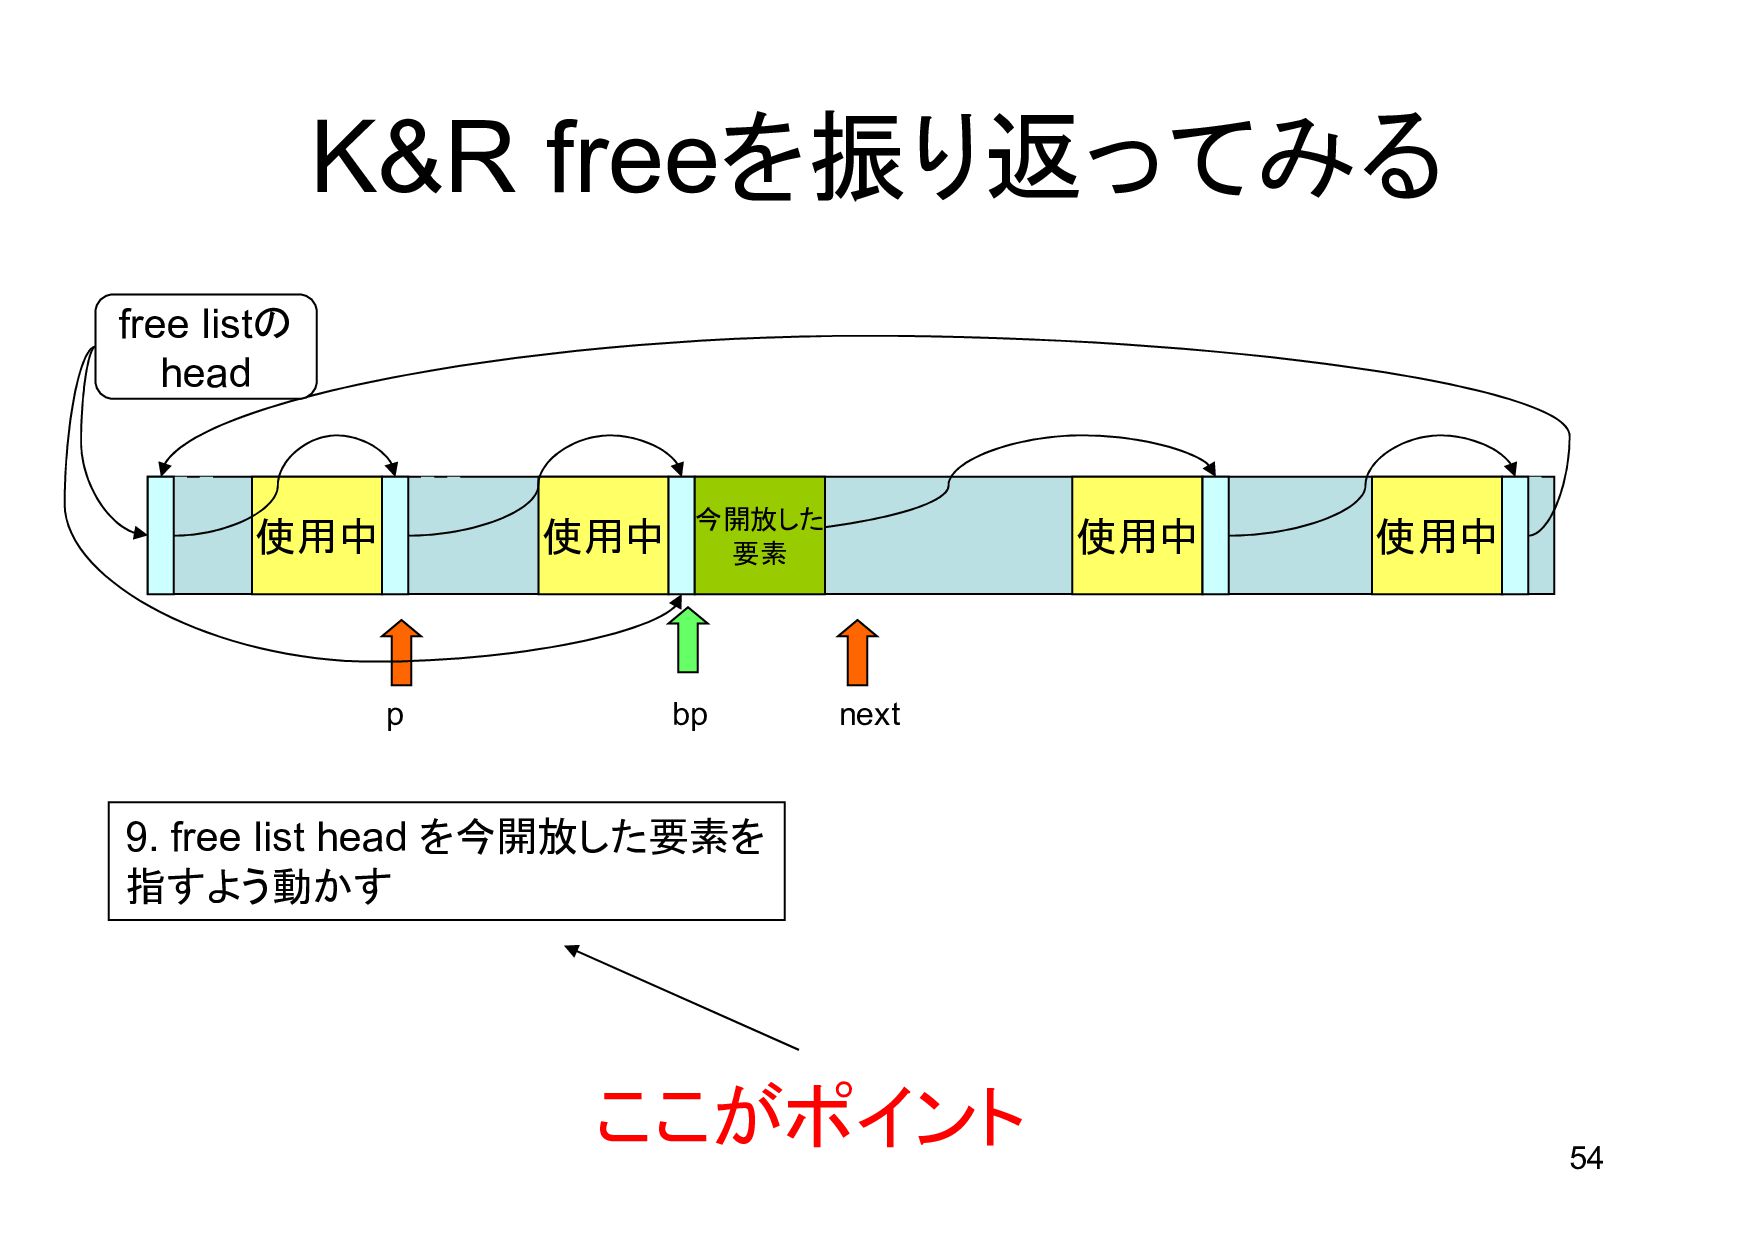
p 7.p とbpは隣接していない (p + p->s.size != bp) ので併合しない next 1.free list headから最初のポインタをゲット 2.最初の要素の、さらに次のポインタもゲット (next = p->s.ptr) 3.p < bp < next が成立しないので次へ 4.p を次の要素に進める 5.次のポインタをゲット 6.p < bp < next が成立した 8. bpとp->s.ptrは隣接しているので (bp + bp->s.size == next) 併合 9. free list head を今開放した要素を 指すよう動かす -
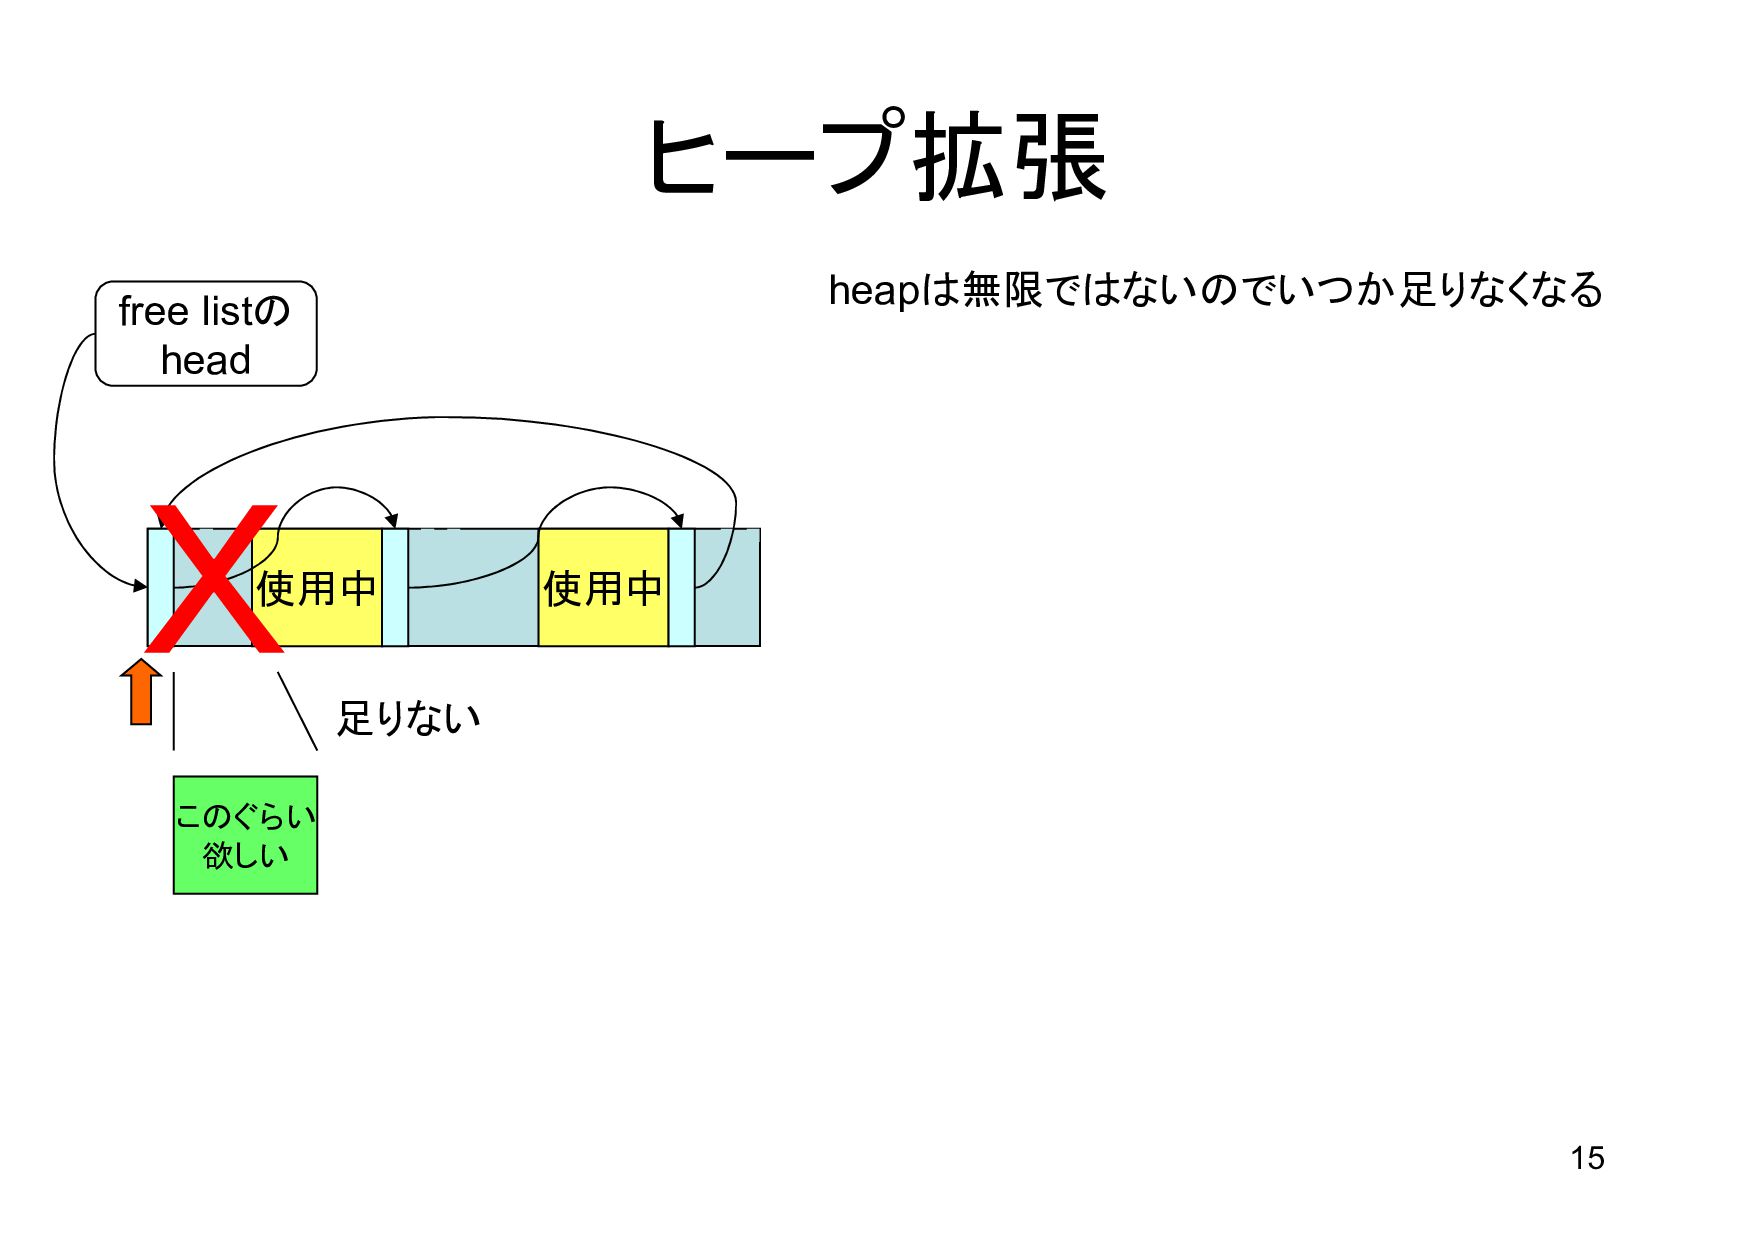
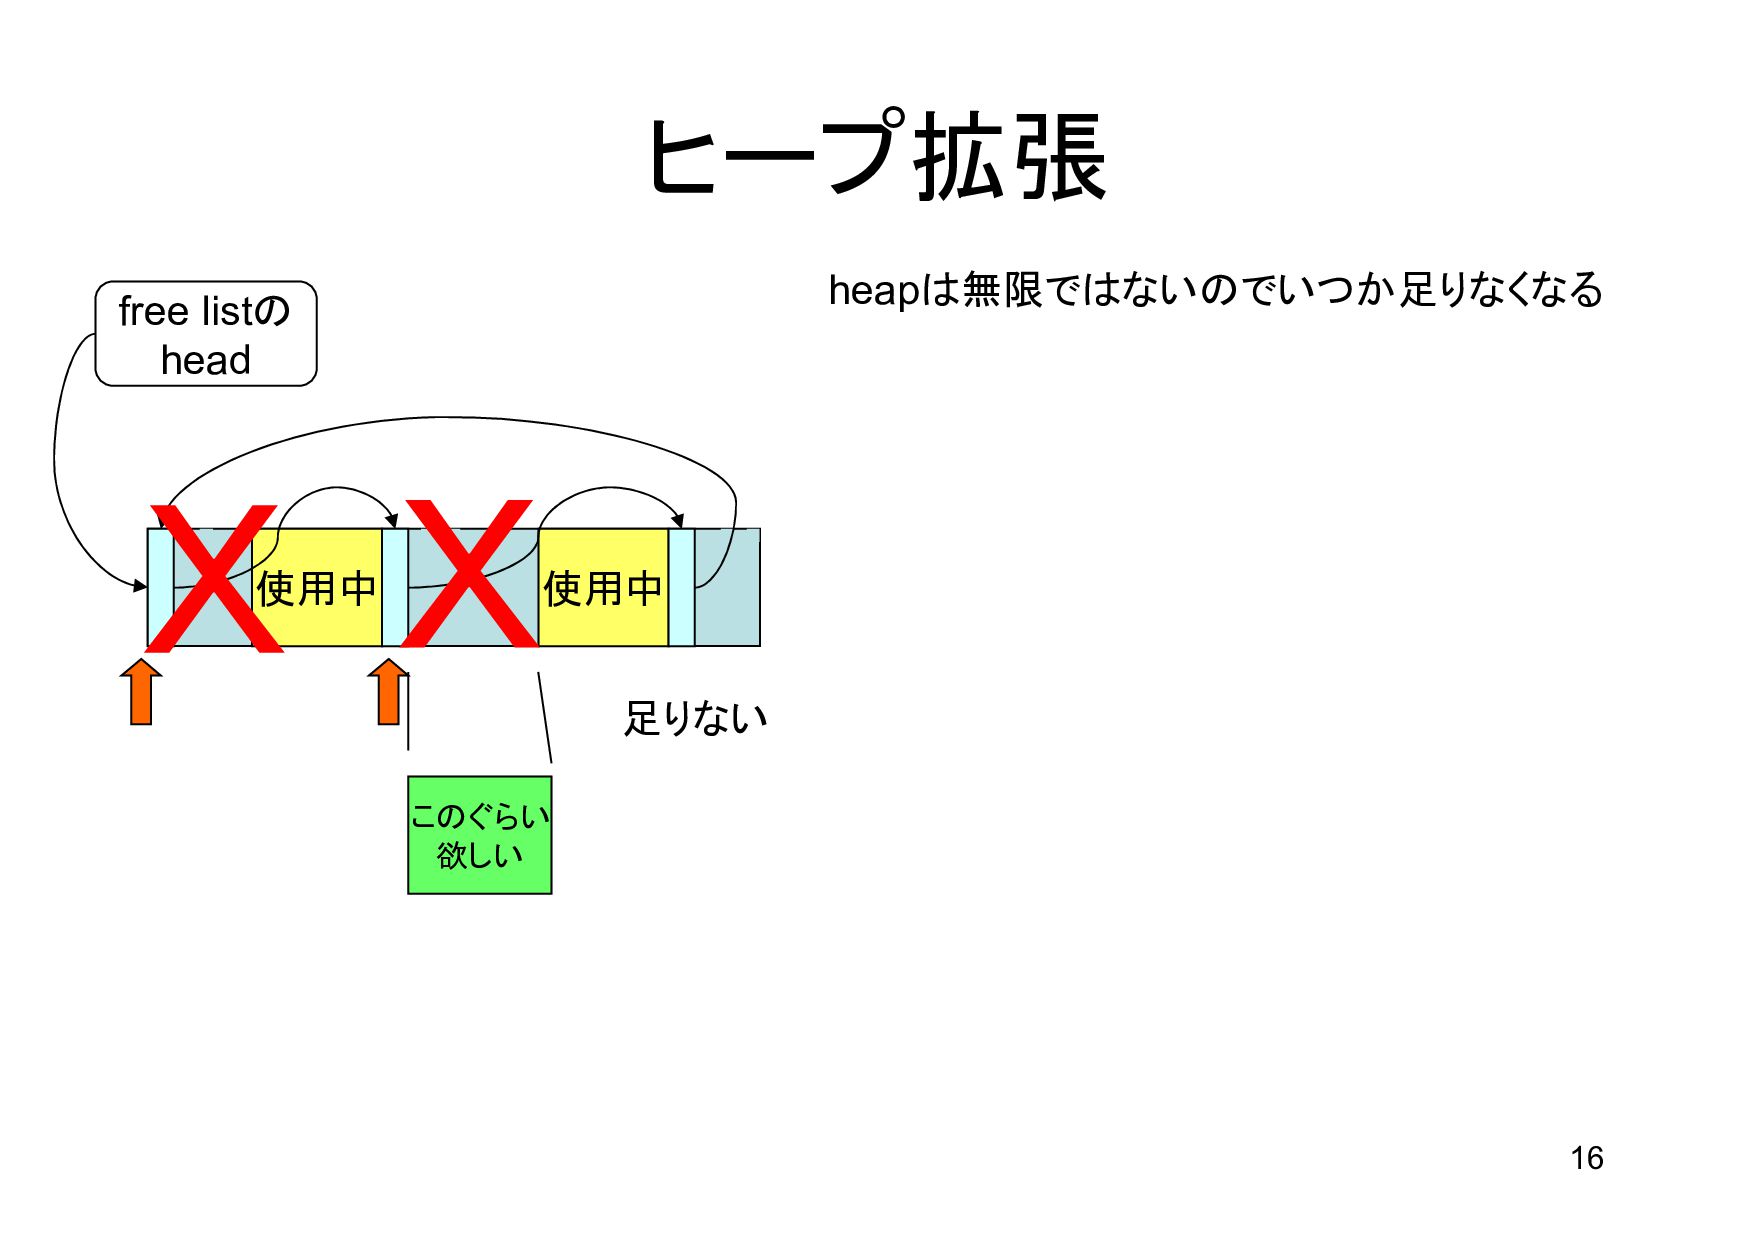
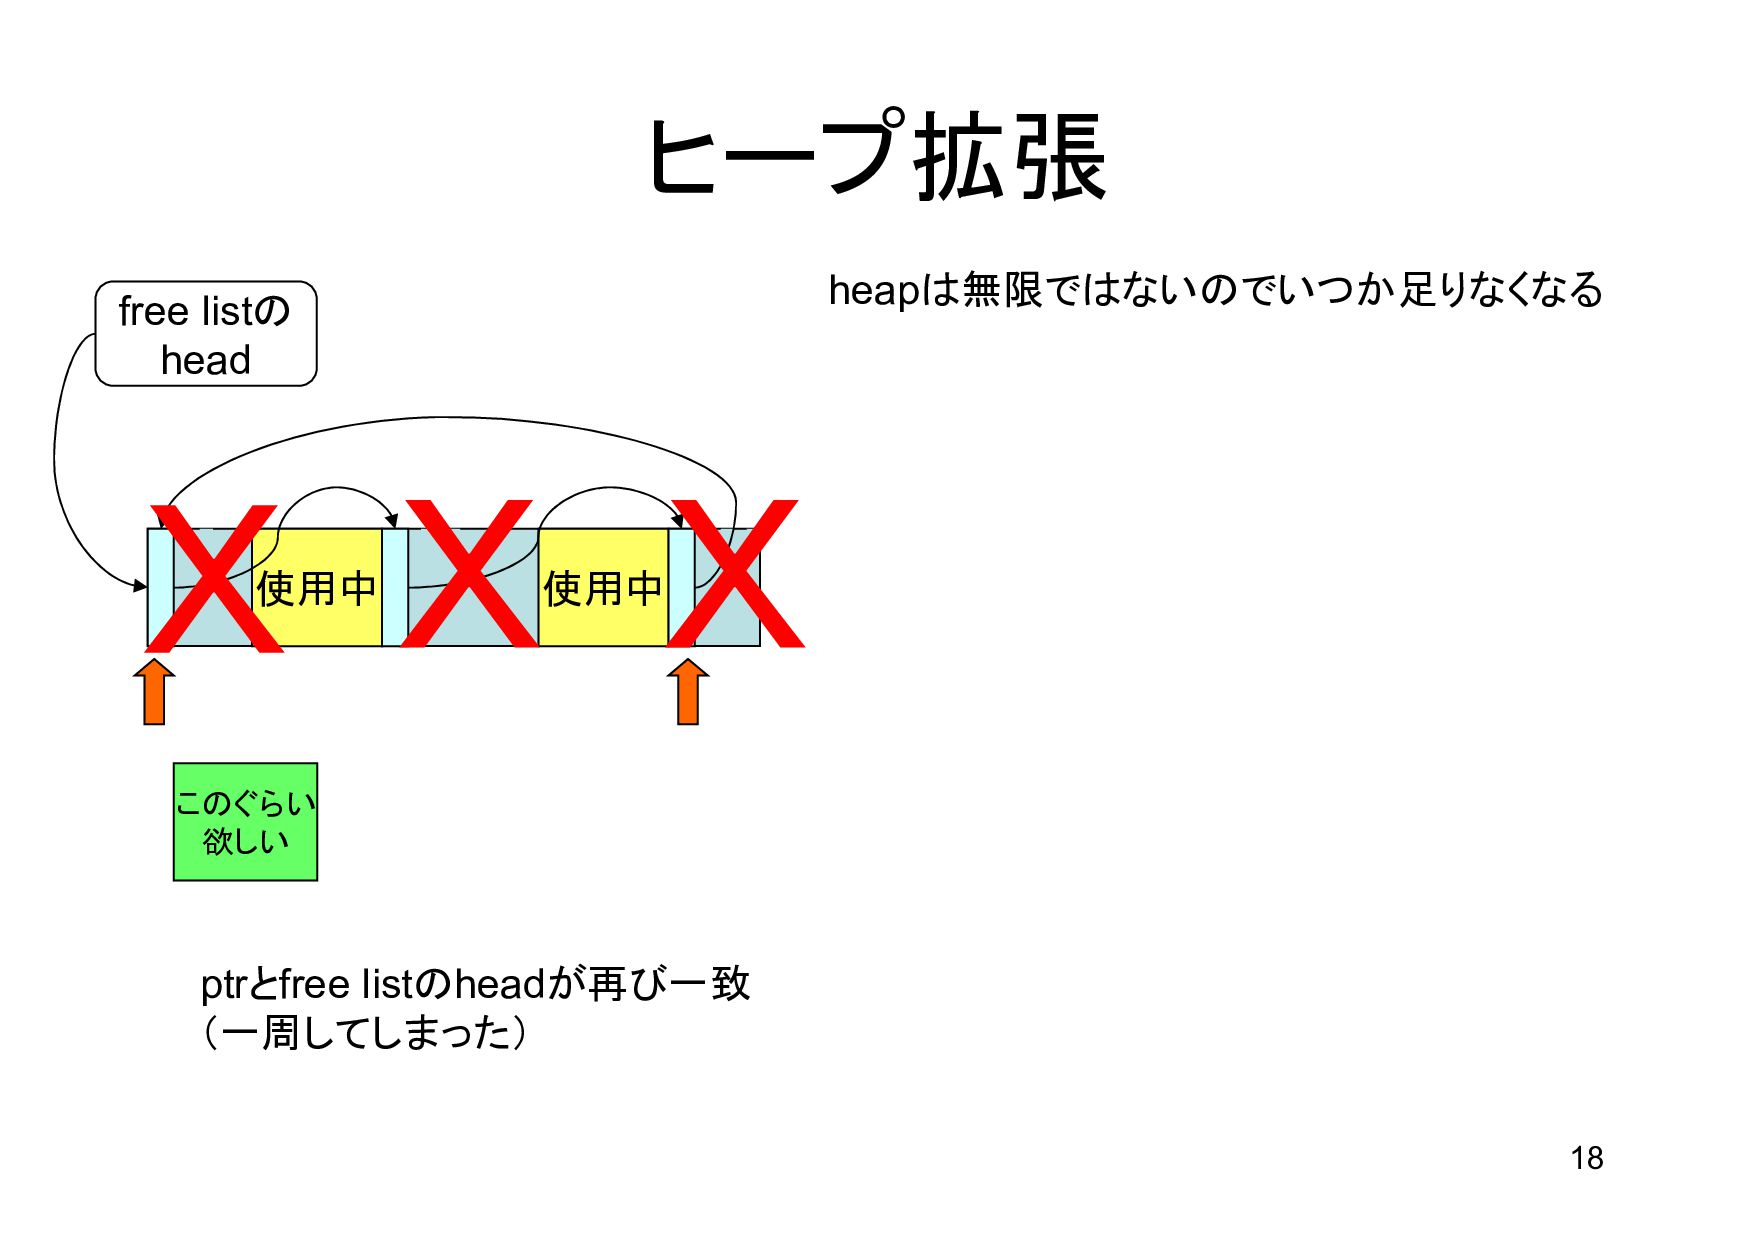
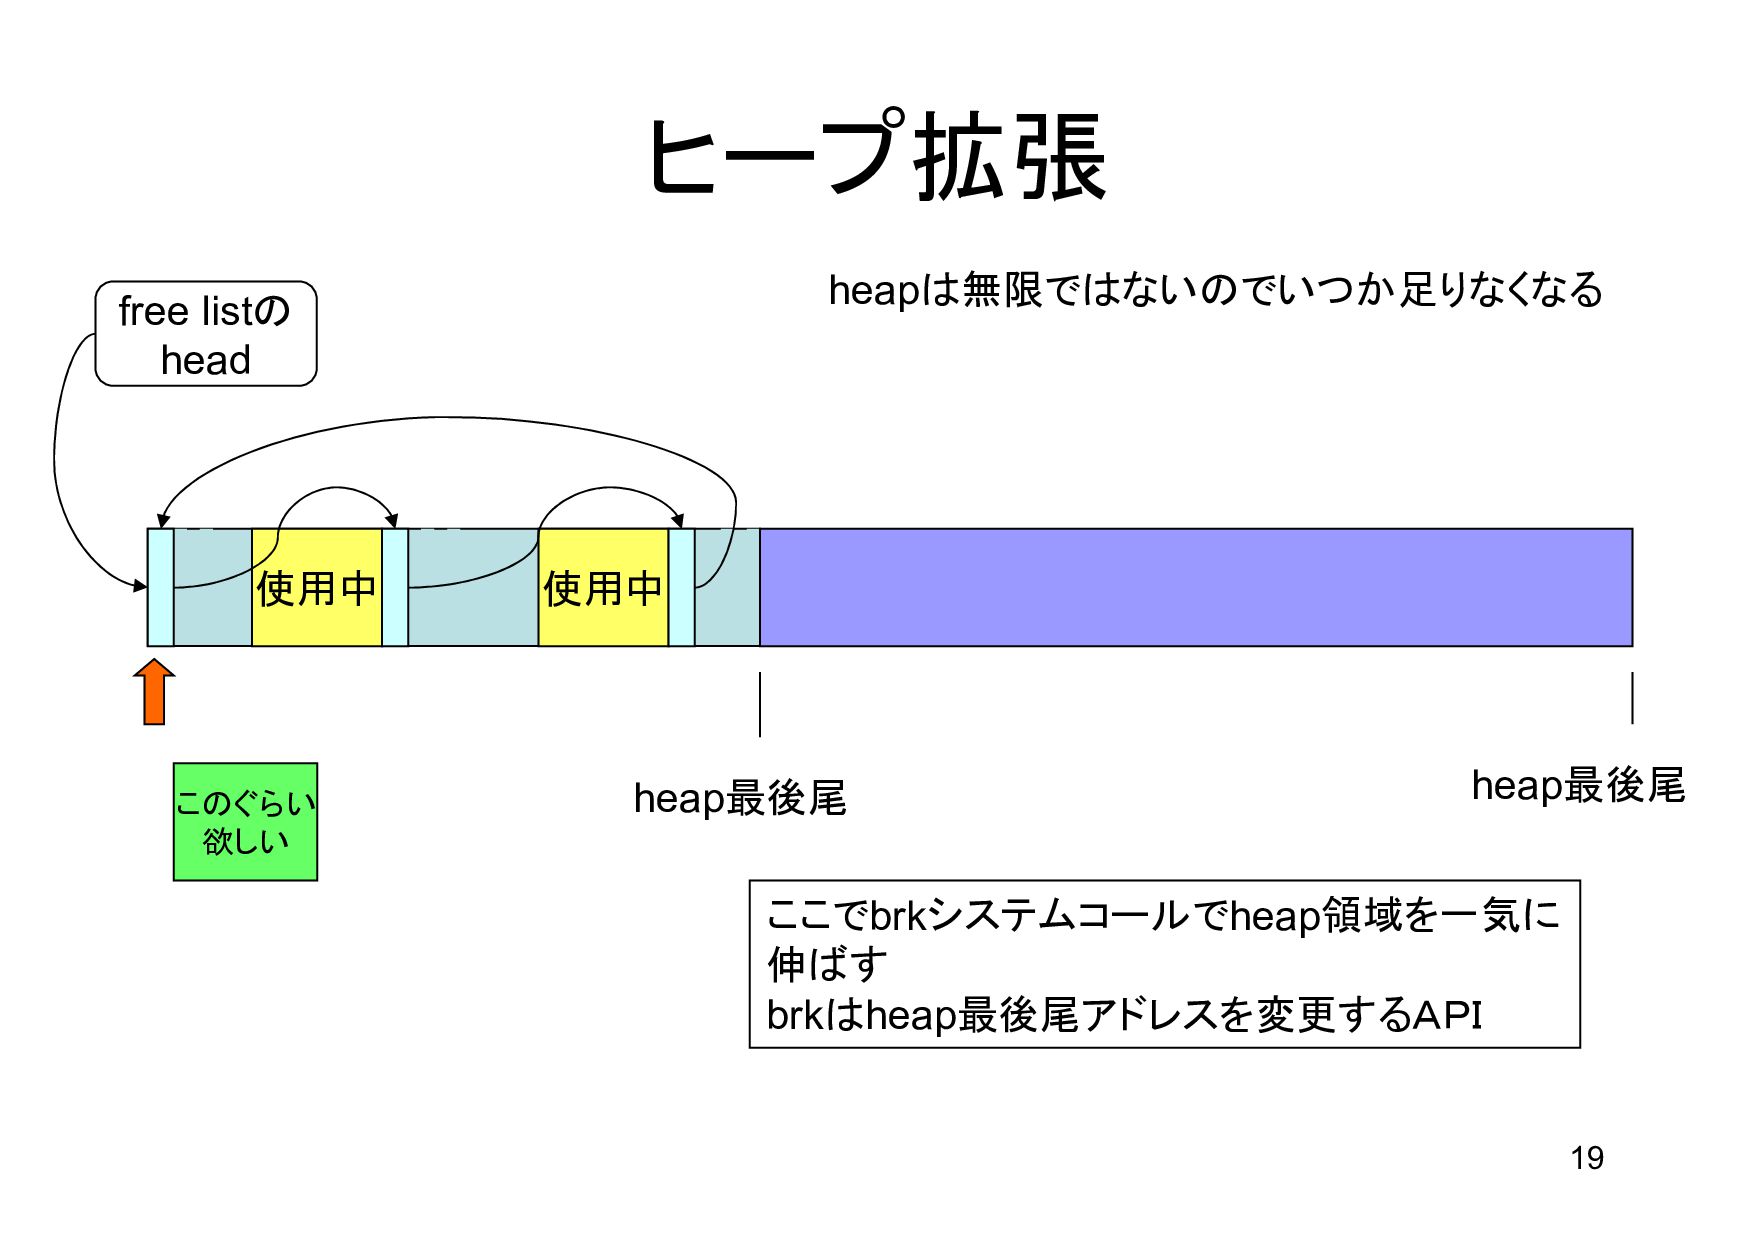
18 ヒープ拡張 使用中 free listの head 使用中 このぐらい 欲しい heapは無限ではないのでいつか足りなくなる
ptrとfree listのheadが再び一致 (一周してしまった) -
19 ヒープ拡張 使用中 free listの head 使用中 このぐらい 欲しい heapは無限ではないのでいつか足りなくなる
ここでbrkシステムコールでheap領域を一気に 伸ばす brkはheap最後尾アドレスを変更するAPI heap最後尾 heap最後尾 -
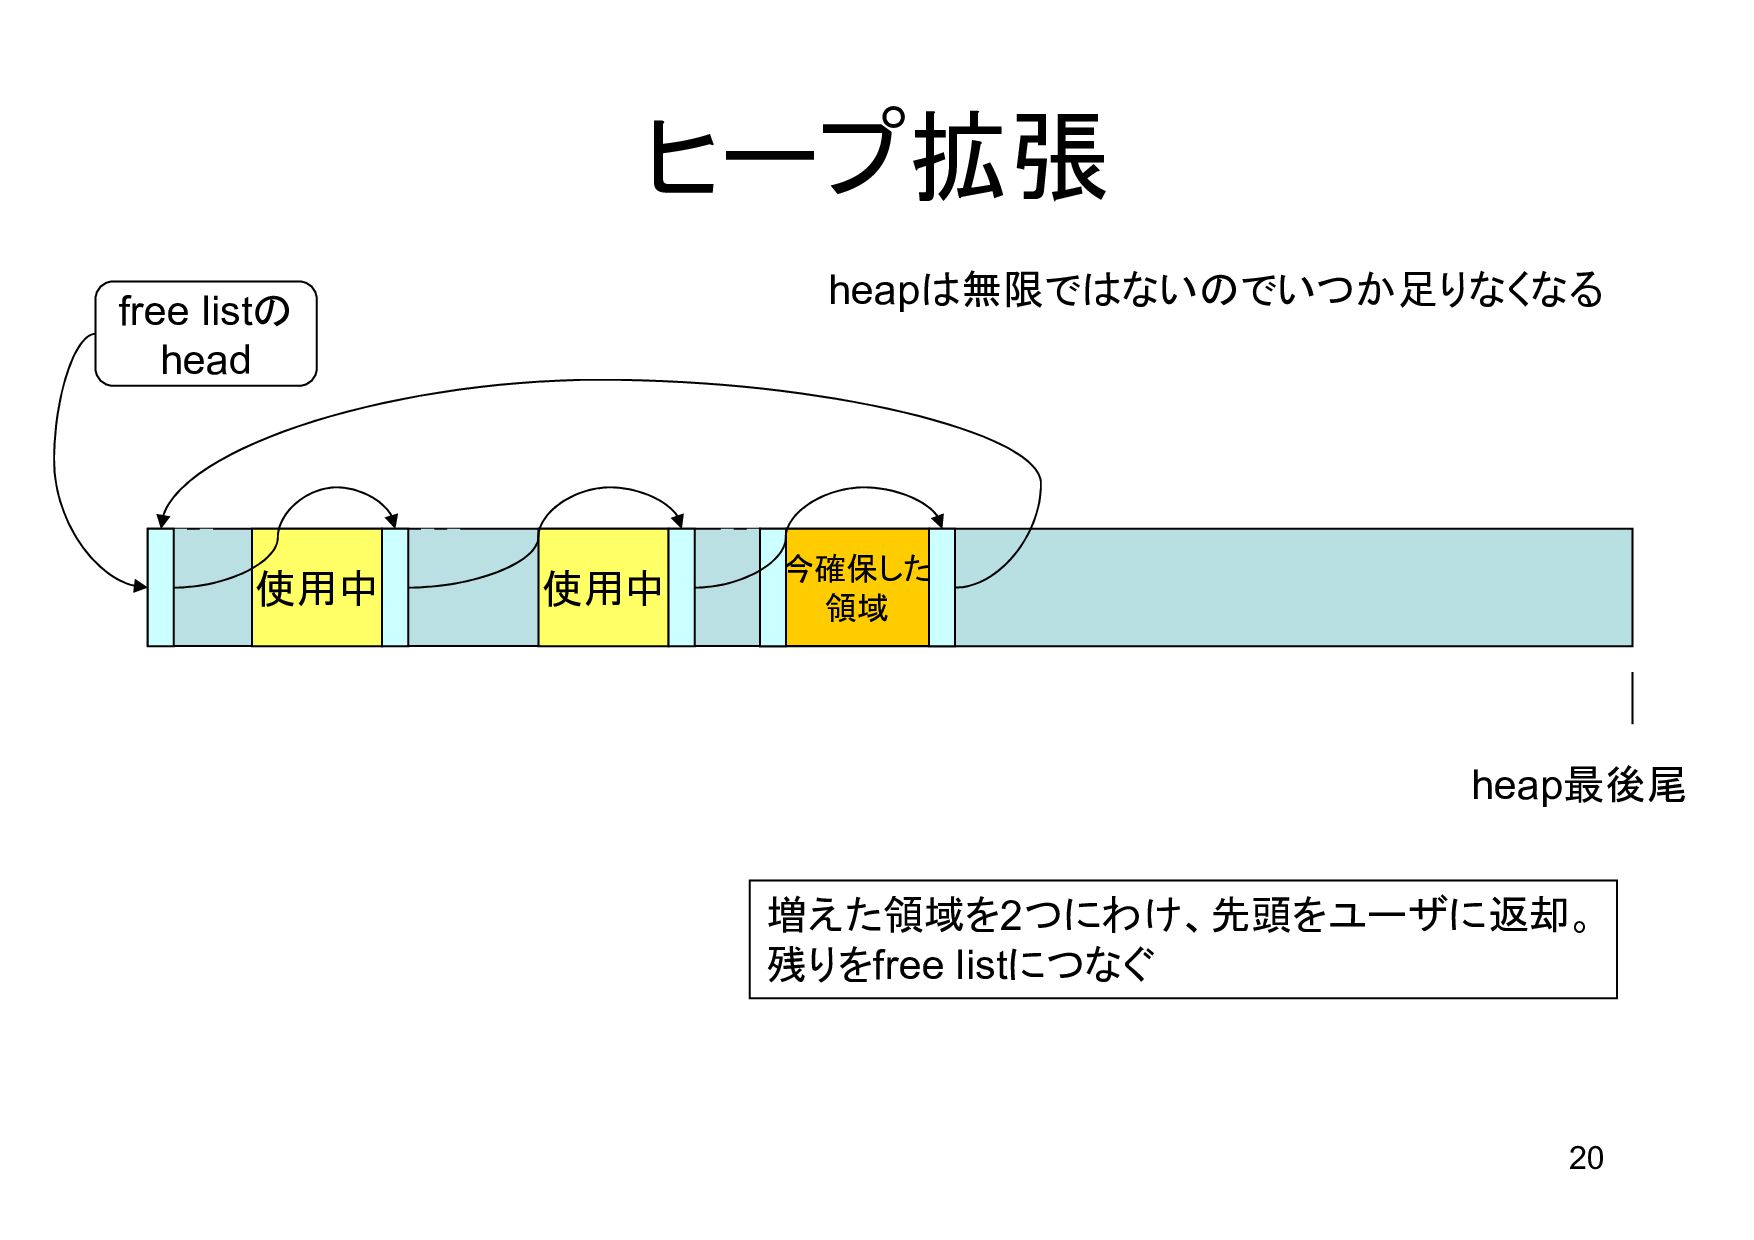
20 ヒープ拡張 使用中 使用中 heapは無限ではないのでいつか足りなくなる heap最後尾 今確保した 領域 増えた領域を2つにわけ、先頭をユーザに返却。 残りをfree
listにつなぐ free listの head -
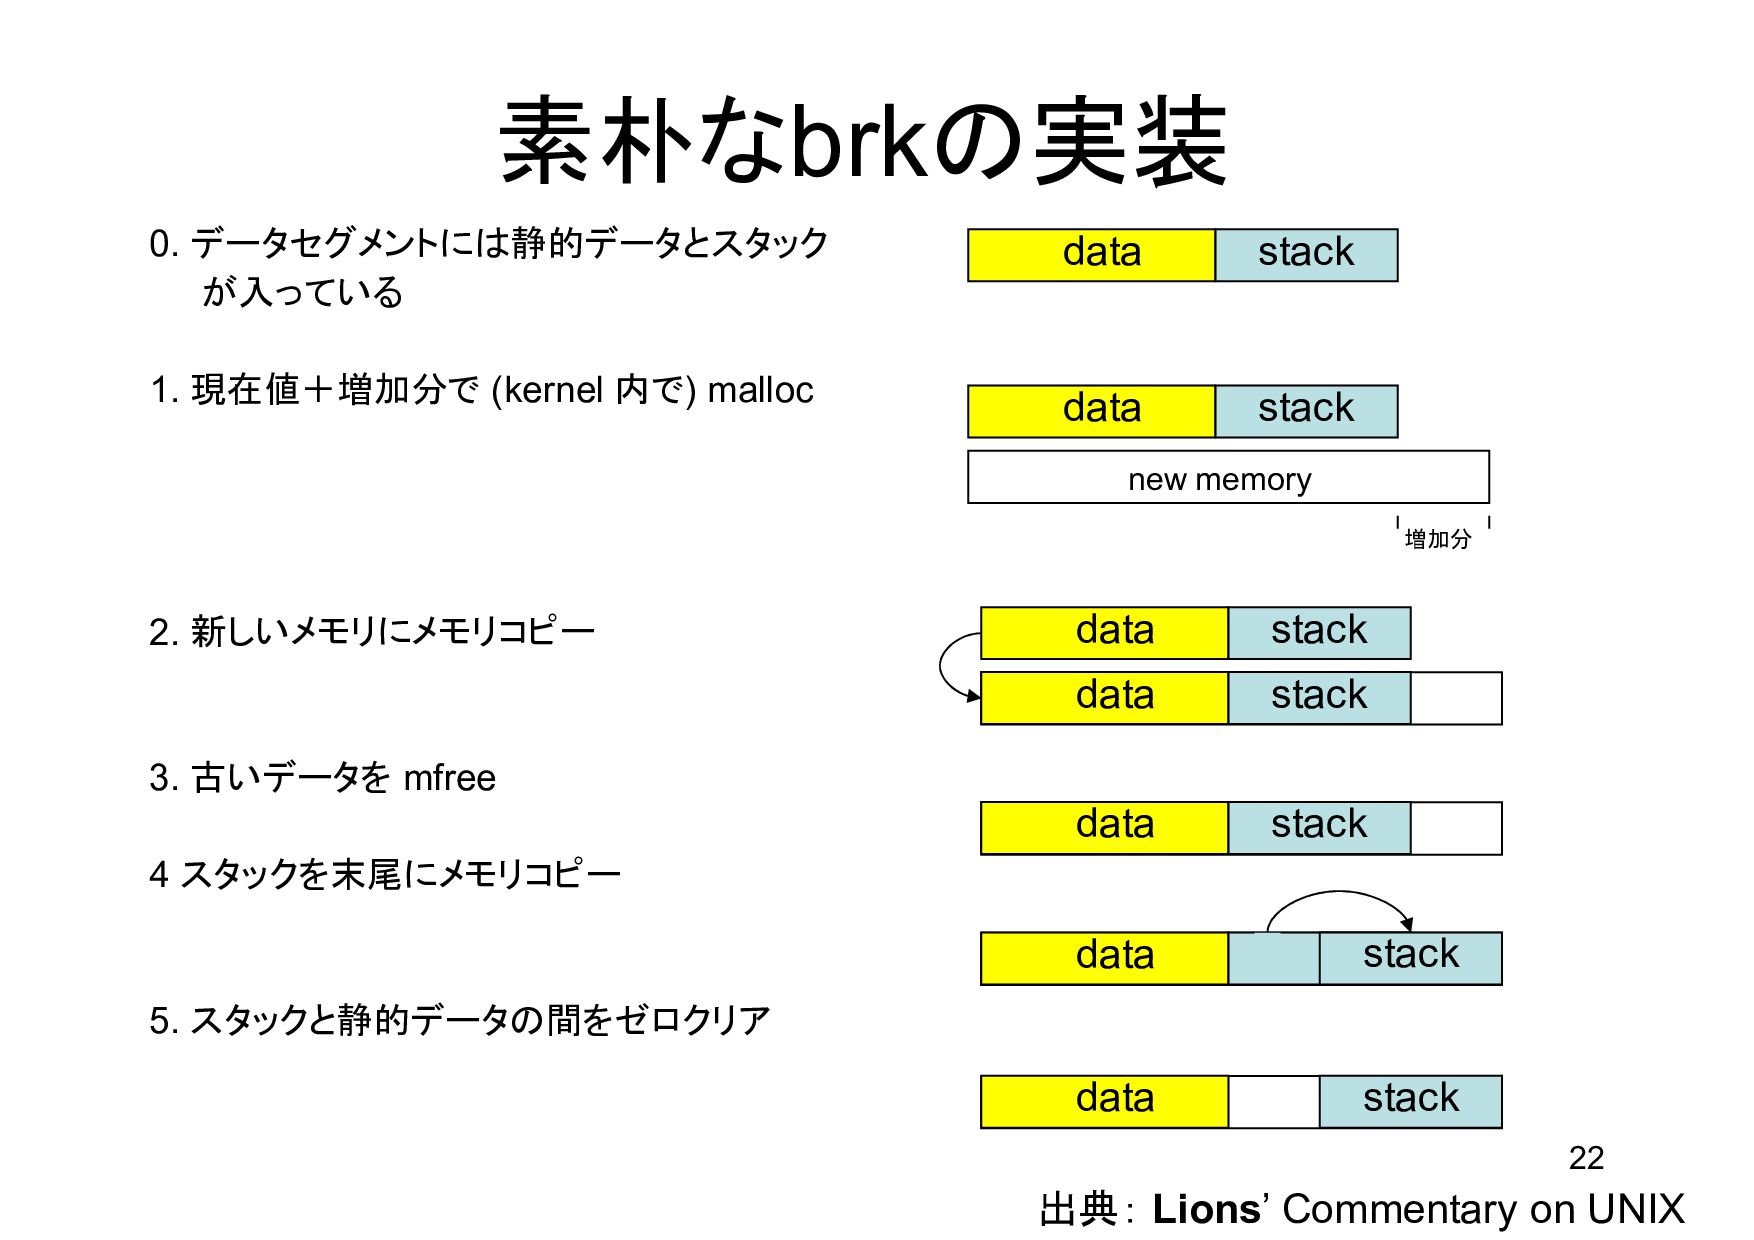
22 素朴なbrkの実装 0. データセグメントには静的データとスタック が入っている 1. 現在値+増加分で (kernel 内で) malloc
2. 新しいメモリにメモリコピー 3. 古いデータを mfree 4 スタックを末尾にメモリコピー 5. スタックと静的データの間をゼロクリア data stack data stack data stack new memory data stack data stack data data stack stack 出典: Lions’ Commentary on UNIX 増加分 -
25 K&R mallocのいいところ • 単純 • コードサイズが小さい。 (組み込みとかもmallocはいまだにこんな形 しとるよ) •
フラグメンテーションが進まない限りmallocは O(1) • プログラム全体で数十回しかmallocしないよ うな小規模プログラムではとてもうまく動く -
26 K&R mallocのダメなところ • 小さいmallocが多発するとフラグメンテーショ ンがすぐ進む • freeがO(n) • brkが呼ばれる状況では一回freelistを一周す
る必要がある (リストが数万個もあれば、なにそのキャッ シュ・フラッシング・コード状態) • フラグメンテーションが進むとメモリ効率も急 激に悪化 -
27 時代は変わった・・・ • イマドキなプログラミング – GUI – スクリプト言語やJava – C++プログラミング
– 等々 は、まさに小さいmallocが連発される -
28 最大の問題はなんだろう? • ここは、とりあえずフラグメンテーションが最 大の問題だと仮定しよう • フラグメンテーションさえ解決すれば – メモリ使用効率UP! –
使用メモリ量が減れば、それだけキャッシュに載 る確率UP! – なんか カコ(・∀・)イイ! -
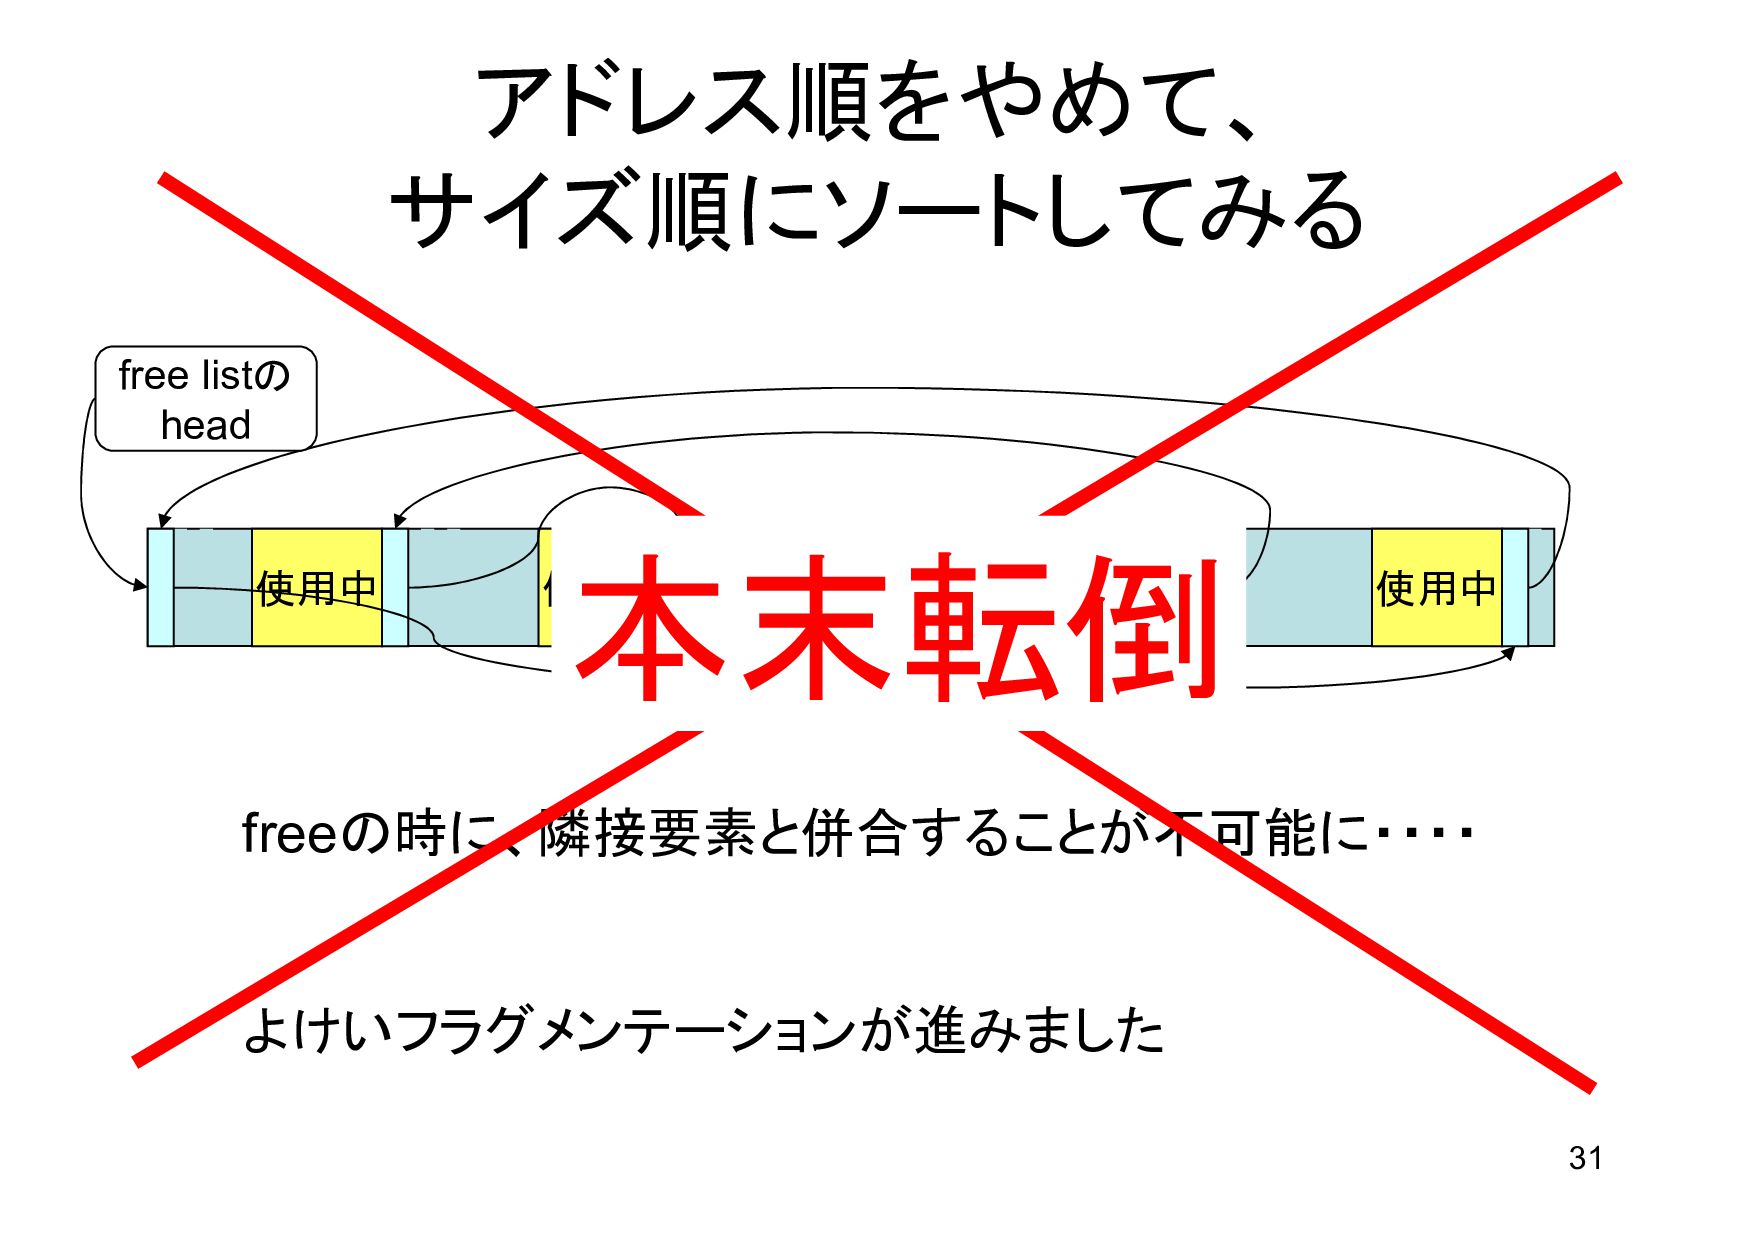
31 アドレス順をやめて、 サイズ順にソートしてみる 使用中 使用中 使用中 free listの head 使用中
freeの時に、隣接要素と併合することが不可能に・・・・ よけいフラグメンテーションが進みました 本末転倒 -
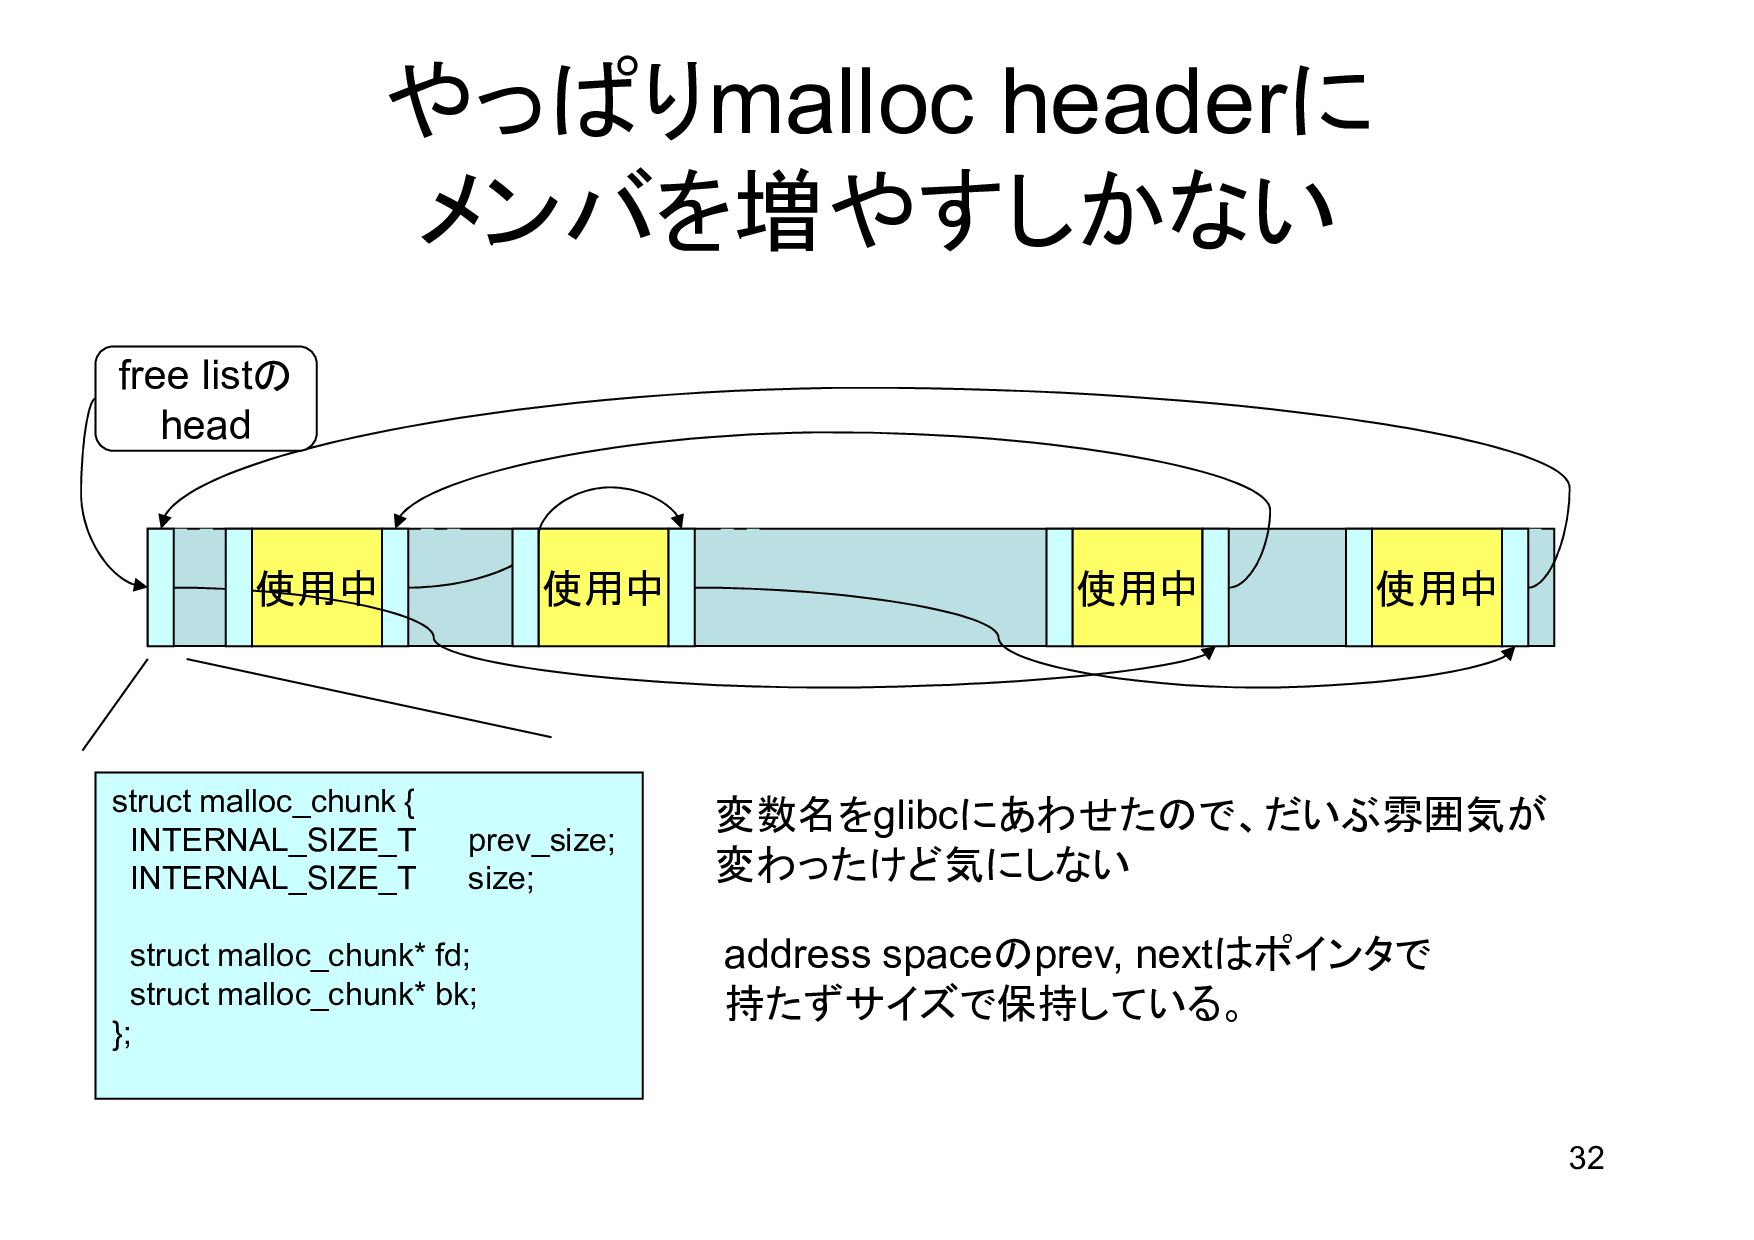
32 やっぱりmalloc headerに メンバを増やすしかない struct malloc_chunk { INTERNAL_SIZE_T prev_size; INTERNAL_SIZE_T
size; struct malloc_chunk* fd; struct malloc_chunk* bk; }; 使用中 使用中 使用中 free listの head 使用中 変数名をglibcにあわせたので、だいぶ雰囲気が 変わったけど気にしない address spaceのprev, nextはポインタで 持たずサイズで保持している。 -
33 何が変わったのか • 良くなったところ – freeがtypicalでO(n)からO(1)へ – フラグメンテーションによる空間の無駄が減る • 悪くなったところ
– mallocがtypicalでO(1)からO(n)へ – ヘッダサイズが増えて空間効率ダウン -
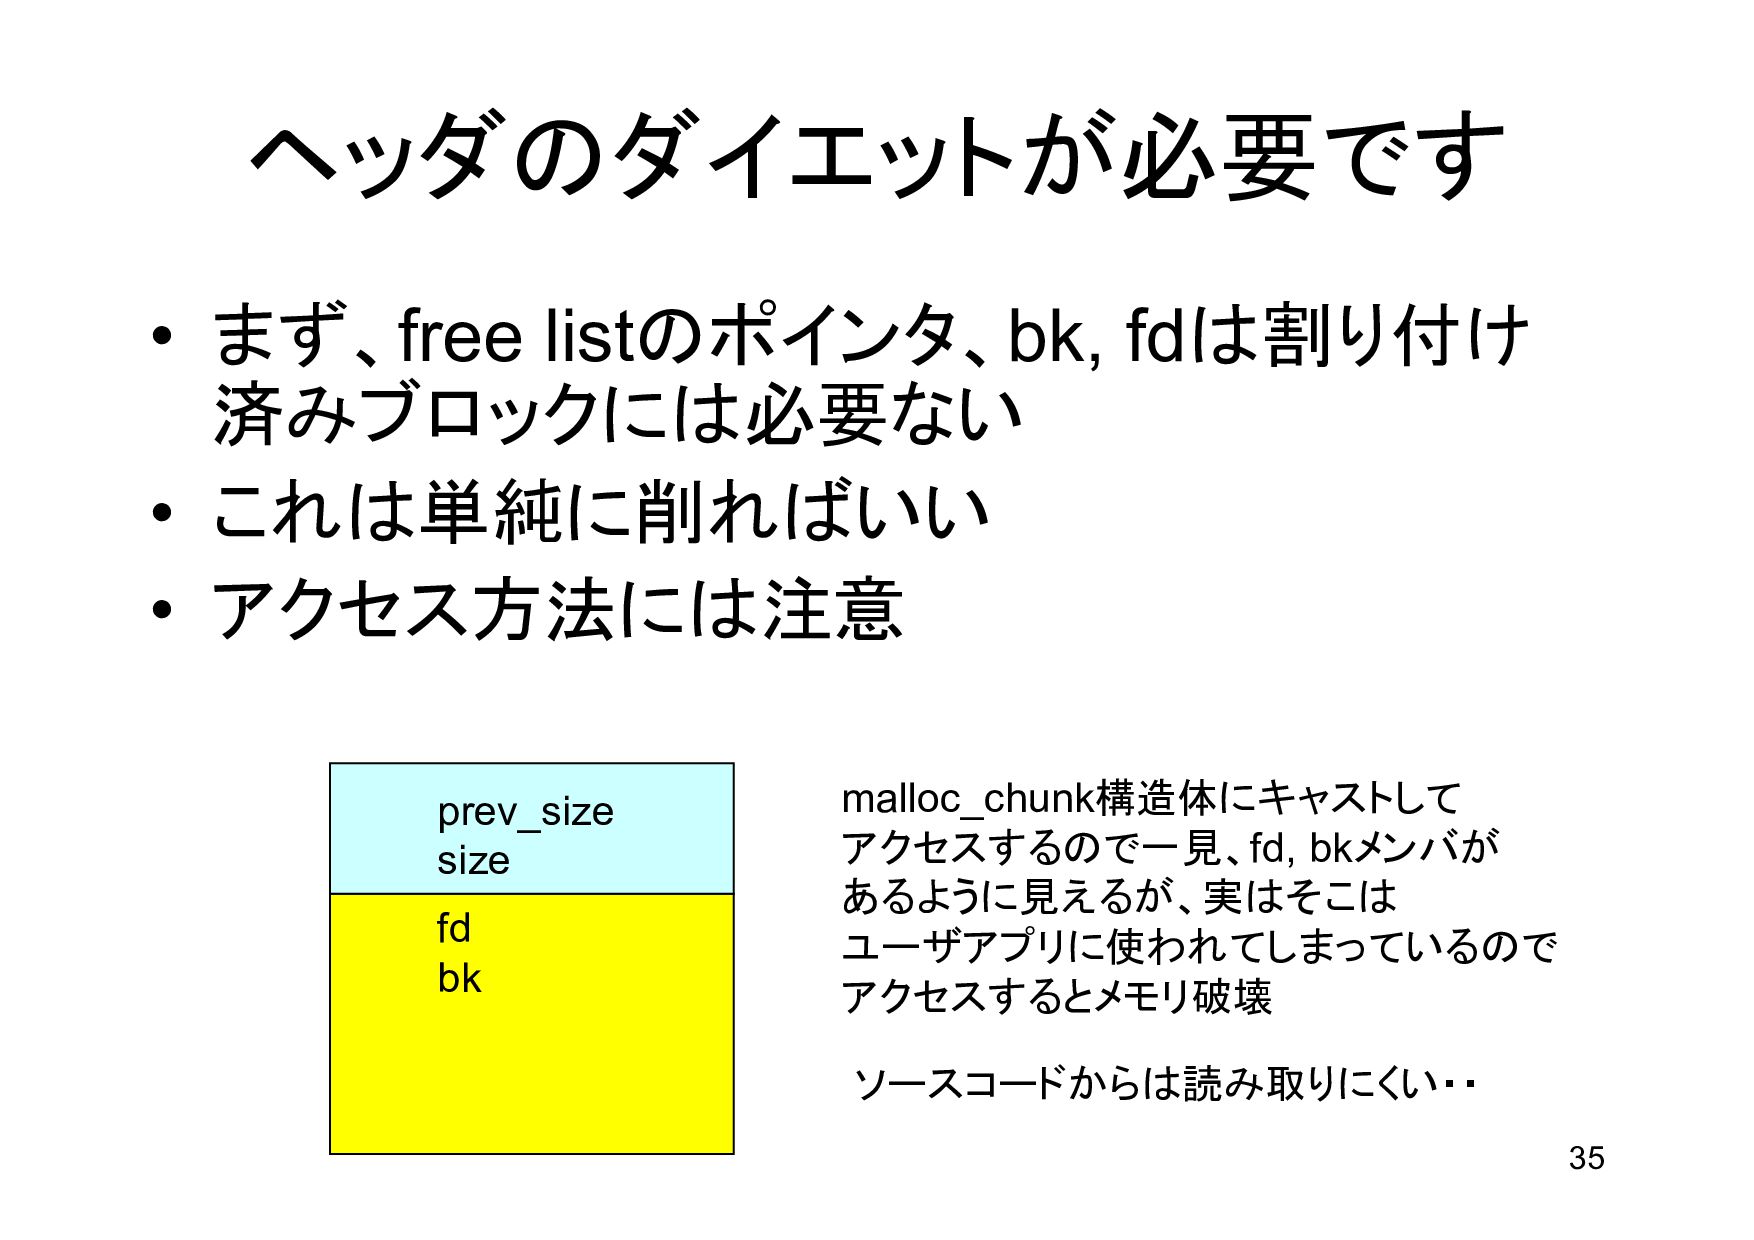
35 ヘッダのダイエットが必要です • まず、free listのポインタ、bk, fdは割り付け 済みブロックには必要ない • これは単純に削ればいい •
アクセス方法には注意 prev_size size fd bk malloc_chunk構造体にキャストして アクセスするので一見、fd, bkメンバが あるように見えるが、実はそこは ユーザアプリに使われてしまっているので アクセスするとメモリ破壊 ソースコードからは読み取りにくい・・ -
36 ダイエットはつづくよ・・・ • よーく考えると • prev_sizeメンバはfree時の合併処理のみに必要 • とゆーことは、prevがfree状態のときのみ必要 • prev_sizeはprevがfreeの時のみ記録したい
ちょっとまって • どうやって、prevがfree状態か調べればいいんだっけ? (卵と鶏問題) -
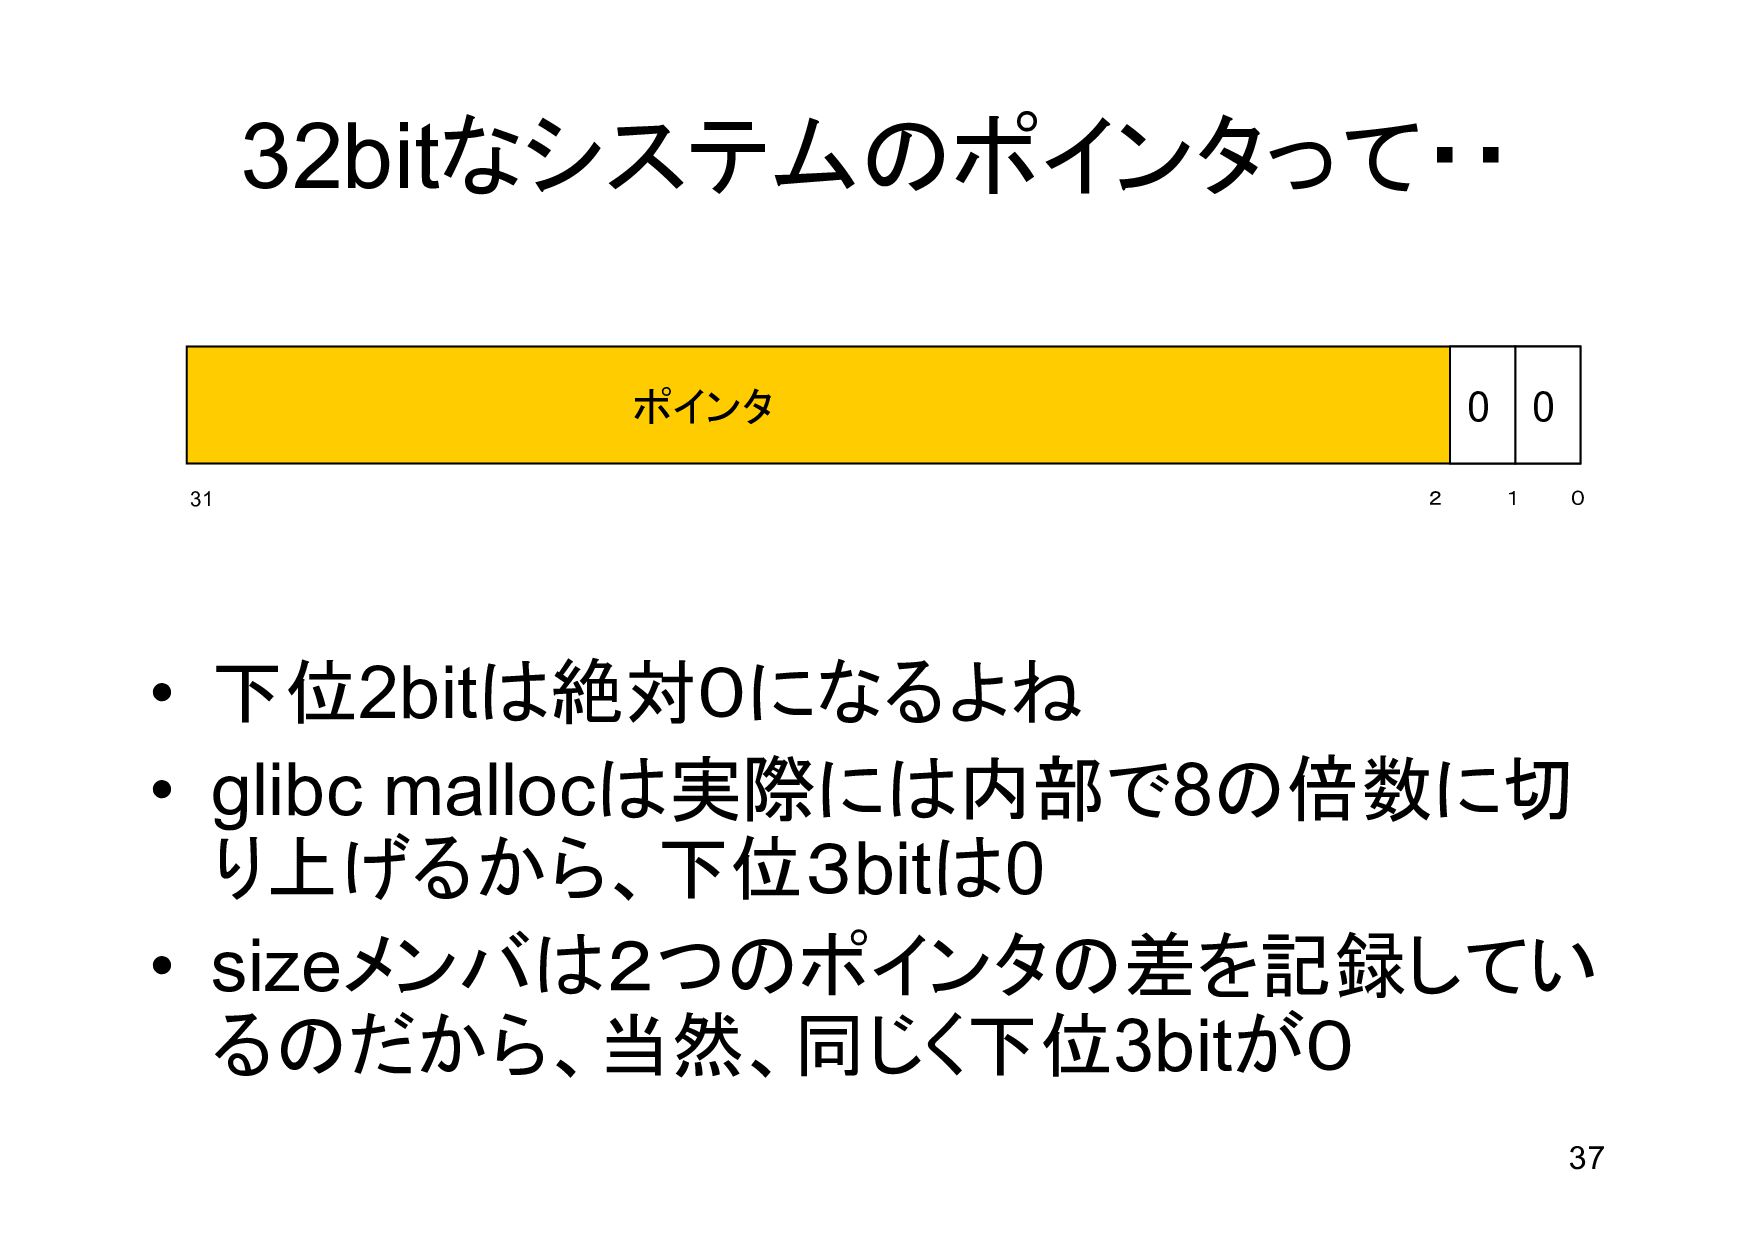
37 32bitなシステムのポインタって・・ 0 31 1 2 ポインタ 0 0 •
下位2bitは絶対0になるよね • glibc mallocは実際には内部で8の倍数に切 り上げるから、下位3bitは0 • sizeメンバは2つのポインタの差を記録してい るのだから、当然、同じく下位3bitが0 -
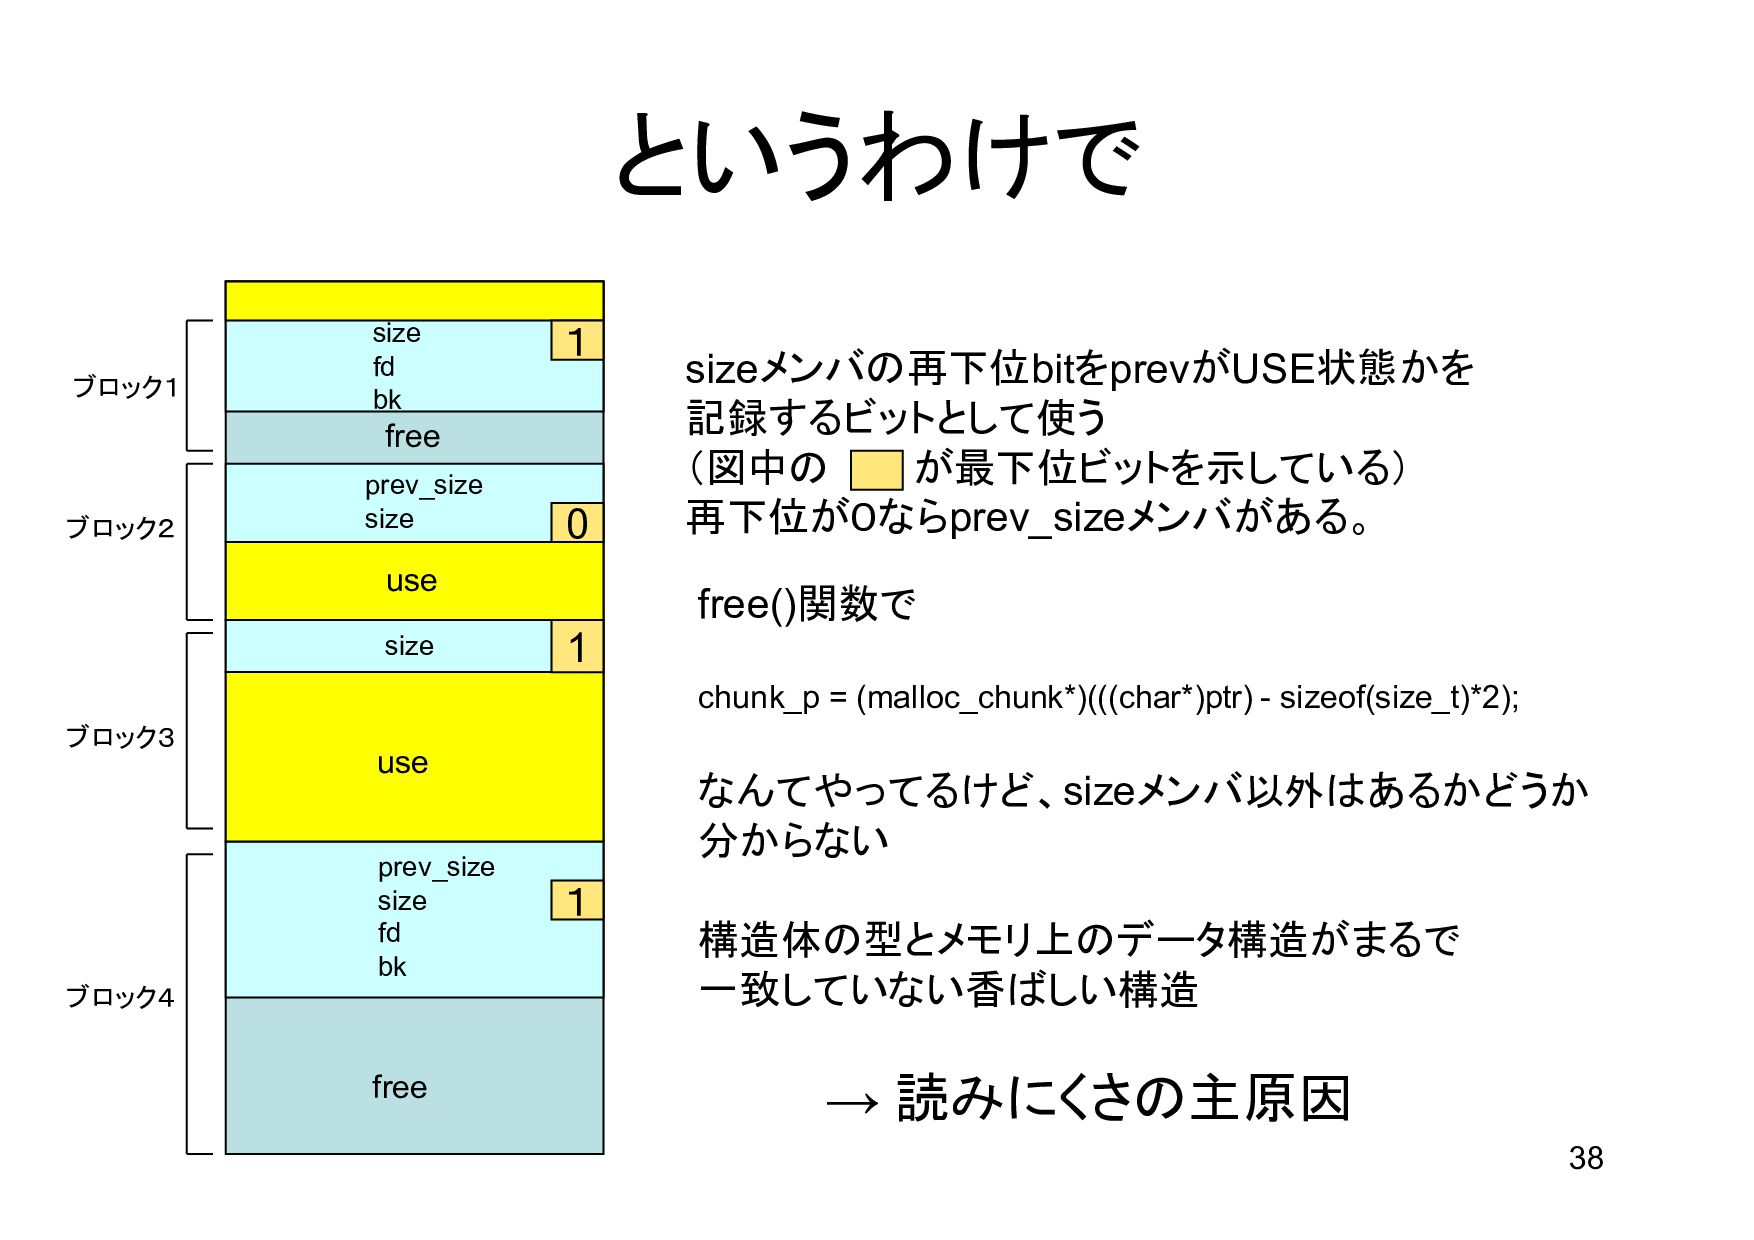
38 というわけで prev_size size fd bk size fd bk use
free free prev_size size use size 1 0 sizeメンバの再下位bitをprevがUSE状態かを 記録するビットとして使う (図中の が最下位ビットを示している) 再下位が0ならprev_sizeメンバがある。 1 1 free()関数で chunk_p = (malloc_chunk*)(((char*)ptr) - sizeof(size_t)*2); なんてやってるけど、sizeメンバ以外はあるかどうか 分からない 構造体の型とメモリ上のデータ構造がまるで 一致していない香ばしい構造 → 読みにくさの主原因 ブロック1 ブロック2 ブロック3 ブロック4 -
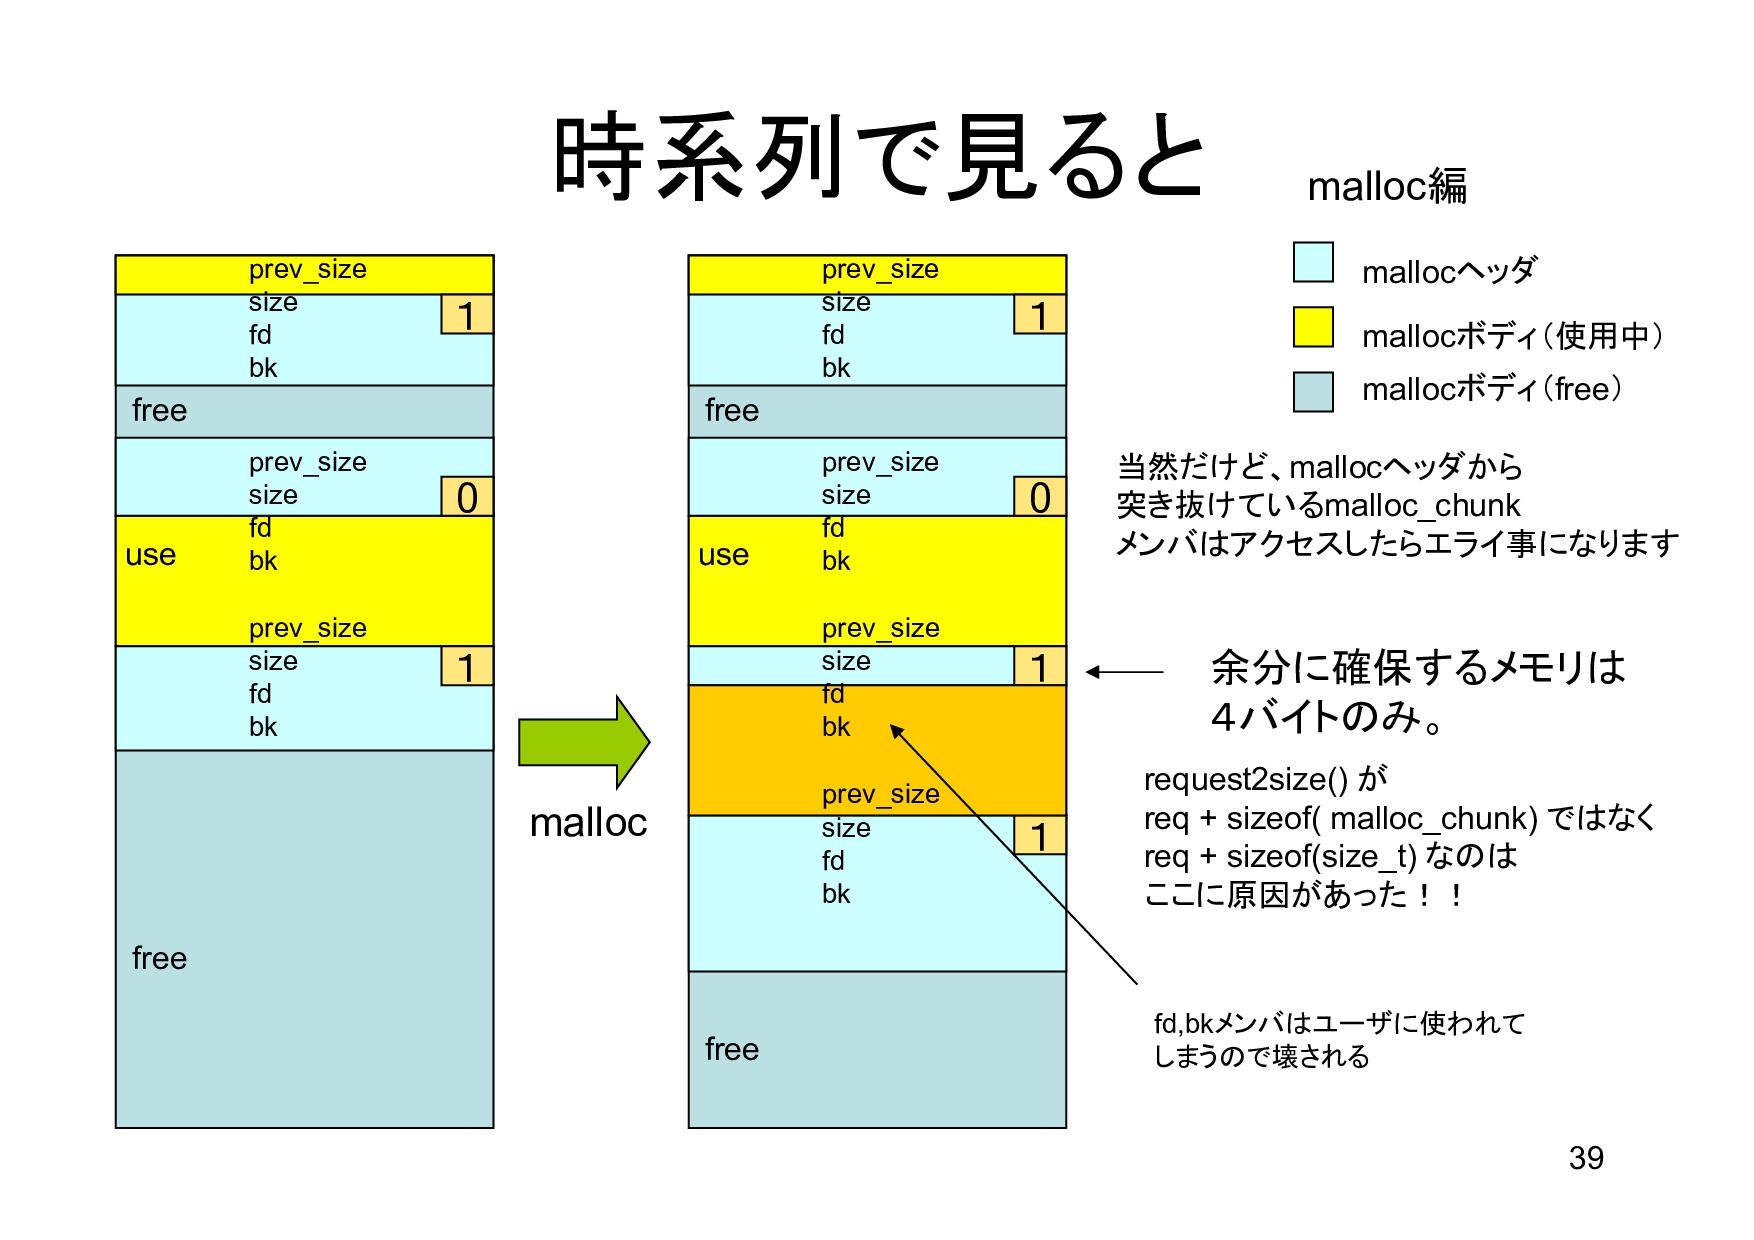
39 時系列で見ると prev_size size fd bk use free free prev_size
size fd bk 0 1 1 prev_size size fd bk use free free prev_size size fd bk 0 1 prev_size size fd bk malloc 1 1 prev_size size fd bk prev_size size fd bk 余分に確保するメモリは 4バイトのみ。 request2size() が req + sizeof( malloc_chunk) ではなく req + sizeof(size_t) なのは ここに原因があった!! malloc編 mallocヘッダ mallocボディ(使用中) mallocボディ(free) 当然だけど、mallocヘッダから 突き抜けているmalloc_chunk メンバはアクセスしたらエライ事になります fd,bkメンバはユーザに使われて しまうので壊される -
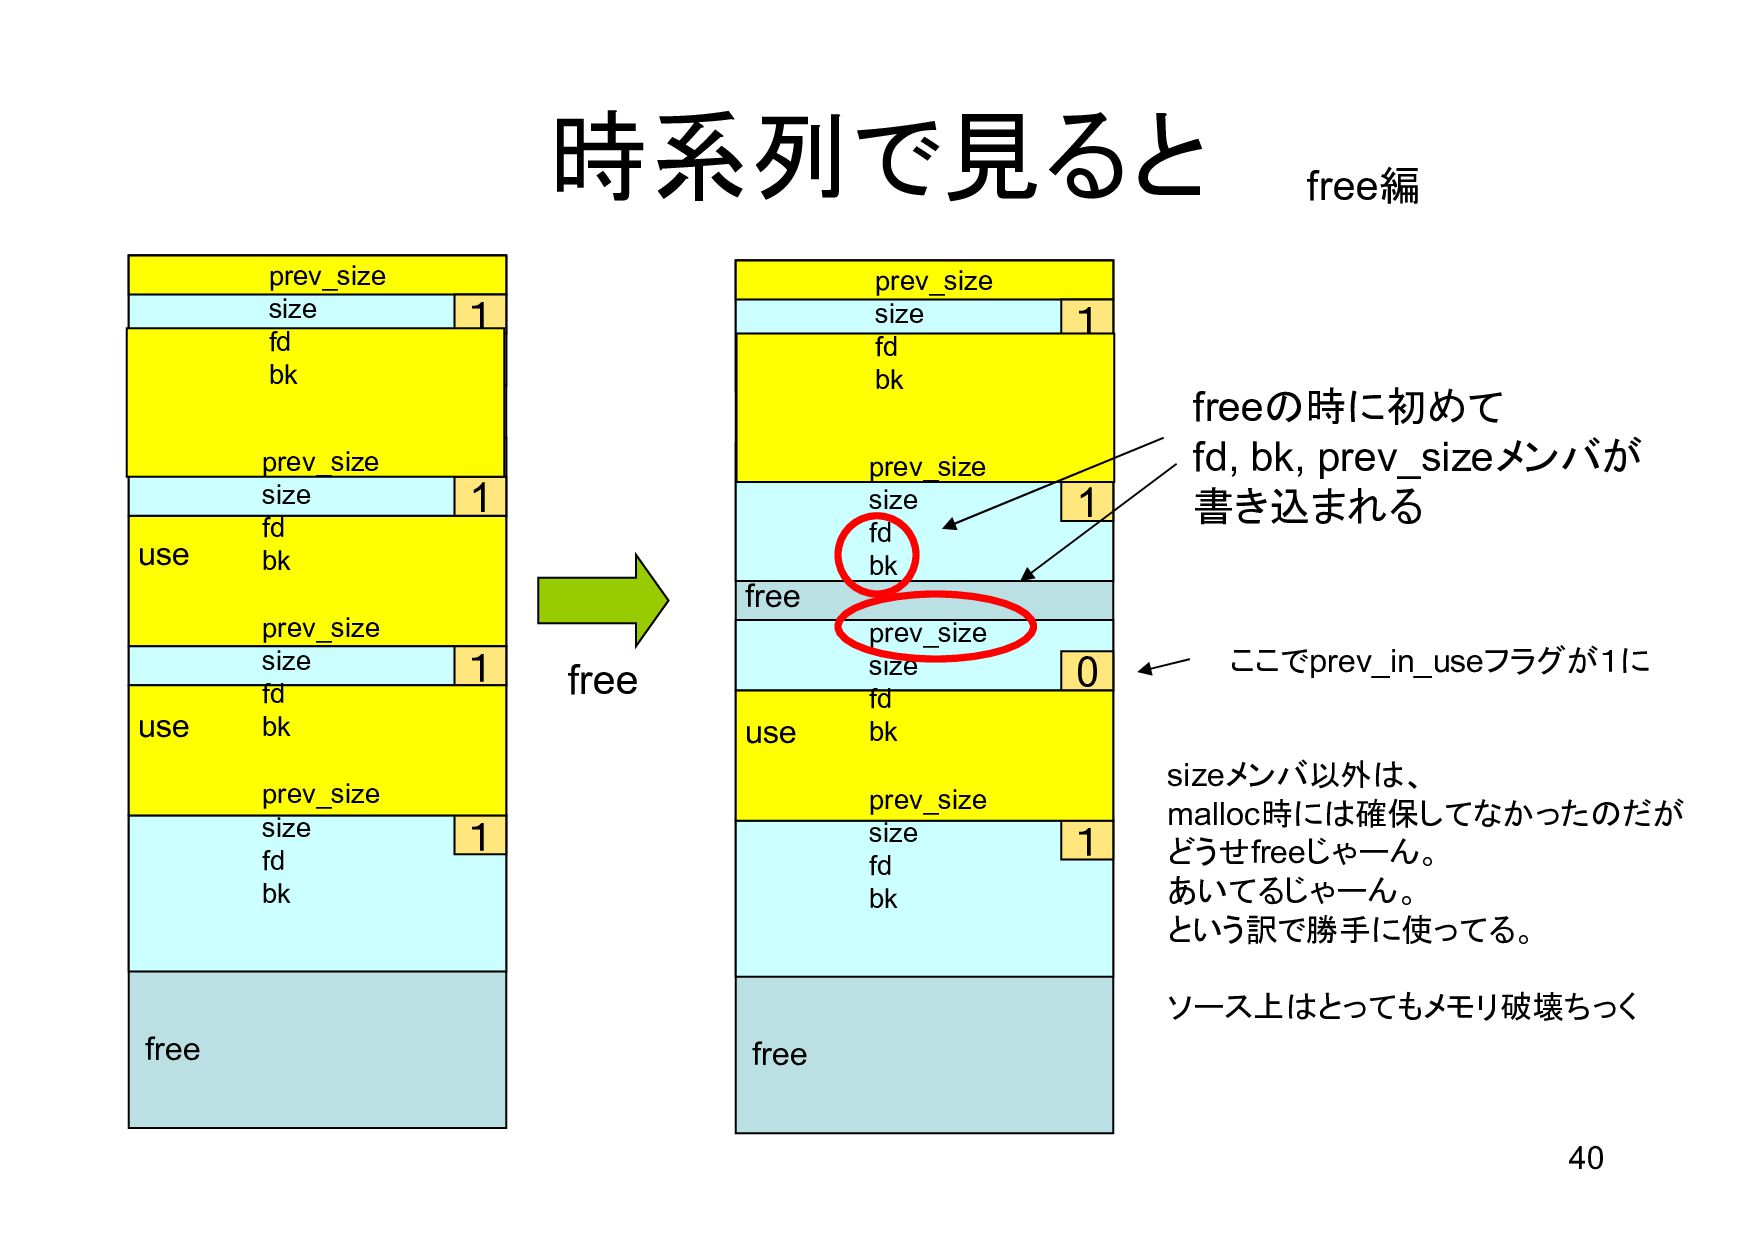
40 時系列で見ると use free 1 1 1 1 prev_size size
fd bk prev_size size fd bk use prev_size size fd bk prev_size size fd bk free free 1 1 0 1 prev_size size fd bk prev_size size fd bk use prev_size size fd bk prev_size size fd bk freeの時に初めて fd, bk, prev_sizeメンバが 書き込まれる sizeメンバ以外は、 malloc時には確保してなかったのだが どうせfreeじゃーん。 あいてるじゃーん。 という訳で勝手に使ってる。 ソース上はとってもメモリ破壊ちっく free free編 ここでprev_in_useフラグが1に -
41 ダイエットは出来たので • ある意味、本日のcode readingの最難関部 分は突破(^-^; (他の部分は、ちゃんとC言語ちっくなCの ソースコード(?)なので) • 次は最大の課題。
malloc() がtypical でO(n)じゃーん。問題を片 付ける -
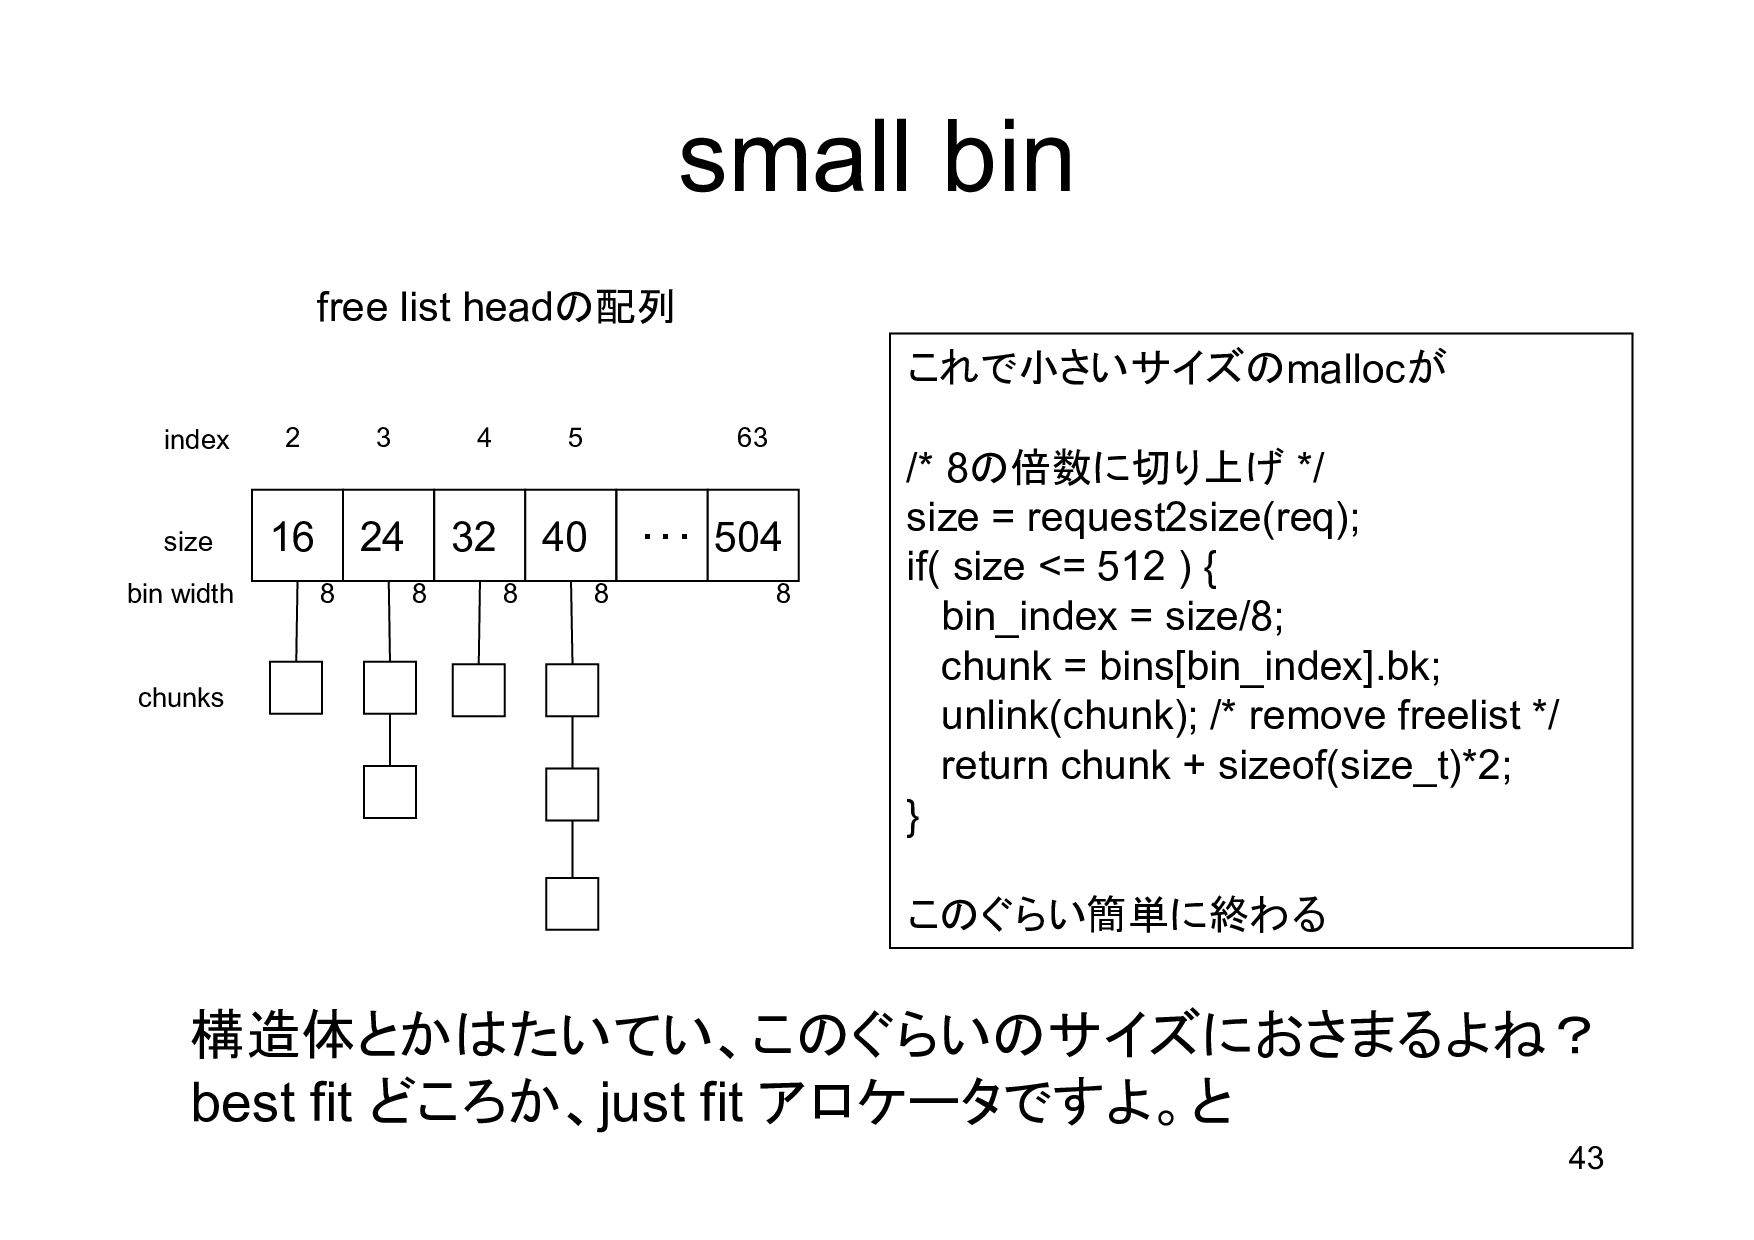
43 small bin 16 24 32 40 504 ・・・ size
index 2 63 3 4 5 chunks これで小さいサイズのmallocが /* 8の倍数に切り上げ */ size = request2size(req); if( size <= 512 ) { bin_index = size/8; chunk = bins[bin_index].bk; unlink(chunk); /* remove freelist */ return chunk + sizeof(size_t)*2; } このぐらい簡単に終わる 構造体とかはたいてい、このぐらいのサイズにおさまるよね? best fit どころか、just fit アロケータですよ。と 8 8 8 8 8 bin width free list headの配列 -
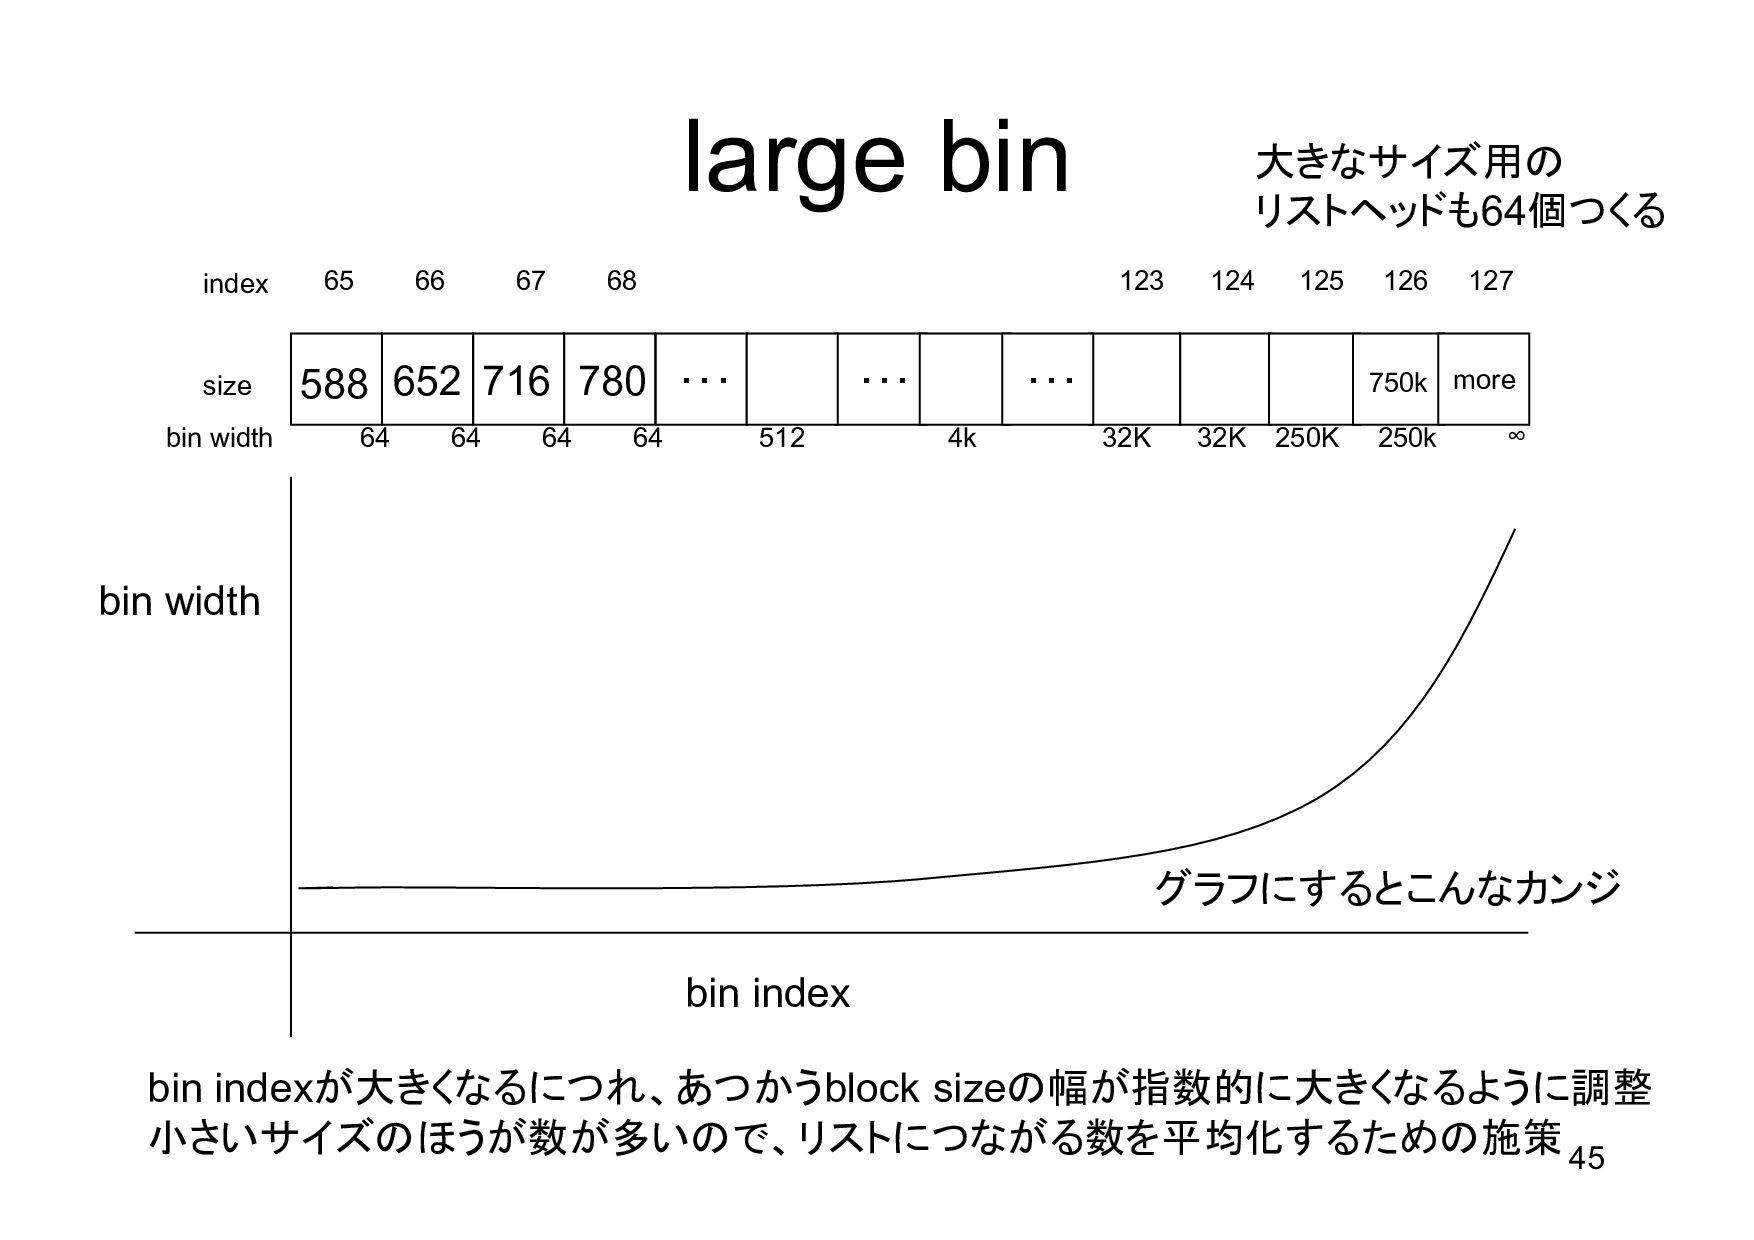
45 large bin 588 652 716 780 ・・・ size index
65 123 66 67 68 64 64 64 64 32K bin width 124 32K 125 250K 126 250k 127 ∞ グラフにするとこんなカンジ bin width bin index bin indexが大きくなるにつれ、あつかうblock sizeの幅が指数的に大きくなるように調整 小さいサイズのほうが数が多いので、リストにつながる数を平均化するための施策 大きなサイズ用の リストヘッドも64個つくる ・・・ 512 4k ・・・ 750k more -
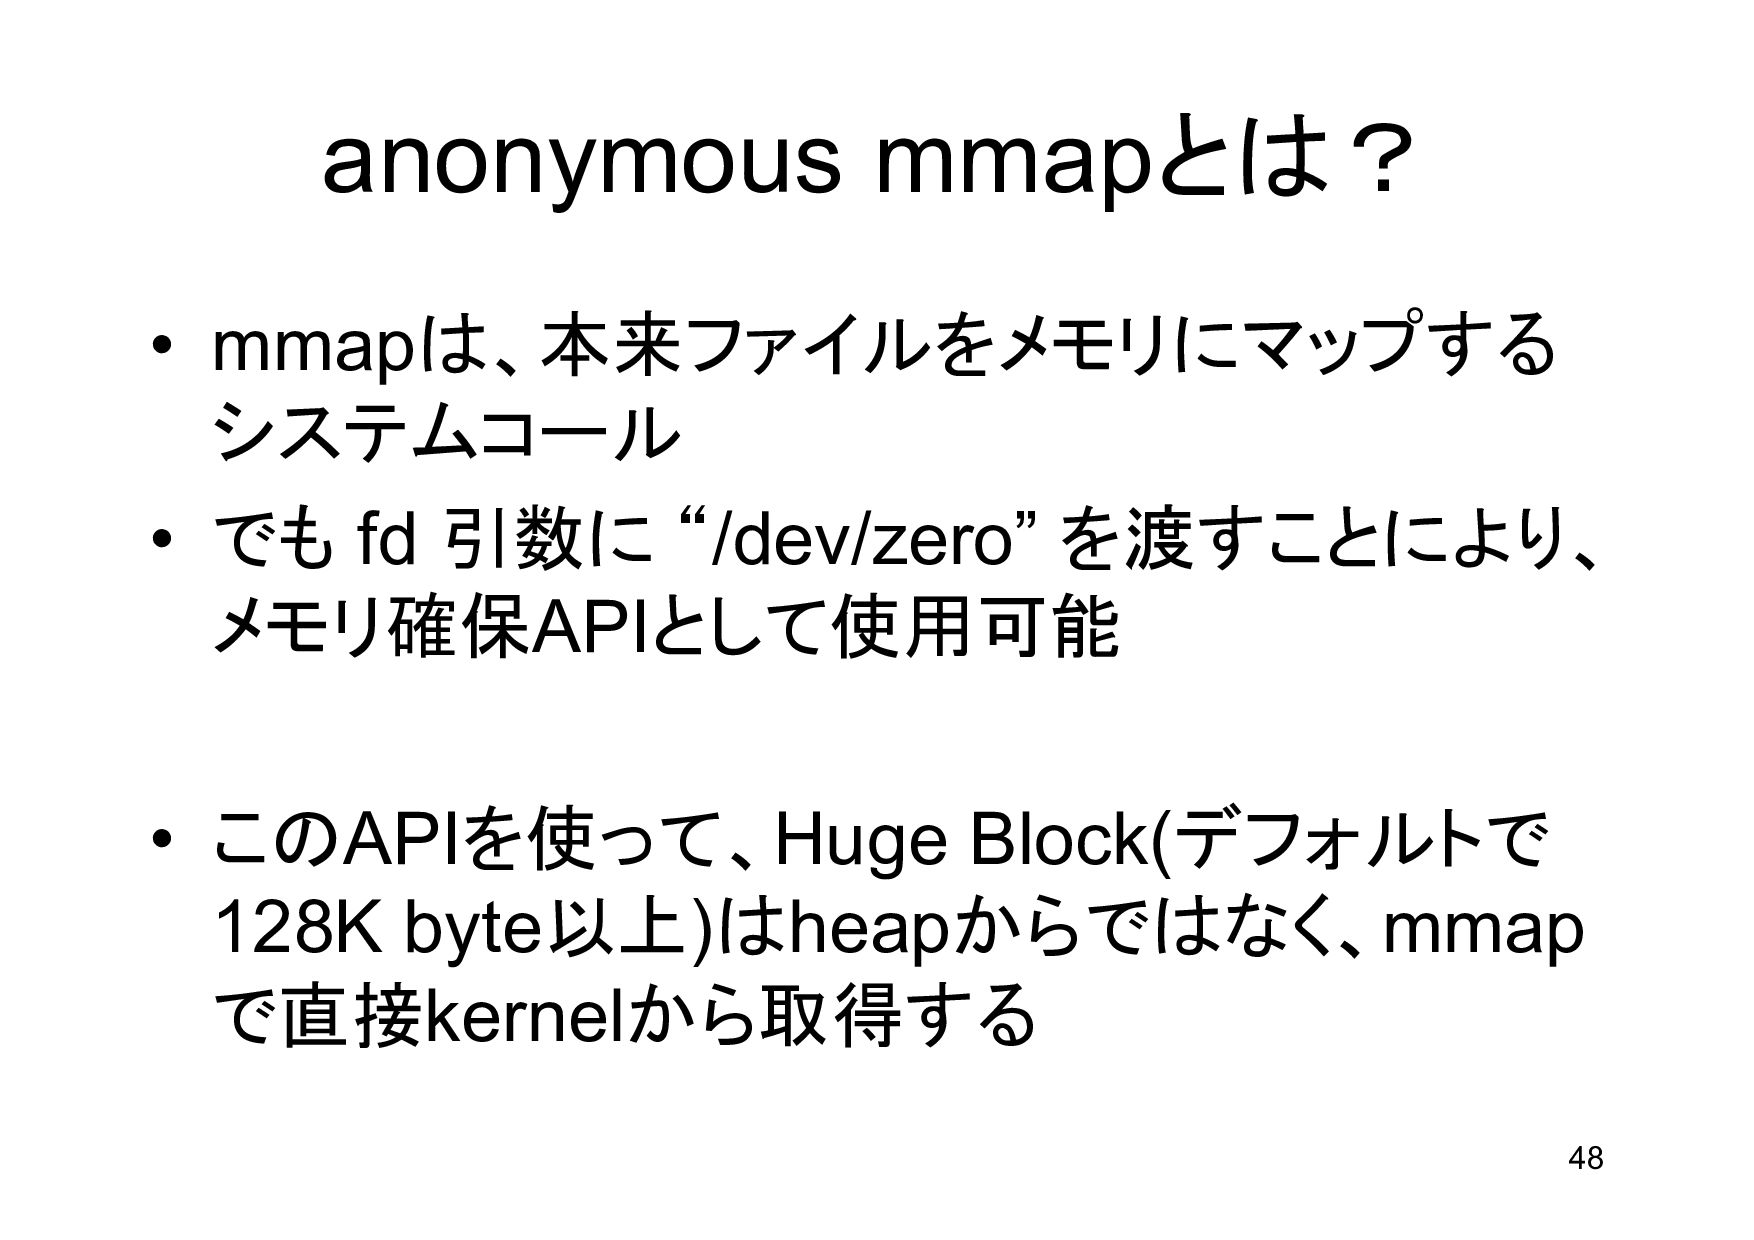
48 anonymous mmapとは? • mmapは、本来ファイルをメモリにマップする システムコール • でも fd 引数に
“/dev/zero” を渡すことにより、 メモリ確保APIとして使用可能 • このAPIを使って、Huge Block(デフォルトで 128K byte以上)はheapからではなく、mmap で直接kernelから取得する -
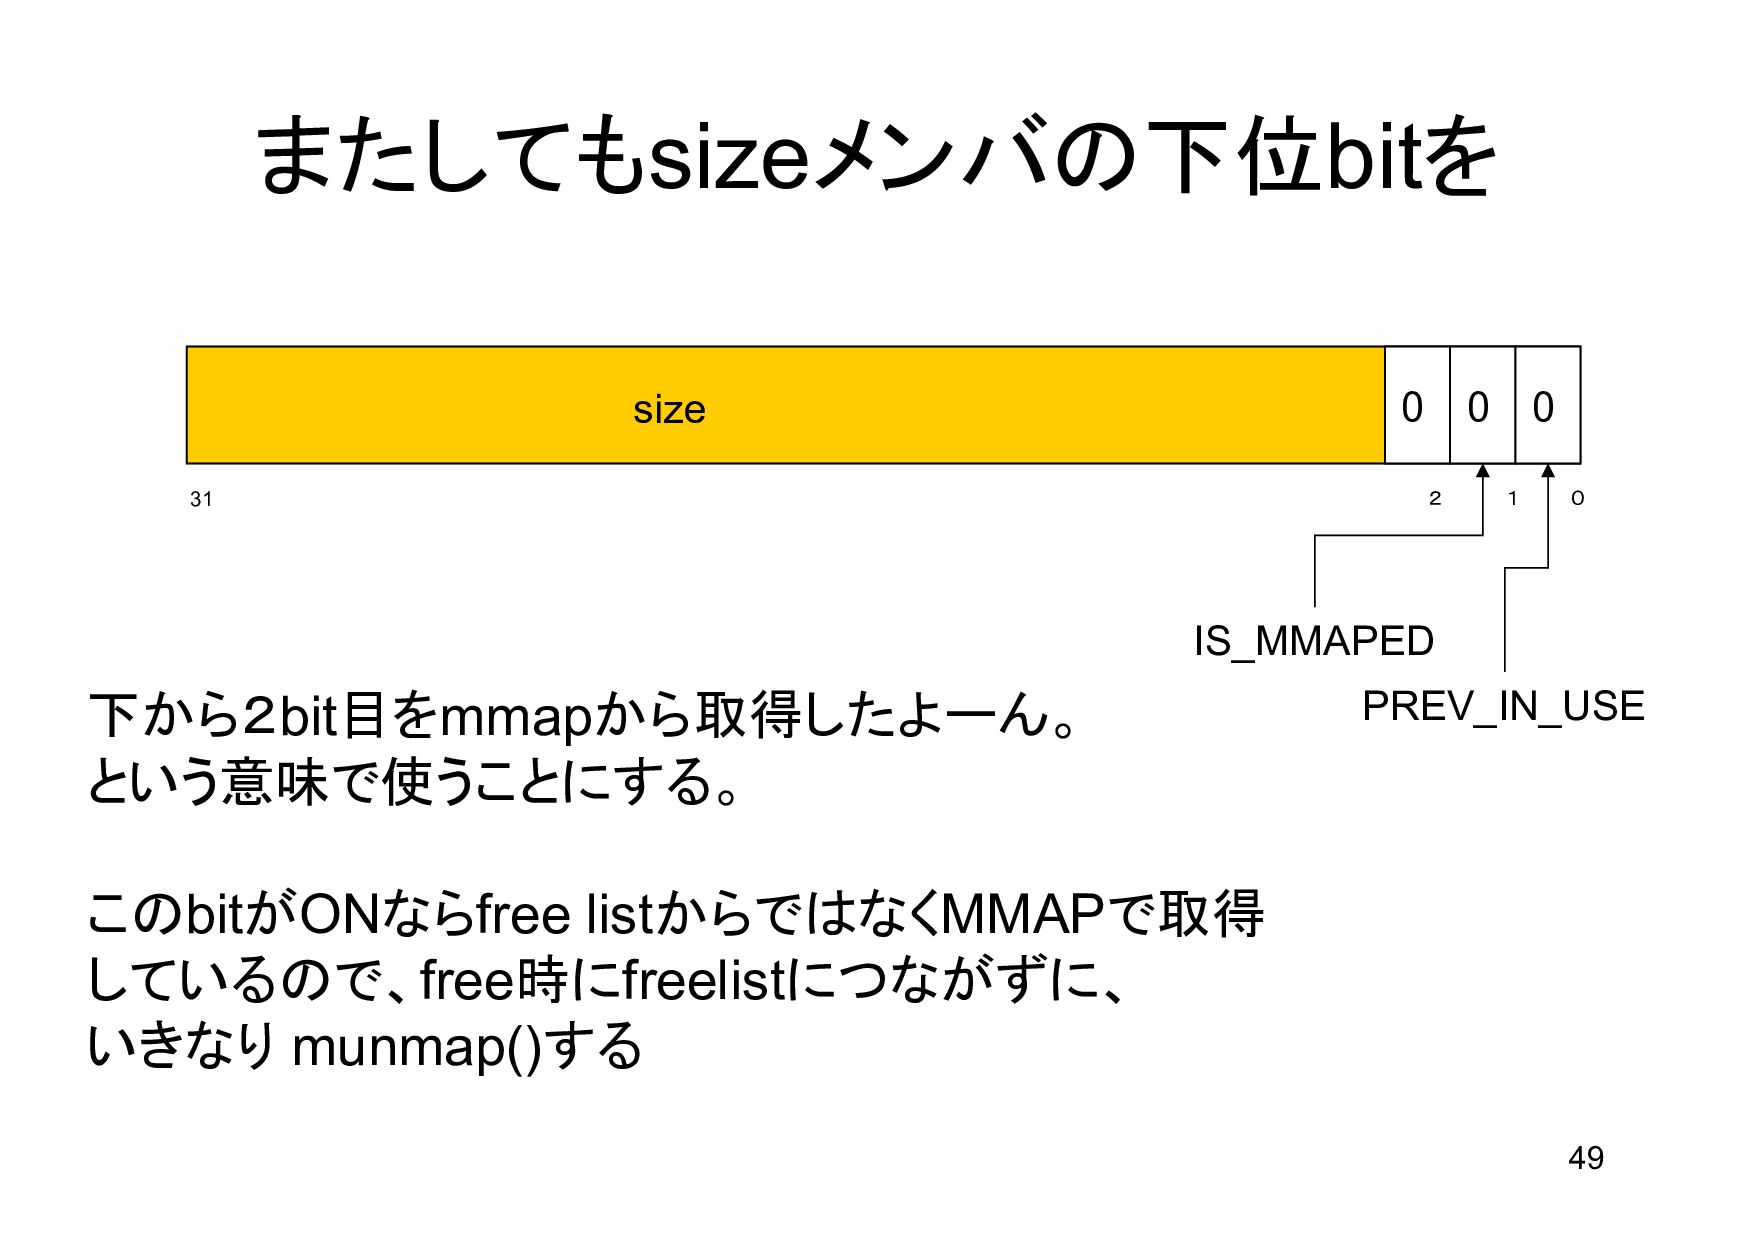
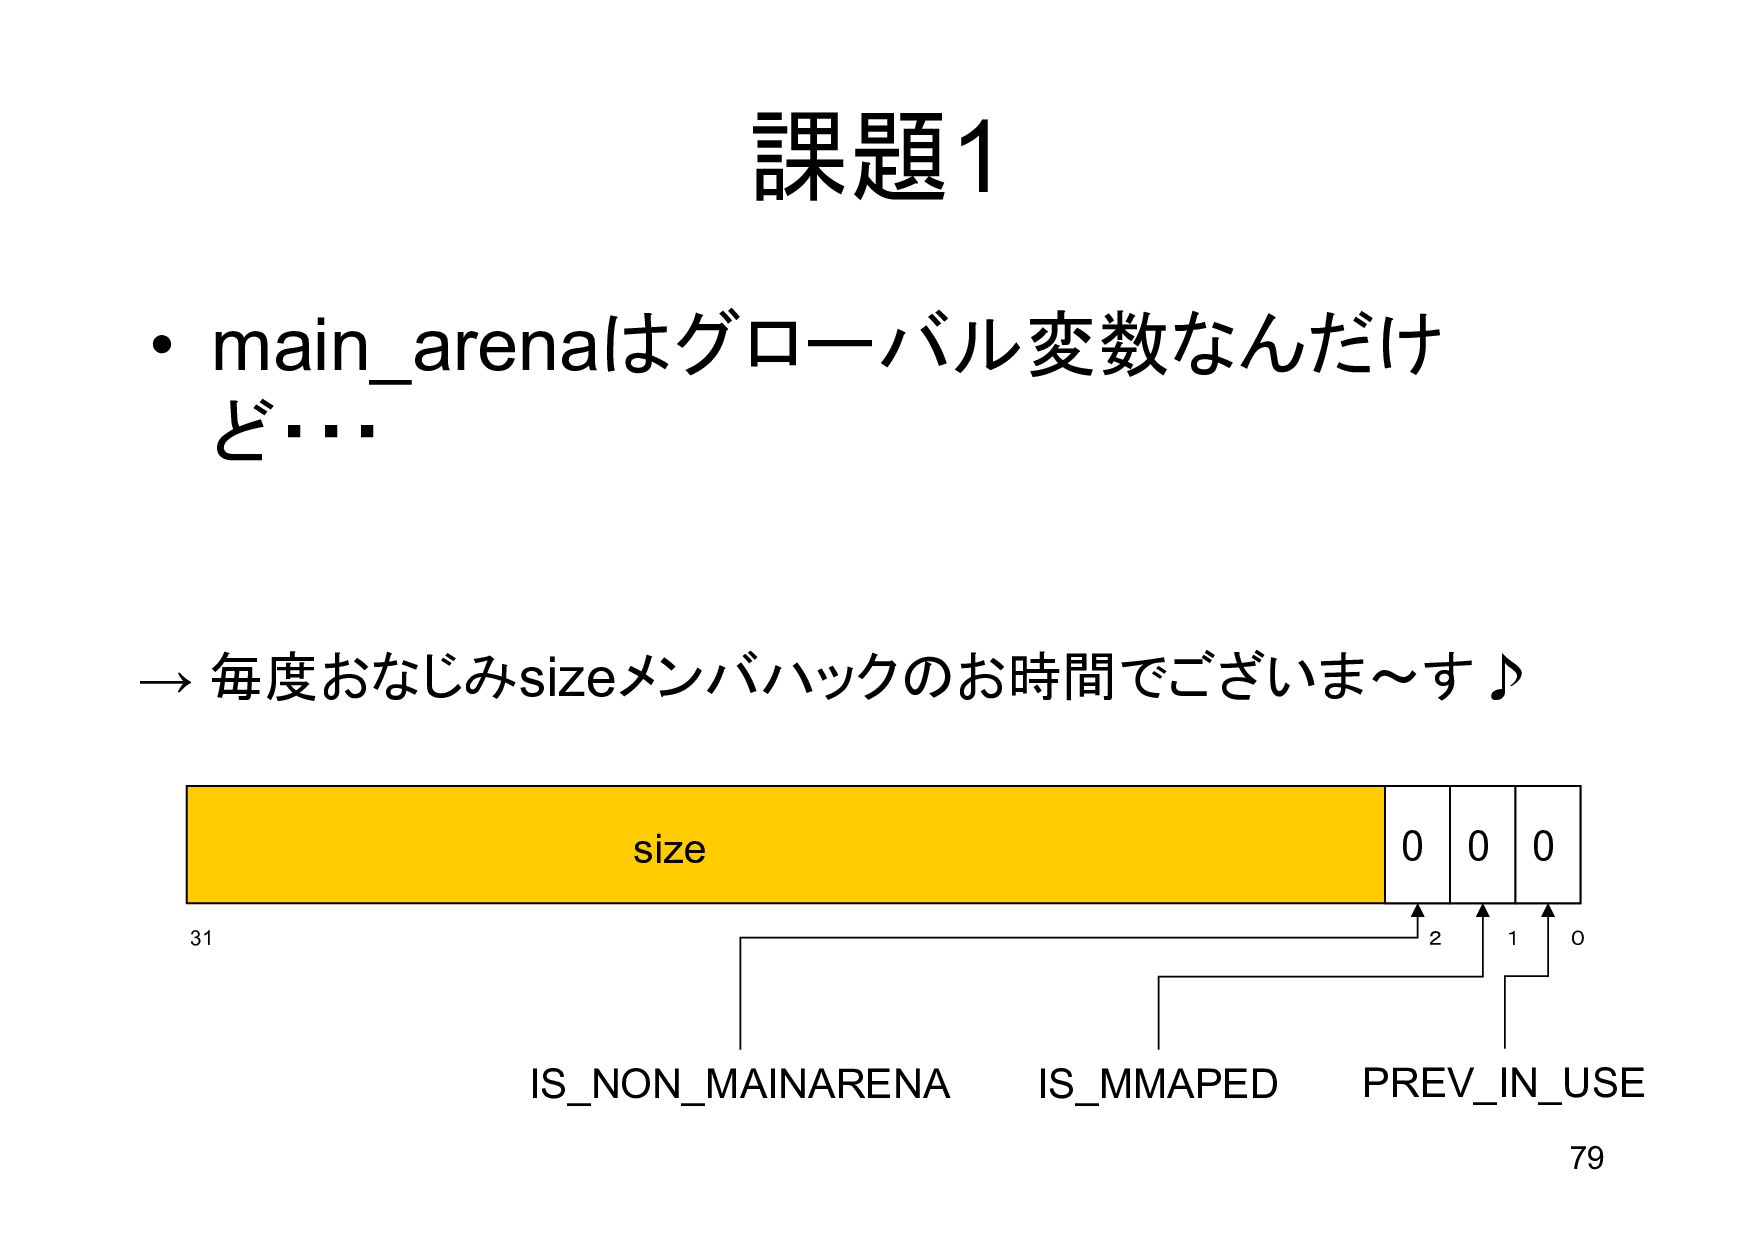
49 またしてもsizeメンバの下位bitを 0 31 1 2 size 0 0 0
IS_MMAPED PREV_IN_USE 下から2bit目をmmapから取得したよーん。 という意味で使うことにする。 このbitがONならfree listからではなくMMAPで取得 しているので、free時にfreelistにつながずに、 いきなり munmap()する -
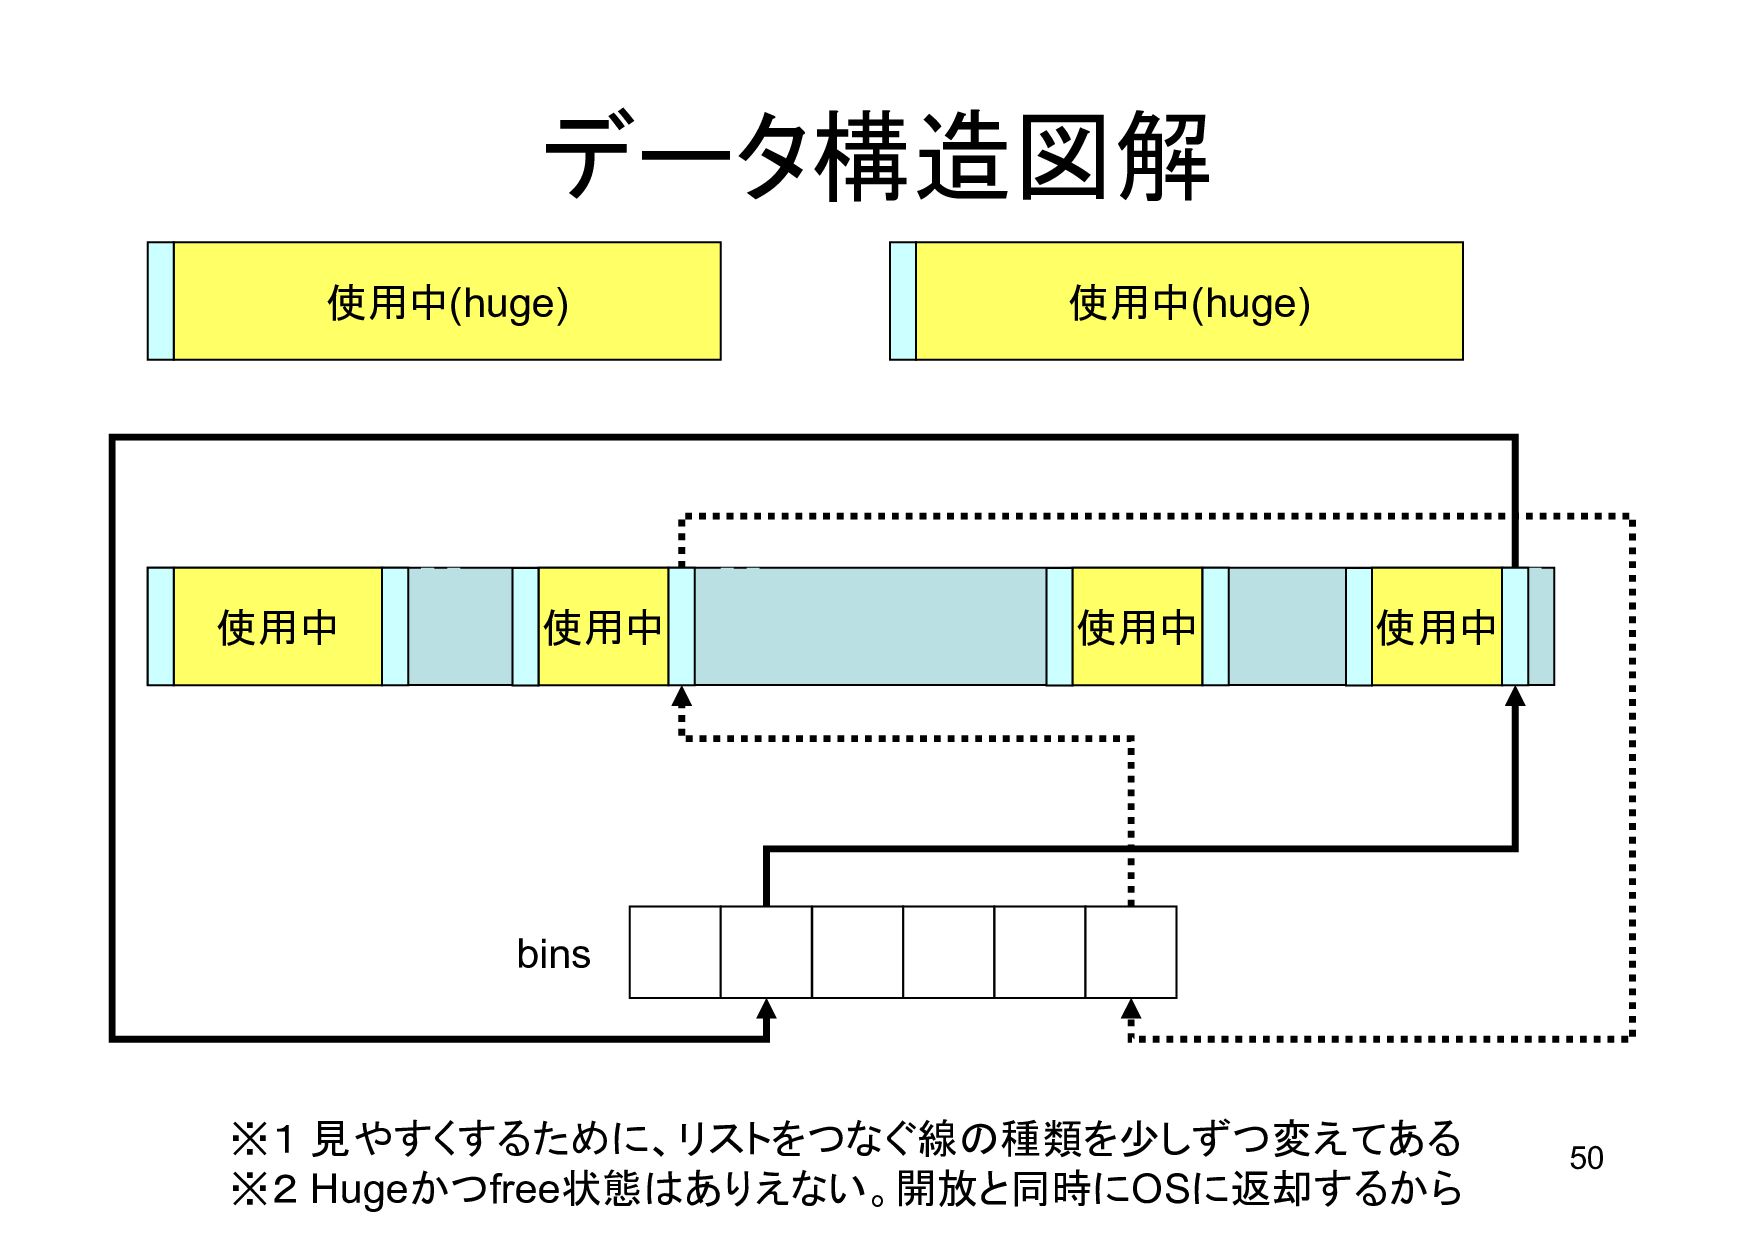
50 データ構造図解 使用中 使用中 使用中 使用中 使用中(huge) 使用中(huge) bins ※1
見やすくするために、リストをつなぐ線の種類を少しずつ変えてある ※2 Hugeかつfree状態はありえない。開放と同時にOSに返却するから -
51 この方法の利点 • Huge Blockもmalloc, freeともにO(1) • フラグメンテーション、むっさ起きにくい (リスト管理してないんだから当たり前) •
メモリの無駄が少ない (でっかいメモリは同じサイズで再度mallocさ れる確率は低いので、すぐさまOSに返却す るのは賢い戦略) -
52 ここまでの結果 • 良くなったところ – mallocがtypical で O(1) – freeがtypicalでO(1)
– フラグメンテーションがすごく起きにくく – ヘッダサイズは実質4バイト – brkが発生するときに、K&R mallocではfreelistを一周す る必要があったのが、要求サイズより大きいbinを検索す るだけでよくなった。 平均で探索コスト1/2 • 悪くなったところ – なんかあったっけ? -
53 でも! それでも! しばしば、K&R mallocに 負けるんです。これが 実はlarge size blockの malloc
– free –malloc – free と 繰り返す割り当てが遅い -
54 K&R freeを振り返ってみる 使用中 使用中 使用中 free listの head 使用中
bp p next 9. free list head を今開放した要素を 指すよう動かす 今開放した 要素 ここがポイント -
55 キャッシュと局所参照性 • heapメモリーに一番アクセスする確率が高い のはmalloc直後とfree直前である • freeされたばかりのメモリはキャッシュに載っ てる確率が高い • そこから優先してメモリ確保することはmalloc
直後のアクセスでキャッシュミスしなくなるとい うこと キャッシュのヒット率重要 -
56 バッファの遅延合体 • freeが呼ばれたときに、すぐに隣と併合&free listに つなぐ処理をやめる • 最初にこのアイデアを実装したのはSVR4らしい(最 前線UNIXのカーネル より)
• malloc – free – malloc – free という非常によくある アクセスパターンでメモリブロックの分離・併合・分 離・併合という無駄な処理が避けられる。 • かつ、freeされた順に時系列にリストにつながって いるので、リスト先頭のblockをアプリに返せば キャッシュヒット率向上 -
57 バッファの遅延合体 その2 • gligc mallocでは最低確保サイズが32なので bins[0]とbins[1]は使ってない • bins[1] をこの遅延されてるblockをつなげるリストの
リストヘッドとして特別な意味で用いる • ソースコード上はunsorted_chunkと呼ばれている が、ソートしない=時系列順である。 • リストをたぐって、要求サイズと一致するものを検索 • 要求サイズと一致しないものは、この時点で、隣と 併合して実際のfree処理 -
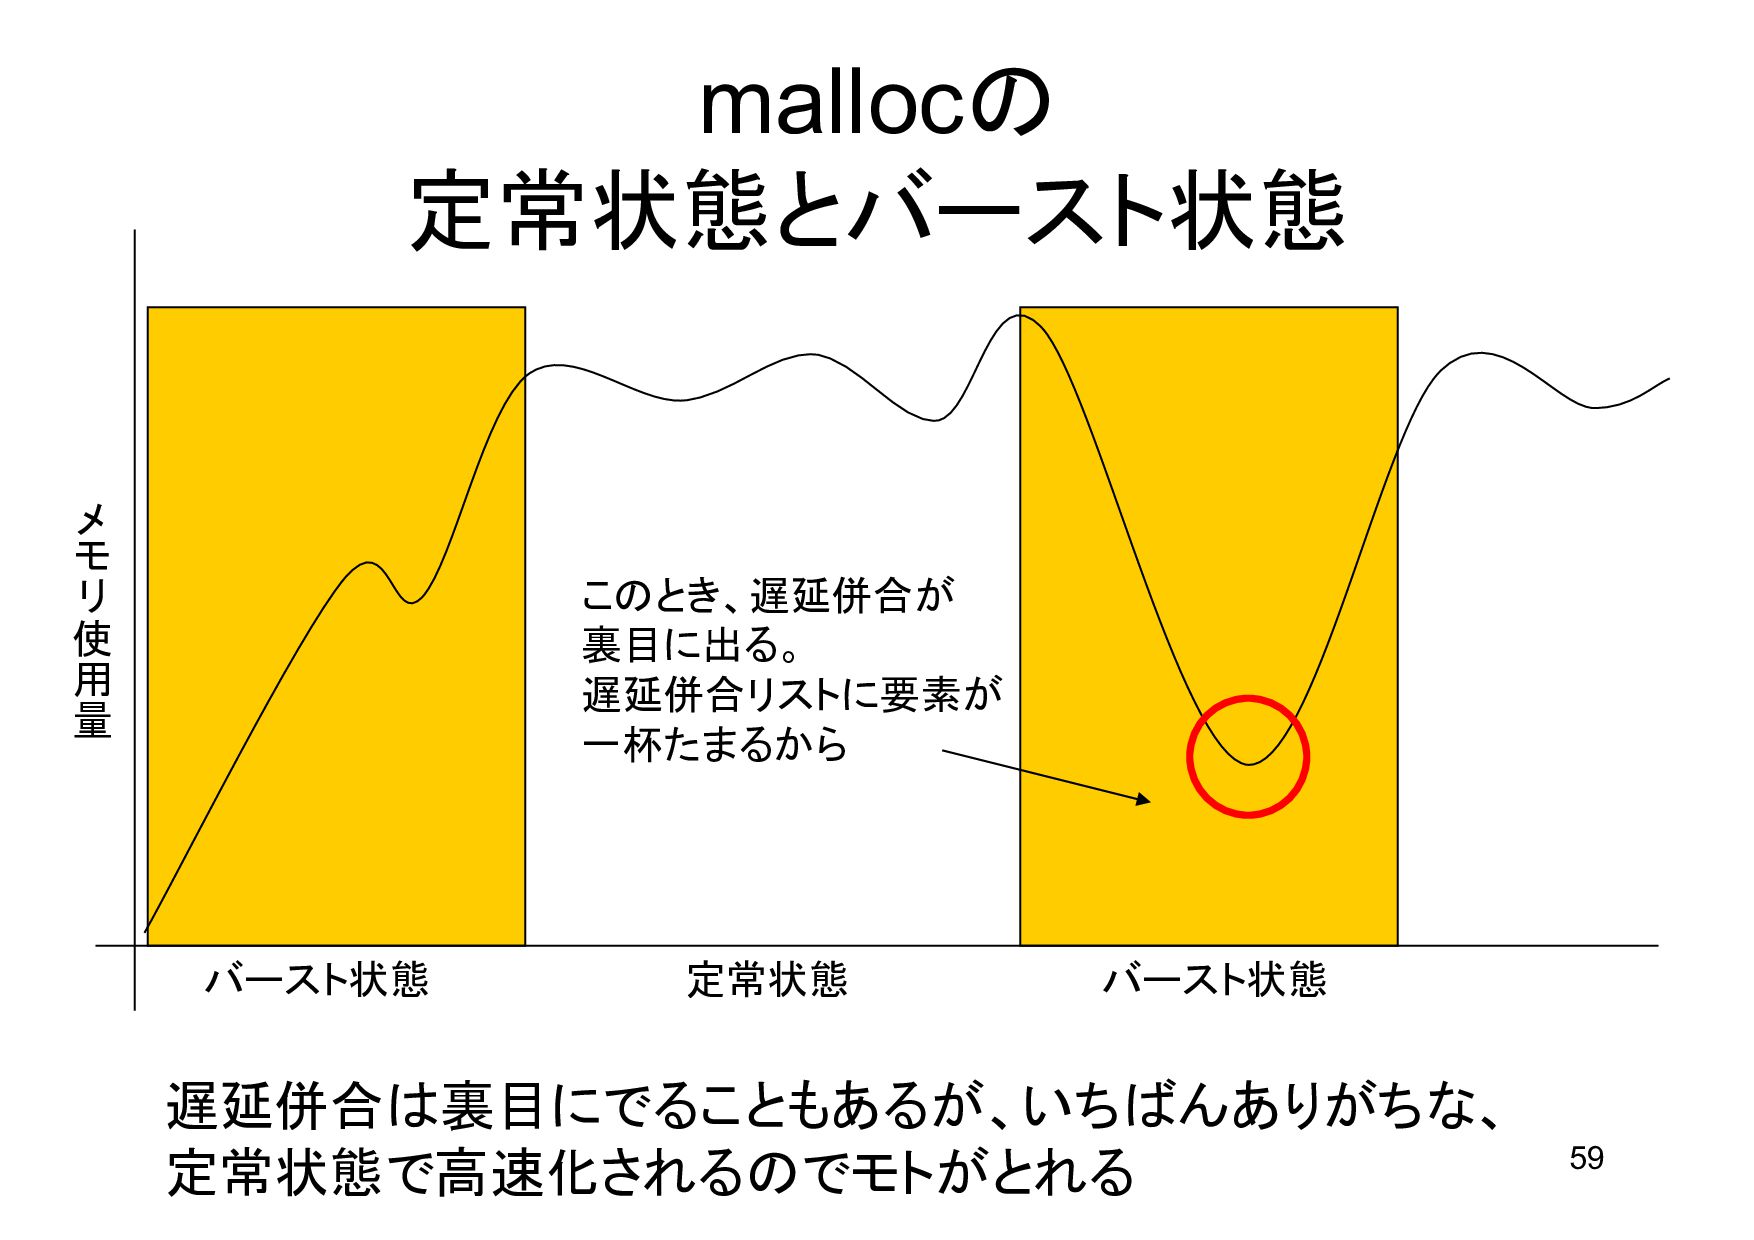
58 マクロな視点で話をすると • mallocの呼び出しパターンはたいてい以下のような 経過をへる • アプリ起動時はやたらmallocが呼ばれる。freeはほ とんど呼ばれない • その後、mallocとfreeがほぼ交互に呼ばれる定常
状態に入る • GUIの画面遷移のような、なんからの契機で、free がひたすら呼ばれ、次にmallocがひたすら呼ばれる データ構造の大転換がおこる • そしてまた定常状態に・・・・ -
59 mallocの 定常状態とバースト状態 バースト状態 バースト状態 このとき、遅延併合が 裏目に出る。 遅延併合リストに要素が 一杯たまるから メ
モ リ 使 用 量 定常状態 遅延併合は裏目にでることもあるが、いちばんありがちな、 定常状態で高速化されるのでモトがとれる -
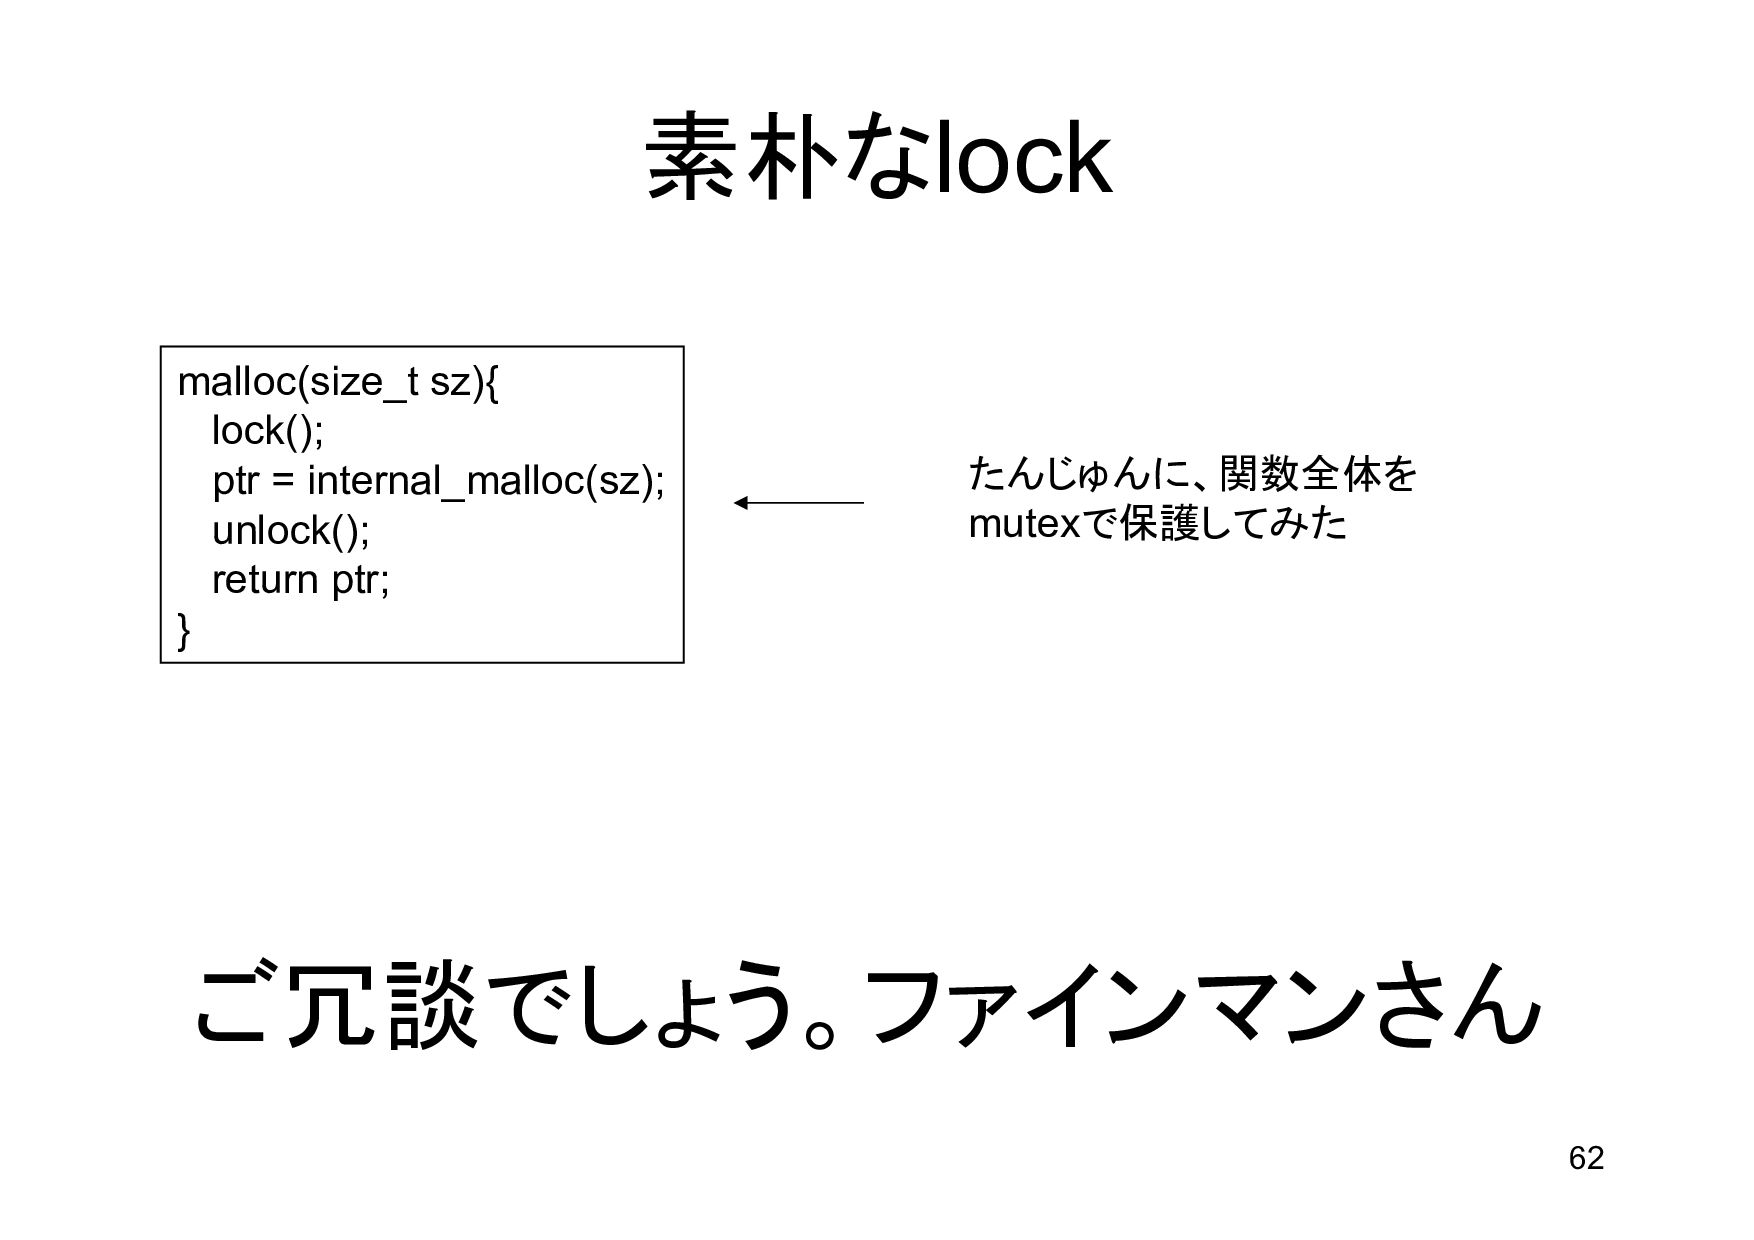
62 素朴なlock malloc(size_t sz){ lock(); ptr = internal_malloc(sz); unlock(); return
ptr; } ご冗談でしょう。ファインマンさん たんじゅんに、関数全体を mutexで保護してみた -
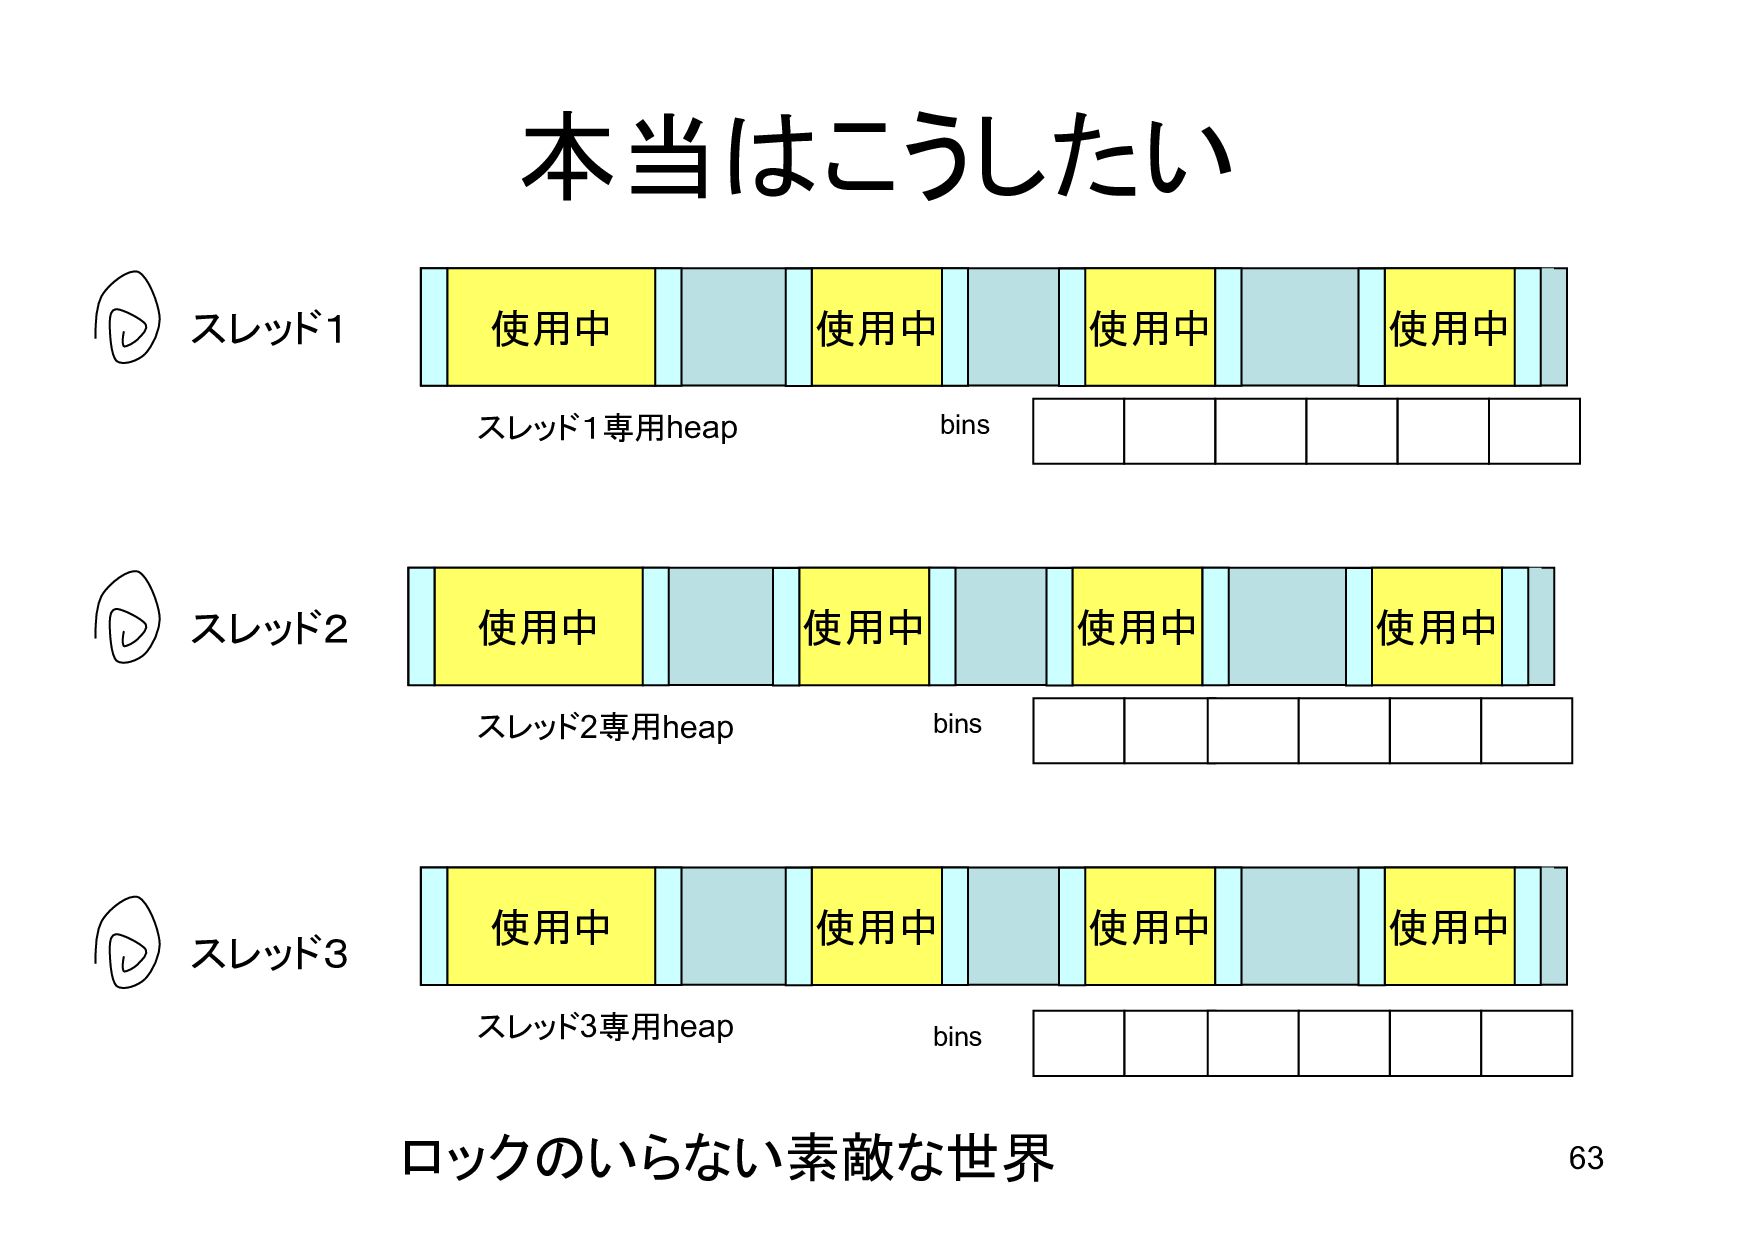
63 本当はこうしたい 使用中 使用中 使用中 使用中 使用中 使用中 使用中 使用中
bins 使用中 使用中 使用中 使用中 bins bins スレッド1 スレッド2 スレッド3 スレッド1専用heap スレッド2専用heap スレッド3専用heap ロックのいらない素敵な世界 -
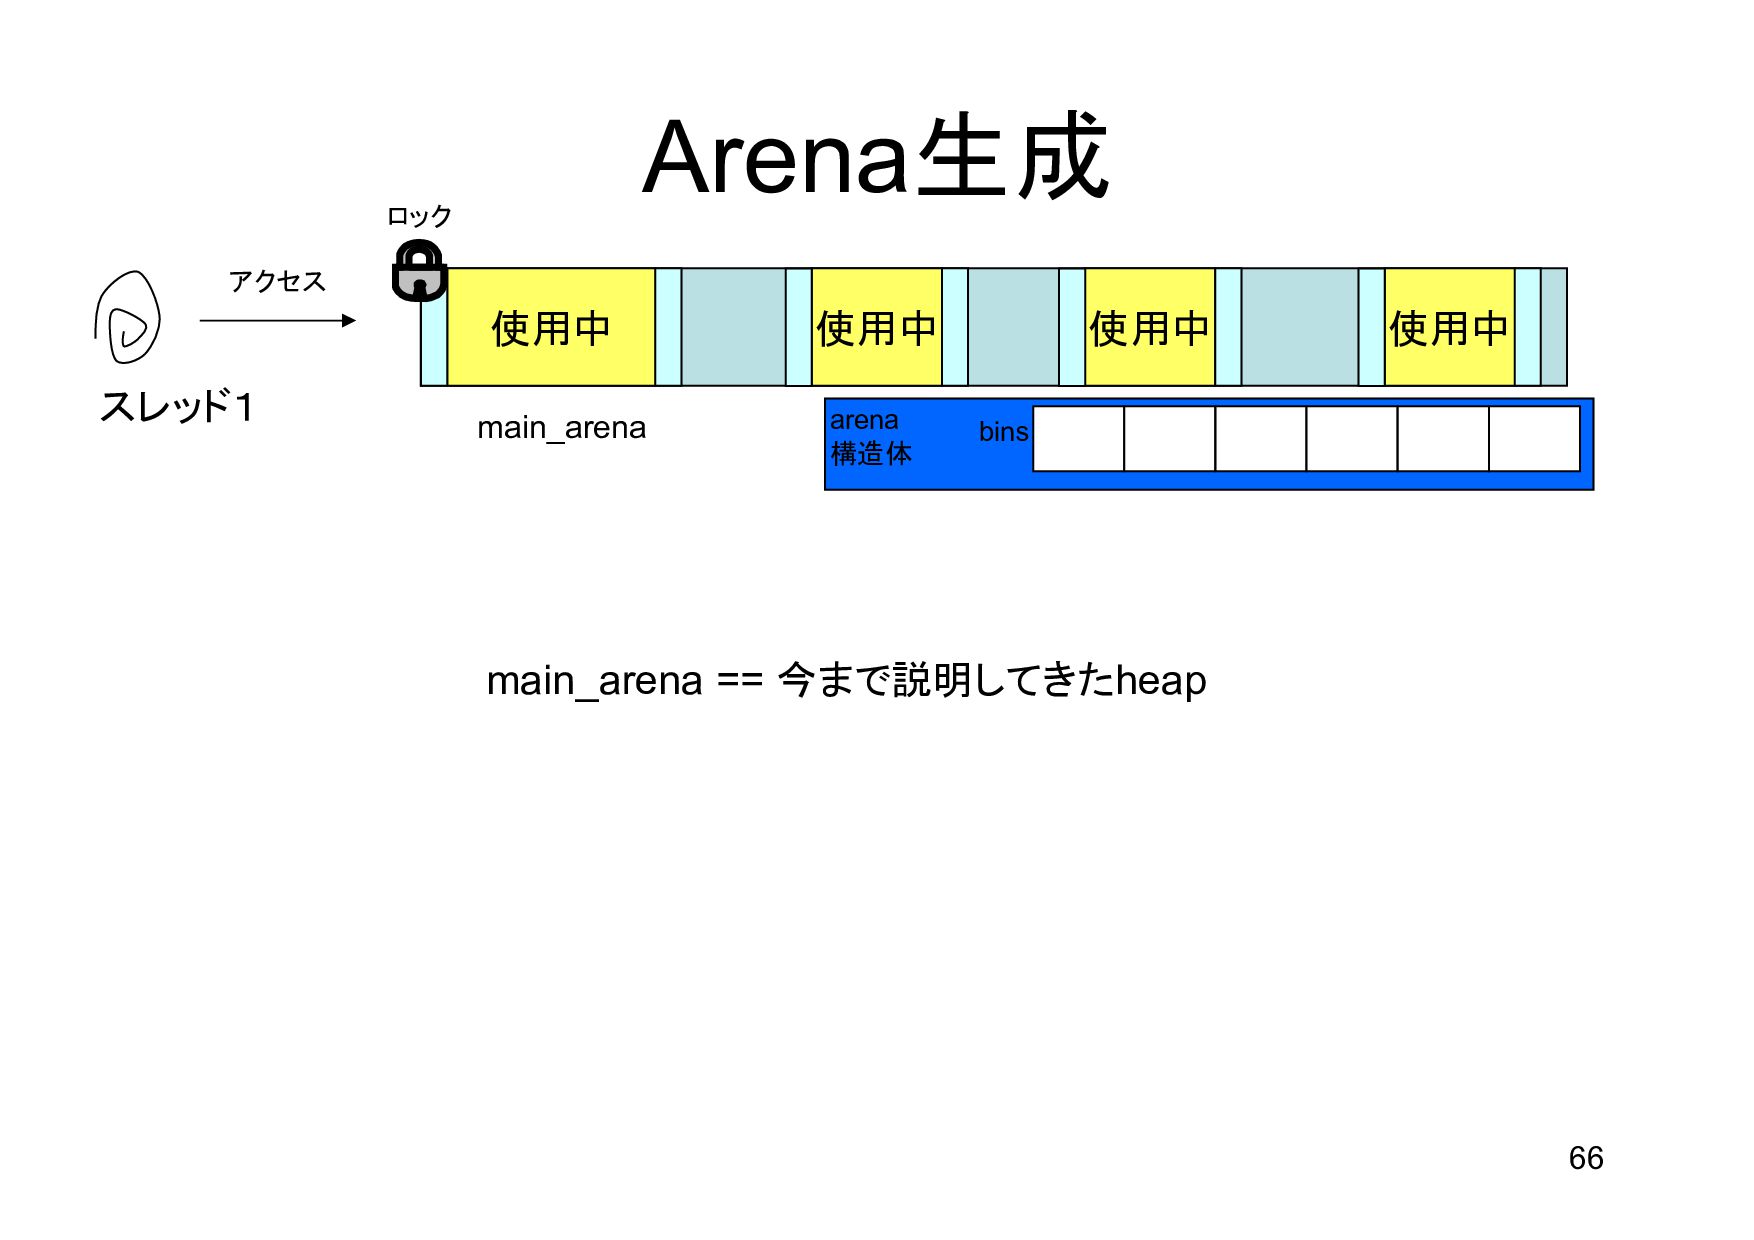
66 Arena生成 使用中 使用中 使用中 使用中 bins スレッド1 main_arena main_arena
== 今まで説明してきたheap アクセス ロック arena 構造体 -
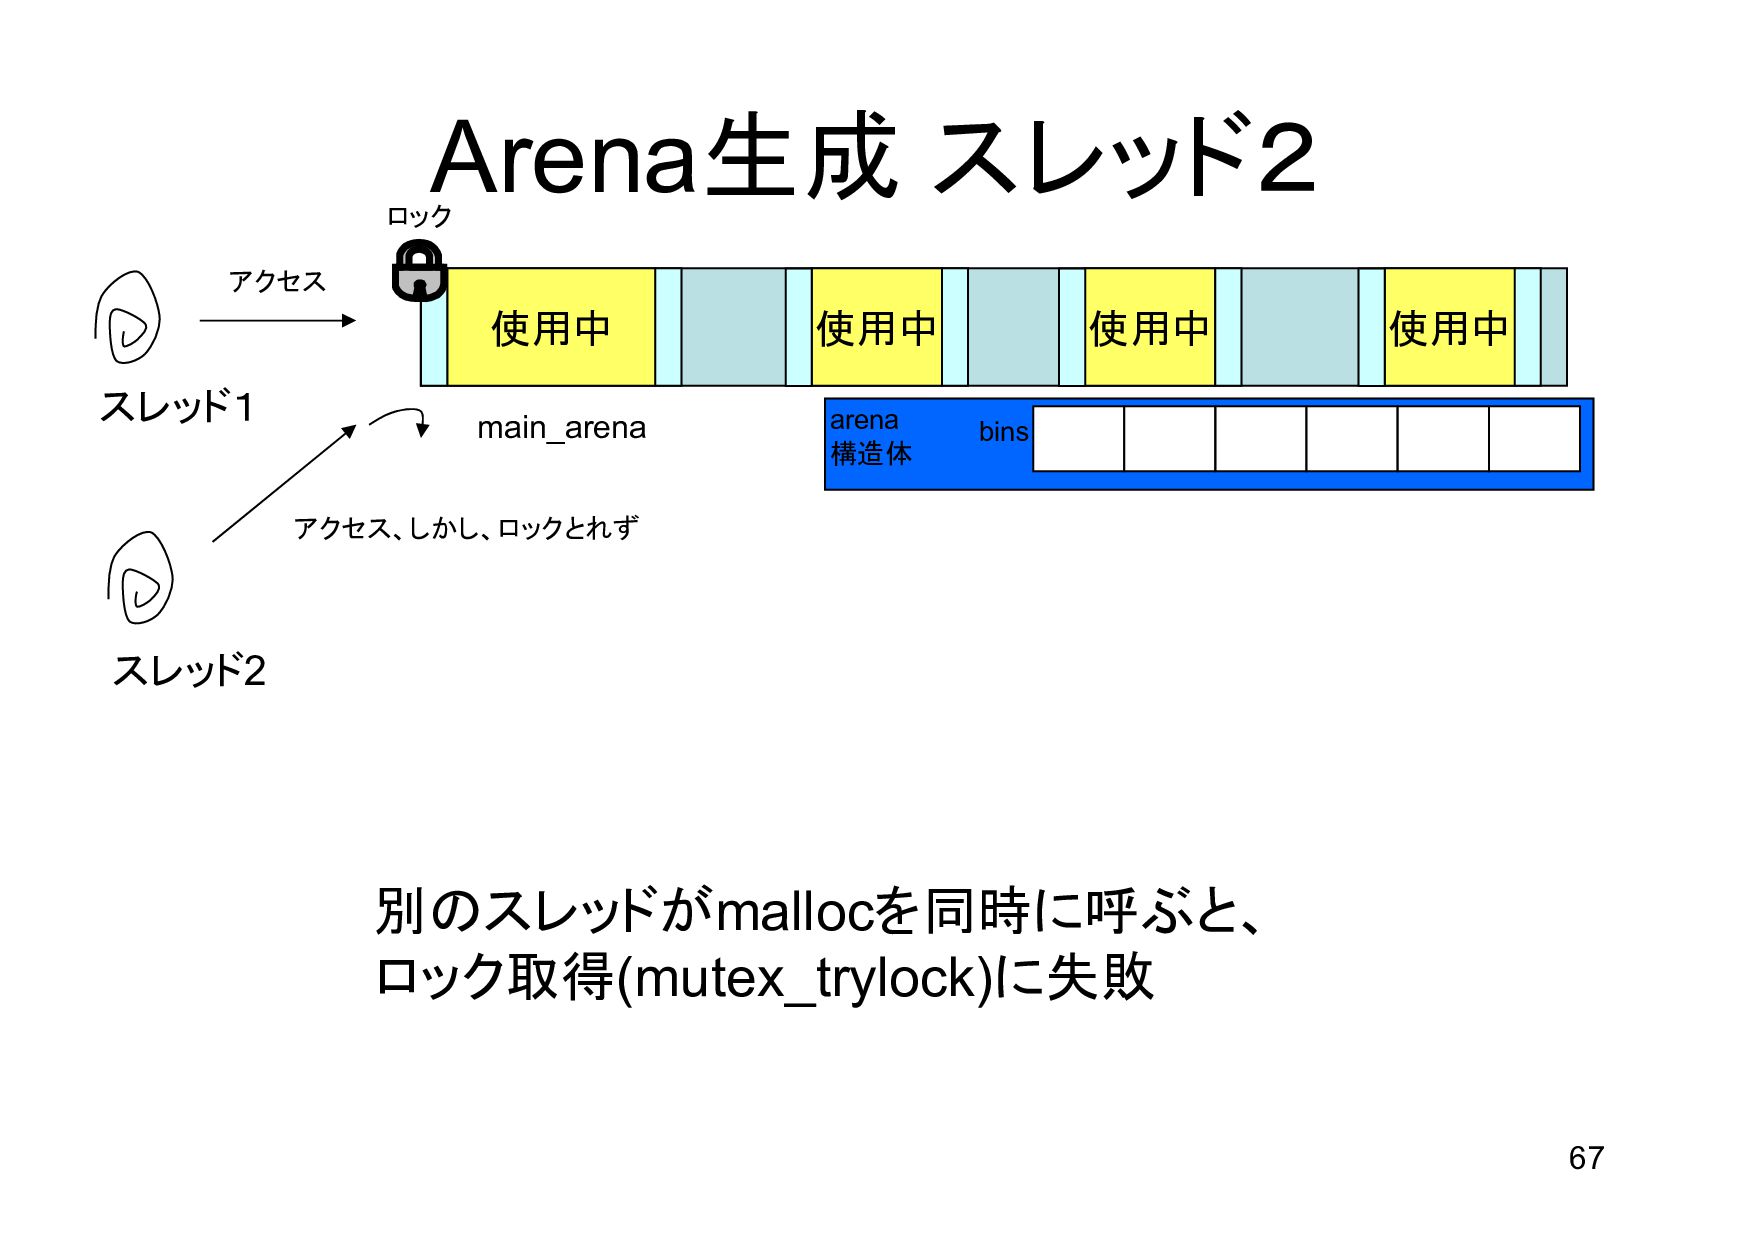
67 使用中 使用中 使用中 使用中 スレッド1 main_arena アクセス ロック アクセス、しかし、ロックとれず
bins arena 構造体 スレッド2 別のスレッドがmallocを同時に呼ぶと、 ロック取得(mutex_trylock)に失敗 Arena生成 スレッド2 -
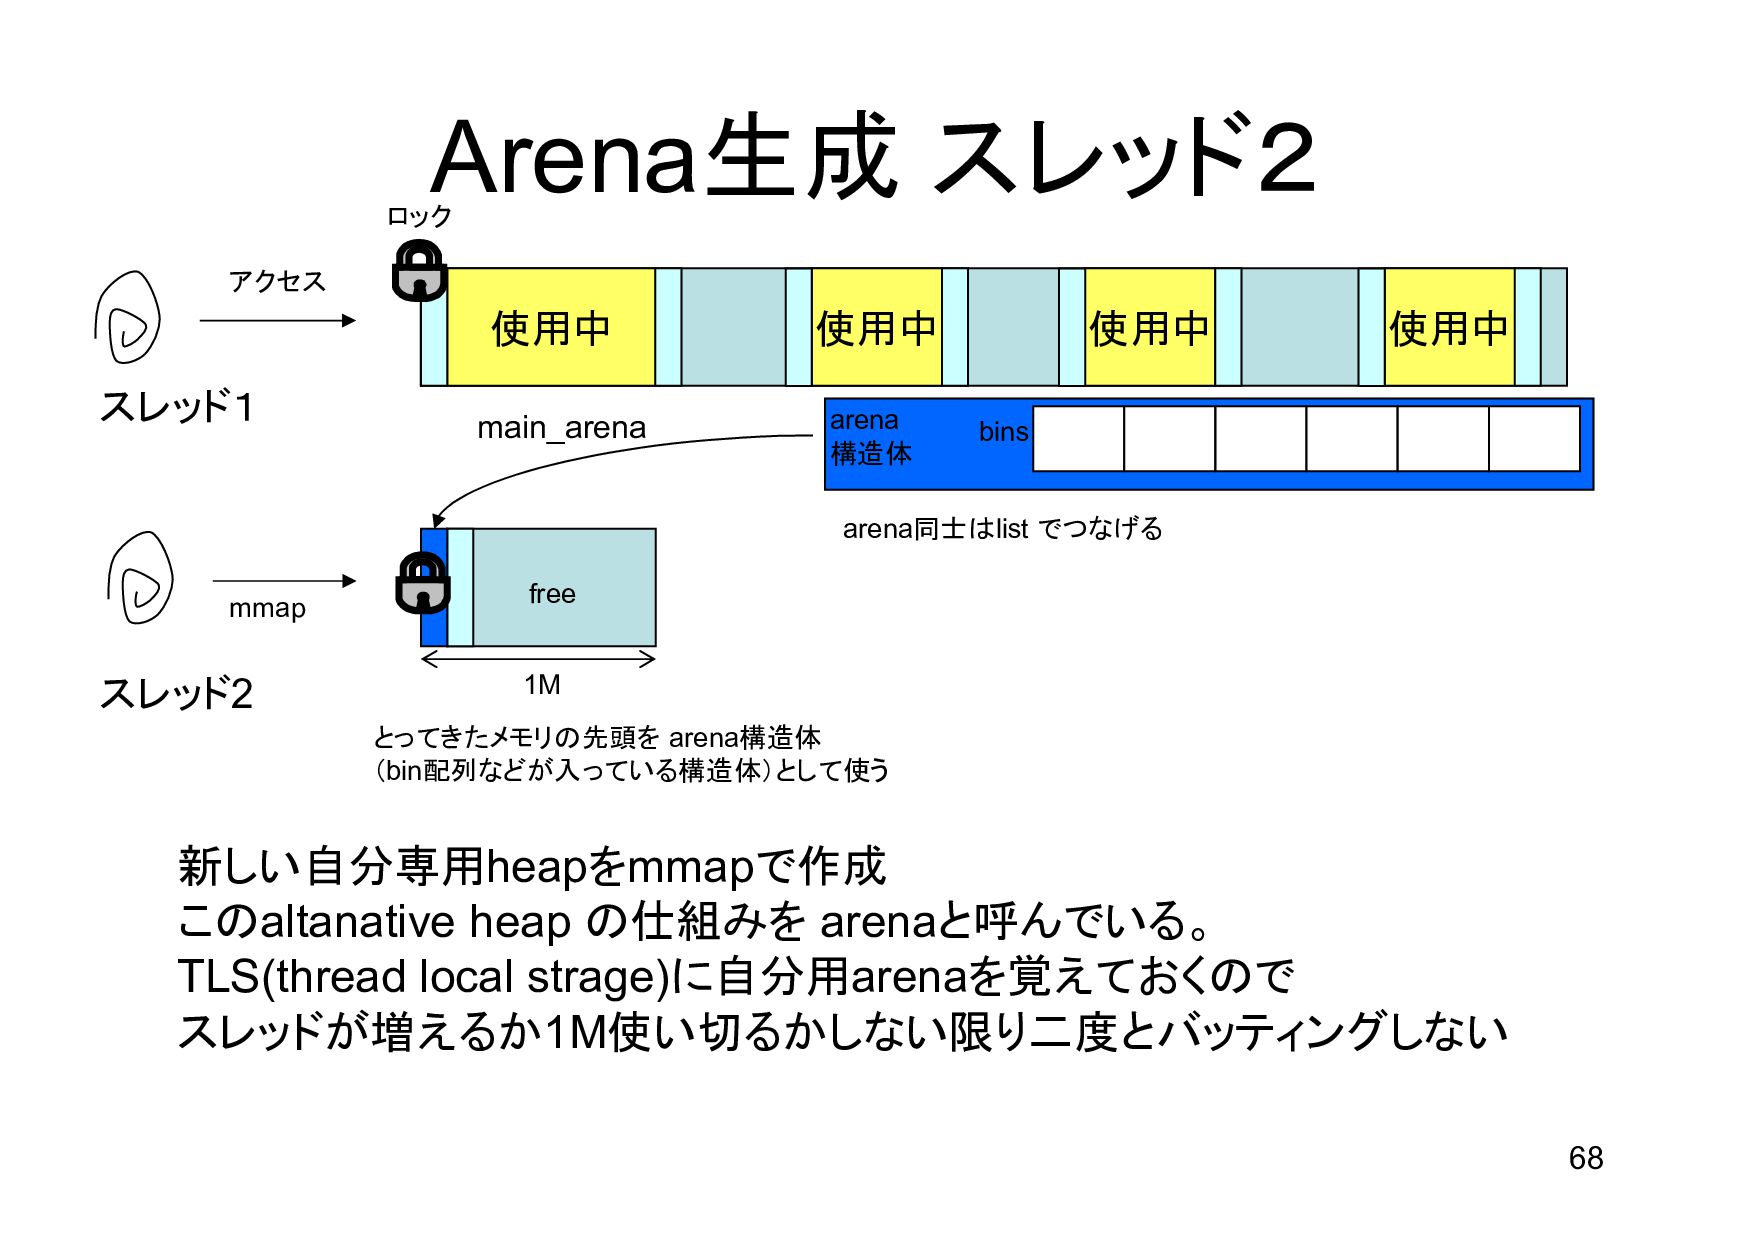
68 Arena生成 スレッド2 使用中 使用中 使用中 使用中 スレッド1 main_arena アクセス
ロック スレッド2 新しい自分専用heapをmmapで作成 このaltanative heap の仕組みを arenaと呼んでいる。 TLS(thread local strage)に自分用arenaを覚えておくので スレッドが増えるか1M使い切るかしない限り二度とバッティングしない bins arena 構造体 とってきたメモリの先頭を arena構造体 (bin配列などが入っている構造体)として使う 1M free mmap arena同士はlist でつなげる -
69 Arena生成 スレッド3 使用中 使用中 使用中 使用中 スレッド1 main_arena スレッド2
bins arena 構造体 free アクセス スレッド3 アクセス 次のスレッドも、ロック競合が起きるまではmain_arenaを 使い続ける -
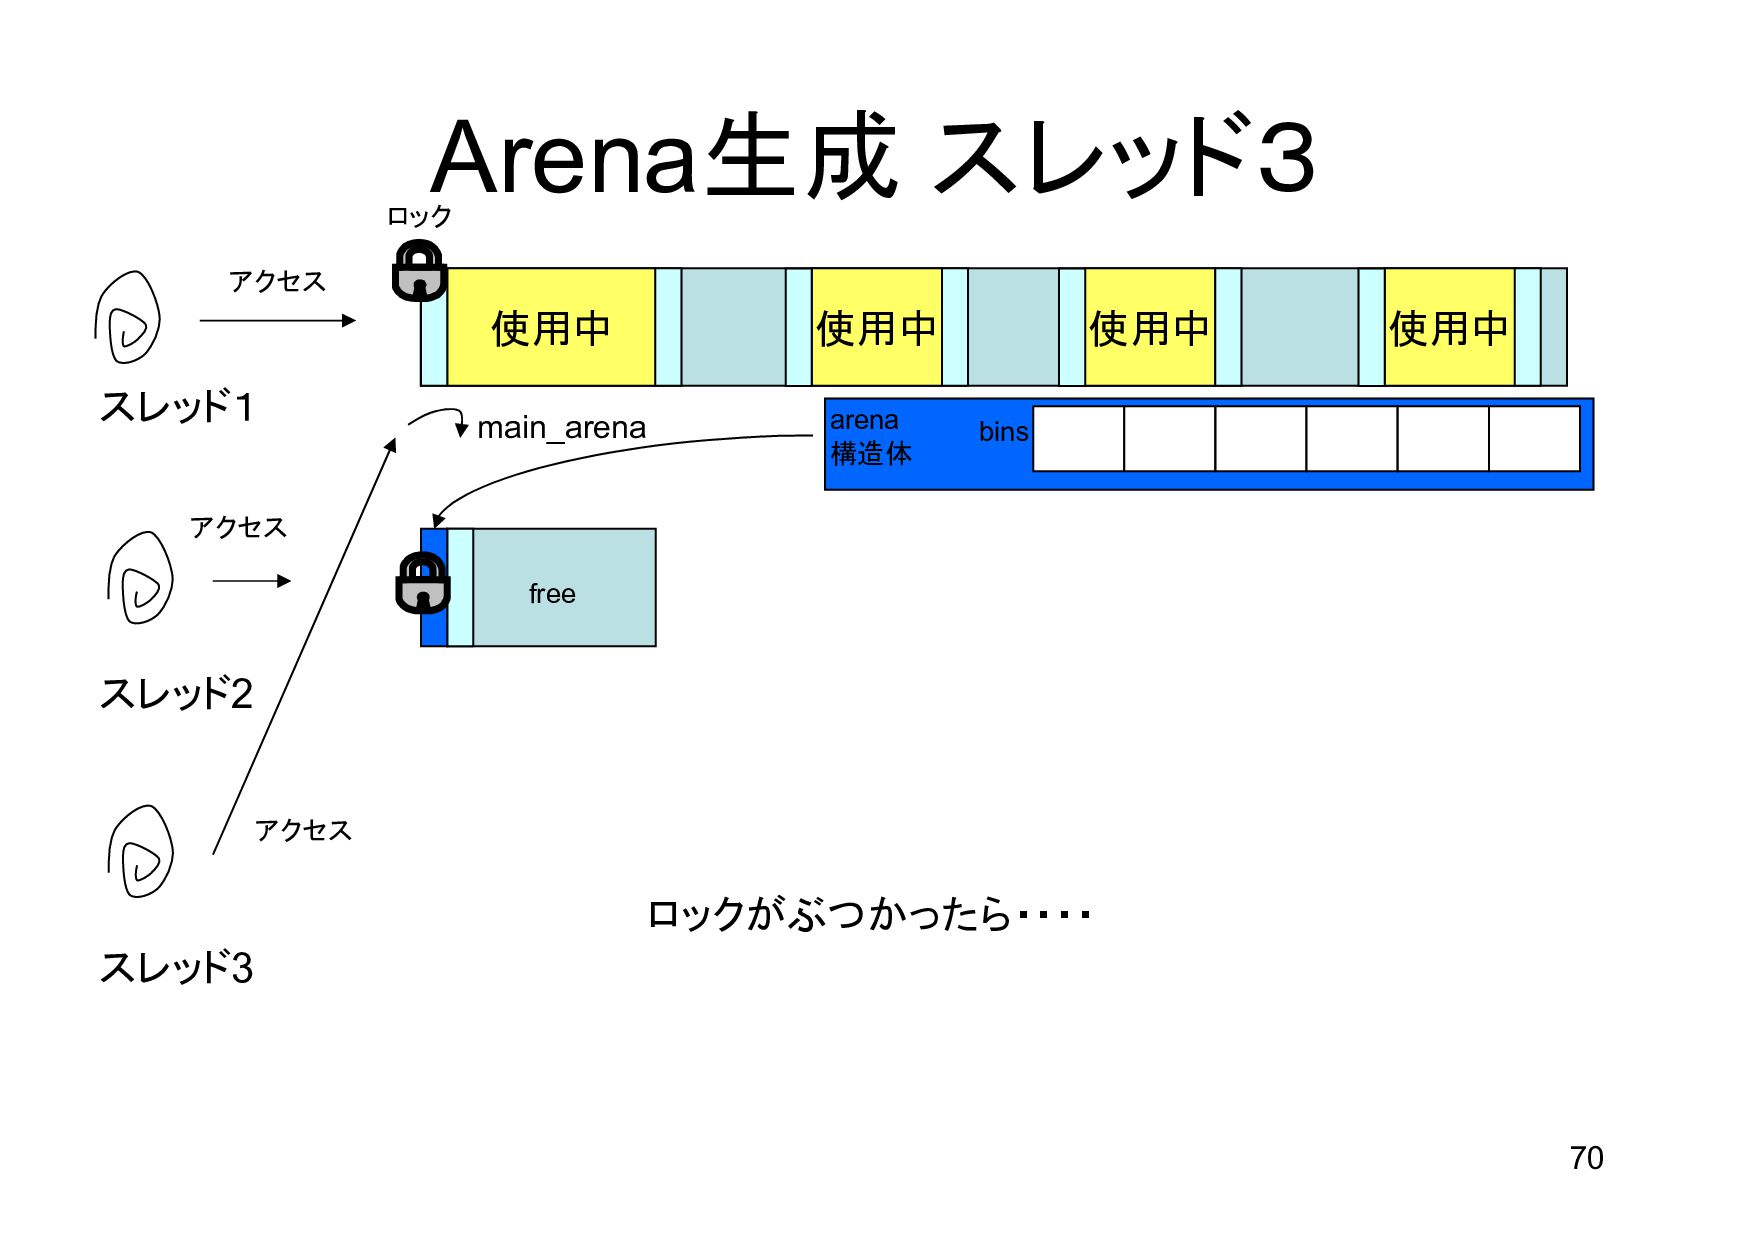
70 Arena生成 スレッド3 使用中 使用中 使用中 使用中 スレッド1 main_arena アクセス
ロック スレッド2 bins arena 構造体 free アクセス スレッド3 アクセス ロックがぶつかったら・・・・ -
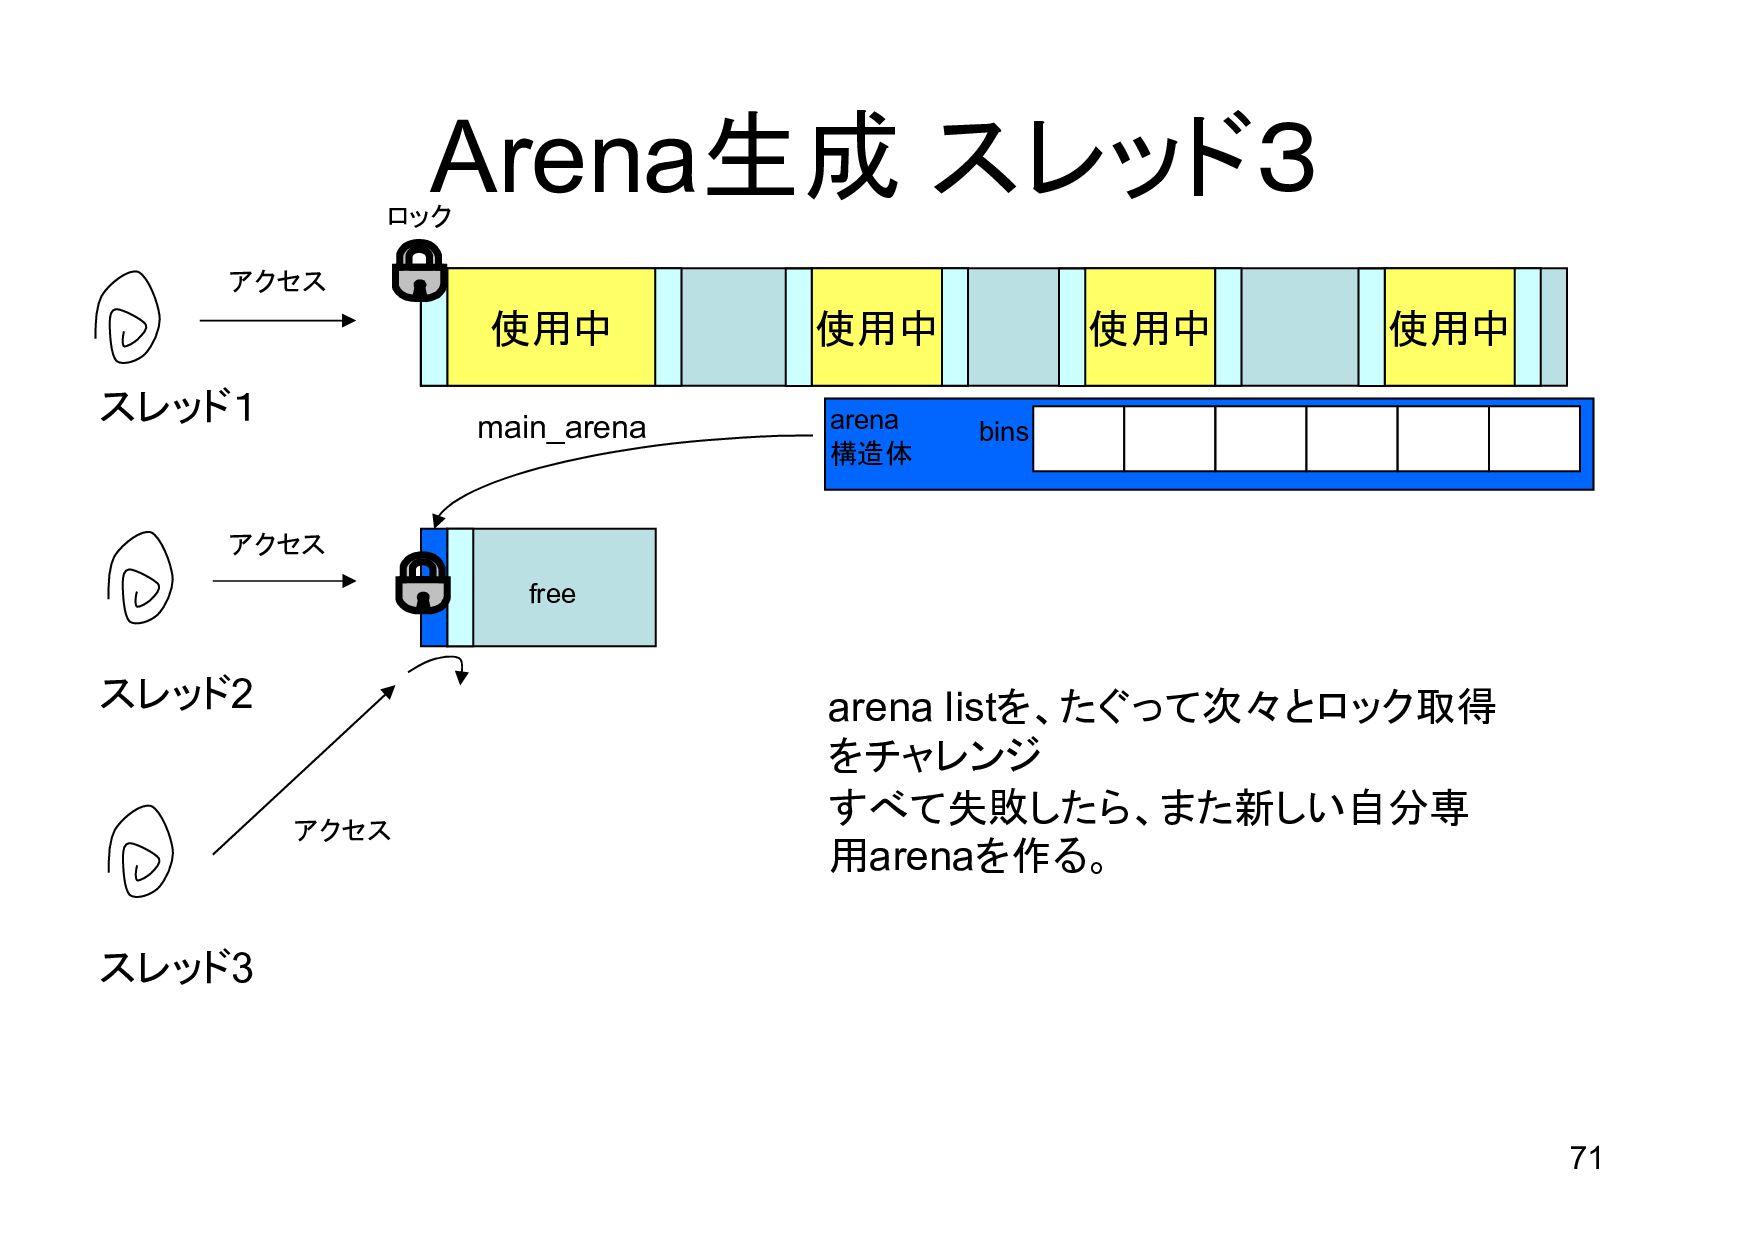
71 Arena生成 スレッド3 使用中 使用中 使用中 使用中 スレッド1 main_arena アクセス
ロック スレッド2 bins arena 構造体 free アクセス スレッド3 アクセス arena listを、たぐって次々とロック取得 をチャレンジ すべて失敗したら、また新しい自分専 用arenaを作る。 -
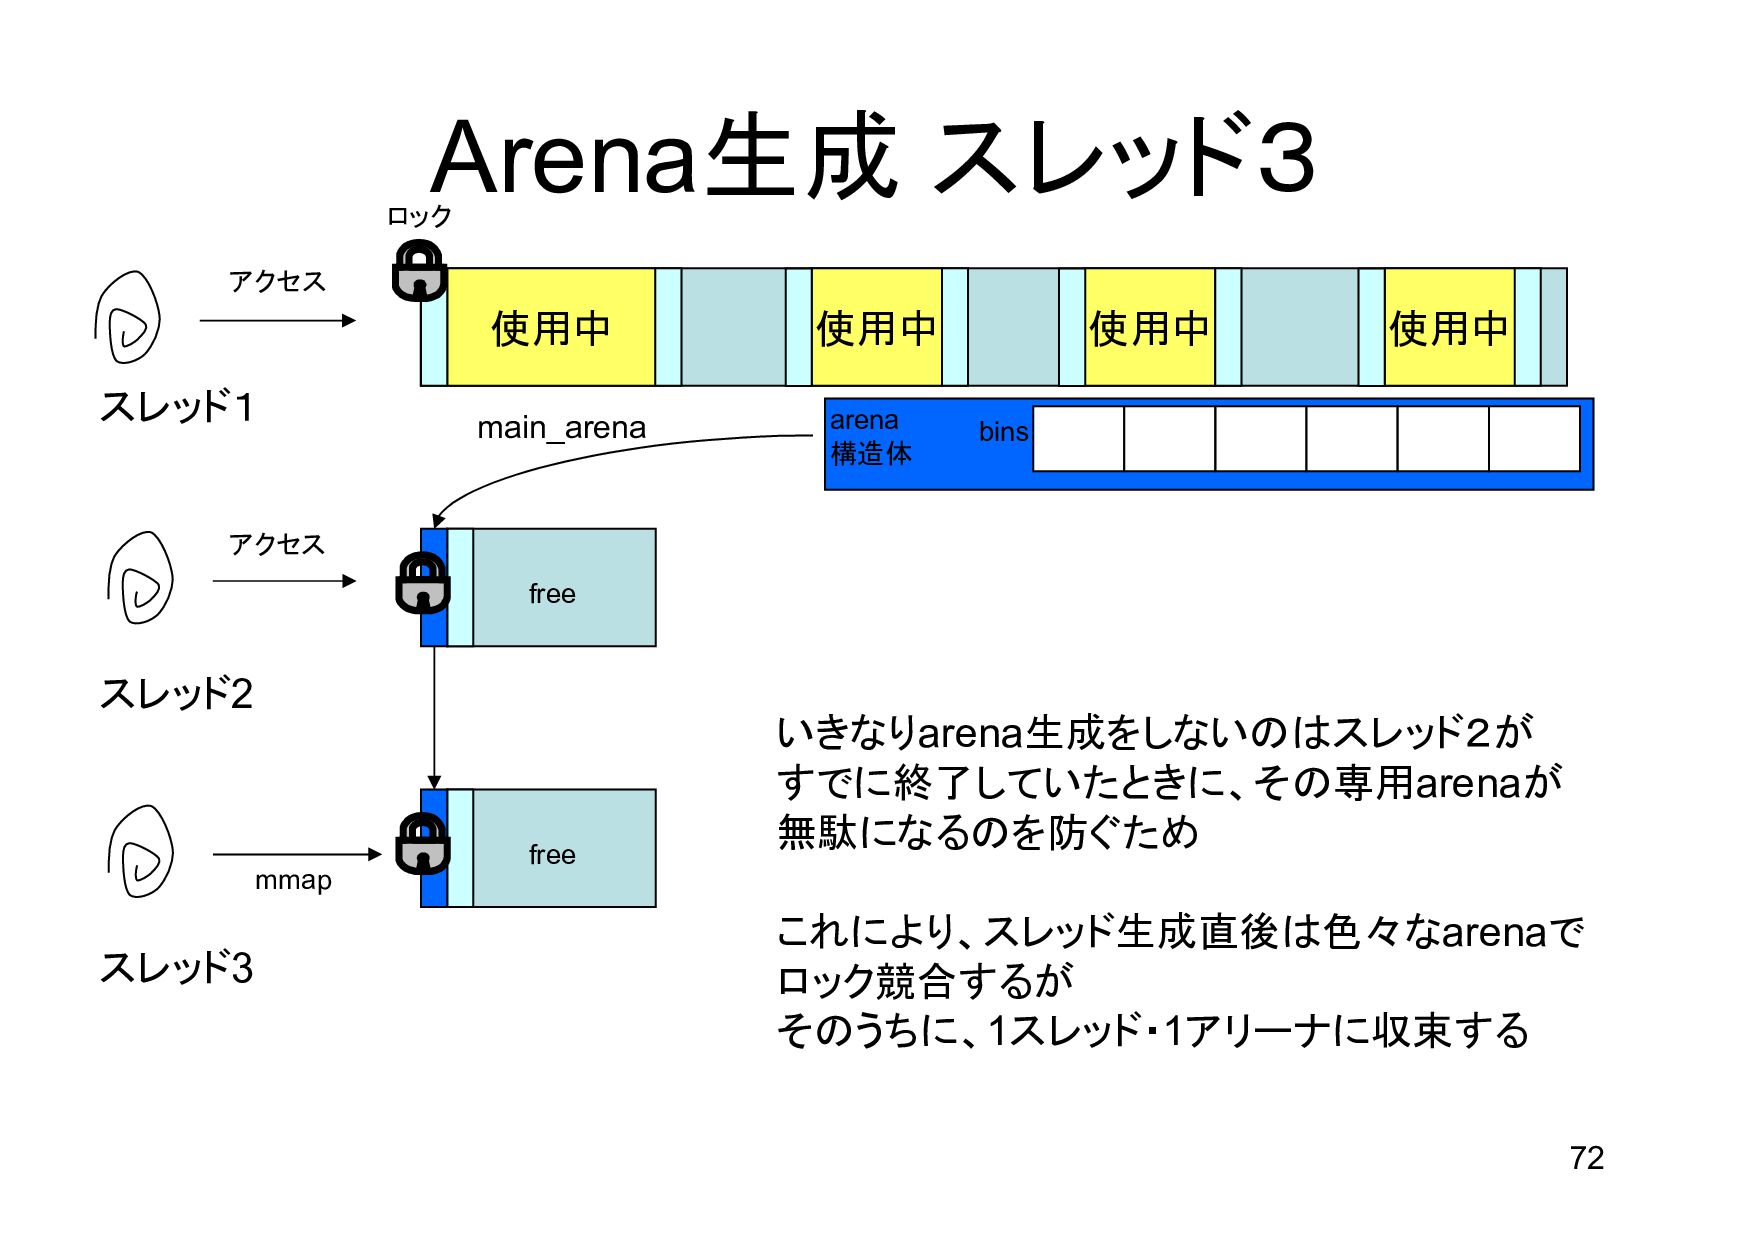
72 Arena生成 スレッド3 使用中 使用中 使用中 使用中 スレッド1 main_arena アクセス
ロック スレッド2 bins arena 構造体 free アクセス スレッド3 mmap いきなりarena生成をしないのはスレッド2が すでに終了していたときに、その専用arenaが 無駄になるのを防ぐため これにより、スレッド生成直後は色々なarenaで ロック競合するが そのうちに、1スレッド・1アリーナに収束する free -
73 1スレッド:1Arenaの隠れた利点 • SMPマシンでは、別のCPUからアクセスしたメモリは自分 CPUのキャッシュには乗らないのでラストアクセスを単純に 管理してはうまくいかない • しかし、ユーザ空間から自分がどのCPUで動いているのか 明に意識するのは無理 (いつのまにか勝手に変わるし)
• そこでカーネルがもつスレッドのCPU affinityスケジューリン グに着目して、自分スレッドがアクセスしたデータは自分 CPUでアクセスした確率が高いと考える • スレッド専用メモリ=キャッシュヒット率がものすごくUp! -
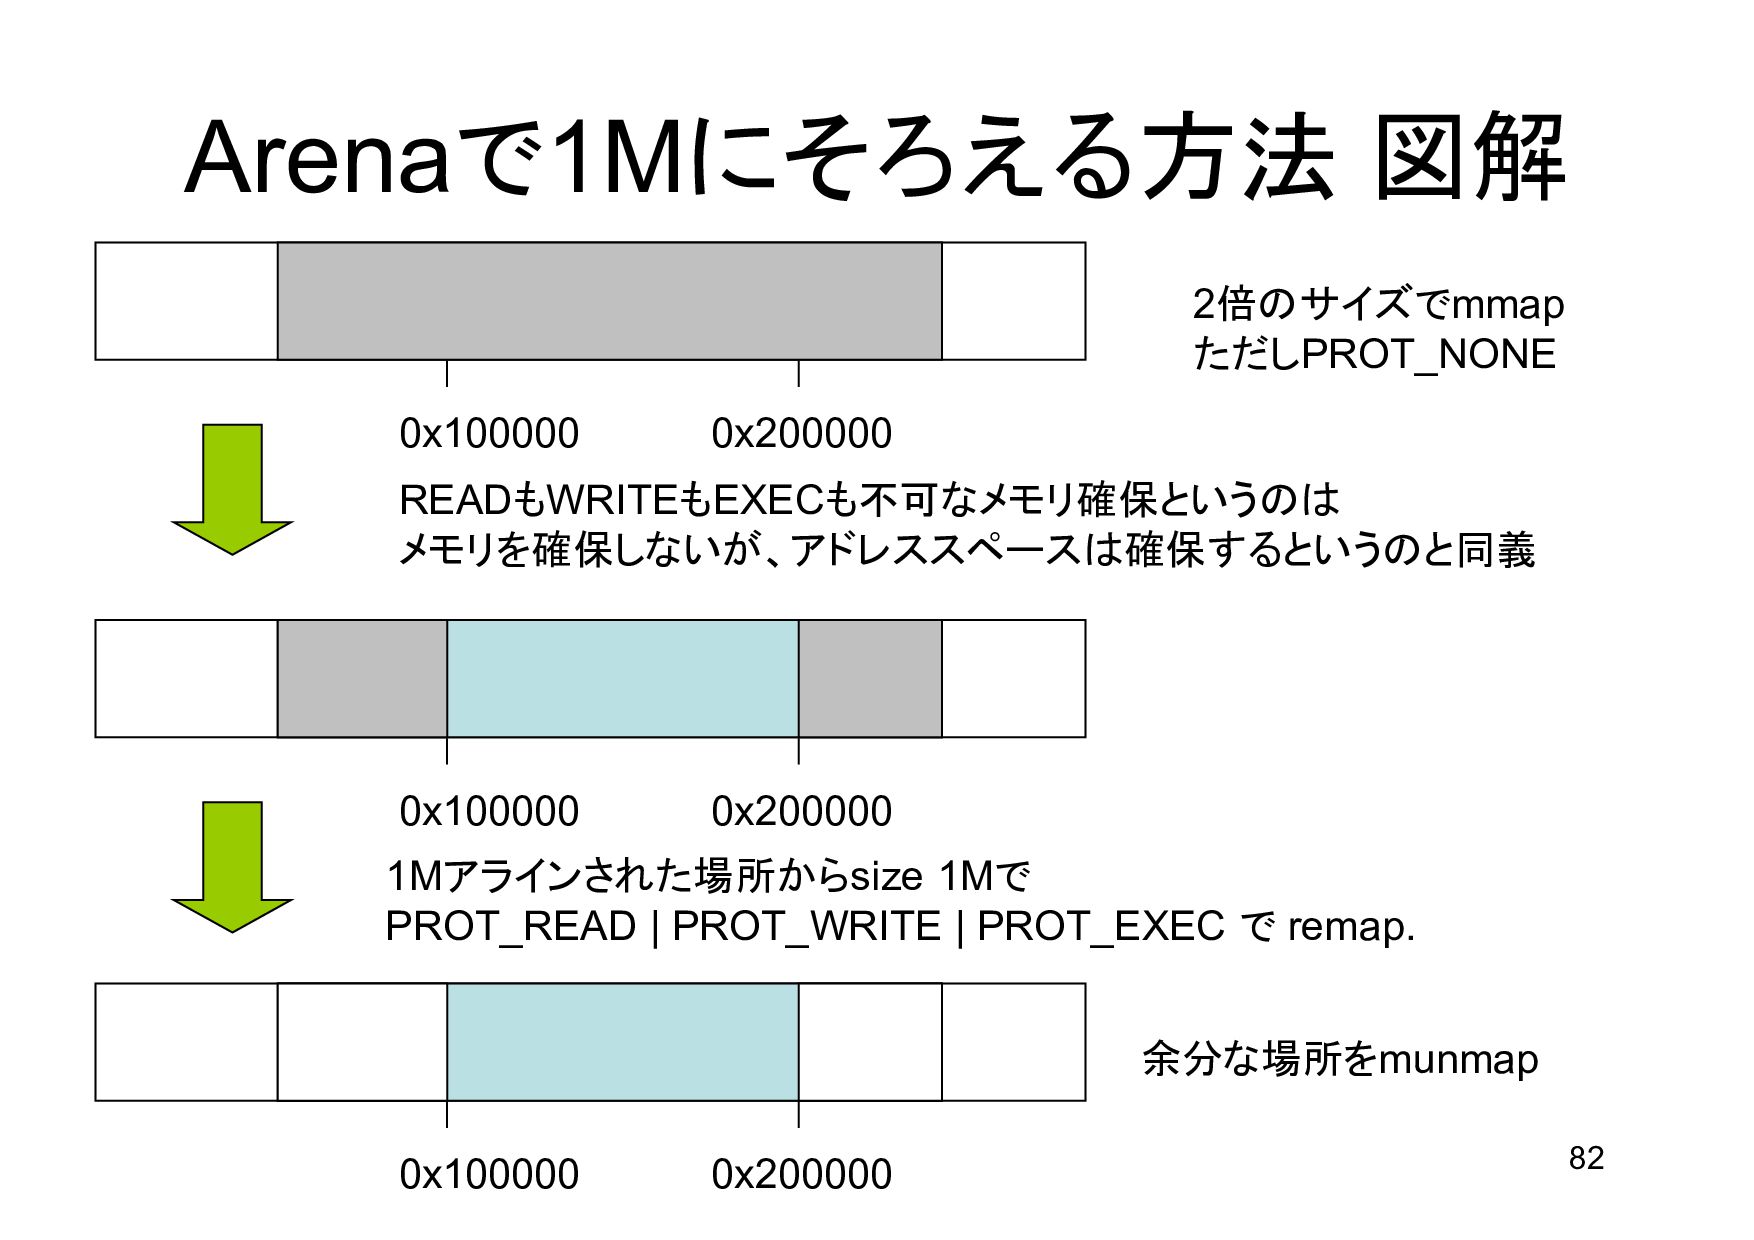
78 結局どうしたか? • arenaを絶対1M alignされるようにメモリを確 保する。 すると、 ptr & ~0xFFFFF
するだけでarena へのポインタが得られるようにする -
79 課題1 • main_arenaはグローバル変数なんだけ ど・・・ 0 31 1 2 size
0 0 0 IS_MMAPED PREV_IN_USE → 毎度おなじみsizeメンバハックのお時間でございま~す♪ IS_NON_MAINARENA -
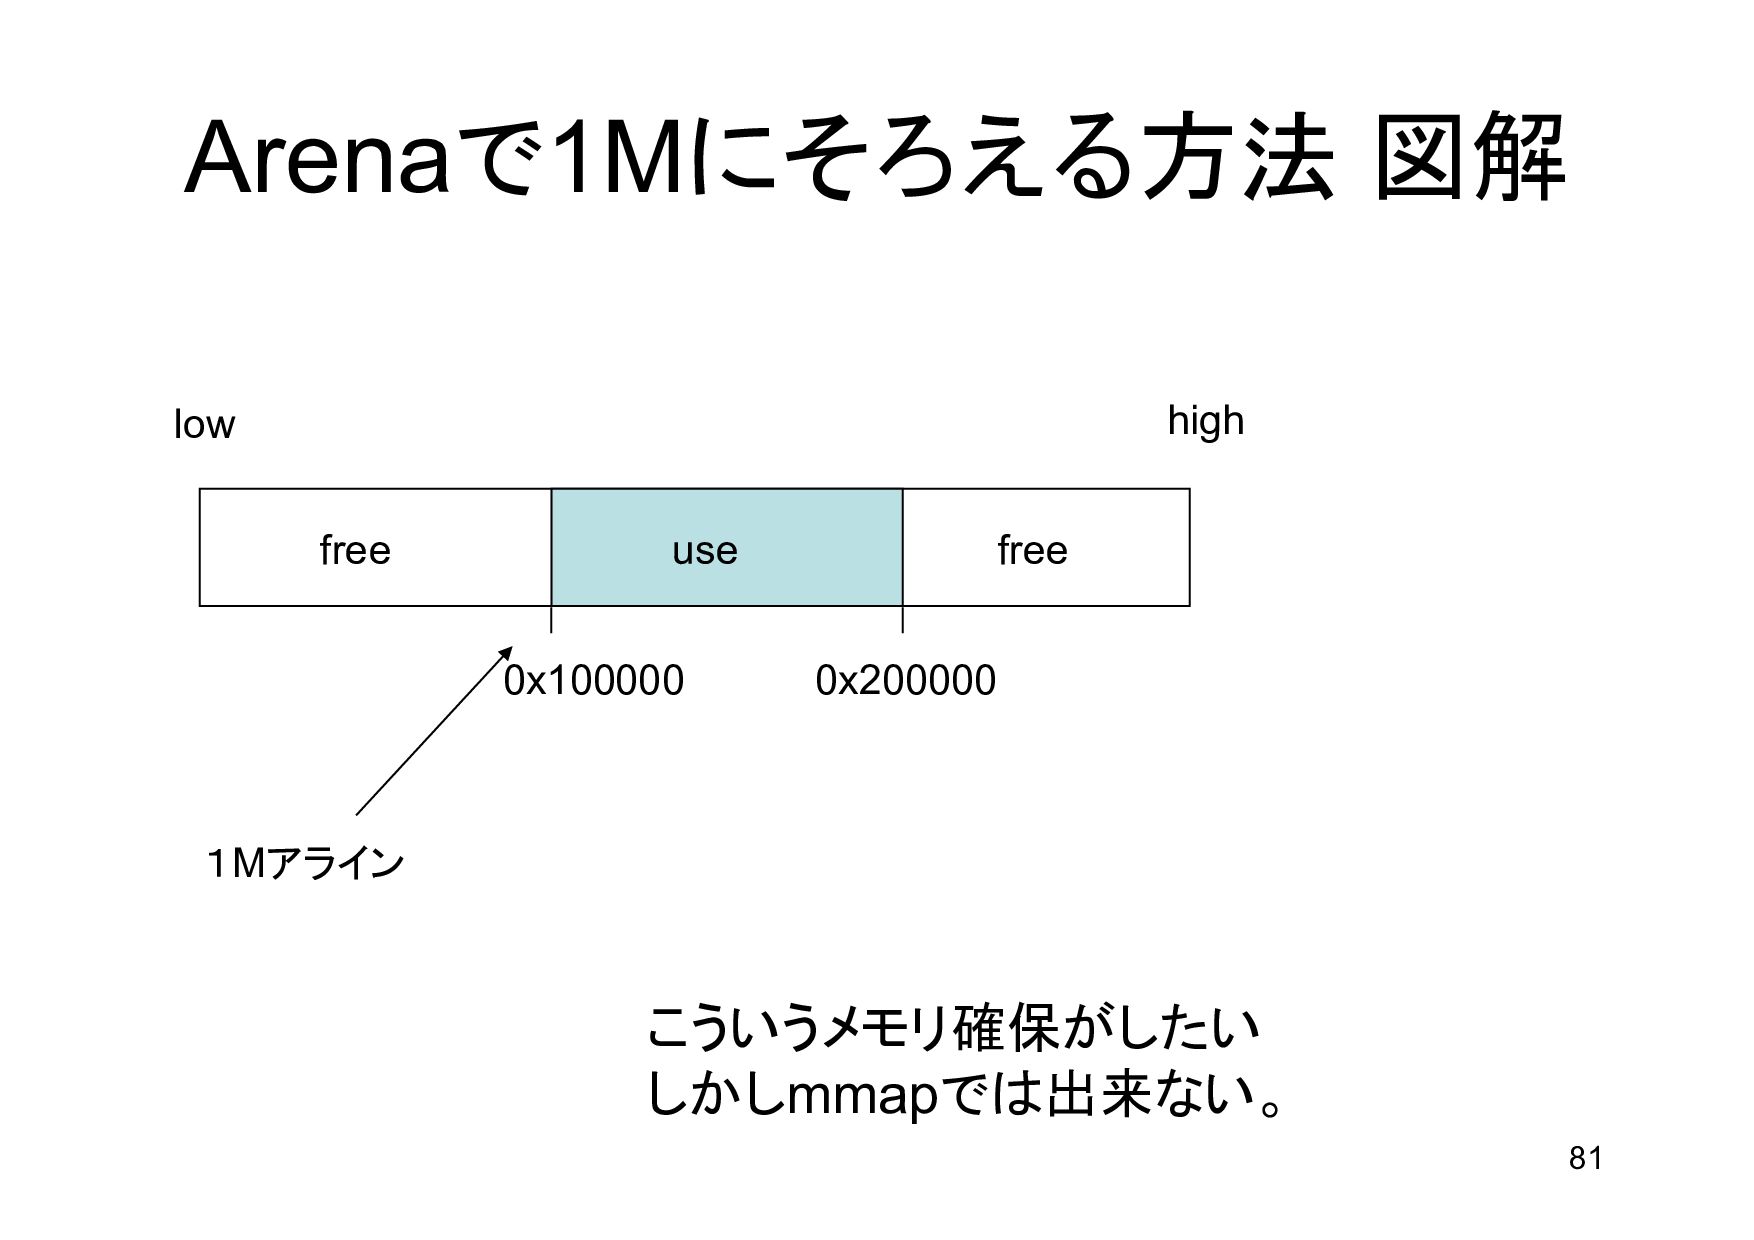
82 Arenaで1Mにそろえる方法 図解 0x100000 0x200000 2倍のサイズでmmap ただしPROT_NONE 0x100000 0x200000 余分な場所をmunmap
READもWRITEもEXECも不可なメモリ確保というのは メモリを確保しないが、アドレススペースは確保するというのと同義 1Mアラインされた場所からsize 1Mで PROT_READ | PROT_WRITE | PROT_EXEC で remap. 0x100000 0x200000 -
83 まとめ • 小さいmallocは回数がすごくたくさん呼ばれ るので、O(n)ではダメ • フラグメンテーションを防ぐにはHuge Block はHeapを分けるのが効果的 •
キャッシュヒット率を上げるには、参照局所性 超重要 • per Threadなデータ構造はper CPUなデータ 構造のよい近似値 -
84 glibc mallocのダメなところ • Huge Blockが絶対page alignされてしまうので、 キャッシュが競合しやすい (HPC分野ではこの機能はOFFにするのが一般的) •
もう一工夫すれば、Arenaへのロック自体なくせる (これが問題になるようなheavy allocationアプリは 自前heap管理をしてるので効果は見えにくいかも) • 最新のdlmallocはlarge-binの管理がリストからバイ ナリツリーに変更されて高速化が図られている(でも 使用率がいまいち低いので効果は微妙か?) -
85 終わりに変えて • glibc mallocは、今日のスライド90枚にわたる色々 なアイデアがint_malloc()という1つの関数にごった 煮で詰め込んであるので、すごく読みにくい • おまいら、ソースコードのコメントにうそを書くなと小 一時間・・
• おまいら、関数分割ぐらいしろと小二時間・・・ • おまいら、構造体の型とメモリ上のデータ構造は合 わせておけと小三時間・・・ • これを見るとLinux kernelってなんて読みやすいの かと・・・・