Share
Embed
Weekly AI Agents News! 2月号 アーカイブ
毎週更新予定のWeekly AI Agents News! の過去のアーカイブです。
https://speakerdeck.com/masatoto/weekly-ai-agents-news

masatoto
February 28, 2025
Transcript
45 slides
-
はじめに • LLMエージェントに関するニュースや論文をほぼ毎週更新しています。 • 論文、プロダクトの順番でまとめています。 • 個人の備忘録で取り組んでおり、誤りがある場合もあります。 • 文字サイズ16ptで小さいのでPCで見ることをおすすめします。 •
SpeakerDeckに過去の24年4~25年1月の資料を分けて公開しています。 • 7月から隔週で更新します。 -
論文 2/10~2/21まで 計画 • PlanGenLLMs: A Modern Survey of LLM
Planning Capabilities ツール • SMART: Self-Aware Agent for Tool Overuse Mitigation • OctoTools: An Agentic Framework with Extensible Tools for Complex Reasoning • LLM Agents Making Agent Tools メモリ • Position: Episodic Memory is the Missing Piece for Long-Term LLM Agents • A-MEM: Agentic Memory for LLM Agents -
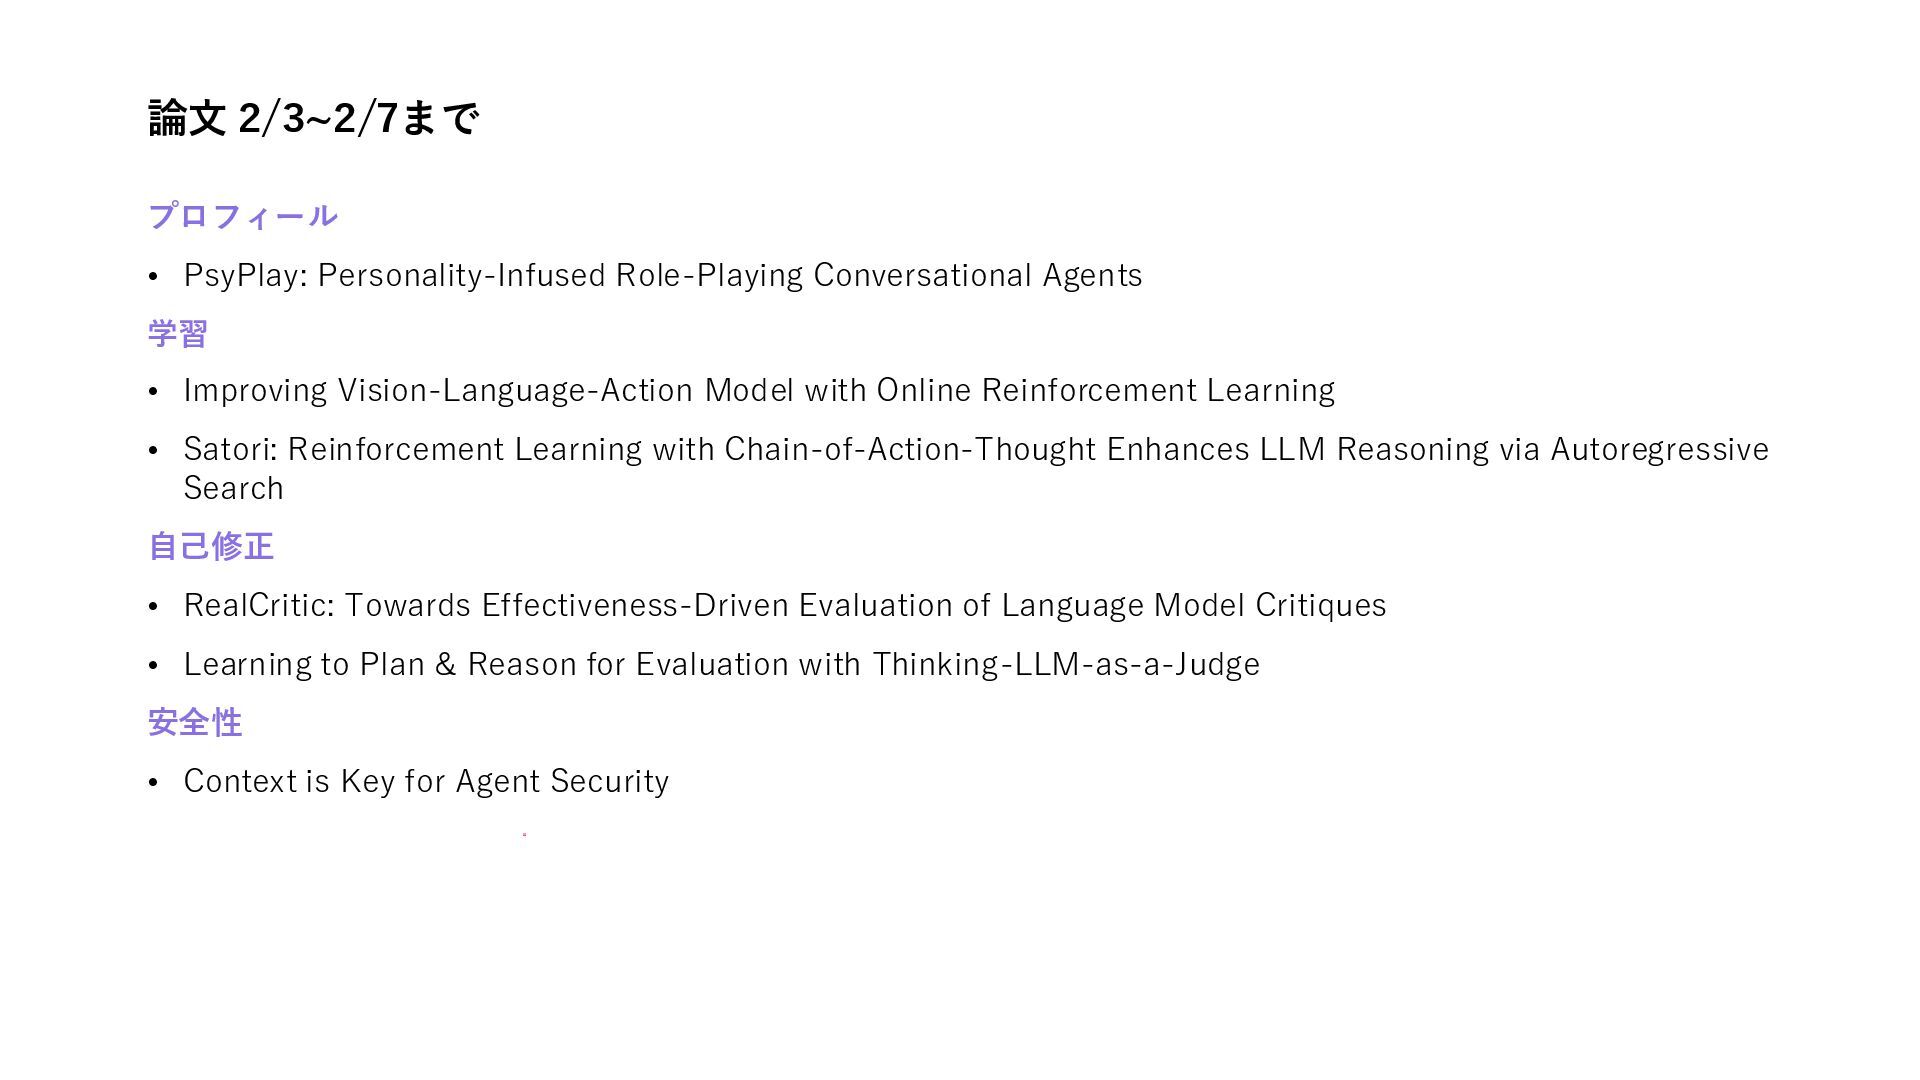
論文 2/3~2/7まで プロフィール • PsyPlay: Personality-Infused Role-Playing Conversational Agents 学習
• Improving Vision-Language-Action Model with Online Reinforcement Learning • Satori: Reinforcement Learning with Chain-of-Action-Thought Enhances LLM Reasoning via Autoregressive Search 自己修正 • RealCritic: Towards Effectiveness-Driven Evaluation of Language Model Critiques • Learning to Plan & Reason for Evaluation with Thinking-LLM-as-a-Judge 安全性 • Context is Key for Agent Security -
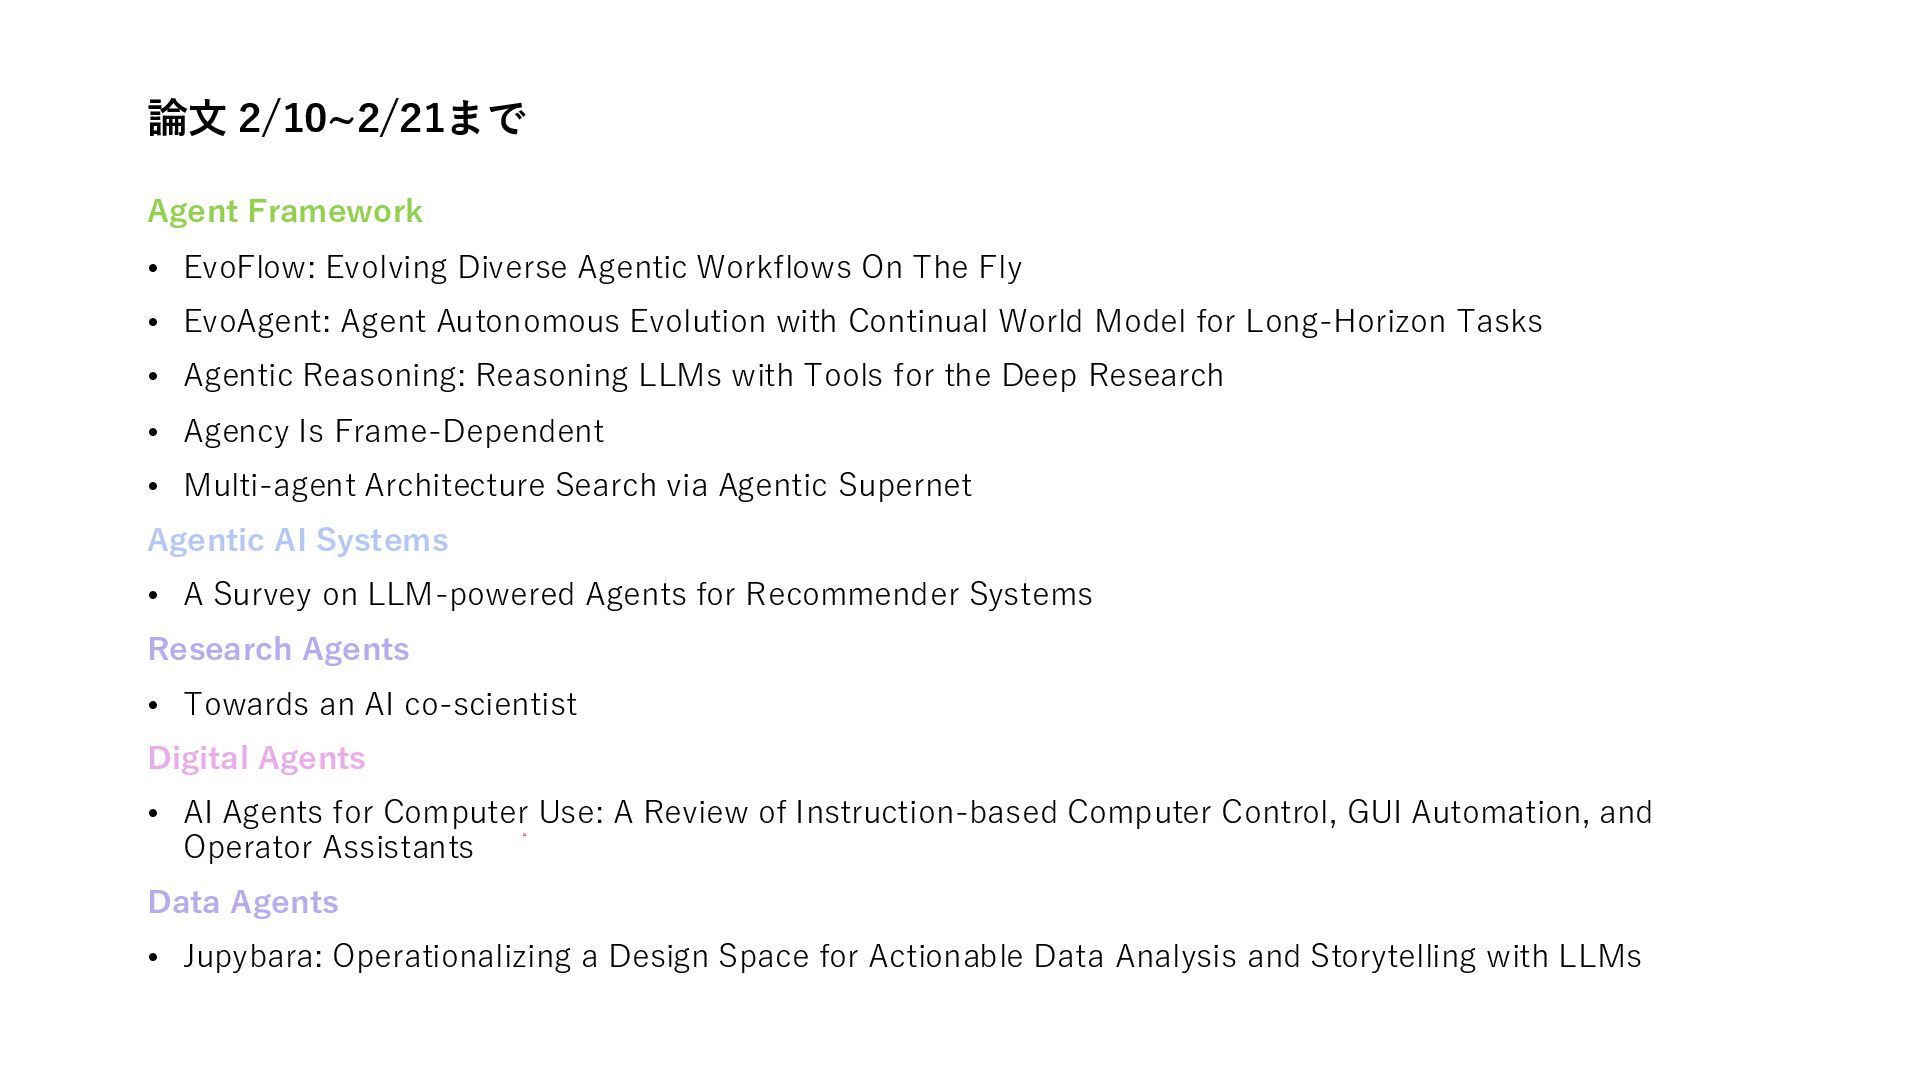
論文 2/10~2/21まで Agent Framework • EvoFlow: Evolving Diverse Agentic Workflows
On The Fly • EvoAgent: Agent Autonomous Evolution with Continual World Model for Long-Horizon Tasks • Agentic Reasoning: Reasoning LLMs with Tools for the Deep Research • Agency Is Frame-Dependent • Multi-agent Architecture Search via Agentic Supernet Agentic AI Systems • A Survey on LLM-powered Agents for Recommender Systems Research Agents • Towards an AI co-scientist Digital Agents • AI Agents for Computer Use: A Review of Instruction-based Computer Control, GUI Automation, and Operator Assistants Data Agents • Jupybara: Operationalizing a Design Space for Actionable Data Analysis and Storytelling with LLMs -
論文 2/3~2/7まで Multi Agent Systems • AgentSociety: Large-Scale Simulation of
LLM-Driven Generative Agents Advances Understanding of Human Behaviors and Society • Flow-of-Action: SOP Enhanced LLM-Based Multi-Agent System for Root Cause Analysis • Position: Towards a Responsible LLM-empowered Multi-Agent Systems • ToM-agent: Large Language Models as Theory of Mind Aware Generative Agents with Counterfactual Reflection • Multi-Agent Geospatial Copilots for Remote Sensing Workflows -
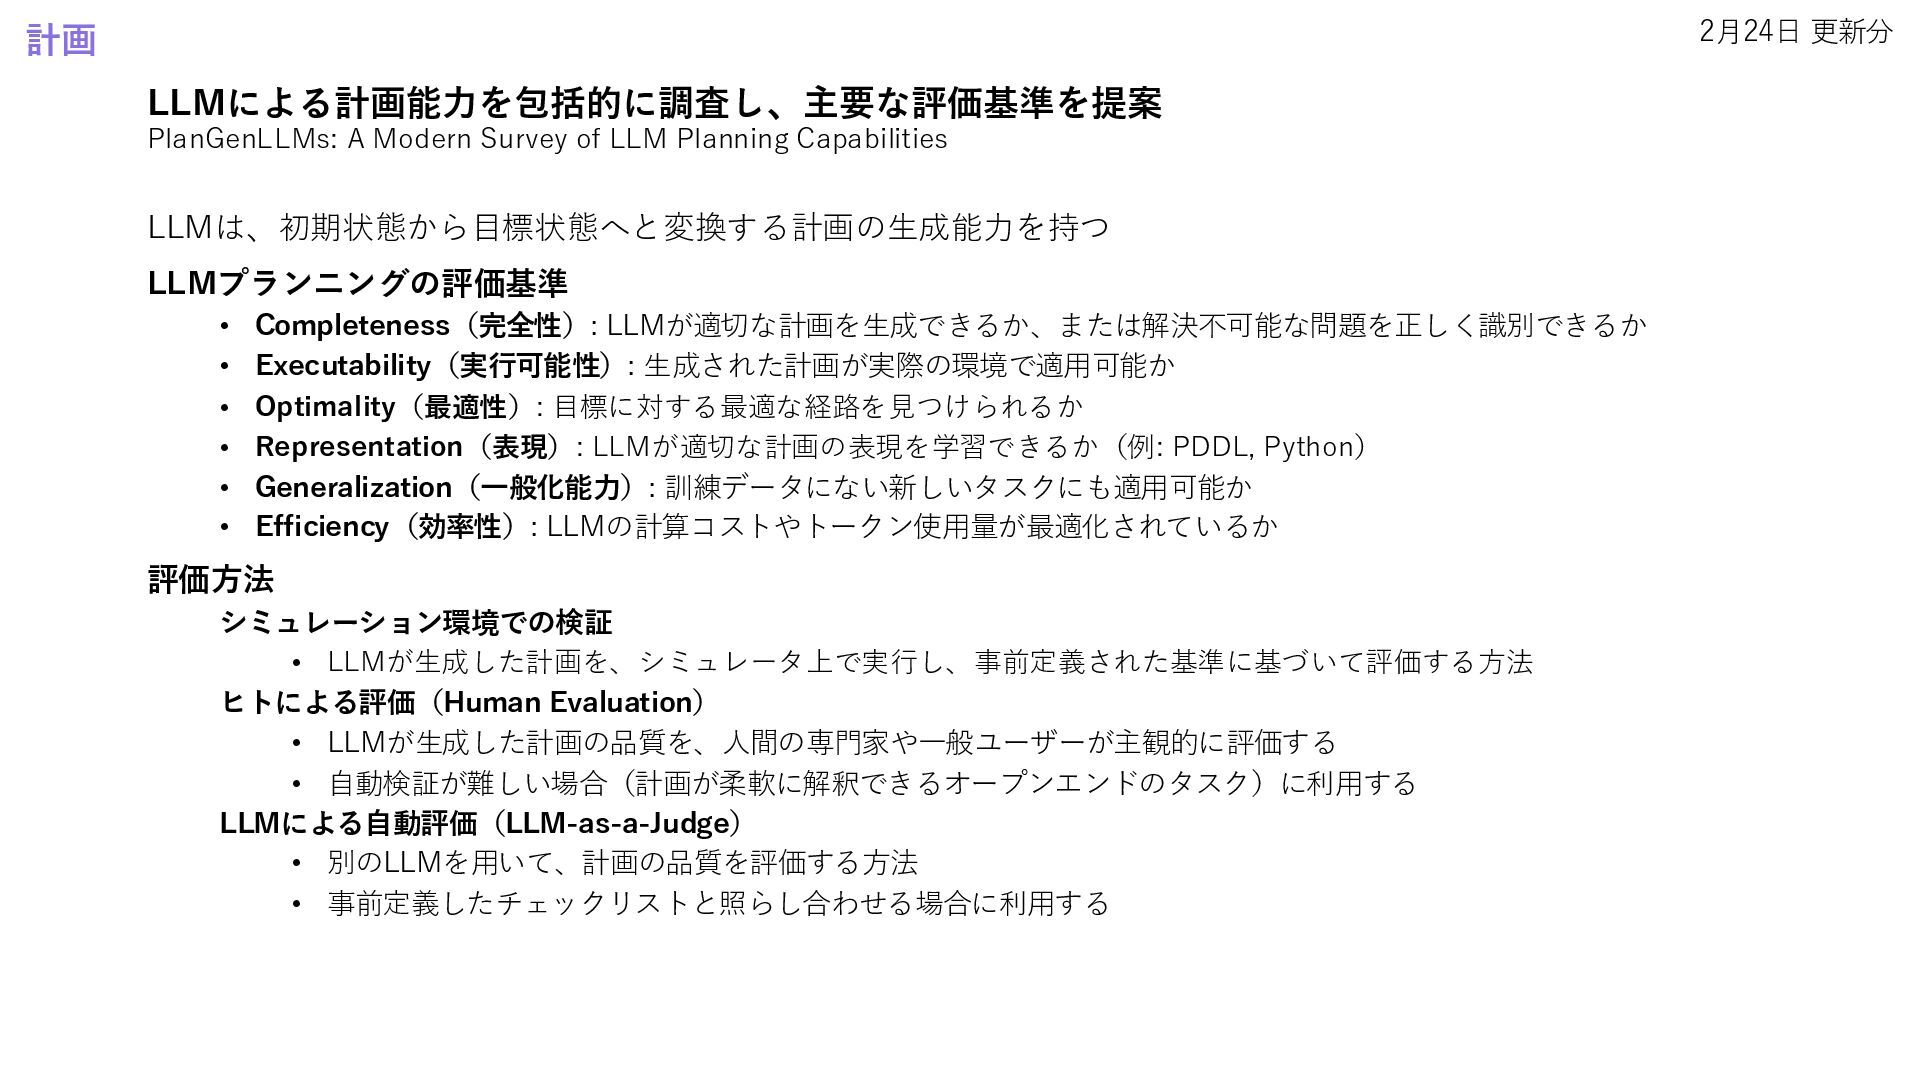
LLMによる計画能力を包括的に調査し、主要な評価基準を提案 PlanGenLLMs: A Modern Survey of LLM Planning Capabilities LLMは、初期状態から目標状態へと変換する計画の生成能力を持つ
LLMプランニングの評価基準 • Completeness(完全性): LLMが適切な計画を生成できるか、または解決不可能な問題を正しく識別できるか • Executability(実行可能性): 生成された計画が実際の環境で適用可能か • Optimality(最適性): 目標に対する最適な経路を見つけられるか • Representation(表現): LLMが適切な計画の表現を学習できるか(例: PDDL, Python) • Generalization(一般化能力): 訓練データにない新しいタスクにも適用可能か • Efficiency(効率性): LLMの計算コストやトークン使用量が最適化されているか 評価方法 シミュレーション環境での検証 • LLMが生成した計画を、シミュレータ上で実行し、事前定義された基準に基づいて評価する方法 ヒトによる評価(Human Evaluation) • LLMが生成した計画の品質を、人間の専門家や一般ユーザーが主観的に評価する • 自動検証が難しい場合(計画が柔軟に解釈できるオープンエンドのタスク)に利用する LLMによる自動評価(LLM-as-a-Judge) • 別のLLMを用いて、計画の品質を評価する方法 • 事前定義したチェックリストと照らし合わせる場合に利用する 2月24日 更新分 計画 -
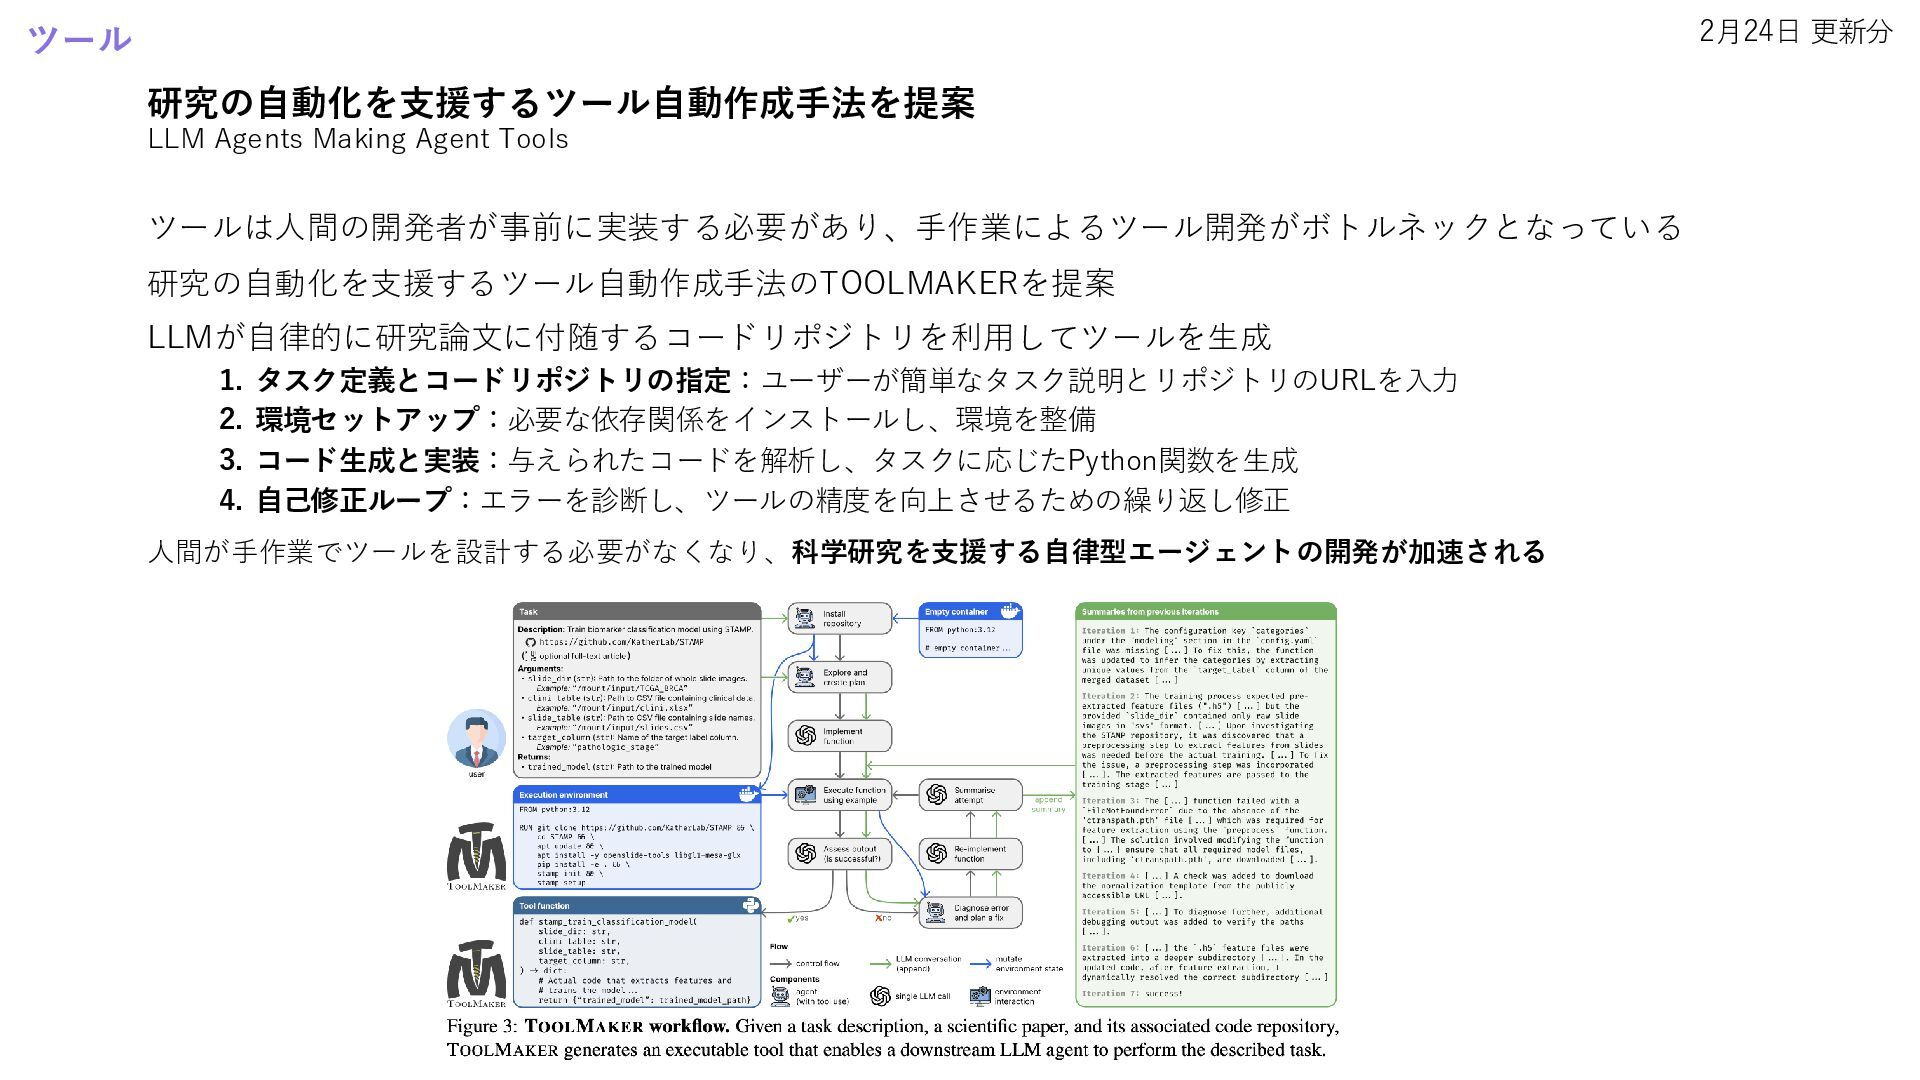
研究の自動化を支援するツール自動作成手法を提案 LLM Agents Making Agent Tools ツールは人間の開発者が事前に実装する必要があり、手作業によるツール開発がボトルネックとなっている 研究の自動化を支援するツール自動作成手法のTOOLMAKERを提案 LLMが自律的に研究論文に付随するコードリポジトリを利用してツールを生成 1.
タスク定義とコードリポジトリの指定:ユーザーが簡単なタスク説明とリポジトリのURLを入力 2. 環境セットアップ:必要な依存関係をインストールし、環境を整備 3. コード生成と実装:与えられたコードを解析し、タスクに応じたPython関数を生成 4. 自己修正ループ:エラーを診断し、ツールの精度を向上させるための繰り返し修正 人間が手作業でツールを設計する必要がなくなり、科学研究を支援する自律型エージェントの開発が加速される 2月24日 更新分 ツール -
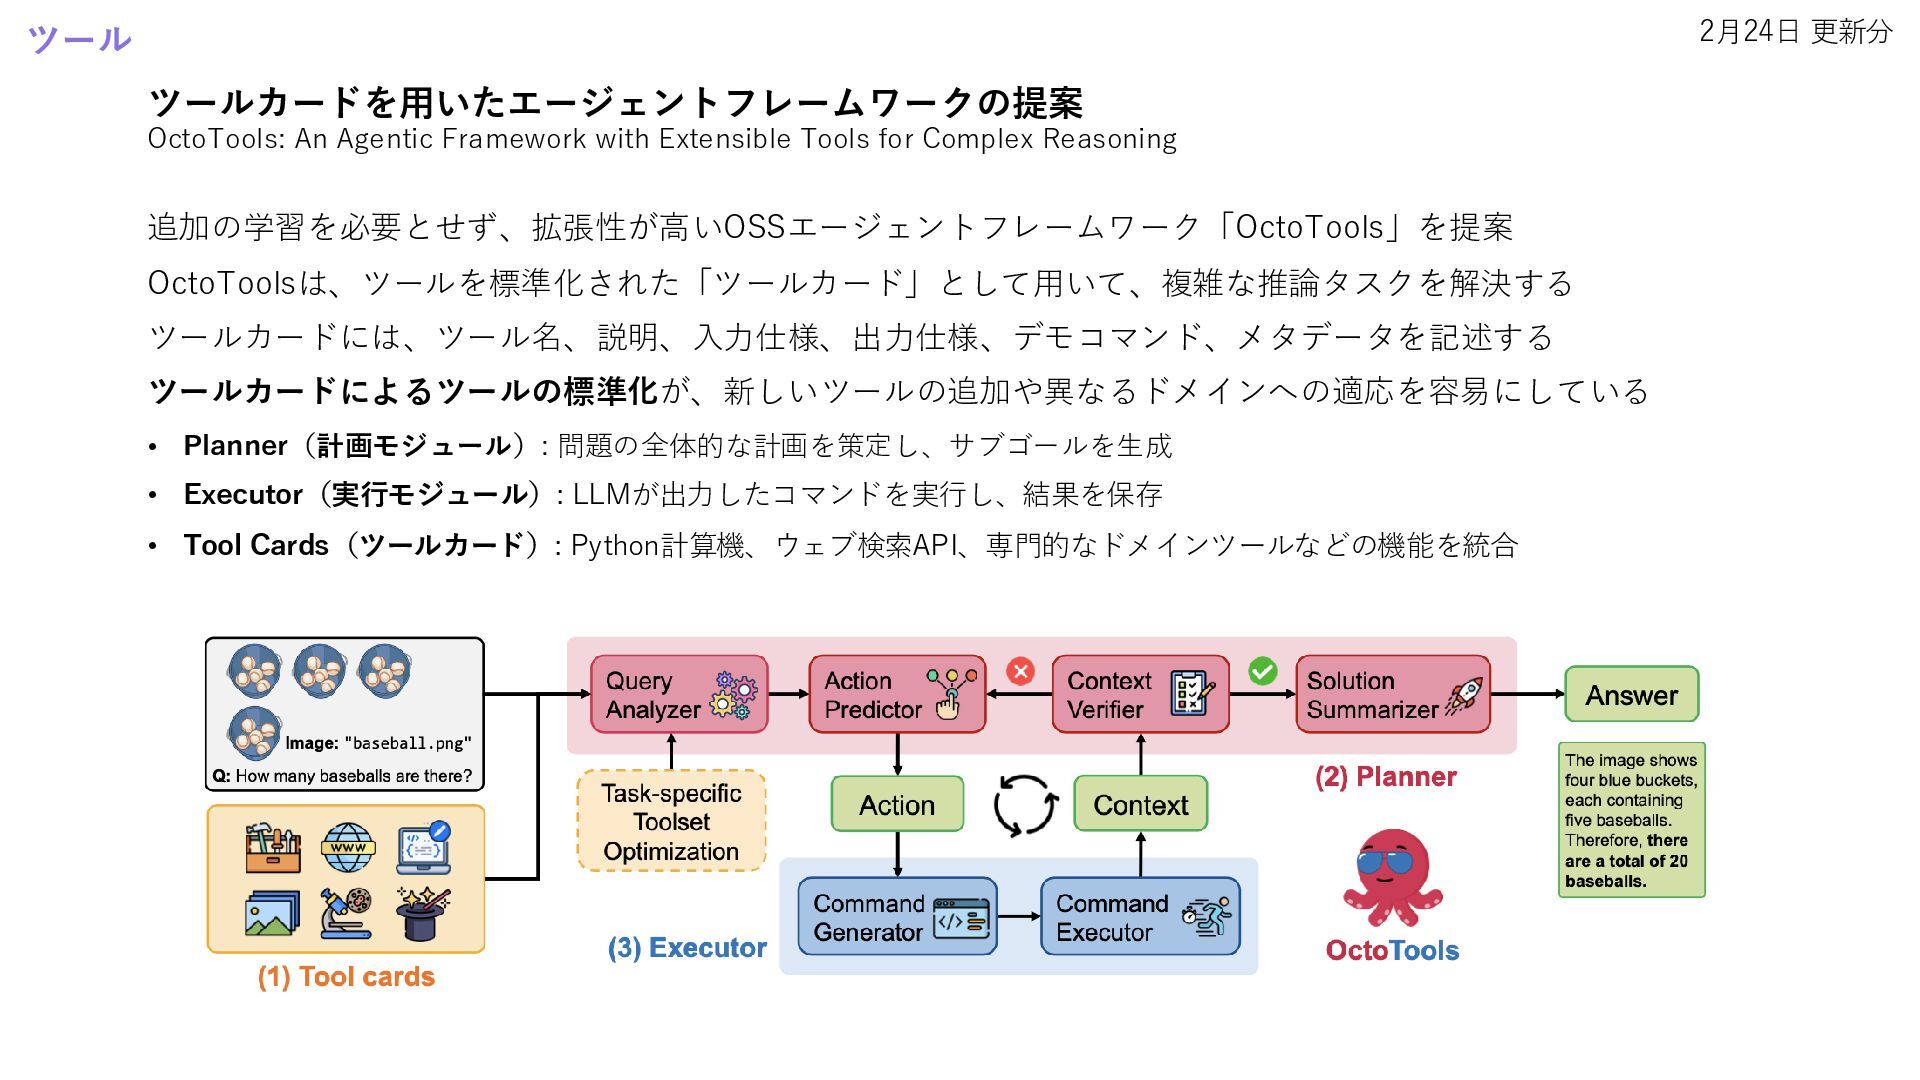
ツールカードを用いたエージェントフレームワークの提案 OctoTools: An Agentic Framework with Extensible Tools for Complex
Reasoning 追加の学習を必要とせず、拡張性が高いOSSエージェントフレームワーク「OctoTools」を提案 OctoToolsは、ツールを標準化された「ツールカード」として用いて、複雑な推論タスクを解決する ツールカードには、ツール名、説明、入力仕様、出力仕様、デモコマンド、メタデータを記述する ツールカードによるツールの標準化が、新しいツールの追加や異なるドメインへの適応を容易にしている • Planner(計画モジュール): 問題の全体的な計画を策定し、サブゴールを生成 • Executor(実行モジュール): LLMが出力したコマンドを実行し、結果を保存 • Tool Cards(ツールカード): Python計算機、ウェブ検索API、専門的なドメインツールなどの機能を統合 2月24日 更新分 ツール -
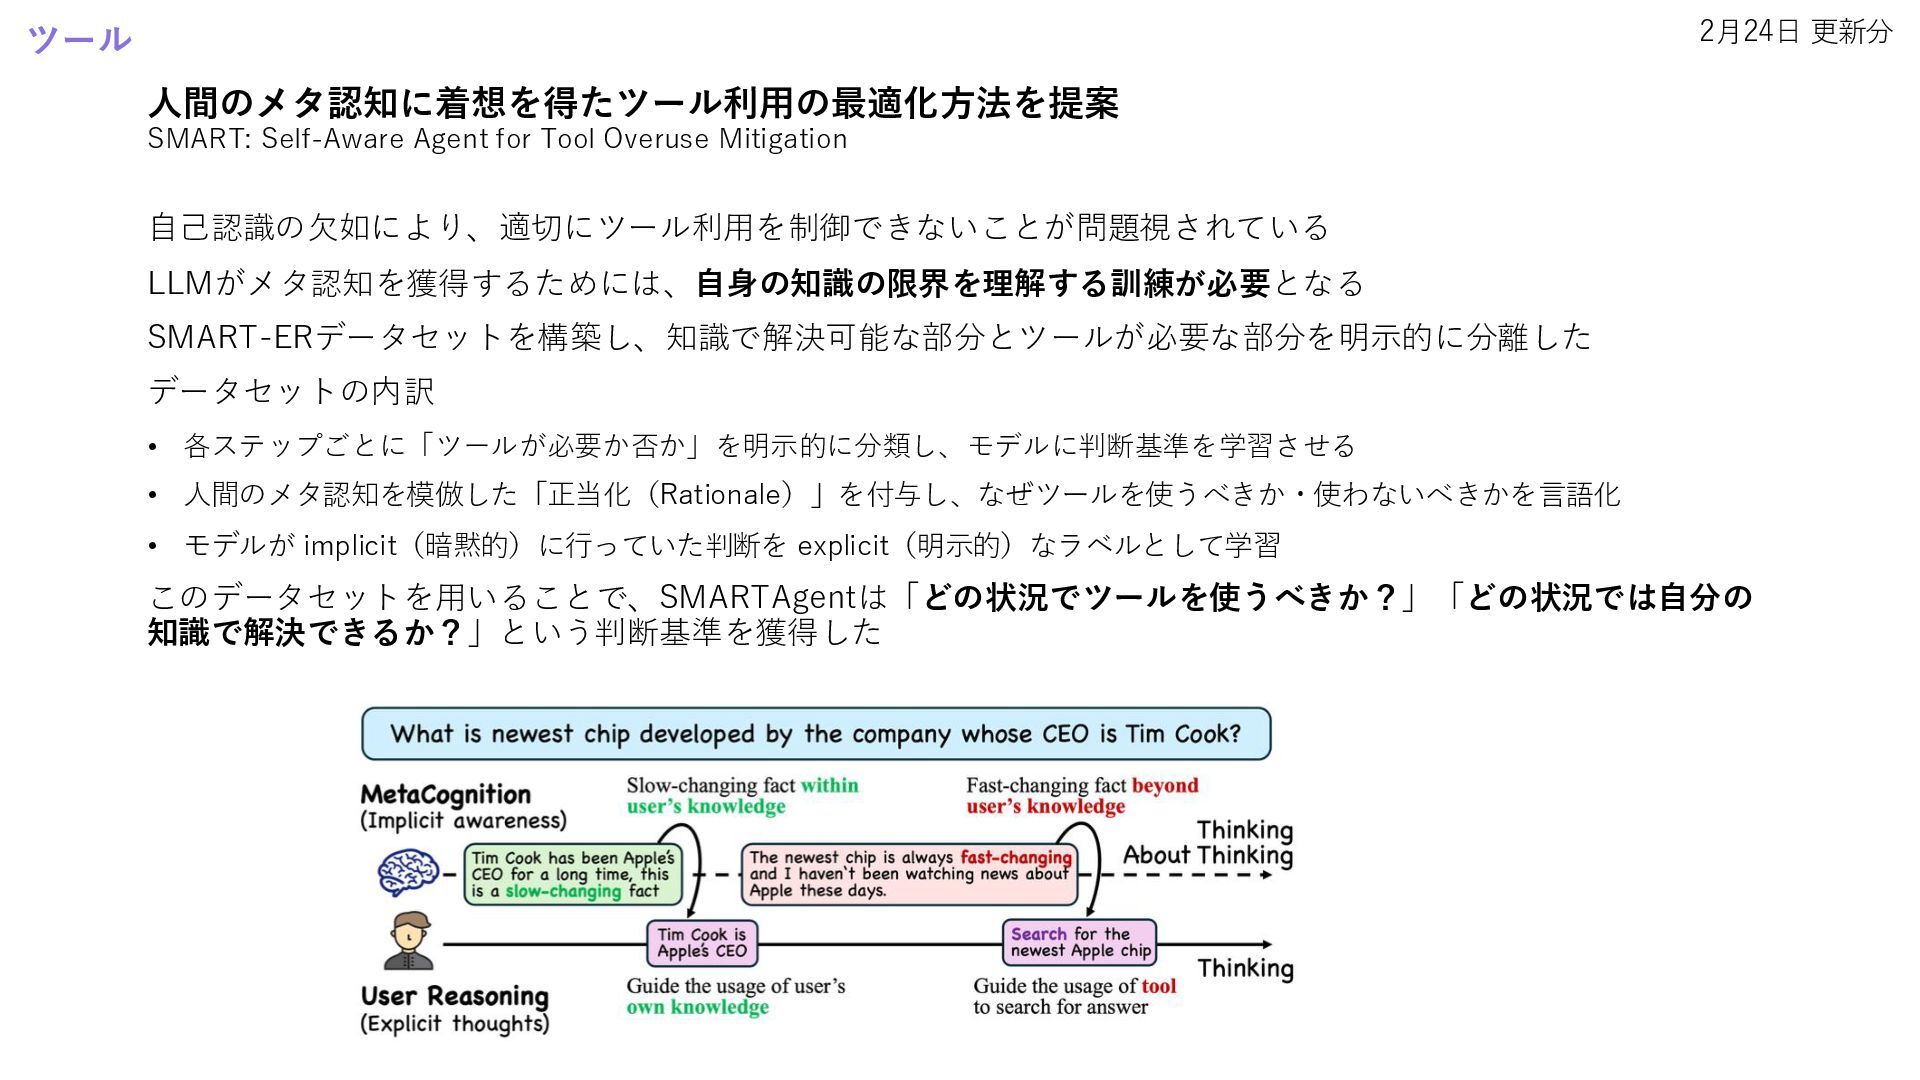
人間のメタ認知に着想を得たツール利用の最適化方法を提案 SMART: Self-Aware Agent for Tool Overuse Mitigation 自己認識の欠如により、適切にツール利用を制御できないことが問題視されている LLMがメタ認知を獲得するためには、自身の知識の限界を理解する訓練が必要となる
SMART-ERデータセットを構築し、知識で解決可能な部分とツールが必要な部分を明示的に分離した データセットの内訳 • 各ステップごとに「ツールが必要か否か」を明示的に分類し、モデルに判断基準を学習させる • 人間のメタ認知を模倣した「正当化(Rationale)」を付与し、なぜツールを使うべきか・使わないべきかを言語化 • モデルが implicit(暗黙的)に行っていた判断を explicit(明示的)なラベルとして学習 このデータセットを用いることで、SMARTAgentは「どの状況でツールを使うべきか?」「どの状況では自分の 知識で解決できるか?」という判断基準を獲得した 2月24日 更新分 ツール -
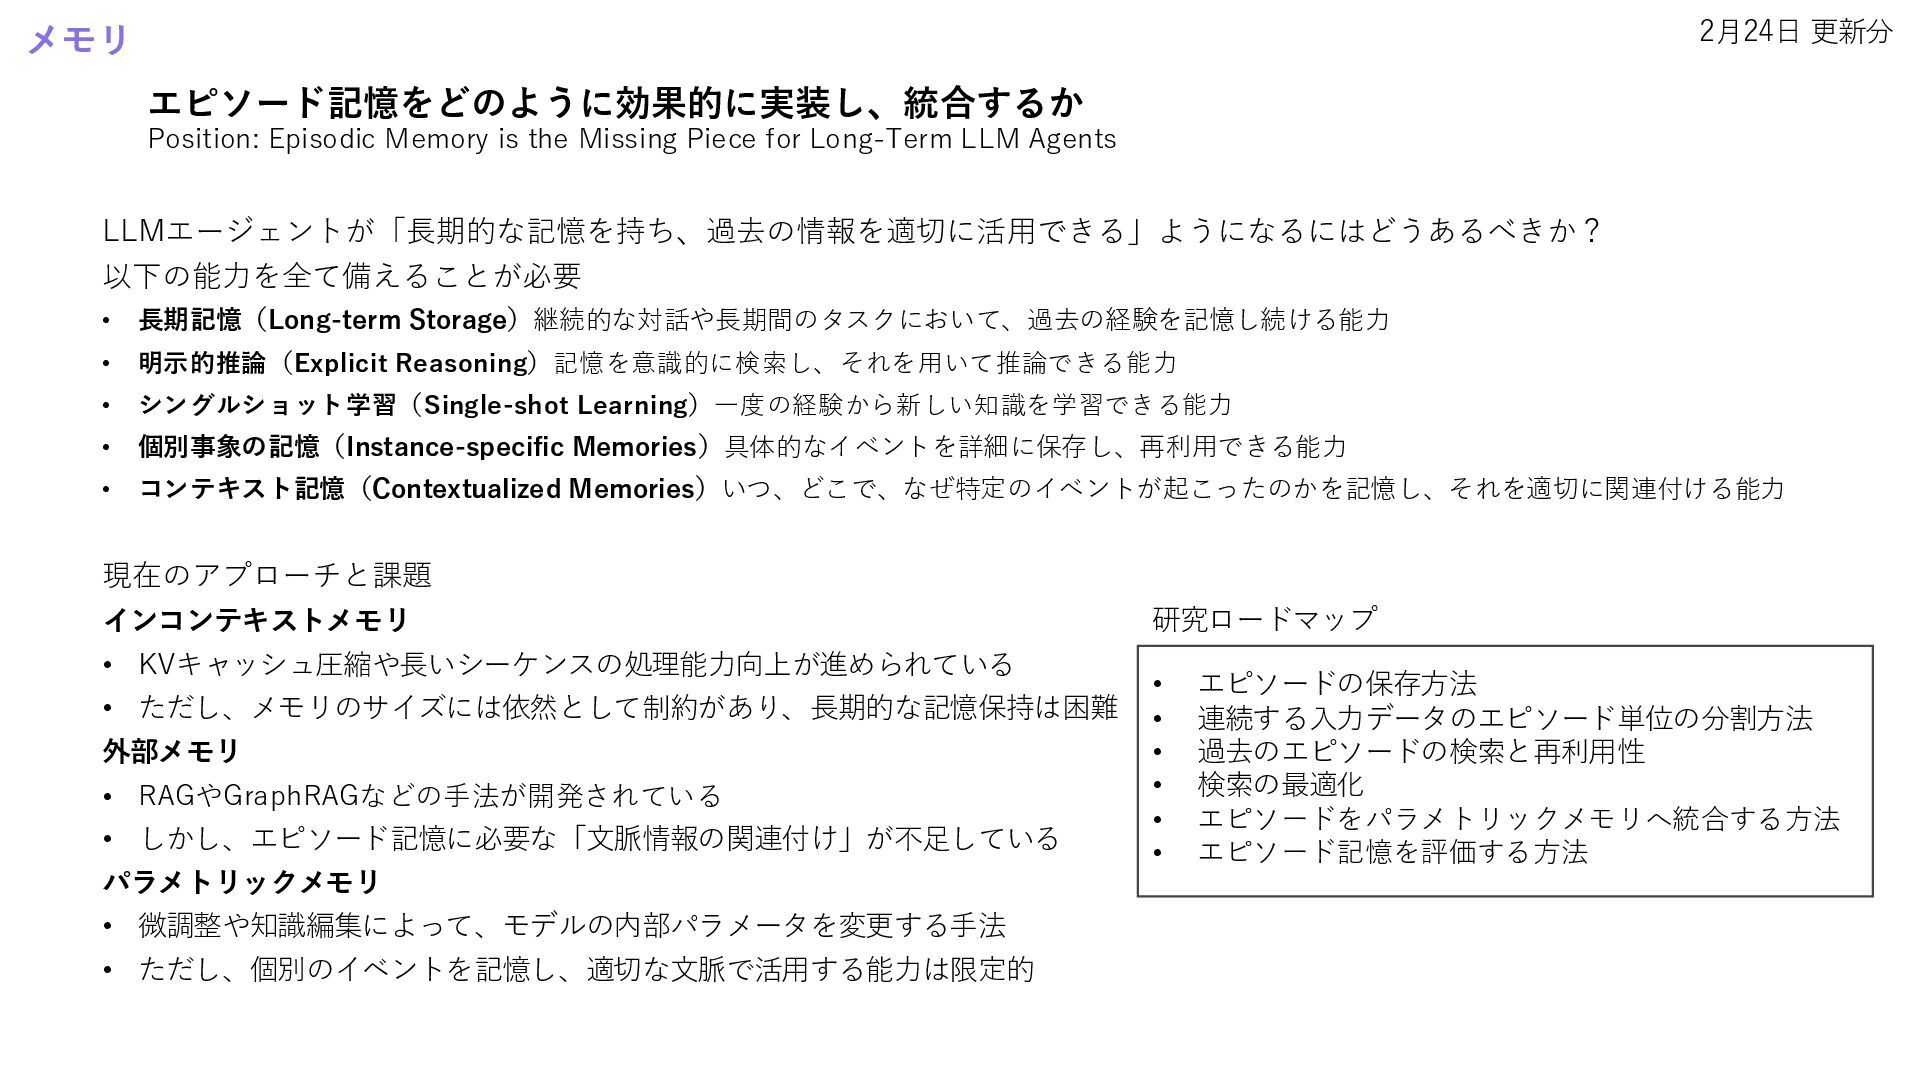
エピソード記憶をどのように効果的に実装し、統合するか Position: Episodic Memory is the Missing Piece for Long-Term
LLM Agents LLMエージェントが「長期的な記憶を持ち、過去の情報を適切に活用できる」ようになるにはどうあるべきか? 以下の能力を全て備えることが必要 • 長期記憶(Long-term Storage)継続的な対話や長期間のタスクにおいて、過去の経験を記憶し続ける能力 • 明示的推論(Explicit Reasoning)記憶を意識的に検索し、それを用いて推論できる能力 • シングルショット学習(Single-shot Learning)一度の経験から新しい知識を学習できる能力 • 個別事象の記憶(Instance-specific Memories)具体的なイベントを詳細に保存し、再利用できる能力 • コンテキスト記憶(Contextualized Memories)いつ、どこで、なぜ特定のイベントが起こったのかを記憶し、それを適切に関連付ける能力 現在のアプローチと課題 インコンテキストメモリ • KVキャッシュ圧縮や長いシーケンスの処理能力向上が進められている • ただし、メモリのサイズには依然として制約があり、長期的な記憶保持は困難 外部メモリ • RAGやGraphRAGなどの手法が開発されている • しかし、エピソード記憶に必要な「文脈情報の関連付け」が不足している パラメトリックメモリ • 微調整や知識編集によって、モデルの内部パラメータを変更する手法 • ただし、個別のイベントを記憶し、適切な文脈で活用する能力は限定的 2月24日 更新分 メモリ 研究ロードマップ • エピソードの保存方法 • 連続する入力データのエピソード単位の分割方法 • 過去のエピソードの検索と再利用性 • 検索の最適化 • エピソードをパラメトリックメモリへ統合する方法 • エピソード記憶を評価する方法 -
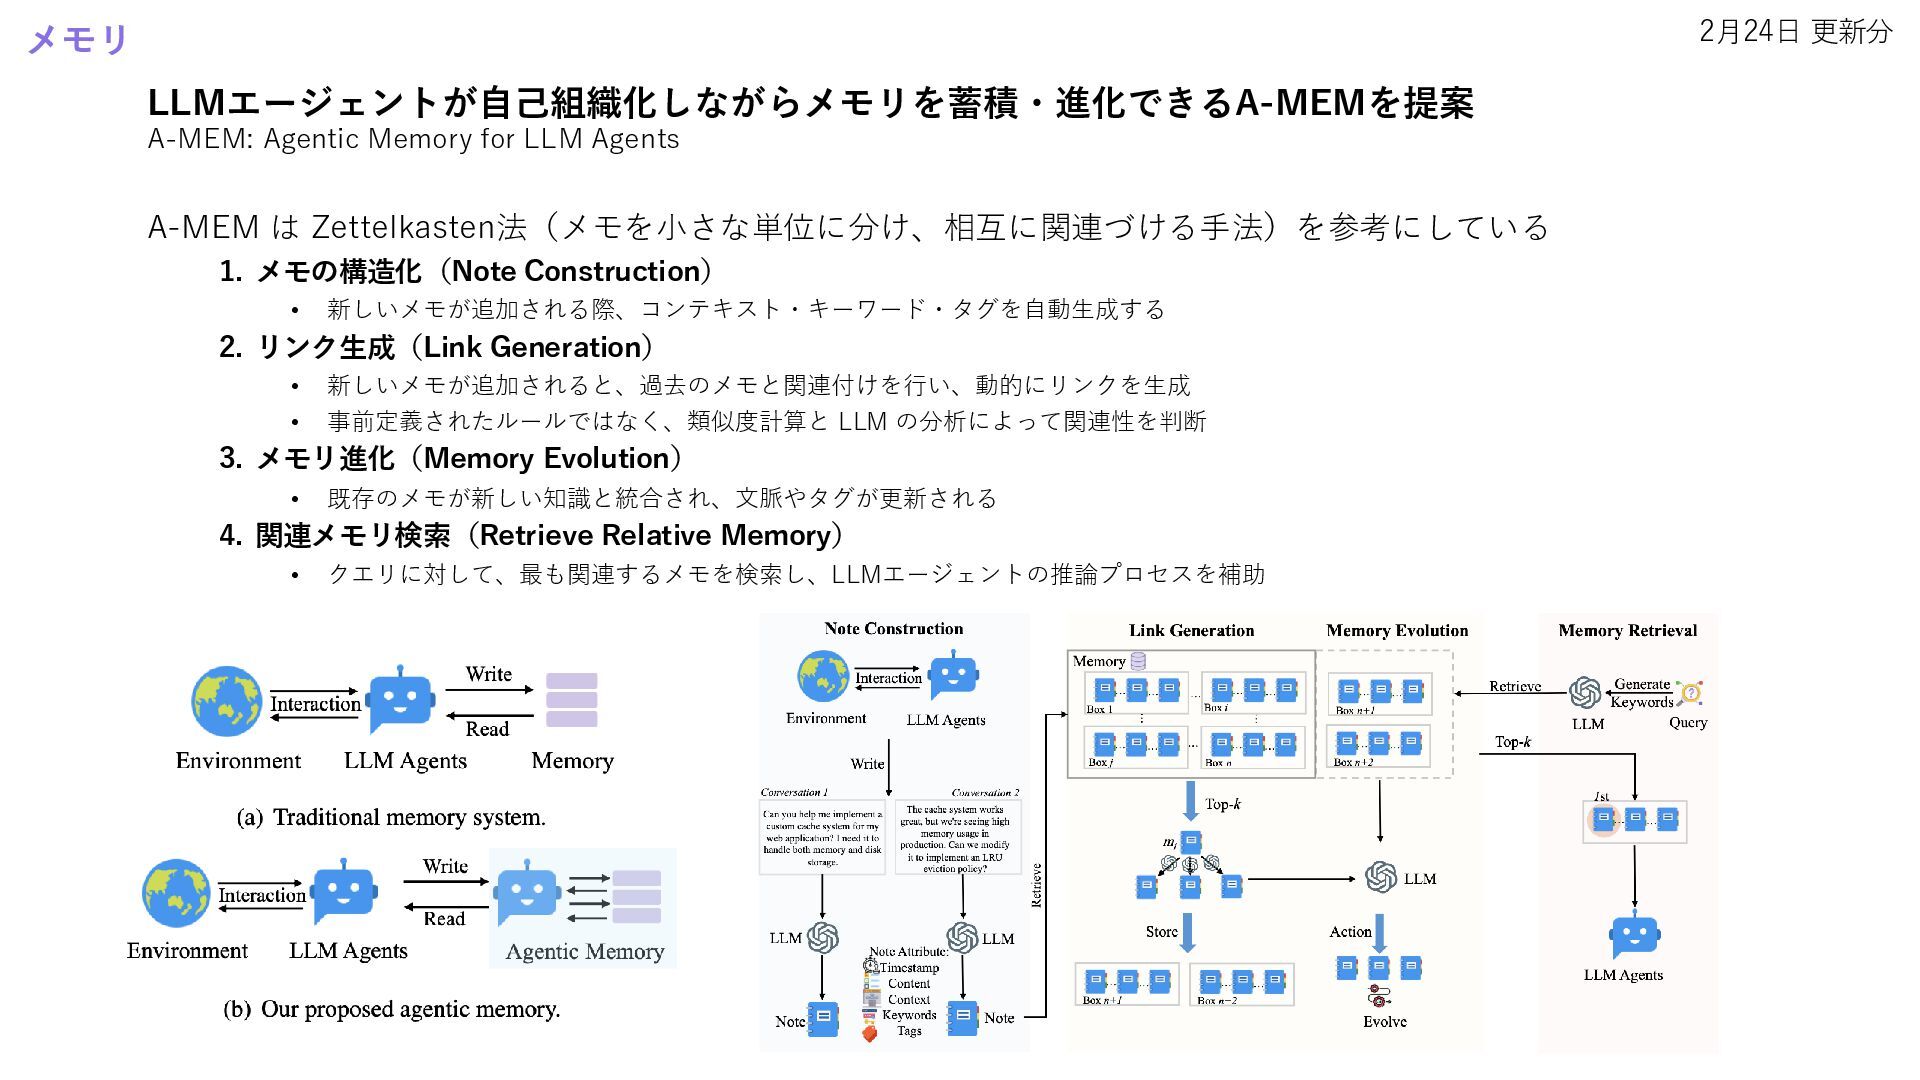
LLMエージェントが自己組織化しながらメモリを蓄積・進化できるA-MEMを提案 A-MEM: Agentic Memory for LLM Agents A-MEM は Zettelkasten法(メモを小さな単位に分け、相互に関連づける手法)を参考にしている
1. メモの構造化(Note Construction) • 新しいメモが追加される際、コンテキスト・キーワード・タグを自動生成する 2. リンク生成(Link Generation) • 新しいメモが追加されると、過去のメモと関連付けを行い、動的にリンクを生成 • 事前定義されたルールではなく、類似度計算と LLM の分析によって関連性を判断 3. メモリ進化(Memory Evolution) • 既存のメモが新しい知識と統合され、文脈やタグが更新される 4. 関連メモリ検索(Retrieve Relative Memory) • クエリに対して、最も関連するメモを検索し、LLMエージェントの推論プロセスを補助 2月24日 更新分 メモリ -
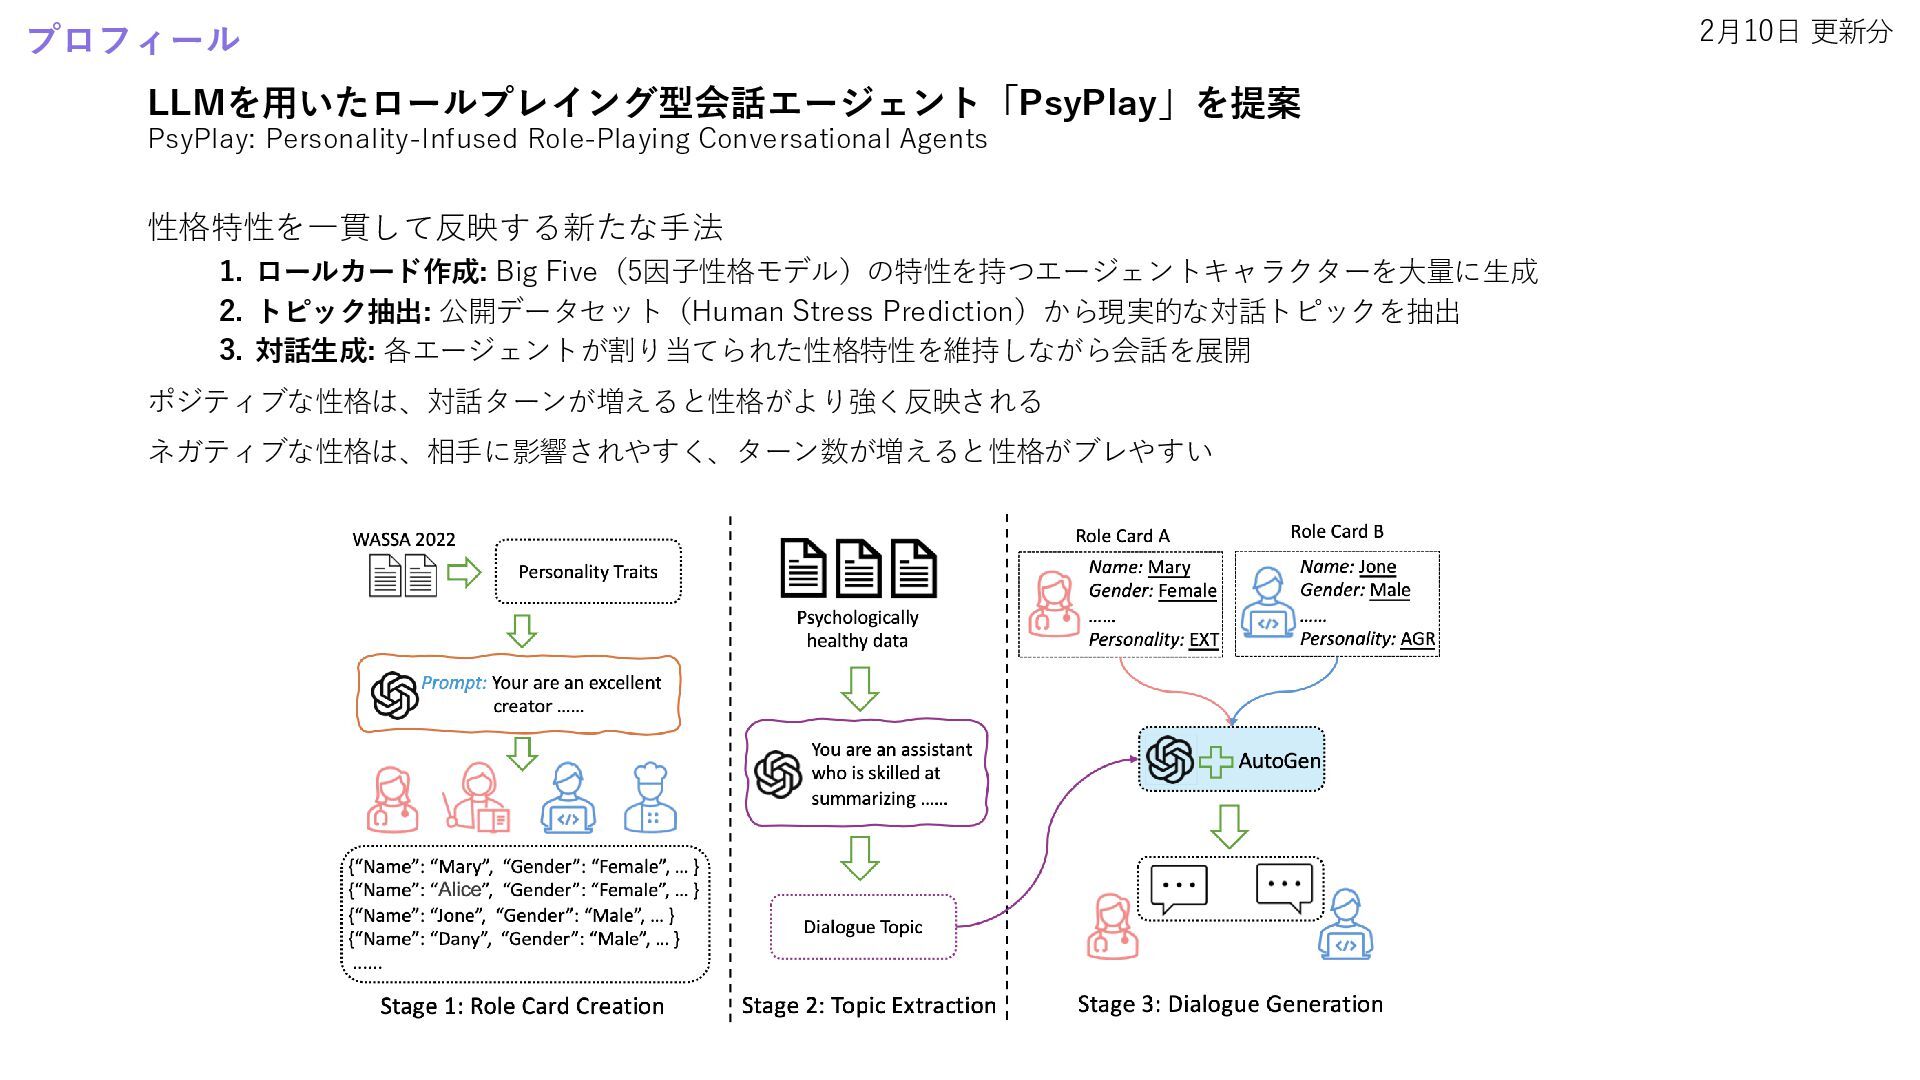
LLMを用いたロールプレイング型会話エージェント「PsyPlay」を提案 PsyPlay: Personality-Infused Role-Playing Conversational Agents 性格特性を一貫して反映する新たな手法 1. ロールカード作成: Big
Five(5因子性格モデル)の特性を持つエージェントキャラクターを大量に生成 2. トピック抽出: 公開データセット(Human Stress Prediction)から現実的な対話トピックを抽出 3. 対話生成: 各エージェントが割り当てられた性格特性を維持しながら会話を展開 ポジティブな性格は、対話ターンが増えると性格がより強く反映される ネガティブな性格は、相手に影響されやすく、ターン数が増えると性格がブレやすい 2月10日 更新分 プロフィール -
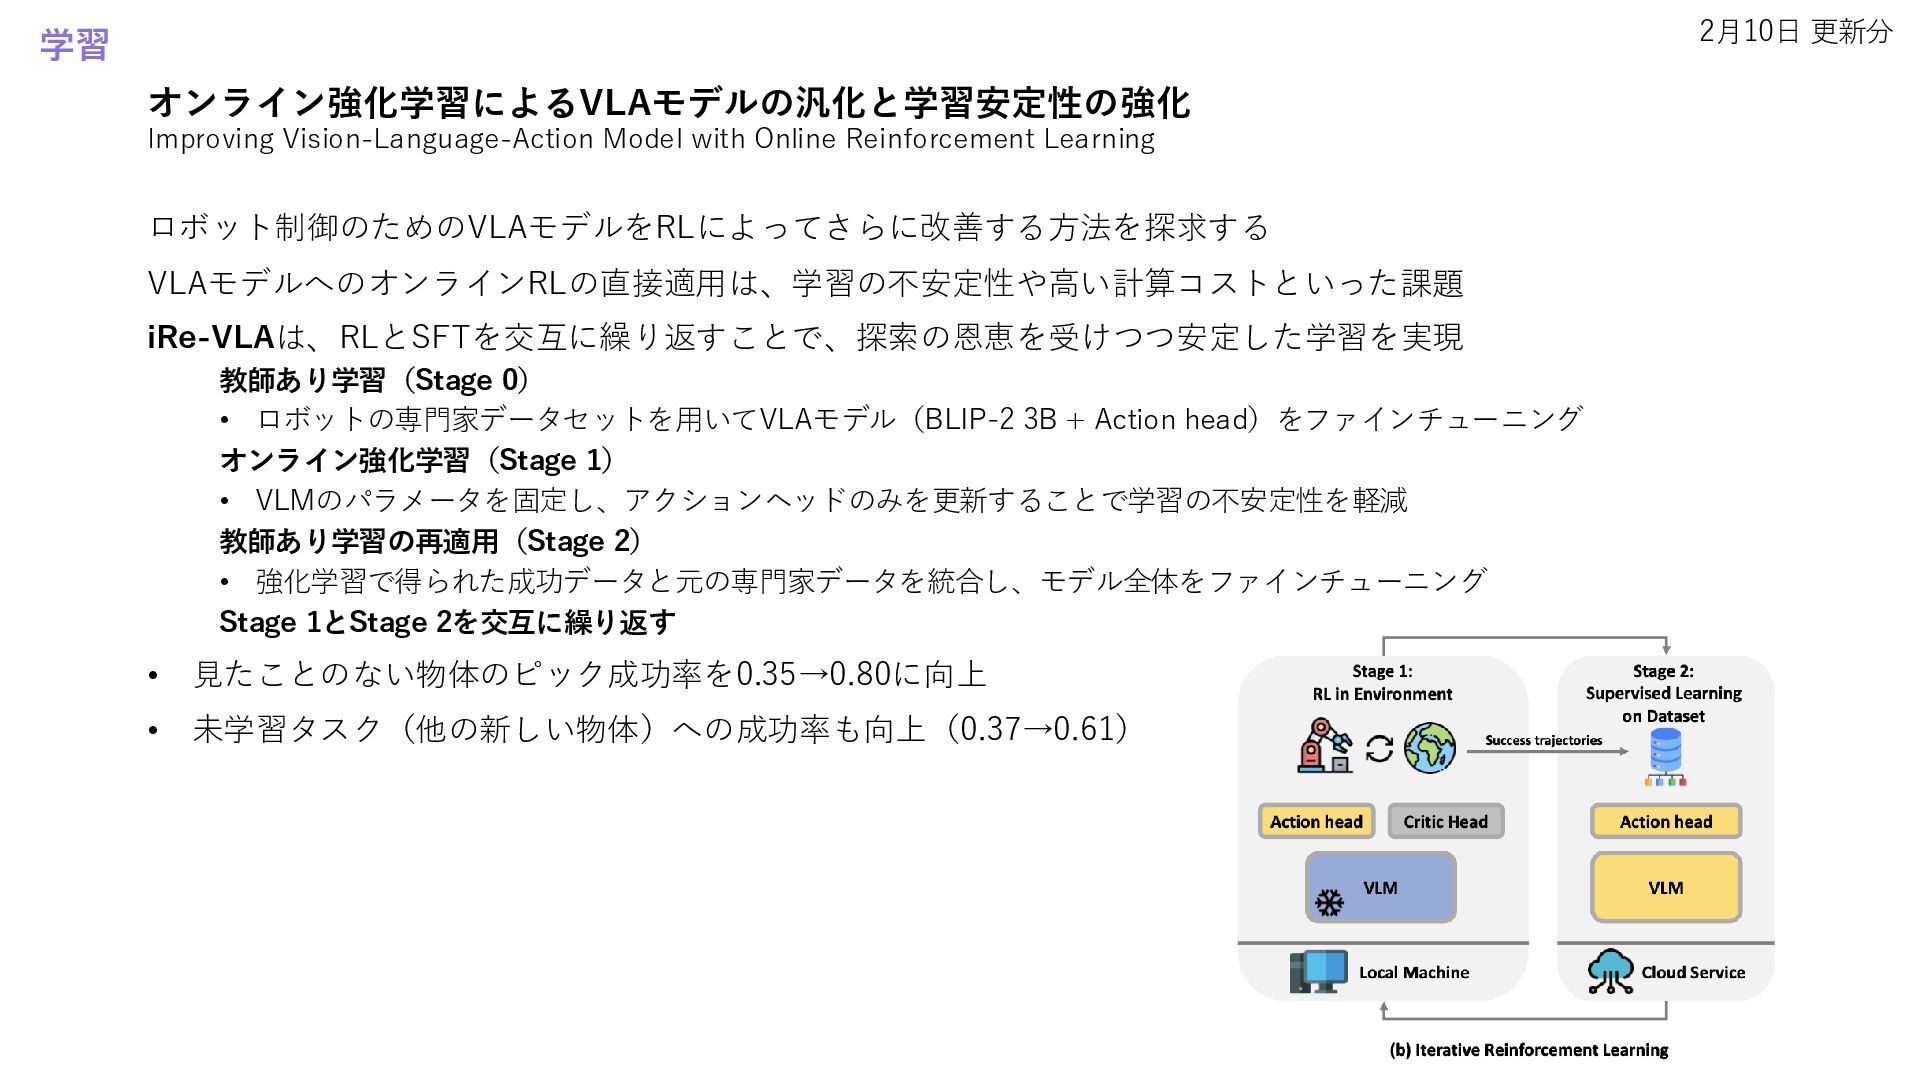
オンライン強化学習によるVLAモデルの汎化と学習安定性の強化 Improving Vision-Language-Action Model with Online Reinforcement Learning ロボット制御のためのVLAモデルをRLによってさらに改善する方法を探求する VLAモデルへのオンラインRLの直接適用は、学習の不安定性や高い計算コストといった課題
iRe-VLAは、RLとSFTを交互に繰り返すことで、探索の恩恵を受けつつ安定した学習を実現 教師あり学習(Stage 0) • ロボットの専門家データセットを用いてVLAモデル(BLIP-2 3B + Action head)をファインチューニング オンライン強化学習(Stage 1) • VLMのパラメータを固定し、アクションヘッドのみを更新することで学習の不安定性を軽減 教師あり学習の再適用(Stage 2) • 強化学習で得られた成功データと元の専門家データを統合し、モデル全体をファインチューニング Stage 1とStage 2を交互に繰り返す • 見たことのない物体のピック成功率を0.35→0.80に向上 • 未学習タスク(他の新しい物体)への成功率も向上(0.37→0.61) 2月10日 更新分 学習 -
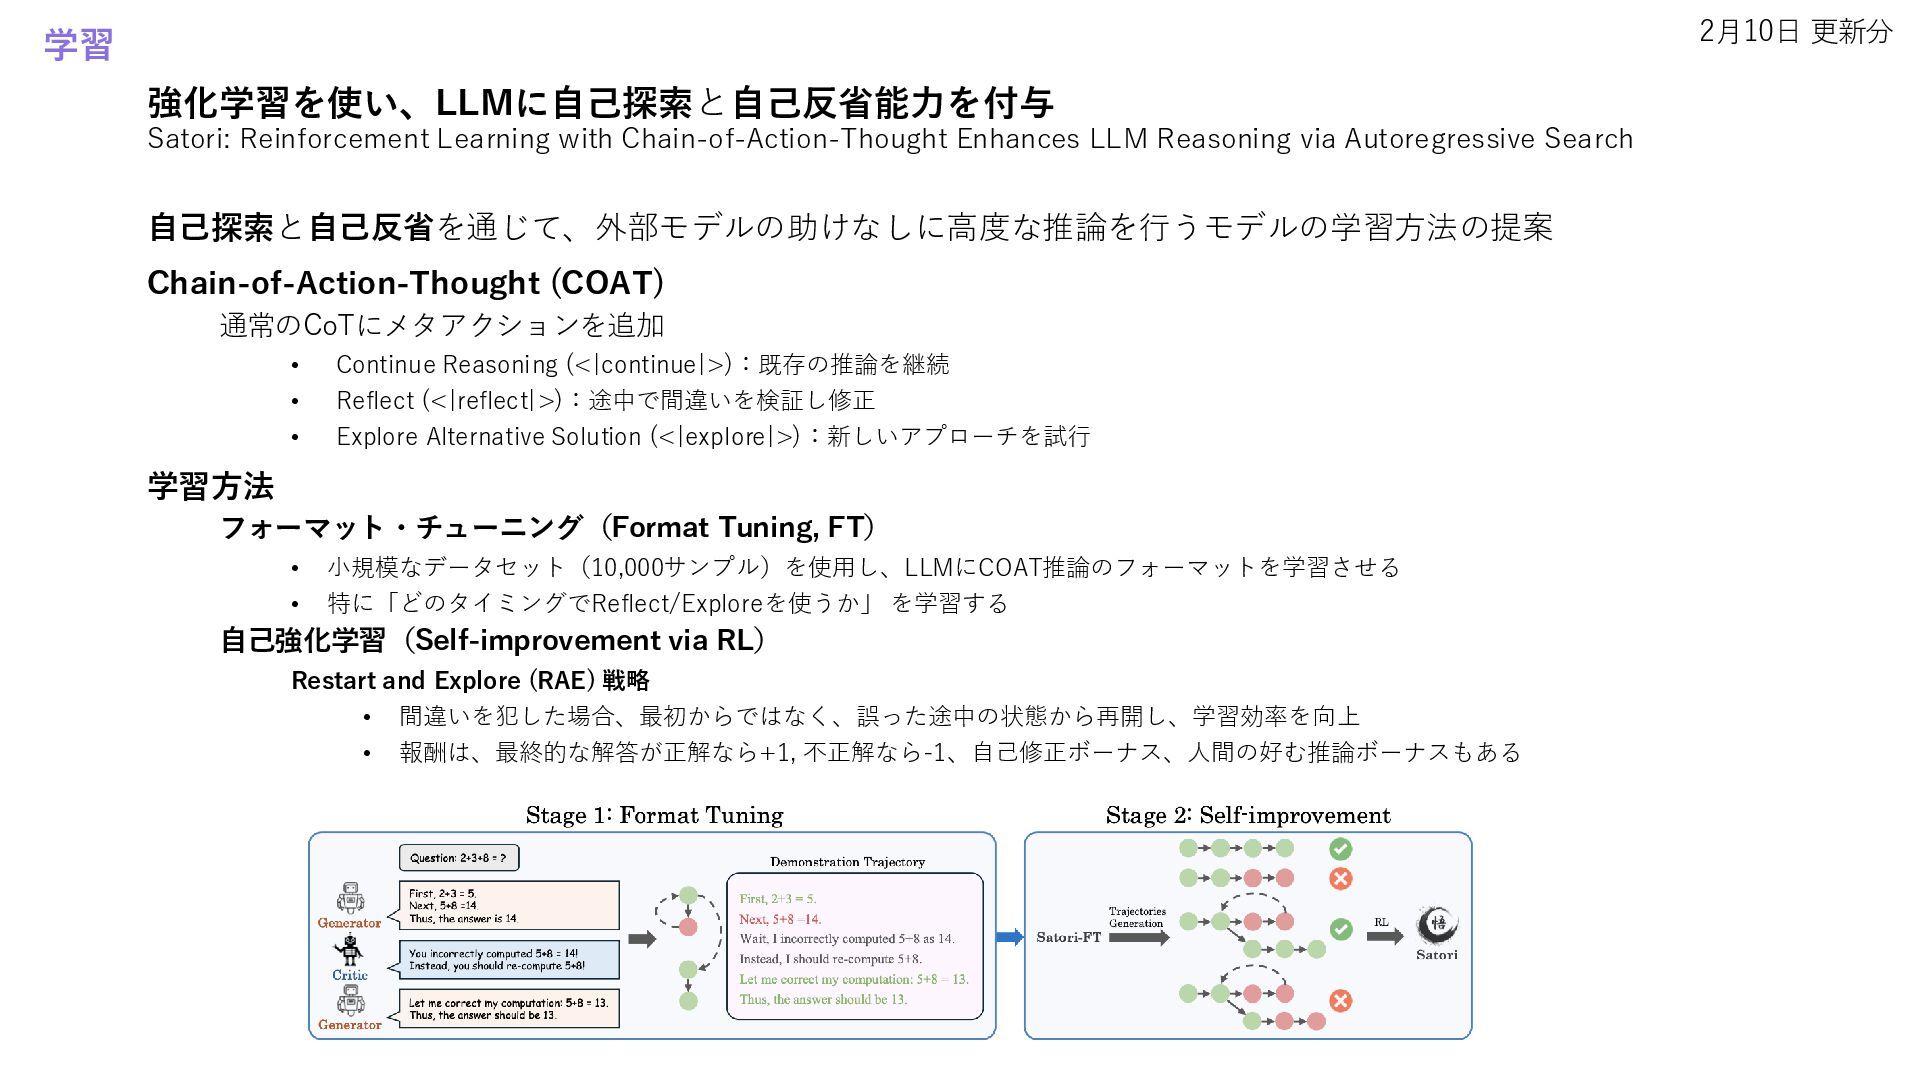
強化学習を使い、LLMに自己探索と自己反省能力を付与 Satori: Reinforcement Learning with Chain-of-Action-Thought Enhances LLM Reasoning via
Autoregressive Search 自己探索と自己反省を通じて、外部モデルの助けなしに高度な推論を行うモデルの学習方法の提案 Chain-of-Action-Thought (COAT) 通常のCoTにメタアクションを追加 • Continue Reasoning (<|continue|>):既存の推論を継続 • Reflect (<|reflect|>):途中で間違いを検証し修正 • Explore Alternative Solution (<|explore|>):新しいアプローチを試行 学習方法 フォーマット・チューニング(Format Tuning, FT) • 小規模なデータセット(10,000サンプル)を使用し、LLMにCOAT推論のフォーマットを学習させる • 特に「どのタイミングでReflect/Exploreを使うか」 を学習する 自己強化学習(Self-improvement via RL) Restart and Explore (RAE) 戦略 • 間違いを犯した場合、最初からではなく、誤った途中の状態から再開し、学習効率を向上 • 報酬は、最終的な解答が正解なら+1, 不正解なら-1、自己修正ボーナス、人間の好む推論ボーナスもある 2月10日 更新分 学習 -
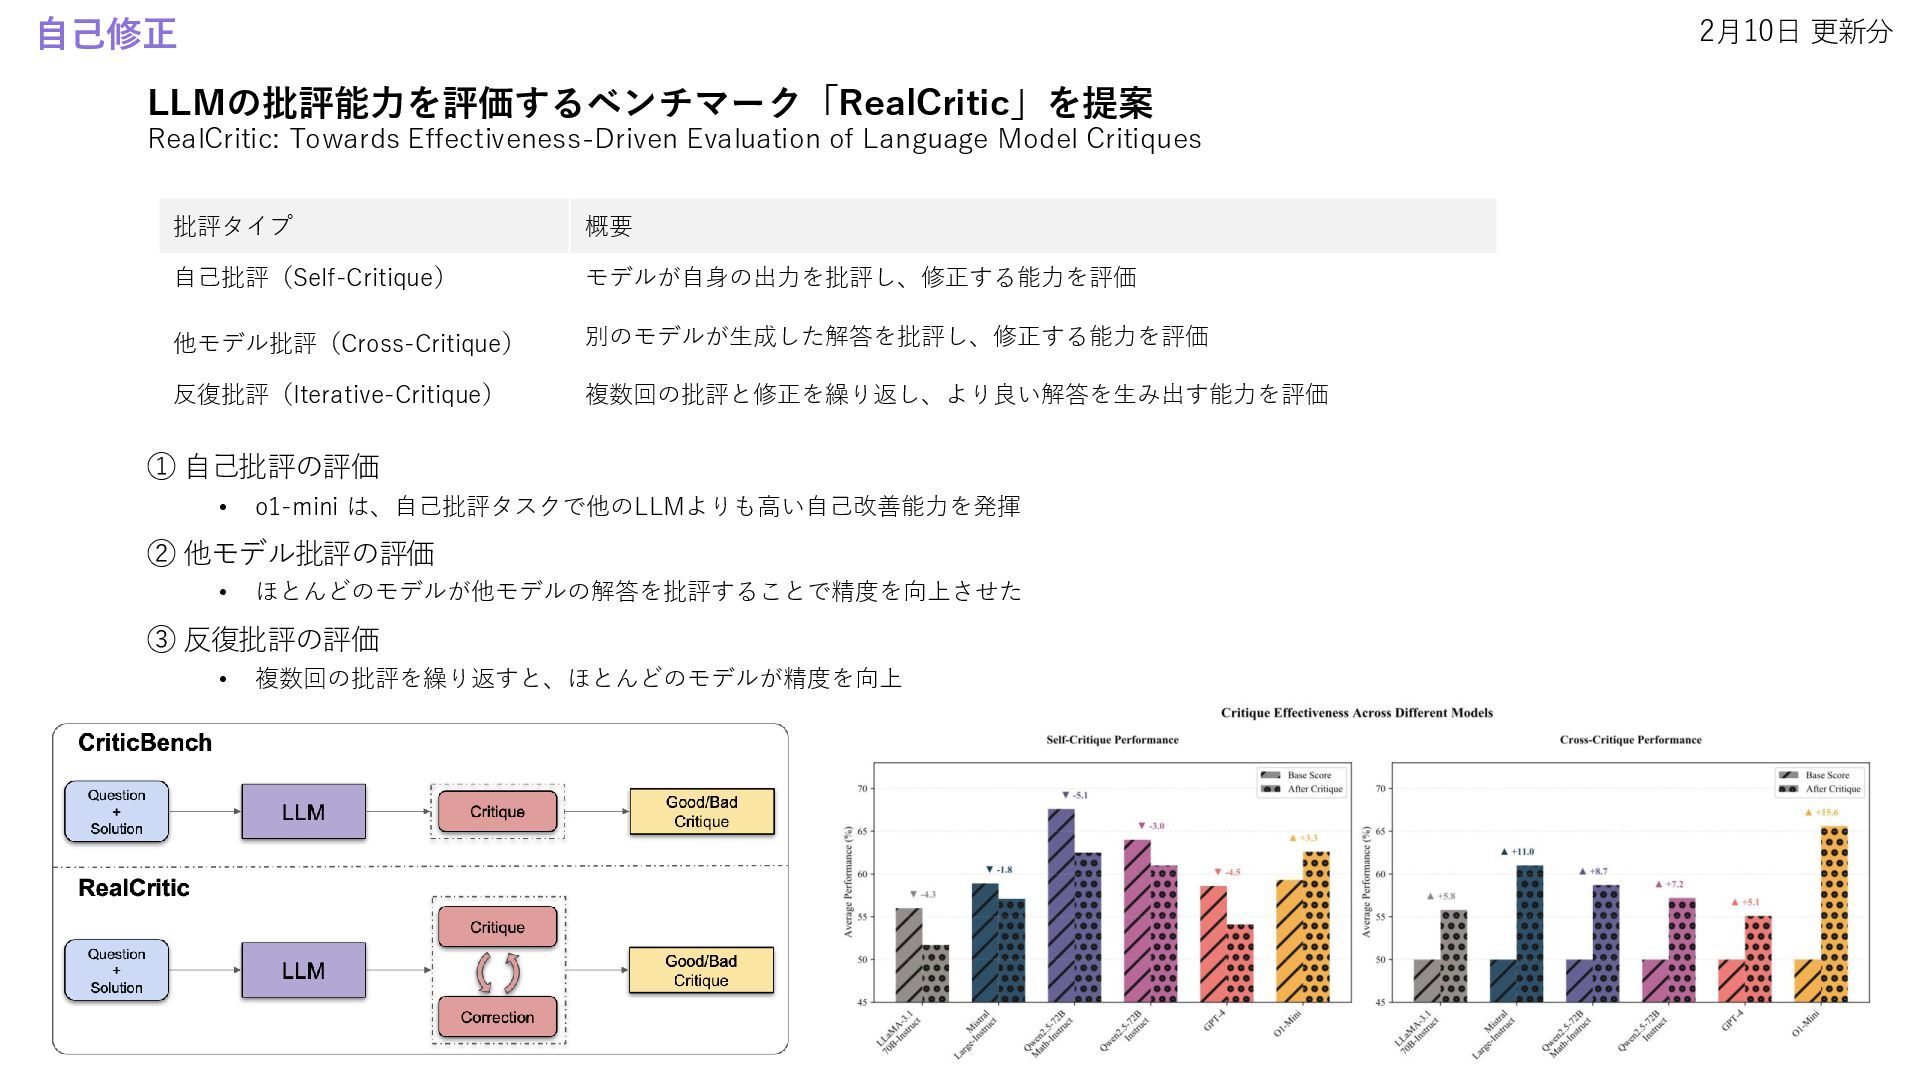
LLMの批評能力を評価するベンチマーク「RealCritic」を提案 RealCritic: Towards Effectiveness-Driven Evaluation of Language Model Critiques ①
自己批評の評価 • o1-mini は、自己批評タスクで他のLLMよりも高い自己改善能力を発揮 ② 他モデル批評の評価 • ほとんどのモデルが他モデルの解答を批評することで精度を向上させた ③ 反復批評の評価 • 複数回の批評を繰り返すと、ほとんどのモデルが精度を向上 批評タイプ 概要 自己批評(Self-Critique) モデルが自身の出力を批評し、修正する能力を評価 他モデル批評(Cross-Critique) 別のモデルが生成した解答を批評し、修正する能力を評価 反復批評(Iterative-Critique) 複数回の批評と修正を繰り返し、より良い解答を生み出す能力を評価 2月10日 更新分 自己修正 -
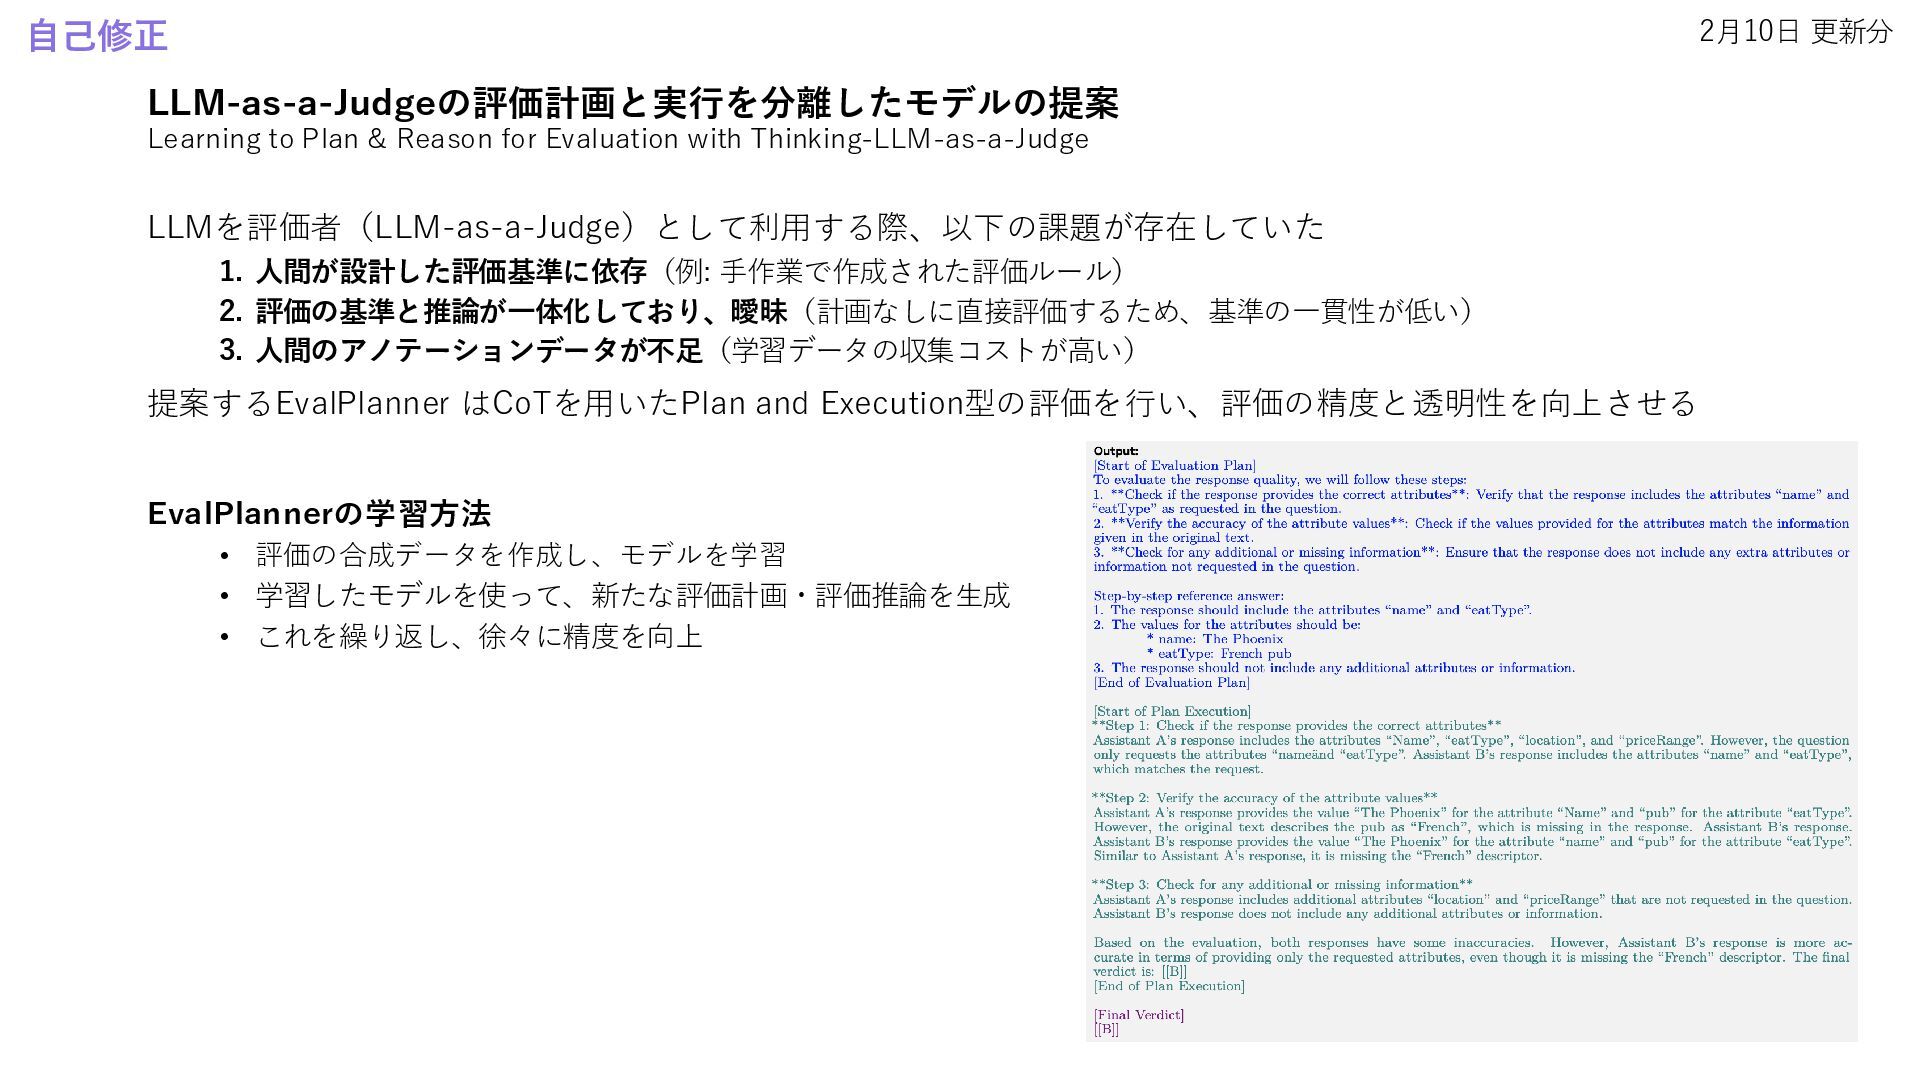
LLM-as-a-Judgeの評価計画と実行を分離したモデルの提案 Learning to Plan & Reason for Evaluation with Thinking-LLM-as-a-Judge
LLMを評価者(LLM-as-a-Judge)として利用する際、以下の課題が存在していた 1. 人間が設計した評価基準に依存(例: 手作業で作成された評価ルール) 2. 評価の基準と推論が一体化しており、曖昧(計画なしに直接評価するため、基準の一貫性が低い) 3. 人間のアノテーションデータが不足(学習データの収集コストが高い) 提案するEvalPlanner はCoTを用いたPlan and Execution型の評価を行い、評価の精度と透明性を向上させる EvalPlannerの学習方法 • 評価の合成データを作成し、モデルを学習 • 学習したモデルを使って、新たな評価計画・評価推論を生成 • これを繰り返し、徐々に精度を向上 2月10日 更新分 自己修正 -
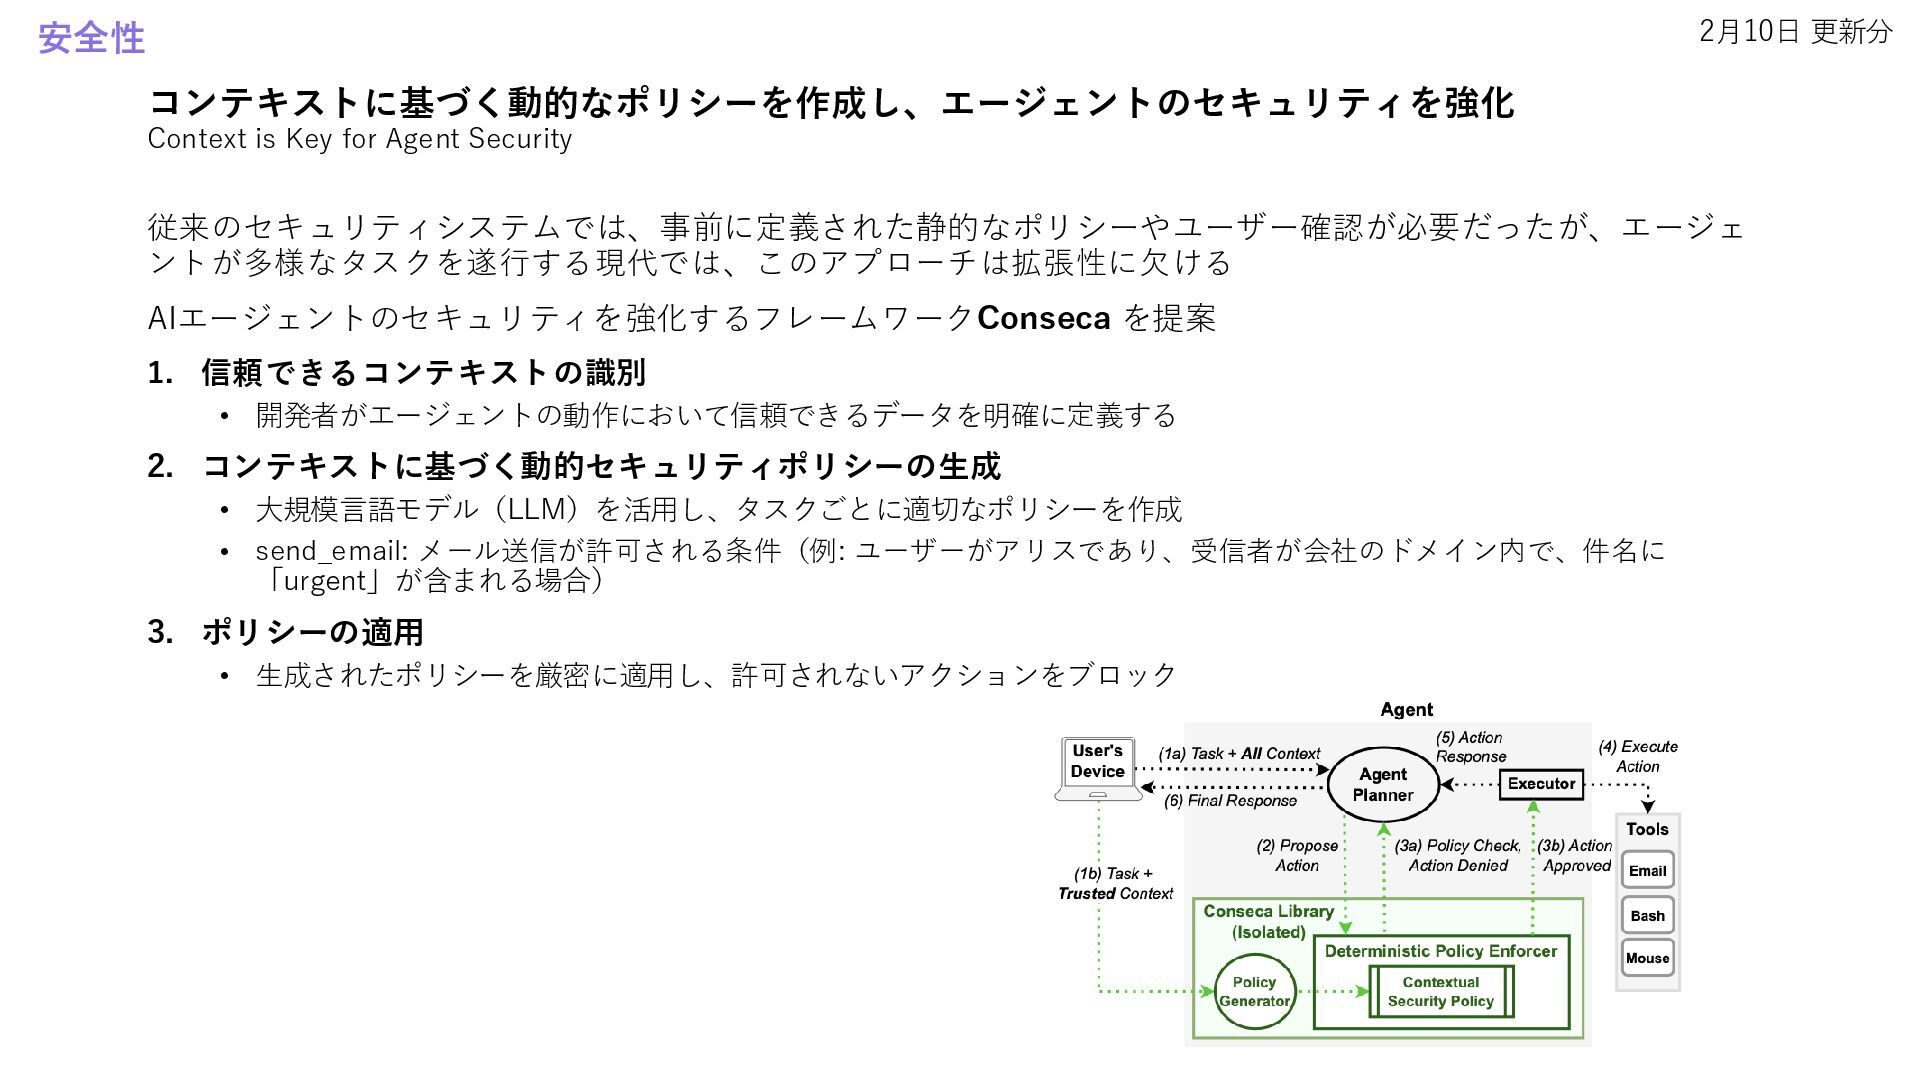
コンテキストに基づく動的なポリシーを作成し、エージェントのセキュリティを強化 Context is Key for Agent Security 従来のセキュリティシステムでは、事前に定義された静的なポリシーやユーザー確認が必要だったが、エージェ ントが多様なタスクを遂行する現代では、このアプローチは拡張性に欠ける AIエージェントのセキュリティを強化するフレームワークConseca
を提案 1. 信頼できるコンテキストの識別 • 開発者がエージェントの動作において信頼できるデータを明確に定義する 2. コンテキストに基づく動的セキュリティポリシーの生成 • 大規模言語モデル(LLM)を活用し、タスクごとに適切なポリシーを作成 • send_email: メール送信が許可される条件(例: ユーザーがアリスであり、受信者が会社のドメイン内で、件名に 「urgent」が含まれる場合) 3. ポリシーの適用 • 生成されたポリシーを厳密に適用し、許可されないアクションをブロック 2月10日 更新分 安全性 -
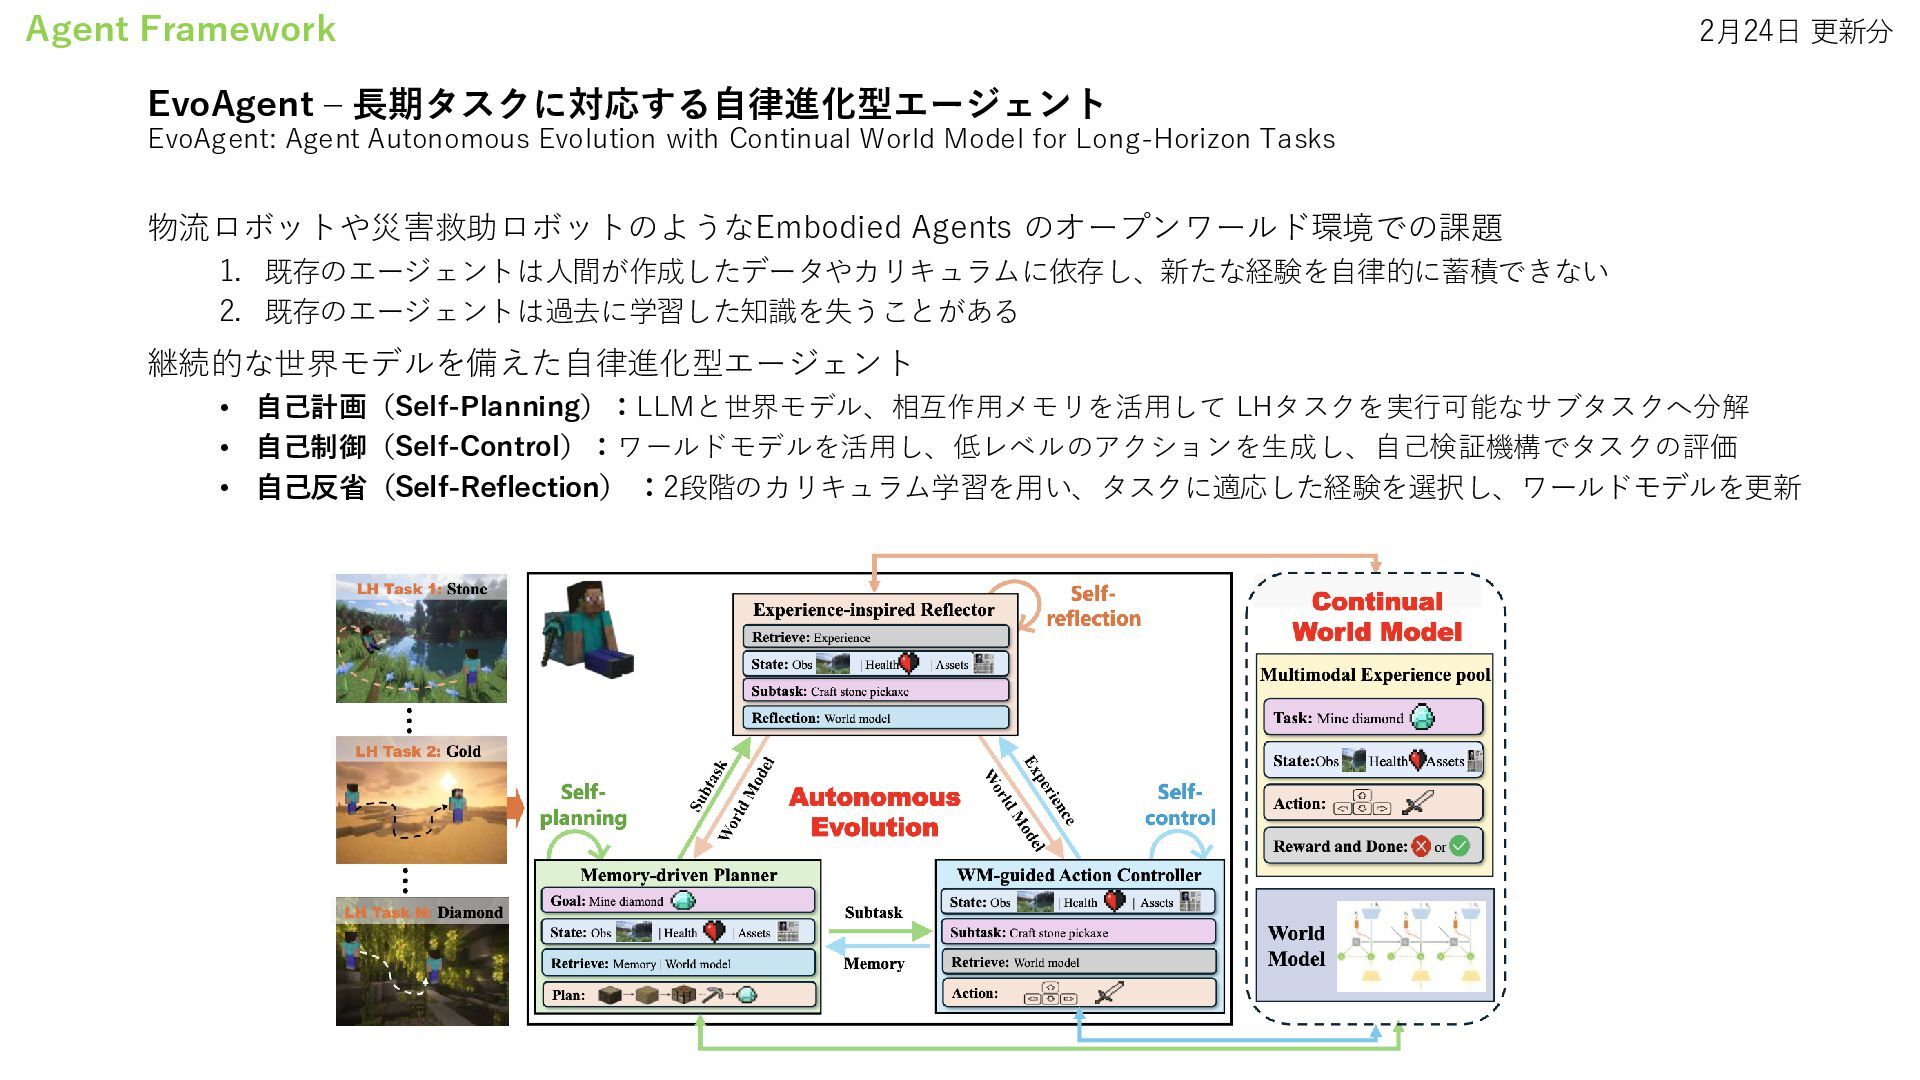
EvoAgent – 長期タスクに対応する自律進化型エージェント EvoAgent: Agent Autonomous Evolution with Continual World
Model for Long-Horizon Tasks 物流ロボットや災害救助ロボットのようなEmbodied Agents のオープンワールド環境での課題 1. 既存のエージェントは人間が作成したデータやカリキュラムに依存し、新たな経験を自律的に蓄積できない 2. 既存のエージェントは過去に学習した知識を失うことがある 継続的な世界モデルを備えた自律進化型エージェント • 自己計画(Self-Planning):LLMと世界モデル、相互作用メモリを活用して LHタスクを実行可能なサブタスクへ分解 • 自己制御(Self-Control):ワールドモデルを活用し、低レベルのアクションを生成し、自己検証機構でタスクの評価 • 自己反省(Self-Reflection) :2段階のカリキュラム学習を用い、タスクに適応した経験を選択し、ワールドモデルを更新 2月24日 更新分 Agent Framework -
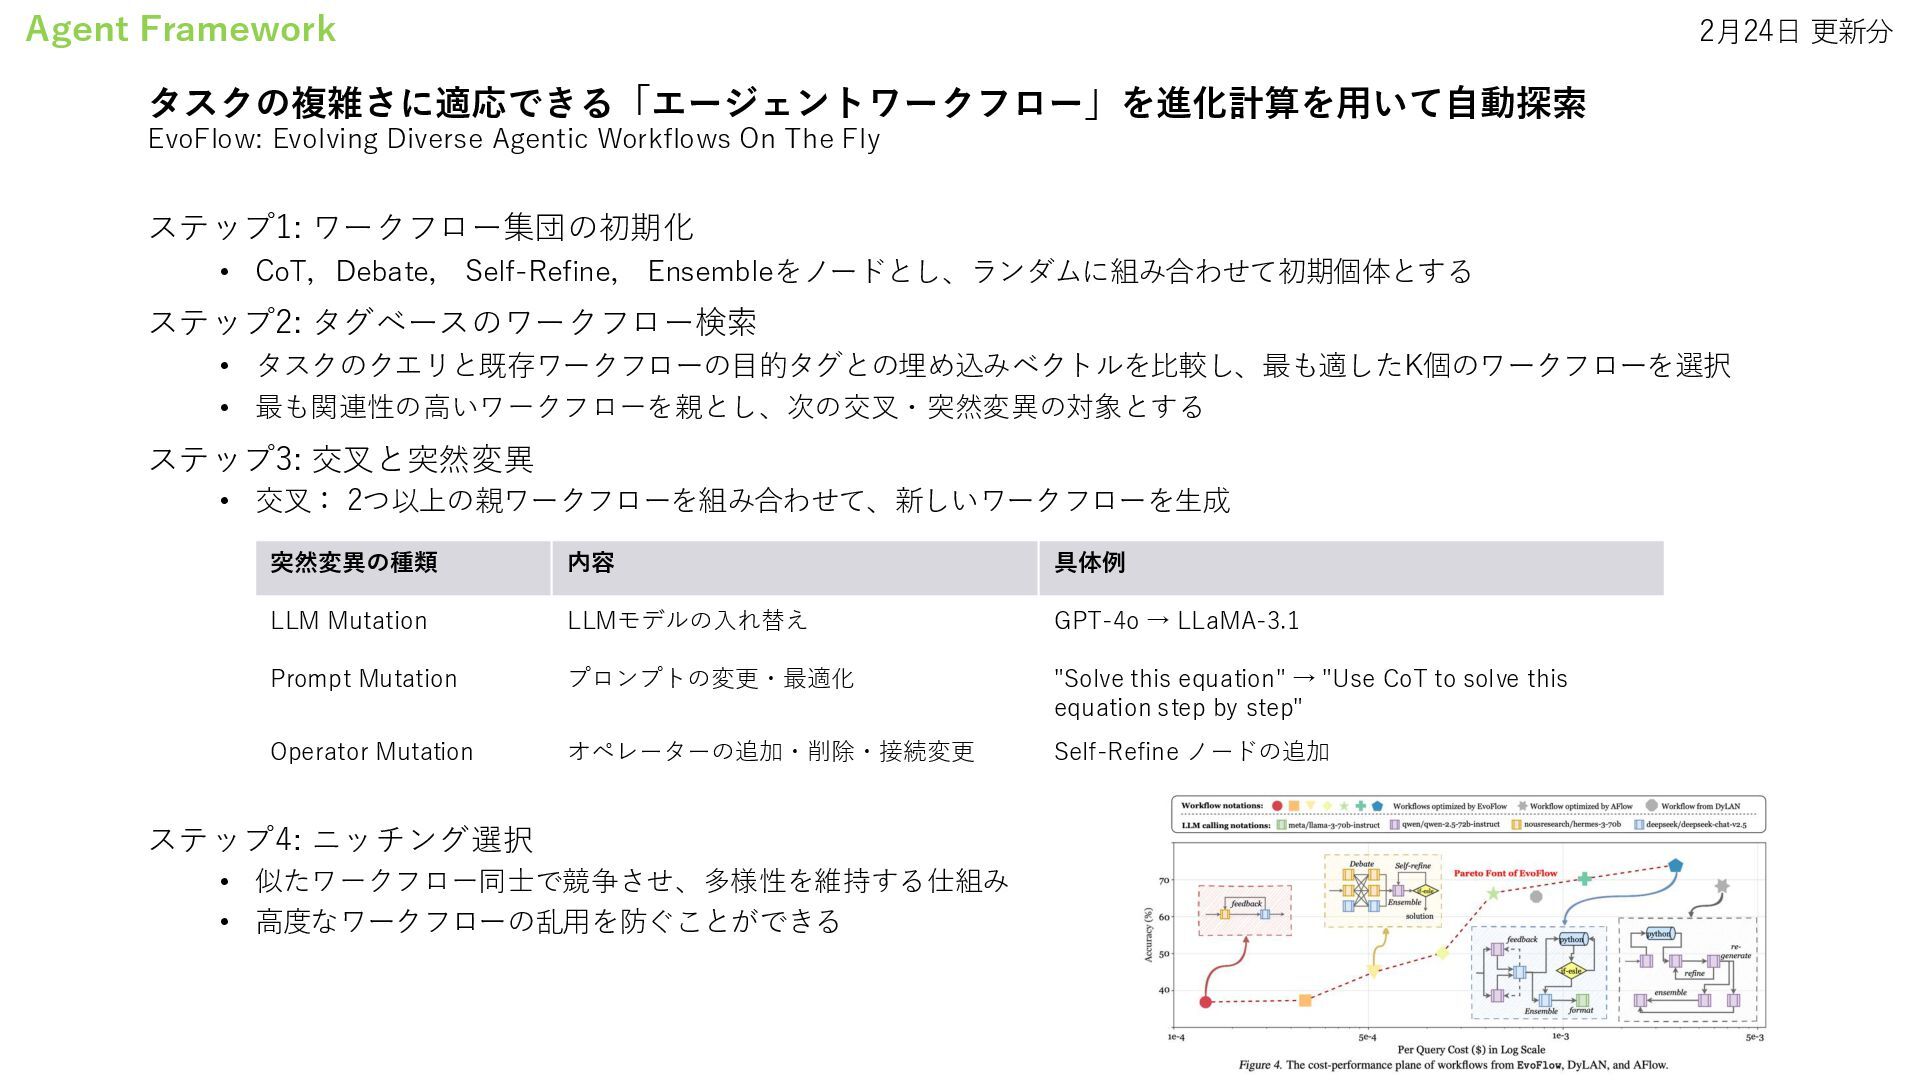
タスクの複雑さに適応できる「エージェントワークフロー」を進化計算を用いて自動探索 EvoFlow: Evolving Diverse Agentic Workflows On The Fly ステップ1:
ワークフロー集団の初期化 • CoT,Debate, Self-Refine, Ensembleをノードとし、ランダムに組み合わせて初期個体とする ステップ2: タグベースのワークフロー検索 • タスクのクエリと既存ワークフローの目的タグとの埋め込みベクトルを比較し、最も適したK個のワークフローを選択 • 最も関連性の高いワークフローを親とし、次の交叉・突然変異の対象とする ステップ3: 交叉と突然変異 • 交叉: 2つ以上の親ワークフローを組み合わせて、新しいワークフローを生成 ステップ4: ニッチング選択 • 似たワークフロー同士で競争させ、多様性を維持する仕組み • 高度なワークフローの乱用を防ぐことができる 2月24日 更新分 Agent Framework 突然変異の種類 内容 具体例 LLM Mutation LLMモデルの入れ替え GPT-4o → LLaMA-3.1 Prompt Mutation プロンプトの変更・最適化 "Solve this equation" → "Use CoT to solve this equation step by step" Operator Mutation オペレーターの追加・削除・接続変更 Self-Refine ノードの追加 -
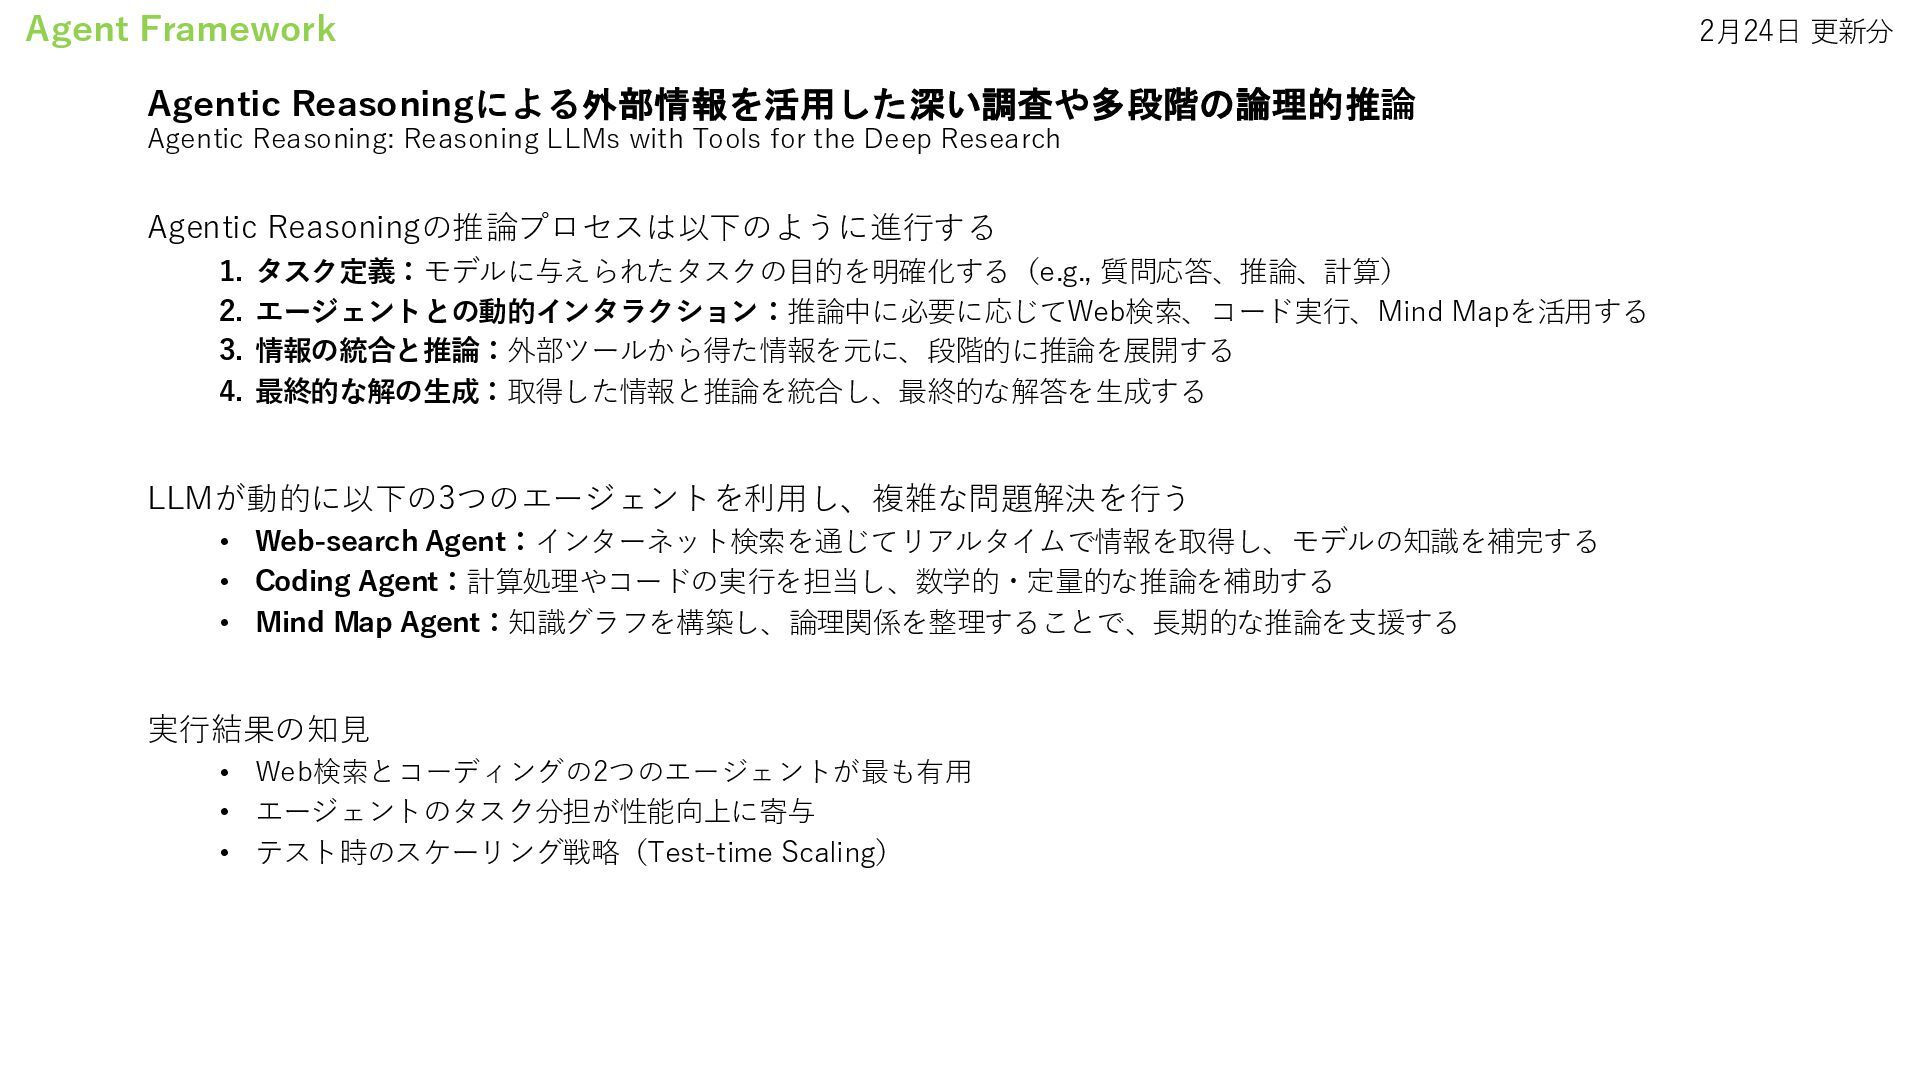
Agentic Reasoningによる外部情報を活用した深い調査や多段階の論理的推論 Agentic Reasoning: Reasoning LLMs with Tools for the
Deep Research Agentic Reasoningの推論プロセスは以下のように進行する 1. タスク定義:モデルに与えられたタスクの目的を明確化する(e.g., 質問応答、推論、計算) 2. エージェントとの動的インタラクション:推論中に必要に応じてWeb検索、コード実行、Mind Mapを活用する 3. 情報の統合と推論:外部ツールから得た情報を元に、段階的に推論を展開する 4. 最終的な解の生成:取得した情報と推論を統合し、最終的な解答を生成する LLMが動的に以下の3つのエージェントを利用し、複雑な問題解決を行う • Web-search Agent:インターネット検索を通じてリアルタイムで情報を取得し、モデルの知識を補完する • Coding Agent:計算処理やコードの実行を担当し、数学的・定量的な推論を補助する • Mind Map Agent:知識グラフを構築し、論理関係を整理することで、長期的な推論を支援する 実行結果の知見 • Web検索とコーディングの2つのエージェントが最も有用 • エージェントのタスク分担が性能向上に寄与 • テスト時のスケーリング戦略(Test-time Scaling) 2月24日 更新分 Agent Framework -
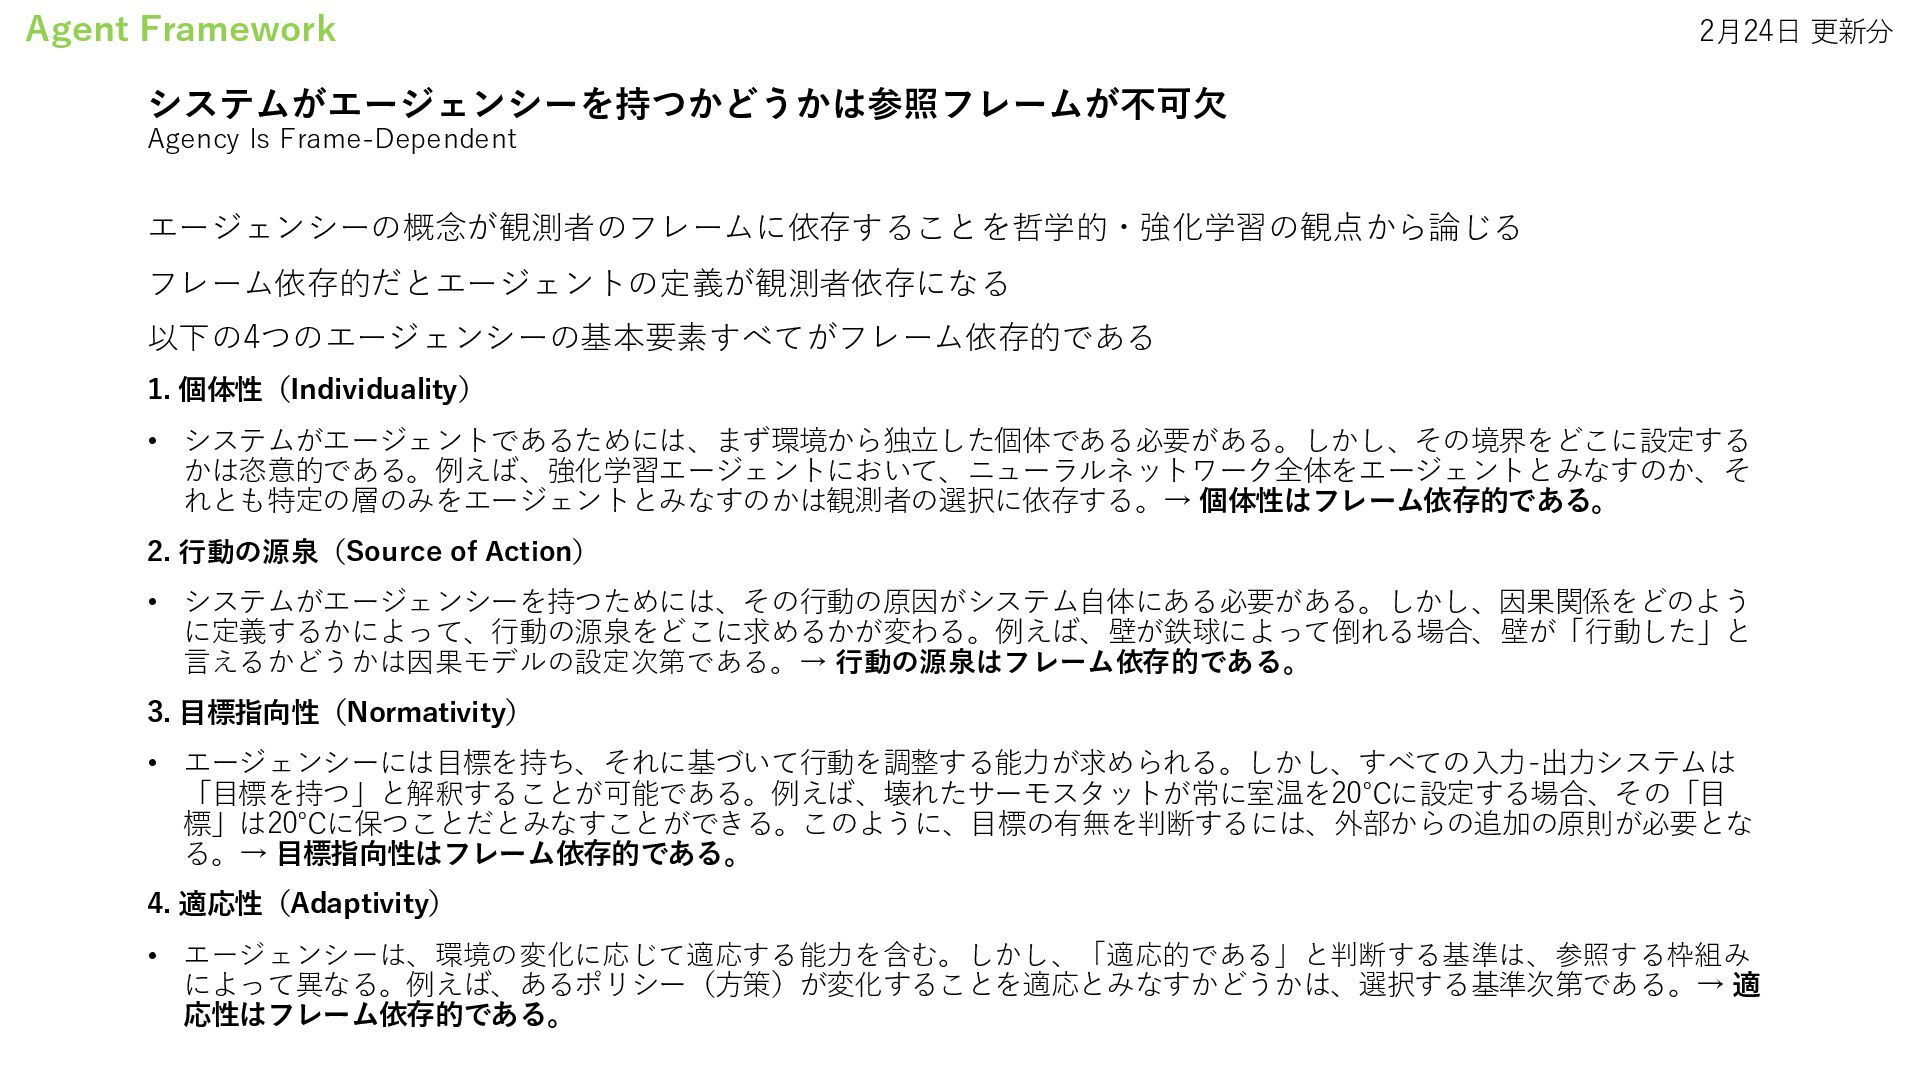
システムがエージェンシーを持つかどうかは参照フレームが不可欠 Agency Is Frame-Dependent エージェンシーの概念が観測者のフレームに依存することを哲学的・強化学習の観点から論じる フレーム依存的だとエージェントの定義が観測者依存になる 以下の4つのエージェンシーの基本要素すべてがフレーム依存的である 1. 個体性(Individuality) •
システムがエージェントであるためには、まず環境から独立した個体である必要がある。しかし、その境界をどこに設定する かは恣意的である。例えば、強化学習エージェントにおいて、ニューラルネットワーク全体をエージェントとみなすのか、そ れとも特定の層のみをエージェントとみなすのかは観測者の選択に依存する。→ 個体性はフレーム依存的である。 2. 行動の源泉(Source of Action) • システムがエージェンシーを持つためには、その行動の原因がシステム自体にある必要がある。しかし、因果関係をどのよう に定義するかによって、行動の源泉をどこに求めるかが変わる。例えば、壁が鉄球によって倒れる場合、壁が「行動した」と 言えるかどうかは因果モデルの設定次第である。→ 行動の源泉はフレーム依存的である。 3. 目標指向性(Normativity) • エージェンシーには目標を持ち、それに基づいて行動を調整する能力が求められる。しかし、すべての入力-出力システムは 「目標を持つ」と解釈することが可能である。例えば、壊れたサーモスタットが常に室温を20℃に設定する場合、その「目 標」は20℃に保つことだとみなすことができる。このように、目標の有無を判断するには、外部からの追加の原則が必要とな る。→ 目標指向性はフレーム依存的である。 4. 適応性(Adaptivity) • エージェンシーは、環境の変化に応じて適応する能力を含む。しかし、「適応的である」と判断する基準は、参照する枠組み によって異なる。例えば、あるポリシー(方策)が変化することを適応とみなすかどうかは、選択する基準次第である。→ 適 応性はフレーム依存的である。 2月24日 更新分 Agent Framework -
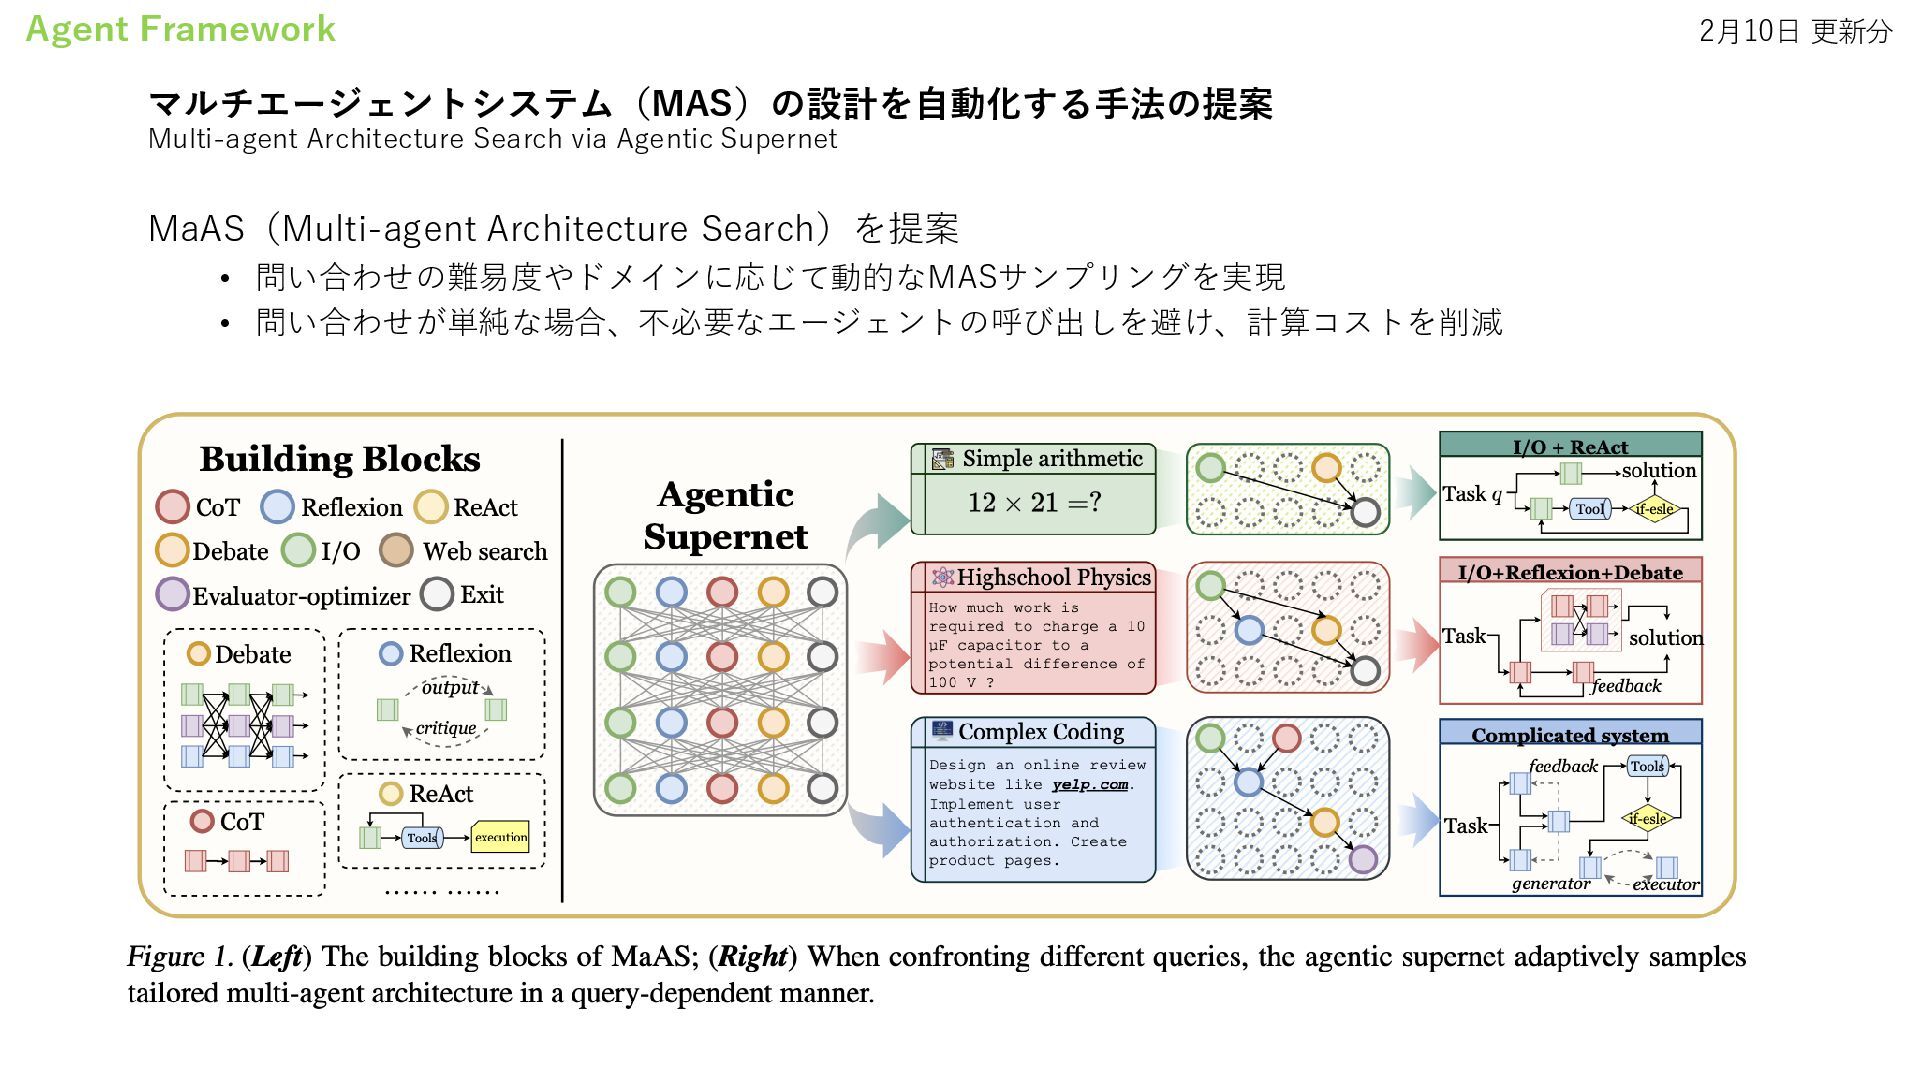
マルチエージェントシステム(MAS)の設計を自動化する手法の提案 Multi-agent Architecture Search via Agentic Supernet MaAS(Multi-agent Architecture Search)を提案
• 問い合わせの難易度やドメインに応じて動的なMASサンプリングを実現 • 問い合わせが単純な場合、不必要なエージェントの呼び出しを避け、計算コストを削減 2月10日 更新分 Agent Framework -
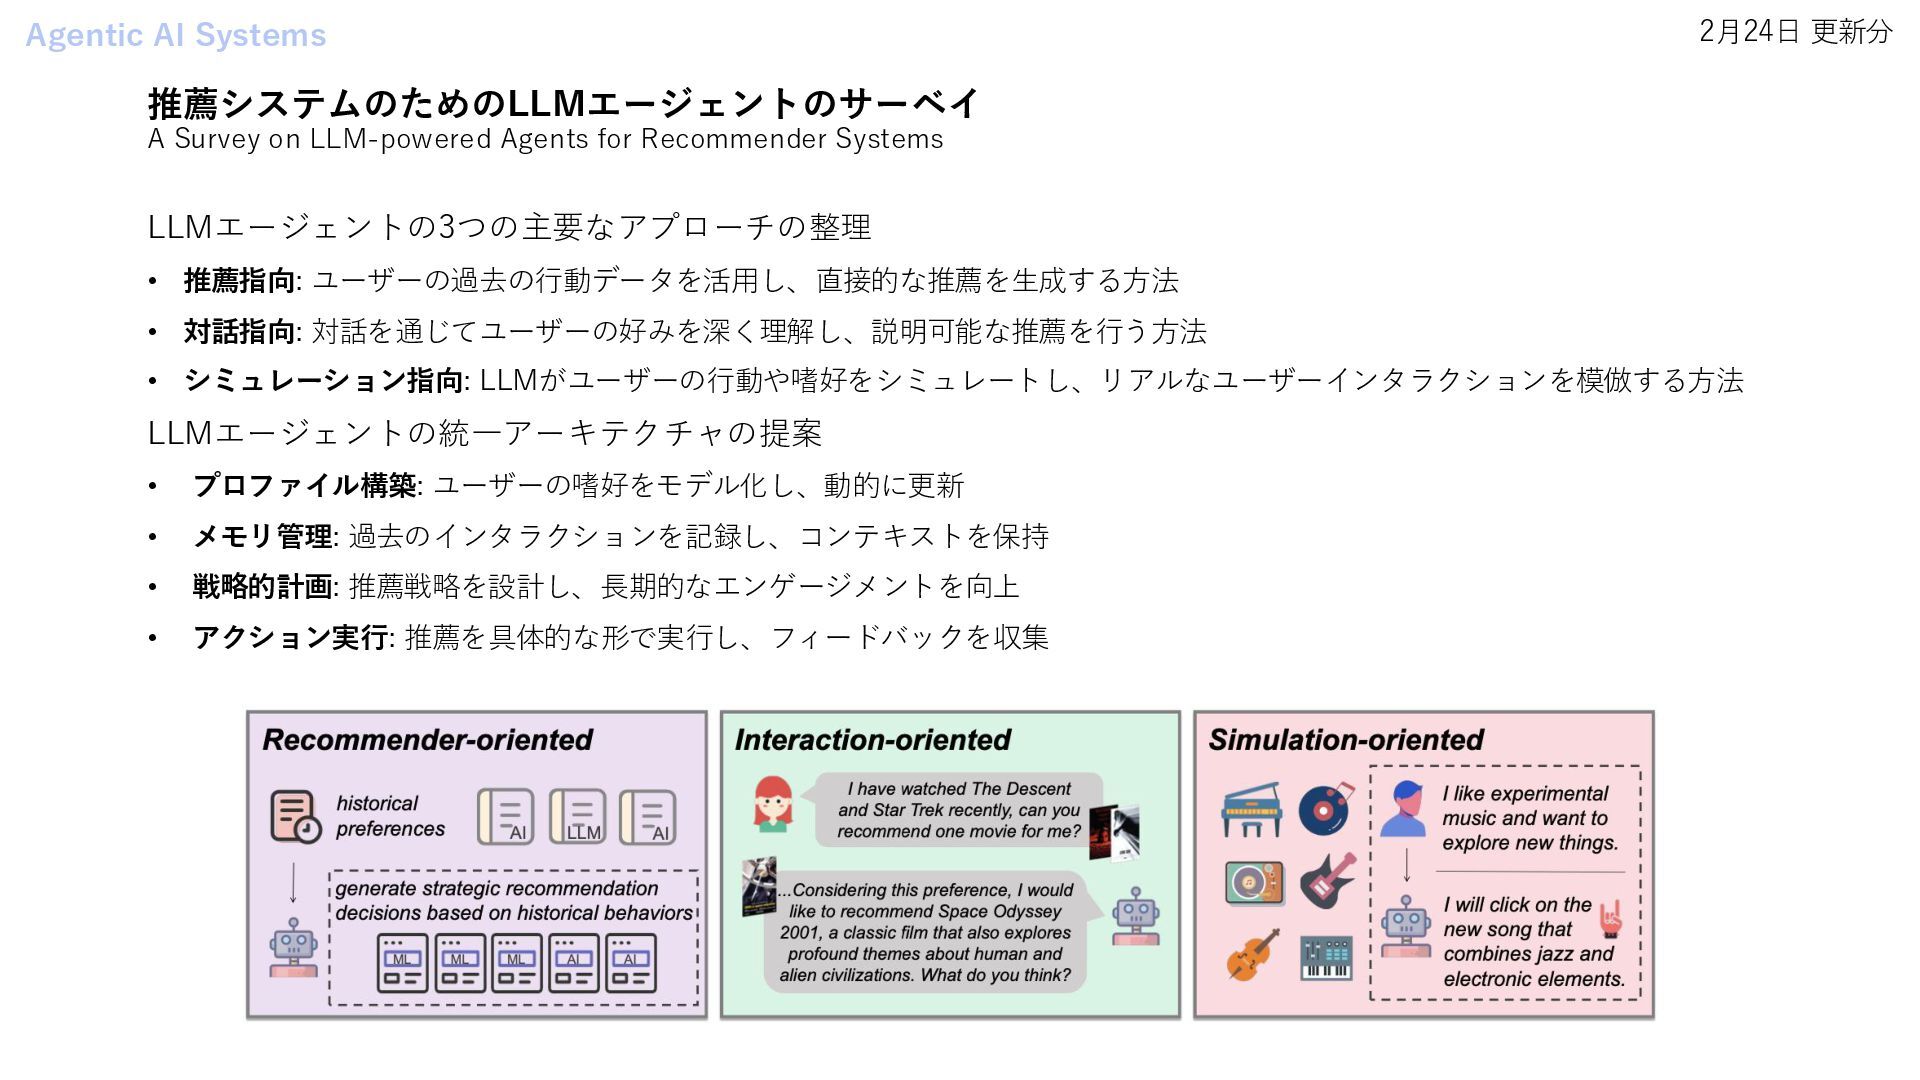
推薦システムのためのLLMエージェントのサーベイ A Survey on LLM-powered Agents for Recommender Systems LLMエージェントの3つの主要なアプローチの整理
• 推薦指向: ユーザーの過去の行動データを活用し、直接的な推薦を生成する方法 • 対話指向: 対話を通じてユーザーの好みを深く理解し、説明可能な推薦を行う方法 • シミュレーション指向: LLMがユーザーの行動や嗜好をシミュレートし、リアルなユーザーインタラクションを模倣する方法 LLMエージェントの統一アーキテクチャの提案 • プロファイル構築: ユーザーの嗜好をモデル化し、動的に更新 • メモリ管理: 過去のインタラクションを記録し、コンテキストを保持 • 戦略的計画: 推薦戦略を設計し、長期的なエンゲージメントを向上 • アクション実行: 推薦を具体的な形で実行し、フィードバックを収集 2月24日 更新分 Agentic AI Systems -
研究者の仮説生成を支援するマルチエージェントシステム Towards an AI co-scientist 以下の順番で処理する 仮説を広げて、質を高めて、絞り込んで、更に尖らせて、似たものを統合して、最終版を作る ① 生成エージェント •
文献探索(Web検索)を行い、既存研究を要約・統合して新たな仮説を提案 • 「科学的議論のシミュレーション」を通じて、仮説の洗練を行う ② リフレクションエージェント • 生成された仮説の質を評価 • 外部データベースやWeb検索を活用し、仮説が既存研究と矛盾しないか検証 ③ ランキングエージェント • 仮説をEloレーティングでスコアリングし、ランキング付け • トーナメント形式で仮説同士を比較し、勝ち残った仮説を上位にランクイン ④ 進化エージェント • ランキング上位の仮説を改善 • 既存の仮説を改良し、新たな仮説を生み出す ⑤ 近接エージェント • 既存の仮説と類似するアイデアをクラスタリング • 類似仮説を統合し、研究の重複を防ぐ ⑥ メタレビューエージェント • 過去の議論やフィードバックを統合 • 反映エージェントや進化エージェントが見逃した点を補完 2月24日 更新分 Research Agents -
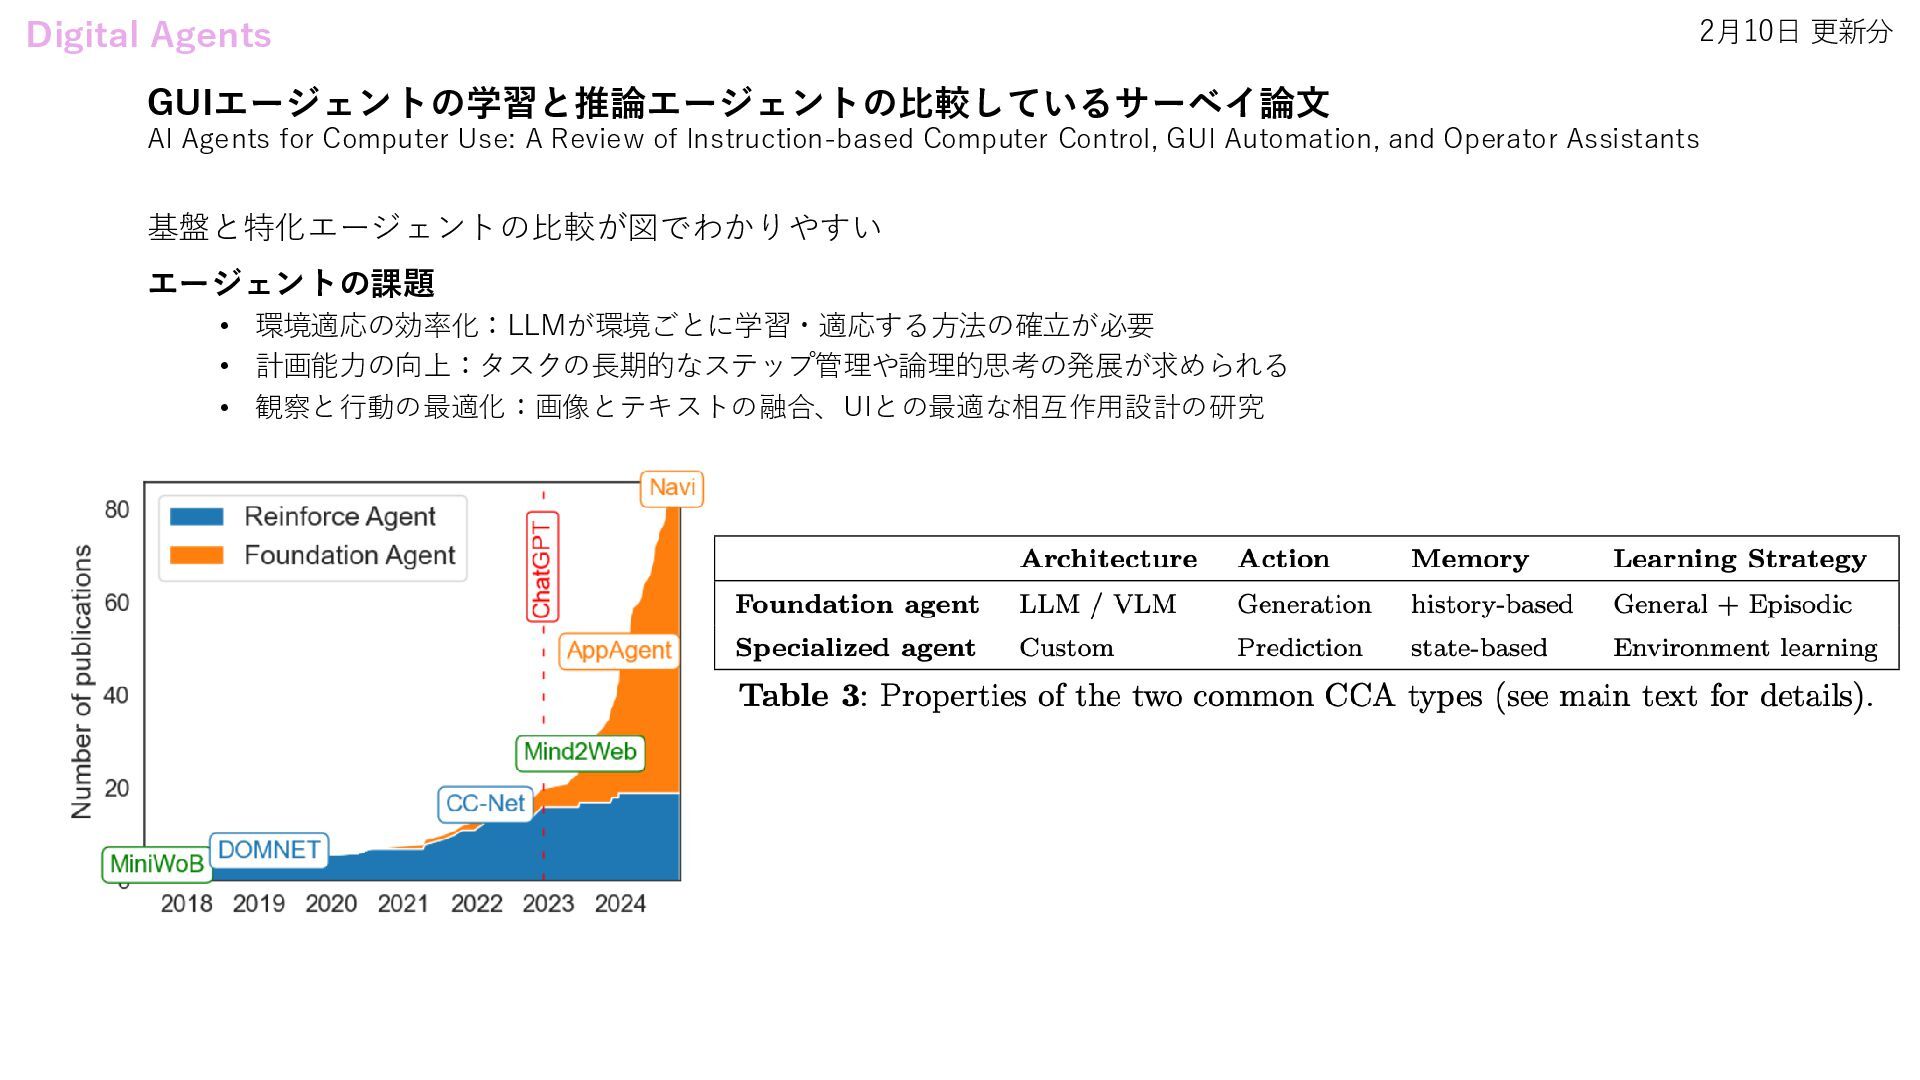
GUIエージェントの学習と推論エージェントの比較しているサーベイ論文 AI Agents for Computer Use: A Review of Instruction-based
Computer Control, GUI Automation, and Operator Assistants 基盤と特化エージェントの比較が図でわかりやすい エージェントの課題 • 環境適応の効率化:LLMが環境ごとに学習・適応する方法の確立が必要 • 計画能力の向上:タスクの長期的なステップ管理や論理的思考の発展が求められる • 観察と行動の最適化:画像とテキストの融合、UIとの最適な相互作用設計の研究 2月10日 更新分 Digital Agents -
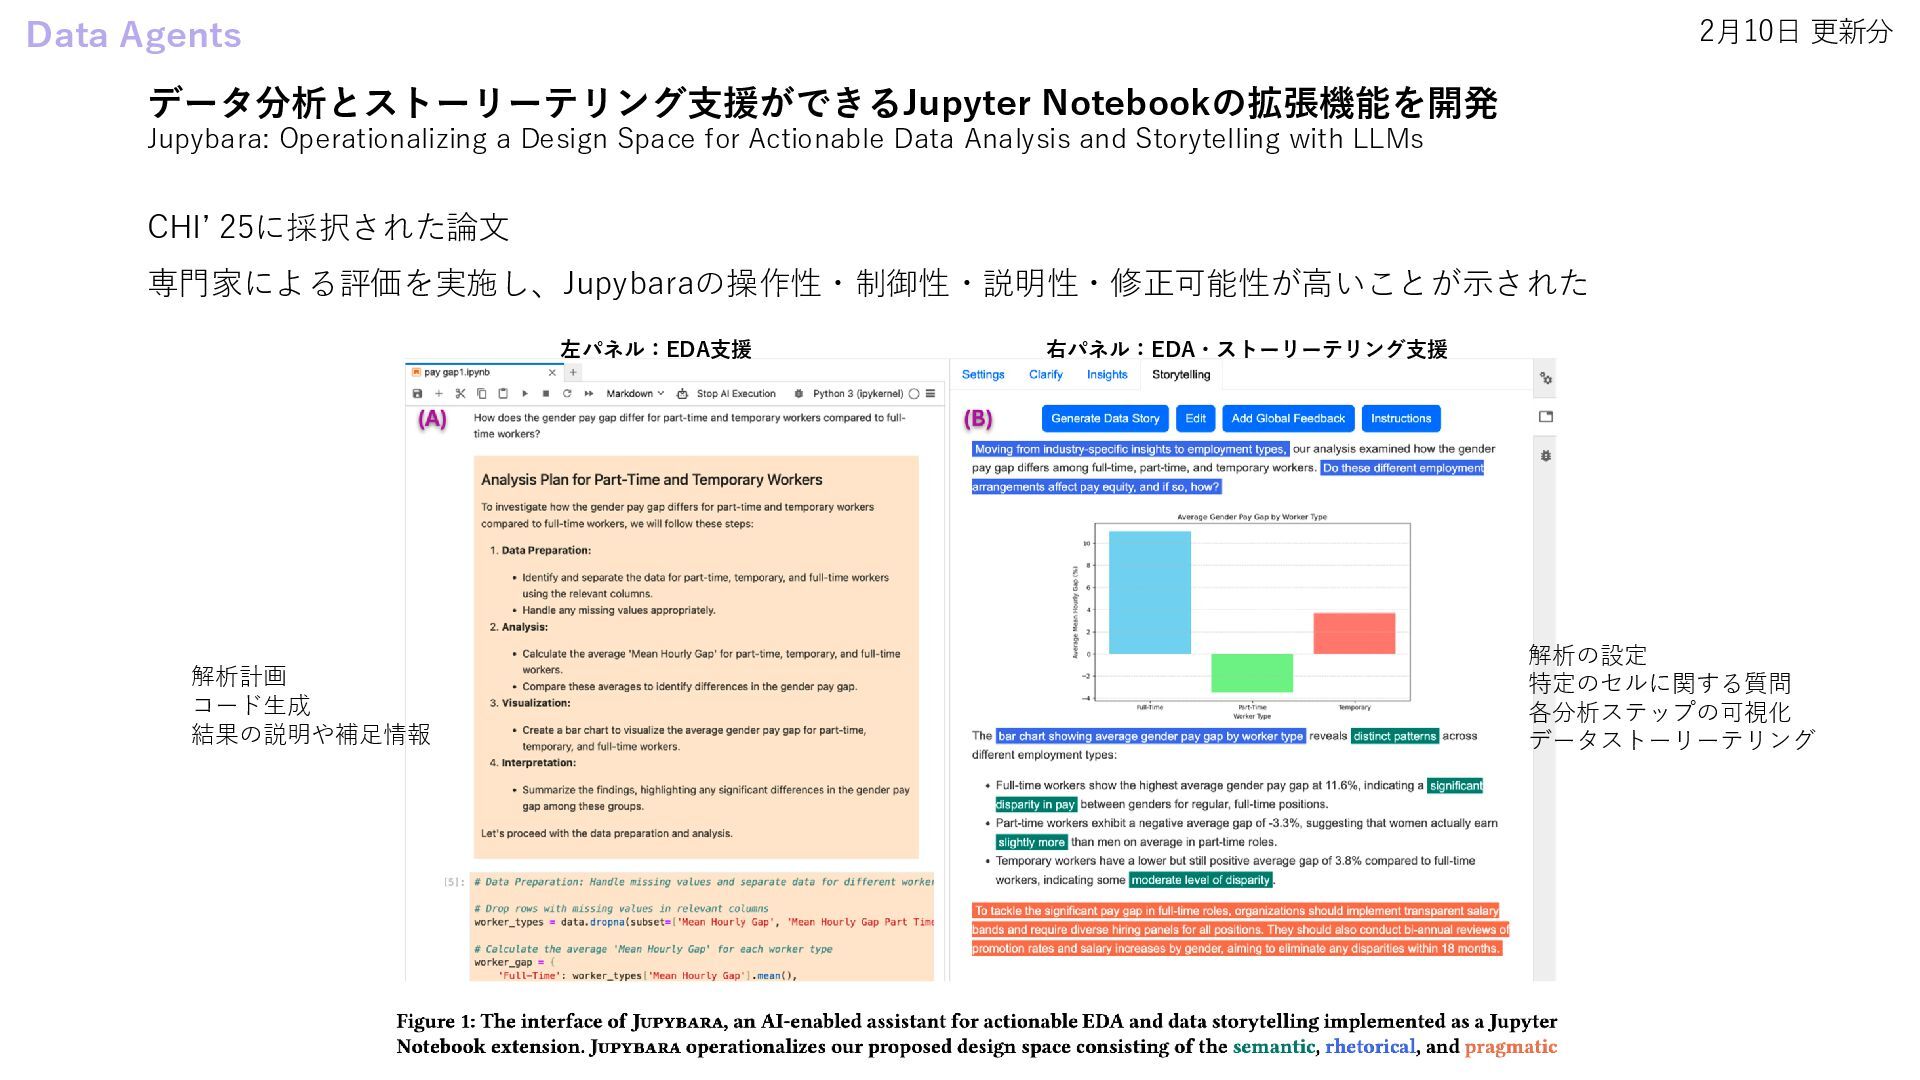
データ分析とストーリーテリング支援ができるJupyter Notebookの拡張機能を開発 Jupybara: Operationalizing a Design Space for Actionable Data
Analysis and Storytelling with LLMs CHI’ 25に採択された論文 専門家による評価を実施し、Jupybaraの操作性・制御性・説明性・修正可能性が高いことが示された 左パネル:EDA支援 右パネル:EDA・ストーリーテリング支援 解析計画 コード生成 結果の説明や補足情報 解析の設定 特定のセルに関する質問 各分析ステップの可視化 データストーリーテリング 2月10日 更新分 Data Agents -
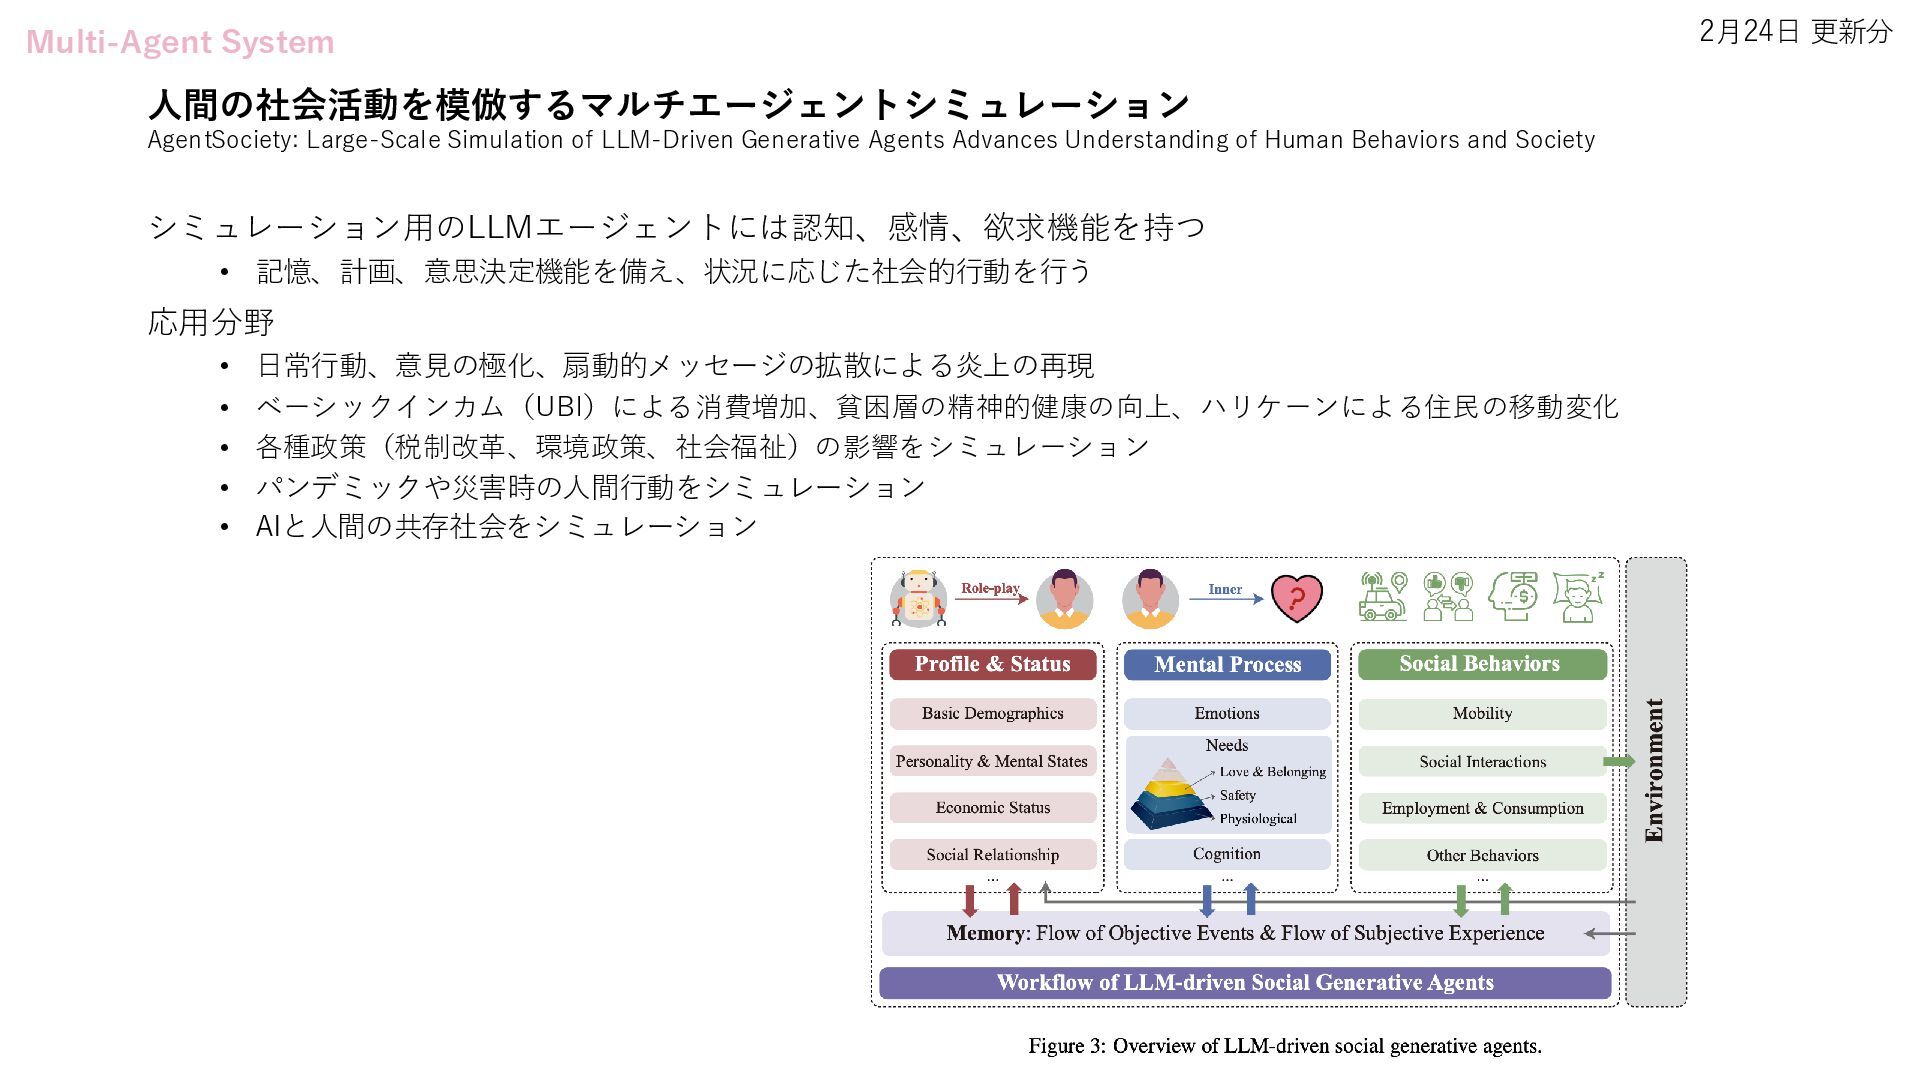
人間の社会活動を模倣するマルチエージェントシミュレーション AgentSociety: Large-Scale Simulation of LLM-Driven Generative Agents Advances Understanding
of Human Behaviors and Society シミュレーション用のLLMエージェントには認知、感情、欲求機能を持つ • 記憶、計画、意思決定機能を備え、状況に応じた社会的行動を行う 応用分野 • 日常行動、意見の極化、扇動的メッセージの拡散による炎上の再現 • ベーシックインカム(UBI)による消費増加、貧困層の精神的健康の向上、ハリケーンによる住民の移動変化 • 各種政策(税制改革、環境政策、社会福祉)の影響をシミュレーション • パンデミックや災害時の人間行動をシミュレーション • AIと人間の共存社会をシミュレーション 2月24日 更新分 Multi-Agent System -
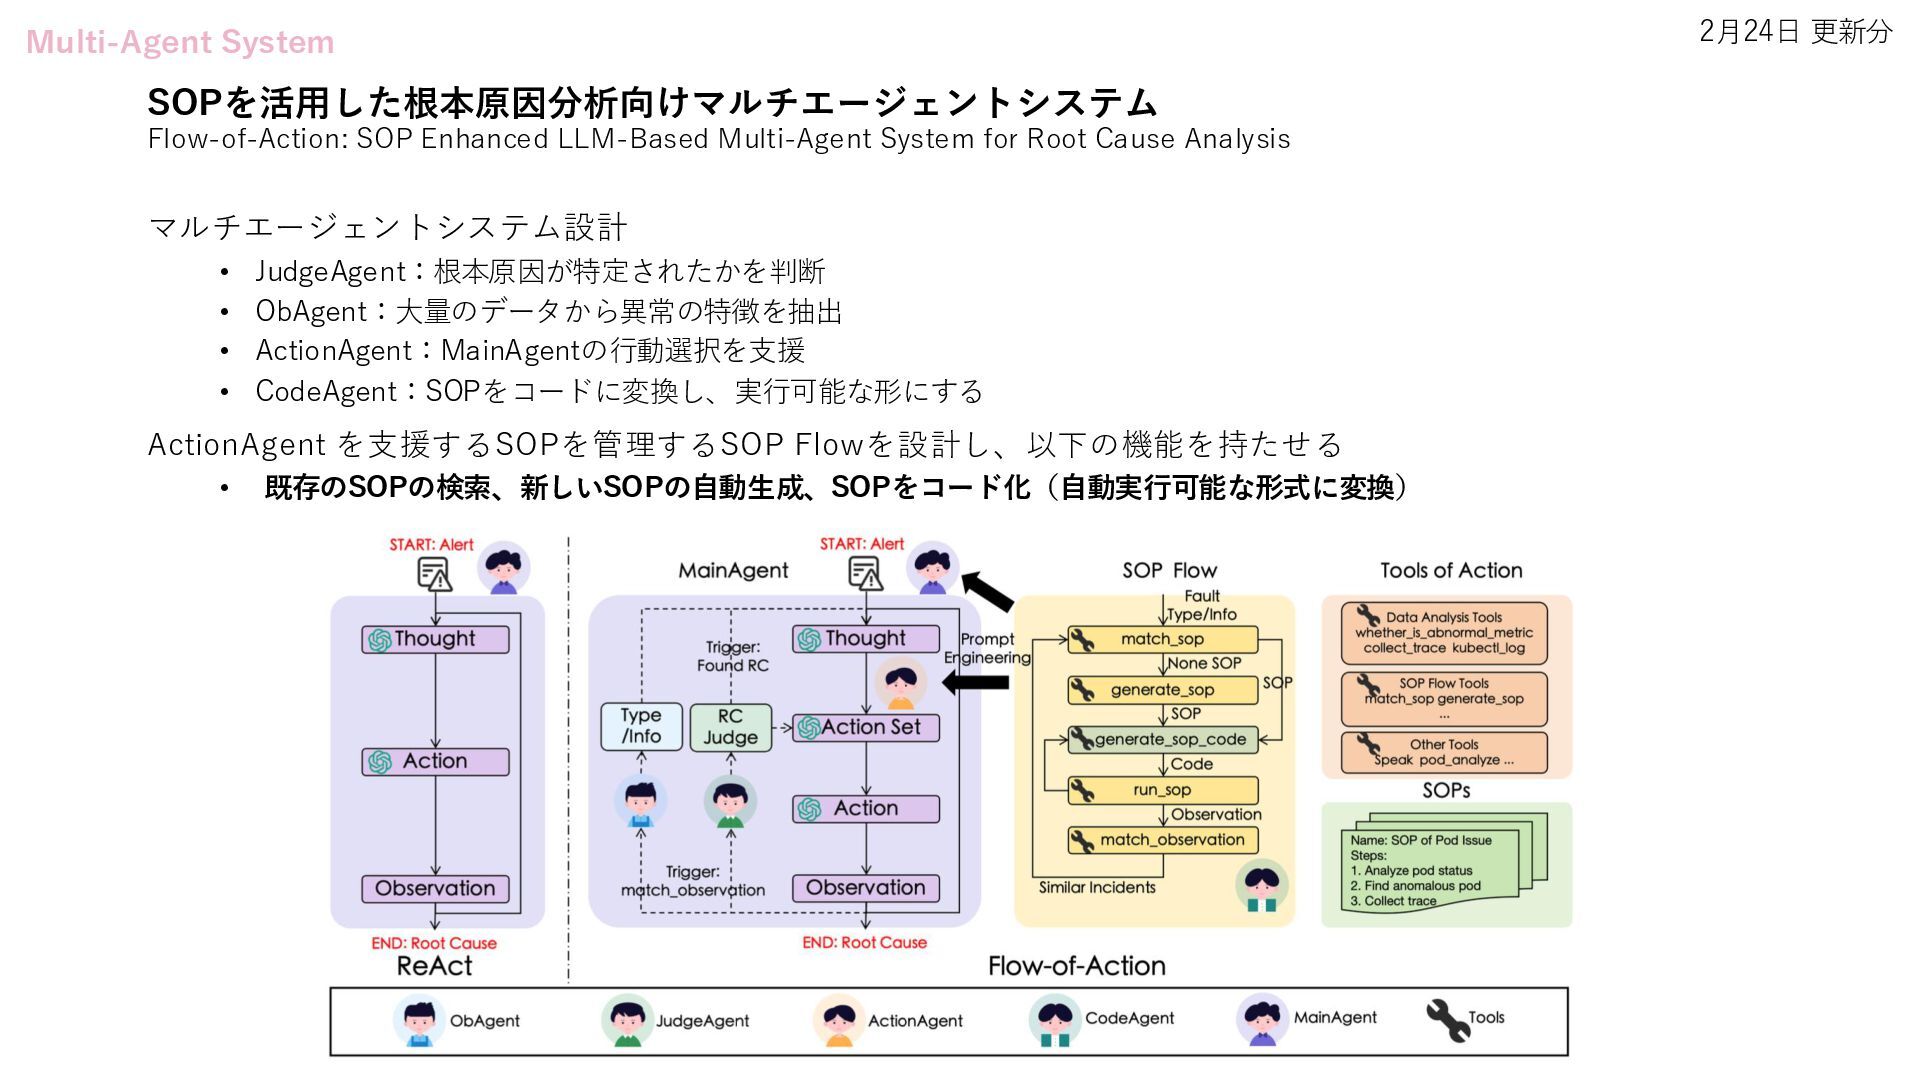
SOPを活用した根本原因分析向けマルチエージェントシステム Flow-of-Action: SOP Enhanced LLM-Based Multi-Agent System for Root Cause
Analysis マルチエージェントシステム設計 • JudgeAgent:根本原因が特定されたかを判断 • ObAgent:大量のデータから異常の特徴を抽出 • ActionAgent:MainAgentの行動選択を支援 • CodeAgent:SOPをコードに変換し、実行可能な形にする ActionAgent を支援するSOPを管理するSOP Flowを設計し、以下の機能を持たせる • 既存のSOPの検索、新しいSOPの自動生成、SOPをコード化(自動実行可能な形式に変換) 2月24日 更新分 Multi-Agent System -
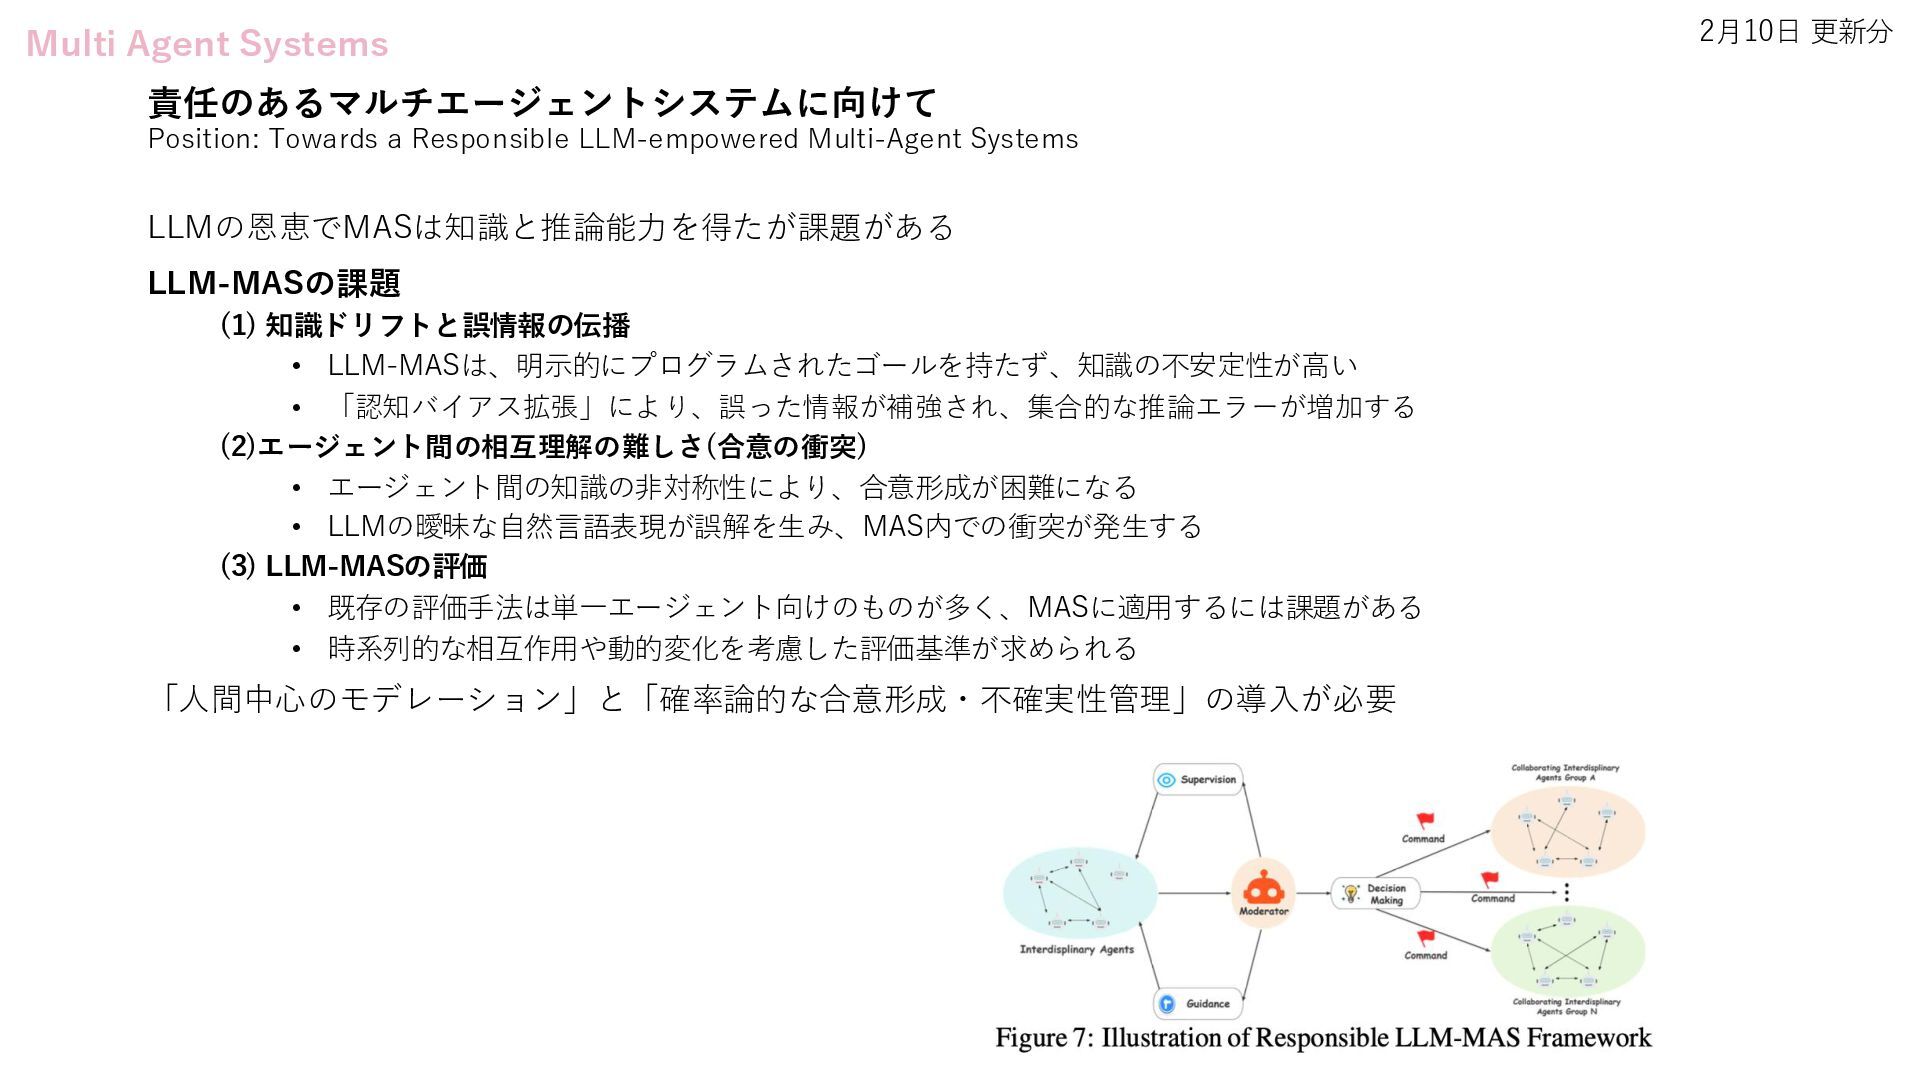
責任のあるマルチエージェントシステムに向けて Position: Towards a Responsible LLM-empowered Multi-Agent Systems LLMの恩恵でMASは知識と推論能力を得たが課題がある LLM-MASの課題
(1) 知識ドリフトと誤情報の伝播 • LLM-MASは、明示的にプログラムされたゴールを持たず、知識の不安定性が高い • 「認知バイアス拡張」により、誤った情報が補強され、集合的な推論エラーが増加する (2)エージェント間の相互理解の難しさ(合意の衝突) • エージェント間の知識の非対称性により、合意形成が困難になる • LLMの曖昧な自然言語表現が誤解を生み、MAS内での衝突が発生する (3) LLM-MASの評価 • 既存の評価手法は単一エージェント向けのものが多く、MASに適用するには課題がある • 時系列的な相互作用や動的変化を考慮した評価基準が求められる 「人間中心のモデレーション」と「確率論的な合意形成・不確実性管理」の導入が必要 2月10日 更新分 Multi Agent Systems -
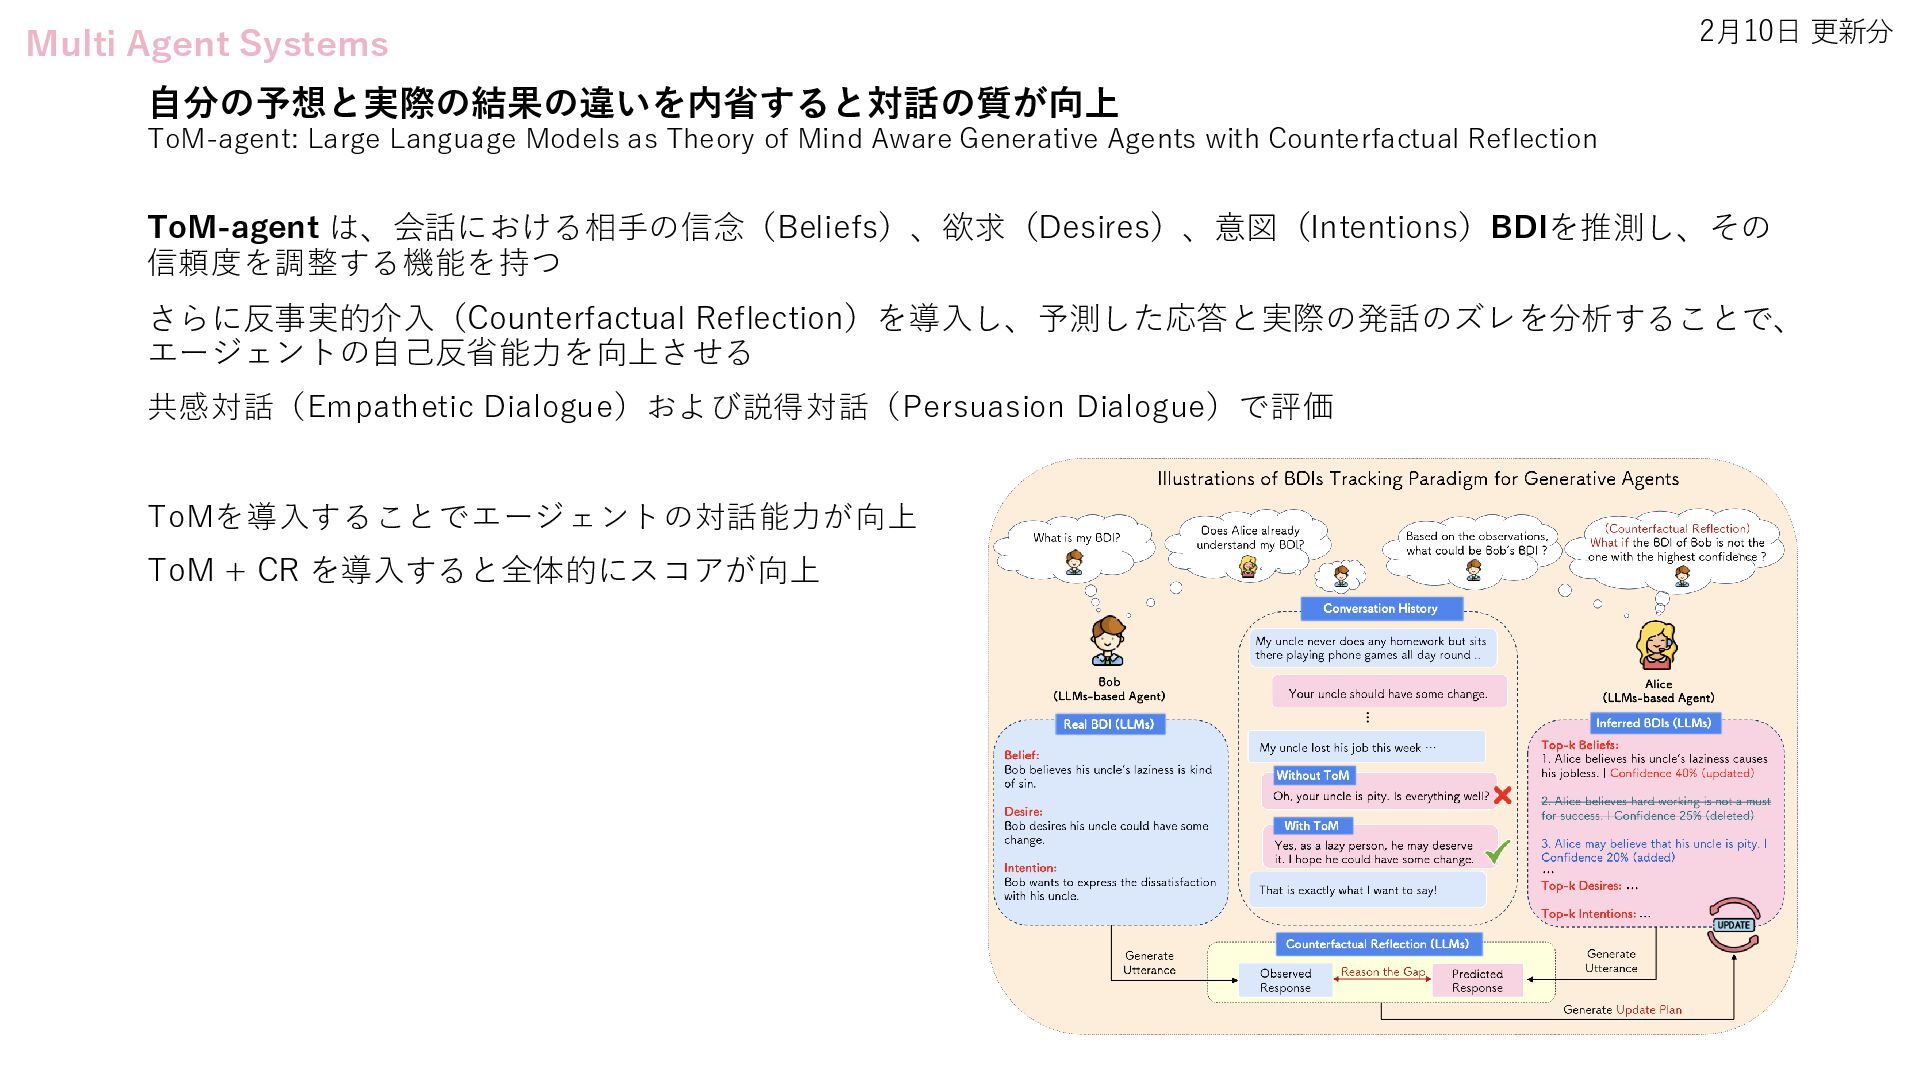
自分の予想と実際の結果の違いを内省すると対話の質が向上 ToM-agent: Large Language Models as Theory of Mind Aware
Generative Agents with Counterfactual Reflection ToM-agent は、会話における相手の信念(Beliefs)、欲求(Desires)、意図(Intentions)BDIを推測し、その 信頼度を調整する機能を持つ さらに反事実的介入(Counterfactual Reflection)を導入し、予測した応答と実際の発話のズレを分析することで、 エージェントの自己反省能力を向上させる 共感対話(Empathetic Dialogue)および説得対話(Persuasion Dialogue)で評価 ToMを導入することでエージェントの対話能力が向上 ToM + CR を導入すると全体的にスコアが向上 2月10日 更新分 Multi Agent Systems -
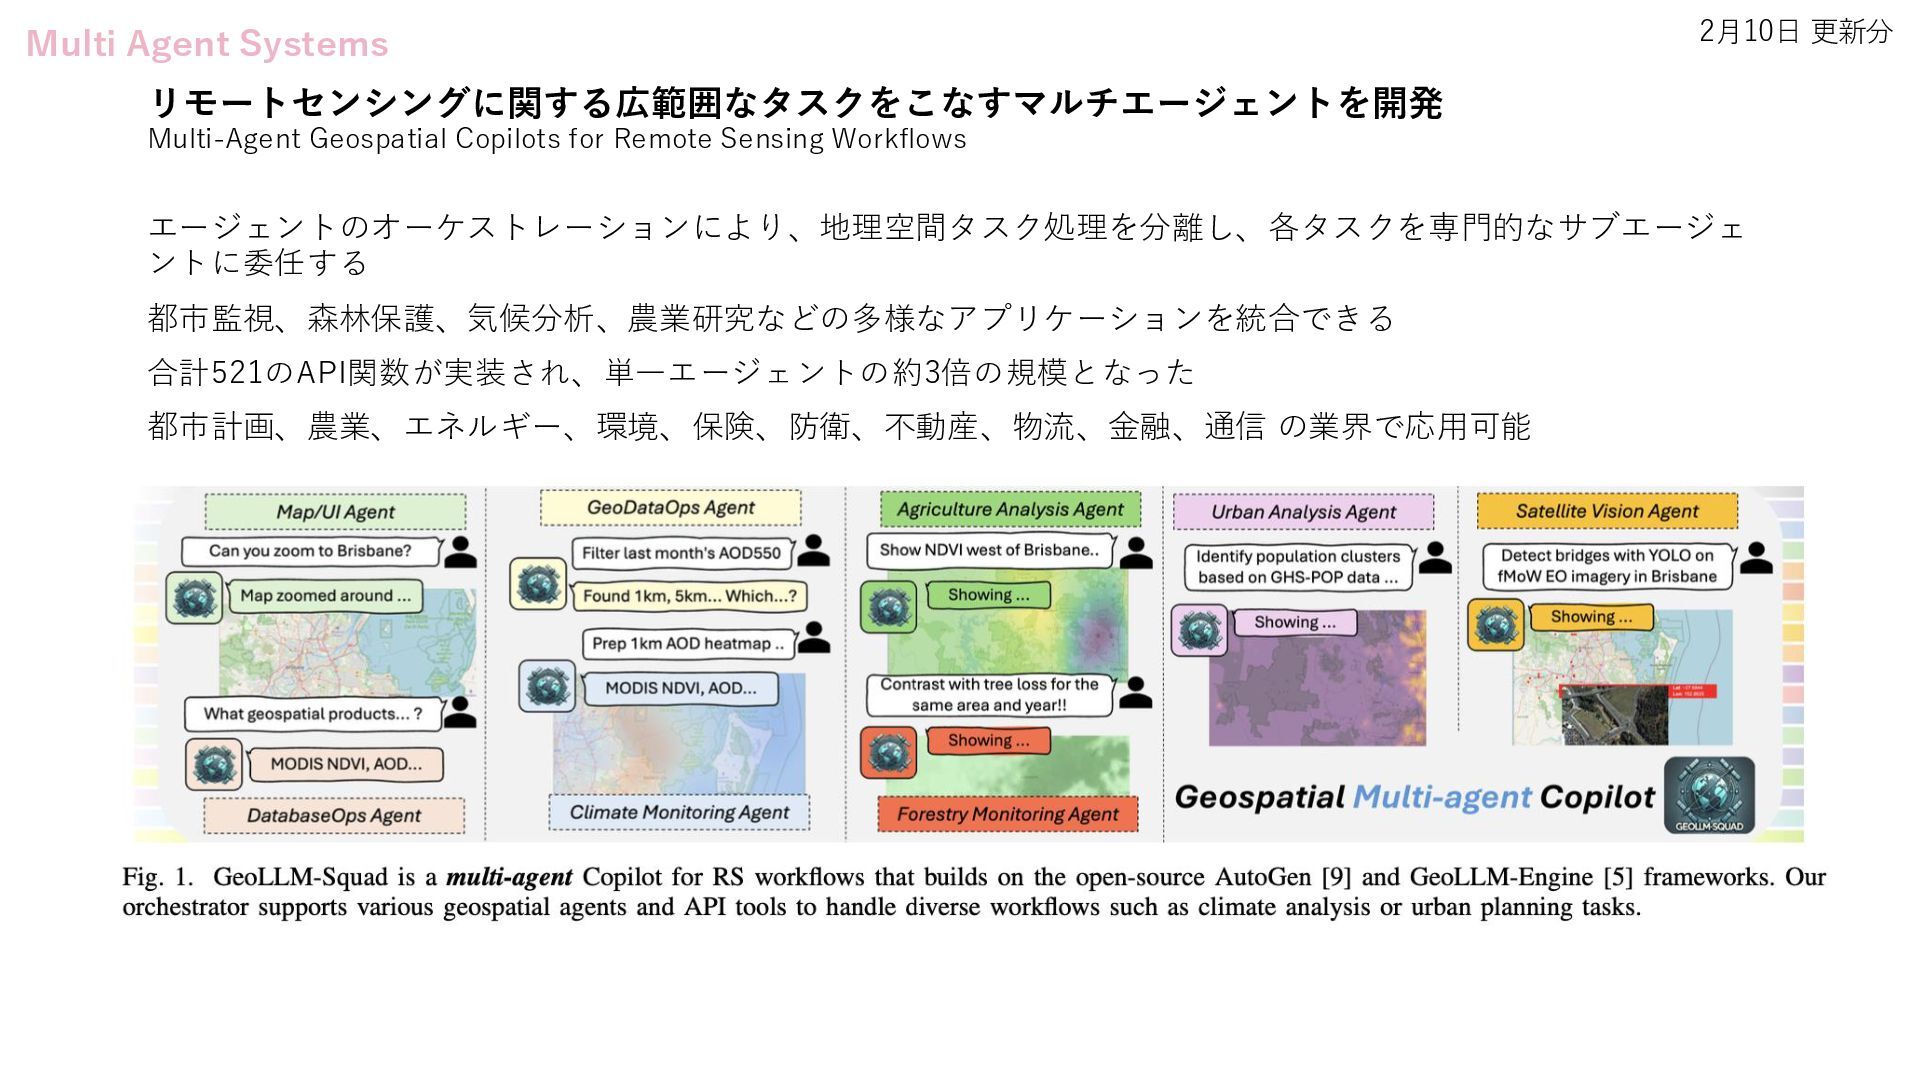
リモートセンシングに関する広範囲なタスクをこなすマルチエージェントを開発 Multi-Agent Geospatial Copilots for Remote Sensing Workflows エージェントのオーケストレーションにより、地理空間タスク処理を分離し、各タスクを専門的なサブエージェ ントに委任する
都市監視、森林保護、気候分析、農業研究などの多様なアプリケーションを統合できる 合計521のAPI関数が実装され、単一エージェントの約3倍の規模となった 都市計画、農業、エネルギー、環境、保険、防衛、不動産、物流、金融、通信 の業界で応用可能 2月10日 更新分 Multi Agent Systems -
ニュース • AIエージェント実用化は“限界の把握”から 2025年はユースケースを血眼で探す年 • デロイト トーマツ、企業内の暗黙知をデータ化する「AIインタビューエージェント」を開発 • 従業員エクスペリエンス向上をサポートするAIエージェントを発表 従業員の生産性を最適化—オラクル
• 10 Lessons to Get Started Building AI Agents • Google Cloud 主催 AI Agent Summit ’25 Spring • 2025年 生成AIの新たな波「AI エージェント」の可能性(オラクル) -
AIエージェント実用化は“限界の把握”から 2025年はユースケースを血眼で探す年 • 2024年後半からAIエージェントの認知が進み、第2回ブームが到来 • 生成AIの進化、RAGの限界、海外の影響がエージェントの発展を後押し • AIエージェントは複数ステップの業務に適用可能で、業務効率化や専門人材の代替が期待される • 知性と自律性を軸に分類され、現在の主流は自律性の低い業務支援型
• 2025年はユースケース探索が重要だが、誇大広告や技術未熟性に注意が必要 • 導入には既存ツール活用、エージェントビルダー利用、フルスクラッチ開発の3つの選択肢がある https://ascii.jp/elem/000/004/251/4251720/ -
デロイト トーマツ、企業内の暗黙知をデータ化する「AIインタビューエージェント」を開発 AIインタビューエージェントによる自然な音声対話から、データの構造化、データ検索までの一連のプロセスを 複数のAI技術を用いてプログラム化 設定されたシナリオに沿ってAIが音声でインタビューを行い、聞き出した情報を構造的に整理するもの • 人材スキル・実績の把握:社員に対して定期的にAIからインタビューを行うことで保有するスキルや経験した 業務をデータ化し、適切な人材検索やアサインを可能とする • 営業ノウハウの共有:優秀な営業社員のテクニックや姿勢等のノウハウを引き出し、ミドルレベルの社員のス
キルを向上させる • ベテランエンジニアの技能伝承:ベテランエンジニアの長年の経験やそれを通じて培った暗黙知を形式知化し、 若手エンジニアに伝承することで、後継者を育成する • 医療診断支援:専門医の診断プロセスや治療方法の選択ノウハウを形式知化し、他の医師の診断スキルを向上 させる https://www2.deloitte.com/jp/ja/pages/about-deloitte/articles/news-releases/nr20250213.html -
従業員エクスペリエンス向上をサポートするAIエージェントを発表 従業員の生産性を最適化 オラクル オラクルは「Oracle Fusion Cloud Human Capital Management(Oracle Cloud
HCM)」に、新たなロール・ベースの AIエージェントを導入すると発表した。 このAIエージェントは、従業員のキャリアサポートや管理業務の自動化を通じて、従業員エクスペリエンス(EX)と生産 性の向上を支援する。 AIエージェントの主な機能 1. キャリアおよび能力開発 • 従業員プロファイルをもとにキャリア目標を提案し、スキル開発プログラムを案内 • 目標設定のサポートやパフォーマンス評価の準備を支援 • 過去の学習履歴やキャリア目標に基づき、適切なトレーニング機会を推薦 2. 報酬および福利厚生管理 • 勤務時間の記録を自動化し、正確なタイムカード提出を支援 • 税務申告(例:米国のW-4フォーム)をサポート • 昇給や新規採用時の報酬決定に関する市場動向や企業方針を提供 • 休暇・欠勤ポリシーの理解を支援し、申請プロセスを簡素化 3. 従業員ライフサイクル管理 • 企業文化やポリシーに関する情報提供を通じて、新入社員のスムーズな適応を支援 • 社内異動やキャリアアップに向けた履歴書作成、面接対策を支援 • 利用可能な福利厚生や受賞資格のある表彰プログラムを従業員・マネージャーに通知 • プロファイルの更新や昇進・異動などのライフサイクルイベントの管理を支援 • 雇用契約の内容をレビューし、条項を要約 https://hrzine.jp/article/detail/6422 -
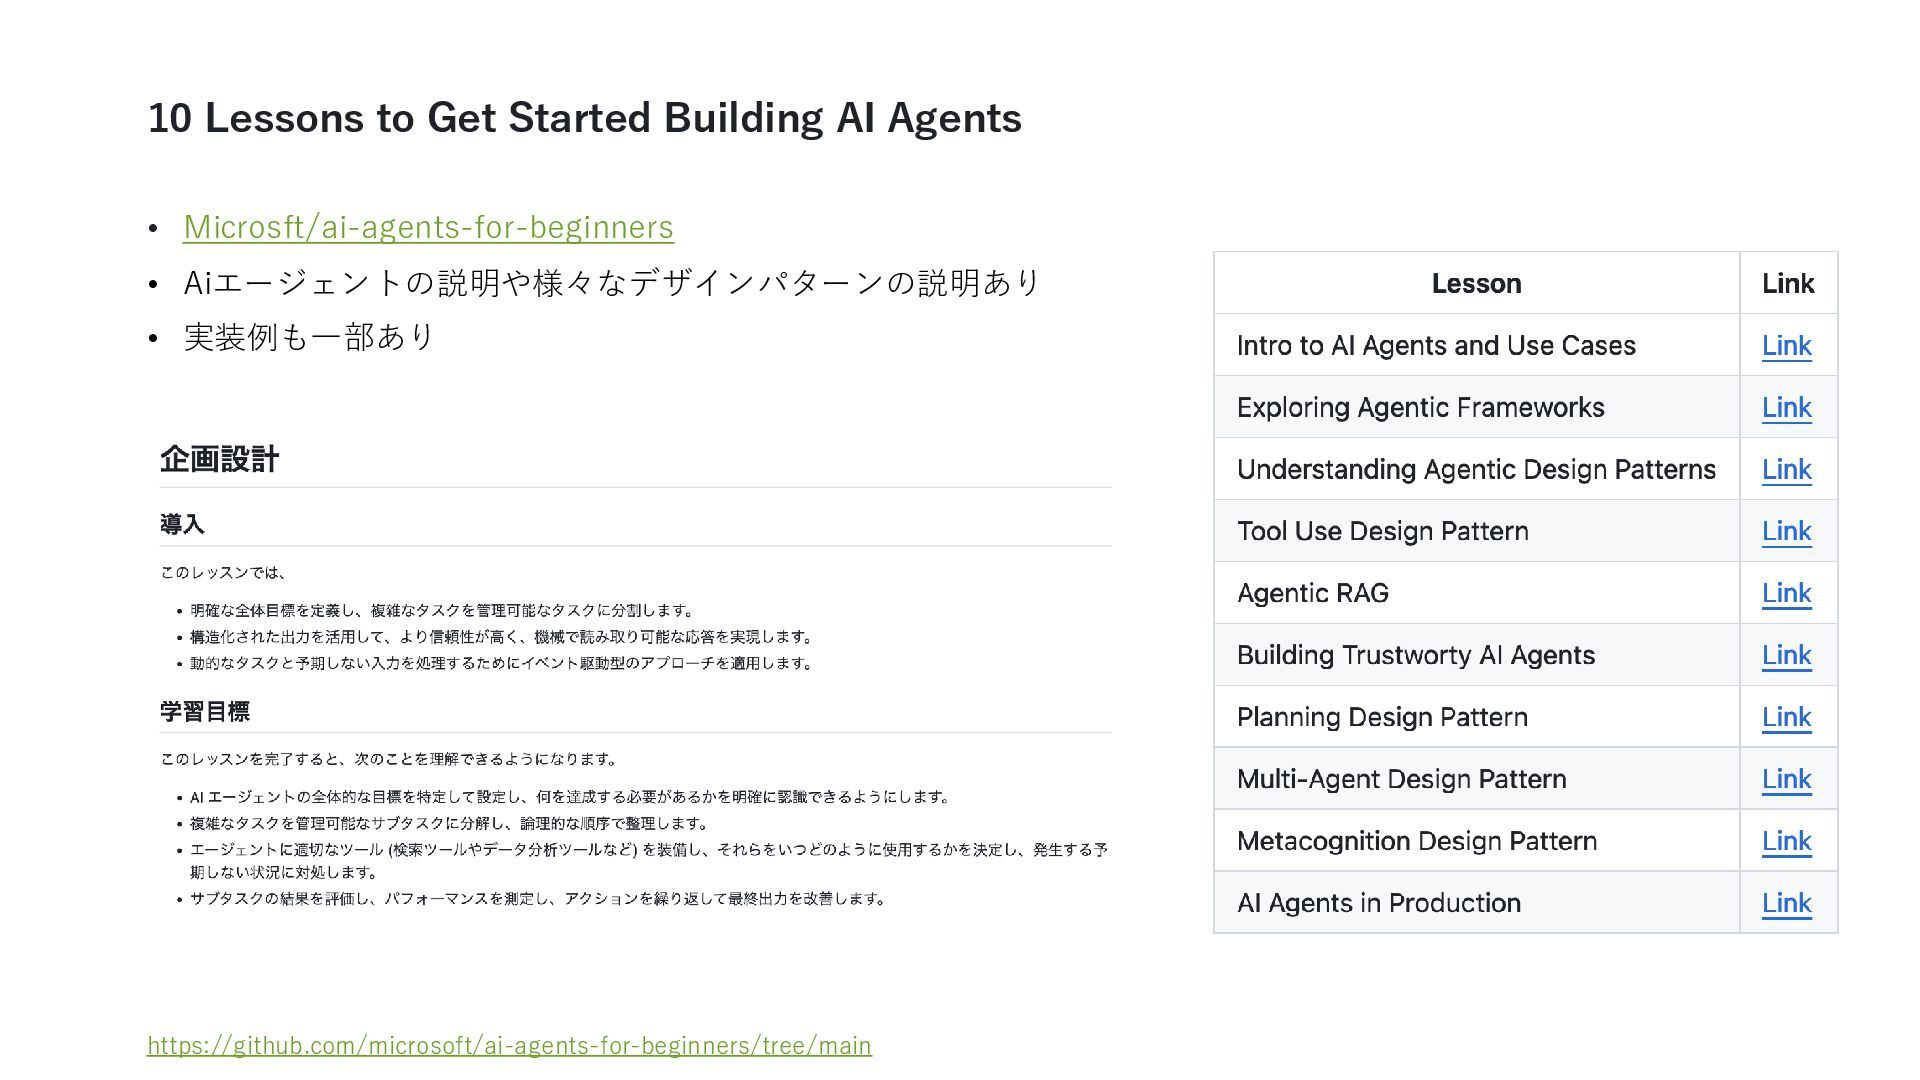
10 Lessons to Get Started Building AI Agents • Microsft/ai-agents-for-beginners
• Aiエージェントの説明や様々なデザインパターンの説明あり • 実装例も一部あり https://github.com/microsoft/ai-agents-for-beginners/tree/main -
Google Cloud 主催 AI Agent Summit ’25 Spring 本イベントでは、AI エージェントを活用して生産性を向上する方法や、独自の
AI エージェントを構築するためのヒ ント、そして Google Cloud の最新の生成 AI 製品のアップデート、多くのお客様のユースケースをお届け 2025年、従来のチャットボットから、より高度な「AI エージェント」へと進化しつつある AIエージェントはユーザーのコンテキストを理解し、人間のように振る舞いながら複雑なタスクを実行するシステム https://cloudonair.withgoogle.com/events/gcai-agent-summit-25-spring 開催日 : 2025 年 3 月 13 日(木) 10:30 - 18:30(予定) 開催方法:ハイブリッド(ベルサール渋谷ガーデン / オンライン配信) 会場定員:1,000 名 -
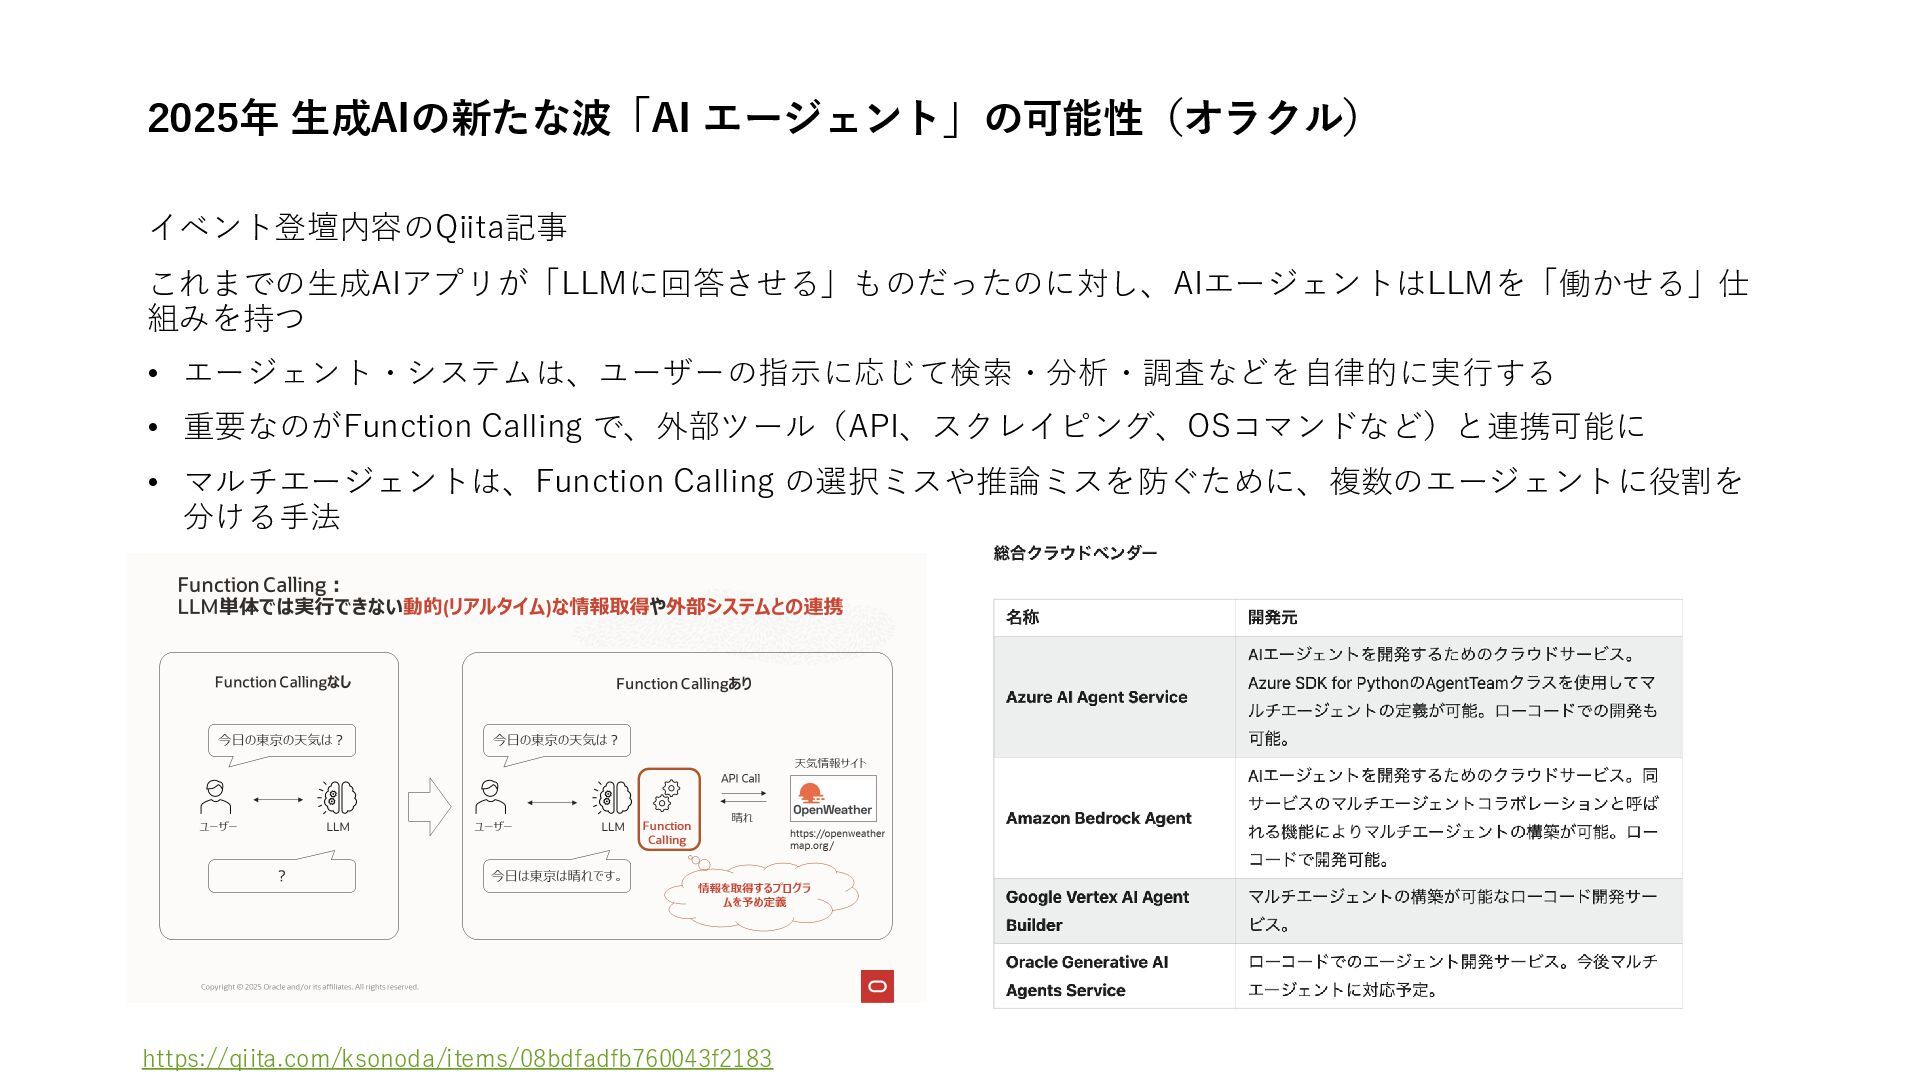
2025年 生成AIの新たな波「AI エージェント」の可能性(オラクル) イベント登壇内容のQiita記事 これまでの生成AIアプリが「LLMに回答させる」ものだったのに対し、AIエージェントはLLMを「働かせる」仕 組みを持つ • エージェント・システムは、ユーザーの指示に応じて検索・分析・調査などを自律的に実行する • 重要なのがFunction
Calling で、外部ツール(API、スクレイピング、OSコマンドなど)と連携可能に • マルチエージェントは、Function Calling の選択ミスや推論ミスを防ぐために、複数のエージェントに役割を 分ける手法 https://qiita.com/ksonoda/items/08bdfadfb760043f2183 -
Deep ResearchがOpenAIからも登場 アカウント調査・キャリア相談 • SNSのアカウントレポートを作成、SNSでバズった投稿を抽出しテーマを分析 • 経歴書を入力してキャリア相談 学術論文サーベイ • ある研究分野の最新動向を網羅的にリサーチ(専門家が見ても重要な論文を網羅)
ビジネス領域(市場調査・競合分析) • 事業成長戦略の提案、業界分析、競合調査 プライベート利用 • プレゼントの選定、家族旅行のプラン作成、子育て計画 仮想通貨・株関連 • ビットコインのレポート作成、仮想通貨トレード戦略の策定 ドキュメント作成 • Tipsのまとめ、ブログ記事の作成、書籍の執筆 ITエンジニア向け活用 • 技術調査、開発レポートの作成 Deep Researchのプロンプト構成例 https://note.com/currypurin/n/nda17942144f4 -
GitHub Copilot:エージェント GitHub Copilotの新機能としてエージェントモードの導入 • コードの自己修正、ターミナルコマンドの提案・実行、ランタイムエラーの自己修復 • OpenAI: GPT-4o •
Anthropic: Claude 3.5 Sonnet • Google: Gemini 2.0 Flash Copilot Editsの一般提供(GA) • 複数ファイルの編集、自然言語での変更リクエスト、編集結果をインラインで確認・調整 • OpenAI: GPT-4o, o1, o3-mini • Anthropic: Claude 3.5 Sonnet • Google: Gemini 2.0 Flash GitHubと紐づくSWEエージェント • AI駆動の自律型エージェントがソフトウェア開発を支援・代行 • コードの生成・レビュー • コードベースのリファクタリング・最適化 • テストやCI/CDパイプラインの自動化 • エラーのトラブルシューティング • ベストプラクティスの提案 https://github.blog/jp/2025-02-07-github-copilot-the-agent-awakens/ -
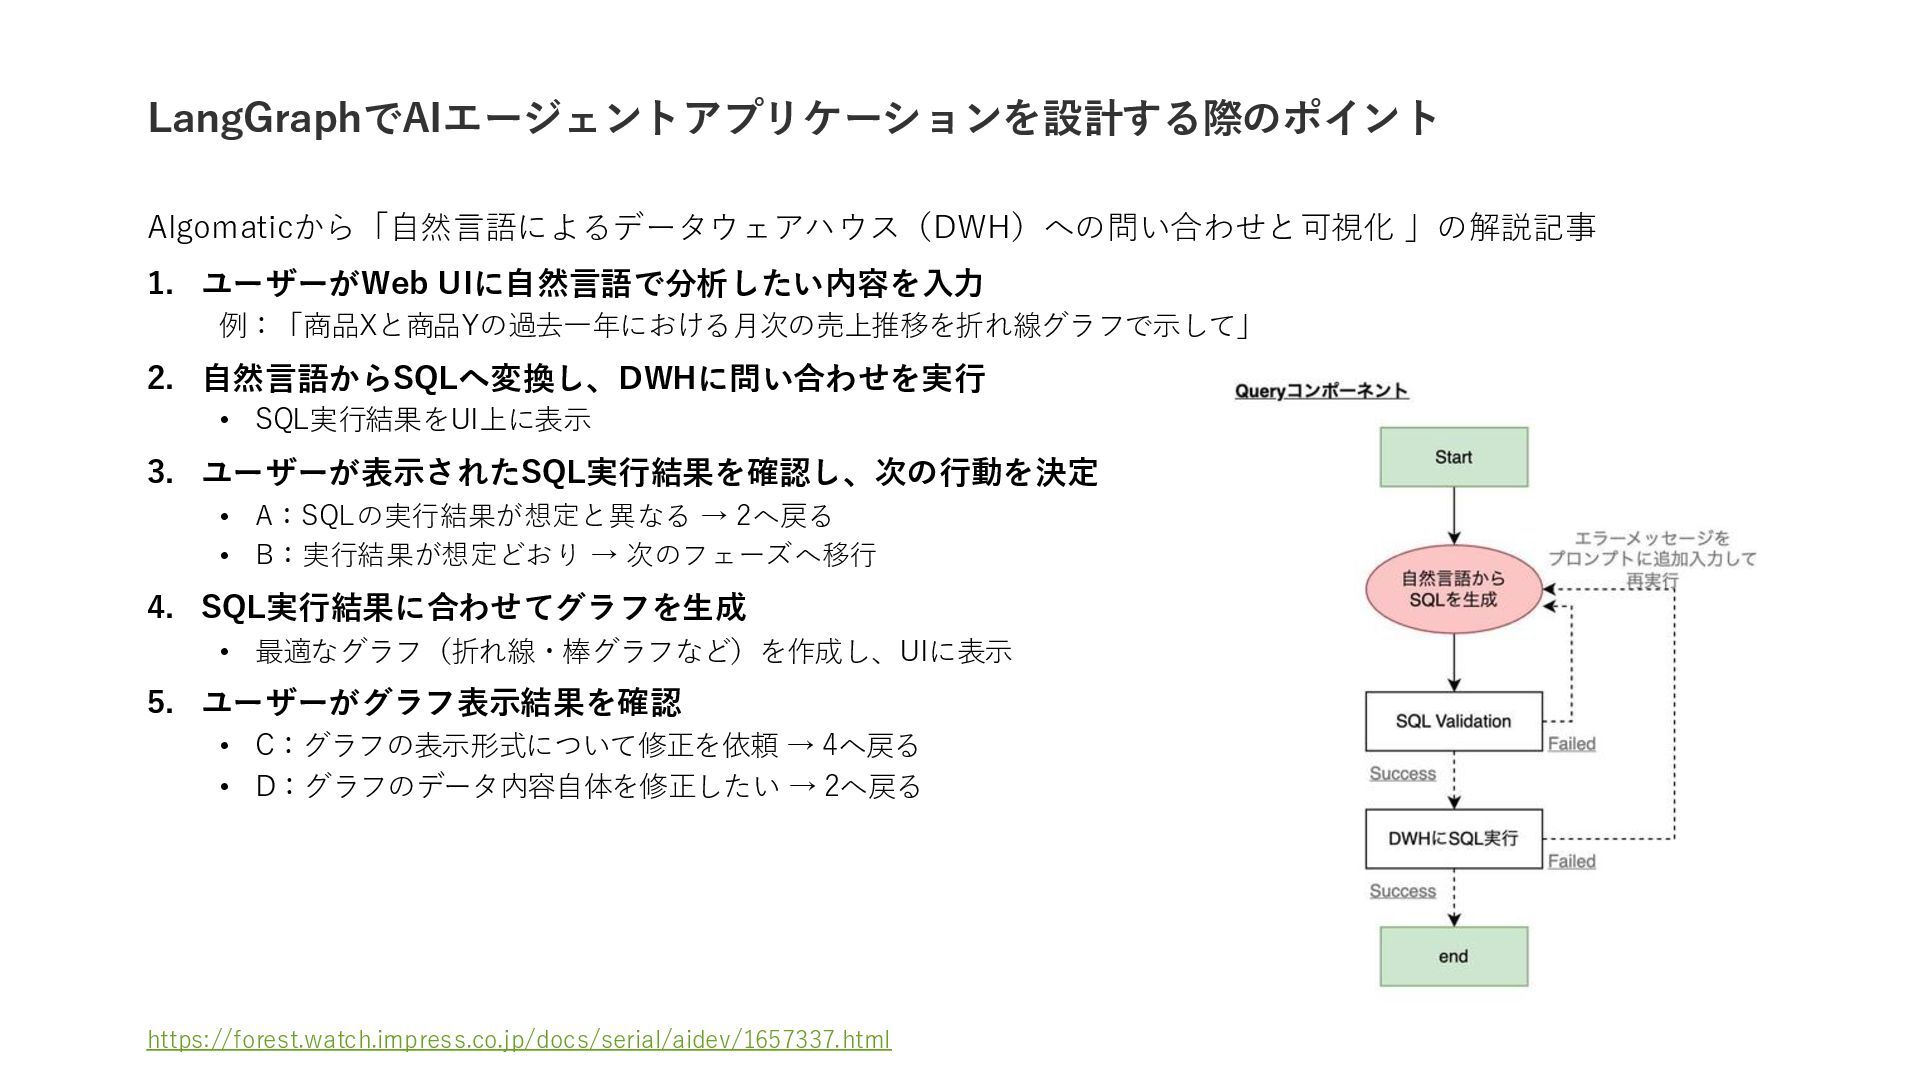
LangGraphでAIエージェントアプリケーションを設計する際のポイント Algomaticから「自然言語によるデータウェアハウス(DWH)への問い合わせと可視化 」の解説記事 1. ユーザーがWeb UIに自然言語で分析したい内容を入力 例:「商品Xと商品Yの過去一年における月次の売上推移を折れ線グラフで示して」 2. 自然言語からSQLへ変換し、DWHに問い合わせを実行 •
SQL実行結果をUI上に表示 3. ユーザーが表示されたSQL実行結果を確認し、次の行動を決定 • A:SQLの実行結果が想定と異なる → 2へ戻る • B:実行結果が想定どおり → 次のフェーズへ移行 4. SQL実行結果に合わせてグラフを生成 • 最適なグラフ(折れ線・棒グラフなど)を作成し、UIに表示 5. ユーザーがグラフ表示結果を確認 • C:グラフの表示形式について修正を依頼 → 4へ戻る • D:グラフのデータ内容自体を修正したい → 2へ戻る https://forest.watch.impress.co.jp/docs/serial/aidev/1657337.html -
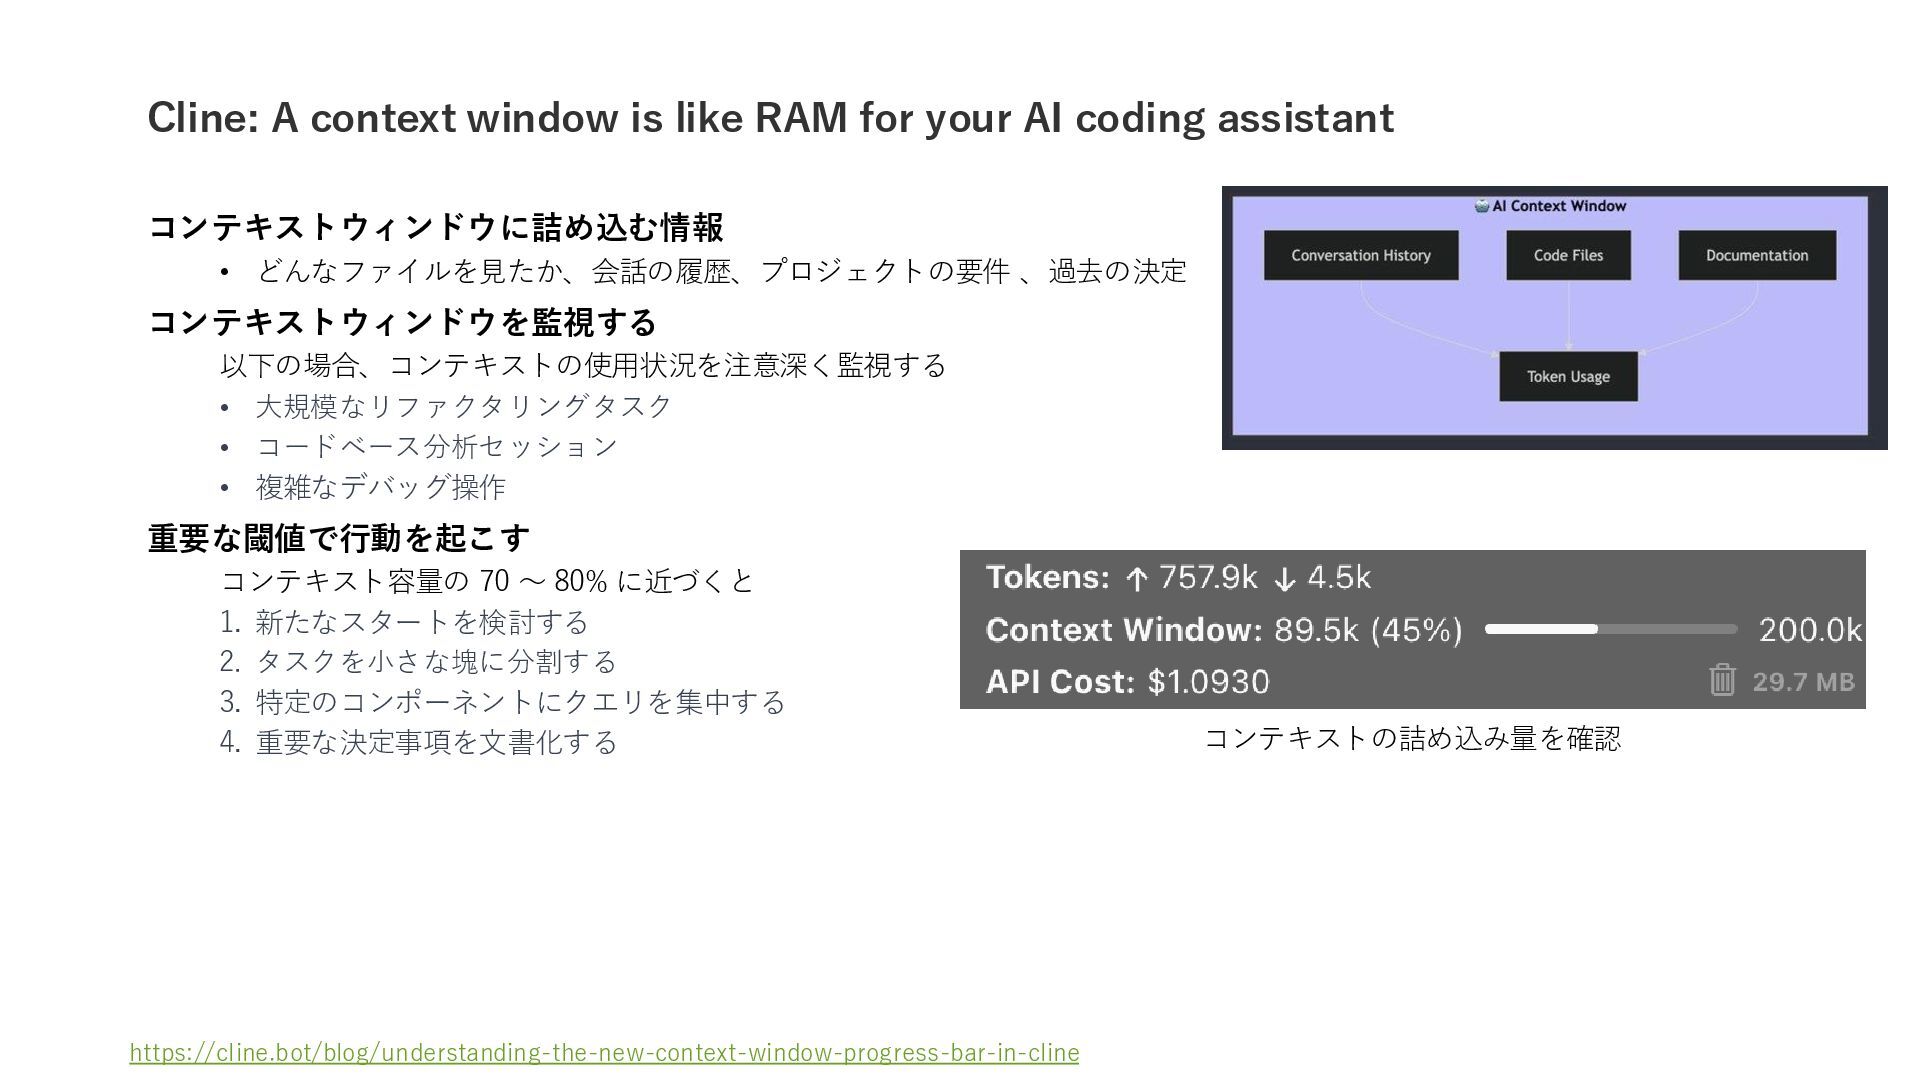
Cline: A context window is like RAM for your AI
coding assistant コンテキストウィンドウに詰め込む情報 • どんなファイルを見たか、会話の履歴、プロジェクトの要件 、過去の決定 コンテキストウィンドウを監視する 以下の場合、コンテキストの使用状況を注意深く監視する • 大規模なリファクタリングタスク • コードベース分析セッション • 複雑なデバッグ操作 重要な閾値で行動を起こす コンテキスト容量の 70 ~ 80% に近づくと 1. 新たなスタートを検討する 2. タスクを小さな塊に分割する 3. 特定のコンポーネントにクエリを集中する 4. 重要な決定事項を文書化する コンテキストの詰め込み量を確認 https://cline.bot/blog/understanding-the-new-context-window-progress-bar-in-cline -
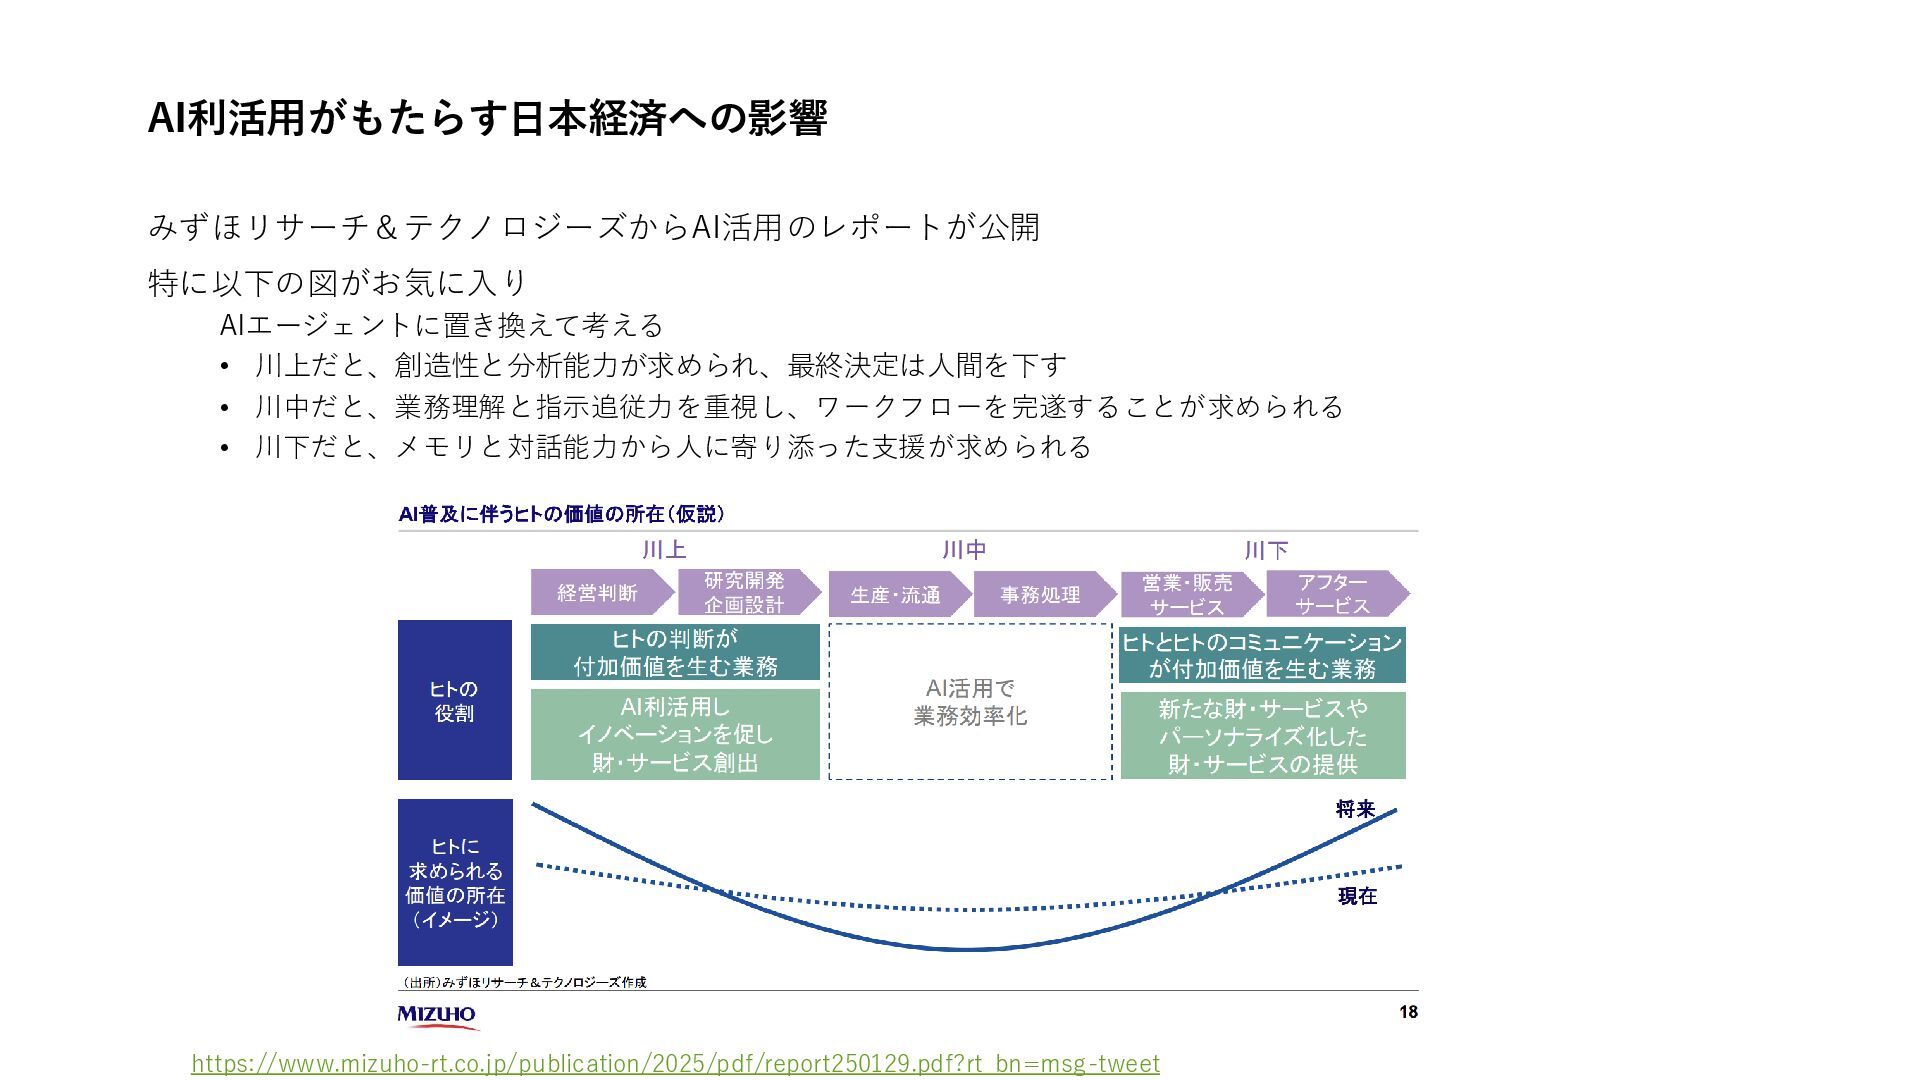
AI利活用がもたらす日本経済への影響 みずほリサーチ&テクノロジーズからAI活用のレポートが公開 特に以下の図がお気に入り AIエージェントに置き換えて考える • 川上だと、創造性と分析能力が求められ、最終決定は人間を下す • 川中だと、業務理解と指示追従力を重視し、ワークフローを完遂することが求められる • 川下だと、メモリと対話能力から人に寄り添った支援が求められる
https://www.mizuho-rt.co.jp/publication/2025/pdf/report250129.pdf?rt_bn=msg-tweet
 masatoto
 beale
 ishiirikie
 satai
 rfujii
 s_mizuki_nlp
 yukiar
 resolutionfoundation
 institutdelelevage
 hisaokatsumi
 pman0214
 ftakahashi
 rkendrick25
 aleyda
 axbom
 scottboms
 cassininazir
 soudai
 denniskardys
 csswizardry
 katarinadahlin
 jnunemaker
 codingconduct
 addyosmani