Share
Embed
Transcript
34 slides
-
はてなアンテナ • 2002 年サービス開始 • 創業サービスである人力検索はてなに続くサービス • URL を登録すると、クローラが巡回して更新順にひ とめで閲覧できる
◦ WWWC などのフリーウェアのサービス版 -
はてなアンテナ、ラボサービスへ • 2018 年、複数のサービスを提供終了告知 ◦ 今後、はてなグラフ、ポケットはてななど、複数のサービスの提 供を終了する予定です • はてなアンテナは はてラボへ
◦ 「はてなの実験的サービス置き場」 ◦ サービスレベルを低くしつつ、はてなスタッフがサービスを公開 できる場所 -
やりたいこと: Go でクローラを書く • はてなとしては、Go/TypeScript を主要な言語とし て選定 • Go でそこそこの規模のコードを書きたかった
◦ クローラなら、goroutine とか channel とかいかにも使いそう -
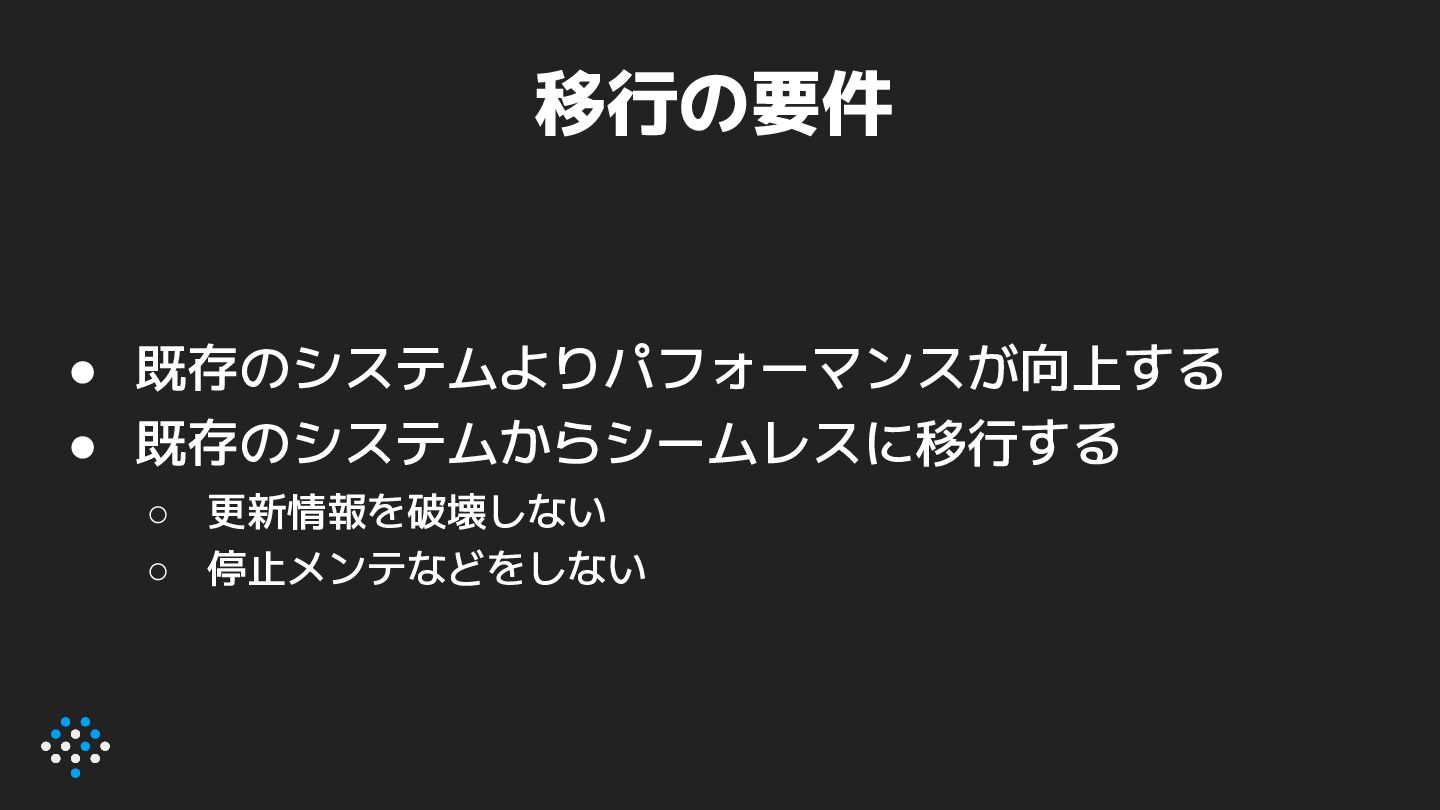
要件 • はてなアンテナのクローラを作り直す ◦ ウェブサービス部分は既存の Perl のまま • パフォーマンスを落とさない ◦
数百万ページのオーダー • 既存のシステムからシームレスに移行する ◦ 更新情報を破壊しない -
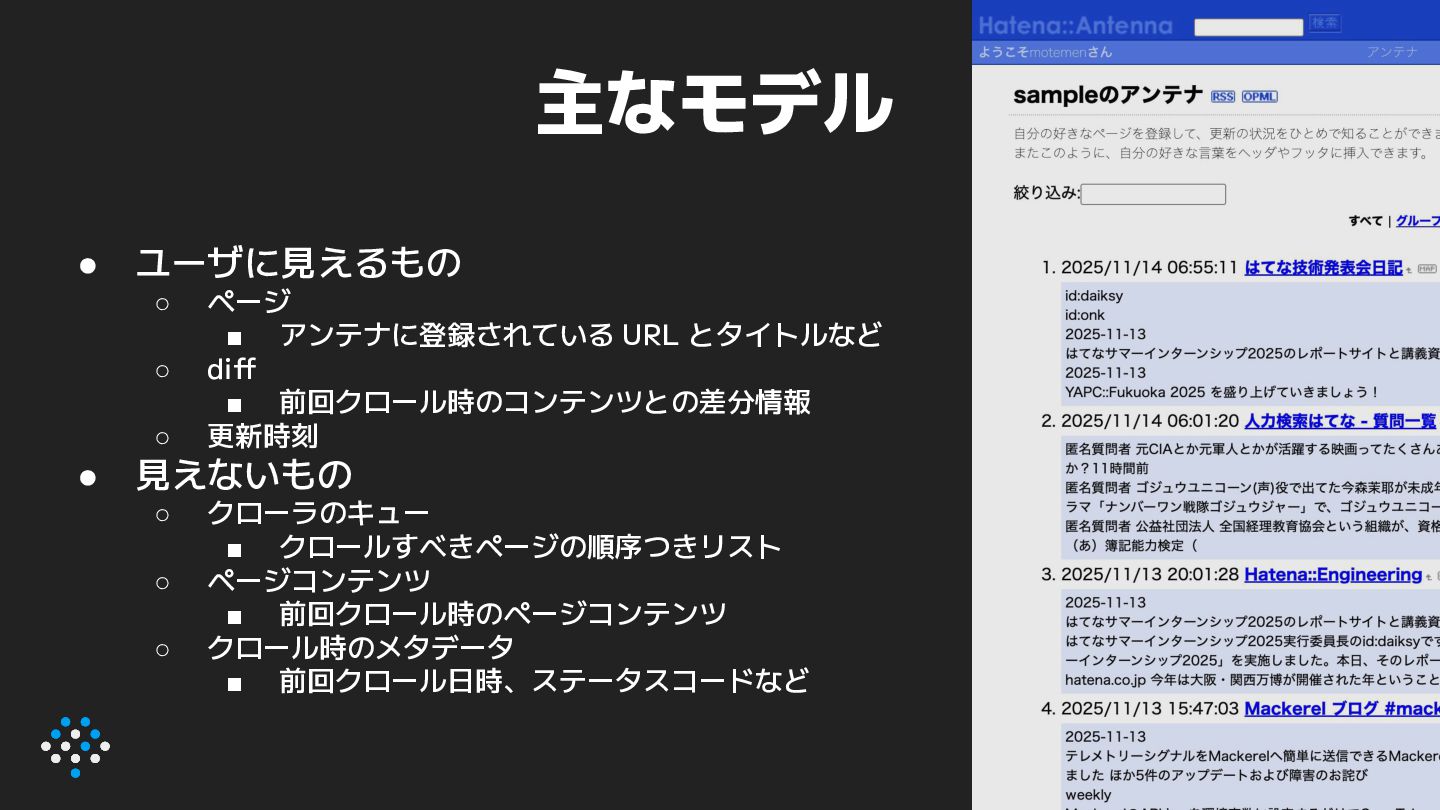
主なモデル • ユーザに見えるもの ◦ ページ ▪ アンテナに登録されている URL とタイトルなど ◦
diff ▪ 前回クロール時のコンテンツとの差分情報 ◦ 更新時刻 • 見えないもの ◦ クローラのキュー ▪ クロールすべきページの順序つきリスト ◦ ページコンテンツ ▪ 前回クロール時のページコンテンツ ◦ クロール時のメタデータ ▪ 前回クロール日時、ステータスコードなど -
旧システム概要 • Linux + Apache + MySQL 4 + Perl
5.8.8 • 設計当時、すべてが MySQL だった ◦ Memcached の登場すら 2003 年のこと • その後の運用で、インフラのモダン化はできている ◦ EKS + Aurora MySQL + Perl 5.40 -
新データストア • メイン DB: AWS Aurora MySQL ◦ ここは引き続き •
キュー・ページメタデータ: Elasticache for Redis ◦ ほかにも選択肢はあったが、コストとシンプルさを優先 • ページコンテンツ: S3 -
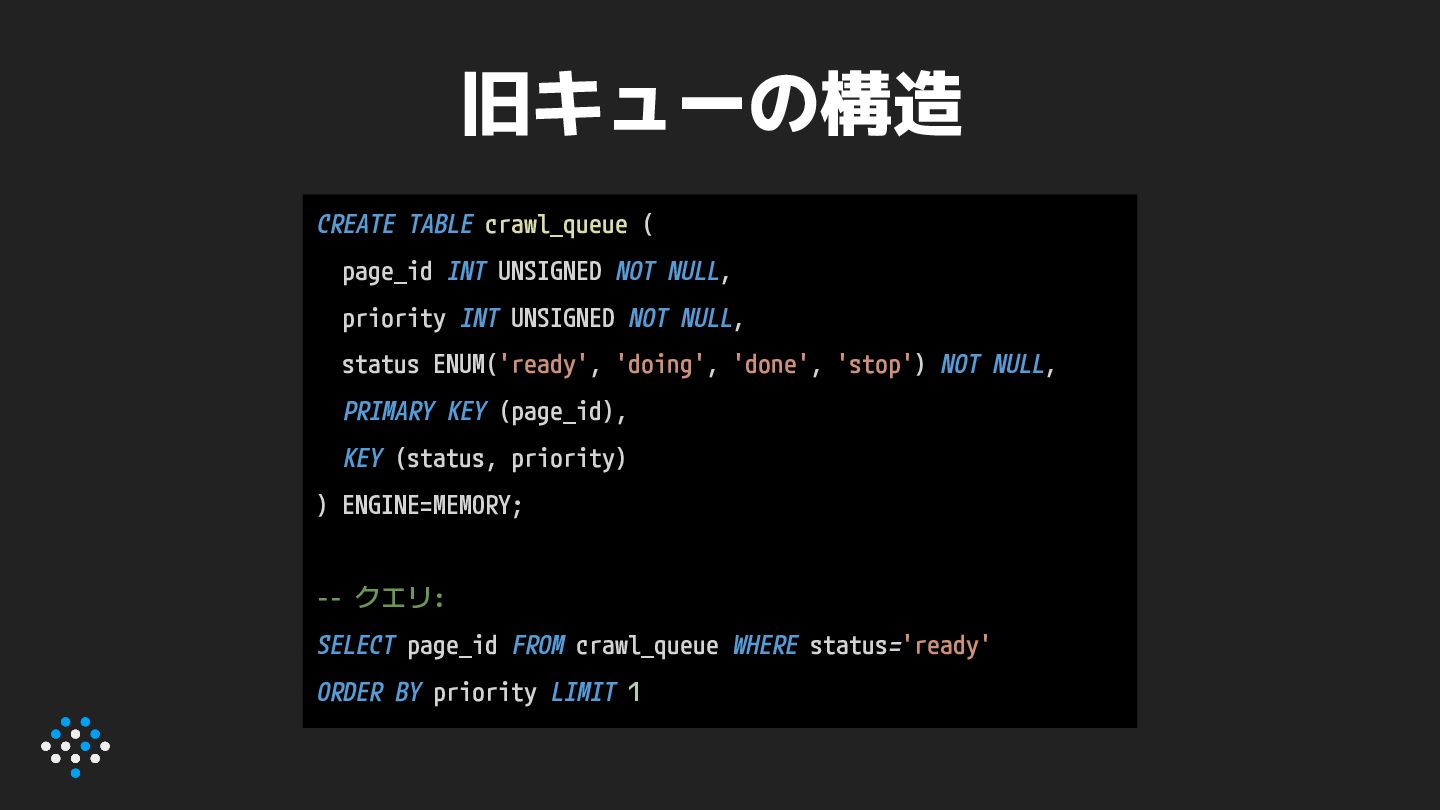
旧キューの構造 CREATE TABLE crawl_queue ( page_id INT UNSIGNED NOT NULL,
priority INT UNSIGNED NOT NULL, status ENUM('ready', 'doing', 'done', 'stop') NOT NULL, PRIMARY KEY (page_id), KEY (status, priority) ) ENGINE=MEMORY; -- クエリ: SELECT page_id FROM crawl_queue WHERE status='ready' ORDER BY priority LIMIT 1 -
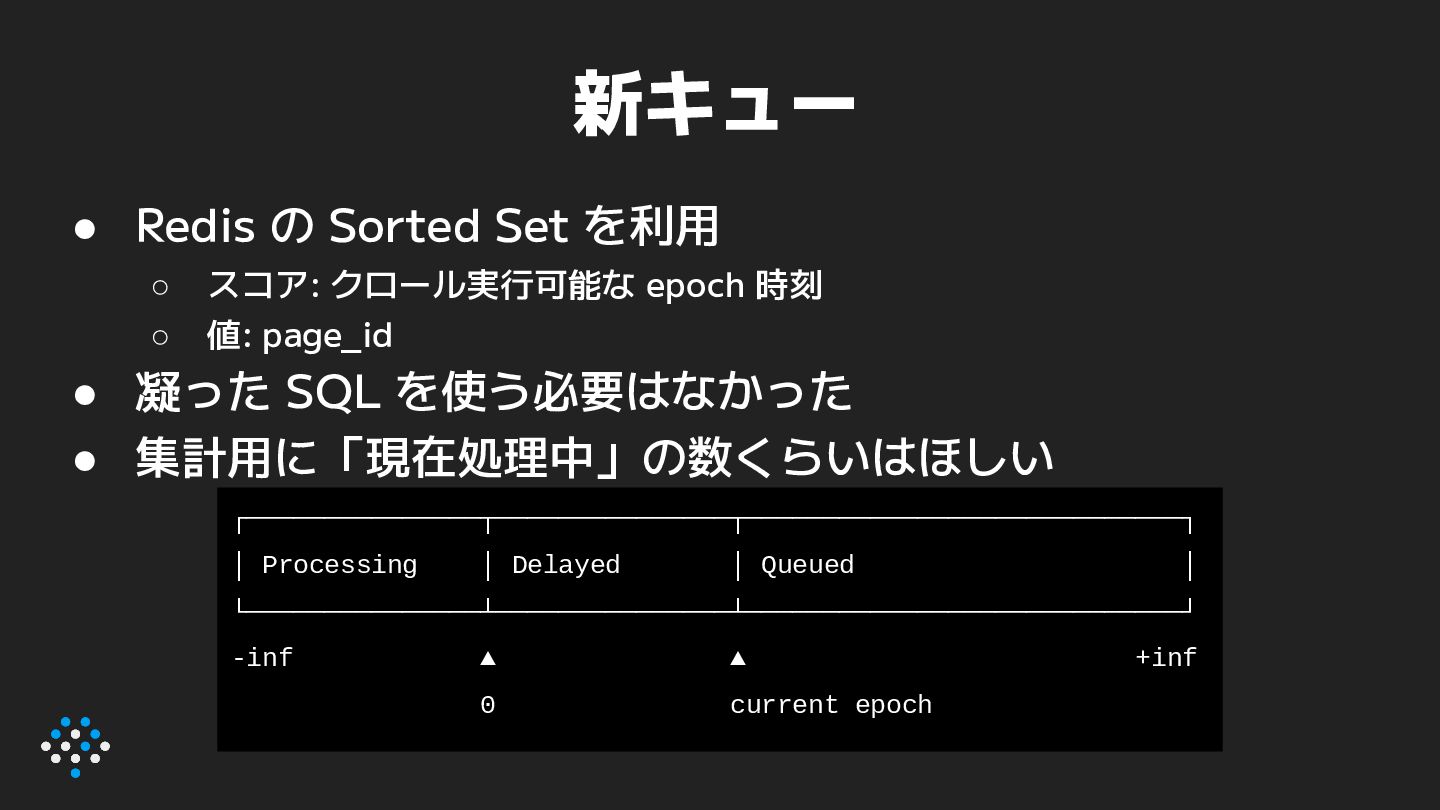
新キュー • Redis の Sorted Set を利用 ◦ スコア: クロール実行可能な
epoch 時刻 ◦ 値: page_id • 凝った SQL を使う必要はなかった • 集計用に「現在処理中」の数くらいはほしい ┌───────────────┬───────────────┬────────────────────────────┐ │ Processing │ Delayed │ Queued │ └───────────────┴───────────────┴────────────────────────────┘ -inf ▲ ▲ +inf 0 current epoch -
ページコンテンツ • MySQL から S3 へ • ページ URL からコンテンツが特定できればよい
• ページの全文を保存するわけではないので、容量は 膨大ではない ◦ 先頭切り詰め・プレーンテキスト化 -
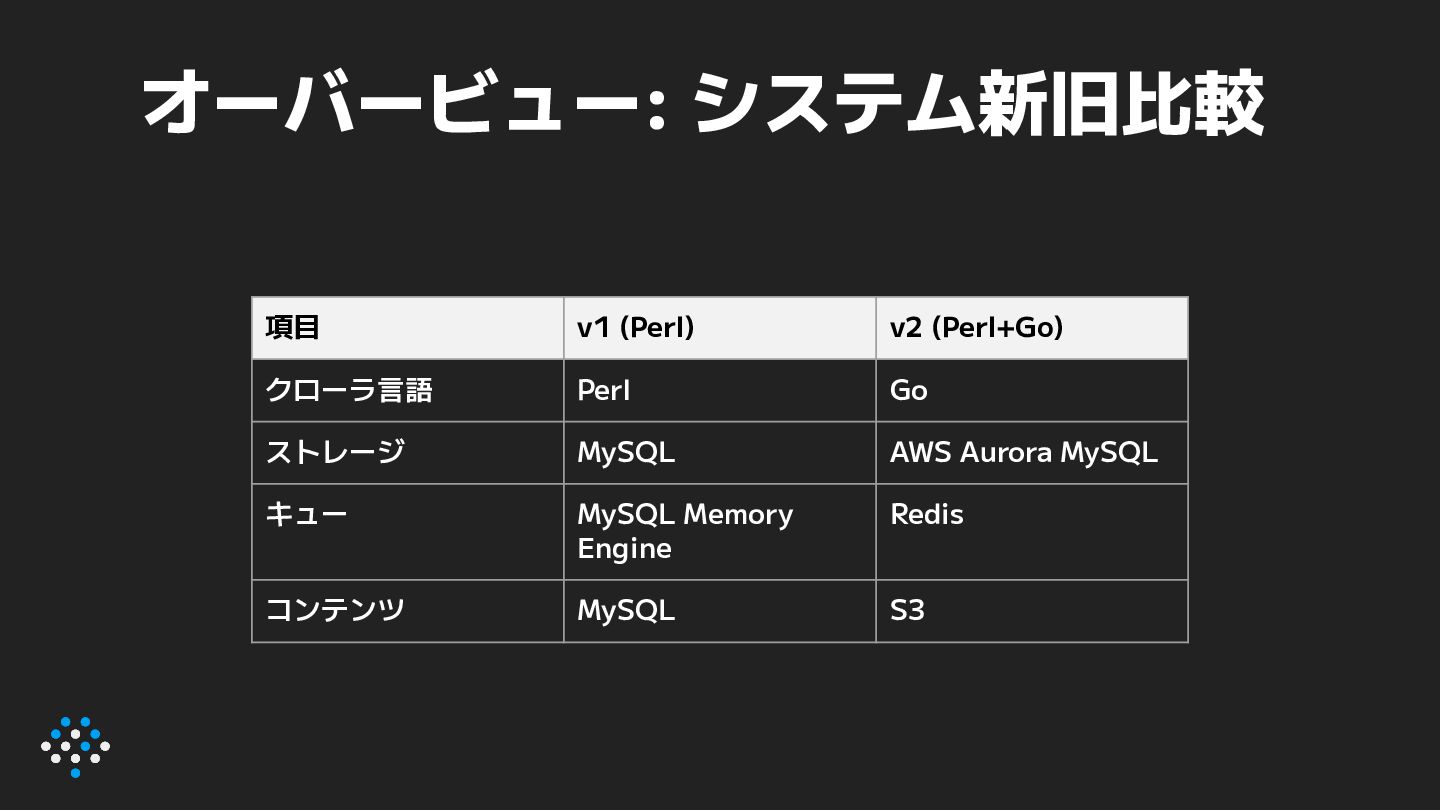
オーバービュー: システム新旧比較 項目 v1 (Perl) v2 (Perl+Go) クローラ言語 Perl Go
ストレージ MySQL AWS Aurora MySQL キュー MySQL Memory Engine Redis コンテンツ MySQL S3 -
クローラの実装概要 • v1 では Pararell::ForkManager ◦ while (1) { デキュー();
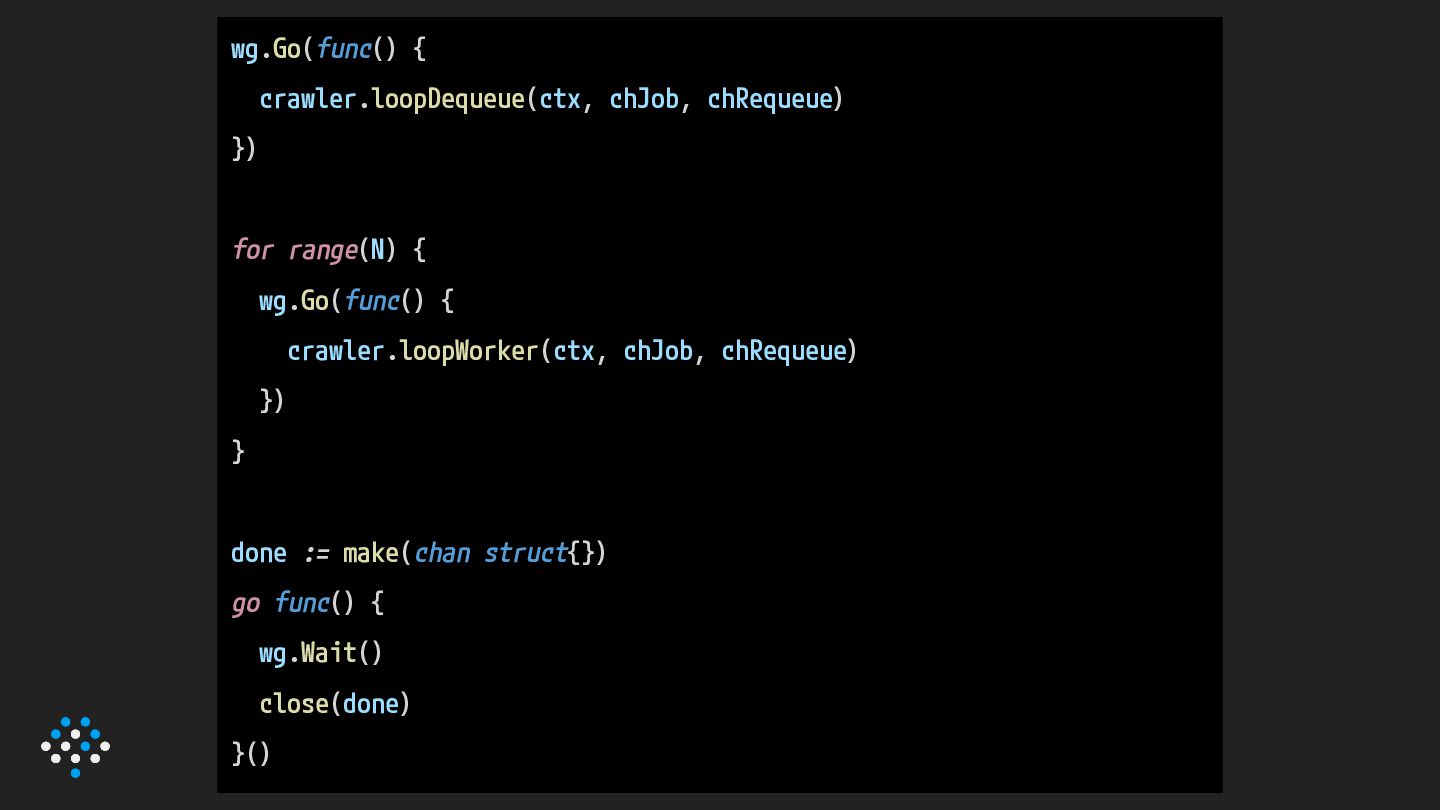
クロール(); 再キュー(); } • 3 goroutine: ◦ デキュー ◦ ワーカー群(クロールの本処理) ◦ 再キュー • 2 チャンネル: ◦ ワーカーにジョブ(URL)を送るチャンネル ◦ キューにジョブを戻すチャンネル -
wg.Go(func() { crawler.loopDequeue(ctx, chJob, chRequeue) }) for range(N) { wg.Go(func()
{ crawler.loopWorker(ctx, chJob, chRequeue) }) } done := make(chan struct{}) go func() { wg.Wait() close(done) }() -
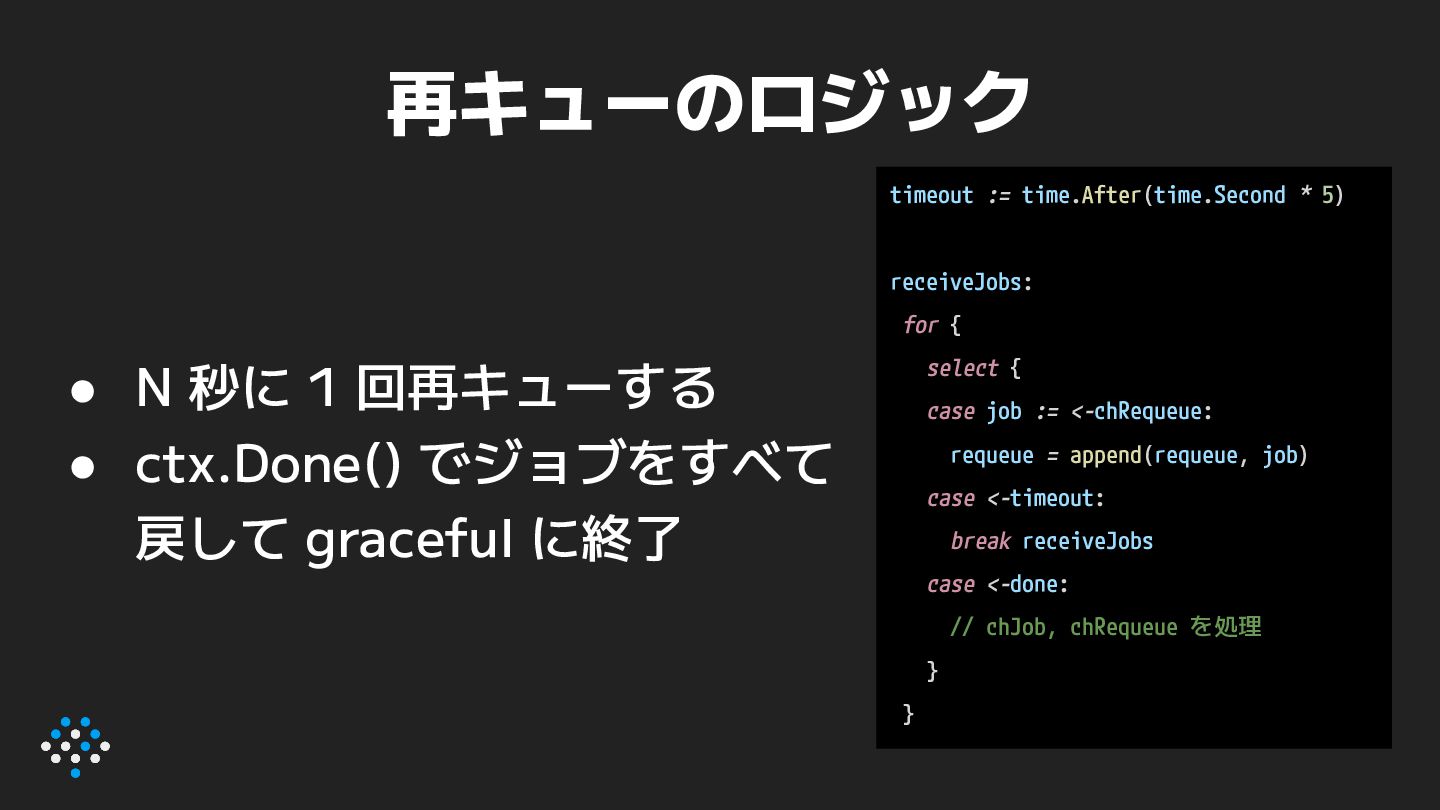
再キューのロジック • N 秒に 1 回再キューする • ctx.Done() でジョブをすべて 戻して
graceful に終了 timeout := time.After(time.Second * 5) receiveJobs: for { select { case job := <-chRequeue: requeue = append(requeue, job) case <-timeout: break receiveJobs case <-done: // chJob, chRequeue を処理 } } -
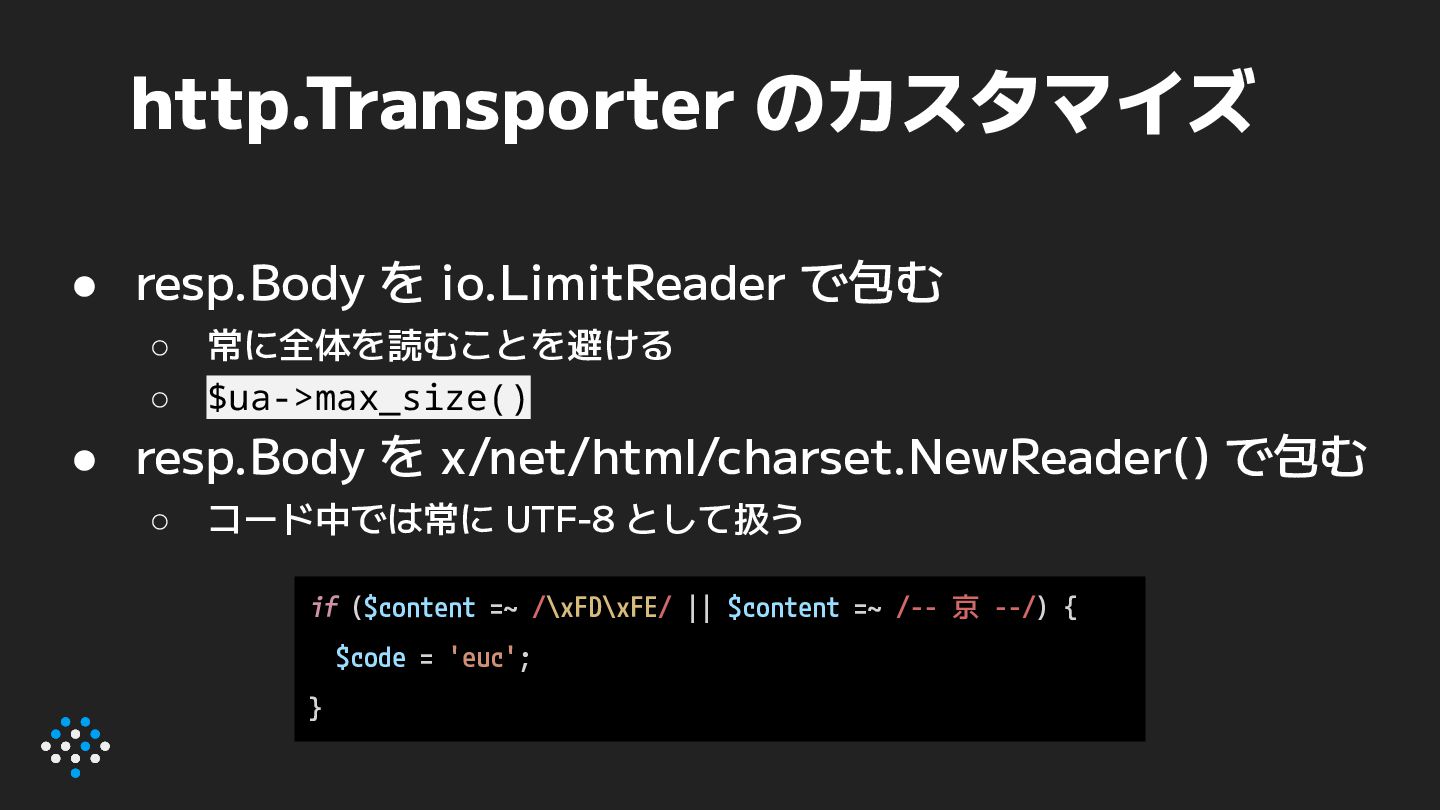
http.Transporter のカスタマイズ • resp.Body を io.LimitReader で包む ◦ 常に全体を読むことを避ける ◦
$ua->max_size() • resp.Body を x/net/html/charset.NewReader() で包む ◦ コード中では常に UTF-8 として扱う if ($content =~ /\xFD\xFE/ || $content =~ /-- 京 --/) { $code = 'euc'; } -
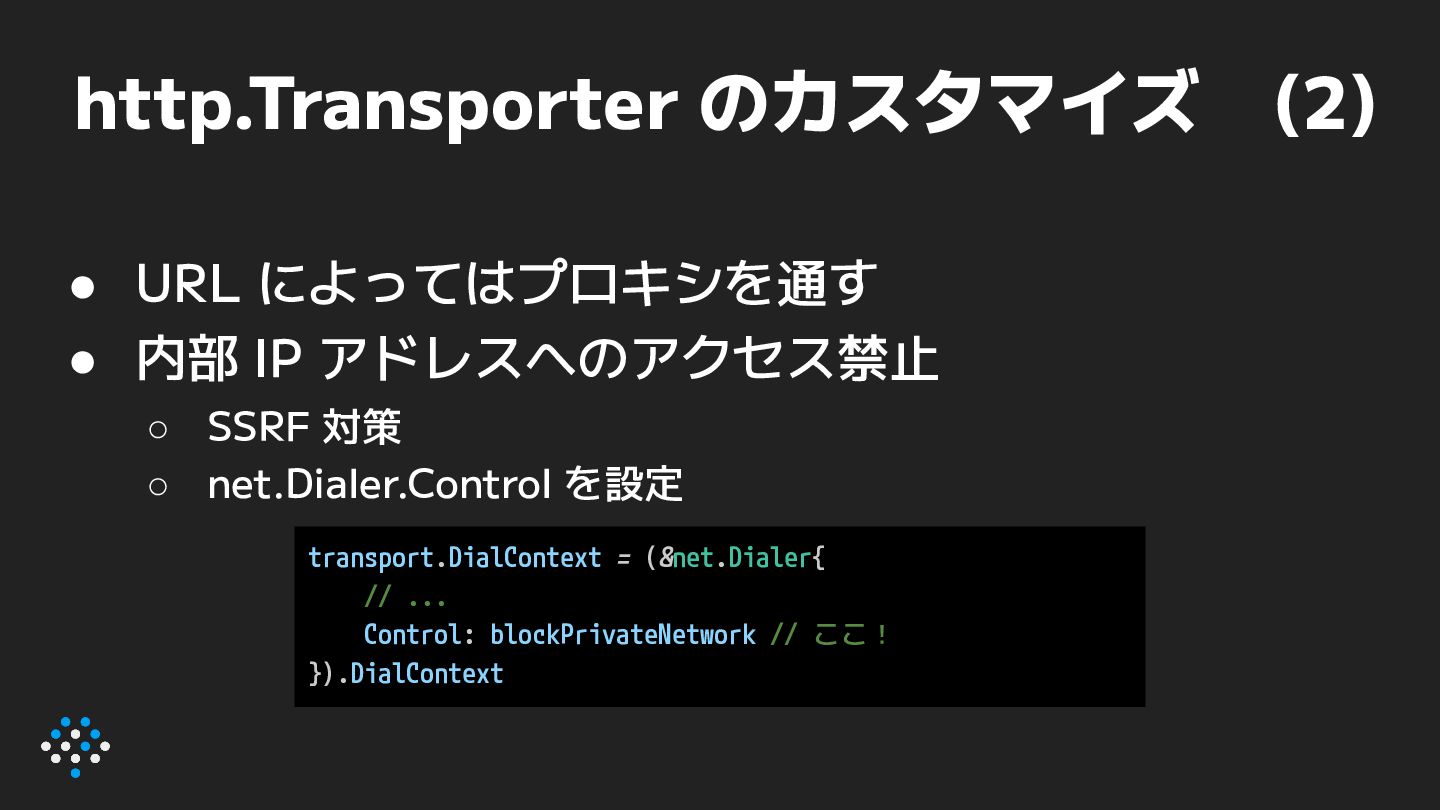
http.Transporter のカスタマイズ (2) • URL によってはプロキシを通す • 内部 IP アドレスへのアクセス禁止
◦ SSRF 対策 ◦ net.Dialer.Control を設定 transport.DialContext = (&net.Dialer{ // ... Control: blockPrivateNetwork // ここ! }).DialContext -
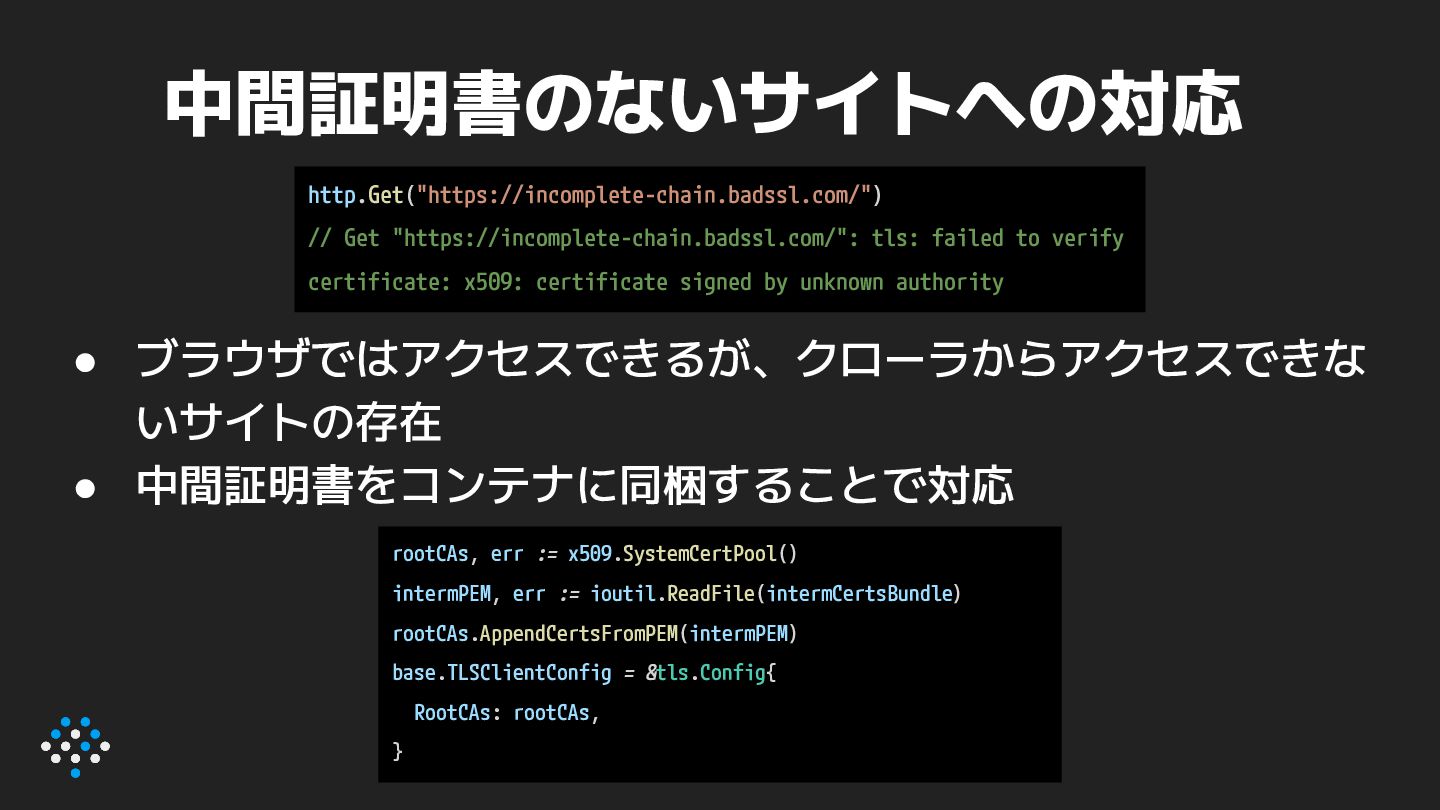
中間証明書のないサイトへの対応 • ブラウザではアクセスできるが、クローラからアクセスできな いサイトの存在 • 中間証明書をコンテナに同梱することで対応 http.Get("https://incomplete-chain.badssl.com/") // Get "https://incomplete-chain.badssl.com/":
tls: failed to verify certificate: x509: certificate signed by unknown authority rootCAs, err := x509.SystemCertPool() intermPEM, err := ioutil.ReadFile(intermCertsBundle) rootCAs.AppendCertsFromPEM(intermPEM) base.TLSClientConfig = &tls.Config{ RootCAs: rootCAs, } -
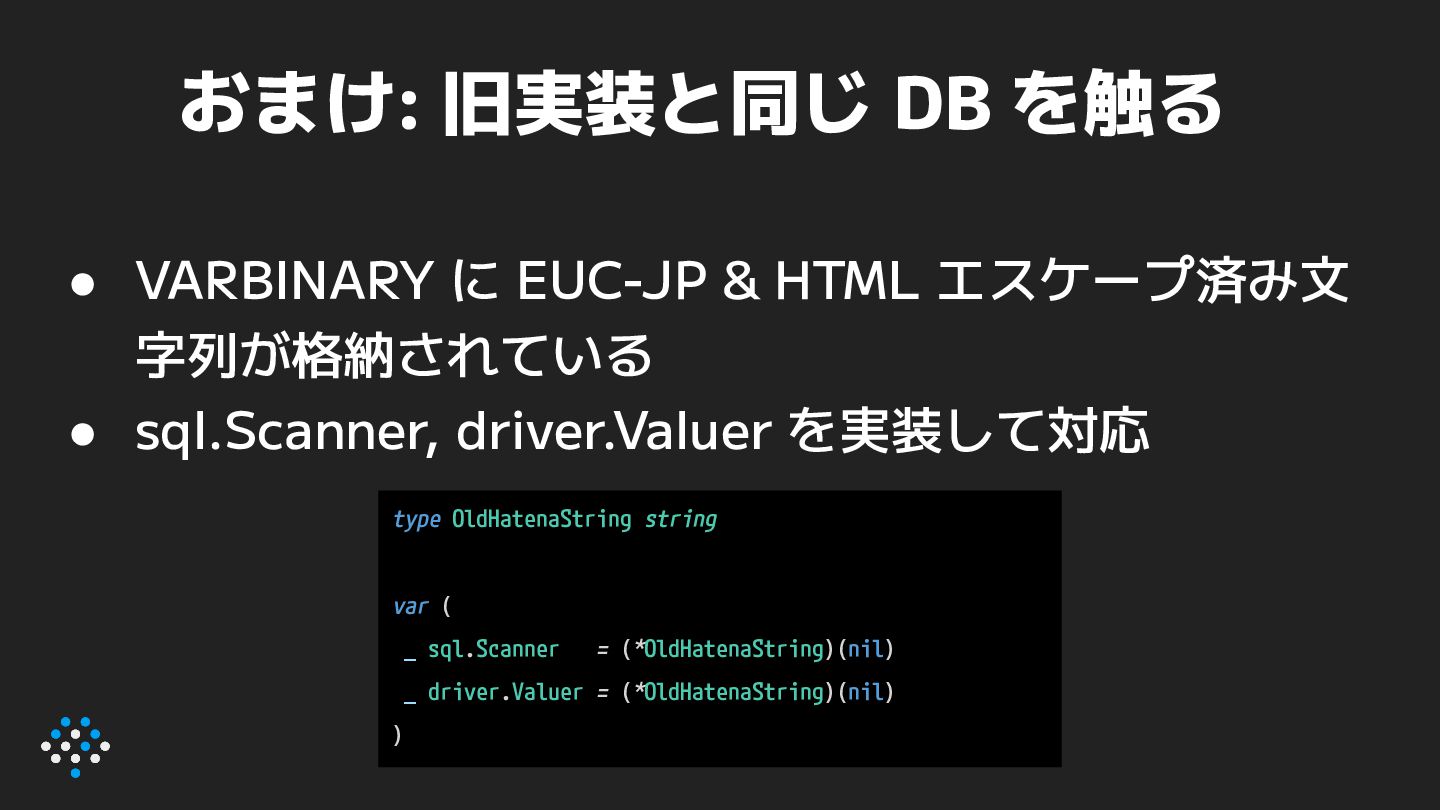
おまけ: 旧実装と同じ DB を触る • VARBINARY に EUC-JP & HTML
エスケープ済み文 字列が格納されている • sql.Scanner, driver.Valuer を実装して対応 type OldHatenaString string var ( _ sql.Scanner = (*OldHatenaString)(nil) _ driver.Valuer = (*OldHatenaString)(nil) ) -
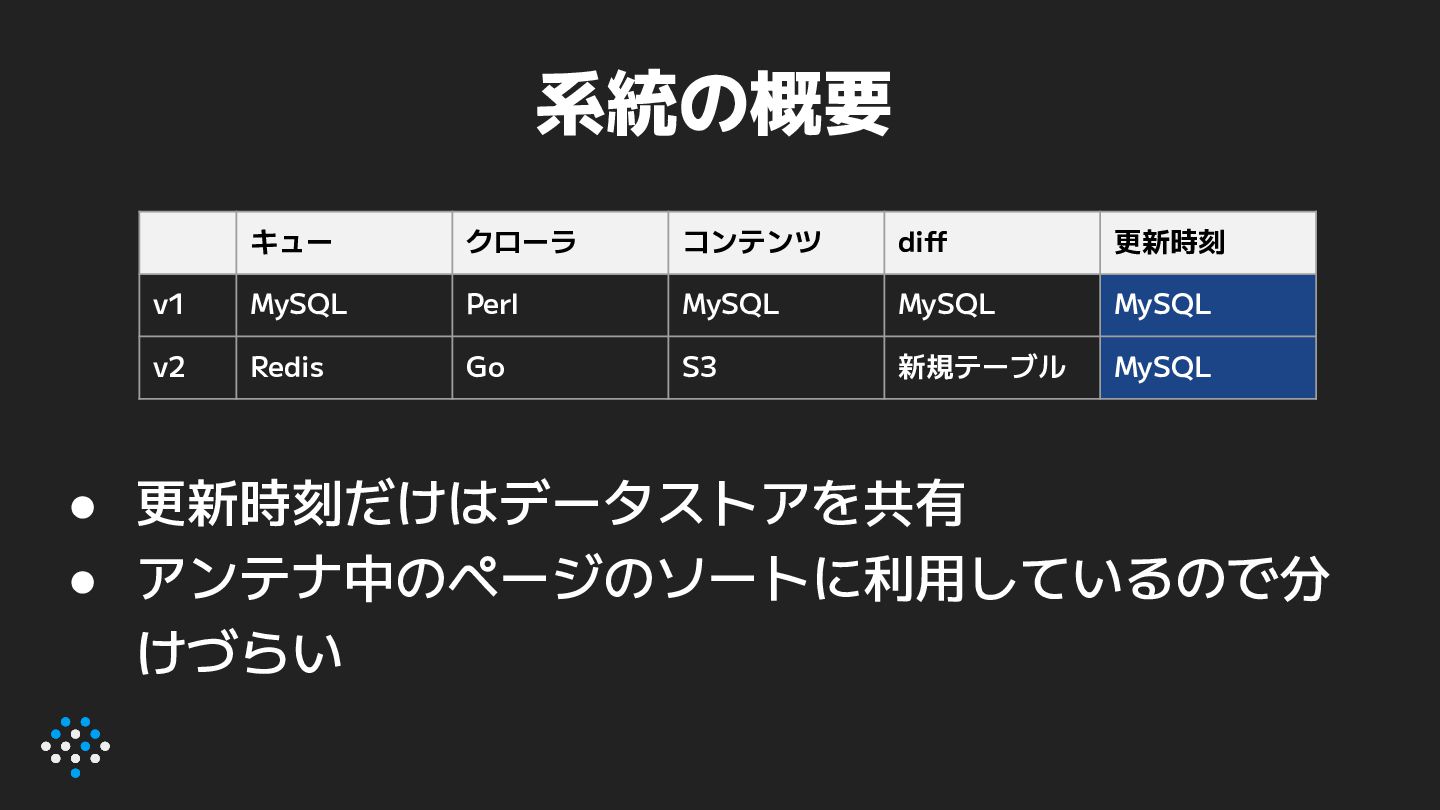
系統の概要 • 更新時刻だけはデータストアを共有 • アンテナ中のページのソートに利用しているので分 けづらい キュー クローラ コンテンツ diff
更新時刻 v1 MySQL Perl MySQL MySQL MySQL v2 Redis Go S3 新規テーブル MySQL -
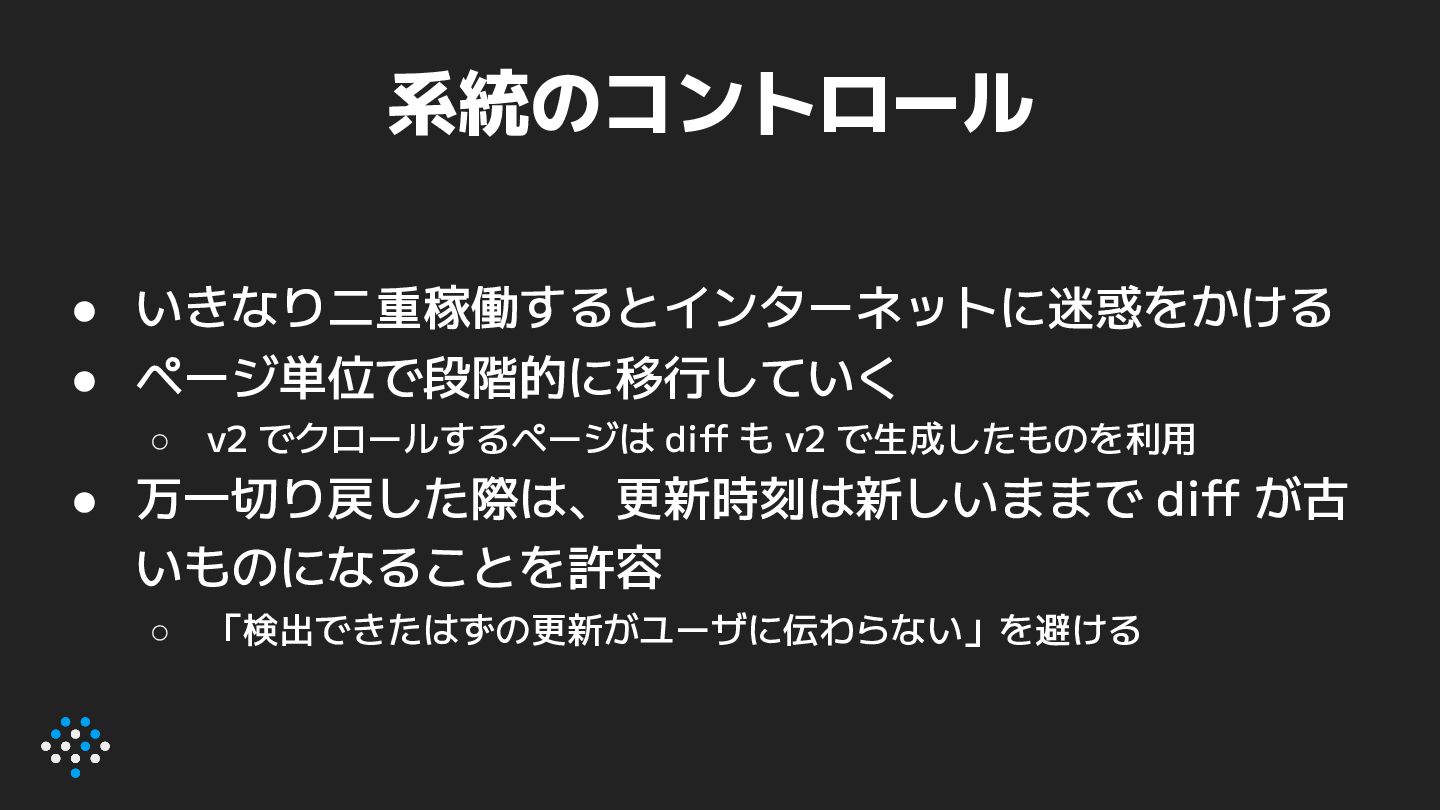
系統のコントロール • いきなり二重稼働するとインターネットに迷惑をかける • ページ単位で段階的に移行していく ◦ v2 でクロールするページは diff も
v2 で生成したものを利用 • 万一切り戻した際は、更新時刻は新しいままで diff が古 いものになることを許容 ◦ 「検出できたはずの更新がユーザに伝わらない」を避ける -
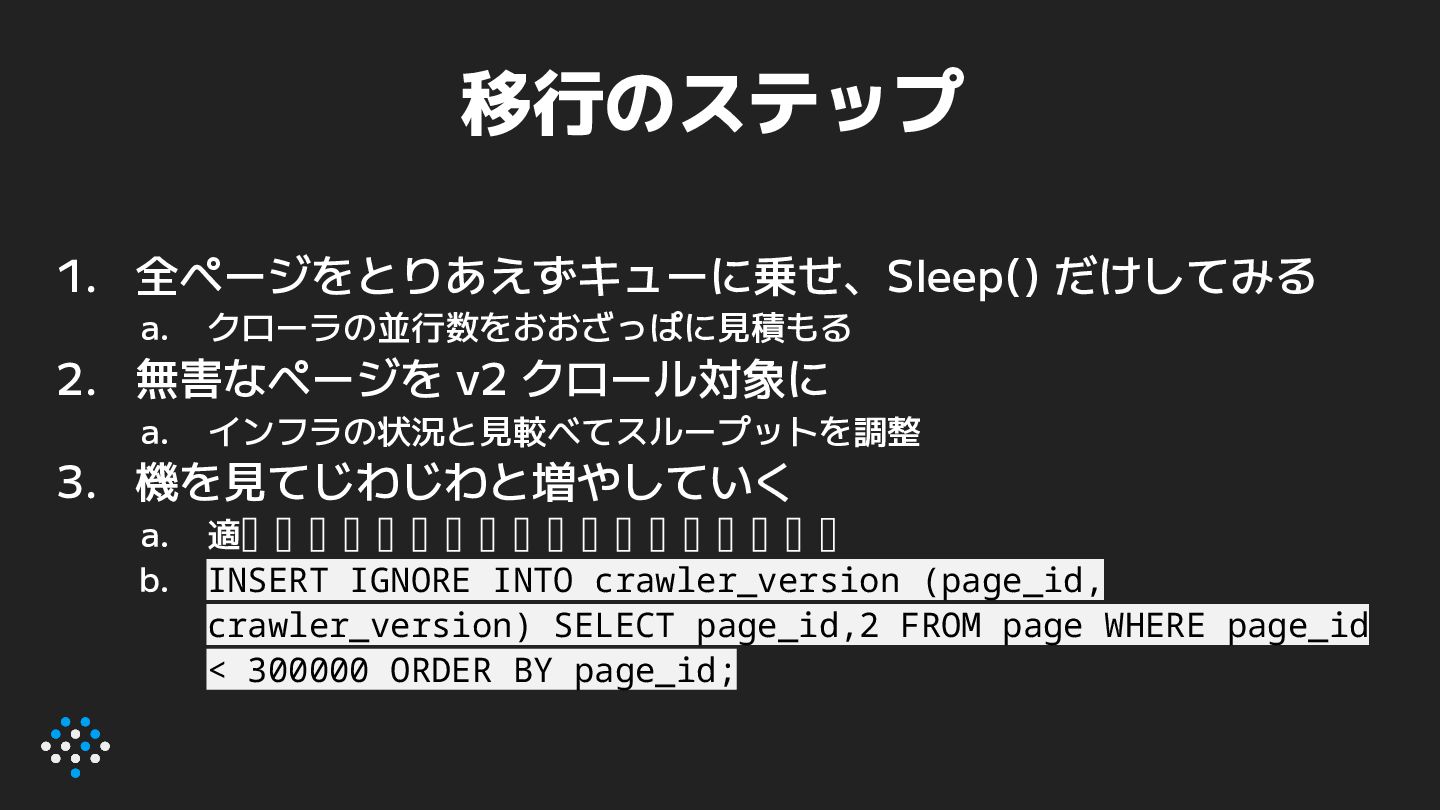
移行のステップ 1. 全ページをとりあえずキューに乗せ、Sleep() だけしてみる a. クローラの並行数をおおざっぱに見積もる 2. 無害なページを v2 クロール対象に
a. インフラの状況と見較べてスループットを調整 3. 機を見てじわじわと増やしていく a. 適当なタイミングで、新規登録ページも v2 対象に b. INSERT IGNORE INTO crawler_version (page_id, crawler_version) SELECT page_id,2 FROM page WHERE page_id < 300000 ORDER BY page_id; -
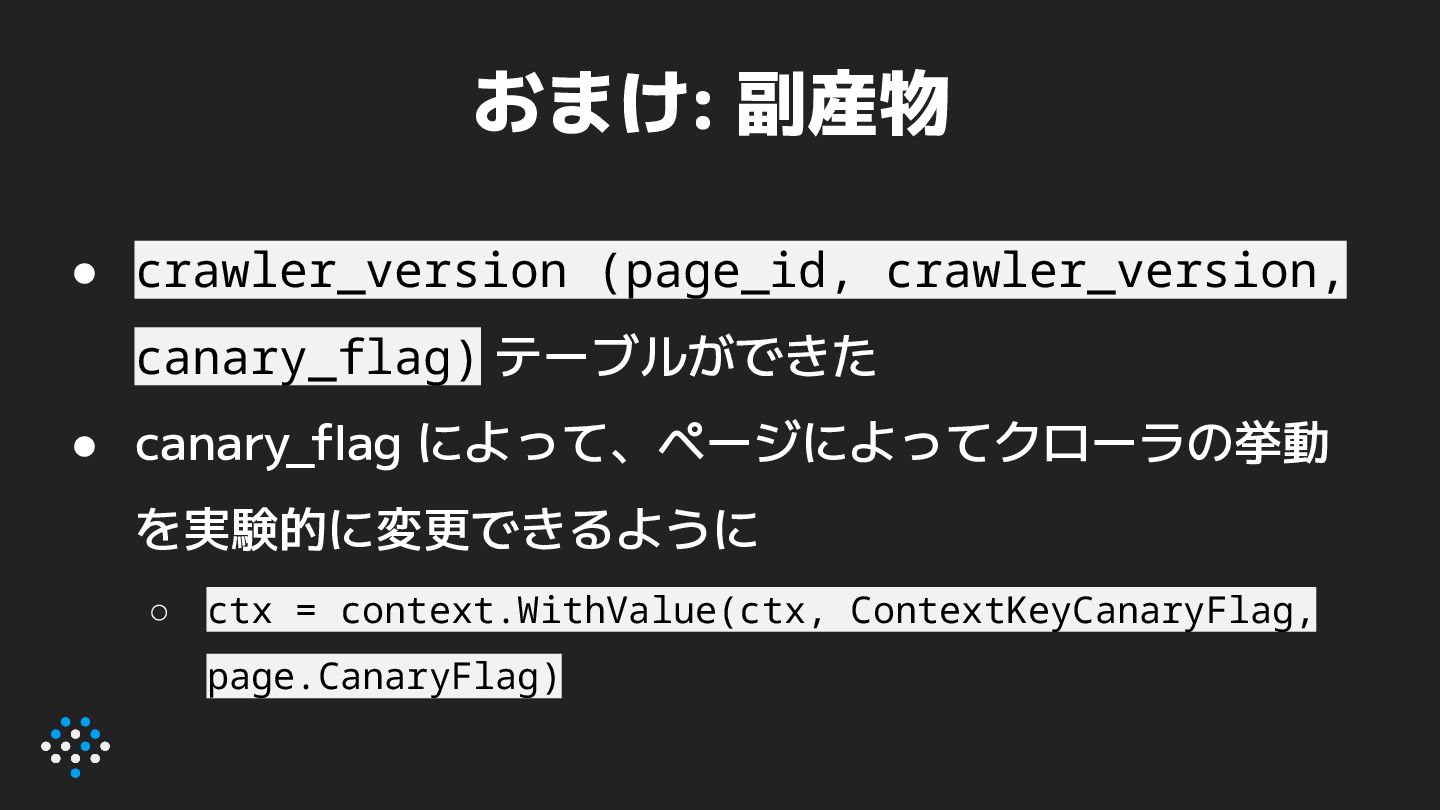
おまけ: 副産物 • crawler_version (page_id, crawler_version, canary_flag) テーブルができた • canary_flag
によって、ページによってクローラの挙動 を実験的に変更できるように ◦ ctx = context.WithValue(ctx, ContextKeyCanaryFlag, page.CanaryFlag) -
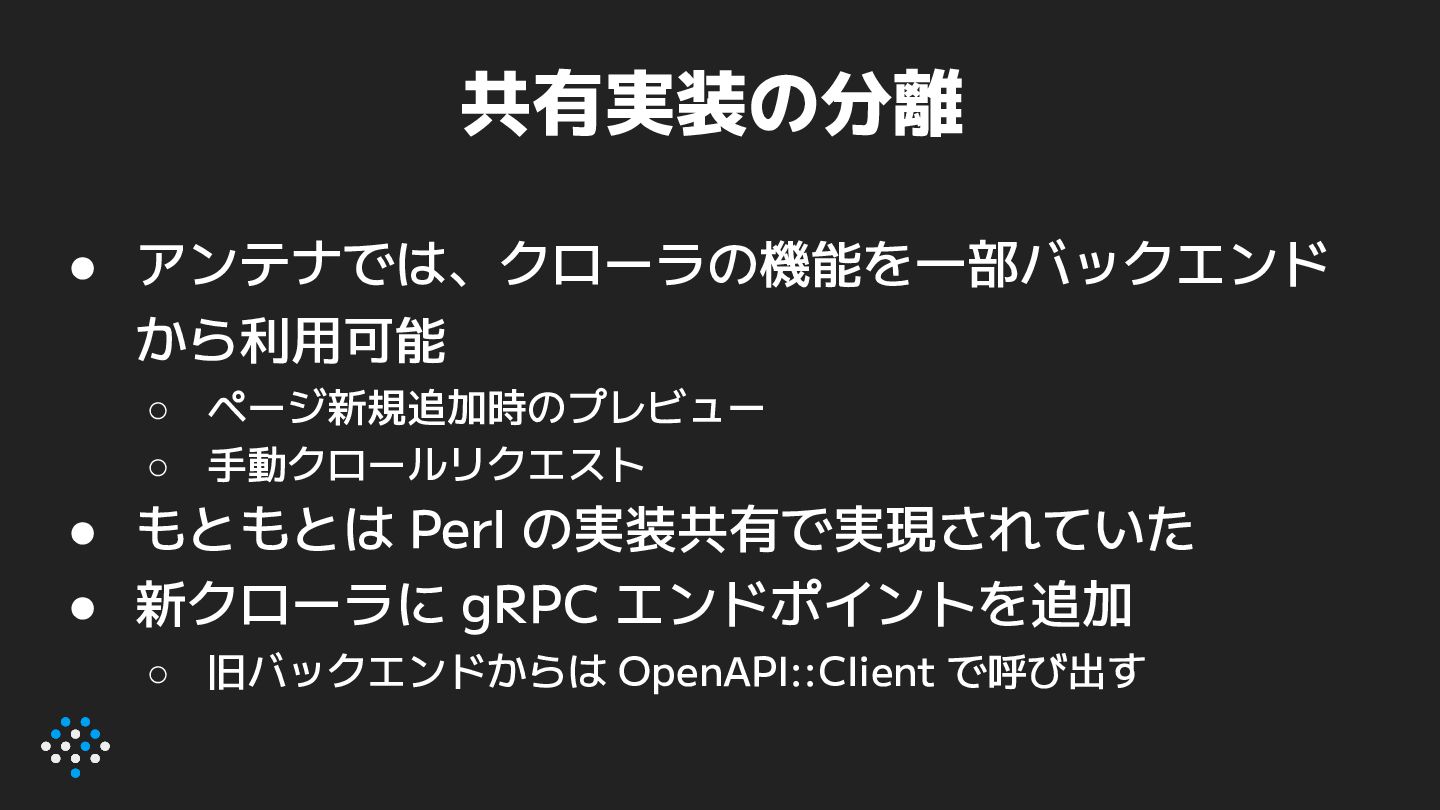
共有実装の分離 • アンテナでは、クローラの機能を一部バックエンド から利用可能 ◦ ページ新規追加時のプレビュー ◦ 手動クロールリクエスト • もともとは
Perl の実装共有で実現されていた • 新クローラに gRPC エンドポイントを追加 ◦ 旧バックエンドからは OpenAPI::Client で呼び出す -
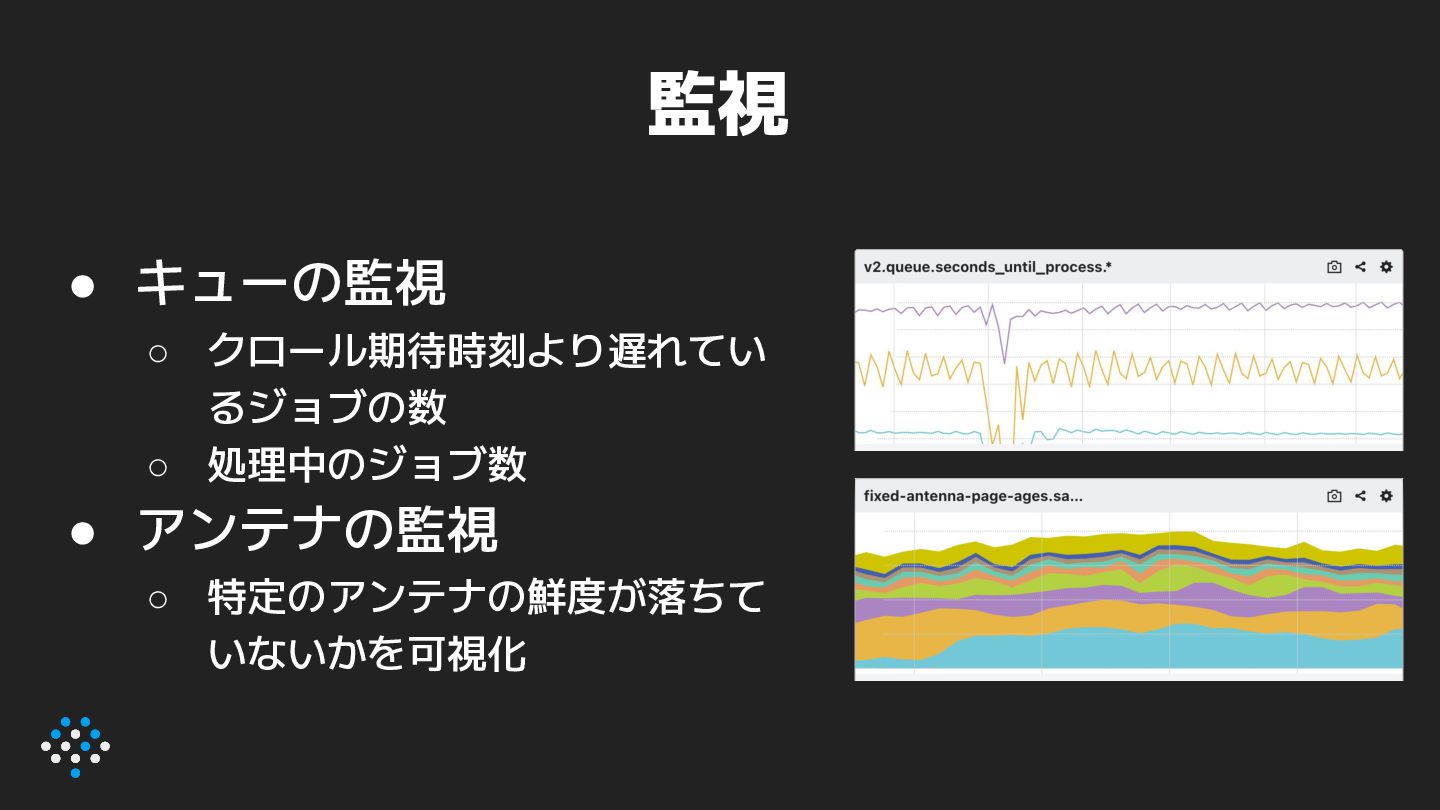
監視 • キューの監視 ◦ クロール期待時刻より遅れてい るジョブの数 ◦ 処理中のジョブ数 • アンテナの監視
◦ 特定のアンテナの鮮度が落ちて いないかを可視化