Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
AI時代でも性能試験はつらかった
Search
Negima
August 04, 2026
Technology
44
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
AI時代でも性能試験はつらかった
Negima
August 04, 2026
More Decks by Negima
See All by Negima
振り返りこそエンジニアの本領
negima
0
450
Javaで学ぶSOLID原則
negima
1
550
AIを導入する前にやるべきこと
negima
3
570
Other Decks in Technology
See All in Technology
JAWSUG TOHOKU 青森支部 「LoGoチャット」のAWS移行で 乗り越えたこと
taketakekaho
0
230
AIにシークレットを見せない、WSL2で安全な開発環境
yazm
0
180
事業活動を AI Ready にする攻めと守りのデータエンジニアリング / data-engineering-for-ai-ready-business
pei0804
7
2.7k
[AWS 秋のクラウドオペレーション祭り 2026]AWS DevOps Agentで変わる リリースと運用対応 ~リリース管理機能と Directed actions のご紹介~
furuton
4
1.2k
TinyGoでオブザーバビリティ?OpenTelemetryはTinyGoで使えるのか / Is OpenTelemetry available in TinyGo environment?
ymotongpoo
2
140
Conditional PED-ANOVA: Hyperparameter Importance in Hierarchical & Dynamic Search Spaces
pfn
PRO
0
110
遠藤な_めぐろLT #38 「社内のAI活用推進」@麻布台_20261009
endonanana
0
120
"優秀な誰か"の下位互換にならないために
yut0naga1_fa
1
1.8k
脆弱性診断って、何をしているの? 〜弱点を見つけて、会社の改善につなげるまで〜
keeg
0
900
メルペイ 会計システム概要と歴史
mewuto
1
220
「事実」を「計測」して、「解釈」する 〜AWS Lambdaのメモリ最適解の見つけ方〜
maimyyym
0
150
大型犬好きによるPugの紹介
yamanoku
1
150
Featured
See All Featured
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
Between Models and Reality
mayunak
4
490
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
Done Done
chrislema
187
17k
The World Runs on Bad Software
bkeepers
PRO
72
12k
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M
Improving Core Web Vitals using Speculation Rules API
sergeychernyshev
21
1.7k
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.8k
Data-driven link building: lessons from a $708K investment (BrightonSEO talk)
szymonslowik
1
1.4k
JavaScript: Past, Present, and Future - NDC Porto 2020
reverentgeek
52
6.1k
Documentation Writing (for coders)
carmenintech
77
5.6k
30 Presentation Tips
portentint
PRO
1
430
Transcript
AI時代でも 性能試験はつらかった Aug 5, 2026 X:@negimaboy_1293 @Re+ LT会 #6 Negima
皆さんが管理しているDB 3年後に何件積まれていますか︖
そのDBには3年後どのように データが積まれていますか︖
$ whoami Negima(根本 銀河) 2023卒 • NTTデータフィナンシャルテクノロジー 決済イノベーション事業部 • クレジットカード会社向けサービスのSRE・性能改善・AI導⼊⽀援など
• Javaとソフトウェアアーキテクチャの話が好き • JJUGとか地域の技術コミュニティでちょこちょこ登壇している
現在の案件の性能試験事情 現在の案件の特徴 • 2025年にリリースされたクレジットカード会社向けの業務代⾏サービス • 決済中継のようなリアルタイム処理ではなくバッチ処理がメインのシステム、 ユーザが触るWebもあるにはある • DBはMySQLを使⽤し、テーブル数は300弱 •
開発チームは⼯数的に単性能試験を実施する余裕がなく、 性能担保はSRE(⾃チーム)に依存する
現在の案件の性能試験事情
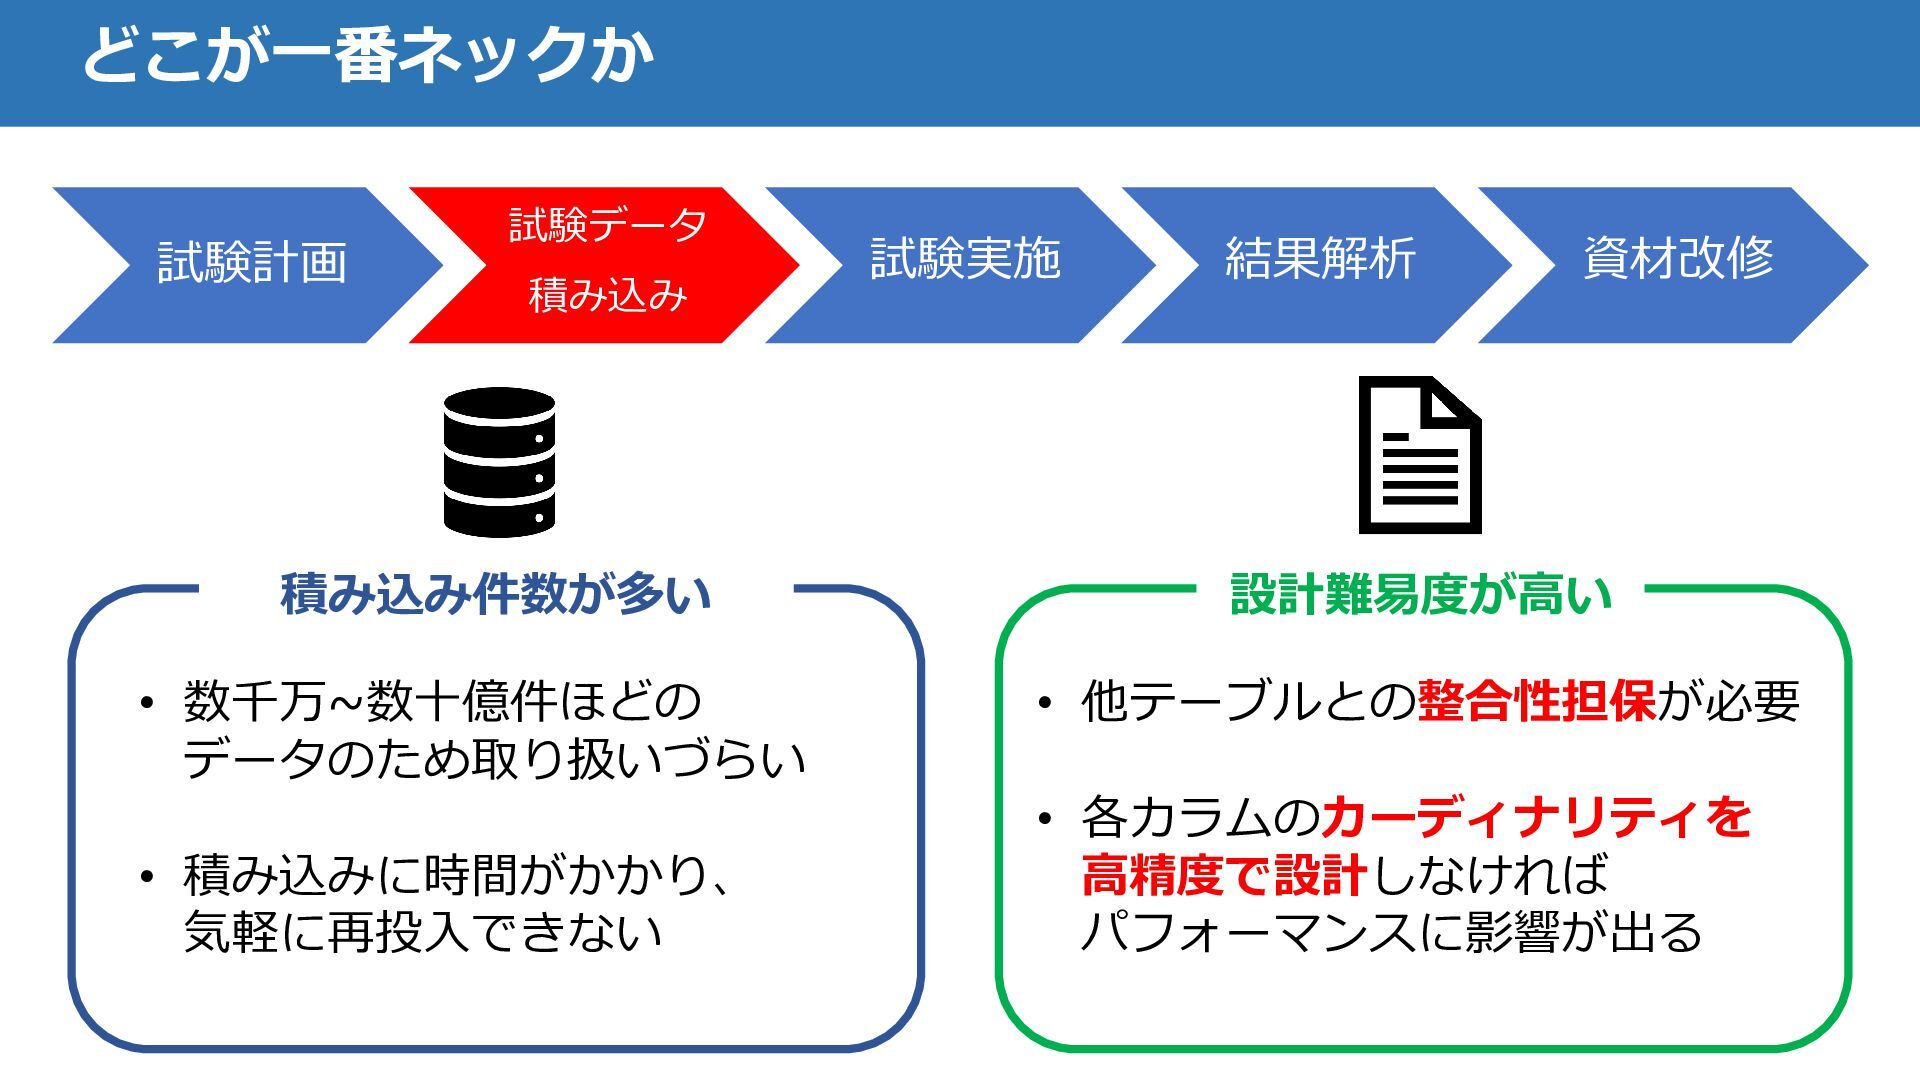
どこが⼀番ネックか 試験計画 試験データ 積み込み 試験実施 結果解析 資材改修 積み込み件数が多い 設計難易度が⾼い •
数千万~数⼗億件ほどの データのため取り扱いづらい • 他テーブルとの整合性担保が必要 • 積み込みに時間がかかり、 気軽に再投⼊できない • 各カラムのカーディナリティを ⾼精度で設計しなければ パフォーマンスに影響が出る
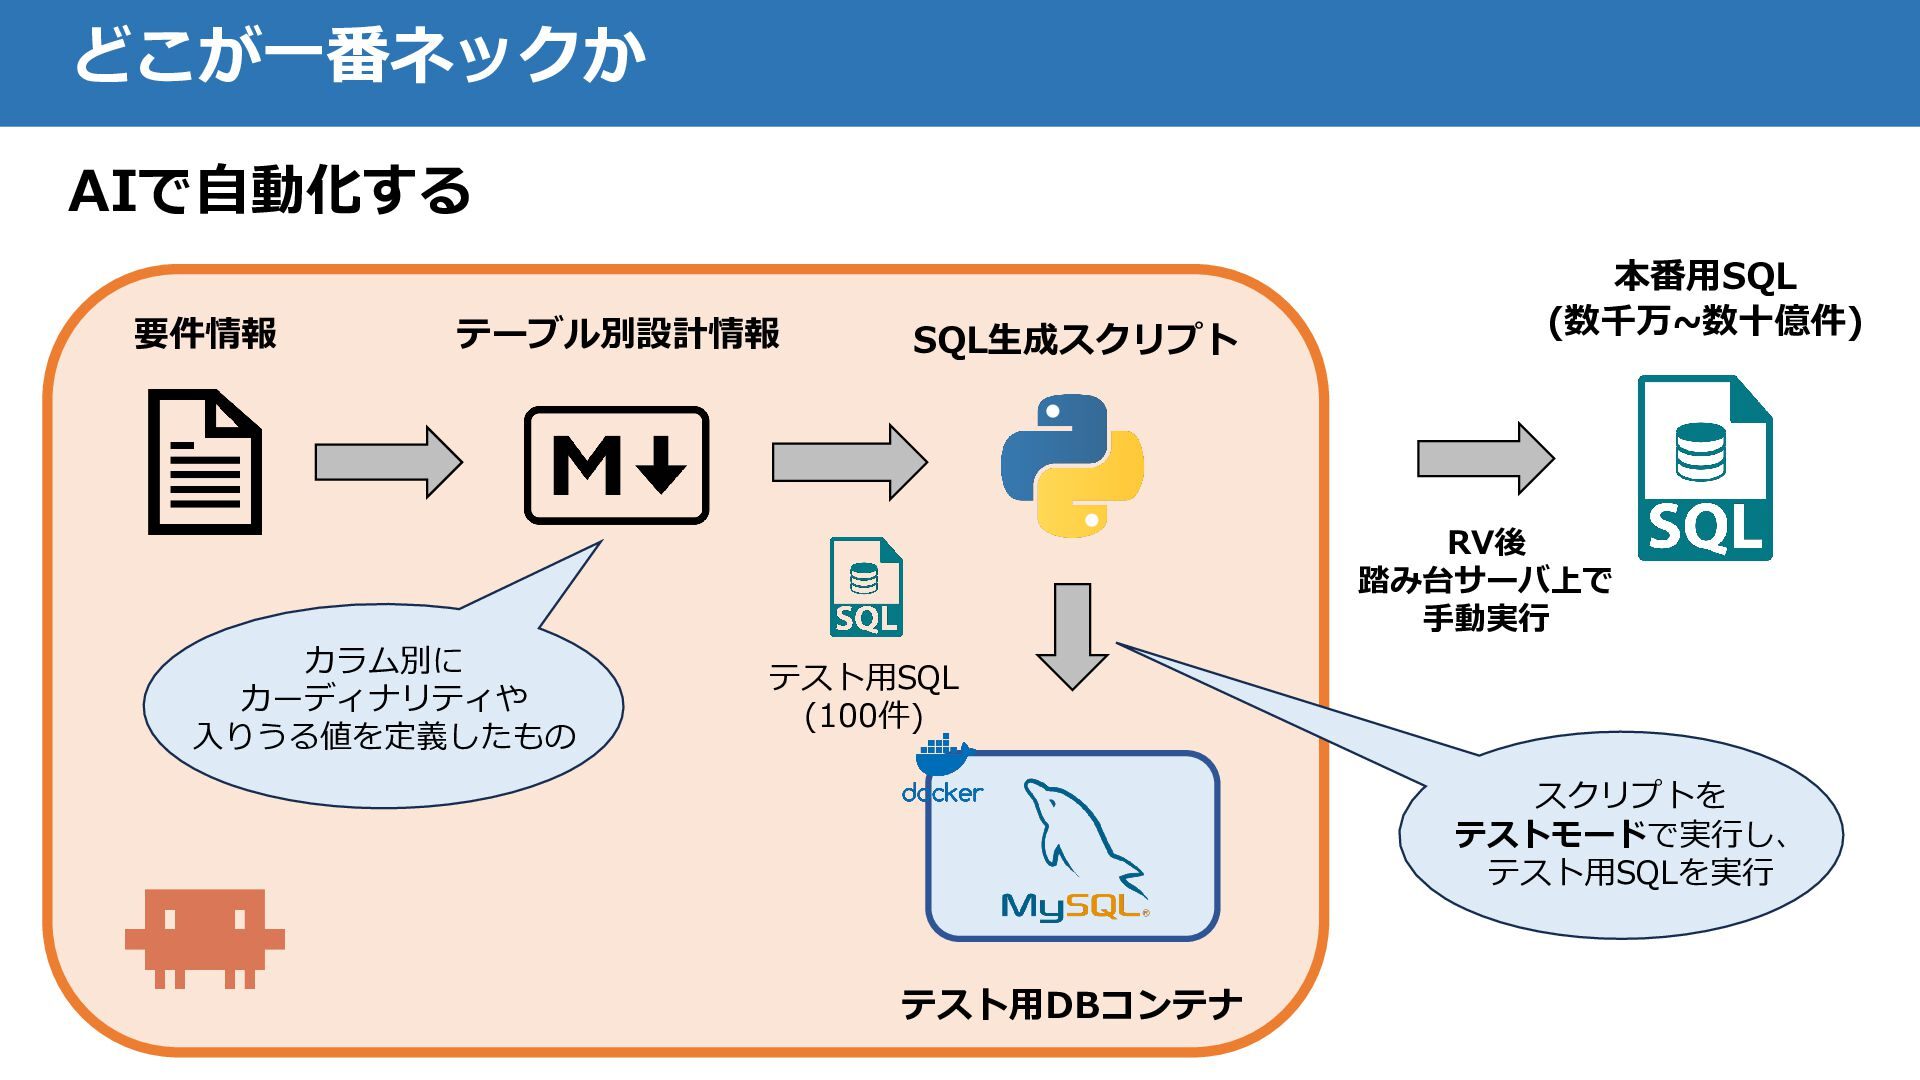
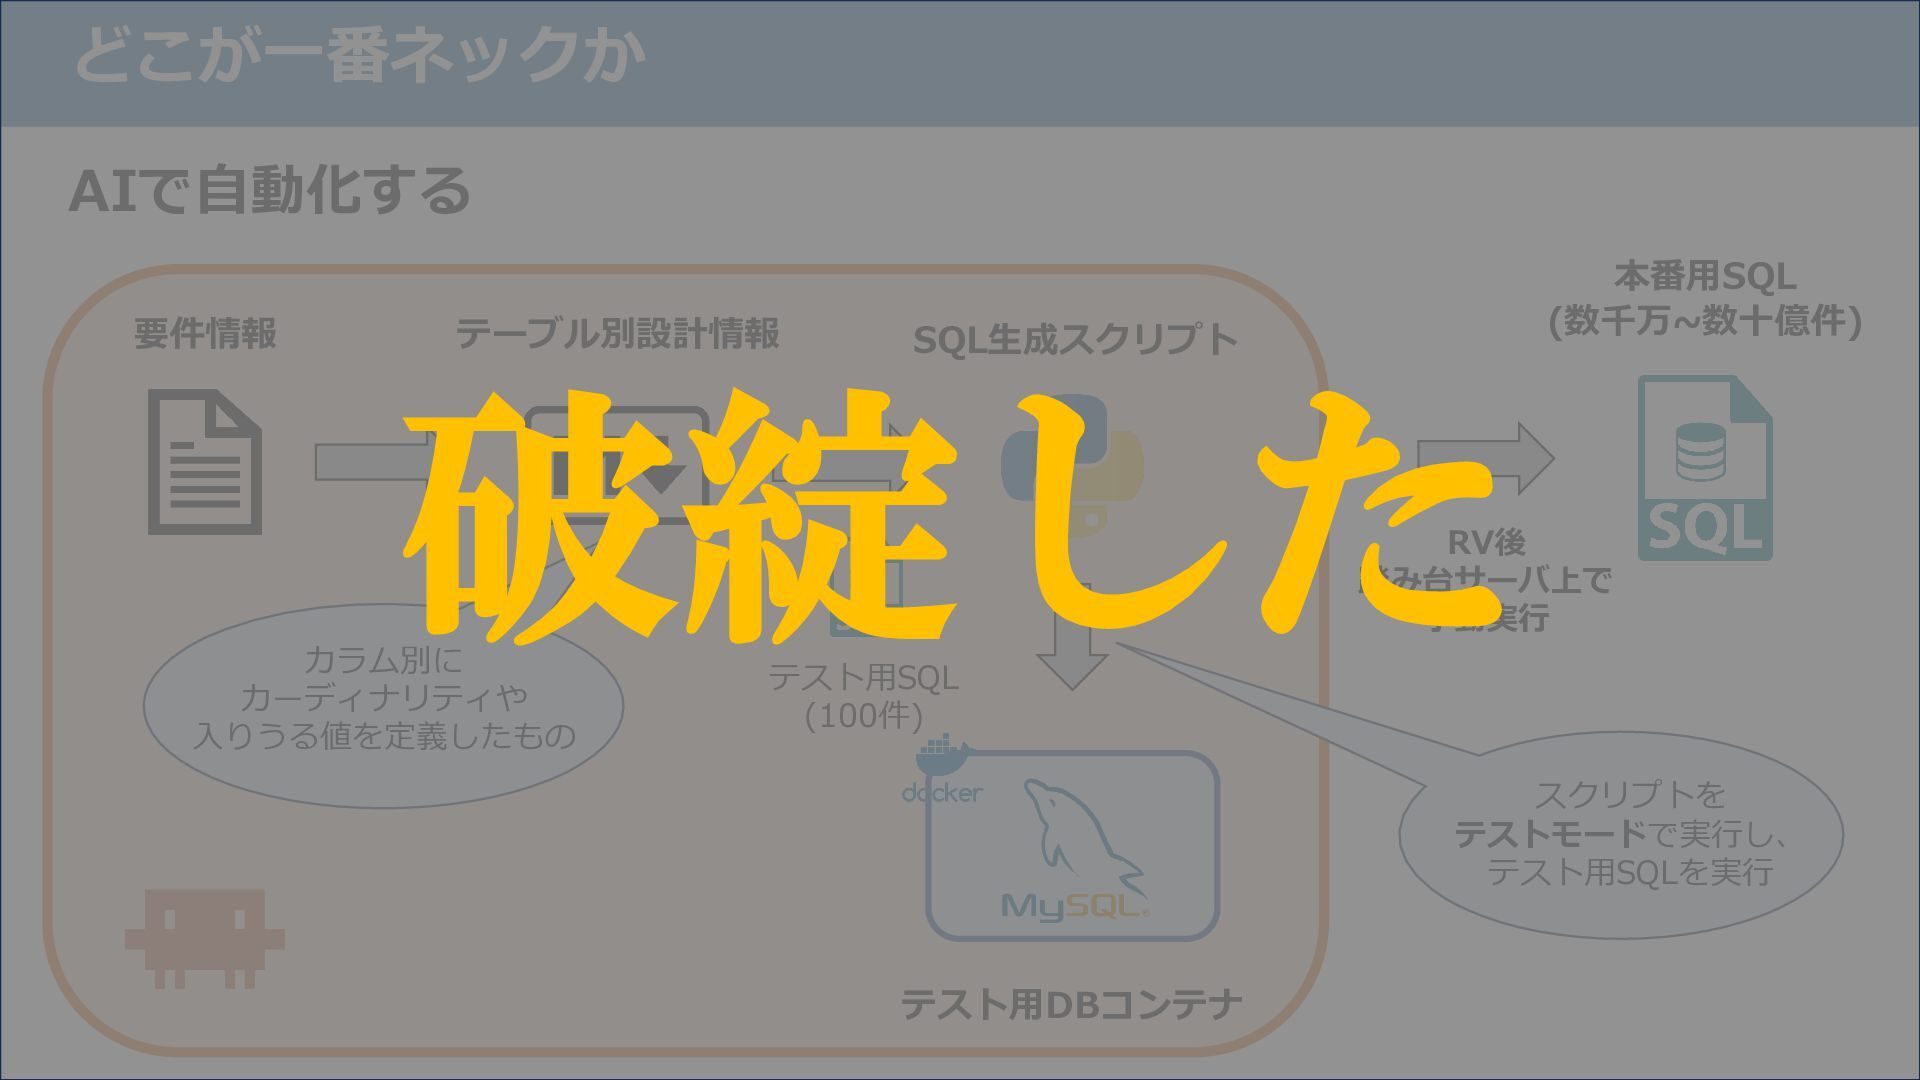
どこが⼀番ネックか AIで⾃動化する 要件情報 テーブル別設計情報 カラム別に カーディナリティや ⼊りうる値を定義したもの SQL⽣成スクリプト 本番⽤SQL (数千万~数⼗億件)
RV後 踏み台サーバ上で ⼿動実⾏ テスト⽤SQL (100件) スクリプトを テストモードで実⾏し、 テスト⽤SQLを実⾏ テスト⽤DBコンテナ
どこが⼀番ネックか AIで⾃動化する 要件情報 テーブル別設計情報 本番⽤SQL (数千万~数⼗億件) SQL⽣成スクリプト 破綻した カラム別に カーディナリティや
⼊りうる値を定義したもの RV後 踏み台サーバ上で ⼿動実⾏ テスト⽤SQL (100件) スクリプトを テストモードで実⾏し、 テスト⽤SQLを実⾏ テスト⽤DBコンテナ
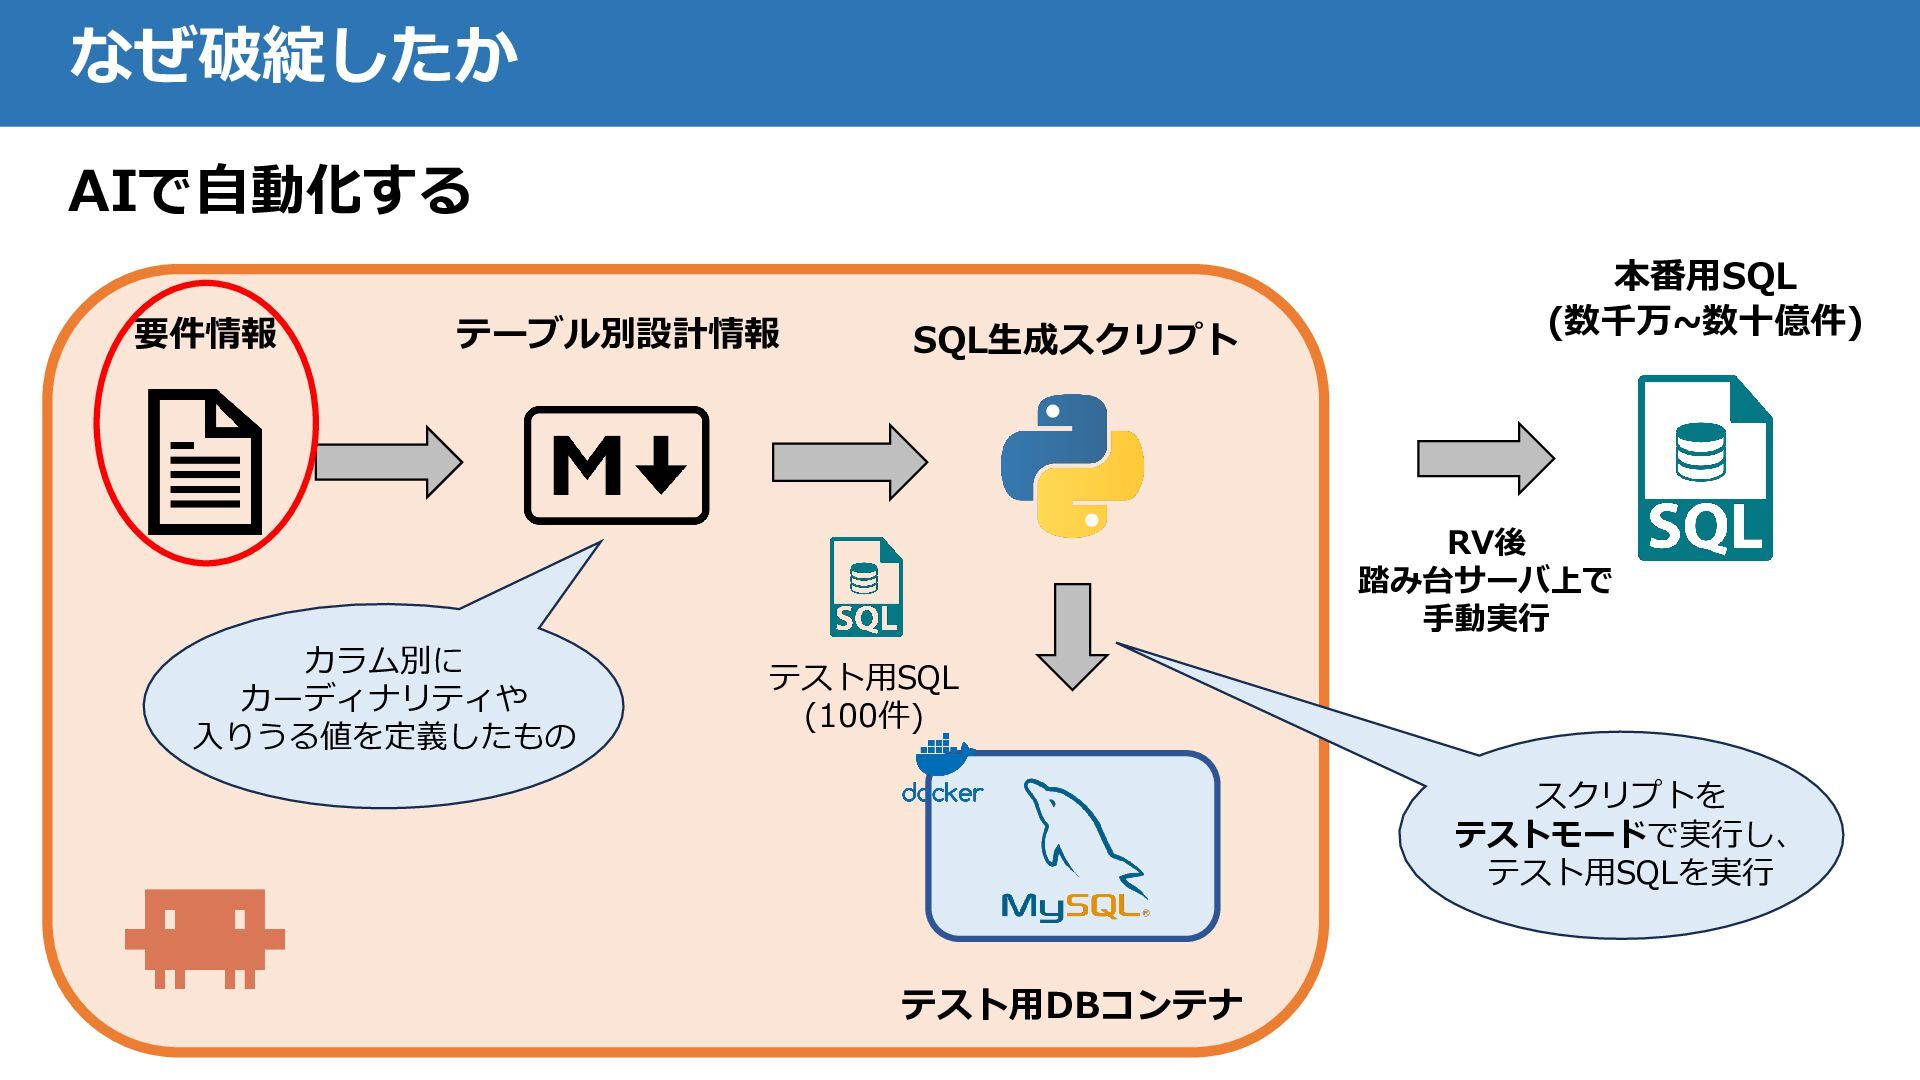
なぜ破綻したか AIで⾃動化する 要件情報 テーブル別設計情報 カラム別に カーディナリティや ⼊りうる値を定義したもの SQL⽣成スクリプト 本番⽤SQL (数千万~数⼗億件)
RV後 踏み台サーバ上で ⼿動実⾏ テスト⽤SQL (100件) スクリプトを テストモードで実⾏し、 テスト⽤SQLを実⾏ テスト⽤DBコンテナ
なぜ破綻したか 要件情報︖
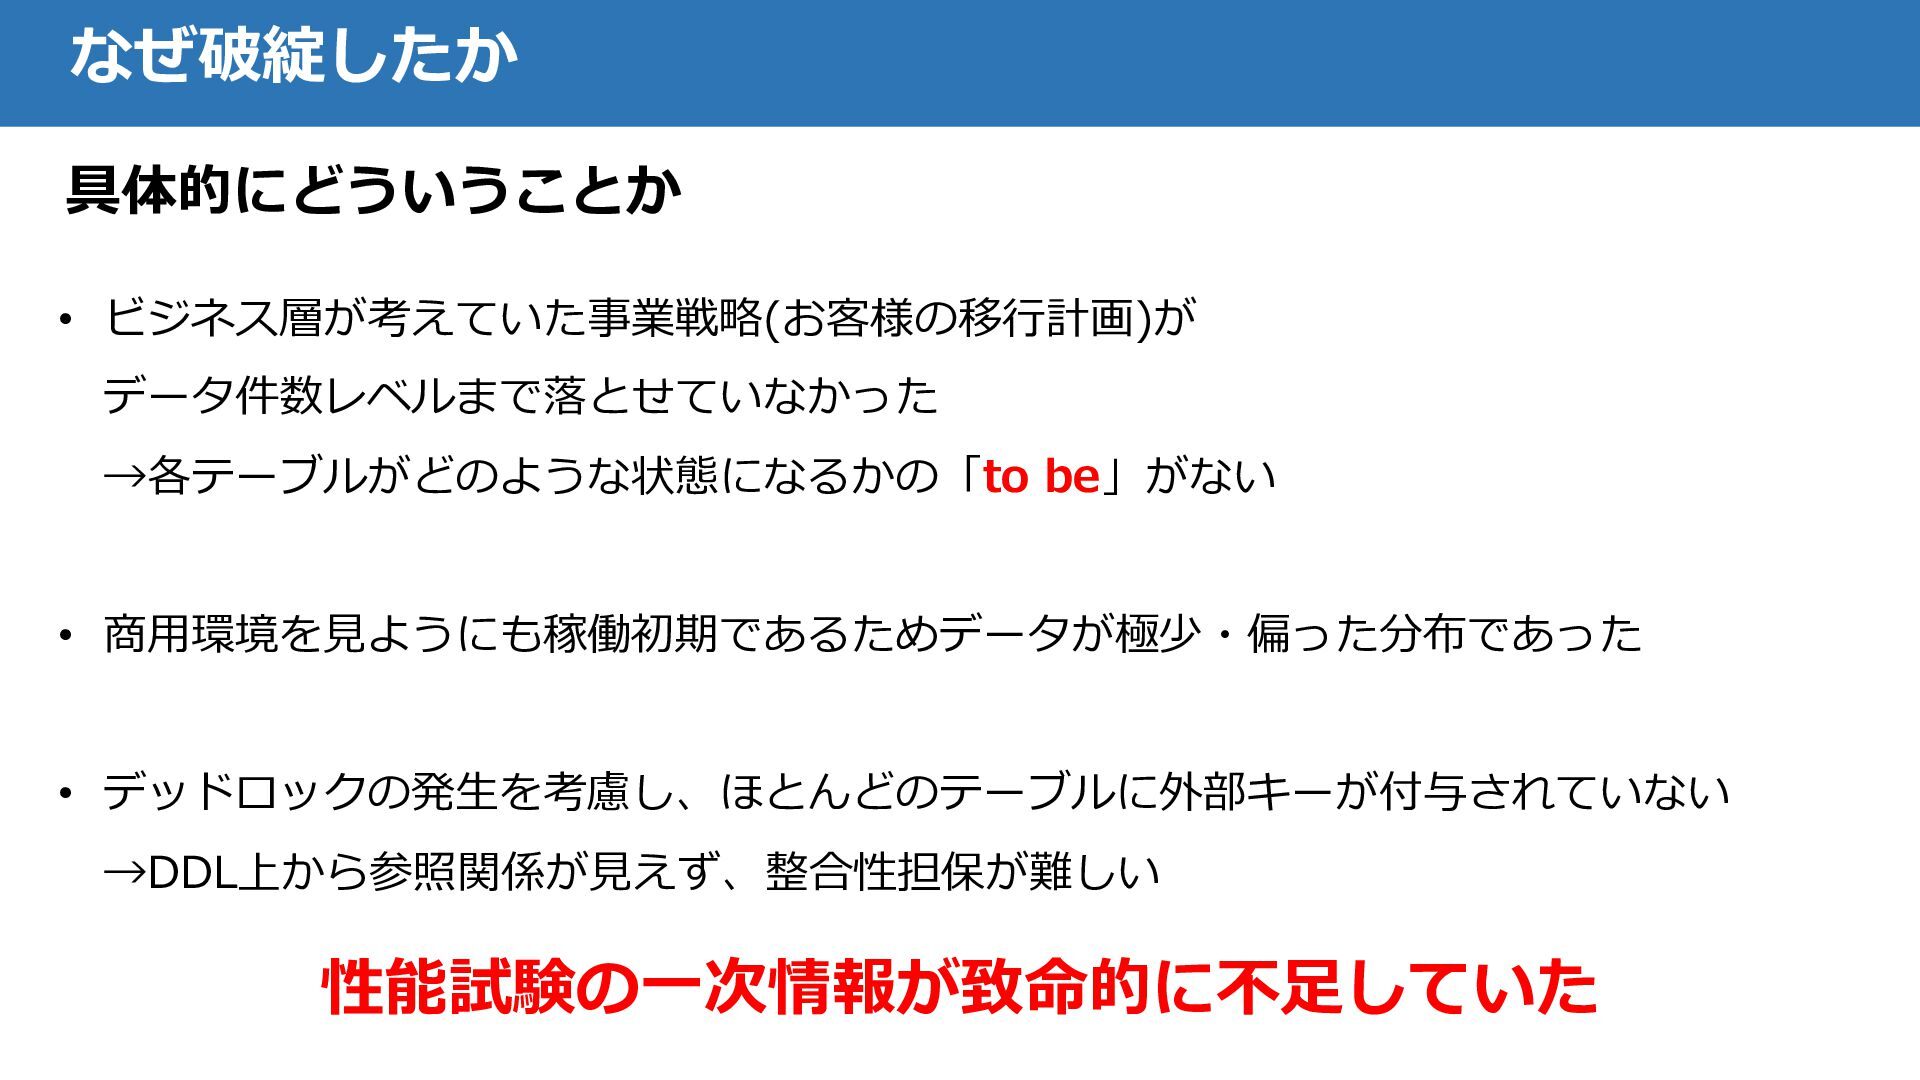
なぜ破綻したか 具体的にどういうことか • ビジネス層が考えていた事業戦略(お客様の移⾏計画)が データ件数レベルまで落とせていなかった →各テーブルがどのような状態になるかの「to be」がない • 商⽤環境を⾒ようにも稼働初期であるためデータが極少・偏った分布であった •
デッドロックの発⽣を考慮し、ほとんどのテーブルに外部キーが付与されていない →DDL上から参照関係が⾒えず、整合性担保が難しい 性能試験の⼀次情報が致命的に不⾜していた
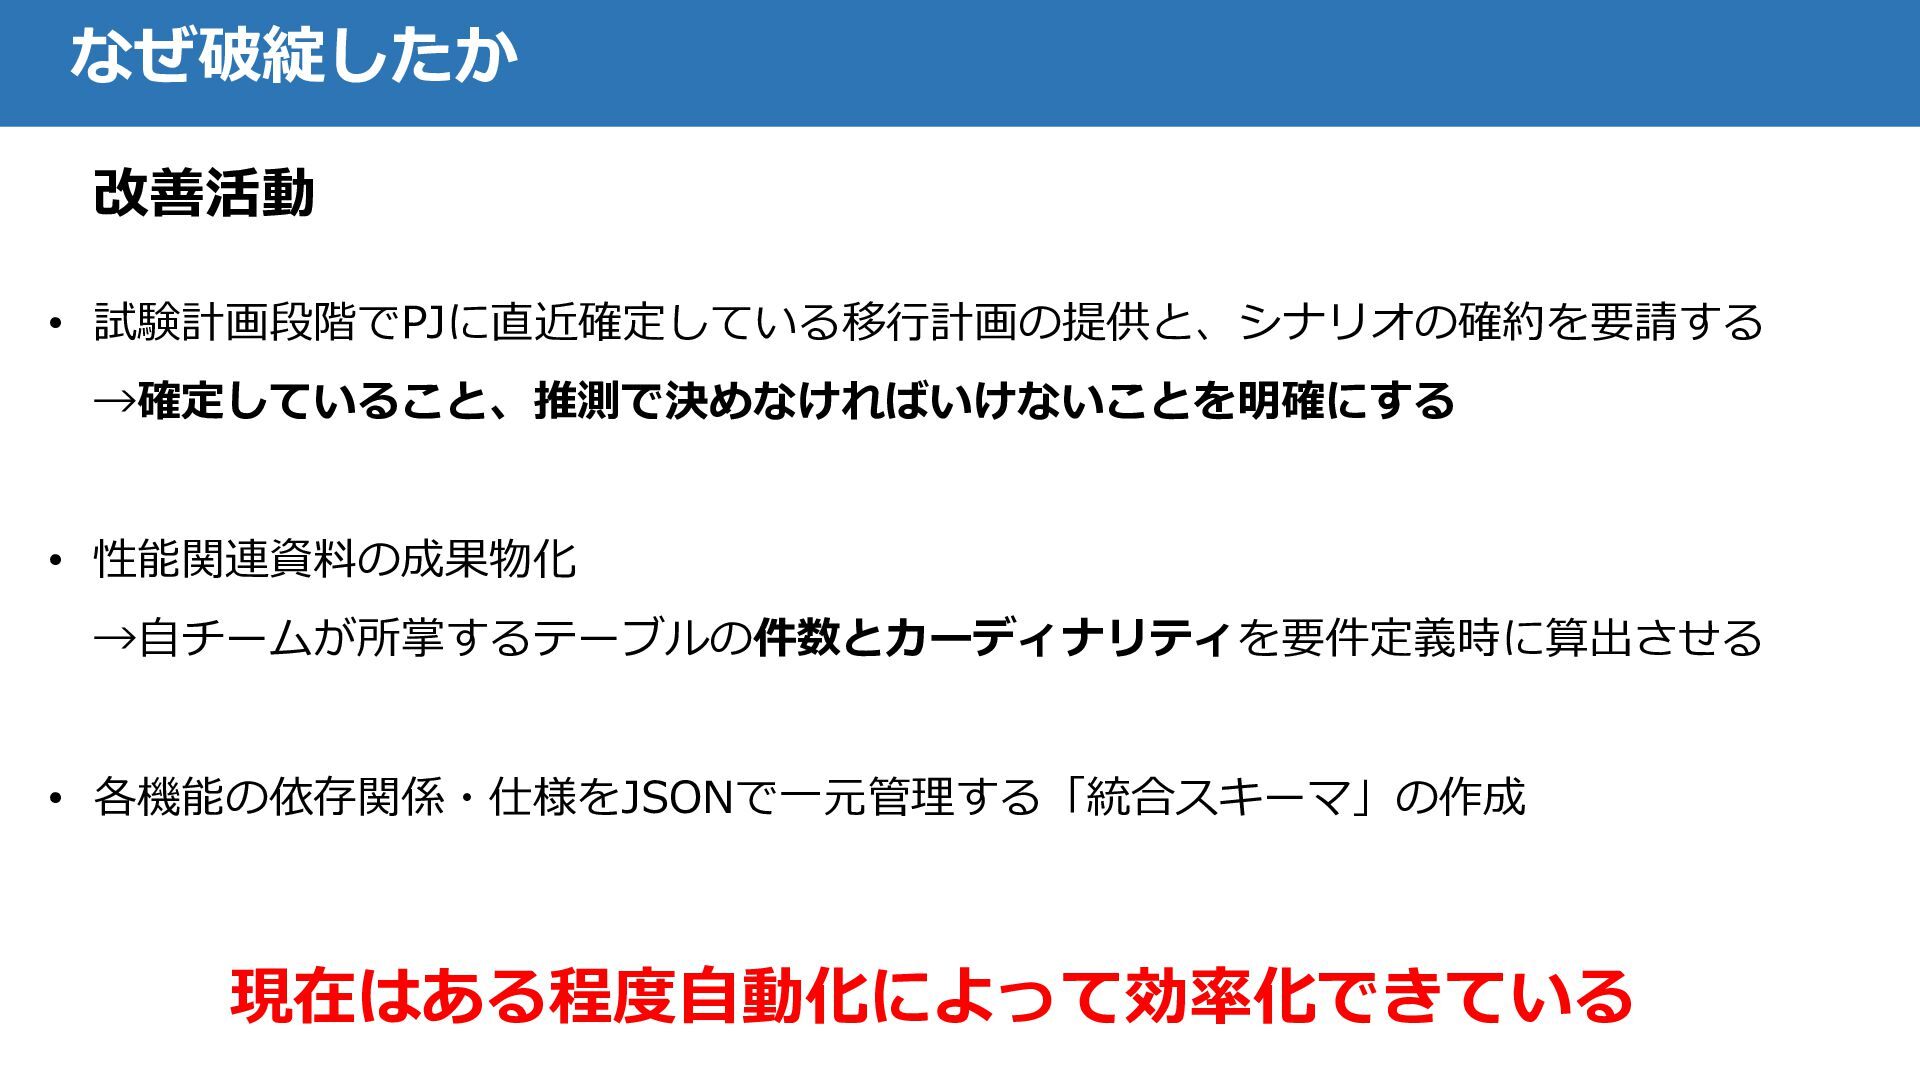
なぜ破綻したか 改善活動 • 試験計画段階でPJに直近確定している移⾏計画の提供と、シナリオの確約を要請する →確定していること、推測で決めなければいけないことを明確にする • 性能関連資料の成果物化 →⾃チームが所掌するテーブルの件数とカーディナリティを要件定義時に算出させる • 各機能の依存関係・仕様をJSONで⼀元管理する「統合スキーマ」の作成
現在はある程度⾃動化によって効率化できている
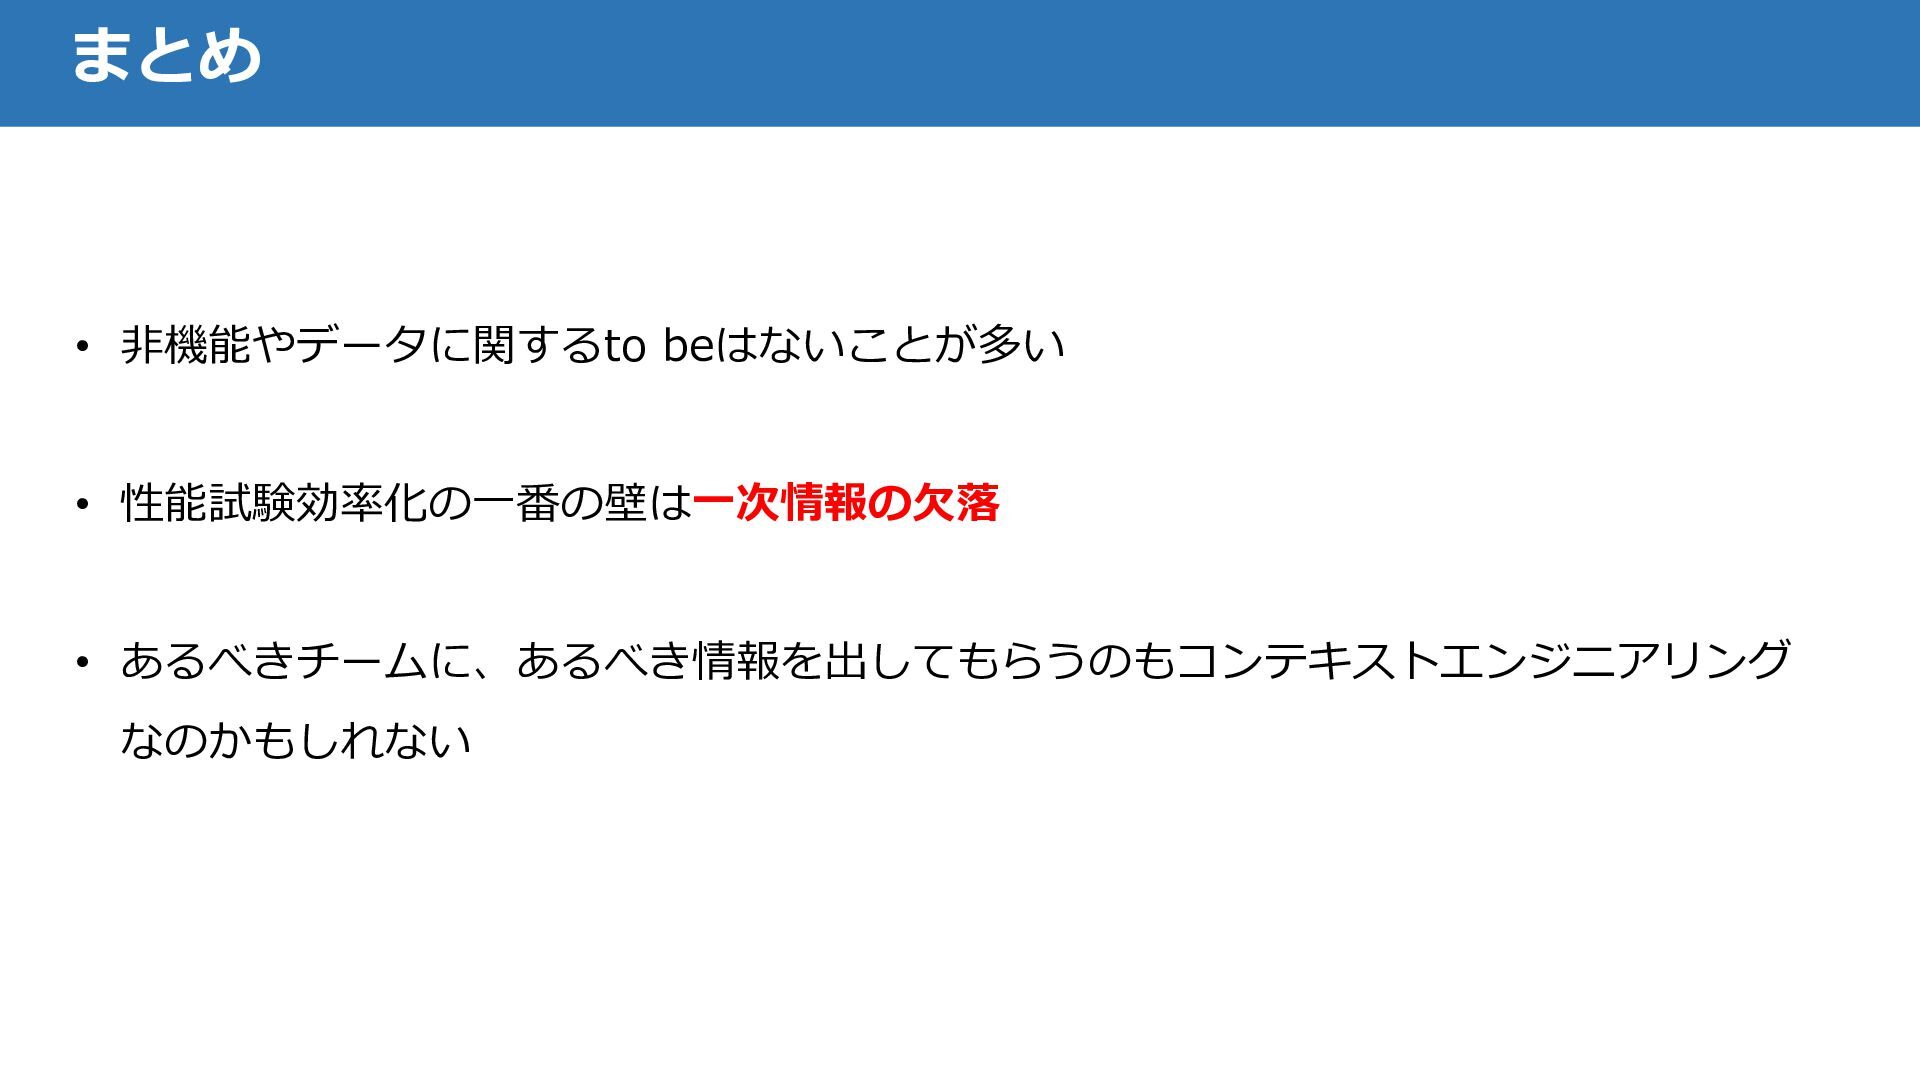
まとめ • ⾮機能やデータに関するto beはないことが多い • 性能試験効率化の⼀番の壁は⼀次情報の⽋落 • あるべきチームに、あるべき情報を出してもらうのもコンテキストエンジニアリング なのかもしれない
皆さんが管理しているDB 3年後に何件積まれていますか︖
そのDBには3年後どのように データが積まれていますか︖
Enjoy your hacking︕


 negima
 taketakekaho
 yazm
 pei0804
 furuton
 ymotongpoo
 pfn
 endonanana
 yut0naga1_fa
 keeg
 mewuto
 maimyyym
 yamanoku
 mongodb
 mayunak
 aleyda
 chrislema
 bkeepers
 sugarenia
 sergeychernyshev
 rmw
 szymonslowik
 reverentgeek
 carmenintech
 portentint