Share
Embed
CA20新卒研修 Redshift Hands-on
株式会社サイバーエージェントのAI事業本部にて、2020年度新卒のデータサイエンティスト向けにRedshiftのハンズオン研修を行ないました。
nkato
May 08, 2020
Transcript
54 slides
-
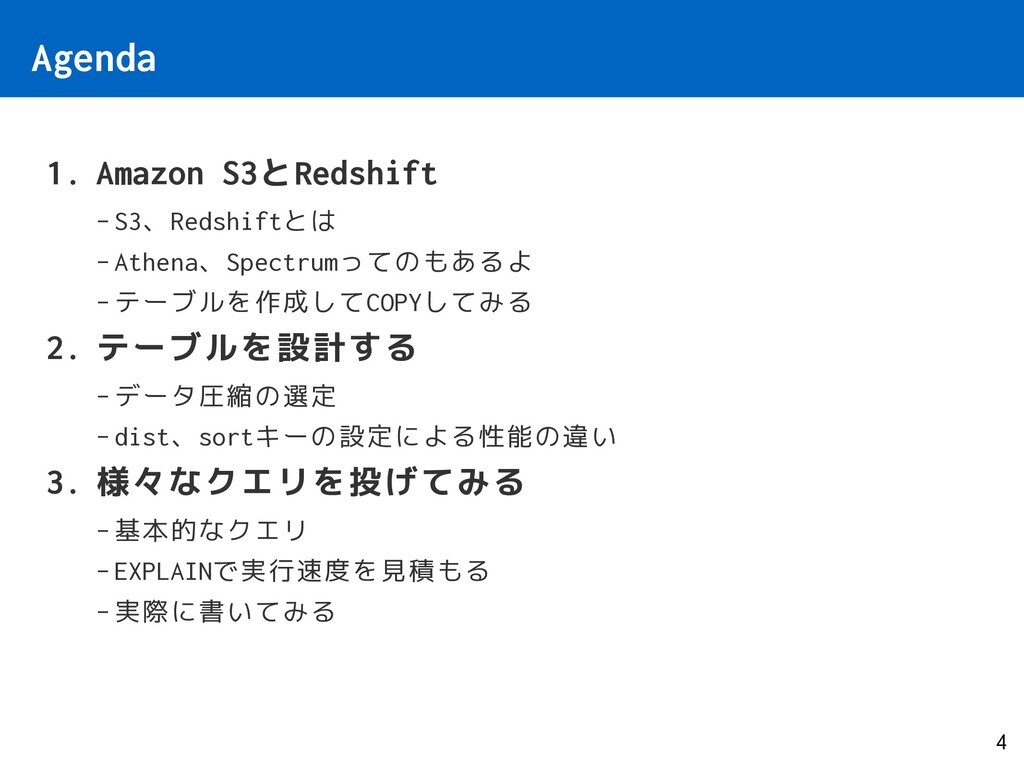
Agenda 1. Amazon S3とRedshift -S3、Redshiftとは -Athena、Spectrumってのもあるよ -テーブルを作成してCOPYしてみる 2. テーブルを設計する -データ圧縮の選定
-dist、sortキーの設定による性能の違い 3. 様々なクエリを投げてみる -基本的なクエリ -EXPLAINで実行速度を見積もる -実際に書いてみる 4 -
1. Amazon S3とRedshift Amazon S3: - Amazon Simple Storage Serviceの略
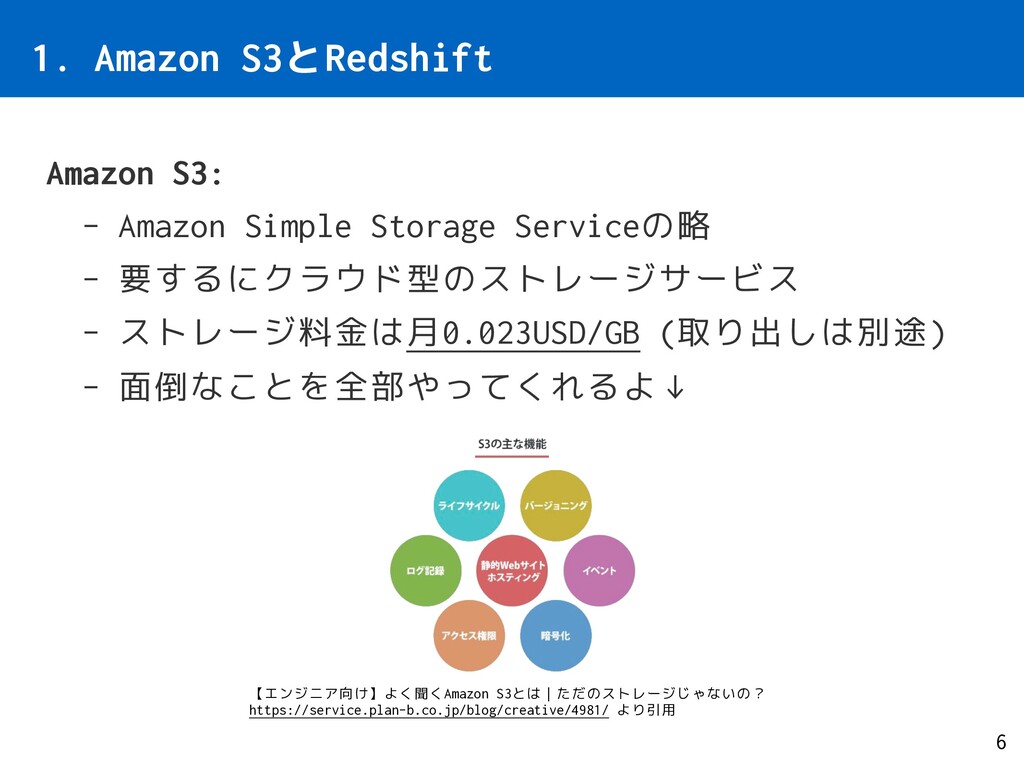
- 要するにクラウド型のストレージサービス - ストレージ料金は月0.023USD/GB (取り出しは別途) - 面倒なことを全部やってくれるよ↓ 6 【エンジニア向け】よく聞くAmazon S3とは|ただのストレージじゃないの? https://service.plan-b.co.jp/blog/creative/4981/ より引用 -
1. Amazon S3とRedshift Amazon Redshift: - クラウド型のデータウェアハウスサービス - 継続的な書き込みや更新には向いていない -
一括データ書込・大容量データ読出に最適化 - 並列コンピューティング - 列指向ストレージ 7 -
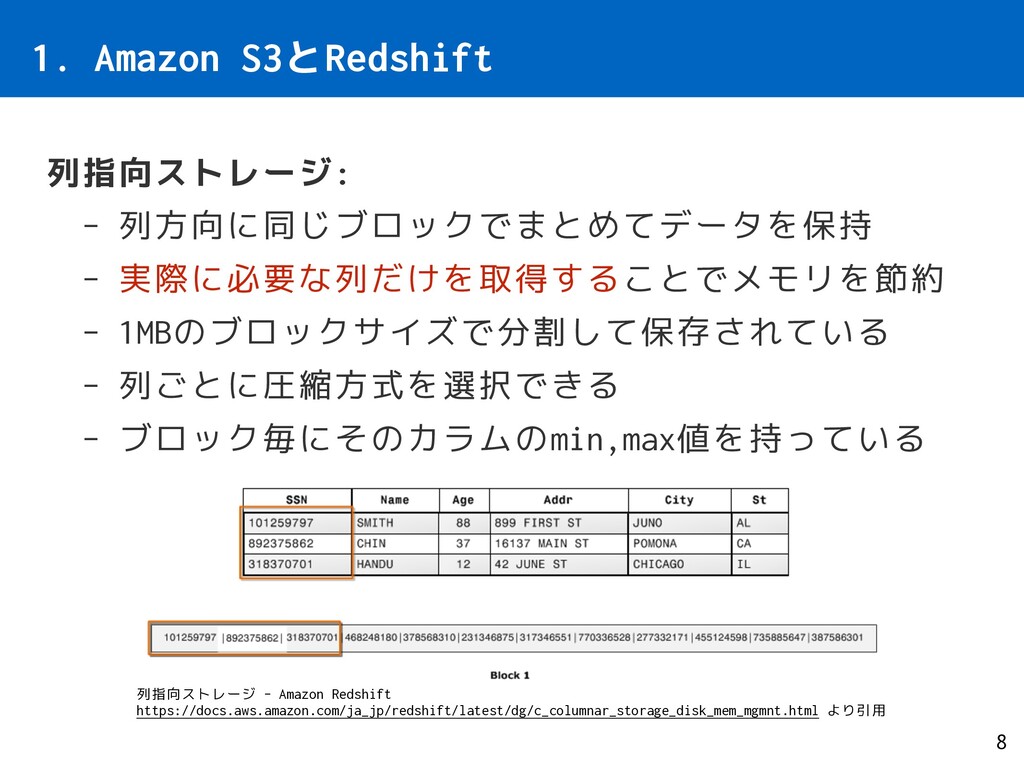
1. Amazon S3とRedshift 列指向ストレージ: - 列方向に同じブロックでまとめてデータを保持 - 実際に必要な列だけを取得することでメモリを節約 - 1MBのブロックサイズで分割して保存されている
- 列ごとに圧縮方式を選択できる - ブロック毎にそのカラムのmin,max値を持っている 8 列指向ストレージ - Amazon Redshift https://docs.aws.amazon.com/ja_jp/redshift/latest/dg/c_columnar_storage_disk_mem_mgmnt.html より引用 -
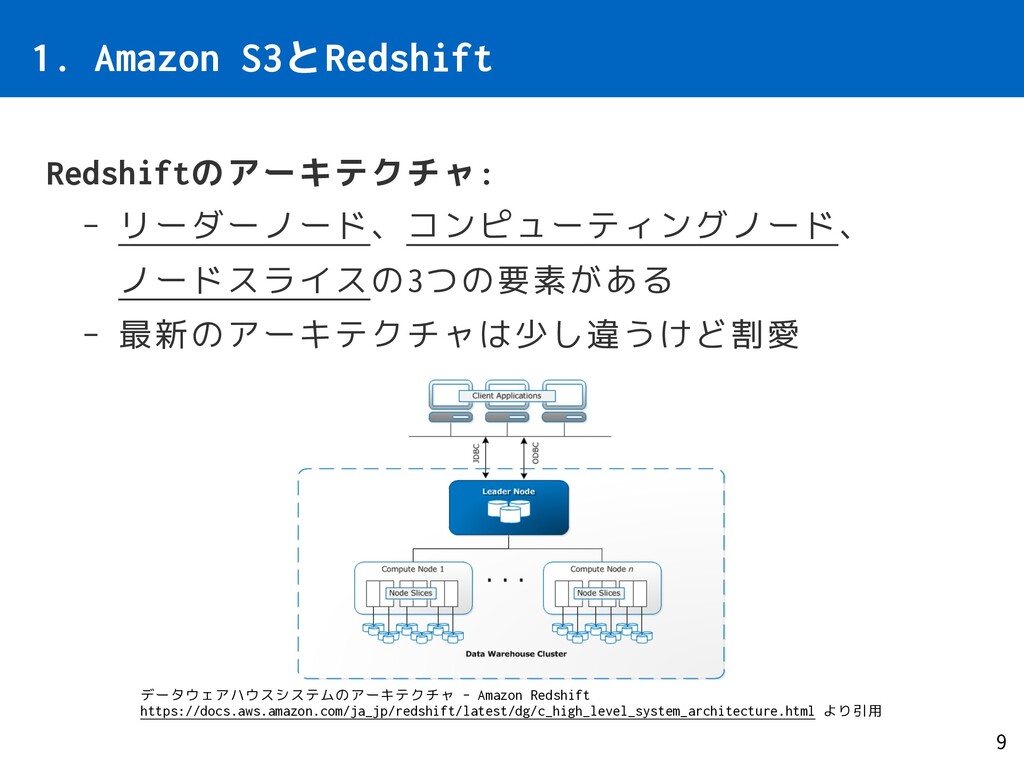
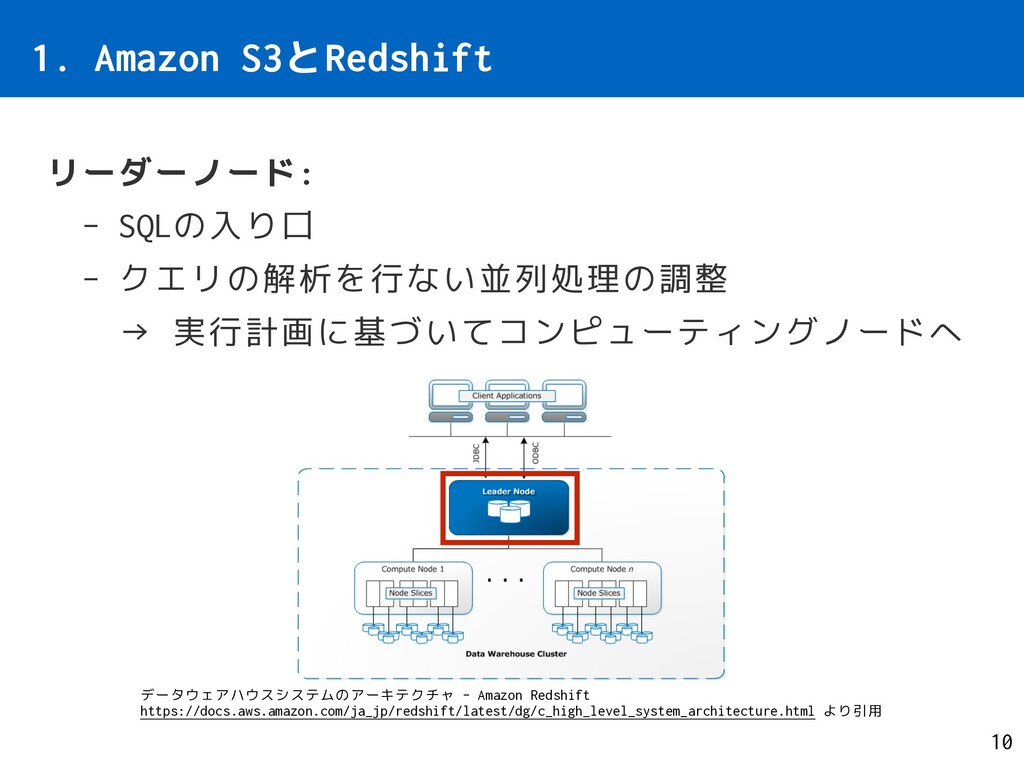
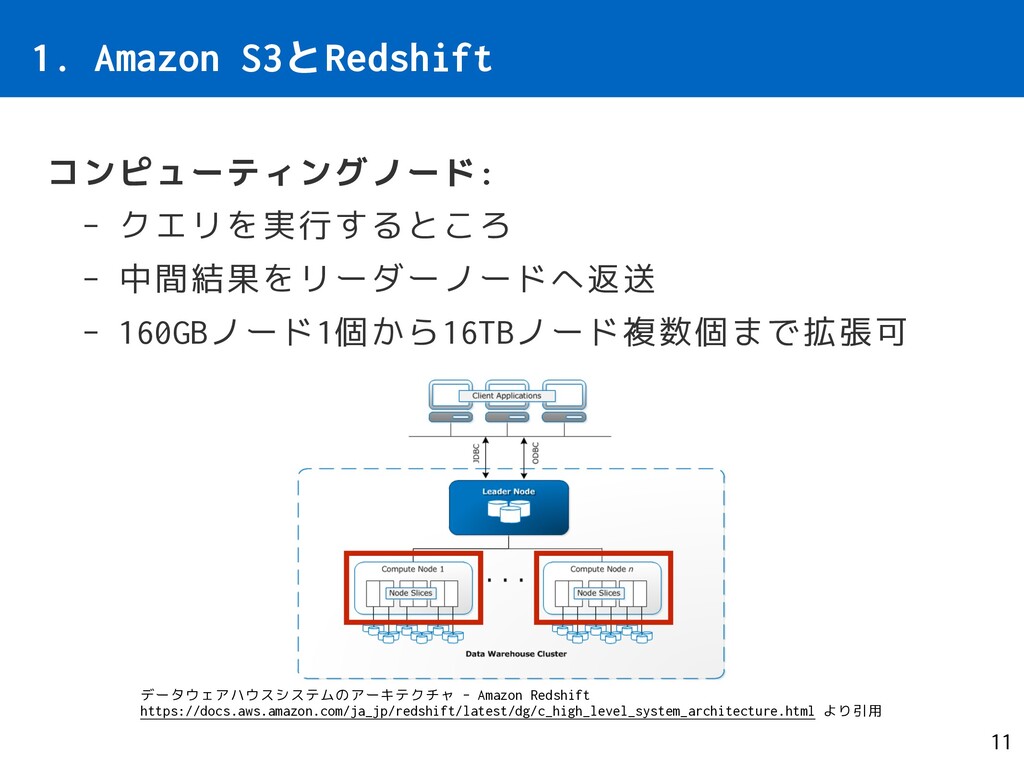
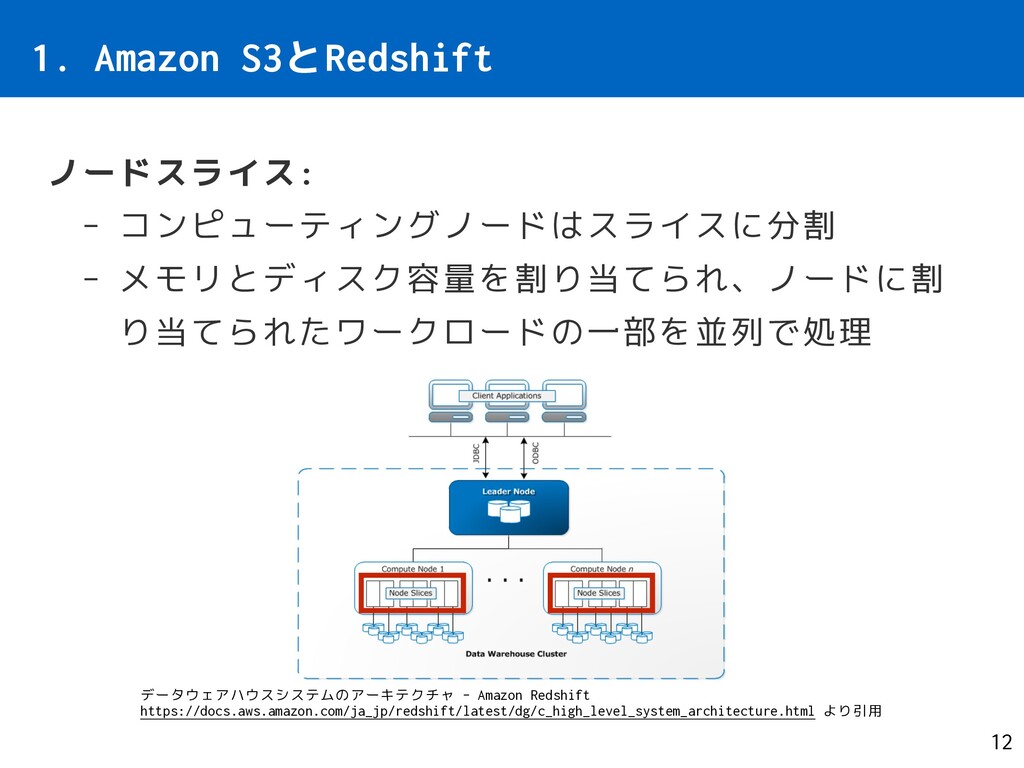
1. Amazon S3とRedshift Redshiftのアーキテクチャ: - リーダーノード、コンピューティングノード、 ノードスライスの3つの要素がある - 最新のアーキテクチャは少し違うけど割愛 9
データウェアハウスシステムのアーキテクチャ - Amazon Redshift https://docs.aws.amazon.com/ja_jp/redshift/latest/dg/c_high_level_system_architecture.html より引用 -
1. Amazon S3とRedshift リーダーノード: - SQLの入り口 - クエリの解析を行ない並列処理の調整 → 実行計画に基づいてコンピューティングノードへ
10 データウェアハウスシステムのアーキテクチャ - Amazon Redshift https://docs.aws.amazon.com/ja_jp/redshift/latest/dg/c_high_level_system_architecture.html より引用 -
1. Amazon S3とRedshift コンピューティングノード: - クエリを実行するところ - 中間結果をリーダーノードへ返送 - 160GBノード1個から16TBノード複数個まで拡張可
11 データウェアハウスシステムのアーキテクチャ - Amazon Redshift https://docs.aws.amazon.com/ja_jp/redshift/latest/dg/c_high_level_system_architecture.html より引用 -
データウェアハウスシステムのアーキテクチャ - Amazon Redshift https://docs.aws.amazon.com/ja_jp/redshift/latest/dg/c_high_level_system_architecture.html より引用 1. Amazon S3とRedshift ノードスライス:
- コンピューティングノードはスライスに分割 - メモリとディスク容量を割り当てられ、ノードに割 り当てられたワークロードの一部を並列で処理 12 -
1. Amazon S3とRedshift ざっくりこんな感じで使うよ: - S3にデータを貯める - S3からRedshiftにデータをCOPY - Redshiftでクエリを叩いて分析
- Redshiftのクエリ結果をS3にUNLOAD - etc... 13 -
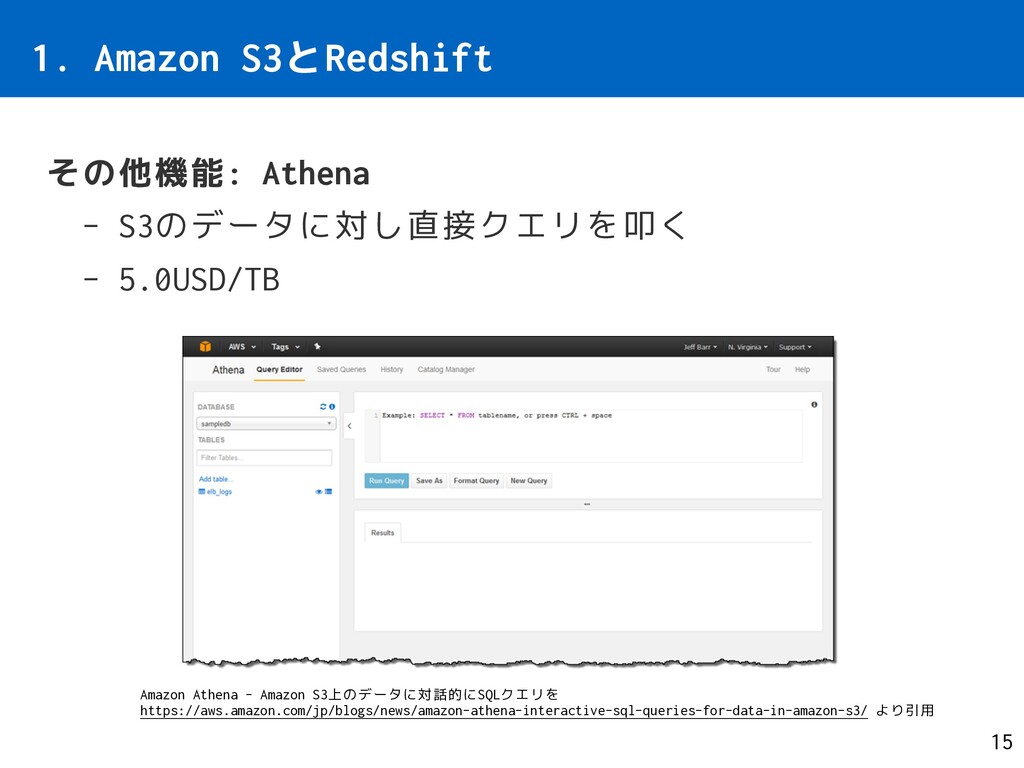
1. Amazon S3とRedshift その他機能: Athena - S3のデータに対し直接クエリを叩く - 5.0USD/TB 15
Amazon Athena - Amazon S3上のデータに対話的にSQLクエリを https://aws.amazon.com/jp/blogs/news/amazon-athena-interactive-sql-queries-for-data-in-amazon-s3/ より引用 -
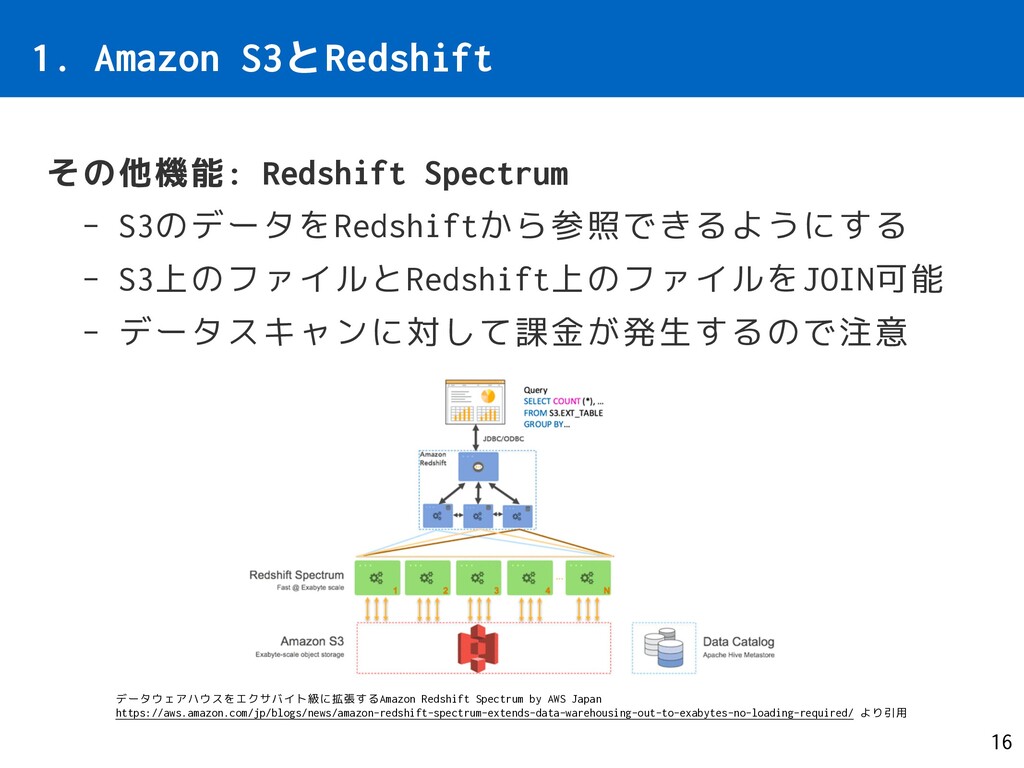
1. Amazon S3とRedshift その他機能: Redshift Spectrum - S3のデータをRedshiftから参照できるようにする - S3上のファイルとRedshift上のファイルをJOIN可能
- データスキャンに対して課金が発生するので注意 16 データウェアハウスをエクサバイト級に拡張するAmazon Redshift Spectrum by AWS Japan https://aws.amazon.com/jp/blogs/news/amazon-redshift-spectrum-extends-data-warehousing-out-to-exabytes-no-loading-required/ より引用 -
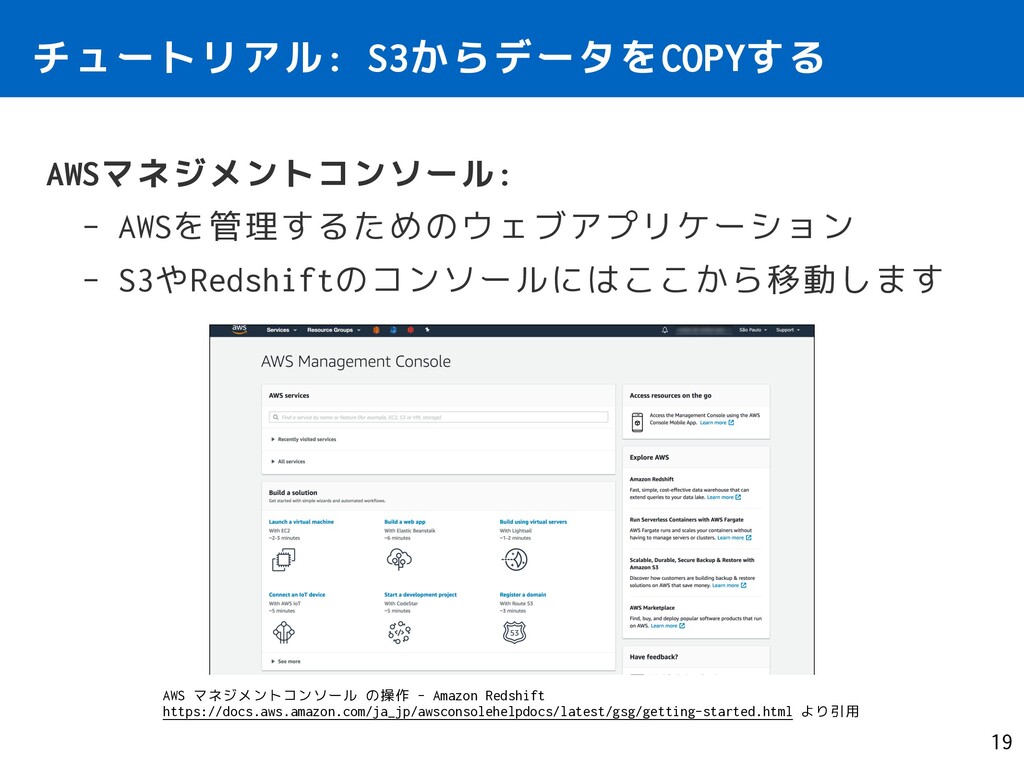
チュートリアル: S3からデータをCOPYする AWSマネジメントコンソール: - AWSを管理するためのウェブアプリケーション - S3やRedshiftのコンソールにはここから移動します 19 AWS マネジメントコンソール
の操作 - Amazon Redshift https://docs.aws.amazon.com/ja_jp/awsconsolehelpdocs/latest/gsg/getting-started.html より引用 -
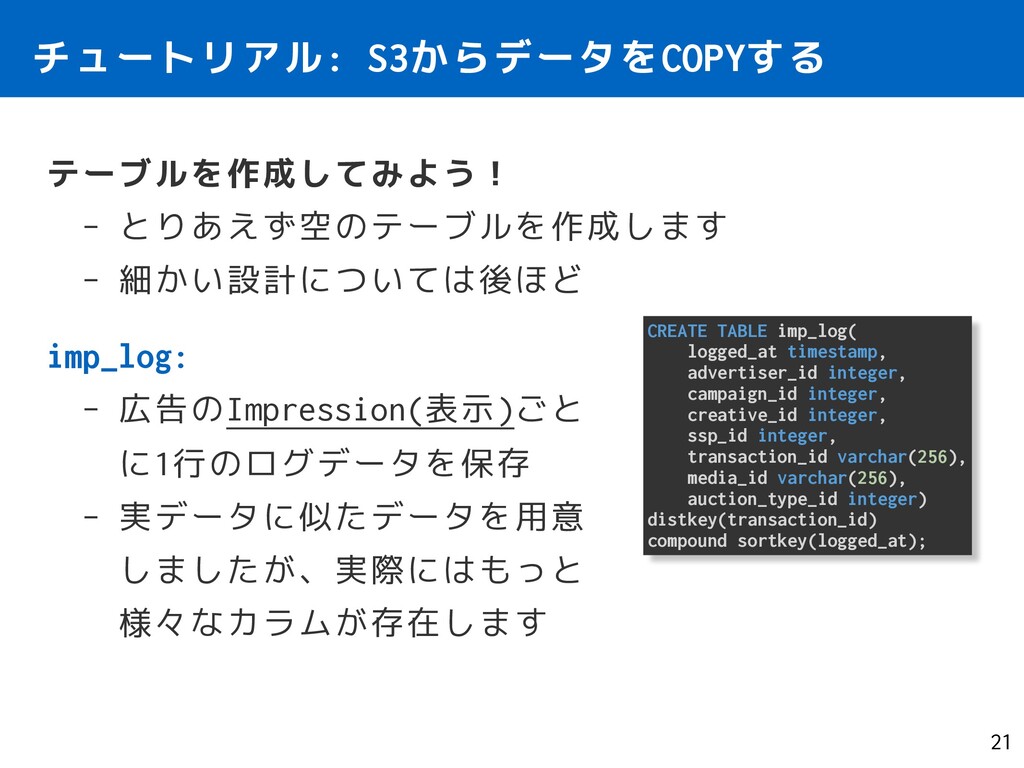
チュートリアル: S3からデータをCOPYする テーブルを作成してみよう! - とりあえず空のテーブルを作成します - 細かい設計については後ほど imp_log: - 広告のImpression(表示)ごと
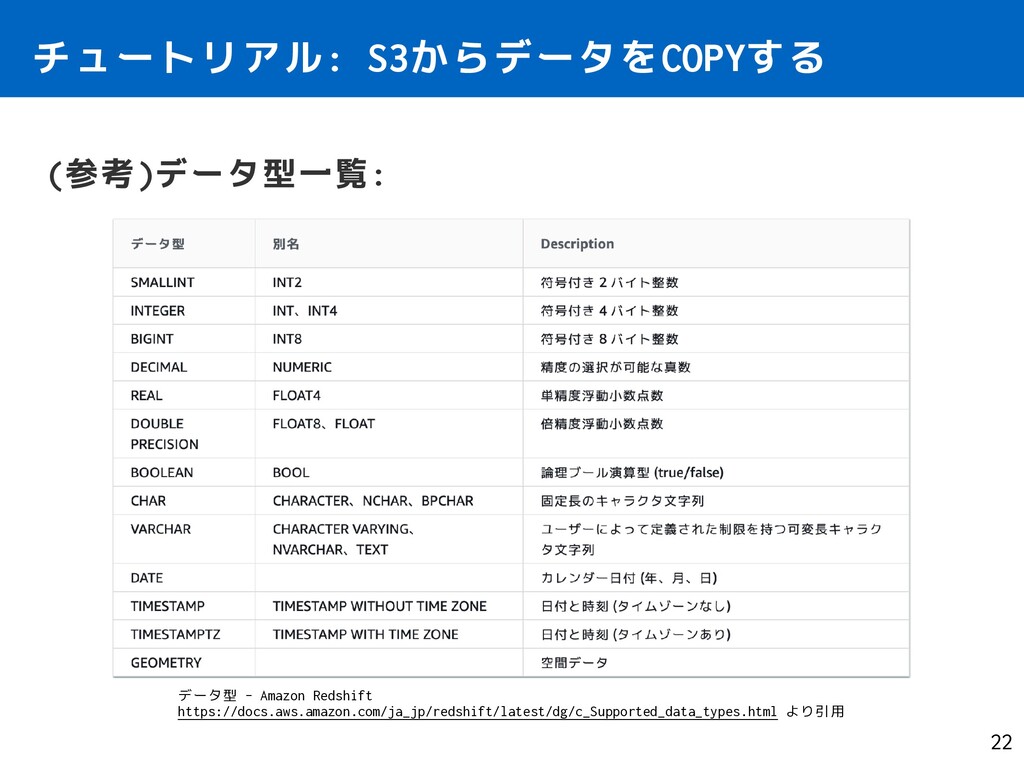
に1行のログデータを保存 - 実データに似たデータを用意 しましたが、実際にはもっと 様々なカラムが存在します 21 CREATE TABLE imp_log( logged_at timestamp, advertiser_id integer, campaign_id integer, creative_id integer, ssp_id integer, transaction_id varchar(256), media_id varchar(256), auction_type_id integer) distkey(transaction_id) compound sortkey(logged_at); -
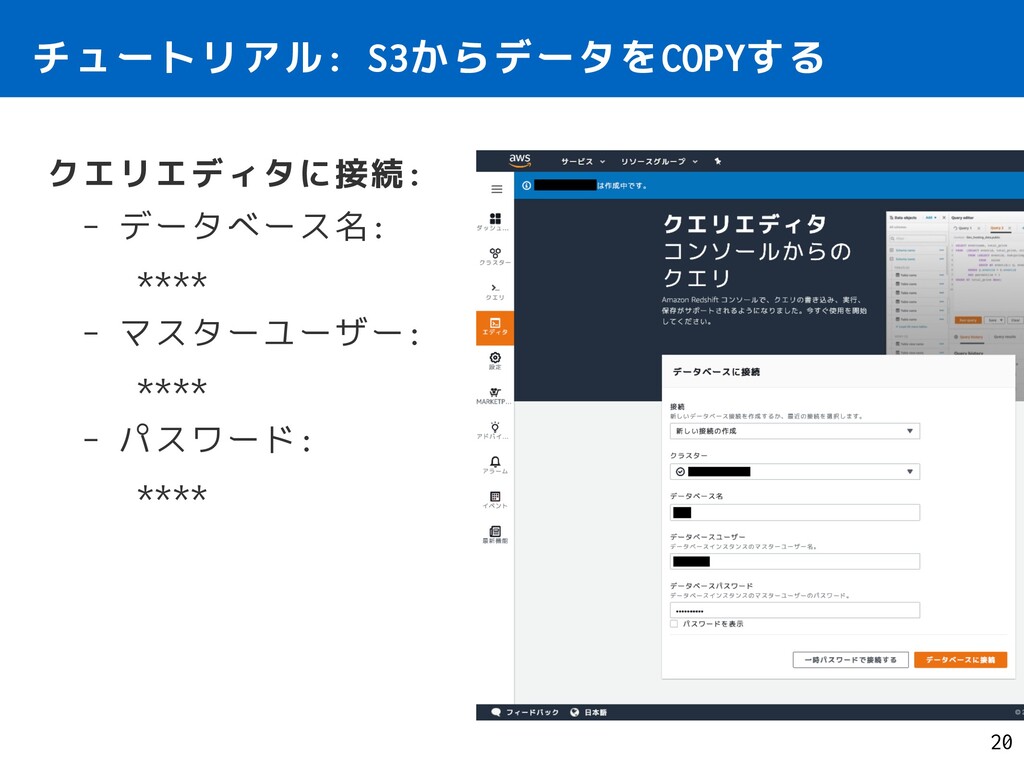
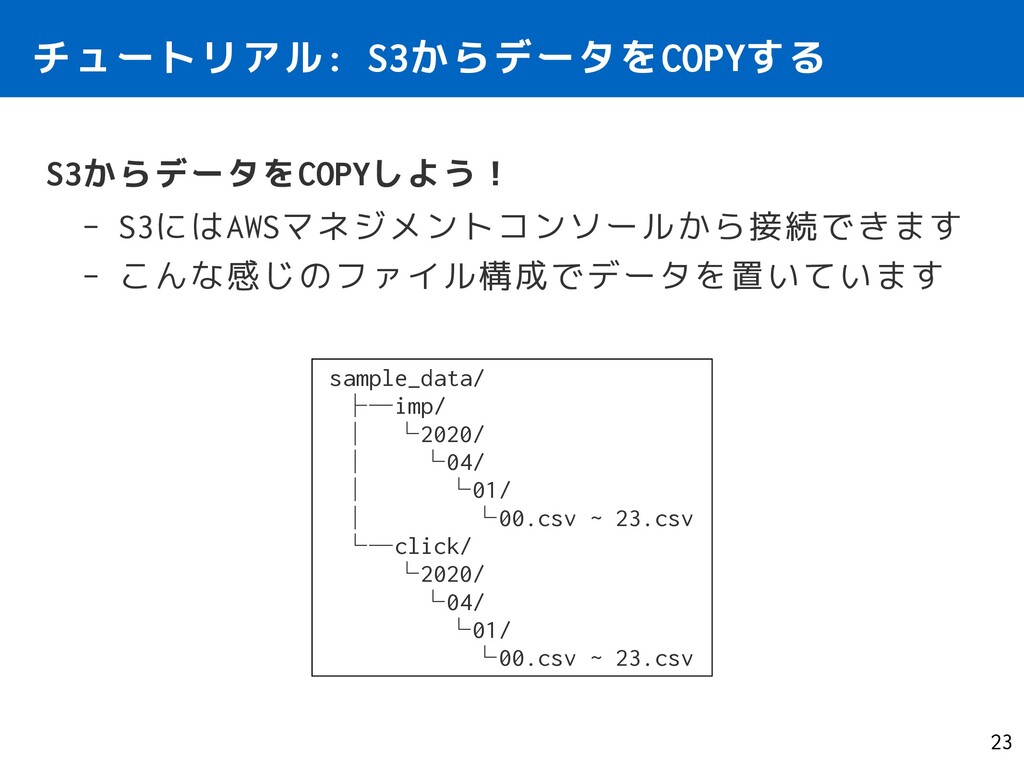
チュートリアル: S3からデータをCOPYする S3からデータをCOPYしよう! - S3にはAWSマネジメントコンソールから接続できます - こんな感じのファイル構成でデータを置いています 23 sample_data/ ├─imp/
│ └2020/ │ └04/ │ └01/ │ └00.csv ~ 23.csv └─click/ └2020/ └04/ └01/ └00.csv ~ 23.csv -
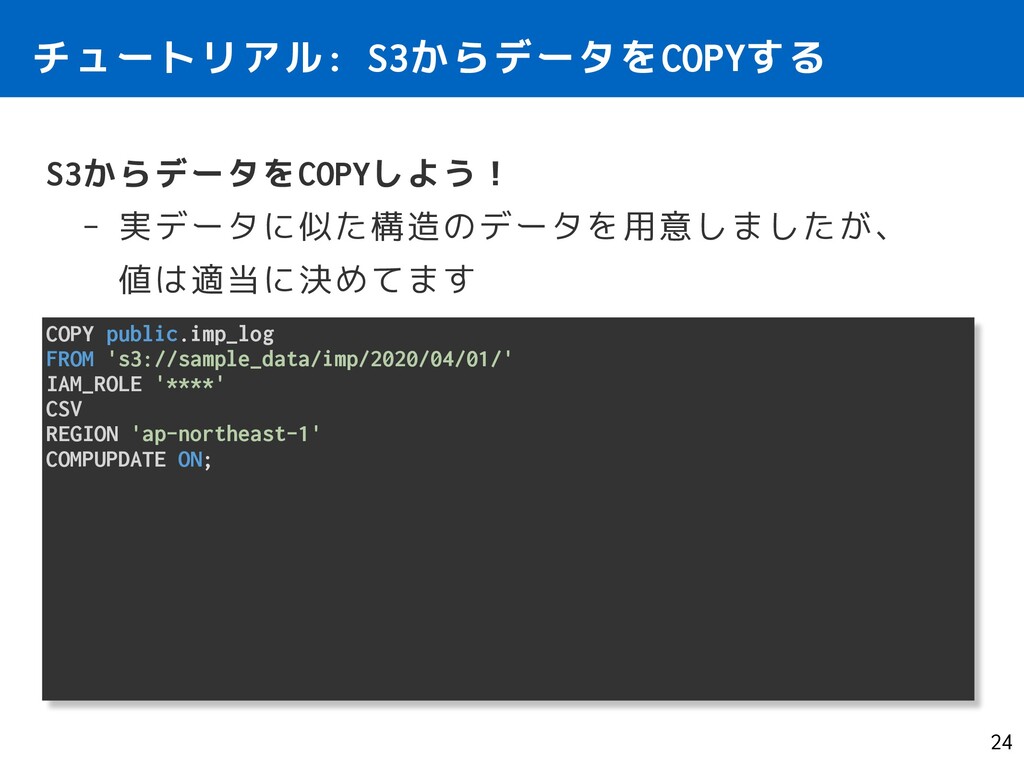
チュートリアル: S3からデータをCOPYする S3からデータをCOPYしよう! - 実データに似た構造のデータを用意しましたが、 値は適当に決めてます 24 COPY public.imp_log FROM
's3://sample_data/imp/2020/04/01/' IAM_ROLE '****' CSV REGION 'ap-northeast-1' COMPUPDATE ON; -
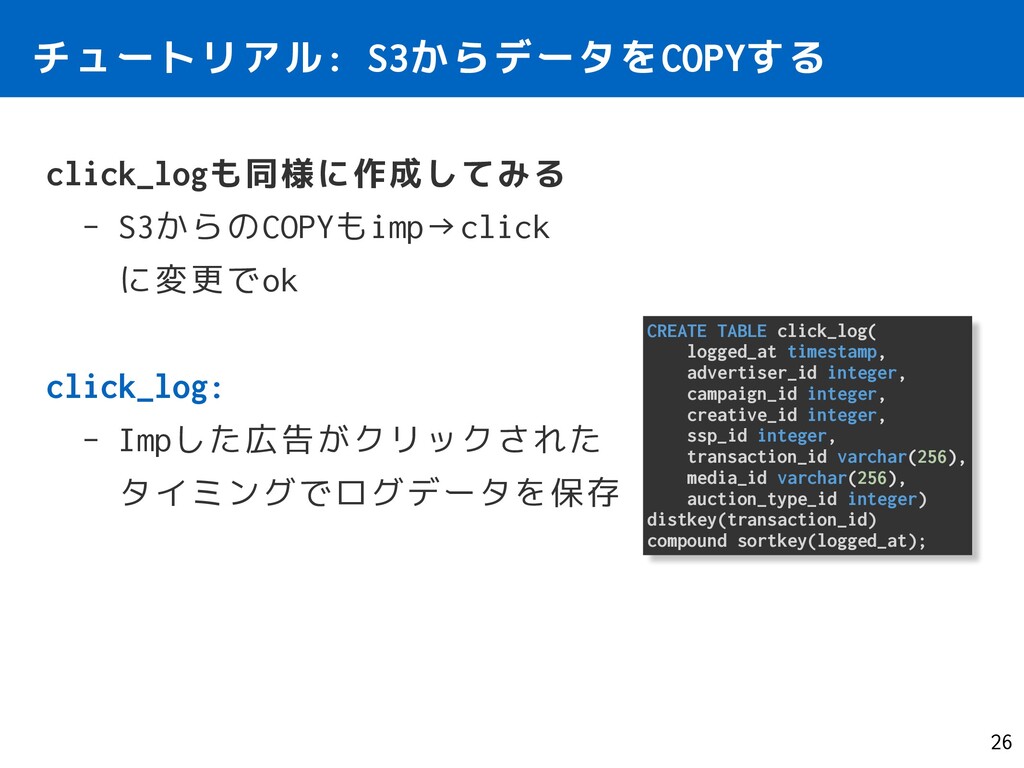
チュートリアル: S3からデータをCOPYする click_logも同様に作成してみる - S3からのCOPYもimp→click に変更でok click_log: - Impした広告がクリックされた タイミングでログデータを保存
26 CREATE TABLE click_log( logged_at timestamp, advertiser_id integer, campaign_id integer, creative_id integer, ssp_id integer, transaction_id varchar(256), media_id varchar(256), auction_type_id integer) distkey(transaction_id) compound sortkey(logged_at); -
2. テーブルを設計する 列ごとに圧縮形式を指定できる: - ディスクI/Oの量が減少しクエリが高速になる - テーブル作成時に圧縮タイプを自動/手動で設定する ANALYZE COMPRESSION: -
既存テーブルを分析し推奨エンコードを返す - 変更を適用するにはテーブルを再作成しないとだめ COMPUPDATE: - カラムの圧縮形式が自動で選ばれる - 全カラムを自動で任せるならこれも書かなくてok …らしいんだけど、書かないと動かなかった 28 -
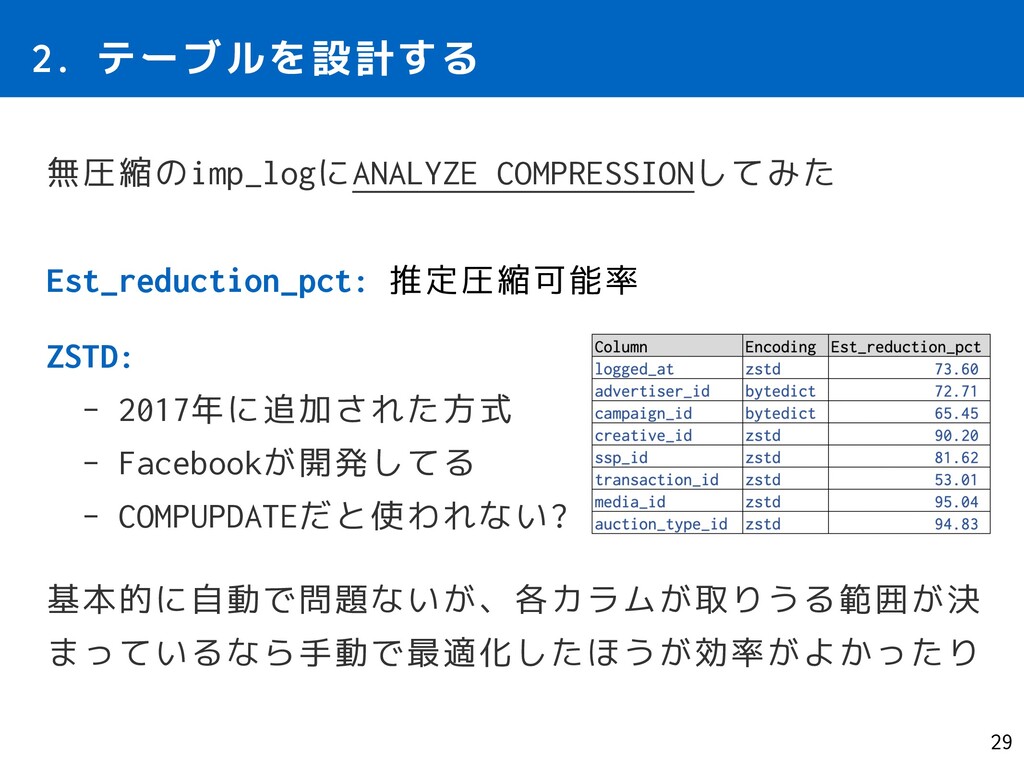
2. テーブルを設計する 無圧縮のimp_logにANALYZE COMPRESSIONしてみた Est_reduction_pct: 推定圧縮可能率 ZSTD: - 2017年に追加された方式 -
Facebookが開発してる - COMPUPDATEだと使われない? 基本的に自動で問題ないが、各カラムが取りうる範囲が決 まっているなら手動で最適化したほうが効率がよかったり 29 -
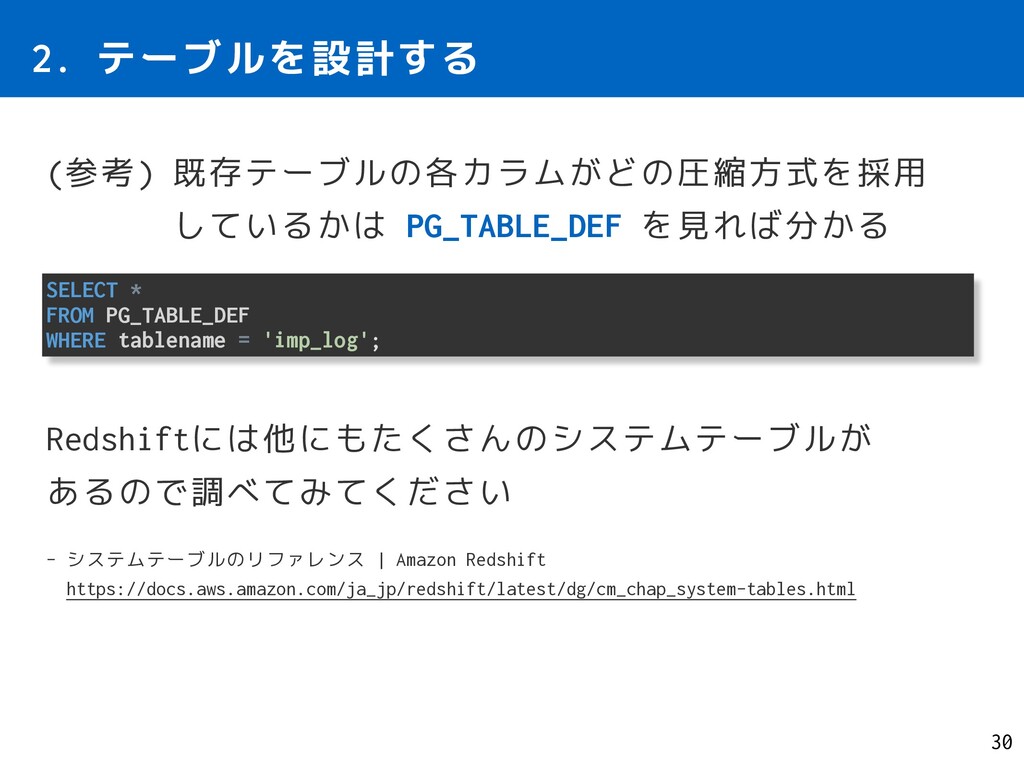
2. テーブルを設計する (参考) 既存テーブルの各カラムがどの圧縮方式を採用 しているかは PG_TABLE_DEF を見れば分かる Redshiftには他にもたくさんのシステムテーブルが あるので調べてみてください -
システムテーブルのリファレンス | Amazon Redshift https://docs.aws.amazon.com/ja_jp/redshift/latest/dg/cm_chap_system-tables.html 30 SELECT * FROM PG_TABLE_DEF WHERE tablename = 'imp_log'; -
2. テーブルを設計する 分散スタイル: - データのロード時に、テーブルの分散スタイルに従っ てRedshiftがテーブルの行を各コンピューティング ノードに分散する - クエリ実行時に、結合と集計を実行するために、行が コンピューティングノードに再分散される
→ 適切な分散スタイルを選択することで再分散ステッ プの影響を最小限に抑える必要がある 31 -
2. テーブルを設計する AUTO、EVEN、KEY、ALLの4つの分散スタイル: - AUTO分散: - テーブルのサイズに基づいて最適な分散スタイルを 自動で割り当てる - EVEN分散:
- ラウンドロビン方式によって複数のスライス間で行 を分散させる - テーブルが結合に関与していない場合に適切 32 -
2. テーブルを設計する AUTO、EVEN、KEY、ALLの4つの分散スタイル: - KEY分散: - 特定の列に含まれている値に従って分散させる - 同じカラムの値でJOINすることが多いならこれ -
分散が偏らないよう注意 - ALL分散: - テーブル全体のコピーが全ノードに分散される - ノードの数だけ必要なストレージが増える - 更新が低頻度で範囲も広くないテーブルに適する 33 -
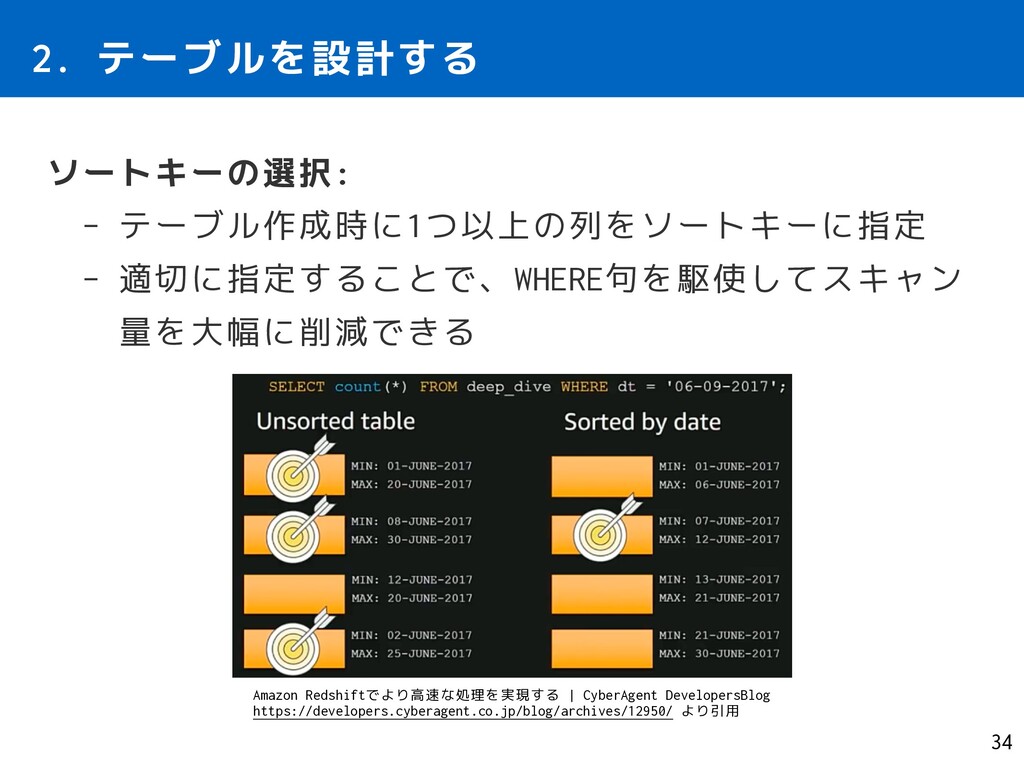
2. テーブルを設計する ソートキーの選択: - テーブル作成時に1つ以上の列をソートキーに指定 - 適切に指定することで、WHERE句を駆使してスキャン 量を大幅に削減できる 34 Amazon
Redshiftでより高速な処理を実現する | CyberAgent DevelopersBlog https://developers.cyberagent.co.jp/blog/archives/12950/ より引用 -
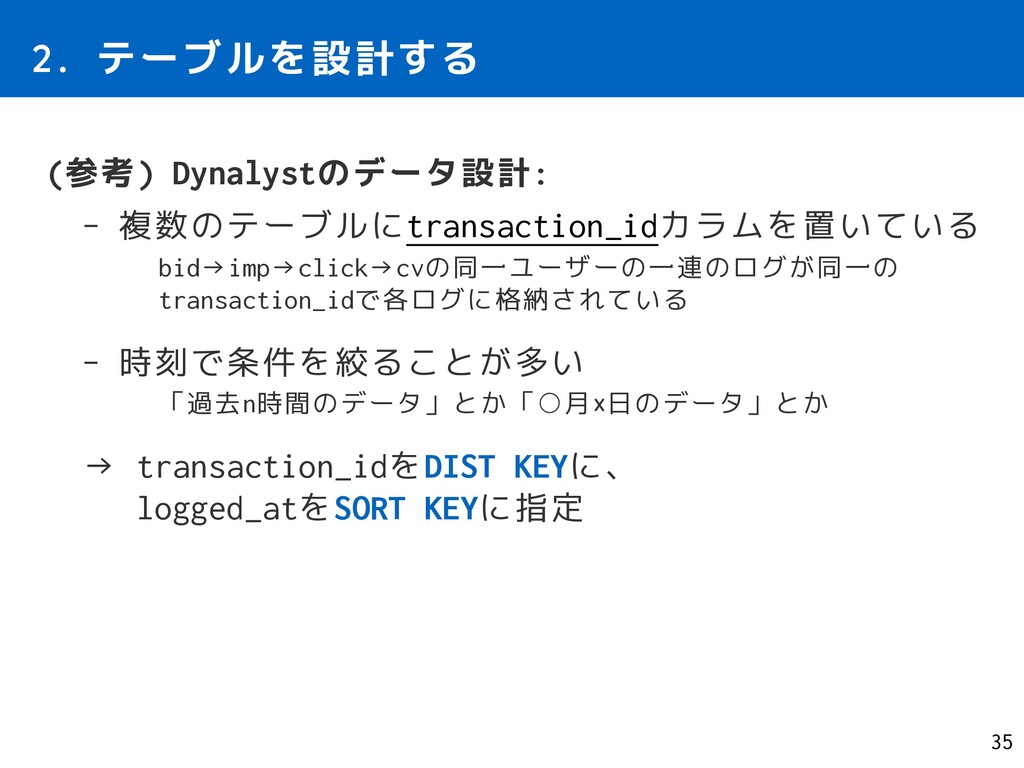
2. テーブルを設計する (参考) Dynalystのデータ設計: - 複数のテーブルにtransaction_idカラムを置いている bid→imp→click→cvの同一ユーザーの一連のログが同一の transaction_idで各ログに格納されている - 時刻で条件を絞ることが多い
「過去n時間のデータ」とか「◦月×日のデータ」とか → transaction_idをDIST KEYに、 logged_atをSORT KEYに指定 35 -
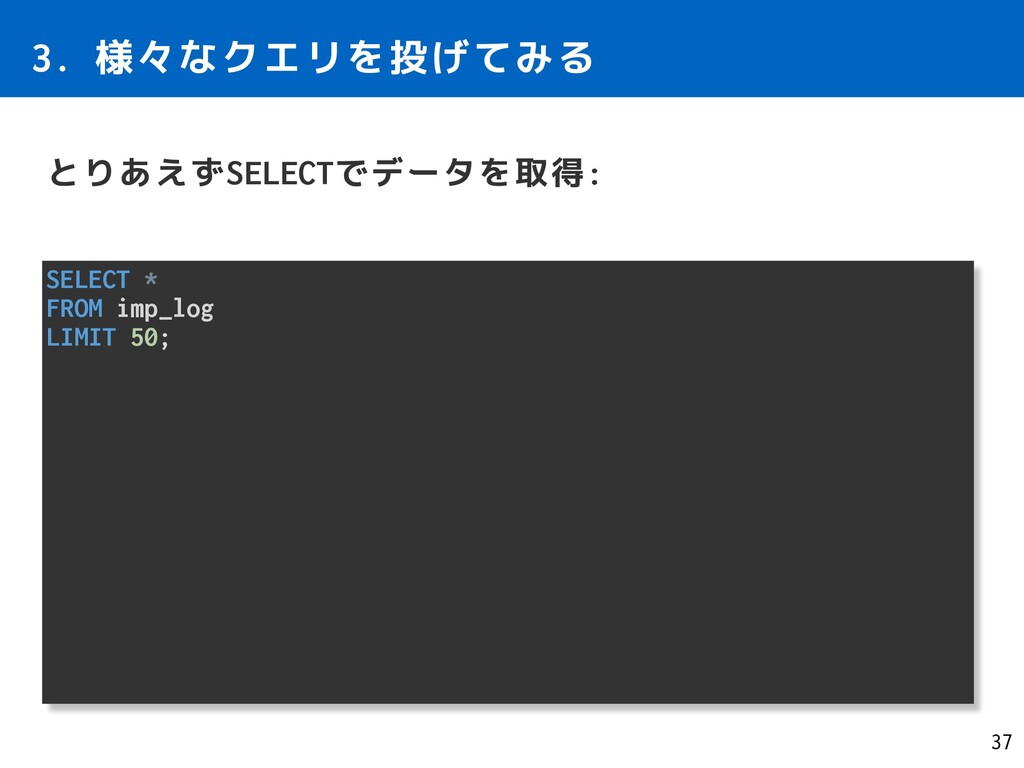
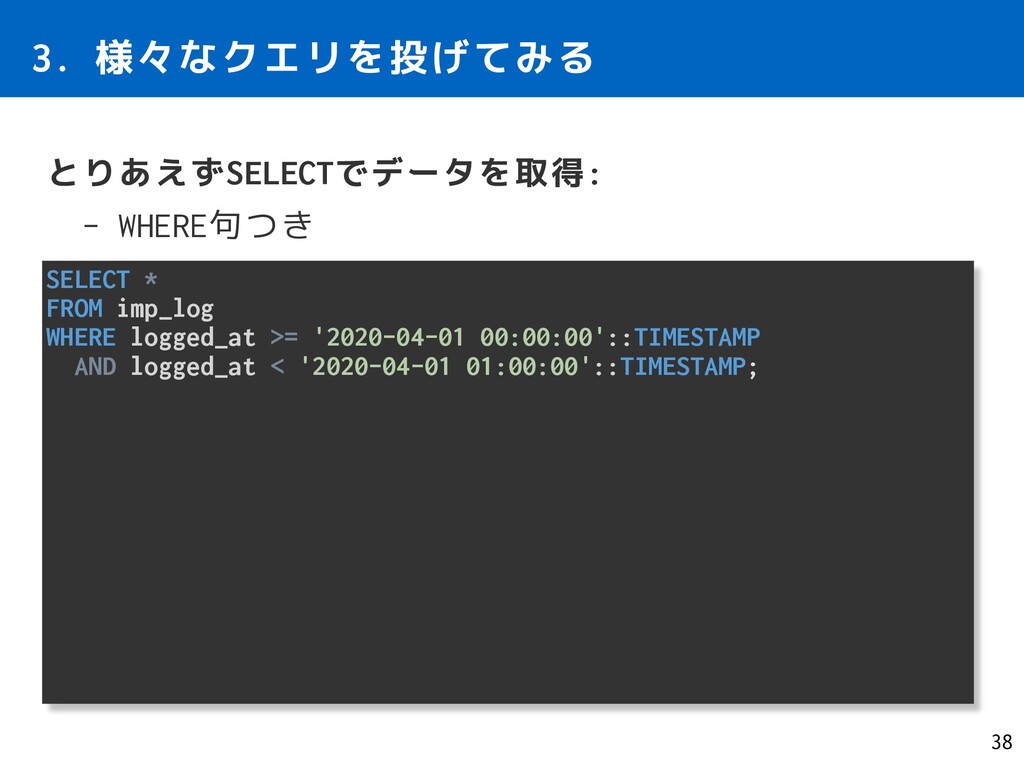
3. 様々なクエリを投げてみる とりあえずSELECTでデータを取得: - WHERE句つき 38 SELECT * FROM imp_log
WHERE logged_at >= '2020-04-01 00:00:00'::TIMESTAMP AND logged_at < '2020-04-01 01:00:00'::TIMESTAMP; -
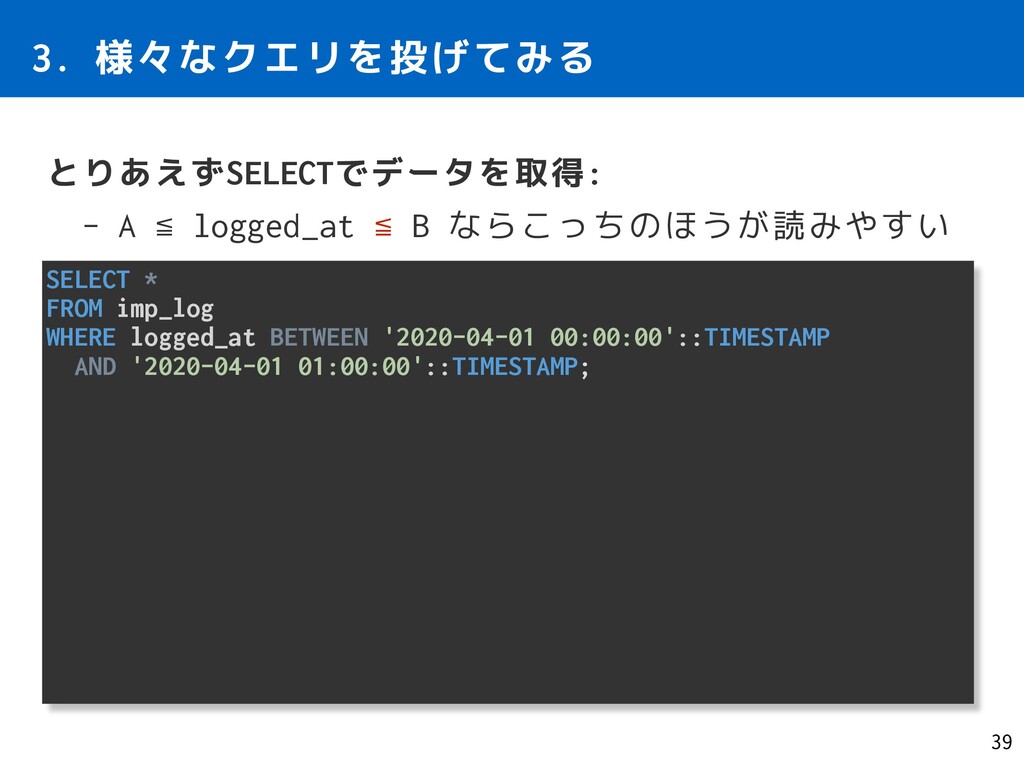
3. 様々なクエリを投げてみる とりあえずSELECTでデータを取得: - A ≦ logged_at ≦ B ならこっちのほうが読みやすい
39 SELECT * FROM imp_log WHERE logged_at BETWEEN '2020-04-01 00:00:00'::TIMESTAMP AND '2020-04-01 01:00:00'::TIMESTAMP; -
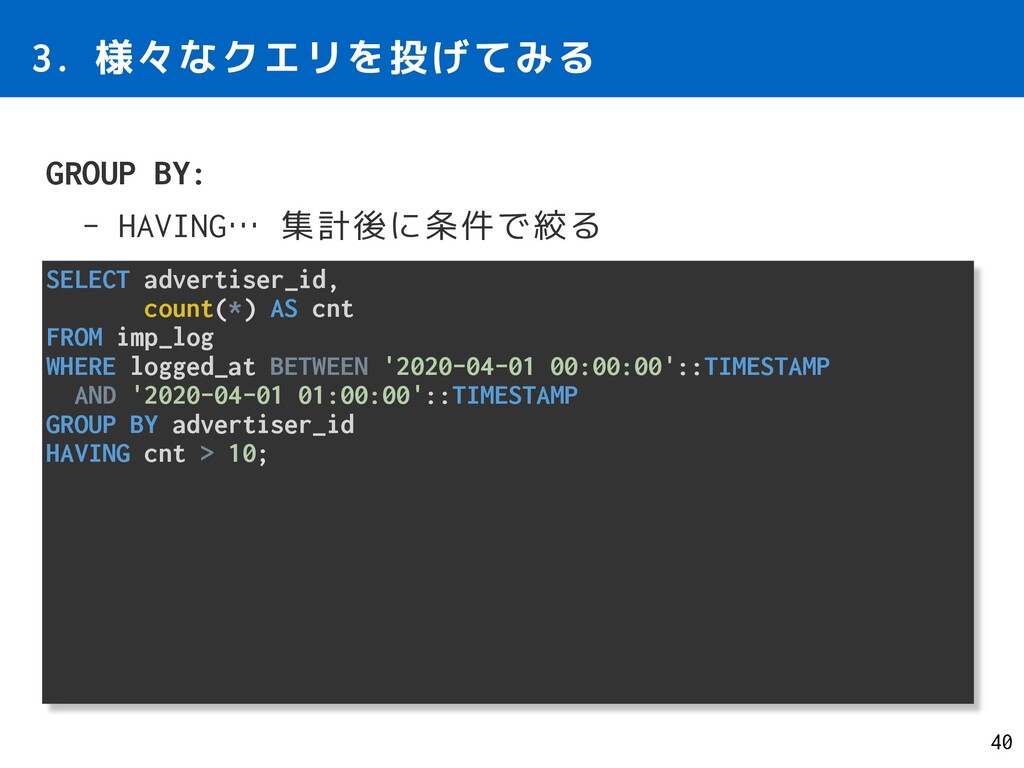
3. 様々なクエリを投げてみる GROUP BY: - HAVING… 集計後に条件で絞る 40 SELECT advertiser_id,
count(*) AS cnt FROM imp_log WHERE logged_at BETWEEN '2020-04-01 00:00:00'::TIMESTAMP AND '2020-04-01 01:00:00'::TIMESTAMP GROUP BY advertiser_id HAVING cnt > 10; -
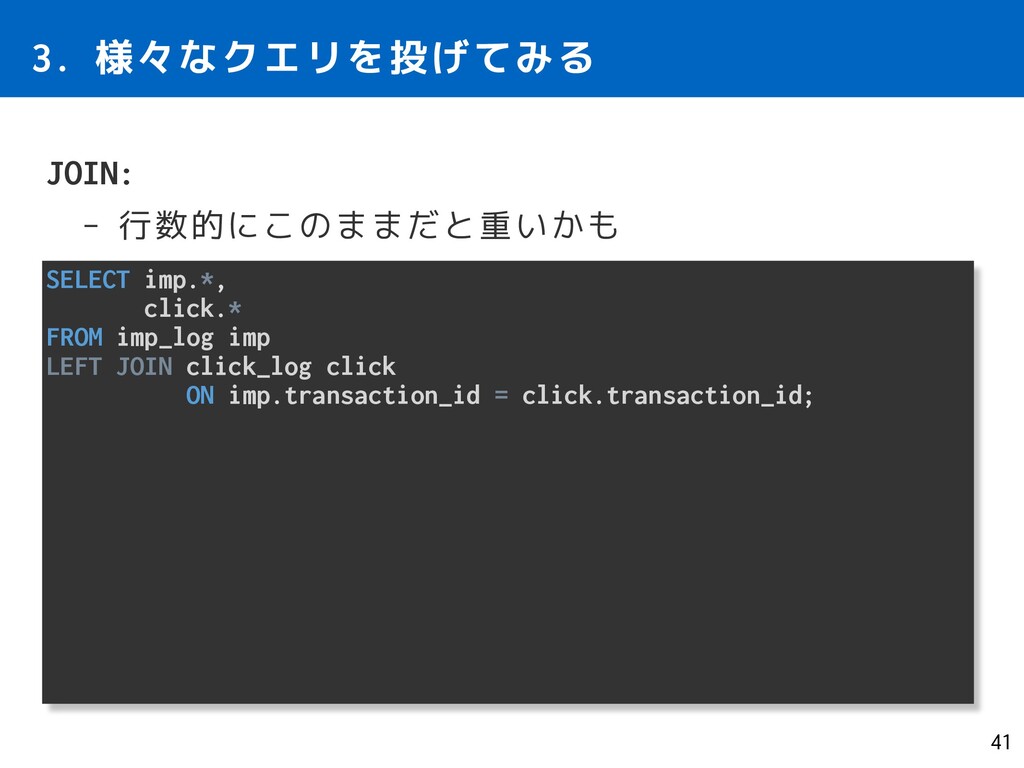
3. 様々なクエリを投げてみる JOIN: - 行数的にこのままだと重いかも 41 SELECT imp.*, click.* FROM
imp_log imp LEFT JOIN click_log click ON imp.transaction_id = click.transaction_id; -
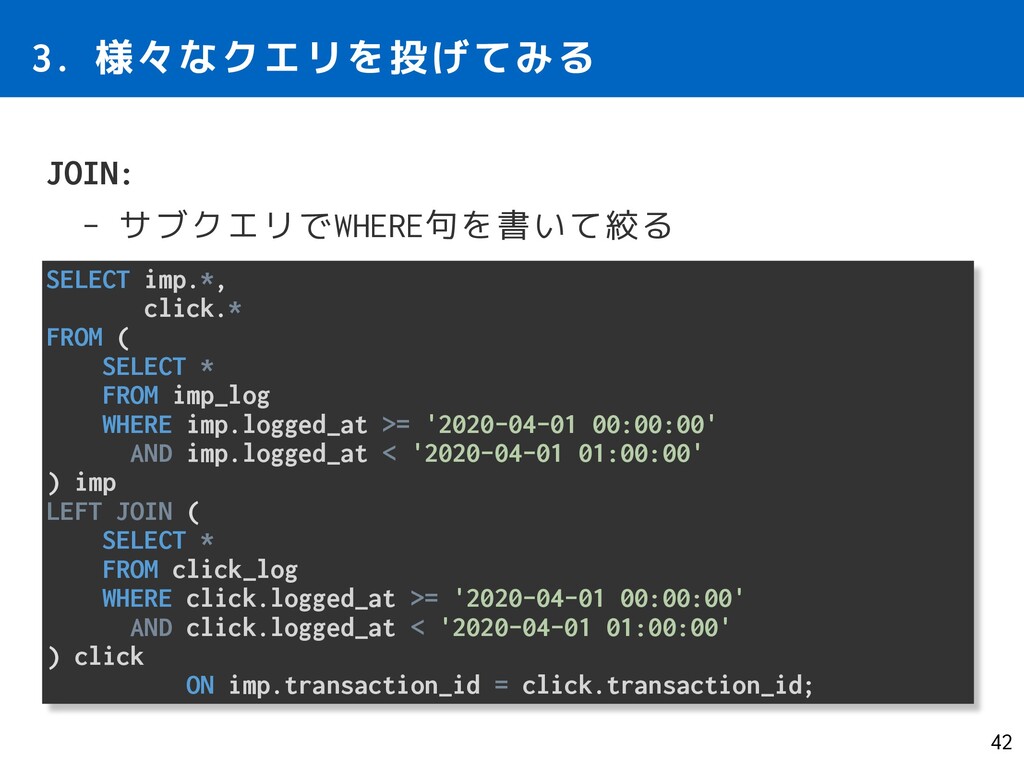
3. 様々なクエリを投げてみる JOIN: - サブクエリでWHERE句を書いて絞る 42 SELECT imp.*, click.* FROM
( SELECT * FROM imp_log WHERE imp.logged_at >= '2020-04-01 00:00:00' AND imp.logged_at < '2020-04-01 01:00:00' ) imp LEFT JOIN ( SELECT * FROM click_log WHERE click.logged_at >= '2020-04-01 00:00:00' AND click.logged_at < '2020-04-01 01:00:00' ) click ON imp.transaction_id = click.transaction_id; -
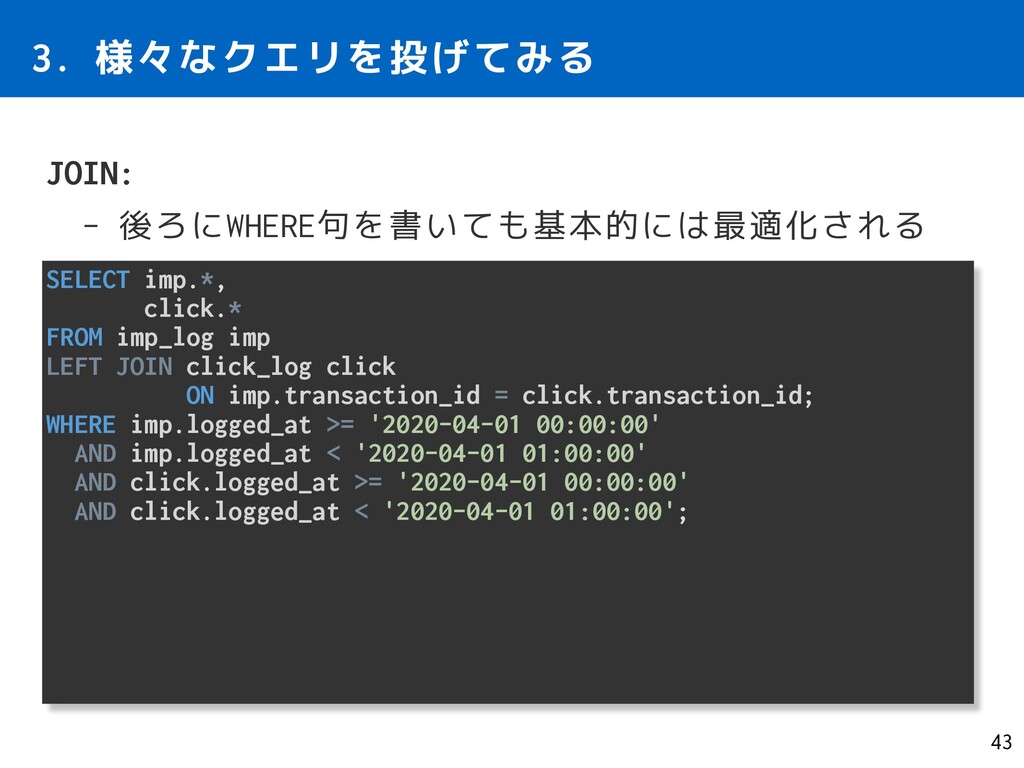
3. 様々なクエリを投げてみる JOIN: - 後ろにWHERE句を書いても基本的には最適化される 43 SELECT imp.*, click.* FROM
imp_log imp LEFT JOIN click_log click ON imp.transaction_id = click.transaction_id; WHERE imp.logged_at >= '2020-04-01 00:00:00' AND imp.logged_at < '2020-04-01 01:00:00' AND click.logged_at >= '2020-04-01 00:00:00' AND click.logged_at < '2020-04-01 01:00:00'; -
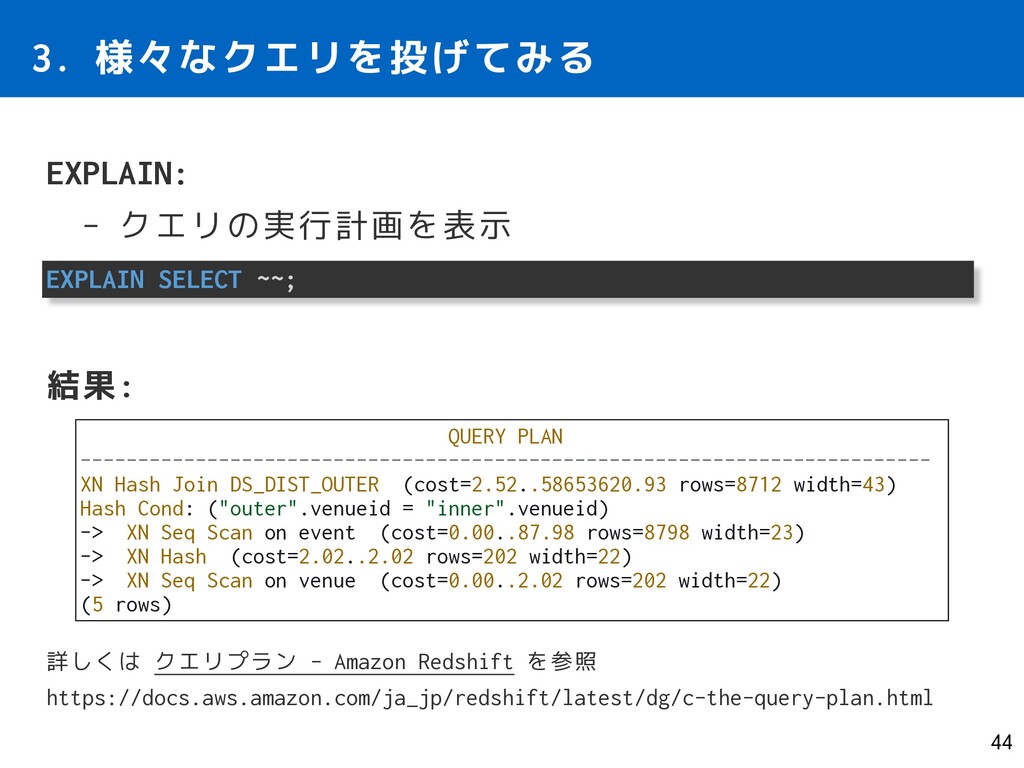
3. 様々なクエリを投げてみる EXPLAIN: - クエリの実行計画を表示 結果: 詳しくは クエリプラン - Amazon
Redshift を参照 https://docs.aws.amazon.com/ja_jp/redshift/latest/dg/c-the-query-plan.html 44 EXPLAIN SELECT ~~; QUERY PLAN -------------------------------------------------------------------------- XN Hash Join DS_DIST_OUTER (cost=2.52..58653620.93 rows=8712 width=43) Hash Cond: ("outer".venueid = "inner".venueid) -> XN Seq Scan on event (cost=0.00..87.98 rows=8798 width=23) -> XN Hash (cost=2.02..2.02 rows=202 width=22) -> XN Seq Scan on venue (cost=0.00..2.02 rows=202 width=22) (5 rows) -
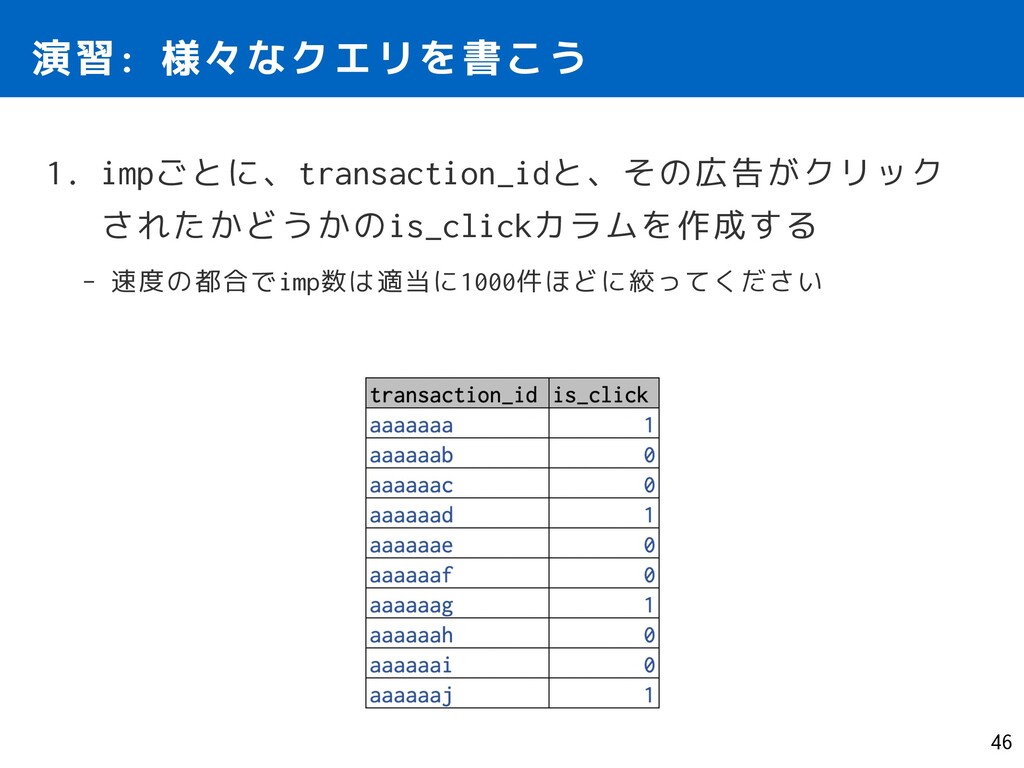
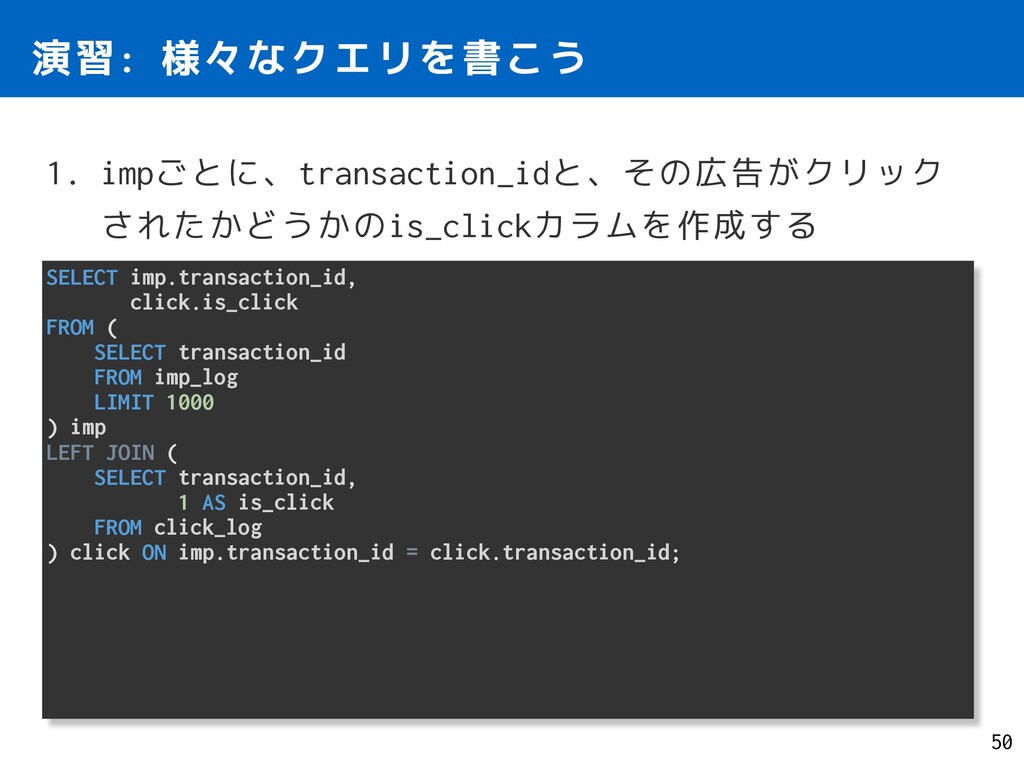
演習: 様々なクエリを書こう 1. impごとに、transaction_idと、その広告がクリック されたかどうかのis_clickカラムを作成する 50 SELECT imp.transaction_id, click.is_click FROM
( SELECT transaction_id FROM imp_log LIMIT 1000 ) imp LEFT JOIN ( SELECT transaction_id, 1 AS is_click FROM click_log ) click ON imp.transaction_id = click.transaction_id; -
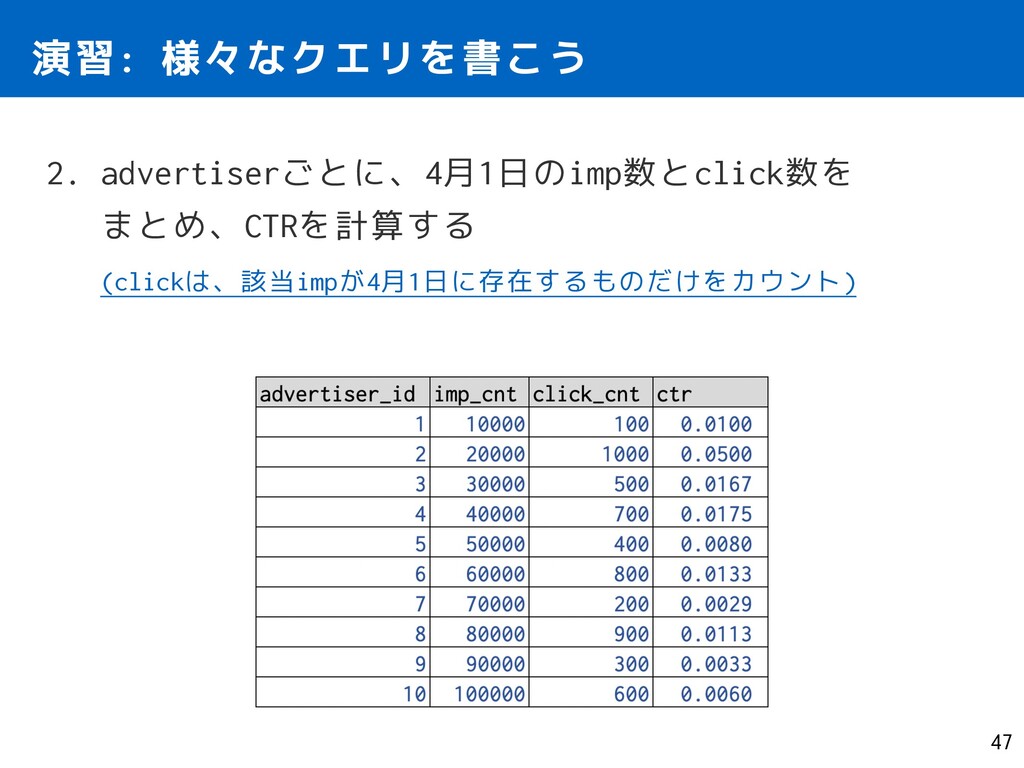
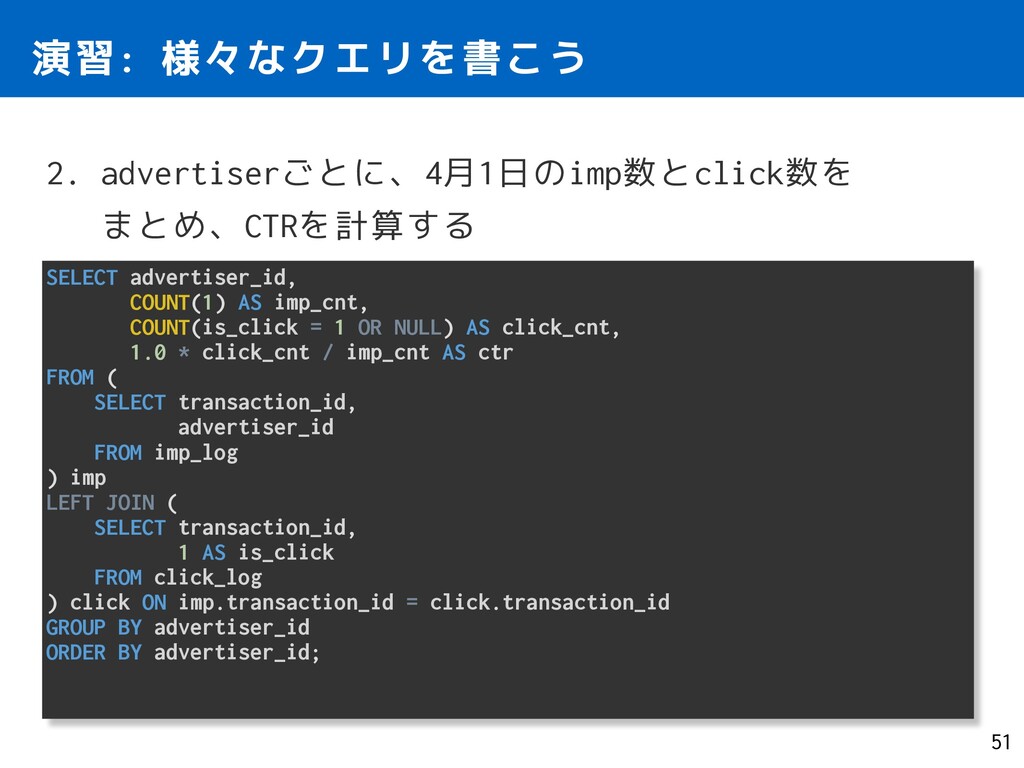
2. advertiserごとに、4月1日のimp数とclick数を まとめ、CTRを計算する SELECT advertiser_id, COUNT(1) AS imp_cnt, COUNT(is_click =
1 OR NULL) AS click_cnt, 1.0 * click_cnt / imp_cnt AS ctr FROM ( SELECT transaction_id, advertiser_id FROM imp_log ) imp LEFT JOIN ( SELECT transaction_id, 1 AS is_click FROM click_log ) click ON imp.transaction_id = click.transaction_id GROUP BY advertiser_id ORDER BY advertiser_id; 演習: 様々なクエリを書こう 51 -
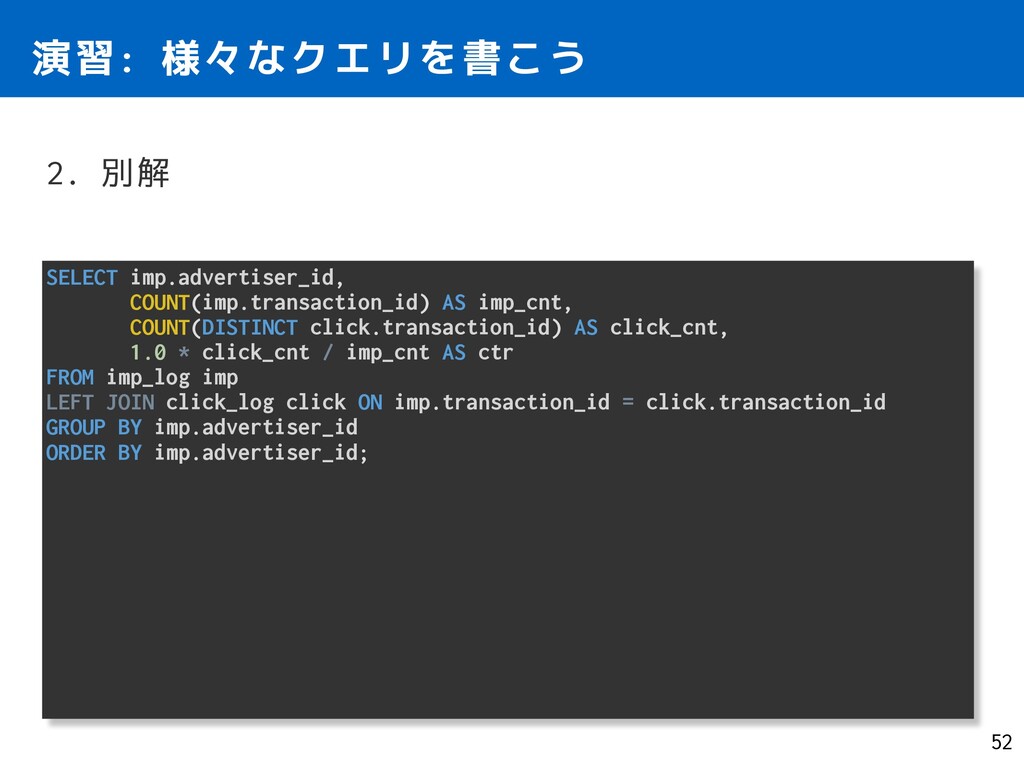
2. 別解 SELECT imp.advertiser_id, COUNT(imp.transaction_id) AS imp_cnt, COUNT(DISTINCT click.transaction_id) AS
click_cnt, 1.0 * click_cnt / imp_cnt AS ctr FROM imp_log imp LEFT JOIN click_log click ON imp.transaction_id = click.transaction_id GROUP BY imp.advertiser_id ORDER BY imp.advertiser_id; 演習: 様々なクエリを書こう 52 -
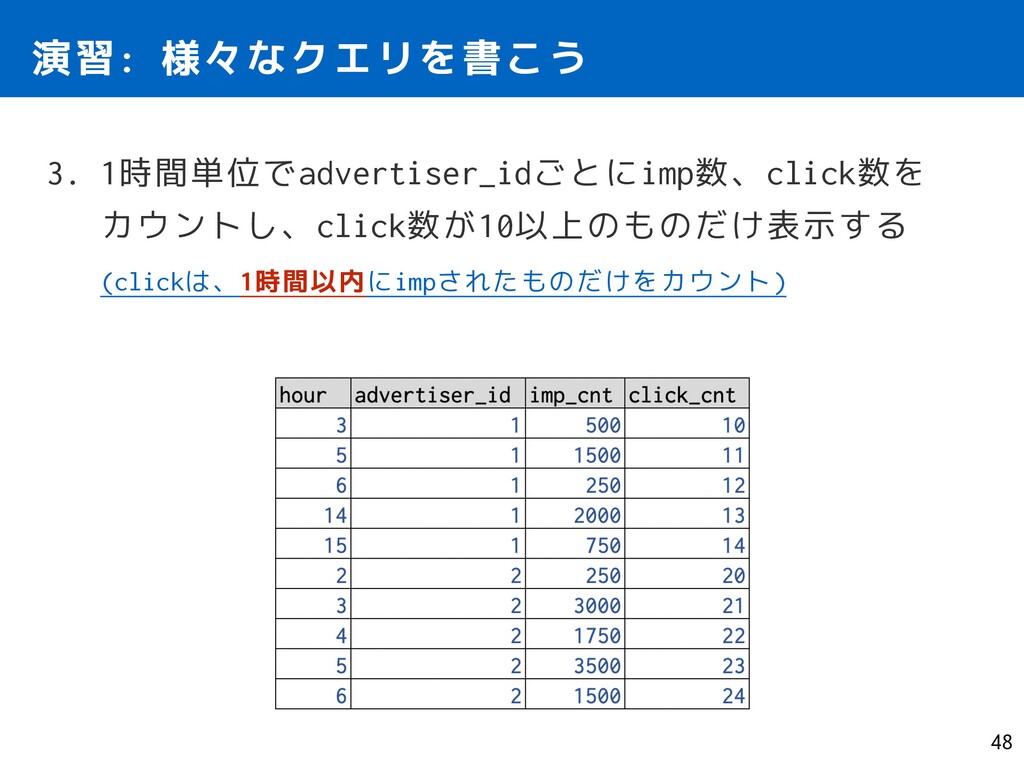
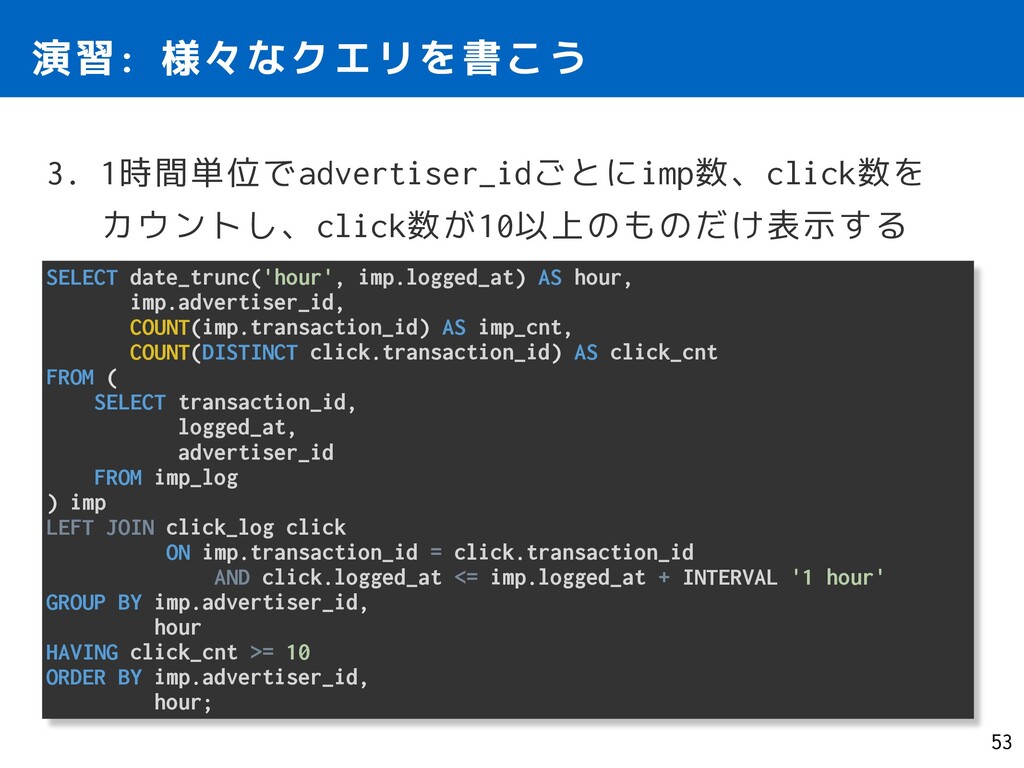
演習: 様々なクエリを書こう 3. 1時間単位でadvertiser_idごとにimp数、click数を カウントし、click数が10以上のものだけ表示する 53 SELECT date_trunc('hour', imp.logged_at) AS
hour, imp.advertiser_id, COUNT(imp.transaction_id) AS imp_cnt, COUNT(DISTINCT click.transaction_id) AS click_cnt FROM ( SELECT transaction_id, logged_at, advertiser_id FROM imp_log ) imp LEFT JOIN click_log click ON imp.transaction_id = click.transaction_id AND click.logged_at <= imp.logged_at + INTERVAL '1 hour' GROUP BY imp.advertiser_id, hour HAVING click_cnt >= 10 ORDER BY imp.advertiser_id, hour;