Upgrade to Pro — share decks privately, control downloads, hide ads and more …

Deep Learning book 11. Practical Methodology

Kento Nozawa
November 06, 2017

Deep Learning book 11. Practical Methodology

Kento Nozawa

November 06, 2017

Transcript

41 slides
  1. Intro 2 • DLアルゴリズムがどう機能するかを知っていることは,適用上重要 ◦ nzw:(DLに限らないが)ライブラリを実行することは,理解したことにならない • 実践する上で様々な判断が必要 ◦ データを増やすか減らすか

    ◦ モデルを複雑にするか ◦ 正則化をどういれるか ◦ Optimizerで何を使うか ◦ 近似推論を使うか ◦ デバッグ,… • それぞれを試すのは時間がかかるので,闇雲には試したくない
  2. Recommendations are adapted from Ng (2015) 3 1. Determine your

    goal ◦ 使う評価関数とその目標値を設定 ▪ 例) validation accuracyで0.95 ◦ 解こうとしている問題から決める 2. 評価値計算を含めた end-to-end なパイプライン 3. パフォーマンスでどこがボトルネックか計測 ◦ 目標値に対してどこが足を引っ張っているのか明らかに ◦ 精度が悪い理由)Overfitting, Underfitting, データやソフトウェアの欠陥 4. インクリメンタルな変更を繰り返す ◦ 3つ目の結果をもと ▪ データ増やす ▪ パラメタ変える ▪ アルゴリズム変える等
  3. 1. Performance Metrics • 最初にどのメトリクスを使うかを決める ◦ 決めたら次に取る行動が決まってくる ◦ 設定したメトリクスで達成したい値も設定すべき ◦

    例)「Deep Learningでとりあえず凄いことしたい」は抽象的すぎるのでよくない • ほとんどの応用上,誤差が0は不可能 ◦ 特徴量は予測値の推定に必要な情報をすべてのもっていない ◦ モデルは確率的(初期値,ミニバッチなど) ◦ データは有限 4
  4. 1. メトリクスとデータ • 利用できるデータは限定的 ◦ いいモデルを作るために,大量のデータは重要 ◦ しかしそのコストに見合うだけの価値が,誤差を減らしたときにあるかを判断すること ▪ 極端な例)正解率99%のシステムを99.01%するために100TBのデータを集めたいか

    • データ収集には時間,お金,人的コストがかかる ◦ 例)医療や脳波における侵略的測定 • ベンチマークに対してどのアルゴリズムが良いかを調べる場合は増やさない ◦ 例)ImageNetなどコンペ 5
  5. • 解く問題やデータに依存 ◦ 間違え方によっては致命的に使えない • 2値分類での例 ◦ メールのスパム分類器 i. 非スパムをスパムと判定し,迷惑ボックスへ:重要なメール見落とすので危ない

    ii. スパムを非スパムと判定し,受信ボックスへ:イラッとする程度 ◦ もっと直感的な例:きのこ分類器 i. 毒キノコを食用キノコと判定し,食べた:やばい,死ぬかもしれない ii. 食用きのこを毒キノコと判定し,捨てた:あとでしょんぼりする程度 • 対応例)誤差関数における前者のコストをあげる 1. 誤り方が平等でないケース 7
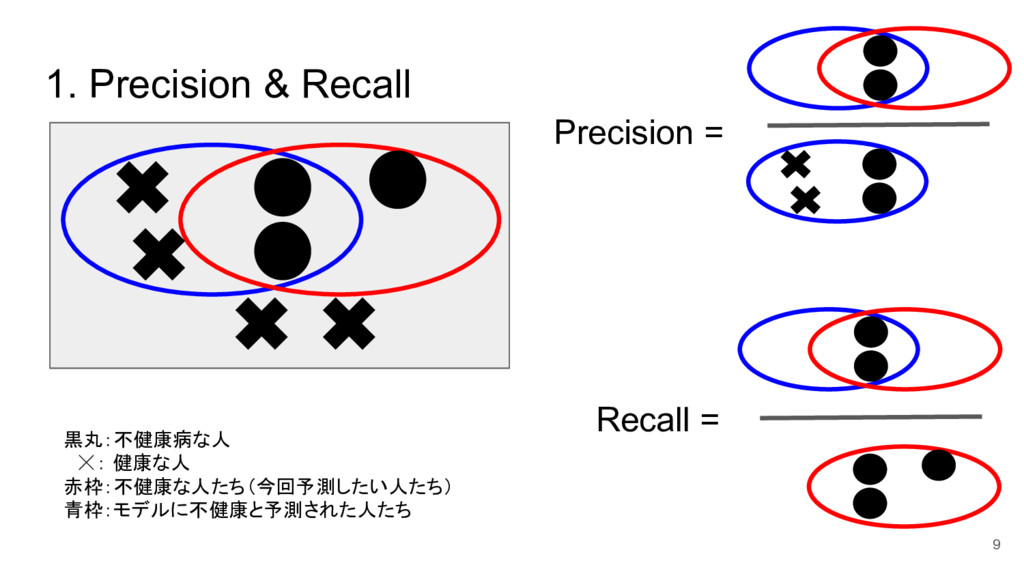
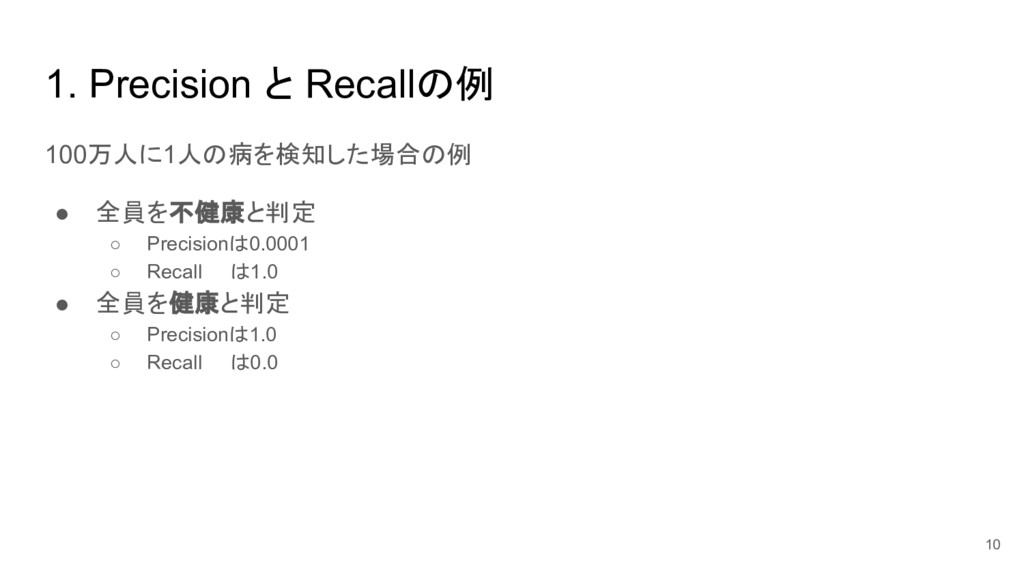
  6. • PR curve ◦ y軸をprecision,x軸をrecallとしたグラフ ◦ precisionとrecallはトレードオフの関係:閾値を変えて判断 • F-socre (F1-score)

    ◦ PR curveは2変数なので1変数に集約 ◦ precisionとrecallの調和平均 ◦ どちらか一方を重み付けする場合: f-measure 1. PR curveとF-score 11
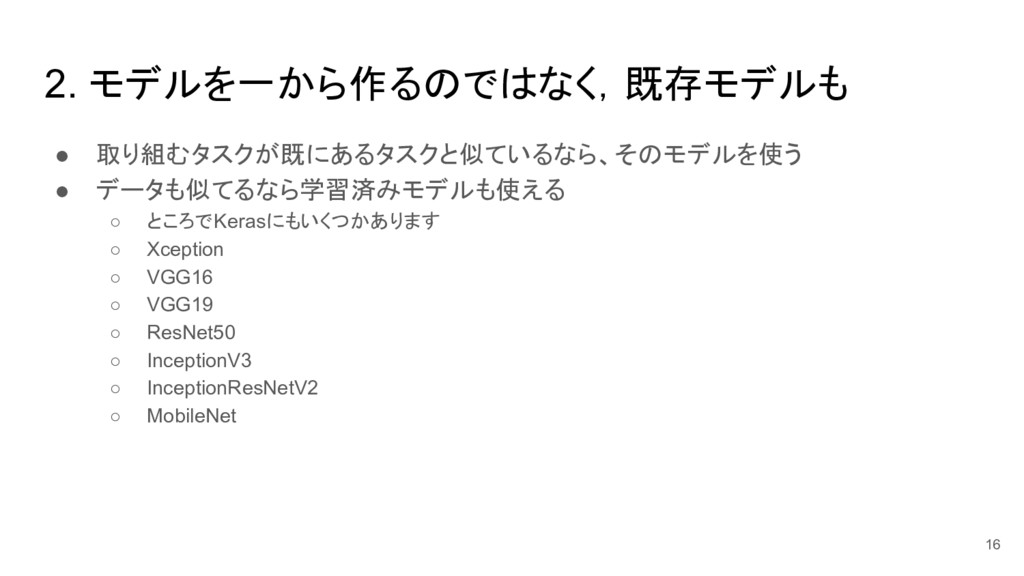
  7. 2. Default Baseline Models • 問題に応じてDeep Learningを使わないところから考える ◦ “AI-complete” な問題ならDeep

    Learningから始めるのがいい ◦ 例)Object recognition, speech recognition, machine translation • データに応じてモデルを選ぶ ◦ 画像など局所構造なら CNN ◦ シーケンスの情報が有効なタスクなら RNN 13
  8. 2. 最適化関係のデフォルト • SGD with momentum with a deacying learning

    rate ◦ 最小のlrまで線形/指数的に減らしていく ◦ validation errorを追跡し,plateuに入ったら2~10で割る • Adam ◦ (余談)個人的な経験で VAE系と相性が悪いことがある • Batch Normalization ◦ CNNにシグモイド系の非線形関数を使っている場合は特に有効 ◦ BNなしでもベースライン ▪ ただし,収束が遅かったり汎化性能に問題があれば BNいれる 14
  9. 2. 教師なし機械学習を使うかどうか • NLPでは教師なし機械学習で得られた特徴量を使うとよい ◦ word2vec, Glove, FastTextのword embeddings ◦

    余談)学習済みの部分は lrを小さめにしたり,学習しないなど • CVではsemi-supervisedや教師データが少数な場合除き利益は微妙 • 取り組むタスクで教師なしが重要だと既知なら含める • 入れなくてもbaselineのモデルがoverfitしてたらあとで足すのも可 17
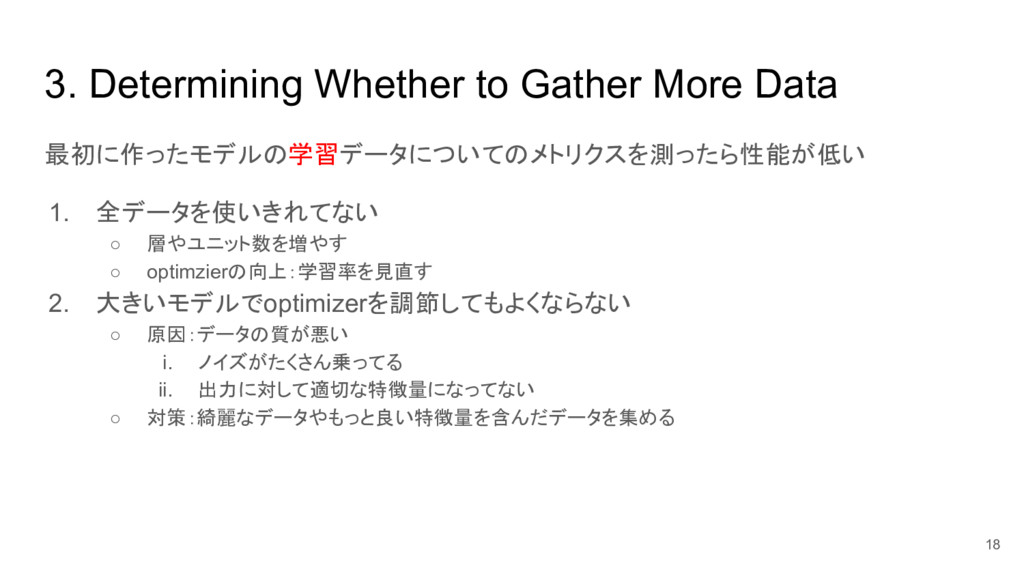
  10. 最初に作ったモデルの学習データについてのメトリクスを測ったら性能が低い 1. 全データを使いきれてない ◦ 層やユニット数を増やす ◦ optimzierの向上:学習率を見直す 2. 大きいモデルでoptimizerを調節してもよくならない ◦

    原因:データの質が悪い i. ノイズがたくさん乗ってる ii. 出力に対して適切な特徴量になってない ◦ 対策:綺麗なデータやもっと良い特徴量を含んだデータを集める 3. Determining Whether to Gather More Data 18
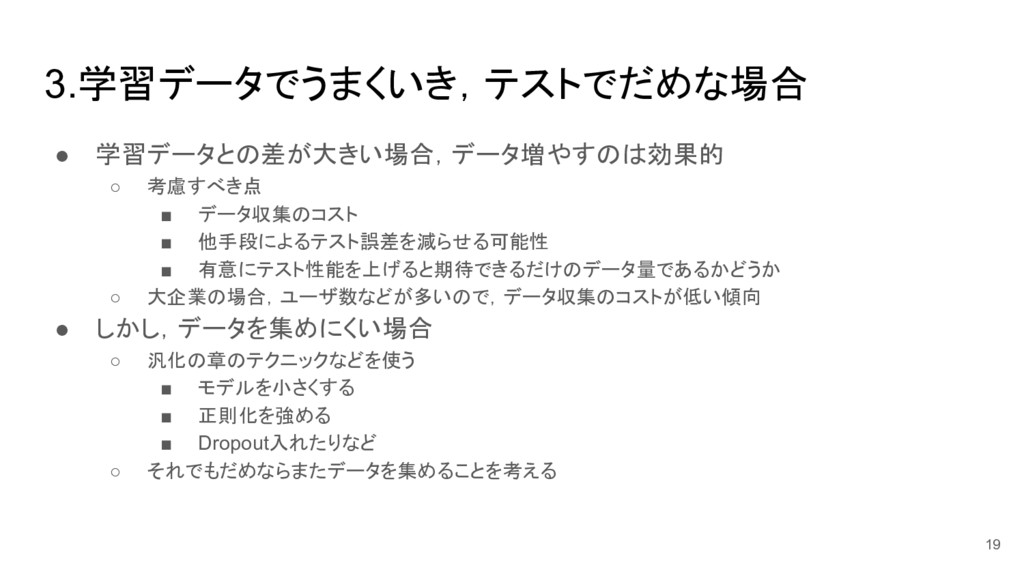
  11. 3.学習データでうまくいき,テストでだめな場合 19 • 学習データとの差が大きい場合,データ増やすのは効果的 ◦ 考慮すべき点 ▪ データ収集のコスト ▪ 他手段によるテスト誤差を減らせる可能性

    ▪ 有意にテスト性能を上げると期待できるだけのデータ量であるかどうか ◦ 大企業の場合,ユーザ数などが多いので,データ収集のコストが低い傾向 • しかし,データを集めにくい場合 ◦ 汎化の章のテクニックなどを使う ▪ モデルを小さくする ▪ 正則化を強める ▪ Dropout入れたりなど ◦ それでもだめならまたデータを集めることを考える
  12. 4. Selecting Hyperparameters 21 • Deep Learningではアルゴリズムの挙動を制御するハイパーパラメタ ◦ 学習時間 ◦

    メモリ ◦ モデルの質 ◦ 汎化性能 • ハイパーパラメタの選び方 ◦ 人手:それぞれのパラメタについての理解が必要 ◦ 自動:理解が乏しくてもいいが,コストがかかりやすい
  13. 4.1 U字曲線にならないパラメタ 24 • 離散値をとるパラメタ ◦ ユニット数 ◦ 層数 •

    Binary値しかとれないパラメタや処理 ◦ 入力データの前処理
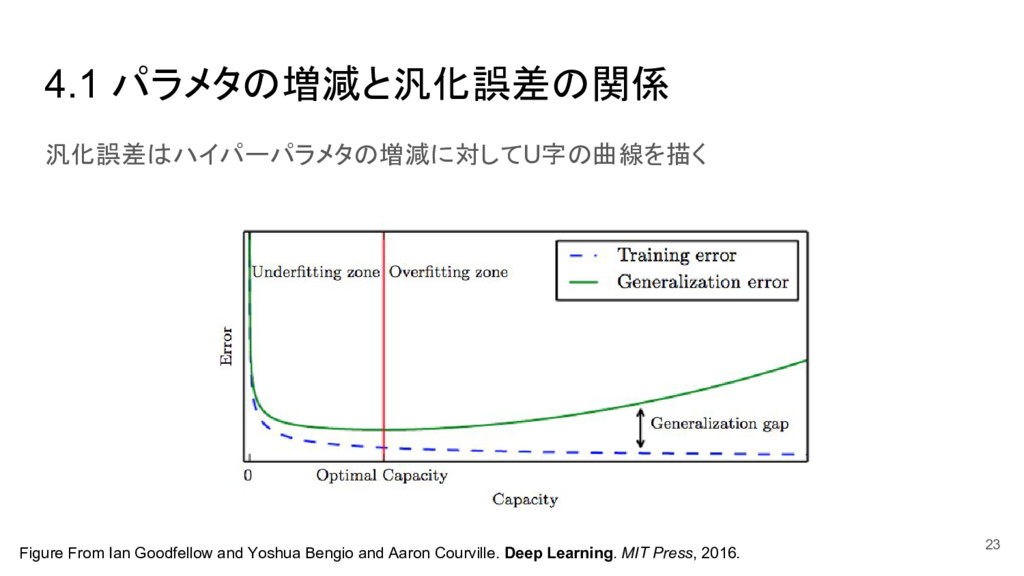
  14. 4.1 学習率 25 • 1つしか調節できない場合:学習率を触れ ◦ 学習率が正しく設定されていれば,モデルの capacityは最大になる • 学習率の増減に対しても訓練誤差はU字曲線

    ◦ 学習率が大きすぎる ▪ 誤差関数は増加する ◦ 学習率が小さすぎる ▪ 収束までのepoch数が増える ▪ 訓練誤差が高いところに停滞 (* 誤差関数が凸の場合は起こらないので特性)
  15. 4.1 目標の値に満たない場合とパラメタ 26 • 訓練時に値が満たないとき ◦ 正則化を外す・緩める ◦ optimizerがちゃんと動作させる ◦

    ユニット数・層数を増やしてモデルの表現力を上げる • テスト時に値が満たないとき ◦ test error = (train error) + (gap between train error and test error) ▪ NNでは訓練誤差は基本的に小さい値になる ▪ train errorを上げることなく,後者を小さくする:正則化や dropout
  16. 4.2 Automatic Hyperparameter Optimization Algorithms • 理想的なアルゴリズム ◦ パラメタの指定が不要で入力値と出力関数を決めるだけ ◦

    SVMやlogistic regressionは調節するパラメタが少ないので人気でもある • NNでは選ぶパラメタが多いあるの調節に時間がかかる ◦ 特に新しいネットワークやアルゴリズム • hyperparamater optimization ◦ 学習アルゴリズムとパラメタ探索を一緒にやる ◦ これ自体がパラメタをもつが,それを選ぶのは相対的に楽 27
  17. 4.3 Grid Search 28 数個しかない場合に有効なパラメタ探索アルゴリズム 1. 利用するパラメタの候補を少数だけ決める a. ここは経験的 b.

    log scaleにすることが多い i. 学習率 {0.1, 0.01, ...} ii. ユニット数 {50, 100, 200, ...} 2. これらのパラメタの直積集合の1要素ごとに学習 3. validation errorが低い要素を出力
  18. 連続値をとるパラメタ α = {-1, 0, 1} を考える 1. α =

    1が最良 a. 1以上がより良い可能性があるので, α= {1, 2 ,3} で再実行 2. α = 0が最良 a. 0±1の間がより良い可能性があるので, α = {-0.1, 0, 0.1}で再実行 4.3 Grid Searchはiterative 29
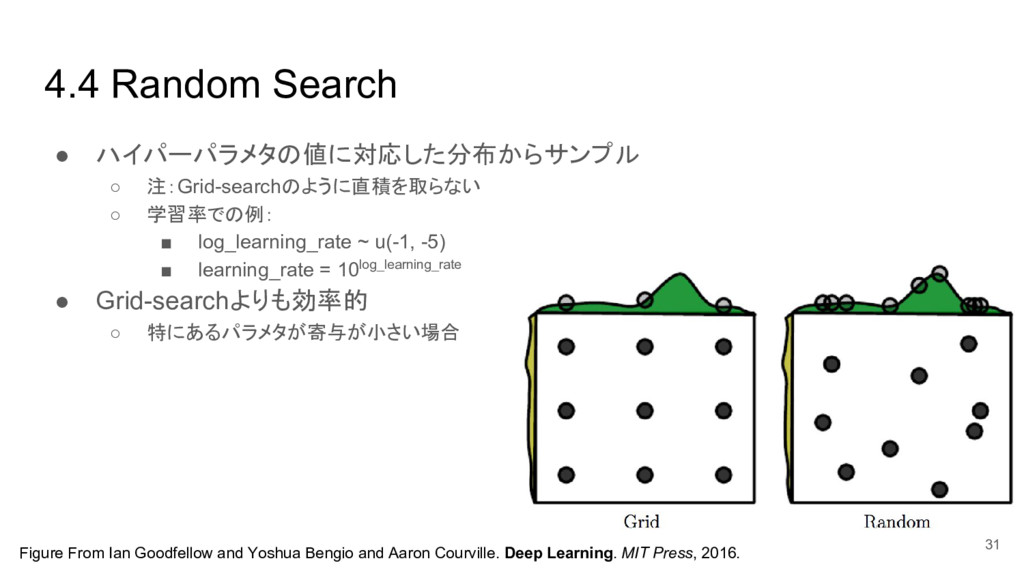
  19. • ハイパーパラメタの値に対応した分布からサンプル ◦ 注:Grid-searchのように直積を取らない ◦ 学習率での例: ▪ log_learning_rate ~ u(-1,

    -5) ▪ learning_rate = 10log_learning_rate • Grid-searchよりも効率的 ◦ 特にあるパラメタが寄与が小さい場合 4.4 Random Search 31 Figure From Ian Goodfellow and Yoshua Bengio and Aaron Courville. Deep Learning. MIT Press, 2016.
  20. 4.5 Model-Based Hyperparameter Optimization • ハイパーパラメタの探索:最適化問題として考える ◦ validation errorを最小化するようなパラメタを決める ◦

    ハイパーパラメタで微分ができない /困難なことが多い • Bayesian Hyperparameter Search ◦ あるハイパーパラメタにおける validation errorの期待値とそのuncertaintyを求める ◦ 強くお勧めはしてない • その他 ◦ NNの構造を自動で決める [ICLR2017] ▪ 進化計算 ▪ 強化学習 (これ自体もNN) 32
  21. 4.5 The Drawbacks of Hyperparameter Search Algorithms • 明らかに悪いパラメタであっても事前情報がないと実行しきってしまう ◦

    非効率 ◦ 探索中に不要なパラメタが含まれる組み合わせも試してしまう • Freeze-Thaw Bayesian Optimization [Swersky+, 2014] ◦ 微妙な組み合わせであれば早い段階で学習を止める (freeze) ◦ いくつか実行して”freeze”した組み合わせがよさそうであれば “thaw”して学習を再開 33
  22. 5. Debugging Strategies • MLシステムの性能が悪い ◦ アルゴリズムが悪い ?実装が間違っている? • 色々な理由からデバッグが難しい

    ◦ 事前にアルゴリズムがうまくいくかわからない ▪ 例:ResNet152を医療画像に使ったら精度はどのくらいかは試さないとわからない ◦ 複数の構造があり,それを段階的に適用してる ▪ 一部がバグっていてもその近くでは許容できる誤差に収まることがありうる • ニューラルネットワークでは以下の2つの方法をとる ◦ 正しい挙動かを予測できる程度に単純なケースをつくる ◦ ネットワークのある部分で独立したテストをつくる 34
  23. 5. Visualize the model in action 35 • モデルの出力を聴覚的・視覚的に確認 ◦

    物体検知:実際にモデルが検知検知した画像を見る ◦ 音声の生成:実際に生成されたサンプルを聞く • accuracyやlog-likelyhoodなど量的な指標だけ見る場合には不適切 • 実際に確認しつつ,今の量的な指標が適切か判断できる ◦ 評価部分にバグがある場合,数値上高くても生成された音声が壊れてる等がありうる
  24. Visualize the worst mistake • 分類問題では,softmaxやsigmoidといった確率値を出力 ◦ このとき [確率値 =

    サンプルがそのクラスである確信度 ] • 正解の確率値が低く推定されているサンプル ◦ データの前処理やラベル付けが間違っている可能性 ◦ Googleの例:Street viewでcroppingの範囲が小さすぎて数字が削れていた 36
  25. ソフトウェアが正しく実装されているか • If training error is low but test error

    is high a. 実装は正しくてoverfittingしてる b. test errorの計算に至るまでにバグがある c. test dataがtrain dataとは異なる前処理をされている • If both errors are high ◦ 以下が考えられるが,判断できない (次のスライドへ) ▪ 実装ミス ▪ underfitting Reason about software using training and test error 37
  26. Monitor histgrams of activations and gradient 41 • 活性化関数の適用前 ◦

    どれくらいサチってるか ◦ サチってるのはいくつあるか • 活性化関数(ReLUの場合) ◦ どのくらい0になるか ◦ 常に0になるユニットはいくつあるか • 勾配を見る ◦ すぐに消えたり,爆発していれば学習がうまくいってない • 勾配の変化の大きさを見る ◦ 大体1%くらい変わる ◦ NLPのような疎なデータは時間軸を取る

More Decks by Kento Nozawa

Other Decks in Research