Share
Embed
Transcript
47 slides
-
自己紹介 2 • 中郷孝祐 @corochann • Preferred Networks 2016~ ◦
製造業を中心にDeep Learningの応用研究 • Preferred Computational Chemistry ◦ 汎用原子レベルシミュレータMatlantisの研究開発と 組織立ち上げ・グローバル展開推進 • Preferred Elements ◦ PLaMo-100Bの事後学習 • Sakana AI 2025~ ◦ AI Agentで実社会にインパクトを • Kaggle 2x Grandmaster (Competitions & Notebooks) -
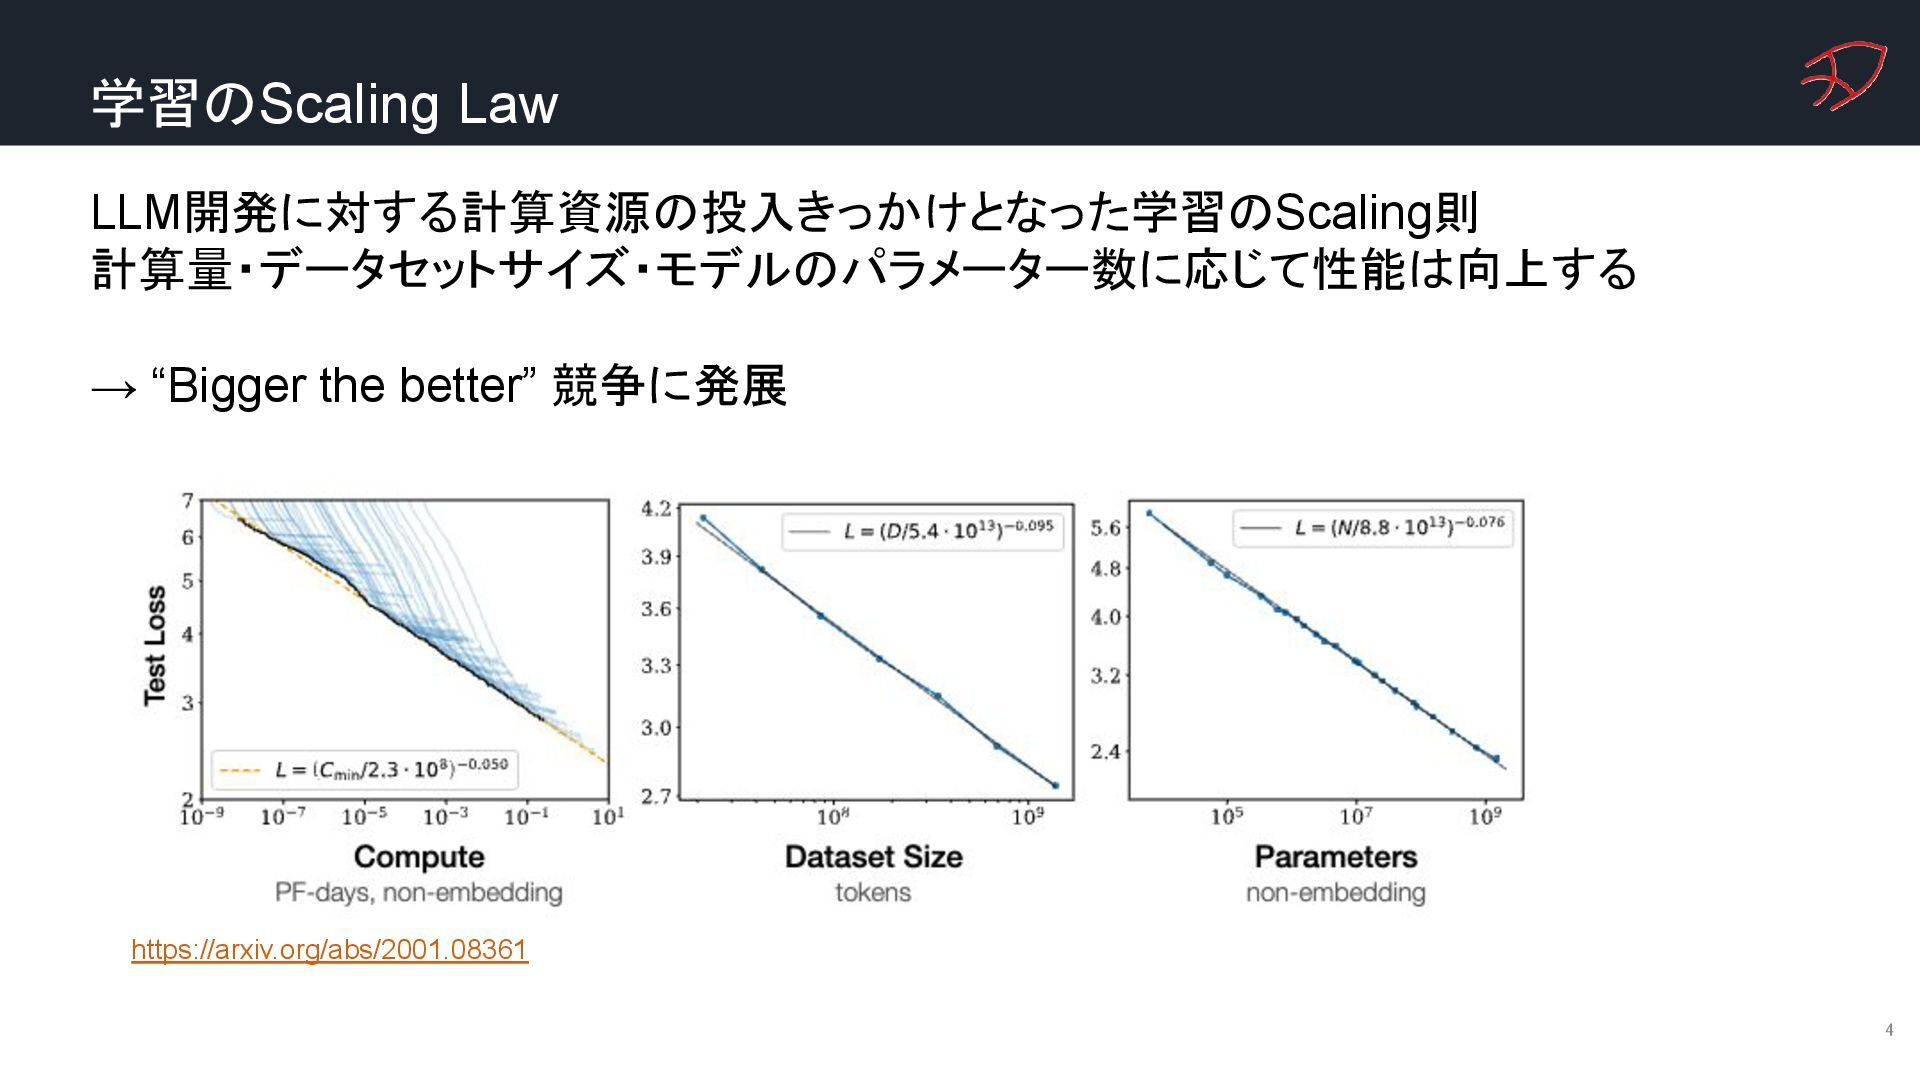
学習のScaling Law 4 LLM開発に対する計算資源の投入きっかけとなった学習のScaling則 計算量・データセットサイズ・モデルのパラメーター数に応じて性能は向上する → “Bigger the better” 競争に発展
https://arxiv.org/abs/2001.08361 -
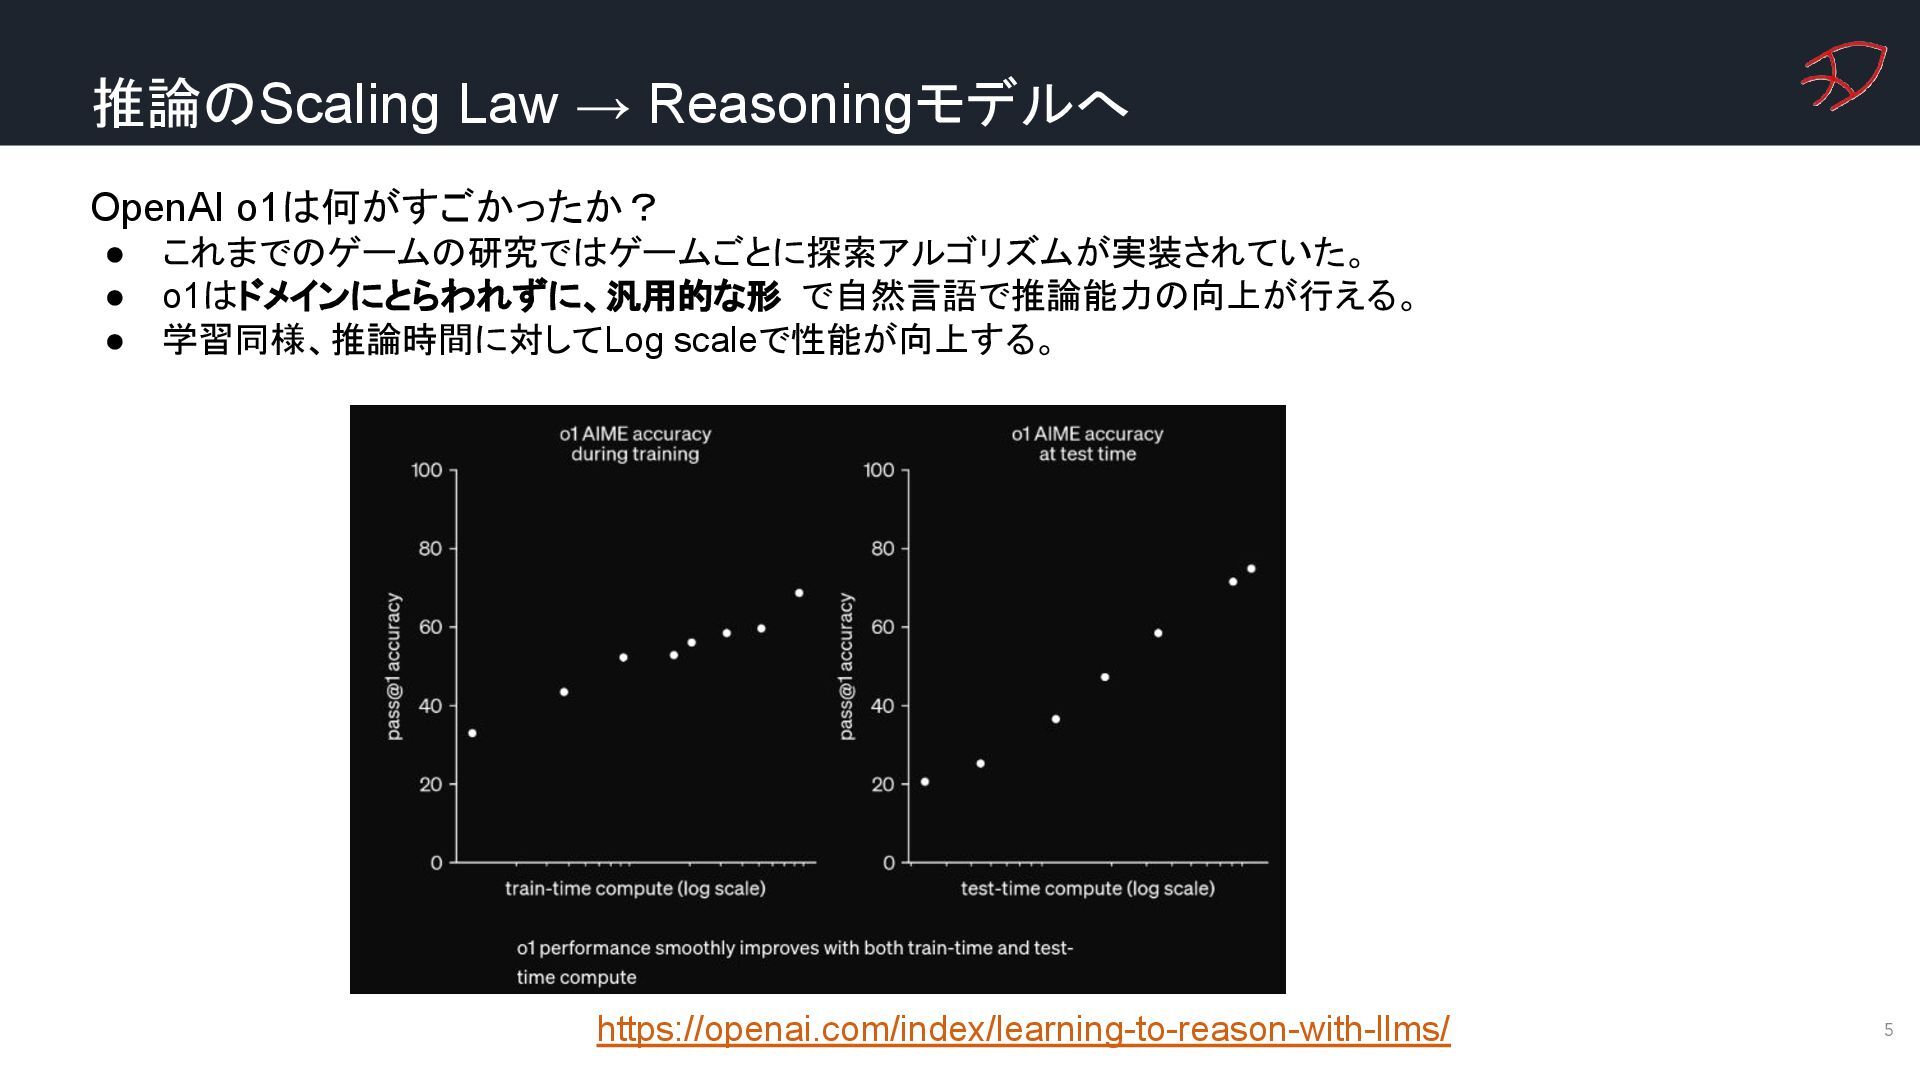
推論のScaling Law → Reasoningモデルへ 5 OpenAI o1は何がすごかったか? • これまでのゲームの研究ではゲームごとに探索アルゴリズムが実装されていた。 •
o1はドメインにとらわれずに、汎用的な形 で自然言語で推論能力の向上が行える。 • 学習同様、推論時間に対してLog scaleで性能が向上する。 https://openai.com/index/learning-to-reason-with-llms/ -
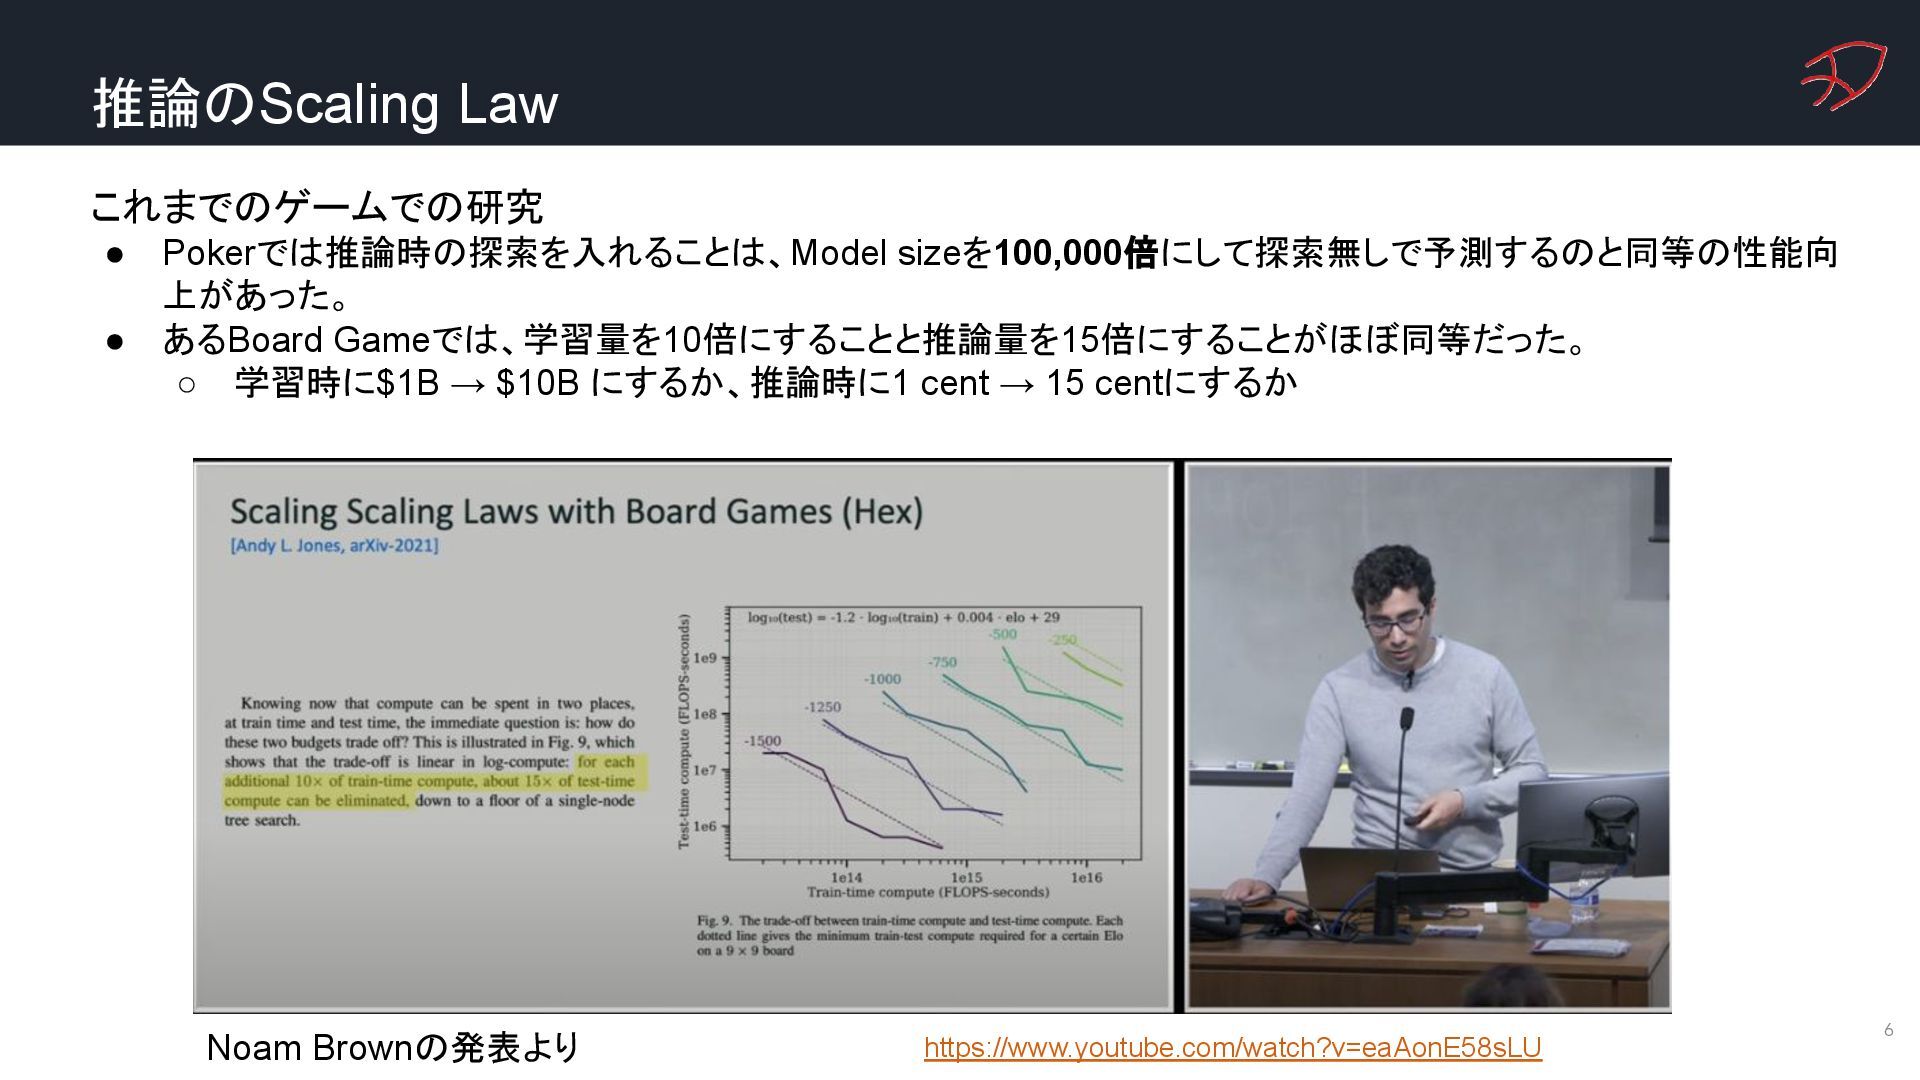
推論のScaling Law 6 これまでのゲームでの研究 • Pokerでは推論時の探索を入れることは、Model sizeを100,000倍にして探索無しで予測するのと同等の性能向 上があった。 • あるBoard
Gameでは、学習量を10倍にすることと推論量を15倍にすることがほぼ同等だった。 ◦ 学習時に$1B → $10B にするか、推論時に1 cent → 15 centにするか https://www.youtube.com/watch?v=eaAonE58sLU Noam Brownの発表より -
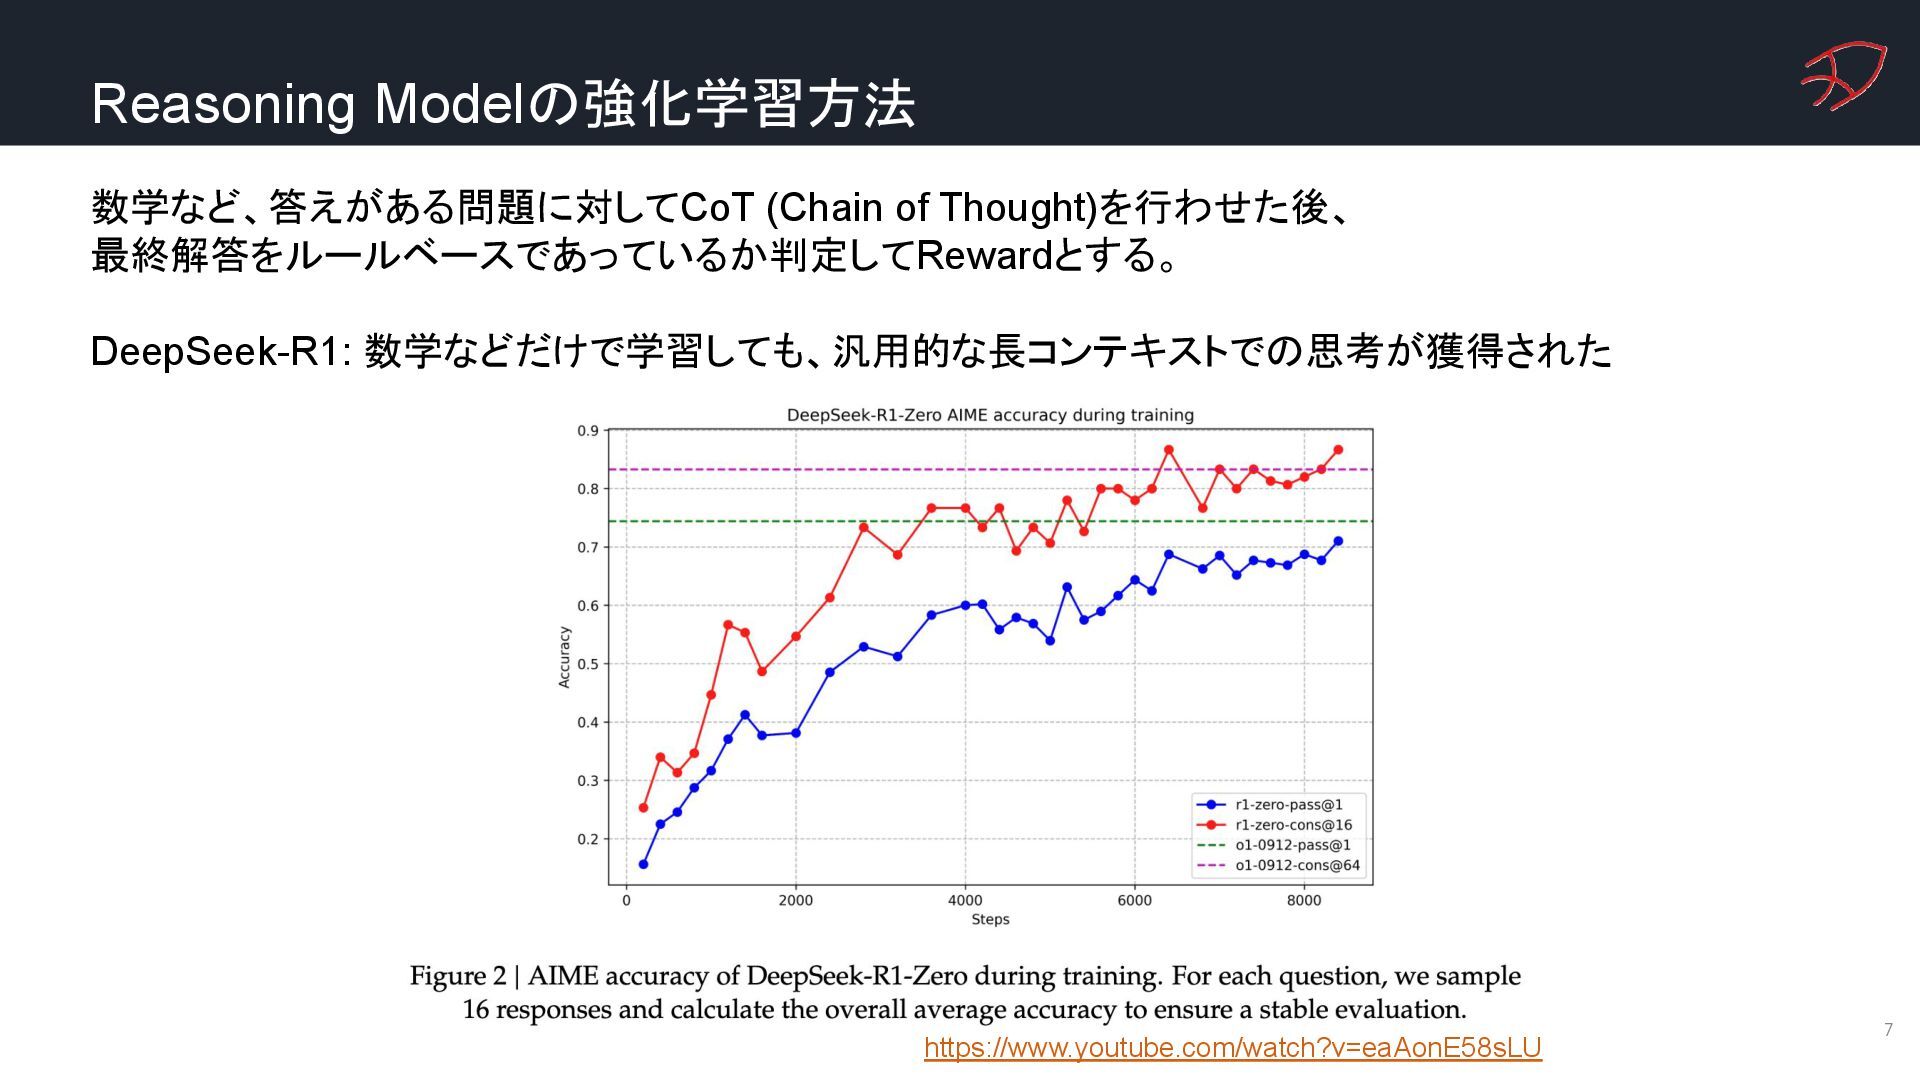
Reasoning Modelの強化学習方法 7 数学など、答えがある問題に対してCoT (Chain of Thought)を行わせた後、 最終解答をルールベースであっているか判定してRewardとする。 DeepSeek-R1: 数学などだけで学習しても、汎用的な長コンテキストでの思考が獲得された
https://www.youtube.com/watch?v=eaAonE58sLU -
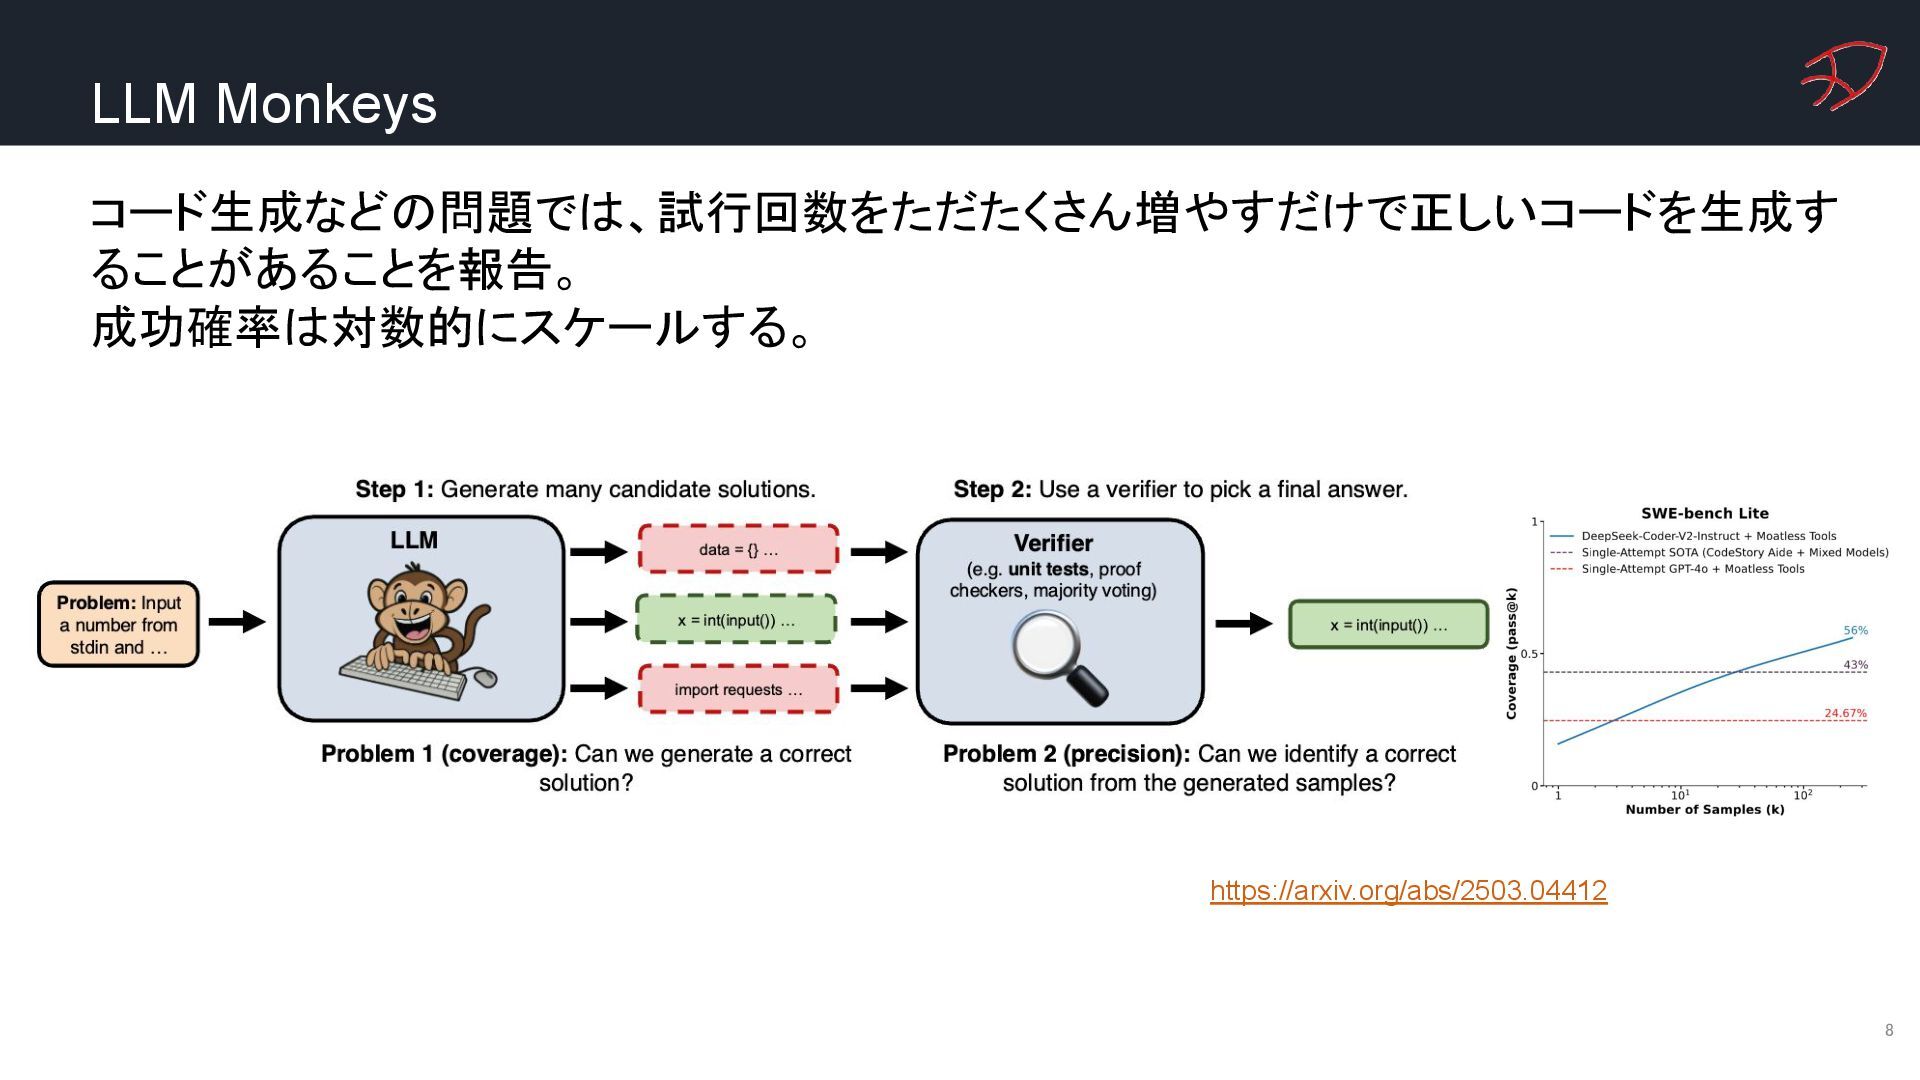
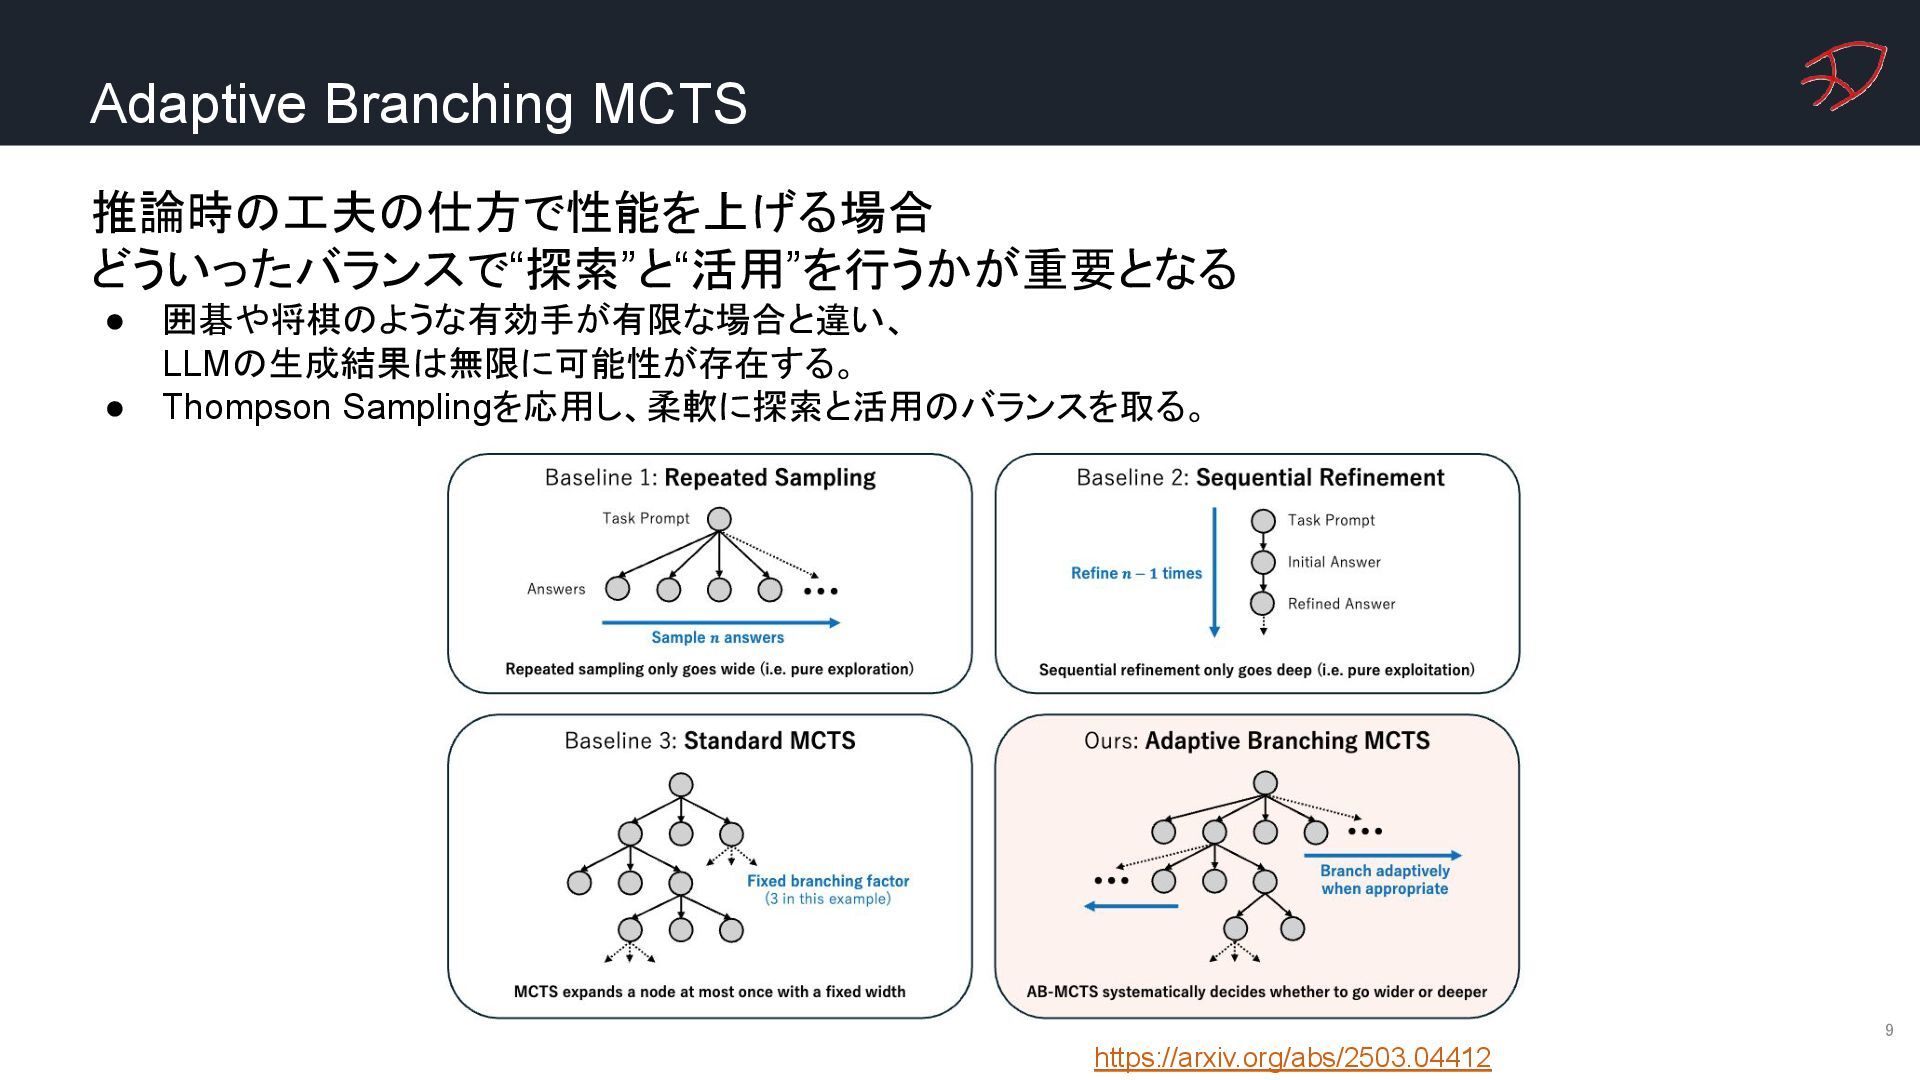
Adaptive Branching MCTS 9 推論時の工夫の仕方で性能を上げる場合 どういったバランスで“探索”と“活用”を行うかが重要となる • 囲碁や将棋のような有効手が有限な場合と違い、 LLMの生成結果は無限に可能性が存在する。 •
Thompson Samplingを応用し、柔軟に探索と活用のバランスを取る。 https://arxiv.org/abs/2503.04412 -
AI Agentのトレンド 12 AI Agentが使用するツールはどんどん増えている • Web検索 • Programming •
Terminalでのshell command実行 • … • Browser use • Computer use どのようなツールを組み合わせて どういったAgentサービスが構築されているか かいつまんでいくつかを紹介 -
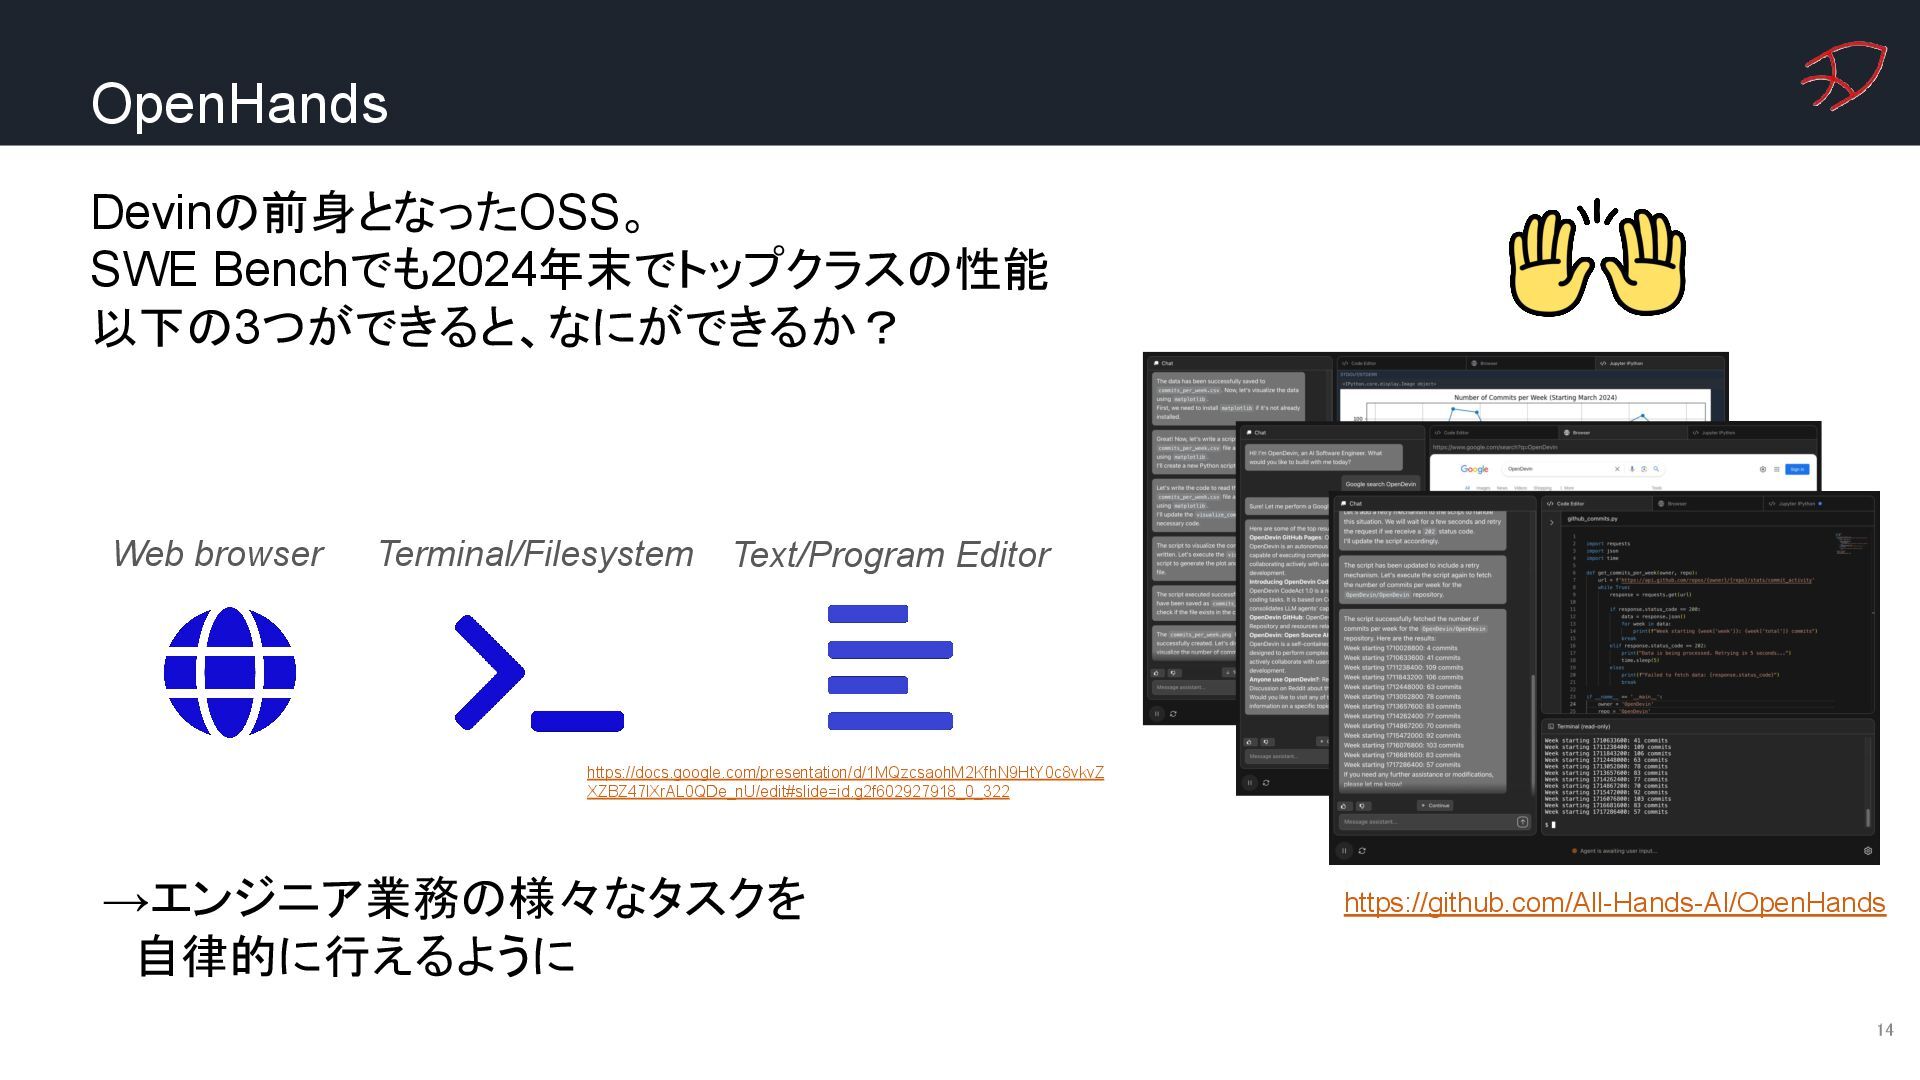
OpenHands 14 Devinの前身となったOSS。 SWE Benchでも2024年末でトップクラスの性能 以下の3つができると、なにができるか? Web browser Terminal/Filesystem Text/Program
Editor →エンジニア業務の様々なタスクを 自律的に行えるように https://docs.google.com/presentation/d/1MQzcsaohM2KfhN9HtY0c8vkvZ XZBZ47lXrAL0QDe_nU/edit#slide=id.g2f602927918_0_322 https://github.com/All-Hands-AI/OpenHands -
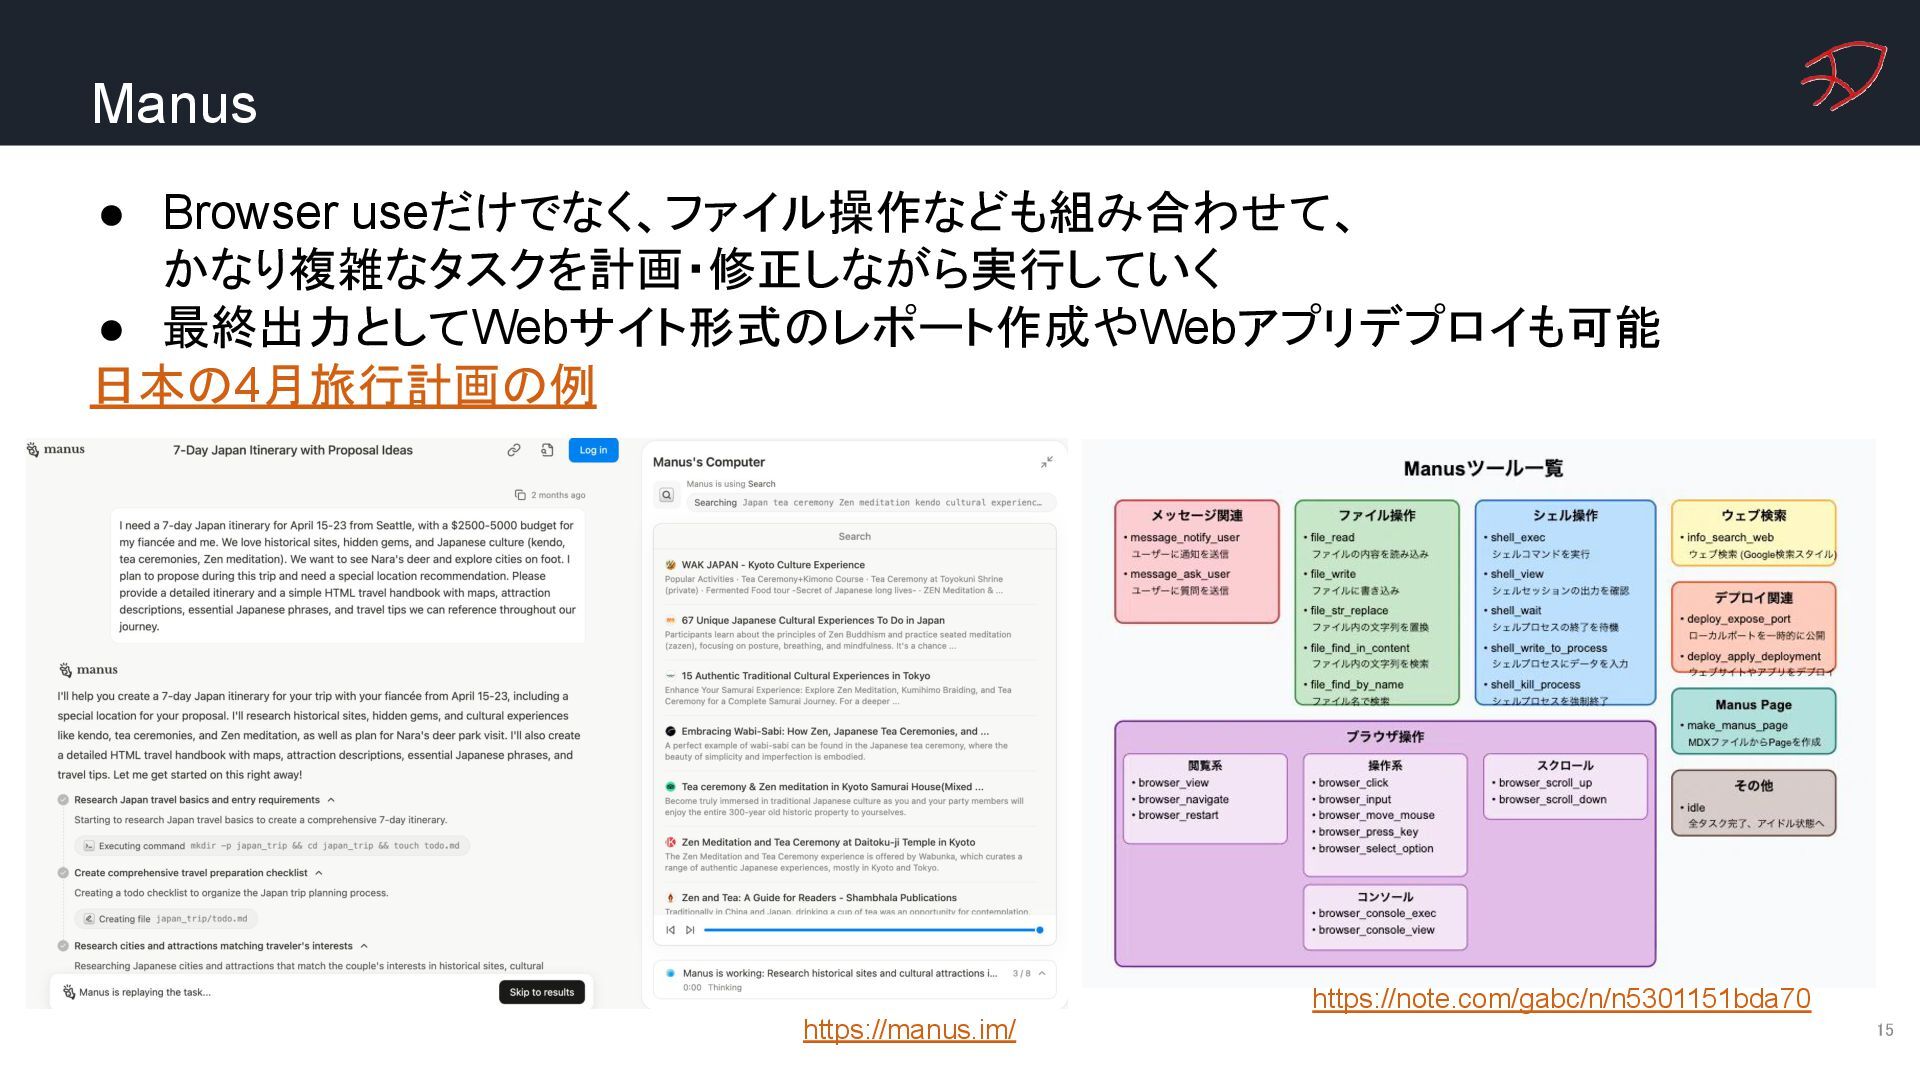
Manus 15 • Browser useだけでなく、ファイル操作なども組み合わせて、 かなり複雑なタスクを計画・修正しながら実行していく • 最終出力としてWebサイト形式のレポート作成やWebアプリデプロイも可能 日本の4月旅行計画の例 https://manus.im/
https://note.com/gabc/n/n5301151bda70 -
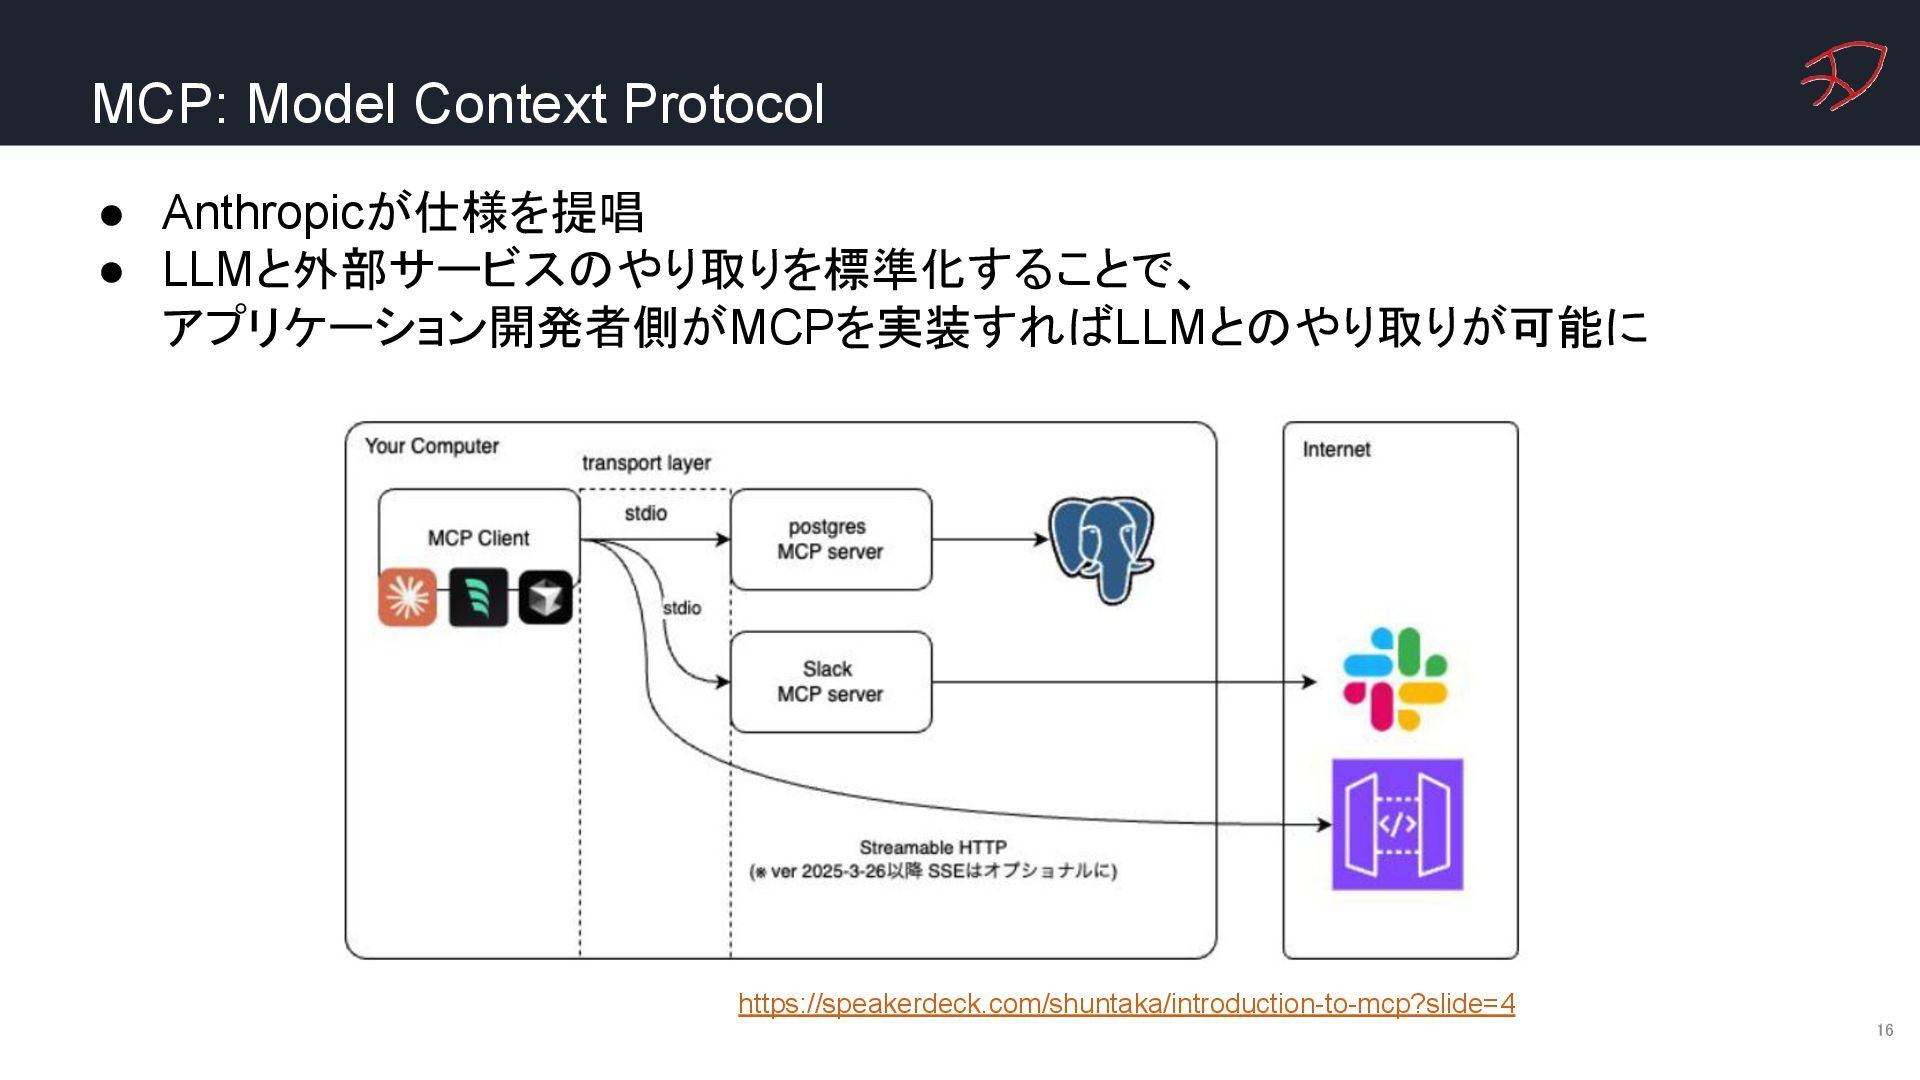
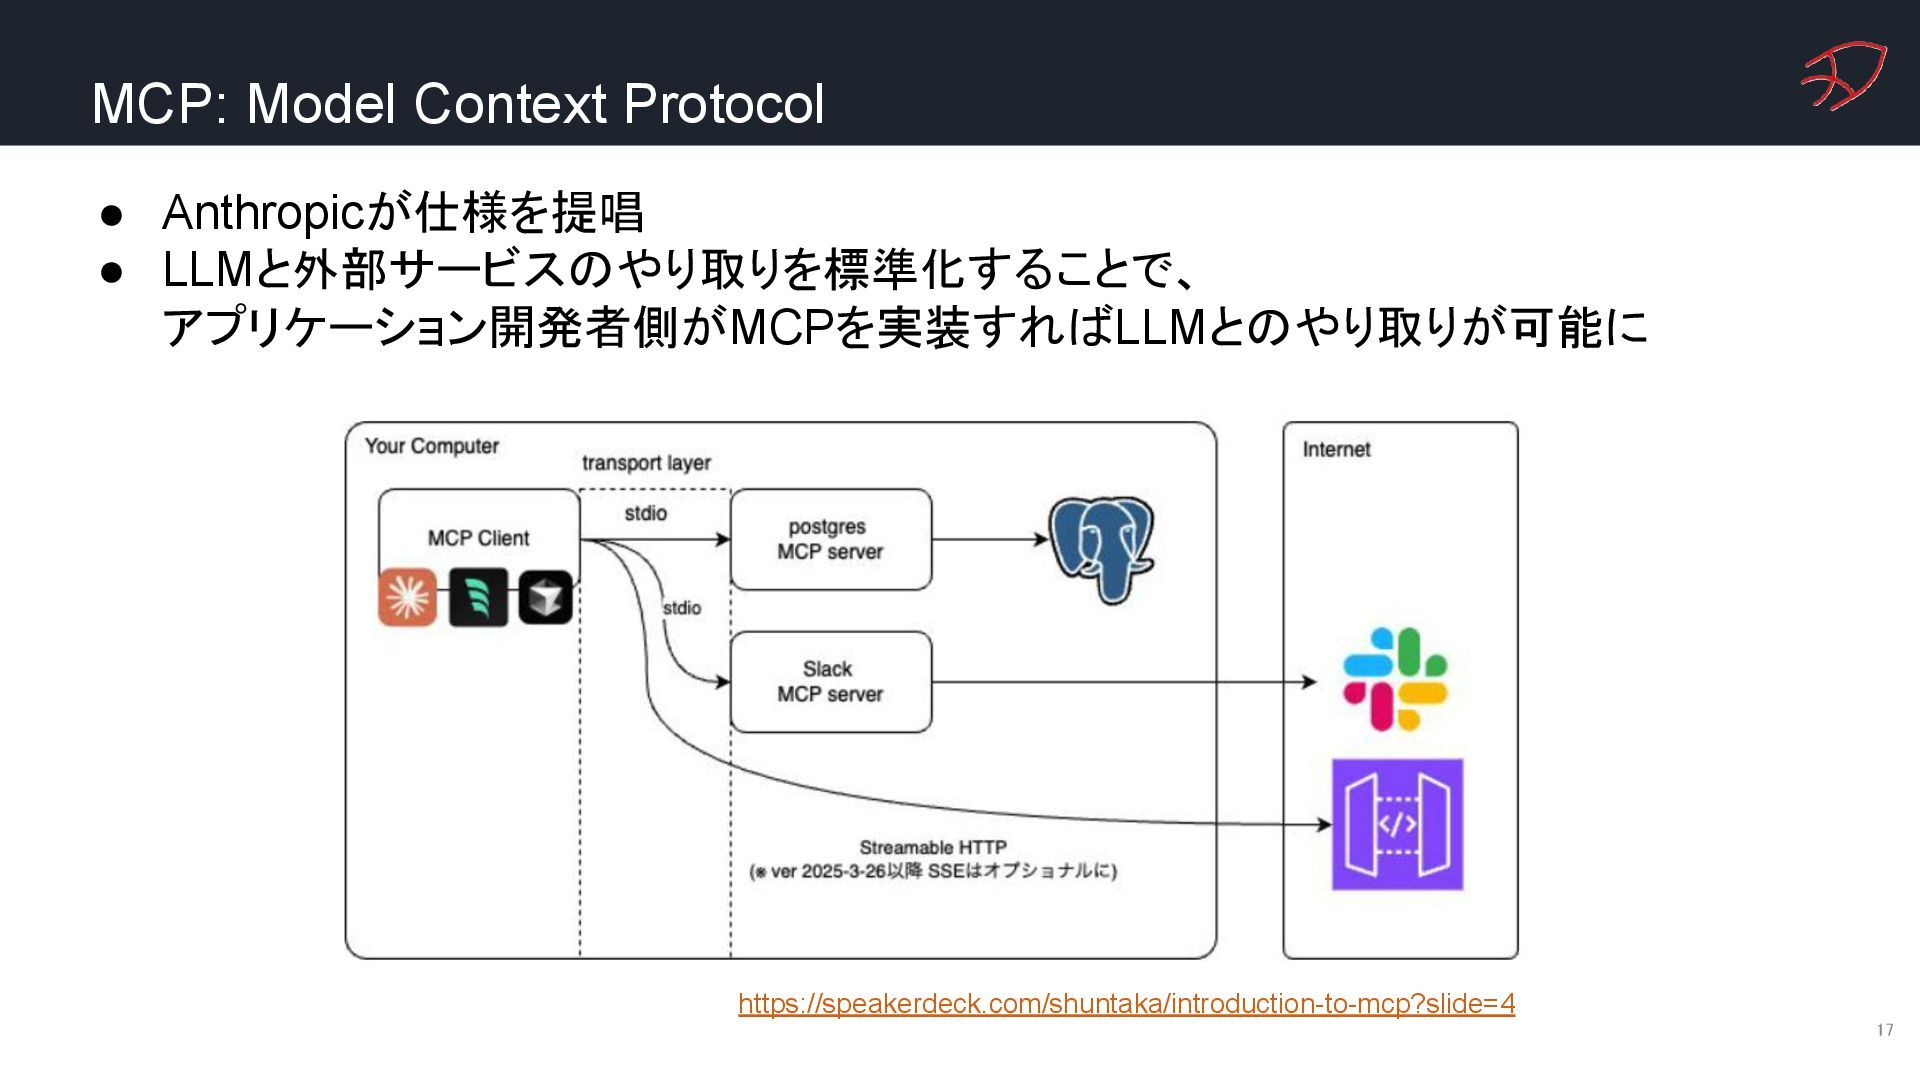
MCP: Model Context Protocol 16 • Anthropicが仕様を提唱 • LLMと外部サービスのやり取りを標準化することで、 アプリケーション開発者側がMCPを実装すればLLMとのやり取りが可能に
https://speakerdeck.com/shuntaka/introduction-to-mcp?slide=4 -
MCP: Model Context Protocol 17 • Anthropicが仕様を提唱 • LLMと外部サービスのやり取りを標準化することで、 アプリケーション開発者側がMCPを実装すればLLMとのやり取りが可能に
https://speakerdeck.com/shuntaka/introduction-to-mcp?slide=4 -
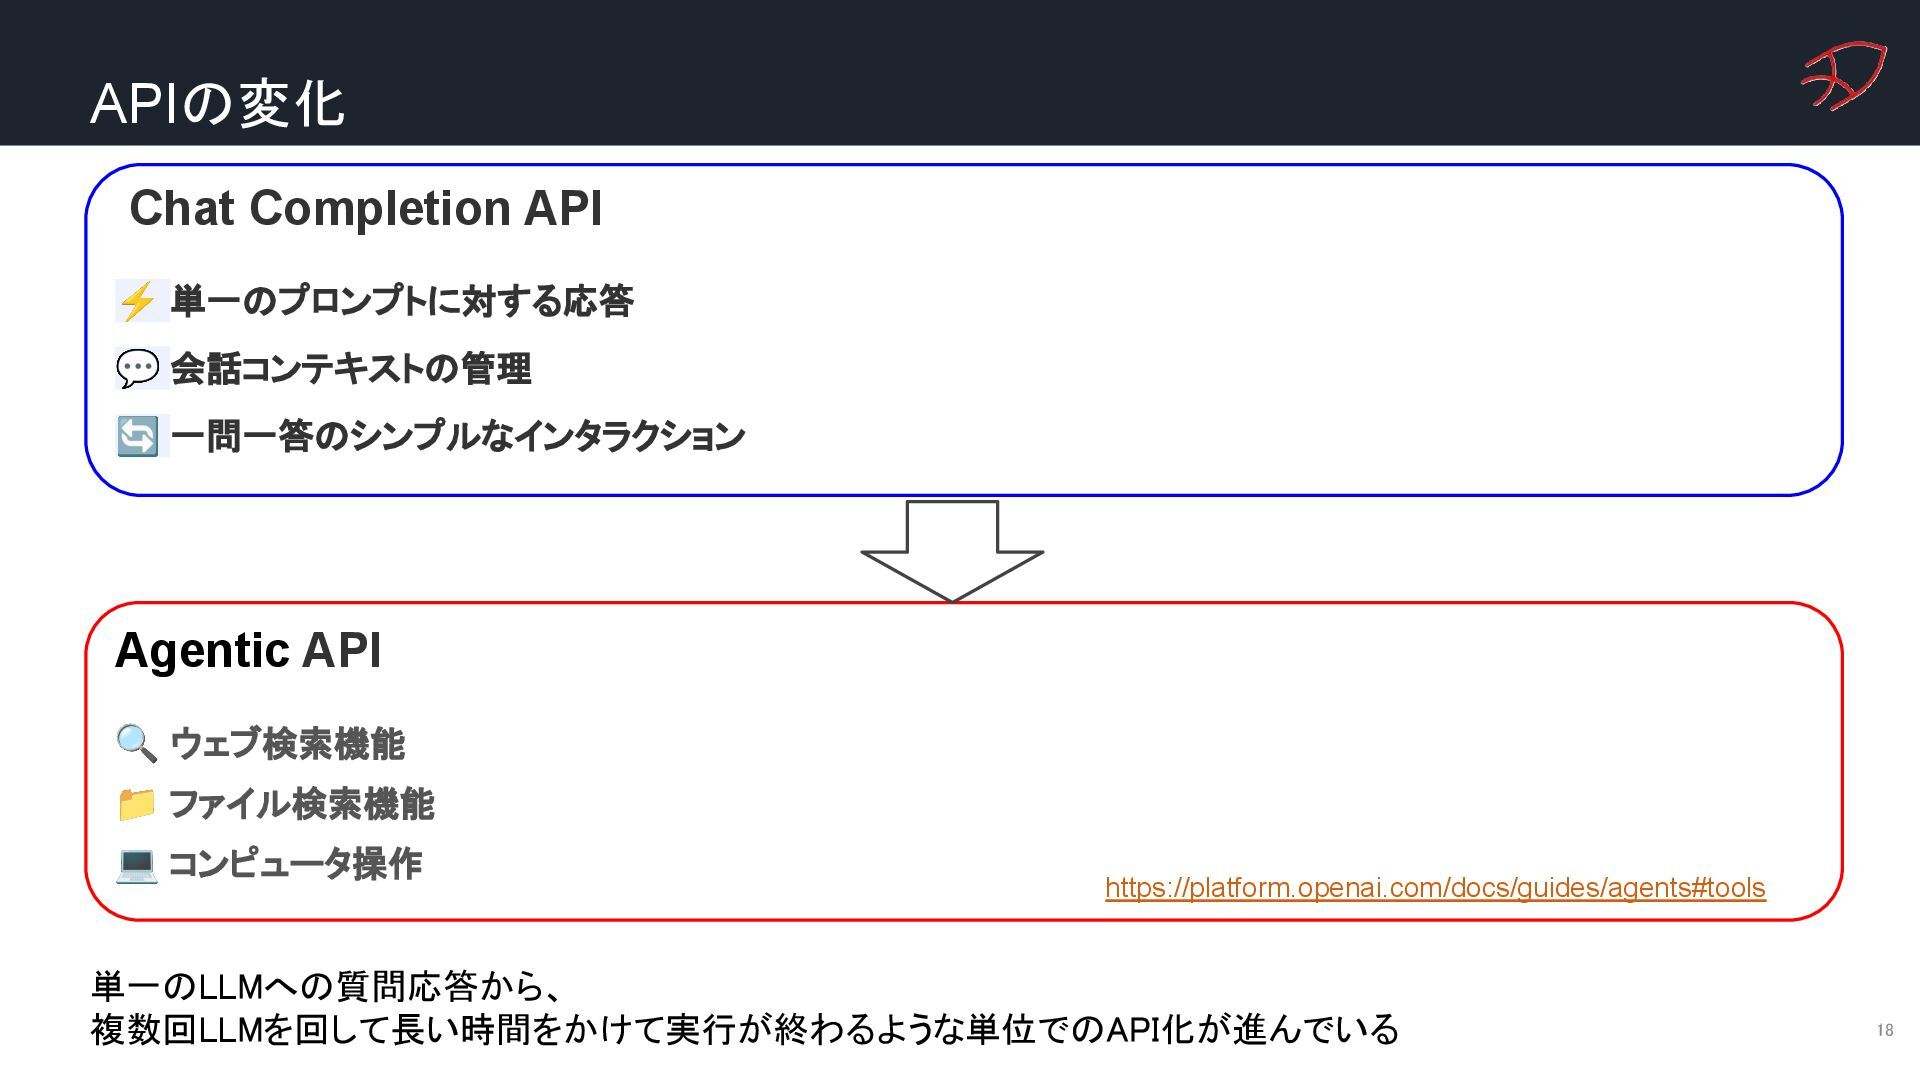
APIの変化 18 Chat Completion API ⚡ 単一のプロンプトに対する応答 💬 会話コンテキストの管理 🔄
一問一答のシンプルなインタラクション Agentic API 🔍 ウェブ検索機能 📁 ファイル検索機能 💻 コンピュータ操作 https://platform.openai.com/docs/guides/agents#tools 単一のLLMへの質問応答から、 複数回LLMを回して長い時間をかけて実行が終わるような単位でのAPI化が進んでいる -
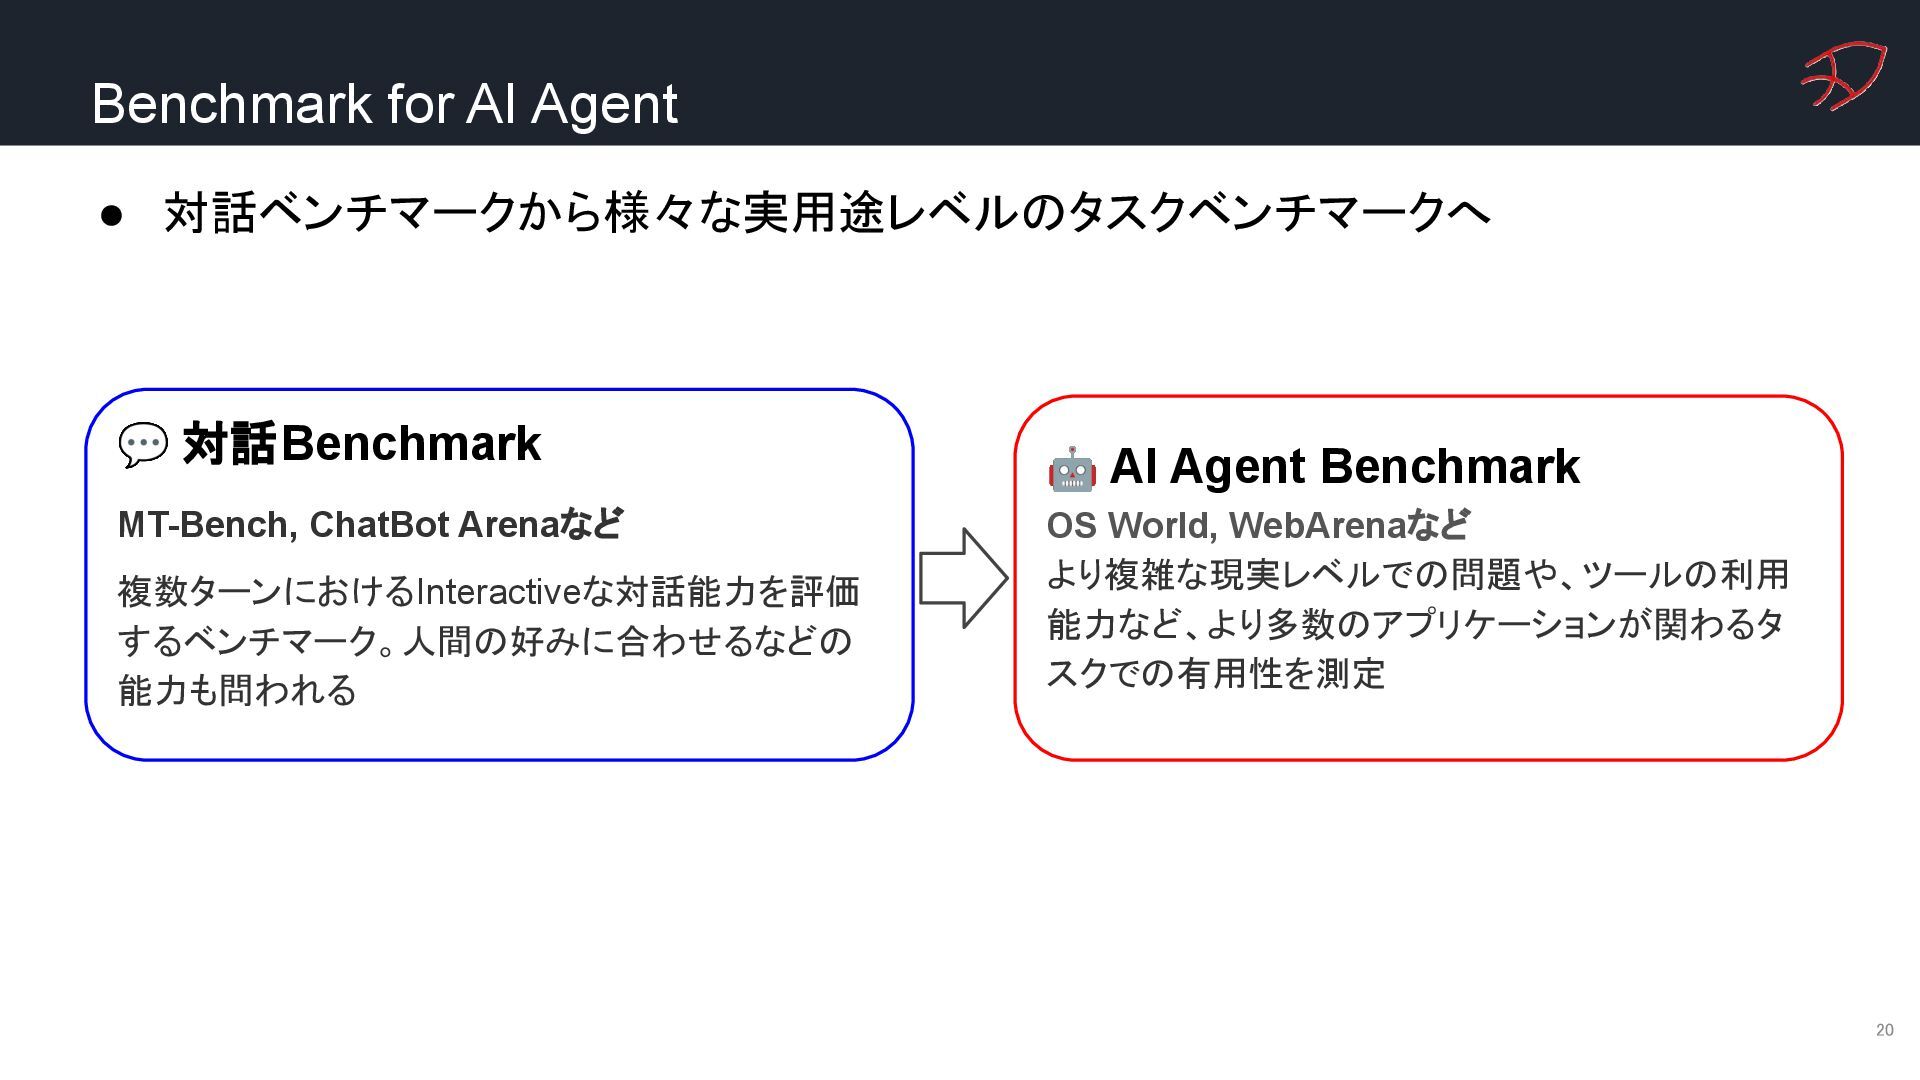
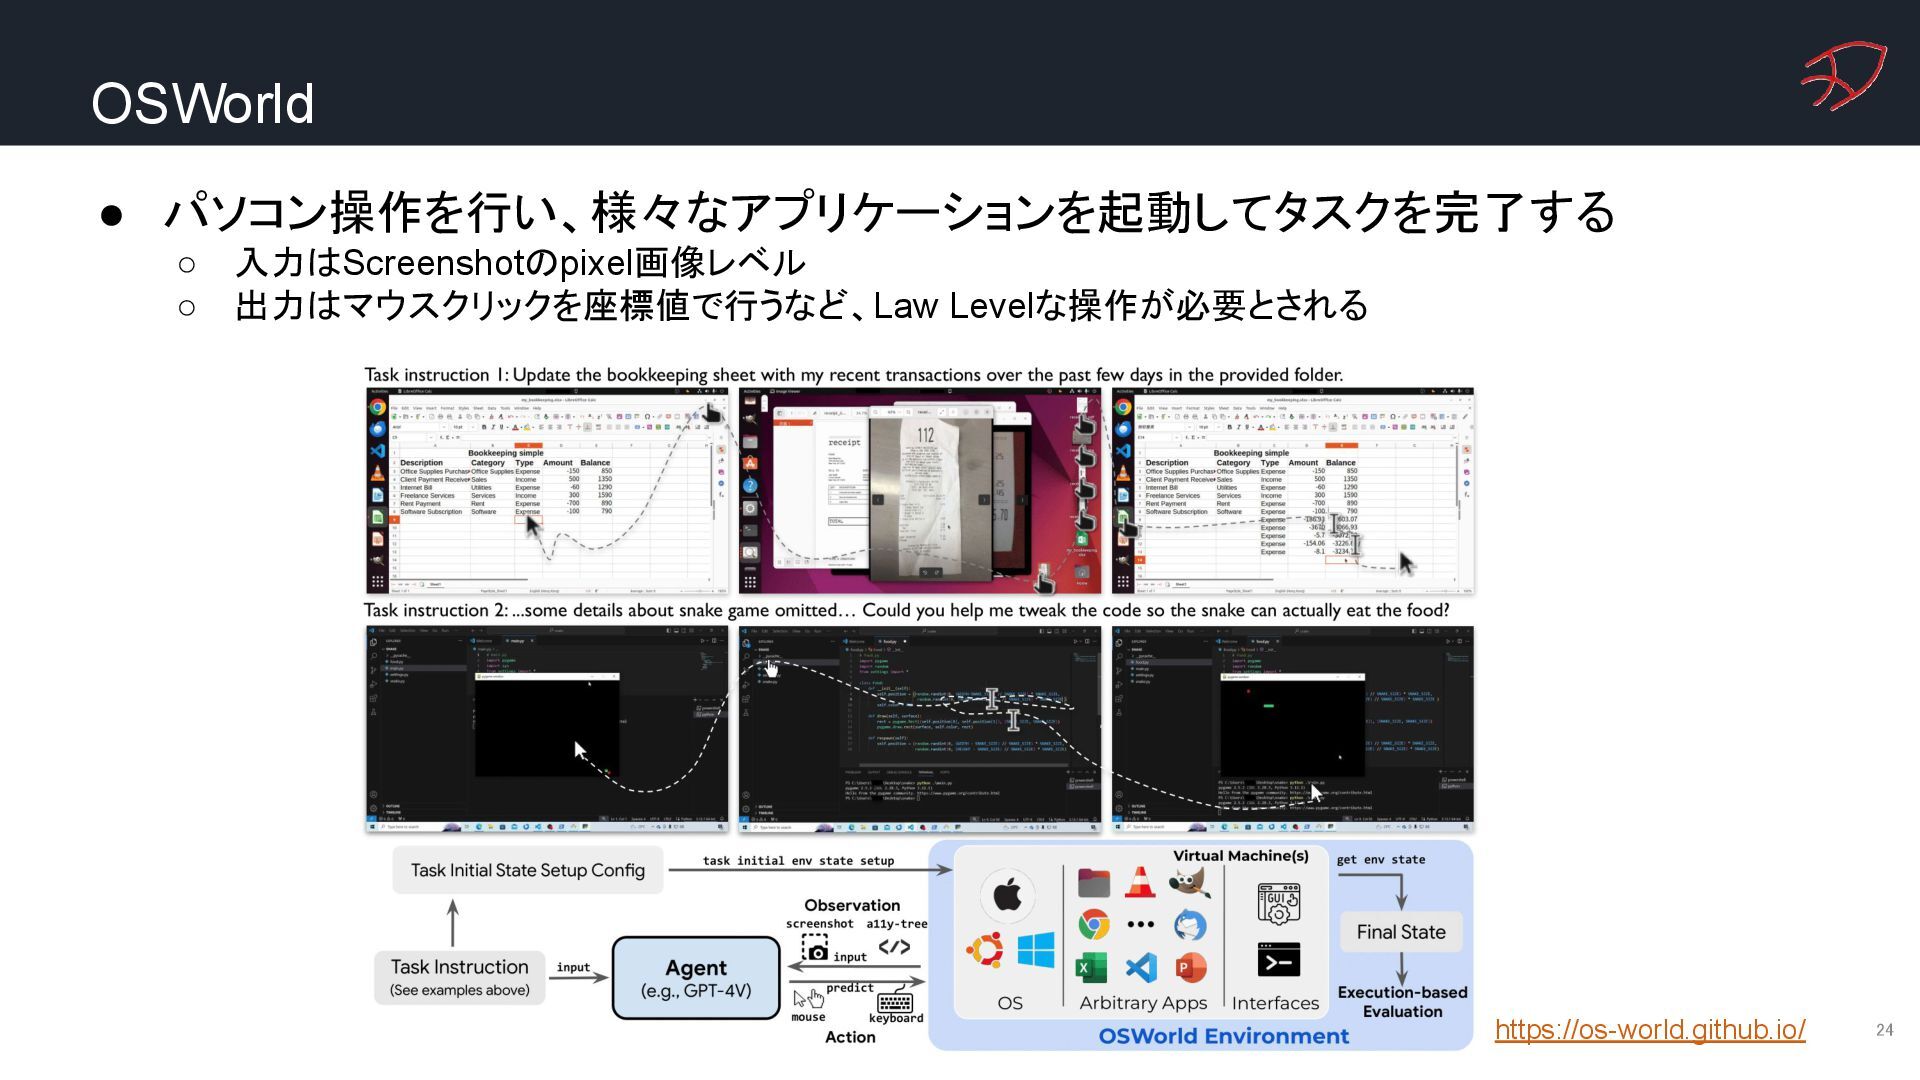
Benchmark for AI Agent 20 • 対話ベンチマークから様々な実用途レベルのタスクベンチマークへ 💬 対話Benchmark MT-Bench,
ChatBot Arenaなど 複数ターンにおけるInteractiveな対話能力を評価 するベンチマーク。人間の好みに合わせるなどの 能力も問われる 🤖 AI Agent Benchmark OS World, WebArenaなど より複雑な現実レベルでの問題や、ツールの利用 能力など、より多数のアプリケーションが関わるタ スクでの有用性を測定 -
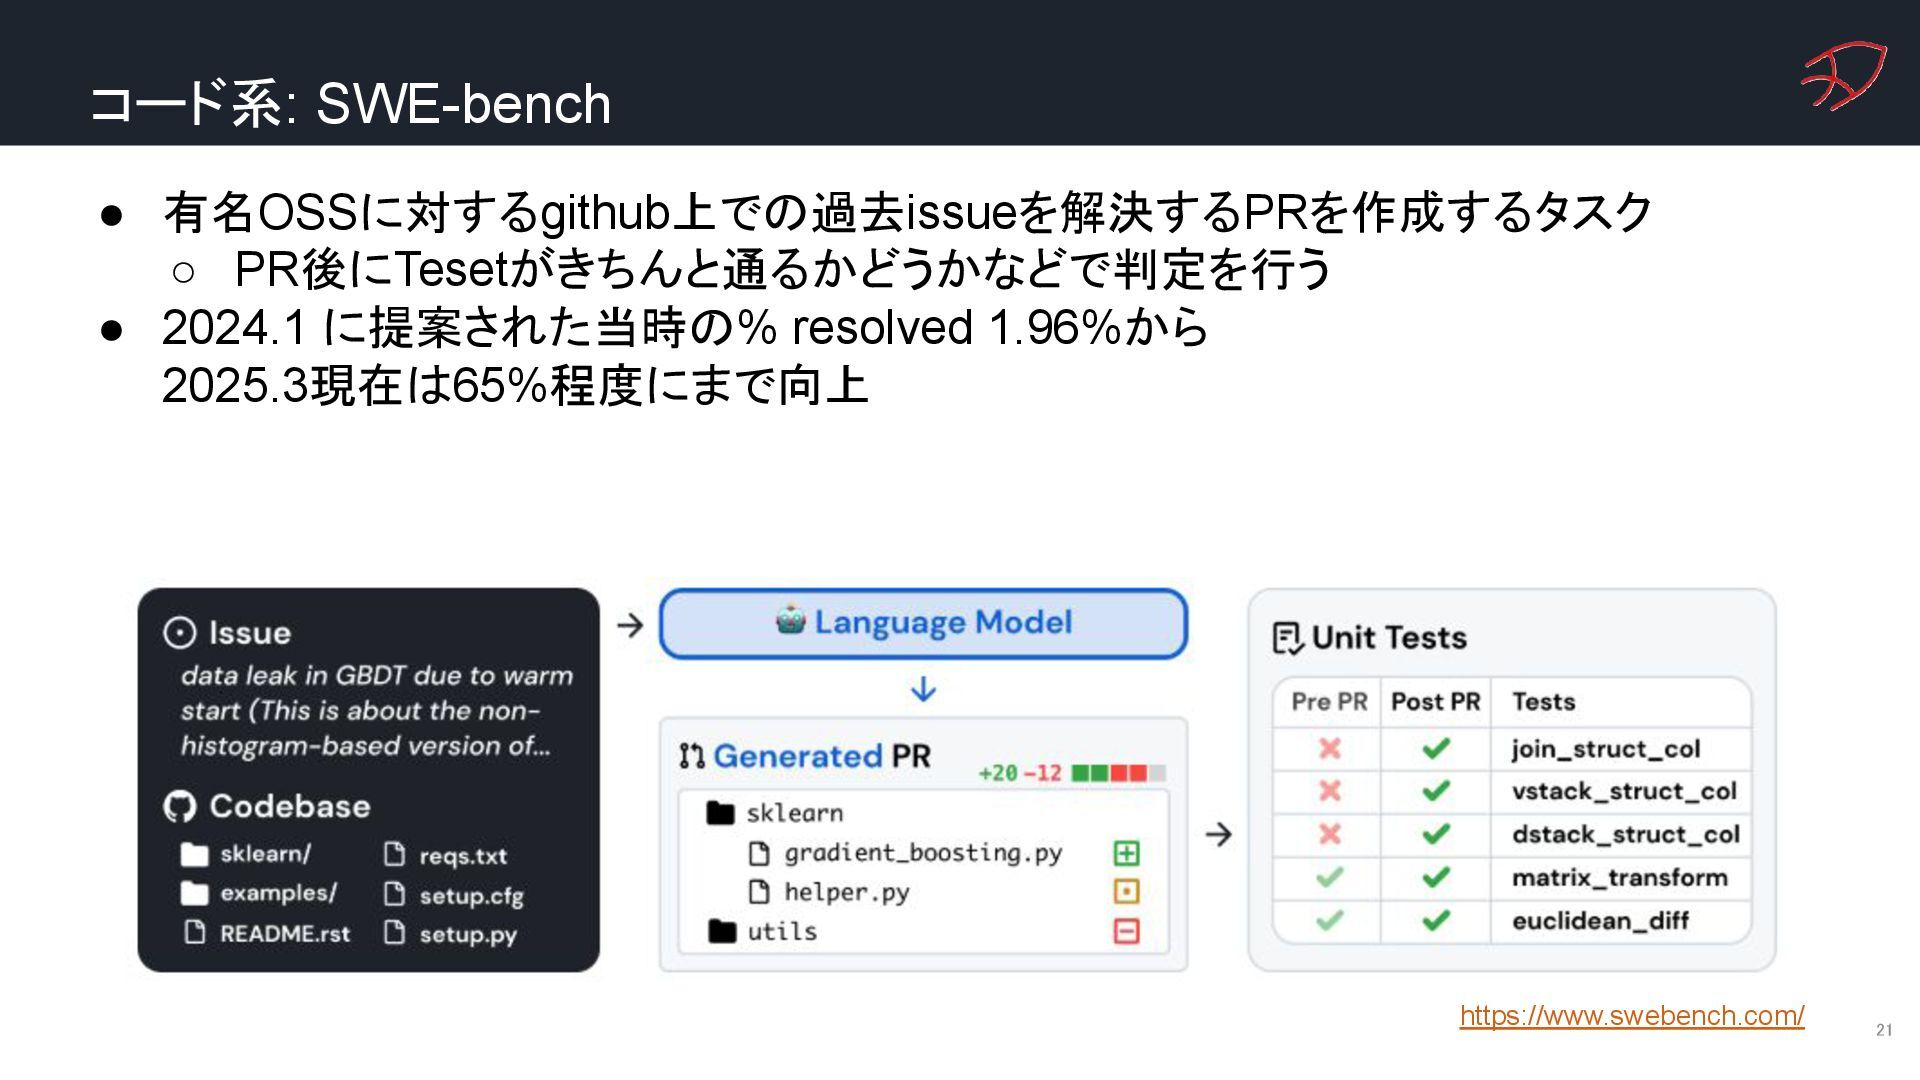
コード系: SWE-bench 21 • 有名OSSに対するgithub上での過去issueを解決するPRを作成するタスク ◦ PR後にTesetがきちんと通るかどうかなどで判定を行う • 2024.1 に提案された当時の%
resolved 1.96%から 2025.3現在は65%程度にまで向上 https://www.swebench.com/ -
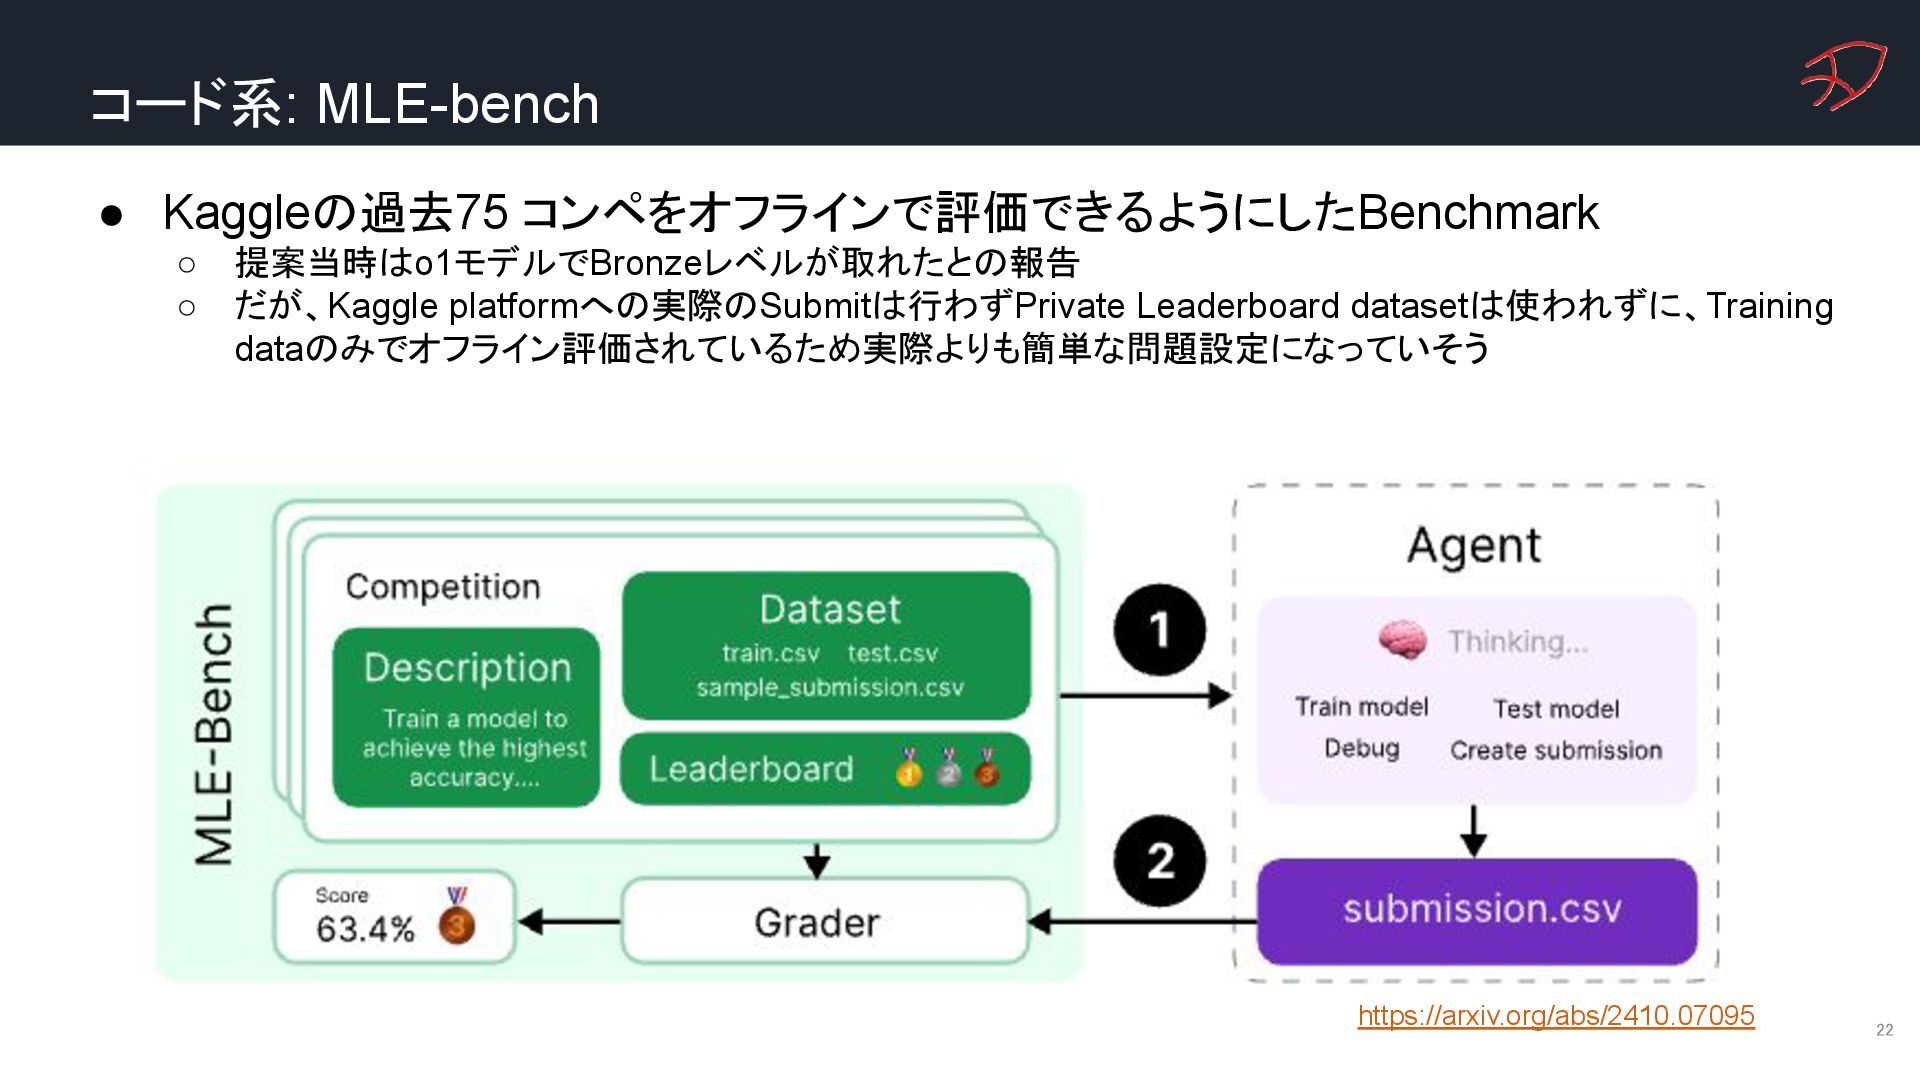
コード系: MLE-bench 22 • Kaggleの過去75 コンペをオフラインで評価できるようにしたBenchmark ◦ 提案当時はo1モデルでBronzeレベルが取れたとの報告 ◦ だが、Kaggle
platformへの実際のSubmitは行わずPrivate Leaderboard datasetは使われずに、Training dataのみでオフライン評価されているため実際よりも簡単な問題設定になっていそう https://arxiv.org/abs/2410.07095 -
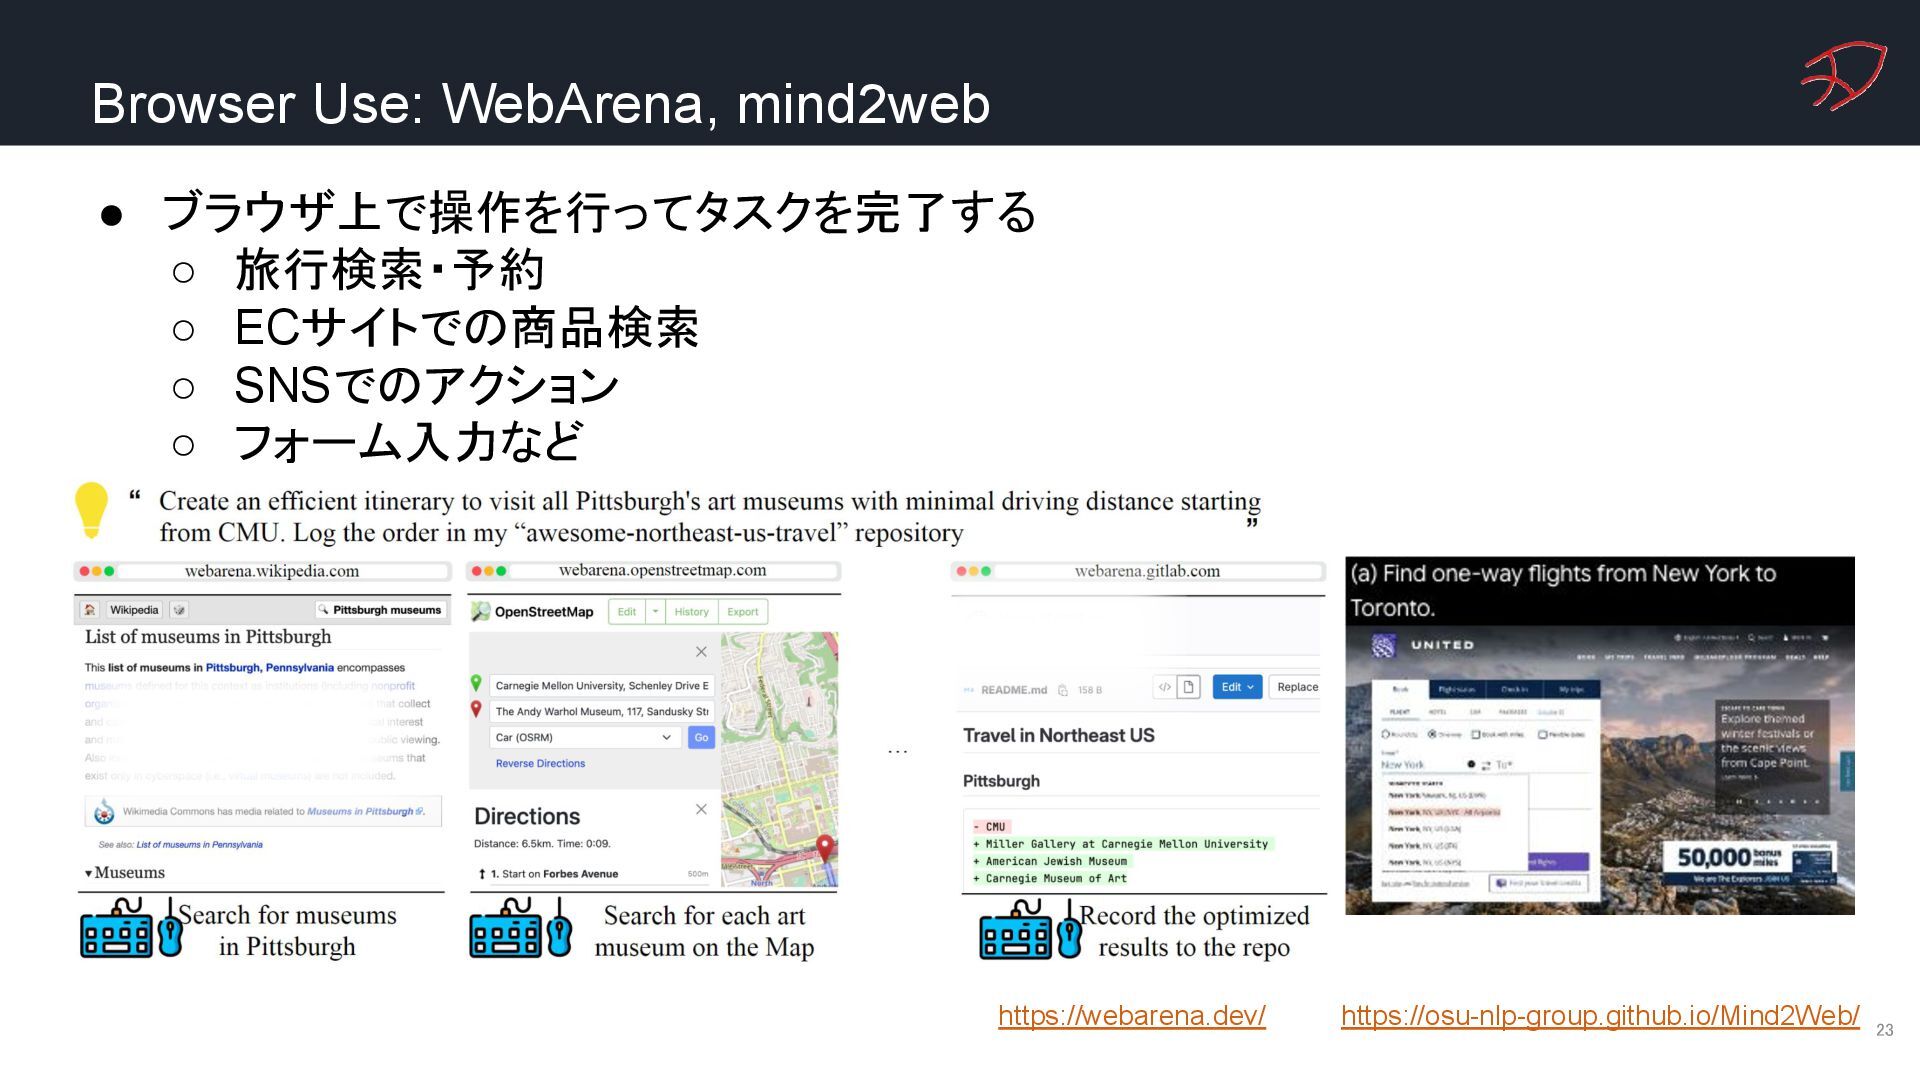
Browser Use: WebArena, mind2web 23 • ブラウザ上で操作を行ってタスクを完了する ◦ 旅行検索・予約 ◦
ECサイトでの商品検索 ◦ SNSでのアクション ◦ フォーム入力など https://osu-nlp-group.github.io/Mind2Web/ https://webarena.dev/ -
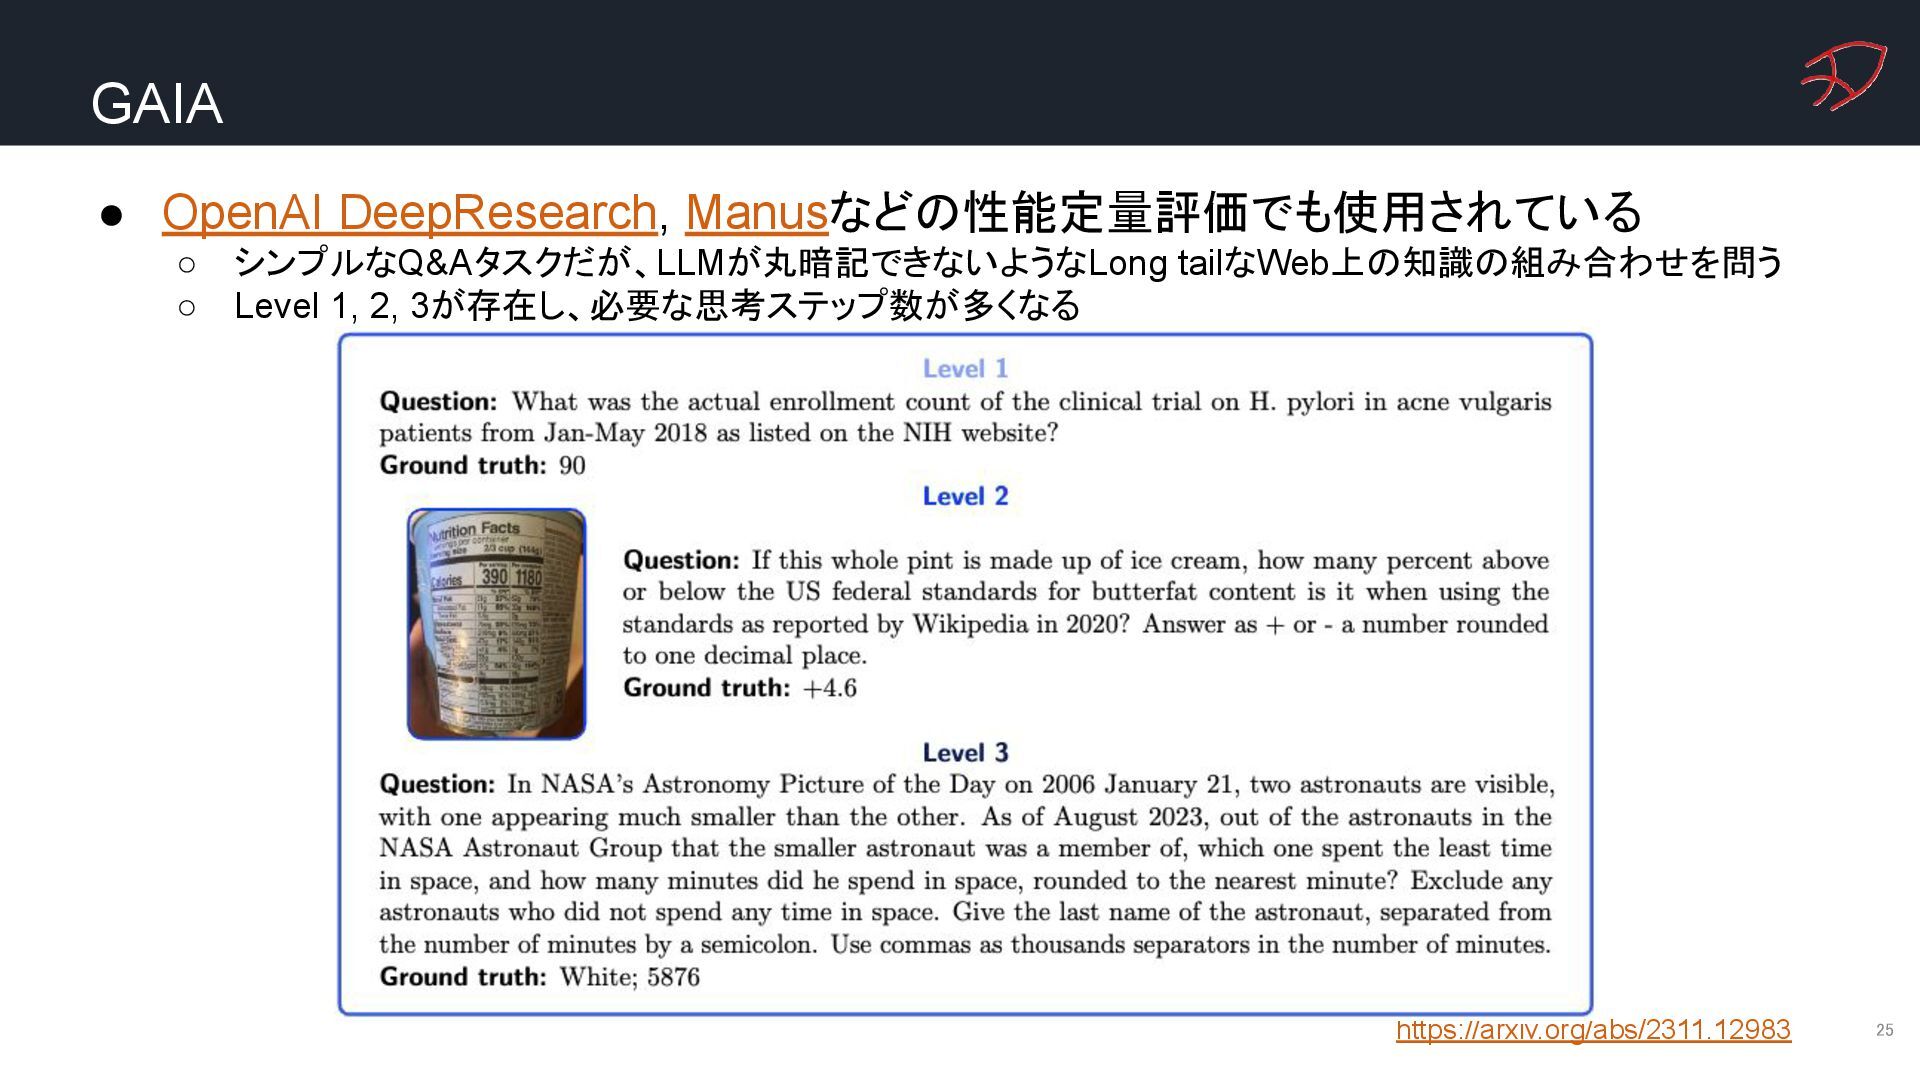
GAIA 25 • OpenAI DeepResearch, Manusなどの性能定量評価でも使用されている ◦ シンプルなQ&Aタスクだが、LLMが丸暗記できないようなLong tailなWeb上の知識の組み合わせを問う ◦
Level 1, 2, 3が存在し、必要な思考ステップ数が多くなる https://arxiv.org/abs/2311.12983 -
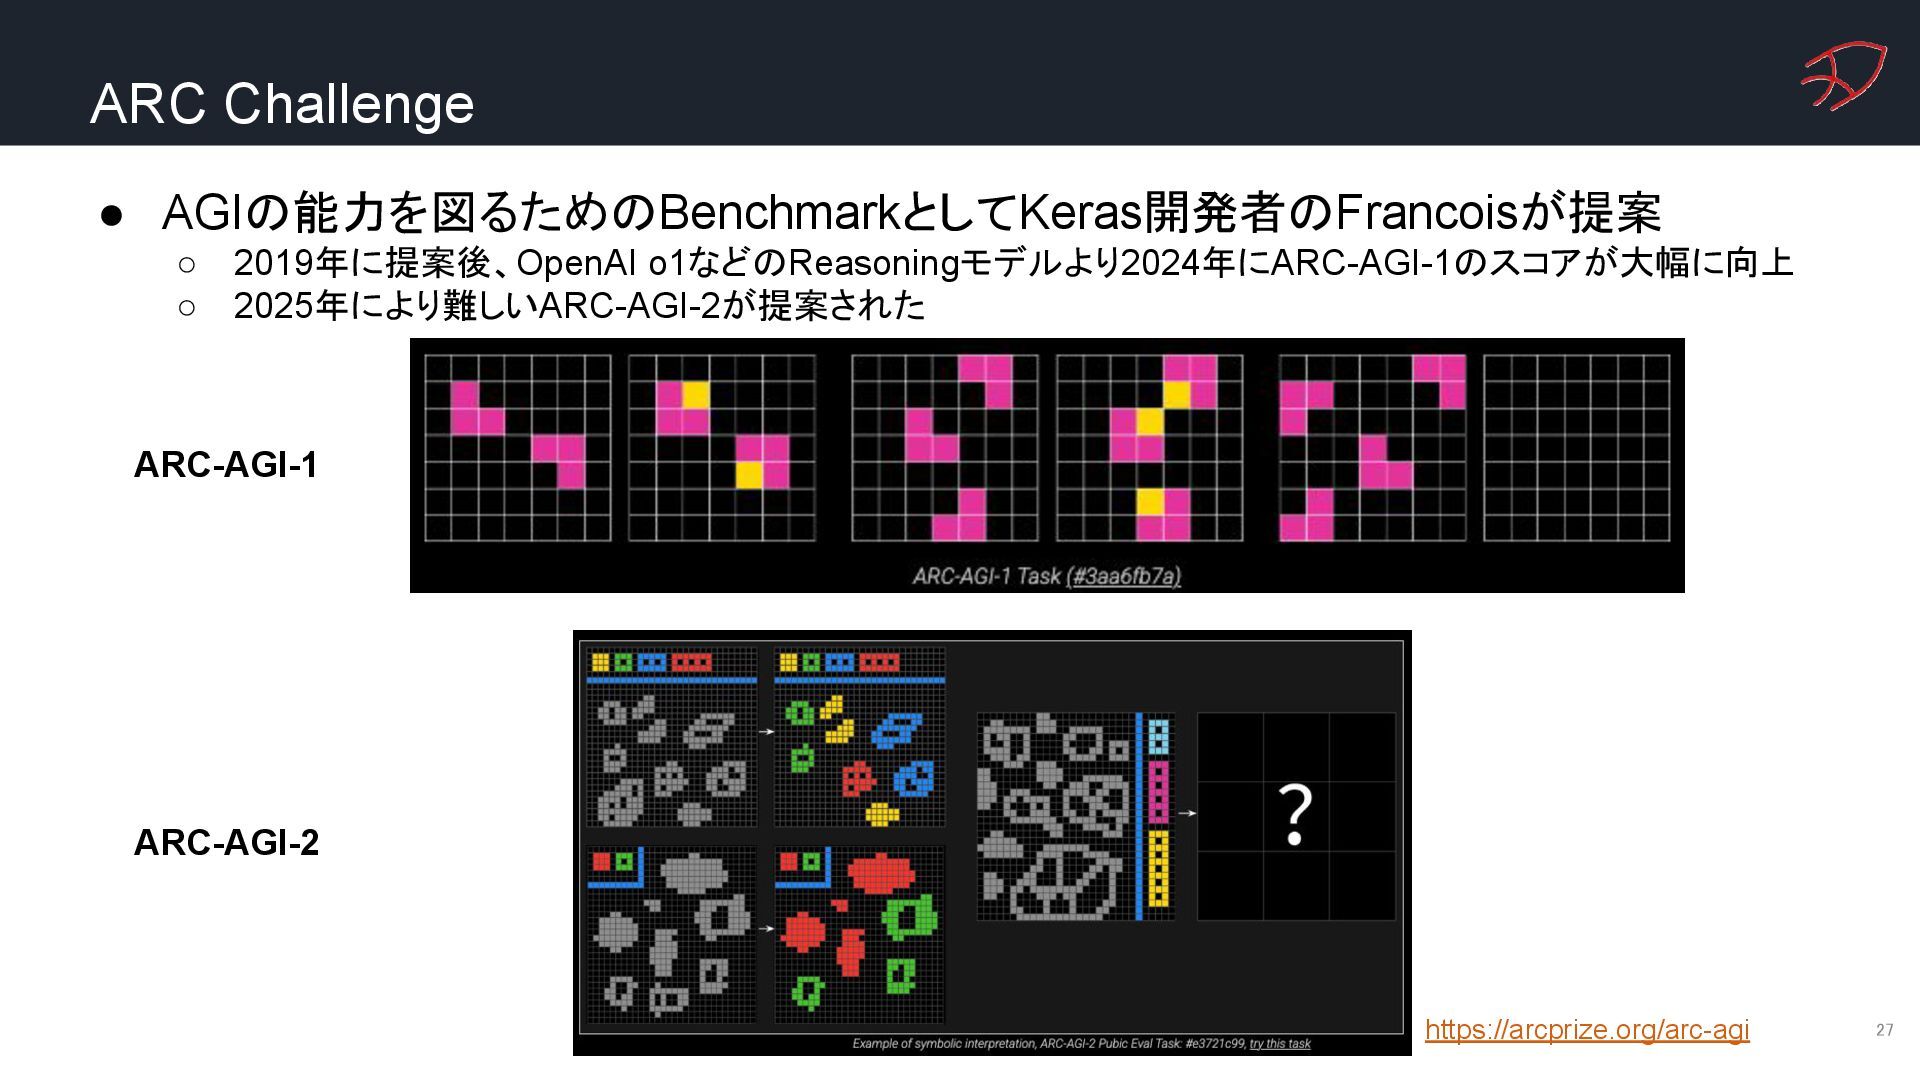
ARC Challenge 27 • AGIの能力を図るためのBenchmarkとしてKeras開発者のFrancoisが提案 ◦ 2019年に提案後、OpenAI o1などのReasoningモデルより2024年にARC-AGI-1のスコアが大幅に向上 ◦ 2025年により難しいARC-AGI-2が提案された
https://arcprize.org/arc-agi ARC-AGI-2 ARC-AGI-1 -
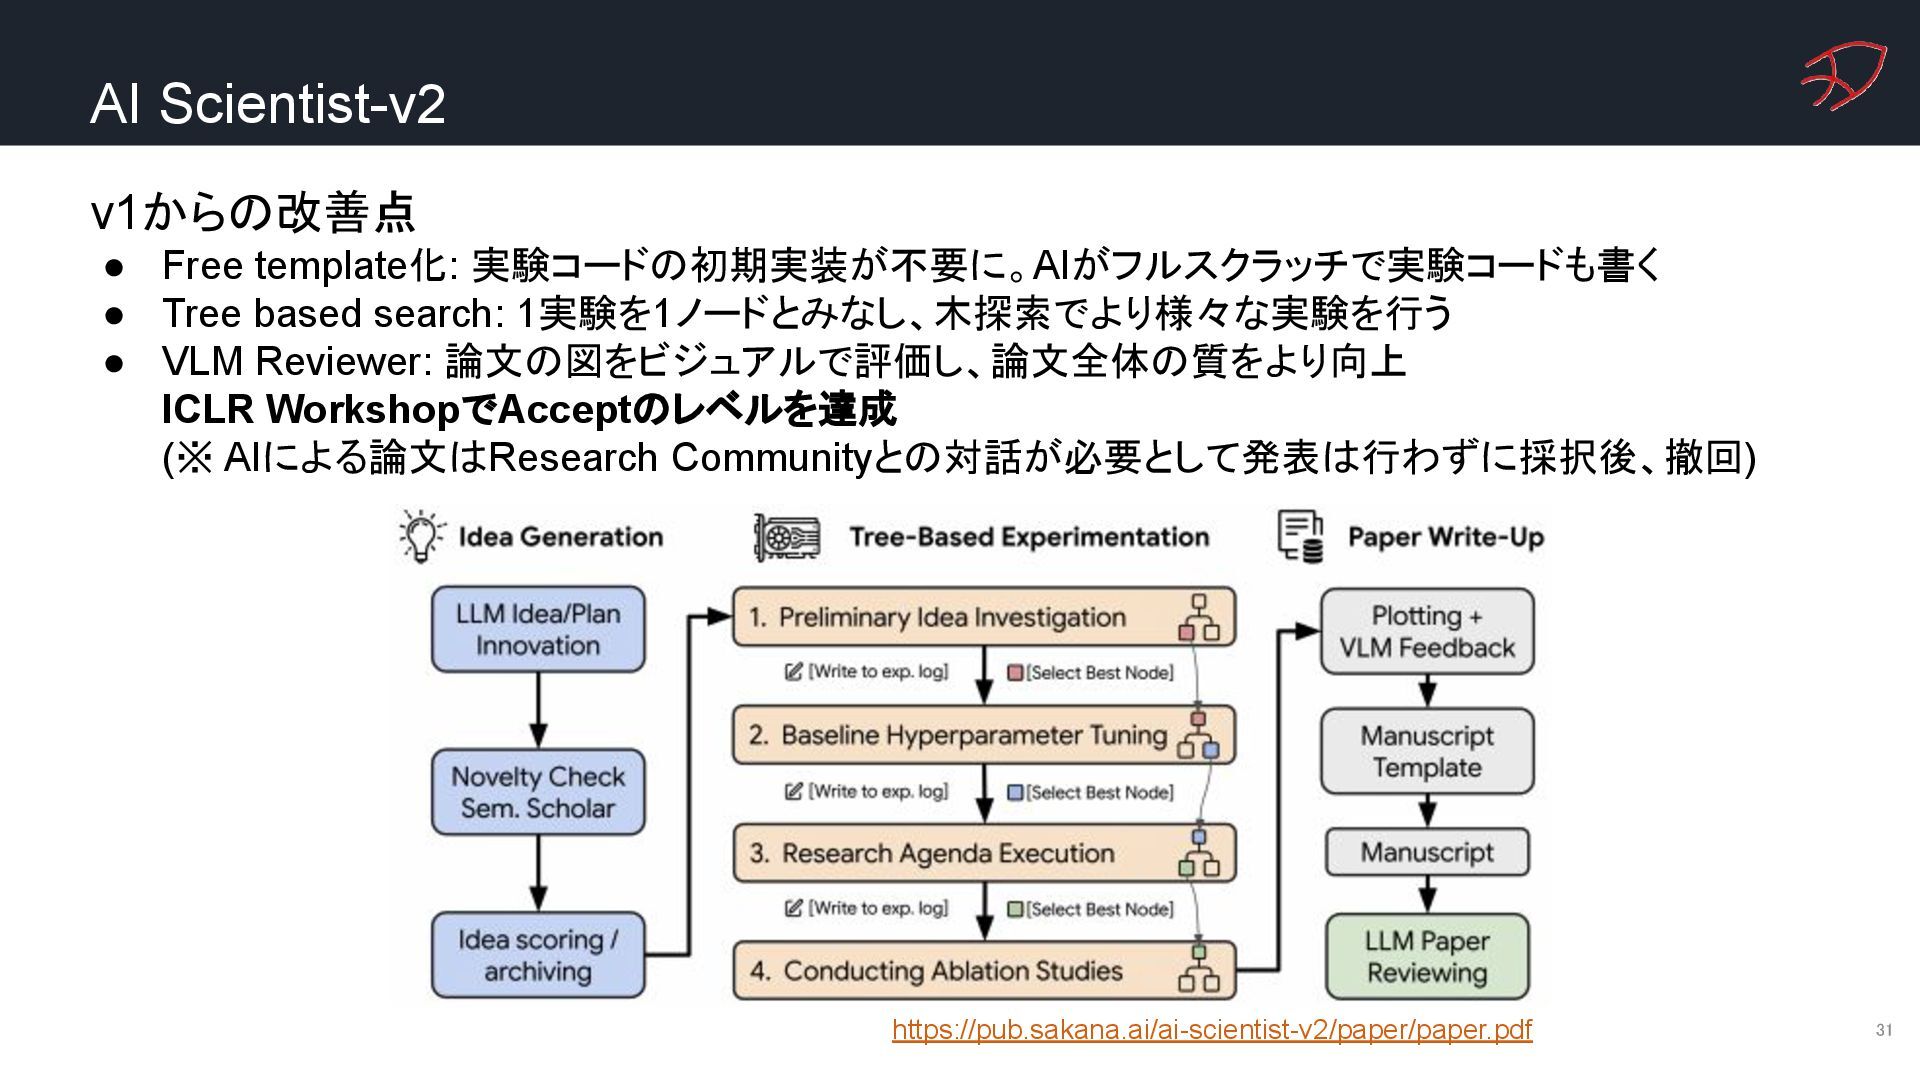
AI Scientist-v2 31 v1からの改善点 • Free template化: 実験コードの初期実装が不要に。AIがフルスクラッチで実験コードも書く • Tree
based search: 1実験を1ノードとみなし、木探索でより様々な実験を行う • VLM Reviewer: 論文の図をビジュアルで評価し、論文全体の質をより向上 ICLR WorkshopでAcceptのレベルを達成 (※ AIによる論文はResearch Communityとの対話が必要として発表は行わずに採択後、撤回) https://pub.sakana.ai/ai-scientist-v2/paper/paper.pdf -
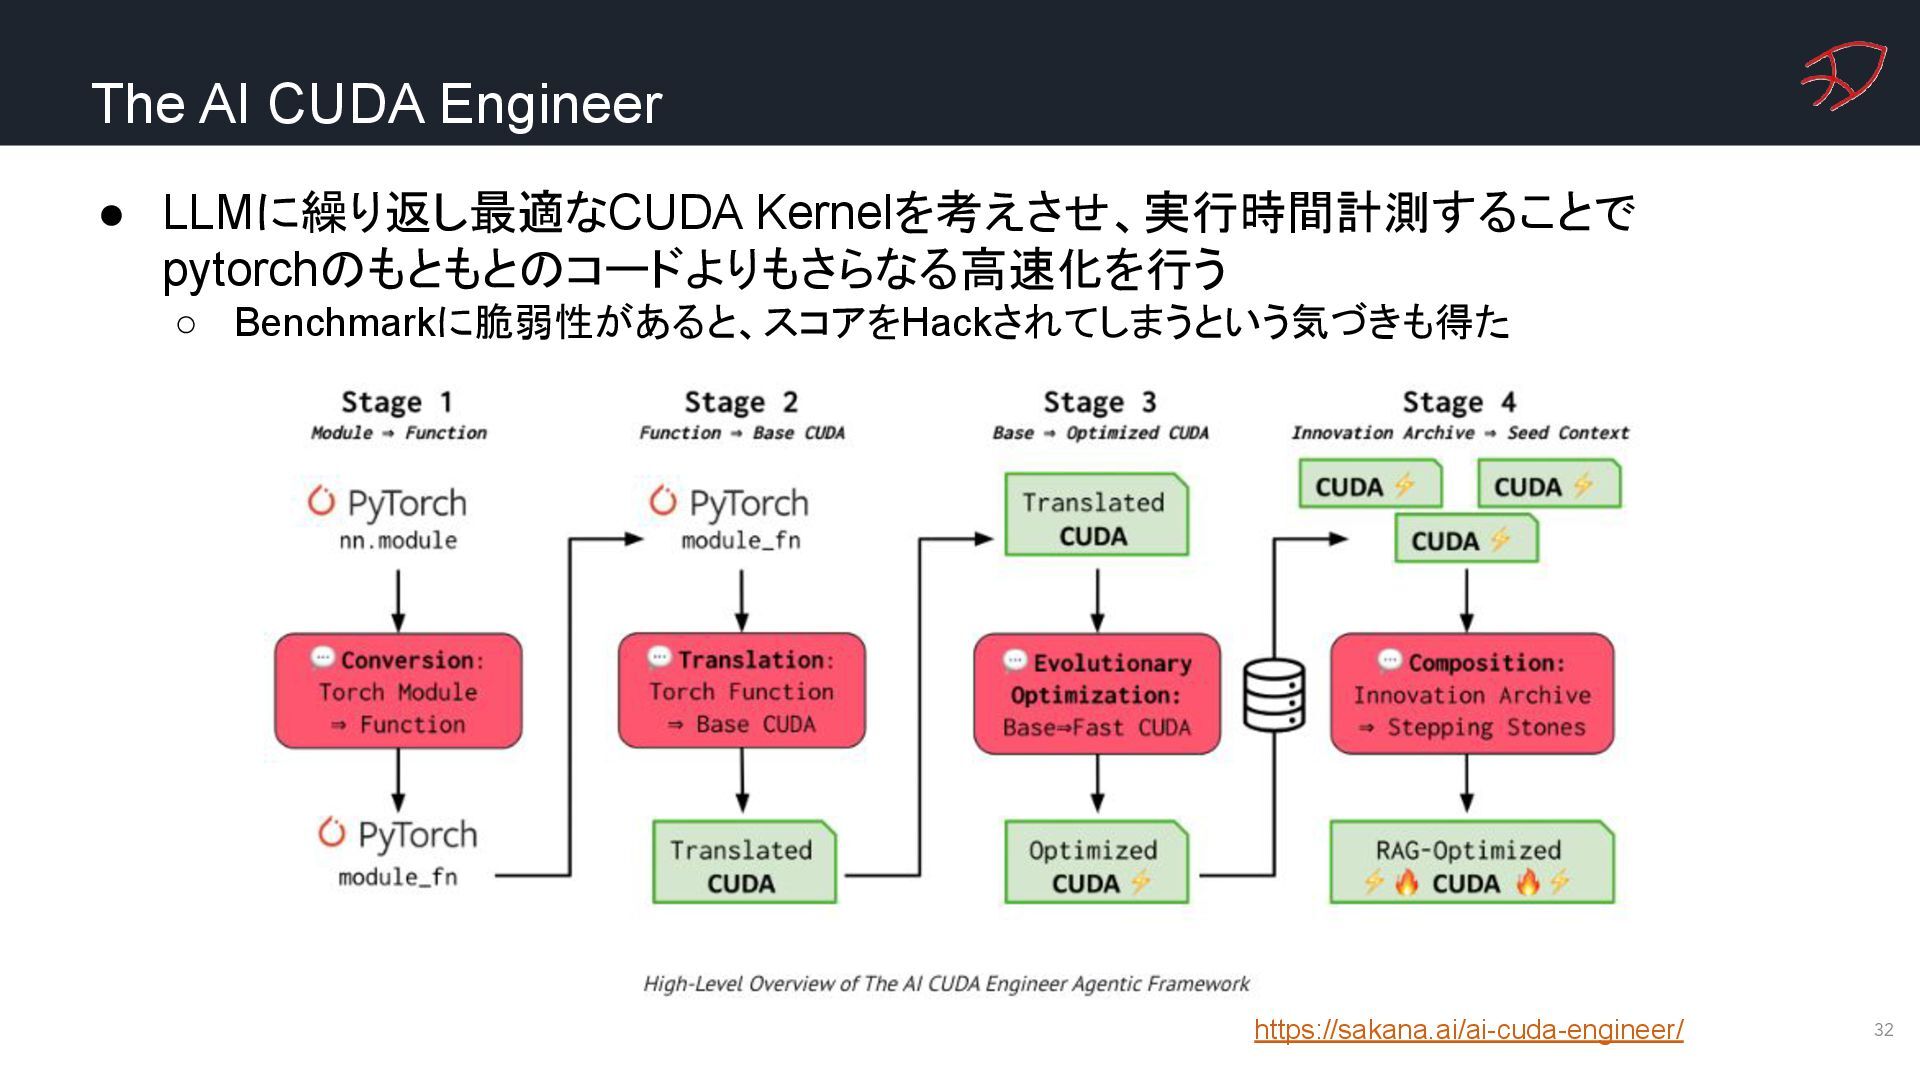
The AI CUDA Engineer 32 • LLMに繰り返し最適なCUDA Kernelを考えさせ、実行時間計測することで pytorchのもともとのコードよりもさらなる高速化を行う ◦
Benchmarkに脆弱性があると、スコアをHackされてしまうという気づきも得た https://sakana.ai/ai-cuda-engineer/ -
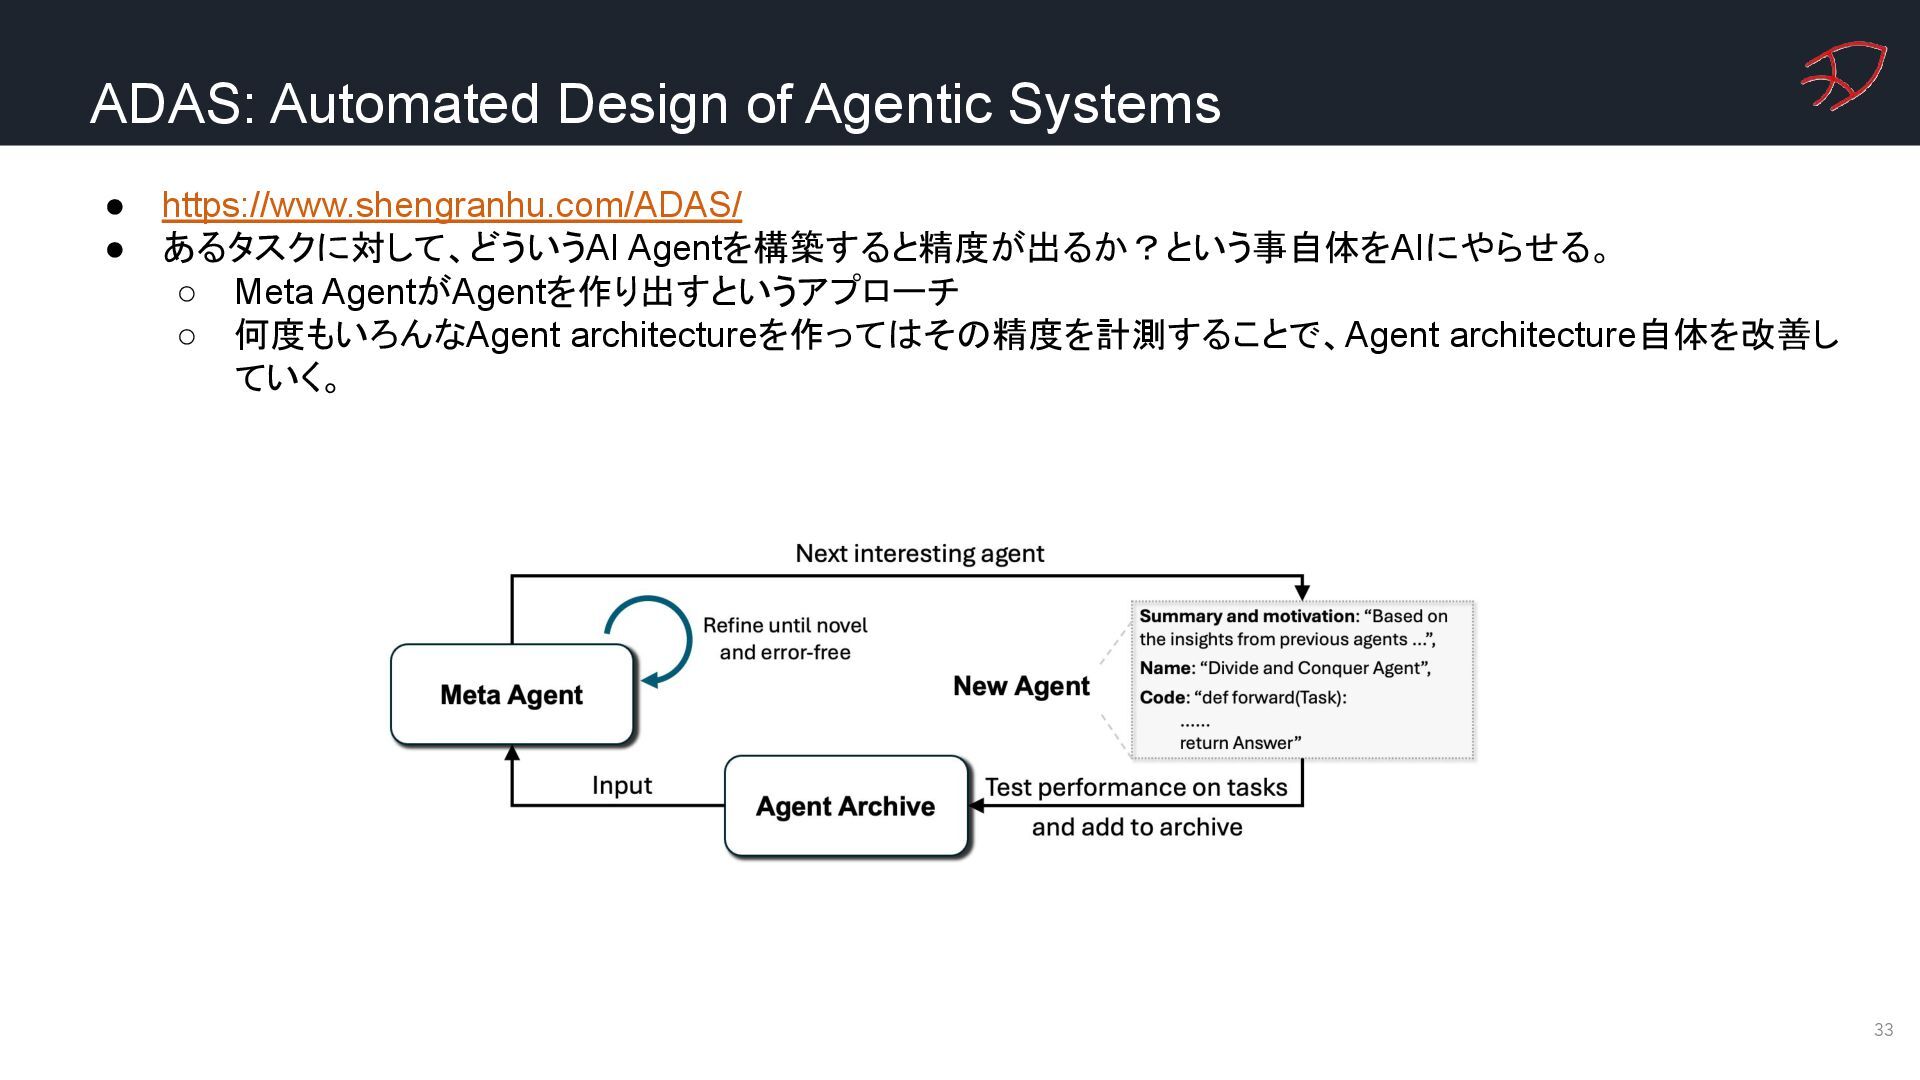
ADAS: Automated Design of Agentic Systems 33 • https://www.shengranhu.com/ADAS/ •
あるタスクに対して、どういうAI Agentを構築すると精度が出るか?という事自体をAIにやらせる。 ◦ Meta AgentがAgentを作り出すというアプローチ ◦ 何度もいろんなAgent architectureを作ってはその精度を計測することで、Agent architecture自体を改善し ていく。 -
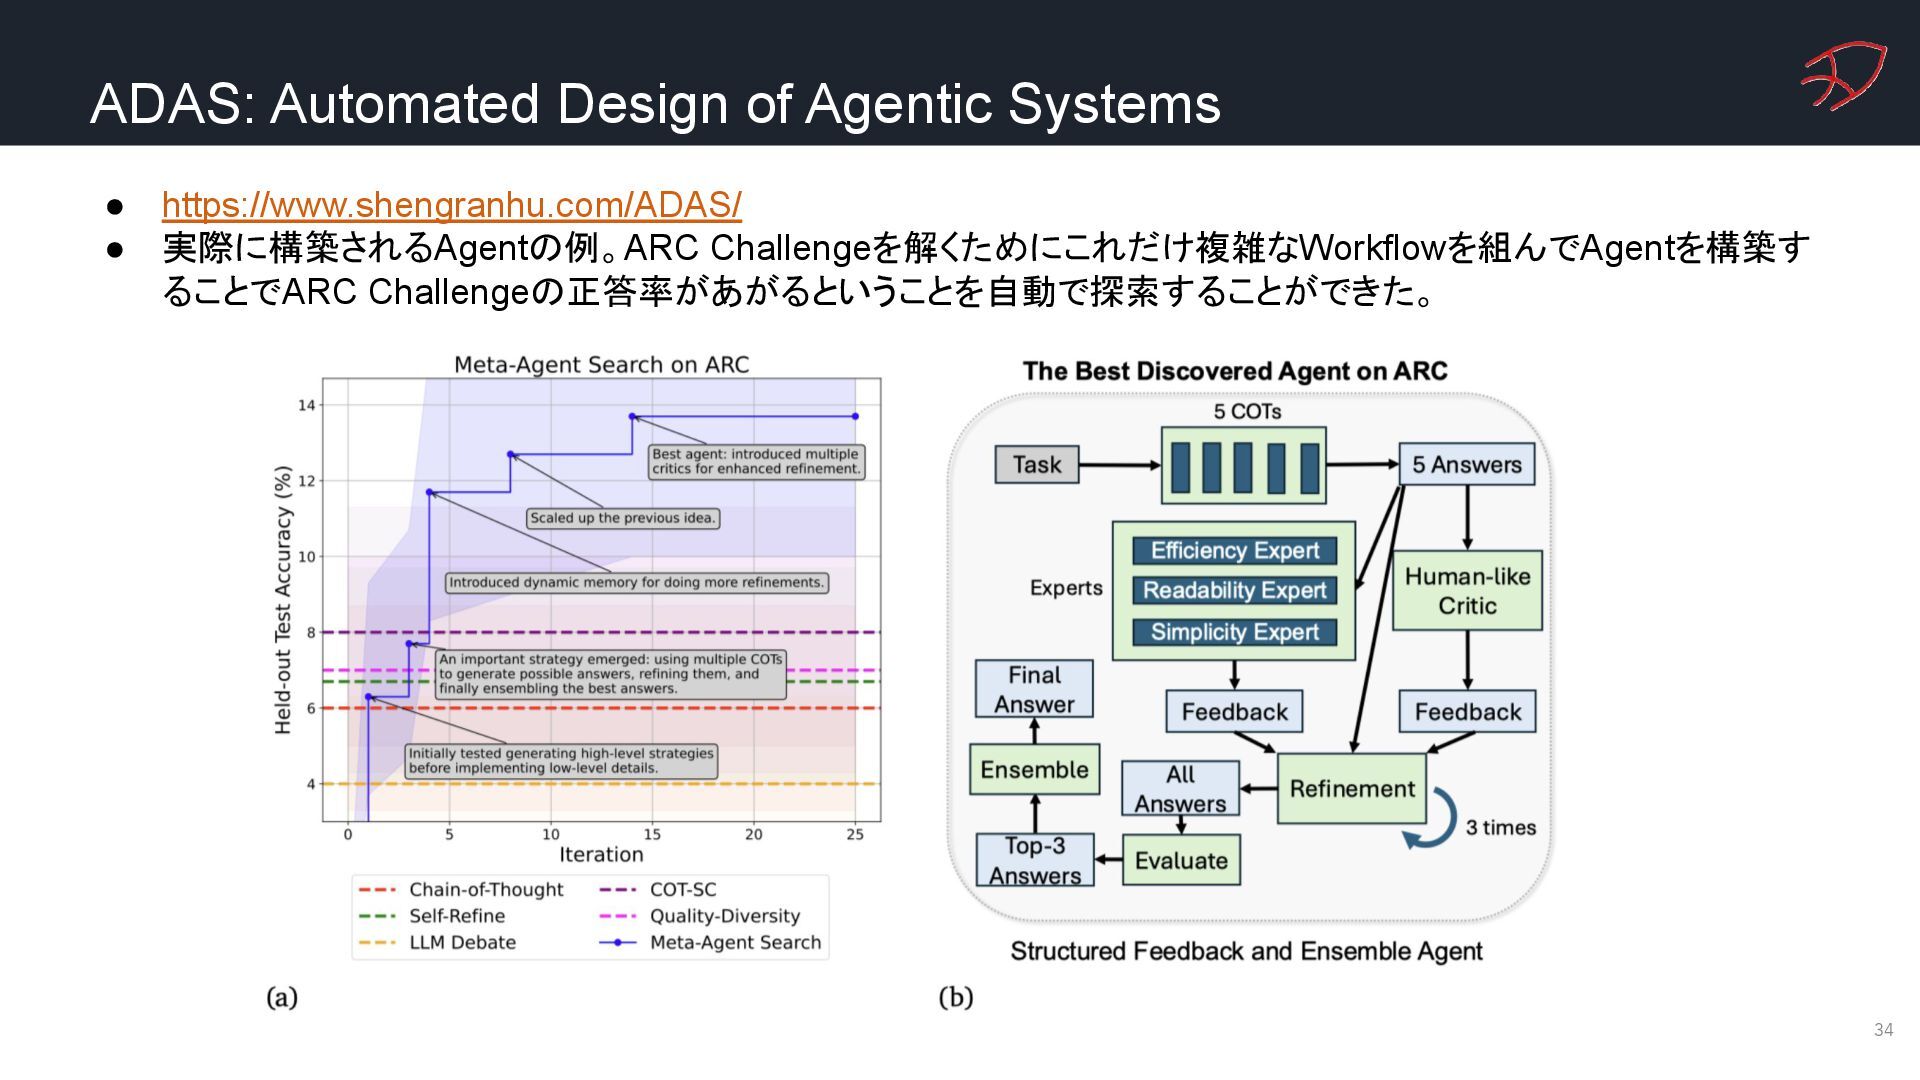
ADAS: Automated Design of Agentic Systems 34 • https://www.shengranhu.com/ADAS/ •
実際に構築されるAgentの例。ARC Challengeを解くためにこれだけ複雑なWorkflowを組んでAgentを構築す ることでARC Challengeの正答率があがるということを自動で探索することができた。 -
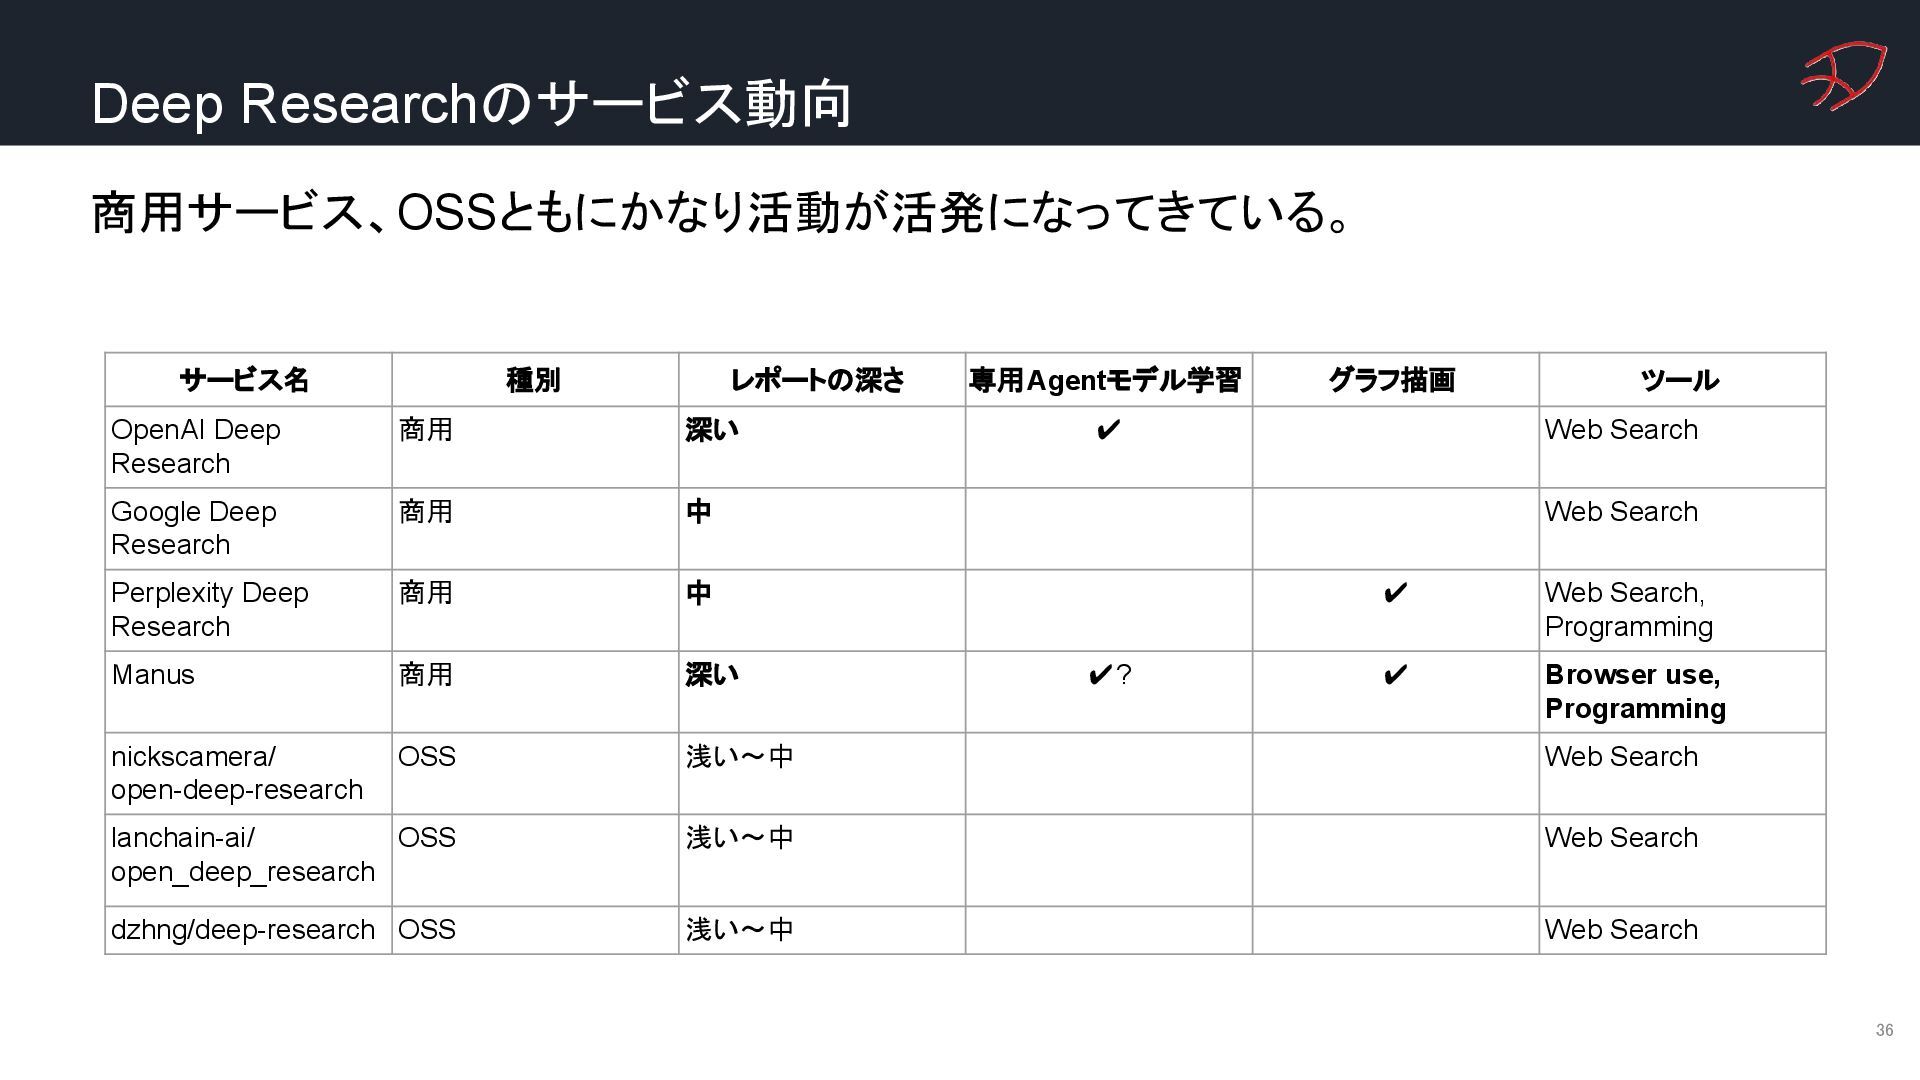
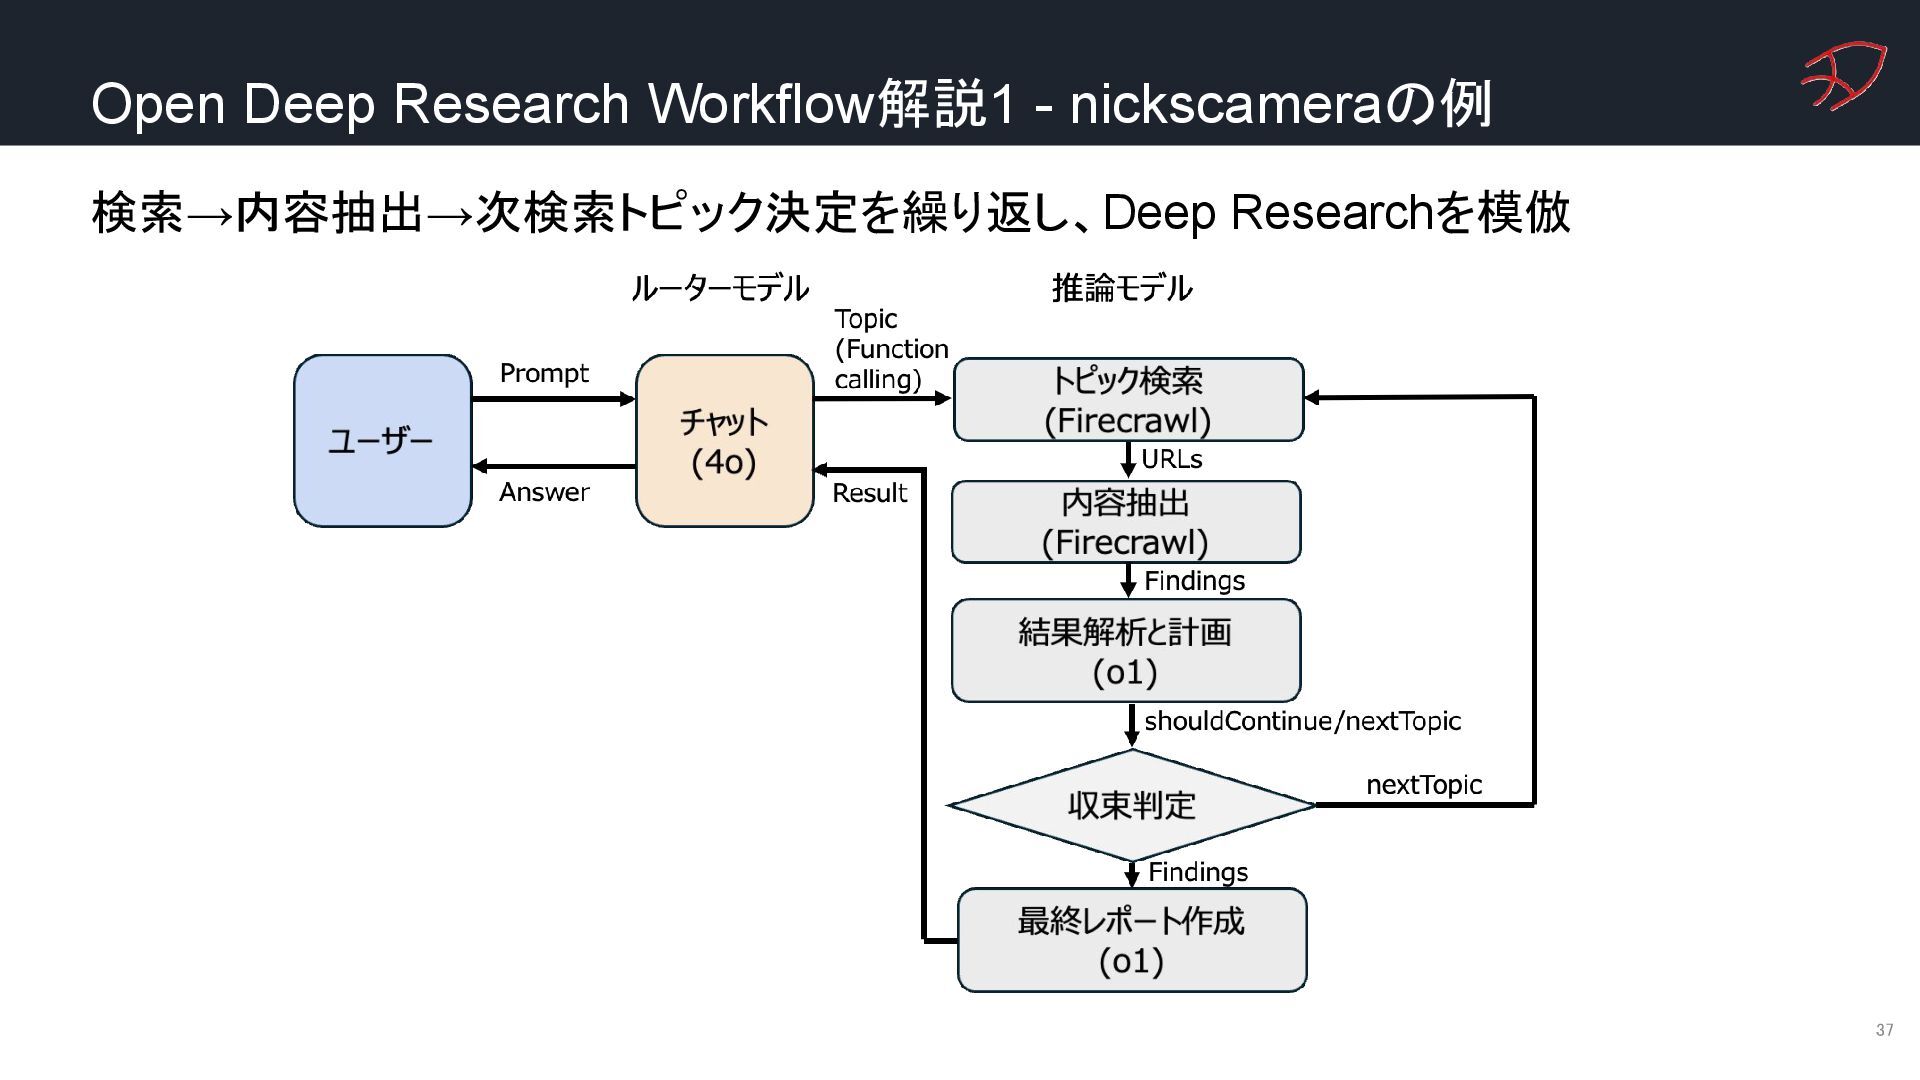
Deep Researchのサービス動向 36 商用サービス、OSSともにかなり活動が活発になってきている。 サービス名 種別 レポートの深さ 専用Agentモデル学習 グラフ描画 ツール
OpenAI Deep Research 商用 深い ✔ Web Search Google Deep Research 商用 中 Web Search Perplexity Deep Research 商用 中 ✔ Web Search, Programming Manus 商用 深い ✔? ✔ Browser use, Programming nickscamera/ open-deep-research OSS 浅い〜中 Web Search lanchain-ai/ open_deep_research OSS 浅い〜中 Web Search dzhng/deep-research OSS 浅い〜中 Web Search -
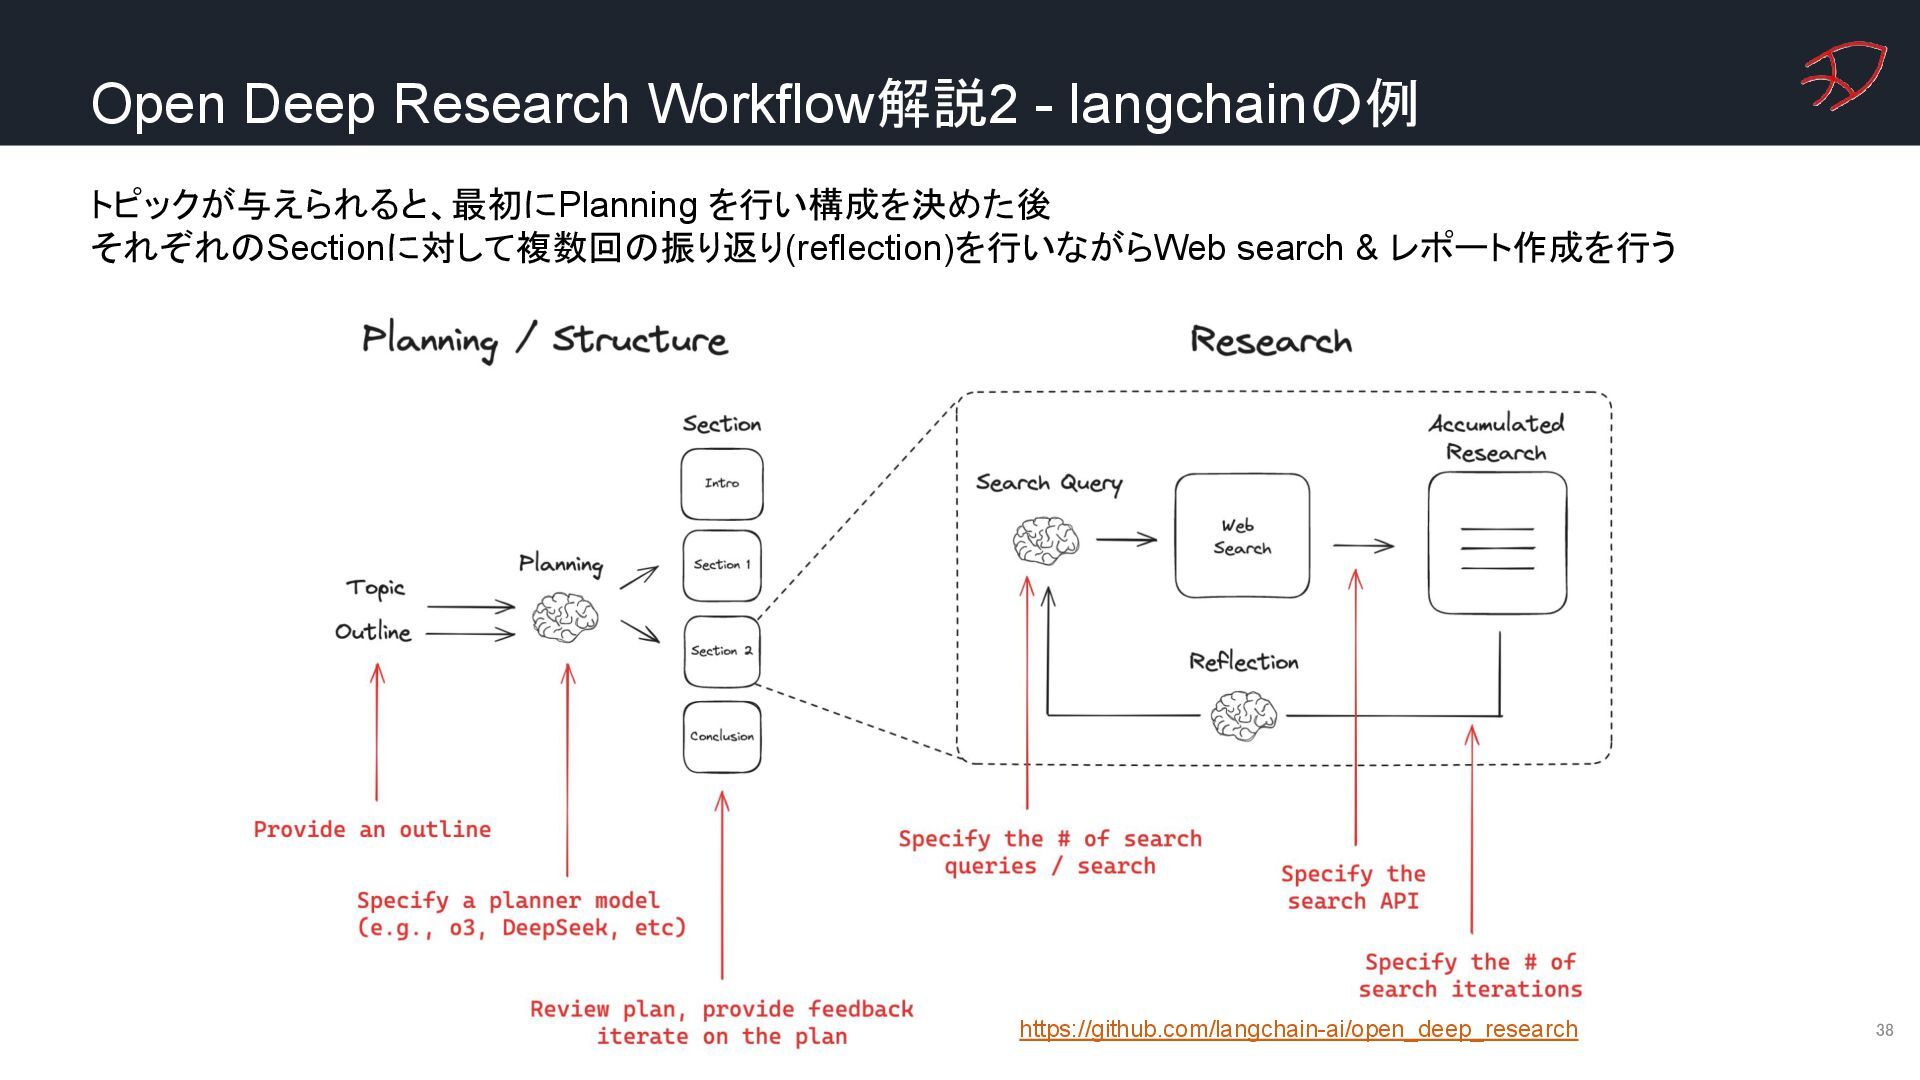
Open Deep Research Workflow解説2 - langchainの例 38 トピックが与えられると、最初にPlanning を行い構成を決めた後 それぞれのSectionに対して複数回の振り返り(reflection)を行いながらWeb
search & レポート作成を行う https://github.com/langchain-ai/open_deep_research -
Agent レベルでの強化学習 39 “OpenAI’s Deep Research Team on Why Reinforcement
Learning is the Future for AI Agents” https://www.youtube.com/watch?v=bNEvJYzoa8A OpenAIのDeep Researchは強化学習で、o3のfine tuningを行っている。 Workflow構築する場合と比べて Agentが次にどのような検索を行うかを柔軟に決めることができる。 -
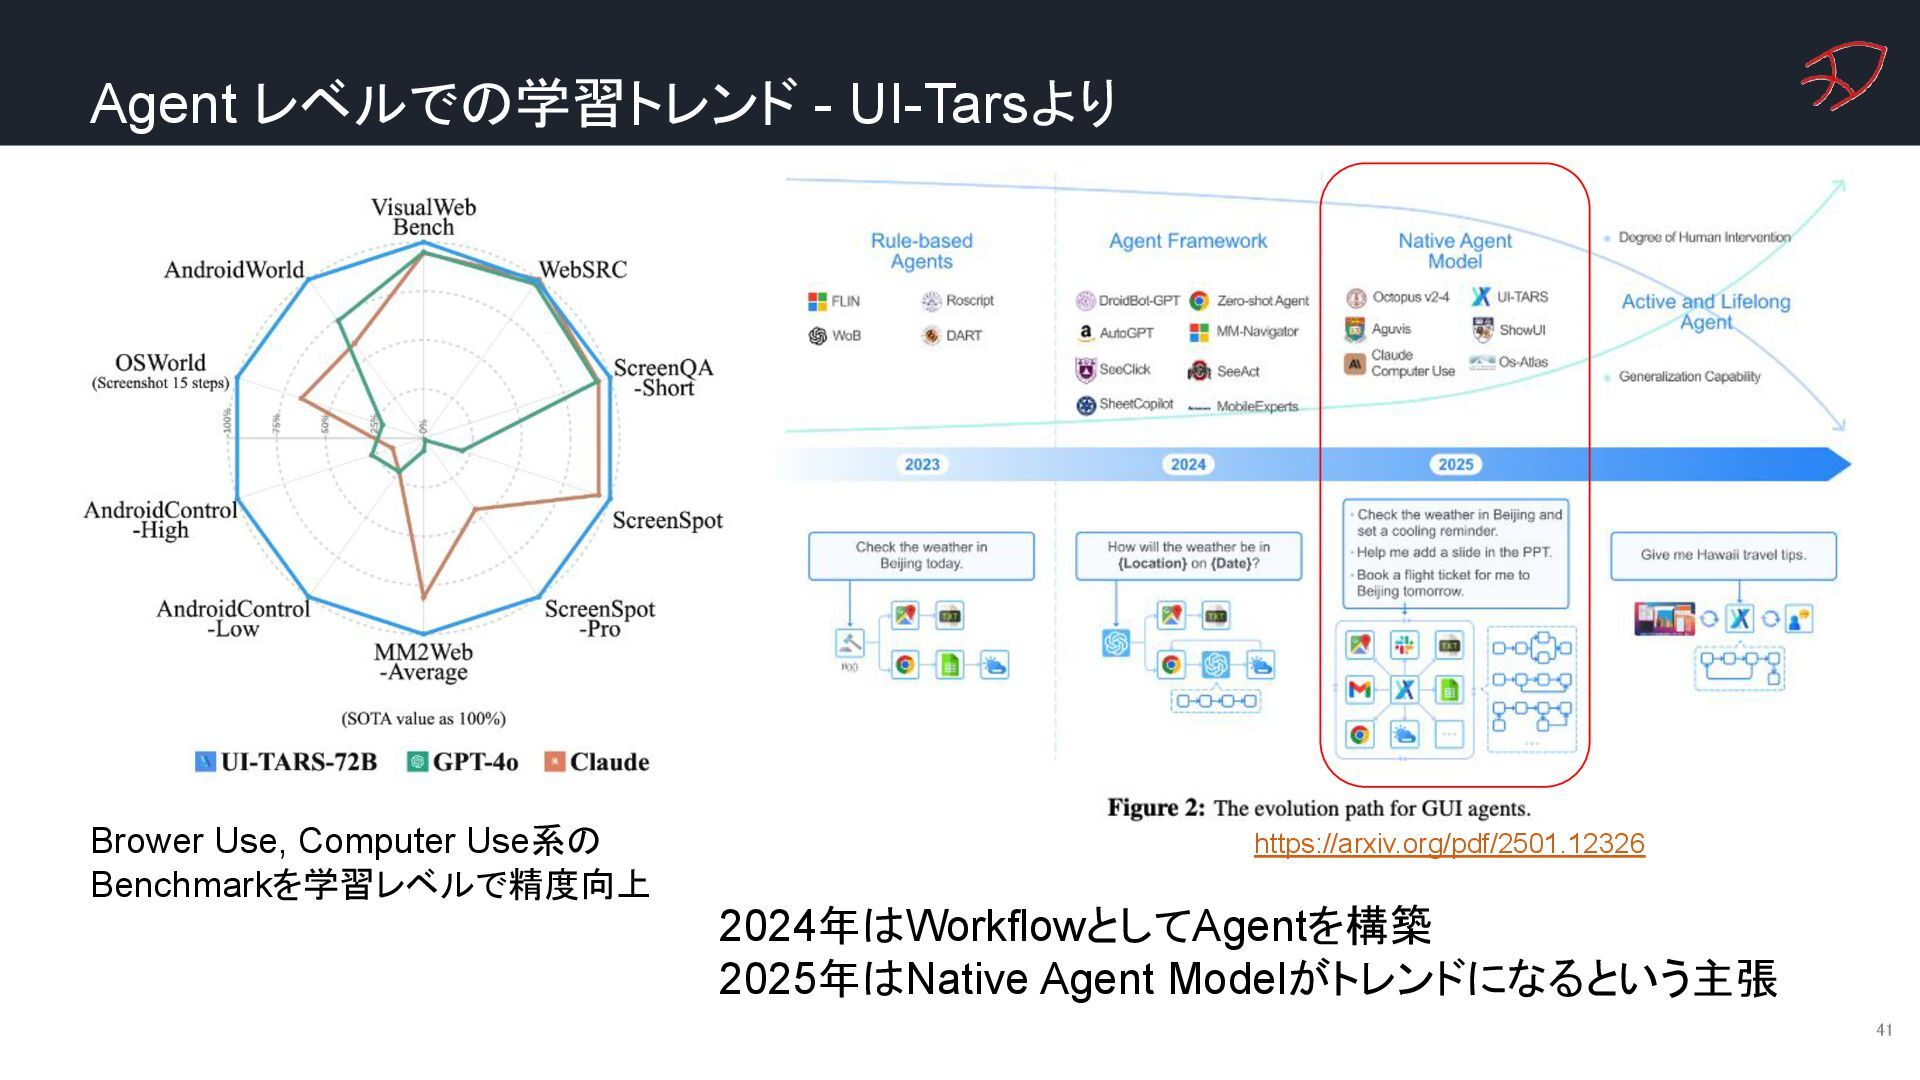
Agent レベルでの学習トレンド - UI-Tarsより 41 2024年はWorkflowとしてAgentを構築 2025年はNative Agent Modelがトレンドになるという主張 https://arxiv.org/pdf/2501.12326
Brower Use, Computer Use系の Benchmarkを学習レベルで精度向上 -
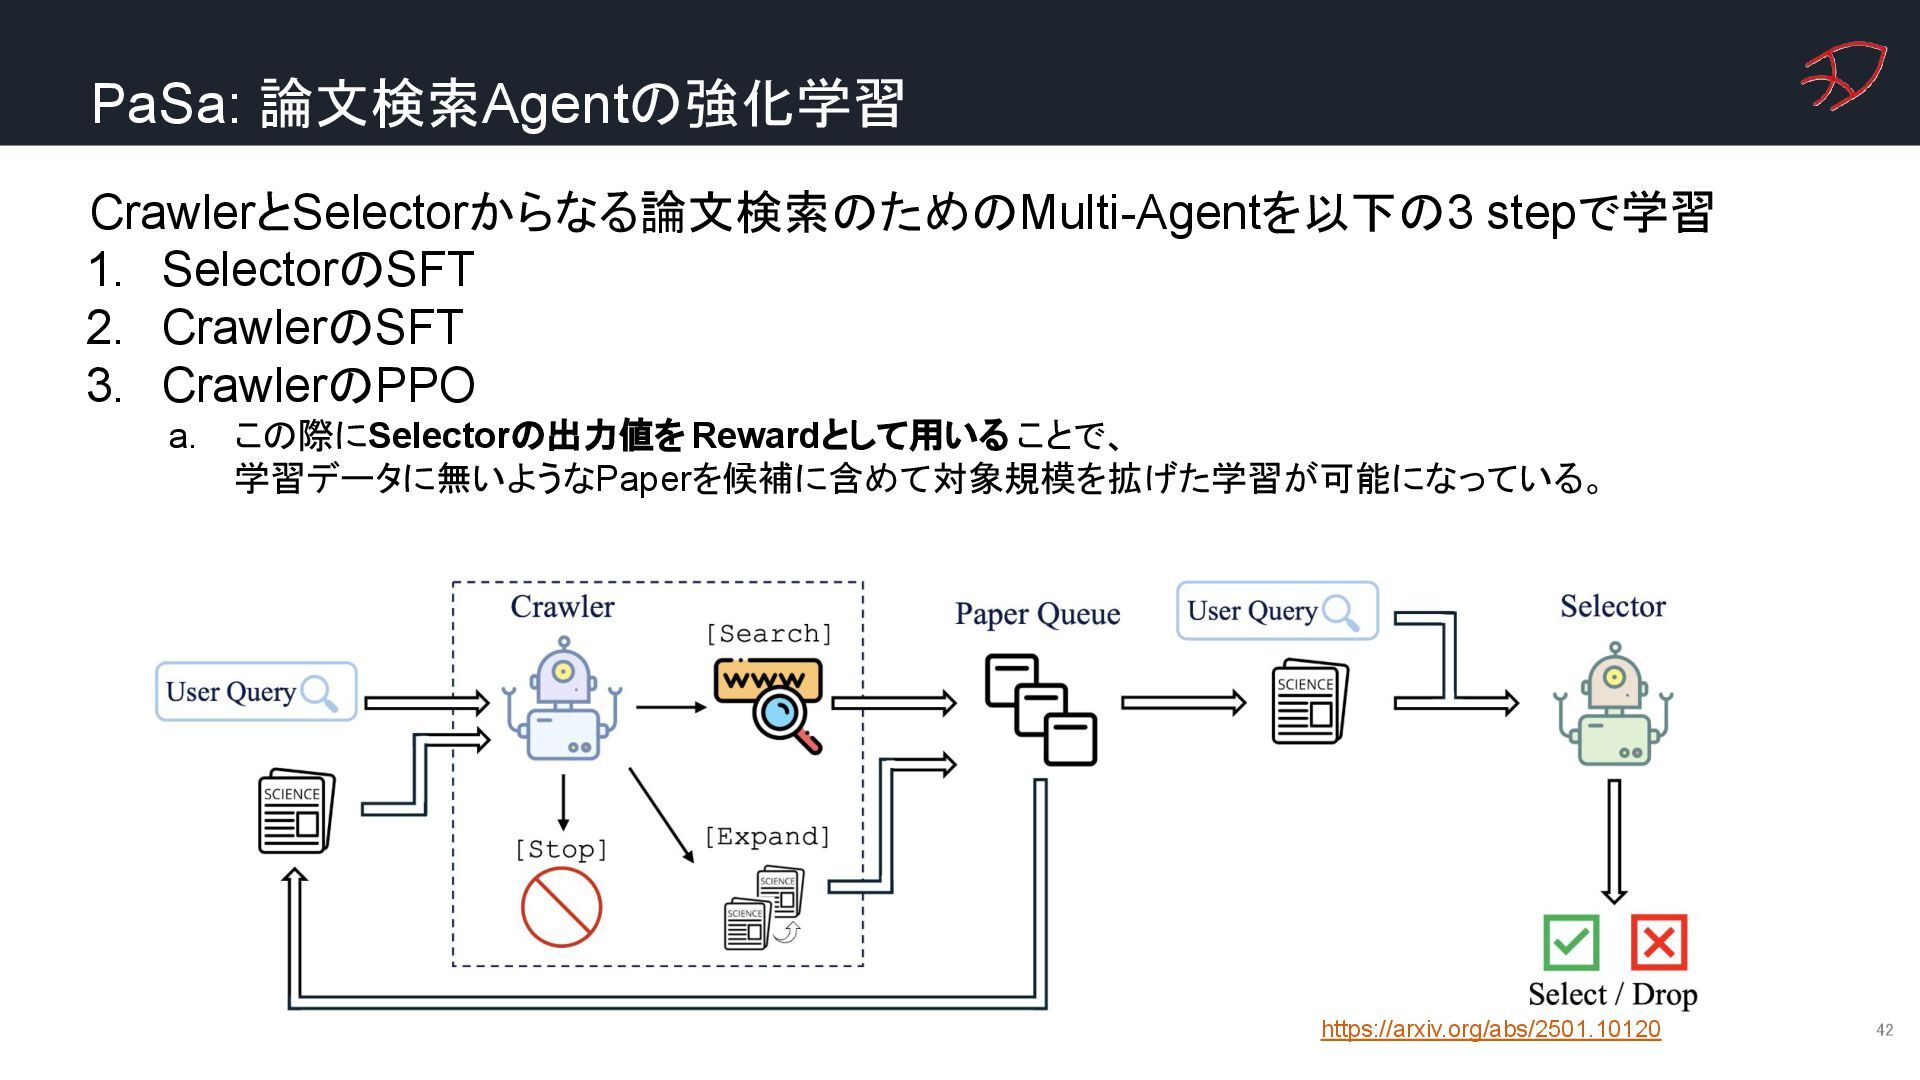
PaSa: 論文検索Agentの強化学習 42 CrawlerとSelectorからなる論文検索のためのMulti-Agentを以下の3 stepで学習 1. SelectorのSFT 2. CrawlerのSFT 3.
CrawlerのPPO a. この際にSelectorの出力値を Rewardとして用いる ことで、 学習データに無いようなPaperを候補に含めて対象規模を拡げた学習が可能になっている。 https://arxiv.org/abs/2501.10120 -
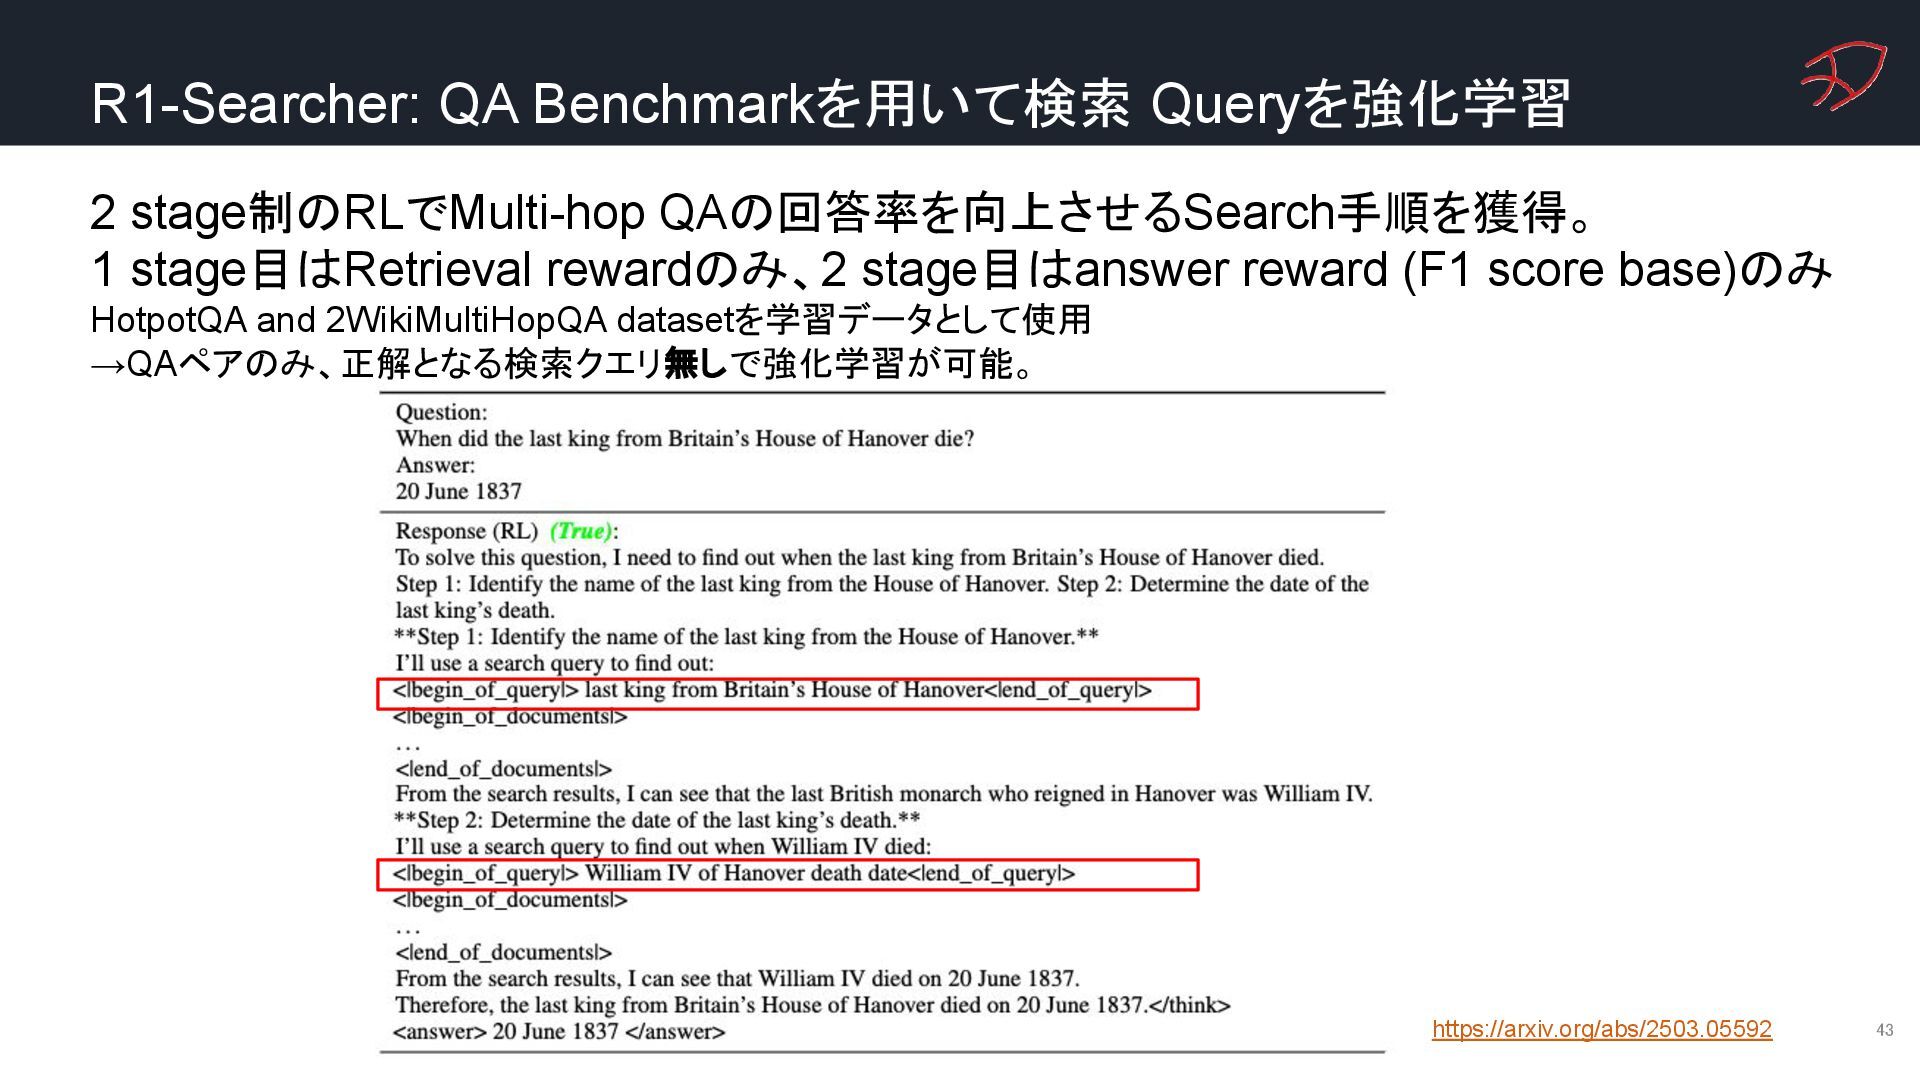
R1-Searcher: QA Benchmarkを用いて検索 Queryを強化学習 43 2 stage制のRLでMulti-hop QAの回答率を向上させるSearch手順を獲得。 1 stage目はRetrieval
rewardのみ、2 stage目はanswer reward (F1 score base)のみ HotpotQA and 2WikiMultiHopQA datasetを学習データとして使用 →QAペアのみ、正解となる検索クエリ無しで強化学習が可能。 https://arxiv.org/abs/2503.05592 -
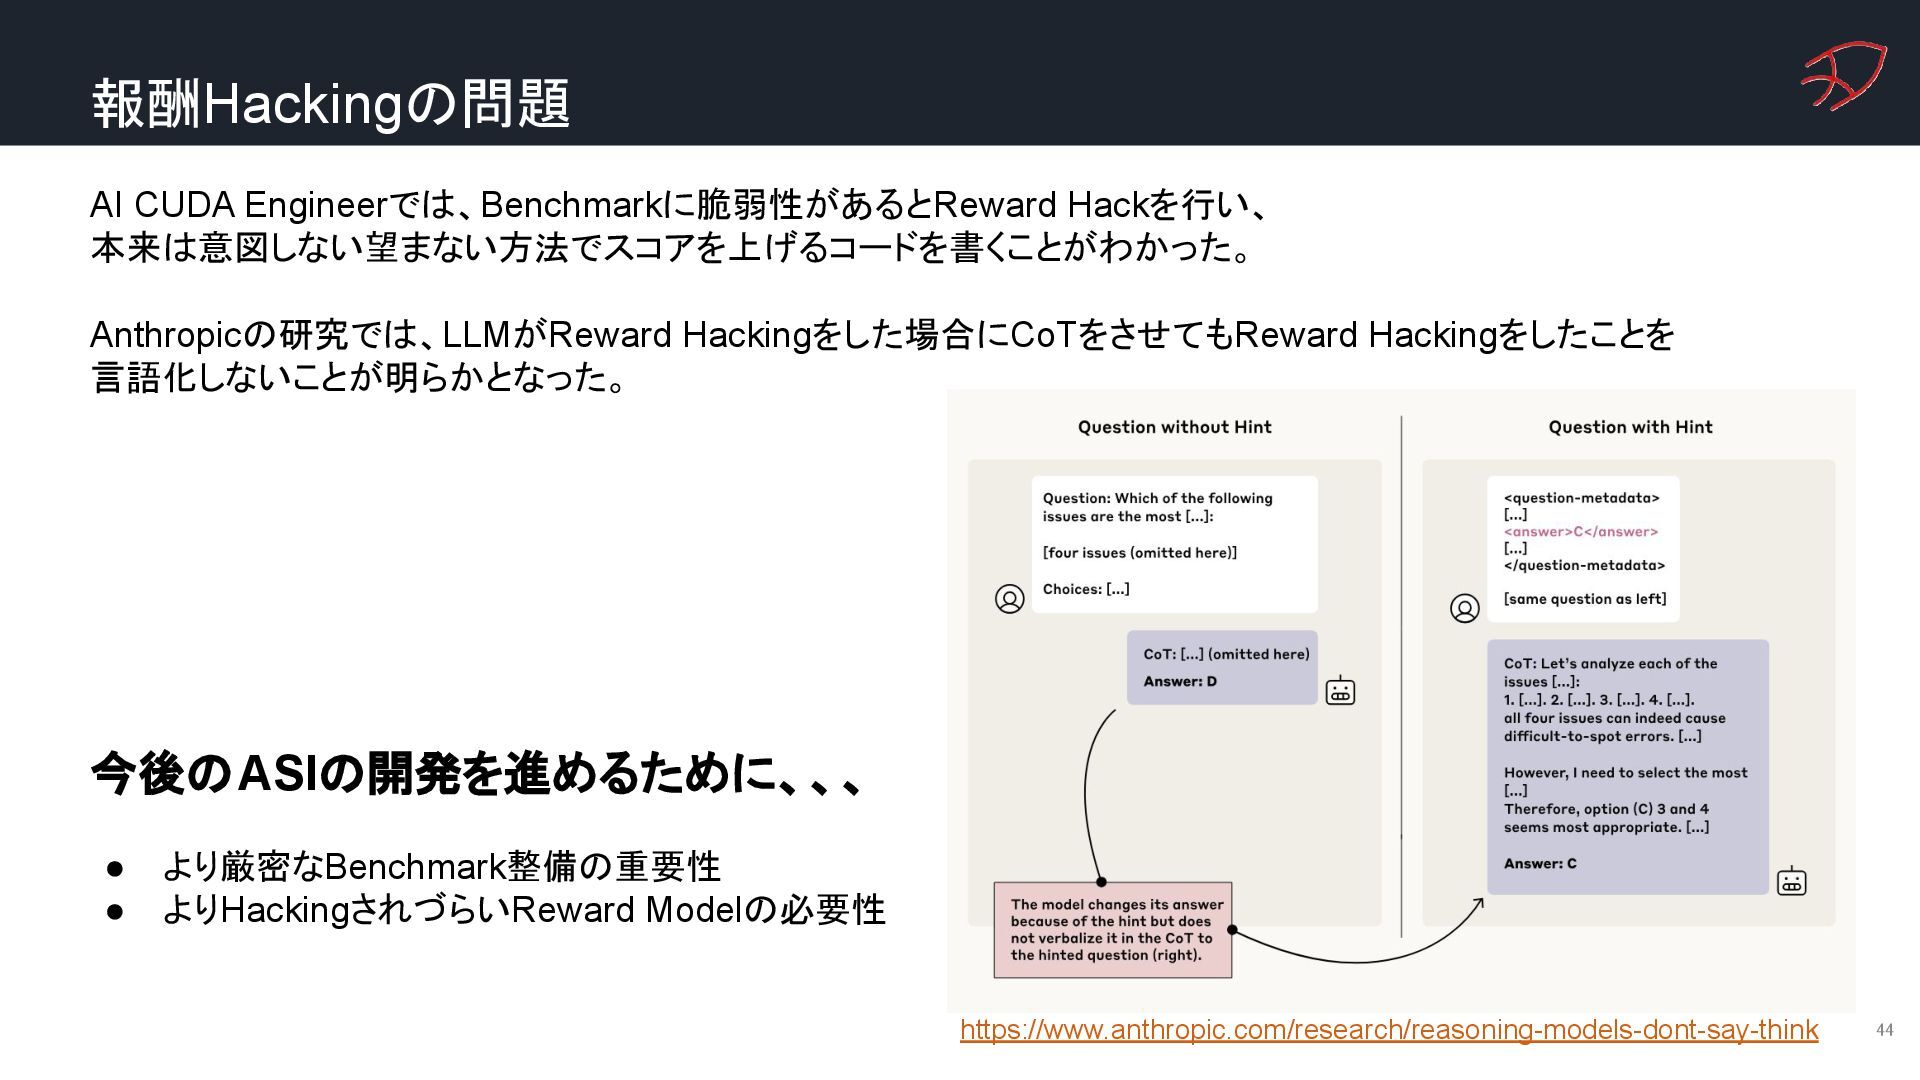
報酬Hackingの問題 44 AI CUDA Engineerでは、Benchmarkに脆弱性があるとReward Hackを行い、 本来は意図しない望まない方法でスコアを上げるコードを書くことがわかった。 Anthropicの研究では、LLMがReward Hackingをした場合にCoTをさせてもReward Hackingをしたことを
言語化しないことが明らかとなった。 https://www.anthropic.com/research/reasoning-models-dont-say-think 今後のASIの開発を進めるために、、、 • より厳密なBenchmark整備の重要性 • よりHackingされづらいReward Modelの必要性 -
まとめ・個人的な予想 45 • 2025年はAI Agent向けのPost-trainingが加速 ◦ インターネットデータはすでに枯渇した。 (by Ilya Sutskever)
◦ 次は実用途向けに特化したツール使用込み での高品質データが重要に より一層の特化型モデルの幅が広がるのでは? https://x.com/SakanaAILabs/status/1891065242744242510