Share
Embed
R-SCoRe: Revisiting Scene Coordinate Regression for Robust Large-Scale Visual Localization
Takuya MINAGAWA
August 22, 2025
Transcript
44 slides
-
第64回 CV勉強会@関東「CVPR2025読み会(後編)」 R-SCoRe: Revisiting Scene Coordinate Regression for Robust Large-Scale
Visual Localization 2025/08/24 takmin -
自己紹介 2 株式会社ビジョン&ITラボ 代表取締役 皆川 卓也(みながわ たくや) 博士(工学) 「コンピュータビジョン勉強会@関東」主催 株式会社フューチャースタンダード
技術顧問 略歴: 1999-2003年 日本HP(後にアジレント・テクノロジーへ分社)にて、ITエンジニアとしてシステム構築、プリ セールス、プロジェクトマネジメント、サポート等の業務に従事 2004-2009年 コンピュータビジョンを用いたシステム/アプリ/サービス開発等に従事 2007-2010年 慶應義塾大学大学院 後期博士課程にて、コンピュータビジョンを専攻 単位取得退学後、博士号取得(2014年) 2009年-現在 フリーランスとして、コンピュータビジョンのコンサル/研究/開発等に従事(2018年法人化) http://visitlab.jp -
3 この本の第7章「CV をとりまく環境」を執 筆 • コンピュータビジョ ンのオープンソー スやプラットフォー ムの紹介 •
コンピュータビジョ ンを使ったビジネ ス事例 -
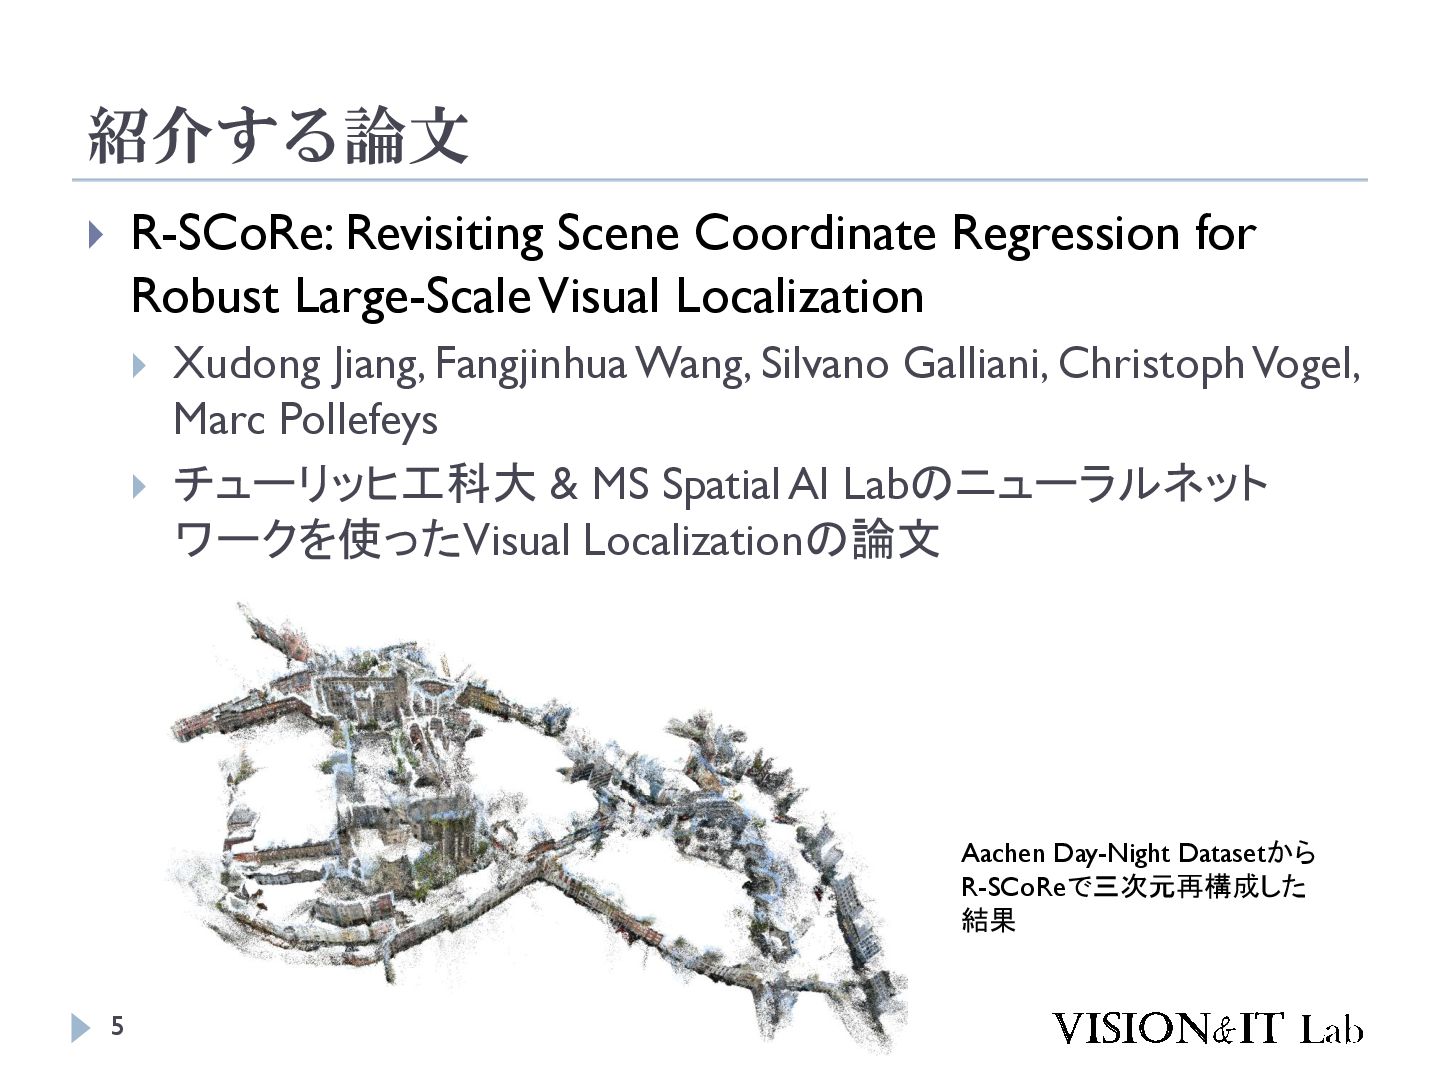
紹介する論文 5 R-SCoRe: Revisiting Scene Coordinate Regression for Robust
Large-Scale Visual Localization Xudong Jiang, FangjinhuaWang, Silvano Galliani, Christoph Vogel, Marc Pollefeys チューリッヒ工科大 & MS Spatial AI Labのニューラルネット ワークを使ったVisual Localizationの論文 Aachen Day-Night Datasetから R-SCoReで三次元再構成した 結果 -
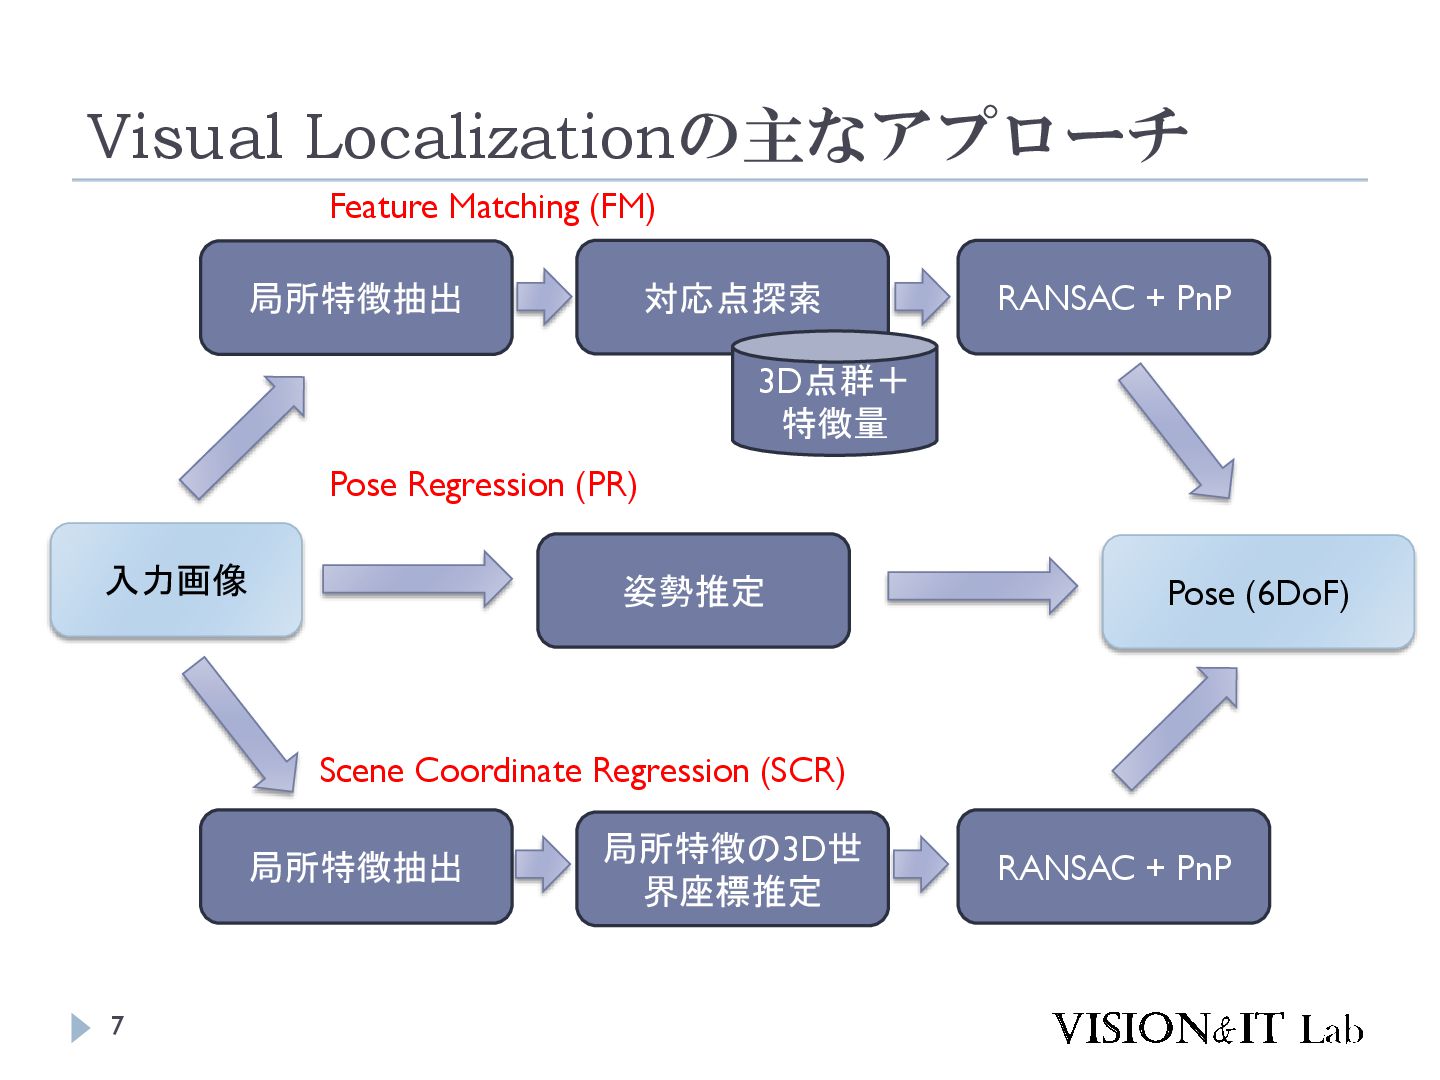
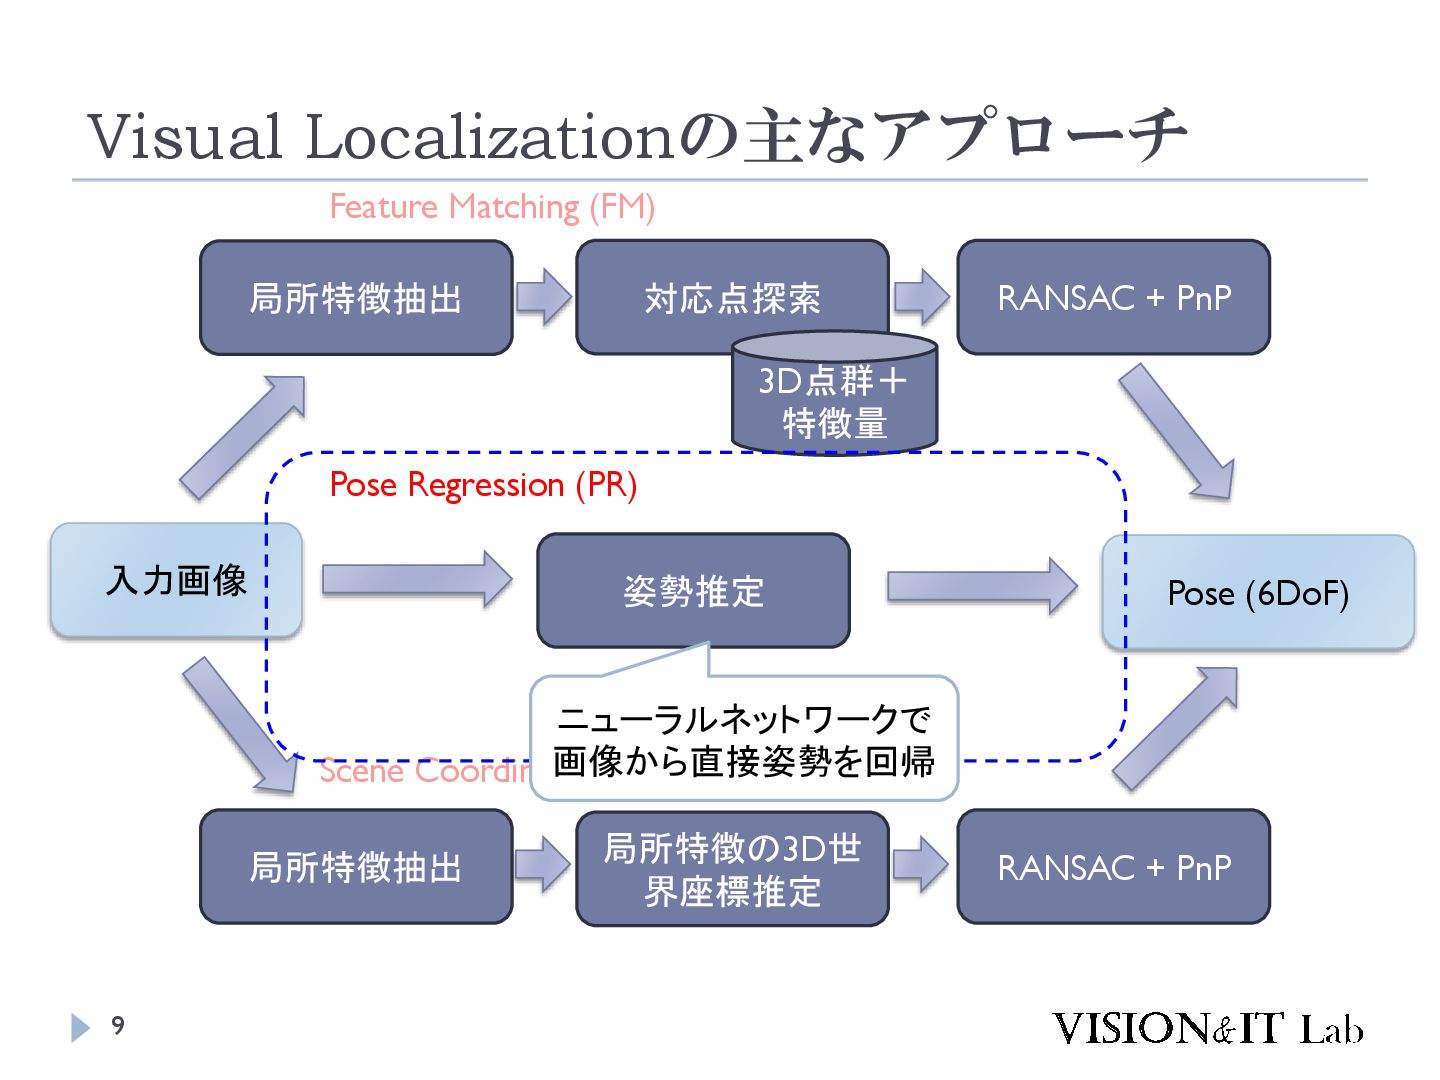
Visual Localizationの主なアプローチ 7 入力画像 姿勢推定 Pose (6DoF) 局所特徴抽出 対応点探索 RANSAC
+ PnP 局所特徴の3D世 界座標推定 RANSAC + PnP 局所特徴抽出 3D点群+ 特徴量 Feature Matching (FM) Pose Regression (PR) Scene Coordinate Regression (SCR) -
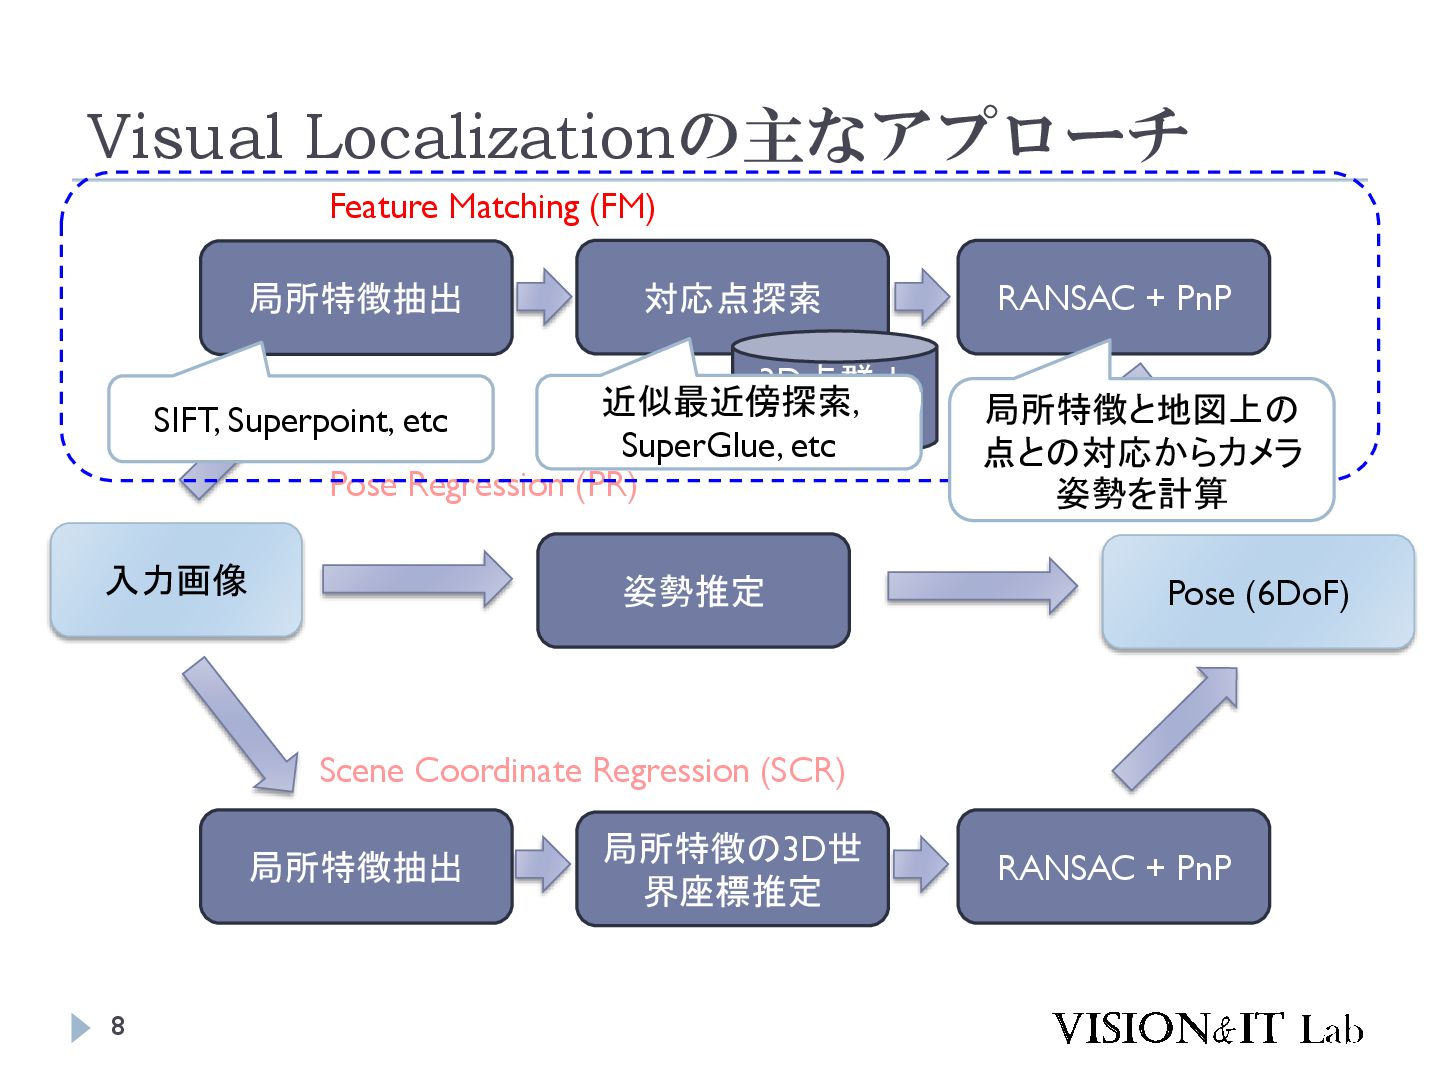
Visual Localizationの主なアプローチ 8 入力画像 姿勢推定 Pose (6DoF) 局所特徴抽出 対応点探索 RANSAC
+ PnP 局所特徴の3D世 界座標推定 RANSAC + PnP 局所特徴抽出 3D点群+ 特徴量 Feature Matching (FM) Pose Regression (PR) Scene Coordinate Regression (SCR) SIFT, Superpoint, etc 近似最近傍探索, SuperGlue, etc 局所特徴と地図上の 点との対応からカメラ 姿勢を計算 -
Visual Localizationの主なアプローチ 9 入力画像 姿勢推定 Pose (6DoF) 局所特徴抽出 対応点探索 RANSAC
+ PnP 局所特徴の3D世 界座標推定 RANSAC + PnP 局所特徴抽出 3D点群+ 特徴量 Feature Matching (FM) Pose Regression (PR) Scene Coordinate Regression (SCR) ニューラルネットワークで 画像から直接姿勢を回帰 -
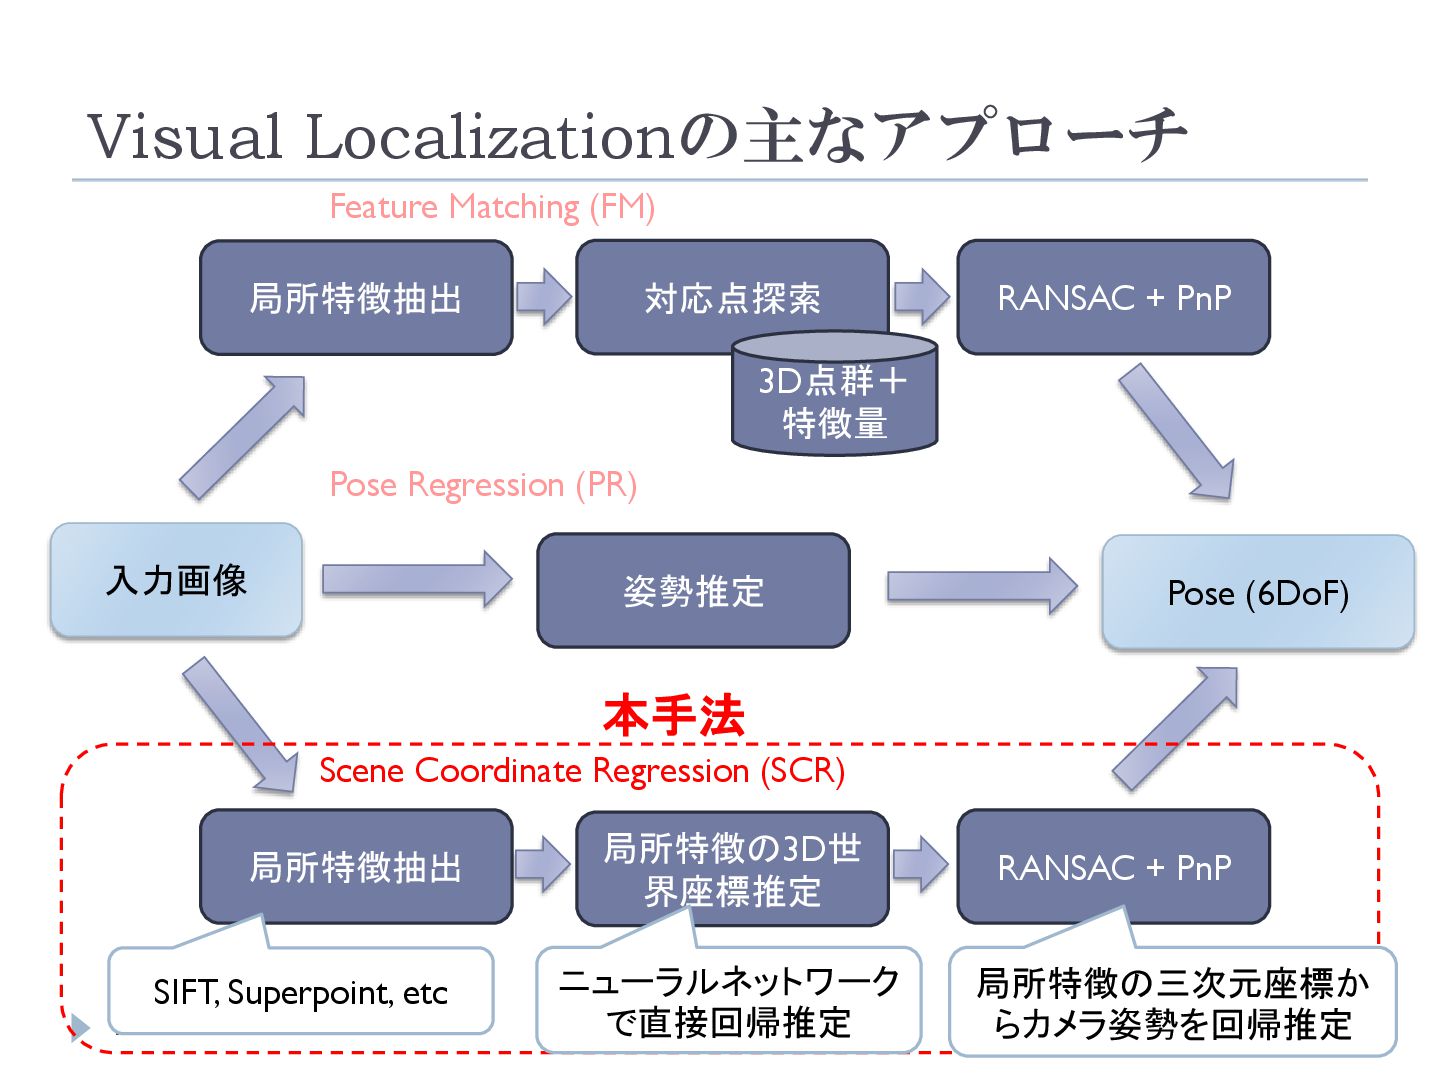
Visual Localizationの主なアプローチ 10 入力画像 姿勢推定 Pose (6DoF) 局所特徴抽出 対応点探索 RANSAC
+ PnP 局所特徴の3D世 界座標推定 RANSAC + PnP 局所特徴抽出 3D点群+ 特徴量 Feature Matching (FM) Pose Regression (PR) Scene Coordinate Regression (SCR) SIFT, Superpoint, etc ニューラルネットワーク で直接回帰推定 局所特徴の三次元座標か らカメラ姿勢を回帰推定 本手法 -
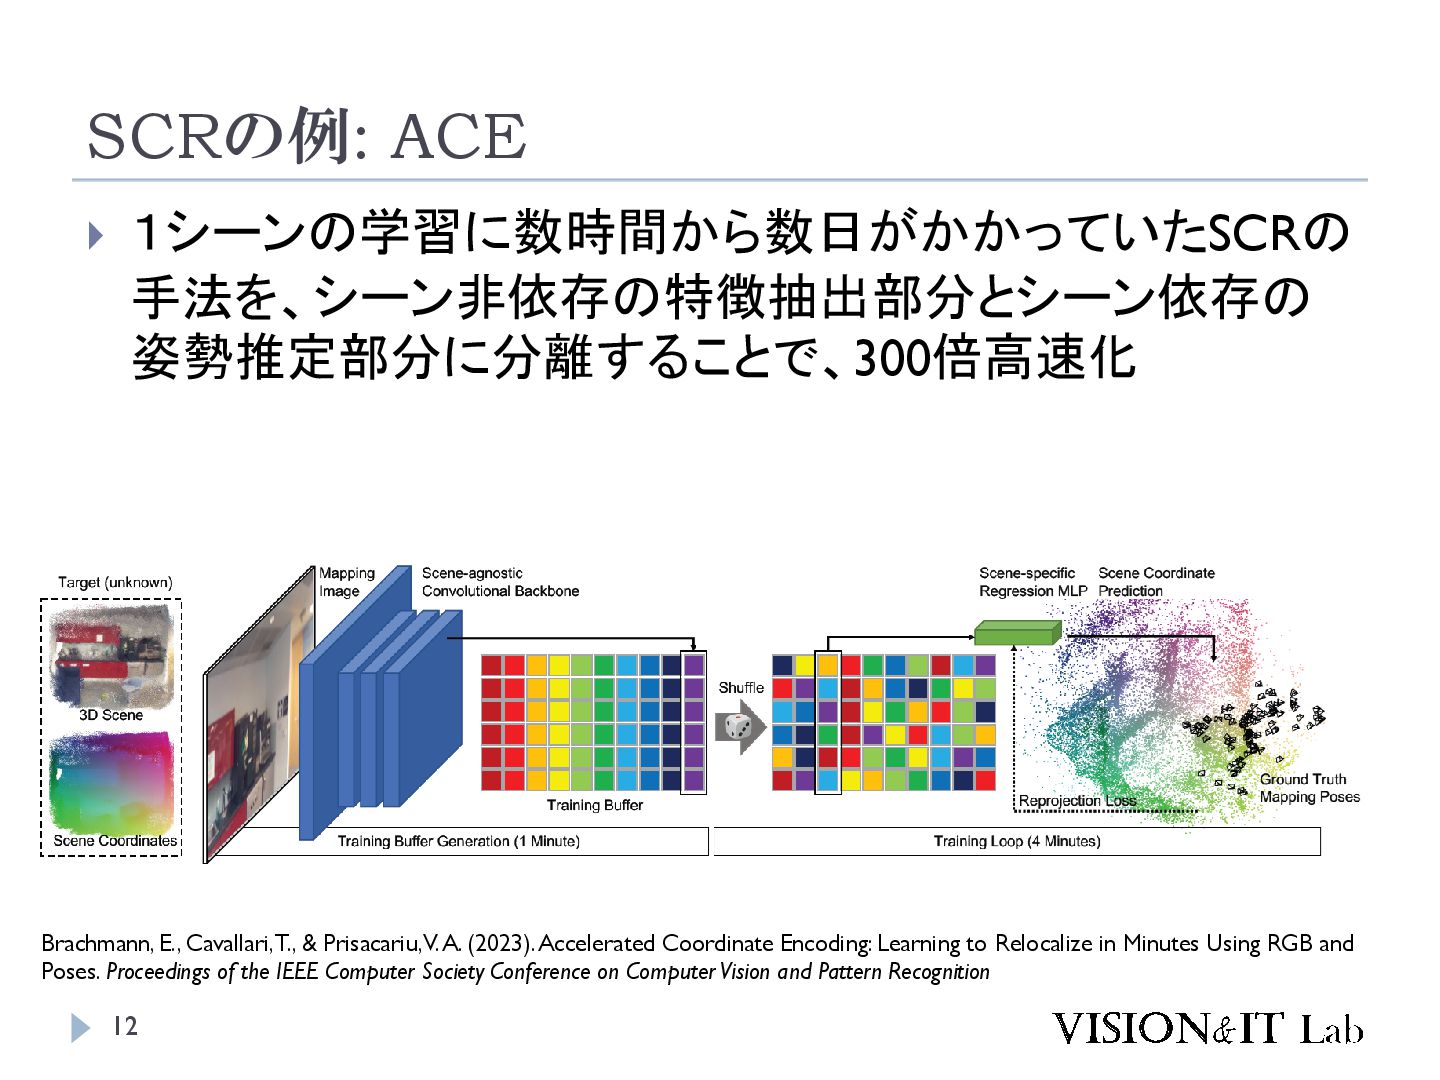
SCRの例: ACE 12 1シーンの学習に数時間から数日がかかっていたSCRの 手法を、シーン非依存の特徴抽出部分とシーン依存の 姿勢推定部分に分離することで、300倍高速化 Brachmann, E., Cavallari,
T., & Prisacariu, V. A. (2023). Accelerated Coordinate Encoding: Learning to Relocalize in Minutes Using RGB and Poses. Proceedings of the IEEE Computer Society Conference on Computer Vision and Pattern Recognition -
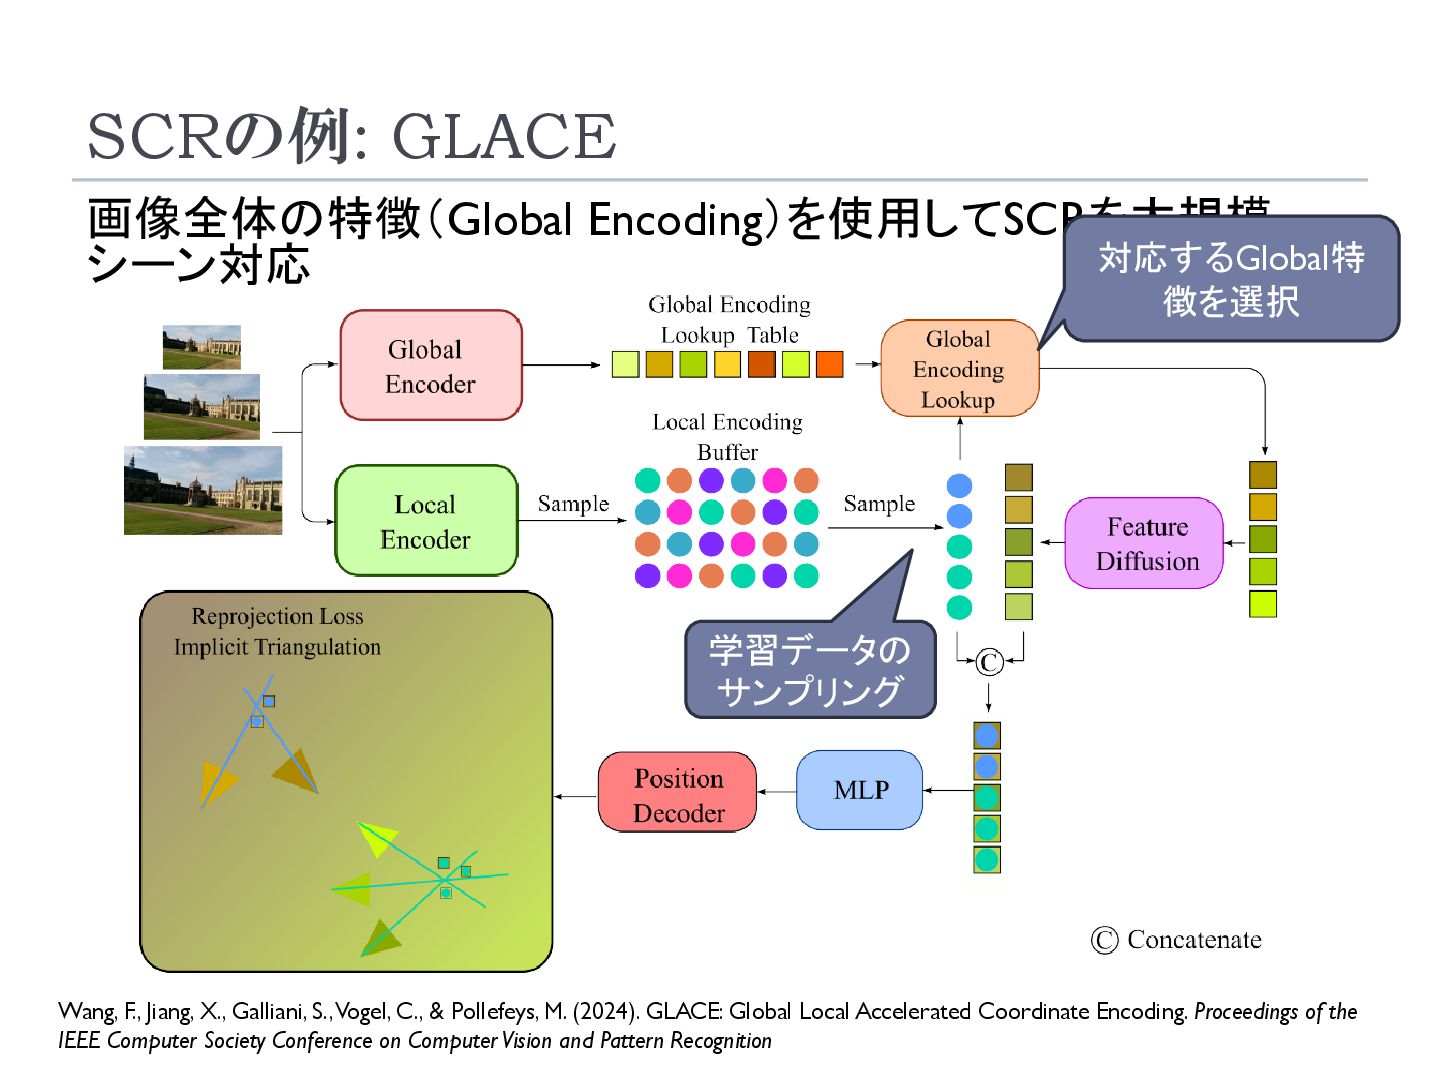
SCRの例: GLACE 13 似た局所特徴をニューラルネットワークに入力すると、 似た三次元座標を出力する Wang, F., Jiang, X., Galliani,
S., Vogel, C., & Pollefeys, M. (2024). GLACE: Global Local Accelerated Coordinate Encoding. Proceedings of the IEEE Computer Society Conference on Computer Vision and Pattern Recognition 大規模なマップでは、似た特徴を持つ点が異なるシーン で現れることがあり、精度低下の原因となる 画像全体の特徴を局所特徴に追加することで、異なる シーンで異なる座標を出力するようにネットワークを学 習する -
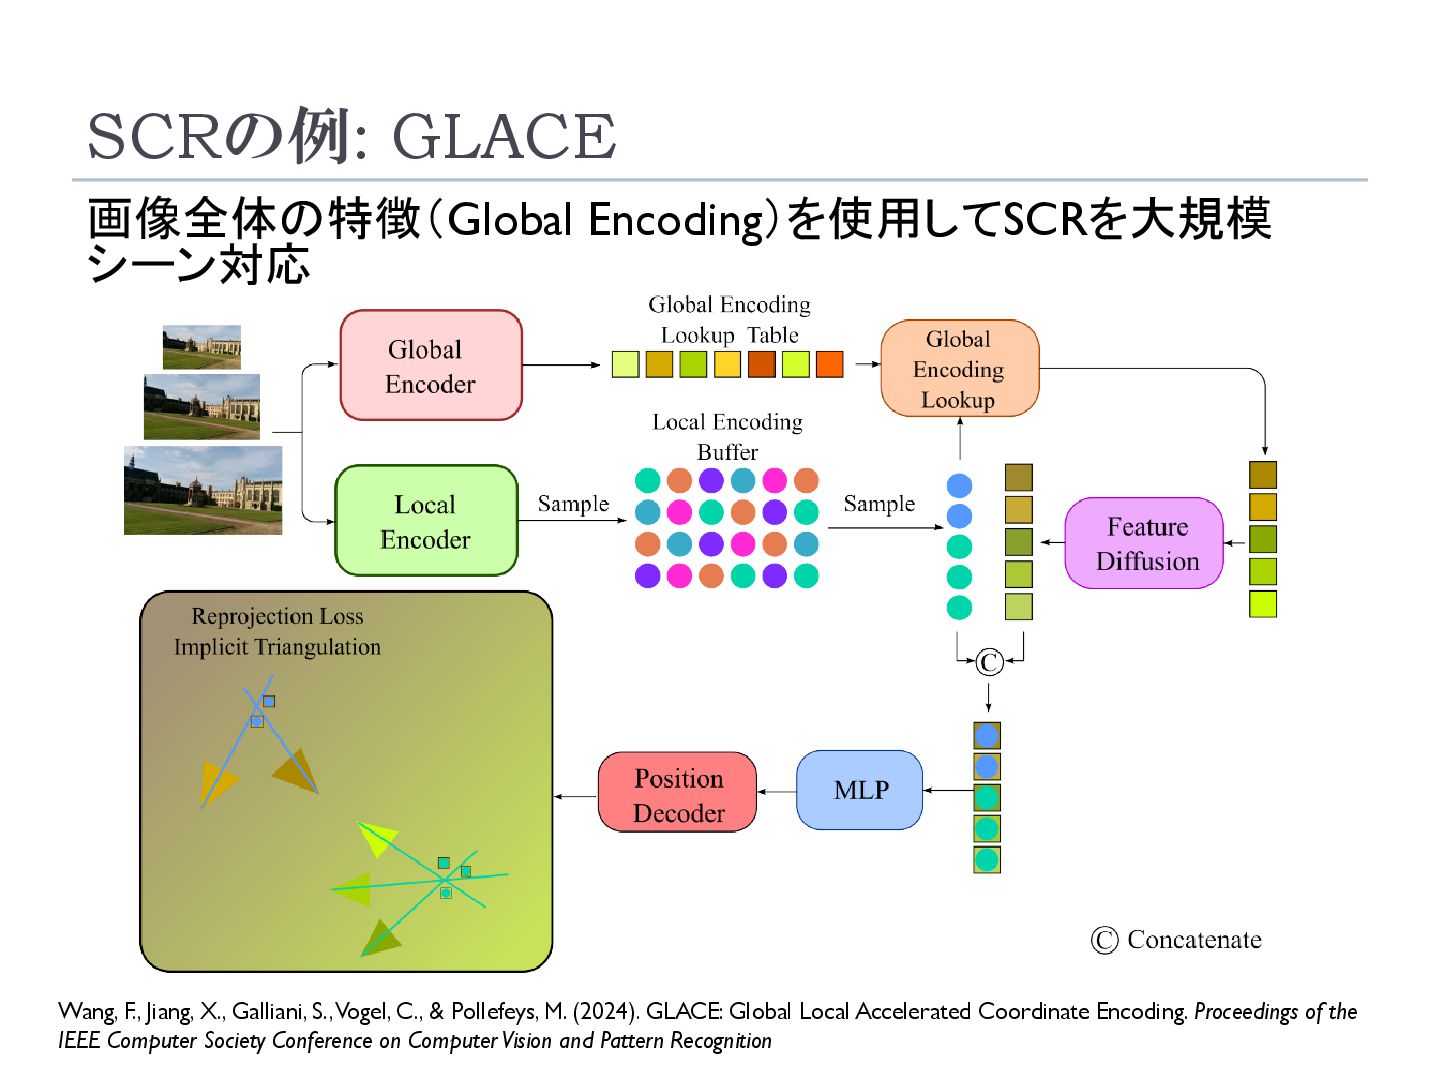
SCRの例: GLACE 14 画像全体の特徴(Global Encoding)を使用してSCRを大規模 シーン対応 Wang, F., Jiang, X.,
Galliani, S., Vogel, C., & Pollefeys, M. (2024). GLACE: Global Local Accelerated Coordinate Encoding. Proceedings of the IEEE Computer Society Conference on Computer Vision and Pattern Recognition -
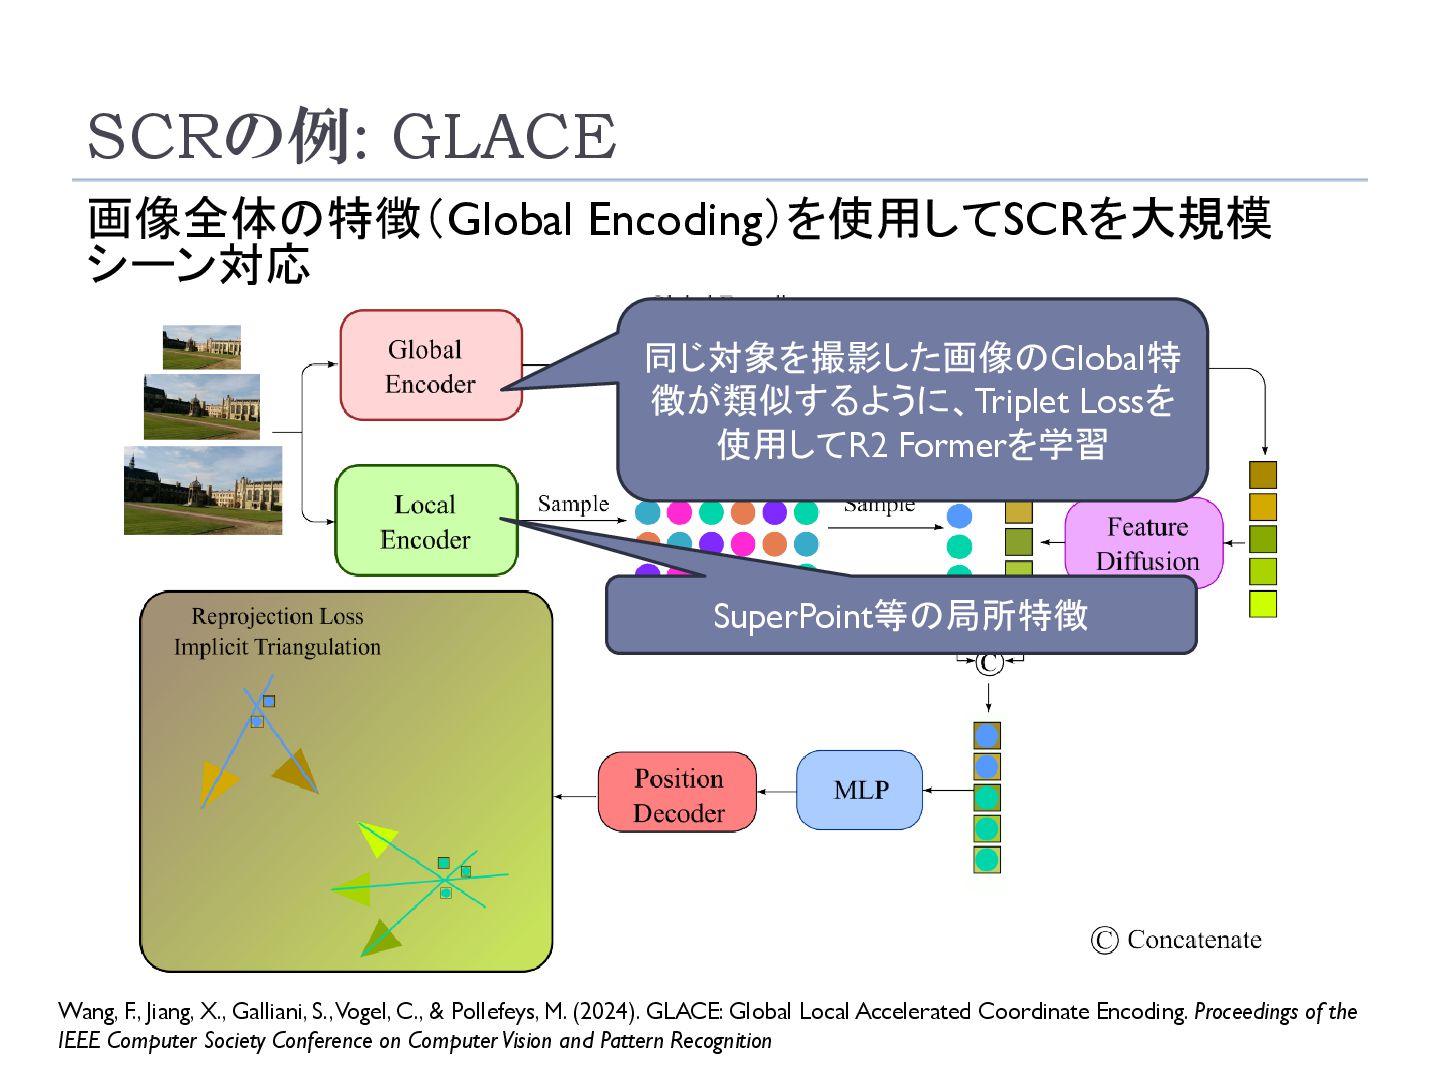
SCRの例: GLACE 15 画像全体の特徴(Global Encoding)を使用してSCRを大規模 シーン対応 Wang, F., Jiang, X.,
Galliani, S., Vogel, C., & Pollefeys, M. (2024). GLACE: Global Local Accelerated Coordinate Encoding. Proceedings of the IEEE Computer Society Conference on Computer Vision and Pattern Recognition 同じ対象を撮影した画像のGlobal特 徴が類似するように、Triplet Lossを 使用してR2 Formerを学習 SuperPoint等の局所特徴 -
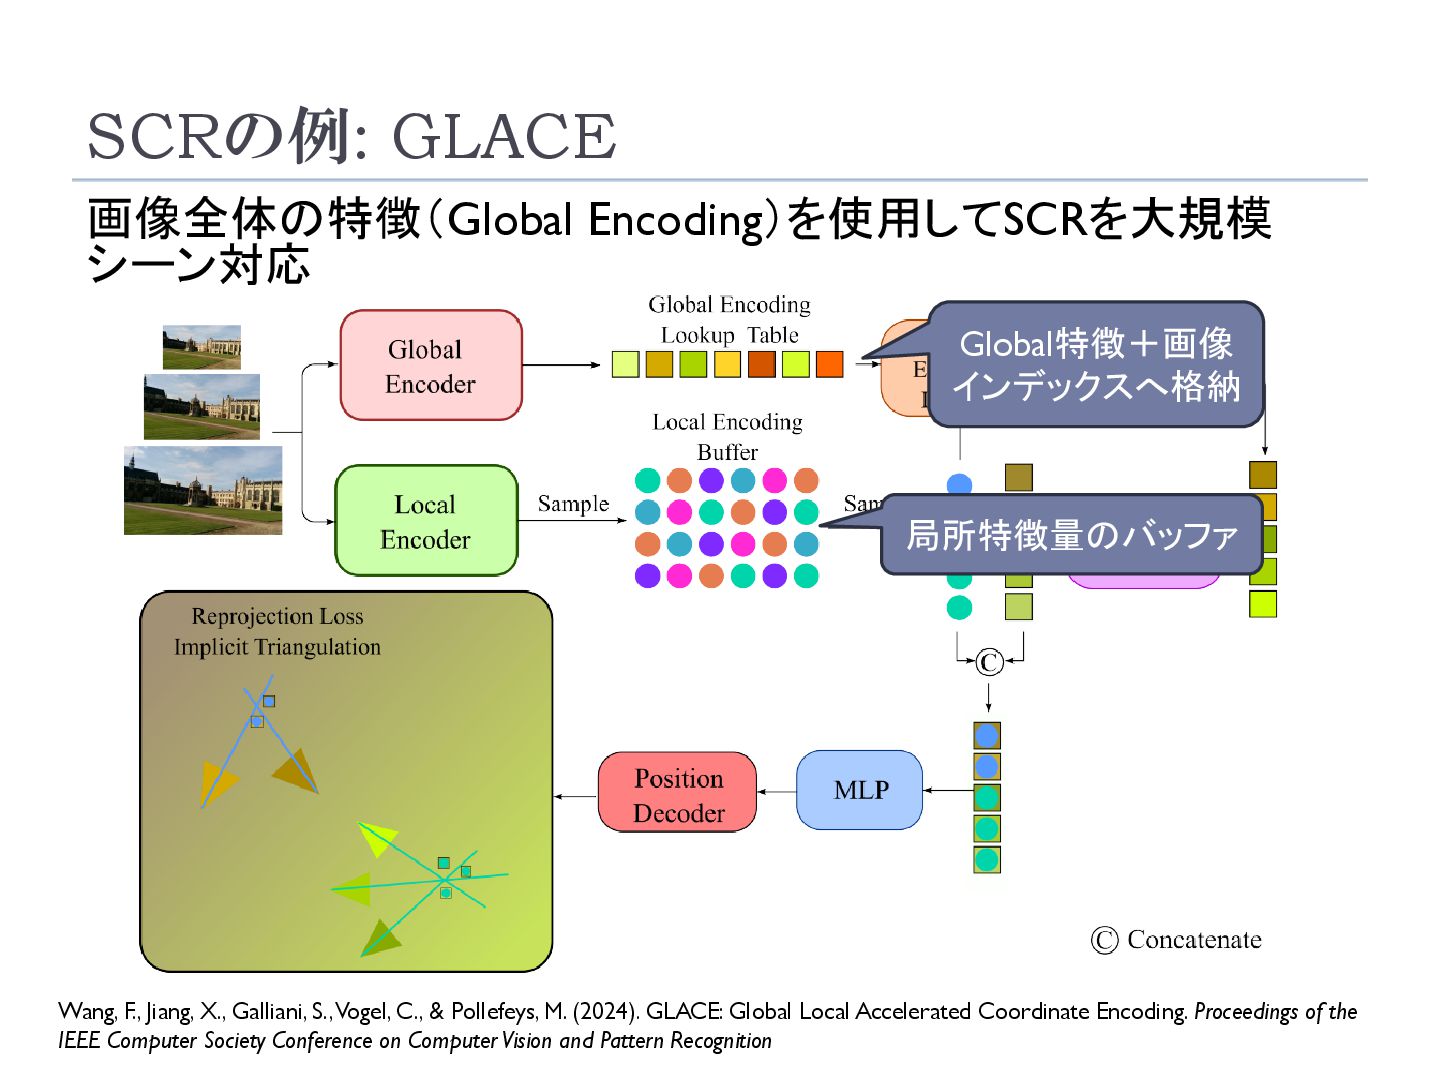
SCRの例: GLACE 16 画像全体の特徴(Global Encoding)を使用してSCRを大規模 シーン対応 Wang, F., Jiang, X.,
Galliani, S., Vogel, C., & Pollefeys, M. (2024). GLACE: Global Local Accelerated Coordinate Encoding. Proceedings of the IEEE Computer Society Conference on Computer Vision and Pattern Recognition Global特徴+画像 インデックスへ格納 局所特徴量のバッファ -
SCRの例: GLACE 17 画像全体の特徴(Global Encoding)を使用してSCRを大規模 シーン対応 Wang, F., Jiang, X.,
Galliani, S., Vogel, C., & Pollefeys, M. (2024). GLACE: Global Local Accelerated Coordinate Encoding. Proceedings of the IEEE Computer Society Conference on Computer Vision and Pattern Recognition 対応するGlobal特 徴を選択 学習データの サンプリング -
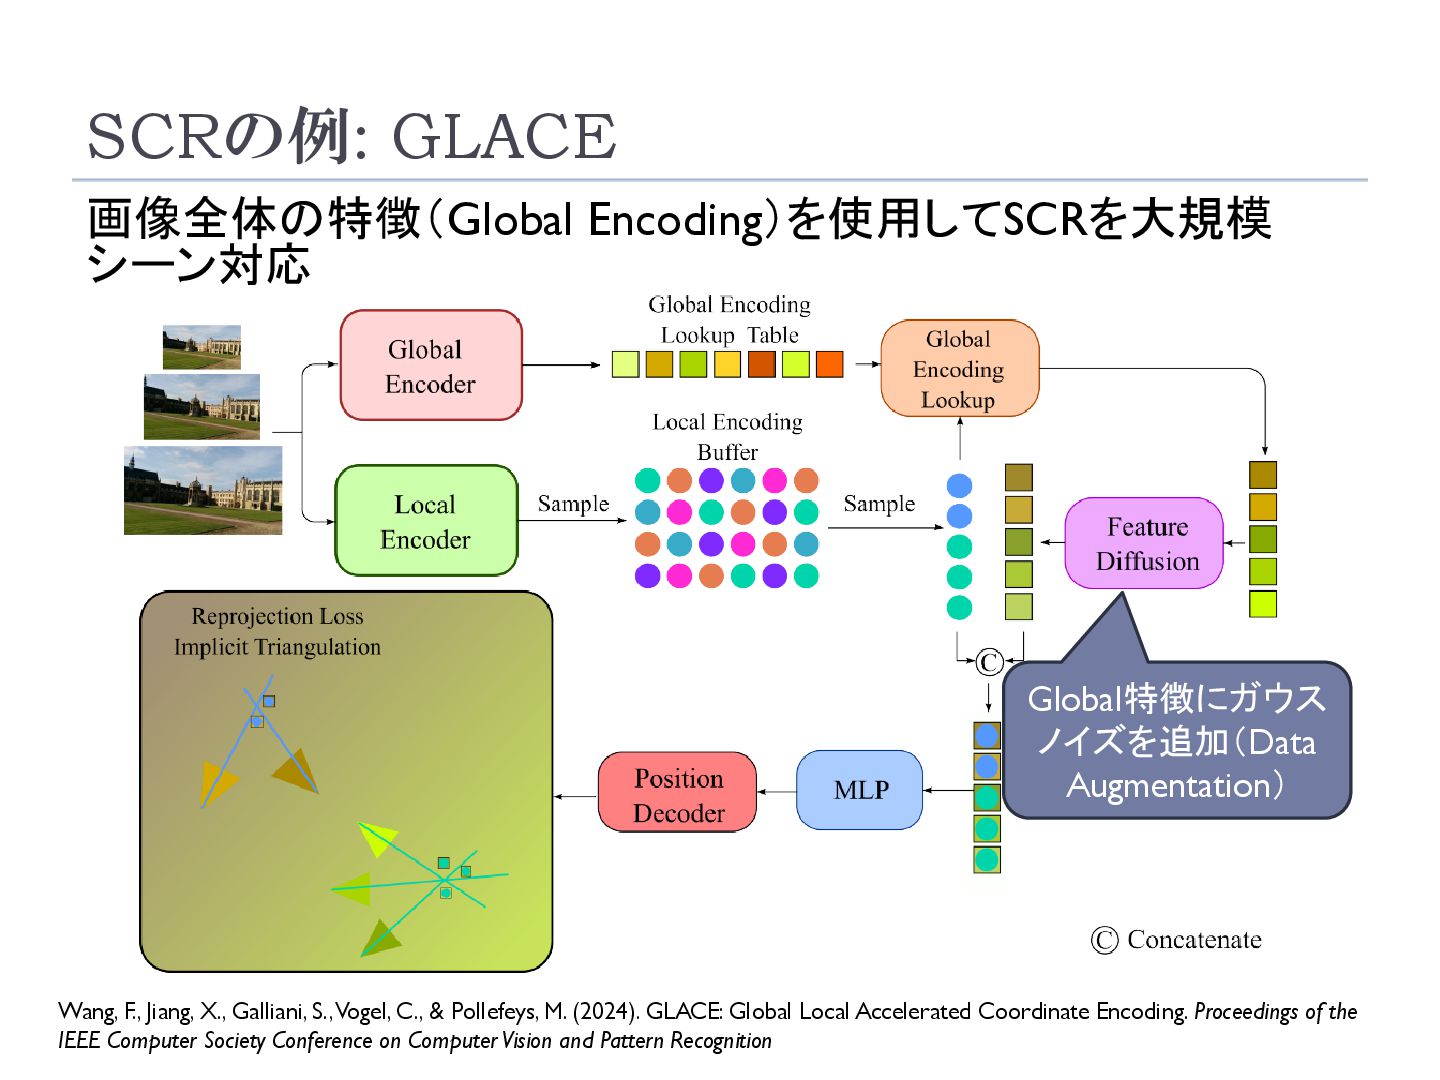
SCRの例: GLACE 18 画像全体の特徴(Global Encoding)を使用してSCRを大規模 シーン対応 Wang, F., Jiang, X.,
Galliani, S., Vogel, C., & Pollefeys, M. (2024). GLACE: Global Local Accelerated Coordinate Encoding. Proceedings of the IEEE Computer Society Conference on Computer Vision and Pattern Recognition Global特徴にガウス ノイズを追加(Data Augmentation) -
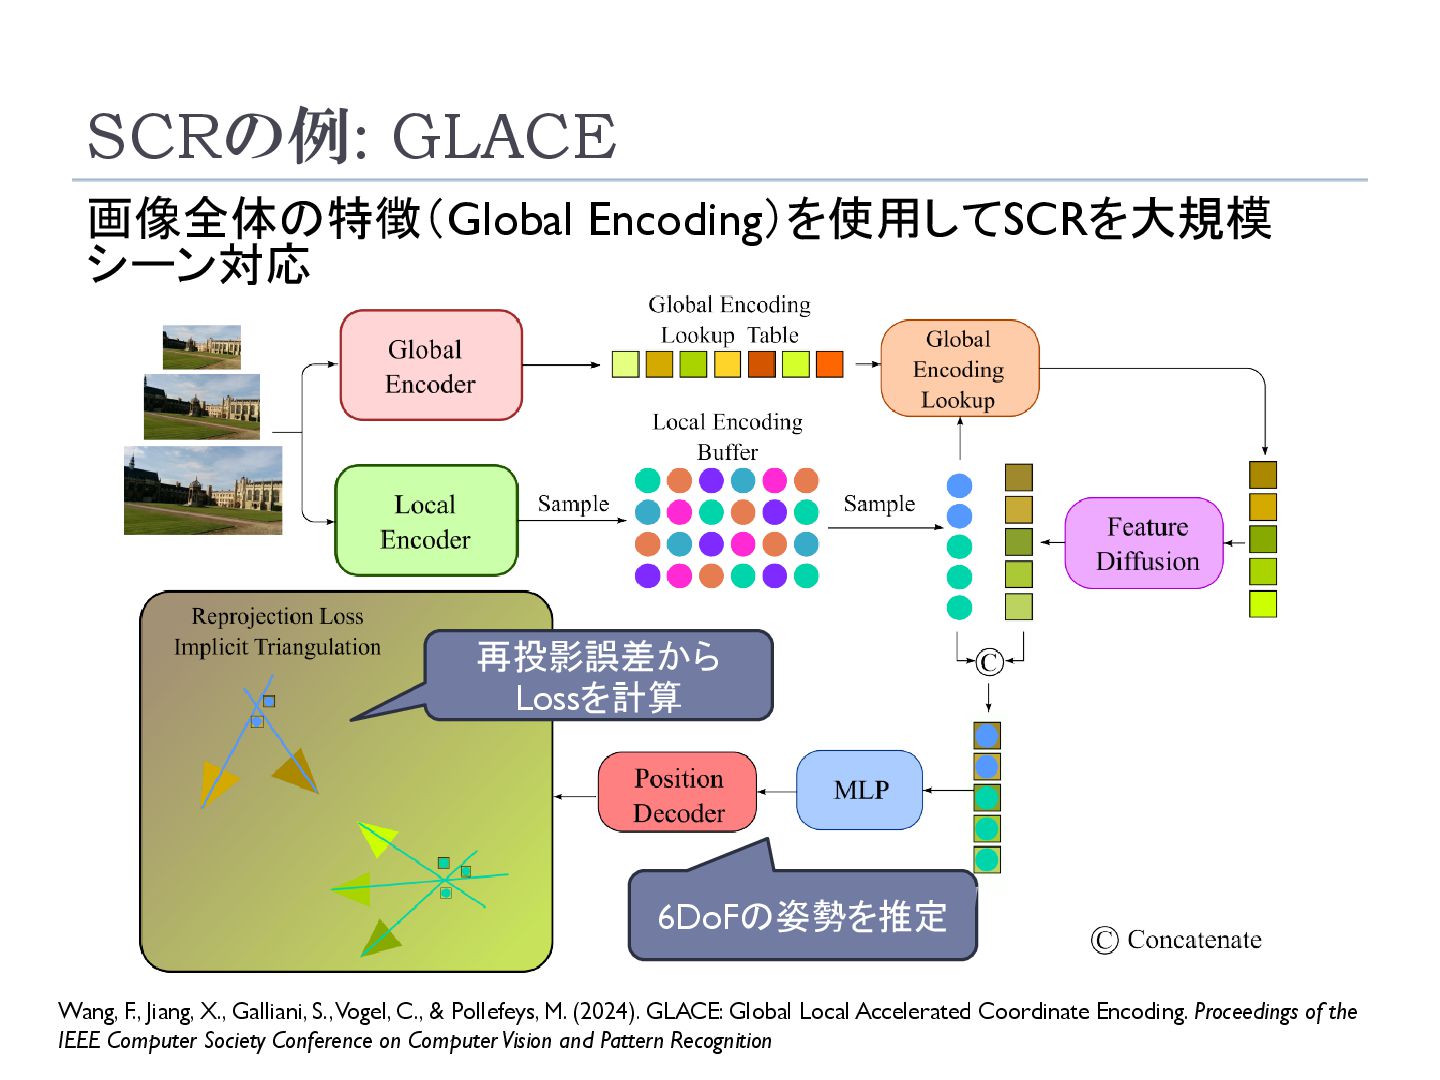
SCRの例: GLACE 19 画像全体の特徴(Global Encoding)を使用してSCRを大規模 シーン対応 Wang, F., Jiang, X.,
Galliani, S., Vogel, C., & Pollefeys, M. (2024). GLACE: Global Local Accelerated Coordinate Encoding. Proceedings of the IEEE Computer Society Conference on Computer Vision and Pattern Recognition 6DoFの姿勢を推定 再投影誤差から Lossを計算 -
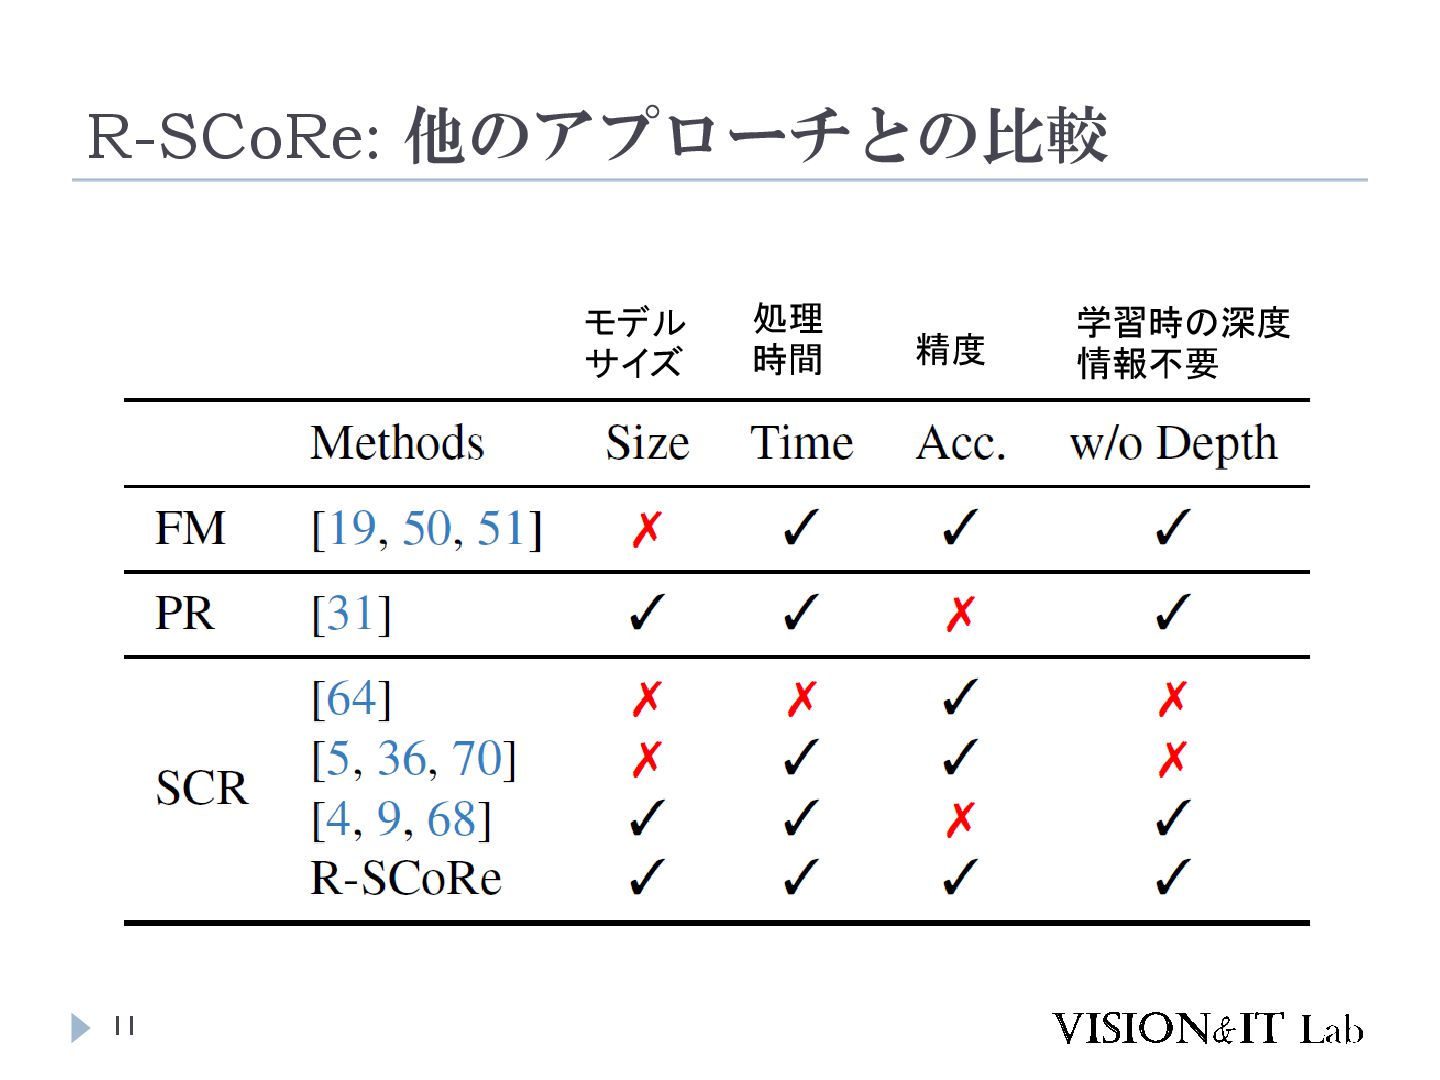
R-SCoRe 20 SCRは各点の三次元座標と特徴ベクトルを保持する必 要がないため、Feature Matching (FM)の手法よりもモデ ルサイズが小さいという利点があるものの、小さなマップ にしか対応できず、精度でも劣っていた。
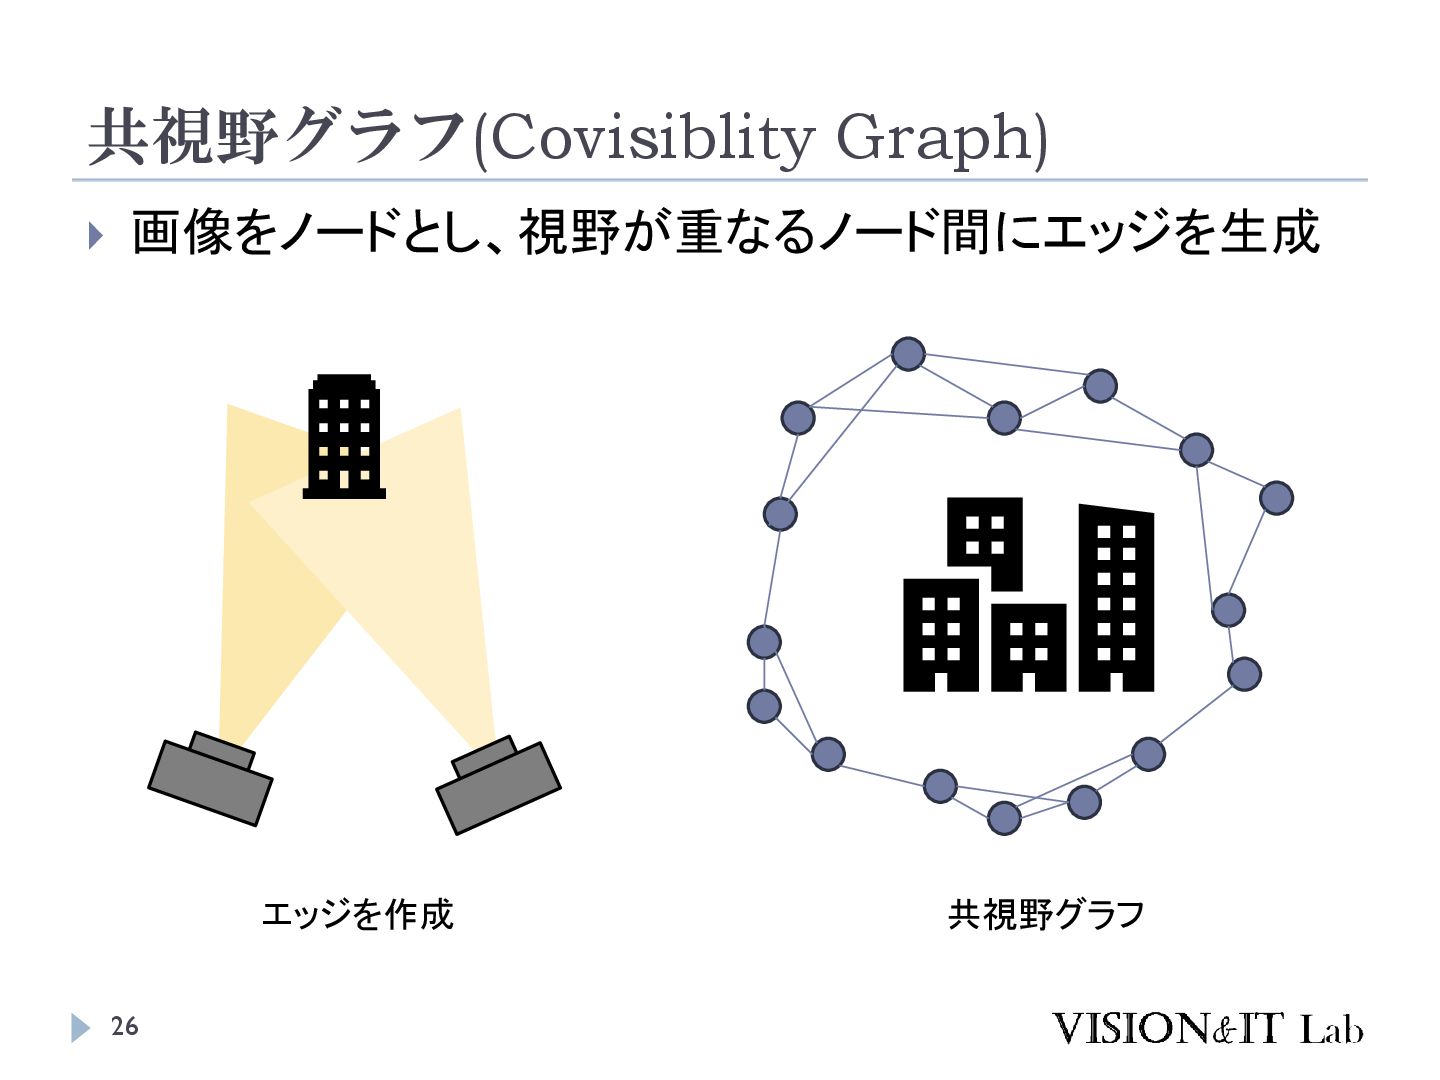
GLACEによって大規模なマップに対応できるようになっ たが、照明変化に弱いなど、精度面ではFMに劣ってい た。 R-SCoReでは以下の工夫によって、照明変化のある環 境でも精度向上し、FMに匹敵する精度を達成 共視野グラフ(Covisibility Graph)に基づくGlobal Encoding 奥行に基づいた再投影誤差の導入 -
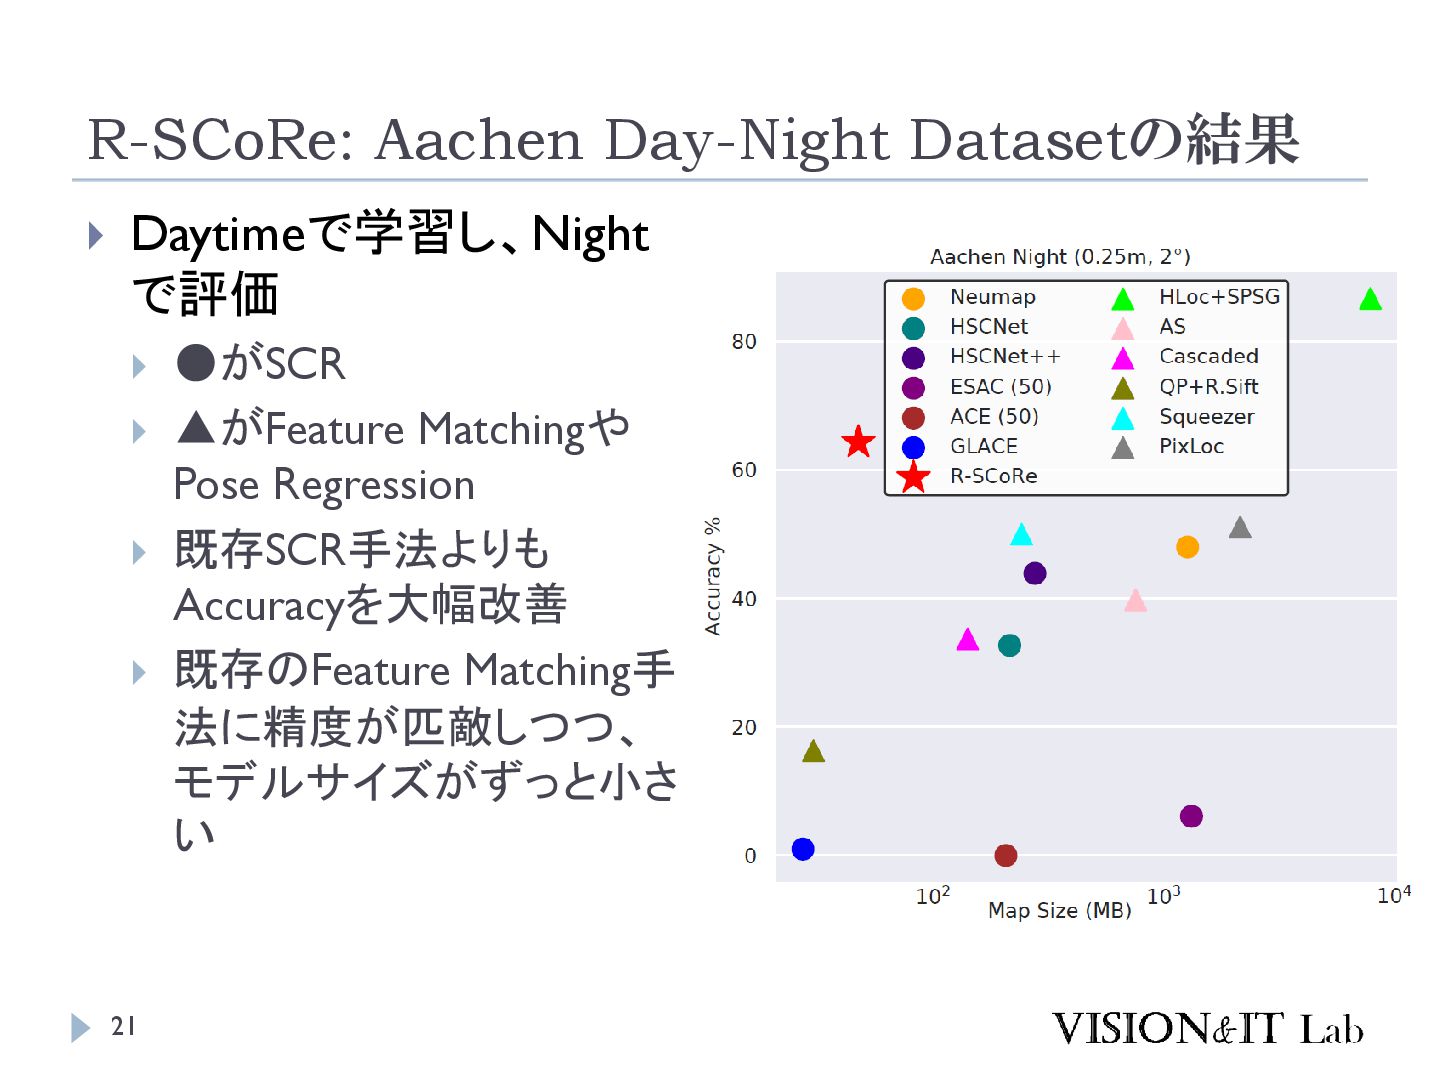
R-SCoRe: Aachen Day-Night Datasetの結果 21 Daytimeで学習し、Night で評価 •がSCR
▲がFeature Matchingや Pose Regression 既存SCR手法よりも Accuracyを大幅改善 既存のFeature Matching手 法に精度が匹敵しつつ、 モデルサイズがずっと小さ い -
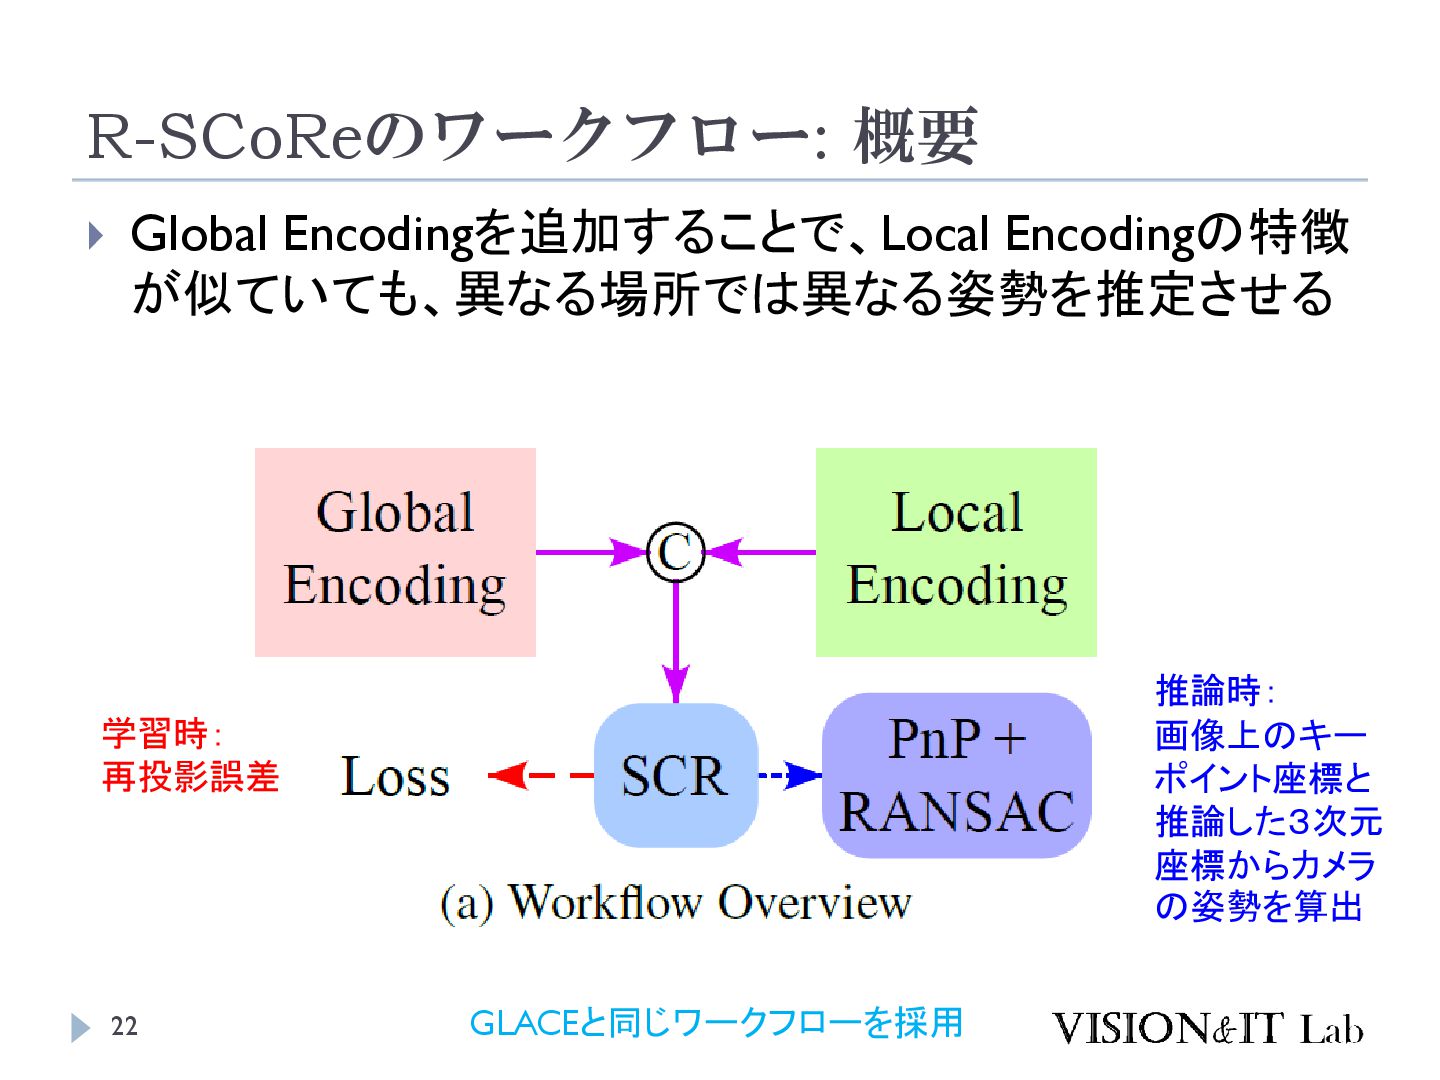
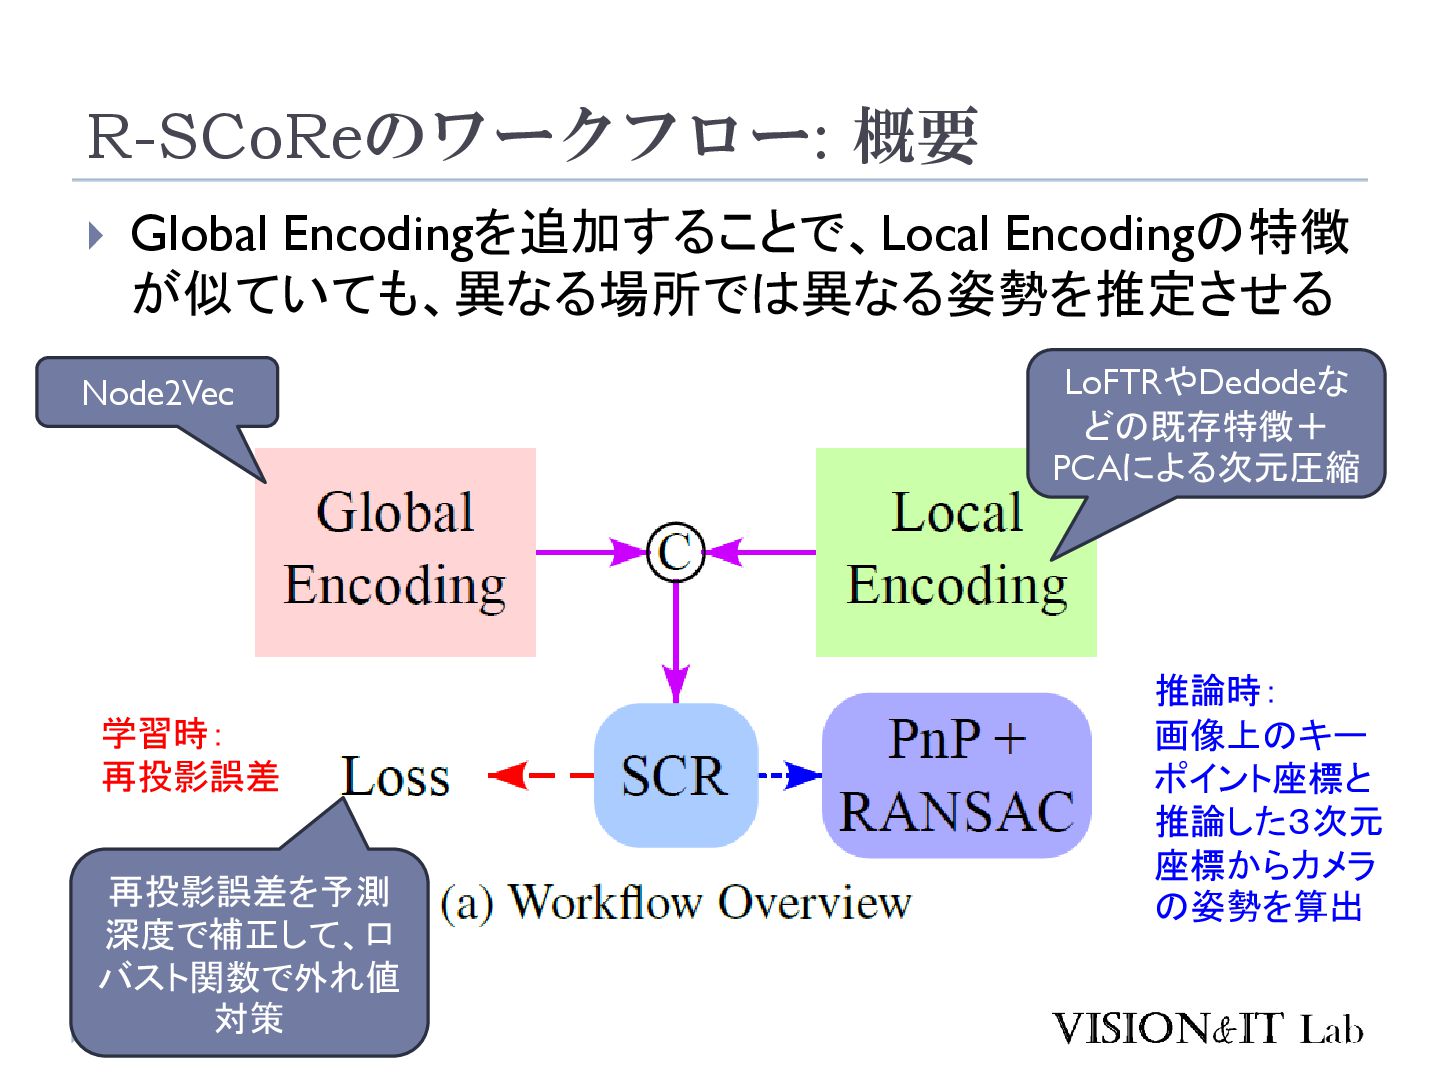
R-SCoReのワークフロー: 概要 22 Global Encodingを追加することで、Local Encodingの特徴 が似ていても、異なる場所では異なる姿勢を推定させる GLACEと同じワークフローを採用 学習時:
再投影誤差 推論時: 画像上のキー ポイント座標と 推論した3次元 座標からカメラ の姿勢を算出 -
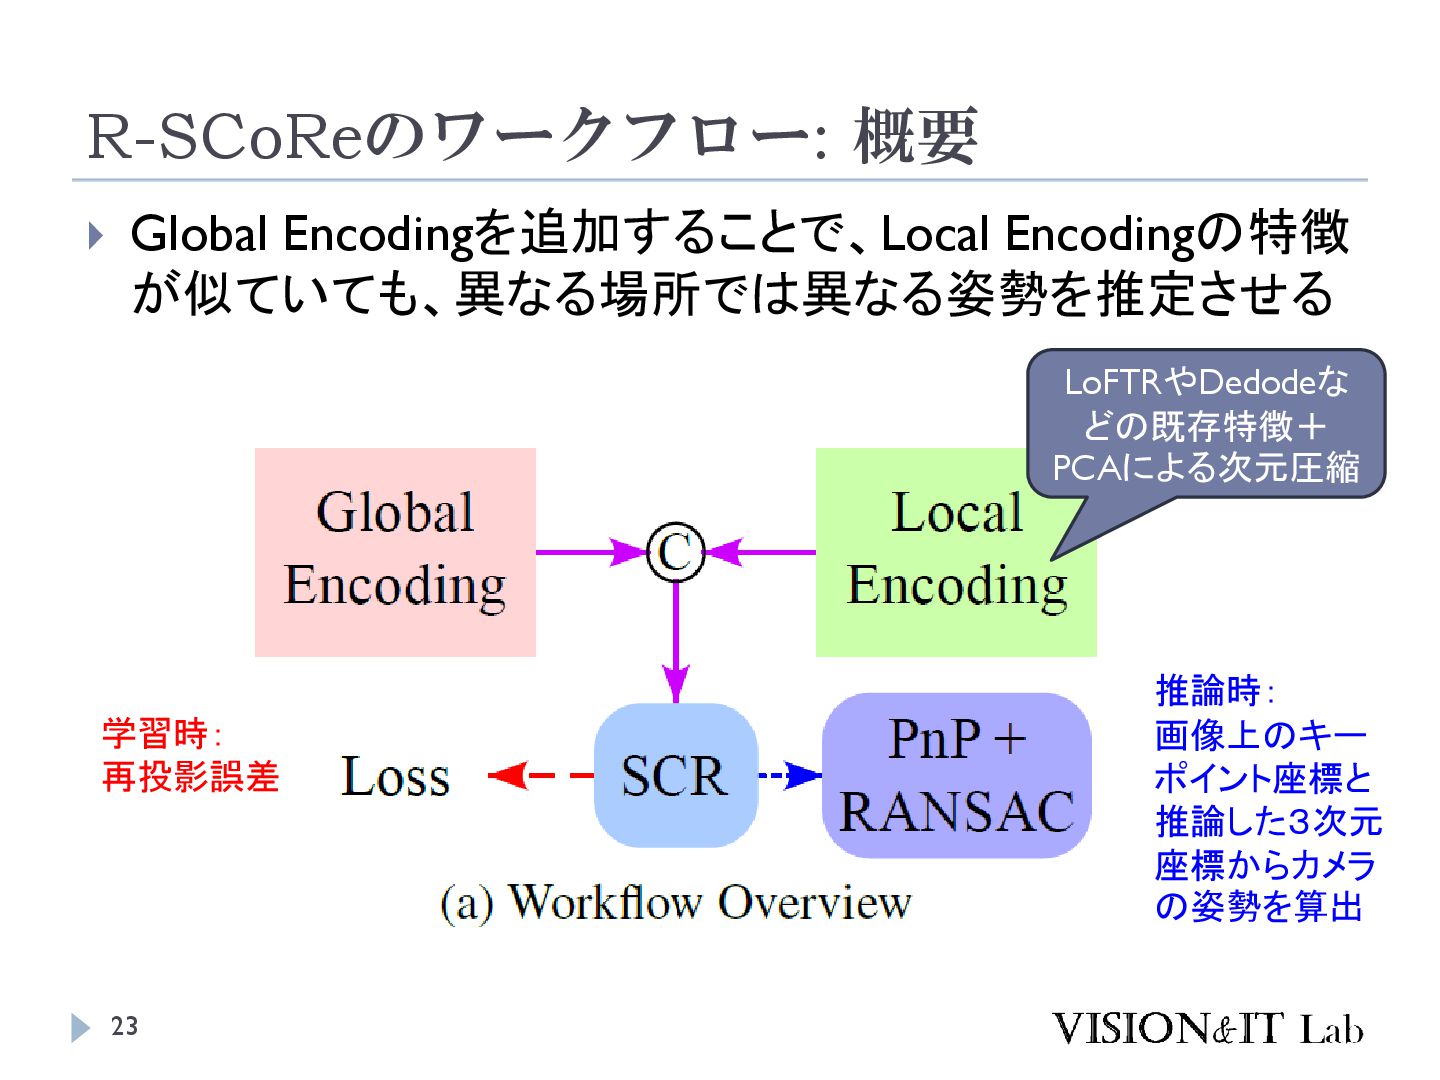
R-SCoReのワークフロー: 概要 23 Global Encodingを追加することで、Local Encodingの特徴 が似ていても、異なる場所では異なる姿勢を推定させる 学習時: 再投影誤差
推論時: 画像上のキー ポイント座標と 推論した3次元 座標からカメラ の姿勢を算出 LoFTRやDedodeな どの既存特徴+ PCAによる次元圧縮 -
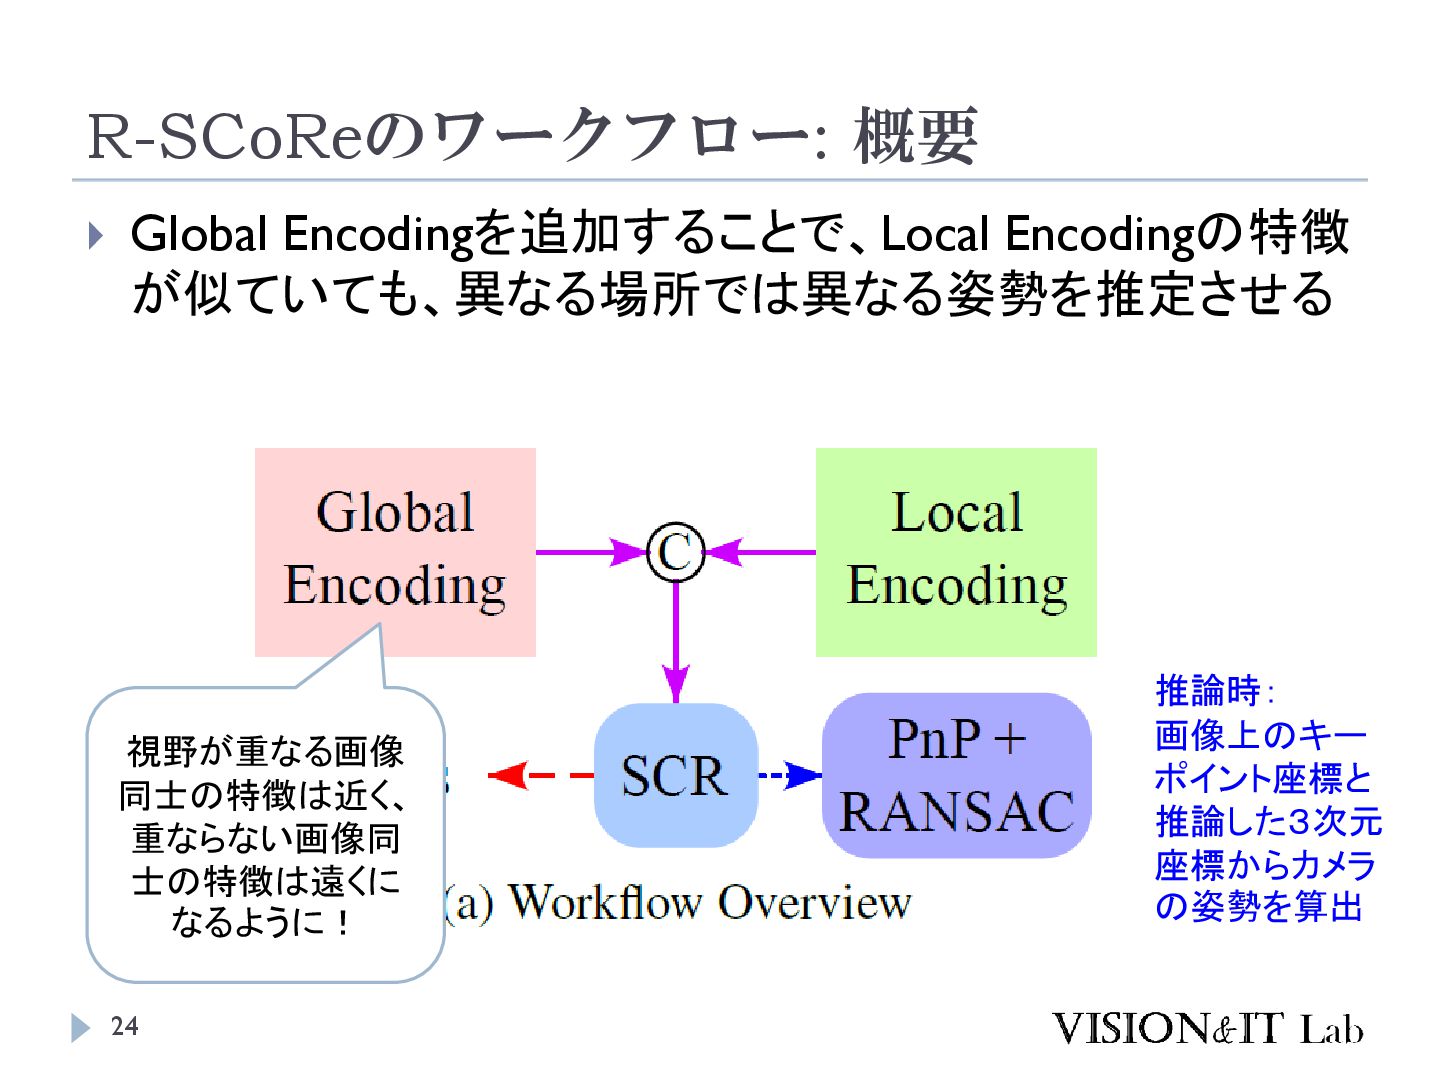
R-SCoReのワークフロー: 概要 24 Global Encodingを追加することで、Local Encodingの特徴 が似ていても、異なる場所では異なる姿勢を推定させる 学習時: 再投影誤差
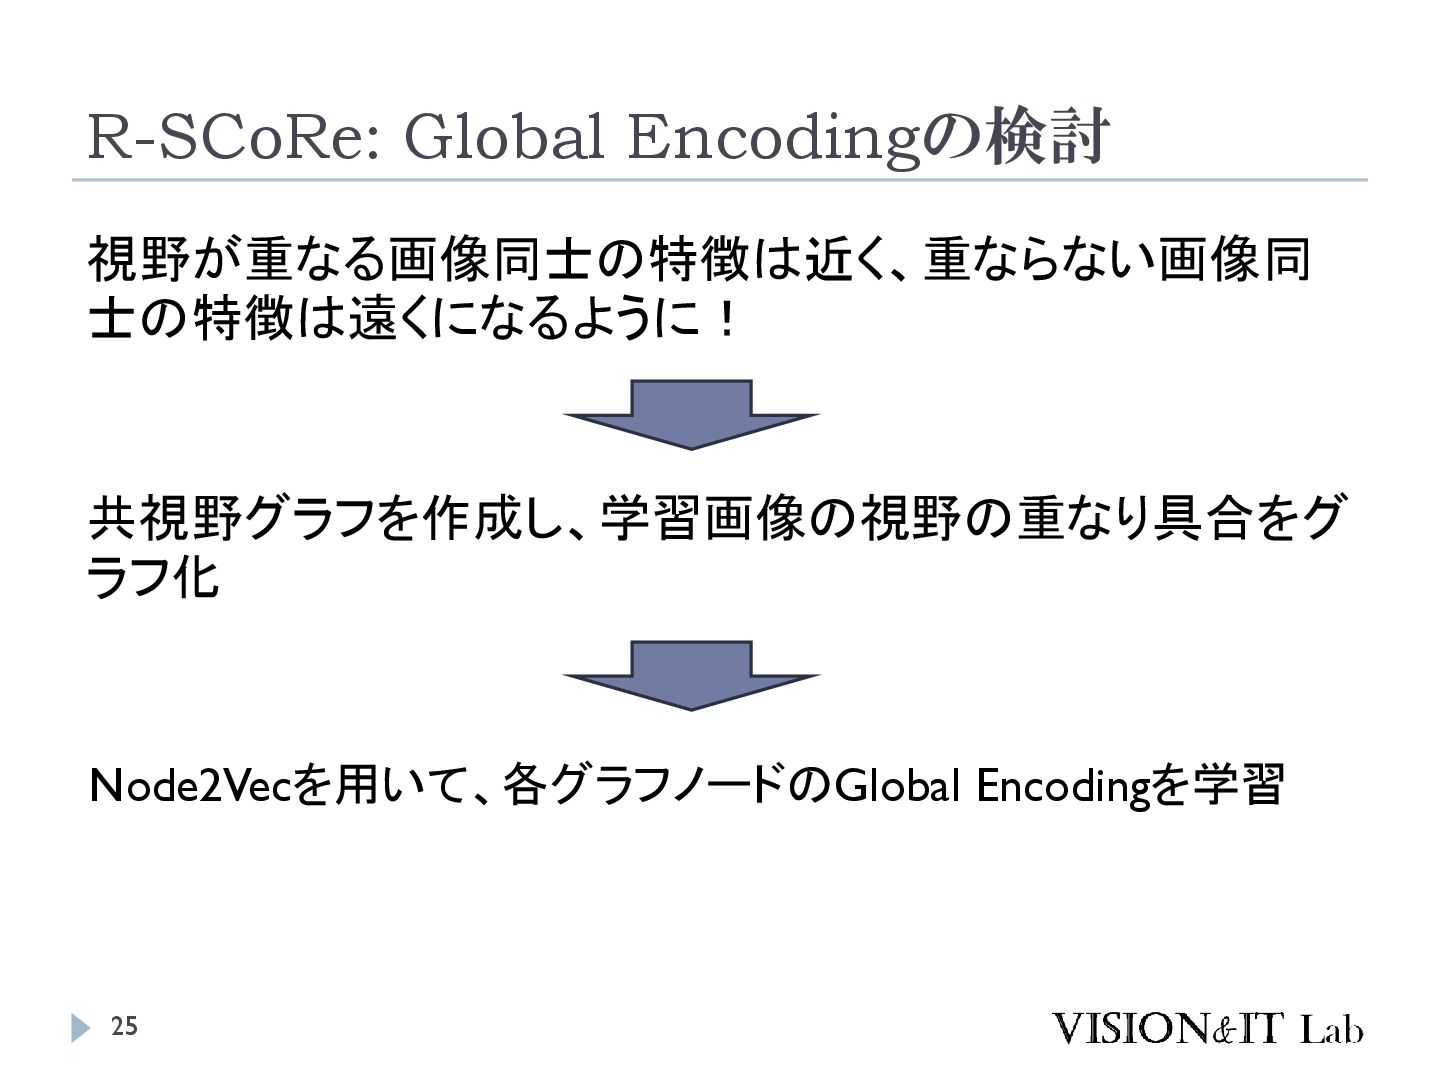
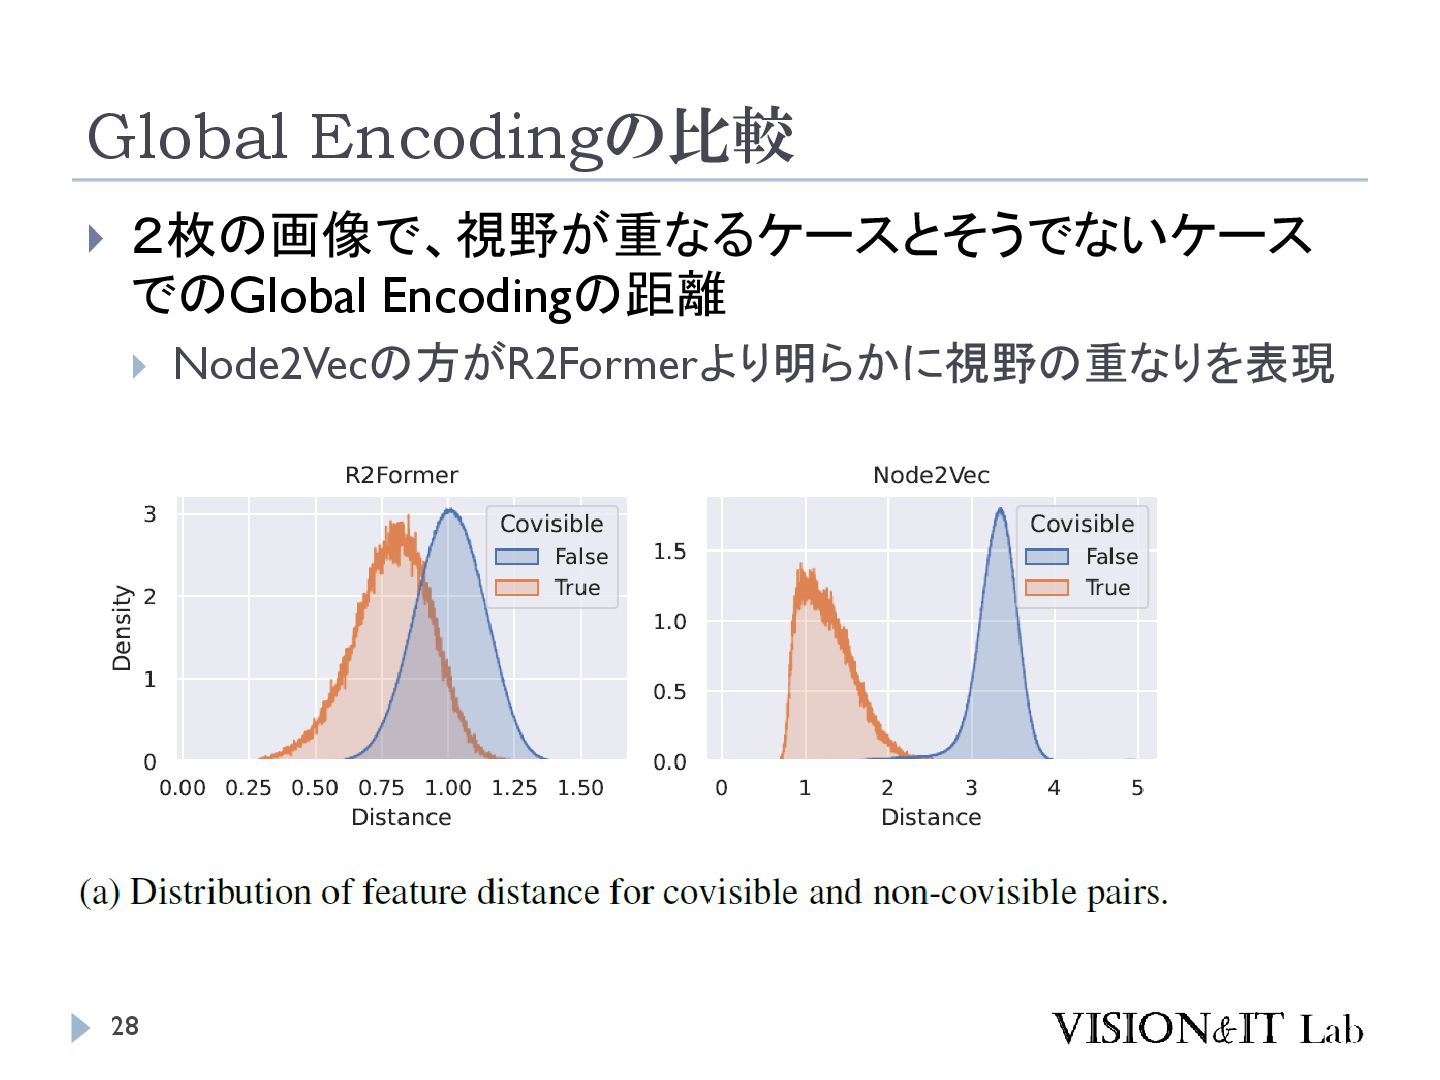
推論時: 画像上のキー ポイント座標と 推論した3次元 座標からカメラ の姿勢を算出 視野が重なる画像 同士の特徴は近く、 重ならない画像同 士の特徴は遠くに なるように! -
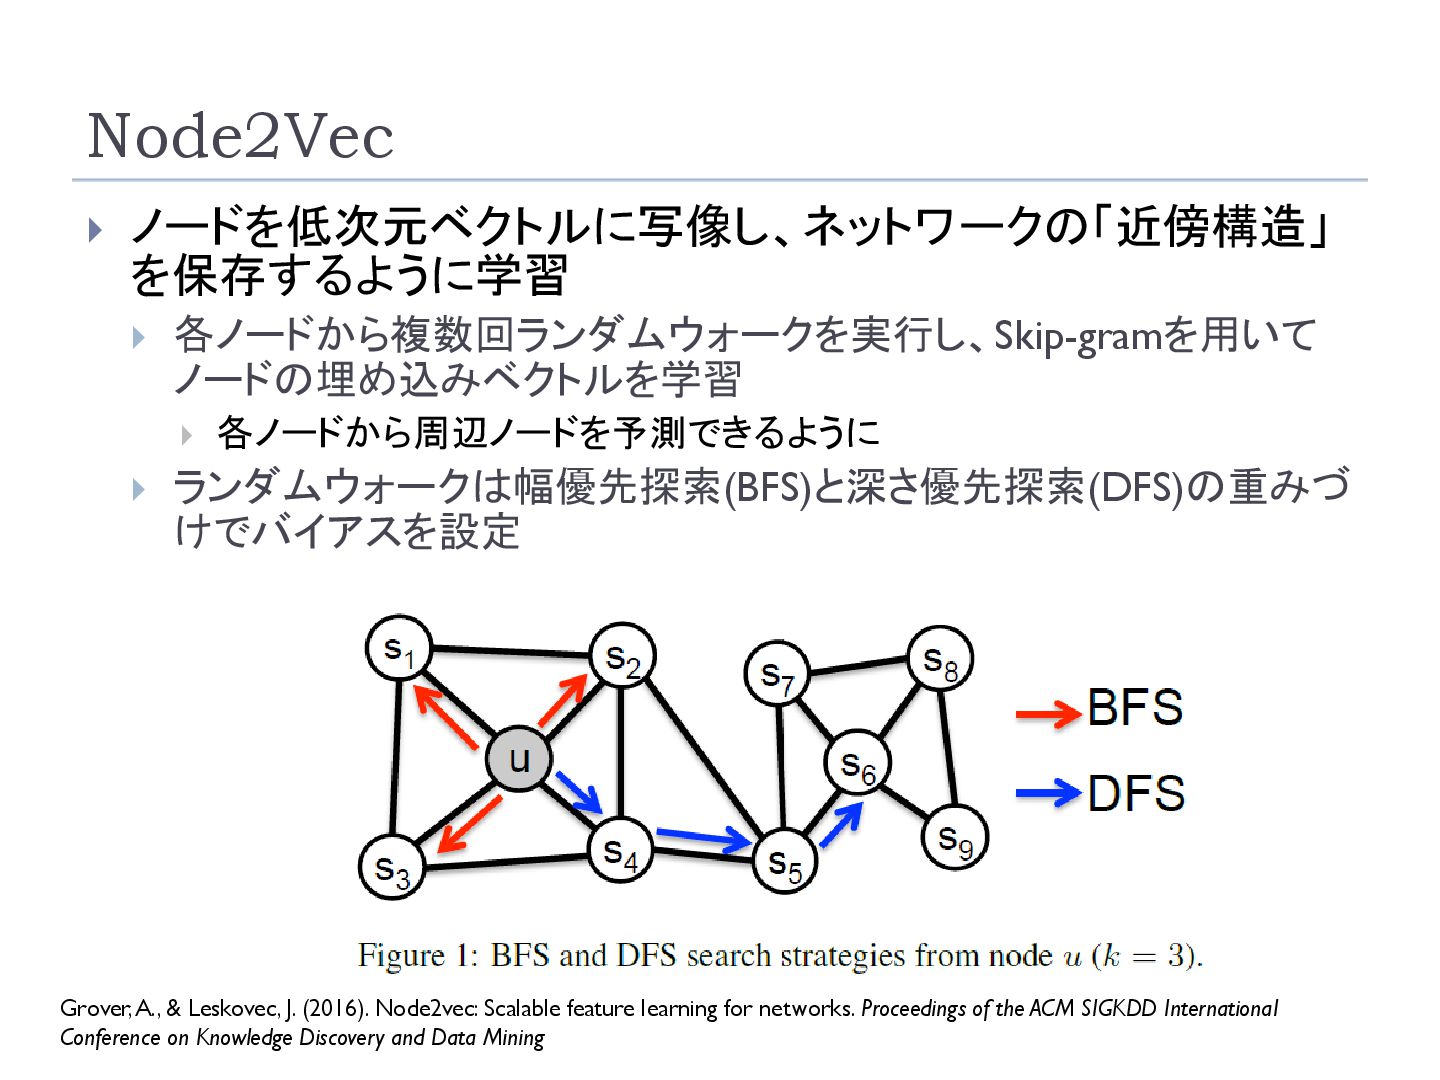
Node2Vec 27 Grover, A., & Leskovec, J. (2016). Node2vec: Scalable
feature learning for networks. Proceedings of the ACM SIGKDD International Conference on Knowledge Discovery and Data Mining ノードを低次元ベクトルに写像し、ネットワークの「近傍構造」 を保存するように学習 各ノードから複数回ランダムウォークを実行し、Skip-gramを用いて ノードの埋め込みベクトルを学習 各ノードから周辺ノードを予測できるように ランダムウォークは幅優先探索(BFS)と深さ優先探索(DFS)の重みづ けでバイアスを設定 -
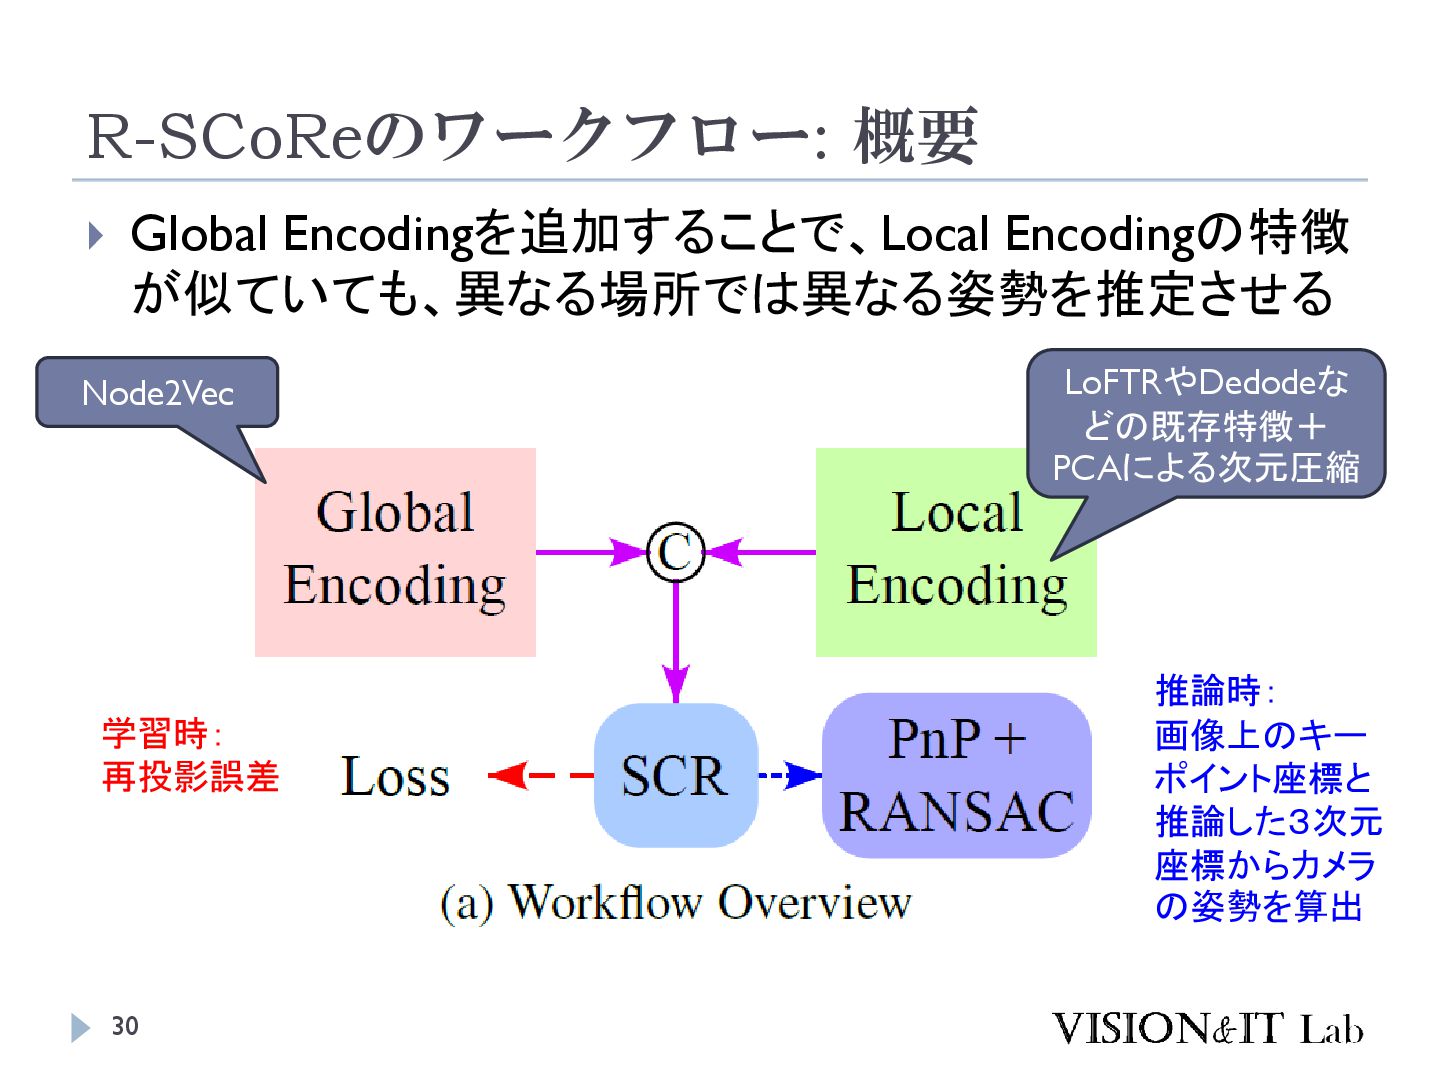
R-SCoReのワークフロー: 概要 30 Global Encodingを追加することで、Local Encodingの特徴 が似ていても、異なる場所では異なる姿勢を推定させる 学習時: 再投影誤差
推論時: 画像上のキー ポイント座標と 推論した3次元 座標からカメラ の姿勢を算出 Node2Vec LoFTRやDedodeな どの既存特徴+ PCAによる次元圧縮 -
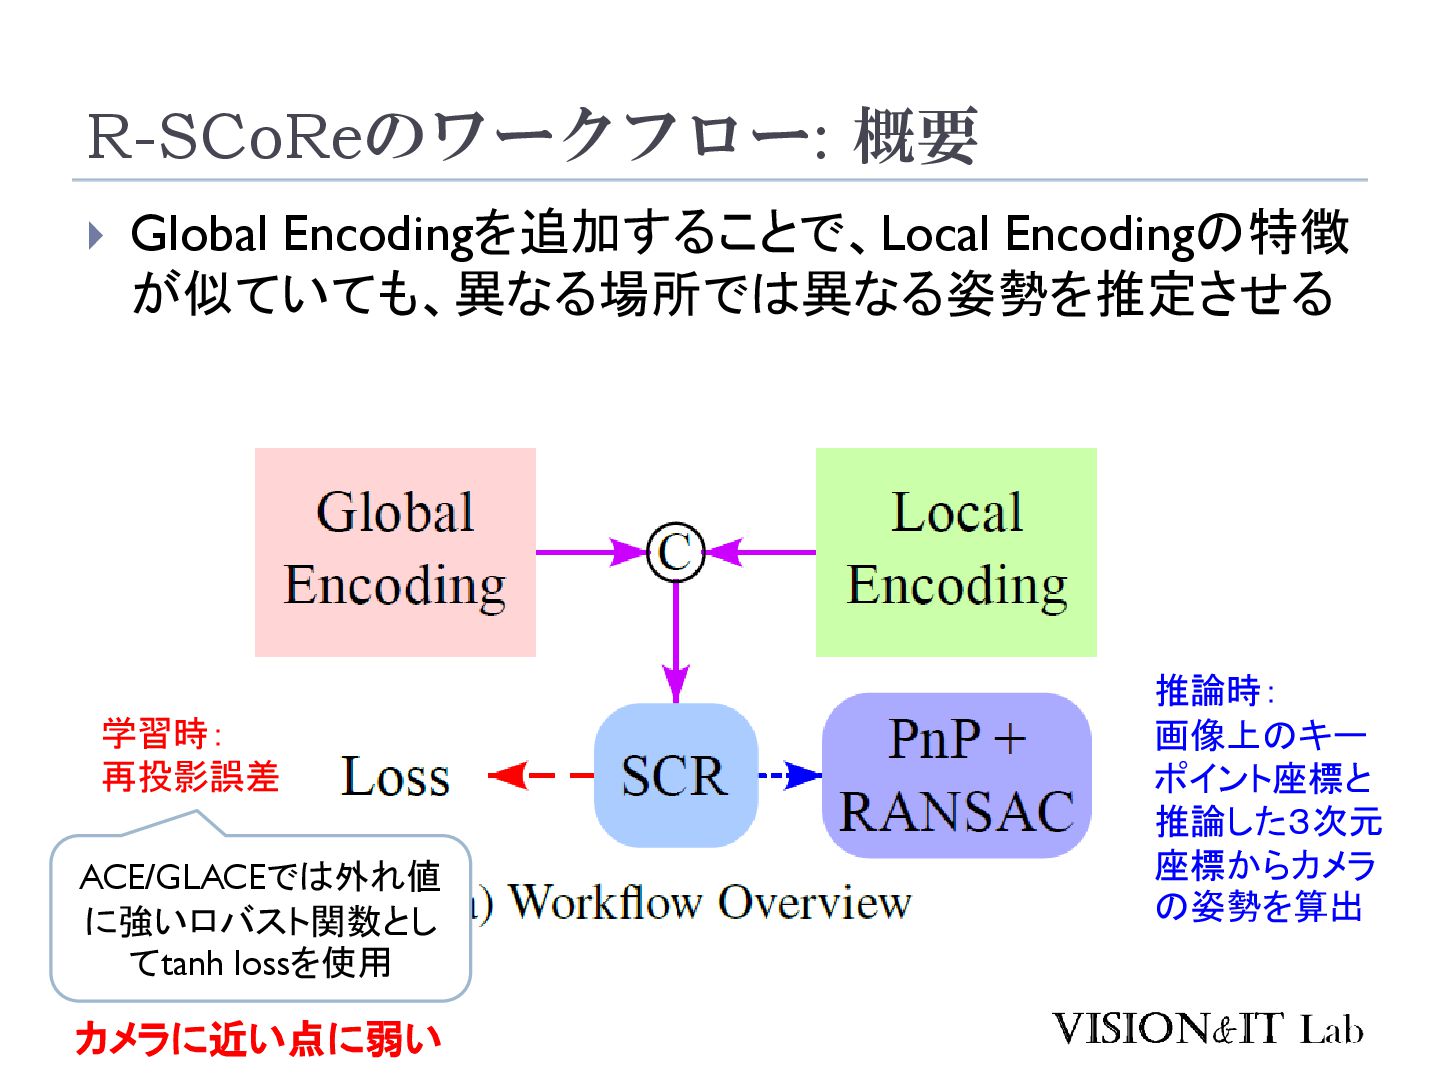
R-SCoReのワークフロー: 概要 31 Global Encodingを追加することで、Local Encodingの特徴 が似ていても、異なる場所では異なる姿勢を推定させる 学習時: 再投影誤差
推論時: 画像上のキー ポイント座標と 推論した3次元 座標からカメラ の姿勢を算出 ACE/GLACEでは外れ値 に強いロバスト関数とし てtanh lossを使用 カメラに近い点に弱い -
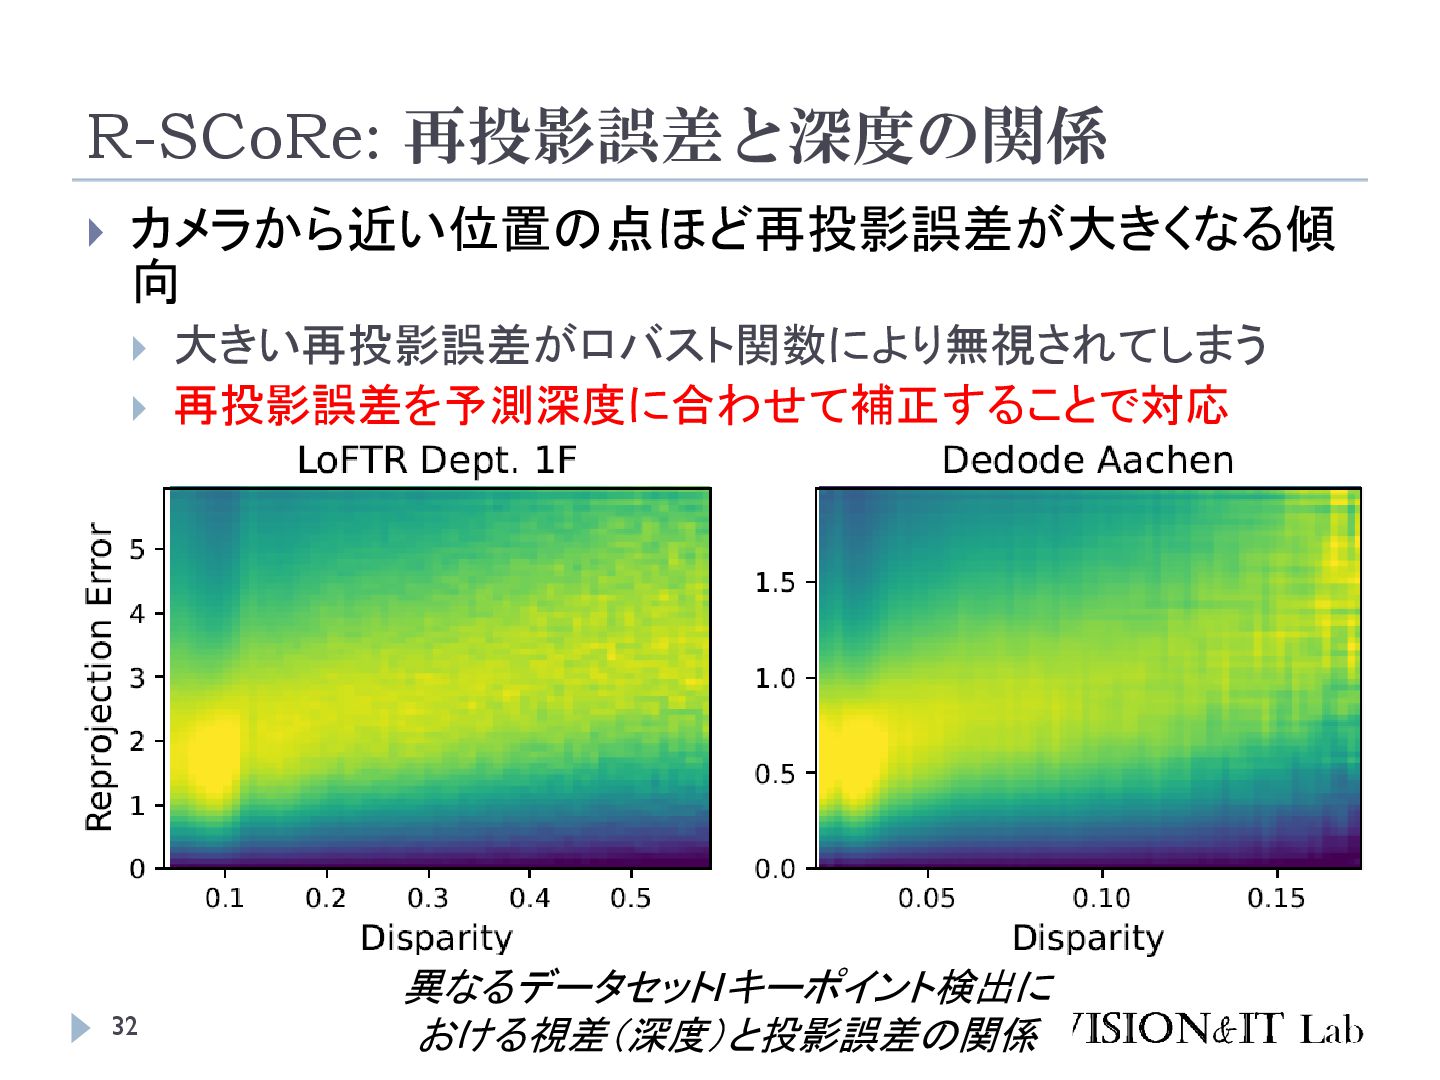
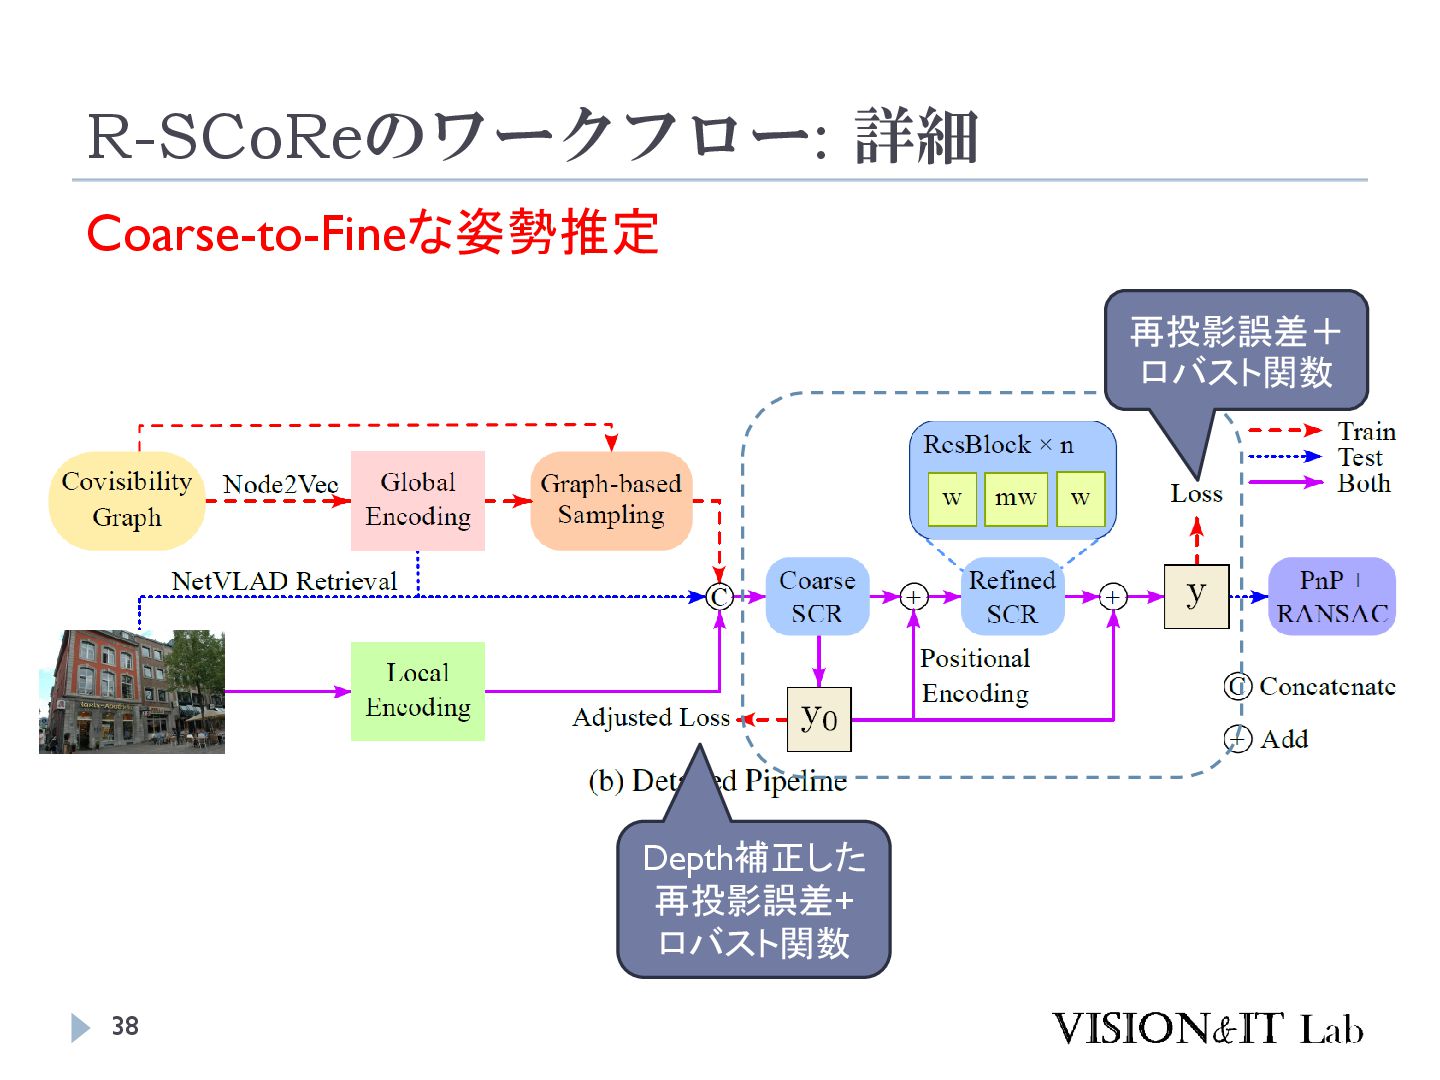
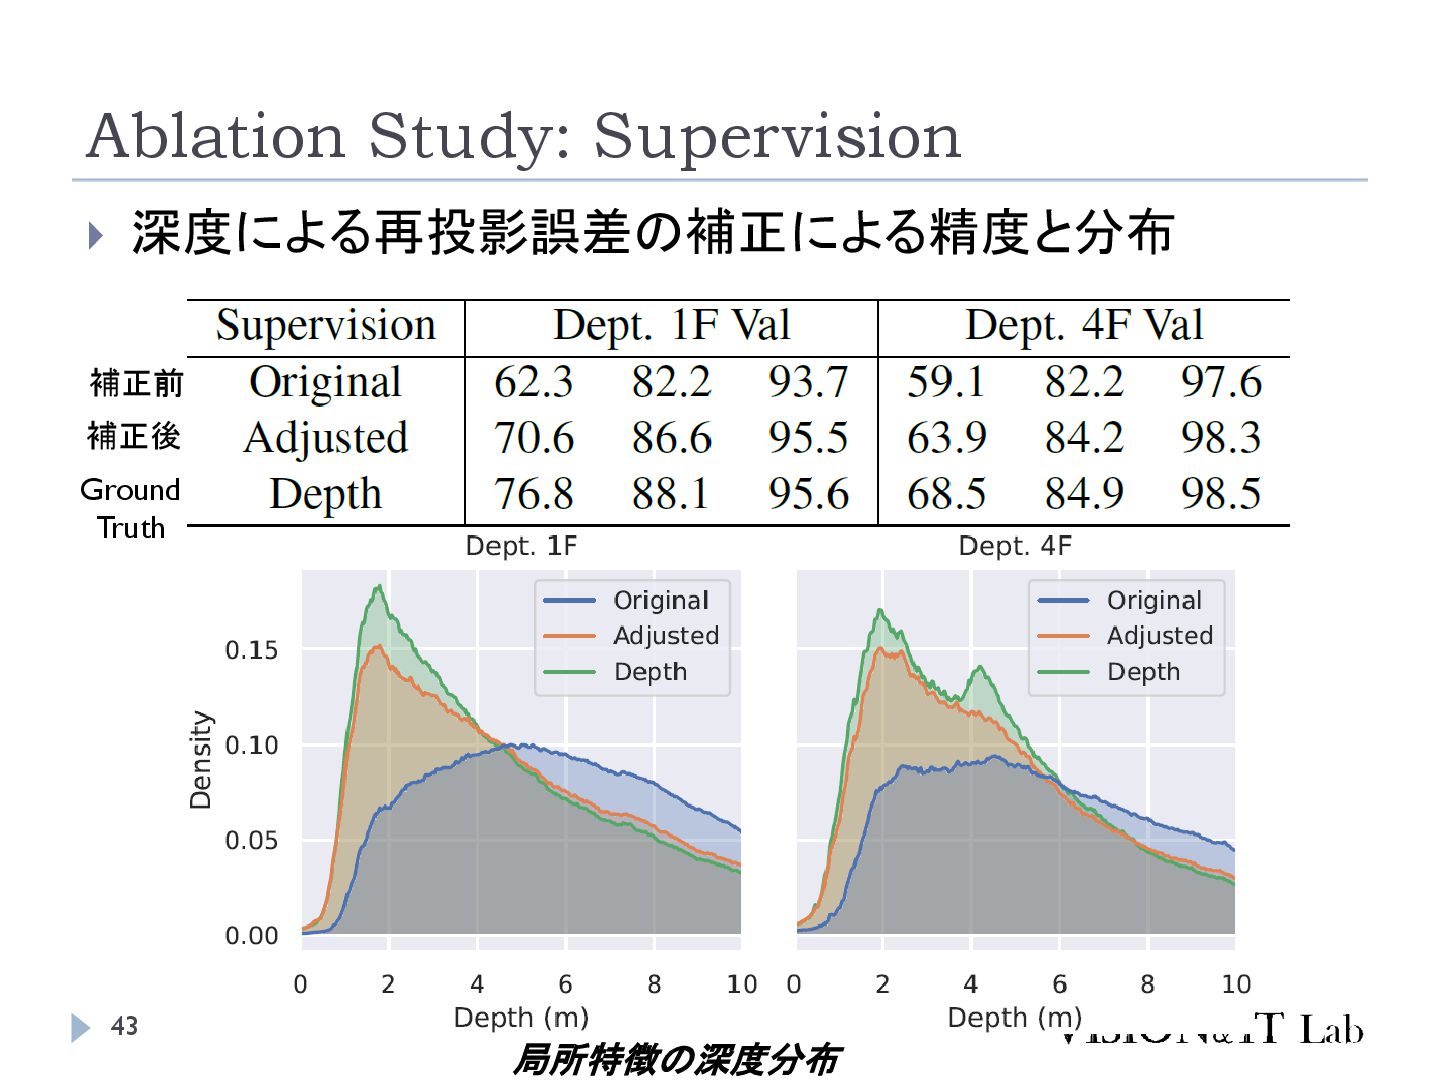
R-SCoRe: 再投影誤差と深度の関係 32 カメラから近い位置の点ほど再投影誤差が大きくなる傾 向 大きい再投影誤差がロバスト関数により無視されてしまう 再投影誤差を予測深度に合わせて補正することで対応
異なるデータセット/キーポイント検出に おける視差(深度)と投影誤差の関係 -
R-SCoReのワークフロー: 概要 33 Global Encodingを追加することで、Local Encodingの特徴 が似ていても、異なる場所では異なる姿勢を推定させる 学習時: 再投影誤差
推論時: 画像上のキー ポイント座標と 推論した3次元 座標からカメラ の姿勢を算出 Node2Vec LoFTRやDedodeな どの既存特徴+ PCAによる次元圧縮 再投影誤差を予測 深度で補正して、ロ バスト関数で外れ値 対策 -
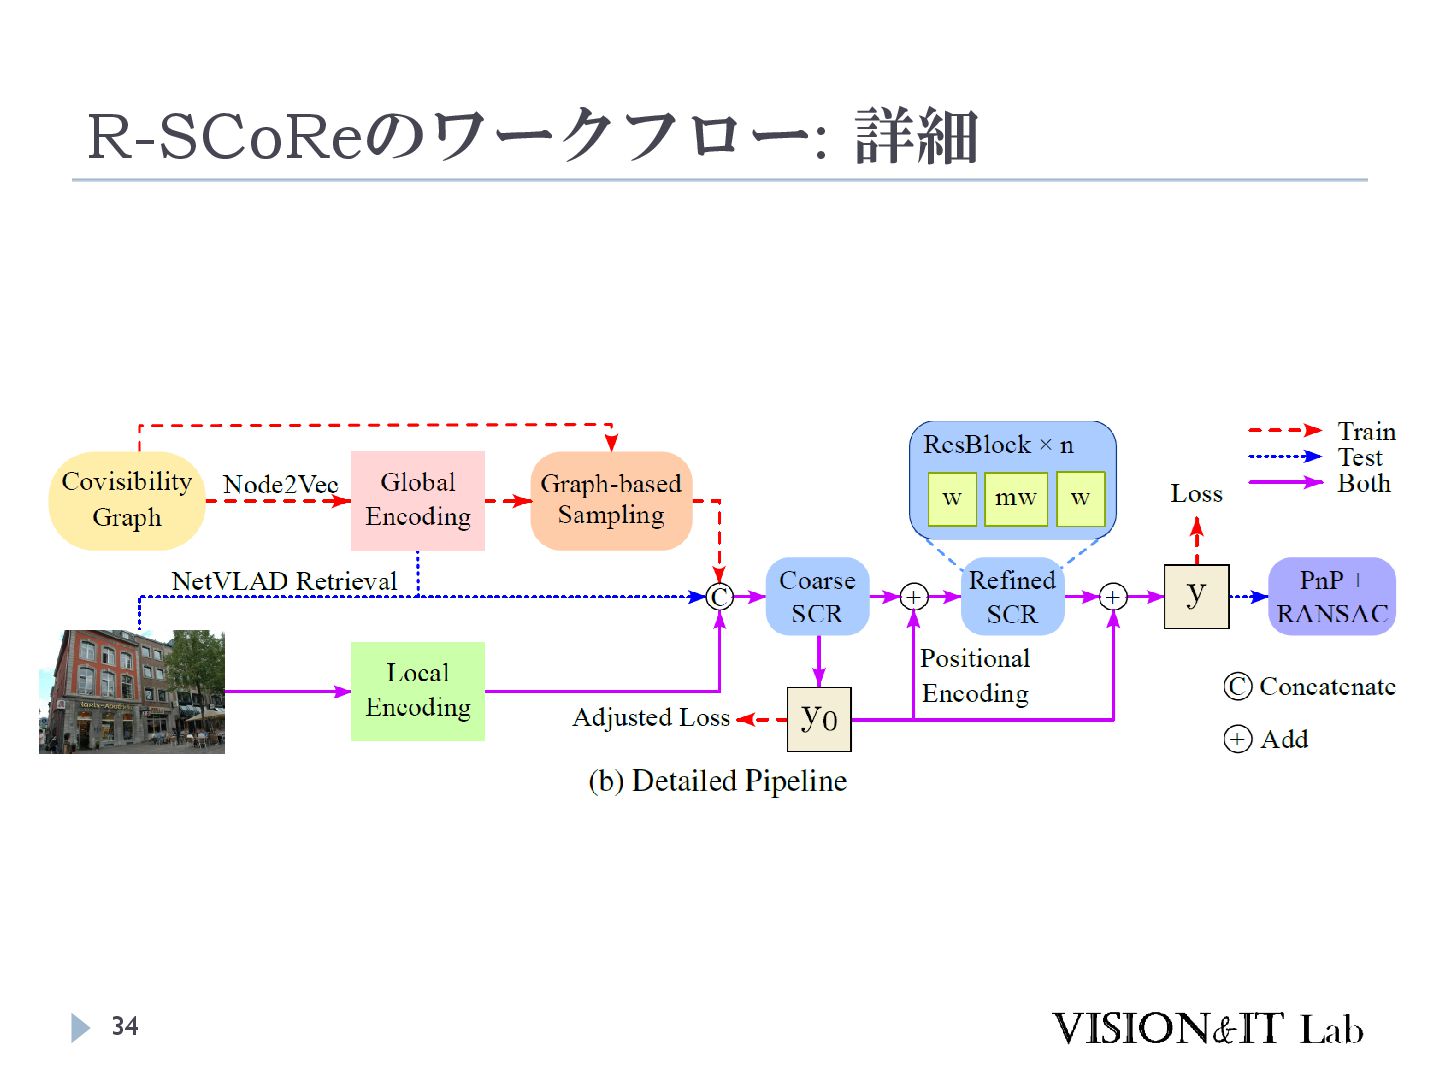
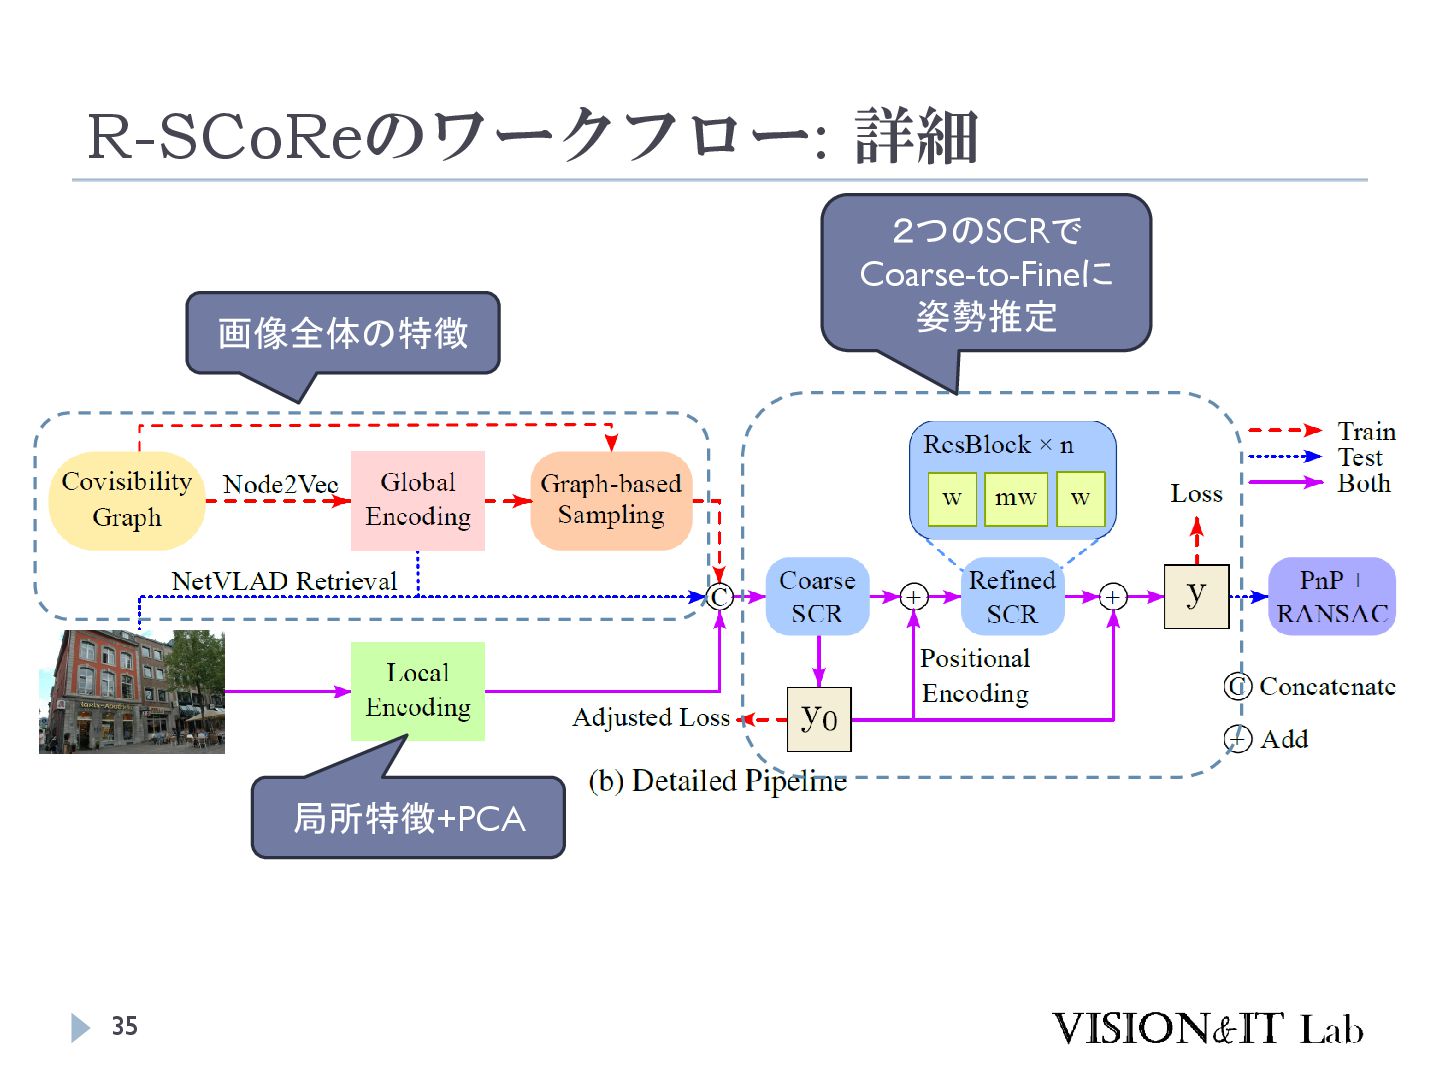
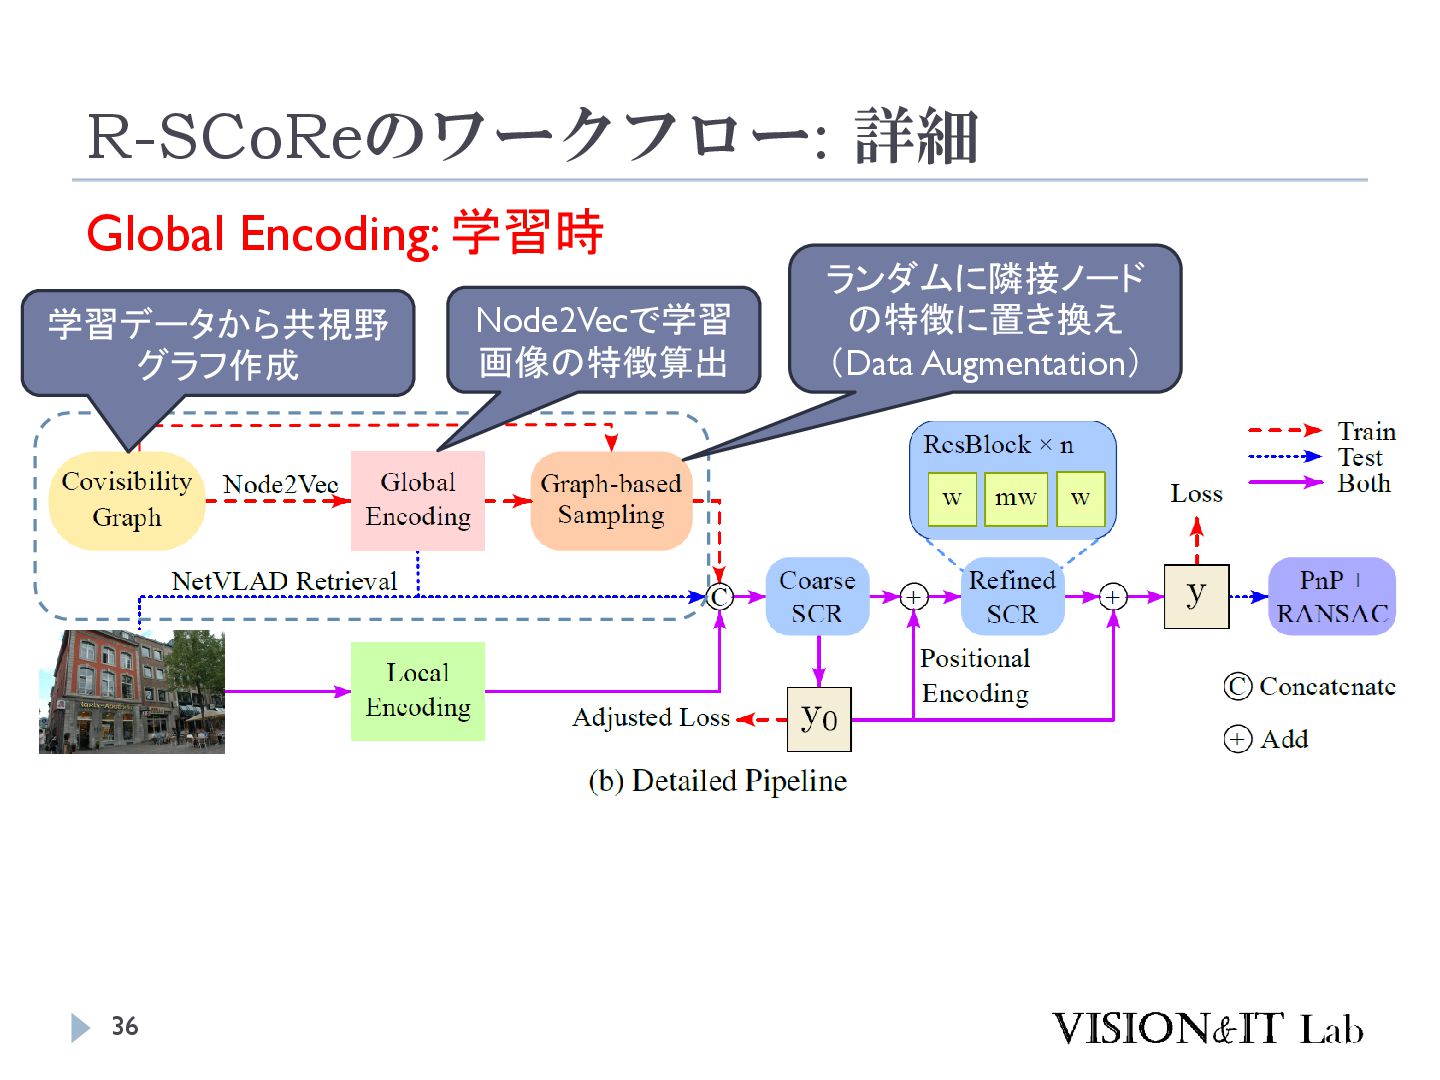
R-SCoReのワークフロー: 詳細 36 Global Encoding: 学習時 学習データから共視野 グラフ作成 Node2Vecで学習 画像の特徴算出
ランダムに隣接ノード の特徴に置き換え (Data Augmentation) -
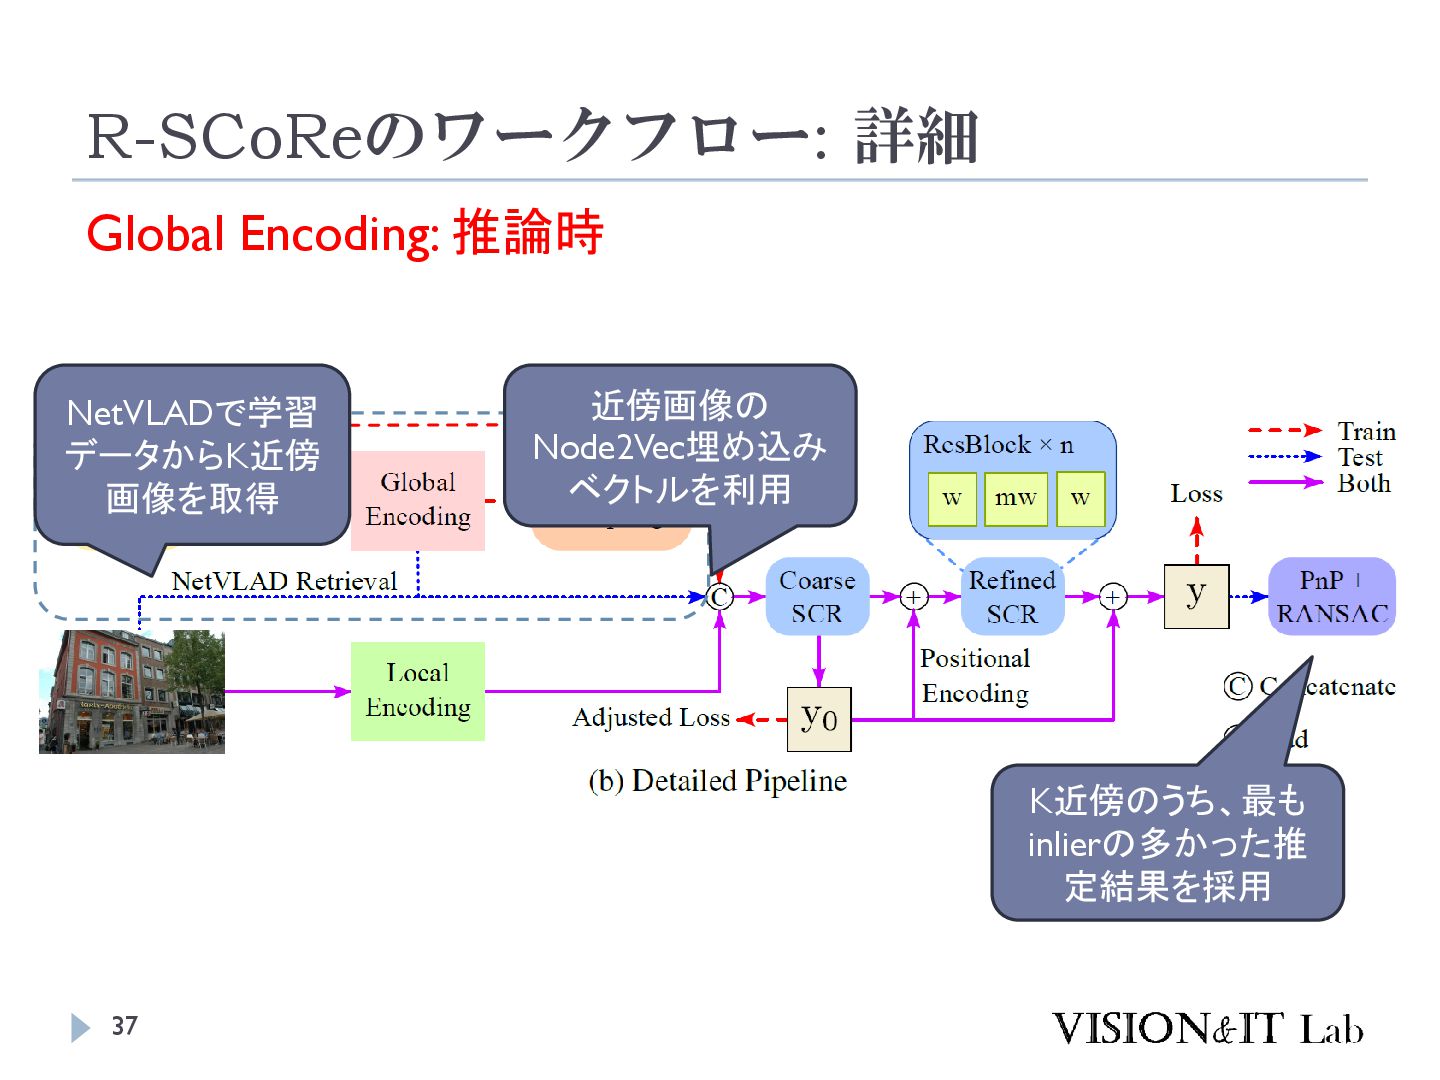
R-SCoReのワークフロー: 詳細 37 Global Encoding: 推論時 NetVLADで学習 データからK近傍 画像を取得 近傍画像の
Node2Vec埋め込み ベクトルを利用 K近傍のうち、最も inlierの多かった推 定結果を採用 -
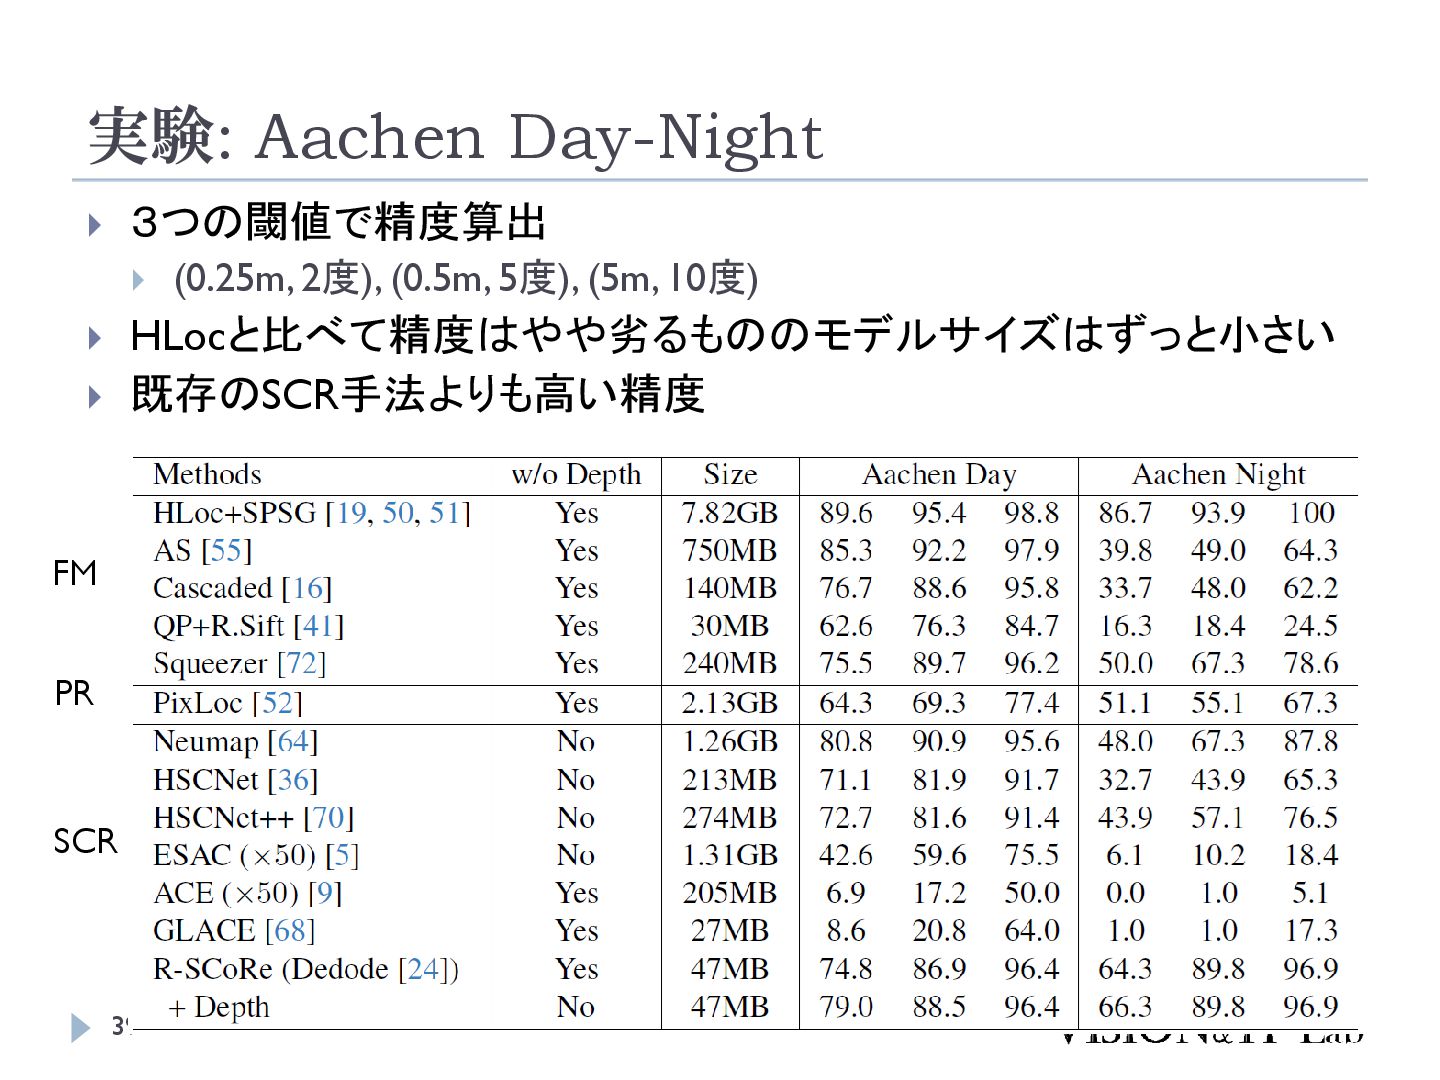
実験: Aachen Day-Night 39 3つの閾値で精度算出 (0.25m, 2度), (0.5m,
5度), (5m, 10度) HLocと比べて精度はやや劣るもののモデルサイズはずっと小さい 既存のSCR手法よりも高い精度 FM PR SCR -
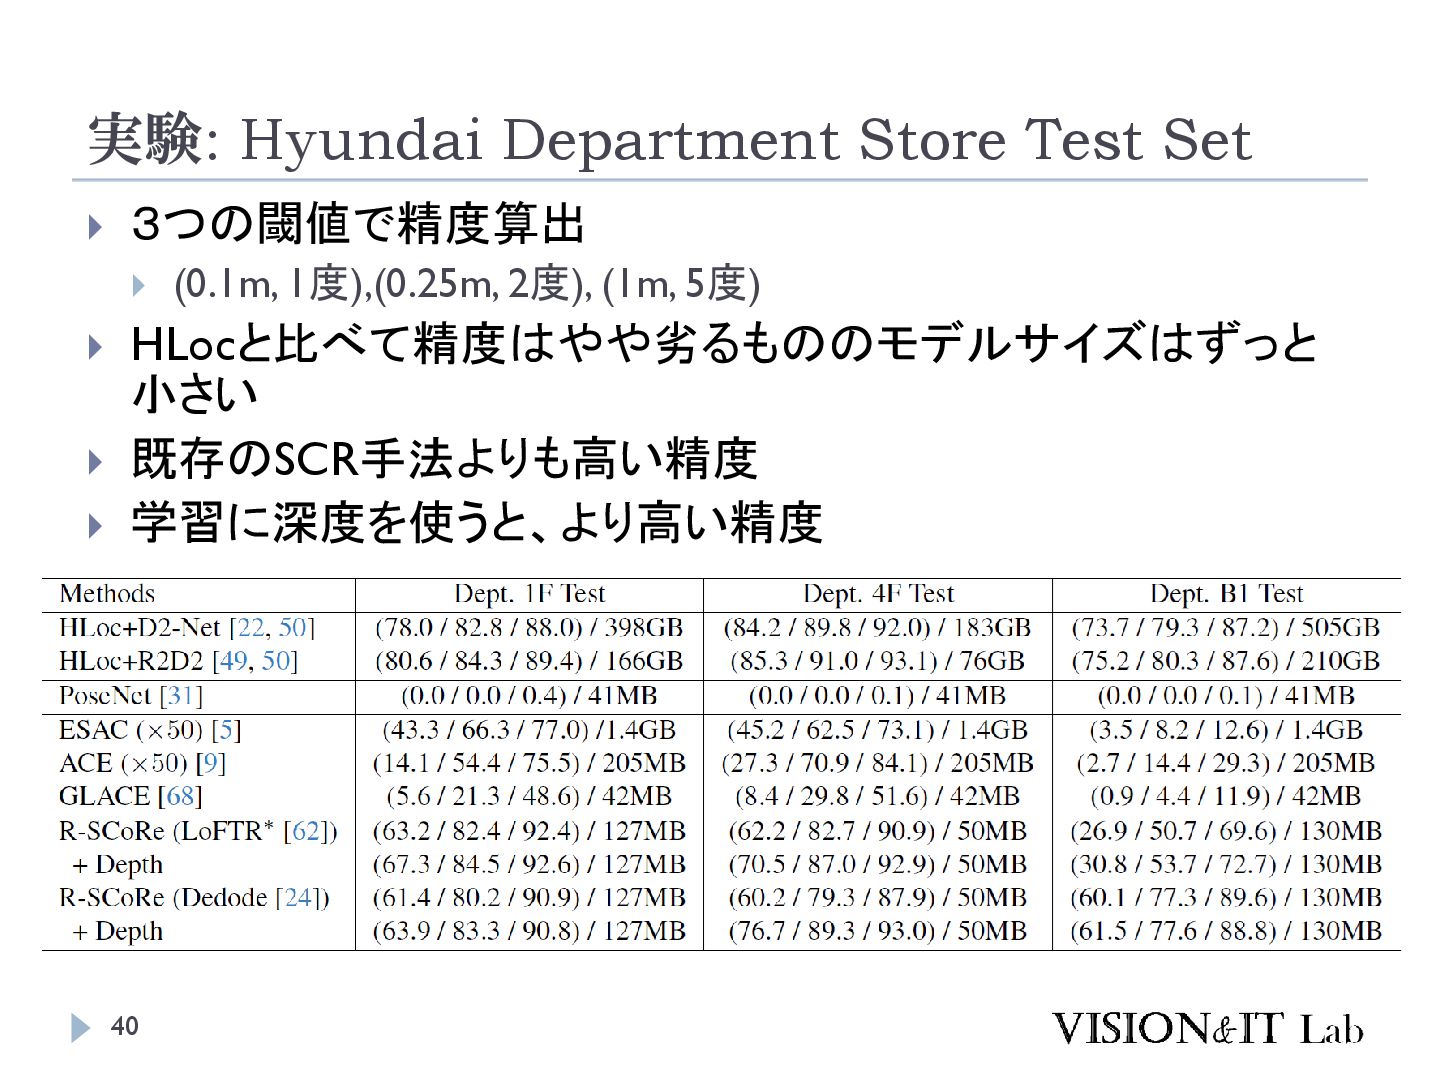
実験: Hyundai Department Store Test Set 40 3つの閾値で精度算出
(0.1m, 1度),(0.25m, 2度), (1m, 5度) HLocと比べて精度はやや劣るもののモデルサイズはずっと 小さい 既存のSCR手法よりも高い精度 学習に深度を使うと、より高い精度 -
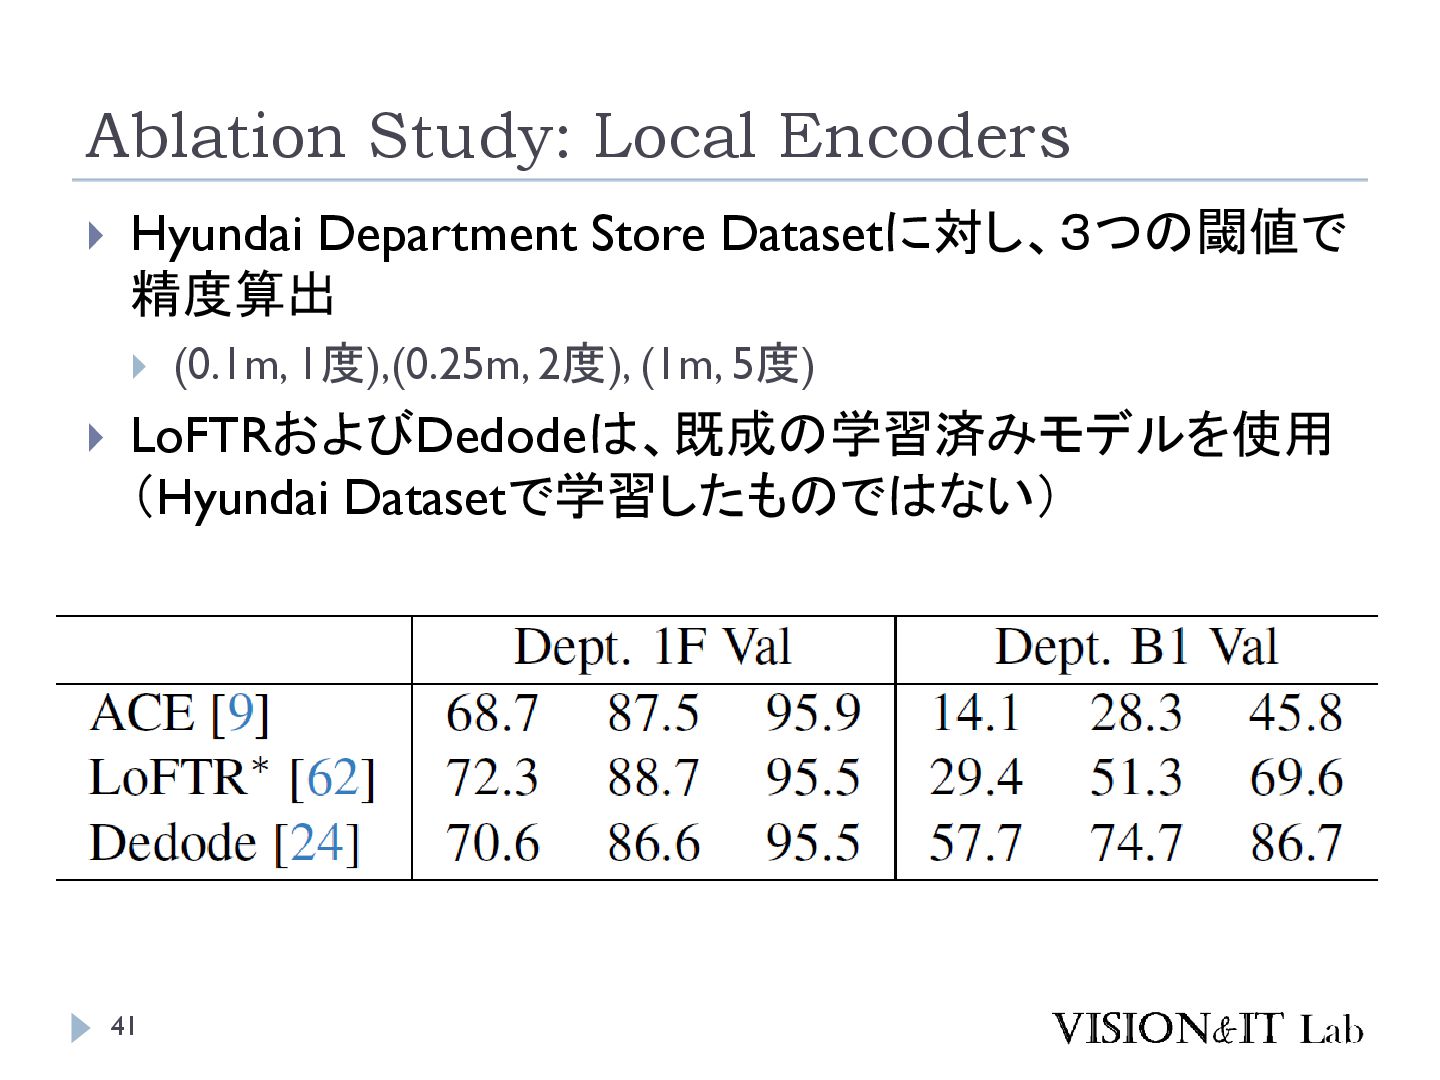
Ablation Study: Local Encoders 41 Hyundai Department Store Datasetに対し、3つの閾値で
精度算出 (0.1m, 1度),(0.25m, 2度), (1m, 5度) LoFTRおよびDedodeは、既成の学習済みモデルを使用 (Hyundai Datasetで学習したものではない) -
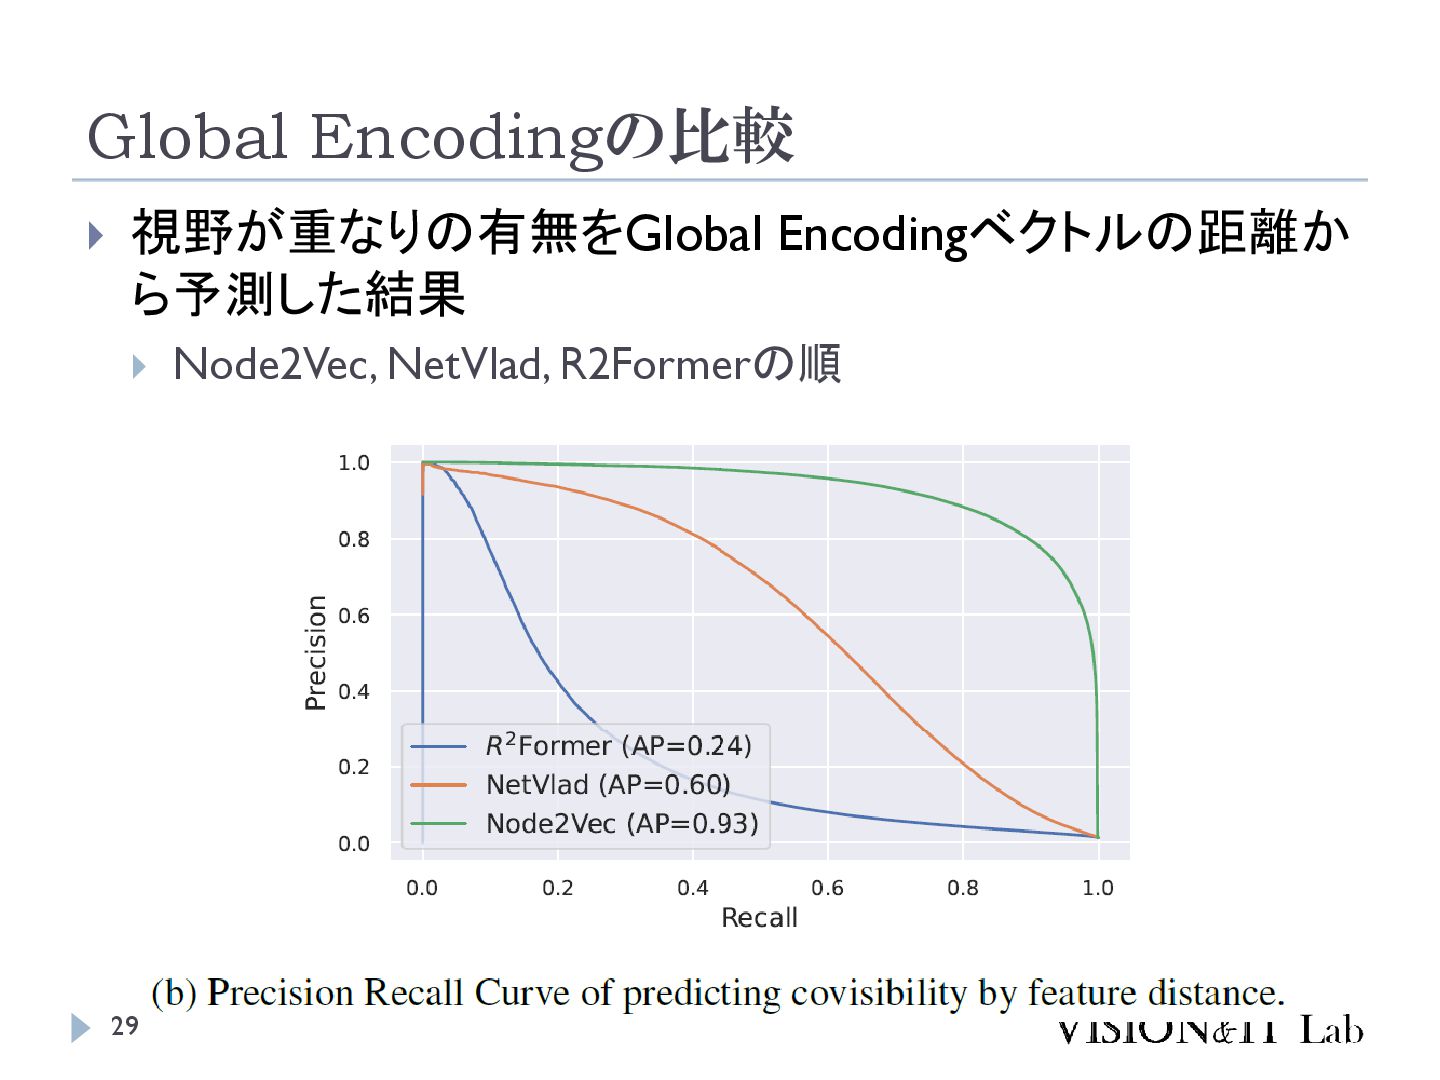
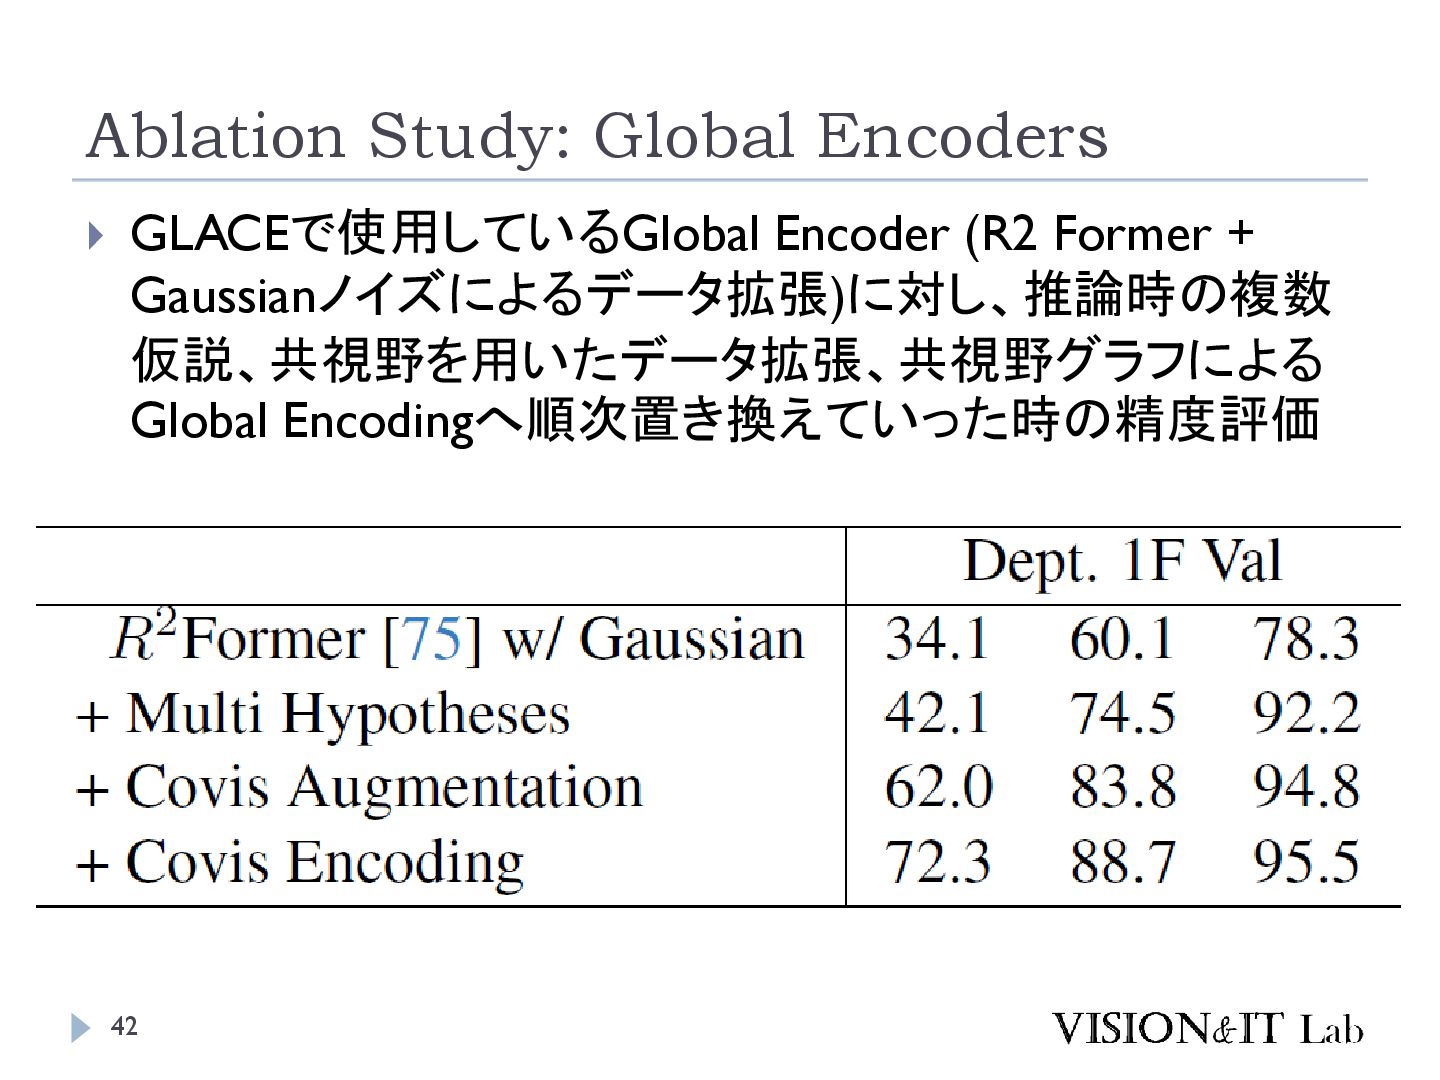
Ablation Study: Global Encoders 42 GLACEで使用しているGlobal Encoder (R2 Former
+ Gaussianノイズによるデータ拡張)に対し、推論時の複数 仮説、共視野を用いたデータ拡張、共視野グラフによる Global Encodingへ順次置き換えていった時の精度評価 -
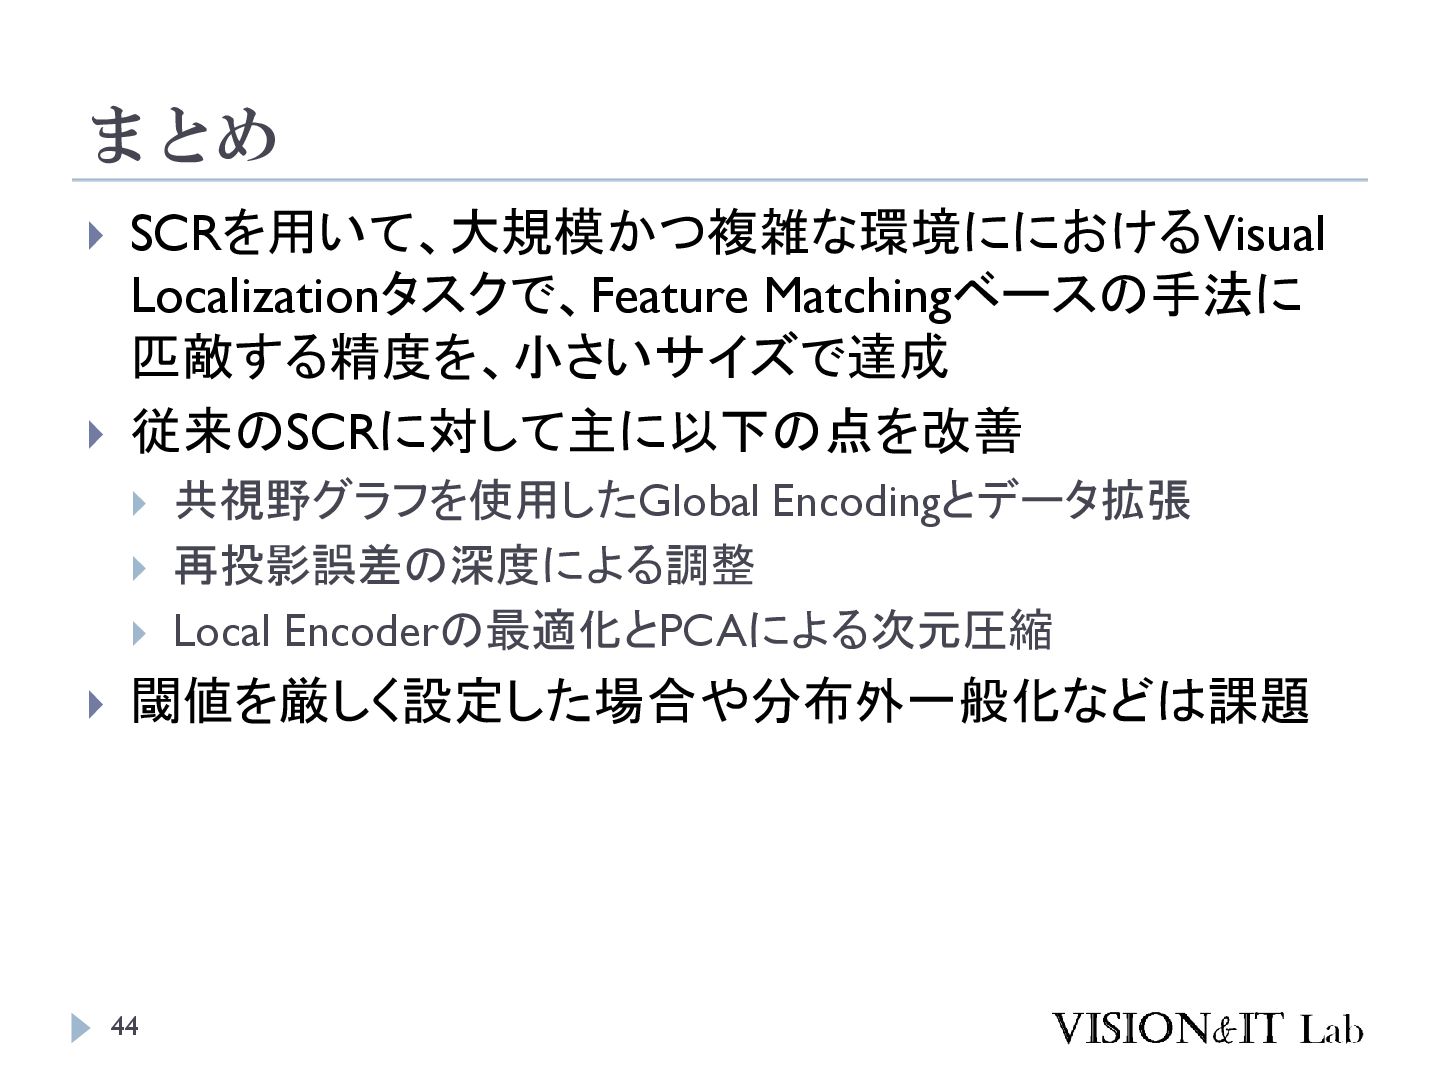
まとめ 44 SCRを用いて、大規模かつ複雑な環境ににおけるVisual Localizationタスクで、Feature Matchingベースの手法に 匹敵する精度を、小さいサイズで達成 従来のSCRに対して主に以下の点を改善
共視野グラフを使用したGlobal Encodingとデータ拡張 再投影誤差の深度による調整 Local Encoderの最適化とPCAによる次元圧縮 閾値を厳しく設定した場合や分布外一般化などは課題