Share
Embed
AgentCoreで実践するハーネスエンジニアリング
AWS-UG 新潟 #34 AWS Step Functions ハンズオン
https://jawsug-niigata.connpass.com/event/404797/
やくも
October 03, 2026
Transcript
50 slides
-
JAWS-UG 新潟 #34 AWS Step Functions ハンズオン AgentCore で実践する ハーネスエンジニアリング
八雲 慎之助 / Shinnosuke Yakumo 2026/10/03 -
Who am I 八雲 慎之助(やくも しんのすけ) • 所属:株式会社クレスコ / JAWS-UG
新潟支部 • 業務:R&D, FDE • AWS Community Builder – AI Engineering • 2025 Japan AWS Jr.Champions 2 -
モデル以外は全部ハーネス "If you're not the model, you're the harness." モデル以外はすべてハーネスだ。
LangChain が書いた定式は Agent = Model + Harness。 AWS は「モデルが脳なら、ハーネスは体」と言っています。 出典: LangChain「The Anatomy of an Agent Harness」 / AWS What's New「AgentCore harness GA」 8 -
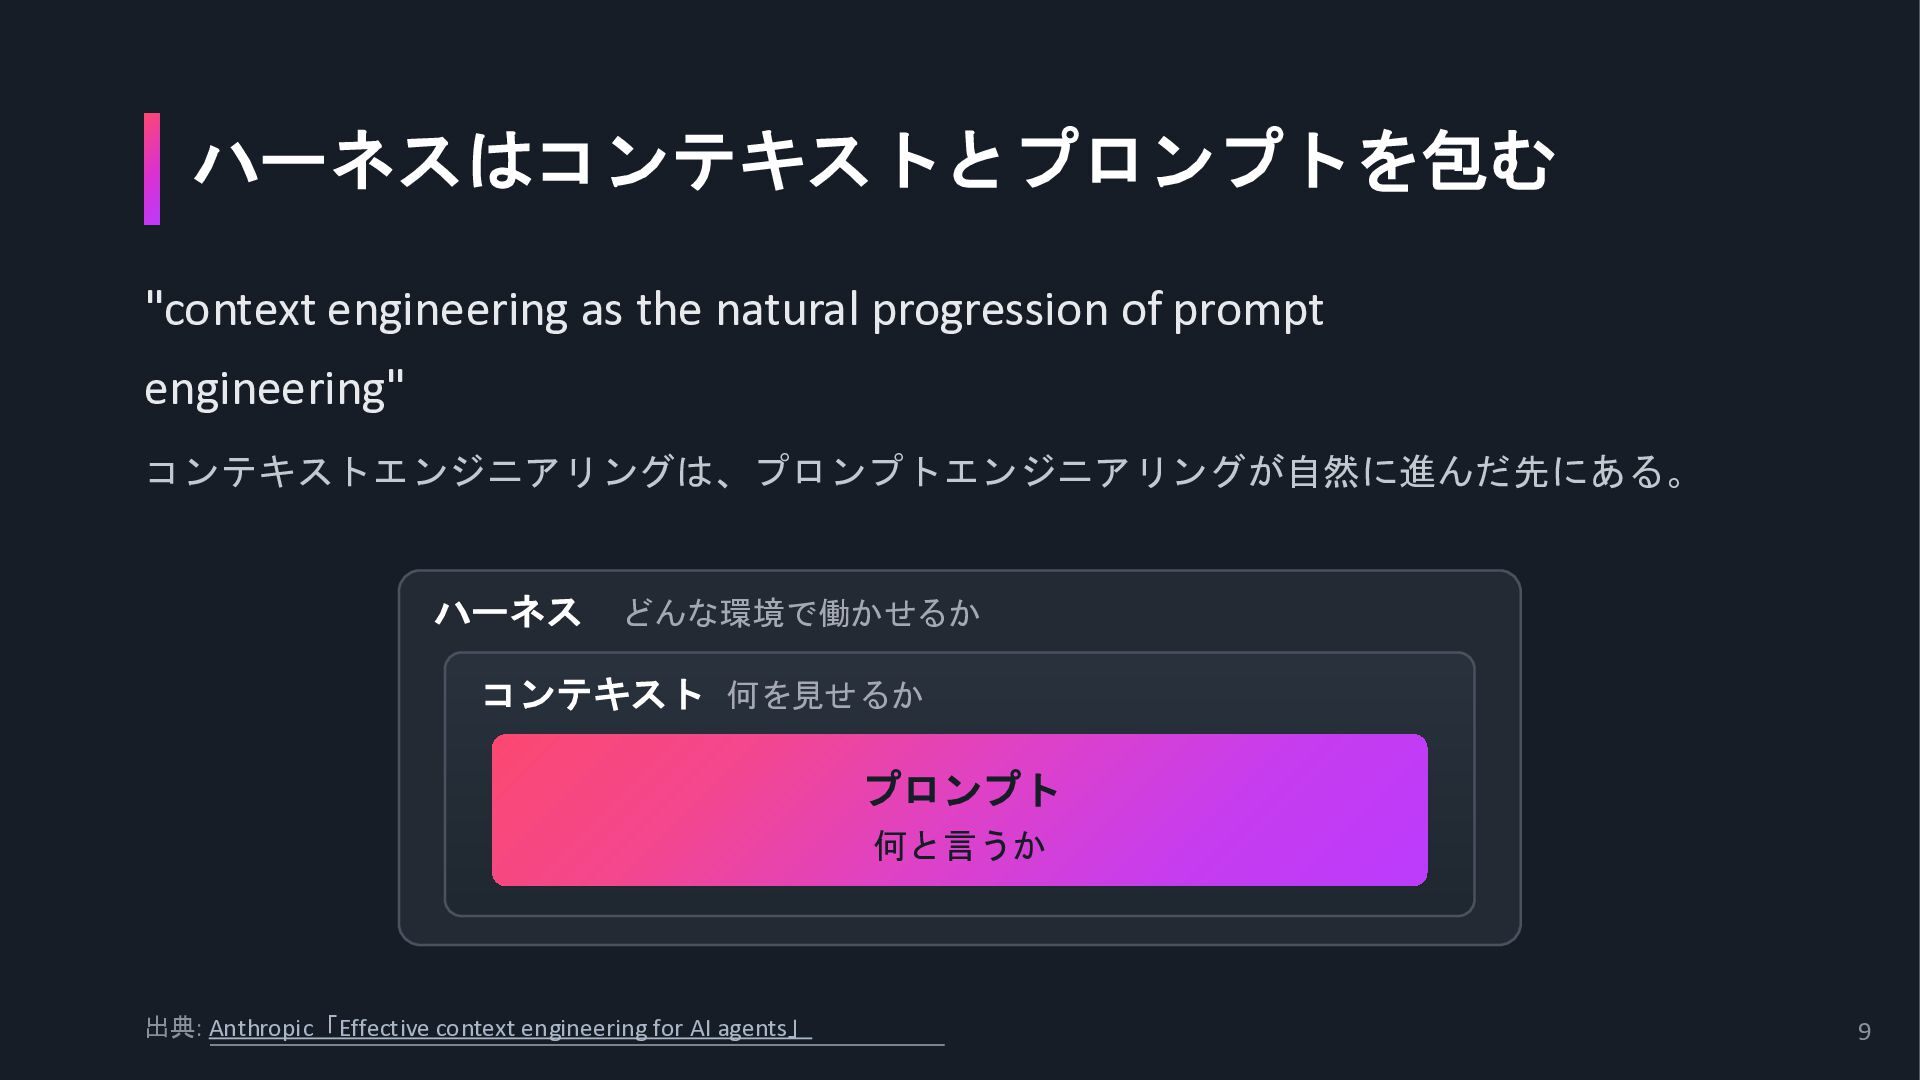
ハーネスはコンテキストとプロンプトを包む "context engineering as the natural progression of prompt engineering"
コンテキストエンジニアリングは、プロンプトエンジニアリングが自然に進んだ先にある。 ハーネス どんな環境で働かせるか コンテキスト 何を見せるか プロンプト 何と言うか 出典: Anthropic「Effective context engineering for AI agents」 9 -
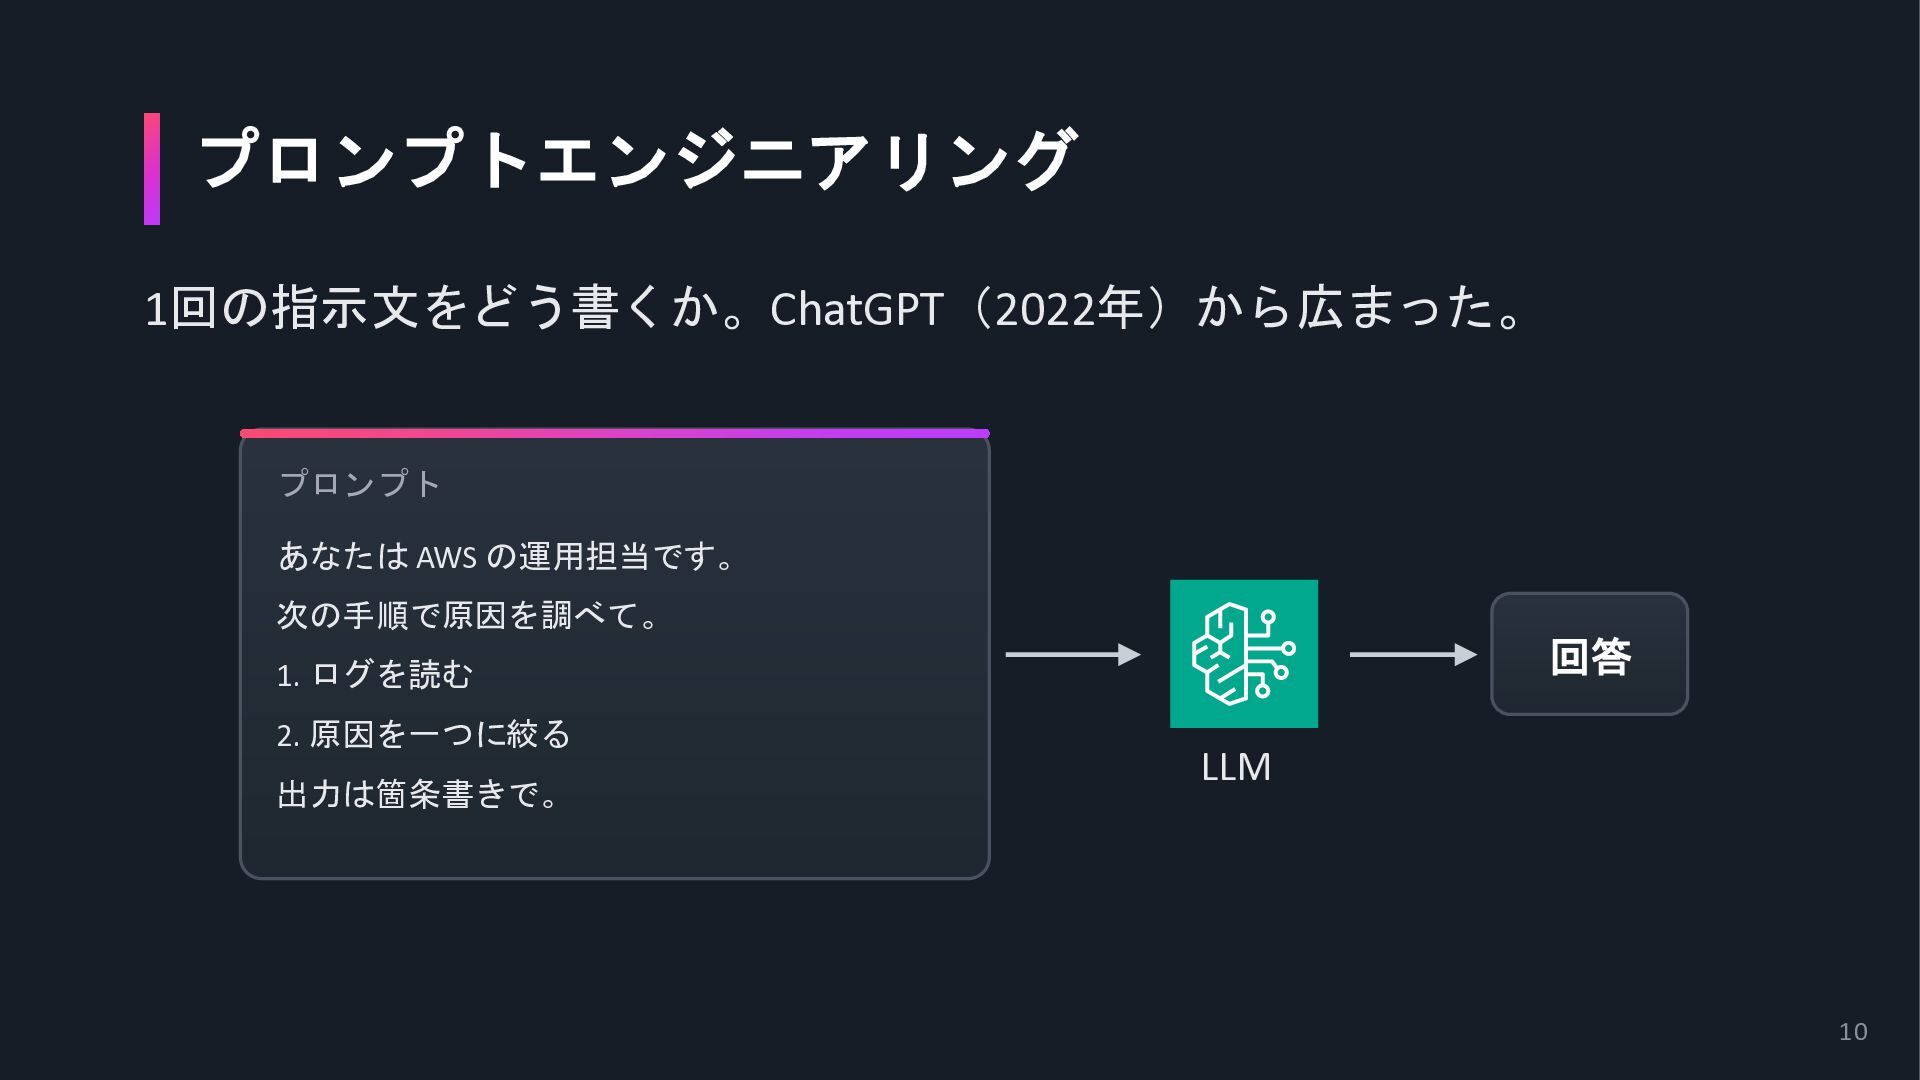
プロンプトエンジニアリング 1回の指示文をどう書くか。ChatGPT(2022年)から広まった。 プロンプト あなたは AWS の運用担当です。 次の手順で原因を調べて。 回答 1. ログを読む
2. 原因を一つに絞る 出力は箇条書きで。 LLM 10 -
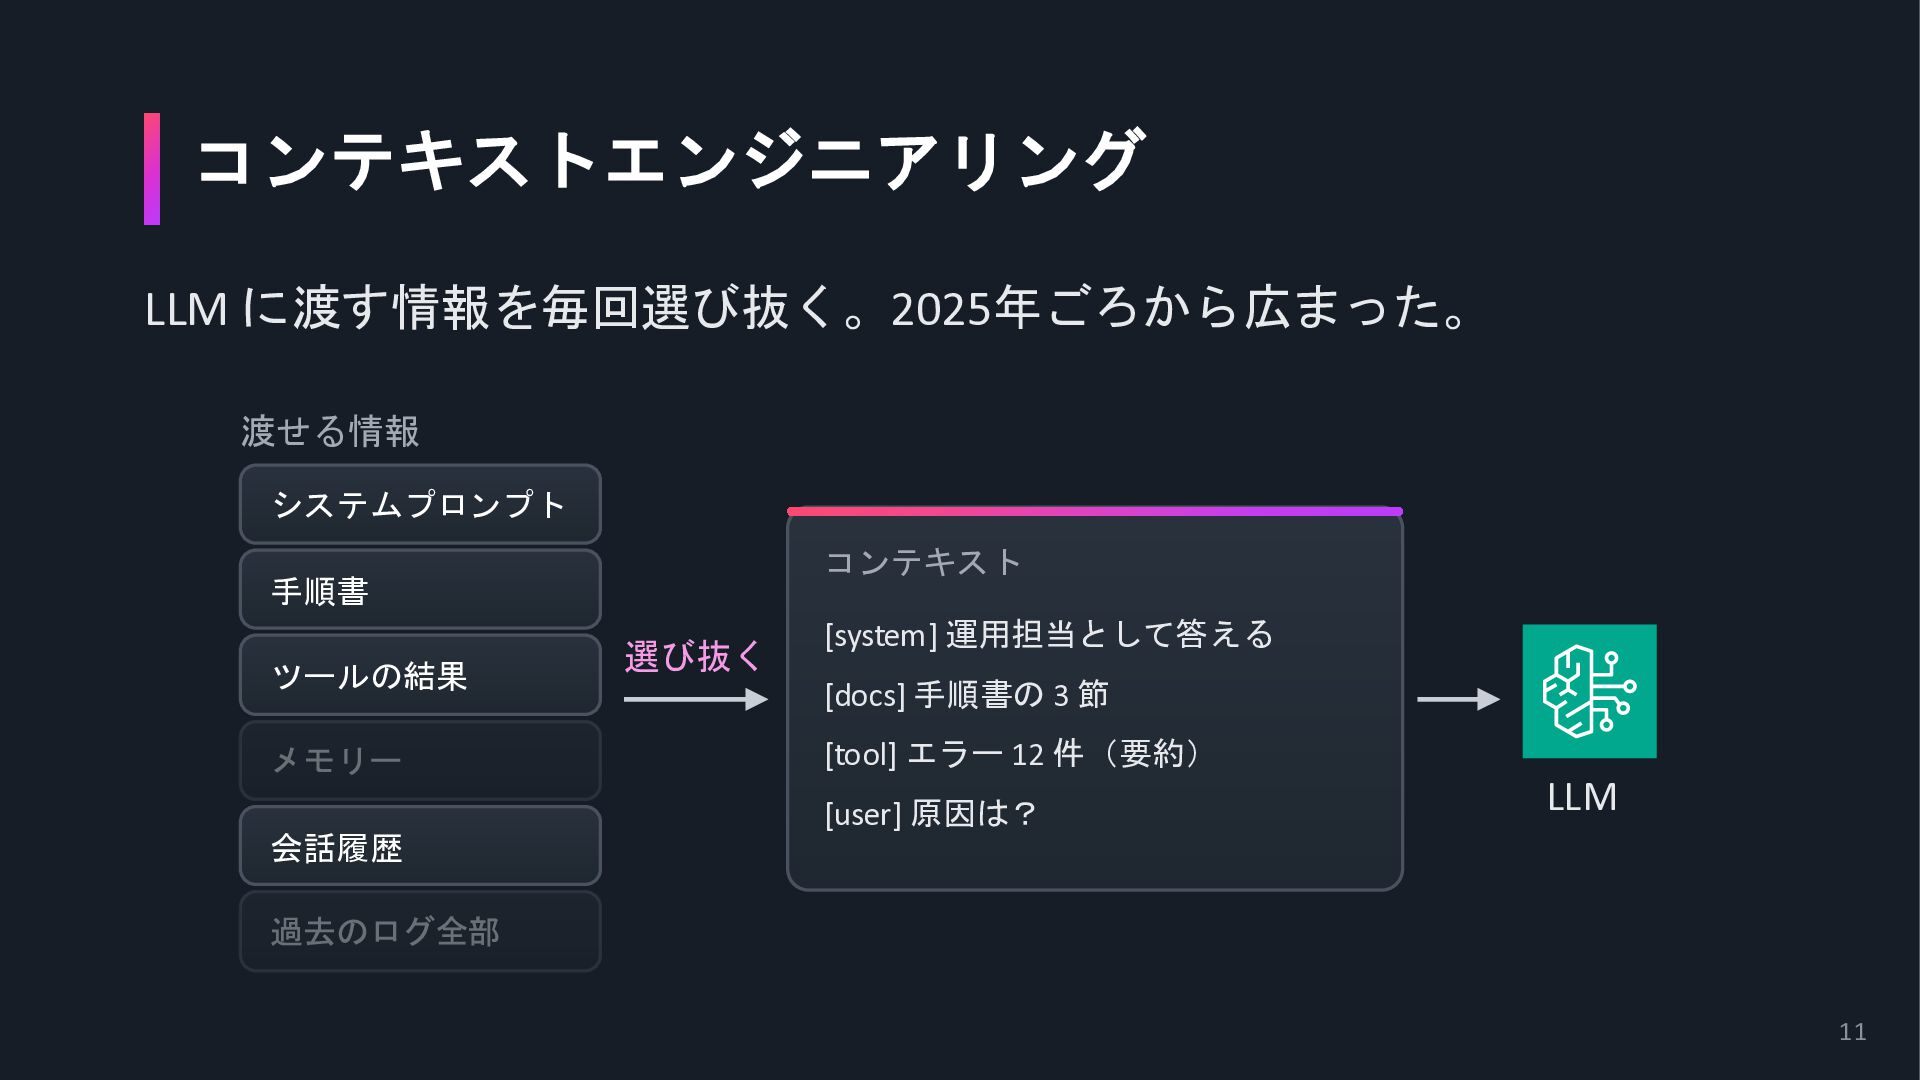
コンテキストエンジニアリング LLM に渡す情報を毎回選び抜く。2025年ごろから広まった。 渡せる情報 システムプロンプト コンテキスト 手順書 ツールの結果 選び抜く [system]
運用担当として答える [docs] 手順書の 3 節 [tool] エラー 12 件(要約) 会話履歴 [user] 原因は? LLM 11 -
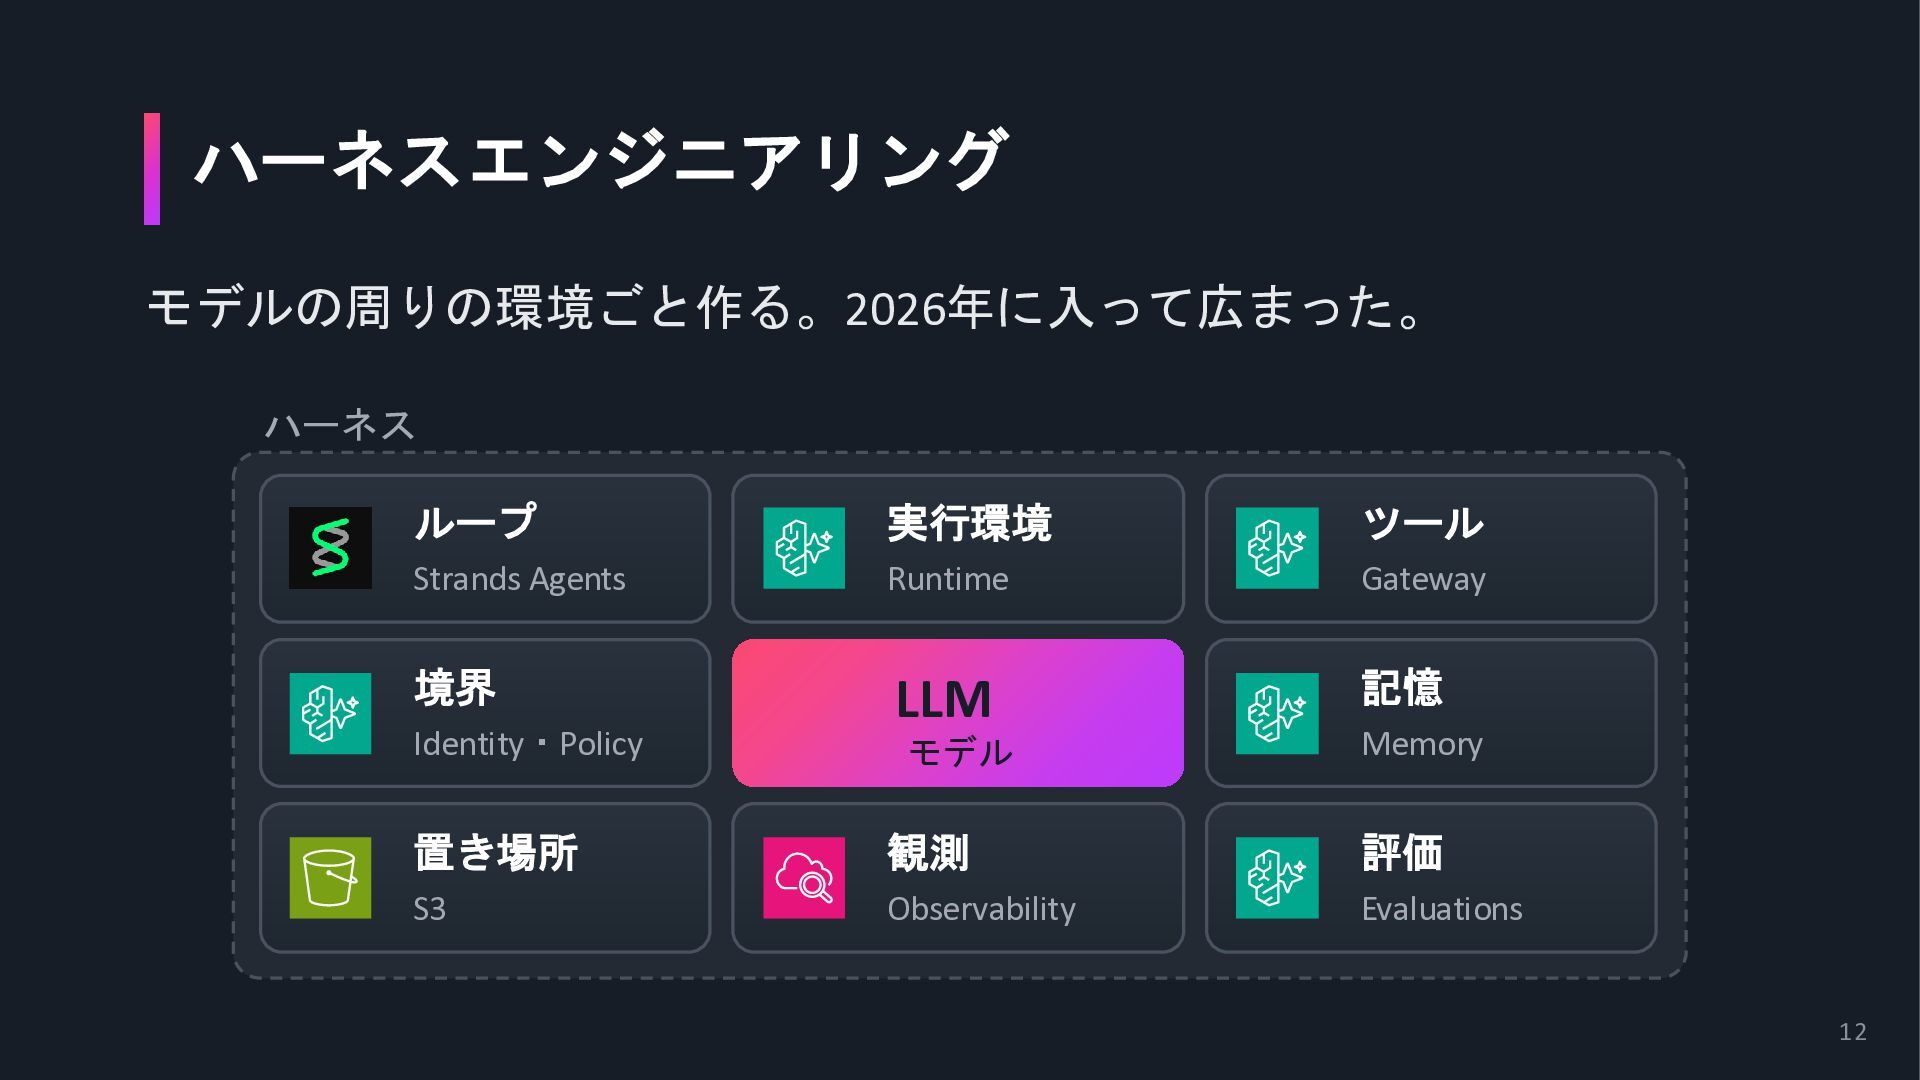
ハーネスエンジニアリング モデルの周りの環境ごと作る。2026年に入って広まった。 ハーネス ループ 実行環境 ツール Strands Agents Runtime Gateway
境界 LLM 記憶 Identity・Policy モデル Memory 置き場所 観測 評価 S3 Observability Evaluations 12 -
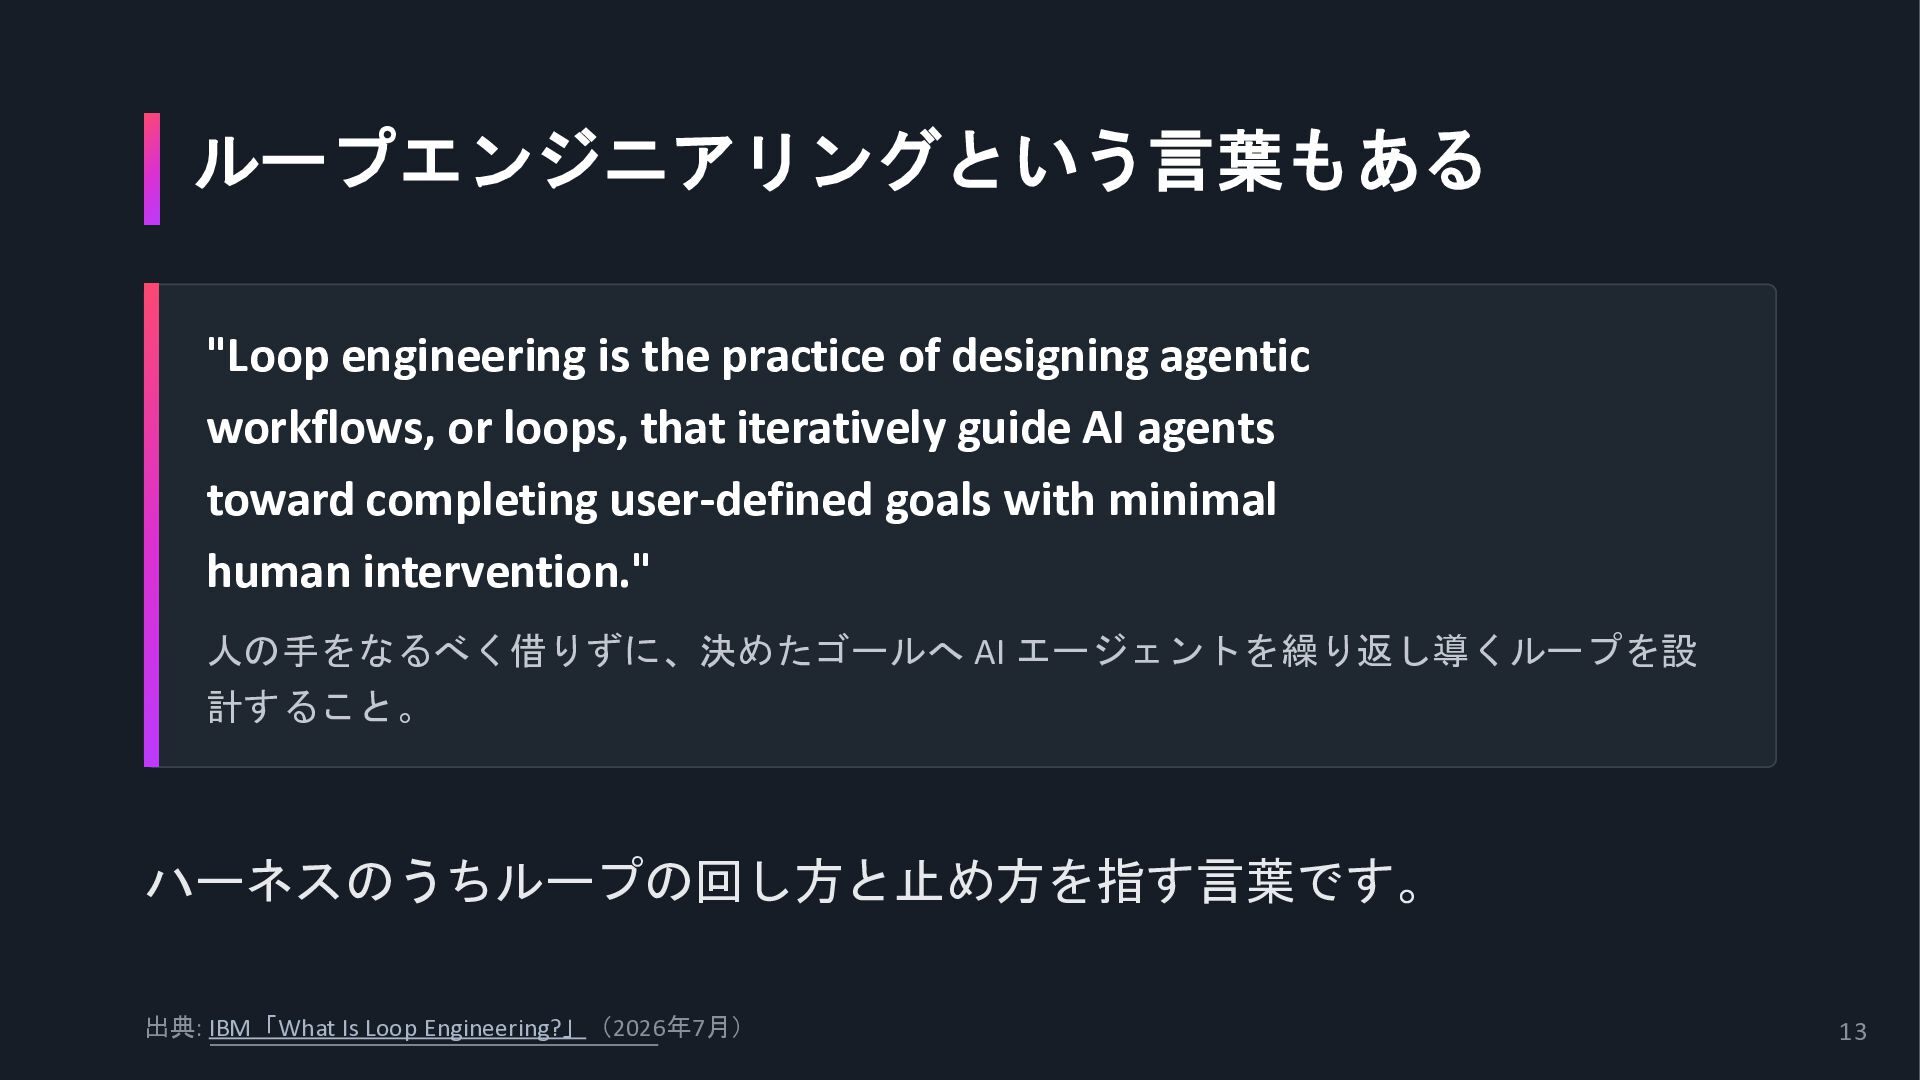
ループエンジニアリングという言葉もある "Loop engineering is the practice of designing agentic workflows,
or loops, that iteratively guide AI agents toward completing user-defined goals with minimal human intervention." 人の手をなるべく借りずに、決めたゴールへ AI エージェントを繰り返し導くループを設 計すること。 ハーネスのうちループの回し方と止め方を指す言葉です。 出典: IBM「What Is Loop Engineering?」(2026年7月) 13 -
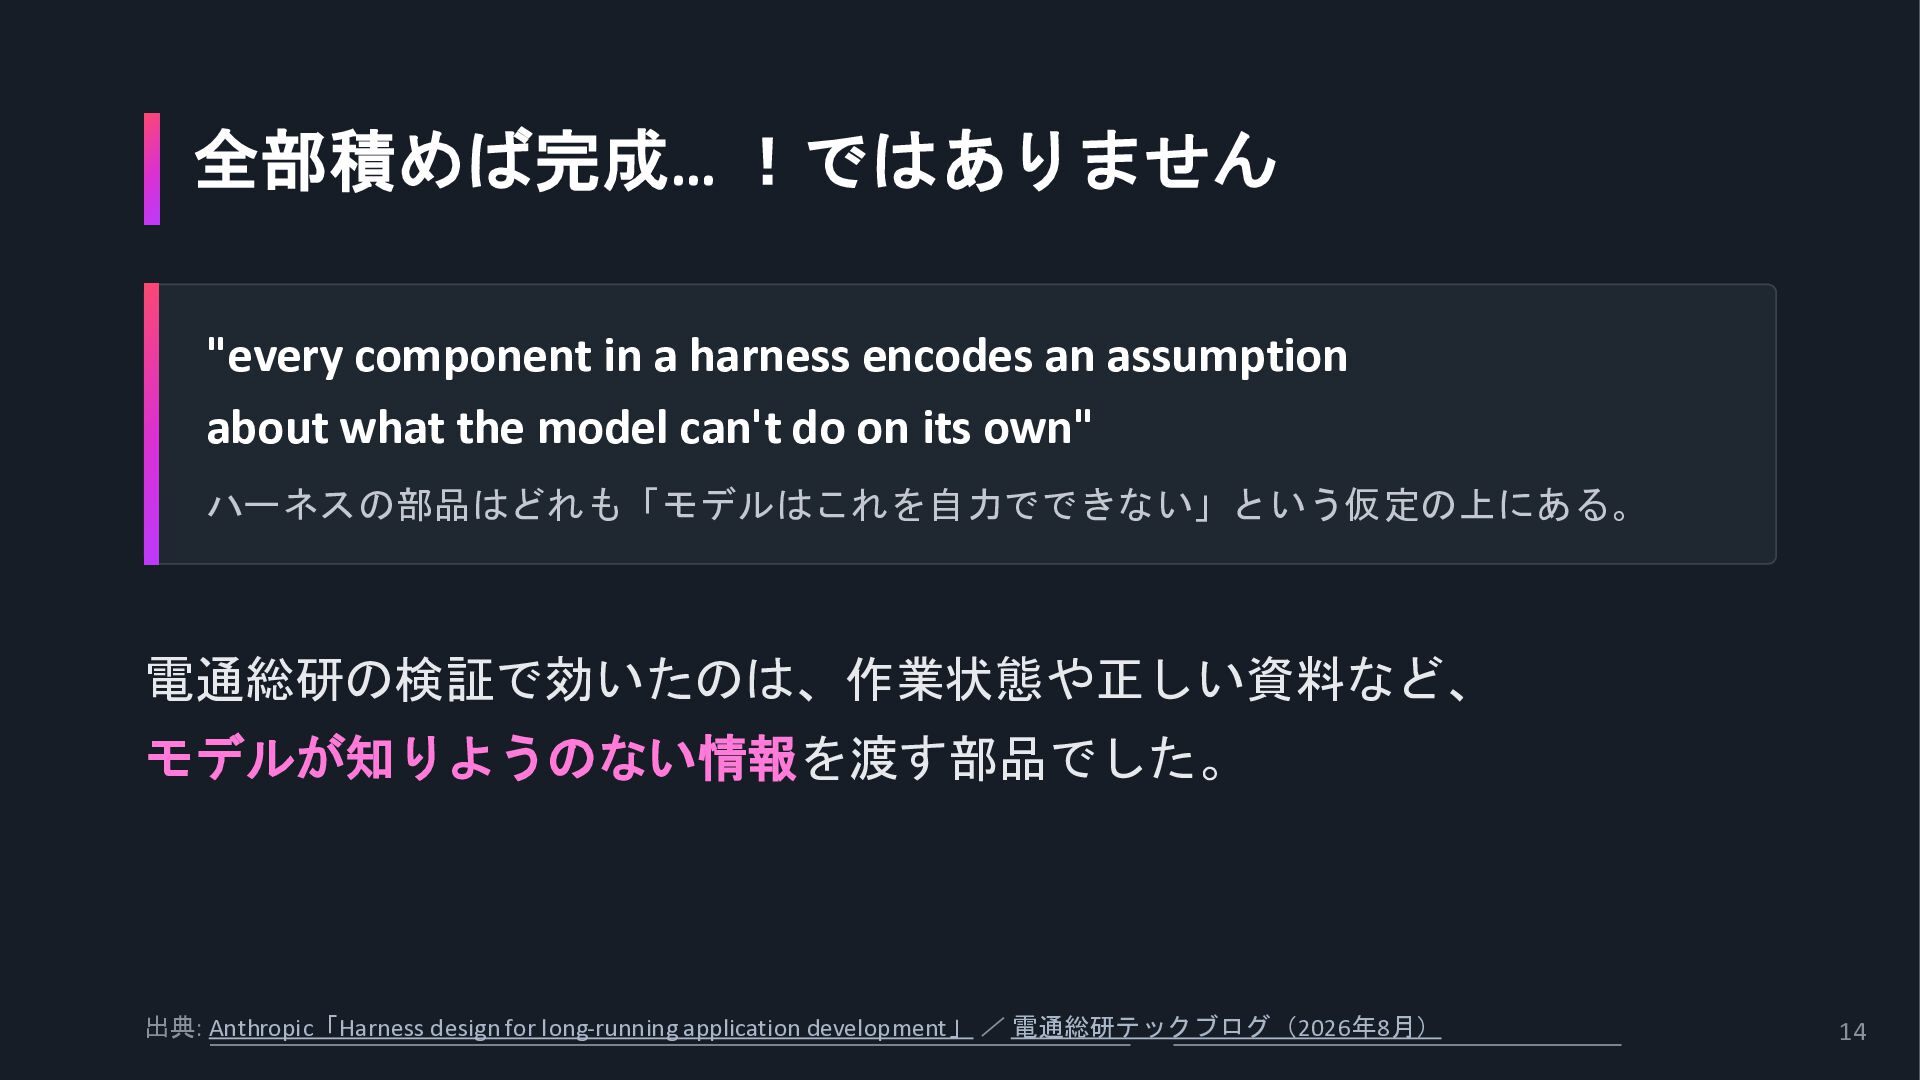
全部積めば完成… !ではありません "every component in a harness encodes an assumption
about what the model can't do on its own" ハーネスの部品はどれも「モデルはこれを自力でできない」という仮定の上にある。 電通総研の検証で効いたのは、作業状態や正しい資料など、 モデルが知りようのない情報を渡す部品でした。 出典: Anthropic「Harness design for long-running application development」 / 電通総研テックブログ(2026年8月) 14 -
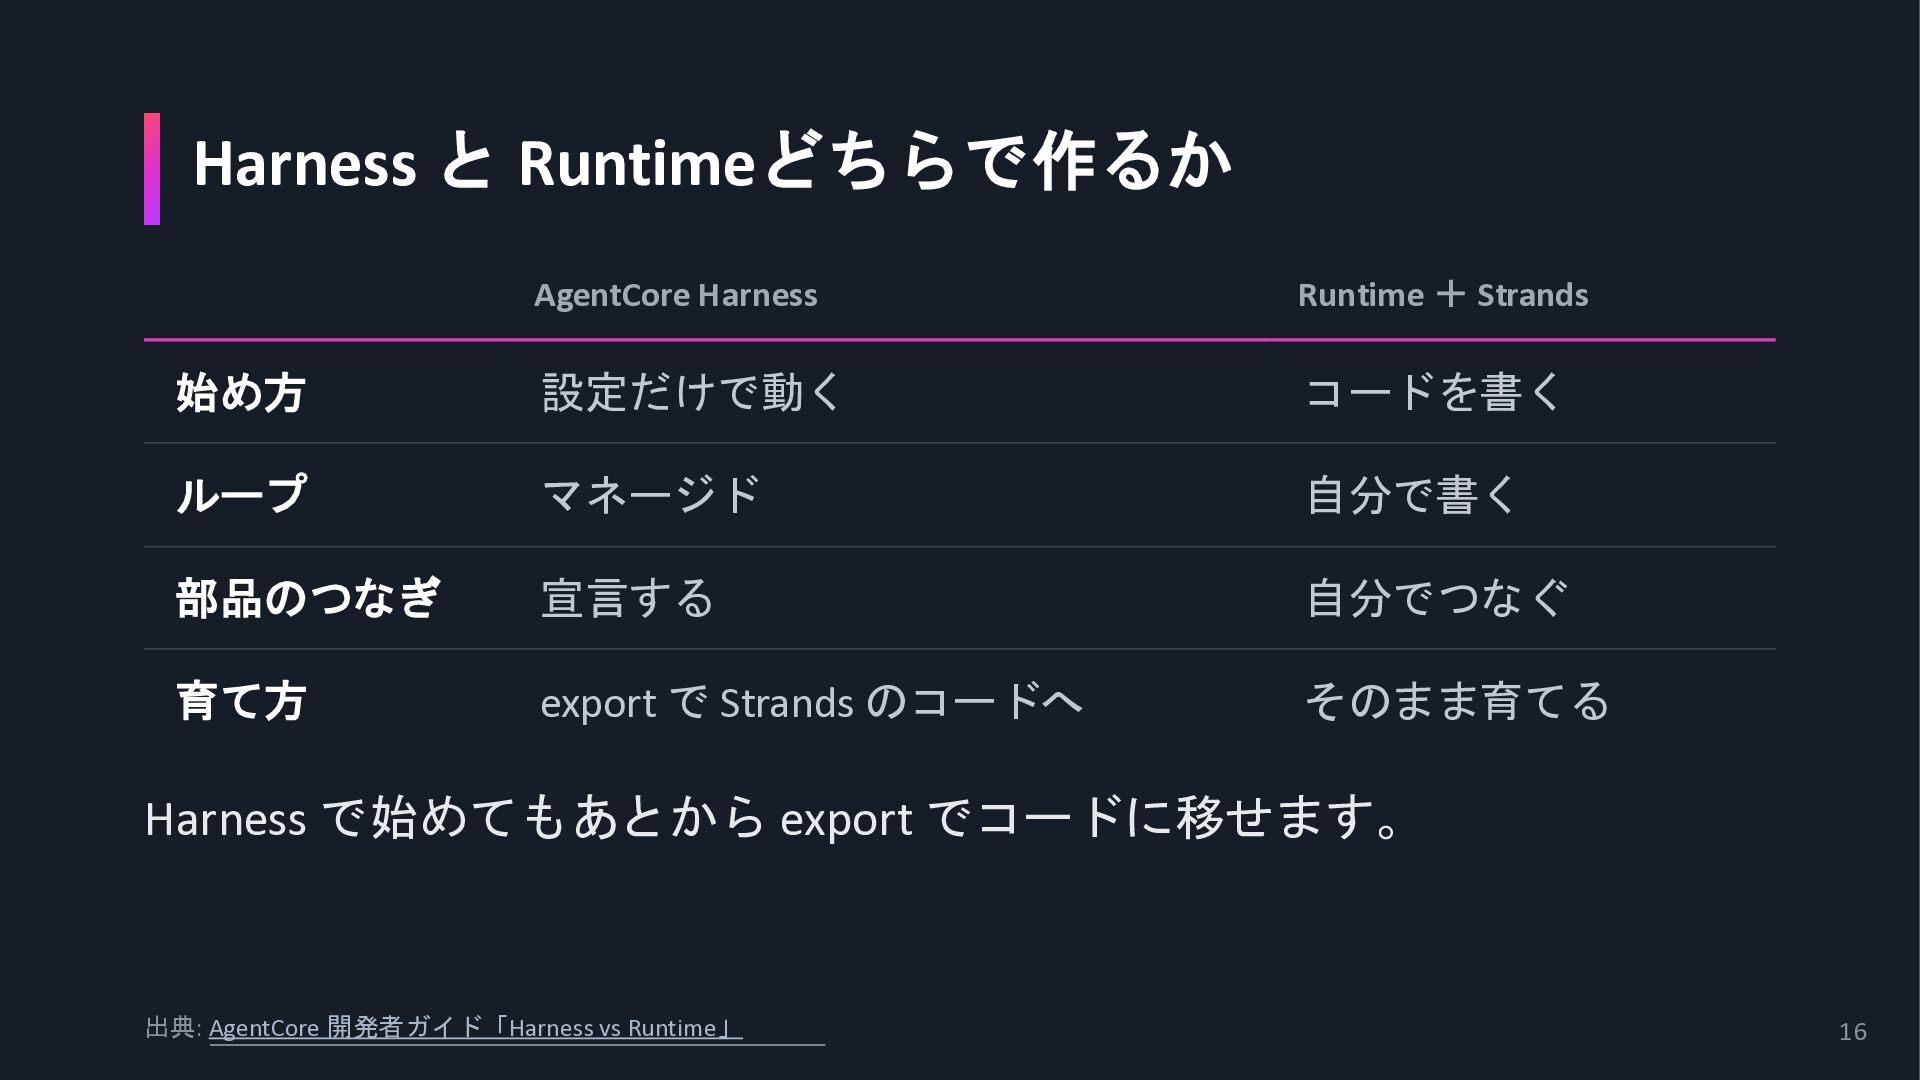
Harness と Runtimeどちらで作るか AgentCore Harness Runtime + Strands 始め方 設定だけで動く
コードを書く ループ マネージド 自分で書く 部品のつなぎ 宣言する 自分でつなぐ 育て方 export で Strands のコードへ そのまま育てる Harness で始めてもあとから export でコードに移せます。 出典: AgentCore 開発者ガイド「Harness vs Runtime」 16 -
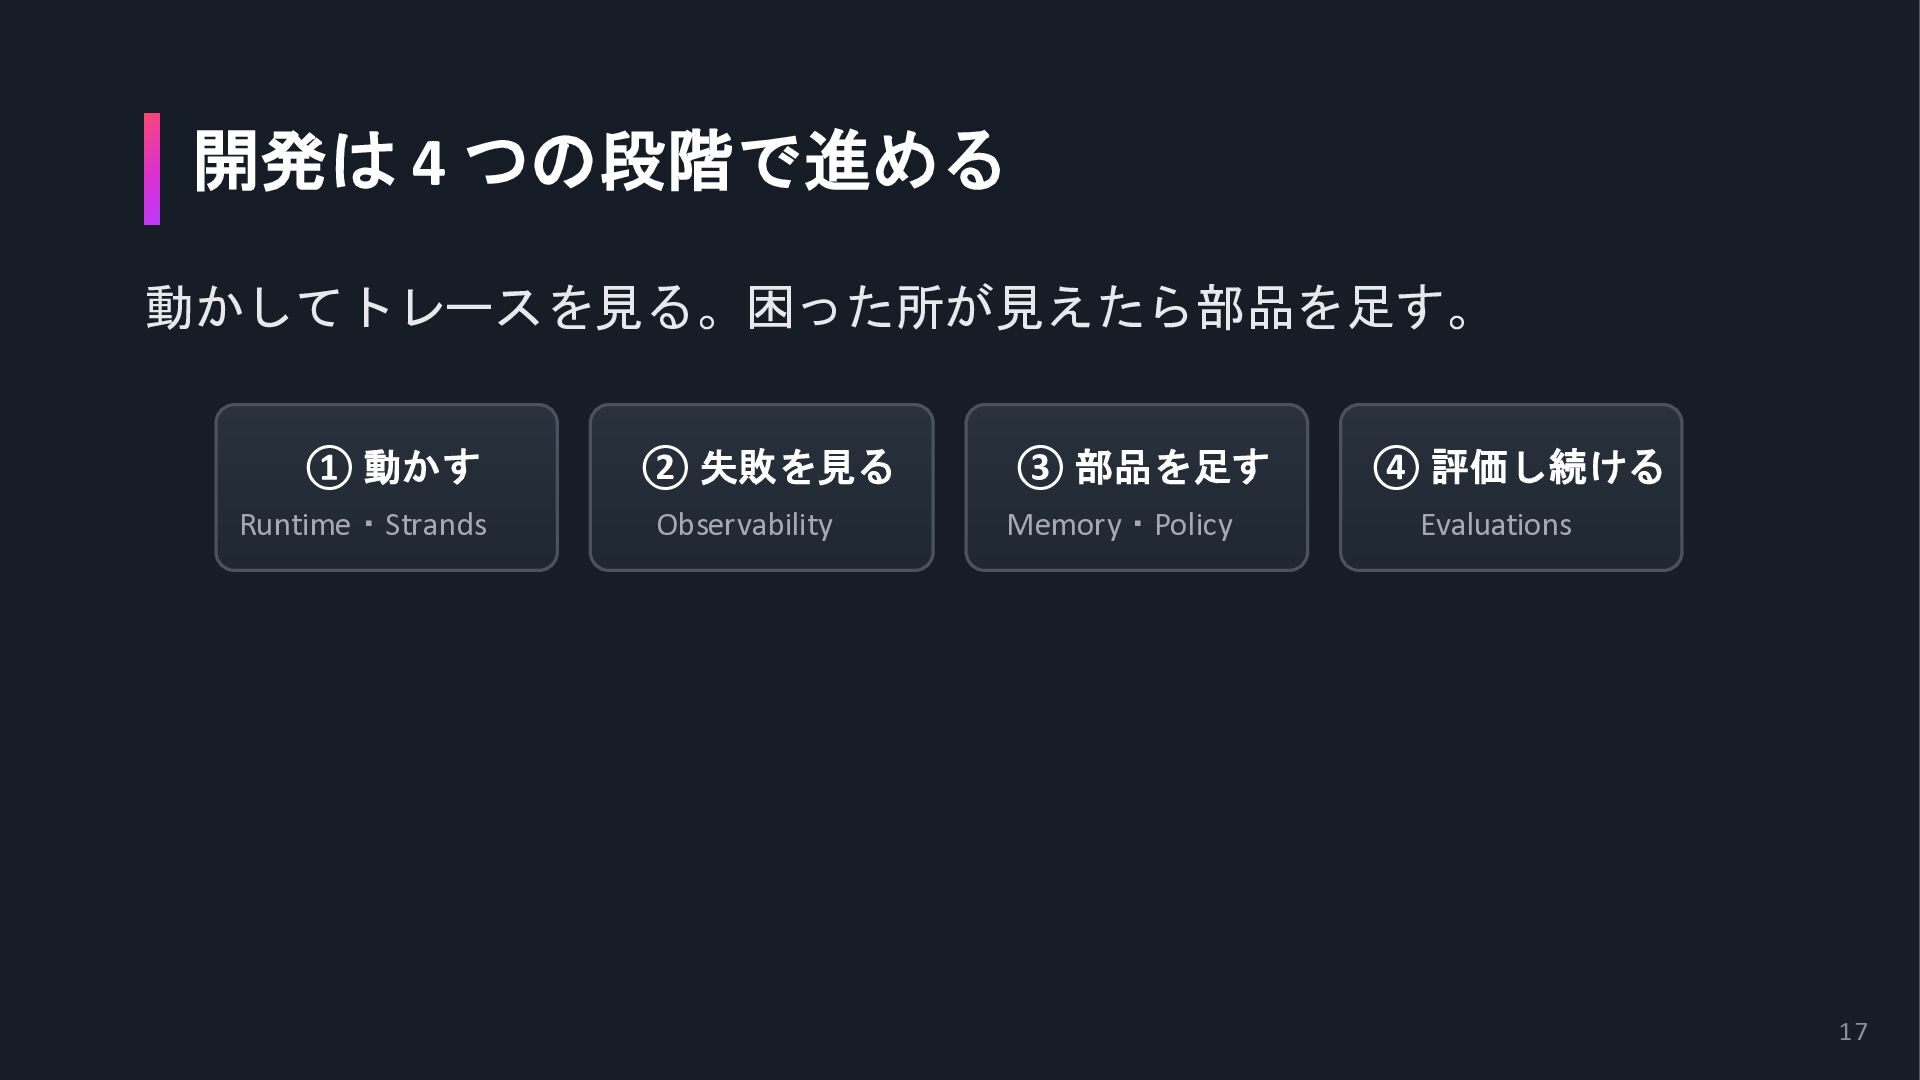
開発は 4 つの段階で進める 動かしてトレースを見る。困った所が見えたら部品を足す。 ① 動かす Runtime・Strands ② 失敗を見る ③
部品を足す ④ 評価し続ける Observability Memory・Policy Evaluations 17 -
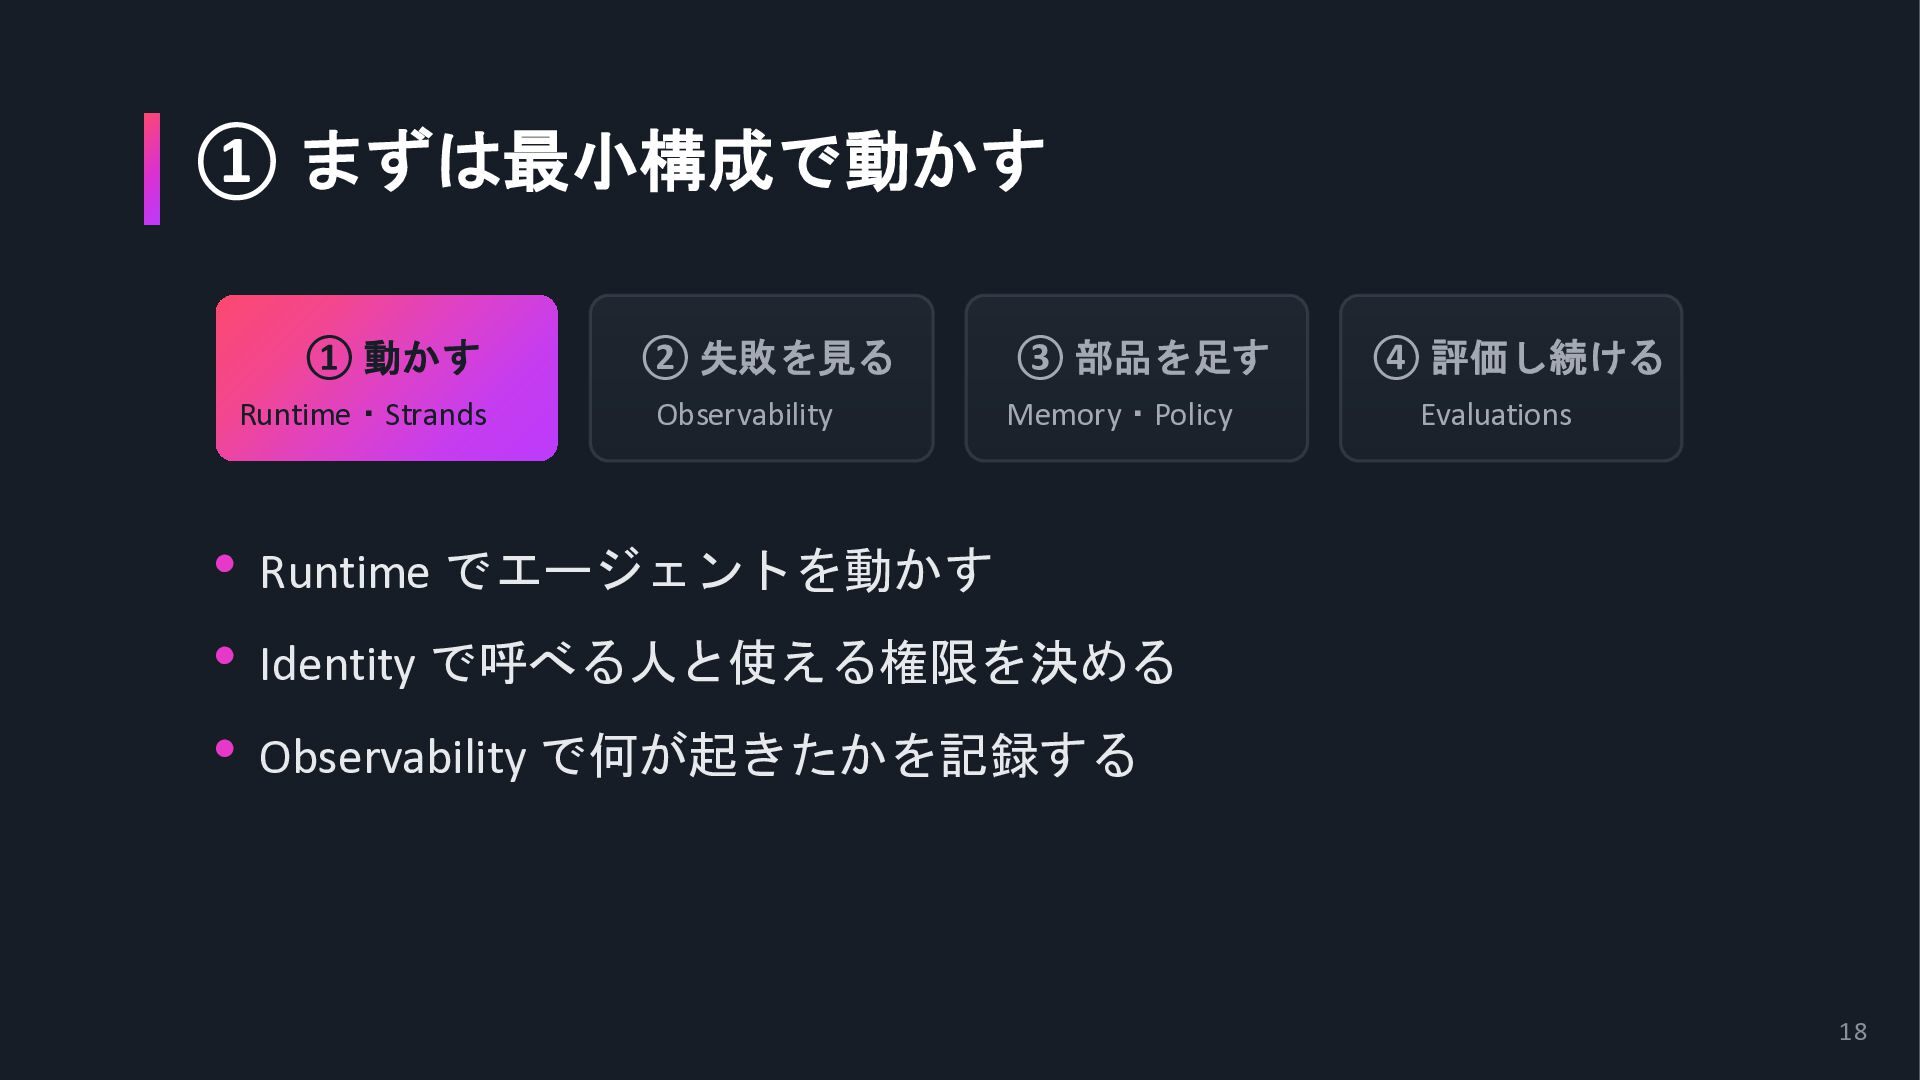
① まずは最小構成で動かす ① 動かす Runtime・Strands ② 失敗を見る ③ 部品を足す ④
評価し続ける Observability Memory・Policy Evaluations • Runtime でエージェントを動かす • Identity で呼べる人と使える権限を決める • Observability で何が起きたかを記録する 18 -
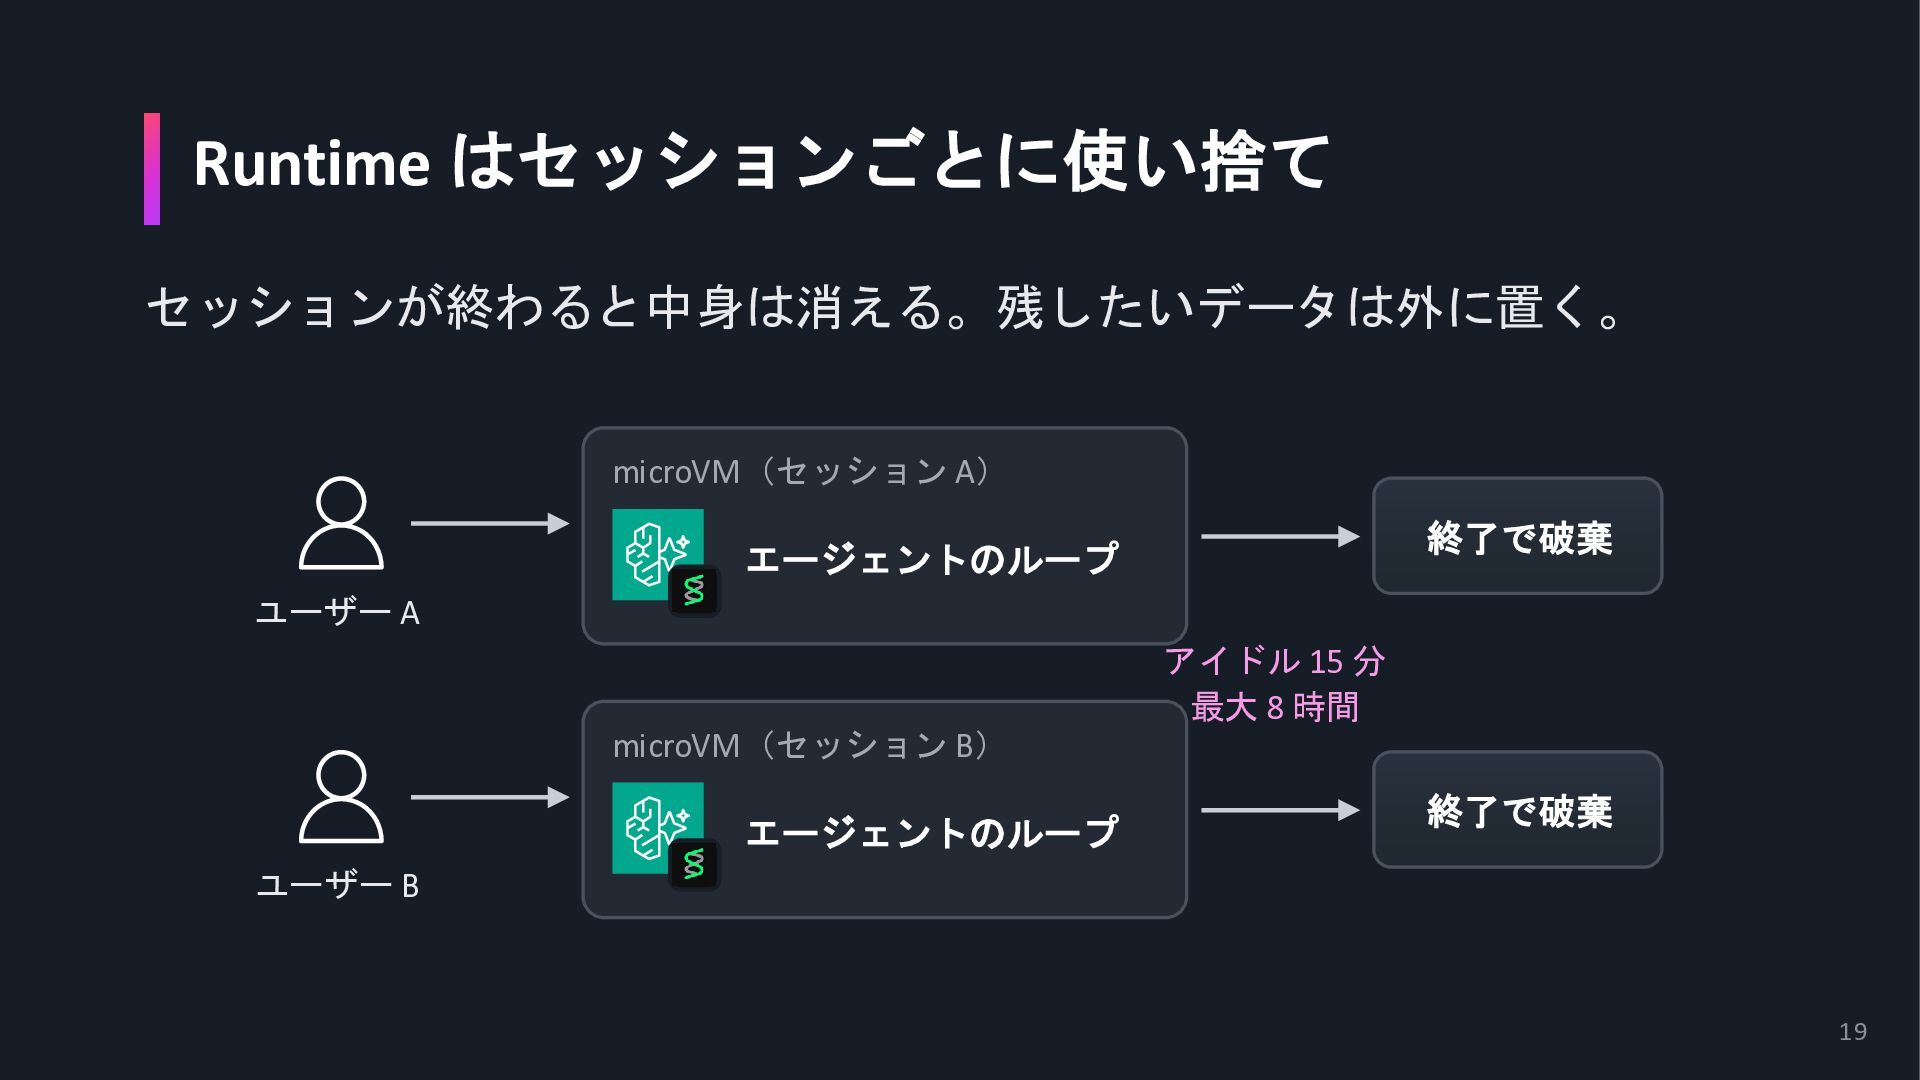
Runtime はセッションごとに使い捨て セッションが終わると中身は消える。残したいデータは外に置く。 microVM(セッション A) 終了で破棄 エージェントのループ ユーザー A アイドル
15 分 最大 8 時間 microVM(セッション B) エージェントのループ 終了で破棄 ユーザー B 19 -
Identity で呼べる人と使える権限を分ける • エージェントを呼べる人はJWT や IAM で絞る • 外部 API
の OAuth トークンや API キーは Identity に預ける • 鍵をコードや環境変数に書かずに済む 20 -
Observability は最初から入れておく • OpenTelemetry のトレースが CloudWatch に集まる • LLM の呼び出しとツールの呼び出しが一手ずつ並ぶ
• 失敗探しにも品質の評価にも同じトレースを使う 21 -
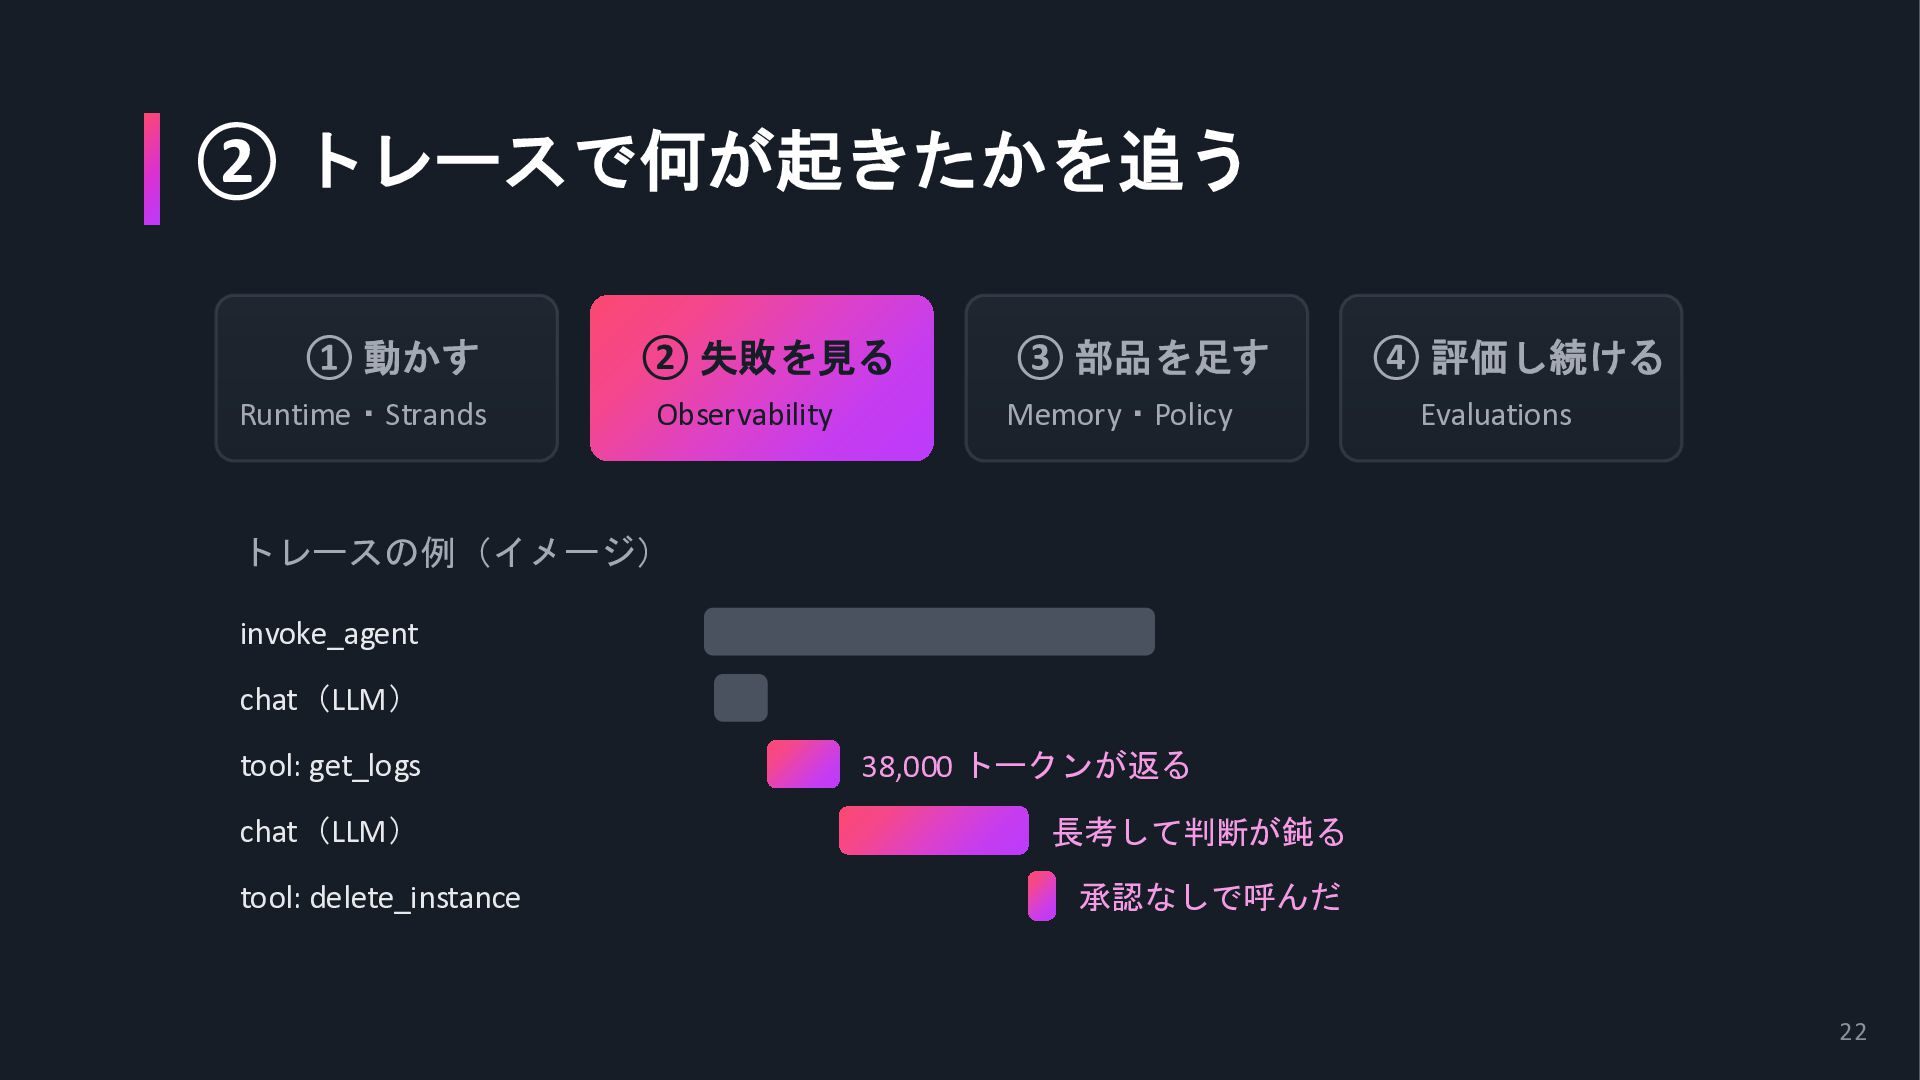
② トレースで何が起きたかを追う ① 動かす Runtime・Strands ② 失敗を見る ③ 部品を足す ④
評価し続ける Observability Memory・Policy Evaluations トレースの例(イメージ) invoke_agent chat(LLM) tool: get_logs chat(LLM) tool: delete_instance 38,000 トークンが返る 長考して判断が鈍る 承認なしで呼んだ 22 -
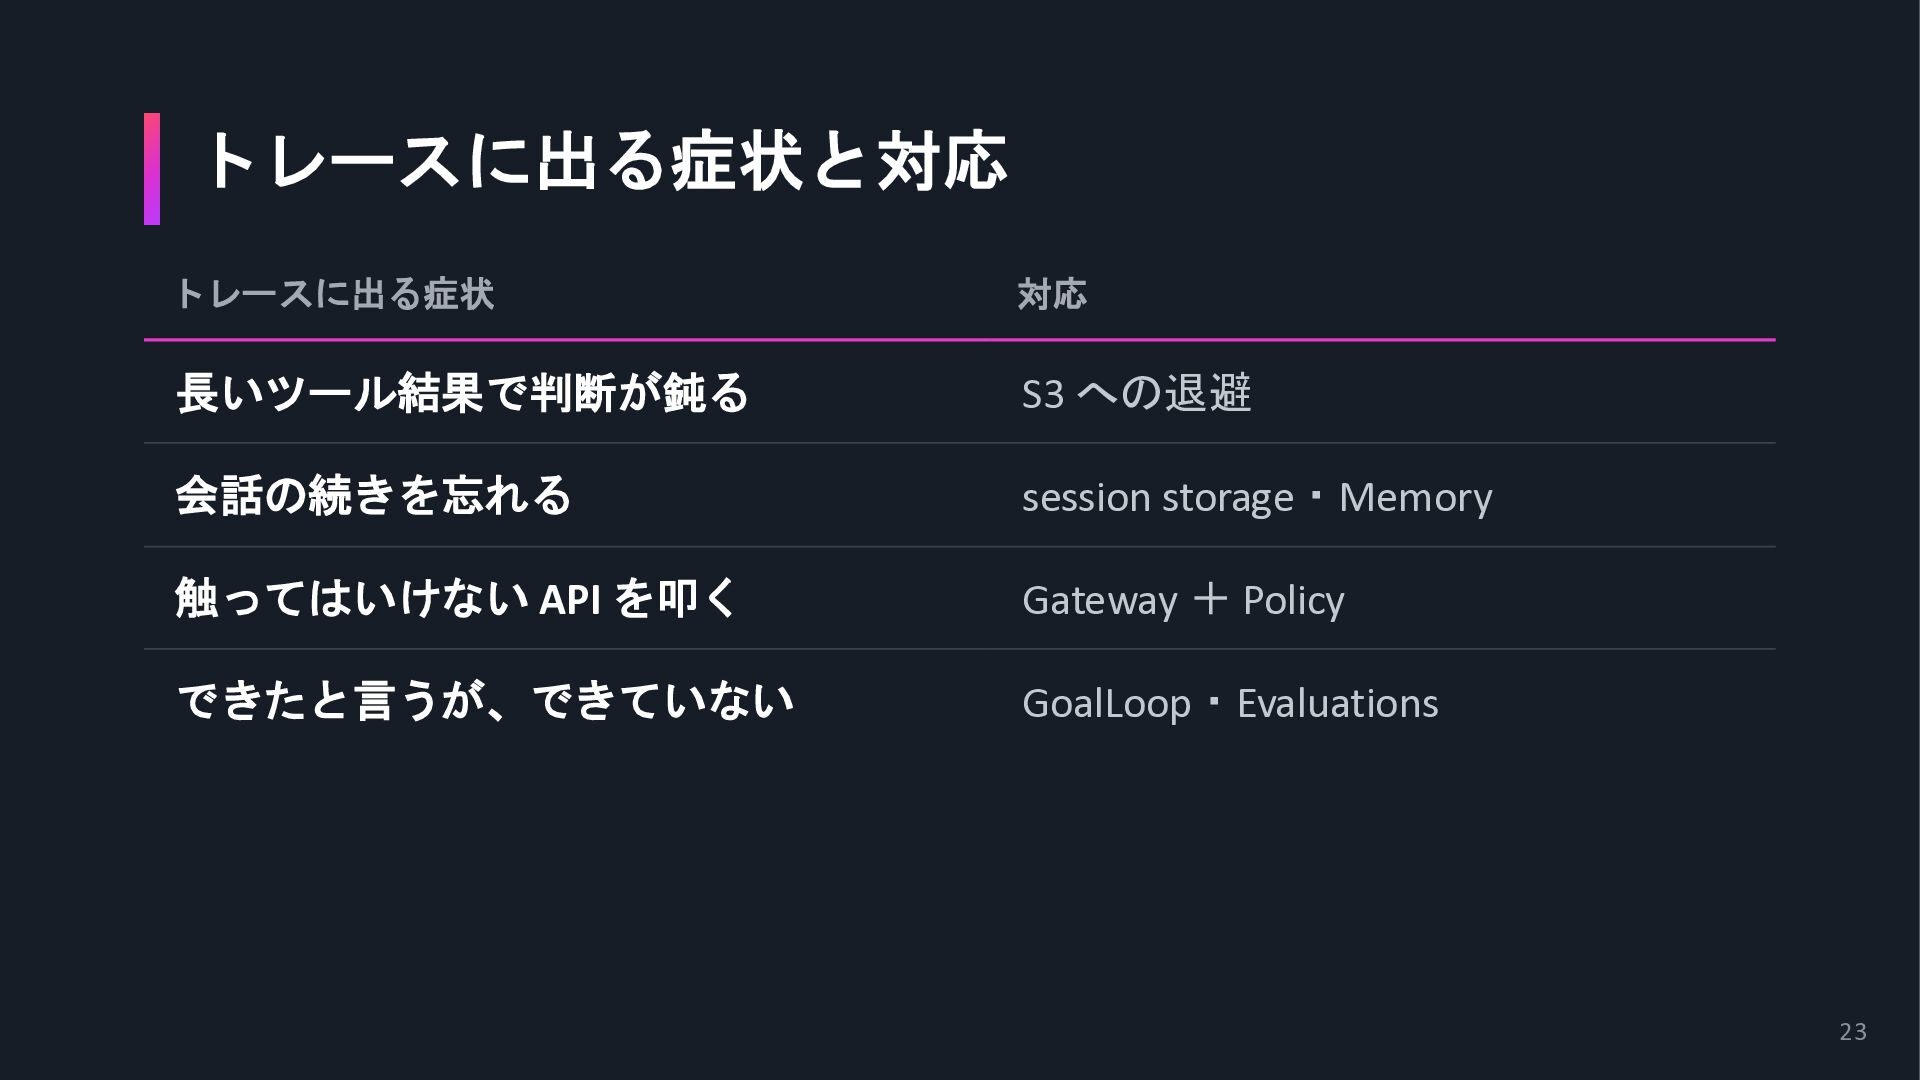
トレースに出る症状と対応 トレースに出る症状 対応 長いツール結果で判断が鈍る S3 への退避 会話の続きを忘れる session storage・Memory 触ってはいけない
API を叩く Gateway + Policy できたと言うが、できていない GoalLoop・Evaluations 23 -
③ 症状に合わせて部品を足す ① 動かす Runtime・Strands ② 失敗を見る ③ 部品を足す ④
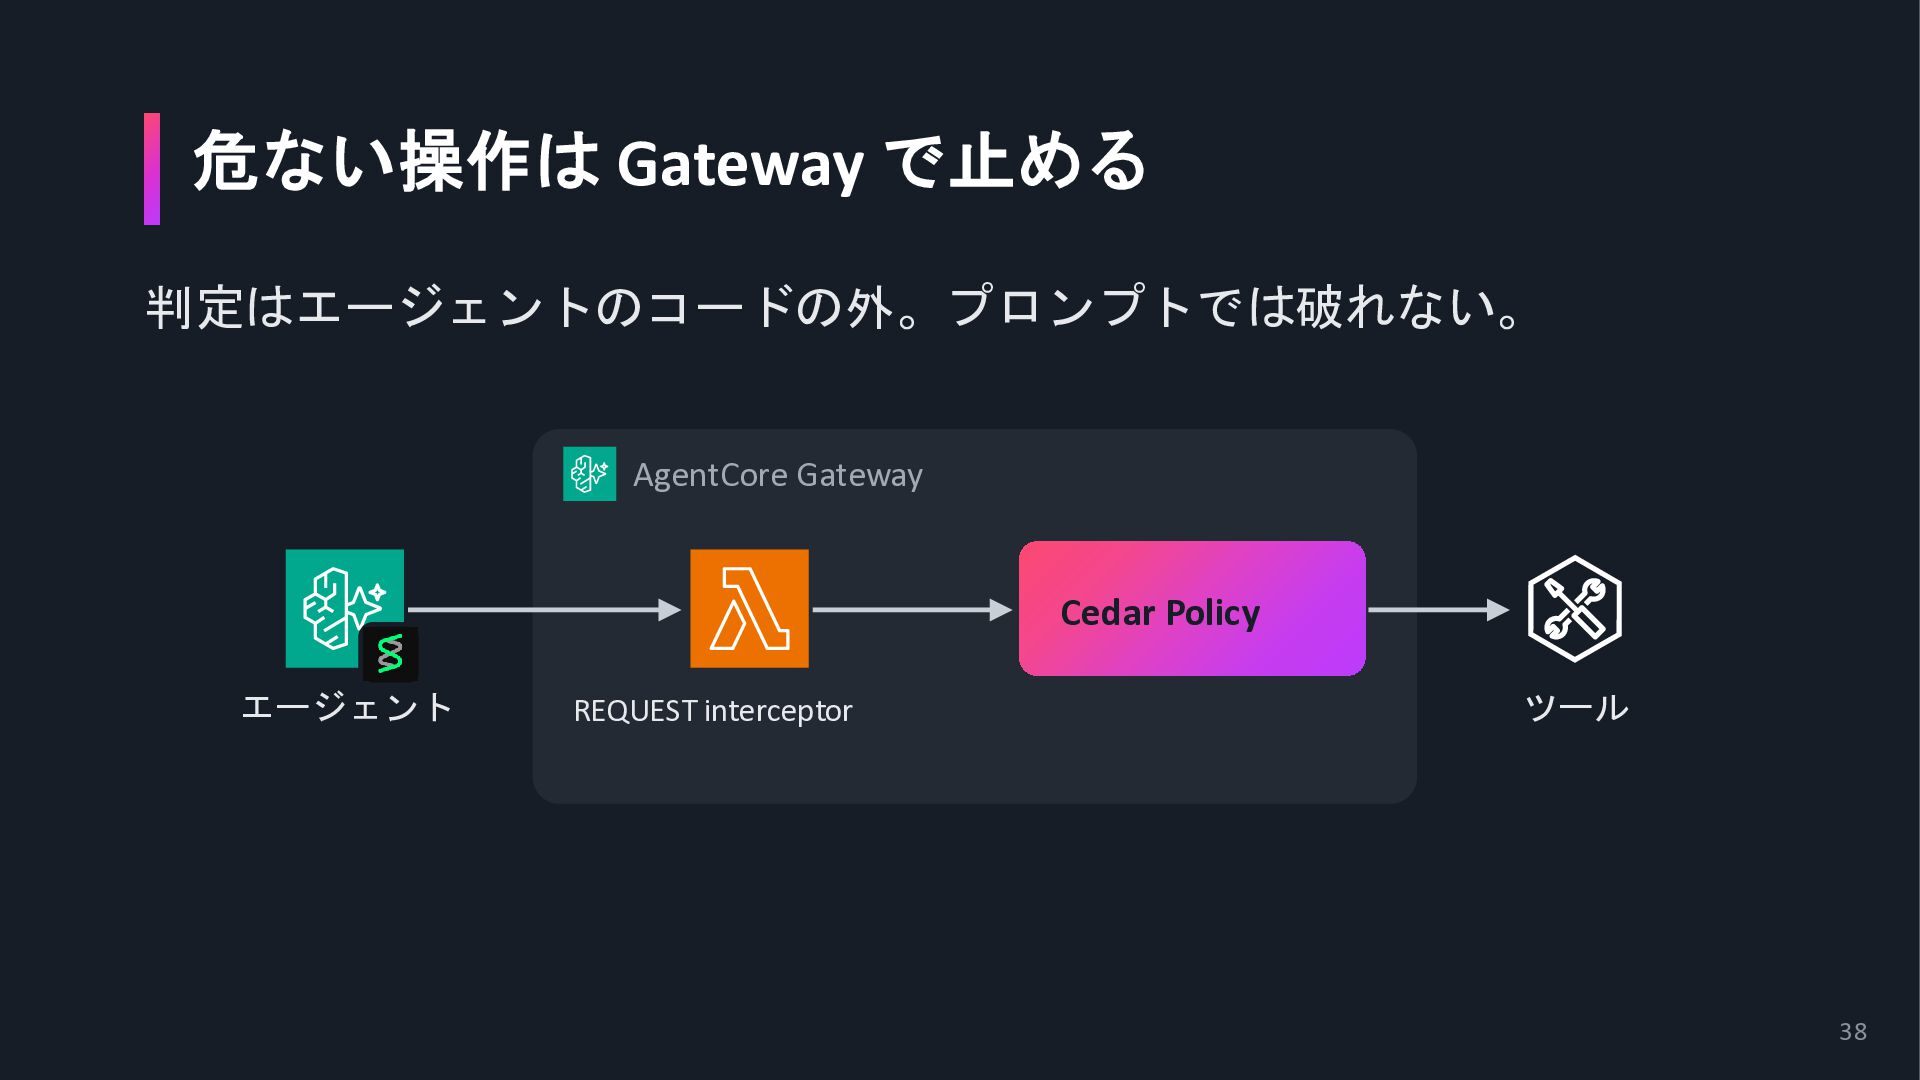
評価し続ける Observability Memory・Policy Evaluations • 長い結果や途中経過は、S3 や Memory に逃がす • ツールは検索して選ばせる • 危ない操作は Gateway と Policy で止める 24 -
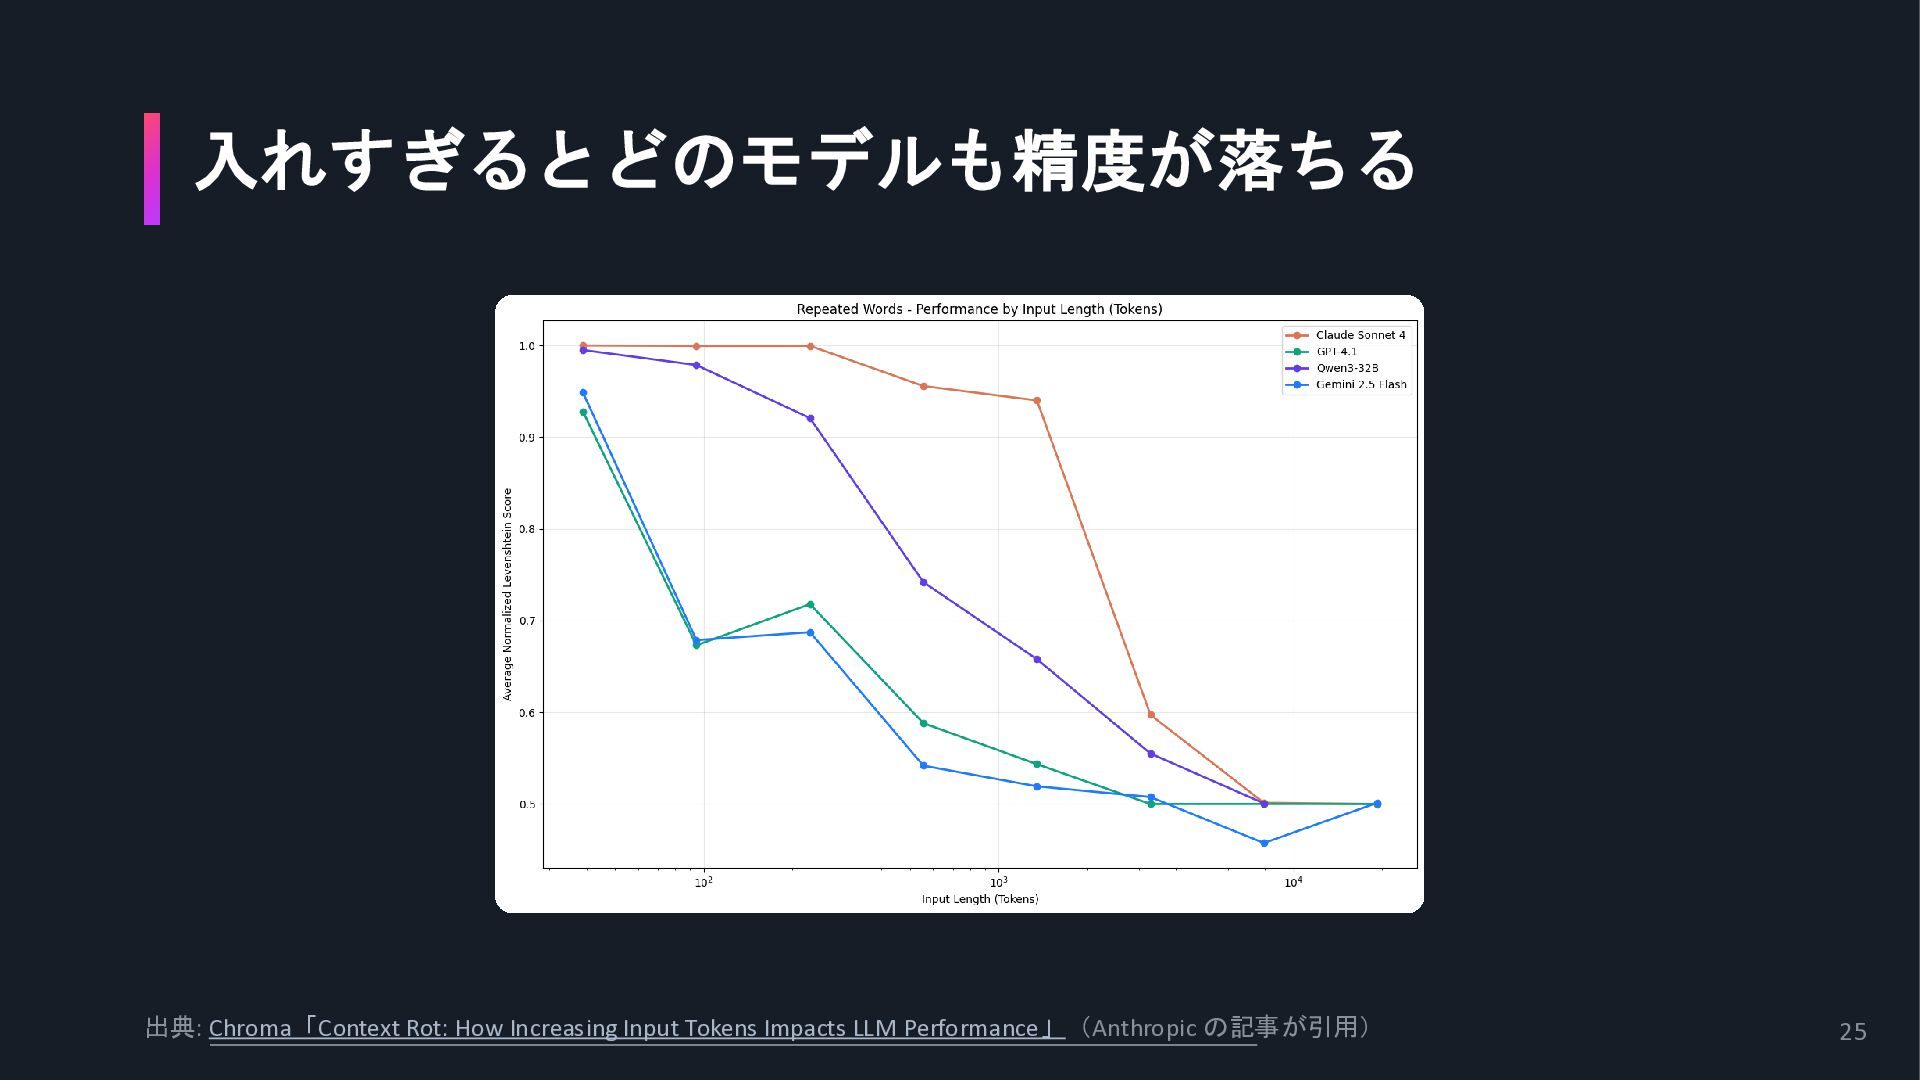
入れすぎるとどのモデルも精度が落ちる 出典: Chroma「Context Rot: How Increasing Input Tokens Impacts LLM
Performance」(Anthropic の記事が引用) 25 -
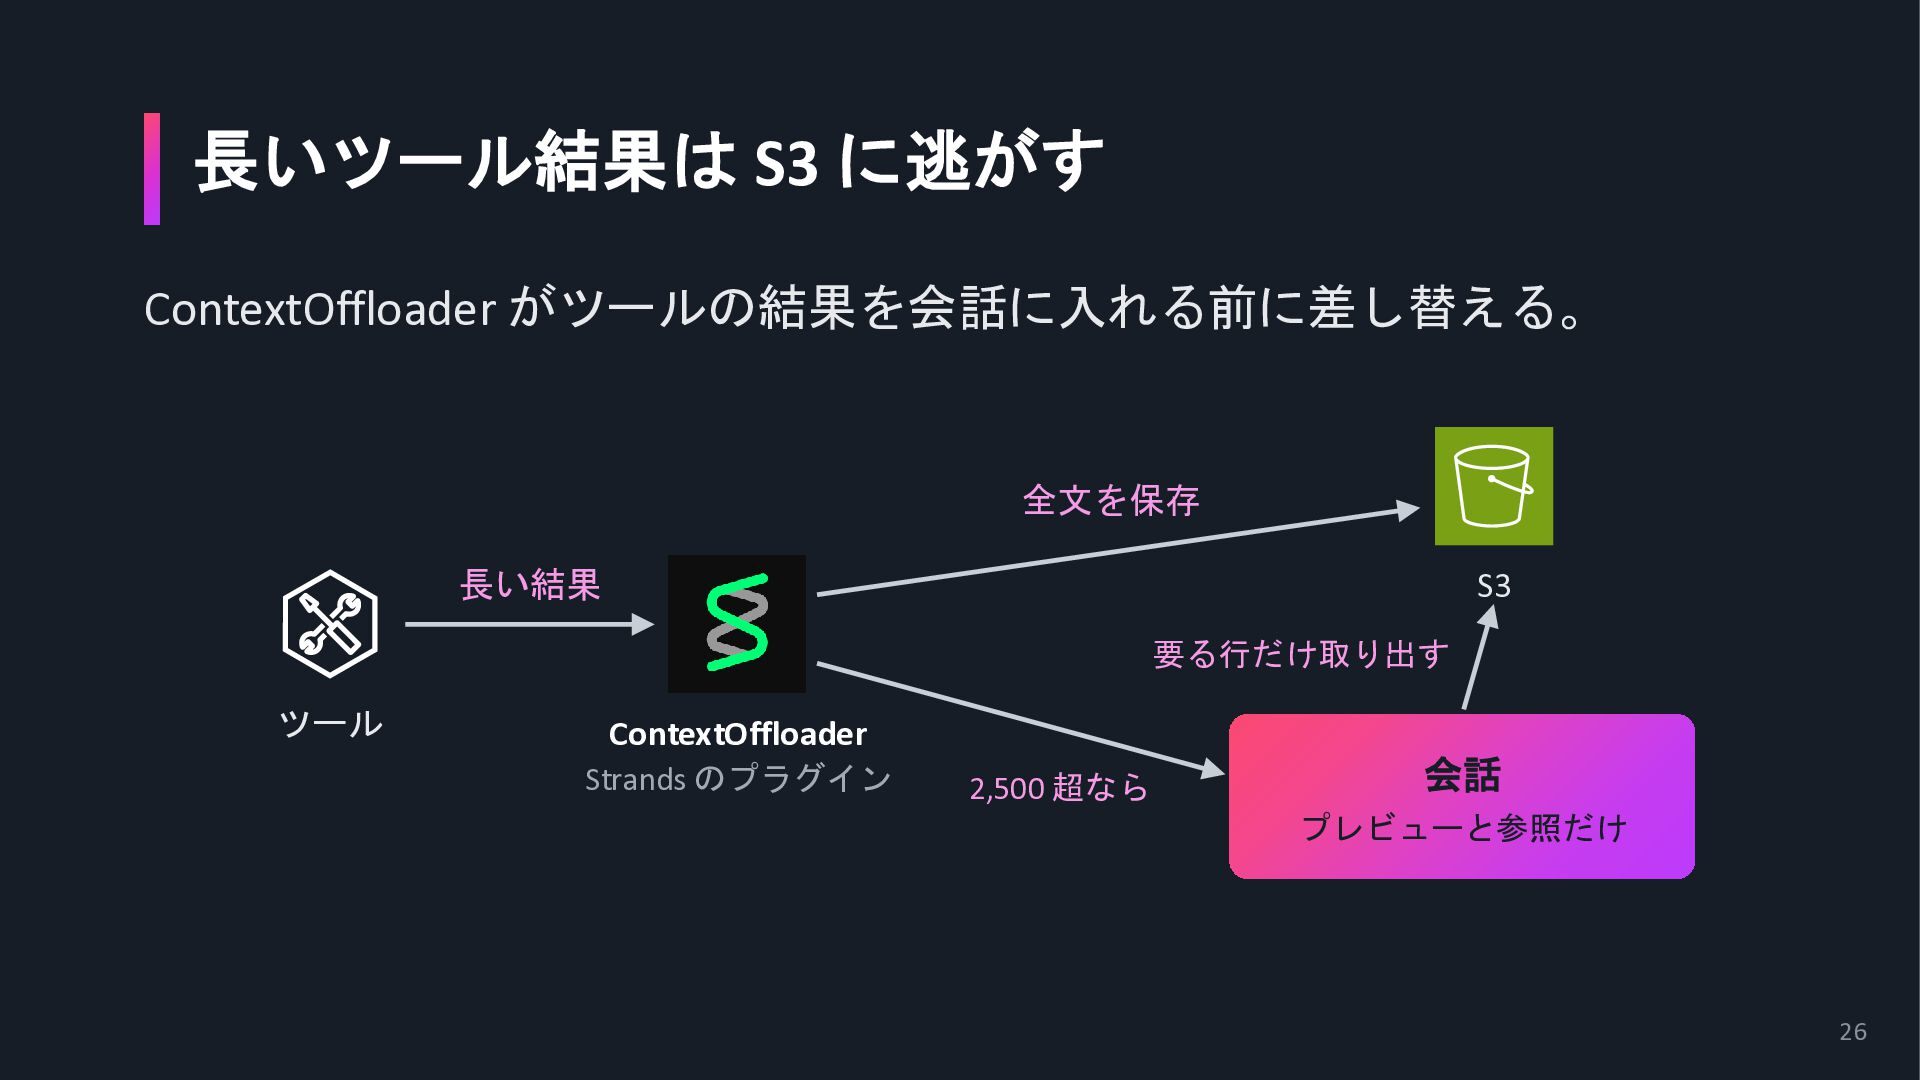
長いツール結果は S3 に逃がす ContextOffloader がツールの結果を会話に入れる前に差し替える。 全文を保存 長い結果 S3 要る行だけ取り出す ツール
ContextOffloader Strands のプラグイン 2,500 超なら 会話 プレビューと参照だけ 26 -
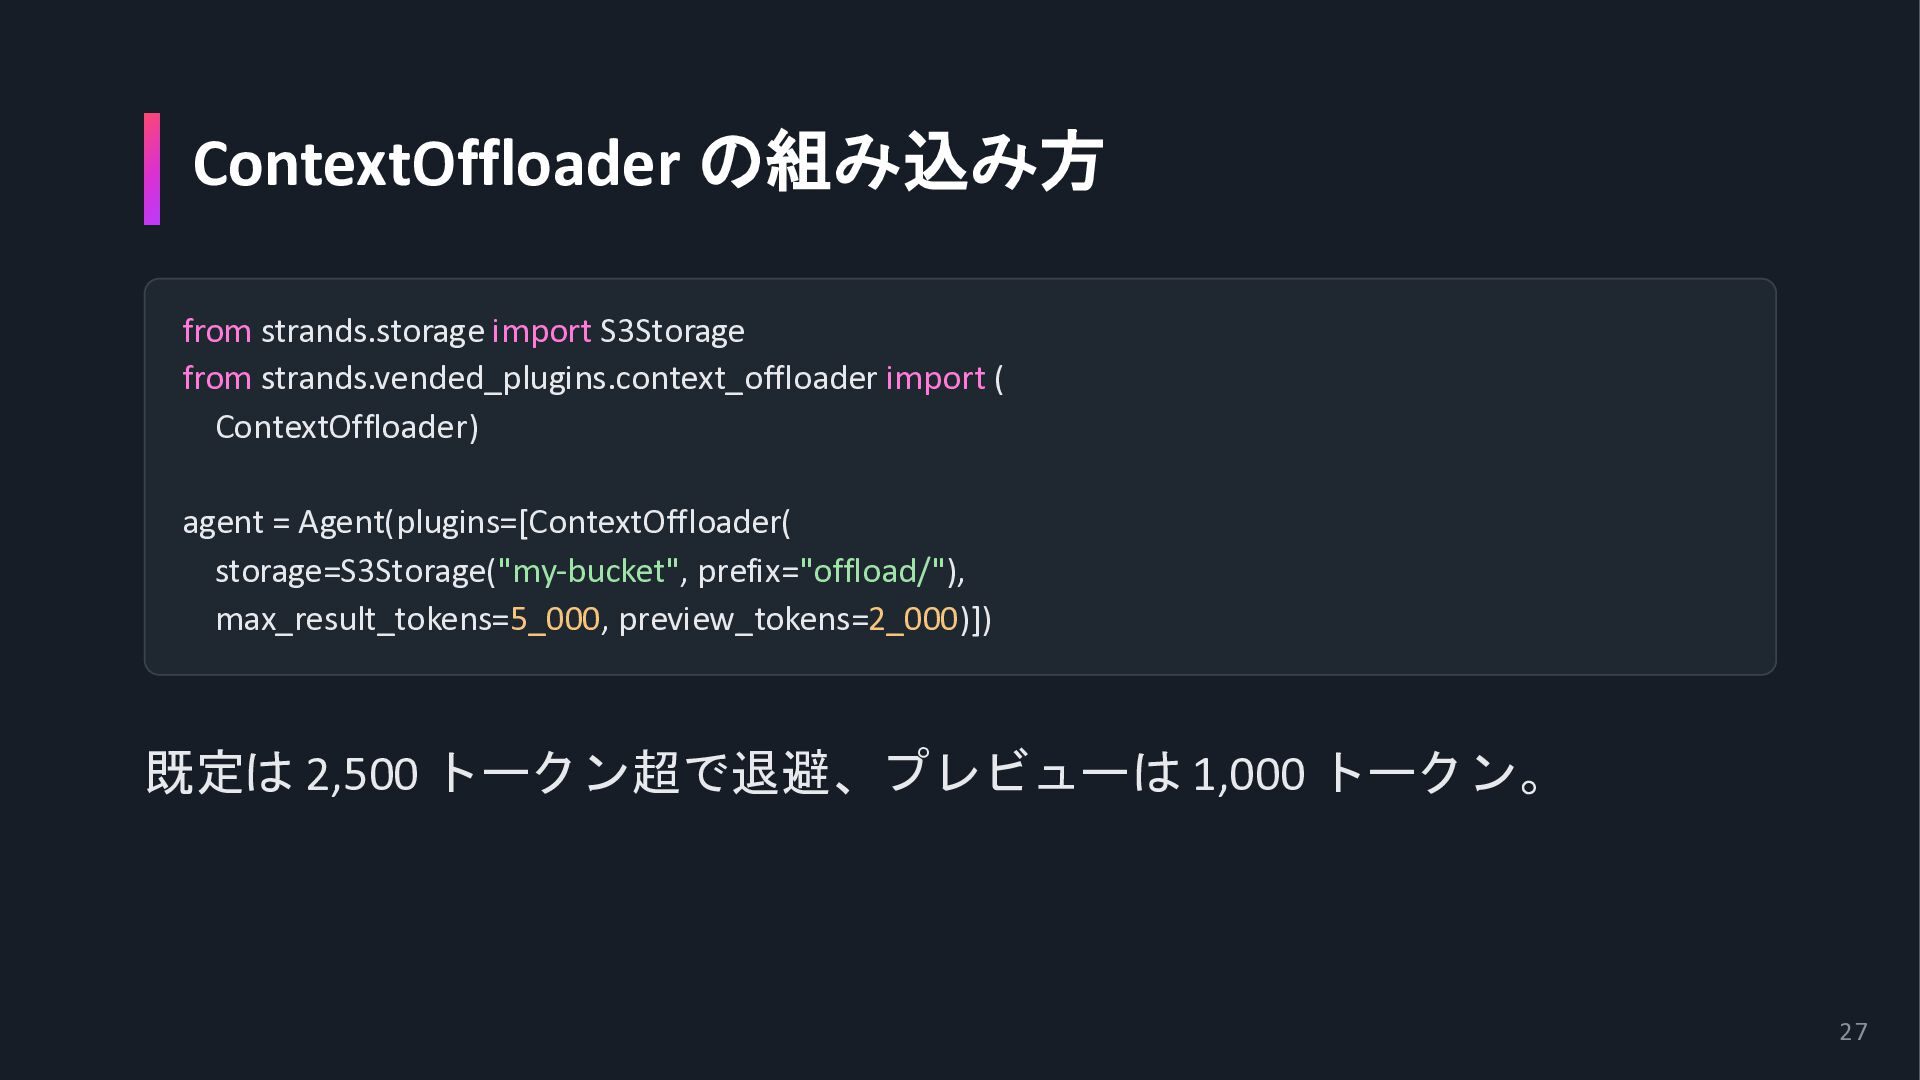
ContextOffloader の組み込み方 from strands.storage import S3Storage from strands.vended_plugins.context_offloader import (
ContextOffloader) agent = Agent(plugins=[ContextOffloader( storage=S3Storage("my-bucket", prefix="offload/"), max_result_tokens=5_000, preview_tokens=2_000)]) 既定は 2,500 トークン超で退避、プレビューは 1,000 トークン。 27 -
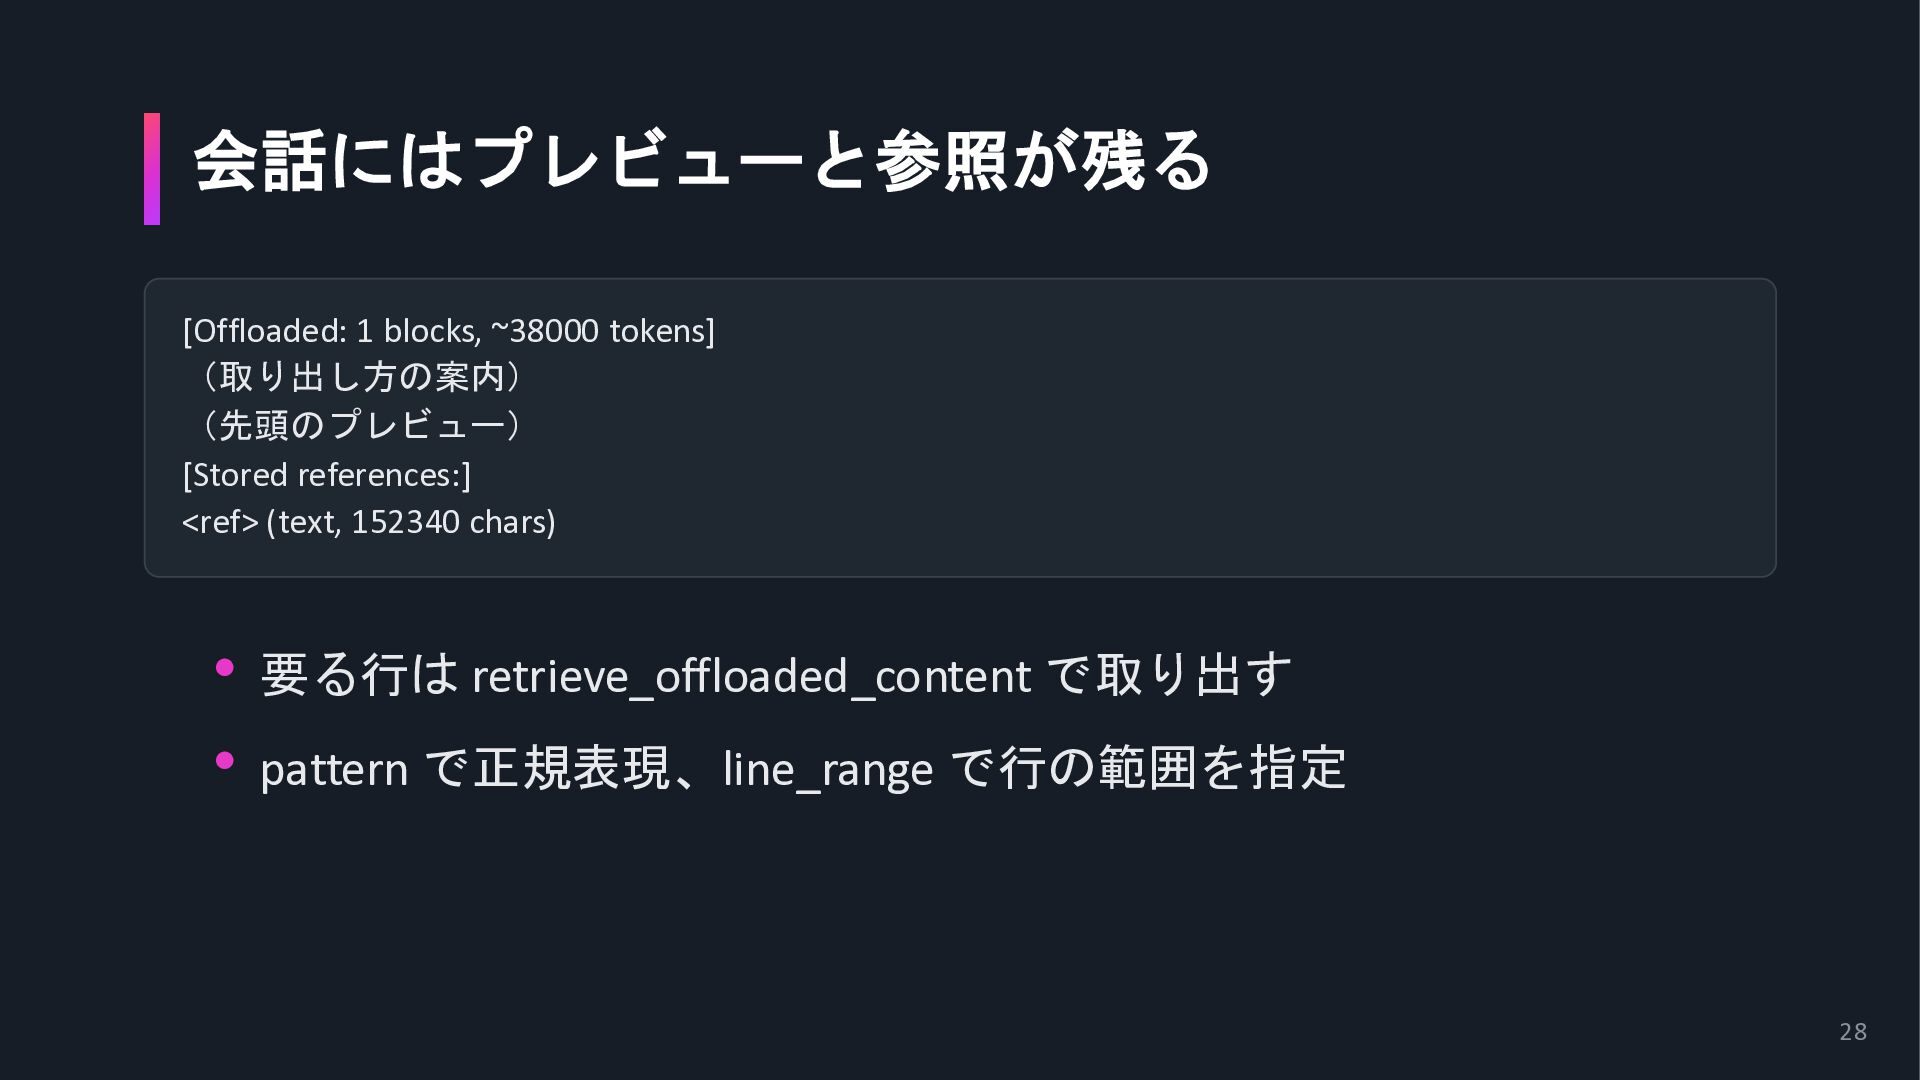
会話にはプレビューと参照が残る [Offloaded: 1 blocks, ~38000 tokens] (取り出し方の案内) (先頭のプレビュー) [Stored references:]
<ref> (text, 152340 chars) • 要る行は retrieve_offloaded_content で取り出す • pattern で正規表現、line_range で行の範囲を指定 28 -
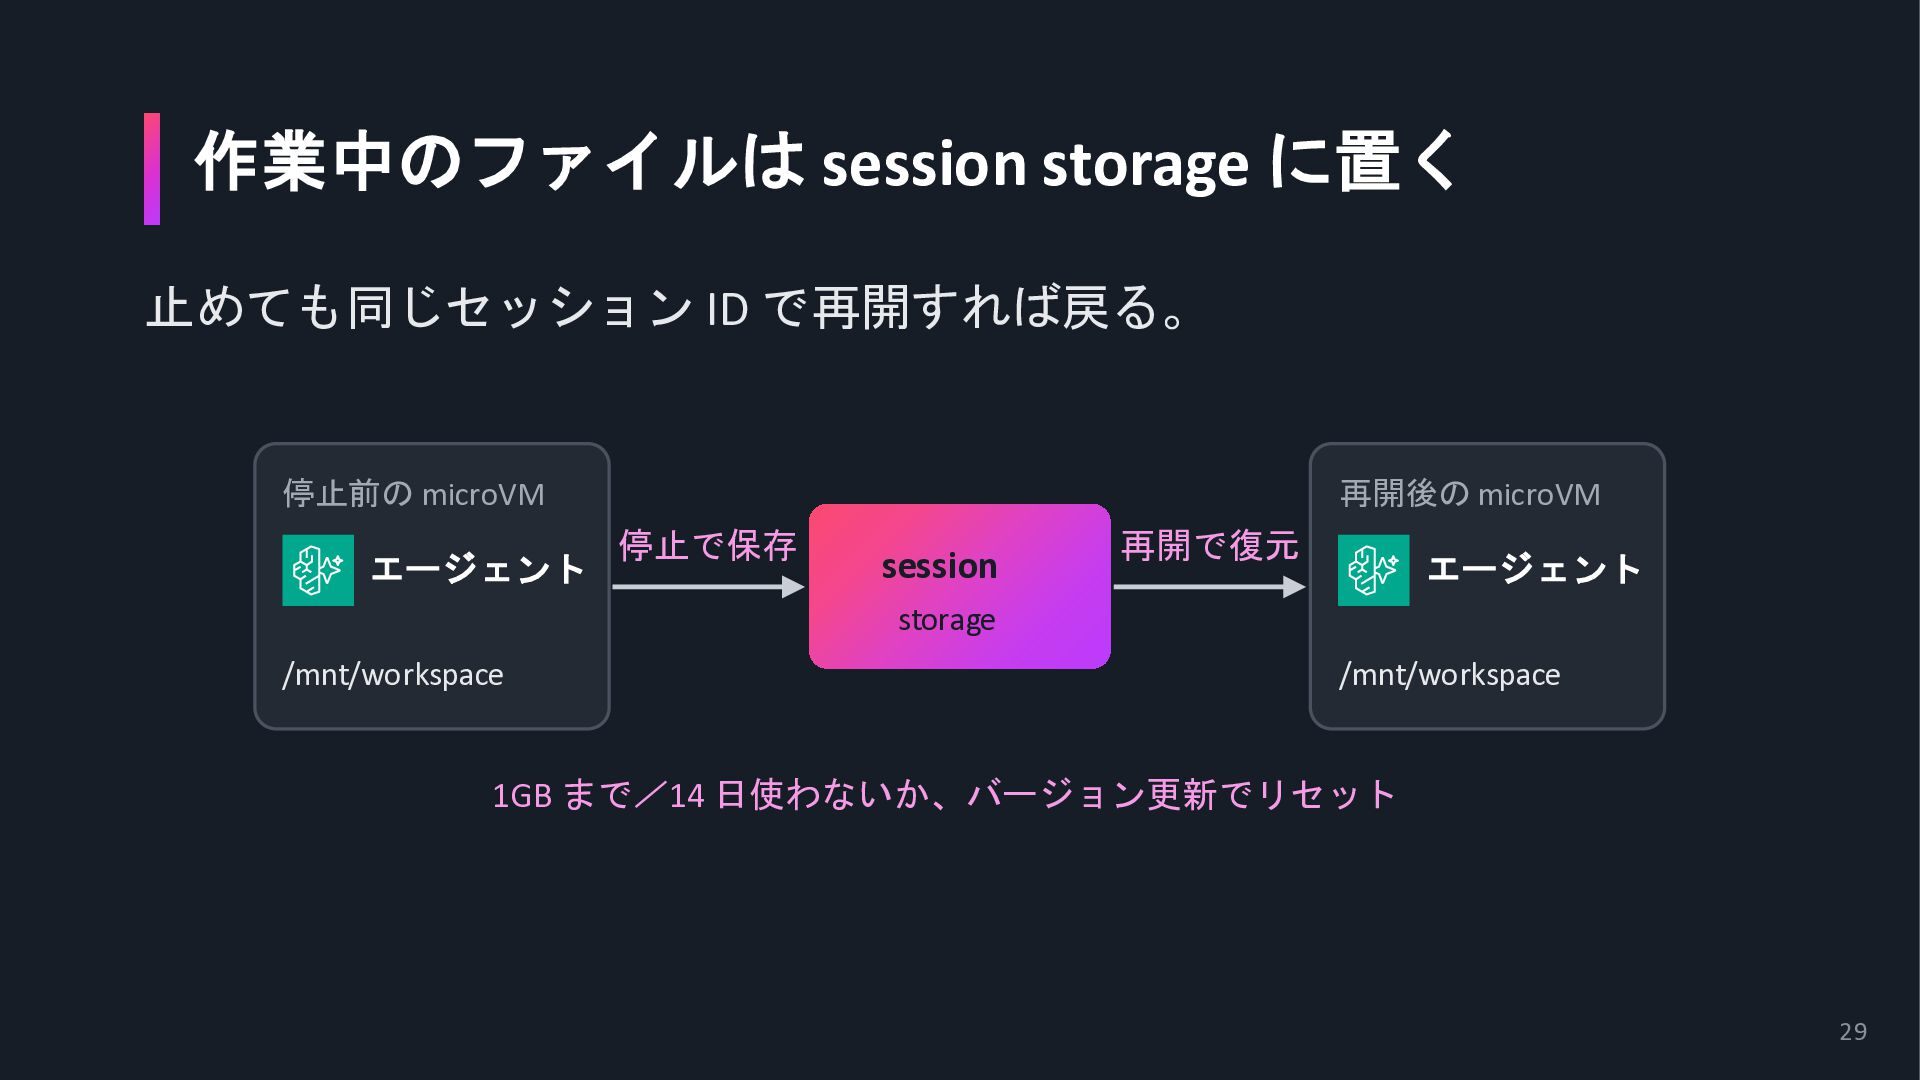
作業中のファイルは session storage に置く 止めても同じセッション ID で再開すれば戻る。 停止前の microVM エージェント
再開後の microVM 停止で保存 session 再開で復元 エージェント storage /mnt/workspace /mnt/workspace 1GB まで/14 日使わないか、バージョン更新でリセット 29 -
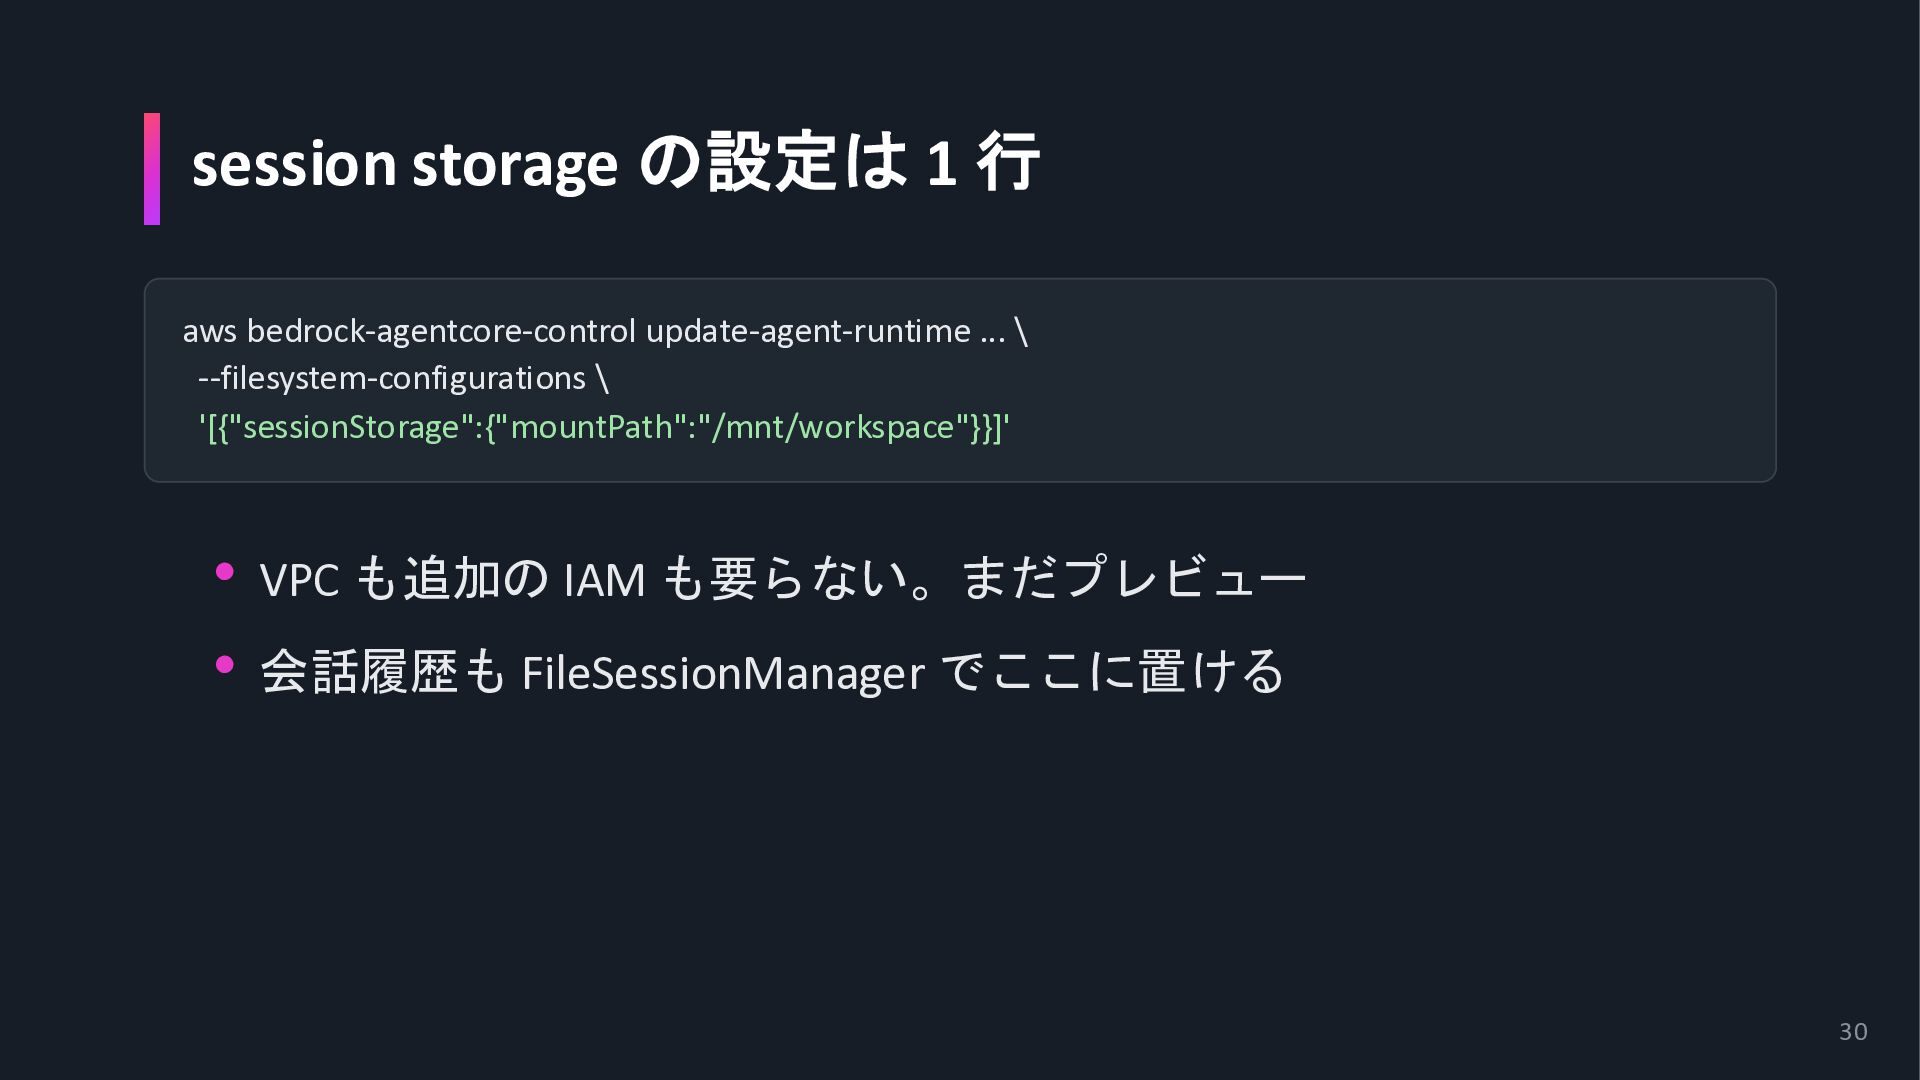
session storage の設定は 1 行 aws bedrock-agentcore-control update-agent-runtime ... \
--filesystem-configurations \ '[{"sessionStorage":{"mountPath":"/mnt/workspace"}}]' • VPC も追加の IAM も要らない。まだプレビュー • 会話履歴も FileSessionManager でここに置ける 30 -
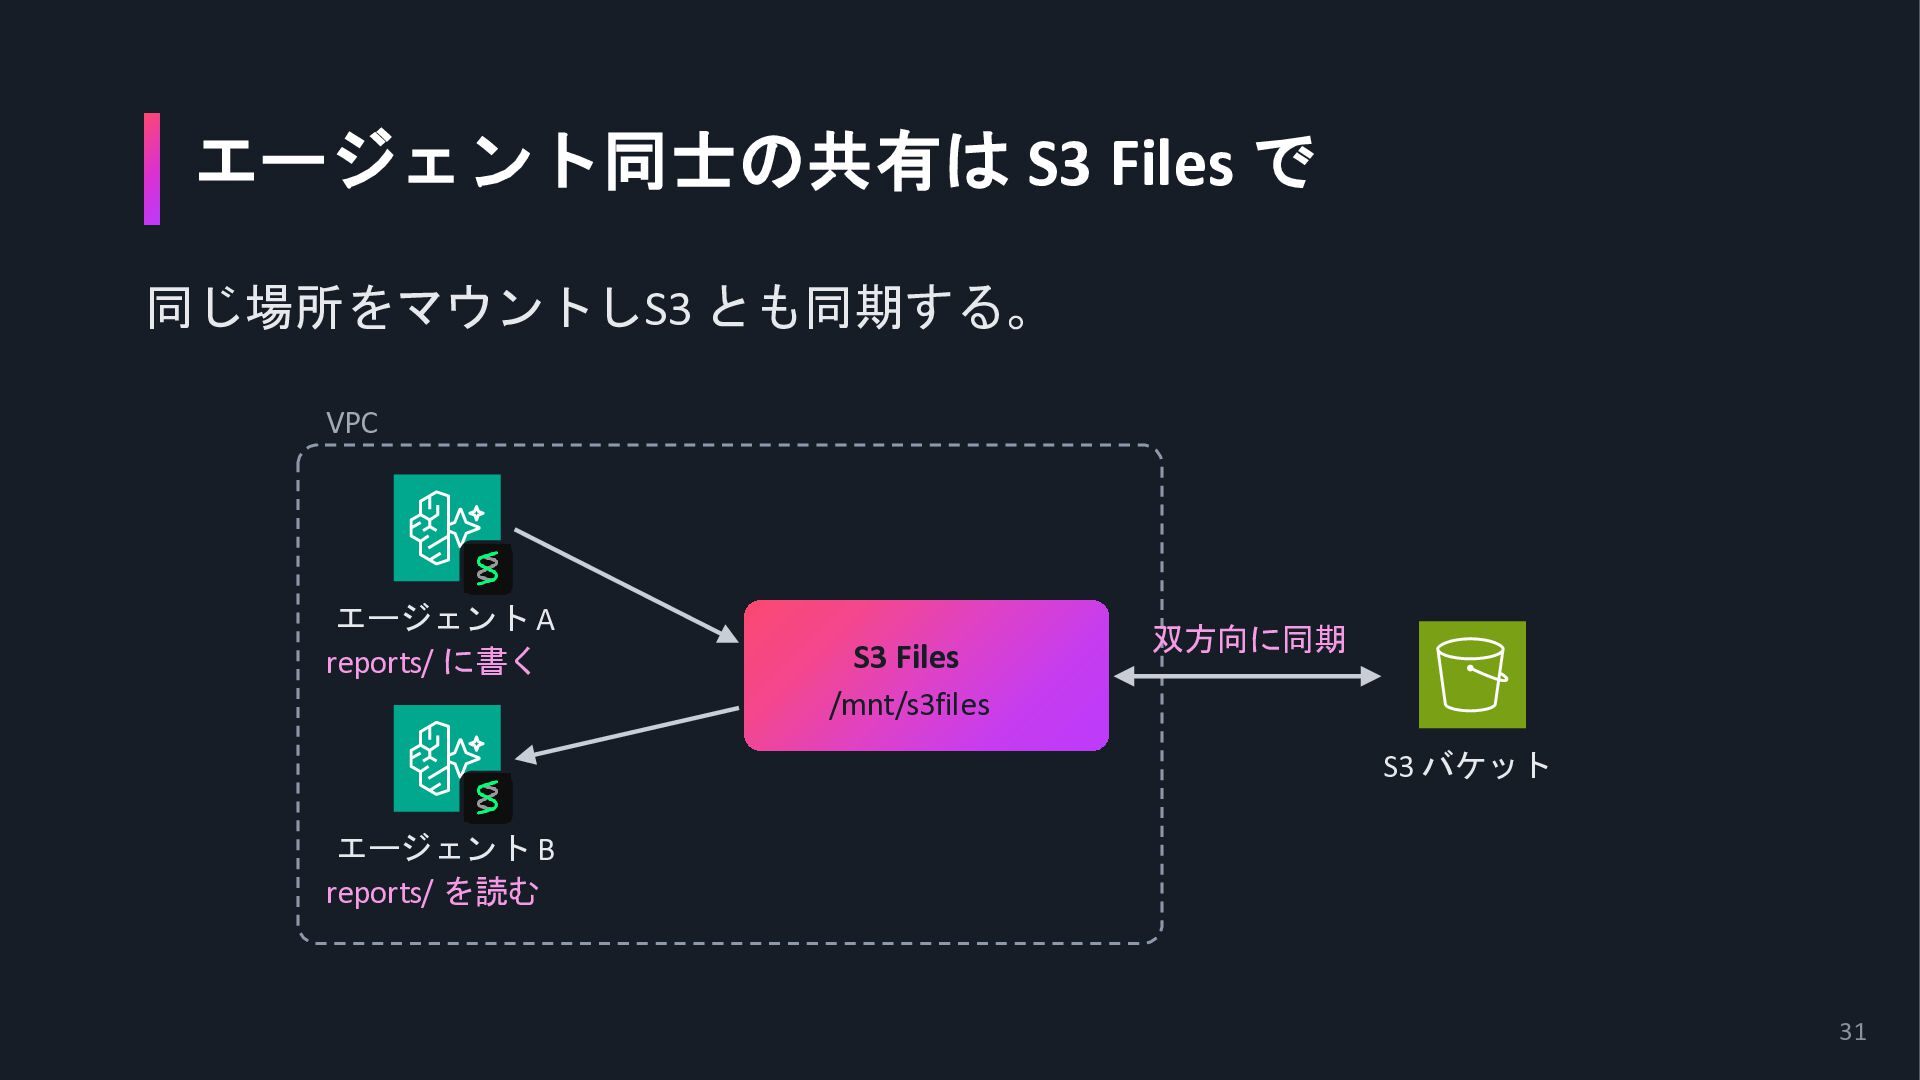
エージェント同士の共有は S3 Files で 同じ場所をマウントしS3 とも同期する。 VPC エージェント A reports/
に書く S3 Files /mnt/s3files 双方向に同期 S3 バケット エージェント B reports/ を読む 31 -
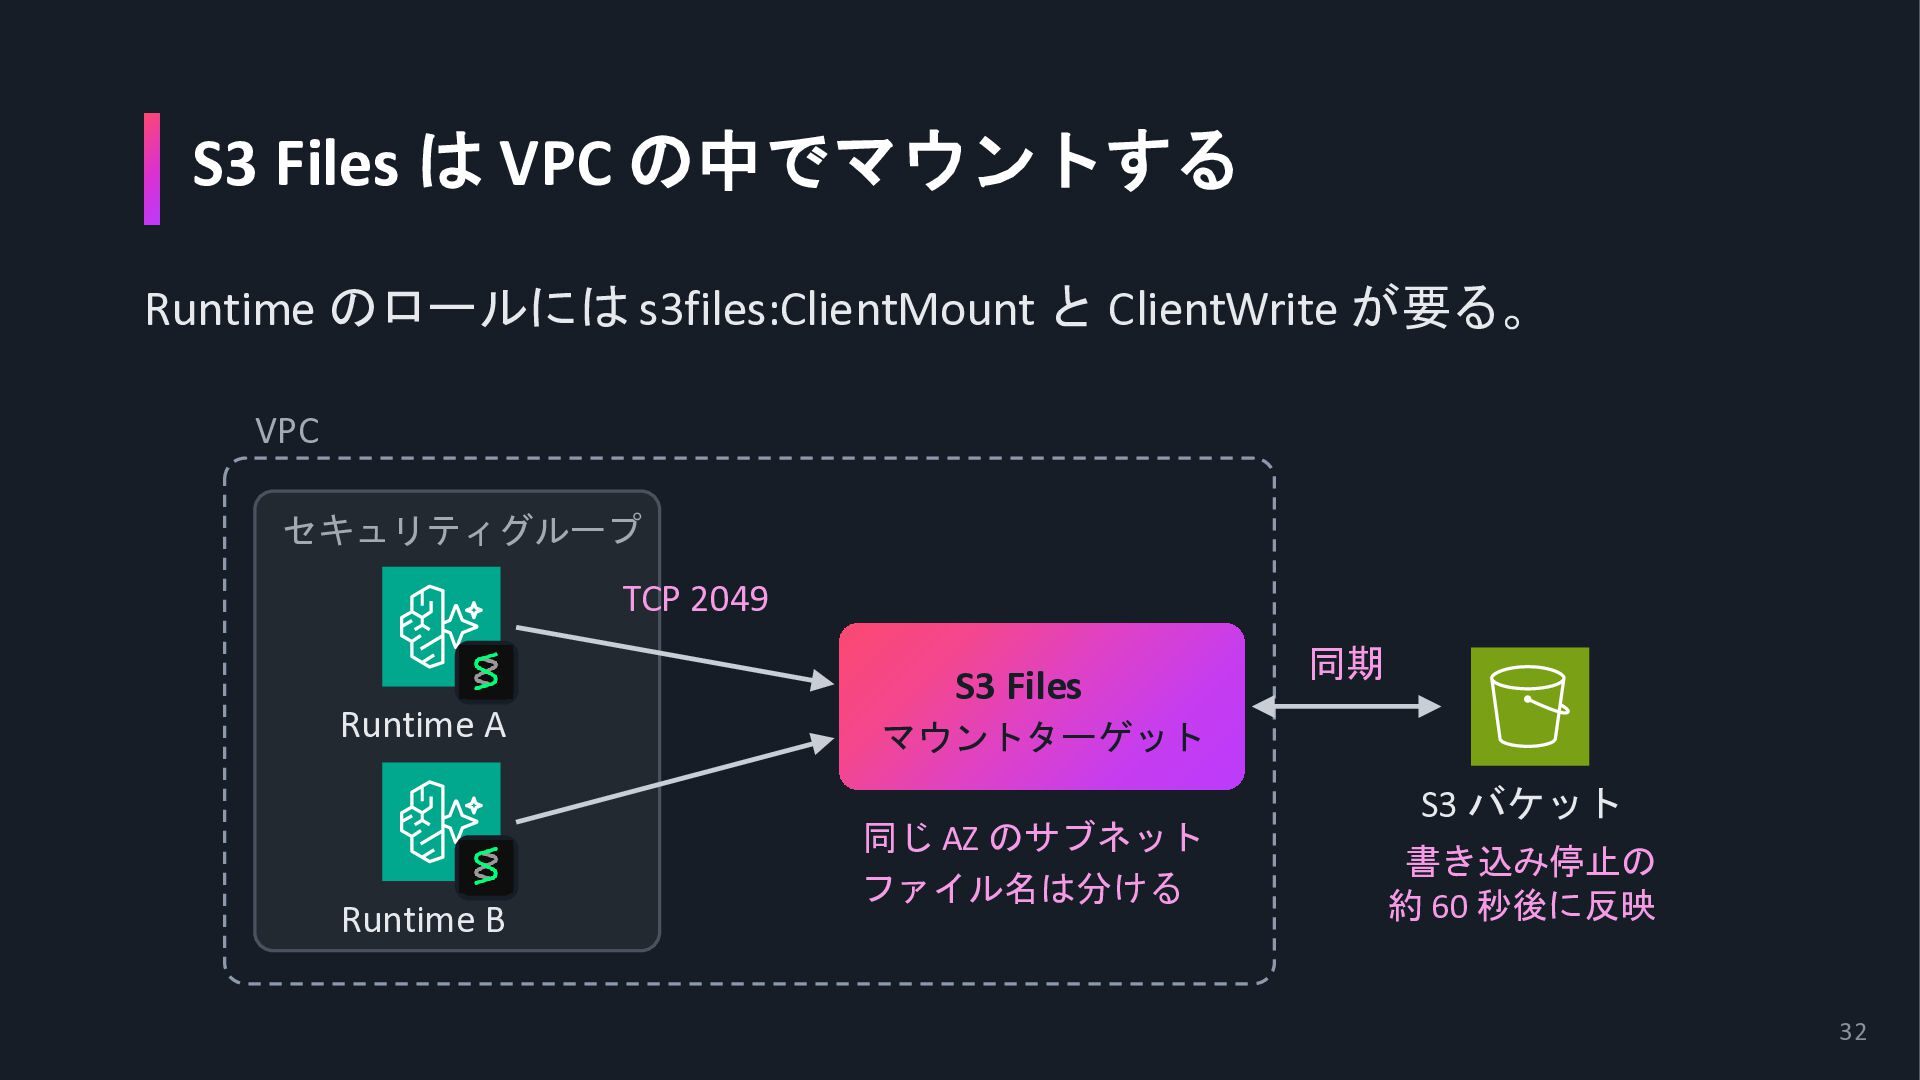
S3 Files は VPC の中でマウントする Runtime のロールには s3files:ClientMount と ClientWrite
が要る。 VPC セキュリティグループ TCP 2049 Runtime A Runtime B S3 Files 同期 マウントターゲット 同じ AZ のサブネット ファイル名は分ける S3 バケット 書き込み停止の 約 60 秒後に反映 32 -
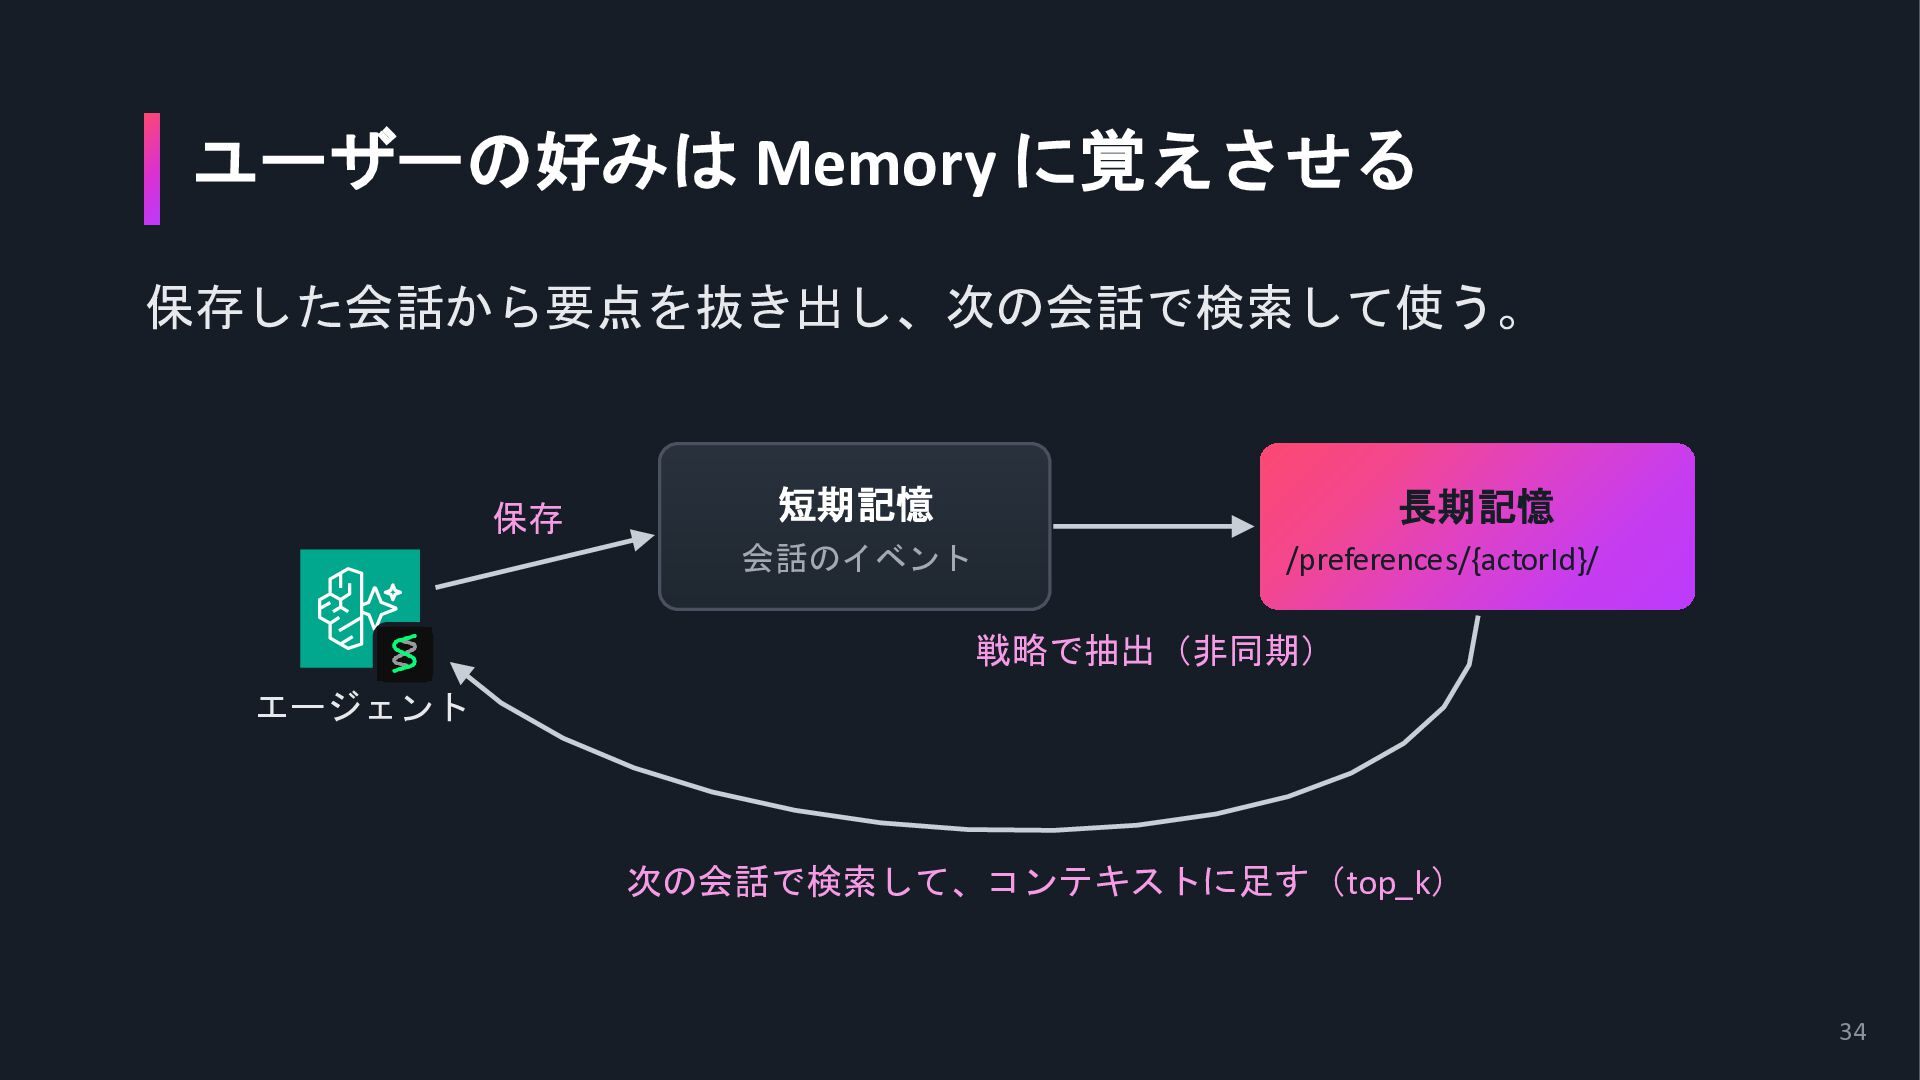
ユーザーの好みは Memory に覚えさせる 保存した会話から要点を抜き出し、次の会話で検索して使う。 保存 短期記憶 会話のイベント 長期記憶 /preferences/{actorId}/ 戦略で抽出(非同期)
エージェント 次の会話で検索して、コンテキストに足す(top_k) 34 -
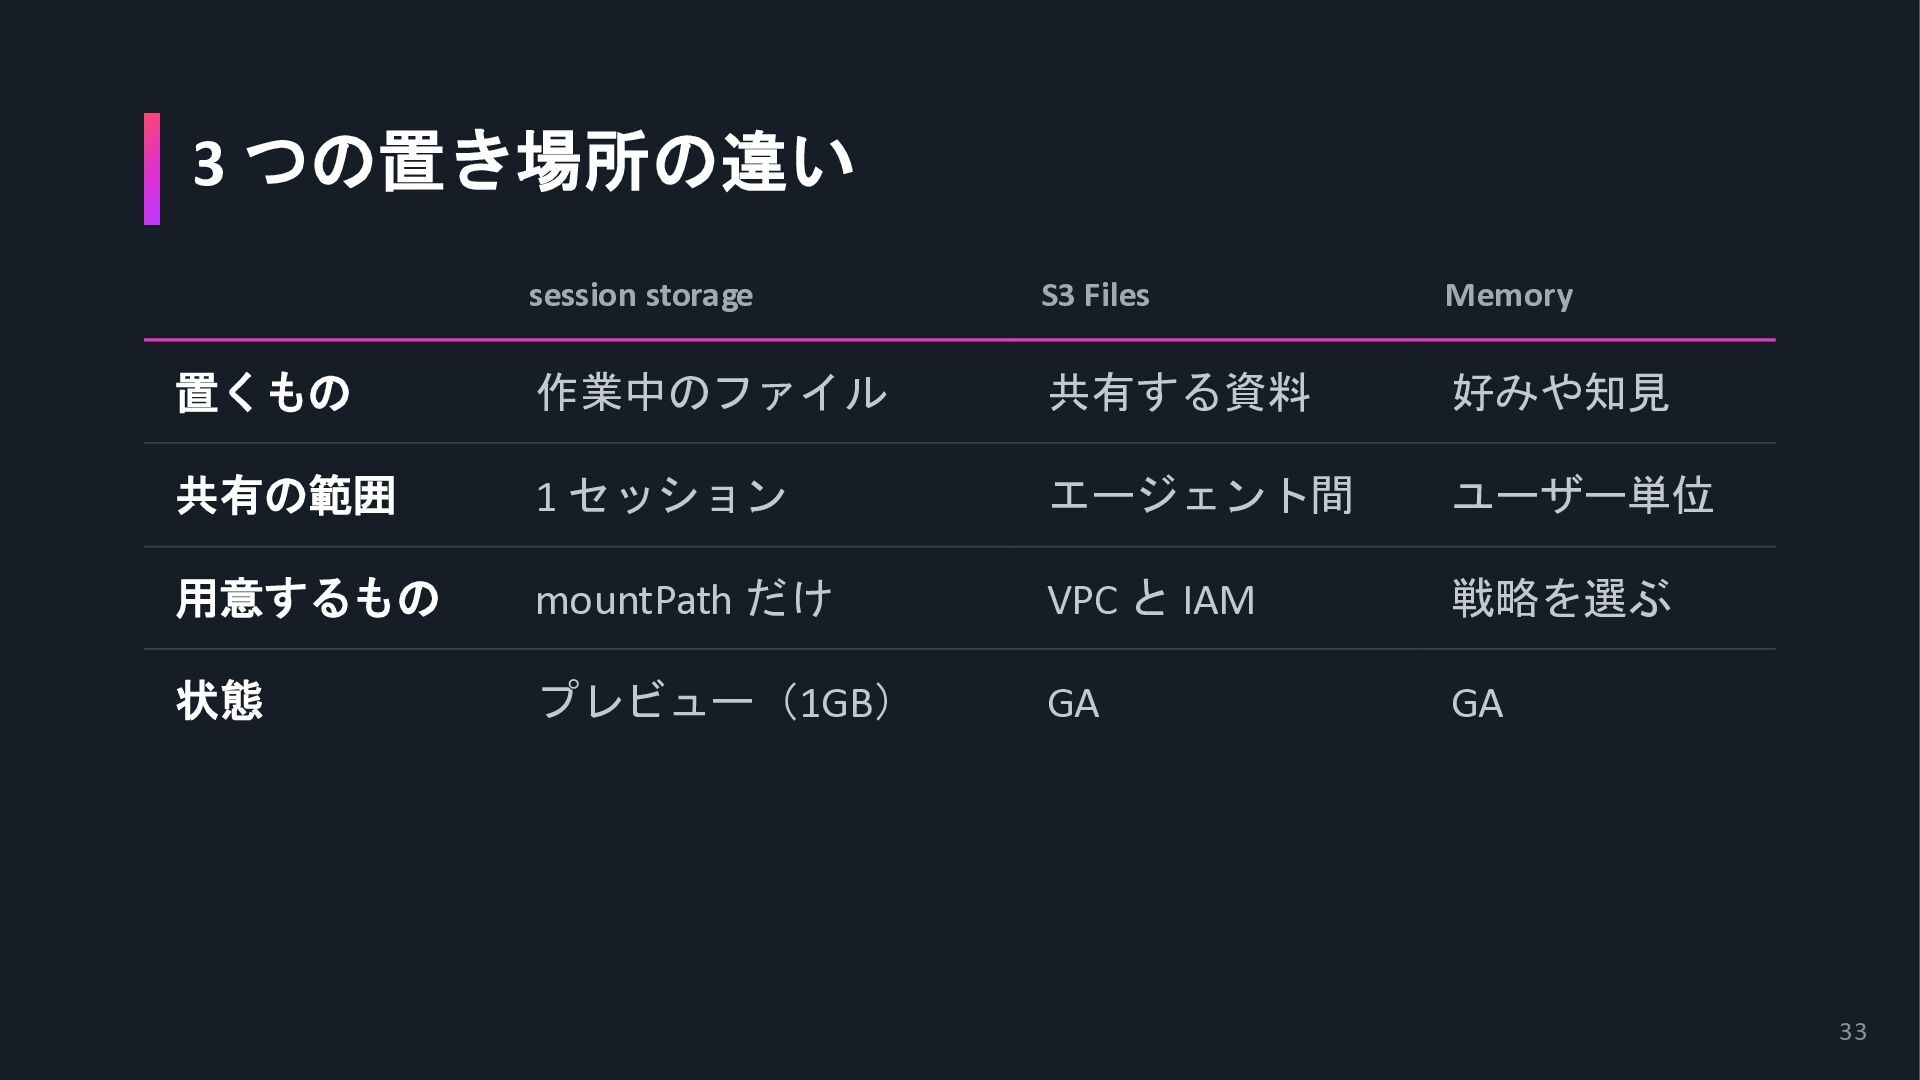
3 つの置き場所の違い session storage S3 Files Memory 置くもの 作業中のファイル 共有する資料
好みや知見 共有の範囲 1 セッション エージェント間 ユーザー単位 用意するもの mountPath だけ VPC と IAM 戦略を選ぶ 状態 プレビュー(1GB) GA GA 33 -
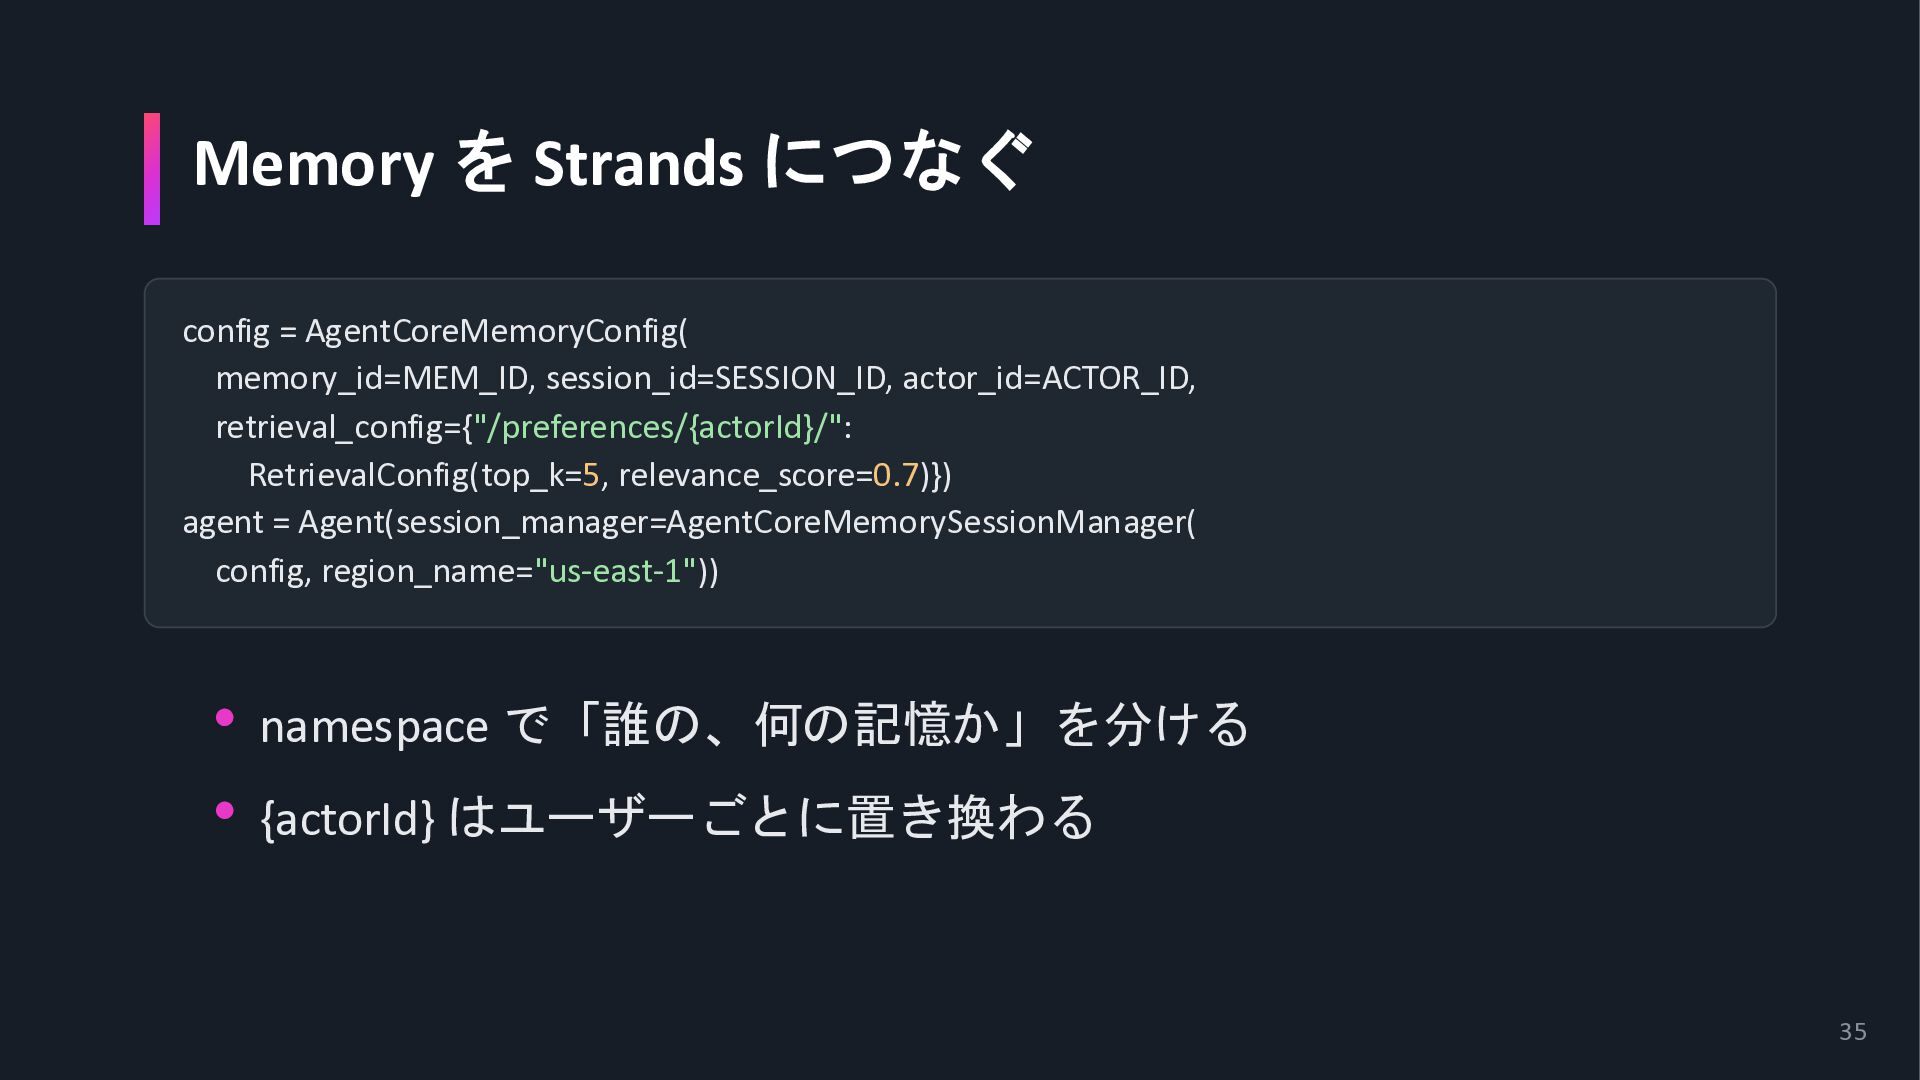
Memory を Strands につなぐ config = AgentCoreMemoryConfig( memory_id=MEM_ID, session_id=SESSION_ID, actor_id=ACTOR_ID,
retrieval_config={"/preferences/{actorId}/": RetrievalConfig(top_k=5, relevance_score=0.7)}) agent = Agent(session_manager=AgentCoreMemorySessionManager( config, region_name="us-east-1")) • namespace で「誰の、何の記憶か」を分ける • {actorId} はユーザーごとに置き換わる 35 -
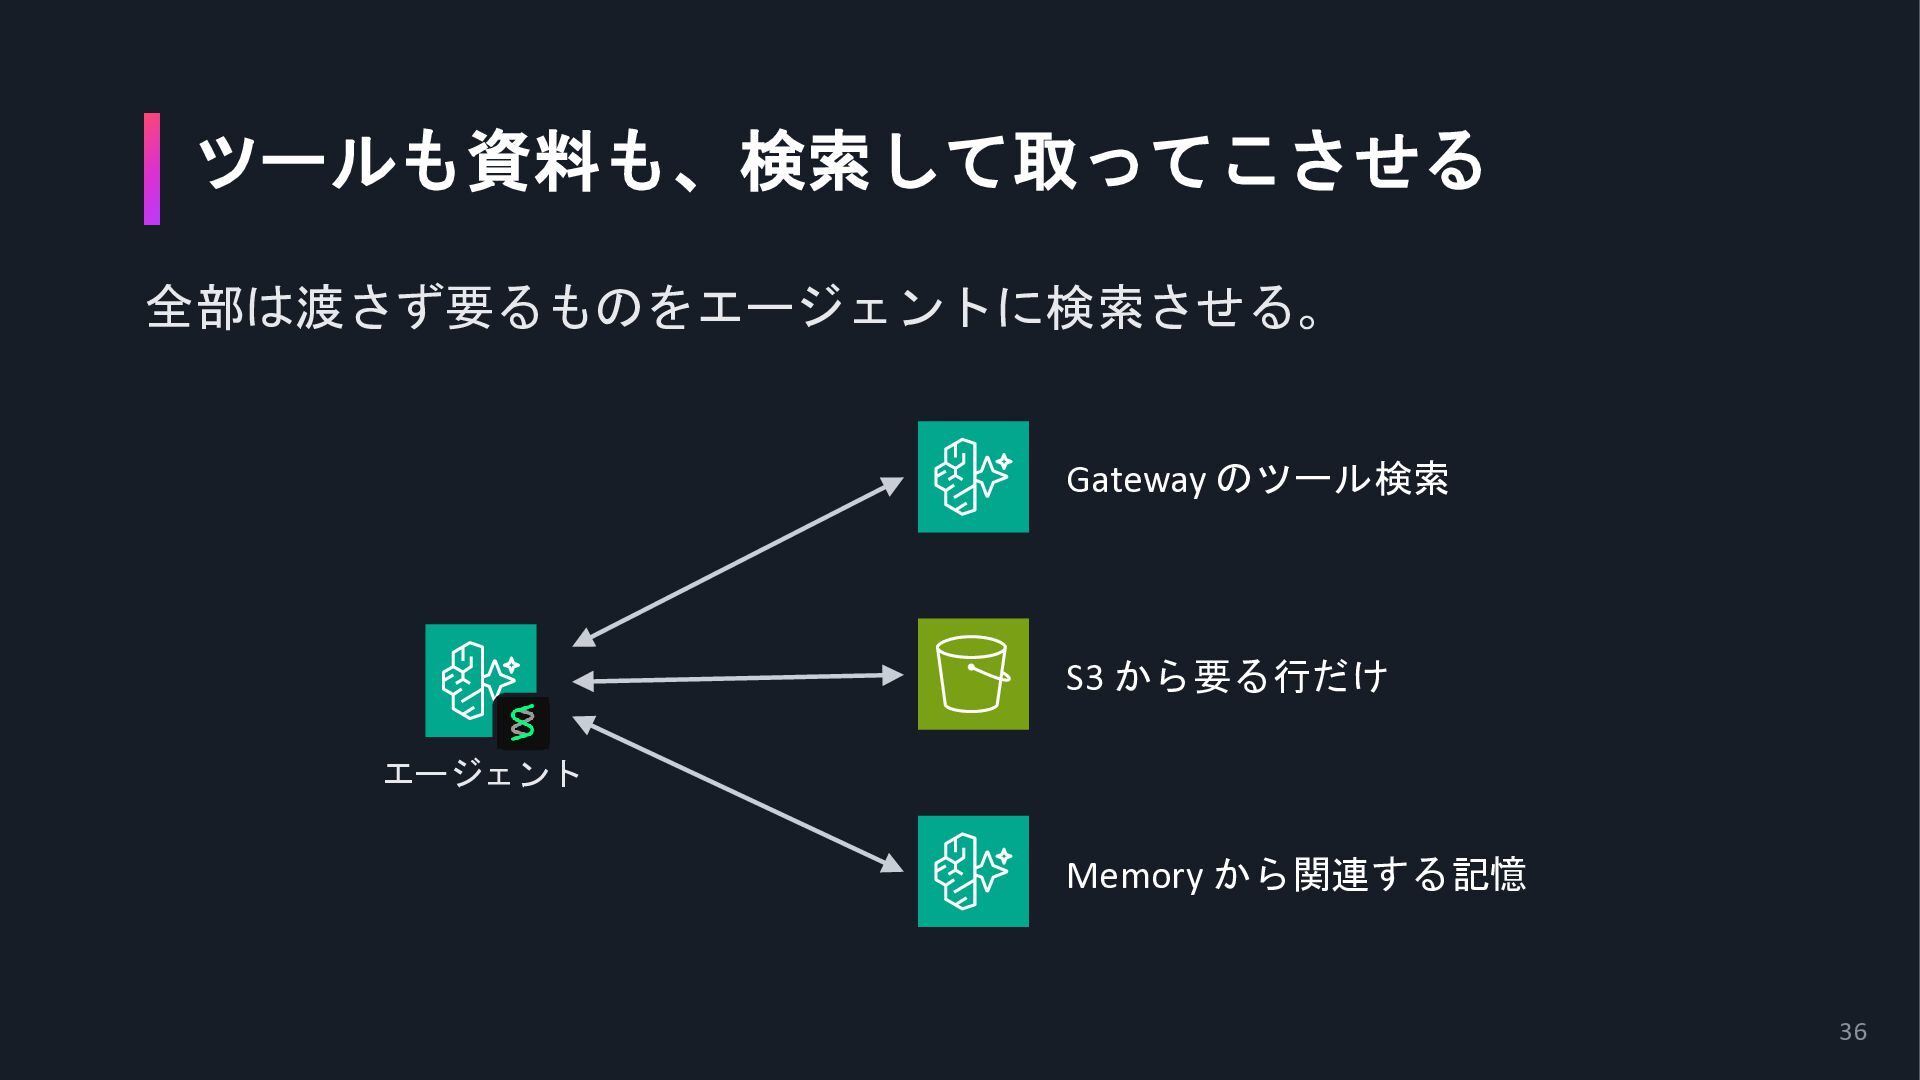
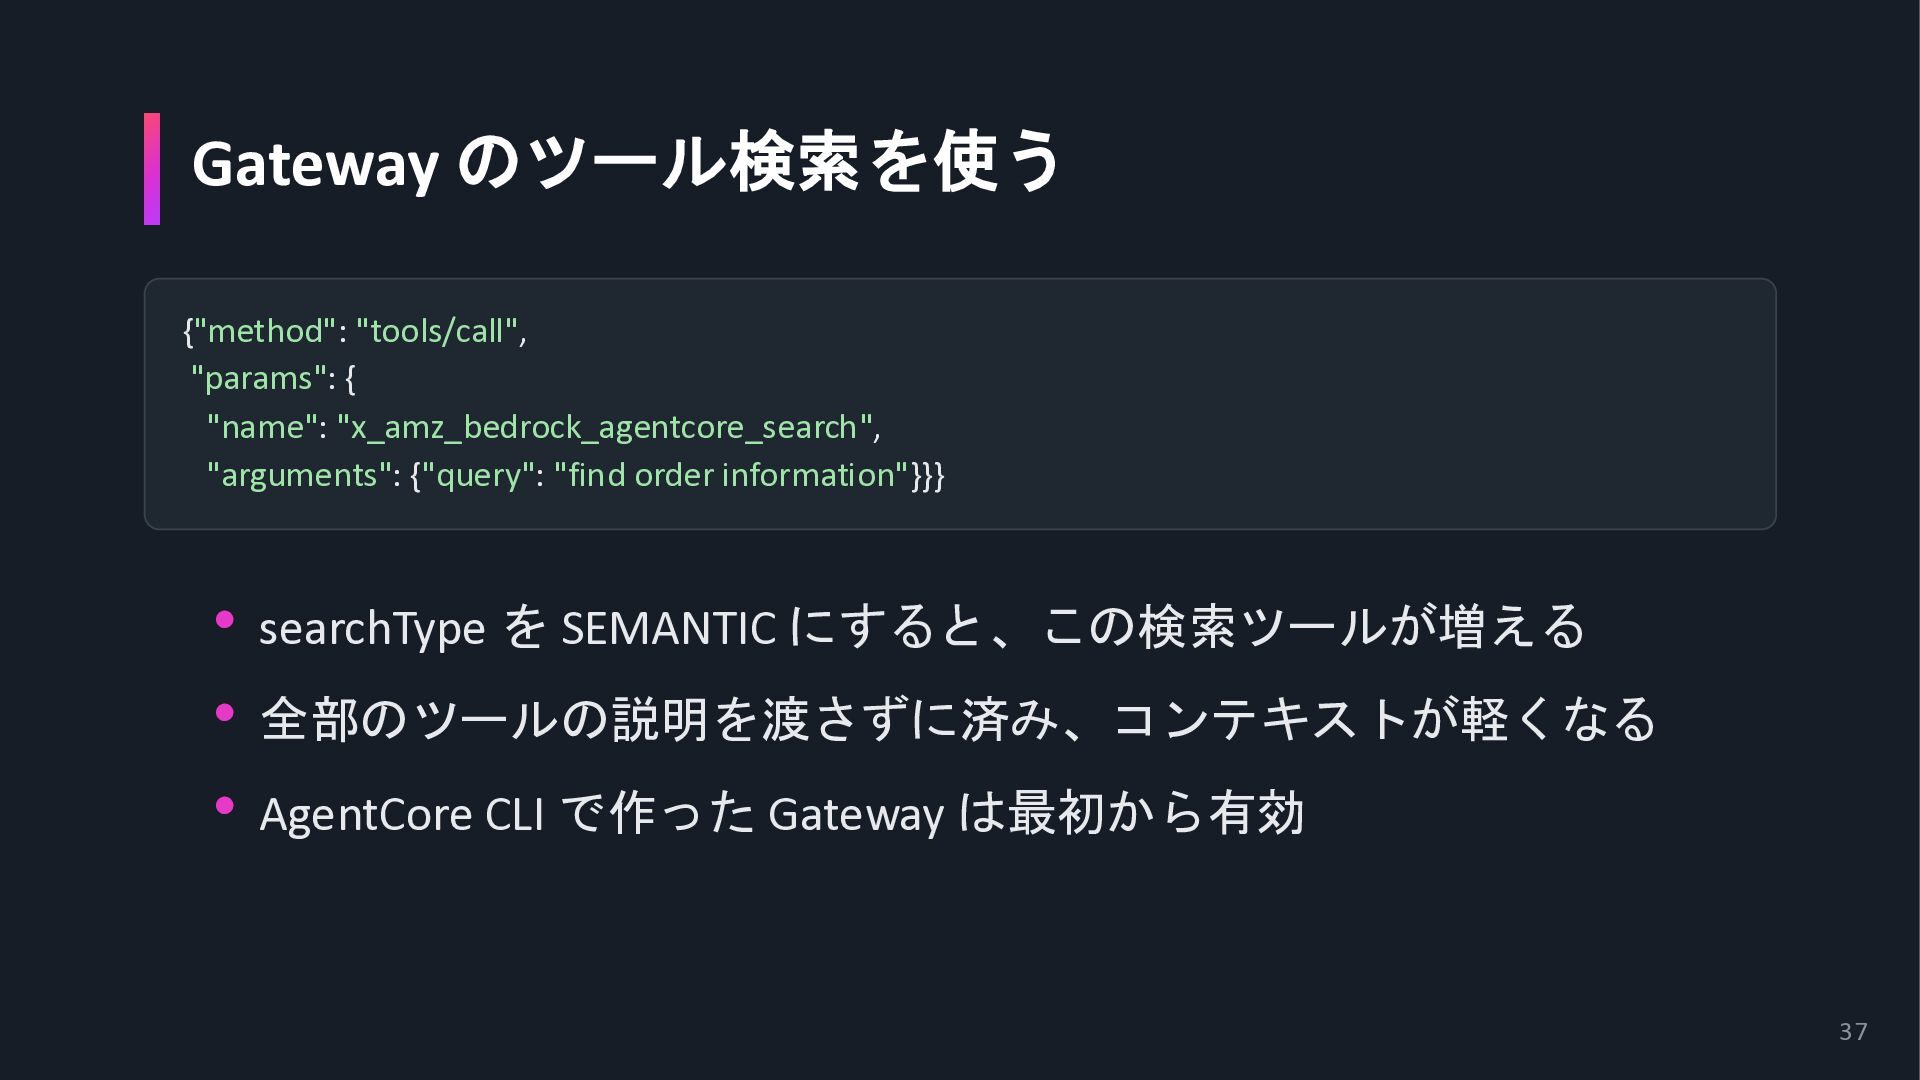
Gateway のツール検索を使う {"method": "tools/call", "params": { "name": "x_amz_bedrock_agentcore_search", "arguments": {"query":
"find order information"}}} • searchType を SEMANTIC にすると、この検索ツールが増える • 全部のツールの説明を渡さずに済み、コンテキストが軽くなる • AgentCore CLI で作った Gateway は最初から有効 37 -
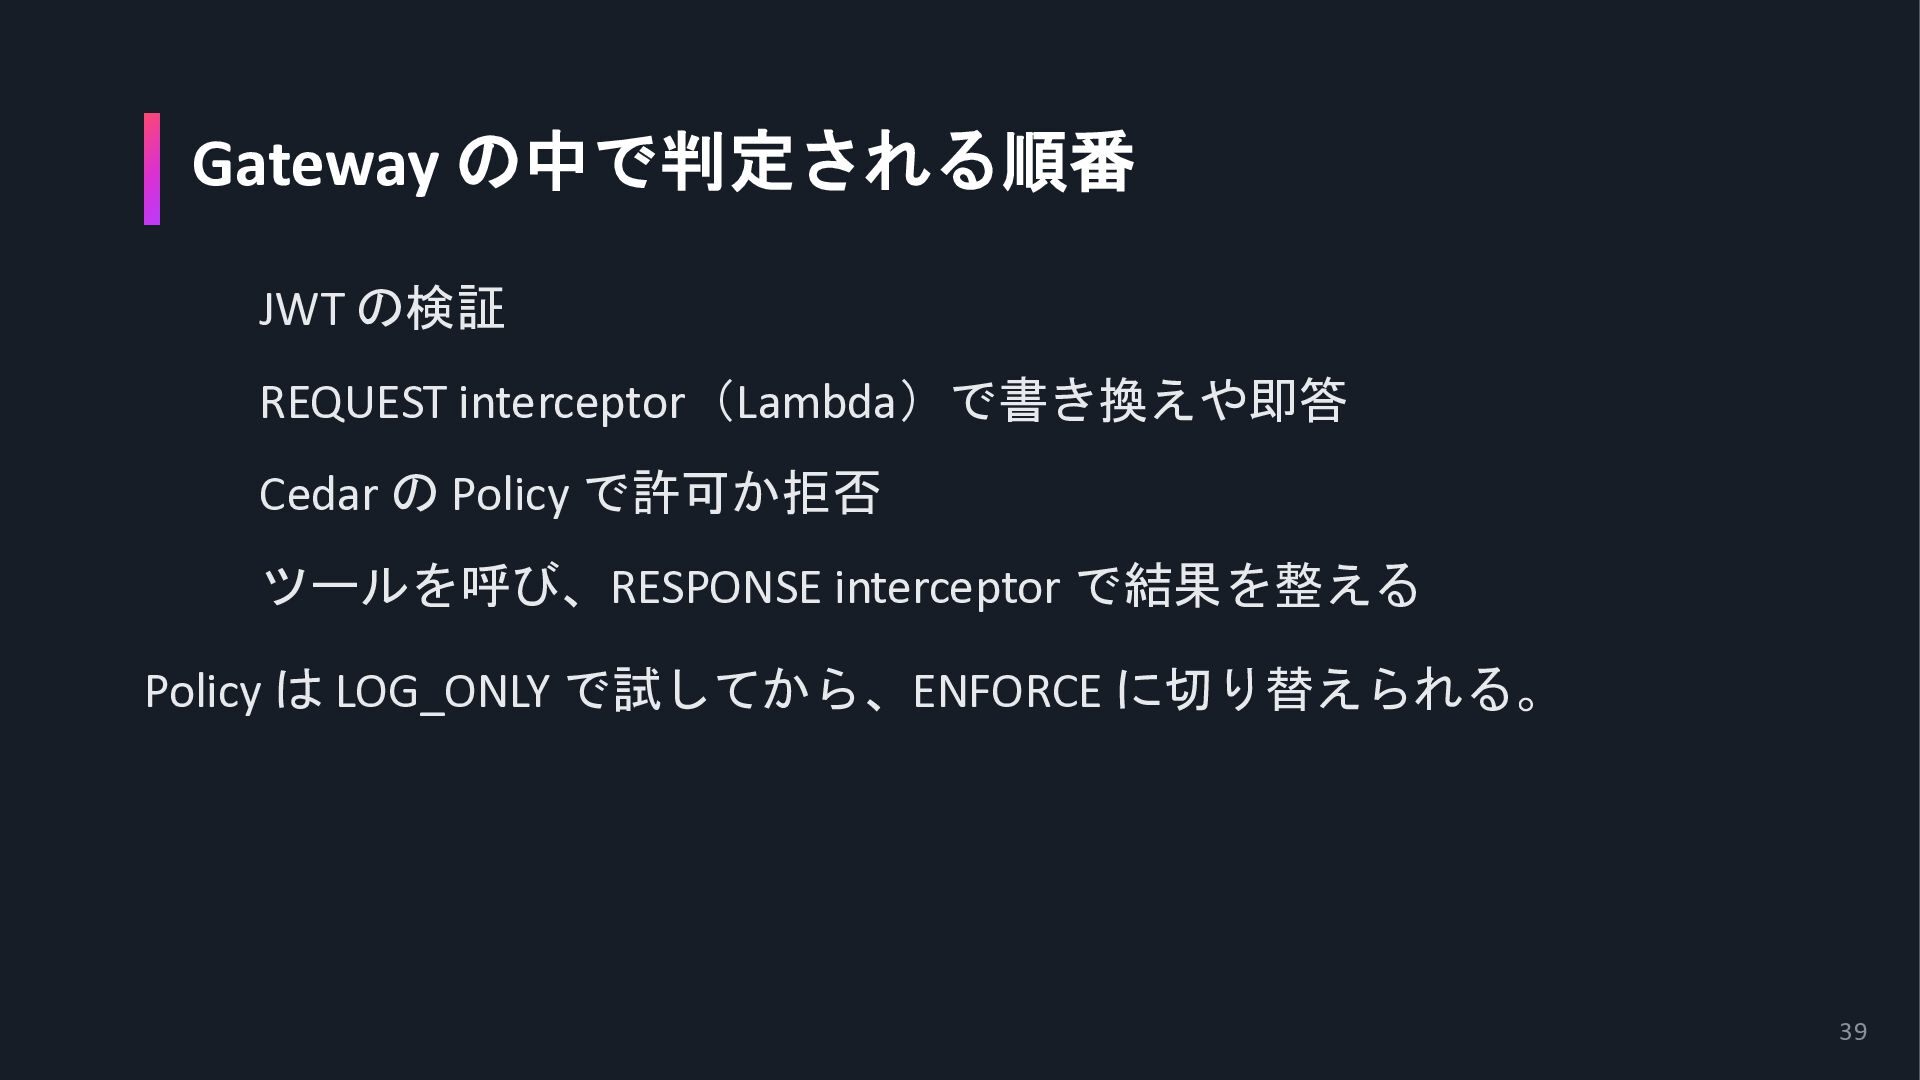
Gateway の中で判定される順番 JWT の検証 REQUEST interceptor(Lambda)で書き換えや即答 Cedar の Policy で許可か拒否
ツールを呼び、RESPONSE interceptor で結果を整える Policy は LOG_ONLY で試してから、ENFORCE に切り替えられる。 39 -
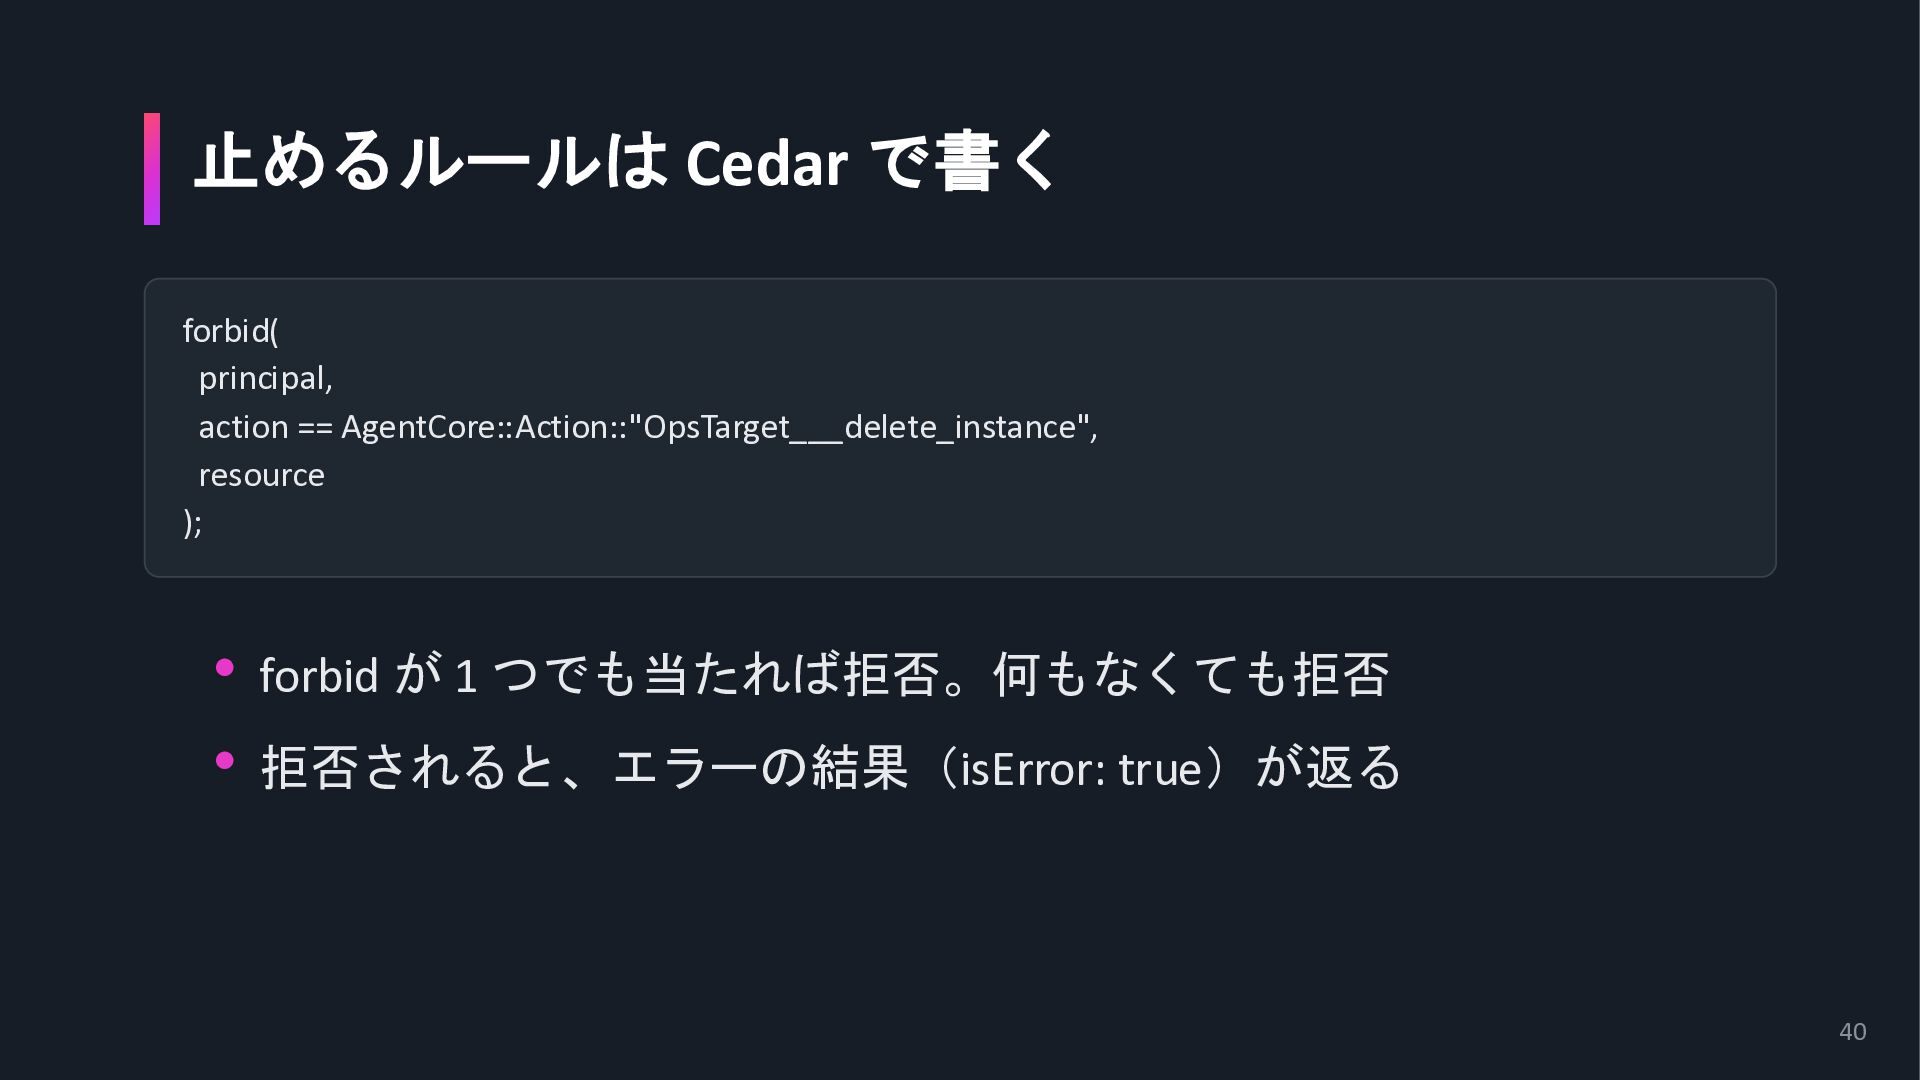
止めるルールは Cedar で書く forbid( principal, action == AgentCore::Action::"OpsTarget___delete_instance", resource );
• forbid が 1 つでも当たれば拒否。何もなくても拒否 • 拒否されると、エラーの結果(isError: true)が返る 40 -
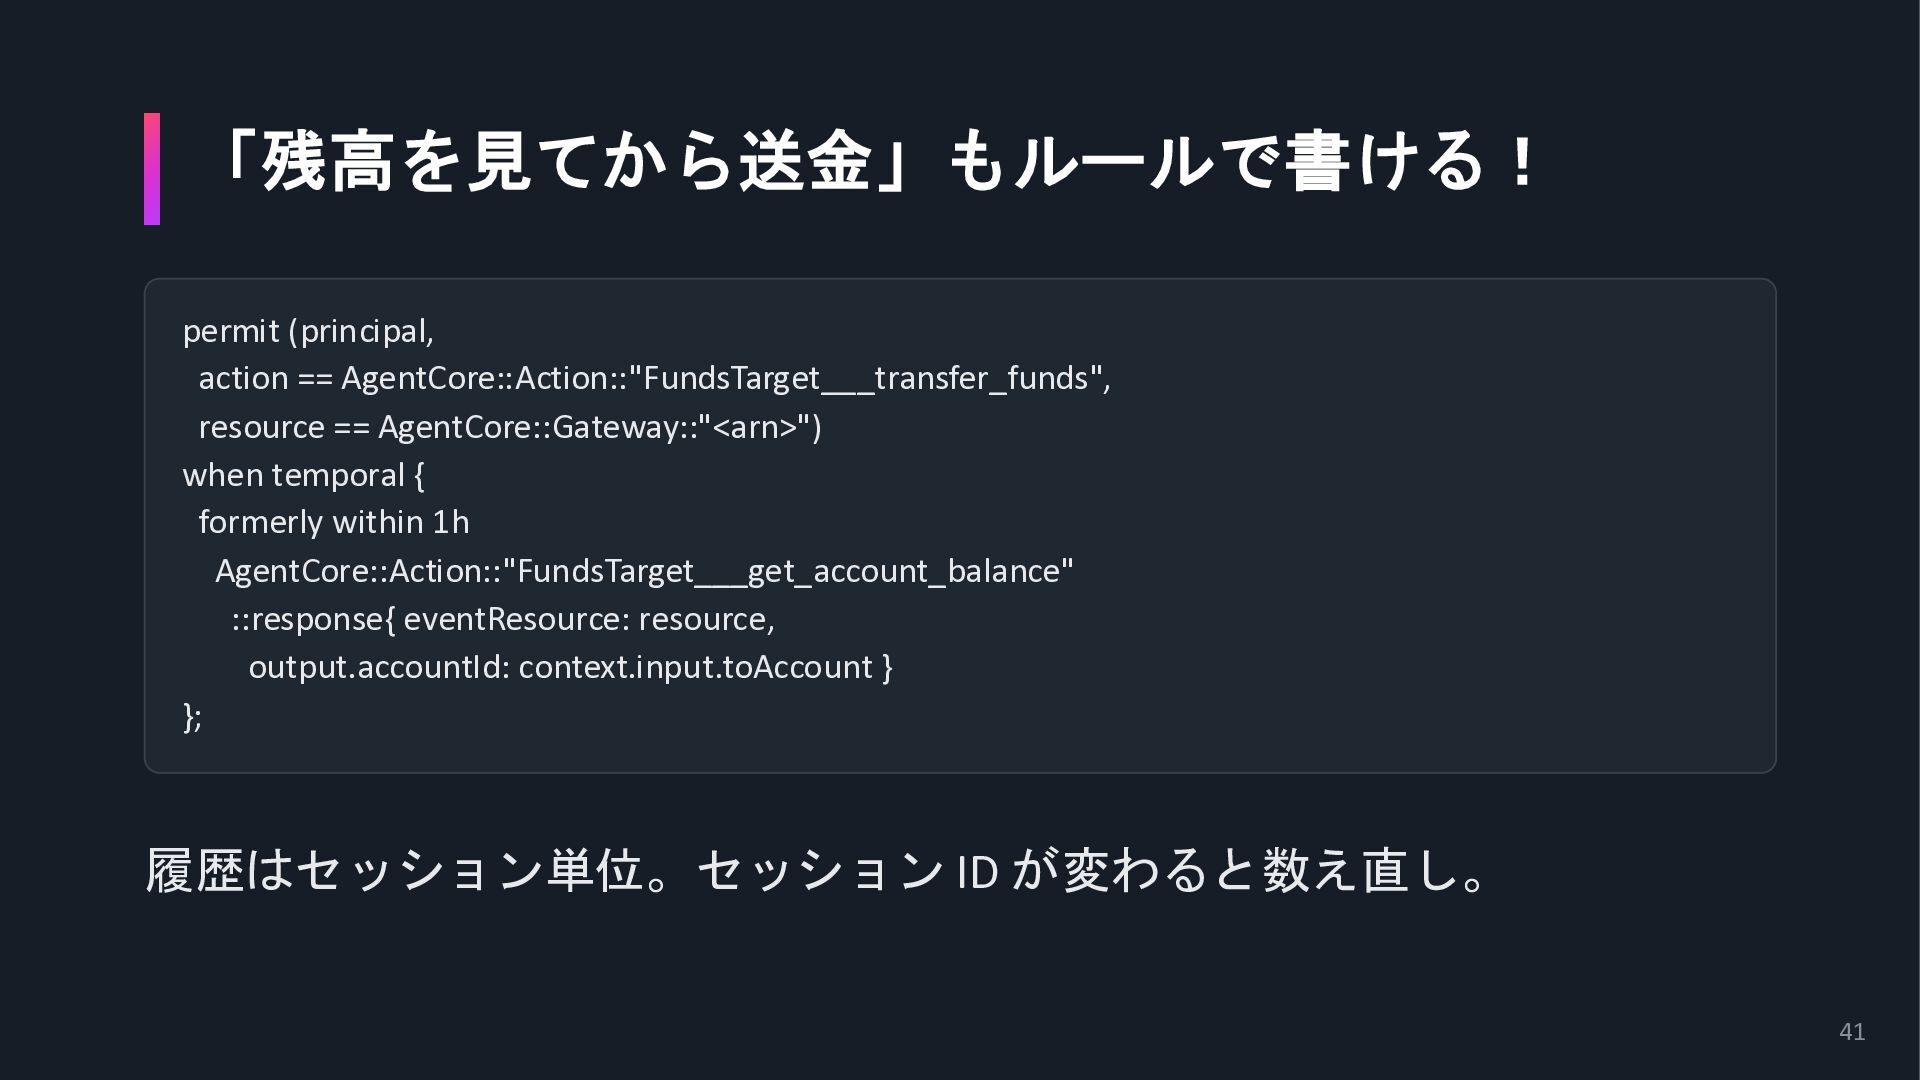
「残高を見てから送金」もルールで書ける! permit (principal, action == AgentCore::Action::"FundsTarget___transfer_funds", resource == AgentCore::Gateway::"<arn>") when
temporal { formerly within 1h AgentCore::Action::"FundsTarget___get_account_balance" ::response{ eventResource: resource, output.accountId: context.input.toAccount } }; 履歴はセッション単位。セッション ID が変わると数え直し。 41 -
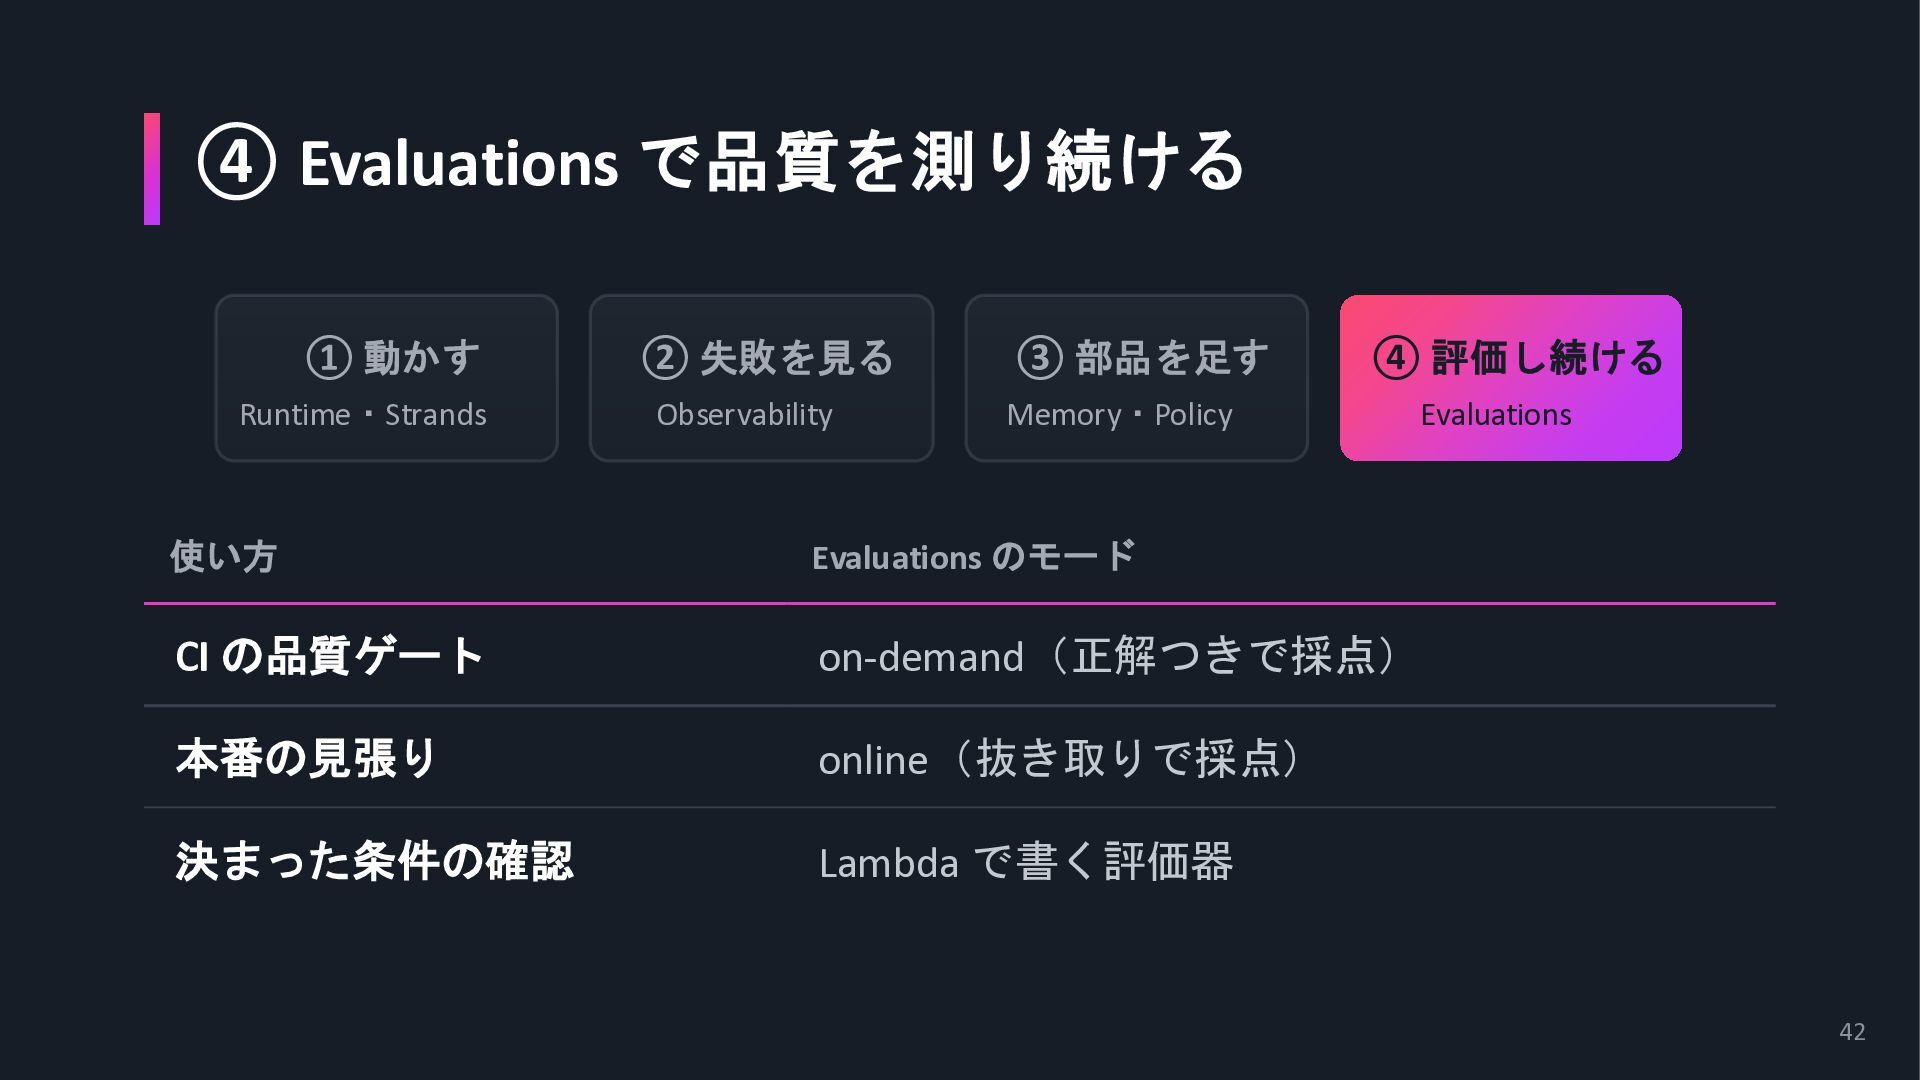
④ Evaluations で品質を測り続ける ① 動かす Runtime・Strands ② 失敗を見る ③ 部品を足す
④ 評価し続ける Observability Memory・Policy Evaluations 使い方 Evaluations のモード CI の品質ゲート on-demand(正解つきで採点) 本番の見張り online(抜き取りで採点) 決まった条件の確認 Lambda で書く評価器 42 -
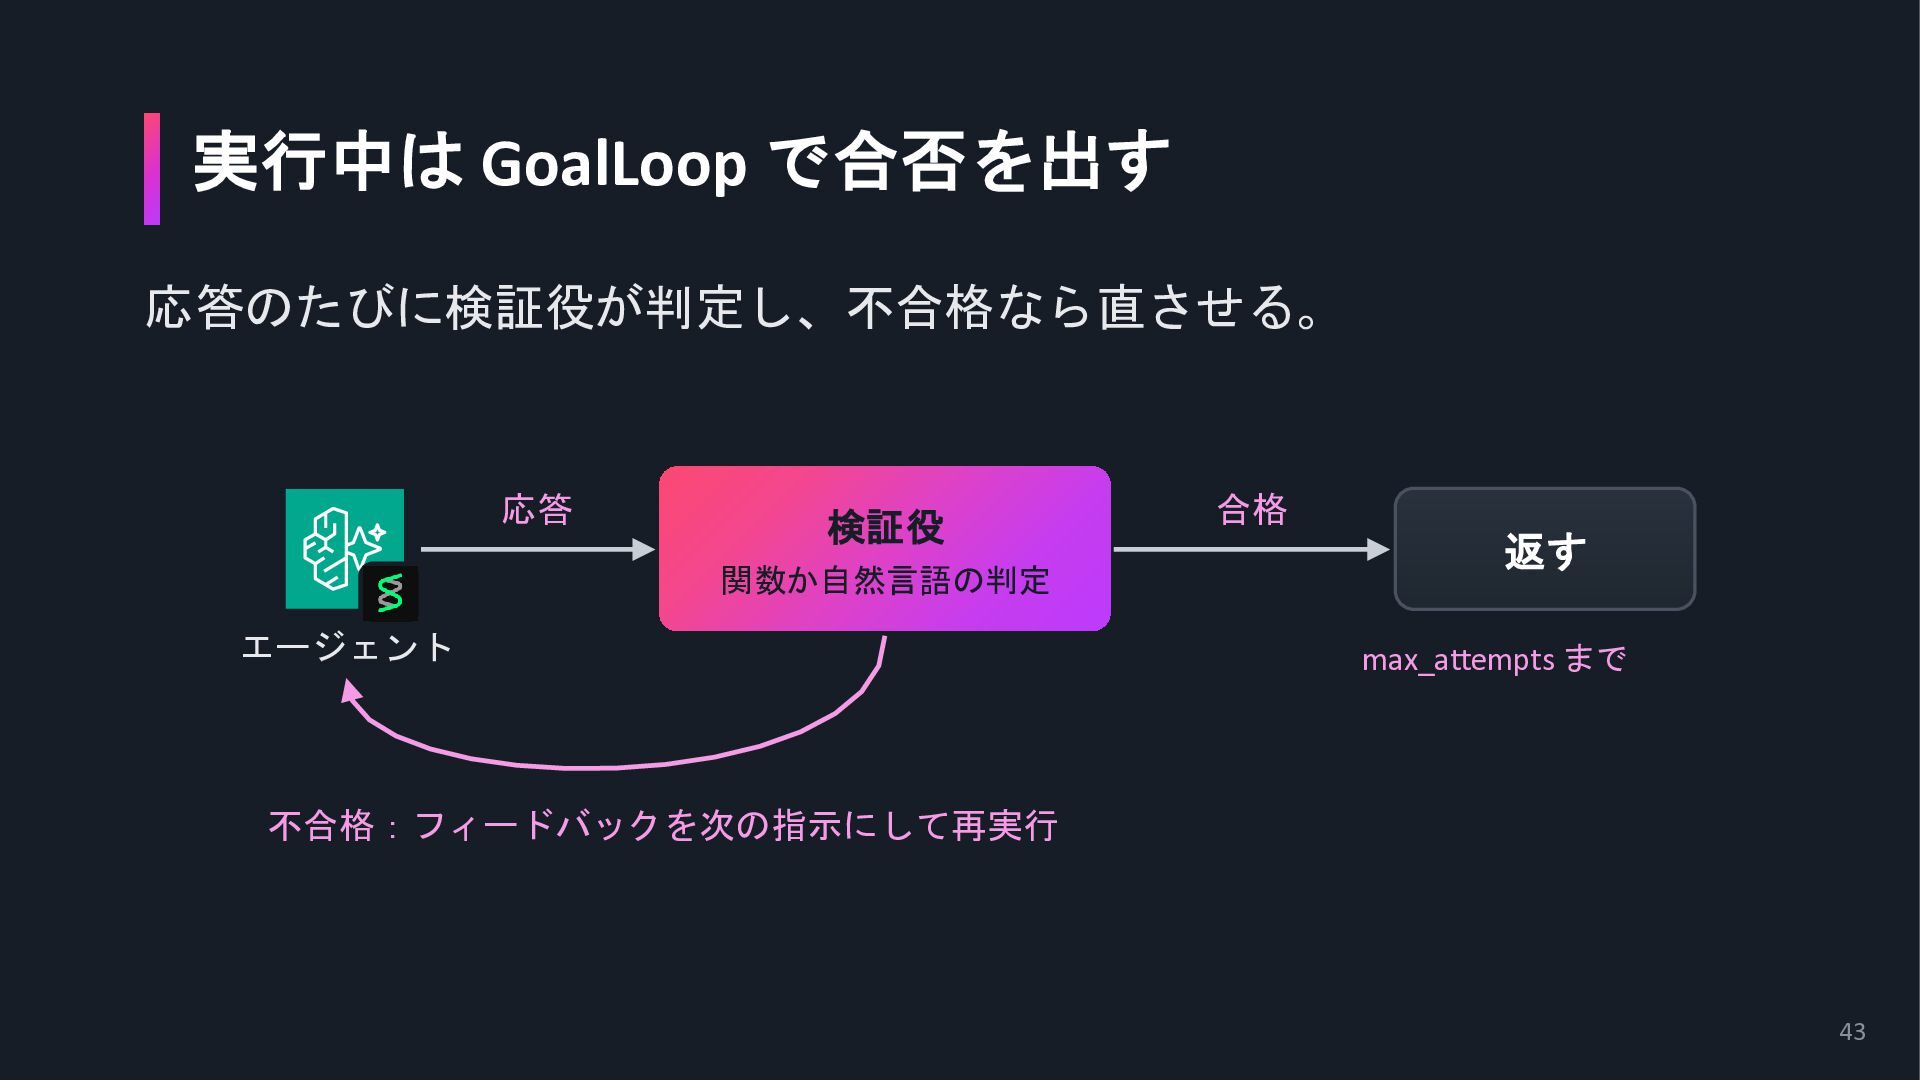
実行中は GoalLoop で合否を出す 応答のたびに検証役が判定し、不合格なら直させる。 応答 検証役 関数か自然言語の判定 エージェント 合格 返す
max_attempts まで 不合格:フィードバックを次の指示にして再実行 43 -
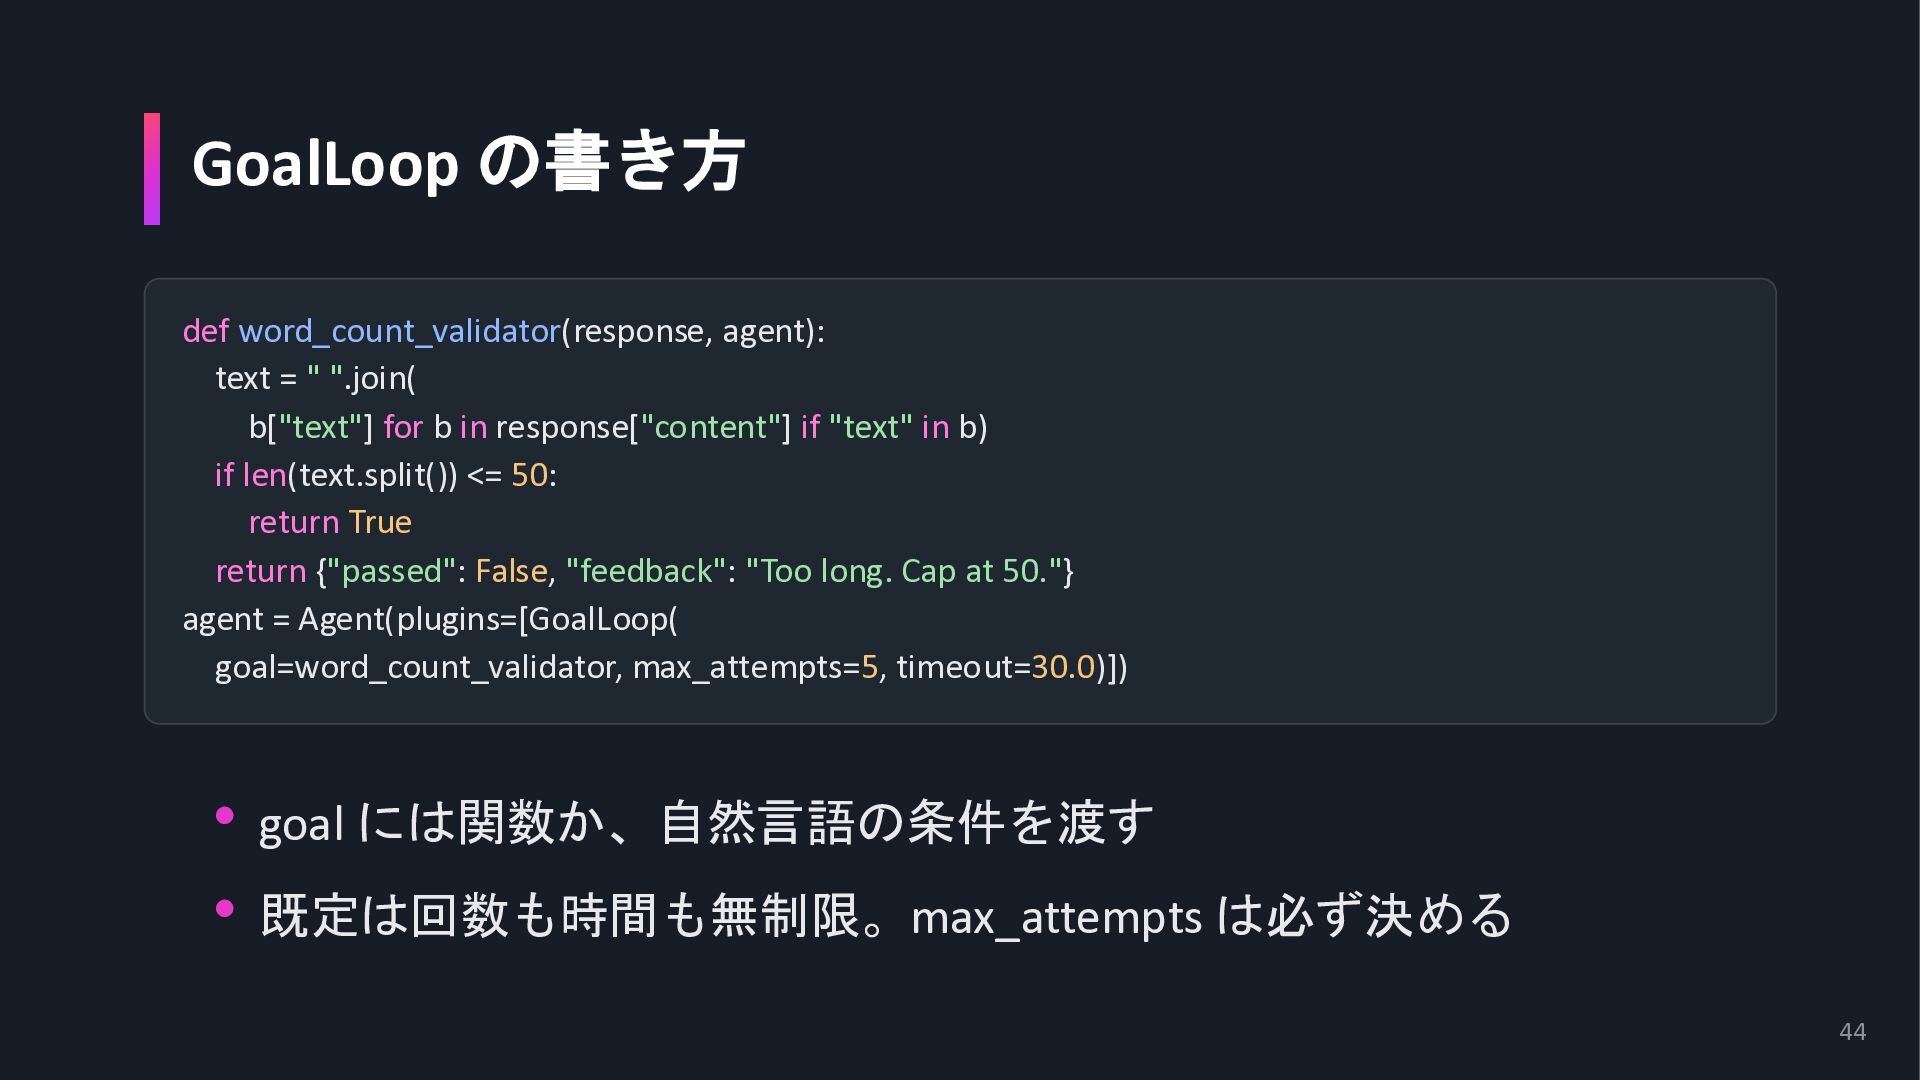
GoalLoop の書き方 def word_count_validator(response, agent): text = " ".join( b["text"]
for b in response["content"] if "text" in b) if len(text.split()) <= 50: return True return {"passed": False, "feedback": "Too long. Cap at 50."} agent = Agent(plugins=[GoalLoop( goal=word_count_validator, max_attempts=5, timeout=30.0)]) • goal には関数か、自然言語の条件を渡す • 既定は回数も時間も無制限。max_attempts は必ず決める 44 -
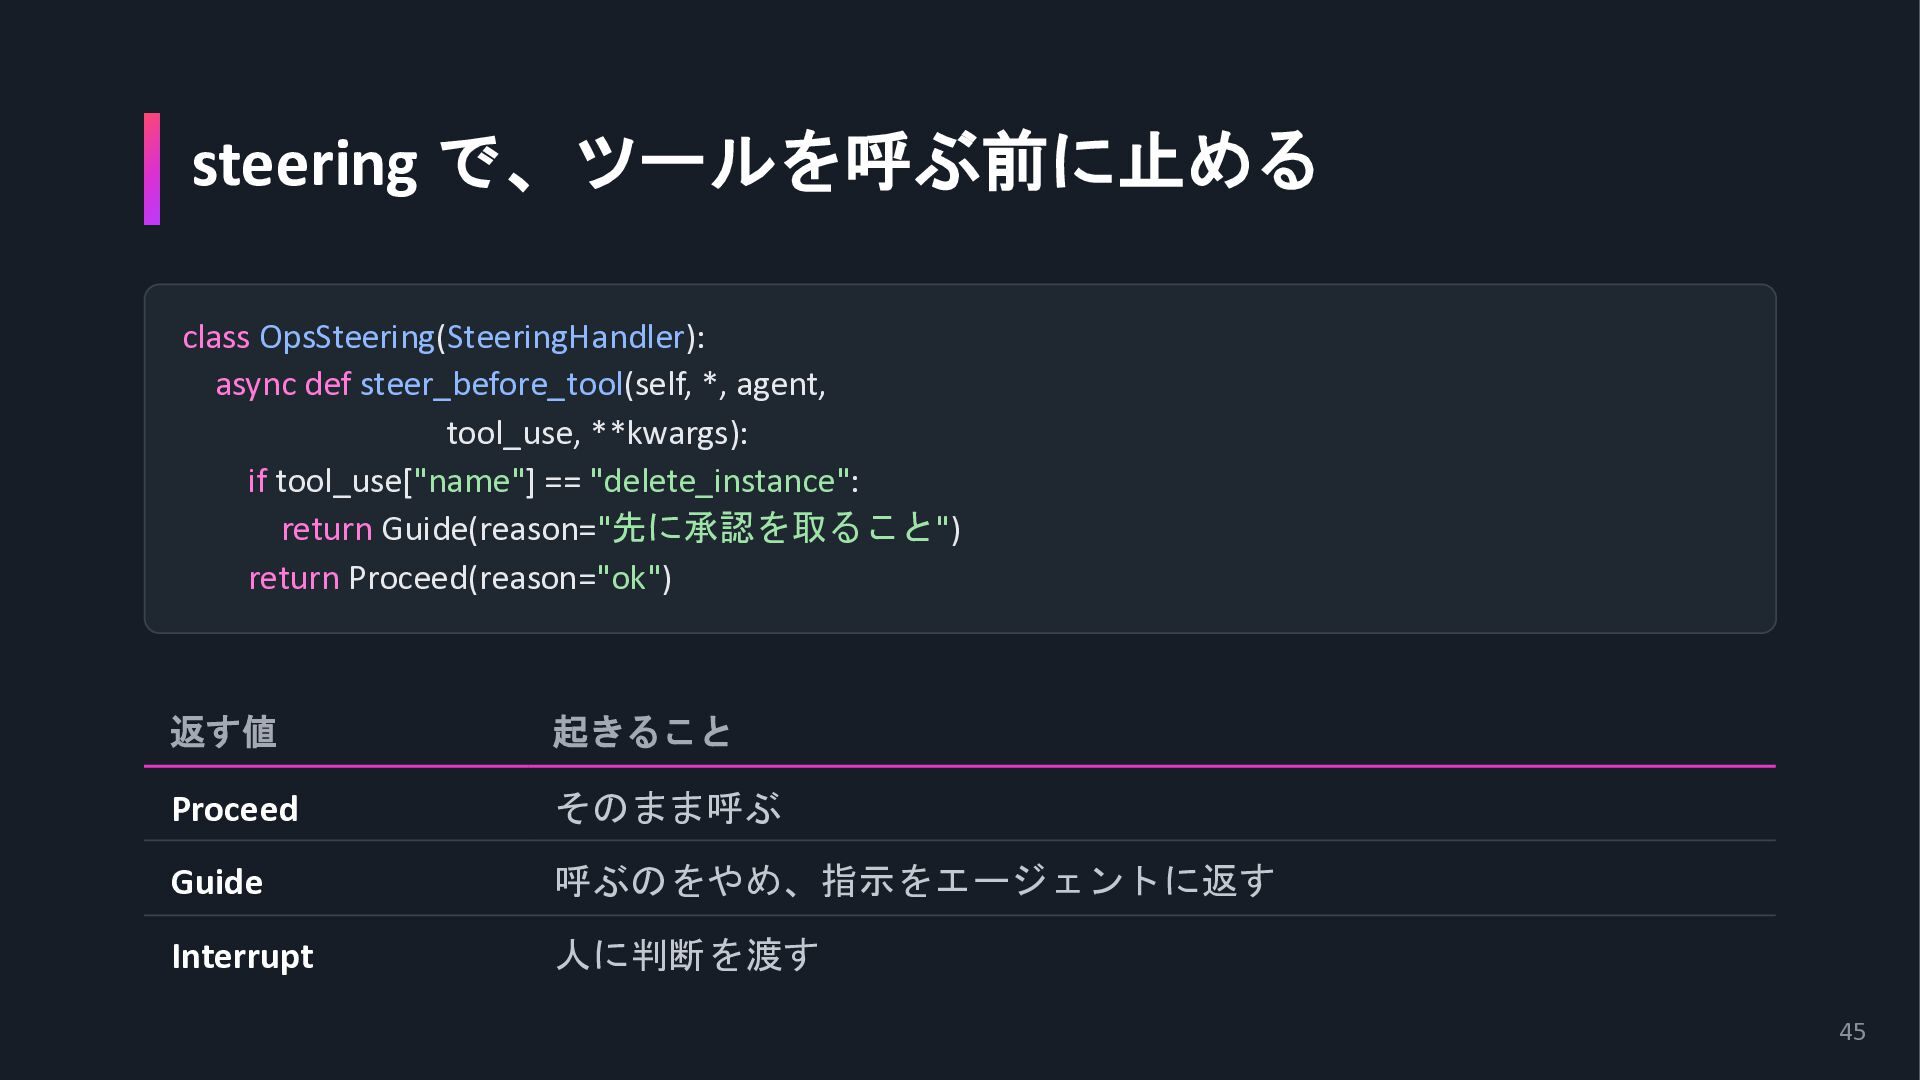
steering で、ツールを呼ぶ前に止める class OpsSteering(SteeringHandler): async def steer_before_tool(self, *, agent, tool_use,
**kwargs): if tool_use["name"] == "delete_instance": return Guide(reason="先に承認を取ること") return Proceed(reason="ok") 返す値 起きること Proceed そのまま呼ぶ Guide 呼ぶのをやめ、指示をエージェントに返す Interrupt 人に判断を渡す 45 -
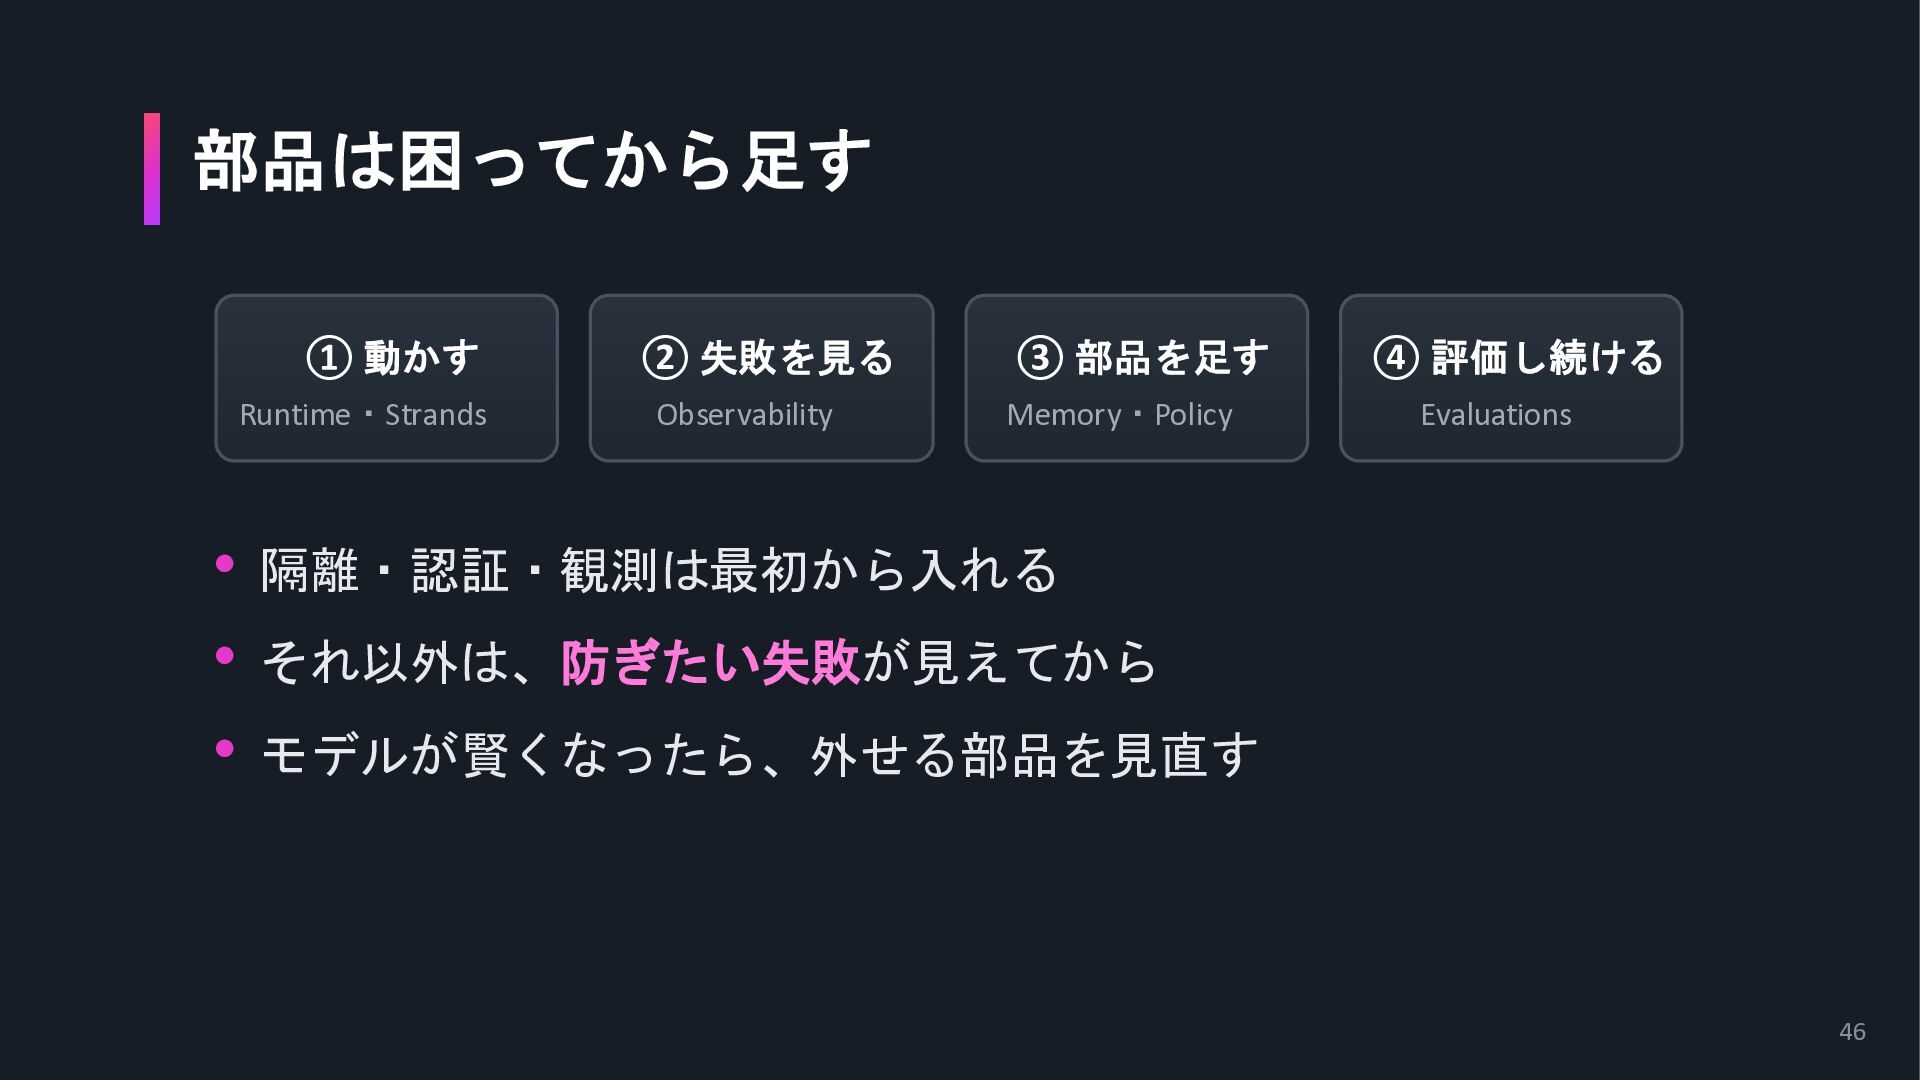
部品は困ってから足す ① 動かす Runtime・Strands ② 失敗を見る ③ 部品を足す ④ 評価し続ける
Observability Memory・Policy Evaluations • 隔離・認証・観測は最初から入れる • それ以外は、防ぎたい失敗が見えてから • モデルが賢くなったら、外せる部品を見直す 46 -
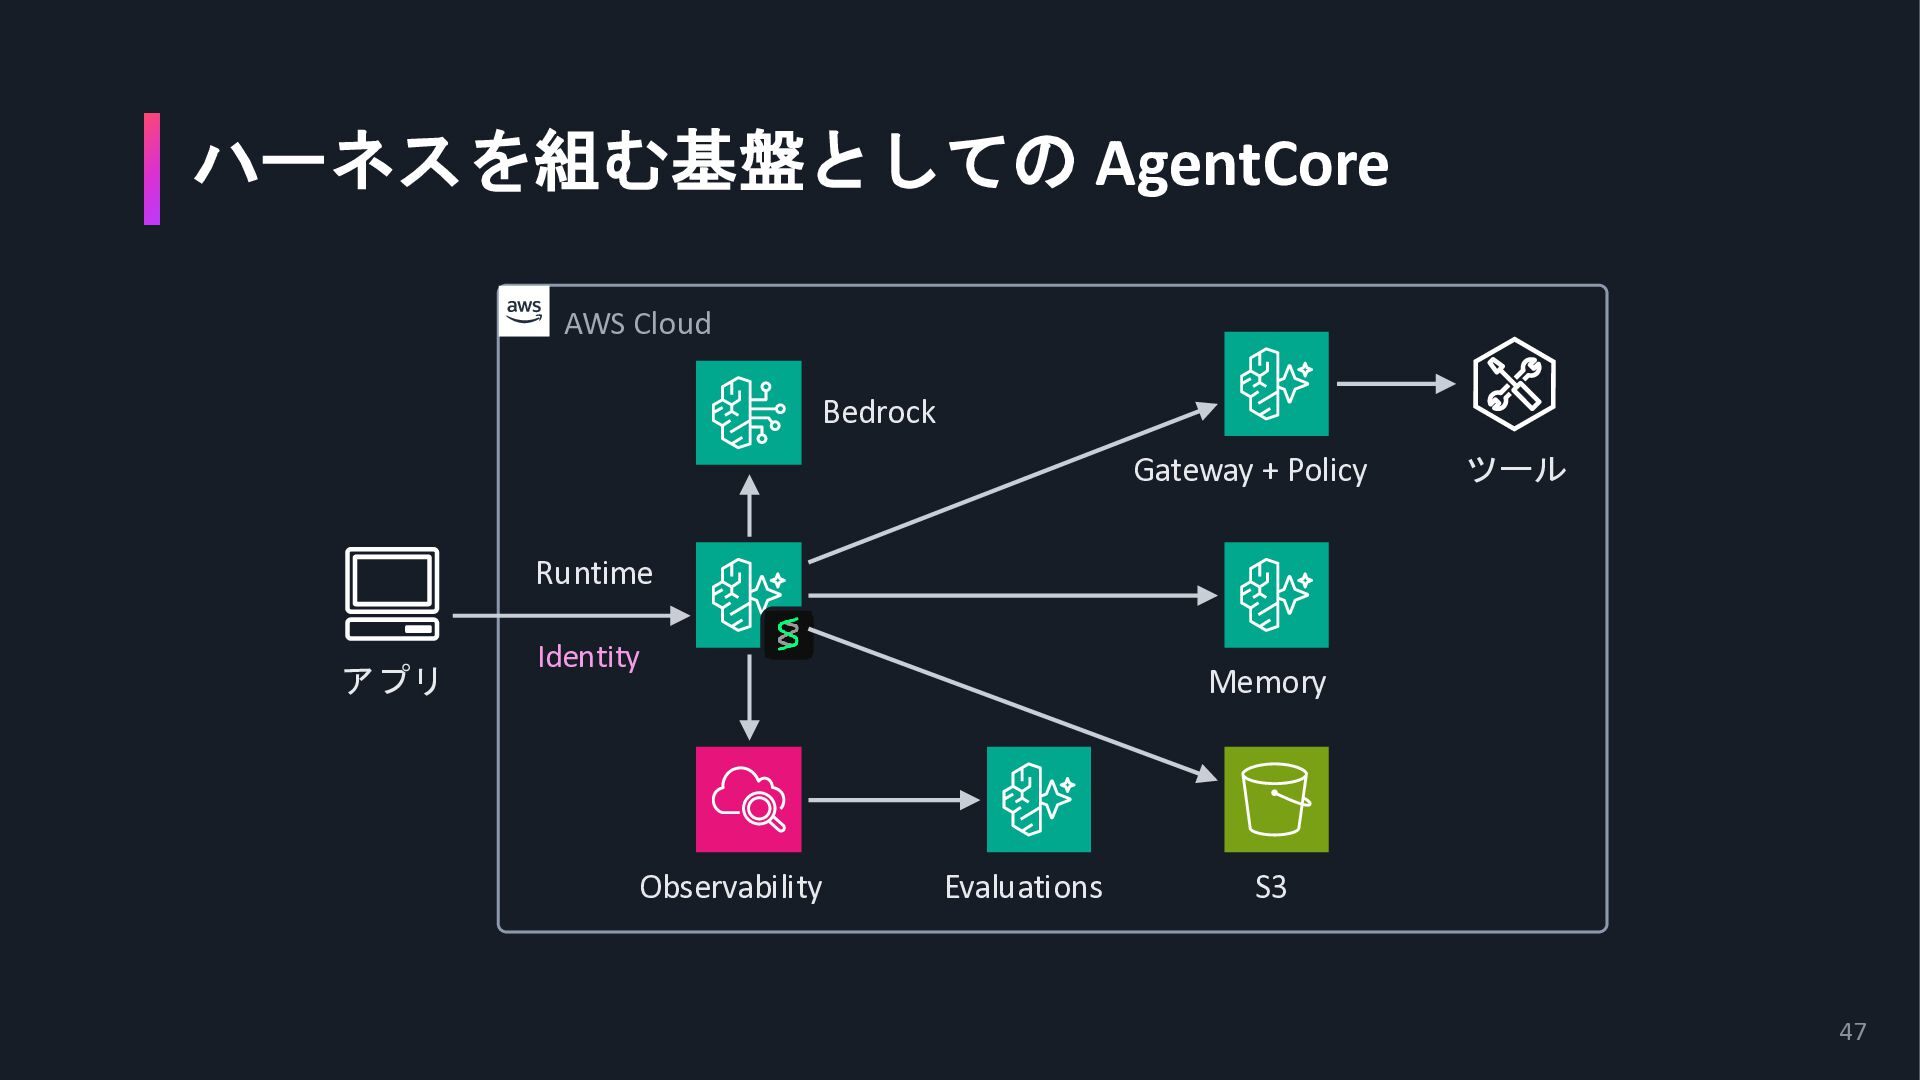
ハーネスを組む基盤としての AgentCore AWS Cloud Bedrock Gateway + Policy ツール Runtime
アプリ Identity Observability Memory Evaluations S3 47