Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ユーザーのプロフィールデータを活用した推薦精度向上の取り組み
Search
Yudai Hayashi
June 19, 2025
Technology
790
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ユーザーのプロフィールデータを活用した推薦精度向上の取り組み
白金鉱業 Meetup Vol.19@六本木 で発表した内容です
Yudai Hayashi
June 19, 2025
More Decks by Yudai Hayashi
See All by Yudai Hayashi
技術キャッチアップ効率化を実現する記事推薦システムの構築
yudai00
4
390
Off-Policy Evaluation and Learning for Matching Markets
yudai00
0
180
ジョブマッチングプラットフォームにおける推薦アルゴリズムの活用事例
yudai00
0
210
MCP Clientを活用するための設計と実装上の工夫
yudai00
1
1.4k
人とシゴトのマッチングを実現するための機械学習技術
yudai00
1
140
MCPを理解する
yudai00
18
16k
データバリデーションによるFeature Storeデータ品質の担保
yudai00
1
300
「仮説行動」で学んだ、仮説を深め ていくための方法
yudai00
8
2.1k
相互推薦システムでのPseudo Label を活用したマッチ予測精度向上の取り組み
yudai00
1
1.2k
Other Decks in Technology
See All in Technology
[2026 Oracle Technical Deep Dive] AI時代のデータベース基盤をどう選ぶ? Exadata Database Serviceの選択肢と使い分け (2026年9月17日開催)
oracle4engineer
PRO
0
220
[2026-09-30]ロックンロールは鳴り止まないっ - 信頼性かまってちゃん - 「データ駆動を投げ捨ててまで。」追いかける信頼性改善に向けた取り組みの話
tosite
0
200
Execution in the Kingdom of Agents: Reflections on Abstraction and Complexity
bcantrill
0
840
生成AIで高い生産性を求められて、 悩み、乗り越えた話
mot_techtalk
2
130
検証フェーズはAIの回答を判断するための学習機会
toru_kubota
2
500
SDDの運用にめげずに向き合った話
sansantech
PRO
0
130
AI 時代の Azure エンジニアリング ~ 私たちは何を磨き、何を任せるのか ~
chack411
1
450
全人類(ほぼ)AWS Organizations の上でAWSを利用している、その世界を知る話
htan
0
110
大阪オフィスに Unitree Go2 がやってきたので Physical AI やってみた
dafujii
0
300
Swap and Memory Reclaim - Squeezing Out More RAM
ennael
PRO
1
1.6k
HacobuにおけるFDEとは/登壇資料(戸井田 裕貴)
hacobu
PRO
1
770
AIは爆速なのに、私が詰まっていた話 ― 音声入力と鳴くマスコットでボトルネックを削る
yama3133
0
520
Featured
See All Featured
4 Signs Your Business is Dying
shpigford
187
23k
Claude Code のすすめ
schroneko
67
230k
The #1 spot is gone: here's how to win anyway
tamaranovitovic
4
1.2k
GraphQLとの向き合い方2022年版
quramy
50
15k
Six Lessons from altMBA
skipperchong
29
4.5k
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.7k
AI in Enterprises - Java and Open Source to the Rescue
ivargrimstad
0
1.5k
実際に使うSQLの書き方 徹底解説 / pgcon21j-tutorial
soudai
PRO
203
76k
Bash Introduction
62gerente
615
220k
Color Theory Basics | Prateek | Gurzu
gurzu
1
480
Reality Check: Gamification 10 Years Later
codingconduct
0
2.3k
Practical Orchestrator
shlominoach
192
12k
Transcript
© 2025 Wantedly, Inc. ユーザーのプロフィールデータを活 用した推薦精度向上の取り組み 白金鉱業 Meetup Vol.19@六本木 Jun.19
2025 - Yudai Hayashi
© 2025 Wantedly, Inc. 自己紹介 林 悠大 • 経歴: ◦
2022年に応用物理分野で Ph.D取得 ◦ 2022年にウォンテッドリー株式会社に新卒入社。データサイ エンティストとして推薦システムの開発に従事 @python_walker @Hayashi-Yudai
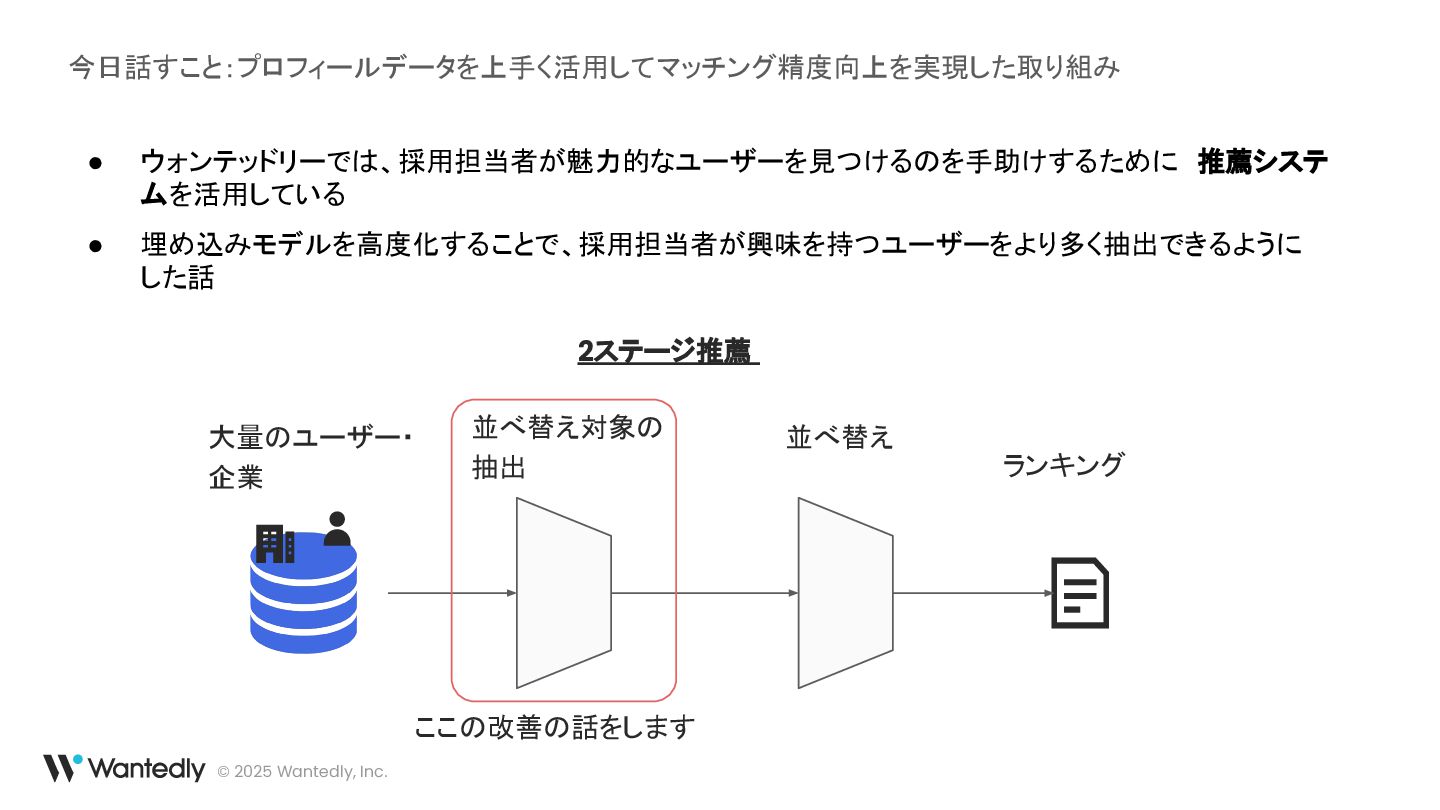
© 2025 Wantedly, Inc. 今日話すこと:プロフィールデータを上手く活用してマッチング精度向上を実現した取り組み • ウォンテッドリーでは、採用担当者が魅力的なユーザーを見つけるのを手助けするために 推薦システ ムを活用している •
埋め込みモデルを高度化することで、採用担当者が興味を持つユーザーをより多く抽出できるように した話 大量のユーザー・ 企業 ランキング 並べ替え対象の 抽出 並べ替え 2ステージ推薦 ここの改善の話をします
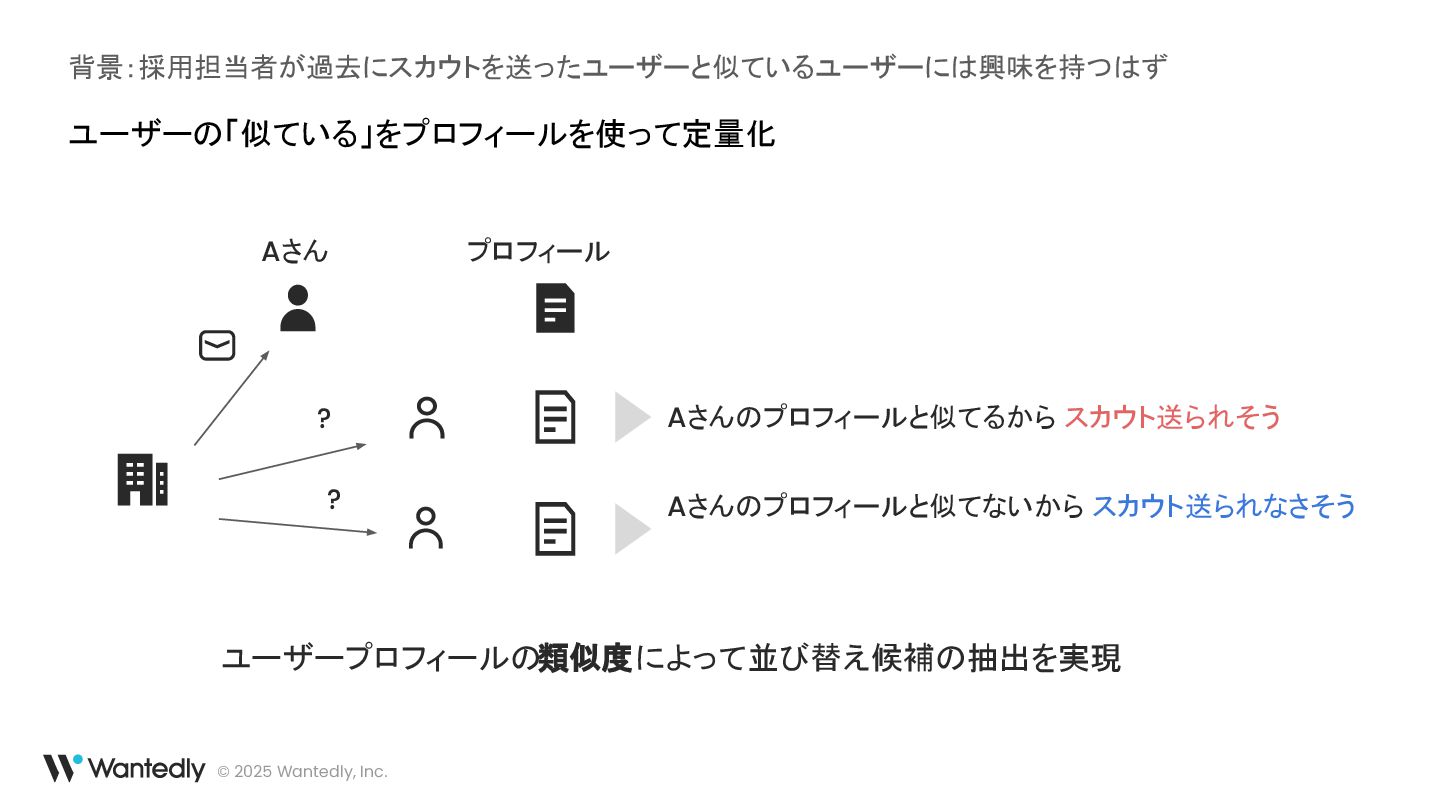
© 2025 Wantedly, Inc. 背景:採用担当者が過去にスカウトを送ったユーザーと似ているユーザーには興味を持つはず ユーザーの「似ている」をプロフィールを使って定量化 ? ? Aさん プロフィール
Aさんのプロフィールと似てるから スカウト送られそう Aさんのプロフィールと似てないから スカウト送られなさそう ユーザープロフィールの類似度によって並び替え候補の抽出を実現
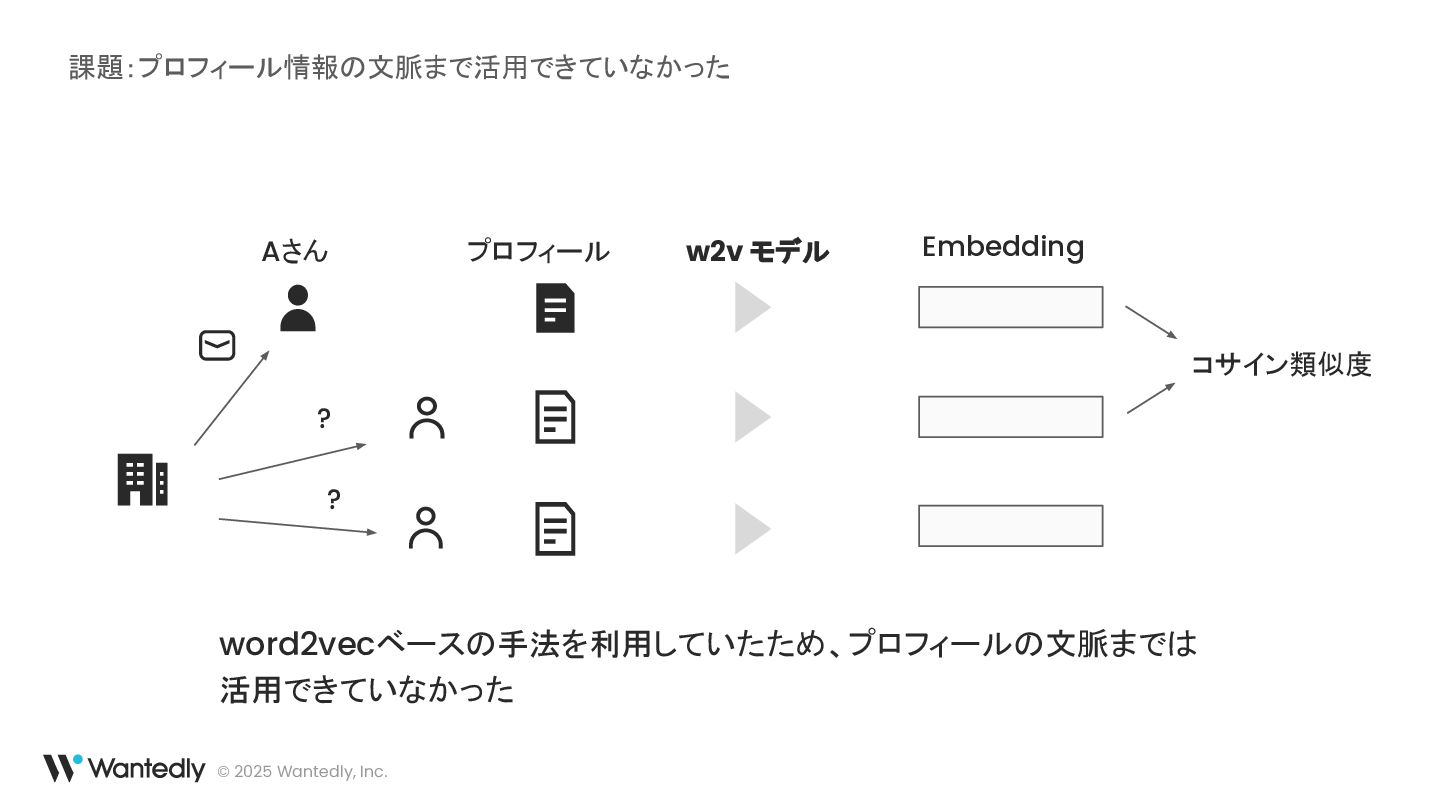
© 2025 Wantedly, Inc. 課題:プロフィール情報の文脈まで活用できていなかった ? ? Aさん プロフィール Embedding
w2v モデル コサイン類似度 word2vecベースの手法を利用していたため、プロフィールの文脈までは 活用できていなかった
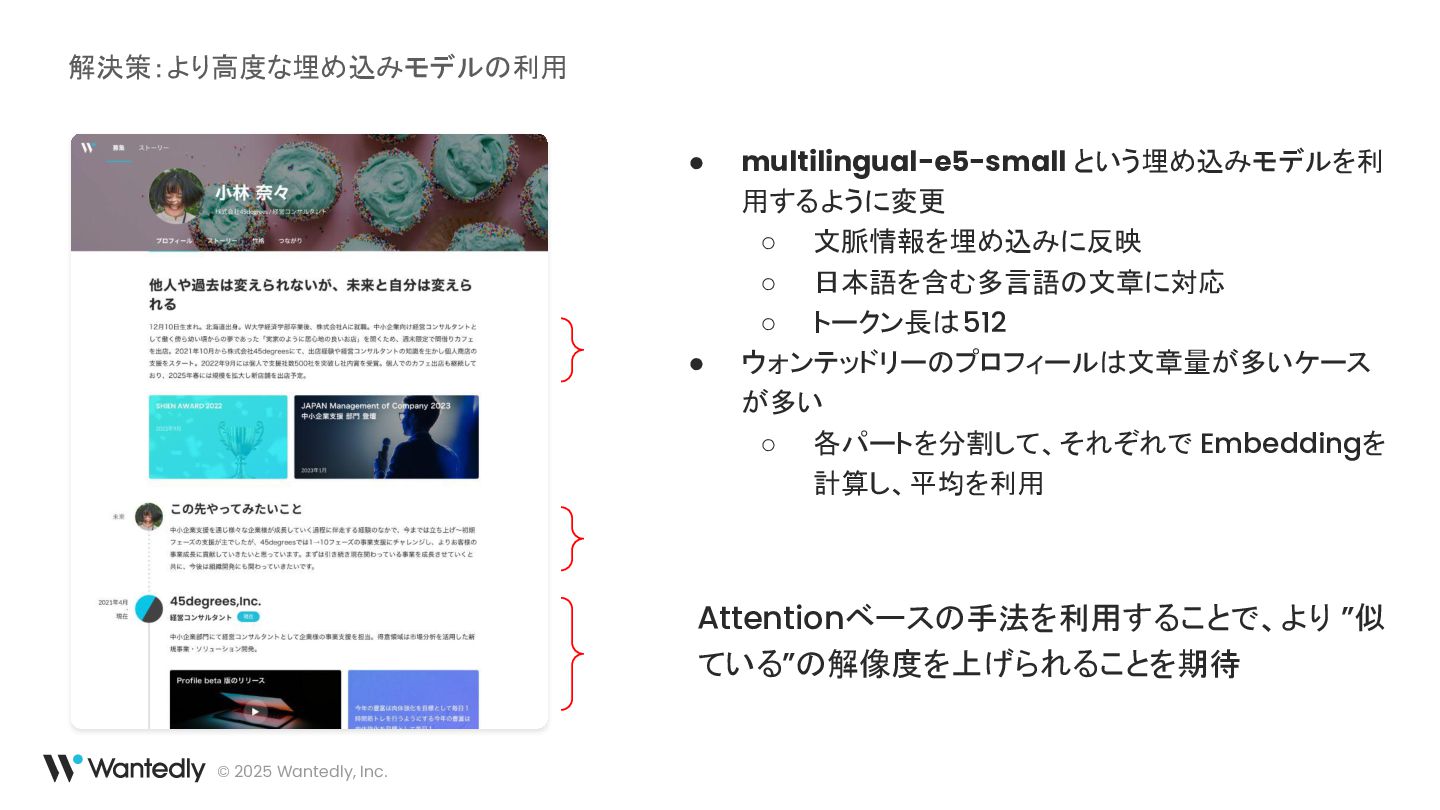
© 2025 Wantedly, Inc. 解決策:より高度な埋め込みモデルの利用 • multilingual-e5-small という埋め込みモデルを利 用するように変更 ◦
文脈情報を埋め込みに反映 ◦ 日本語を含む多言語の文章に対応 ◦ トークン長は512 • ウォンテッドリーのプロフィールは文章量が多いケース が多い ◦ 各パートを分割して、それぞれで Embeddingを 計算し、平均を利用 Attentionベースの手法を利用することで、より ”似 ている”の解像度を上げられることを期待
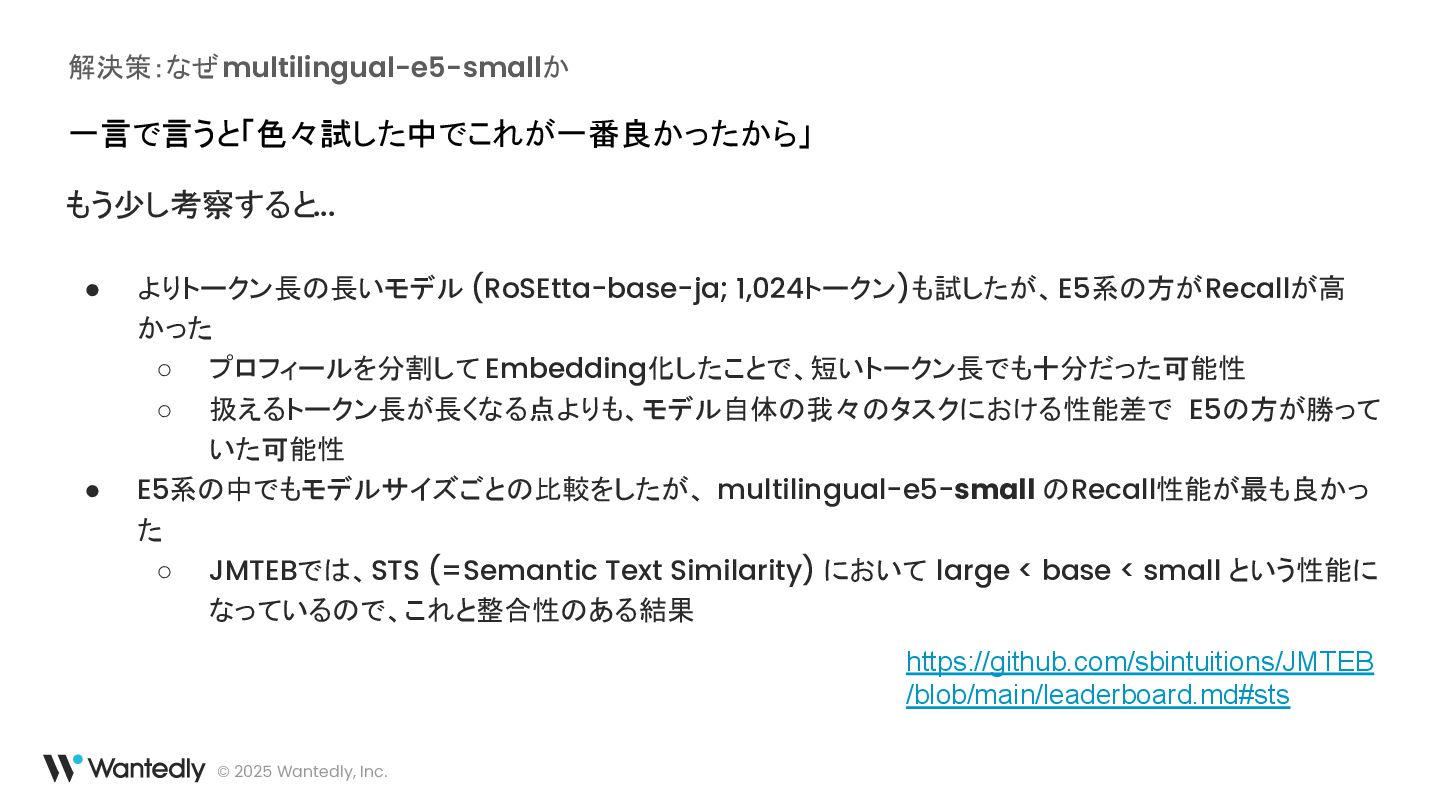
© 2025 Wantedly, Inc. 解決策:なぜmultilingual-e5-smallか • よりトークン長の長いモデル (RoSEtta-base-ja; 1,024トークン)も試したが、E5系の方がRecallが高 かった
◦ プロフィールを分割して Embedding化したことで、短いトークン長でも十分だった可能性 ◦ 扱えるトークン長が長くなる点よりも、モデル自体の我々のタスクにおける性能差で E5の方が勝って いた可能性 • E5系の中でもモデルサイズごとの比較をしたが、 multilingual-e5-small のRecall性能が最も良かっ た ◦ JMTEBでは、STS (=Semantic Text Similarity) において large < base < small という性能に なっているので、これと整合性のある結果 https://github.com/sbintuitions/JMTEB /blob/main/leaderboard.md#sts 一言で言うと「色々試した中でこれが一番良かったから」 もう少し考察すると...
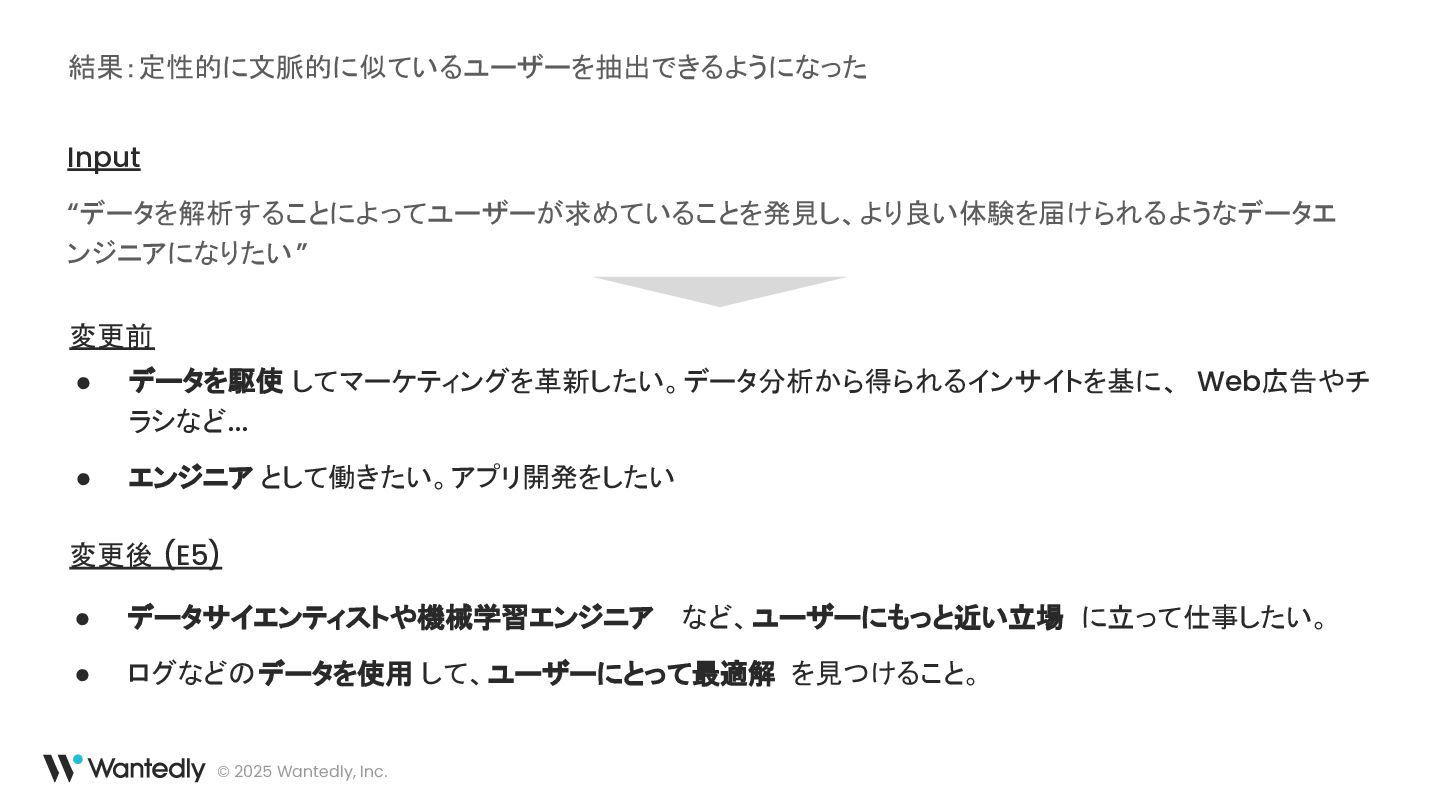
© 2025 Wantedly, Inc. 結果:定性的に文脈的に似ているユーザーを抽出できるようになった Input “データを解析することによってユーザーが求めていることを発見し、より良い体験を届けられるようなデータエ ンジニアになりたい” • データを駆使
してマーケティングを革新したい。データ分析から得られるインサイトを基に、 Web広告やチ ラシなど... • エンジニア として働きたい。アプリ開発をしたい 変更前 変更後 (E5) • データサイエンティストや機械学習エンジニア など、ユーザーにもっと近い立場 に立って仕事したい。 • ログなどのデータを使用 して、ユーザーにとって最適解 を見つけること。
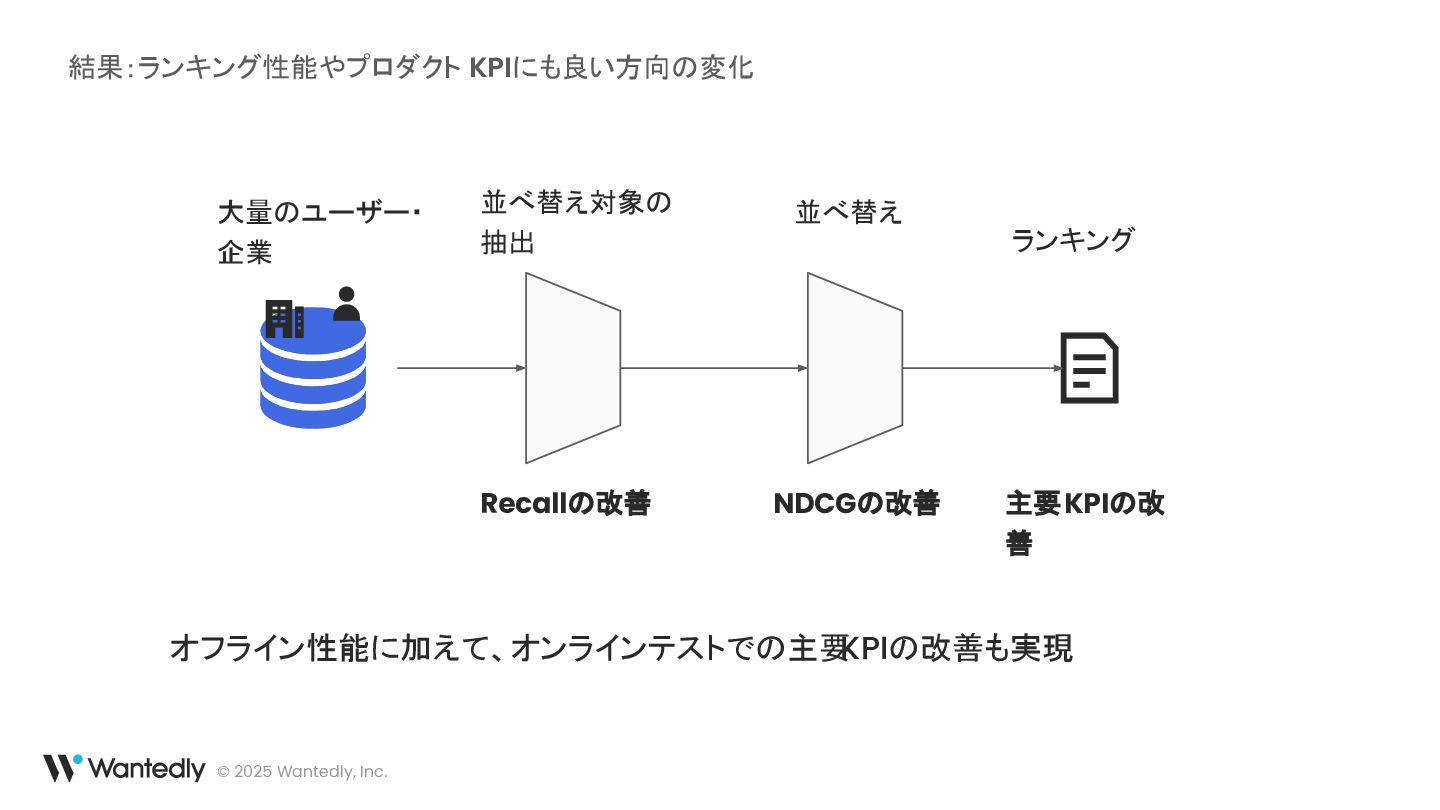
© 2025 Wantedly, Inc. 結果:ランキング性能やプロダクト KPIにも良い方向の変化 大量のユーザー・ 企業 ランキング 並べ替え対象の
抽出 並べ替え Recallの改善 NDCGの改善 オフライン性能に加えて、オンラインテストでの主要 KPIの改善も実現 主要KPIの改 善
© 2025 Wantedly, Inc. まとめ • 埋め込みモデルを改善することで、推薦精度を高めることができた取り組みについて紹介 • 並べ替え候補の抽出ロジックの改善を、後段のランキング性能や主要 KPIの改善まで伝播させることがで
きた ◦ プロフィールをパートごとに分割して平均することで、広い範囲の情報を Embeddingに含められる ようにした ◦ これまでより文脈的に似ているユーザーが抽出できていることを定性的に確認 ◦ オンラインテストにより主要 KPIが改善していることを確認


 yudai00
 oracle4engineer
 tosite
 bcantrill
 mot_techtalk
 toru_kubota
 sansantech
 chack411
 htan
 dafujii
 ennael
 hacobu
 yama3133
 shpigford
 schroneko
 tamaranovitovic
 quramy
 skipperchong
 eileencodes
 ivargrimstad
 soudai
 62gerente
 gurzu
 codingconduct
 shlominoach