Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
超効率化への挑戦:1bit LLMの現状と展望
Search
Yuma Ichikawa
August 06, 2026
Research
930
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
超効率化への挑戦:1bit LLMの現状と展望
現在トレンドとなっている「1bit LLM」をはじめとする極低ビットAI技術の技術動向と今後のトレンドについて解説します。
Yuma Ichikawa
August 06, 2026
More Decks by Yuma Ichikawa
See All by Yuma Ichikawa
NLPコロキウム20251022_超効率化への挑戦: LLM 1bit量子化のロードマップ
yumaichikawa
5
1.7k
Other Decks in Research
See All in Research
Visual SLAM未来予測 / Future Prediction in Visual SLAM
koide3
1
1.3k
湯村研究室の紹介2026 / yumulab2026
yumulab
0
180
Santé et fertilité des sols : ce que nous disent les pratiques dans les systèmes de polyculture-élevage
institutdelelevage
PRO
0
140
Physical AIでモデリングはどう変わるか/How Physical AI Will Change Modeling
stktu
0
310
論文紹介: Understanding Epistemic Language with a Language-augmented Bayesian Theory of Mind
hisaokatsumi
0
200
Être éleveur dans un monde en transition : Comprendre les changements pour mieux les accompagner
institutdelelevage
PRO
0
150
GLIM とMegaParticles:正規分布近似の限界とタイトカップリング&パーティクルフィルタの進展 / GLIM and MegaParticles : Progress of the distribution representation in SLAM
koide3
0
1k
Hitting the buffers
beale
0
360
某助成金プロジェクト採択に向けて企業研究所のアウトリーチ専任者がやったこと
afroscript
0
220
山中市政が招いた組織崩壊:よこはま安心ボックスを例に
sishi
0
360
Détection des lésions podales par thermographie infrarouge chez les bovins et les ovins
institutdelelevage
PRO
0
110
Pesée et pointage par imagerie 3D : PHENO3D entre en phase de test terrains
institutdelelevage
PRO
0
130
Featured
See All Featured
My Coaching Mixtape
mlcsv
0
370
How Fast Is Fast Enough? [PerfNow 2025]
tammyeverts
3
950
How Software Deployment tools have changed in the past 20 years
geshan
2
35k
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
Beyond borders and beyond the search box: How to win the global "messy middle" with AI-driven SEO
davidcarrasco
3
280
Tell your own story through comics
letsgokoyo
1
1.1k
エンジニアに許された特別な時間の終わり
watany
109
250k
The browser strikes back
jonoalderson
0
1.9k
Bridging the Design Gap: How Collaborative Modelling removes blockers to flow between stakeholders and teams @FastFlow conf
baasie
0
740
brightonSEO & MeasureFest 2025 - Winning Strategies for Black Friday CRO & PPC - Christian Goodrich
cargoodrich
3
880
Have SEOs Ruined the Internet? - User Awareness of SEO in 2025
akashhashmi
0
530
Embracing the Ebb and Flow
colly
88
5.2k
Transcript
超効率化への挑戦: LLM1bit LLMの現状と展望 講演: FPGAX #15: AIで変わるFPGA!1bit LLMから実機チップデモまで 富士通人工知能研究所(Research Director)
理研AIP 市川 佑馬 © 2025 Fujitsu Limited
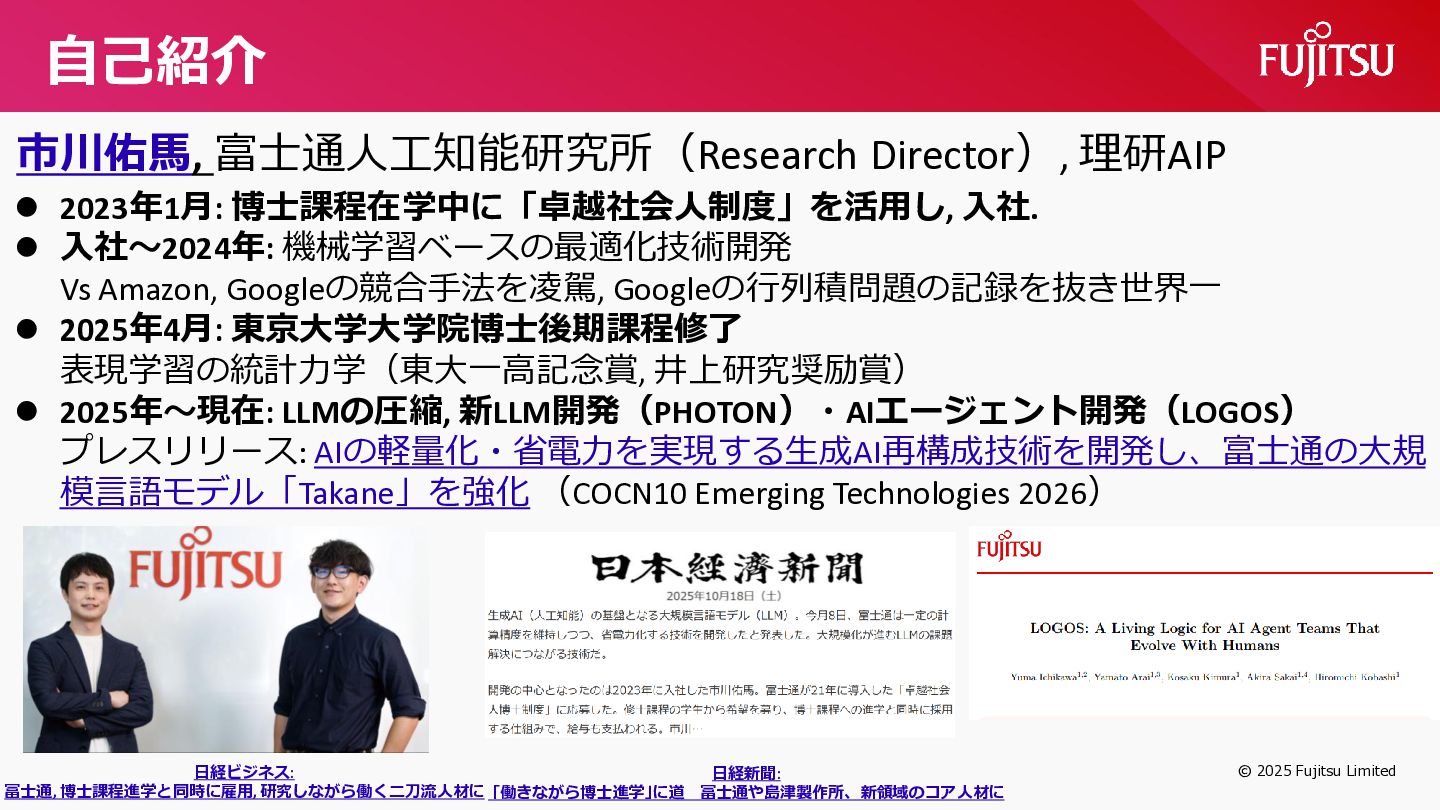
自己紹介 市川佑馬, 富士通人工知能研究所(Research Director), 理研AIP ⚫ 2023年1月: 博士課程在学中に「卓越社会人制度」を活用し, 入社. ⚫
入社~2024年: 機械学習ベースの最適化技術開発 Vs Amazon, Googleの競合手法を凌駕, Googleの行列積問題の記録を抜き世界一 ⚫ 2025年4月: 東京大学大学院博士後期課程修了 表現学習の統計力学(東大一高記念賞, 井上研究奨励賞) ⚫ 2025年~現在: LLMの圧縮, 新LLM開発(PHOTON)・AIエージェント開発(LOGOS) プレスリリース: AIの軽量化・省電力を実現する生成AI再構成技術を開発し、富士通の大規 模言語モデル「Takane」を強化 (COCN10 Emerging Technologies 2026) 日経ビジネス: 日経新聞: 富士通, 博士課程進学と同時に雇用, 研究しながら働く二刀流人材に 「働きながら博士進学」に道 富士通や島津製作所、新領域のコア人材に © 2025 Fujitsu Limited
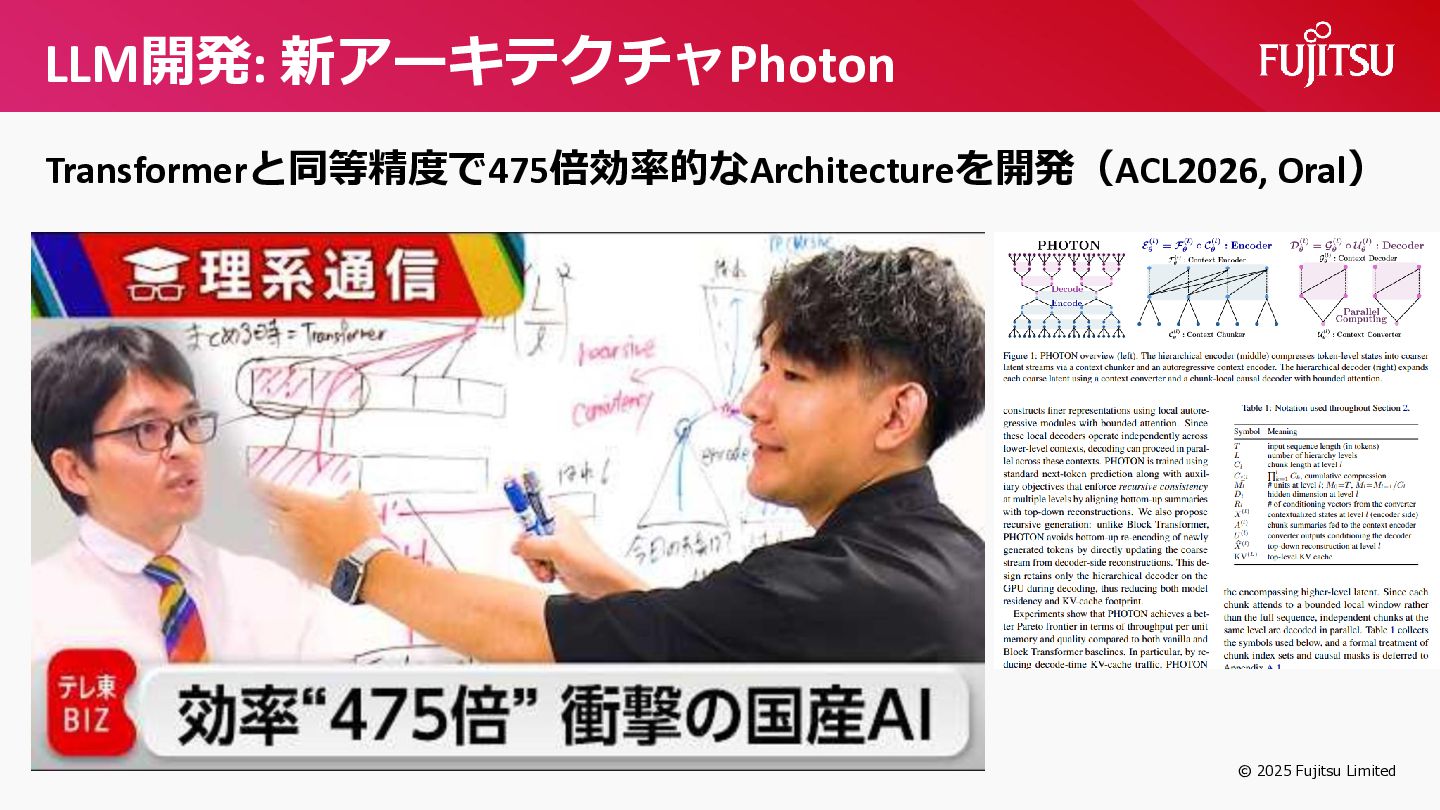
LLM開発: 新アーキテクチャPhoton Transformerと同等精度で475倍効率的なArchitectureを開発(ACL2026, Oral) © 2025 Fujitsu Limited
大規模基盤モデルの圧縮とOneComp © 2025 Fujitsu Limited
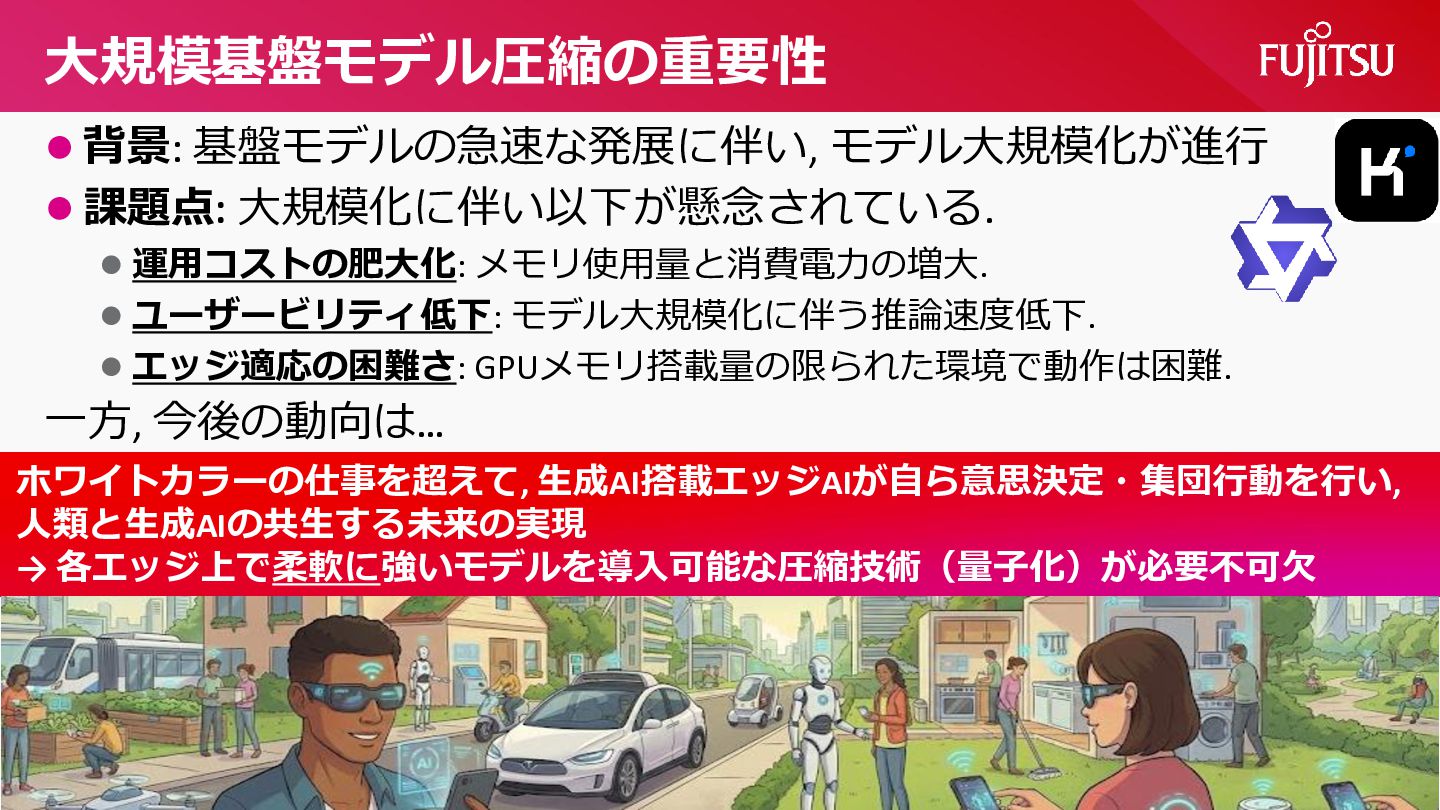
大規模基盤モデル圧縮の重要性 • 背景: 基盤モデルの急速な発展に伴い, モデル大規模化が進行 • 課題点: 大規模化に伴い以下が懸念されている. • 運用コストの肥大化:
メモリ使用量と消費電力の増大. • ユーザービリティ低下: モデル大規模化に伴う推論速度低下. • エッジ適応の困難さ: GPUメモリ搭載量の限られた環境で動作は困難. 一方, 今後の動向は… ホワイトカラーの仕事を超えて, 生成AI搭載エッジAIが自ら意思決定・集団行動を行い, 人類と生成AIの共生する未来の実現 → 各エッジ上で柔軟に強いモデルを導入可能な圧縮技術(量子化)が必要不可欠 © 2025 Fujitsu Limited
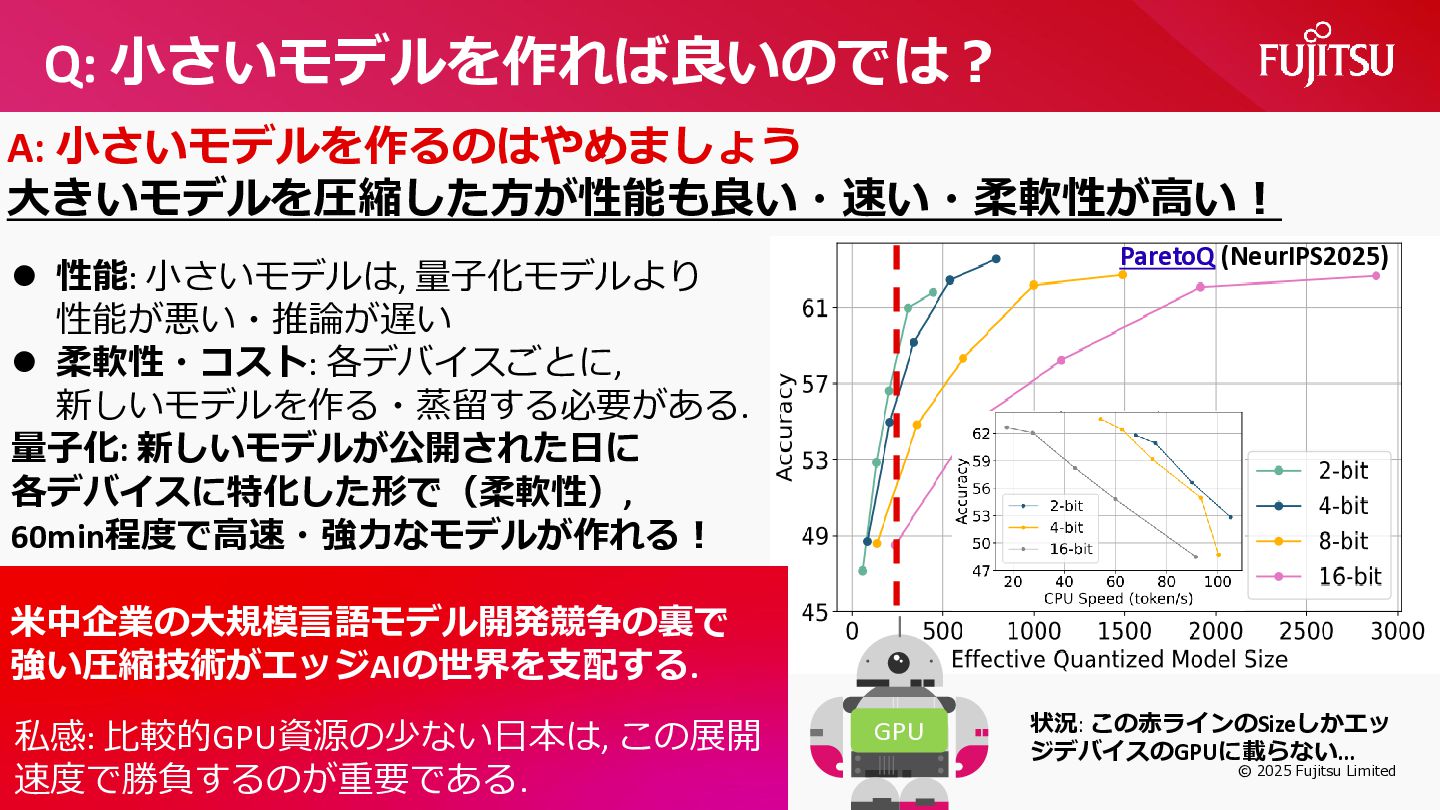
Q: 小さいモデルを作れば良いのでは? A: 小さいモデルを作るのはやめましょう 大きいモデルを圧縮した方が性能も良い・速い・柔軟性が高い! ParetoQ (NeurIPS2025) ⚫ 性能: 小さいモデルは,
量子化モデルより 性能が悪い・推論が遅い ⚫ 柔軟性・コスト: 各デバイスごとに, 新しいモデルを作る・蒸留する必要がある. 量子化: 新しいモデルが公開された日に 各デバイスに特化した形で(柔軟性), 60min程度で高速・強力なモデルが作れる! 米中企業の大規模言語モデル開発競争の裏で 強い圧縮技術がエッジAIの世界を支配する. 私感: 比較的GPU資源の少ない日本は, この展開 速度で勝負するのが重要である. GPU 状況: この赤ラインのSizeしかエッ ジデバイスのGPUに載らない… © 2025 Fujitsu Limited
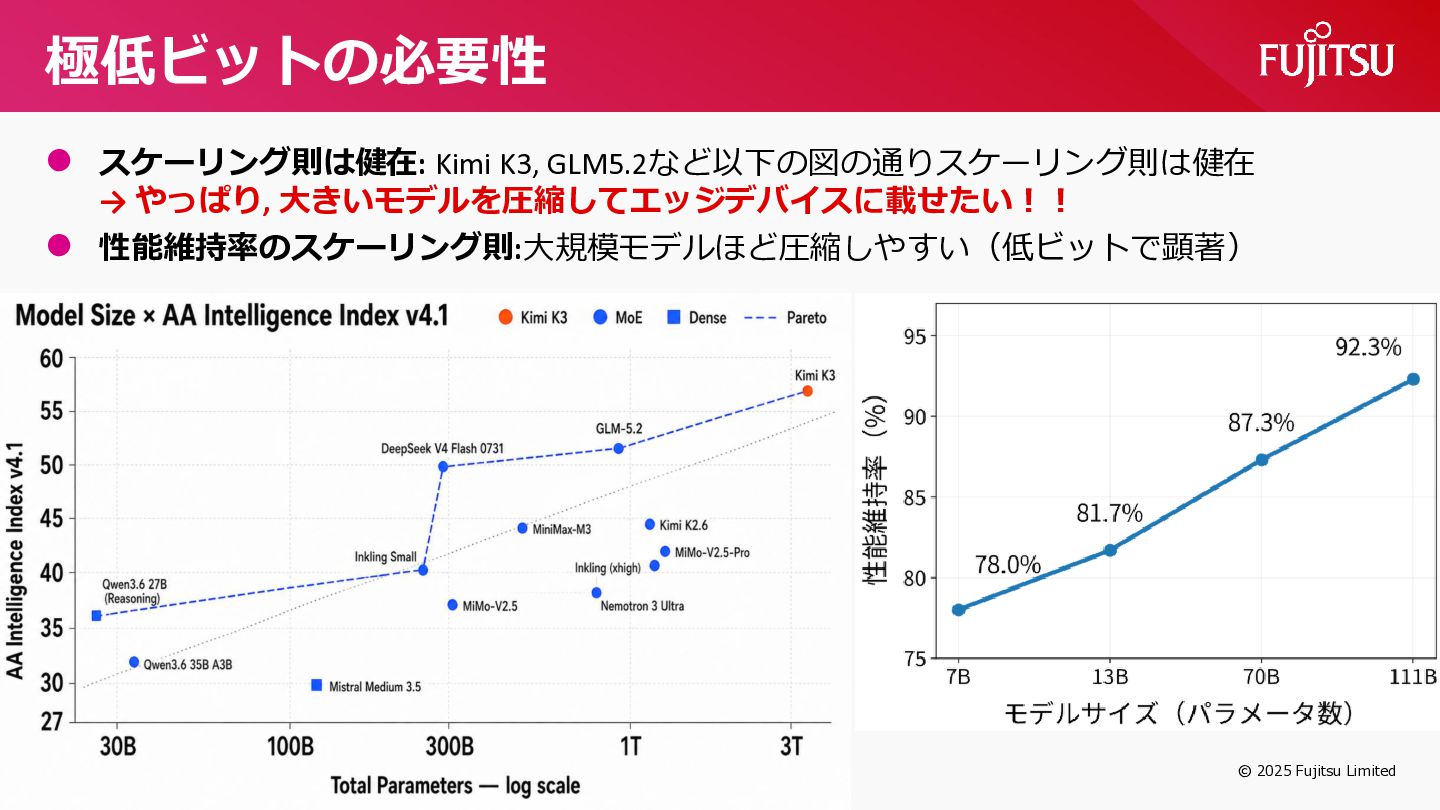
極低ビットの必要性 ⚫ スケーリング則は健在: Kimi K3, GLM5.2など以下の図の通りスケーリング則は健在 ⚫ → やっぱり, 大きいモデルを圧縮してエッジデバイスに載せたい!!
性能維持率のスケーリング則:大規模モデルほど圧縮しやすい(低ビットで顕著) © 2025 Fujitsu Limited
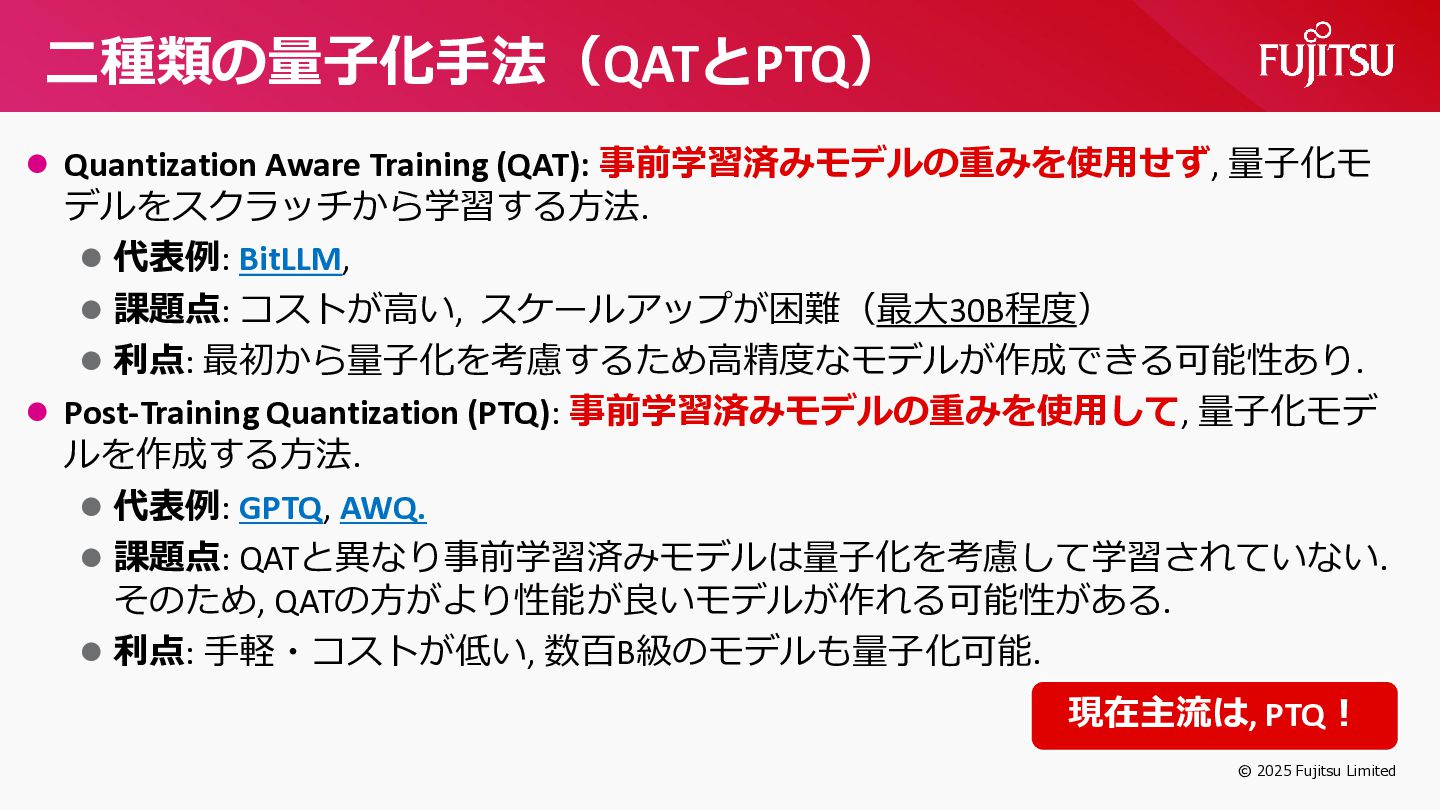
二種類の量子化手法(QATとPTQ) • Quantization Aware Training (QAT): 事前学習済みモデルの重みを使用せず, 量子化モ デルをスクラッチから学習する方法. •
代表例: BitLLM, • 課題点: コストが高い, スケールアップが困難(最大30B程度) • 利点: 最初から量子化を考慮するため高精度なモデルが作成できる可能性あり. • Post-Training Quantization (PTQ): 事前学習済みモデルの重みを使用して, 量子化モデ ルを作成する方法. • 代表例: GPTQ, AWQ. • 課題点: QATと異なり事前学習済みモデルは量子化を考慮して学習されていない. そのため, QATの方がより性能が良いモデルが作れる可能性がある. • 利点: 手軽・コストが低い, 数百B級のモデルも量子化可能. 現在主流は, PTQ! © 2025 Fujitsu Limited
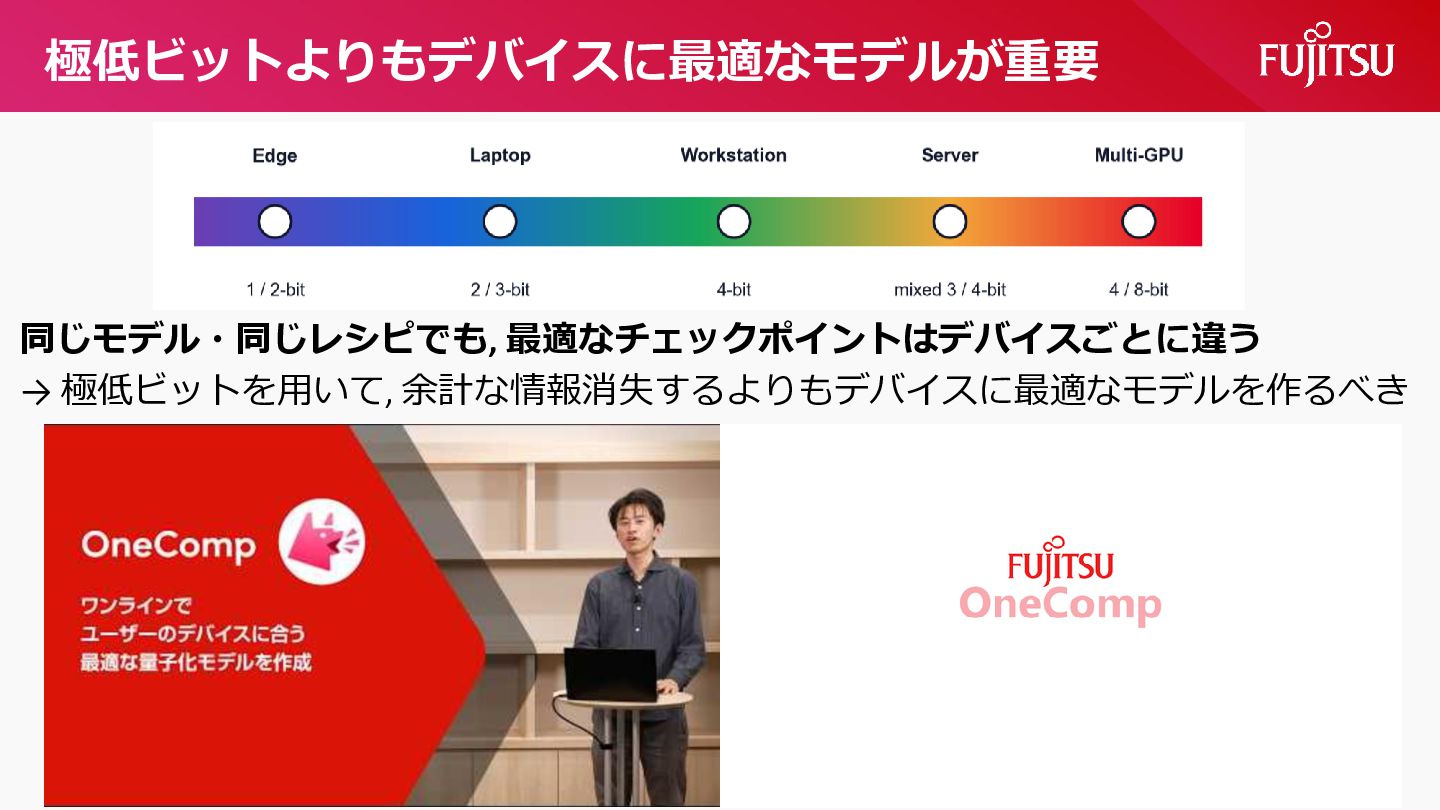
極低ビットよりもデバイスに最適なモデルが重要 同じモデル・同じレシピでも, 最適なチェックポイントはデバイスごとに違う → 極低ビットを用いて, 余計な情報消失するよりもデバイスに最適なモデルを作るべき © 2025 Fujitsu Limited
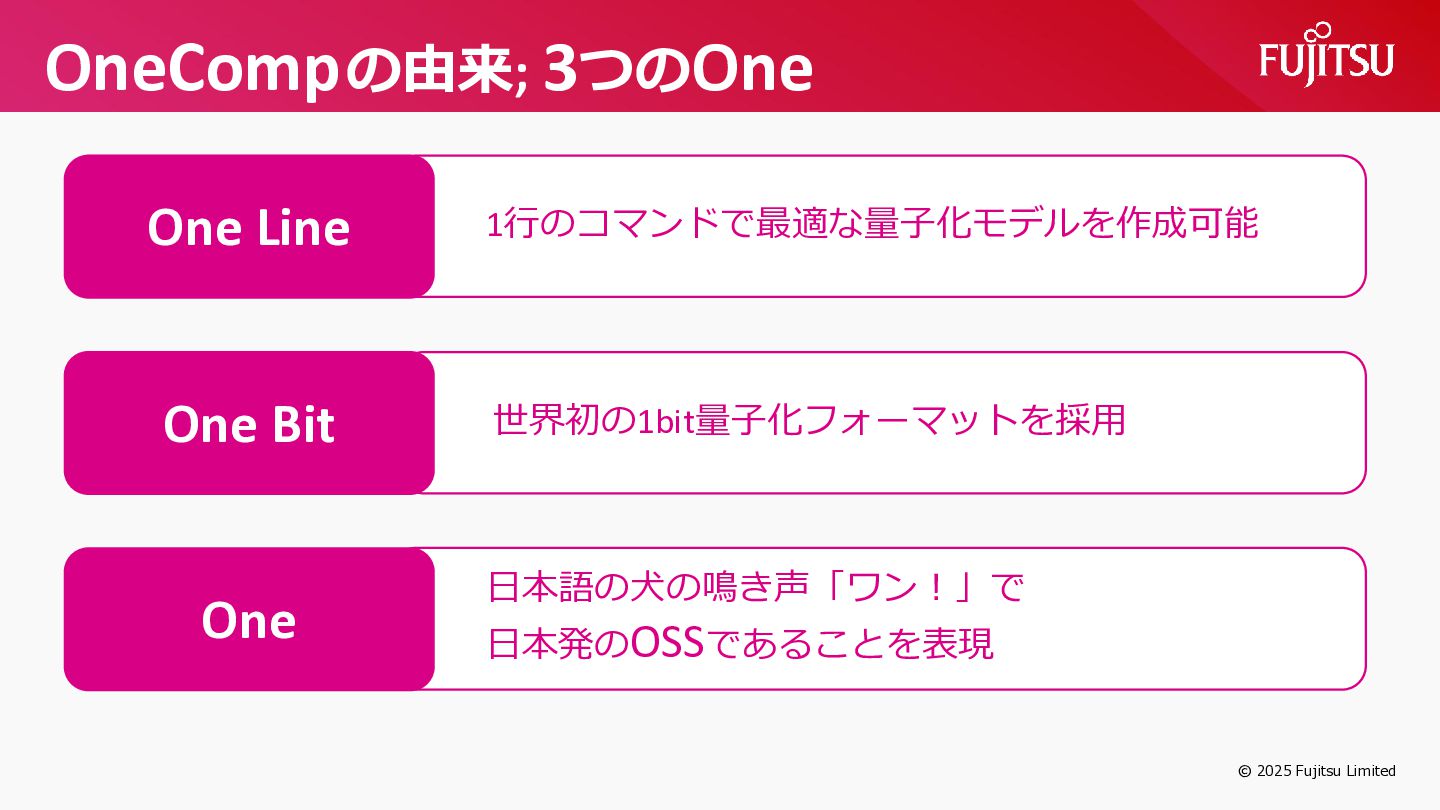
OneComp の由来; 3つのOne One Line 1行のコマンドで最適な量子化モデルを作成可能 One Bit 世界初の1bit量子化フォーマットを採用 One
日本語の犬の鳴き声「ワン!」で 日本発のOSSであることを表現 © 2025 Fujitsu Limited
極低ビット量子化の最新動向 © 2025 Fujitsu Limited
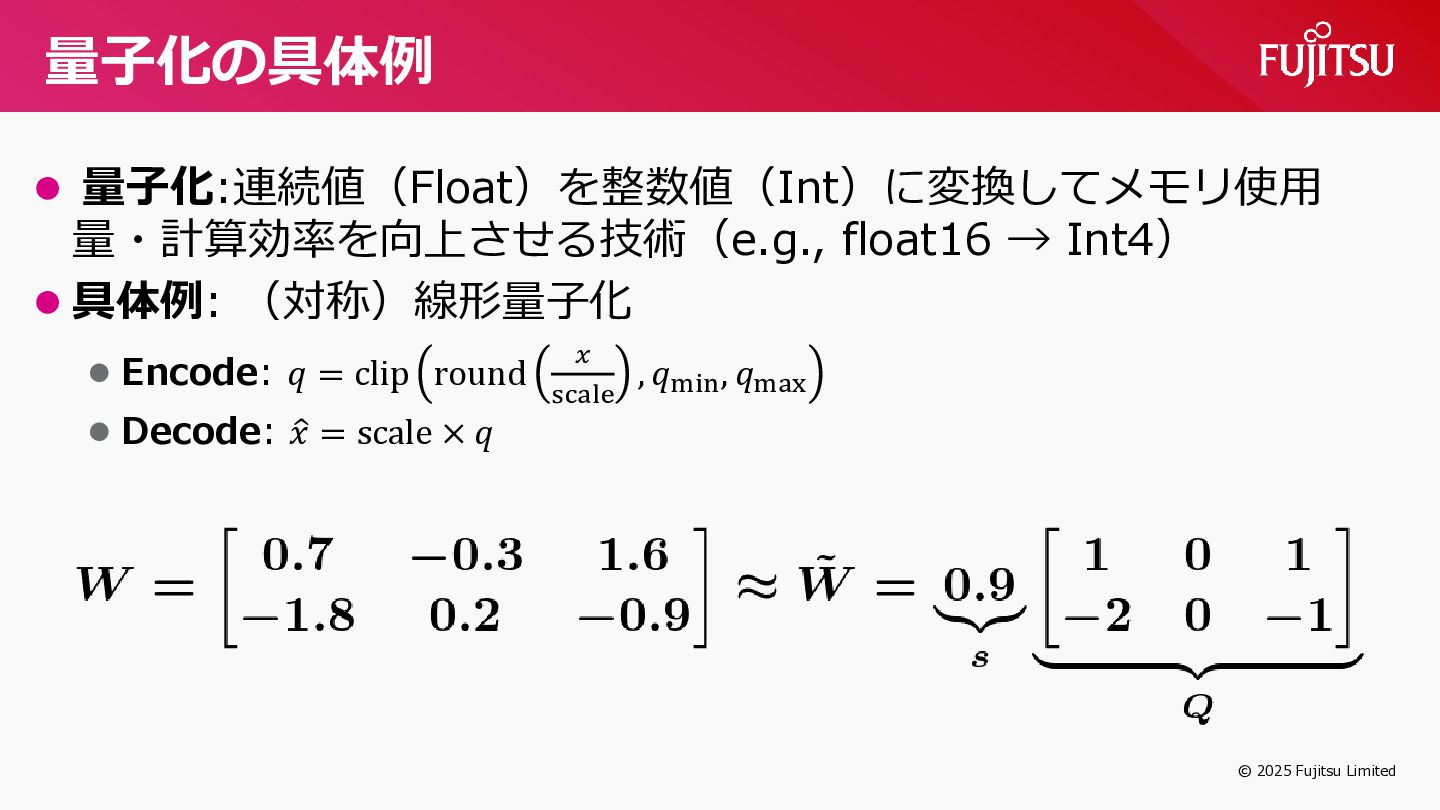
量子化の具体例 • 量子化:連続値(Float)を整数値(Int)に変換してメモリ使用 量・計算効率を向上させる技術(e.g., float16 → Int4) • 具体例: (対称)線形量子化
𝑥 • Encode: 𝑞 = clip round scale , 𝑞min , 𝑞max • Decode: 𝑥ො = scale × 𝑞 © 2025 Fujitsu Limited
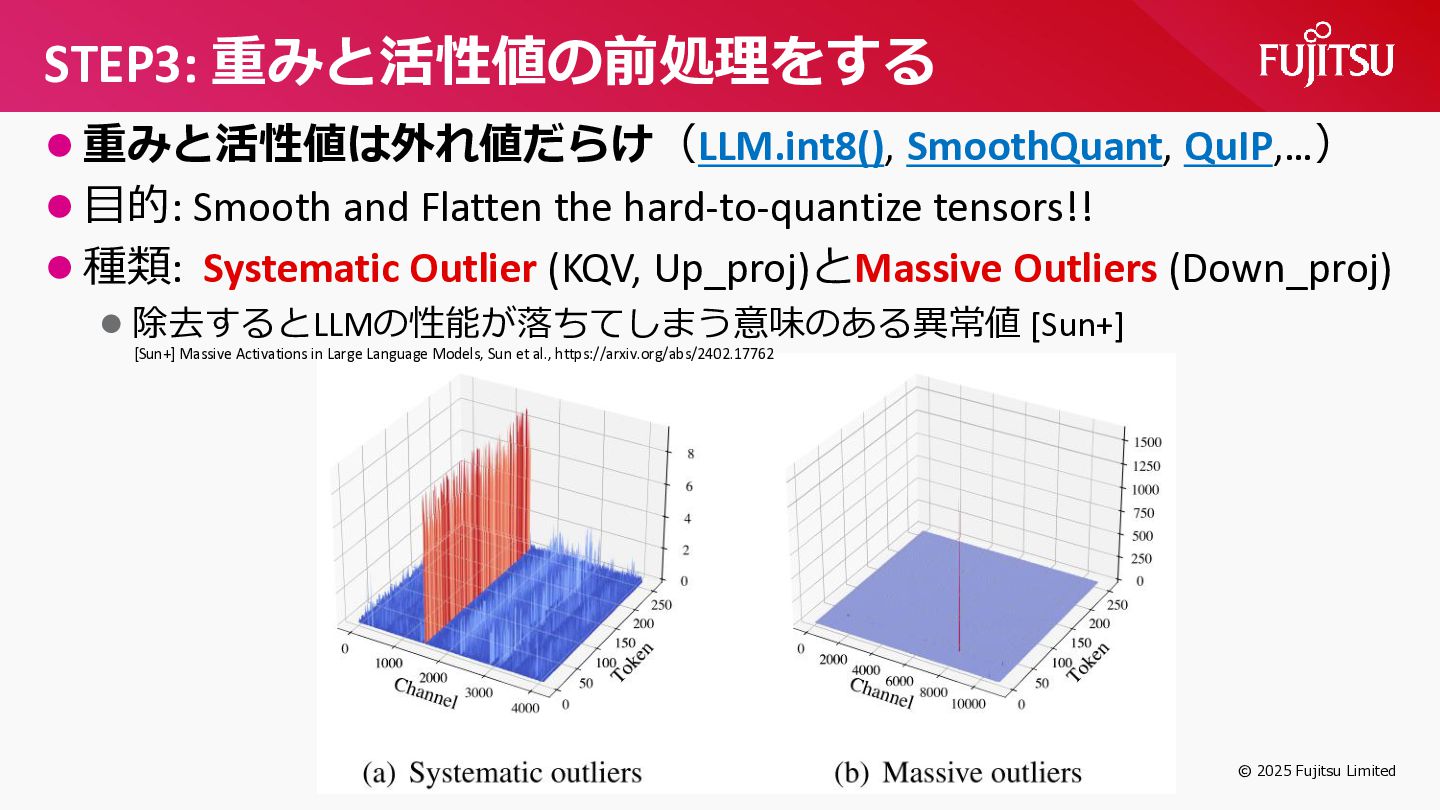
STEP3: 重みと活性値の前処理をする • 重みと活性値は外れ値だらけ(LLM.int8(), SmoothQuant, QuIP,…) • 目的: Smooth and
Flatten the hard-to-quantize tensors!! • 種類: Systematic Outlier (KQV, Up_proj)とMassive Outliers (Down_proj) • 除去するとLLMの性能が落ちてしまう意味のある異常値 [Sun+] [Sun+] Massive Activations in Large Language Models, Sun et al., https://arxiv.org/abs/2402.17762 © 2025 Fujitsu Limited
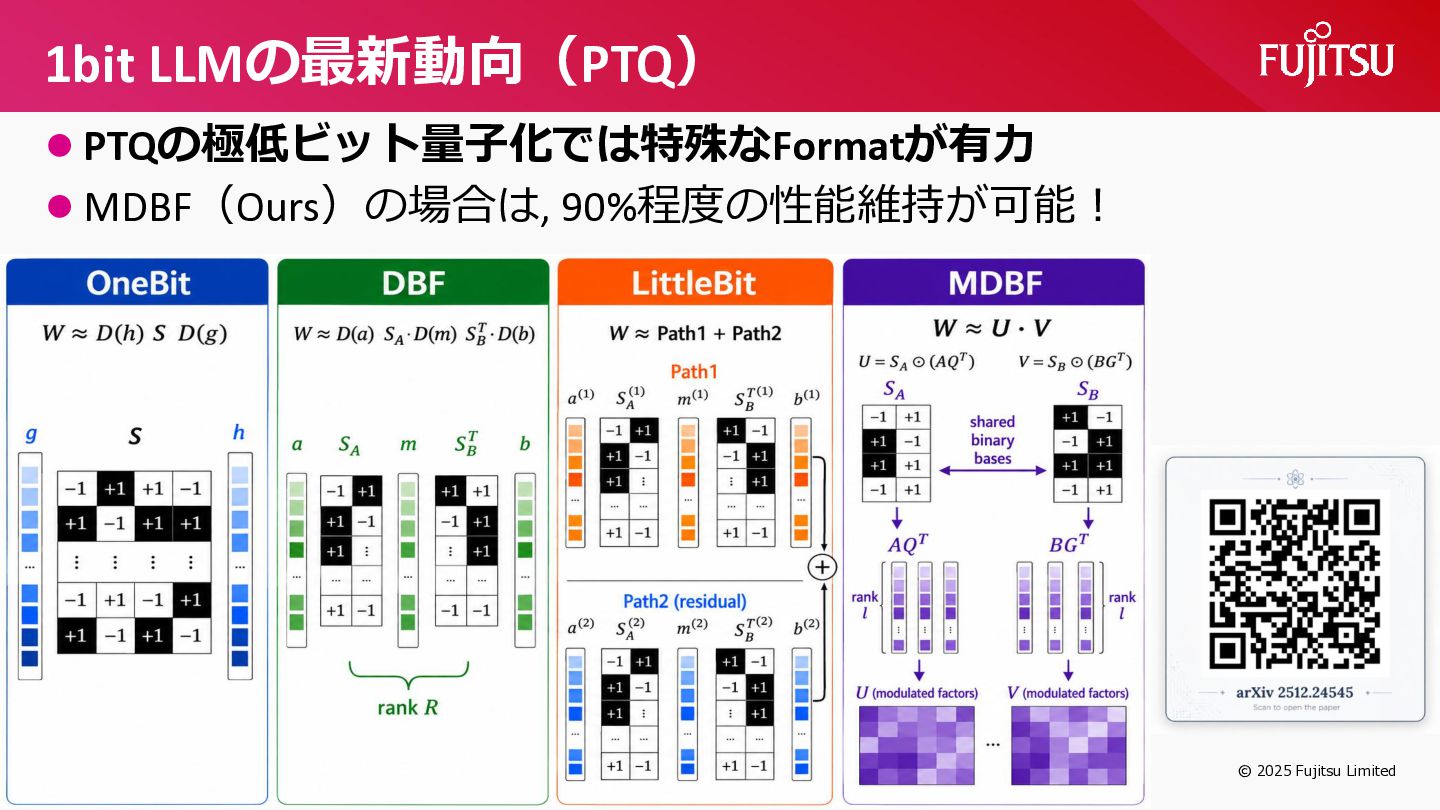
1bit LLMの最新動向(PTQ) • PTQの極低ビット量子化では特殊なFormatが有力 • MDBF(Ours)の場合は, 90%程度の性能維持が可能! © 2025 Fujitsu
Limited
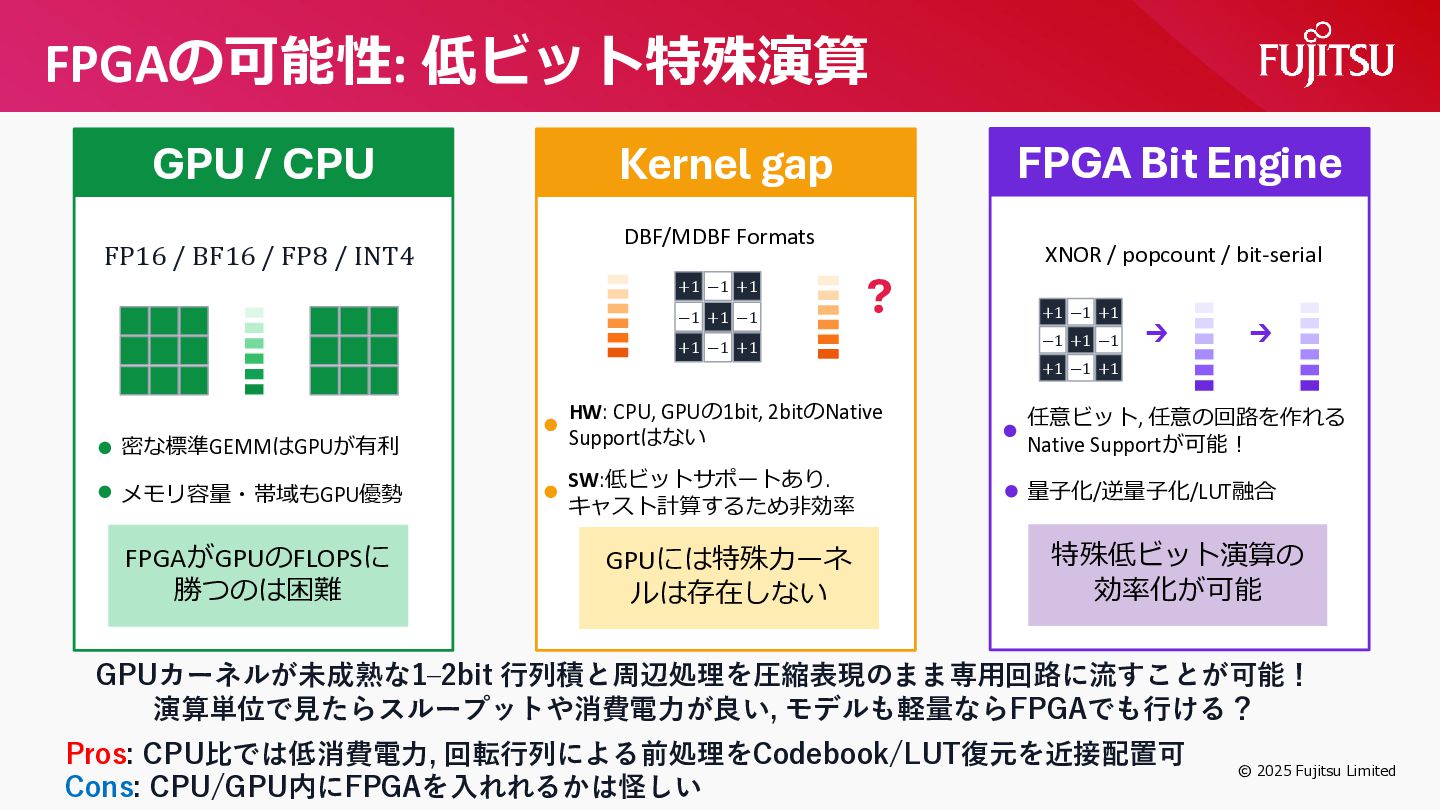
FPGAの可能性: 低ビット特殊演算 GPU / CPU FP16 / BF16 / FP8
/ INT4 FPGA Bit Engine Kernel gap DBF/MDBF Formats +1 −1 +1 −1 +1 −1 ? +1 −1 +1 XNOR / popcount / bit-serial +1 −1 +1 −1 +1 −1 → → +1 −1 +1 HW: CPU, GPUの1bit, 2bitのNative Supportはない 任意ビット, 任意の回路を作れる Native Supportが可能! メモリ容量・帯域もGPU優勢 SW:低ビットサポートあり. キャスト計算するため非効率 量子化/逆量子化/LUT融合 FPGAがGPUのFLOPSに 勝つのは困難 GPUには特殊カーネ ルは存在しない 密な標準GEMMはGPUが有利 特殊低ビット演算の 効率化が可能 GPUカーネルが未成熟な1–2bit 行列積と周辺処理を圧縮表現のまま専用回路に流すことが可能! 演算単位で見たらスループットや消費電力が良い, モデルも軽量ならFPGAでも行ける? Pros: CPU比では低消費電力, 回転行列による前処理をCodebook/LUT復元を近接配置可 Cons: CPU/GPU内にFPGAを入れれるかは怪しい © 2025 Fujitsu Limited
まとめと展望 © 2025 Fujitsu Limited
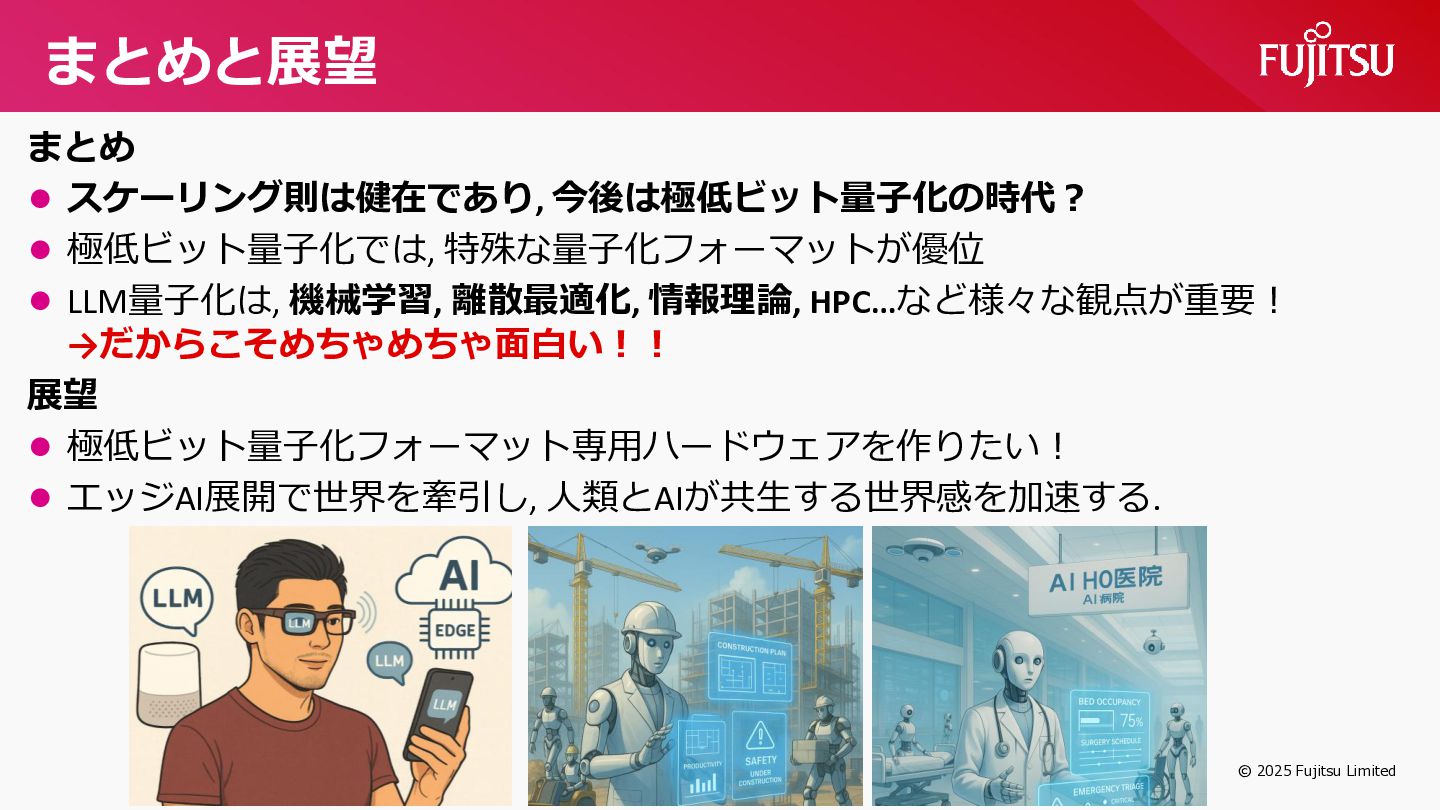
まとめと展望 まとめ • スケーリング則は健在であり, 今後は極低ビット量子化の時代? • 極低ビット量子化では, 特殊な量子化フォーマットが優位 • LLM量子化は,
機械学習, 離散最適化, 情報理論, HPC…など様々な観点が重要! →だからこそめちゃめちゃ面白い!! 展望 • 極低ビット量子化フォーマット専用ハードウェアを作りたい! • エッジAI展開で世界を牽引し, 人類とAIが共生する世界感を加速する. © 2025 Fujitsu Limited
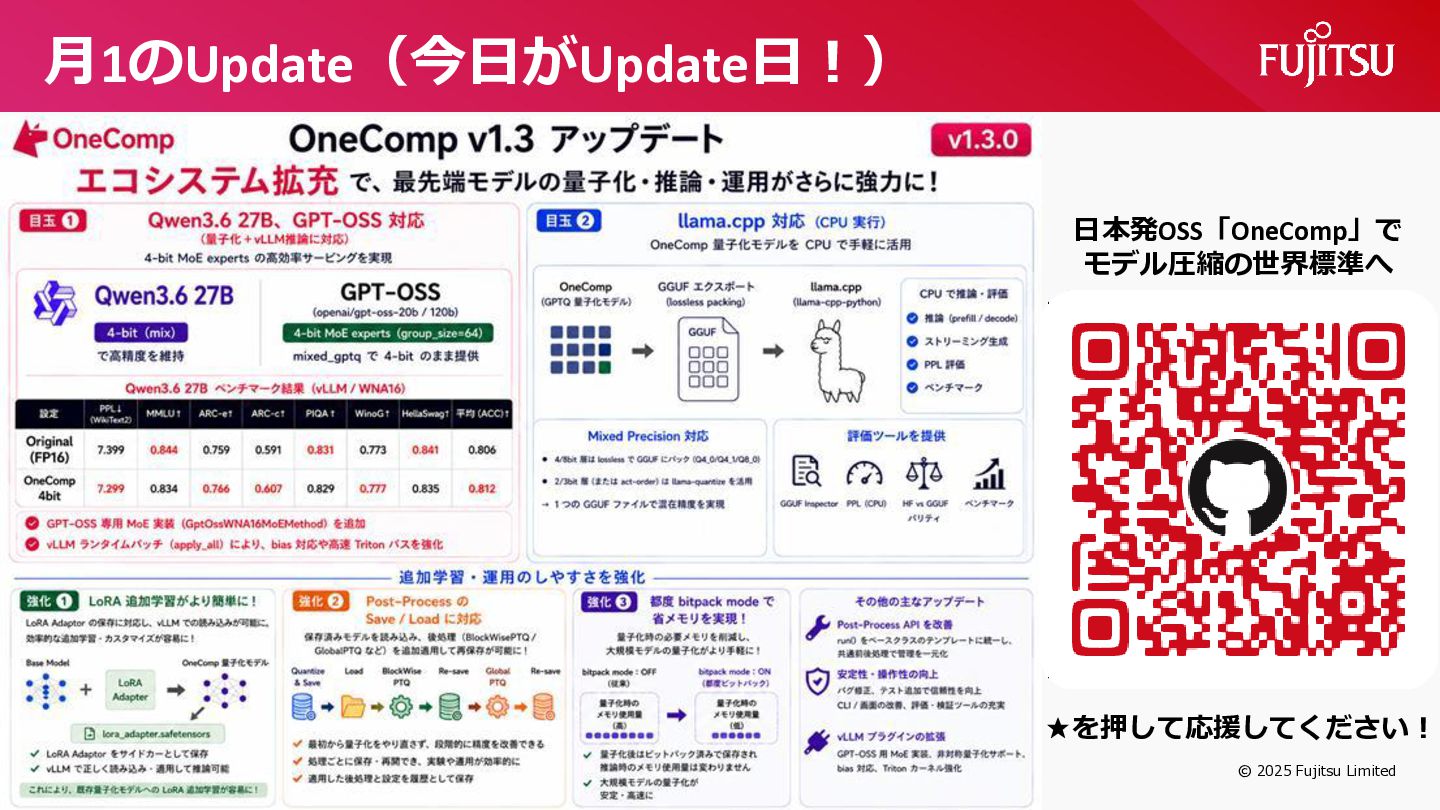
月1のUpdate(今日がUpdate日!) 日本発OSS「OneComp」で モデル圧縮の世界標準へ ★を押して応援してください! © 2025 Fujitsu Limited


 yumaichikawa
 koide3
 yumulab
 institutdelelevage
 stktu
 hisaokatsumi
 beale
 afroscript
 sishi
 mlcsv
 tammyeverts
 geshan
 aleyda
 davidcarrasco
 letsgokoyo
 watany
 jonoalderson
 baasie
 cargoodrich
 akashhashmi
 colly