Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
一風変わったニューラルネットの使い方
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
ALBERT Inc.
November 24, 2020
Technology
310
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
一風変わったニューラルネットの使い方
ALBERT Inc.
November 24, 2020
Transcript
27 slides
⼀⾵変わったニューラル ネットの使い⽅ Data Science Cafe 2020/11/24 ⼭内隆太郎 © 2020 ALBERT
Inc. 1
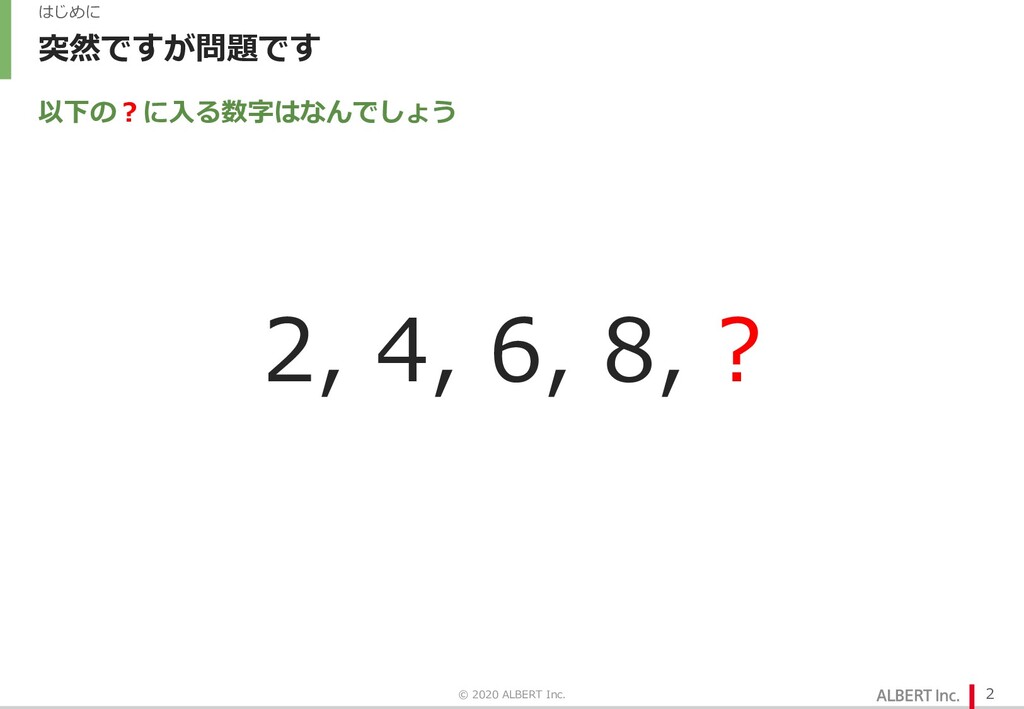
突然ですが問題です 2, 4, 6, 8, ? © 2020 ALBERT Inc.
2 はじめに 以下の︖に⼊る数字はなんでしょう
答え 2, 4, 6, 8, 11 © 2020 ALBERT Inc.
3 はじめに 「規則のパラドックス」として知られる問題。このパラドックスが導くさらにラディカルな帰結が気になる⽅は、飯⽥隆『規則と意味のパラドッ クス』など読むとより混乱できると思います 10進数で表した各桁の和が偶数になる数を⼩さい順に並べたもの 11,13,15,17, … と続きます
帰納の不可能性 n あくまで論理的可能性のみを問題にするのであれば、以下の命題は等価 Ø これまでに⾒てきたカラスはすべて⿊い。次に⾒るカラスは⿊いだろう Ø これまでに⾒てきたカラスはすべて⿊い。次に⾒るカラスは⽩いだろう © 2020 ALBERT
Inc. 4 はじめに 1. https://ja.wikipedia.org/wiki/%E3%82%AB%E3%83%A9%E3%82%B9 有限のサンプルで可能性を⼀つに絞るのは不可能 なんらかの仮説を設けることで仮説を絞ってやる必要がある これまでに観察したカラス アルビノのカラス[1] すべてのカラ スは⿊い…︖
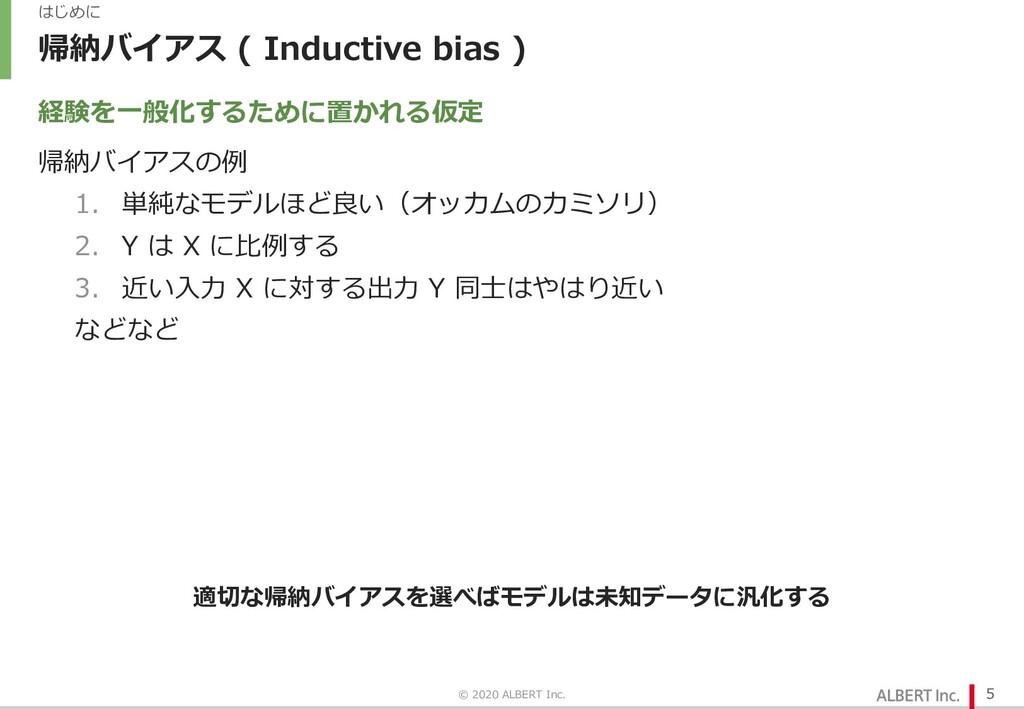
帰納バイアス ( Inductive bias ) 帰納バイアスの例 1. 単純なモデルほど良い(オッカムのカミソリ) 2. Y
は X に⽐例する 3. 近い⼊⼒ X に対する出⼒ Y 同⼠はやはり近い などなど © 2020 ALBERT Inc. 5 はじめに 経験を⼀般化するために置かれる仮定 適切な帰納バイアスを選べばモデルは未知データに汎化する
ニューラルネットワークの表現⼒ ニューラルネットワークの普遍性定理 l 3層パーセプトロン(活性化関数はシグモイド関数)は任意の連続関数を好きな精度で近似で きる(パラメタを⼗分に増やせば) Understanding deep learning requires rethinking
generalization[1] l Zhang et al. ICLRʼ17 l ランダムにラベルを付け替えたデータセットで CNN を訓練しても学習誤差を0にできる l DNN の汎化性能は従来の枠組みでは説明できない(ラデマッハ複雑度などで測ると DNN は とても悪いモデルということに) l 暗黙的な正則化がかかっている︖ © 2020 ALBERT Inc. 6 はじめに 1. https://arxiv.org/abs/1611.03530 多層ニューラルネットワークは表現⼒が⾼い DNNがデータに対して暗黙的に置いている仮定(帰納バイアス)が優れている︖
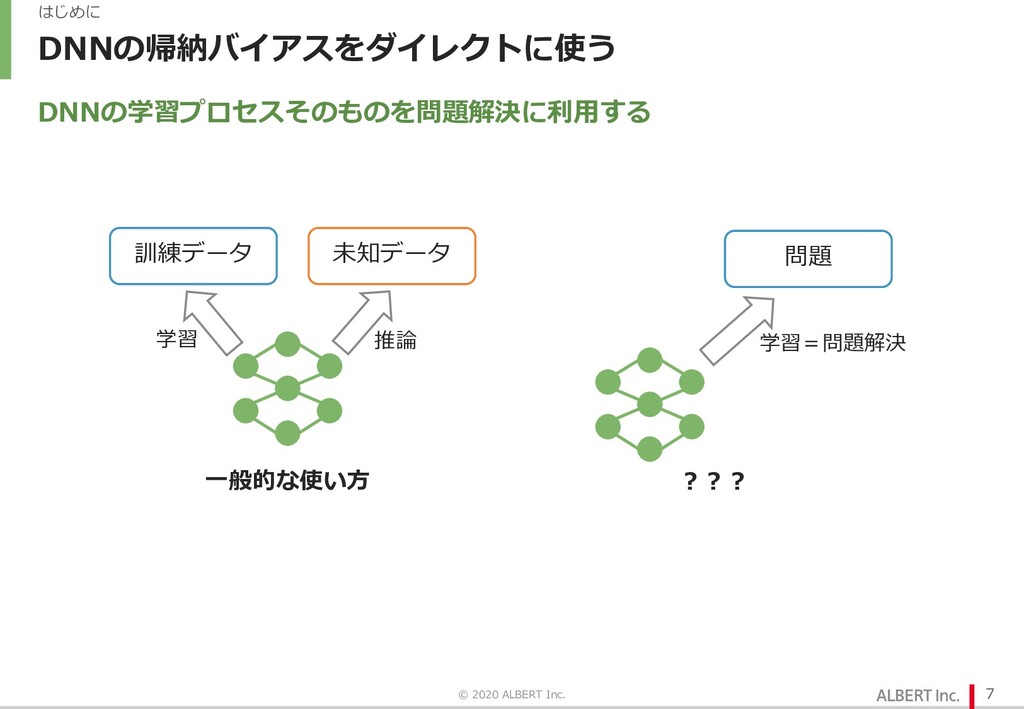
DNNの帰納バイアスをダイレクトに使う © 2020 ALBERT Inc. 7 はじめに DNNの学習プロセスそのものを問題解決に利⽤する 訓練データ 未知データ
学習 推論 ⼀般的な使い⽅ 問題 学習=問題解決 ︖︖︖
Deep Image Prior © 2020 ALBERT Inc. 8
書誌情報 n Dmitry Ulyanov, Andrea Vedaldi, Victor Lempitsky n CVPR
2018 n https://openaccess.thecvf.com/content_cvpr_2018/papers/Ulyanov_Deep_Ima ge_Prior_CVPR_2018_paper.pdf n CNN の構造⾃体が⼀般的な画像についての知識をすでに含んでいると主張 n 未学習 CNN を⽤いて、画像のノイズ除去、超解像などを⾏う © 2020 ALBERT Inc. 9 Deep Image Prior Deep Image Prior
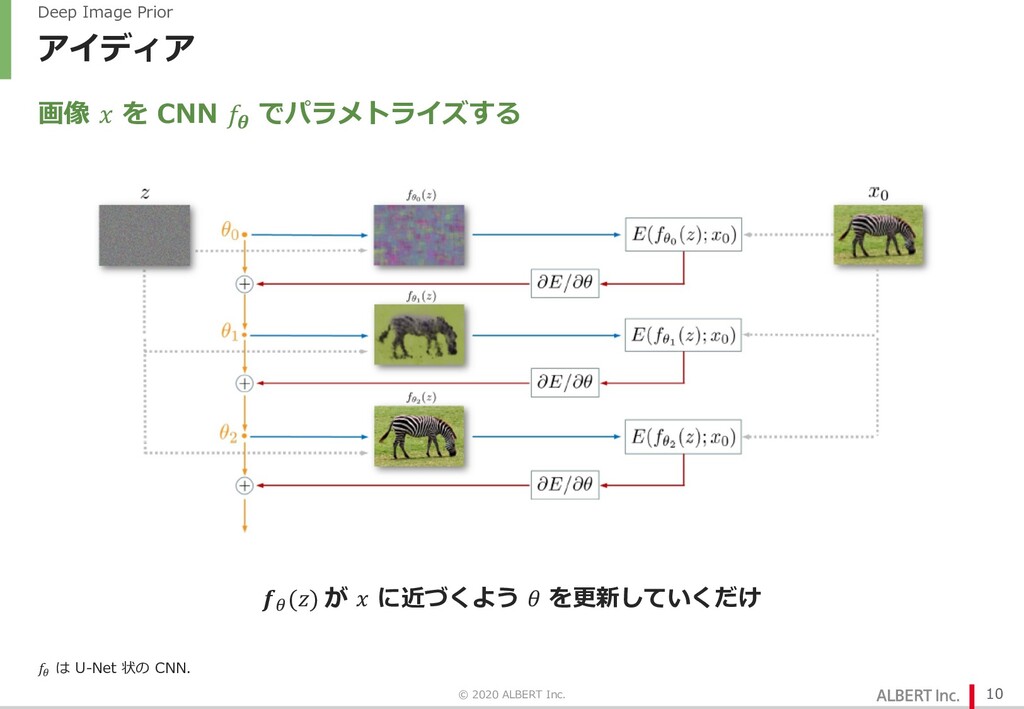
アイディア © 2020 ALBERT Inc. 10 Deep Image Prior !
は U-Net 状の CNN. 画像 を CNN でパラメトライズする ! () が に近づくよう を更新していくだけ
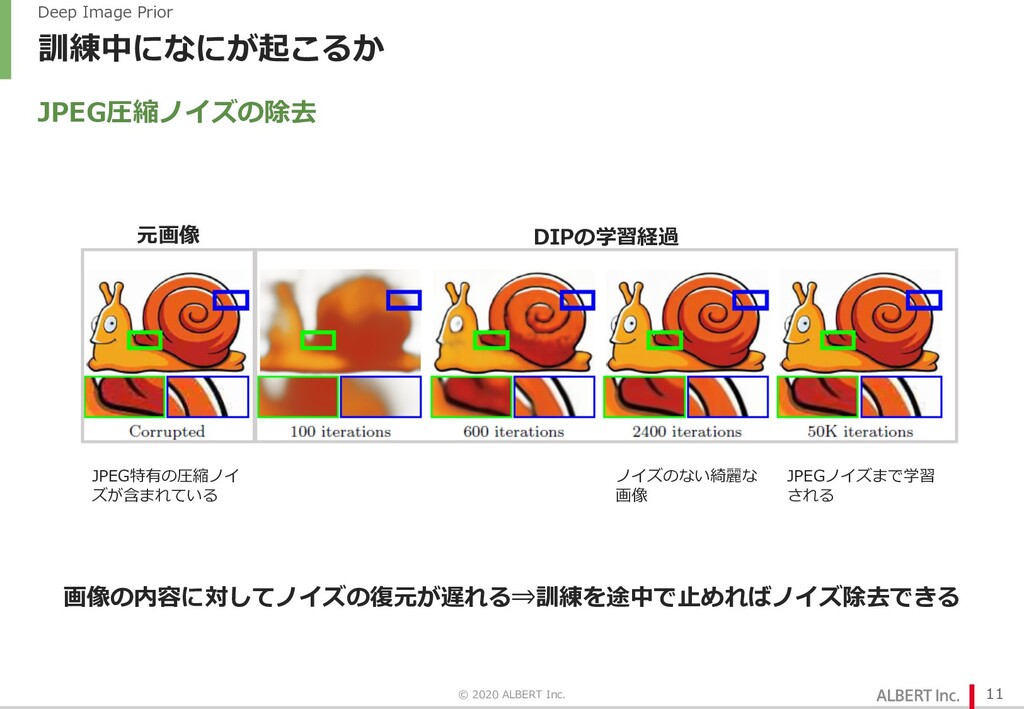
訓練中になにが起こるか © 2020 ALBERT Inc. 11 Deep Image Prior JPEG圧縮ノイズの除去
画像の内容に対してノイズの復元が遅れる⇒訓練を途中で⽌めればノイズ除去できる 元画像 DIPの学習経過 JPEG特有の圧縮ノイ ズが含まれている ノイズのない綺麗な 画像 JPEGノイズまで学習 される
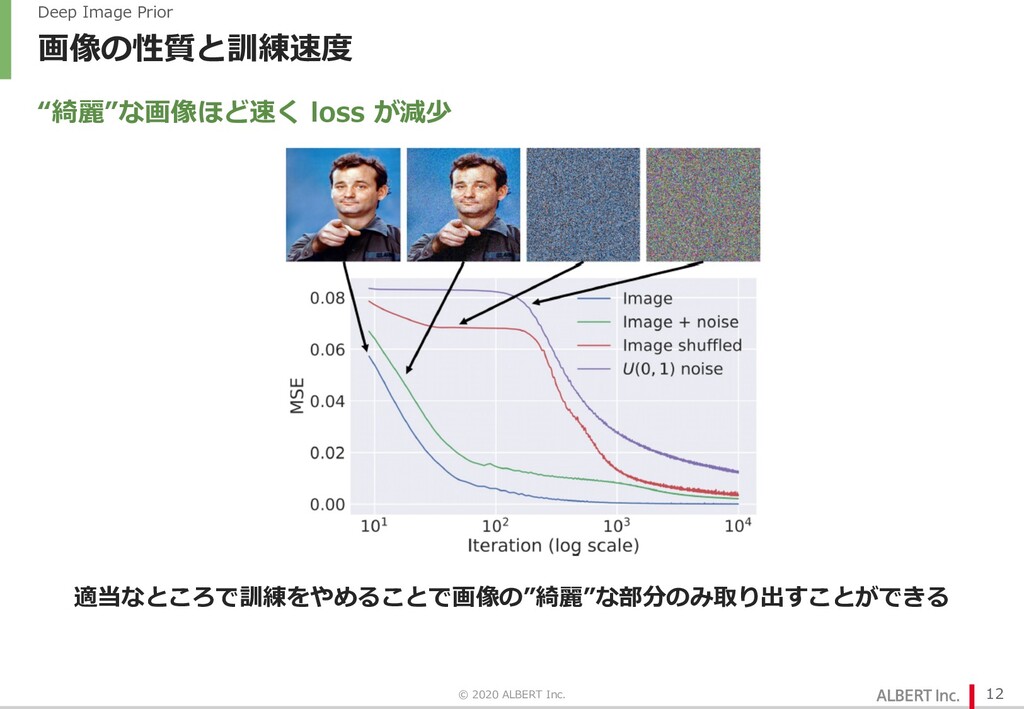
画像の性質と訓練速度 © 2020 ALBERT Inc. 12 Deep Image Prior “綺麗”な画像ほど速く
loss が減少 適当なところで訓練をやめることで画像の”綺麗”な部分のみ取り出すことができる
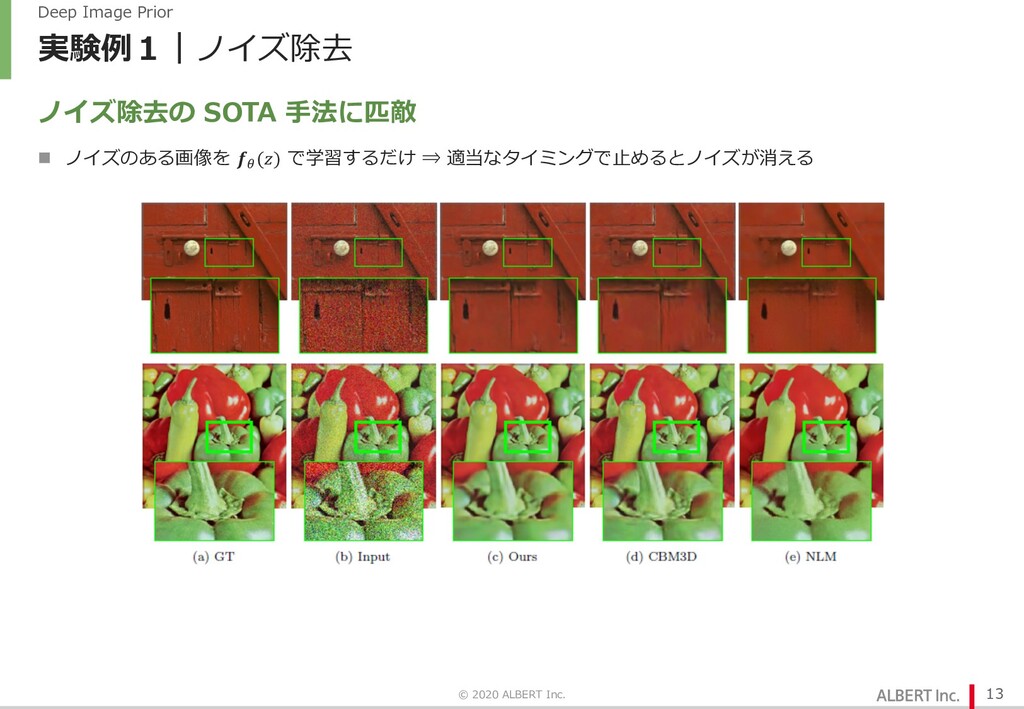
実験例1|ノイズ除去 n ノイズのある画像を ! () で学習するだけ ⇒ 適当なタイミングで⽌めるとノイズが消える © 2020
ALBERT Inc. 13 Deep Image Prior ノイズ除去の SOTA ⼿法に匹敵
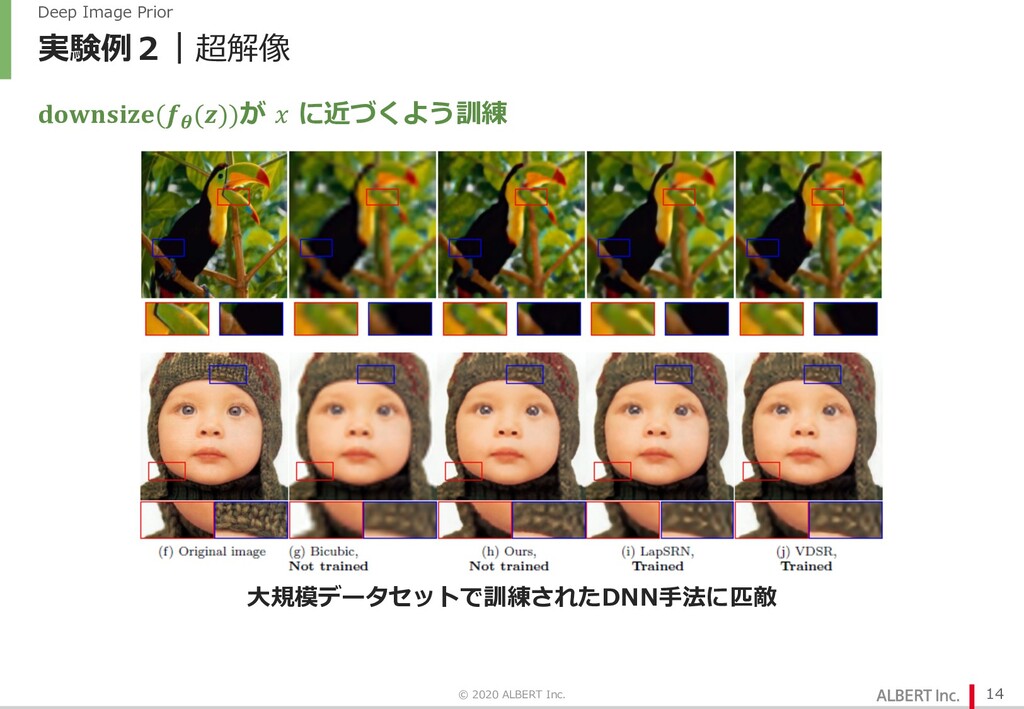
実験例2|超解像 © 2020 ALBERT Inc. 14 Deep Image Prior (())が
に近づくよう訓練 ⼤規模データセットで訓練されたDNN⼿法に匹敵
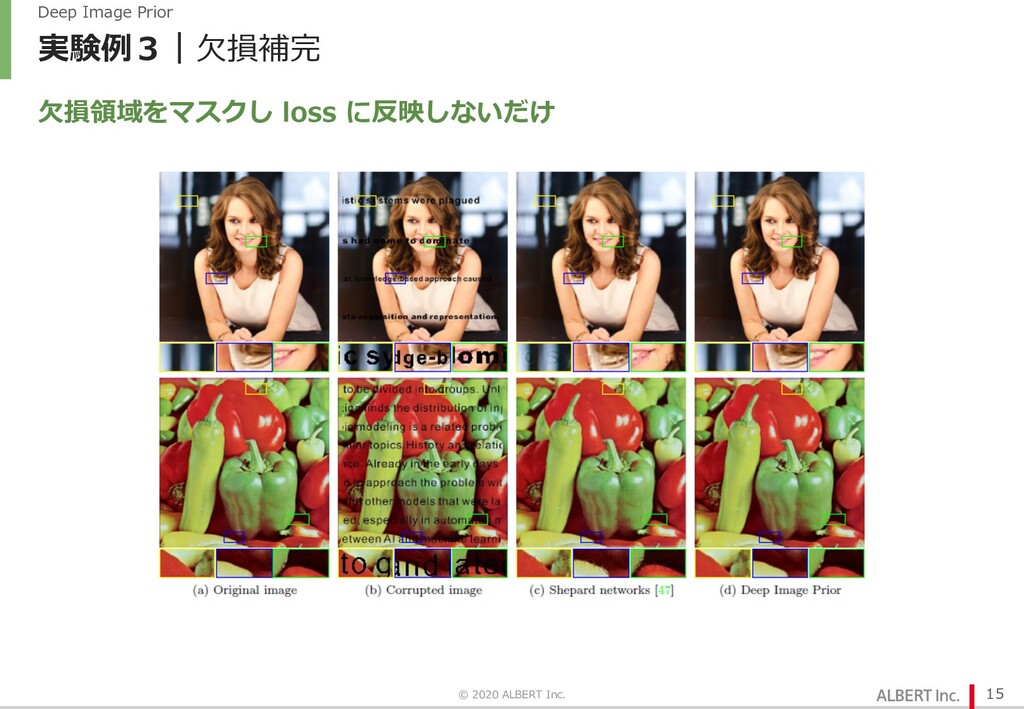
実験例3|⽋損補完 © 2020 ALBERT Inc. 15 Deep Image Prior ⽋損領域をマスクし
loss に反映しないだけ
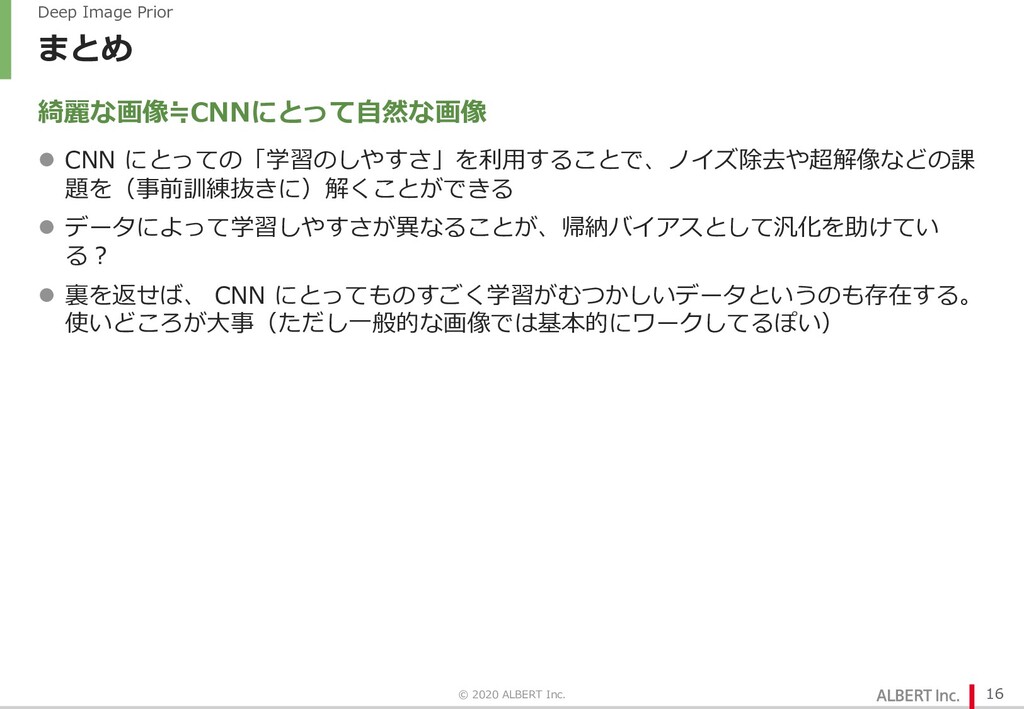
まとめ l CNN にとっての「学習のしやすさ」を利⽤することで、ノイズ除去や超解像などの課 題を(事前訓練抜きに)解くことができる l データによって学習しやすさが異なることが、帰納バイアスとして汎化を助けてい る︖ l 裏を返せば、
CNN にとってものすごく学習がむつかしいデータというのも存在する。 使いどころが⼤事(ただし⼀般的な画像では基本的にワークしてるぽい) © 2020 ALBERT Inc. 16 Deep Image Prior 綺麗な画像≒CNNにとって⾃然な画像
Deep Mapping © 2020 ALBERT Inc. 17
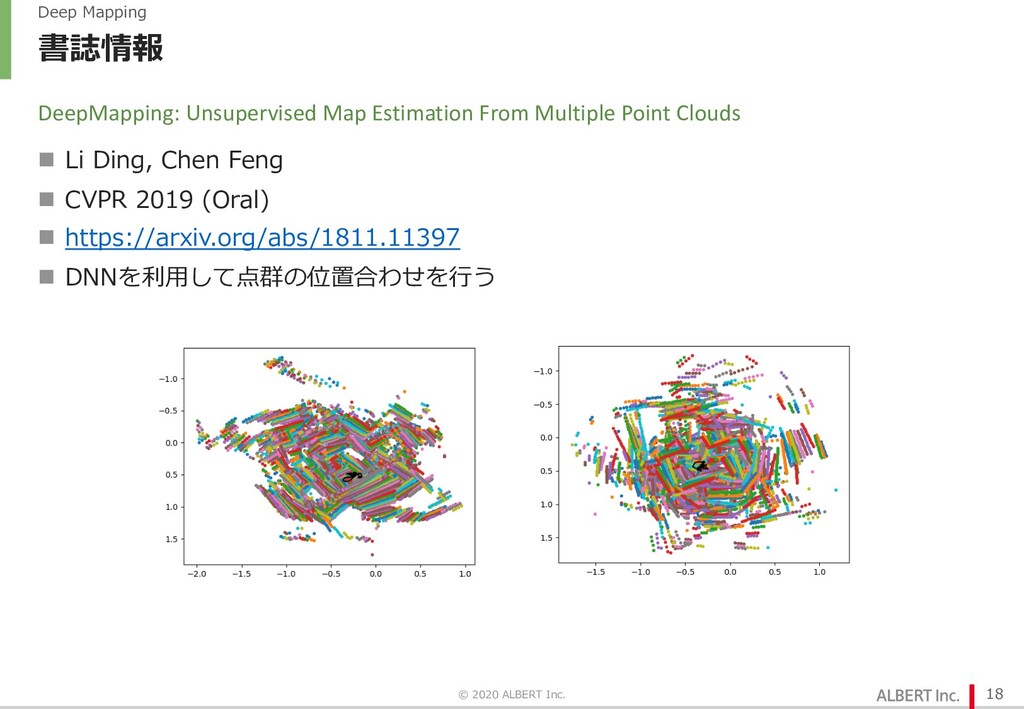
書誌情報 n Li Ding, Chen Feng n CVPR 2019 (Oral)
n https://arxiv.org/abs/1811.11397 n DNNを利⽤して点群の位置合わせを⾏う © 2020 ALBERT Inc. 18 Deep Mapping DeepMapping: Unsupervised Map Estimation From Multiple Point Clouds
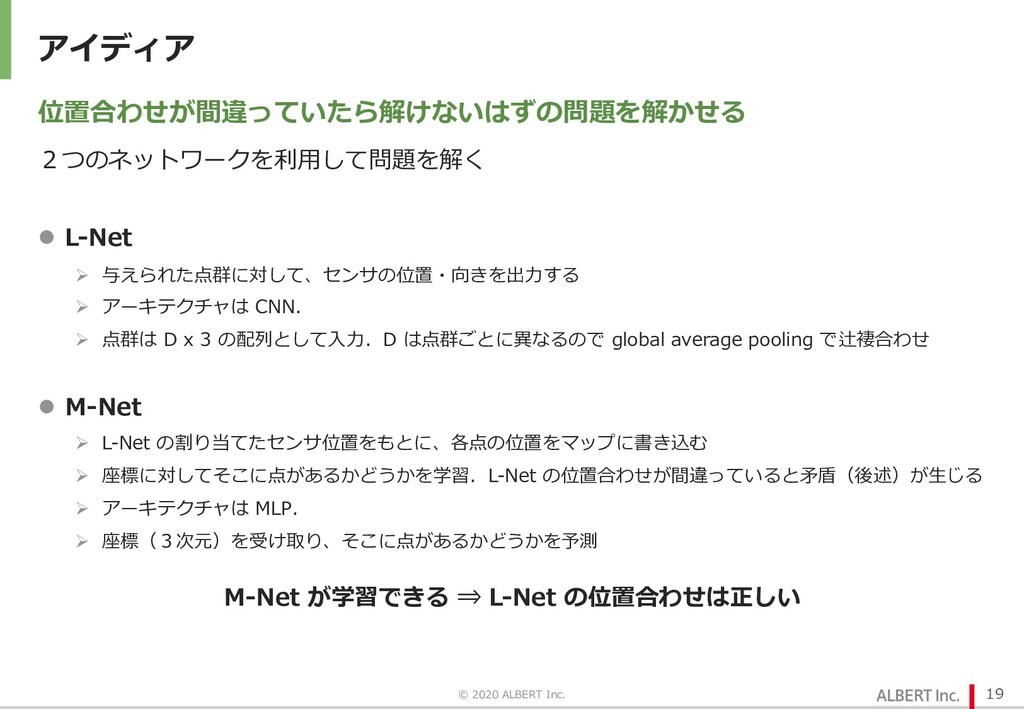
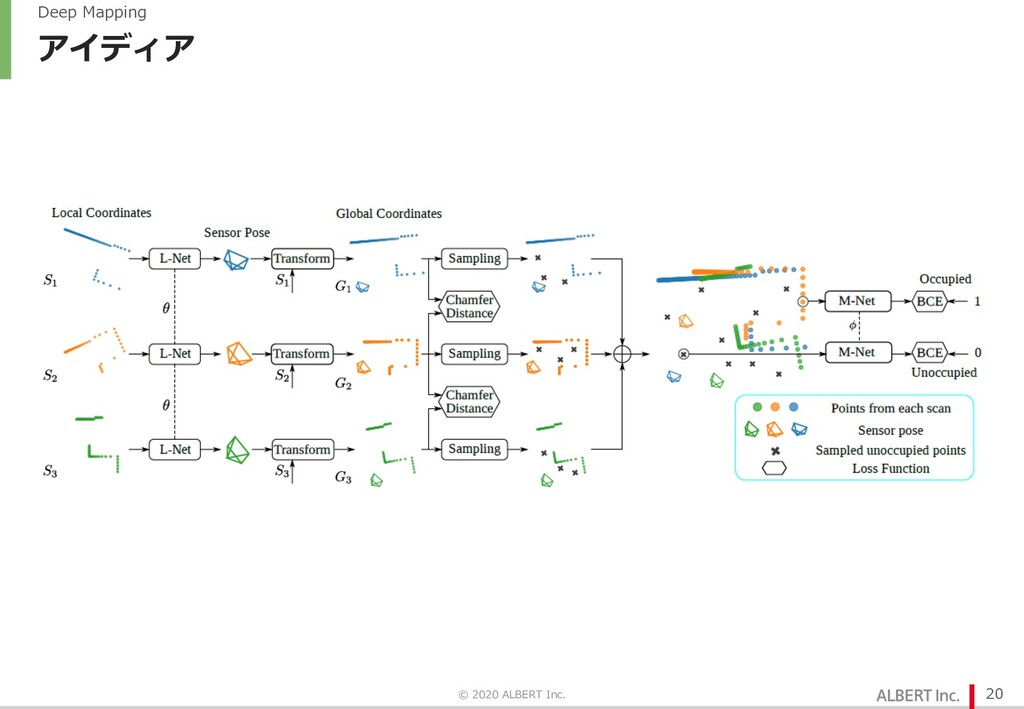
アイディア 2つのネットワークを利⽤して問題を解く l L-Net Ø 与えられた点群に対して、センサの位置・向きを出⼒する Ø アーキテクチャは CNN. Ø
点群は D x 3 の配列として⼊⼒.D は点群ごとに異なるので global average pooling で辻褄合わせ l M-Net Ø L-Net の割り当てたセンサ位置をもとに、各点の位置をマップに書き込む Ø 座標に対してそこに点があるかどうかを学習.L-Net の位置合わせが間違っていると⽭盾(後述)が⽣じる Ø アーキテクチャは MLP. Ø 座標(3次元)を受け取り、そこに点があるかどうかを予測 © 2020 ALBERT Inc. 19 位置合わせが間違っていたら解けないはずの問題を解かせる M-Net が学習できる ⇒ L-Net の位置合わせは正しい
アイディア © 2020 ALBERT Inc. 20 Deep Mapping
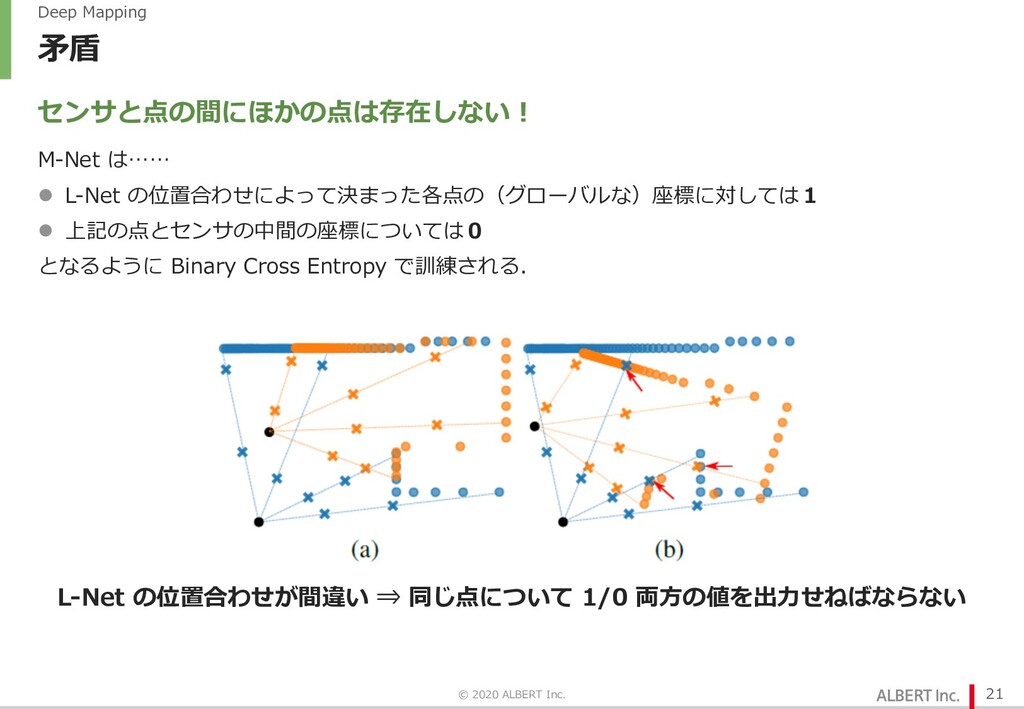
⽭盾 M-Net は…… l L-Net の位置合わせによって決まった各点の(グローバルな)座標に対しては1 l 上記の点とセンサの中間の座標については0 となるように Binary
Cross Entropy で訓練される. © 2020 ALBERT Inc. 21 Deep Mapping センサと点の間にほかの点は存在しない︕ L-Net の位置合わせが間違い ⇒ 同じ点について 1/0 両⽅の値を出⼒せねばならない
L-Net を使う意味 © 2020 ALBERT Inc. 22 Deep Mapping NN
による parametrize. L-Netを使わず各点群のセンサ座標を変数として初期化し,それを最適化してもよい (Direct optimization)が、 L-Net を間に挟む⽅がはるかにうまくいく DIP で を ! () で parametrize したのと似ている NN で parametrize することで様々な変数がゆるく関係することが重要︖
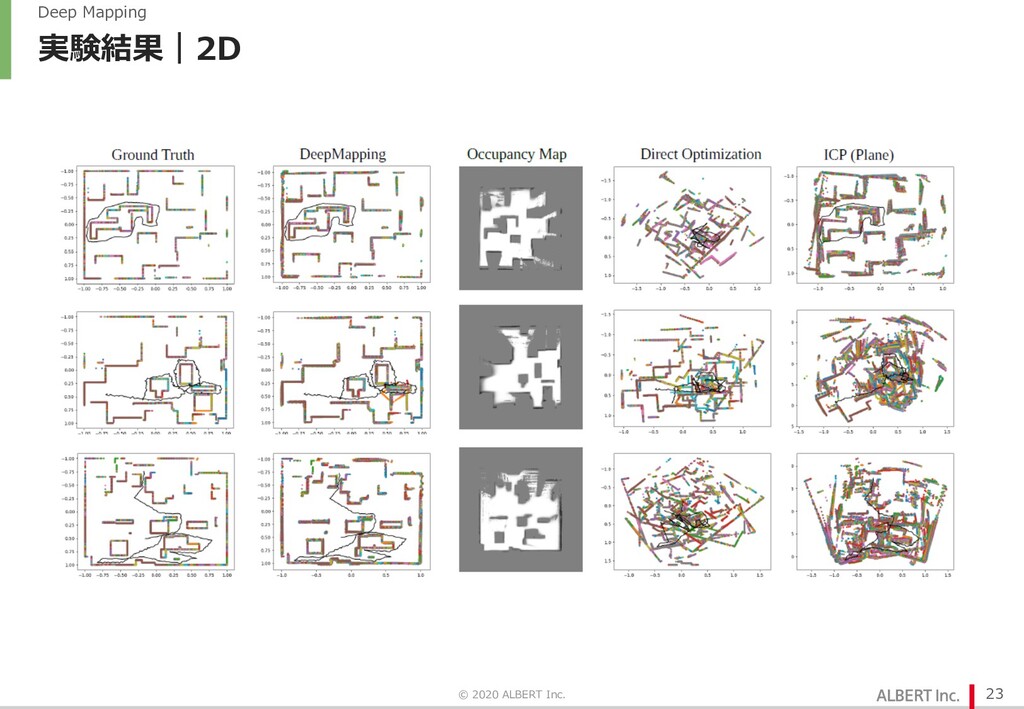
実験結果|2D © 2020 ALBERT Inc. 23 Deep Mapping
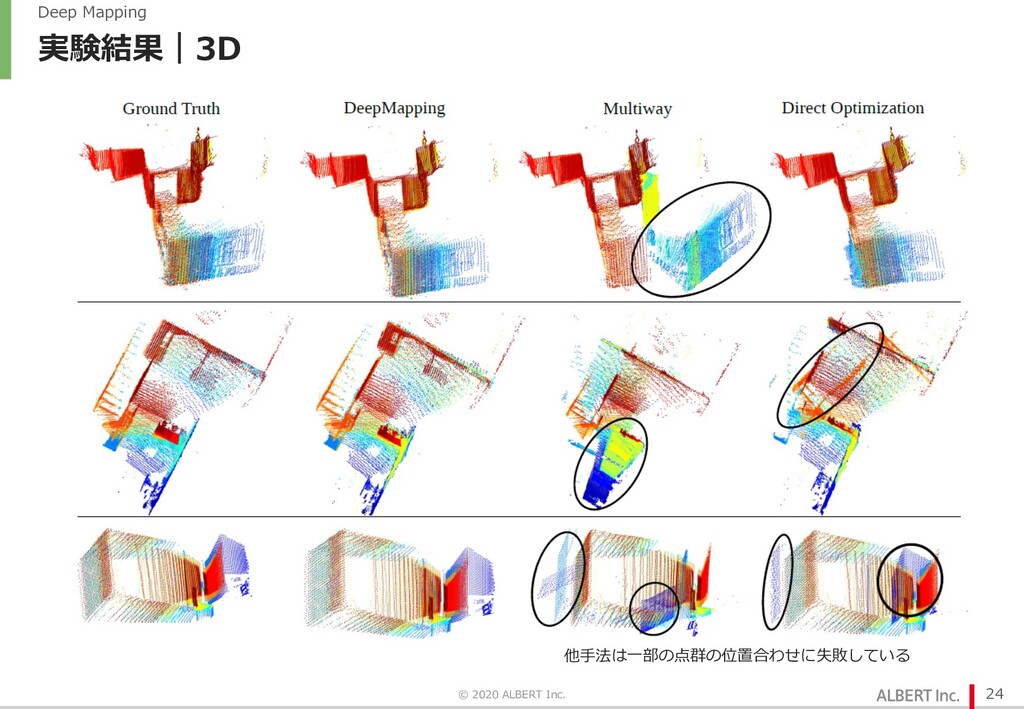
実験結果|3D © 2020 ALBERT Inc. 24 Deep Mapping 他⼿法は⼀部の点群の位置合わせに失敗している
まとめ l L-Net によってセンサー位置を parametrize する l M-Net にセンサー位置が満たすべき辻褄を表現させる l
直接の最適化がむつかしかった問題が, DNN を間に挟むことでうまくいくようになる l 実⽤性はそんなにない(時間がかかるし3次元だと失敗することも多い) l しかしこのアイディアはいろいろな課題に応⽤できると思う © 2020 ALBERT Inc. 25 Deep Mapping DNN で対象を parametrize することで最適化がうまくいく
おわりに DNN を単に経験を蓄える箱と考えるのはもったいない DNN のアーキテクチャは実世界についての知識(=帰納バイアス)を持っており、これ を直接使うこともできる アーキテクチャや訓練⽅法を調整することでもっといろいろな知識・仮定を埋め込むこと ができる︖ ALBERT としてもより新しい
DNN の利⽤法を模索していきたい © 2020 ALBERT Inc. 26 ニューラルネットは可能性に満ちている
None
More Decks by ALBERT Inc.
See All by ALBERT Inc.
TossingBot: Learning to Throw Arbitrary Objects with Residual Physics
albert_study
0
140
人流と COVID-19 の関係性の評価と発表までの議論過程
albert_study
0
110
DNN による動画認識
albert_study
0
190
正則化による変数選択の解説と応用事例の紹介
albert_study
0
730
DNN による特徴点マッチング
albert_study
1
3k
AI技術とドライブレコーダー映像を活用した「事故状況再現システム」のご紹介
albert_study
0
530
Glow の紹介
albert_study
0
380
Other Decks in Technology
See All in Technology
パスワードのない鍵で、 データを手元に置く
ginjihayashi
0
400
現場に渡し、構造で守る AI エージェントを活用したセルフサーブのデータ基盤の運用
legalontechnologies
PRO
0
110
みん強Lightning! データ基盤ひとりでできるかな
endonanana
0
190
サーバーラックは作る時代! 3Dプリンターで作る10インチラックのススメ
jacopen
2
520
メール到達性を支える、リンク先URLのドメイン評価の扱い方
wind111
0
200
Oracle Base Database Service 技術詳細
oracle4engineer
PRO
17
120k
Well, that’s weird…
csswizardry
1
200
MCPでネットワーク障害調査を自動化する前に直すべき3つのこと
yama3133
1
660
[関西Kaggler会 20261113] 続・コミュニティコンペのススメ
nejumi
0
200
2026-11-16 JAWS-UG コンテナ支部 #31 ゆるLT大会 ECR のライフサイクルポリシーを いい感じに設定したい / ECR Lifecycle policy
masasuzu
3
620
メルカリの小規模チーム「Pod」で、 エンジニアがデータアナリストなしで、 AIを使ってデータ分析の自走を目指す取り組み
jackojacko_
1
350
Amazon Bedrock AgentCore の基礎とセキュリティ・ガバナンス
ren8k
0
270
Featured
See All Featured
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
70
69k
Git: the NoSQL Database
bkeepers
PRO
433
67k
The Power of CSS Pseudo Elements
geoffreycrofte
82
6.7k
From π to Pie charts
rasagy
1
460
How STYLIGHT went responsive
nonsquared
100
6.4k
BBQ
matthewcrist
90
10k
Amusing Abliteration
ianozsvald
1
400
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
The State of eCommerce SEO: How to Win in Today's Products SERPs - #SEOweek
aleyda
2
12k
Mozcon NYC 2025: Stop Losing SEO Traffic
samtorres
1
610
Odyssey Design
rkendrick25
PRO
3
970
The Myth of the Modular Monolith - Day 2 Keynote - Rails World 2024
eileencodes
28
3.8k


 albert_study
 ginjihayashi
 legalontechnologies
 endonanana
 jacopen
 wind111
 oracle4engineer
 csswizardry
 yama3133
 nejumi
 masasuzu
 jackojacko_
 ren8k
 madoxten
 bkeepers
 geoffreycrofte
 rasagy
 nonsquared
 matthewcrist
 ianozsvald
 marcelosomers
 aleyda
 samtorres
 rkendrick25
 eileencodes