Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
リアルタイムサーバー運用改善 〜メタバースプラットフォームにおけるEKS運用とDatadog活...
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
COVER Corporation
September 15, 2026
Programming
28
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
リアルタイムサーバー運用改善 〜メタバースプラットフォームにおけるEKS運用とDatadog活用によるオートスケール実践〜
COVER Corporation
September 15, 2026
More Decks by COVER Corporation
See All by COVER Corporation
メタバースプロジェクトにおけるObservability構築とユーザー視点での信頼性可視化の現在地
covercorp
0
23
カバー株式会社_新規投資家向け資料
covercorp
1
530k
COVER_Presentation for New Investors
covercorp
0
61k
COVER Value Deck
covercorp
2
17k
カバー株式会社採用候補者向け会社紹介資料 / COVER Corp Introduction
covercorp
0
1.2M
Other Decks in Programming
See All in Programming
思考垂れ流し開発 ~音声入力 × AIエージェント × 開発ハーネスによる試行錯誤~
npostring
0
1.1k
go-spidermonkeyでAIエージェントのCode Modeを実装する
syumai
3
1.5k
AIを上手に使っていこうとしたら越境せざるを得なくなった話 〜実践1年で見えた境界を越えなければならない理由と進め方〜 / Crossing borders with AI
tomoyakitaura
4
1.1k
XHTMLが残したもの
yosuke_furukawa
PRO
2
690
AIとGame Jamで、ゲームを完成させた話
takahirosaeki
0
120
Laravelのアプリケーションをどこにデプロイするか #ツナギメオフライン.9
akase244
0
120
マイコン向けの軽量Ruby「PicoRuby」で各種デバイスを制御するネイティブアプリの実現手法
bash0c7
0
330
Seeing Through Serverless: Observability for AWS Lambda with ADOT and CloudWatch Application Signals
seike460
PRO
1
130
フロントエンドUIフレームワークのこれまでとこれから
ssssota
5
2.4k
Deep dive into the select statement (GopherCon UK)
jespino
0
170
tsc.rip を支える技術 / Kyoto.なんか #8
susisu
0
4.4k
App Storeの外へ──日本のiOSサイドローディング入門 for iOSDC Japan 2026
yuukiw00w
0
180
Featured
See All Featured
Are puppies a ranking factor?
jonoalderson
2
3.9k
JAMstack: Web Apps at Ludicrous Speed - All Things Open 2022
reverentgeek
1
590
How to optimise 3,500 product descriptions for ecommerce in one day using ChatGPT
katarinadahlin
PRO
2
3.8k
Evolving SEO for Evolving Search Engines
ryanjones
0
280
Bioeconomy Workshop: Dr. Julius Ecuru, Opportunities for a Bioeconomy in West Africa
akademiya2063
PRO
1
350
AI Search: Where Are We & What Can We Do About It?
aleyda
0
7.9k
The Pragmatic Product Professional
lauravandoore
37
7.4k
Refactoring Trust on Your Teams (GOTO; Chicago 2020)
rmw
35
3.8k
Code Review Best Practice
trishagee
74
20k
Site-Speed That Sticks
csswizardry
13
1.5k
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
520
Paper Plane
katiecoart
PRO
3
53k
Transcript
リアルタイムサーバー運⽤改善 〜メタバースプラットフォームにおけるEKS運⽤ とDatadog活⽤によるオートスケール実践〜 2025年11⽉18⽇ CloudNative Days Winter 2025 1
⾃⼰紹介 Toshiki Ishii CTO室インフラチーム所属 ホロアースSRE(2024/10~) 興味: Edge Computing/Peformance Tuning 2
01 カバーについて 3
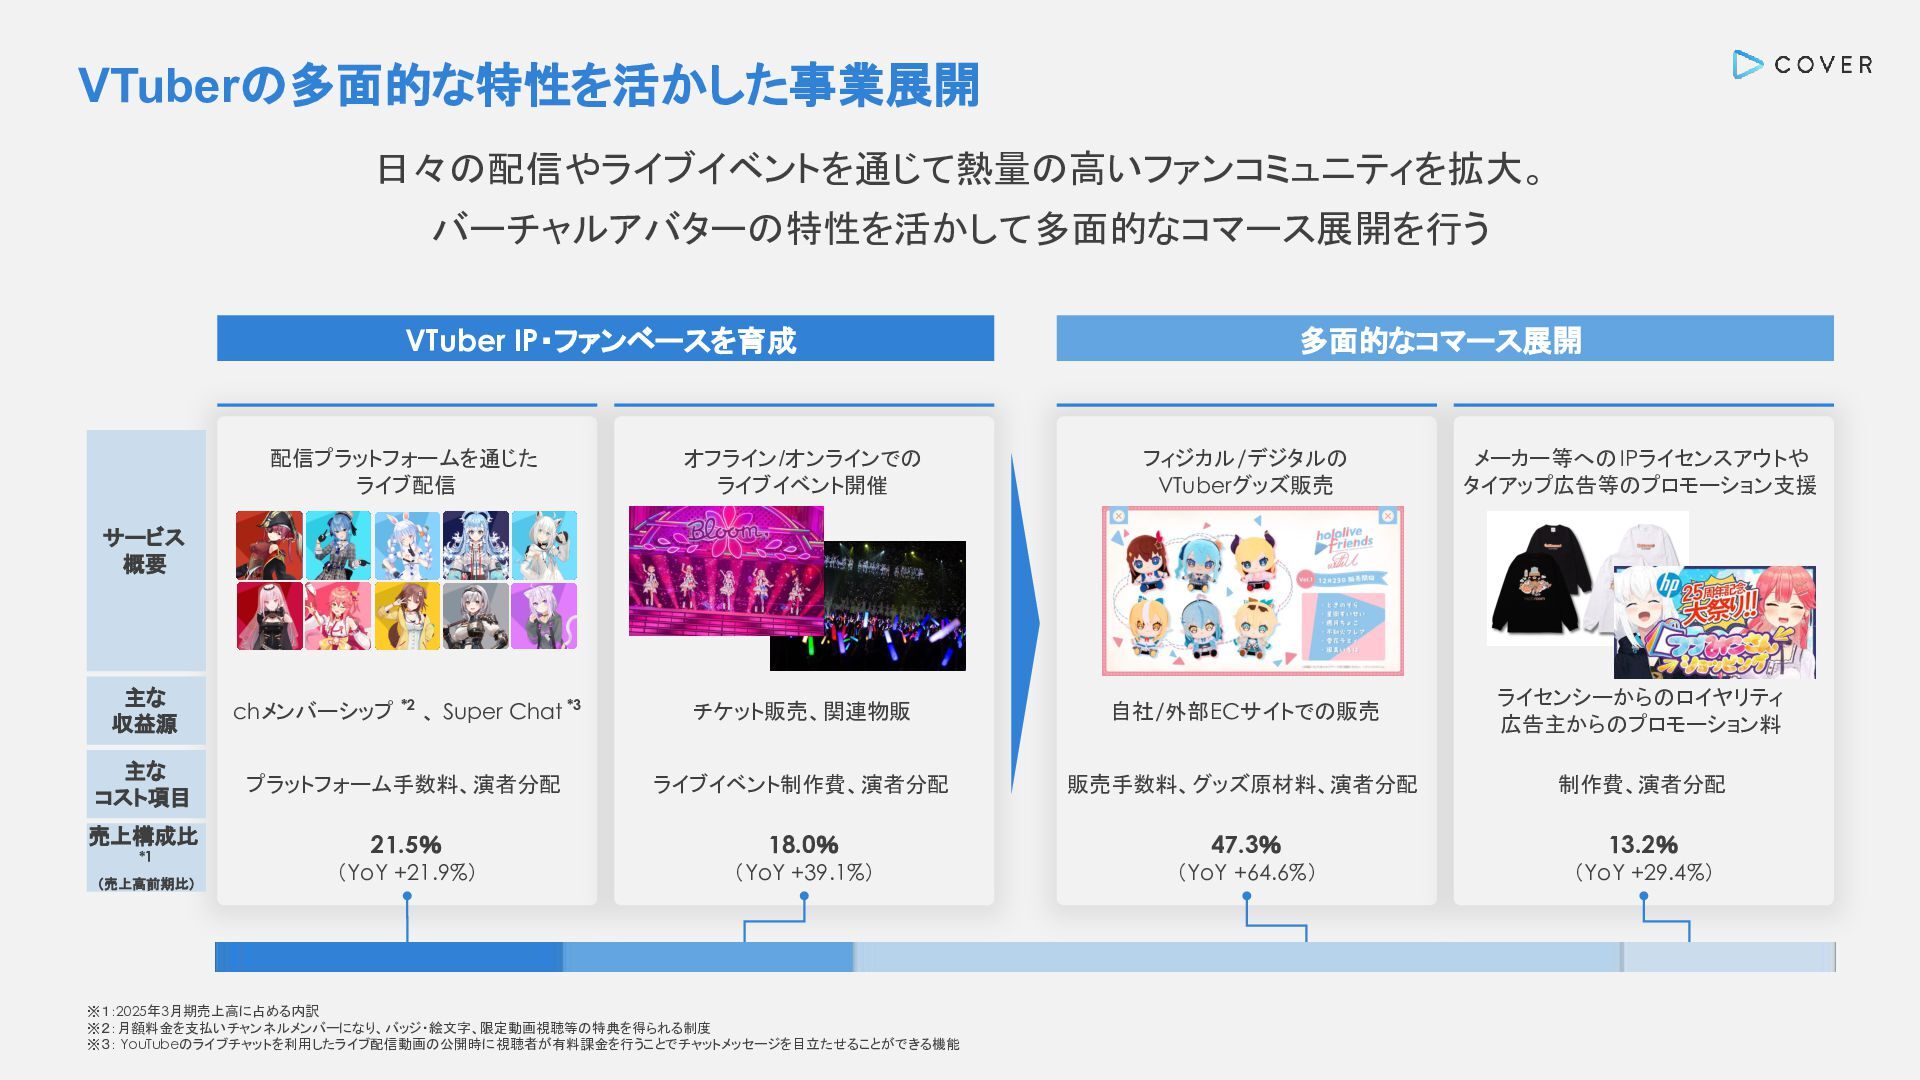
VTuberの多面的な特性を活かした事業展開 日々の配信やライブイベントを通じて熱量の高いファンコミュニティを拡大。 バーチャルアバターの特性を活かして多面的なコマース展開を行う 多面的なコマース展開 VTuber IP・ファンベースを育成 配信プラットフォームを通じた ライブ配信 オフライン/オンラインでの ライブイベント開催
フィジカル/デジタルの VTuberグッズ販売 メーカー等への IPライセンスアウトや タイアップ広告等のプロモーション支援 主な 収益源 chメンバーシップ *2 、 Super Chat *3 チケット販売、関連物販 自社/外部ECサイトでの販売 ライセンシーからのロイヤリティ 広告主からのプロモーション料 主な コスト項目 プラットフォーム手数料、演者分配 ライブイベント制作費、演者分配 販売手数料、グッズ原材料、演者分配 制作費、演者分配 サービス 概要 売上構成比 *1 (売上高前期比) 21.5% 18.0% 47.3% 13.2% (YoY +21.9%) (YoY +39.1%) (YoY +64.6%) (YoY +29.4%) ※1:2025年3月期売上高に占める内訳 ※2:月額料金を支払いチャンネルメンバーになり、バッジ・絵文字、限定動画視聴等の特典を得られる制度 ※3: YouTubeのライブチャットを利用したライブ配信動画の公開時に視聴者が有料課金を行うことでチャットメッセージを目立たせることができる機能
02 ホロアースについて 5
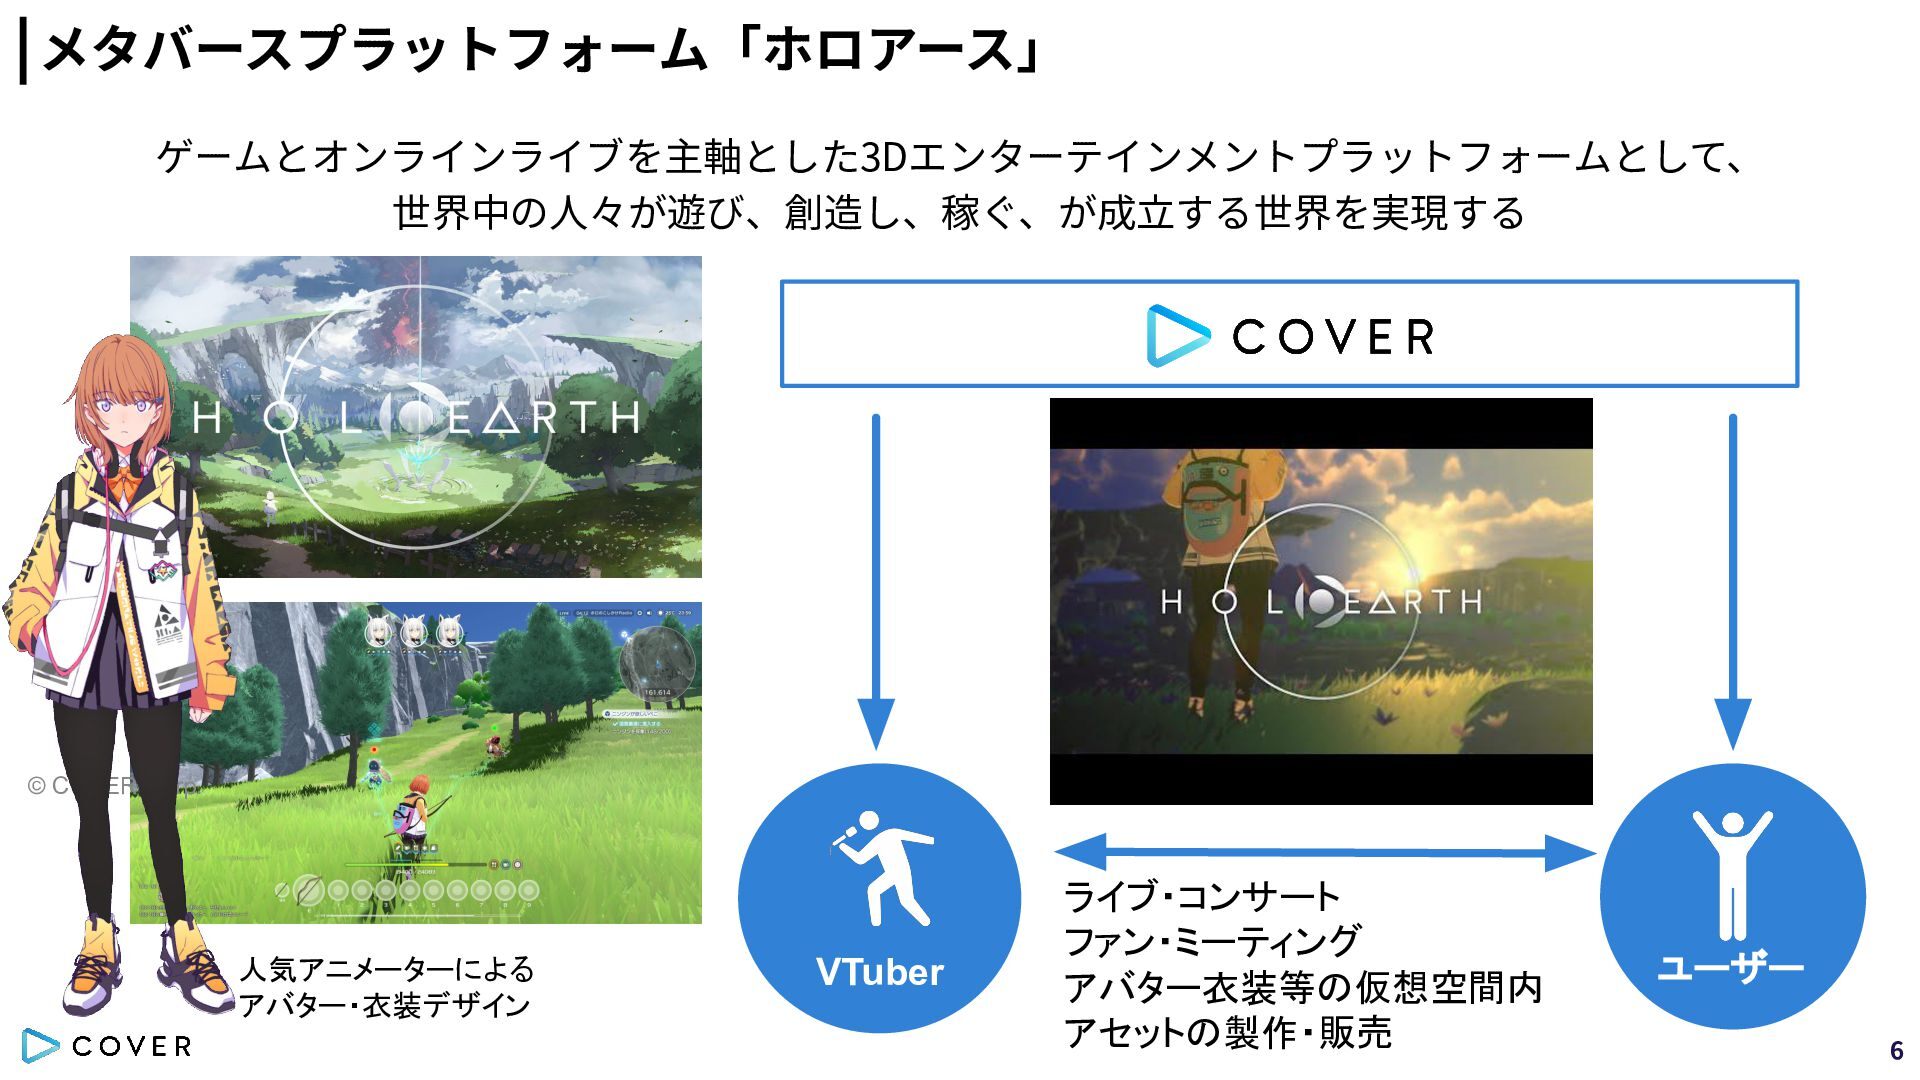
メタバースプラットフォーム「ホロアース」 ゲームとオンラインライブを主軸とした3Dエンターテインメントプラットフォームとして、 世界中の⼈々が遊び、創造し、稼ぐ、が成⽴する世界を実現する © COVER Corp. 人気アニメーターによる アバター・衣装デザイン VTuber ライブ・コンサート
ファン・ミーティング アバター衣装等の仮想空間内 アセットの製作・販売 ユーザー 6
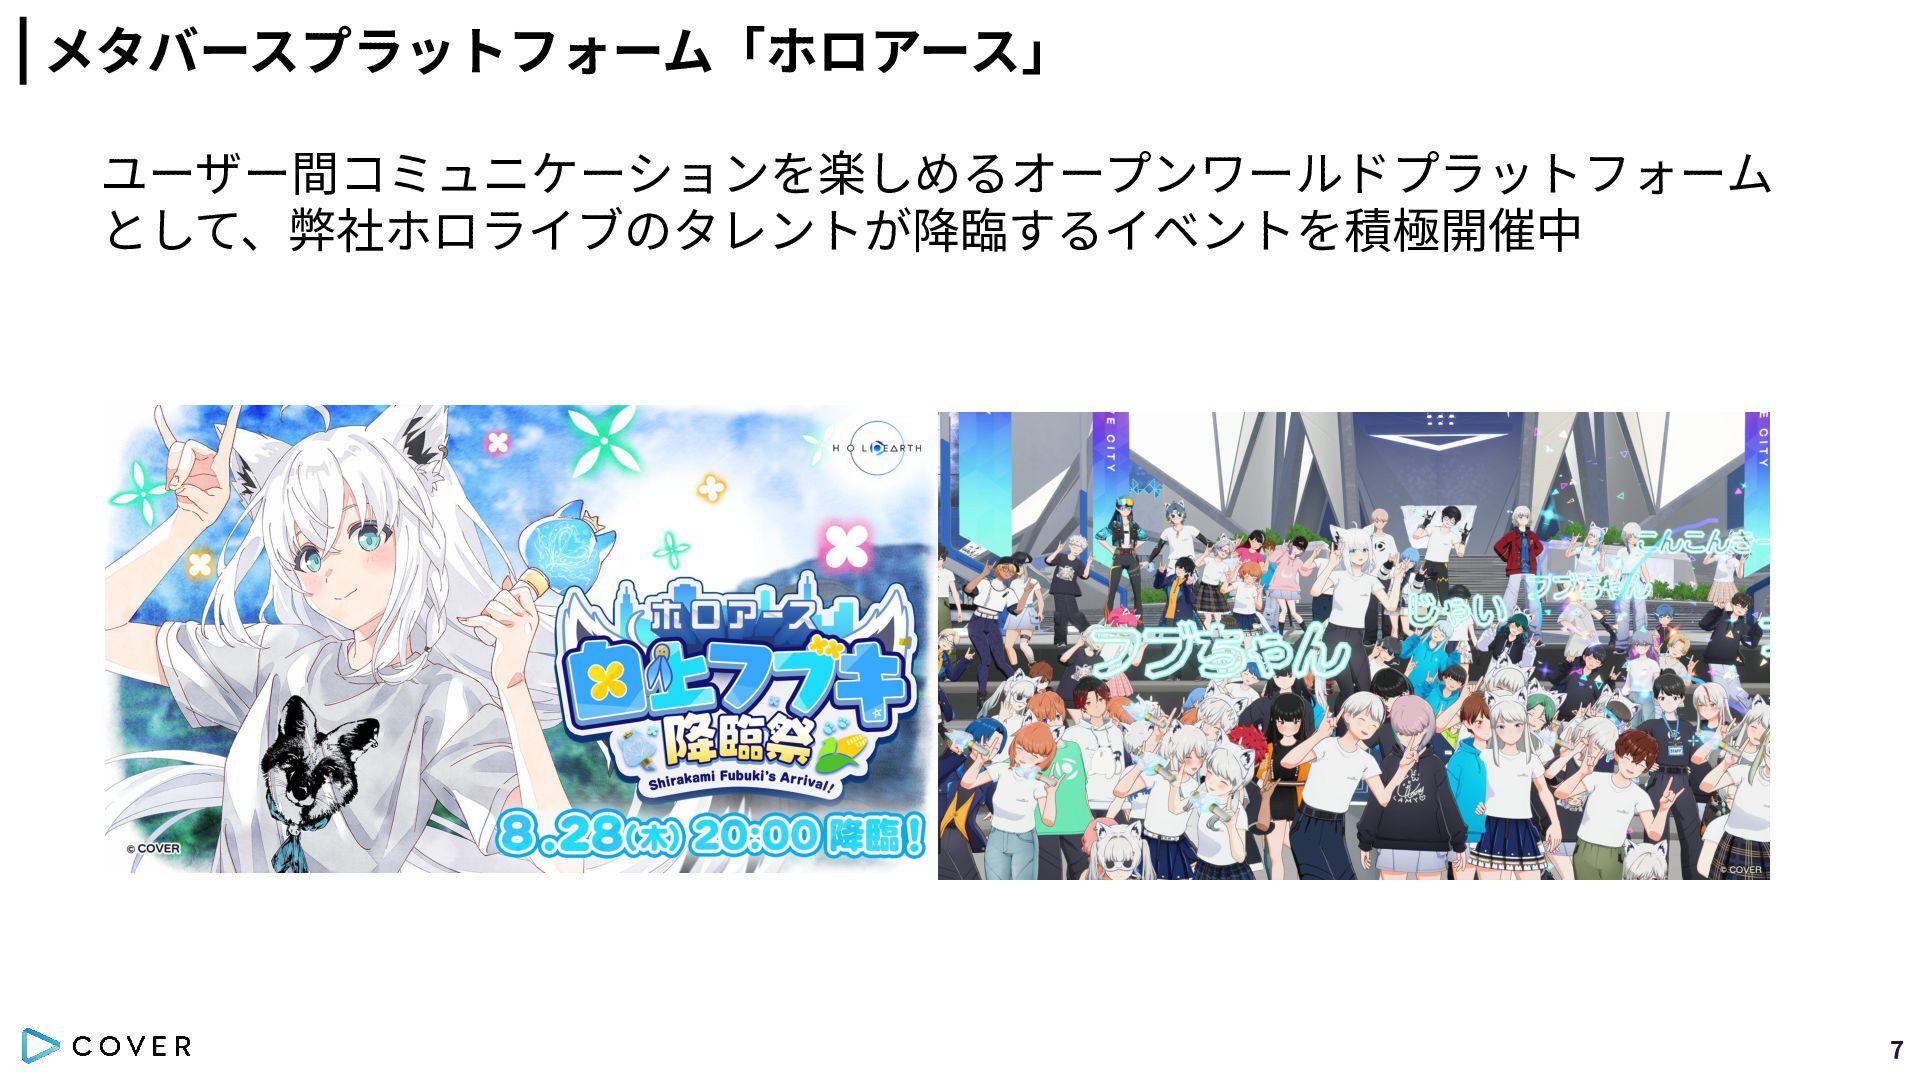
メタバースプラットフォーム「ホロアース」 ユーザー間コミュニケーションを楽しめるオープンワールドプラットフォーム として、弊社ホロライブのタレントが降臨するイベントを積極開催中 7
03 SREのロードマップと課題 8
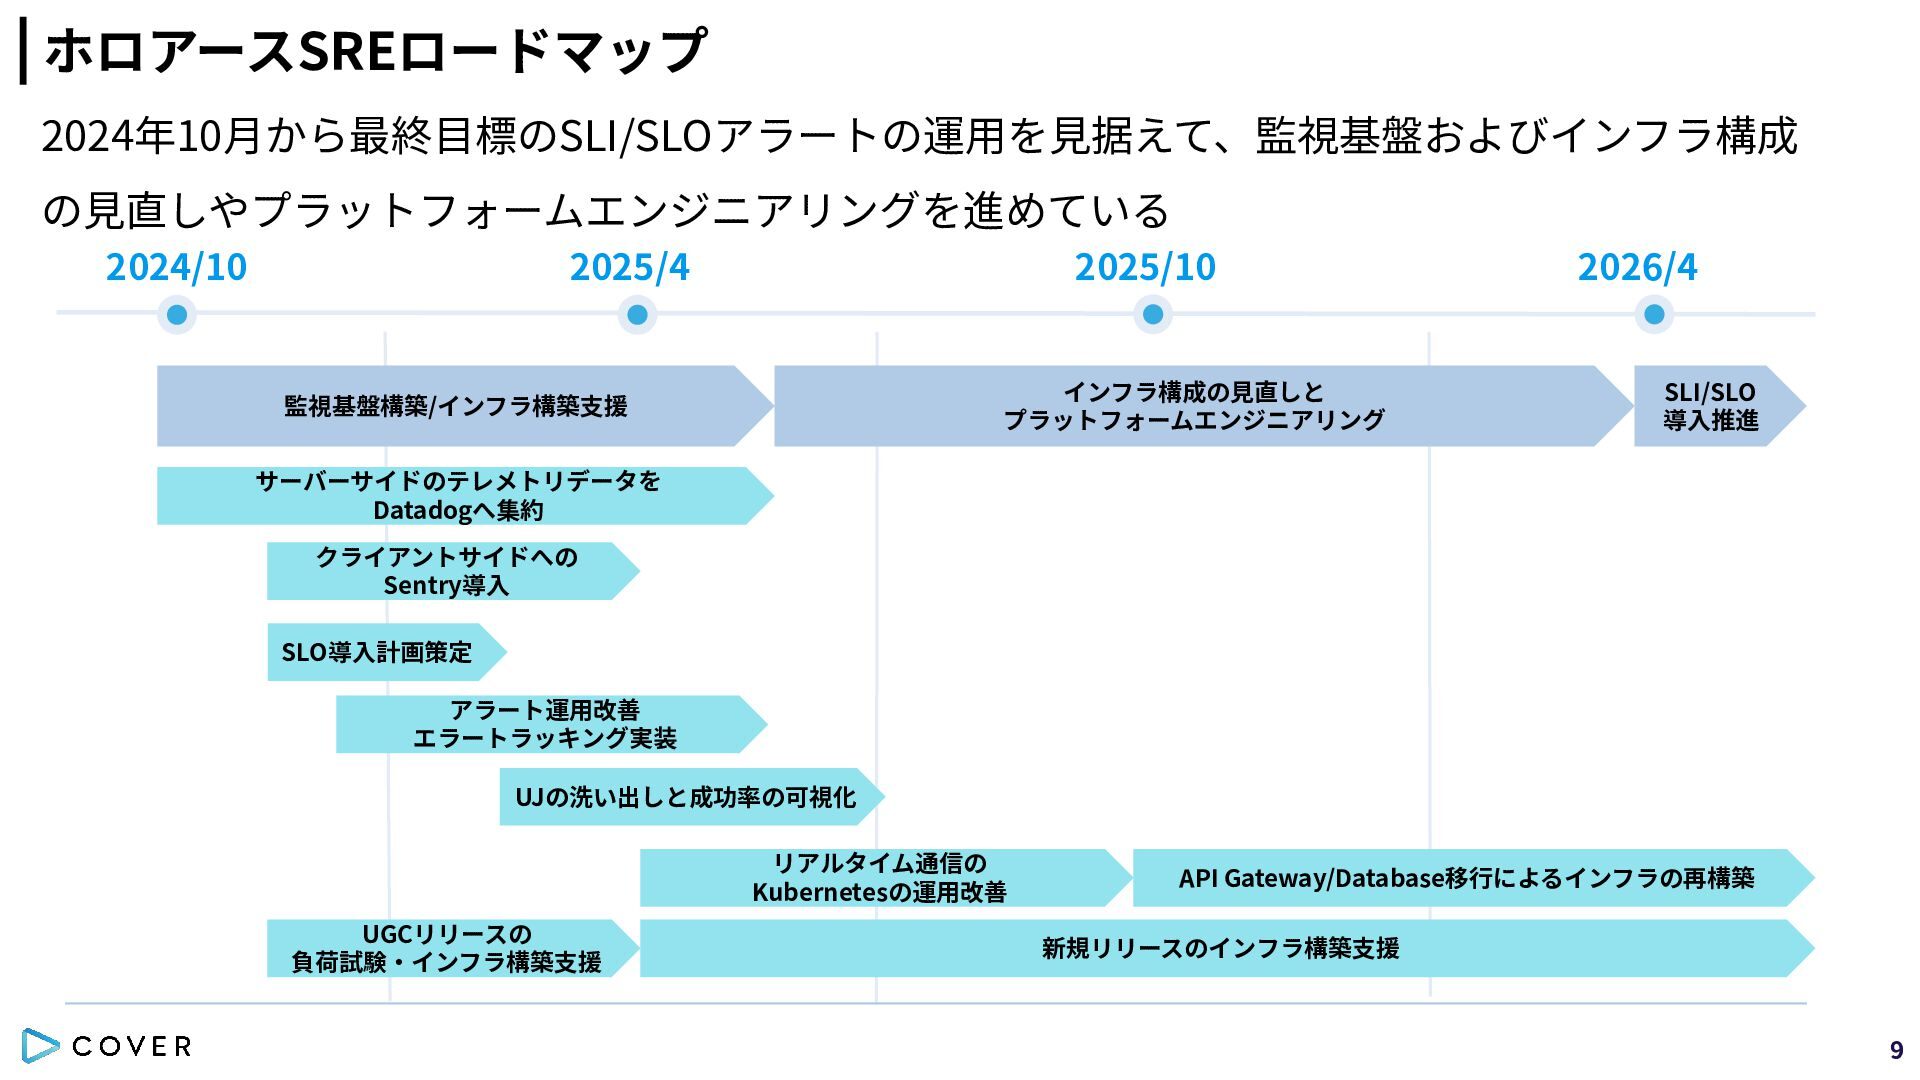
ホロアースSREロードマップ 2024年10⽉から最終⽬標のSLI/SLOアラートの運⽤を⾒据えて、監視基盤およびインフラ構成 の⾒直しやプラットフォームエンジニアリングを進めている 2024/10 2025/4 2025/10 インフラ構成の⾒直しと プラットフォームエンジニアリング 監視基盤構築/インフラ構築⽀援 2026/4
SLI/SLO 導⼊推進 サーバーサイドのテレメトリデータを Datadogへ集約 クライアントサイドへの Sentry導⼊ SLO導⼊計画策定 アラート運⽤改善 エラートラッキング実装 UJの洗い出しと成功率の可視化 リアルタイム通信の Kubernetesの運⽤改善 UGCリリースの 負荷試験‧インフラ構築⽀援 API Gateway/Database移⾏によるインフラの再構築 新規リリースのインフラ構築⽀援 9
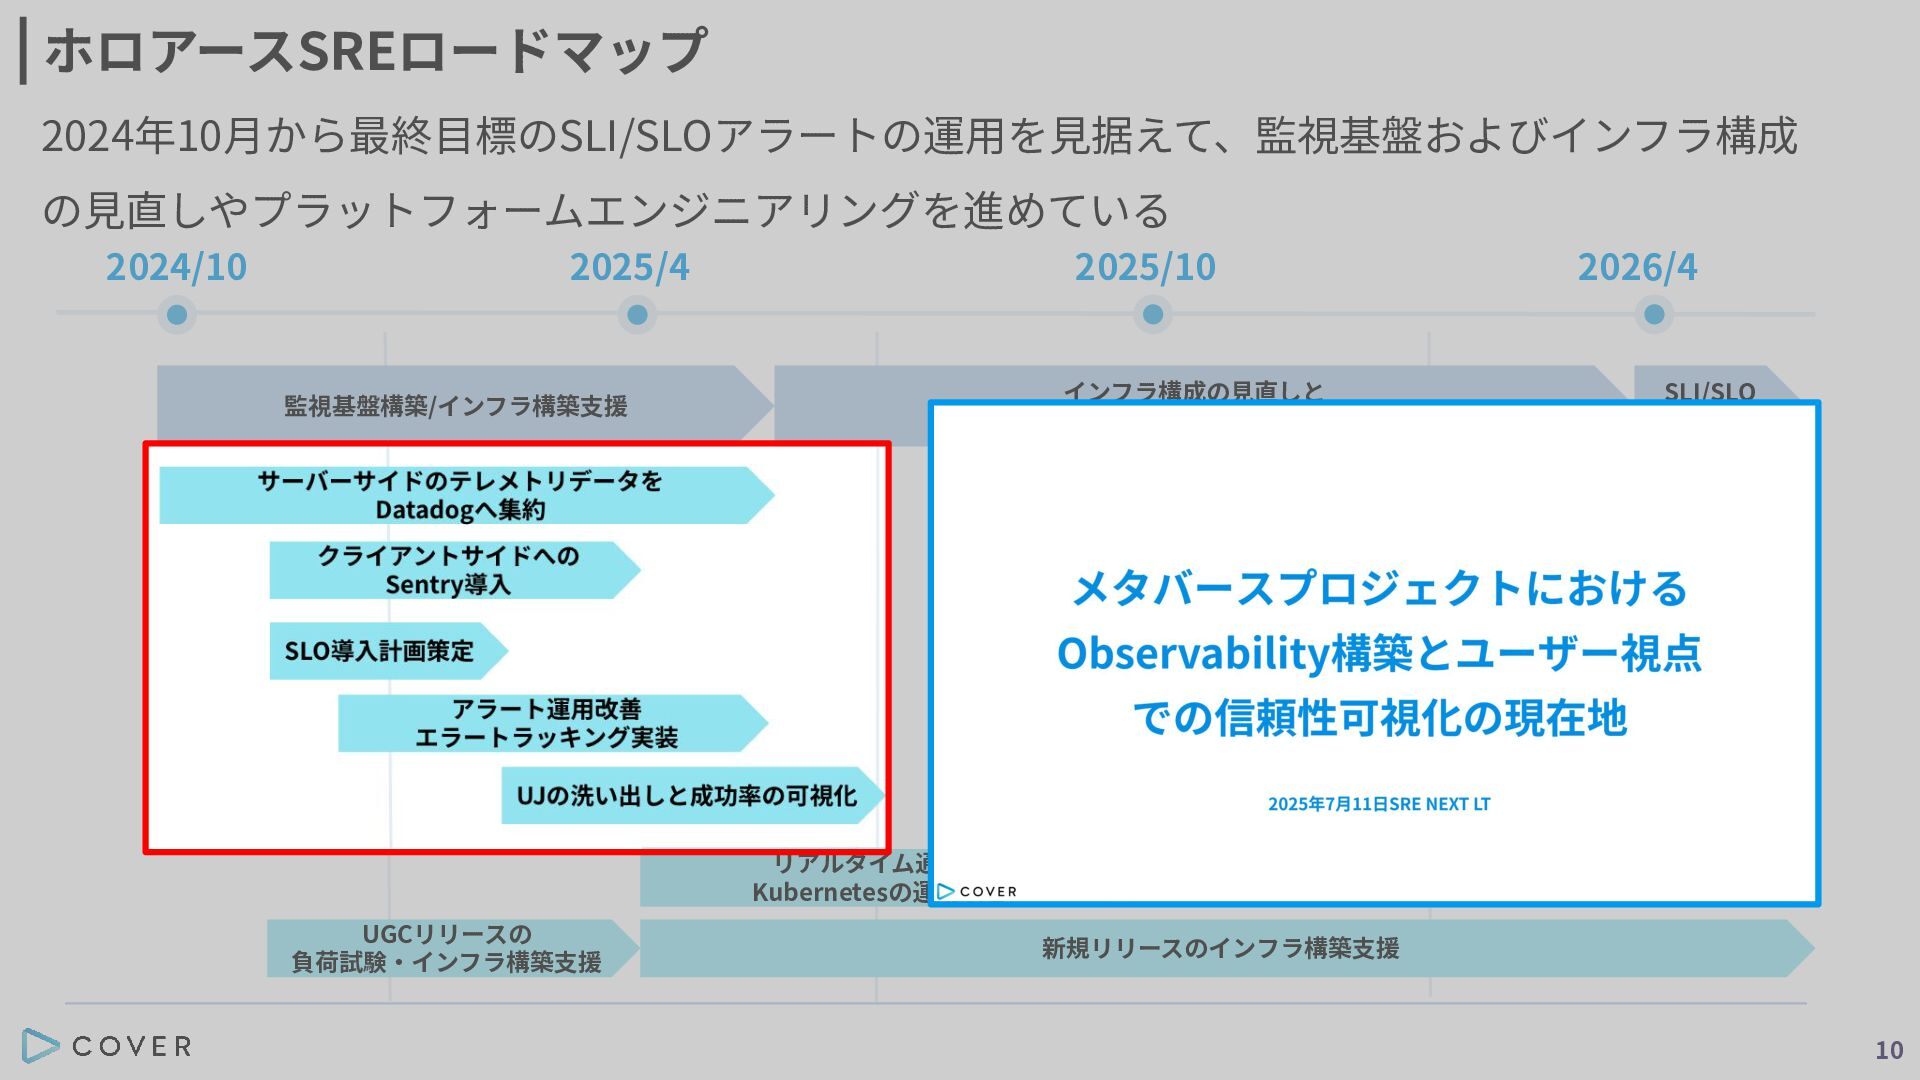
ホロアースSREロードマップ 2024年10⽉から最終⽬標のSLI/SLOアラートの運⽤を⾒据えて、監視基盤およびインフラ構成 の⾒直しやプラットフォームエンジニアリングを進めている 2024/10 2025/4 2025/10 インフラ構成の⾒直しと プラットフォームエンジニアリング 監視基盤構築/インフラ構築⽀援 2026/4
SLI/SLO 導⼊推進 サーバーサイドのテレメトリデータを Datadogへ集約 クライアントサイドへの Sentry導⼊ SLO導⼊計画策定 アラート運⽤改善 エラートラッキング実装 UJの洗い出しと成功率の可視化 リアルタイム通信の Kubernetesの運⽤改善 UGCリリースの 負荷試験‧インフラ構築⽀援 API Gateway/Database移⾏によるインフラの再構築 新規リリースのインフラ構築⽀援 10
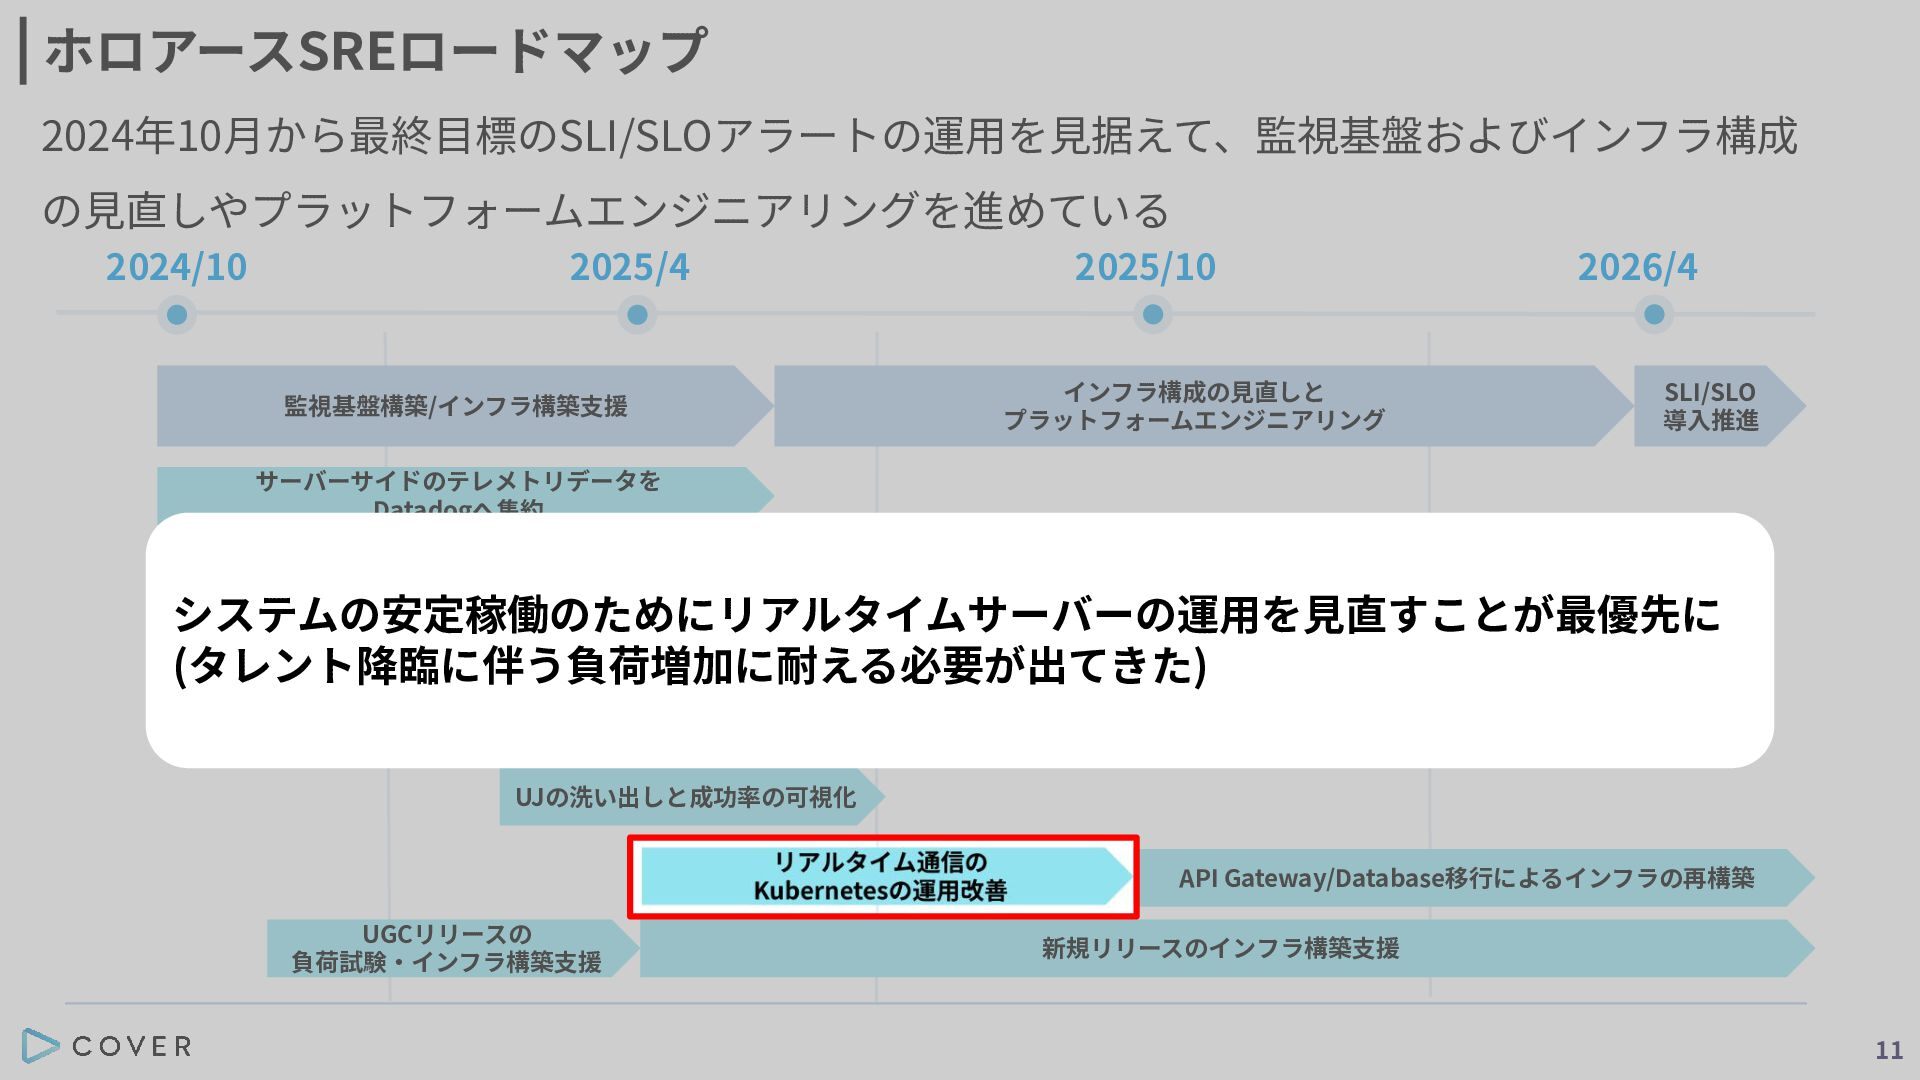
ホロアースSREロードマップ 2024年10⽉から最終⽬標のSLI/SLOアラートの運⽤を⾒据えて、監視基盤およびインフラ構成 の⾒直しやプラットフォームエンジニアリングを進めている 2024/10 2025/4 2025/10 インフラ構成の⾒直しと プラットフォームエンジニアリング 監視基盤構築/インフラ構築⽀援 2026/4
SLI/SLO 導⼊推進 サーバーサイドのテレメトリデータを Datadogへ集約 クライアントサイドへの Sentry導⼊ システムの安定稼働のためにリアルタイムサーバーの運⽤を⾒直すことが最優先に SLO導⼊計画策定 (タレント降臨に伴う負荷増加に耐える必要が出てきた) アラート運⽤改善 エラートラッキング実装 UJの洗い出しと成功率の可視化 リアルタイム通信の Kubernetesの運⽤改善 UGCリリースの 負荷試験‧インフラ構築⽀援 API Gateway/Database移⾏によるインフラの再構築 新規リリースのインフラ構築⽀援 11
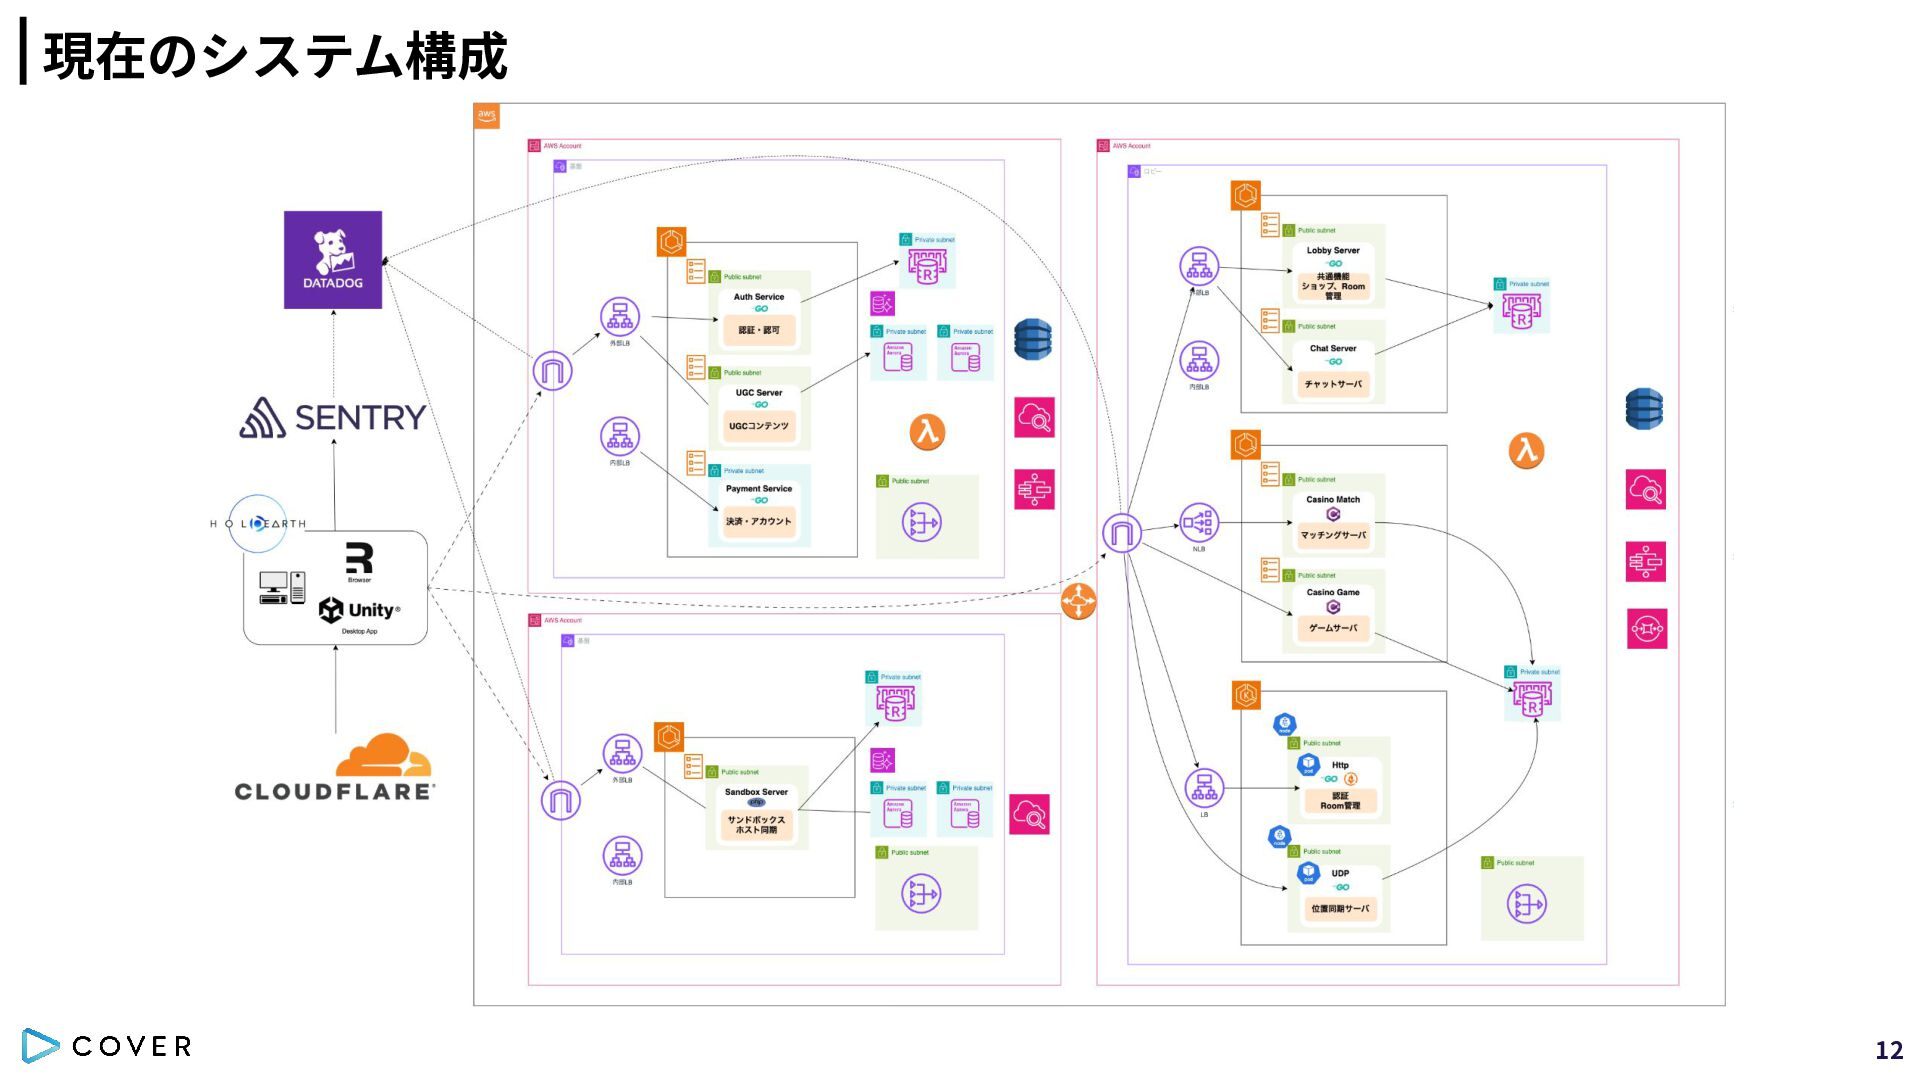
現在のシステム構成 12
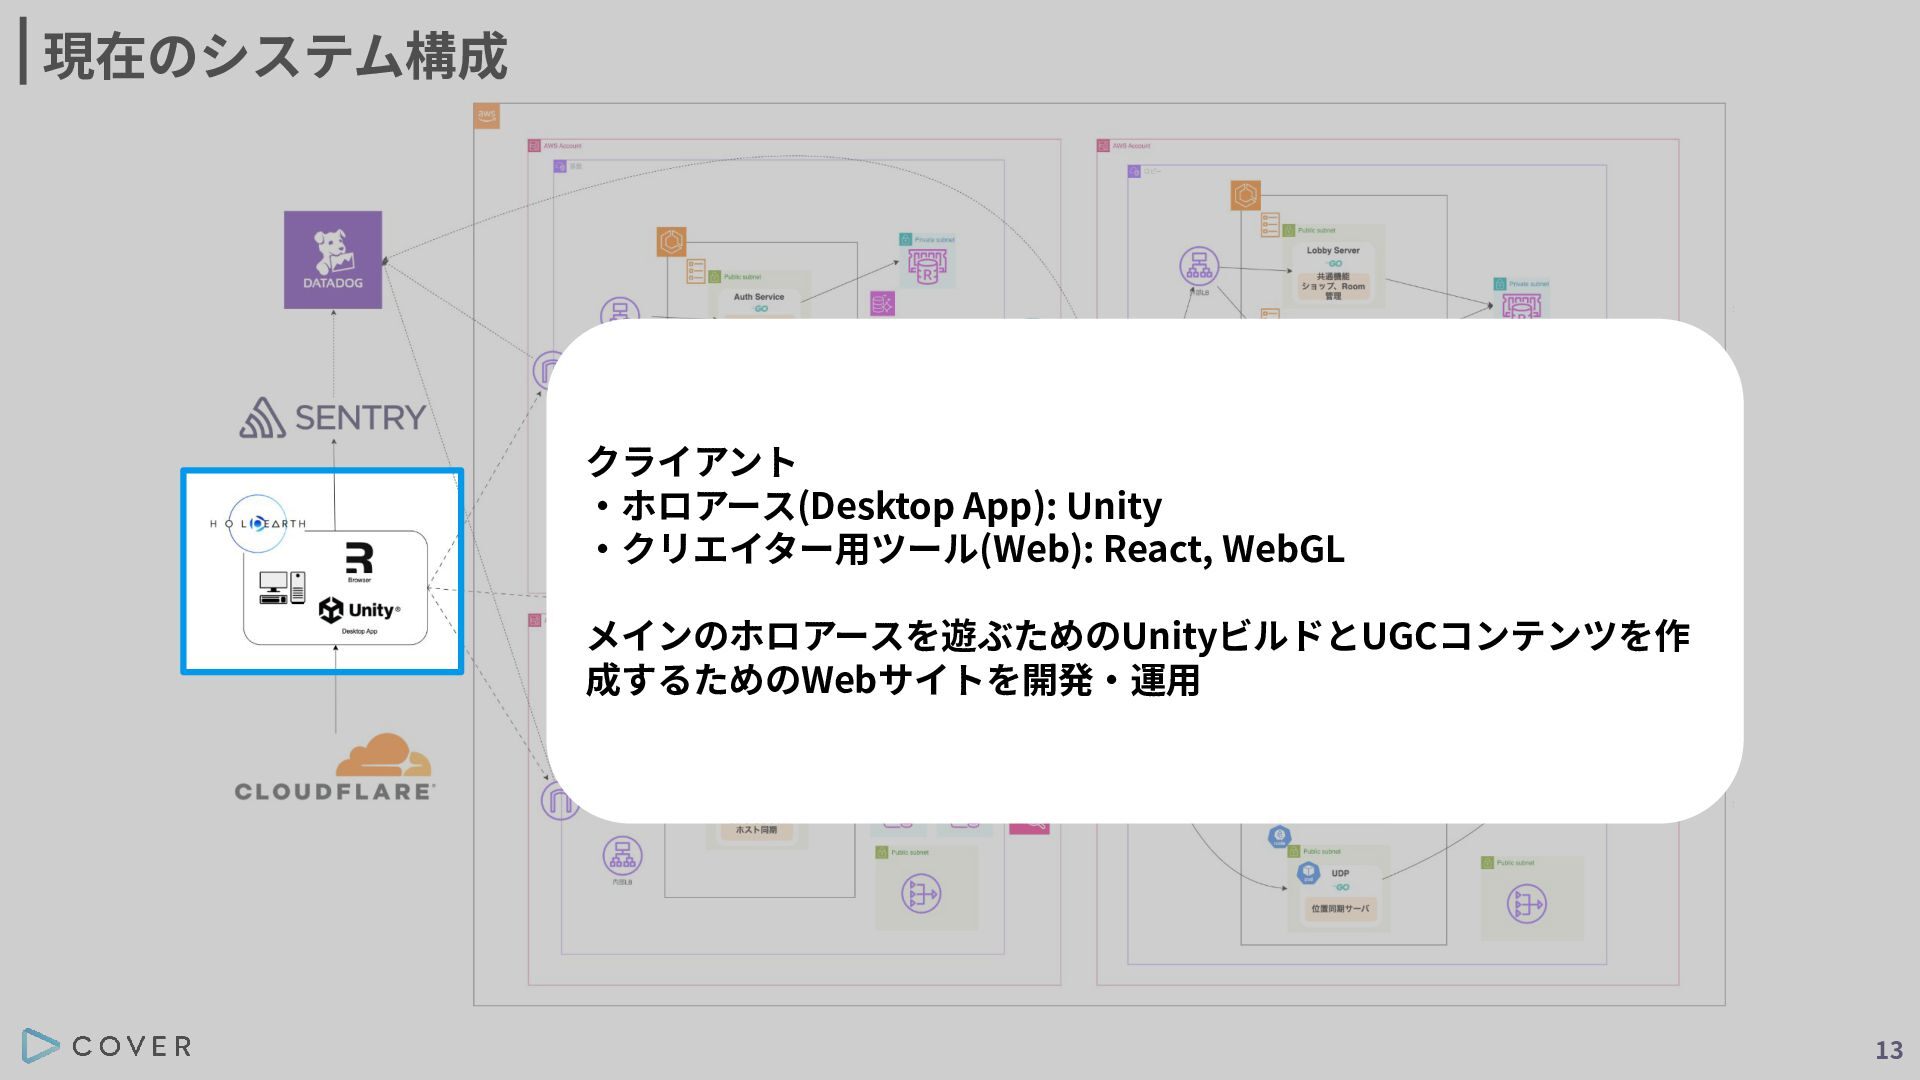
現在のシステム構成 クライアント ‧ホロアース(Desktop App): Unity ‧クリエイター⽤ツール(Web): React, WebGL メインのホロアースを遊ぶためのUnityビルドとUGCコンテンツを作 成するためのWebサイトを開発‧運⽤
13
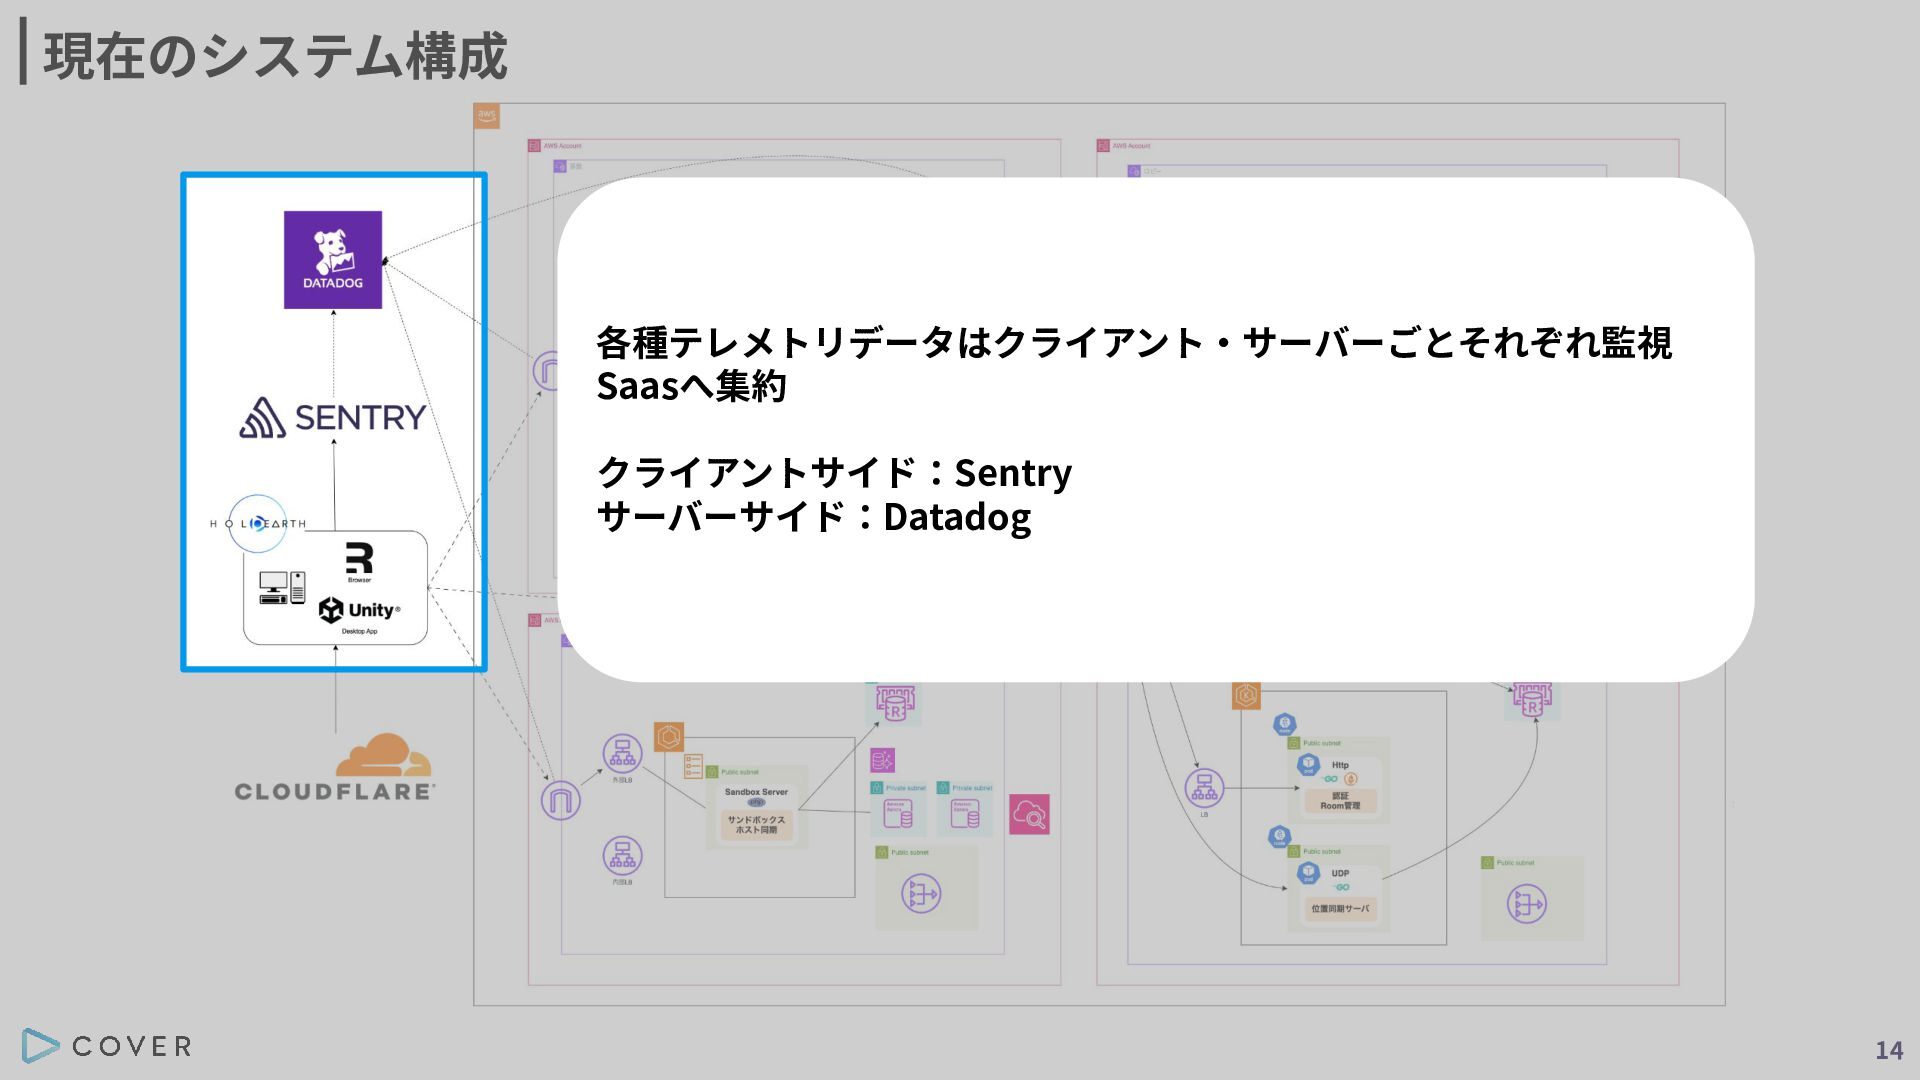
現在のシステム構成 各種テレメトリデータはクライアント‧サーバーごとそれぞれ監視 Saasへ集約 クライアントサイド:Sentry サーバーサイド:Datadog 14
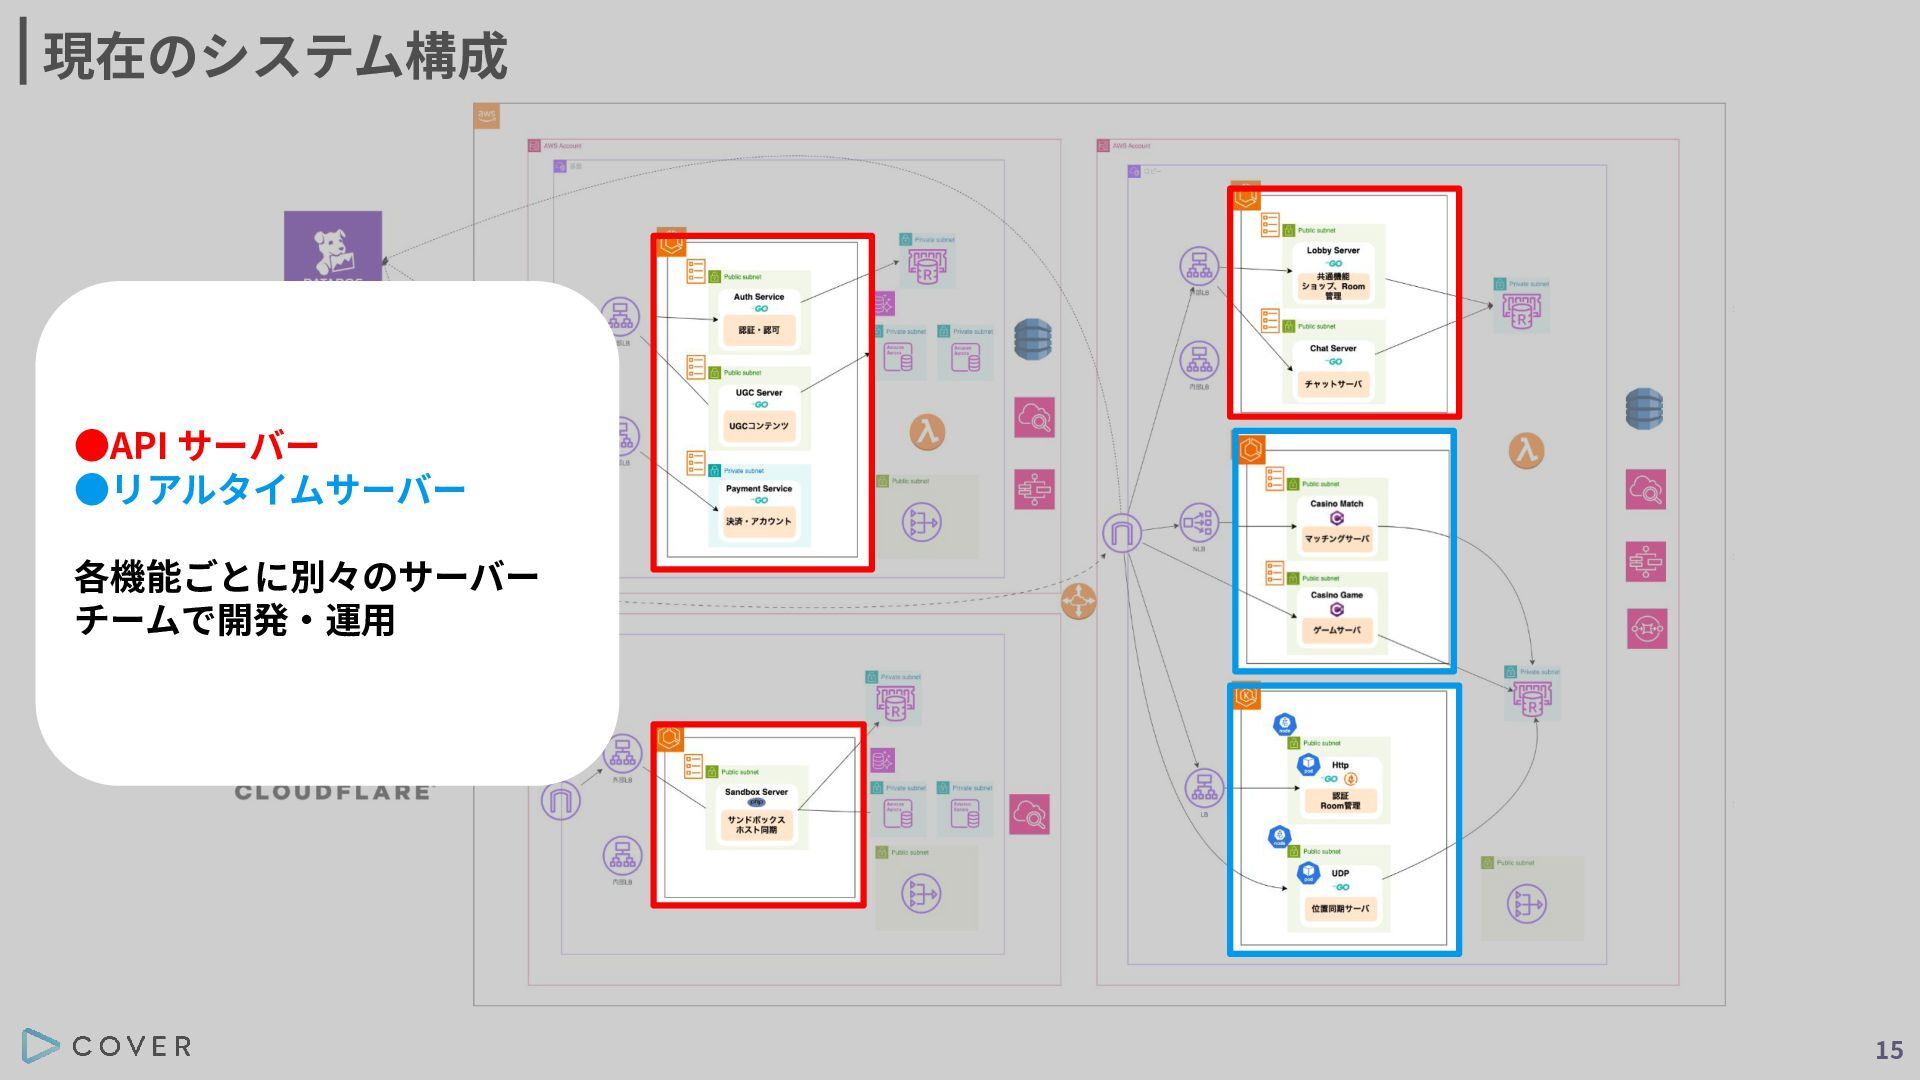
現在のシステム構成 •API サーバー •リアルタイムサーバー 各機能ごとに別々のサーバー チームで開発‧運⽤ 15
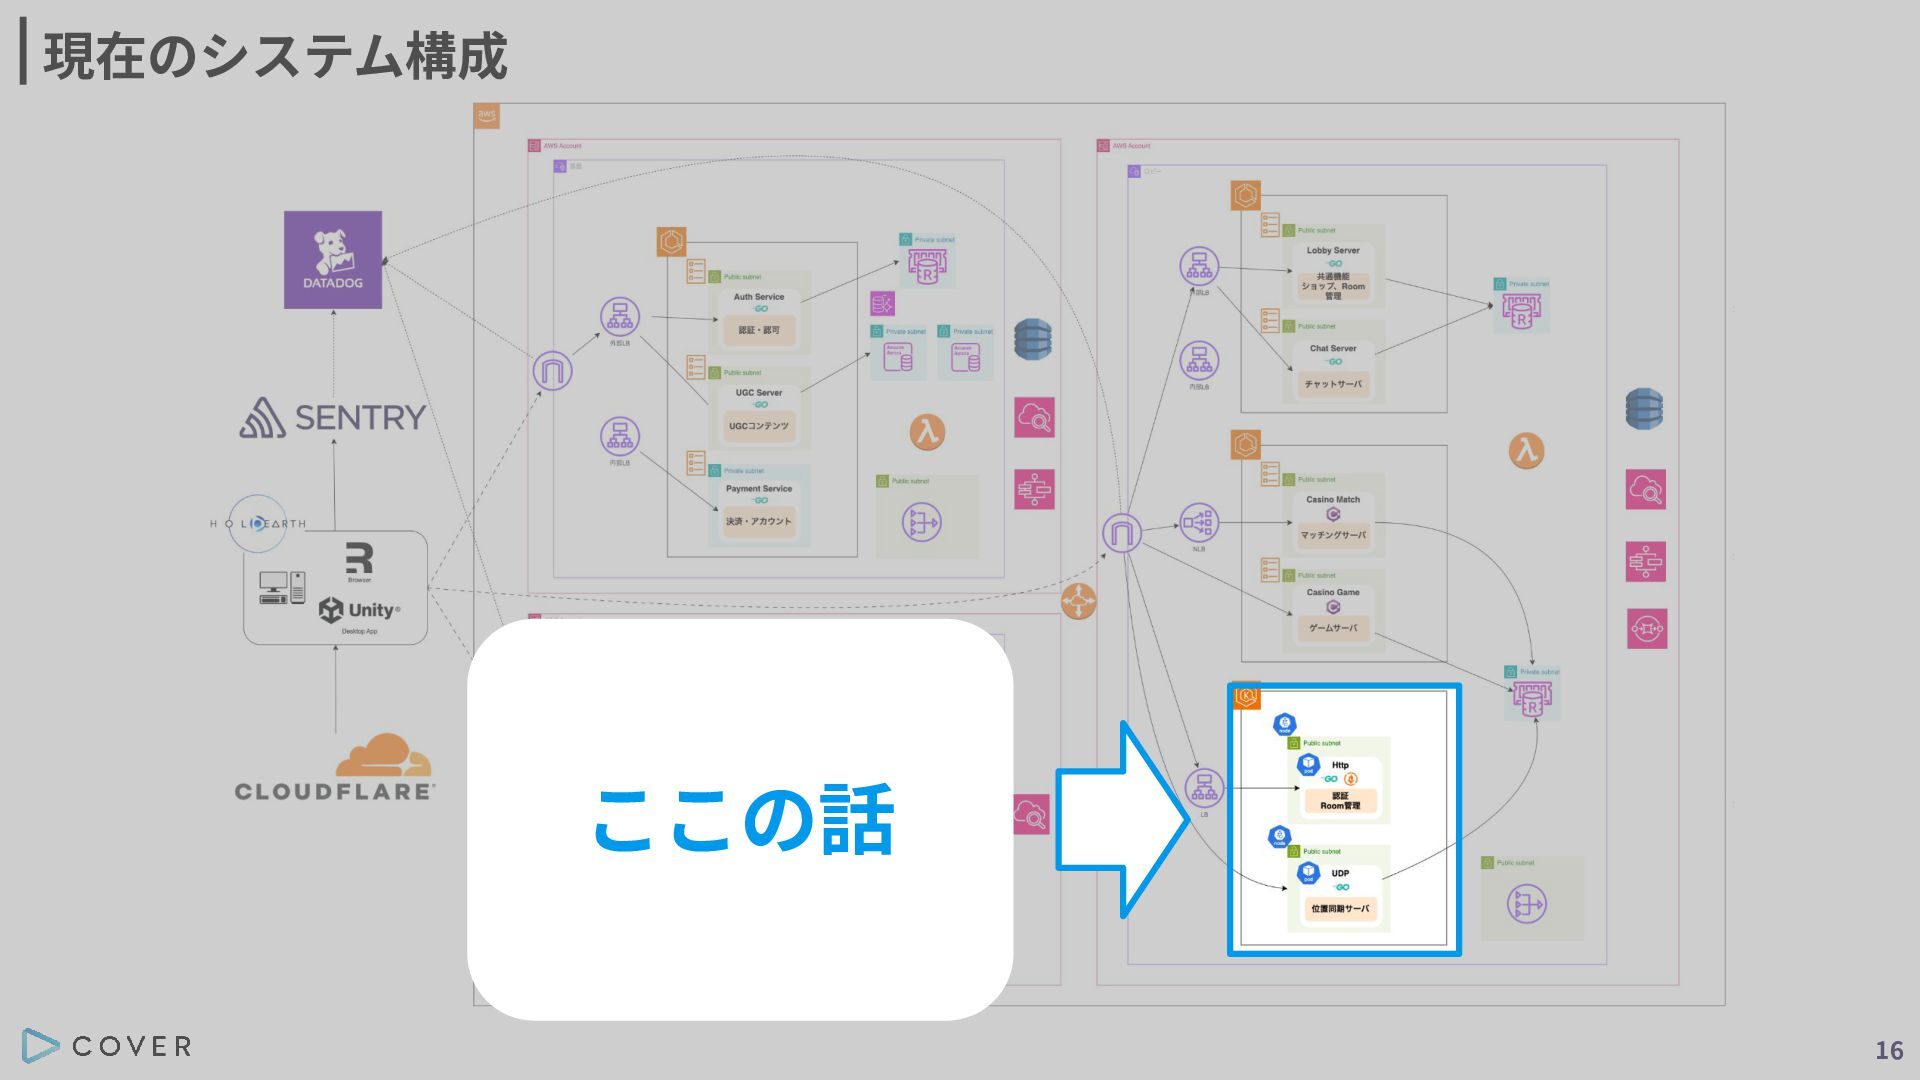
現在のシステム構成 ここの話 16
⼀般的なゲームサーバーとKubernetes ‧ゲームサーバーはステートフルなため負荷分散が難しい →Node IP経由でPodとUDP直接通信を⾏い、Ingress等での負荷分散が難しい ‧ゲームクライアントは特定のゲームサーバーインスタンスに直接接続する →⼀部のCaaSではNode IPの利⽤に制約があり、ゲームサーバー運⽤に不向き ‧⼤量のNode(VM)の管理を⾏う必要がある →KubernetesによるNodeプロビジョニングを活⽤したい 17
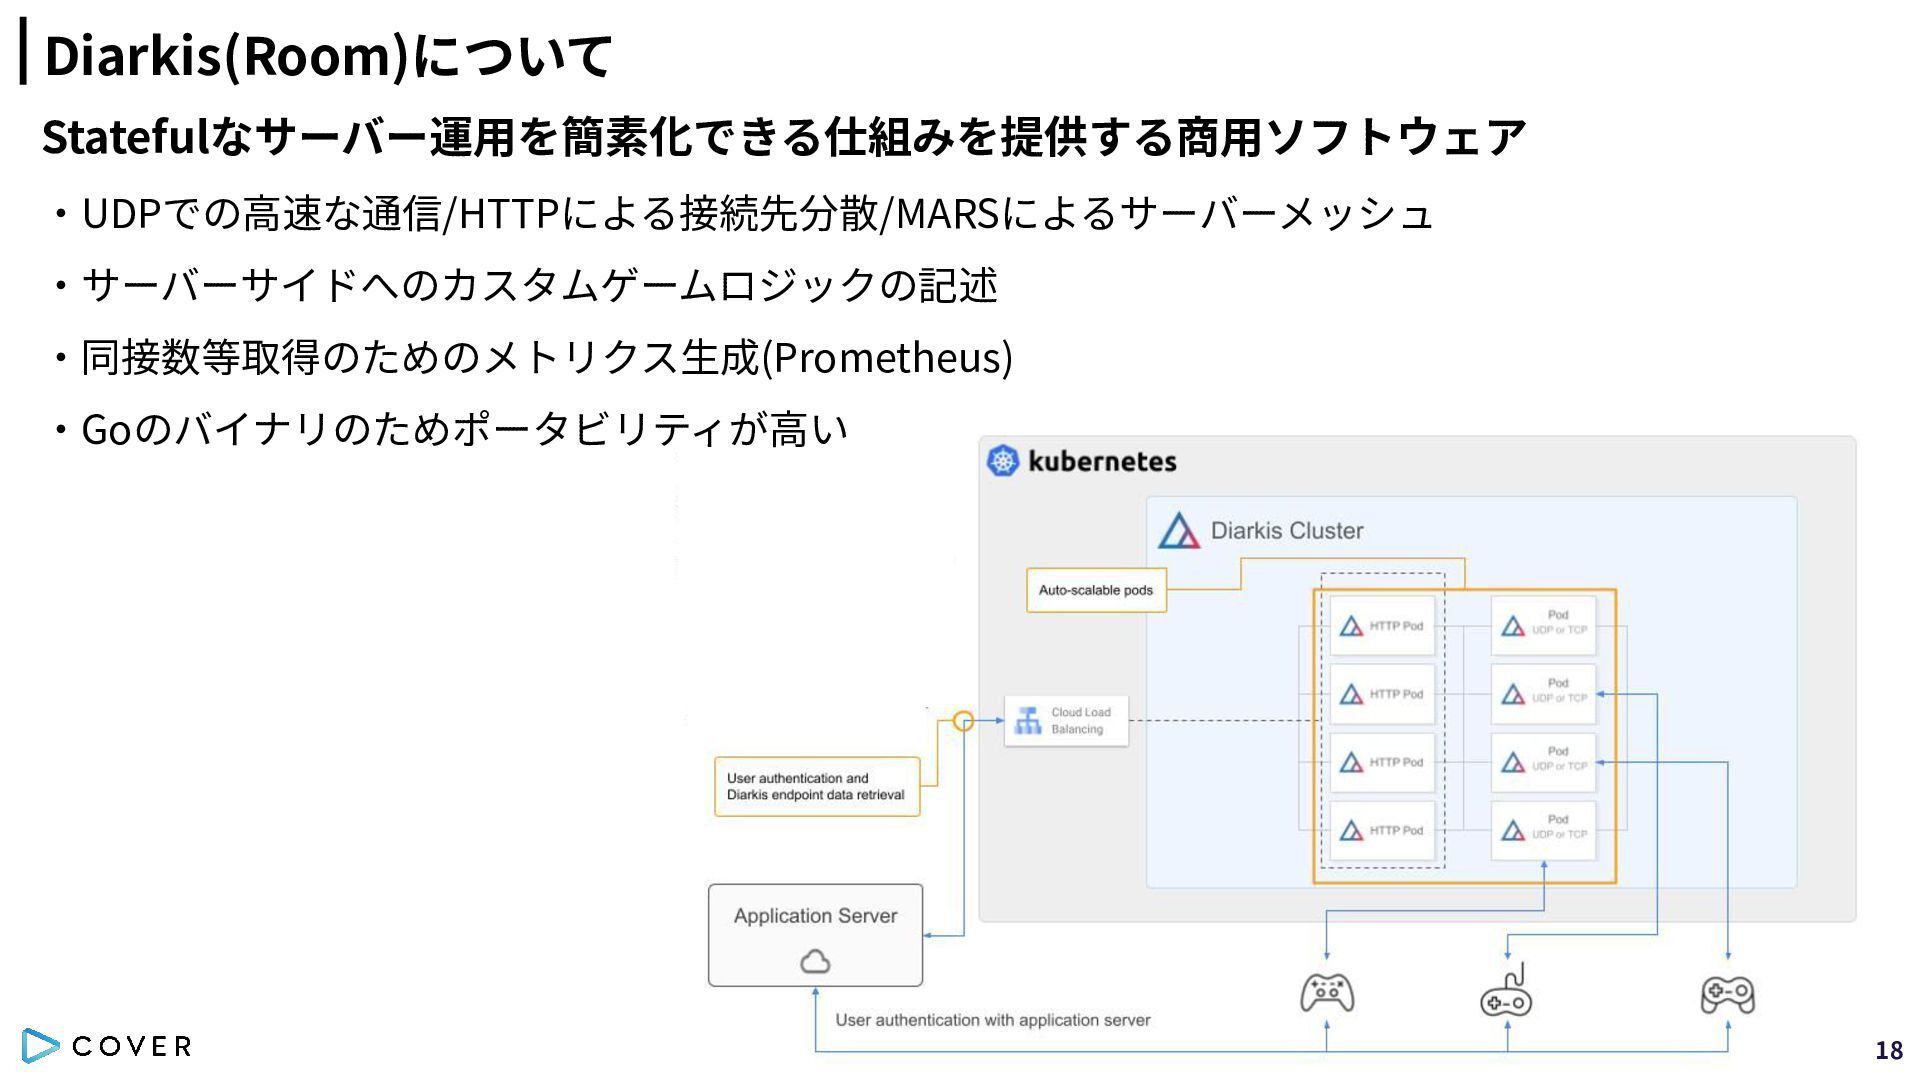
Diarkis(Room)について Statefulなサーバー運⽤を簡素化できる仕組みを提供する商⽤ソフトウェア ‧UDPでの⾼速な通信/HTTPによる接続先分散/MARSによるサーバーメッシュ ‧サーバーサイドへのカスタムゲームロジックの記述 ‧同接数等取得のためのメトリクス⽣成(Prometheus) ‧Goのバイナリのためポータビリティが⾼い 18
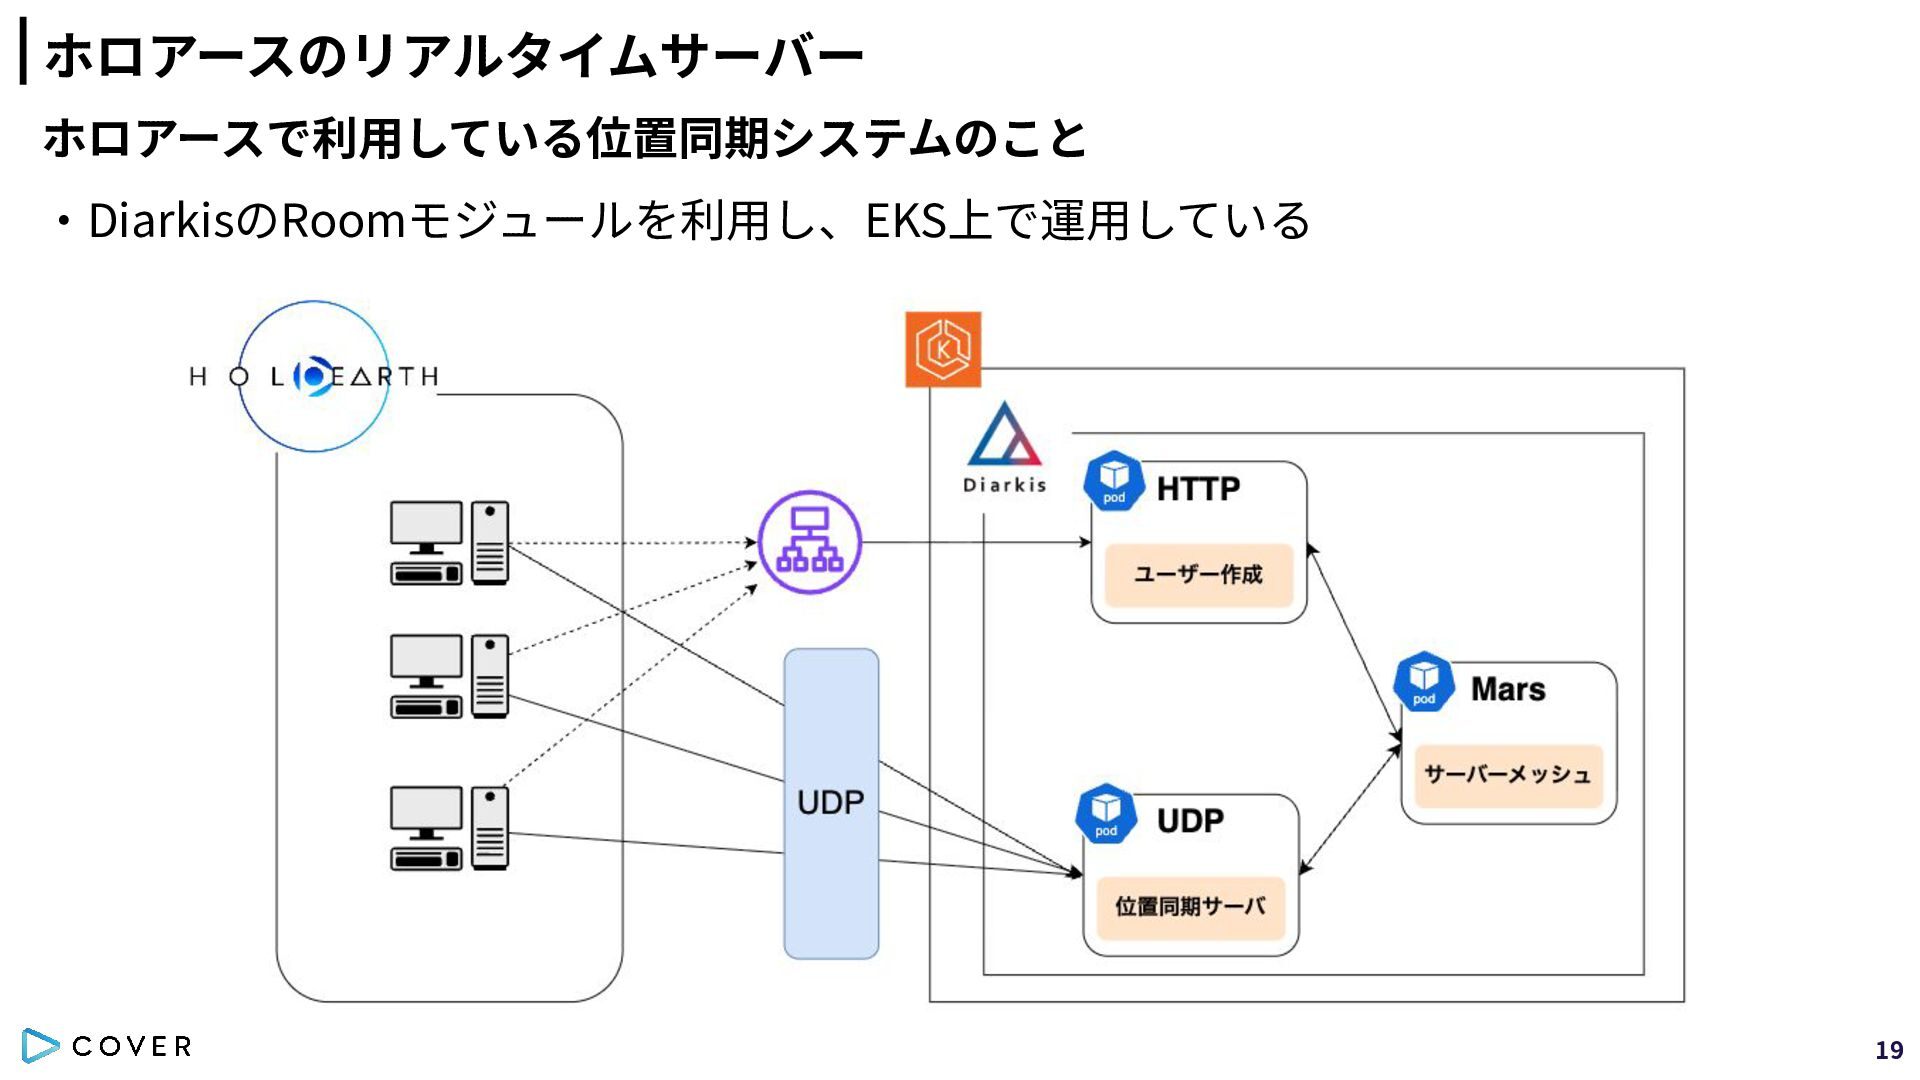
ホロアースのリアルタイムサーバー ホロアースで利⽤している位置同期システムのこと ‧DiarkisのRoomモジュールを利⽤し、EKS上で運⽤している 19
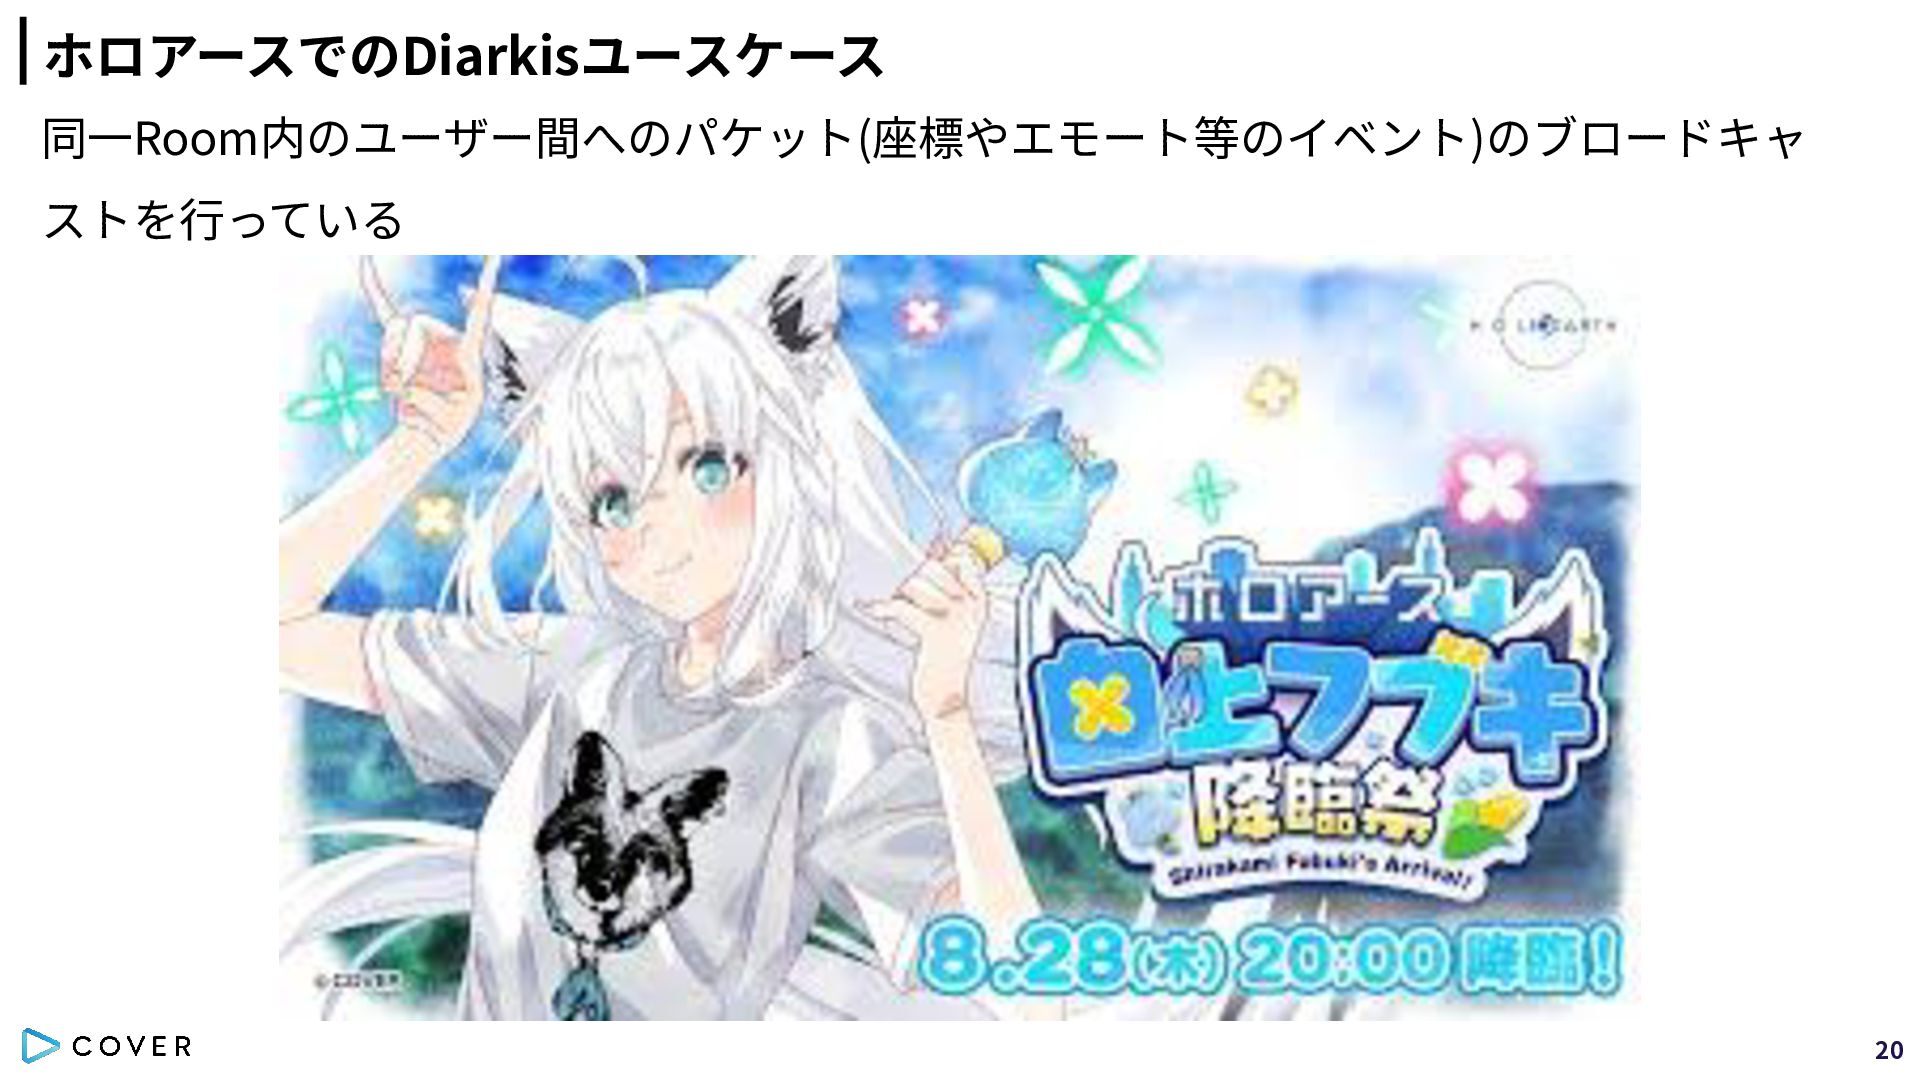
ホロアースでのDiarkisユースケース 同⼀Room内のユーザー間へのパケット(座標やエモート等のイベント)のブロードキャ ストを⾏っている 20
ホロアースにおけるEKS運⽤の課題 2025年の年始当時に抱えていた課題 • リアルタイムサーバーとしての安定運⽤に難あり ◦ 2025年4⽉にホロアースがv1.0としてリリース ▪ これを機にタレントの協業を進めホロアースのユーザーを拡⼤していく⽅針へ ▪ ⼤量のユーザーの流⼊‧⼤型のアップデートが潜む中が、⼤規模なトラフィックに
対応できる構成‧運⽤体制ではなかった • 開発⽣産性‧運⽤体制に難あり ◦ EKSを運⽤できる⼈員が不⾜しており2023年ごろからほとんど塩漬けだった ▪ Cluster/Addon等のアップデートや構成管理は全て⼿動(eksctl) ▪ Github上のマニフェストの状態が稼働しているClusterの状態と⼀致してお らずいつ事故が起きてもおかしくない状況だった 21
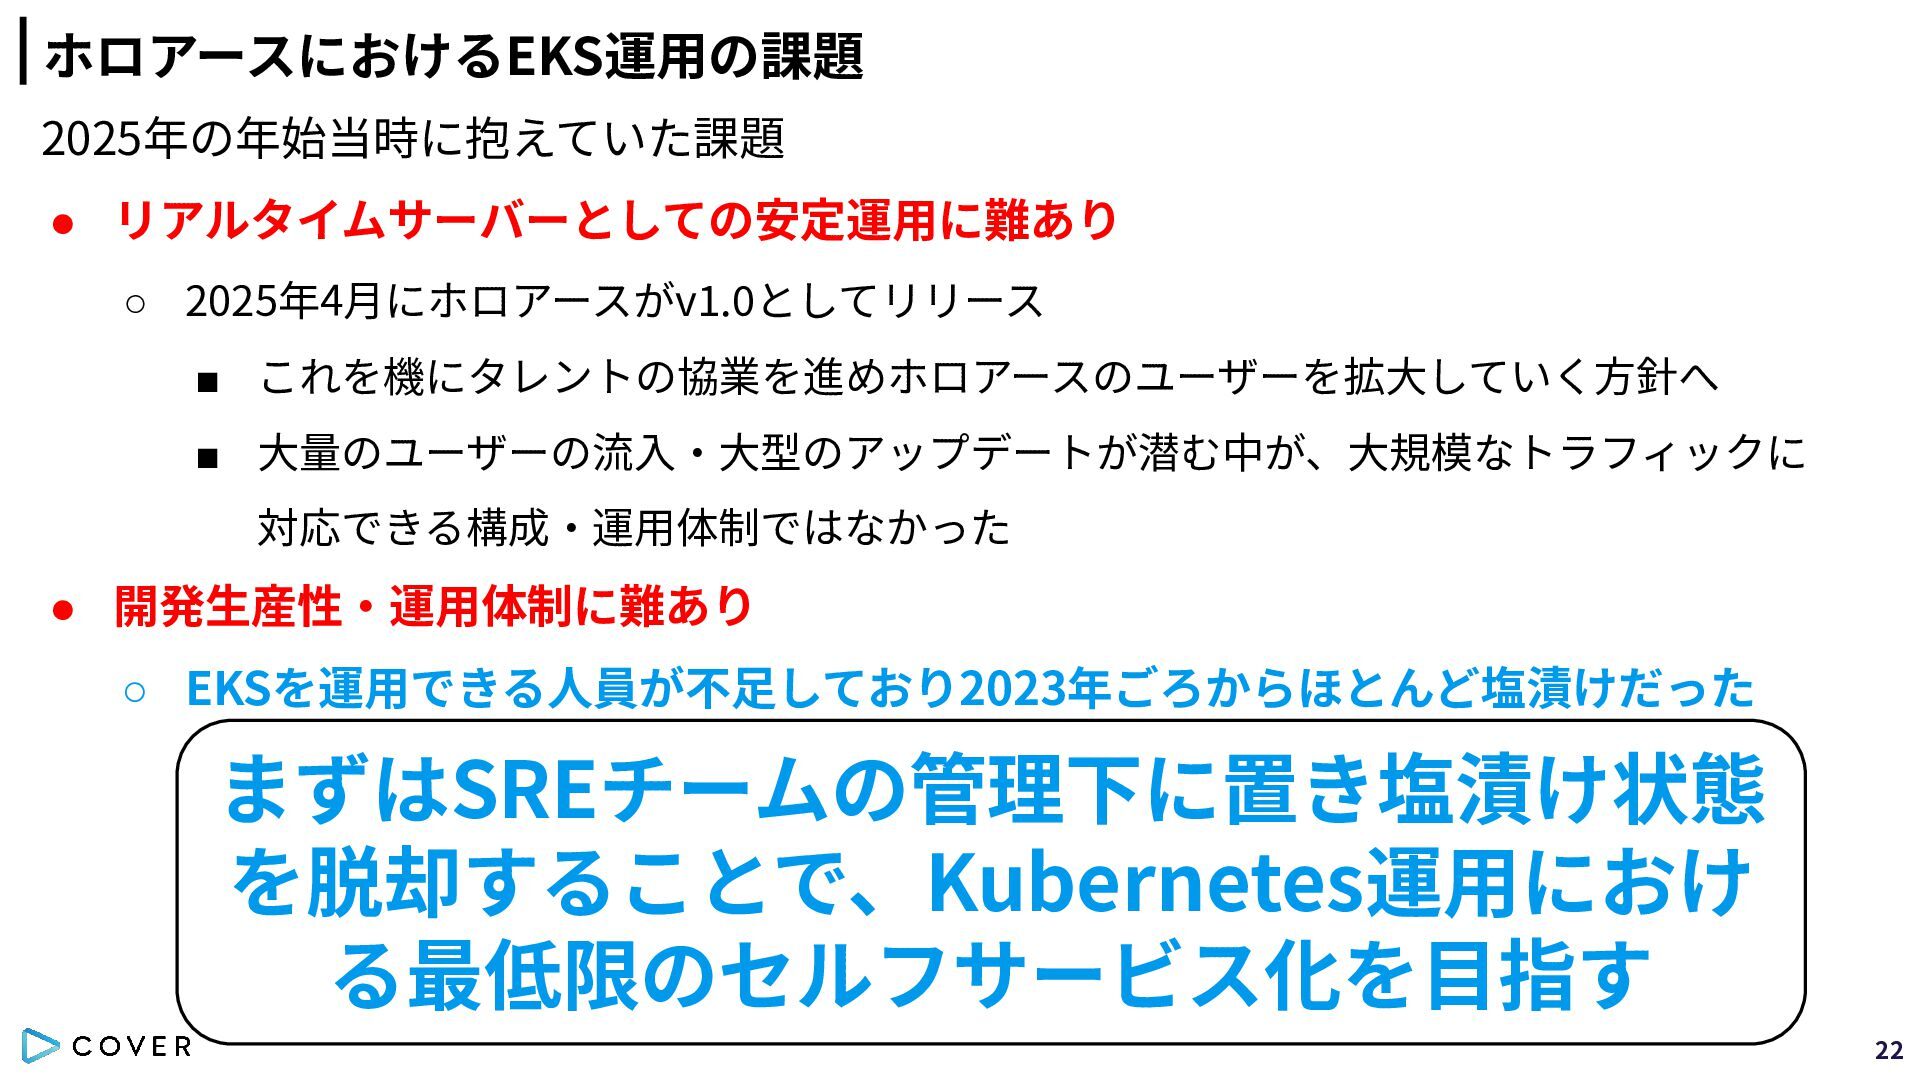
ホロアースにおけるEKS運⽤の課題 2025年の年始当時に抱えていた課題 • リアルタイムサーバーとしての安定運⽤に難あり ◦ 2025年4⽉にホロアースがv1.0としてリリース ▪ これを機にタレントの協業を進めホロアースのユーザーを拡⼤していく⽅針へ ▪ ⼤量のユーザーの流⼊‧⼤型のアップデートが潜む中が、⼤規模なトラフィックに
対応できる構成‧運⽤体制ではなかった • 開発⽣産性‧運⽤体制に難あり ◦ EKSを運⽤できる⼈員が不⾜しており2023年ごろからほとんど塩漬けだった ▪ Cluster/Addon等のアップデートや構成管理は全て⼿動(eksctl) まずはSREチームの管理下に置き塩漬け状態 ▪ Github上のマニフェストの状態が稼働しているClusterの状態と⼀致してお を脱却することで、Kubernetes運⽤におけ らずいつ事故が起きてもおかしくない状況だった る最低限のセルフサービス化を⽬指す 22
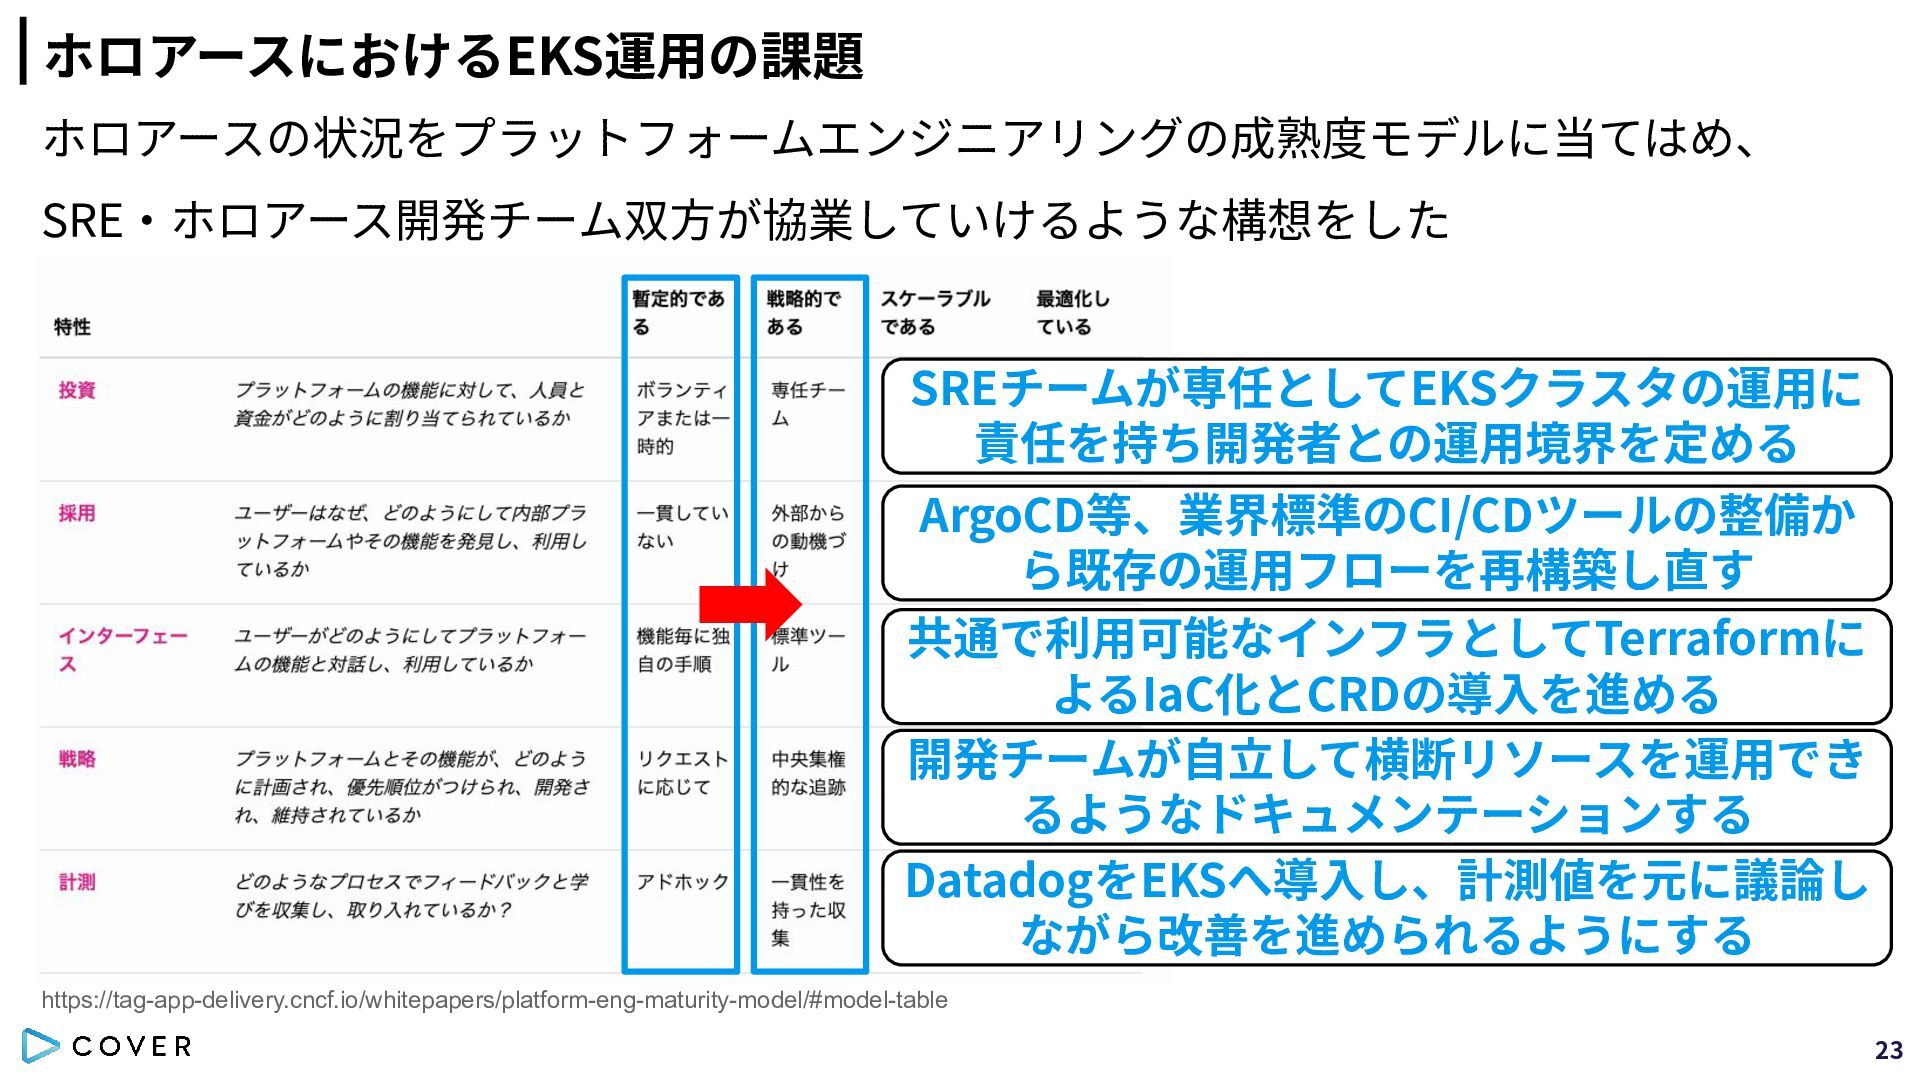
ホロアースにおけるEKS運⽤の課題 ホロアースの状況をプラットフォームエンジニアリングの成熟度モデルに当てはめ、 SRE‧ホロアース開発チーム双⽅が協業していけるような構想をした SREチームが専任としてEKSクラスタの運⽤に 責任を持ち開発者との運⽤境界を定める ArgoCD等、業界標準のCI/CDツールの整備か ら既存の運⽤フローを再構築し直す 共通で利⽤可能なインフラとしてTerraformに よるIaC化とCRDの導⼊を進める 開発チームが⾃⽴して横断リソースを運⽤でき
るようなドキュメンテーションする DatadogをEKSへ導⼊し、計測値を元に議論し ながら改善を進められるようにする https://tag-app-delivery.cncf.io/whitepapers/platform-eng-maturity-model/#model-table 23
04 EKSプラットフォームへの 道のり 24
バックログ 構想をもとに改善を進めるために⼤枠の課題を分割した。 1.EKSクラスタの管理の放置問題 2.ワークロードクラスタの内部状態の可視化 3.Room管理とインスタンスのサイジングによるコスト適正化 4.オートスケールの改善 5.⼤規模利⽤に向けて 25
バックログ 構想をもとに改善を進めるために⼤枠の課題を分割した。 1.EKSクラスタの管理の放置問題 2.ワークロードクラスタの内部状態の可視化 3.Room管理とインスタンスのサイジングによるコスト適正化 4.オートスケールの改善 5.⼤規模利⽤に向けて 26
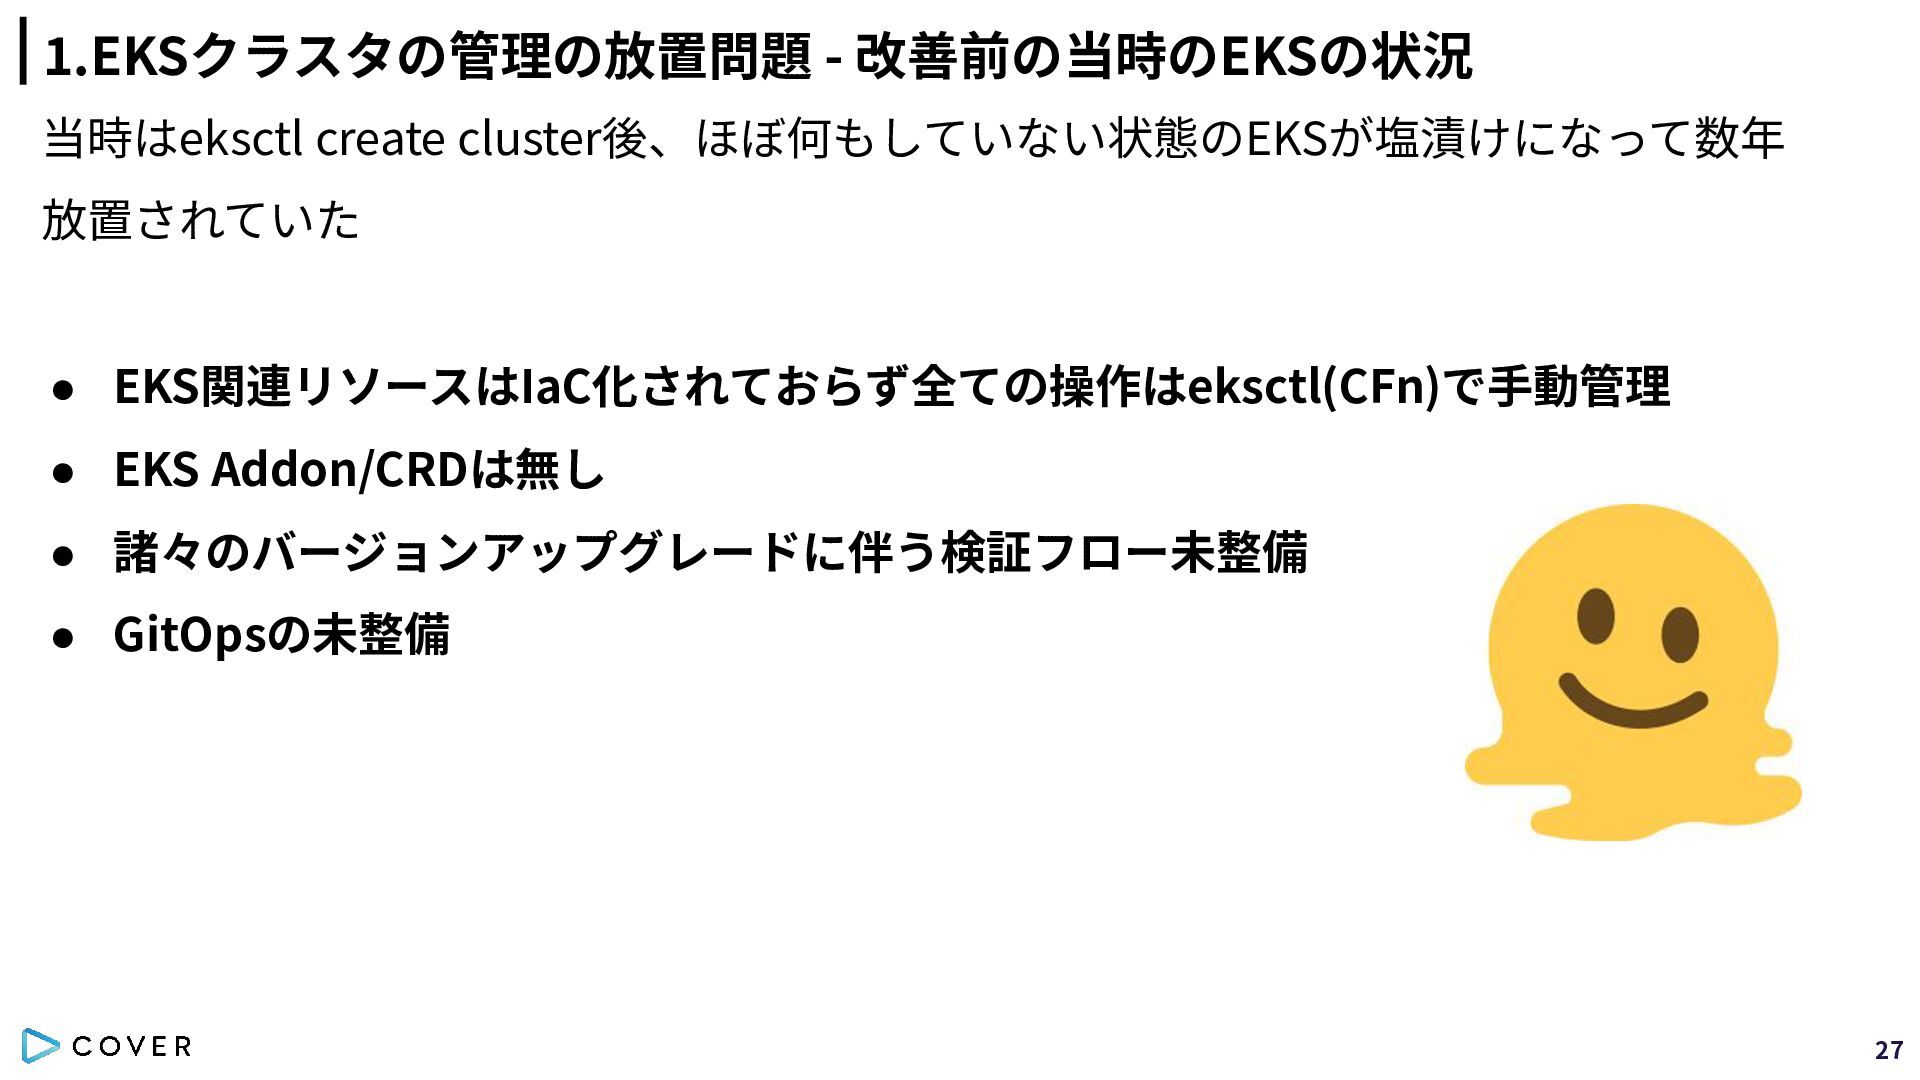
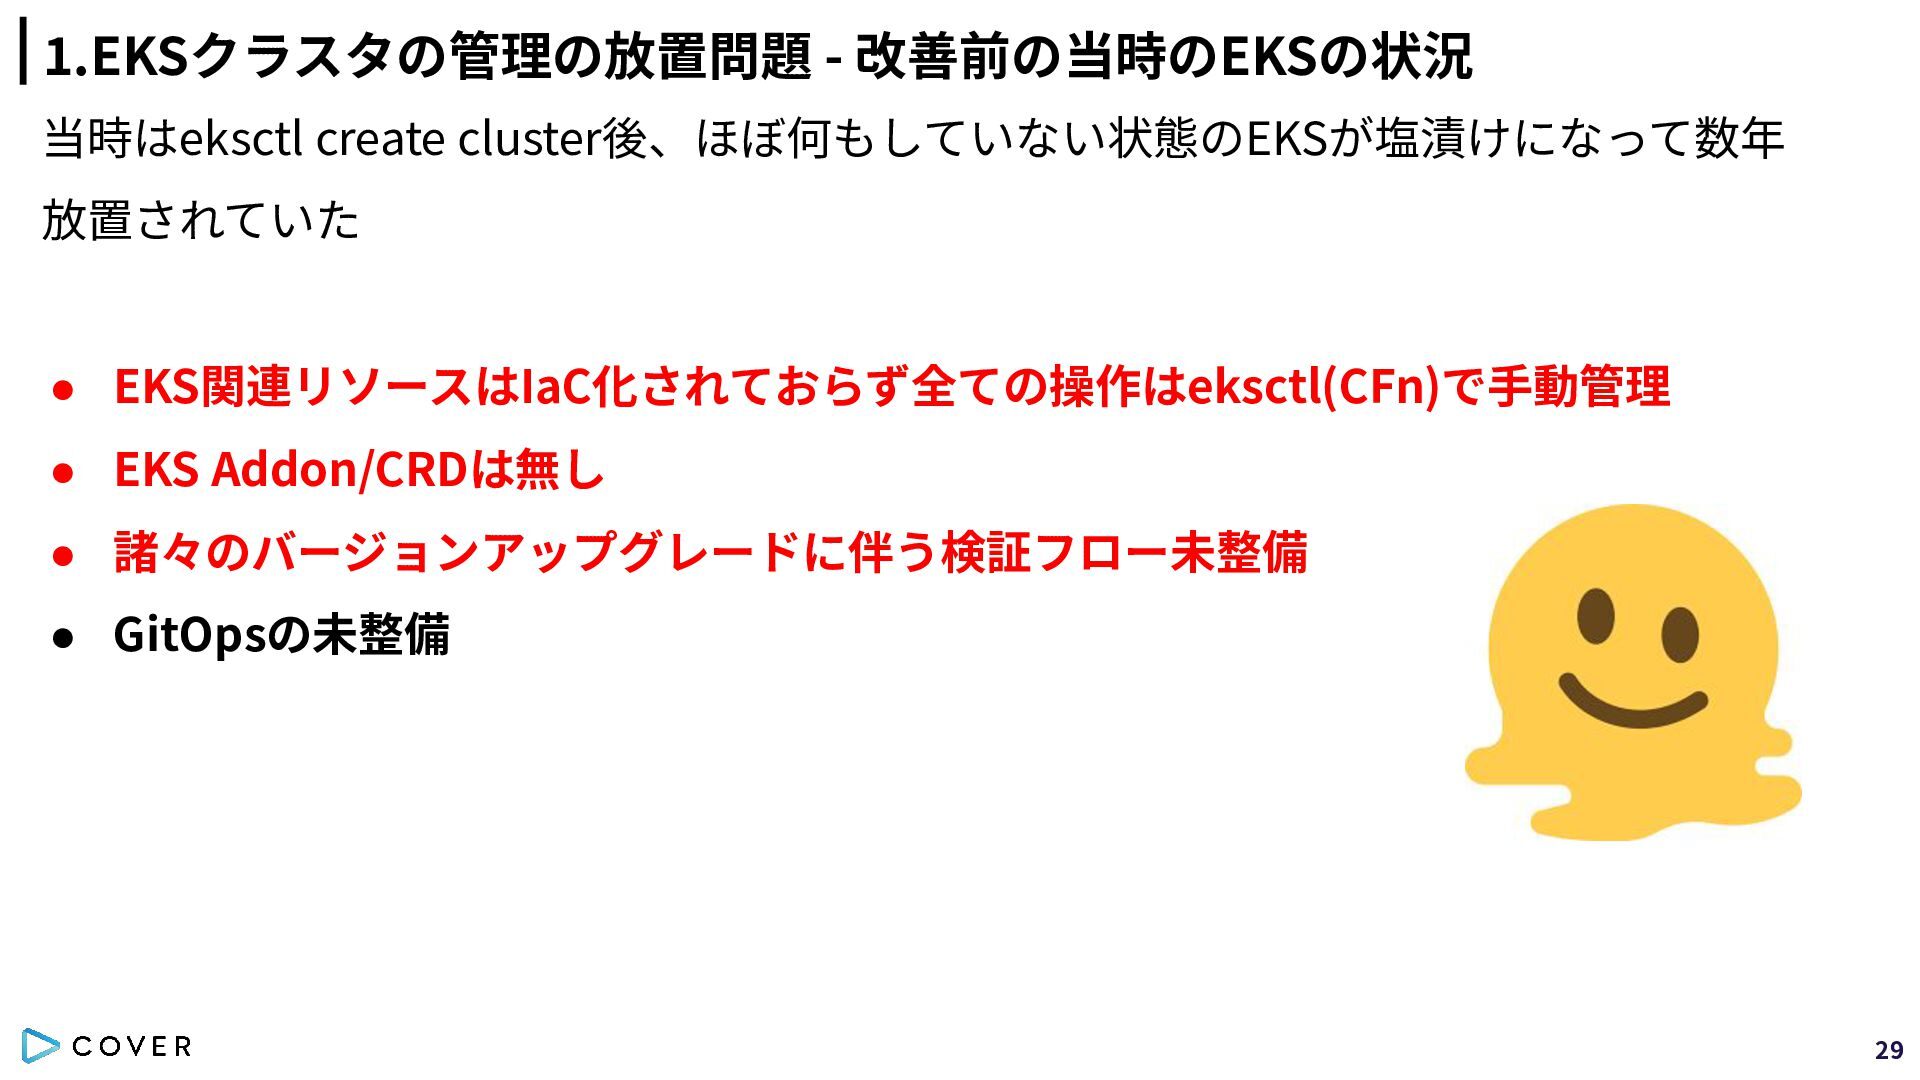
1.EKSクラスタの管理の放置問題 - 改善前の当時のEKSの状況 当時はeksctl create cluster後、ほぼ何もしていない状態のEKSが塩漬けになって数年 放置されていた • EKS関連リソースはIaC化されておらず全ての操作はeksctl(CFn)で⼿動管理 •
EKS Addon/CRDは無し • 諸々のバージョンアップグレードに伴う検証フロー未整備 • GitOpsの未整備 27
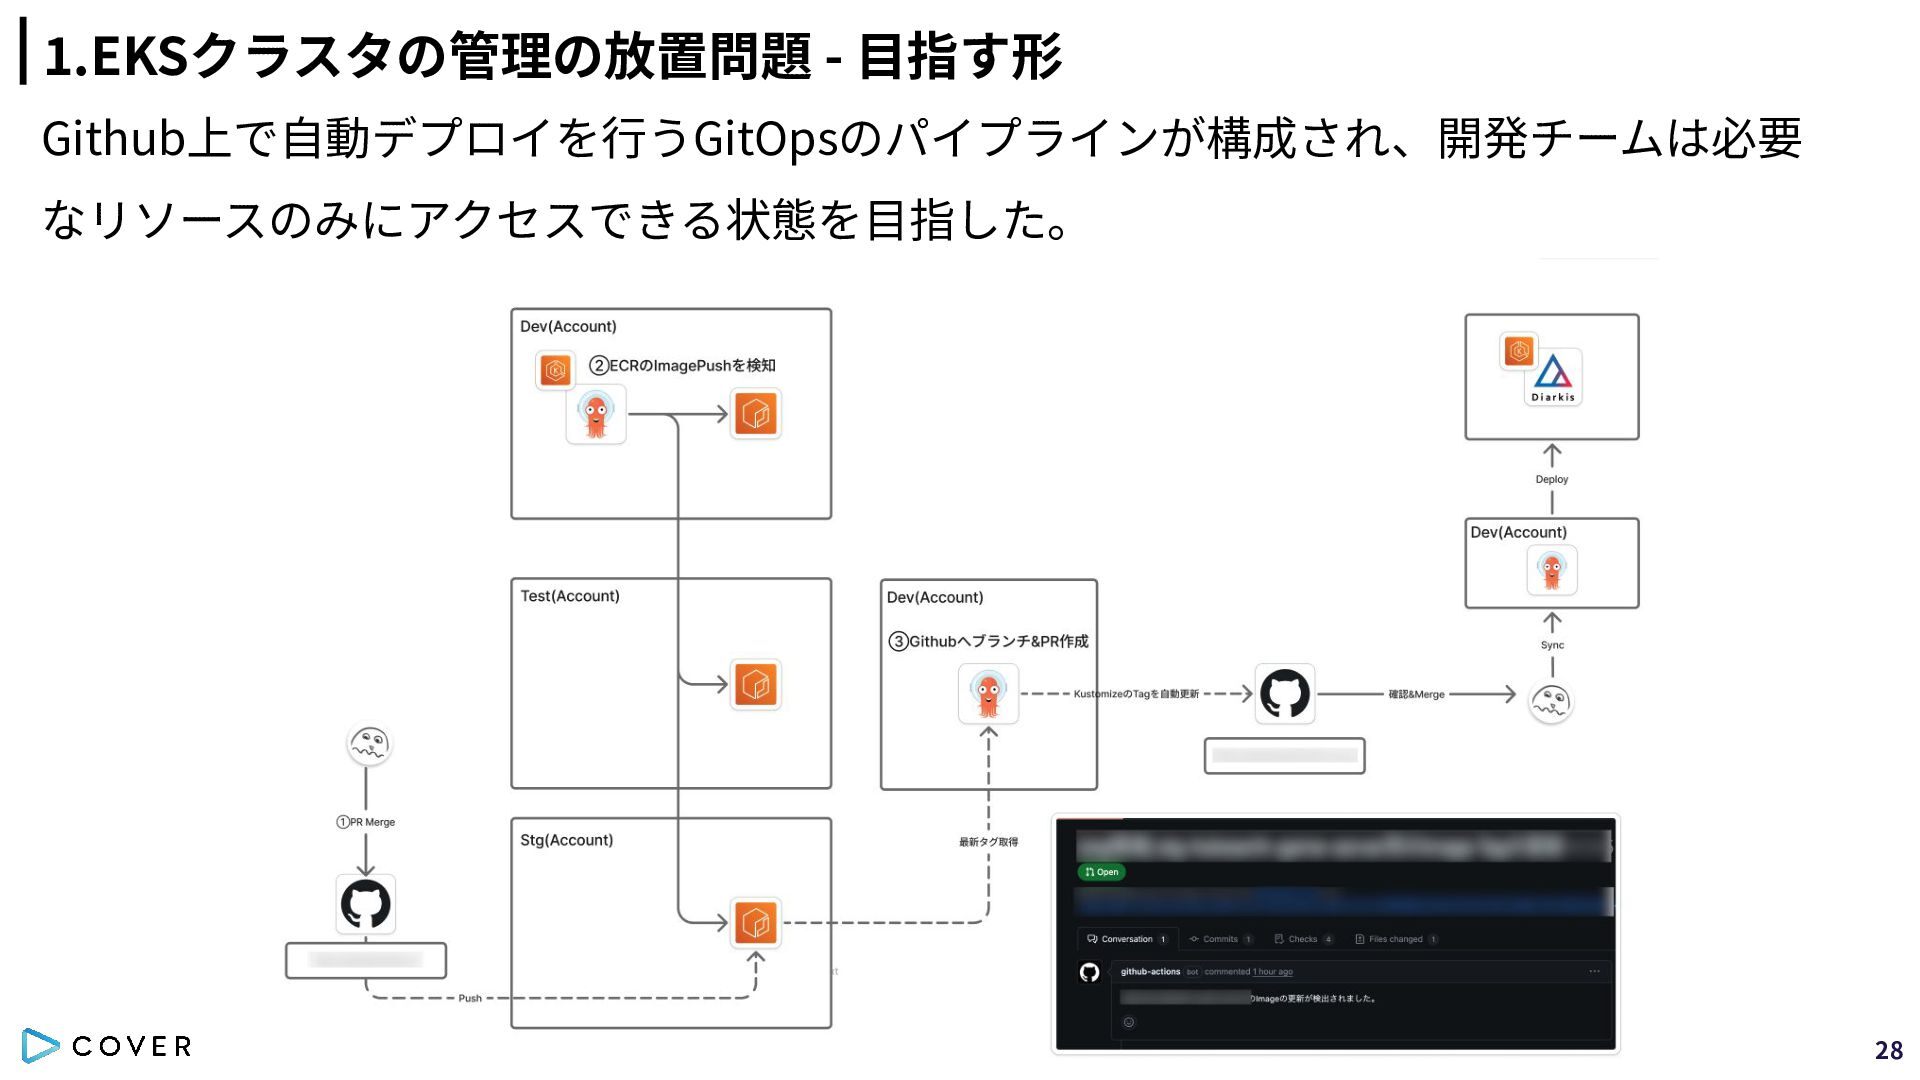
1.EKSクラスタの管理の放置問題 - ⽬指す形 Github上で⾃動デプロイを⾏うGitOpsのパイプラインが構成され、開発チームは必要 なリソースのみにアクセスできる状態を⽬指した。 28
1.EKSクラスタの管理の放置問題 - 改善前の当時のEKSの状況 当時はeksctl create cluster後、ほぼ何もしていない状態のEKSが塩漬けになって数年 放置されていた • EKS関連リソースはIaC化されておらず全ての操作はeksctl(CFn)で⼿動管理 •
EKS Addon/CRDは無し • 諸々のバージョンアップグレードに伴う検証フロー未整備 • GitOpsの未整備 29
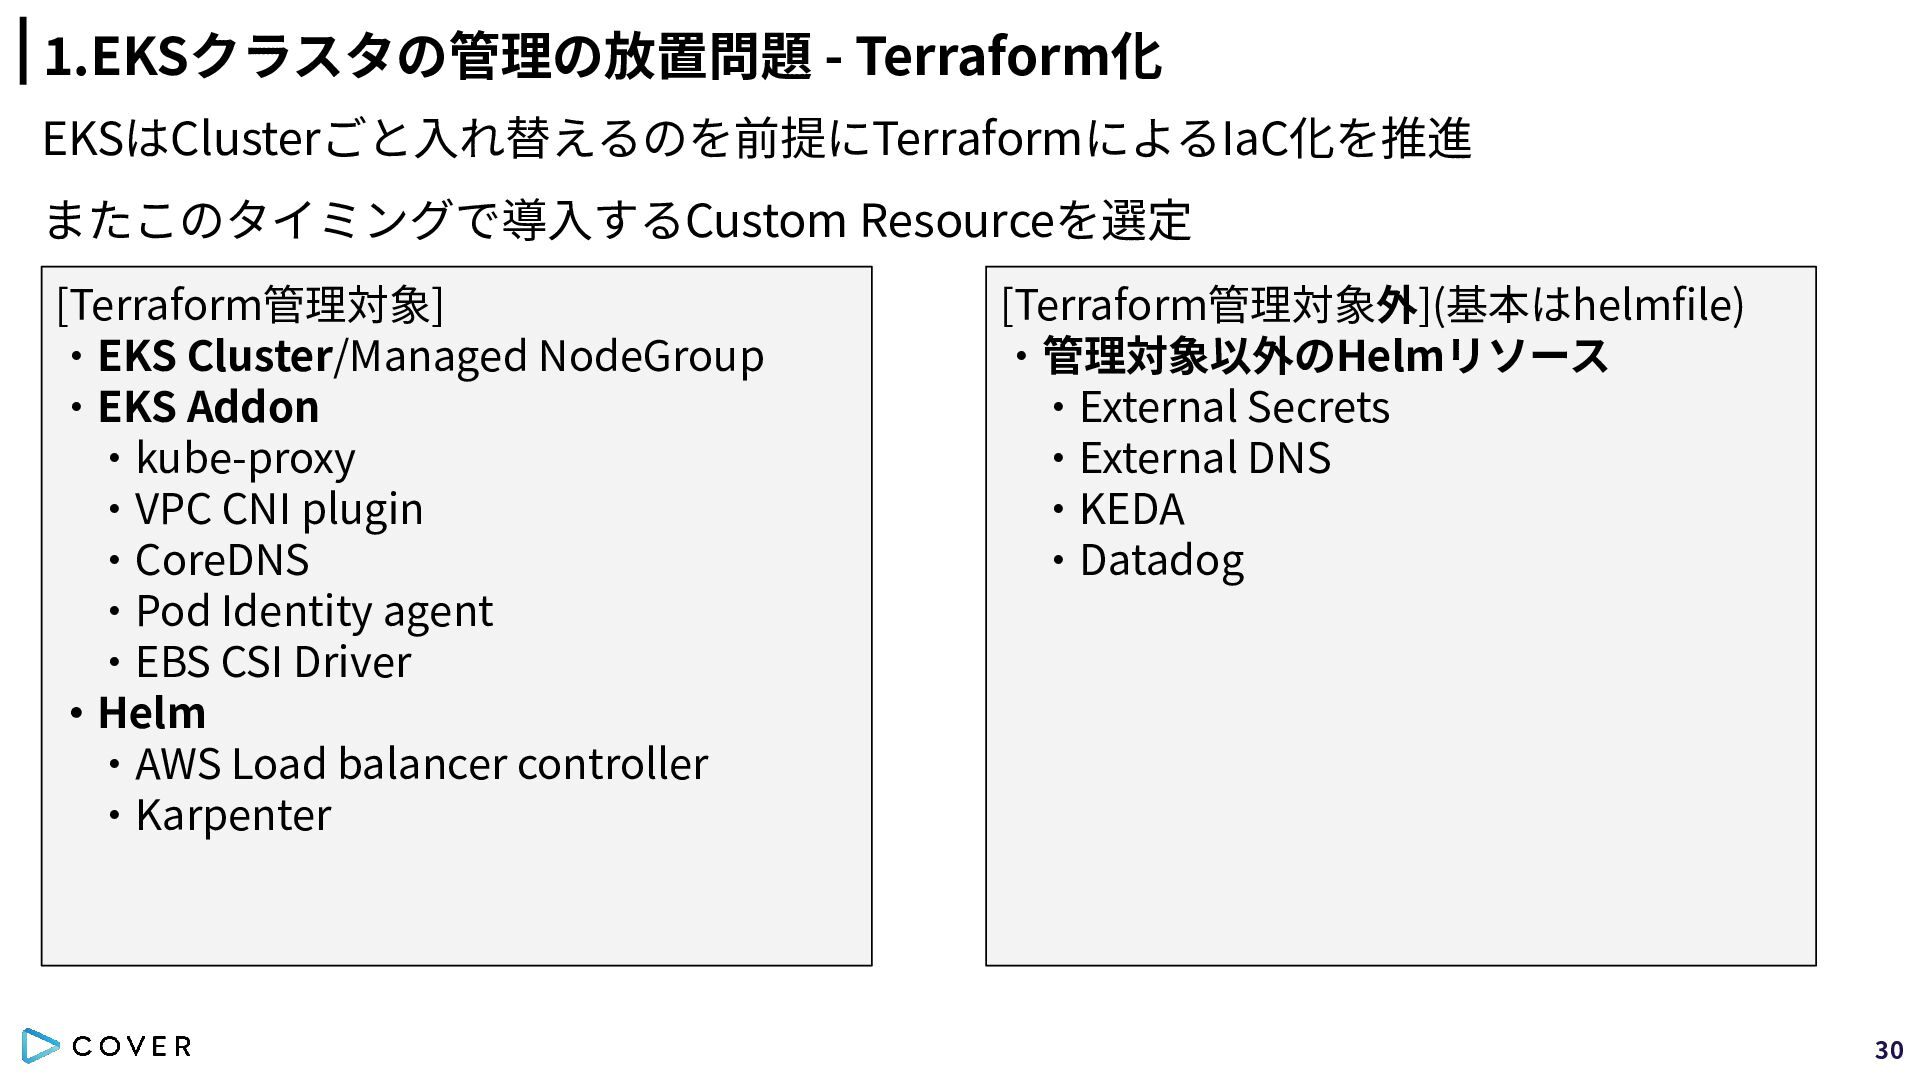
1.EKSクラスタの管理の放置問題 - Terraform化 EKSはClusterごと⼊れ替えるのを前提にTerraformによるIaC化を推進 またこのタイミングで導⼊するCustom Resourceを選定 [Terraform管理対象] ‧EKS Cluster/Managed NodeGroup
‧EKS Addon ‧kube-proxy ‧VPC CNI plugin ‧CoreDNS ‧Pod Identity agent ‧EBS CSI Driver ‧Helm ‧AWS Load balancer controller ‧Karpenter [Terraform管理対象外](基本はhelmfile) ‧管理対象以外のHelmリソース ‧External Secrets ‧External DNS ‧KEDA ‧Datadog 30
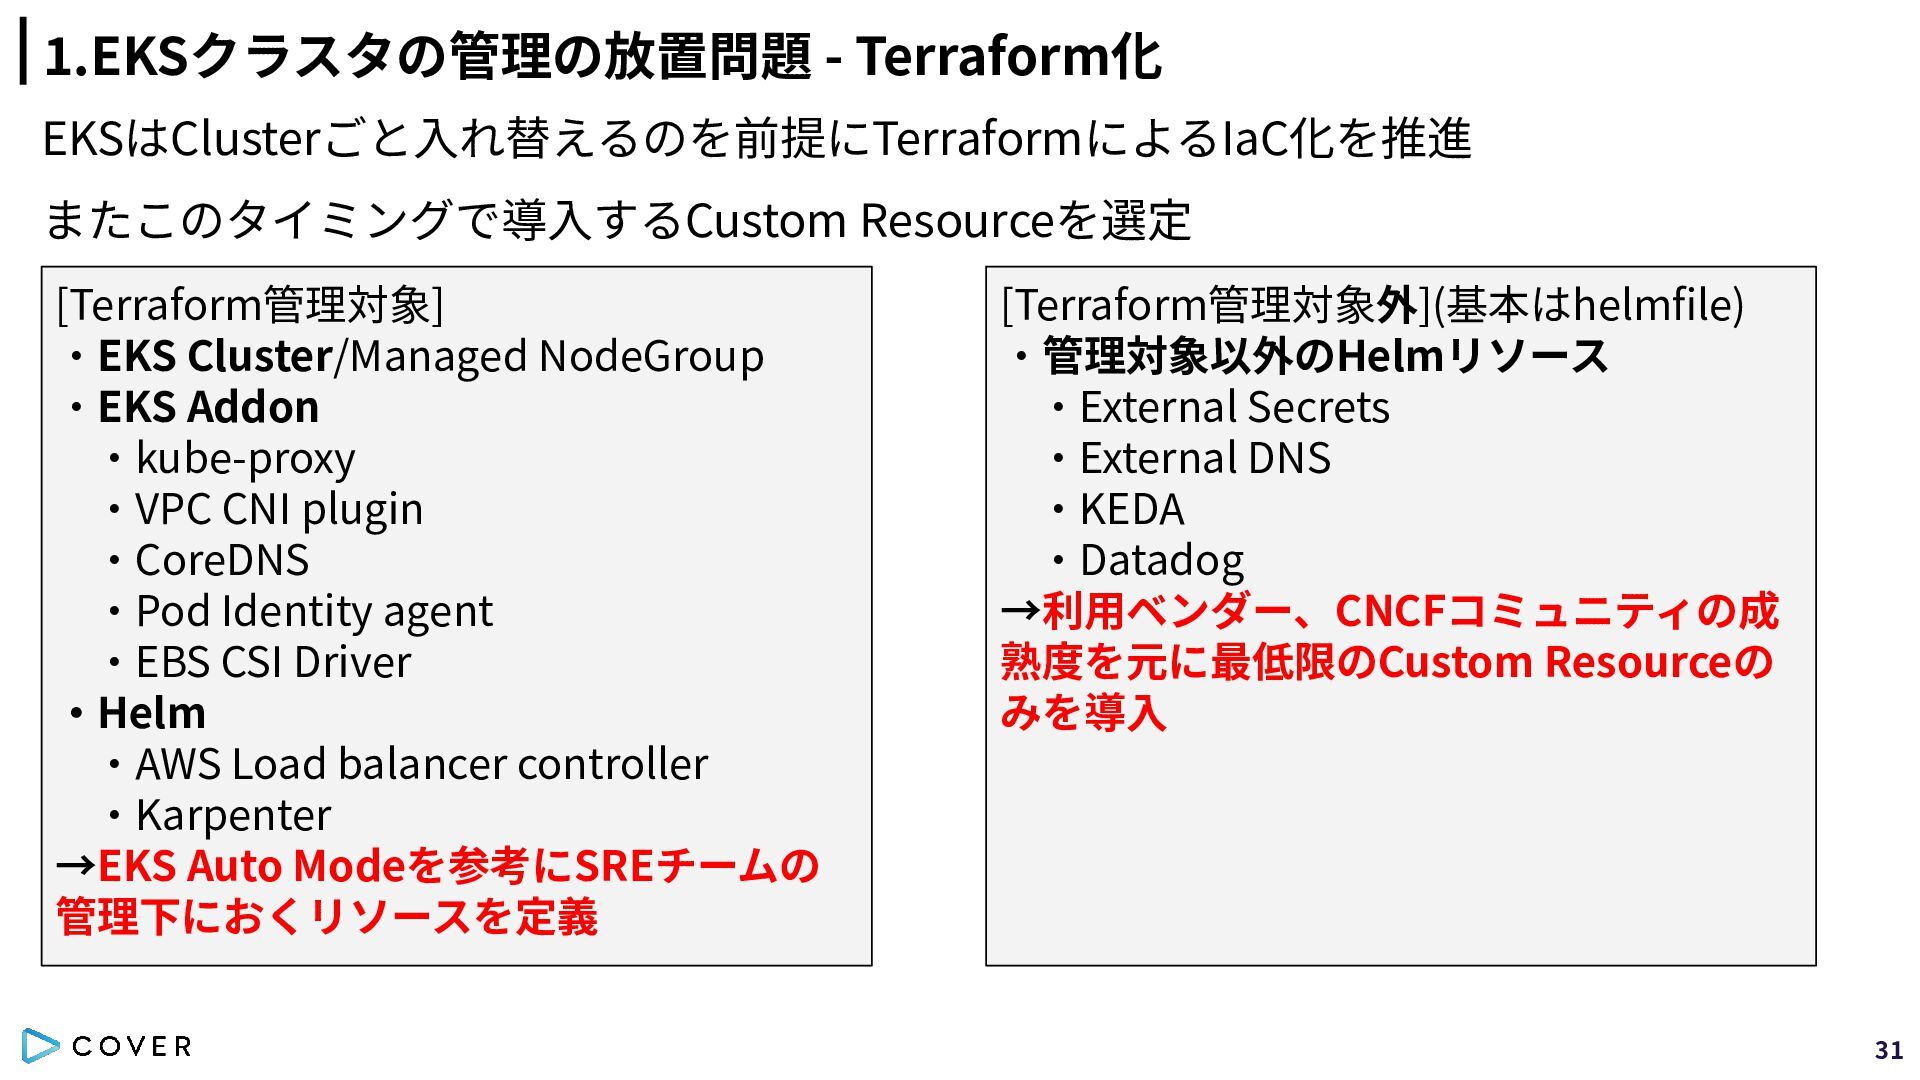
1.EKSクラスタの管理の放置問題 - Terraform化 EKSはClusterごと⼊れ替えるのを前提にTerraformによるIaC化を推進 またこのタイミングで導⼊するCustom Resourceを選定 [Terraform管理対象] ‧EKS Cluster/Managed NodeGroup
‧EKS Addon ‧kube-proxy ‧VPC CNI plugin ‧CoreDNS ‧Pod Identity agent ‧EBS CSI Driver ‧Helm ‧AWS Load balancer controller ‧Karpenter →EKS Auto Modeを参考にSREチームの 管理下におくリソースを定義 [Terraform管理対象外](基本はhelmfile) ‧管理対象以外のHelmリソース ‧External Secrets ‧External DNS ‧KEDA ‧Datadog →利⽤ベンダー、CNCFコミュニティの成 熟度を元に最低限のCustom Resourceの みを導⼊ 31
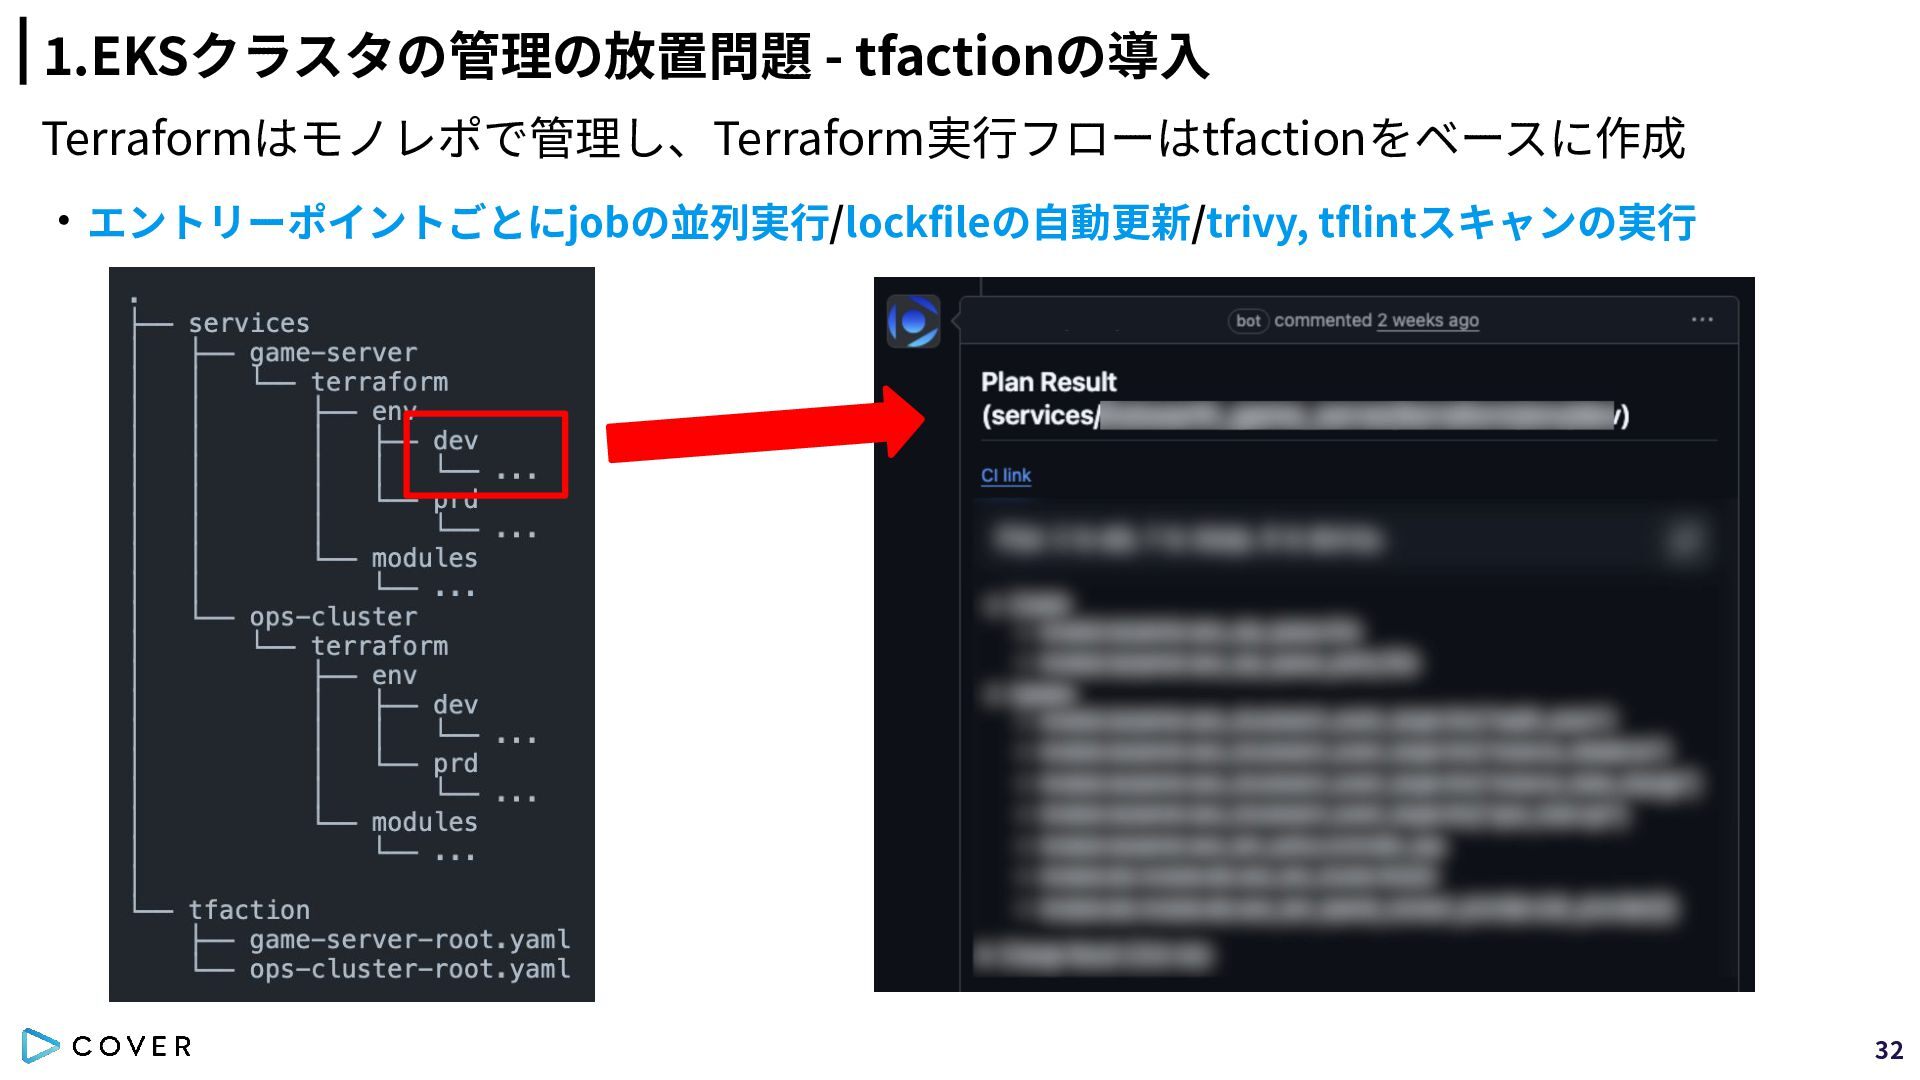
1.EKSクラスタの管理の放置問題 - tfactionの導⼊ Terraformはモノレポで管理し、Terraform実⾏フローはtfactionをベースに作成 ‧エントリーポイントごとにjobの並列実⾏/lockfileの⾃動更新/trivy, tflintスキャンの実⾏ 32
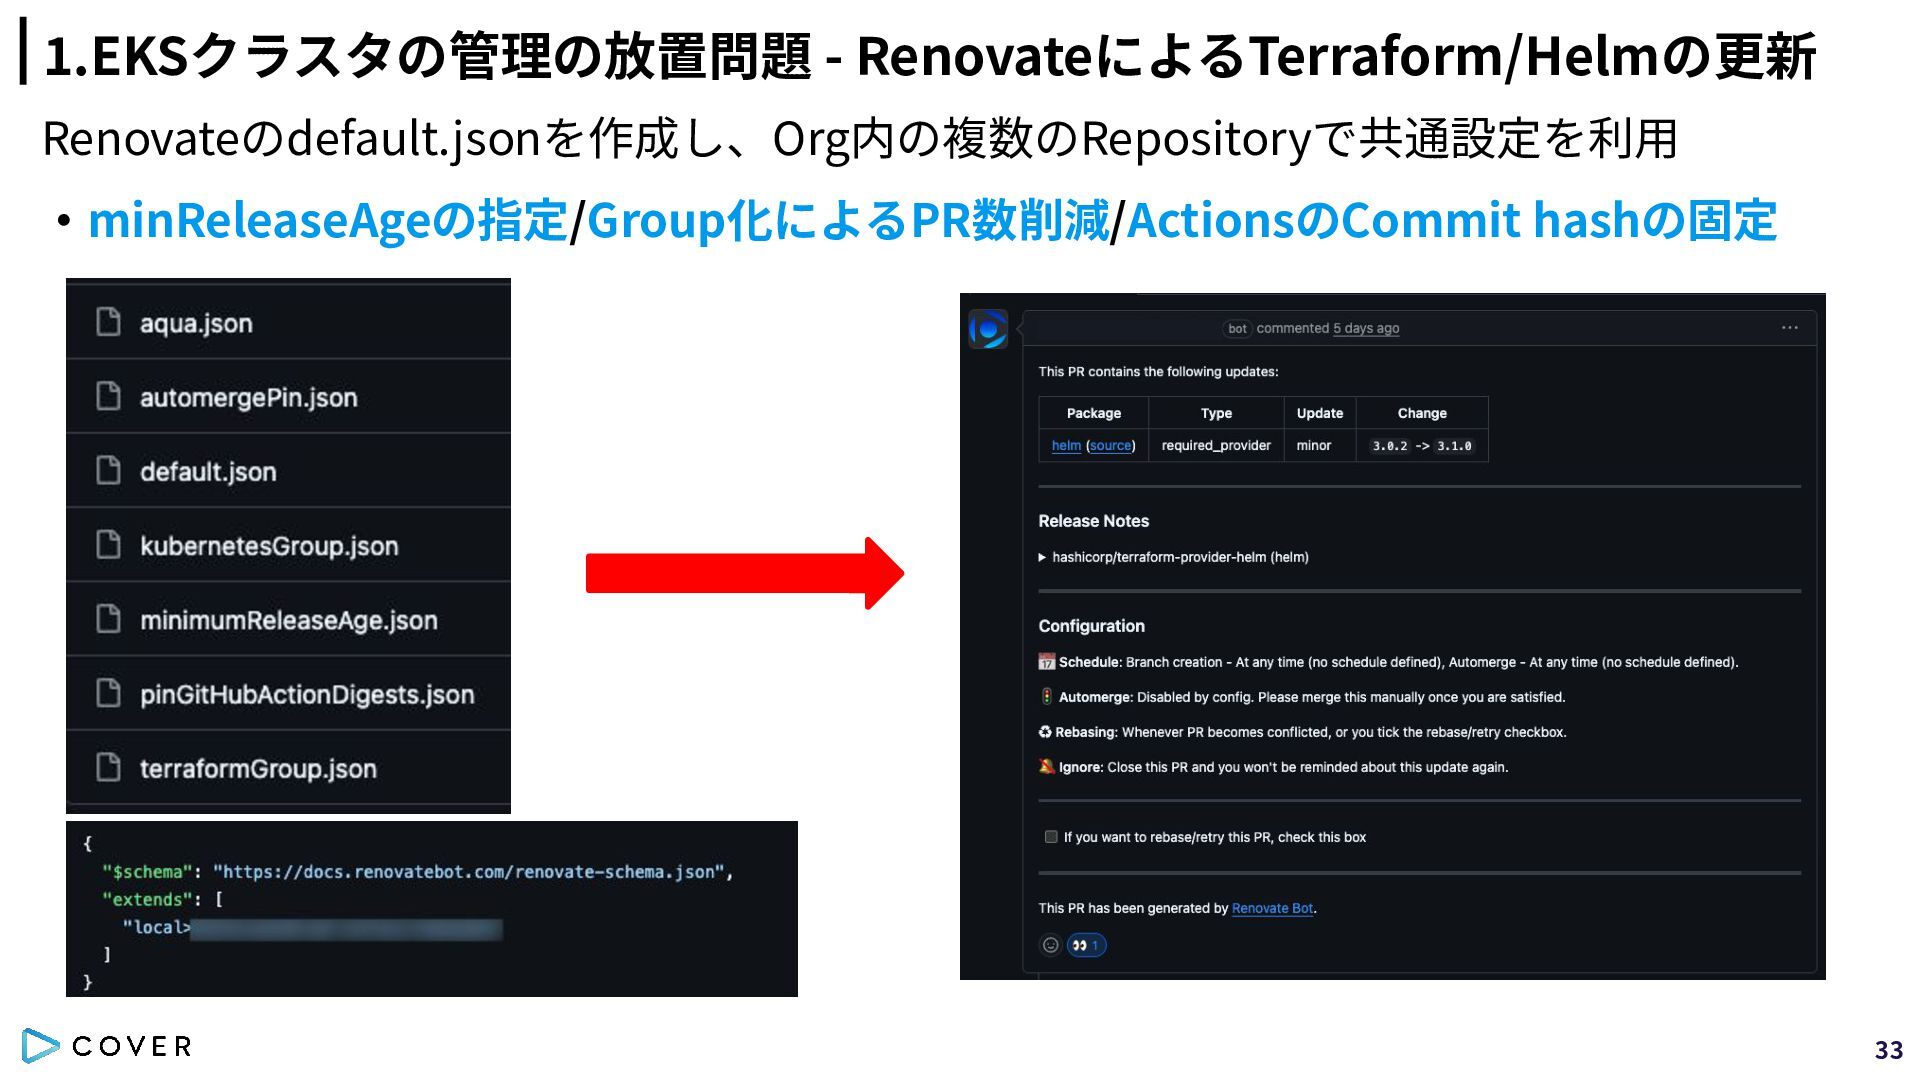
1.EKSクラスタの管理の放置問題 - RenovateによるTerraform/Helmの更新 Renovateのdefault.jsonを作成し、Org内の複数のRepositoryで共通設定を利⽤ ‧minReleaseAgeの指定/Group化によるPR数削減/ActionsのCommit hashの固定 33
1.EKSクラスタの管理の放置問題 - 改善前の当時のEKSの状況 当時はeksctl create cluster後、ほぼ何もしていない状態のEKSが塩漬けになって数年 放置されていた • EKS関連リソースはIaC化されておらず全ての操作はeksctl(CFn)で⼿動管理 •
EKS Addon/CRDは無し • 諸々のバージョンアップグレードに伴う検証フロー未整備 • GitOpsの未整備 34
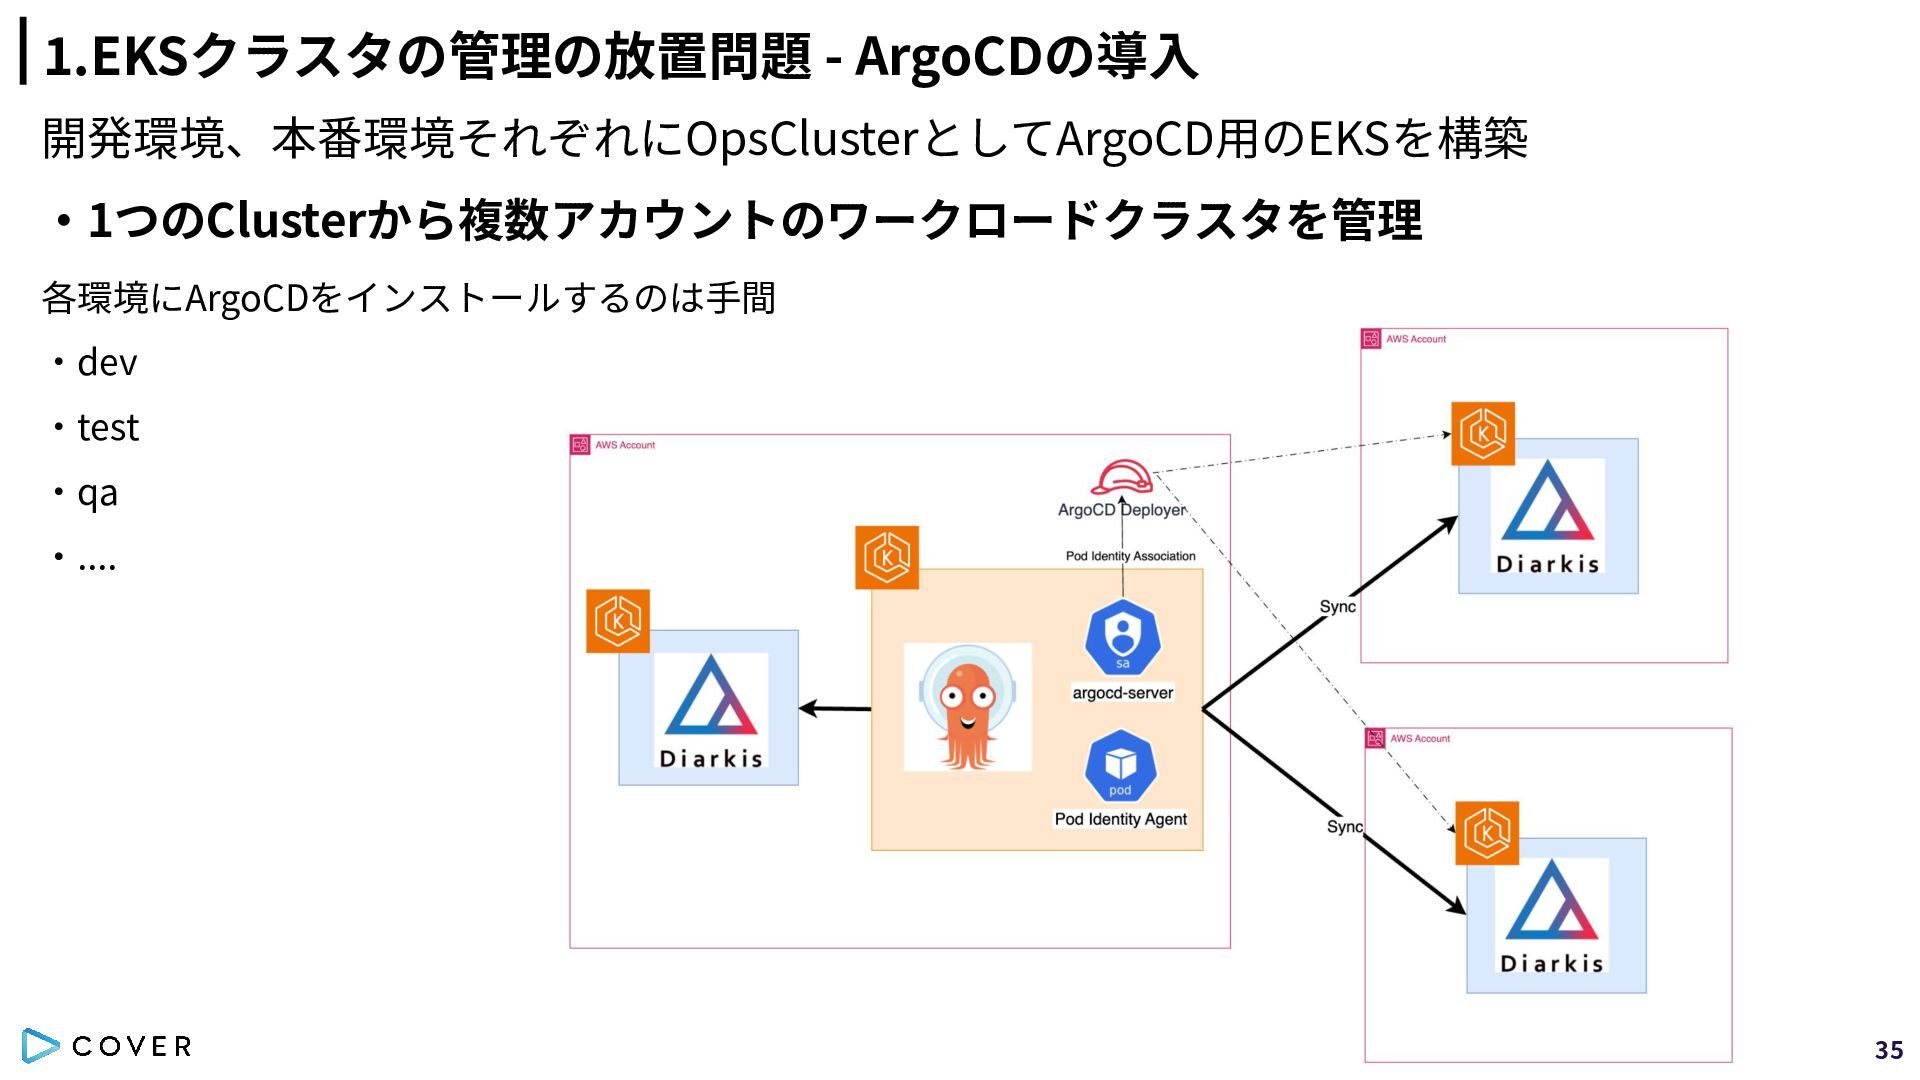
1.EKSクラスタの管理の放置問題 - ArgoCDの導⼊ 開発環境、本番環境それぞれにOpsClusterとしてArgoCD⽤のEKSを構築 ‧1つのClusterから複数アカウントのワークロードクラスタを管理 各環境にArgoCDをインストールするのは⼿間 ‧dev ‧test ‧qa ‧....
35
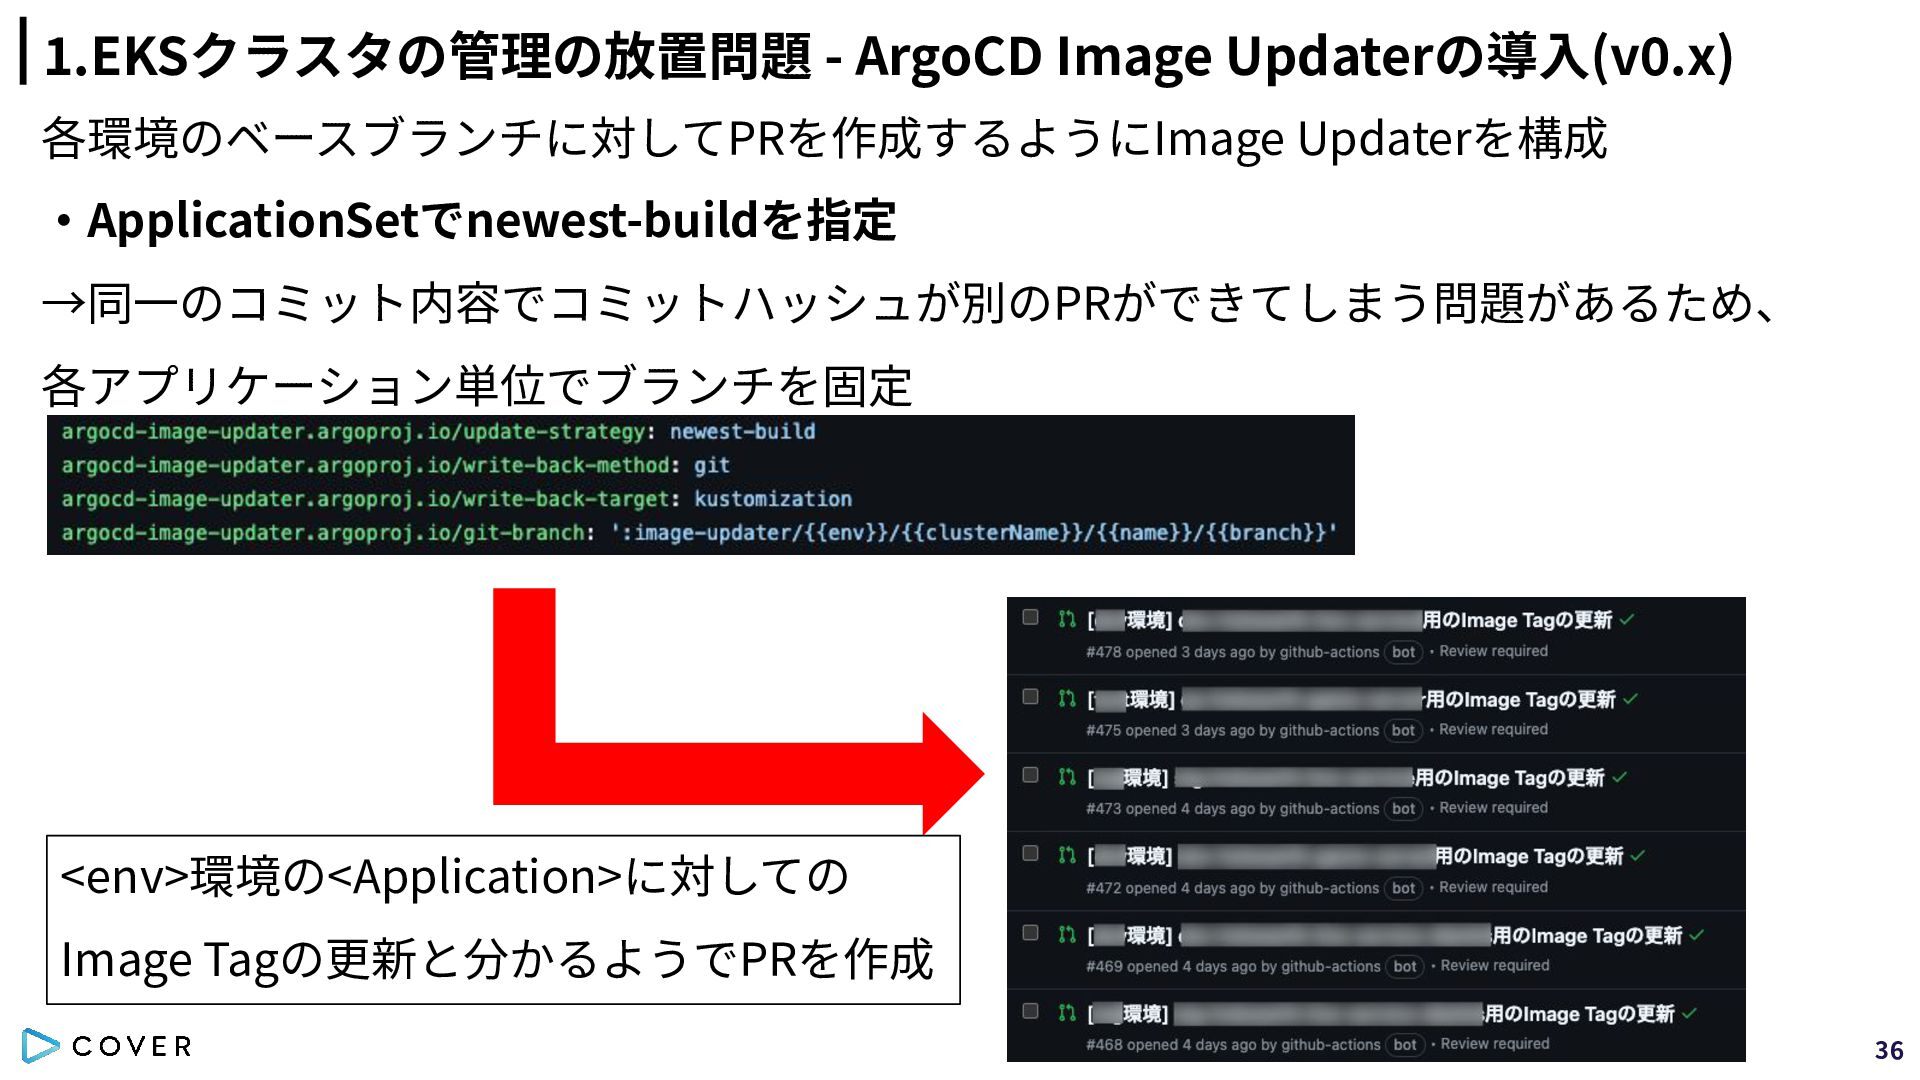
1.EKSクラスタの管理の放置問題 - ArgoCD Image Updaterの導⼊(v0.x) 各環境のベースブランチに対してPRを作成するようにImage Updaterを構成 ‧ApplicationSetでnewest-buildを指定 →同⼀のコミット内容でコミットハッシュが別のPRができてしまう問題があるため、 各アプリケーション単位でブランチを固定
<env>環境の<Application>に対しての Image Tagの更新と分かるようでPRを作成 36
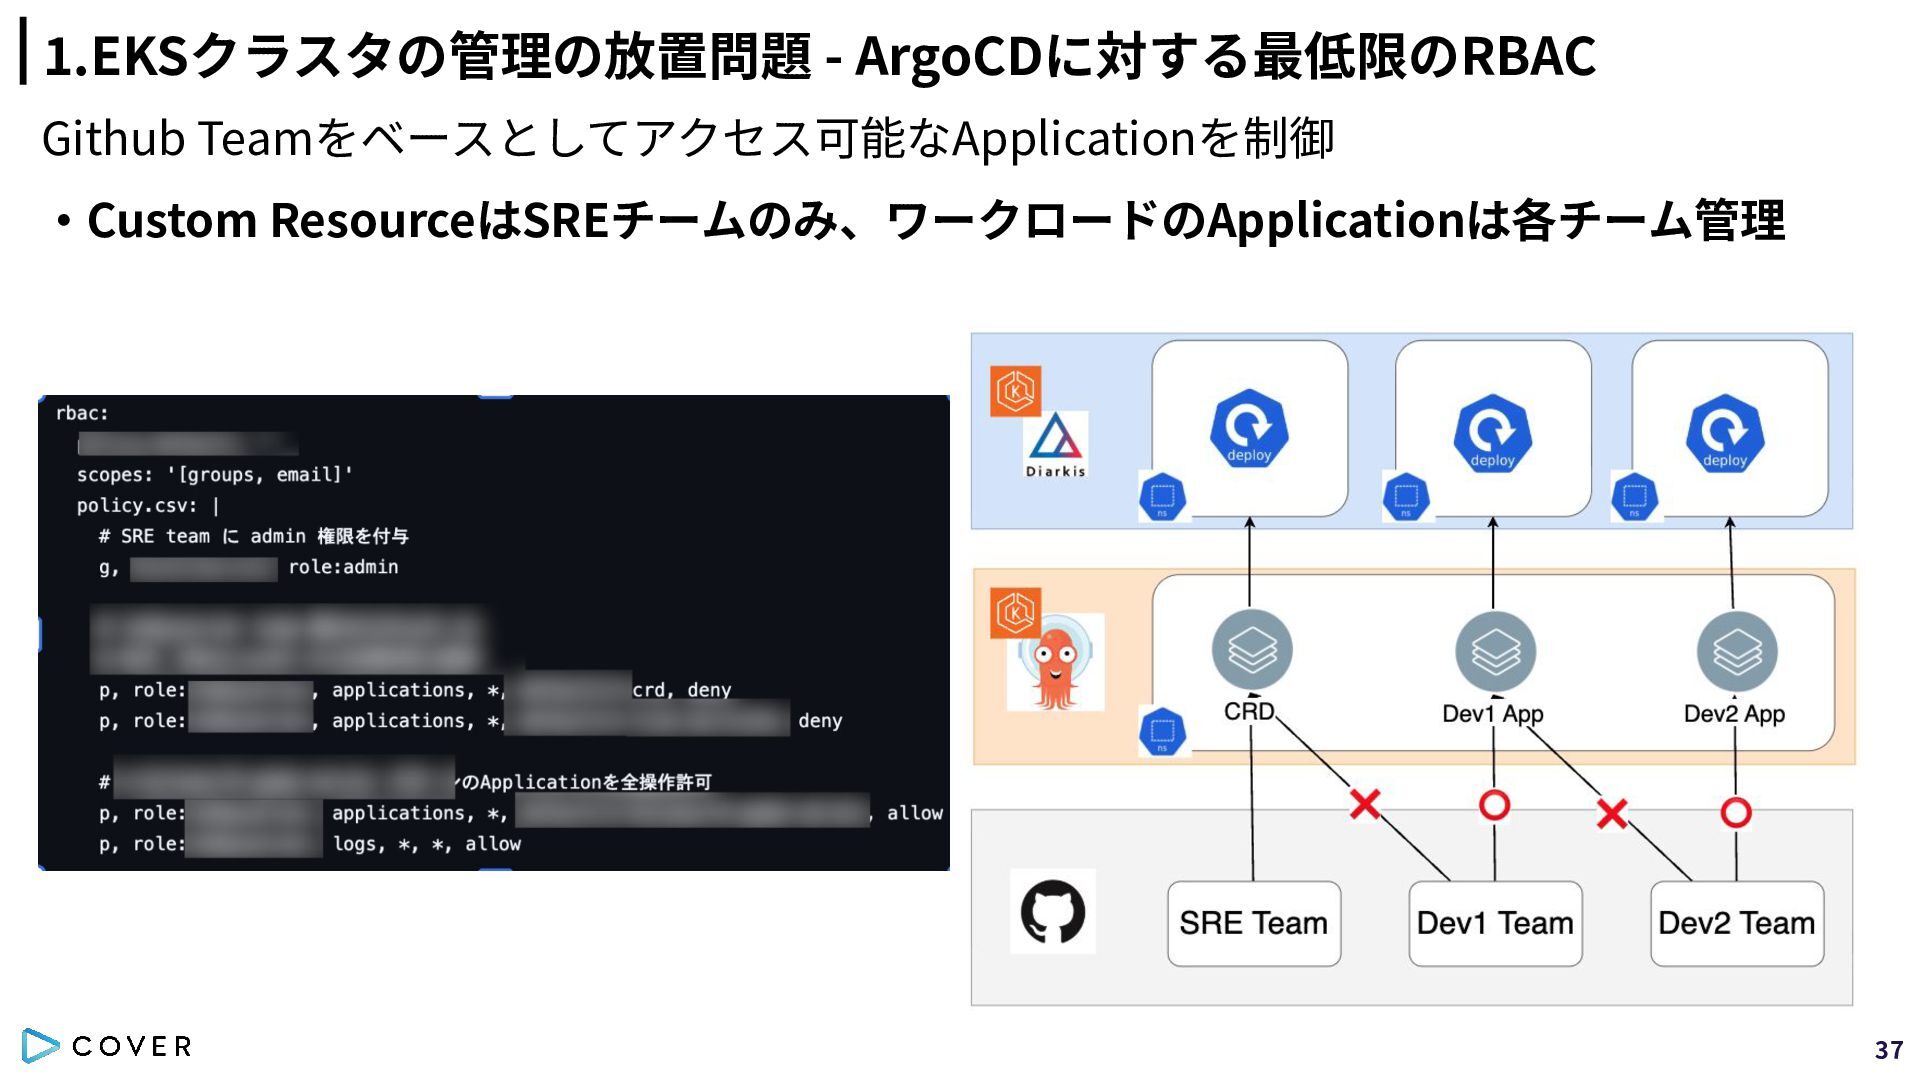
1.EKSクラスタの管理の放置問題 - ArgoCDに対する最低限のRBAC Github Teamをベースとしてアクセス可能なApplicationを制御 ‧Custom ResourceはSREチームのみ、ワークロードのApplicationは各チーム管理 37
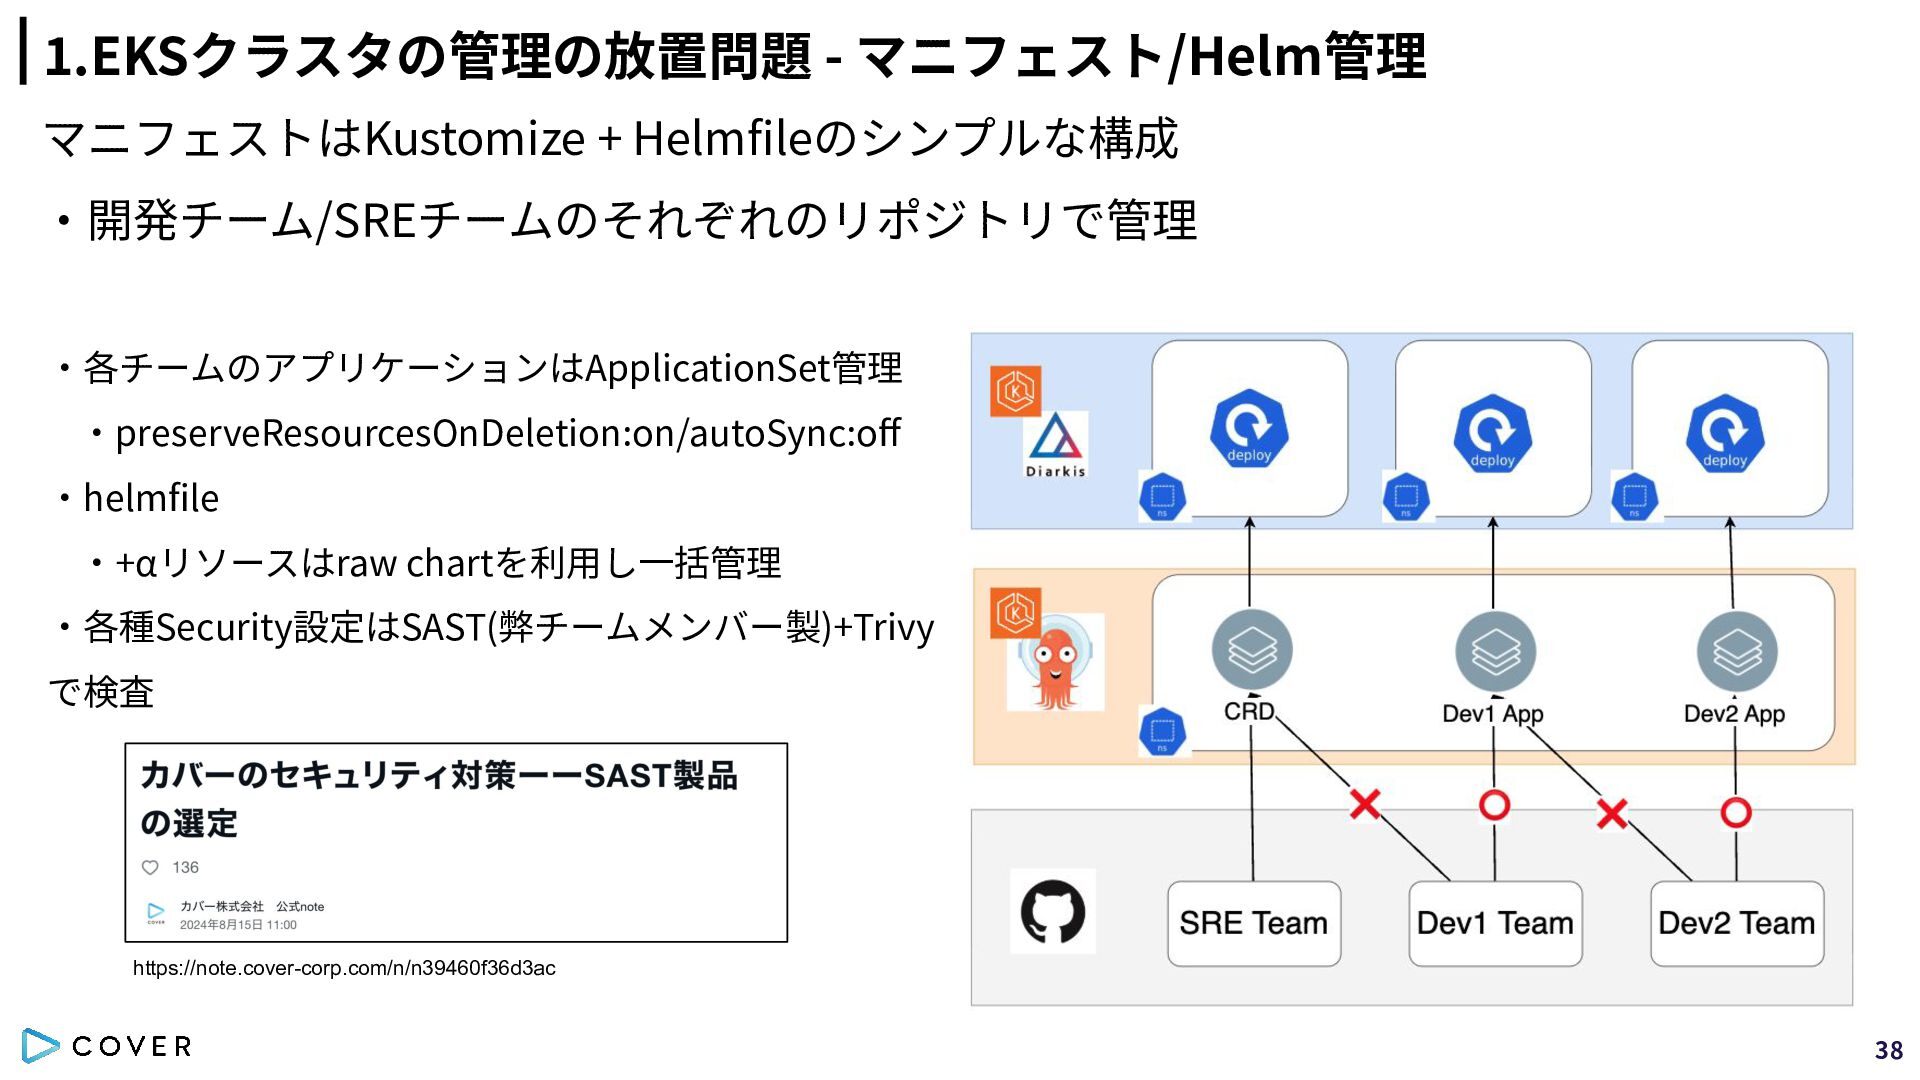
1.EKSクラスタの管理の放置問題 - マニフェスト/Helm管理 マニフェストはKustomize + Helmfileのシンプルな構成 ‧開発チーム/SREチームのそれぞれのリポジトリで管理 ‧各チームのアプリケーションはApplicationSet管理 ‧preserveResourcesOnDeletion:on/autoSync:off ‧helmfile
‧+αリソースはraw chartを利⽤し⼀括管理 ‧各種Security設定はSAST(弊チームメンバー製)+Trivy で検査 https://note.cover-corp.com/n/n39460f36d3ac 38
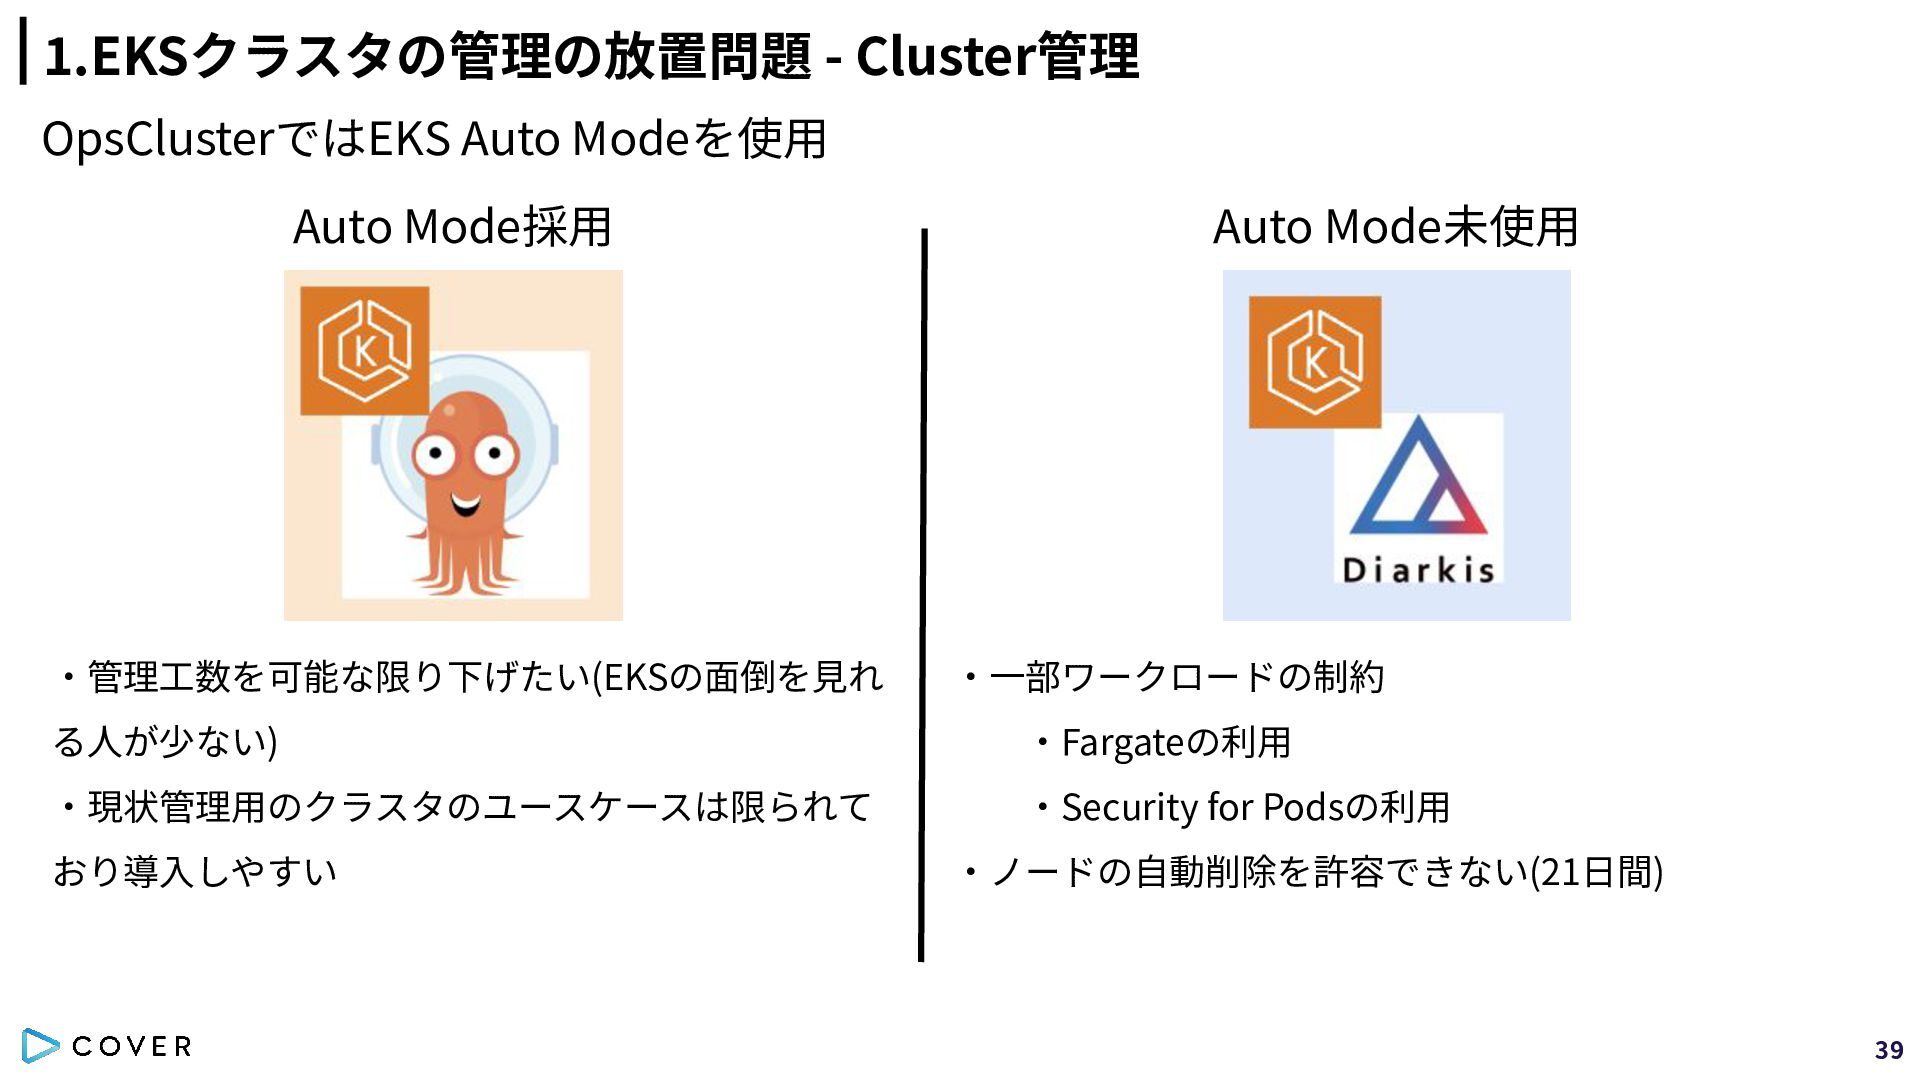
1.EKSクラスタの管理の放置問題 - Cluster管理 OpsClusterではEKS Auto Modeを使⽤ Auto Mode採⽤ ‧管理⼯数を可能な限り下げたい(EKSの⾯倒を⾒れ Auto
Mode未使⽤ ‧⼀部ワークロードの制約 る⼈が少ない) ‧Fargateの利⽤ ‧現状管理⽤のクラスタのユースケースは限られて ‧Security for Podsの利⽤ おり導⼊しやすい ‧ノードの⾃動削除を許容できない(21⽇間) 39
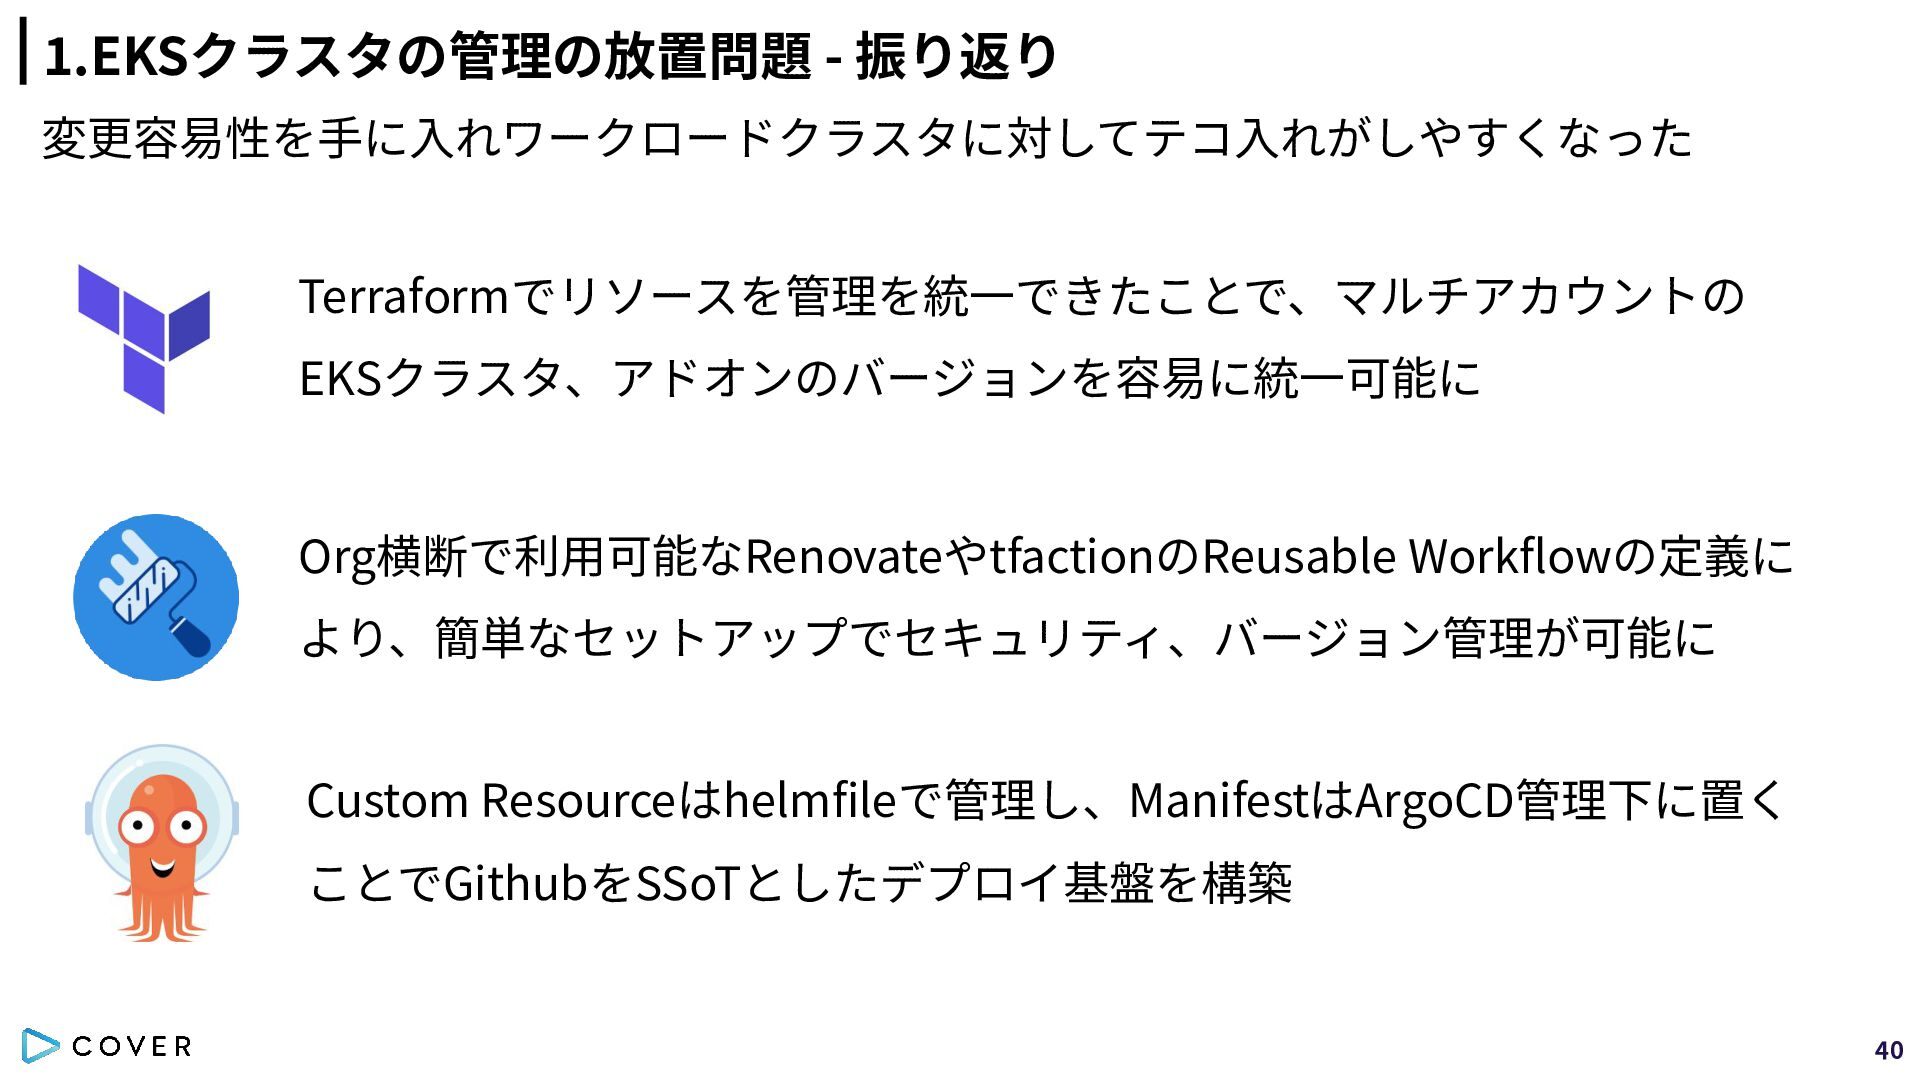
1.EKSクラスタの管理の放置問題 - 振り返り 変更容易性を⼿に⼊れワークロードクラスタに対してテコ⼊れがしやすくなった Terraformでリソースを管理を統⼀できたことで、マルチアカウントの EKSクラスタ、アドオンのバージョンを容易に統⼀可能に Org横断で利⽤可能なRenovateやtfactionのReusable Workflowの定義に より、簡単なセットアップでセキュリティ、バージョン管理が可能に Custom
Resourceはhelmfileで管理し、ManifestはArgoCD管理下に置く ことでGithubをSSoTとしたデプロイ基盤を構築 40
バックログ 構想をもとに改善を進めるために⼤枠の課題を分割した。 1.EKSクラスタの管理の放置問題 2.ワークロードクラスタの内部状態の可視化 3.Room管理とインスタンスのサイジングによるコスト適正化 4.オートスケールの改善 5.⼤規模利⽤における課題への対応 41
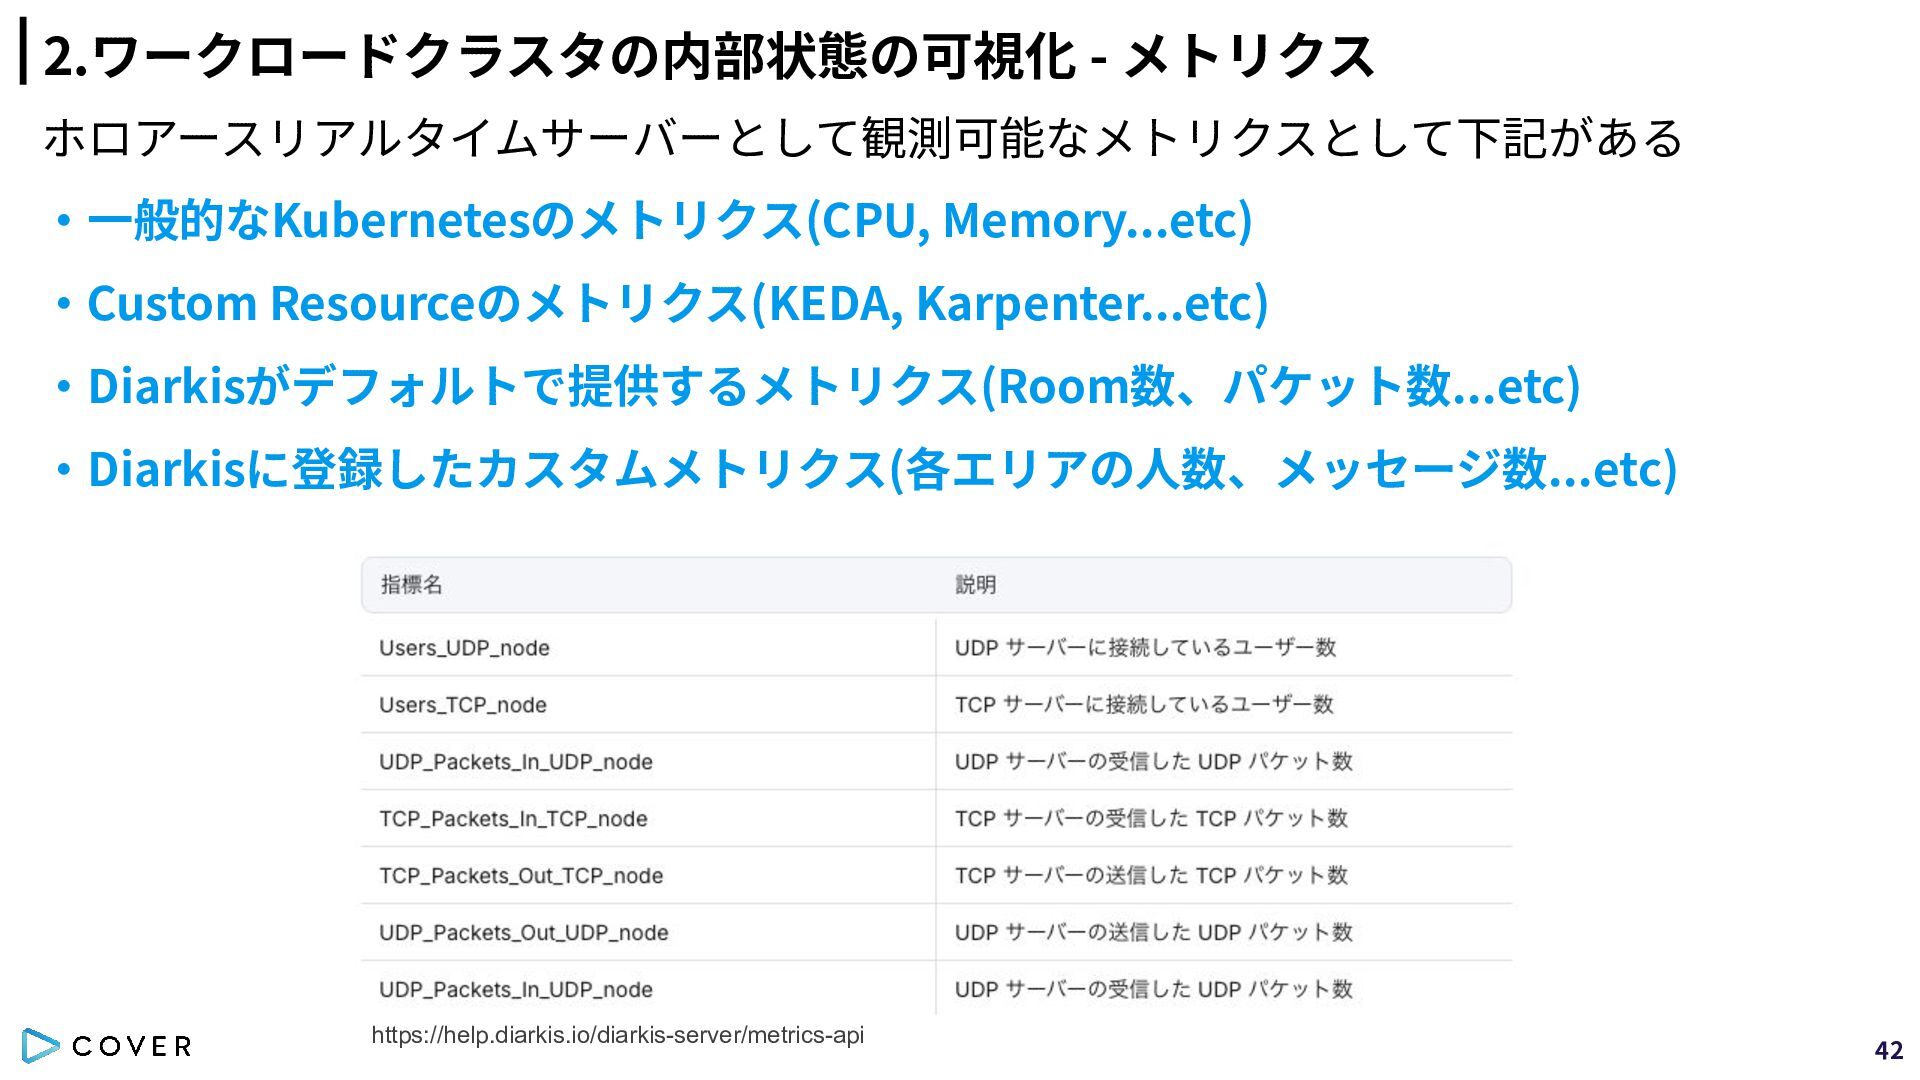
2.ワークロードクラスタの内部状態の可視化 - メトリクス ホロアースリアルタイムサーバーとして観測可能なメトリクスとして下記がある ‧⼀般的なKubernetesのメトリクス(CPU, Memory...etc) ‧Custom Resourceのメトリクス(KEDA, Karpenter...etc) ‧Diarkisがデフォルトで提供するメトリクス(Room数、パケット数...etc)
‧Diarkisに登録したカスタムメトリクス(各エリアの⼈数、メッセージ数...etc) https://help.diarkis.io/diarkis-server/metrics-api 42
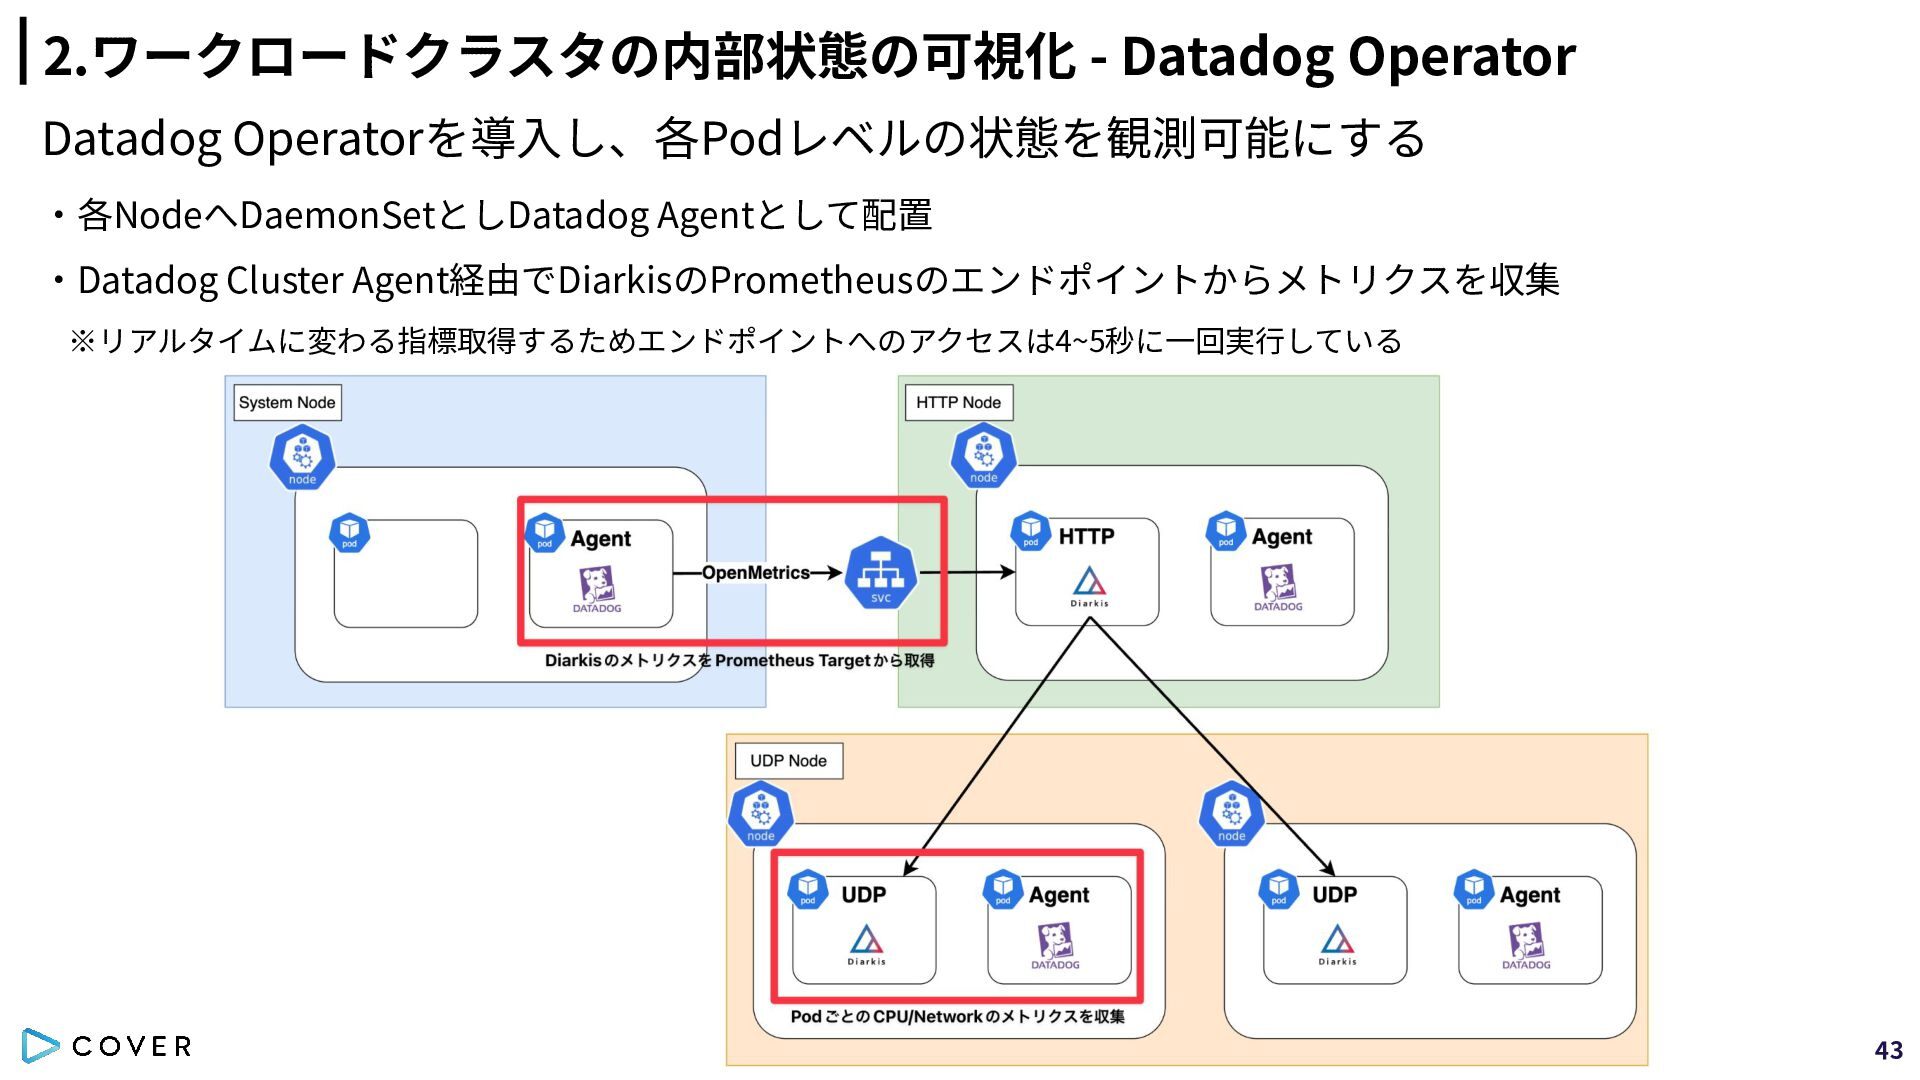
2.ワークロードクラスタの内部状態の可視化 - Datadog Operator Datadog Operatorを導⼊し、各Podレベルの状態を観測可能にする ‧各NodeへDaemonSetとしDatadog Agentとして配置 ‧Datadog Cluster
Agent経由でDiarkisのPrometheusのエンドポイントからメトリクスを収集 ※リアルタイムに変わる指標取得するためエンドポイントへのアクセスは4~5秒に⼀回実⾏している 43
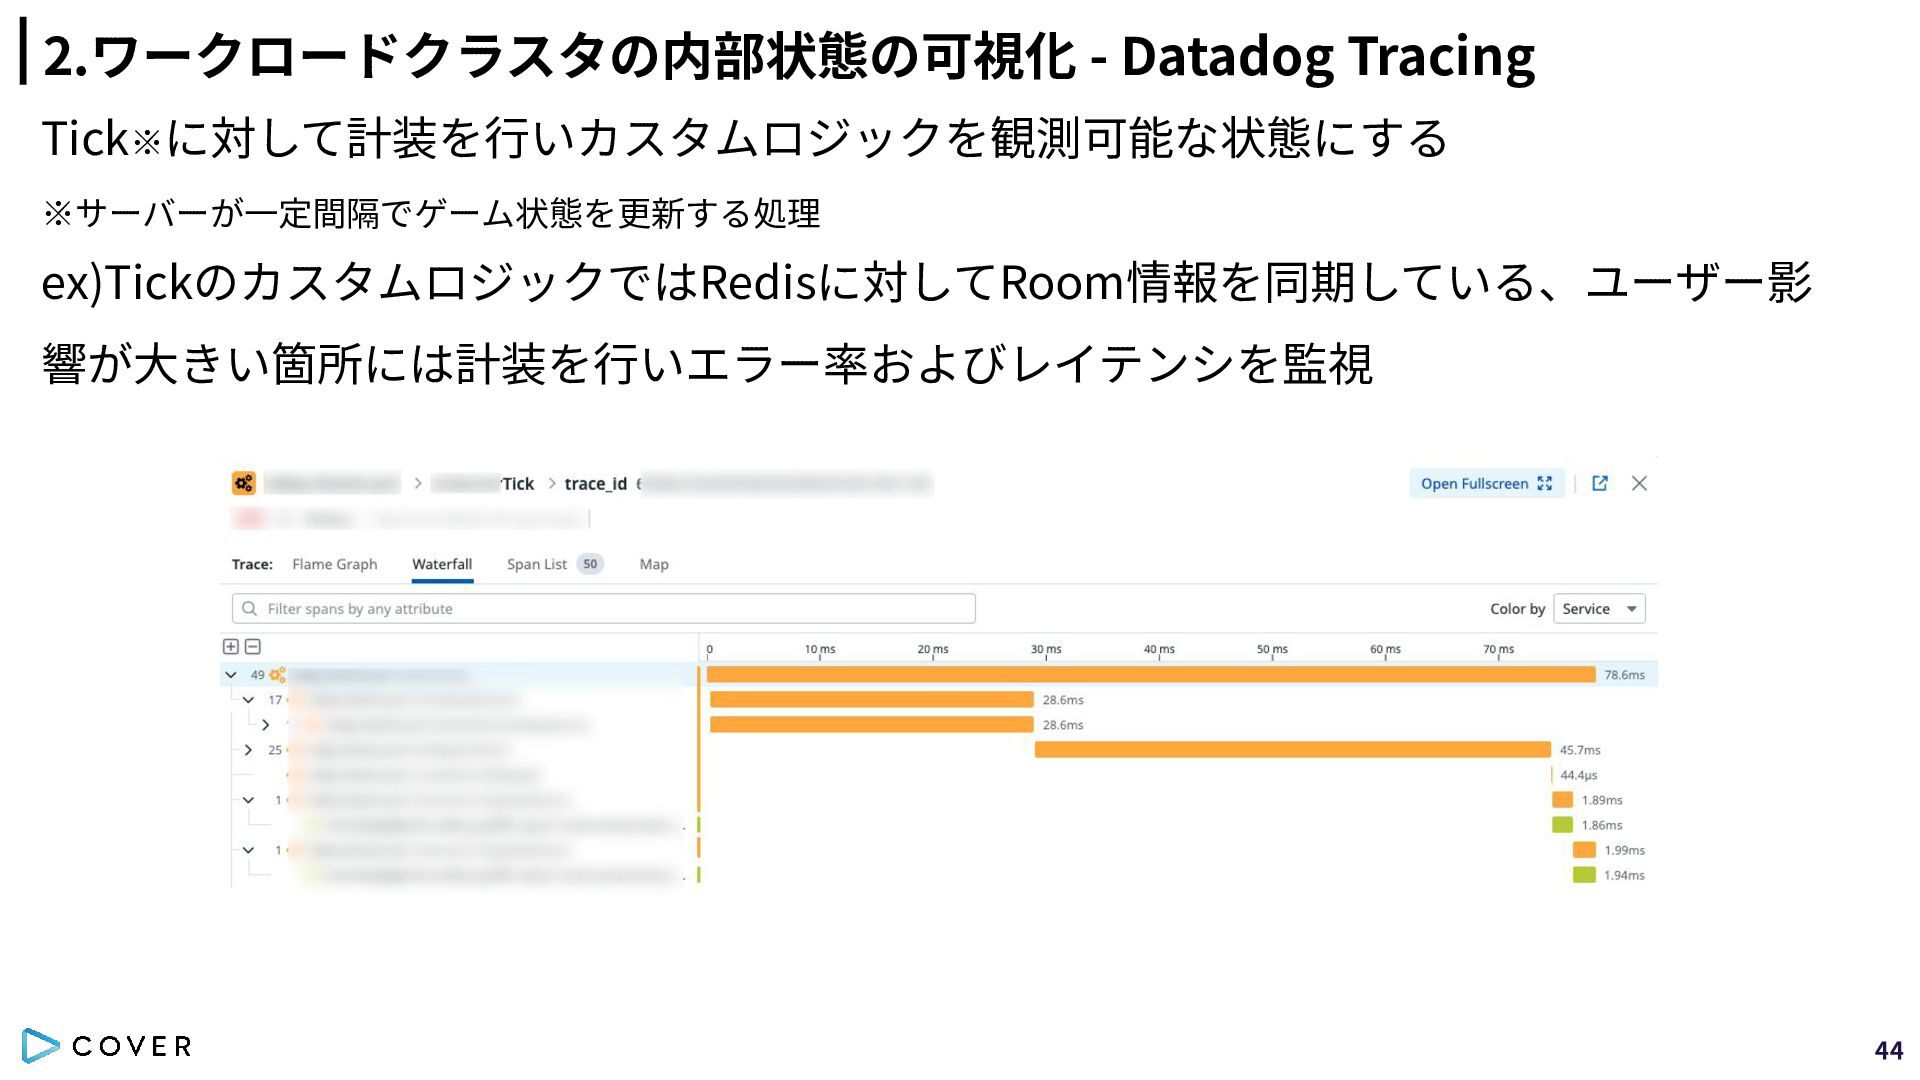
2.ワークロードクラスタの内部状態の可視化 - Datadog Tracing Tick※に対して計装を⾏いカスタムロジックを観測可能な状態にする ※サーバーが⼀定間隔でゲーム状態を更新する処理 ex)TickのカスタムロジックではRedisに対してRoom情報を同期している、ユーザー影 響が⼤きい箇所には計装を⾏いエラー率およびレイテンシを監視 44
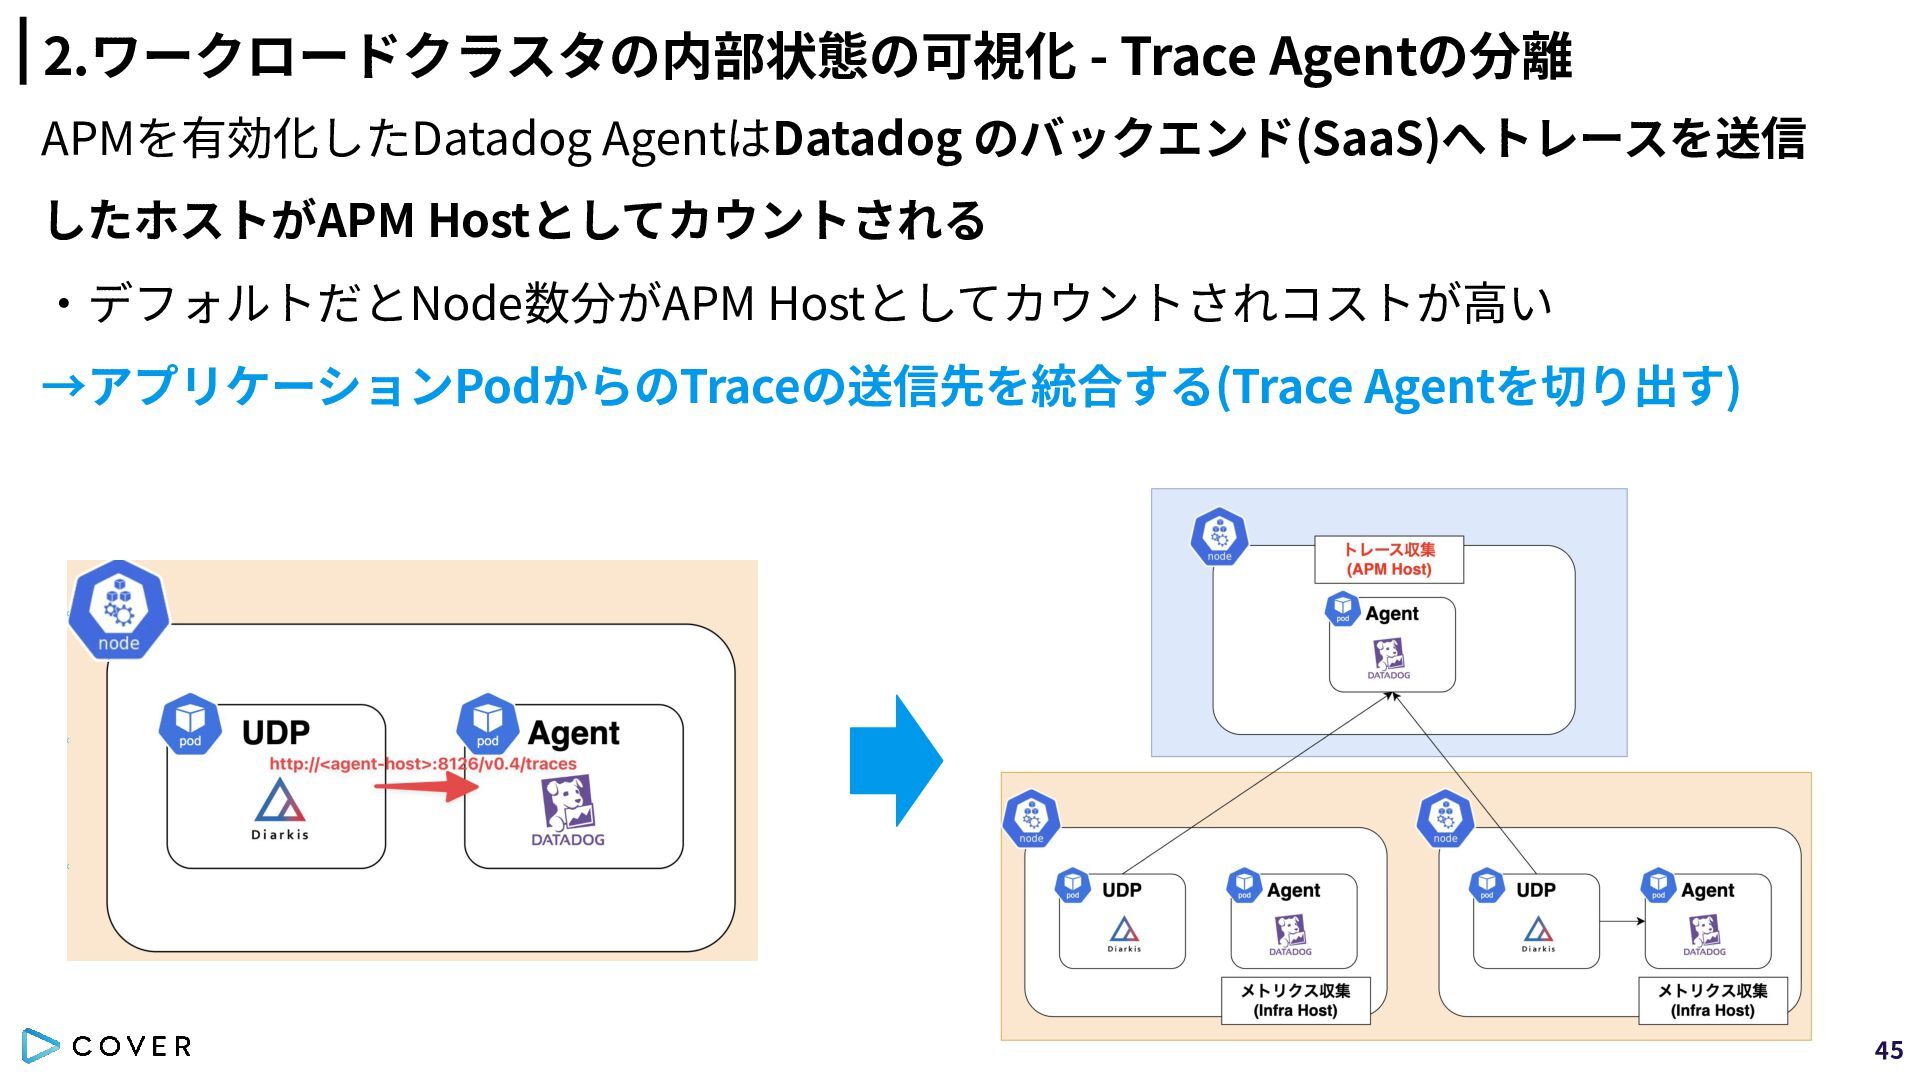
2.ワークロードクラスタの内部状態の可視化 - Trace Agentの分離 APMを有効化したDatadog AgentはDatadog のバックエンド(SaaS)へトレースを送信 したホストがAPM Hostとしてカウントされる ‧デフォルトだとNode数分がAPM
Hostとしてカウントされコストが⾼い →アプリケーションPodからのTraceの送信先を統合する(Trace Agentを切り出す) 45
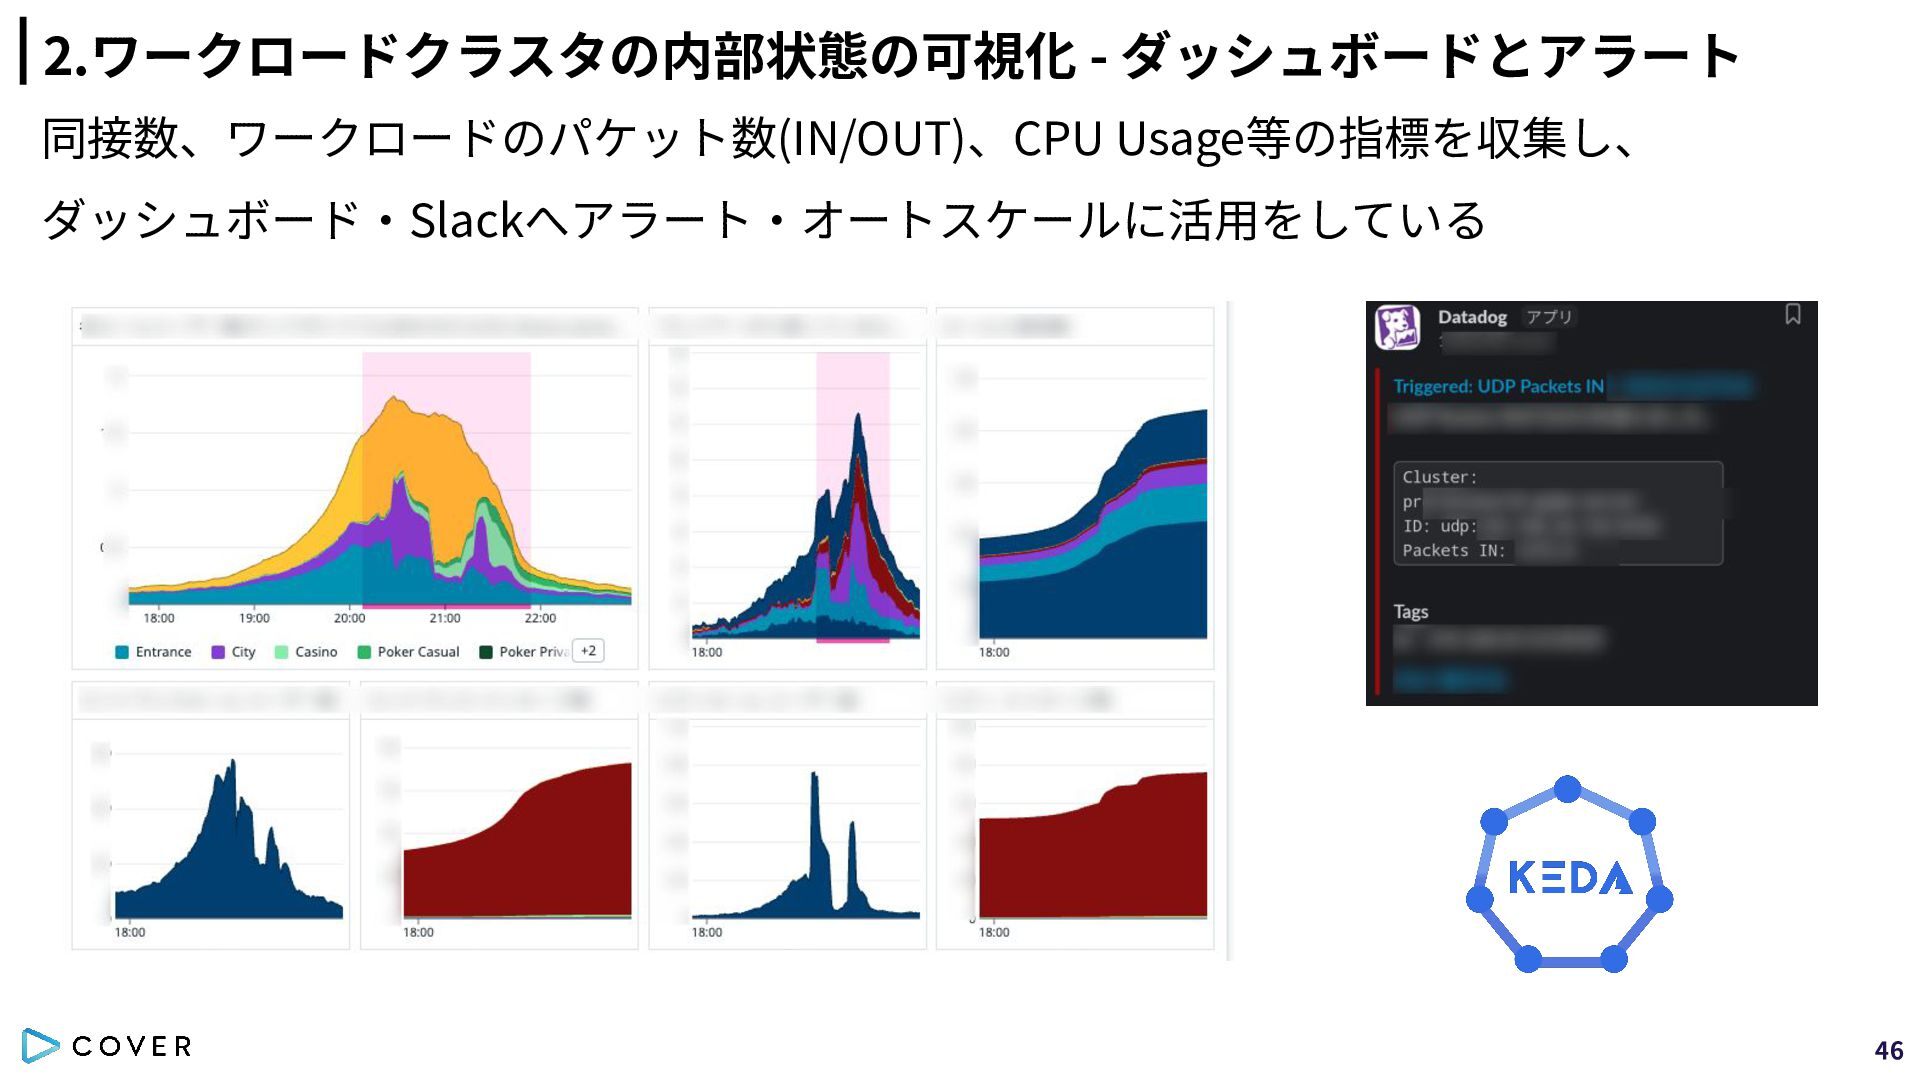
2.ワークロードクラスタの内部状態の可視化 - ダッシュボードとアラート 同接数、ワークロードのパケット数(IN/OUT)、CPU Usage等の指標を収集し、 ダッシュボード‧Slackへアラート‧オートスケールに活⽤をしている 46
2.ワークロードクラスタの内部状態の可視化 - 振り返り EKSにDatadogを導⼊したことでリアルタイムサーバーも含め観測可能な状態となっ た Diarkis/Kubernetes どちらのメトリクス‧トレースを収集することがで き、リアルタイムサーバーのボトルネックの調査が可能に ダッシュボード‧アラートを整備することで、開発チームも簡単にリア ルタイムサーバーの状態を確認可能に
47
バックログ 構想をもとに改善を進めるために⼤枠の問題を分割し進めた。 1.EKSクラスタの管理の放置問題 2.Kubernetesの内部状態の可視化 3.Room管理とインスタンスのサイジングによるコスト適正化 4.オートスケールの改善 5.⼤規模利⽤に向けて 48
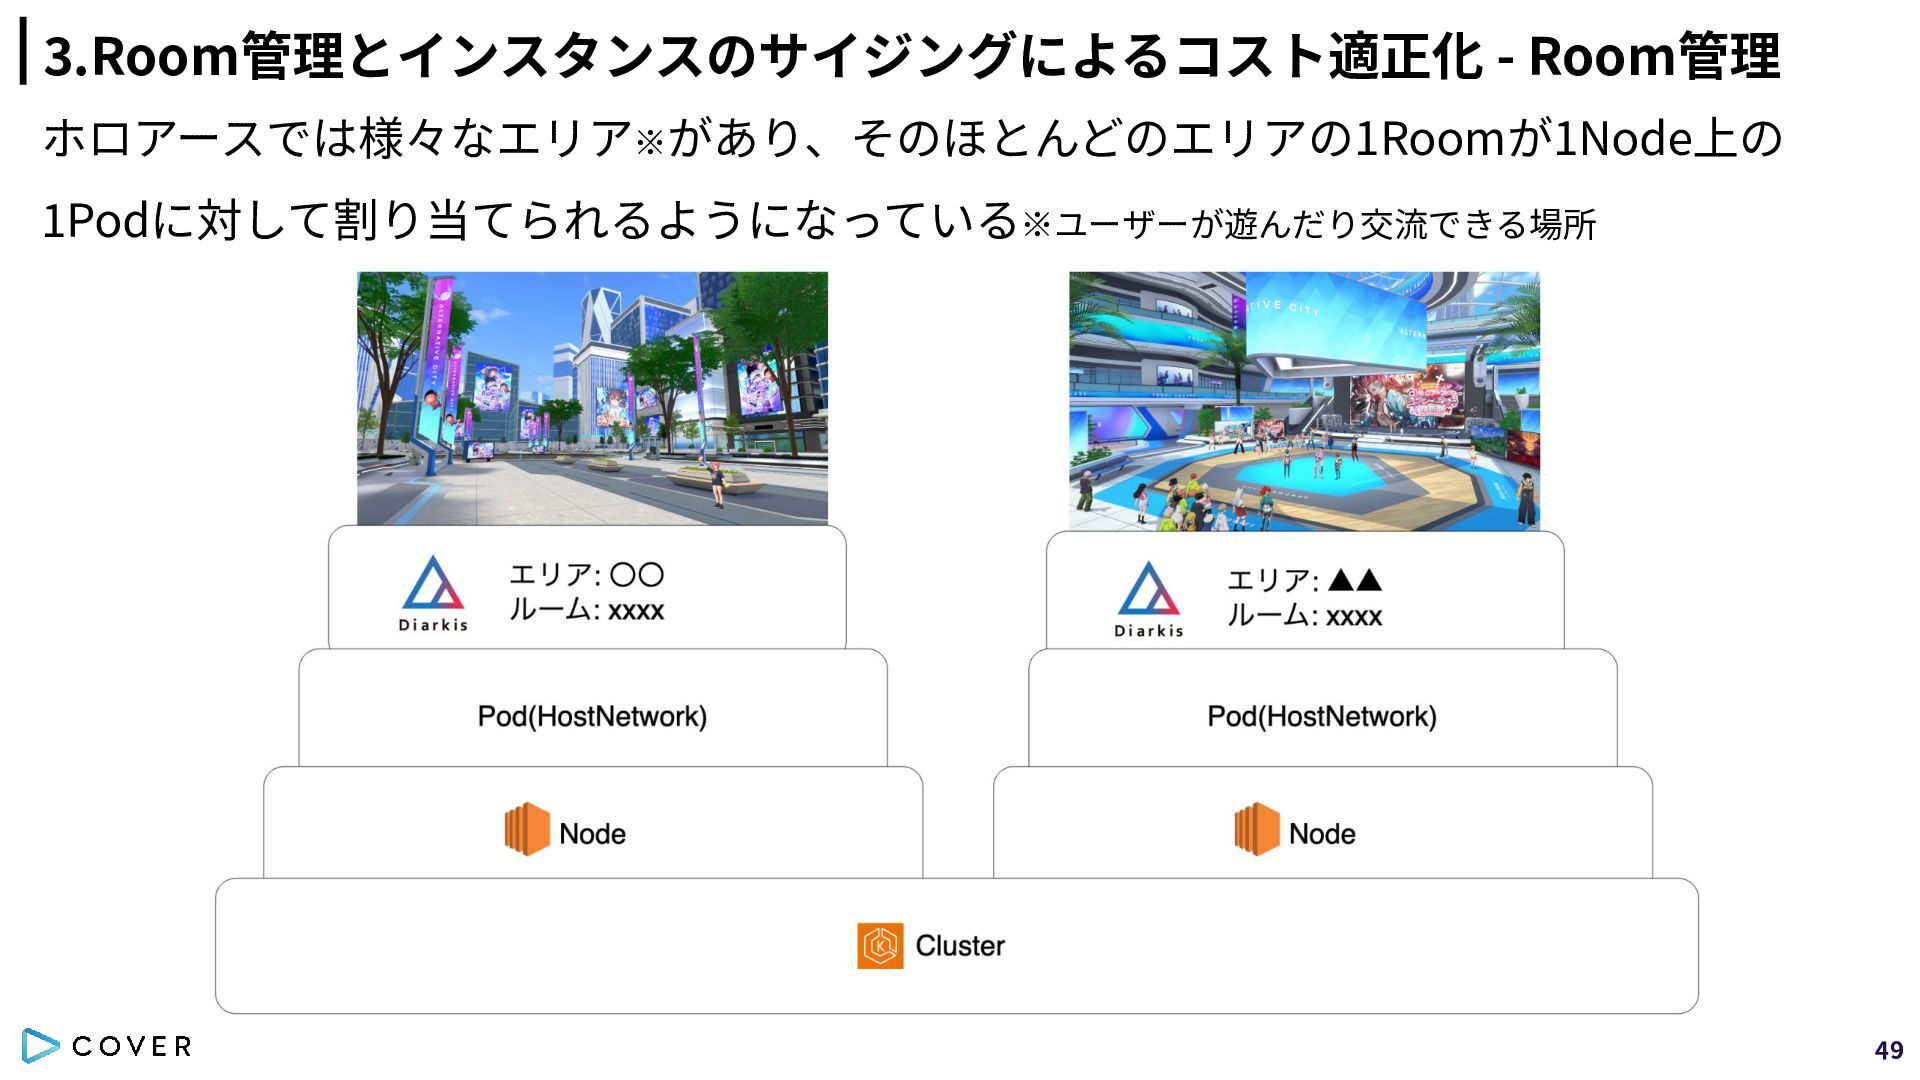
3.Room管理とインスタンスのサイジングによるコスト適正化 - Room管理 ホロアースでは様々なエリア※があり、そのほとんどのエリアの1Roomが1Node上の 1Podに対して割り当てられるようになっている※ユーザーが遊んだり交流できる場所 49
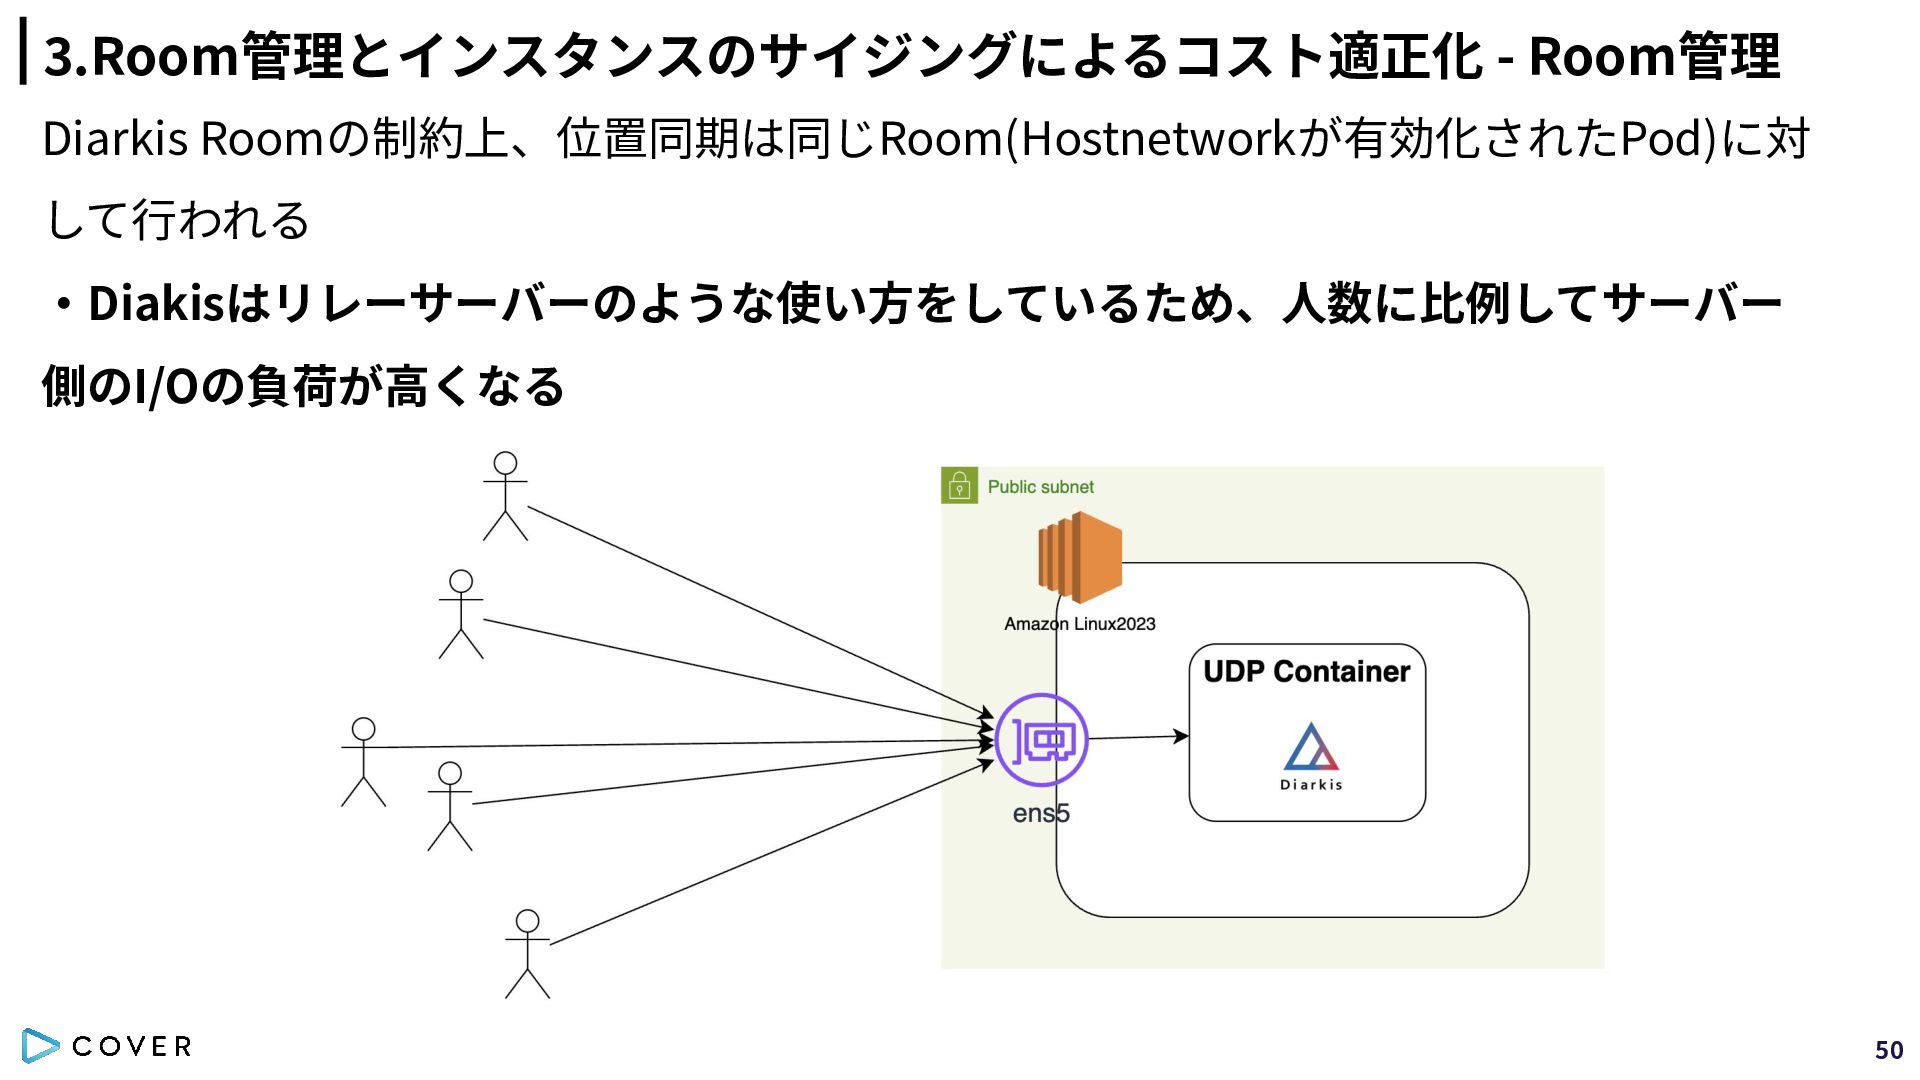
3.Room管理とインスタンスのサイジングによるコスト適正化 - Room管理 Diarkis Roomの制約上、位置同期は同じRoom(Hostnetworkが有効化されたPod)に対 して⾏われる ‧Diakisはリレーサーバーのような使い⽅をしているため、⼈数に⽐例してサーバー 側のI/Oの負荷が⾼くなる 50
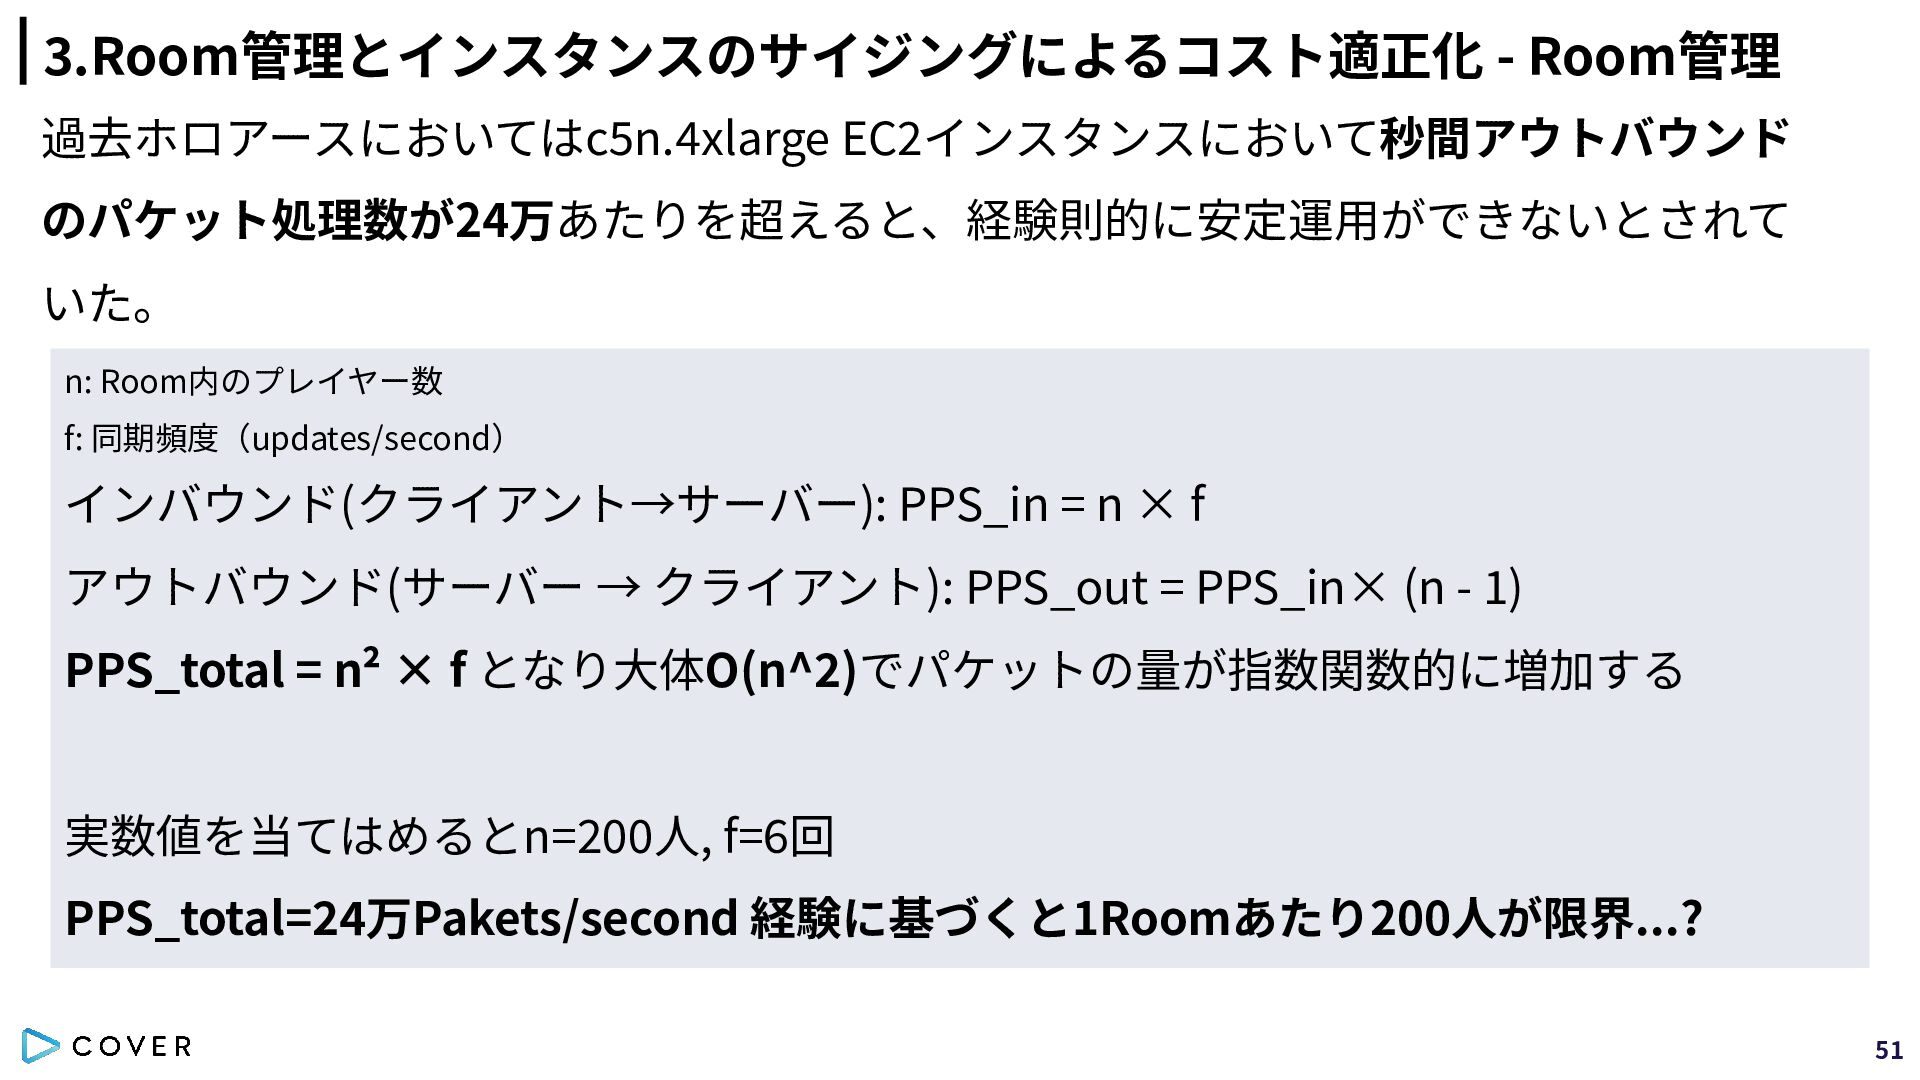
3.Room管理とインスタンスのサイジングによるコスト適正化 - Room管理 過去ホロアースにおいてはc5n.4xlarge EC2インスタンスにおいて秒間アウトバウンド のパケット処理数が24万あたりを超えると、経験則的に安定運⽤ができないとされて いた。 n: Room内のプレイヤー数 f:
同期頻度(updates/second) インバウンド(クライアント→サーバー): PPS_in = n × f アウトバウンド(サーバー → クライアント): PPS_out = PPS_in× (n - 1) PPS_total = n² × f となり⼤体O(n^2)でパケットの量が指数関数的に増加する 実数値を当てはめるとn=200⼈, f=6回 PPS_total=24万Pakets/second 経験に基づくと1Roomあたり200⼈が限界...? 51
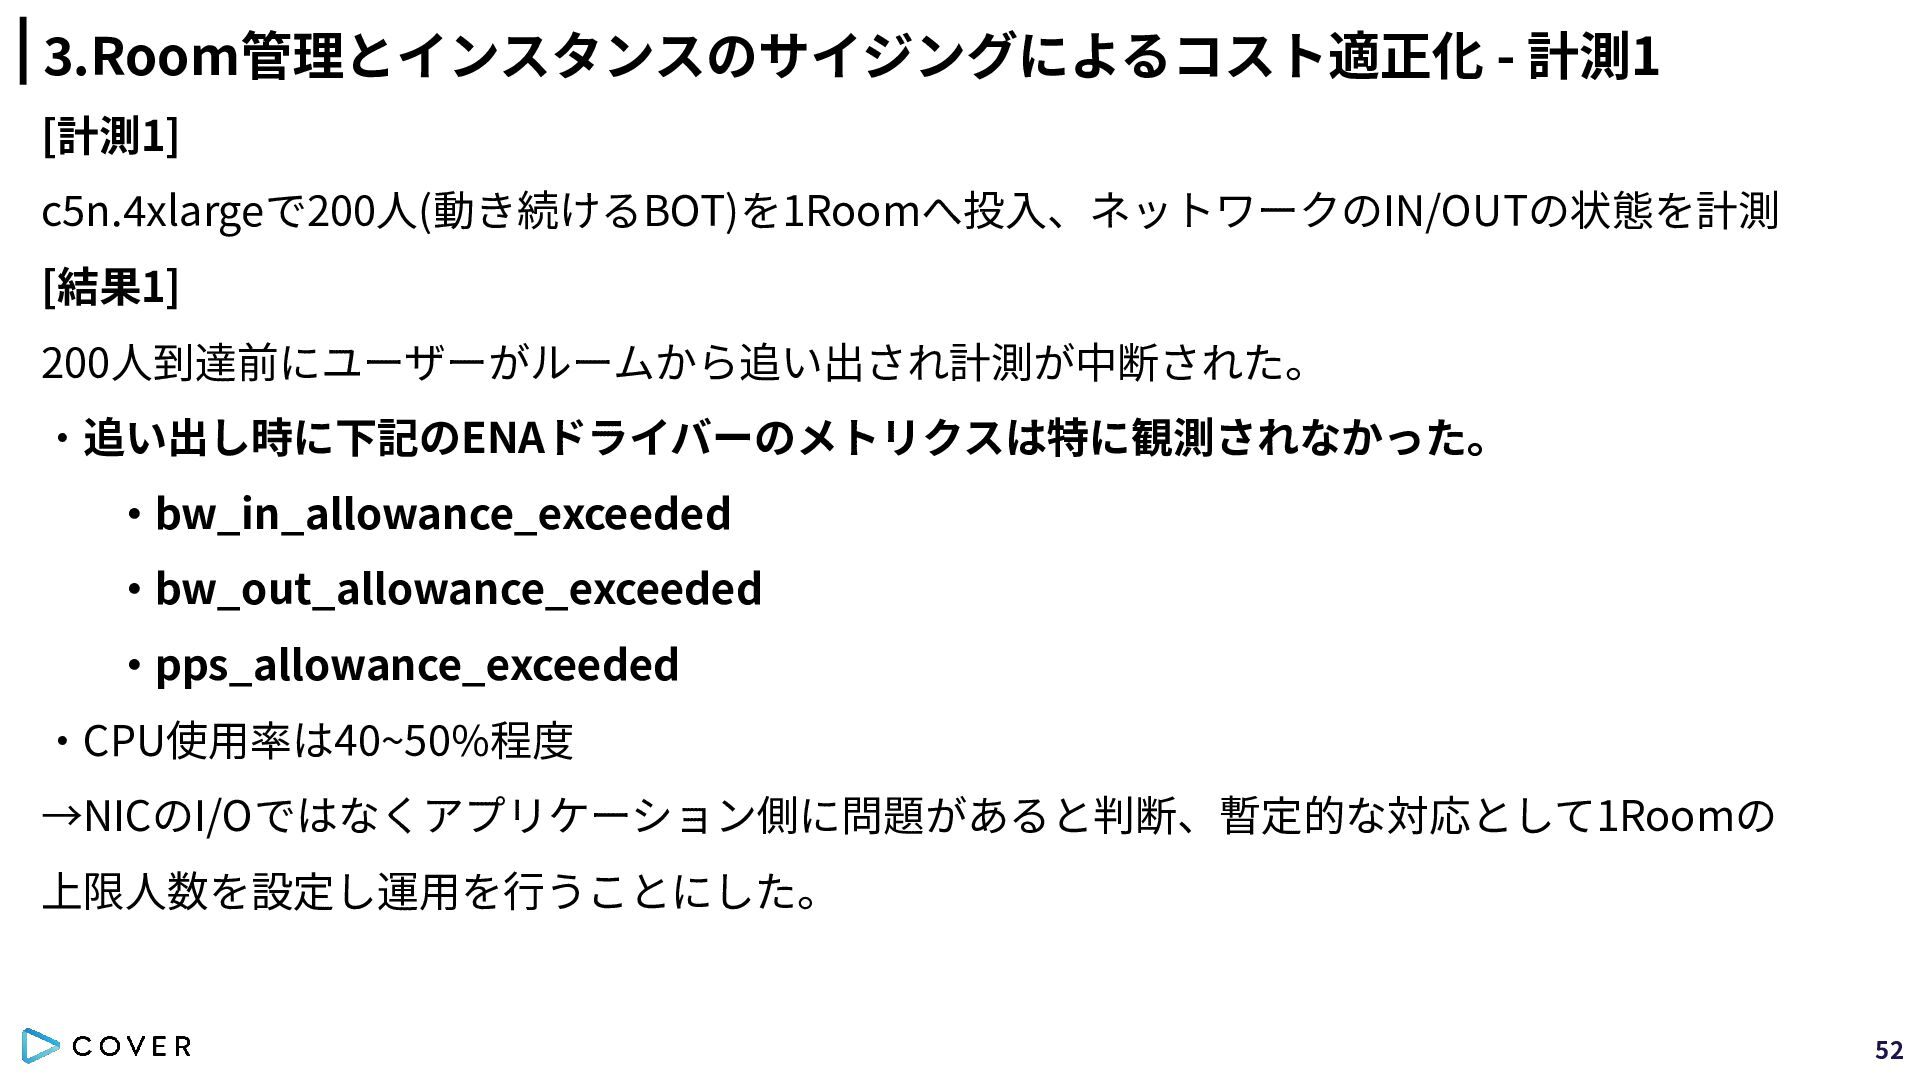
3.Room管理とインスタンスのサイジングによるコスト適正化 - 計測1 [計測1] c5n.4xlargeで200⼈(動き続けるBOT)を1Roomへ投⼊、ネットワークのIN/OUTの状態を計測 [結果1] 200⼈到達前にユーザーがルームから追い出され計測が中断された。 ‧追い出し時に下記のENAドライバーのメトリクスは特に観測されなかった。 ‧bw_in_allowance_exceeded ‧bw_out_allowance_exceeded
‧pps_allowance_exceeded ‧CPU使⽤率は40~50%程度 →NICのI/Oではなくアプリケーション側に問題があると判断、暫定的な対応として1Roomの 上限⼈数を設定し運⽤を⾏うことにした。 52
3.Room管理とインスタンスのサイジングによるコスト適正化 - 計測2 [計測2] c5n.4xlarge ~ c5n.xlargeで100⼈(動き続けるBOT)を投⼊、ネットワークのIN/OUTの状態を計測 [結果2] ‧どのパターンも下記のENAドライバーのメトリクスは特に観測されなかった。 ‧bw_in_allowance_exceeded
‧bw_out_allowance_exceeded ‧pps_allowance_exceeded ‧CPU使⽤率は4xlarge:5%, 2xlarge:10%, xlarge:20%とコア数に対してほぼ線形に推移して いた。 →Diarkis社と相談しピークのCPU使⽤率が20%程度で運⽤するのが良いと判断したため、 1Room 100⼈を上限としてc5n.xlargeでUDPサーバーのインスタンスで運⽤を決断 53
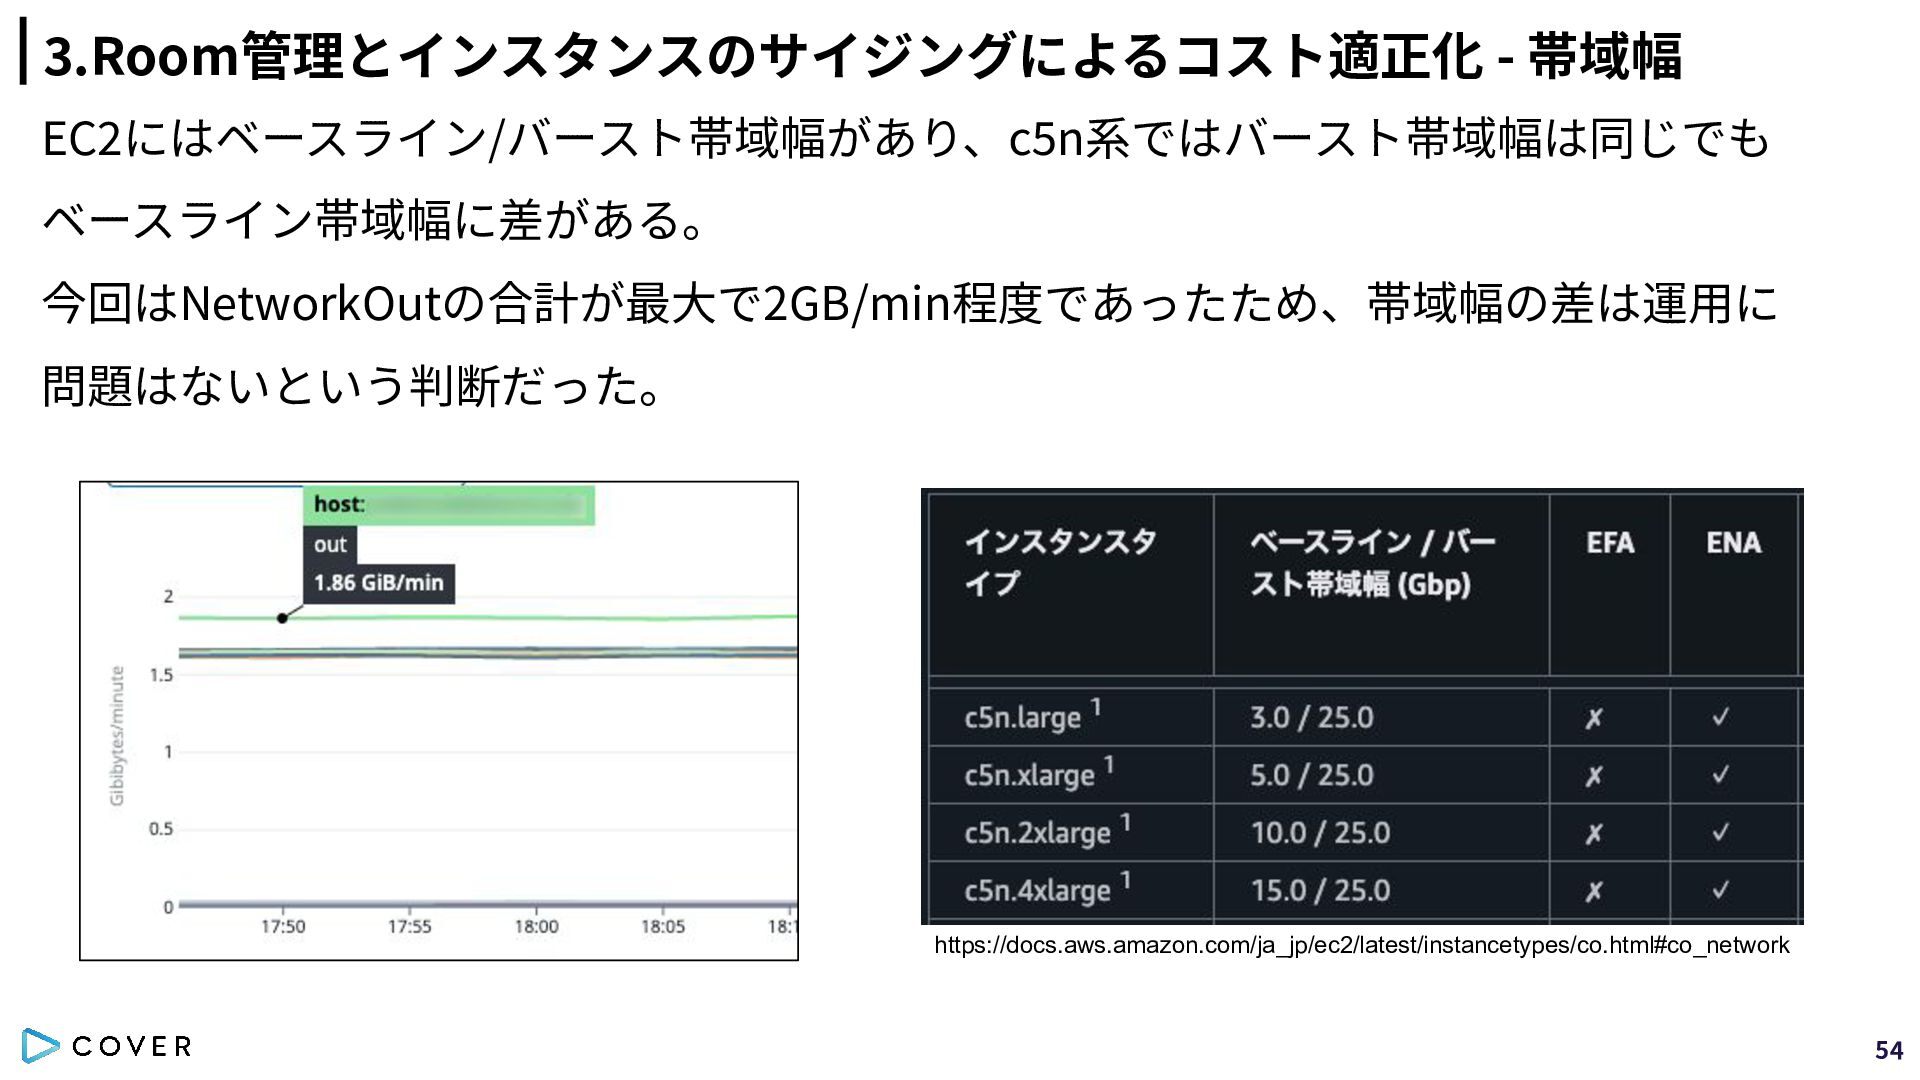
3.Room管理とインスタンスのサイジングによるコスト適正化 - 帯域幅 EC2にはベースライン/バースト帯域幅があり、c5n系ではバースト帯域幅は同じでも ベースライン帯域幅に差がある。 今回はNetworkOutの合計が最⼤で2GB/min程度であったため、帯域幅の差は運⽤に 問題はないという判断だった。 https://docs.aws.amazon.com/ja_jp/ec2/latest/instancetypes/co.html#co_network 54
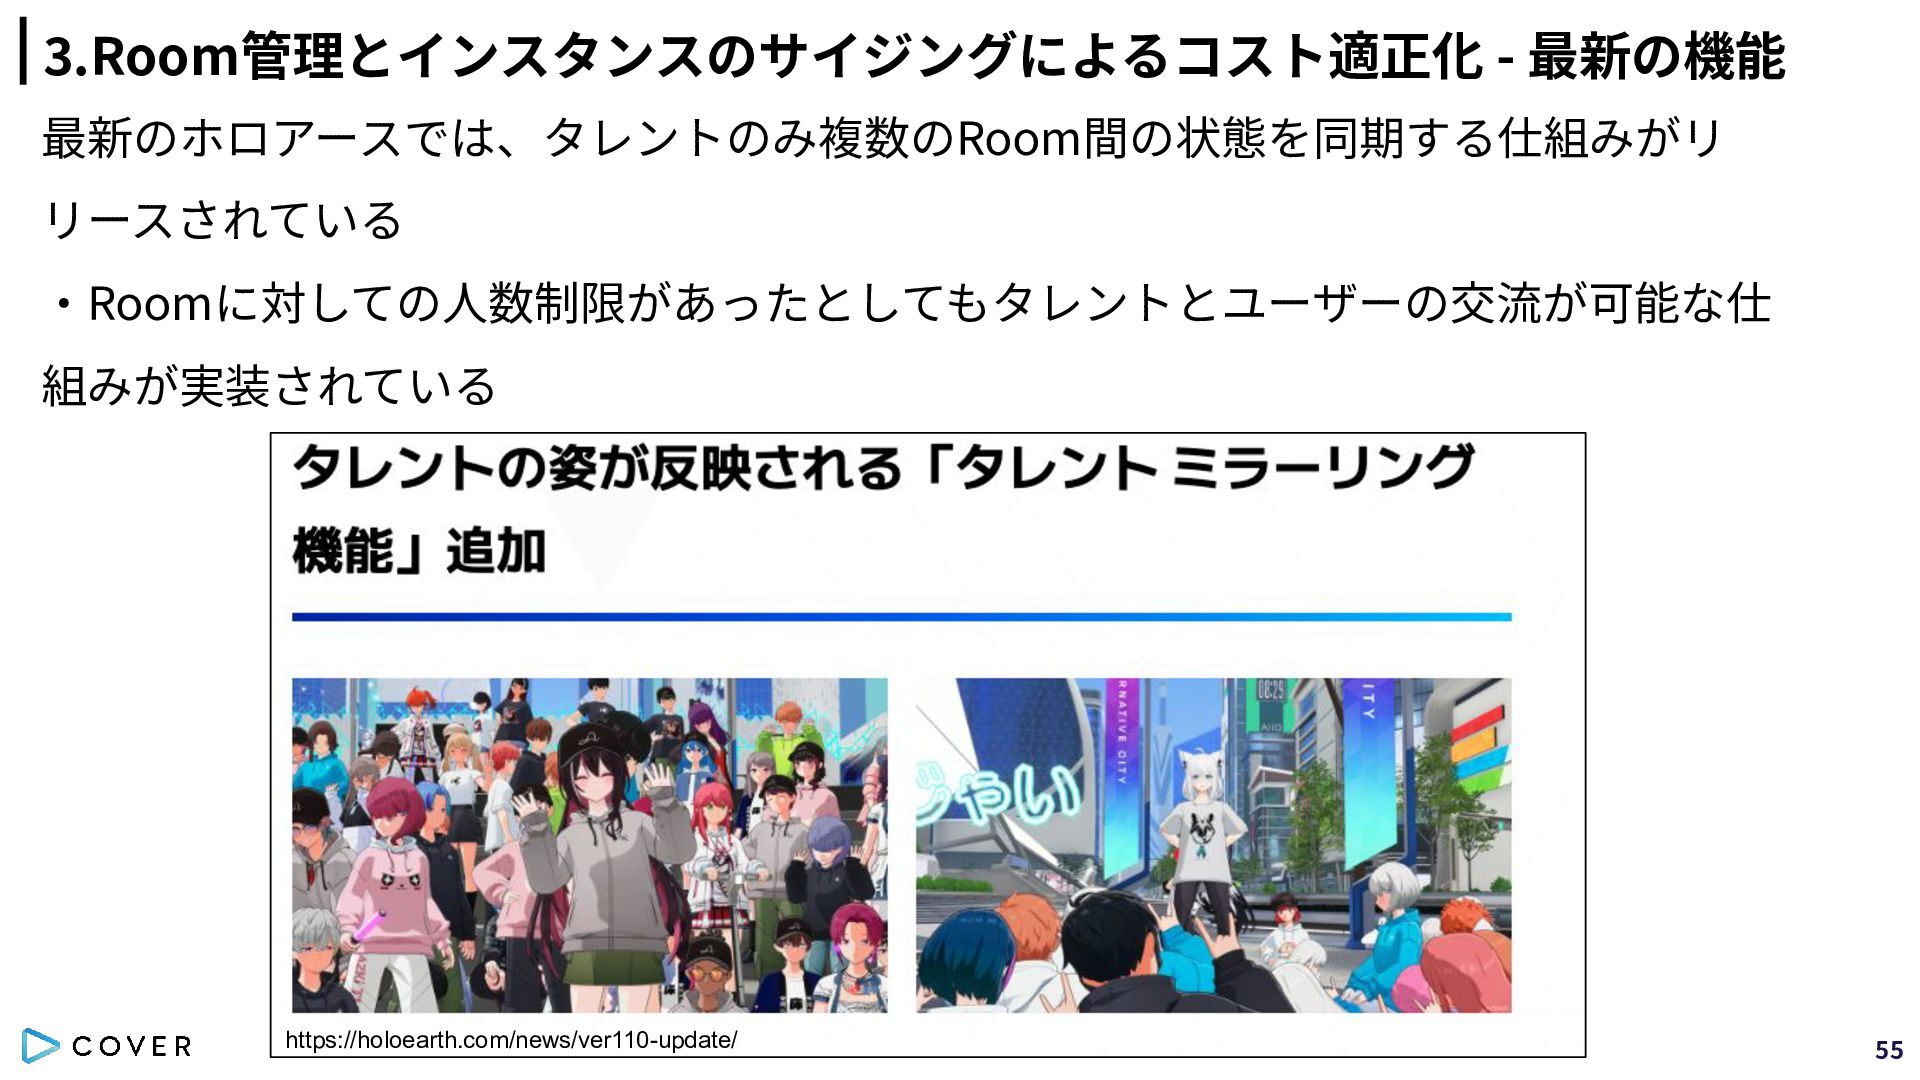
3.Room管理とインスタンスのサイジングによるコスト適正化 - 最新の機能 最新のホロアースでは、タレントのみ複数のRoom間の状態を同期する仕組みがリ リースされている ‧Roomに対しての⼈数制限があったとしてもタレントとユーザーの交流が可能な仕 組みが実装されている https://holoearth.com/news/ver110-update/ 55
3.Room管理とインスタンスのサイジングによるコスト適正化 - 振り返り EC2のサイジングを⾏なったことにより、EKSのコストを⼤幅に下げることができた。 c5n.4xlargeからc5n.xlarge系のEC2インスタンスの変更により、AWSの 料⾦の⼤幅削減を⾏うことができた ENAドライバーのメトリクスまで収集できたことで、今後の運⽤の際に観 測するべき指標を整理することができた 56
バックログ 構想をもとに改善を進めるために⼤枠の問題を分割し進めた。 1.EKSクラスタの管理の放置問題 2.Kubernetesの内部状態の可視化 3.Room管理とインスタンスのサイジングによるコスト適正化 4.オートスケールの改善 5.⼤規模利⽤に向けて 57
4.オートスケールの改善 ホロアースではピークタイム以外で以下の2パターンのスケールが起こりうる ‧事前に予定されたイベント: タレントの降臨祭等 ‧突発のイベント: Youtubeでのタレントのホロアース配信等 58
4.オートスケールの改善 ホロアースではピークタイム以外で以下の2パターンのスケールが起こりうる ‧事前に予定されたイベント: タレントの降臨祭等 ‧突発のイベント: Youtubeでのタレントのホロアース配信等 事前に予測できるものではないため オートスケールが必須 59
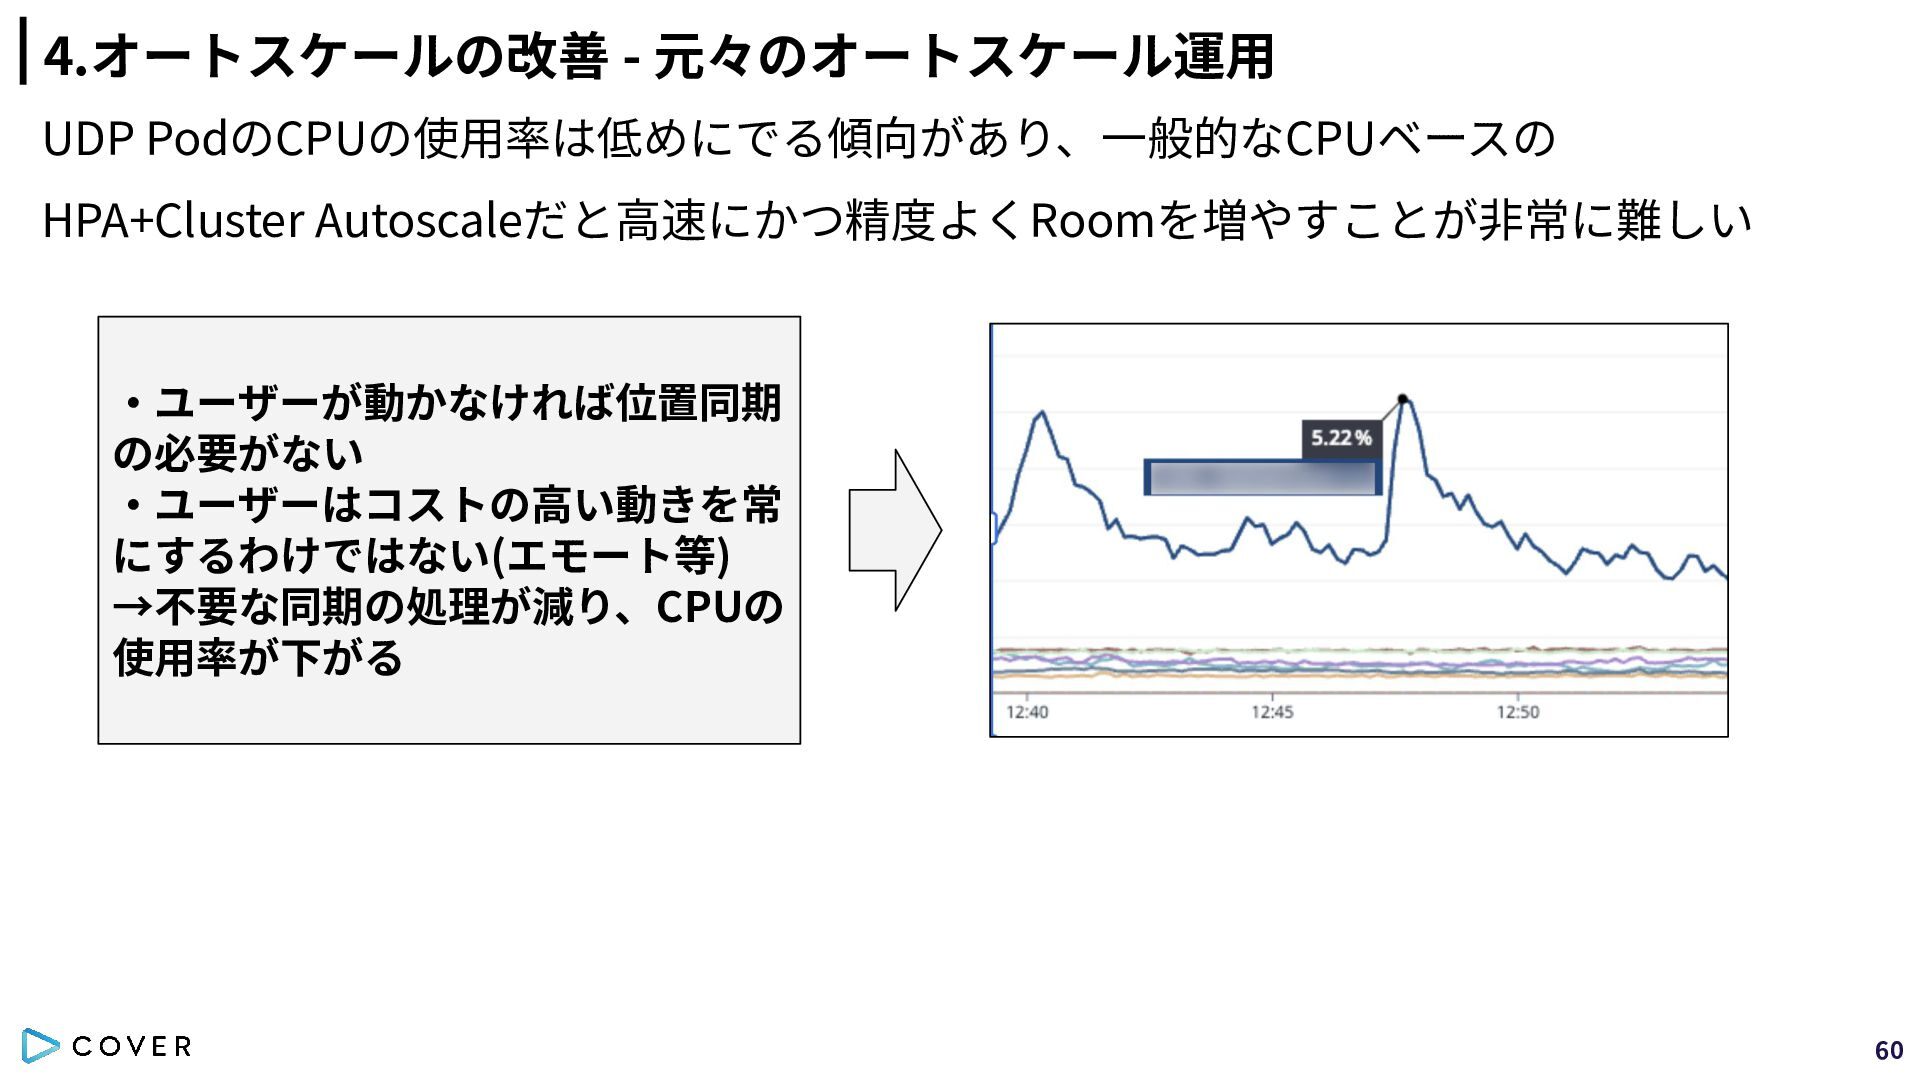
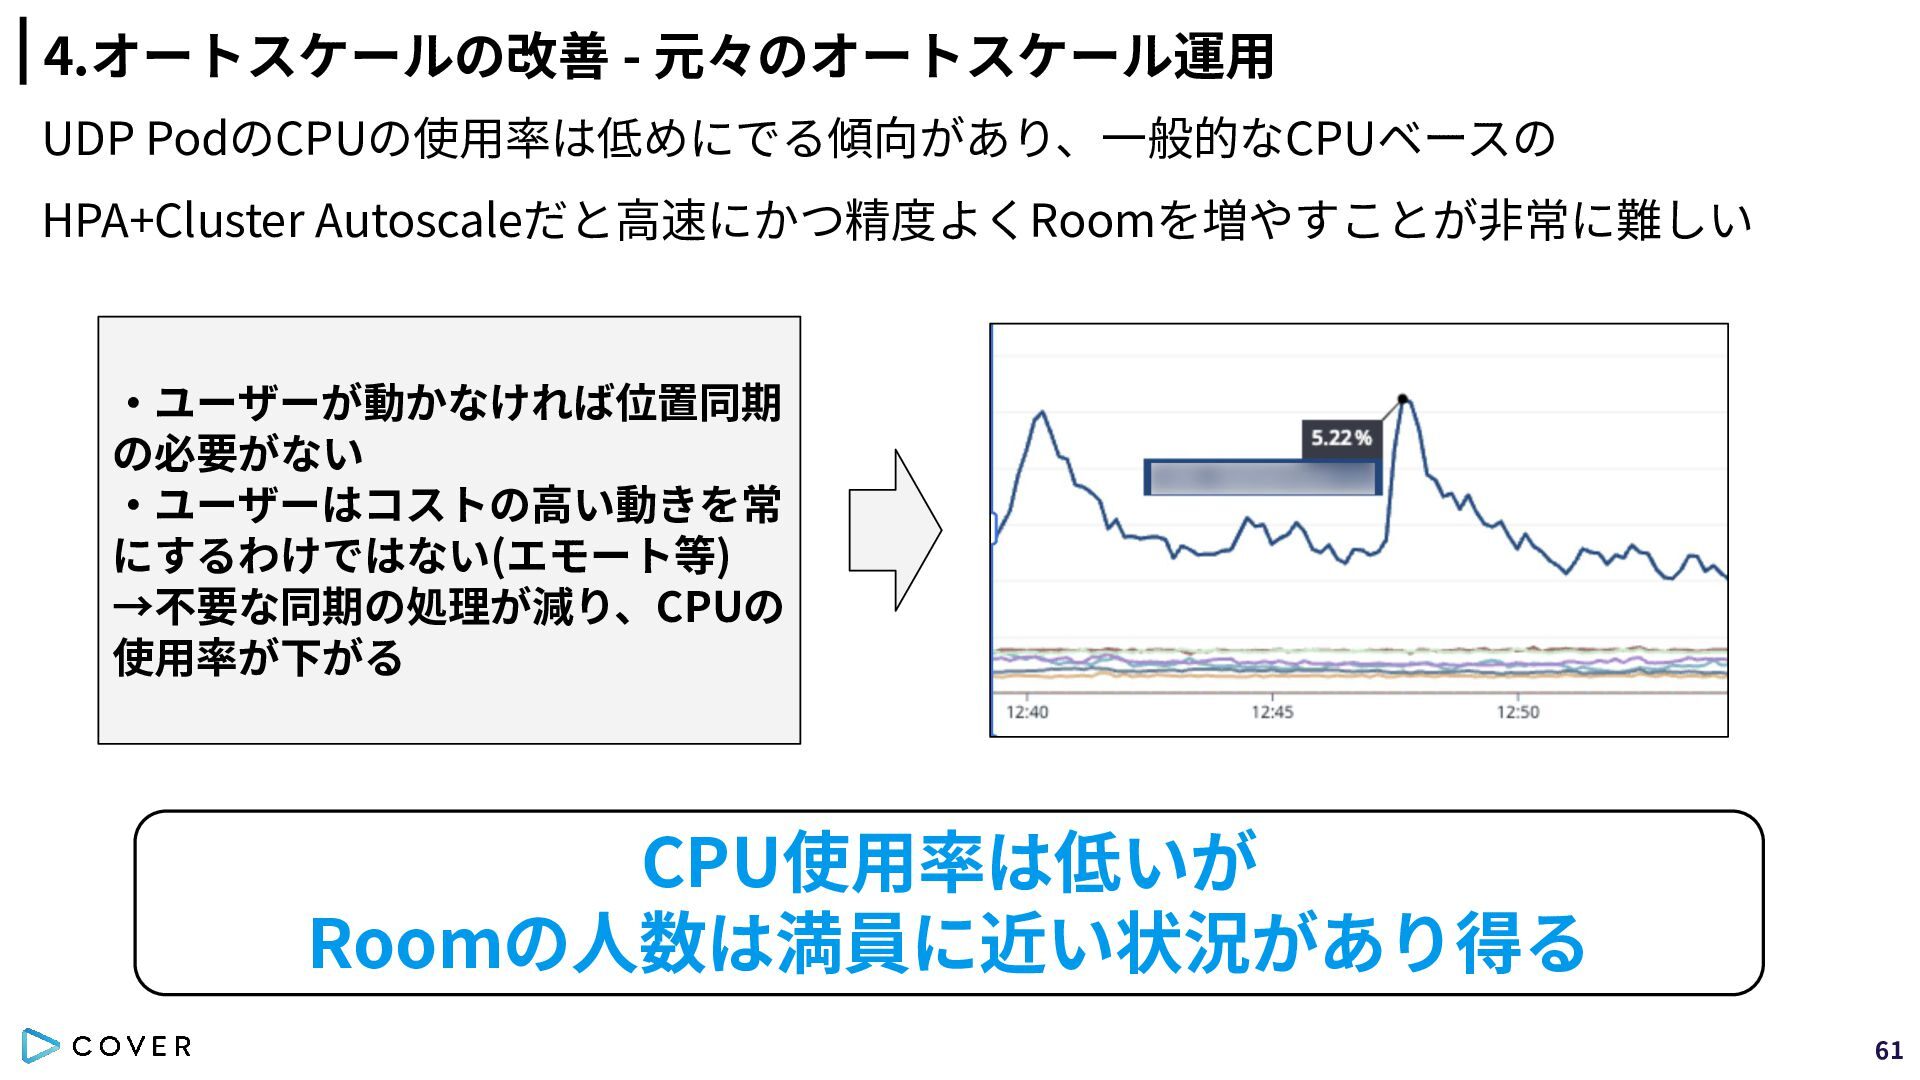
4.オートスケールの改善 - 元々のオートスケール運⽤ UDP PodのCPUの使⽤率は低めにでる傾向があり、⼀般的なCPUベースの HPA+Cluster Autoscaleだと⾼速にかつ精度よくRoomを増やすことが⾮常に難しい ‧ユーザーが動かなければ位置同期 の必要がない ‧ユーザーはコストの⾼い動きを常
にするわけではない(エモート等) →不要な同期の処理が減り、CPUの 使⽤率が下がる 60
4.オートスケールの改善 - 元々のオートスケール運⽤ UDP PodのCPUの使⽤率は低めにでる傾向があり、⼀般的なCPUベースの HPA+Cluster Autoscaleだと⾼速にかつ精度よくRoomを増やすことが⾮常に難しい ‧ユーザーが動かなければ位置同期 の必要がない ‧ユーザーはコストの⾼い動きを常
にするわけではない(エモート等) →不要な同期の処理が減り、CPUの 使⽤率が下がる CPU使⽤率は低いが Roomの⼈数は満員に近い状況があり得る 61
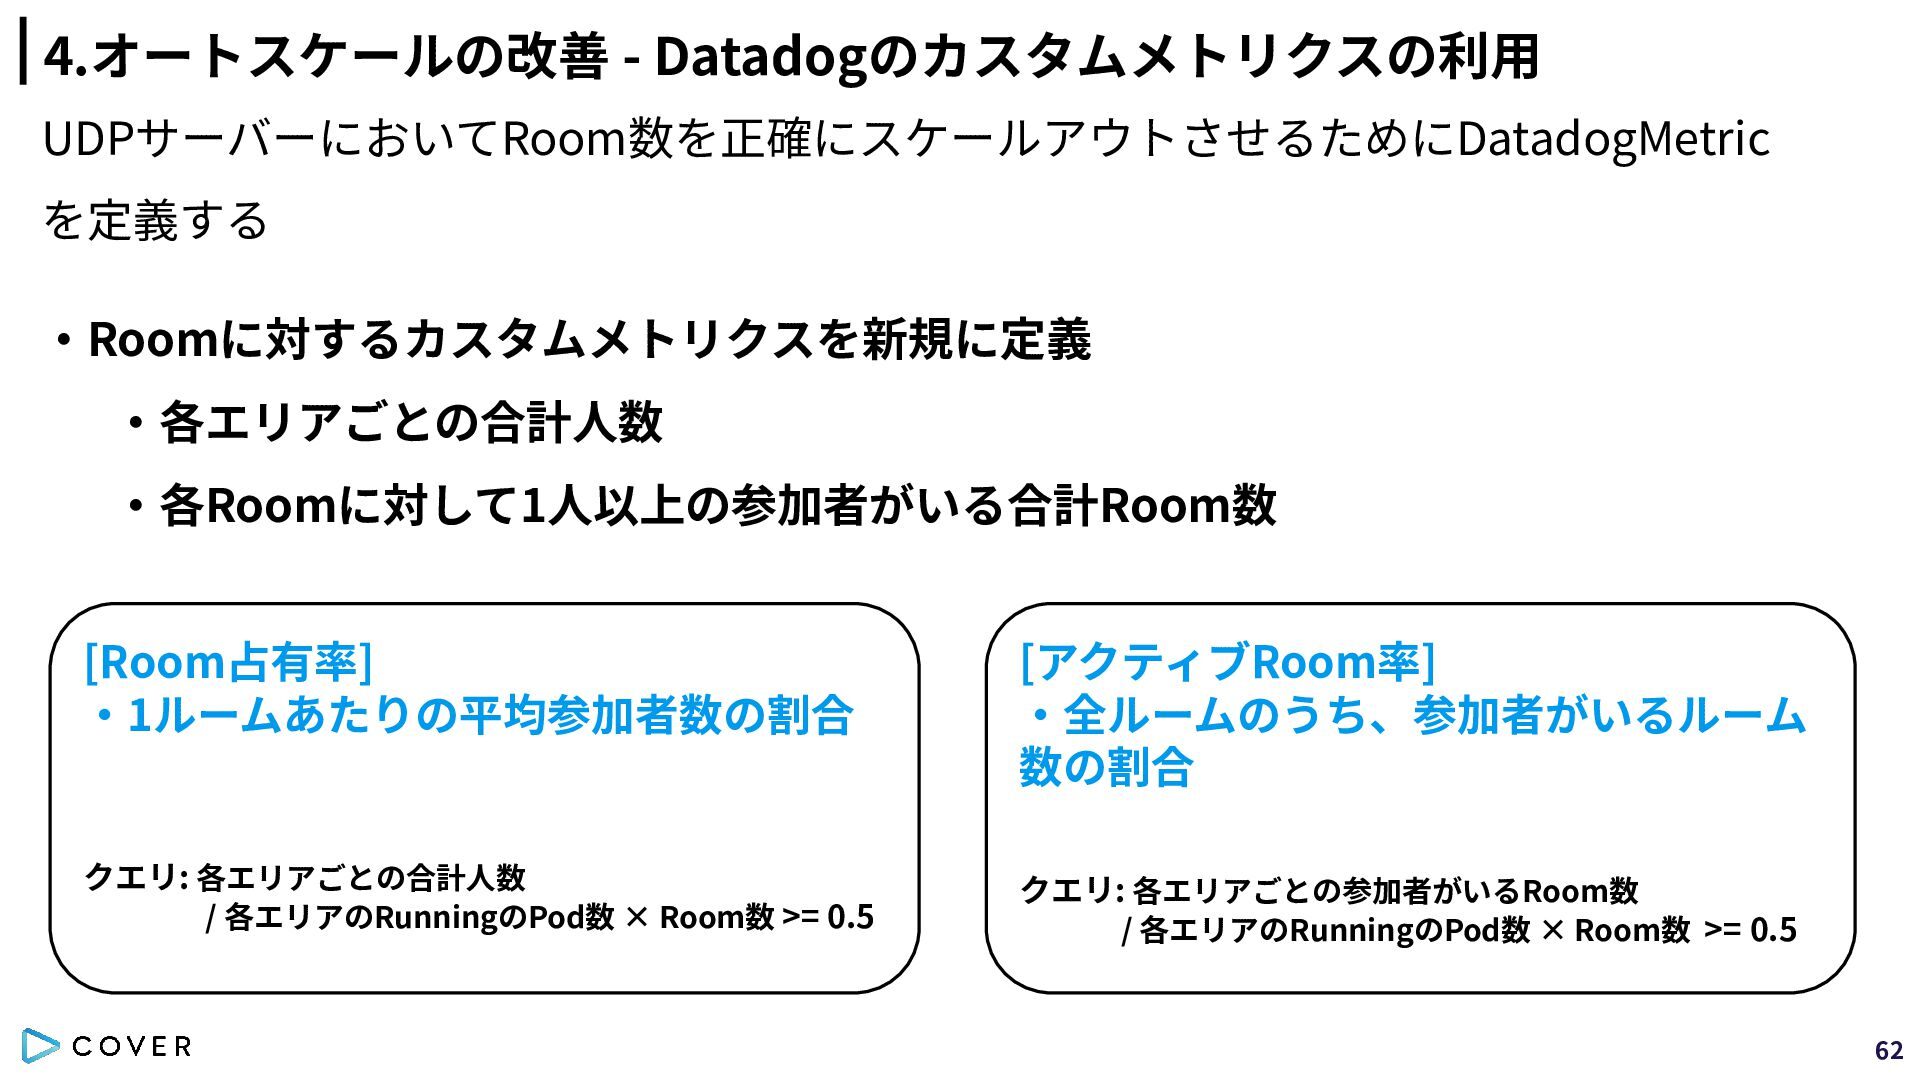
4.オートスケールの改善 - Datadogのカスタムメトリクスの利⽤ UDPサーバーにおいてRoom数を正確にスケールアウトさせるためにDatadogMetric を定義する ‧Roomに対するカスタムメトリクスを新規に定義 ‧各エリアごとの合計⼈数 ‧各Roomに対して1⼈以上の参加者がいる合計Room数 [Room占有率] ‧1ルームあたりの平均参加者数の割合
[アクティブRoom率] ‧全ルームのうち、参加者がいるルーム 数の割合 クエリ: 各エリアごとの合計⼈数 クエリ: 各エリアごとの参加者がいるRoom数 / 各エリアのRunningのPod数 × Room数 >= 0.5 / 各エリアのRunningのPod数 × Room数 >= 0.5 62
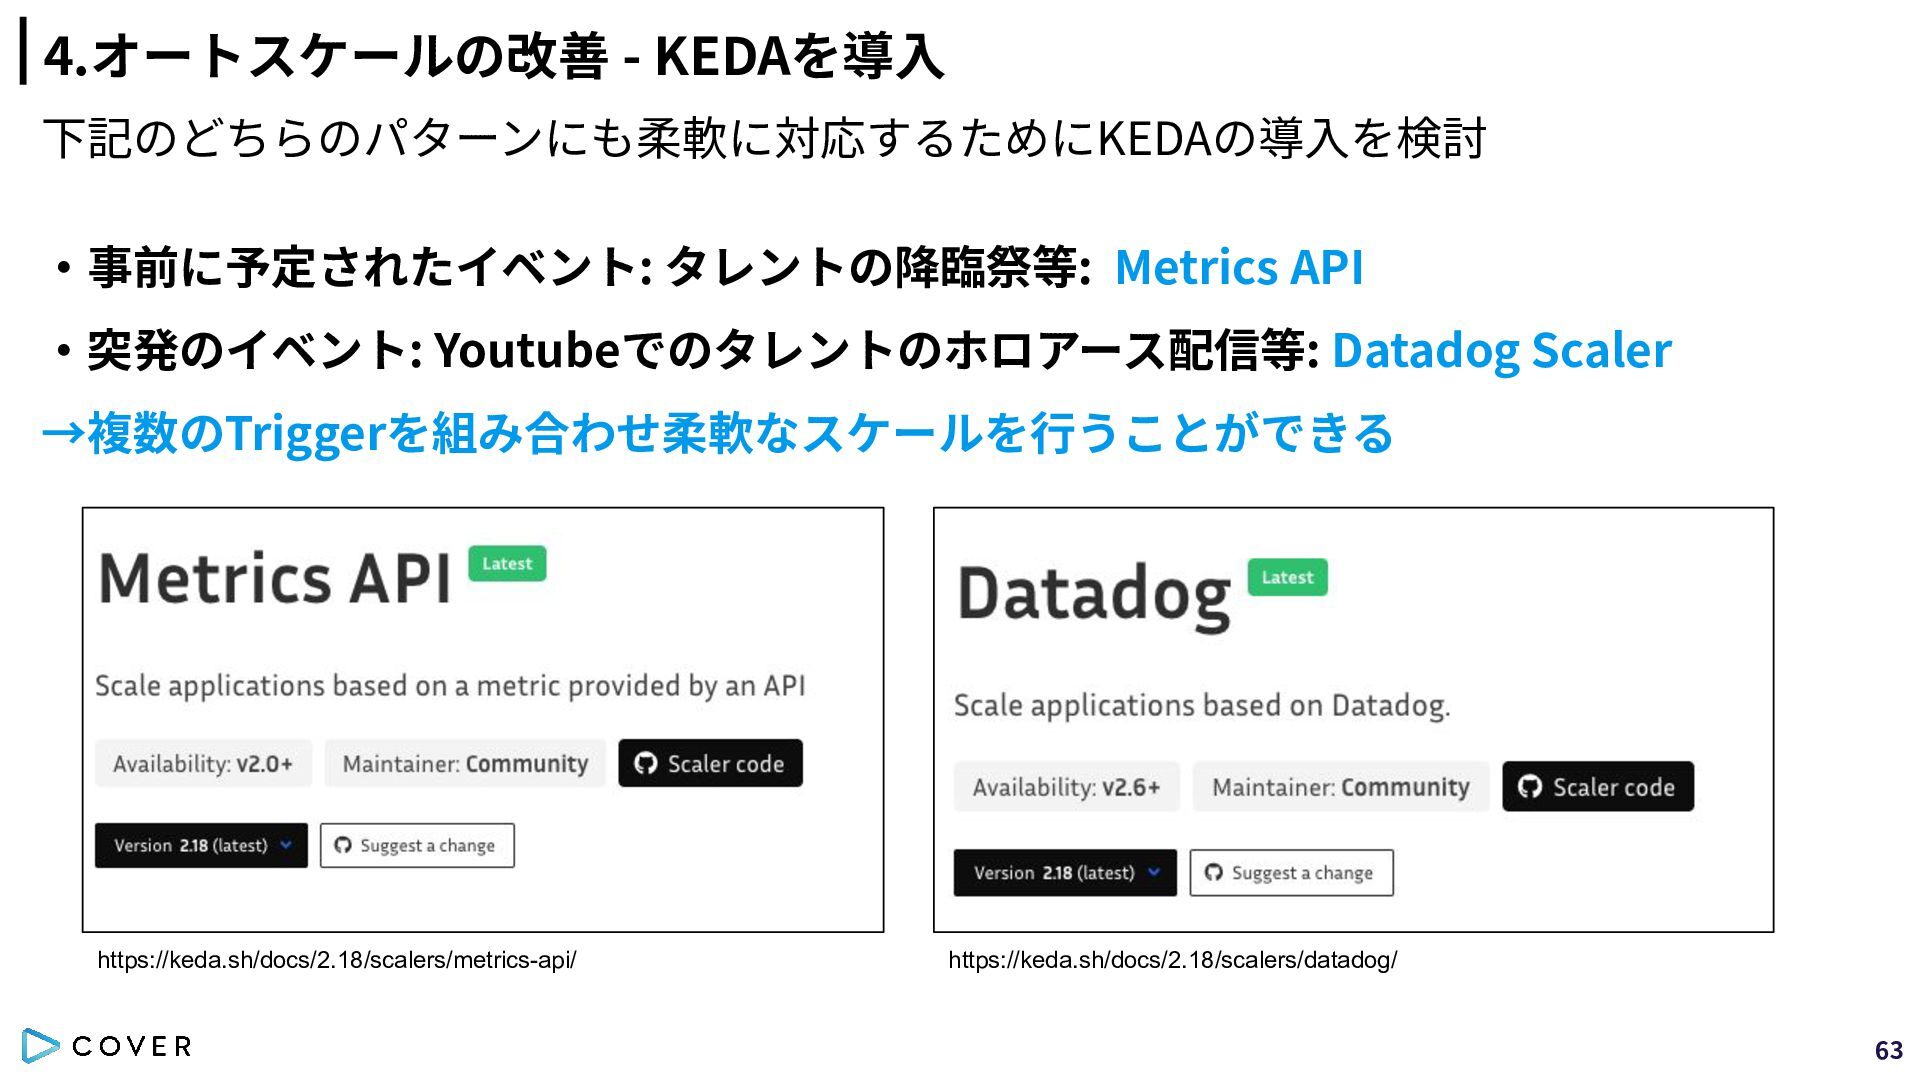
4.オートスケールの改善 - KEDAを導⼊ 下記のどちらのパターンにも柔軟に対応するためにKEDAの導⼊を検討 ‧事前に予定されたイベント: タレントの降臨祭等: Metrics API ‧突発のイベント: Youtubeでのタレントのホロアース配信等:
Datadog Scaler →複数のTriggerを組み合わせ柔軟なスケールを⾏うことができる https://keda.sh/docs/2.18/scalers/metrics-api/ https://keda.sh/docs/2.18/scalers/datadog/ 63
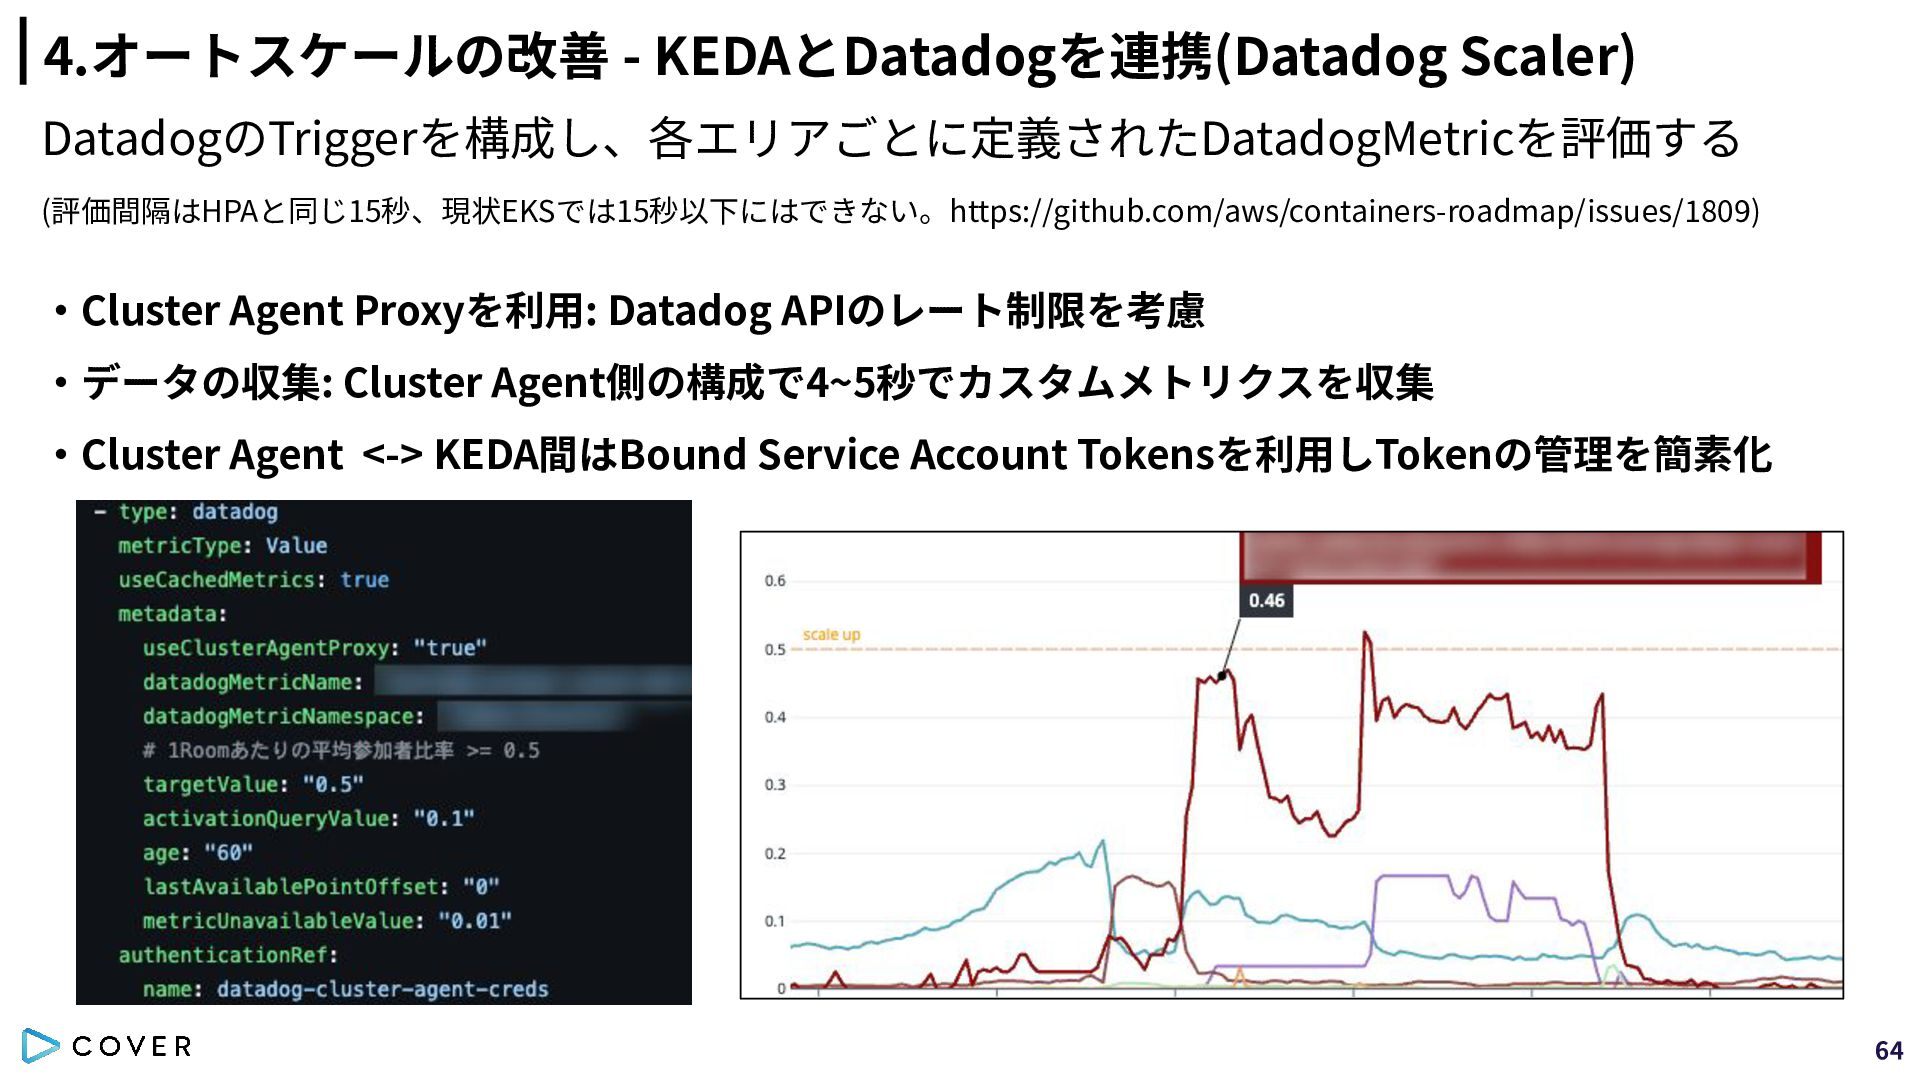
4.オートスケールの改善 - KEDAとDatadogを連携(Datadog Scaler) DatadogのTriggerを構成し、各エリアごとに定義されたDatadogMetricを評価する (評価間隔はHPAと同じ15秒、現状EKSでは15秒以下にはできない。https://github.com/aws/containers-roadmap/issues/1809) ‧Cluster Agent Proxyを利⽤: Datadog
APIのレート制限を考慮 ‧データの収集: Cluster Agent側の構成で4~5秒でカスタムメトリクスを収集 ‧Cluster Agent <-> KEDA間はBound Service Account Tokensを利⽤しTokenの管理を簡素化 64
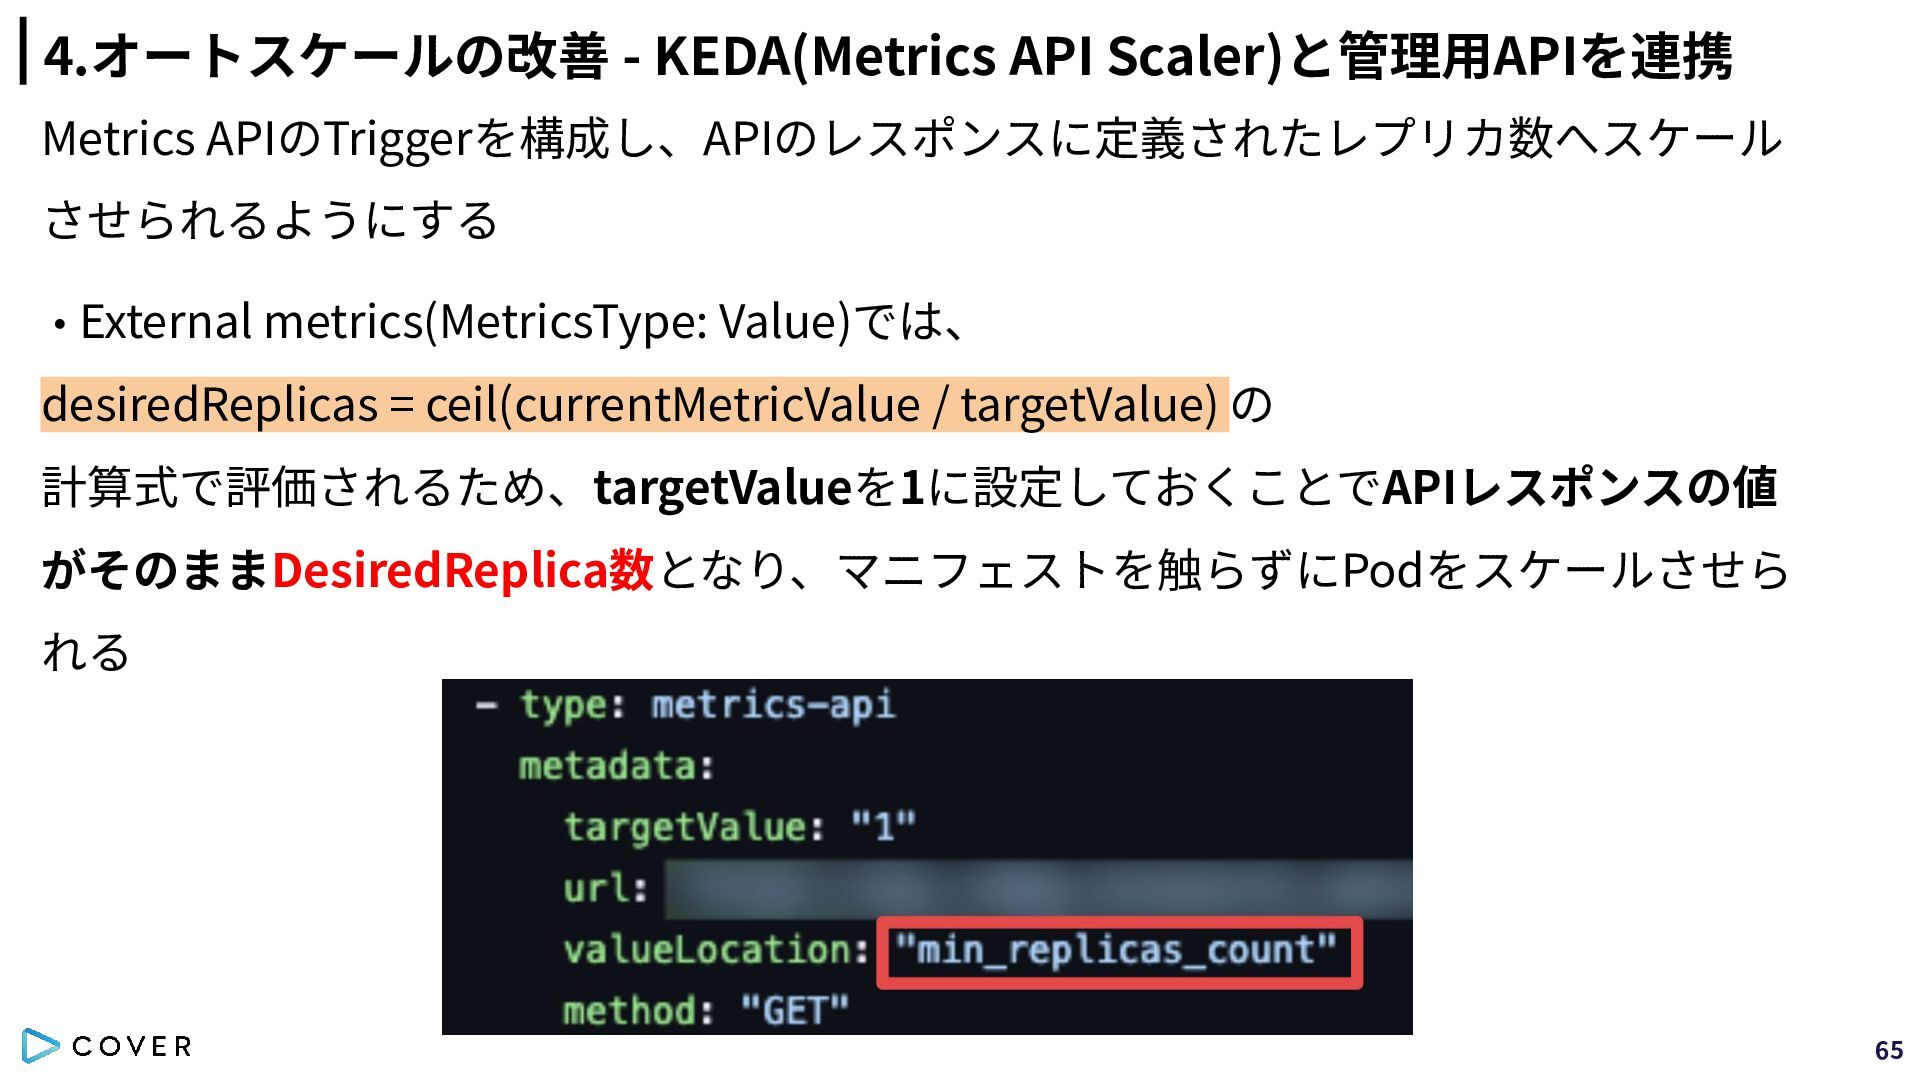
4.オートスケールの改善 - KEDA(Metrics API Scaler)と管理⽤APIを連携 Metrics APIのTriggerを構成し、APIのレスポンスに定義されたレプリカ数へスケール させられるようにする ‧External metrics(MetricsType:
Value)では、 desiredReplicas = ceil(currentMetricValue / targetValue) の 計算式で評価されるため、targetValueを1に設定しておくことでAPIレスポンスの値 がそのままDesiredReplica数となり、マニフェストを触らずにPodをスケールさせら れる 65
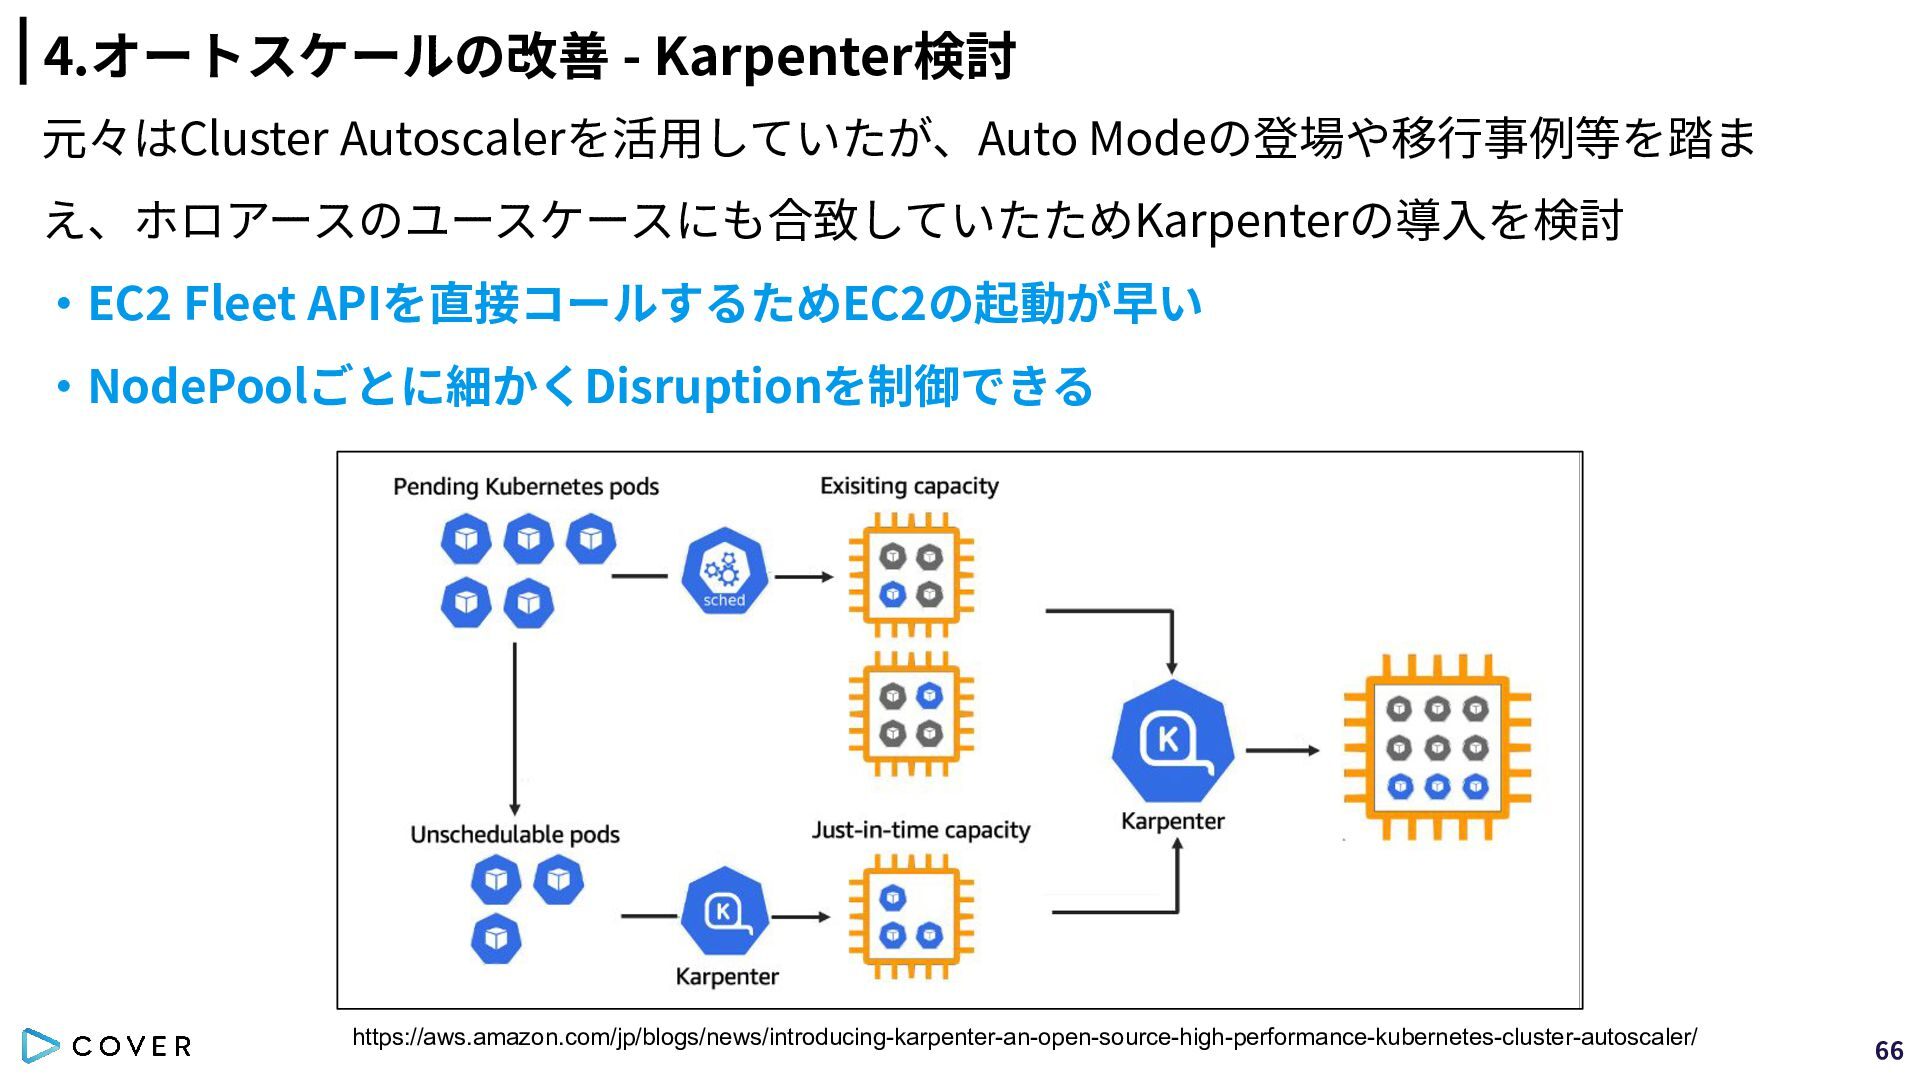
4.オートスケールの改善 - Karpenter検討 元々はCluster Autoscalerを活⽤していたが、Auto Modeの登場や移⾏事例等を踏ま え、ホロアースのユースケースにも合致していたためKarpenterの導⼊を検討 ‧EC2 Fleet APIを直接コールするためEC2の起動が早い
‧NodePoolごとに細かくDisruptionを制御できる https://aws.amazon.com/jp/blogs/news/introducing-karpenter-an-open-source-high-performance-kubernetes-cluster-autoscaler/ 66
4.オートスケールの改善 - Karpenter導⼊ ホロアースにおいてはNodeの管理コストを下げ、細かい中断制御を⾏うために Karpenterを全てのクラスタへ導⼊を⾏なった [導⼊背景] 管理⾯ ‧ UDP⽤のNodeGroupがエリアごとに定義されておりManaged NogeGroupの管理が煩雑になっ
ていた コスト⾯ ‧開発環境でSpotインスタンスが活⽤できていなかった その他 ‧UDPサーバーはNode単位のスケールアウトとなるため、EC2の起動速度を改善させたかった ‧本番環境の中断時間を細かく制御したかった 67
4.オートスケールの改善 - Karpenter運⽤考慮点 NodeClass ‧IMDSを利⽤しているためホップカウントを2に設定 ‧AMIを固定(AMIの更新AL2→AL2023でNIC名が変更) ‧[開発環境]maxPodsを調整しIPの割り当て数を増加(VPC CNI のPrefix Delegationを有効化)
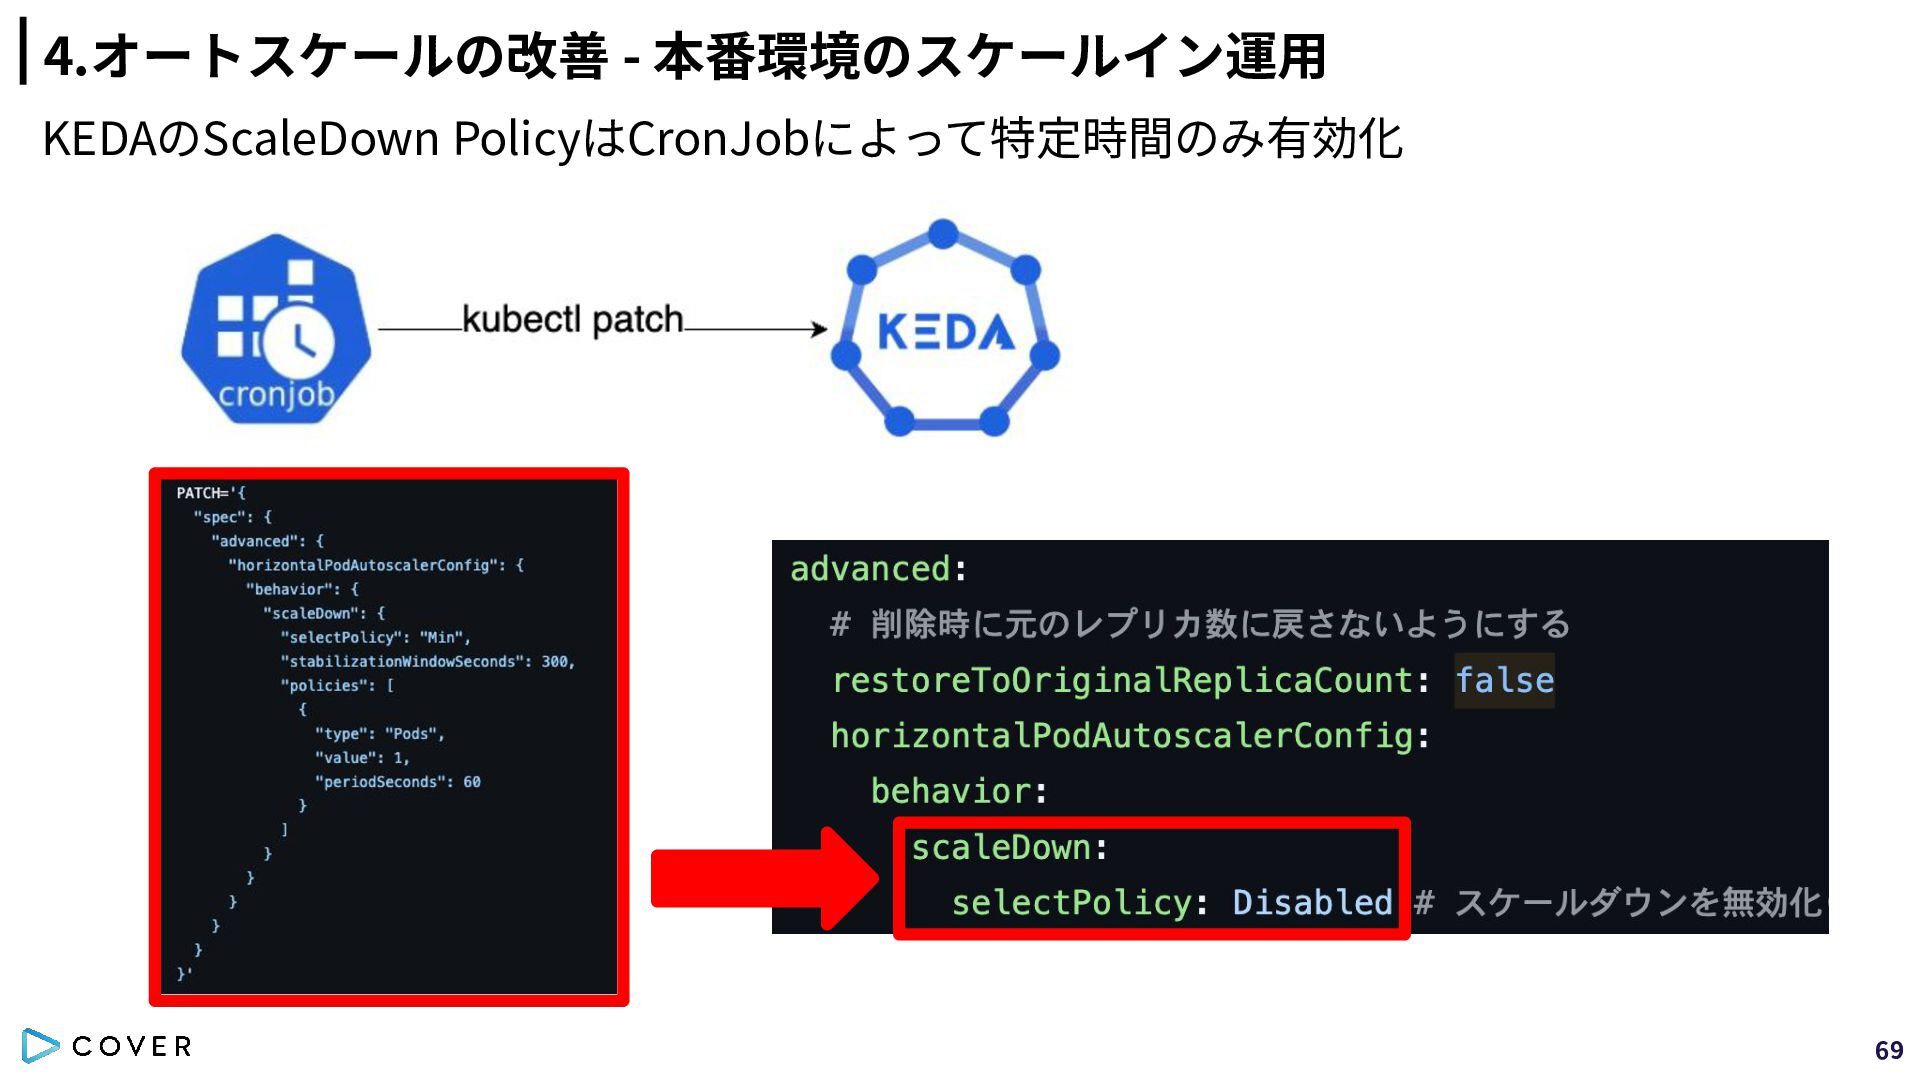
NodePool ‧[開発環境]Spot Instanceを優先的に使⽤ ‧Diarkisの各コンポーネントごとにNodePoolを分割しインスタンスタイプを割り当てる ‧expireAfter: Neverで運⽤、イベント時にNodeの⼊れ替えが起きないようにしている ※AutoModeでは21⽇の⽣存期間があるが、メンテナンス時間をコントロールできず導⼊を断念した ‧[本番環境]DisruptionはDiarkisのWorkload Podが存在しない場合 & ピーク時間以外のみ⾏う ‧consolidationPolicy: WhenEmpty ‧budgets: 特定時間内のみ許可、nodeは1台ずつ減らす(それ以外は0台) 68
4.オートスケールの改善 - 本番環境のスケールイン運⽤ KEDAのScaleDown PolicyはCronJobによって特定時間のみ有効化 69
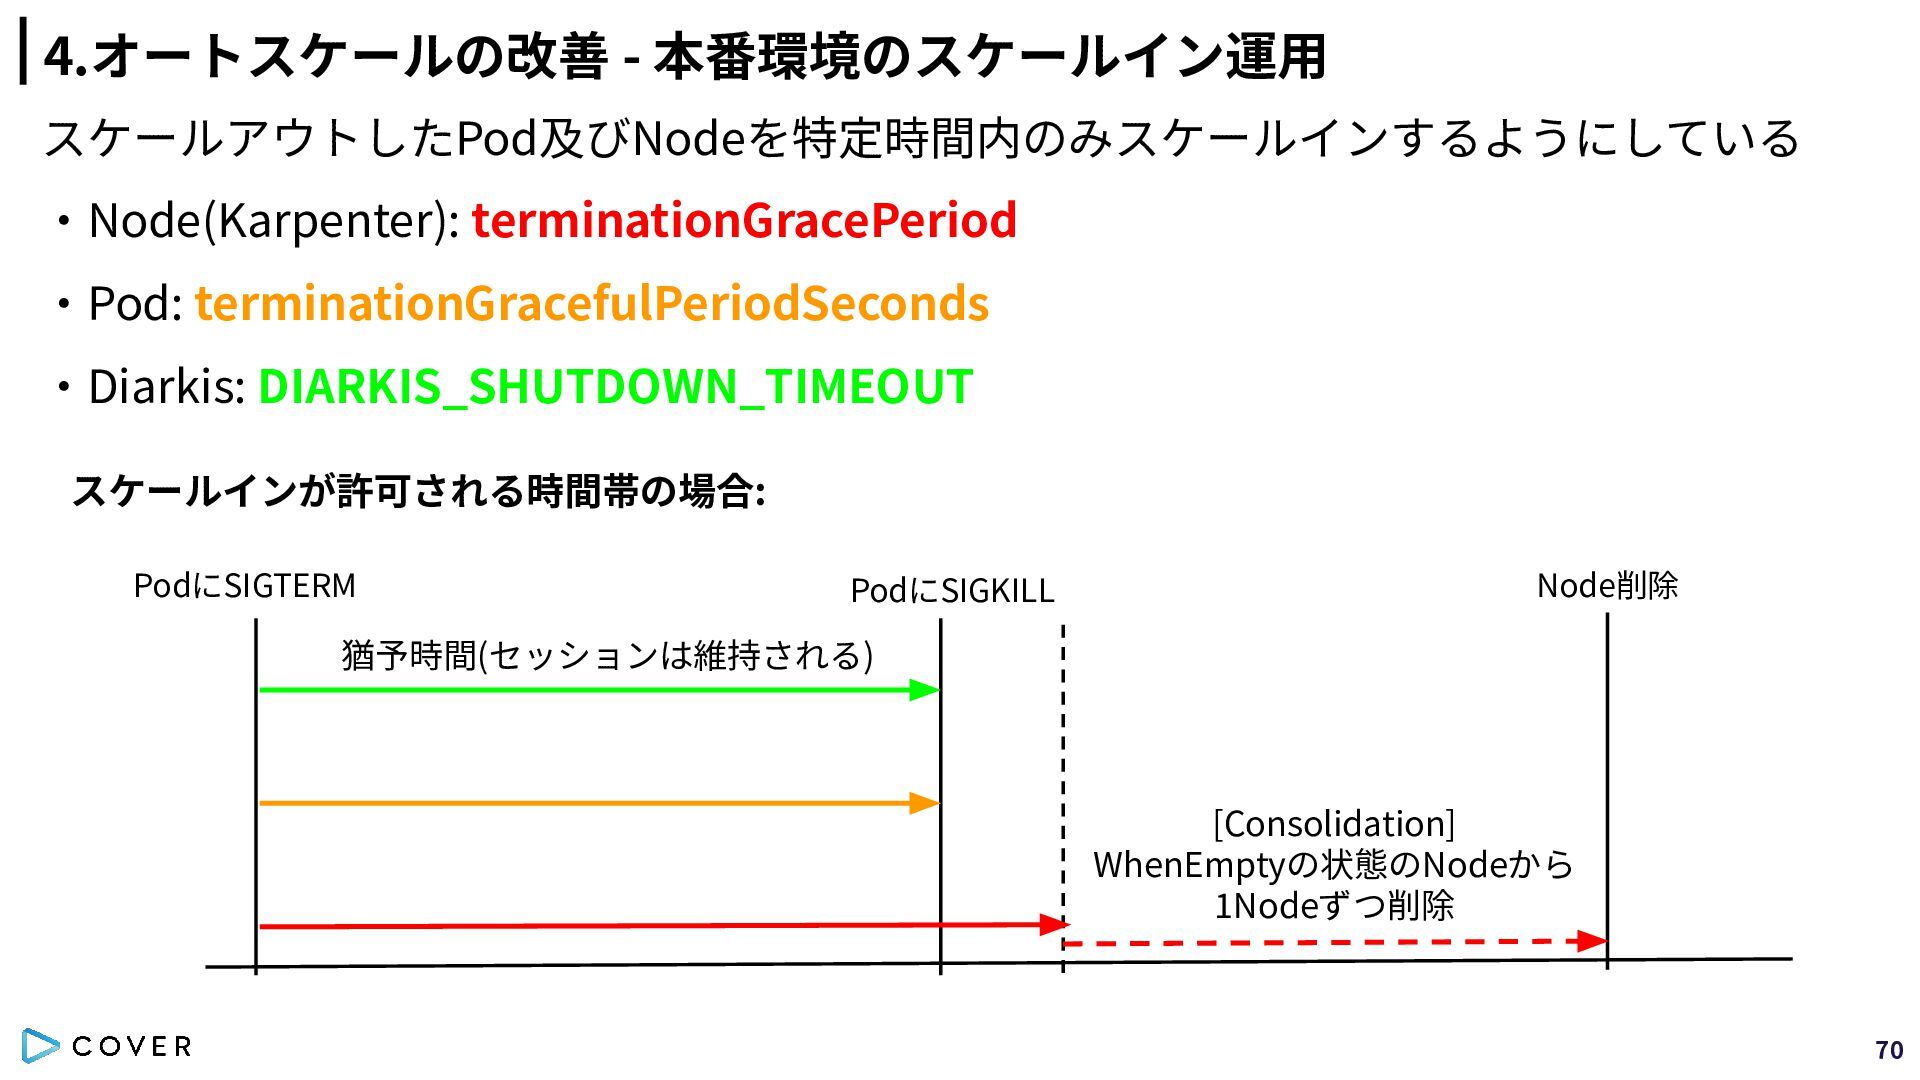
4.オートスケールの改善 - 本番環境のスケールイン運⽤ スケールアウトしたPod及びNodeを特定時間内のみスケールインするようにしている ‧Node(Karpenter): terminationGracePeriod ‧Pod: terminationGracefulPeriodSeconds ‧Diarkis: DIARKIS_SHUTDOWN_TIMEOUT
スケールインが許可される時間帯の場合: PodにSIGTERM PodにSIGKILL Node削除 猶予時間(セッションは維持される) [Consolidation] WhenEmptyの状態のNodeから 1Nodeずつ削除 70
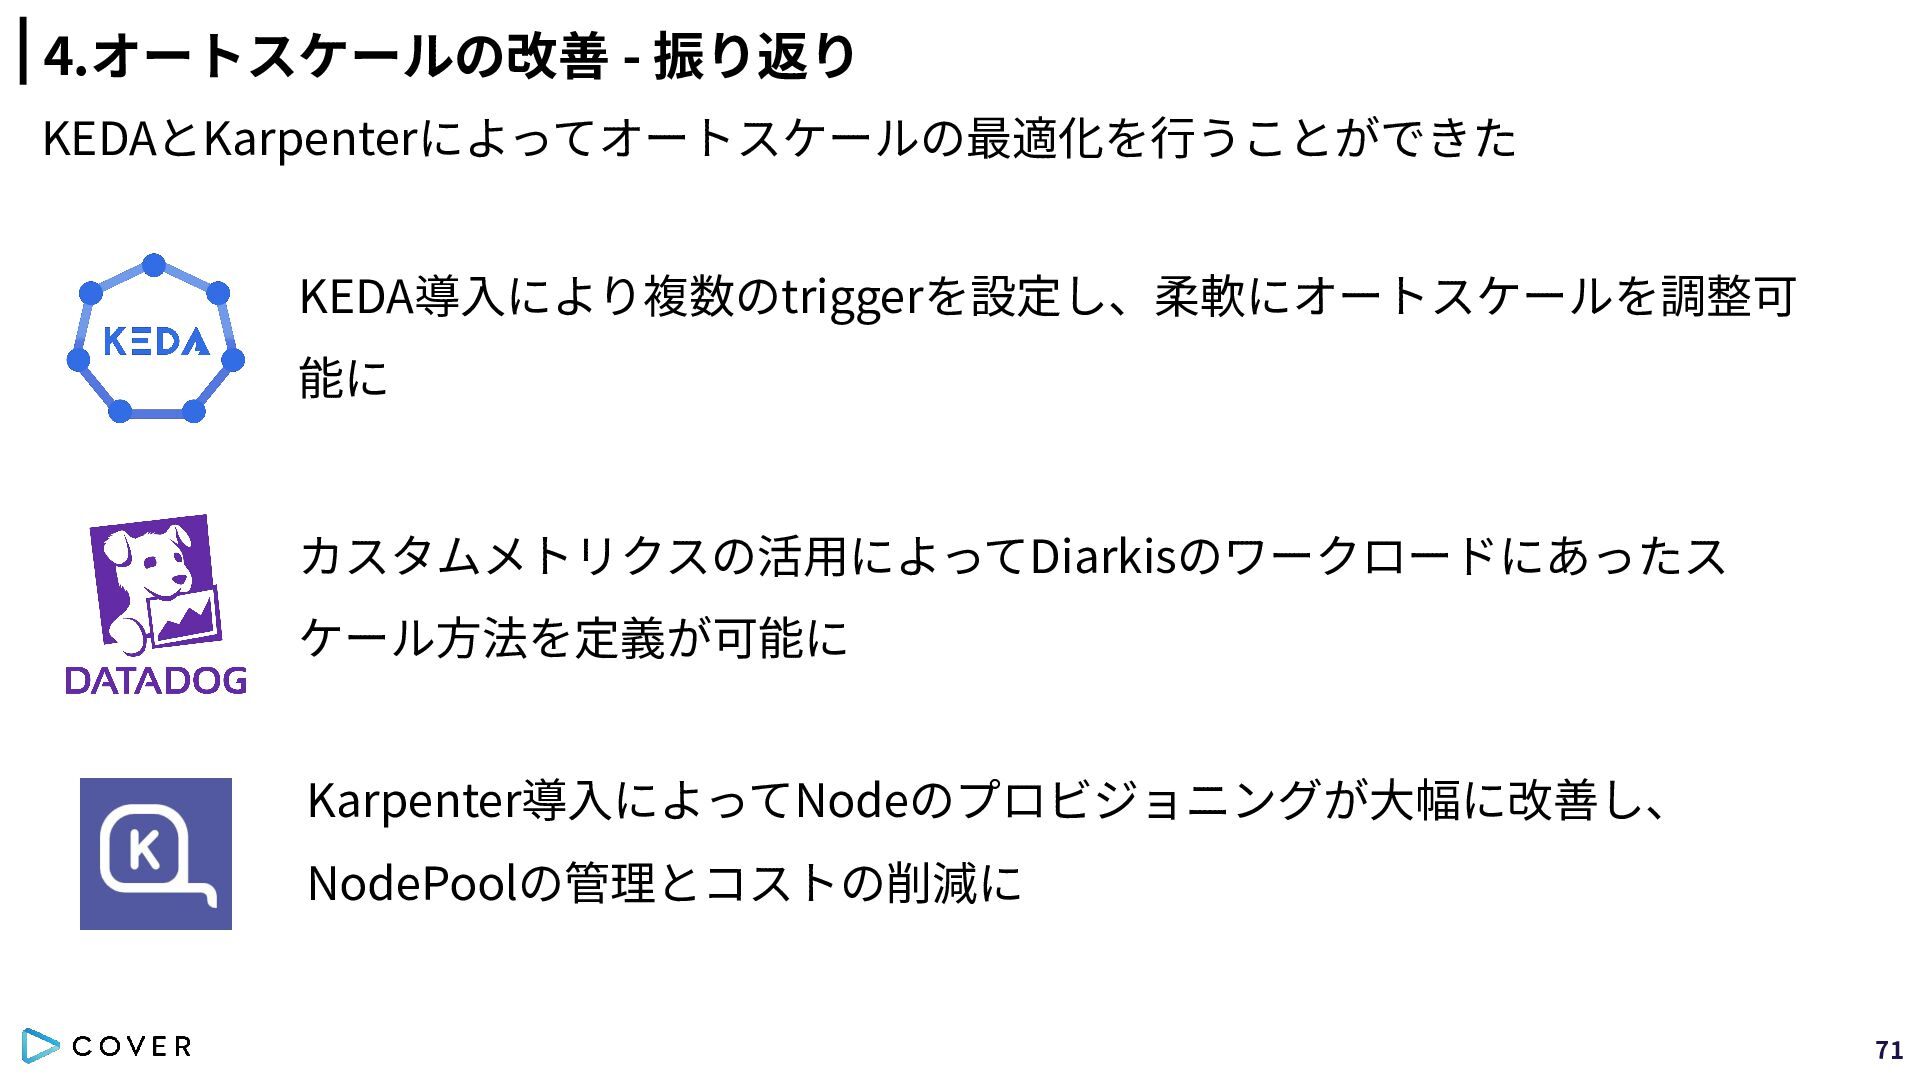
4.オートスケールの改善 - 振り返り KEDAとKarpenterによってオートスケールの最適化を⾏うことができた KEDA導⼊により複数のtriggerを設定し、柔軟にオートスケールを調整可 能に カスタムメトリクスの活⽤によってDiarkisのワークロードにあったス ケール⽅法を定義が可能に Karpenter導⼊によってNodeのプロビジョニングが⼤幅に改善し、 NodePoolの管理とコストの削減に
71
バックログ 構想をもとに改善を進めるために⼤枠の問題を分割し進めた。 1.EKSクラスタの管理の放置問題 2.Kubernetesの内部状態の可視化 3.Room管理とインスタンスのサイジングによるコスト適正化 4.オートスケールの改善 5.⼤規模利⽤に向けて 72
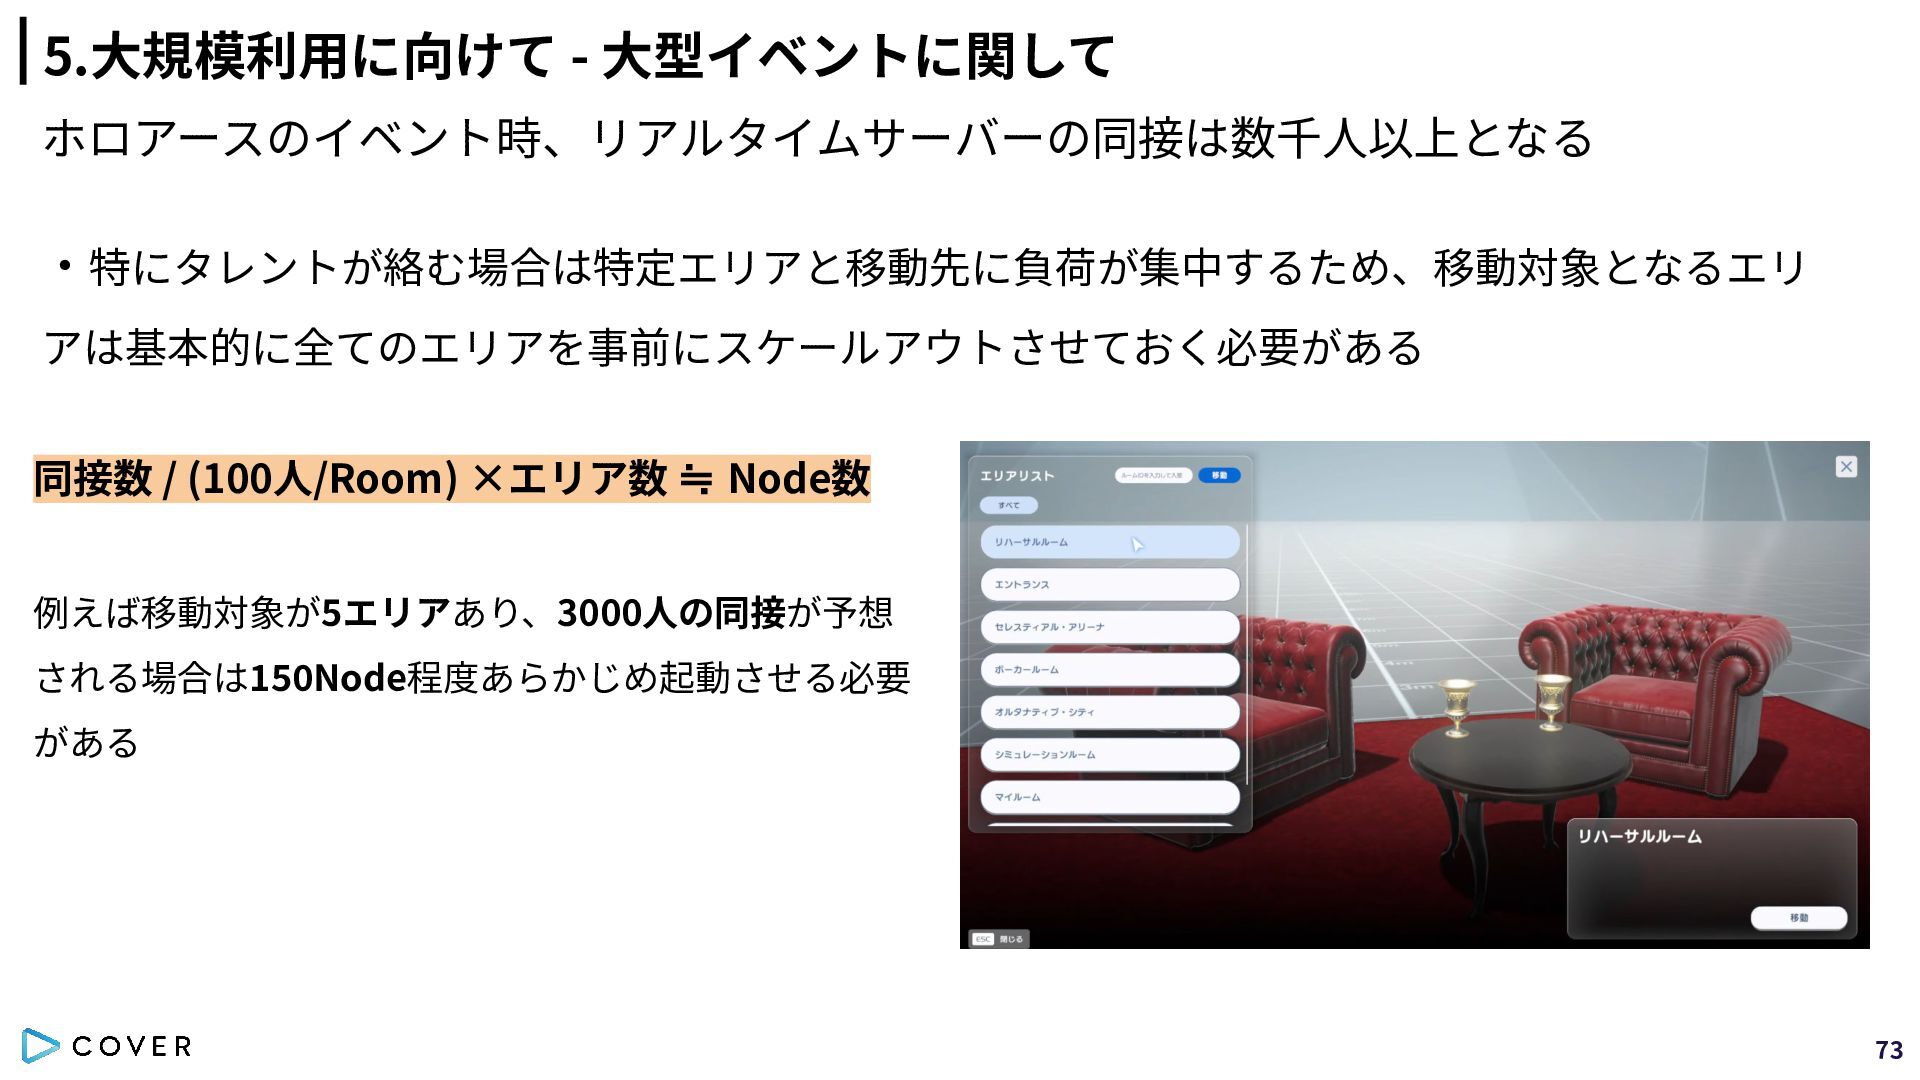
5.⼤規模利⽤に向けて - ⼤型イベントに関して ホロアースのイベント時、リアルタイムサーバーの同接は数千⼈以上となる ‧特にタレントが絡む場合は特定エリアと移動先に負荷が集中するため、移動対象となるエリ アは基本的に全てのエリアを事前にスケールアウトさせておく必要がある 同接数 / (100⼈/Room) ×エリア数
≒ Node数 例えば移動対象が5エリアあり、3000⼈の同接が予想 される場合は150Node程度あらかじめ起動させる必要 がある 73
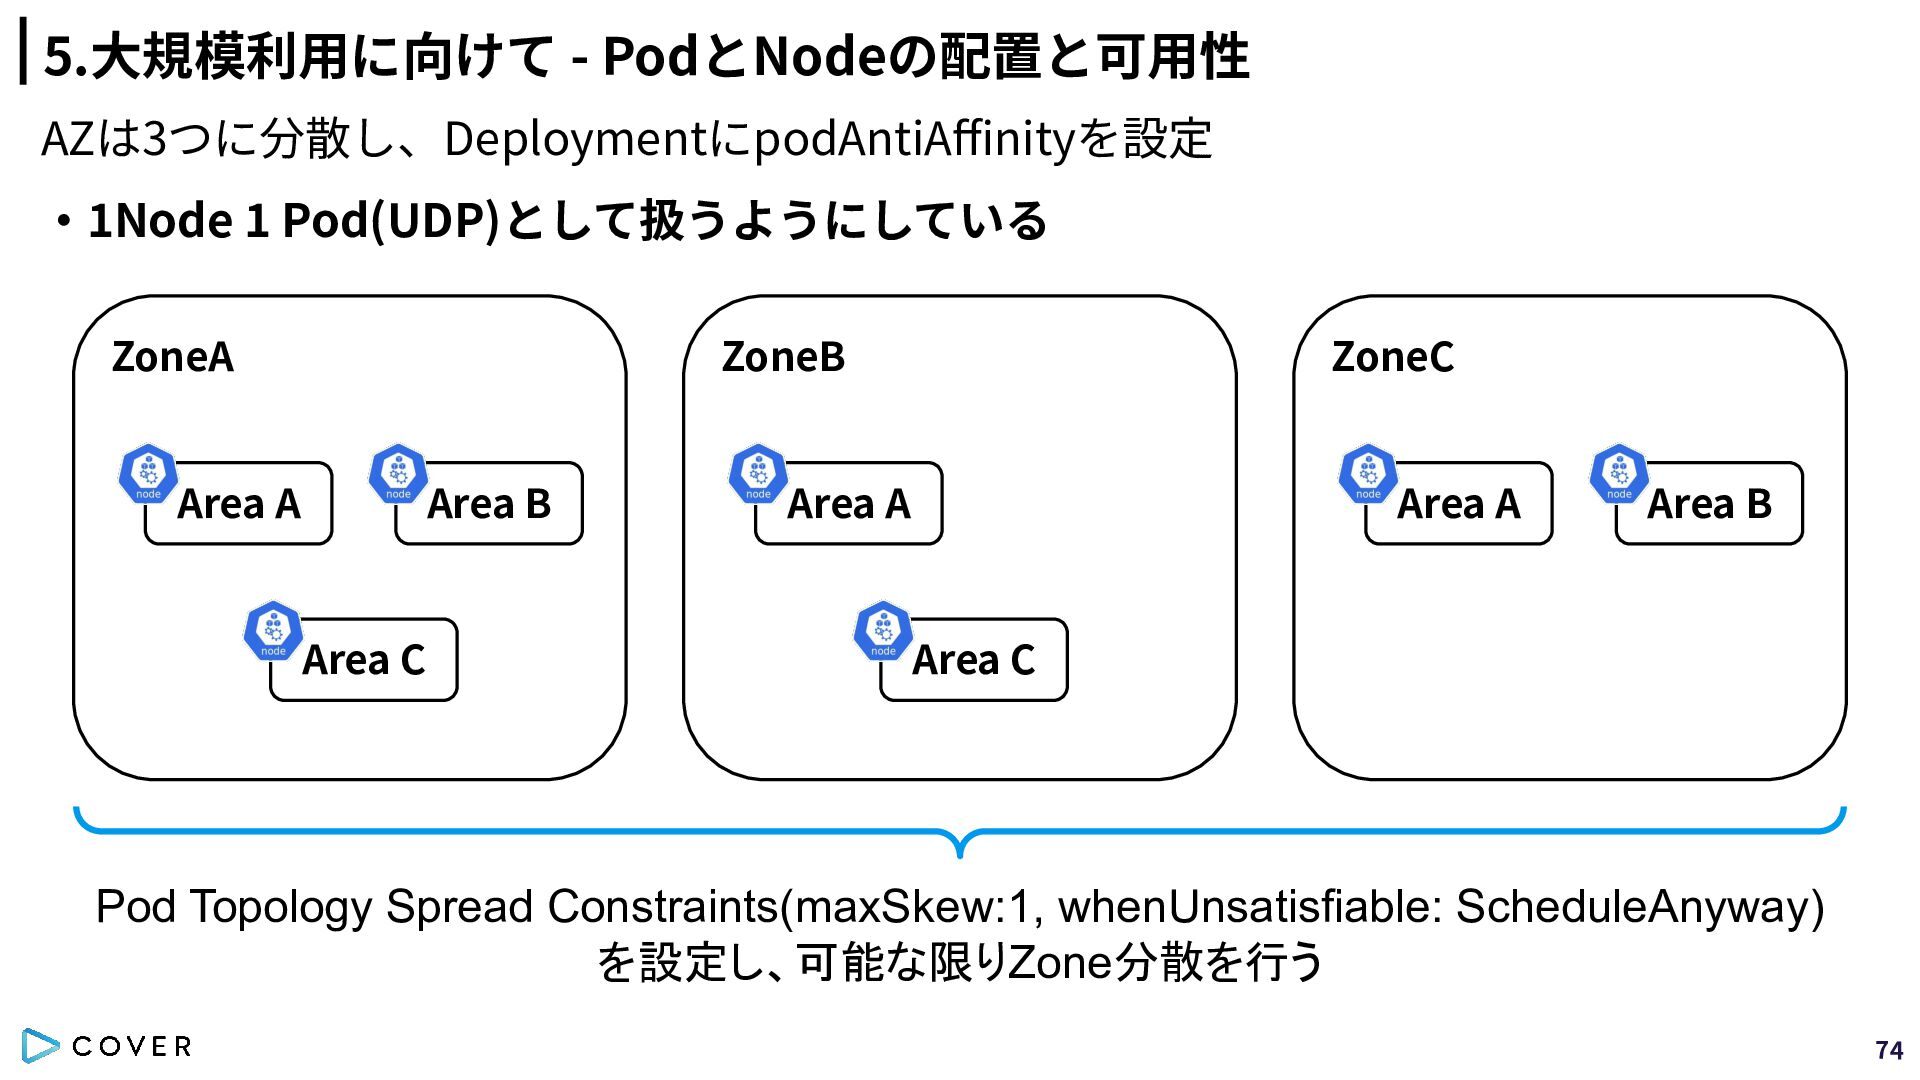
5.⼤規模利⽤に向けて - PodとNodeの配置と可⽤性 AZは3つに分散し、DeploymentにpodAntiAffinityを設定 ‧1Node 1 Pod(UDP)として扱うようにしている ZoneA ZoneB Area
A Area B Area C ZoneC Area A Area A Area B Area C Pod Topology Spread Constraints(maxSkew:1, whenUnsatisfiable: ScheduleAnyway) を設定し、可能な限りZone分散を行う 74
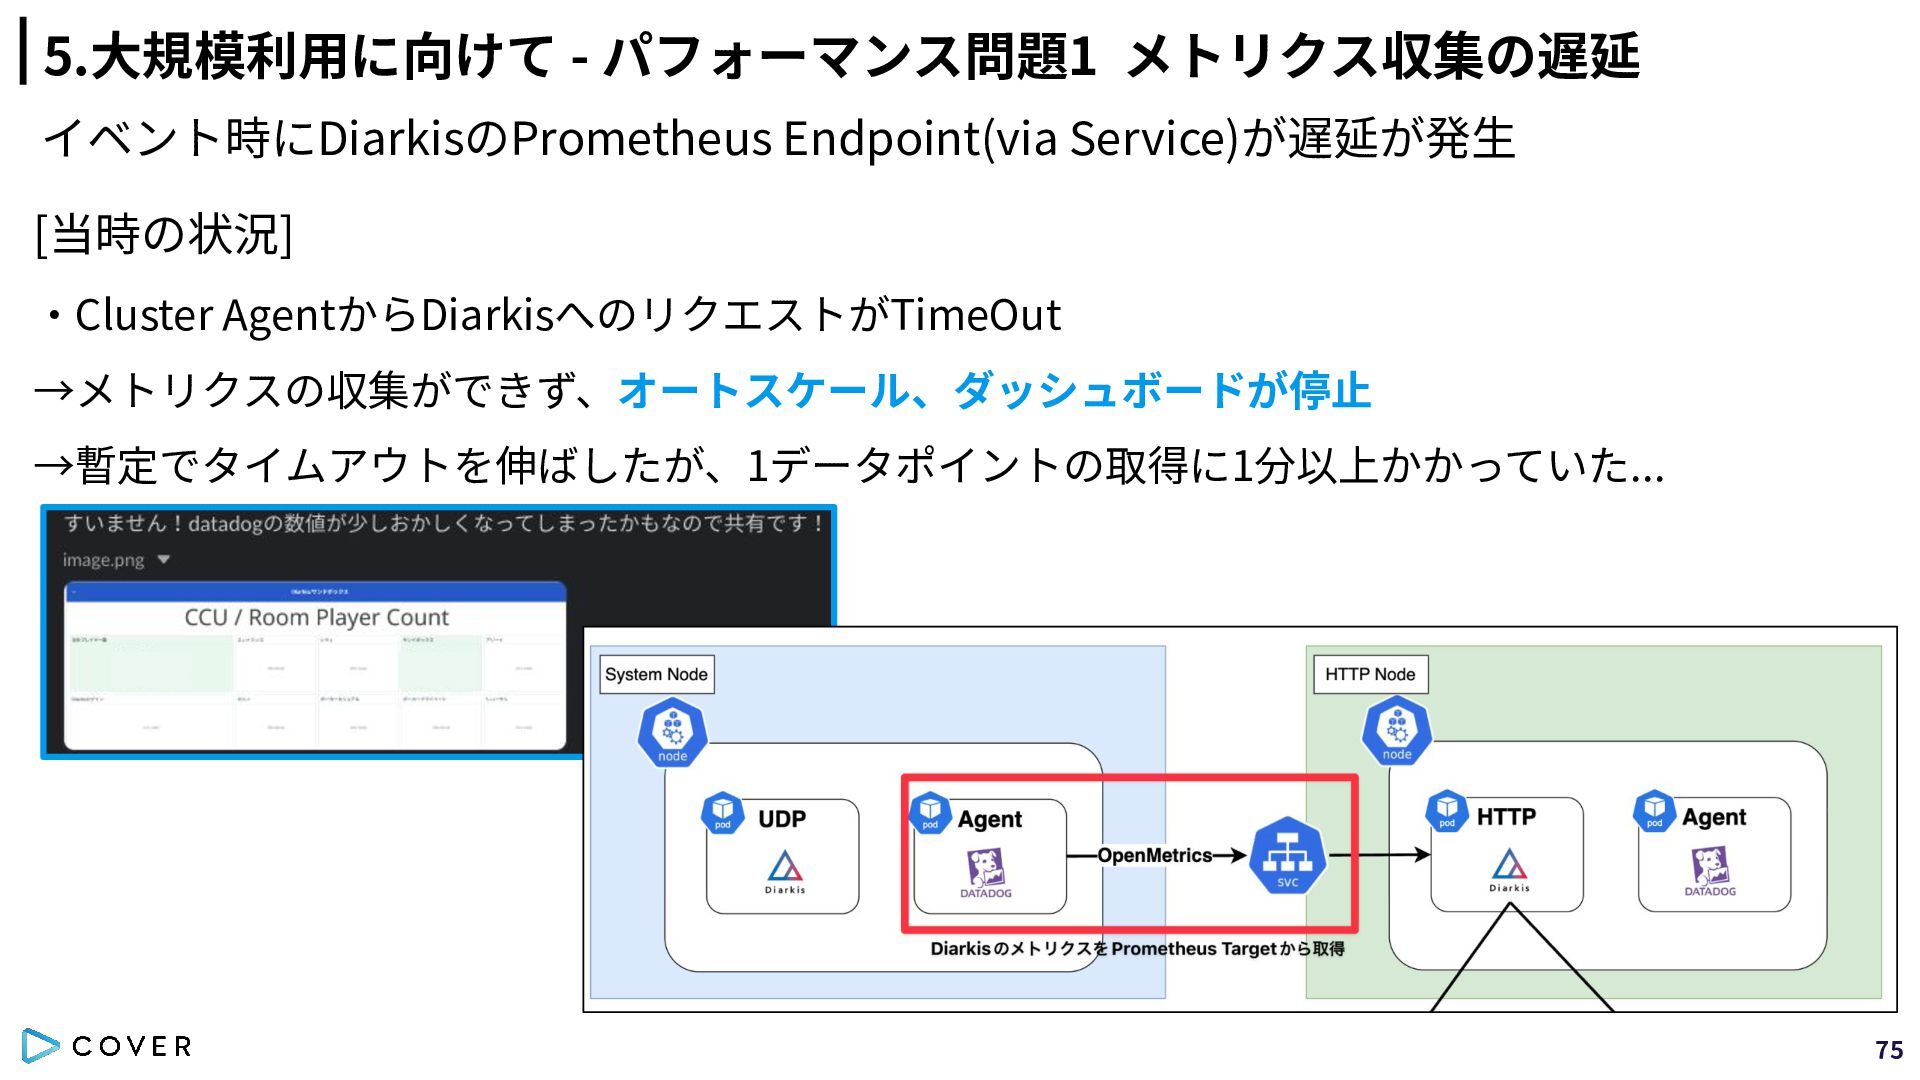
5.⼤規模利⽤に向けて - パフォーマンス問題1 メトリクス収集の遅延 イベント時にDiarkisのPrometheus Endpoint(via Service)が遅延が発⽣ [当時の状況] ‧Cluster AgentからDiarkisへのリクエストがTimeOut
→メトリクスの収集ができず、オートスケール、ダッシュボードが停⽌ →暫定でタイムアウトを伸ばしたが、1データポイントの取得に1分以上かかっていた... 75
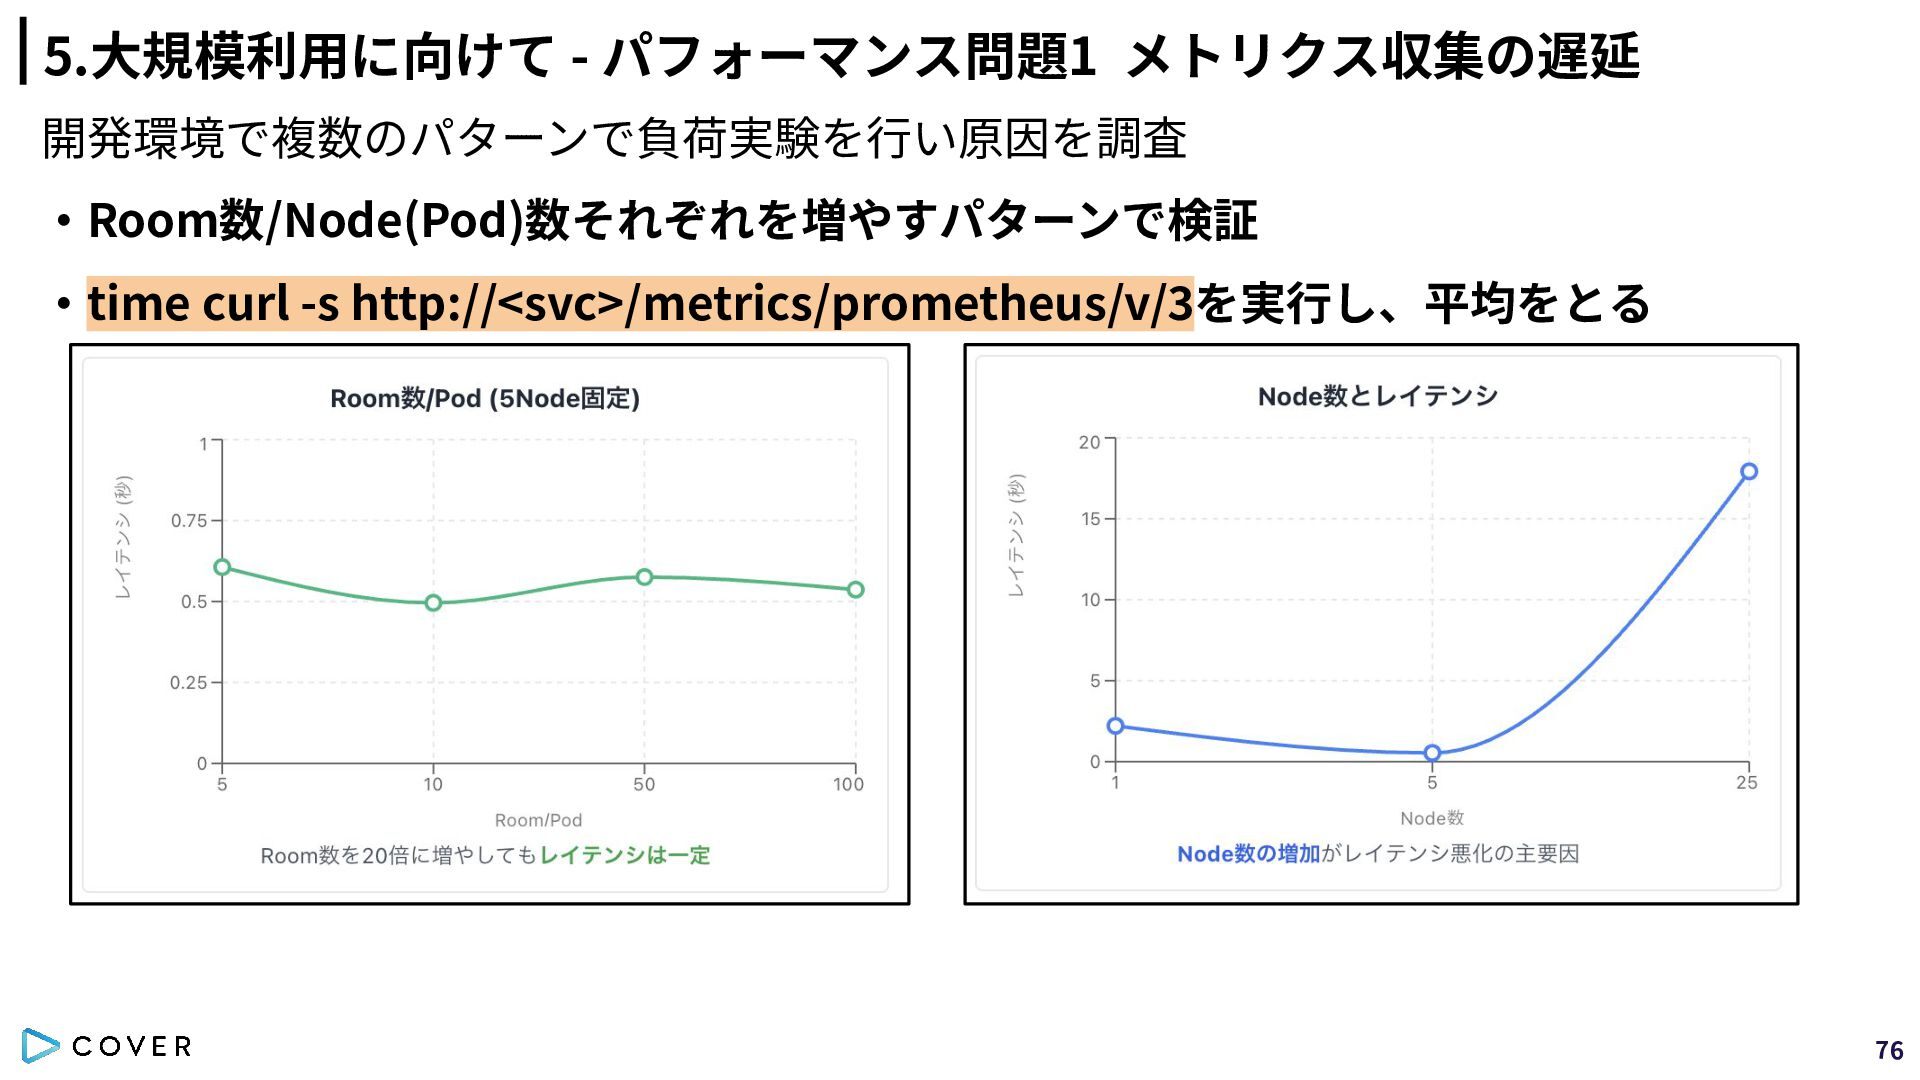
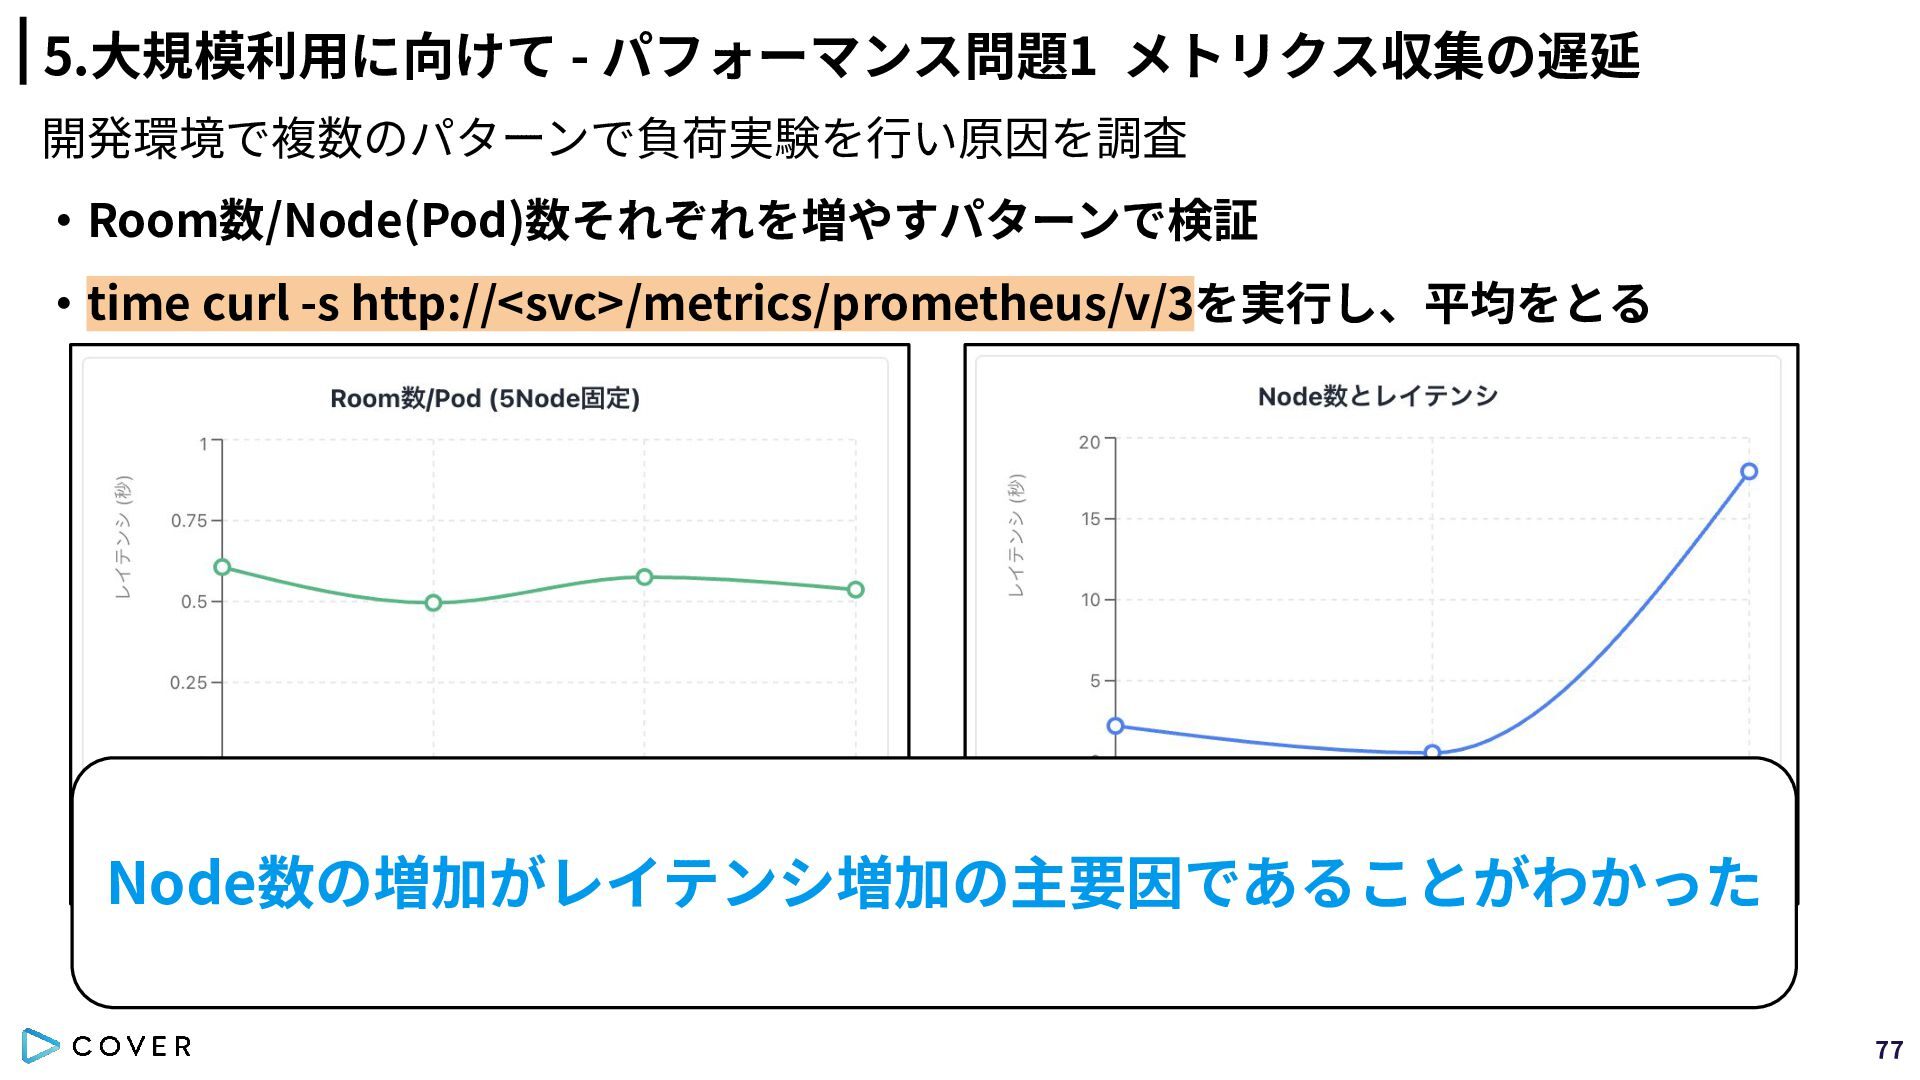
5.⼤規模利⽤に向けて - パフォーマンス問題1 メトリクス収集の遅延 開発環境で複数のパターンで負荷実験を⾏い原因を調査 ‧Room数/Node(Pod)数それぞれを増やすパターンで検証 ‧time curl -s http://<svc>/metrics/prometheus/v/3を実⾏し、平均をとる
76
5.⼤規模利⽤に向けて - パフォーマンス問題1 メトリクス収集の遅延 開発環境で複数のパターンで負荷実験を⾏い原因を調査 ‧Room数/Node(Pod)数それぞれを増やすパターンで検証 ‧time curl -s http://<svc>/metrics/prometheus/v/3を実⾏し、平均をとる
Node数の増加がレイテンシ増加の主要因であることがわかった 77
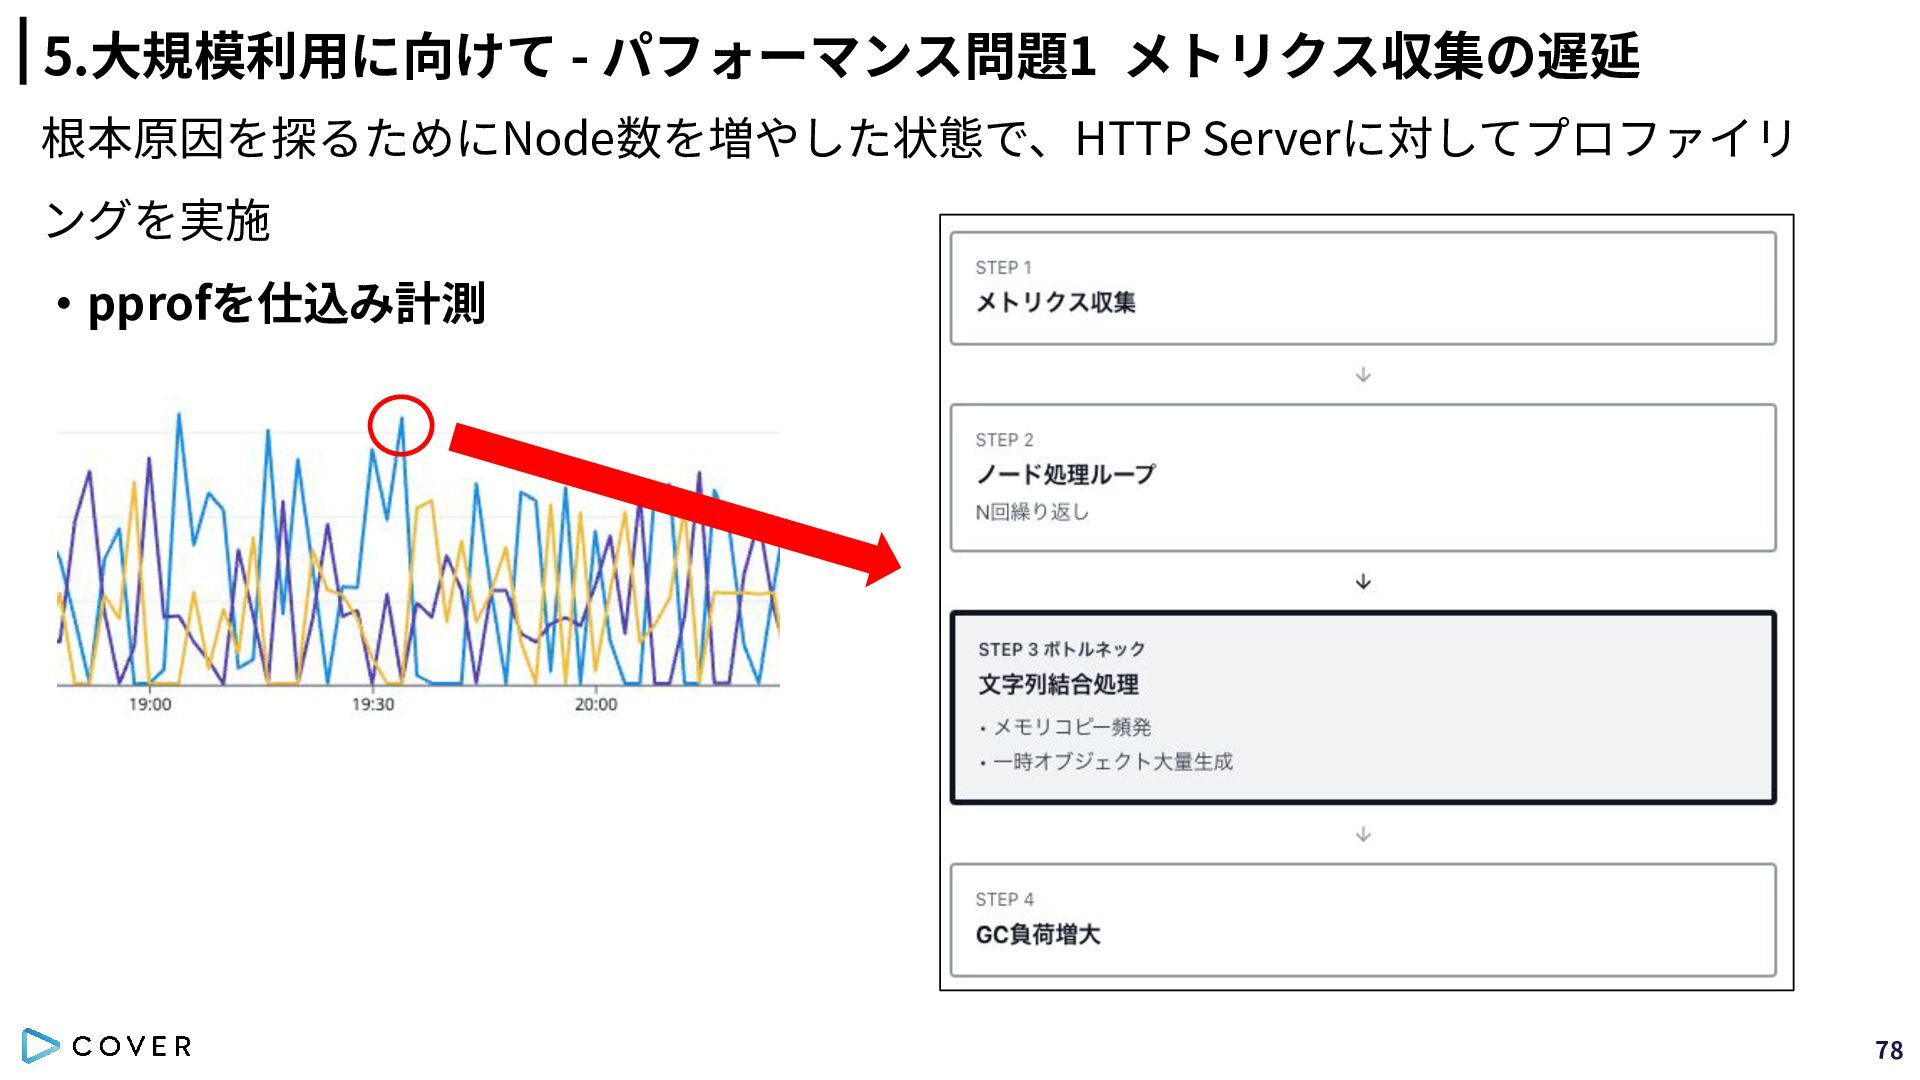
5.⼤規模利⽤に向けて - パフォーマンス問題1 メトリクス収集の遅延 根本原因を探るためにNode数を増やした状態で、HTTP Serverに対してプロファイリ ングを実施 ‧pprofを仕込み計測 78
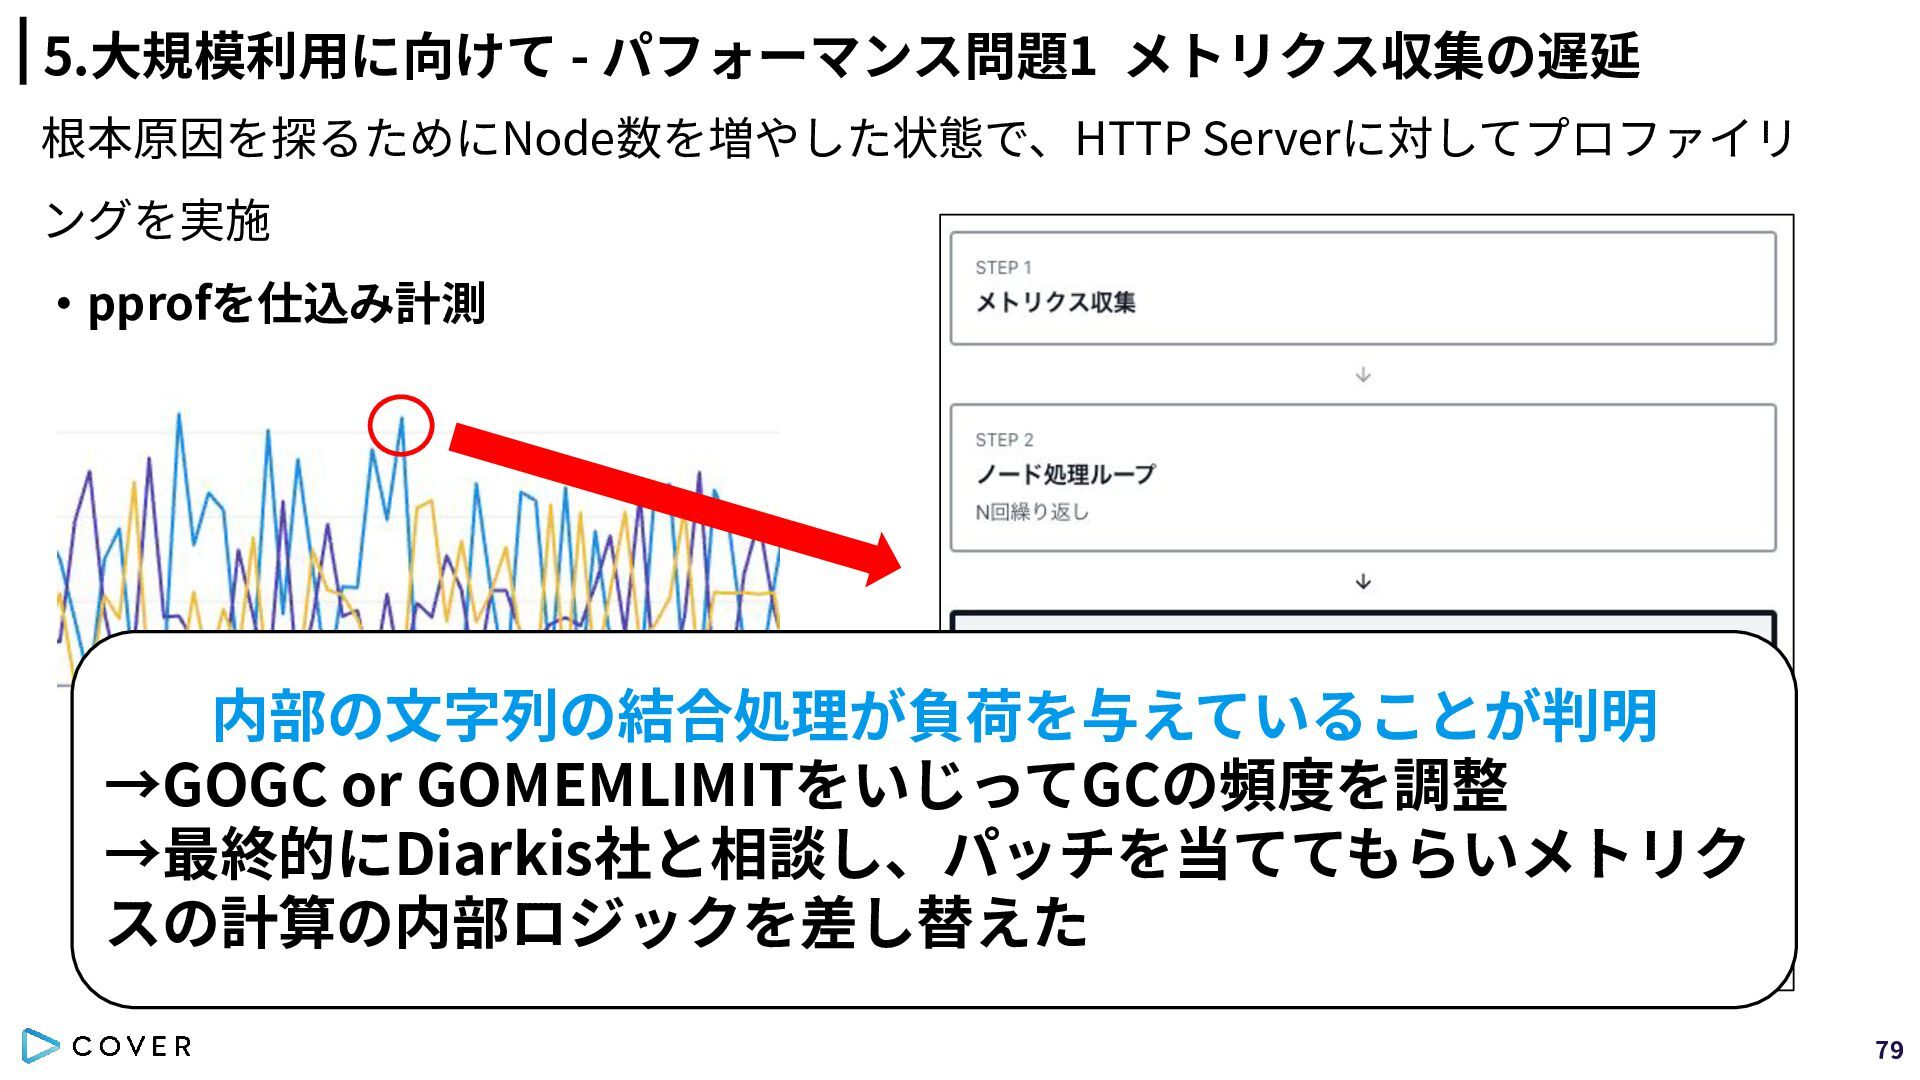
5.⼤規模利⽤に向けて - パフォーマンス問題1 メトリクス収集の遅延 根本原因を探るためにNode数を増やした状態で、HTTP Serverに対してプロファイリ ングを実施 ‧pprofを仕込み計測 内部の⽂字列の結合処理が負荷を与えていることが判明 →GOGC
or GOMEMLIMITをいじってGCの頻度を調整 →最終的にDiarkis社と相談し、パッチを当ててもらいメトリク スの計算の内部ロジックを差し替えた 79
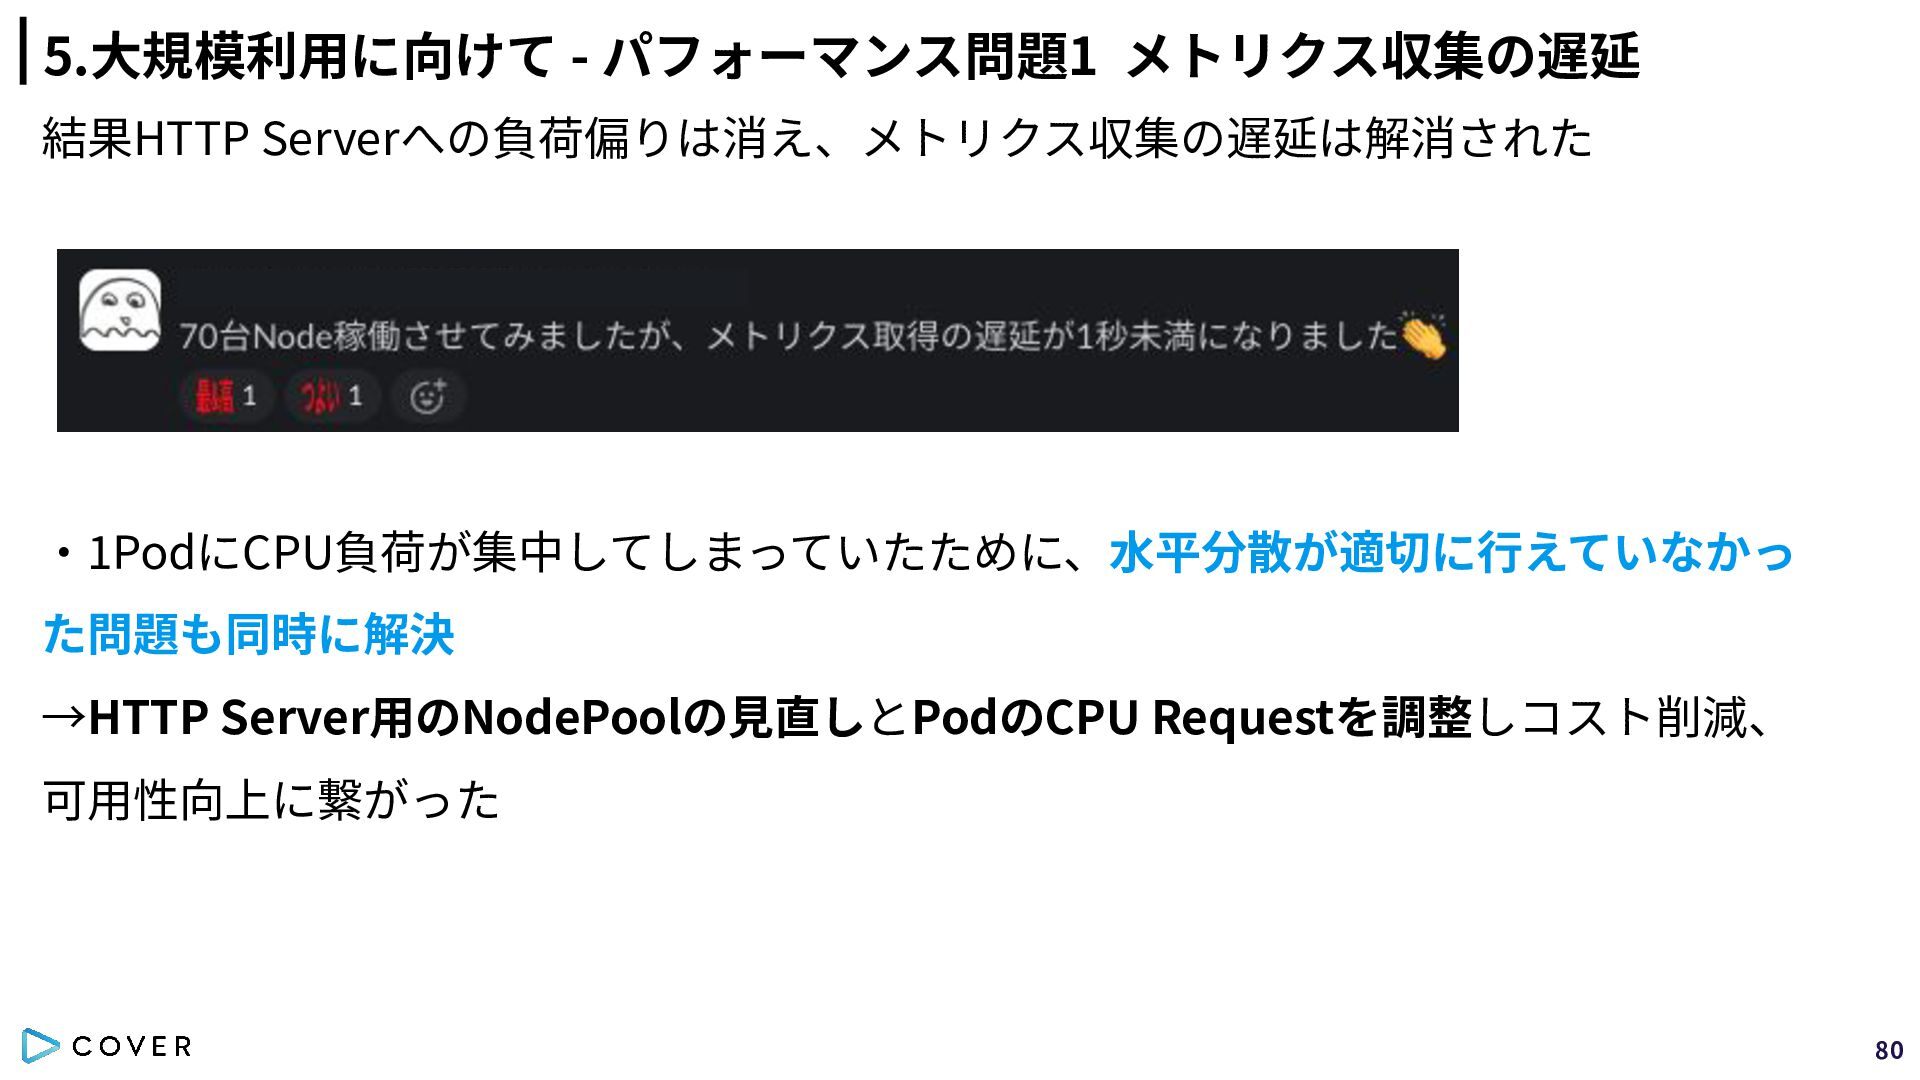
5.⼤規模利⽤に向けて - パフォーマンス問題1 メトリクス収集の遅延 結果HTTP Serverへの負荷偏りは消え、メトリクス収集の遅延は解消された ‧1PodにCPU負荷が集中してしまっていたために、⽔平分散が適切に⾏えていなかっ た問題も同時に解決 →HTTP Server⽤のNodePoolの⾒直しとPodのCPU
Requestを調整しコスト削減、 可⽤性向上に繋がった 80
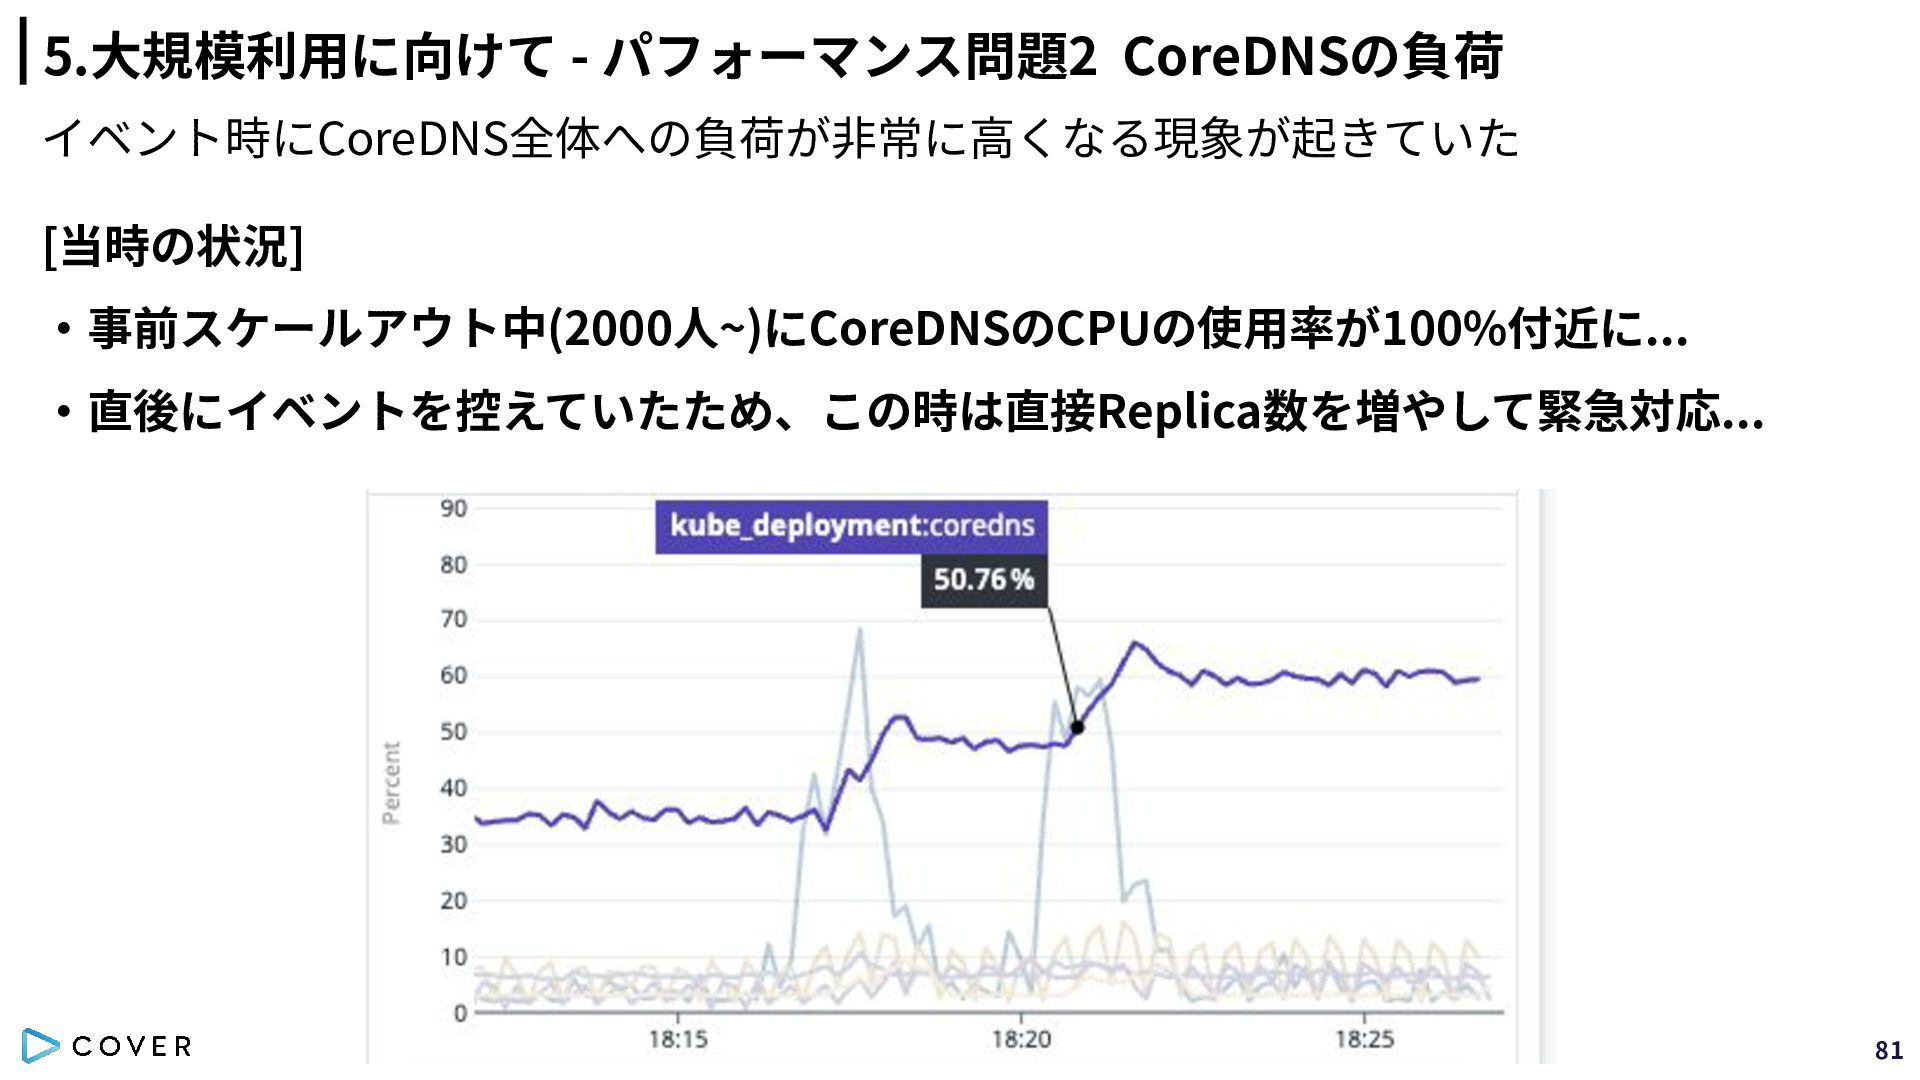
5.⼤規模利⽤に向けて - パフォーマンス問題2 CoreDNSの負荷 イベント時にCoreDNS全体への負荷が⾮常に⾼くなる現象が起きていた [当時の状況] ‧事前スケールアウト中(2000⼈~)にCoreDNSのCPUの使⽤率が100%付近に... ‧直後にイベントを控えていたため、この時は直接Replica数を増やして緊急対応... 81
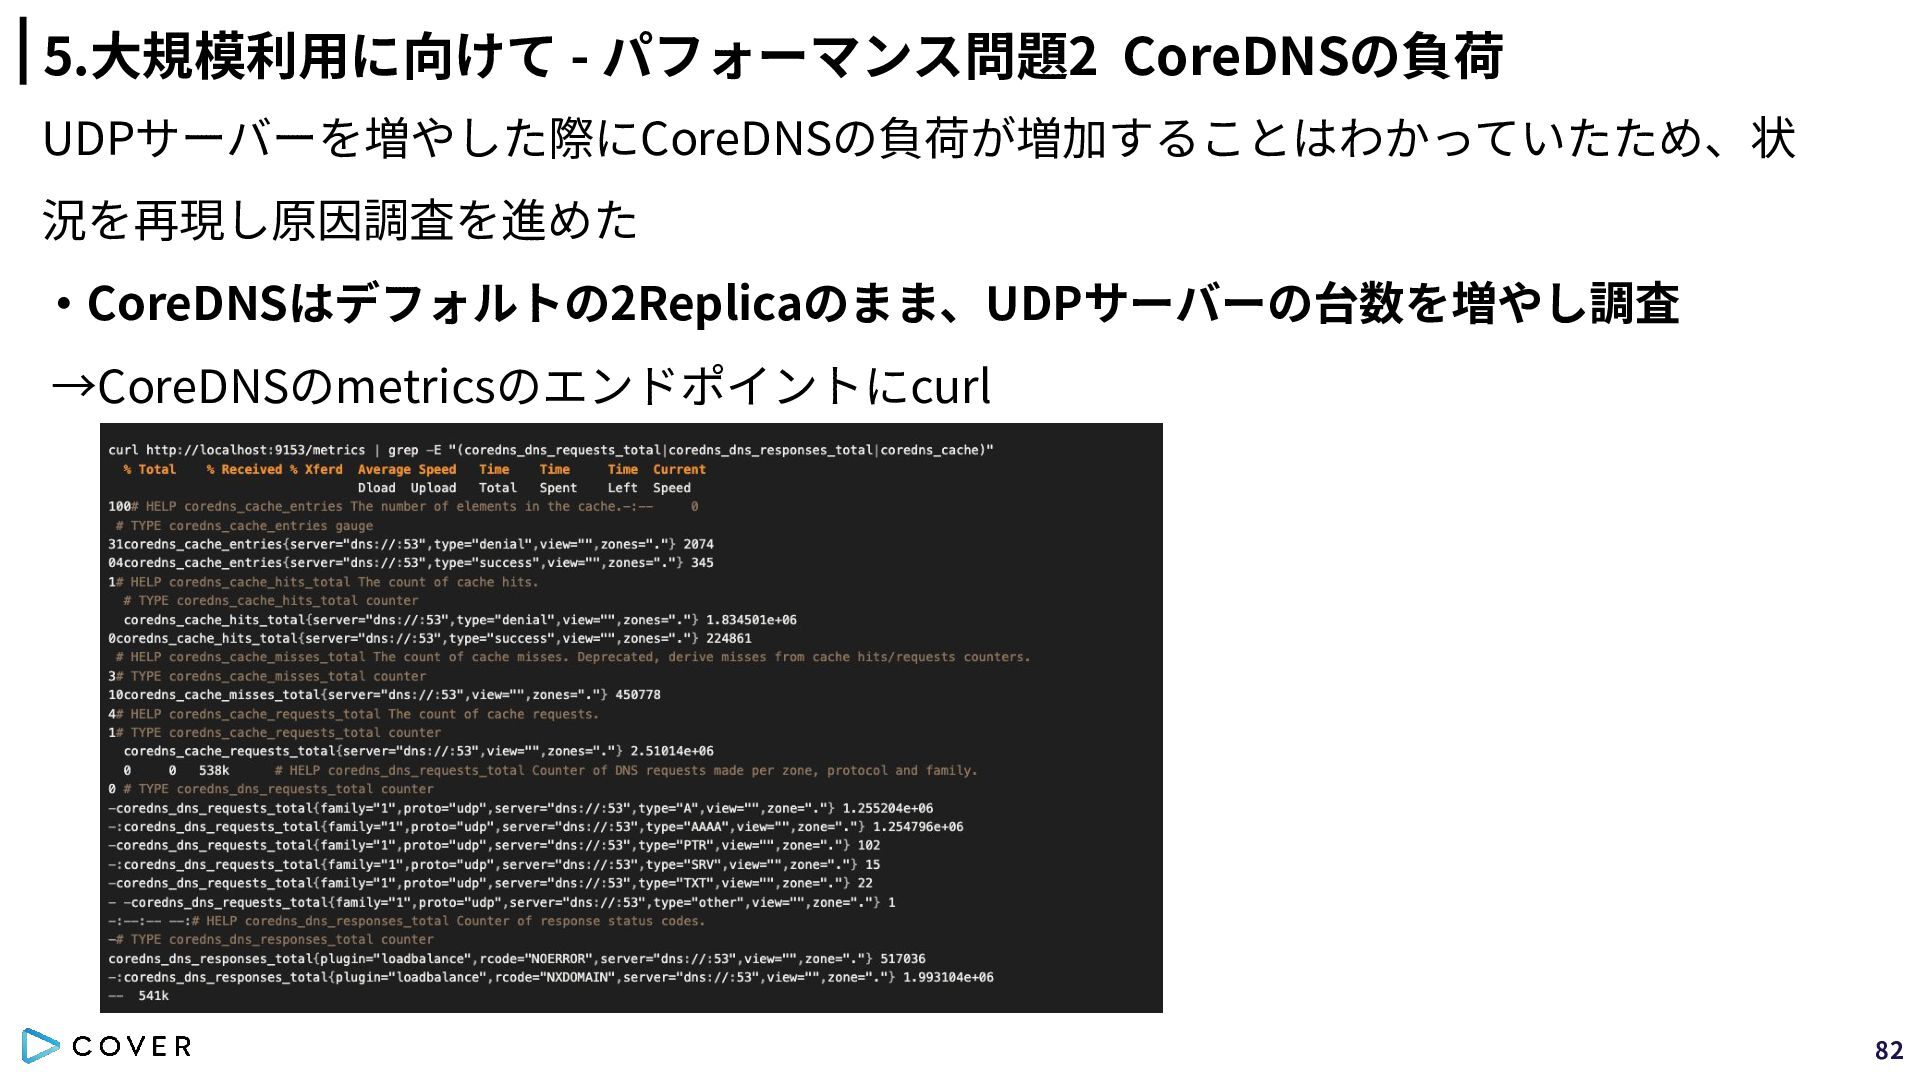
5.⼤規模利⽤に向けて - パフォーマンス問題2 CoreDNSの負荷 UDPサーバーを増やした際にCoreDNSの負荷が増加することはわかっていたため、状 況を再現し原因調査を進めた ‧CoreDNSはデフォルトの2Replicaのまま、UDPサーバーの台数を増やし調査 →CoreDNSのmetricsのエンドポイントにcurl 82
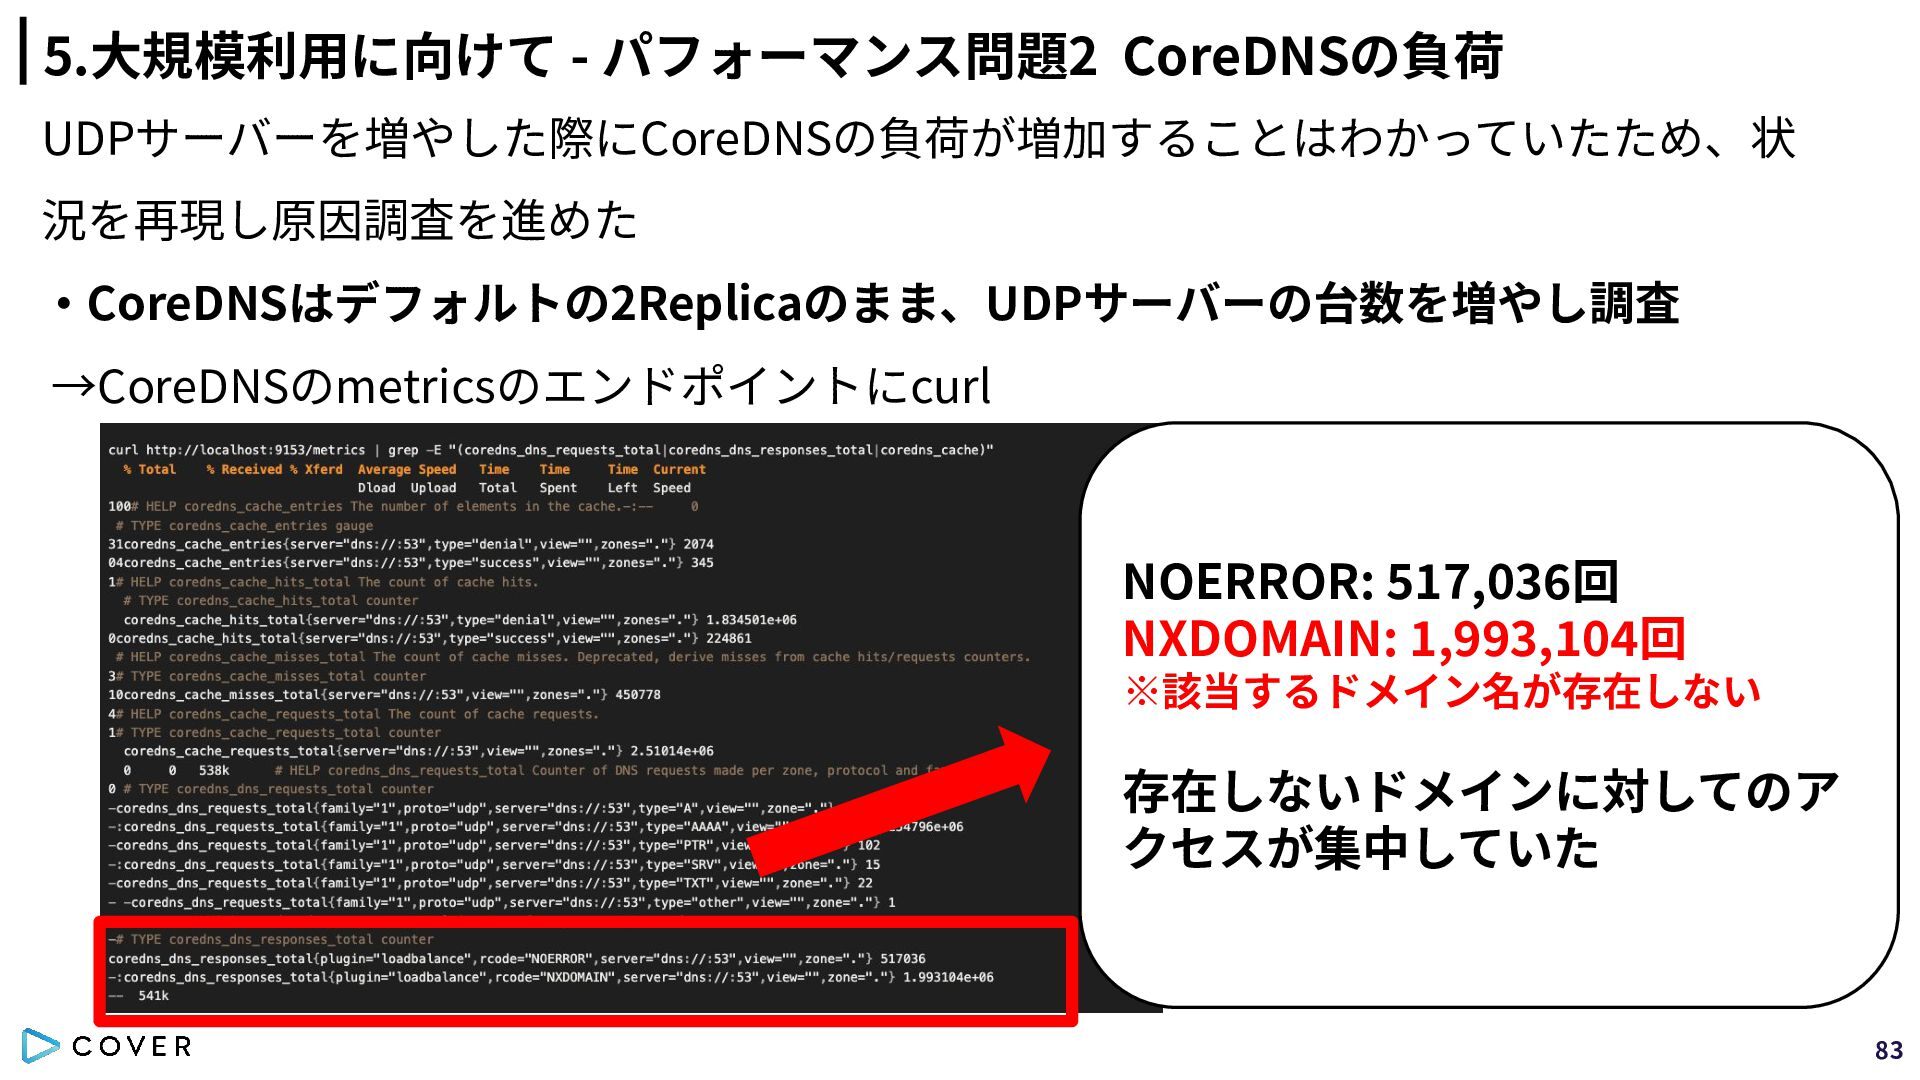
5.⼤規模利⽤に向けて - パフォーマンス問題2 CoreDNSの負荷 UDPサーバーを増やした際にCoreDNSの負荷が増加することはわかっていたため、状 況を再現し原因調査を進めた ‧CoreDNSはデフォルトの2Replicaのまま、UDPサーバーの台数を増やし調査 →CoreDNSのmetricsのエンドポイントにcurl NOERROR: 517,036回
NXDOMAIN: 1,993,104回 ※該当するドメイン名が存在しない 存在しないドメインに対してのア クセスが集中していた 83
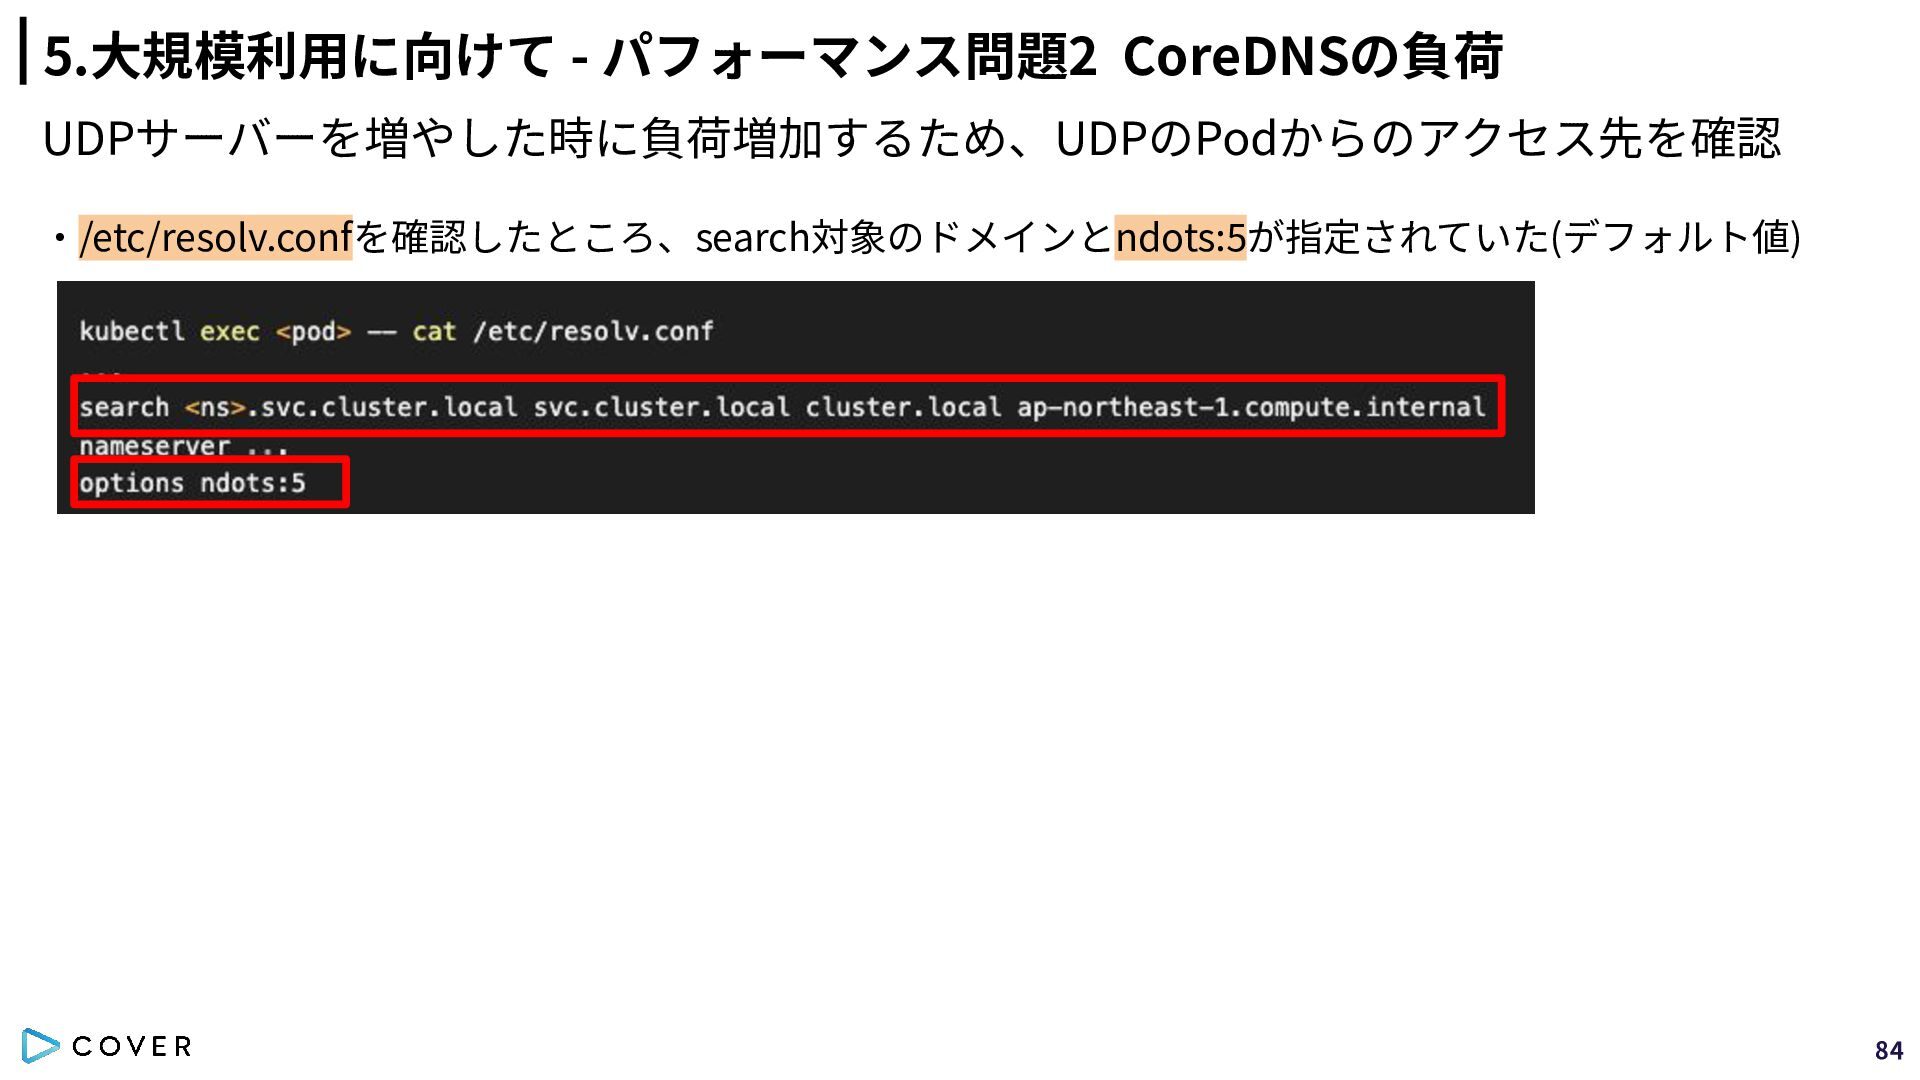
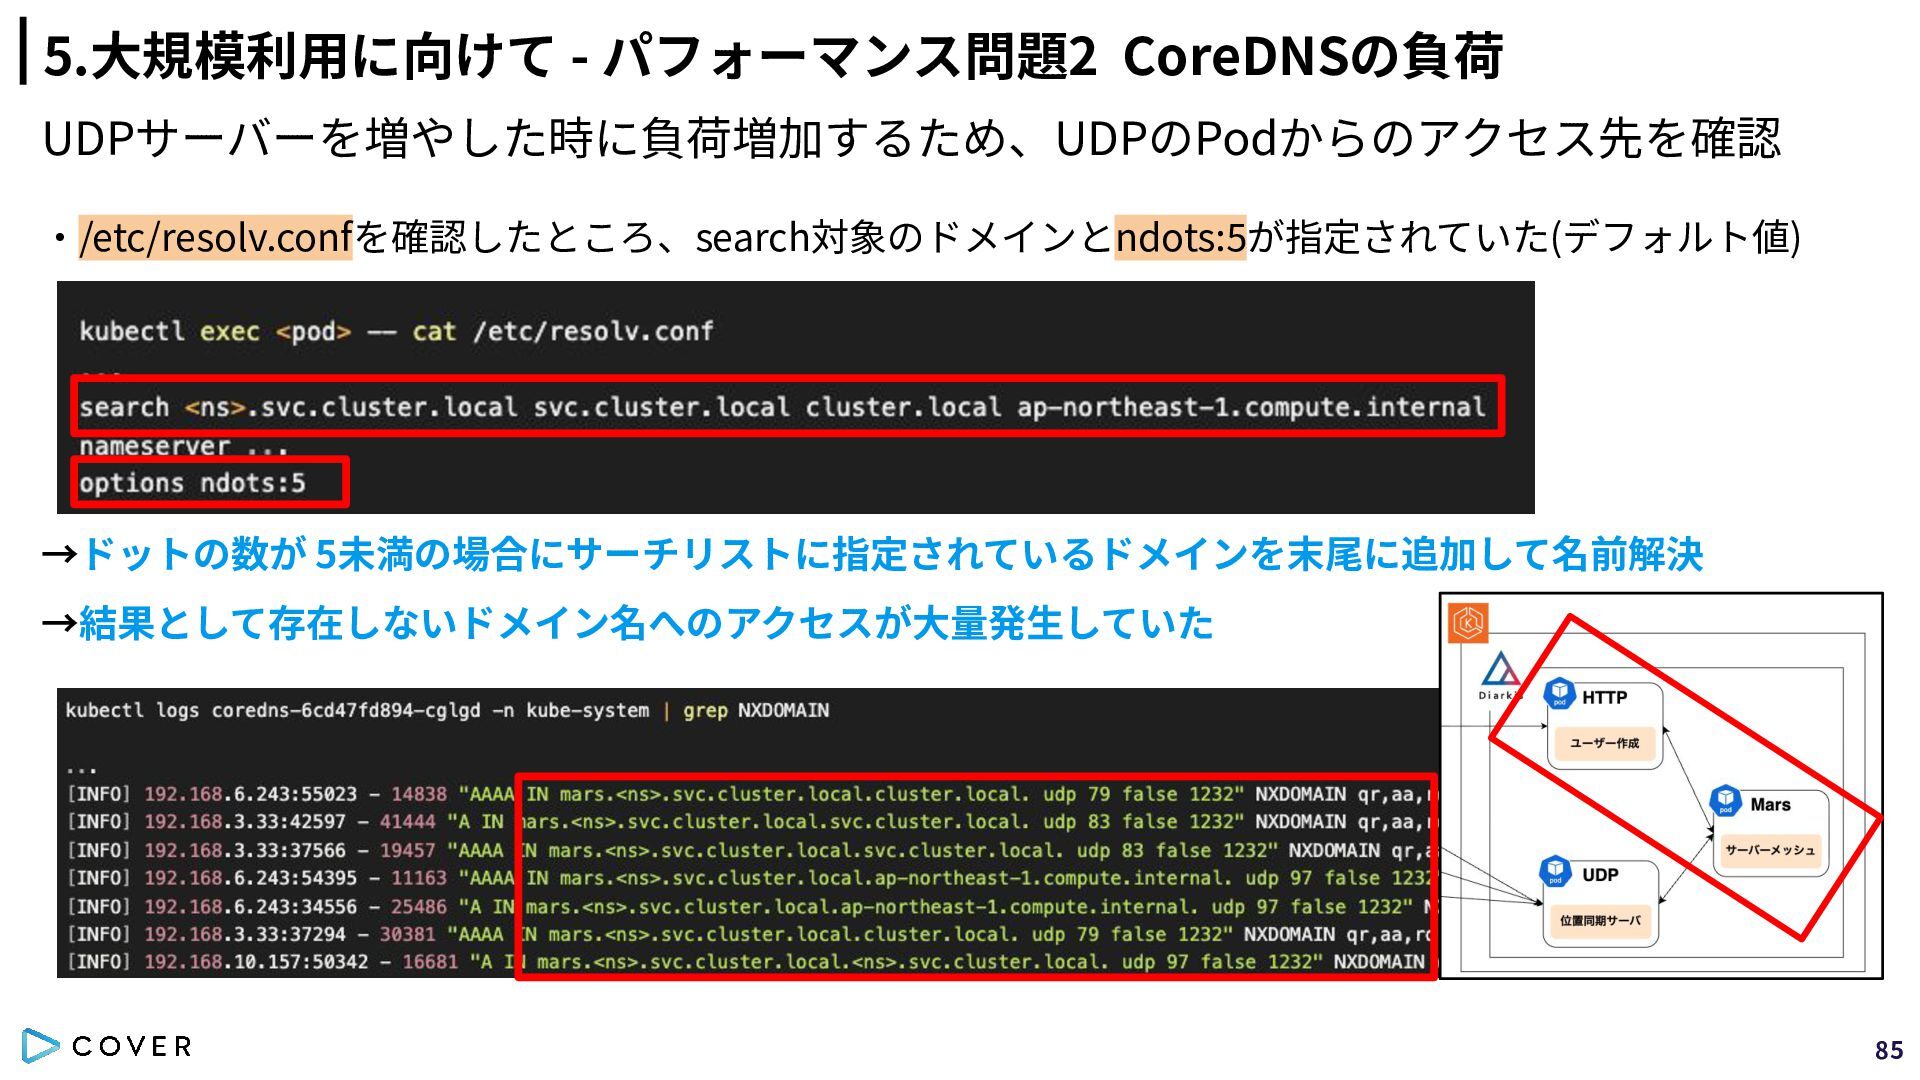
5.⼤規模利⽤に向けて - パフォーマンス問題2 CoreDNSの負荷 UDPサーバーを増やした時に負荷増加するため、UDPのPodからのアクセス先を確認 ‧/etc/resolv.confを確認したところ、search対象のドメインとndots:5が指定されていた(デフォルト値) 84
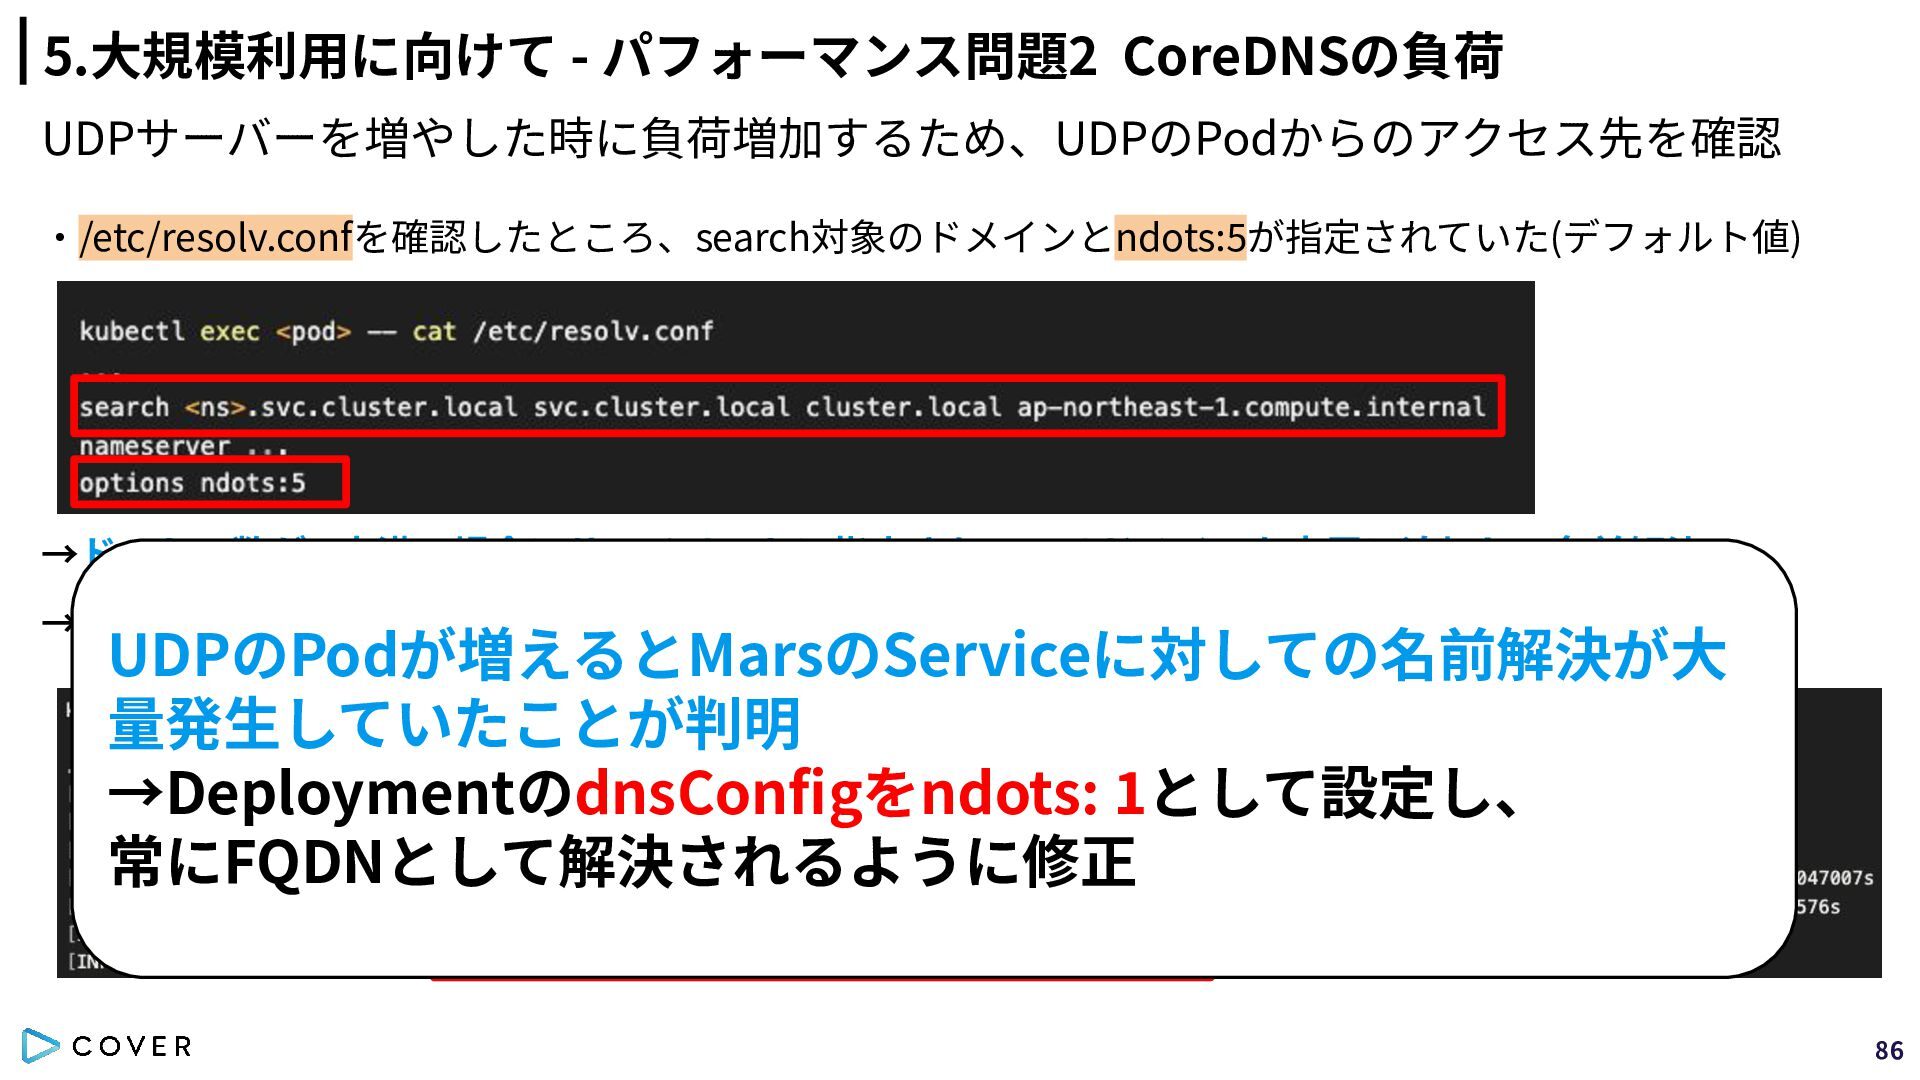
5.⼤規模利⽤に向けて - パフォーマンス問題2 CoreDNSの負荷 UDPサーバーを増やした時に負荷増加するため、UDPのPodからのアクセス先を確認 ‧/etc/resolv.confを確認したところ、search対象のドメインとndots:5が指定されていた(デフォルト値) →ドットの数が 5未満の場合にサーチリストに指定されているドメインを末尾に追加して名前解決 →結果として存在しないドメイン名へのアクセスが⼤量発⽣していた 85
5.⼤規模利⽤に向けて - パフォーマンス問題2 CoreDNSの負荷 UDPサーバーを増やした時に負荷増加するため、UDPのPodからのアクセス先を確認 ‧/etc/resolv.confを確認したところ、search対象のドメインとndots:5が指定されていた(デフォルト値) →ドットの数が 5未満の場合にサーチリストに指定されているドメインを末尾に追加して名前解決 →結果として存在しないドメイン名へのアクセスが⼤量発⽣していた UDPのPodが増えるとMarsのServiceに対しての名前解決が⼤
量発⽣していたことが判明 →DeploymentのdnsConfigをndots: 1として設定し、 常にFQDNとして解決されるように修正 86
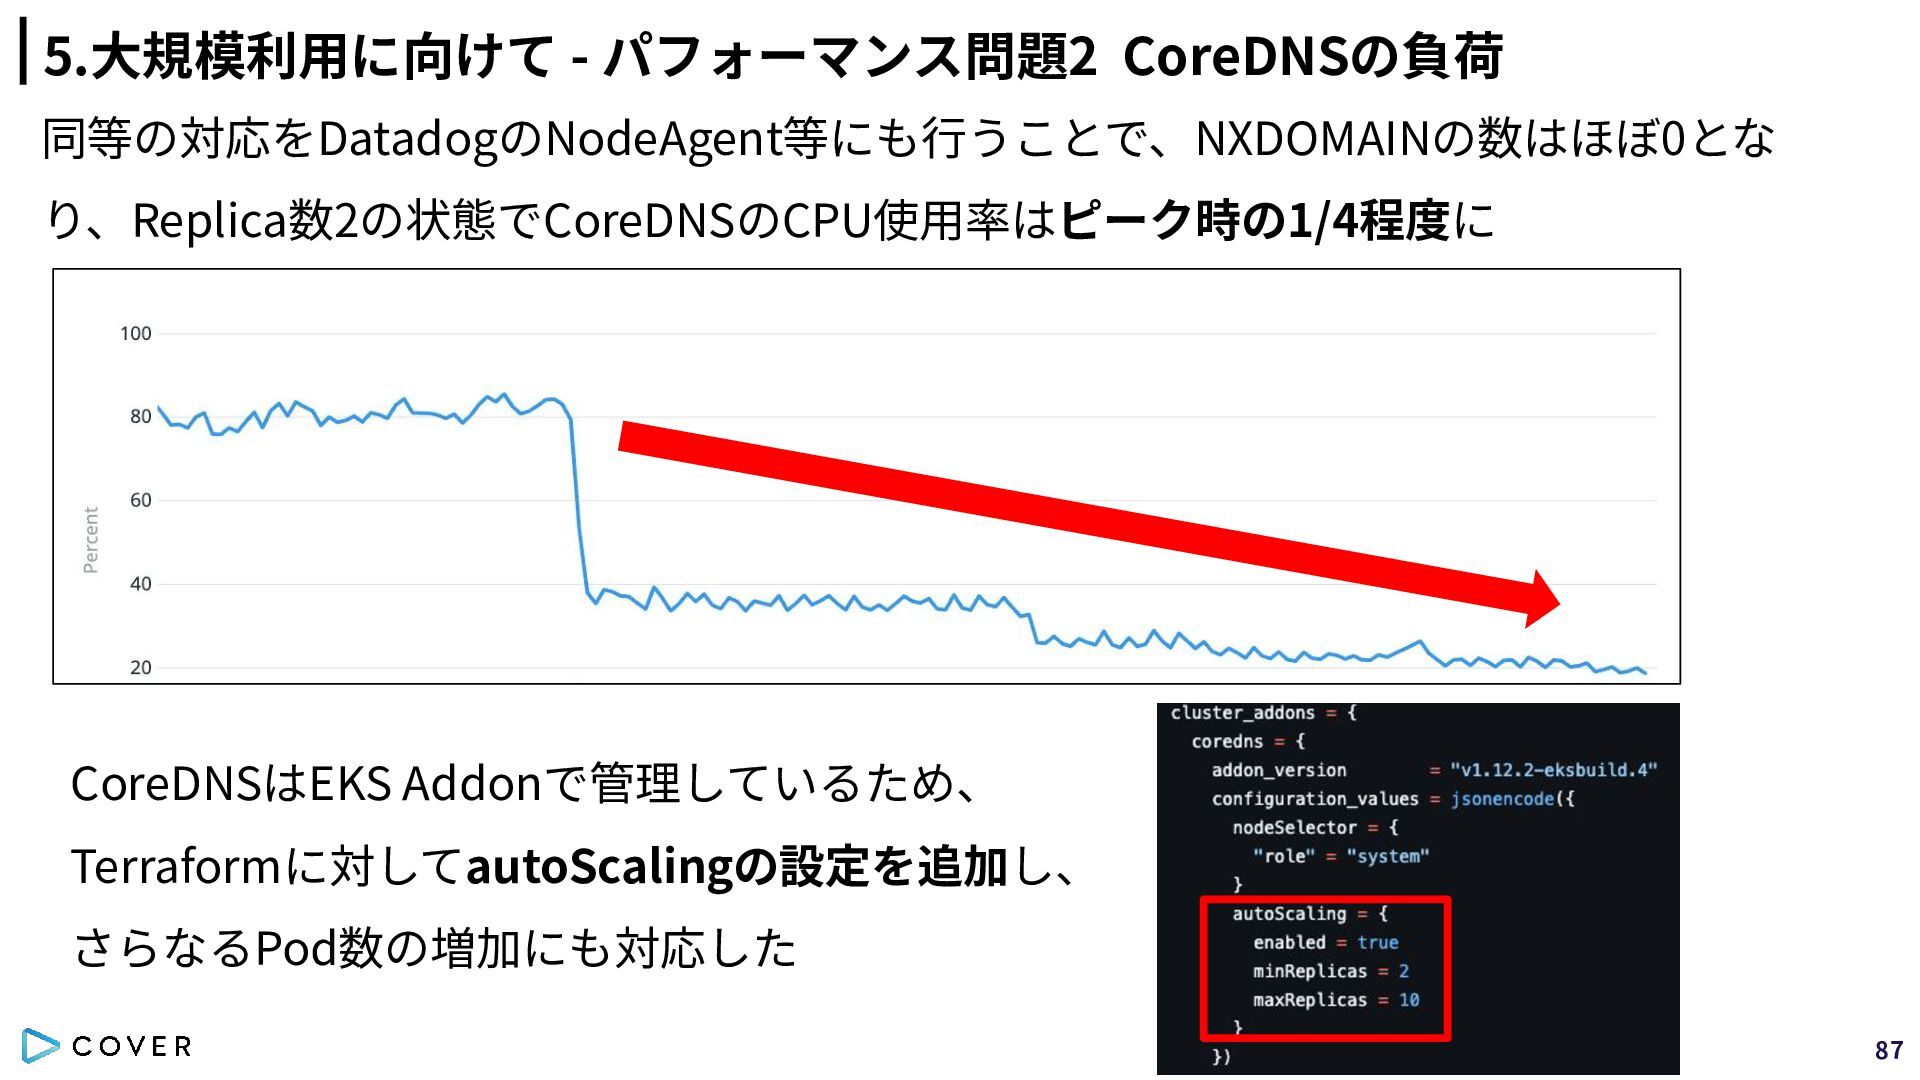
5.⼤規模利⽤に向けて - パフォーマンス問題2 CoreDNSの負荷 同等の対応をDatadogのNodeAgent等にも⾏うことで、NXDOMAINの数はほぼ0とな り、Replica数2の状態でCoreDNSのCPU使⽤率はピーク時の1/4程度に CoreDNSはEKS Addonで管理しているため、 Terraformに対してautoScalingの設定を追加し、 さらなるPod数の増加にも対応した
87
5.⼤規模利⽤に向けて - 振り返り ⼤規模なNode運⽤に向けてパフォーマンス上の課題へ対応し、イベントを乗り越える ための基盤を整備ができた リアルタイムサーバーの可⽤性を向上させるためにNodeの配置戦略を⾒ 直した ⼤規模イベント時に起きたパフォーマンス上の課題を負荷試験を⾏いな がら改善し、安定運⽤が可能なようにチューニングを⾏なった 88
05 今後の展望とまとめ 89
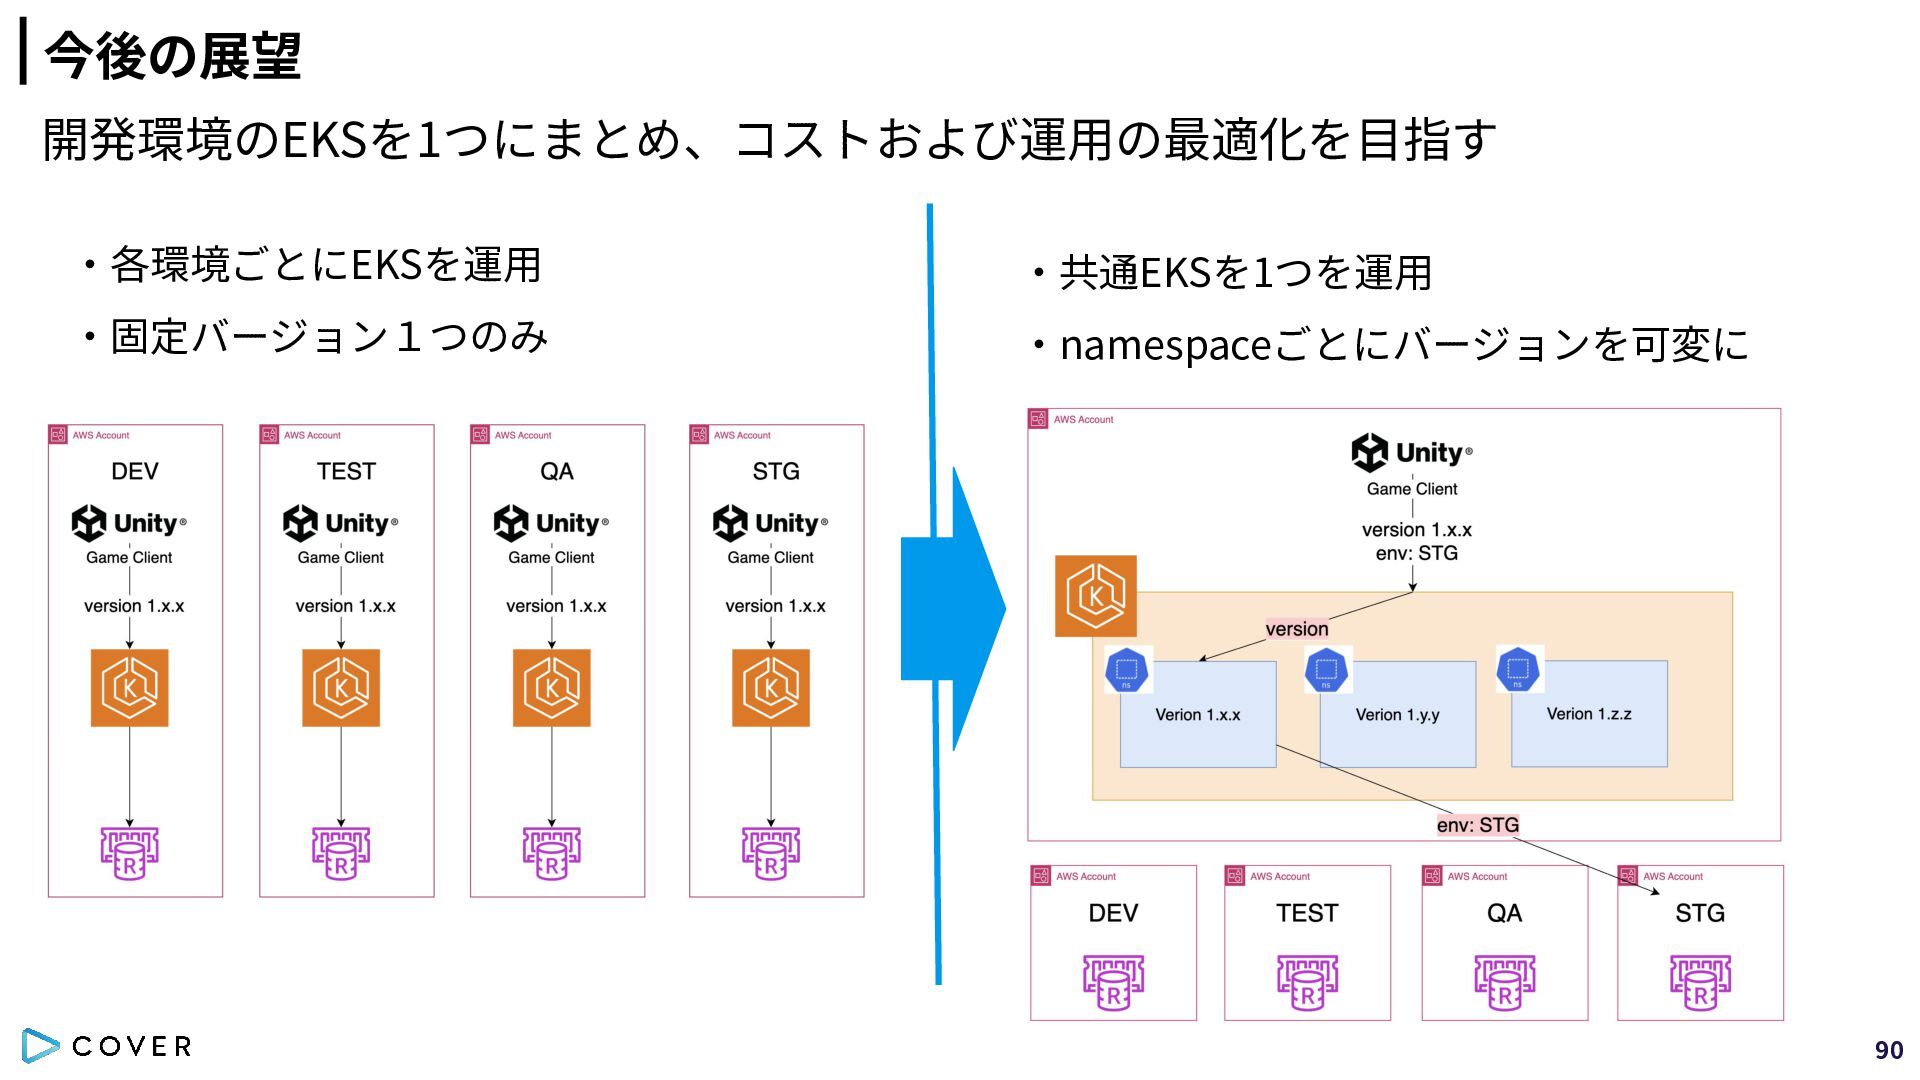
今後の展望 開発環境のEKSを1つにまとめ、コストおよび運⽤の最適化を⽬指す ‧各環境ごとにEKSを運⽤ ‧共通EKSを1つを運⽤ ‧固定バージョン1つのみ ‧namespaceごとにバージョンを可変に 90
まとめ • SREチームの管理下でEKSを管理し、開発チームと協⼒しながら新しいリアル タイムサーバー基盤を構築をした • ⼤規模な運⽤に備えて信頼性‧可⽤性を向上させるために負荷試験や監視基盤 の整備を⾏なった 91
Thank You! 92


 covercorp
 npostring
 syumai
 tomoyakitaura
 yosuke_furukawa
 takahirosaeki
 akase244
 bash0c7
 seike460
 ssssota
 jespino
 susisu
 yuukiw00w
 jonoalderson
 reverentgeek
 katarinadahlin
 ryanjones
 akademiya2063
 aleyda
 lauravandoore
 rmw
 trishagee
 csswizardry
 mfonobong
 katiecoart