Share
Embed
クラウドネイティブ時代の分散データベース「YugabyteDB」を触ってみよう!
クラウドネイティブ時代の分散データベース「YugabyteDB」について、基礎から実践まで学べる勉強会です。
コンテナやKubernetesを使ったアプリケーション開発が当たり前になった今、バックエンドDBはどうしていますか?
そんな悩みを解決する、スケール可能なPostgreSQL互換の分散データベース、YugabyteDBをゼロから学びます。
とことんDevOps
December 17, 2025
Transcript
50 slides
-
日本仮想化技術株式会社 概要 • 社名:日本仮想化技術株式会社 • 英語名:VirtualTech Japan Inc. • 設立:2006年12月
• 資本金:3,000万円 • 本社:東京都渋谷区渋谷1-8-1 • 取締役:宮原 徹(代表取締役社長兼CEO)、伊藤 宏通(取締役CTO) • スタッフ:9名(うち、8名が仮想化技術専門エンジニアです) • URL:http://VirtualTech.jp/ • 仮想化技術に関する研究および開発 • 仮想化技術に関する各種調査 • 仮想化技術に関連したソフトウェアの開発 • 仮想化技術を導入したシステムの構築 • OpenStackやKubernetes、DevOps基盤の導入支援・新規機能開発 2 ベンダーニュートラルな 独立系仮想化技術の エキスパート集団 会社概要 -
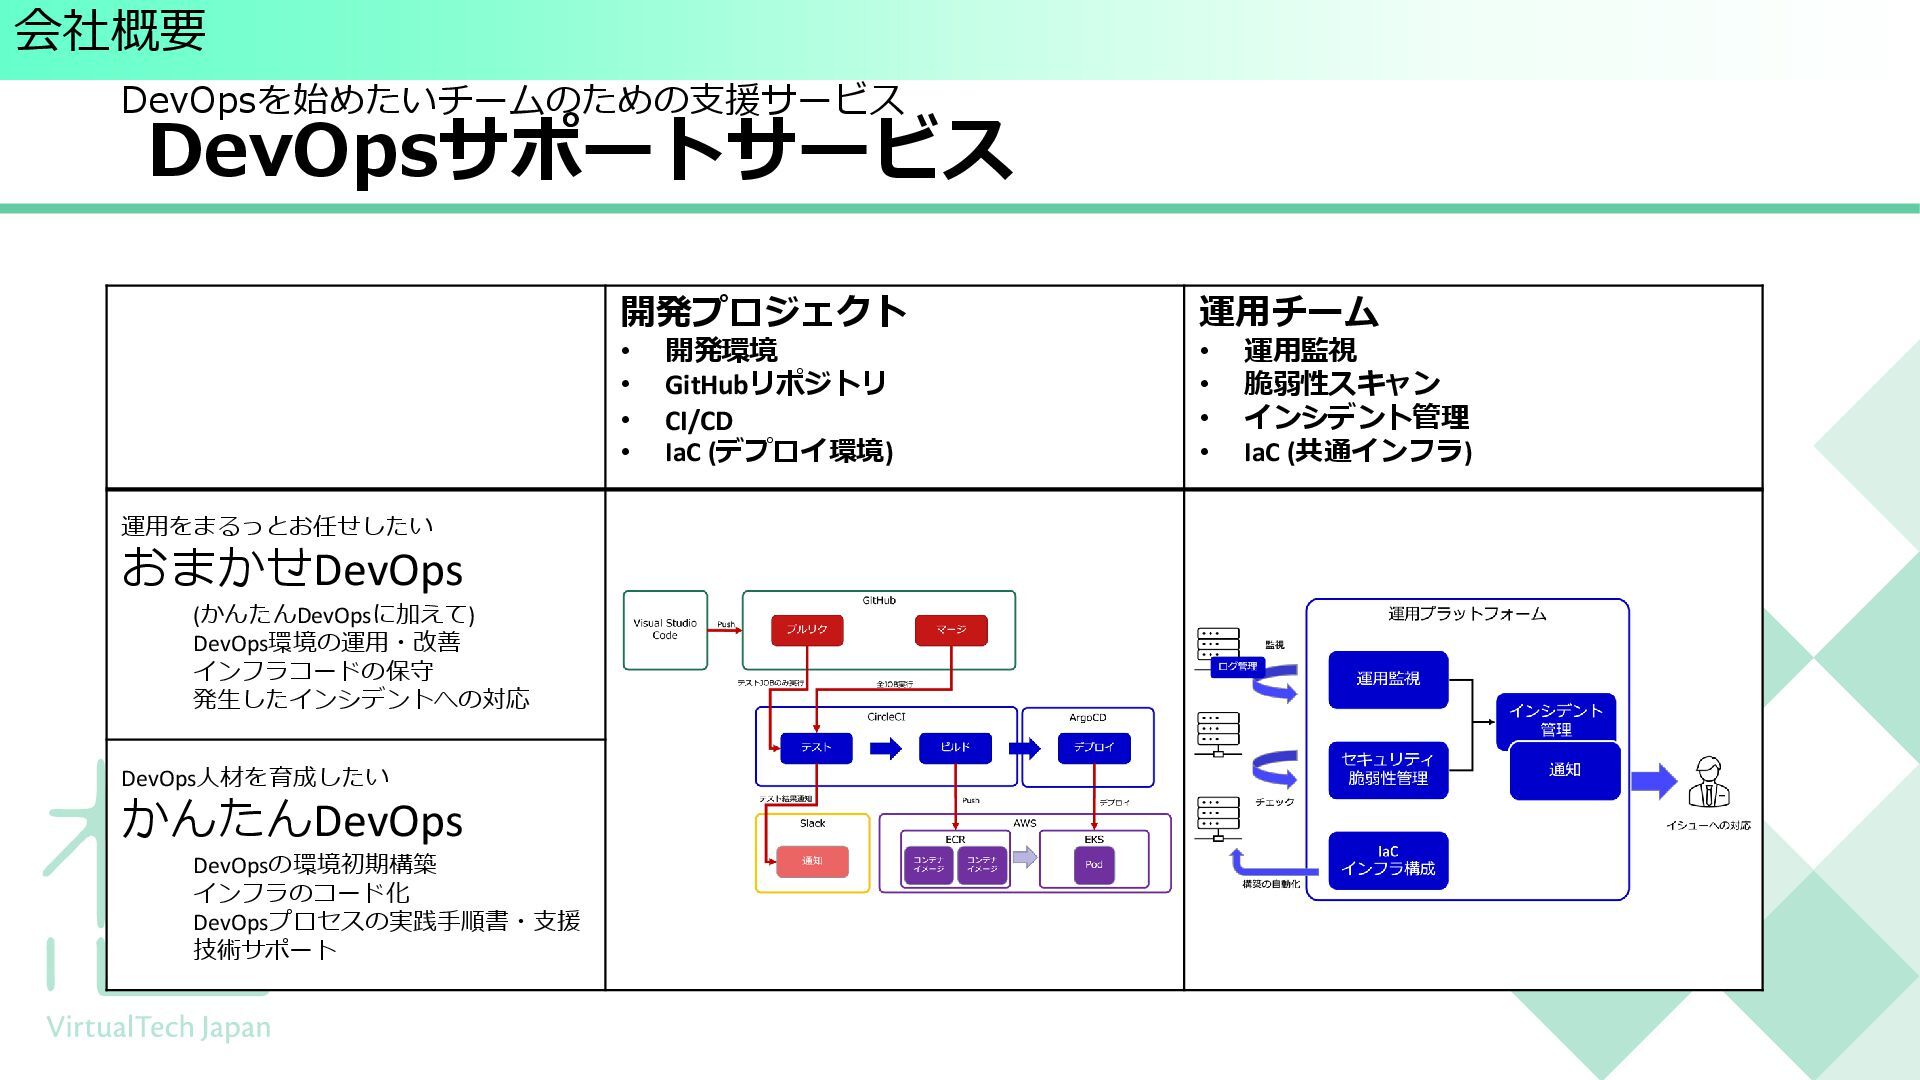
DevOpsサポートサービス DevOpsを始めたいチームのための支援サービス 開発プロジェクト • 開発環境 • GitHubリポジトリ • CI/CD •
IaC (デプロイ環境) 運用チーム • 運用監視 • 脆弱性スキャン • インシデント管理 • IaC (共通インフラ) 運用をまるっとお任せしたい おまかせDevOps (かんたんDevOpsに加えて) DevOps環境の運用・改善 インフラコードの保守 発生したインシデントへの対応 DevOps人材を育成したい かんたんDevOps DevOpsの環境初期構築 インフラのコード化 DevOpsプロセスの実践手順書・支援 技術サポート 会社概要 -
私について • 氏名 遠山 洋平 • 現在地 宮城県大崎市(リモートワーク) • 仕事
• 「GPUでPostgreSQLを高速処理」のPG-Stromの研究、導入支援 • PG-Stromのコンテナー利用についての研究 • PG-Stromの簡単導入を目指したPG-Strom Ansibleの研究 • お客様の技術研究の開発支援 • 日本語は難しい • 要は「XX(という技術)について知りたいので一緒に調査研究してほしい」と いうオーダーに応える役 • YugabyteDBはその業務の中で知り、その魅力にハマりました 4 -
• コンテナプラットフォームとしてはKubernetesが事実上の業界 標準になりました • アプリケーションをコンテナーで実行するのが当たり前になり ました • コンテナーはスケールが容易なのがメリットの一つです • バックエンドDBはどうしますか?
• そもそもそのバックエンドDBはスケールを容易にできます か? 6 -
今回のテーマ • テーマはYugabyteDB • YugabyteDBとは何? • YugabyteDBを動かしてみよう • 「言語」からYugabyteDBを使ってみよう •
YugabyteDBと「AI」 • 色々なDB分散の方法 7 -
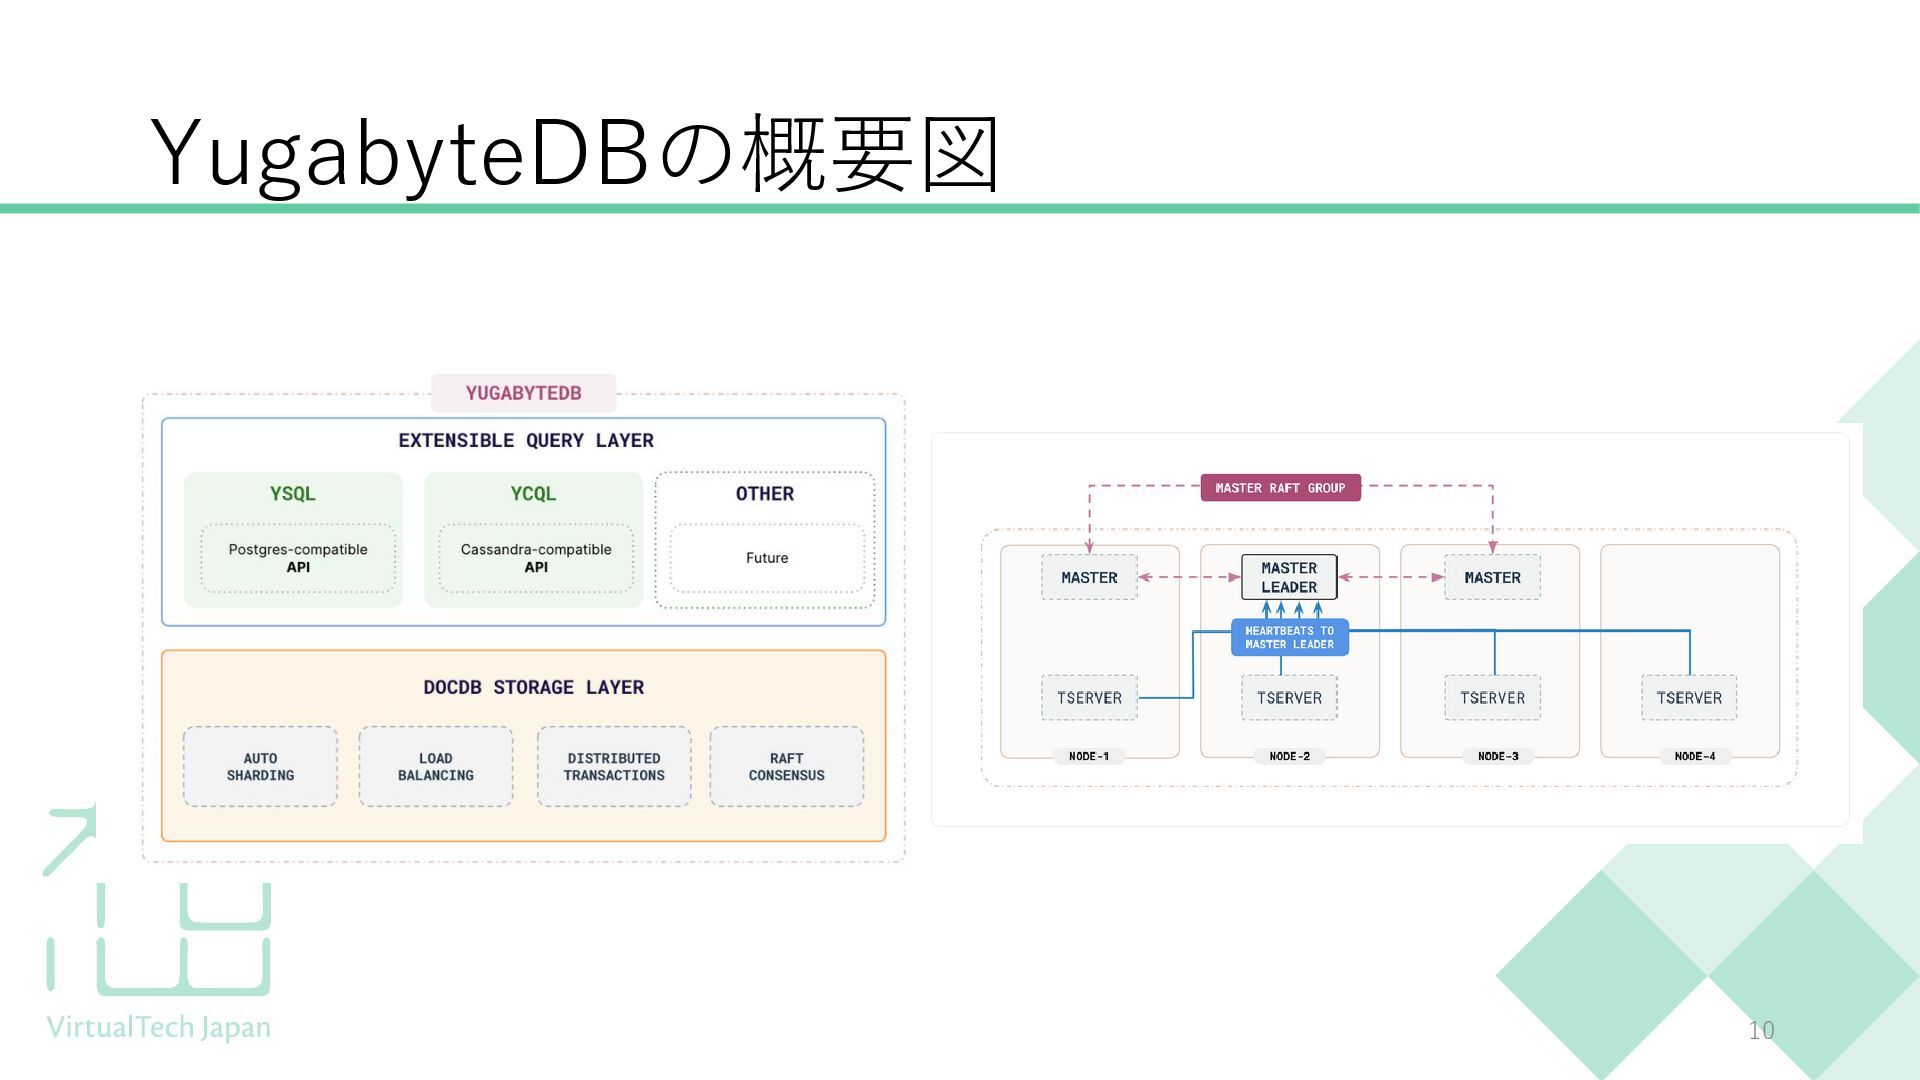
YugabyteDBの基本 • YugabyteDBはクラウドネイティブな分散型SQLデータベース • いい感じにスケール、分散配置 • PostgreSQL互換のオープンソースのソフトウェア • Master ServerとTServerから構成される
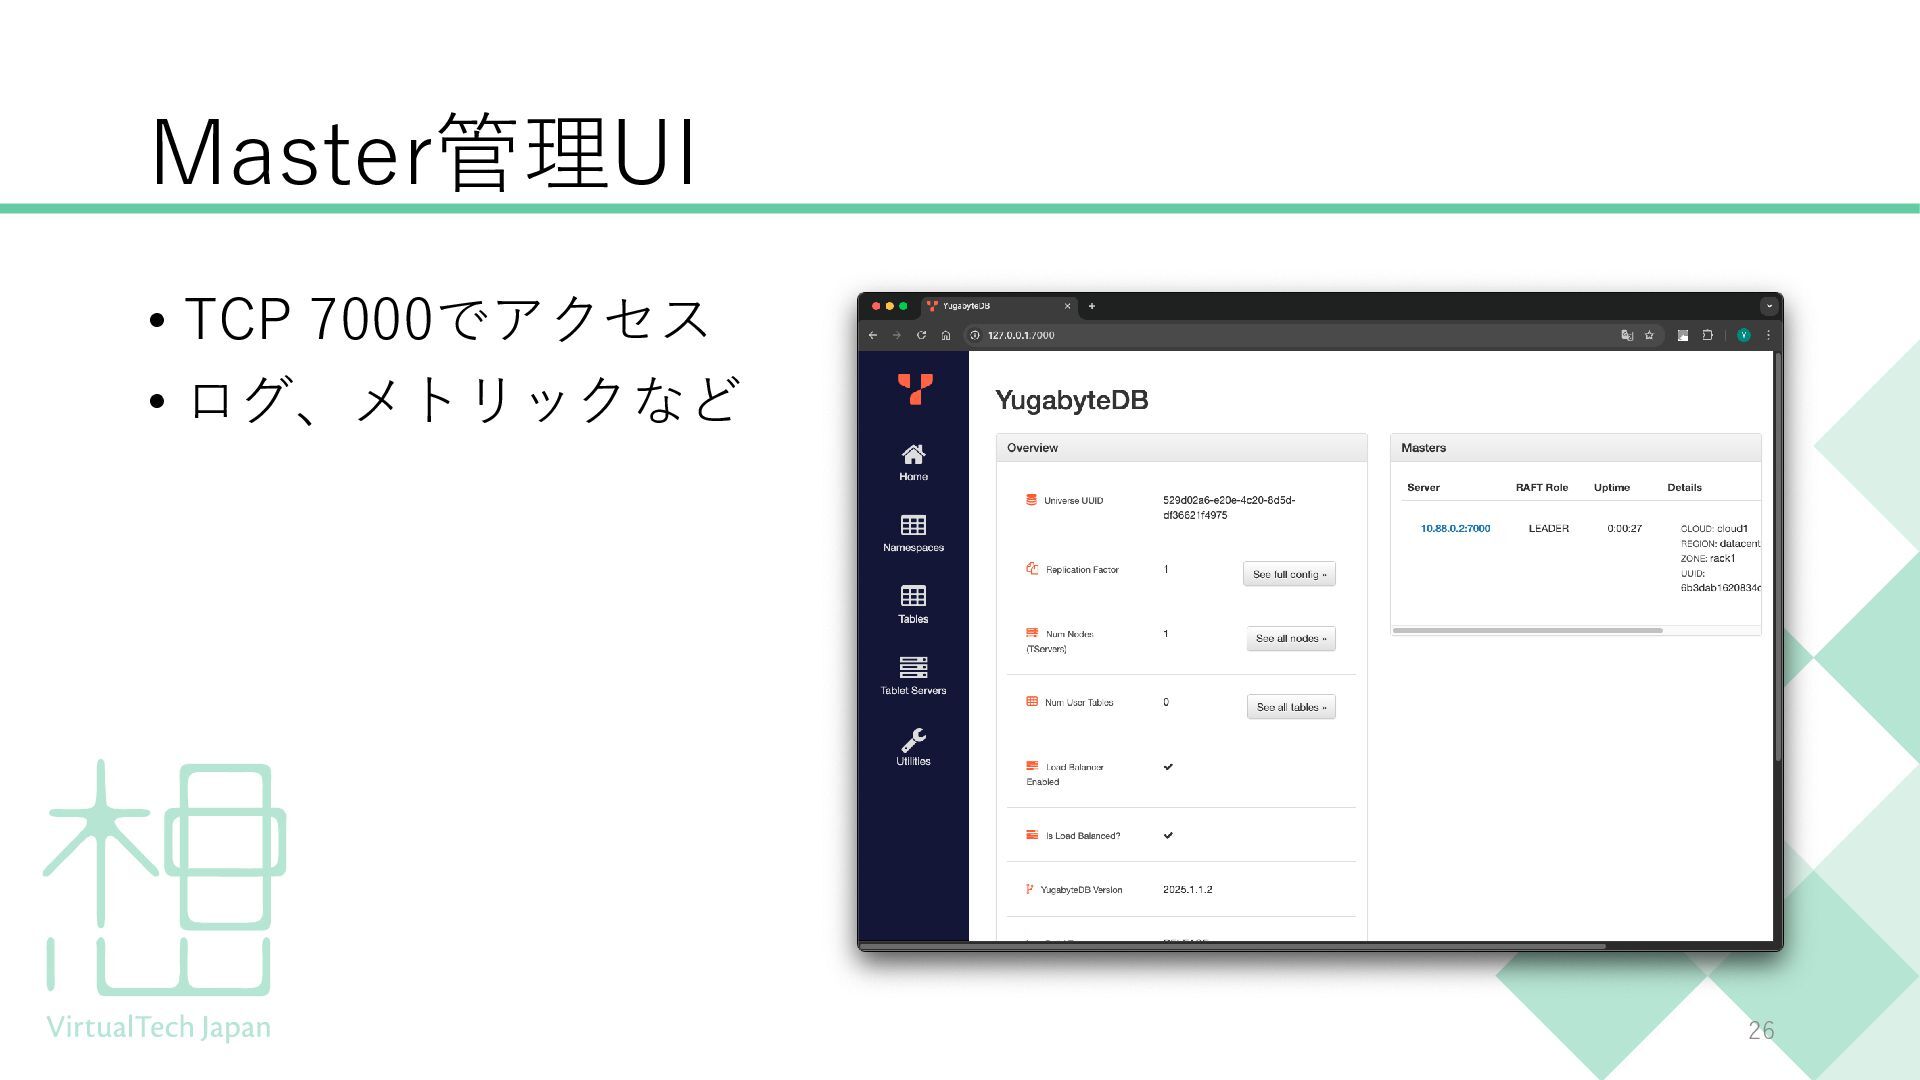
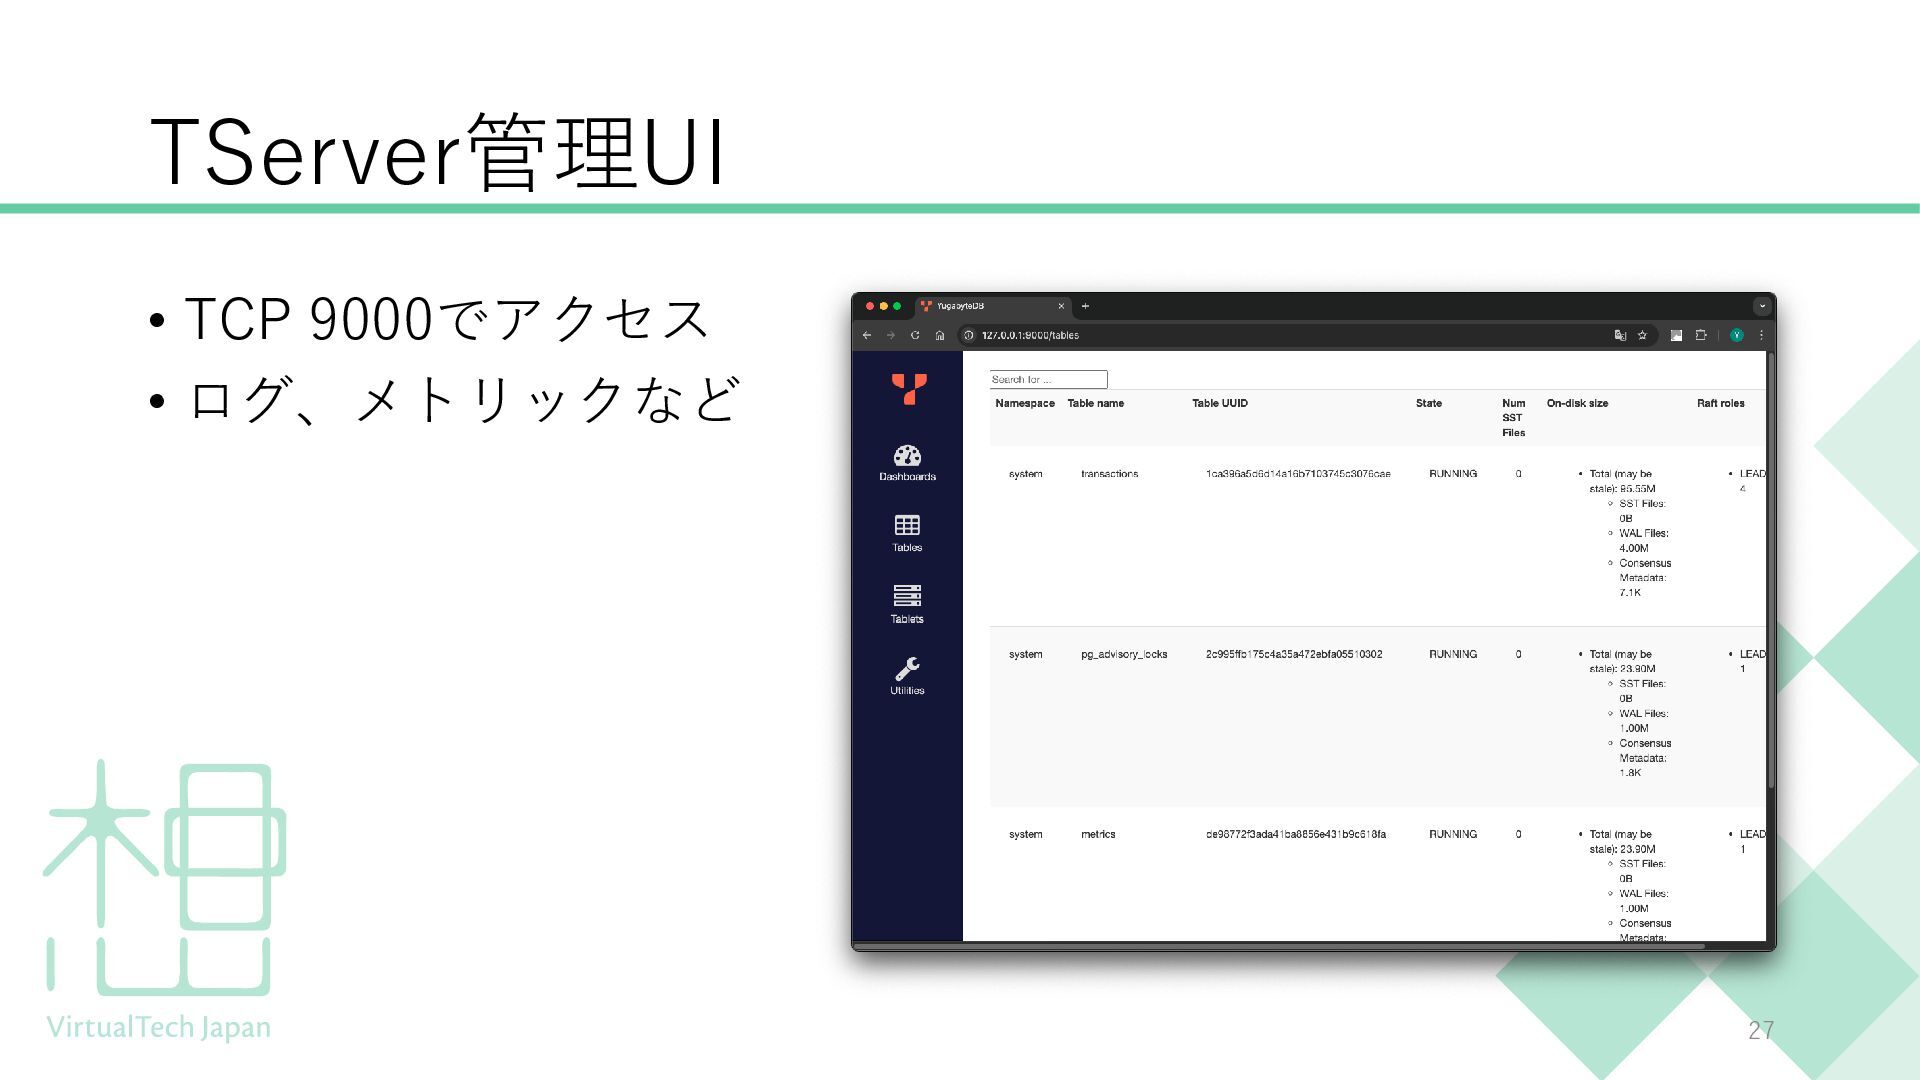
• Master Server • カタログマネージャーとクラスターオーケストレーターを担当 • 多くのバックグラウンドタスクを管理 • Master Server Leader • Master Serverの親 • TServer • テーブルデータをタブレットに分割 • タブレットをTServerの各ノードで管理 8 -
YugabyteDBとクラスタリング • PostgreSQLはPgpool-ⅡやPowerGres HAのようなソフトウェ アを使って、可用性を高める • 追加ソフトウェア • YugabyteDBは元々分散DBを想定した設計であり、追加ソフト ウェアを導入する必要なくクラスタリングできるのが特徴
• 色々な方法でクラスタリングできます • 今回は入門編なので具体的には触れませんが、後述のようなクラス ターの構築方法があります 9 -
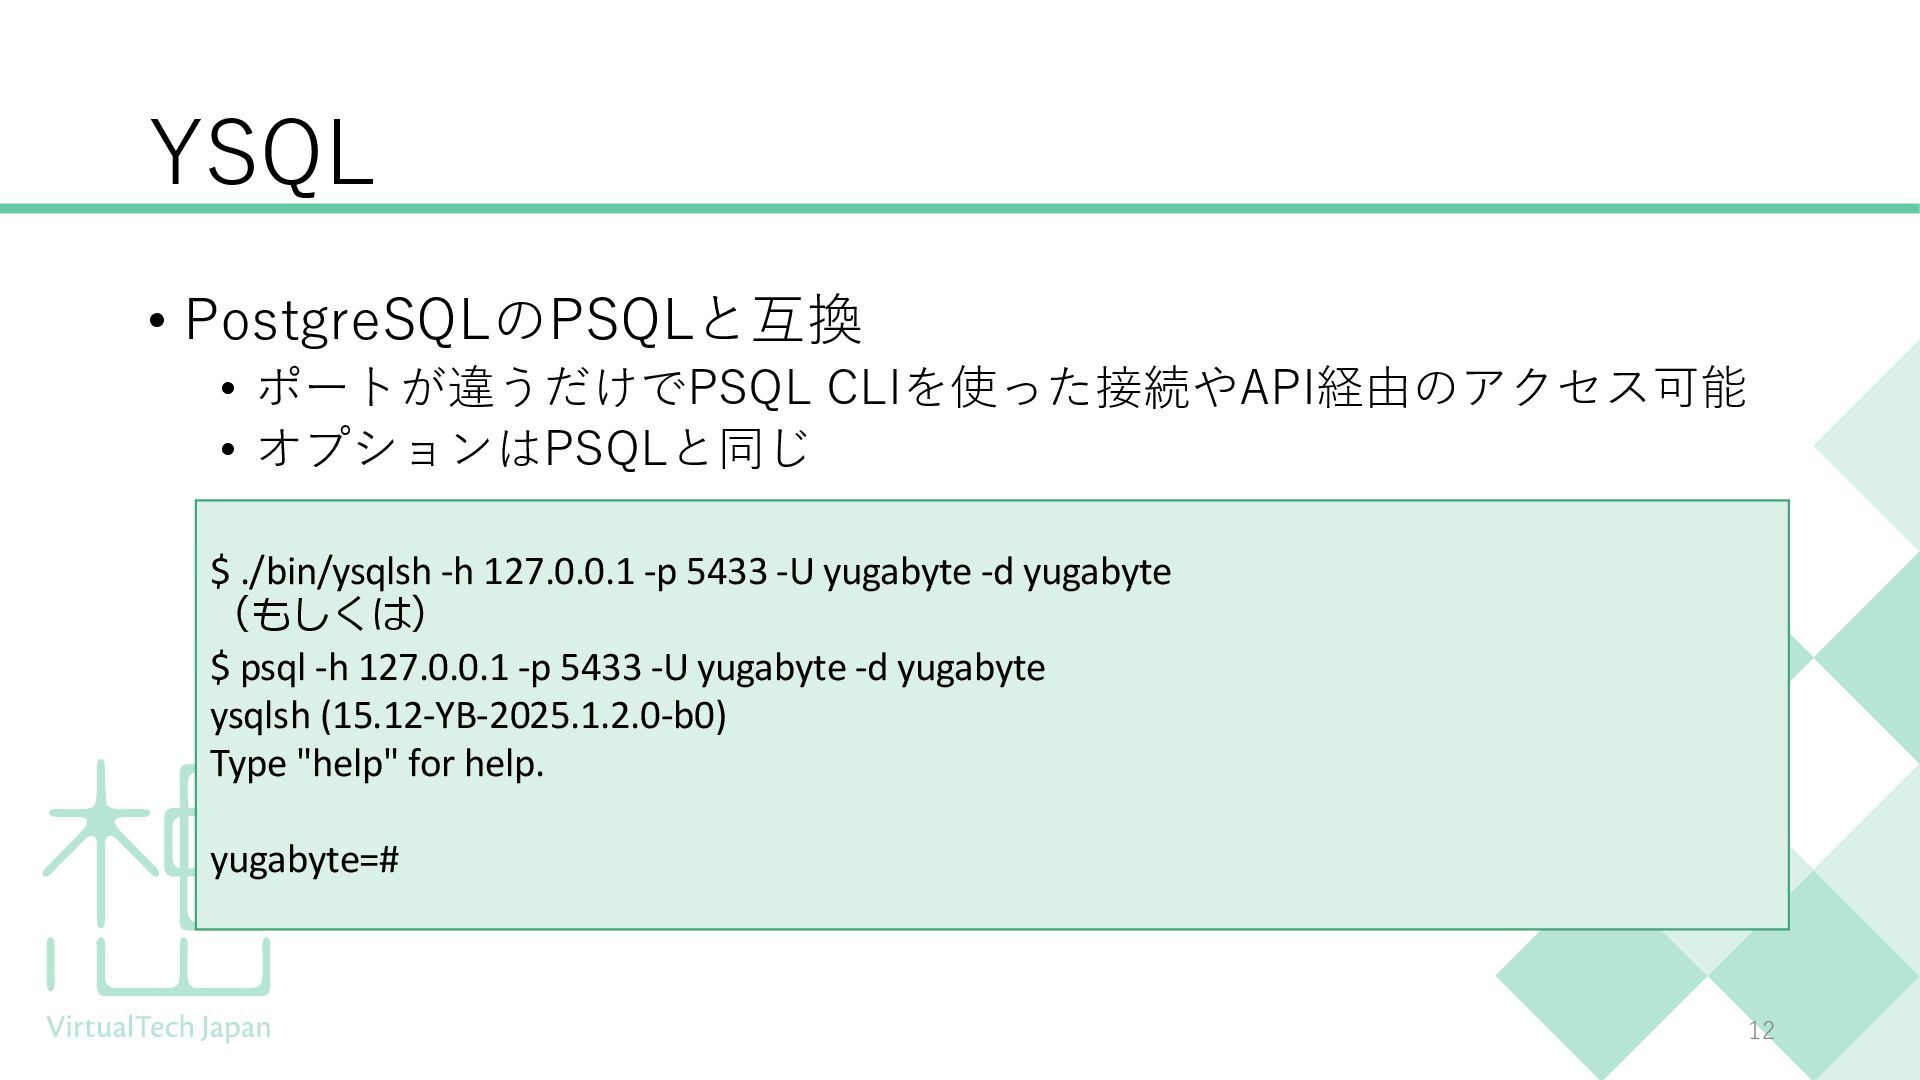
YSQL • PostgreSQLのPSQLと互換 • ポートが違うだけでPSQL CLIを使った接続やAPI経由のアクセス可能 • オプションはPSQLと同じ 12 $
./bin/ysqlsh -h 127.0.0.1 -p 5433 -U yugabyte -d yugabyte (もしくは) $ psql -h 127.0.0.1 -p 5433 -U yugabyte -d yugabyte ysqlsh (15.12-YB-2025.1.2.0-b0) Type "help" for help. yugabyte=# -
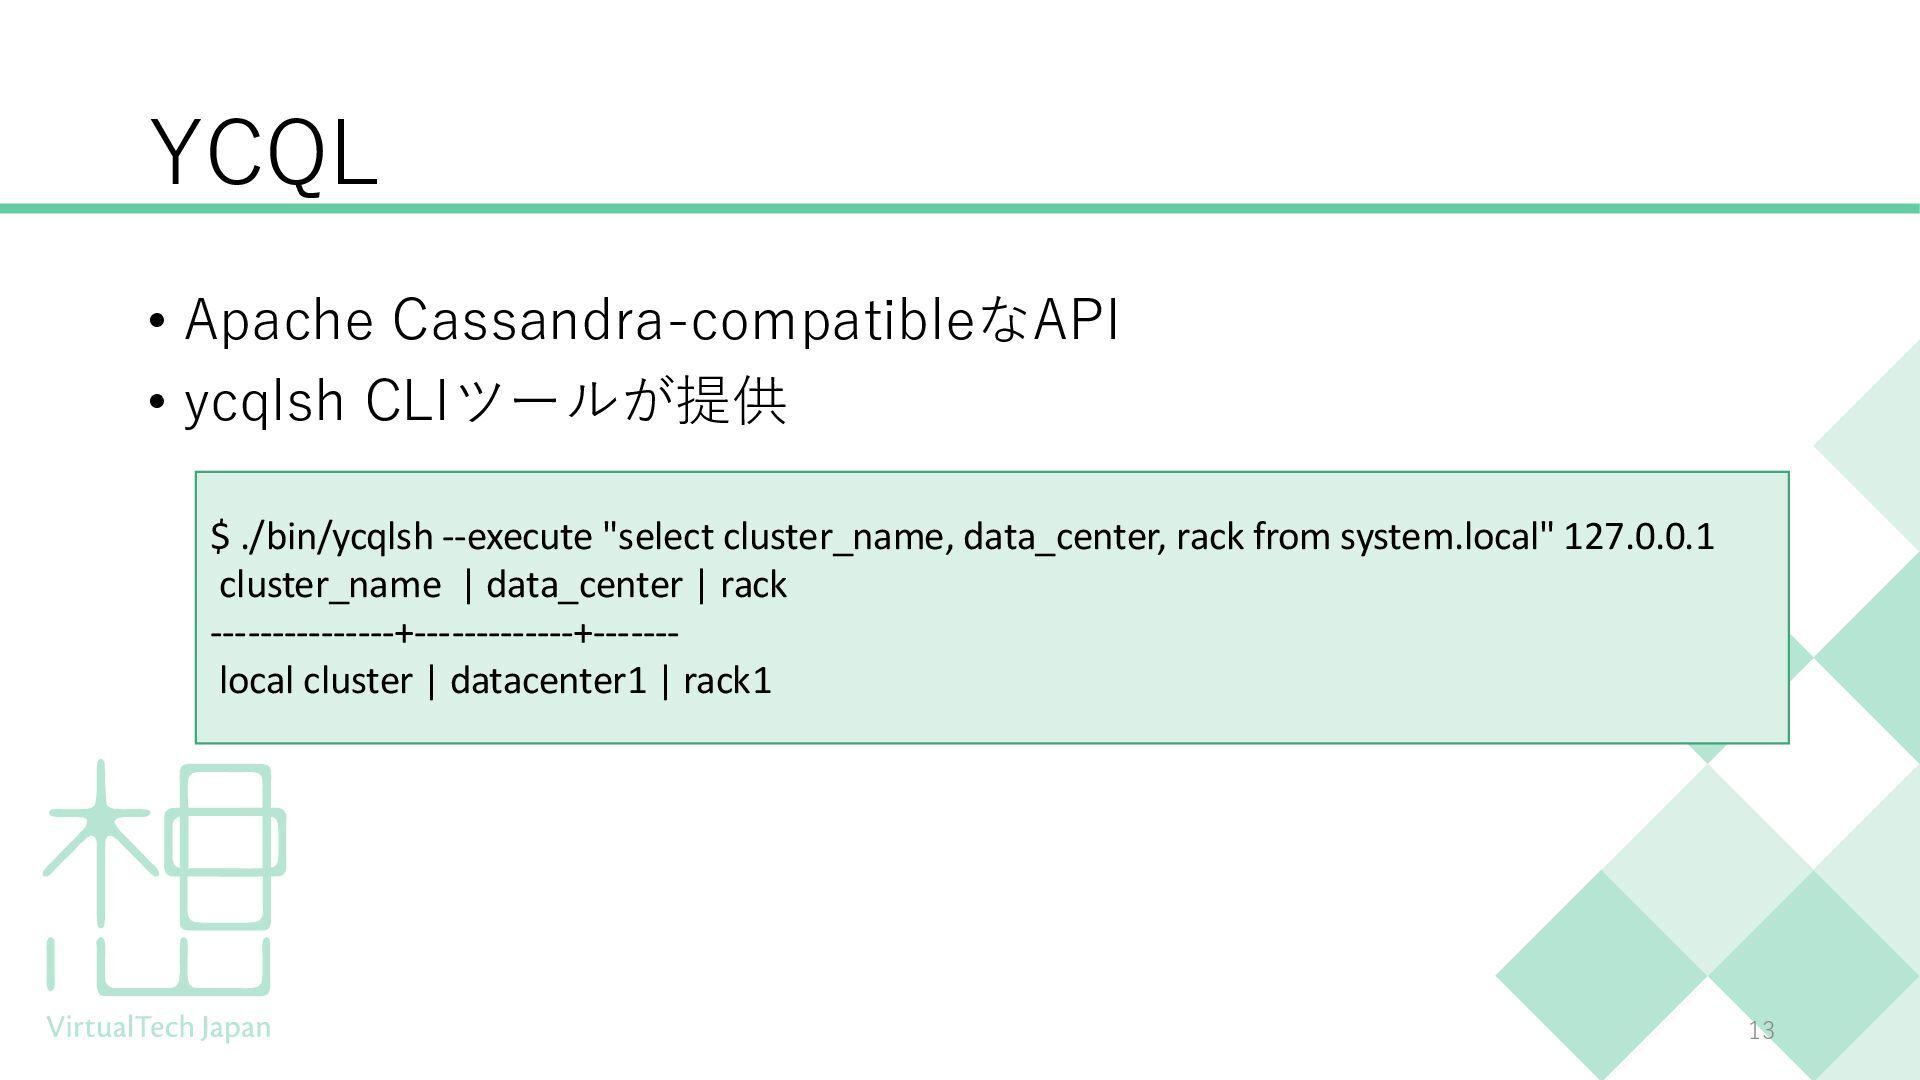
YCQL • Apache Cassandra-compatibleなAPI • ycqlsh CLIツールが提供 13 $ ./bin/ycqlsh
--execute "select cluster_name, data_center, rack from system.local" 127.0.0.1 cluster_name | data_center | rack ---------------+-------------+------- local cluster | datacenter1 | rack1 -
YugabyteDBの下回りの話(1) • YugabyteDB は論理的にクエリ層とストレージ層の2つのレイ ヤーに分割 • クエリ層 • 要するにサーバーにSQLクエリを投げて応答する役割 •
ユーザーリクエストの処理およびリクエストを適切なデータに送信す る責任を担っている • YugabyteDBはYSQLとYCQLという2つのAPIを提供している • API経由で送信されたユーザークエリを取得し、適切なタブレットセッ トとの間でデータを送受信 14 -
YugabyteDBの下回りの話(2) • YugabyteDB は論理的にクエリ層とストレージ層の2つのレイ ヤーに分割 • ストレージ層 • 要するにデータ保存とノード間同期をする役割 •
データをディスクに最適に保存し、レプリケーションと一貫性を管理 する役割を果たす • タブレットデータはより高いパフォーマンスと持続性を実現するため に、RocksDB上に構築されたドキュメントストアDocDBによって最適 に保存および管理 • タブレットは耐障害性、高可用性、および耐障害性を実現するために 常に強調して複製が行われる 15 -
YugabyteDBとリリース • LTS • v2024.2が最新 • 商用向けの安定版 • 現時点(2025/11/25)ではPostgreSQL 11互換
• STS • v2025.1が最新 • LTSとPreviewの中間的な位置付け • 現時点(2025/11/25)ではPostgreSQL 15互換 • Preview • 名が示す通りの開発版 16 -
つまりYugabyteDBは? • 割と簡単に動くので怖くはない • スケール、サービス可用性は基本機能、追加ソフトウェア導入 の必要は無し • スケールするので、コンテナで実行するアプリケーションバッ クエンドとして相性が良い •
最新版はPostgreSQL 15と互換性があるので移行は比較的ラク • オープンソースで開発 • YugabyteDBはApache License 2.0 • サービスの管理機能以外はオープンソースで無料 17 -
YugabyteDBをインストールしてみよう • ローカルで動かす方法、DockerやPodmanで動かす方法、 Kubernetesで動かす方法を紹介します • 次のサイトで配布されており、手順に従って導入できます • https://download.yugabyte.com/ • ローカルインストールはmacOSとLinuxに対応
• DockerやPodmanはオフィシャルのイメージで実行 • Kubernetesはシングルノードやマルチノード構成に対応 • クラウドのK8sやオンプレK8sで利用可能 19 -
ローカルインストールでの実行例(1) • macOSとLinuxに対応 • aarch64とamd64に対応 • 現バージョンはPython 3.11が必要 • tarballをダウンロード展開して、次を実行
• ./bin/yugabyted start --advertise_address 127.0.0.1 • advertise_addressは未指定でも良いが、マルチノードで動かす場合は 必須。未指定の場合、ディストリビューションによってアドレスが変 わる場合がある • Ubuntuには127.0.1.1とhostsに書かれていて...という話 20 -
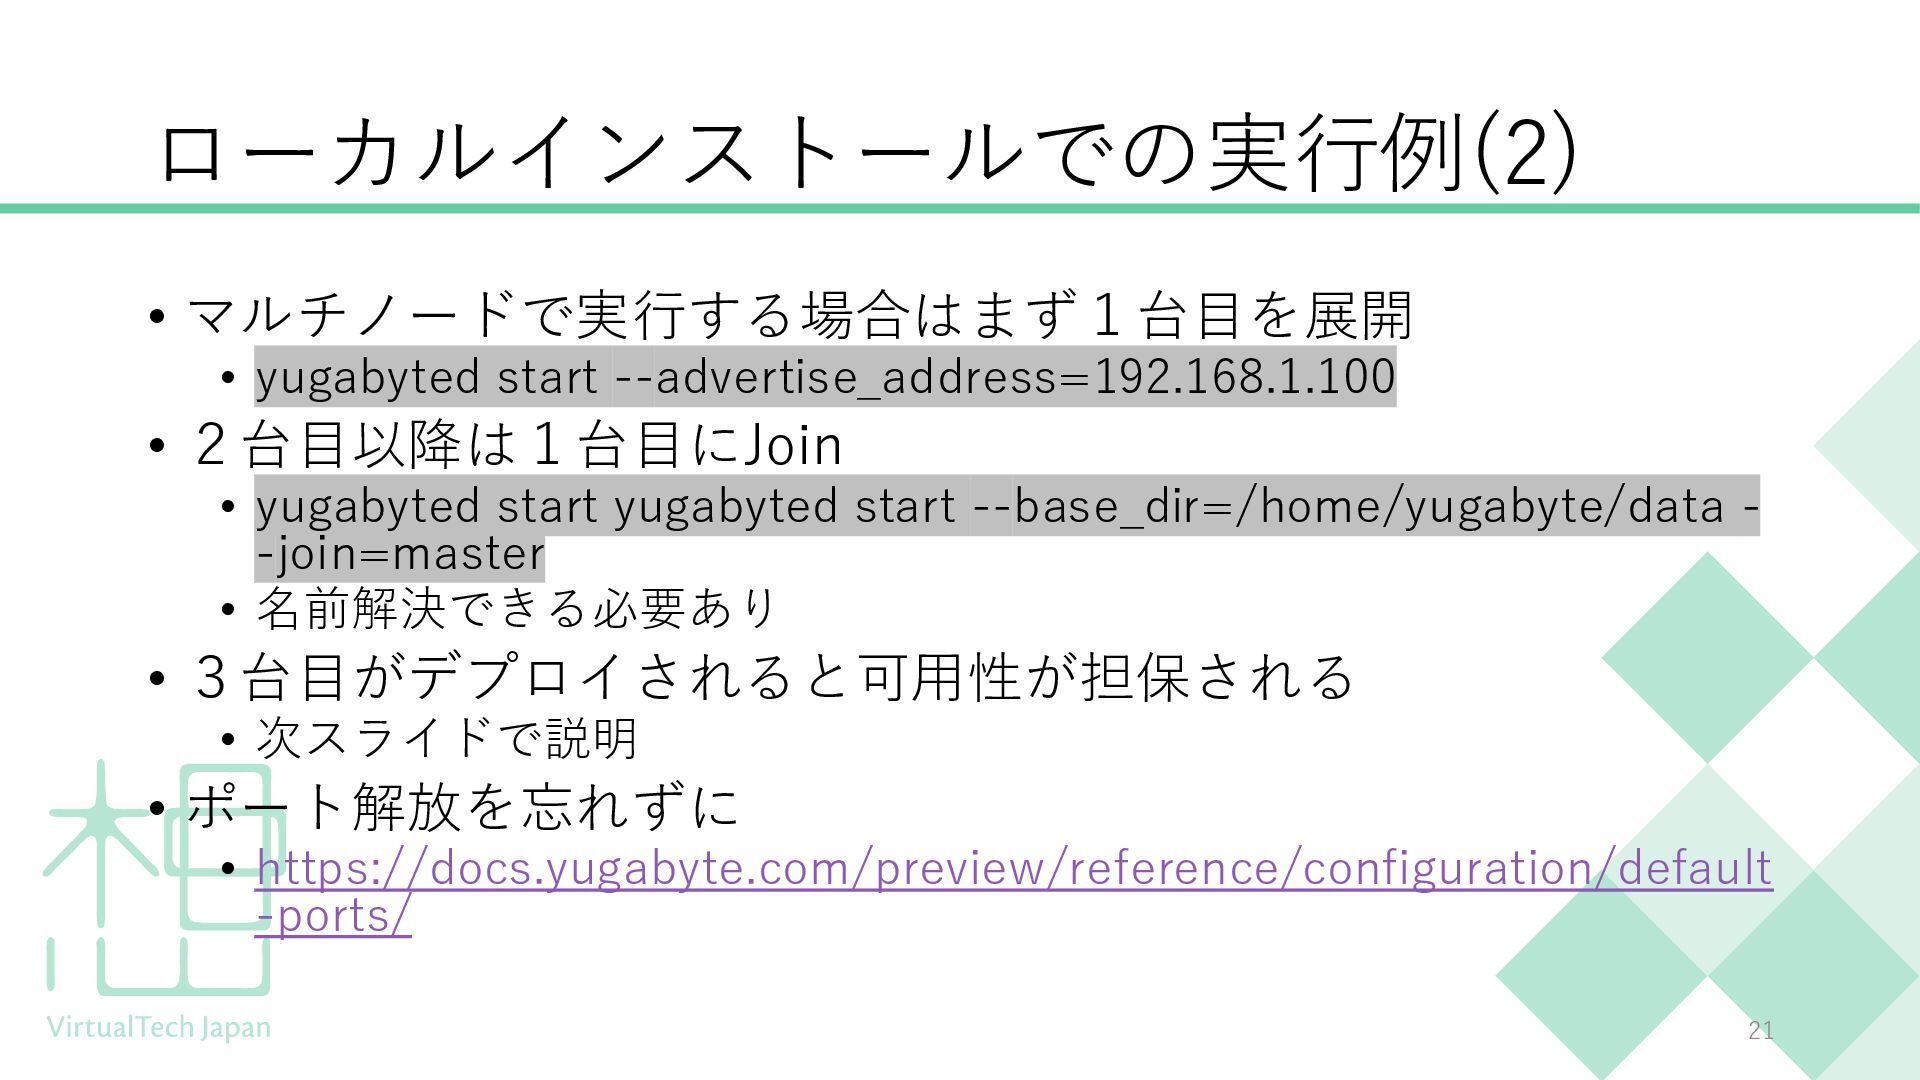
ローカルインストールでの実行例(2) • マルチノードで実行する場合はまず1台目を展開 • yugabyted start --advertise_address=192.168.1.100 • 2台目以降は1台目にJoin •
yugabyted start yugabyted start --base_dir=/home/yugabyte/data - -join=master • 名前解決できる必要あり • 3台目がデプロイされると可用性が担保される • 次スライドで説明 • ポート解放を忘れずに • https://docs.yugabyte.com/preview/reference/configuration/default -ports/ 21 -
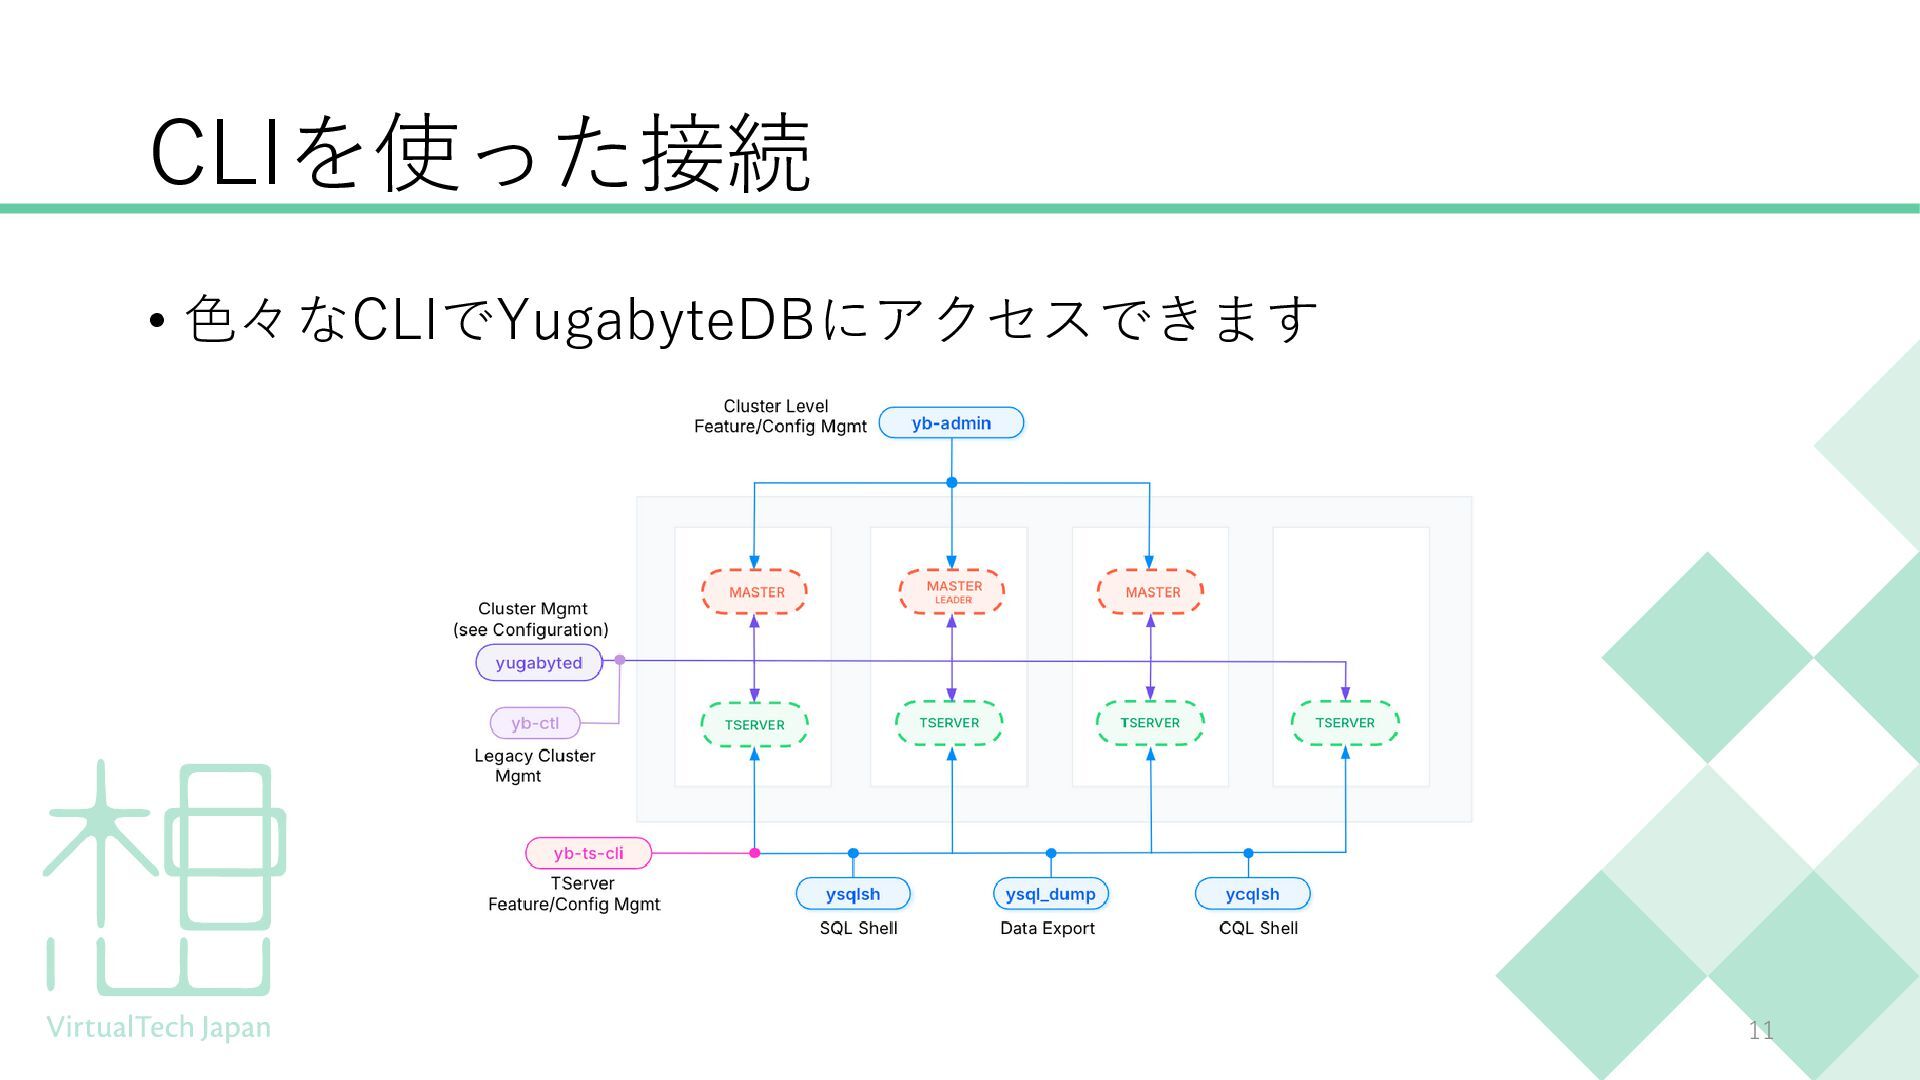
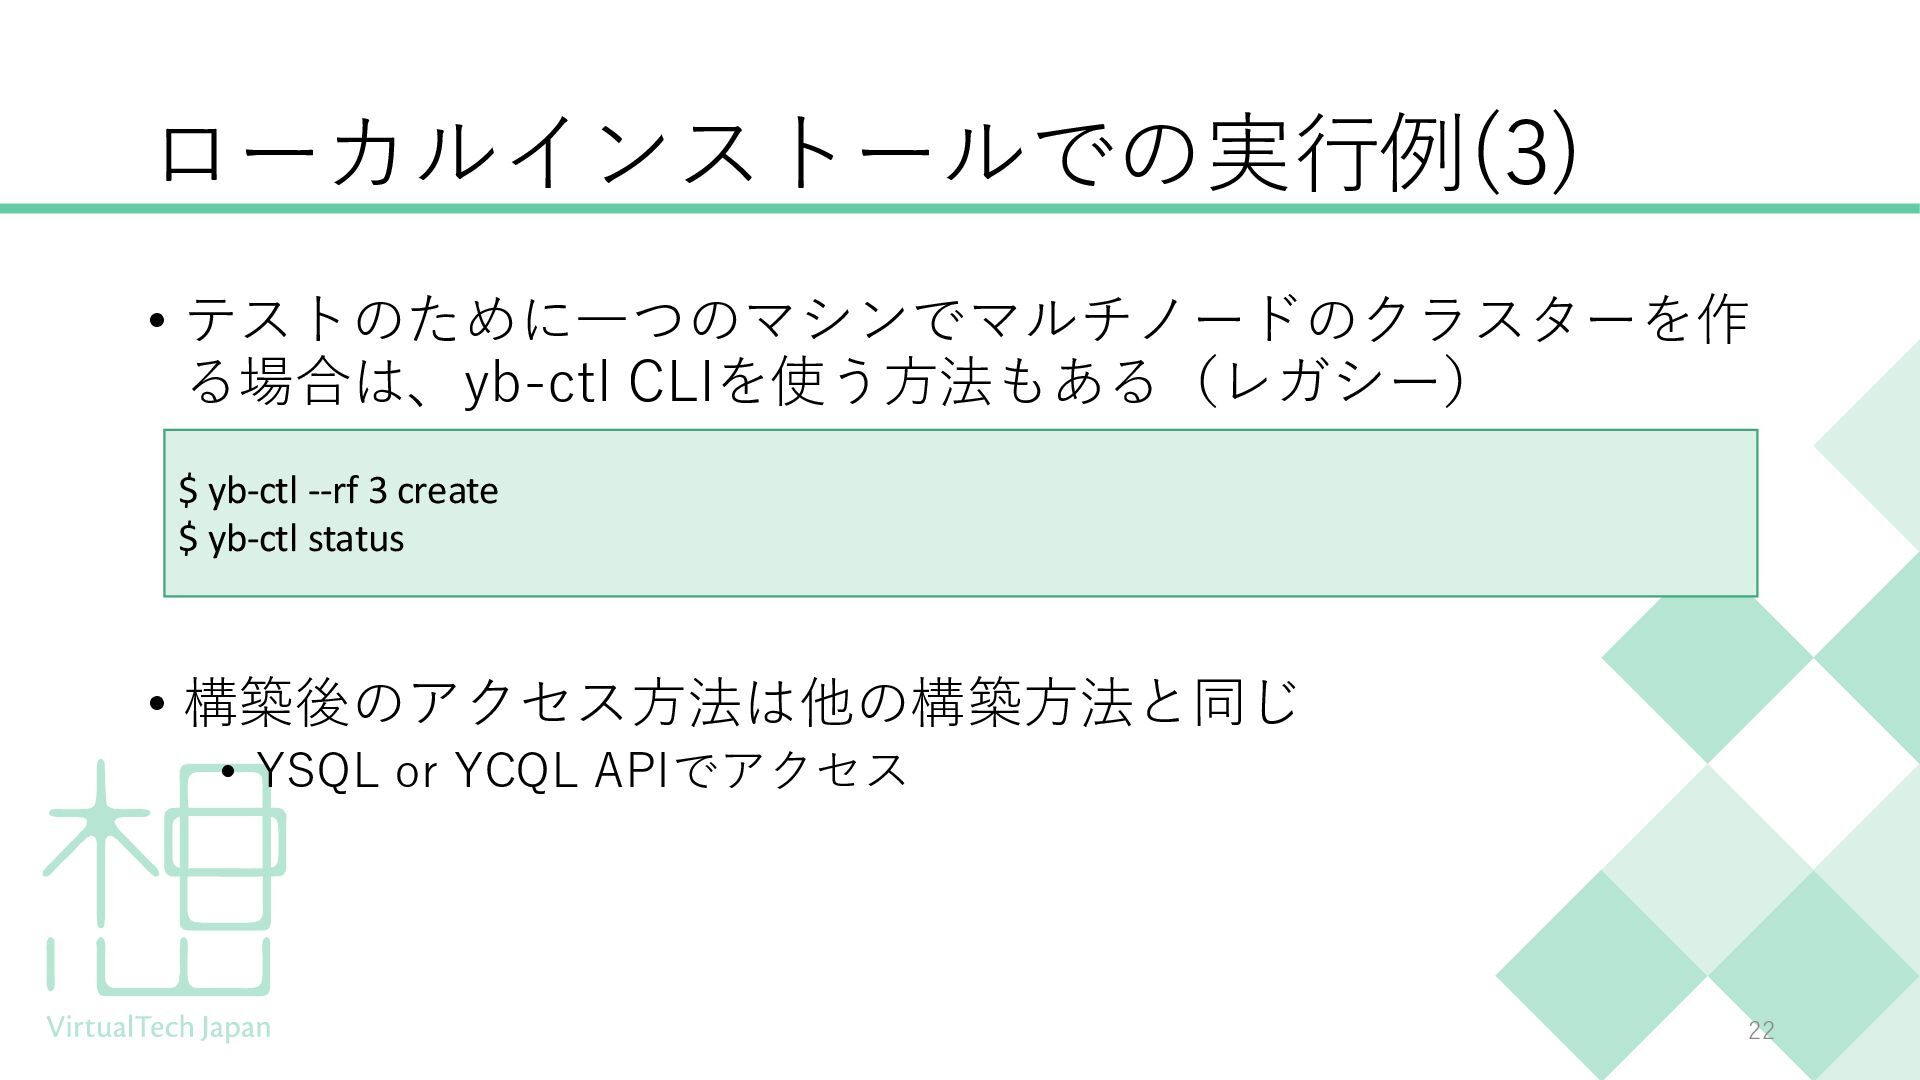
ローカルインストールでの実行例(3) • テストのために一つのマシンでマルチノードのクラスターを作 る場合は、yb-ctl CLIを使う方法もある(レガシー) • 構築後のアクセス方法は他の構築方法と同じ • YSQL or
YCQL APIでアクセス 22 $ yb-ctl --rf 3 create $ yb-ctl status -
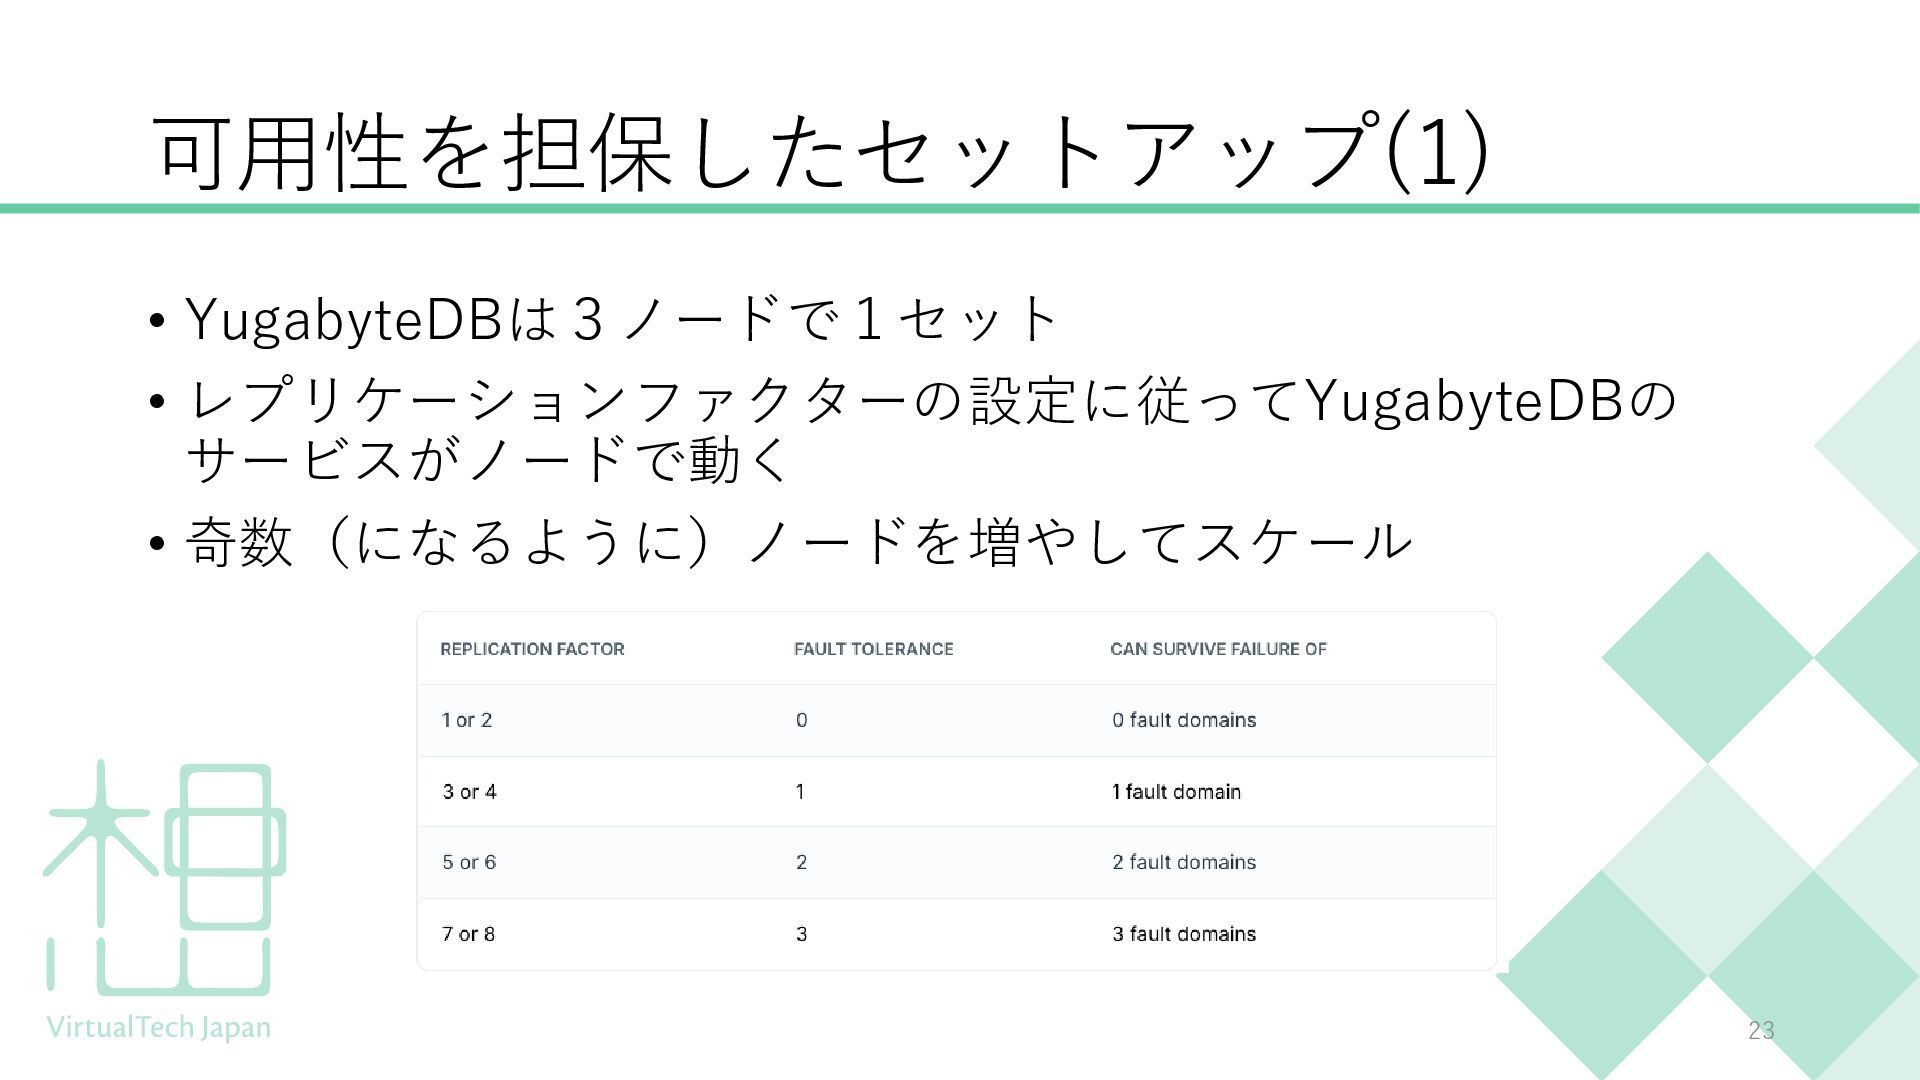
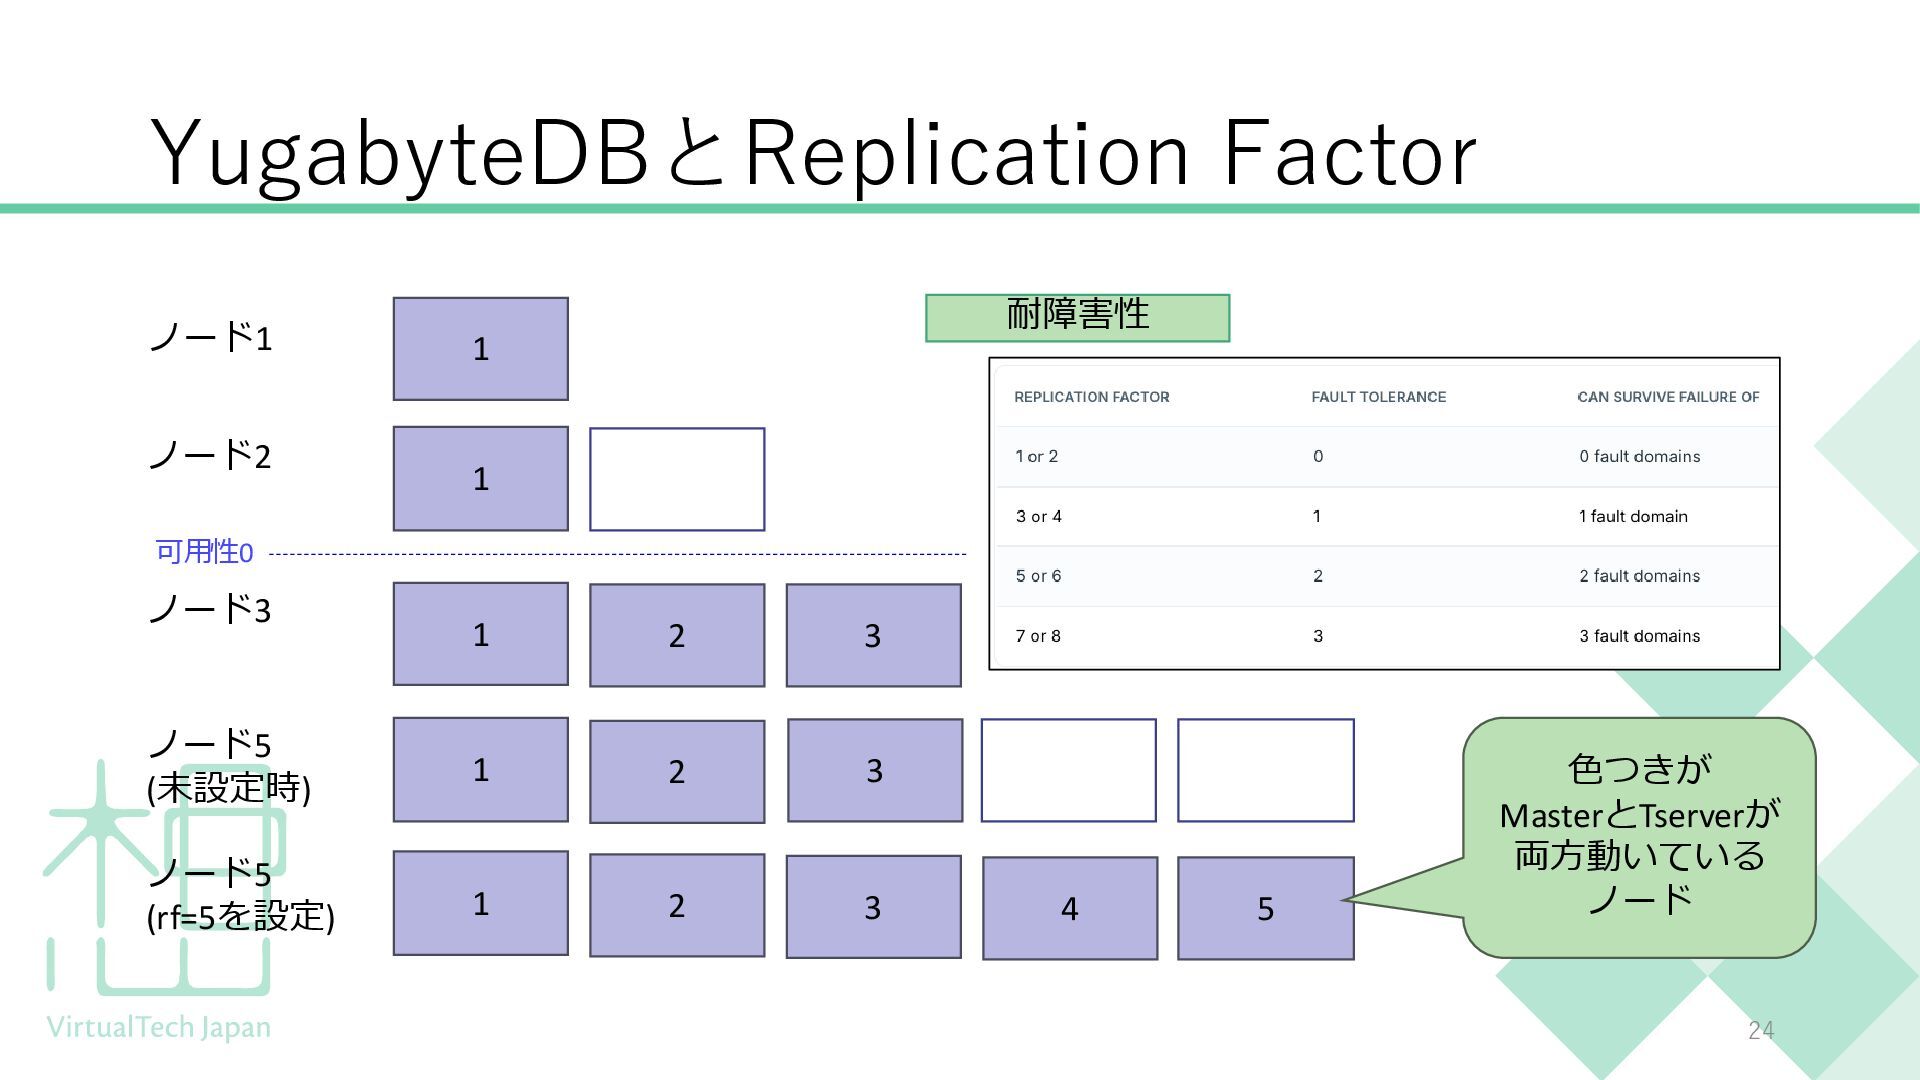
YugabyteDBとReplication Factor 24 1 ノード1 ノード2 ノード3 ノード5 (未設定時) 1
1 2 3 1 2 5 4 3 ノード5 (rf=5を設定) 1 2 3 耐障害性 色つきが MasterとTserverが 両方動いている ノード 可用性0 -
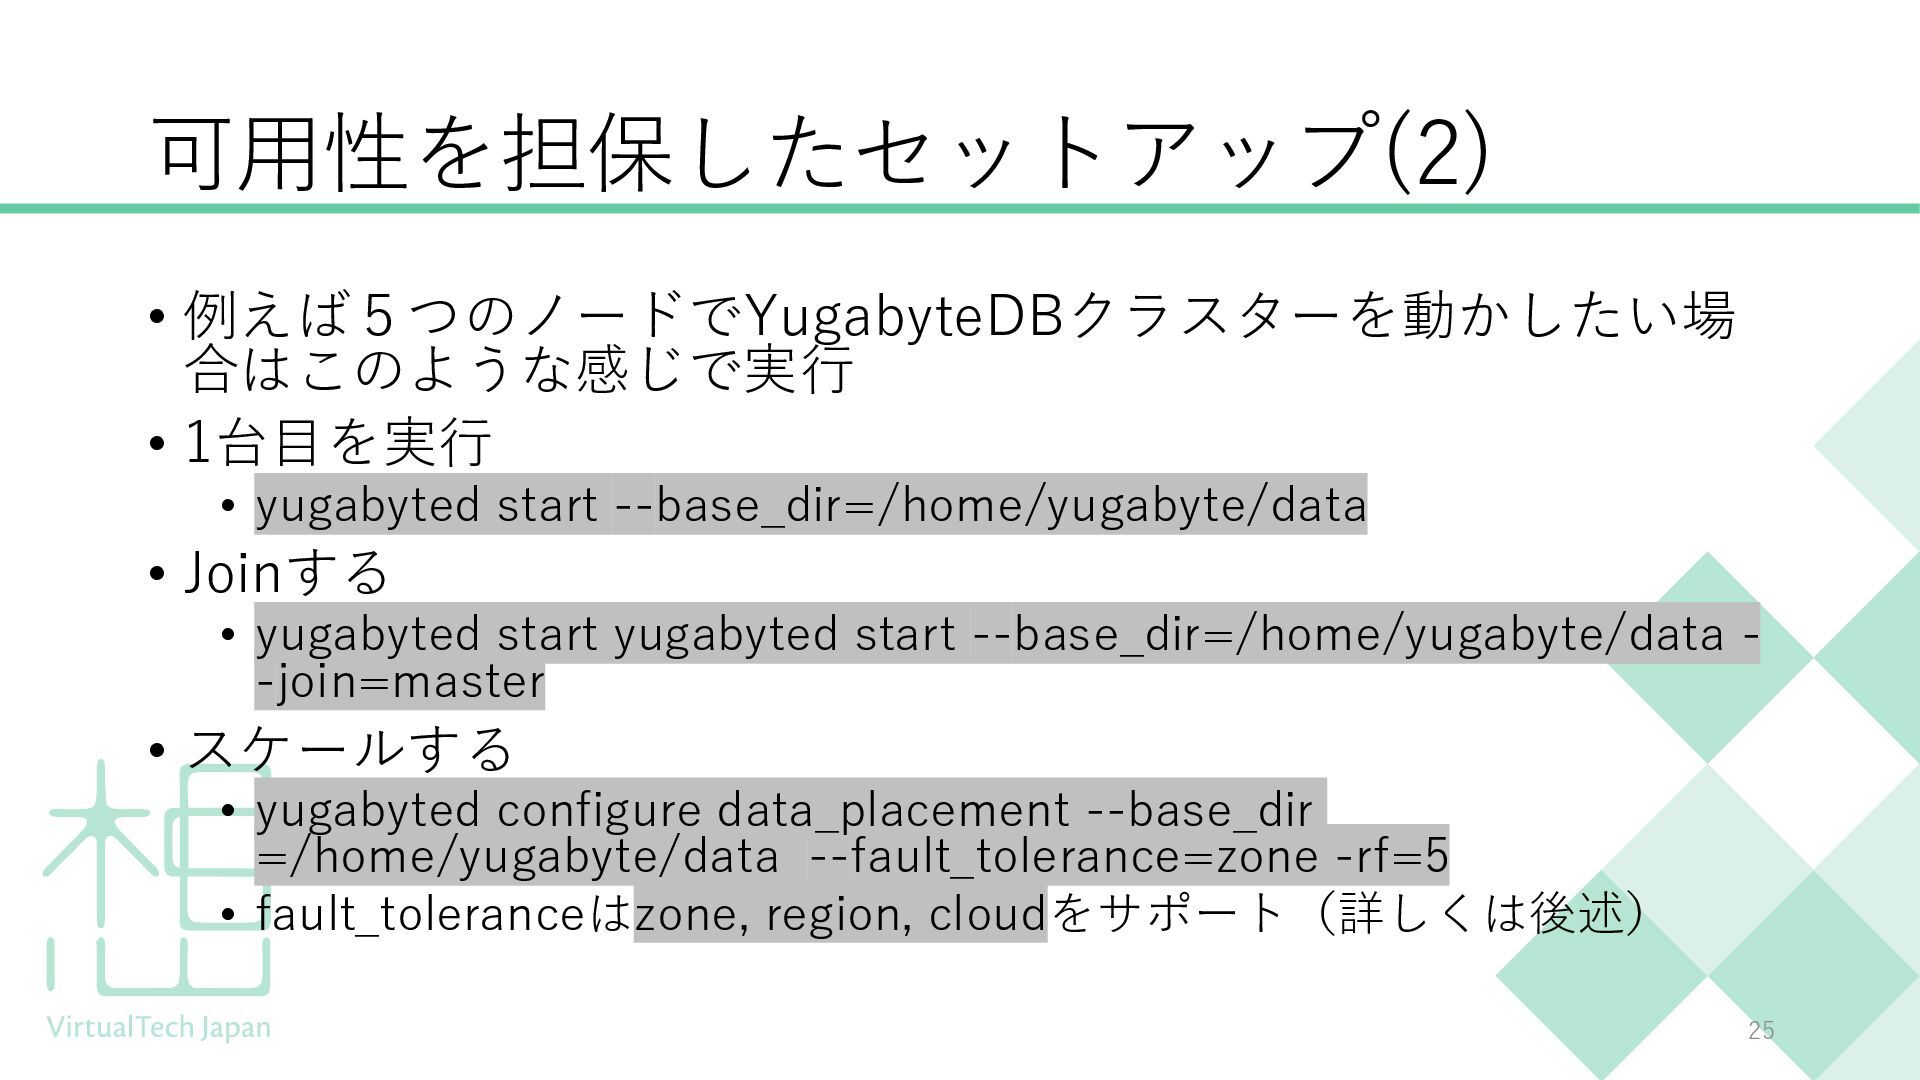
可用性を担保したセットアップ(2) • 例えば5つのノードでYugabyteDBクラスターを動かしたい場 合はこのような感じで実行 • 1台目を実行 • yugabyted start --base_dir=/home/yugabyte/data
• Joinする • yugabyted start yugabyted start --base_dir=/home/yugabyte/data - -join=master • スケールする • yugabyted configure data_placement --base_dir =/home/yugabyte/data --fault_tolerance=zone -rf=5 • fault_toleranceはzone, region, cloudをサポート(詳しくは後述) 25 -
コンテナイメージ • イメージはDocker Hubで配布されている • https://hub.docker.com/r/yugabytedb/yugabyte • https://download.yugabyte.com/#docker • Dockerで動かす前提だが、Podmanでも動作
• このスライドでは2025.1.2.0-b110を指定していますが、試す頃 には新しいイメージが出ているかも? 30 -
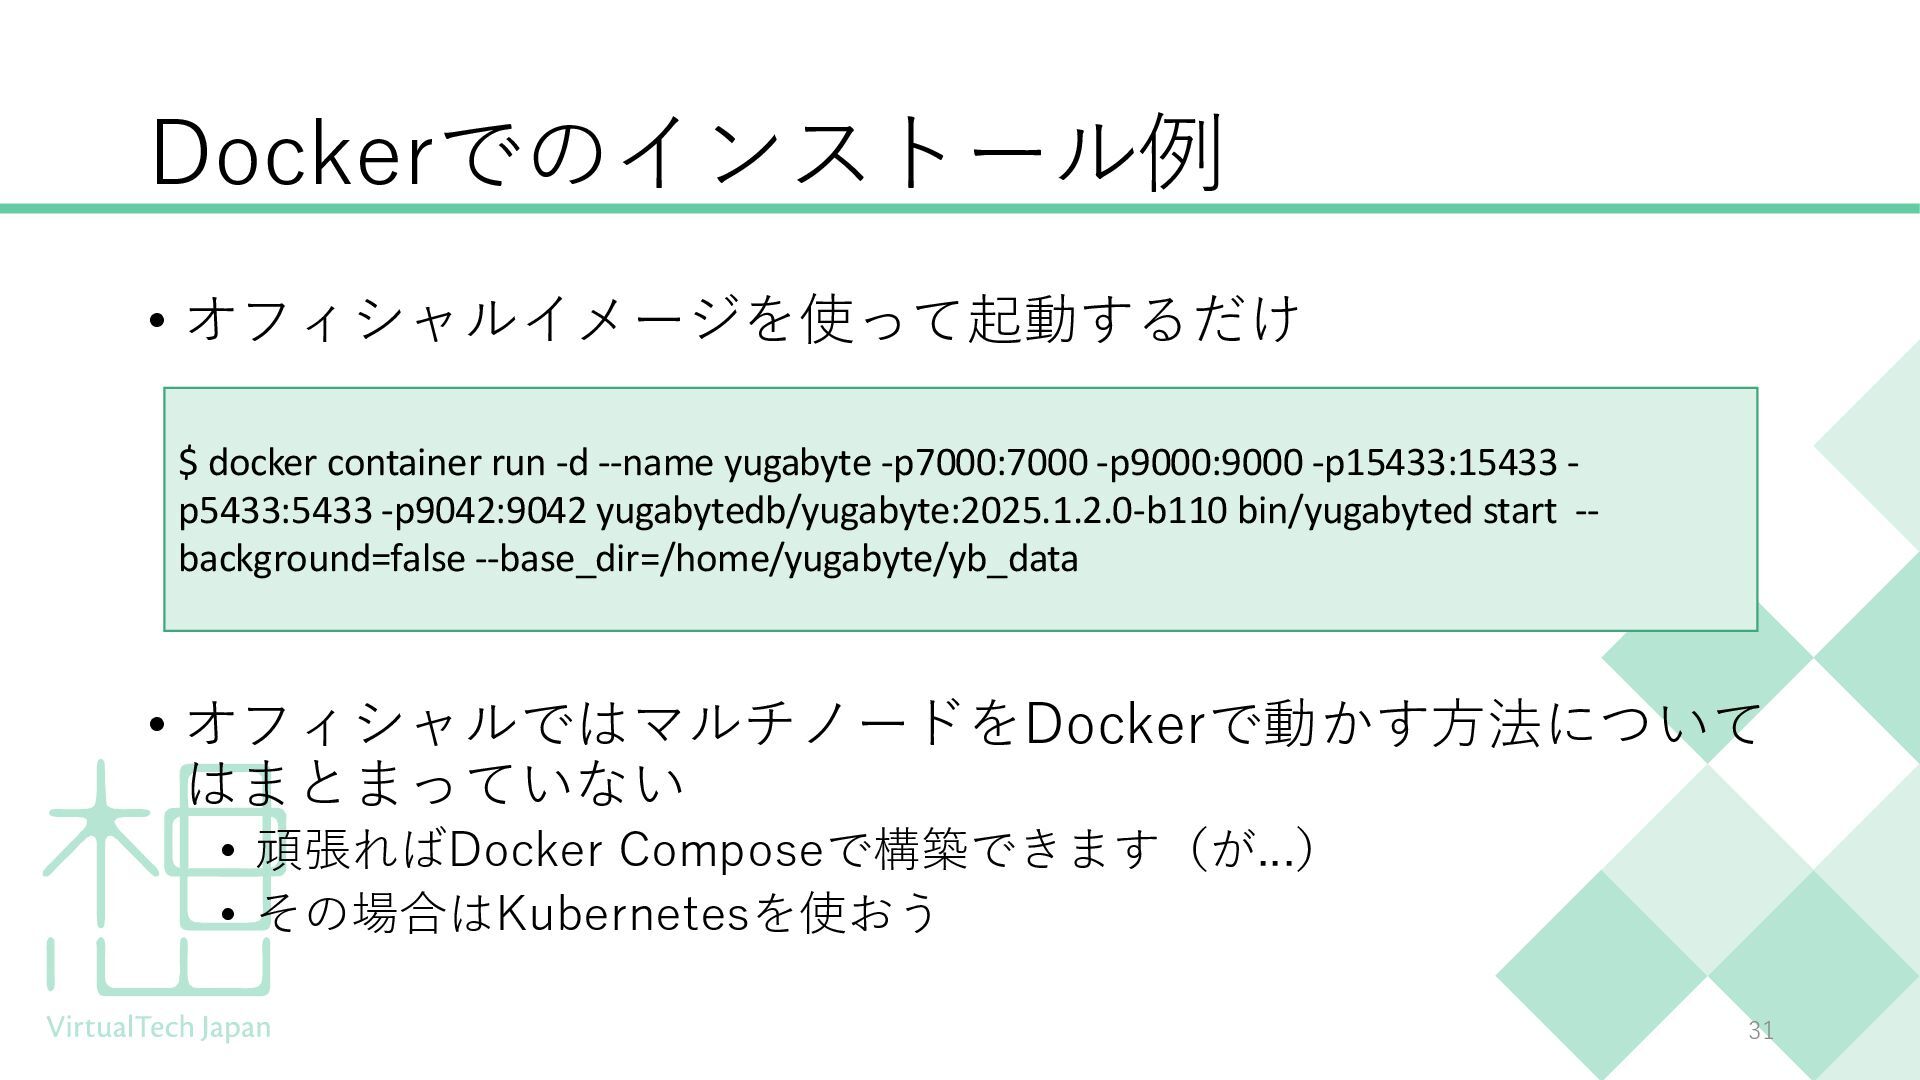
Dockerでのインストール例 • オフィシャルイメージを使って起動するだけ • オフィシャルではマルチノードをDockerで動かす方法について はまとまっていない • 頑張ればDocker Composeで構築できます(が...) •
その場合はKubernetesを使おう 31 $ docker container run -d --name yugabyte -p7000:7000 -p9000:9000 -p15433:15433 - p5433:5433 -p9042:9042 yugabytedb/yugabyte:2025.1.2.0-b110 bin/yugabyted start -- background=false --base_dir=/home/yugabyte/yb_data -
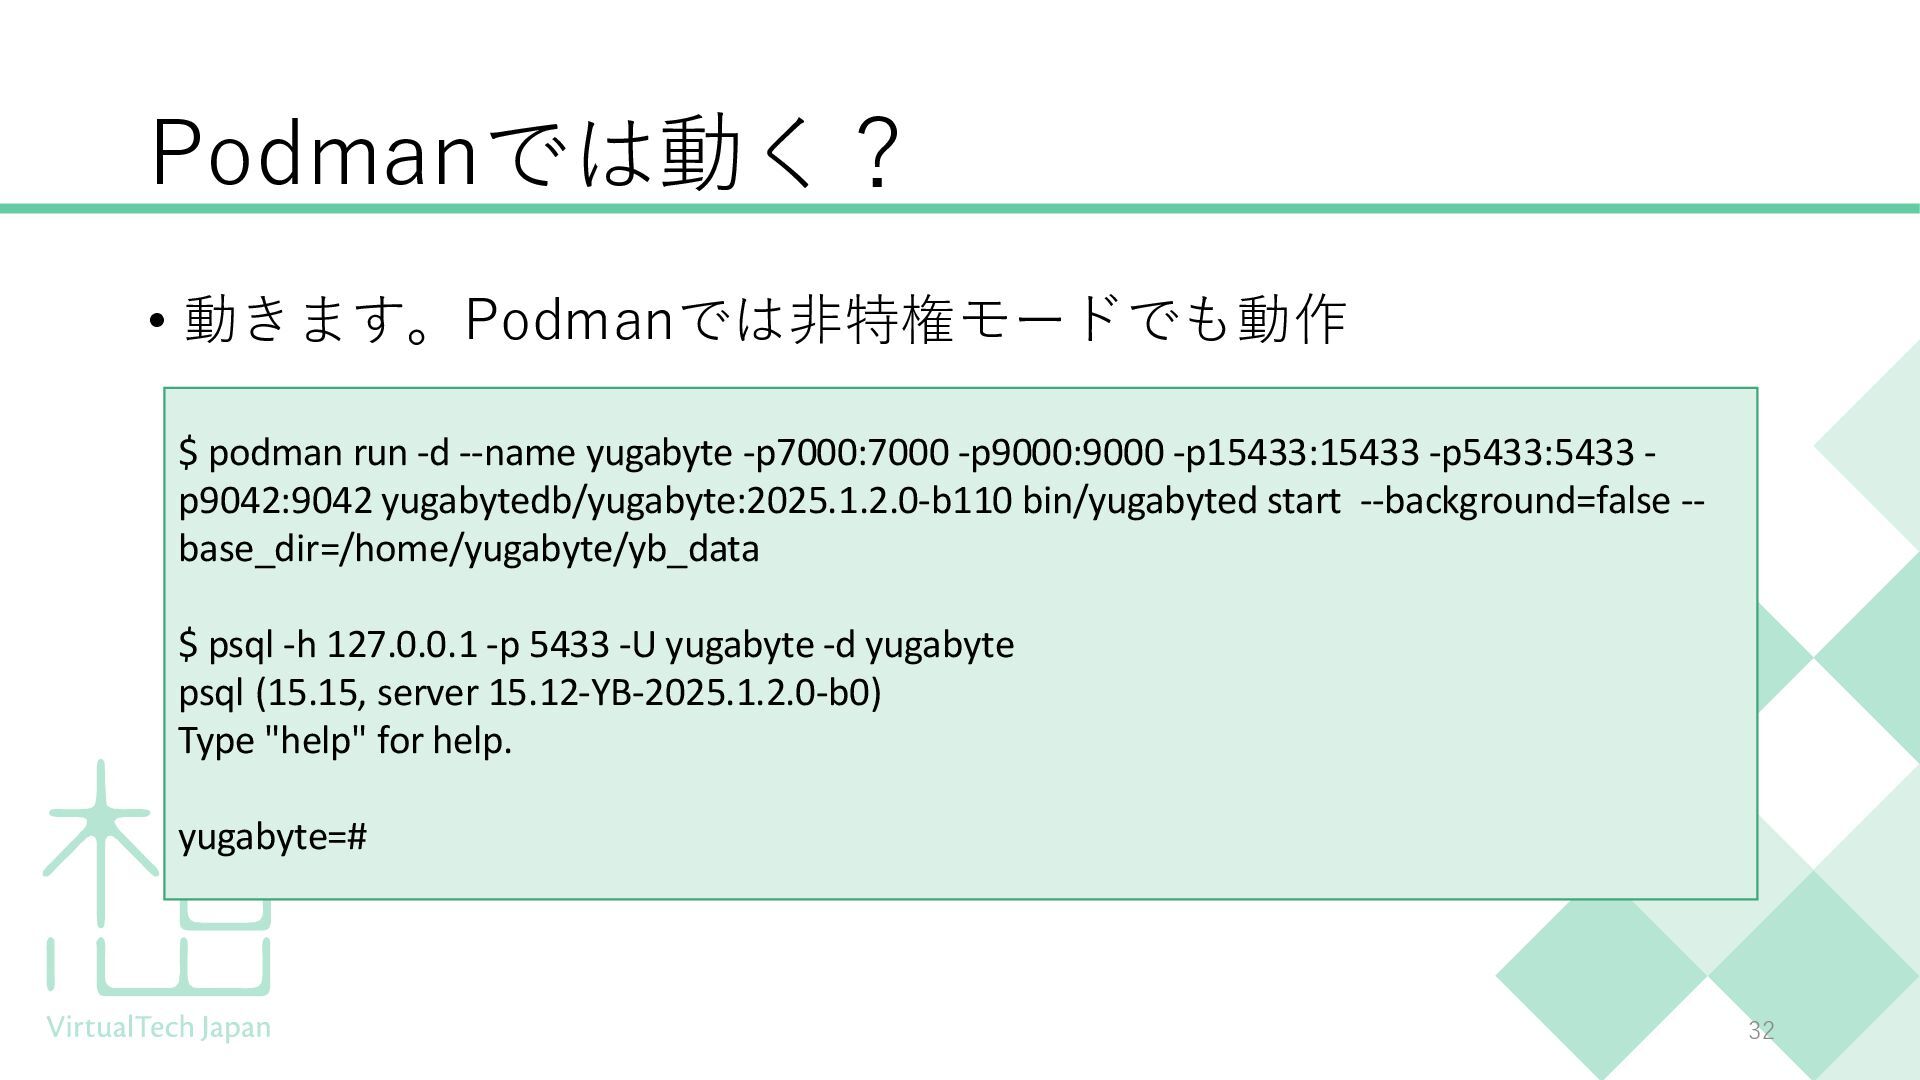
Podmanでは動く? • 動きます。Podmanでは非特権モードでも動作 32 $ podman run -d --name yugabyte
-p7000:7000 -p9000:9000 -p15433:15433 -p5433:5433 - p9042:9042 yugabytedb/yugabyte:2025.1.2.0-b110 bin/yugabyted start --background=false -- base_dir=/home/yugabyte/yb_data $ psql -h 127.0.0.1 -p 5433 -U yugabyte -d yugabyte psql (15.15, server 15.12-YB-2025.1.2.0-b0) Type "help" for help. yugabyte=# -
Kubernetesで動かすには • ローカルでは • helm chartがある • minikubeなどで動かせる • マルチノードでは
• Amazon AWS,Google Cloud, Microsoft Azureなどで • オンプレK8sにはKubernetes Operatorがある • 詳細は https://download.yugabyte.com/ 33 -
「言語」からYugabyteDBを使う • YugabyteDBはYSQLとYCQL APIを実装している • PostgreSQLやCassandraに接続してデータ入出力するやり方で、 色々な 言語からYugabyteDBを利用可能 • 例えば次のような言語に対応
• Python • Go • Rust • Node.js • Ruby • Java • C, C#, C++ • PHP • 詳細は https://docs.yugabyte.com/preview/develop/tutorials/build- apps/ 36 -
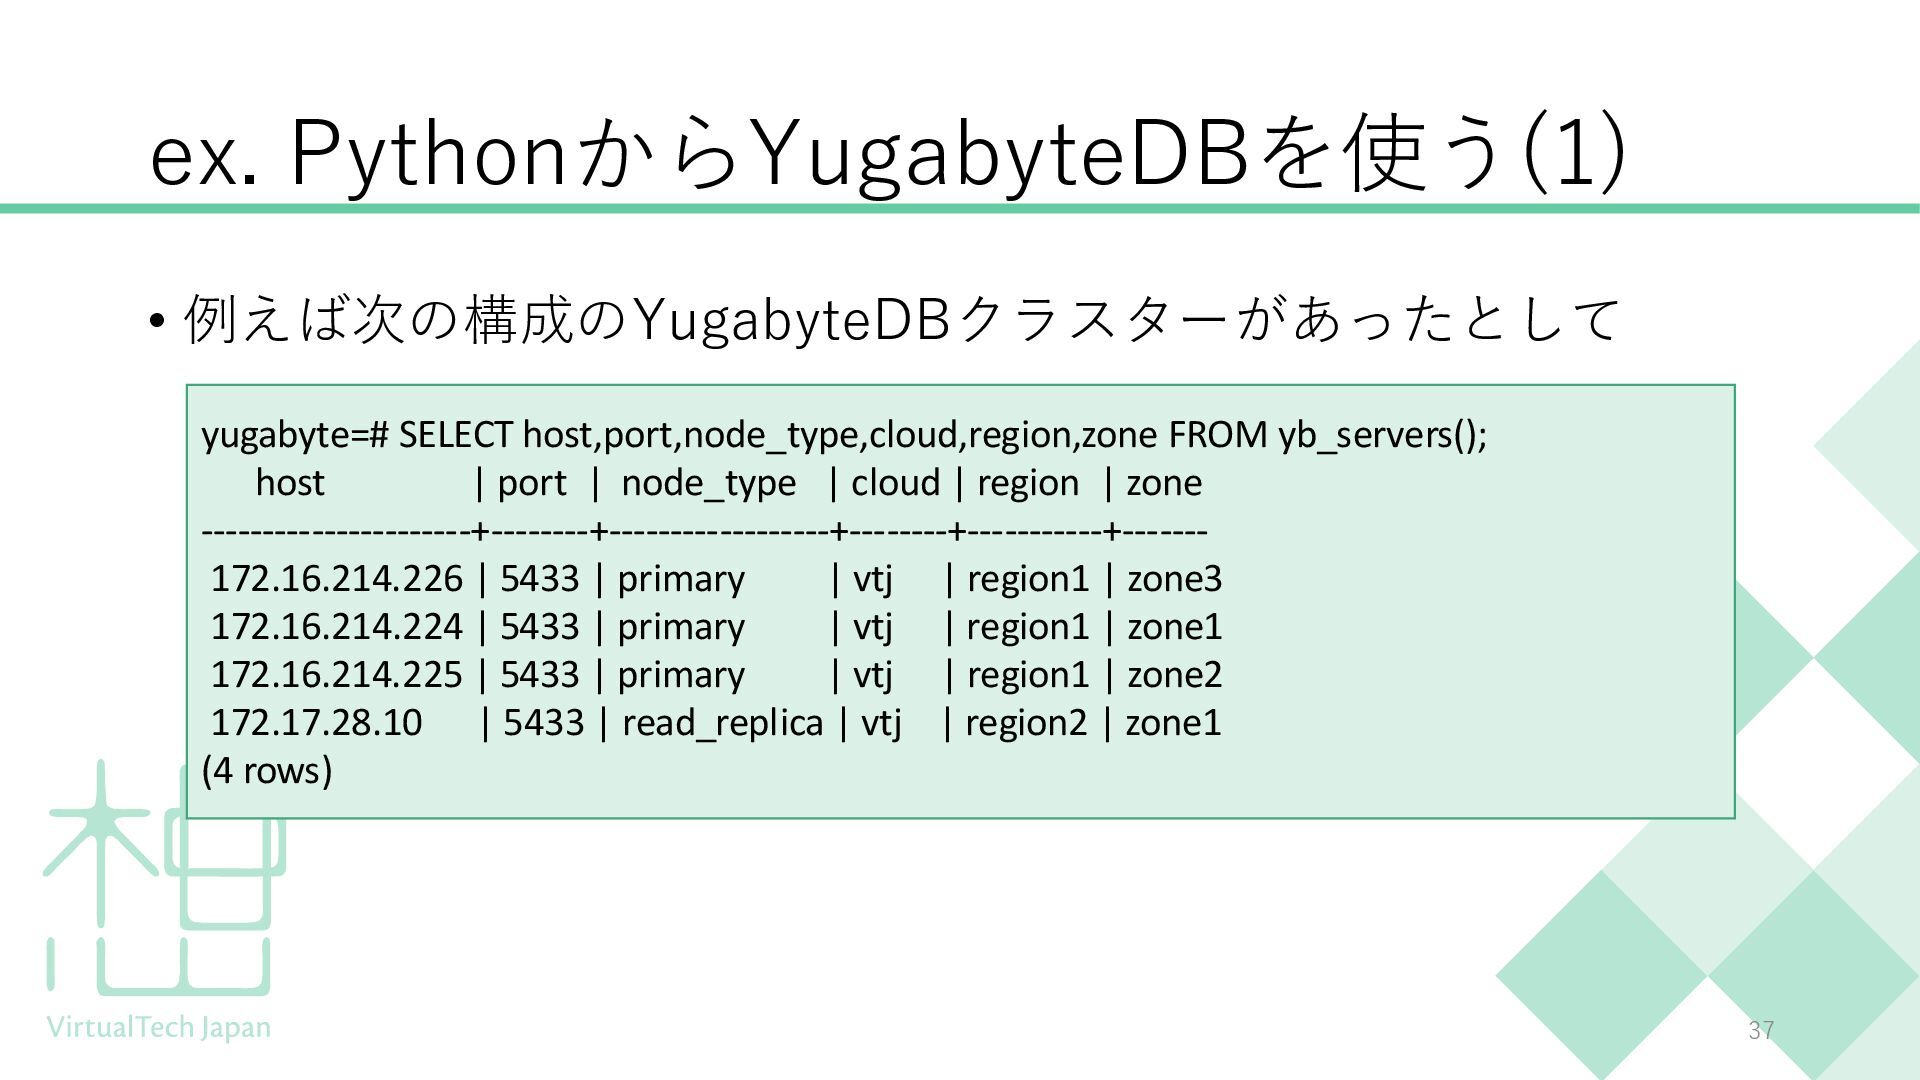
ex. PythonからYugabyteDBを使う(1) • 例えば次の構成のYugabyteDBクラスターがあったとして 37 yugabyte=# SELECT host,port,node_type,cloud,region,zone FROM yb_servers();
host | port | node_type | cloud | region | zone ----------------------+--------+------------------+--------+-----------+------- 172.16.214.226 | 5433 | primary | vtj | region1 | zone3 172.16.214.224 | 5433 | primary | vtj | region1 | zone1 172.16.214.225 | 5433 | primary | vtj | region1 | zone2 172.17.28.10 | 5433 | read_replica | vtj | region2 | zone1 (4 rows) -
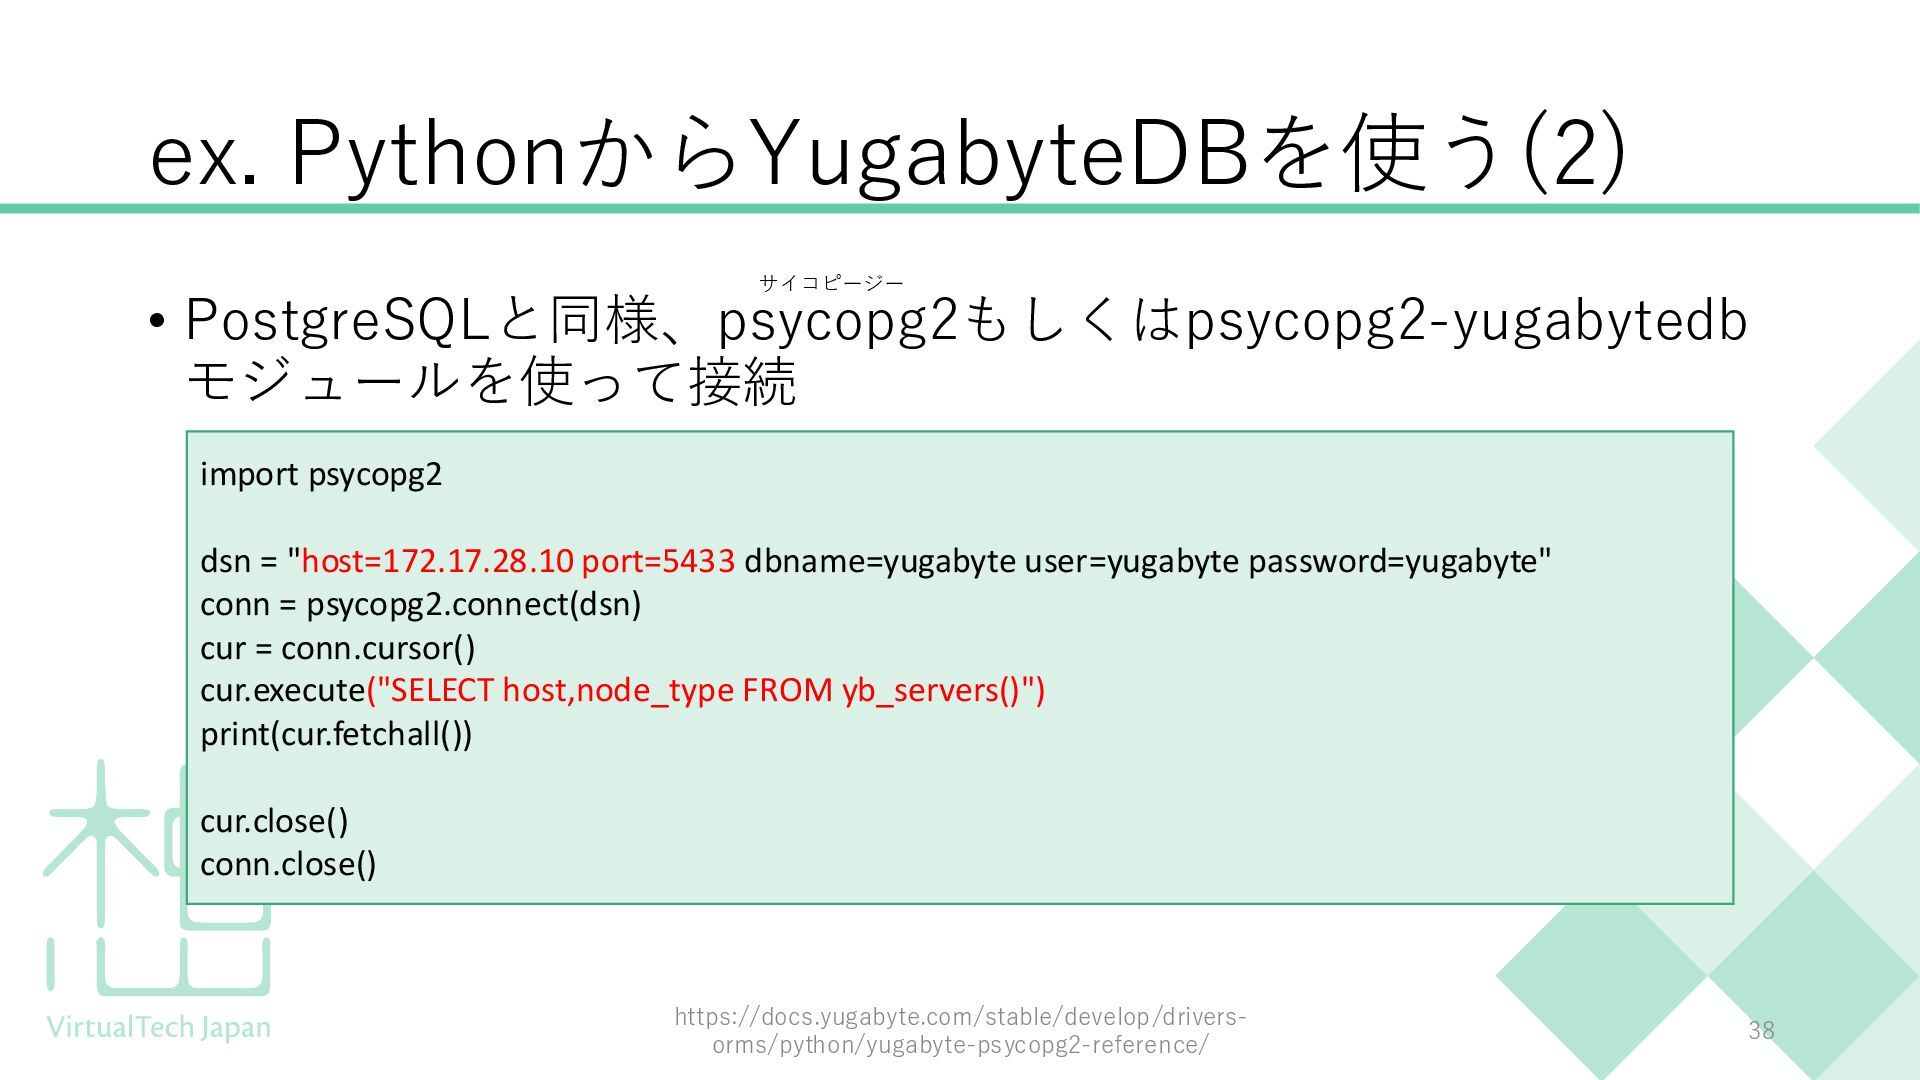
ex. PythonからYugabyteDBを使う(2) • PostgreSQLと同様、psycopg2もしくはpsycopg2-yugabytedb モジュールを使って接続 https://docs.yugabyte.com/stable/develop/drivers- orms/python/yugabyte-psycopg2-reference/ 38 import psycopg2
dsn = "host=172.17.28.10 port=5433 dbname=yugabyte user=yugabyte password=yugabyte" conn = psycopg2.connect(dsn) cur = conn.cursor() cur.execute("SELECT host,node_type FROM yb_servers()") print(cur.fetchall()) cur.close() conn.close() サイコピージー -
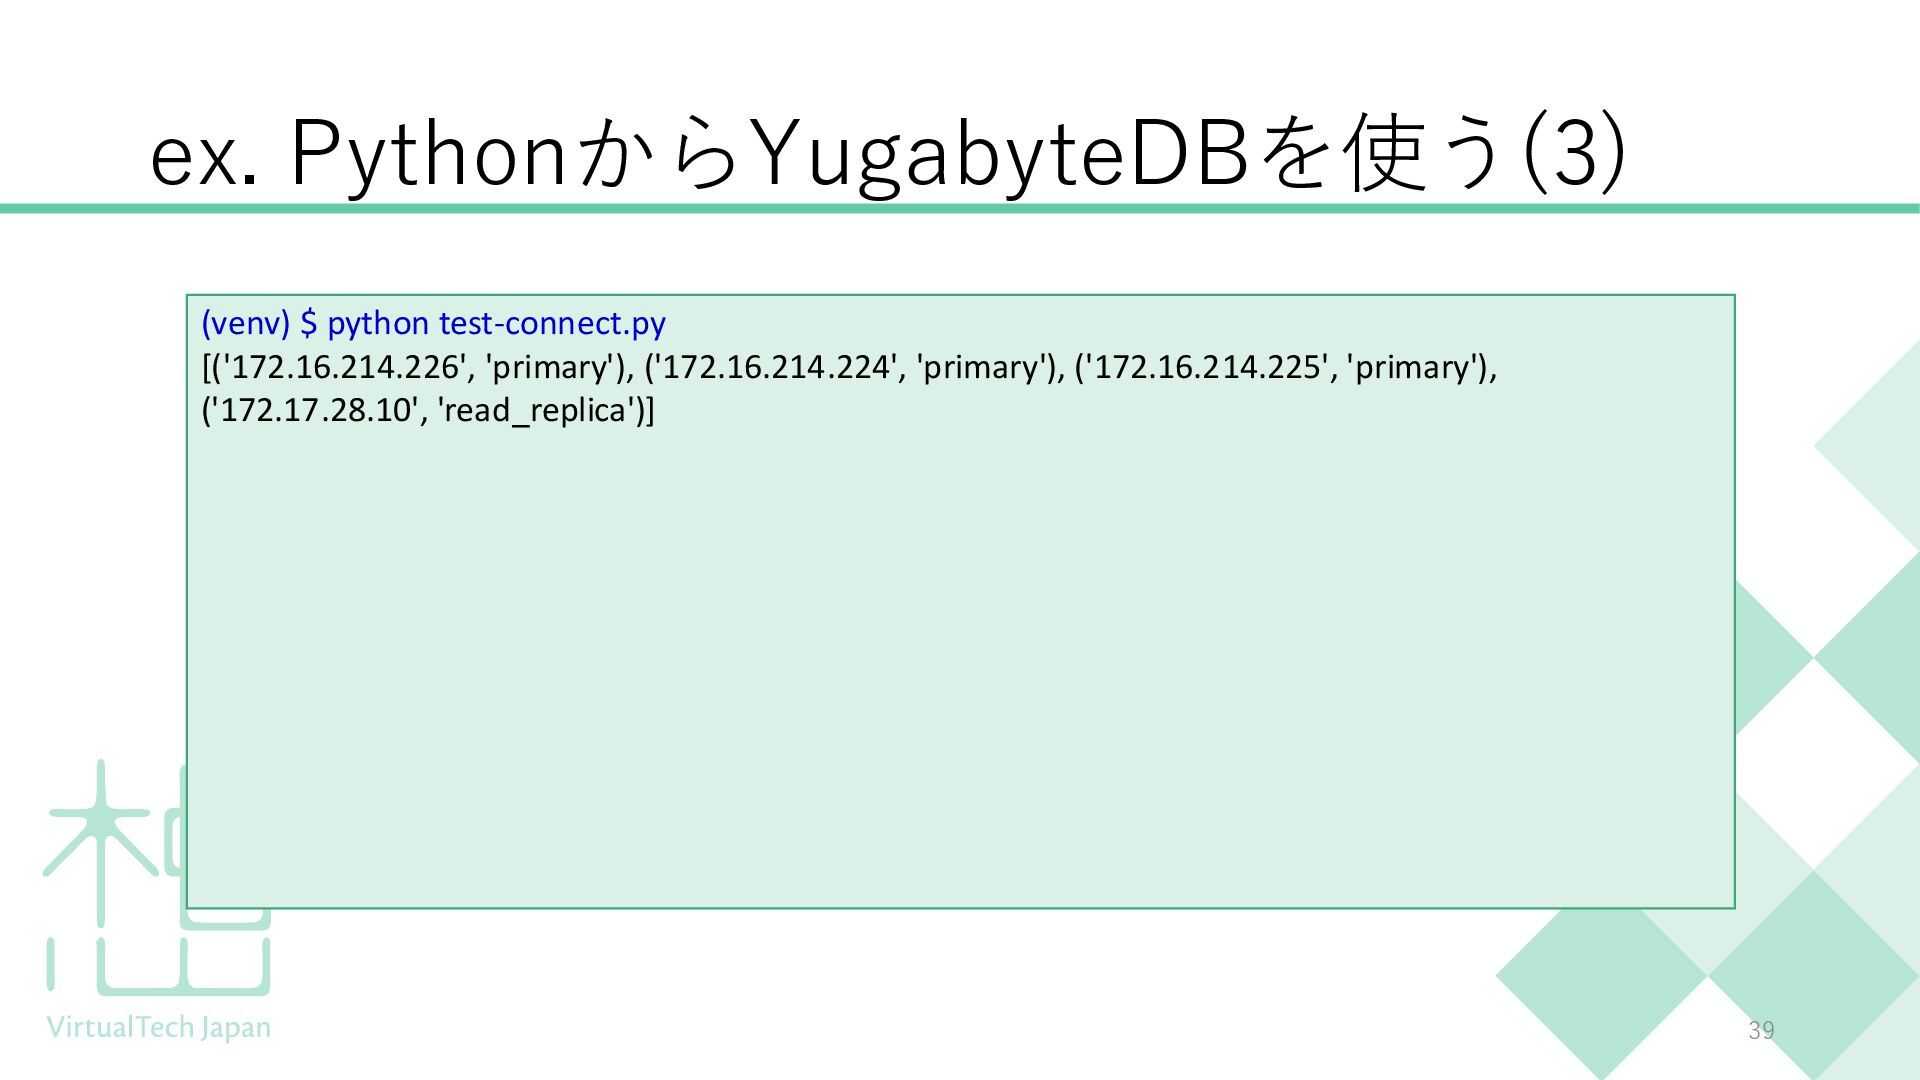
ex. PythonからYugabyteDBを使う(3) 39 (venv) $ python test-connect.py [('172.16.214.226', 'primary'), ('172.16.214.224',
'primary'), ('172.16.214.225', 'primary'), ('172.17.28.10', 'read_replica')] -
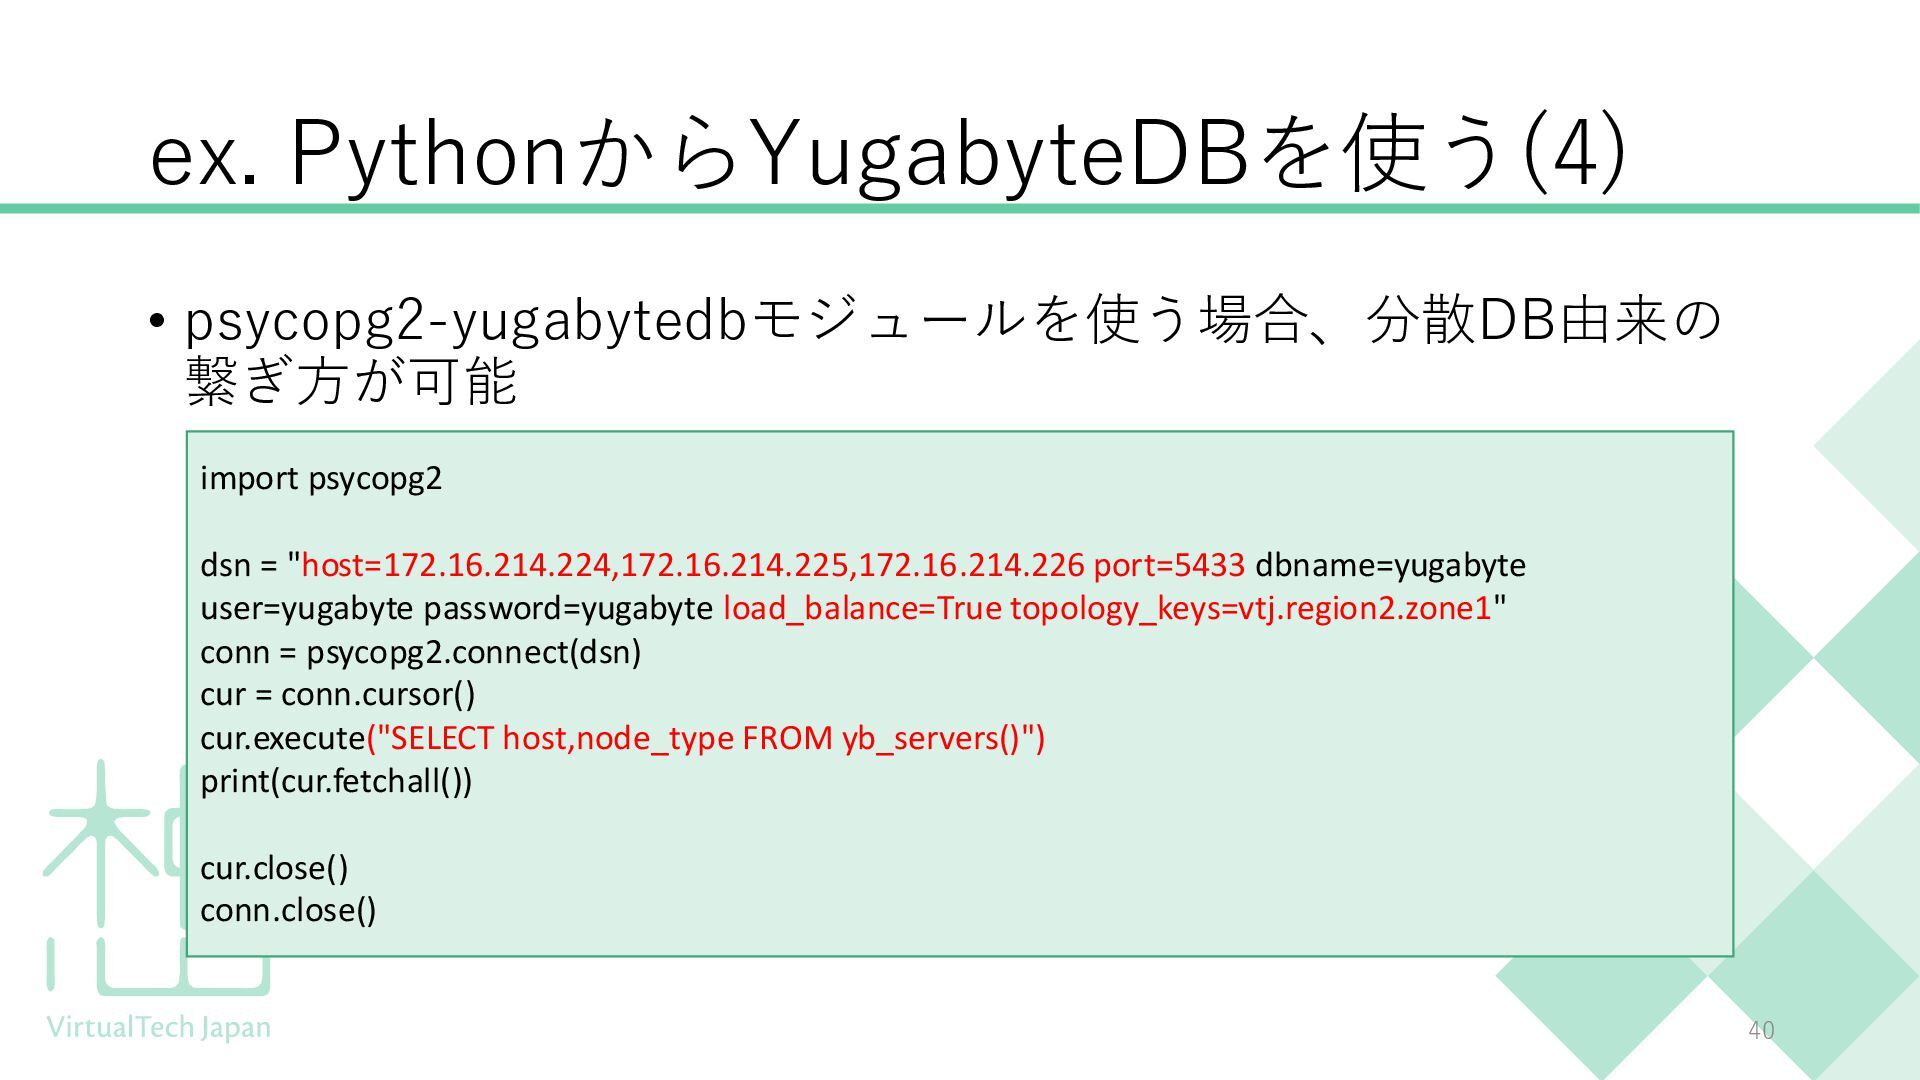
ex. PythonからYugabyteDBを使う(4) • psycopg2-yugabytedbモジュールを使う場合、分散DB由来の 繋ぎ方が可能 40 import psycopg2 dsn =
"host=172.16.214.224,172.16.214.225,172.16.214.226 port=5433 dbname=yugabyte user=yugabyte password=yugabyte load_balance=True topology_keys=vtj.region2.zone1" conn = psycopg2.connect(dsn) cur = conn.cursor() cur.execute("SELECT host,node_type FROM yb_servers()") print(cur.fetchall()) cur.close() conn.close() -
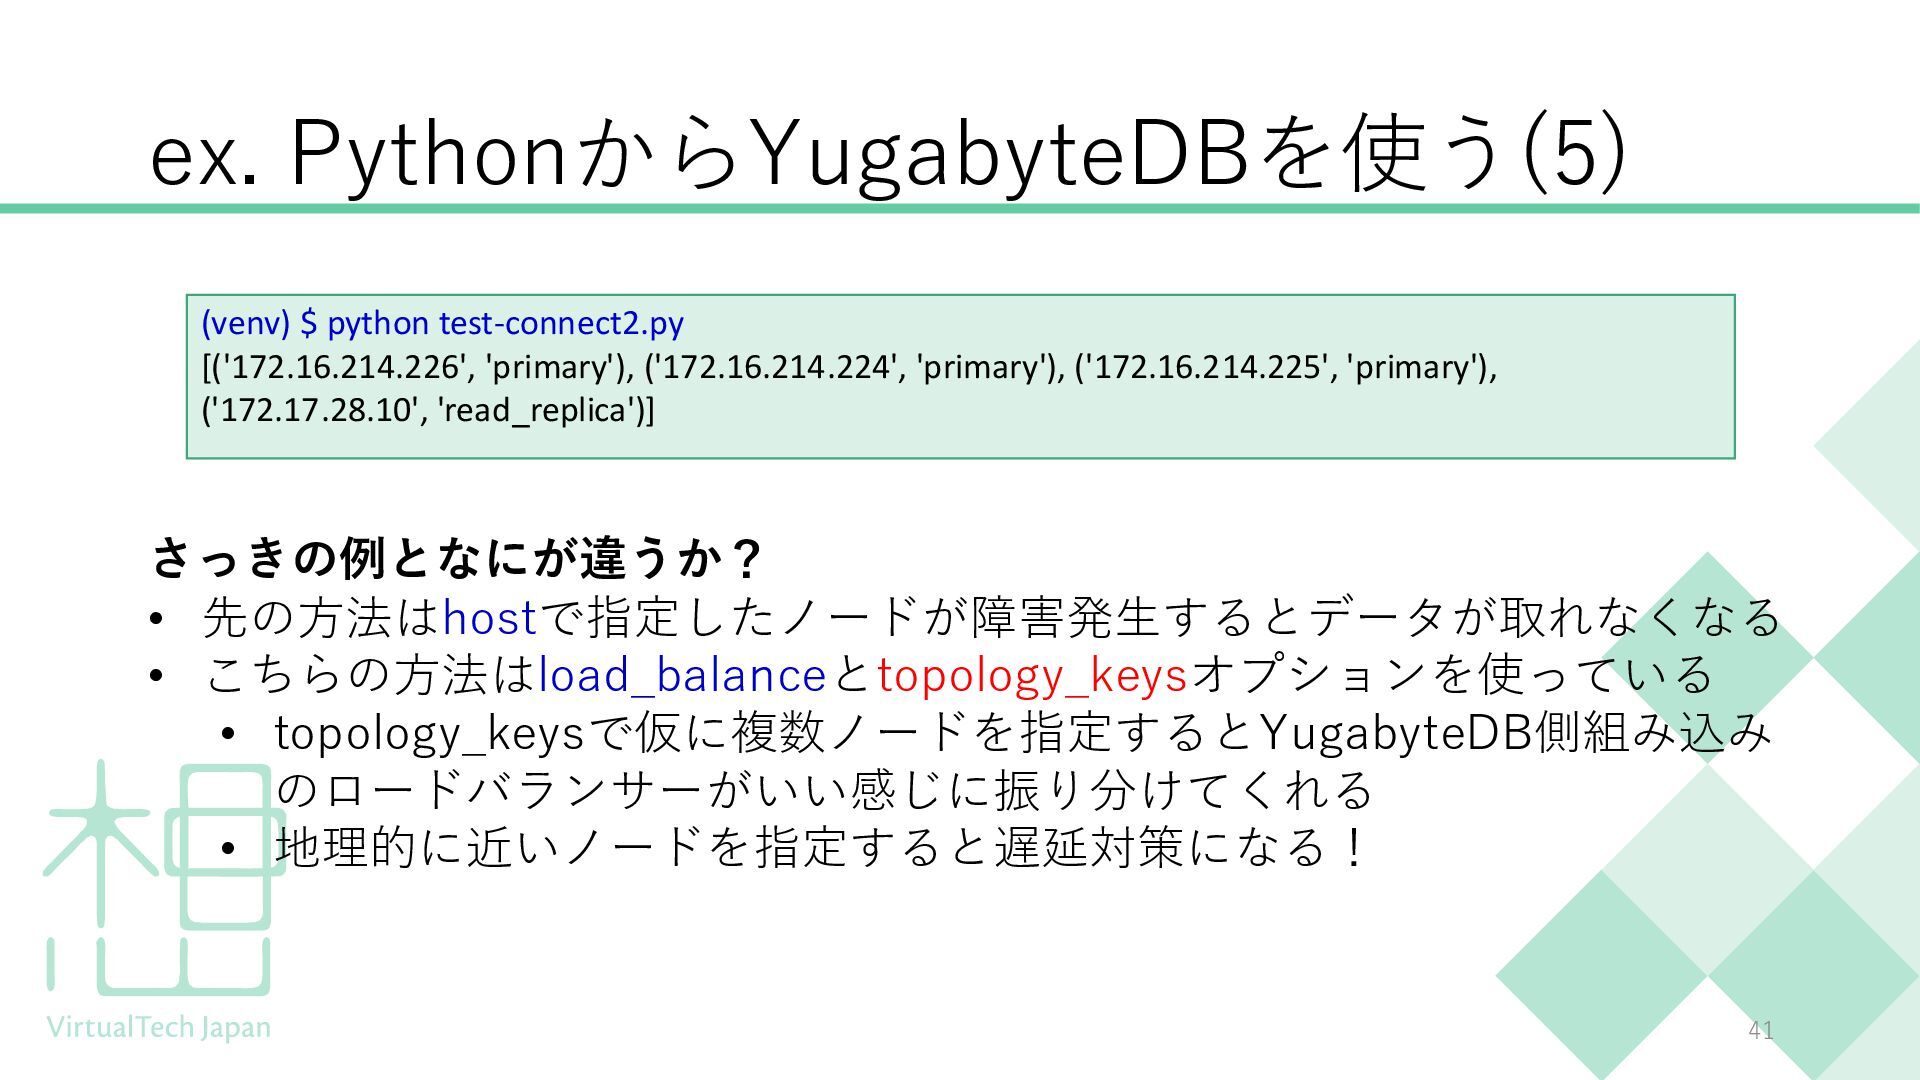
ex. PythonからYugabyteDBを使う(5) 41 (venv) $ python test-connect2.py [('172.16.214.226', 'primary'), ('172.16.214.224',
'primary'), ('172.16.214.225', 'primary'), ('172.17.28.10', 'read_replica')] さっきの例となにが違うか? • 先の方法はhostで指定したノードが障害発生するとデータが取れなくなる • こちらの方法はload_balanceとtopology_keysオプションを使っている • topology_keysで仮に複数ノードを指定するとYugabyteDB側組み込み のロードバランサーがいい感じに振り分けてくれる • 地理的に近いノードを指定すると遅延対策になる! -
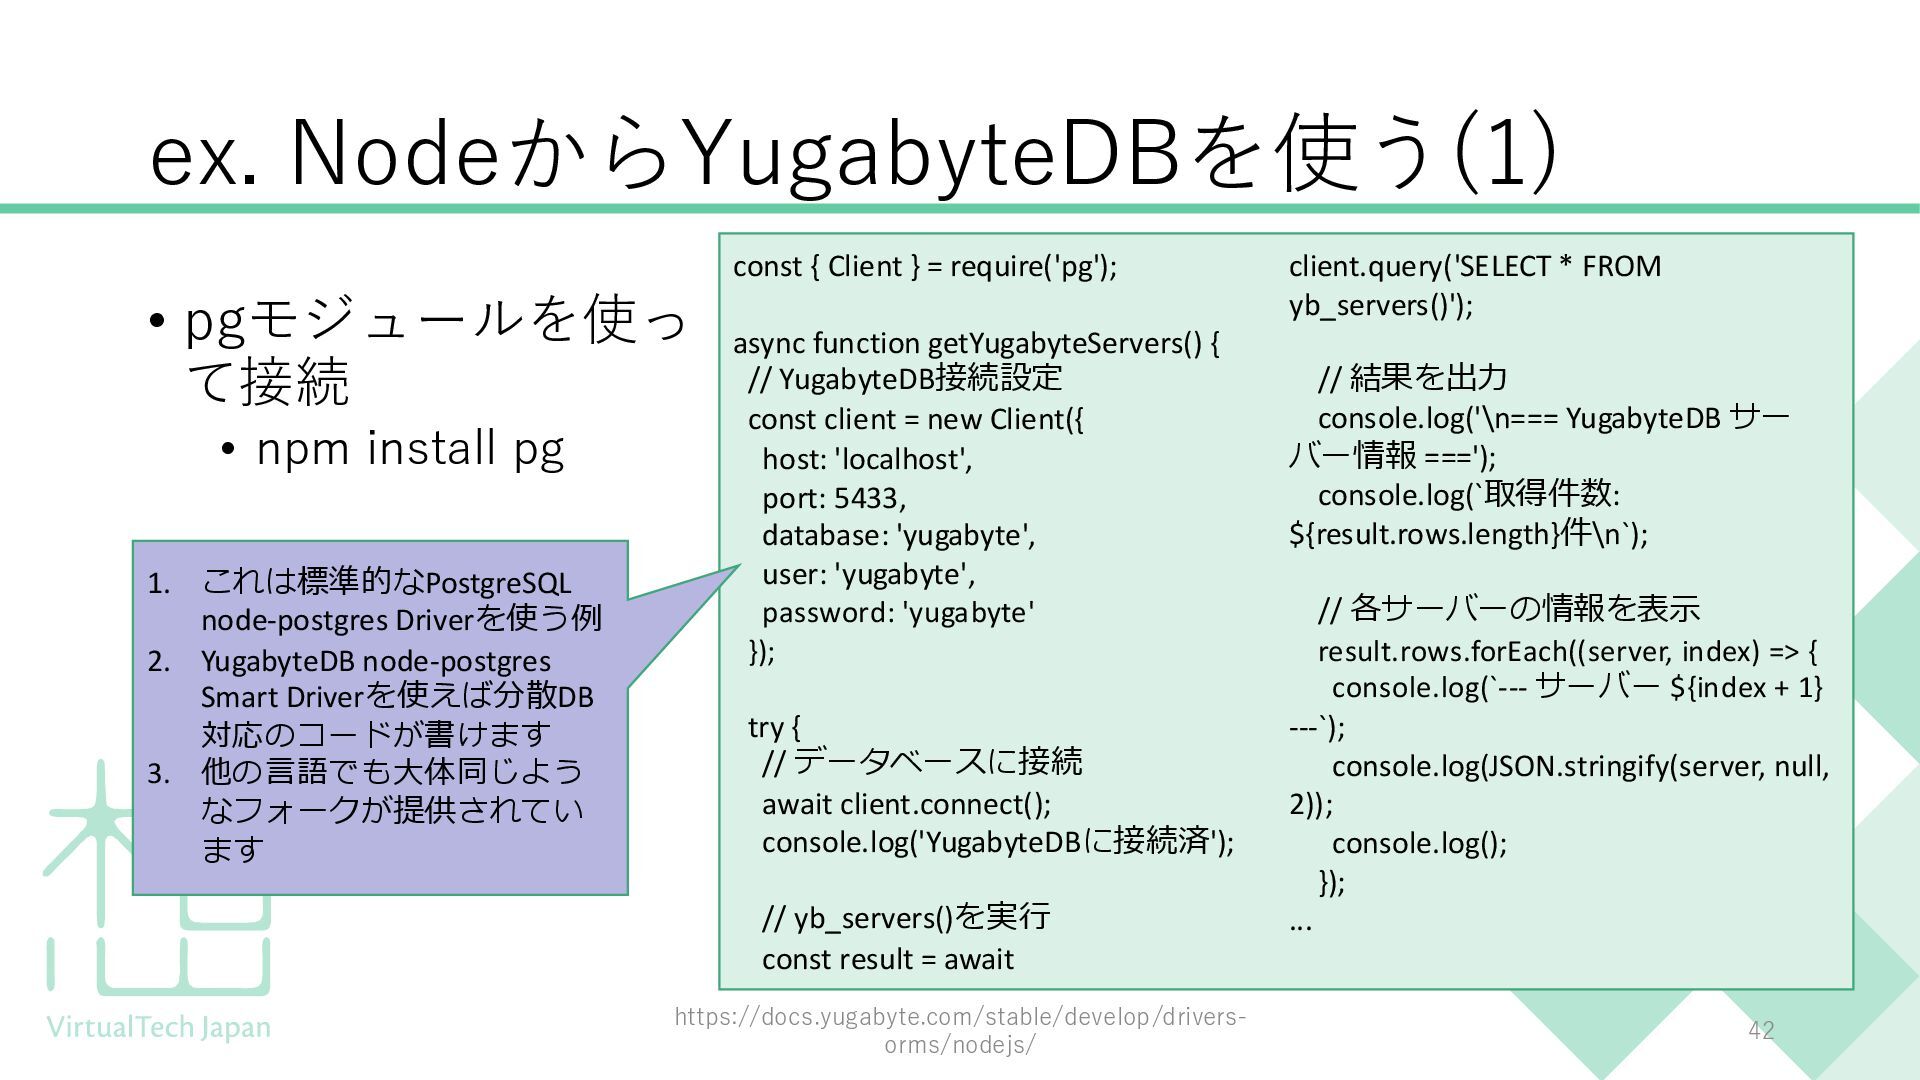
ex. NodeからYugabyteDBを使う(1) • pgモジュールを使っ て接続 • npm install pg https://docs.yugabyte.com/stable/develop/drivers-
orms/nodejs/ 42 const { Client } = require('pg'); async function getYugabyteServers() { // YugabyteDB接続設定 const client = new Client({ host: 'localhost', port: 5433, database: 'yugabyte', user: 'yugabyte', password: 'yugabyte' }); try { // データベースに接続 await client.connect(); console.log('YugabyteDBに接続済'); // yb_servers()を実行 const result = await client.query('SELECT * FROM yb_servers()'); // 結果を出力 console.log('\n=== YugabyteDB サー バー情報 ==='); console.log(`取得件数: ${result.rows.length}件\n`); // 各サーバーの情報を表示 result.rows.forEach((server, index) => { console.log(`--- サーバー ${index + 1} ---`); console.log(JSON.stringify(server, null, 2)); console.log(); }); ... 1. これは標準的なPostgreSQL node-postgres Driverを使う例 2. YugabyteDB node-postgres Smart Driverを使えば分散DB 対応のコードが書けます 3. 他の言語でも大体同じよう なフォークが提供されてい ます -
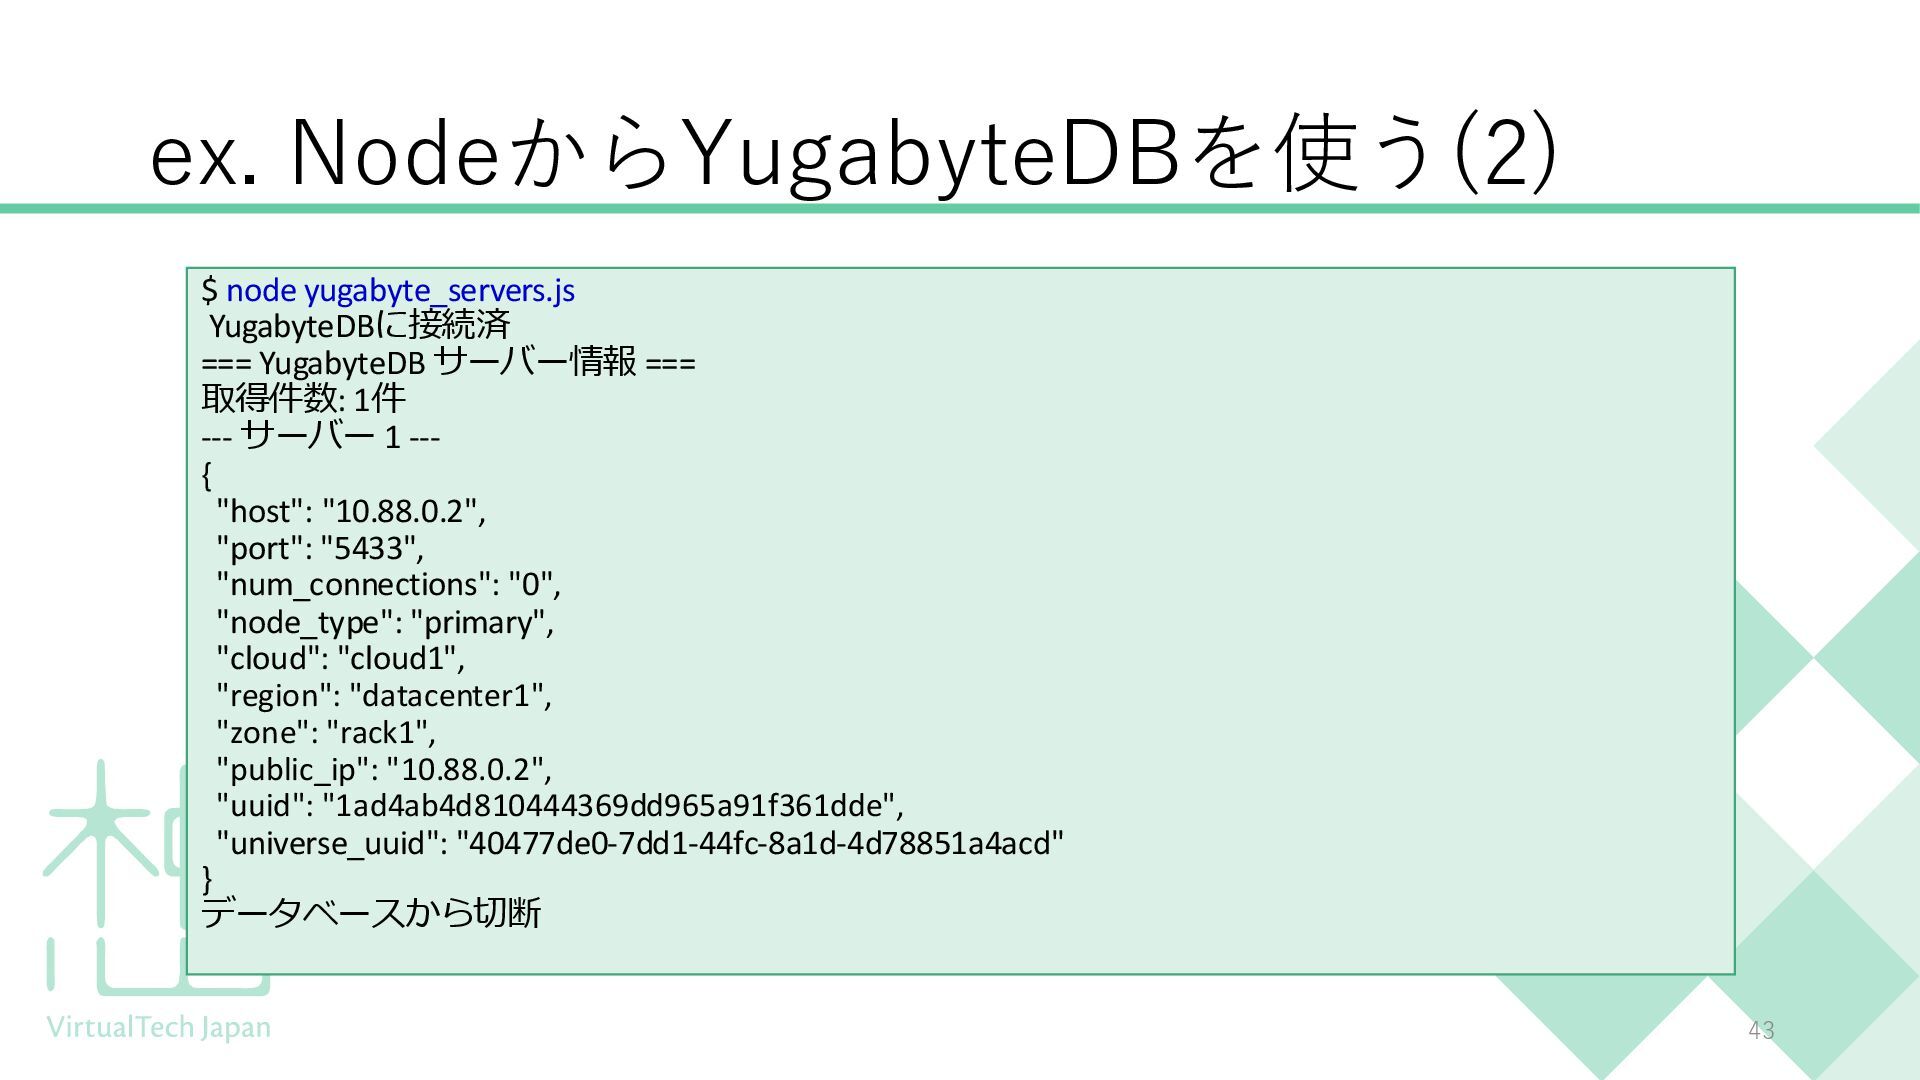
ex. NodeからYugabyteDBを使う(2) 43 $ node yugabyte_servers.js YugabyteDBに接続済 === YugabyteDB サーバー情報
=== 取得件数: 1件 --- サーバー 1 --- { "host": "10.88.0.2", "port": "5433", "num_connections": "0", "node_type": "primary", "cloud": "cloud1", "region": "datacenter1", "zone": "rack1", "public_ip": "10.88.0.2", "uuid": "1ad4ab4d810444369dd965a91f361dde", "universe_uuid": "40477de0-7dd1-44fc-8a1d-4d78851a4acd" } データベースから切断 -
YugabyteDBとAI • YugabyteDBは「AI」にも対応しています • 「AI」はデータをたくさん蓄積した上でそのデータを活用して 目的を達するためのもの • 刻々と蓄積されていくデータをYugabyteDBに任せることで、 データの置き場に容易に可用性を担保 •
詳細は https://docs.yugabyte.com/preview/develop/tutorials/ai/ 44 -
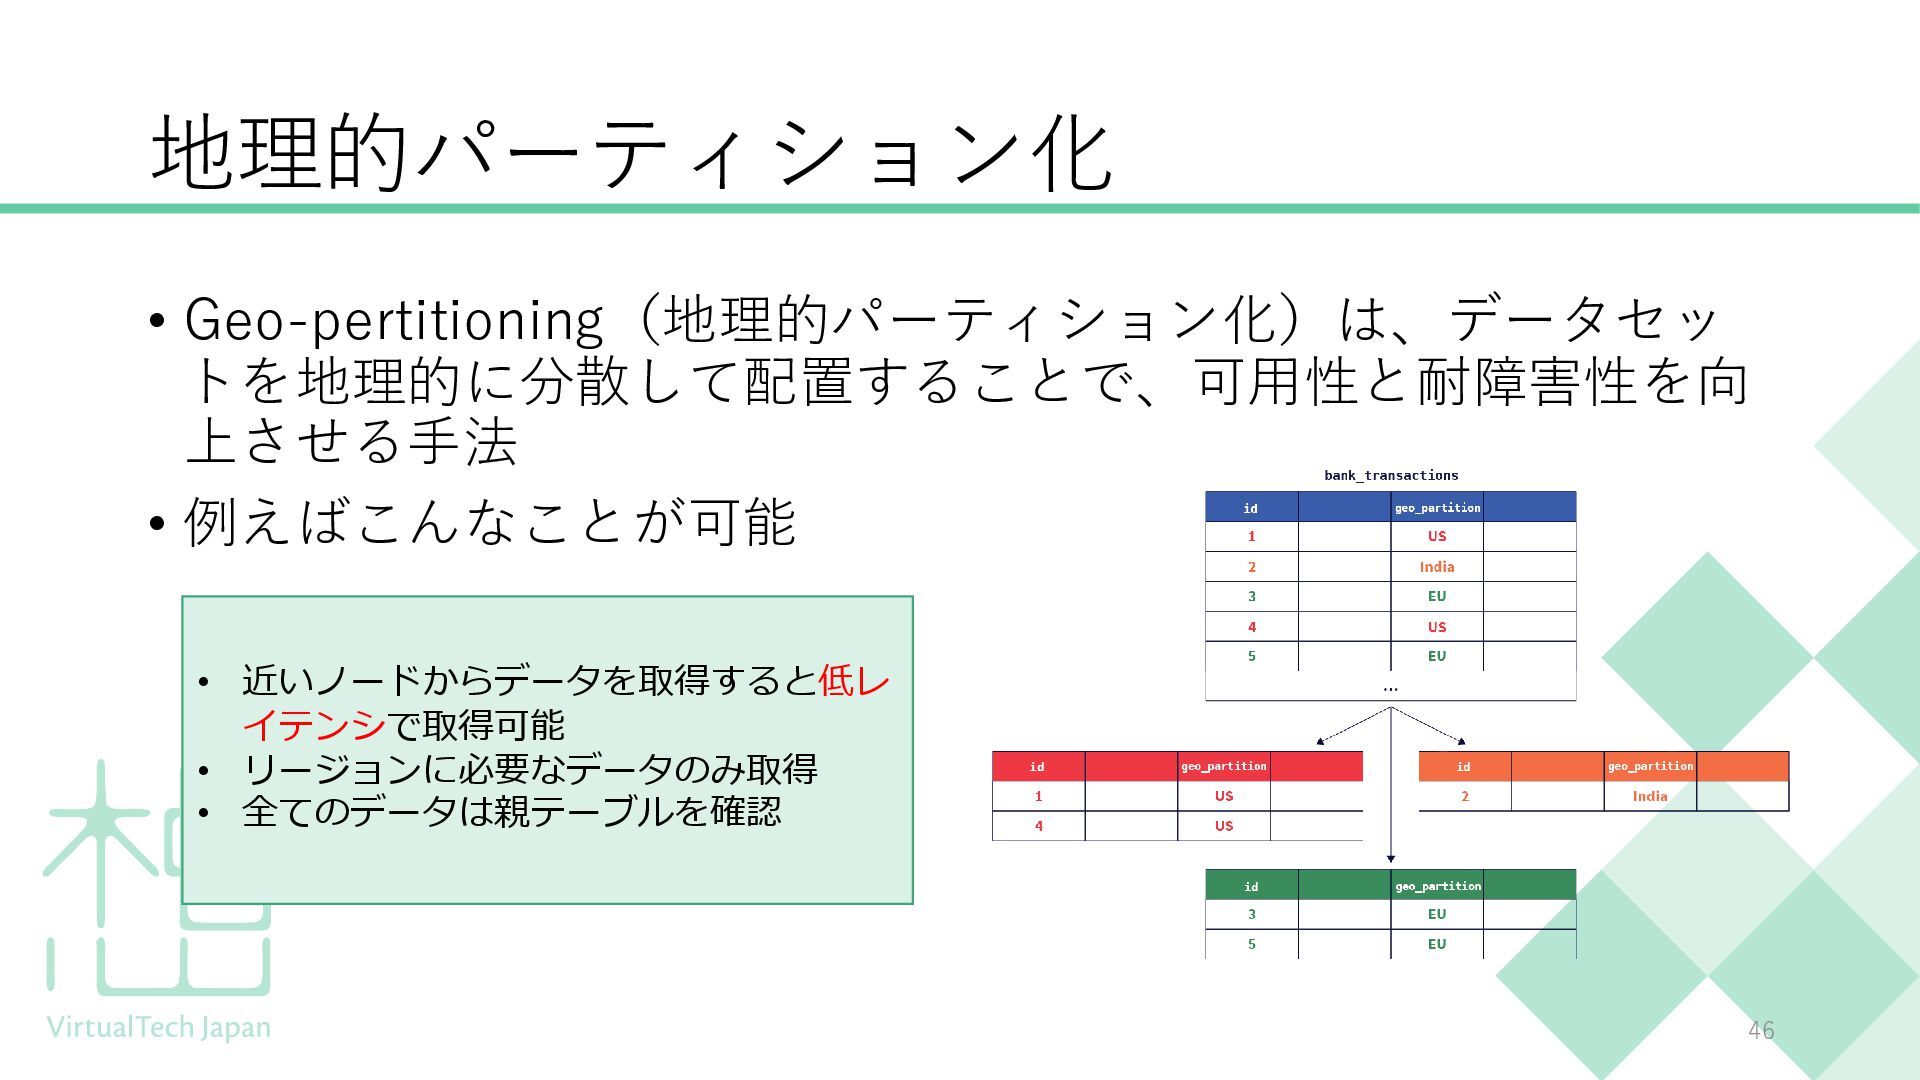
地理的パーティション化 • Geo-pertitioning(地理的パーティション化)は、データセッ トを地理的に分散して配置することで、可用性と耐障害性を向 上させる手法 • 例えばこんなことが可能 46 • 近いノードからデータを取得すると低レ
イテンシで取得可能 • リージョンに必要なデータのみ取得 • 全てのデータは親テーブルを確認 -
Read Replica • Read Replicaは、データの読み取り操作を効率的に処理するた めの仕組み • 読取り専用のノードを増やして読取り速度を向上する • 読取り操作の負荷を分散させるためにRead
Replicaが有用 • データの書込みがほぼなく、読取りのみを必要とするアプリ ケーションでのバックエンド利用に有用 • 書込み処理は所属するYugabyteDBクラスターで実施 • データは親から非同期レプリケーション 47 -
xCluster Replication • xCluster Replicationは別々のYugabyteDBクラスターのDB データを非同期レプリケーションする手法 • 普通のクラスターは全部同期される • xCluster
Replicationは任意のDBが同期される • 二つの方法でレプリケーション可能 • Active-active single-master xCluster • 片方向書き込み • 読取りは速いが、書込みは親側で対応するので遅い • Active-active multi-master xCluster • 双方向書き込み • 読み書き速い 48 -
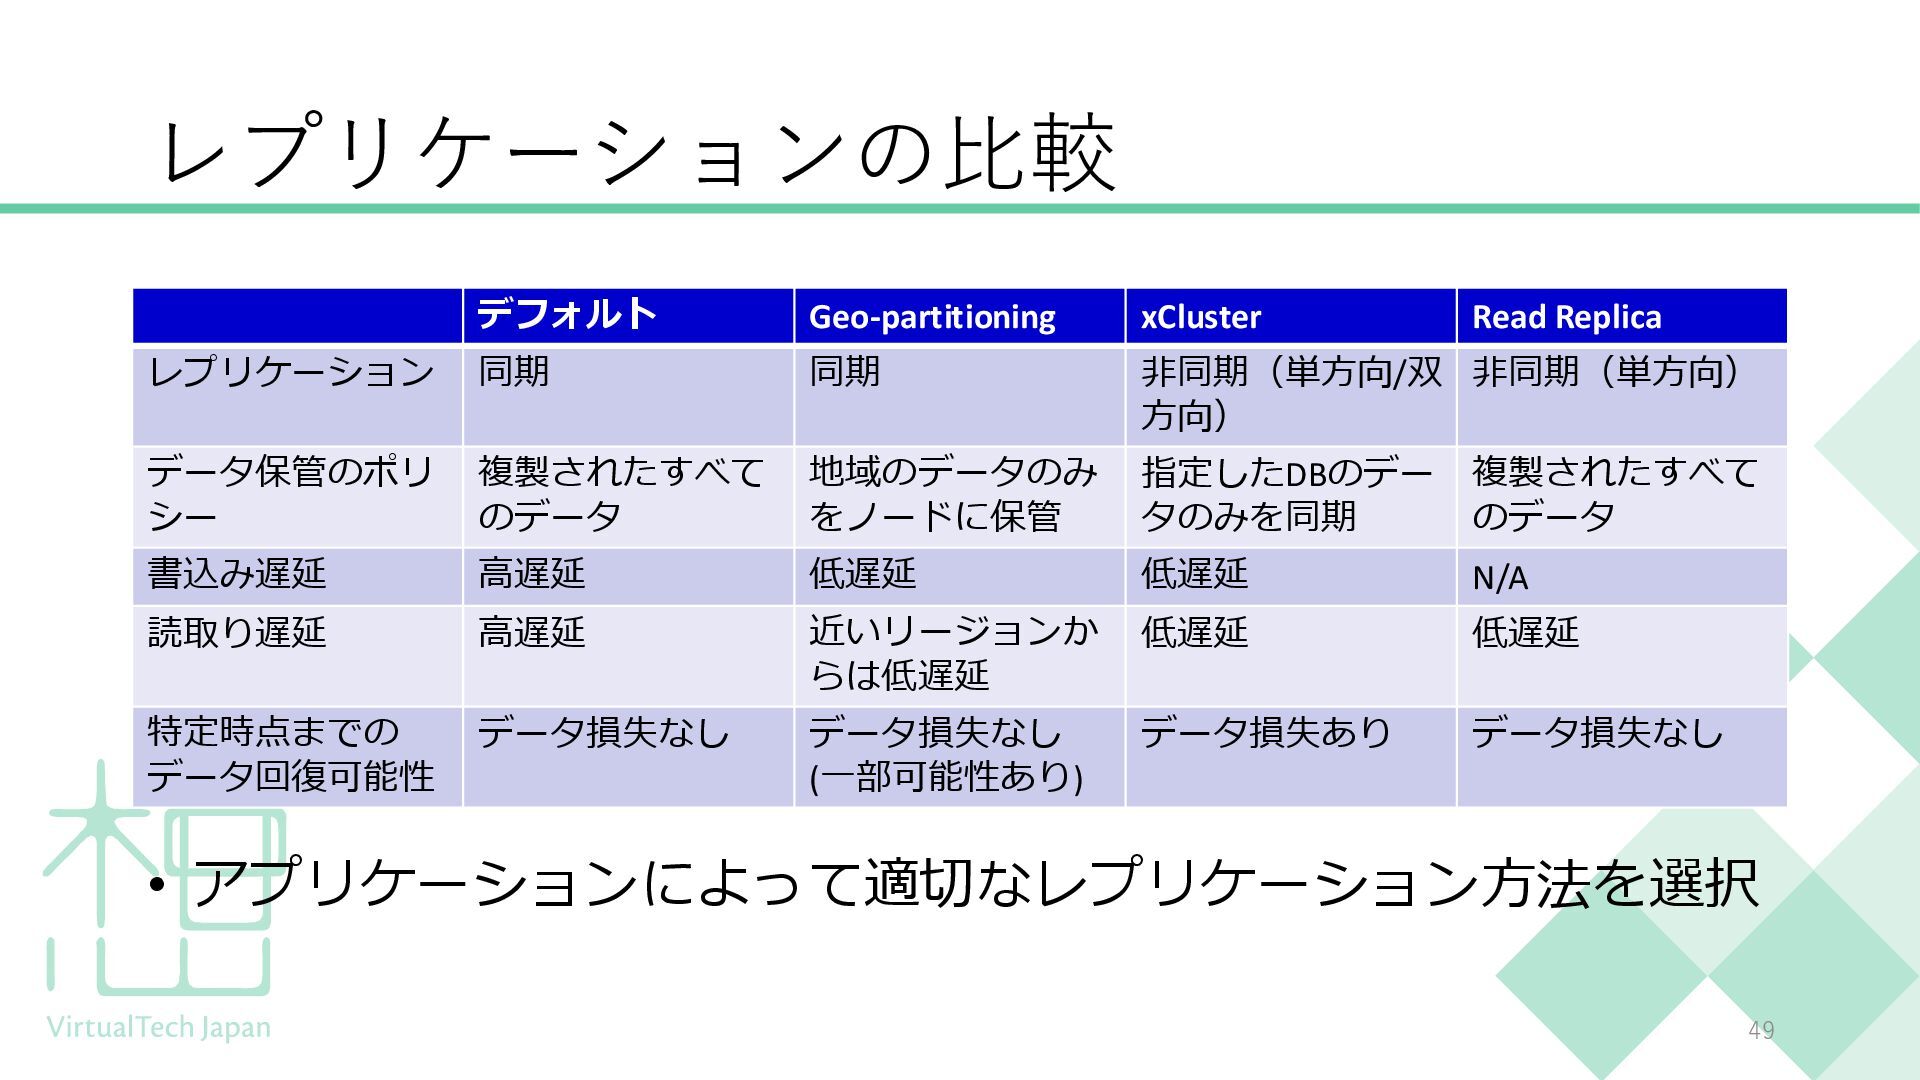
レプリケーションの比較 デフォルト Geo-partitioning xCluster Read Replica レプリケーション 同期 同期 非同期(単方向/双
方向) 非同期(単方向) データ保管のポリ シー 複製されたすべて のデータ 地域のデータのみ をノードに保管 指定したDBのデー タのみを同期 複製されたすべて のデータ 書込み遅延 高遅延 低遅延 低遅延 N/A 読取り遅延 高遅延 近いリージョンか らは低遅延 低遅延 低遅延 特定時点までの データ回復可能性 データ損失なし データ損失なし (一部可能性あり) データ損失あり データ損失なし 49 • アプリケーションによって適切なレプリケーション方法を選択