Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ADKで始める業務改善 - AIエージェント開発時の考えと設計
Search
Kazuki Hara
September 18, 2026
Technology
370
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ADKで始める業務改善 - AIエージェント開発時の考えと設計
Kazuki Hara
September 18, 2026
Transcript
35 slides
ADKで始める業務改善 AIエージェント開発時の考えと設計 ML女子部/ [AIエージェント] 秋のLT大会 株式会社サイバーエージェント | 原 和希 ©CyberAgent,
Inc. All Rights Reserved
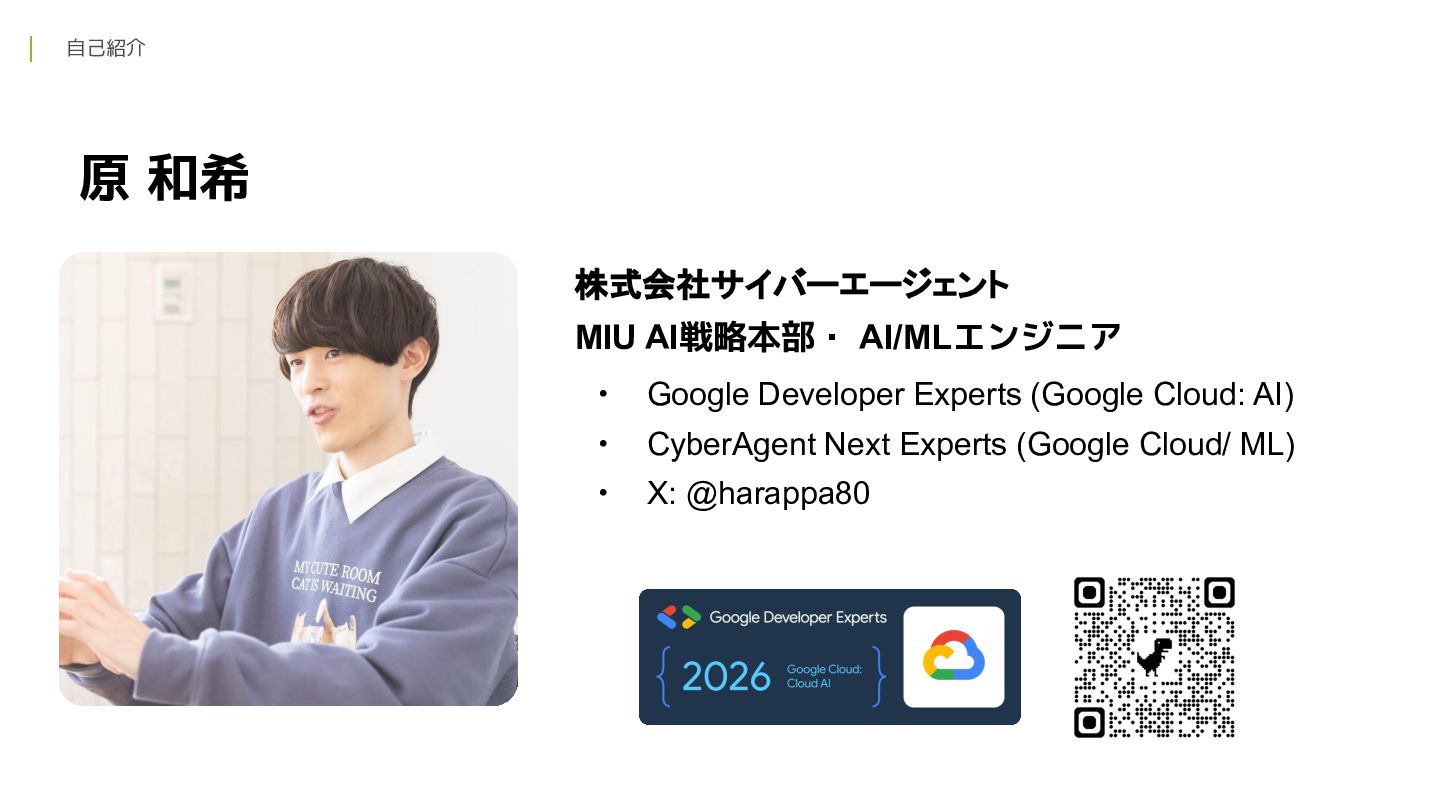
自己紹介 原 和希 株式会社サイバーエージェント MIU AI戦略本部・ AI/MLエンジニア • Google Developer
Experts (Google Cloud: AI) • CyberAgent Next Experts (Google Cloud/ ML) • X: @harappa80
自己紹介 MIU(Media & IP United)管轄とは MIUは、株式会社サイバーエージェントにおいて、 メディア事業とIP領域を横断的に推進する事業領域です。 多様なメディアサービスやコンテンツ、知的財産を掛け合わせることで、 新たな価値創出と事業成長の加速を目指しています。 ©CyberAgent,
Inc. All Rights Reserved
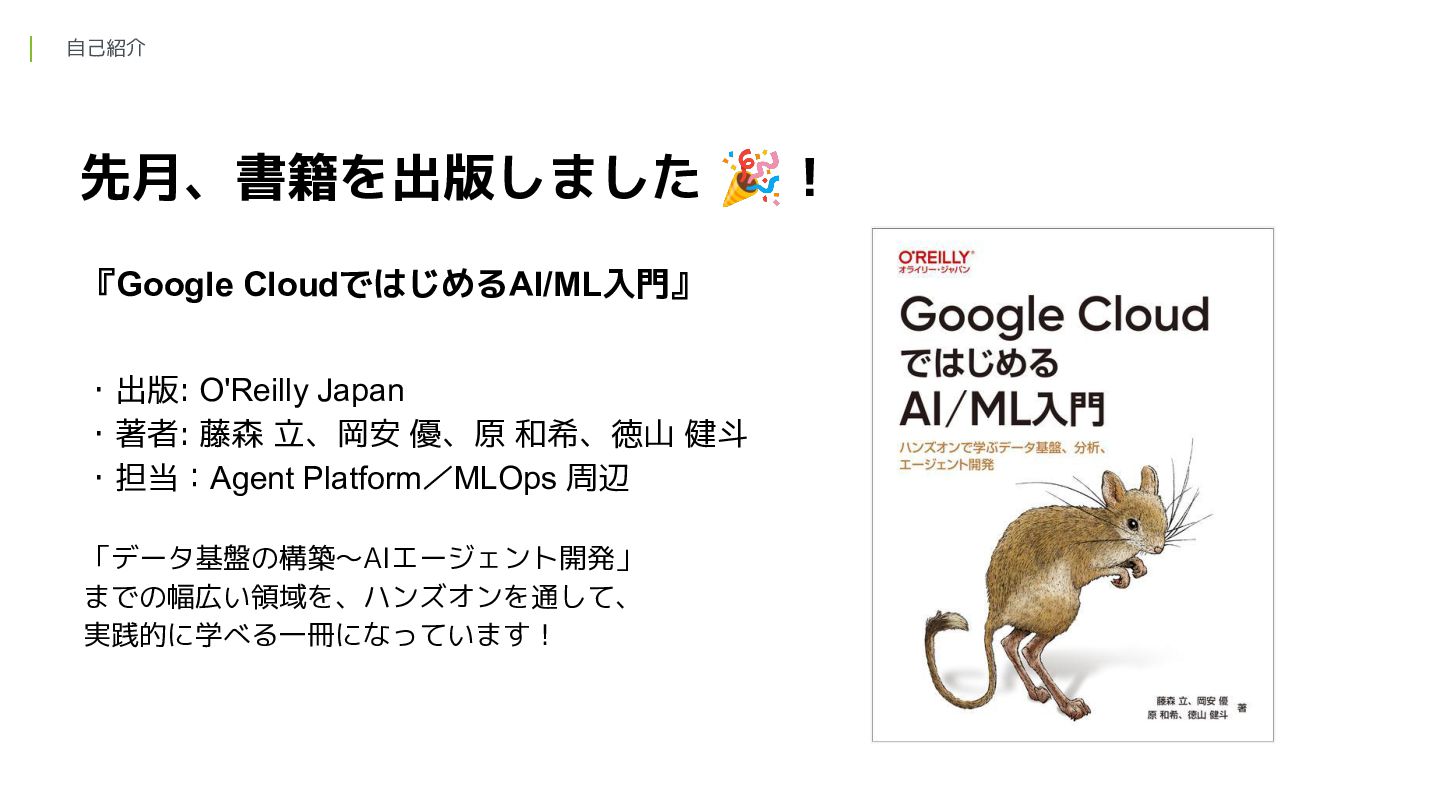
自己紹介 先月、書籍を出版しました 🎉! 『Google CloudではじめるAI/ML入門』 ・出版: O'Reilly Japan ・著者: 藤森
立、岡安 優、原 和希、徳山 健斗 ・担当:Agent Platform/MLOps 周辺 「データ基盤の構築〜AIエージェント開発」 までの幅広い領域を、ハンズオンを通して、 実践的に学べる一冊になっています!
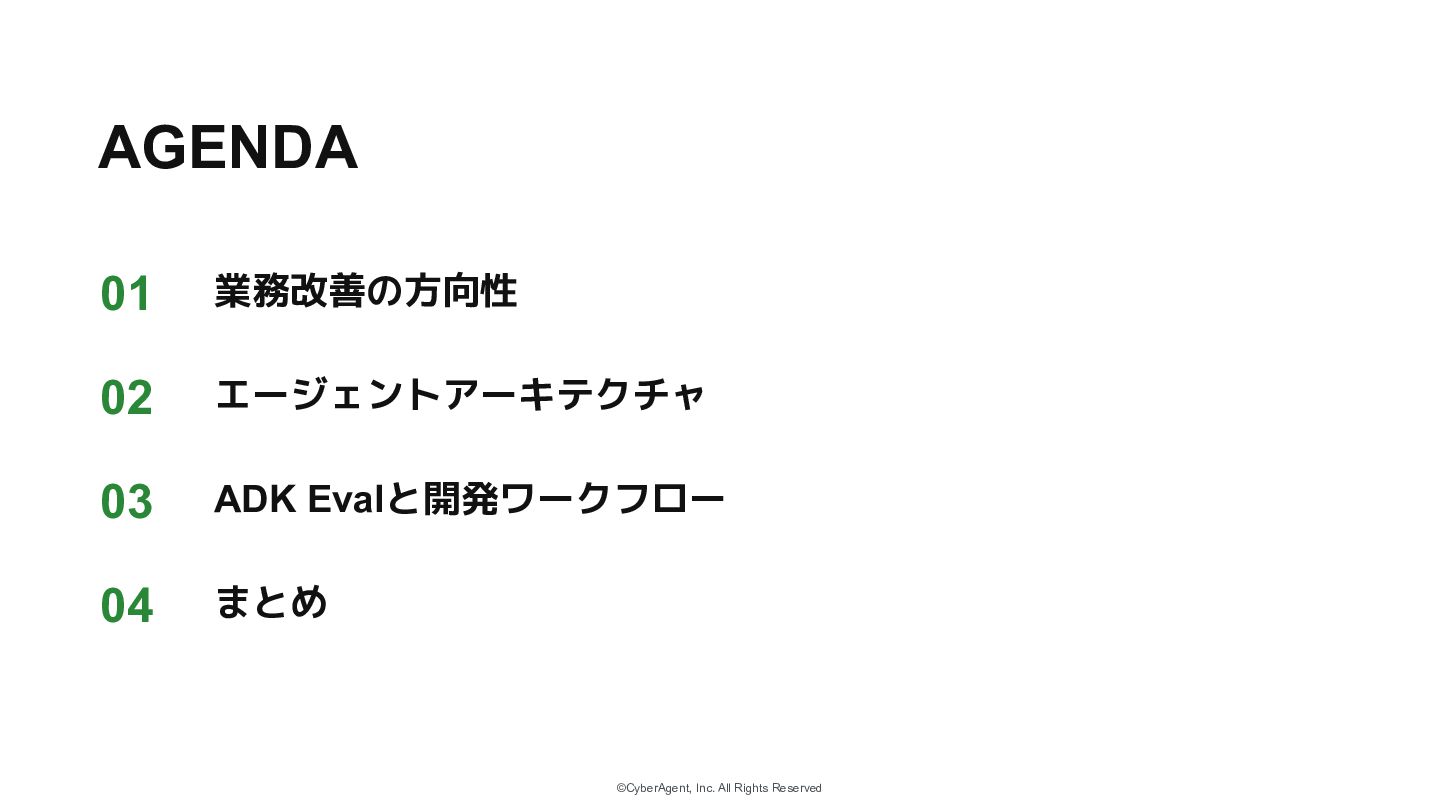
AGENDA 01 業務改善の方向性 02 エージェントアーキテクチャ 03 ADK Evalと開発ワークフロー 04 まとめ
©CyberAgent, Inc. All Rights Reserved
はじめに 今日話すこと/話さないこと 話すこと • • 社内エージェントの開発を通して得られた、業務効率化時の考え Google Cloud を使ってどのようにエージェントを開発・運用しているか 話さないこと
• 開発しているエージェントの具体的な機能・仕様の詳細
業務効率化エージェントを開発する際の エッセンス・技術・開発プロセス に焦点を当てる
01 業務改善の方向性 01
01 業務改善の方向性 解決したかった業務課題 1,000+ ドキュメントの品質を保つ 洗い出しと編集作業による、人的コストが積み上がっていた。 加えて、更新性を向上したかった。 ©CyberAgent, Inc. All
Rights Reserved
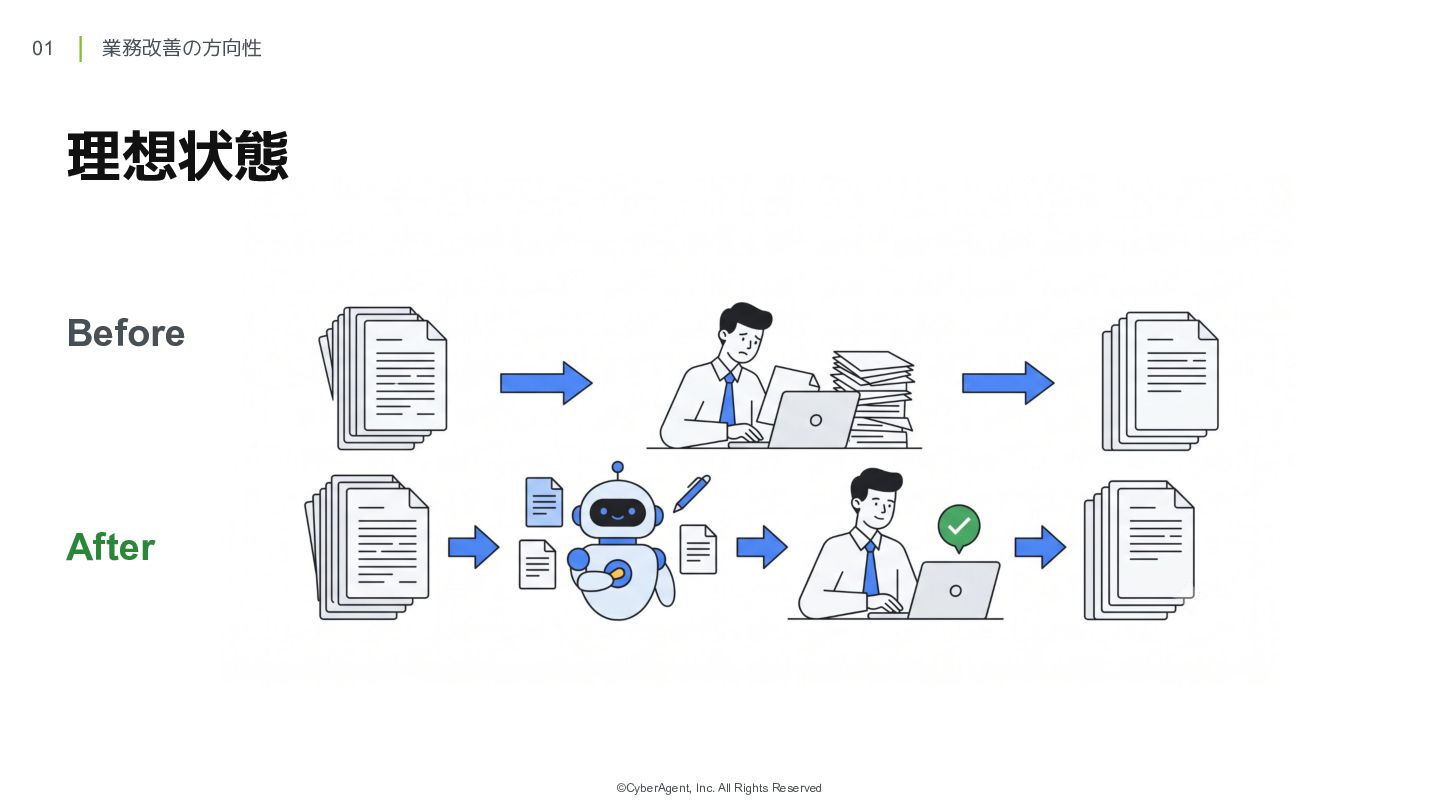
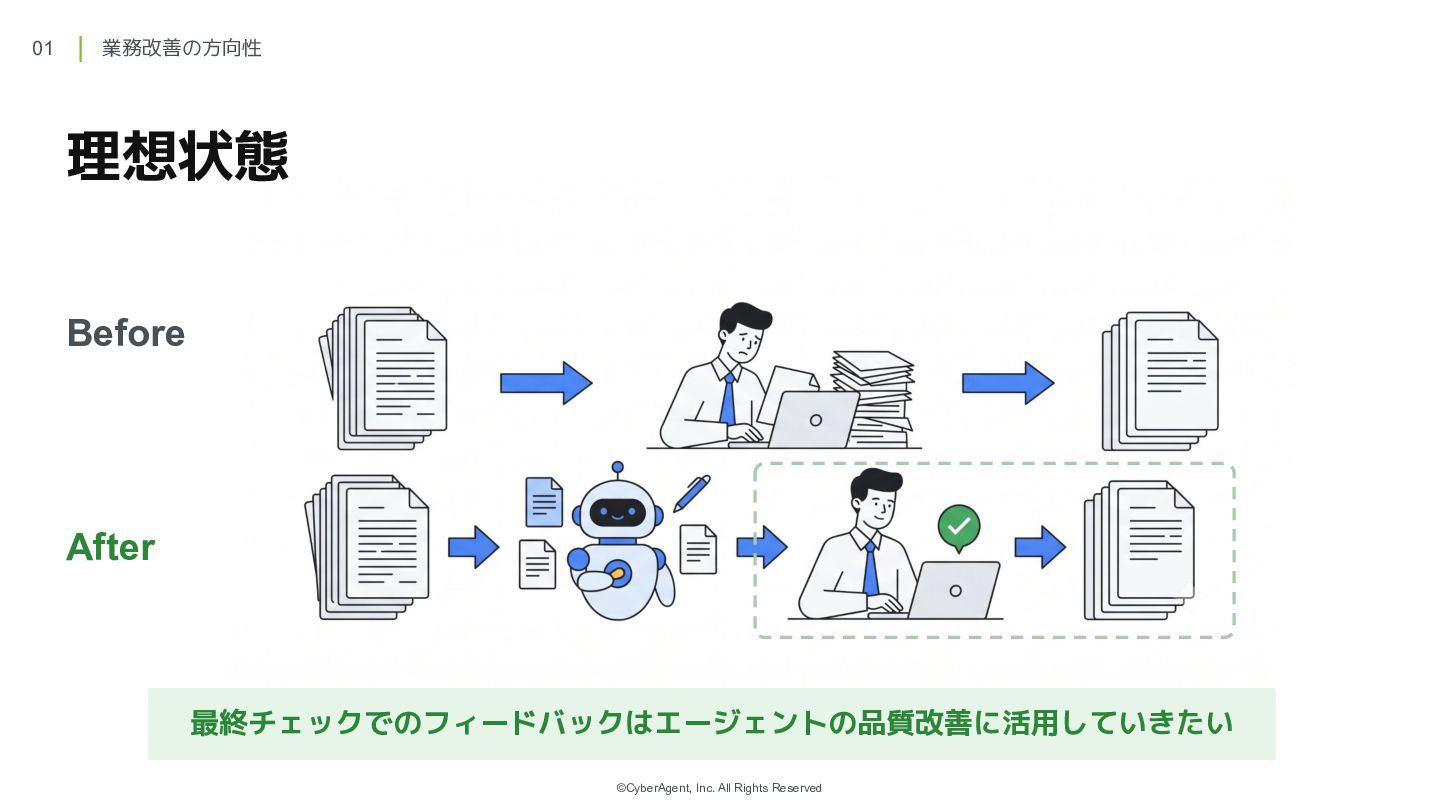
01 業務改善の方向性 理想状態 Before After ©CyberAgent, Inc. All Rights Reserved
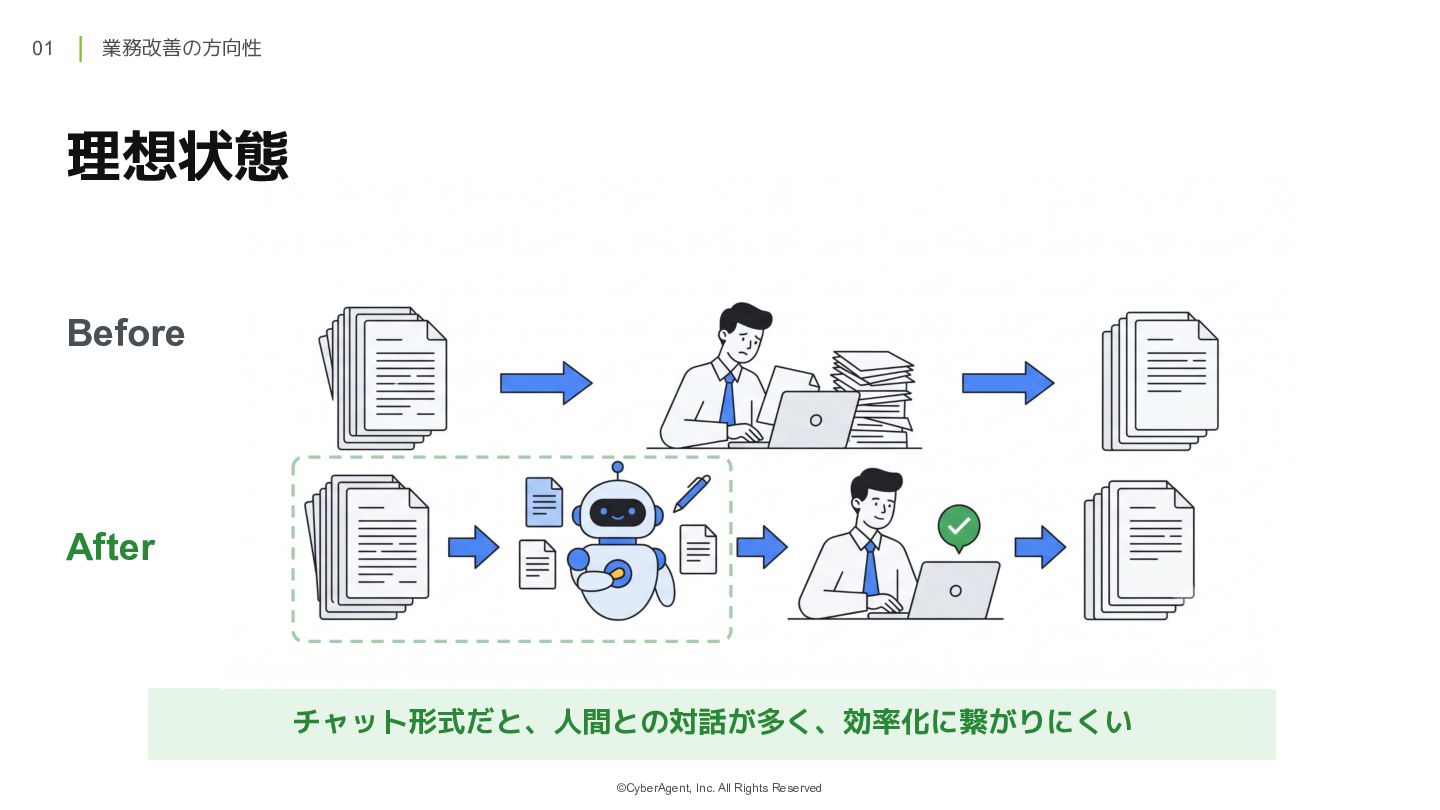
01 業務改善の方向性 理想状態 Before After チャット形式だと、人間との対話が多く、効率化に繋がりにくい ©CyberAgent, Inc. All Rights
Reserved
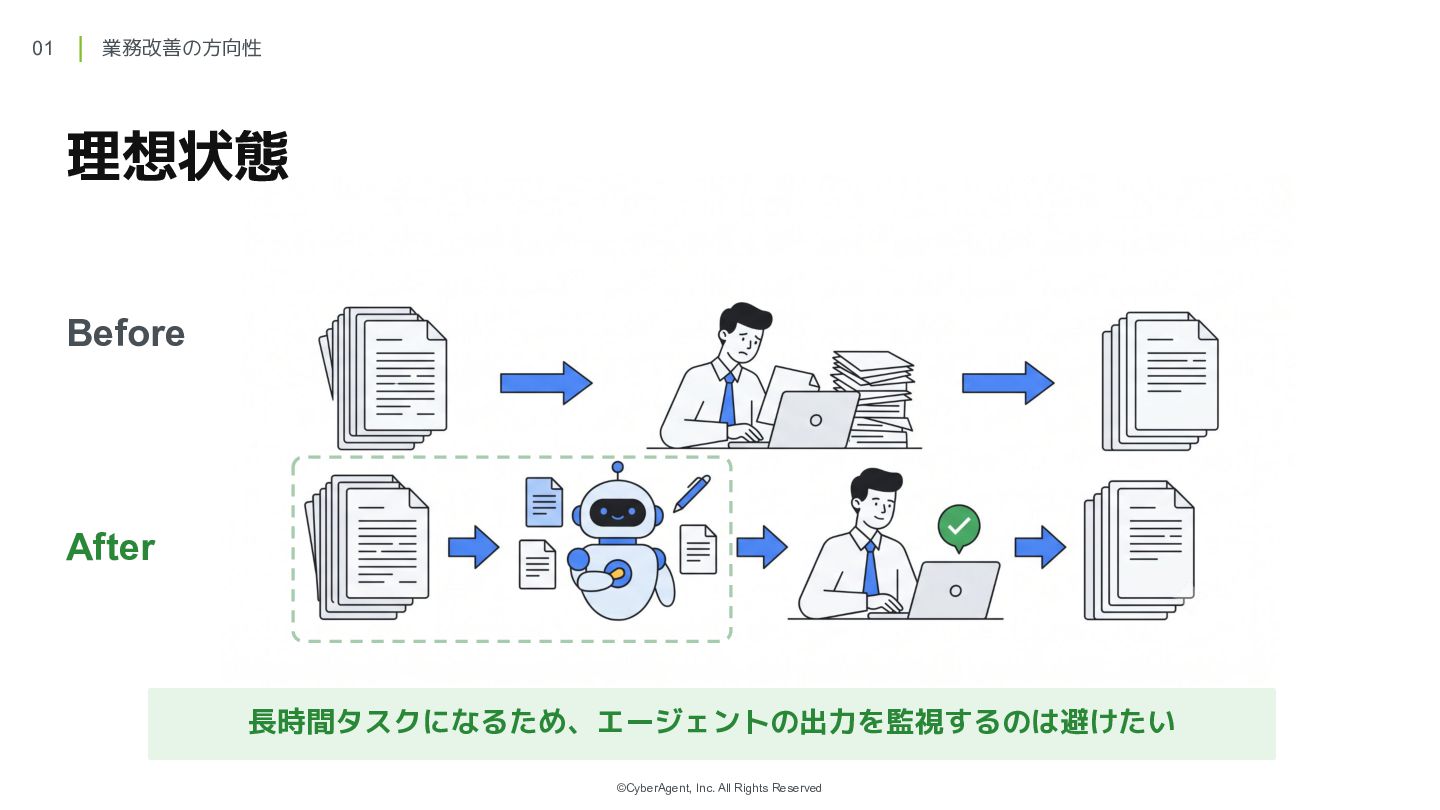
01 業務改善の方向性 理想状態 Before After 長時間タスクになるため、エージェントの出力を監視するのは避けたい ©CyberAgent, Inc. All Rights
Reserved
01 業務改善の方向性 理想状態 Before After 最終チェックでのフィードバックはエージェントの品質改善に活用していきたい ©CyberAgent, Inc. All Rights
Reserved
人の時間を『作業』から 専門性を活かした『判断』へ
02 エージェント アーキテクチャ 02
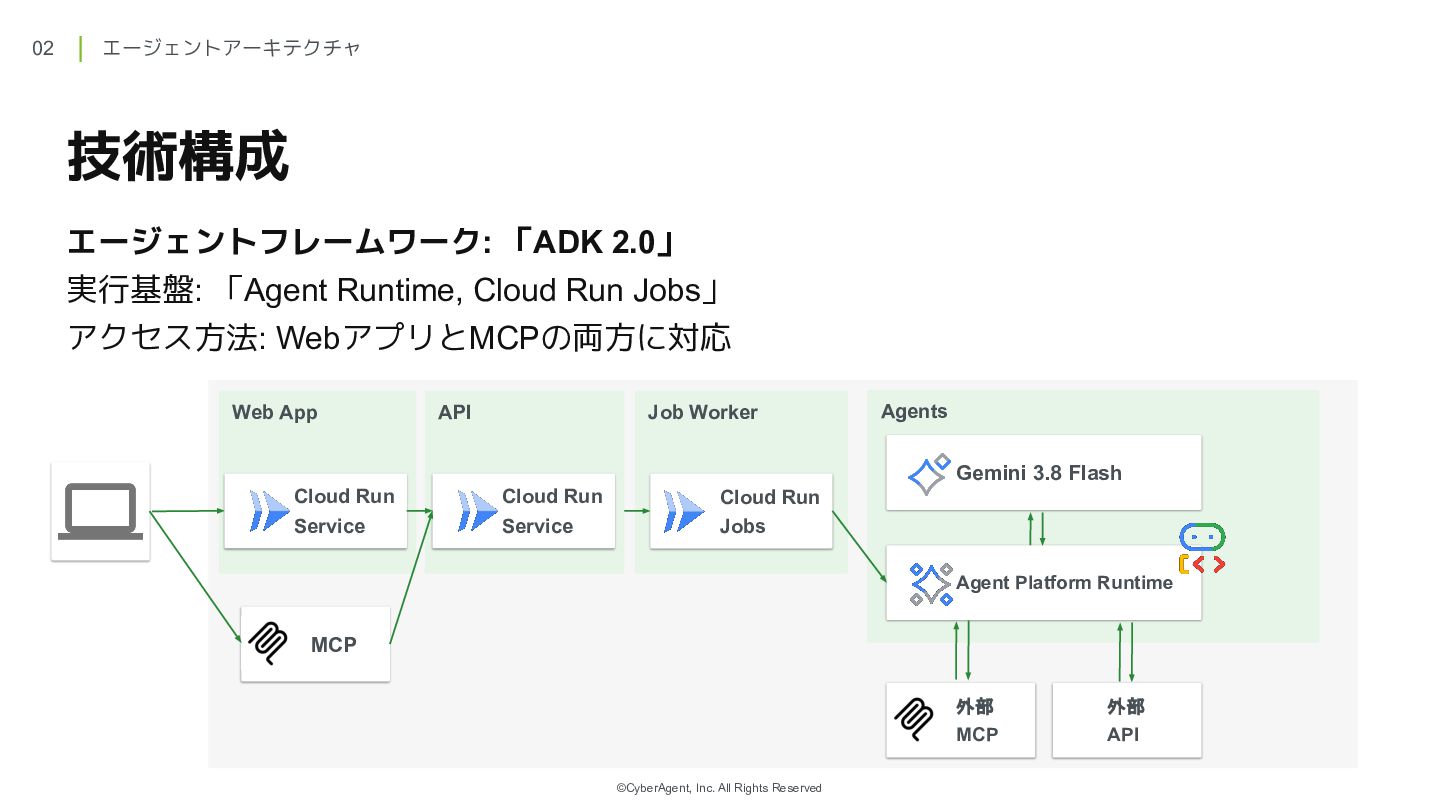
02 エージェントアーキテクチャ 技術構成 エージェントフレームワーク: 「ADK 2.0」 実行基盤: 「Agent Runtime, Cloud
Run Jobs」 アクセス方法: WebアプリとMCPの両方に対応 Web App API Job Worker Agents Gemini 3.8 Flash Cloud Run Service Cloud Run Service Cloud Run Jobs Agent Platform Runtime MCP 外部 MCP ©CyberAgent, Inc. All Rights Reserved 外部 API
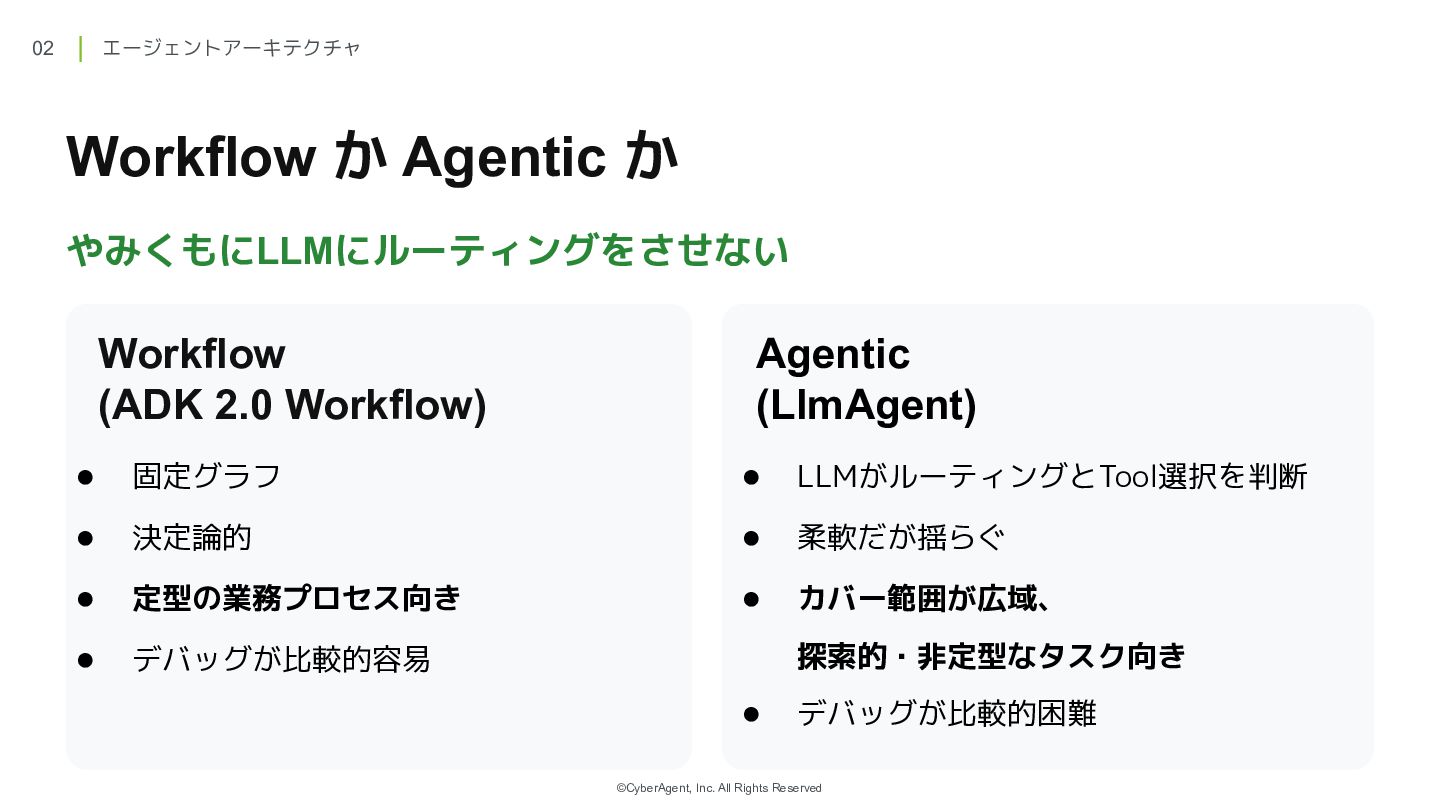
エージェントアーキテクチャ 02 Workflow か Agentic か やみくもにLLMにルーティングをさせない Workflow (ADK 2.0
Workflow) Agentic (LlmAgent) • 固定グラフ • LLMがルーティングとTool選択を判断 • 決定論的 • 柔軟だが揺らぐ • 定型の業務プロセス向き • カバー範囲が広域、 • デバッグが比較的容易 探索的・非定型なタスク向き • デバッグが比較的困難 ©CyberAgent, Inc. All Rights Reserved
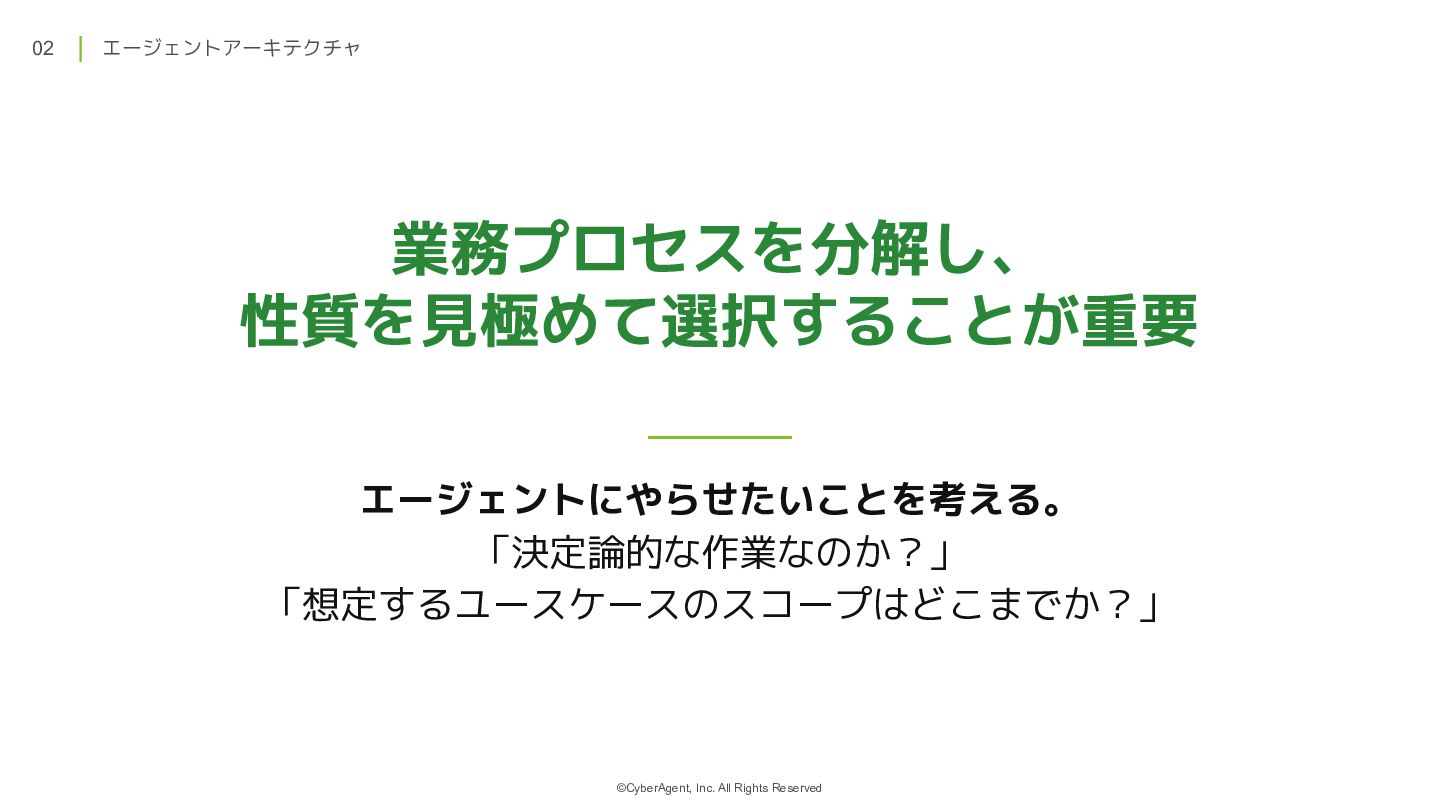
02 エージェントアーキテクチャ 業務プロセスを分解し、 性質を見極めて選択することが重要 エージェントにやらせたいことを考える。 「決定論的な作業なのか?」 「想定するユースケースのスコープはどこまでか?」 ©CyberAgent, Inc. All
Rights Reserved
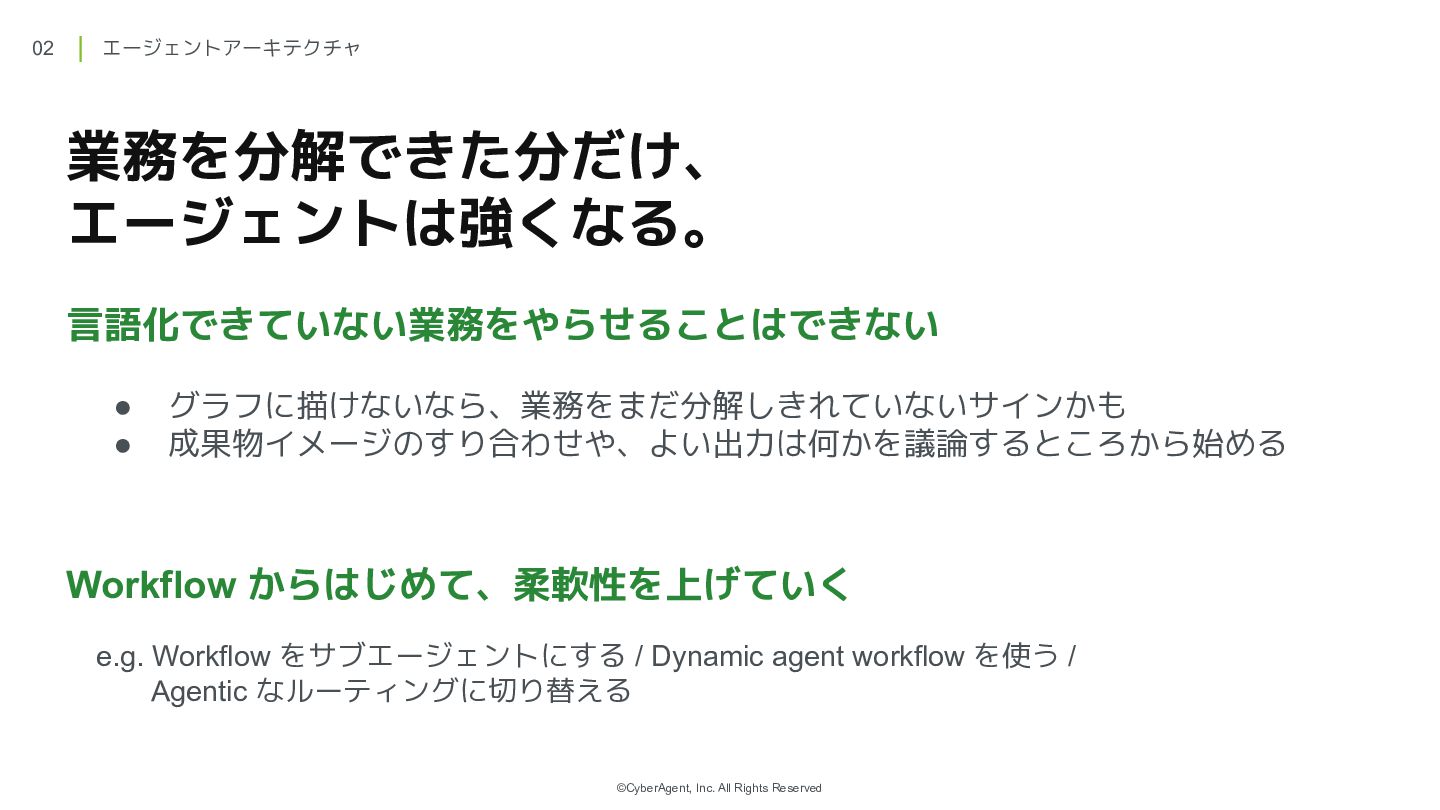
02 エージェントアーキテクチャ 業務を分解できた分だけ、 エージェントは強くなる。 言語化できていない業務をやらせることはできない • • グラフに描けないなら、業務をまだ分解しきれていないサインかも 成果物イメージのすり合わせや、よい出力は何かを議論するところから始める Workflow
からはじめて、柔軟性を上げていく e.g. Workflow をサブエージェントにする / Dynamic agent workflow を使う / Agentic なルーティングに切り替える ©CyberAgent, Inc. All Rights Reserved
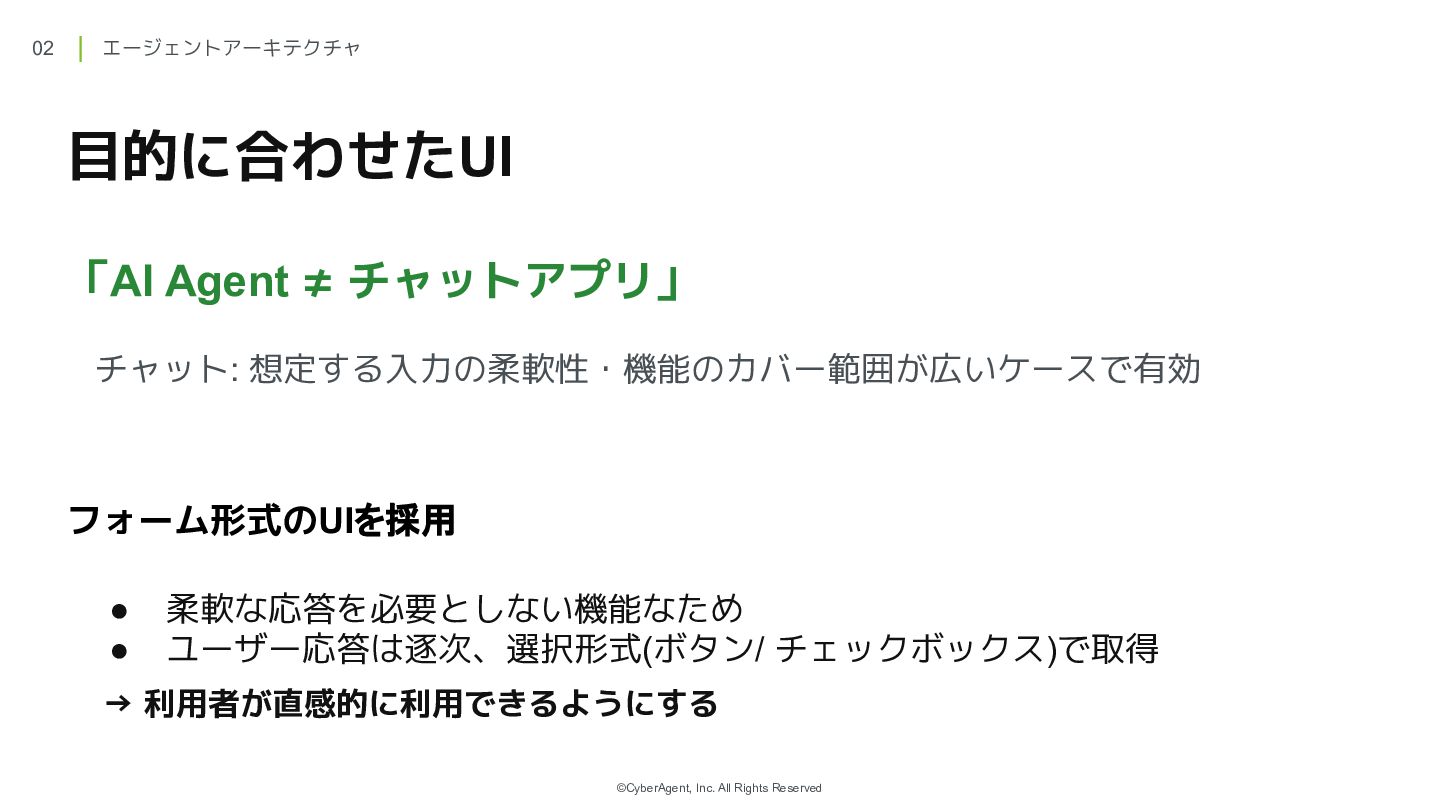
02 エージェントアーキテクチャ 目的に合わせたUI 「AI Agent ≠ チャットアプリ」 チャット: 想定する入力の柔軟性・機能のカバー範囲が広いケースで有効 フォーム形式のUIを採用
• • 柔軟な応答を必要としない機能なため ユーザー応答は逐次、選択形式(ボタン/ チェックボックス)で取得 → 利用者が直感的に利用できるようにする ©CyberAgent, Inc. All Rights Reserved
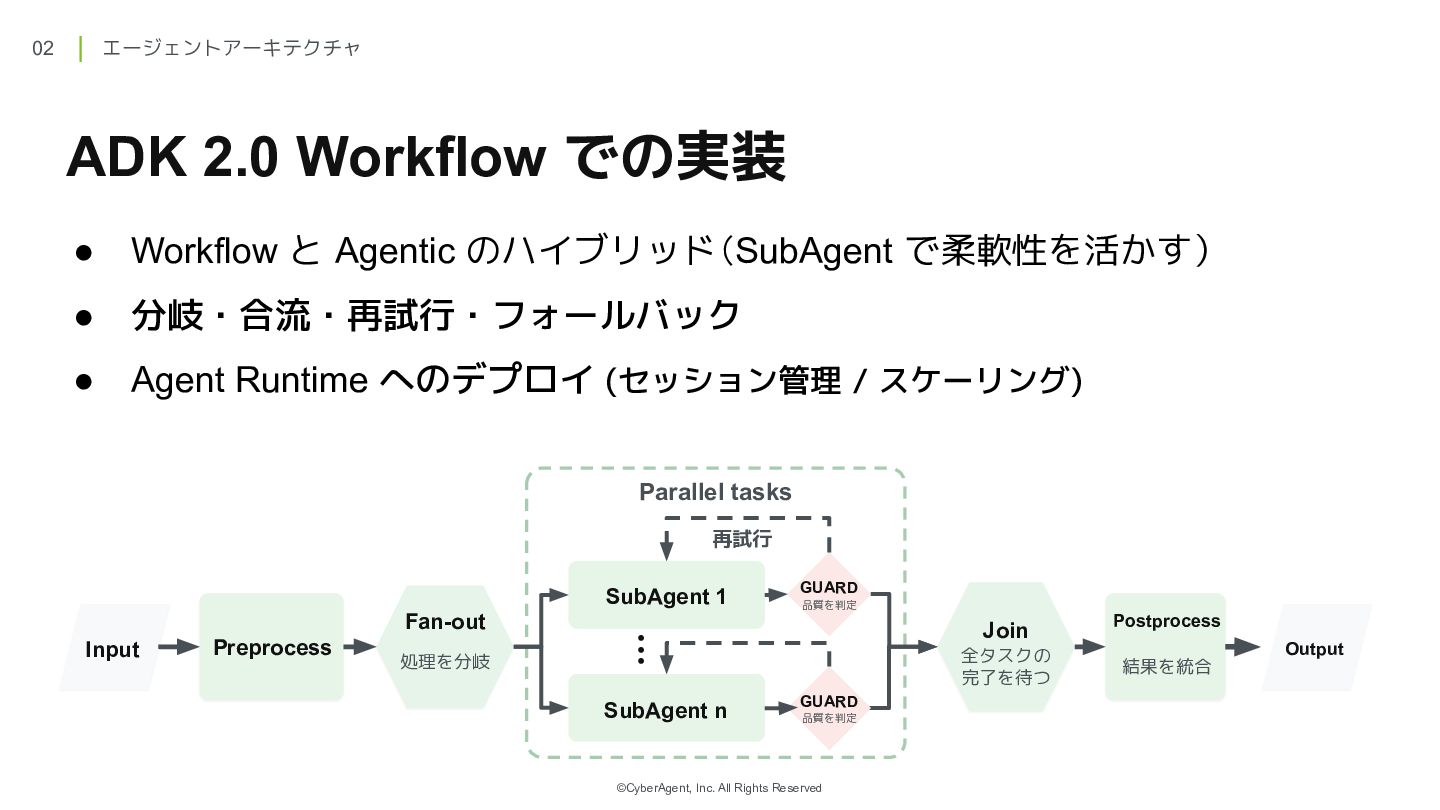
エージェントアーキテクチャ 02 ADK 2.0 Workflow での実装 • Workflow と Agentic
のハイブリッド(SubAgent で柔軟性を活かす) • 分岐・合流・再試行・フォールバック • Agent Runtime へのデプロイ (セッション管理 / スケーリング) Parallel tasks 再試行 SubAgent 1 Input Preprocess 処理を分岐 品質を判定 Join ••• Fan-out GUARD SubAgent n 全タスクの 完了を待つ GUARD 品質を判定 ©CyberAgent, Inc. All Rights Reserved Postprocess 結果を統合 Output
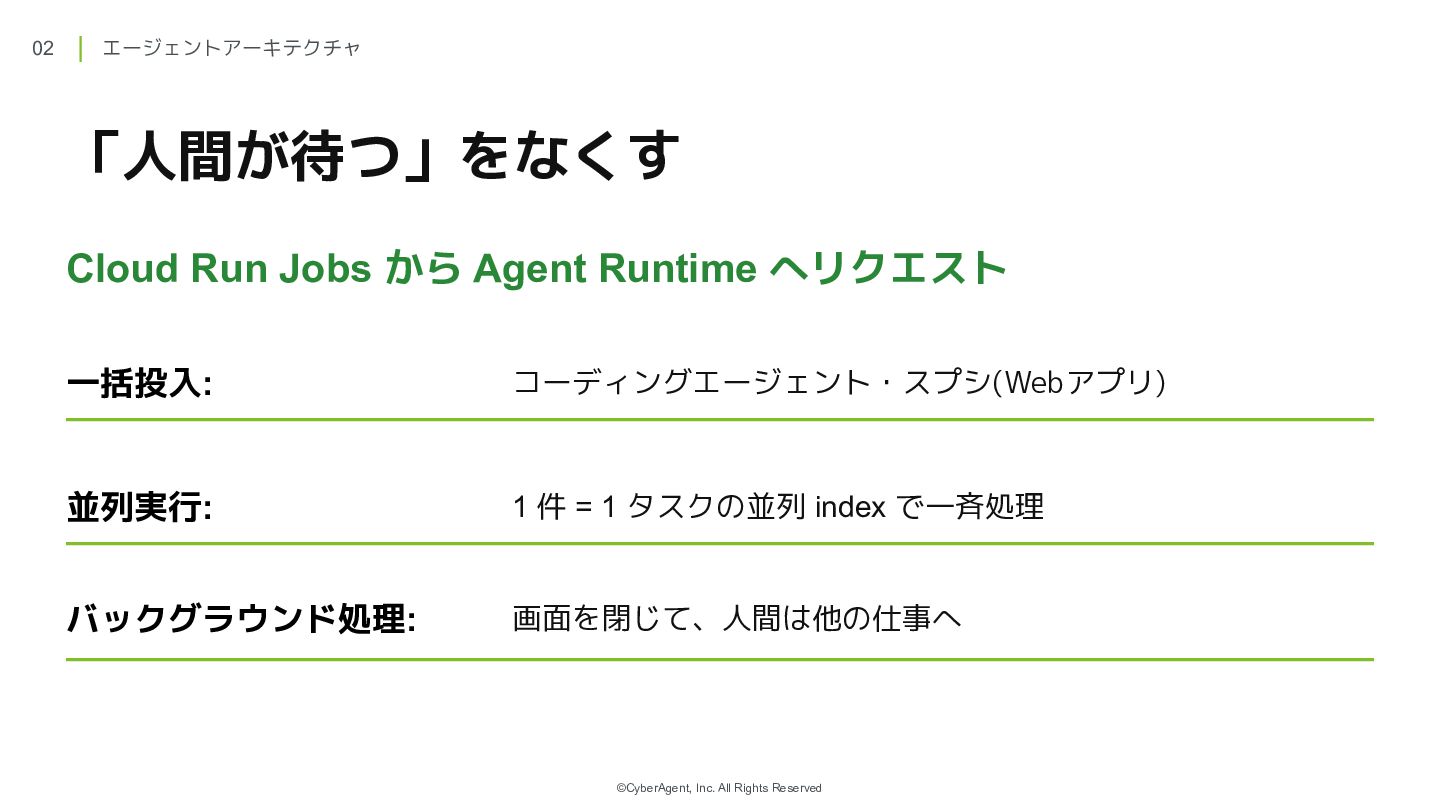
02 エージェントアーキテクチャ 「人間が待つ」をなくす Cloud Run Jobs から Agent Runtime へリクエスト
一括投入: コーディングエージェント・スプシ(Webアプリ)から並列処理 並列実行: 1 件 = 1 タスクの並列 index で一斉処理 バックグラウンド処理: 画面を閉じて、人間は他の仕事へ ©CyberAgent, Inc. All Rights Reserved
03 ADK Evalと 開発ワークフロー 03
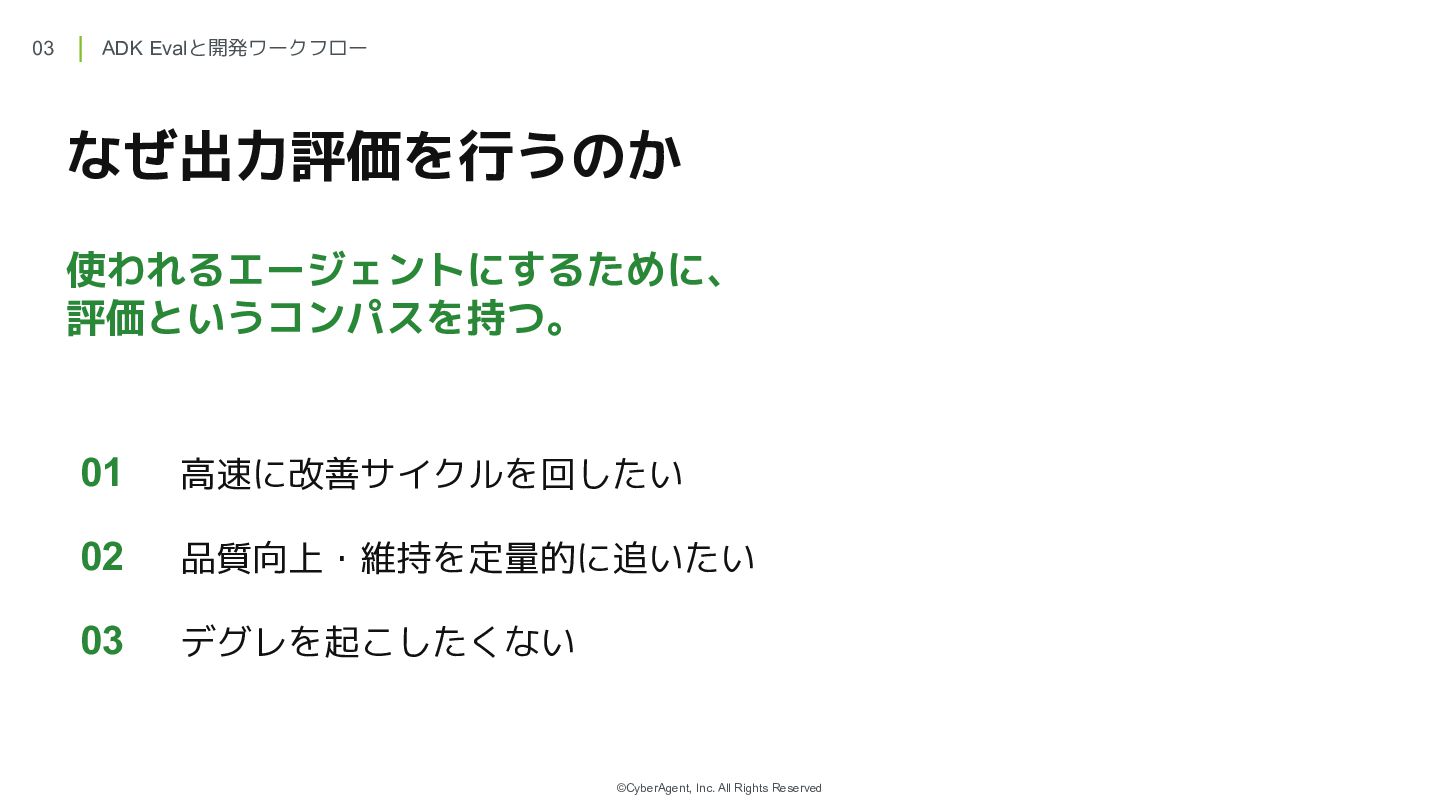
03 ADK Evalと開発ワークフロー なぜ出力評価を行うのか 使われるエージェントにするために、 評価というコンパスを持つ。 01 高速に改善サイクルを回したい 02 品質向上・維持を定量的に追いたい
03 デグレを起こしたくない ©CyberAgent, Inc. All Rights Reserved
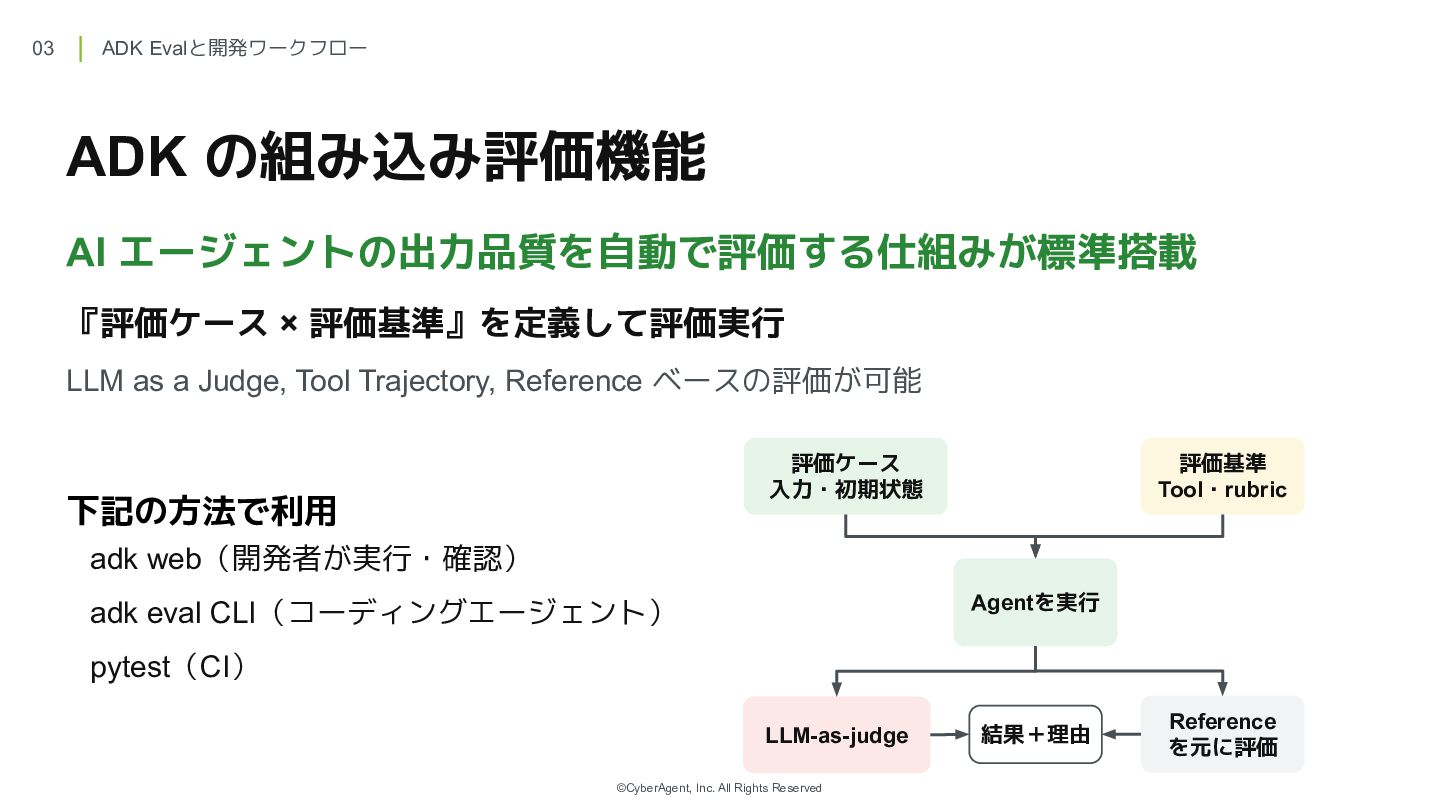
03 ADK Evalと開発ワークフロー ADK の組み込み評価機能 AI エージェントの出力品質を自動で評価する仕組みが標準搭載 『評価ケース × 評価基準』を定義して評価実行
LLM as a Judge, Tool Trajectory, Reference ベースの評価が可能 評価ケース 入力・初期状態 下記の方法で利用 評価基準 Tool・rubric adk web(開発者が実行・確認) Agentを実行 adk eval CLI(コーディングエージェント) pytest(CI) LLM-as-judge ©CyberAgent, Inc. All Rights Reserved 結果+理由 Reference を元に評価
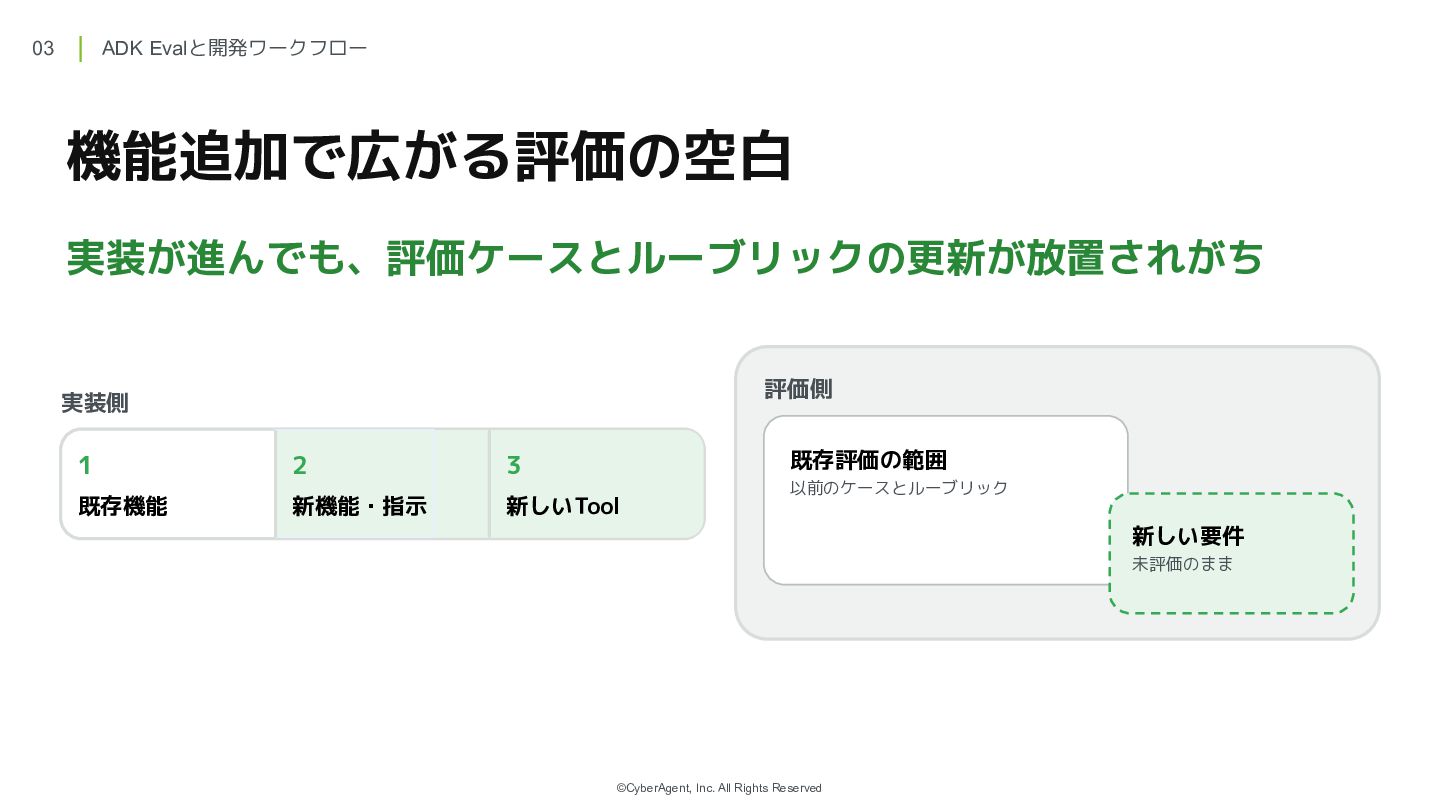
03 ADK Evalと開発ワークフロー 機能追加で広がる評価の空白 実装が進んでも、評価ケースとルーブリックの更新が放置されがち 評価側 実装側 既存評価の範囲 1 2
3 既存機能 新機能・指示 新しいTool 以前のケースとルーブリック 新しい要件 未評価のまま ©CyberAgent, Inc. All Rights Reserved
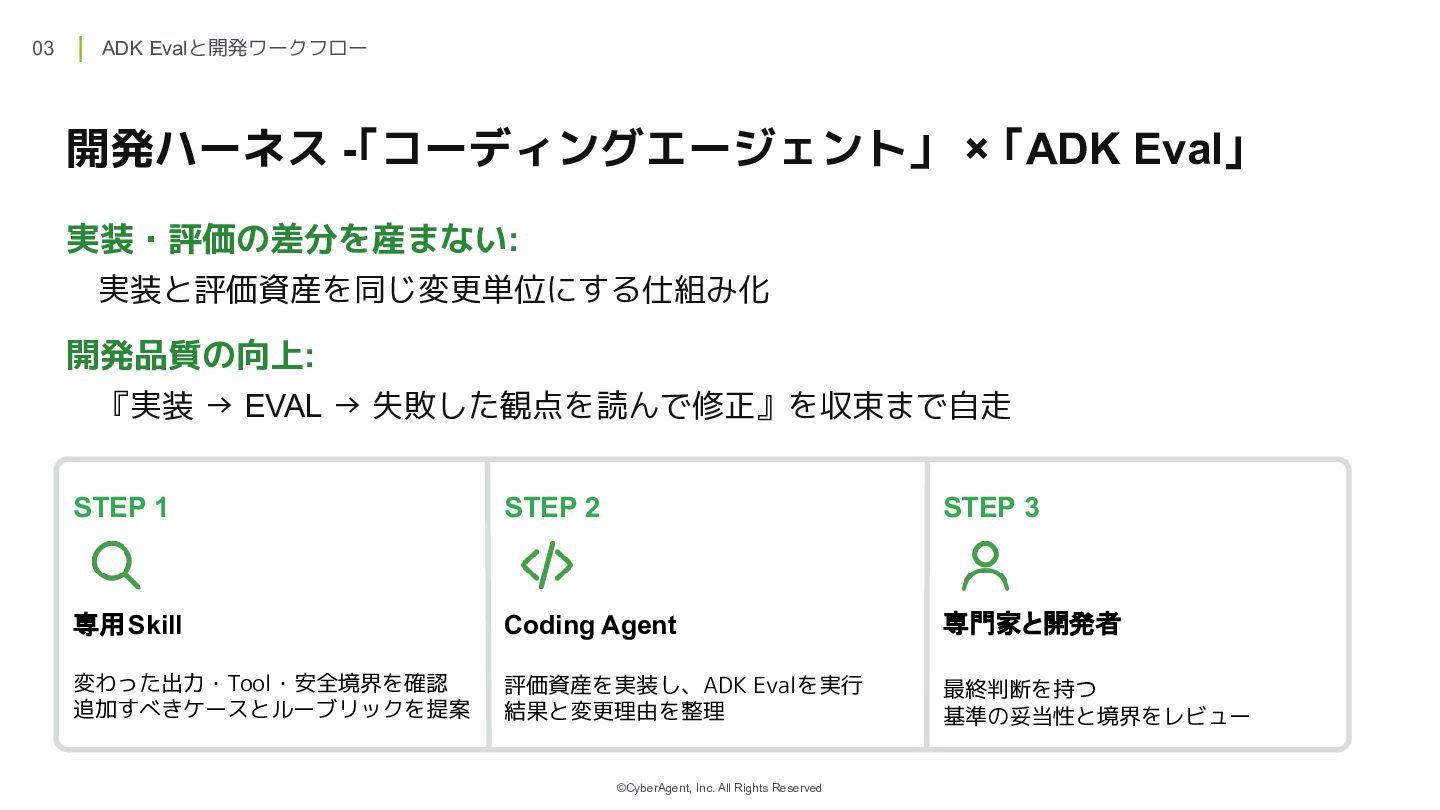
03 ADK Evalと開発ワークフロー 開発ハーネス -「コーディングエージェント」 × 「ADK Eval」 実装・評価の差分を産まない: 実装と評価資産を同じ変更単位にする仕組み化
開発品質の向上: 『実装 → EVAL → 失敗した観点を読んで修正』を収束まで自走 STEP 1 STEP 2 STEP 3 専用 Skill Coding Agent 専門家と開発者 変わった出力・Tool・安全境界を確認 追加すべきケースとルーブリックを提案 評価資産を実装し、ADK Evalを実行 結果と変更理由を整理 最終判断を持つ 基準の妥当性と境界をレビュー ©CyberAgent, Inc. All Rights Reserved
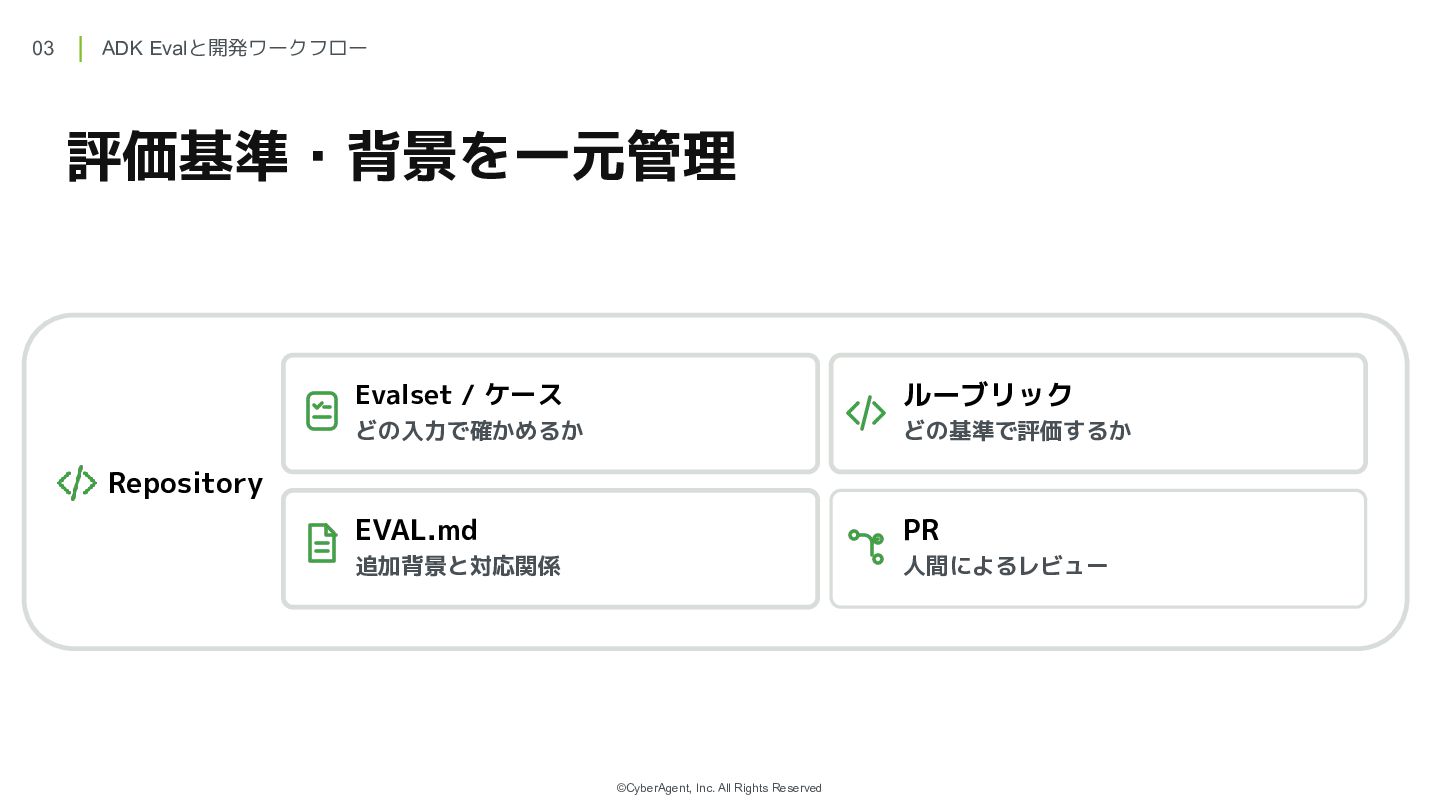
03 ADK Evalと開発ワークフロー 評価基準・背景を一元管理 - Evalset / ケース ルーブリック どの入力で確かめるか
どの基準で評価するか EVAL.md PR 追加背景と対応関係 人間によるレビュー Repository ©CyberAgent, Inc. All Rights Reserved
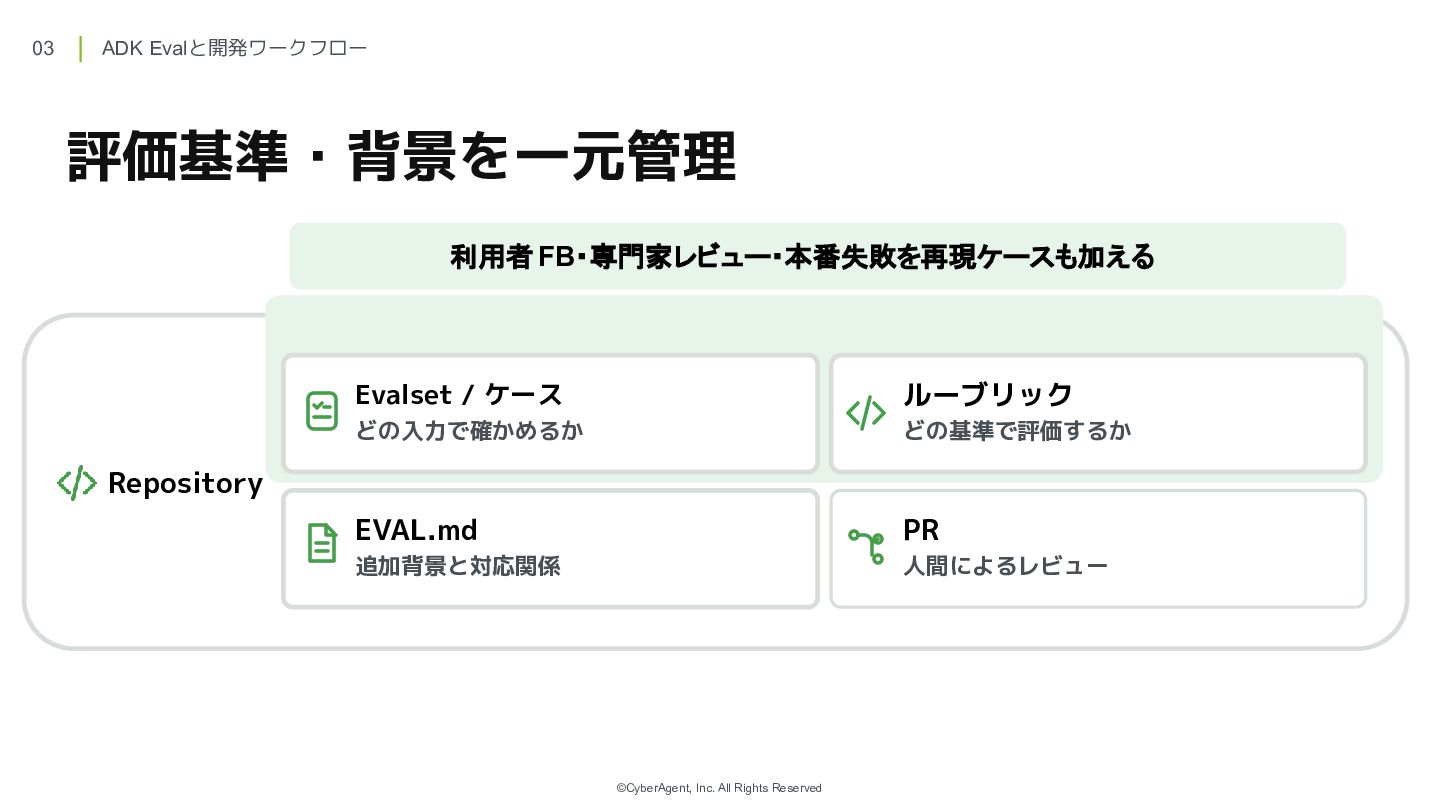
03 ADK Evalと開発ワークフロー 評価基準・背景を一元管理 利用者 FB・専門家レビュー・本番失敗を再現ケースも加える - Evalset / ケース
ルーブリック どの入力で確かめるか どの基準で評価するか EVAL.md PR 追加背景と対応関係 人間によるレビュー Repository ©CyberAgent, Inc. All Rights Reserved
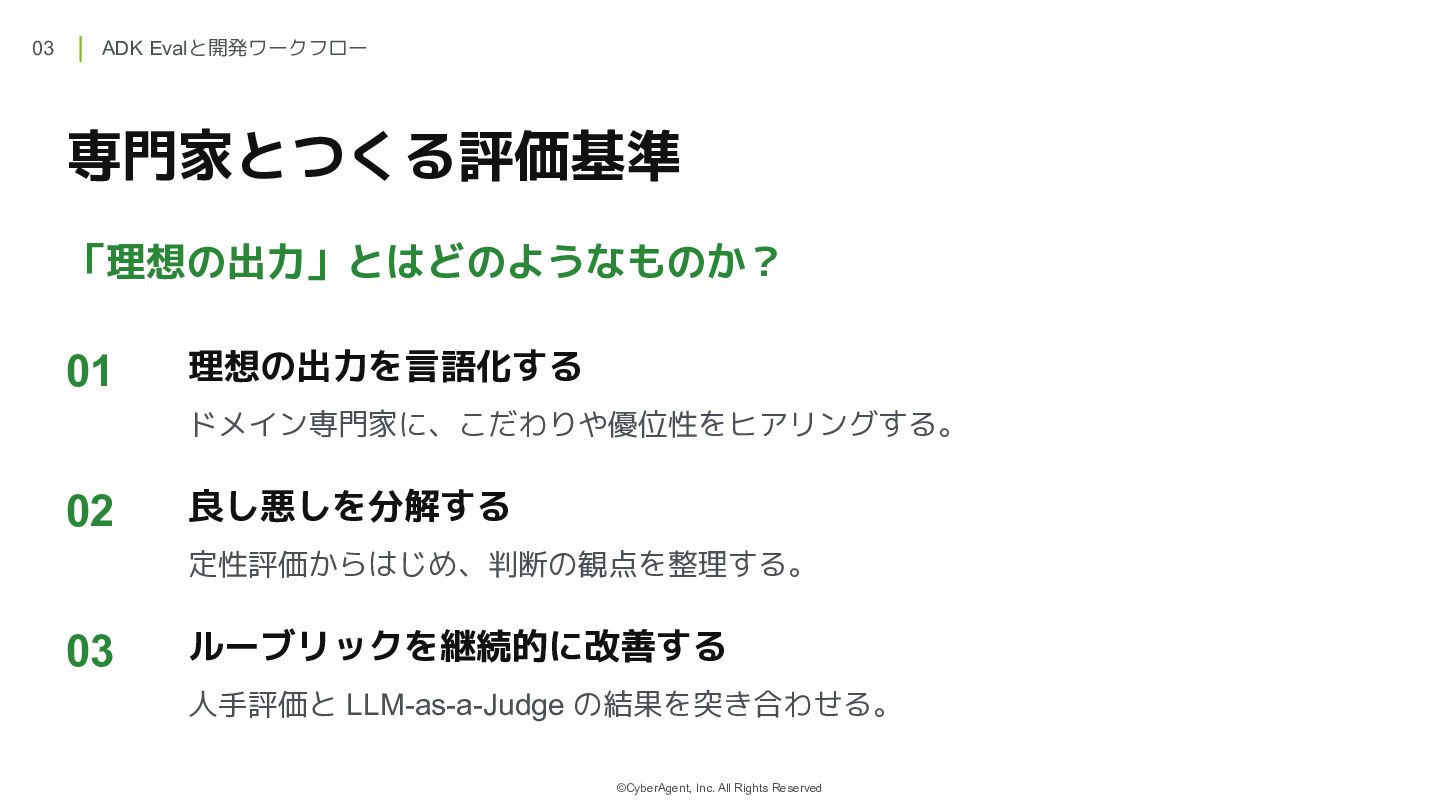
03 ADK Evalと開発ワークフロー 専門家とつくる評価基準 「理想の出力」とはどのようなものか? 01 理想の出力を言語化する ドメイン専門家に、こだわりや優位性をヒアリングする。 02 良し悪しを分解する
定性評価からはじめ、判断の観点を整理する。 03 ルーブリックを継続的に改善する 人手評価と LLM-as-a-Judge の結果を突き合わせる。 ©CyberAgent, Inc. All Rights Reserved
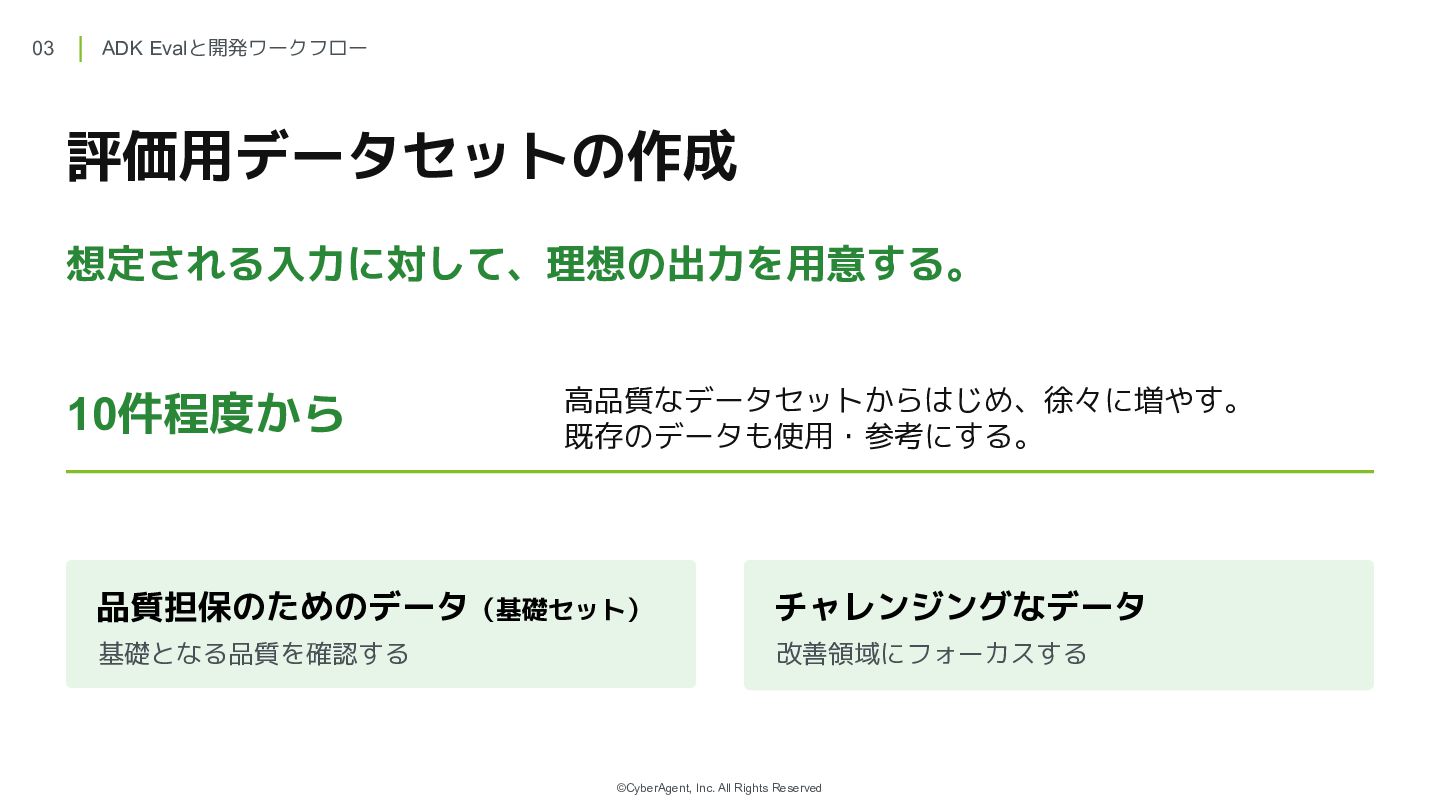
03 ADK Evalと開発ワークフロー 評価用データセットの作成 想定される入力に対して、理想の出力を用意する。 10件程度から 高品質なデータセットからはじめ、徐々に増やす。 既存のデータも使用・参考にする。 品質担保のためのデータ(基礎セット) チャレンジングなデータ
基礎となる品質を確認する 改善領域にフォーカスする ©CyberAgent, Inc. All Rights Reserved
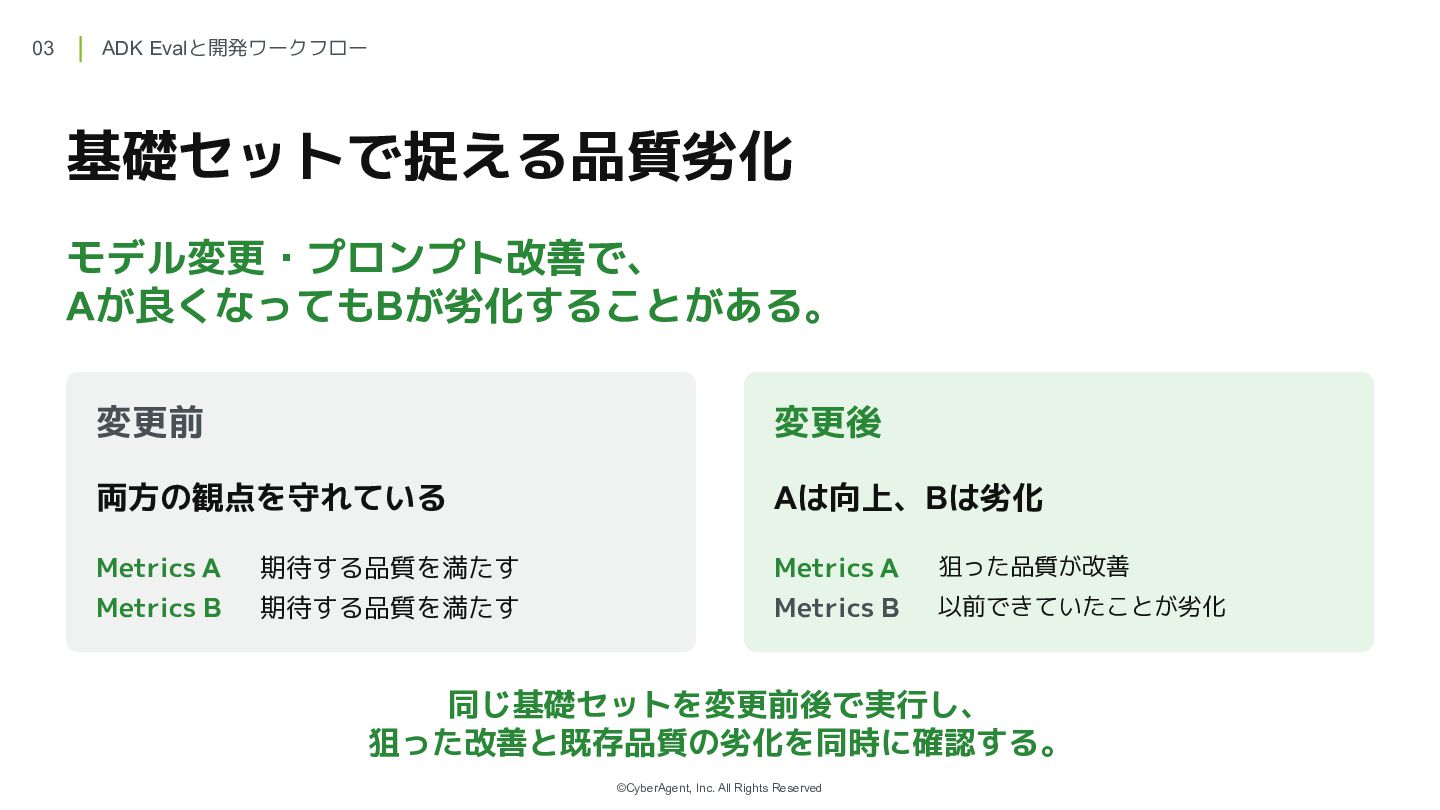
03 ADK Evalと開発ワークフロー 基礎セットで捉える品質劣化 モデル変更・プロンプト改善で、 Aが良くなってもBが劣化することがある。 変更前 変更後 両方の観点を守れている Aは向上、Bは劣化
Metrics A 期待する品質を満たす Metrics A 狙った品質が改善 Metrics B 期待する品質を満たす Metrics B 以前できていたことが劣化 同じ基礎セットを変更前後で実行し、 狙った改善と既存品質の劣化を同時に確認する。 ©CyberAgent, Inc. All Rights Reserved
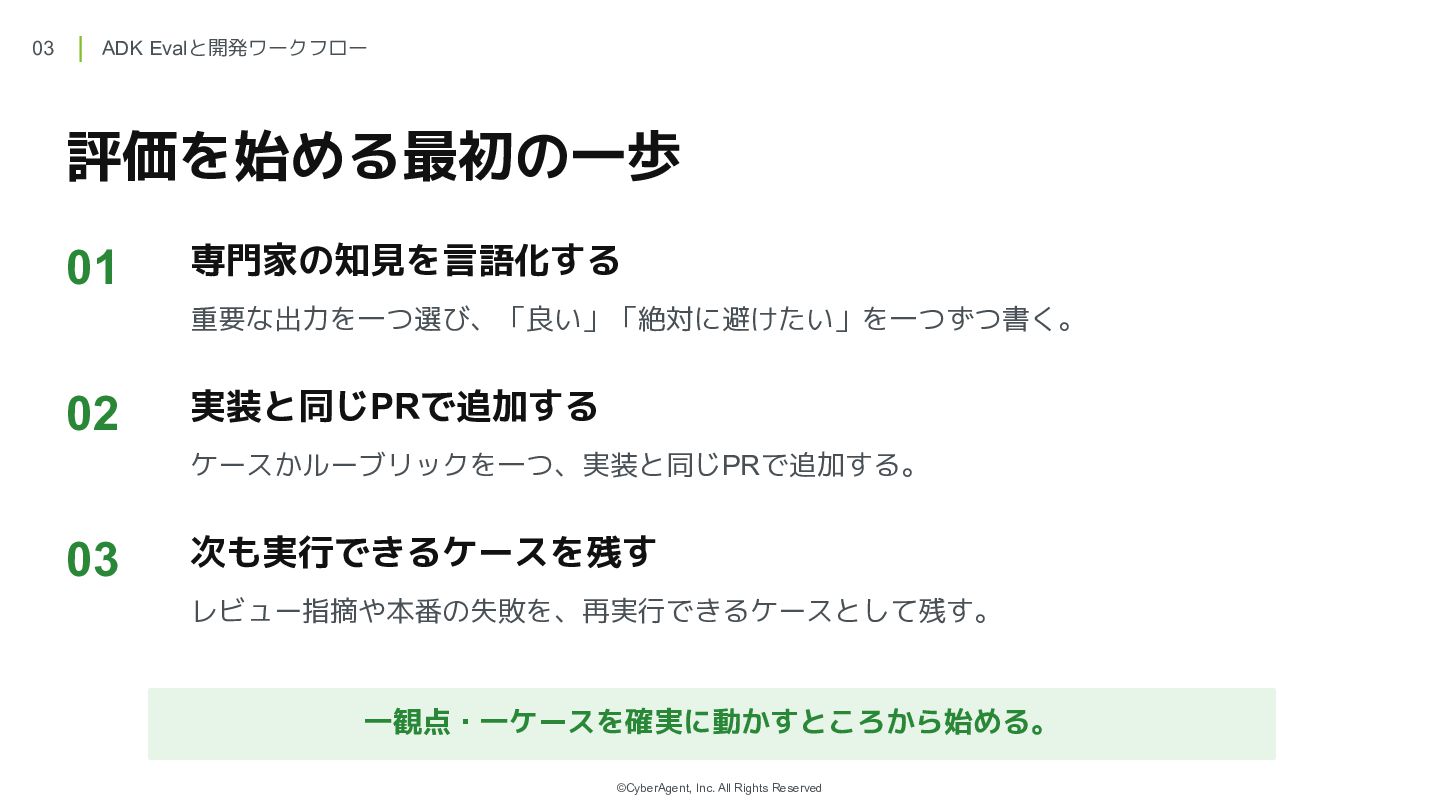
03 ADK Evalと開発ワークフロー 評価を始める最初の一歩 01 専門家の知見を言語化する 重要な出力を一つ選び、「良い」「絶対に避けたい」を一つずつ書く。 02 実装と同じPRで追加する ケースかルーブリックを一つ、実装と同じPRで追加する。
03 次も実行できるケースを残す レビュー指摘や本番の失敗を、再実行できるケースとして残す。 一観点・一ケースを確実に動かすところから始める。 ©CyberAgent, Inc. All Rights Reserved
04 まとめ 04
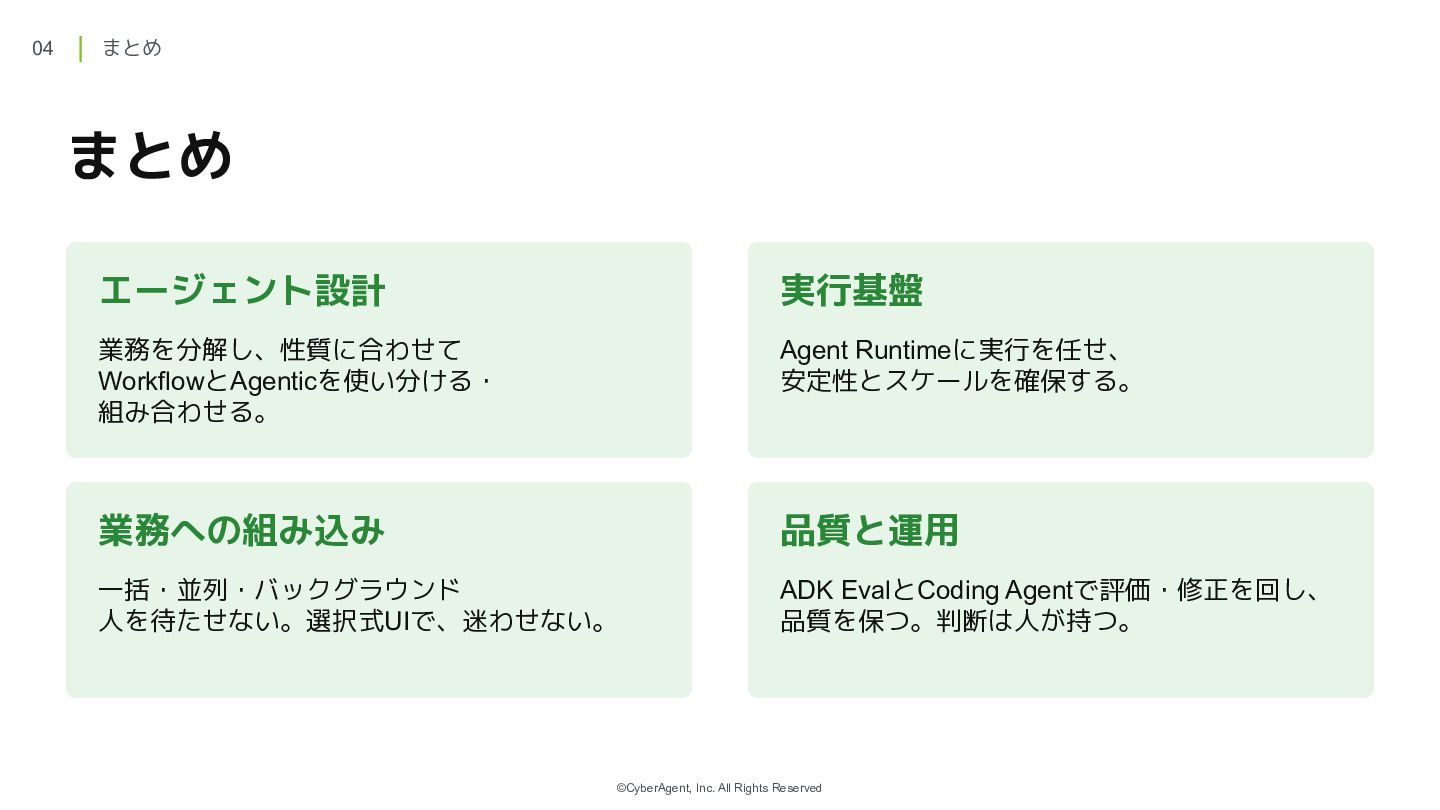
04 まとめ まとめ エージェント設計 実行基盤 業務を分解し、性質に合わせて WorkflowとAgenticを使い分ける・ 組み合わせる。 Agent Runtimeに実行を任せ、
安定性とスケールを確保する。 業務への組み込み 品質と運用 一括・並列・バックグラウンド 人を待たせない。選択式UIで、迷わせない。 ADK EvalとCoding Agentで評価・修正を回し、 品質を保つ。判断は人が持つ。 ©CyberAgent, Inc. All Rights Reserved
More Decks by Kazuki Hara
See All by Kazuki Hara
【CA.ai #4】Vertex AI Gen AI Evaluation Service の活用事例紹介
harappa80
0
26
【Google Cloud Next Tokyo 26】Agent Development Kit (ADK) と Agent Platformで実現する、次世代の業務効率化
harappa80
0
17
Build with AI:ADKとGemini CLIで自分だけのAIアシスタントを作ろう!
harappa80
0
28
【CA.ai #3】Google ADKを活用したAI Agent開発と運用知見
harappa80
1
580
Other Decks in Technology
See All in Technology
異夢同船〜異なる夢でも同じ船でなんとかする〜
fortegp05
1
520
設計手法を「道具」として使いこなすために
a_suenami
4
810
変更差分を読むために環境を整備しよう
pipepasta
1
470
会社説明資料_最新版
demaecan
0
32k
Sonnetだけで業務はまわる?
kintotechdev
1
150
アラートを見直していたら営業組織への理解にちょっとだけ繋がった話
z63d
1
210
re:Inventを楽しむために、 1日1つ「これが楽しみ」を決めよう
beli68
0
120
マネージャーをエスパーにしない マネジメントされる側から始める、働きやすい現場づくり
comi190327
1
780
ぼくのClaude Codeの使い方
falken
PRO
5
7.5k
Context parameters で作る!はじめての型クラス
kworkdev
PRO
1
150
メール到達性を支える、リンク先URLのドメイン評価の扱い方
wind111
0
160
2026-11-16 JAWS-UG コンテナ支部 #31 ゆるLT大会 ECR のライフサイクルポリシーを いい感じに設定したい / ECR Lifecycle policy
masasuzu
2
520
Featured
See All Featured
DBのスキルで生き残る技術 - AI時代におけるテーブル設計の勘所
soudai
PRO
68
60k
WCS-LA-2024
lcolladotor
0
1k
Making the Leap to Tech Lead
cromwellryan
135
10k
KATA
mclloyd
PRO
35
16k
Building Flexible Design Systems
yeseniaperezcruz
330
41k
First, design no harm
axbom
PRO
2
1.4k
Building the Perfect Custom Keyboard
takai
2
960
What does AI have to do with Human Rights?
axbom
PRO
1
2.5k
Improving Core Web Vitals using Speculation Rules API
sergeychernyshev
21
1.7k
Impact Scores and Hybrid Strategies: The future of link building
tamaranovitovic
0
490
Reality Check: Gamification 10 Years Later
codingconduct
0
2.4k
The Invisible Side of Design
smashingmag
301
52k


 harappa80
 fortegp05
 a_suenami
 pipepasta
 demaecan
 kintotechdev
 z63d
 beli68
 comi190327
 falken
 kworkdev
 wind111
 masasuzu
 soudai
 lcolladotor
 cromwellryan
 mclloyd
 yeseniaperezcruz
 axbom
 takai
 sergeychernyshev
 tamaranovitovic
 codingconduct
 smashingmag