Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
BigQueryで行う、 機械学習のための データ前処理
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
hiroaki
December 18, 2019
Technology
2.7k
4
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
BigQueryで行う、 機械学習のための データ前処理
hiroaki
December 18, 2019
More Decks by hiroaki
See All by hiroaki
機械学習を無理なく広告システムに導入する
hiroaki8388
2
6.4k
Pythonで、処理をより効率化するためのTips集
hiroaki8388
15
12k
Other Decks in Technology
See All in Technology
データ_AIの事業の勝敗をわけるもの
nek0128
1
460
AI時代の「技術的負債」の変質ー概念の終焉と再解釈、エージェントと共に向かう先
nwiizo
1
2.9k
リアーキテクチャ後の障害ゼロを目指したShadow Testingの取り組み
nihonbuson
PRO
1
160
作って終わりじゃないサーバーレス 〜9年運用する大規模EC物流API基盤の設計・運用のリアル〜
zozotech
PRO
0
300
AI 時代のスタートアップエコシステ厶から考究する技術的負債との向き合い方
m3m0r7
PRO
3
2.3k
Deployment の 先にある AI Agent 基盤 - kagent vNext、Agent Substrate、Hermes から読み解く Agent Runtime の現在地 / k8s-matsuri-2-ai-agent-platform-amsy810
masayaaoyama
4
680
AIエージェントの一手は 誰も見ていない - Falco拡張OSS「Prempti」とeBPFで サーバーレス実行基盤を二層防御する
keitah
0
320
Slack上でインフラをトラブルシュートする! Agentic Platform Engineeringの第一歩
teru0x1
5
1.8k
Claude Code本って、 読む必要あるの?
oikon48
2
490
人間はどの意思決定を手放せるのか
kawasima
15
7.5k
AI時代、データエンジニアが一番おもろい
genshun9
0
670
AIエージェントの権限管理 3: Agentic RAG の Fine grained access control 編
ren8k
0
150
Featured
See All Featured
How to Align SEO within the Product Triangle To Get Buy-In & Support - #RIMC
aleyda
2
1.8k
svc-hook: hooking system calls on ARM64 by binary rewriting
retrage
2
580
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
1
6.2k
So, you think you're a good person
axbom
PRO
2
2.2k
A designer walks into a library…
pauljervisheath
211
25k
The Invisible Side of Design
smashingmag
301
52k
Stewardship and Sustainability of Urban and Community Forests
pwiseman
0
530
Agile that works and the tools we love
rasmusluckow
331
22k
Building Applications with DynamoDB
mza
96
7.2k
SEO in 2025: How to Prepare for the Future of Search
ipullrank
3
3.8k
Agile Actions for Facilitating Distributed Teams - ADO2019
mkilby
0
280
SERP Conf. Vienna - Web Accessibility: Optimizing for Inclusivity and SEO
sarafernandez
2
1.6k
Transcript
BigQueryで行う、 機械学習のための データ前処理 GCPUG Tokyo December 2019 長谷川大耀 (Fringe81)
自己紹介 長谷川大耀(@Hase8388) で 機械学習の開発やってます
BigQueryで機械学習が行えると何が嬉しい? • 大量のデータから、安く簡単にデータセットを構築できる • SQLで処理ができるので、誰でも簡単に実行可能 • BQMLで構築したモデルにシームレスにデータを流し込める 今回話すこと さらによりよいモデルを作るために、 BQ(ML)での前処理を行うための方法の紹介
話さないこと アルゴリズムの話など、モデル自体の仕組みの話
機械学習では、前処理がなぜ重要? 解くべきタスクの本質を、 より明らかな形として表現するデータに加工することで、 モデルの性能を更に引き出すことができる 1. 概観の把握 2. 特徴量の作成、変換 3. モデルにデータセットを流し込む
それぞれのフェイズで 代表的な関数+自分が好きな関数を紹介します
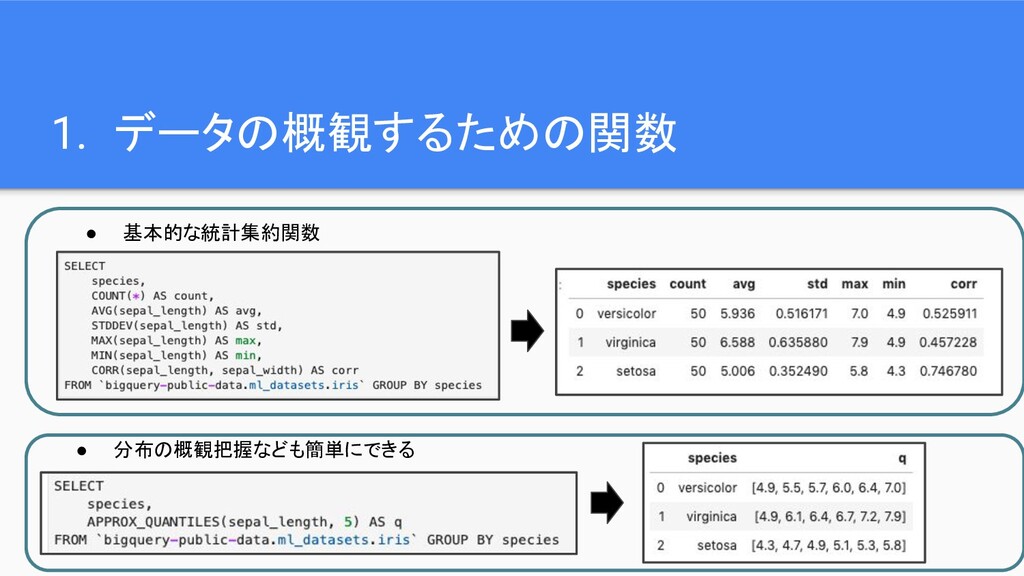
1. データの概観するための関数 • 分布の概観把握なども簡単にできる • 基本的な統計集約関数
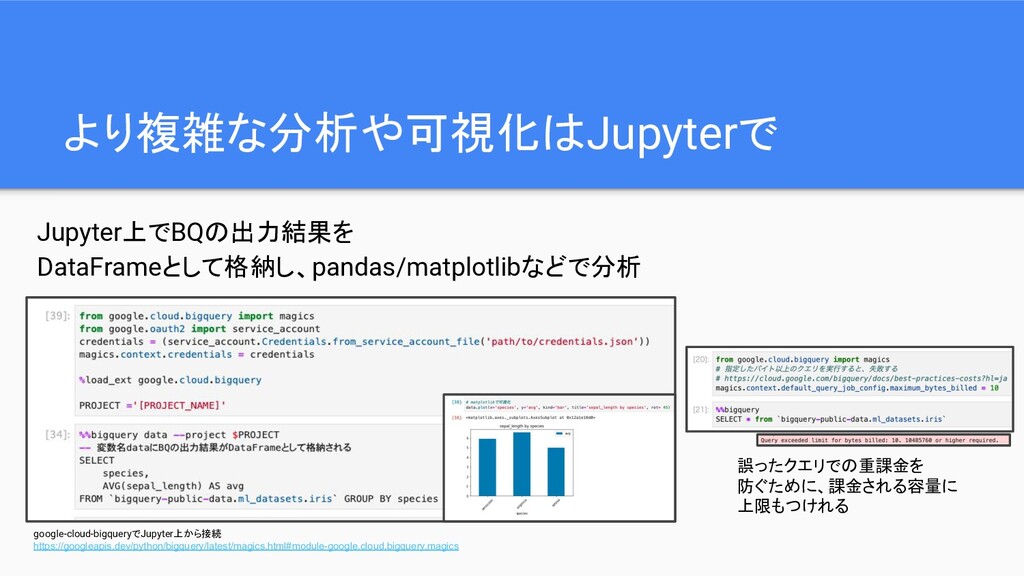
より複雑な分析や可視化はJupyterで Jupyter上でBQの出力結果を DataFrameとして格納し、pandas/matplotlibなどで分析 google-cloud-bigqueryでJupyter上から接続 https://googleapis.dev/python/bigquery/latest/magics.html#module-google.cloud.bigquery.magics 誤ったクエリでの重課金を 防ぐために、課金される容量に 上限もつけれる
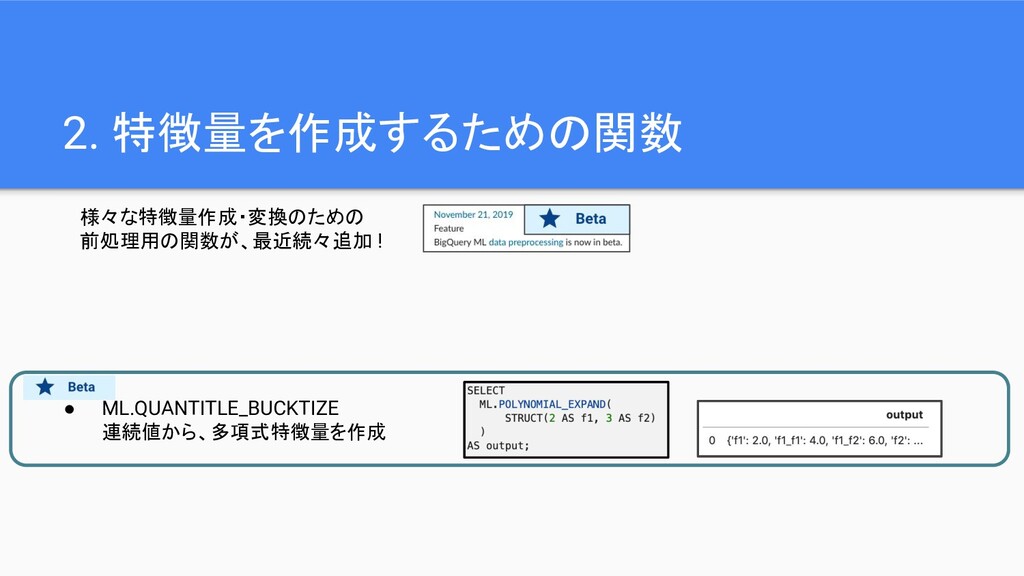
2. 特徴量を作成するための関数 様々な特徴量作成・変換のための 前処理用の関数が、最近続々追加 ! • ML.QUANTITLE_BUCKTIZE 連続値から、多項式特徴量を作成
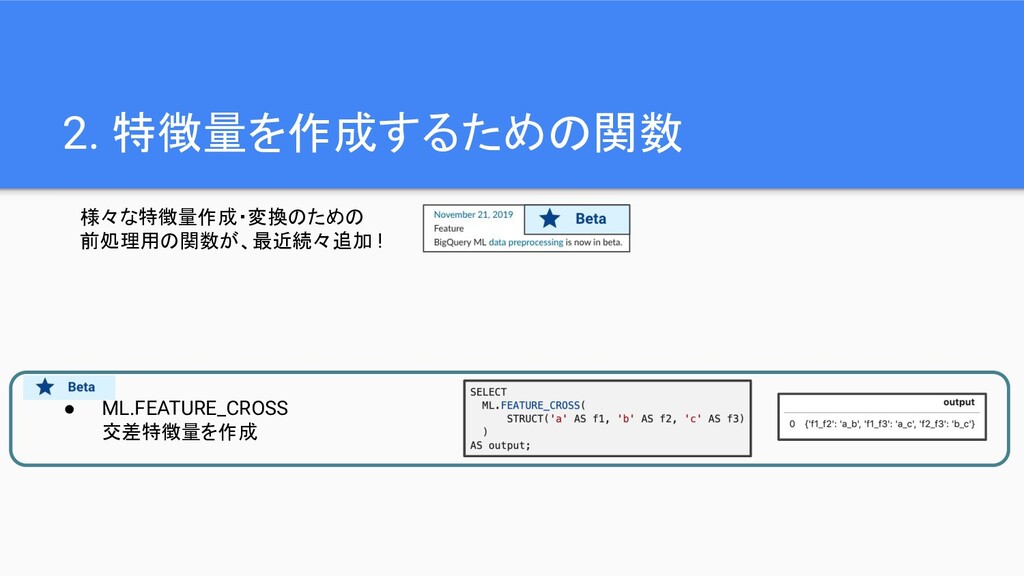
2. 特徴量を作成するための関数 様々な特徴量作成・変換のための 前処理用の関数が、最近続々追加 ! • ML.FEATURE_CROSS 交差特徴量を作成
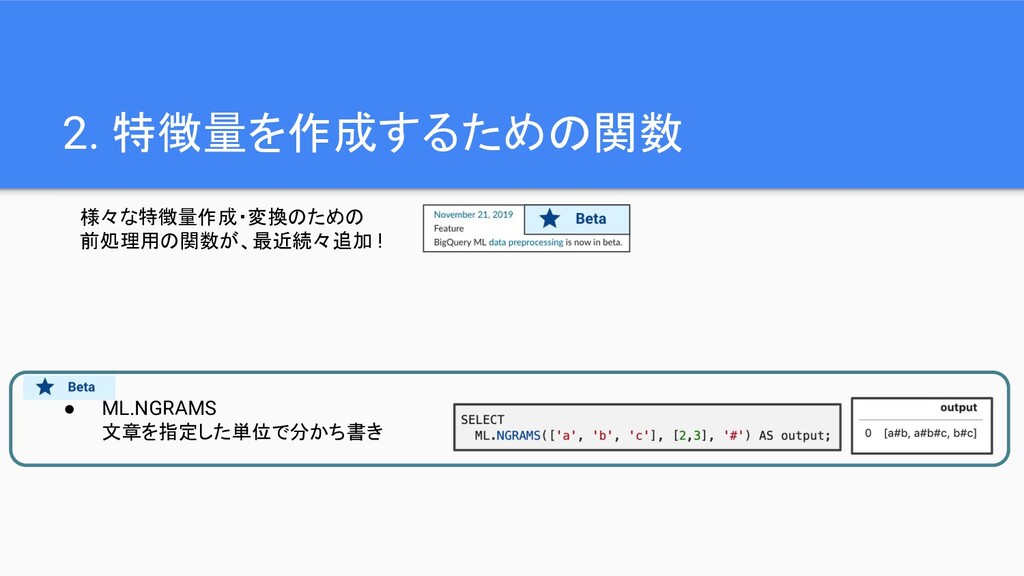
2. 特徴量を作成するための関数 様々な特徴量作成・変換のための 前処理用の関数が、最近続々追加 ! • ML.NGRAMS 文章を指定した単位で分かち書き
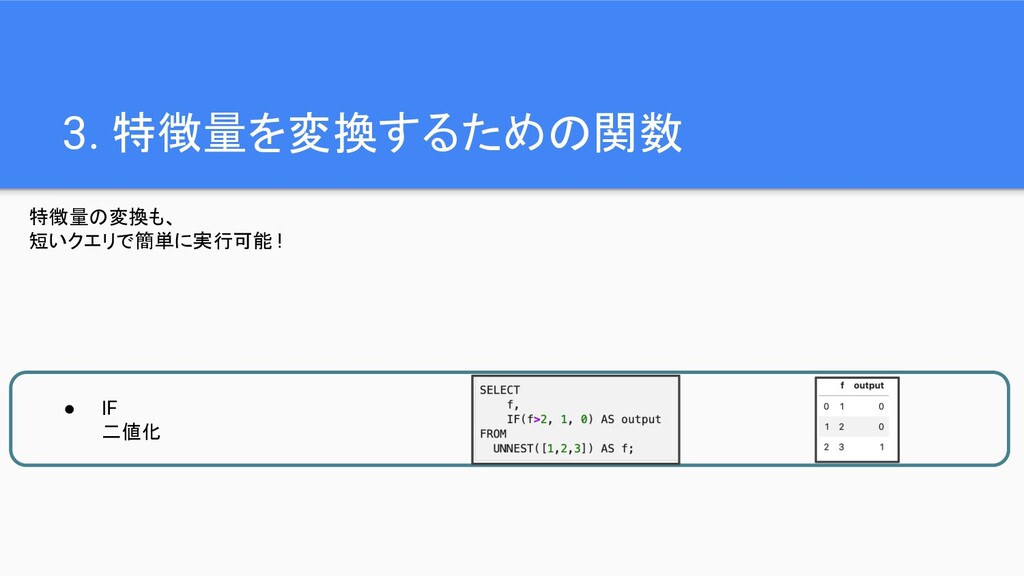
3. 特徴量を変換するための関数 特徴量の変換も、 短いクエリで簡単に実行可能 ! • IF 二値化
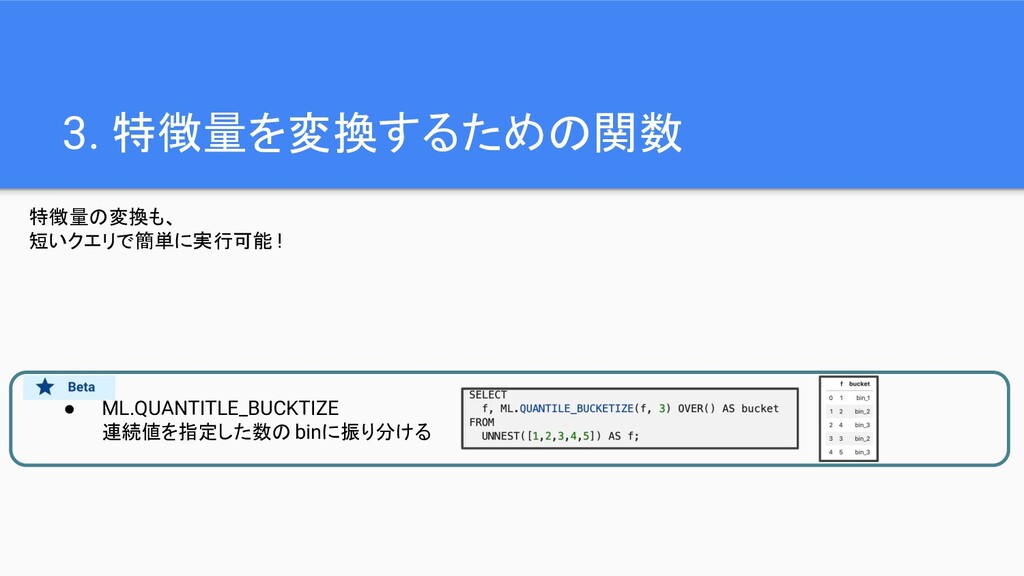
3. 特徴量を変換するための関数 特徴量の変換も、 短いクエリで簡単に実行可能 ! • ML.QUANTITLE_BUCKTIZE 連続値を指定した数の binに振り分ける
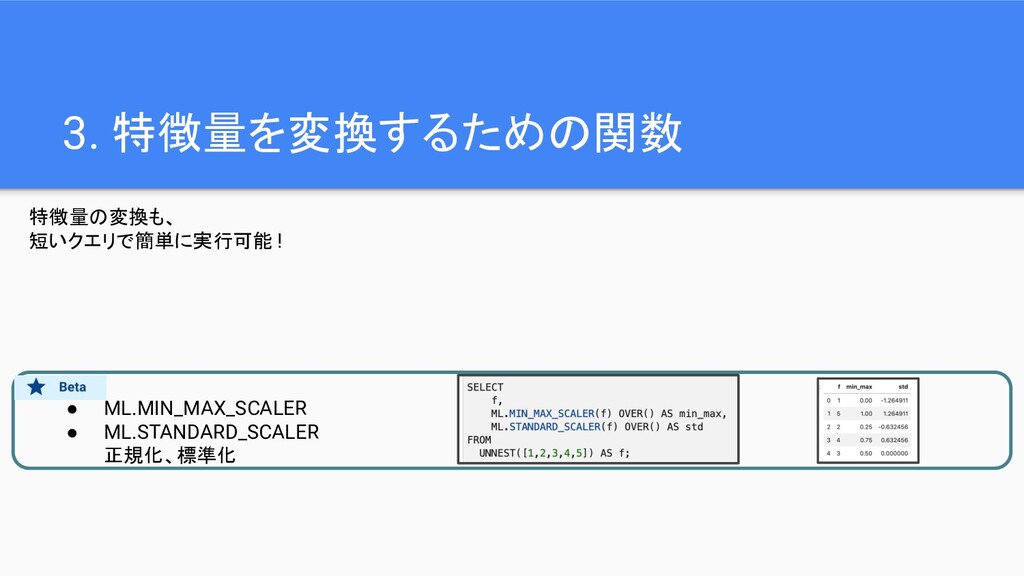
3. 特徴量を変換するための関数 特徴量の変換も、 短いクエリで簡単に実行可能 ! • ML.MIN_MAX_SCALER • ML.STANDARD_SCALER 正規化、標準化
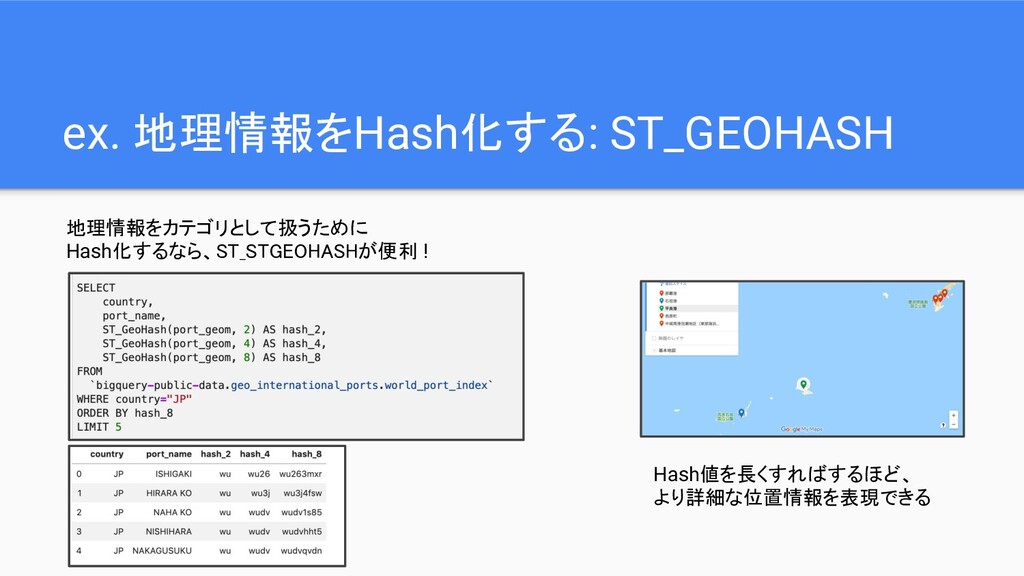
ex. 地理情報をHash化する: ST_GEOHASH 地理情報をカテゴリとして扱うために Hash化するなら、ST_STGEOHASHが便利 ! Hash値を長くすればするほど、 より詳細な位置情報を表現できる
3. 前処理したデータをモデルに流し込む 課題: BQMLで作成したモデルにデータセットを流し込む その時、学習、予測、評価で、イチイチ同じ前処理を行うのはシンドい 学習 データ 前処理 評価 データ
前処理 予測 データ 前処理 モデル モデルを使う人が前処理のロジックを 知っている必要がある。つらい 学習時 予測時 重複!
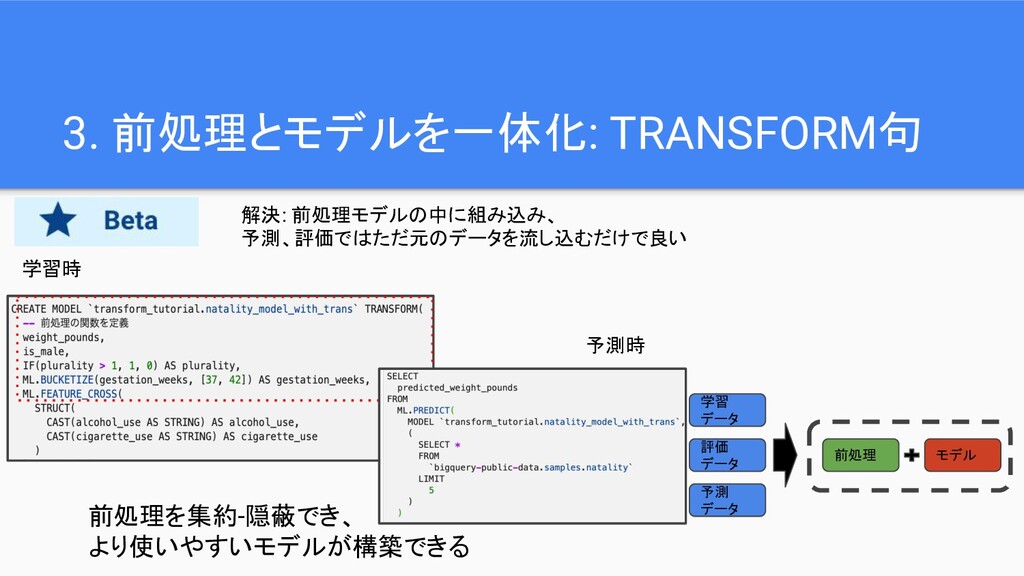
3. 前処理とモデルを一体化: TRANSFORM句 前処理を集約-隠蔽でき、 より使いやすいモデルが構築できる 学習 データ 評価 データ 前処理
予測 データ モデル 解決: 前処理モデルの中に組み込み、 予測、評価ではただ元のデータを流し込むだけで良い 学習時 予測時
最後に BigQuery(ML)を使うと、SQLだけで簡単に前処理とモデル構築が行える 新しい関数とアルゴリズムがどんどん追加されているので、今後がより楽しみ
エンジニアを積極採用中です ! Front-end Back-end Scala / Go Python JS /
Elm React / RN


 hiroaki8388
 nek0128
 nwiizo
 nihonbuson
 zozotech
 m3m0r7
 masayaaoyama
 keitah
 teru0x1
 oikon48
 kawasima
 genshun9
 ren8k
 aleyda
 retrage
 axbom
 pauljervisheath
 smashingmag
 pwiseman
 rasmusluckow
 mza
 ipullrank
 mkilby
 sarafernandez