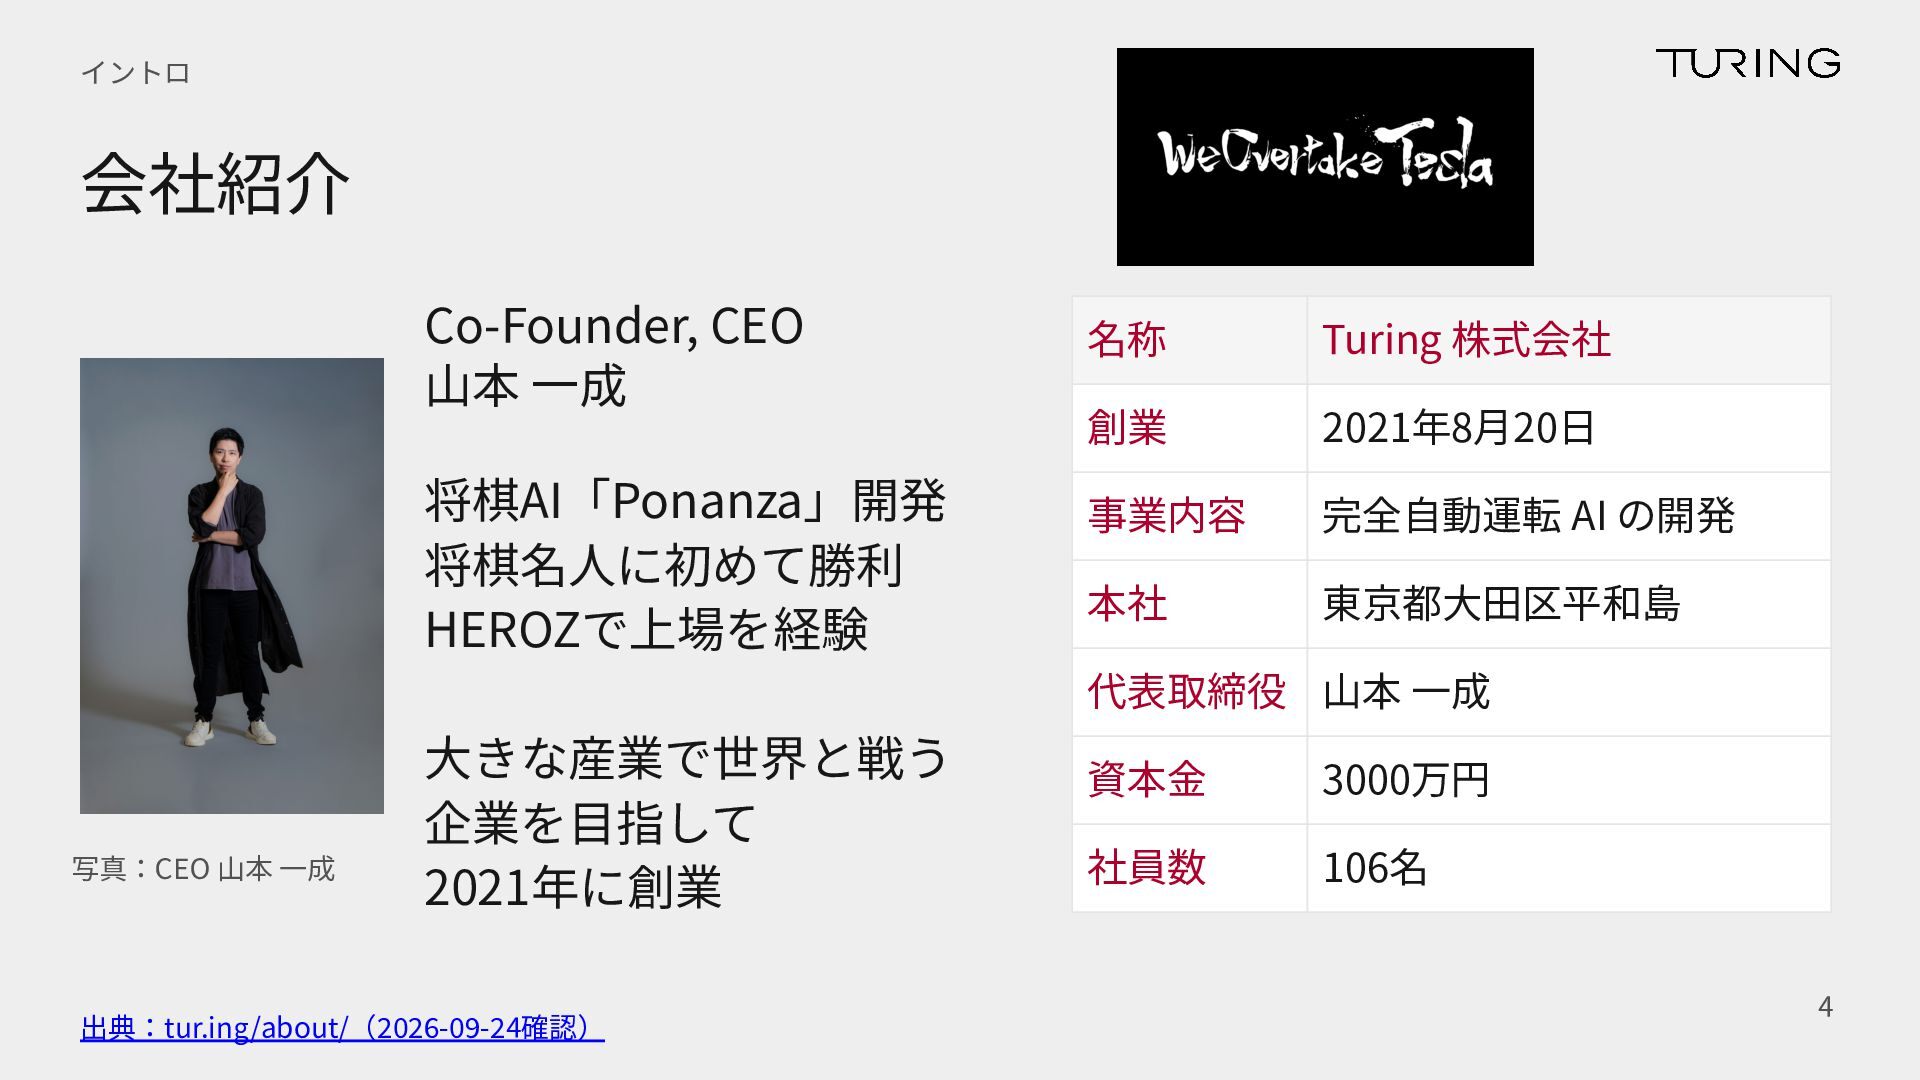
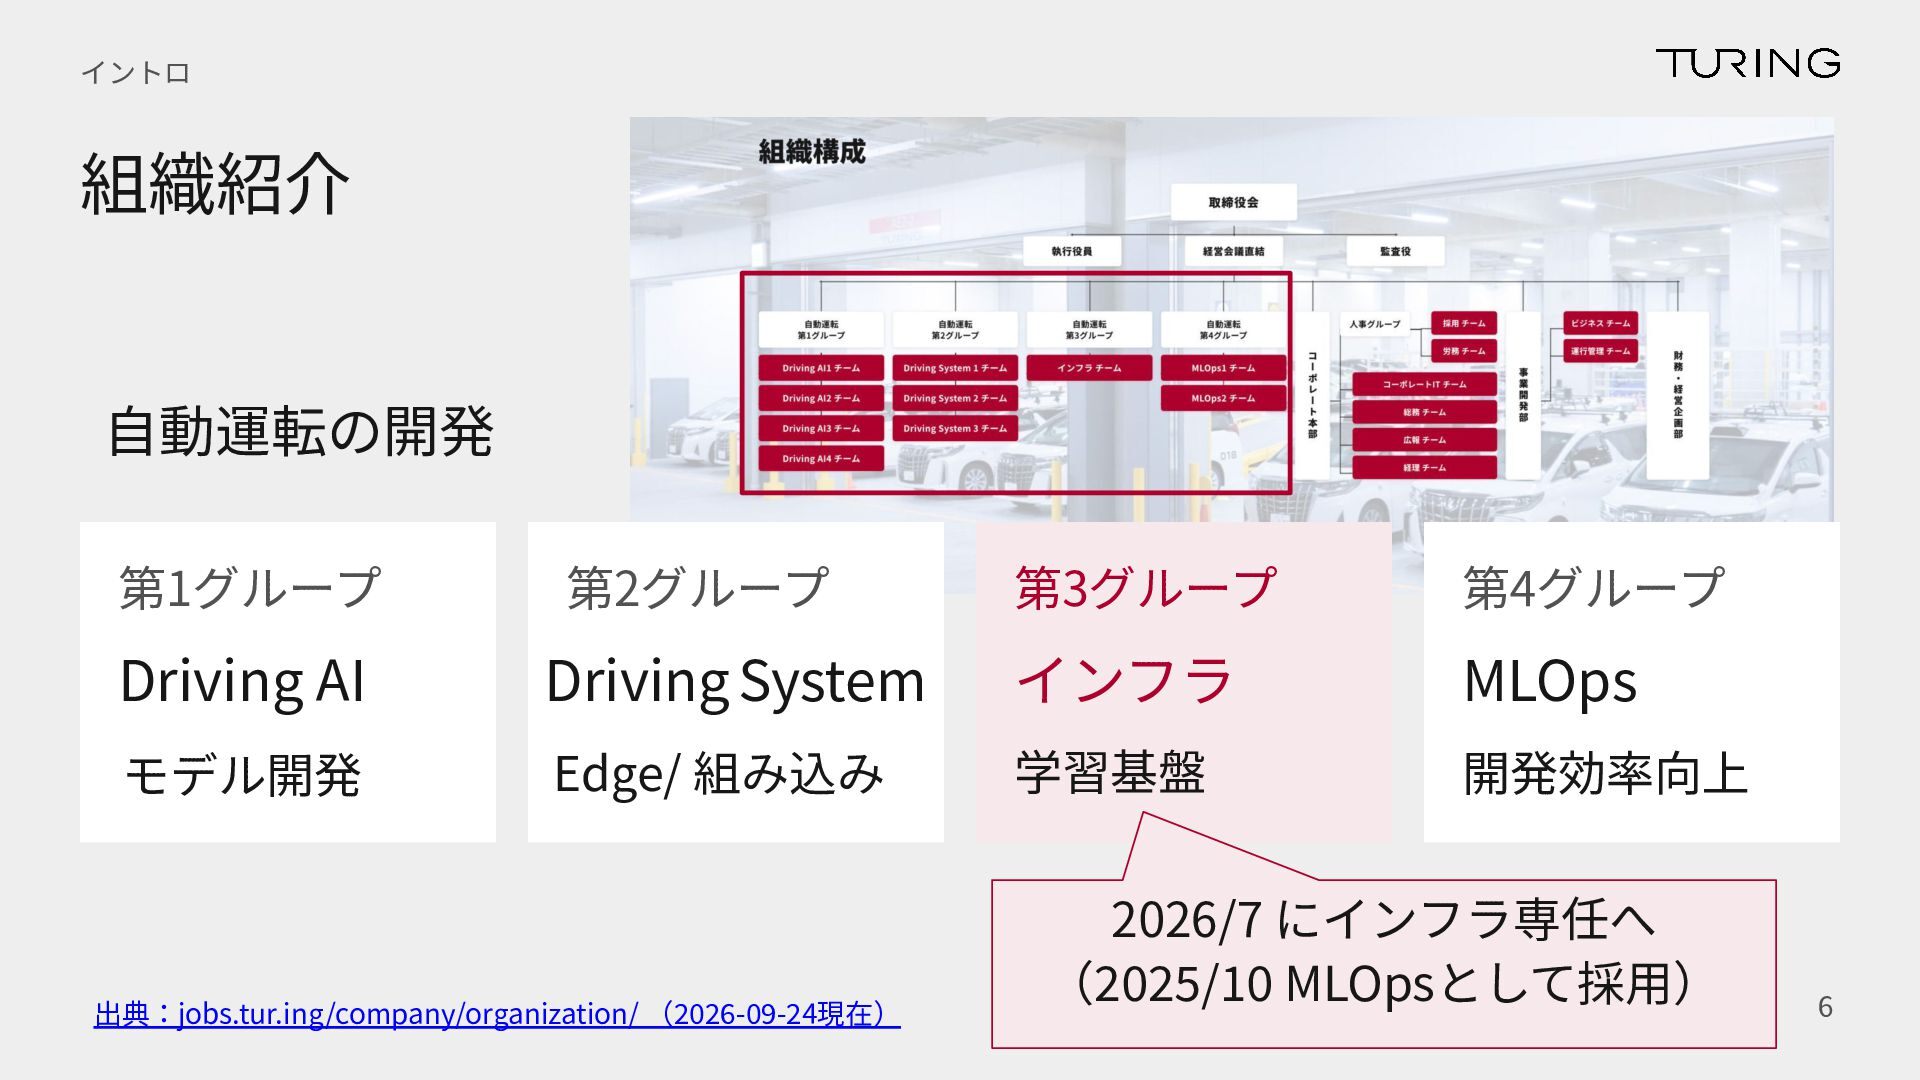
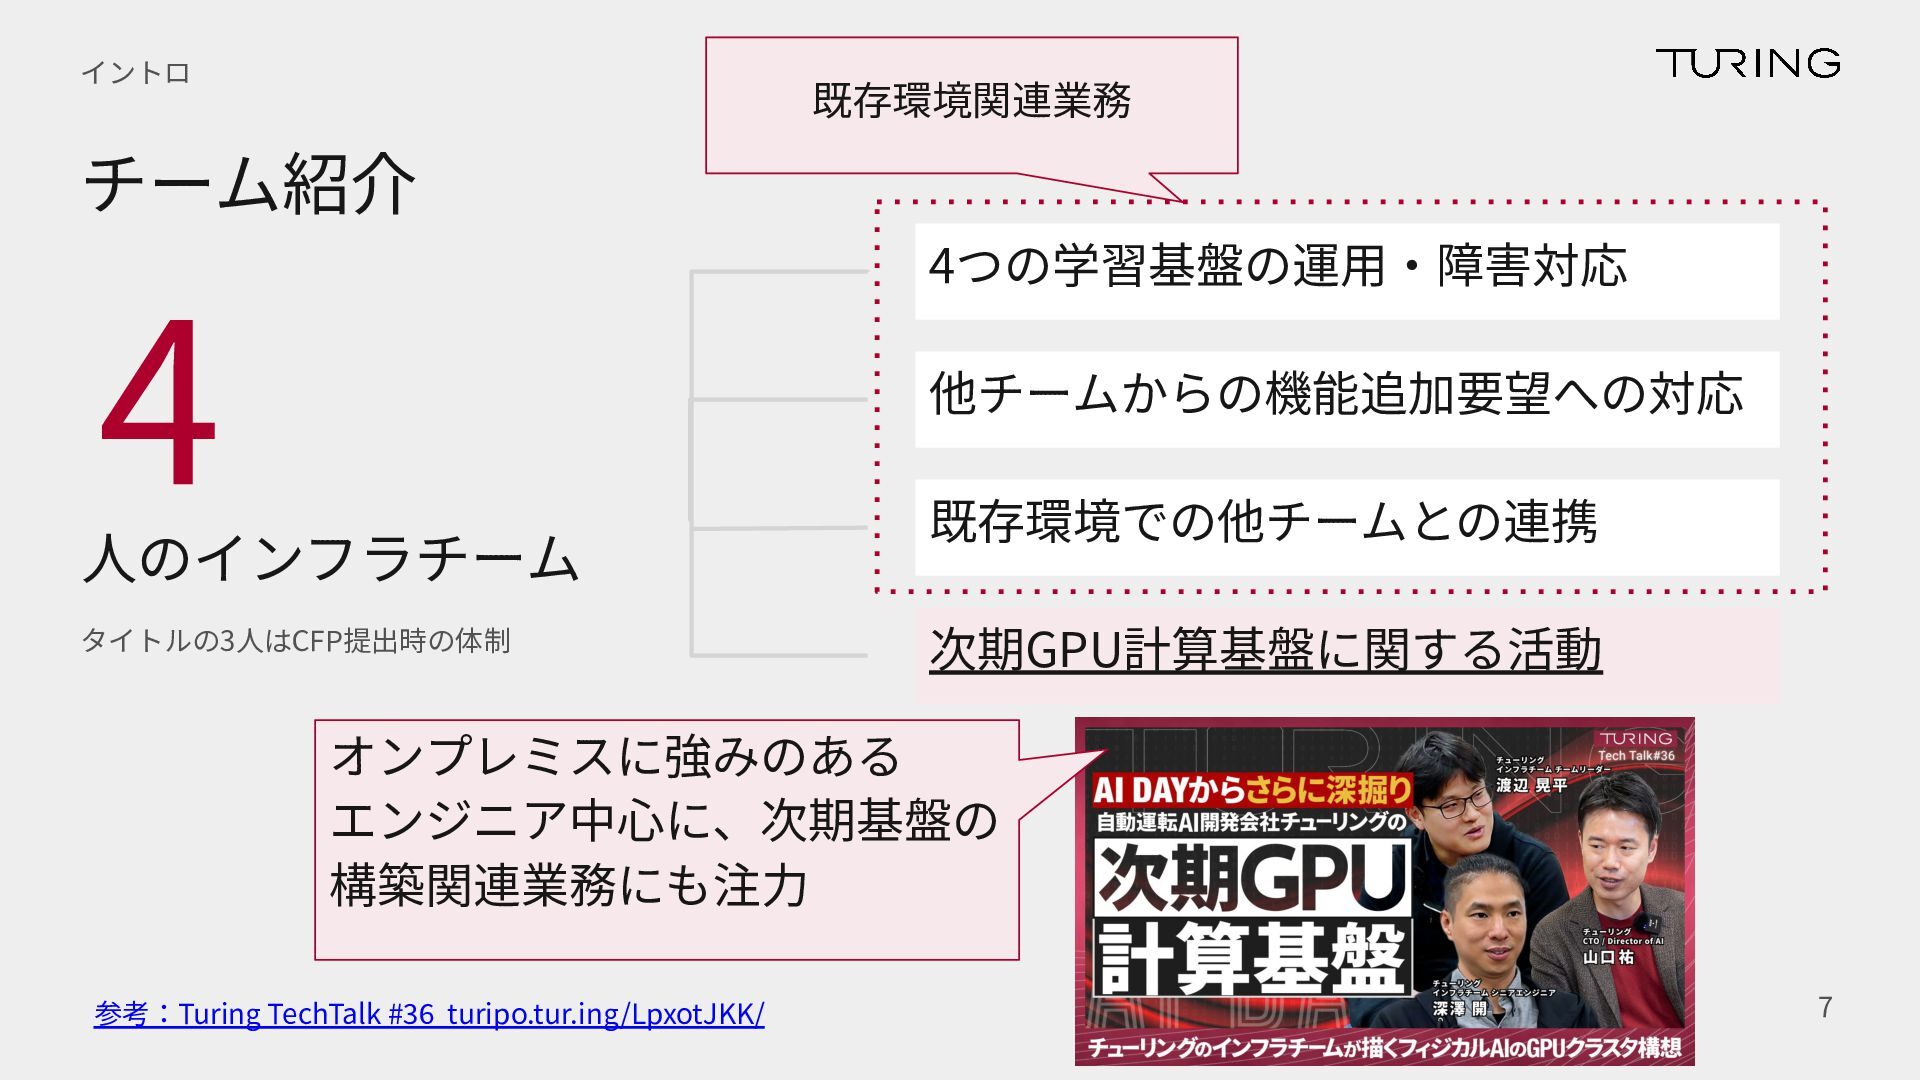
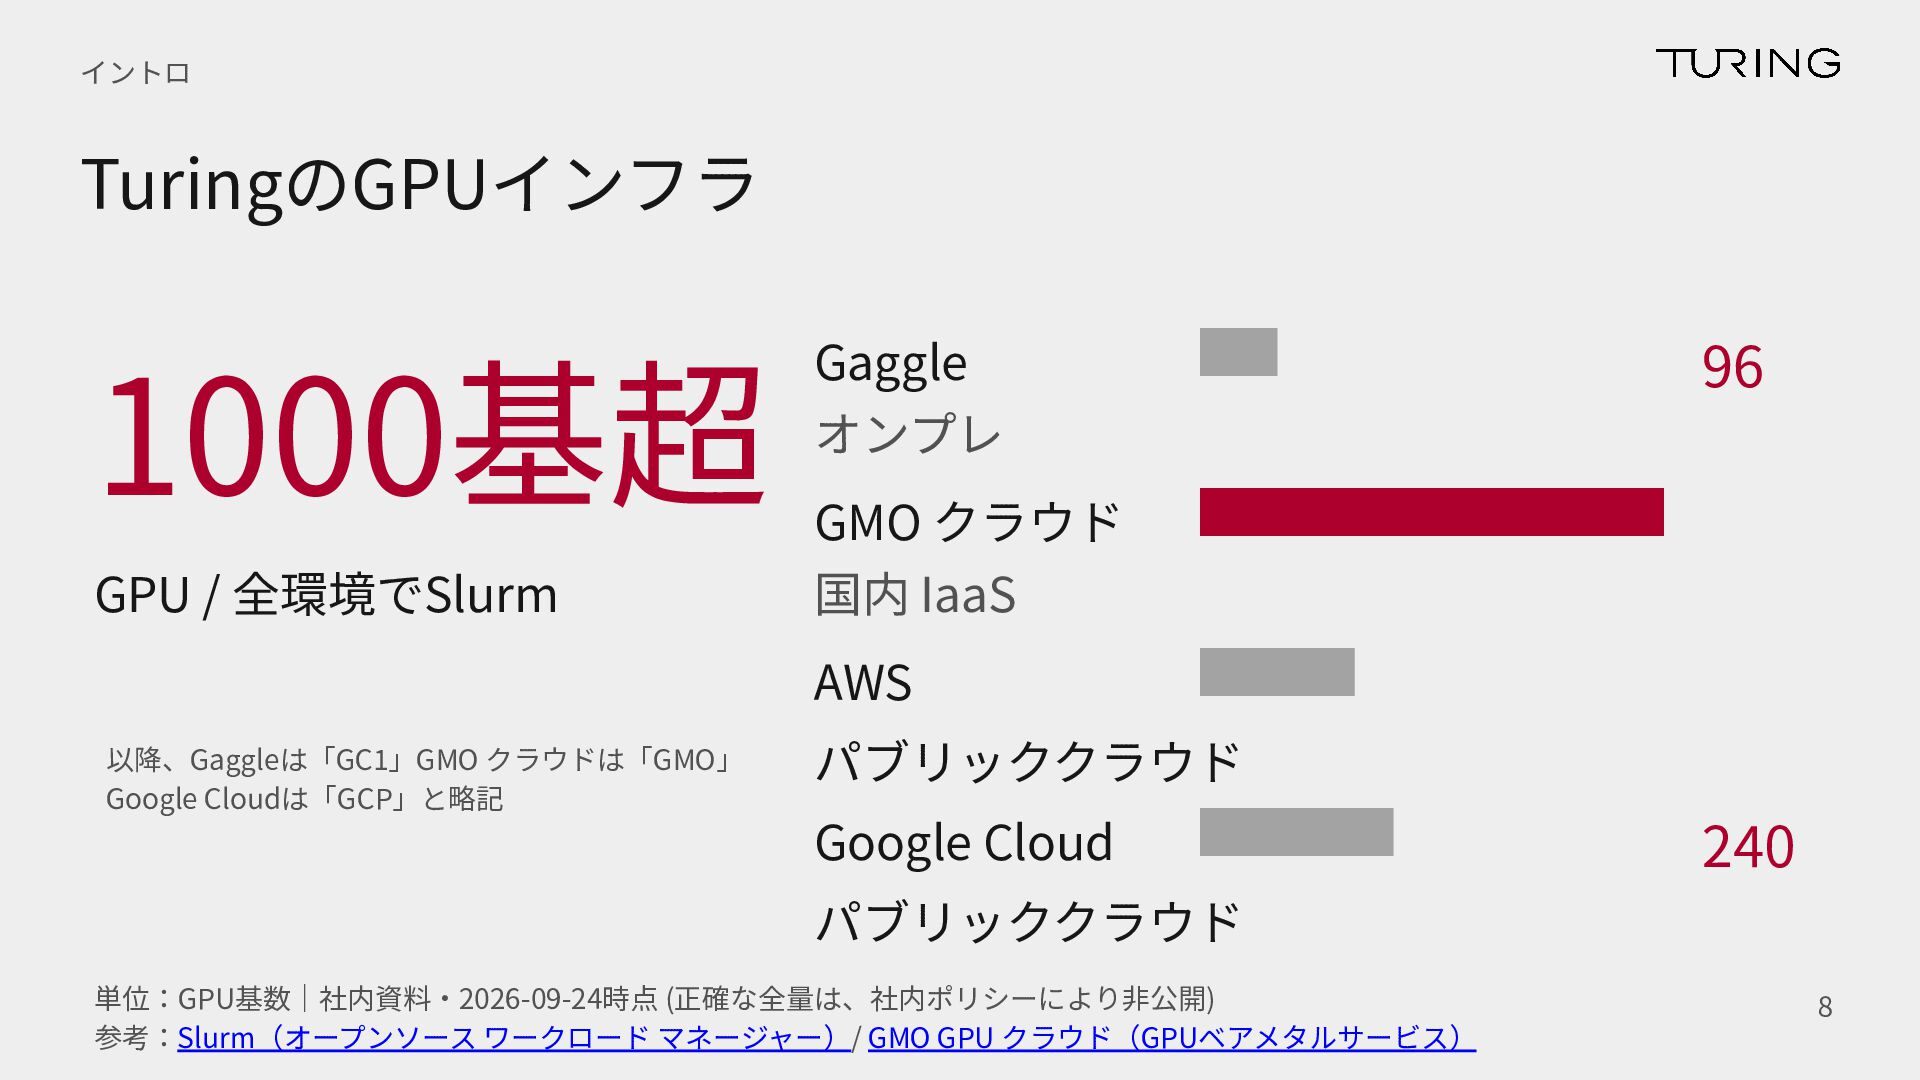
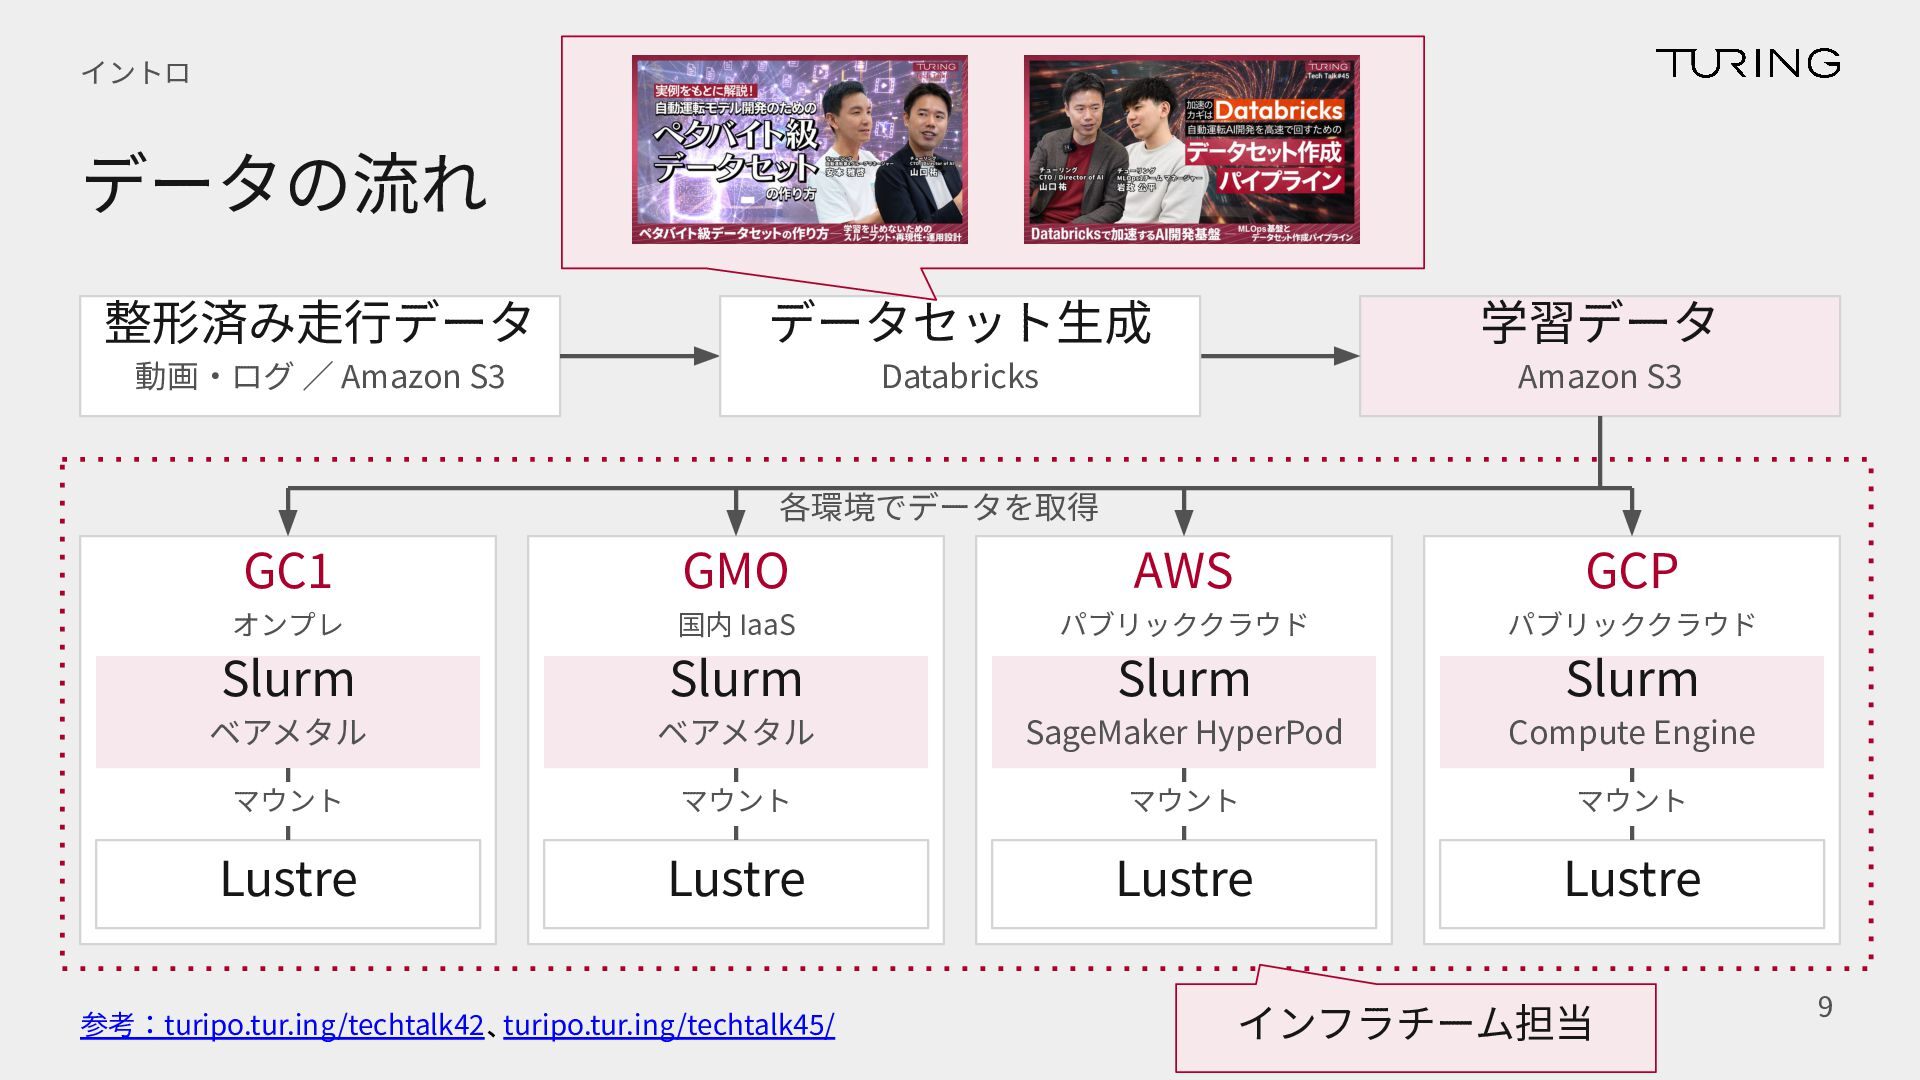
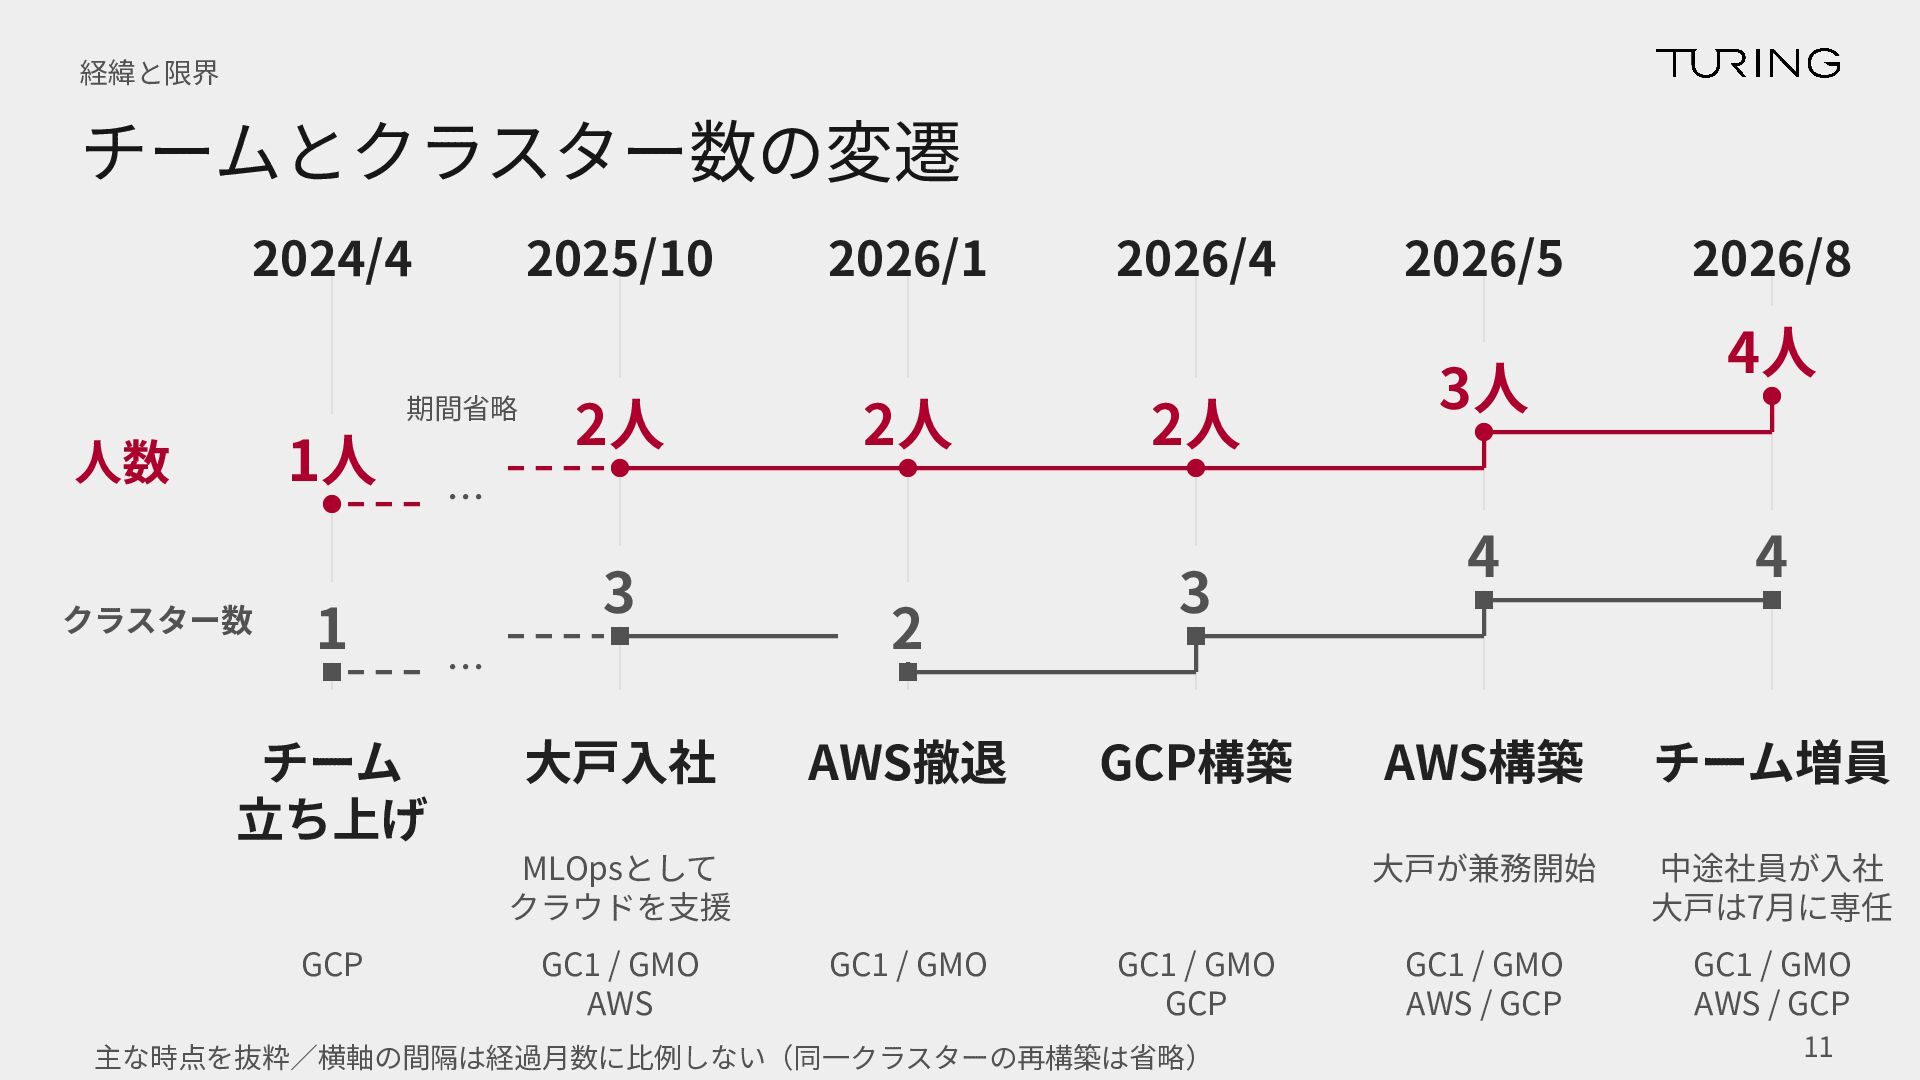
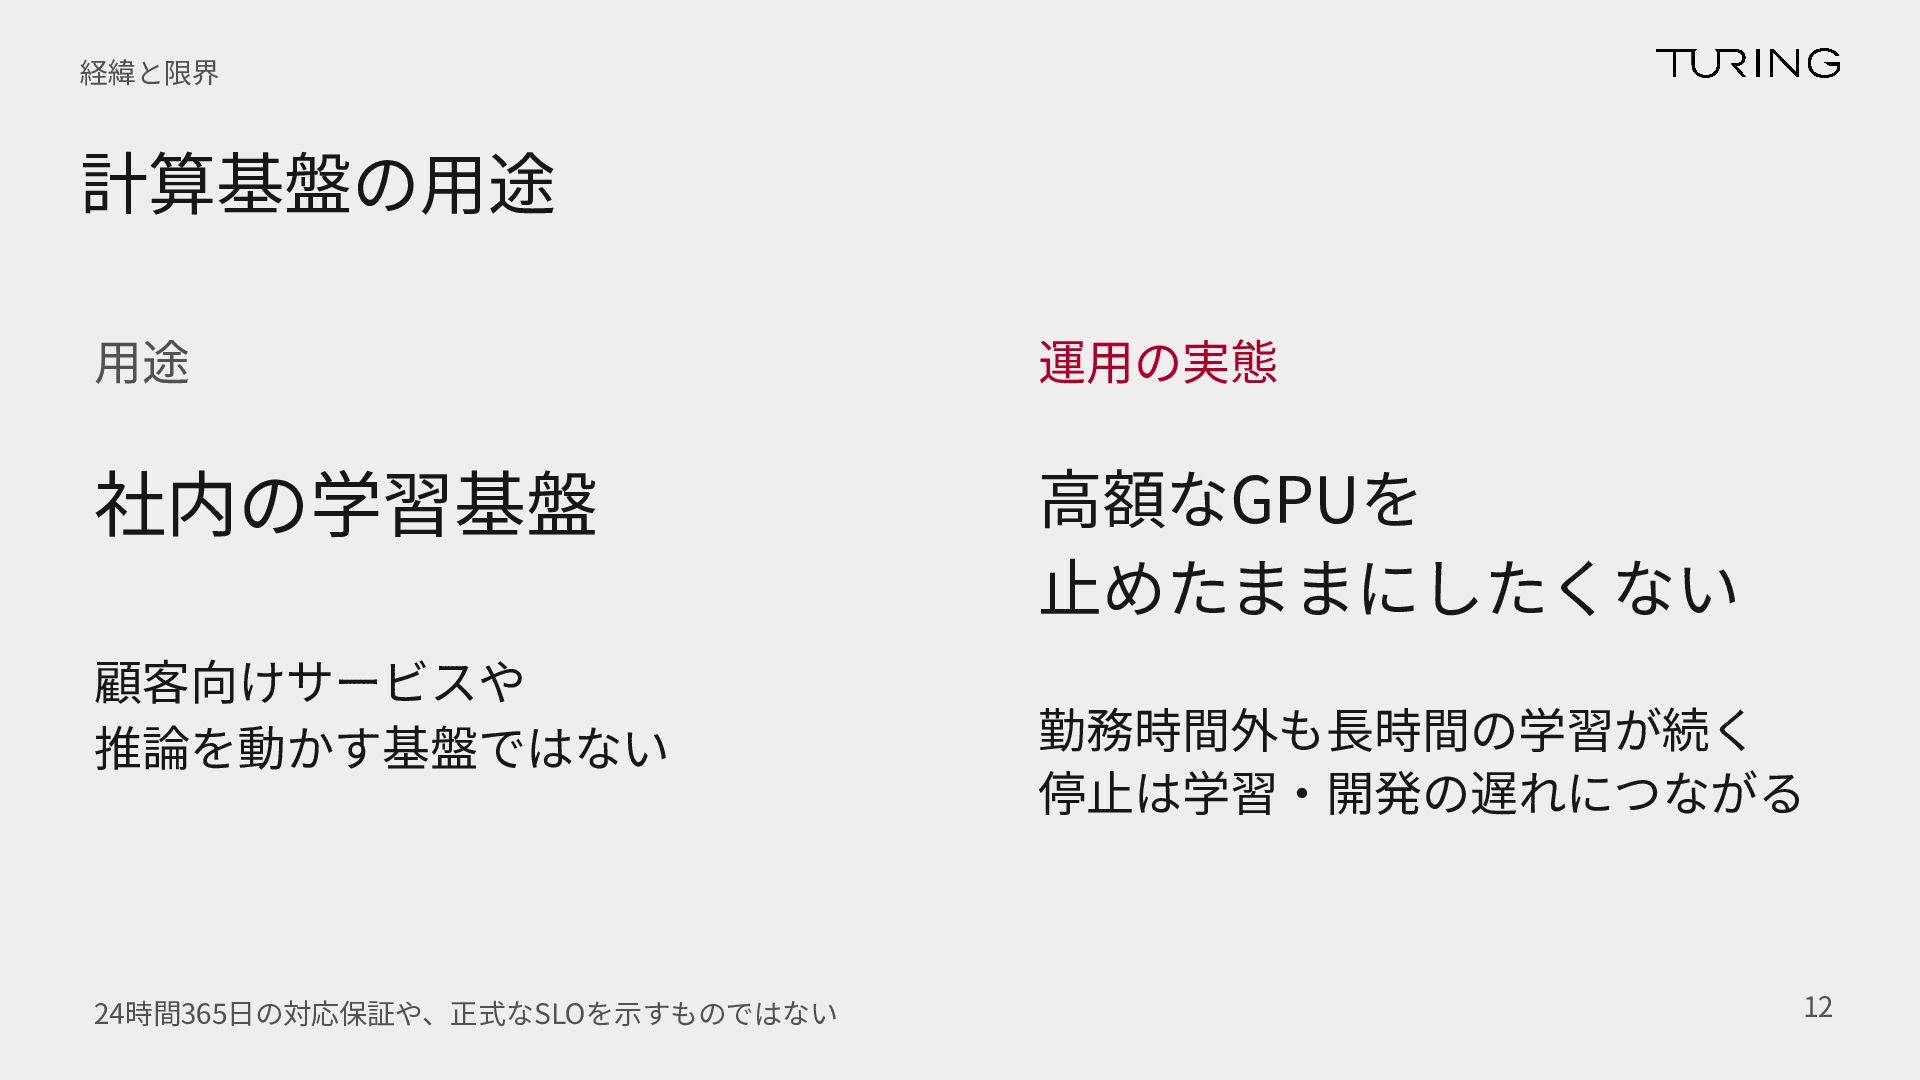
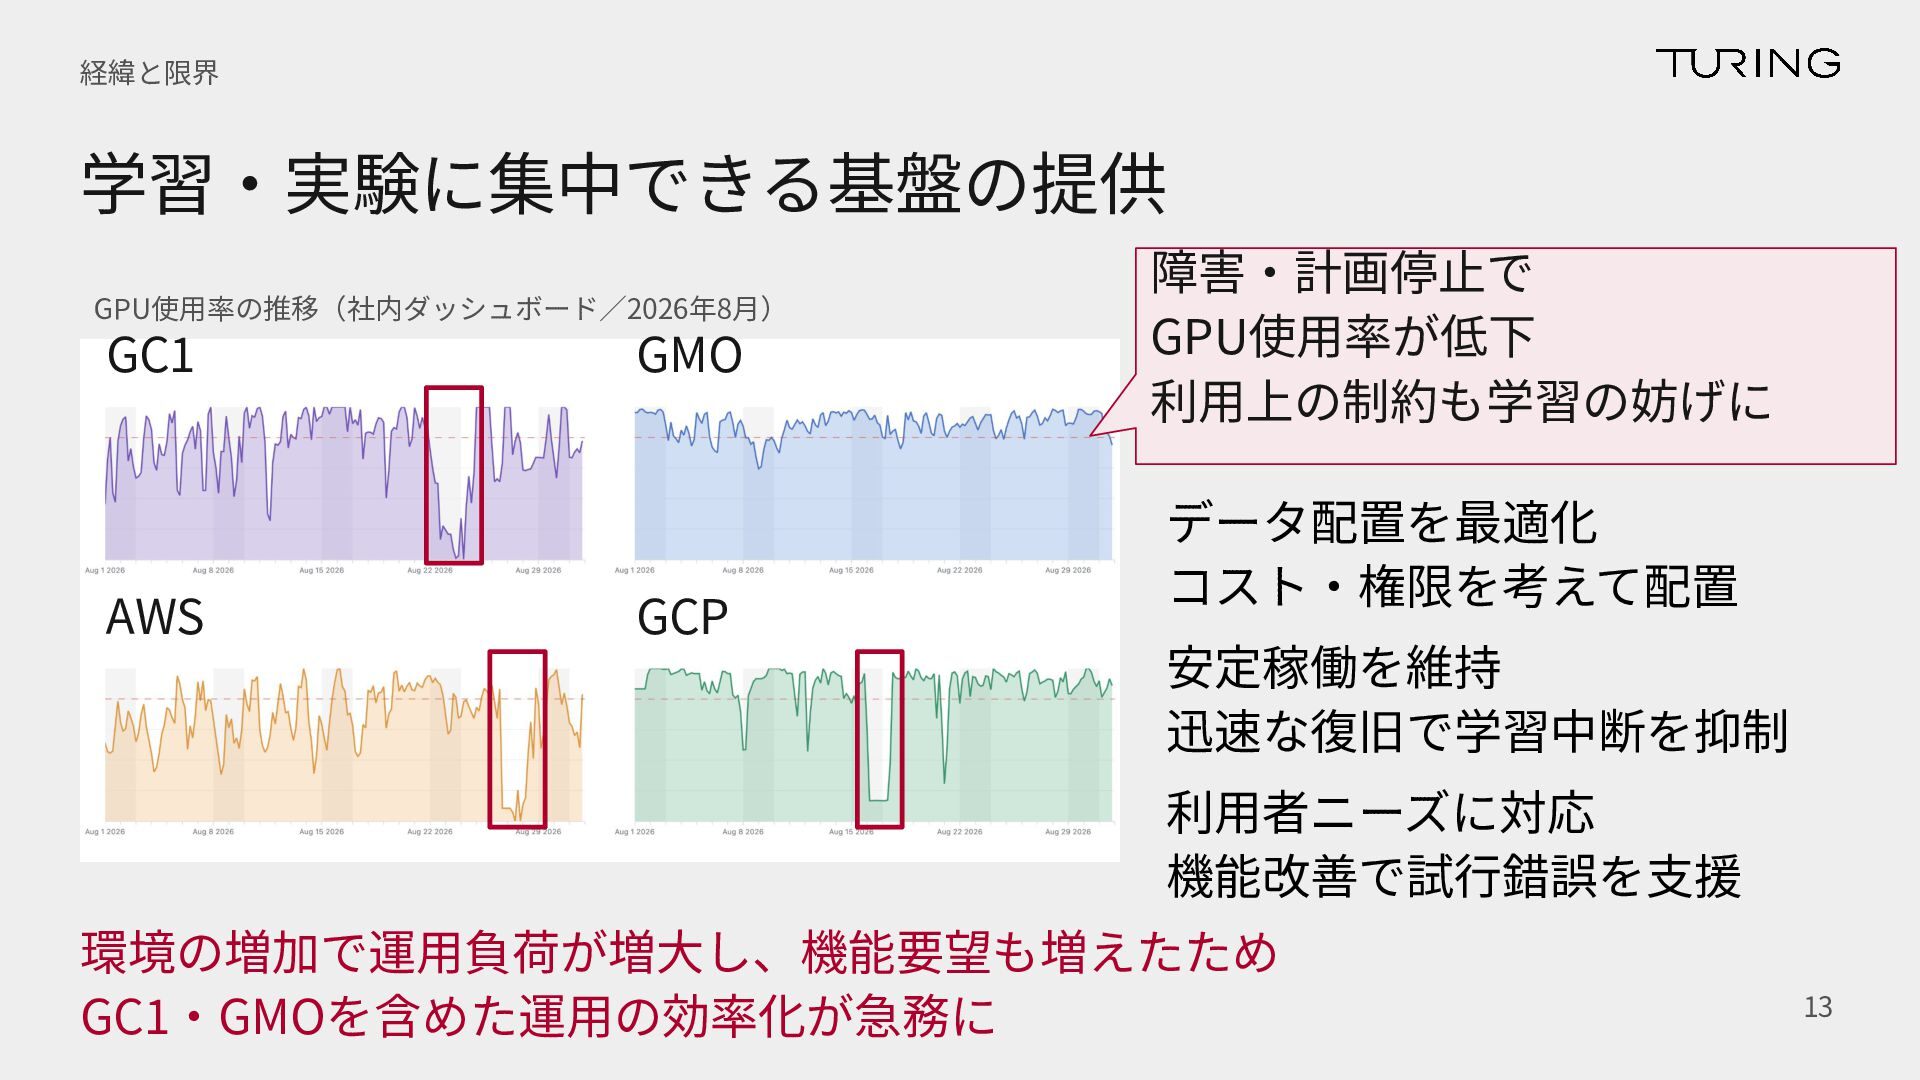
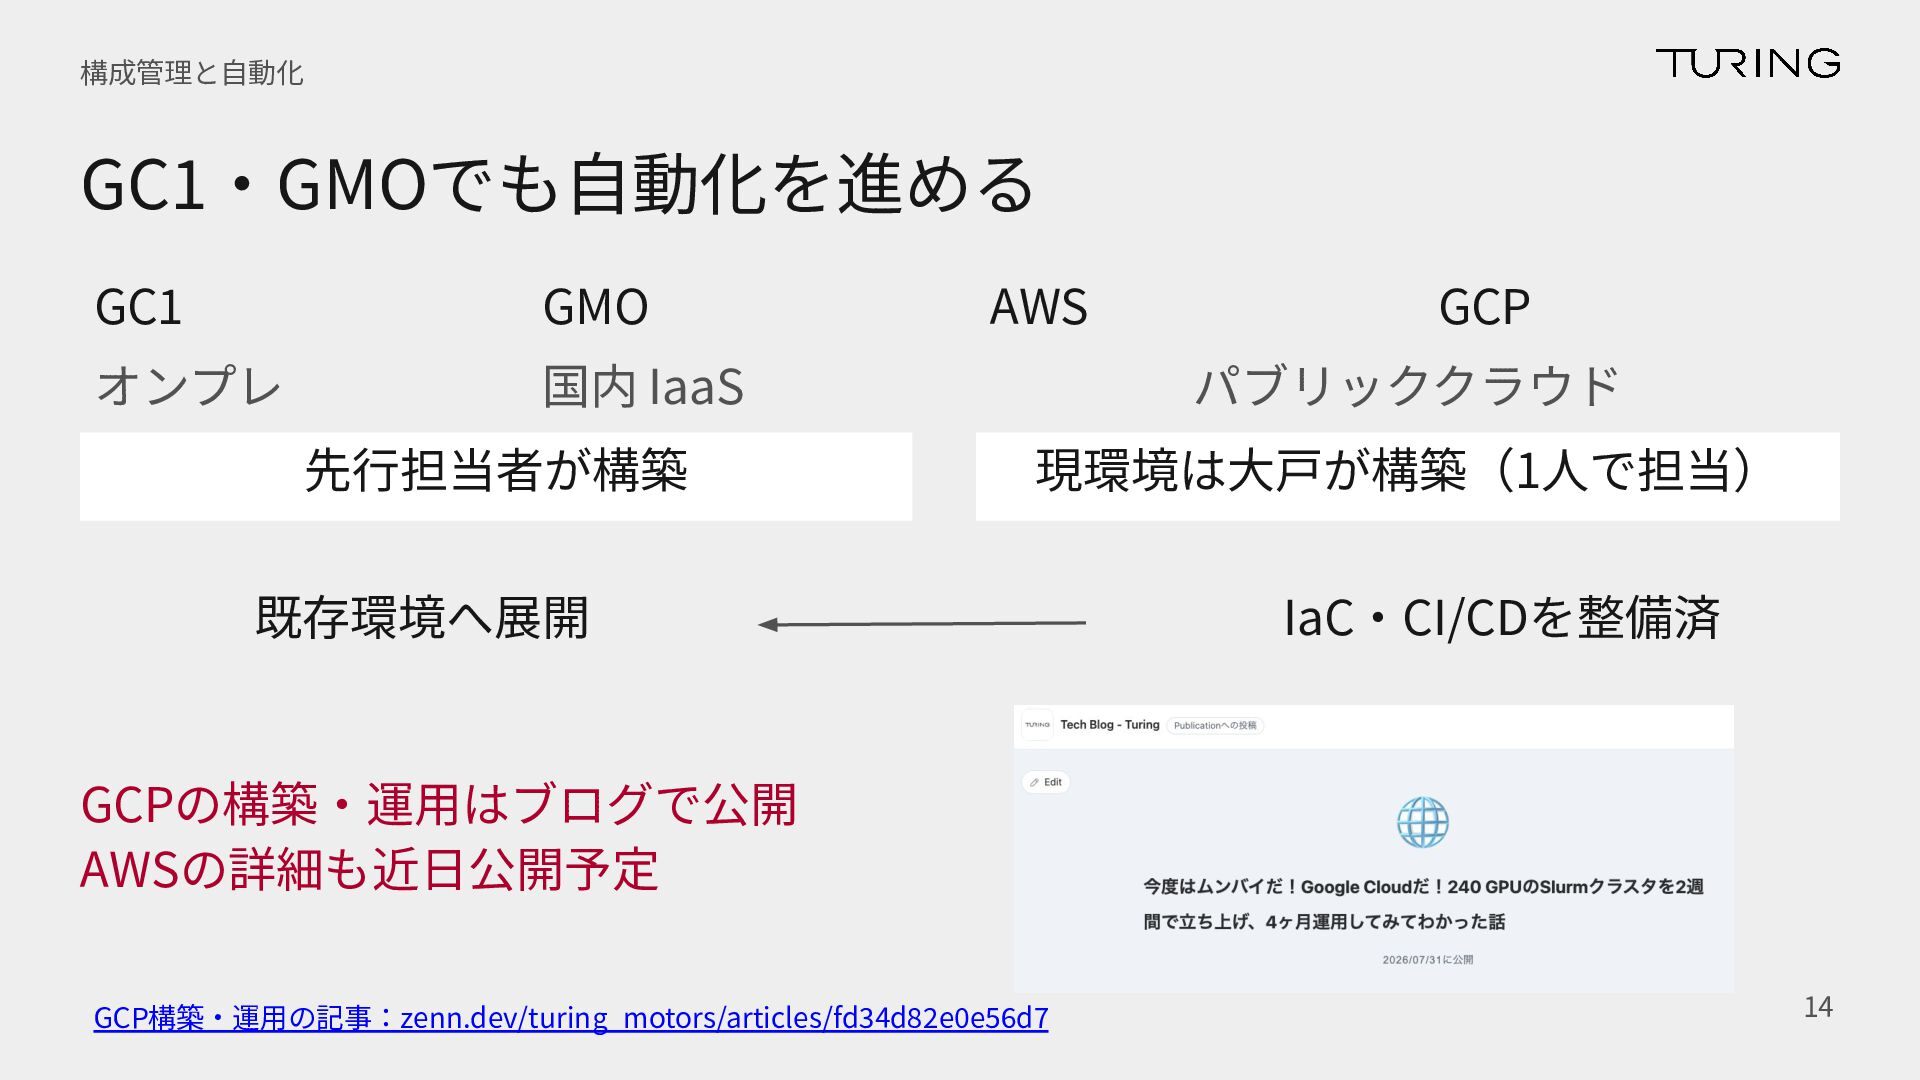
Turingでは、完全自動運転AIの開発を支える1,000基超のGPU学習基盤を、少人数のインフラチームで運用しています。対象は、オンプレミスのGC1、国内IaaSのGMO クラウド、AWS、Google Cloudの4環境です。チームはCFP提出時の3人から現在は4人になりましたが、基盤の拡大や障害対応と並行して、運用改善やMLエンジニアの要望に応える時間をどう確保するかが課題になっています。
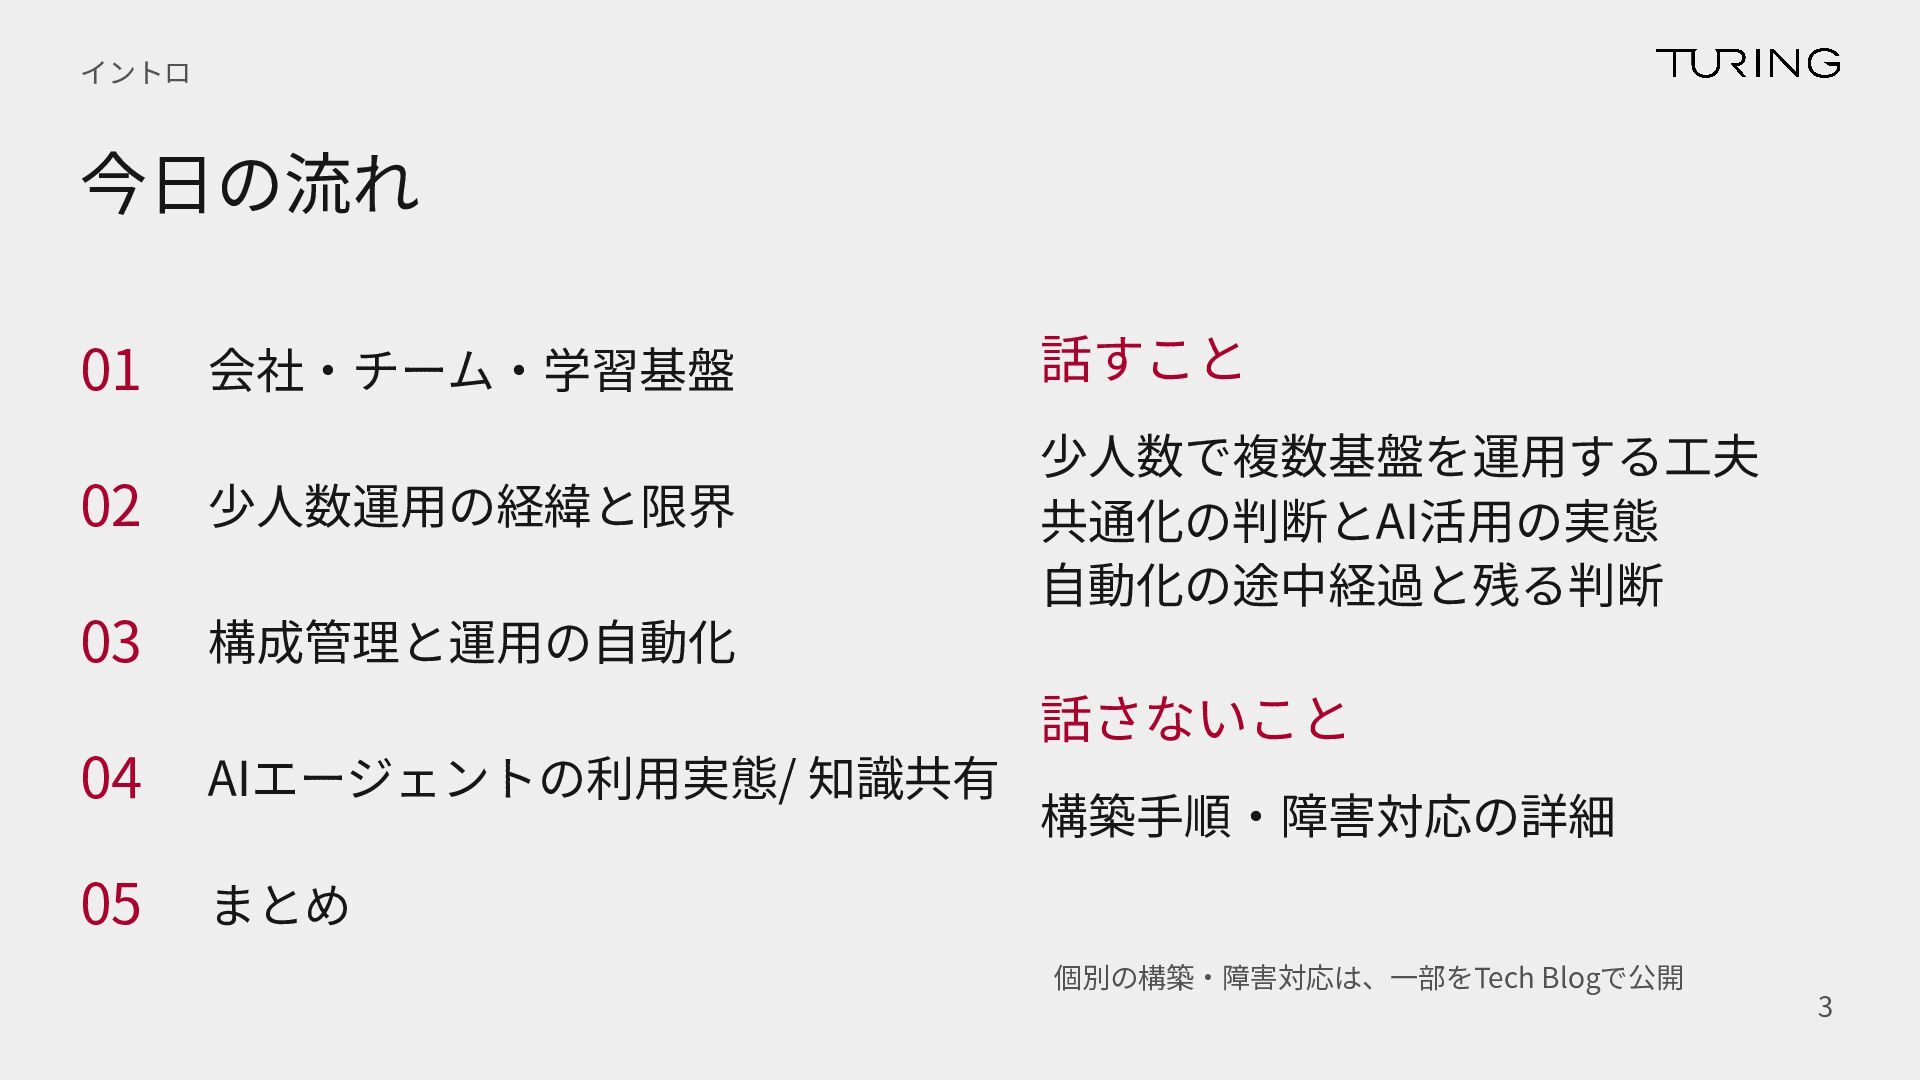
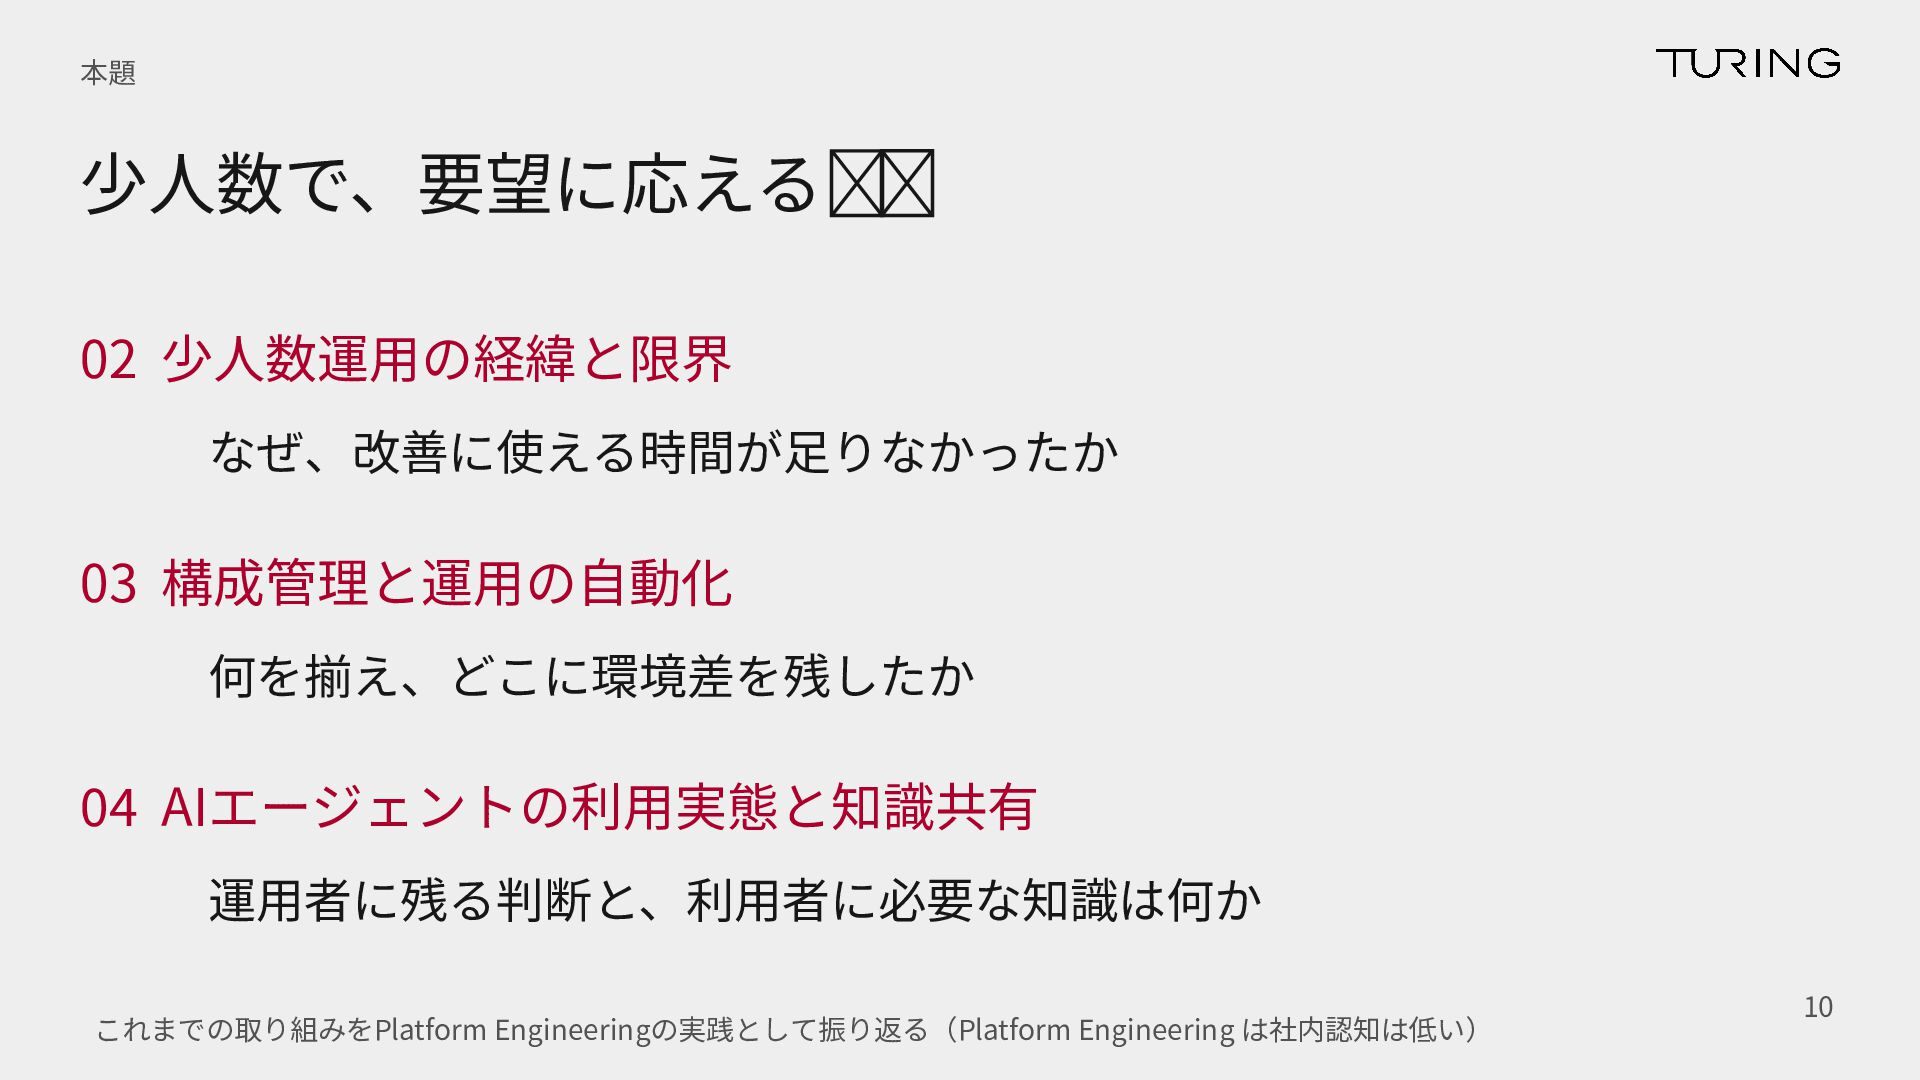
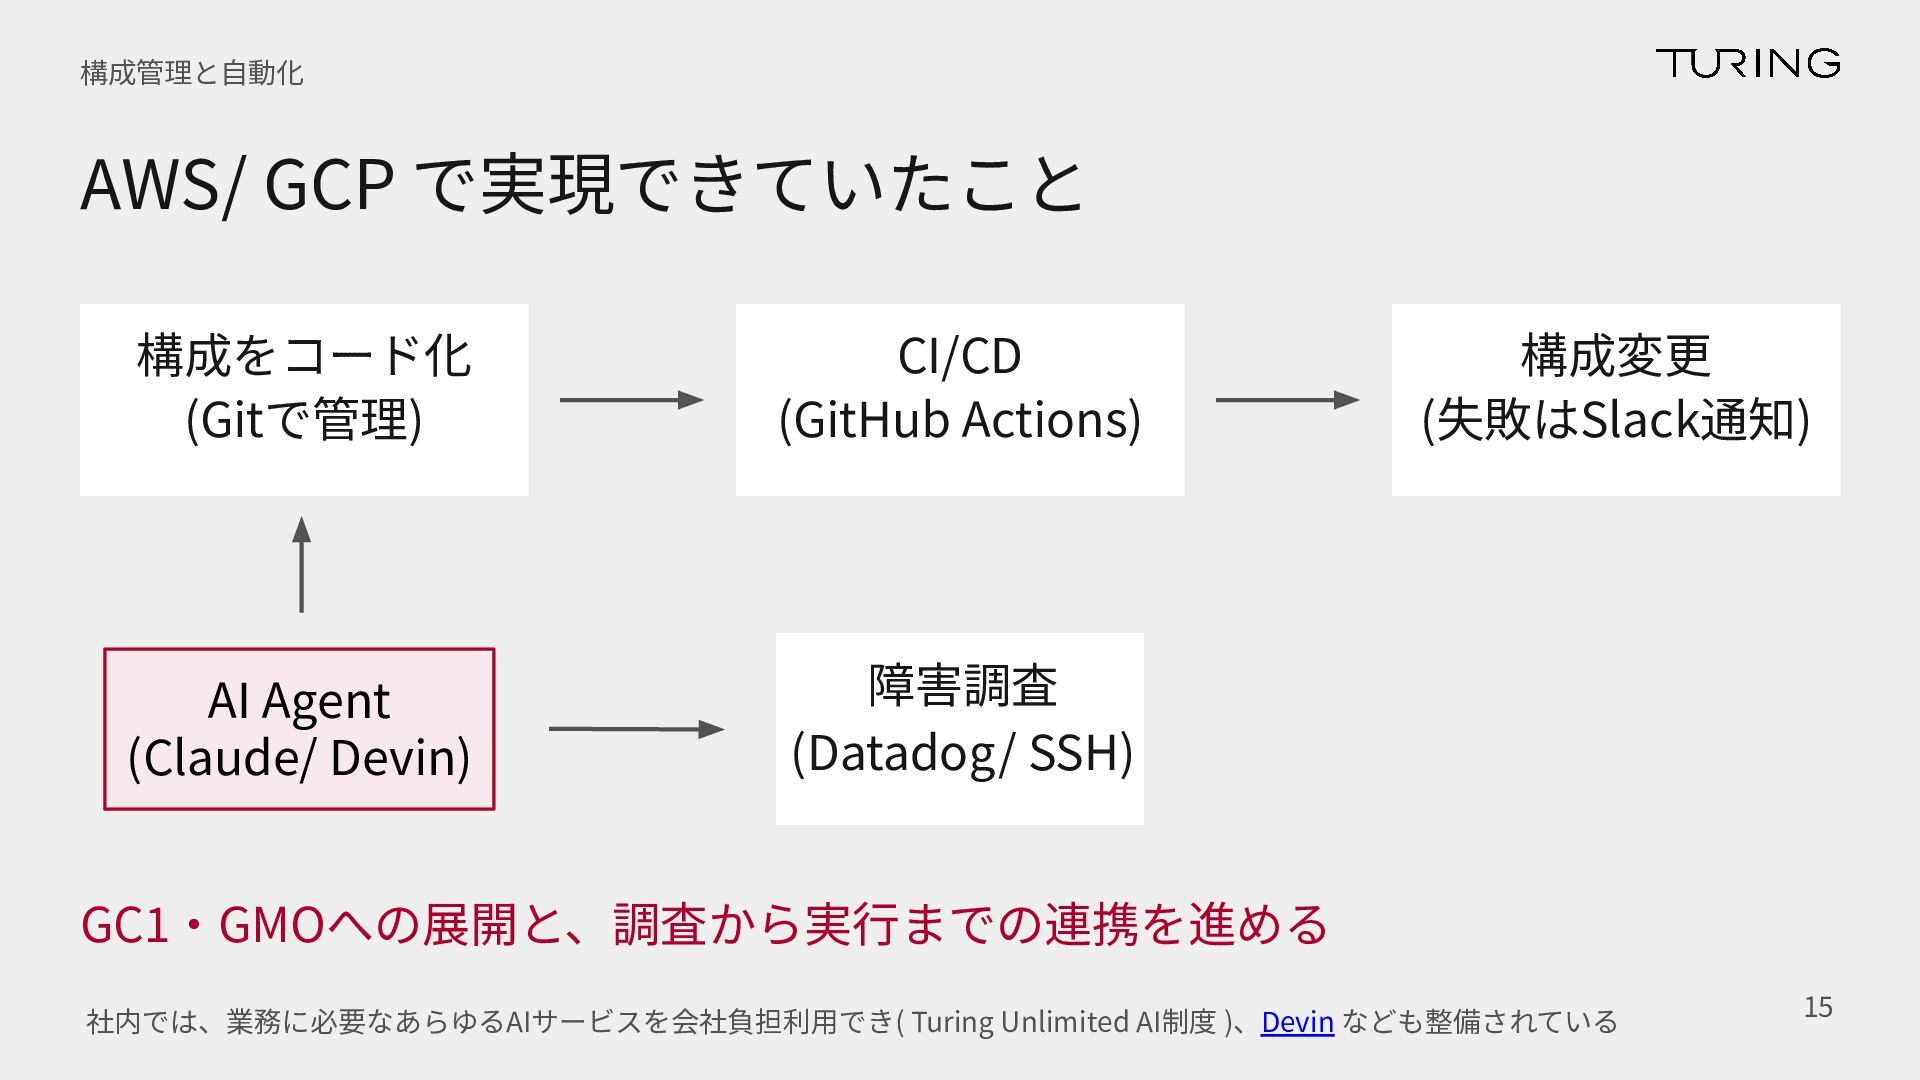
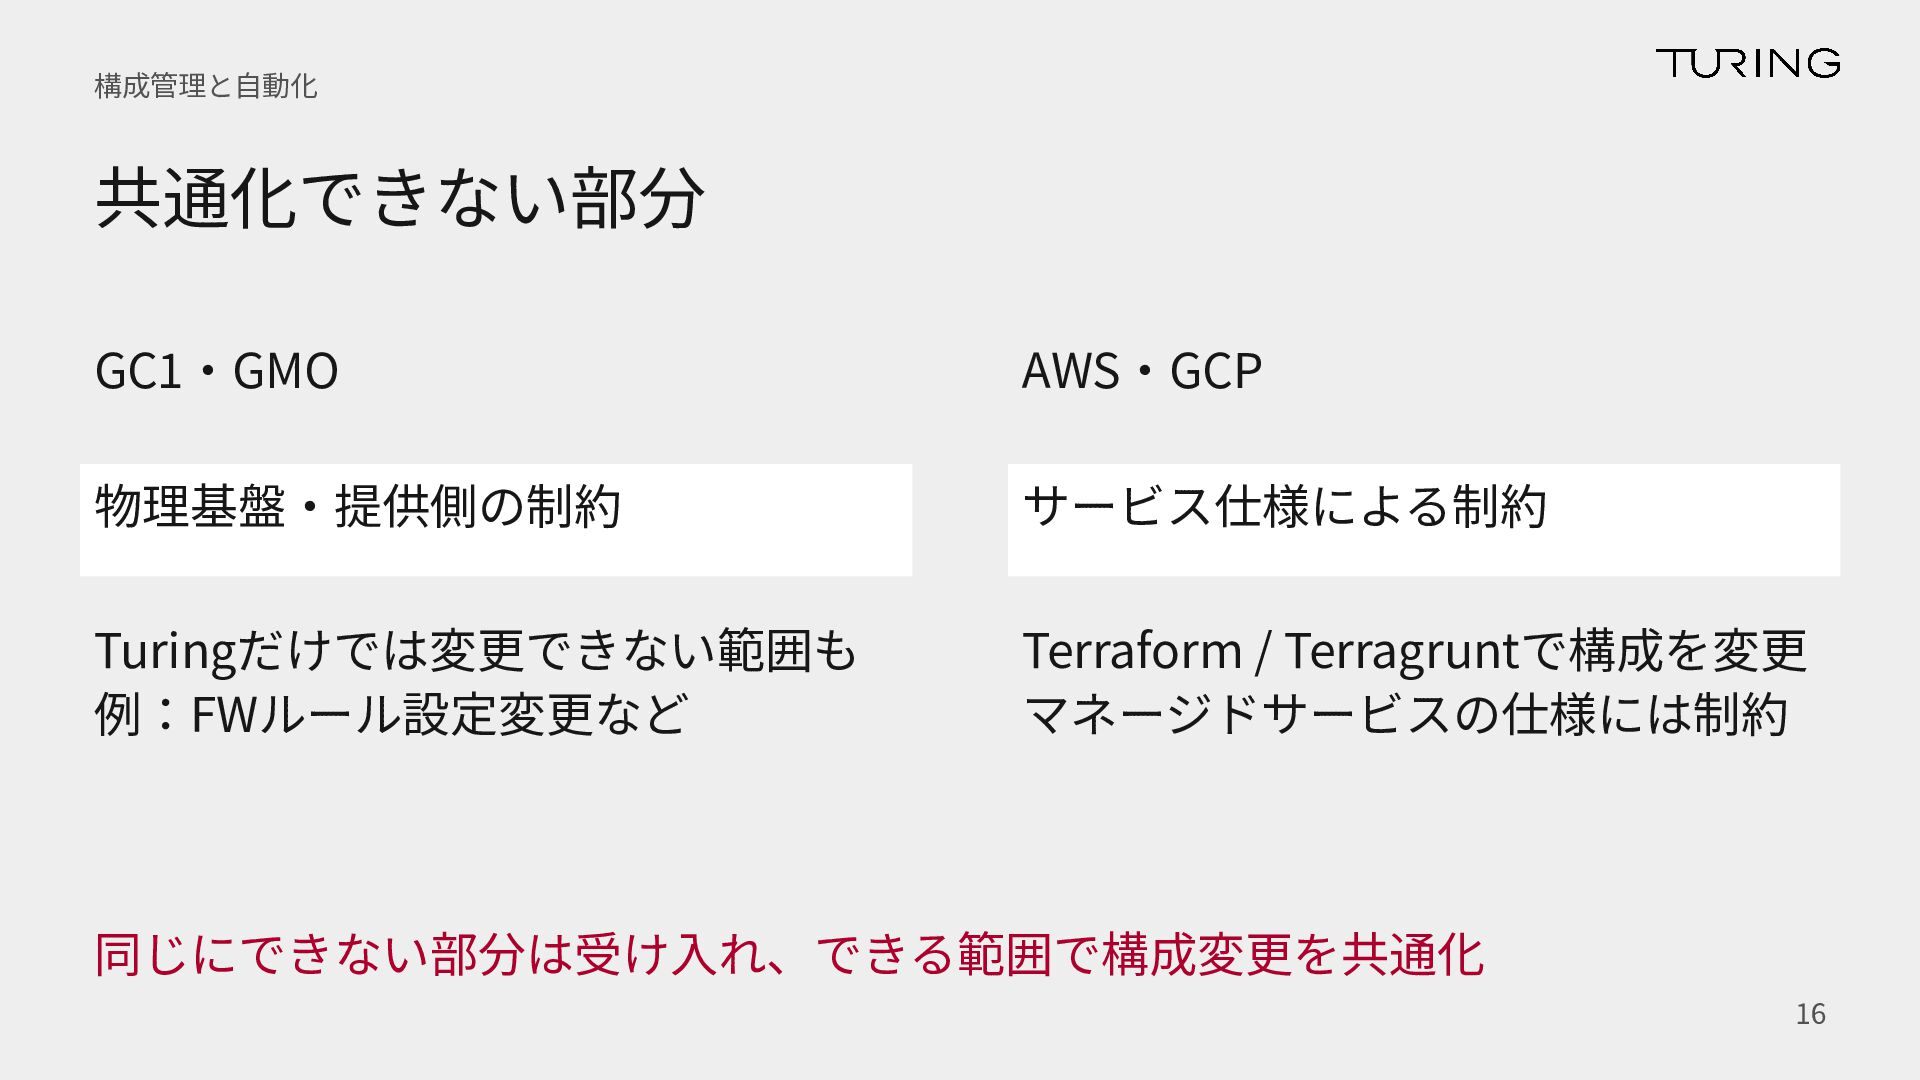
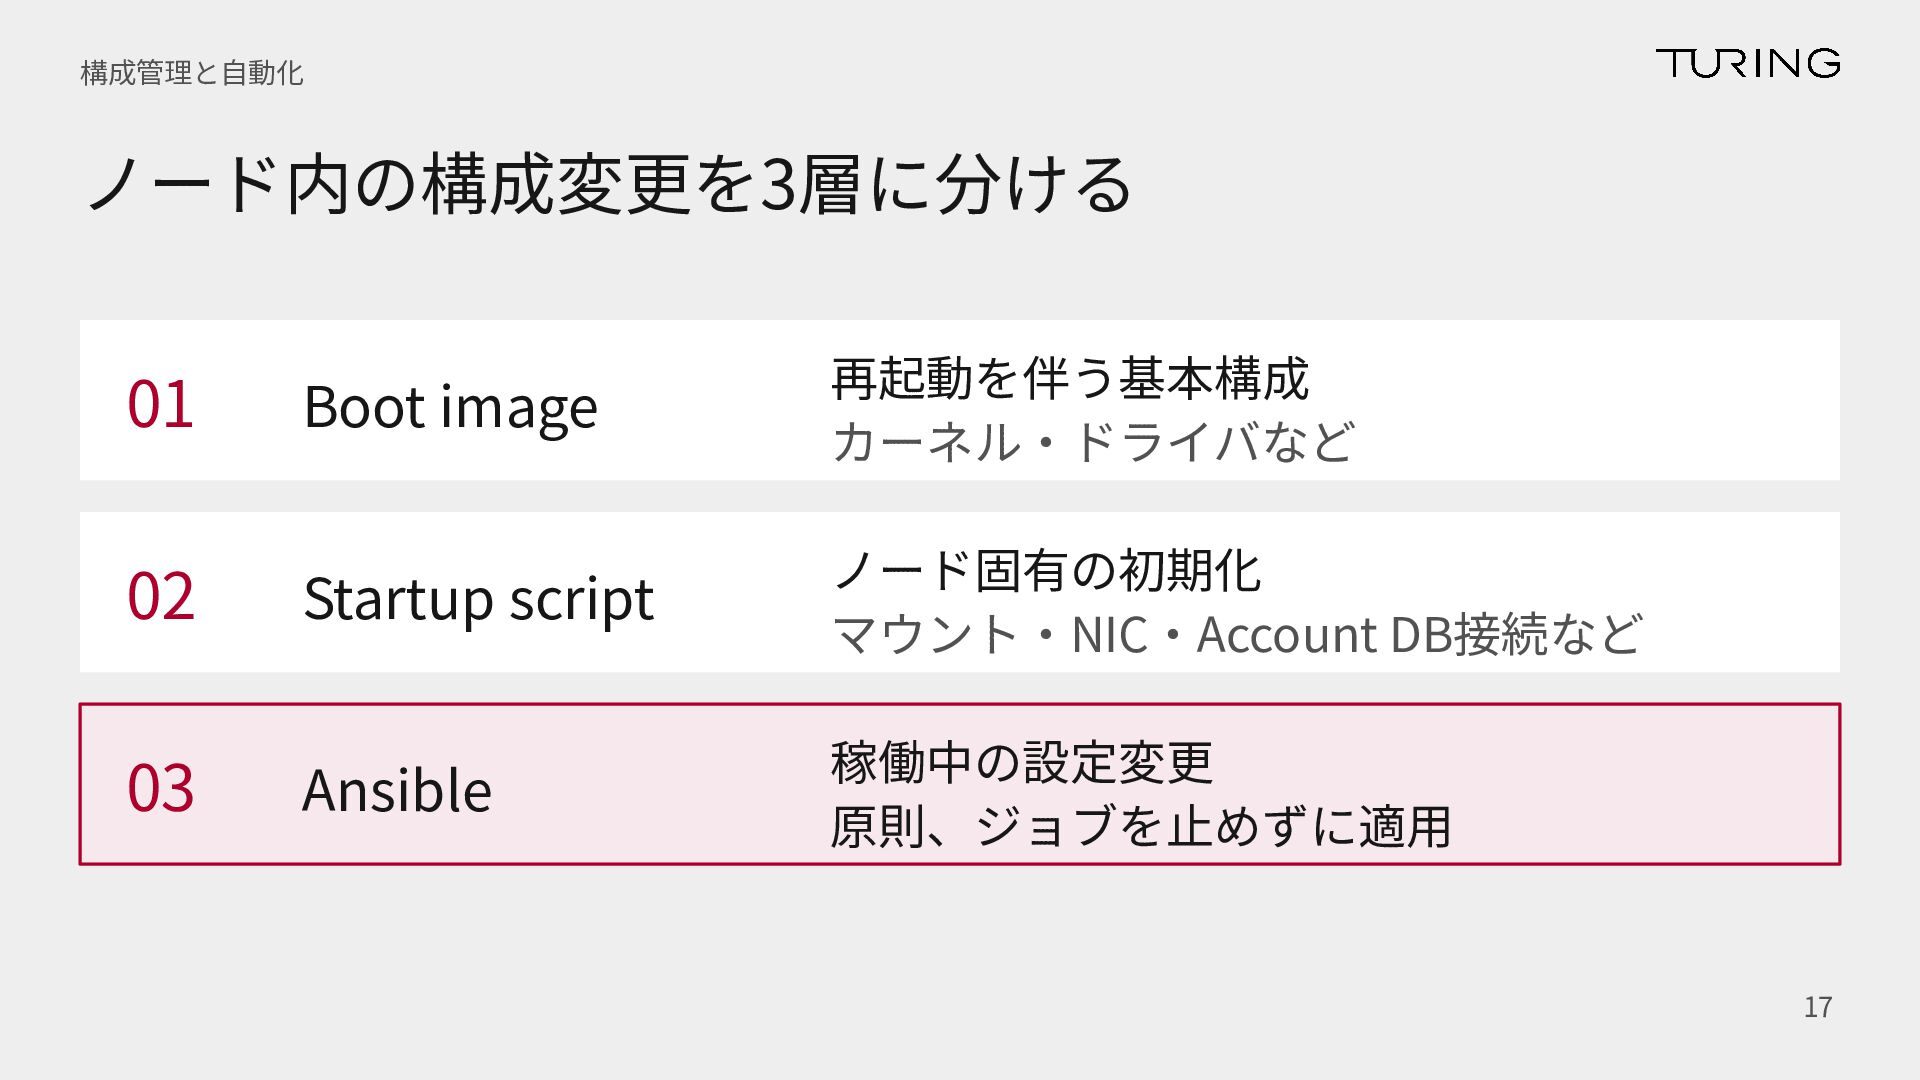
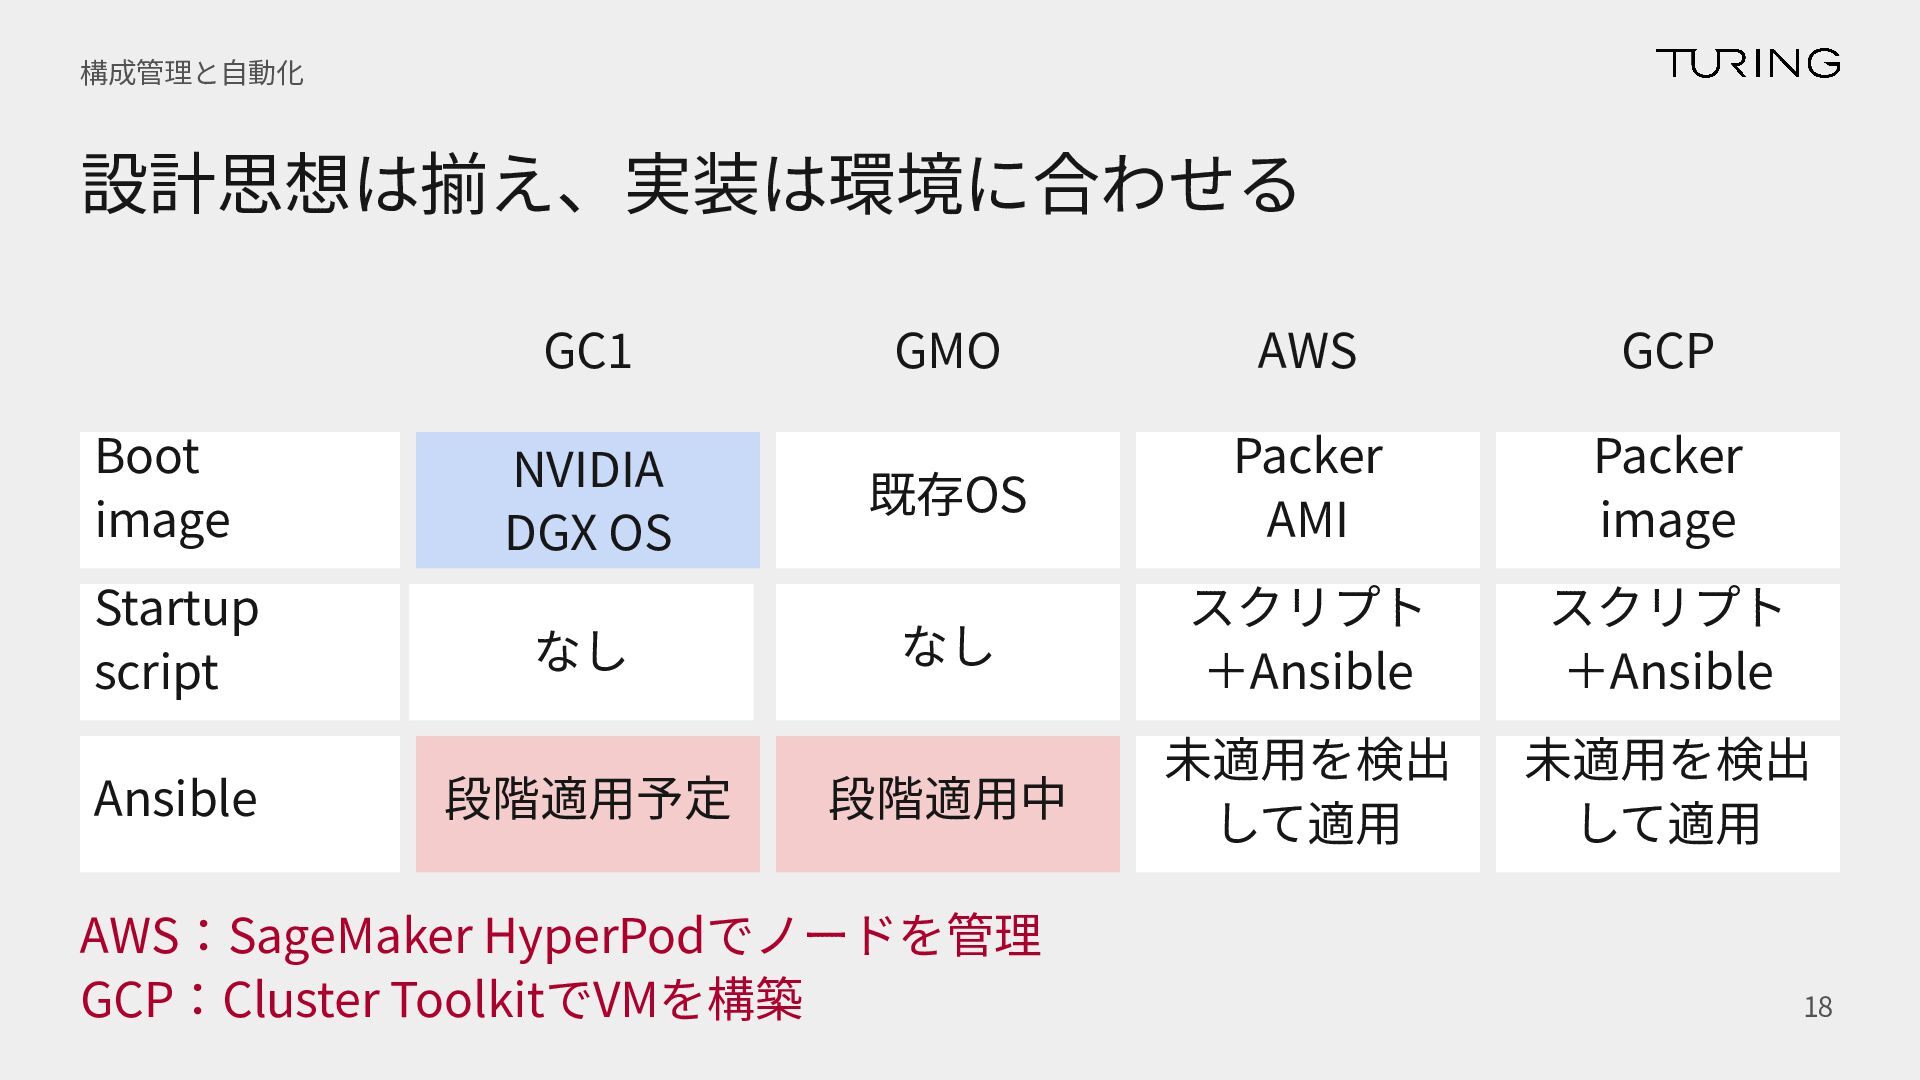
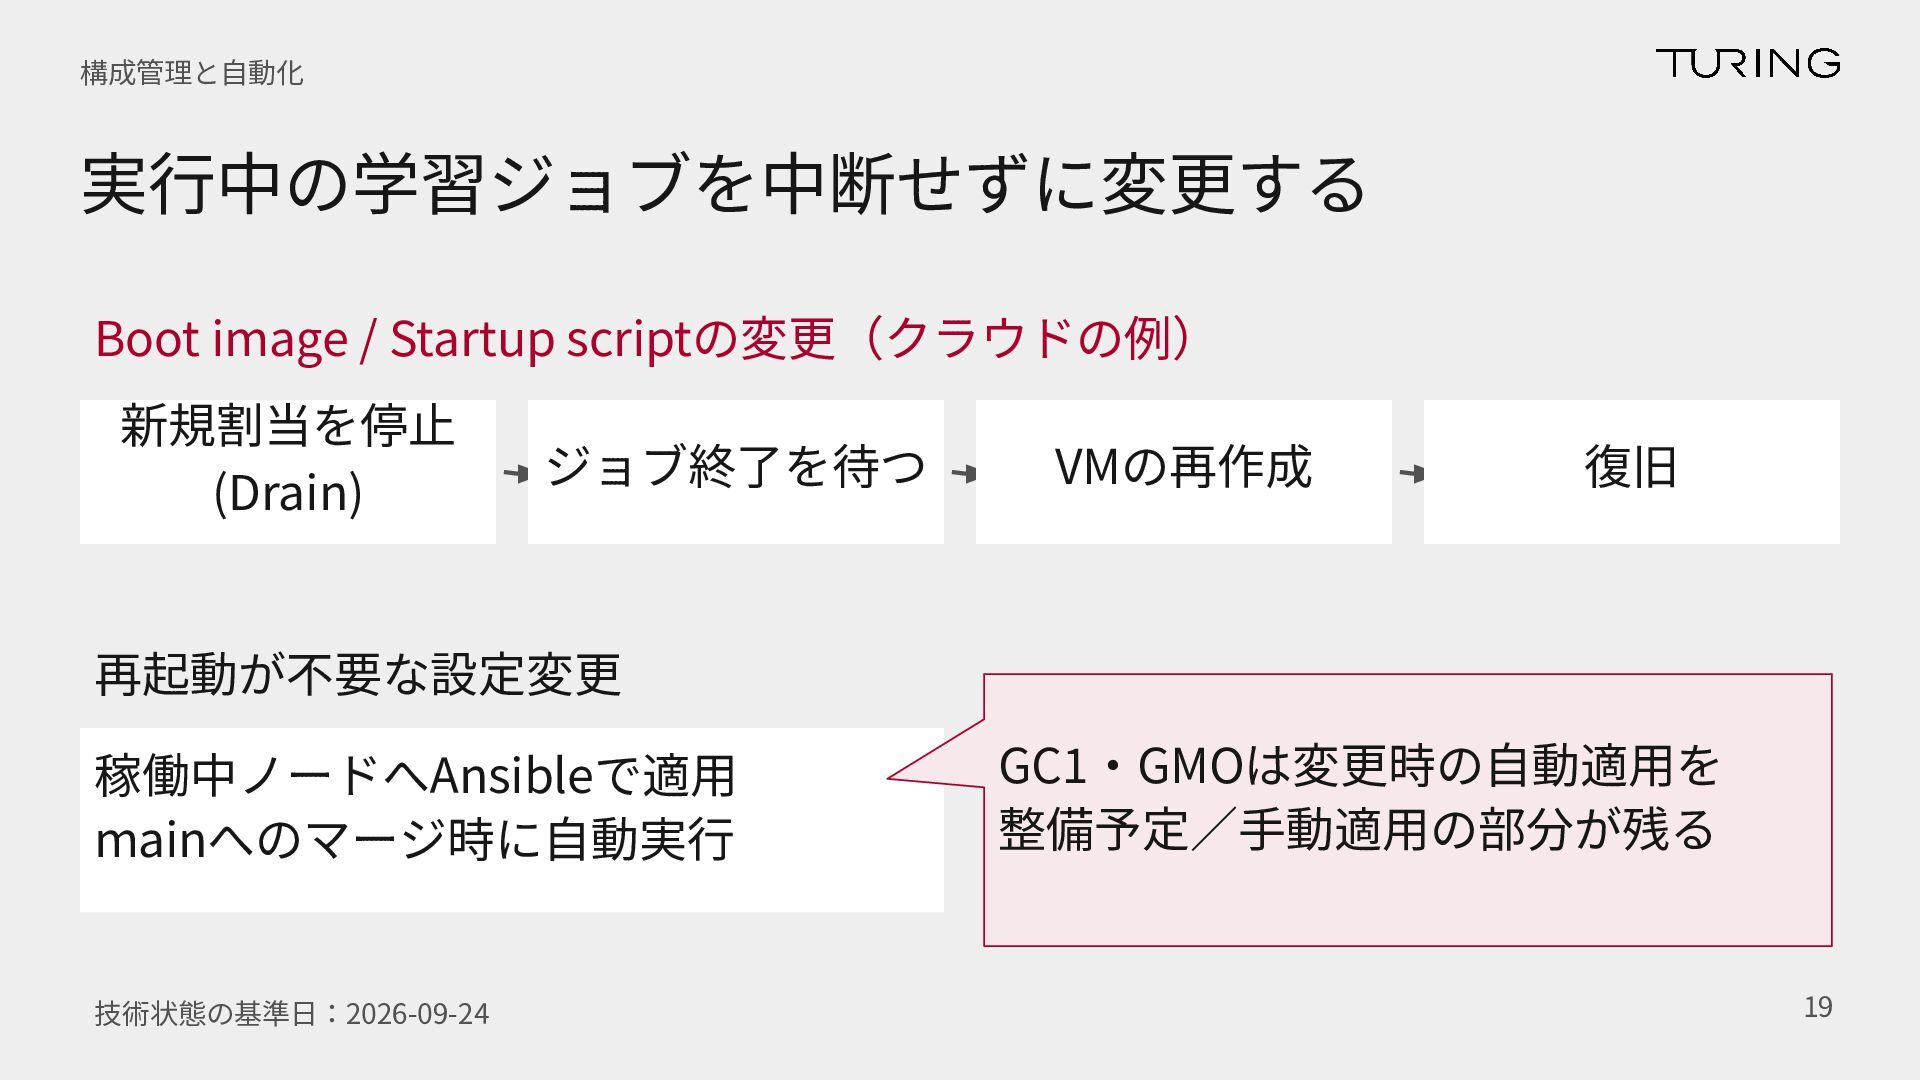
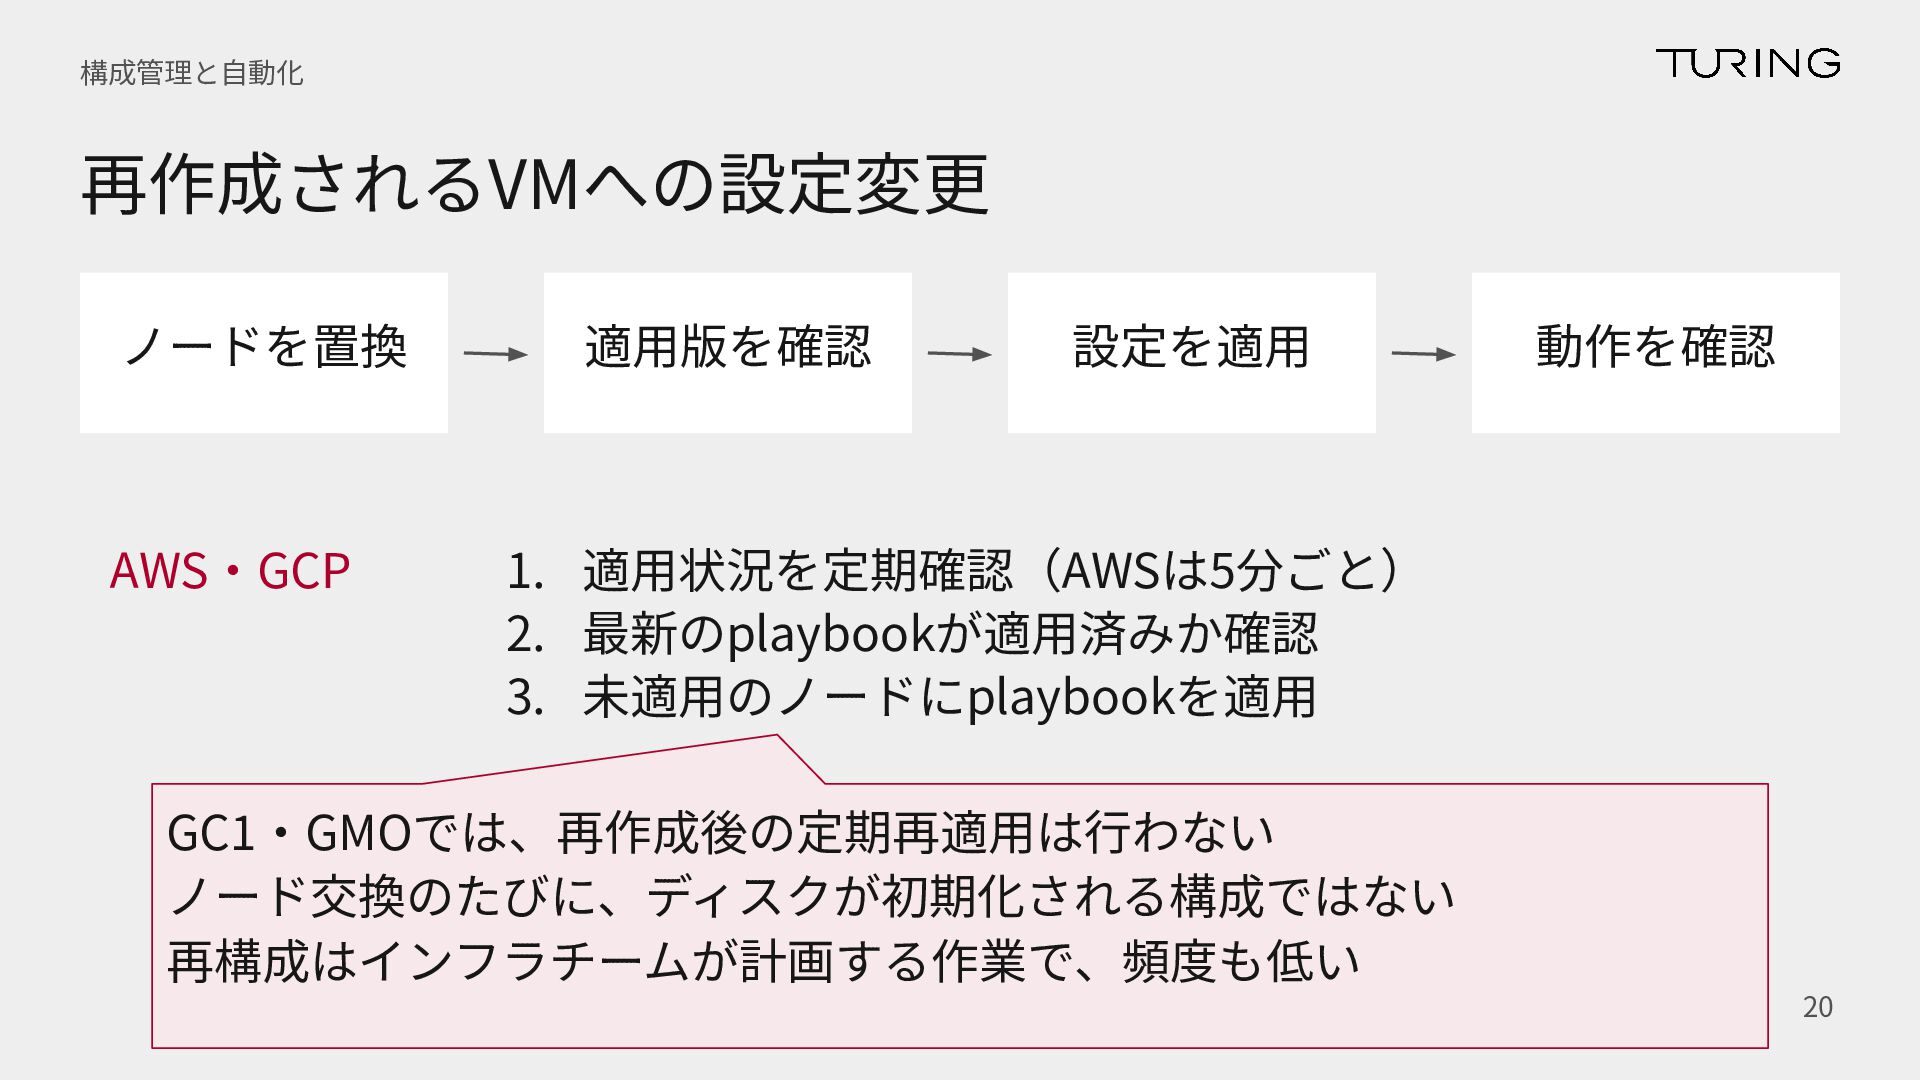
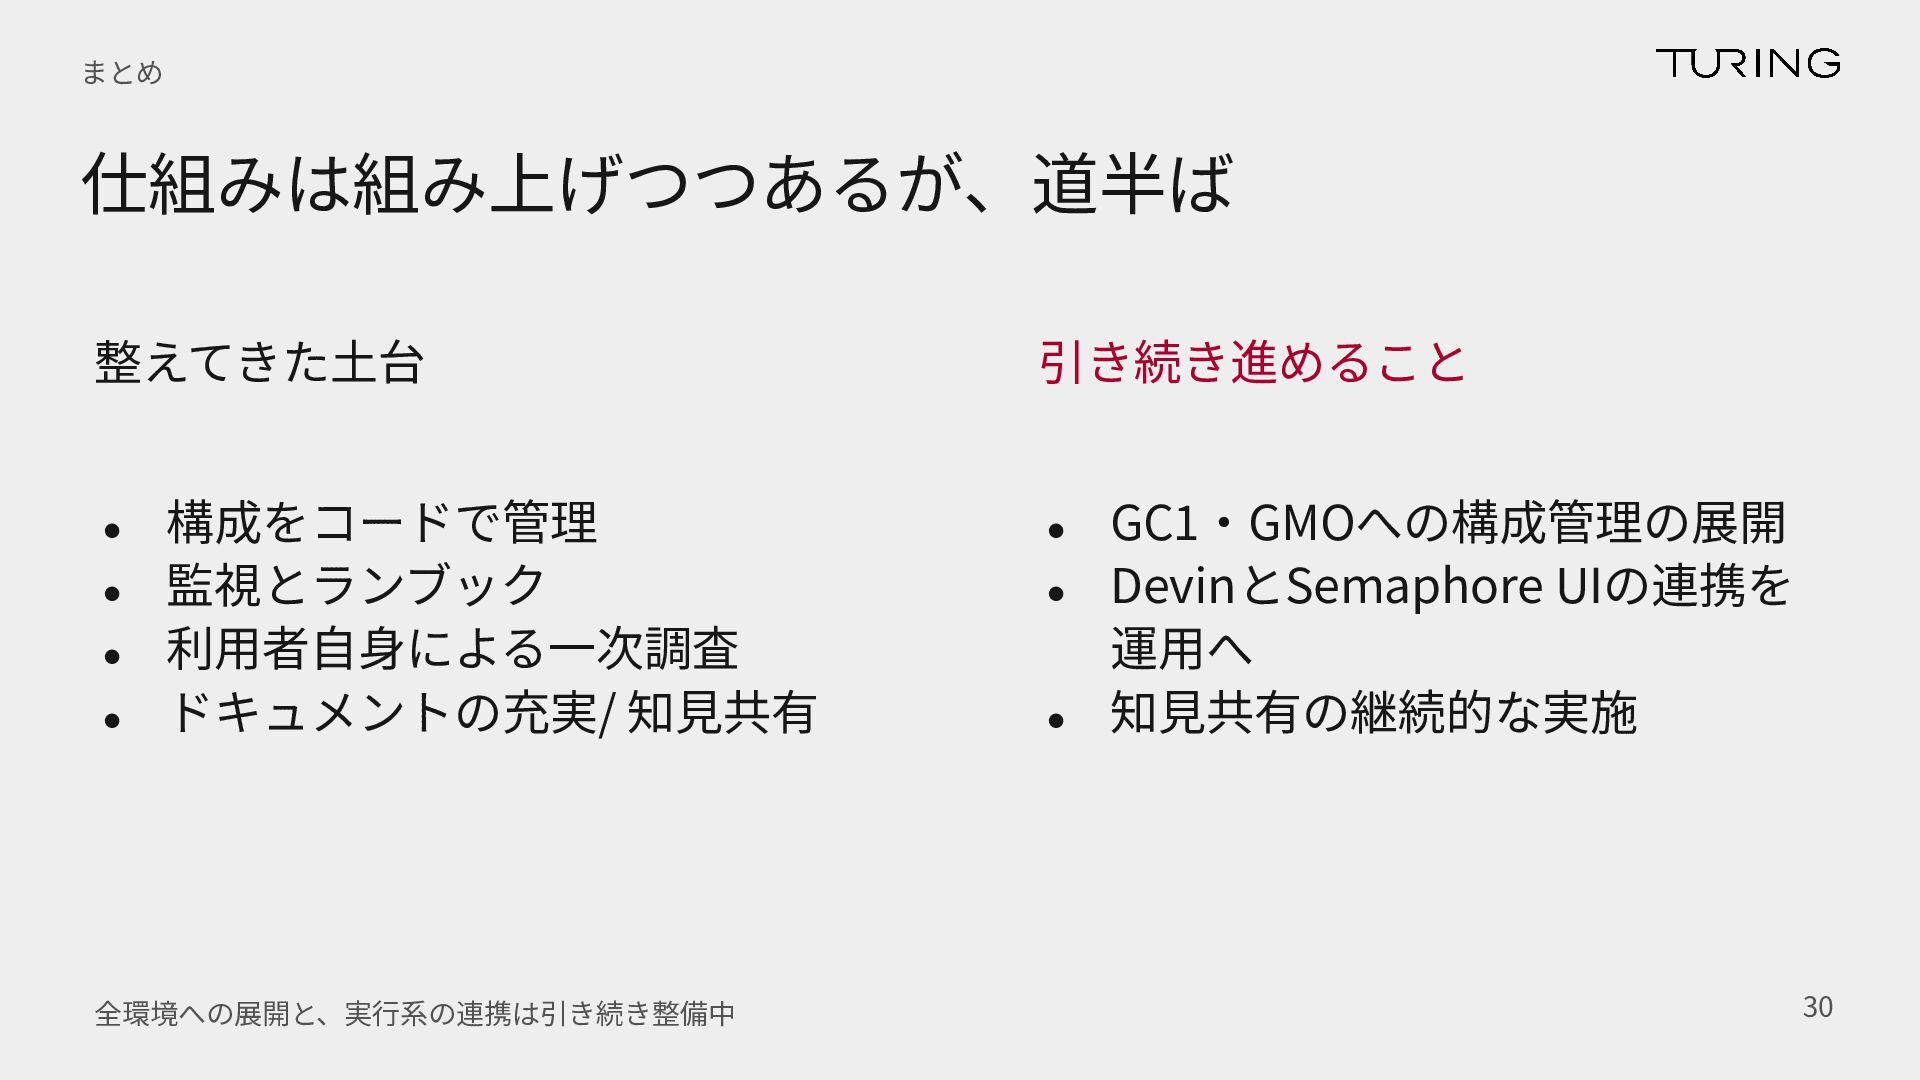
本セッションでは、その余力を作るために進めてきた構成管理、自動化、AIエージェントの活用を紹介します。AWS・Google Cloudで整えたIaCやCI/CDを既存環境にも広げる中で、Boot image・Startup script・Ansibleの役割をどう分け、どこを共通化し、どこに環境ごとの違いを残したのか。学習ジョブへの影響を抑えながら変更を届けるための判断を共有します。
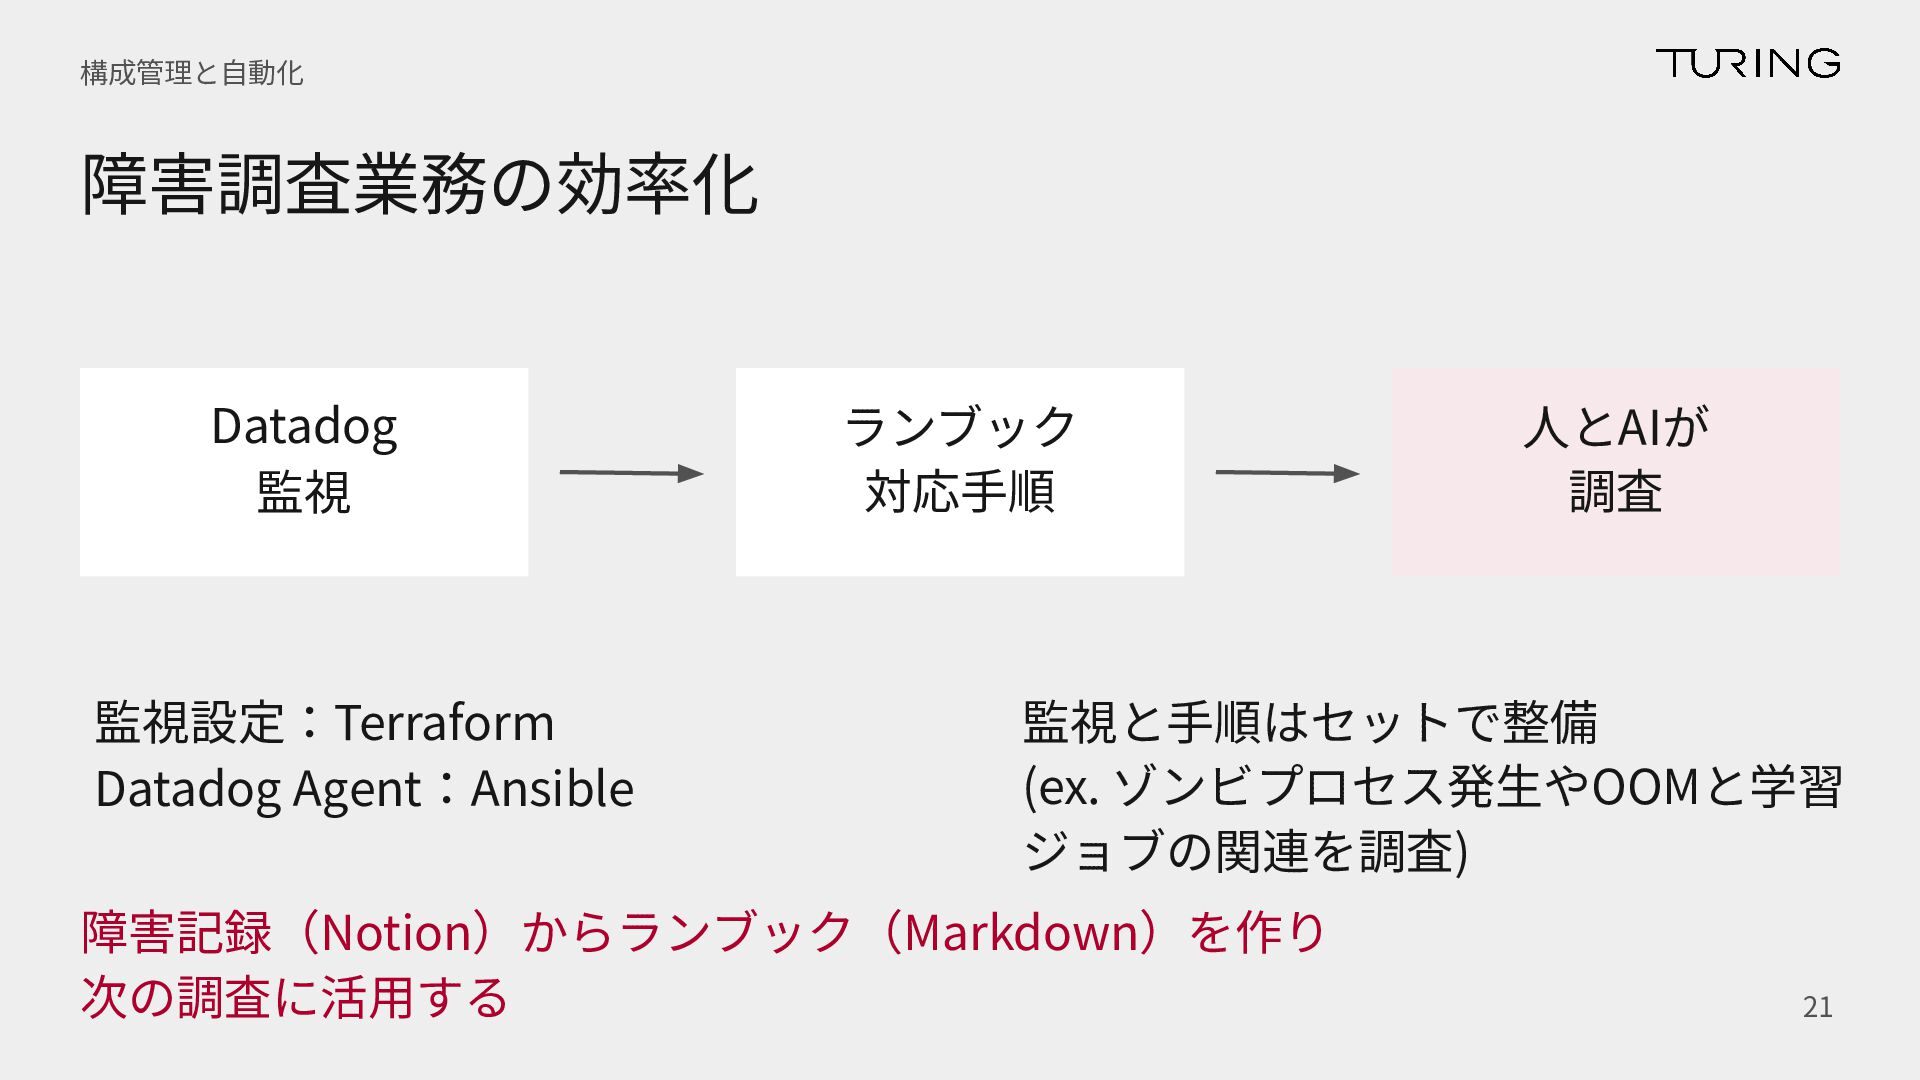
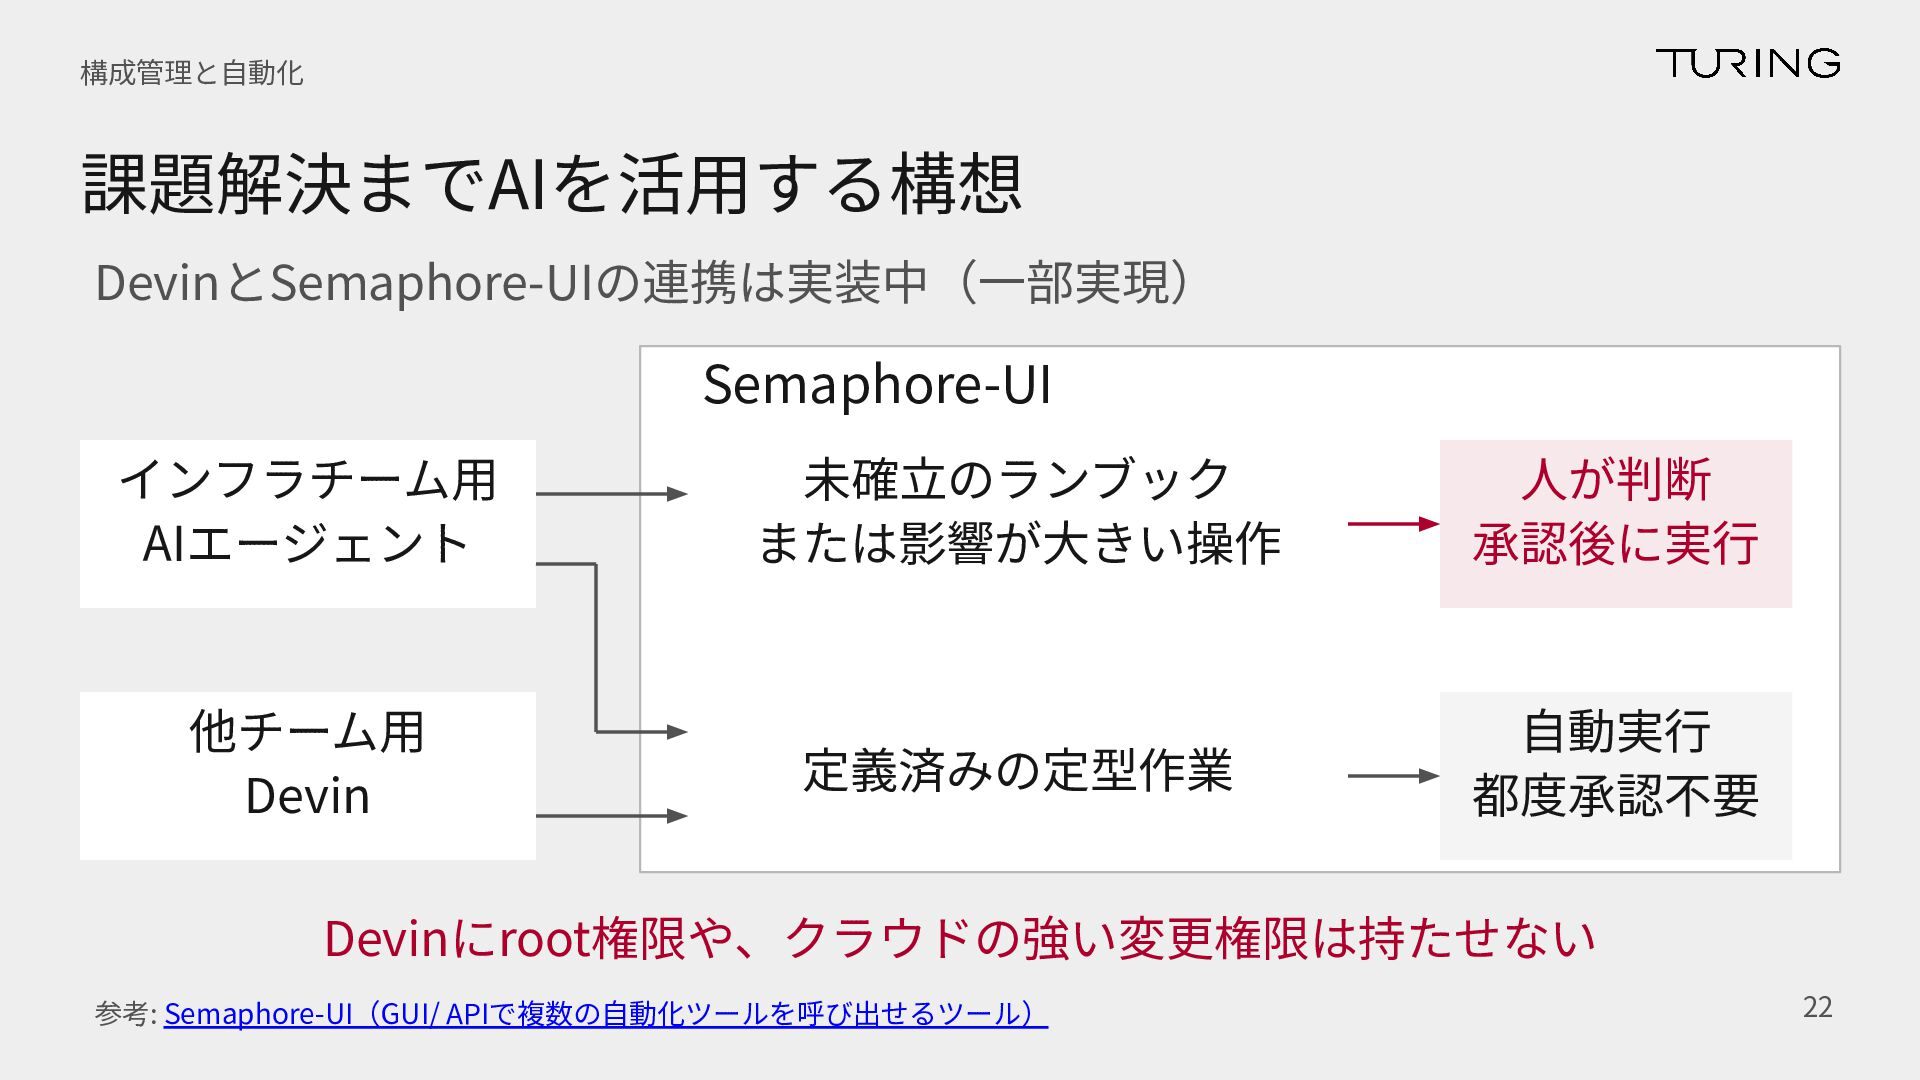
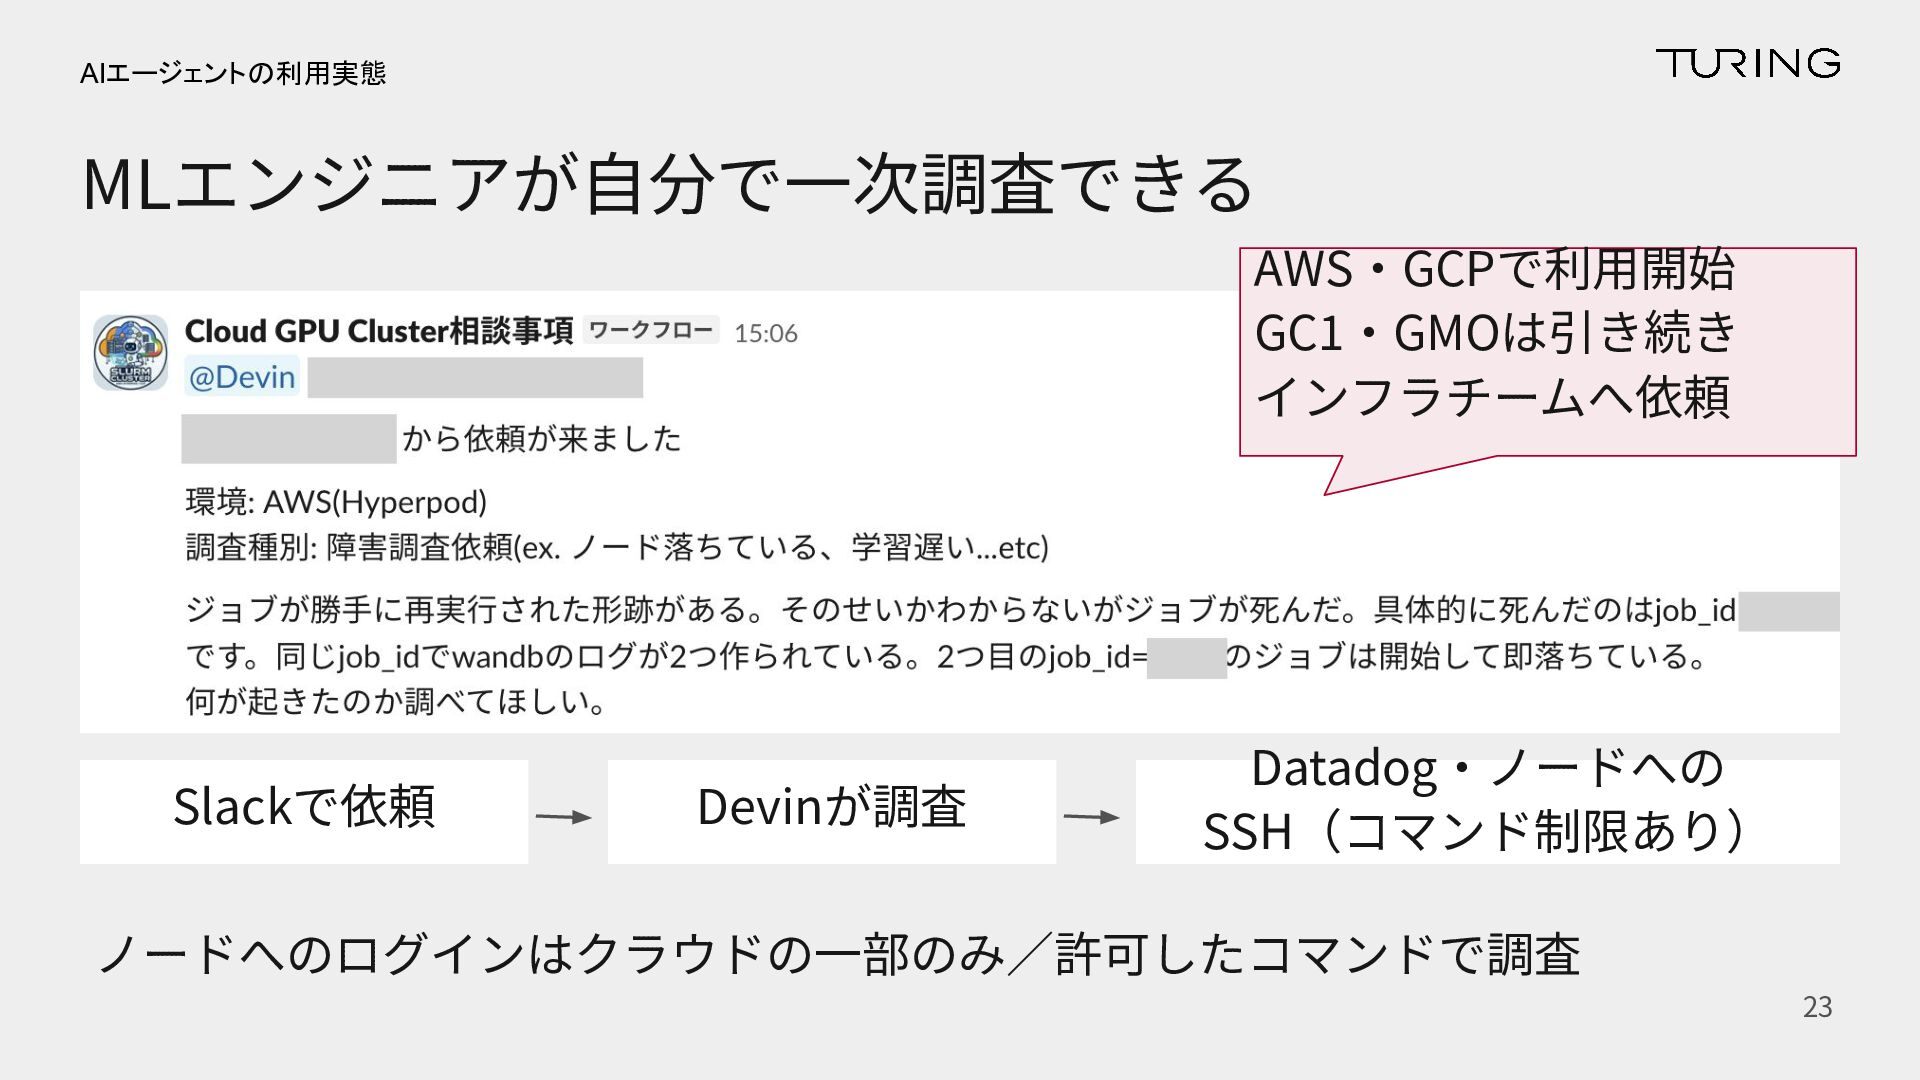
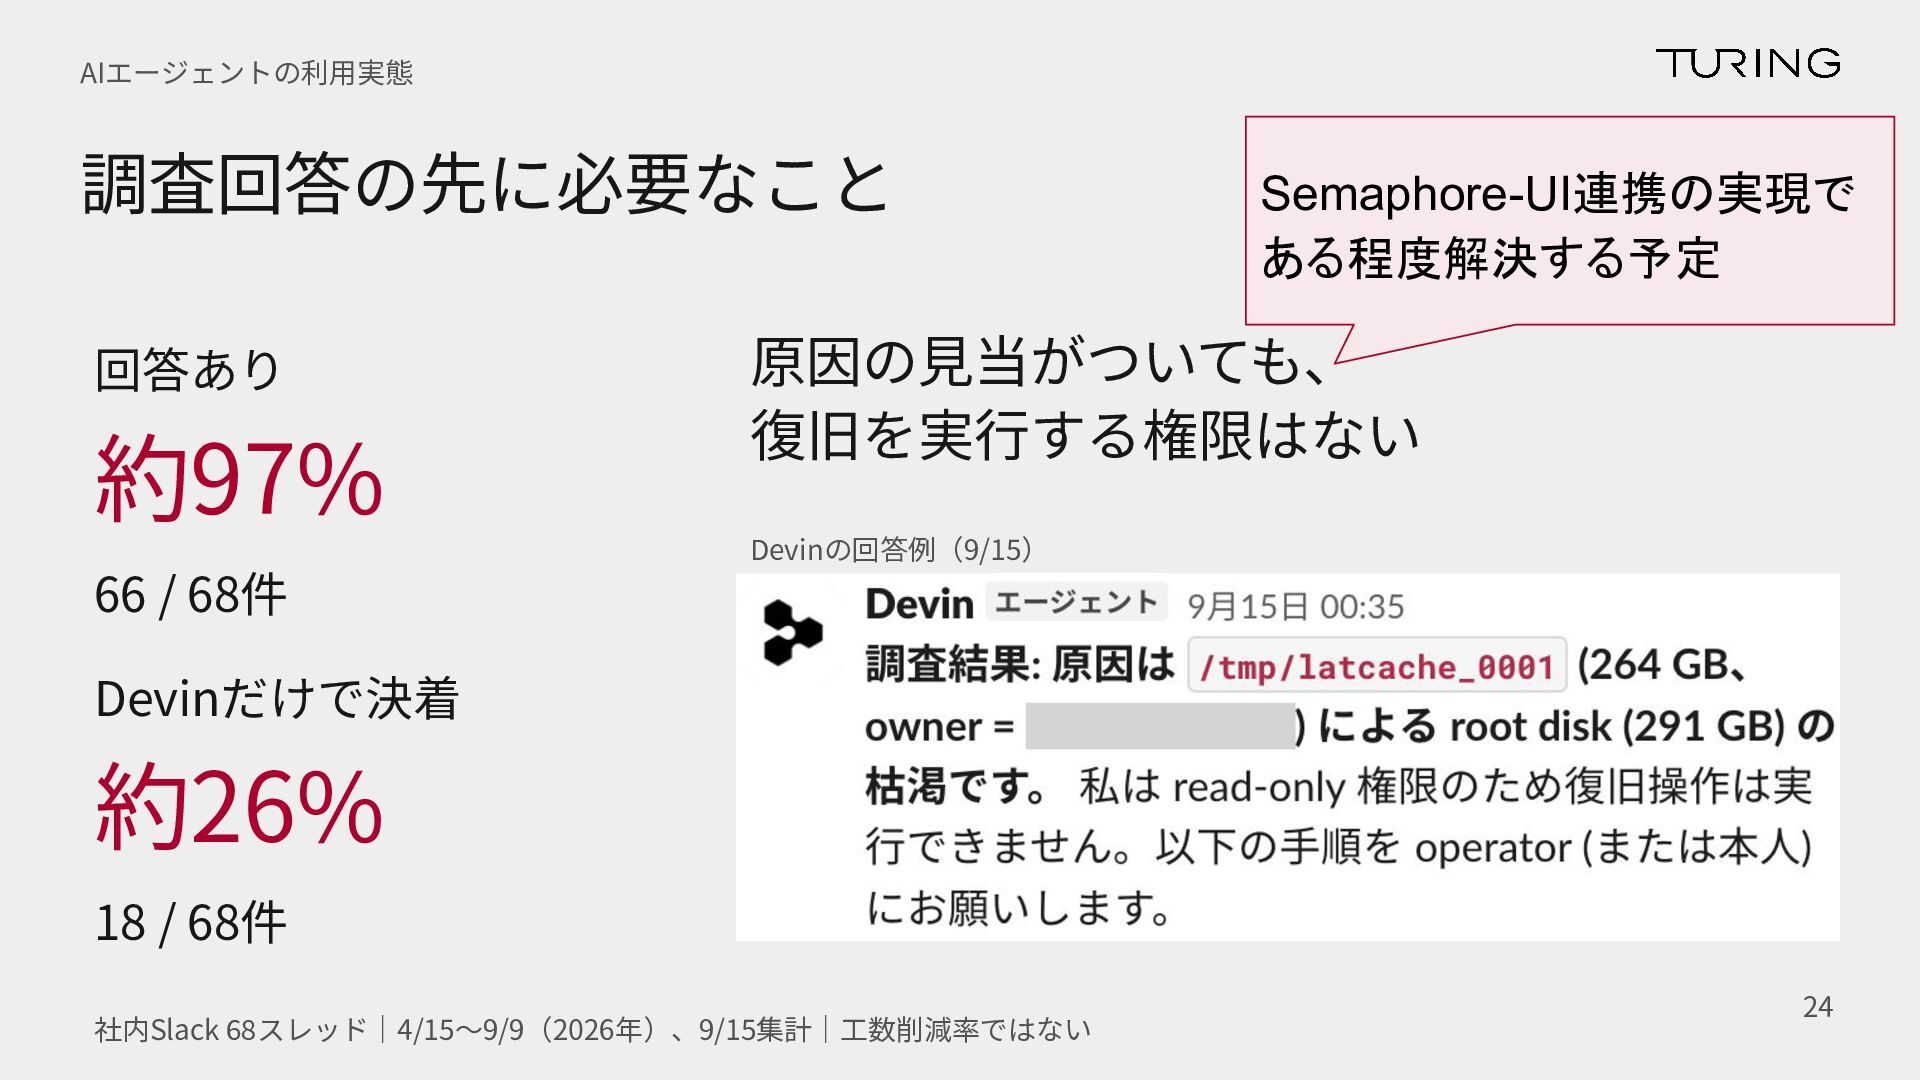
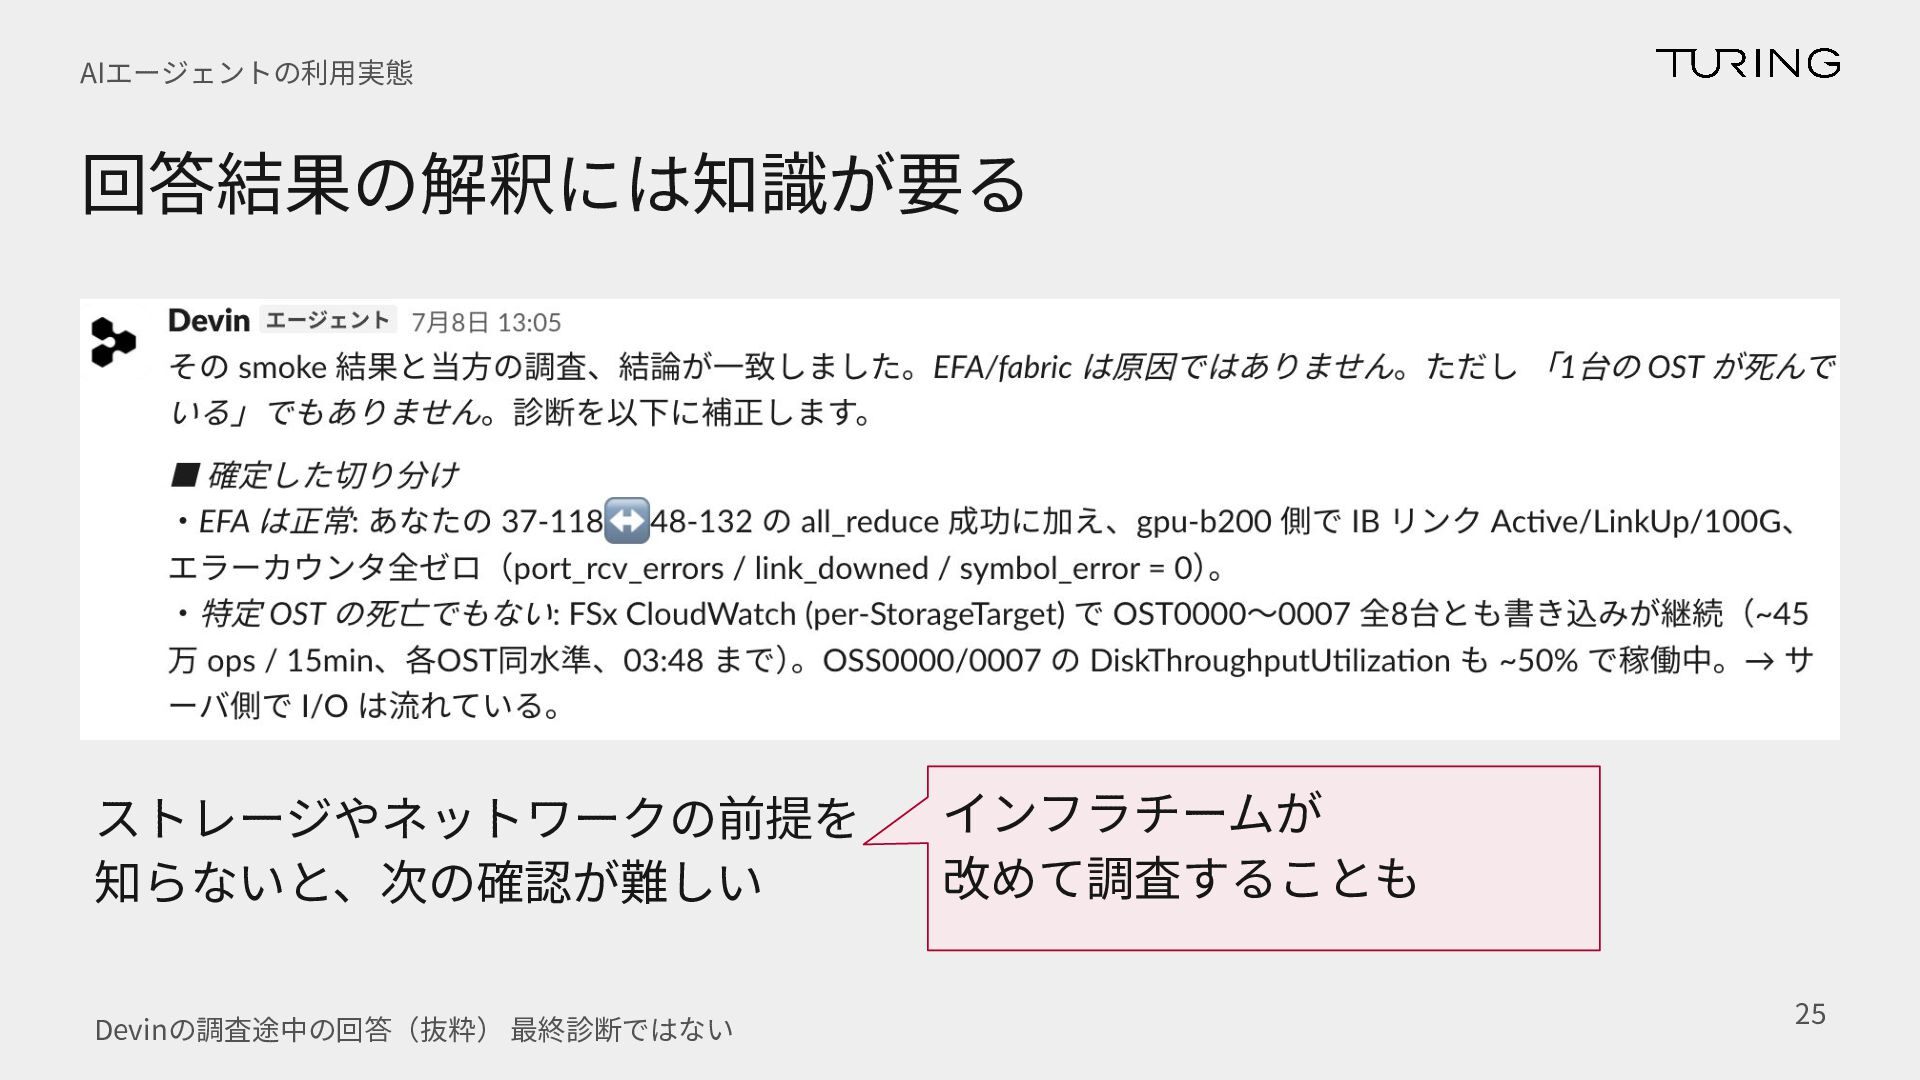
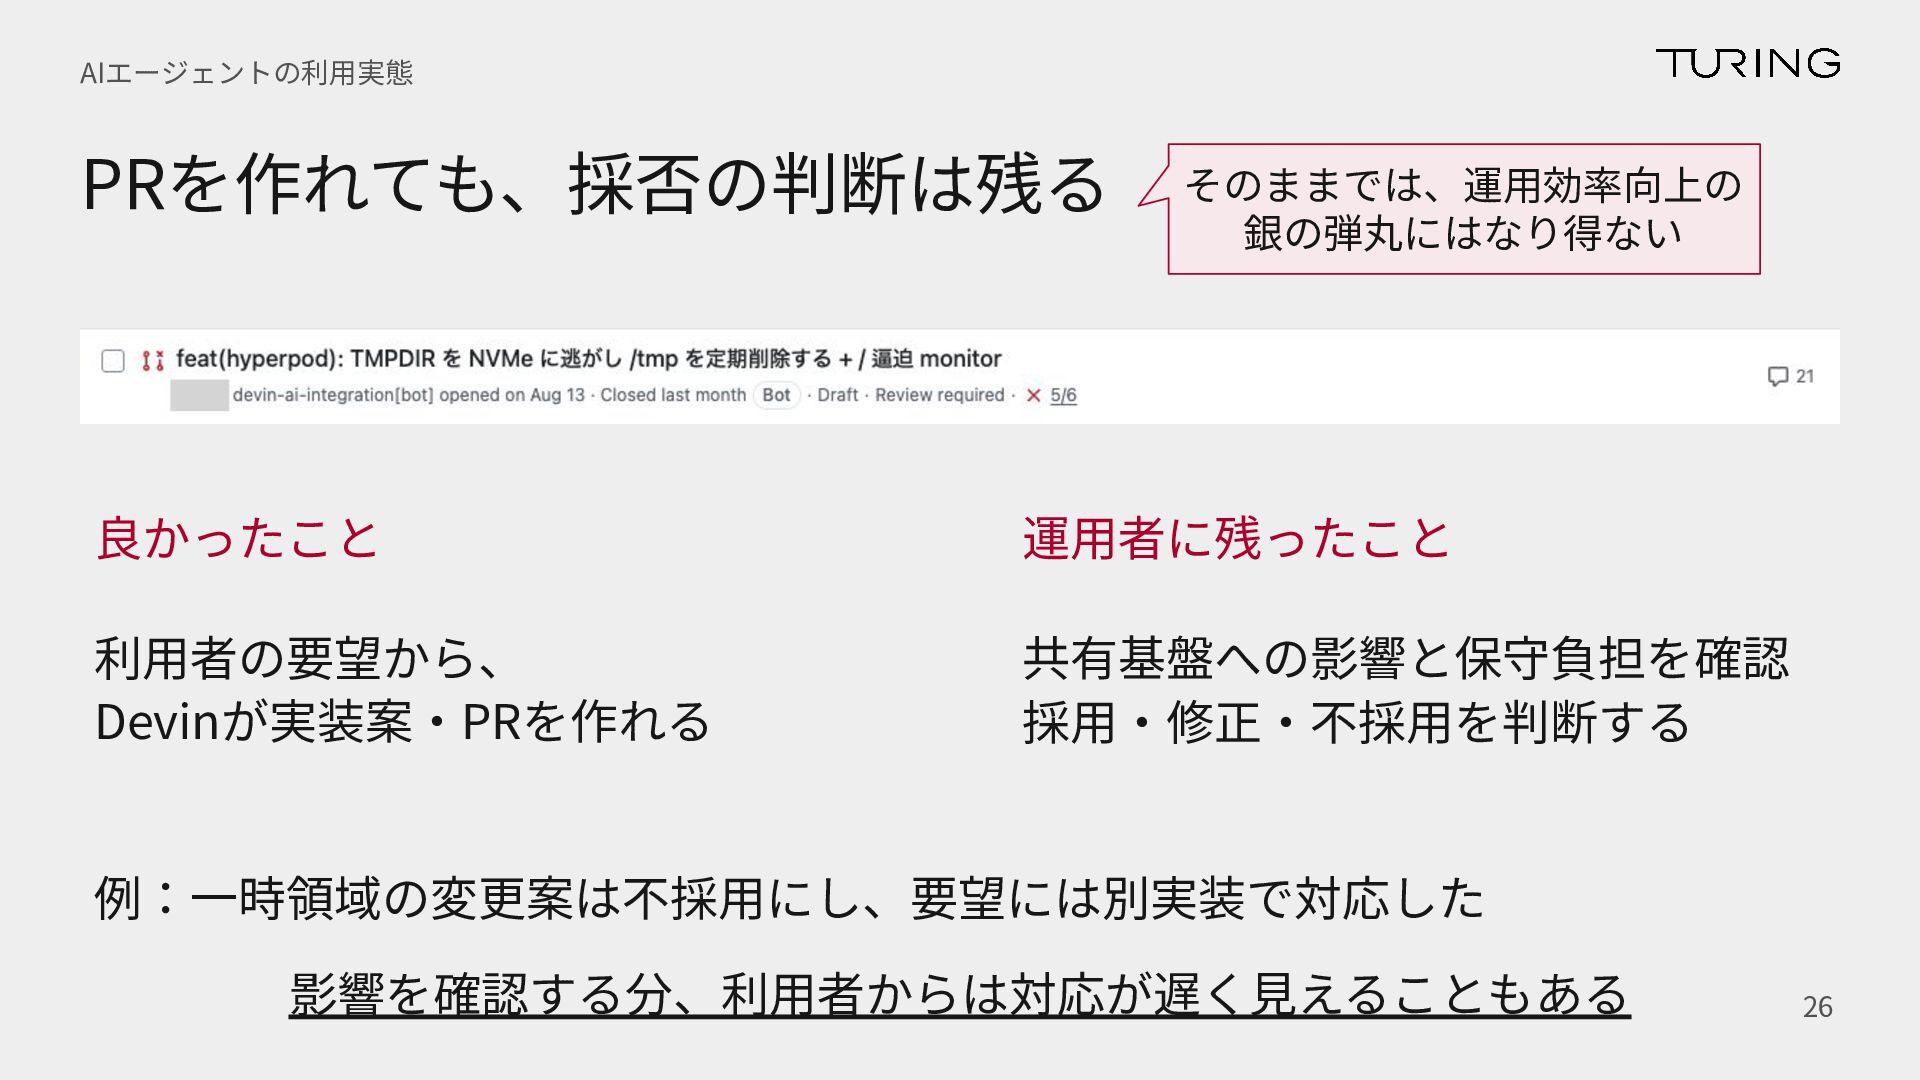
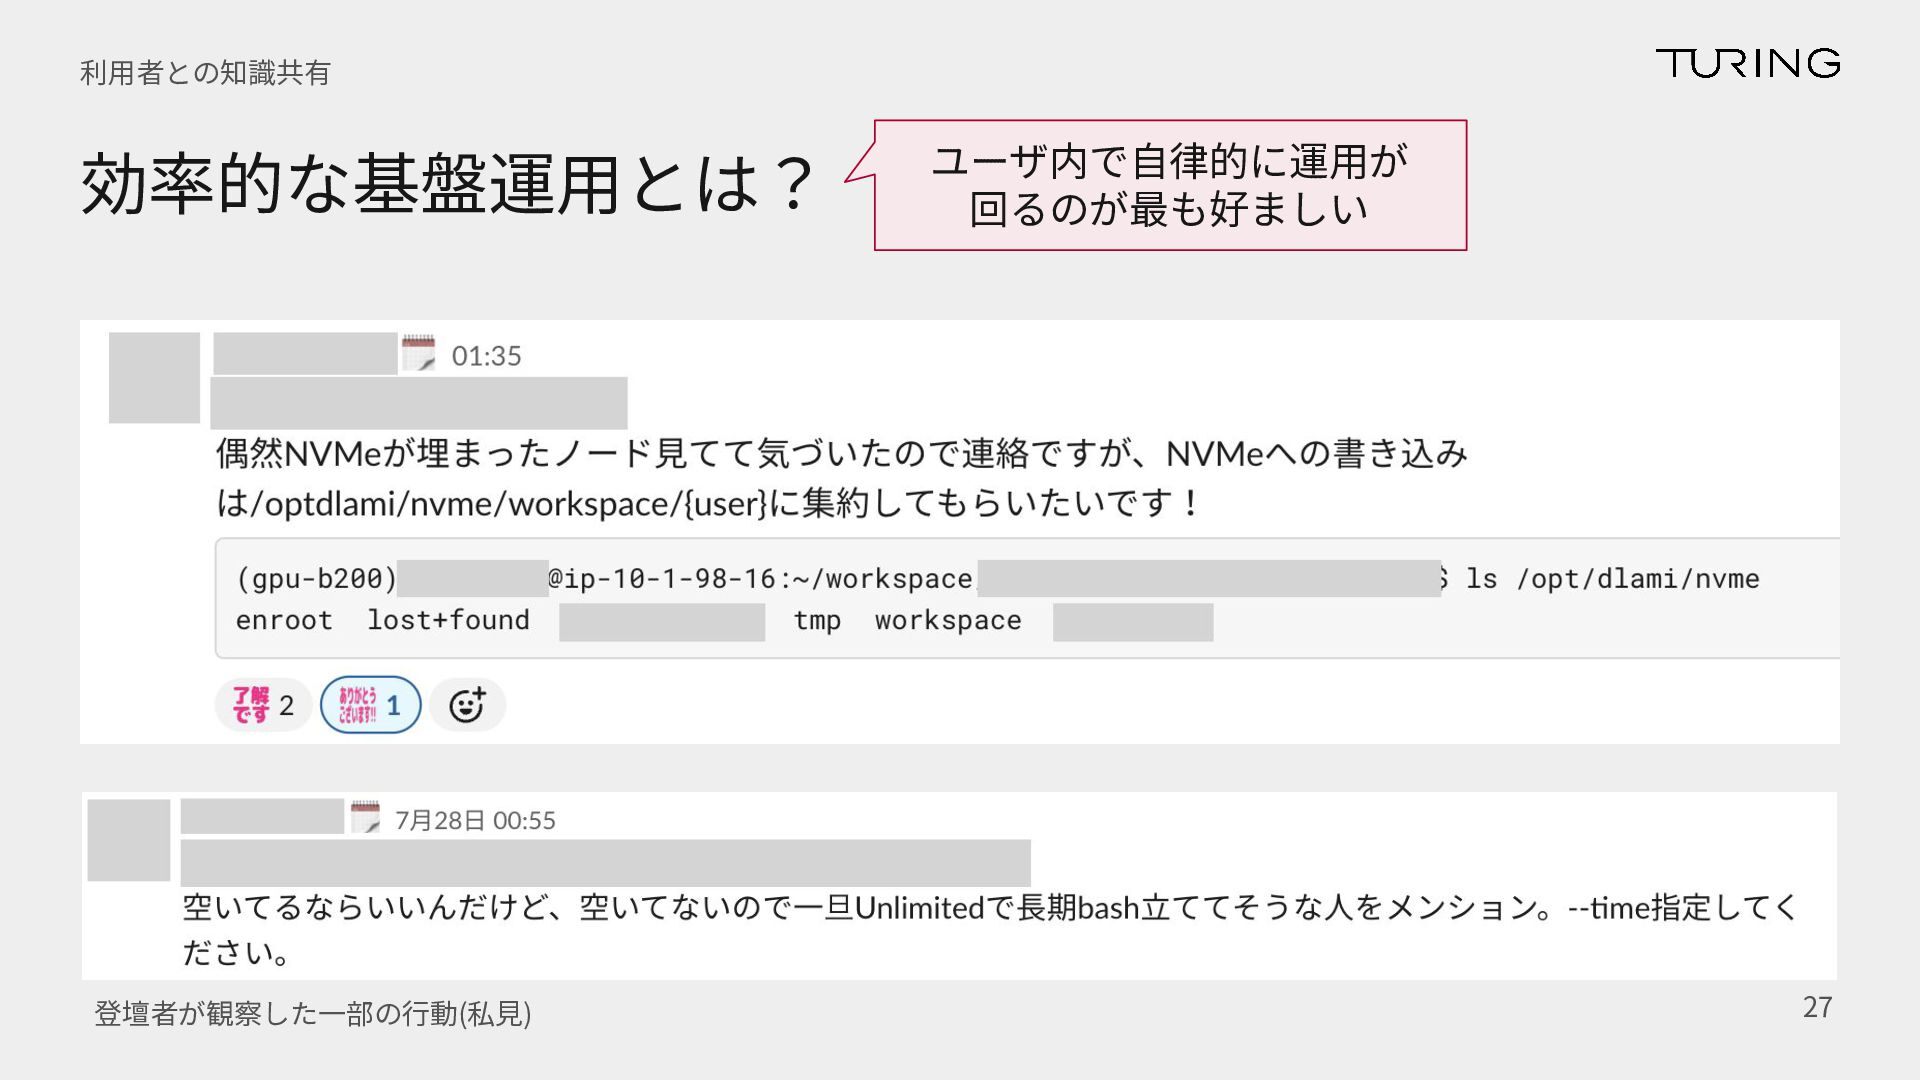
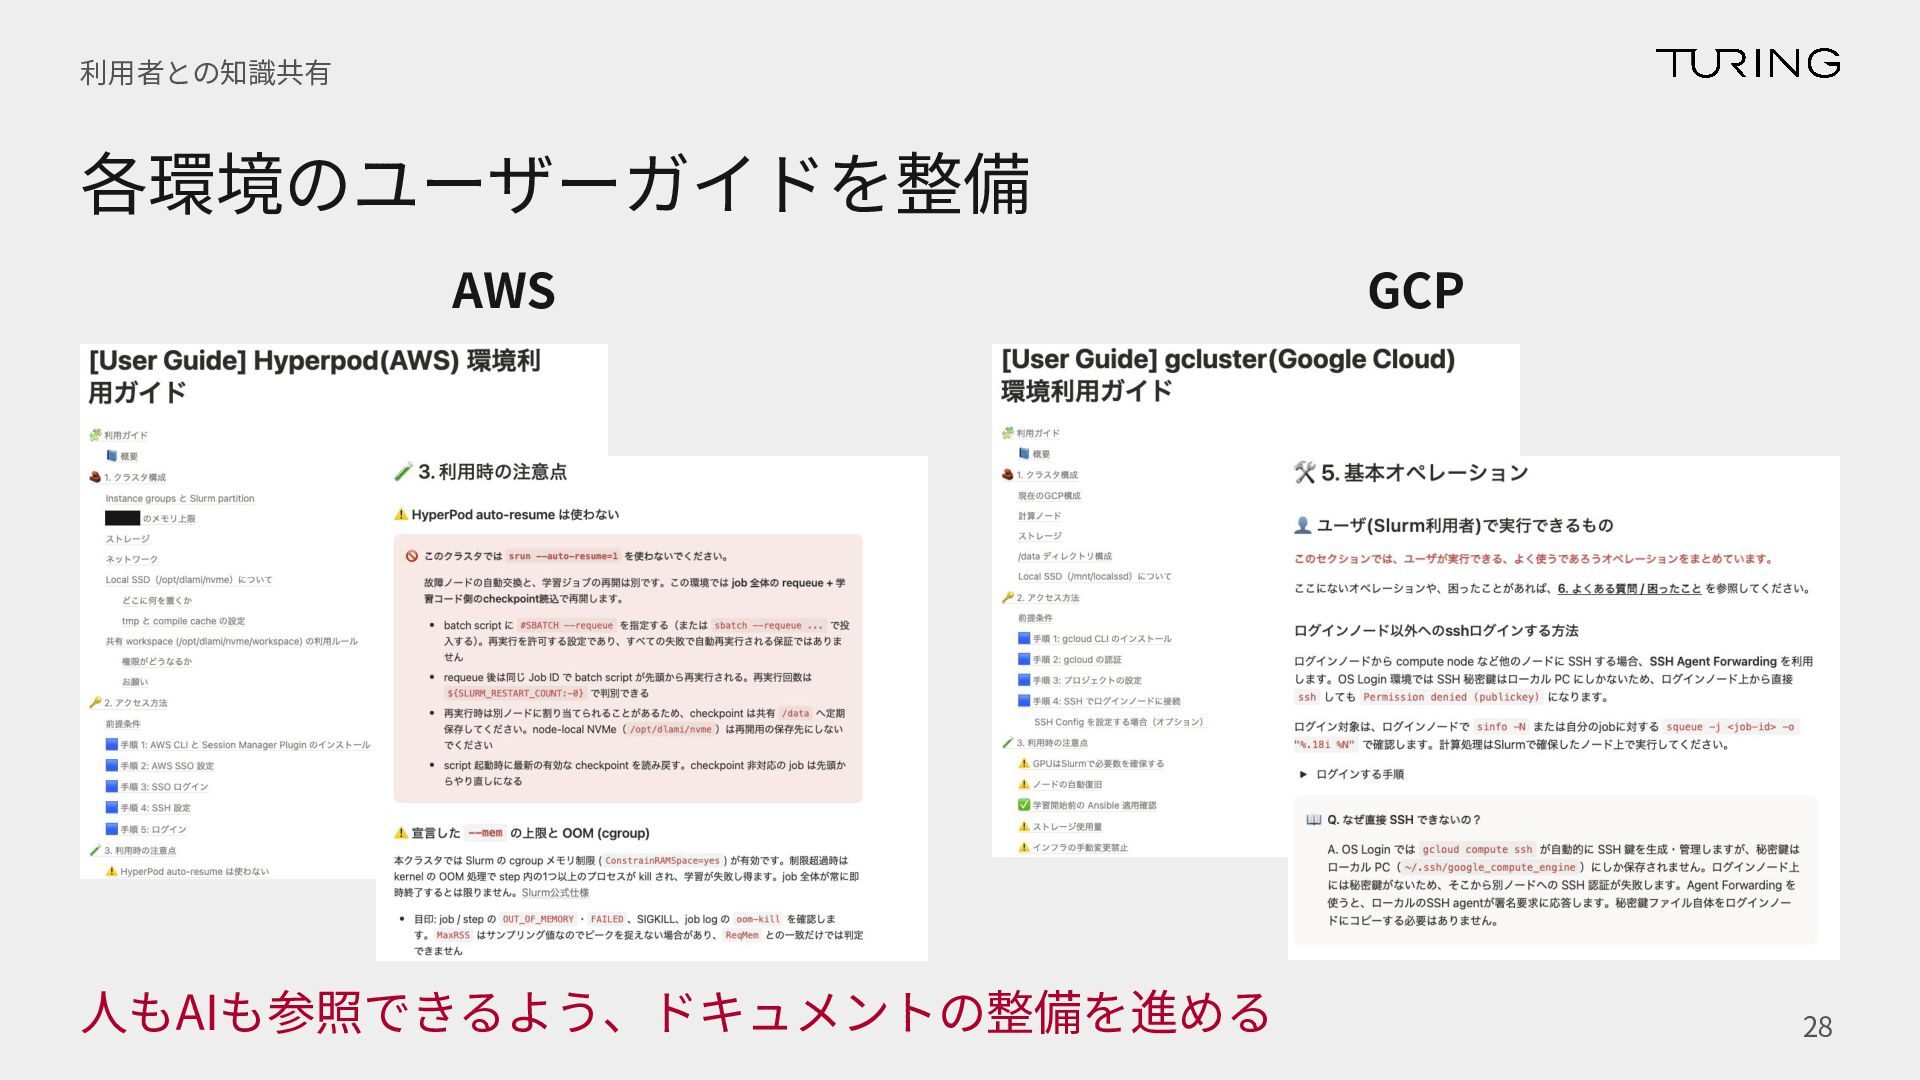
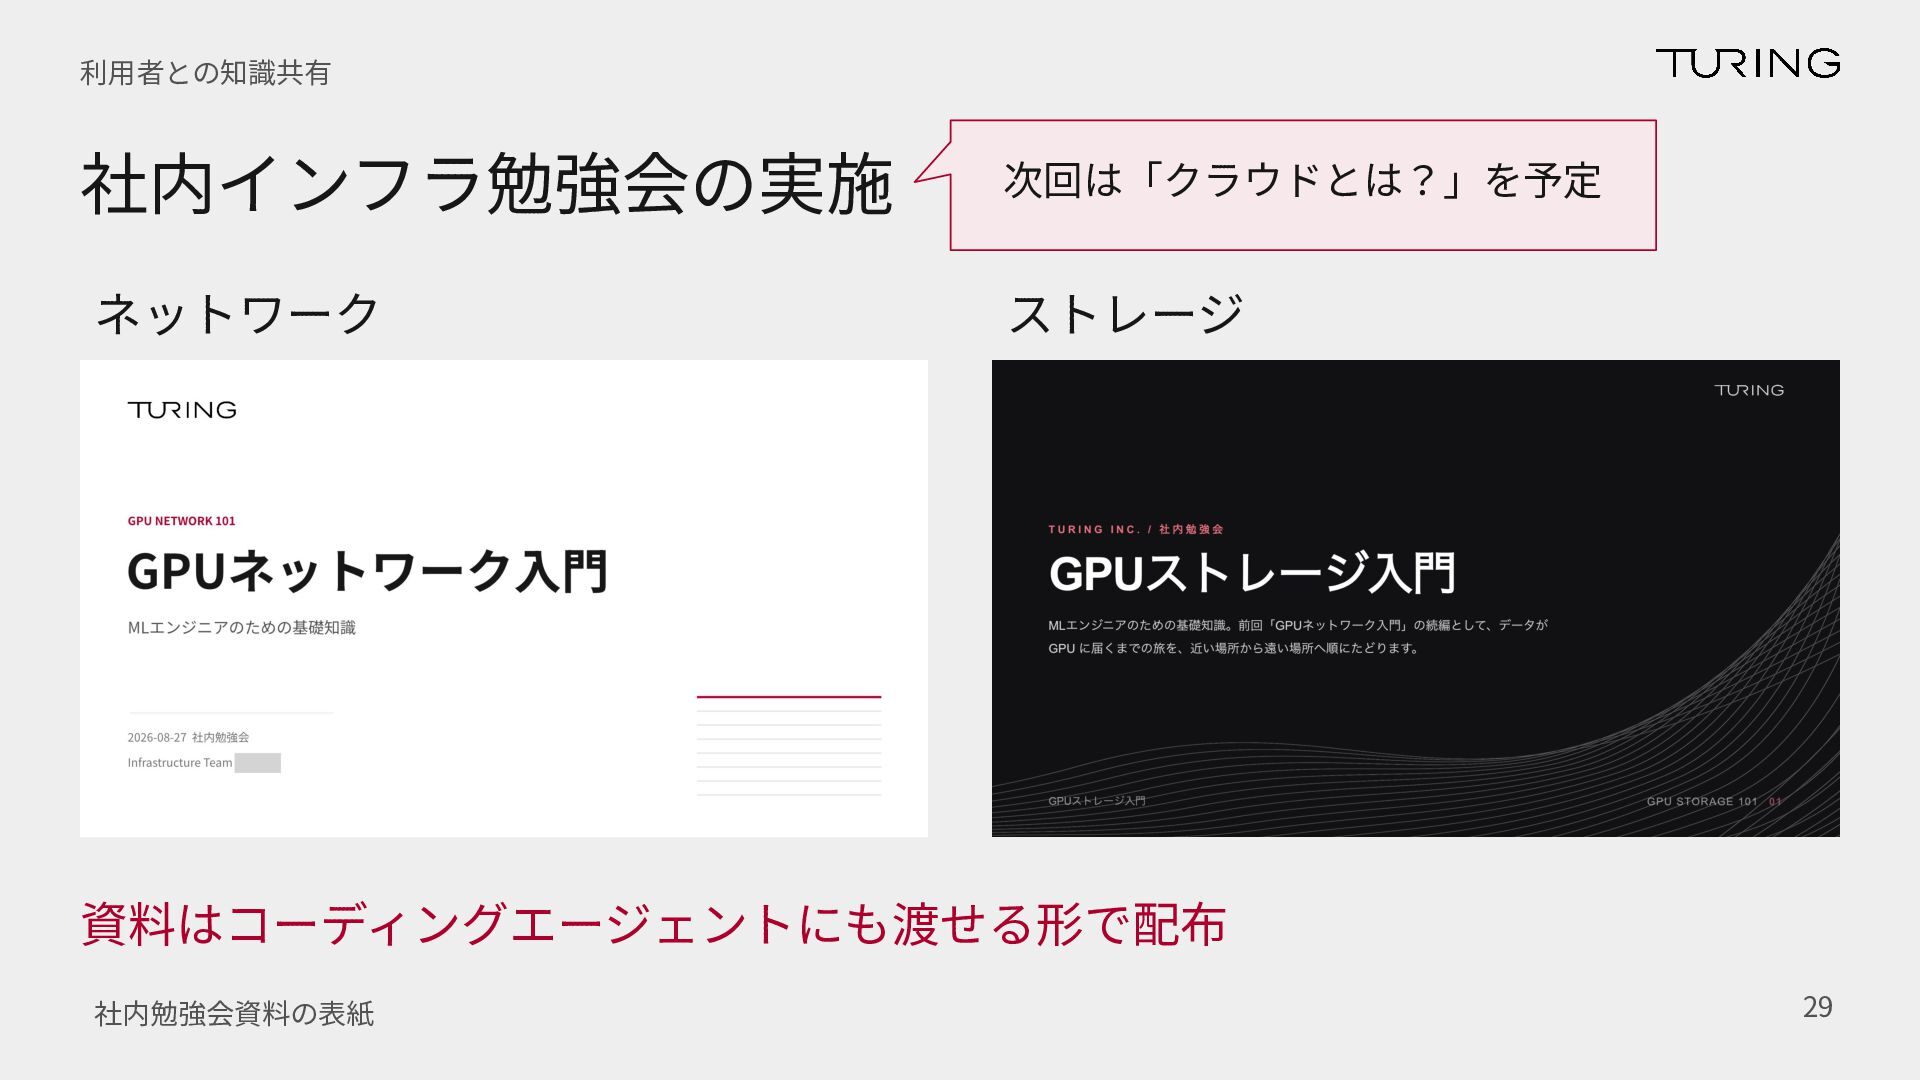
また、Datadogとランブック、Devinによる一次調査、Semaphore UIを介した定型作業の実行に向けた取り組みも紹介します。利用者自身が調査を始め、実装案を作れるようになった一方で、回答の解釈や共有基盤への影響確認、提案の採否判断は運用者に残りました。ユーザーガイドや社内勉強会を通じて、利用者と基盤の前提知識を共有する活動にも触れます。
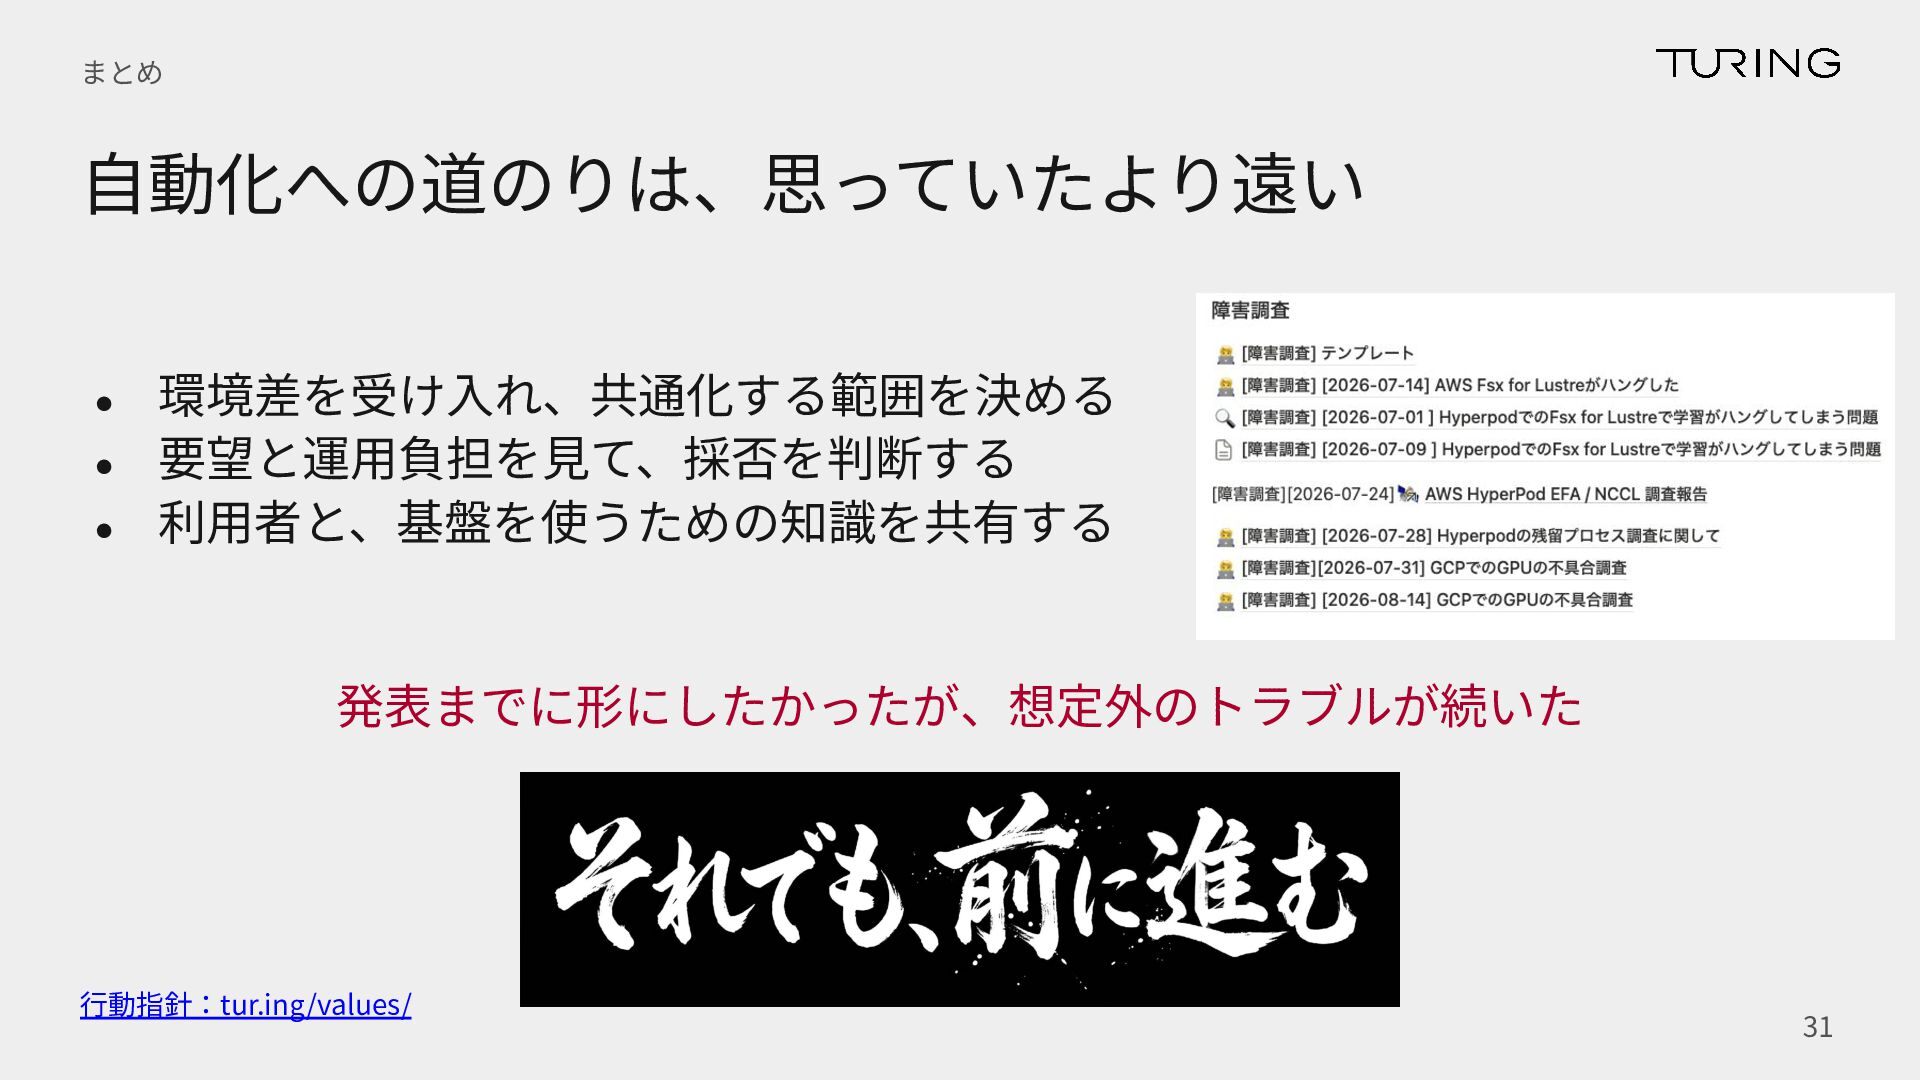
自動化はまだ完成していません。想定外のトラブルや、仕組みを作るだけでは解決しなかった課題を含め、少人数で運用を続けながら改善を進める過程を、Platform Engineeringの実践として振り返ります。


 nasa9084
 kameitomohiro
 yama3133
 elmodev09
 harappa80
 kekekenta
 k_adachi_01
 dak2
 har1101
 oracle4engineer
 kazumax55
 twada
 akademiya2063
 aleyda
 soysaucechin
 reverentgeek
 sugarenia
 letsgokoyo
 colly
 rkaga
 frankvandijk
 ivargrimstad
 soudai
 sarafernandez