Ultra Ethernet (UEC) v1.0 仕様概説
Sponsored
·
 Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→

Share
Embed
Ultra Ethernet (UEC) v1.0 仕様概説
Ultra Ethernet (UEC) v1.0 Specification Overview

Masayuki Kobayashi
March 04, 2026
Transcript
82 slides
-
UEC - Ultra Ethernet v1.0 概説 2026/3/2 Interconnect Architecture SIG
Masayuki Kobayashi Public -
Disclaimer • 本資料の内容は公開されているUEC spec v1.0.2の内容に基づきます ◦ Ultra Ethernet Specification v1.0.2
January 28, 2026 ◦ https://ultraethernet.org/wp-content/uploads/sites/20/2026/01/UE-Specification-1.0.2-1.pdf • 仕様策定中の技術であるため、常に内容は変更されます • 基本的な最低限の重要仕様のみ解説しています • 本資料内の画像は上記仕様書と関連論⽂から引⽤しています -
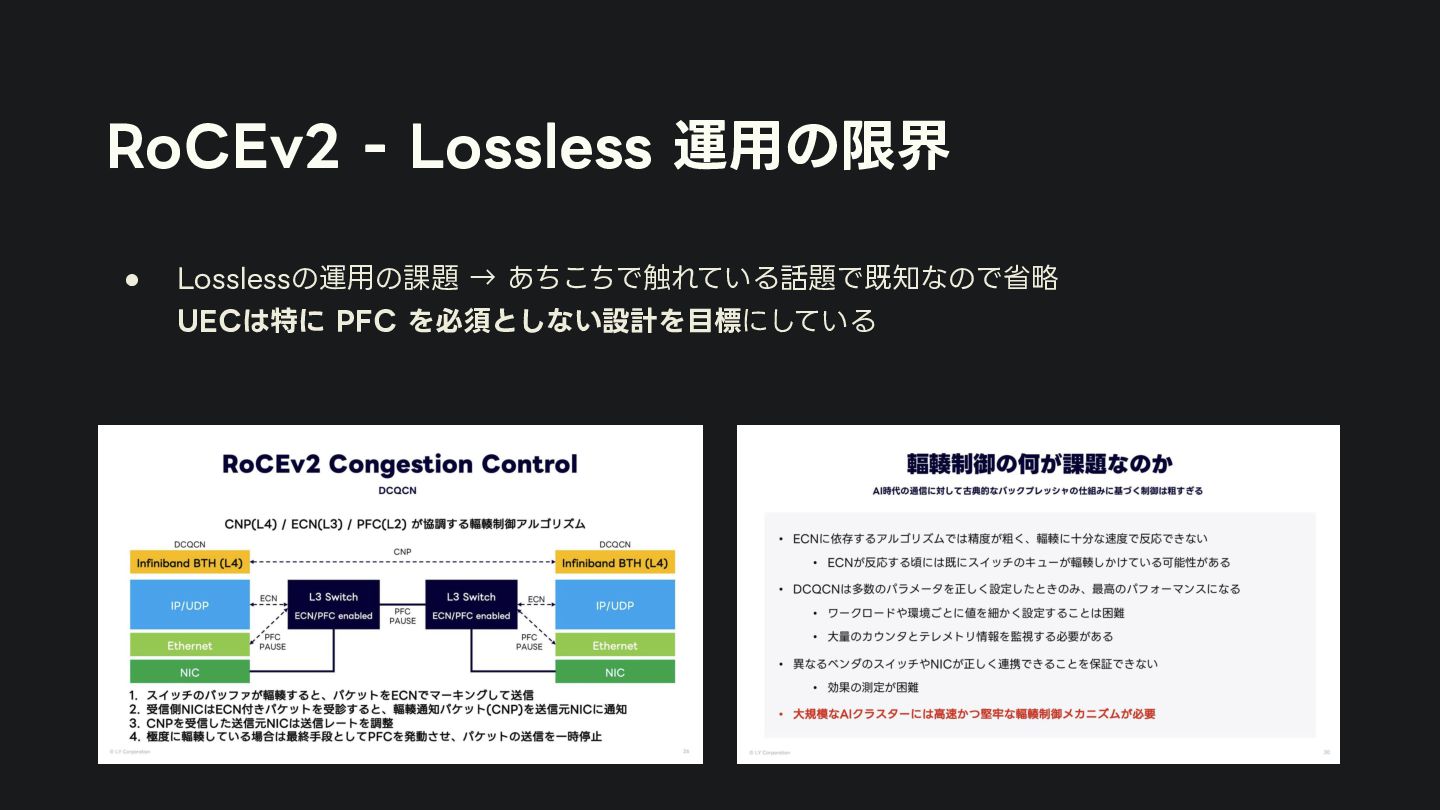
Ultra Ethernet - UE Ultra Ethernet(UE)は、AI/HPCの⼤規模分散計算のためにネットワークがボトルネックとなら ないように開発された、Ethernetをベースとしたオープン標準技術。 • モチベーション:分散学習・推論は、帯域だけでなく輻輳・テール遅延・運⽤の難しさが性能とスケールの限 界になる。従来のRDMA運⽤は「ロスレス前提」に依存しがちで、⼤規模化すると設計・運⽤が難しくなり
やすい。 • 解決する課題:UEは、ドロップや経路のばらつきが起こり得る現実のネットワーク上でも、⾼いスループッ トと安定した遅延を出せるように設計されている。 • 嬉しさ:結果として、巨⼤クラスタでも性能が安定し、既存Ethernet資産を活かしながらマルチベンダ相互 運⽤でロックインを避けられる。 -
Ultra Ethernet の仕様について • 仕様書はv1.0.2で564ページあるため、最初に設計原則とアーキテクチャを解説した論⽂を 読むことをおすすめします • Ultra Ethernetʼs Design
Principles and Architectural Innovations ◦ https://arxiv.org/html/2508.08906v1 -
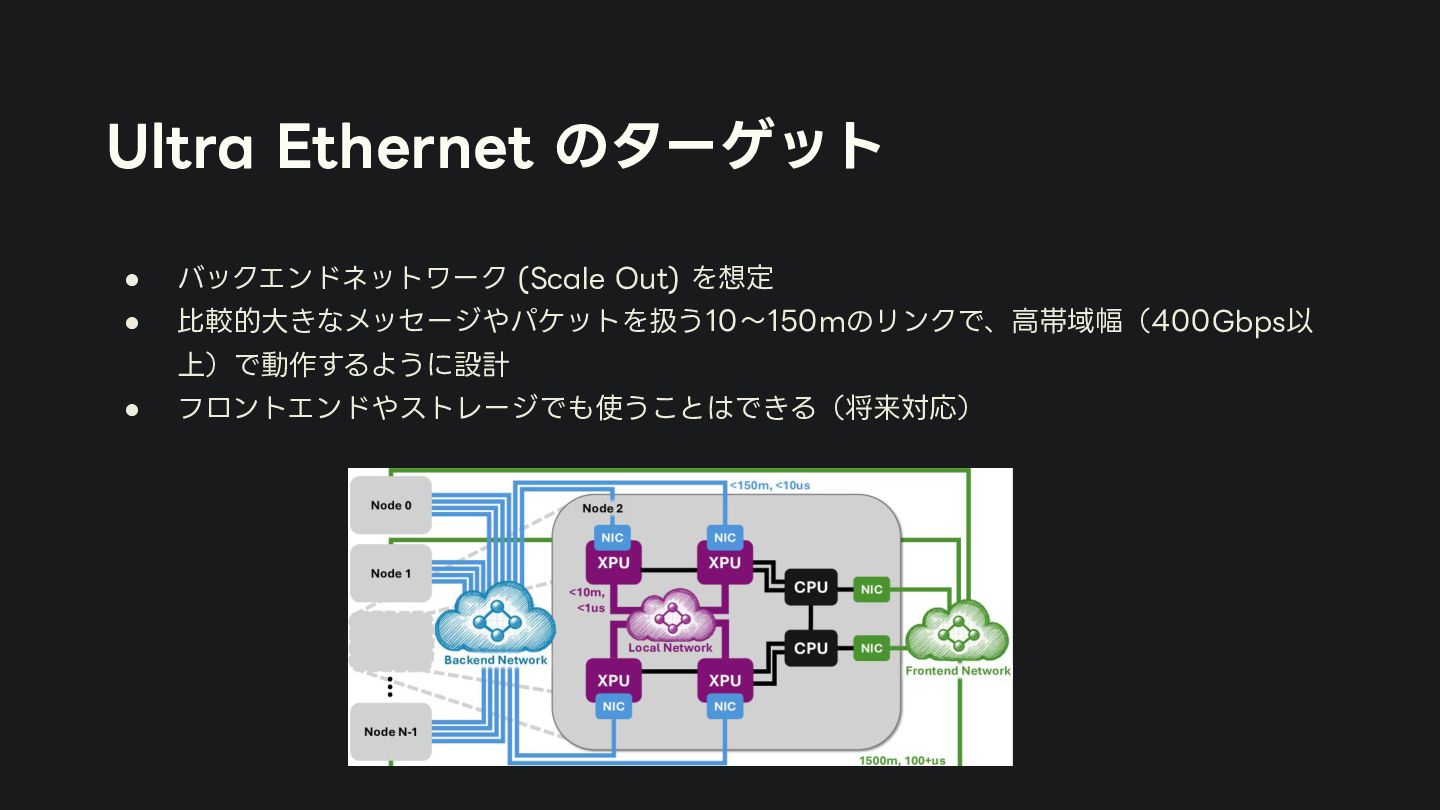
Ultra Ethernet のターゲット • バックエンドネットワーク (Scale Out) を想定 • ⽐較的⼤きなメッセージやパケットを扱う10〜150mのリンクで、⾼帯域幅(400Gbps以
上)で動作するように設計 • フロントエンドやストレージでも使うことはできる(将来対応) -
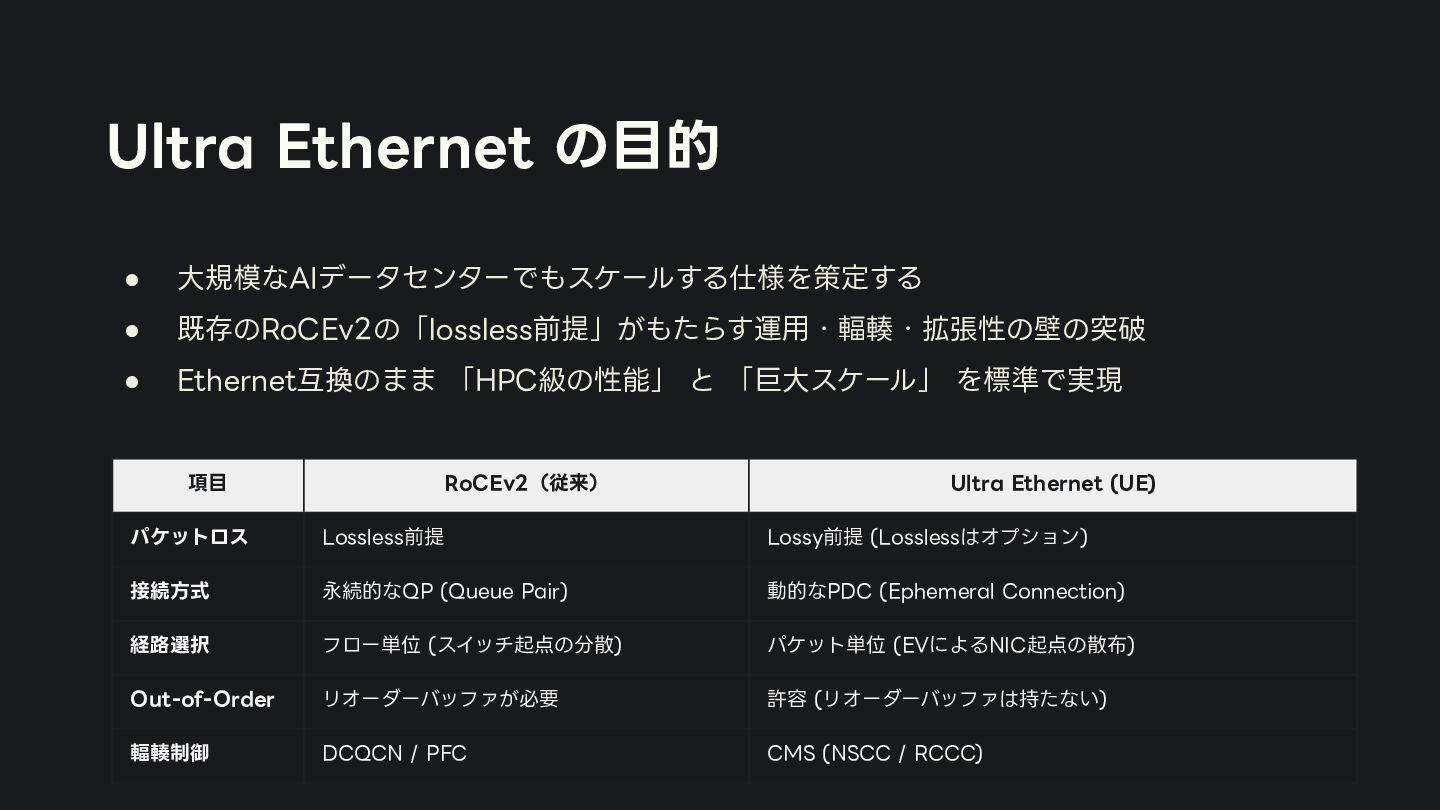
Ultra Ethernet の⽬的 • ⼤規模なAIデータセンターでもスケールする仕様を策定する • 既存のRoCEv2の「lossless前提」がもたらす運⽤・輻輳・拡張性の壁の突破 • Ethernet互換のまま 「HPC級の性能」
と 「巨⼤スケール」 を標準で実現 項⽬ RoCEv2(従来) Ultra Ethernet (UE) パケットロス Lossless前提 Lossy前提 (Losslessはオプション) 接続⽅式 永続的なQP (Queue Pair) 動的なPDC (Ephemeral Connection) 経路選択 フロー単位 (スイッチ起点の分散) パケット単位 (EVによるNIC起点の散布) Out-of-Order リオーダーバッファが必要 許容 (リオーダーバッファは持たない) 輻輳制御 DCQCN / PFC CMS (NSCC / RCCC) -
Ultra Ethernetの設計原則 ⽬標:Ethernetエコシステムを活かしてAI/HPCをスケールさせる 主要設計原則 • Fully lossy(ドロップ許容) • Out-of-order許容(reorder buffer無しで成⽴させる考え⽅)
Statelessness(⼤規模endpoint) • Per-packet multipath(EV+ECMP) -
Ultra Ethernetの設計原則 • スイッチ要求を極限まで軽く=既存Ethernetインフラ資産を最⼤限活かす • Microsoft発の強い要求として「既存DCスイッチで成⽴させたい」 → スイッチ側の必須機能を最⼩化 • 必要なインテリジェンス==機能
をエンドポイントであるNICに集約 • 極⼒スイッチは新たに何もしないことに徹する → ⼀部オプション機能はスイッチASICのサポートを必要とする -
Ultra Ethernetの技術的コア lossy + out-of-order + per-packet multipath + statelessness
• ドロップを許容することで運⽤の単純化・PFC由来の問題を緩和する • 現代はNIC/XPU側に計算資源があるため、順序性を捨てて柔軟にできる → 各パケットに必要情報を持たせ、宛先が直接メモリにコミット できる設計 • 同じメッセージのパケットが別経路を通り、前後して到着しても成⽴する • ⼤規模エンドポイントでも破綻しない状態管理(接続確⽴・配送制御など) -
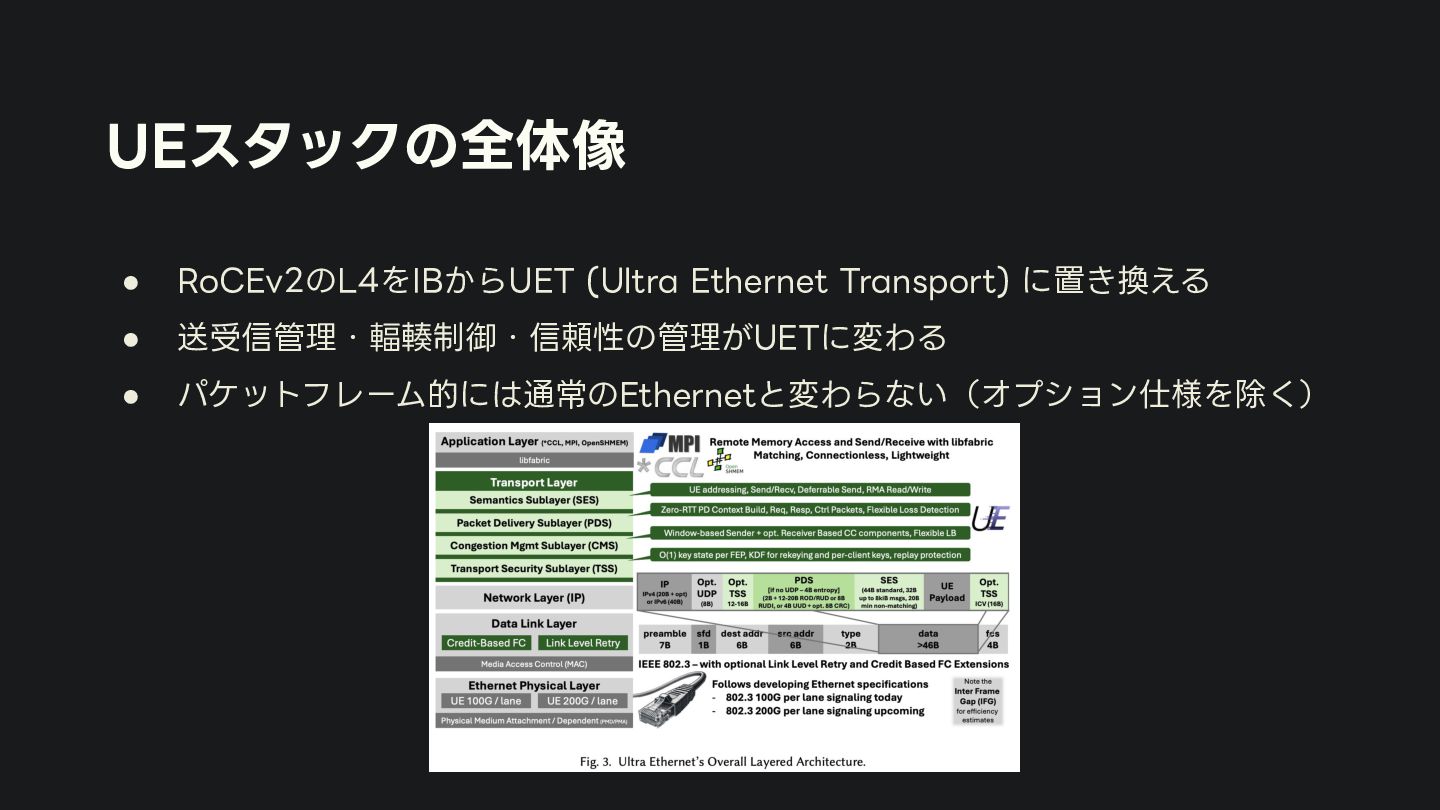
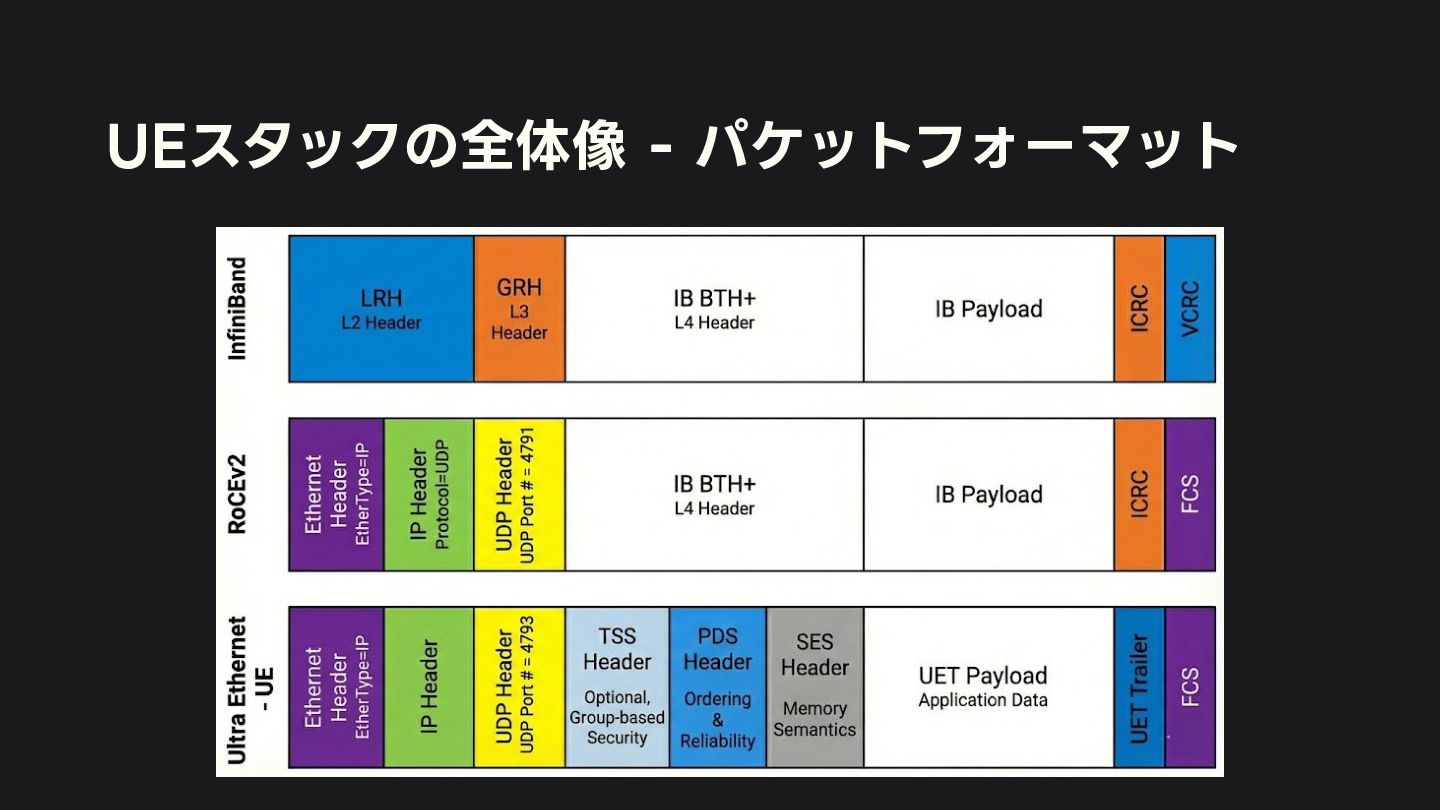
UEスタックの全体像 • RoCEv2のL4をIBからUET (Ultra Ethernet Transport) に置き換える • 送受信管理・輻輳制御・信頼性の管理がUETに変わる •
パケットフレーム的には通常のEthernetと変わらない(オプション仕様を除く) -
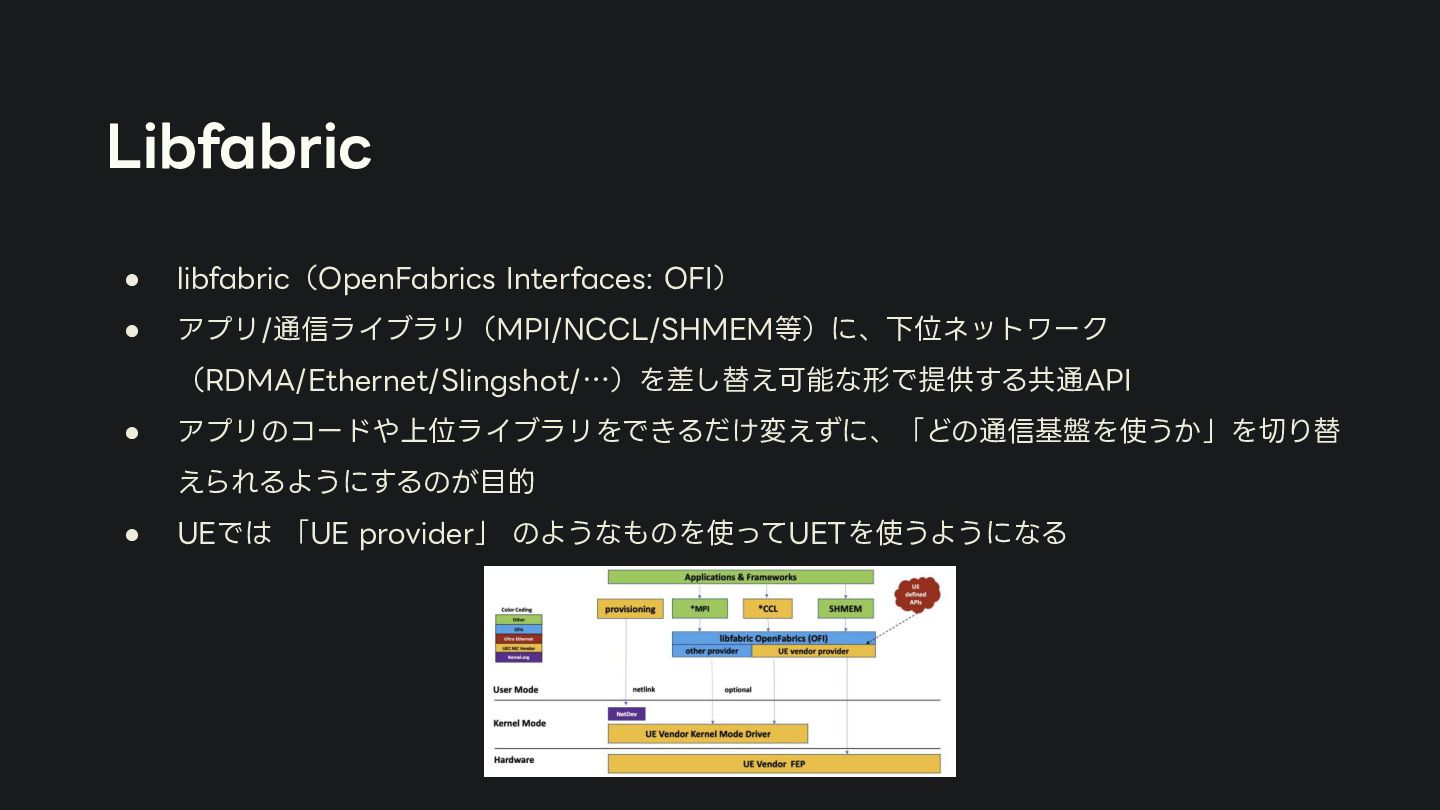
Libfabric • libfabric(OpenFabrics Interfaces: OFI) • アプリ/通信ライブラリ(MPI/NCCL/SHMEM等)に、下位ネットワーク (RDMA/Ethernet/Slingshot/…)を差し替え可能な形で提供する共通API • アプリのコードや上位ライブラリをできるだけ変えずに、「どの通信基盤を使うか」を切り替
えられるようにするのが⽬的 • UEでは 「UE provider」 のようなものを使ってUETを使うようになる -
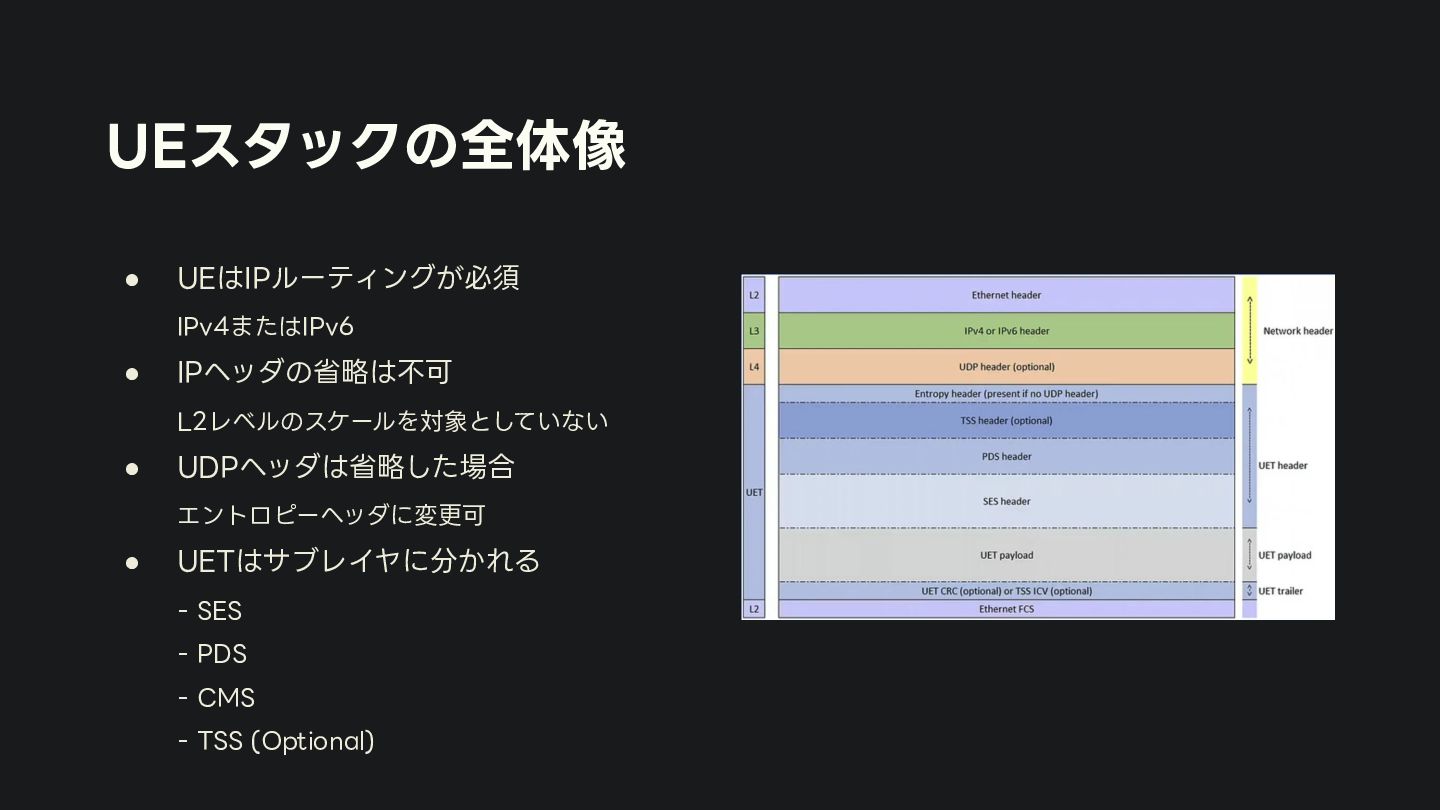
UEスタックの全体像 • UEはIPルーティングが必須 IPv4またはIPv6 • IPヘッダの省略は不可 L2レベルのスケールを対象としていない • UDPヘッダは省略した場合、 エントロピーヘッダに変更可
• UETはサブレイヤに分かれる - SES - PDS - CMS - TSS (Optional) -
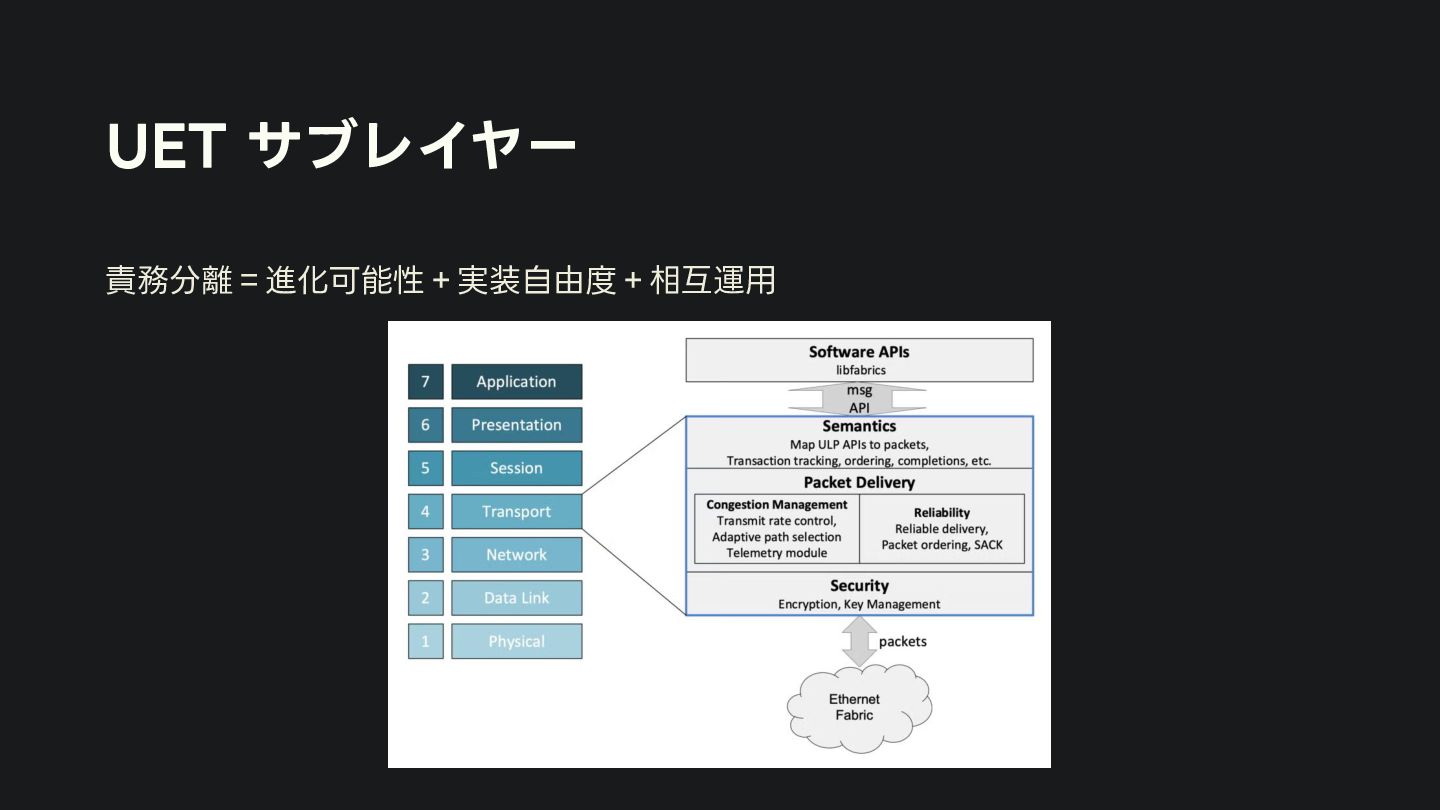
UET SES:セマンティクス(操作体系) • SES(Semantics Sublayer) ◦ 端点間のアドレッシング、認可、メッセージ種別、プロトコル、 セマンティックヘッダを定義 ◦ libfabric
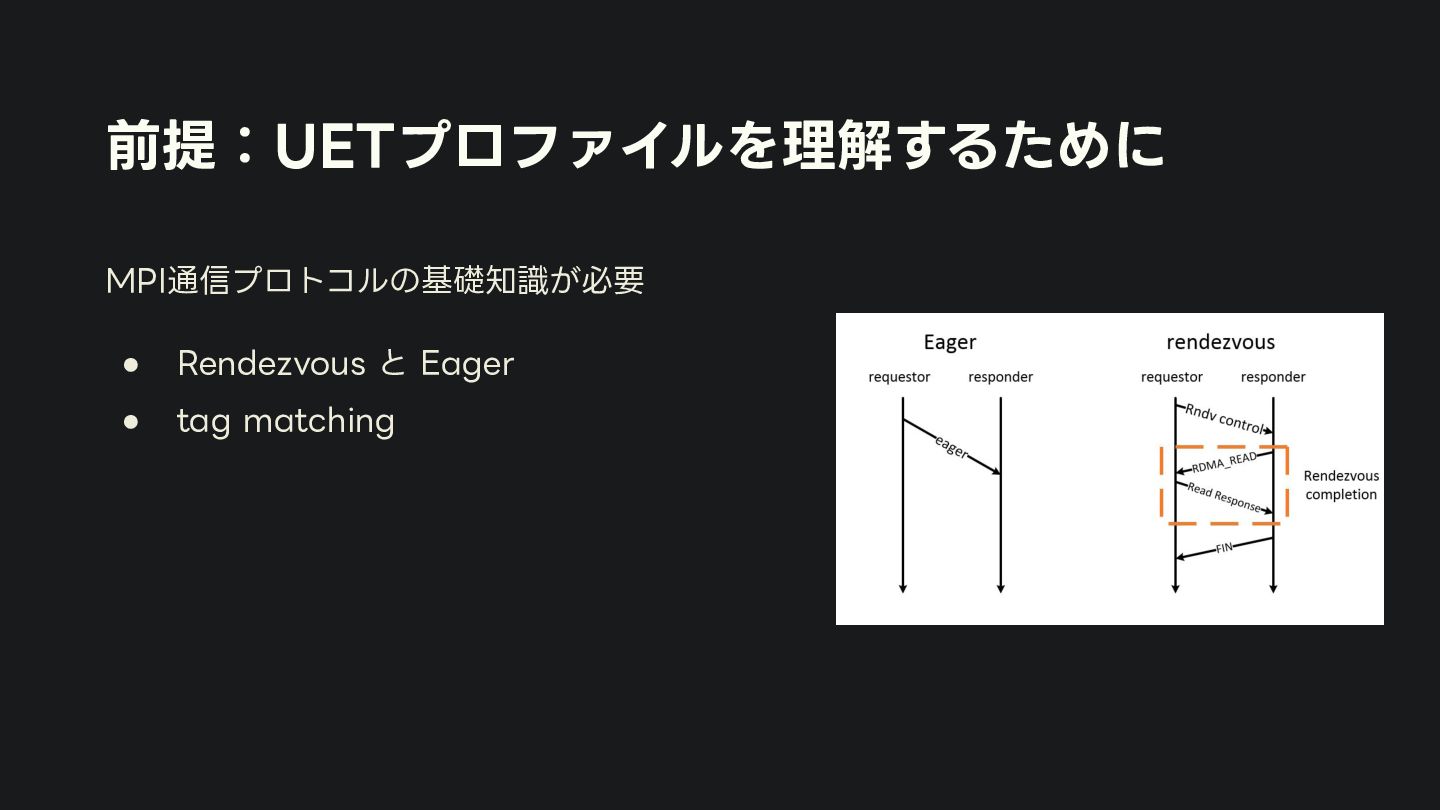
API からの呼び出しを UETの操作(tagged/untagged send/recv、RMA read/write、atomics等)にマップするユーザ側の⼊⼝ ◦ トランザクションを複数パケットに分割して、PDSに渡す役割 ◦ SESはメッセージのパケット化/再構成とパケットごとにレスポンスを⽣成 ◦ ⼤きいメッセージの扱いとして rendezvous と deferrable send を定義 → 詳細は後述 -
UET PDS:配送・信頼性・順序 • PDS(Packet Delivery Sublayer) ◦ パケットを相⼿側FEPに運ぶ層で、信頼性(ACK/NACK)と順序を提供 ◦ ACK/NACKを⽣成・解釈し、到達・未到達パケットを追跡
◦ PDSはそのパケット列を運ぶことに集中し、PDSはSESトランザクション種別を意識し ない -
UET CMS:輻輳制御とマルチパス制御 • CMS(Congestion Management Sublayer) ◦ 輻輳制御を提供 ◦ パケットを最⾼レートで送る⼀⽅で輻輳を最⼩化することに注⼒
◦ NSCC/RCCCやEV per-packet multipathなどもこのレイヤで管理 -
UET TSS:セキュリティとマルチテナント • TSS(Transport Security Sublayer) ◦ UETのエンドツーエンド暗号・認証・(基本的な)サービス保護を提供 ◦ ECN/DSCPはCC/QoSに必要だが、スイッチは信頼しないため、改ざん/誤設定はDoS
要因になりうる ◦ パケットトリミングでは認証タグも消え得るため、トリムパケット由来の情報は、 輻輳制御/リプレイ状態にしか影響させてはいけない(データ配置や整合性に影響させ ない)という脅威モデルを採⽤する -
FEP(Fabric End Point) UEの最重要概念・⽤語 • FEP (Fabric End Point): ◦
UETを終端する論理エンドポイント • FI(Fabric Interface): ◦ 1つ以上の物理ポートをもつFEPとして振る舞うNIC • FA(Fabric Address): ◦ FIをネットワーク上で識別するためのIPv4/IPv6アドレス ◦ 到達性確保のルーティングに使う • Libfabric Fabric Endpoint Address: ◦ FAやJob IDなどを含むlibfabricのアドレスフォーマット -
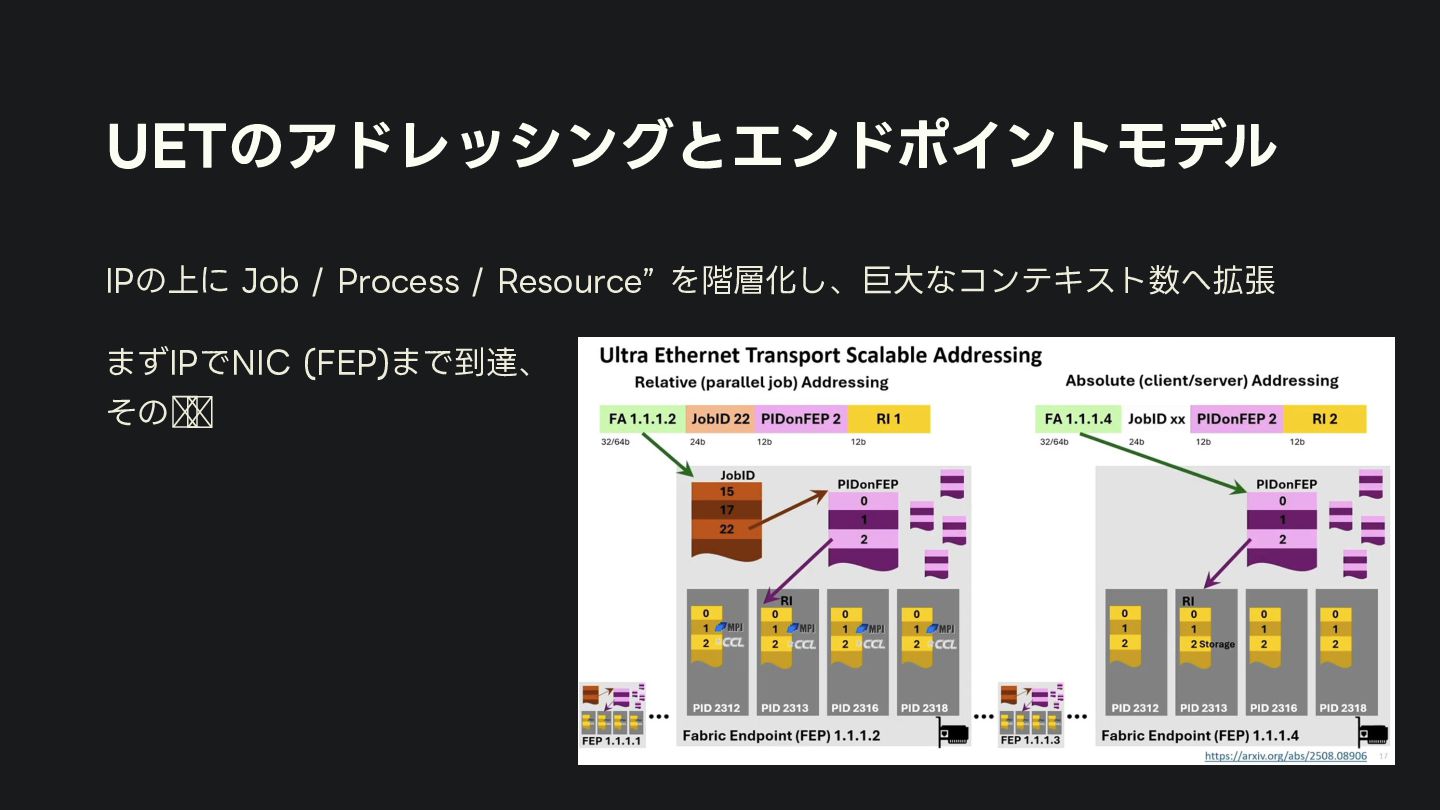
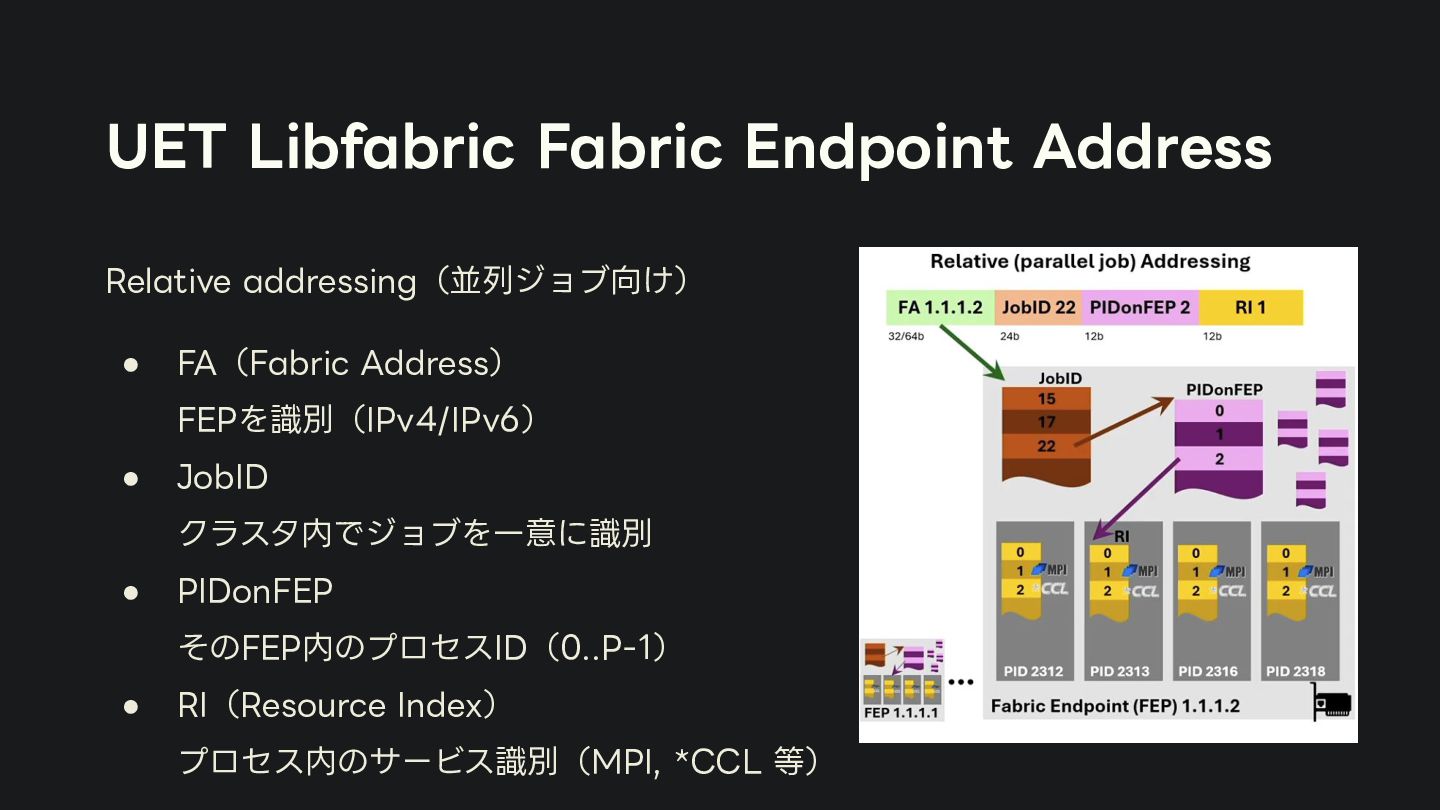
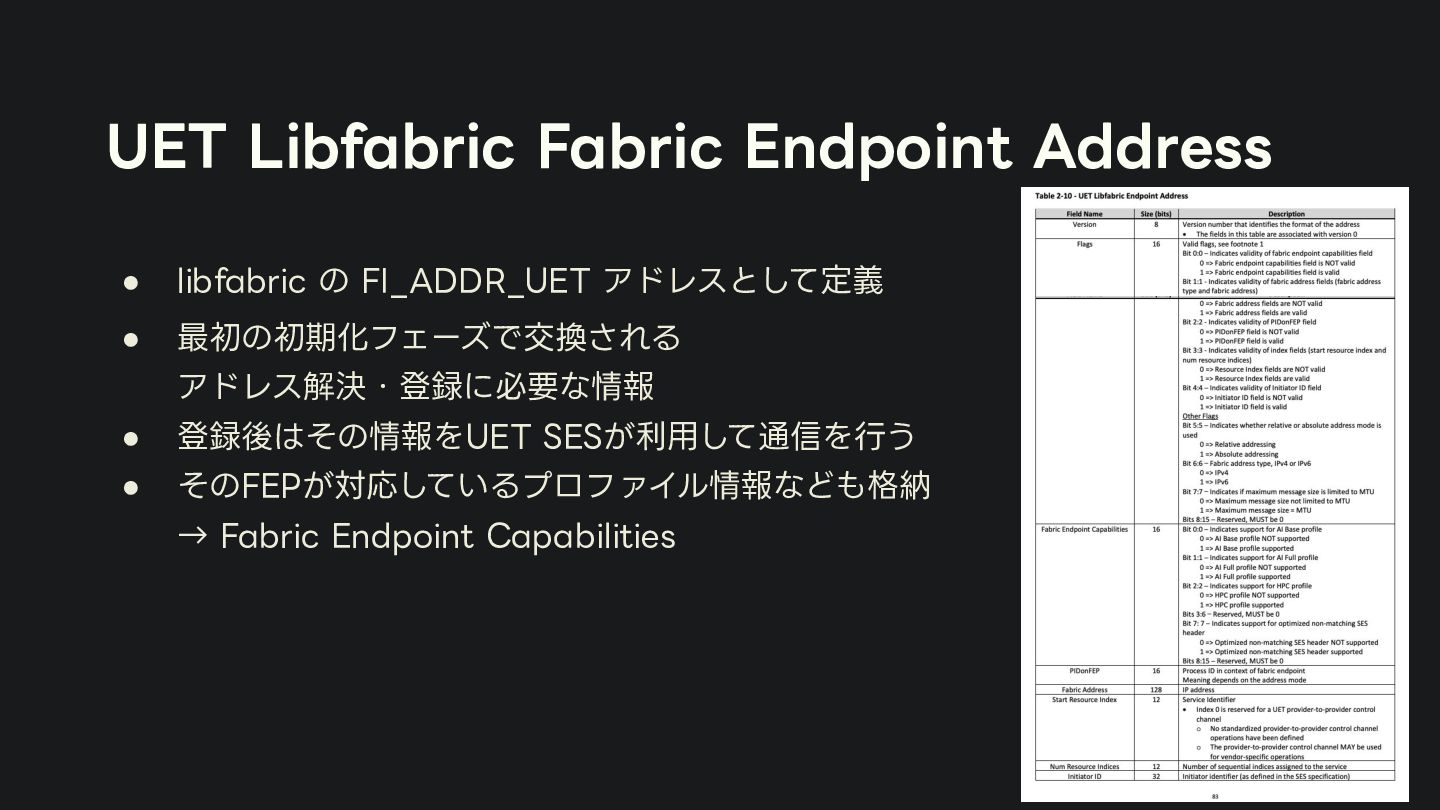
UET Libfabric Fabric Endpoint Address Relative addressing(並列ジョブ向け) • FA(Fabric Address)
FEPを識別(IPv4/IPv6) • JobID クラスタ内でジョブを⼀意に識別 • PIDonFEP そのFEP内のプロセスID(0..P-1) • RI(Resource Index) プロセス内のサービス識別(MPI, *CCL 等) -
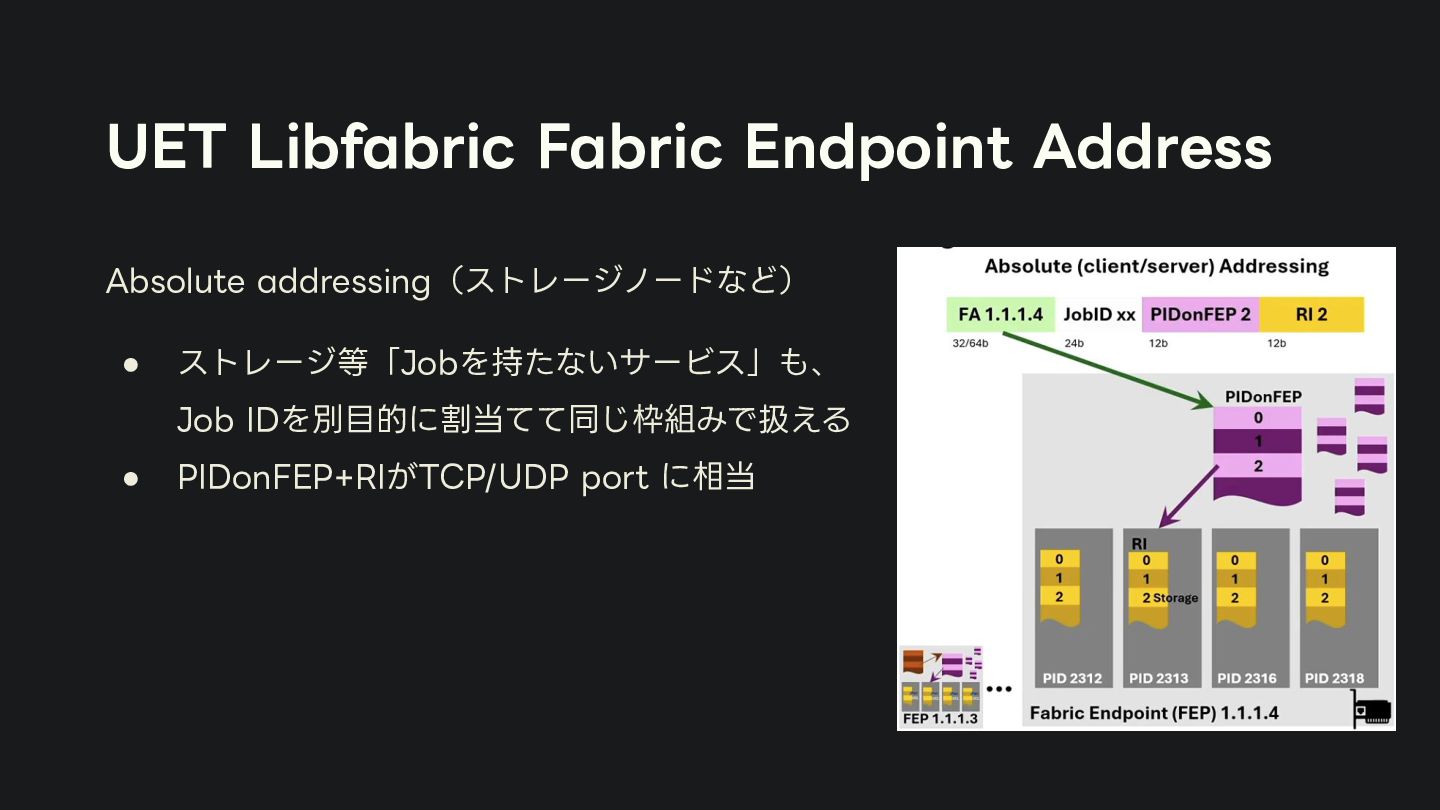
UET Libfabric Fabric Endpoint Address Absolute addressing(ストレージノードなど) • ストレージ等「Jobを持たないサービス」も、 Job
IDを別⽬的に割当てて同じ枠組みで扱える • PIDonFEP+RIがTCP/UDP port に相当 -
UET Libfabric Fabric Endpoint Address • libfabric の FI_ADDR_UET アドレスとして定義
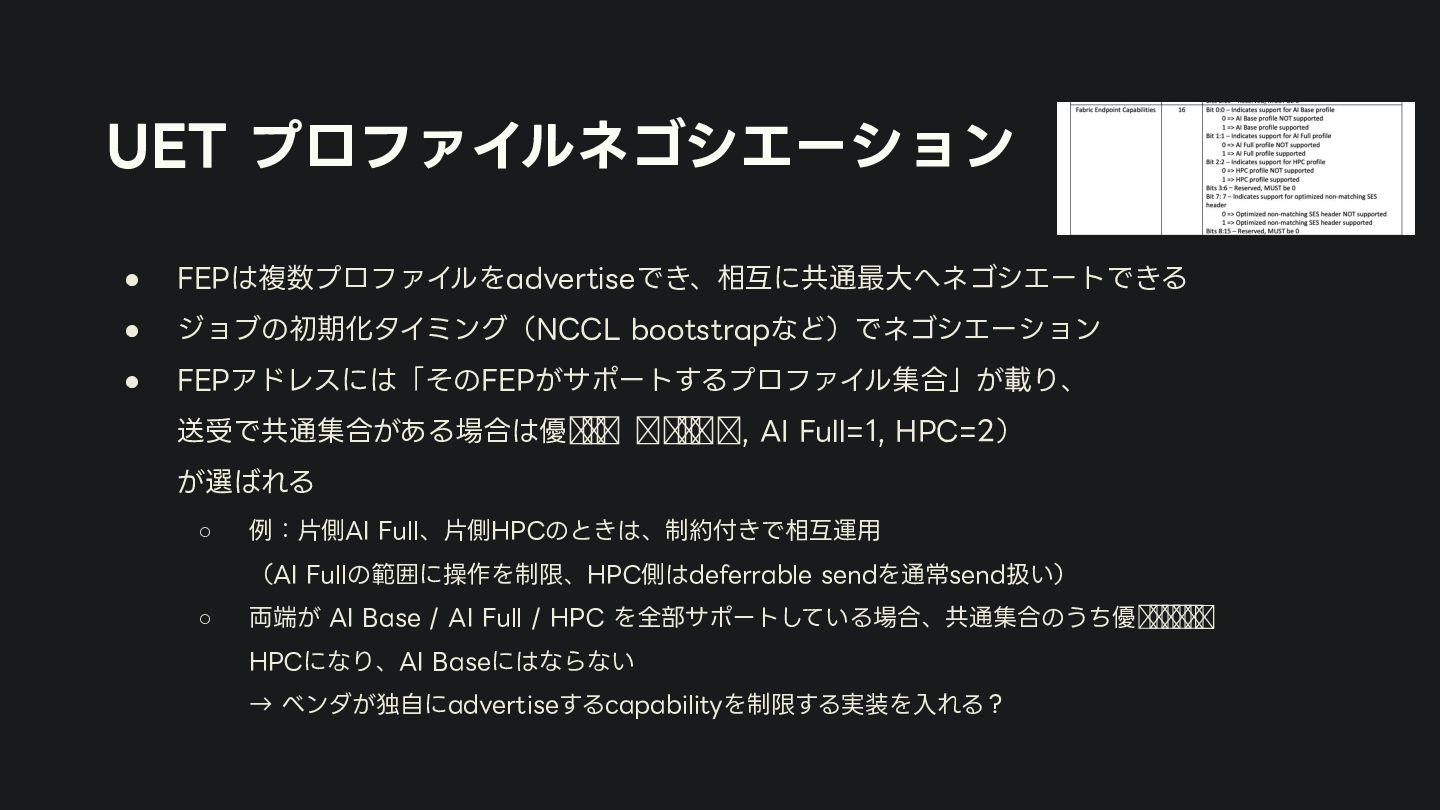
• 最初の初期化フェーズで交換される アドレス解決・登録に必要な情報 • 登録後はその情報をUET SESが利⽤して通信を⾏う • そのFEPが対応しているプロファイル情報なども格納 → Fabric Endpoint Capabilities -
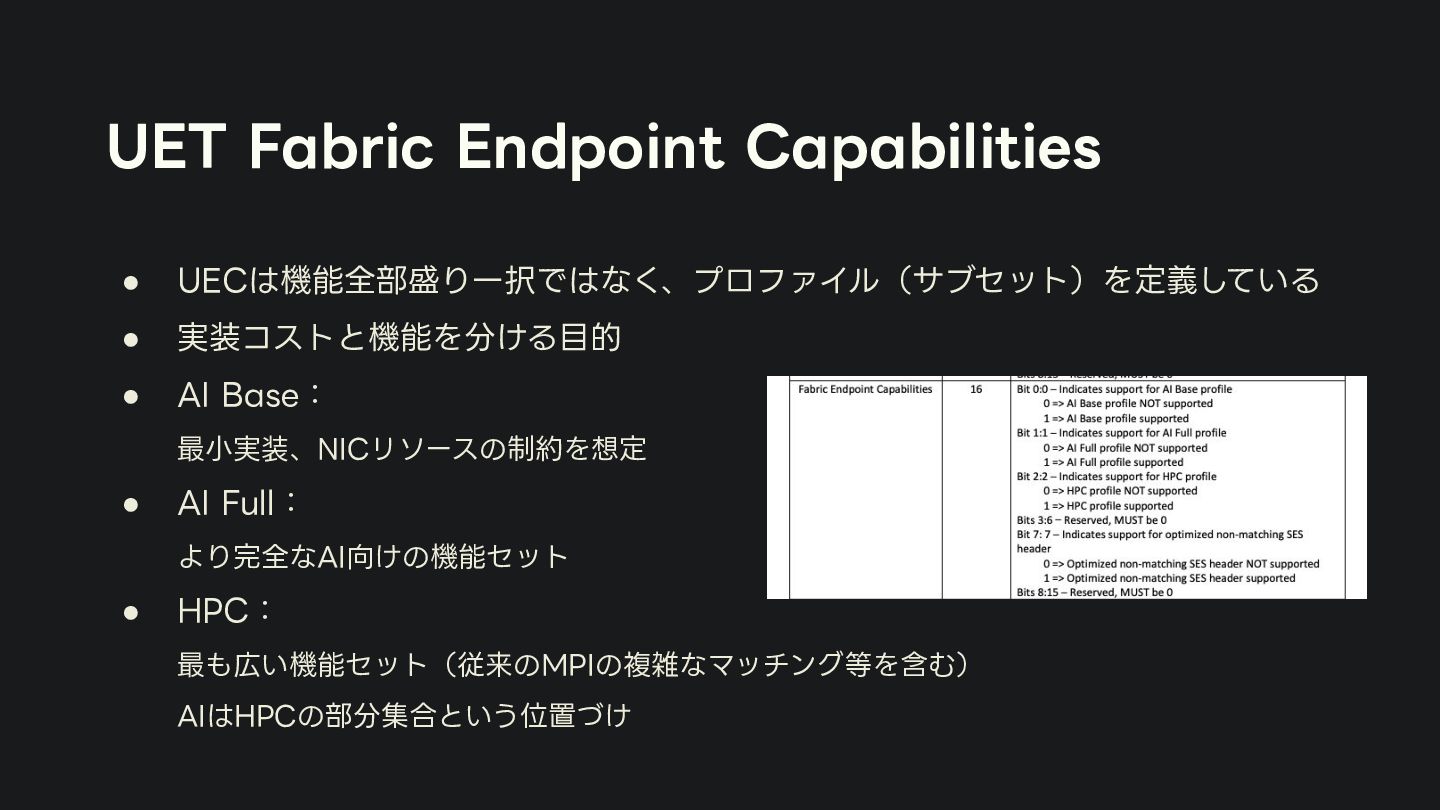
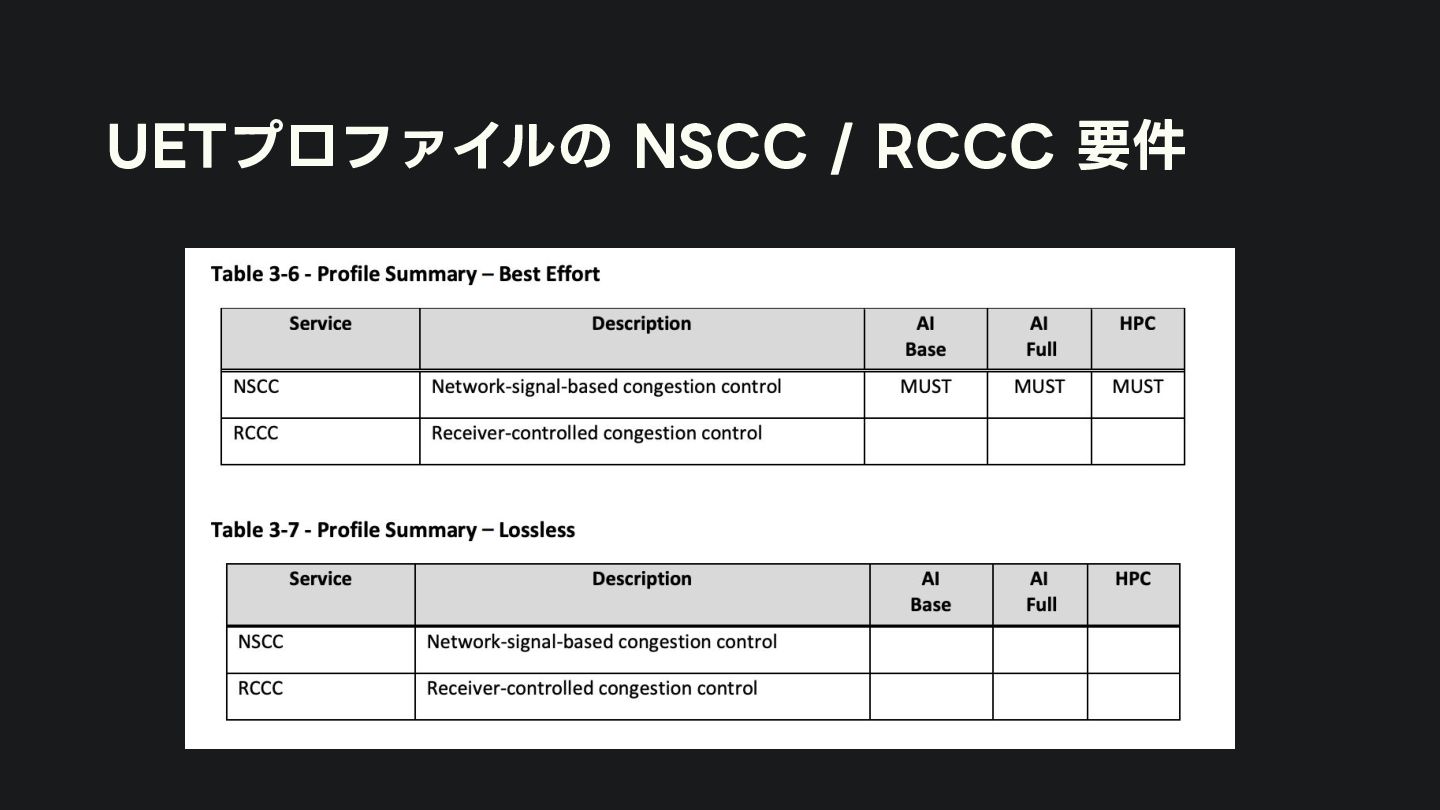
UET Fabric Endpoint Capabilities • UECは機能全部盛り⼀択ではなく、プロファイル(サブセット)を定義している • 実装コストと機能を分ける⽬的 • AI
Base: 最⼩実装、NICリソースの制約を想定 • AI Full: より完全なAI向けの機能セット • HPC: 最も広い機能セット(従来のMPIの複雑なマッチング等を含む) AIはHPCの部分集合という位置づけ -
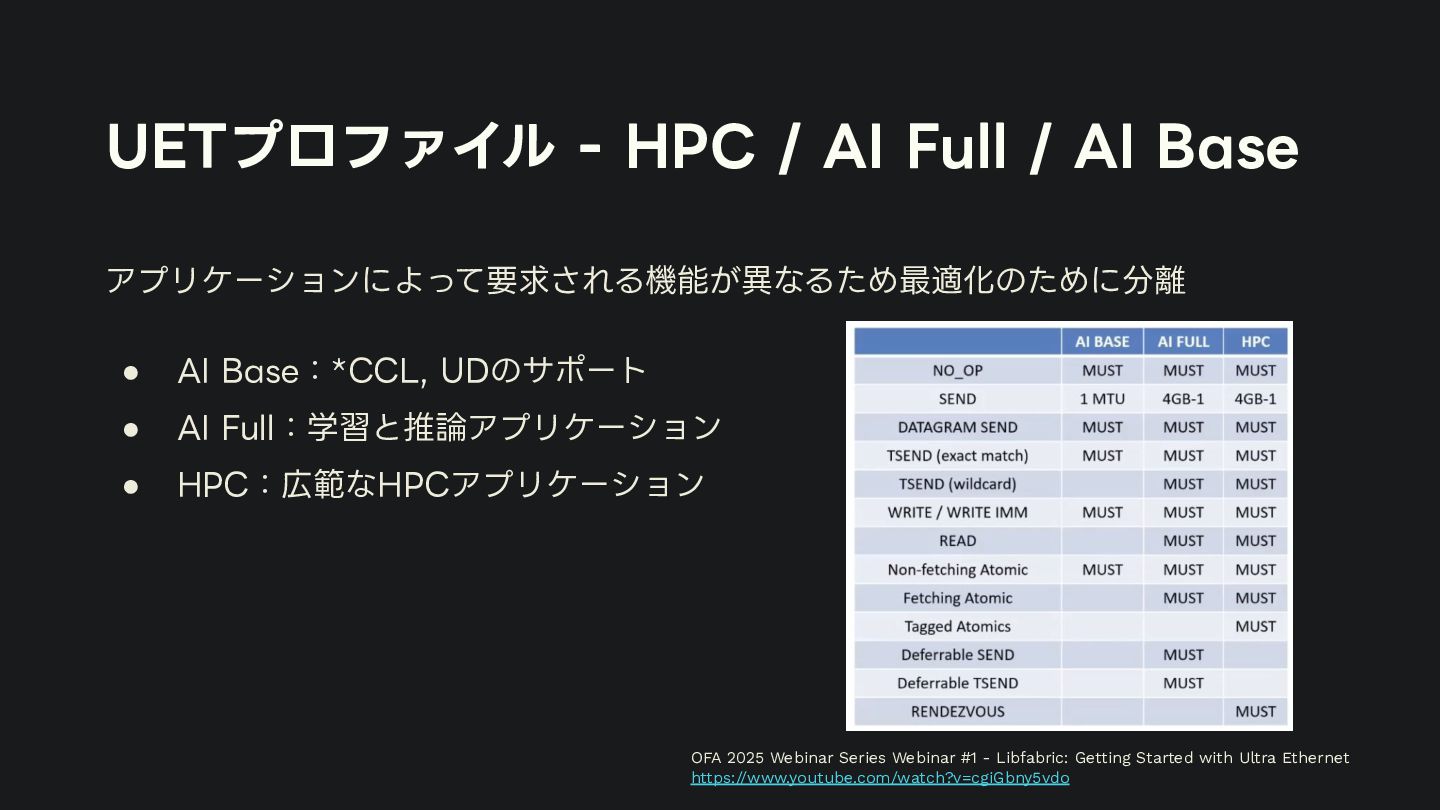
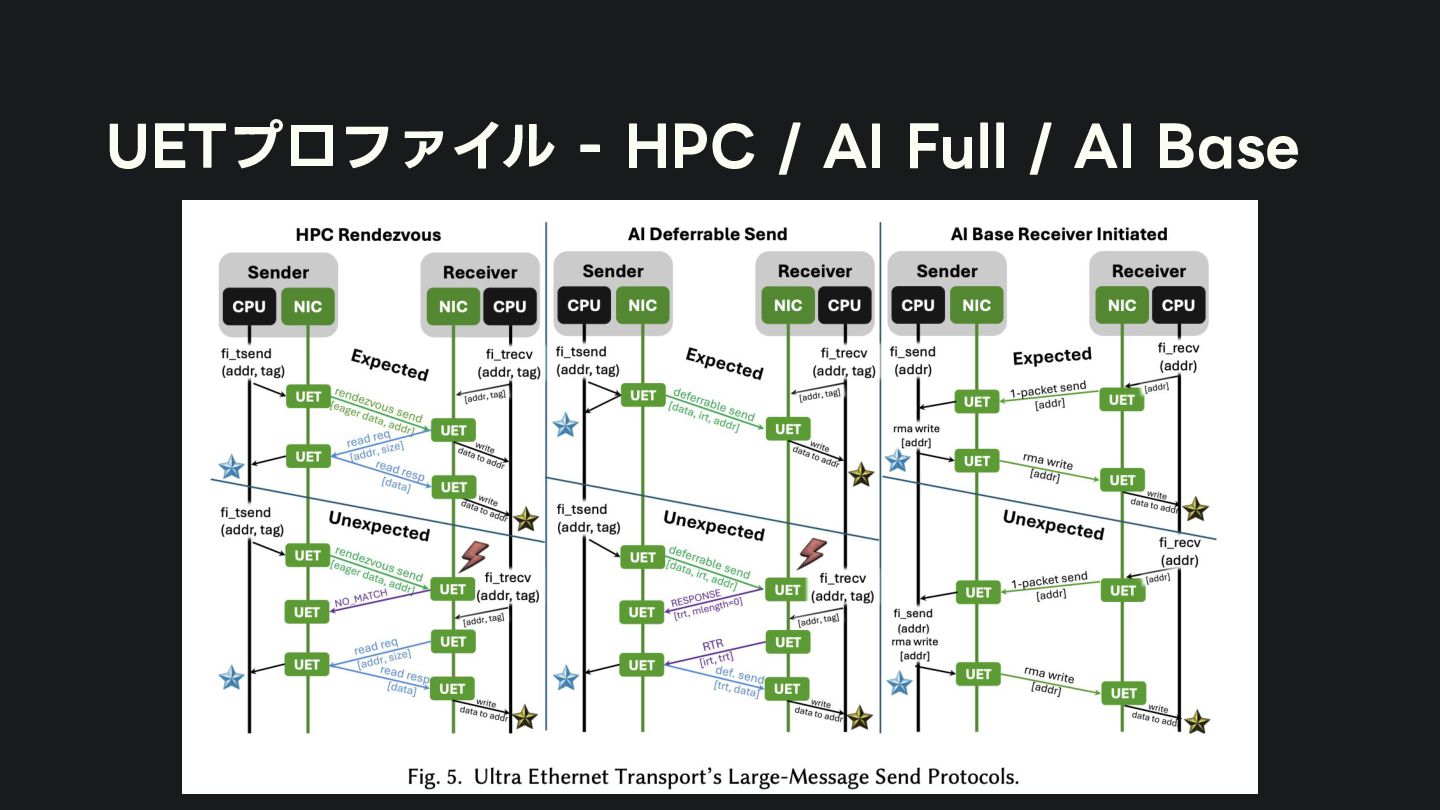
UETプロファイル - HPC / AI Full / AI Base アプリケーションによって要求される機能が異なるため最適化のために分離
• AI Base:*CCL, UDのサポート • AI Full:学習と推論アプリケーション • HPC:広範なHPCアプリケーション OFA 2025 Webinar Series Webinar #1 - Libfabric: Getting Started with Ultra Ethernet https://www.youtube.com/watch?v=cgiGbny5vdo -
UETプロファイル - 受信バッファの状態 • expected:受信バッファが準備できている状態 ◦ 受信側が先に recv(例:fi_trecv)を発行していて、(src, tag, context
など) がマッチする受 信エントリと、書き込み先バッファ (addr) が準備済み ◦ 送信側からメッセージが届いた瞬間に NICは「どのバッファにDMAで書けば良いか」分かる → すぐ配置して完了できる -
UETプロファイル - 受信バッファの状態 • unexpected:受信バッファが準備できていない状態 ◦ 送信側メッセージが先に来たが、受信側ではまだ recv を出しておらず、 マッチする受信エントリや、書き込み先バッファが未準備
◦ その結果、受信側はどこに置いていいか分からない ◦ (特に大きいメッセージだと)一時バッファにも入らないという問題が起きる ▪ HPCプロファイル では「eagerで少しだけ入れて、残りは後でreadで回収」 ▪ AI Fullプロファイル では「止める(defer)→recvが出たら再開(resume)」 ▪ AI Base プロファイル では「1パケット通知→ソフトがRMA writeを起動」 などのような破綻しないための仕組みが必要 -
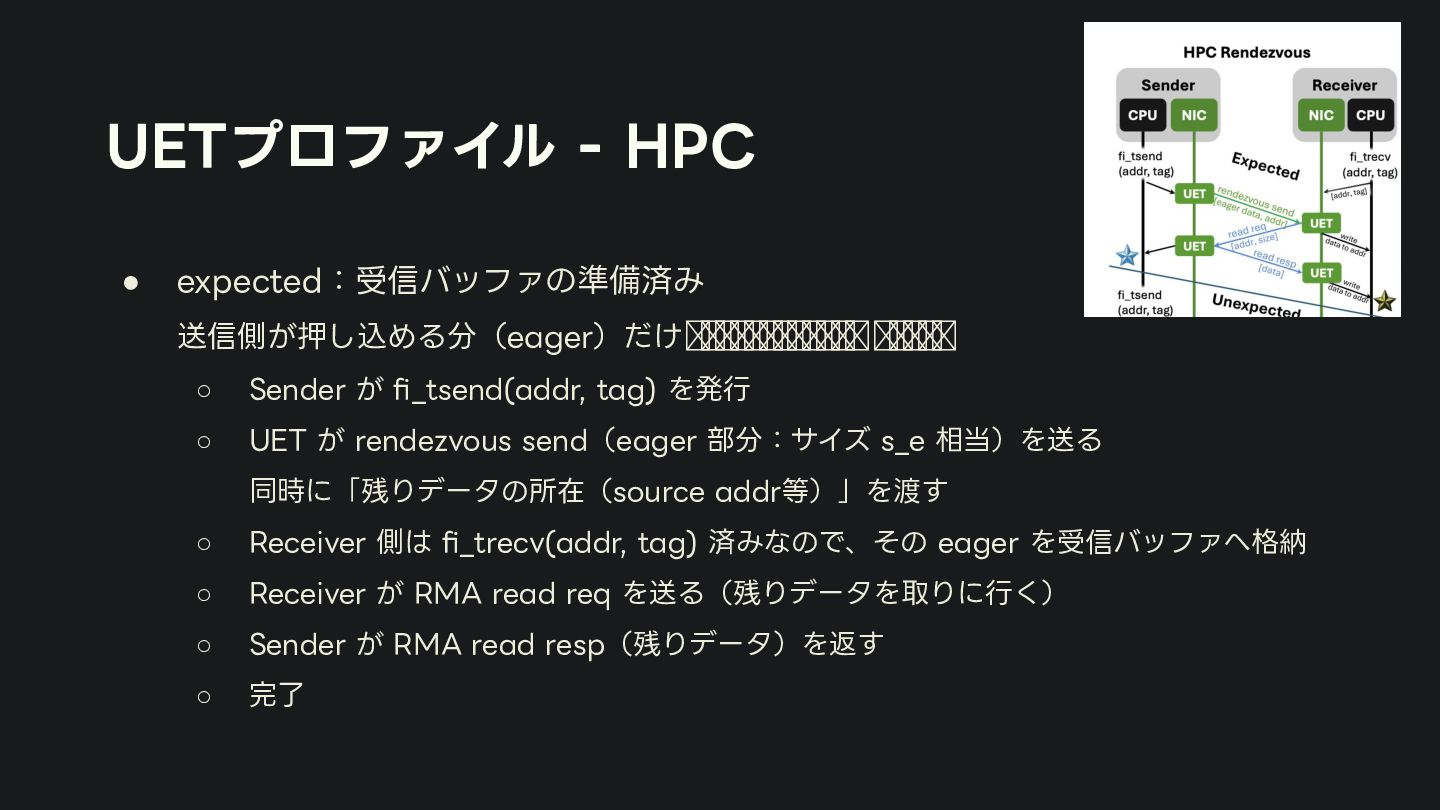
UETプロファイル - HPC • expected:受信バッファの準備済み 送信側が押し込める分(eager)だけ先に送り、残りは受信側が取りに行く(pull) ◦ Sender が fi_tsend(addr,
tag) を発行 ◦ UET が rendezvous send(eager 部分:サイズ s_e 相当)を送る 同時に「残りデータの所在( source addr等)」を渡す ◦ Receiver 側は fi_trecv(addr, tag) 済みなので、その eager を受信バッファへ格納 ◦ Receiver が RMA read req を送る(残りデータを取りに行く) ◦ Sender が RMA read resp(残りデータ)を返す ◦ 完了 -
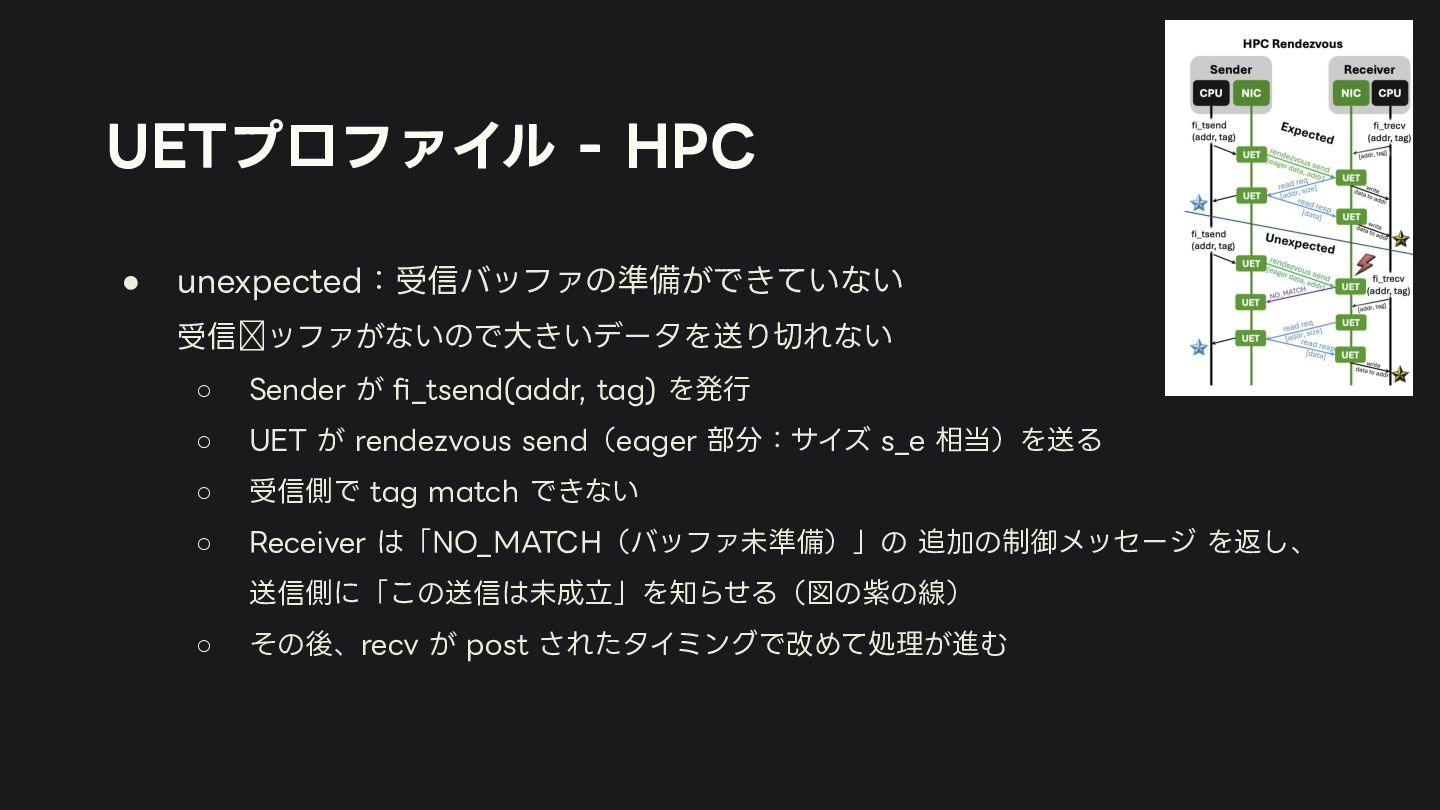
UETプロファイル - HPC • unexpected:受信バッファの準備ができていない 受信先バッファがないので大きいデータを送り切れない ◦ Sender が fi_tsend(addr,
tag) を発行 ◦ UET が rendezvous send(eager 部分:サイズ s_e 相当)を送る ◦ 受信側で tag match できない ◦ Receiver は「NO_MATCH(バッファ未準備)」の 追加の制御メッセージ を返し、送信側に 「この送信は未成立」を知らせる(図の紫の線) ◦ その後、recv が post されたタイミングで改めて処理が進む -
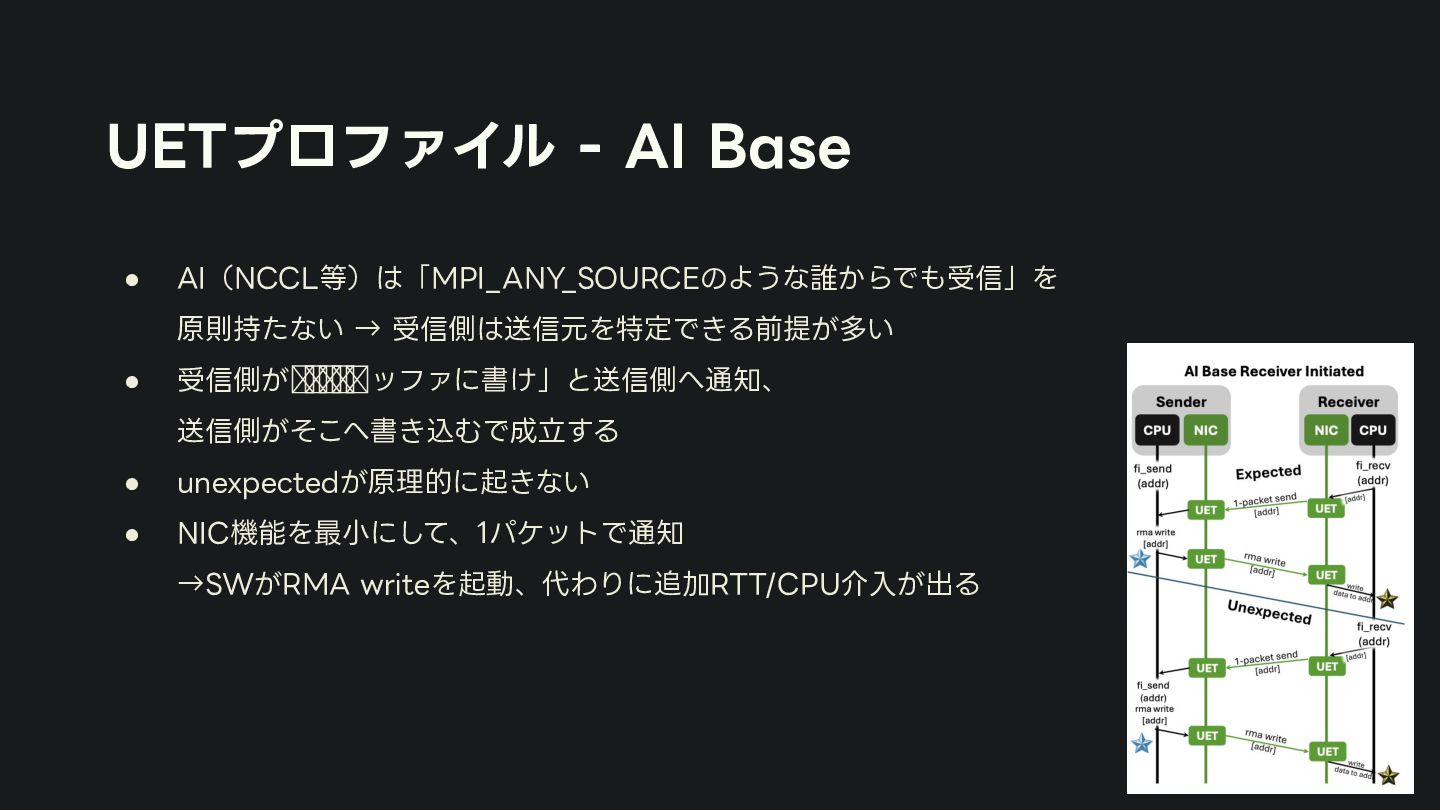
UETプロファイル - AI Base • AI(NCCL等)は「MPI_ANY_SOURCEのような誰からでも受信」を 原則持たない → 受信側は送信元を特定できる前提が多い •
受信側が先に「このバッファに書け」と送信側へ通知、 送信側がそこへ書き込むで成立する • unexpectedが原理的に起きない • NIC機能を最小にして、1パケットで通知 →SWがRMA writeを起動、代わりに追加 RTT/CPU介入が出る -
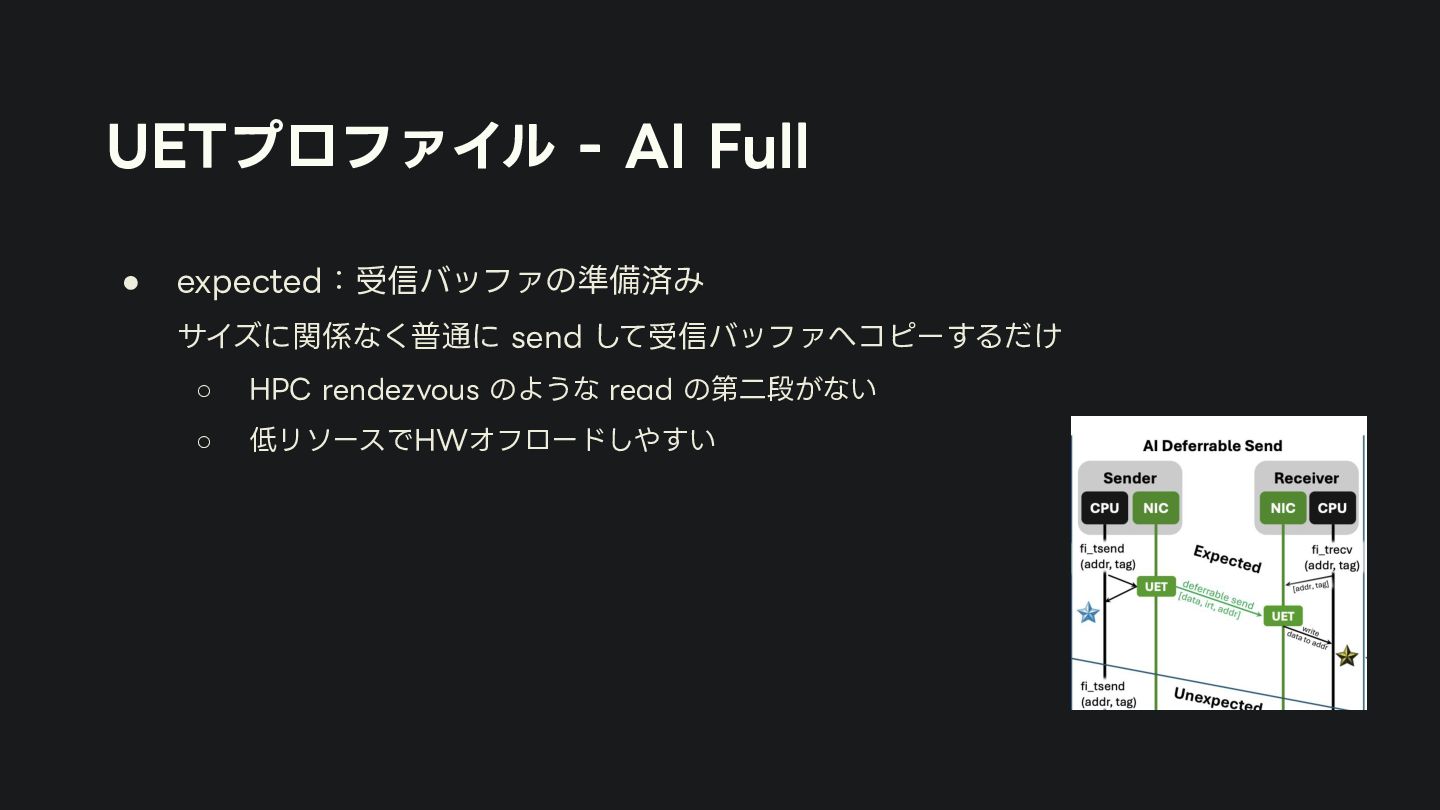
UETプロファイル - AI Full • expected:受信バッファの準備済み サイズに関係なく普通に send して受信バッファへコピーするだけ ◦
HPC rendezvous のような read の第⼆段がない ◦ 低リソースでHWオフロードしやすい -
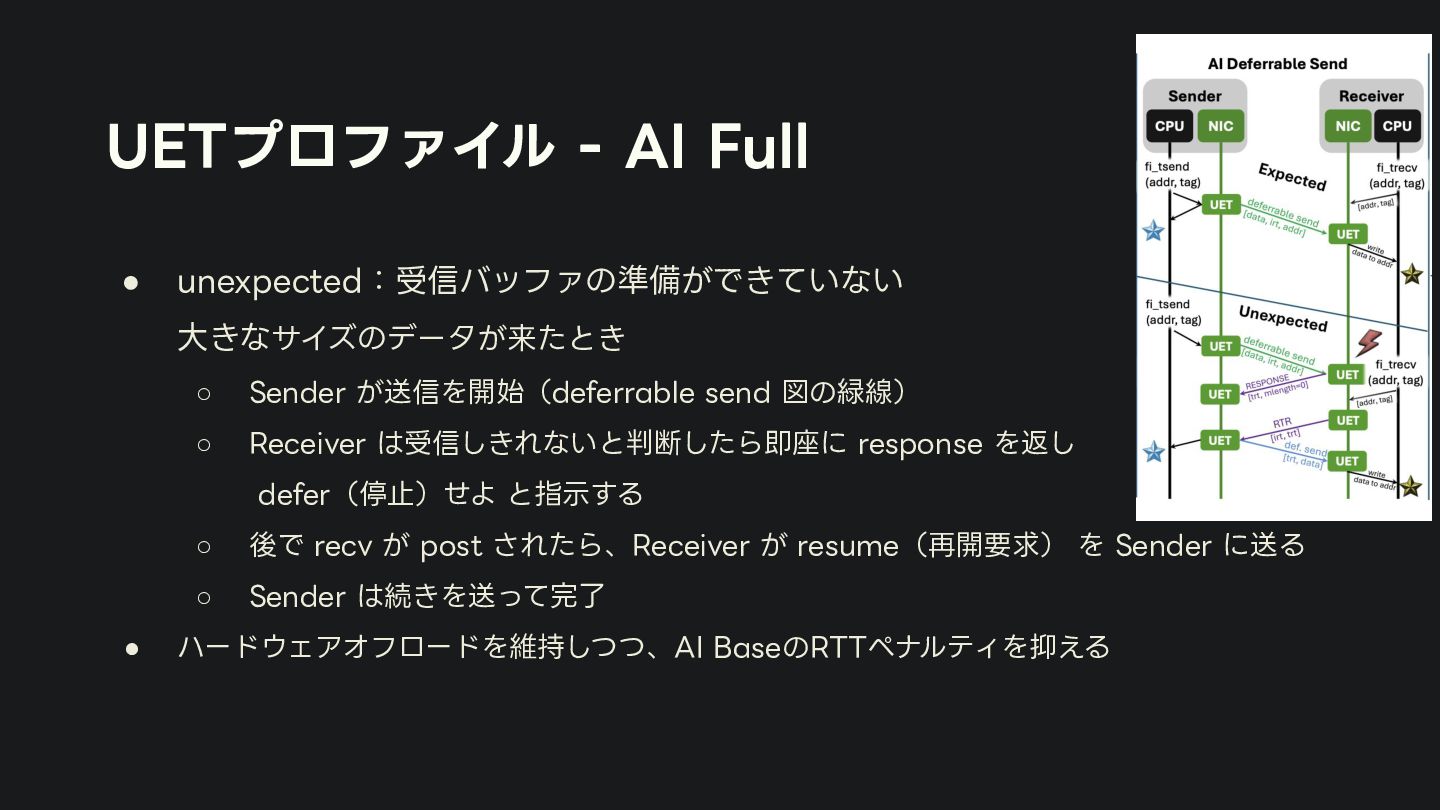
UETプロファイル - AI Full • unexpected:受信バッファの準備ができていない ⼤きなサイズのデータが来たとき ◦ Sender が送信を開始(deferrable
send 図の緑線) ◦ Receiver は受信しきれないと判断したら即座に response を返し defer(停⽌)せよ と指⽰する ◦ 後で recv が post されたら、Receiver が resume(再開要求) を Sender に送る ◦ Sender は続きを送って完了 • ハードウェアオフロードを維持しつつ、AI BaseのRTTペナルティを抑える -
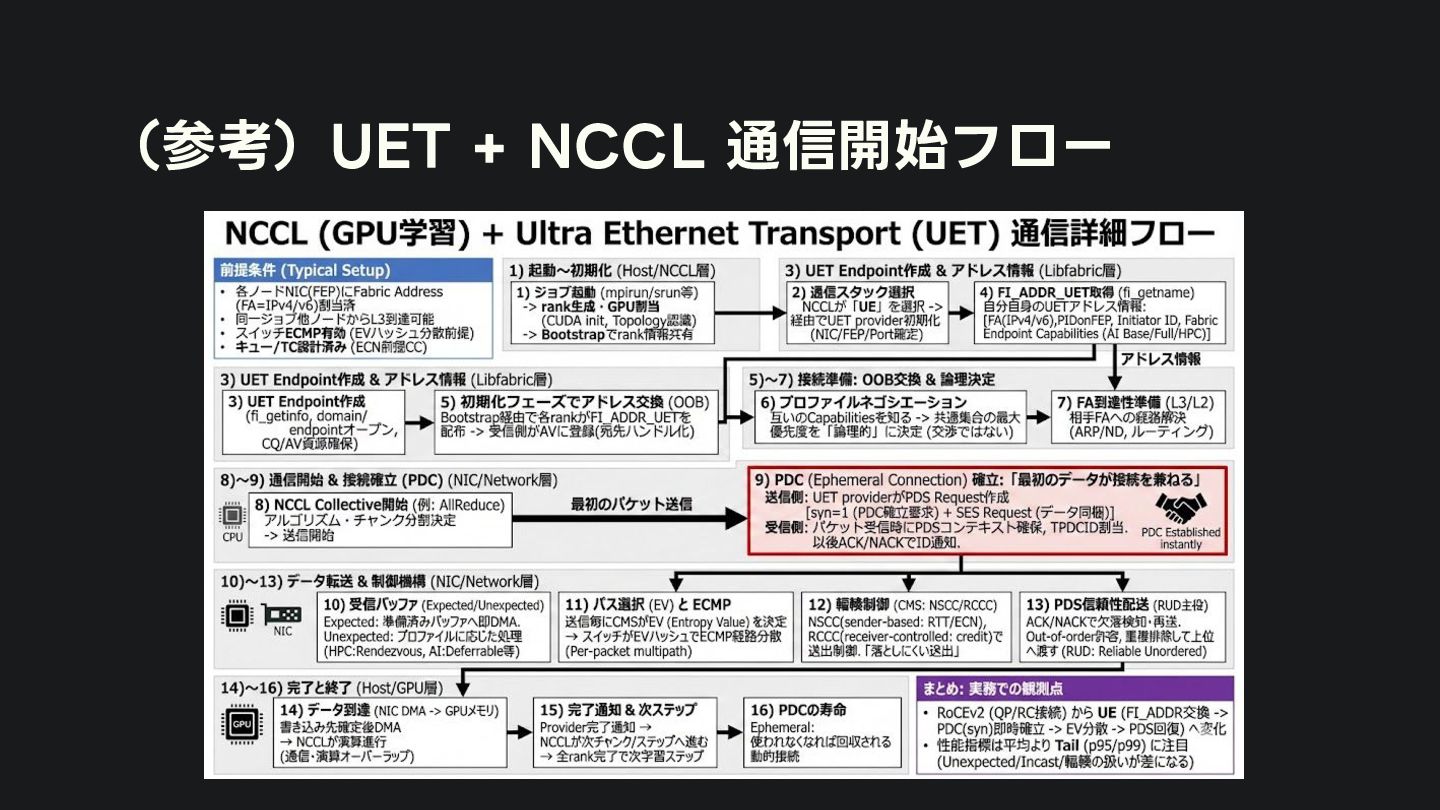
UET プロファイルネゴシエーション • FEPは複数プロファイルを advertiseでき、相互に共通最大へネゴシエートできる • ジョブの初期化タイミング( NCCL bootstrapなど)でネゴシエーション •
FEPアドレスには「そのFEPがサポートするプロファイル集合」が載り、 送受で共通集合がある場合は優先度最大( AI Base=0, AI Full=1, HPC=2) が選ばれる ◦ 例:片側AI Full、片側HPCのときは、制約付きで相互運用 (AI Fullの範囲に操作を制限、HPC側はdeferrable sendを通常send扱い) ◦ 両端が AI Base / AI Full / HPC を全部サポートしている場合、共通集合のうち優先度が一番高いHPCにな り、AI Baseにはならない → ベンダが独自にadvertiseするcapabilityを制限する実装を入れる? -
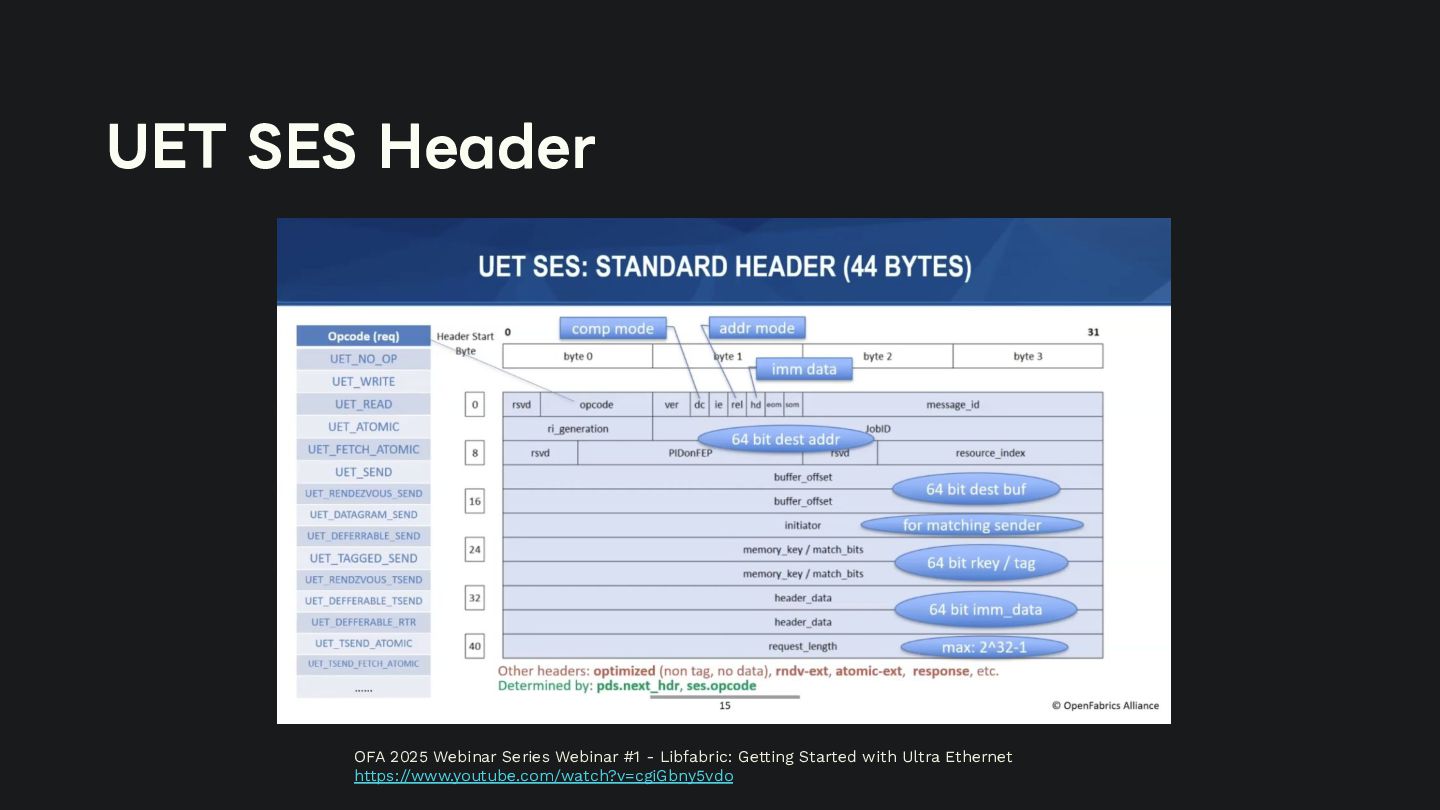
UET SES Header OFA 2025 Webinar Series Webinar #1 -
Libfabric: Getting Started with Ultra Ethernet https://www.youtube.com/watch?v=cgiGbny5vdo -
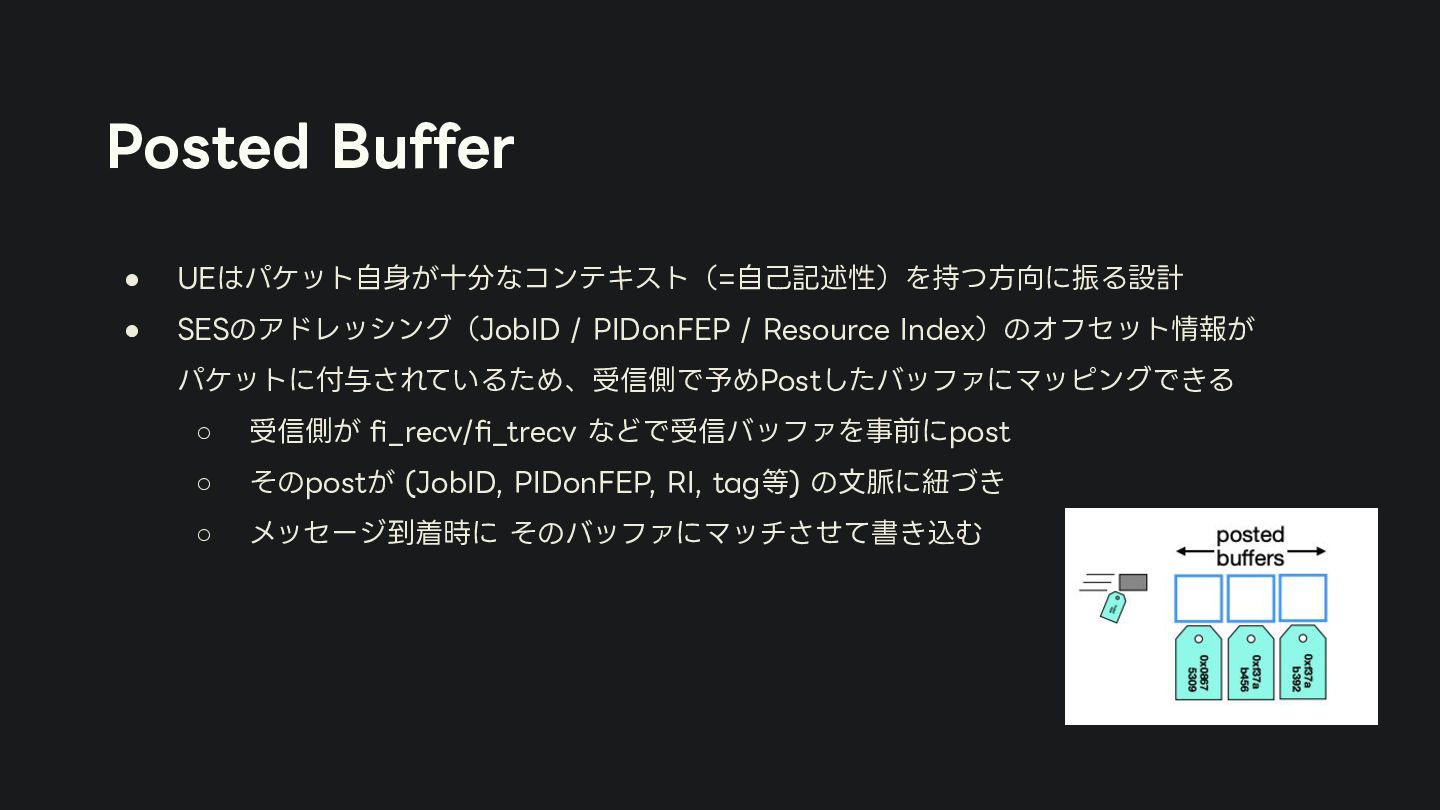
Posted Buffer • UEはパケット⾃⾝が⼗分なコンテキスト(=⾃⼰記述性)を持つ⽅向に振る設計 • SESのアドレッシング(JobID / PIDonFEP / Resource
Index)のオフセット情報が パケットに付与されているため、受信側で予めPostしたバッファにマッピングできる ◦ 受信側が fi_recv/fi_trecv などで受信バッファを事前にpost ◦ そのpostが (JobID, PIDonFEP, RI, tag等) の⽂脈に紐づき ◦ メッセージ到着時に そのバッファにマッチさせて書き込む -
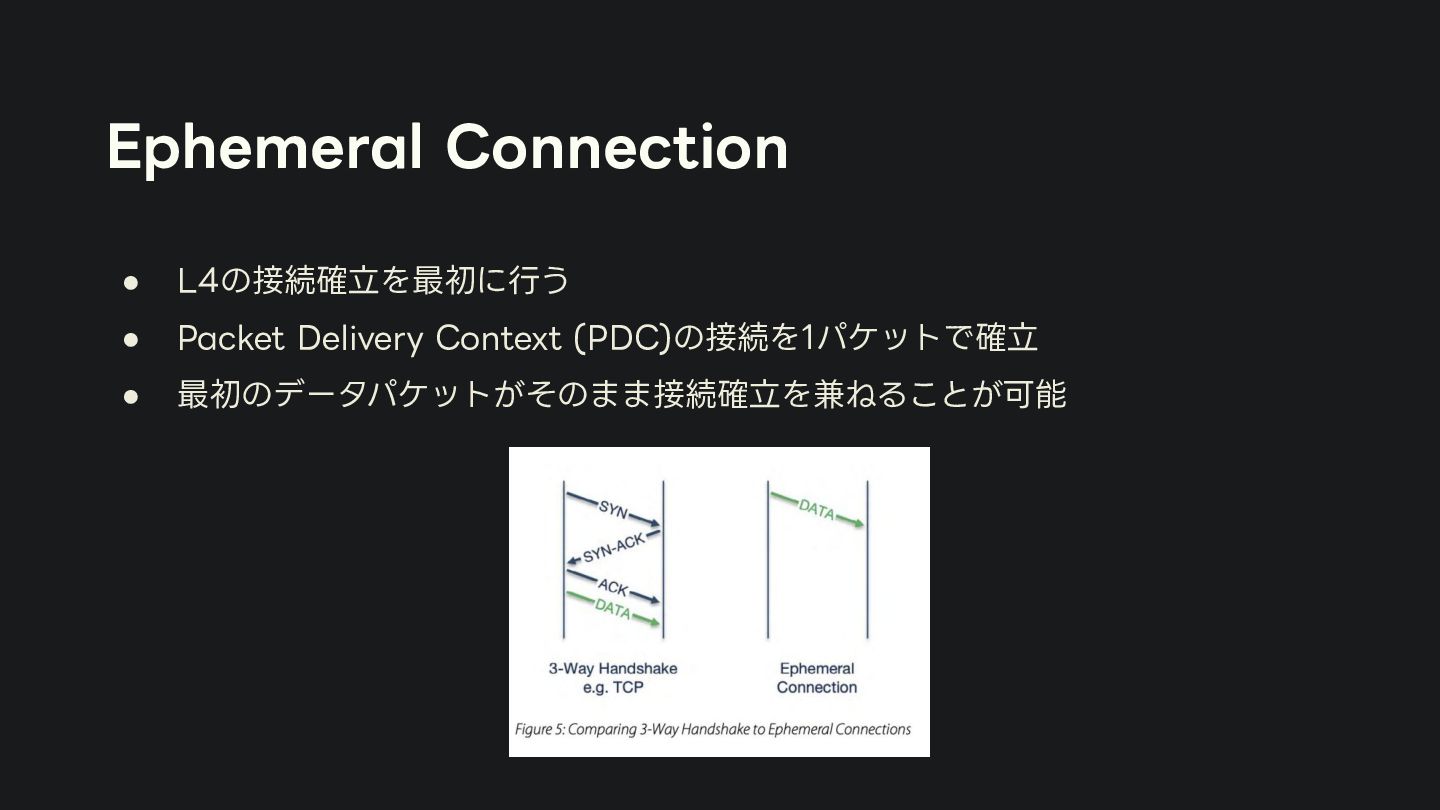
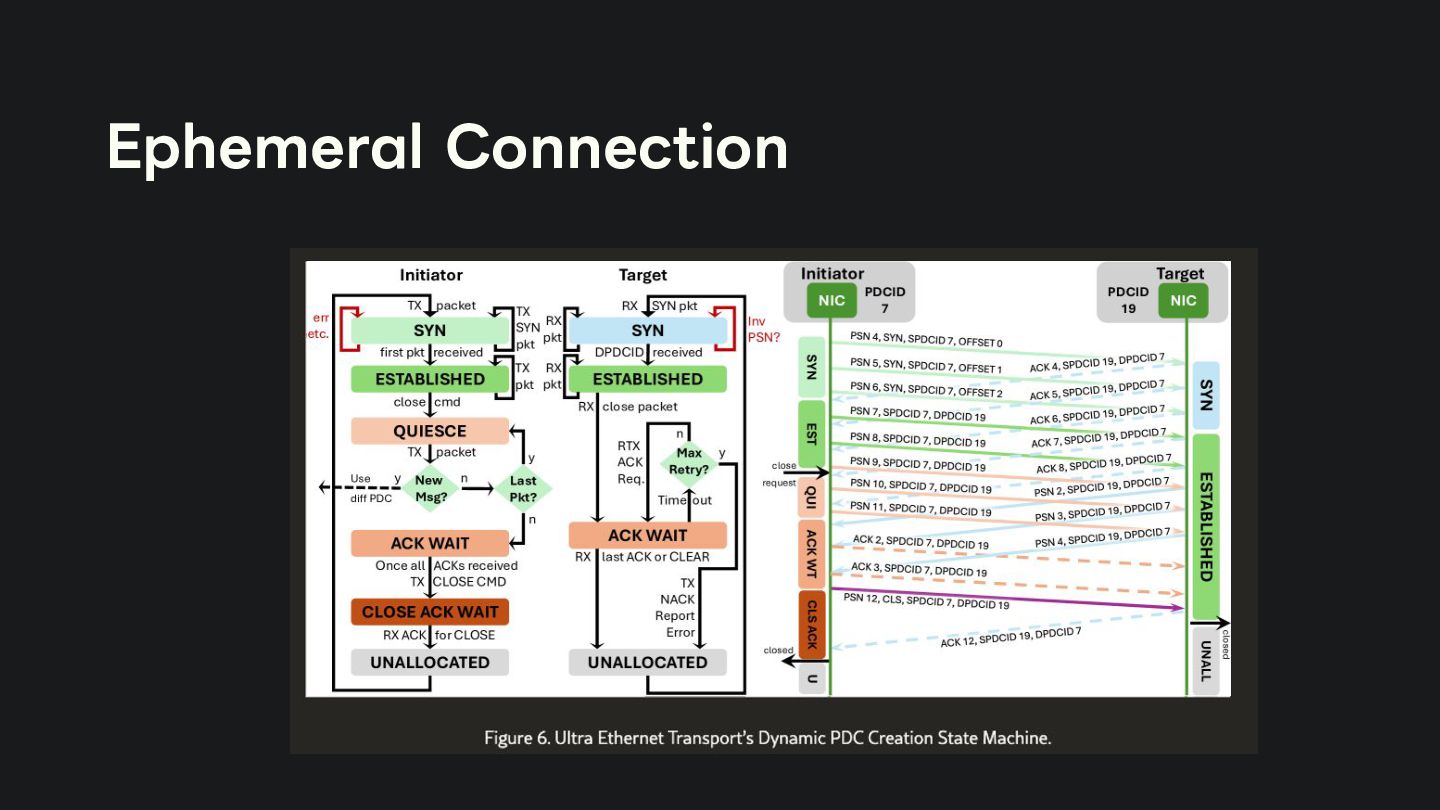
Ephemeral Connection • L4の接続確⽴を最初に⾏う • Packet Delivery Context (PDC)の接続を1パケットで確⽴ •
最初のデータパケットがそのまま接続確⽴を兼ねることが可能 -
Delivery Mode UET PDSでは信頼性(reliable / unreliable)と順序性(ordered / unordered)の組み合わせ として 4つの
delivery mode を定義 • ROD = Reliable Ordered Delivery(信頼+順序保証) • RUD = Reliable Unordered Delivery(信頼+順序なし) • RUDI = Reliable Unordered Delivery for Idempotent Operations (信頼+順序なし+“重複OK”) • UUD = Unreliable Unordered Delivery(⾮信頼+順序なし) -
Delivery Mode - ROD • パケット単位で厳密に順序を保つモード • 送信順どおりに受信側SESへ渡すことを保証する • そのため単⼀パス(単⼀EV)で運ぶ必要があり、順序が崩れるとdrop
+ NACK • 損失回復は Go-Back-N(OOOは捨てて落ちたシーケンスからまとめて再送) • MPIのmatch orderingやOpenSHMEMの特定セマンティクスなど、順序が意味を持つもの を想定 • ヘッダ(制御)だけROD、bulk payloadは別モード(RUDなど)などの混在も想定してい る -
Delivery Mode - RUD • 信頼性はあるが、パケット順序は保証しない(ネットワーク内でreorder可) • out-of-order到着を許容するので、per-packet multipath(spray)と相性が良い •
PSN等を使ってロス/重複を扱う • AI(*CCL系)でwildcard matching不要な通信、bulk payload転送を想定 -
Delivery Mode - RUDI • 特殊⽤途 • 同じパケットが複数回適⽤されても結果が変わらない操作に限って使えるモード • 少なくとも1回は届くが、重複排除しない(届いたものは全部SESへ渡す)
• 多数宛へのRMA write/readを⼤量に投げるケースを想定 -
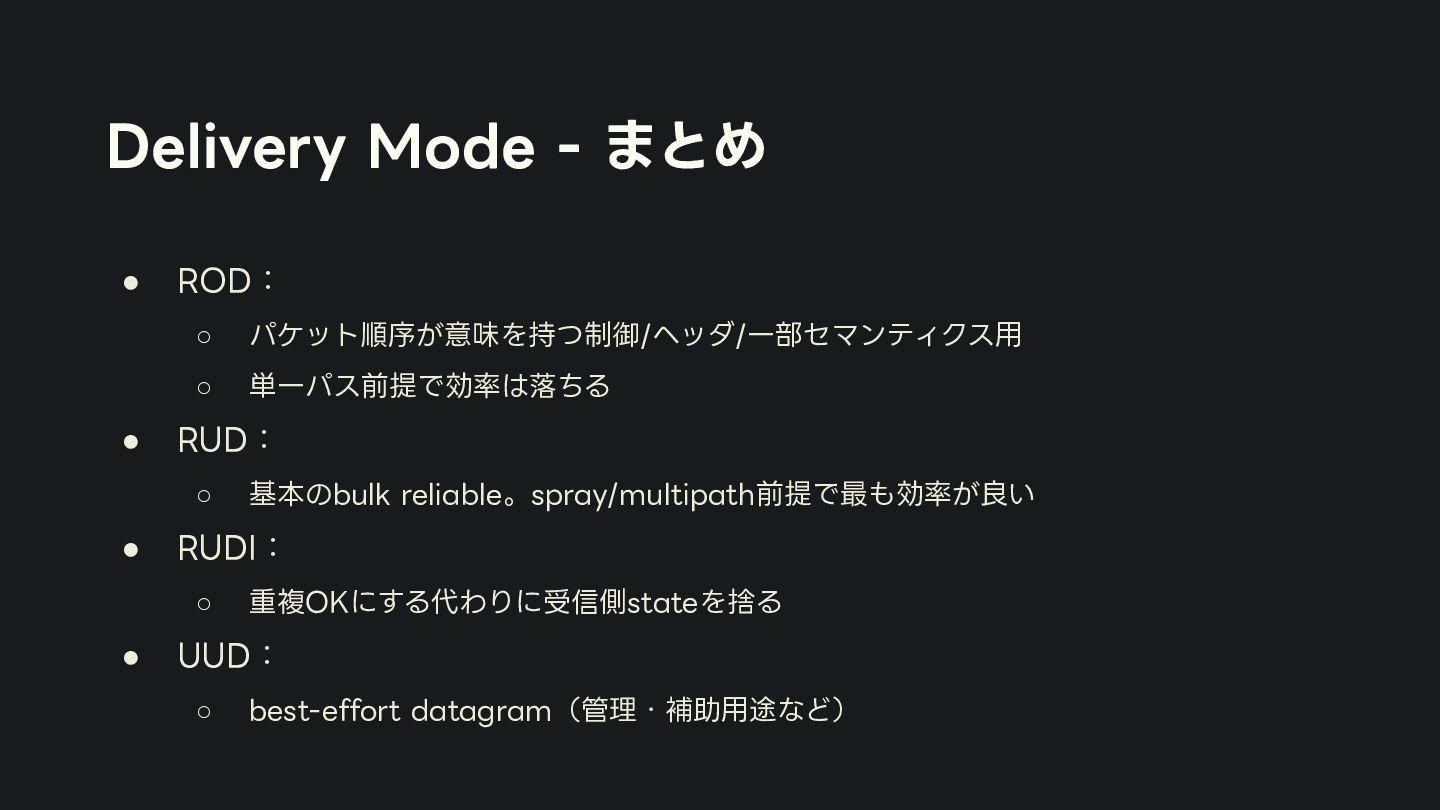
Delivery Mode - まとめ • ROD: ◦ パケット順序が意味を持つ制御/ヘッダ/⼀部セマンティクス⽤ ◦ 単⼀パス前提で効率は落ちる
• RUD: ◦ 基本のbulk reliable。spray/multipath前提で最も効率が良い • RUDI: ◦ 重複OKにする代わりに受信側stateを捨る • UUD: ◦ best-effort datagram(管理・補助⽤途など) -
Delivery Modeと輻輳制御 • RUDI と UUD は UET congestion control
の対象外 • 同じTCに混ぜるとRUD/ROD側の性能を壊し得るので避けるべき • 実運⽤では (RUD/RODはUET-CCありのTC)、(RUDI/UUDは別TC or そもそも限定⽤途) に分離するべき -
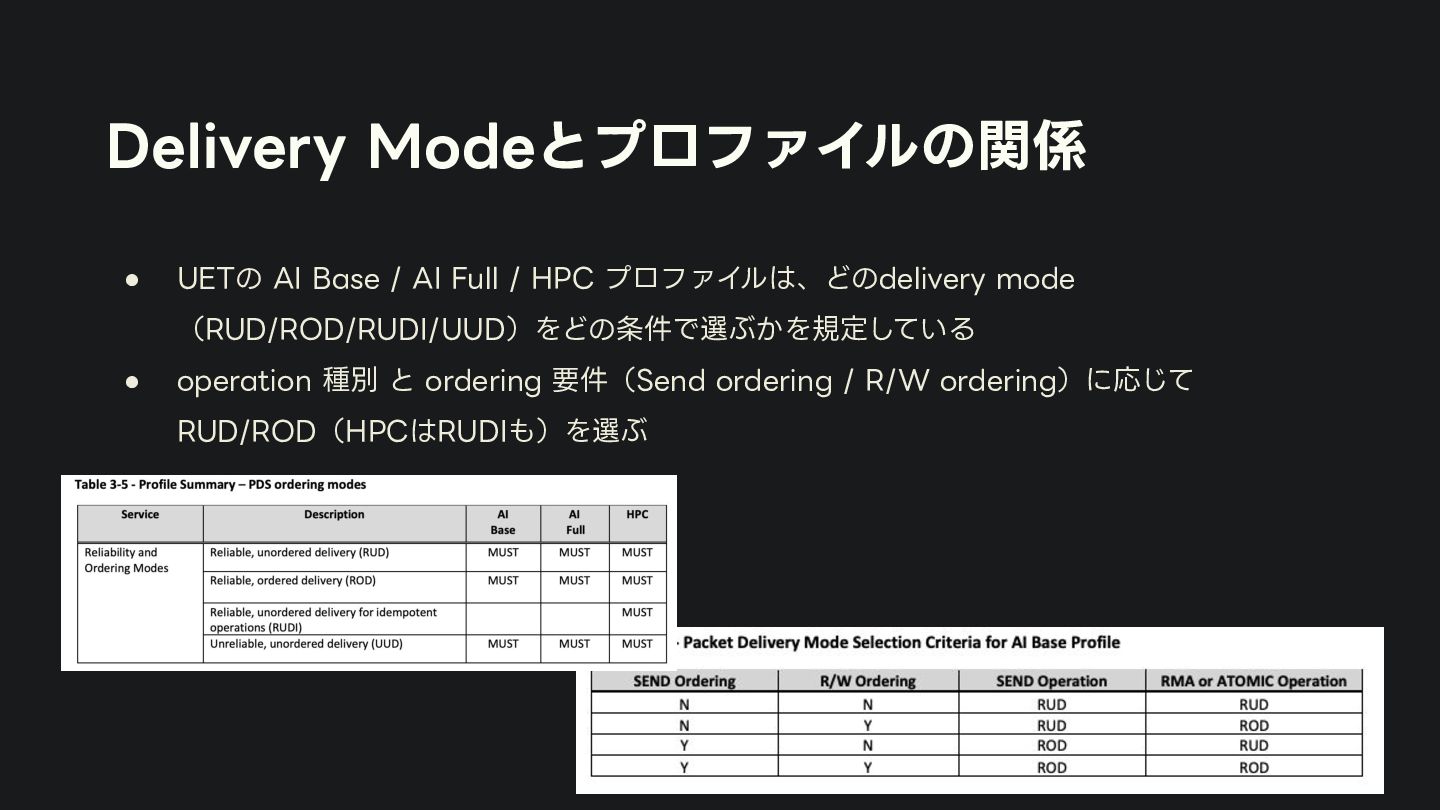
Delivery Modeとプロファイルの関係 • UETの AI Base / AI Full /
HPC プロファイルは、どのdelivery mode (RUD/ROD/RUDI/UUD)をどの条件で選ぶかを規定している • operation 種別 と ordering 要件(Send ordering / R/W ordering)に応じて RUD/ROD(HPCはRUDIも)を選ぶ -
Packet Drops - 3つのC • UEでは3種類のパケットドロップを区別しそれぞれ異なる対策をする ◦ Congestion drops: 輻輳ドロップ
◦ Corruption drops: 破損ドロップ ◦ Configuration drops: 構成ドロップ • 輻輳ドロップの検知はこれまで通り重要だが、UEは破損ドロップの検知も重視 → LLRで確実に検出&回復 -
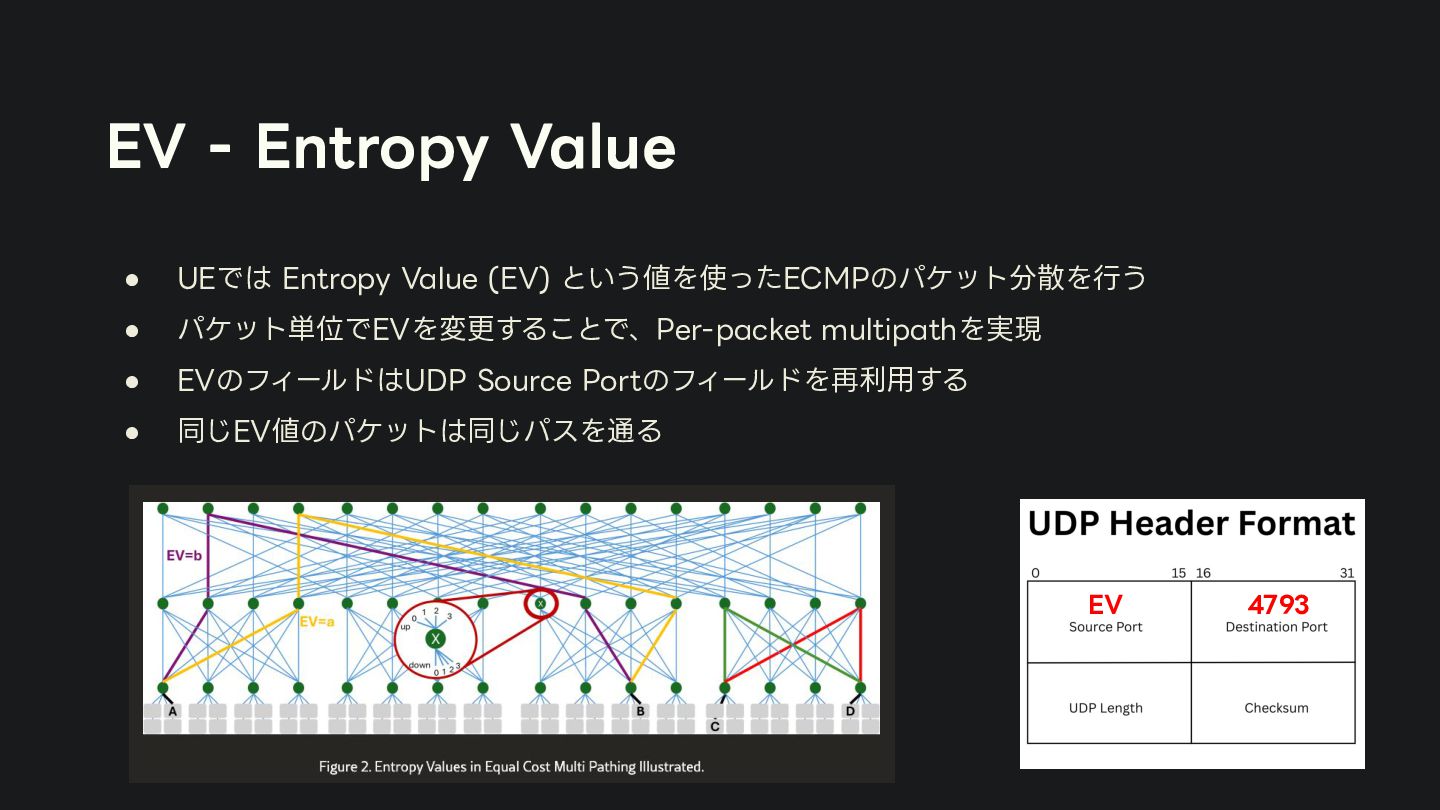
EV - Entropy Value • UEでは Entropy Value (EV) という値を使ったECMPのパケット分散を⾏う
• パケット単位でEVを変更することで、Per-packet multipathを実現 • EVのフィールドはUDP Source Portのフィールドを再利⽤する • 同じEV値のパケットは同じパスを通る EV 4793 -
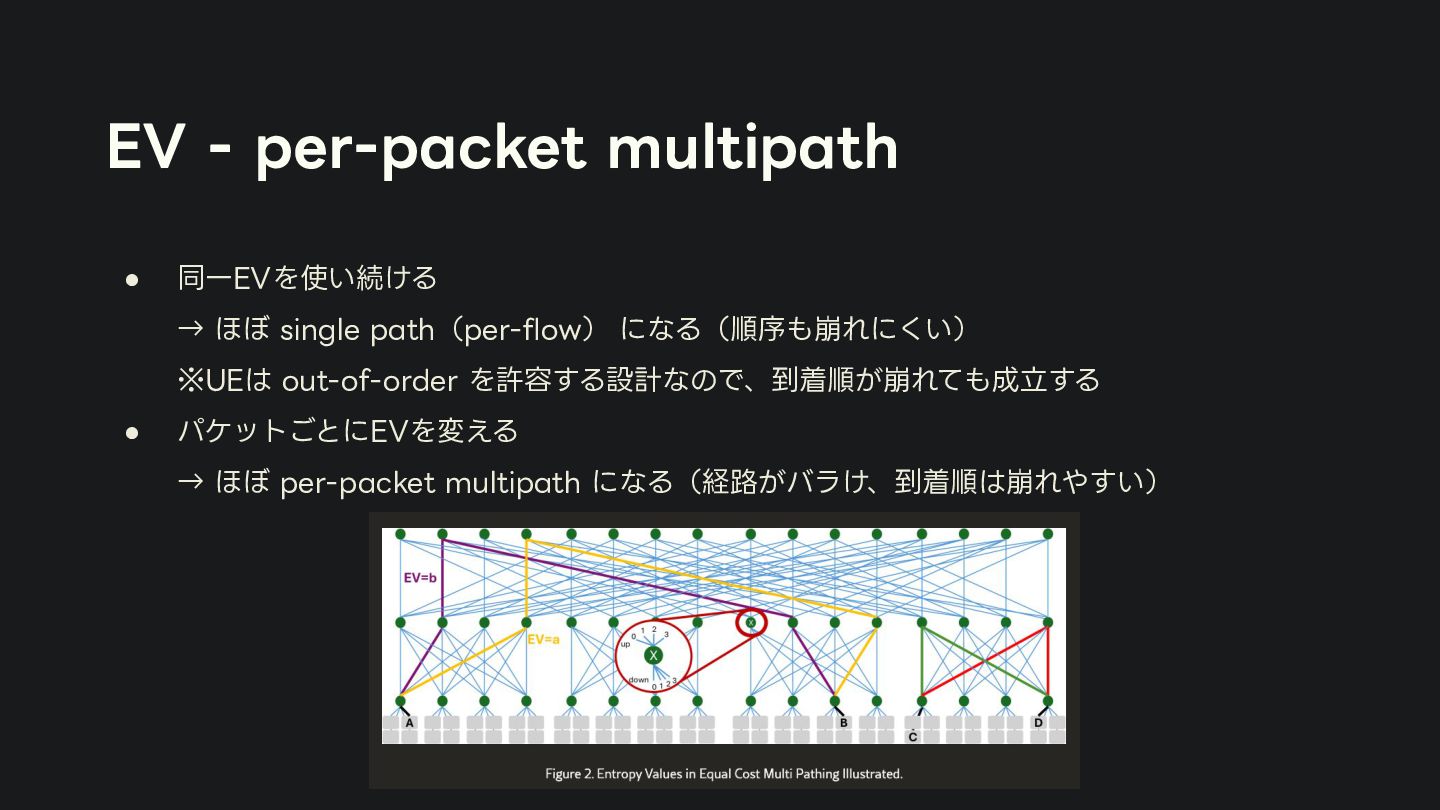
EV - per-packet multipath • 同⼀EVを使い続ける → ほぼ single path(per-flow)
になる(順序も崩れにくい) ※UEは out-of-order を許容する設計なので、到着順が崩れても成⽴する • パケットごとにEVを変える → ほぼ per-packet multipath になる(経路がバラけ、到着順は崩れやすい) -
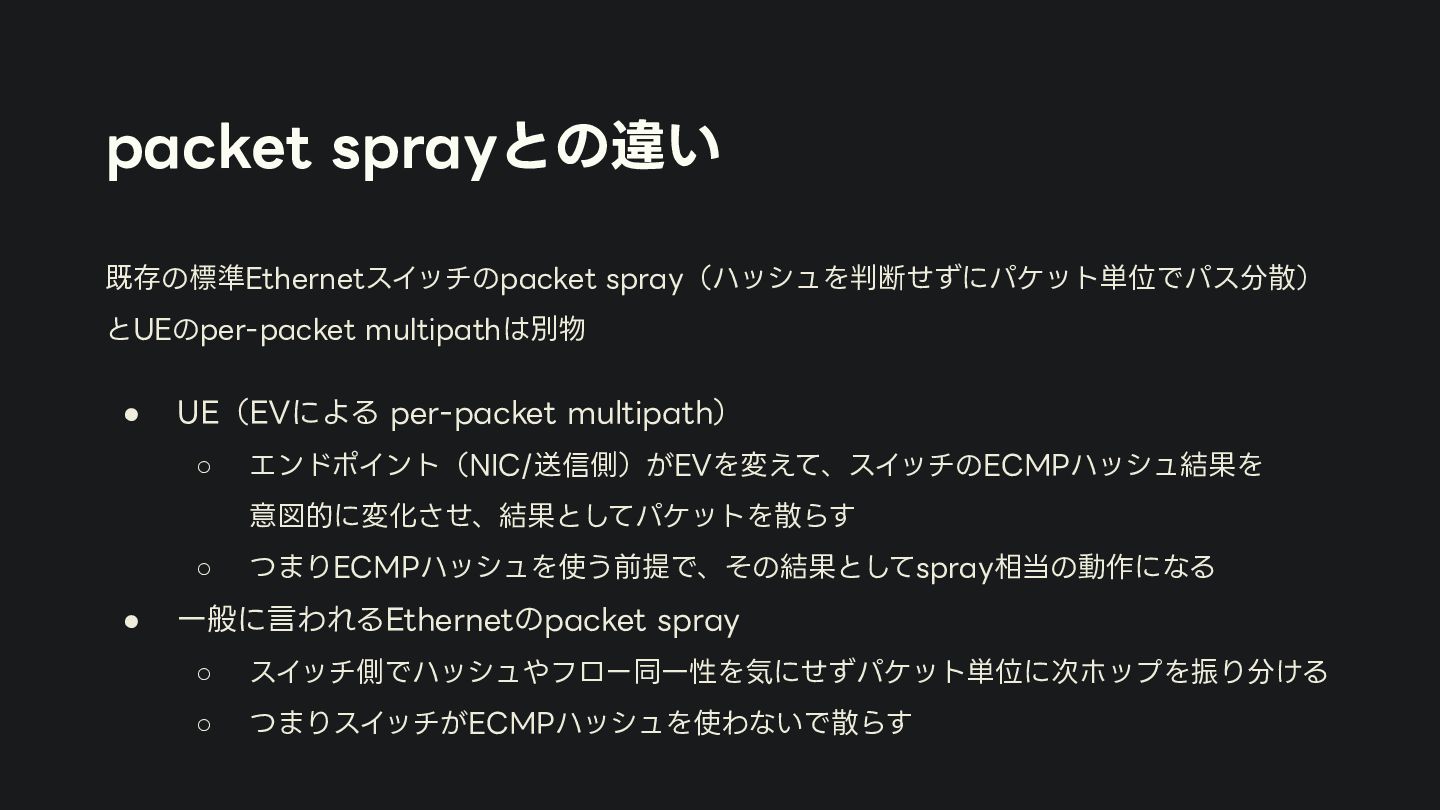
packet sprayとの違い 既存の標準Ethernetスイッチのpacket spray(ハッシュを判断せずにパケット単位でパス分散) とUEのper-packet multipathは別物 • UE(EVによる per-packet multipath)
◦ エンドポイント(NIC/送信側)がEVを変えて、スイッチのECMPハッシュ結果を 意図的に変化させ、結果としてパケットを散らす ◦ つまりECMPハッシュを使う前提で、その結果としてspray相当の動作になる • ⼀般に⾔われるEthernetのpacket spray ◦ スイッチ側でハッシュやフロー同⼀性を気にせずパケット単位に次ホップを振り分ける ◦ つまりスイッチがECMPハッシュを使わないで散らす -
NSCC / RCCC • UETでは2つの輻輳制御アルゴリズムを⽤いる • 送信者ベースのNSCCと受信者ベースのRCCC • NSCCが基本で、オプションでRCCCも組み合わせる •
ECNやRTT, Packet Trimmingのドロップ検知を利⽤する -
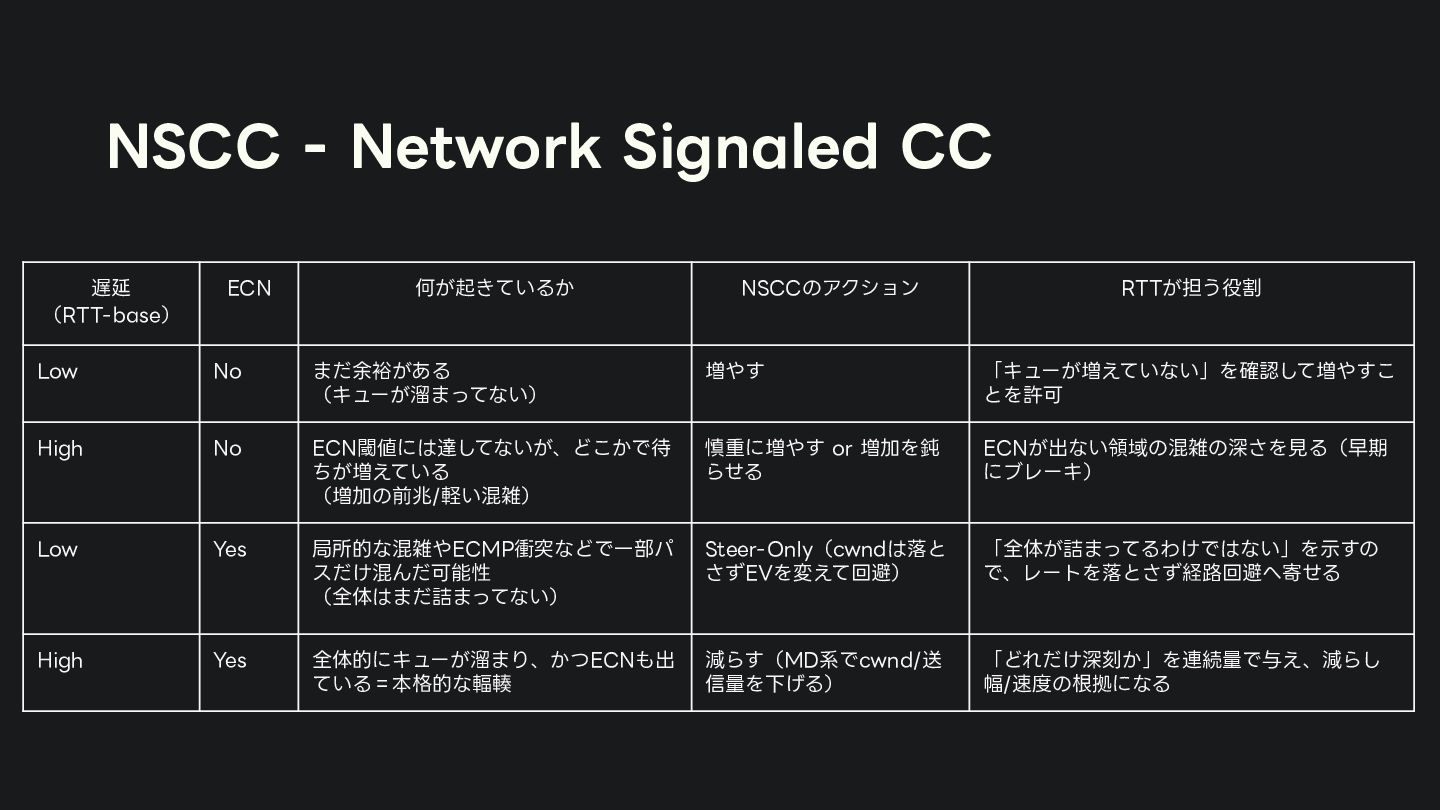
NSCC - Network Signaled CC • UETの基本となるウィンドウサイズ(送信側)ベースの輻輳制御アルゴリズム • FEPとなるNICは必ずNSCCを実装している必要がある •
ECNとRTTの2つのシグナルに基づき輻輳パスを迂回する • 2つを同時に⾒ることで、⼀部パスだけ詰まったのか全体が過負荷なのかを切り分けられる ◦ ECN:宛先から返されたEVでどのパスが輻輳したか特定 ◦ Delay-base RTT:全体傾向を見る指標 -
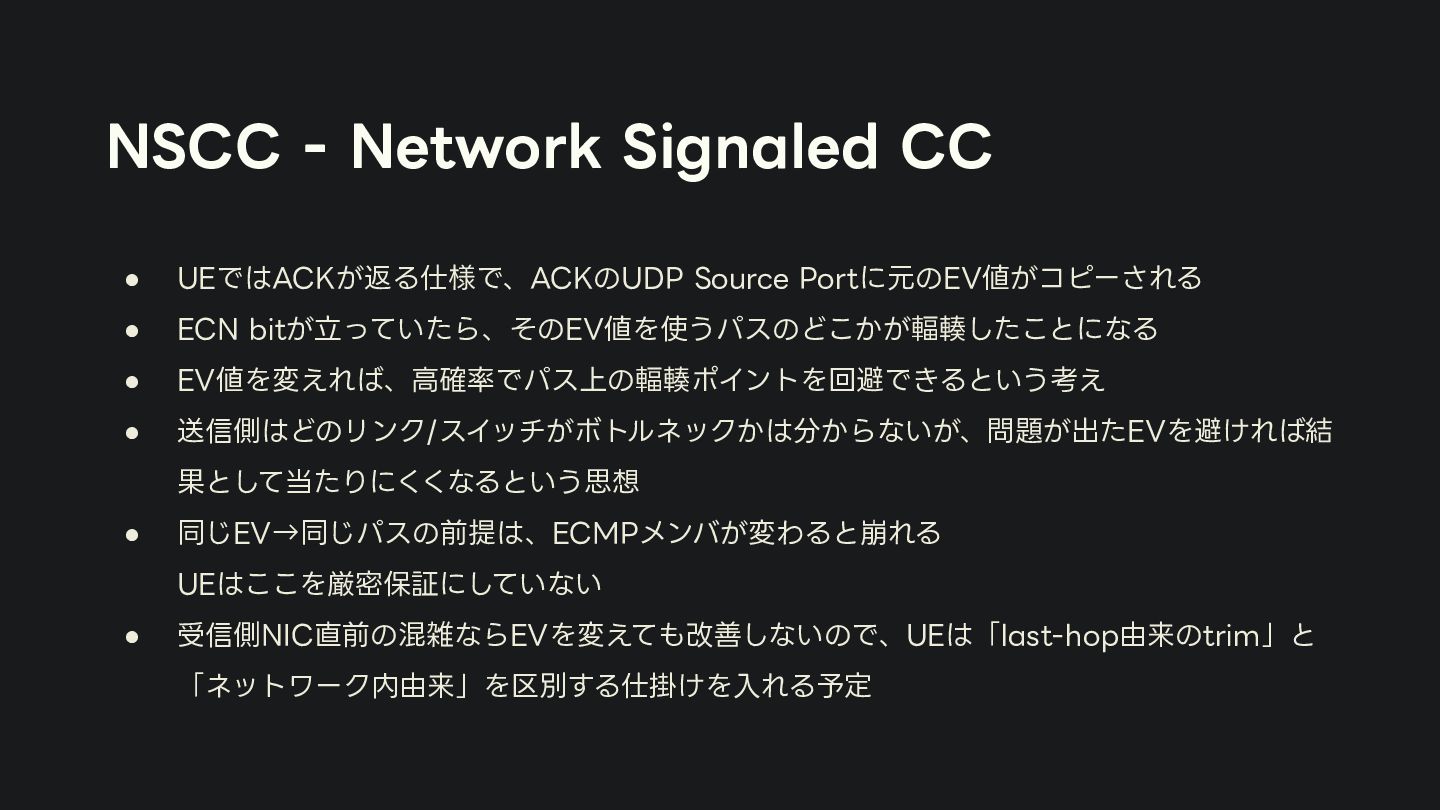
NSCC - Network Signaled CC • UEではACKが返る仕様で、ACKのUDP Source Portに元のEV値がコピーされる •
ECN bitが⽴っていたら、そのEV値を使うパスのどこかが輻輳したことになる • EV値を変えれば、⾼確率でパス上の輻輳ポイントを回避できるという考え • 送信側はどのリンク/スイッチがボトルネックかは分からないが、問題が出たEVを避ければ結 果として当たりにくくなるという思想 • 同じEV→同じパスの前提は、ECMPメンバが変わると崩れる UEはここを厳密保証にしていない • 受信側NIC直前の混雑ならEVを変えても改善しないので、UEは「last-hop由来のtrim」と 「ネットワーク内由来」を区別する仕掛けを⼊れる予定 -
NSCC - Network Signaled CC 遅延 (RTT-base) ECN 何が起きているか NSCCのアクション
RTTが担う役割 Low No まだ余裕がある (キューが溜まってない) 増やす 「キューが増えていない」を確認して増やすこ とを許可 High No ECN閾値には達してないが、どこかで待 ちが増えている (増加の前兆/軽い混雑) 慎重に増やす or 増加を鈍 らせる ECNが出ない領域の混雑の深さを⾒る(早期 にブレーキ) Low Yes 局所的な混雑やECMP衝突などで⼀部パ スだけ混んだ可能性 (全体はまだ詰まってない) Steer-Only(cwndは落と さずEVを変えて回避) 「全体が詰まってるわけではない」を⽰すの で、レートを落とさず経路回避へ寄せる High Yes 全体的にキューが溜まり、かつECNも出 ている=本格的な輻輳 減らす(MD系でcwnd/送 信量を下げる) 「どれだけ深刻か」を連続量で与え、減らし 幅/速度の根拠になる -
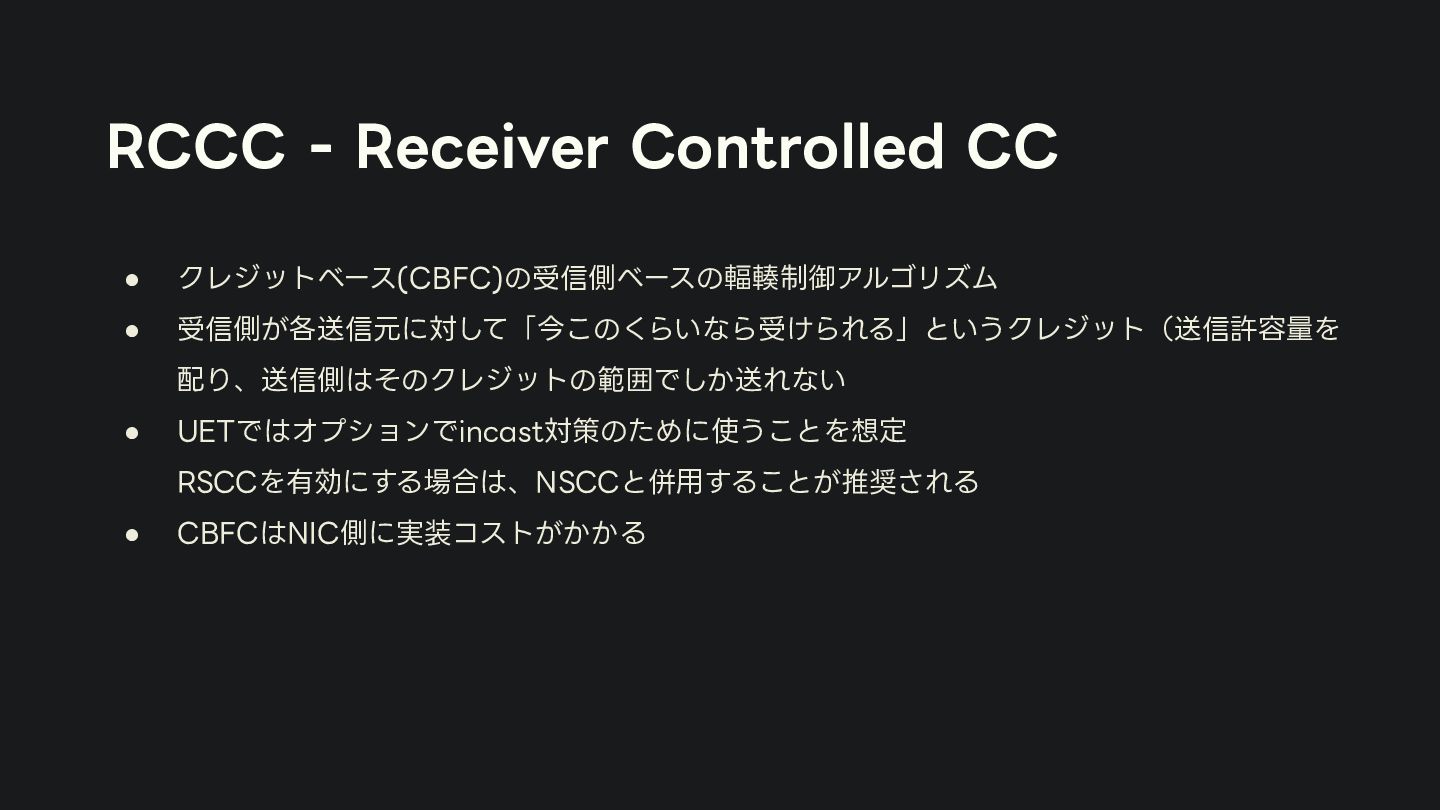
RCCC - Receiver Controlled CC • クレジットベース(CBFC)の受信側ベースの輻輳制御アルゴリズム • 受信側が各送信元に対して「今このくらいなら受けられる」というクレジット(送信許容量を 配り、送信側はそのクレジットの範囲でしか送れない
• UETではオプションでincast対策のために使うことを想定 RSCCを有効にする場合は、NSCCと併⽤することが推奨される • CBFCはNIC側に実装コストがかかる -
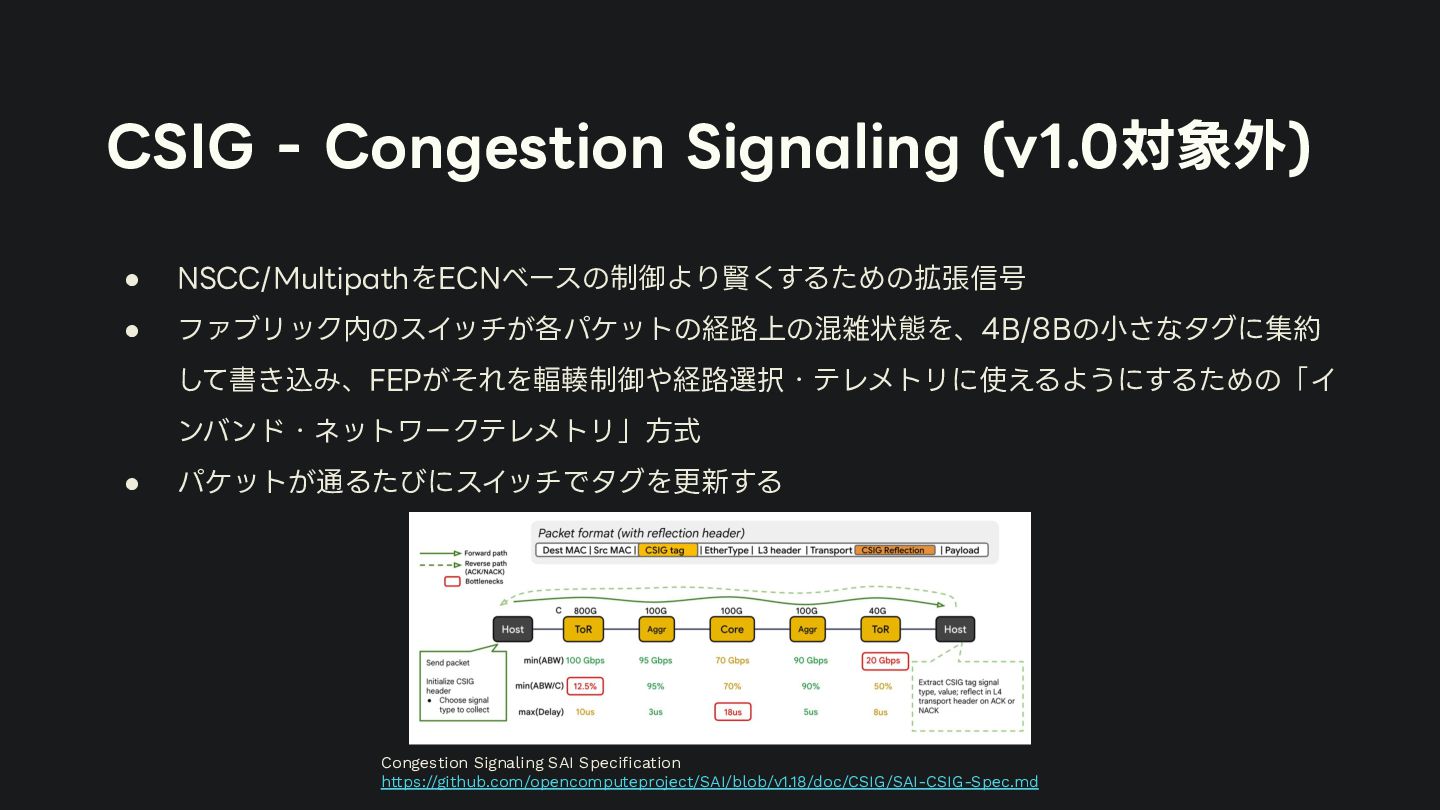
CSIG - Congestion Signaling (v1.0対象外) • NSCC/MultipathをECNベースの制御より賢くするための拡張信号 • ファブリック内のスイッチが各パケットの経路上の混雑状態を、4B/8Bの⼩さなタグに集約 して書き込み、FEPがそれを輻輳制御や経路選択・テレメトリに使えるようにするための「イ
ンバンド・ネットワークテレメトリ」⽅式 • パケットが通るたびにスイッチでタグを更新する Congestion Signaling SAI Specification https://github.com/opencomputeproject/SAI/blob/v1.18/doc/CSIG/SAI-CSIG-Spec.md -
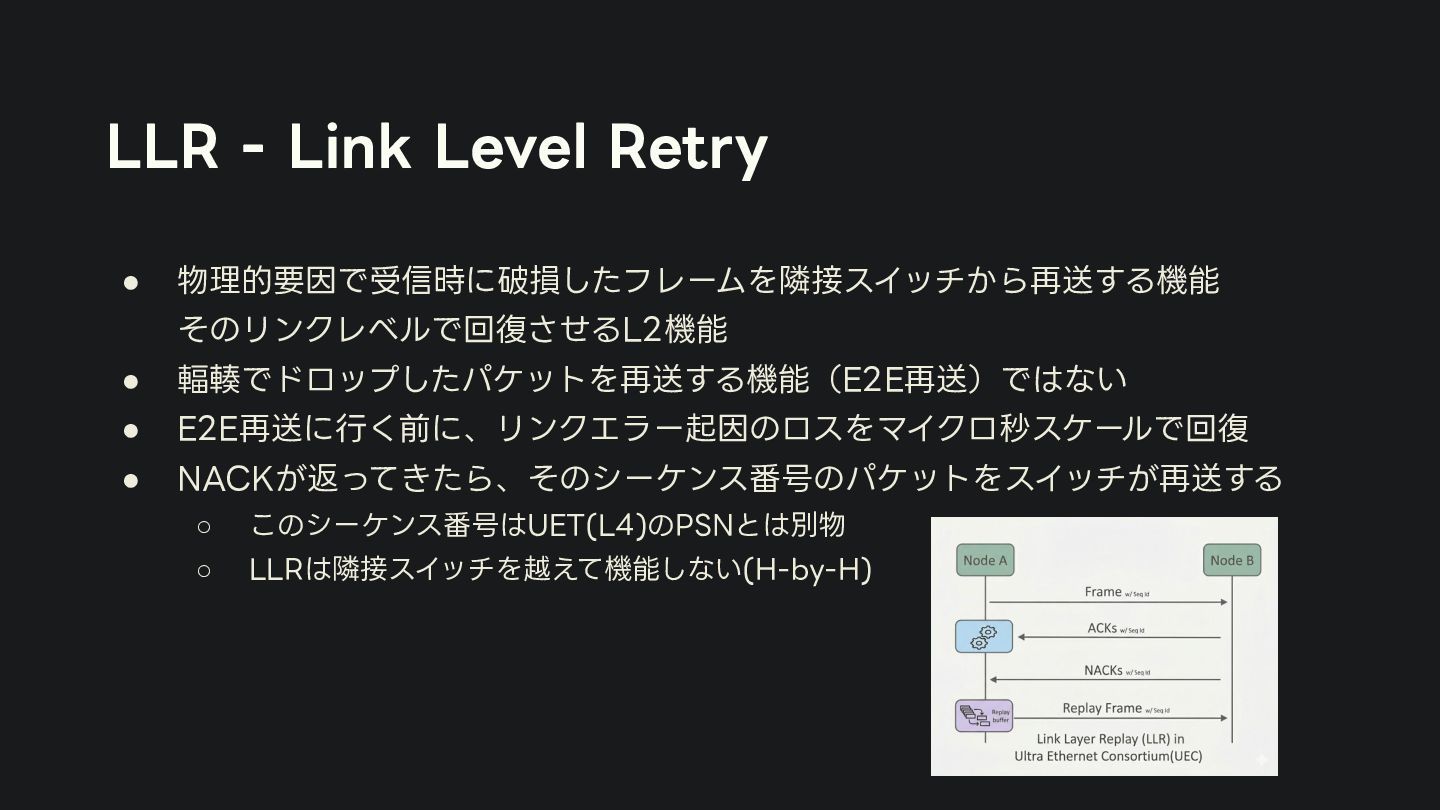
LLR - Link Level Retry • 物理的要因で受信時に破損したフレームを隣接スイッチから再送する機能 そのリンクレベルで回復させるL2機能 • 輻輳でドロップしたパケットを再送する機能(E2E再送)ではない
• E2E再送に⾏く前に、リンクエラー起因のロスをマイクロ秒スケールで回復 • NACKが返ってきたら、そのシーケンス番号のパケットをスイッチが再送する ◦ このシーケンス番号はUET(L4)のPSNとは別物 ◦ LLRは隣接スイッチを越えて機能しない(H-by-H) -
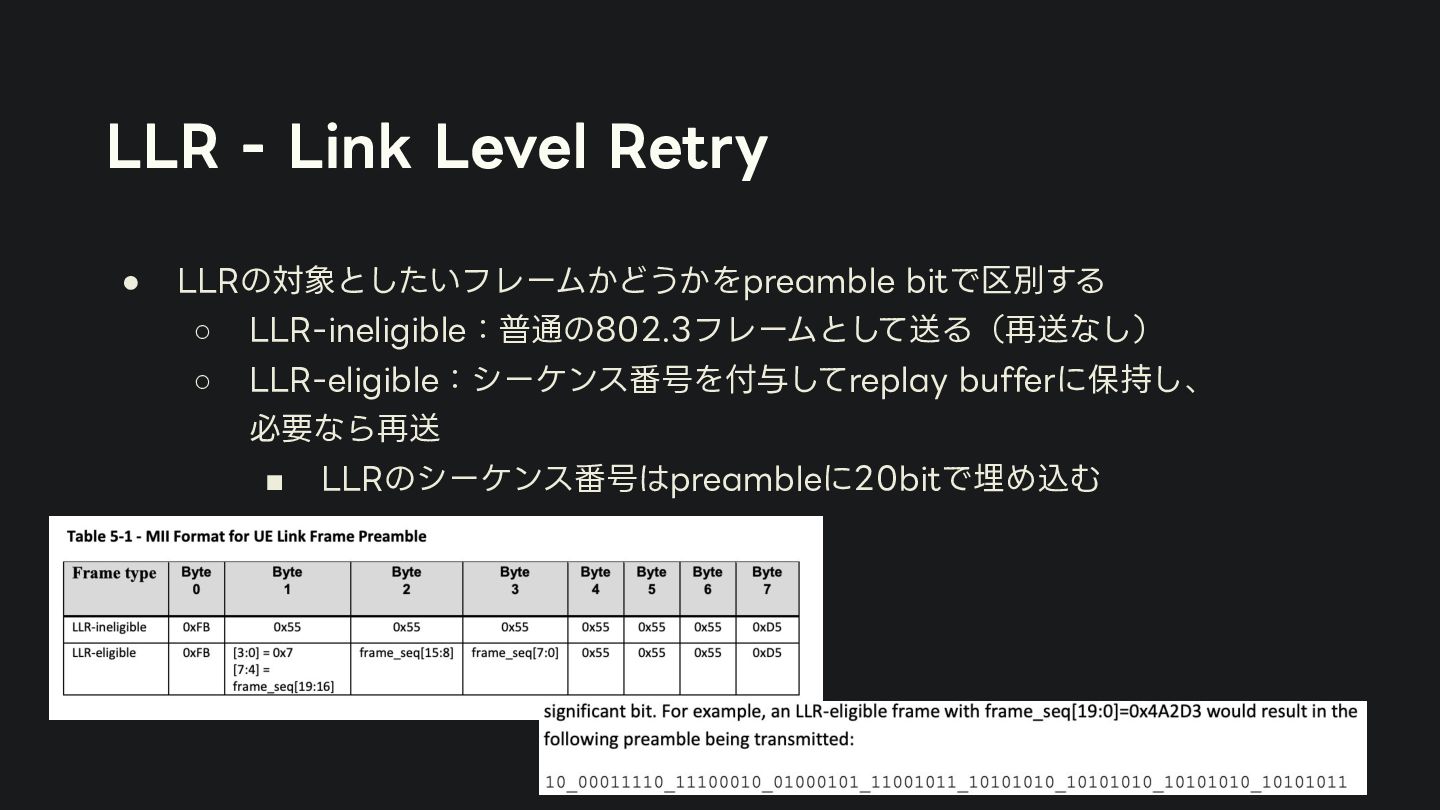
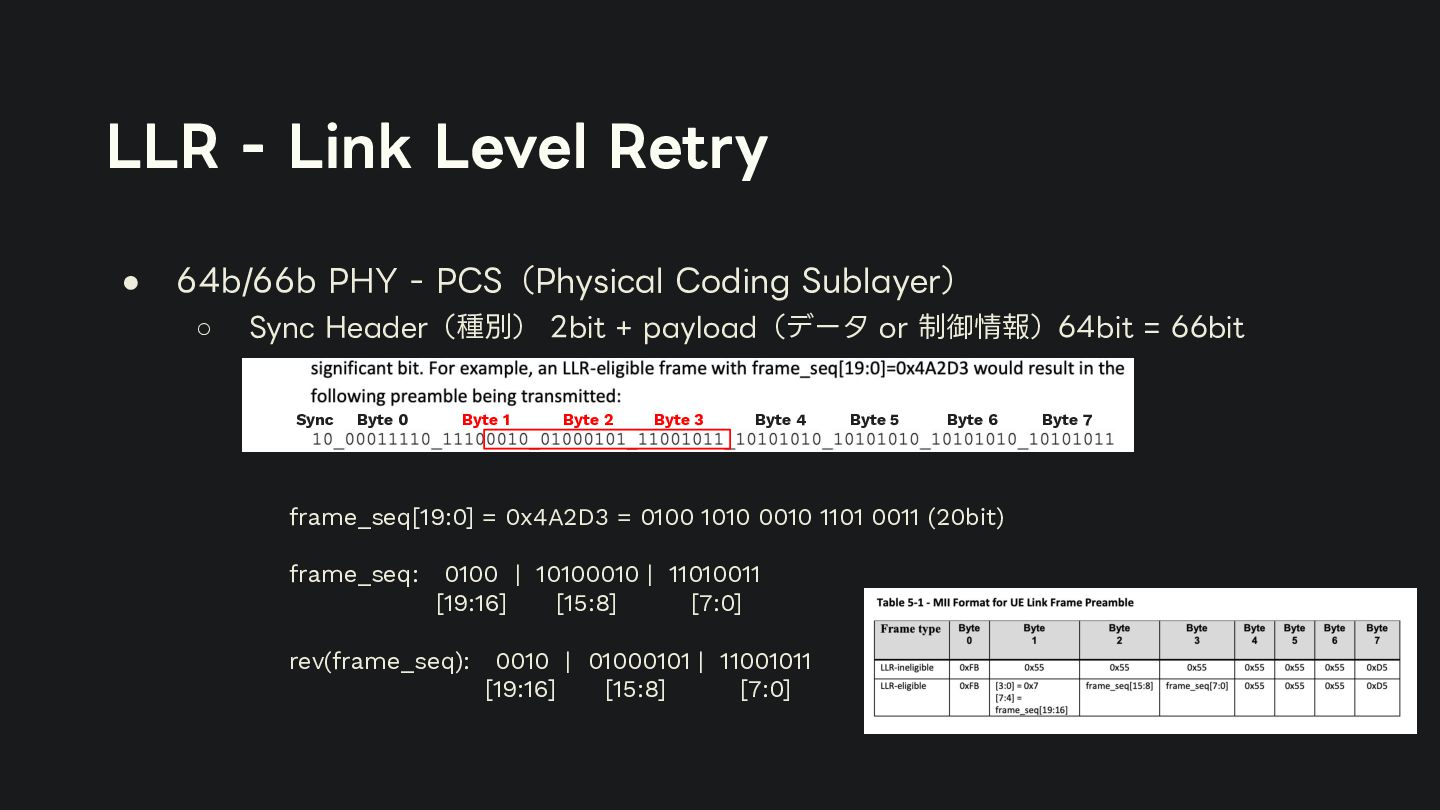
LLR - Link Level Retry • LLRの対象としたいフレームかどうかをpreamble bitで区別する ◦ LLR-ineligible:普通の802.3フレームとして送る(再送なし)
◦ LLR-eligible:シーケンス番号を付与してreplay bufferに保持し、 必要なら再送 ▪ LLRのシーケンス番号はpreambleに20bitで埋め込む -
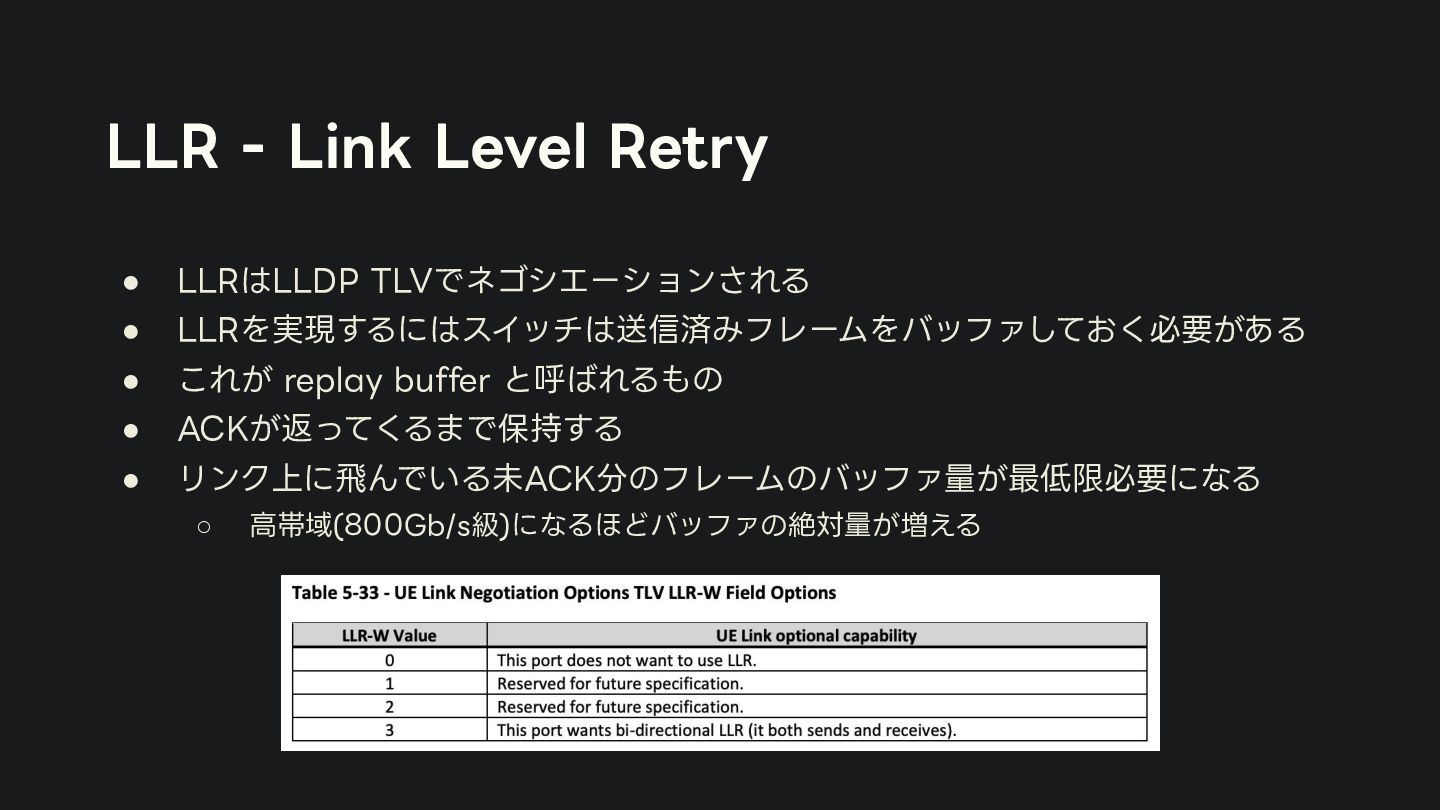
LLR - Link Level Retry • LLRはLLDP TLVでネゴシエーションされる • LLRを実現するにはスイッチは送信済みフレームをバッファしておく必要がある
• これが replay buffer と呼ばれるもの • ACKが返ってくるまで保持する • リンク上に⾶んでいる未ACK分のフレームのバッファ量が最低限必要になる ◦ ⾼帯域(800Gb/s級)になるほどバッファの絶対量が増える -
LLR - Link Level Retry • 64b/66b PHY - PCS(Physical
Coding Sublayer) ◦ Sync Header(種別) 2bit + payload(データ or 制御情報)64bit = 66bit frame_seq[19:0] = 0x4A2D3 = 0100 1010 0010 1101 0011 (20bit) frame_seq: 0100 | 10100010 | 11010011 [19:16] [15:8] [7:0] rev(frame_seq): 0010 | 01000101 | 11001011 [19:16] [15:8] [7:0] Byte 1 Byte 2 Byte 3 Byte 4 Byte 5 Byte 6 Byte 7 Byte 0 Sync -
Packet Trimming - 前提条件 • “valid IP packet” が buffer
admission checks に失敗したときのみトリムしてよい • packet trimming は DSCPで トリム可/トリム済 を区別する ◦ TRIMMABLE(トリムしてよい) ◦ TRIMMED(既にトリム済、再トリム不可、受信側への通知) • ネットワーク運⽤者は、各packet trimming対応スイッチで ◦ DSCP_TRIMMABLE → DSCP_TRIMMED の対応付け(mapping)を必ず設定する ◦ トリム済パケットが元データの後ろに並んで遅延するのを避けるため、TRIMMEDは別のTC (キュー)に割り当てる • トリム対象は DSCP_TRIMMABLE に分類されたパケットだけ • TRIMMED(トリム済)には ECNマーキングしない -
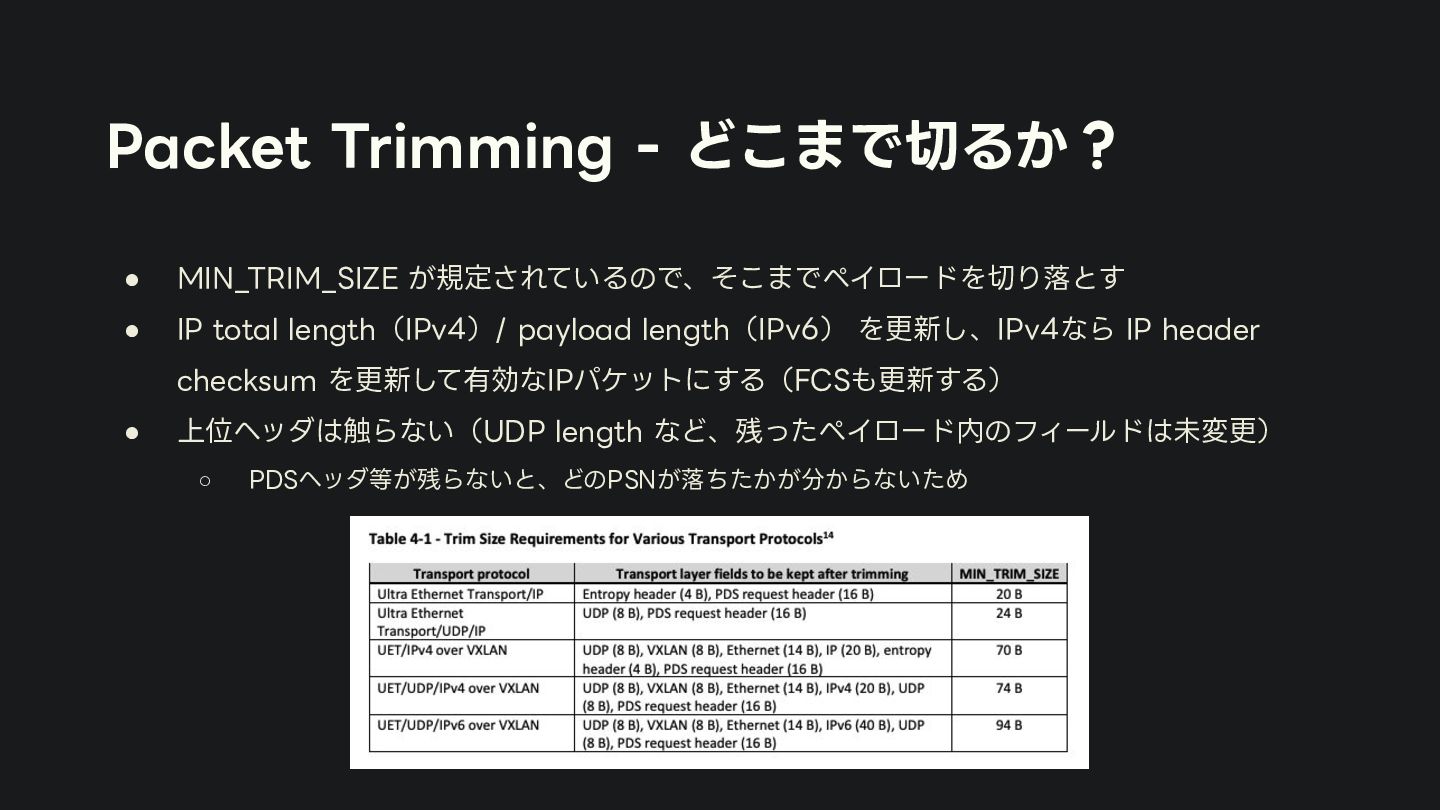
Packet Trimming - どこまで切るか? • MIN_TRIM_SIZE が規定されているので、そこまでペイロードを切り落とす • IP total
length(IPv4)/ payload length(IPv6) を更新し、IPv4なら IP header checksum を更新して有効なIPパケットにする(FCSも更新する) • 上位ヘッダは触らない(UDP length など、残ったペイロード内のフィールドは未変更) ◦ PDSヘッダ等が残らないと、どのPSNが落ちたかが分からないため -
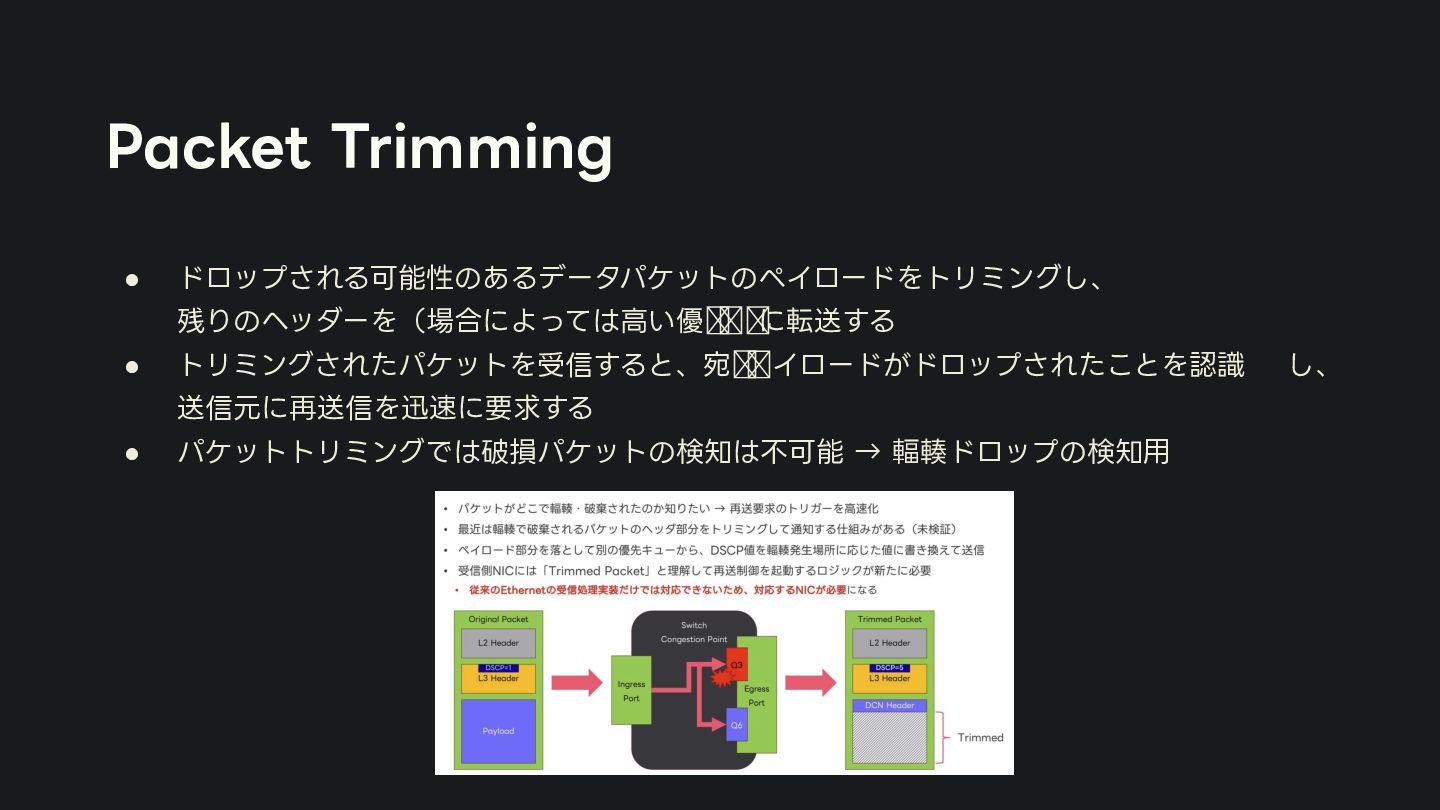
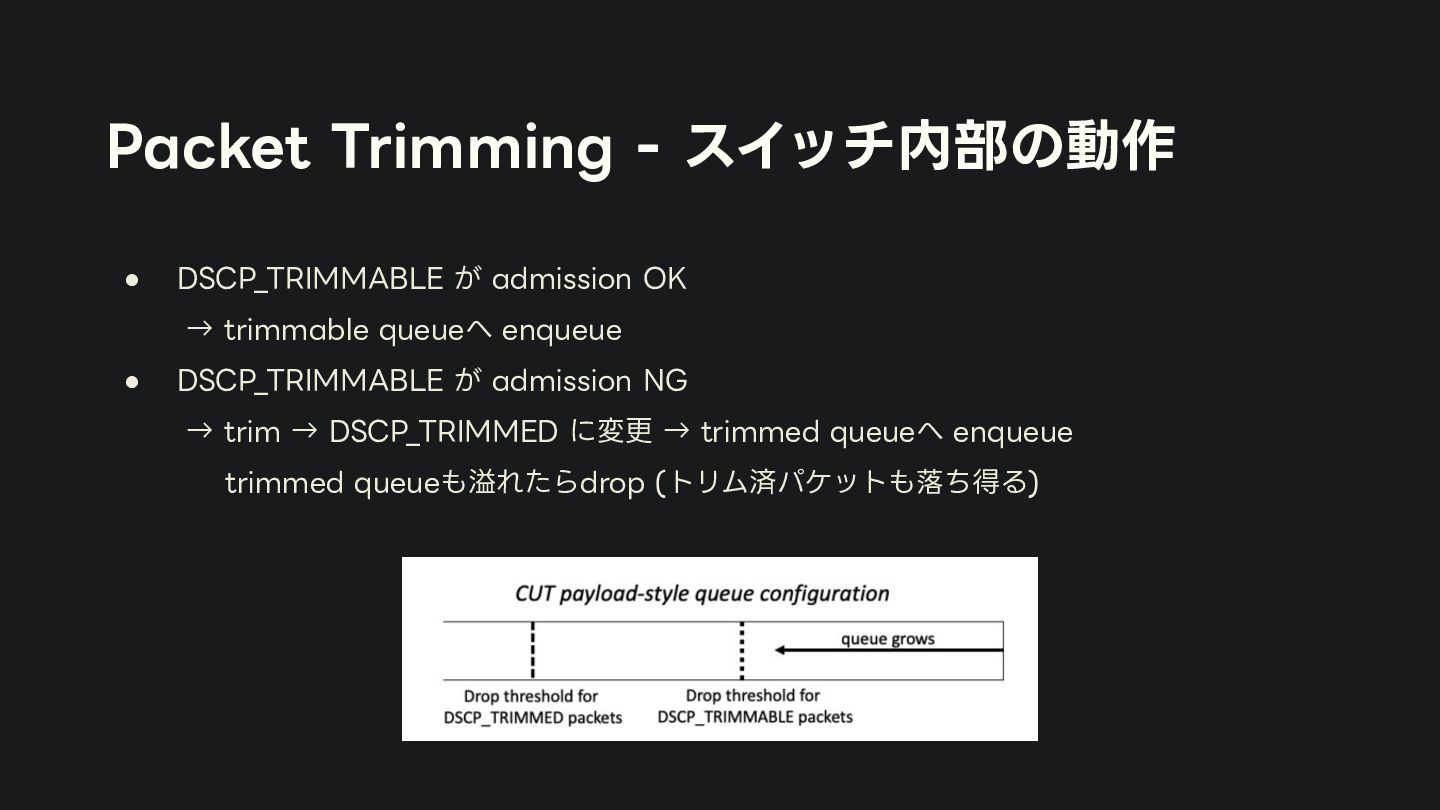
Packet Trimming - スイッチ内部の動作 • DSCP_TRIMMABLE が admission OK →
trimmable queueへ enqueue • DSCP_TRIMMABLE が admission NG → trim → DSCP_TRIMMED に変更 → trimmed queueへ enqueue trimmed queueも溢れたらdrop (トリム済パケットも落ち得る) -
Packet Trimming - 受信側の動作 • 受信側NIC(FEP)のUET PDSは、trimmed packetを⾒たら NACK(= 明⽰ロス通知)
• IP DSCPの値を⾒てトリム済を認識する(MUST) • IP length / UDP length を検証しない(MUST NOT) ◦ トリムで⻑さが変わっているので、通常の整合チェックで落とさないため • どのPSNが失われたかを検出、送信側に再送要求(fast retransmission) ◦ そのパケットが通った混雑していたパスをEVで判別可能 ◦ NACKでそのEVを返すので、送信側で別経路を通るようなEVに変更される -
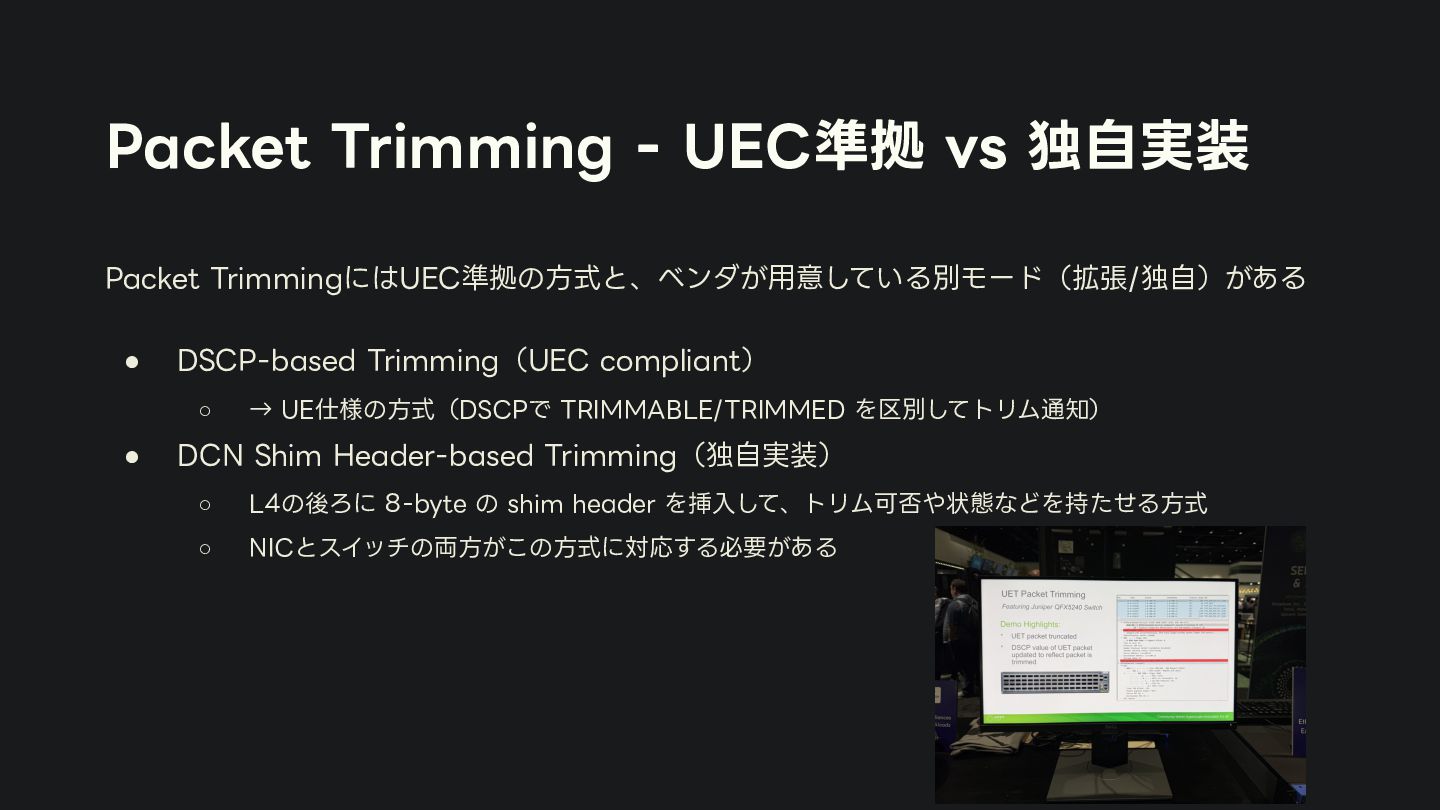
Packet Trimming - UEC準拠 vs 独⾃実装 Packet TrimmingにはUEC準拠の⽅式と、ベンダが⽤意している別モード(拡張/独⾃)がある • DSCP-based
Trimming(UEC compliant) ◦ → UE仕様の⽅式(DSCPで TRIMMABLE/TRIMMED を区別してトリム通知) • DCN Shim Header-based Trimming(独⾃実装) ◦ L4の後ろに 8-byte の shim header を挿⼊して、トリム可否や状態などを持たせる⽅式 ◦ NICとスイッチの両⽅がこの⽅式に対応する必要がある -
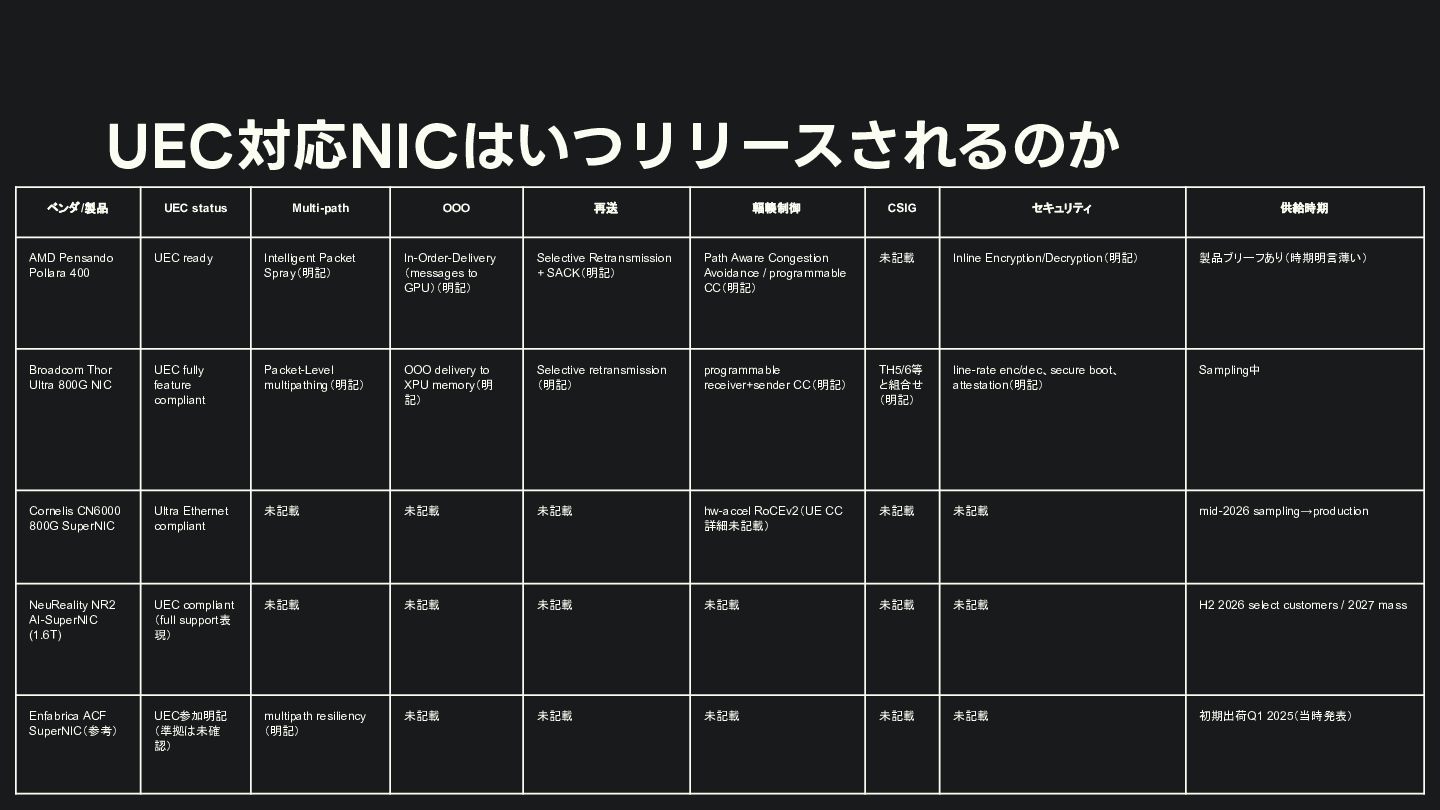
UEC対応NICはいつリリースされるのか ベンダ/製品 UEC status Multi-path OOO 再送 輻輳制御 CSIG セキュリティ
供給時期 AMD Pensando Pollara 400 UEC ready Intelligent Packet Spray(明記) In-Order-Delivery (messages to GPU)(明記) Selective Retransmission + SACK(明記) Path Aware Congestion Avoidance / programmable CC(明記) 未記載 Inline Encryption/Decryption(明記) 製品ブリーフあり(時期明言薄い) Broadcom Thor Ultra 800G NIC UEC fully feature compliant Packet-Level multipathing(明記) OOO delivery to XPU memory(明 記) Selective retransmission (明記) programmable receiver+sender CC(明記) TH5/6等 と組合せ (明記) line-rate enc/dec、secure boot、 attestation(明記) Sampling中 Cornelis CN6000 800G SuperNIC Ultra Ethernet compliant 未記載 未記載 未記載 hw-accel RoCEv2(UE CC 詳細未記載) 未記載 未記載 mid-2026 sampling→production NeuReality NR2 AI-SuperNIC (1.6T) UEC compliant (full support表 現) 未記載 未記載 未記載 未記載 未記載 未記載 H2 2026 select customers / 2027 mass Enfabrica ACF SuperNIC(参考) UEC参加明記 (準拠は未確 認) multipath resiliency (明記) 未記載 未記載 未記載 未記載 未記載 初期出荷Q1 2025(当時発表) -
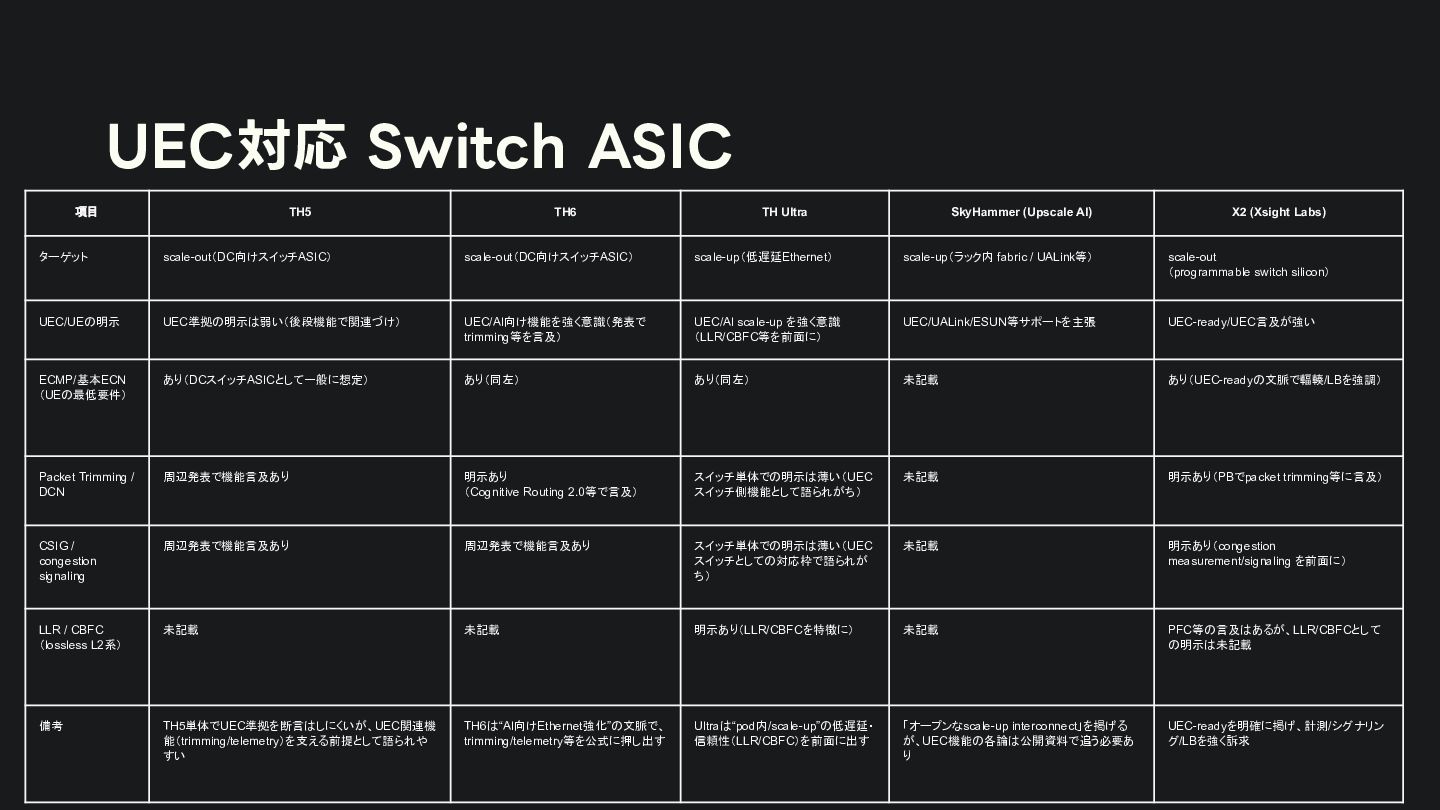
UEC対応 Switch ASIC 項目 TH5 TH6 TH Ultra SkyHammer (Upscale
AI) X2 (Xsight Labs) ターゲット scale-out(DC向けスイッチASIC) scale-out(DC向けスイッチASIC) scale-up(低遅延Ethernet) scale-up(ラック内 fabric / UALink等) scale-out (programmable switch silicon) UEC/UEの明示 UEC準拠の明示は弱い(後段機能で関連づけ) UEC/AI向け機能を強く意識(発表で trimming等を言及) UEC/AI scale-up を強く意識 (LLR/CBFC等を前面に) UEC/UALink/ESUN等サポートを主張 UEC-ready/UEC言及が強い ECMP/基本ECN (UEの最低要件) あり(DCスイッチASICとして一般に想定) あり(同左) あり(同左) 未記載 あり(UEC-readyの文脈で輻輳/LBを強調) Packet Trimming / DCN 周辺発表で機能言及あり 明示あり (Cognitive Routing 2.0等で言及) スイッチ単体での明示は薄い(UEC スイッチ側機能として語られがち) 未記載 明示あり(PBでpacket trimming等に言及) CSIG / congestion signaling 周辺発表で機能言及あり 周辺発表で機能言及あり スイッチ単体での明示は薄い(UEC スイッチとしての対応枠で語られが ち) 未記載 明示あり(congestion measurement/signaling を前面に) LLR / CBFC (lossless L2系) 未記載 未記載 明示あり(LLR/CBFCを特徴に) 未記載 PFC等の言及はあるが、LLR/CBFCとして の明示は未記載 備考 TH5単体でUEC準拠を断言はしにくいが、UEC関連機 能(trimming/telemetry)を支える前提として語られや すい TH6は“AI向けEthernet強化”の文脈で、 trimming/telemetry等を公式に押し出す Ultraは“pod内/scale-up”の低遅延・ 信頼性(LLR/CBFC)を前面に出す 「オープンなscale-up interconnect」を掲げる が、UEC機能の各論は公開資料で追う必要あ り UEC-readyを明確に掲げ、計測/シグナリン グ/LBを強く訴求 -
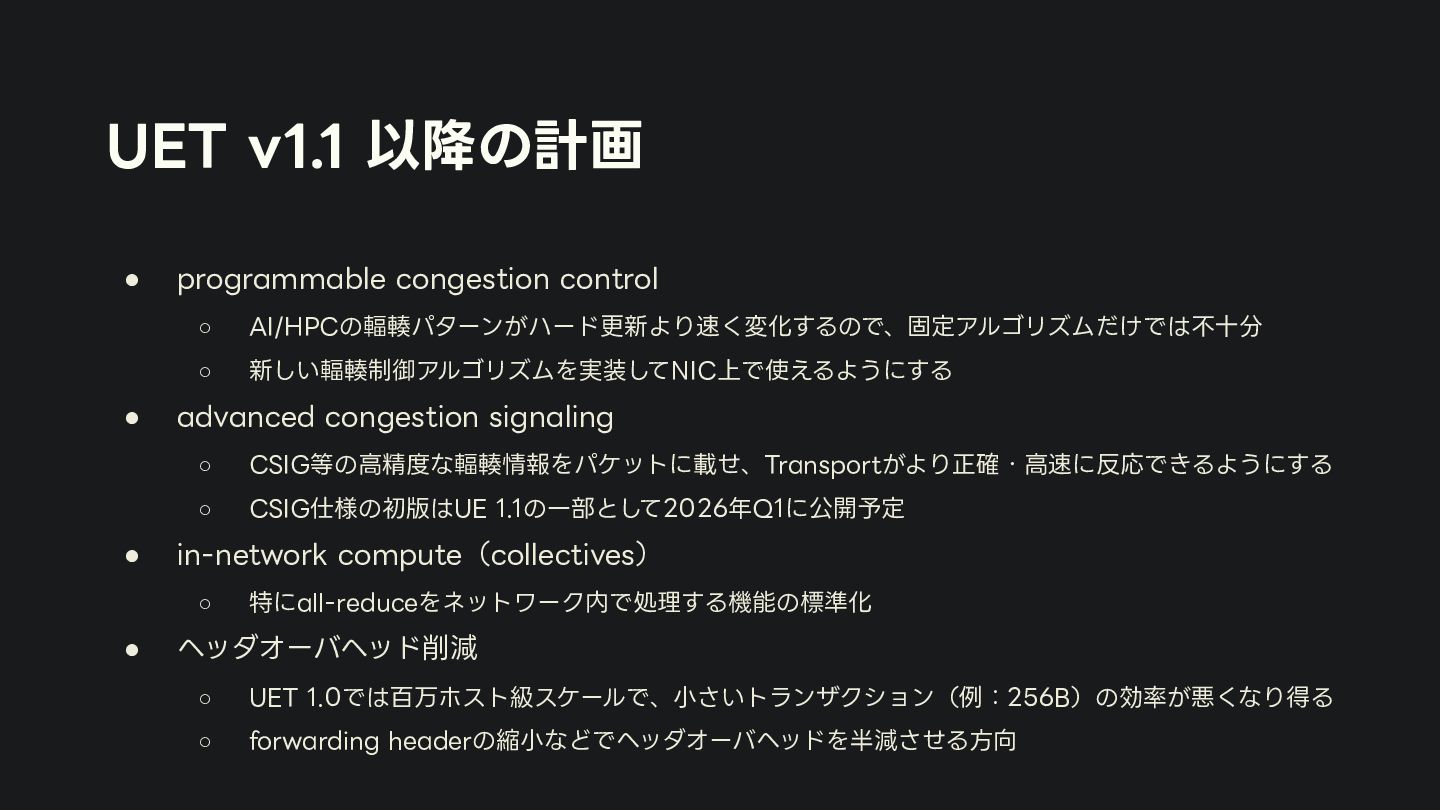
UET v1.1 以降の計画 • programmable congestion control ◦ AI/HPCの輻輳パターンがハード更新より速く変化するので、固定アルゴリズムだけでは不⼗分 ◦
新しい輻輳制御アルゴリズムを実装してNIC上で使えるようにする • advanced congestion signaling ◦ CSIG等の⾼精度な輻輳情報をパケットに載せ、Transportがより正確・⾼速に反応できるようにする ◦ CSIG仕様の初版はUE 1.1の⼀部として2026年Q1に公開予定 • in-network compute(collectives) ◦ 特にall-reduceをネットワーク内で処理する機能の標準化 • ヘッダオーバヘッド削減 ◦ UET 1.0では百万ホスト級スケールで、⼩さいトランザクション(例:256B)の効率が悪くなり得る ◦ forwarding headerの縮⼩などでヘッダオーバヘッドを半減させる⽅向
 markunet
 oracle4engineer
 henryofficial
 falken
 nagix
 kmotohas
 ballas_inc
 shift_evolve
 inariku
 rist
 sh_fk2
 regionbbs
 miu_crescent
 frankvandijk
 sferik
 kneath
 thirion
 gr2m
 dougneiner
 samtorres
 ivargrimstad
 scottboms
 holman
 leimatthew05
 rocio