Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Driving AI Adoption Using In-House GPUs to Serv...
Search
po3rin
September 04, 2026
Technology
570
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Driving AI Adoption Using In-House GPUs to Serve Qwen
po3rin
September 04, 2026
More Decks by po3rin
See All by po3rin
Go × SIMDで高速化するベクトル検索 ~ルーフラインモデルでSIMDが効く境界を探れ! ~
po3rin
1
6.2k
検索設計から 推論設計への重心移動と Recall-First Retrieval
po3rin
5
2.4k
LLMで複雑な検索条件アセットから脱却する!! 生成的検索インタフェースの設計論
po3rin
4
1.6k
C-Shared Buildで突破するAI Agent バックテストの壁
po3rin
0
540
嗚呼、当時の本番環境の状態で AI Agentを再評価したいなぁ...
po3rin
0
630
Temporal Knowledge Graphで作る! 時間変化するナレッジを扱うAI Agentの世界
po3rin
7
2.5k
自作LLM Native GORM Pluginで実現する AI Agentバックテスト基盤構築
po3rin
2
1.2k
麻雀点数計算問題生成タスクから学ぶ Single Agentの限界と Agentic Workflowの底力
po3rin
5
3.3k
LLMOpsのパフォーマンスを支える技術と現場で実践した改善
po3rin
8
1.3k
Other Decks in Technology
See All in Technology
スキルを作る、その前に!複数人で使われるスキルを 作るためのプロセス
junkifurukawa
2
370
AIがコードを書く時代に、エンジニアは何で自分の価値を証明するのか / In an era where AI writes code how do engineers prove their value
carta_engineering
1
780
事業活動を AI Ready にする攻めと守りのデータエンジニアリング / data-engineering-for-ai-ready-business
pei0804
7
2.4k
AI時代に必要な脅威モデリング― 変化の速度に負けない理解とリスク判断
masakane55
5
1.2k
転んだ話が背中を預ける理由になる / A_story_about_falling_down_gives_you_a_reason_to_watch_each_other_s_backs.pdf
pauli
3
350
初対面のメンバーがチームを組み、Claude Codeでゼロからサービスをリリース
mkdev10
1
120
Kiro Crewをはじめよう
kizawa2020
1
130
IoTデバイスを繋げるプロトコルMatterをAndroidで使用する方法
harutiro
0
130
ハードウェアコンペでもAI駆動開発が進んでいる話
iotengineer22
1
680
Claude Code本は、どのように執筆チームで書かれたか
oikon48
1
360
子育てエンジニアの可処分時間が減っても成長を諦めない戦い方
sudoakiy
6
4.4k
今さら理解するウェブフォントver.2026
takanorip
3
650
Featured
See All Featured
Why Our Code Smells
bkeepers
PRO
340
58k
GraphQLの誤解/rethinking-graphql
sonatard
75
12k
How to build an LLM SEO readiness audit: a practical framework
nmsamuel
2
940
Evolving SEO for Evolving Search Engines
ryanjones
0
310
Building an army of robots
kneath
307
47k
The AI Search Optimization Roadmap by Aleyda Solis
aleyda
2
6.3k
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
The Director’s Chair: Orchestrating AI for Truly Effective Learning
tmiket
1
320
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
Exploring the Power of Turbo Streams & Action Cable | RailsConf2023
kevinliebholz
37
6.6k
30 Presentation Tips
portentint
PRO
1
420
Amusing Abliteration
ianozsvald
1
330
Transcript
Driving AI Adoption Using In-House GPUs to Serve Qwen Qwen
Meetup Tokyo LayerX Hiromu Nakamura (@po3rin) 2026/09/04
Hiromu Nakamura Hiromu Nakamura AI-UX/MLOps TechLead AI/MLOps Engineer. Interested in
Information Retrieval Nagoya Univ ~ Graduate School of Science M3, Inc. AI・ML Team MLOps & Data Engineering po3rin LayerX Inc. AI-UX/MLOps TechLead
Driving AI Adoption Using In-House GPUs to Serve Qwen 1.
Introduction
1 Driving AI Adoption Using In-House GPUs to Serve Qwen
社内AIコスト爆あがり😭 * トークンをとにかく使え!!のフェーズは終わり。。。 * トークン利用量を増やしながらコストは下げるという 直感的には逆のことをやっていく必要がある
2 Driving AI Adoption Using In-House GPUs to Serve Qwen
💻 社内GPUサーバーを使おう! * ちょっと前にML学習用に買ったもの (RTX 6000 Ada × 4) * 従量課金を固定費へ (電気代はかかるが) * LayerXでは一部のワークロードをすでに社内GPU上での推論に移行している
3 Driving AI Adoption Using In-House GPUs to Serve Qwen
Qwen3.8 27Bが超主力!! 今日話すこと * Qwenでどのようなワークロードを置き換えているか * どのような推論基盤を構築したか * どのようにスループットを上げているか
Driving AI Adoption Using In-House GPUs to Serve Qwen 2.
Workloads running with Qwen
Driving AI Adoption Using In-House GPUs to Serve Qwen
移すタスクを見極める3軸 * 頻度(一日に何回走るか) * 難易度(フロンティア級の推論が要るか) * 許容条件(どこまでの待ち時間やタスク失敗を許せるか) 👀 狙い目は高頻度かつ低 中難易度で、応答時間と精度の許容幅が大きいタスク!! ~ 4
5 Driving AI Adoption Using In-House GPUs to Serve Qwen
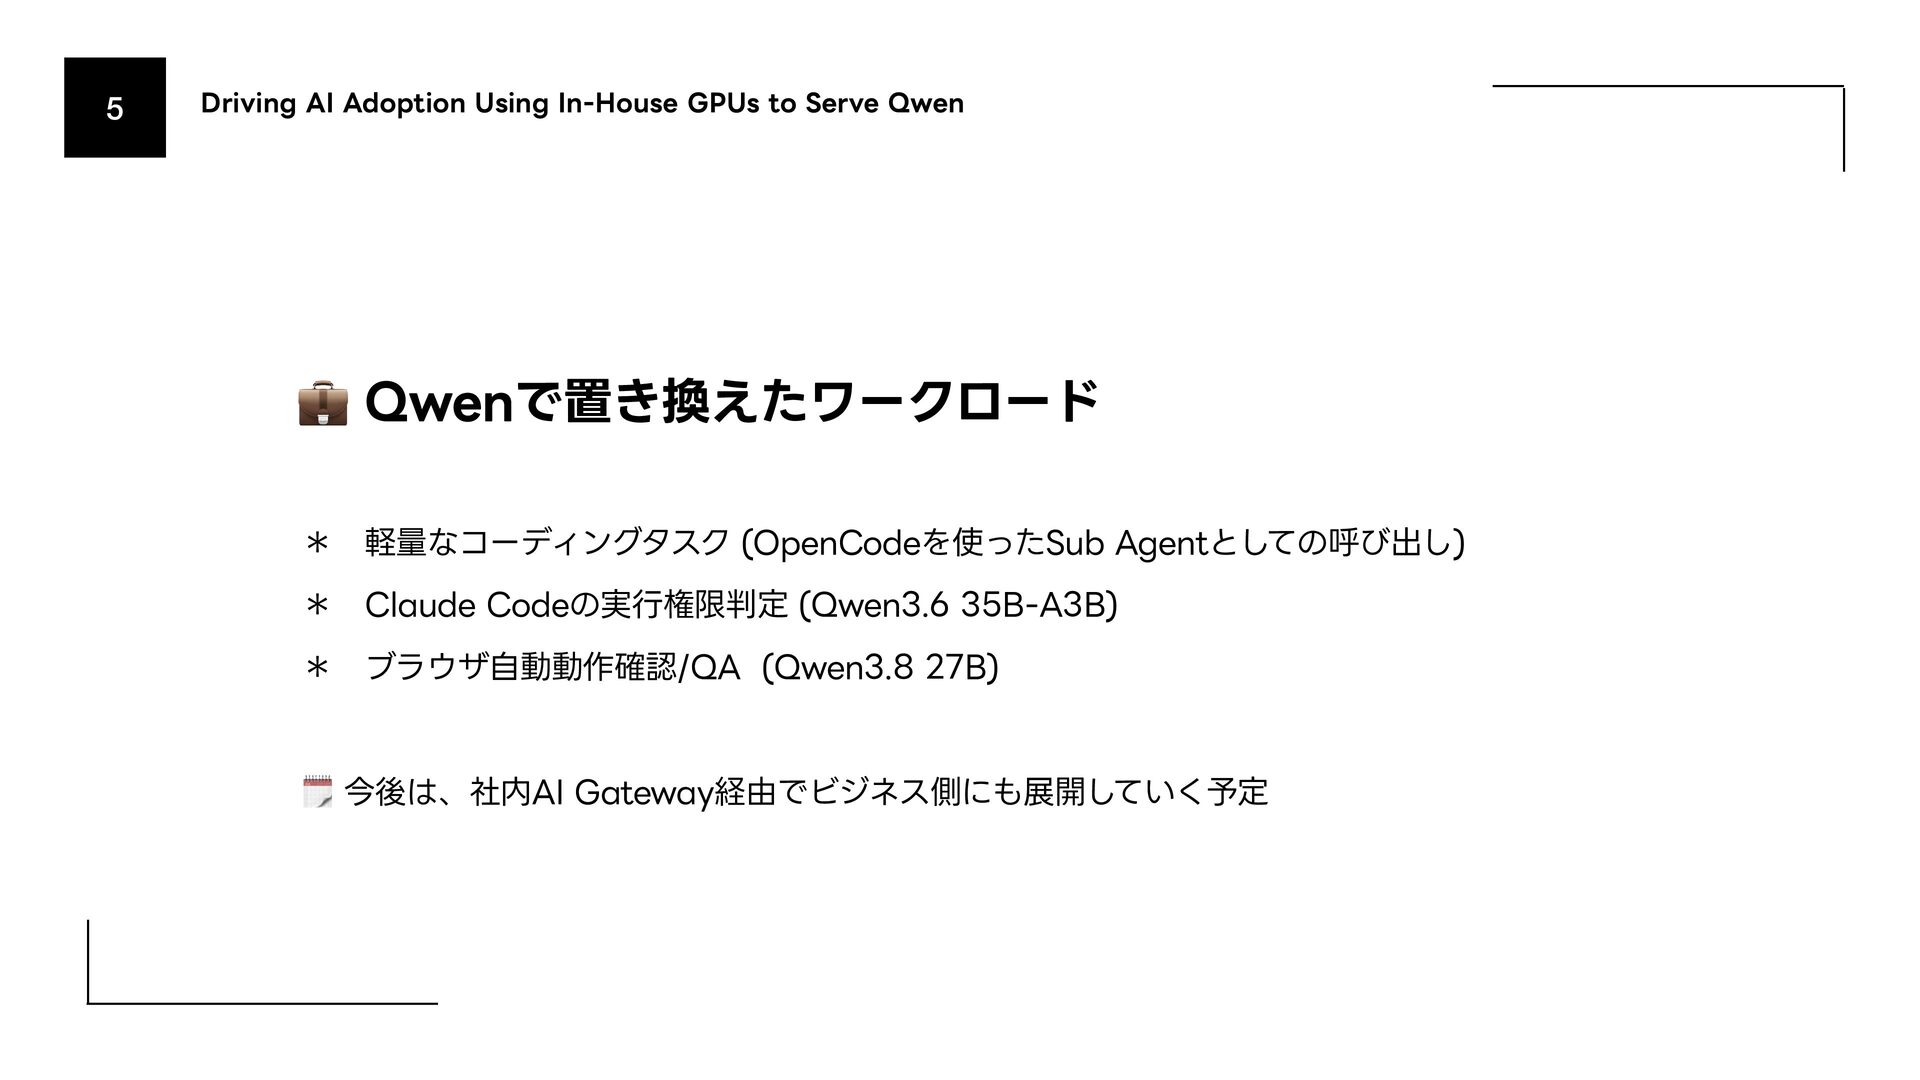
💼 Qwenで置き換えたワークロード * 軽量なコーディングタスク (OpenCodeを使ったSub Agentとしての呼び出し) * Claude Codeの実行権限判定 (Qwen3.6 35B-A3B) * ブラウザ自動動作確認/QA (Qwen3.8 27B) 🗓 今後は、社内AI Gateway経由でビジネス側にも展開していく予定
6 Driving AI Adoption Using In-House GPUs to Serve Qwen
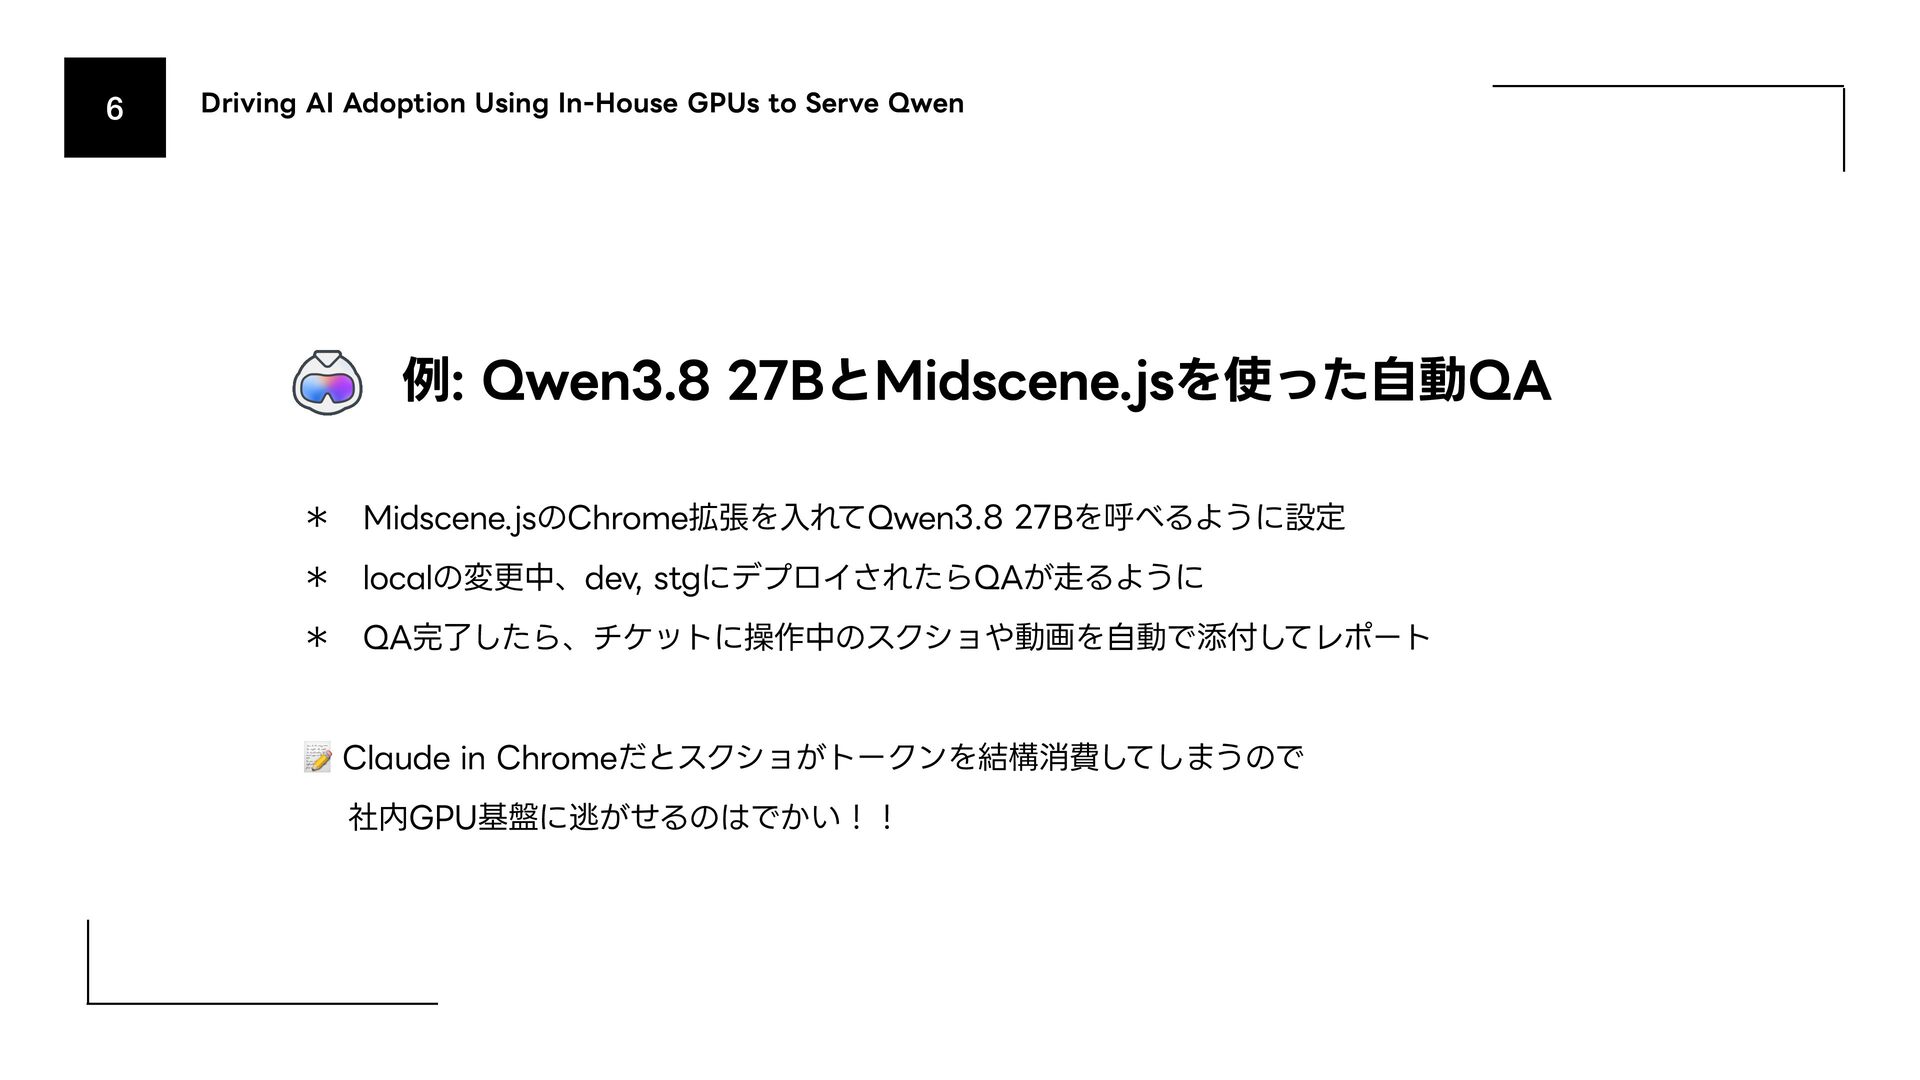
例: Qwen3.8 27BとMidscene.jsを使った自動QA * Midscene.jsのChrome拡張を入れてQwen3.8 27Bを呼べるように設定 * localの変更中、dev, stgにデプロイされたらQAが走るように * QA完了したら、チケットに操作中のスクショや動画を自動で添付してレポート 📝 Claude in Chromeだとスクショがトークンを結構消費してしまうので 社内GPU基盤に逃がせるのはでかい!!
Driving AI Adoption Using In-House GPUs to Serve Qwen 3.
Open-weight model inference infrastructure
7 Driving AI Adoption Using In-House GPUs to Serve Qwen
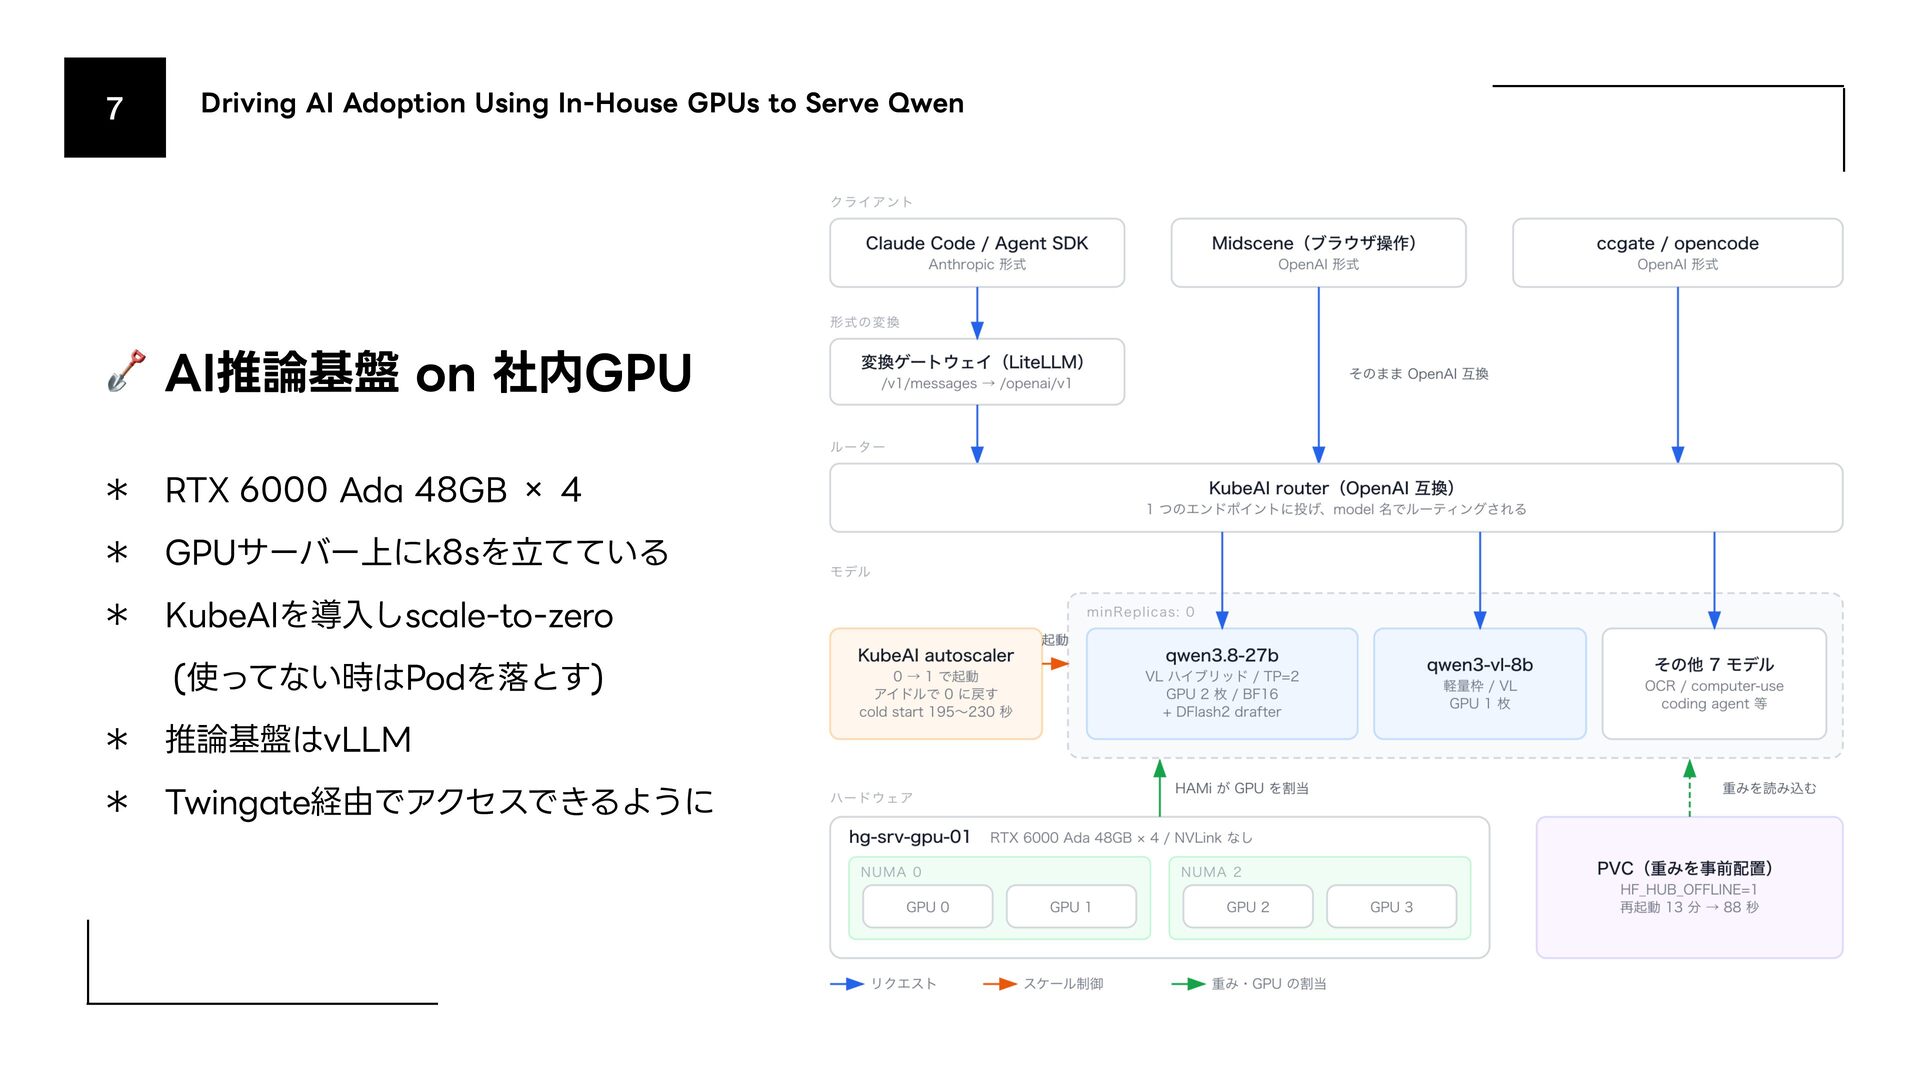
AI推論基盤 on 社内GPU * RTX 6000 Ada 48GB × 4 * GPUサーバー上にk8sを立てている * KubeAIを導入しscale-to-zero (使ってない時はPodを落とす) * 推論基盤はvLLM * Twingate経由でアクセスできるように
8 Driving AI Adoption Using In-House GPUs to Serve Qwen
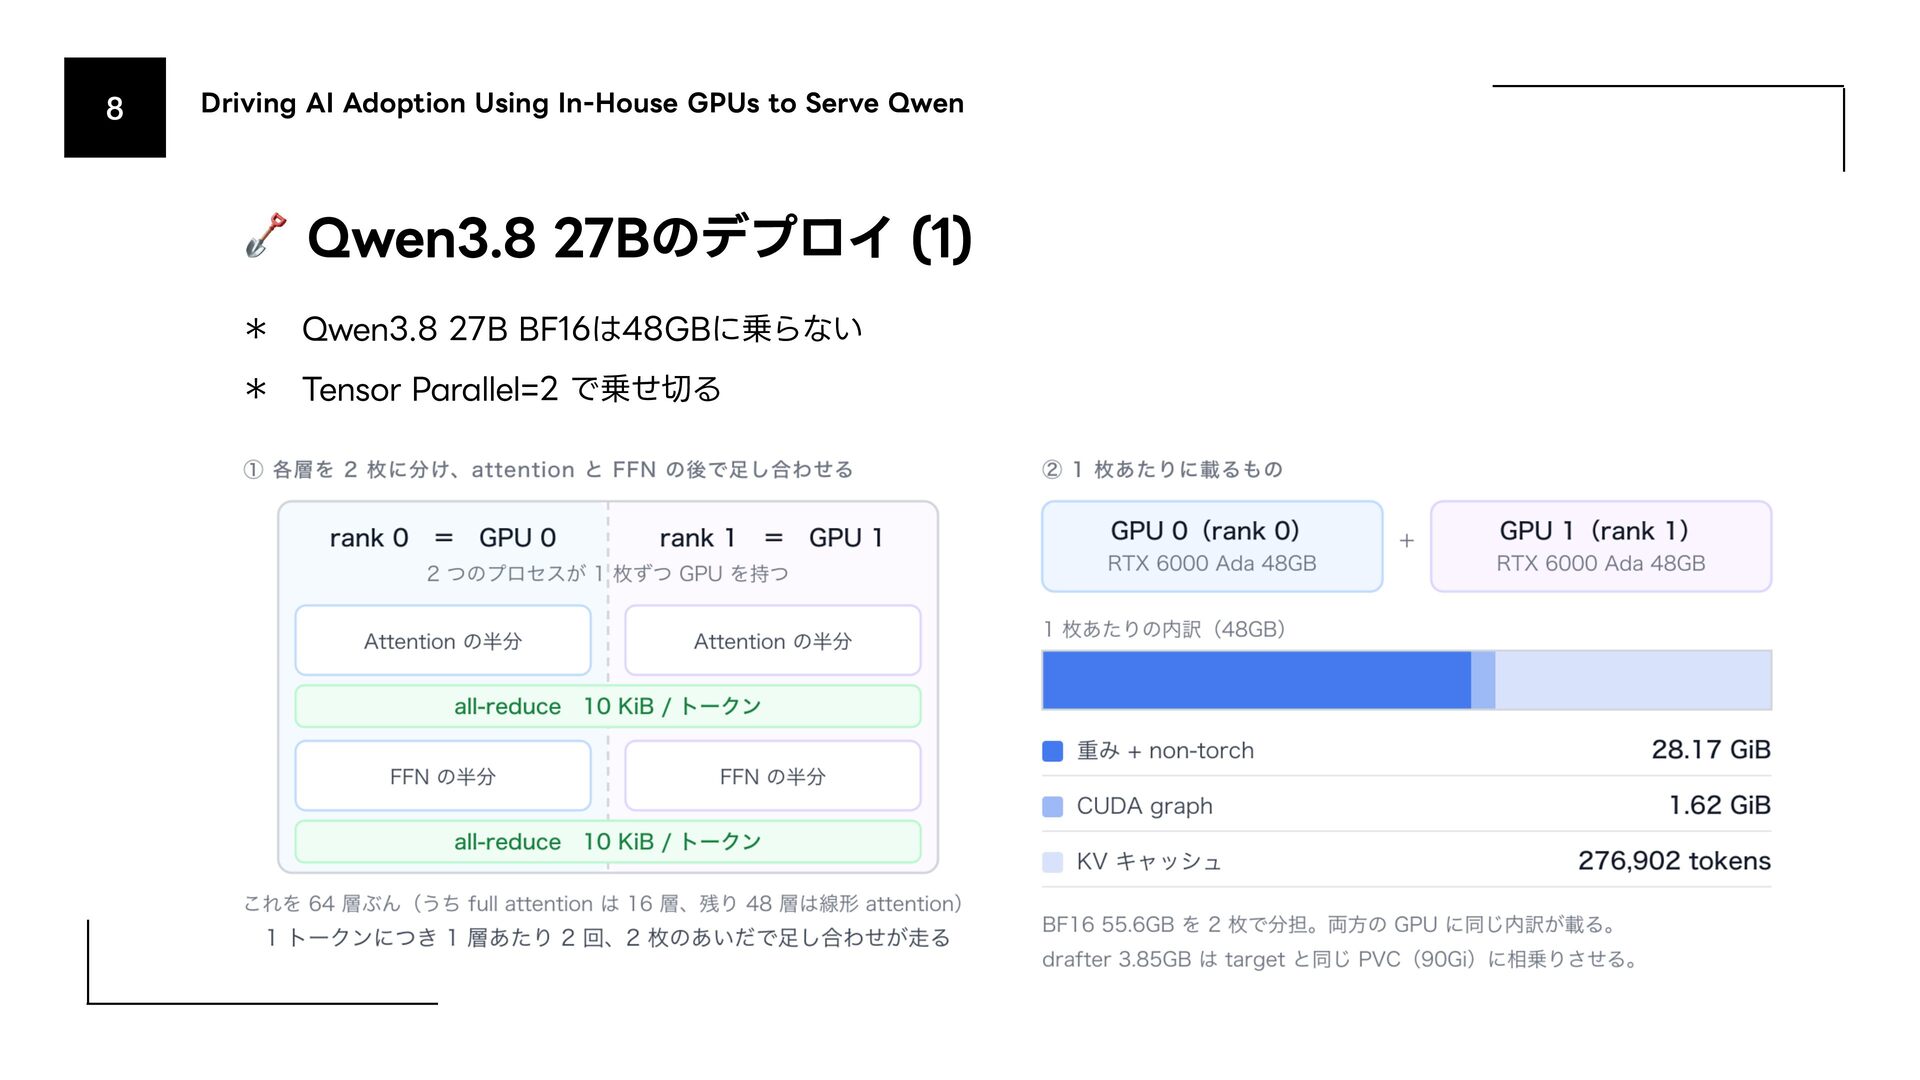
Qwen3.8 27Bのデプロイ (1) * Qwen3.8 27B BF16は48GBに乗らない * Tensor Parallel=2 で乗せ切る
9 Driving AI Adoption Using In-House GPUs to Serve Qwen
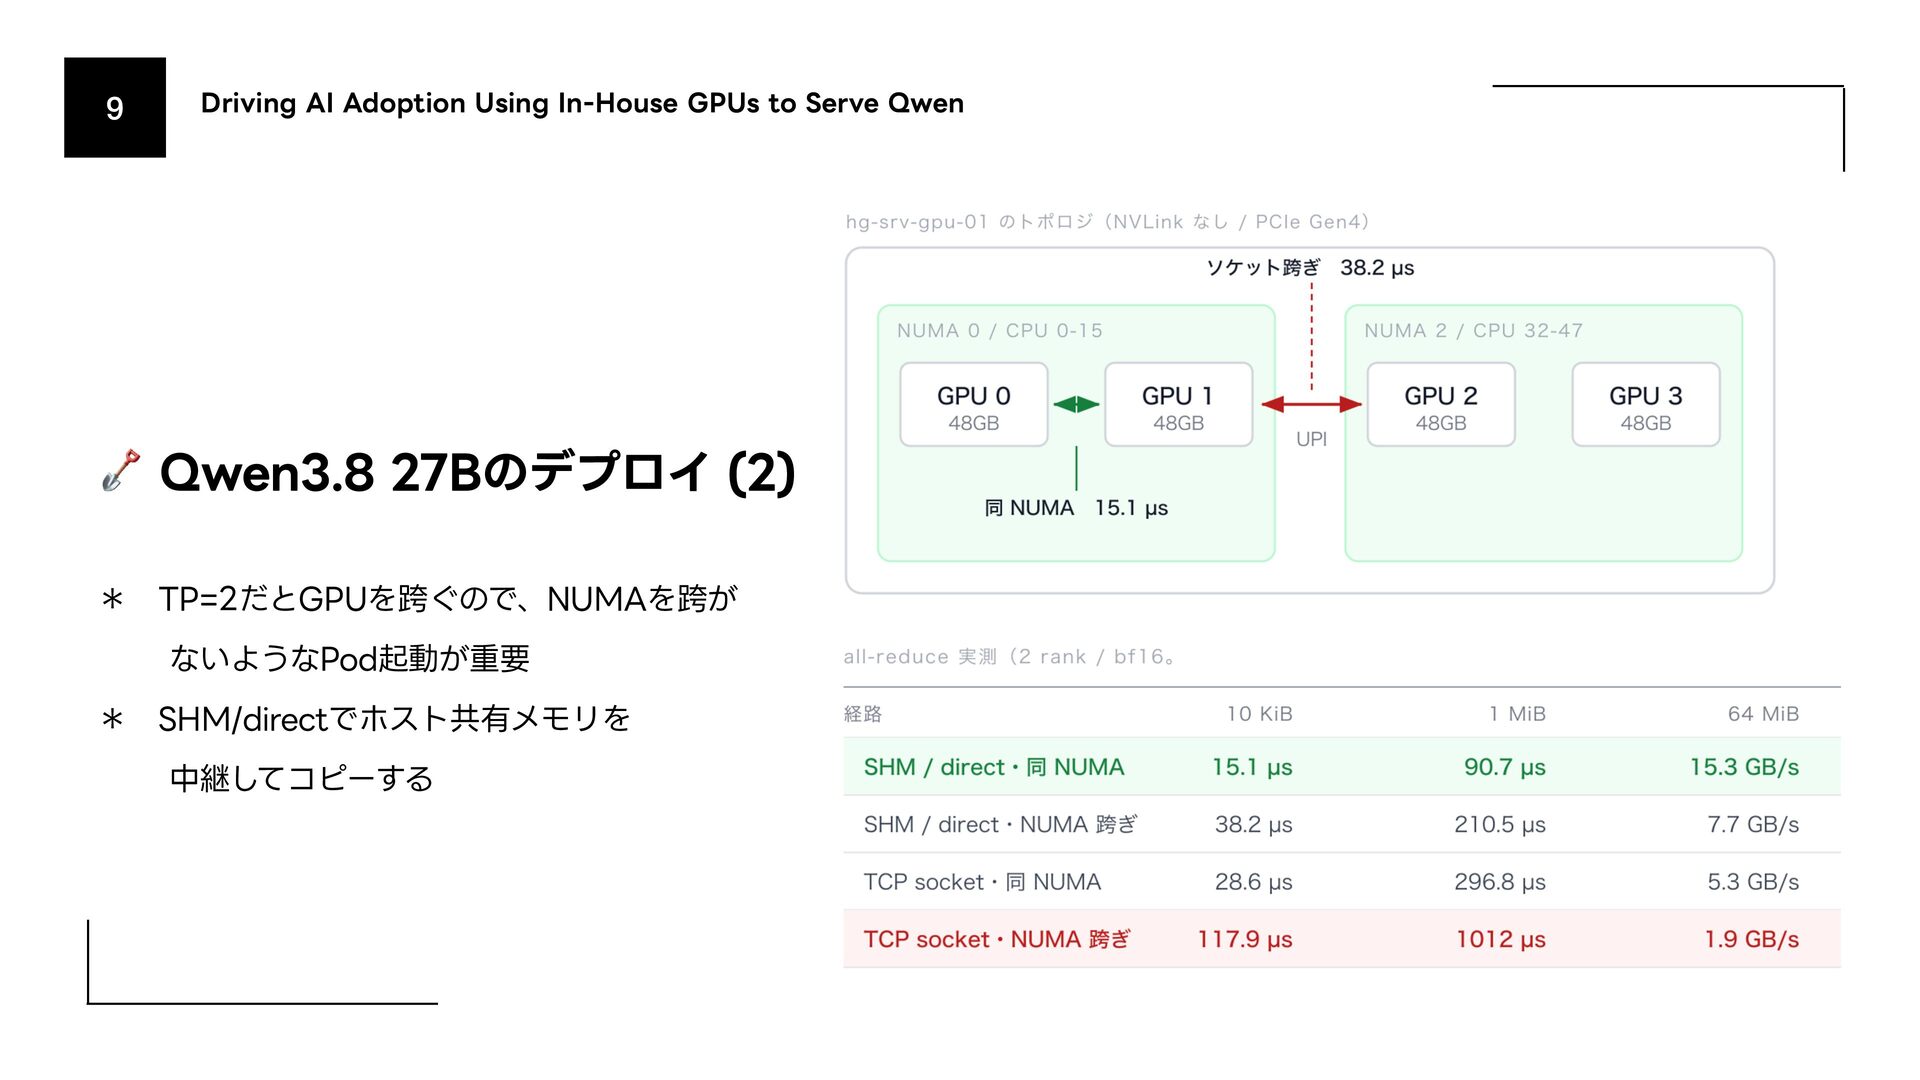
Qwen3.8 27Bのデプロイ (2) * TP=2だとGPUを跨ぐので、NUMAを跨が ないようなPod起動が重要 * SHM/directでホスト共有メモリを 中継してコピーする
Driving AI Adoption Using In-House GPUs to Serve Qwen
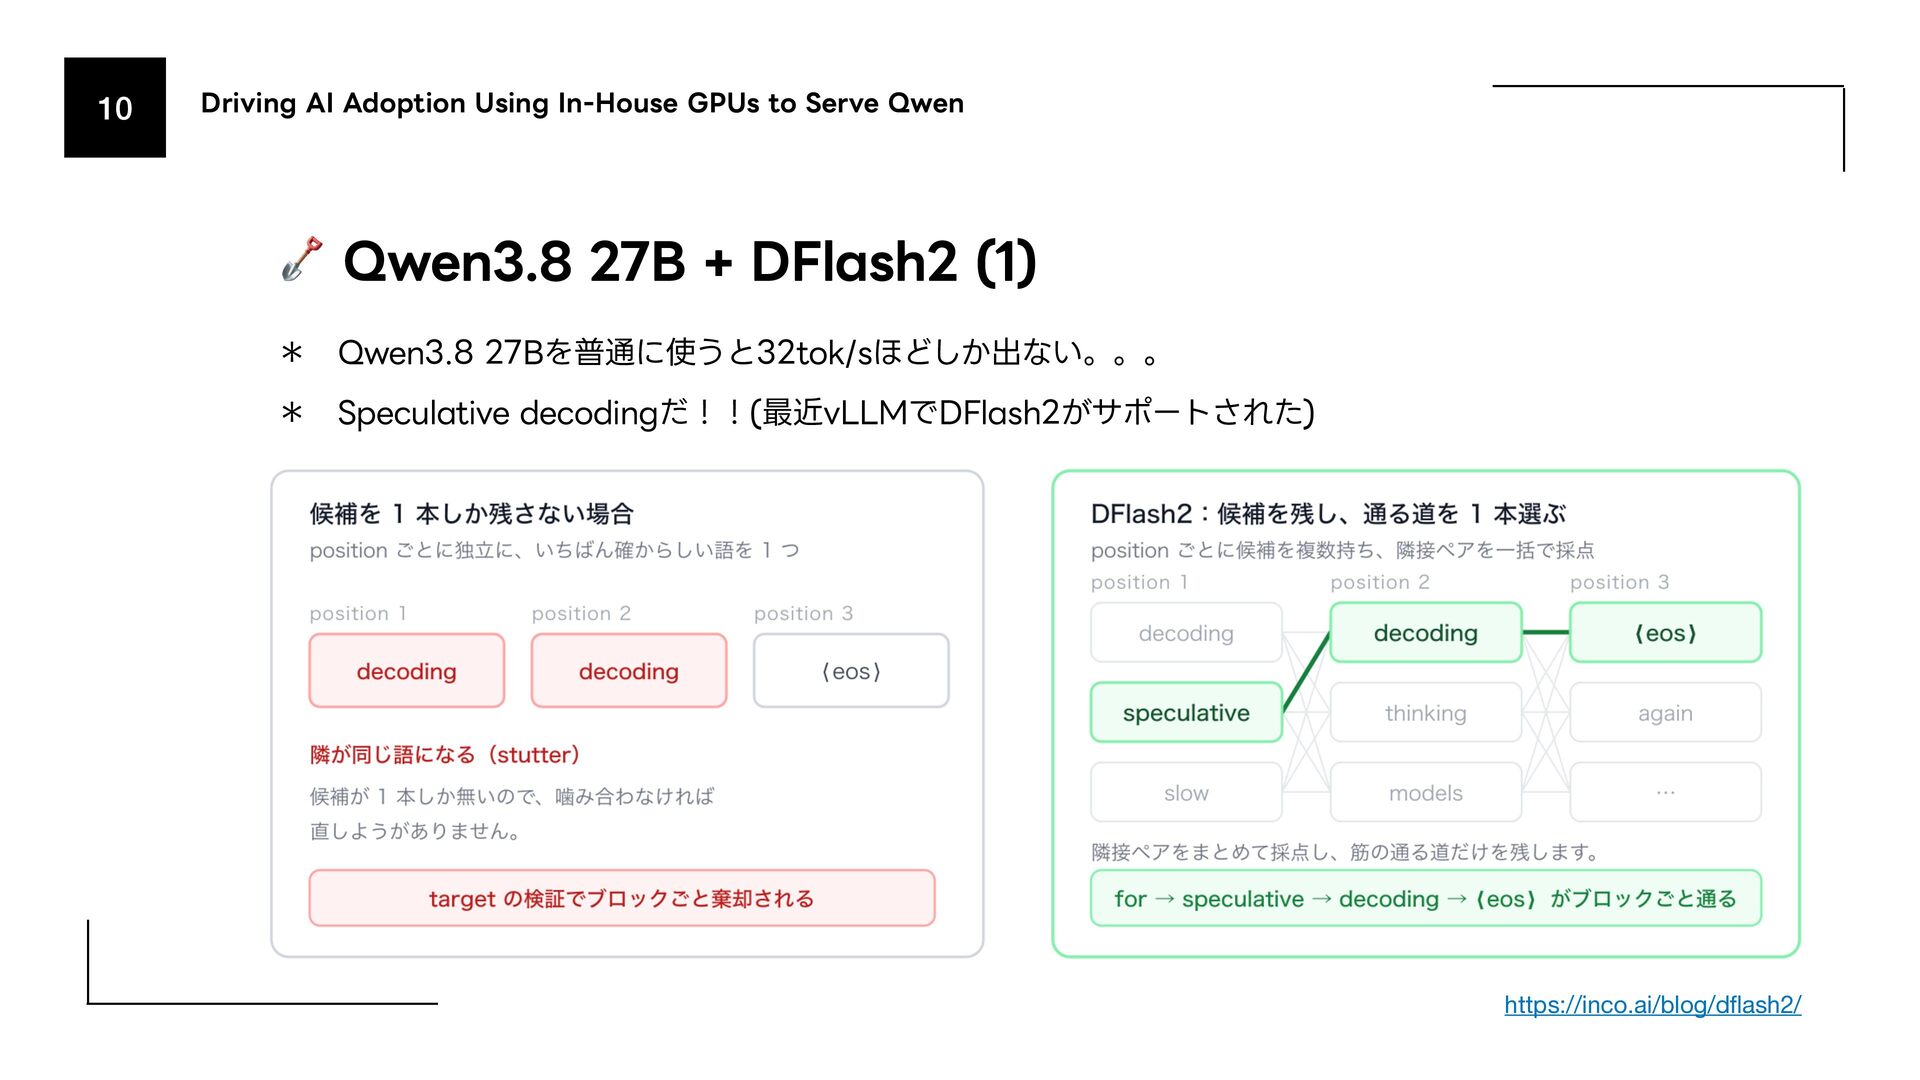
Qwen3.8 27B + DFlash2 (1) * Qwen3.8 27Bを普通に使うと32tok/sほどしか出ない。。。 * Speculative decodingだ!!(最近vLLMでDFlash2がサポートされた) https://inco.ai/blog/d ash2/ fl 10
11 Driving AI Adoption Using In-House GPUs to Serve Qwen
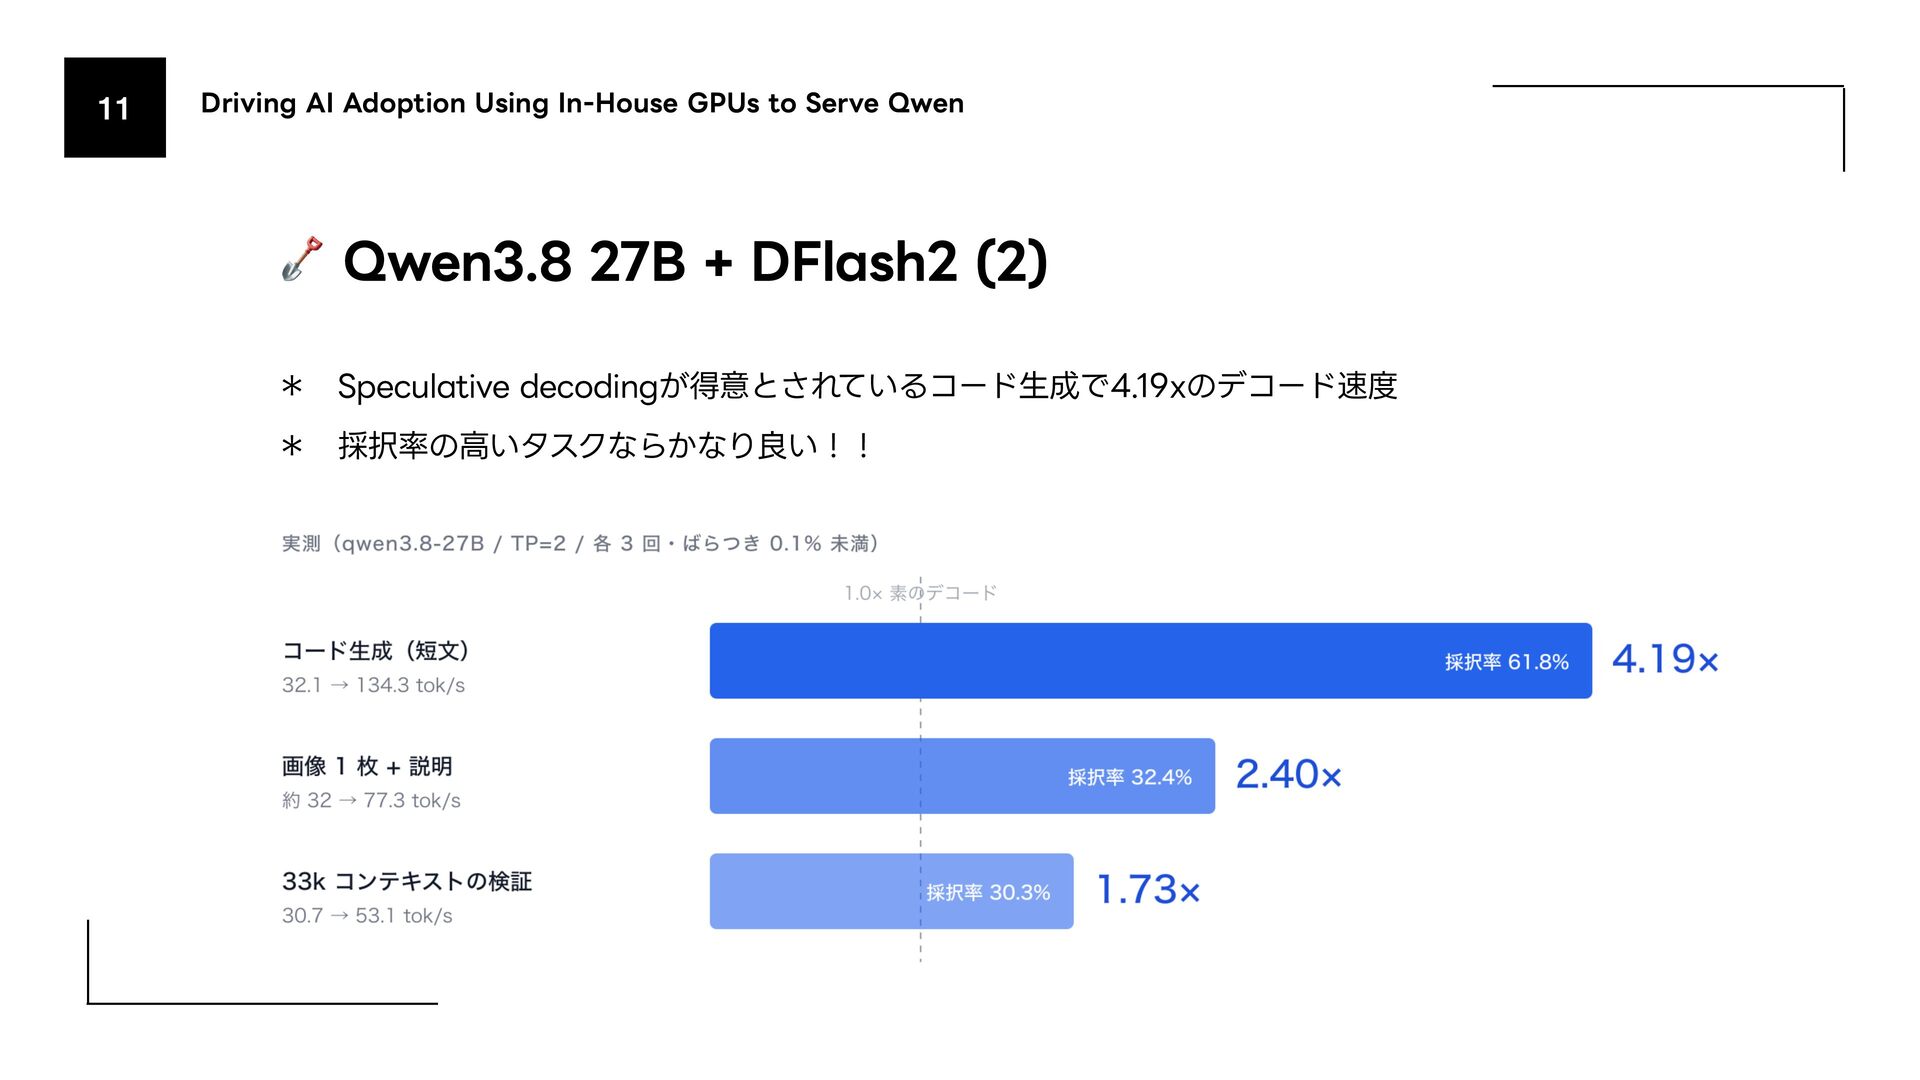
Qwen3.8 27B + DFlash2 (2) * Speculative decodingが得意とされているコード生成で4.19xのデコード速度 * 採択率の高いタスクならかなり良い!!
12 Driving AI Adoption Using In-House GPUs to Serve Qwen
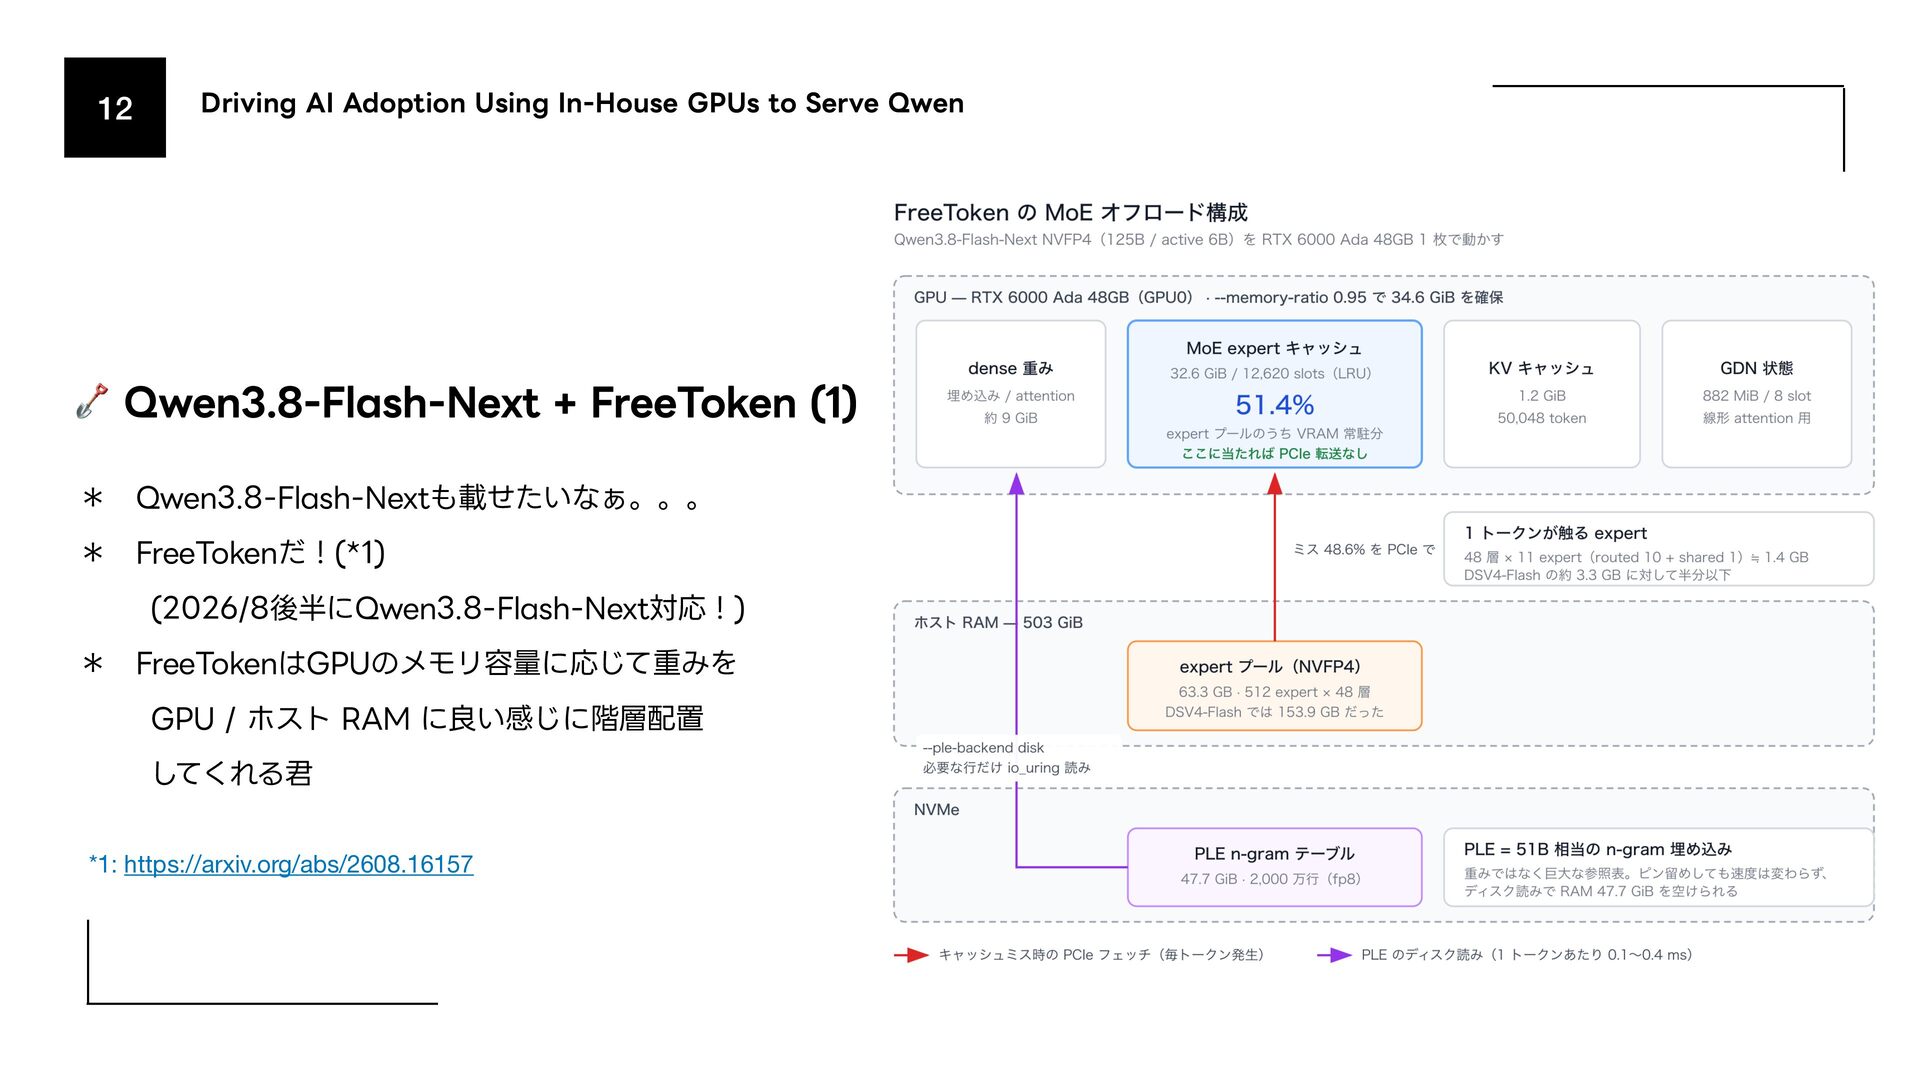
Qwen3.8-Flash-Next + FreeToken (1) * Qwen3.8-Flash-Nextも載せたいなぁ。。。 * FreeTokenだ!(*1) (2026/8後半にQwen3.8-Flash-Next対応!) * FreeTokenはGPUのメモリ容量に応じて重みを GPU / ホスト RAM に良い感じに階層配置 してくれる君 *1: https://arxiv.org/abs/2608.16157
13 Driving AI Adoption Using In-House GPUs to Serve Qwen
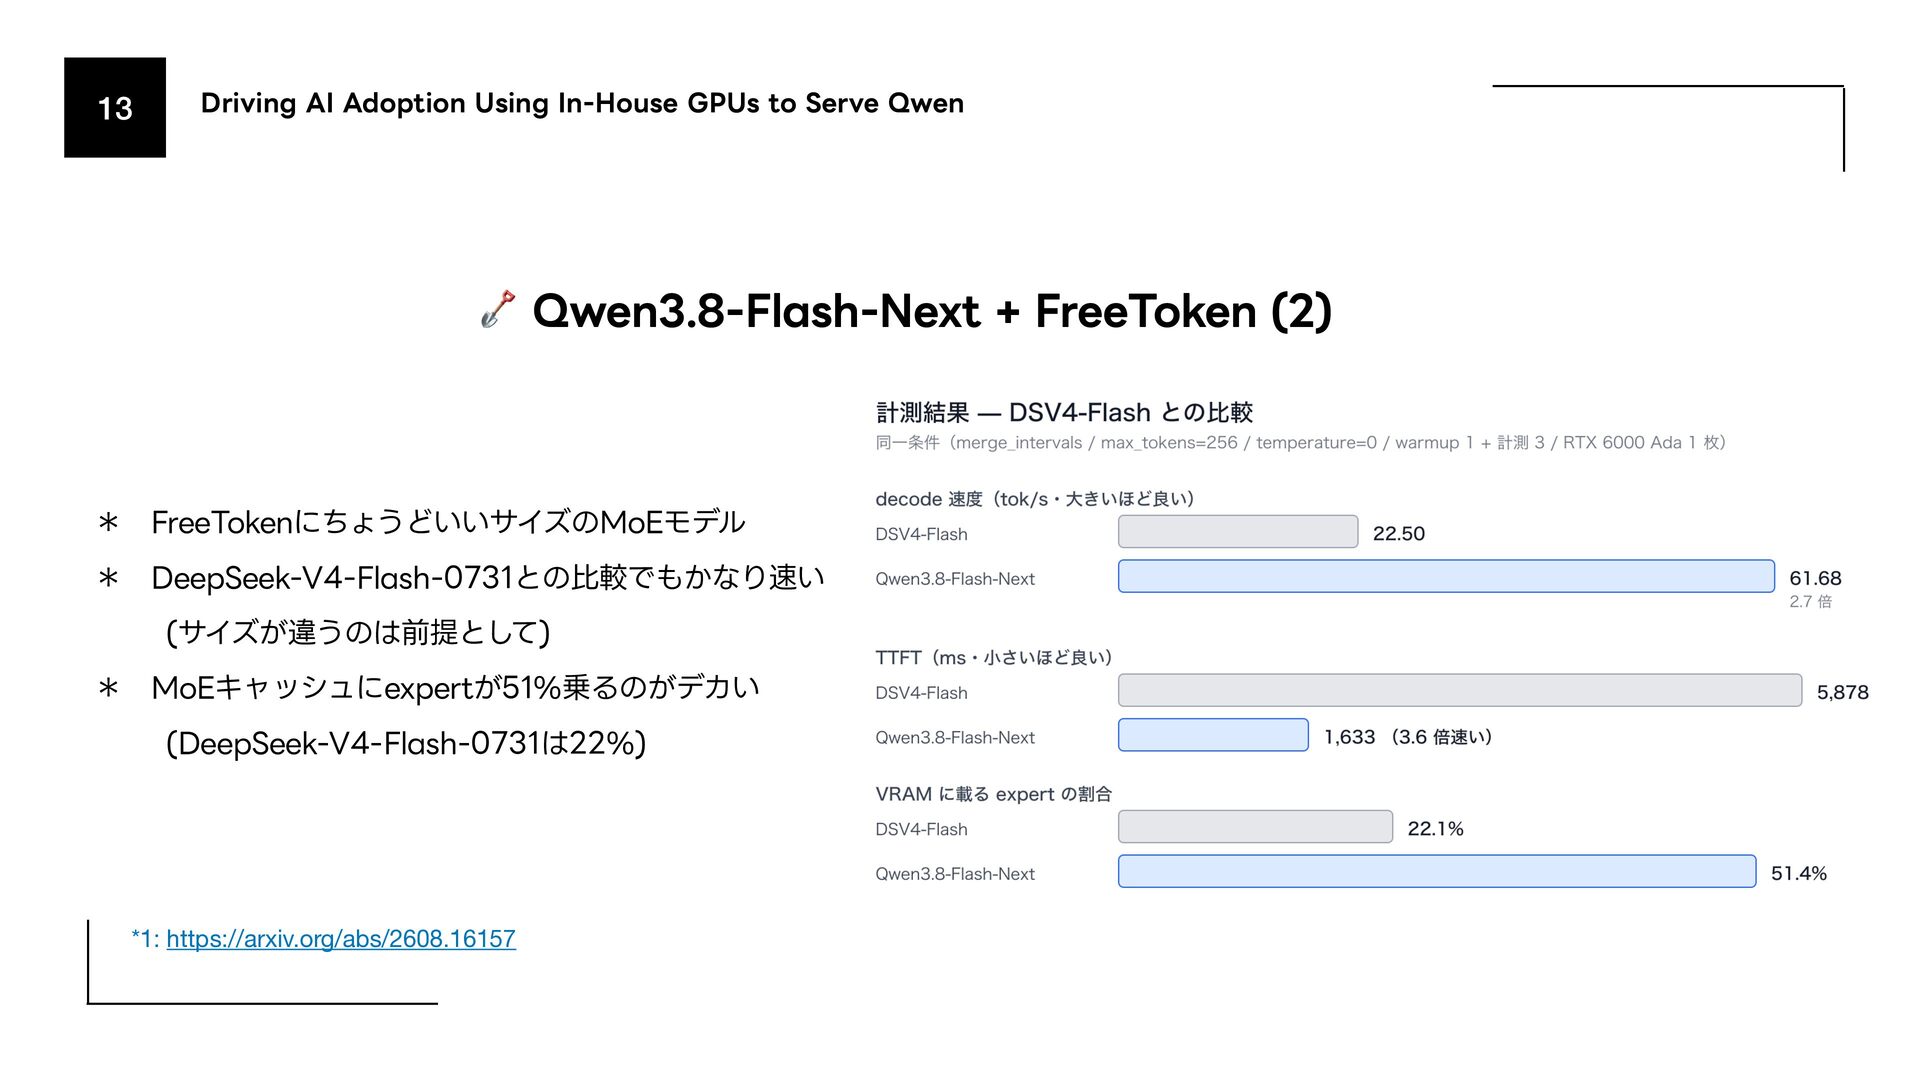
Qwen3.8-Flash-Next + FreeToken (2) * FreeTokenにちょうどいいサイズのMoEモデル * DeepSeek-V4-Flash-0731との比較でもかなり速い (サイズが違うのは前提として) * MoEキャッシュにexpertが51%乗るのがデカい (DeepSeek-V4-Flash-0731は22%) *1: https://arxiv.org/abs/2608.16157
Driving AI Adoption Using In-House GPUs to Serve Qwen 4.
Conclusion
14 Driving AI Adoption Using In-House GPUs to Serve Qwen
🙌 Qwenと社内GPU基盤でコスト削減に成功 * 個人のQA利用だけでも一日4000円ほど削減できている。 * 社内展開して、全社でのAI利用を後押し。ビジネス職種でも使えるようにAI Gateway整備中 * Qwen3.8 27Bが良すぎる。
15 Driving AI Adoption Using In-House GPUs to Serve Qwen
😫 課題 * 全社員を捌くにはまだスループットが足りない。GPU欲しい。 * Qwen3.8-Flash-Next + FreeTokenがKubeAIに乗らない(FreeTokenをサポートしてない) ので、KubeAIのサポート状況に完全依存している構成をやめるのも一手。
16 Driving AI Adoption Using In-House GPUs to Serve Qwen
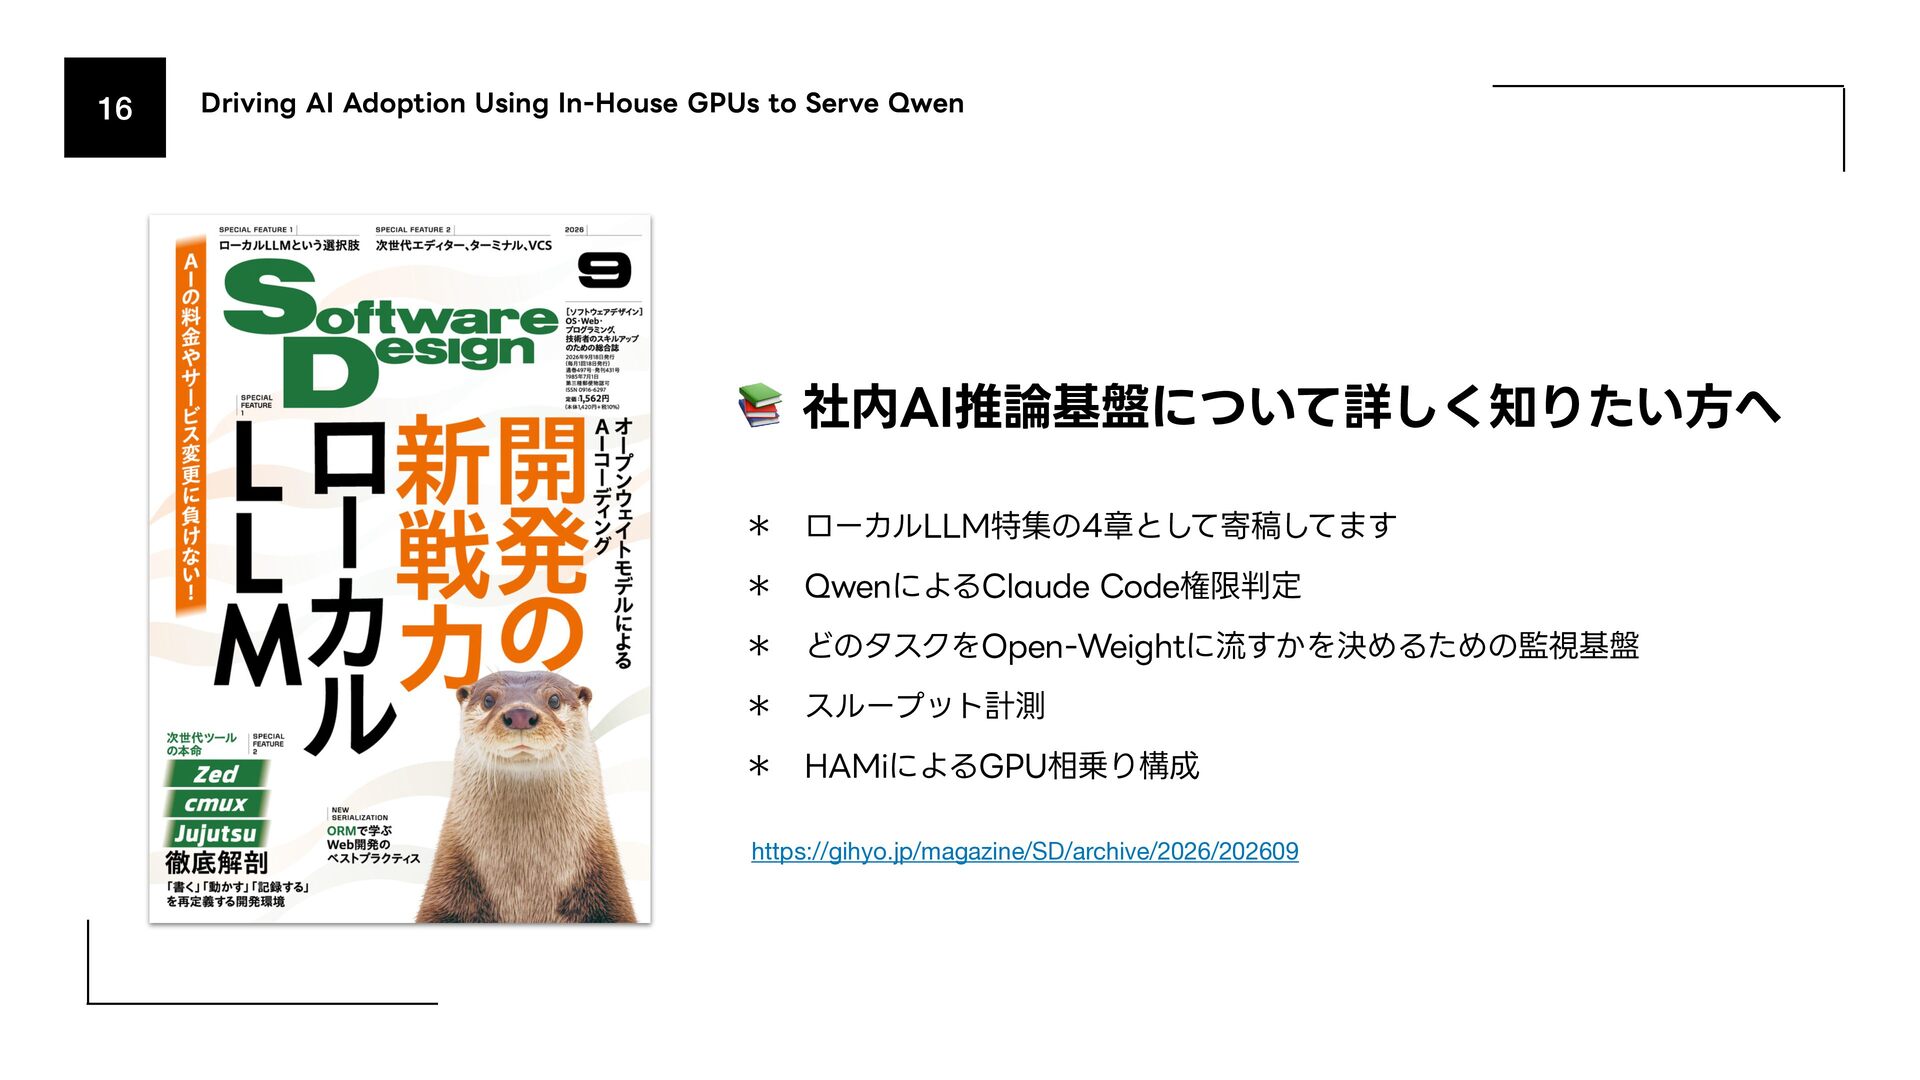
📚 社内AI推論基盤について詳しく知りたい方へ * ローカルLLM特集の4章として寄稿してます * QwenによるClaude Code権限判定 * どのタスクをOpen-Weightに流すかを決めるための監視基盤 * スループット計測 * HAMiによるGPU相乗り構成 https://gihyo.jp/magazine/SD/archive/2026/202609
Driving AI Adoption Using In-House GPUs to Serve Qwen Qwen
Meetup Tokyo LayerX Hiromu Nakamura (@po3rin) 2026/09/04


 po3rin
 junkifurukawa
 carta_engineering
 pei0804
 masakane55
 pauli
 mkdev10
 kizawa2020
 harutiro
 iotengineer22
 oikon48
 sudoakiy
 takanorip
 bkeepers
 sonatard
 nmsamuel
 ryanjones
 kneath
 aleyda
 samlambert
 tmiket
 danielanewman
 kevinliebholz
 portentint
 ianozsvald