Share
Embed
Transcript
27 slides
-
2024/07/07 1 第61回 コンピュータビジョン勉強会@関東(前編) MLP Can Be A Good Transformer
Learner 2024/07/07 鬼城 渉(@onixwr) セーフィー株式会社 -
2024/07/07 2 ◆鬼城 渉(@onixwr) ◼セーフィー株式会社 • 開発本部第3開発部 Ai Vision G
グループリーダー • クラウドカメラ向けの画像認識の開発 ◆略歴 ◼サキコーポレーション(1社目) • 外観検査装置の開発 ◼オリンパスデジタルシステムデザイン(2社目) • 画像処理・画像認識の研究開発 ◼トヨタ自動車(3社目) • 自動運転のカメラ・画像処理の開発 自己紹介 -
2024/07/07 3 ◆MLP Can Be A Good Transformer Learner, CVPR
2024 Sihao Lin1, Pumeng Lyu2, Dongrui Liu2,3, Tao Tang4, Xiaodan Liang4,5,7, Andy Song1, Xiaojun Chang6,7 1.RMIT University, 2.Shanghai AI Laboratory, 3.Shanghai Jiao Tong University, 4.Shenzhen Campus of Sun Yat-sen University, 5.DarkMatter AI Research, 6.University of Technology Sydney, 7.MBZUAI 今回紹介する論文 -
2024/07/07 5 ◆Vision Transformerの計算コストを減らしたい ◼既存研究ではToken aggregation/pruningを行うことで計算量を削減しているが、 ネットワークをすべてロードするのでメモリのロードコストは変わらない ◆既存研究 ◼Token Aggregation:似たトークンを結合する
• [5] Daniel Bolya et al. : “Token Merging: Your ViT But Faster”, ICLR 2023など ◼Token Pruning:冗長なトークンを除去 • [27] Yongming Rao et al. : “Efficient vision transformers with dynamic token sparsification”, Advances in neural information processing systems 2021など モチベーション・既存研究 -
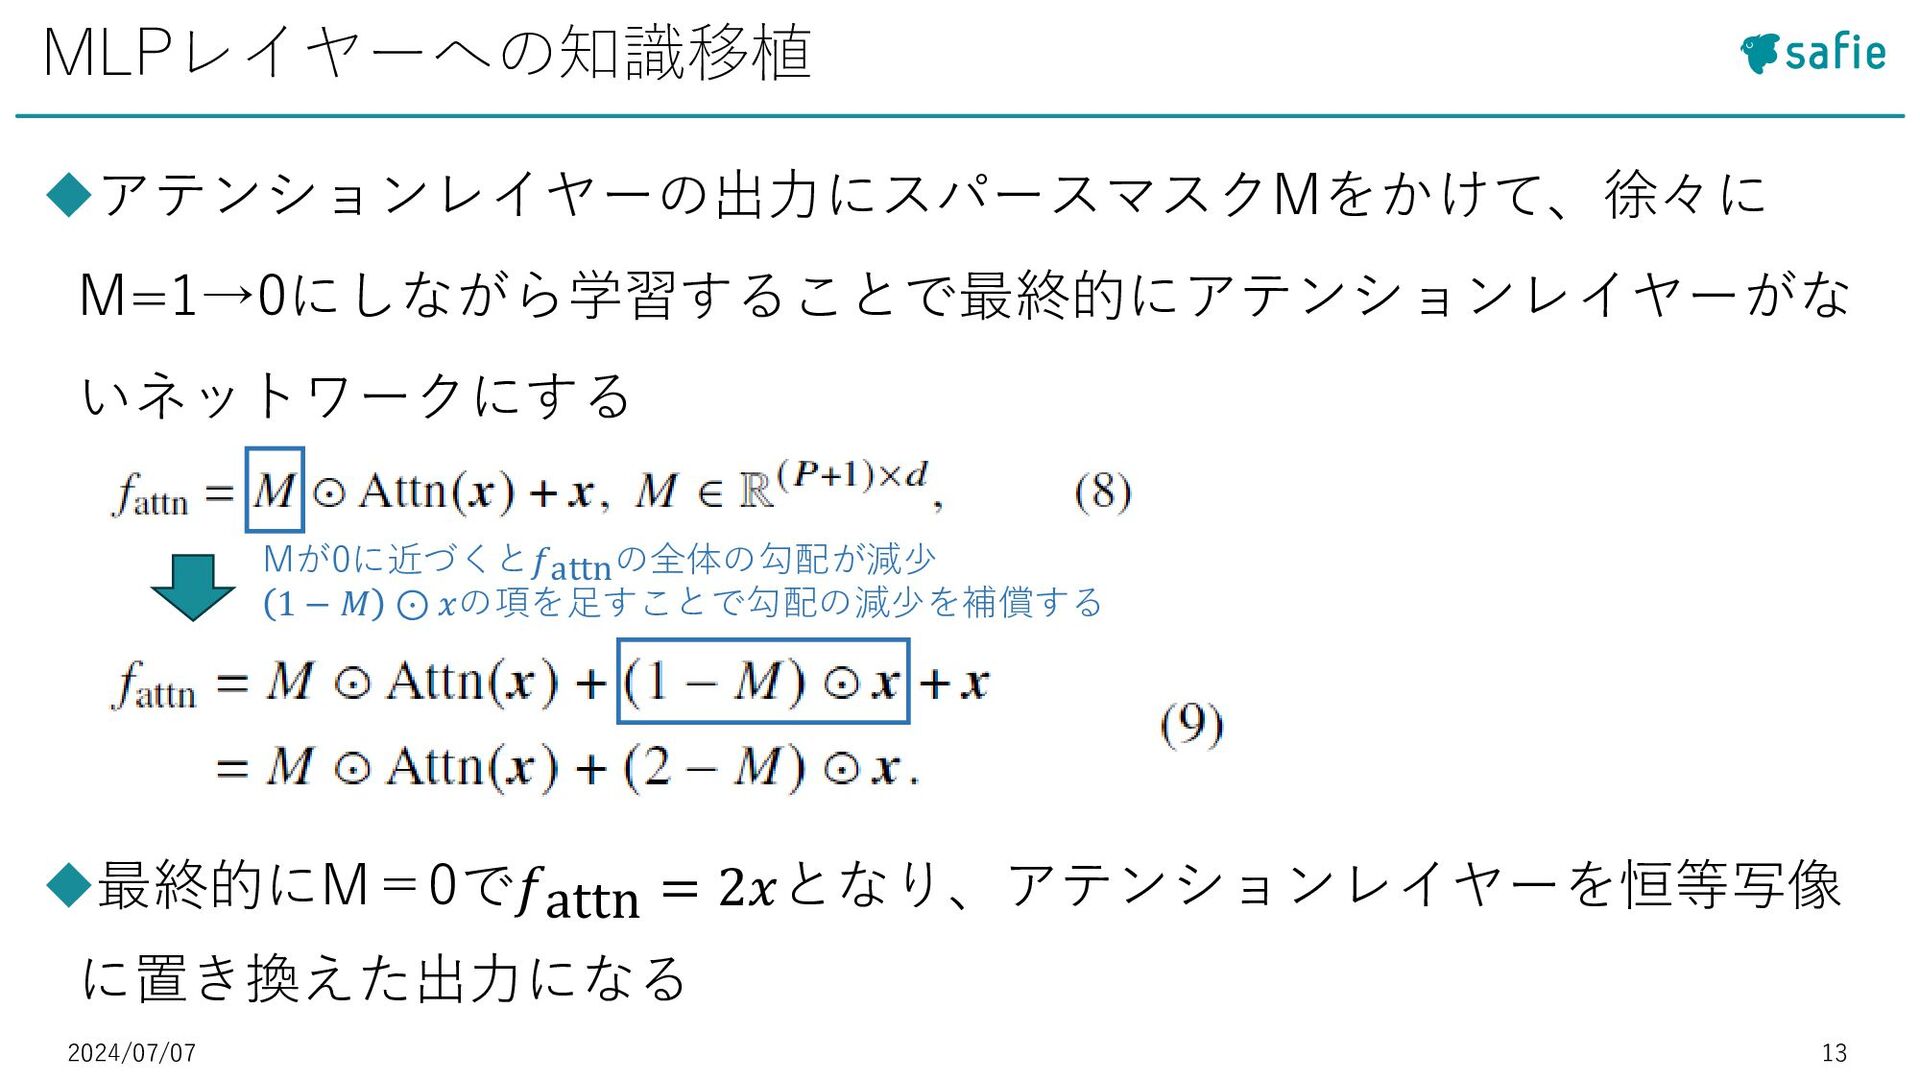
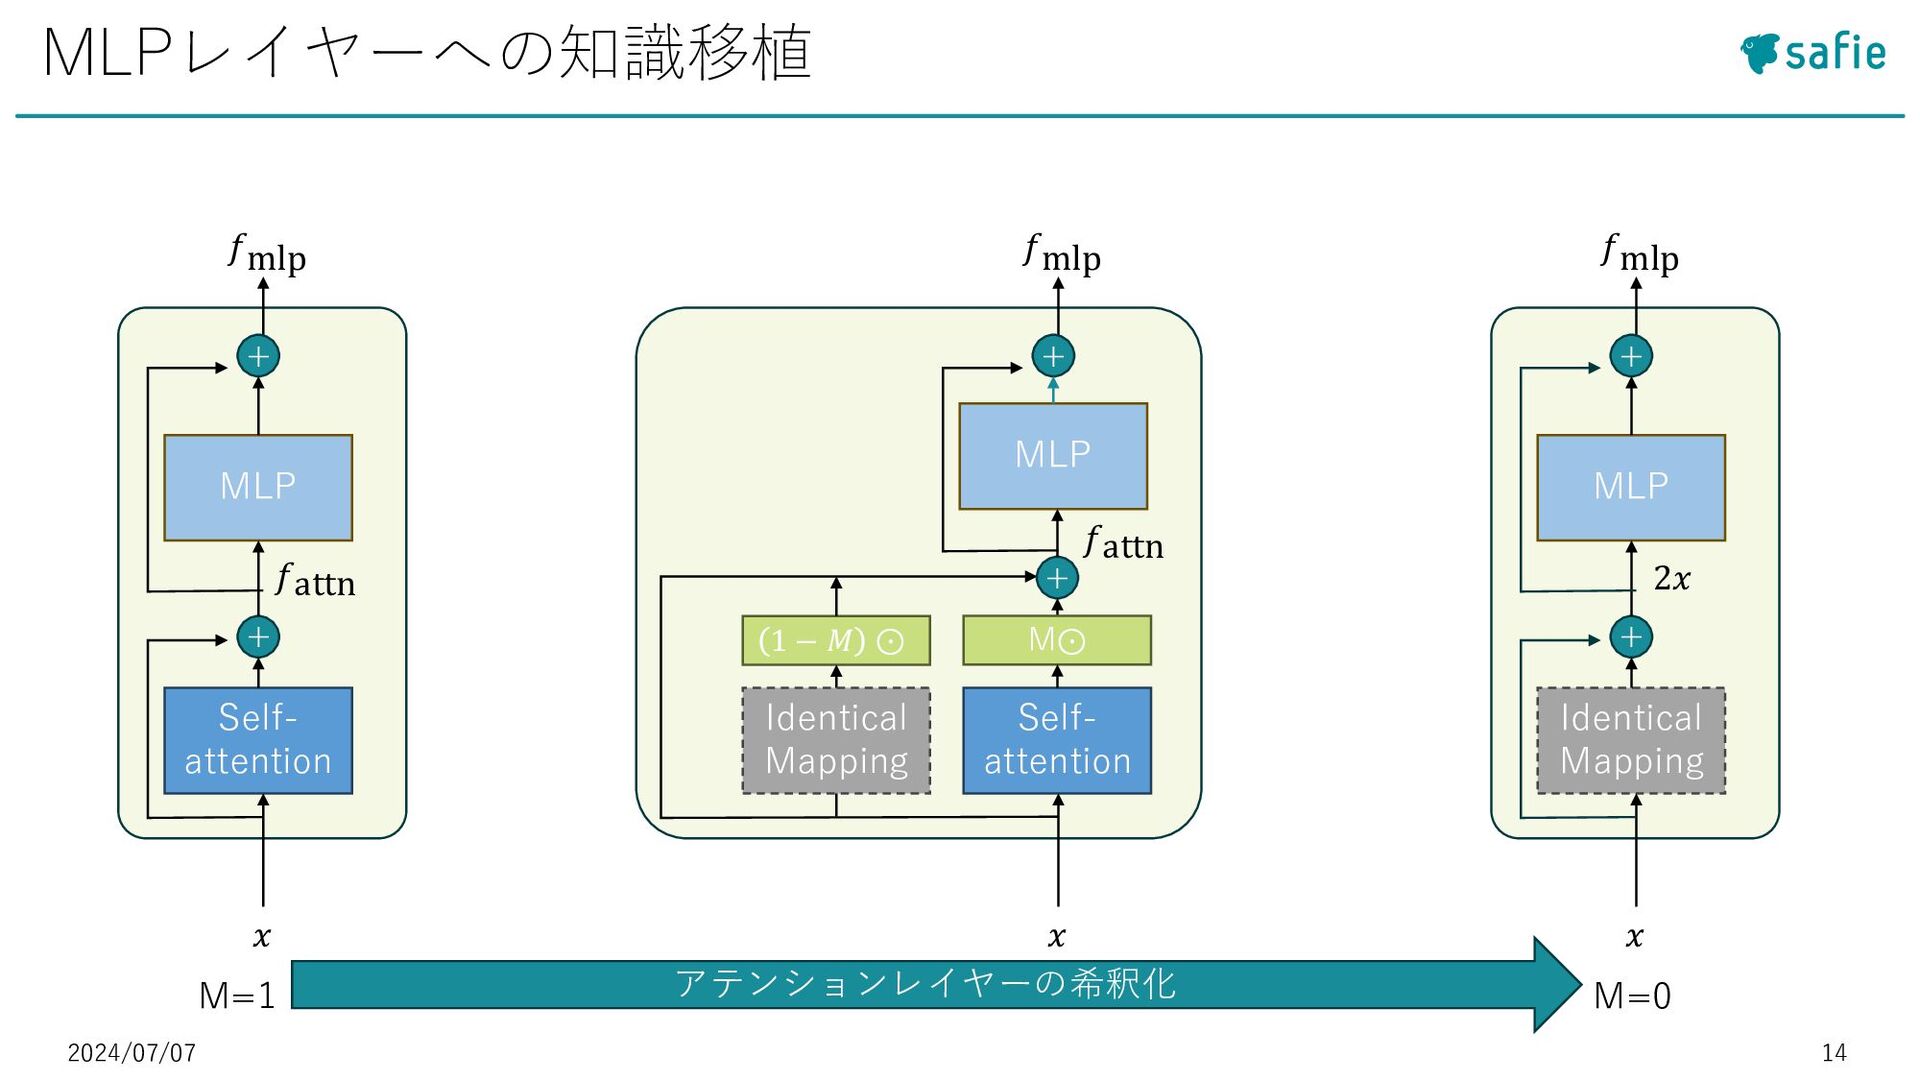
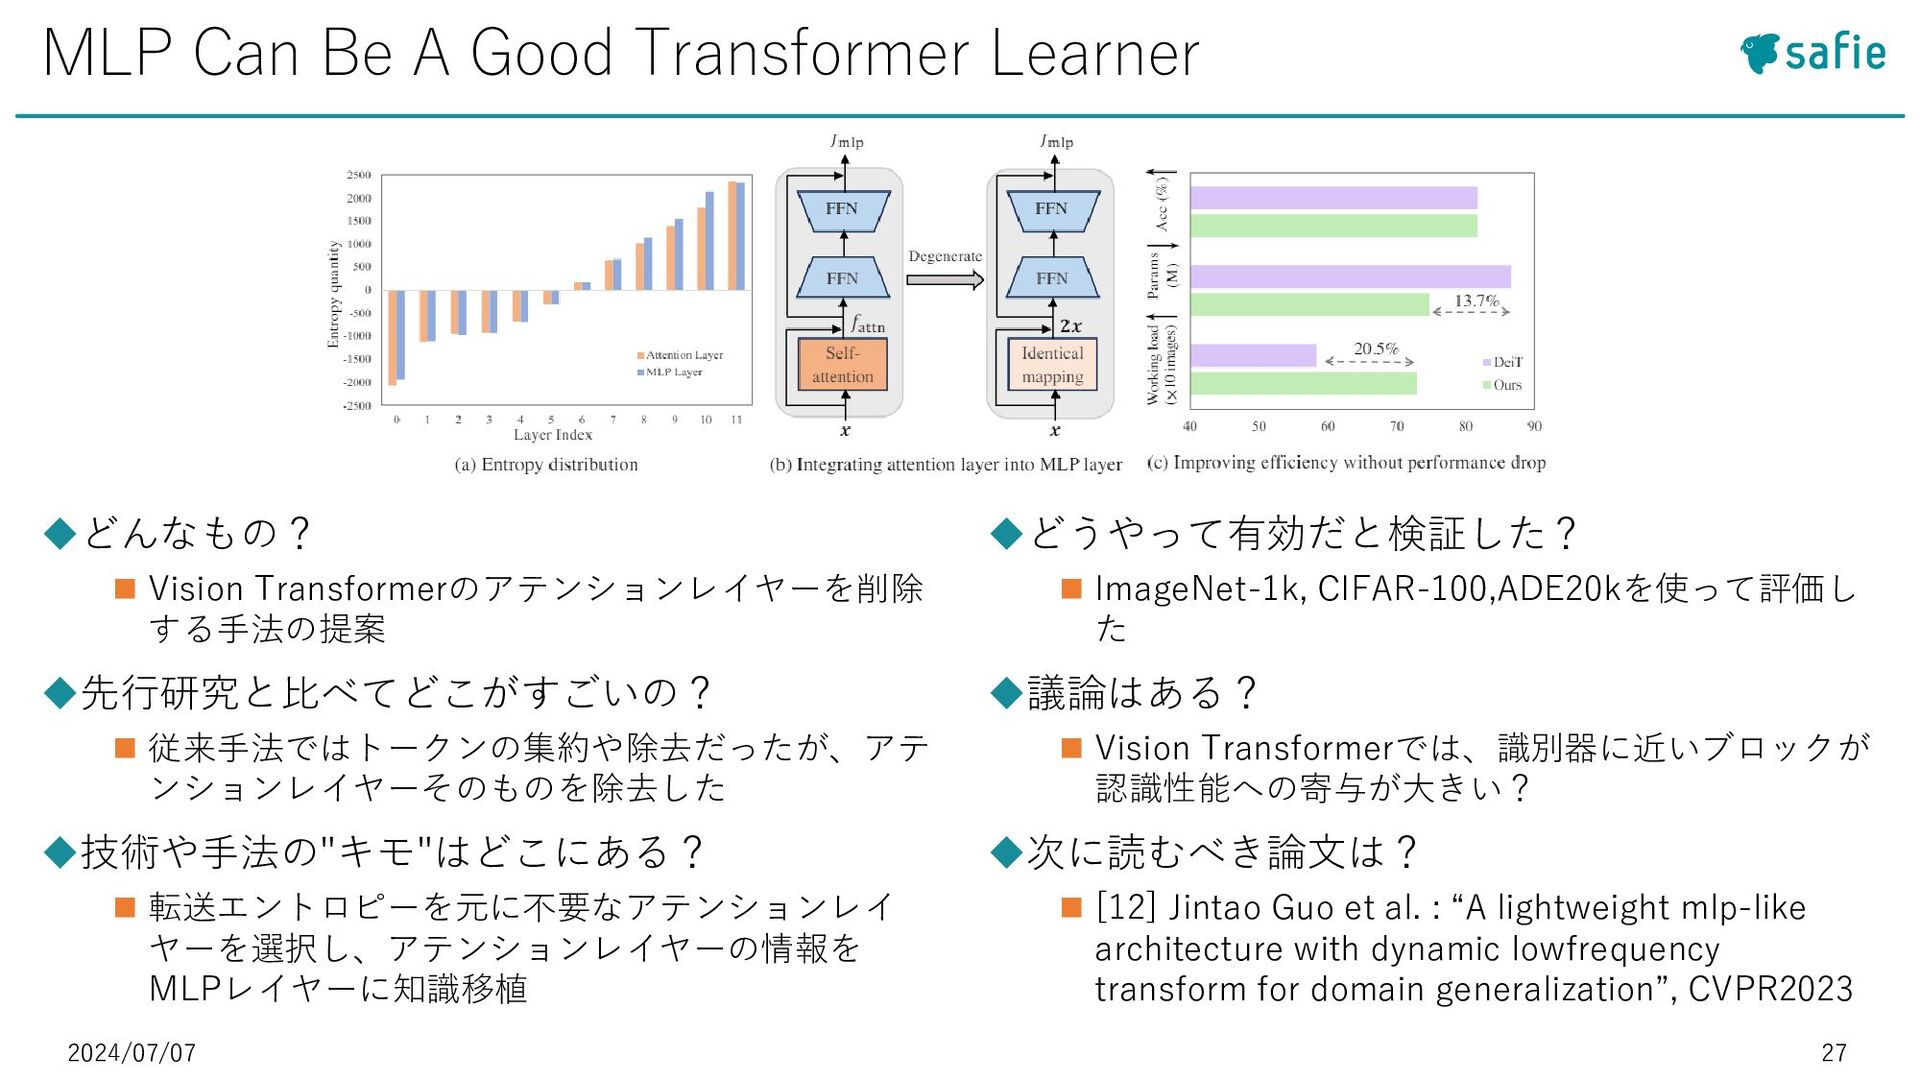
2024/07/07 13 ◆アテンションレイヤーの出力にスパースマスクMをかけて、徐々に M=1→0にしながら学習することで最終的にアテンションレイヤーがな いネットワークにする MLPレイヤーへの知識移植 Mが0に近づくと𝑓attnの全体の勾配が減少 1 − 𝑀
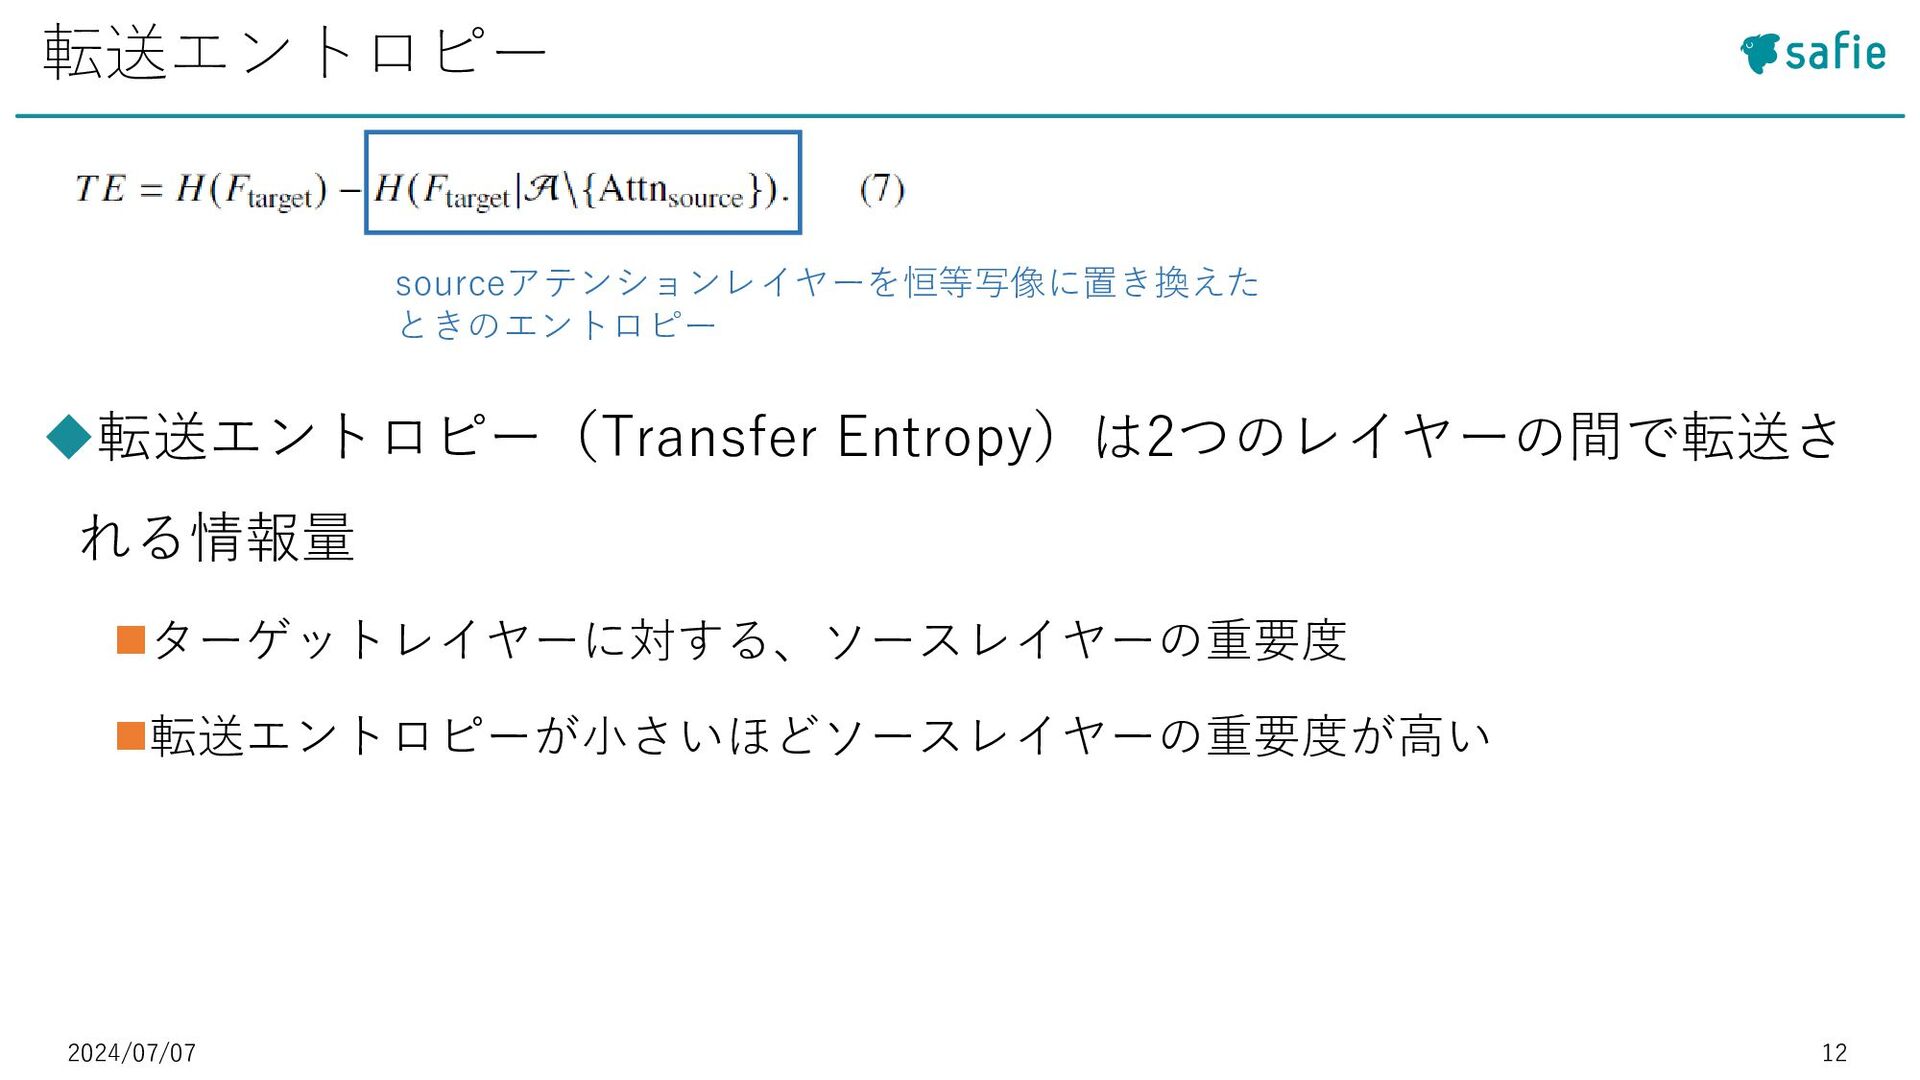
⊙ 𝑥の項を足すことで勾配の減少を補償する ◆最終的にM=0で𝑓attn = 2𝑥となり、アテンションレイヤーを恒等写像 に置き換えた出力になる -
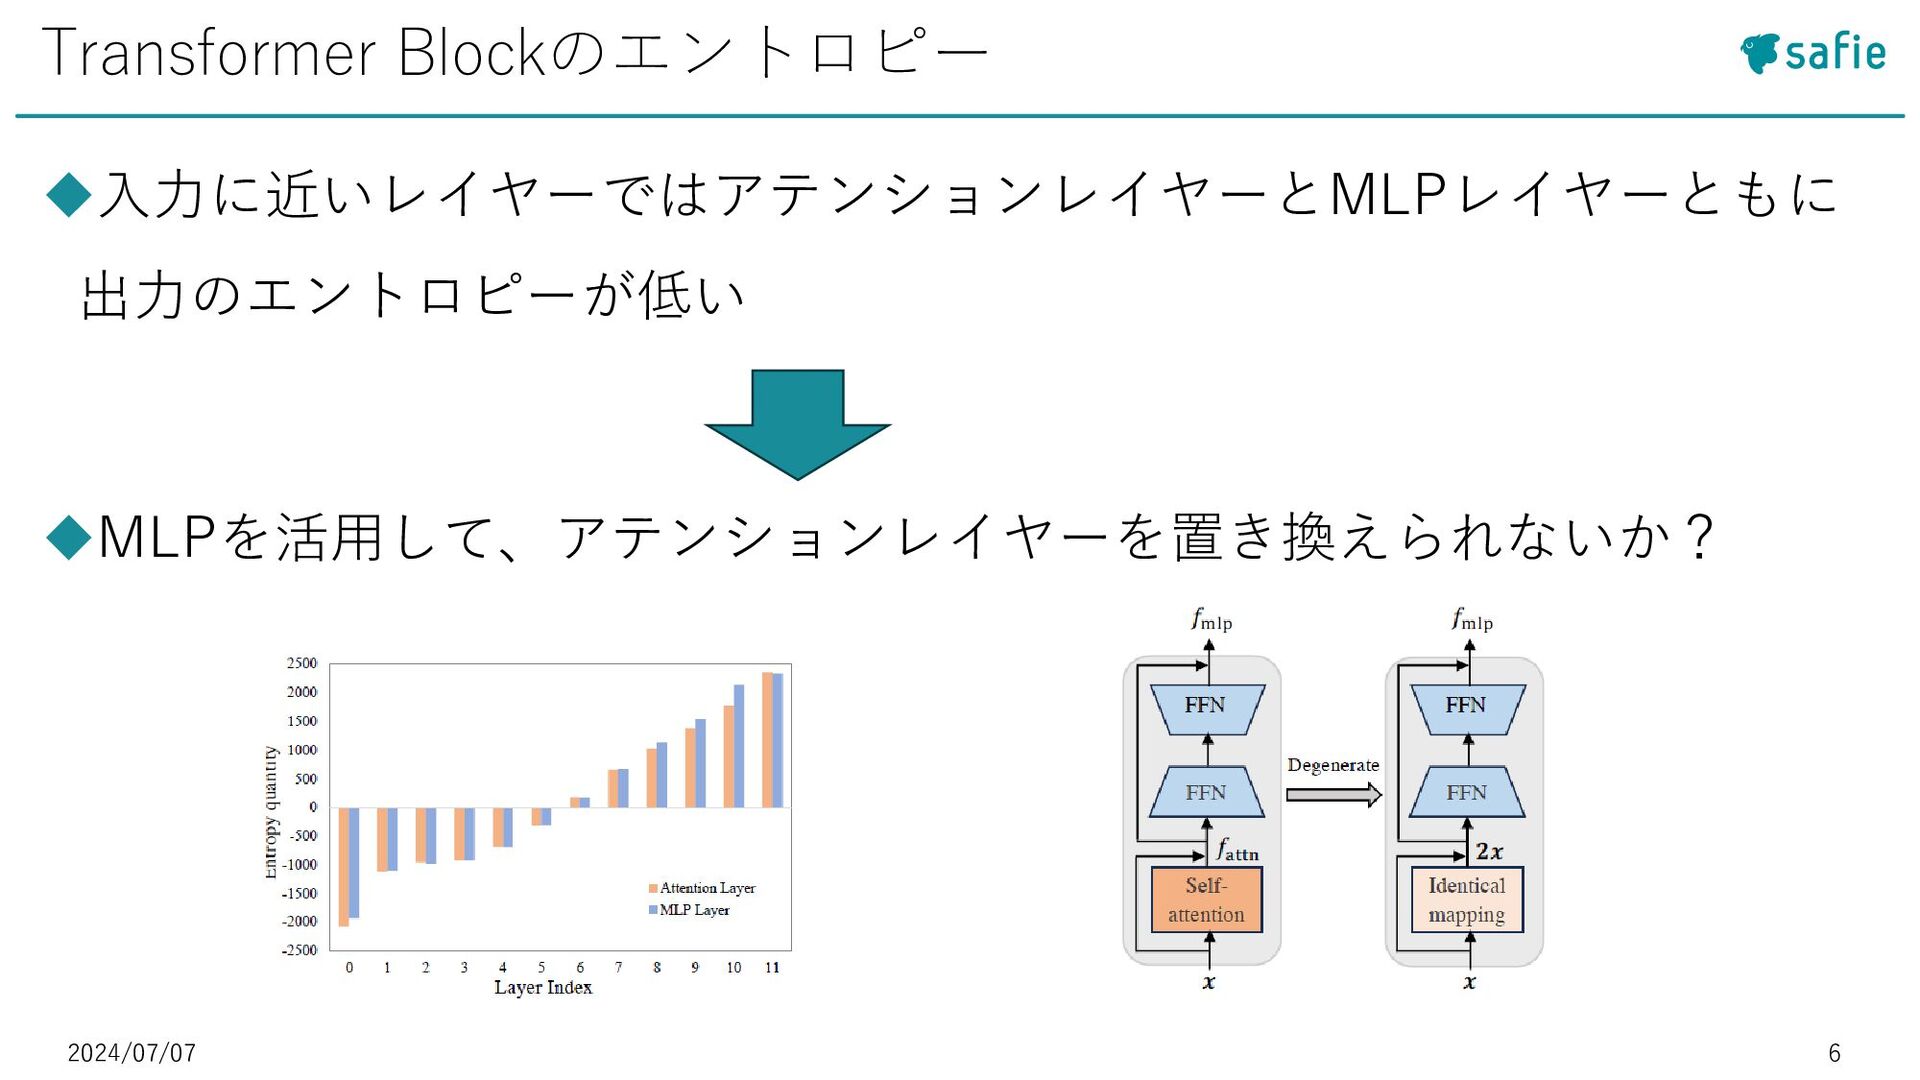
2024/07/07 14 MLPレイヤーへの知識移植 Self- attention MLP 𝑥 + + 𝑓mlp
Self- attention MLP 𝑥 + + 𝑓mlp 1 − 𝑀 ⊙ M⊙ Identical Mapping Identical Mapping MLP 𝑥 + + 𝑓mlp 𝑓attn 𝑓attn 2𝑥 M=1 M=0 アテンションレイヤーの希釈化 -
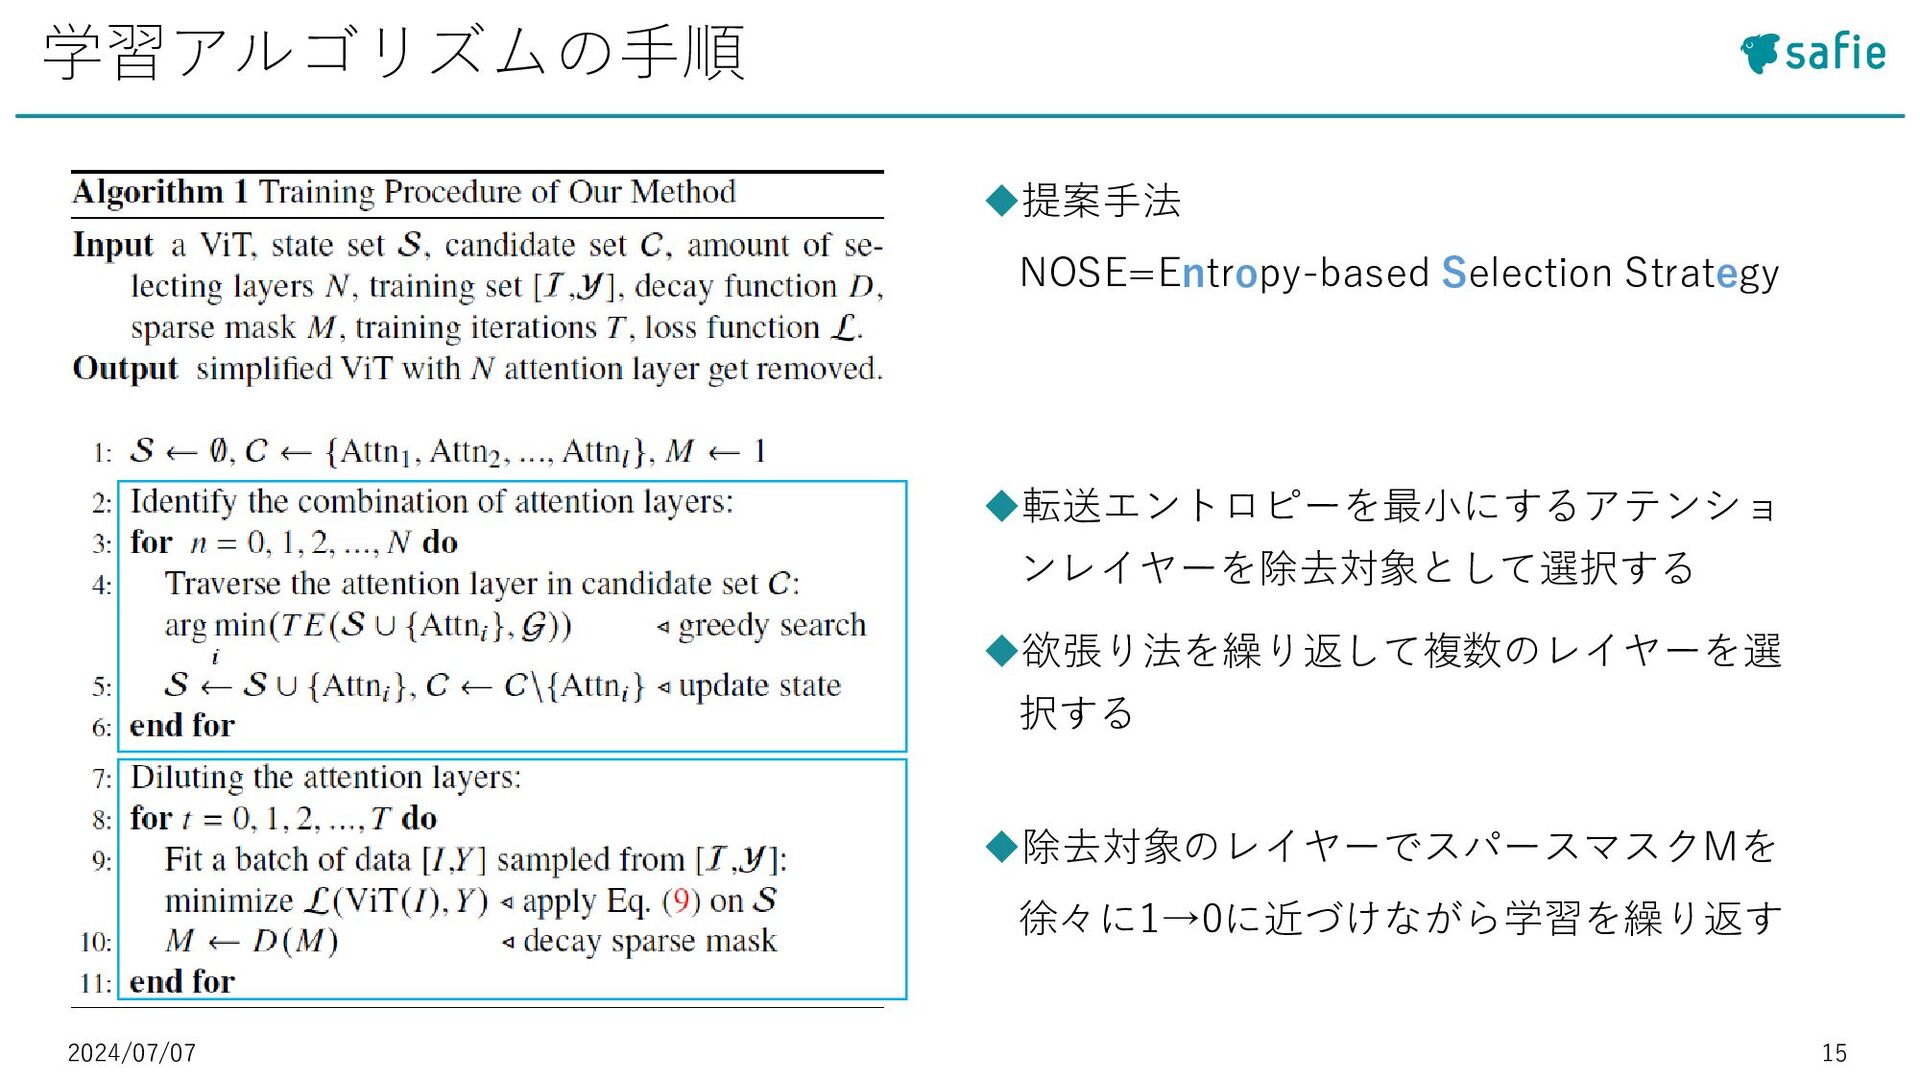
2024/07/07 15 ◆転送エントロピーを最小にするアテンショ ンレイヤーを除去対象として選択する ◆欲張り法を繰り返して複数のレイヤーを選 択する 学習アルゴリズムの手順 ◆除去対象のレイヤーでスパースマスクMを 徐々に1→0に近づけながら学習を繰り返す ◆提案手法
NOSE=Entropy-based Selection Strategy -
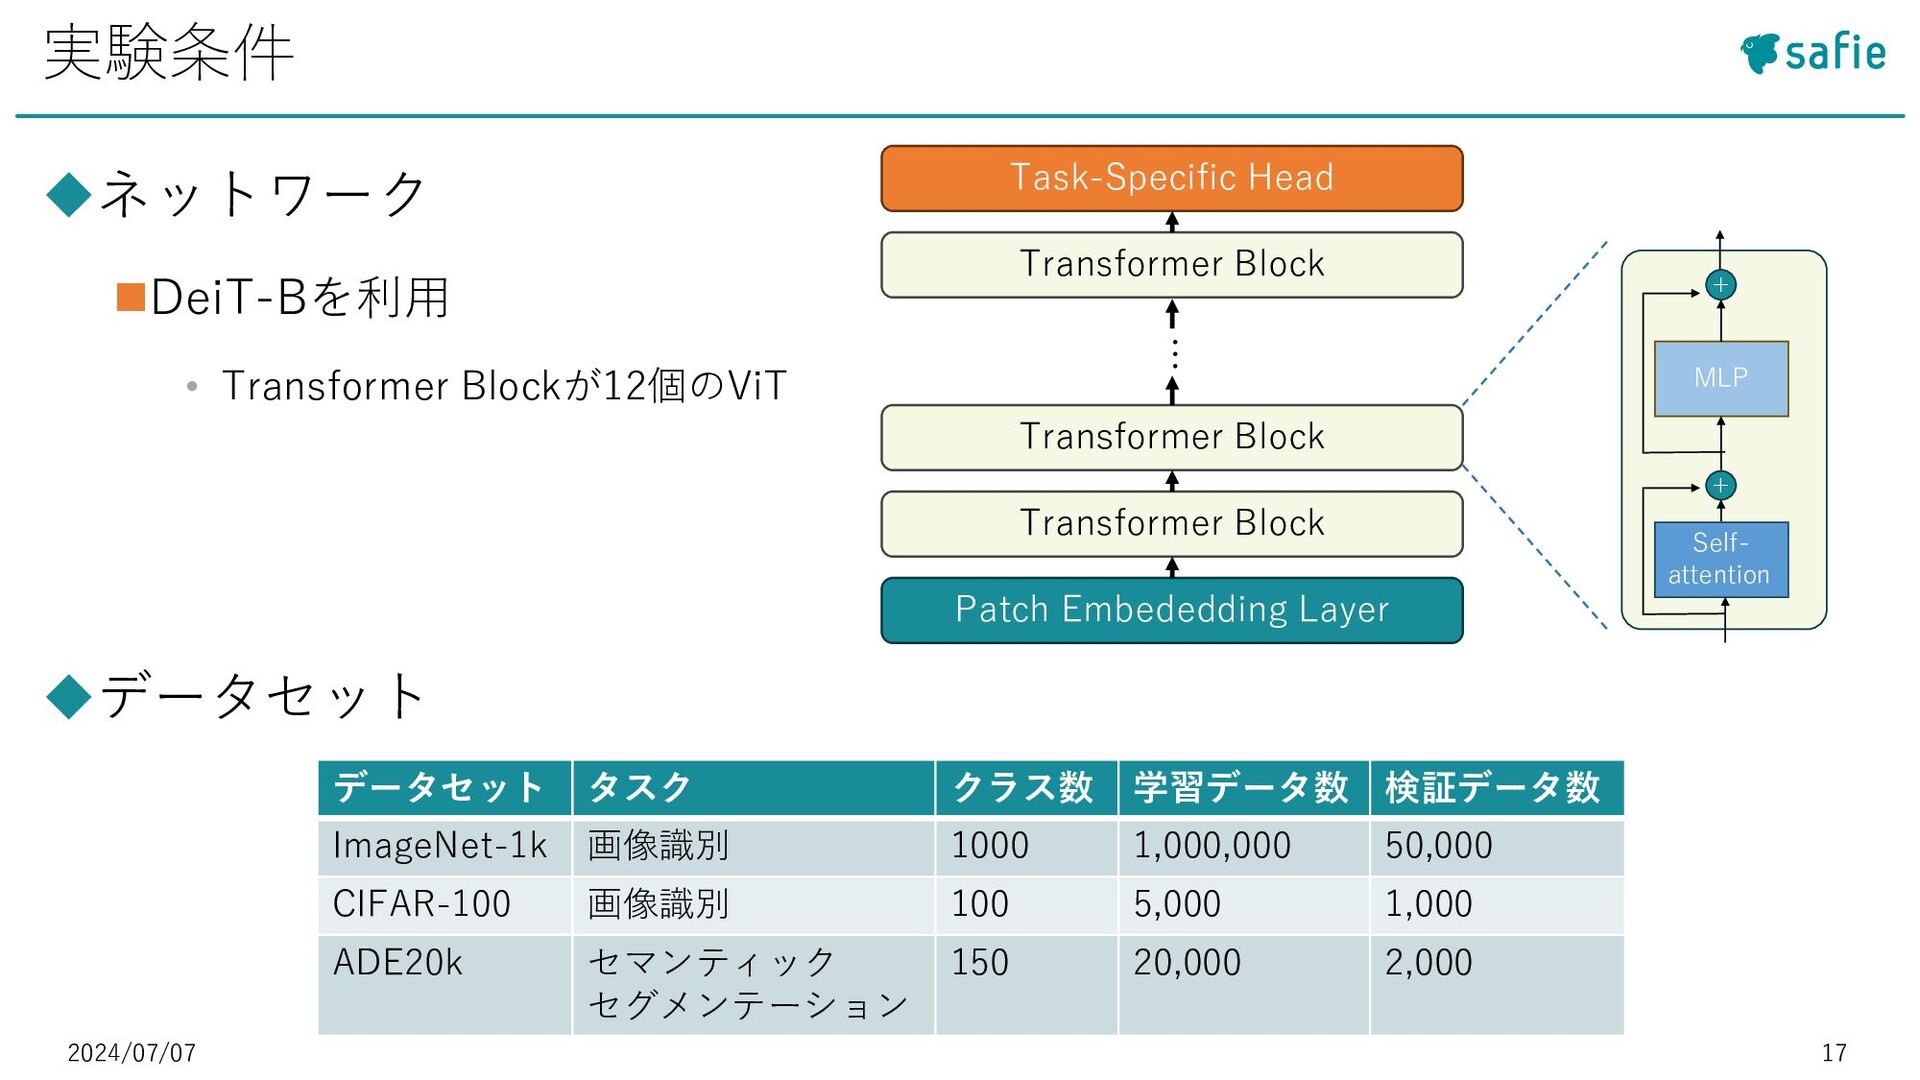
2024/07/07 17 ◆ネットワーク ◼DeiT-Bを利用 • Transformer Blockが12個のViT ◆データセット 実験条件 データセット
タスク クラス数 学習データ数 検証データ数 ImageNet-1k 画像識別 1000 1,000,000 50,000 CIFAR-100 画像識別 100 5,000 1,000 ADE20k セマンティック セグメンテーション 150 20,000 2,000 Patch Embededding Layer Transformer Block Transformer Block Transformer Block Task-Specific Head … elf attention ML -
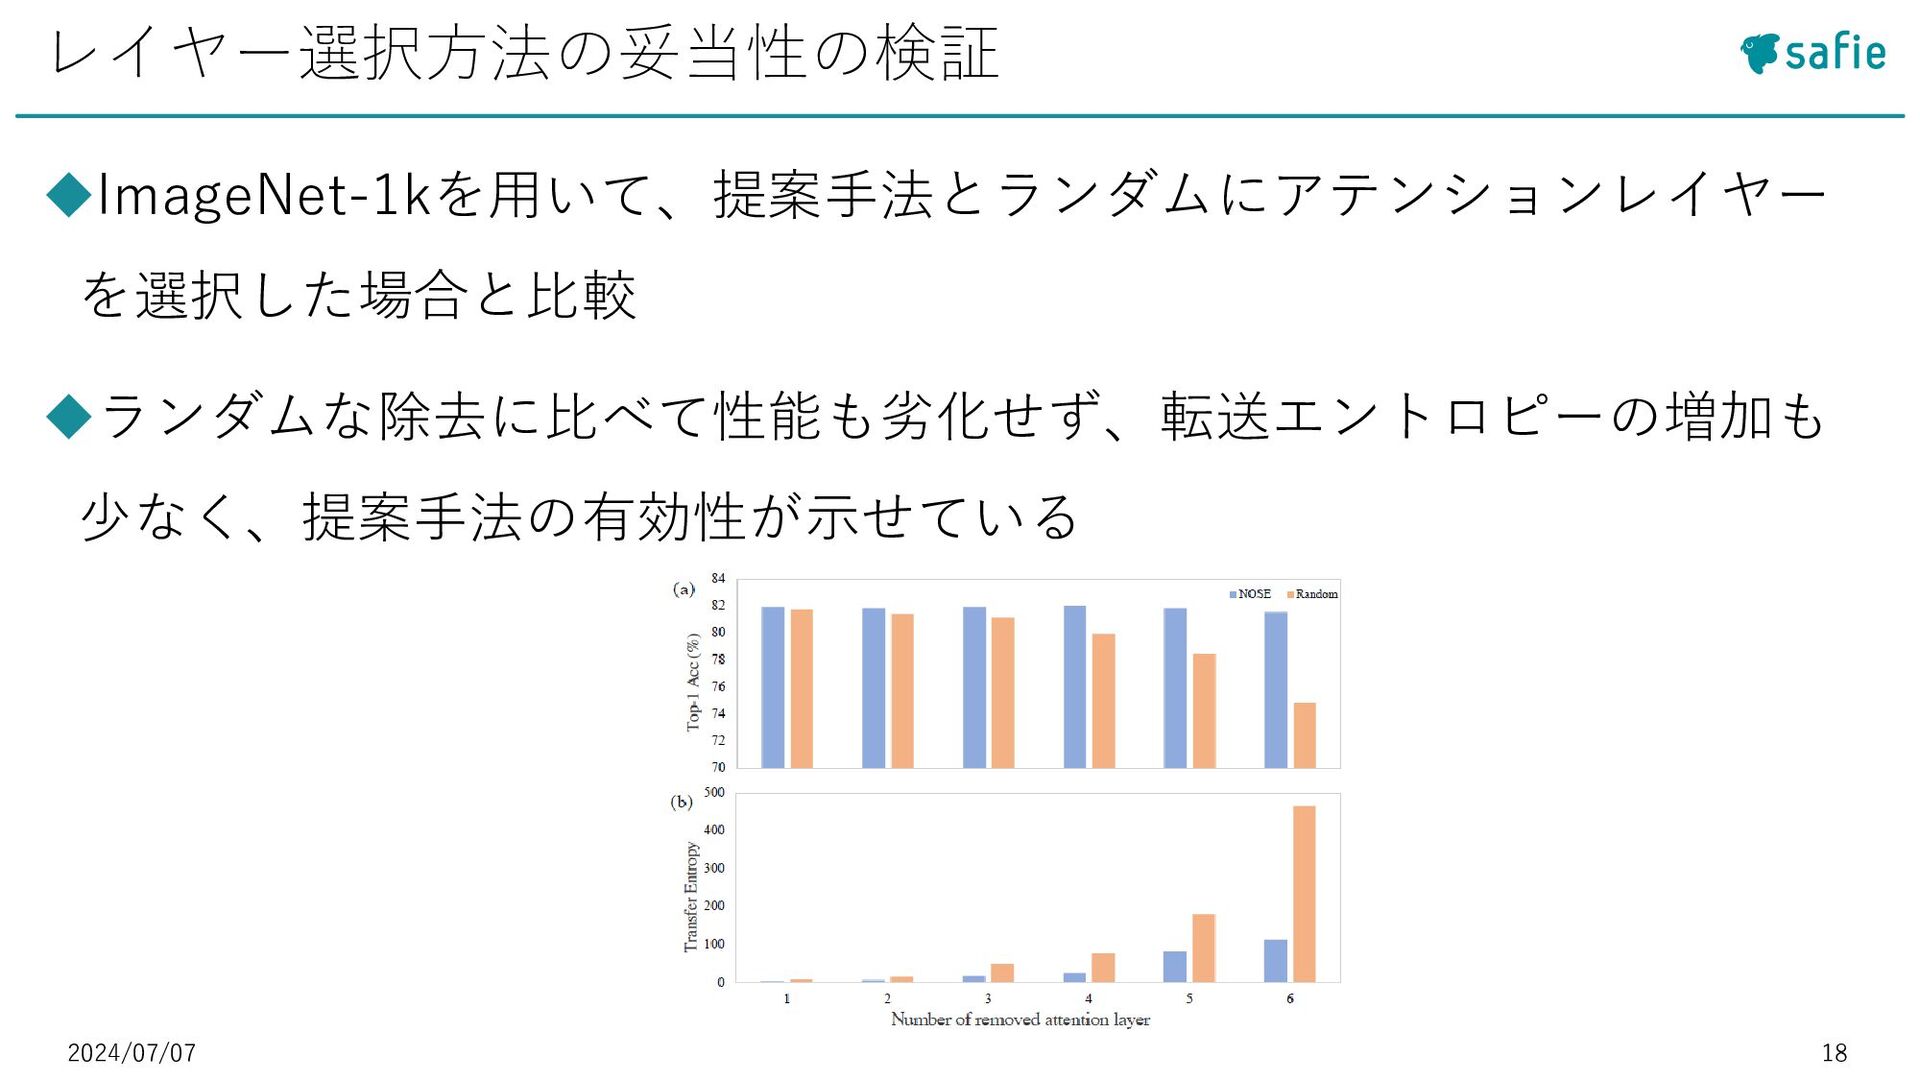
2024/07/07 19 ◆アテンションレイヤーを除去することで、スループットとメモリー限界を改善しつ つ、認識精度を実現 ◆Token Merging手法(ToMe[5])と合わせると更に性能向上 ◼ [5] Daniel Bolya
et al. : “Token Merging: Your ViT But Faster”, ICLR 2023 ImageNet1Kによる実験結果 -
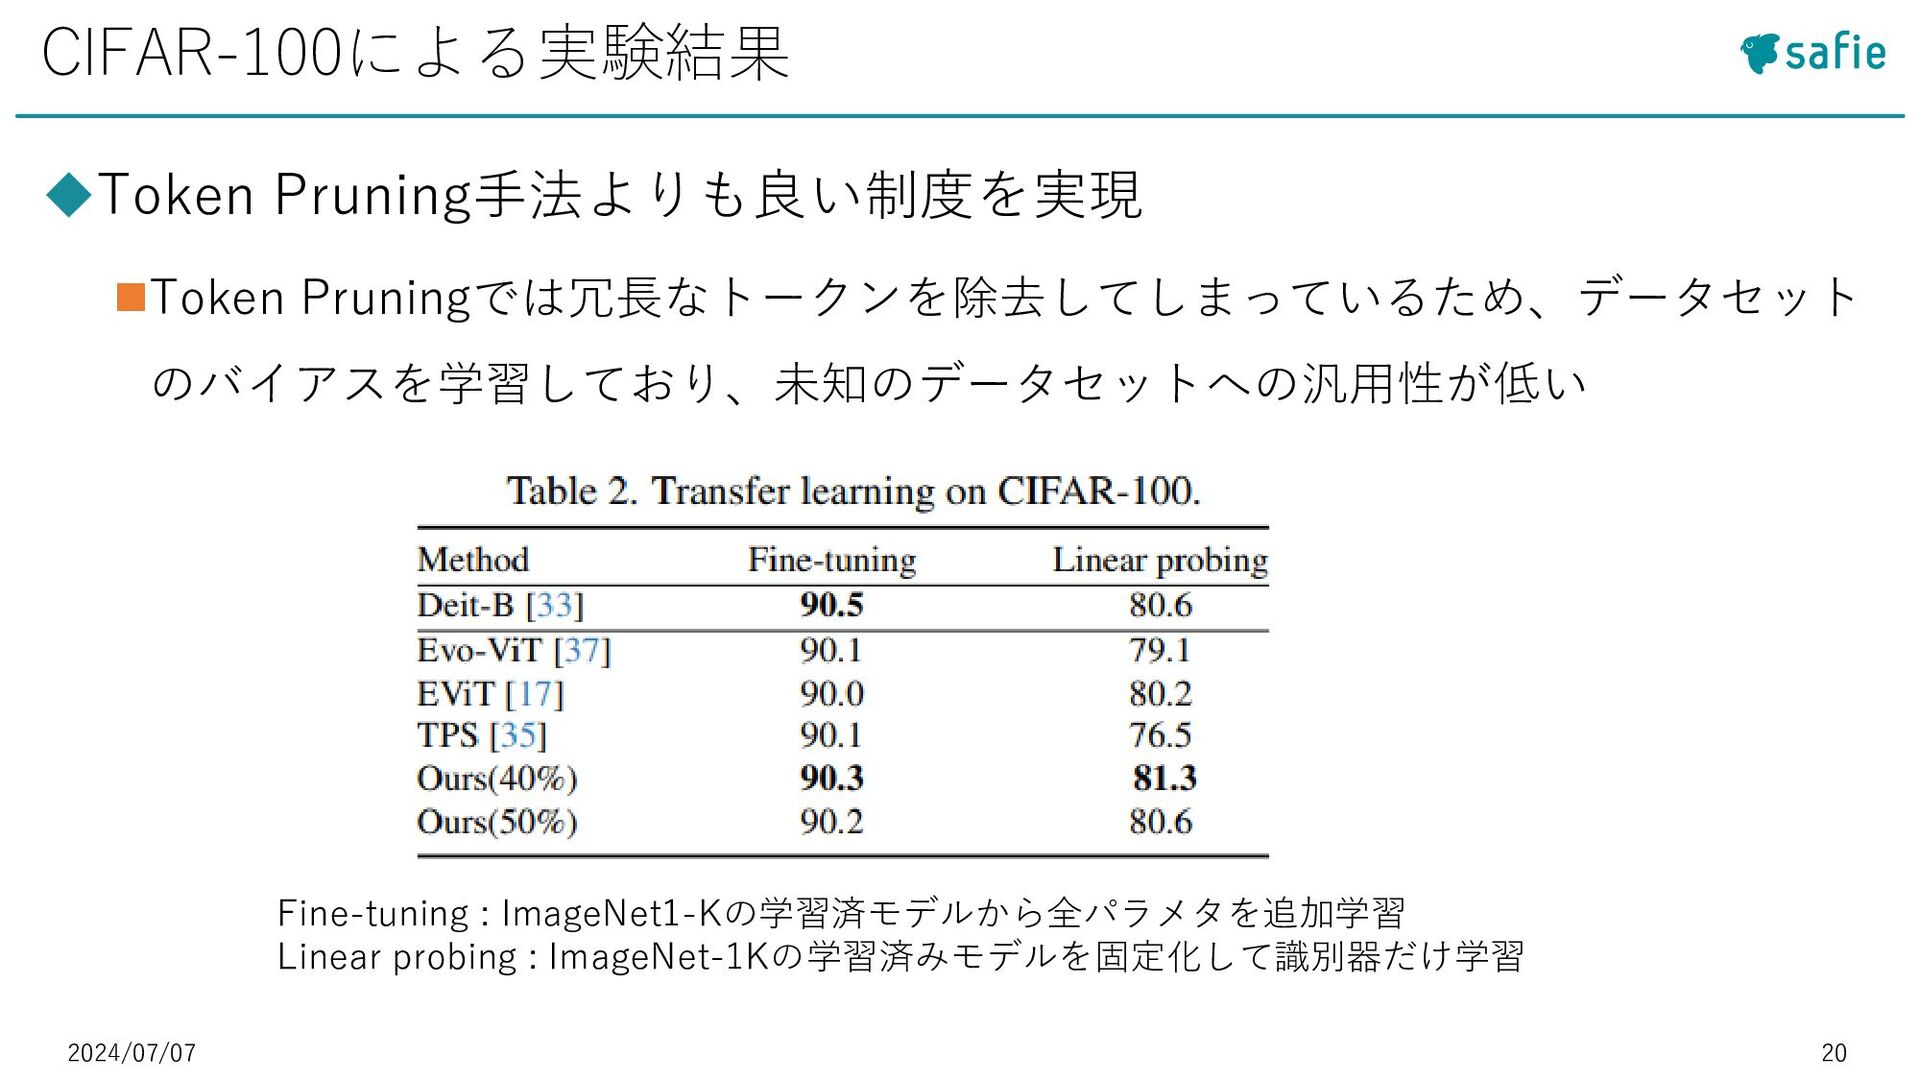
2024/07/07 20 ◆Token Pruning手法よりも良い制度を実現 ◼Token Pruningでは冗長なトークンを除去してしまっているため、データセット のバイアスを学習しており、未知のデータセットへの汎用性が低い CIFAR-100による実験結果 Fine-tuning :
ImageNet1-Kの学習済モデルから全パラメタを追加学習 Linear probing : ImageNet-1Kの学習済みモデルを固定化して識別器だけ学習 -
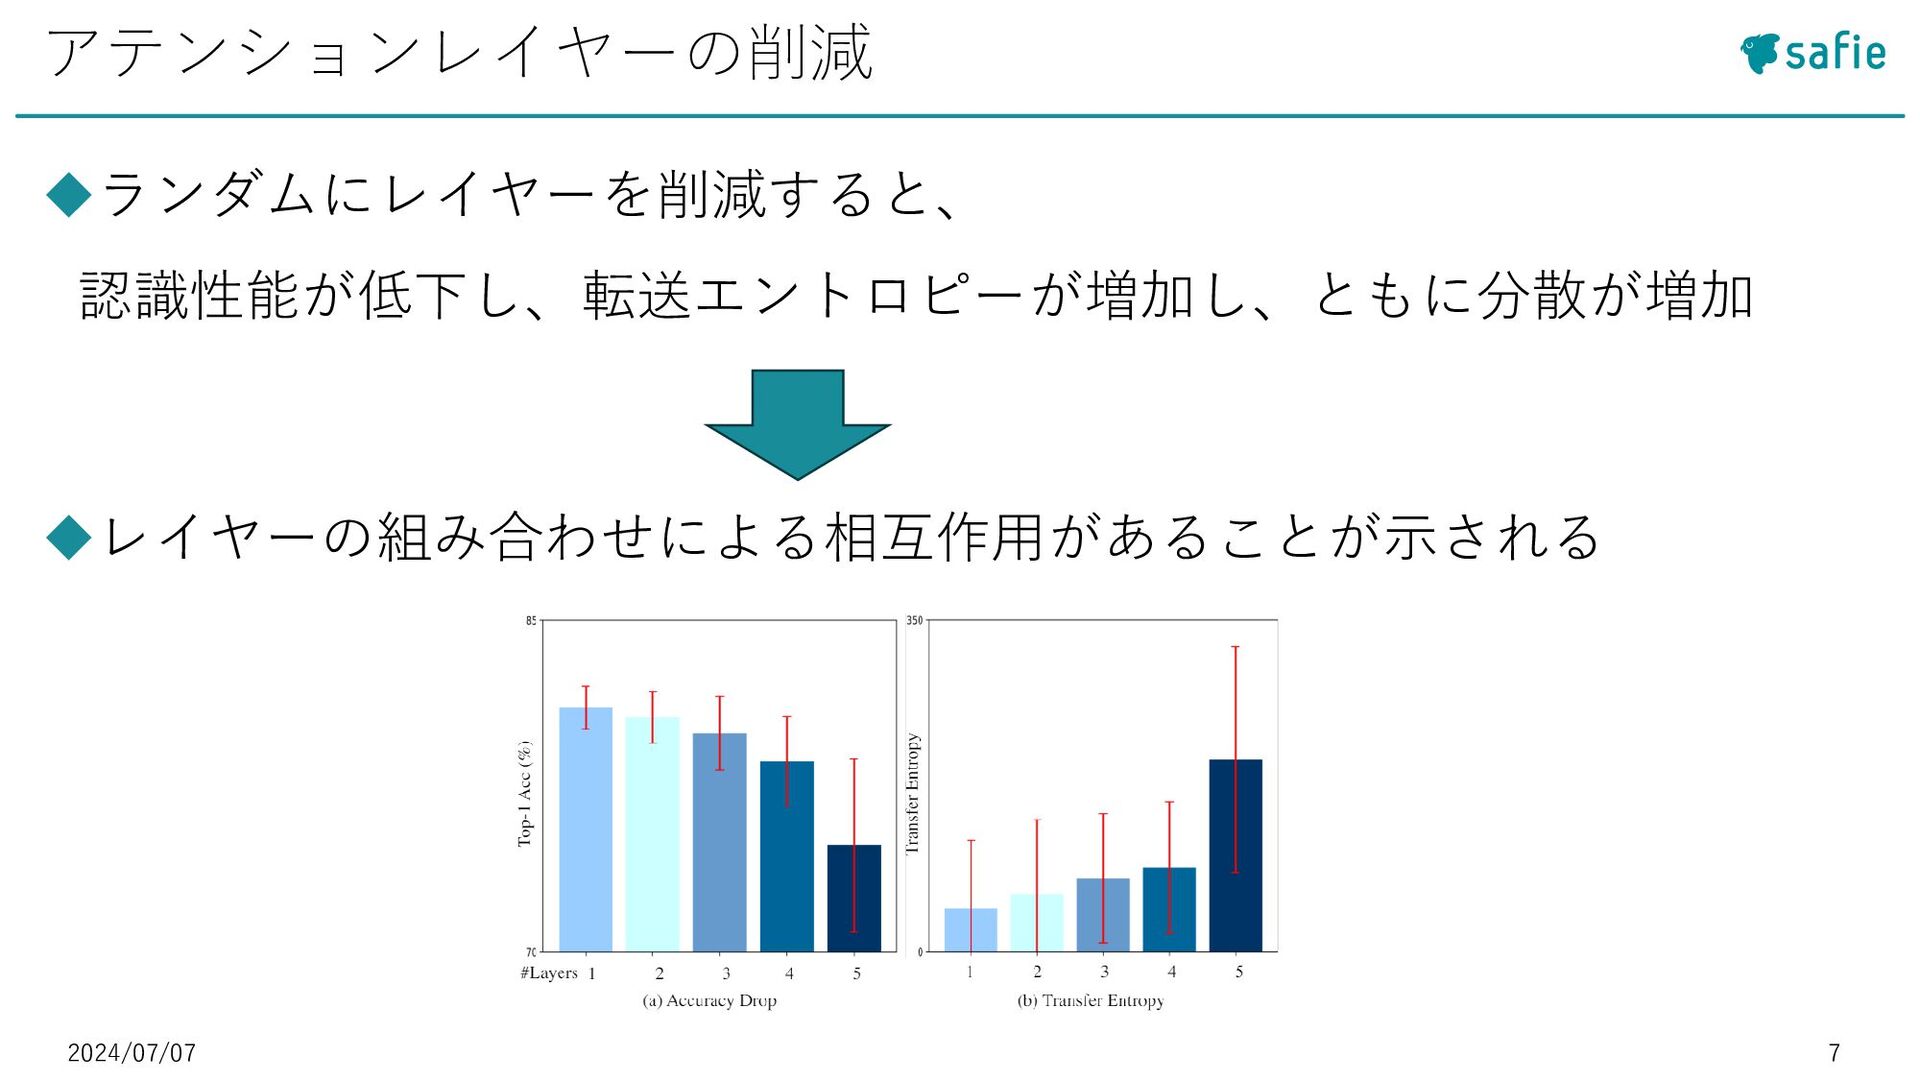
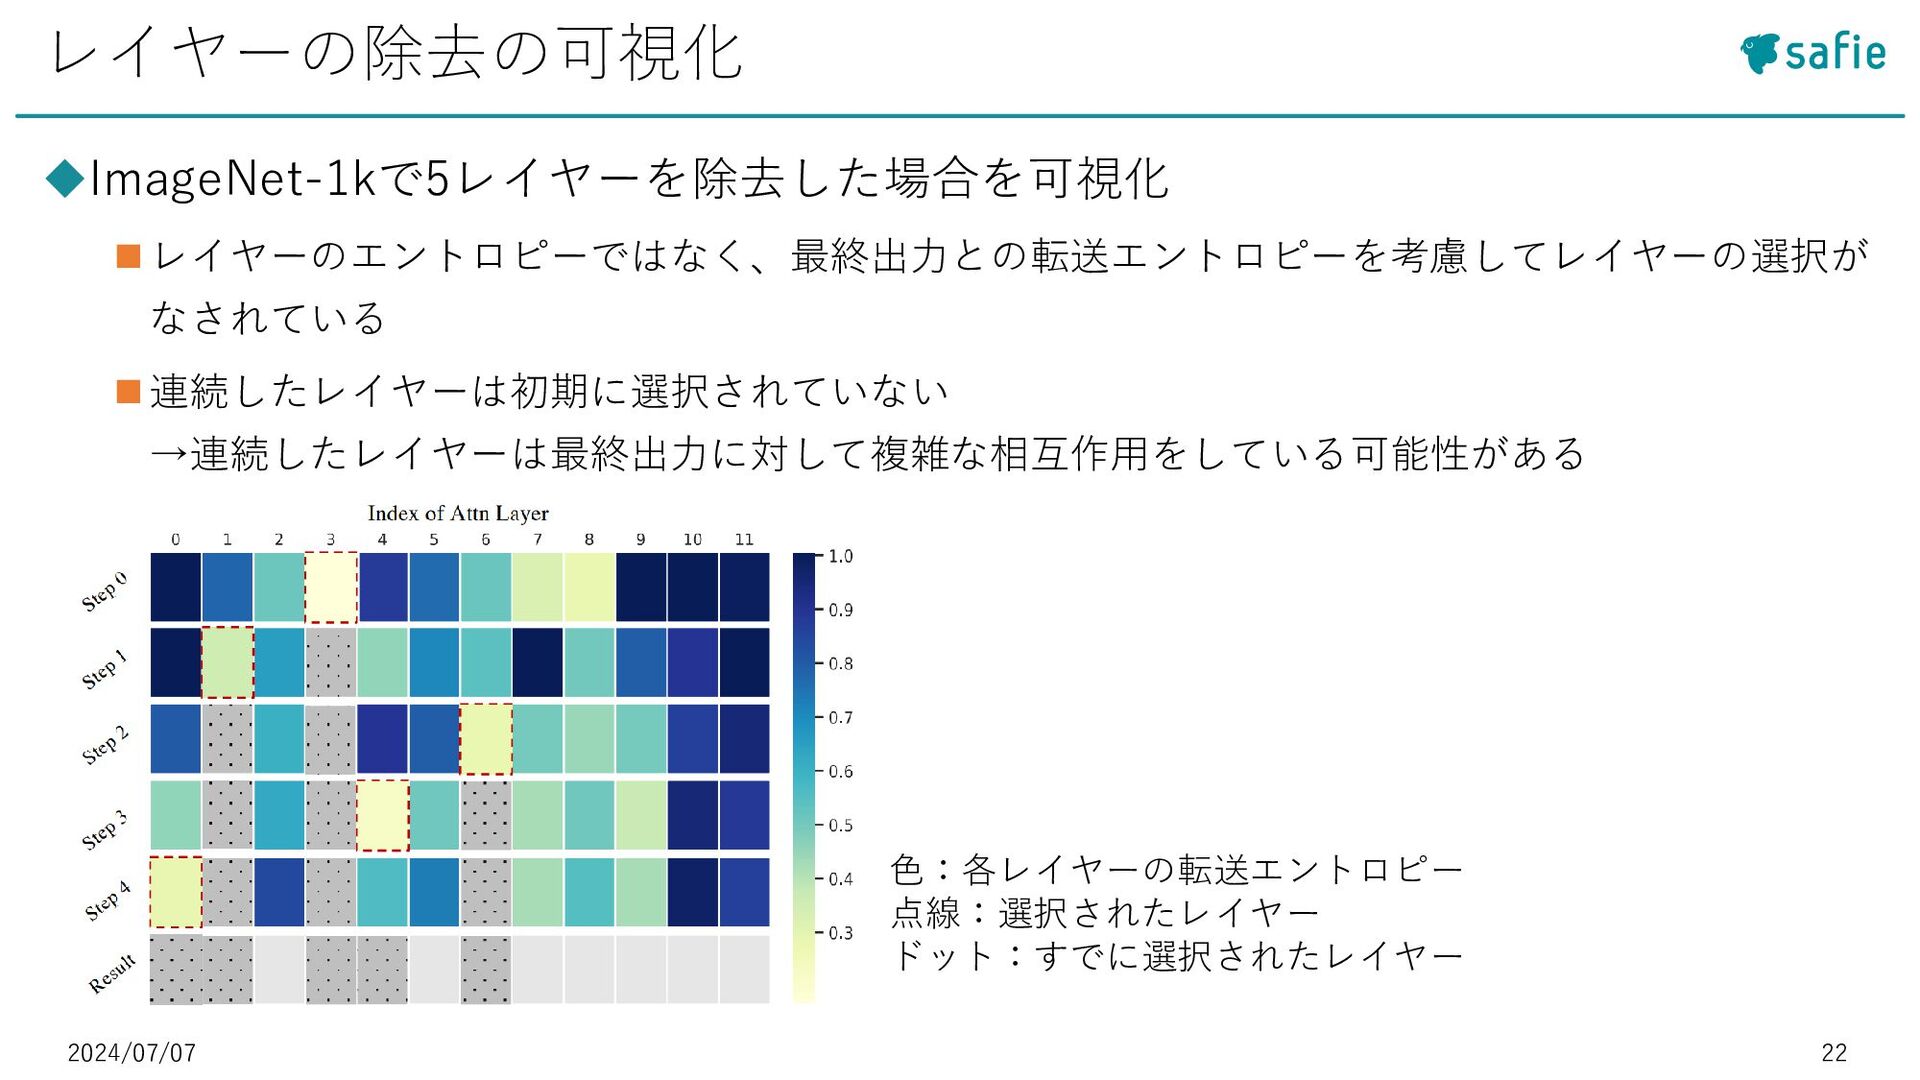
2024/07/07 22 ◆ImageNet-1kで5レイヤーを除去した場合を可視化 ◼ レイヤーのエントロピーではなく、最終出力との転送エントロピーを考慮してレイヤーの選択が なされている ◼ 連続したレイヤーは初期に選択されていない →連続したレイヤーは最終出力に対して複雑な相互作用をしている可能性がある レイヤーの除去の可視化
色:各レイヤーの転送エントロピー 点線:選択されたレイヤー ドット:すでに選択されたレイヤー -
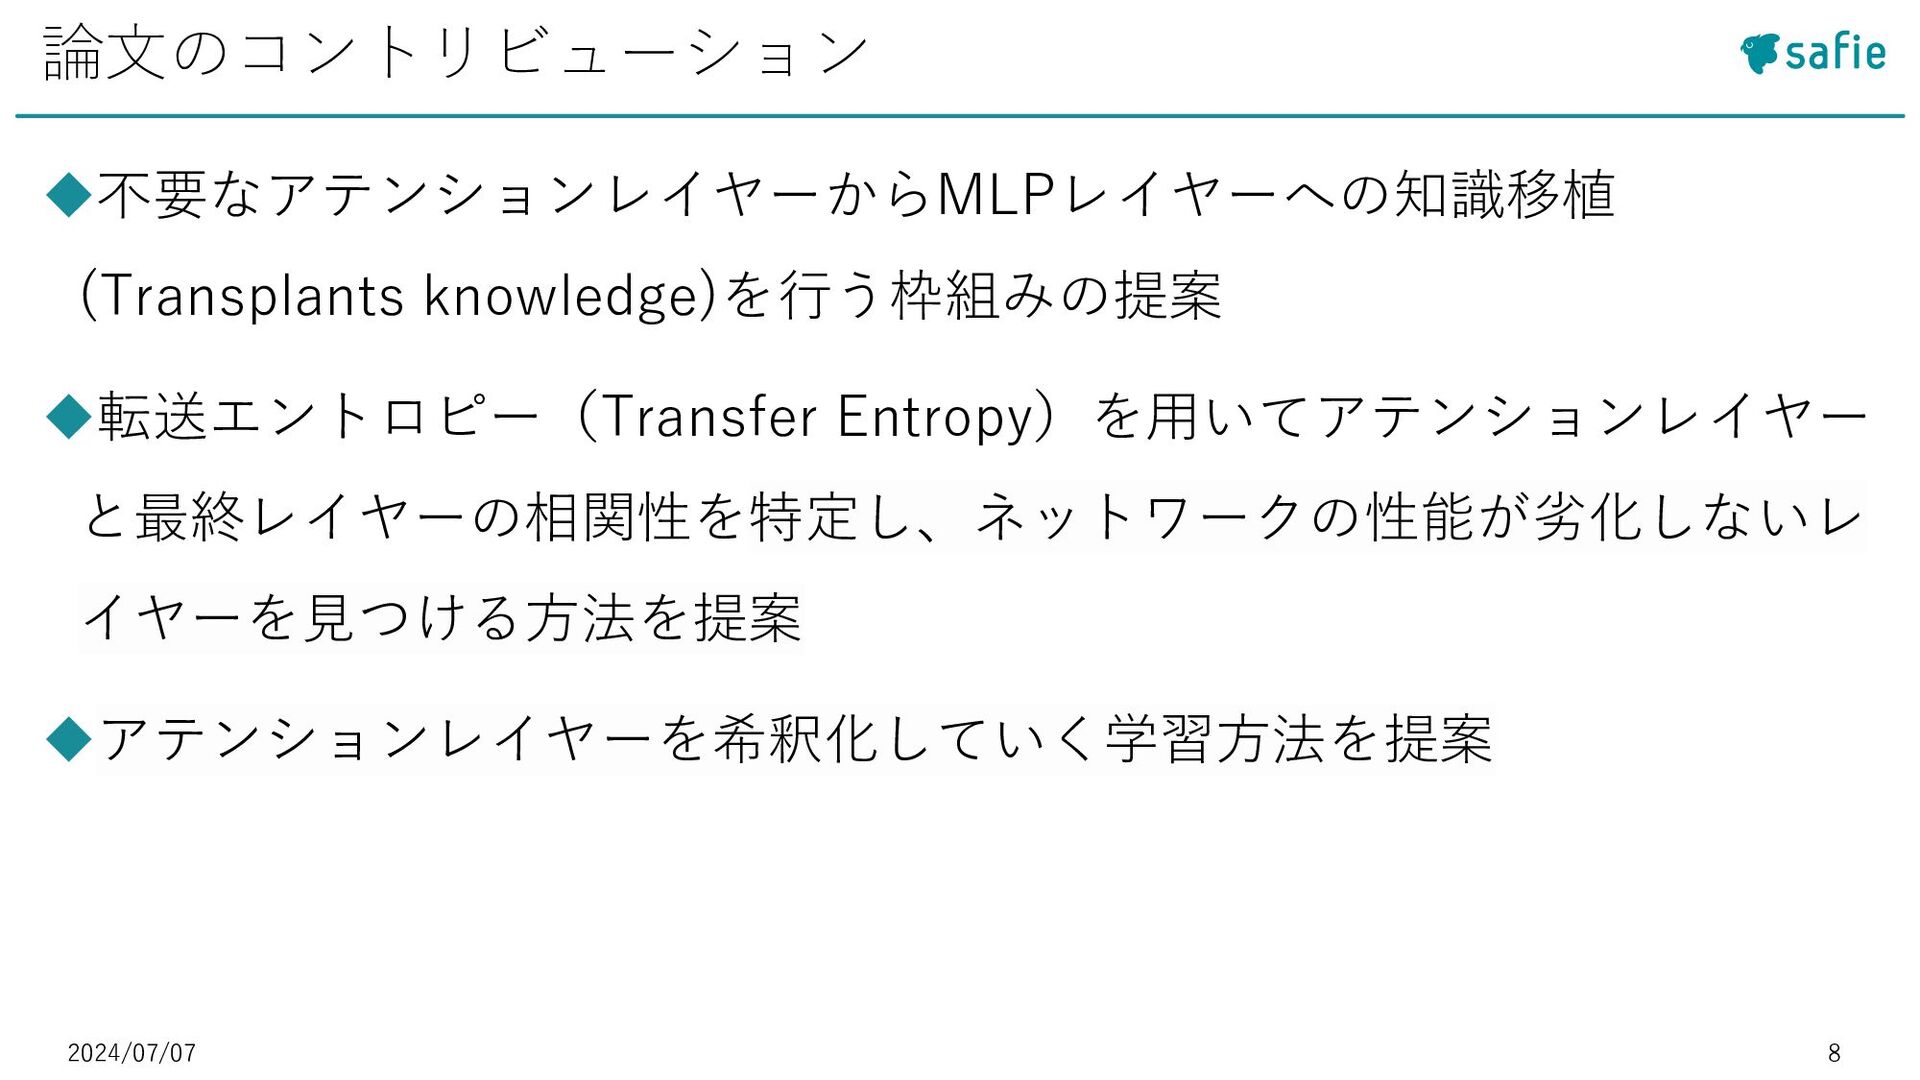
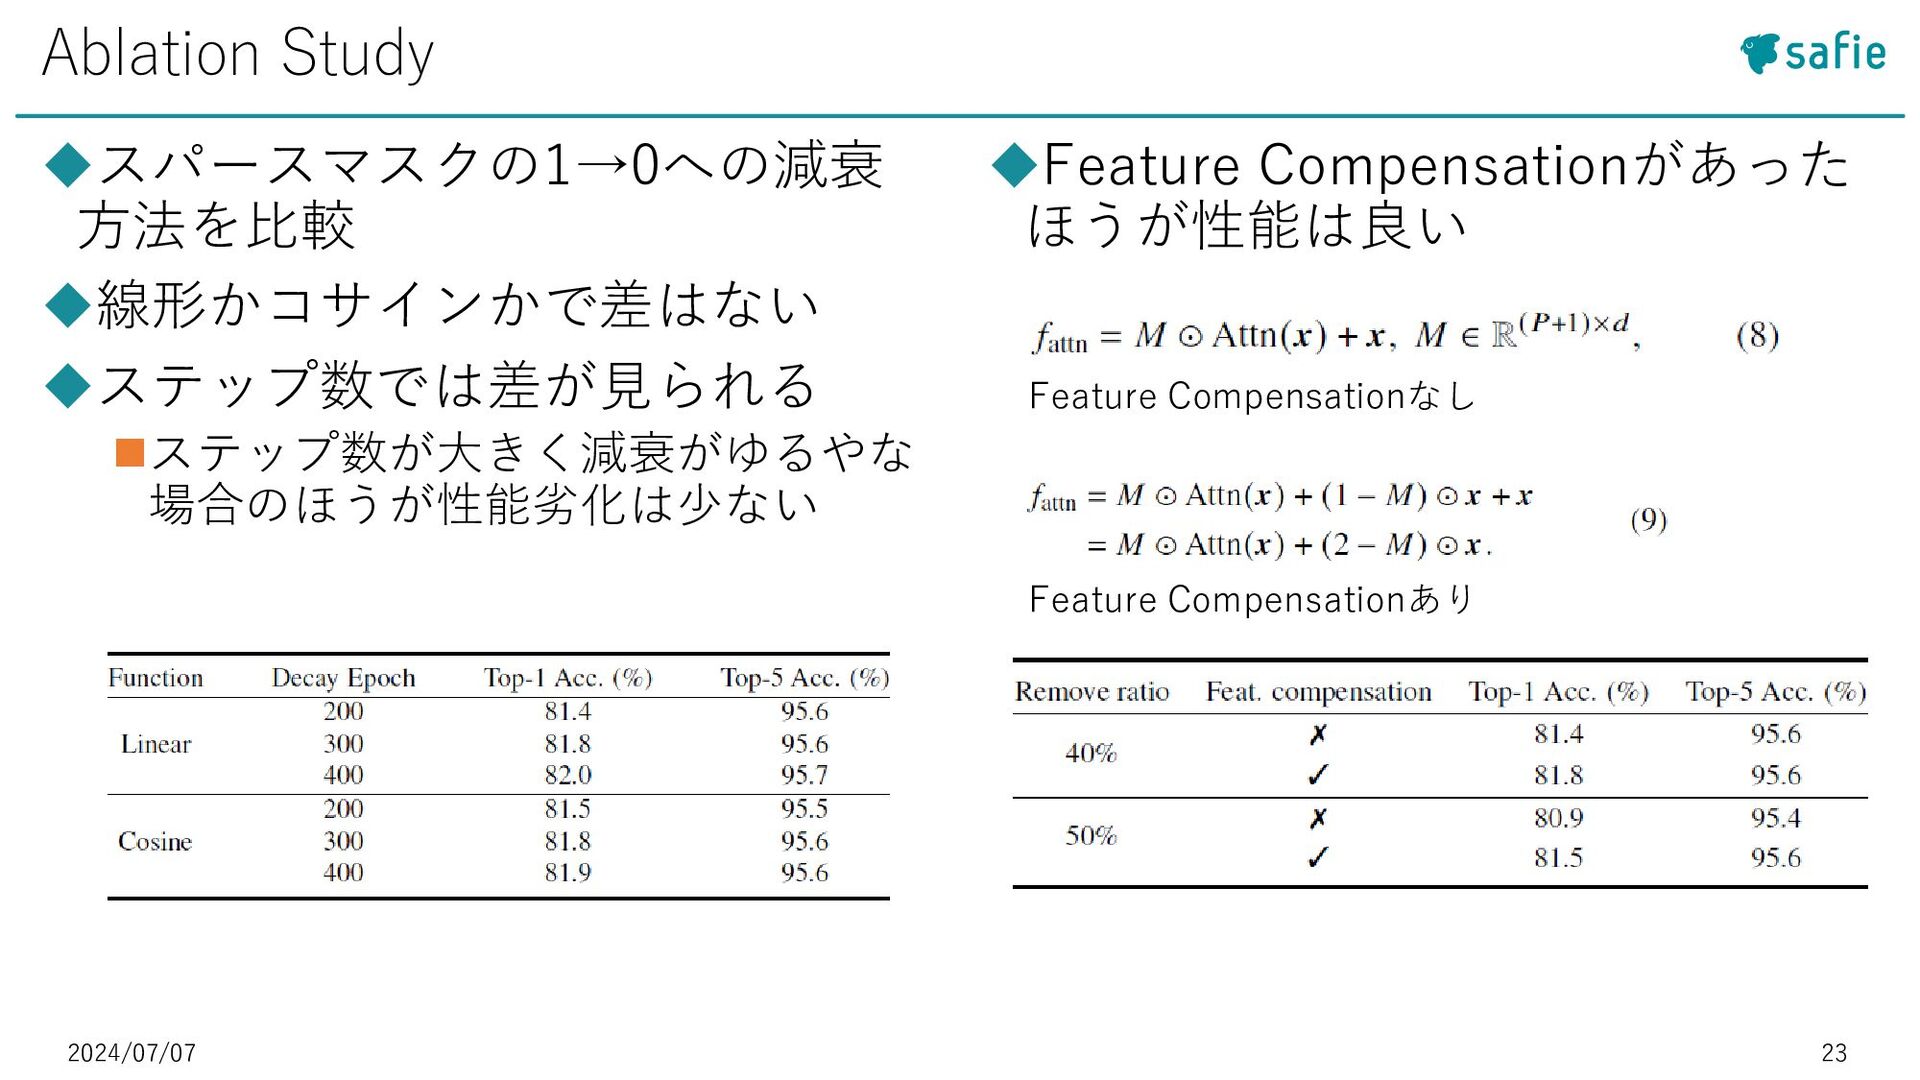
2024/07/07 23 Ablation Study ◆スパースマスクの1→0への減衰 方法を比較 ◆線形かコサインかで差はない ◆ステップ数では差が見られる ◼ステップ数が大きく減衰がゆるやな 場合のほうが性能劣化は少ない
◆Feature Compensationがあった ほうが性能は良い Feature Compensationなし Feature Compensationあり -
2024/07/07 27 MLP Can Be A Good Transformer Learner ◆どんなもの?
◼ Vision Transformerのアテンションレイヤーを削除 する手法の提案 ◆先行研究と比べてどこがすごいの? ◼ 従来手法ではトークンの集約や除去だったが、アテ ンションレイヤーそのものを除去した ◆技術や手法の"キモ"はどこにある? ◼ 転送エントロピーを元に不要なアテンションレイ ヤーを選択し、アテンションレイヤーの情報を MLPレイヤーに知識移植 ◆どうやって有効だと検証した? ◼ ImageNet-1k, CIFAR-100,ADE20kを使って評価し た ◆議論はある? ◼ Vision Transformerでは、識別器に近いブロックが 認識性能への寄与が大きい? ◆次に読むべき論文は? ◼ [12] Jintao Guo et al. : “A lightweight mlp-like architecture with dynamic lowfrequency transform for domain generalization”, CV R2023