Upgrade to Pro — share decks privately, control downloads, hide ads and more …

契約書SaaSにAIエージェントを組み込む

Avatar for SansanTech SansanTech PRO
November 11, 2026

 契約書SaaSにAIエージェントを組み込む

■イベント
SaaSにAIを組み込むための境界設計
https://saas-harbor.connpass.com/event/410700/

■登壇概要
タイトル:契約書SaaSにAIエージェントを組み込む
登壇者:技術本部 Contract One Engineering Unit 南 直人

■ 技術本部 採用情報
https://media.sansan-engineering.com

Avatar for SansanTech

SansanTech PRO

November 11, 2026

More Decks by SansanTech

Other Decks in Technology

Transcript

  1. 南 直⼈ Sansan株式会社 技術本部 Contract One Engineering Unit Senior Software

    Engineer – Search, AI 2019/04 ‒ 2026/02: Solr向けランキングプラグインの開発 2026/03 ‒ 現在: 契約書領域のAI・検索エンジニア 全⽂検索エンジンやベクトル検索エンジンのアルゴリズムが好き 今⽇は検索エンジニアの⽬線で、AI エージェントの境界の話をします
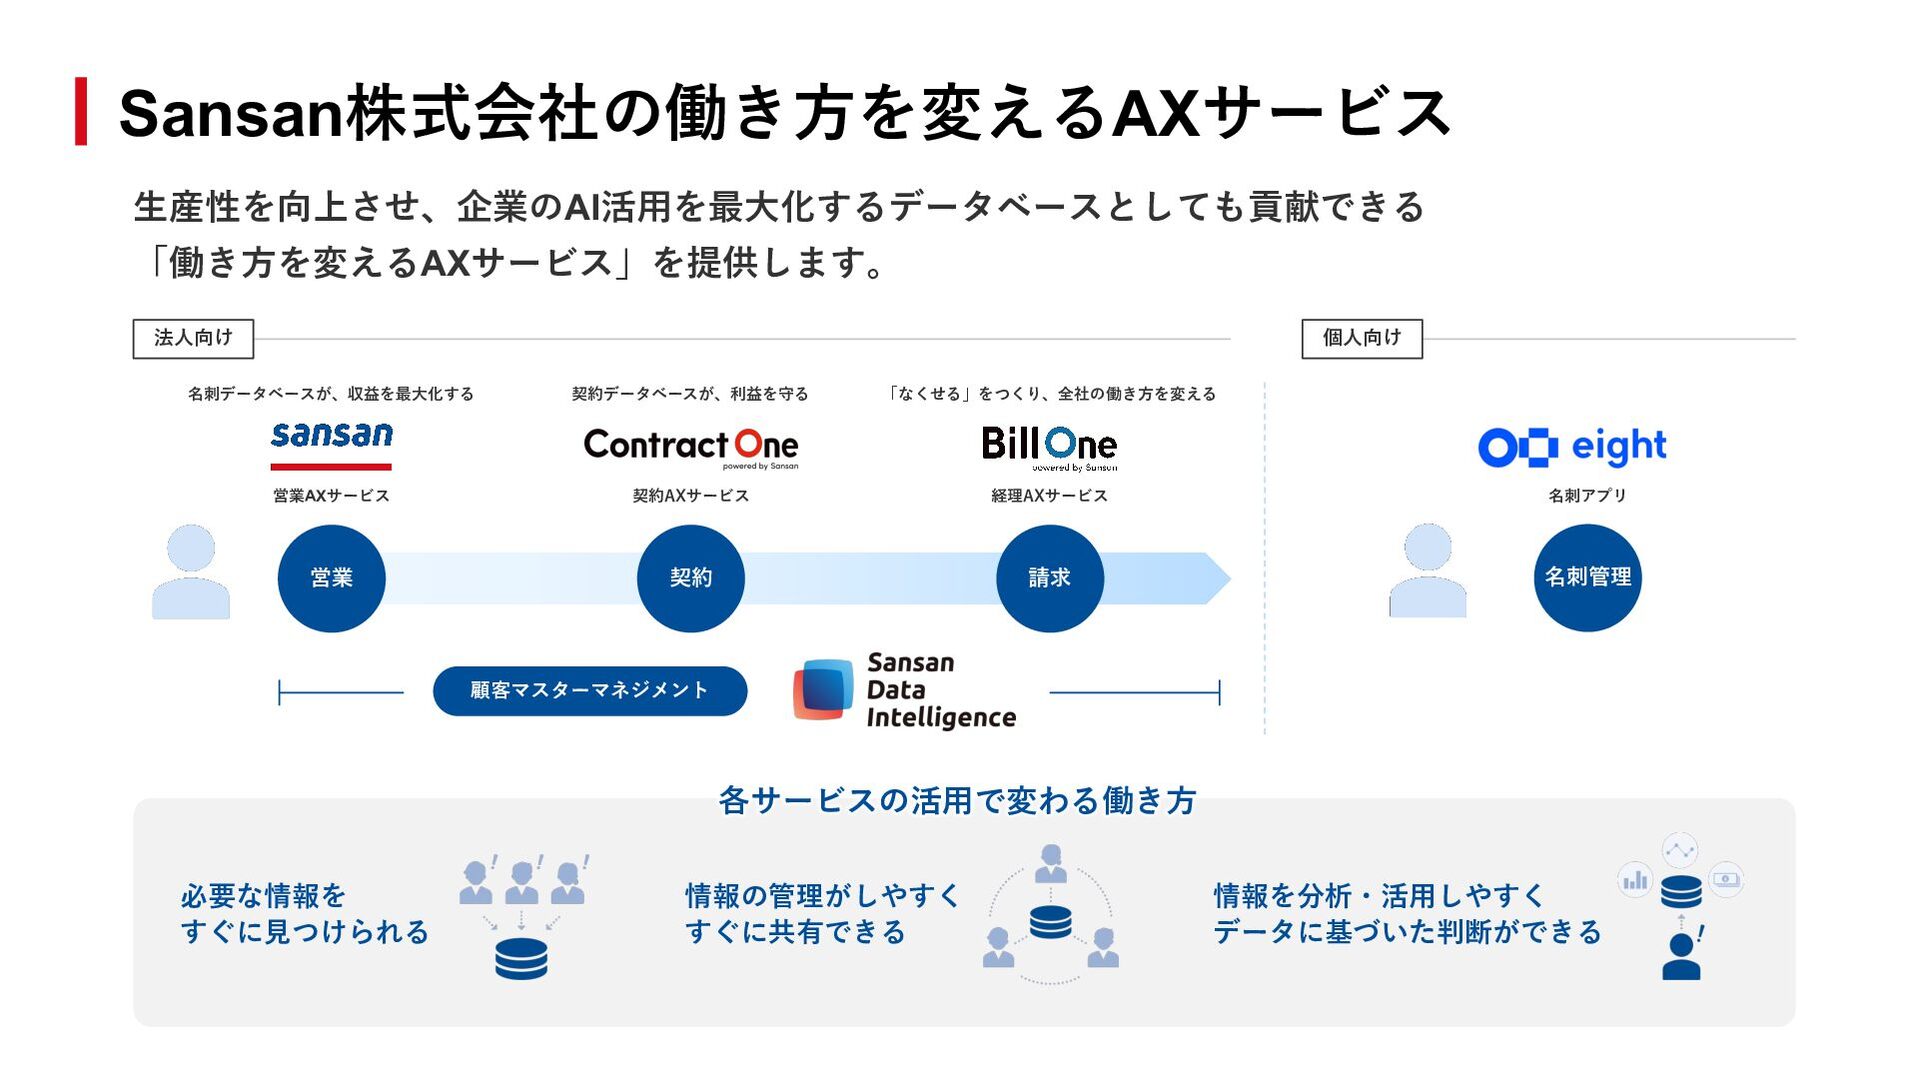
  2. Sansan株式会社の働き⽅を変えるAXサービス ⽣産性を向上させ、企業のAI活⽤を最⼤化するデータベースとしても貢献できる 「働き⽅を変えるAXサービス」を提供します。 法⼈向け 個⼈向け 名刺データベースが、収益を最⼤化する 契約データベースが、利益を守る 「なくせる」をつくり、全社の働き⽅を変える 営業AXサービス 契約AXサービス

    経理AXサービス 名刺アプリ 営業 契約 請求 名刺管理 顧客マスターマネジメント 各サービスの活⽤で変わる働き⽅ 必要な情報を すぐに⾒つけられる 情報の管理がしやすく すぐに共有できる 情報を分析・活⽤しやすく データに基づいた判断ができる
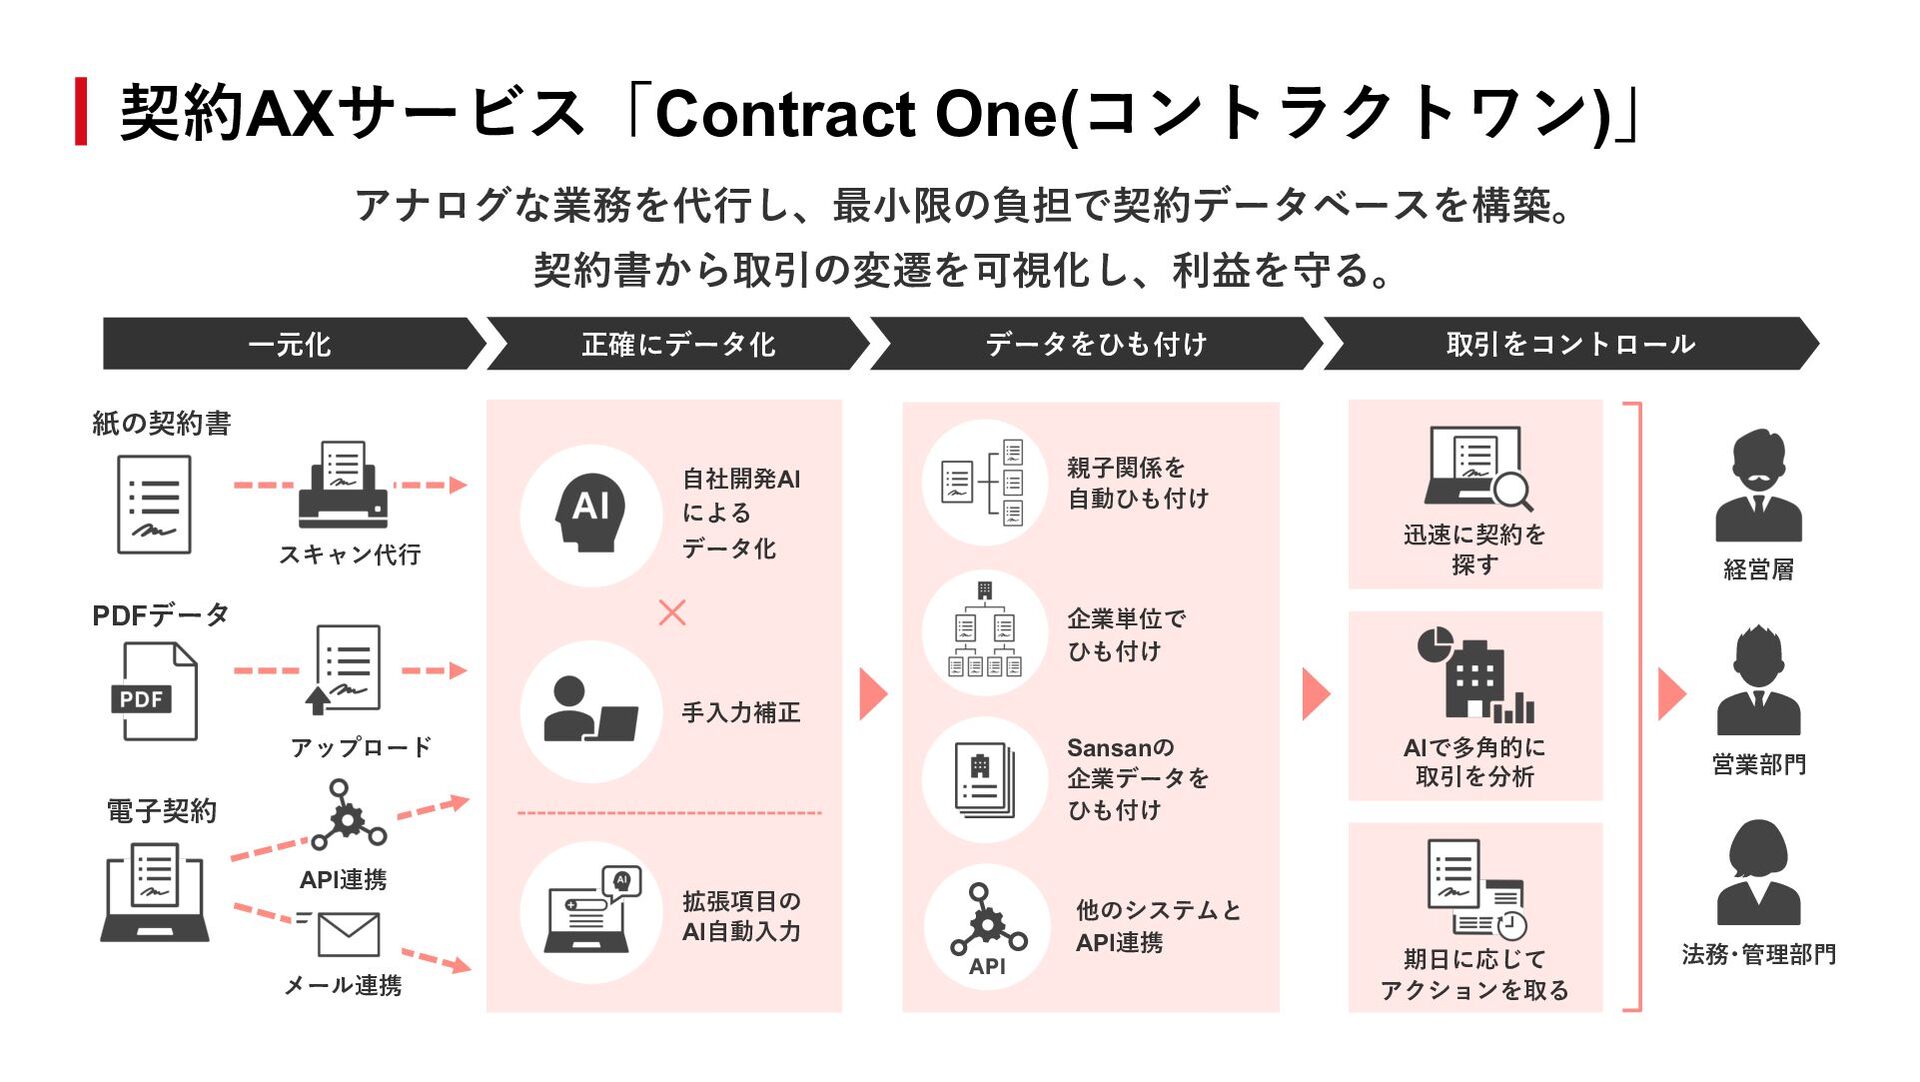
  3. 契約AXサービス「Contract One(コントラクトワン)」 アナログな業務を代⾏し、最⼩限の負担で契約データベースを構築。 契約書から取引の変遷を可視化し、利益を守る。 ⼀元化 正確にデータ化 データをひも付け 取引をコントロール 紙の契約書 スキャン代⾏

    ⾃社開発AI による データ化 × PDFデータ 親⼦関係を ⾃動ひも付け 迅速に契約を 探す 経営層 企業単位で ひも付け ⼿⼊⼒補正 Sansanの 企業データを ひも付け アップロード 電⼦契約 API連携 メール連携 拡張項⽬の AI⾃動⼊⼒ 他のシステムと API連携 AIで多⾓的に 取引を分析 期⽇に応じて アクションを取る 営業部⾨ 法務・管理部⾨
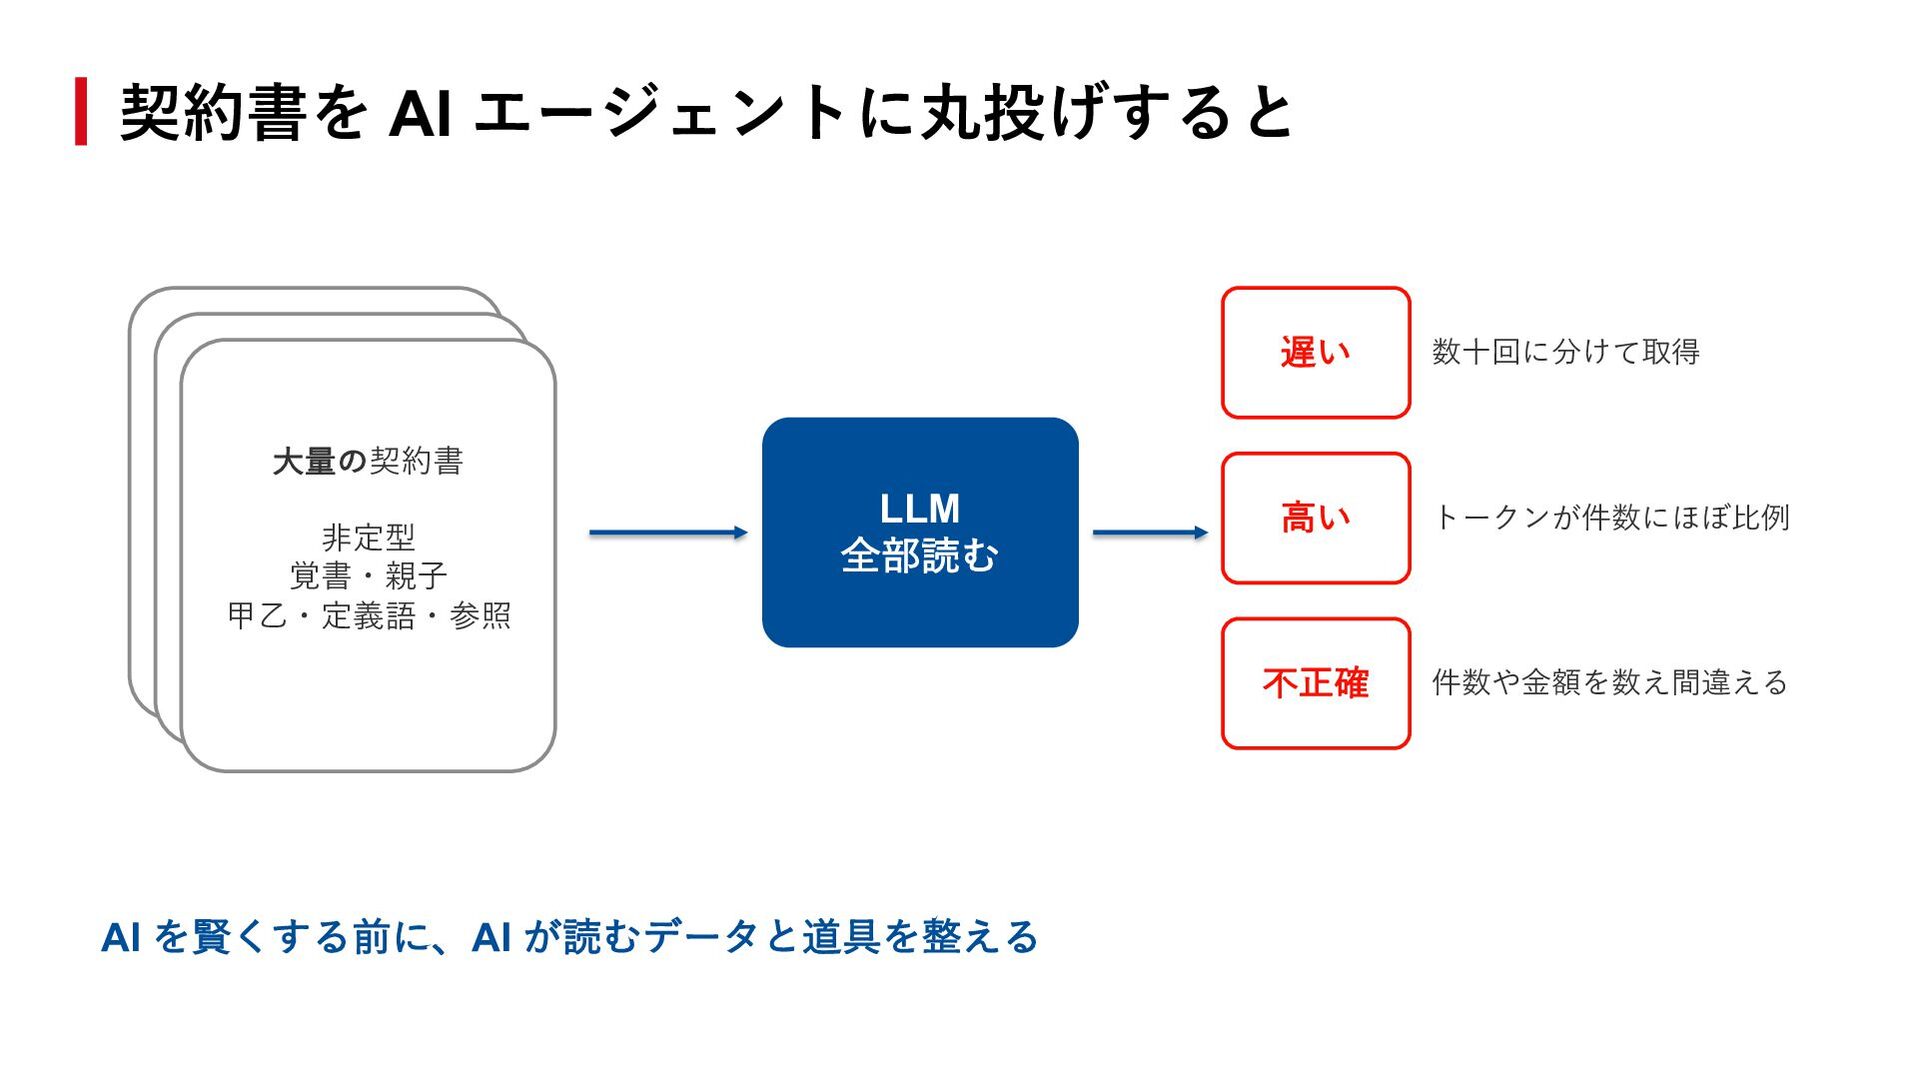
  4. 契約書を AI エージェントに丸投げすると 遅い 数⼗回に分けて取得 ⾼い トークンが件数にほぼ⽐例 不正確 件数や⾦額を数え間違える ⼤量の契約書

    ⾮定型 覚書・親⼦ 甲⼄・定義語・参照 LLM 全部読む AI を賢くする前に、AI が読むデータと道具を整える
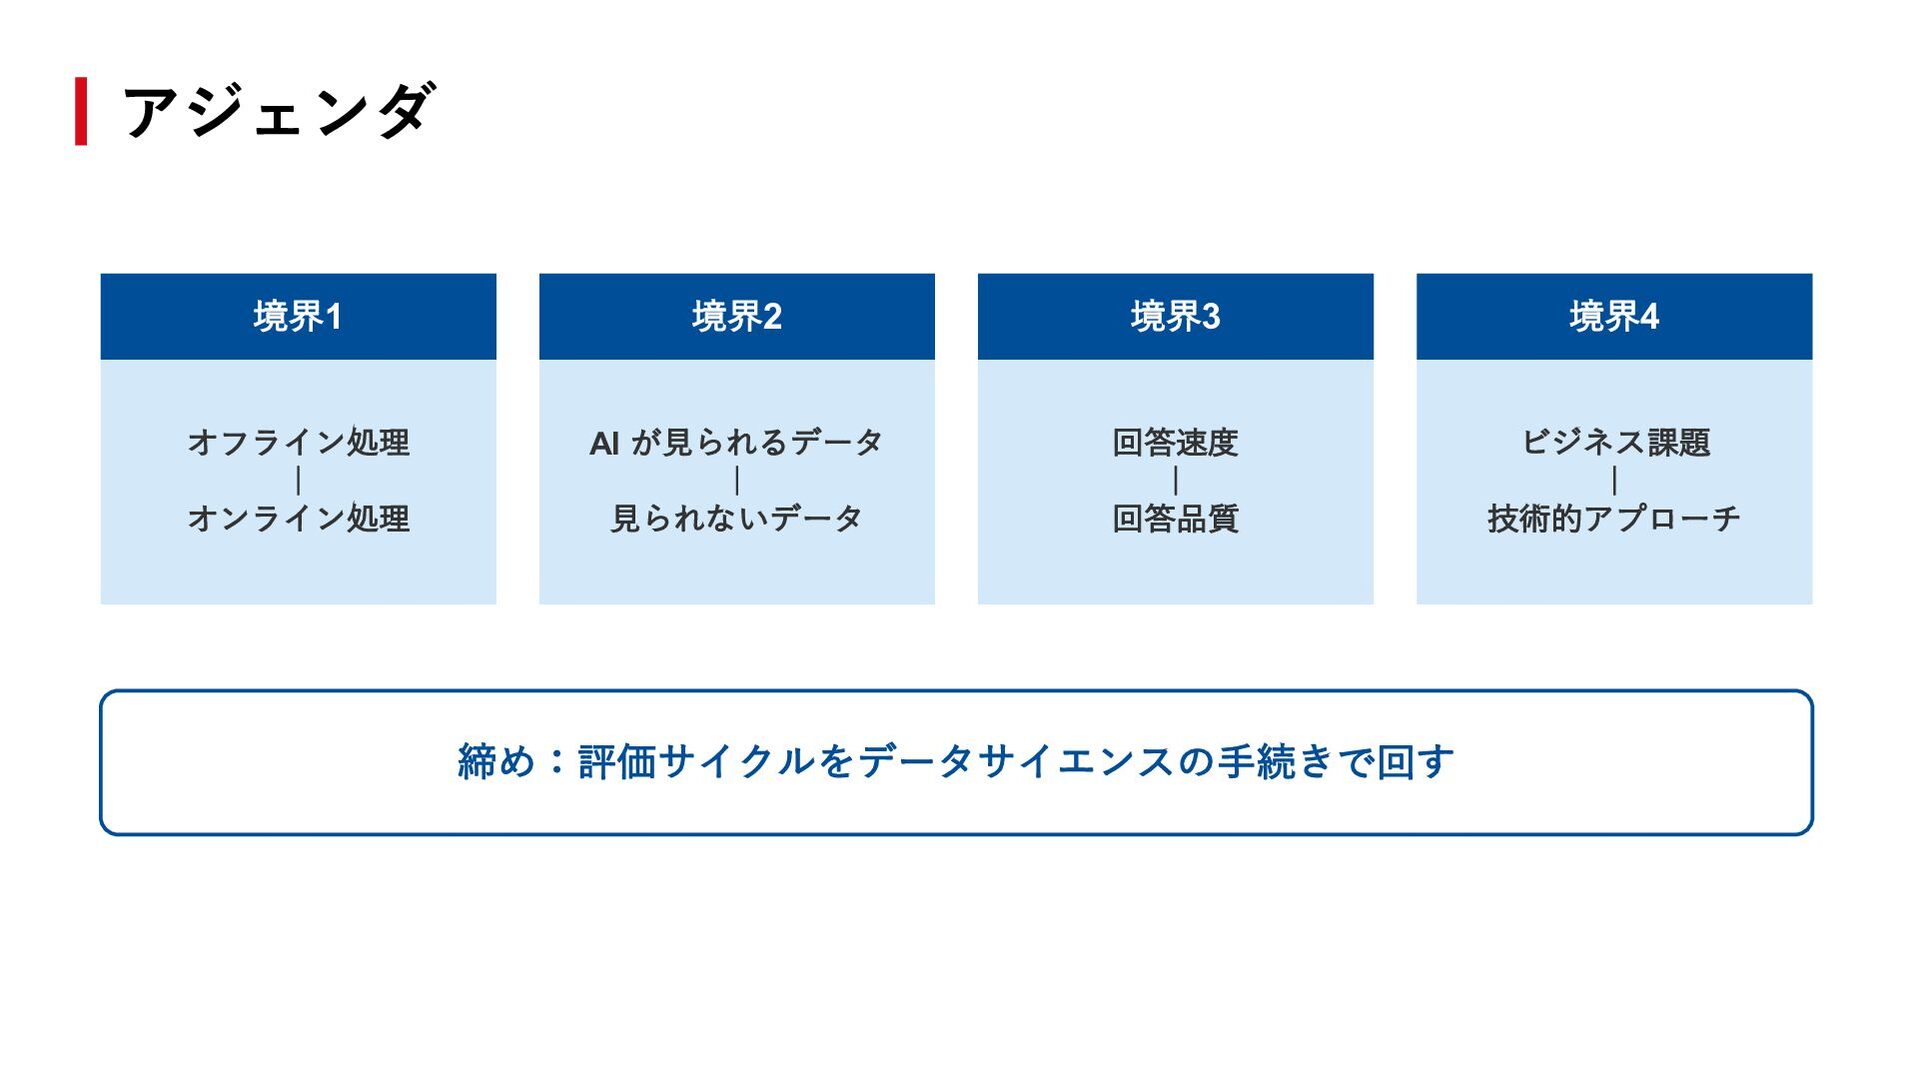
  5. アジェンダ 境界1 境界2 境界3 境界4 オフライン処理 | オンライン処理 AI が⾒られるデータ

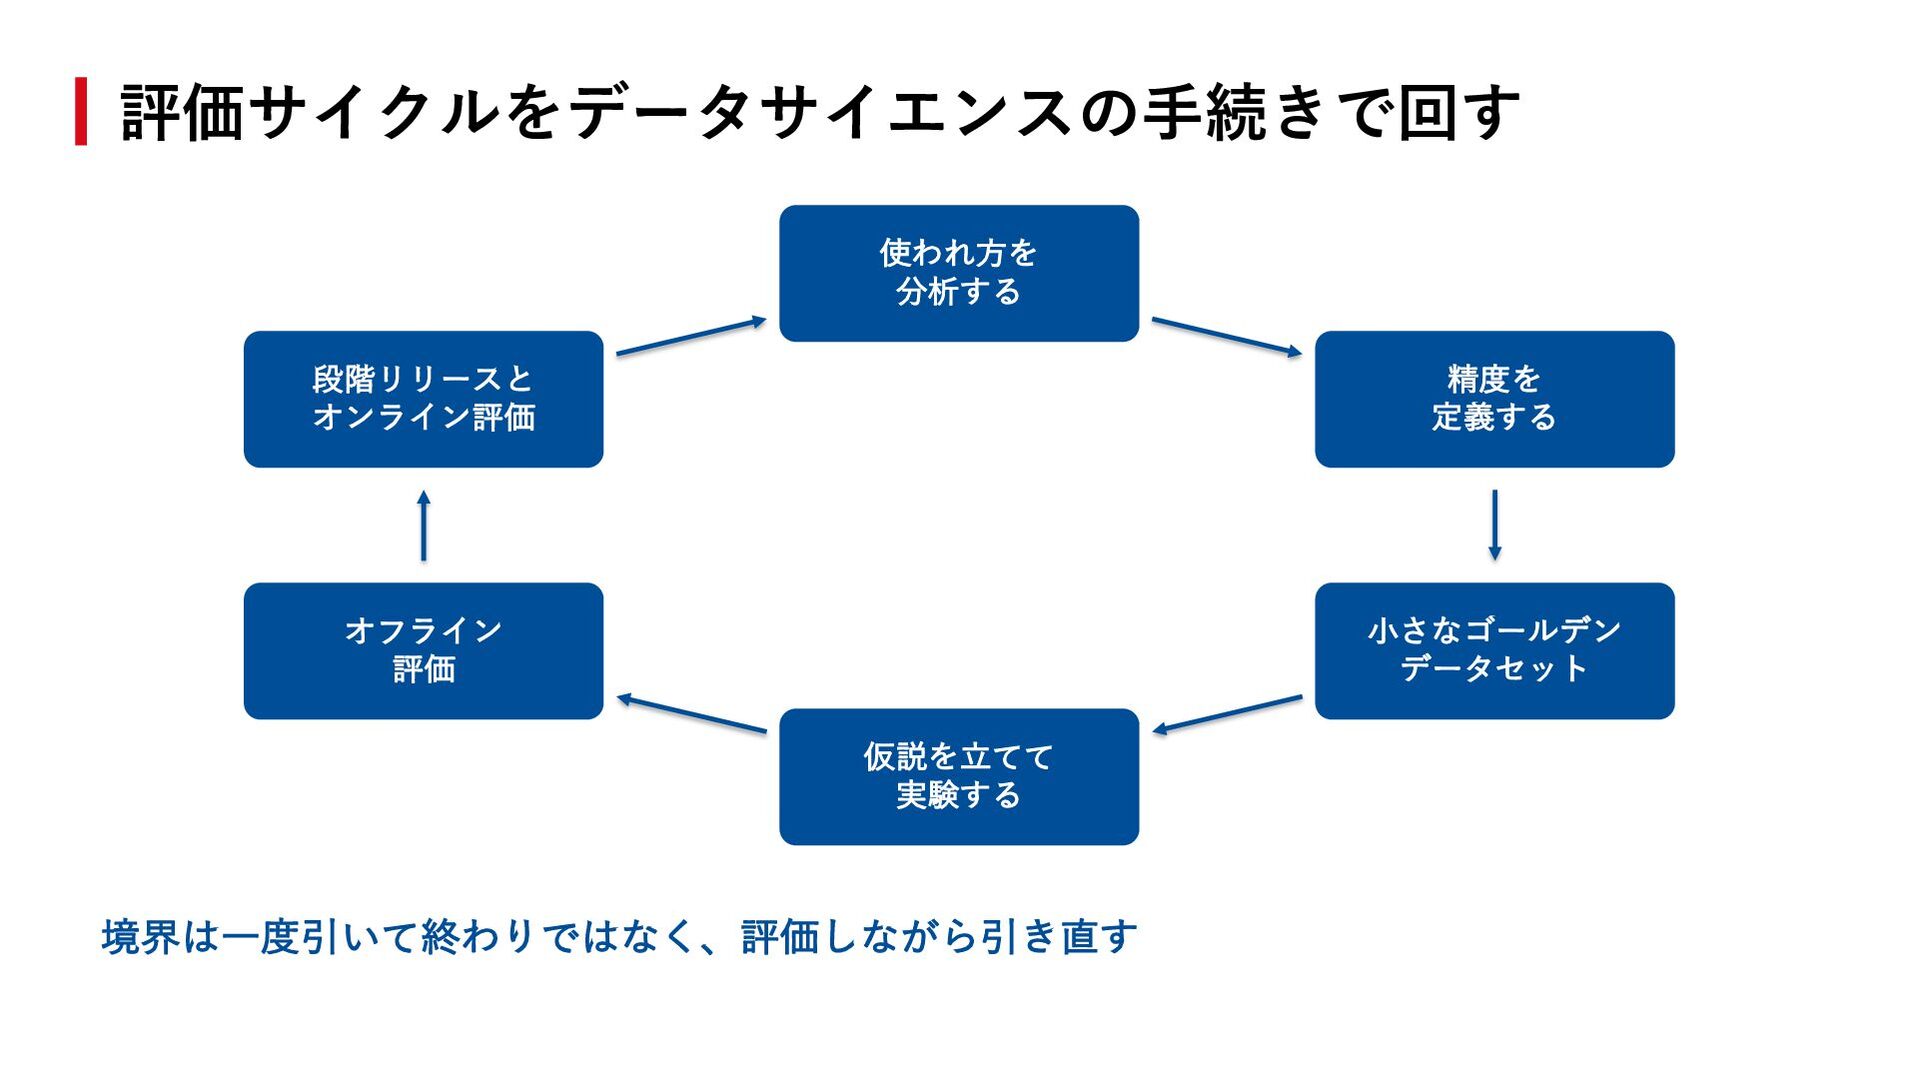
    | ⾒られないデータ 回答速度 | 回答品質 ビジネス課題 | 技術的アプローチ 締め:評価サイクルをデータサイエンスの⼿続きで回す
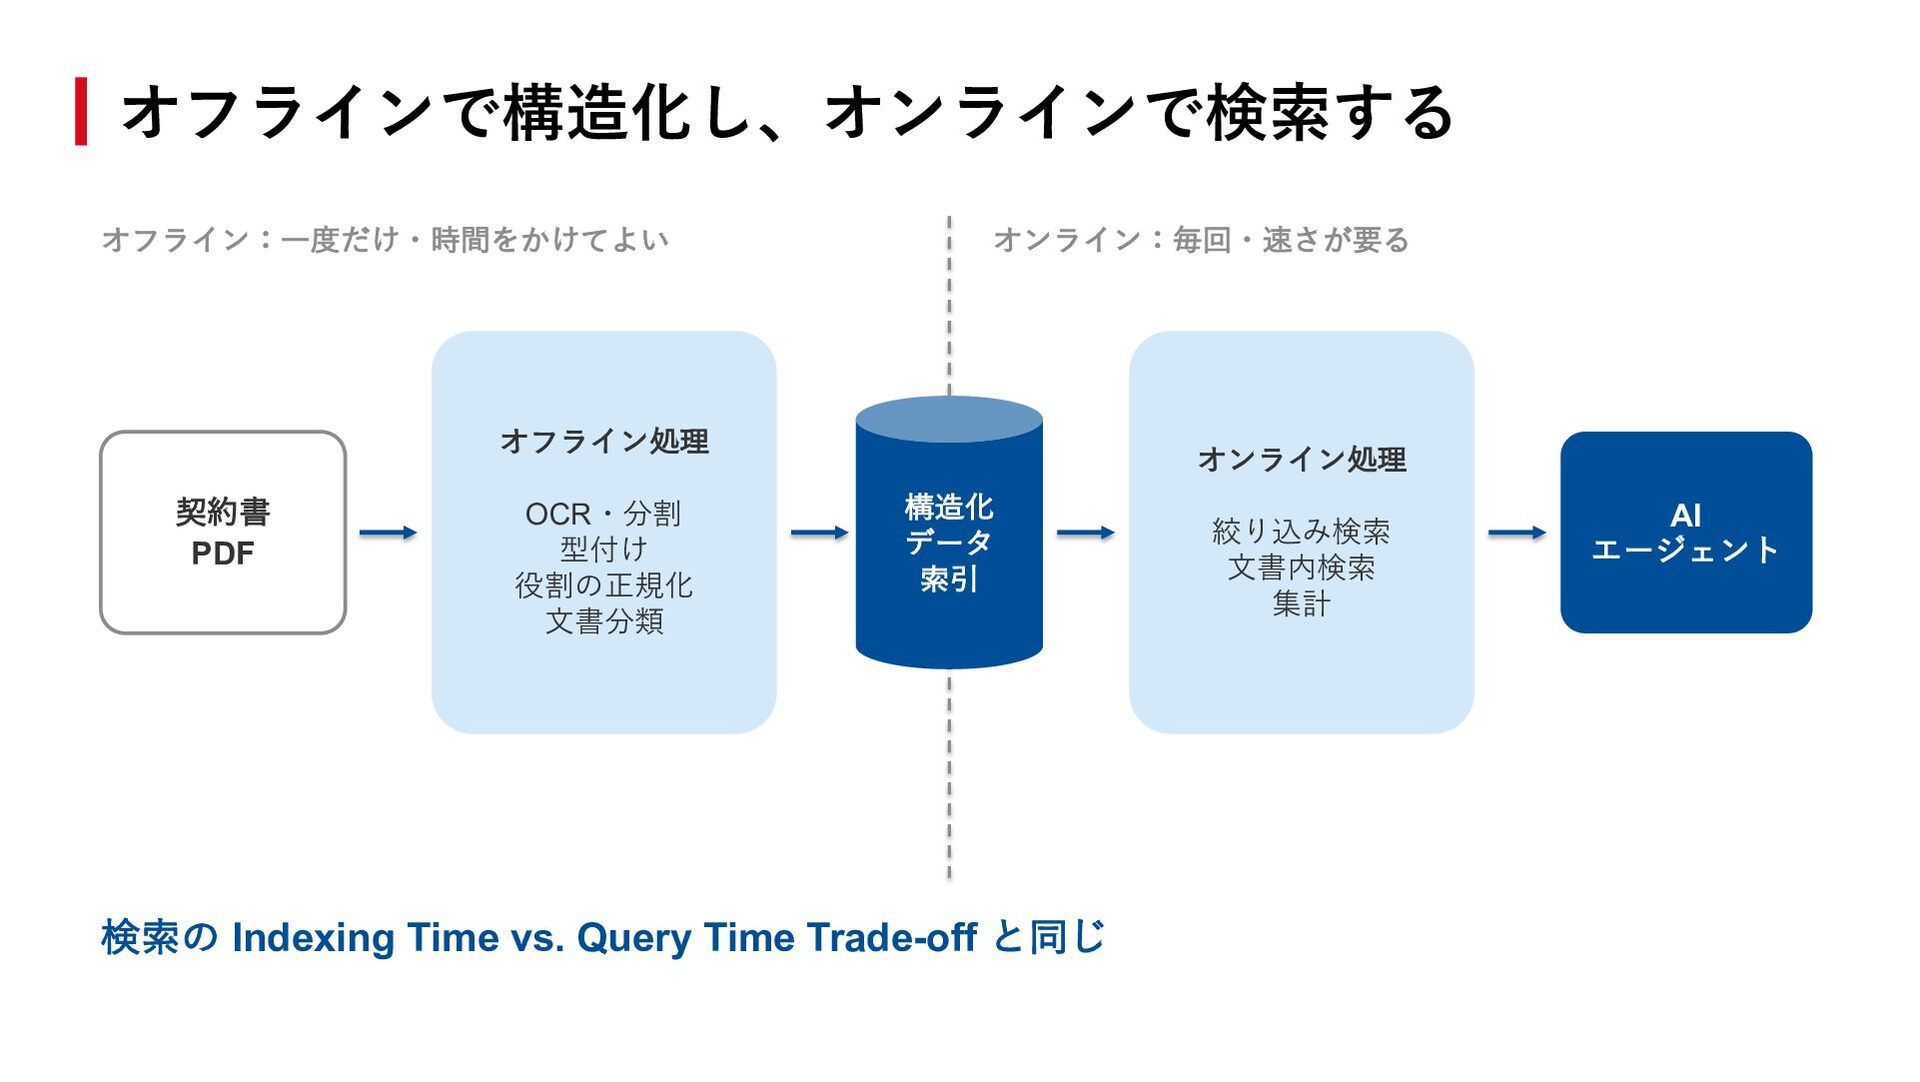
  6. オフラインで構造化し、オンラインで検索する オフライン:⼀度だけ・時間をかけてよい オンライン:毎回・速さが要る オフライン処理 契約書 PDF OCR・分割 型付け 役割の正規化 ⽂書分類

    オンライン処理 構造化 データ 索引 検索の Indexing Time vs. Query Time Trade-off と同じ 絞り込み検索 ⽂書内検索 集計 AI エージェント
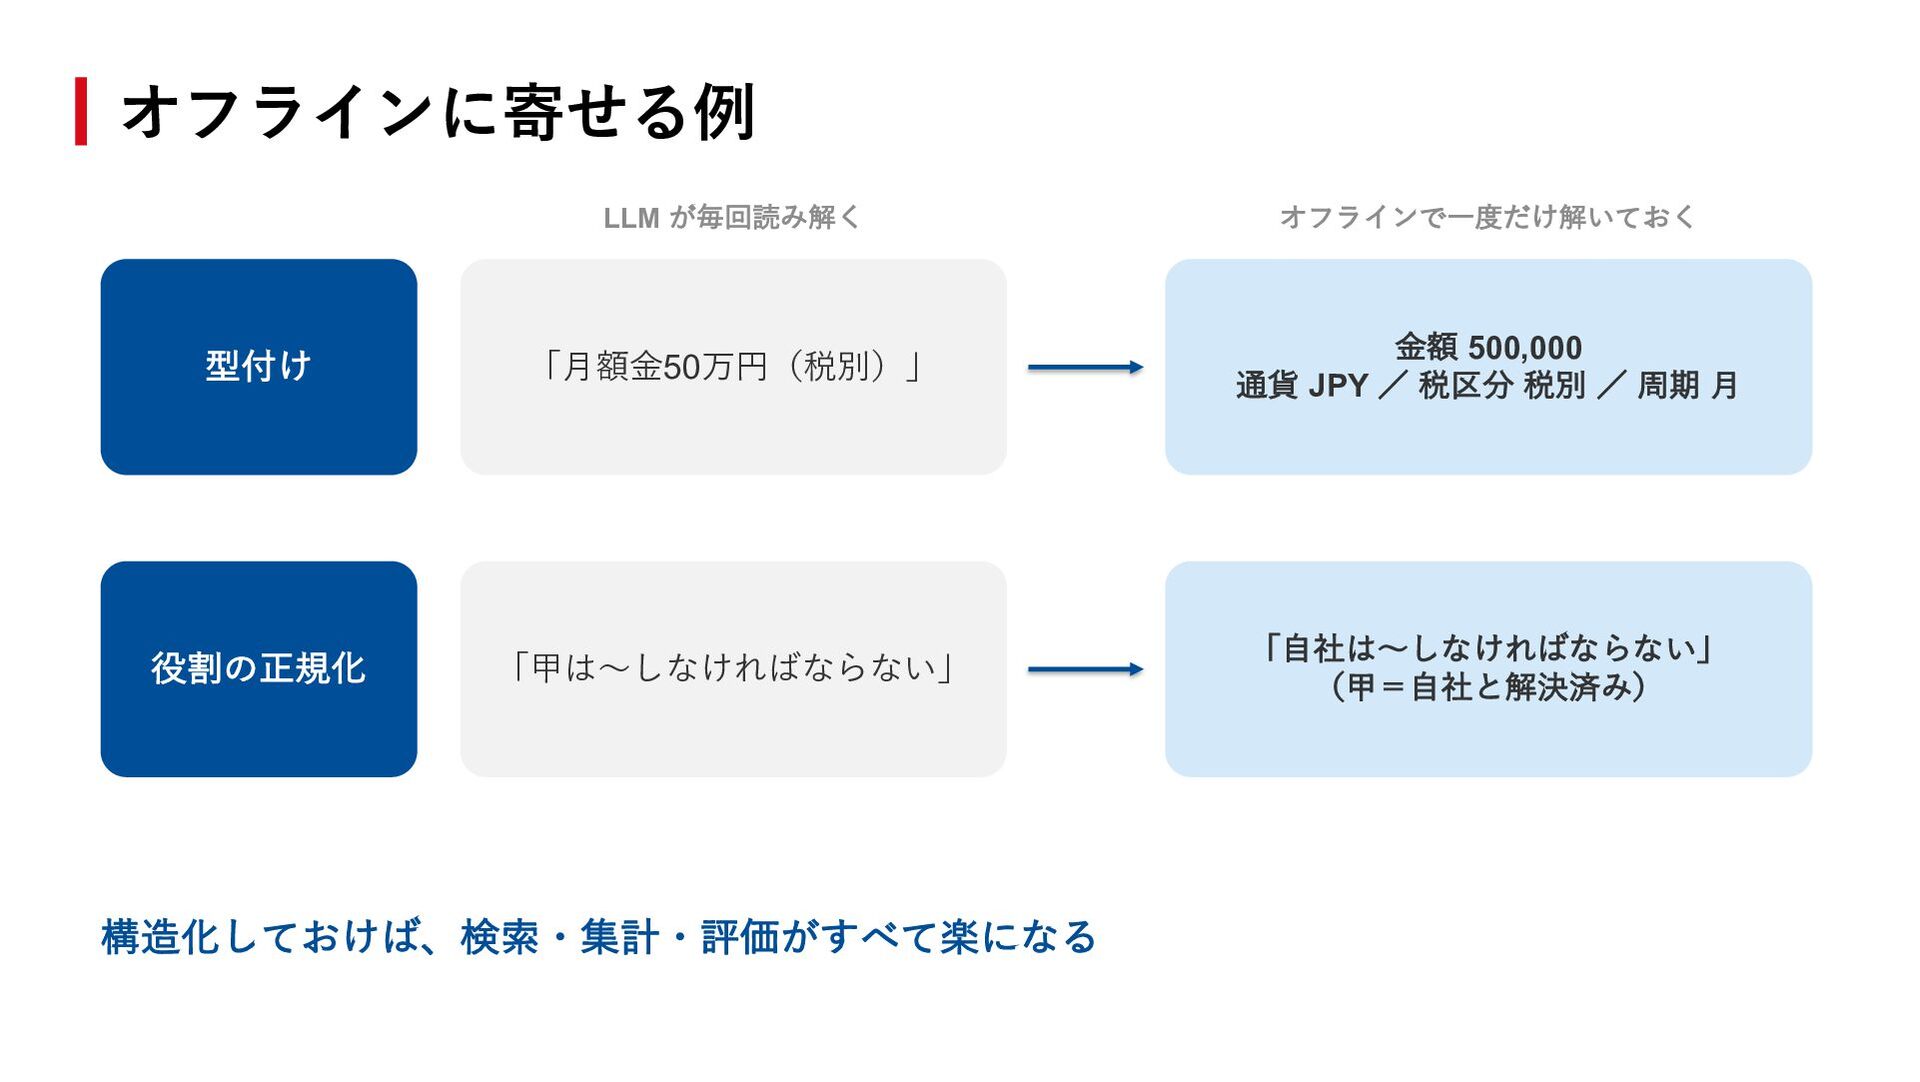
  7. オフラインに寄せる例 LLM が毎回読み解く オフラインで⼀度だけ解いておく 型付け 「⽉額⾦50万円(税別)」 ⾦額 500,000 通貨 JPY

    / 税区分 税別 / 周期 ⽉ 役割の正規化 「甲は〜しなければならない」 「⾃社は〜しなければならない」 (甲=⾃社と解決済み) 構造化しておけば、検索・集計・評価がすべて楽になる
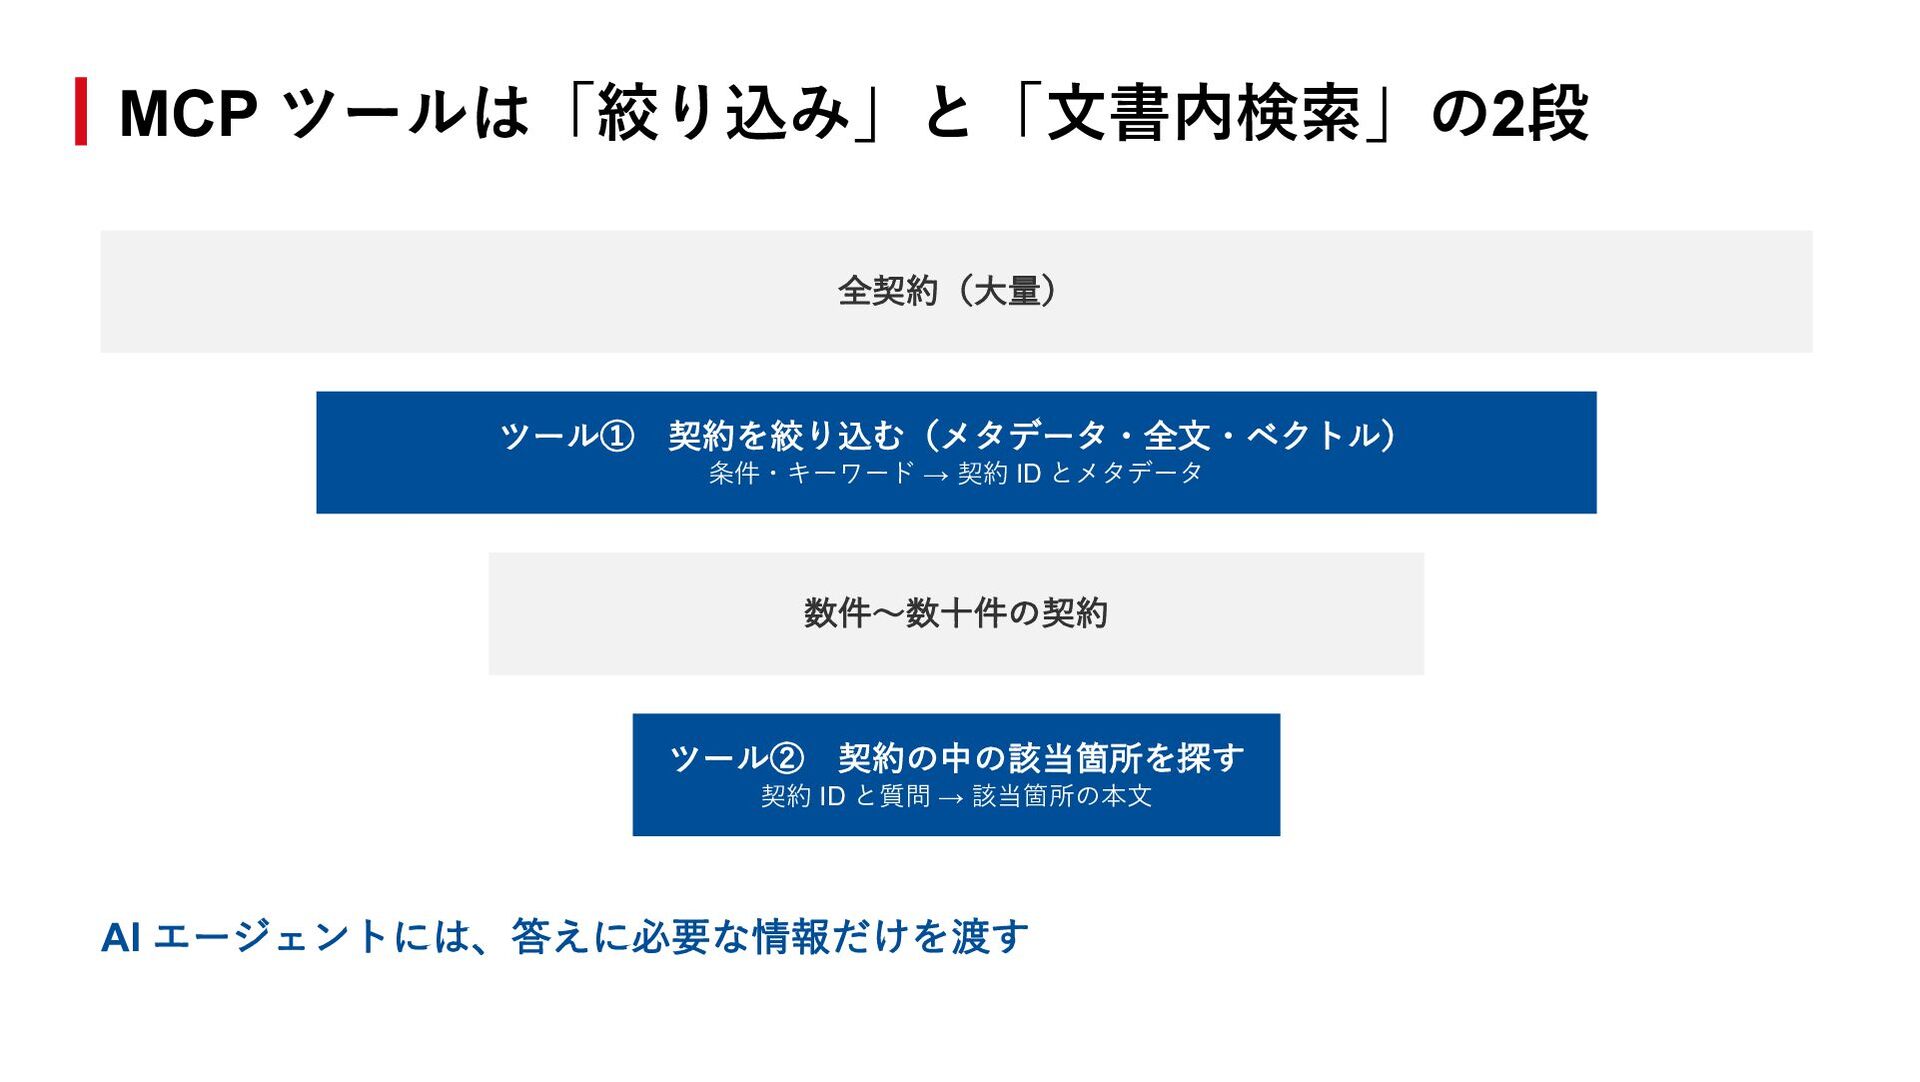
  8. MCP ツールは「絞り込み」と「⽂書内検索」の2段 全契約(⼤量) ツール① 契約を絞り込む(メタデータ・全⽂・ベクトル) 条件・キーワード → 契約 ID とメタデータ

    数件〜数⼗件の契約 ツール② 契約の中の該当箇所を探す 契約 ID と質問 → 該当箇所の本⽂ AI エージェントには、答えに必要な情報だけを渡す
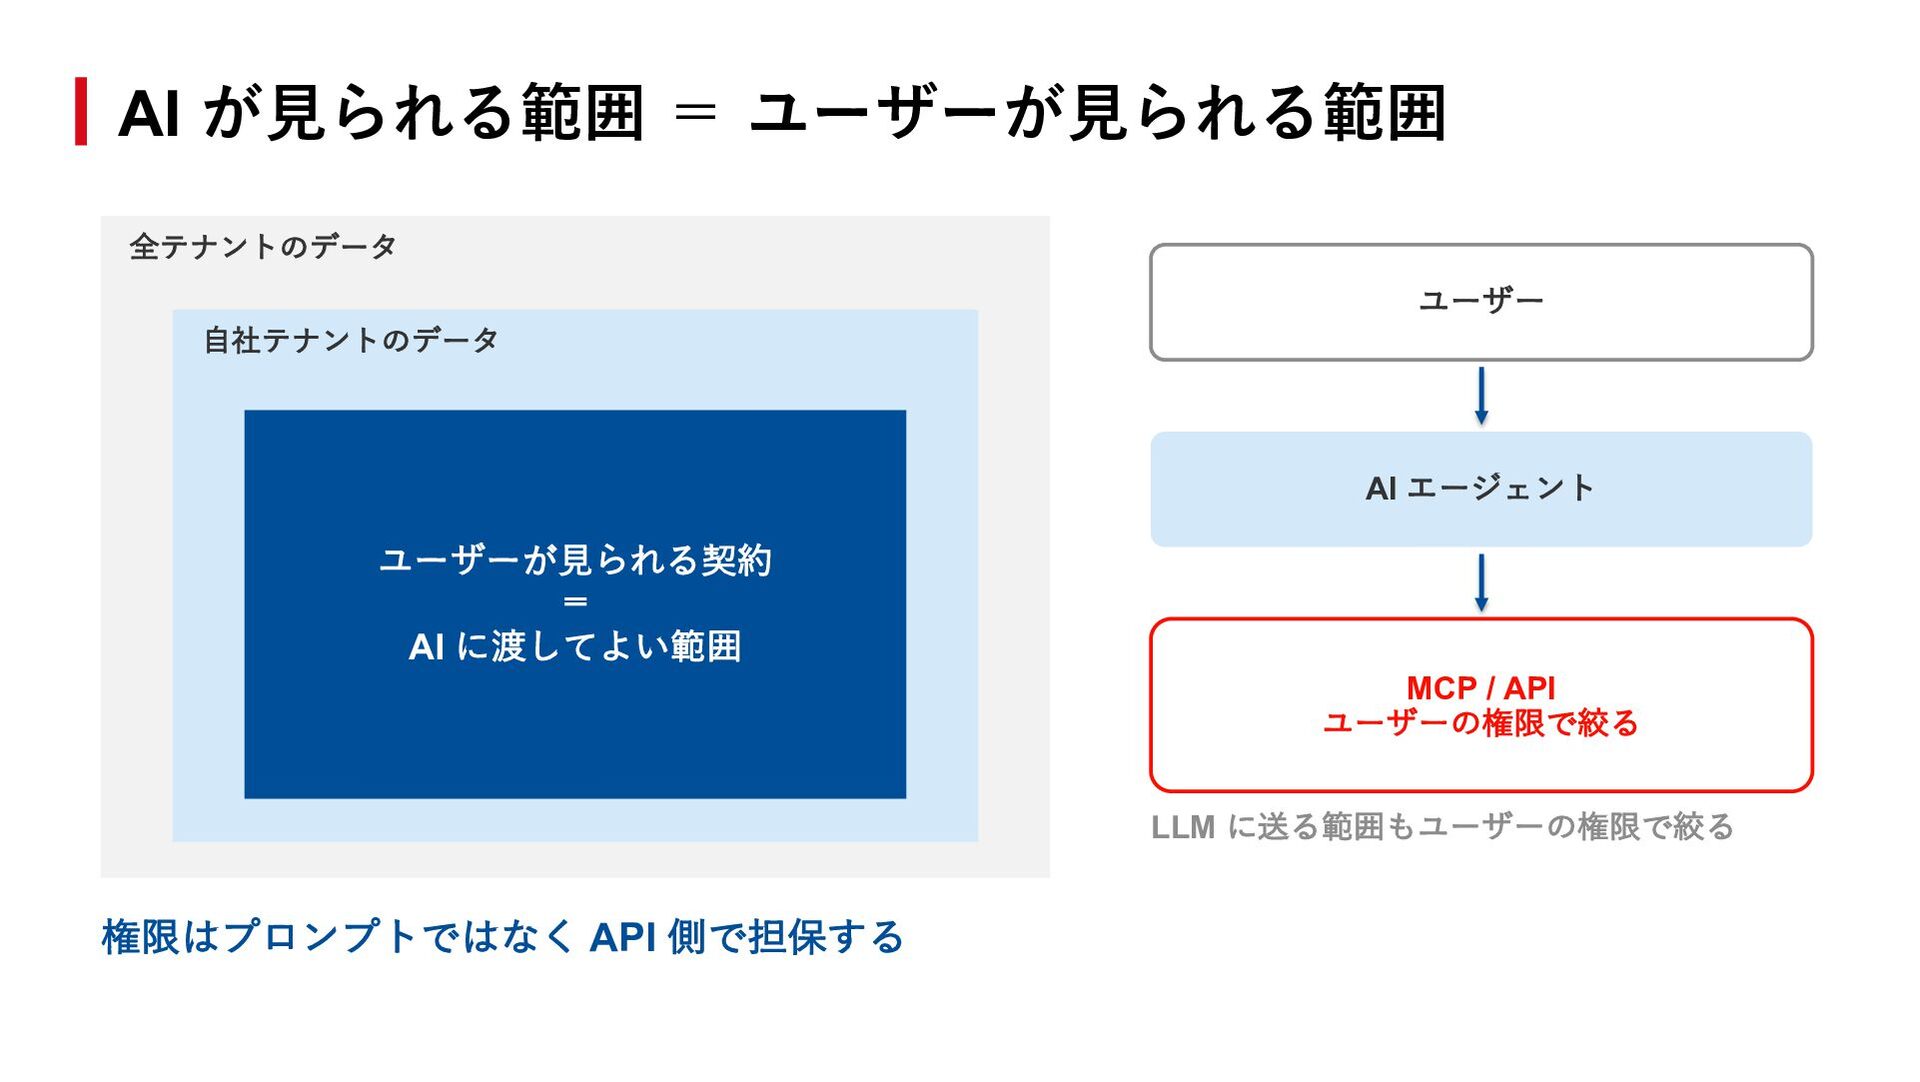
  9. AI が⾒られる範囲 = ユーザーが⾒られる範囲 全テナントのデータ ユーザー ⾃社テナントのデータ AI エージェント ユーザーが⾒られる契約

    = AI に渡してよい範囲 MCP / API ユーザーの権限で絞る LLM に送る範囲もユーザーの権限で絞る 権限はプロンプトではなく API 側で担保する
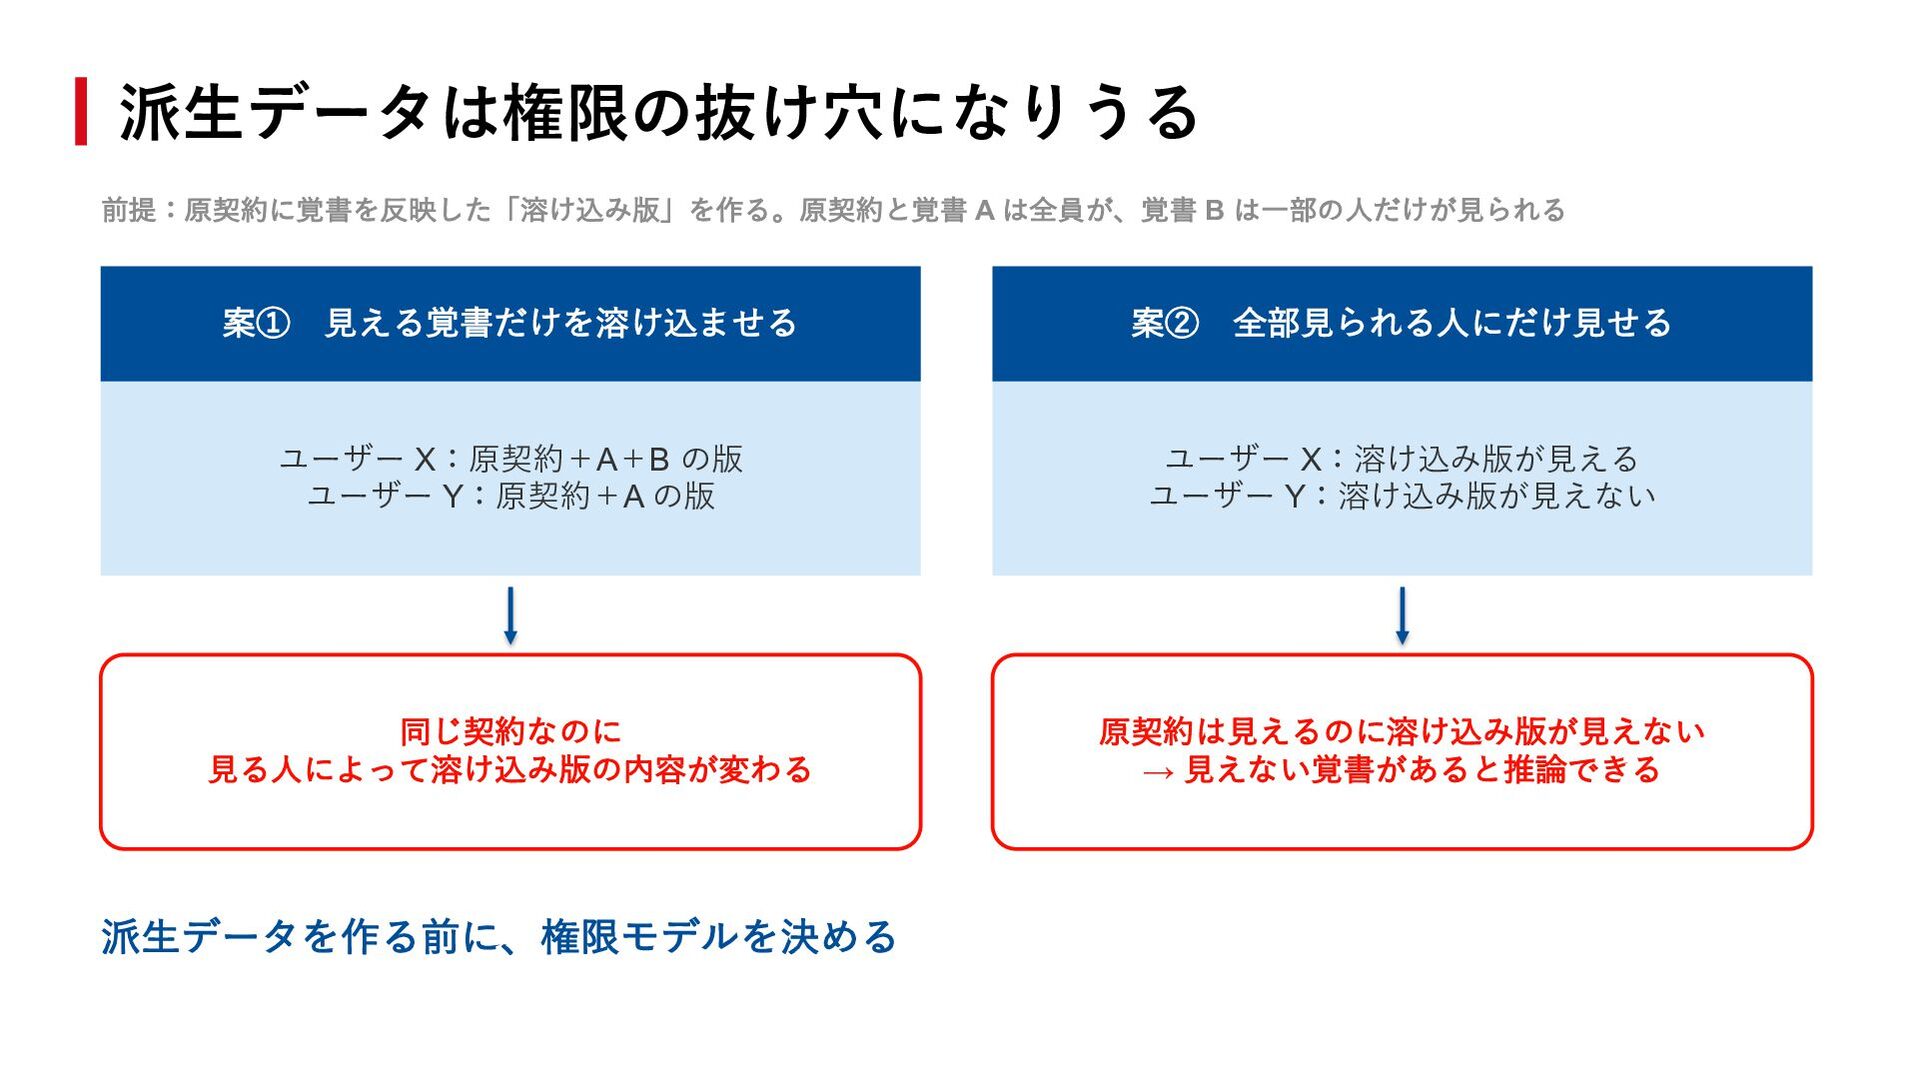
  10. 派⽣データは権限の抜け⽳になりうる 前提:原契約に覚書を反映した「溶け込み版」を作る。原契約と覚書 A は全員が、覚書 B は⼀部の⼈だけが⾒られる 案① ⾒える覚書だけを溶け込ませる 案② 全部⾒られる⼈にだけ⾒せる

    ユーザー X:原契約+A+B の版 ユーザー Y:原契約+A の版 ユーザー X:溶け込み版が⾒える ユーザー Y:溶け込み版が⾒えない 同じ契約なのに ⾒る⼈によって溶け込み版の内容が変わる 原契約は⾒えるのに溶け込み版が⾒えない → ⾒えない覚書があると推論できる 派⽣データを作る前に、権限モデルを決める
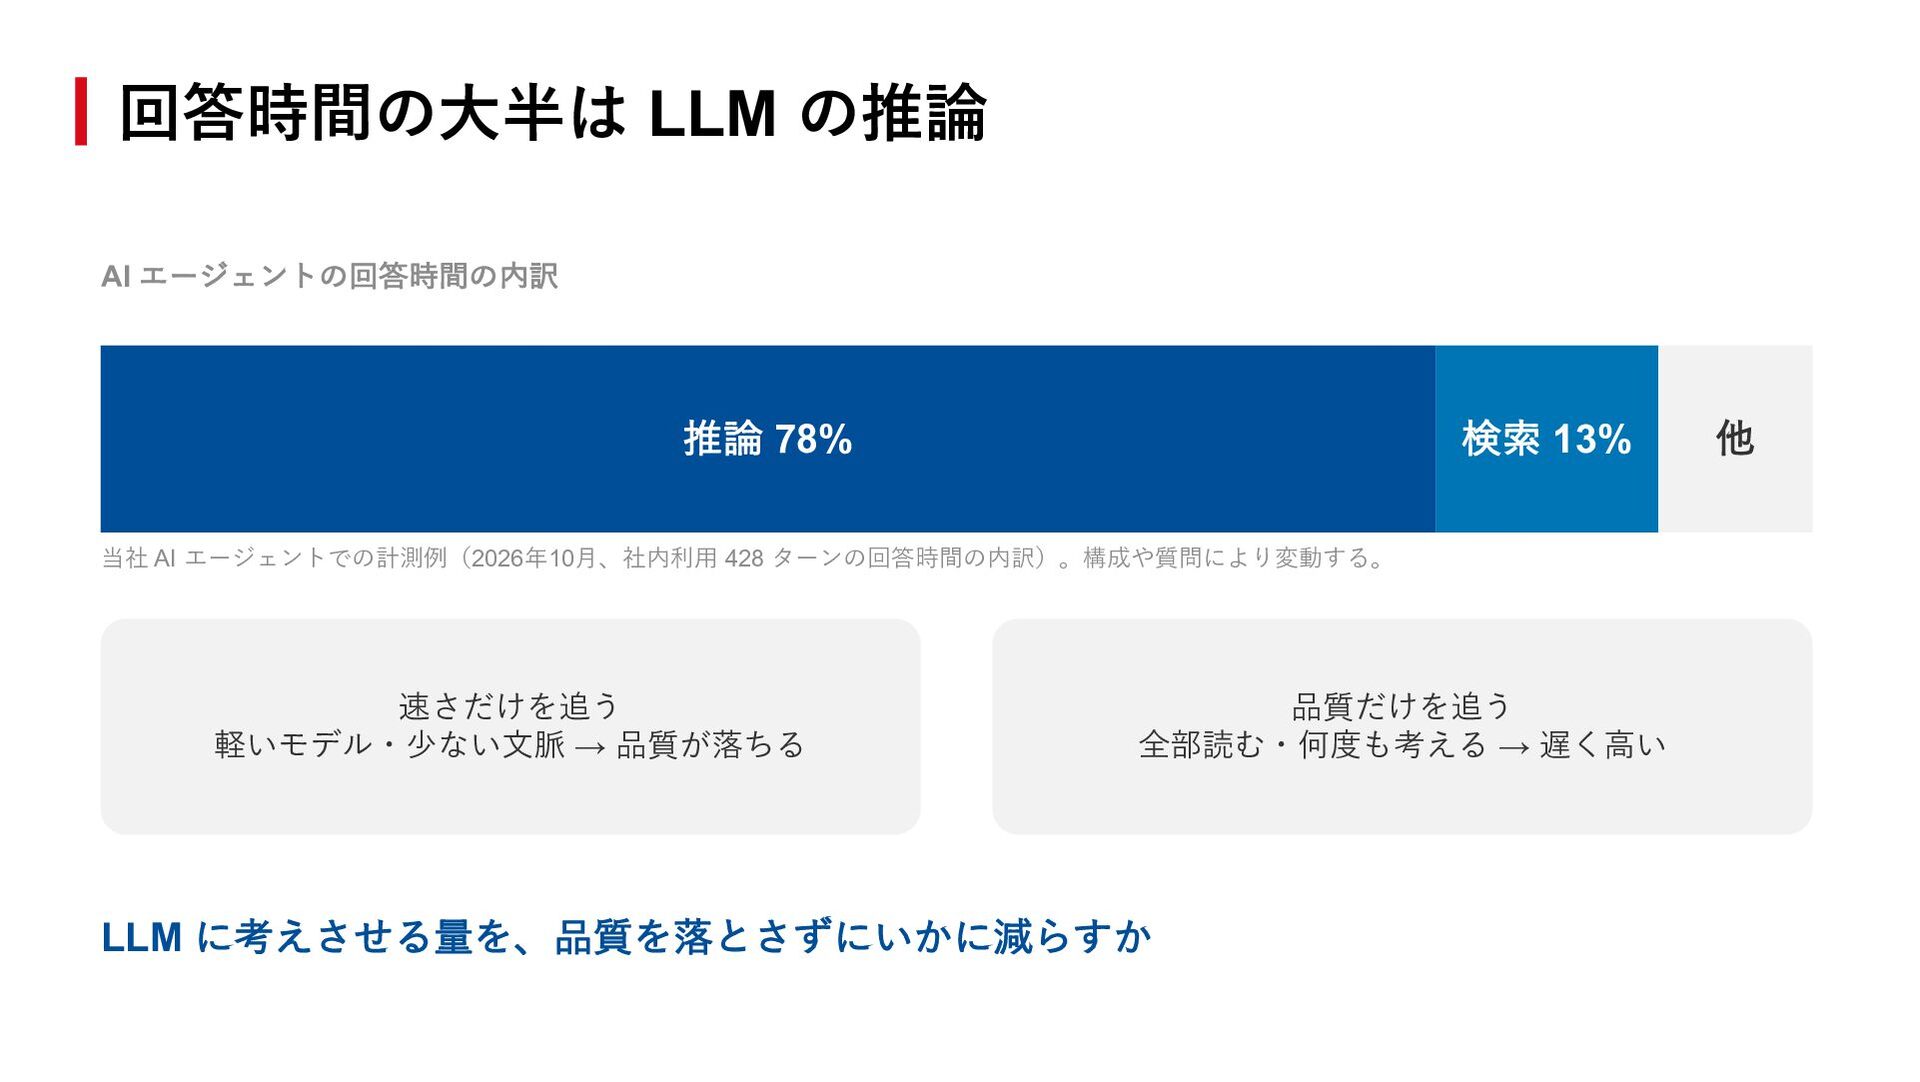
  11. 回答時間の⼤半は LLM の推論 AI エージェントの回答時間の内訳 推論 78% 検索 13% 当社

    AI エージェントでの計測例(2026年10⽉、社内利⽤ 428 ターンの回答時間の内訳)。構成や質問により変動する。 速さだけを追う 軽いモデル・少ない⽂脈 → 品質が落ちる 品質だけを追う 全部読む・何度も考える → 遅く⾼い LLM に考えさせる量を、品質を落とさずにいかに減らすか 他
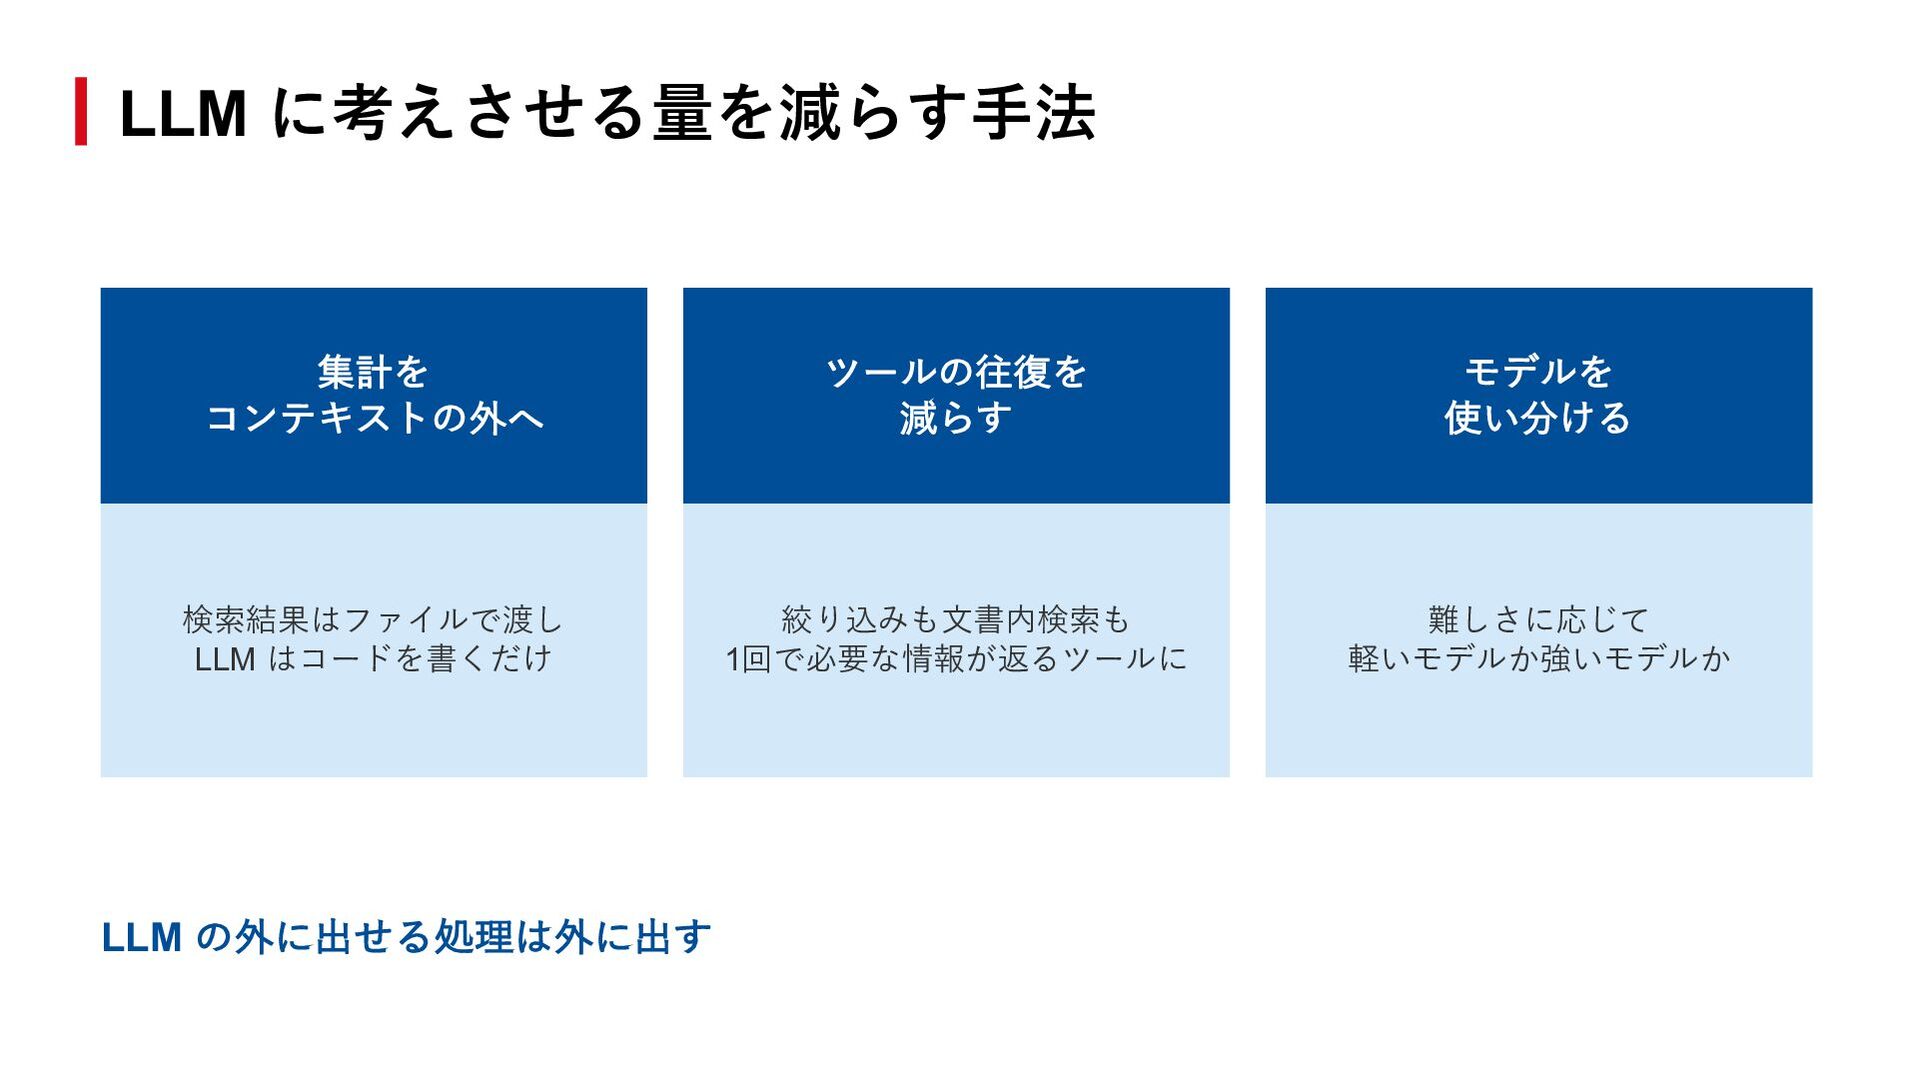
  12. LLM に考えさせる量を減らす⼿法 集計を コンテキストの外へ ツールの往復を 減らす モデルを 使い分ける 検索結果はファイルで渡し LLM

    はコードを書くだけ 絞り込みも⽂書内検索も 1回で必要な情報が返るツールに 難しさに応じて 軽いモデルか強いモデルか LLM の外に出せる処理は外に出す
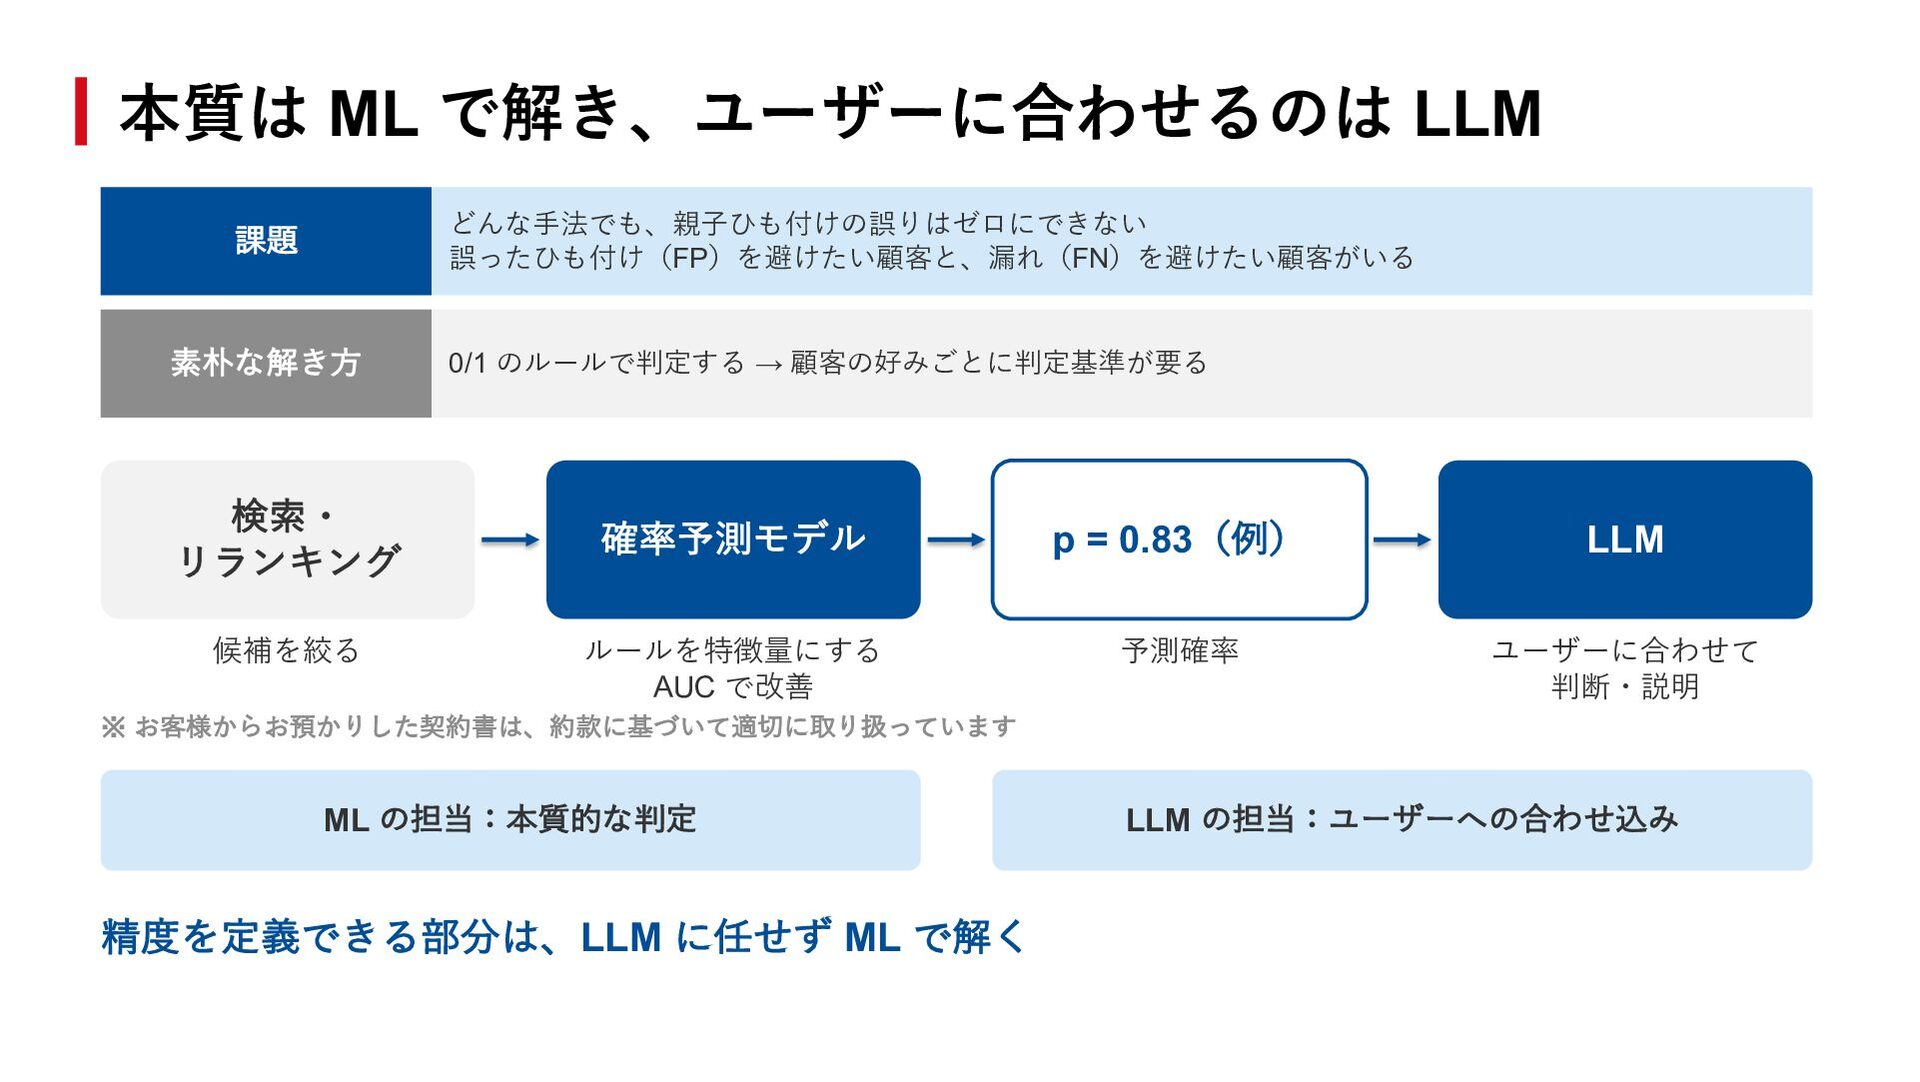
  13. 本質は ML で解き、ユーザーに合わせるのは LLM どんな⼿法でも、親⼦ひも付けの誤りはゼロにできない 誤ったひも付け(FP)を避けたい顧客と、漏れ(FN)を避けたい顧客がいる 課題 素朴な解き⽅ 検索・ リランキング

    候補を絞る 0/1 のルールで判定する → 顧客の好みごとに判定基準が要る 確率予測モデル p = 0.83(例) LLM ルールを特徴量にする AUC で改善 予測確率 ユーザーに合わせて 判断・説明 ※ お客様からお預かりした契約書は、約款に基づいて適切に取り扱っています ML の担当:本質的な判定 精度を定義できる部分は、LLM に任せず ML で解く LLM の担当:ユーザーへの合わせ込み
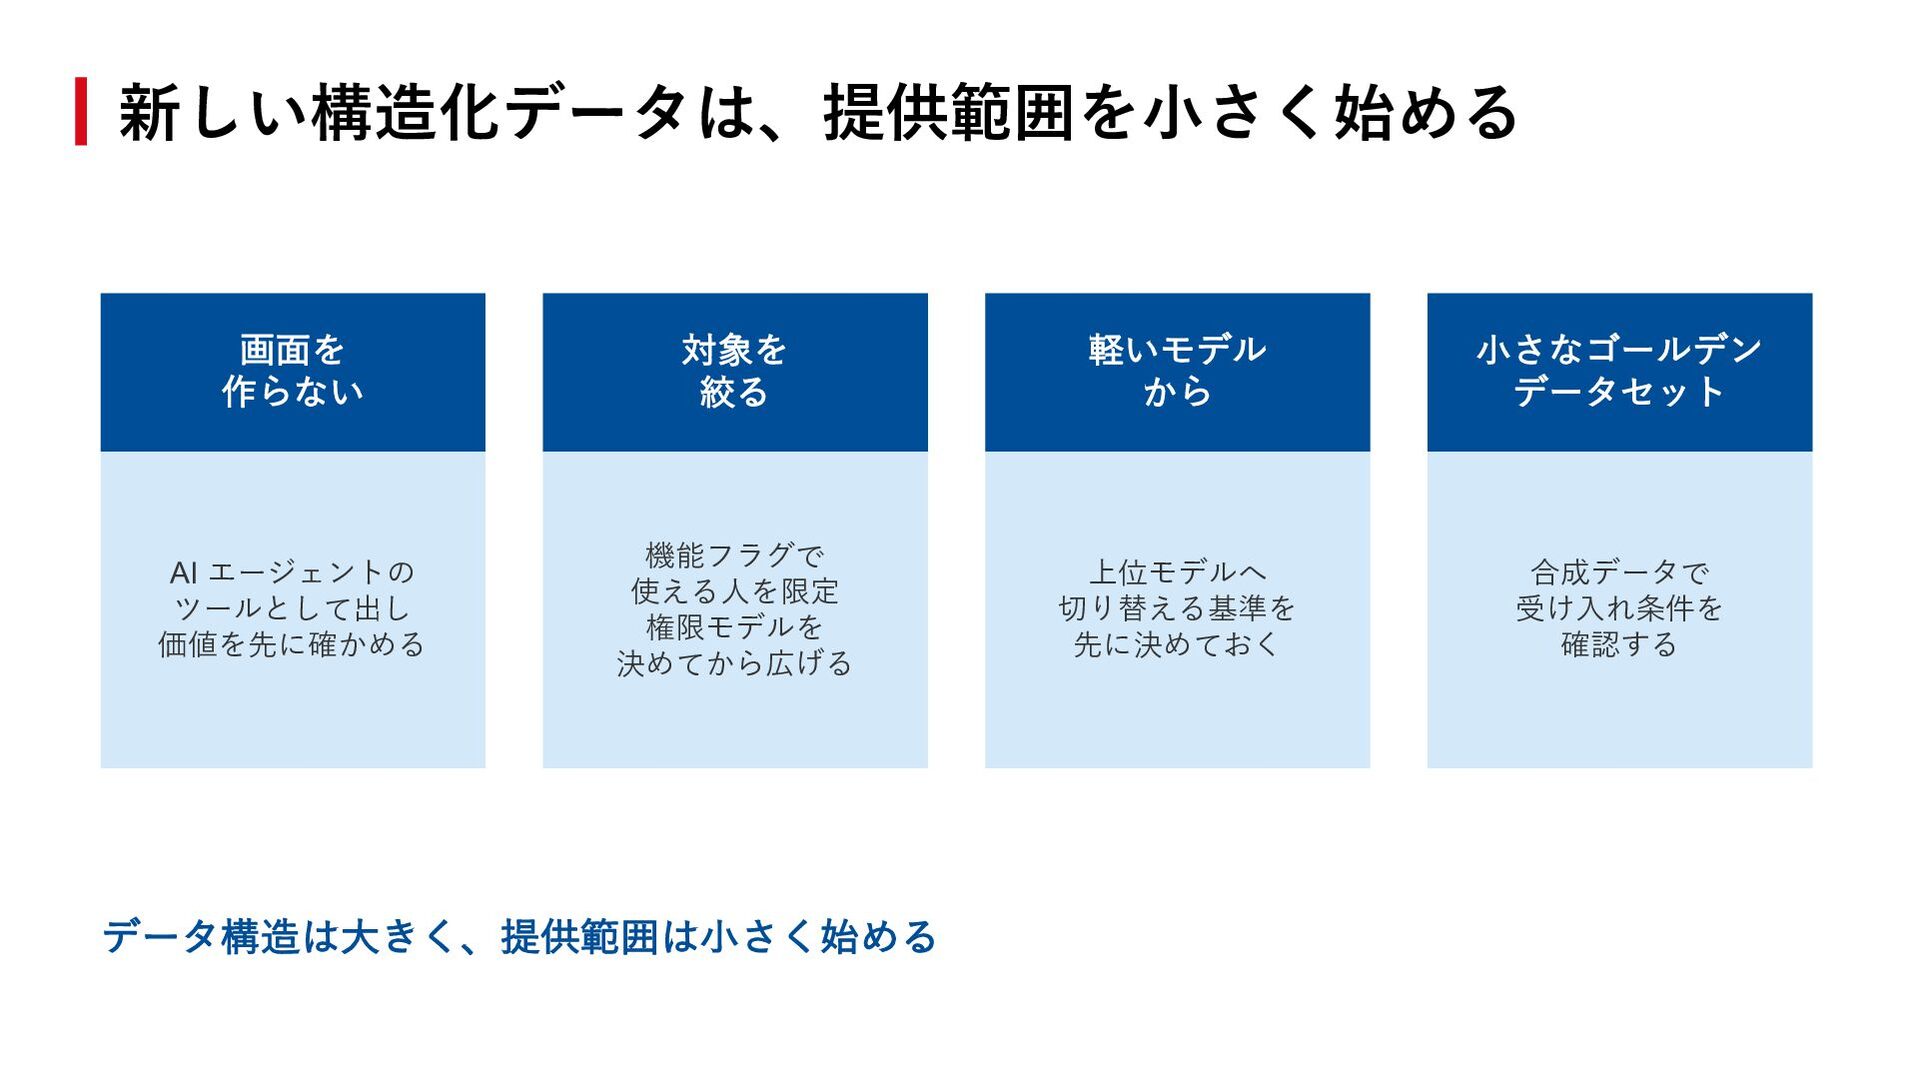
  14. 新しい構造化データは、提供範囲を⼩さく始める 画⾯を 作らない 対象を 絞る 軽いモデル から ⼩さなゴールデン データセット AI

    エージェントの ツールとして出し 価値を先に確かめる 機能フラグで 使える⼈を限定 権限モデルを 決めてから広げる 上位モデルへ 切り替える基準を 先に決めておく 合成データで 受け⼊れ条件を 確認する データ構造は⼤きく、提供範囲は⼩さく始める
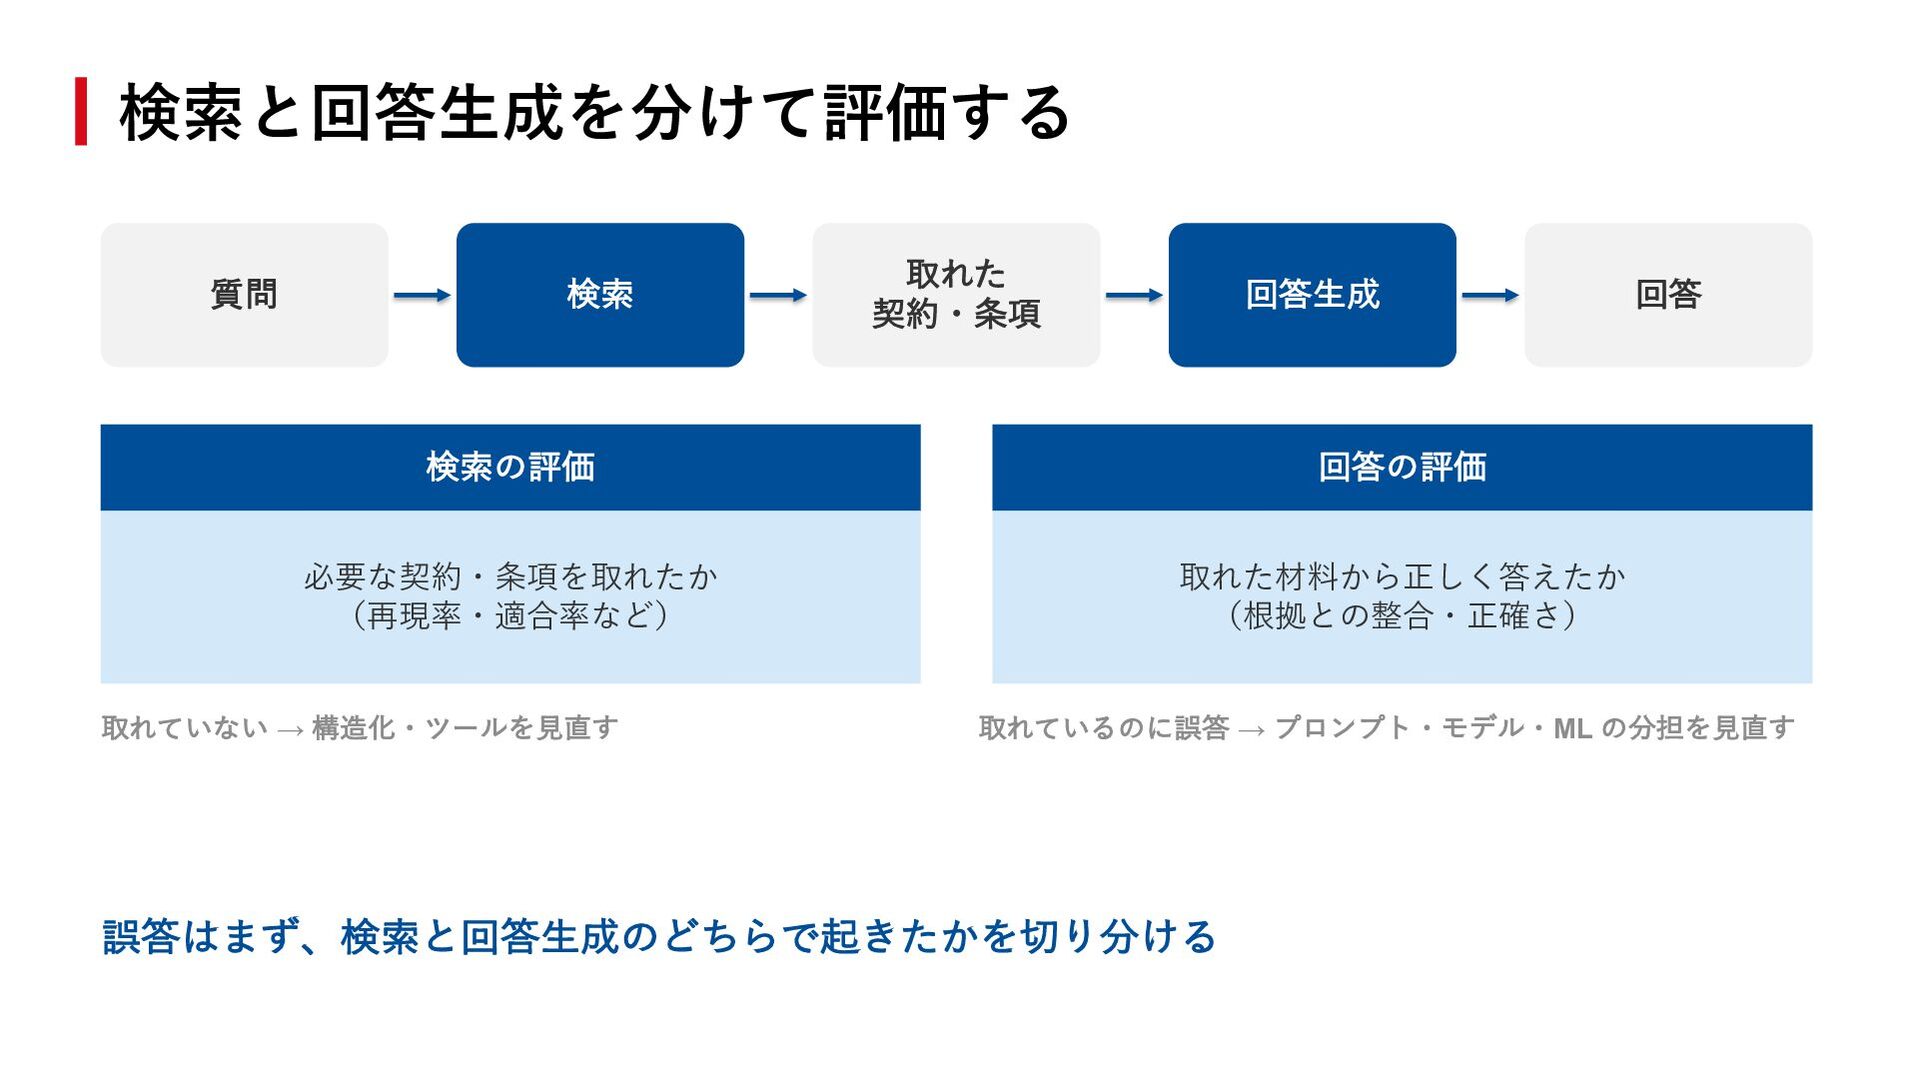
  15. 検索と回答⽣成を分けて評価する 質問 検索 取れた 契約・条項 回答⽣成 検索の評価 回答の評価 必要な契約・条項を取れたか (再現率・適合率など)

    取れた材料から正しく答えたか (根拠との整合・正確さ) 取れていない → 構造化・ツールを⾒直す 回答 取れているのに誤答 → プロンプト・モデル・ML の分担を⾒直す 誤答はまず、検索と回答⽣成のどちらで起きたかを切り分ける
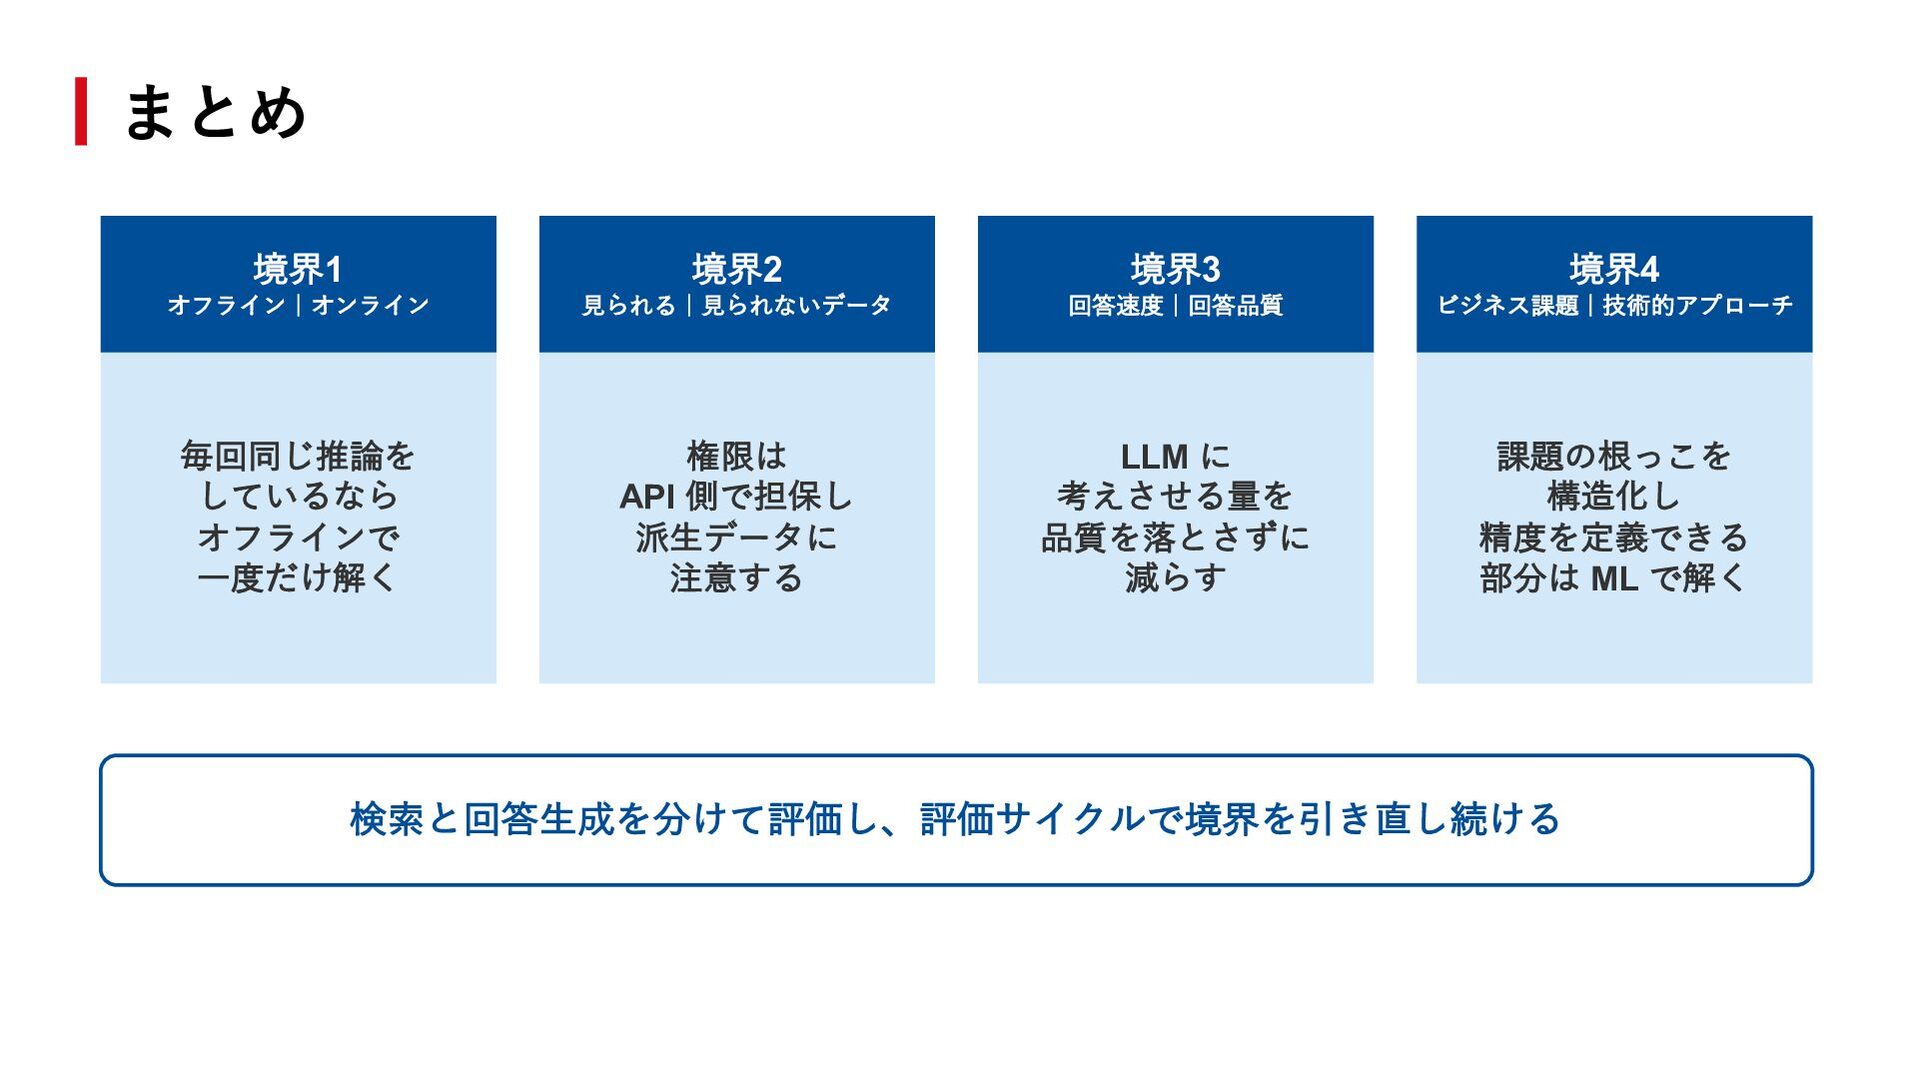
  16. まとめ 境界1 境界2 境界3 境界4 オフライン|オンライン ⾒られる|⾒られないデータ 回答速度|回答品質 ビジネス課題|技術的アプローチ 毎回同じ推論を

    しているなら オフラインで ⼀度だけ解く 権限は API 側で担保し 派⽣データに 注意する LLM に 考えさせる量を 品質を落とさずに 減らす 課題の根っこを 構造化し 精度を定義できる 部分は ML で解く 検索と回答⽣成を分けて評価し、評価サイクルで境界を引き直し続ける