Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
JAWS_FESTA2026_オンプレ-AWS間プロキシサーバの移行_性能_障害対応で得た実践...
Search
tkazuaki0820
November 07, 2026
Technology
100
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
JAWS_FESTA2026_オンプレ-AWS間プロキシサーバの移行_性能_障害対応で得た実践ノウハウ_高島一晃.pdf
tkazuaki0820
November 07, 2026
Transcript
27 slides
オンプレ-AWS間プロキシサーバの 移行・性能・障害対応で得た実践ノウハウ 日本電気株式会社 高島 一晃 #jawsug #jawsfesta2026
担当業務 Rufus君 メイン業務は通信業界のお客様向けのPJで、 AWSのネットワークインフラ、セキュリティ周りの 設計、構築の推進リーダを担当しています。 AWSの生成AI活用の検討も少し対応しています。 2025,2026 Japan AWS Top
Engineers AWS Community Builders(Networking and Content Delivery) 趣味 ひとこと ラグビー観戦、ポケモン、ゲーム等 Qiitaでブログを執筆しています。 https://qiita.com/tkazuaki0820 好きなAWSサービスは Kiro、CloudTrail Rufus君と一緒にAWSイベントに 参加すること AWS社製AIエディタ「Kiro」で アプリを作ること 日本電気株式会社 OMCS統括部 高島 一晃
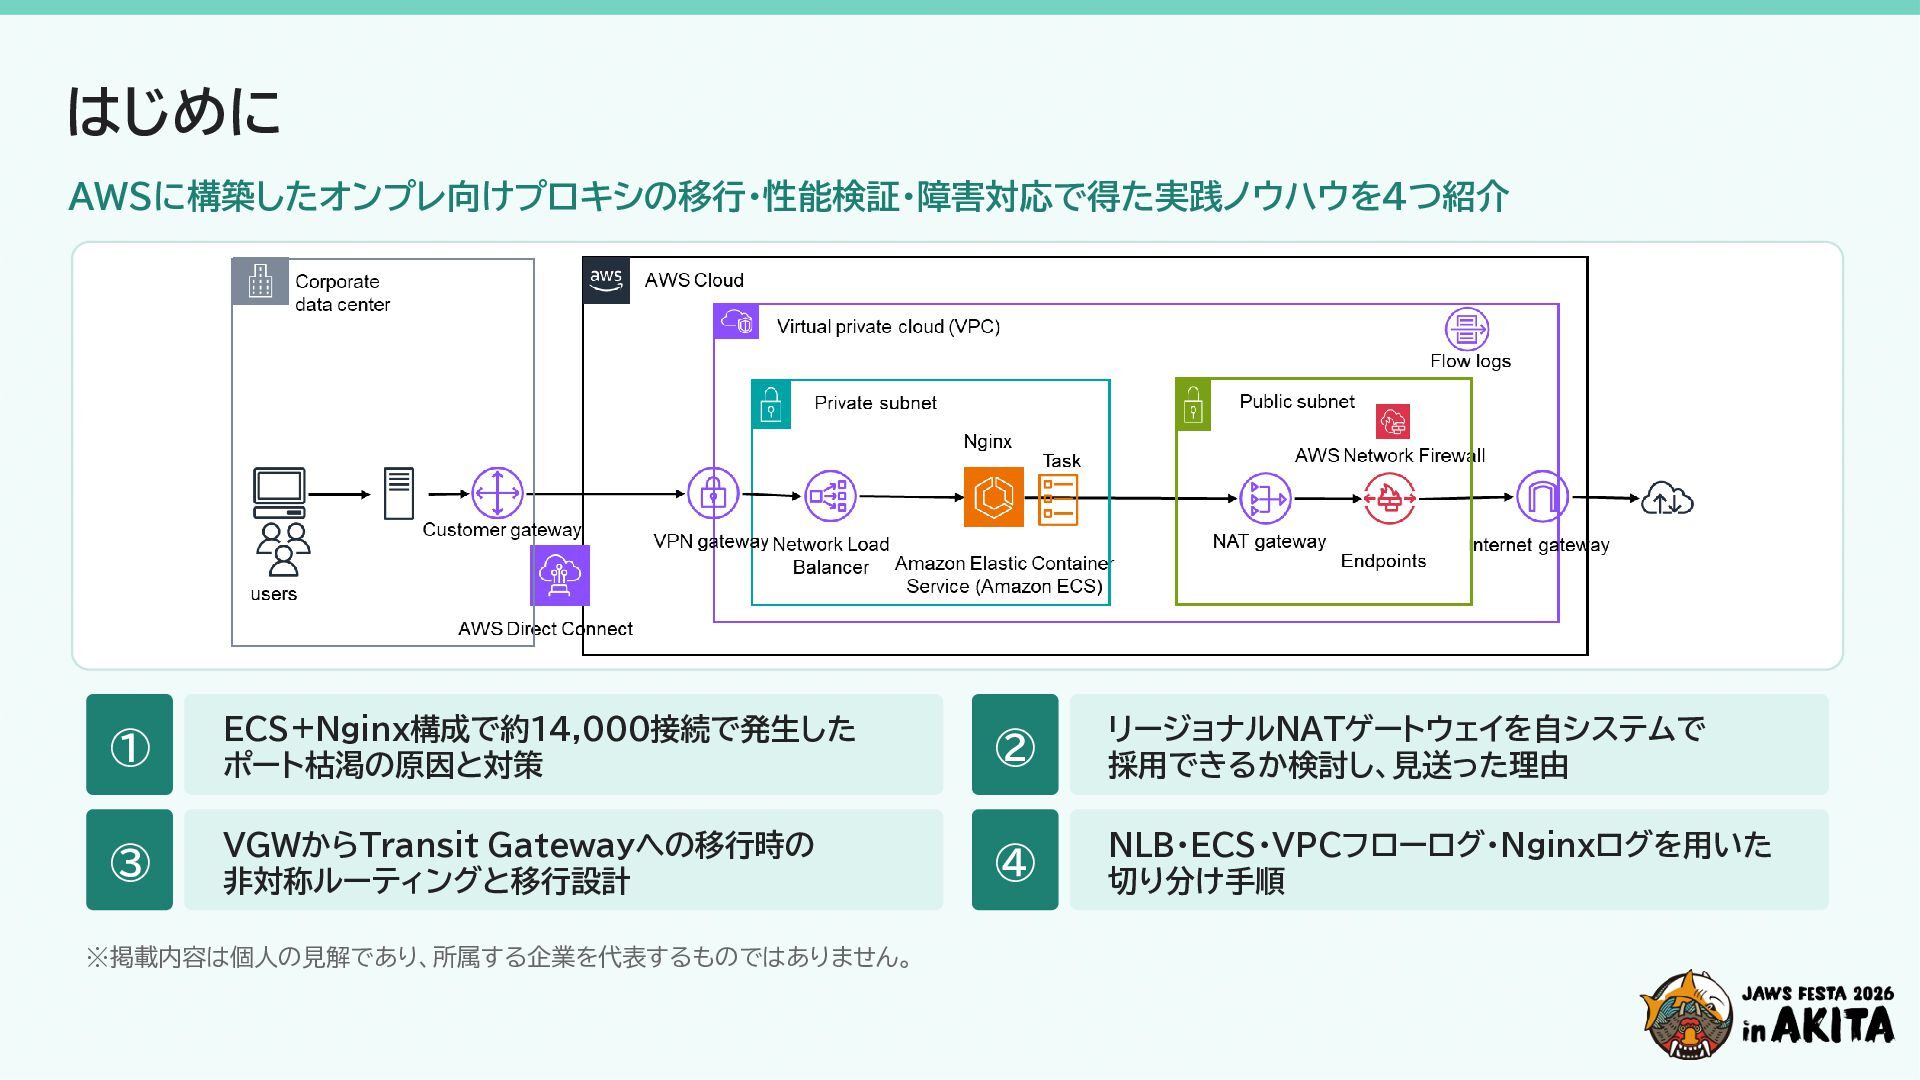
はじめに AWSに構築したオンプレ向けプロキシの移行・性能検証・障害対応で得た実践ノウハウを4つ紹介 ① ECS+Nginx構成で約14,000接続で発生した ポート枯渇の原因と対策 ② リージョナルNATゲートウェイを自システムで 採用できるか検討し、見送った理由 ③ VGWからTransit
Gatewayへの移行時の 非対称ルーティングと移行設計 ④ NLB・ECS・VPCフローログ・Nginxログを用いた 切り分け手順 ※掲載内容は個人の見解であり、所属する企業を代表するものではありません。
トピック① ECS+Nginx構成で発生した ポート枯渇の原因と対策
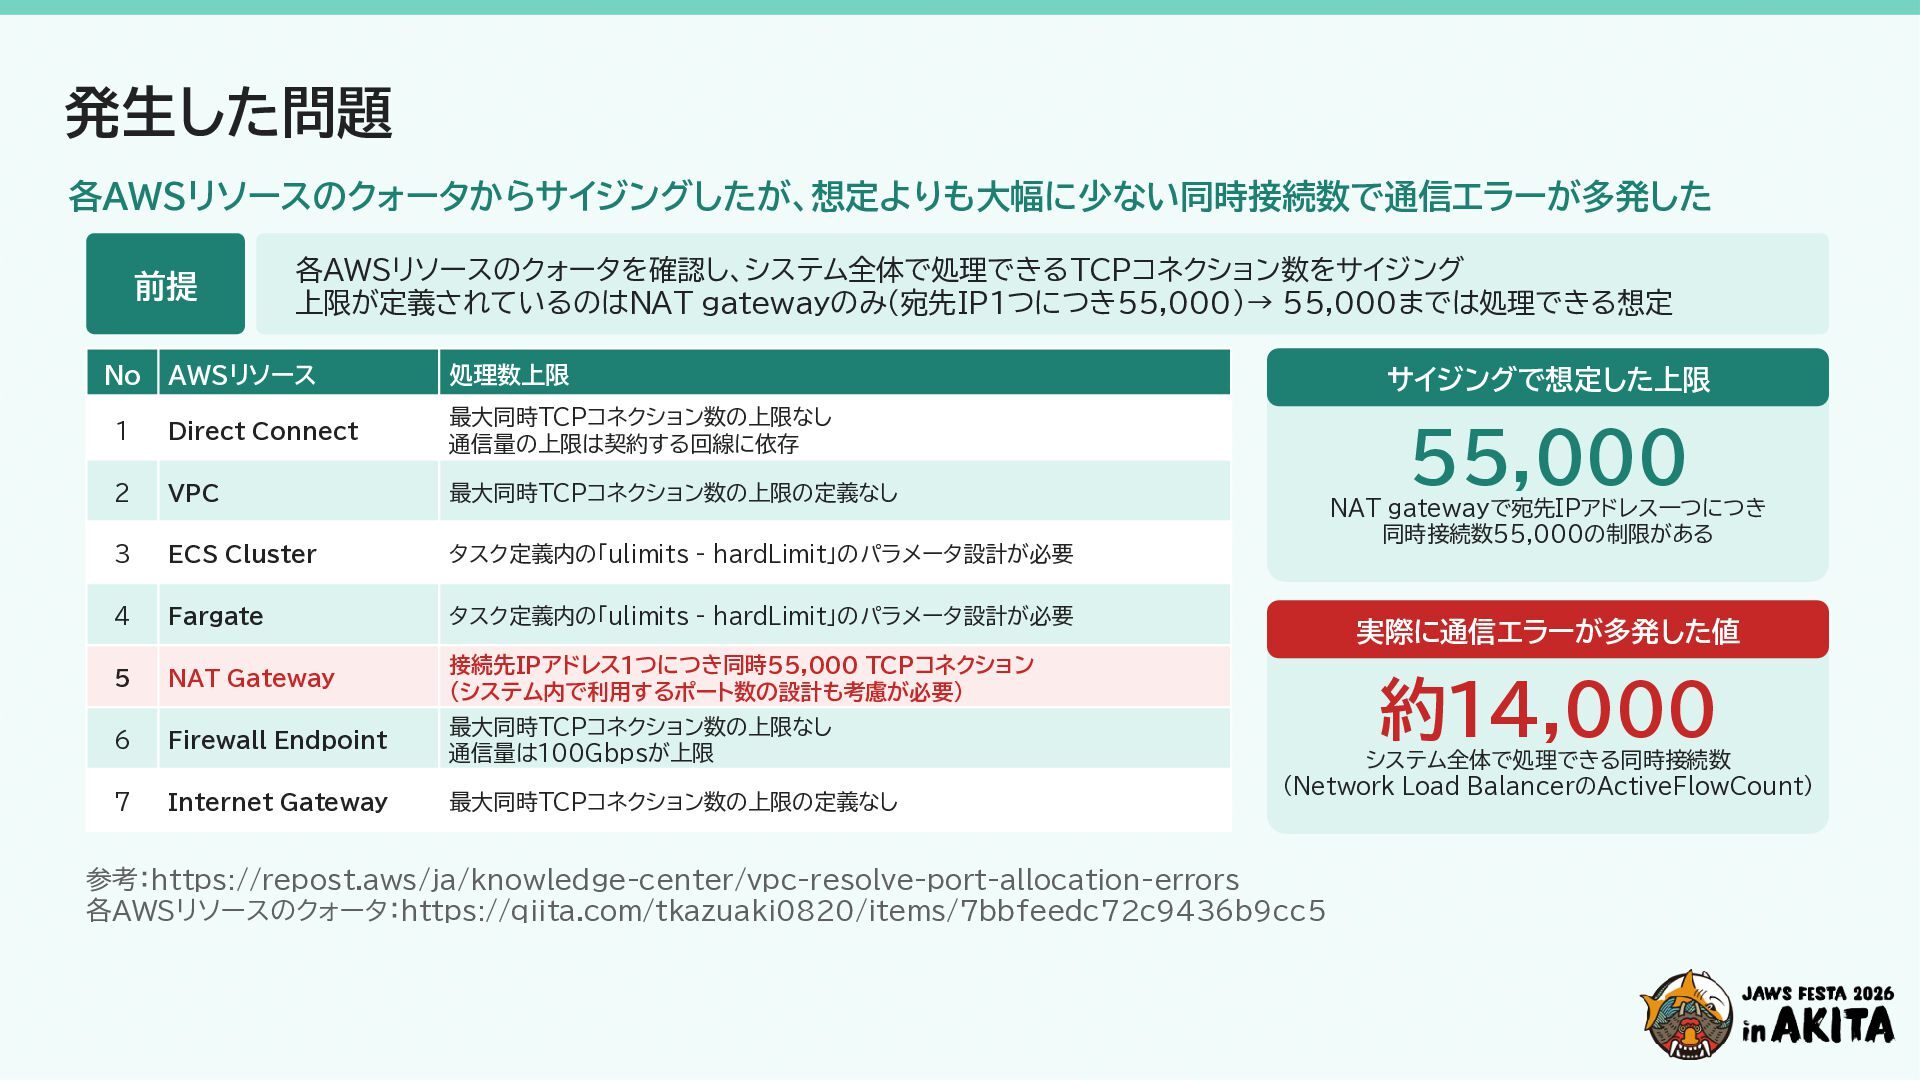
発生した問題 各AWSリソースのクォータからサイジングしたが、想定よりも大幅に少ない同時接続数で通信エラーが多発した 前提 各AWSリソースのクォータを確認し、システム全体で処理できるTCPコネクション数をサイジング 上限が定義されているのはNAT gatewayのみ(宛先IP1つにつき55,000)→ 55,000までは処理できる想定 No AWSリソース 処理数上限
1 Direct Connect 最大同時TCPコネクション数の上限なし 通信量の上限は契約する回線に依存 2 VPC 最大同時TCPコネクション数の上限の定義なし 3 ECS Cluster タスク定義内の「ulimits - hardLimit」のパラメータ設計が必要 4 Fargate タスク定義内の「ulimits - hardLimit」のパラメータ設計が必要 5 NAT Gateway 接続先IPアドレス1つにつき同時55,000 TCPコネクション (システム内で利用するポート数の設計も考慮が必要) 6 Firewall Endpoint 最大同時TCPコネクション数の上限なし 通信量は100Gbpsが上限 7 Internet Gateway 最大同時TCPコネクション数の上限の定義なし サイジングで想定した上限 55,000 NAT gatewayで宛先IPアドレス一つにつき 同時接続数55,000の制限がある 実際に通信エラーが多発した値 約14,000 システム全体で処理できる同時接続数 (Network Load BalancerのActiveFlowCount) 参考:https://repost.aws/ja/knowledge-center/vpc-resolve-port-allocation-errors 各AWSリソースのクォータ:https://qiita.com/tkazuaki0820/items/7bbfeedc72c9436b9cc5
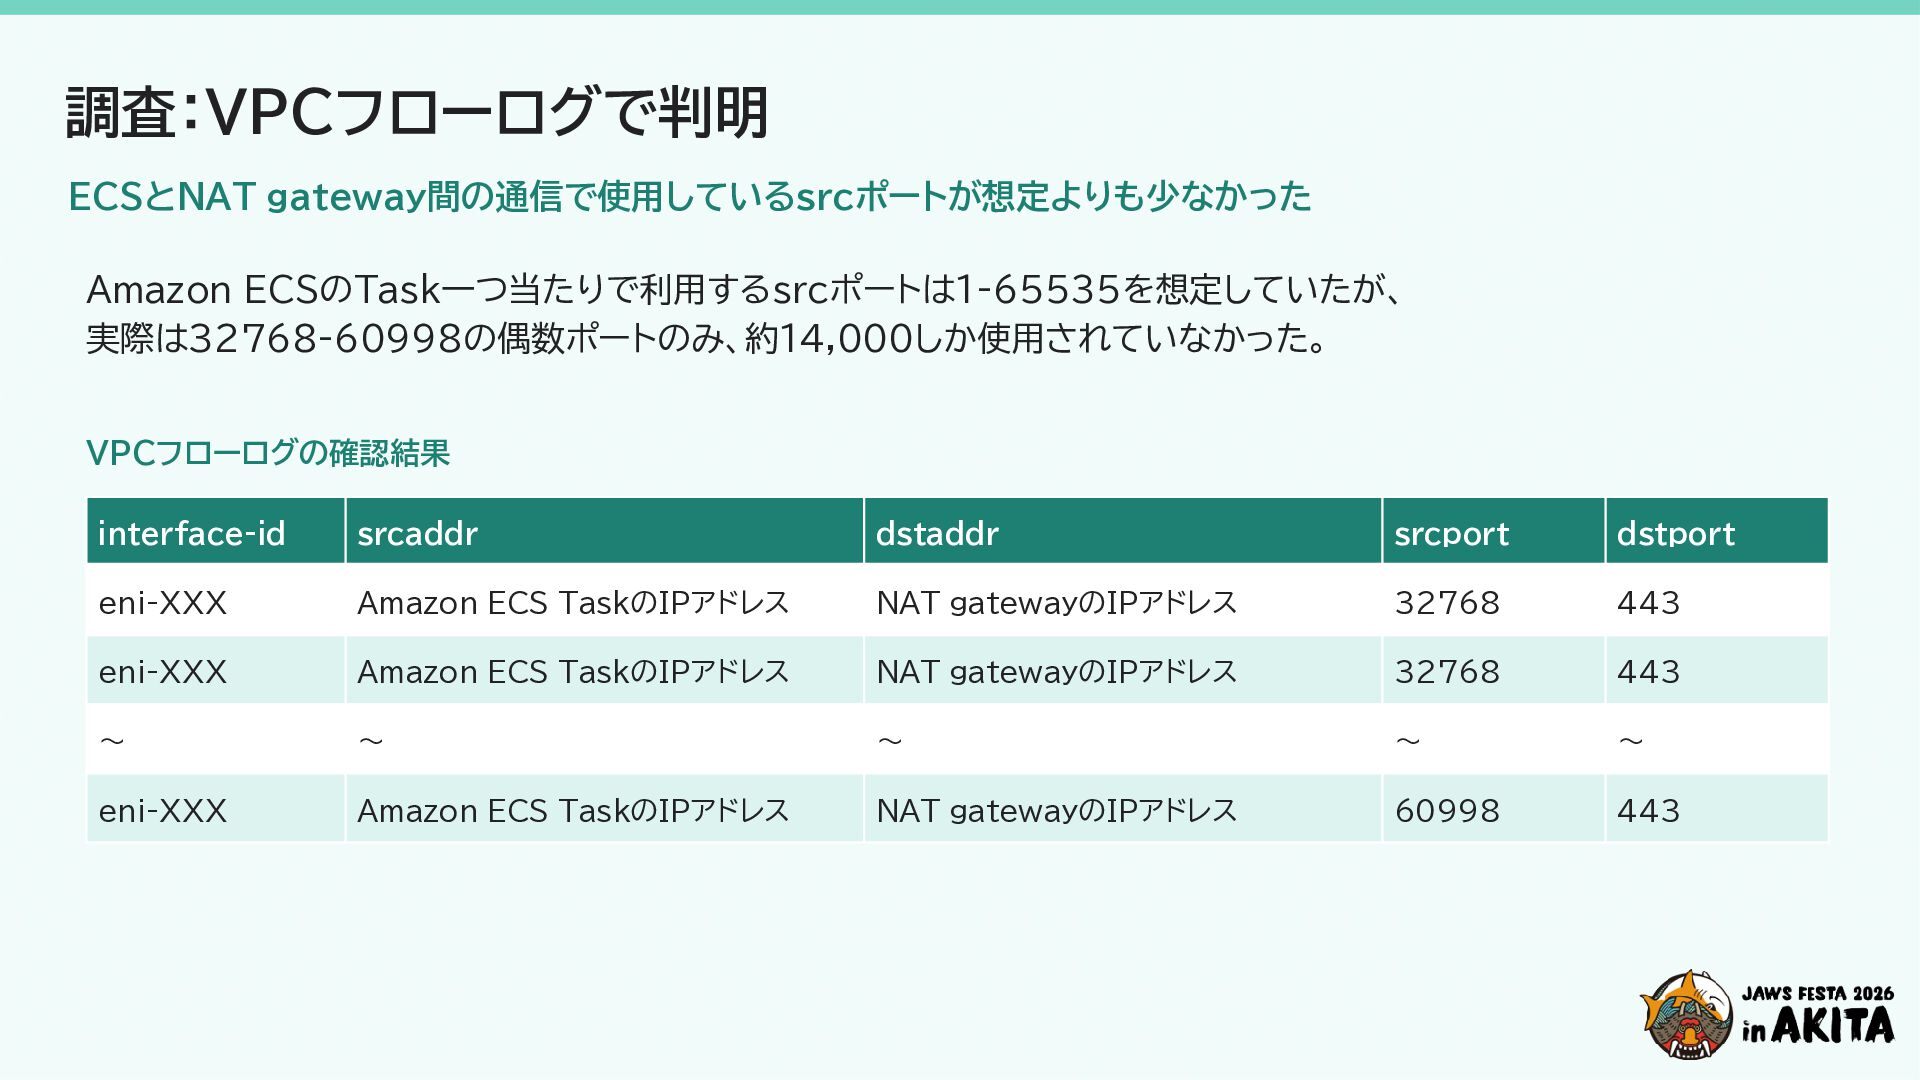
調査:VPCフローログで判明 ECSとNAT gateway間の通信で使用しているsrcポートが想定よりも少なかった Amazon ECSのTask一つ当たりで利用するsrcポートは1-65535を想定していたが、 実際は32768-60998の偶数ポートのみ、約14,000しか使用されていなかった。 VPCフローログの確認結果 interface-id srcaddr dstaddr
srcport dstport eni-XXX Amazon ECS TaskのIPアドレス NAT gatewayのIPアドレス 32768 443 eni-XXX Amazon ECS TaskのIPアドレス NAT gatewayのIPアドレス 32768 443 ~ ~ ~ ~ ~ eni-XXX Amazon ECS TaskのIPアドレス NAT gatewayのIPアドレス 60998 443
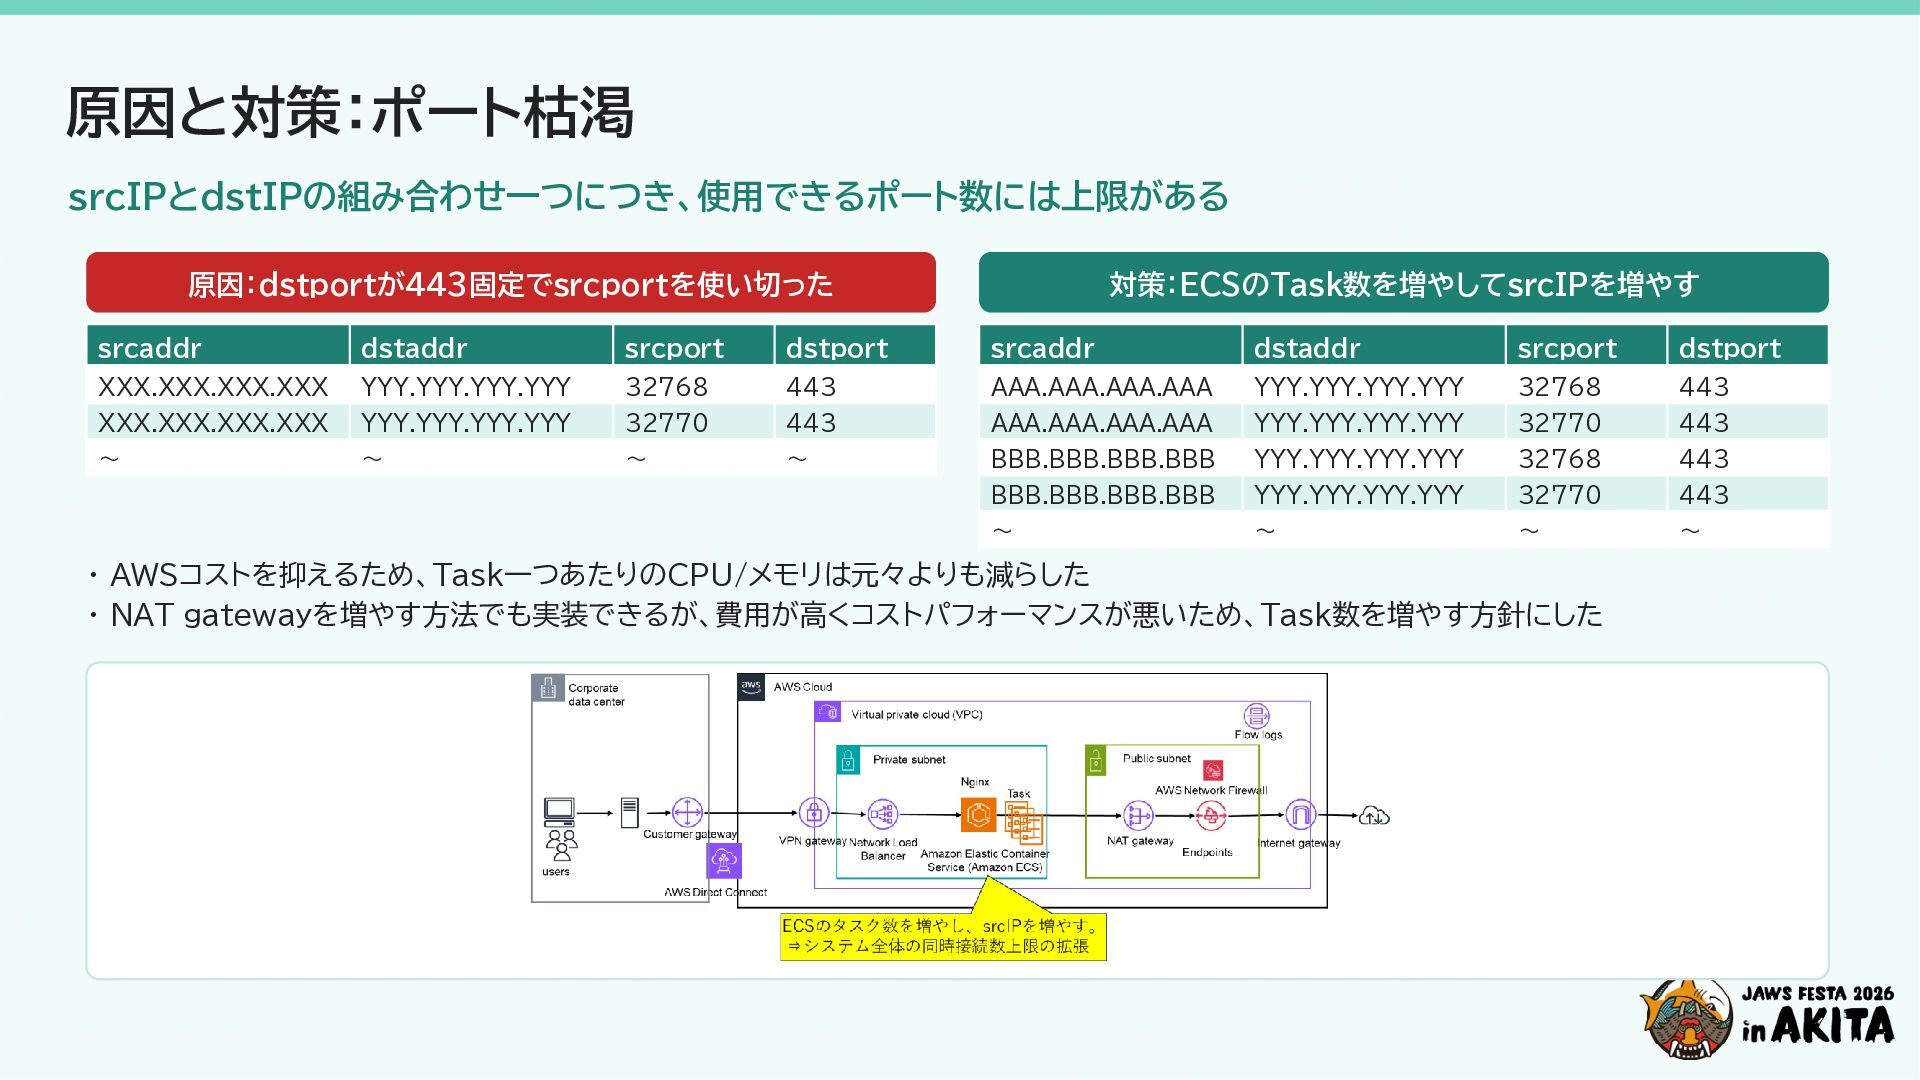
原因と対策:ポート枯渇 srcIPとdstIPの組み合わせ一つにつき、使用できるポート数には上限がある 原因:dstportが443固定でsrcportを使い切った 対策:ECSのTask数を増やしてsrcIPを増やす srcaddr dstaddr srcport dstport srcaddr dstaddr
srcport dstport XXX.XXX.XXX.XXX YYY.YYY.YYY.YYY 32768 443 AAA.AAA.AAA.AAA YYY.YYY.YYY.YYY 32768 443 XXX.XXX.XXX.XXX YYY.YYY.YYY.YYY 32770 443 AAA.AAA.AAA.AAA YYY.YYY.YYY.YYY 32770 443 ~ ~ ~ ~ BBB.BBB.BBB.BBB YYY.YYY.YYY.YYY 32768 443 BBB.BBB.BBB.BBB YYY.YYY.YYY.YYY 32770 443 ~ ~ ~ ~ ・ AWSコストを抑えるため、Task一つあたりのCPU/メモリは元々よりも減らした ・ NAT gatewayを増やす方法でも実装できるが、費用が高くコストパフォーマンスが悪いため、Task数を増やす方針にした
トピック② リージョナルNATゲートウェイの 採用検討と見送った理由
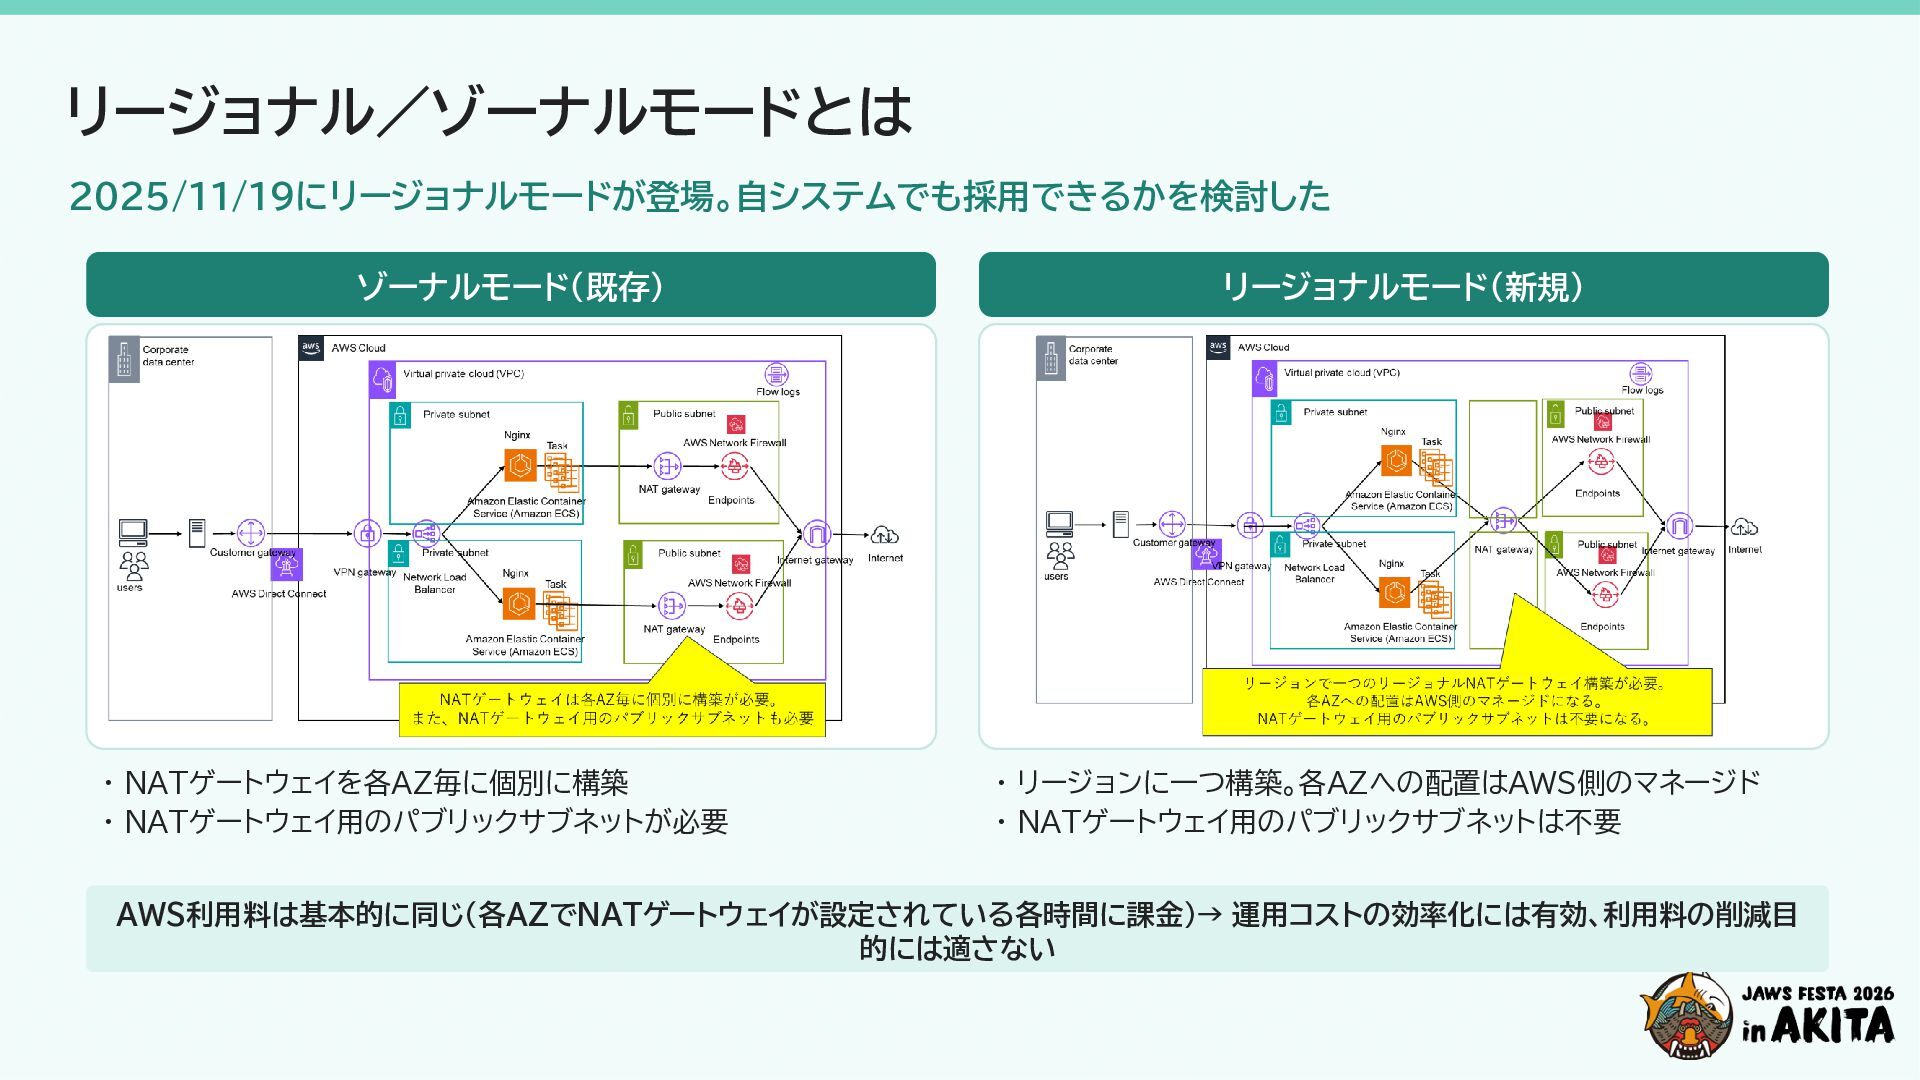
リージョナル/ゾーナルモードとは 2025/11/19にリージョナルモードが登場。自システムでも採用できるかを検討した ゾーナルモード(既存) ・ NATゲートウェイを各AZ毎に個別に構築 ・ NATゲートウェイ用のパブリックサブネットが必要 リージョナルモード(新規) ・ リージョンに一つ構築。各AZへの配置はAWS側のマネージド
・ NATゲートウェイ用のパブリックサブネットは不要 AWS利用料は基本的に同じ(各AZでNATゲートウェイが設定されている各時間に課金)→ 運用コストの効率化には有効、利用料の削減目 的には適さない
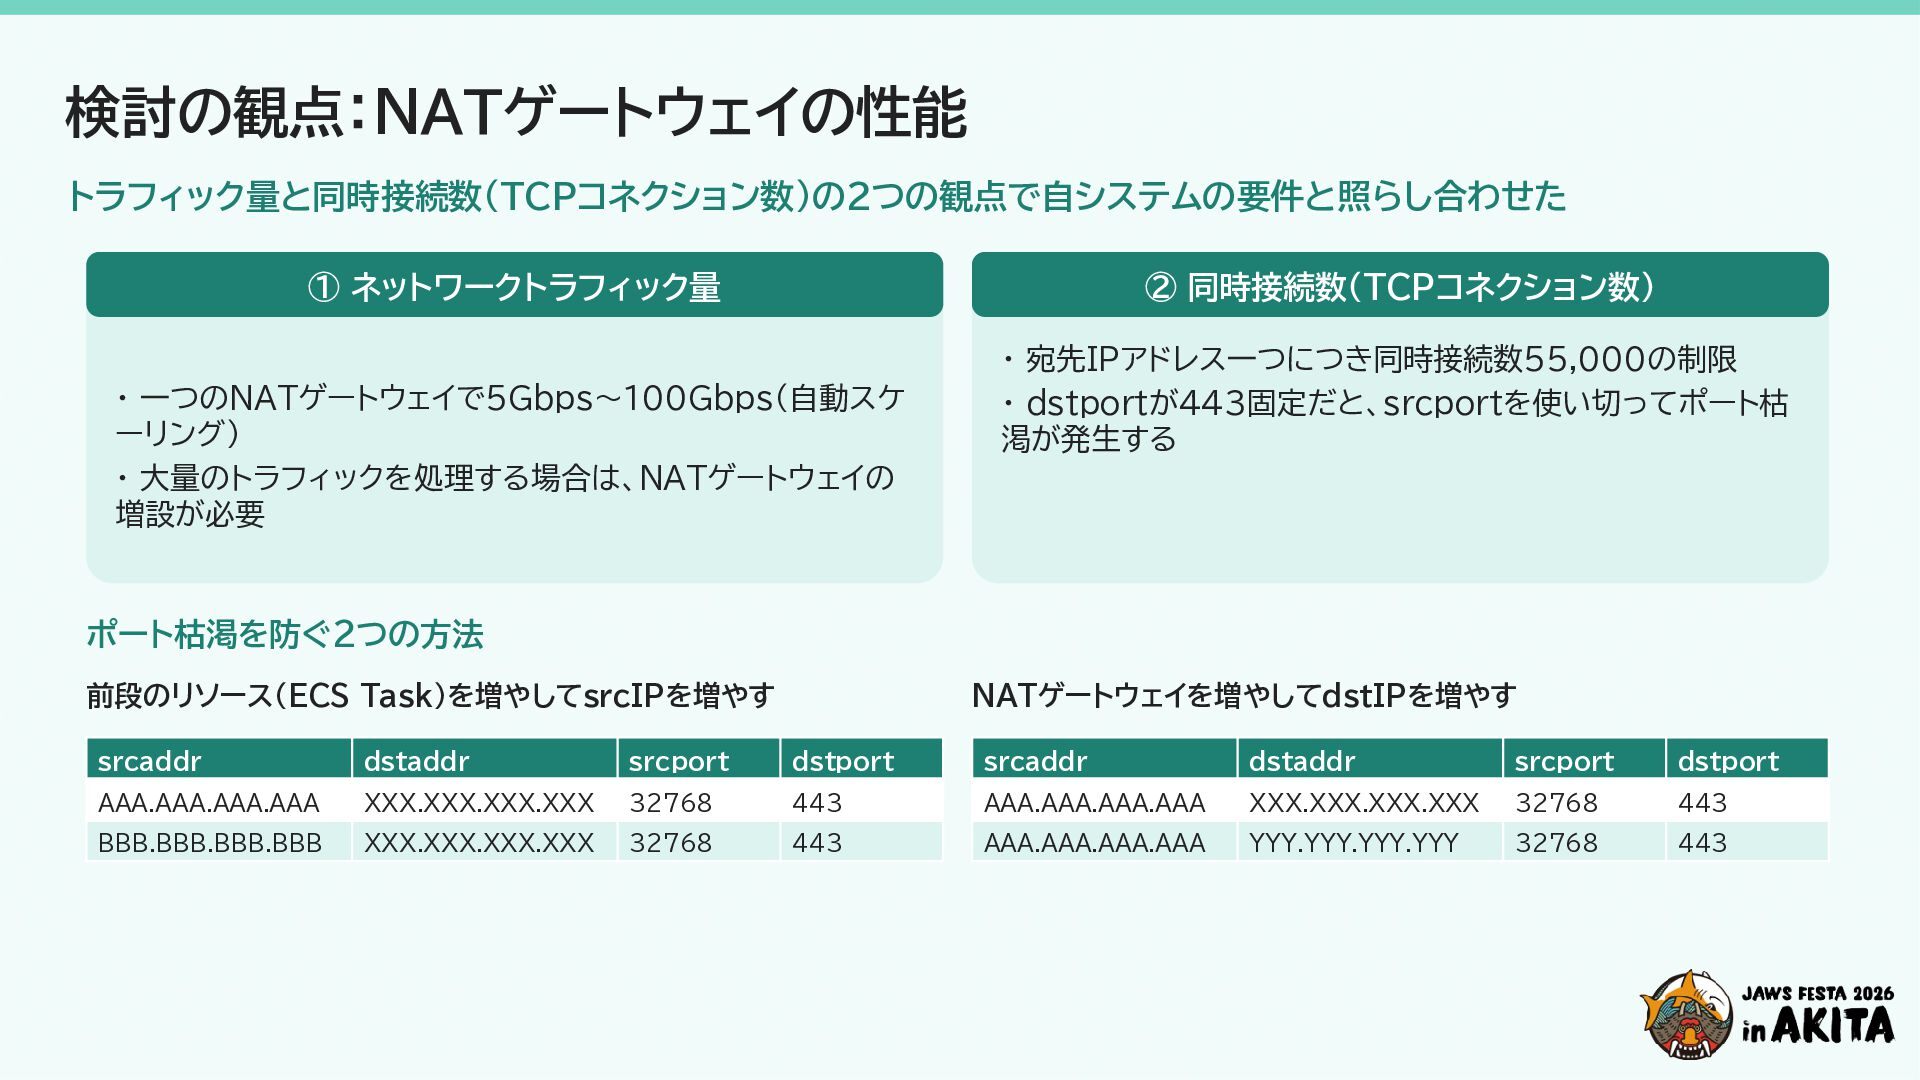
検討の観点:NATゲートウェイの性能 トラフィック量と同時接続数(TCPコネクション数)の2つの観点で自システムの要件と照らし合わせた ① ネットワークトラフィック量 ② 同時接続数(TCPコネクション数) ・ 一つのNATゲートウェイで5Gbps~100Gbps(自動スケ ーリング) ・
大量のトラフィックを処理する場合は、NATゲートウェイの 増設が必要 ・ 宛先IPアドレス一つにつき同時接続数55,000の制限 ・ dstportが443固定だと、srcportを使い切ってポート枯 渇が発生する ポート枯渇を防ぐ2つの方法 前段のリソース(ECS Task)を増やしてsrcIPを増やす NATゲートウェイを増やしてdstIPを増やす srcaddr dstaddr srcport dstport srcaddr dstaddr srcport dstport AAA.AAA.AAA.AAA XXX.XXX.XXX.XXX 32768 443 AAA.AAA.AAA.AAA XXX.XXX.XXX.XXX 32768 443 BBB.BBB.BBB.BBB XXX.XXX.XXX.XXX 32768 443 AAA.AAA.AAA.AAA YYY.YYY.YYY.YYY 32768 443
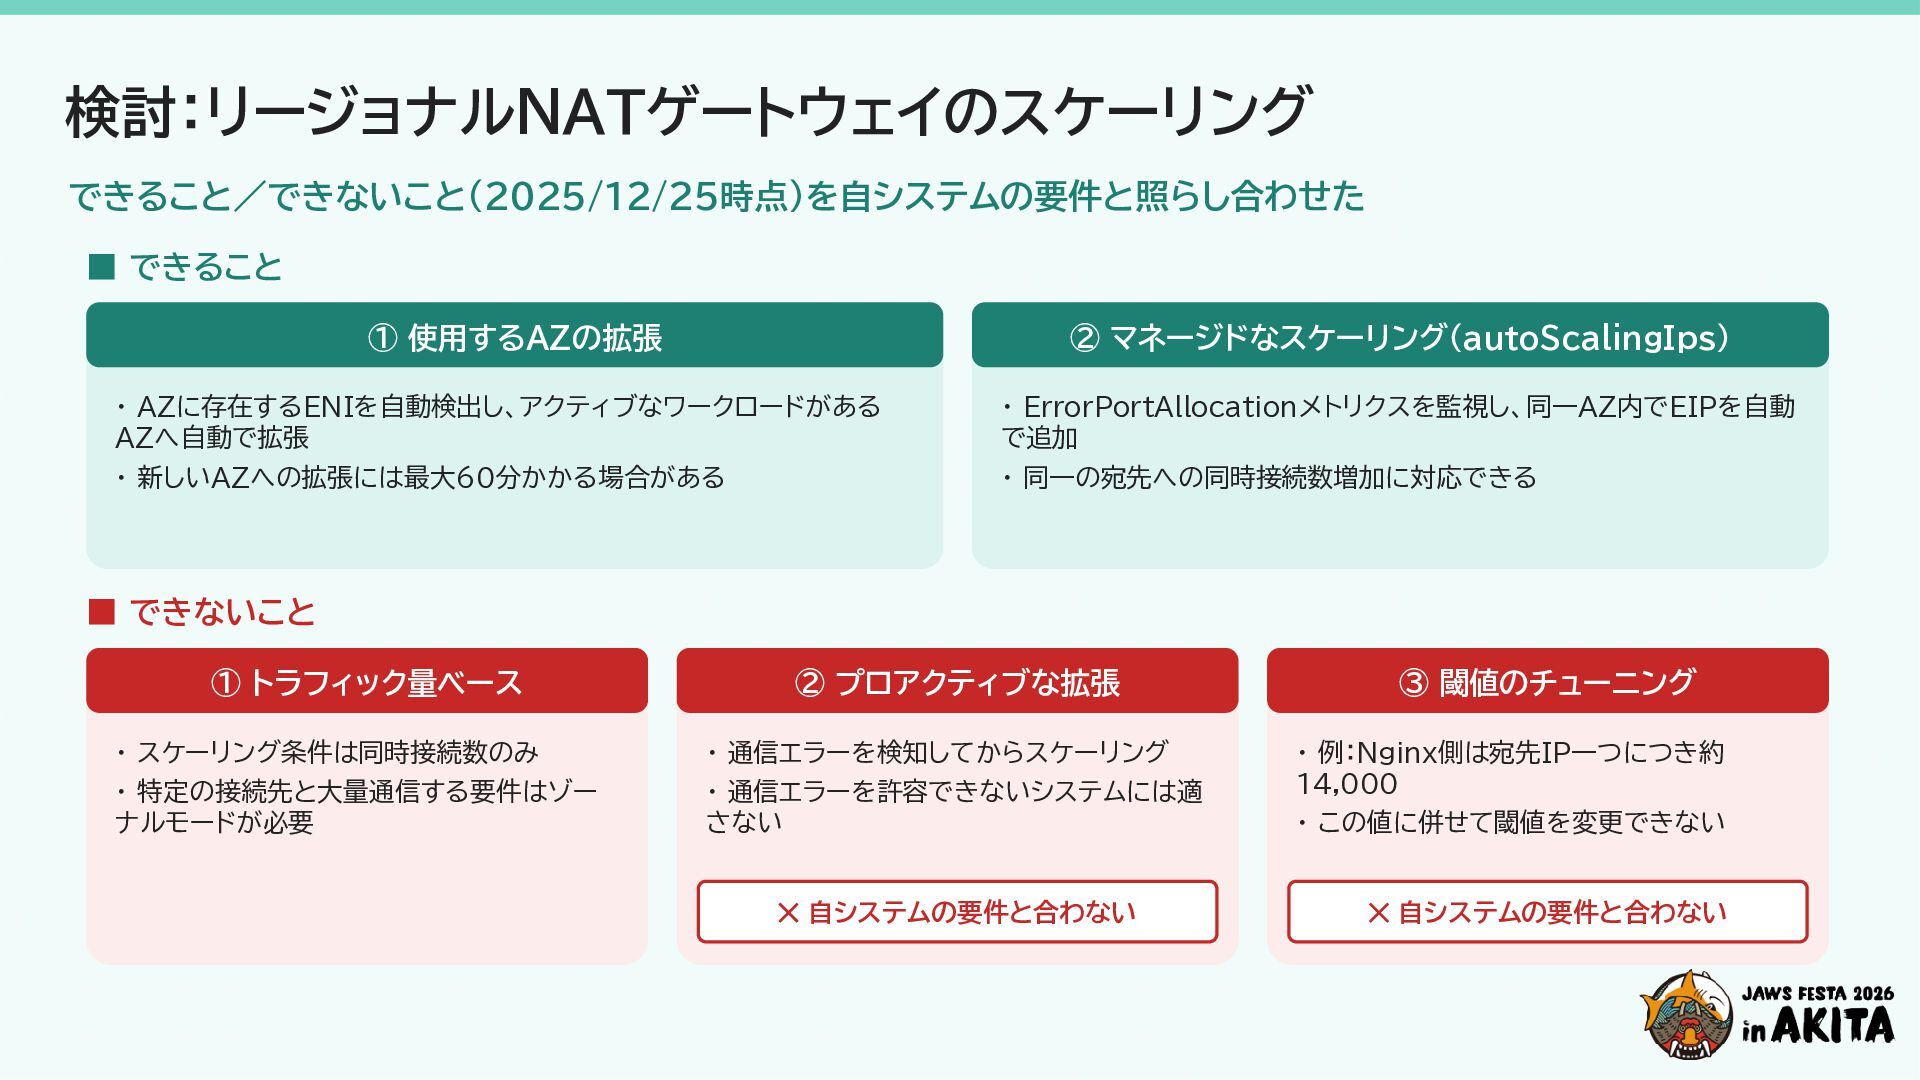
検討:リージョナルNATゲートウェイのスケーリング できること/できないこと(2025/12/25時点)を自システムの要件と照らし合わせた ▪ できること ① 使用するAZの拡張 ② マネージドなスケーリング(autoScalingIps) ・ AZに存在するENIを自動検出し、アクティブなワークロードがある
AZへ自動で拡張 ・ ErrorPortAllocationメトリクスを監視し、同一AZ内でEIPを自動 で追加 ・ 新しいAZへの拡張には最大60分かかる場合がある ・ 同一の宛先への同時接続数増加に対応できる ▪ できないこと ① トラフィック量ベース ② プロアクティブな拡張 ・ スケーリング条件は同時接続数のみ ・ 通信エラーを検知してからスケーリング ・ 特定の接続先と大量通信する要件はゾー ナルモードが必要 ・ 通信エラーを許容できないシステムには適 さない ✕ 自システムの要件と合わない ③ 閾値のチューニング ・ 例:Nginx側は宛先IP一つにつき約 14,000 ・ この値に併せて閾値を変更できない ✕ 自システムの要件と合わない
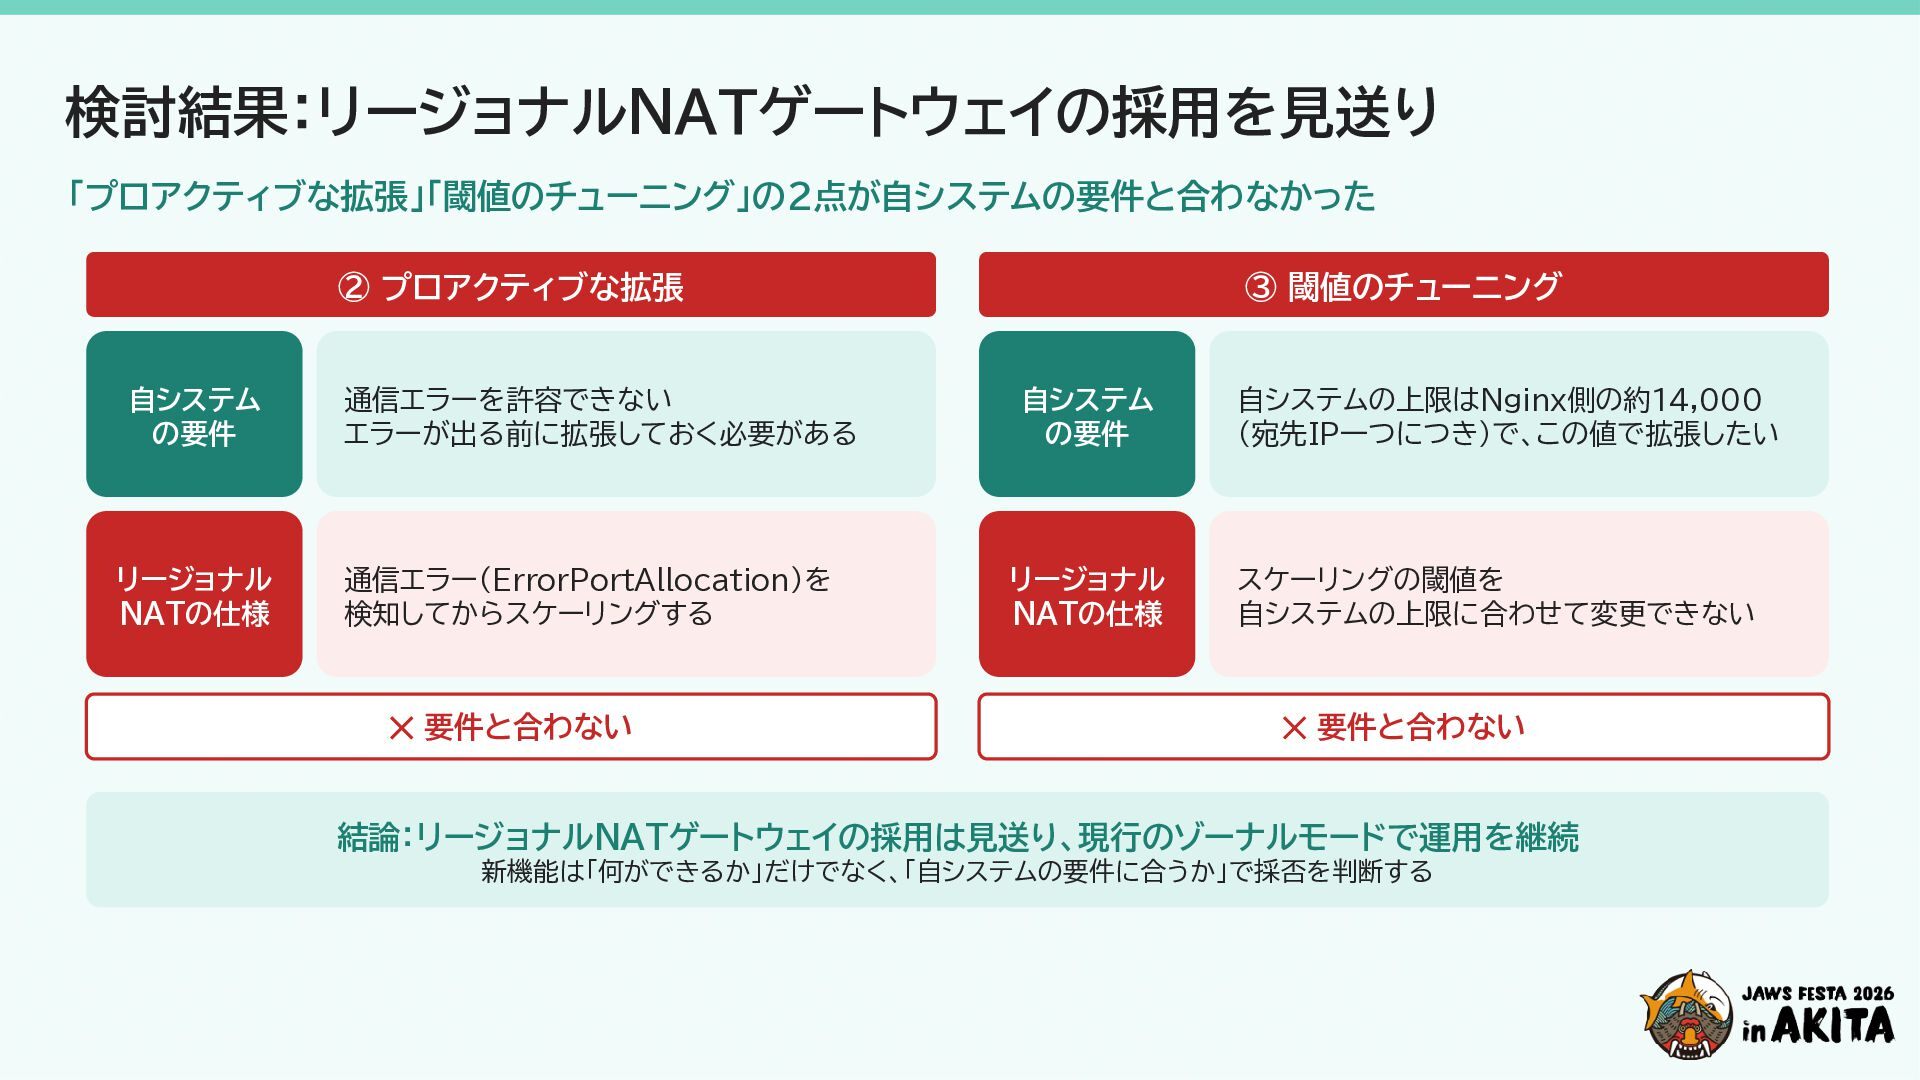
検討結果:リージョナルNATゲートウェイの採用を見送り 「プロアクティブな拡張」「閾値のチューニング」の2点が自システムの要件と合わなかった ② プロアクティブな拡張 ③ 閾値のチューニング 自システム の要件 通信エラーを許容できない エラーが出る前に拡張しておく必要がある
自システム の要件 自システムの上限はNginx側の約14,000 (宛先IP一つにつき)で、この値で拡張したい リージョナル NATの仕様 通信エラー(ErrorPortAllocation)を 検知してからスケーリングする リージョナル NATの仕様 スケーリングの閾値を 自システムの上限に合わせて変更できない ✕ 要件と合わない ✕ 要件と合わない 結論:リージョナルNATゲートウェイの採用は見送り、現行のゾーナルモードで運用を継続 新機能は「何ができるか」だけでなく、「自システムの要件に合うか」で採否を判断する
トピック③ Transit Gatewayへの移行で発生した 非対称ルーティングと移行設計
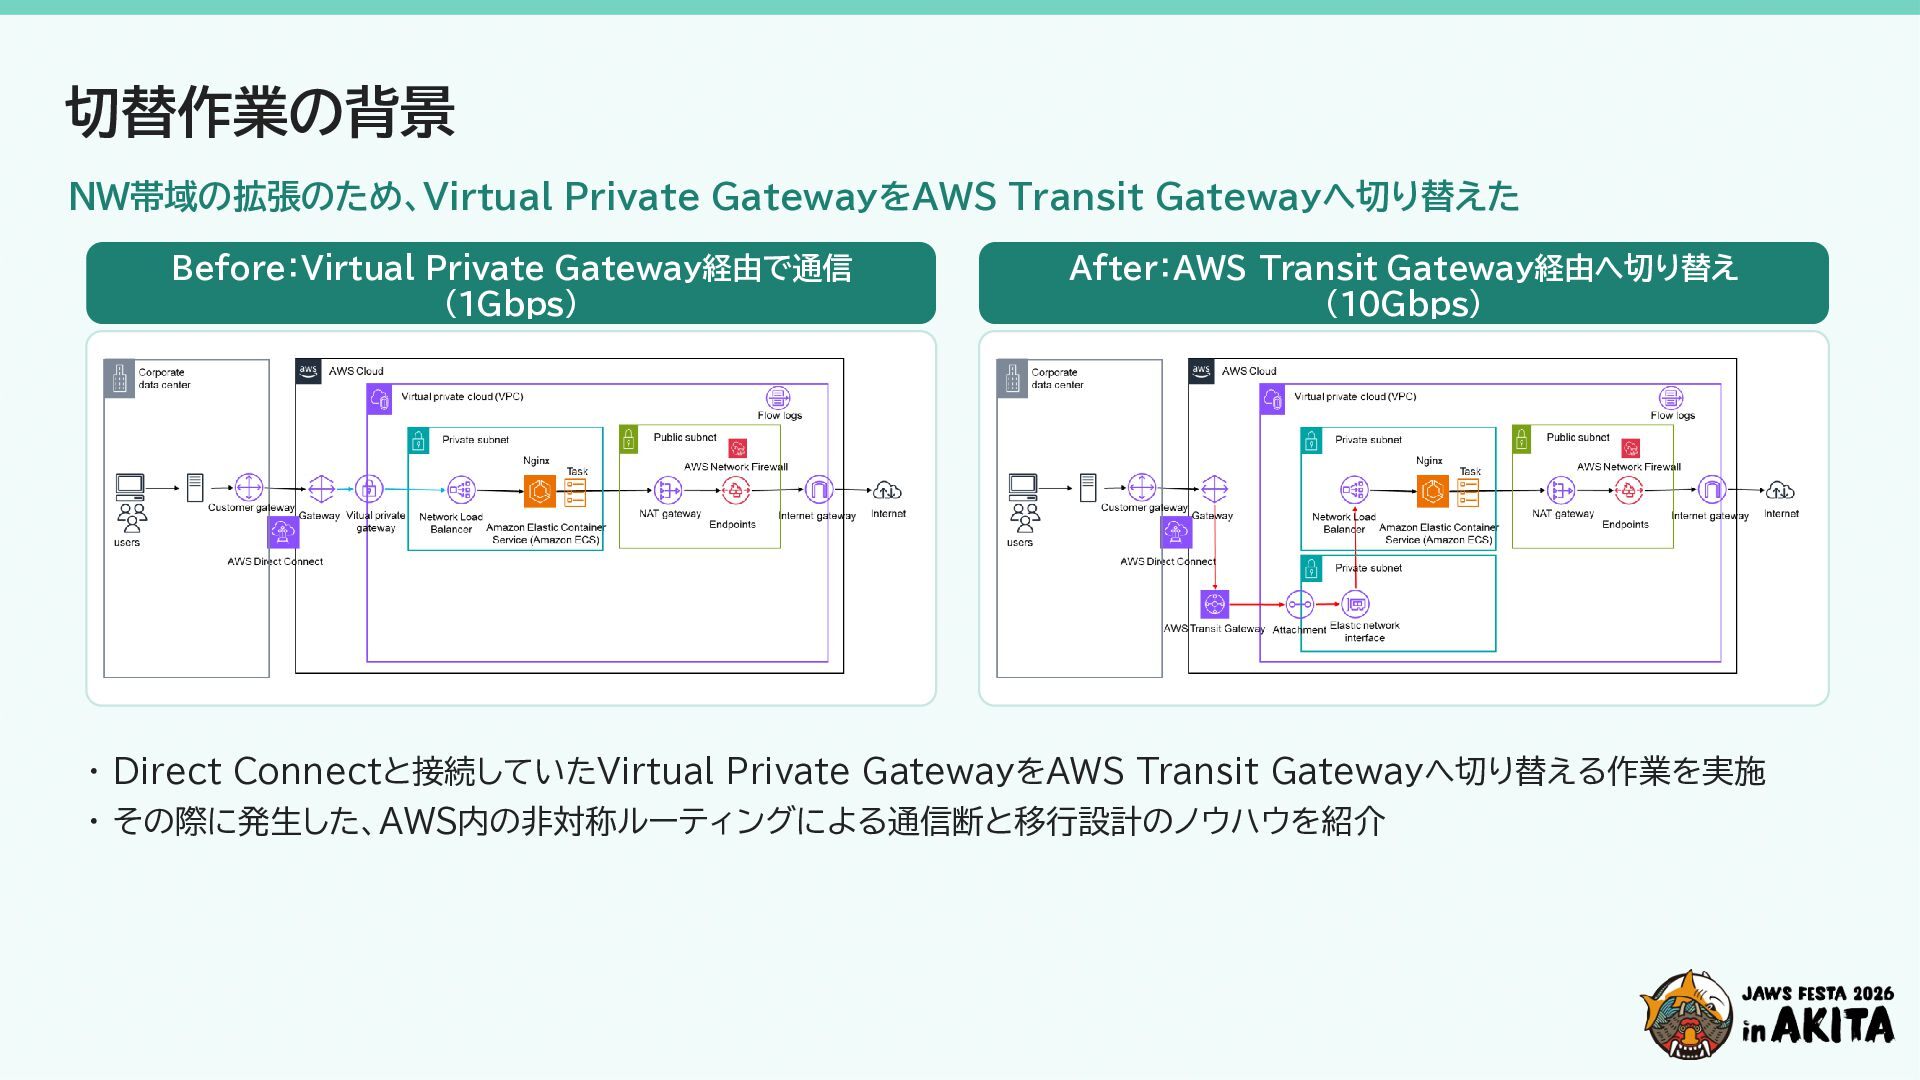
切替作業の背景 NW帯域の拡張のため、Virtual Private GatewayをAWS Transit Gatewayへ切り替えた Before:Virtual Private Gateway経由で通信 (1Gbps)
After:AWS Transit Gateway経由へ切り替え (10Gbps) ・ Direct Connectと接続していたVirtual Private GatewayをAWS Transit Gatewayへ切り替える作業を実施 ・ その際に発生した、AWS内の非対称ルーティングによる通信断と移行設計のノウハウを紹介
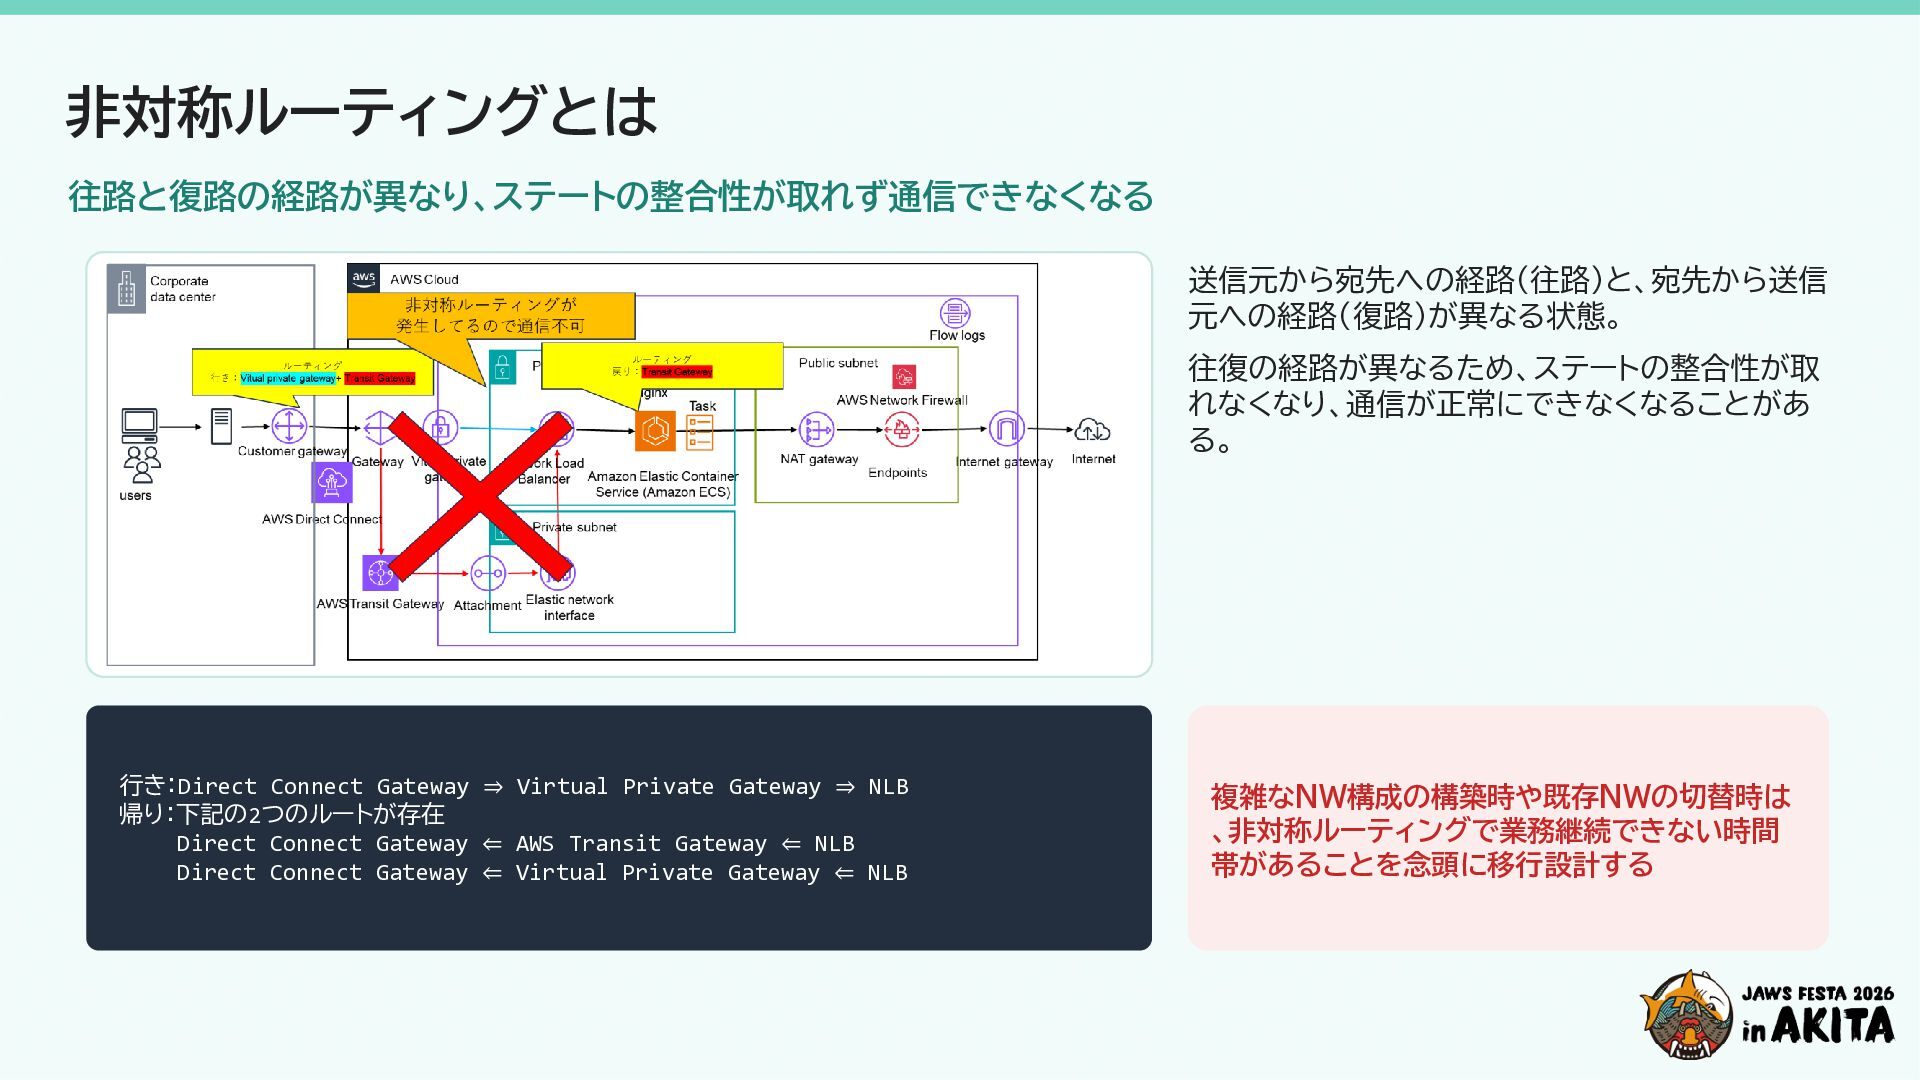
非対称ルーティングとは 往路と復路の経路が異なり、ステートの整合性が取れず通信できなくなる 送信元から宛先への経路(往路)と、宛先から送信 元への経路(復路)が異なる状態。 往復の経路が異なるため、ステートの整合性が取 れなくなり、通信が正常にできなくなることがあ る。 行き:Direct Connect Gateway
⇒ Virtual Private Gateway ⇒ NLB 帰り:下記の2つのルートが存在 Direct Connect Gateway ⇐ AWS Transit Gateway ⇐ NLB Direct Connect Gateway ⇐ Virtual Private Gateway ⇐ NLB 複雑なNW構成の構築時や既存NWの切替時は 、非対称ルーティングで業務継続できない時間 帯があることを念頭に移行設計する
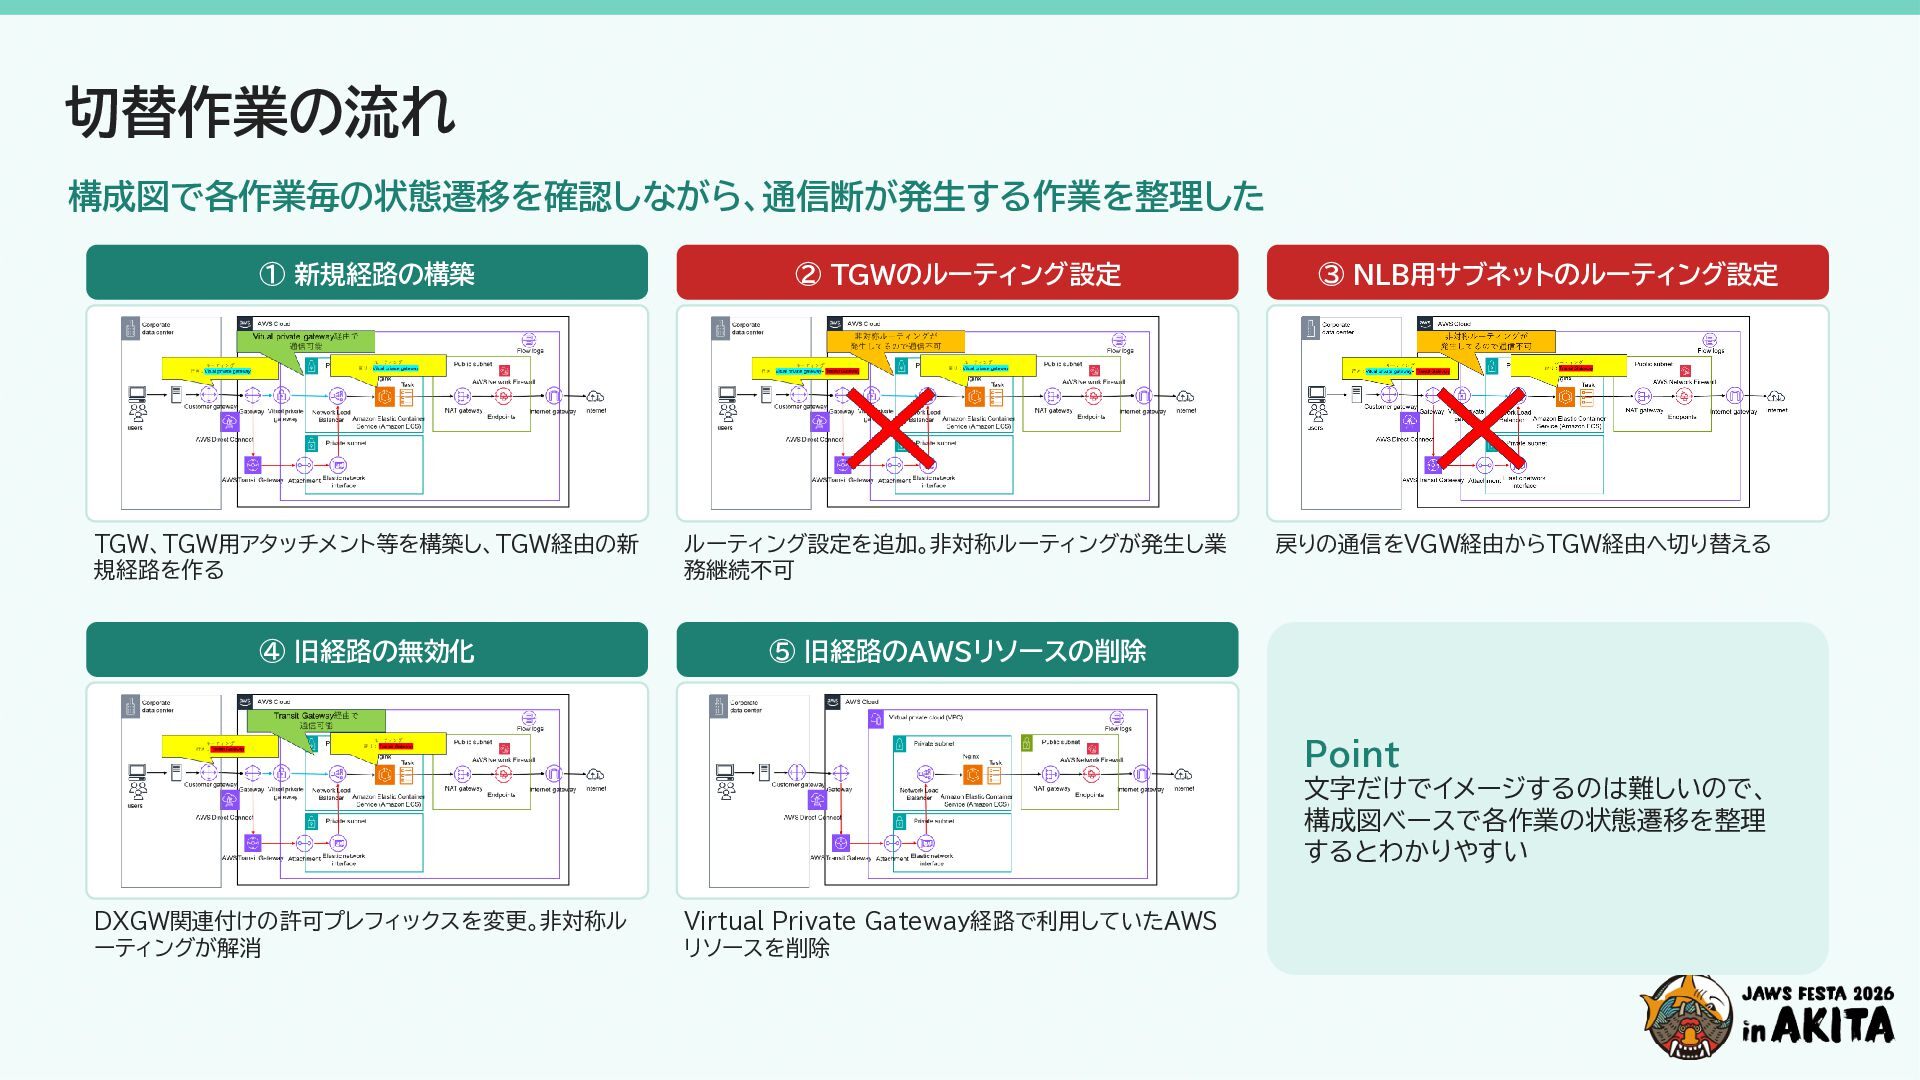
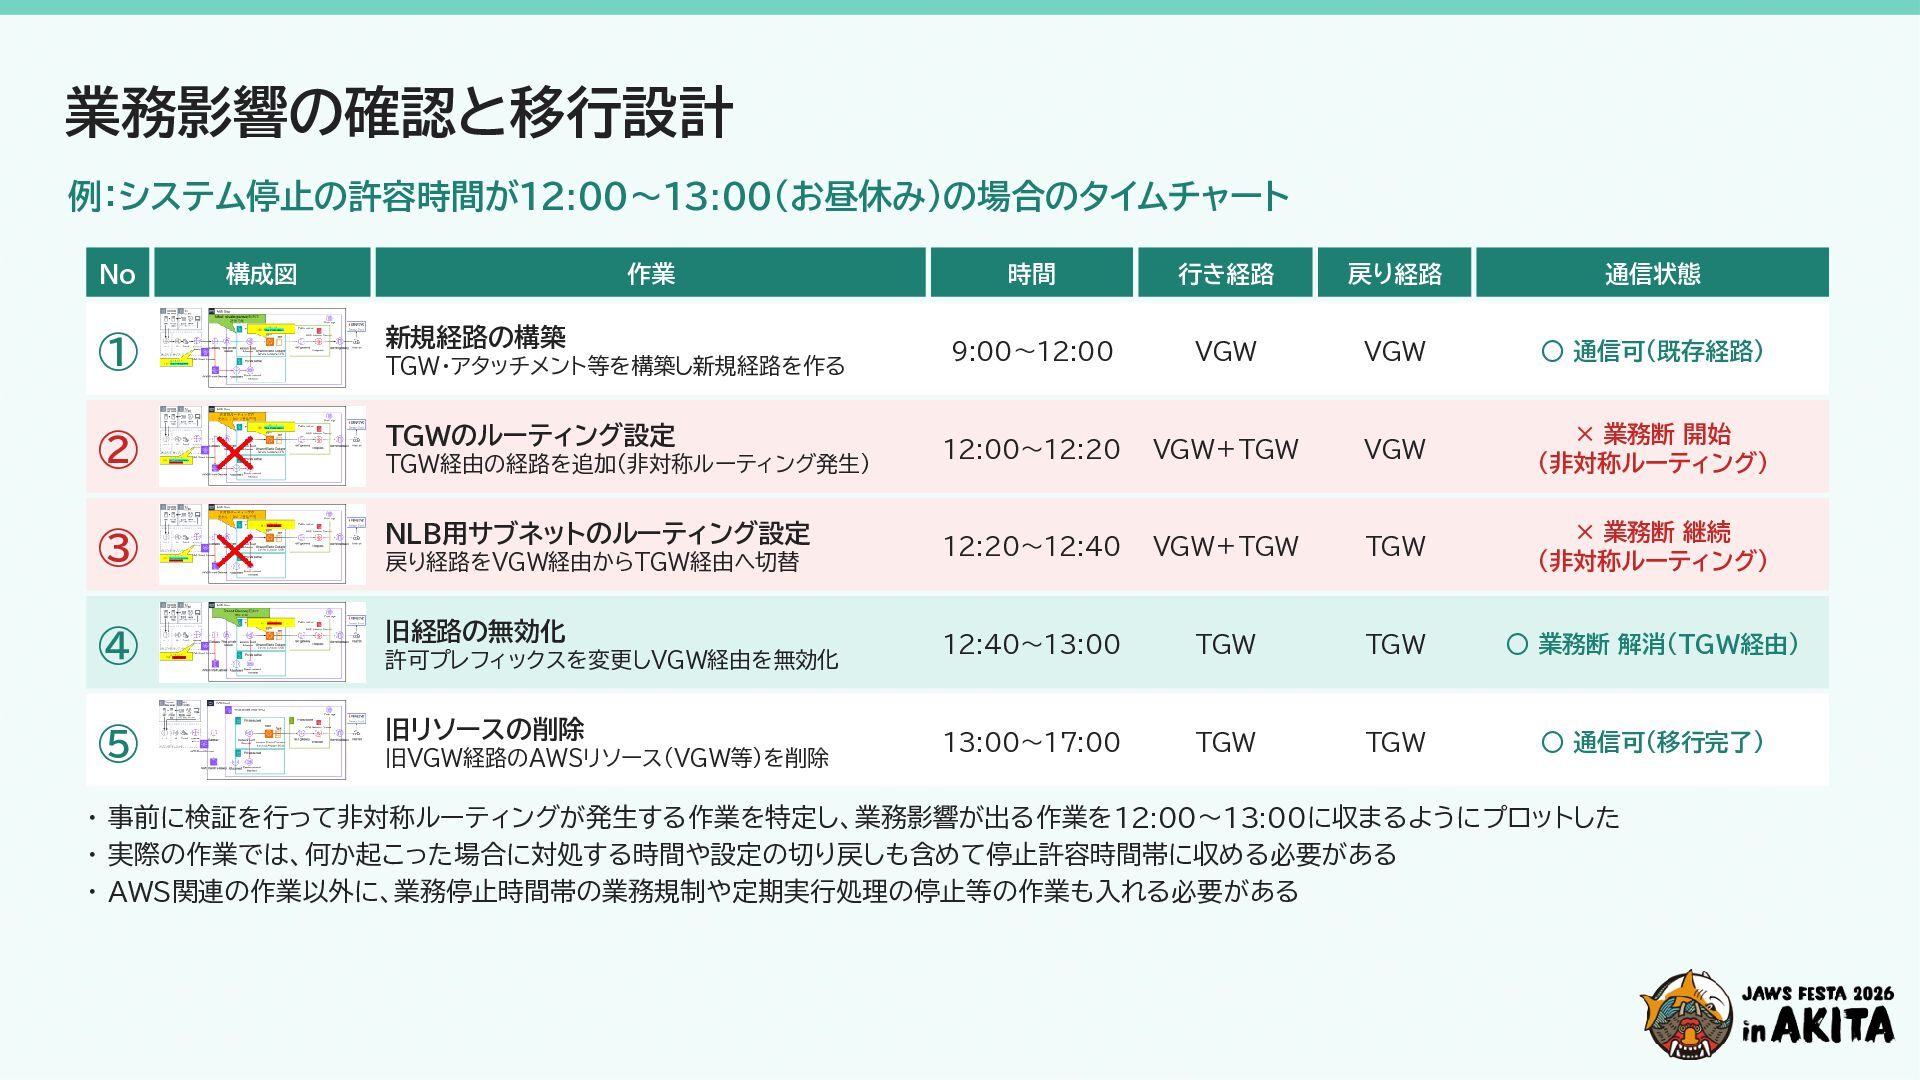
切替作業の流れ 構成図で各作業毎の状態遷移を確認しながら、通信断が発生する作業を整理した ① 新規経路の構築 ② TGWのルーティング設定 TGW、TGW用アタッチメント等を構築し、TGW経由の新 規経路を作る ルーティング設定を追加。非対称ルーティングが発生し業 務継続不可
④ 旧経路の無効化 ⑤ 旧経路のAWSリソースの削除 ③ NLB用サブネットのルーティング設定 戻りの通信をVGW経由からTGW経由へ切り替える Point 文字だけでイメージするのは難しいので、 構成図ベースで各作業の状態遷移を整理 するとわかりやすい DXGW関連付けの許可プレフィックスを変更。非対称ル ーティングが解消 Virtual Private Gateway経路で利用していたAWS リソースを削除
業務影響の確認と移行設計 例:システム停止の許容時間が12:00~13:00(お昼休み)の場合のタイムチャート No 構成図 作業 ① 新規経路の構築 ② TGWのルーティング設定 ③
NLB用サブネットのルーティング設定 ④ 旧経路の無効化 ⑤ 旧リソースの削除 TGW・アタッチメント等を構築し新規経路を作る TGW経由の経路を追加(非対称ルーティング発生) 戻り経路をVGW経由からTGW経由へ切替 許可プレフィックスを変更しVGW経由を無効化 旧VGW経路のAWSリソース(VGW等)を削除 時間 行き経路 戻り経路 通信状態 9:00〜12:00 VGW VGW ◦ 通信可(既存経路) 12:00〜12:20 VGW+TGW VGW × 業務断 開始 (非対称ルーティング) 12:20〜12:40 VGW+TGW TGW × 業務断 継続 (非対称ルーティング) 12:40〜13:00 TGW TGW ◦ 業務断 解消(TGW経由) 13:00〜17:00 TGW TGW ◦ 通信可(移行完了) ・ 事前に検証を行って非対称ルーティングが発生する作業を特定し、業務影響が出る作業を12:00~13:00に収まるようにプロットした ・ 実際の作業では、何か起こった場合に対処する時間や設定の切り戻しも含めて停止許容時間帯に収める必要がある ・ AWS関連の作業以外に、業務停止時間帯の業務規制や定期実行処理の停止等の作業も入れる必要がある
トピック④ 接続エラー・性能問題の 切り分け手順
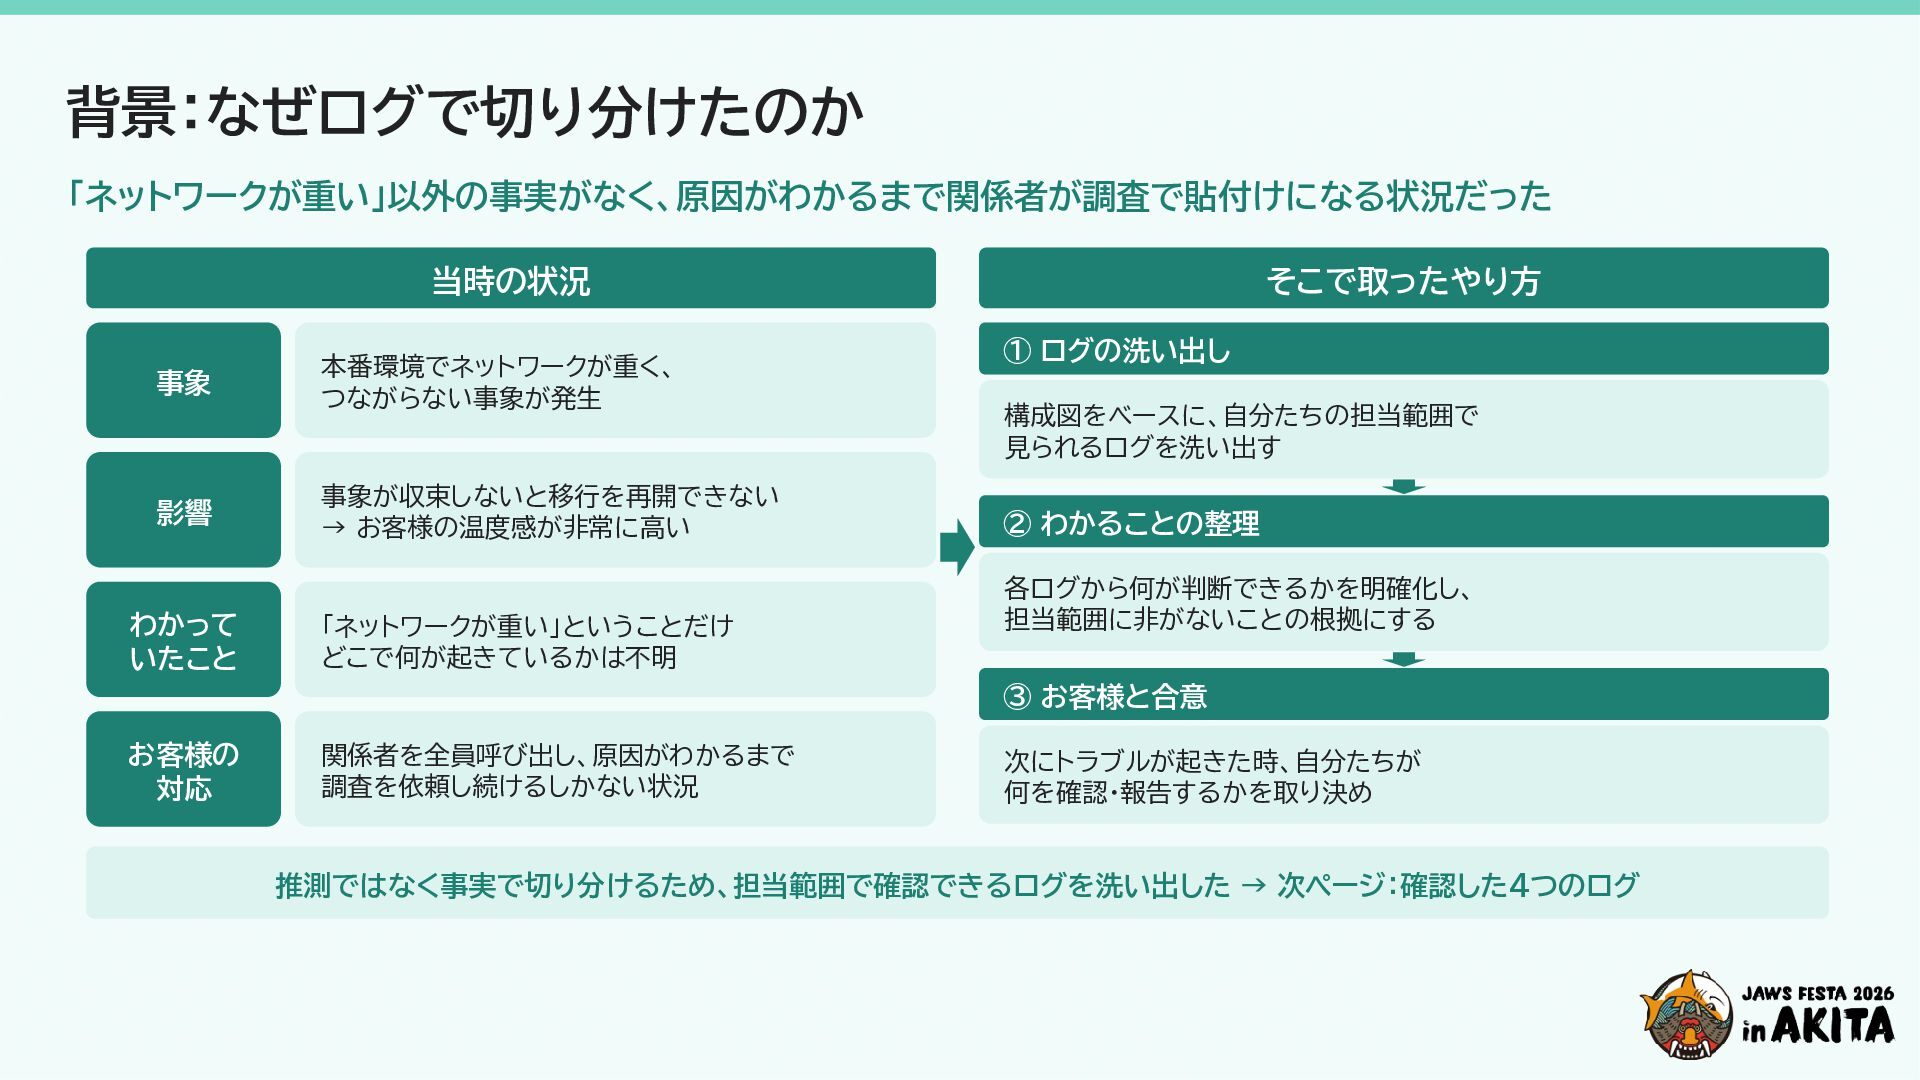
背景:なぜログで切り分けたのか 「ネットワークが重い」以外の事実がなく、原因がわかるまで関係者が調査で貼付けになる状況だった 当時の状況 事象 影響 わかって いたこと 本番環境でネットワークが重く、 つながらない事象が発生 事象が収束しないと移行を再開できない
→ お客様の温度感が非常に高い 「ネットワークが重い」ということだけ どこで何が起きているかは不明 そこで取ったやり方 ① ログの洗い出し 構成図をベースに、自分たちの担当範囲で 見られるログを洗い出す ② わかることの整理 各ログから何が判断できるかを明確化し、 担当範囲に非がないことの根拠にする ③ お客様と合意 お客様の 対応 関係者を全員呼び出し、原因がわかるまで 調査を依頼し続けるしかない状況 次にトラブルが起きた時、自分たちが 何を確認・報告するかを取り決め 推測ではなく事実で切り分けるため、担当範囲で確認できるログを洗い出した → 次ページ:確認した4つのログ
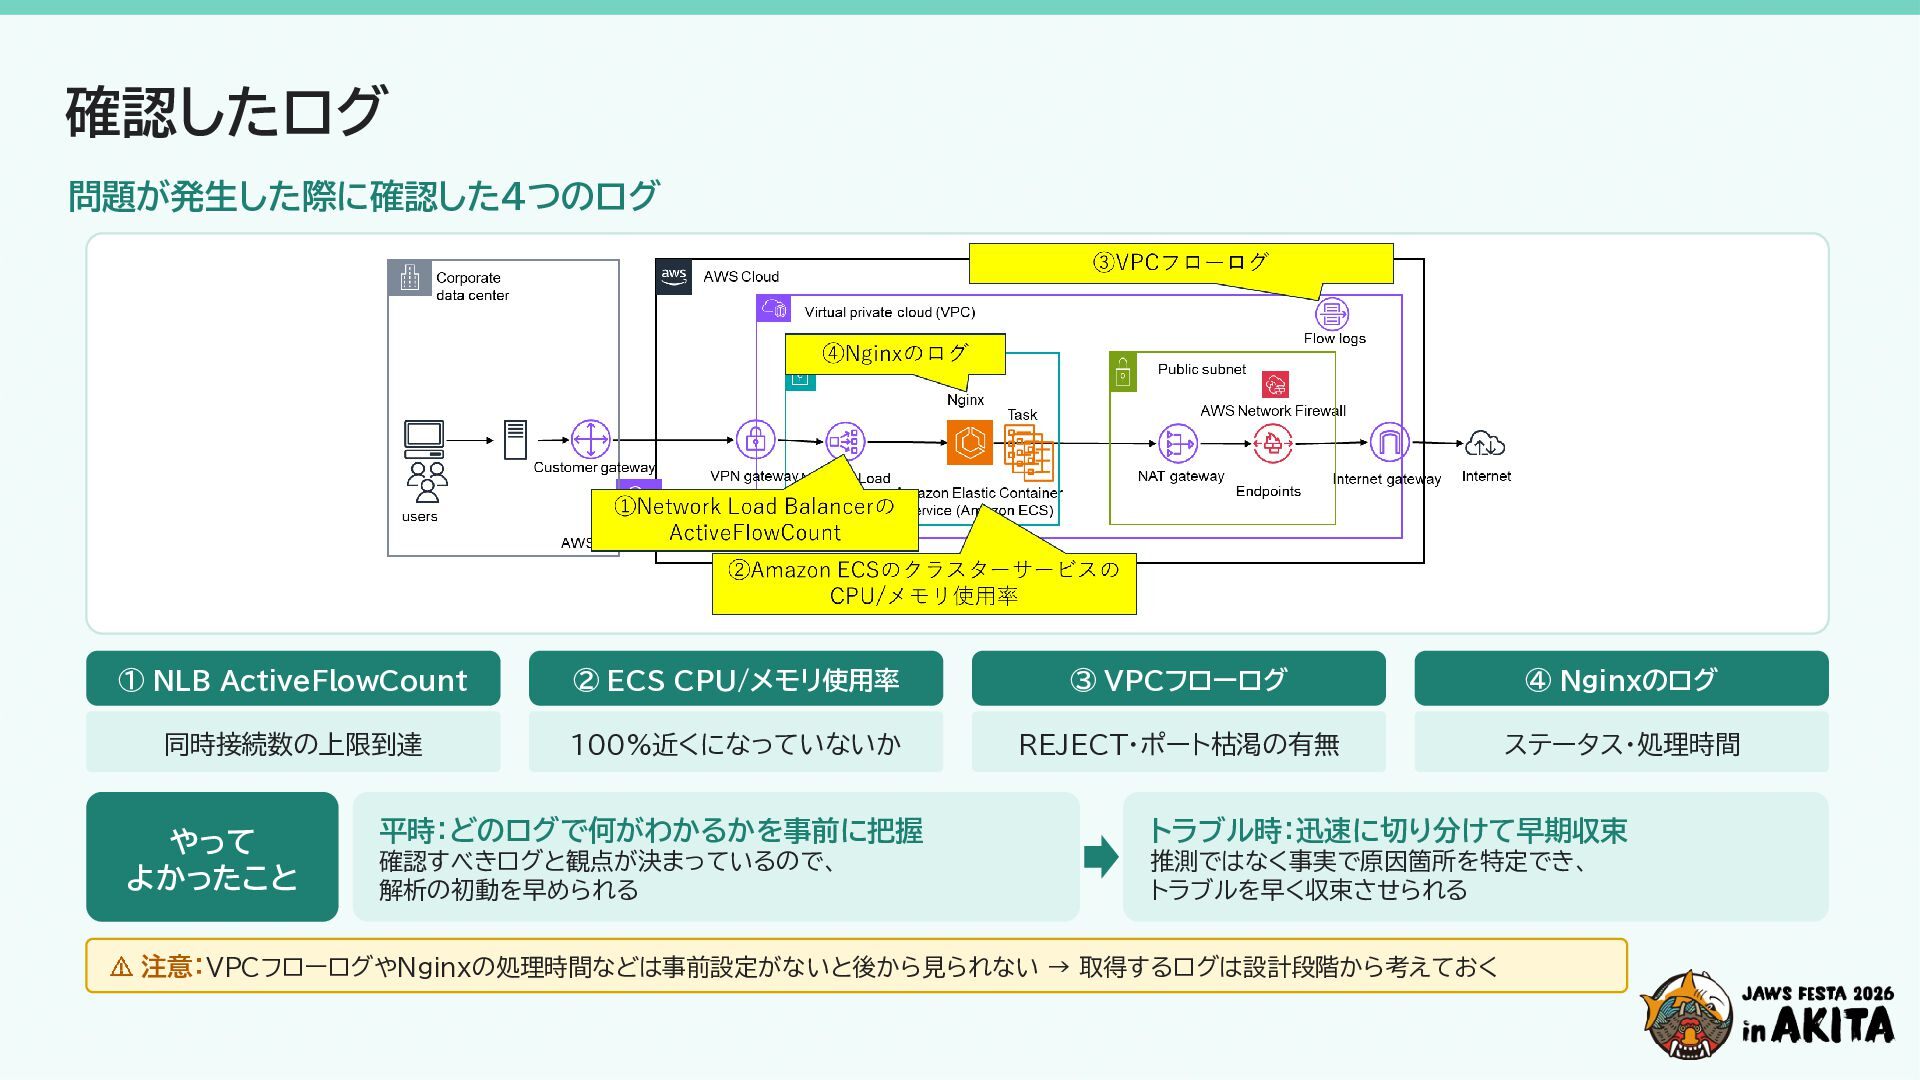
確認したログ 問題が発生した際に確認した4つのログ ① NLB ActiveFlowCount ② ECS CPU/メモリ使用率 ③ VPCフローログ
④ Nginxのログ 同時接続数の上限到達 100%近くになっていないか REJECT・ポート枯渇の有無 ステータス・処理時間 やって よかったこと 平時:どのログで何がわかるかを事前に把握 トラブル時:迅速に切り分けて早期収束 確認すべきログと観点が決まっているので、 解析の初動を早められる 推測ではなく事実で原因箇所を特定でき、 トラブルを早く収束させられる 注意:VPCフローログやNginxの処理時間などは事前設定がないと後から見られない → 取得するログは設計段階から考えておく
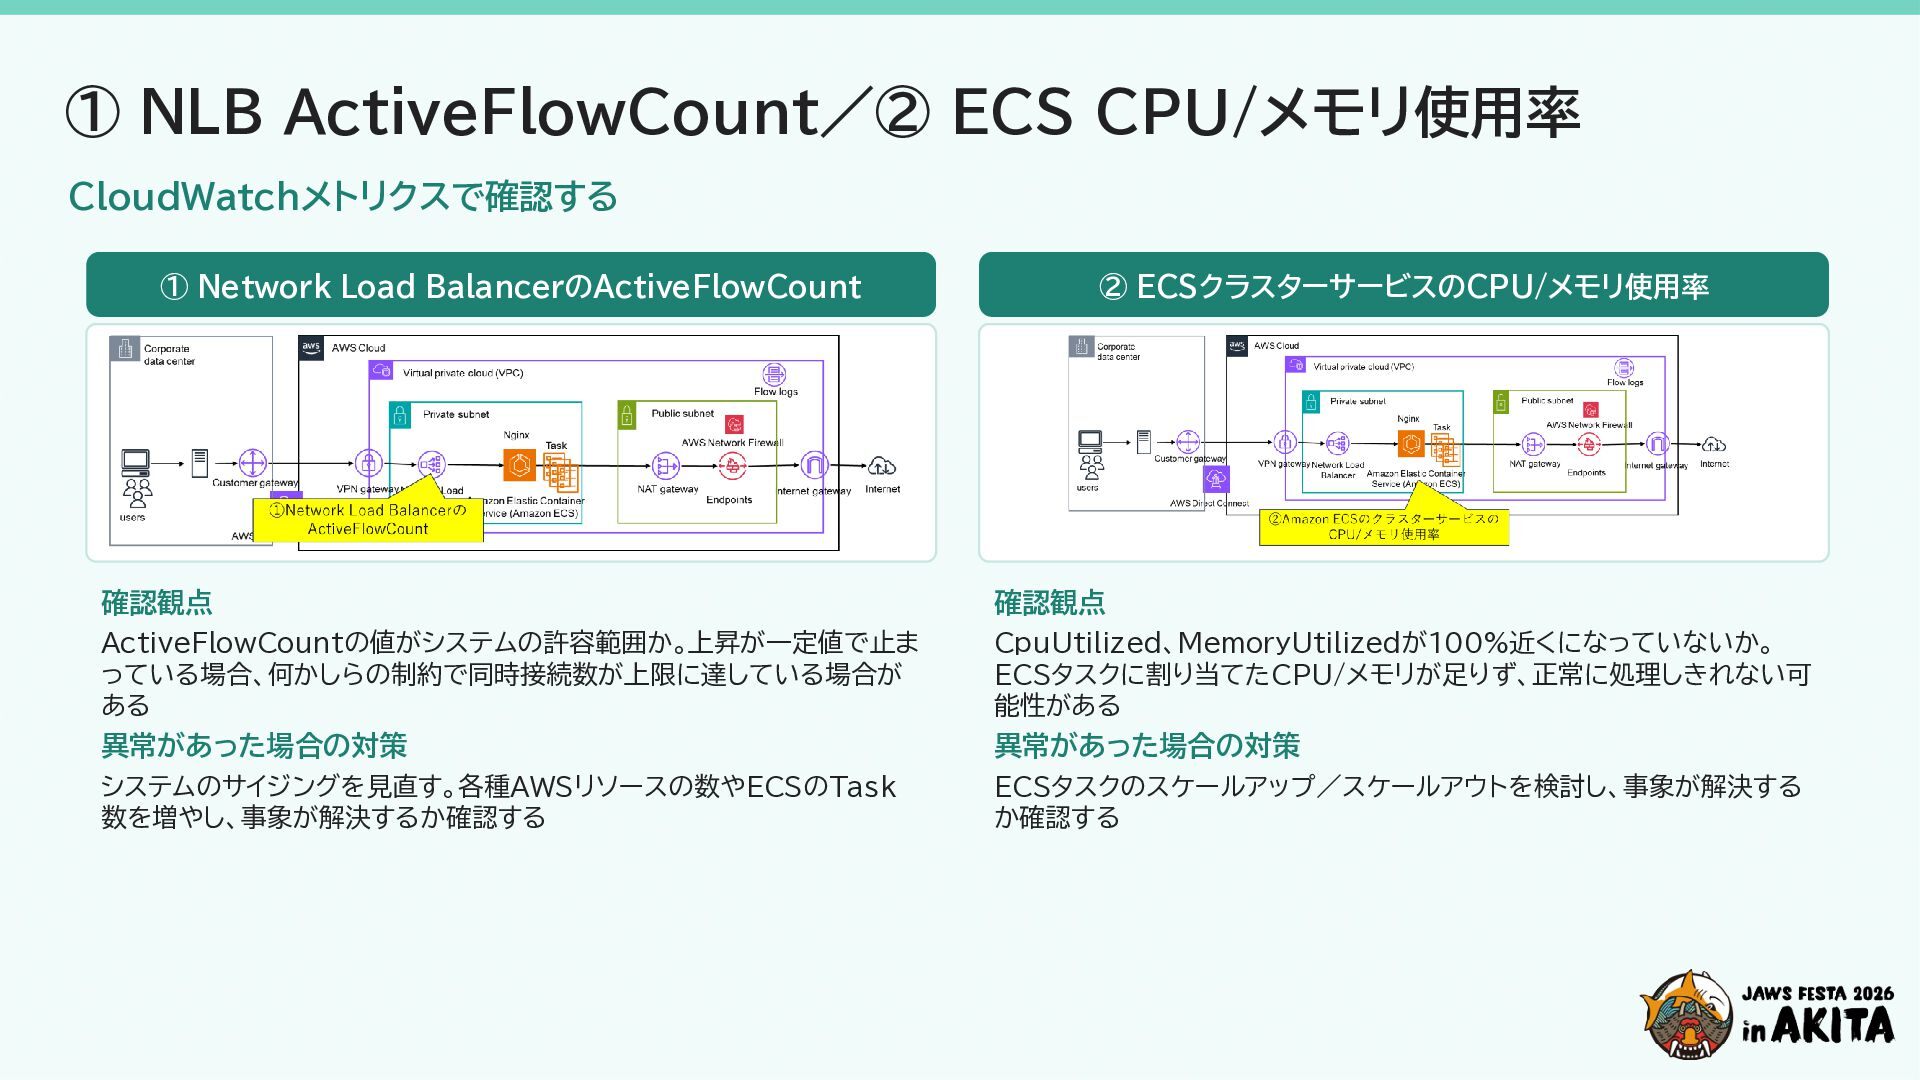
① NLB ActiveFlowCount/② ECS CPU/メモリ使用率 CloudWatchメトリクスで確認する ① Network Load BalancerのActiveFlowCount
② ECSクラスターサービスのCPU/メモリ使用率 確認観点 確認観点 ActiveFlowCountの値がシステムの許容範囲か。上昇が一定値で止ま っている場合、何かしらの制約で同時接続数が上限に達している場合が ある CpuUtilized、MemoryUtilizedが100%近くになっていないか。 ECSタスクに割り当てたCPU/メモリが足りず、正常に処理しきれない可 能性がある 異常があった場合の対策 異常があった場合の対策 システムのサイジングを見直す。各種AWSリソースの数やECSのTask 数を増やし、事象が解決するか確認する ECSタスクのスケールアップ/スケールアウトを検討し、事象が解決する か確認する
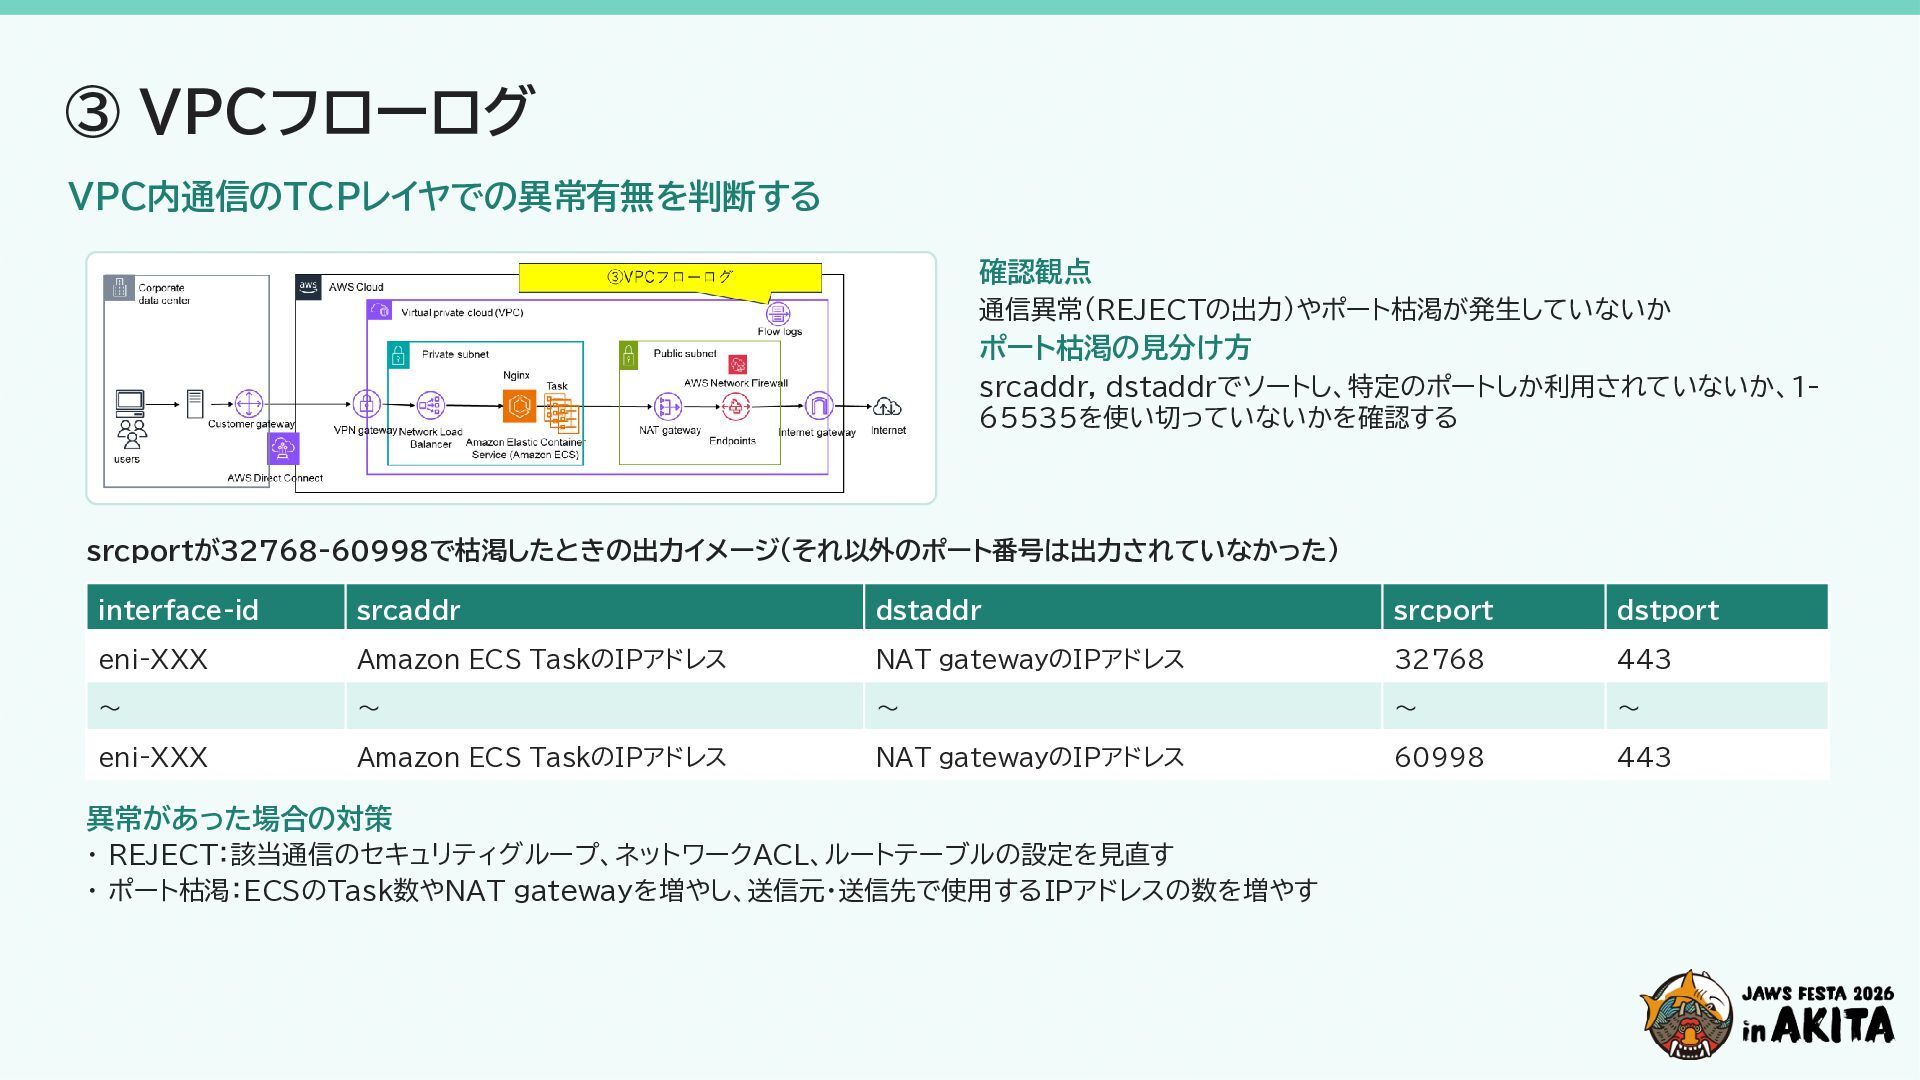
③ VPCフローログ VPC内通信のTCPレイヤでの異常有無を判断する 確認観点 通信異常(REJECTの出力)やポート枯渇が発生していないか ポート枯渇の見分け方 srcaddr, dstaddrでソートし、特定のポートしか利用されていないか、165535を使い切っていないかを確認する srcportが32768-60998で枯渇したときの出力イメージ(それ以外のポート番号は出力されていなかった) interface-id
srcaddr dstaddr srcport dstport eni-XXX Amazon ECS TaskのIPアドレス NAT gatewayのIPアドレス 32768 443 ~ ~ ~ ~ ~ eni-XXX Amazon ECS TaskのIPアドレス NAT gatewayのIPアドレス 60998 443 異常があった場合の対策 ・ REJECT:該当通信のセキュリティグループ、ネットワークACL、ルートテーブルの設定を見直す ・ ポート枯渇:ECSのTask数やNAT gatewayを増やし、送信元・送信先で使用するIPアドレスの数を増やす
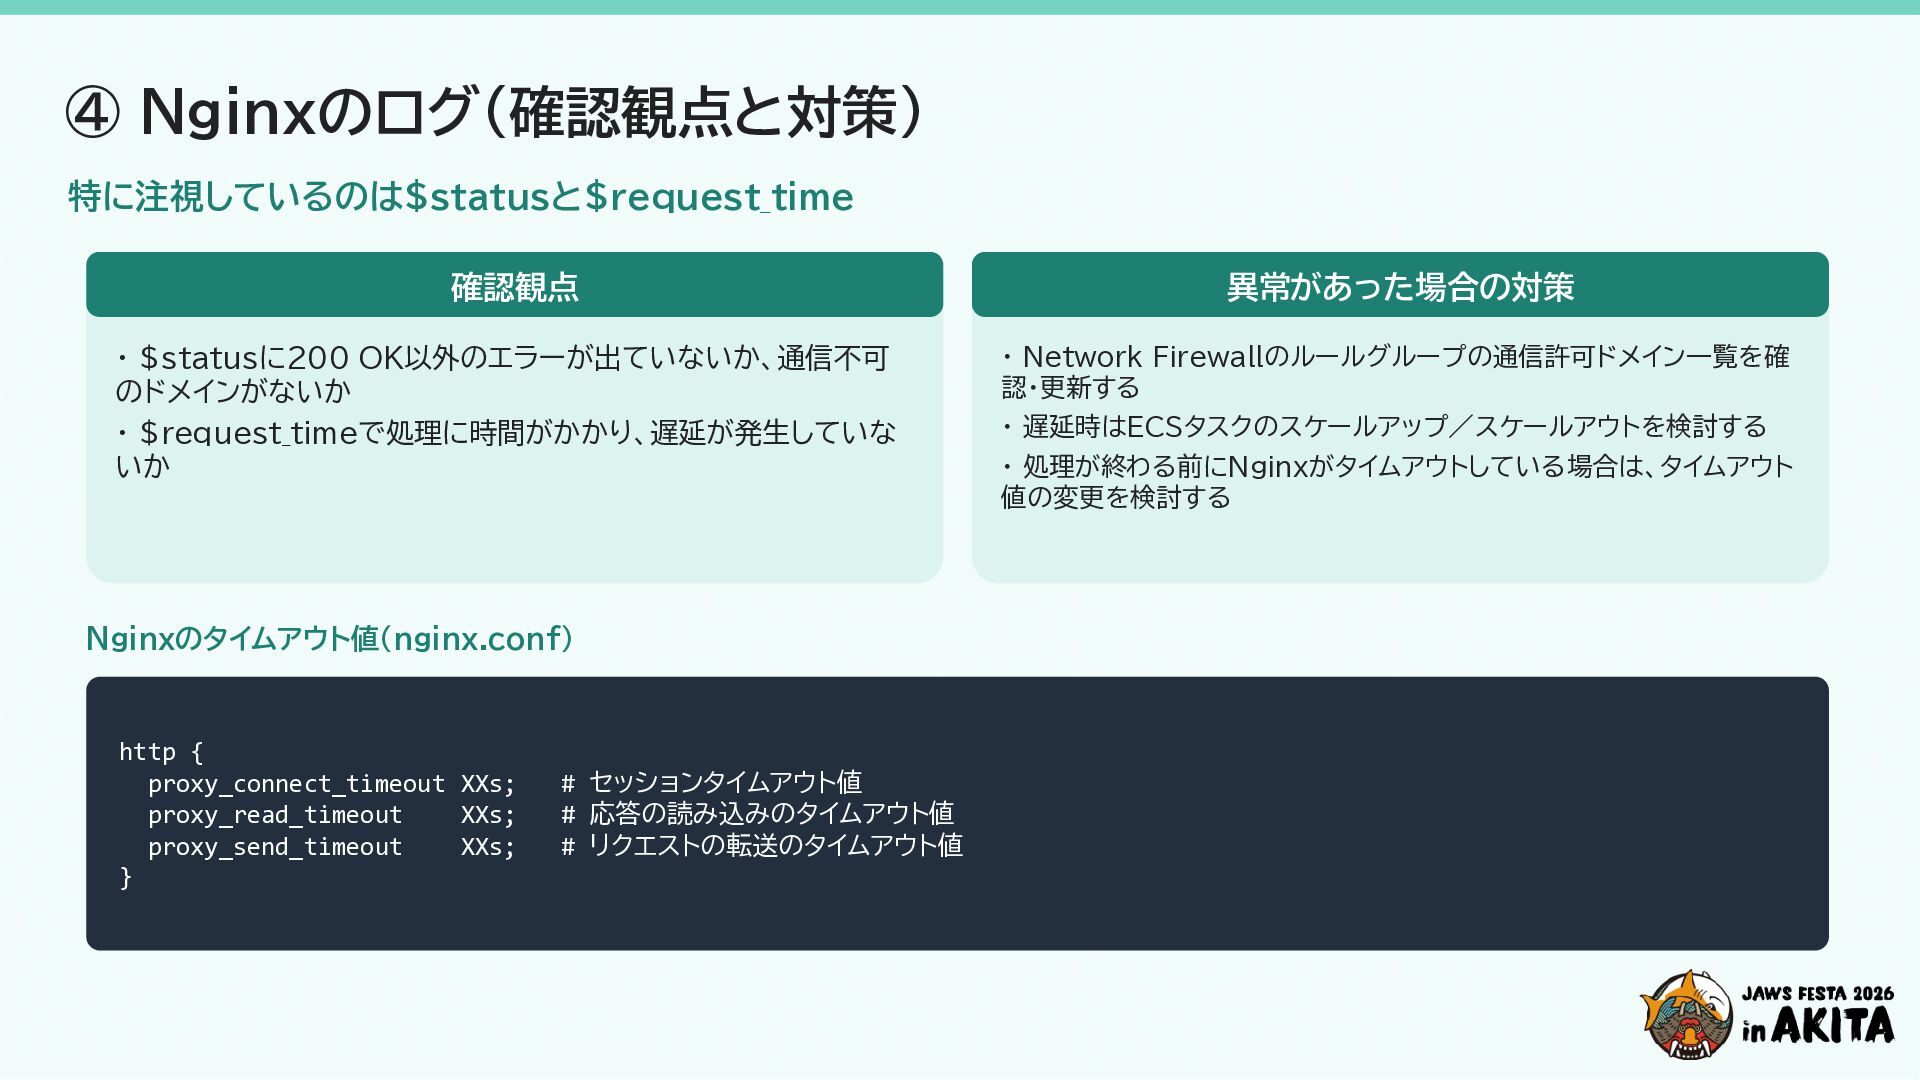
④ Nginxのログ(確認観点と対策) 特に注視しているのは$statusと$request_time 確認観点 異常があった場合の対策 ・ $statusに200 OK以外のエラーが出ていないか、通信不可 のドメインがないか ・
$request_timeで処理に時間がかかり、遅延が発生していな いか ・ Network Firewallのルールグループの通信許可ドメイン一覧を確 認・更新する Nginxのタイムアウト値(nginx.conf) http { proxy_connect_timeout XXs; proxy_read_timeout XXs; proxy_send_timeout XXs; } # セッションタイムアウト値 # 応答の読み込みのタイムアウト値 # リクエストの転送のタイムアウト値 ・ 遅延時はECSタスクのスケールアップ/スケールアウトを検討する ・ 処理が終わる前にNginxがタイムアウトしている場合は、タイムアウト 値の変更を検討する
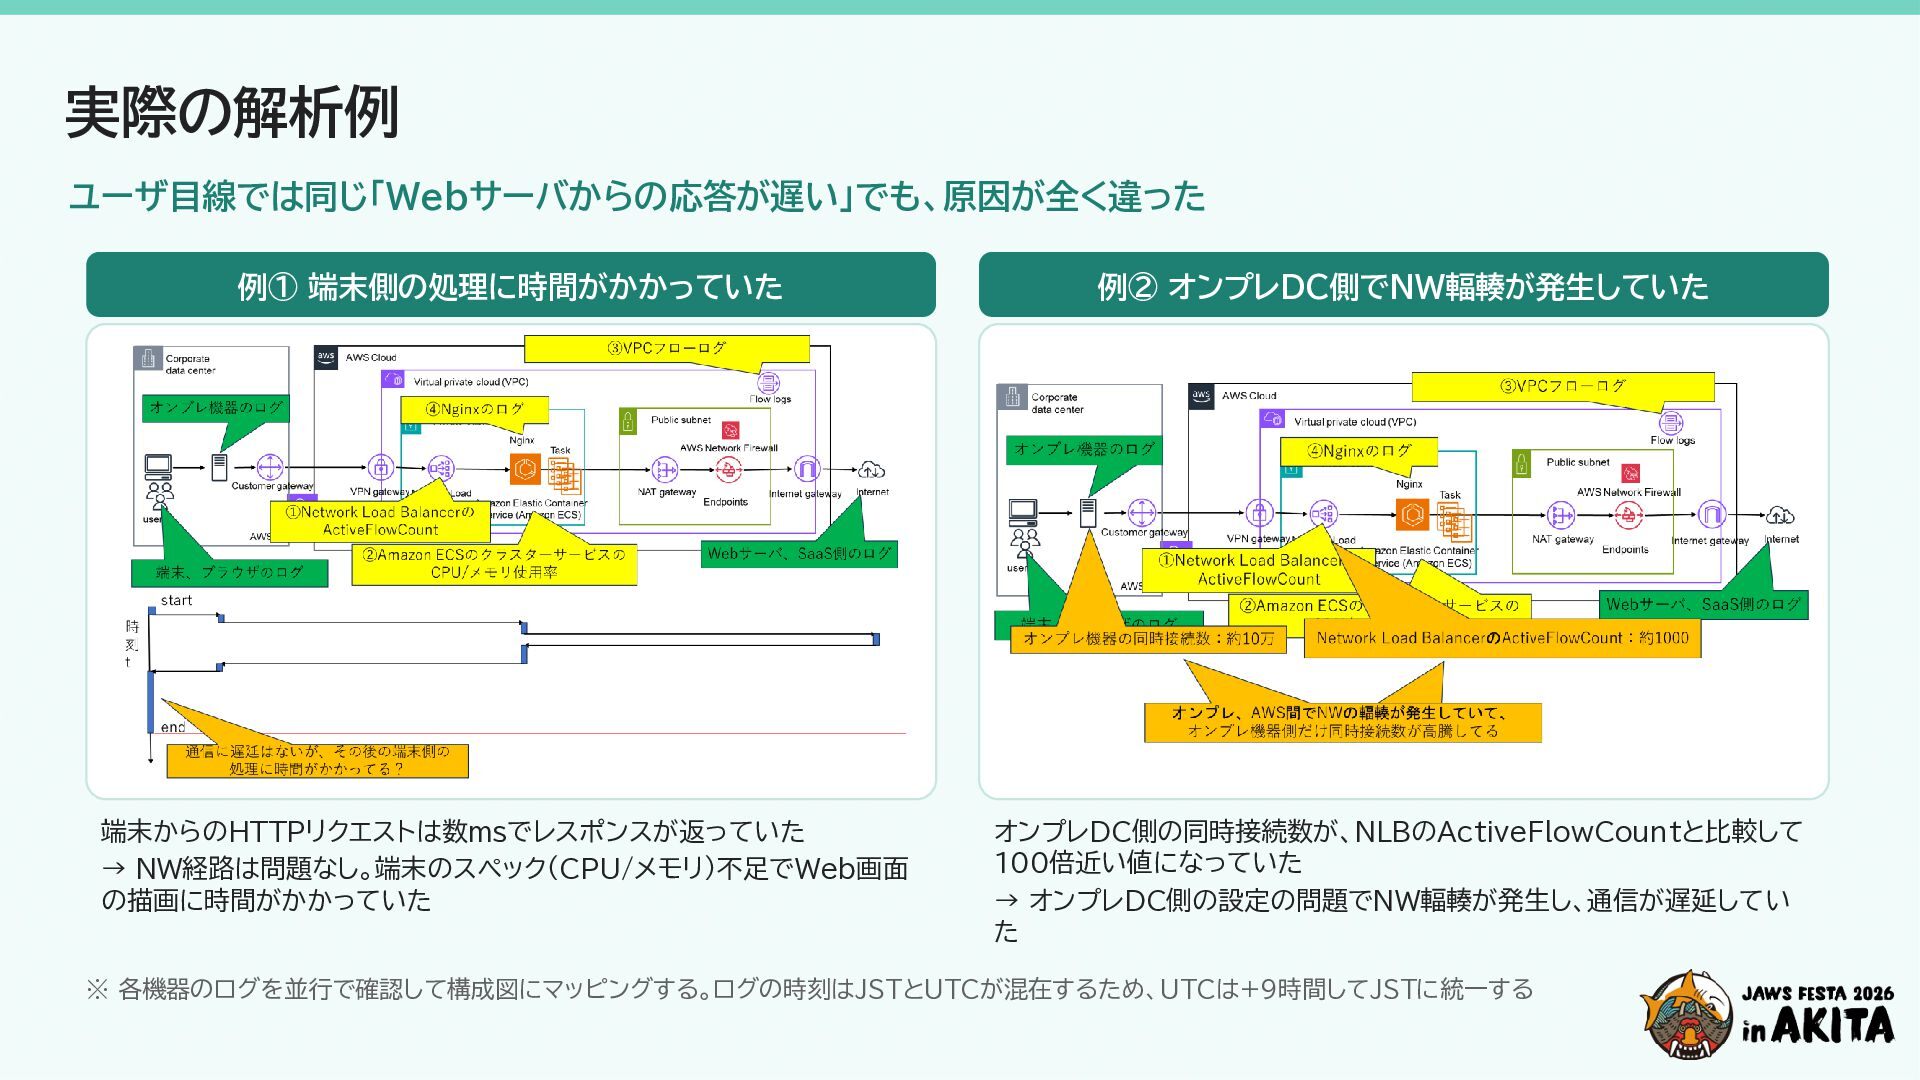
実際の解析例 ユーザ目線では同じ「Webサーバからの応答が遅い」でも、原因が全く違った 例① 端末側の処理に時間がかかっていた 例② オンプレDC側でNW輻輳が発生していた 端末からのHTTPリクエストは数msでレスポンスが返っていた → NW経路は問題なし。端末のスペック(CPU/メモリ)不足でWeb画面 の描画に時間がかかっていた
オンプレDC側の同時接続数が、NLBのActiveFlowCountと比較して 100倍近い値になっていた → オンプレDC側の設定の問題でNW輻輳が発生し、通信が遅延してい た ※ 各機器のログを並行で確認して構成図にマッピングする。ログの時刻はJSTとUTCが混在するため、UTCは+9時間してJSTに統一する
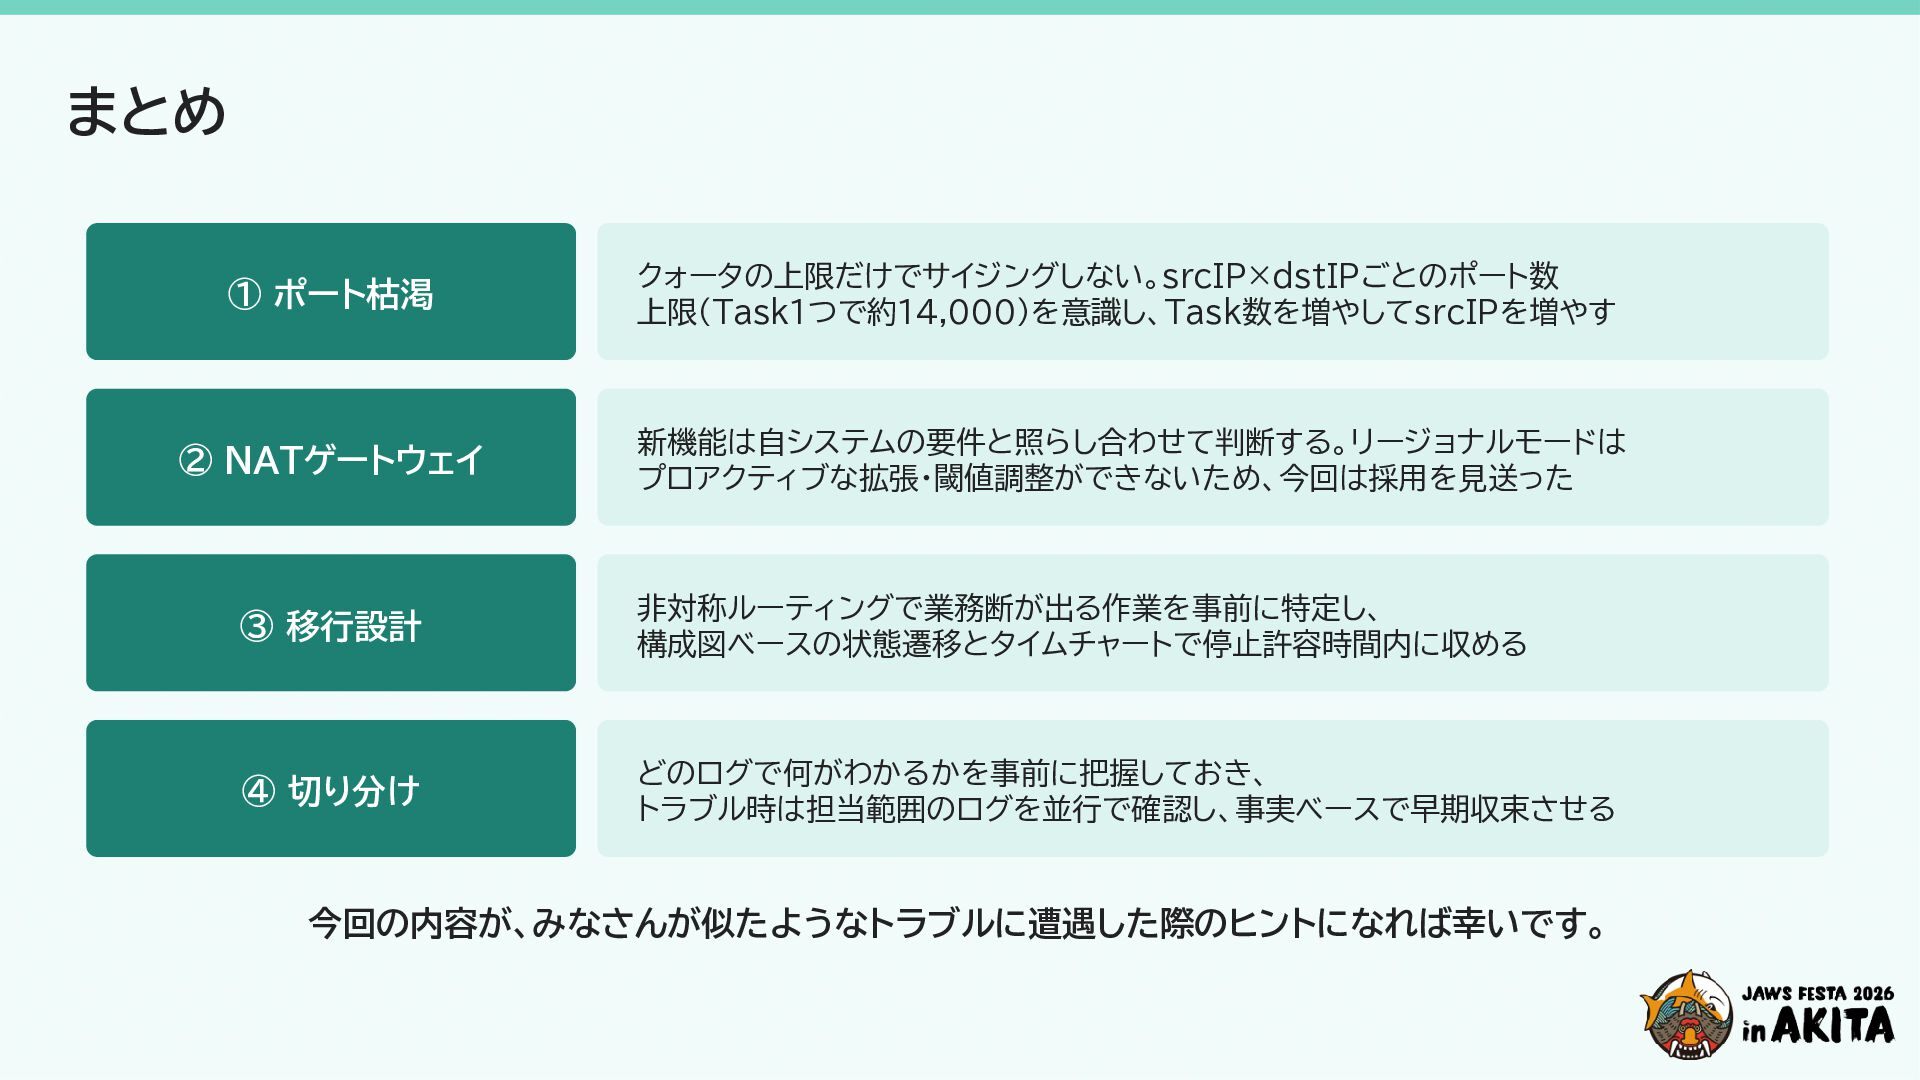
まとめ ① ポート枯渇 クォータの上限だけでサイジングしない。srcIP×dstIPごとのポート数 上限(Task1つで約14,000)を意識し、Task数を増やしてsrcIPを増やす ② NATゲートウェイ 新機能は自システムの要件と照らし合わせて判断する。リージョナルモードは プロアクティブな拡張・閾値調整ができないため、今回は採用を見送った ③
移行設計 非対称ルーティングで業務断が出る作業を事前に特定し、 構成図ベースの状態遷移とタイムチャートで停止許容時間内に収める ④ 切り分け どのログで何がわかるかを事前に把握しておき、 トラブル時は担当範囲のログを並行で確認し、事実ベースで早期収束させる 今回の内容が、みなさんが似たようなトラブルに遭遇した際のヒントになれば幸いです。
参考リンク(Qiita) ① ECS,Nginxを利用した際にポート枯渇にハマった話 https://qiita.com/tkazuaki0820/items/2afa7ad253d4d65b4af1 ② AWS NATゲートウェイの性能とリージョナルNATゲートウェイのスケーリングについて https://qiita.com/tkazuaki0820/items/7bbfeedc72c9436b9cc5 ③ AWS内のネットワーク切替作業時に発生する非対称ルーティングと移行設計について
https://qiita.com/tkazuaki0820/items/281ad9b097754cf3d557 ④ AWS(NLB,ECS,Nginx)にてNW関連の接続エラー、性能問題発生時のトラブルシューティングノウハウを纏め てみた https://qiita.com/tkazuaki0820/items/f12c598bbac2131bfbda
ご清聴ありがとうございました 日本電気株式会社 高島 一晃 #jawsug #jawsfesta2026
Other Decks in Technology
See All in Technology
仕様と現実の間で落とし所を探るリモートMCPの認証・認可 — Sansanの認証基盤における課題と実践
sansantech
PRO
2
270
サボる子はいねぇがー!AgentCoreハーネスの脆弱性に学ぶ、エージェントの入力バリデーション
iwamot
PRO
5
330
田んぼから始まる挑戦 〜新米農家の1年目〜
miu_crescent
PRO
0
140
The Author Pays
hiccupps
0
180
Claude Codeで新規事業を伸ばせるか? Zennの試行錯誤の記録
wadayusuke
1
150
【Oracle AI SPOTLIGHT ウェビナー】【特別開催:日本語で解説!】Oracle AI World 2026 最新情報フィードバック
oracle4engineer
PRO
1
200
開発者とAIで共に歩み育てていく OSS開発 ~創造しながら育てていく~ / 20261105 Masaki Okuda
shift_evolve
PRO
1
110
ぼくのClaude Codeの使い方
falken
PRO
1
4.1k
AIが会計業務の伴走者に。 マネーフォワード クラウド会計MCPサーバーで実現するAI前提の新しい業務プロセス
nobitabashi
0
100
In-Context Learning再入門。ICLの勾配降下的解釈の研究動向を追ってみる。
dai08srhg
1
820
2026-11-11 Tamachi.sre#7 PaCにインフラリソースの命を救われました。 / PaC saves the infra resource life
masasuzu
0
130
セキュリティ専任チームなしで攻撃を先回りするSREが実践したSIEM on Amazon OpenSearch Service
cscengineer
PRO
1
840
Featured
See All Featured
The Mindset for Success: Future Career Progression
greggifford
PRO
0
560
Producing Creativity
orderedlist
PRO
348
41k
Color Theory Basics | Prateek | Gurzu
gurzu
1
520
Claude Code どこまでも/ Claude Code Everywhere
nwiizo
68
60k
AI: The stuff that nobody shows you
jnunemaker
PRO
11
1.3k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
560
The MySQL Ecosystem @ GitHub 2015
samlambert
251
13k
Design in an AI World
tapps
1
390
Future Trends and Review - Lecture 12 - Web Technologies (1019888BNR)
signer
PRO
0
3.8k
State of Search Keynote: SEO is Dead Long Live SEO
ryanjones
0
350
Responsive Adventures: Dirty Tricks From The Dark Corners of Front-End
smashingmag
254
23k
XXLCSS - How to scale CSS and keep your sanity
sugarenia
250
1.3M


 sansantech
 iwamot
 miu_crescent
 hiccupps
 wadayusuke
 oracle4engineer
 shift_evolve
 falken
 nobitabashi
 dai08srhg
 masasuzu
 cscengineer
 greggifford
 orderedlist
 gurzu
 nwiizo
 jnunemaker
 jct
 samlambert
 tapps
 signer
 ryanjones
 smashingmag
 sugarenia