Share
Embed
Splunk Experience Day 2025 - Splunk Federated Search for S3 ✕ AWS連携
Tkay
August 22, 2025
Transcript
59 slides
-
Profile クラスメソッド クラウド事業本部 コンサルティング部 ソリューションアーキテクト 酒井 剛 クラスメソッド アライアンス事業部で Splunk
をはじめセキュリティ SaaS のプリセールス・デリバリーを担当。 ↓ クラウド事業本部で AWS ソリューションを中心としたコンサルティ ング支援。 日々の提案活動の中で AWS と Splunk のインテグレーションスペシャ リストとして活動。 -
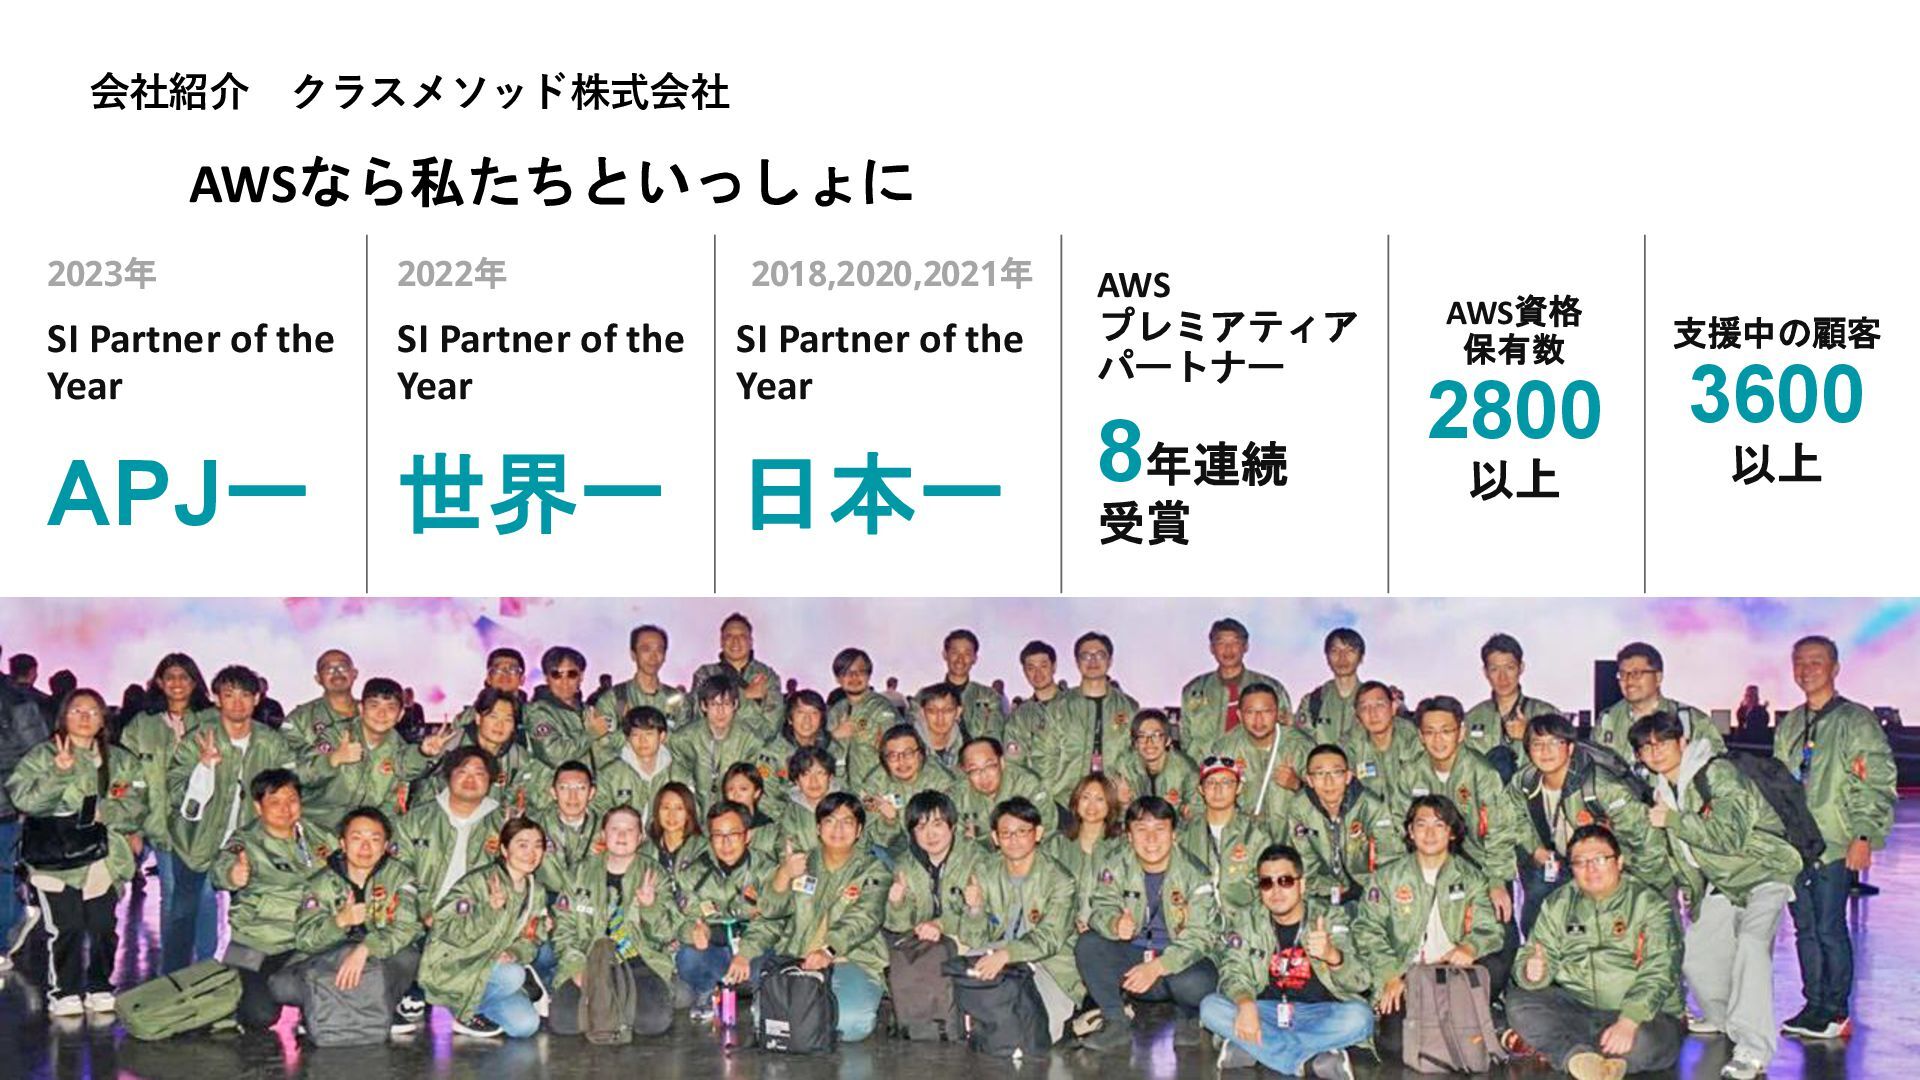
3 ©Classmethod, Inc. 2022年 世界一 SI Partner of the Year
8年連続 受賞 AWS資格 保有数 2800 以上 日本一 SI Partner of the Year 支援中の顧客 3600 以上 AWS プレミアティア パートナー 2023年 APJ一 SI Partner of the Year 2018,2020,2021年 会社紹介 クラスメソッド株式会社 AWSなら私たちといっしょに -
目次 4 1. Splunk Federated Search for S3 (FSS3) とは
2. データパイプラインの構築 3. パフォーマンステスト 4. まとめ -
Splunk Federated Search for S3 (FSS3) とは 6 .conf 23
で発表 みなさん使ってますか? -
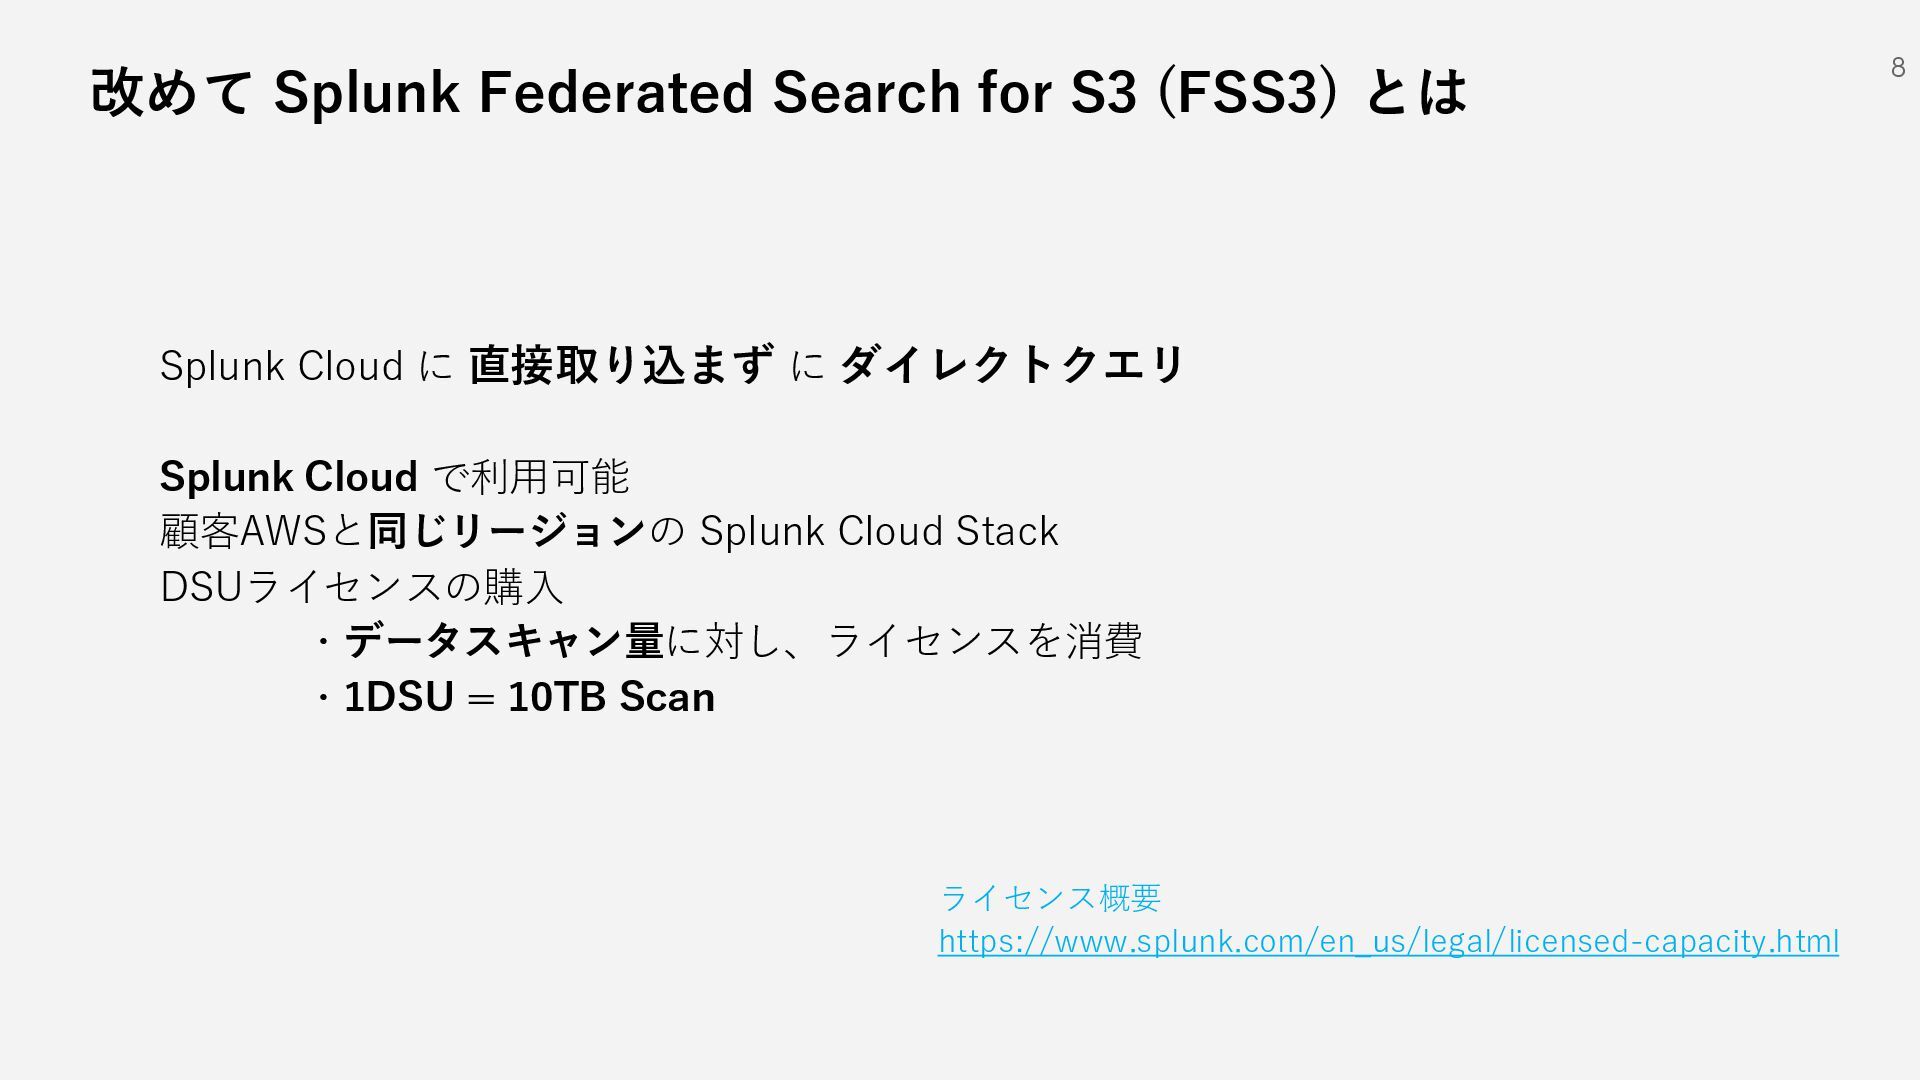
Splunk Cloud に 直接取り込まず に ダイレクトクエリ Splunk Cloud で利用可能 顧客AWSと同じリージョンの
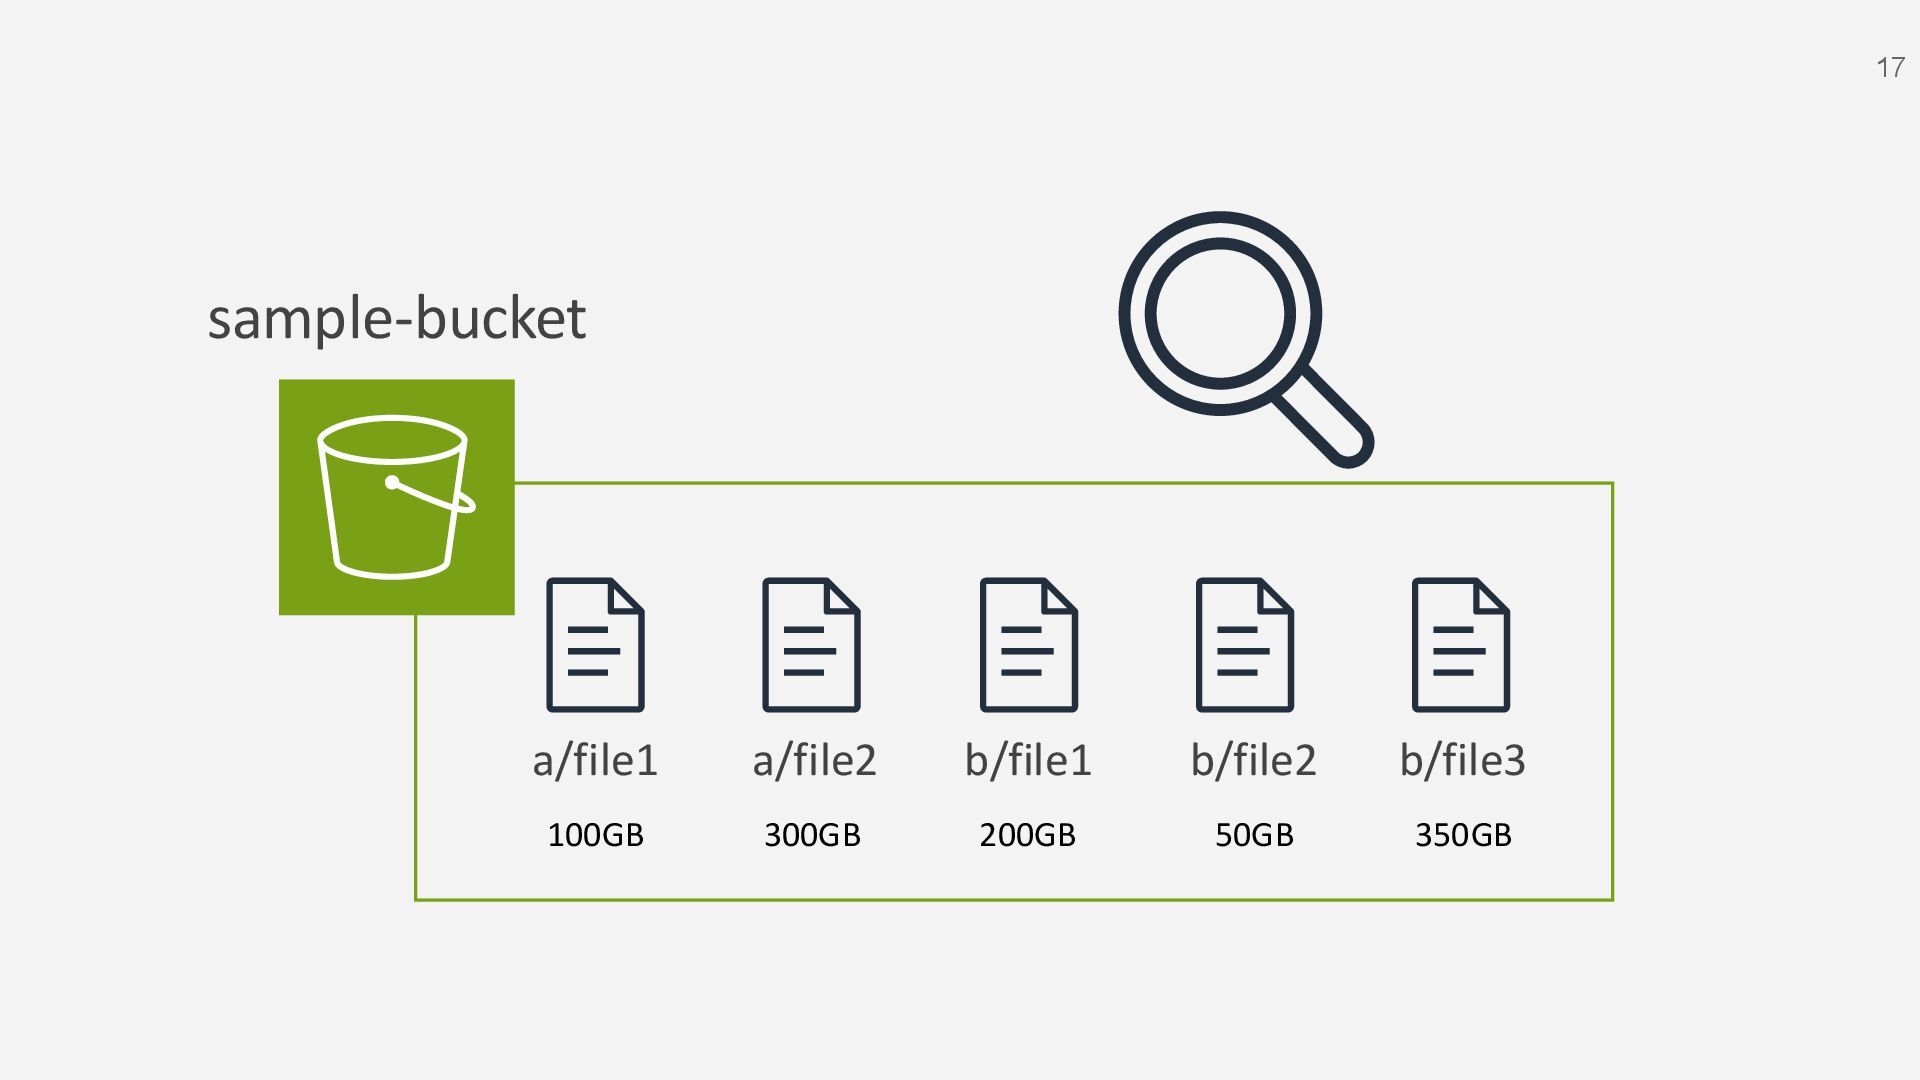
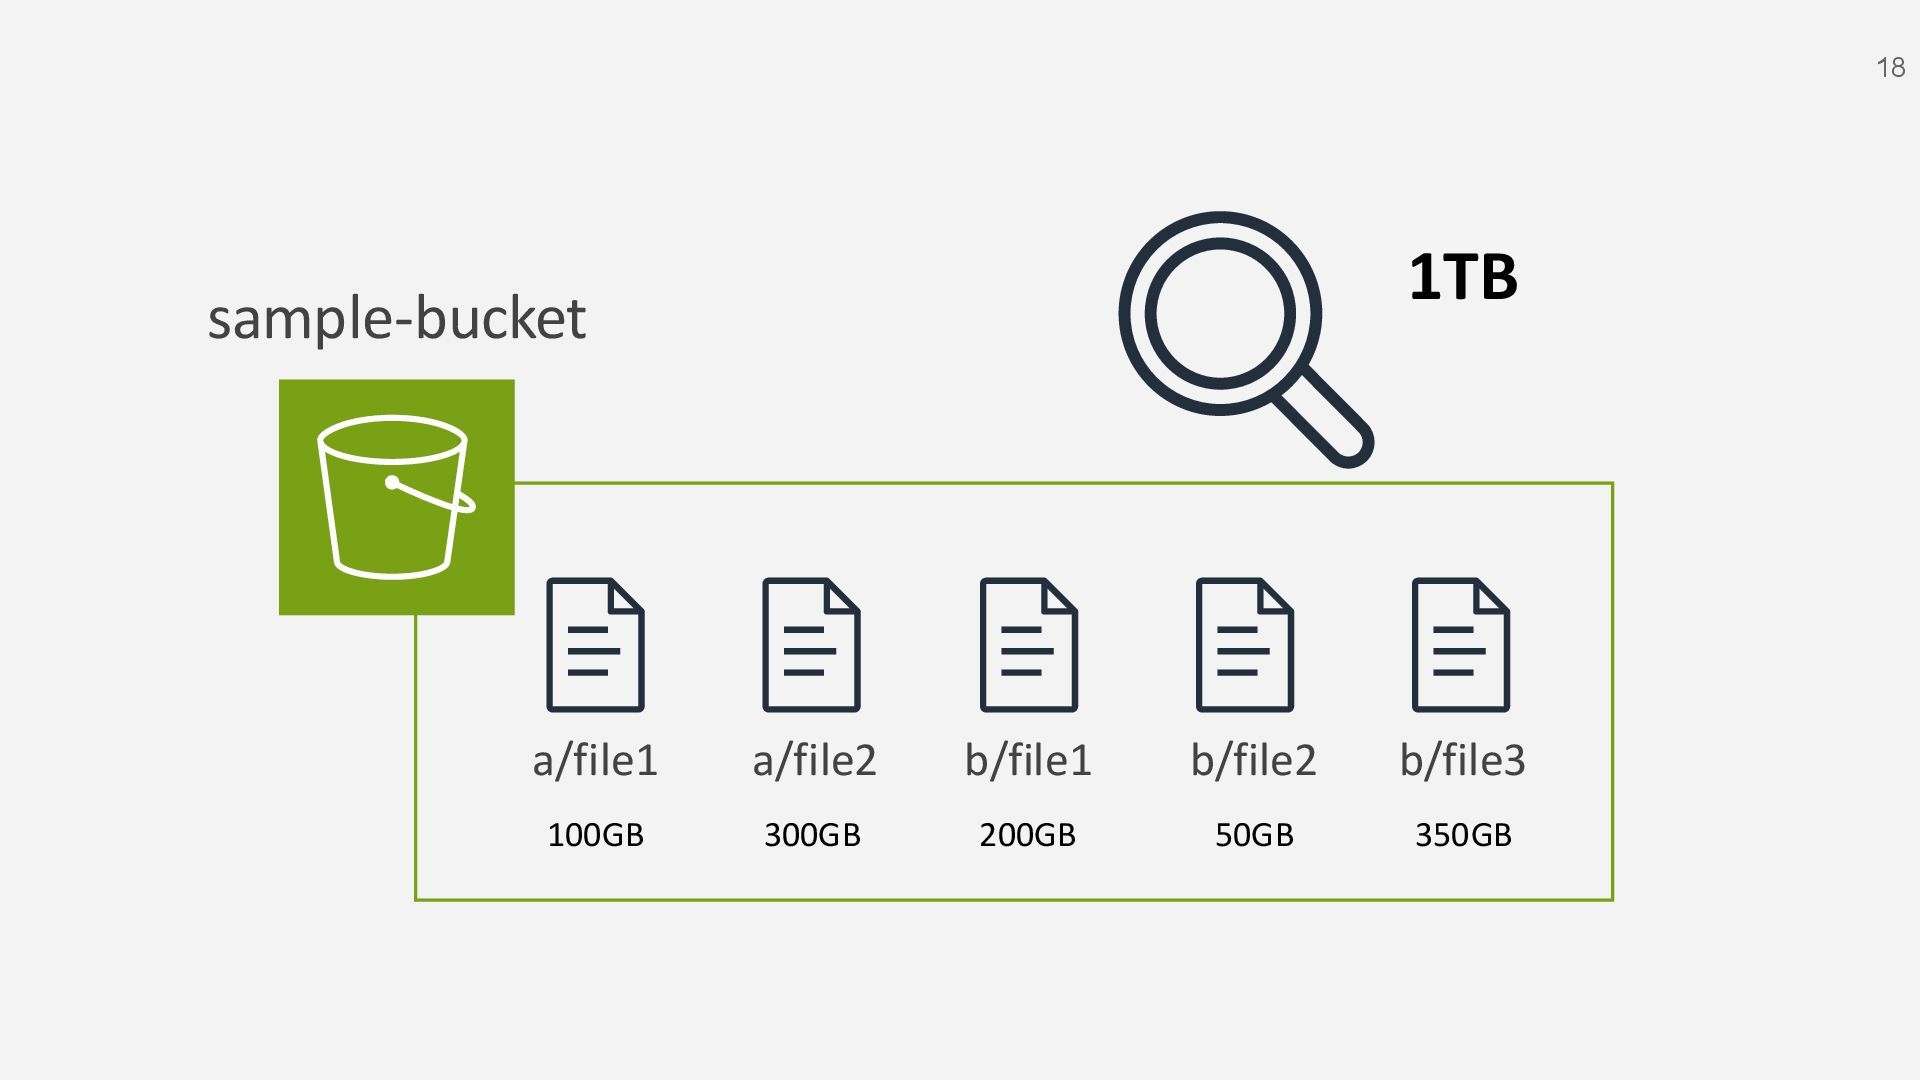
Splunk Cloud Stack DSUライセンスの購入 ・データスキャン量に対し、ライセンスを消費 ・1DSU = 10TB Scan 8 ライセンス概要 https://www.splunk.com/en_us/legal/licensed-capacity.html 改めて Splunk Federated Search for S3 (FSS3) とは -
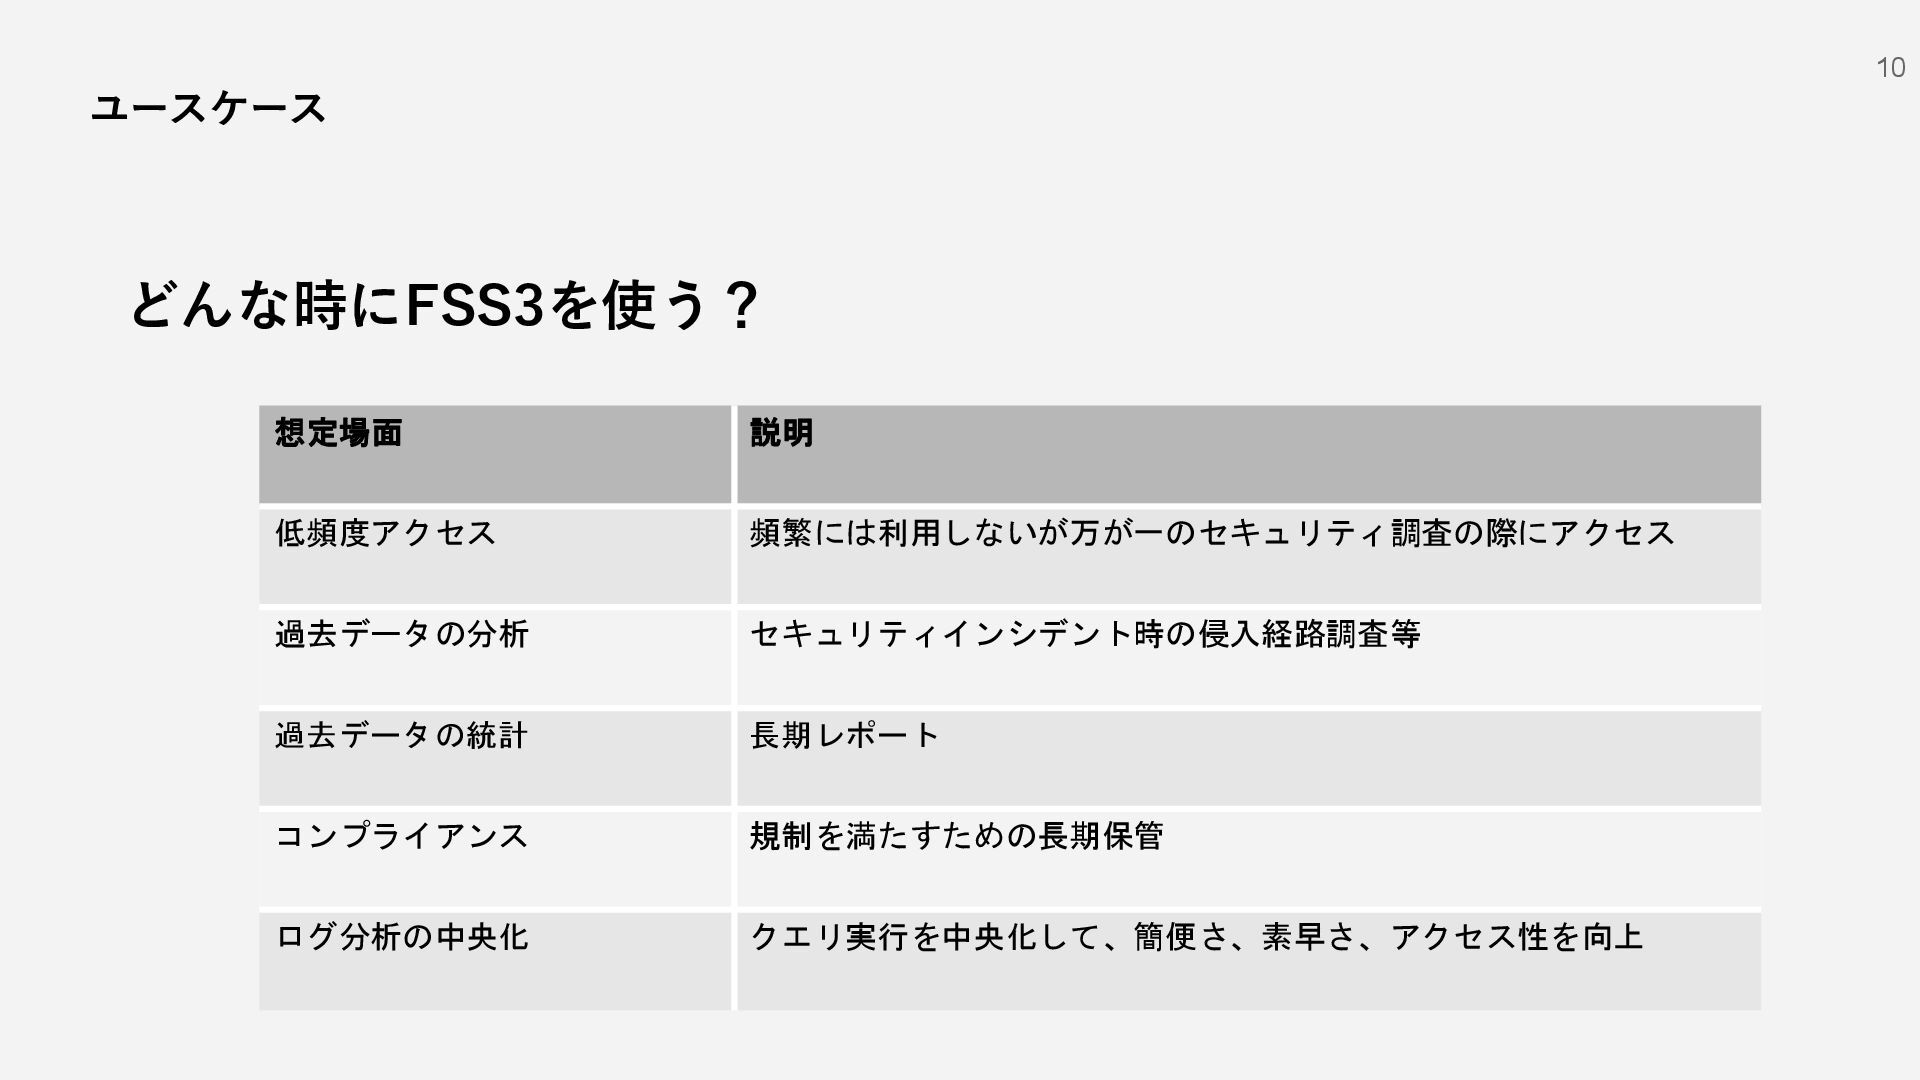
どんな時にFSS3を使う? 10 ユースケース 想定場面 説明 低頻度アクセス 頻繁には利用しないが万が一のセキュリティ調査の際にアクセス 過去データの分析 セキュリティインシデント時の侵入経路調査等 過去データの統計
長期レポート コンプライアンス 規制を満たすための長期保管 ログ分析の中央化 クエリ実行を中央化して、簡便さ、素早さ、アクセス性を向上 -
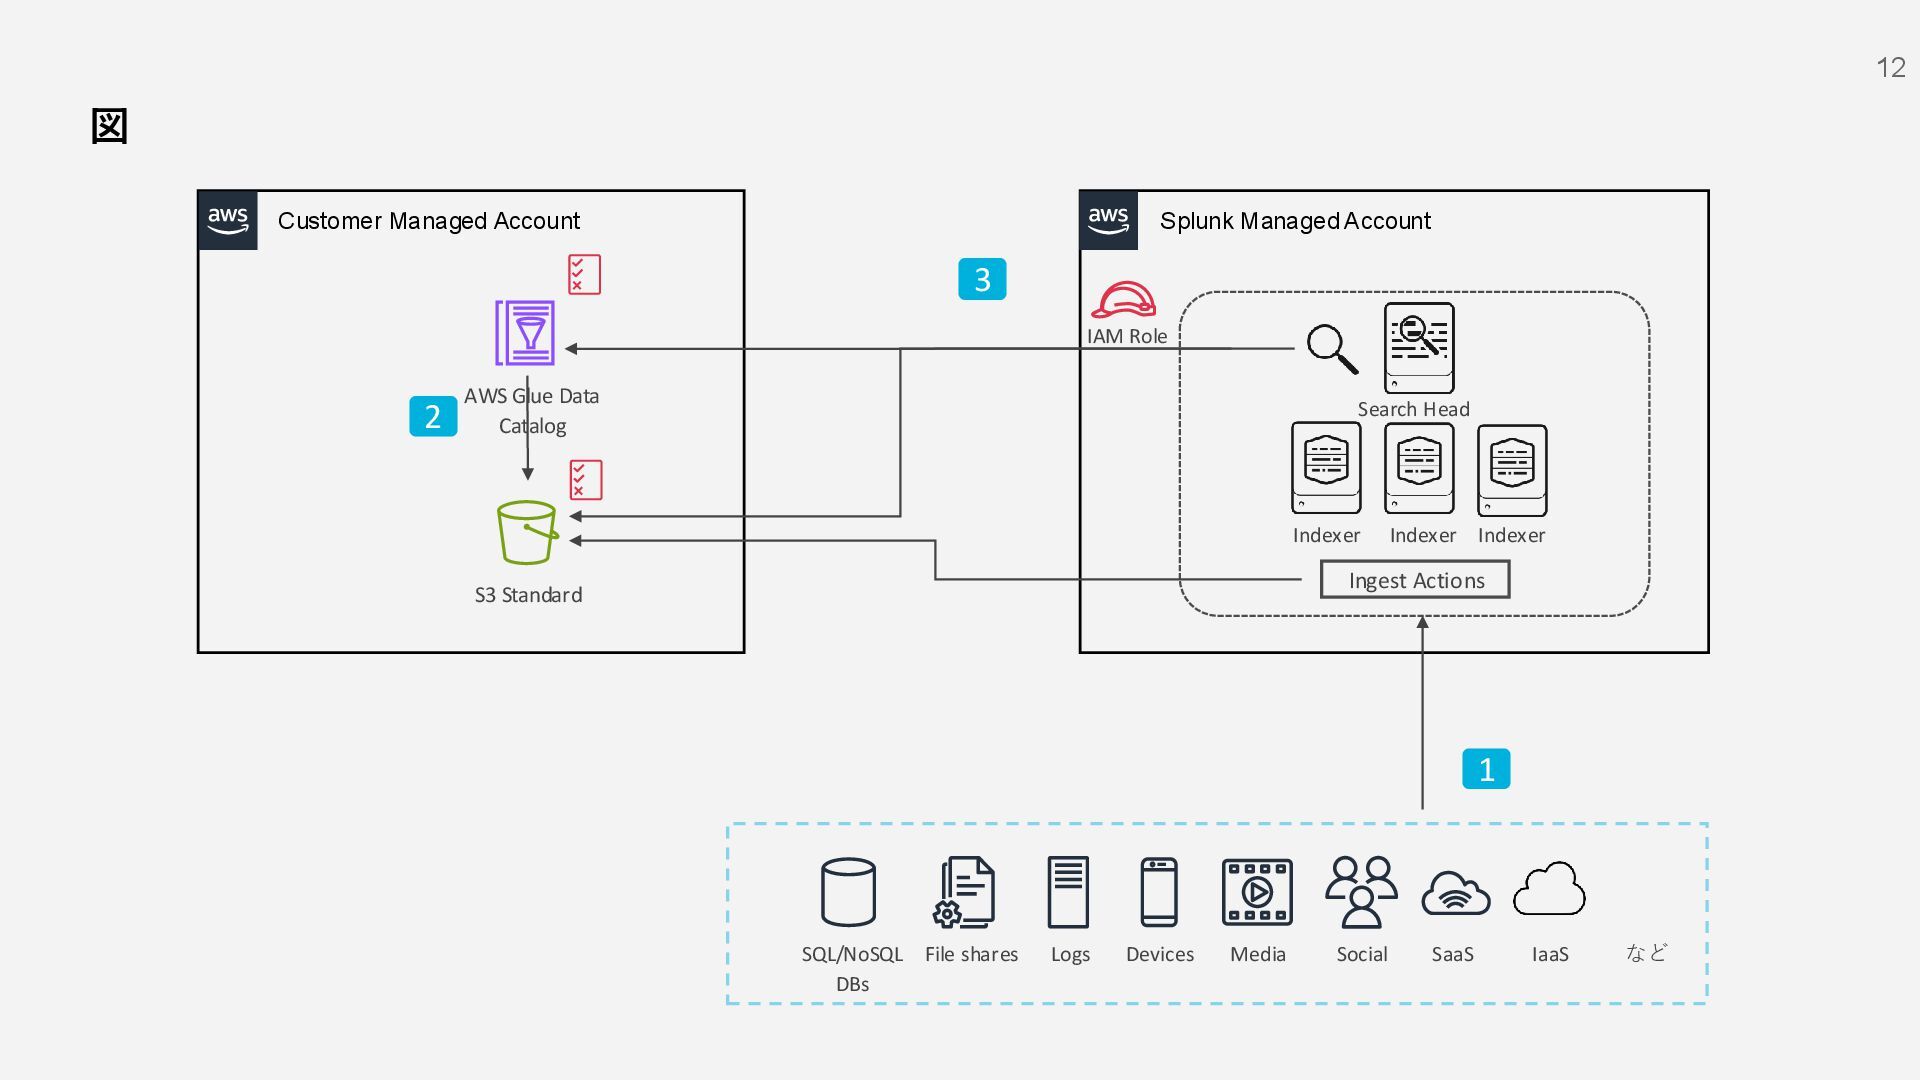
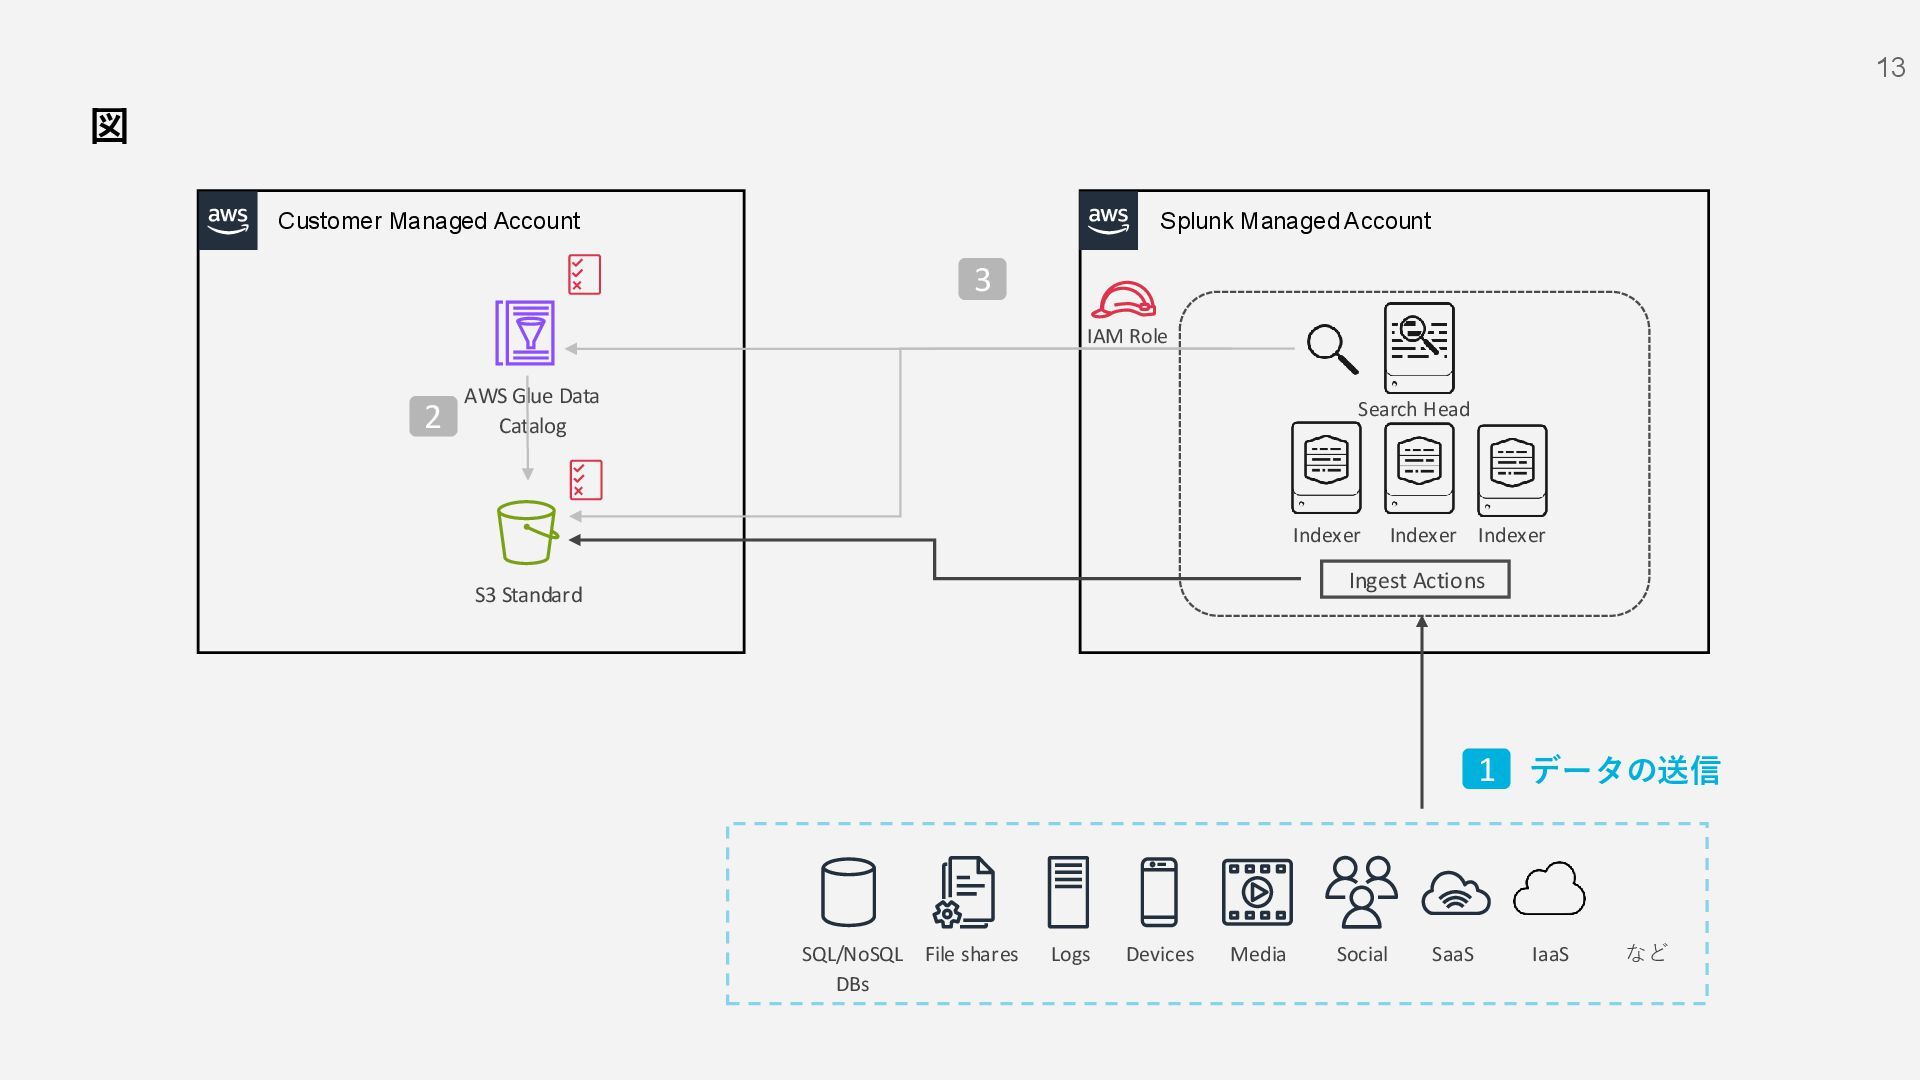
12 図 Splunk Managed Account Customer Managed Account Ingest Actions
S3 Standard File shares Social Devices Media Logs SQL/NoSQL DBs IaaS など SaaS 1 AWS Glue Data Catalog IAM Role Indexer Indexer Indexer Search Head 2 3 -
13 図 Splunk Managed Account Customer Managed Account Ingest Actions
S3 Standard File shares Social Devices Media Logs SQL/NoSQL DBs IaaS など SaaS 1 AWS Glue Data Catalog IAM Role Indexer Indexer Indexer Search Head 2 3 データの送信 -
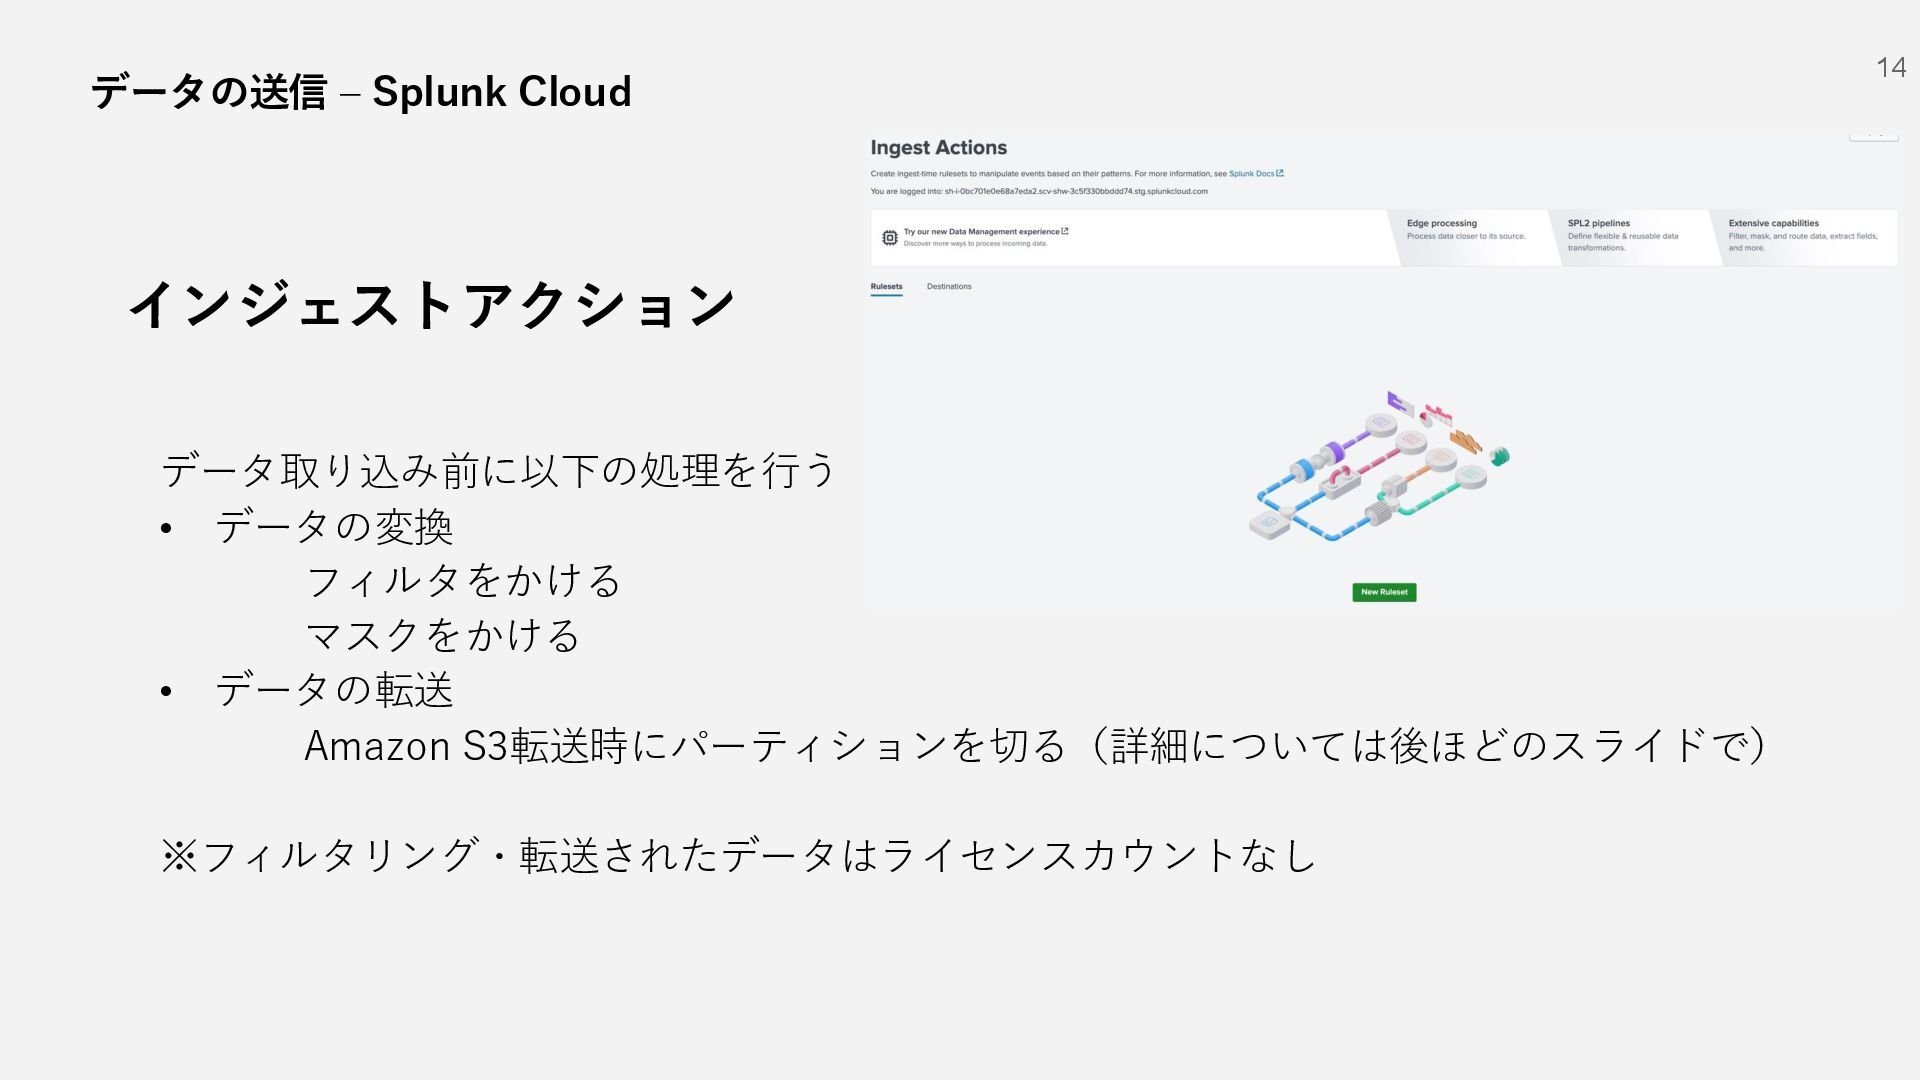
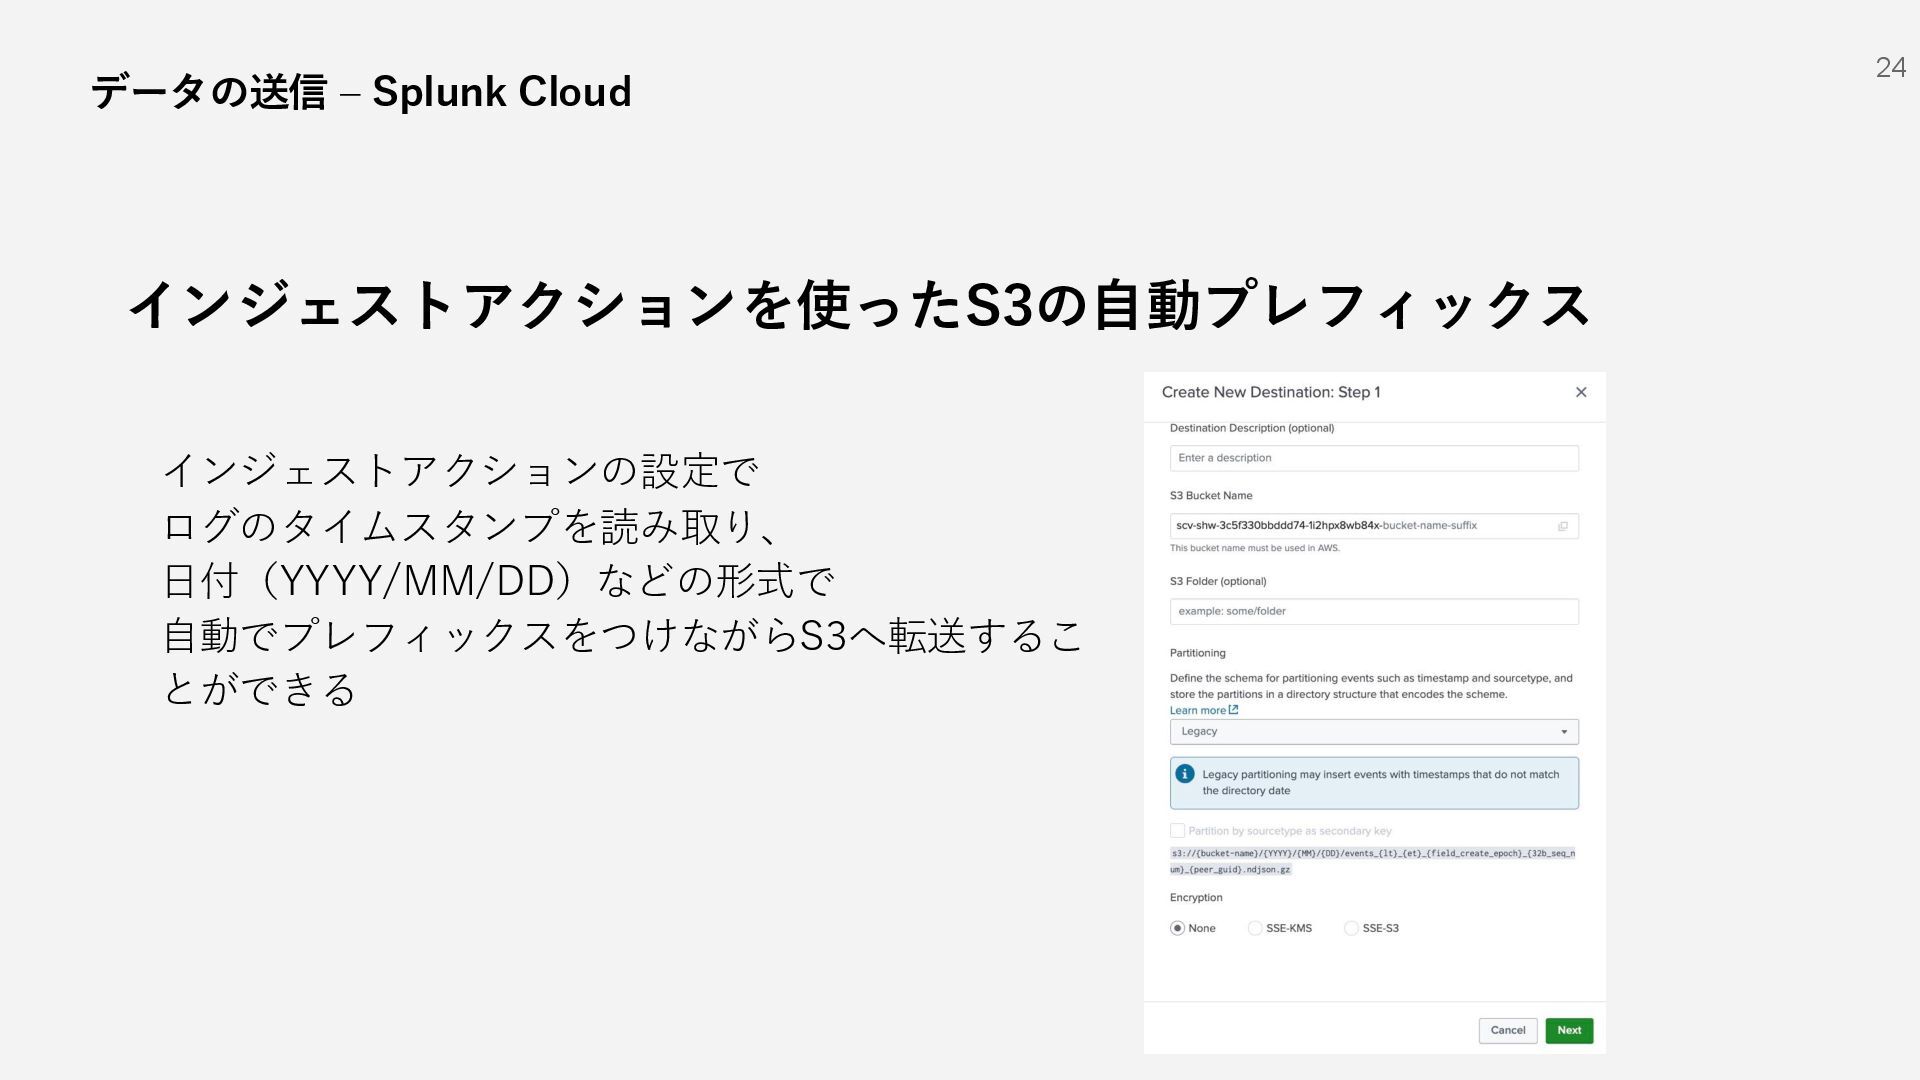
インジェストアクション 14 データの送信 – Splunk Cloud データ取り込み前に以下の処理を行う • データの変換 フィルタをかける
マスクをかける • データの転送 Amazon S3転送時にパーティションを切る(詳細については後ほどのスライドで) ※フィルタリング・転送されたデータはライセンスカウントなし -
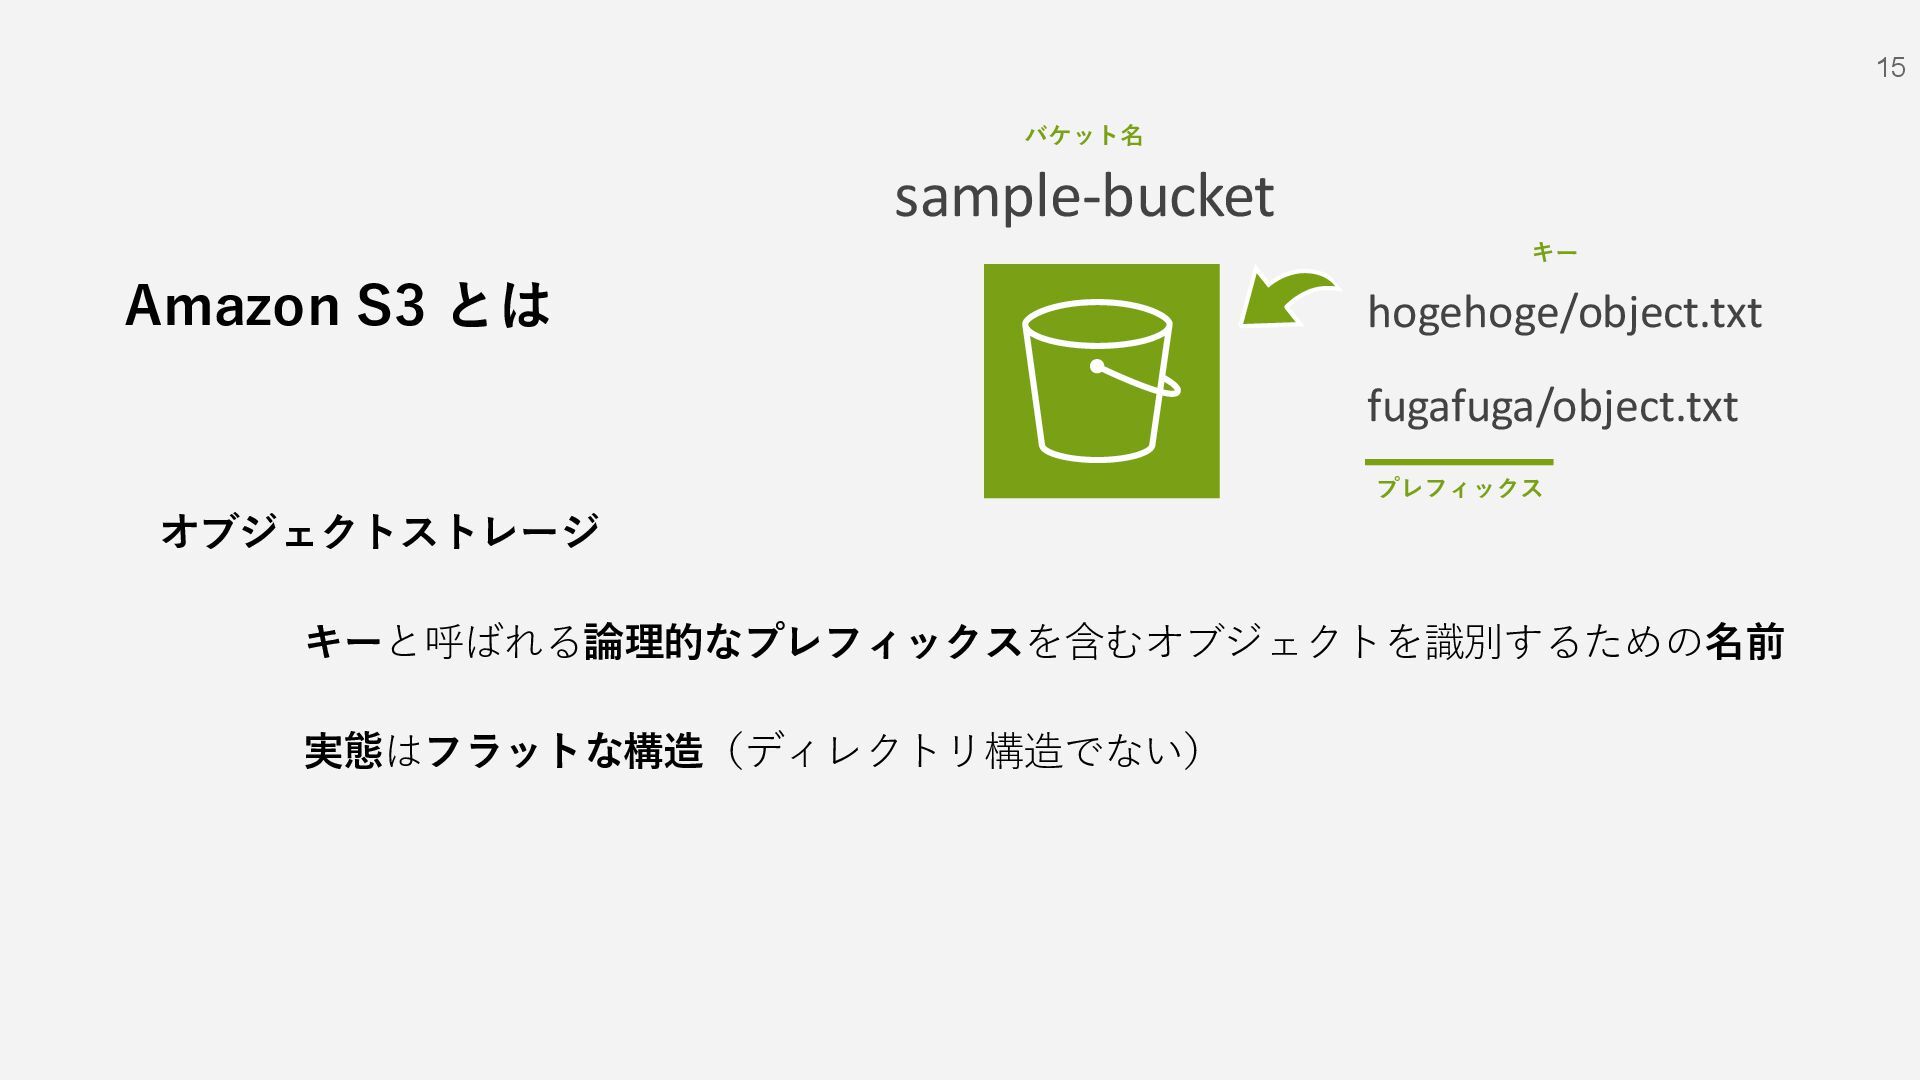
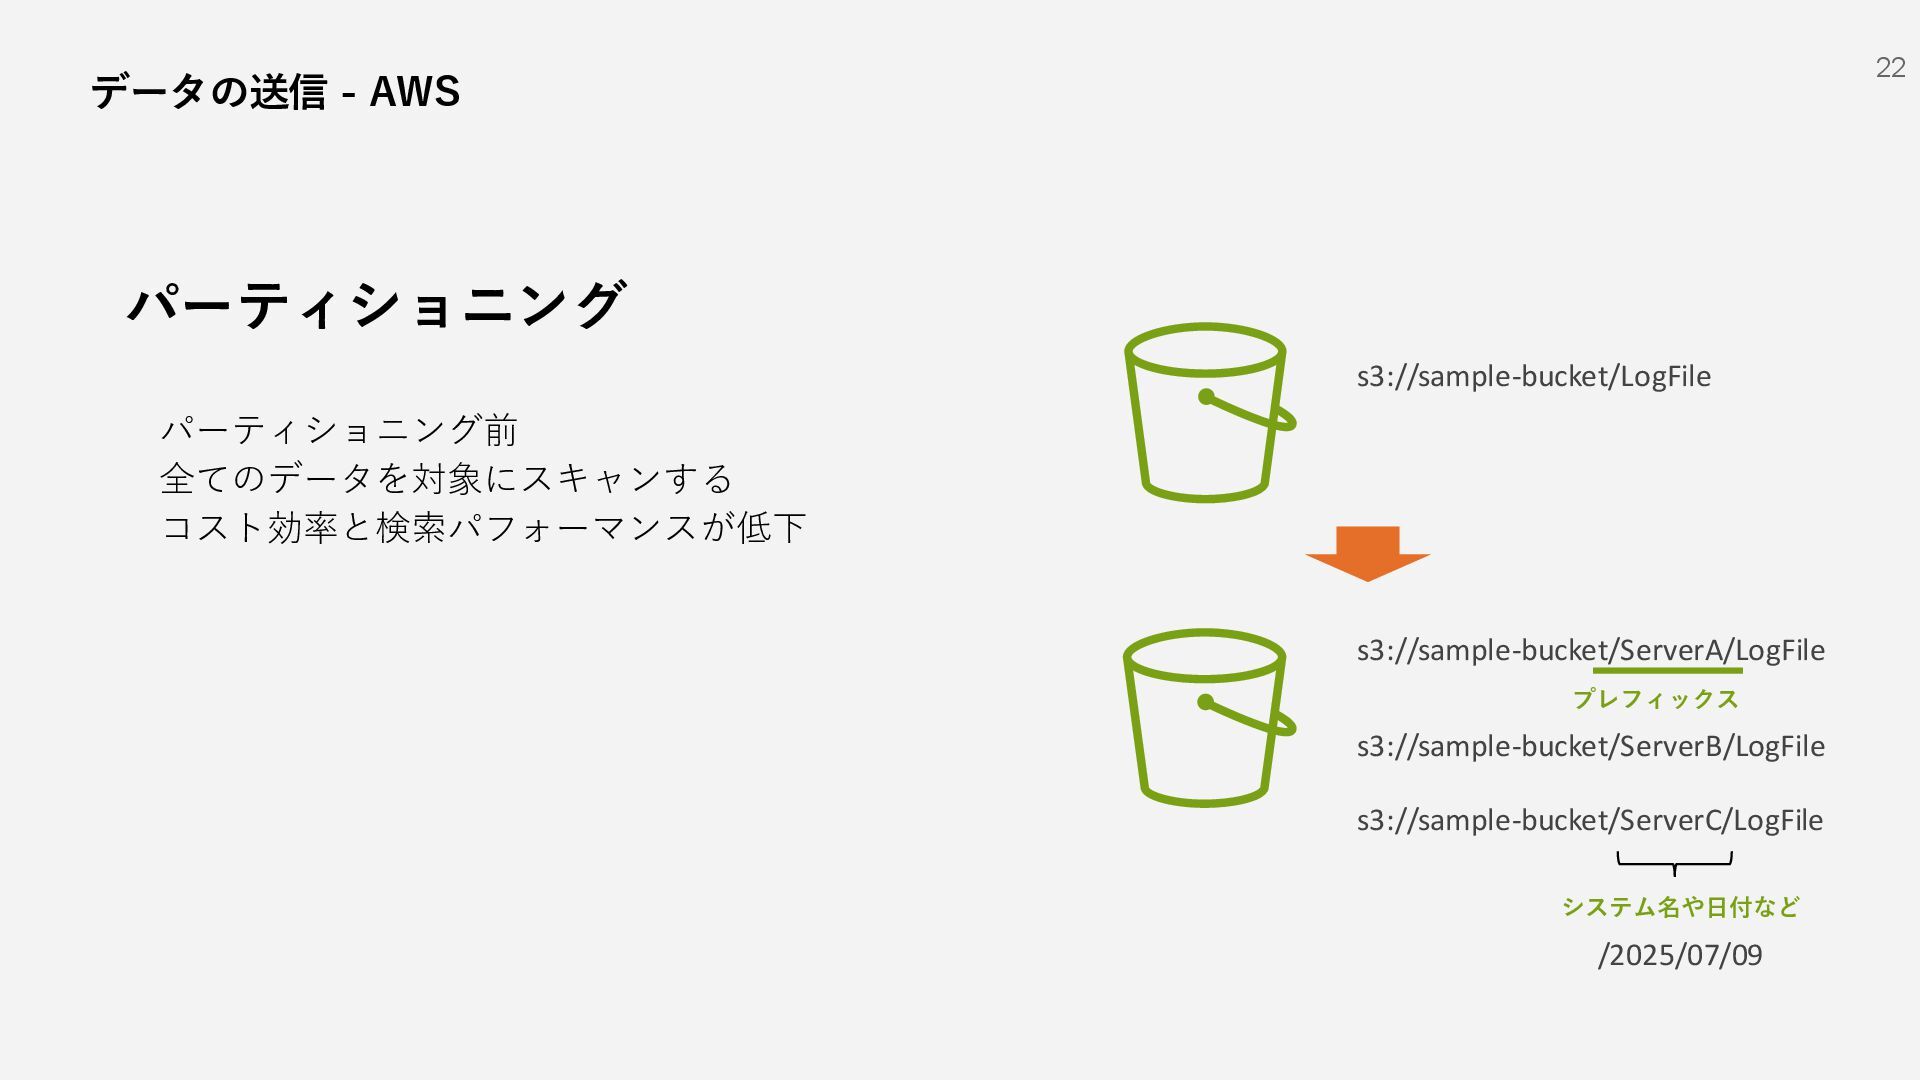
パーティショニング 22 データの送信 - AWS パーティショニング前 全てのデータを対象にスキャンする コスト効率と検索パフォーマンスが低下 s3://sample-bucket/LogFile s3://sample-bucket/ServerA/LogFile
s3://sample-bucket/ServerB/LogFile s3://sample-bucket/ServerC/LogFile システム名や日付など /2025/07/09 プレフィックス -
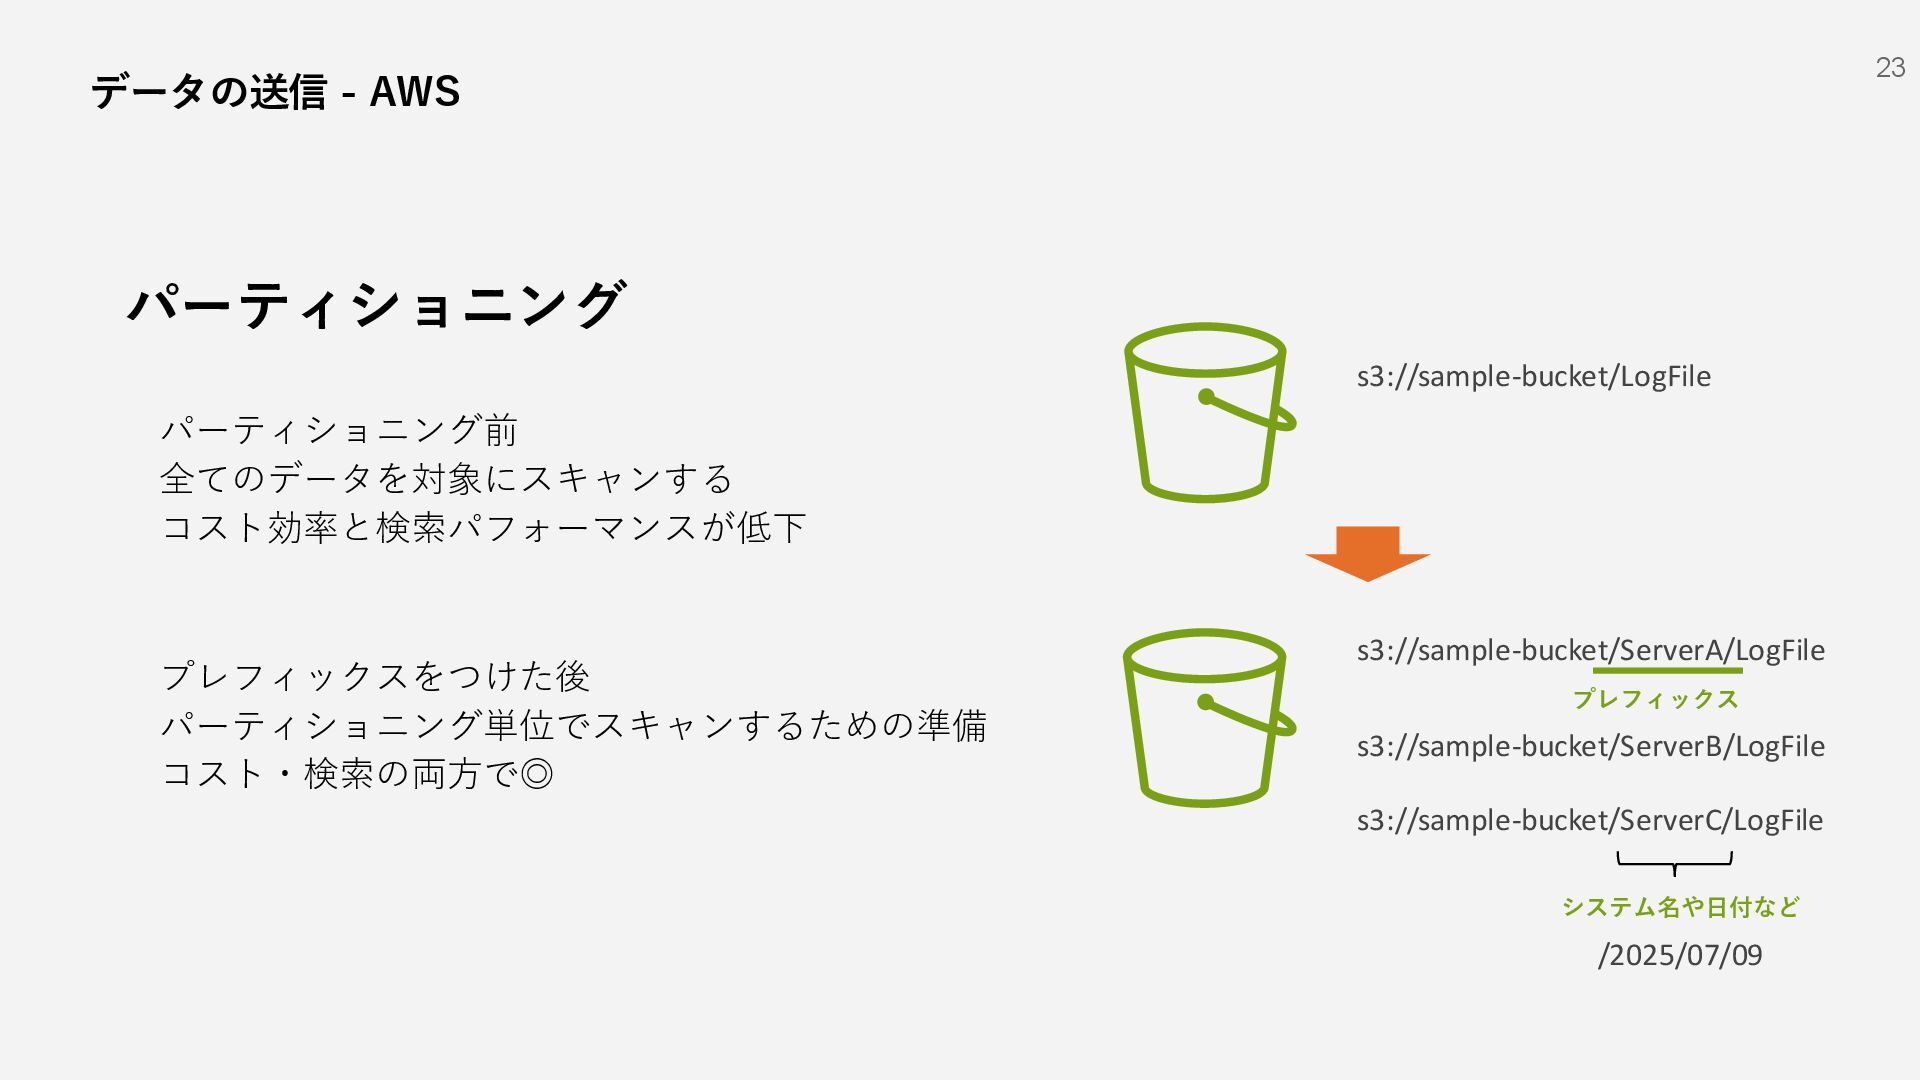
パーティショニング 23 データの送信 - AWS パーティショニング前 全てのデータを対象にスキャンする コスト効率と検索パフォーマンスが低下 プレフィックスをつけた後 パーティショニング単位でスキャンするための準備
コスト・検索の両方で◎ s3://sample-bucket/LogFile s3://sample-bucket/ServerA/LogFile s3://sample-bucket/ServerB/LogFile s3://sample-bucket/ServerC/LogFile システム名や日付など /2025/07/09 プレフィックス -
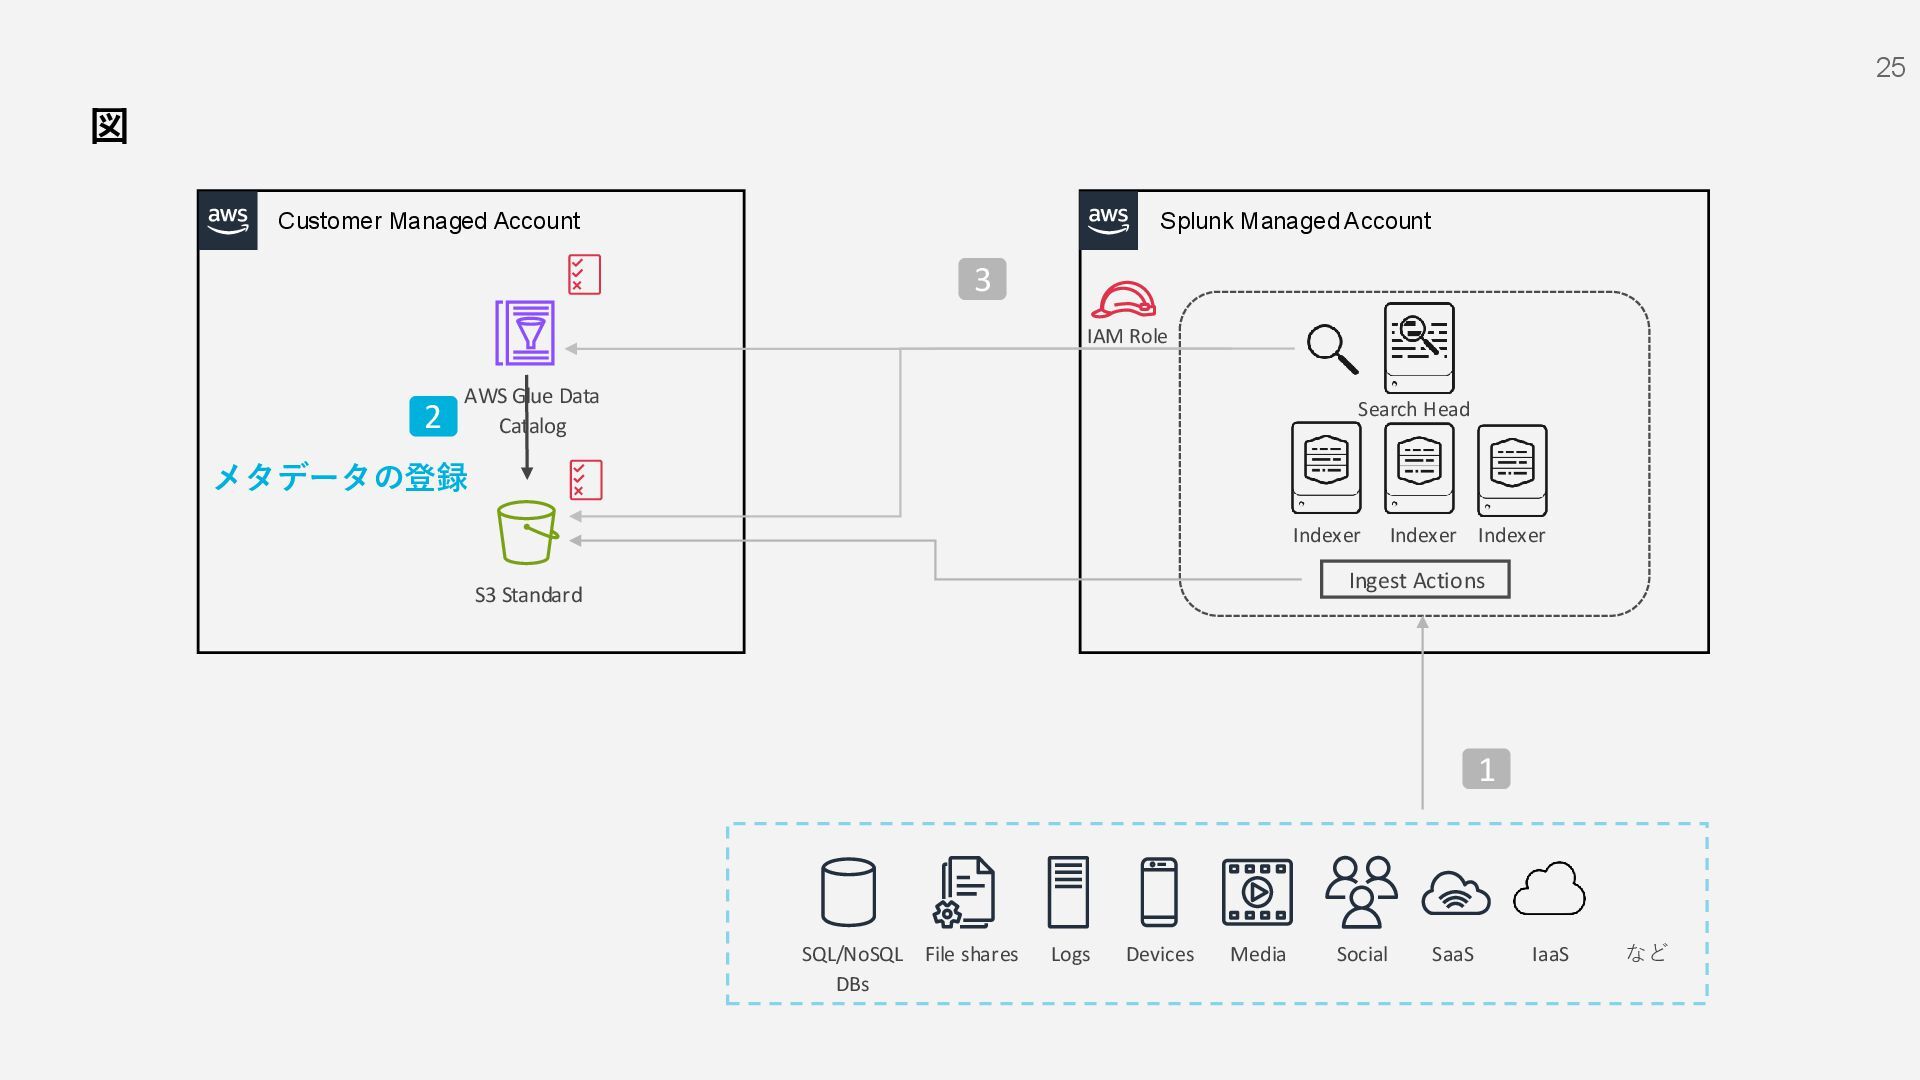
25 図 Splunk Managed Account Customer Managed Account Ingest Actions
S3 Standard File shares Social Devices Media Logs SQL/NoSQL DBs IaaS など SaaS 1 AWS Glue Data Catalog IAM Role Indexer Indexer Indexer Search Head 2 3 メタデータの登録 -
AWS Glue Data Catalogにメタデータを登録 27 メタデータの登録 - AWS • AWS
Glue Data Catalogを使った登録 • AWS Glue Crawlerを使った登録 • Amazon Athena の DDL (Data Defined Language)による登録 -
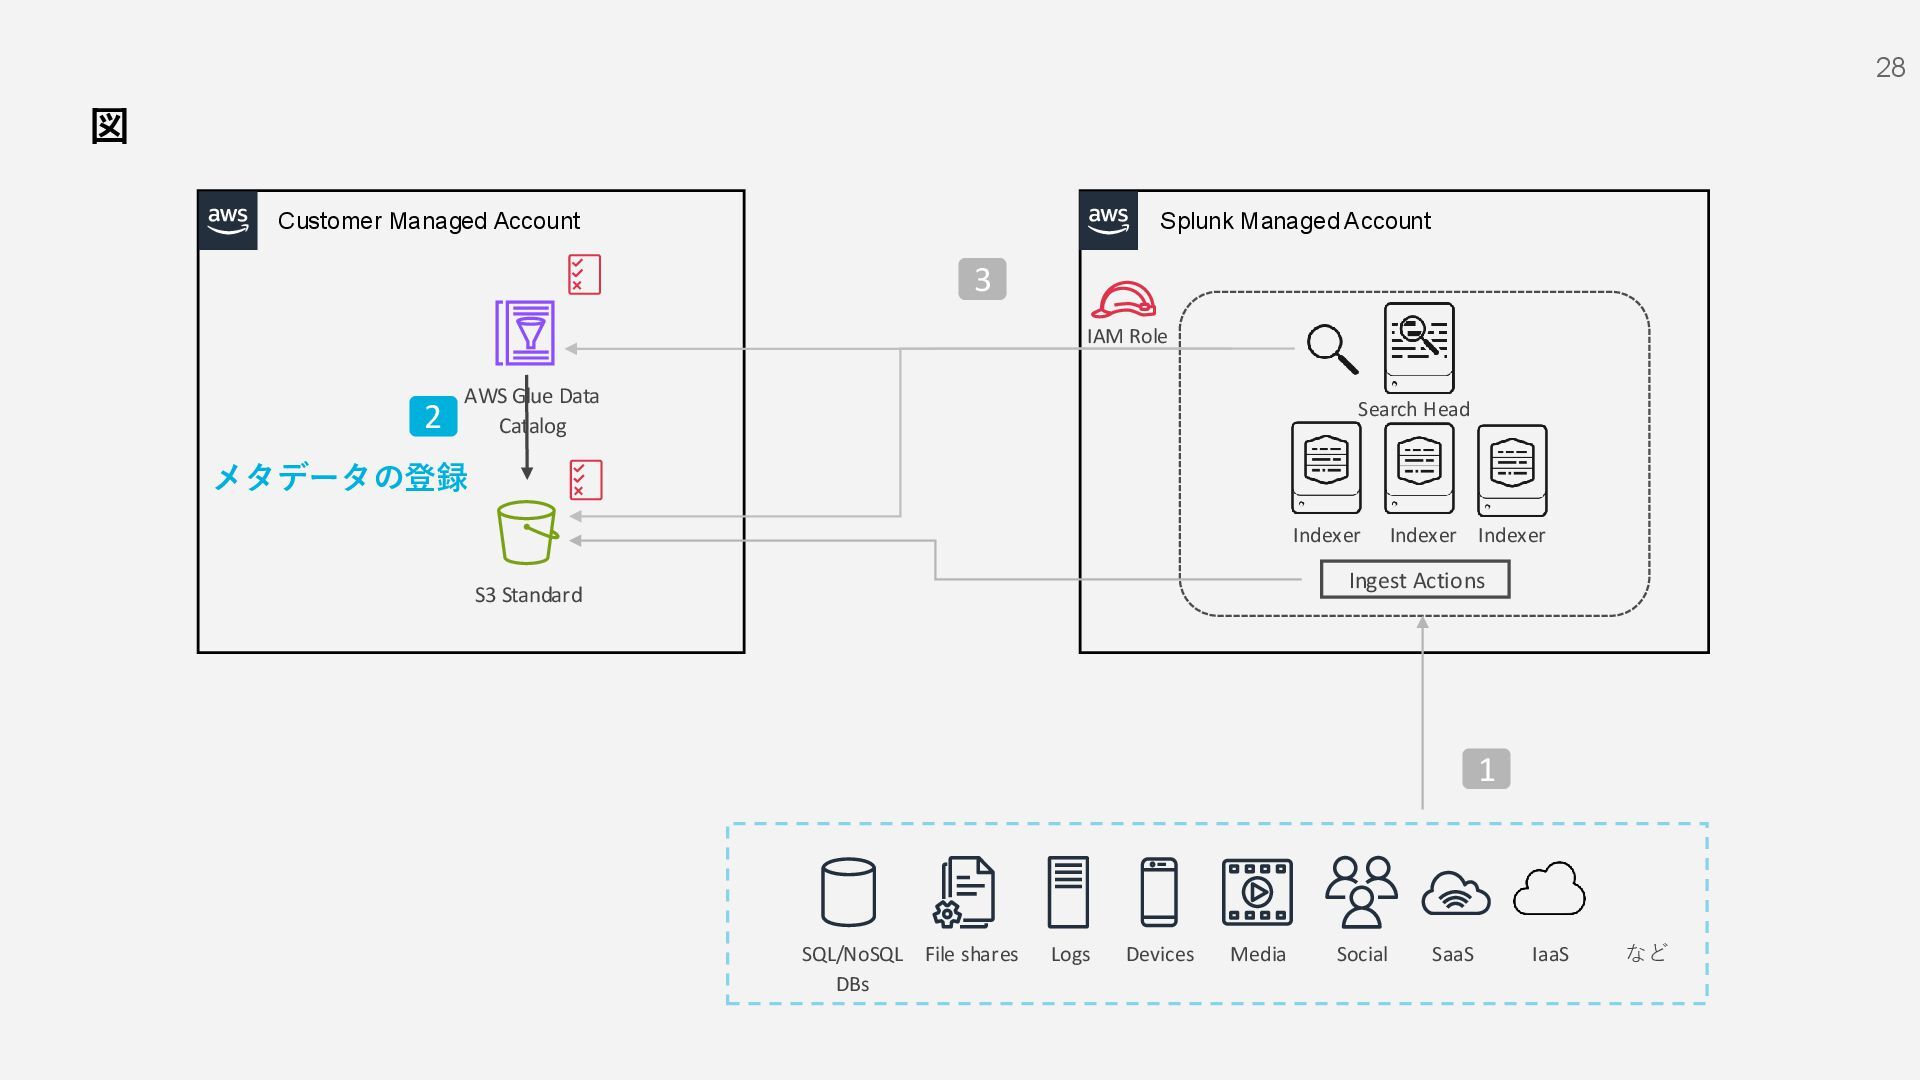
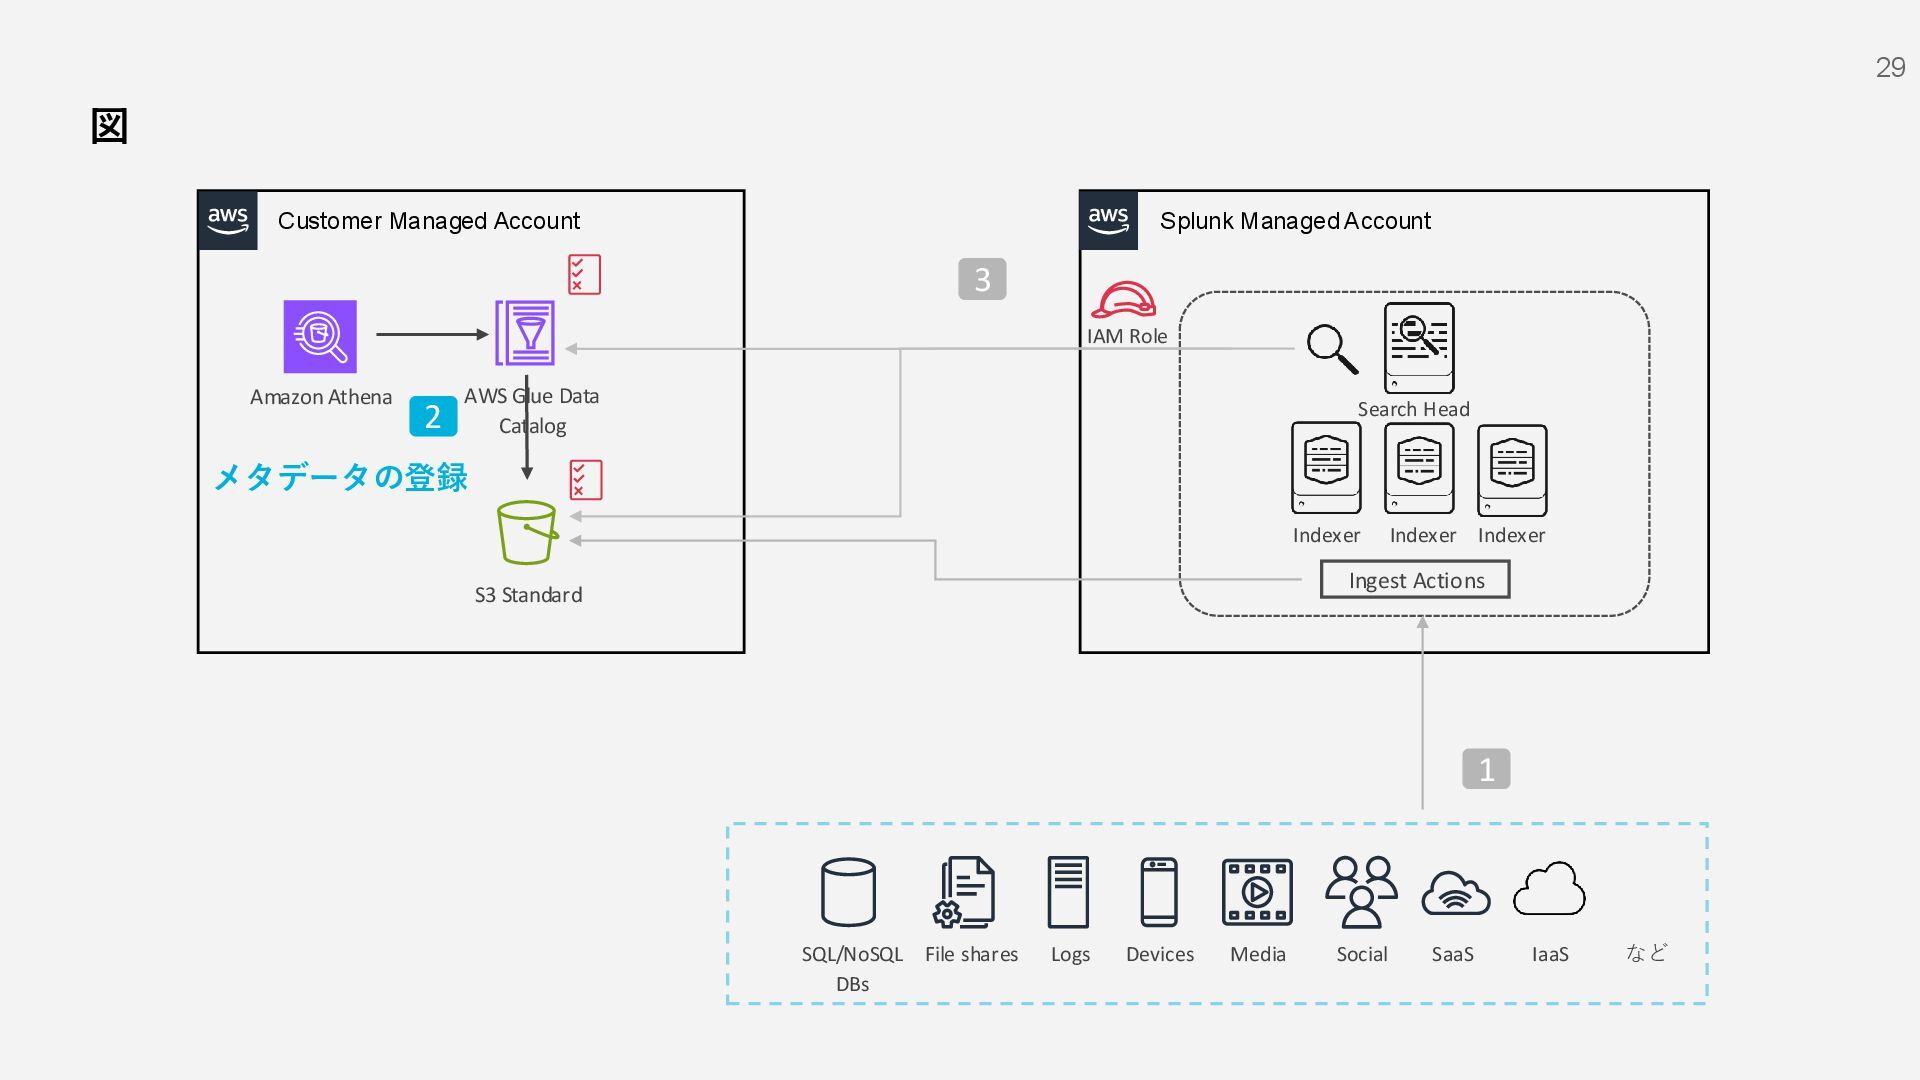
28 図 Splunk Managed Account Customer Managed Account Ingest Actions
S3 Standard File shares Social Devices Media Logs SQL/NoSQL DBs IaaS など SaaS 1 AWS Glue Data Catalog IAM Role Indexer Indexer Indexer Search Head 2 3 メタデータの登録 -
29 図 Splunk Managed Account Customer Managed Account Ingest Actions
S3 Standard File shares Social Devices Media Logs SQL/NoSQL DBs IaaS など SaaS 1 AWS Glue Data Catalog IAM Role Indexer Indexer Indexer Search Head 2 3 Amazon Athena メタデータの登録 -
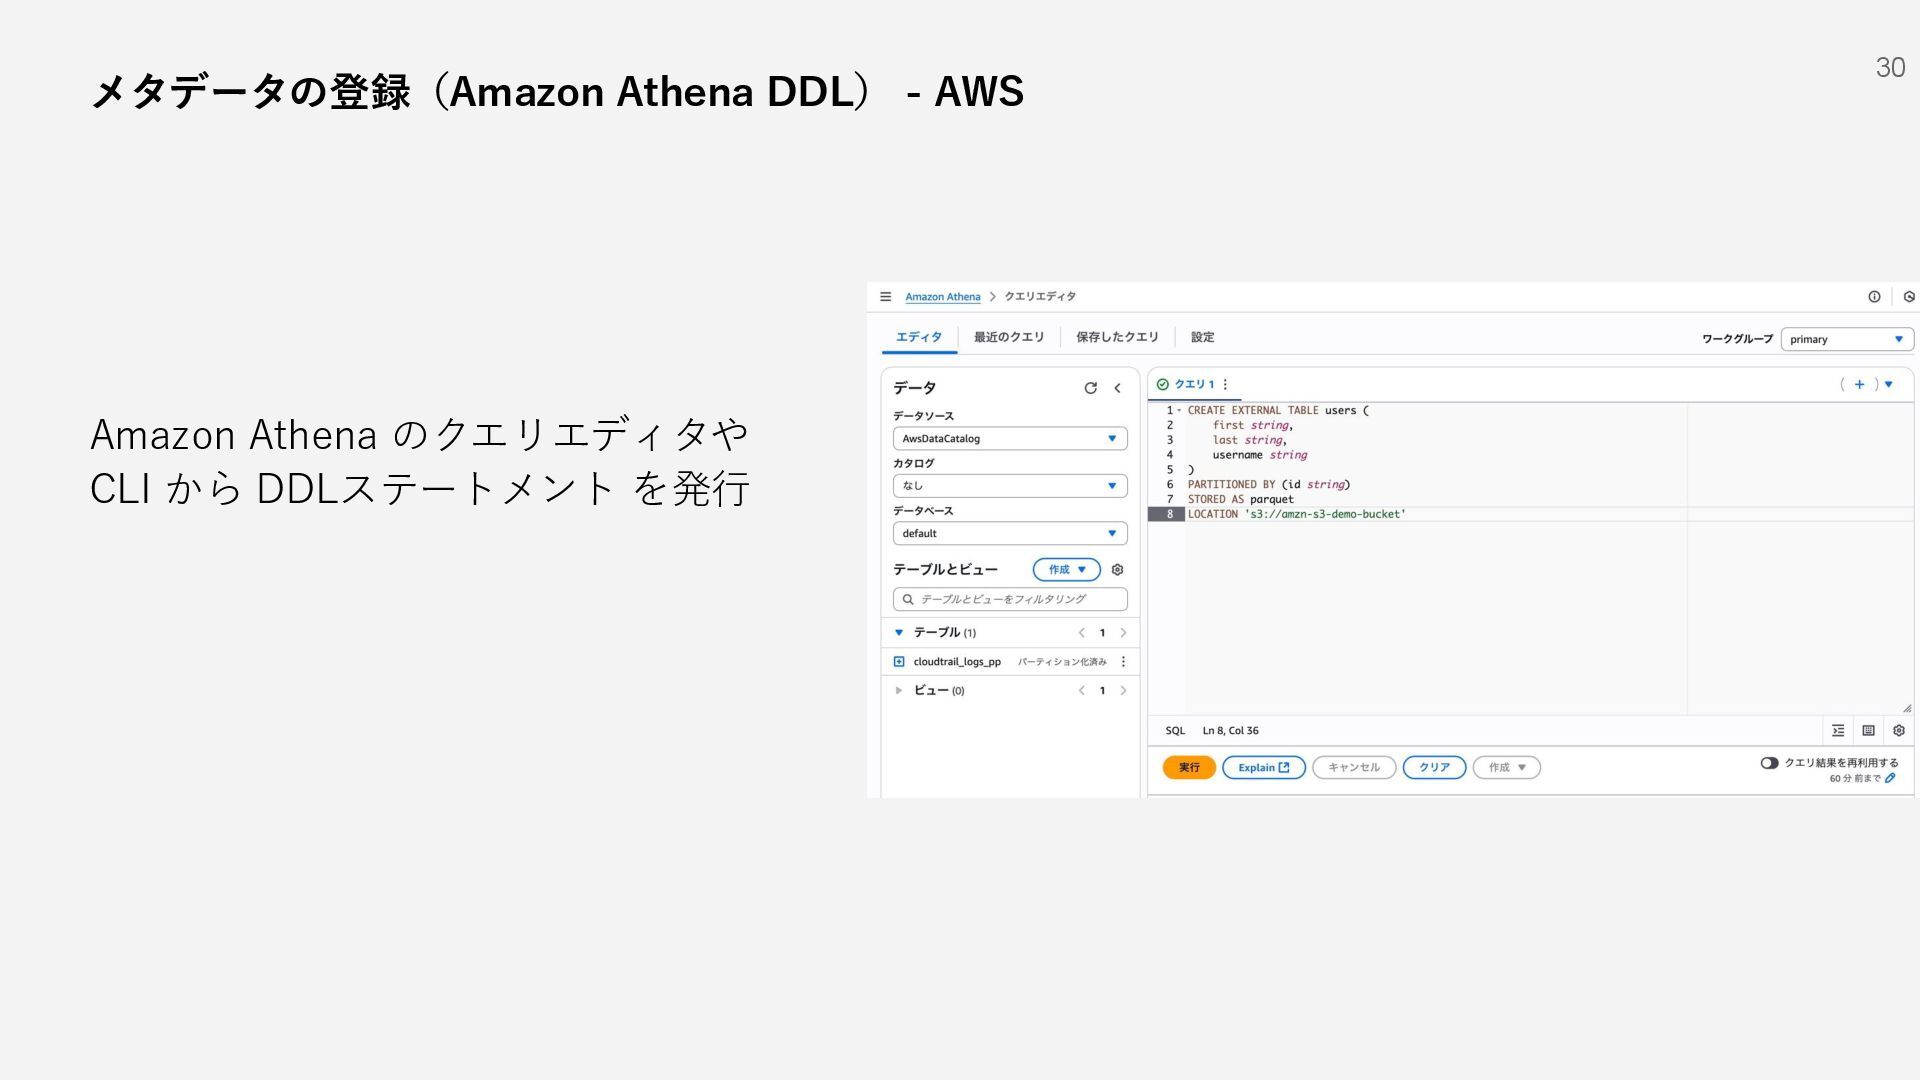
30 メタデータの登録(Amazon Athena DDL) - AWS Amazon Athena のクエリエディタや CLI
から DDLステートメント を発行 -
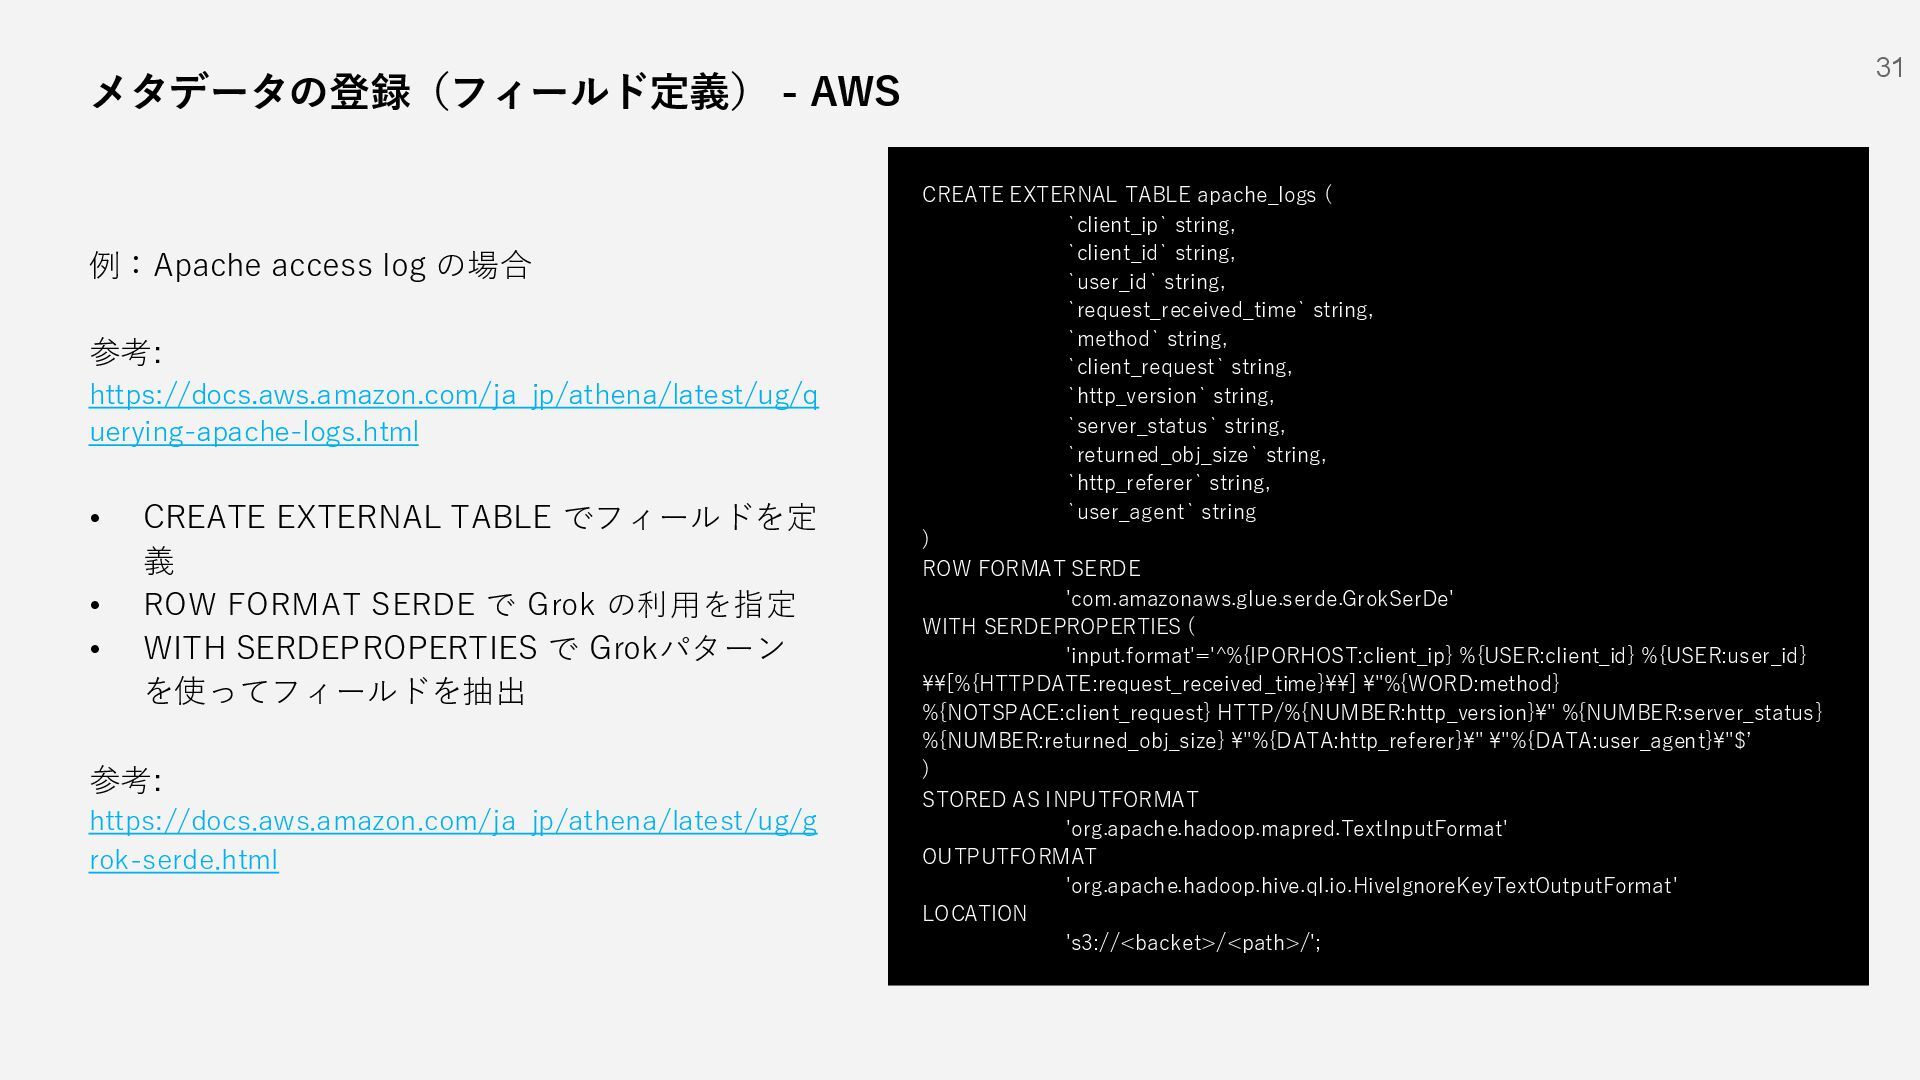
31 メタデータの登録(フィールド定義) - AWS CREATE EXTERNAL TABLE apache_logs ( `client_ip`
string, `client_id` string, `user_id` string, `request_received_time` string, `method` string, `client_request` string, `http_version` string, `server_status` string, `returned_obj_size` string, `http_referer` string, `user_agent` string ) ROW FORMAT SERDE 'com.amazonaws.glue.serde.GrokSerDe' WITH SERDEPROPERTIES ( 'input.format'='^%{IPORHOST:client_ip} %{USER:client_id} %{USER:user_id} \\[%{HTTPDATE:request_received_time}\\] \"%{WORD:method} %{NOTSPACE:client_request} HTTP/%{NUMBER:http_version}\" %{NUMBER:server_status} %{NUMBER:returned_obj_size} \"%{DATA:http_referer}\" \"%{DATA:user_agent}\"$’ ) STORED AS INPUTFORMAT 'org.apache.hadoop.mapred.TextInputFormat' OUTPUTFORMAT 'org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat' LOCATION 's3://<backet>/<path>/'; 例:Apache access log の場合 参考: https://docs.aws.amazon.com/ja_jp/athena/latest/ug/q uerying-apache-logs.html • CREATE EXTERNAL TABLE でフィールドを定 義 • ROW FORMAT SERDE で Grok の利用を指定 • WITH SERDEPROPERTIES で Grokパターン を使ってフィールドを抽出 参考: https://docs.aws.amazon.com/ja_jp/athena/latest/ug/g rok-serde.html -
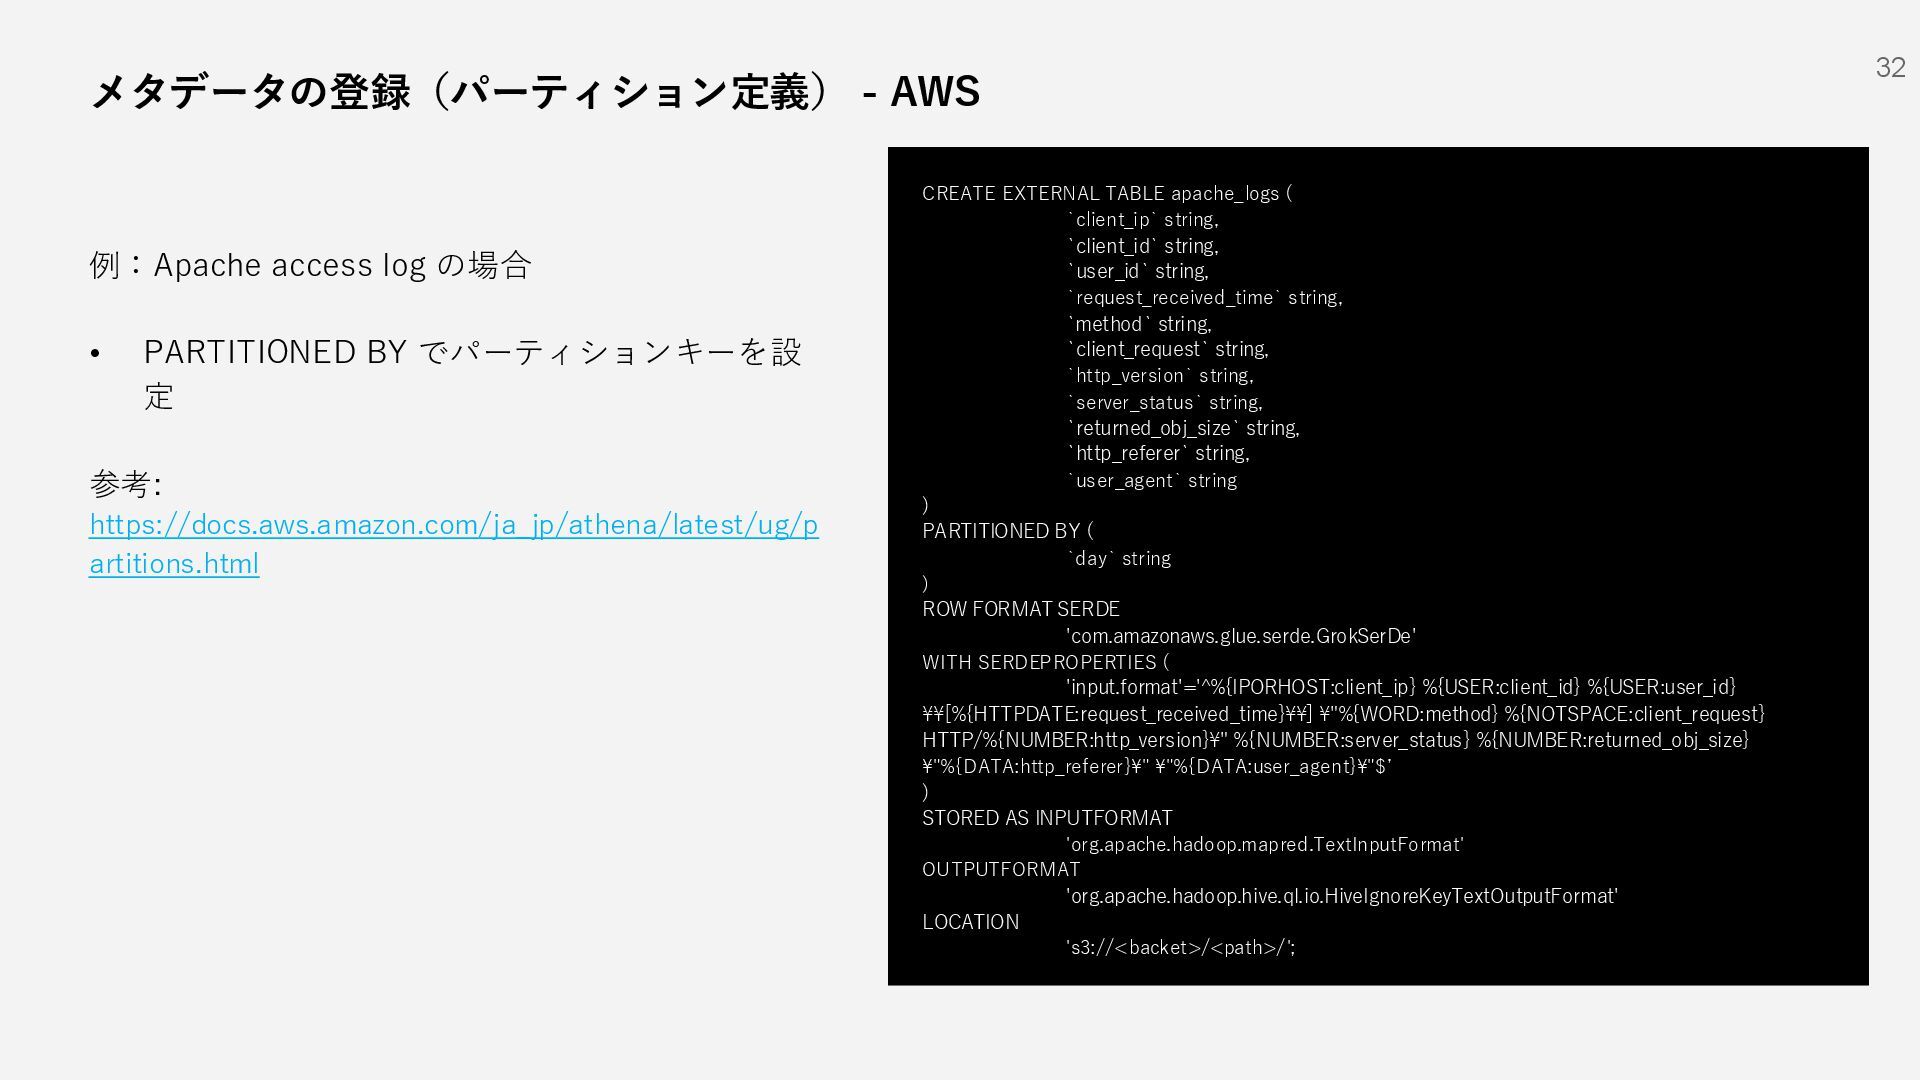
32 メタデータの登録(パーティション定義) - AWS CREATE EXTERNAL TABLE apache_logs ( `client_ip`
string, `client_id` string, `user_id` string, `request_received_time` string, `method` string, `client_request` string, `http_version` string, `server_status` string, `returned_obj_size` string, `http_referer` string, `user_agent` string ) PARTITIONED BY ( `day` string ) ROW FORMAT SERDE 'com.amazonaws.glue.serde.GrokSerDe' WITH SERDEPROPERTIES ( 'input.format'='^%{IPORHOST:client_ip} %{USER:client_id} %{USER:user_id} \\[%{HTTPDATE:request_received_time}\\] \"%{WORD:method} %{NOTSPACE:client_request} HTTP/%{NUMBER:http_version}\" %{NUMBER:server_status} %{NUMBER:returned_obj_size} \"%{DATA:http_referer}\" \"%{DATA:user_agent}\"$’ ) STORED AS INPUTFORMAT 'org.apache.hadoop.mapred.TextInputFormat' OUTPUTFORMAT 'org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat' LOCATION 's3://<backet>/<path>/'; 例:Apache access log の場合 • PARTITIONED BY でパーティションキーを設 定 参考: https://docs.aws.amazon.com/ja_jp/athena/latest/ug/p artitions.html -
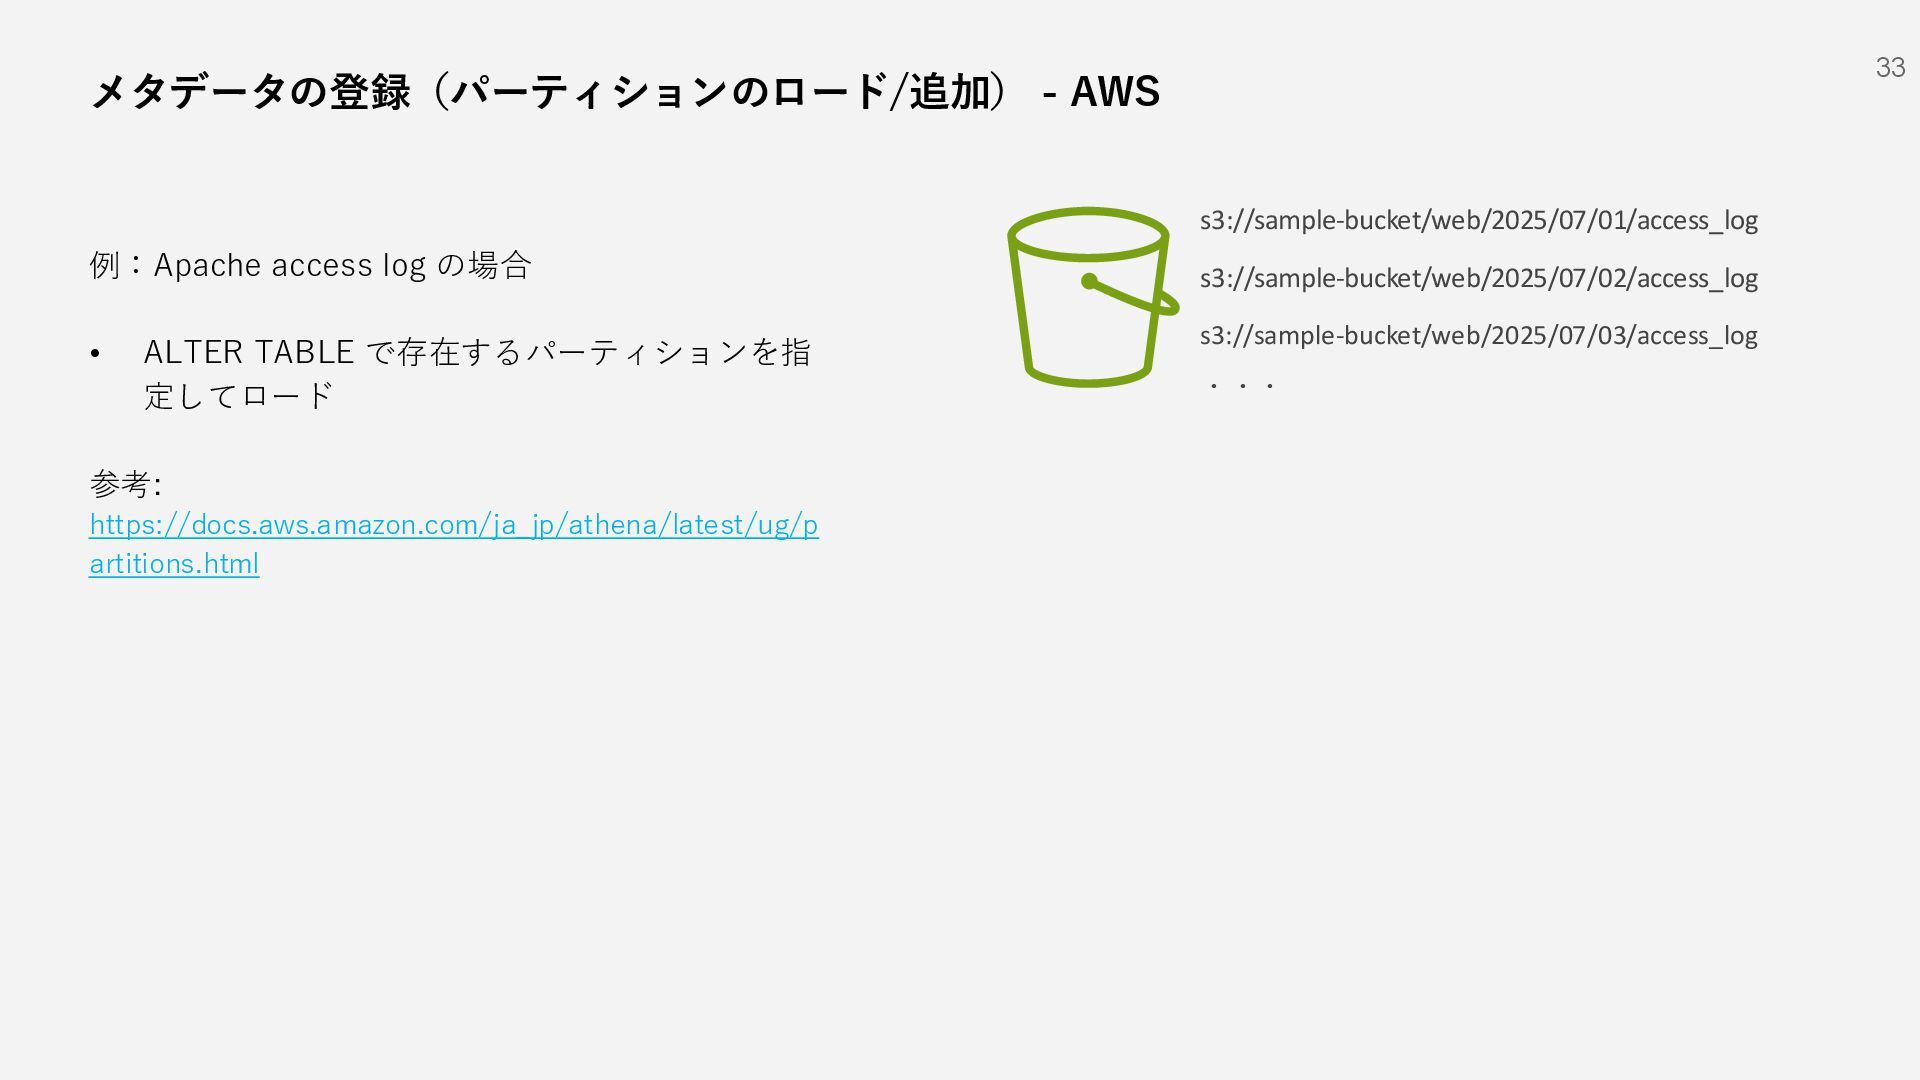
33 メタデータの登録(パーティションのロード/追加) - AWS 例:Apache access log の場合 • ALTER
TABLE で存在するパーティションを指 定してロード 参考: https://docs.aws.amazon.com/ja_jp/athena/latest/ug/p artitions.html s3://sample-bucket/web/2025/07/01/access_log s3://sample-bucket/web/2025/07/02/access_log s3://sample-bucket/web/2025/07/03/access_log ・・・ -
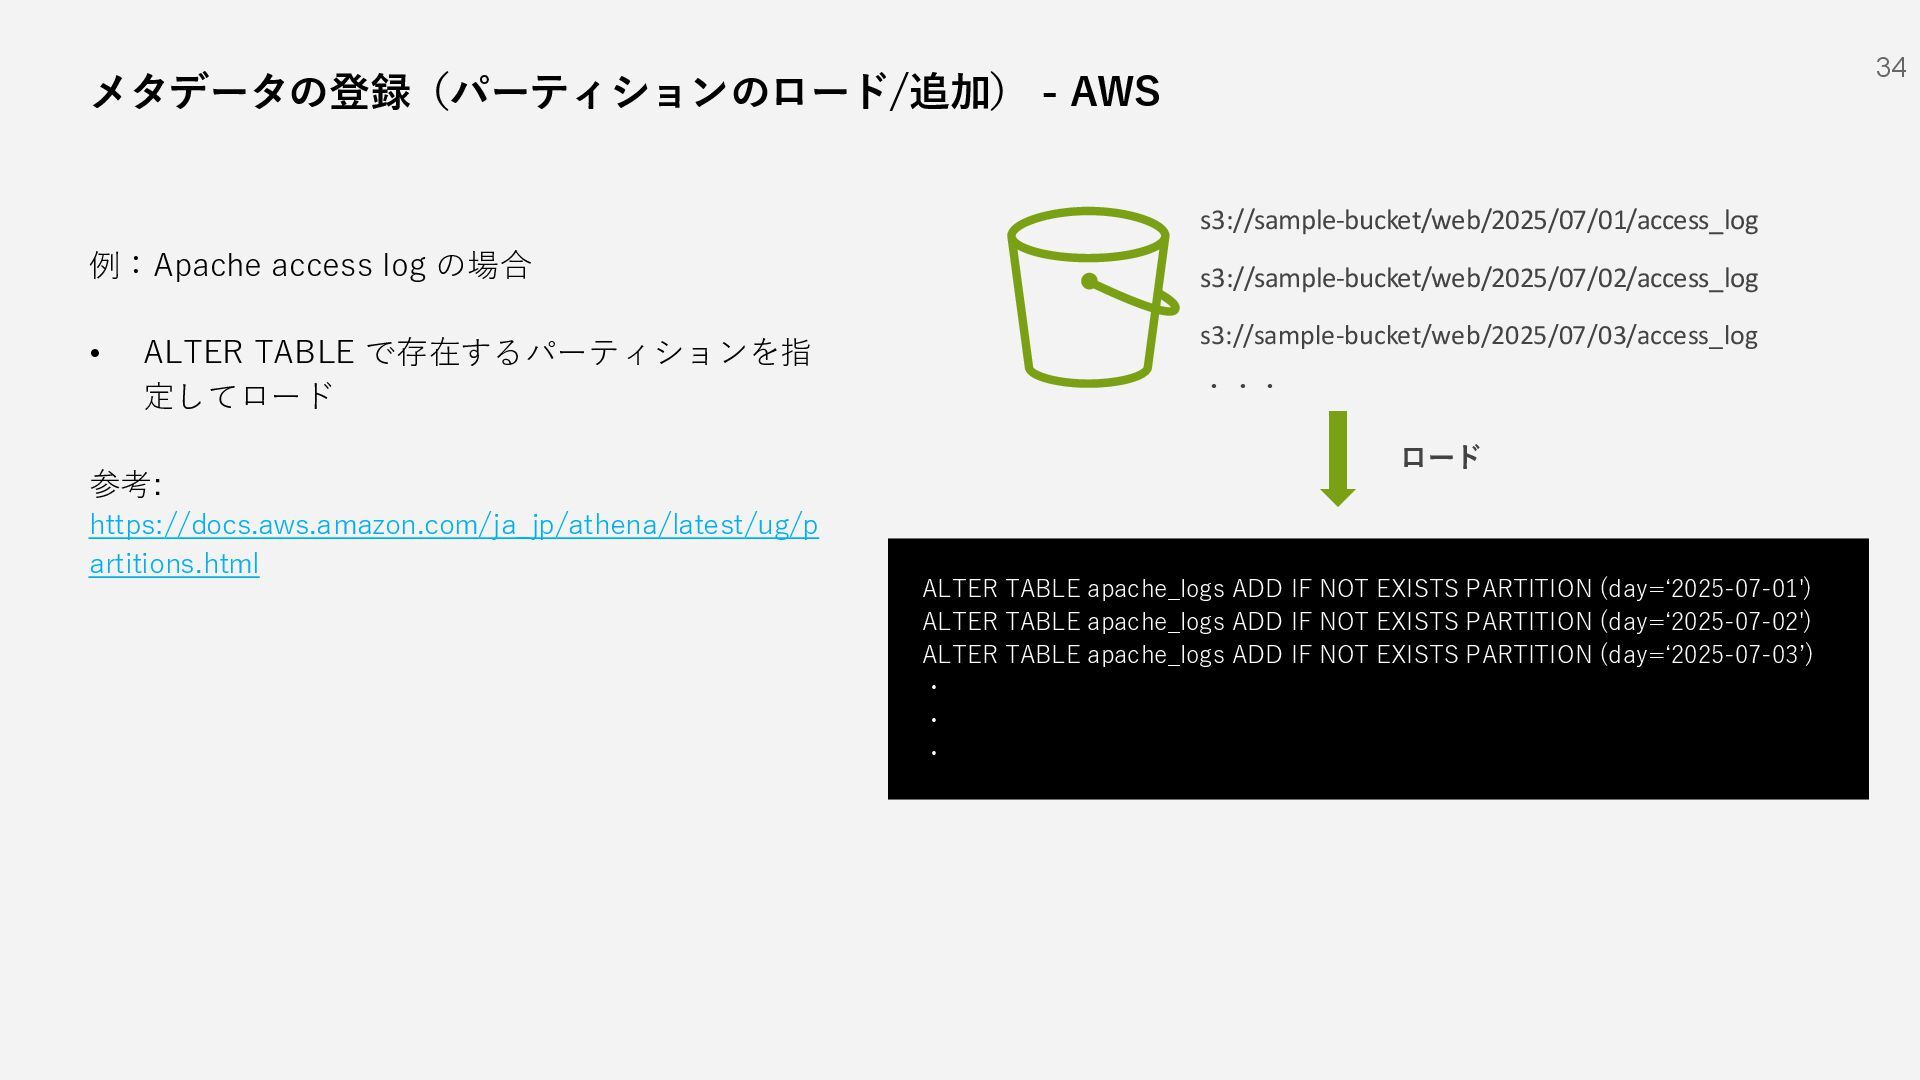
34 メタデータの登録(パーティションのロード/追加) - AWS ALTER TABLE apache_logs ADD IF NOT
EXISTS PARTITION (day=‘2025-07-01') ALTER TABLE apache_logs ADD IF NOT EXISTS PARTITION (day=‘2025-07-02') ALTER TABLE apache_logs ADD IF NOT EXISTS PARTITION (day=‘2025-07-03’) ・ ・ ・ 例:Apache access log の場合 • ALTER TABLE で存在するパーティションを指 定してロード 参考: https://docs.aws.amazon.com/ja_jp/athena/latest/ug/p artitions.html s3://sample-bucket/web/2025/07/01/access_log s3://sample-bucket/web/2025/07/02/access_log s3://sample-bucket/web/2025/07/03/access_log ・・・ ロード -
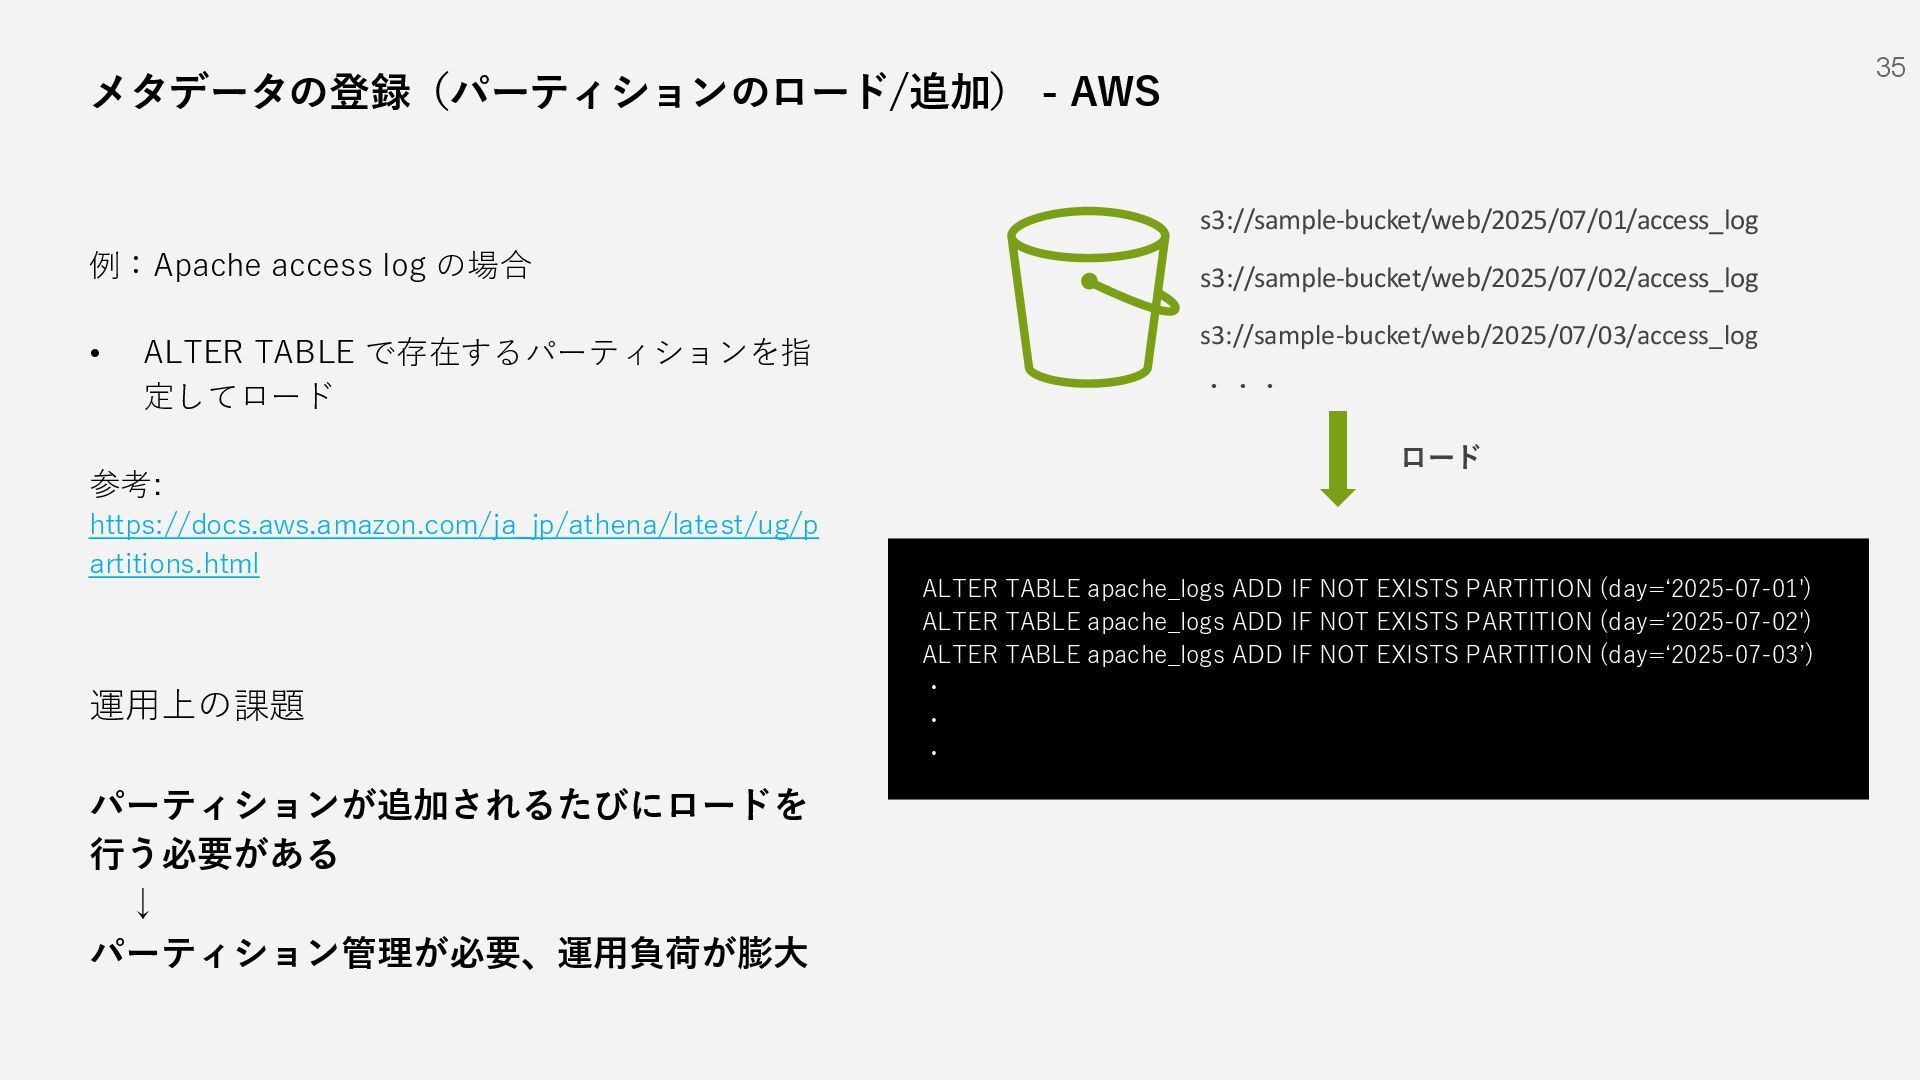
35 メタデータの登録(パーティションのロード/追加) - AWS ALTER TABLE apache_logs ADD IF NOT
EXISTS PARTITION (day=‘2025-07-01') ALTER TABLE apache_logs ADD IF NOT EXISTS PARTITION (day=‘2025-07-02') ALTER TABLE apache_logs ADD IF NOT EXISTS PARTITION (day=‘2025-07-03’) ・ ・ ・ 例:Apache access log の場合 • ALTER TABLE で存在するパーティションを指 定してロード 参考: https://docs.aws.amazon.com/ja_jp/athena/latest/ug/p artitions.html 運用上の課題 パーティションが追加されるたびにロードを 行う必要がある ↓ パーティション管理が必要、運用負荷が膨大 s3://sample-bucket/web/2025/07/01/access_log s3://sample-bucket/web/2025/07/02/access_log s3://sample-bucket/web/2025/07/03/access_log ・・・ ロード -
36 メタデータの登録 - AWS パーフォーマンス上の課題 • パーティショニングによって、スキャン量の軽減には成功するものの、経年とと もにパーティション数があまりにも増えるとクエリ時間が大幅に伸びる なぜか? •
スキャン時にGetPartitionsを実行。パーティション一覧の取得、利用するパー ティションの絞り込みの処理が膨大になる -
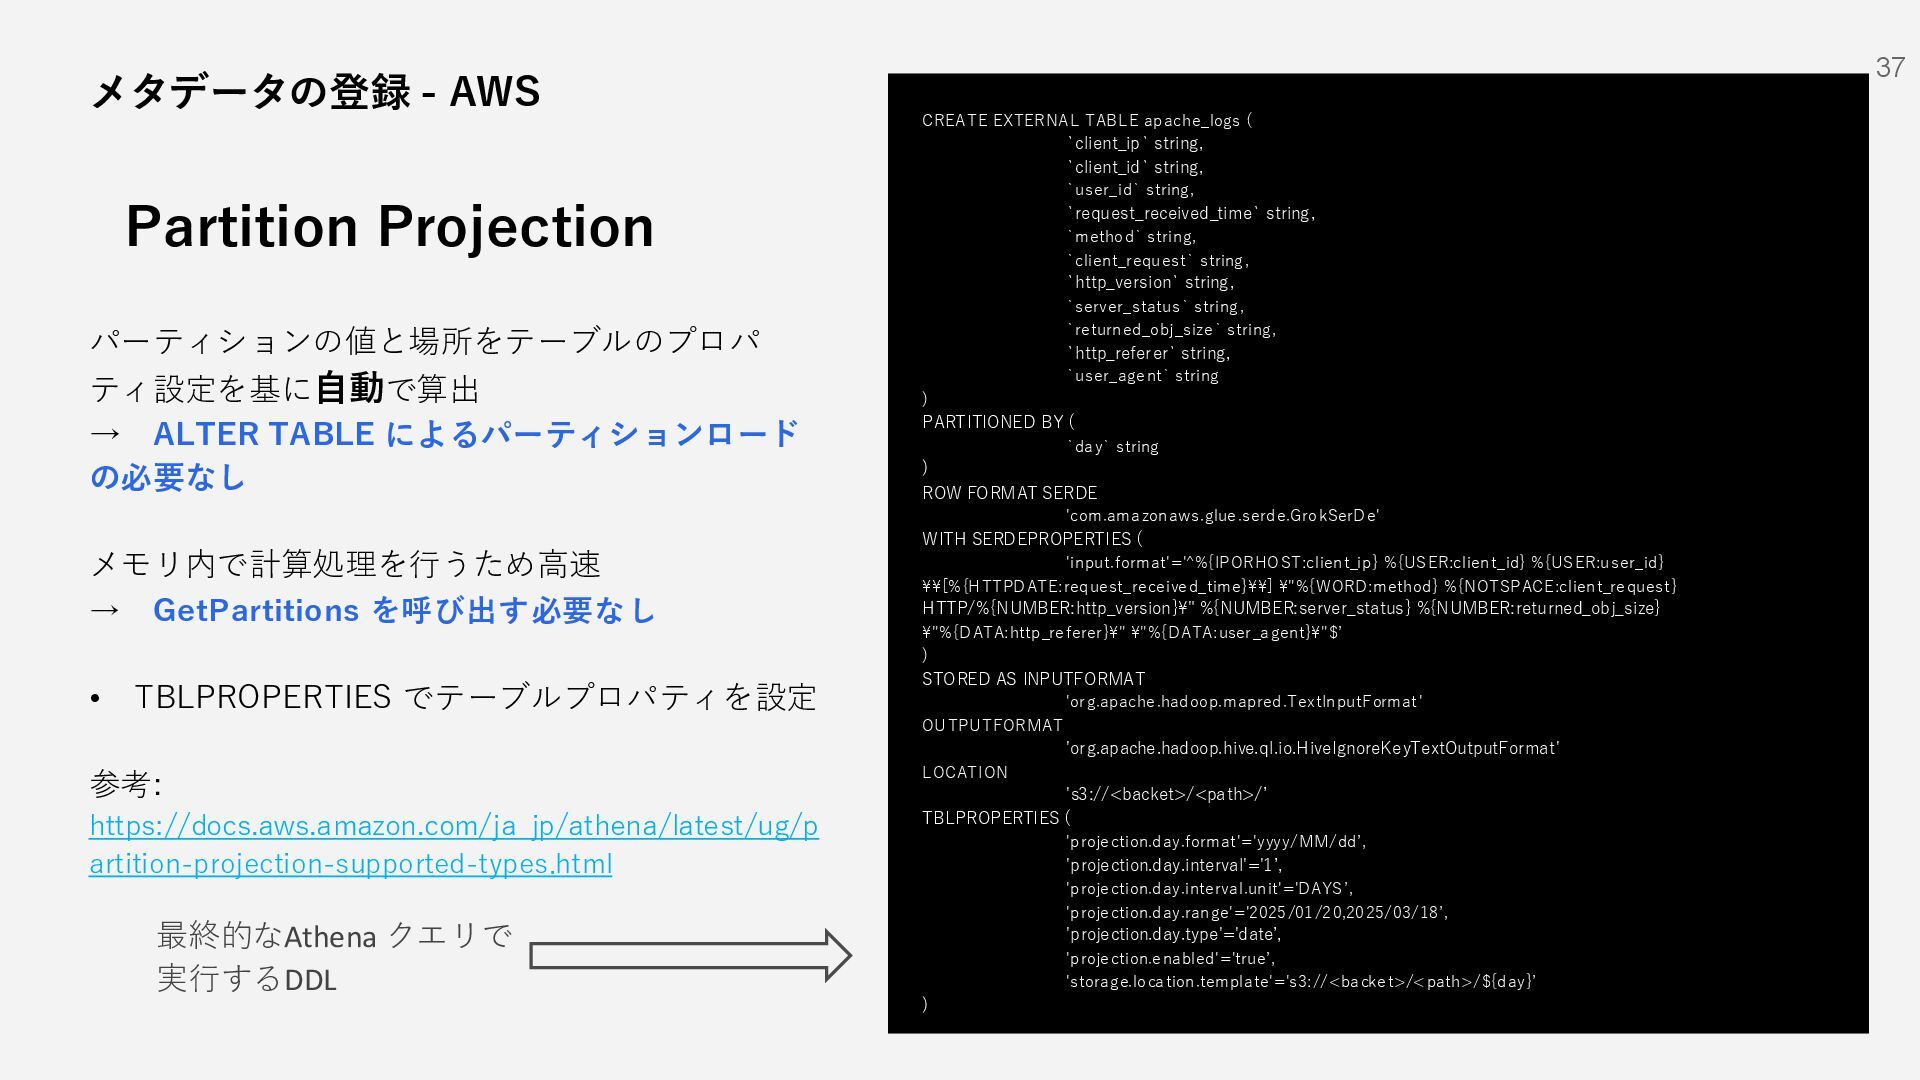
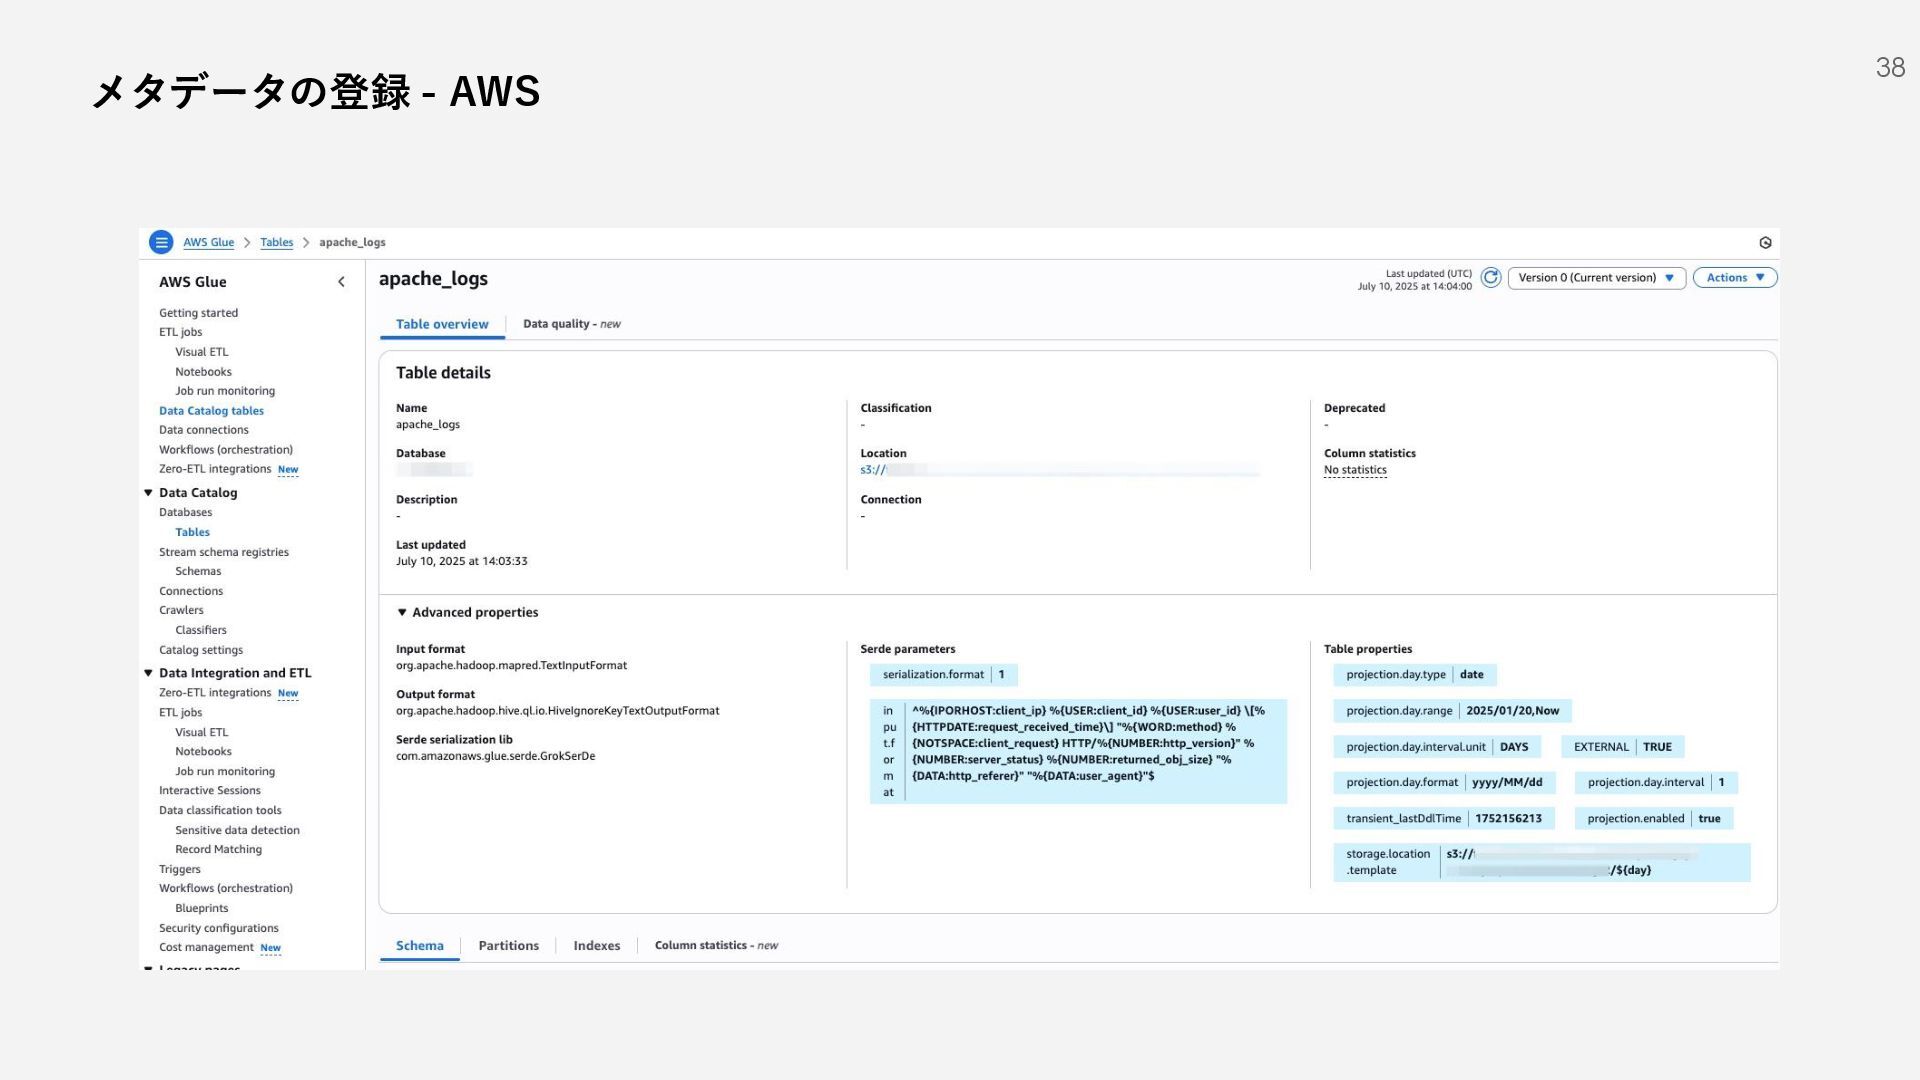
Partition Projection 37 メタデータの登録 - AWS CREATE EXTERNAL TABLE apache_logs
( `client_ip` string, `client_id` string, `user_id` string, `request_received_time` string, `method` string, `client_request` string, `http_version` string, `server_status` string, `returned_obj_size` string, `http_referer` string, `user_agent` string ) PARTITIONED BY ( `day` string ) ROW FORMAT SERDE 'com.amazonaws.glue.serde.GrokSerDe' WITH SERDEPROPERTIES ( 'input.format'='^%{IPORHOST:client_ip} %{USER:client_id} %{USER:user_id} \\[%{HTTPDATE:request_received_time}\\] \"%{WORD:method} %{NOTSPACE:client_request} HTTP/%{NUMBER:http_version}\" %{NUMBER:server_status} %{NUMBER:returned_obj_size} \"%{DATA:http_referer}\" \"%{DATA:user_agent}\"$’ ) STORED AS INPUTFORMAT 'org.apache.hadoop.mapred.TextInputFormat' OUTPUTFORMAT 'org.apache.hadoop.hive.ql.io.HiveIgnoreKeyTextOutputFormat' LOCATION 's3://<backet>/<path>/’ TBLPROPERTIES ( 'projection.day.format'='yyyy/MM/dd’, 'projection.day.interval'='1’, 'projection.day.interval.unit'='DAYS’, 'projection.day.range'='2025/01/20,2025/03/18’, 'projection.day.type'='date’, 'projection.enabled'='true’, 'storage.location.template'='s3://<backet>/<path>/${day}’ ) パーティションの値と場所をテーブルのプロパ ティ設定を基に自動で算出 → ALTER TABLE によるパーティションロード の必要なし メモリ内で計算処理を行うため高速 → GetPartitions を呼び出す必要なし • TBLPROPERTIES でテーブルプロパティを設定 参考: https://docs.aws.amazon.com/ja_jp/athena/latest/ug/p artition-projection-supported-types.html 最終的なAthena クエリで 実行するDDL -
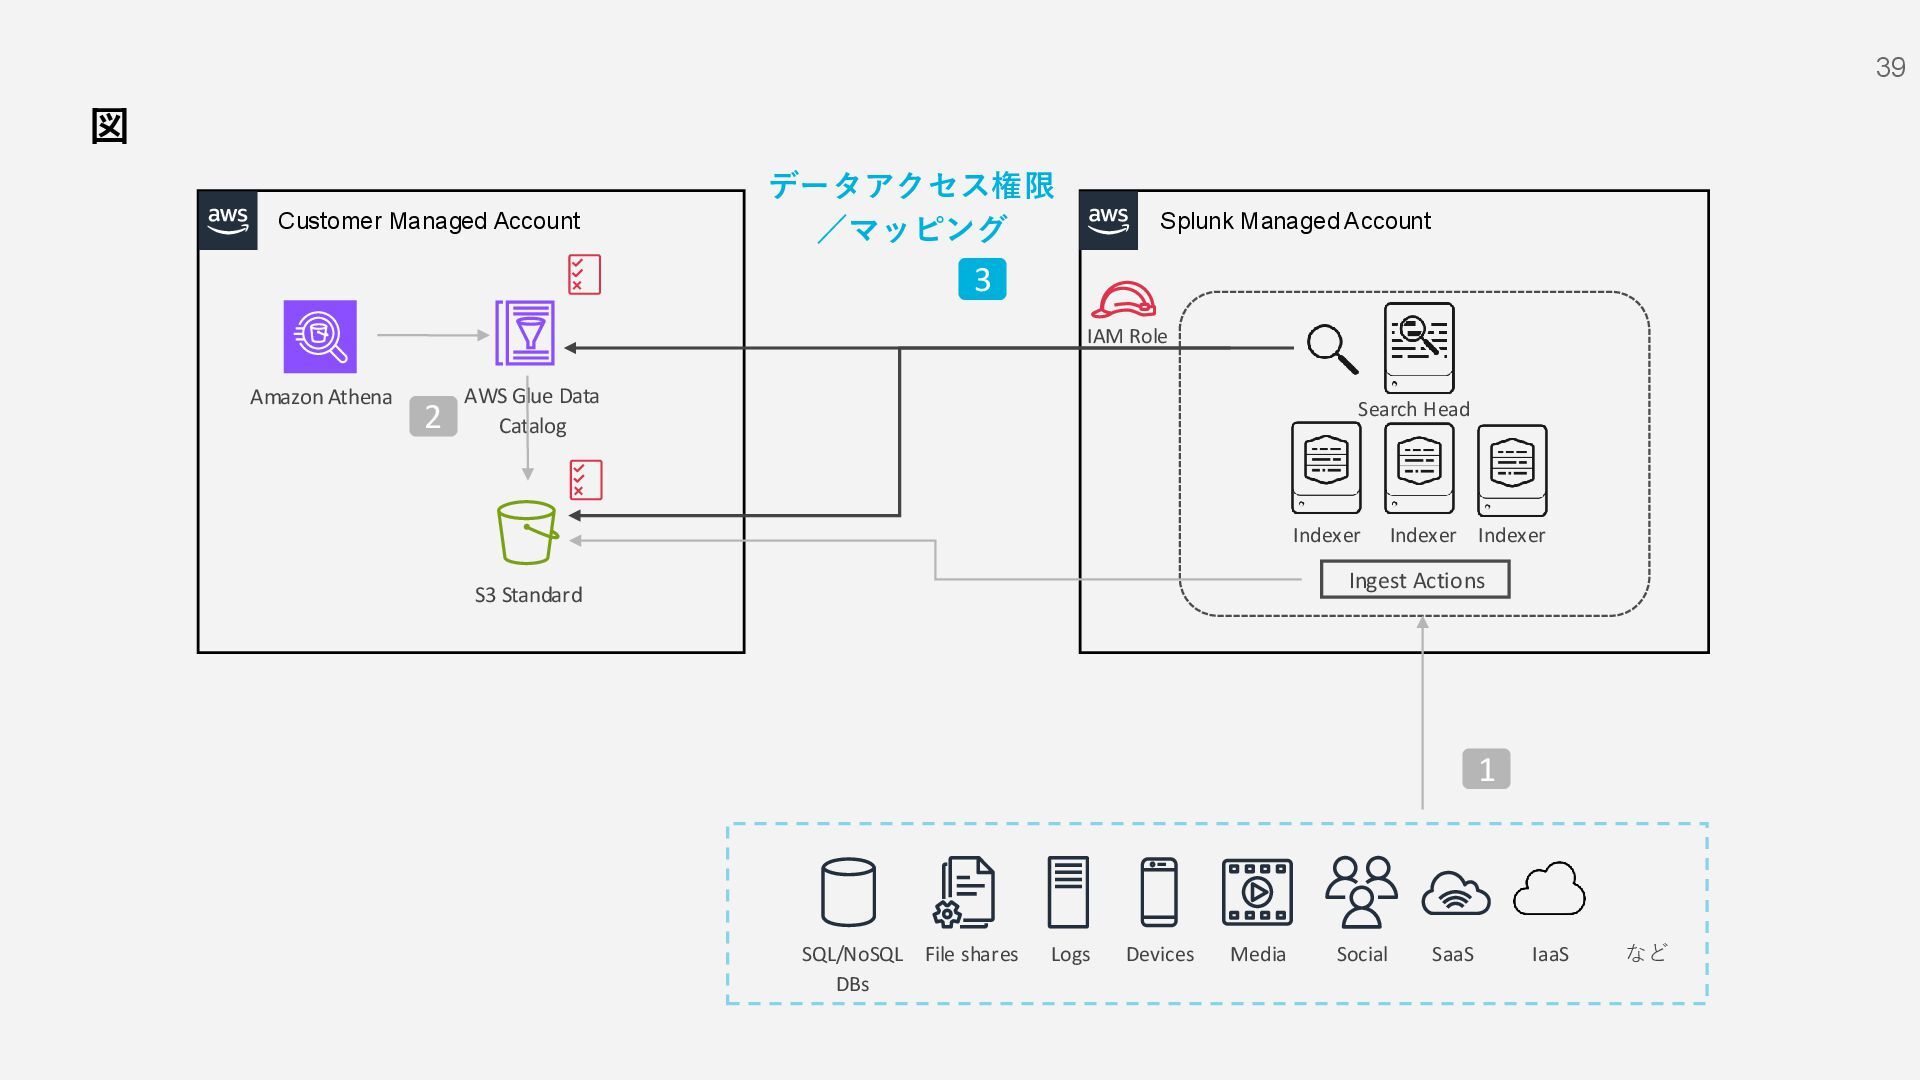
39 図 Splunk Managed Account Customer Managed Account Ingest Actions
S3 Standard File shares Social Devices Media Logs SQL/NoSQL DBs IaaS など SaaS 1 AWS Glue Data Catalog IAM Role Indexer Indexer Indexer Search Head 2 3 Amazon Athena データアクセス権限 /マッピング -
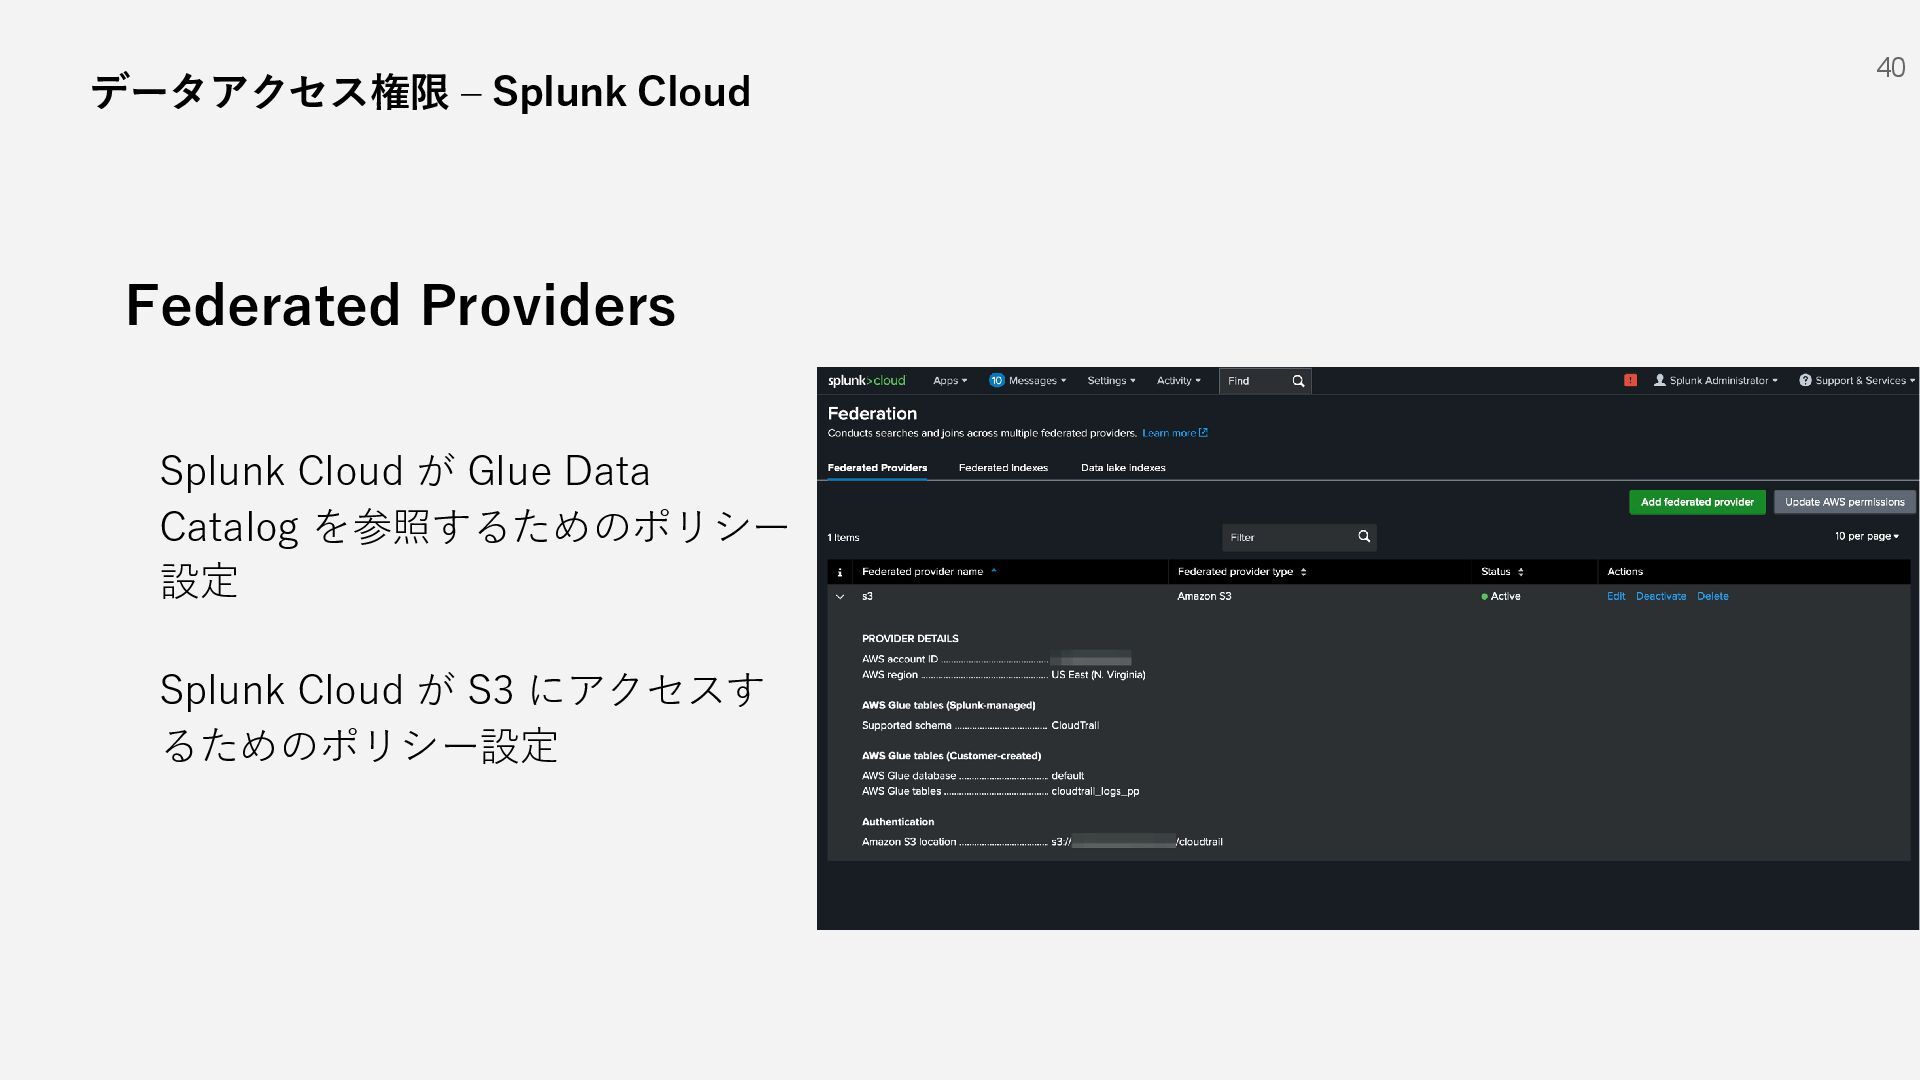
Federated Providers 40 データアクセス権限 – Splunk Cloud Splunk Cloud が
Glue Data Catalog を参照するためのポリシー 設定 Splunk Cloud が S3 にアクセスす るためのポリシー設定 -
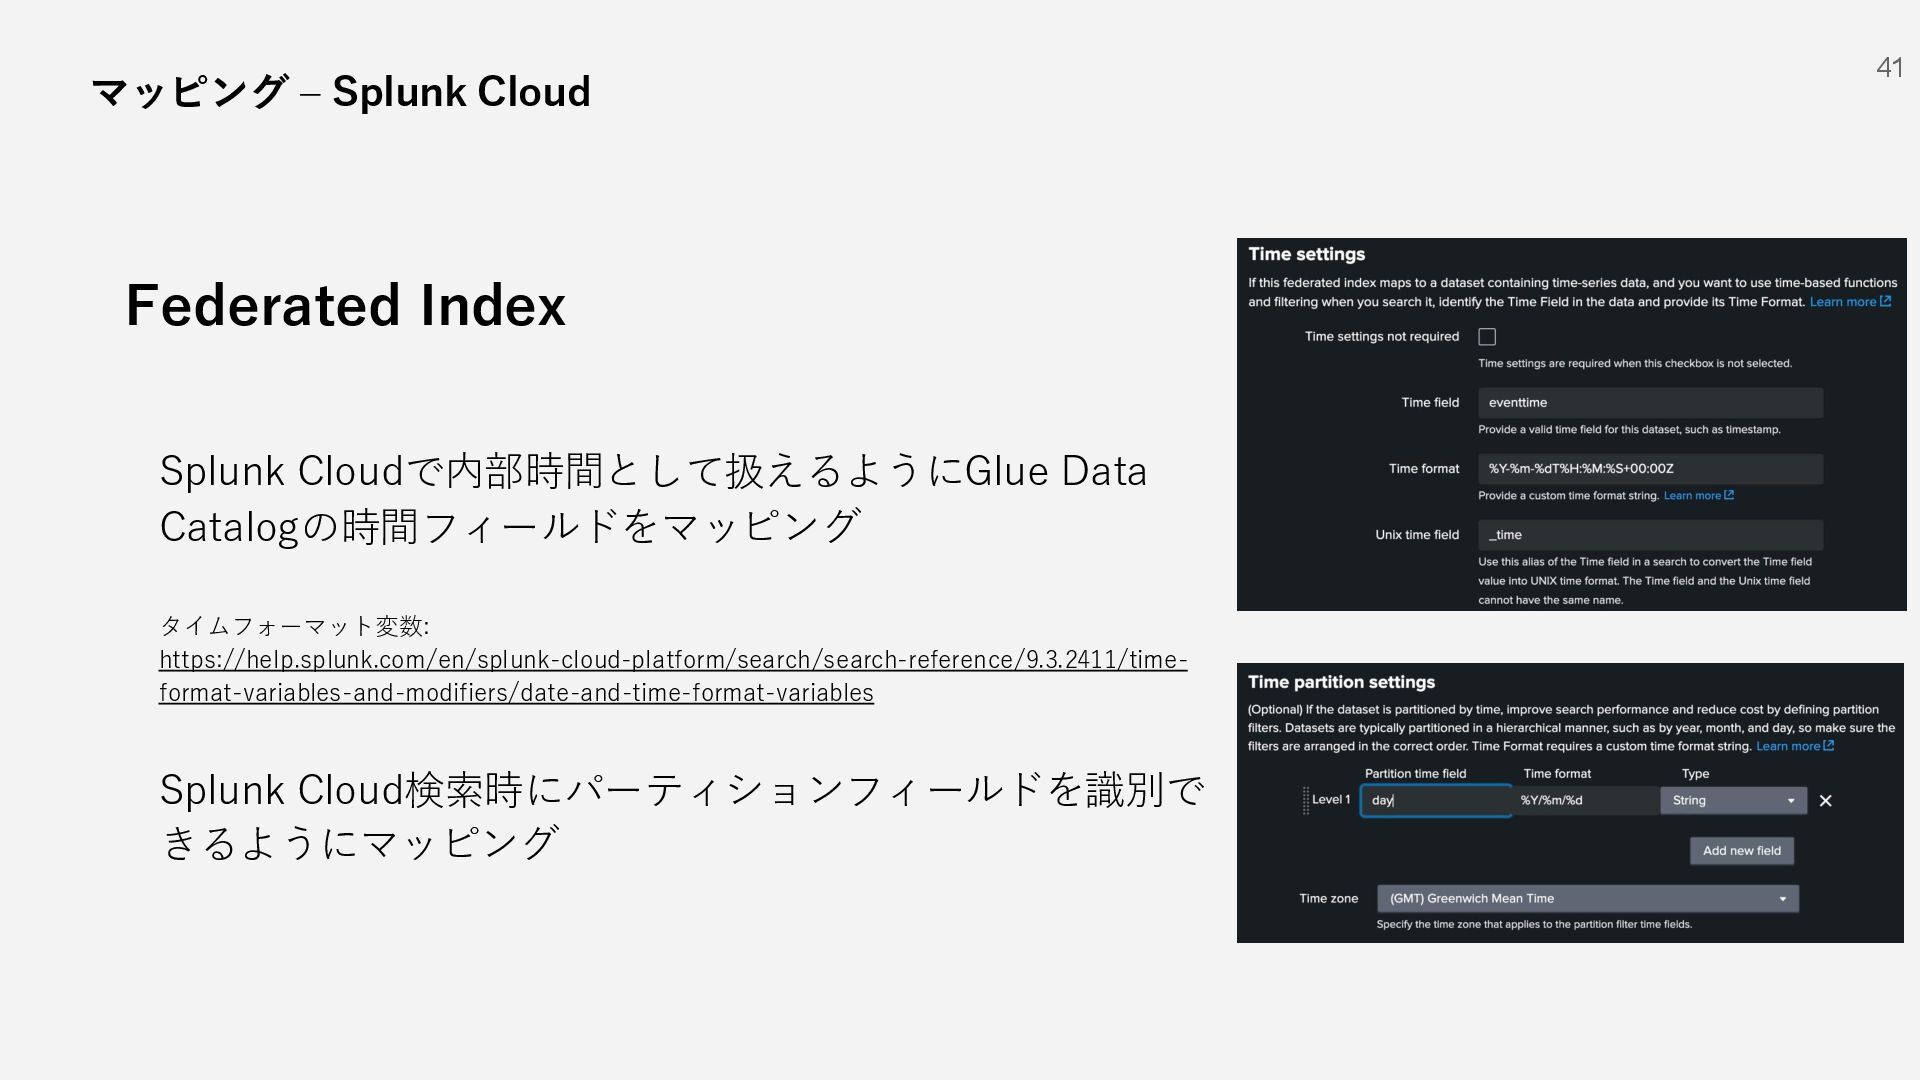
Federated Index 41 マッピング – Splunk Cloud Splunk Cloudで内部時間として扱えるようにGlue Data
Catalogの時間フィールドをマッピング タイムフォーマット変数: https://help.splunk.com/en/splunk-cloud-platform/search/search-reference/9.3.2411/time- format-variables-and-modifiers/date-and-time-format-variables Splunk Cloud検索時にパーティションフィールドを識別で きるようにマッピング -
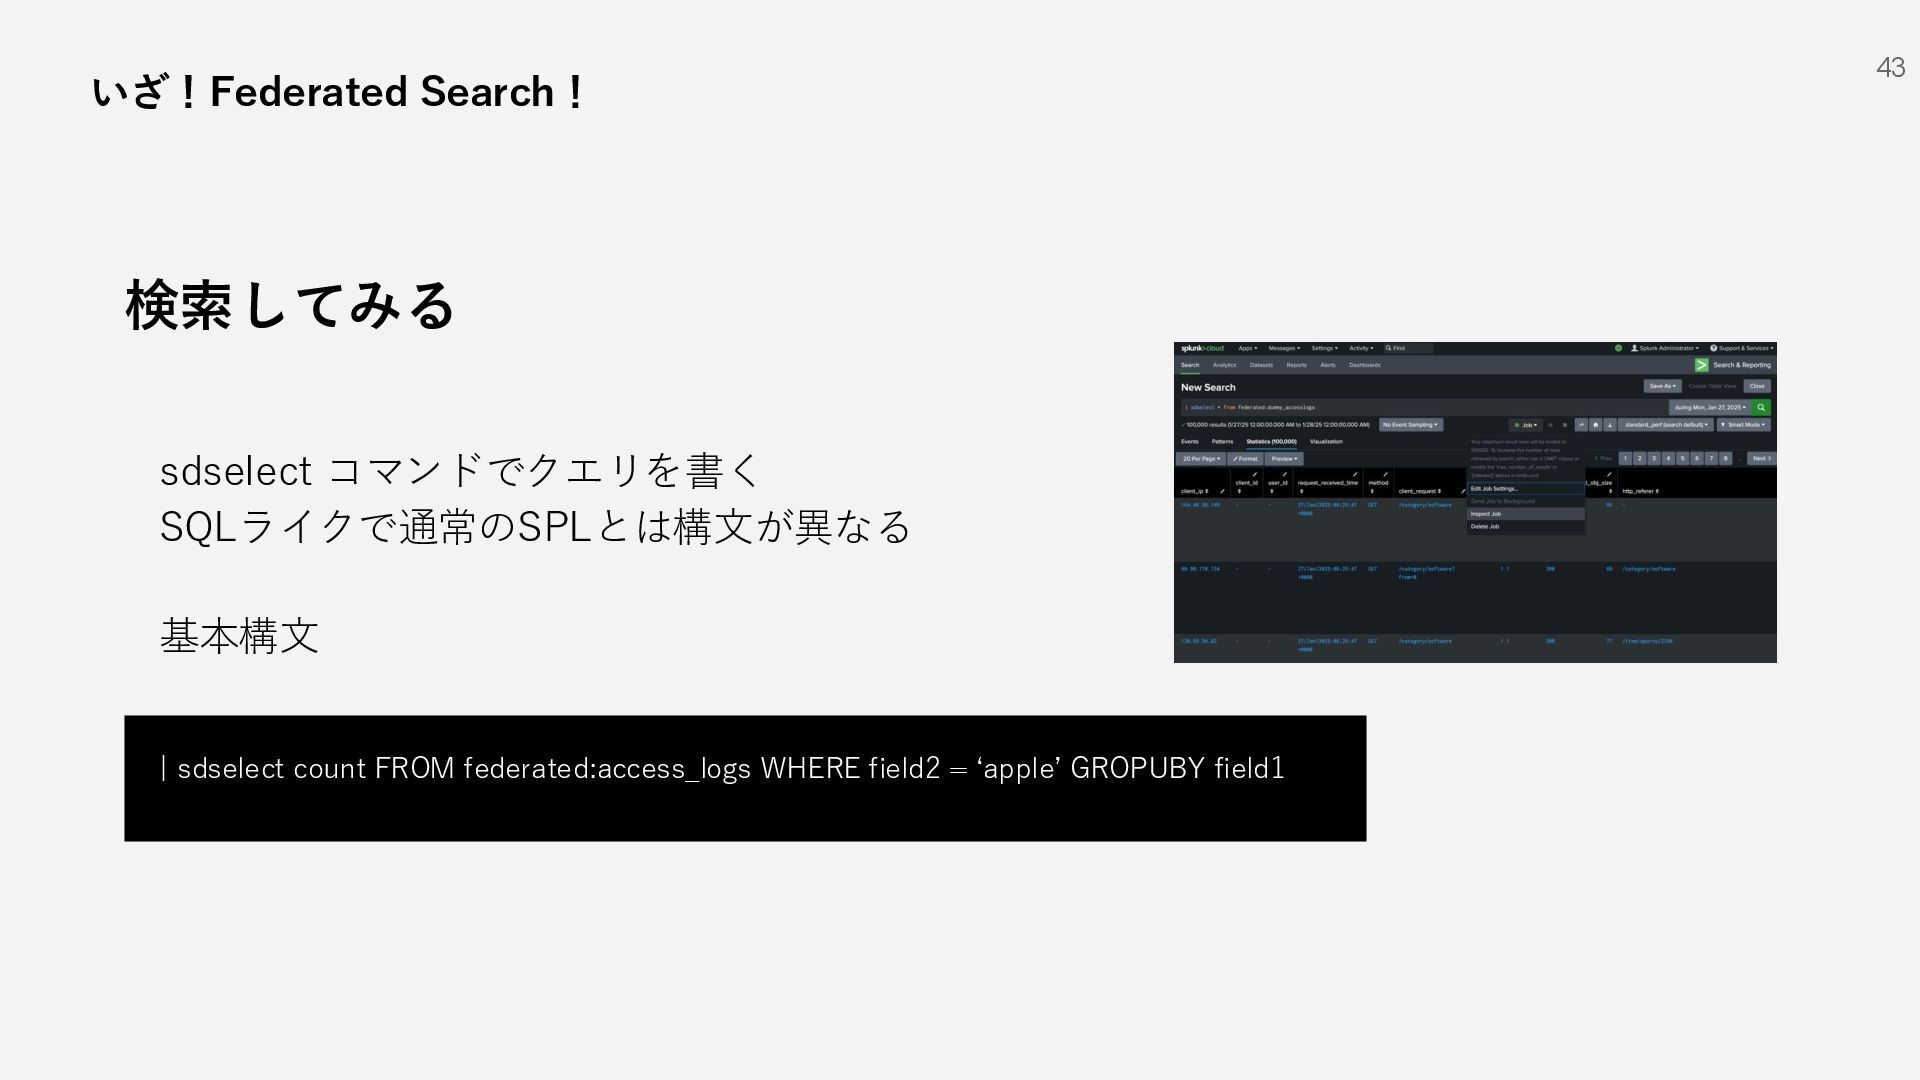
検索してみる 43 いざ!Federated Search! sdselect コマンドでクエリを書く SQLライクで通常のSPLとは構文が異なる 基本構文 | sdselect
count FROM federated:access_logs WHERE field2 = ‘apple’ GROPUBY field1 -
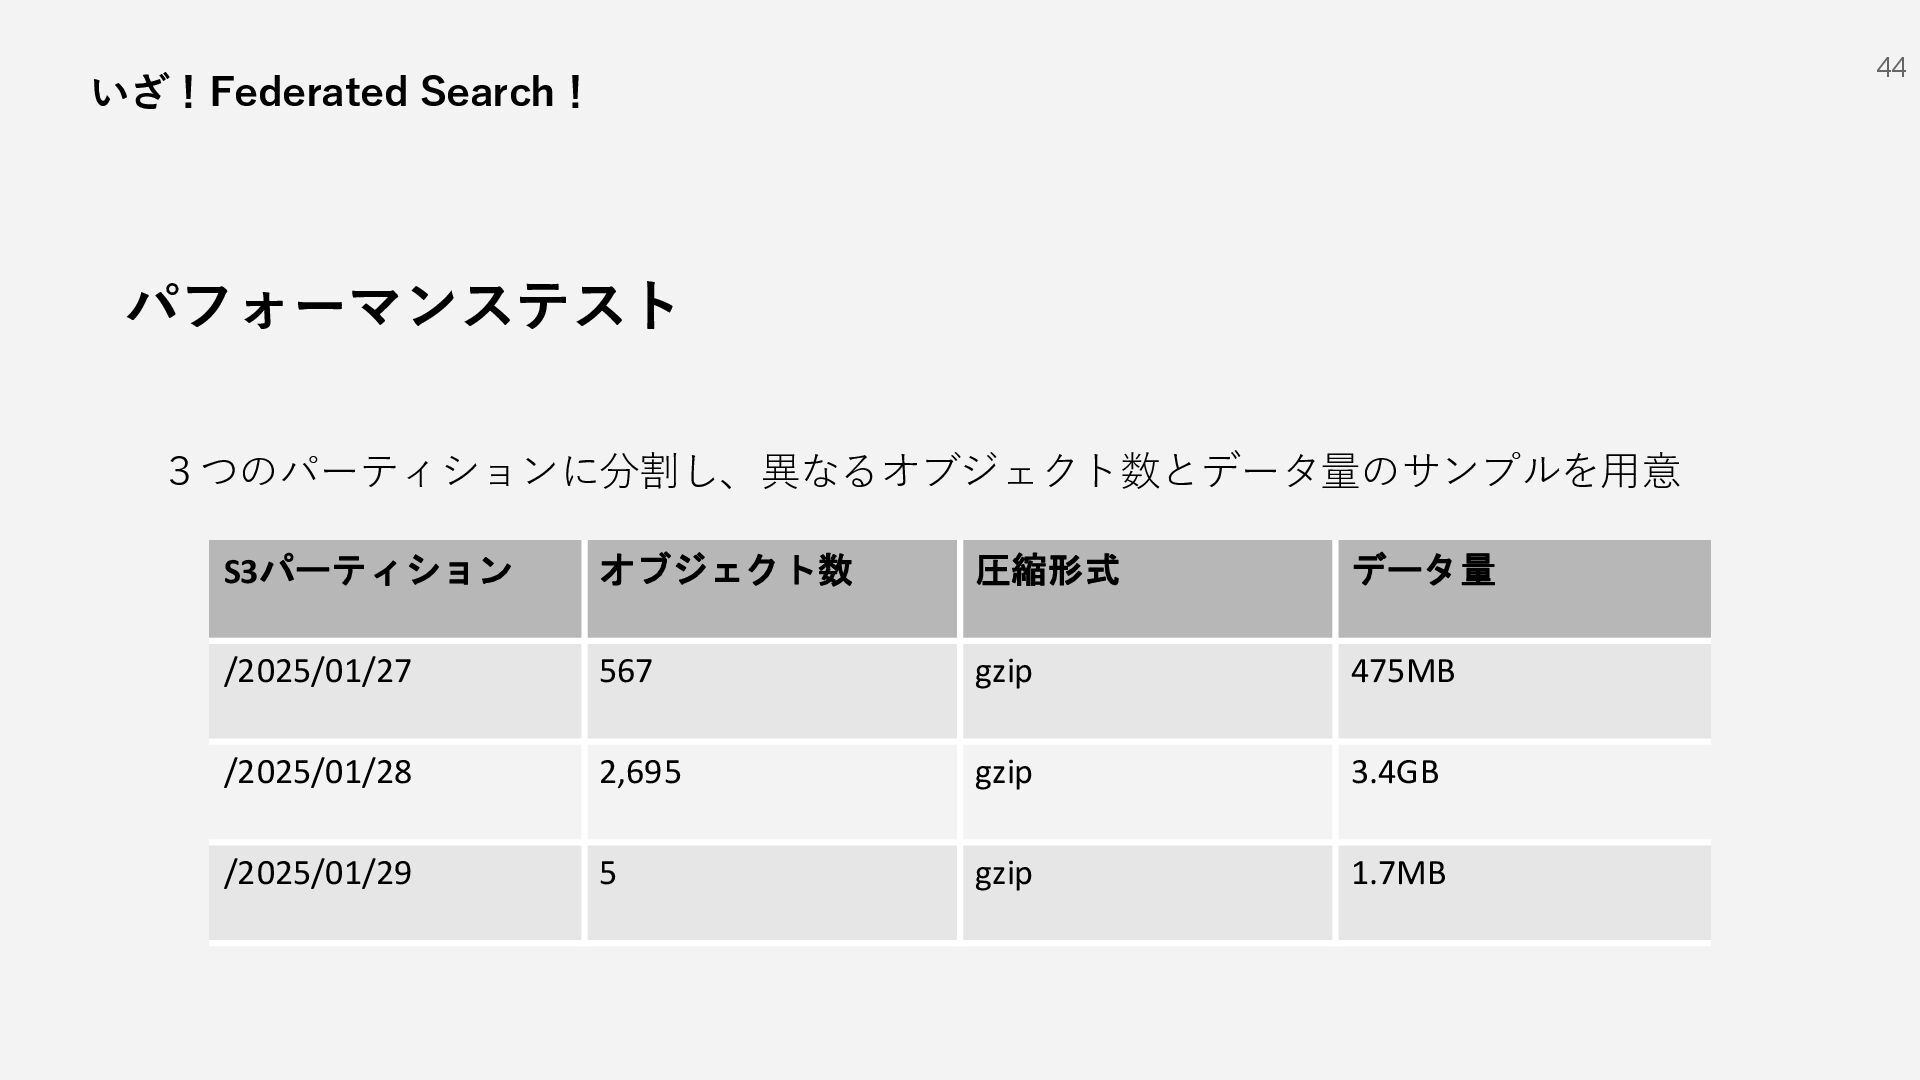
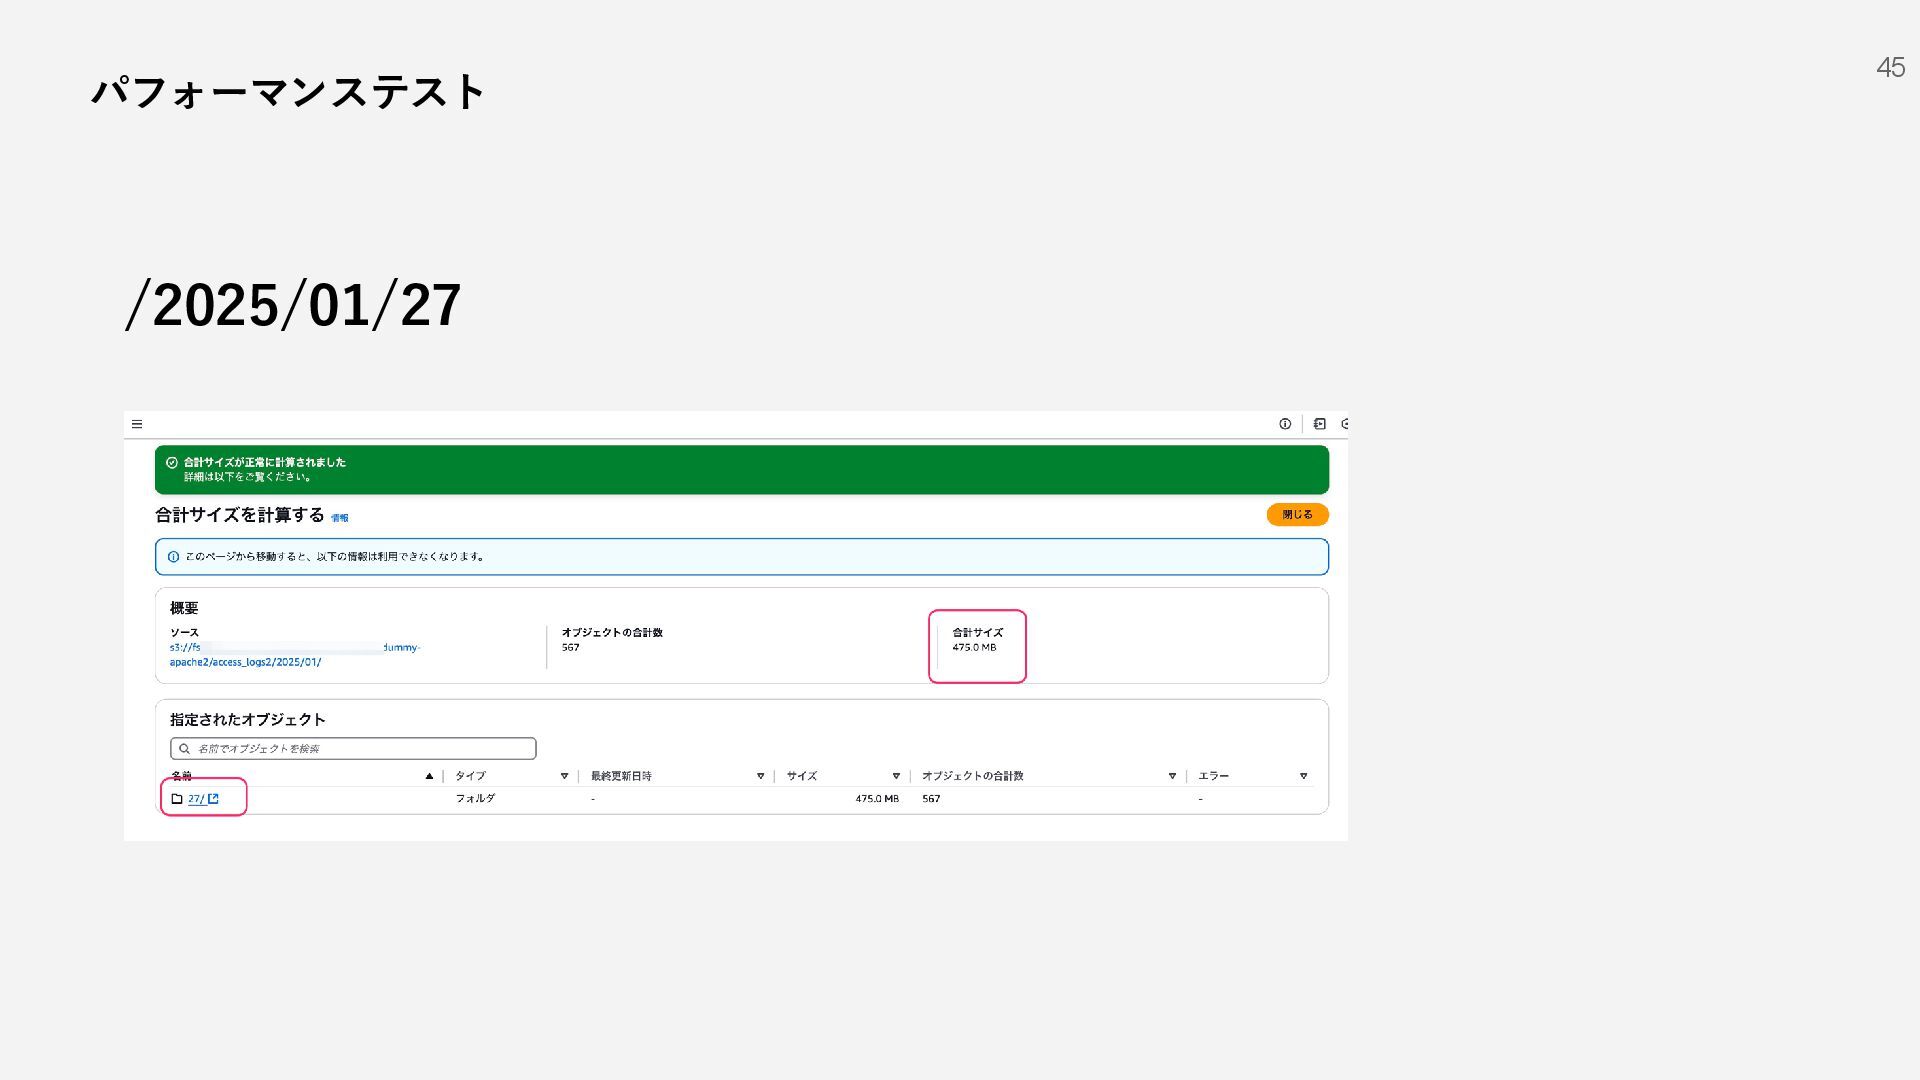
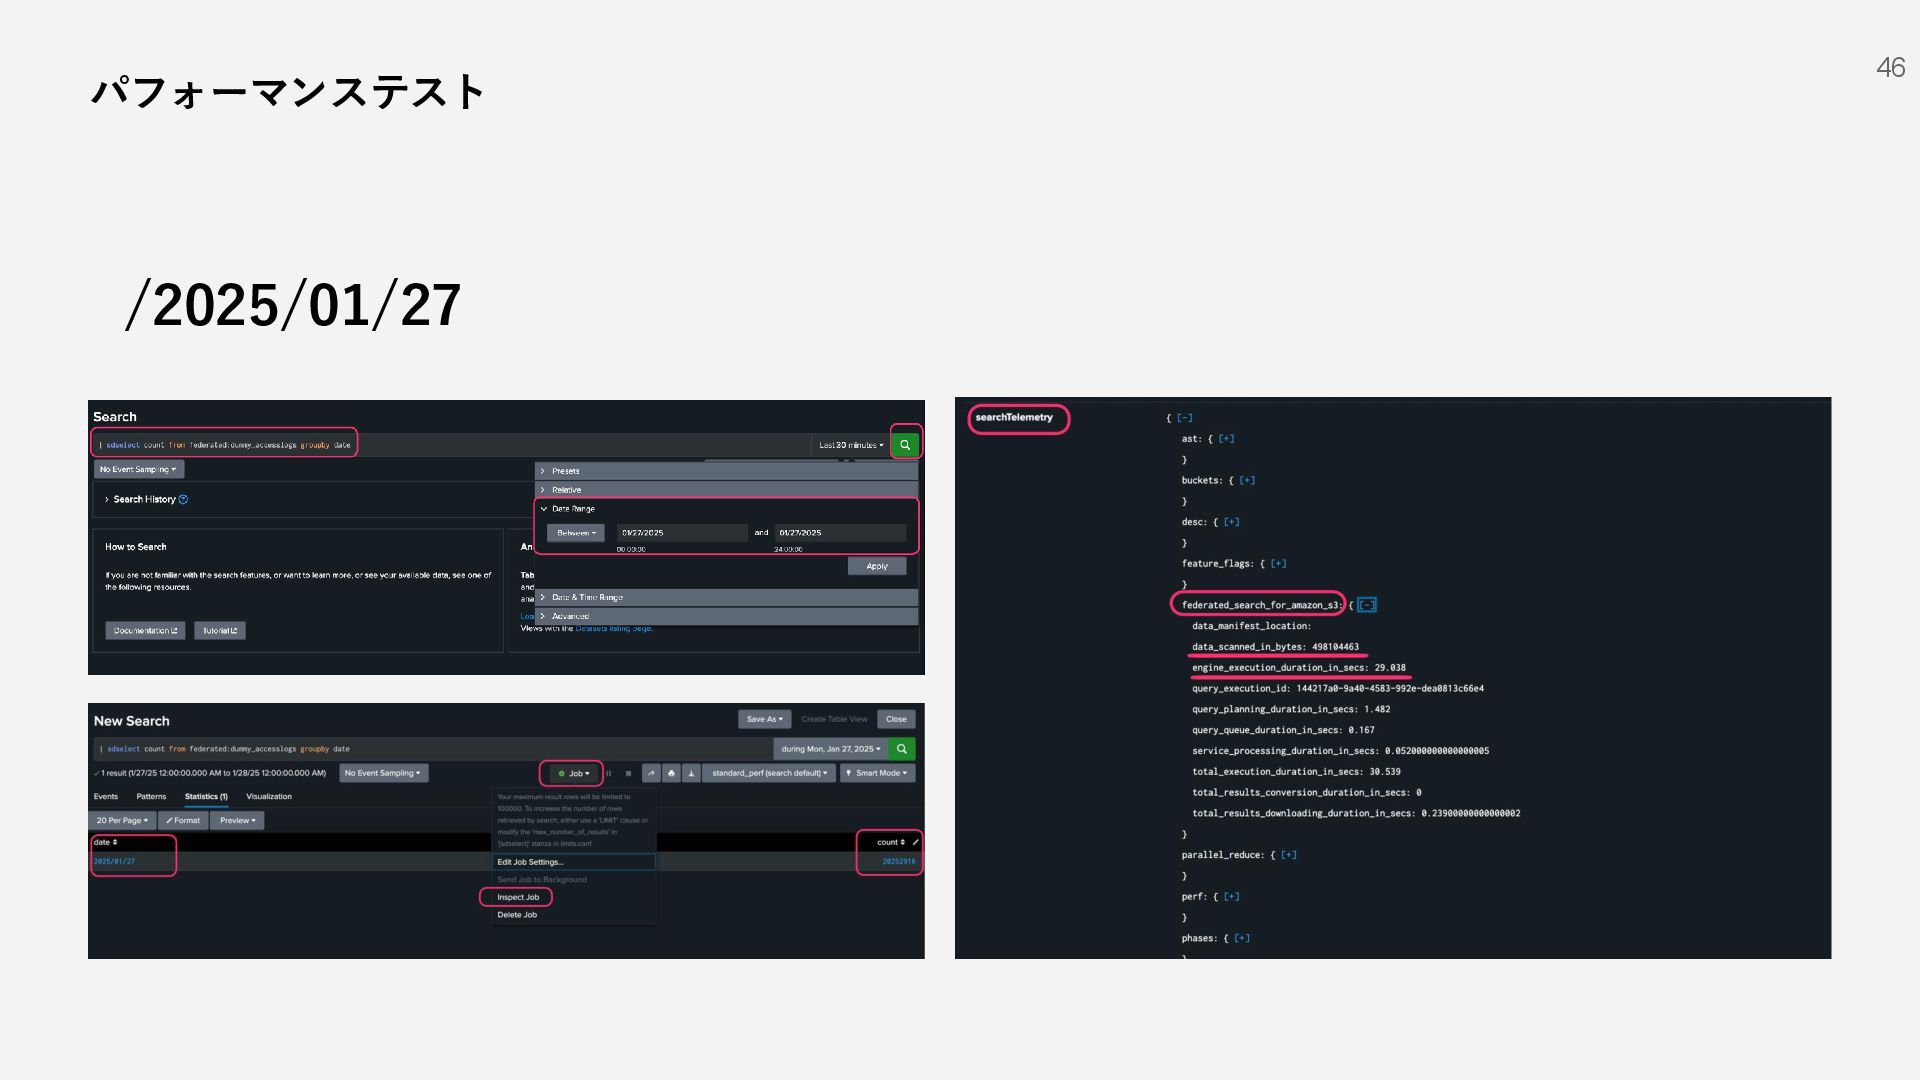
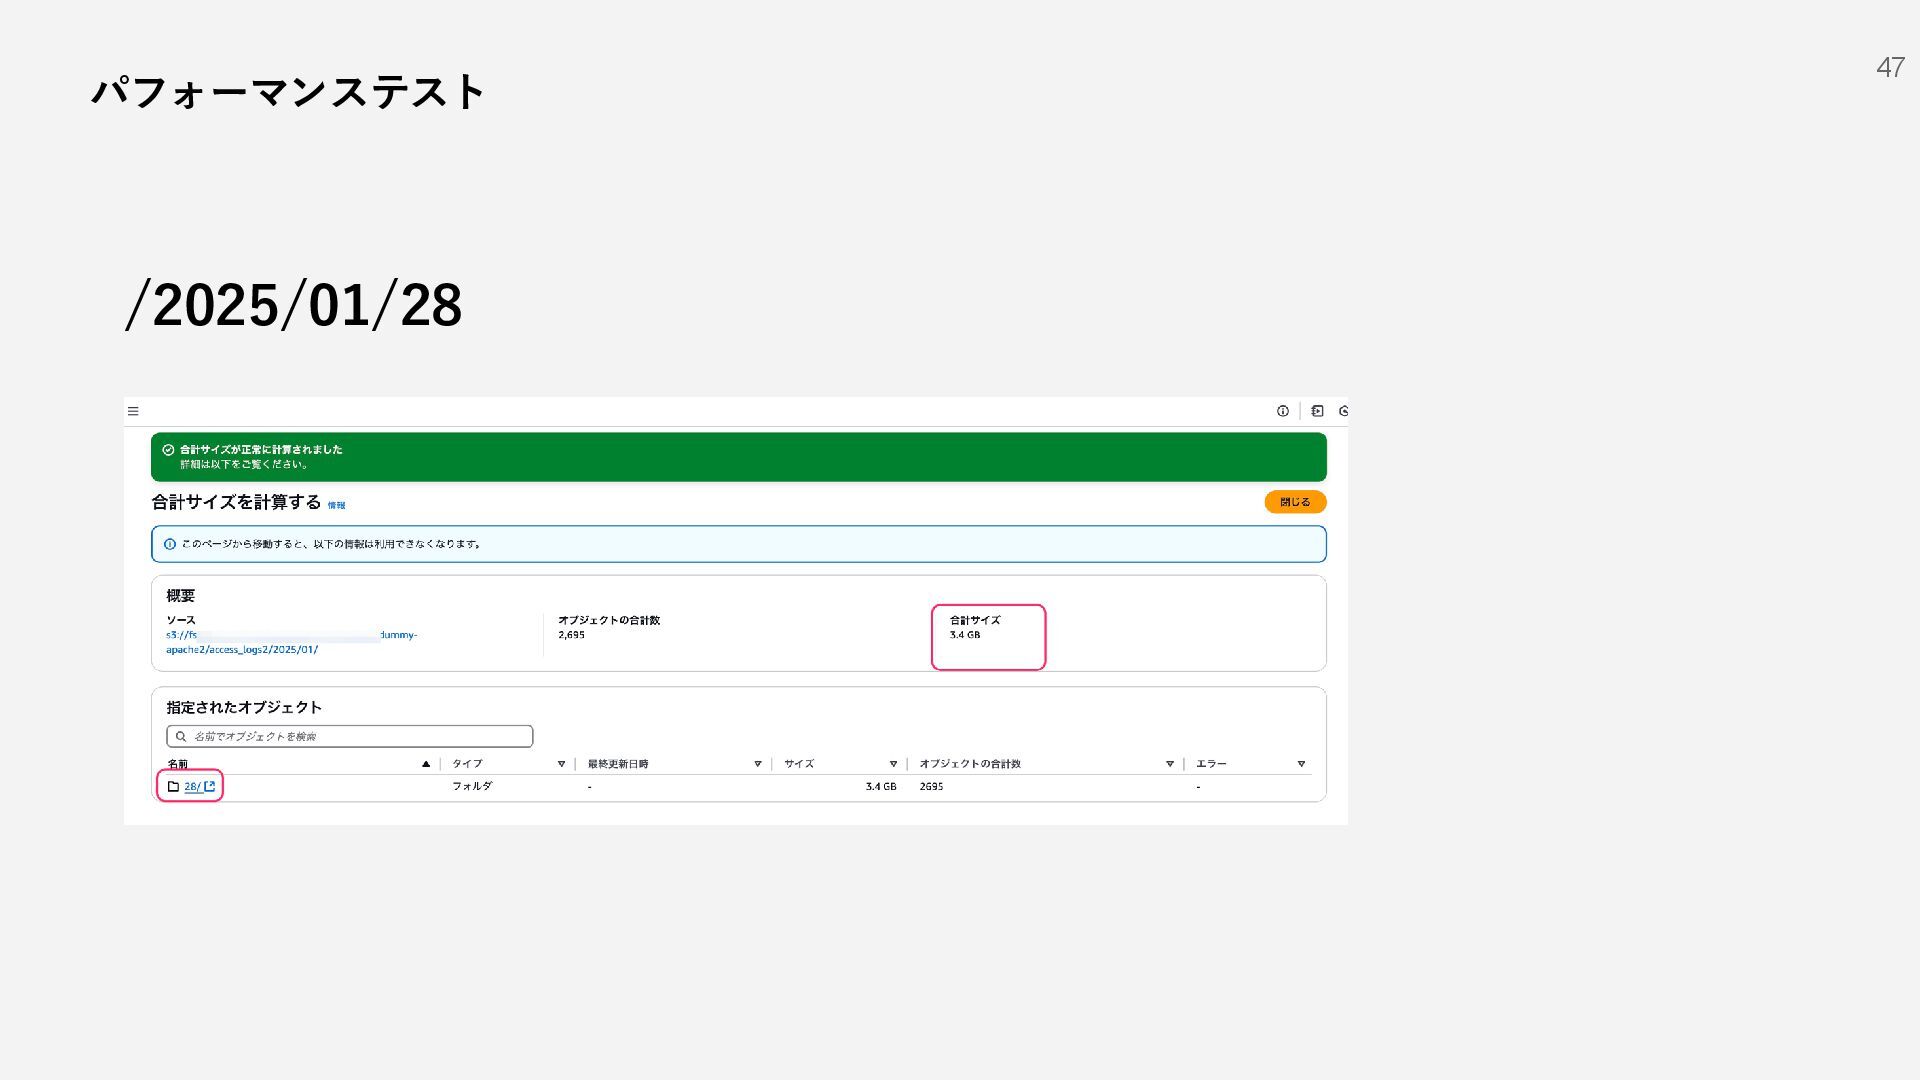
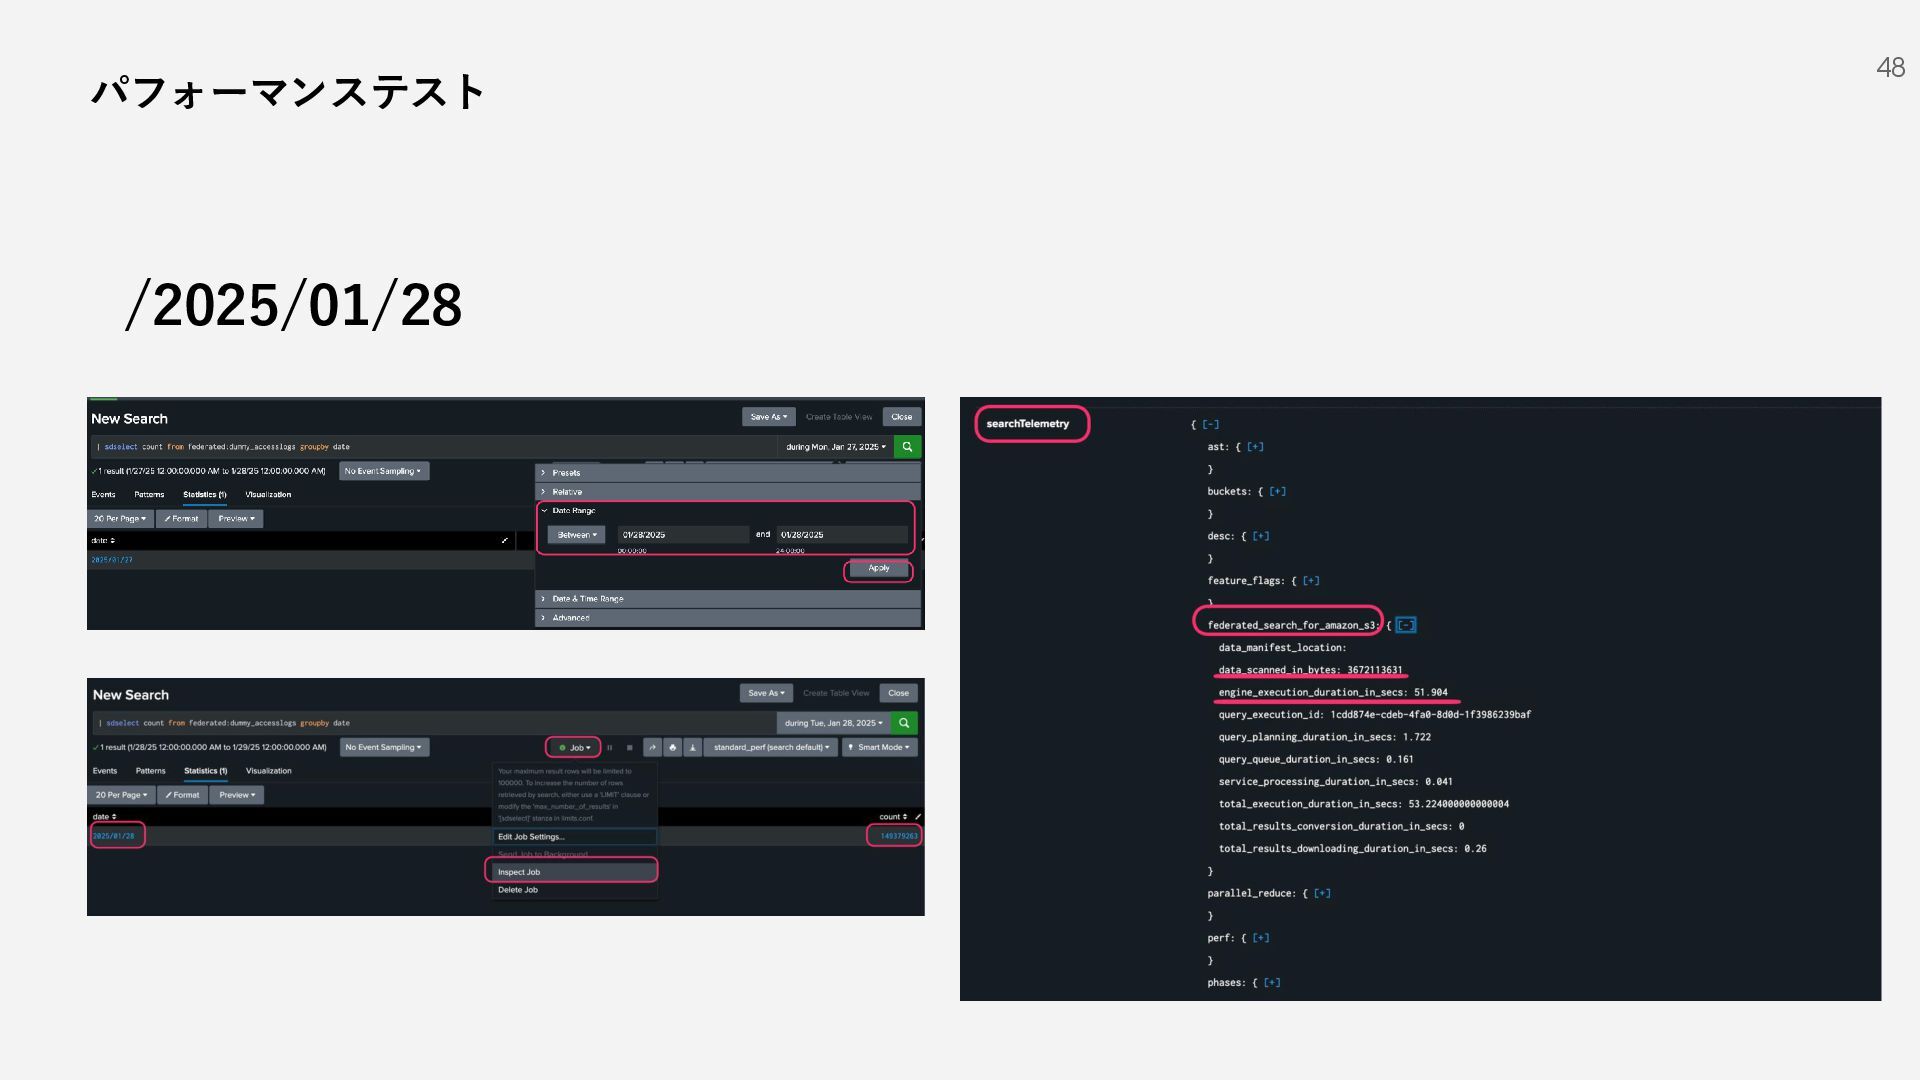
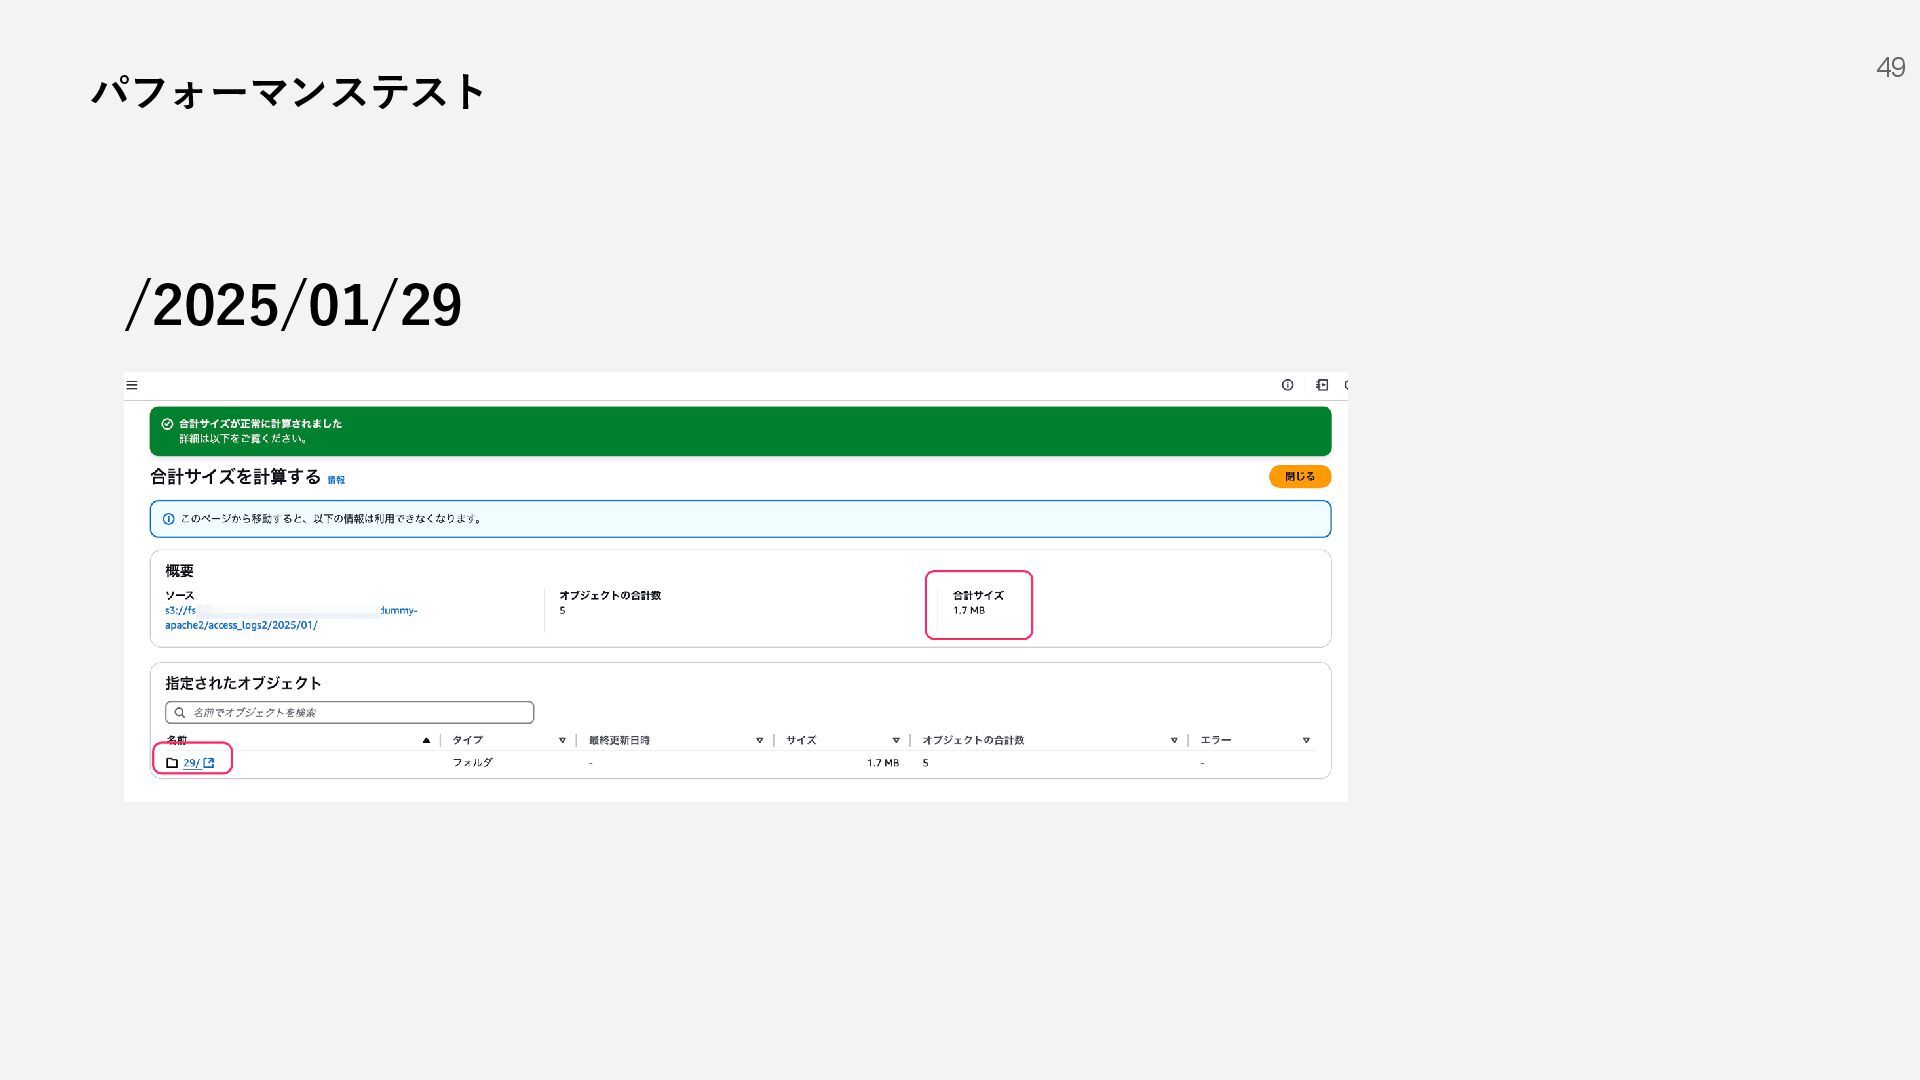
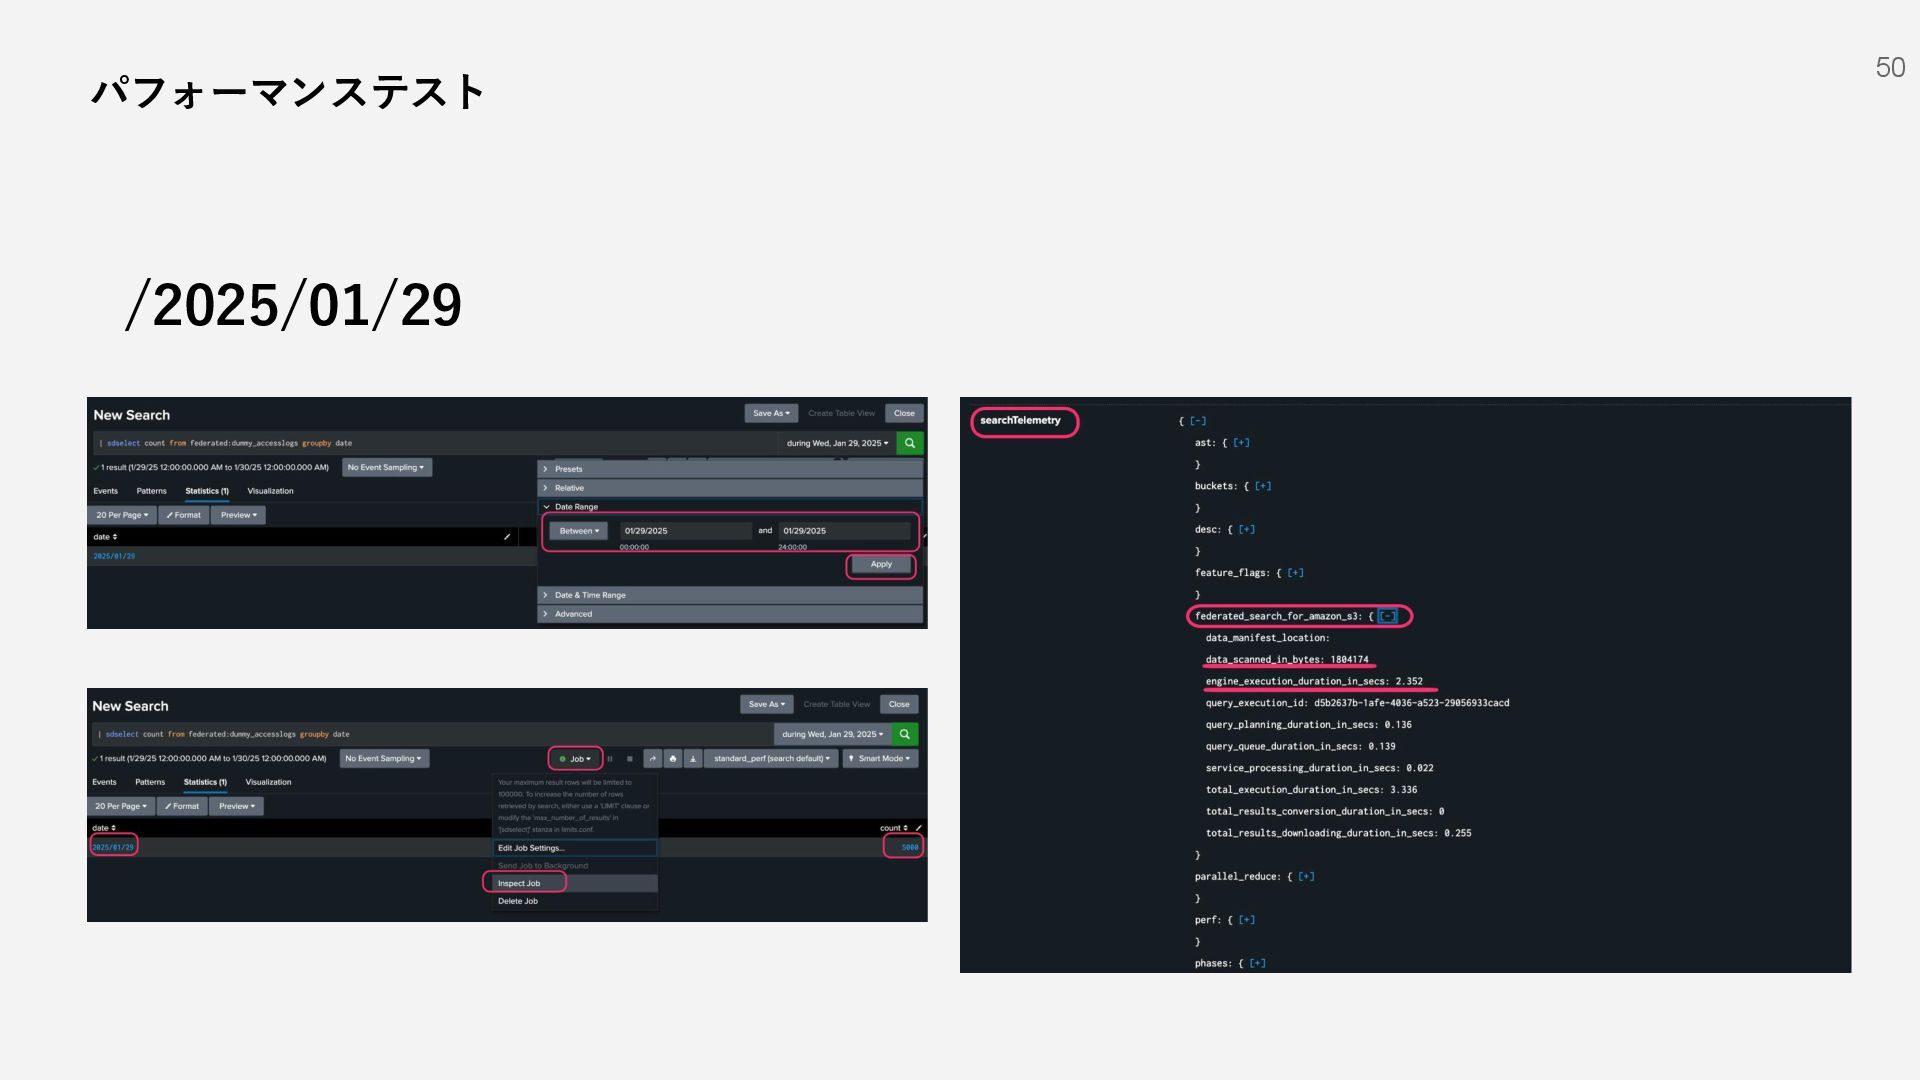
パフォーマンステスト 44 いざ!Federated Search! 3つのパーティションに分割し、異なるオブジェクト数とデータ量のサンプルを用意 S3パーティション オブジェクト数 圧縮形式 データ量 /2025/01/27
567 gzip 475MB /2025/01/28 2,695 gzip 3.4GB /2025/01/29 5 gzip 1.7MB -
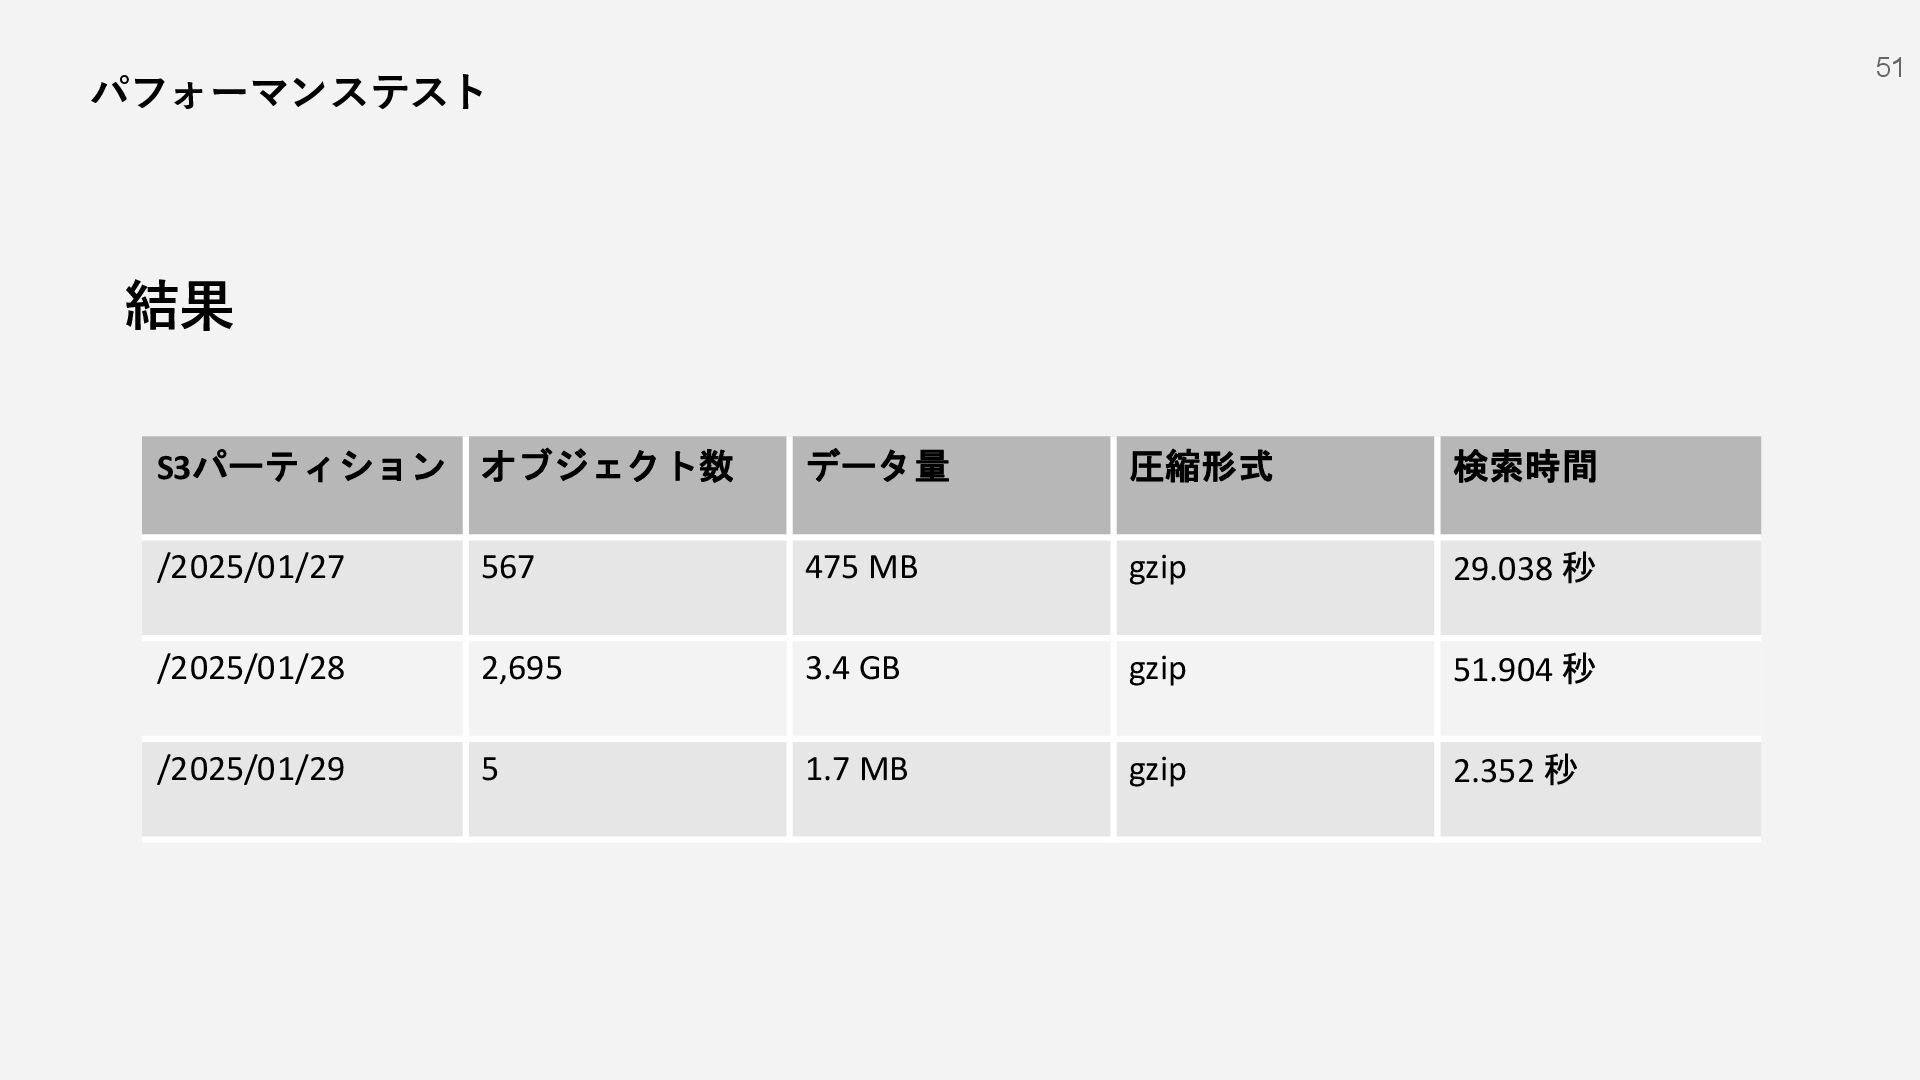
結果 51 パフォーマンステスト S3パーティション オブジェクト数 データ量 圧縮形式 検索時間 /2025/01/27 567
475 MB gzip 29.038 秒 /2025/01/28 2,695 3.4 GB gzip 51.904 秒 /2025/01/29 5 1.7 MB gzip 2.352 秒 -
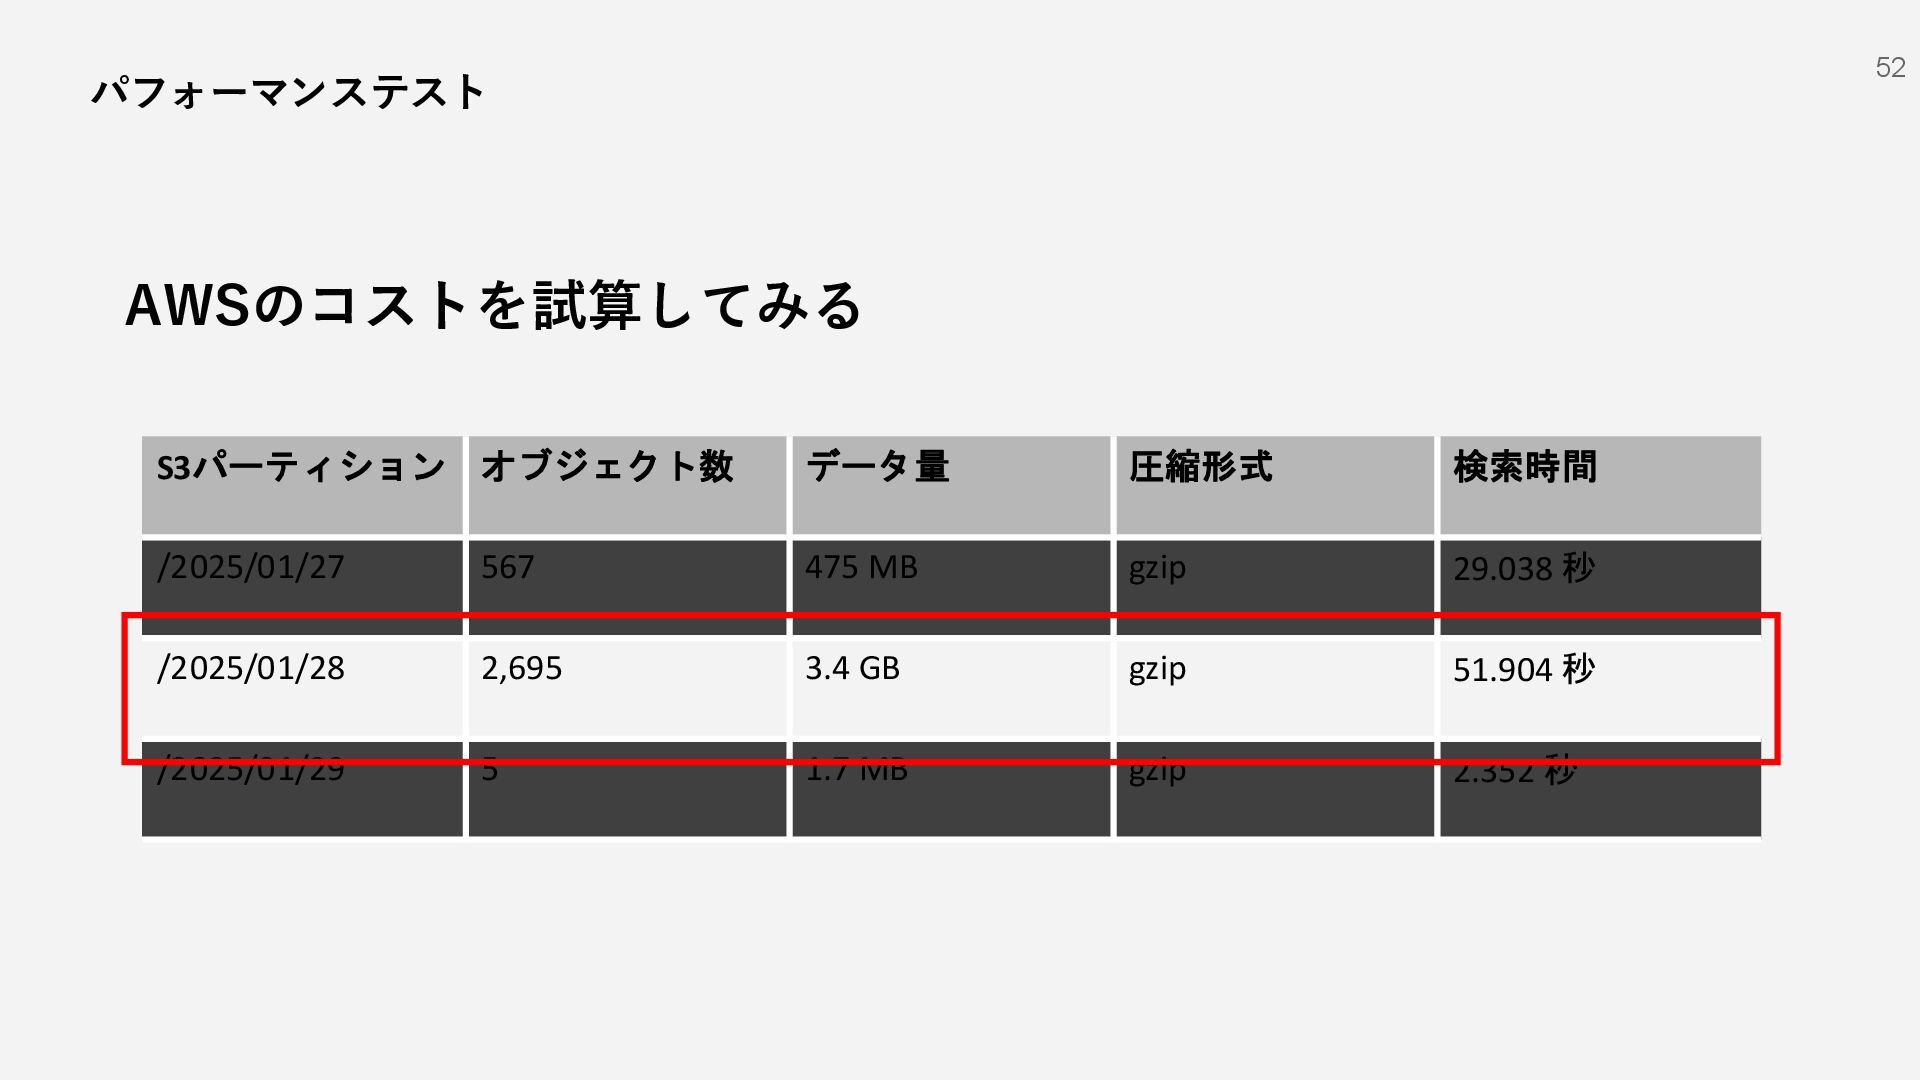
AWSのコストを試算してみる 52 パフォーマンステスト S3パーティション オブジェクト数 データ量 圧縮形式 検索時間 /2025/01/27 567
475 MB gzip 29.038 秒 /2025/01/28 2,695 3.4 GB gzip 51.904 秒 /2025/01/29 5 1.7 MB gzip 2.352 秒 -
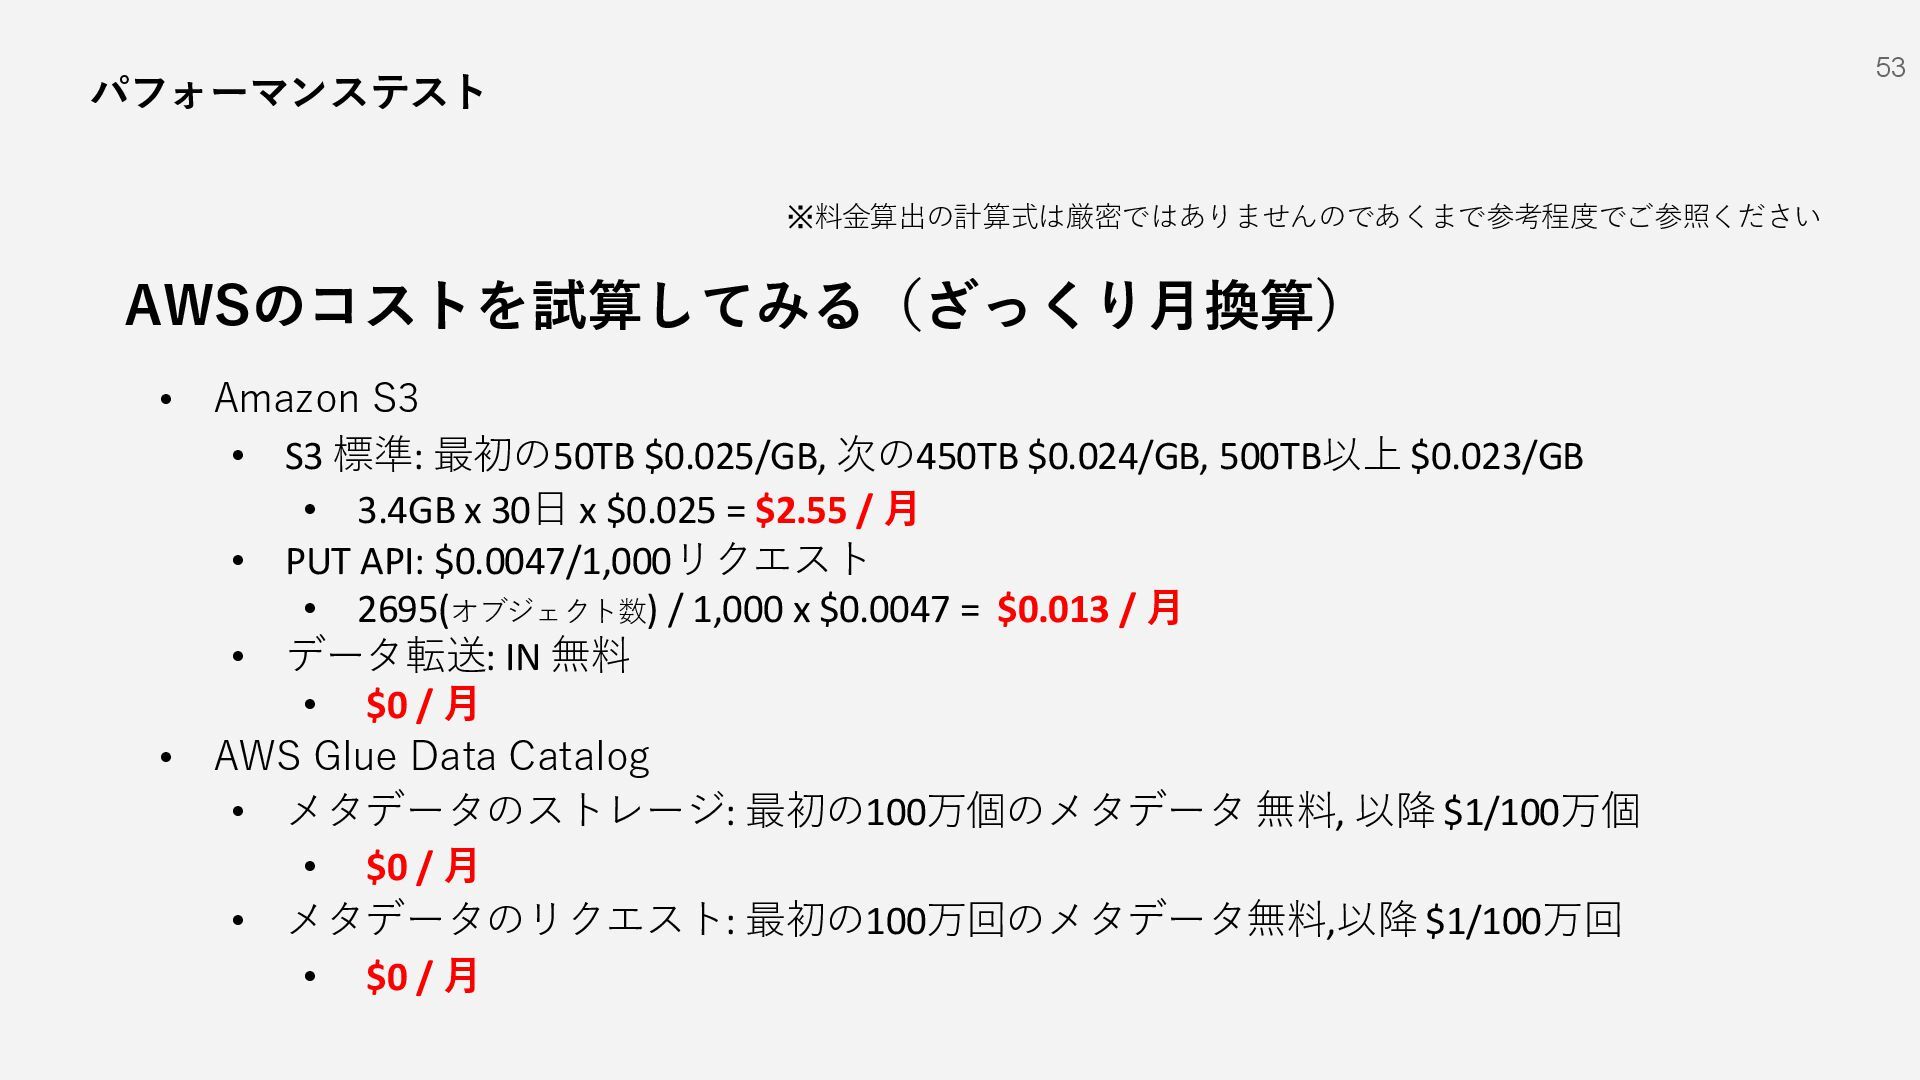
AWSのコストを試算してみる(ざっくり月換算) 53 パフォーマンステスト • Amazon S3 • S3 標準: 最初の50TB
$0.025/GB, 次の450TB $0.024/GB, 500TB以上 $0.023/GB • 3.4GB x 30日 x $0.025 = $2.55 / 月 • PUT API: $0.0047/1,000リクエスト • 2695(オブジェクト数) / 1,000 x $0.0047 = $0.013 / 月 • データ転送: IN 無料 • $0 / 月 • AWS Glue Data Catalog • メタデータのストレージ: 最初の100万個のメタデータ 無料, 以降 $1/100万個 • $0 / 月 • メタデータのリクエスト: 最初の100万回のメタデータ無料,以降 $1/100万回 • $0 / 月 ※料金算出の計算式は厳密ではありませんのであくまで参考程度でご参照ください -
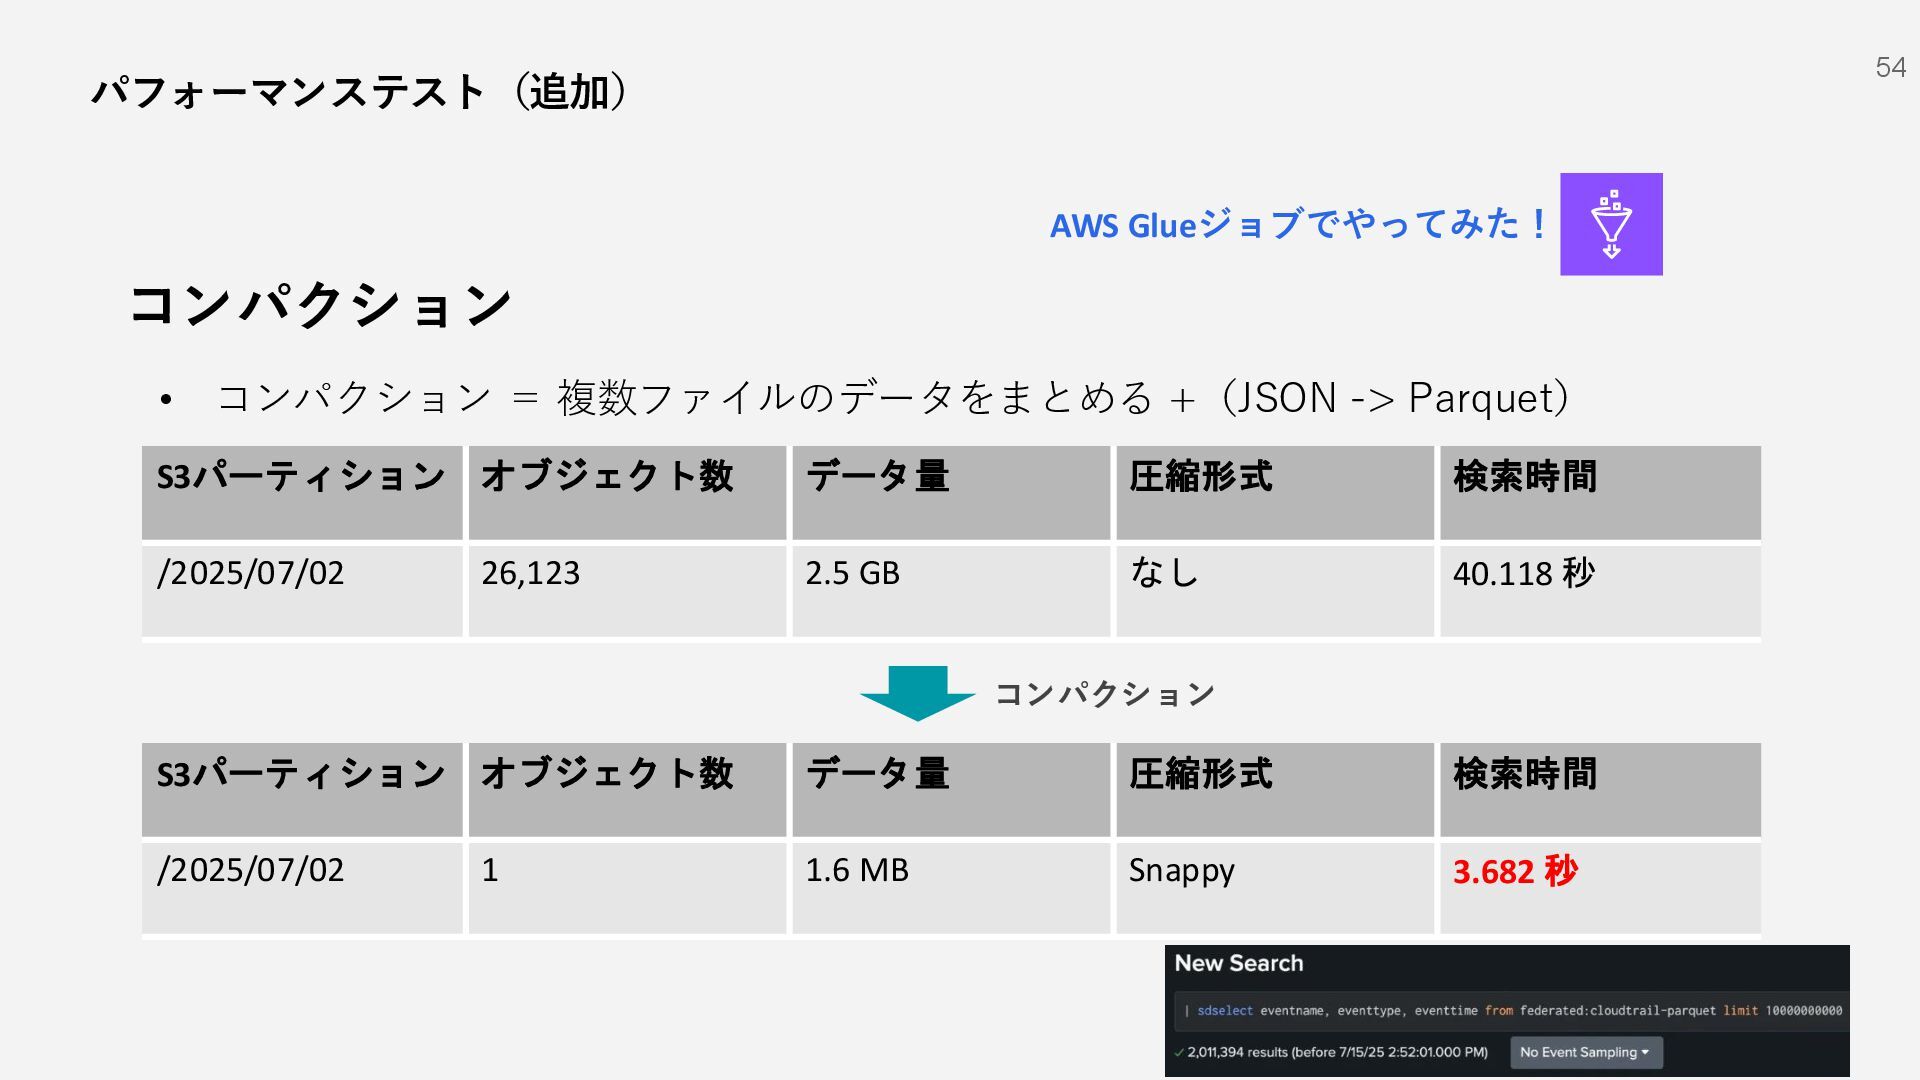
コンパクション 54 パフォーマンステスト(追加) • コンパクション = 複数ファイルのデータをまとめる +(JSON -> Parquet)
S3パーティション オブジェクト数 データ量 圧縮形式 検索時間 /2025/07/02 26,123 2.5 GB なし 40.118 秒 S3パーティション オブジェクト数 データ量 圧縮形式 検索時間 /2025/07/02 1 1.6 MB Snappy 3.682 秒 コンパクション AWS Glueジョブでやってみた! -
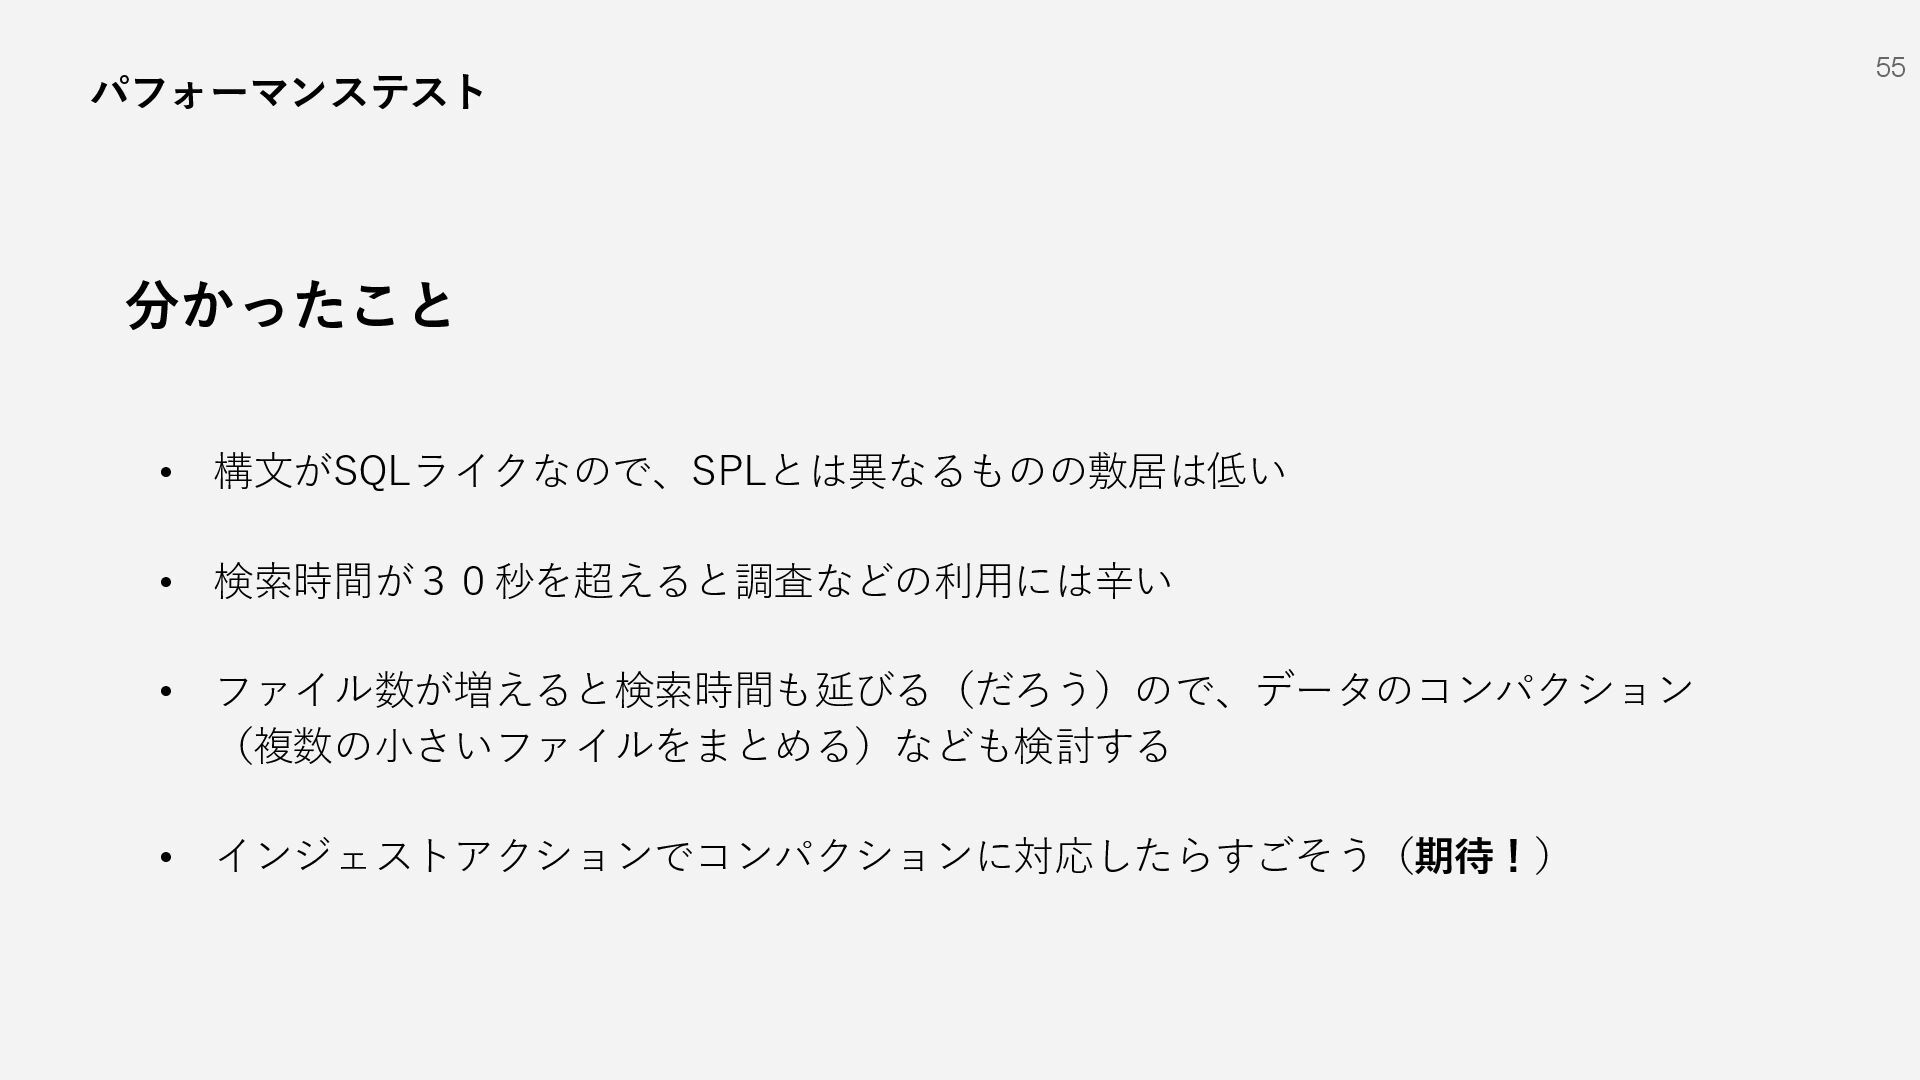
分かったこと 55 パフォーマンステスト • 構文がSQLライクなので、SPLとは異なるものの敷居は低い • 検索時間が30秒を超えると調査などの利用には辛い • ファイル数が増えると検索時間も延びる(だろう)ので、データのコンパクション (複数の小さいファイルをまとめる)なども検討する
• インジェストアクションでコンパクションに対応したらすごそう(期待!) -
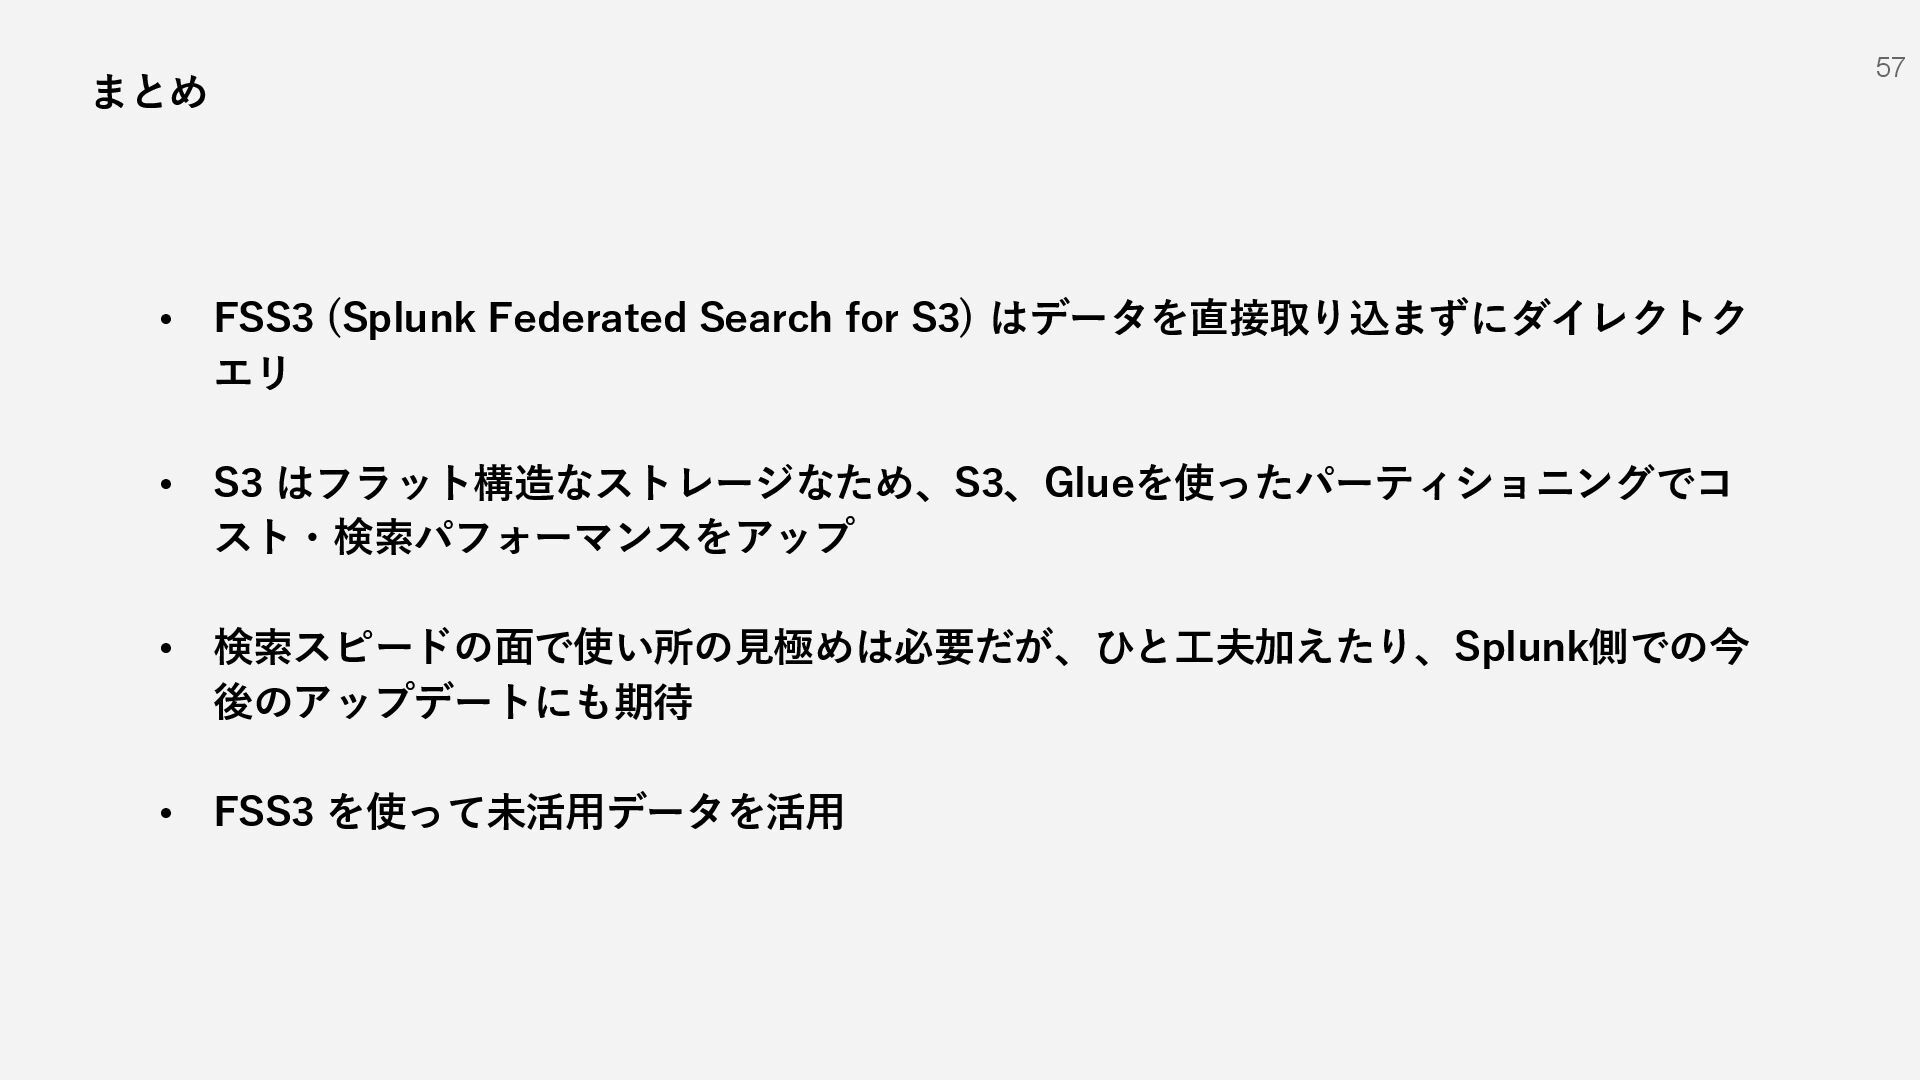
57 まとめ • FSS3 (Splunk Federated Search for S3) はデータを直接取り込まずにダイレクトク
エリ • S3 はフラット構造なストレージなため、S3、Glueを使ったパーティショニングでコ スト・検索パフォーマンスをアップ • 検索スピードの面で使い所の見極めは必要だが、ひと工夫加えたり、Splunk側での今 後のアップデートにも期待 • FSS3 を使って未活用データを活用 -
58 参考 Splunk Federated Search for S3 で大容 量かつ低頻度なアクセスデータに対 してコストを最小にSIEM機能を活用
する Splunk Federated Analytics を試してみ た