Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ゼロから作るアンサンブル学習(第1回)
Search
tatamiya
March 28, 2019
Technology
210
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ゼロから作るアンサンブル学習(第1回)
tatamiya
March 28, 2019
More Decks by tatamiya
See All by tatamiya
生成AIと進める探索的データ分析(2026.10.03 第122回Tokyo.R勉強会)
tatamiya
2
1.6k
サイコロで理解する統計的仮説検定の考え方
tatamiya
5
3.5k
状態空間時系列モデルで見た R と Python の比較 〜 KFAS と statsmodels 〜
tatamiya
1
2k
第1回沖本計量時系列分析輪読
tatamiya
1
770
ゼロから作るアンサンブル学習 第2回資料
tatamiya
0
390
20190409_FasterPythonMeetUp_TAMIYA
tatamiya
0
320
Other Decks in Technology
See All in Technology
リアクションエンジニア ― 小さなリアクションから、話しかけやすい組織をつくる ―
ryuguyana
1
120
分析作業をどこまで任せるか自分で決められる AIネイティブBI『Golden Analytics』が 良さげな話 /golden-analytics-is-ai-native-bi
shinyaa31
0
110
Deep Data Security 機能解説
oracle4engineer
PRO
3
1k
Autonomous AI Lakehouse - Live AI Hubから始めるセキュアなAIデータ活用 -
oracle4engineer
PRO
3
190
AI時代に求められる優秀なTechLeadの振る舞い
pospome
4
4.9k
複雑な業務システムを高速でつくるため、チーム全員をつくれる人へ
ayakurabuchi
0
130
reInvent2026stby LT00 "Change your life!"
shinichirokawano
1
570
これだけは抑えておきたい!後悔しない re:Invent の過ごし方 / AWS re:Invent 2026 prestudy
kinunori
2
700
自律的なチームを作るためにTechPMがやらないこと
ny7760
1
500
You Have Agency(サンキュー、Ruby)
snoozer05
PRO
5
680
基本から分かる!AWSセキュリティ運用の考え方と任せ方
cmusudakeisuke
1
400
20261016_Nagoya Tech Talk #4 データ活用のリアル AIも人も間違える
bessaralink55
0
160
Featured
See All Featured
How to Align SEO within the Product Triangle To Get Buy-In & Support - #RIMC
aleyda
2
1.9k
Design in an AI World
tapps
1
380
I Don’t Have Time: Getting Over the Fear to Launch Your Podcast
jcasabona
35
2.9k
Visualization
eitanlees
153
17k
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
A Guide to Academic Writing Using Generative AI - A Workshop
ks91
PRO
1
550
Git: the NoSQL Database
bkeepers
PRO
433
67k
How Software Deployment tools have changed in the past 20 years
geshan
2
35k
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
620
My Coaching Mixtape
mlcsv
0
380
Site-Speed That Sticks
csswizardry
13
1.6k
YesSQL, Process and Tooling at Scale
rocio
174
15k
Transcript
ゼロから作るアンサンブル学習 ~OSSに学ぶ機械学習の実装~ 第1回 決定⽊・ランダムフォレストの理解と実装 たみや@tatatatatamiya
このセミナーについて u ⽬的 u アルゴリズムの理解 u OSSから良い実装を学ぶ u スケジュール u
第1回(3/28 本⽇) : 決定⽊・ランダムフォレストの理解と実装 u 第2回(4⽉下旬) : scikit-learnの読解 u 第3回(5⽉下旬) : 勾配ブースティング〜XGBoost, LightGBM
アルゴリズムの概要 - 決定⽊ - ランダムフォレスト
決定⽊
決定⽊とは︖ プロフィール 年齢 33歳 ⾝⻑ 168cm 体重 65kg 収⼊ 700万円
!? ⾝⻑ > 170cm? 体重 > 70kg? 体重 > 100kg? 年齢 >30? 収⼊ >1000万円? No No Yes Yes No Yes No Yes No Yes モ テ ⾮ モ テ モ テ ⾮ モ テ モ テ ⾮ モ テ 閾値を設けてYes/Noで振り分けていく モテる︖モテない︖ 課題 - どの特徴量で切る︖ - 閾値はいくつにする︖
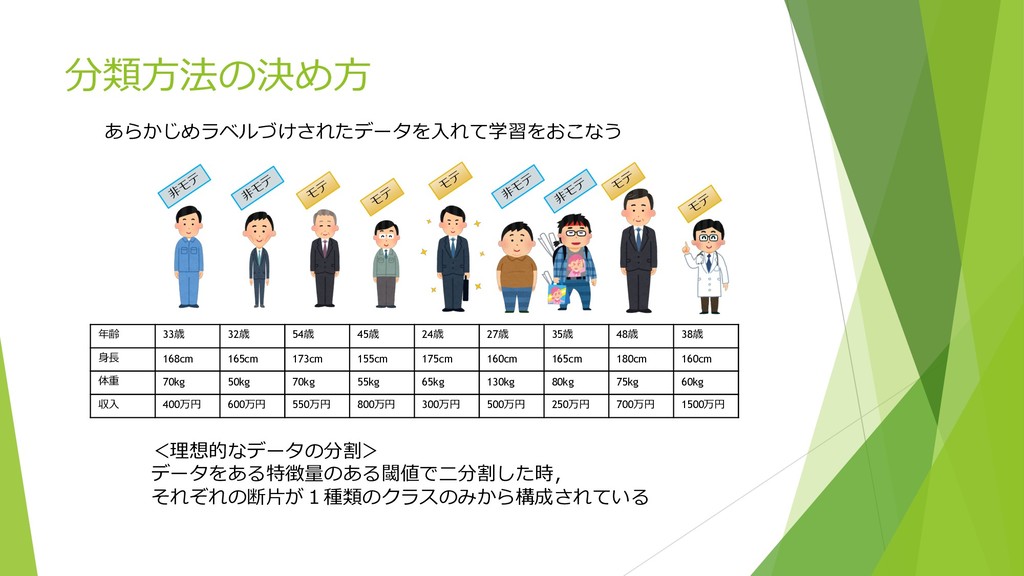
分類⽅法の決め⽅ 年齢 33歳 32歳 54歳 45歳 24歳 27歳 35歳 48歳
38歳 ⾝⻑ 168cm 165cm 173cm 155cm 175cm 160cm 165cm 180cm 160cm 体重 70kg 50kg 70kg 55kg 65kg 130kg 80kg 75kg 60kg 収⼊ 400万円 600万円 550万円 800万円 300万円 500万円 250万円 700万円 1500万円 モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ <理想的なデータの分割> データをある特徴量のある閾値で⼆分割した時, それぞれの断⽚が1種類のクラスのみから構成されている あらかじめラベルづけされたデータを⼊れて学習をおこなう
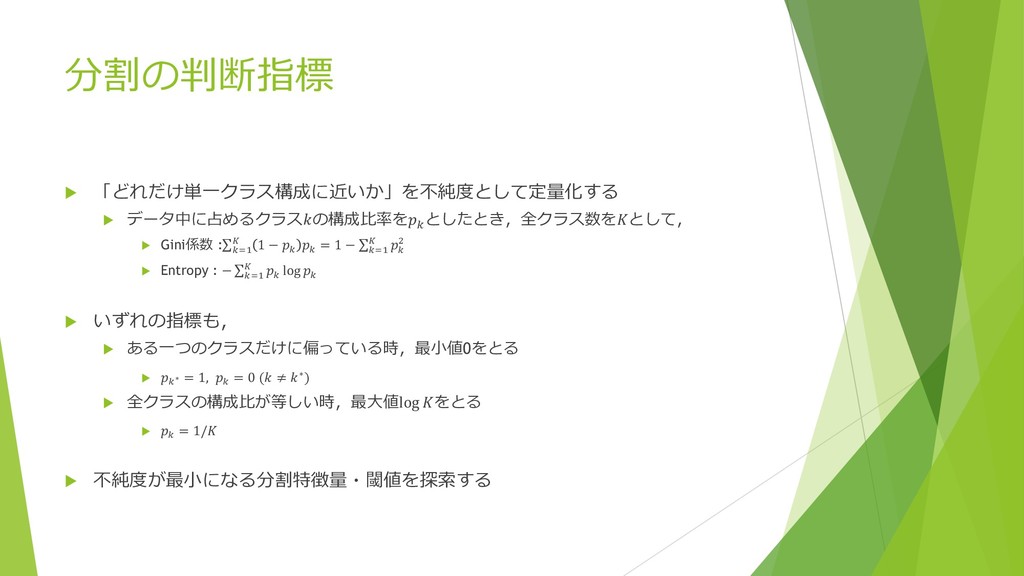
分割の判断指標 u 「どれだけ単⼀クラス構成に近いか」を不純度として定量化する u データ中に占めるクラスの構成⽐率を# としたとき,全クラス数をとして, u Gini係数 :∑#&' (
1 − # # = 1 − ∑#&' ( # , u Entropy : − ∑#&' ( # log # u いずれの指標も, u ある⼀つのクラスだけに偏っている時,最⼩値0をとる u #∗ = 1, # = 0 ( ≠ ∗) u 全クラスの構成⽐が等しい時,最⼤値log をとる u # = 1/ u 不純度が最⼩になる分割特徴量・閾値を探索する
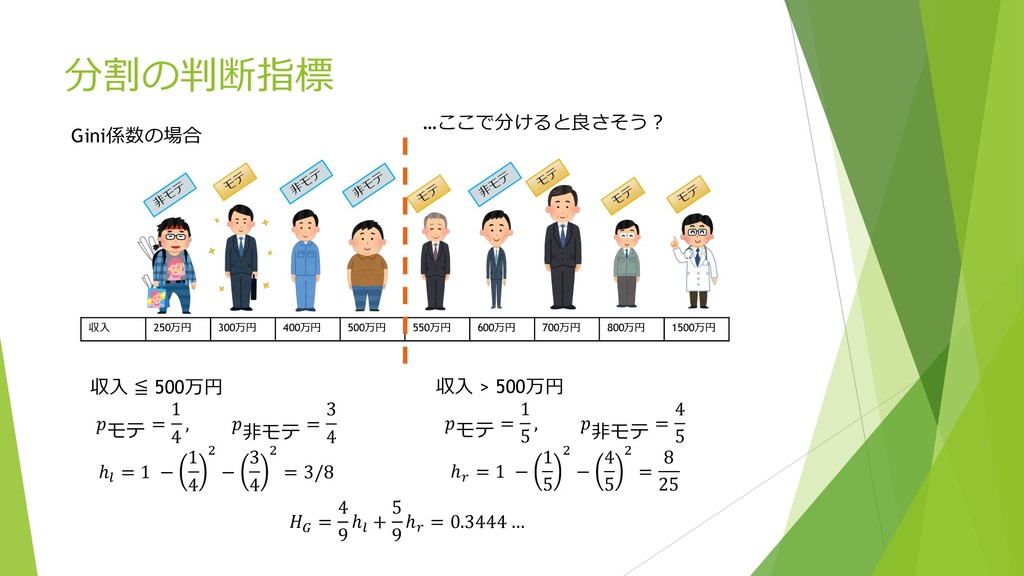
分割の判断指標 モ テ モ テ モ テ ⾮ モ テ
⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ 収⼊ 250万円 300万円 400万円 500万円 550万円 600万円 700万円 800万円 1500万円 収⼊ ≦ 500万円 モテ = 1 4 , ⾮モテ = 3 4 ℎ; = 1 − 1 4 , − 3 4 , = 3/8 収⼊ > 500万円 モテ = 1 5 , ⾮モテ = 4 5 ℎ> = 1 − 1 5 , − 4 5 , = 8 25 A = 4 9 ℎ; + 5 9 ℎ> = 0.3444 … Gini係数の場合 …ここで分けると良さそう︖
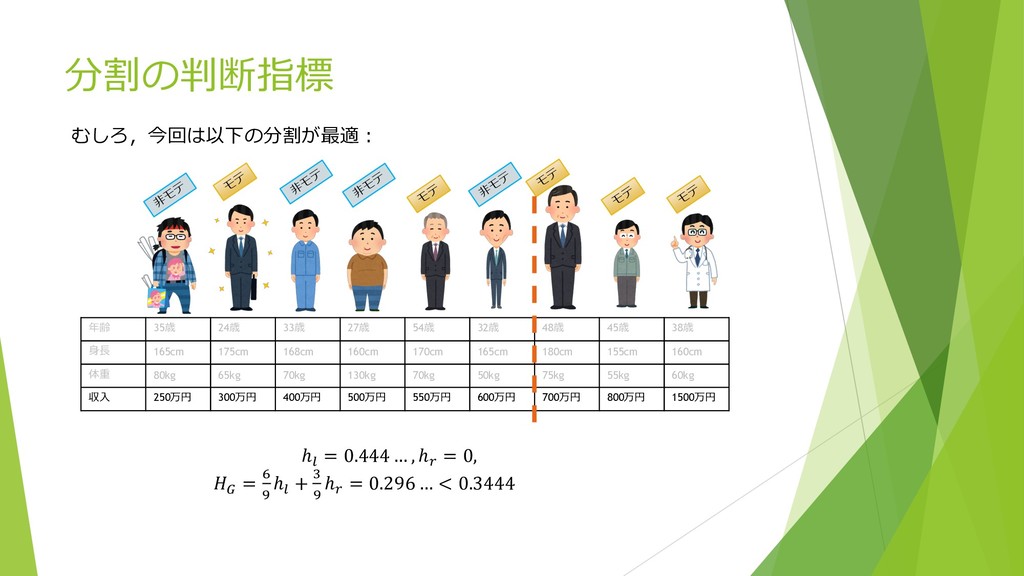
分割の判断指標 モ テ モ テ モ テ ⾮ モ テ
⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ 年齢 35歳 24歳 33歳 27歳 54歳 32歳 48歳 45歳 38歳 ⾝⻑ 165cm 175cm 168cm 160cm 170cm 165cm 180cm 155cm 160cm 体重 80kg 65kg 70kg 130kg 70kg 50kg 75kg 55kg 60kg 収⼊ 250万円 300万円 400万円 500万円 550万円 600万円 700万円 800万円 1500万円 ℎ; = 0.444 … , ℎ> = 0, A = F G ℎ; + H G ℎ> = 0.296 … < 0.3444 むしろ,今回は以下の分割が最適︓
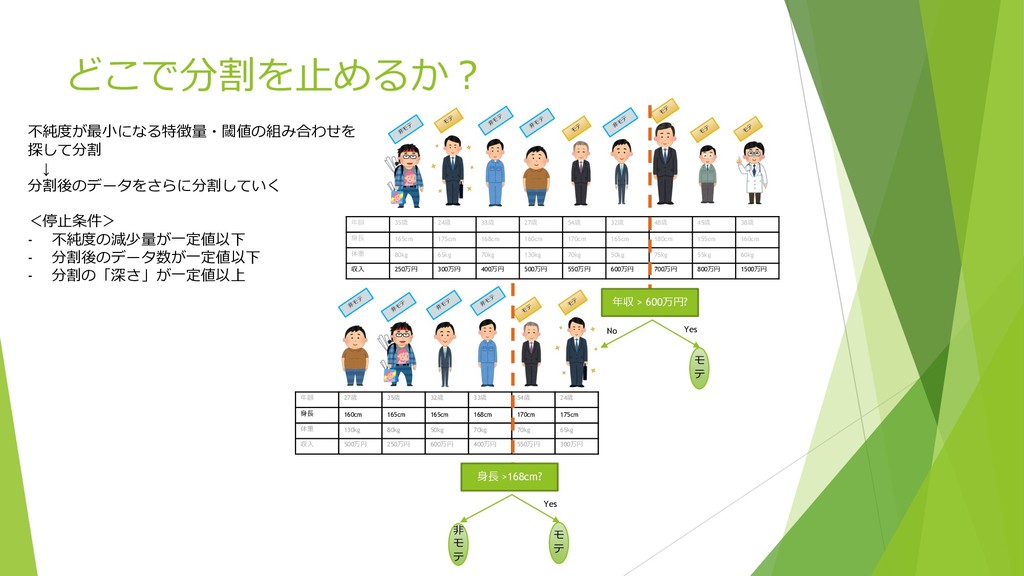
どこで分割を⽌めるか︖ モ テ モ テ モ テ ⾮ モ テ
⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ 年齢 35歳 24歳 33歳 27歳 54歳 32歳 48歳 45歳 38歳 ⾝⻑ 165cm 175cm 168cm 160cm 170cm 165cm 180cm 155cm 160cm 体重 80kg 65kg 70kg 130kg 70kg 50kg 75kg 55kg 60kg 収⼊ 250万円 300万円 400万円 500万円 550万円 600万円 700万円 800万円 1500万円 年収 > 600万円? No Yes モ テ 年齢 27歳 35歳 32歳 33歳 54歳 24歳 ⾝⻑ 160cm 165cm 165cm 168cm 170cm 175cm 体重 130kg 80kg 50kg 70kg 70kg 65kg 収⼊ 500万円 250万円 600万円 400万円 550万円 300万円 ⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ ⾝⻑ >168cm? Yes モ テ ⾮ モ テ 不純度が最⼩になる特徴量・閾値の組み合わせを 探して分割 ↓ 分割後のデータをさらに分割していく <停⽌条件> - 不純度の減少量が⼀定値以下 - 分割後のデータ数が⼀定値以下 - 分割の「深さ」が⼀定値以上
ランダムフォレスト
ランダムフォレスト概要 u 決定⽊の⽋点 u 学習データに強く依存する u ⽊を⼤量に集めて多数決を⾏う u 決定⽊よりは性能の劣る「弱学習器」を⼤量に作る u
弱学習器の構築指針 u 学習に使うデータを変える u ブートストラップサンプリング u 分割につかう特徴量を変える u 全特徴量は使わず,⼀部のみ使⽤する u 分割ごとにランダムに選択する
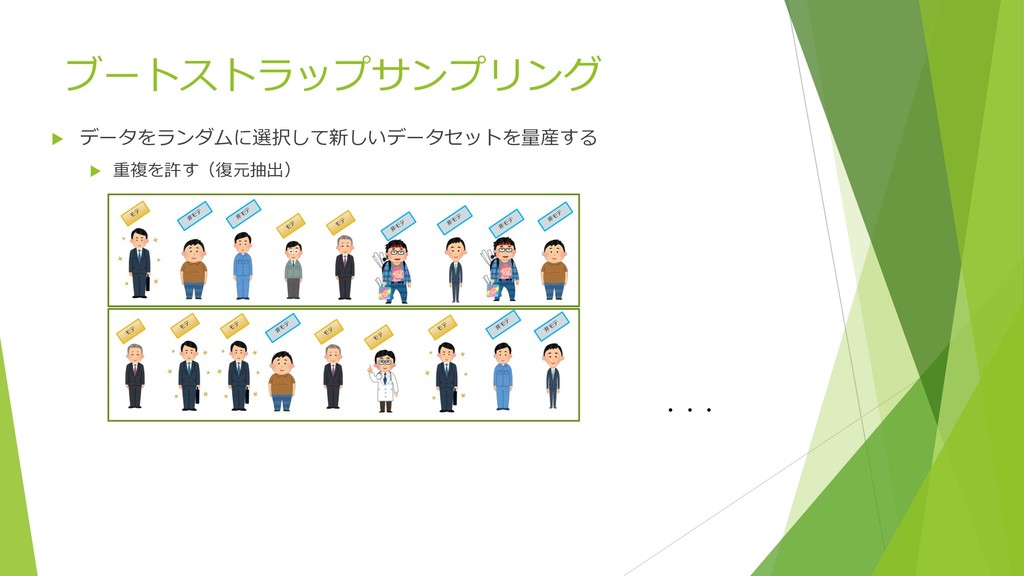
ブートストラップサンプリング u データをランダムに選択して新しいデータセットを量産する u 重複を許す(復元抽出) モ テ ⾮ モ テ
⾮ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ モ テ モ テ モ テ ⾮ モ テ モ テ モ テ モ テ ⾮ モ テ ⾮ モ テ ・・・
特徴量のランダム選択 u 分割の際に,⼀部のランダムに選んだ特徴量のみを⾒る モ テ ⾮ モ テ ⾮ モ
テ モ テ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ ⾮ モ テ 年齢 24歳 27歳 33歳 45歳 54歳 35歳 32歳 35歳 27歳 ⾝⻑ 175cm 160cm 168cm 155cm 170cm 165cm 165cm 165cm 160cm 体重 65kg 130kg 70kg 55kg 70kg 80kg 50kg 80kg 130kg 収⼊ 300万円 500万円 400万円 800万円 550万円 250万円 600万円 250万円 500万円


 tatamiya
 ryuguyana
 shinyaa31
 oracle4engineer
 pospome
 ayakurabuchi
 shinichirokawano
 kinunori
 ny7760
 snoozer05
 cmusudakeisuke
 bessaralink55
 aleyda
 tapps
 jcasabona
 eitanlees
 mongodb
 ks91
 bkeepers
 geshan
 mfonobong
 mlcsv
 csswizardry
 rocio