Share
Embed
SNLP2023:Is GPT-3 a Good Data Annotator?
Yuki Zenimoto
August 19, 2023
Transcript
39 slides
-
Is GPT-3 a Good Data Annotator? https://aclanthology.org/2023.acl-long.626/ Bosheng Ding, Chengwei
Qin, Linlin Liu, Yew Ken Chia, Boyang Li, Shafiq Joty, and Lidong Bing ACL 2023 読み手: 銭本 友樹/Zenimoto Yuki (筑波大) @第15回最先端NLP勉強会 ※特に注釈のない限り,スライド内の画像は紹介論文より引用 -
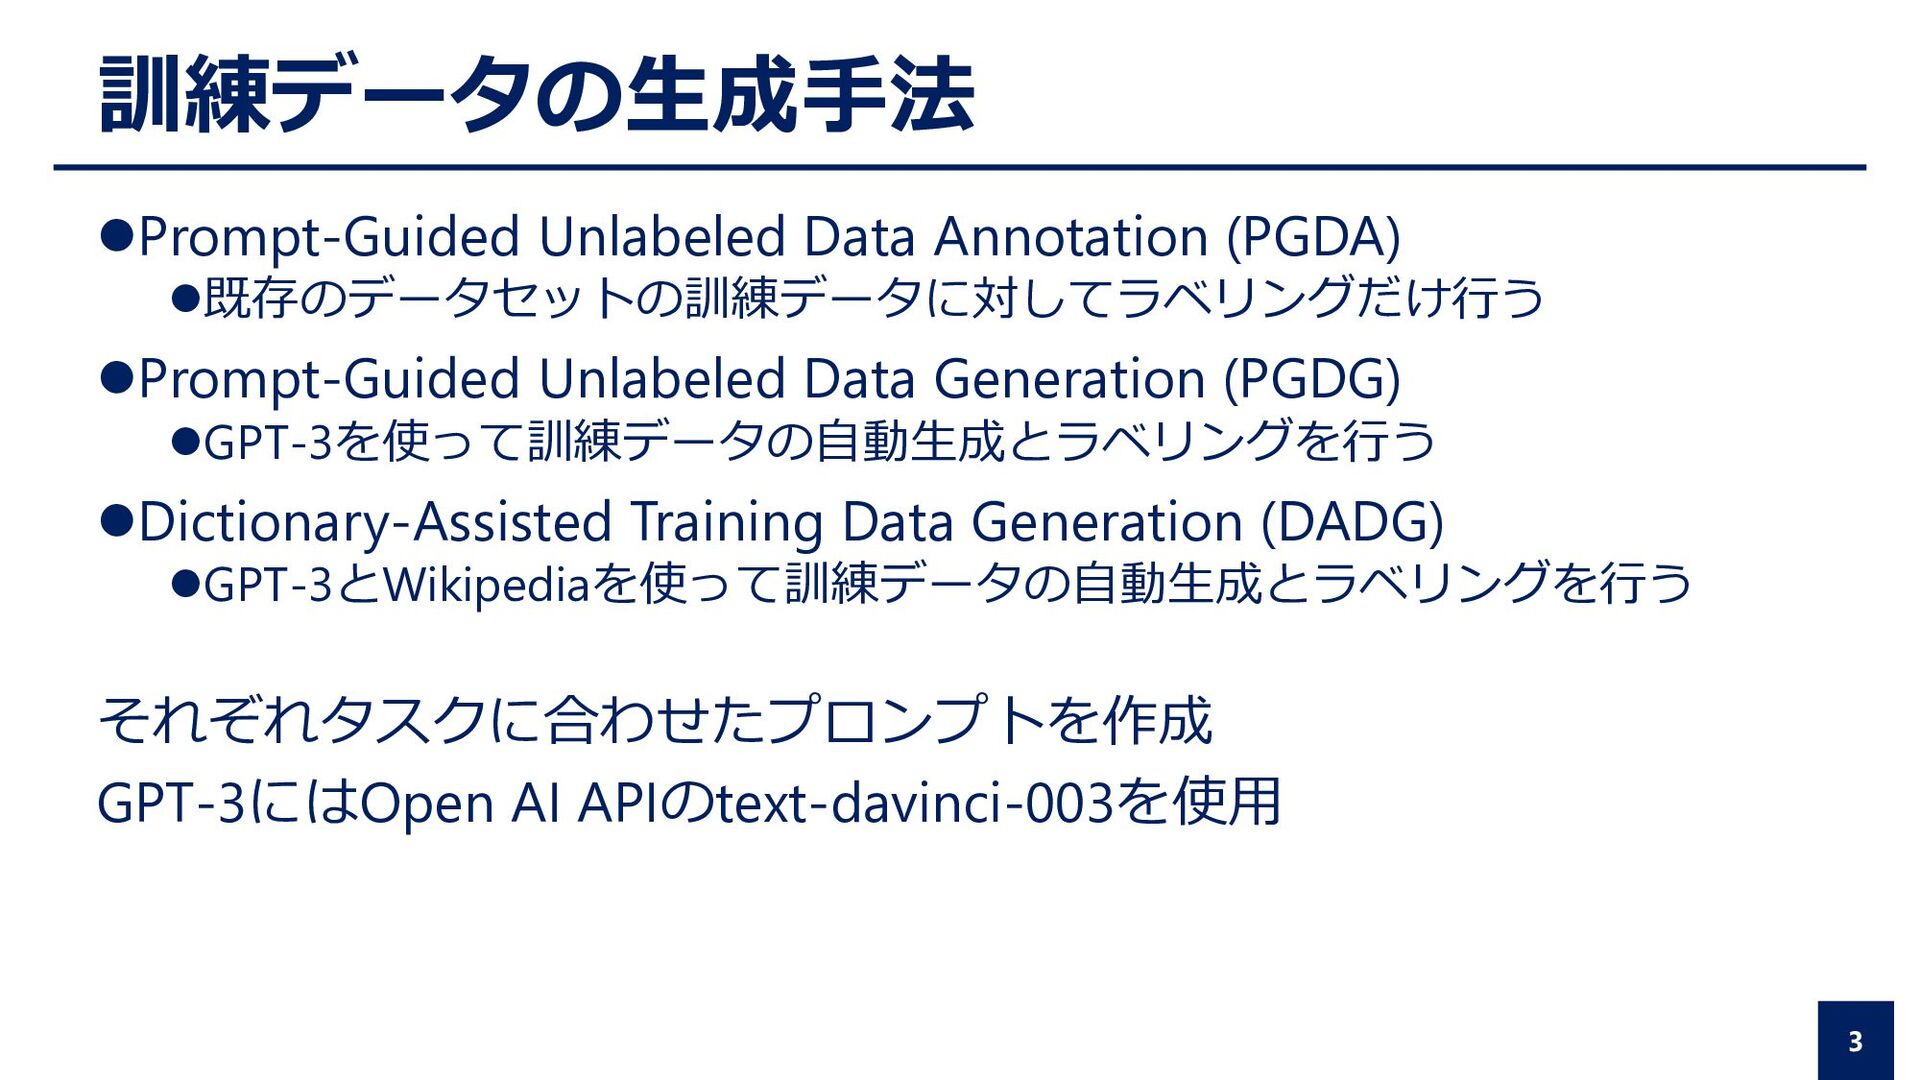
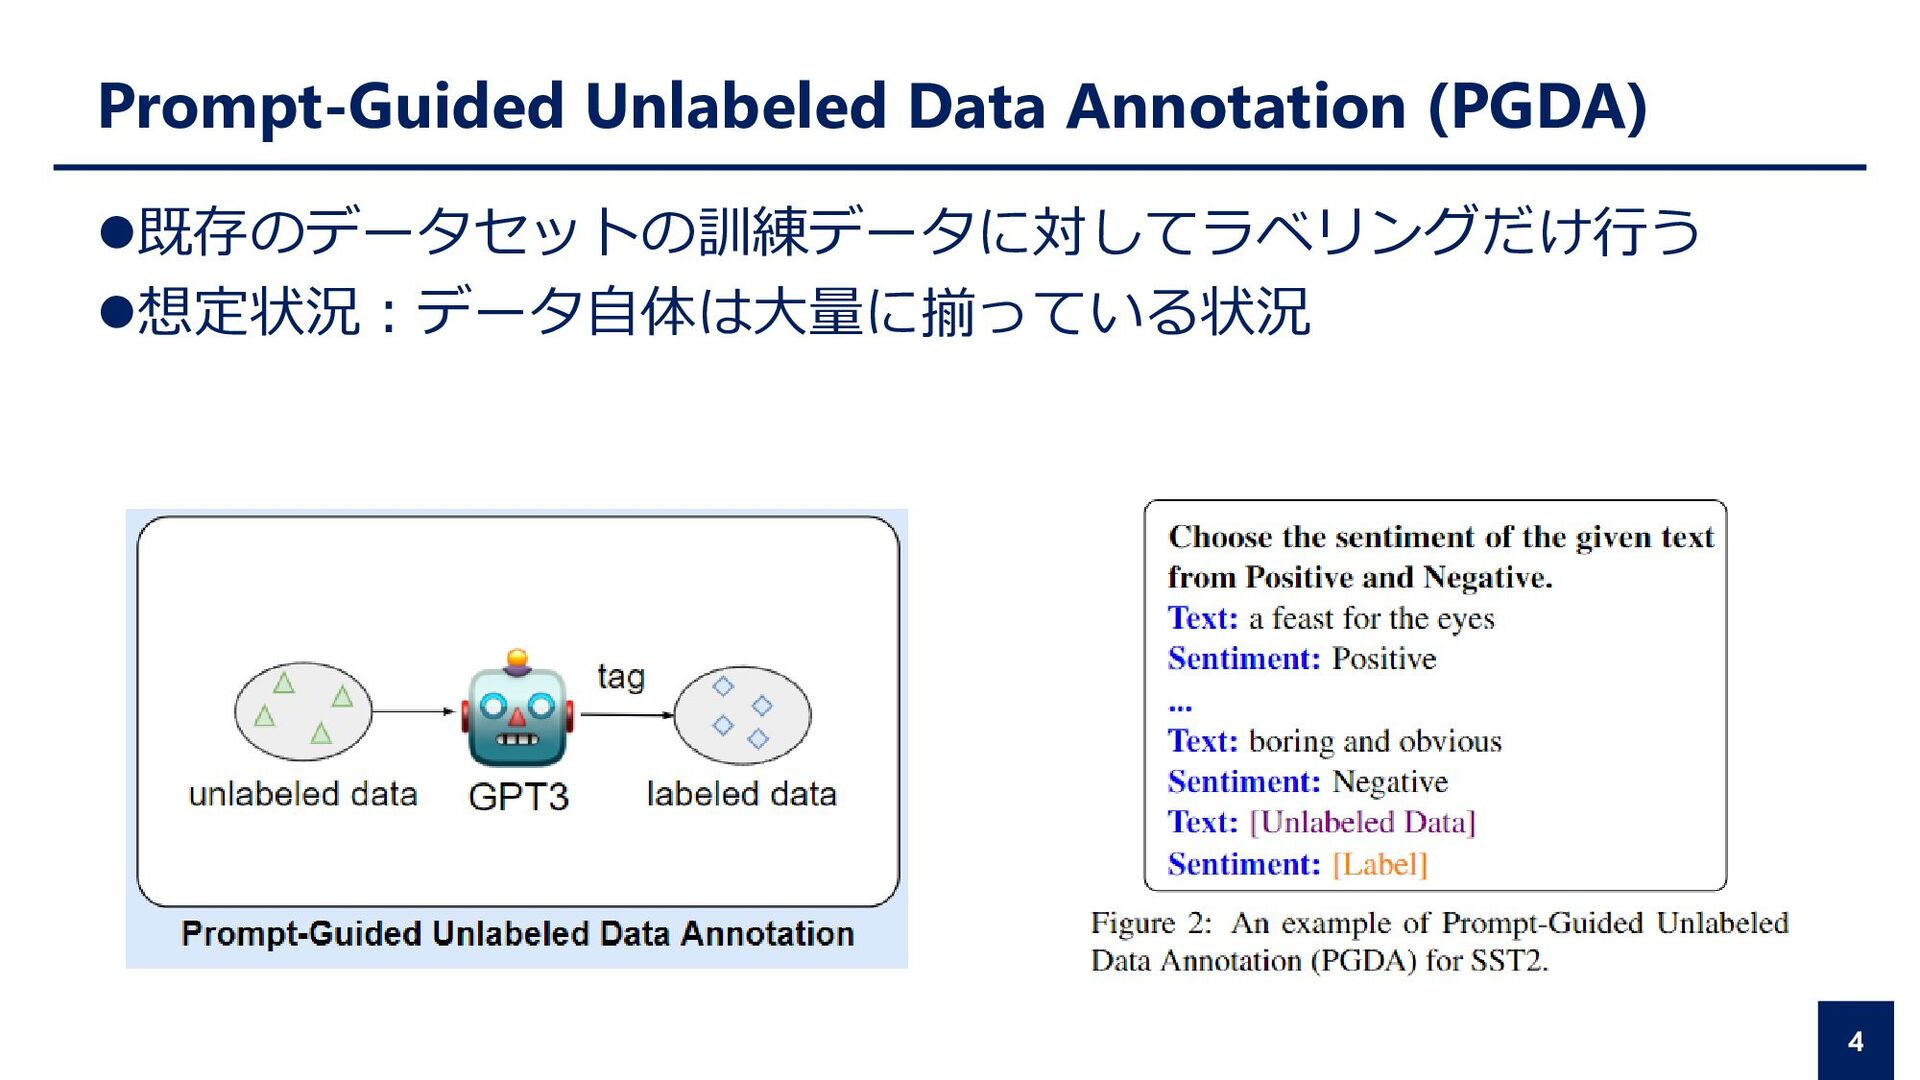
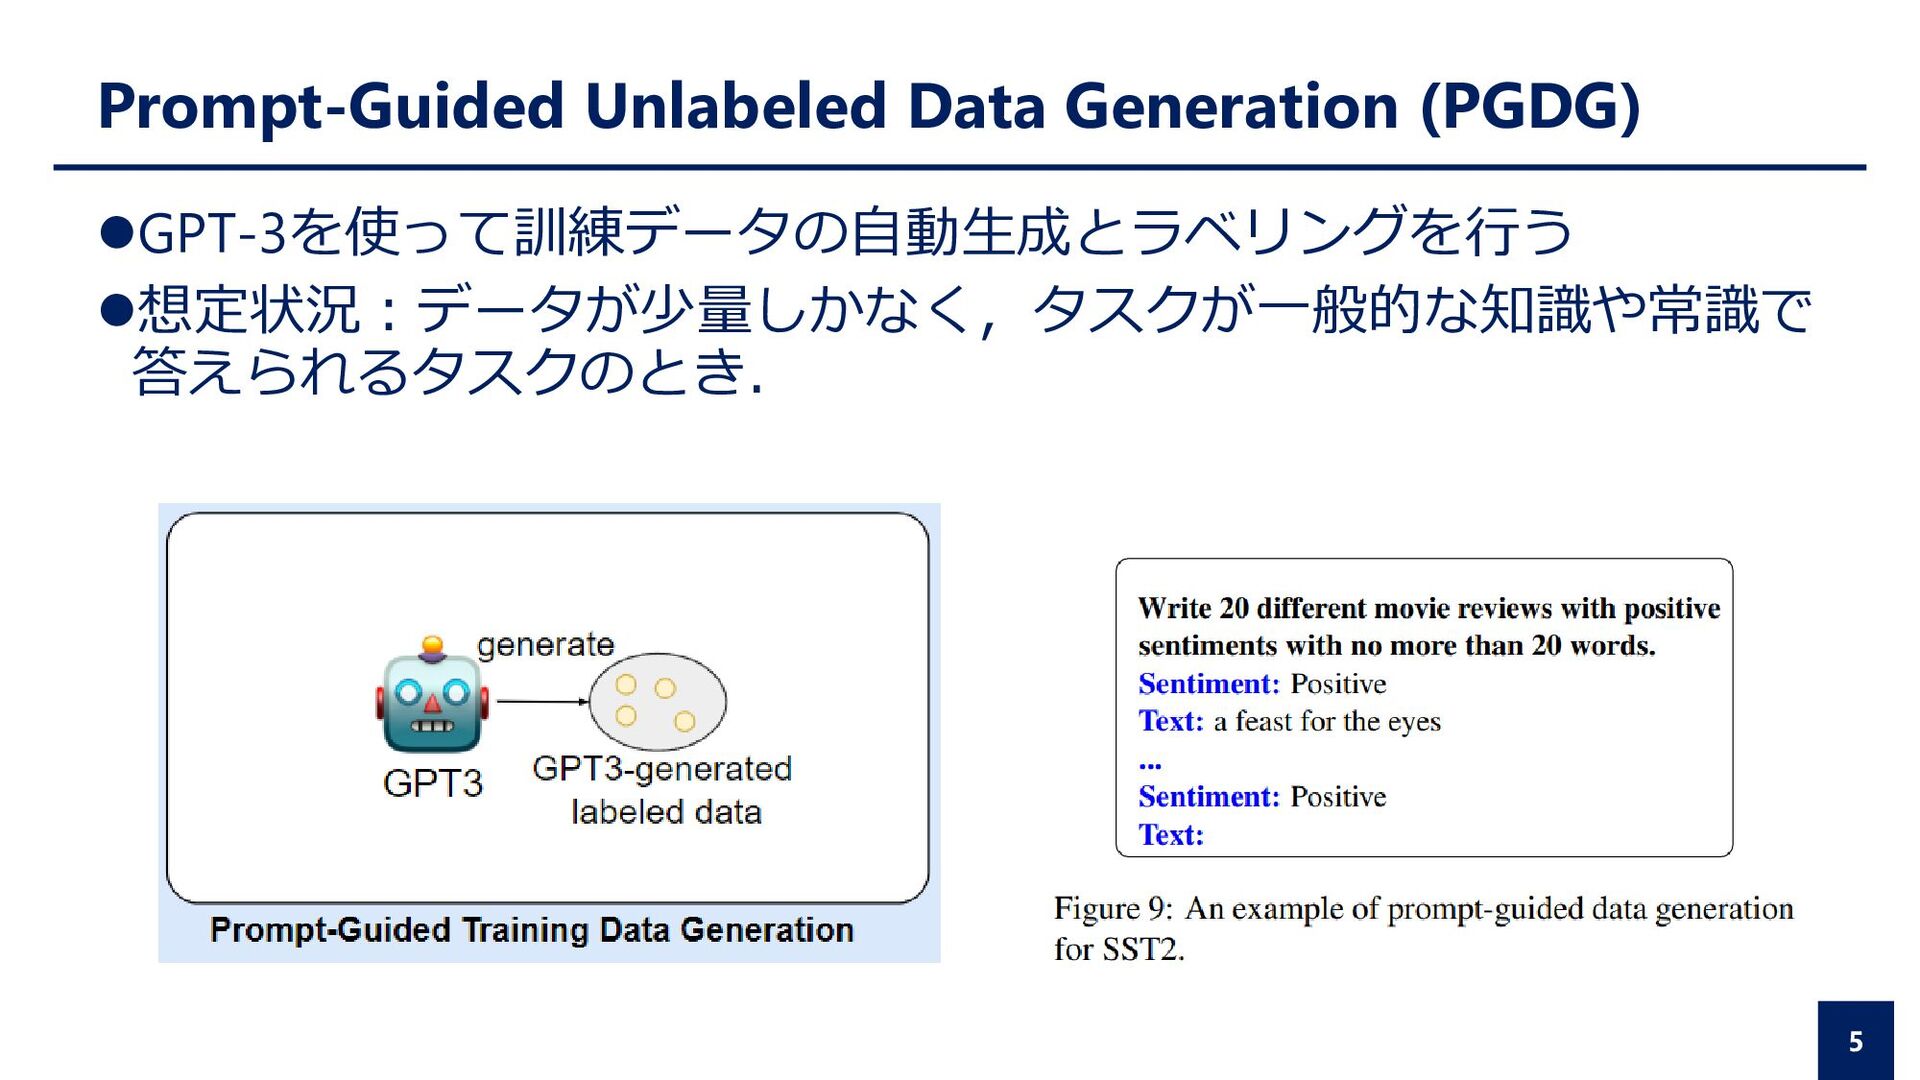
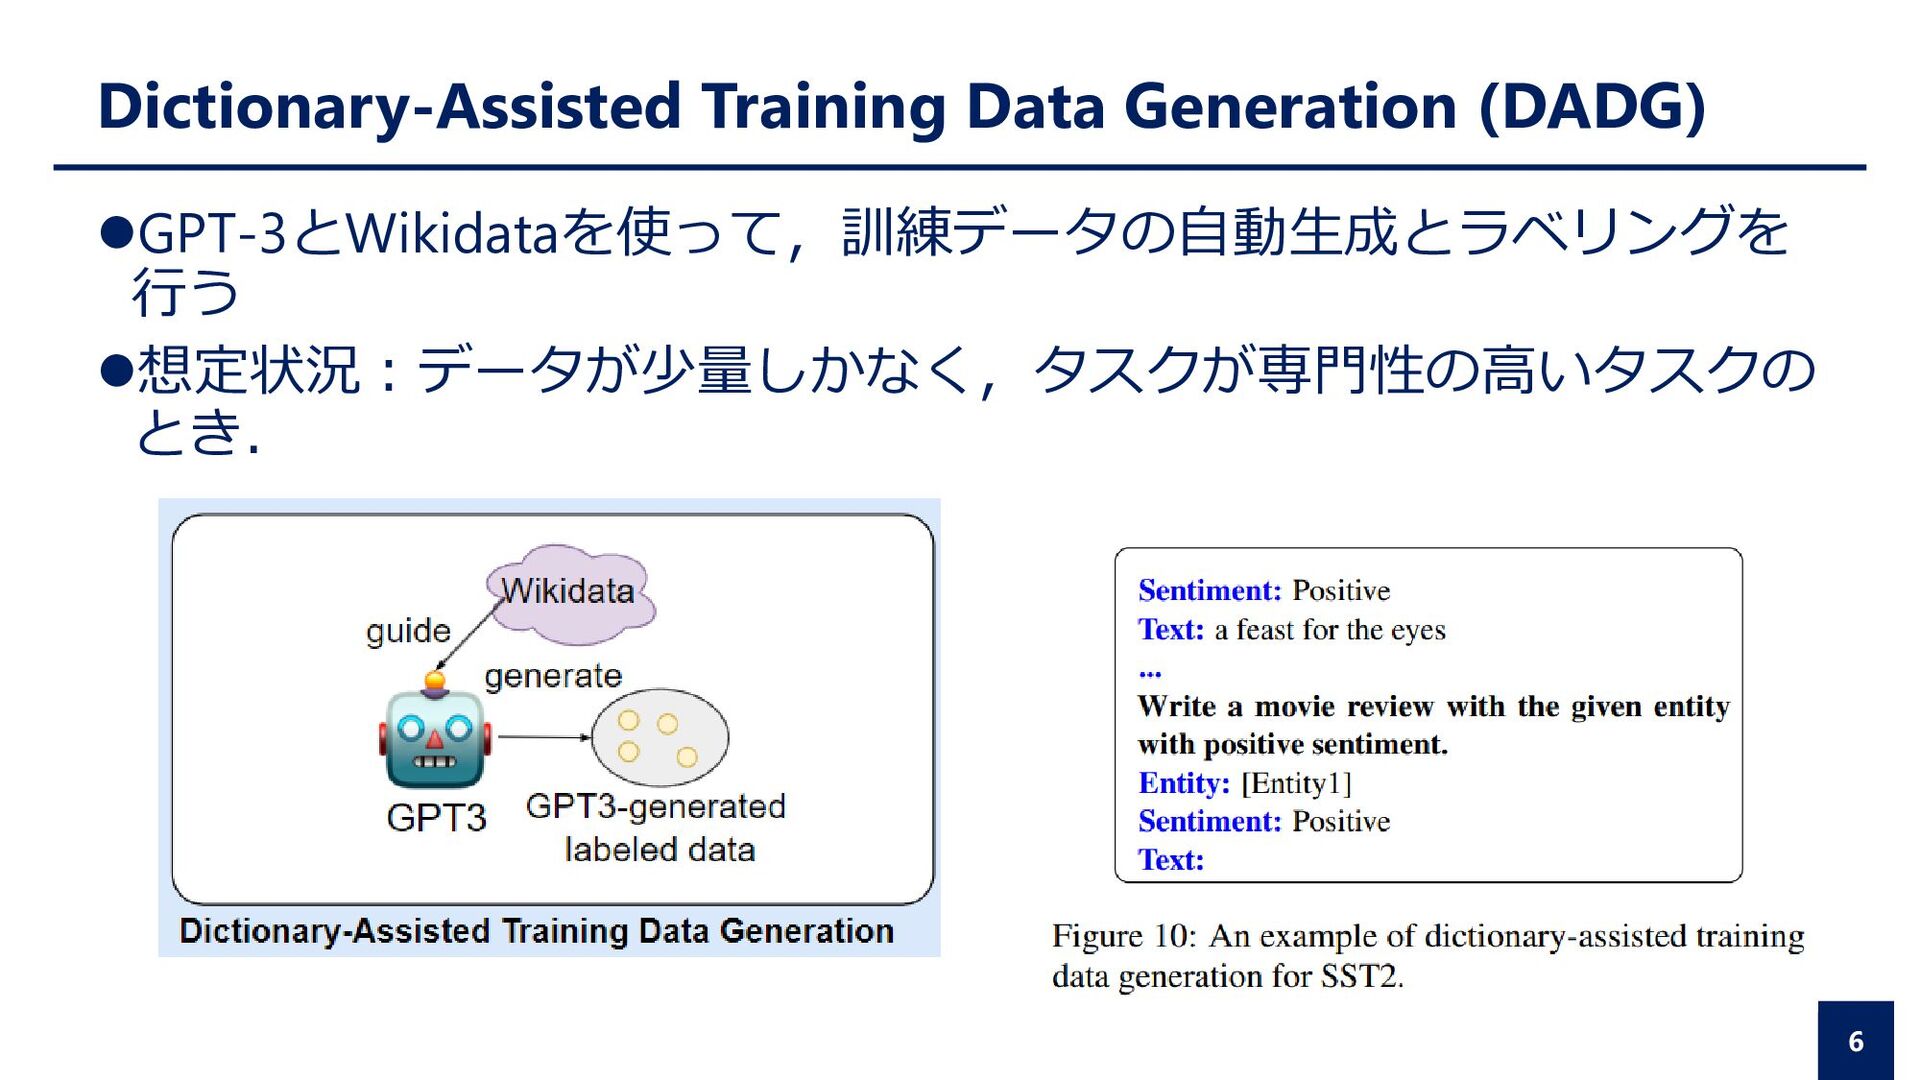
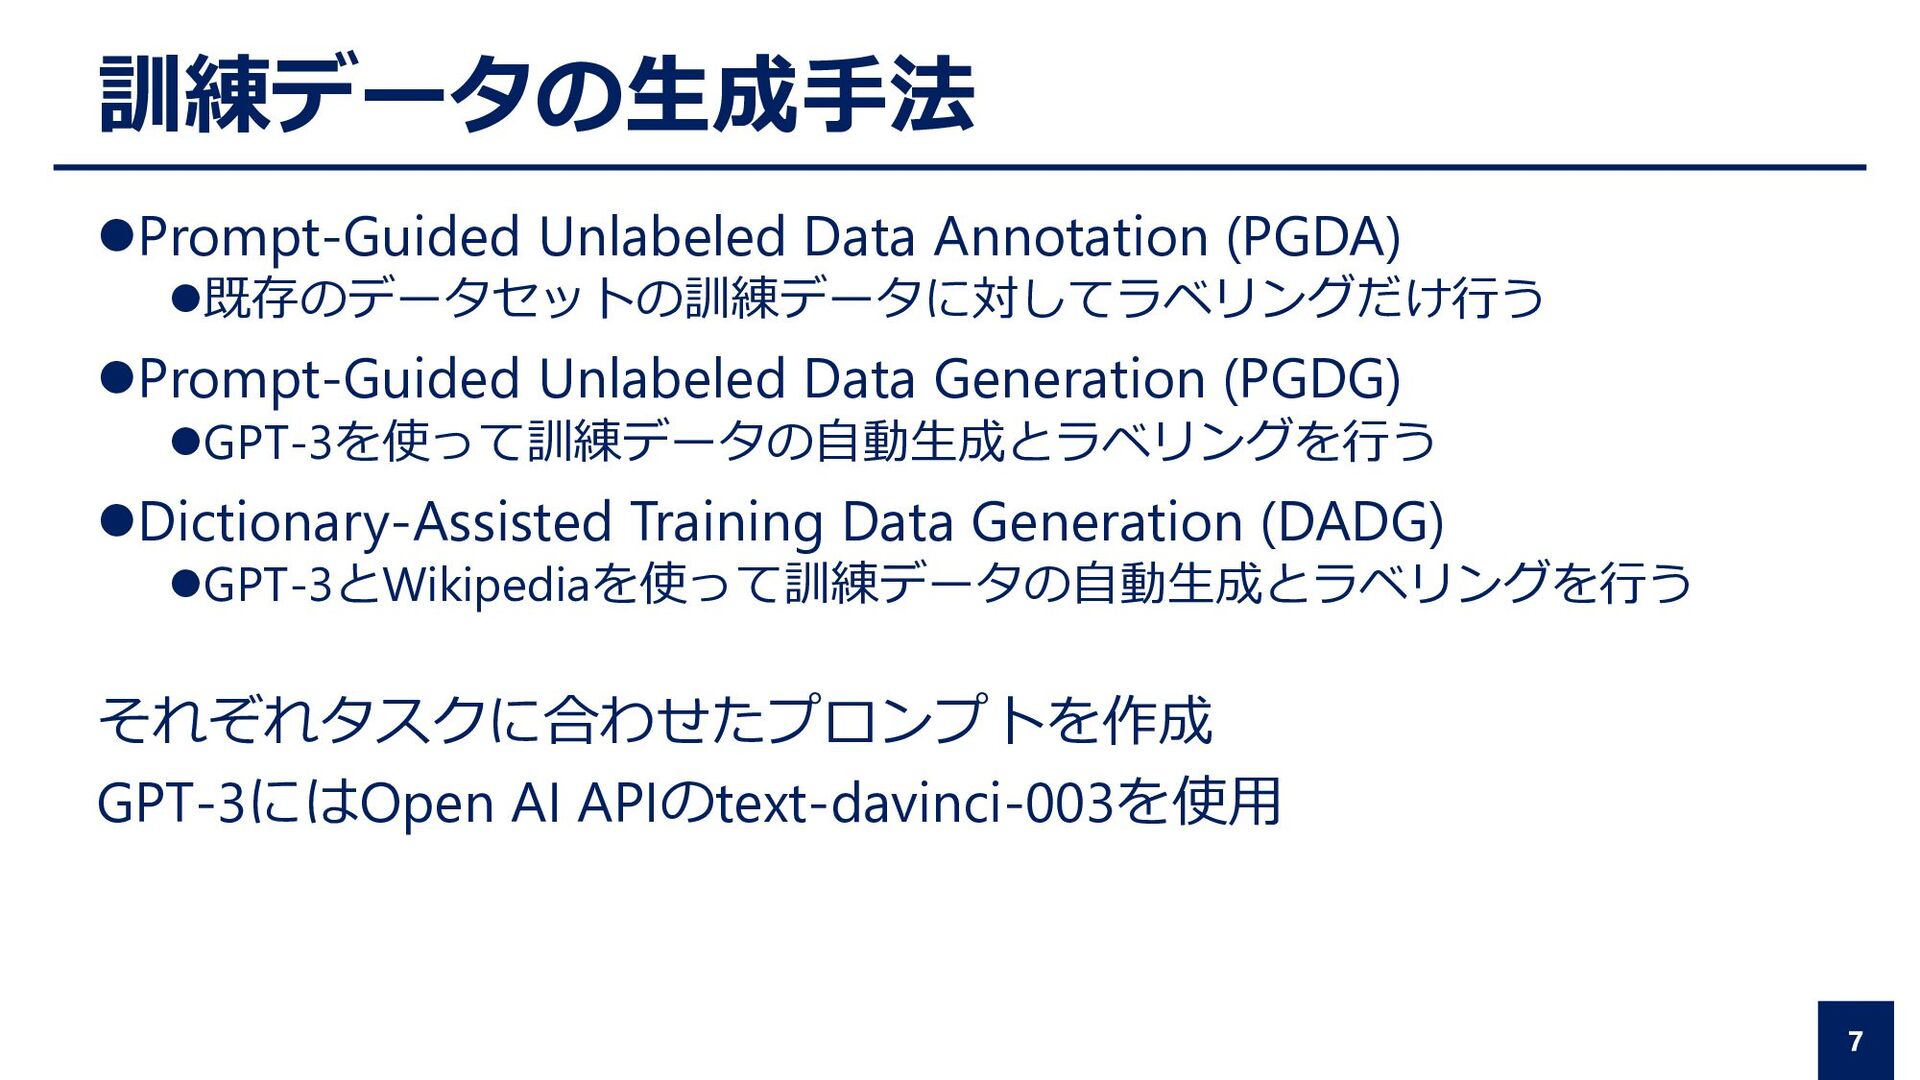
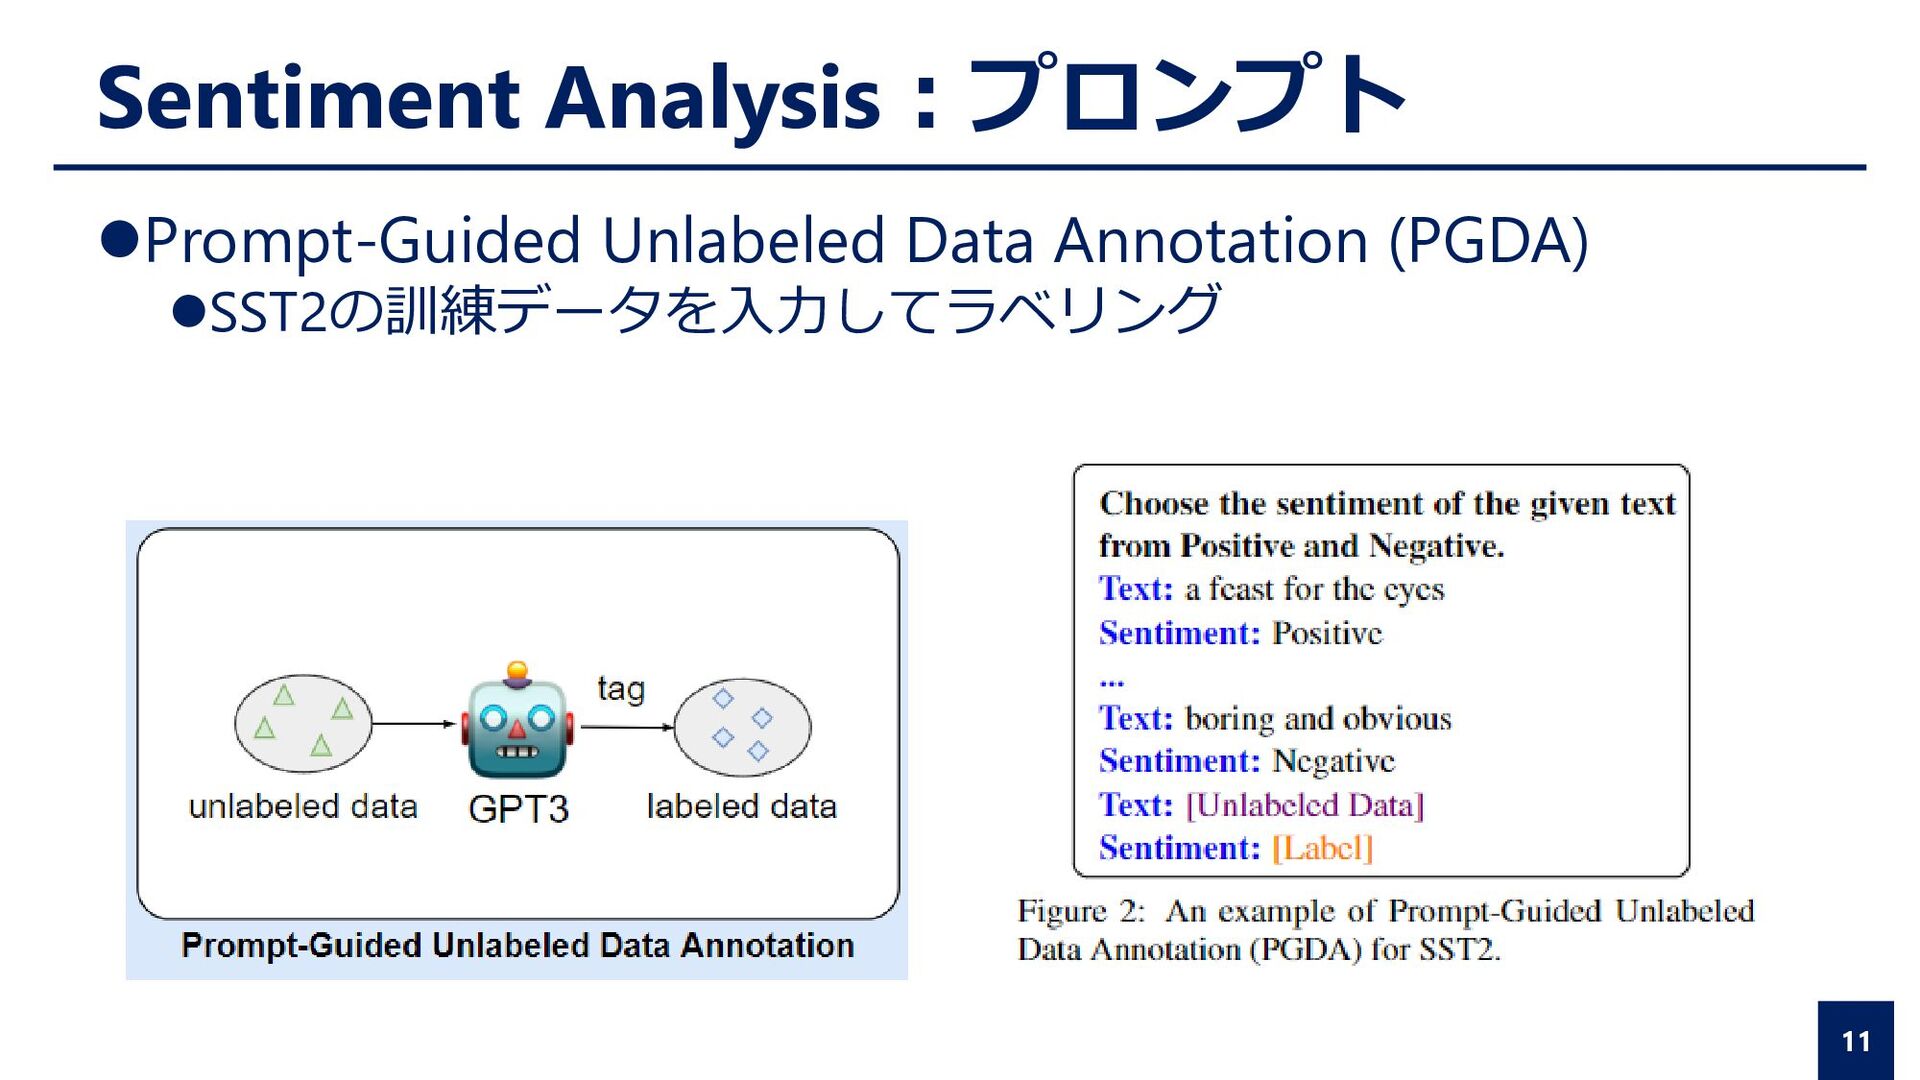
訓練データの生成手法 ⚫Prompt-Guided Unlabeled Data Annotation (PGDA) ⚫既存のデータセットの訓練データに対してラベリングだけ行う ⚫Prompt-Guided Unlabeled Data
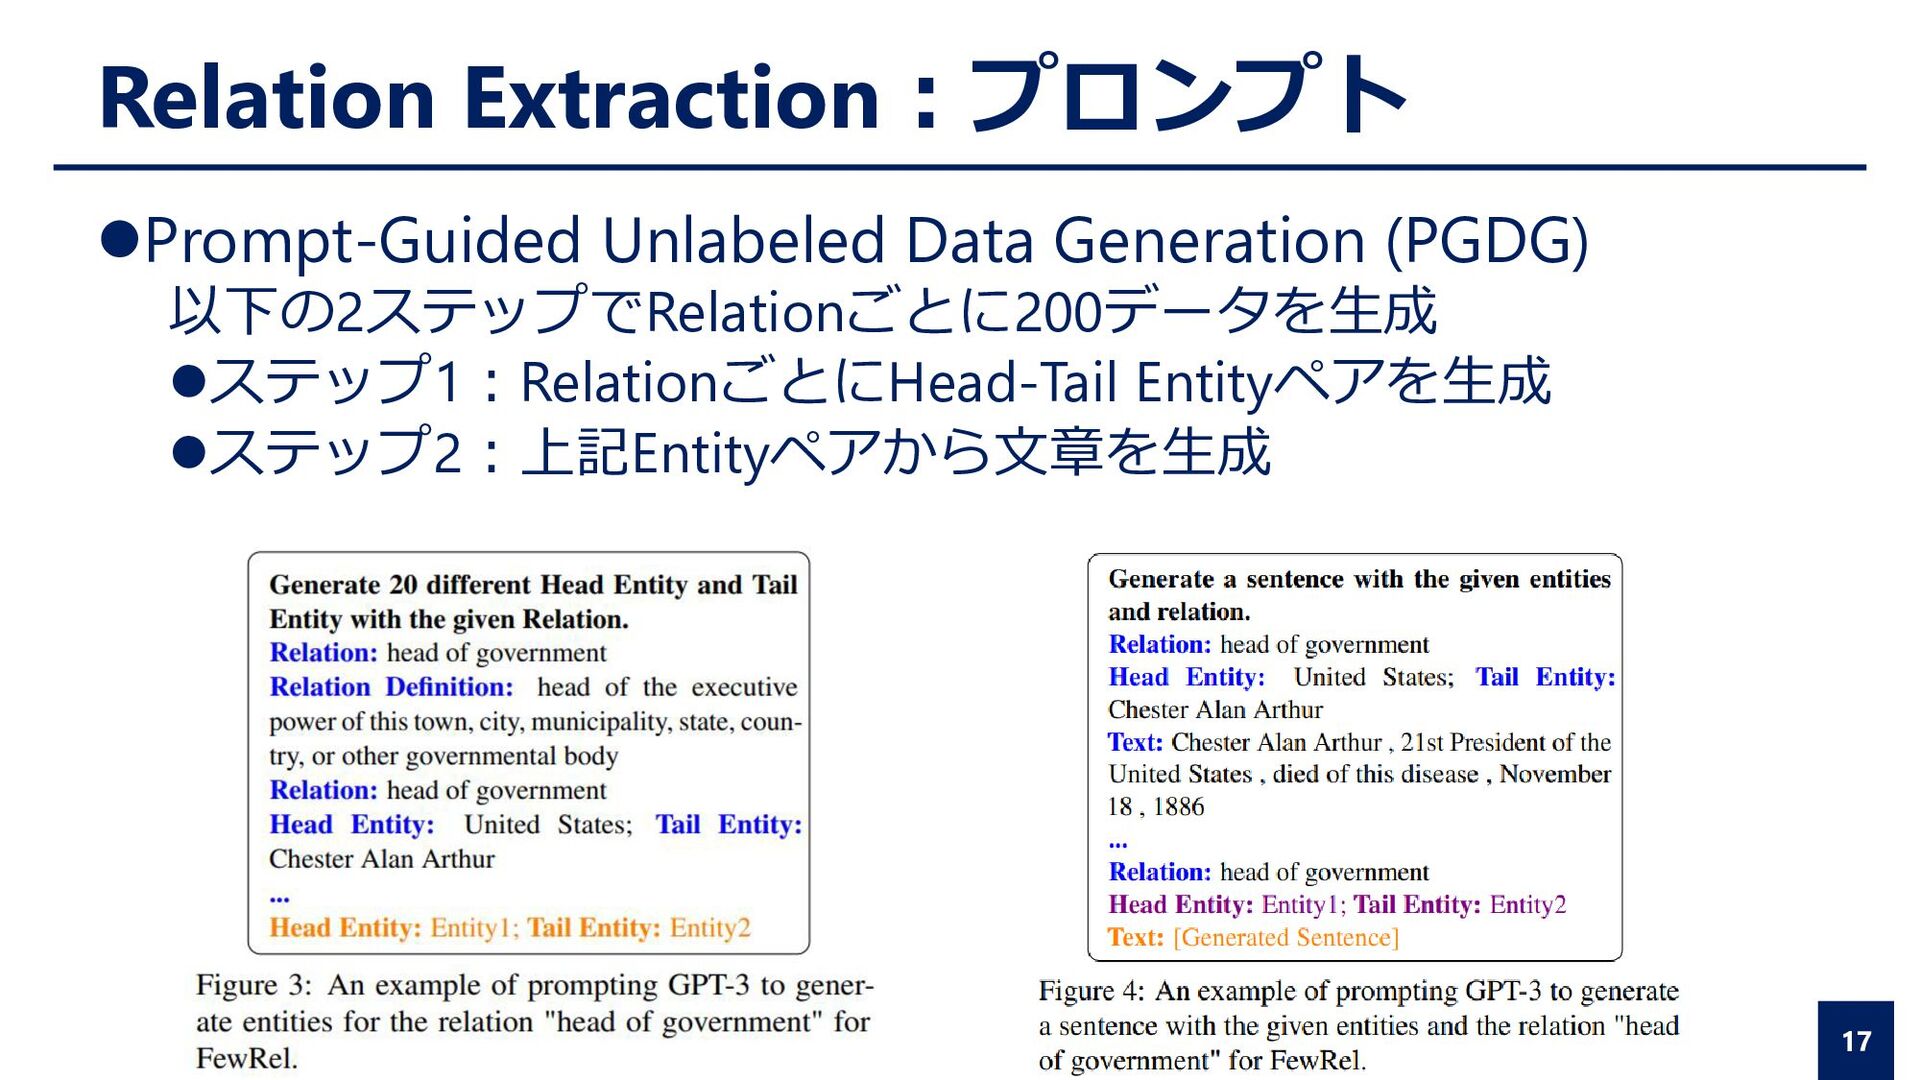
Generation (PGDG) ⚫GPT-3を使って訓練データの自動生成とラベリングを行う ⚫Dictionary-Assisted Training Data Generation (DADG) ⚫GPT-3とWikipediaを使って訓練データの自動生成とラベリングを行う それぞれタスクに合わせたプロンプトを作成 GPT-3にはOpen AI APIのtext-davinci-003を使用 3 -
訓練データの生成手法 ⚫Prompt-Guided Unlabeled Data Annotation (PGDA) ⚫既存のデータセットの訓練データに対してラベリングだけ行う ⚫Prompt-Guided Unlabeled Data
Generation (PGDG) ⚫GPT-3を使って訓練データの自動生成とラベリングを行う ⚫Dictionary-Assisted Training Data Generation (DADG) ⚫GPT-3とWikipediaを使って訓練データの自動生成とラベリングを行う それぞれタスクに合わせたプロンプトを作成 GPT-3にはOpen AI APIのtext-davinci-003を使用 7 -
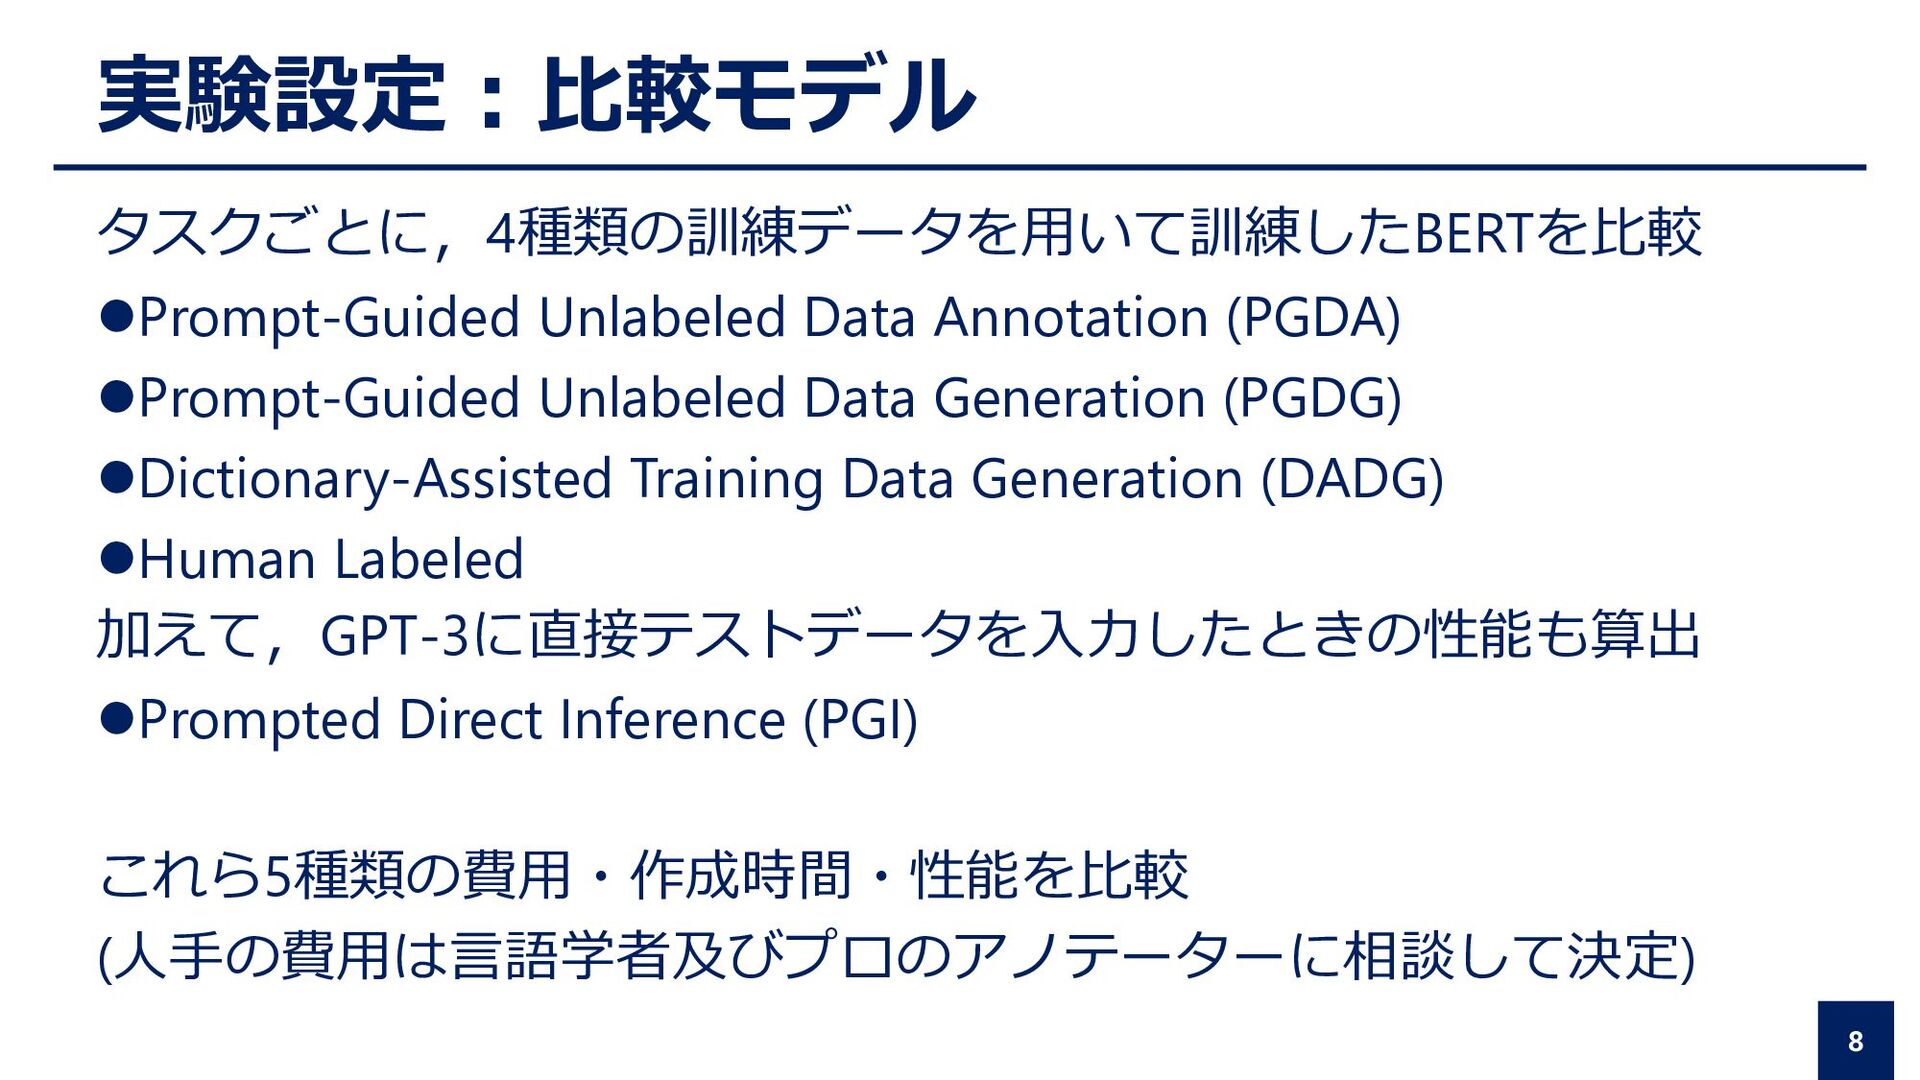
実験設定:比較モデル タスクごとに,4種類の訓練データを用いて訓練したBERTを比較 ⚫Prompt-Guided Unlabeled Data Annotation (PGDA) ⚫Prompt-Guided Unlabeled Data
Generation (PGDG) ⚫Dictionary-Assisted Training Data Generation (DADG) ⚫Human Labeled 加えて,GPT-3に直接テストデータを入力したときの性能も算出 ⚫Prompted Direct Inference (PGI) これら5種類の費用・作成時間・性能を比較 (人手の費用は言語学者及びプロのアノテーターに相談して決定) 8 -
対象タスク (データセット) ⚫Sequence-level Task ⚫Sentiment Analysis (SST2[1]) ⚫Relation Extraction (FewRel[2])
⚫Token-level Task ⚫Named Entity Recognition (Cross NER[3]のAI domainのもの) ⚫Aspect Sentiment Tripret Extraction (laptop domain[4]) 9 [1] Socher et al. Recursive deep models for semantic compositionality over a sentiment treebank, 2013, EMNLP [2] Han et al. FewRel: A Large-Scale Supervised Few-Shot Relation Classification Dataset with State-of-the-Art Evaluation, 2018, ACL [3] Liu et al. Crossner: Evaluating cross-domain named entity recognition, 2020, AAAI [4] Xu et al. Position-Aware Tagging for Aspect Sentiment Triplet Extraction, 2020, EMNLP -
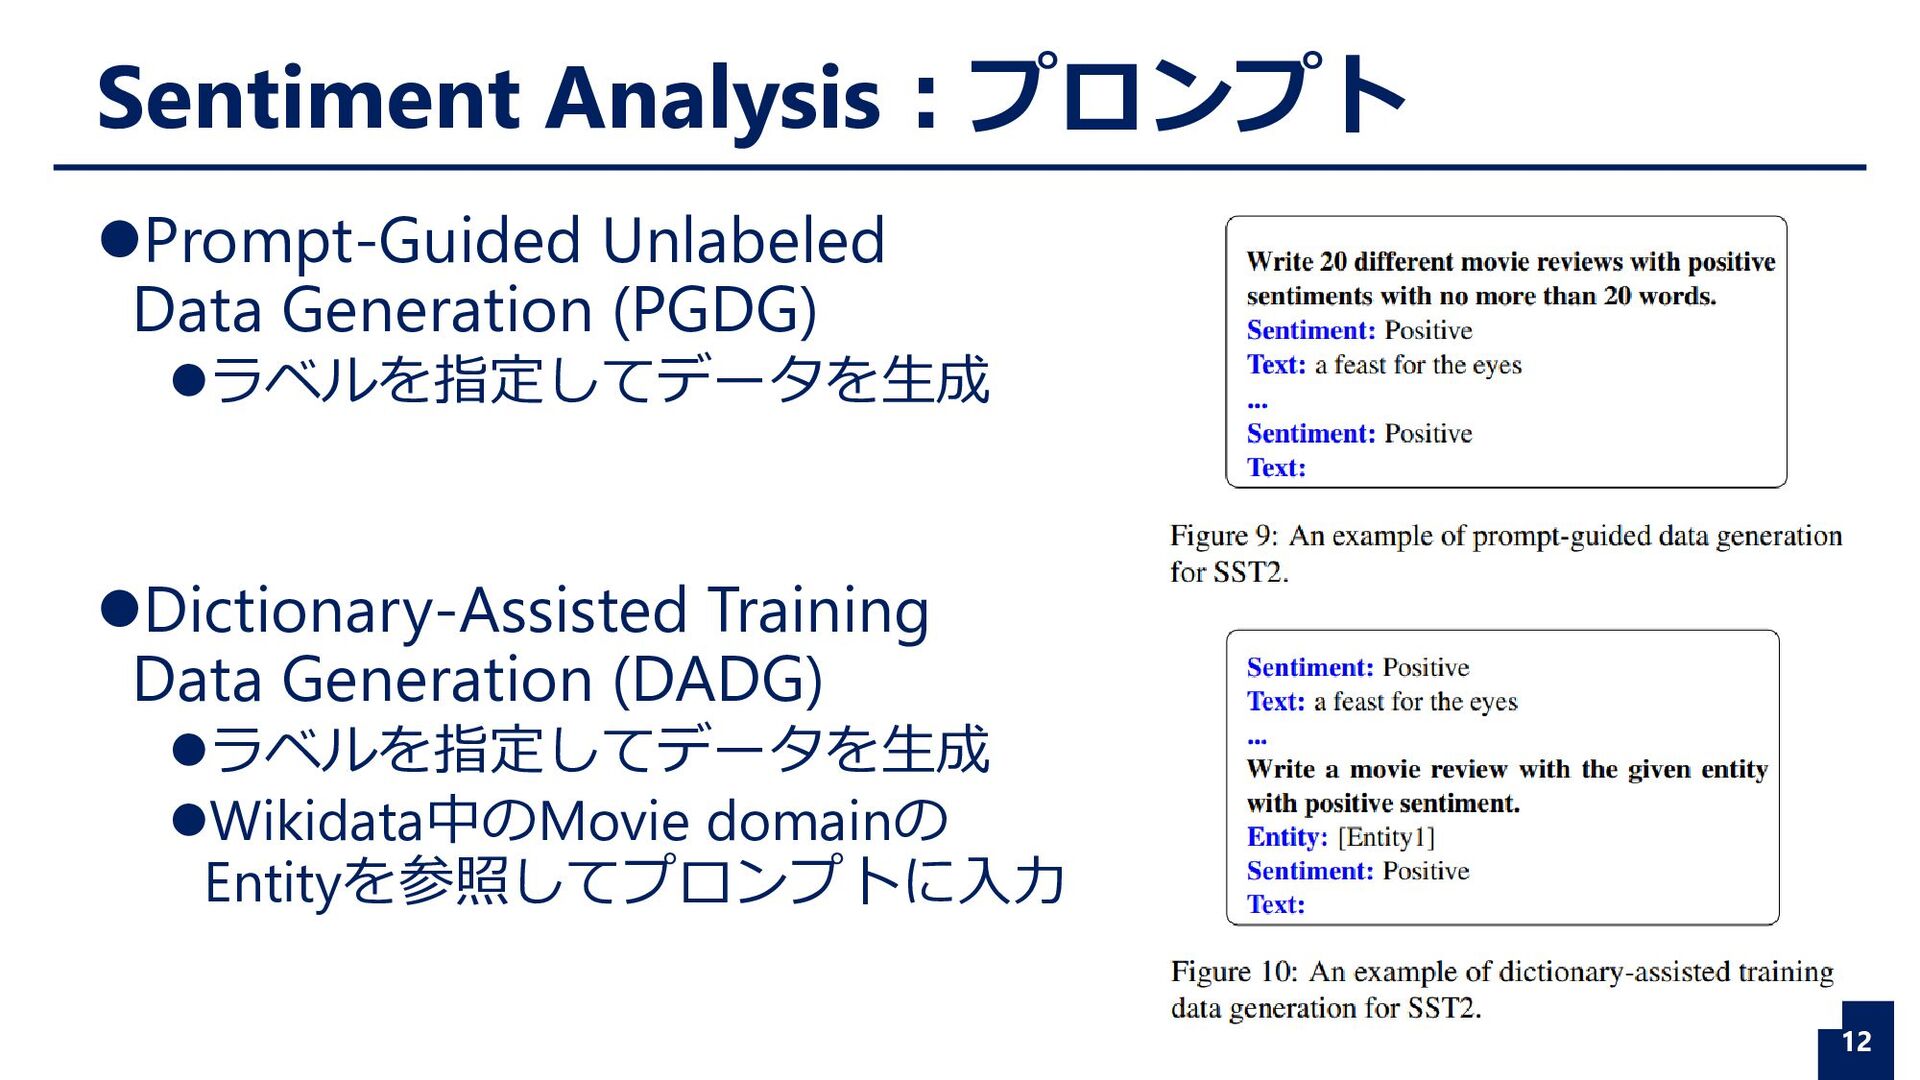
Sentiment Analysis:プロンプト ⚫Prompt-Guided Unlabeled Data Generation (PGDG) ⚫ラベルを指定してデータを生成 ⚫Dictionary-Assisted Training
Data Generation (DADG) ⚫ラベルを指定してデータを生成 ⚫Wikidata中のMovie domainの Entityを参照してプロンプトに入力 12 -
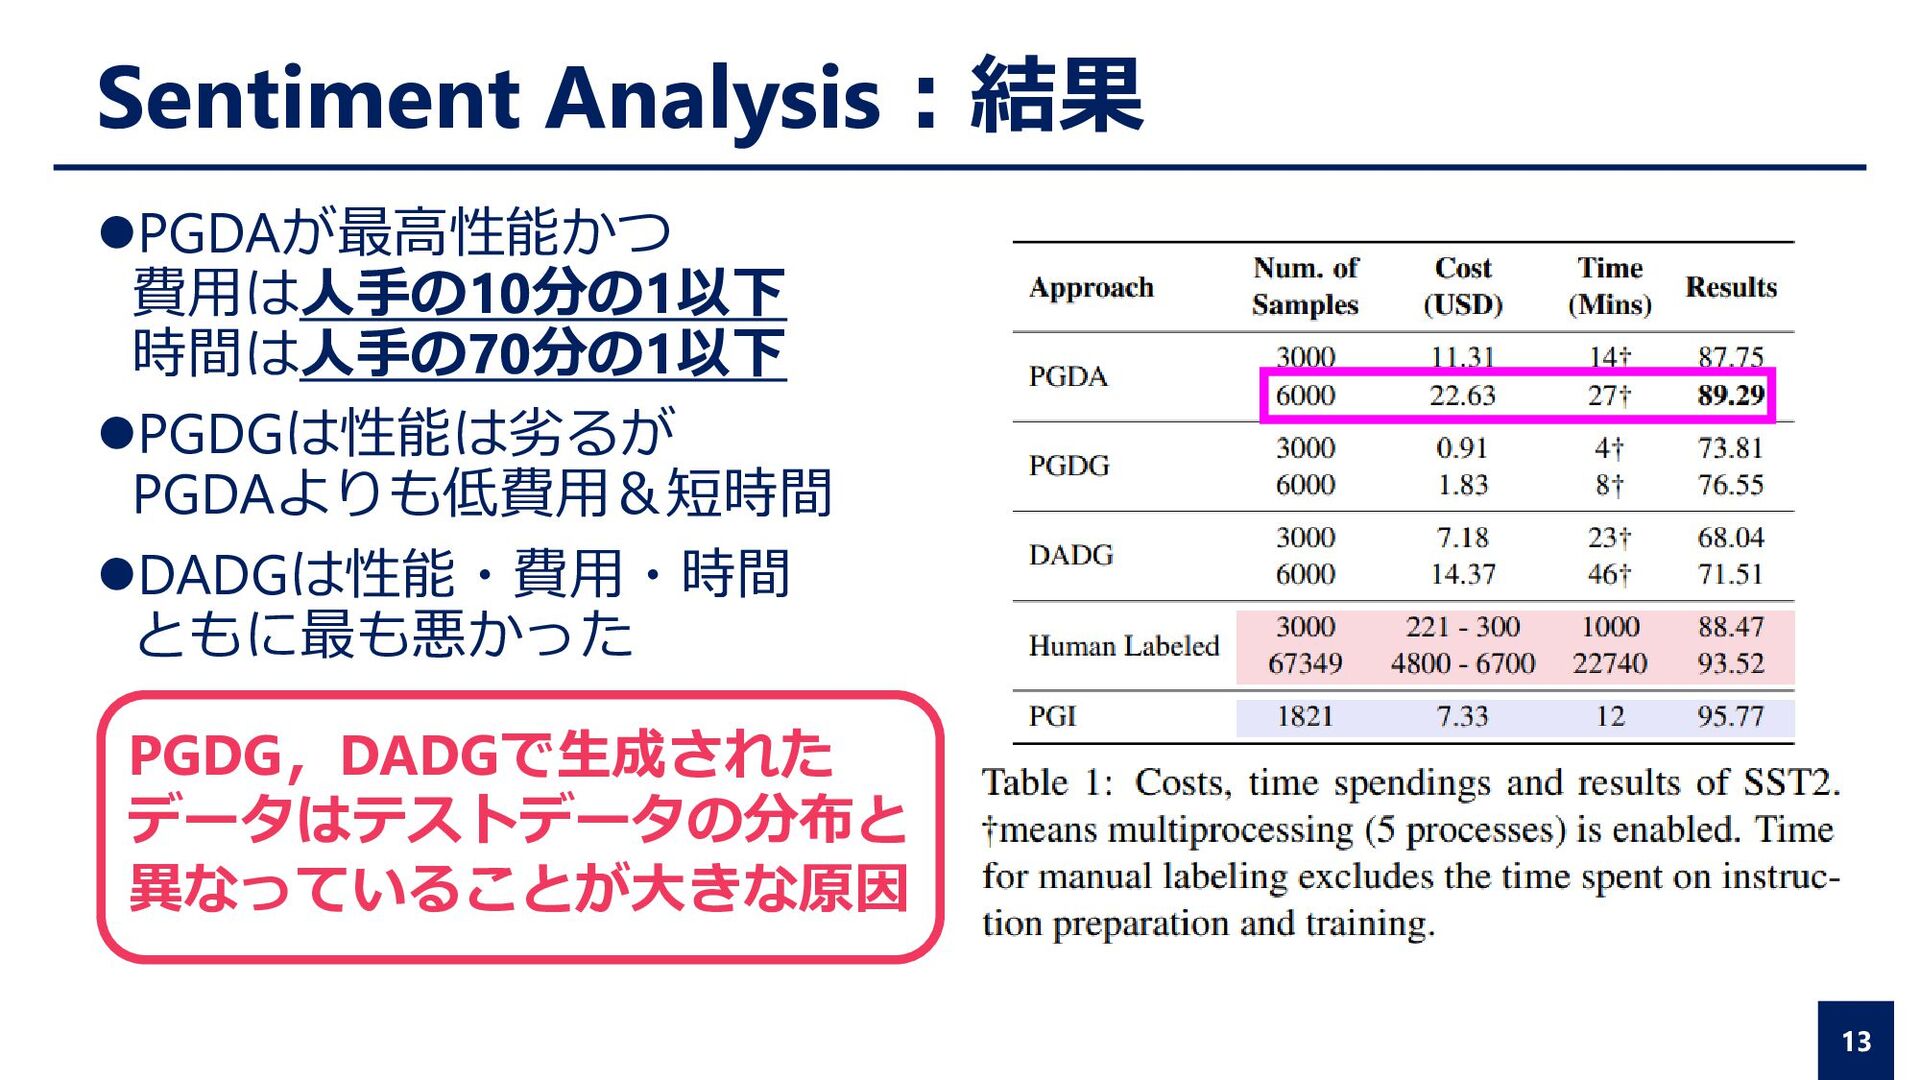
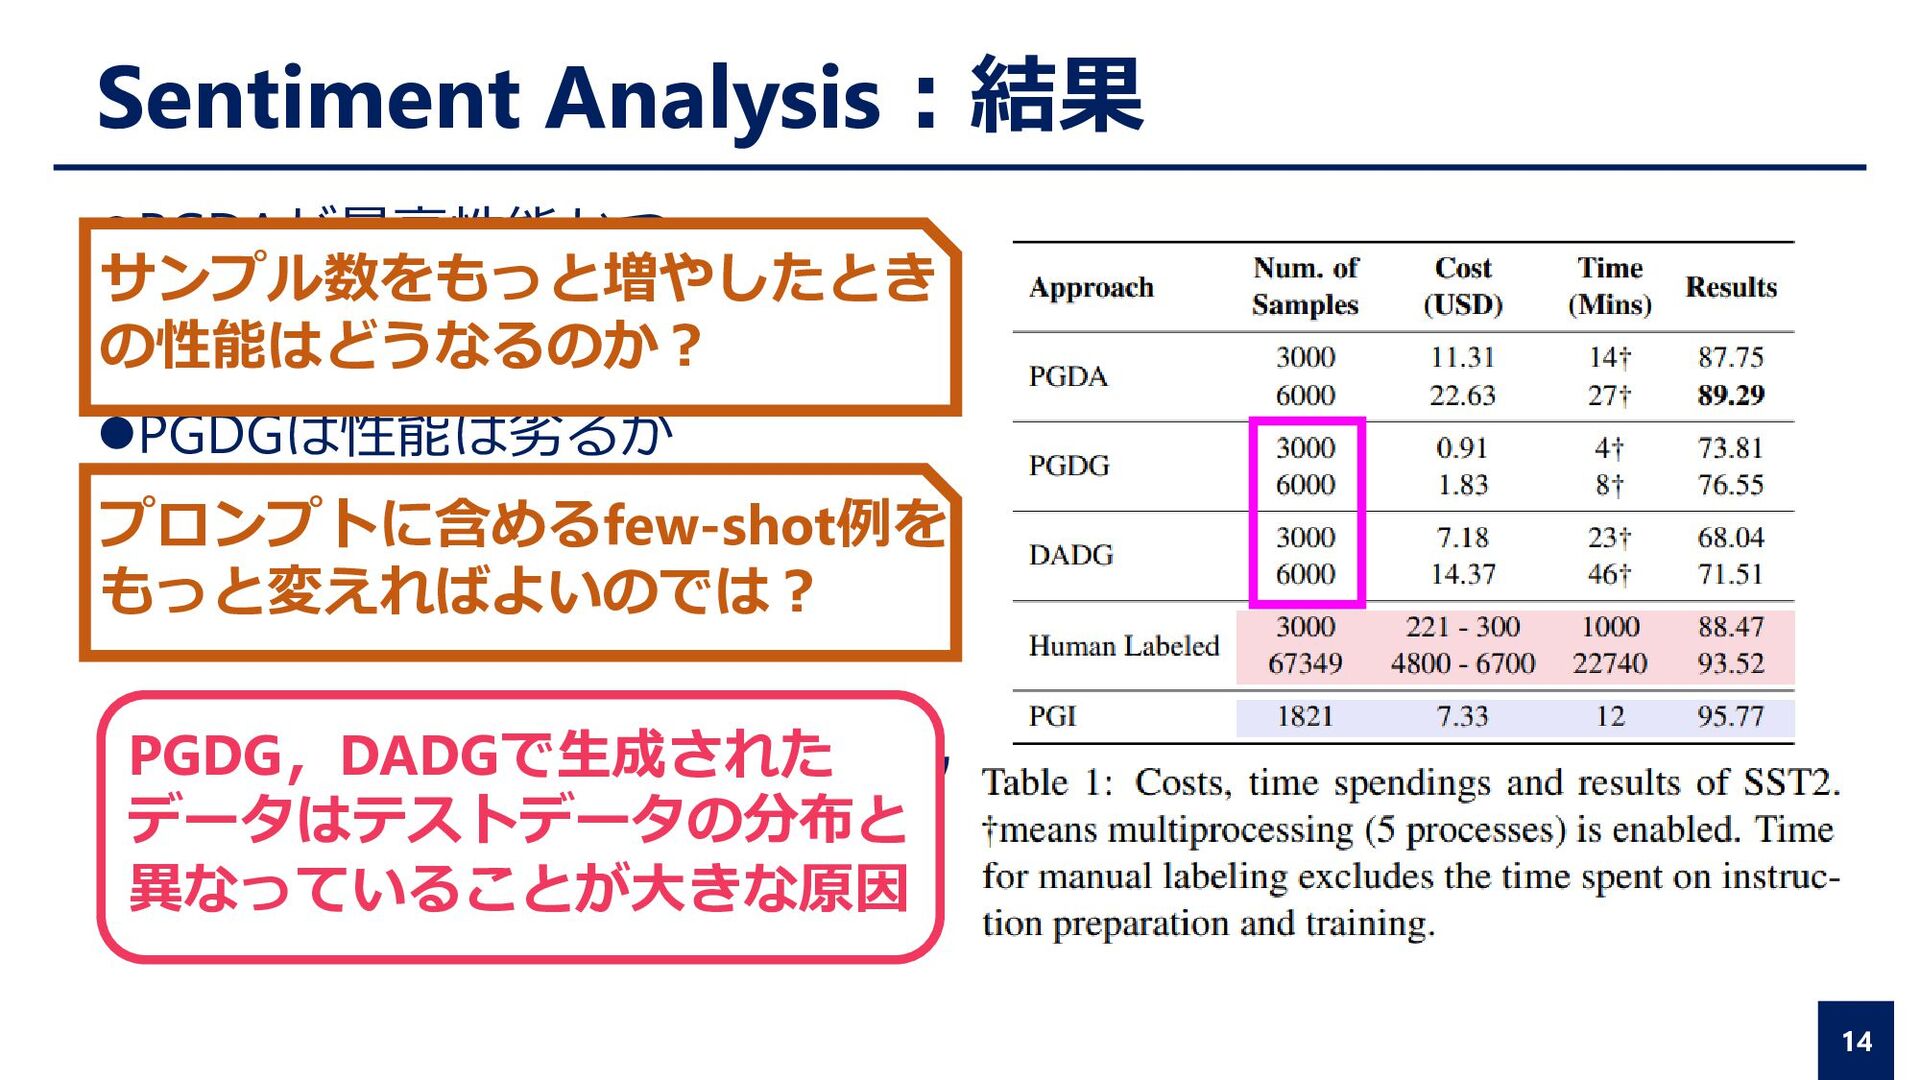
Sentiment Analysis:結果 ⚫PGDAが最高性能かつ 費用は人手の10分の1以下 時間は人手の70分の1以下 ⚫PGDGは性能は劣るが PGDAよりも低費用&短時間 ⚫DADGは性能・費用・時間 ともに最も悪かった 13
PGDG,DADGで生成された データはテストデータの分布と 異なっていることが大きな原因 -
Sentiment Analysis:結果 ⚫PGDAが最高性能かつ 費用は人手の10分の1以下 時間は人手の70分の1以下 ⚫PGDGは性能は劣るが PGDAよりも低コスト&短時間 ⚫DADGは性能・コスト・時間 ともに最も悪かった PGDG,DADGで生成されたデータ
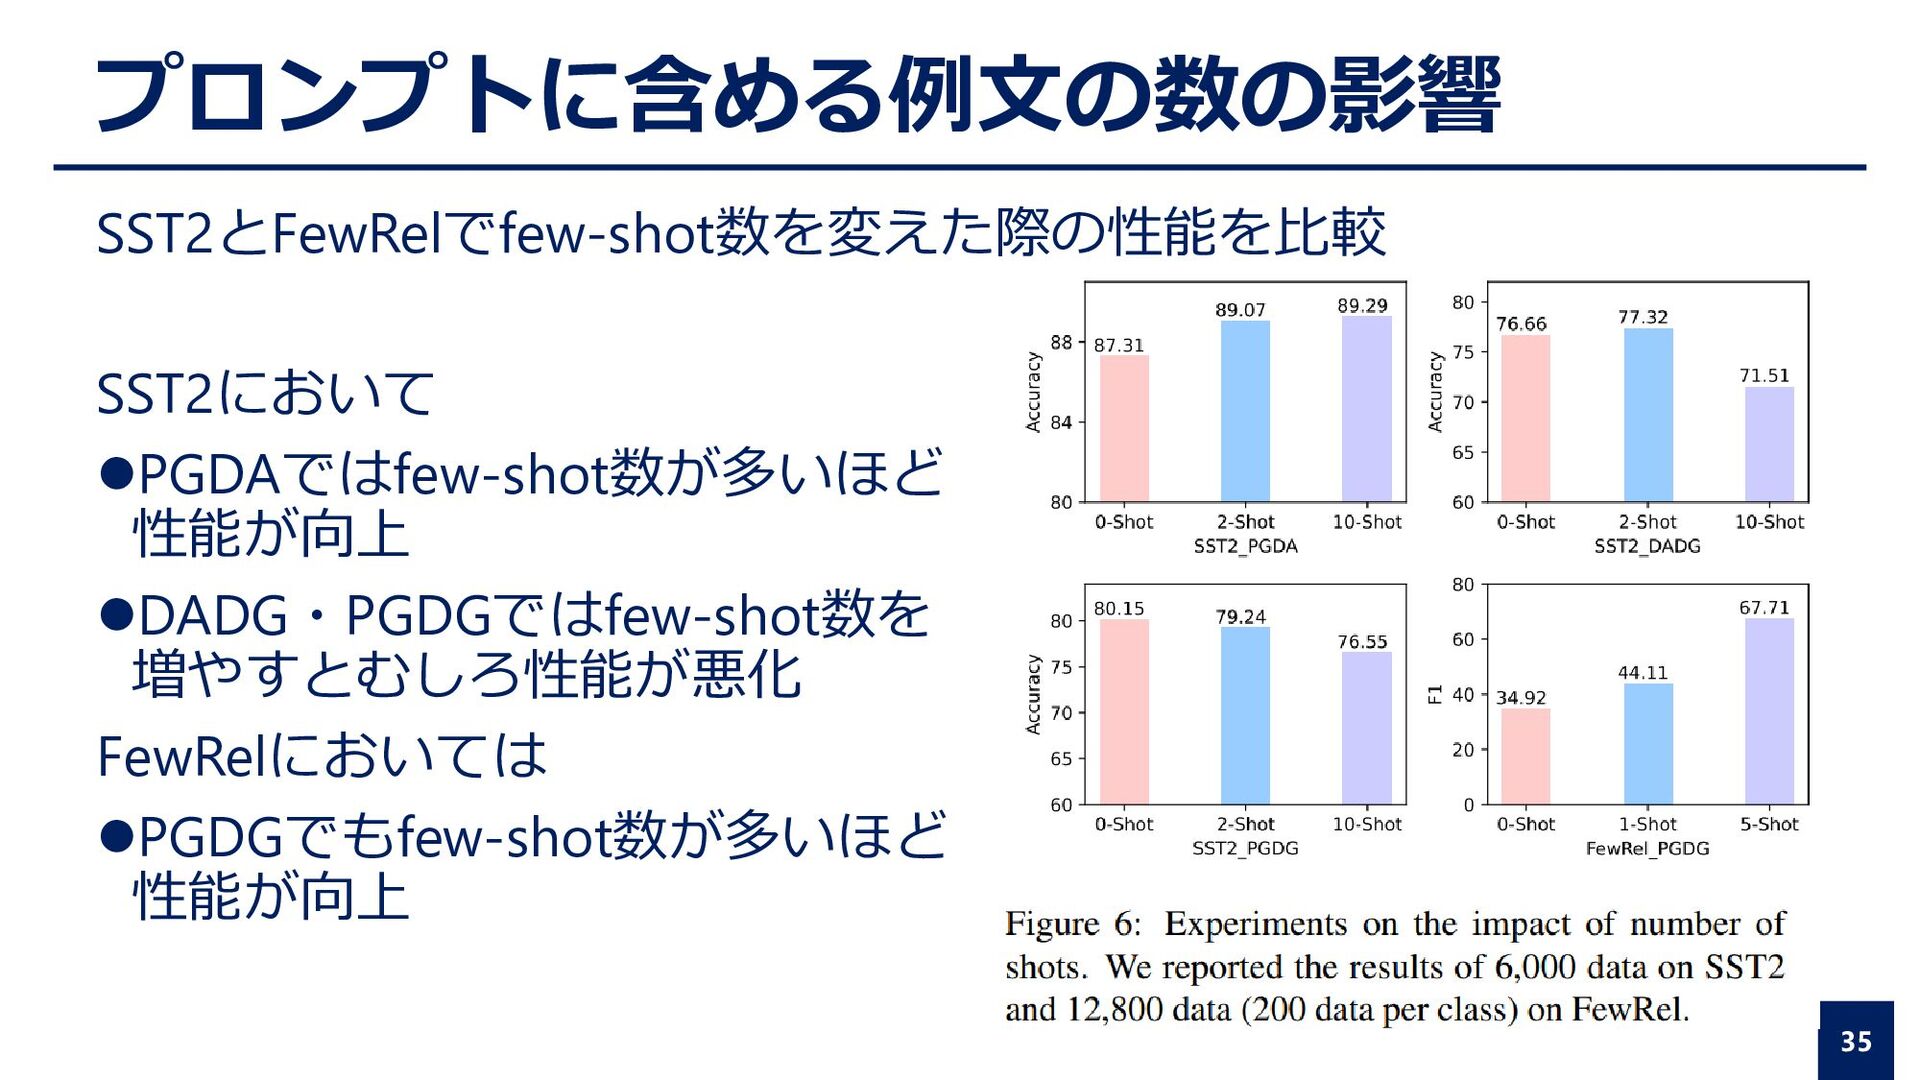
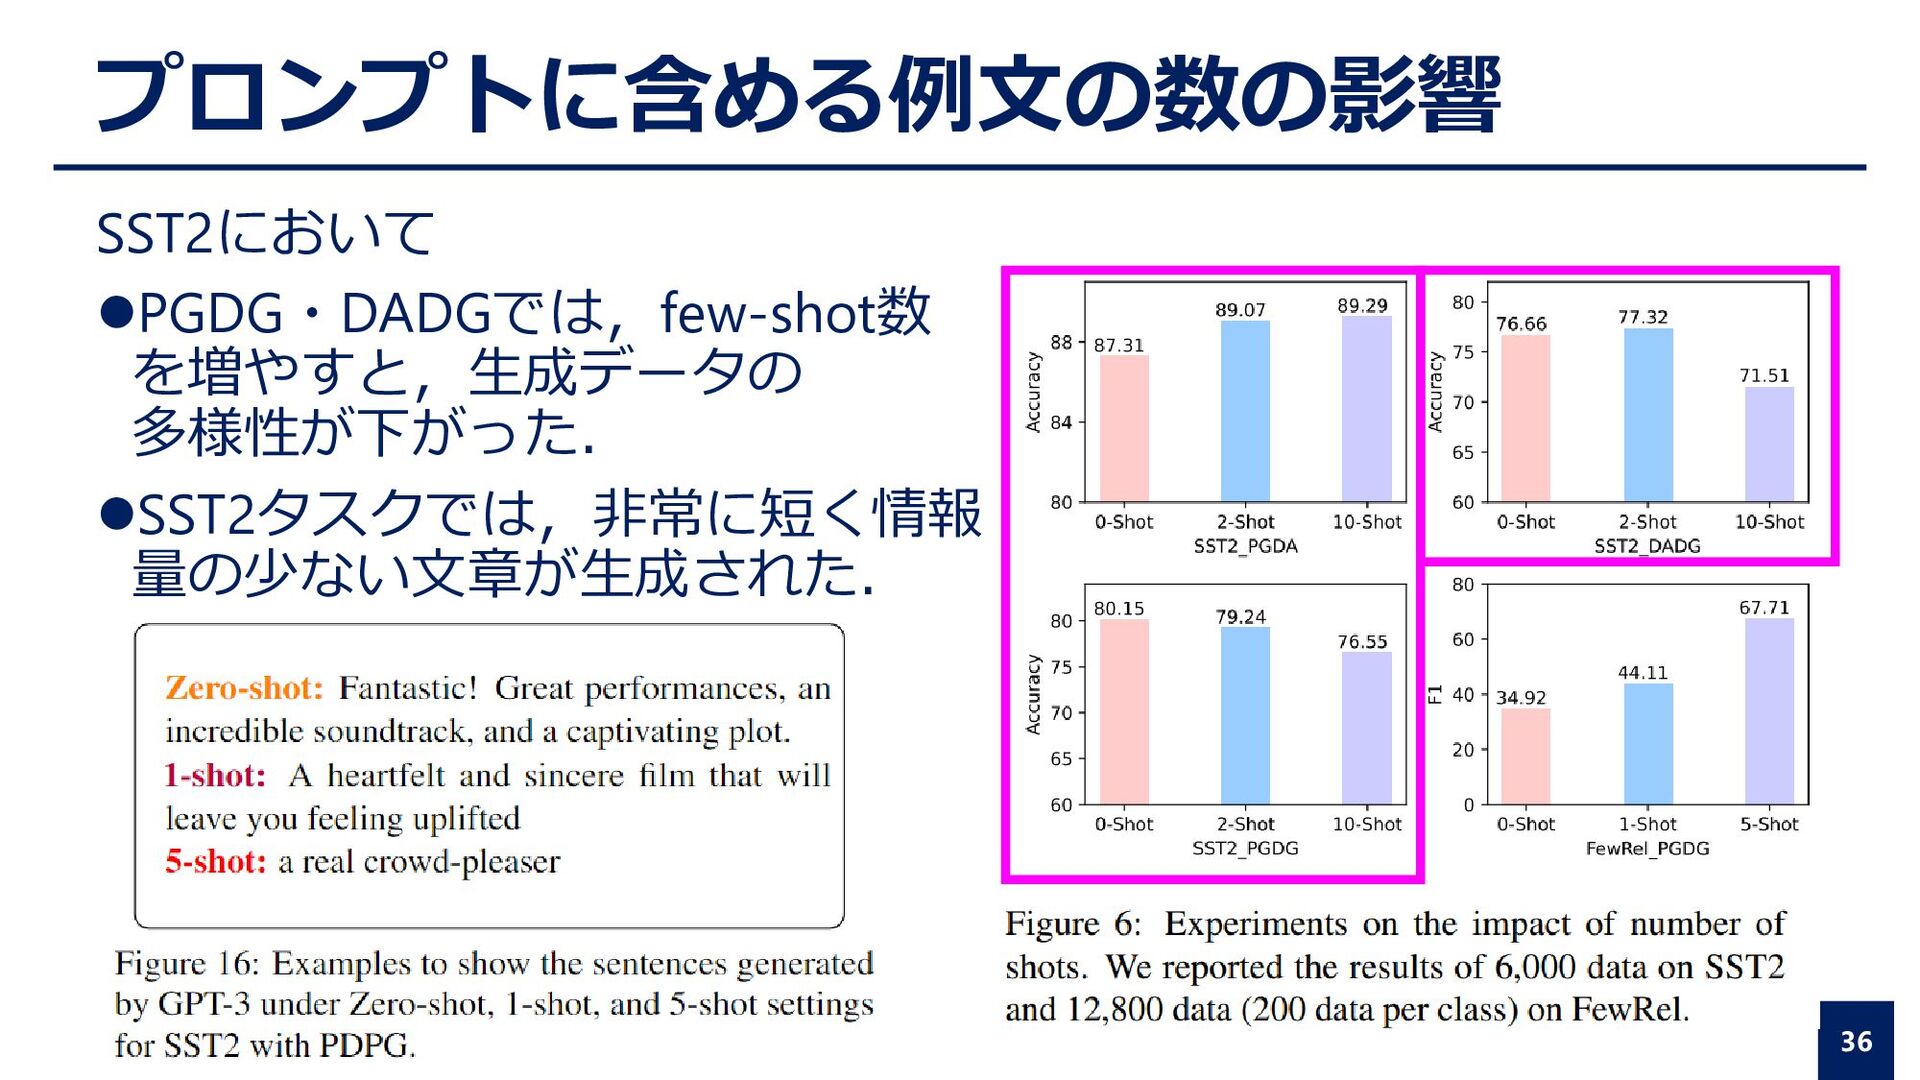
はテストデータの分布と異なって いることが大きな原因 14 サンプル数をもっと増やしたとき の性能はどうなるのか? プロンプトに含めるfew-shot例を もっと変えればよいのでは? PGDG,DADGで生成された データはテストデータの分布と 異なっていることが大きな原因 -
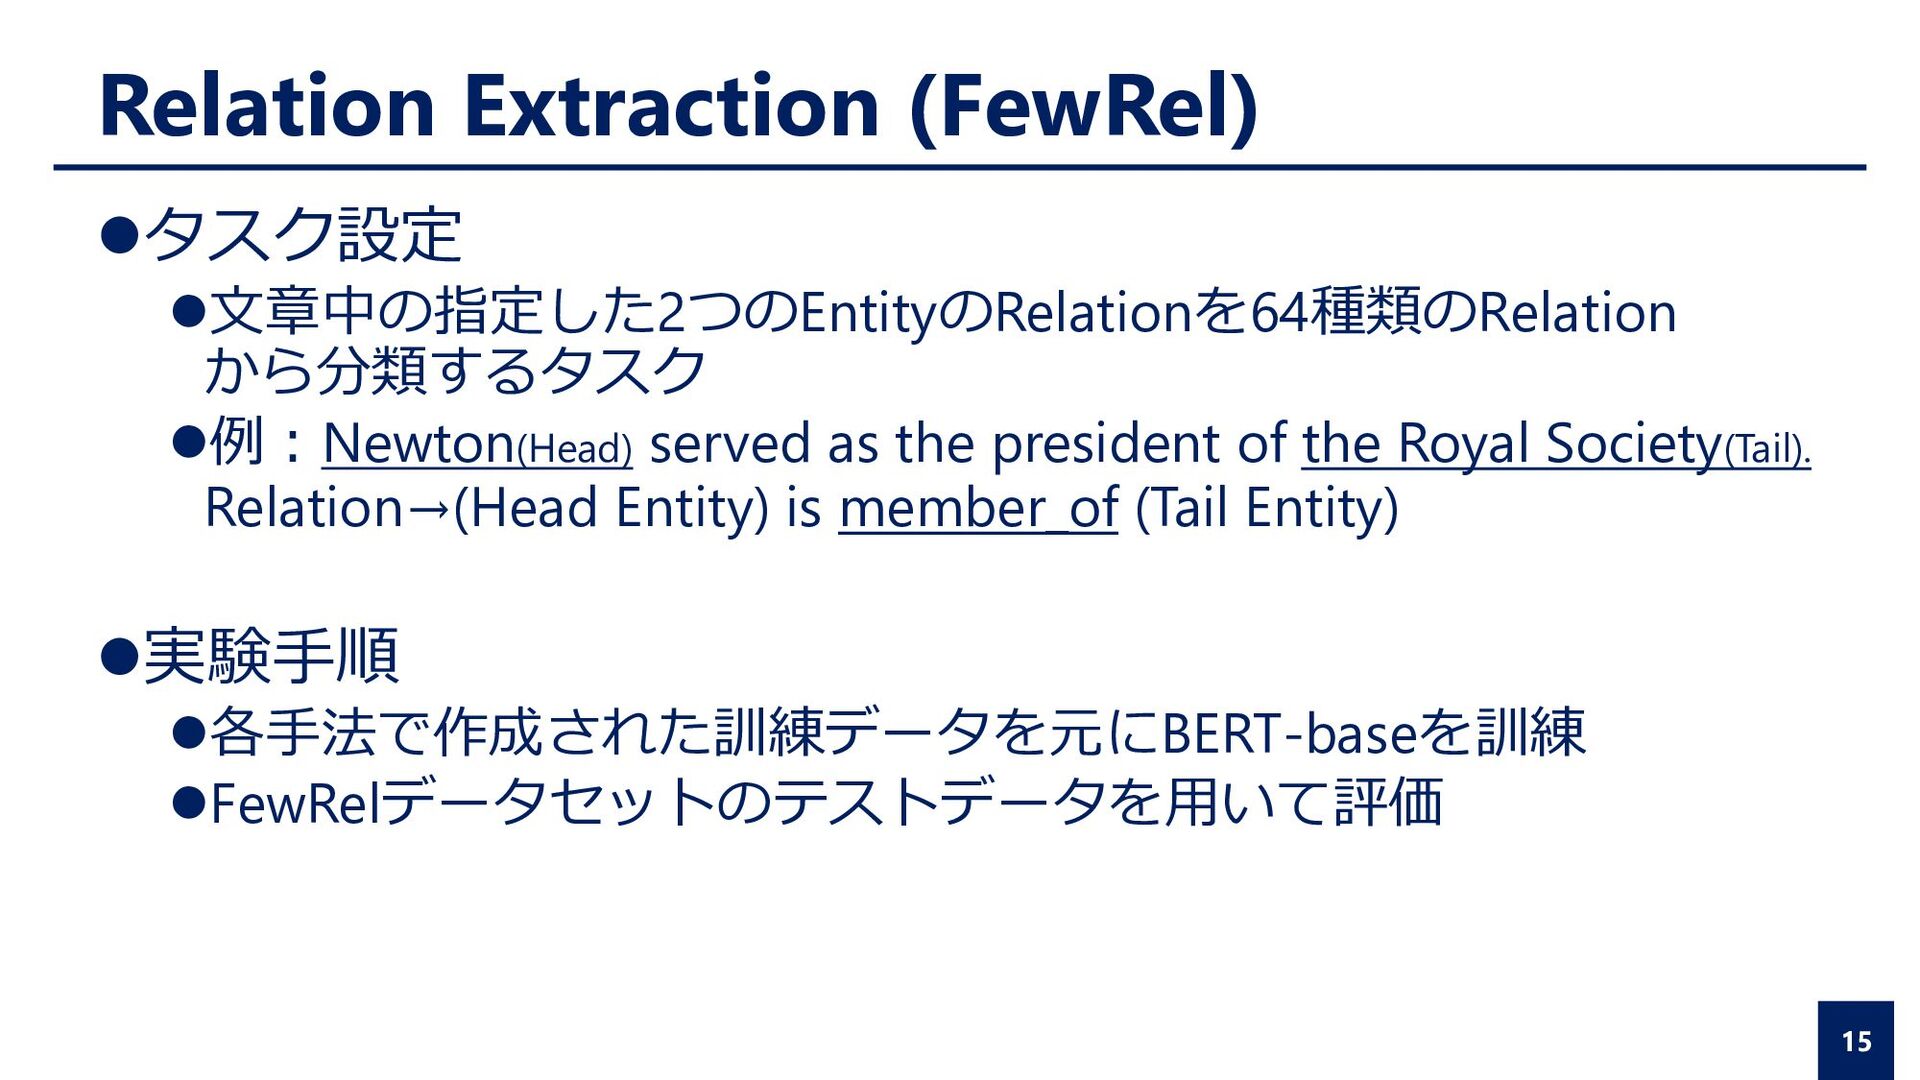
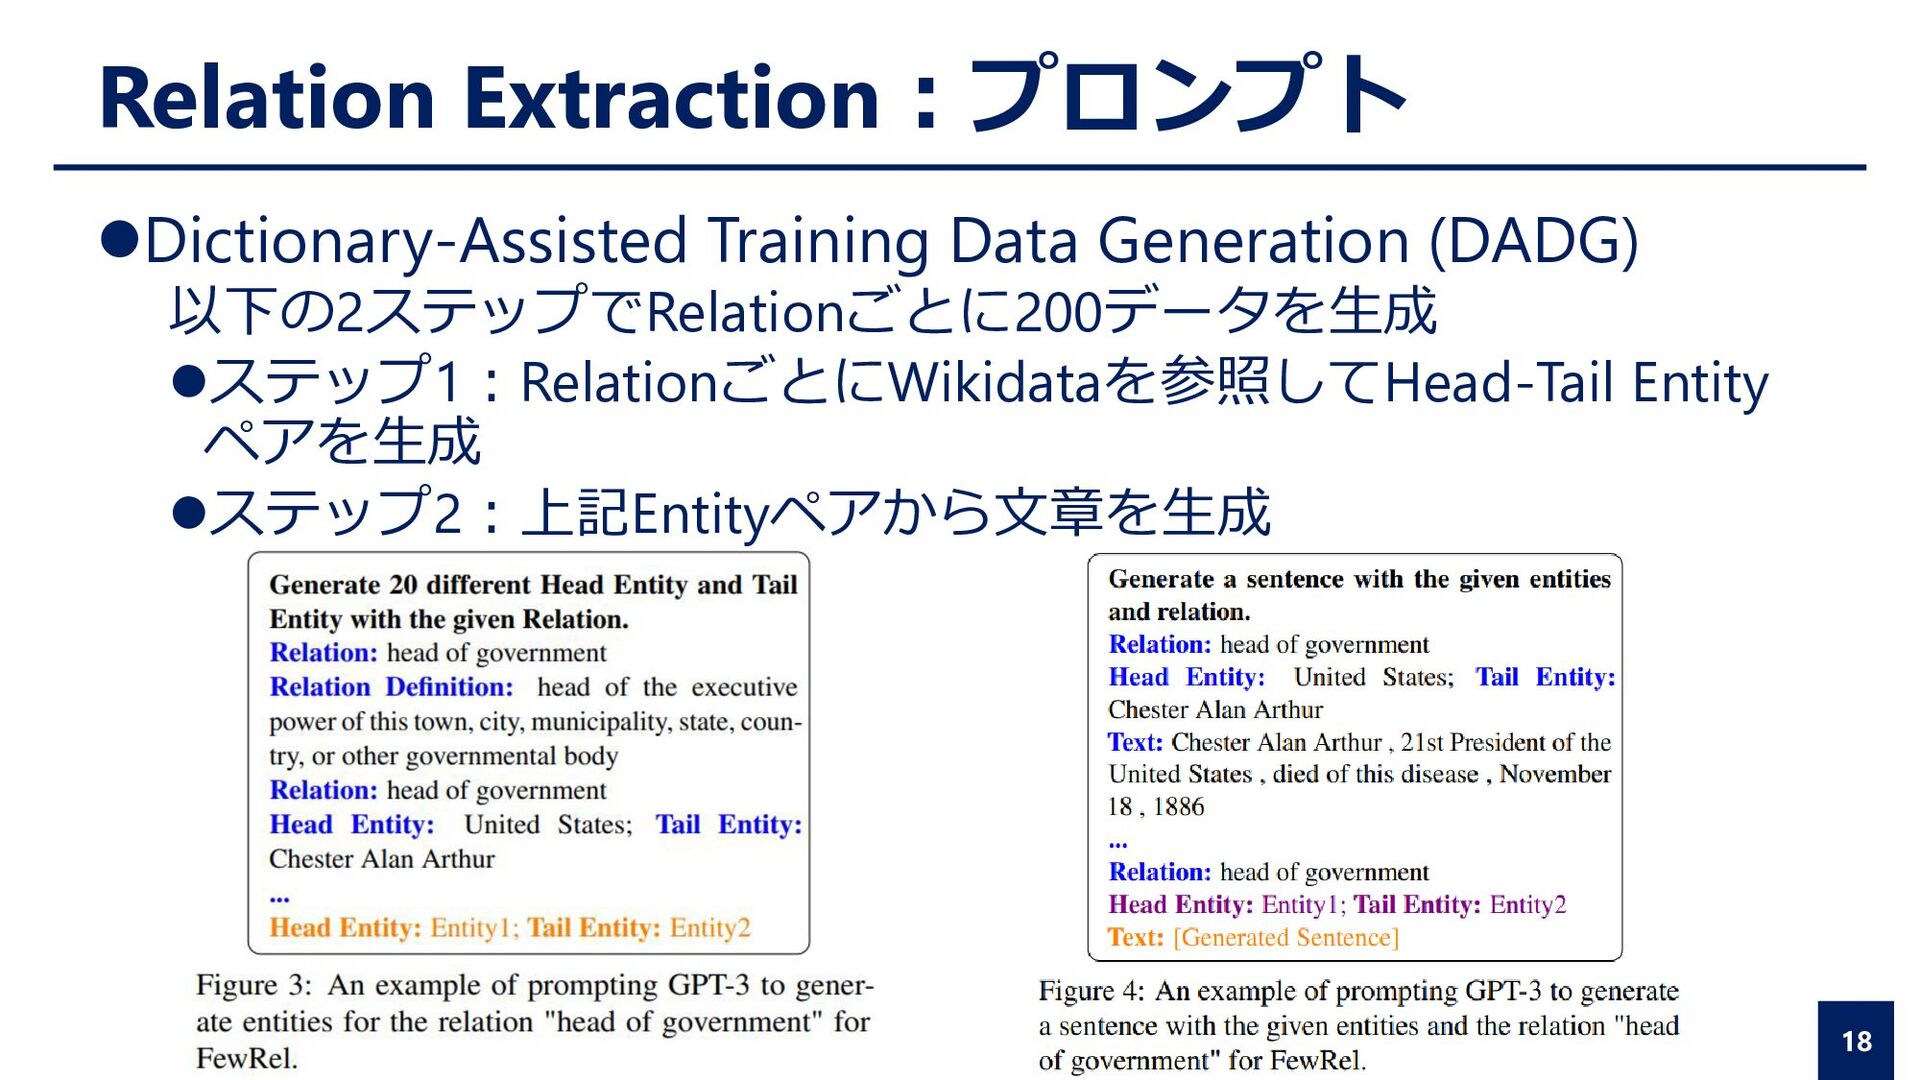
Relation Extraction (FewRel) ⚫タスク設定 ⚫文章中の指定した2つのEntityのRelationを64種類のRelation から分類するタスク ⚫例:Newton(Head) served as the
president of the Royal Society(Tail). Relation→(Head Entity) is member_of (Tail Entity) ⚫実験手順 ⚫各手法で作成された訓練データを元にBERT-baseを訓練 ⚫FewRelデータセットのテストデータを用いて評価 15 -
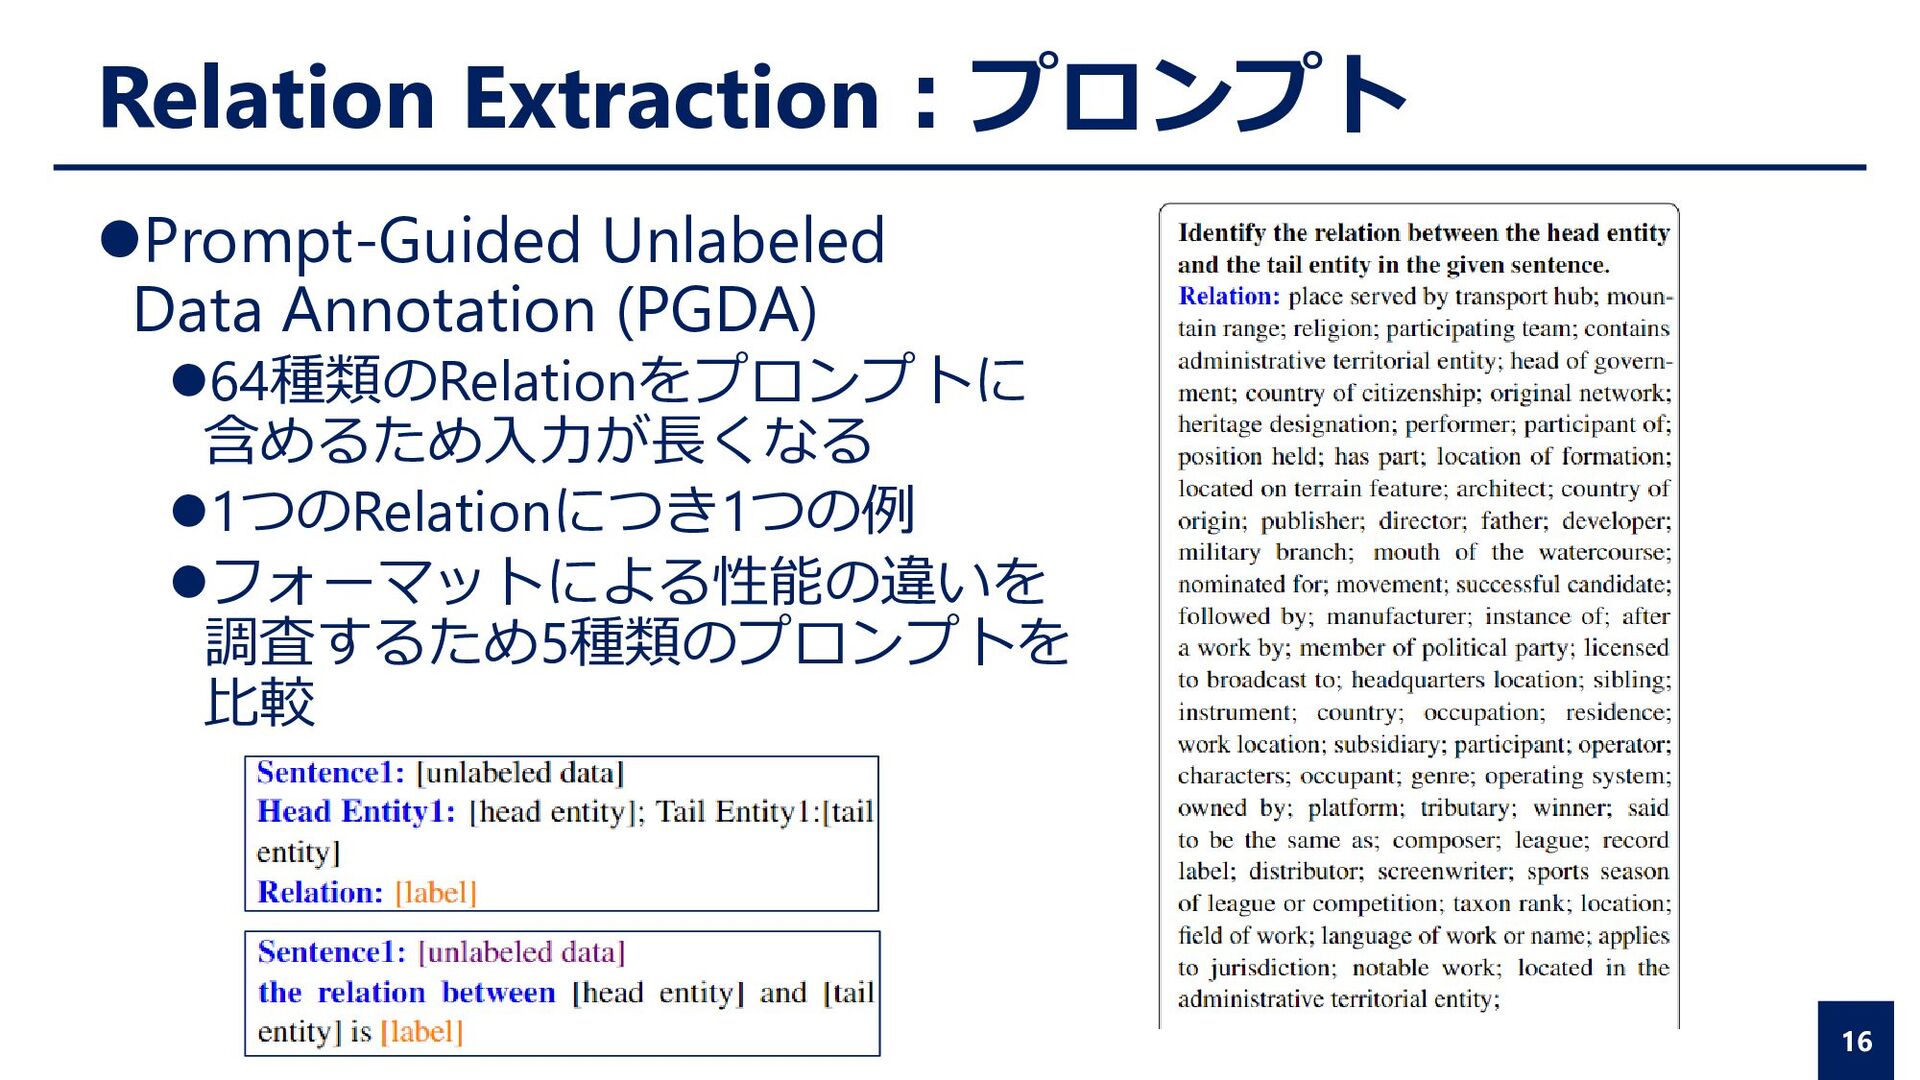
Relation Extraction:プロンプト ⚫Prompt-Guided Unlabeled Data Annotation (PGDA) ⚫64種類のRelationをプロンプトに 含めるため入力が長くなる ⚫1つのRelationにつき1つの例
⚫フォーマットによる性能の違いを 調査するため5種類のプロンプトを 比較 16 -
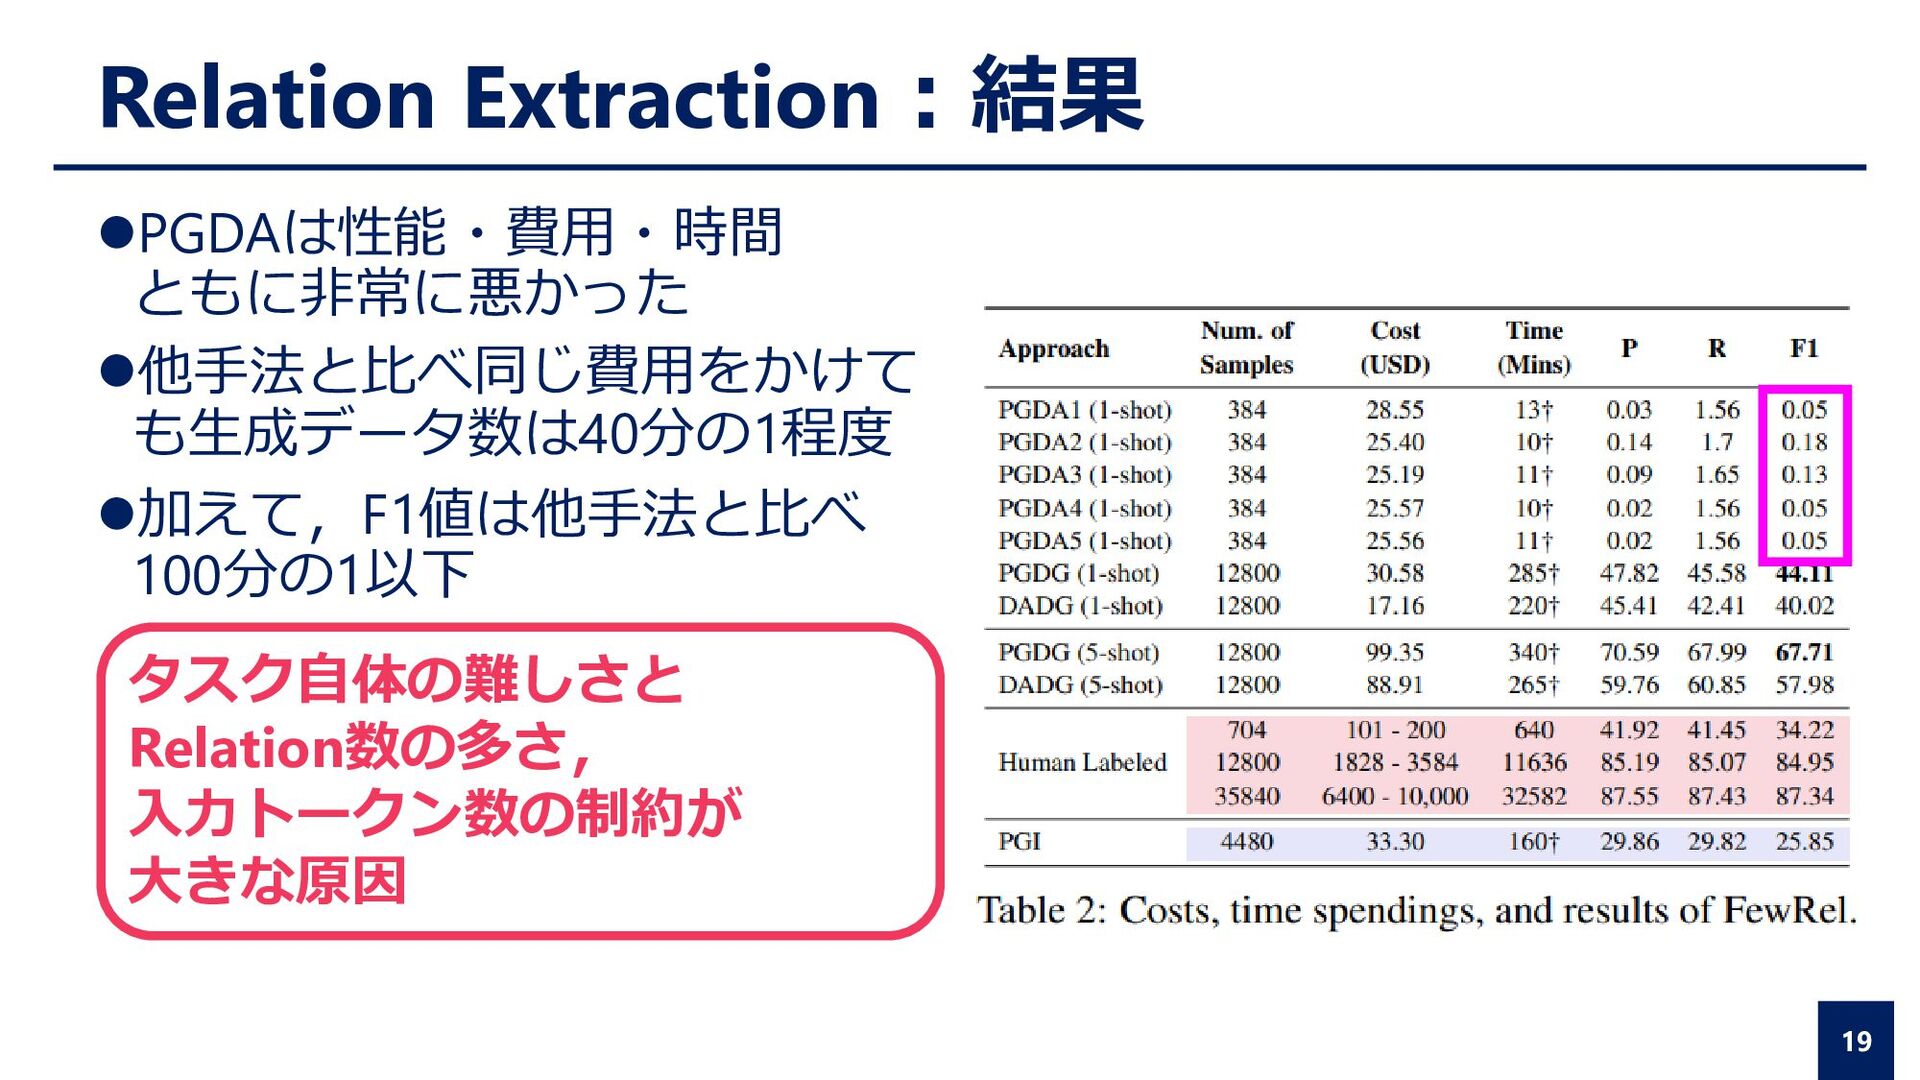
Relation Extraction:結果 ⚫PGDAは性能・費用・時間 ともに非常に悪かった ⚫他手法と比べ同じ費用をかけて も生成データ数は40分の1程度 ⚫加えて,F1値は他手法と比べ 100分の1以下 19 タスク自体の難しさと
Relation数の多さ, 入力トークン数の制約が 大きな原因 -
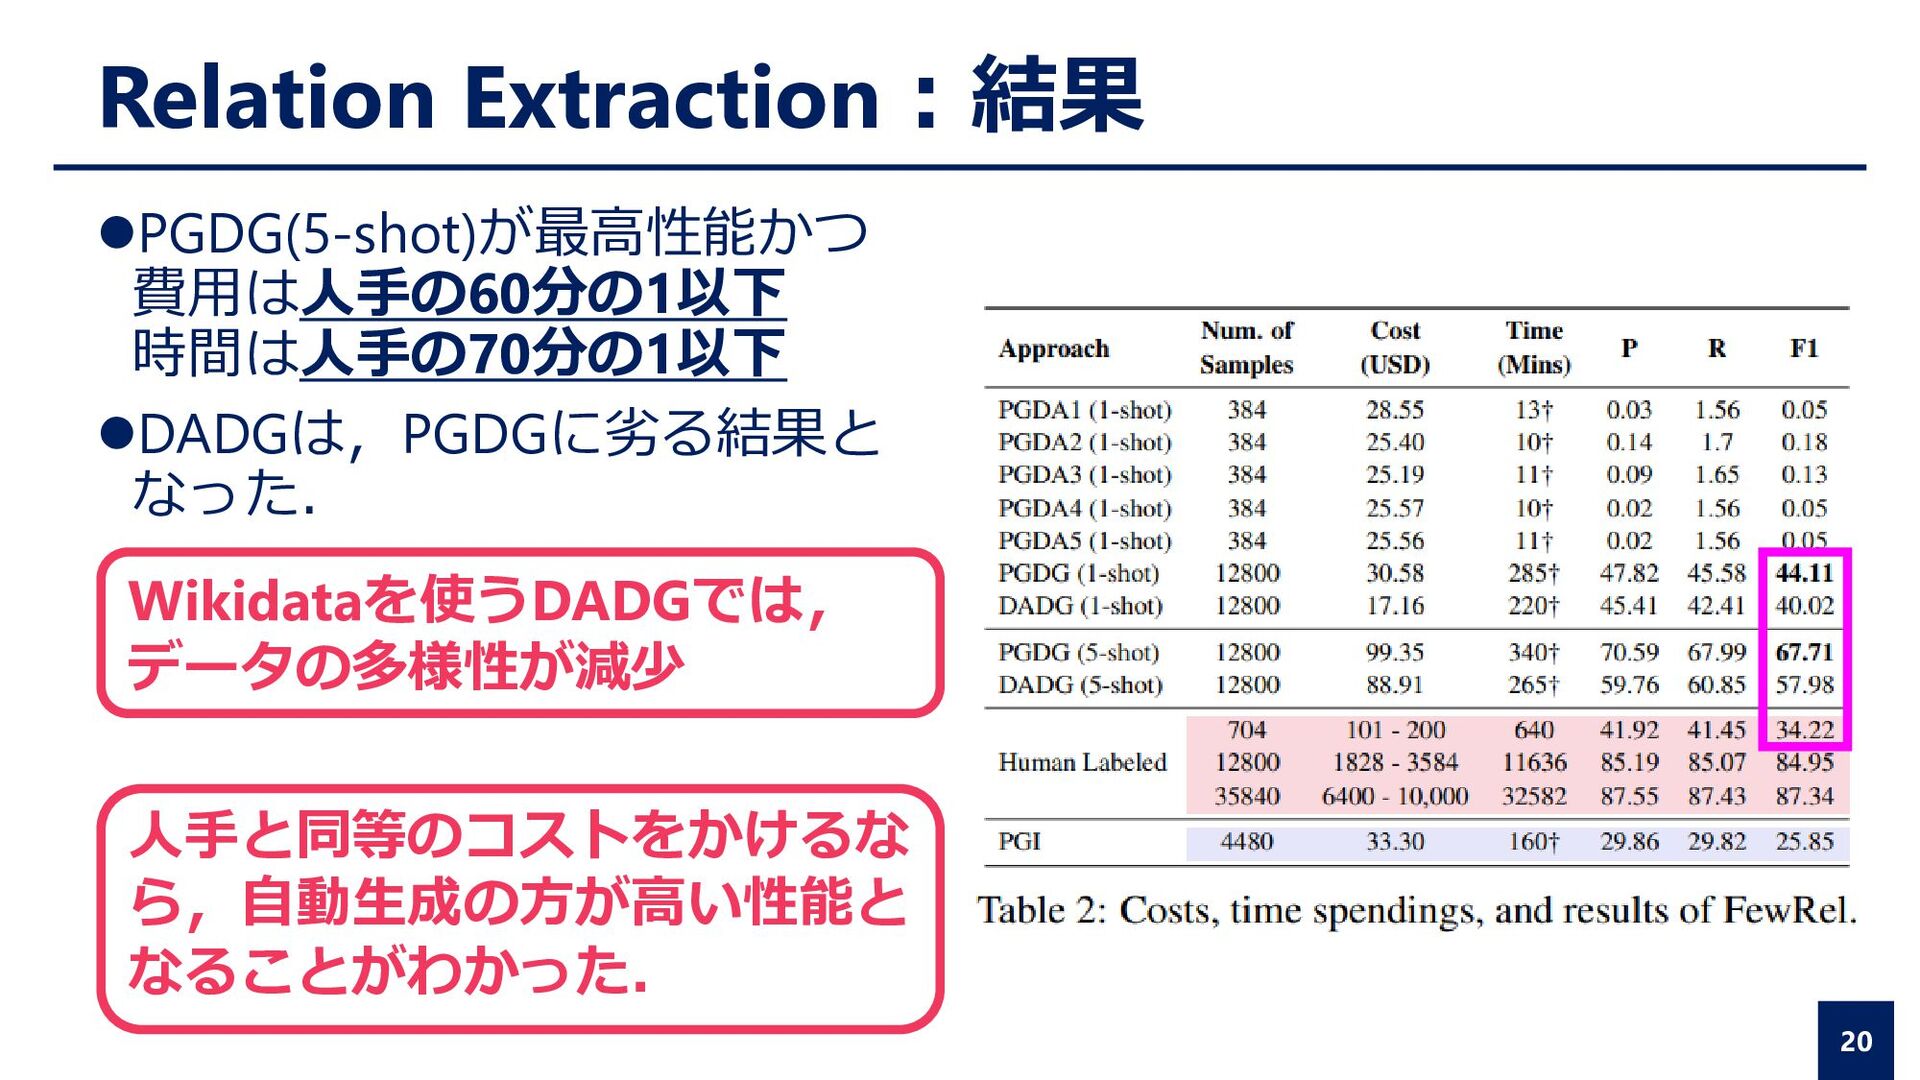
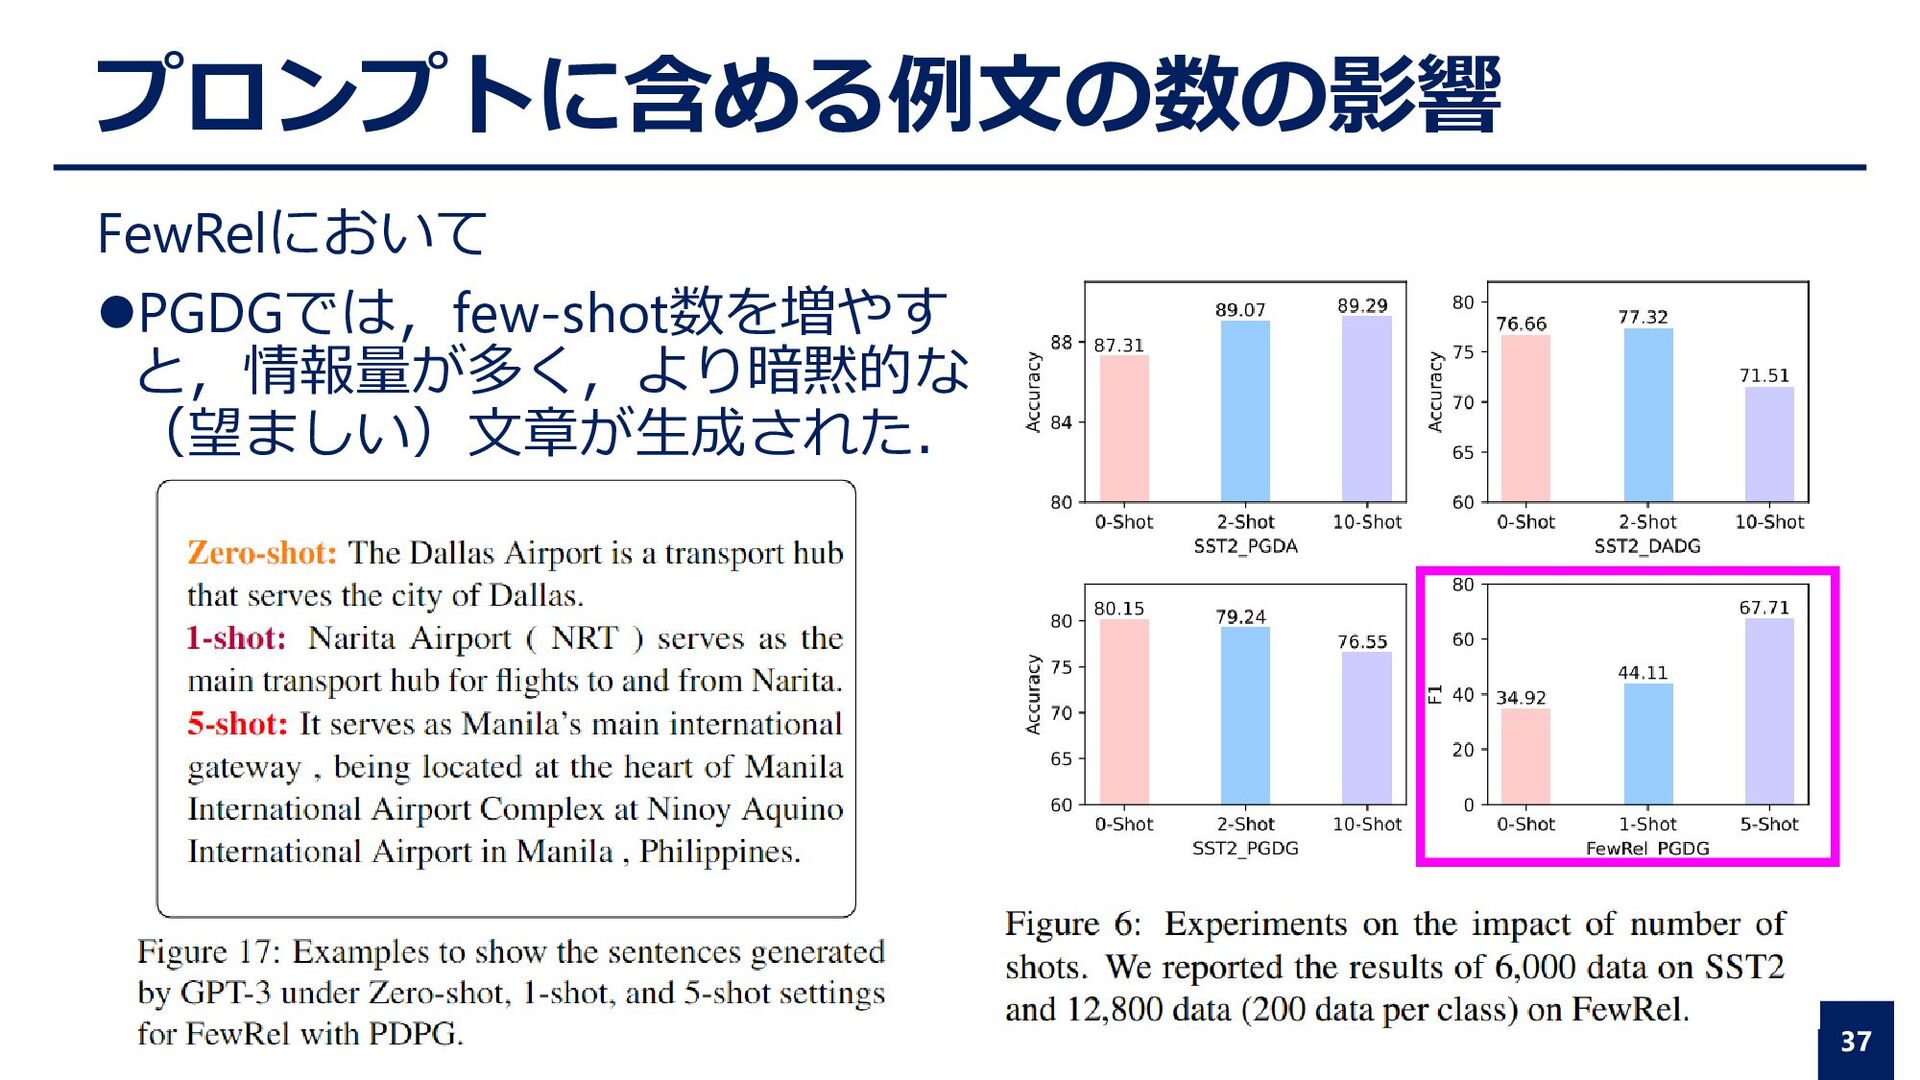
Relation Extraction:結果 ⚫PGDG(5-shot)が最高性能かつ 費用は人手の60分の1以下 時間は人手の70分の1以下 ⚫DADGは,PGDGに劣る結果と なった. 20 Wikidataを使うDADGでは, データの多様性が減少
人手と同等のコストをかけるな ら,自動生成の方が高い性能と なることがわかった. -
Named Entity Recognition (Cross NER) ⚫タスク設定 ⚫Cross NERデータ中のAI domainのデータを対象 ⚫文章中から14種類のEntity(product,
researcher, algorithm, etc.) を判定するタスク ⚫実験手順 ⚫各手法で作成された訓練データを元にBERT-baseを訓練 ⚫Cross NER AI domainデータセットのテストデータを用いて評価 21 -
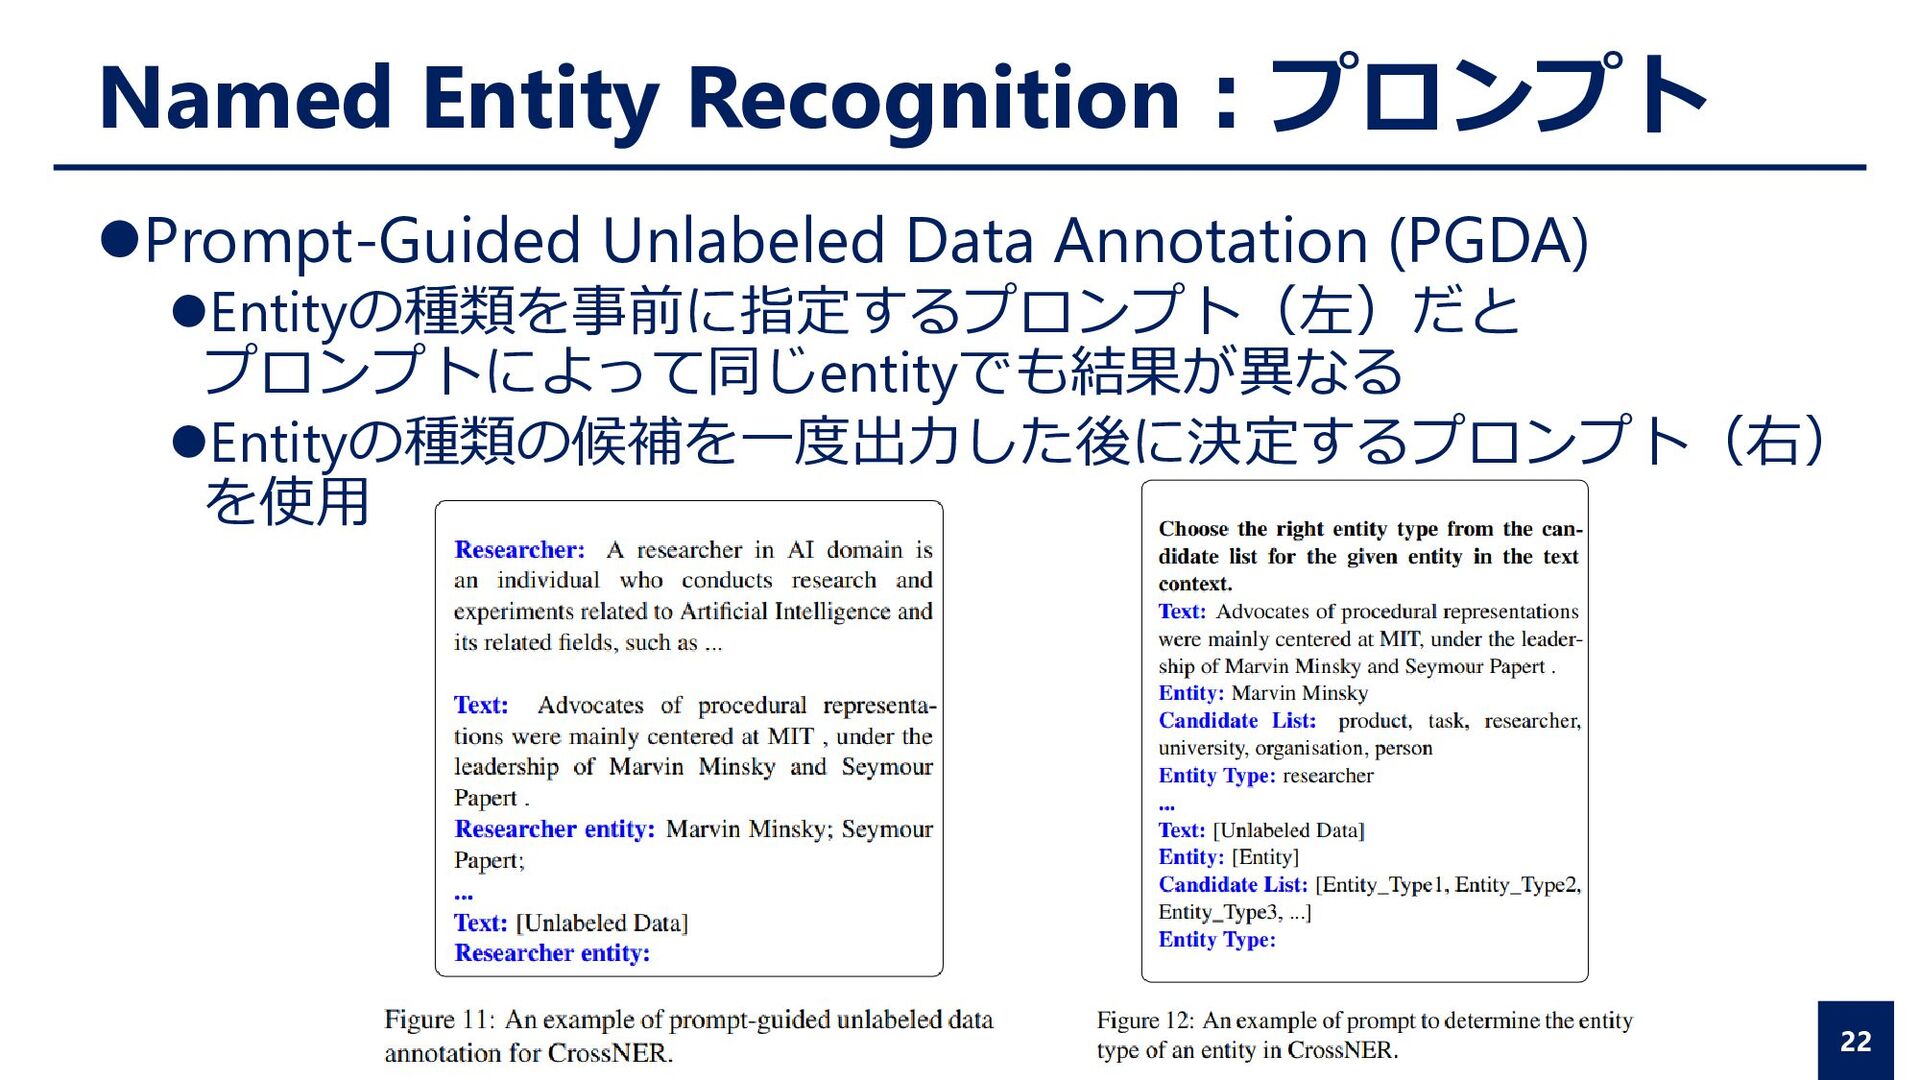
Named Entity Recognition:プロンプト ⚫Prompt-Guided Unlabeled Data Annotation (PGDA) ⚫Entityの種類を事前に指定するプロンプト(左)だと プロンプトによって同じentityでも結果が異なる
⚫Entityの種類の候補を一度出力した後に決定するプロンプト(右) を使用 22 -
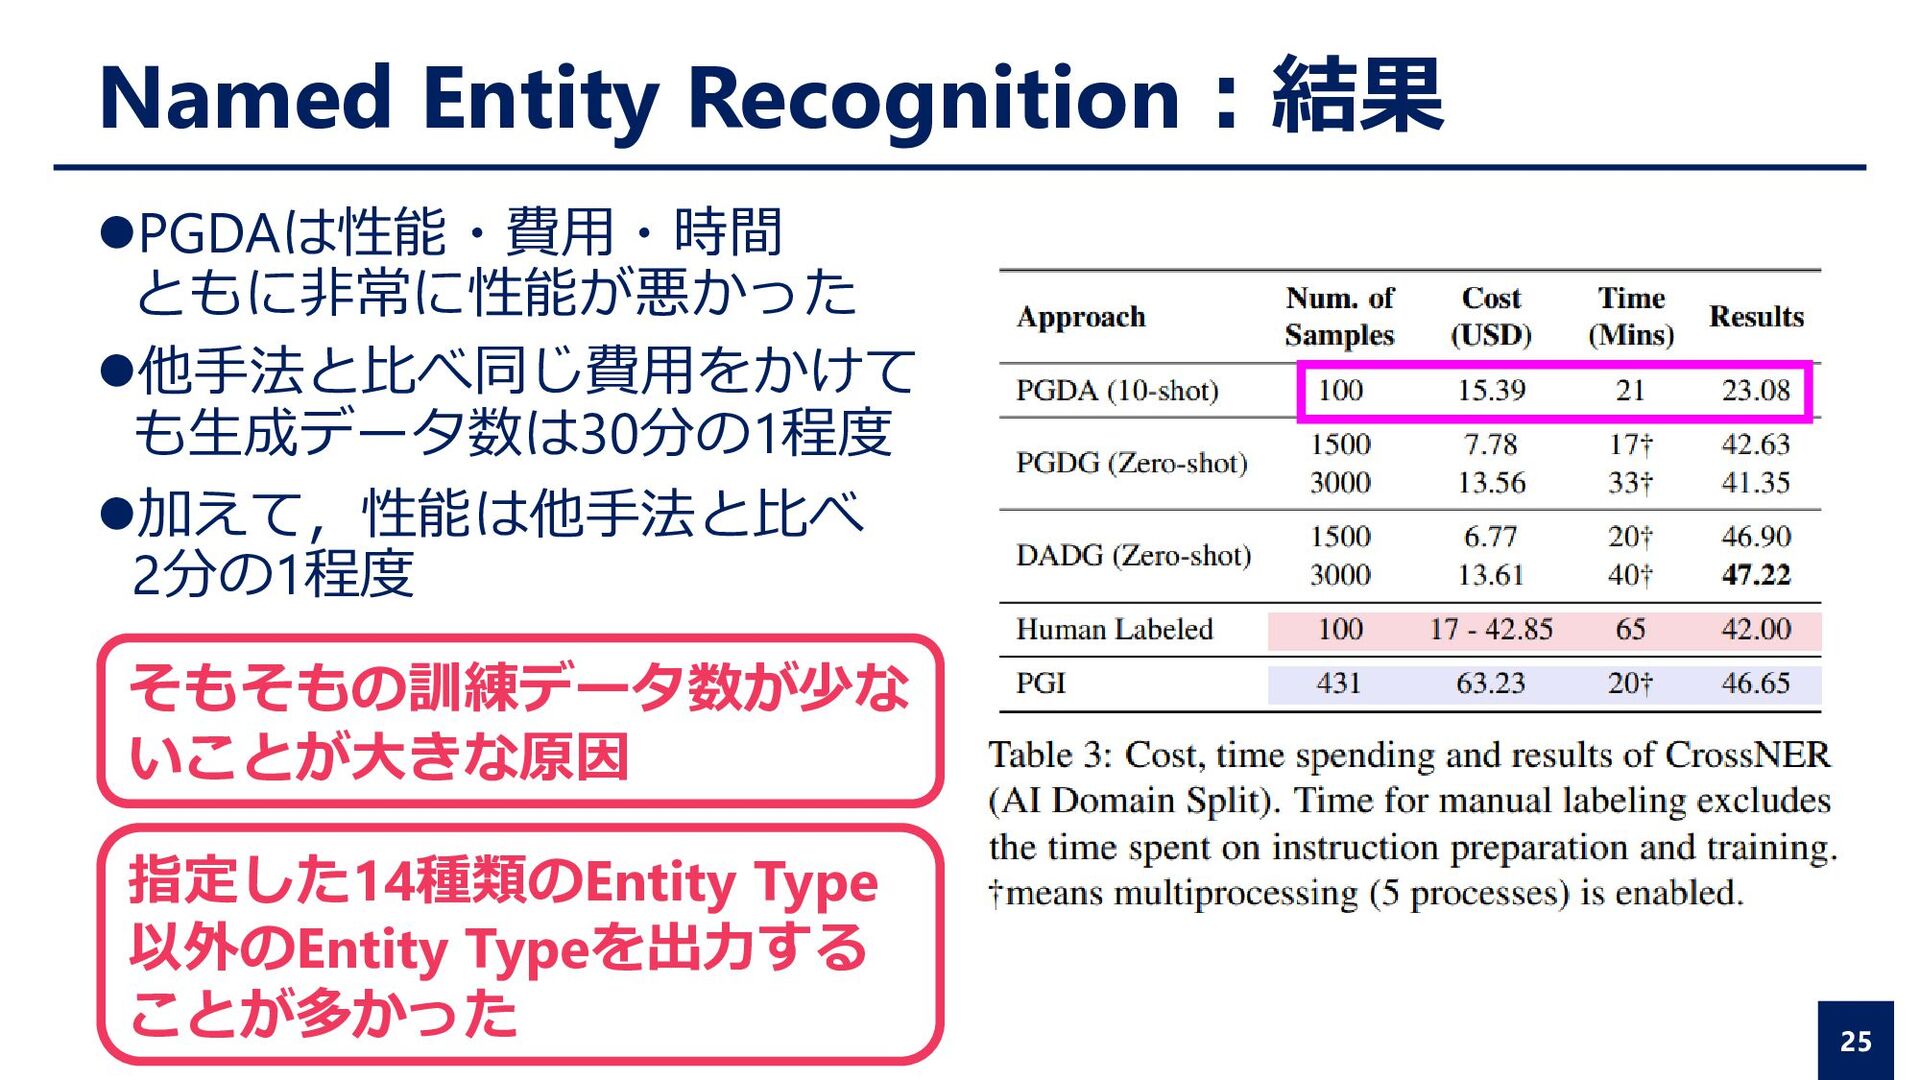
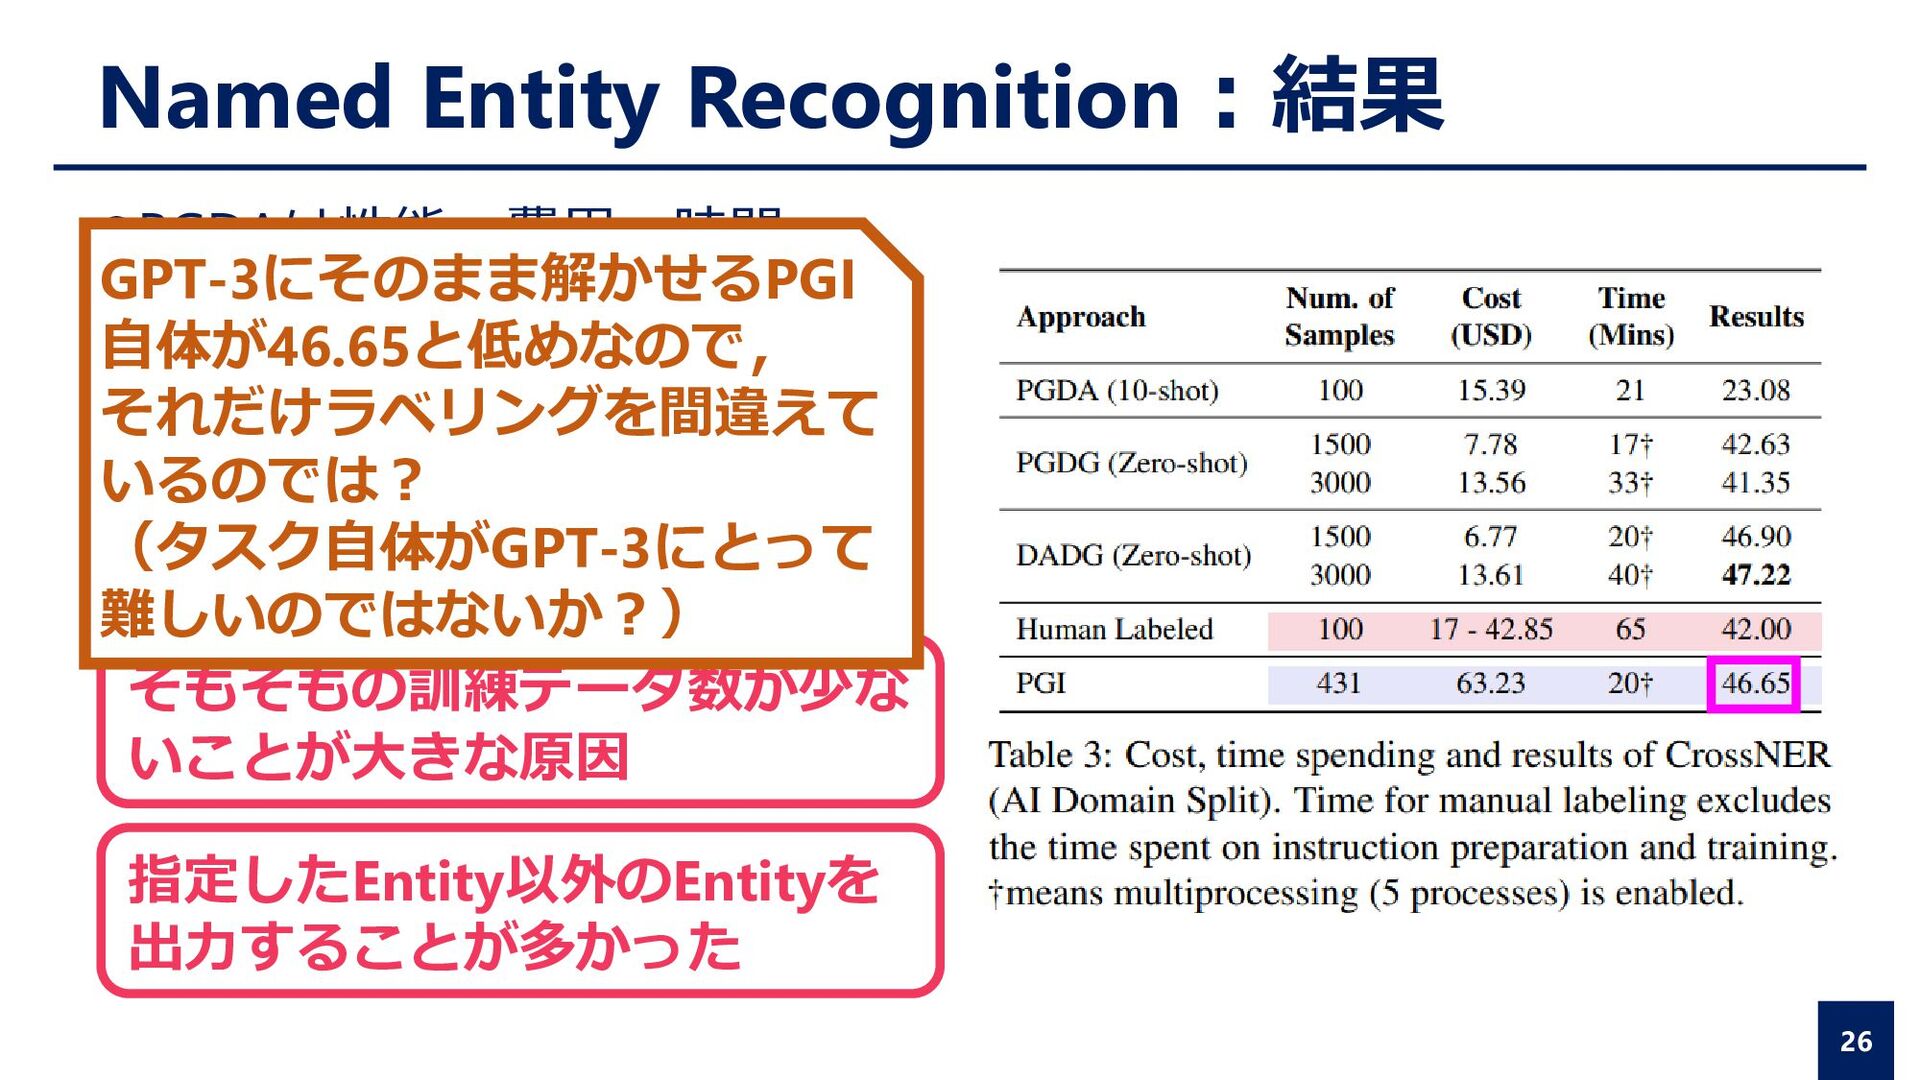
Named Entity Recognition:結果 ⚫PGDAは性能・費用・時間 ともに非常に性能が悪かった ⚫他手法と比べ同じ費用をかけて も生成データ数は30分の1程度 ⚫加えて,性能は他手法と比べ 2分の1程度 25
そもそもの訓練データ数が少な いことが大きな原因 指定した14種類のEntity Type 以外のEntity Typeを出力する ことが多かった -
Named Entity Recognition:結果 ⚫PGDAは性能・費用・時間 ともに非常に性能が悪かった ⚫他手法と比べ同じ費用をかけて も生成データ数は30分の1程度 ⚫加えて,性能は他手法と比べ 2分の1程度 26
そもそもの訓練データ数が少な いことが大きな原因 指定したEntity以外のEntityを 出力することが多かった GPT-3にそのまま解かせるPGI 自体が46.65と低めなので, それだけラベリングを間違えて いるのでは? (タスク自体がGPT-3にとって 難しいのではないか?) -
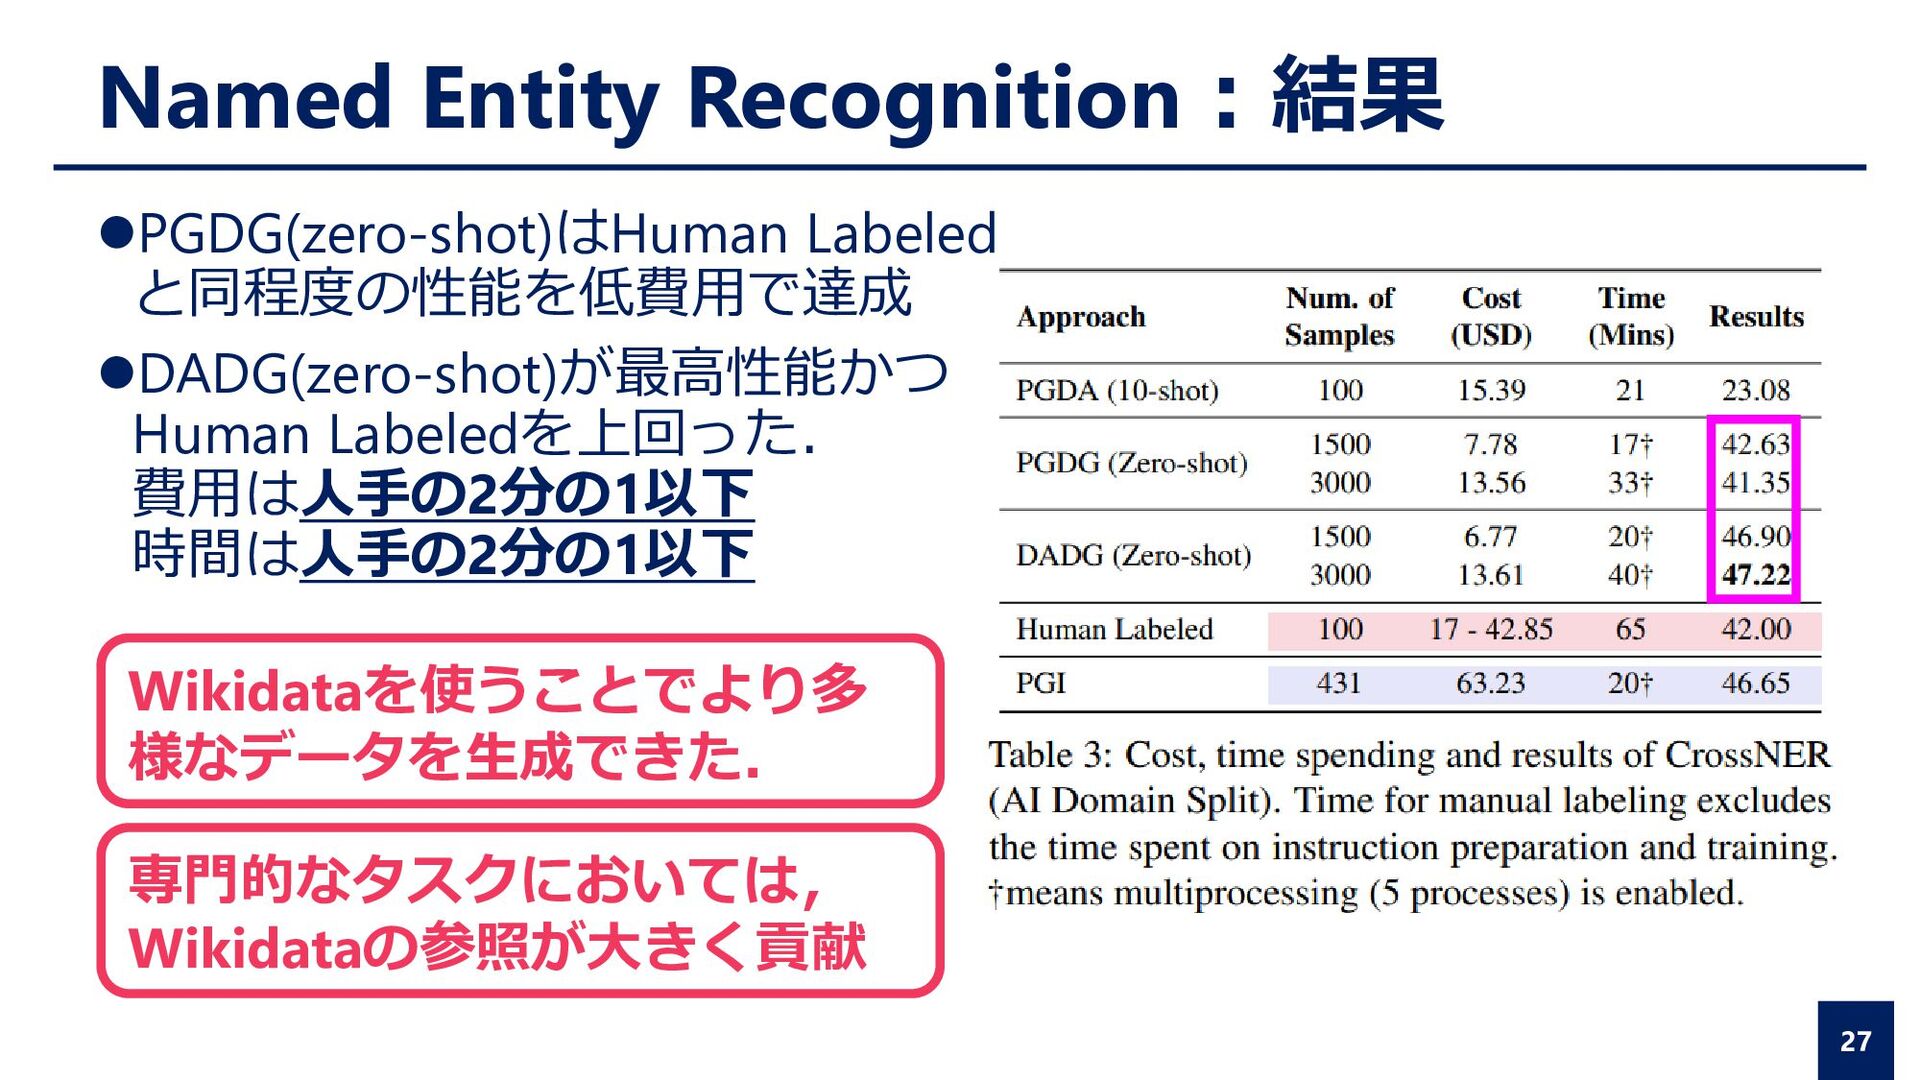
Named Entity Recognition:結果 27 Wikidataを使うことでより多 様なデータを生成できた. 専門的なタスクにおいては, Wikidataの参照が大きく貢献 ⚫PGDG(zero-shot)はHuman Labeled
と同程度の性能を低費用で達成 ⚫DADG(zero-shot)が最高性能かつ Human Labeledを上回った. 費用は人手の2分の1以下 時間は人手の2分の1以下 -
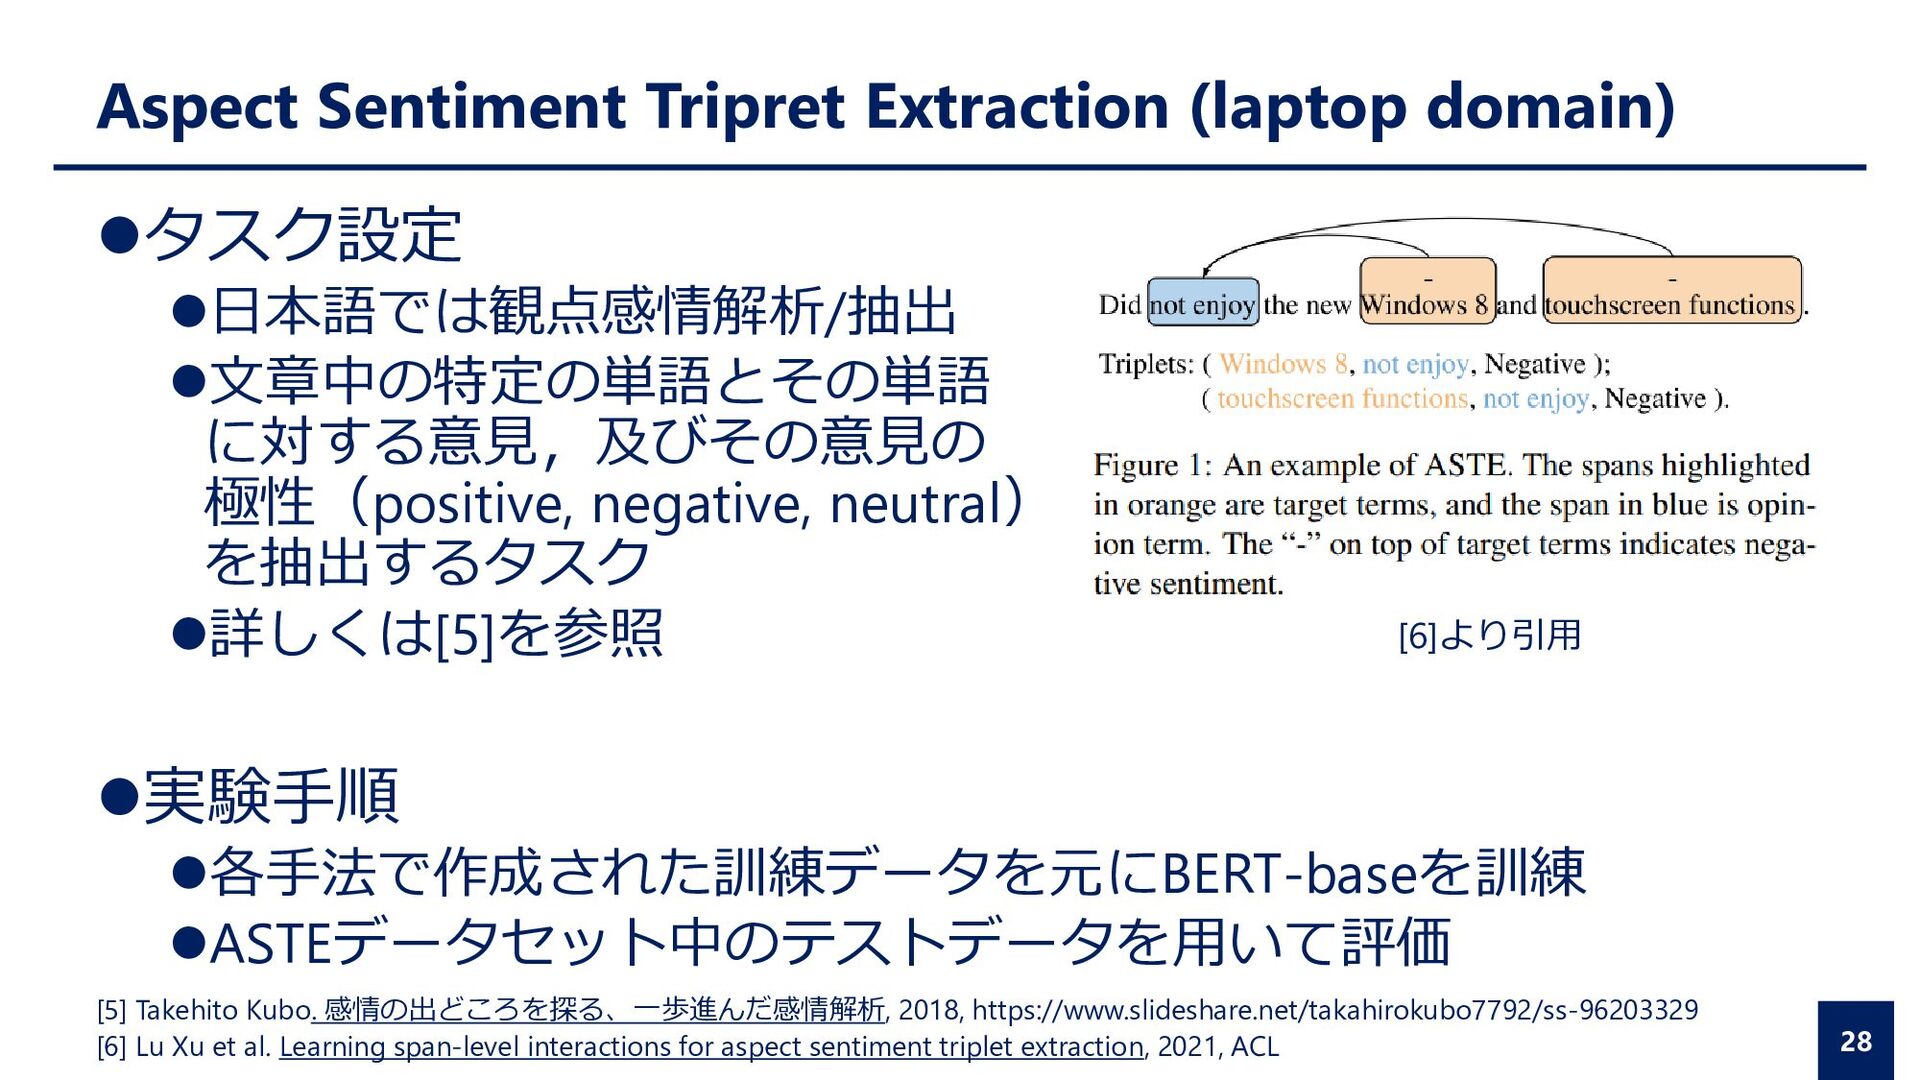
Aspect Sentiment Tripret Extraction (laptop domain) ⚫タスク設定 ⚫日本語では観点感情解析/抽出 ⚫文章中の特定の単語とその単語 に対する意見,及びその意見の
極性(positive, negative, neutral) を抽出するタスク ⚫詳しくは[5]を参照 ⚫実験手順 ⚫各手法で作成された訓練データを元にBERT-baseを訓練 ⚫ASTEデータセット中のテストデータを用いて評価 28 [6]より引用 [5] Takehito Kubo. 感情の出どころを探る、一歩進んだ感情解析, 2018, https://www.slideshare.net/takahirokubo7792/ss-96203329 [6] Lu Xu et al. Learning span-level interactions for aspect sentiment triplet extraction, 2021, ACL -
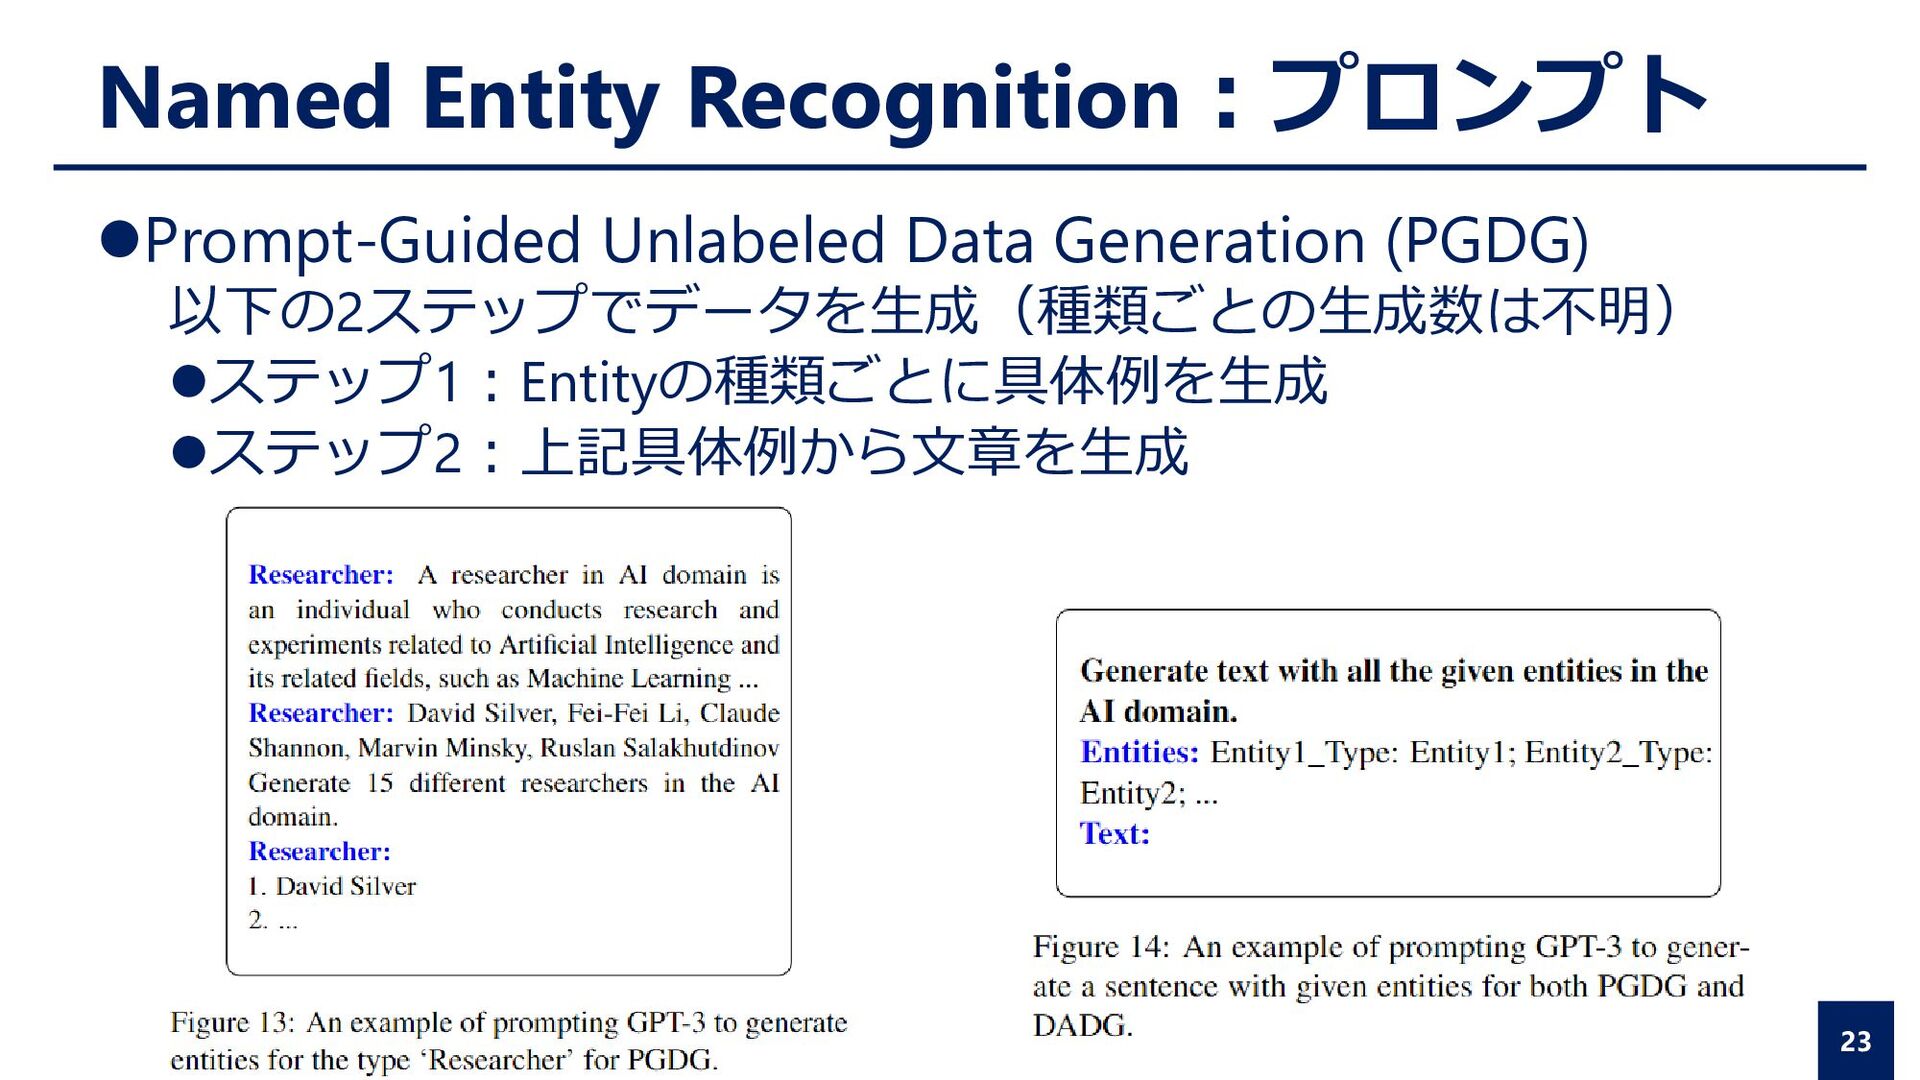
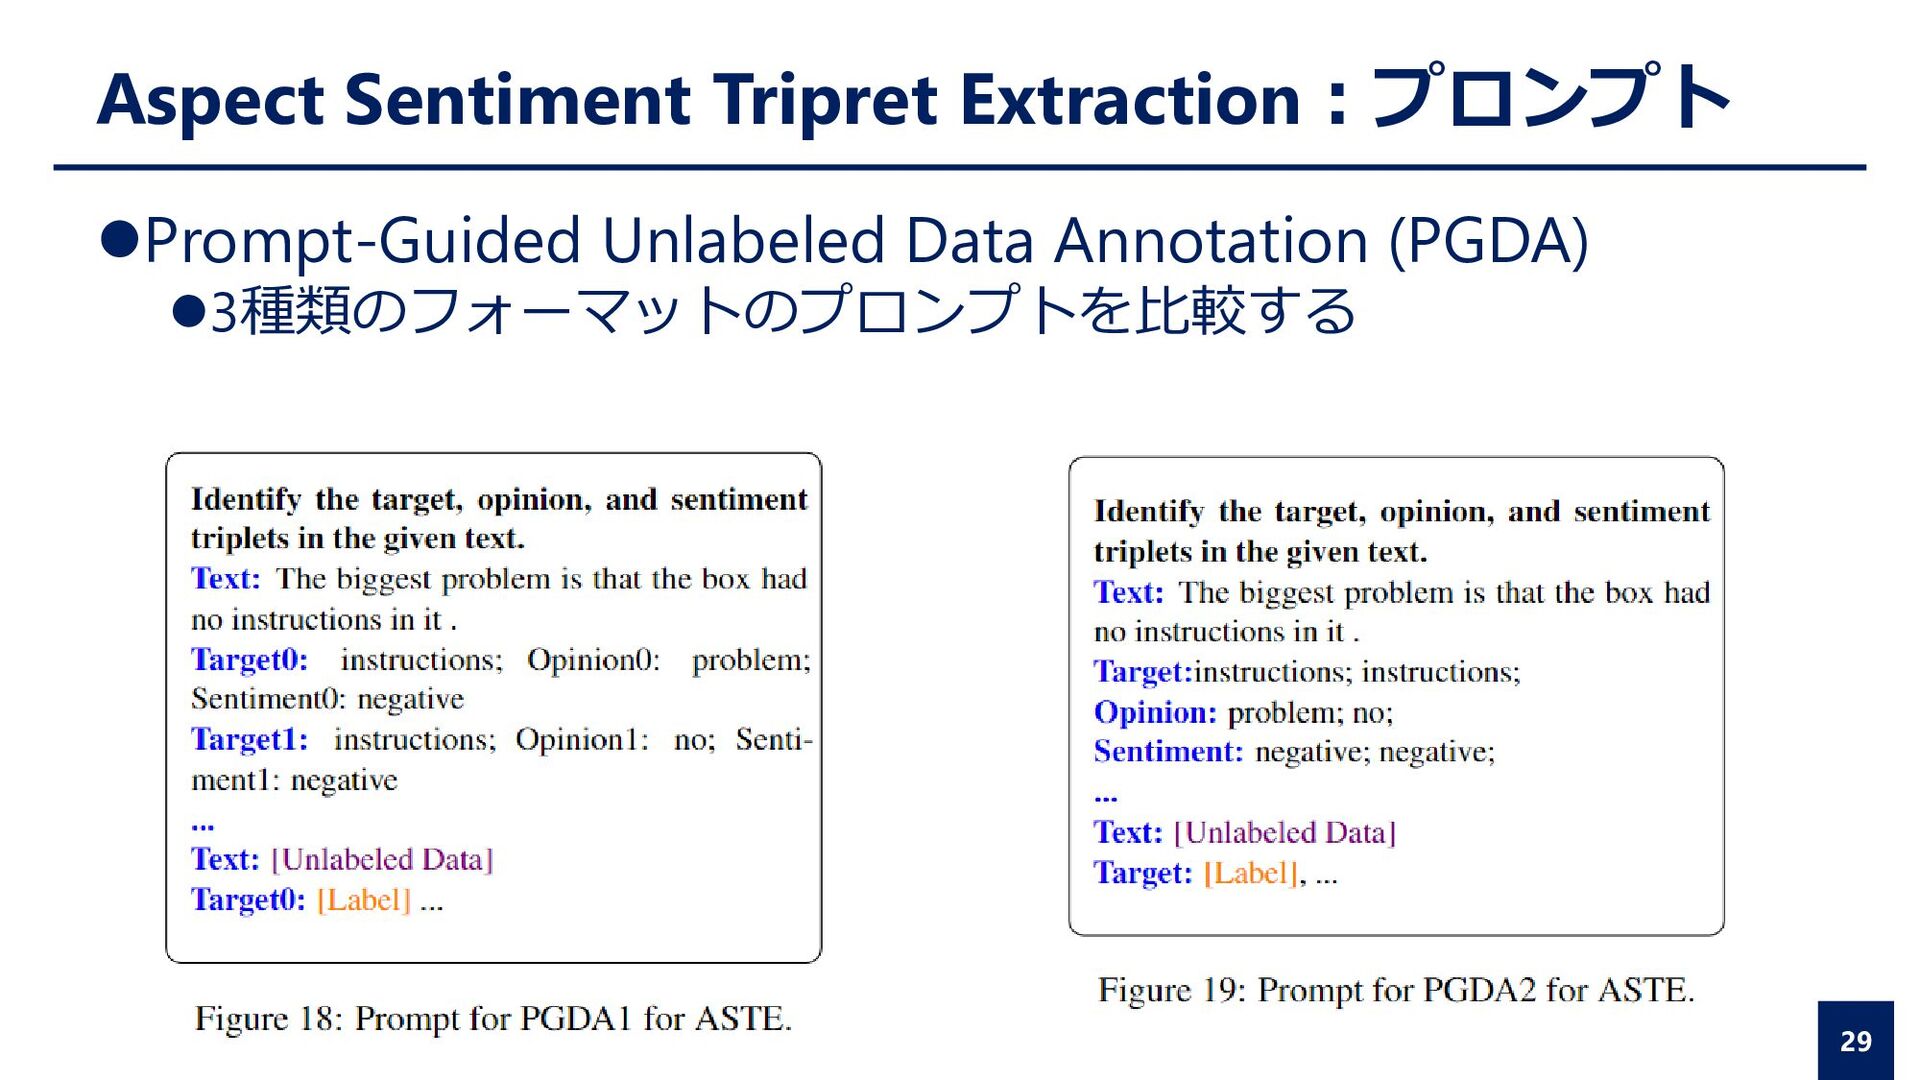
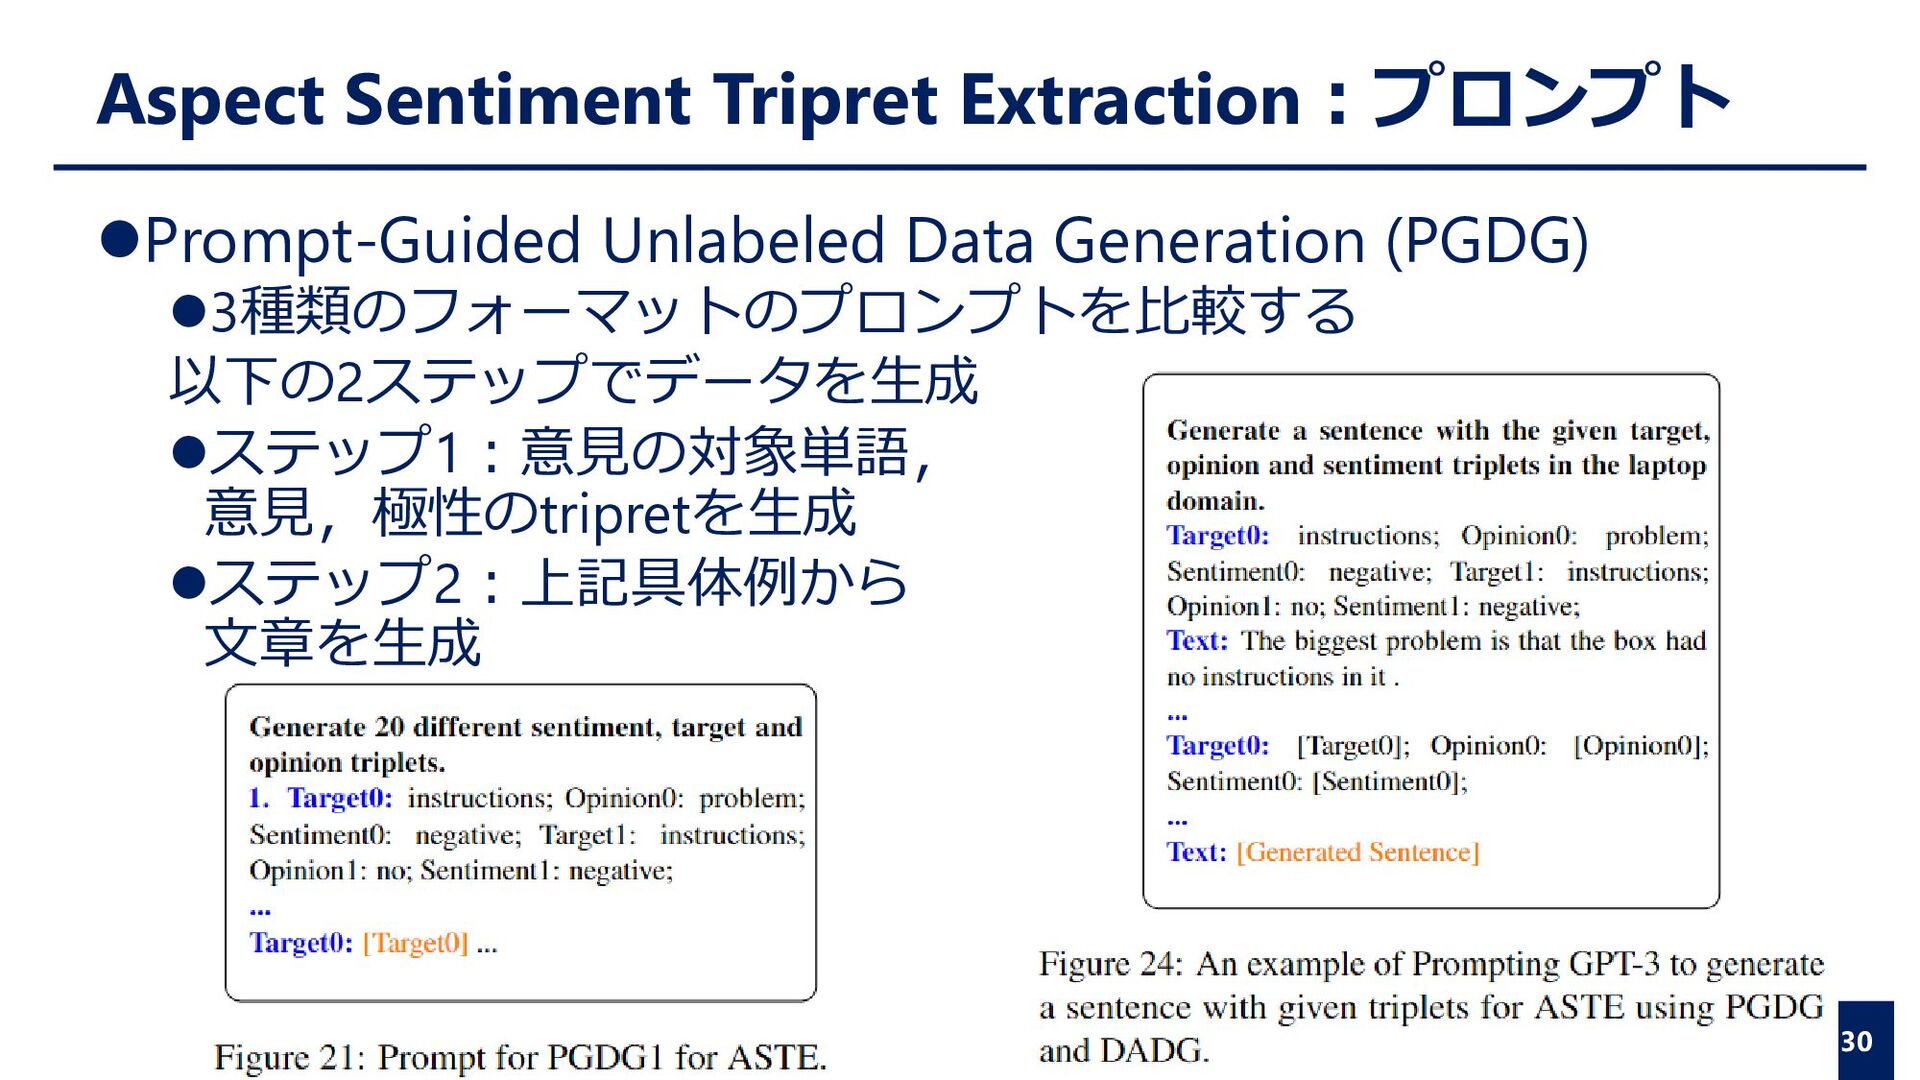
Aspect Sentiment Tripret Extraction:プロンプト 30 ⚫Prompt-Guided Unlabeled Data Generation (PGDG)
⚫3種類のフォーマットのプロンプトを比較する 以下の2ステップでデータを生成 ⚫ステップ1:意見の対象単語, 意見,極性のtripretを生成 ⚫ステップ2:上記具体例から 文章を生成 -
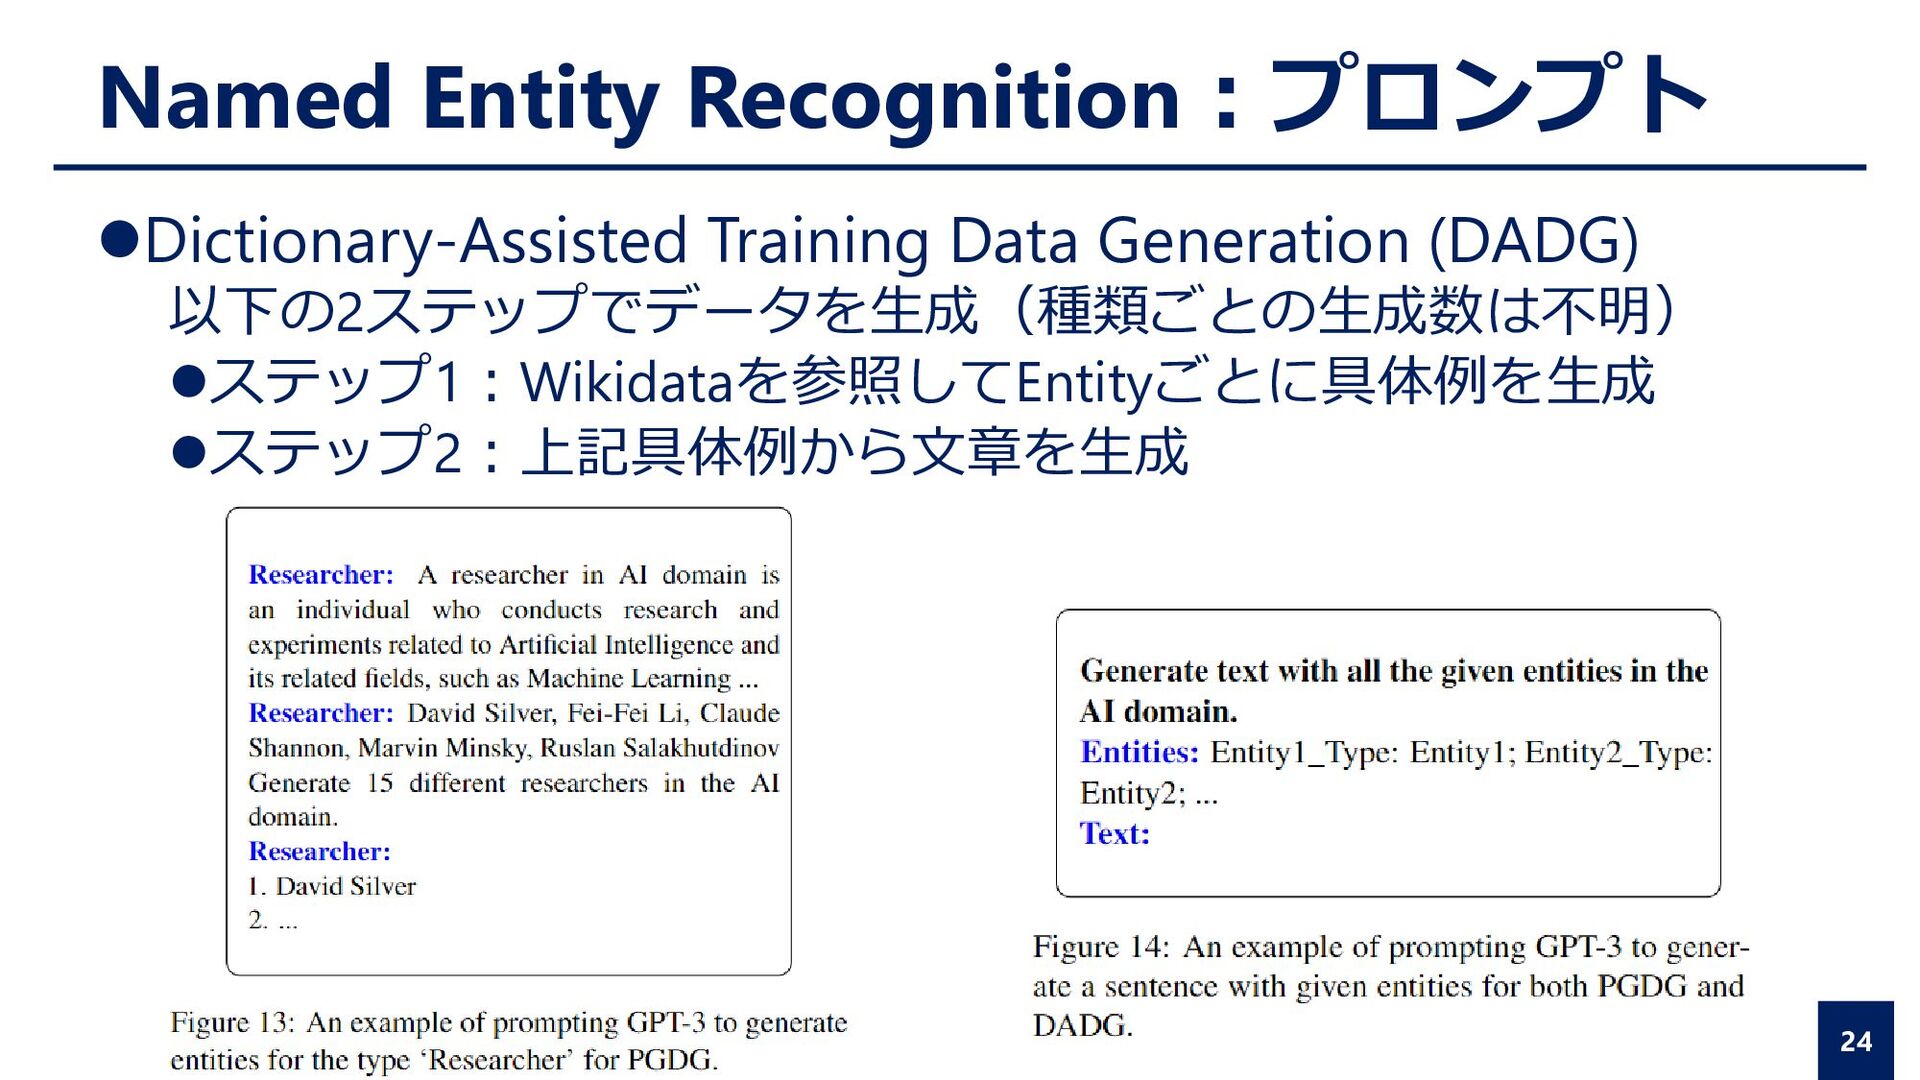
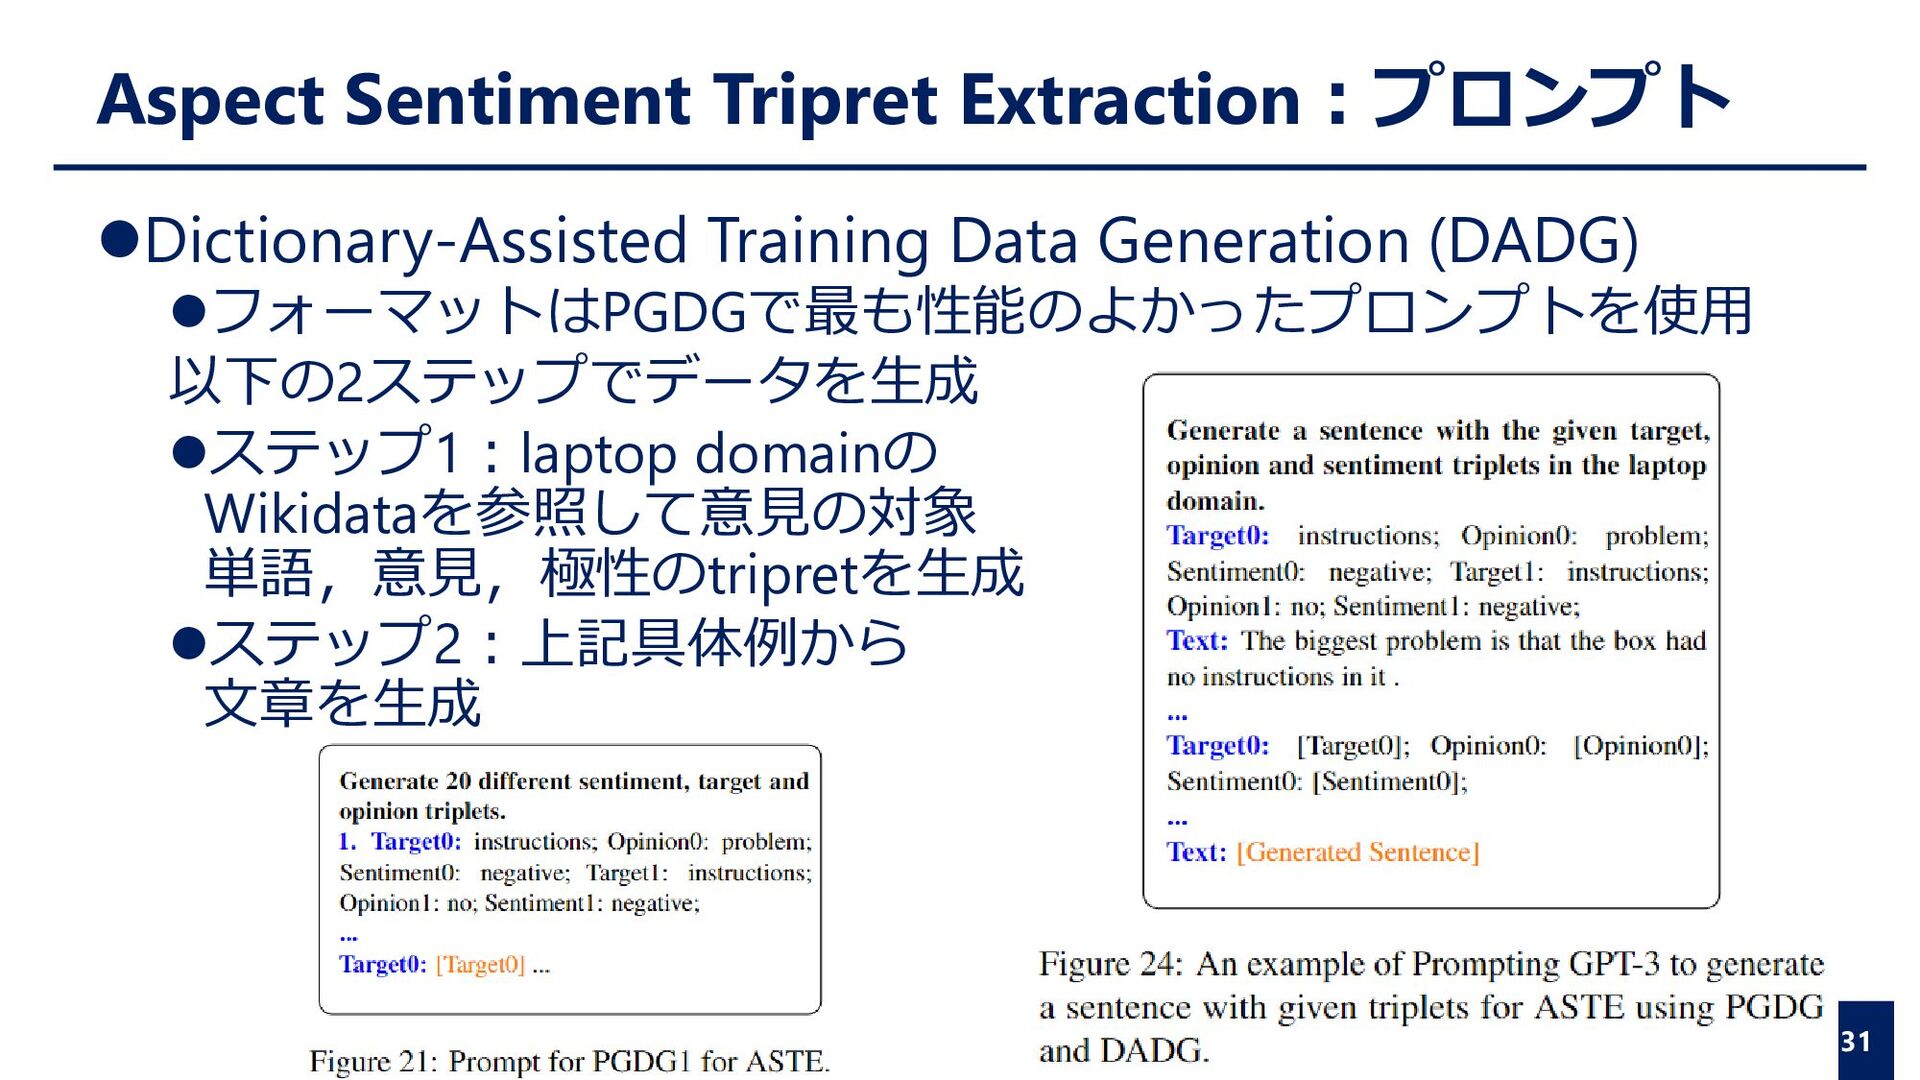
Aspect Sentiment Tripret Extraction:プロンプト 31 ⚫Dictionary-Assisted Training Data Generation (DADG)
⚫フォーマットはPGDGで最も性能のよかったプロンプトを使用 以下の2ステップでデータを生成 ⚫ステップ1:laptop domainの Wikidataを参照して意見の対象 単語,意見,極性のtripretを生成 ⚫ステップ2:上記具体例から 文章を生成 -
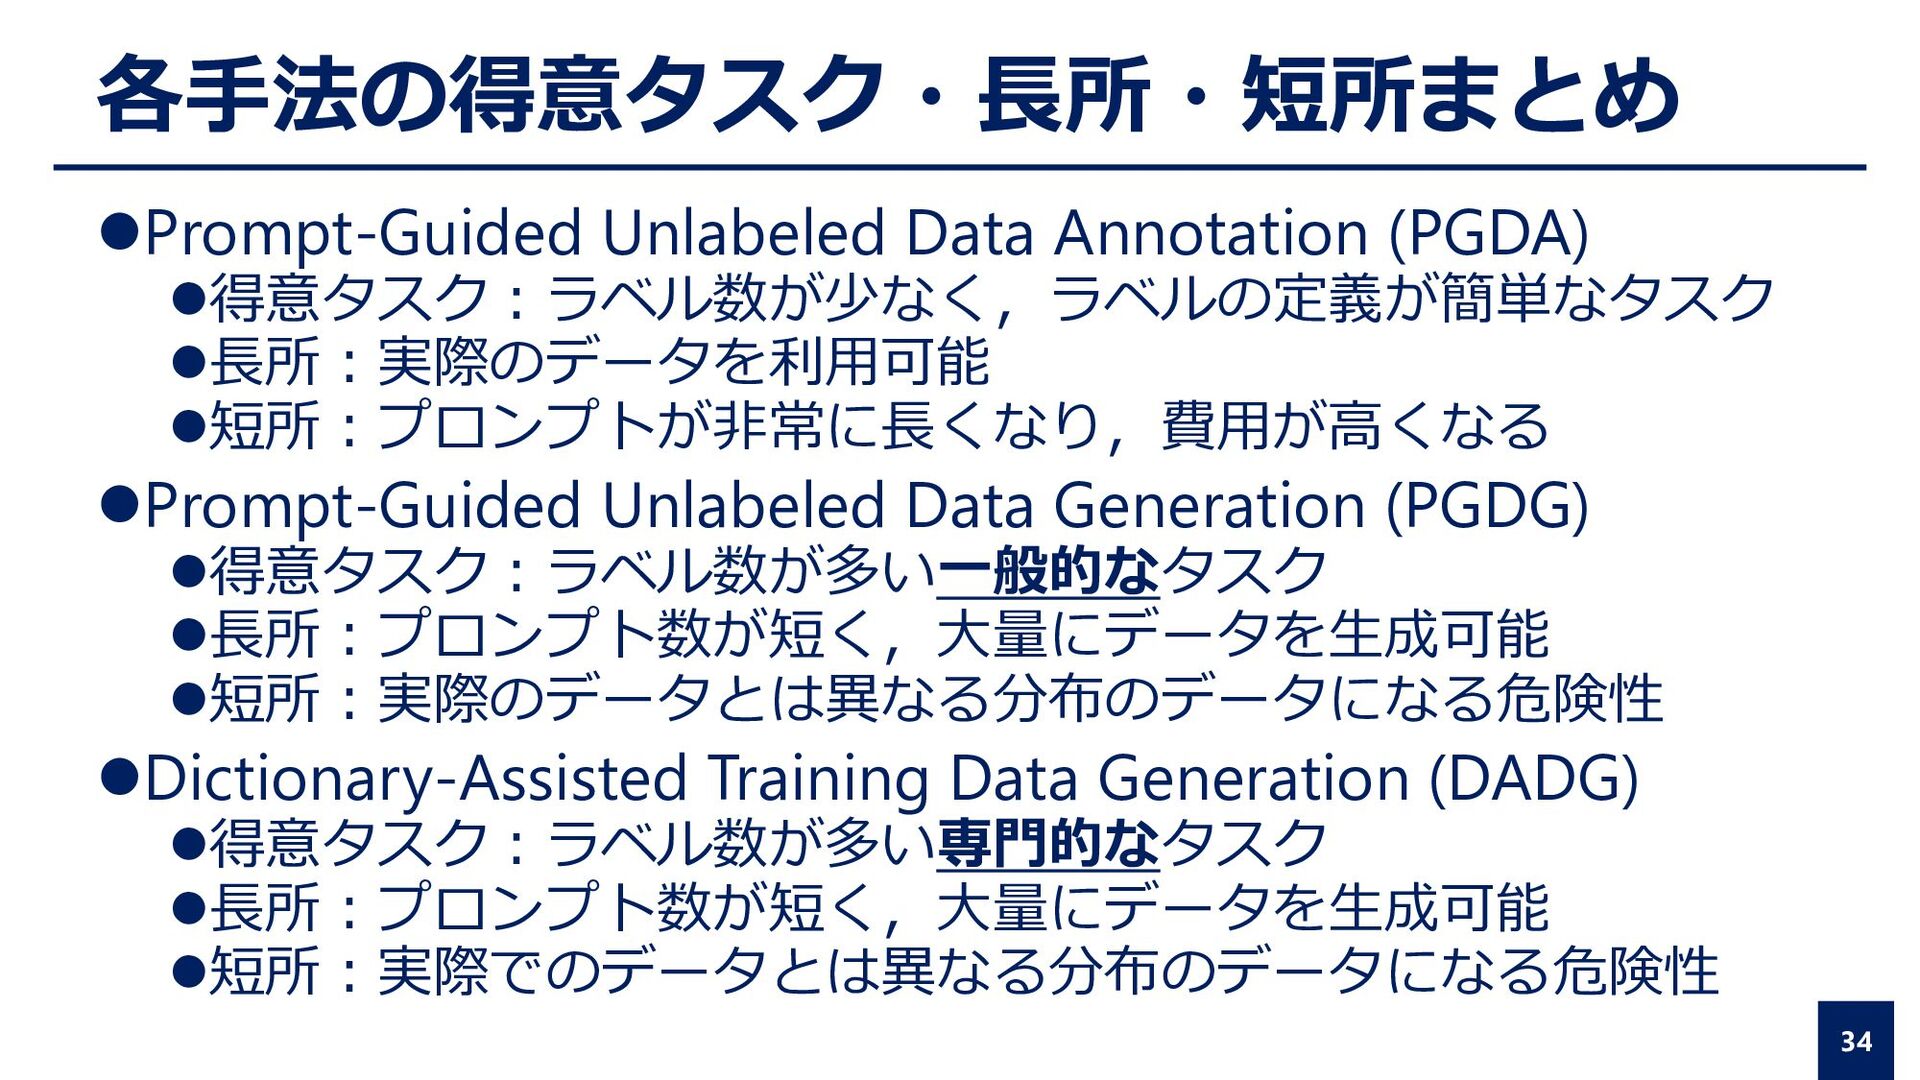
各手法の得意タスク・長所・短所まとめ ⚫Prompt-Guided Unlabeled Data Annotation (PGDA) ⚫得意タスク:ラベル数が少なく,ラベルの定義が簡単なタスク ⚫長所:実際のデータを利用可能 ⚫短所:プロンプトが非常に長くなり,費用が高くなる ⚫Prompt-Guided
Unlabeled Data Generation (PGDG) ⚫得意タスク:ラベル数が多い一般的なタスク ⚫長所:プロンプト数が短く,大量にデータを生成可能 ⚫短所:実際のデータとは異なる分布のデータになる危険性 ⚫Dictionary-Assisted Training Data Generation (DADG) ⚫得意タスク:ラベル数が多い専門的なタスク ⚫長所:プロンプト数が短く,大量にデータを生成可能 ⚫短所:実際でのデータとは異なる分布のデータになる危険性 34 -
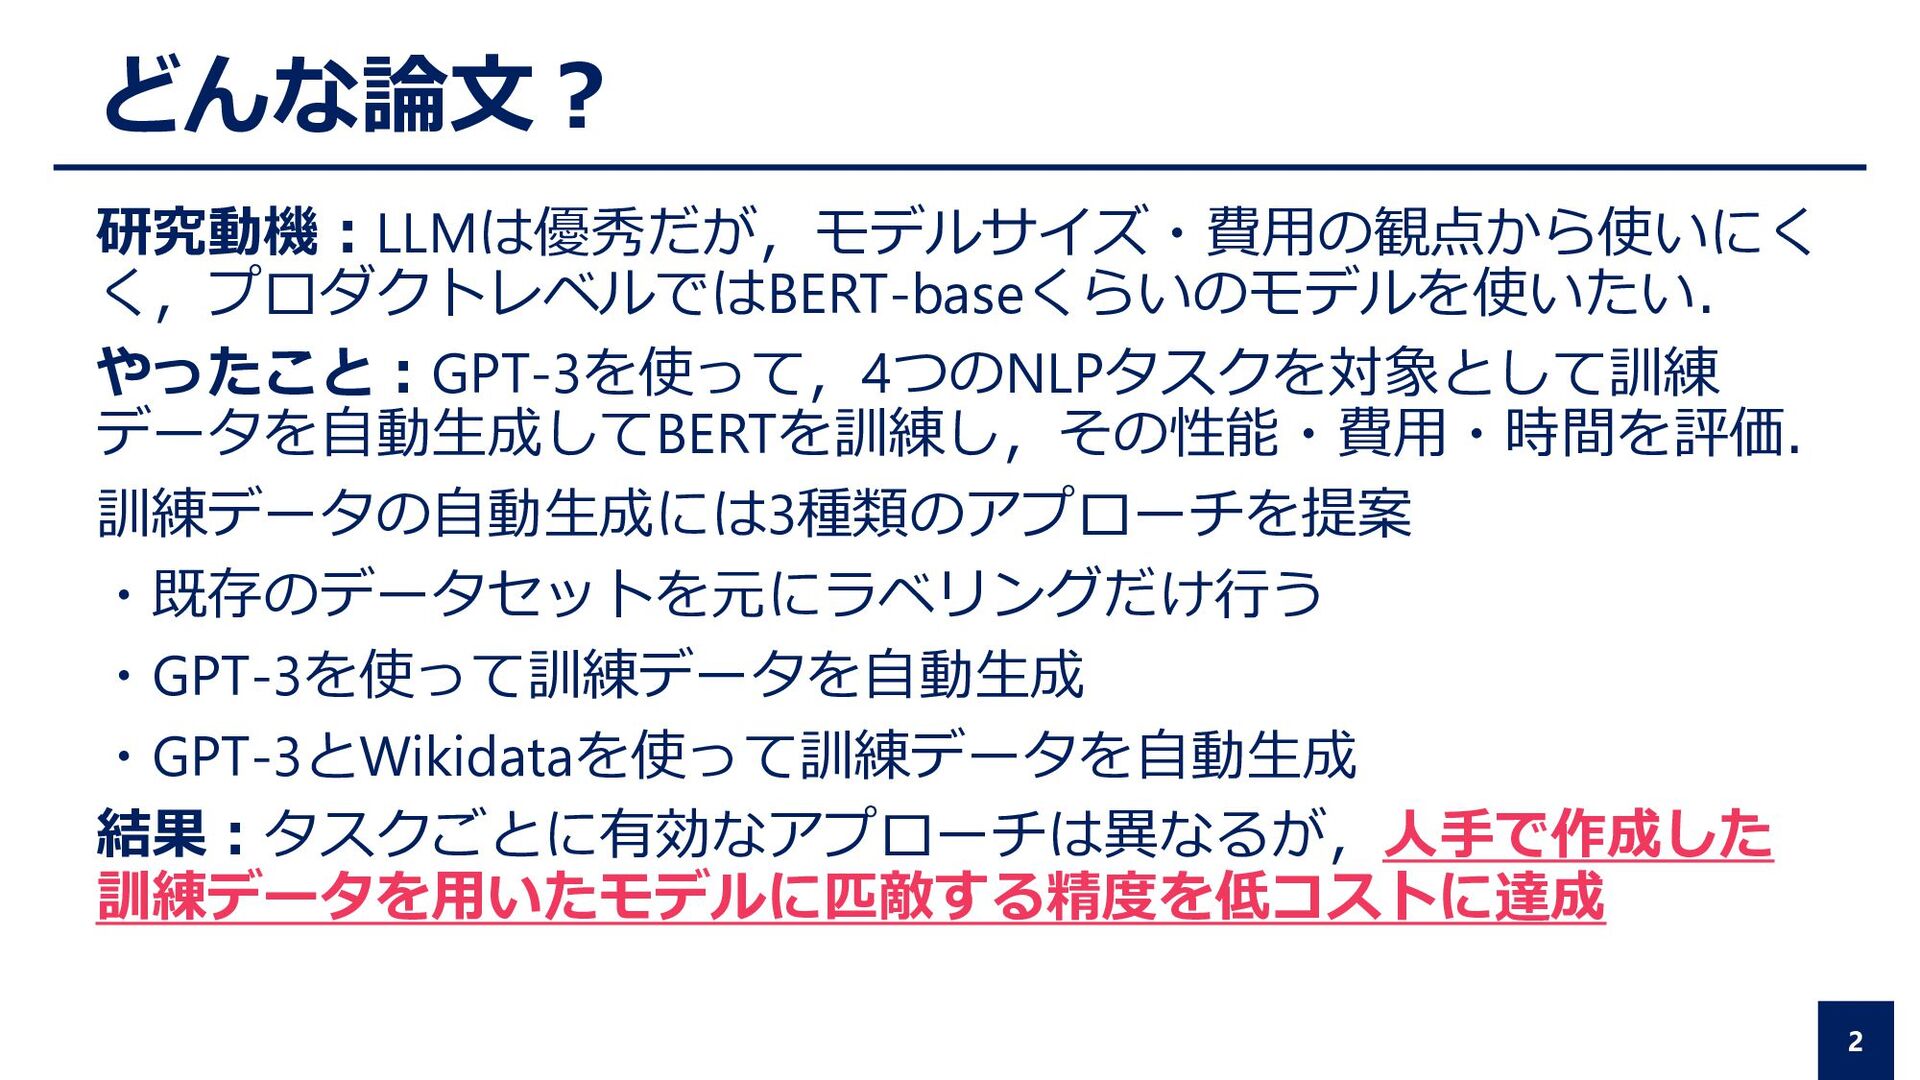
本論文の概要(再掲) 研究動機:LLMは優秀だが,モデルサイズ・費用の観点から使いにく く,プロダクトレベルではBERT-baseくらいのモデルを使いたい. やったこと:GPT-3を使って,4つのNLPタスクを対象として訓練 データを自動生成してBERTを訓練し,その性能・費用・時間を評価. 訓練データの自動生成には3種類のアプローチを提案 ・既存のデータセットを元にラベリングだけ行う ・GPT-3を使って訓練データを自動生成 ・GPT-3とWikidataを使って訓練データを自動生成 結果:タスクごとに有効なアプローチは異なるが,人手で作成した
訓練データを用いたモデルに匹敵する精度を低コストに達成 39