Share
Embed

Transcript
58 slides
-
PaperWithCodeの上位10本の論文を紹介 1. ニューラルネットワークは決定木 (原文: Neural Networks are Decision Trees) 2.
COVID-19パンデミック時の共和党と民主党の過剰死亡率 (原文: Excess death rates for Republicans and Democrats during the COVID-19 pandemic) 3. AIで未来を予測する:指数関数的に成長する知識ネットワークにおける高品質なリンク予測 (原文: Predicting the Future of AI with AI: High-quality link prediction in an exponentially growing knowledge network) 4. ポアソンフロー生成モデル (原文: Poisson Flow Generative Models) 5. 人間の規則的な強化学習とプランニングによって、ノープレス外交ゲームをマスターする (原文: Mastering the Game of No-Press Diplomacy via Human-Regularized Reinforcement Learning and Planning) 6. 人間の規則的な探索と学習による人間とAIの協調 (原文: Human-AI Coordination via Human-Regularized Search and Learning) 7. Imagic: 拡散モデルによるテキストベースの実画像編集 (原文: Imagic: Text-Based Real Image Editing with Diffusion Models) 8. DiffDock:分子ドッキングのための拡散ステップ、ツイスト、そしてターン (原文: DiffDock: Diffusion Steps, Twists, and Turns for Molecular Docking) 9. PDEBENCH: 科学的機械学習のための広範なベンチマーク (原文: PDEBENCH: An Extensive Benchmark for Scientific Machine Learning) 10.フォールディング拡散による蛋白質構造生成 (原文: Protein structure generation via folding diffusion) -
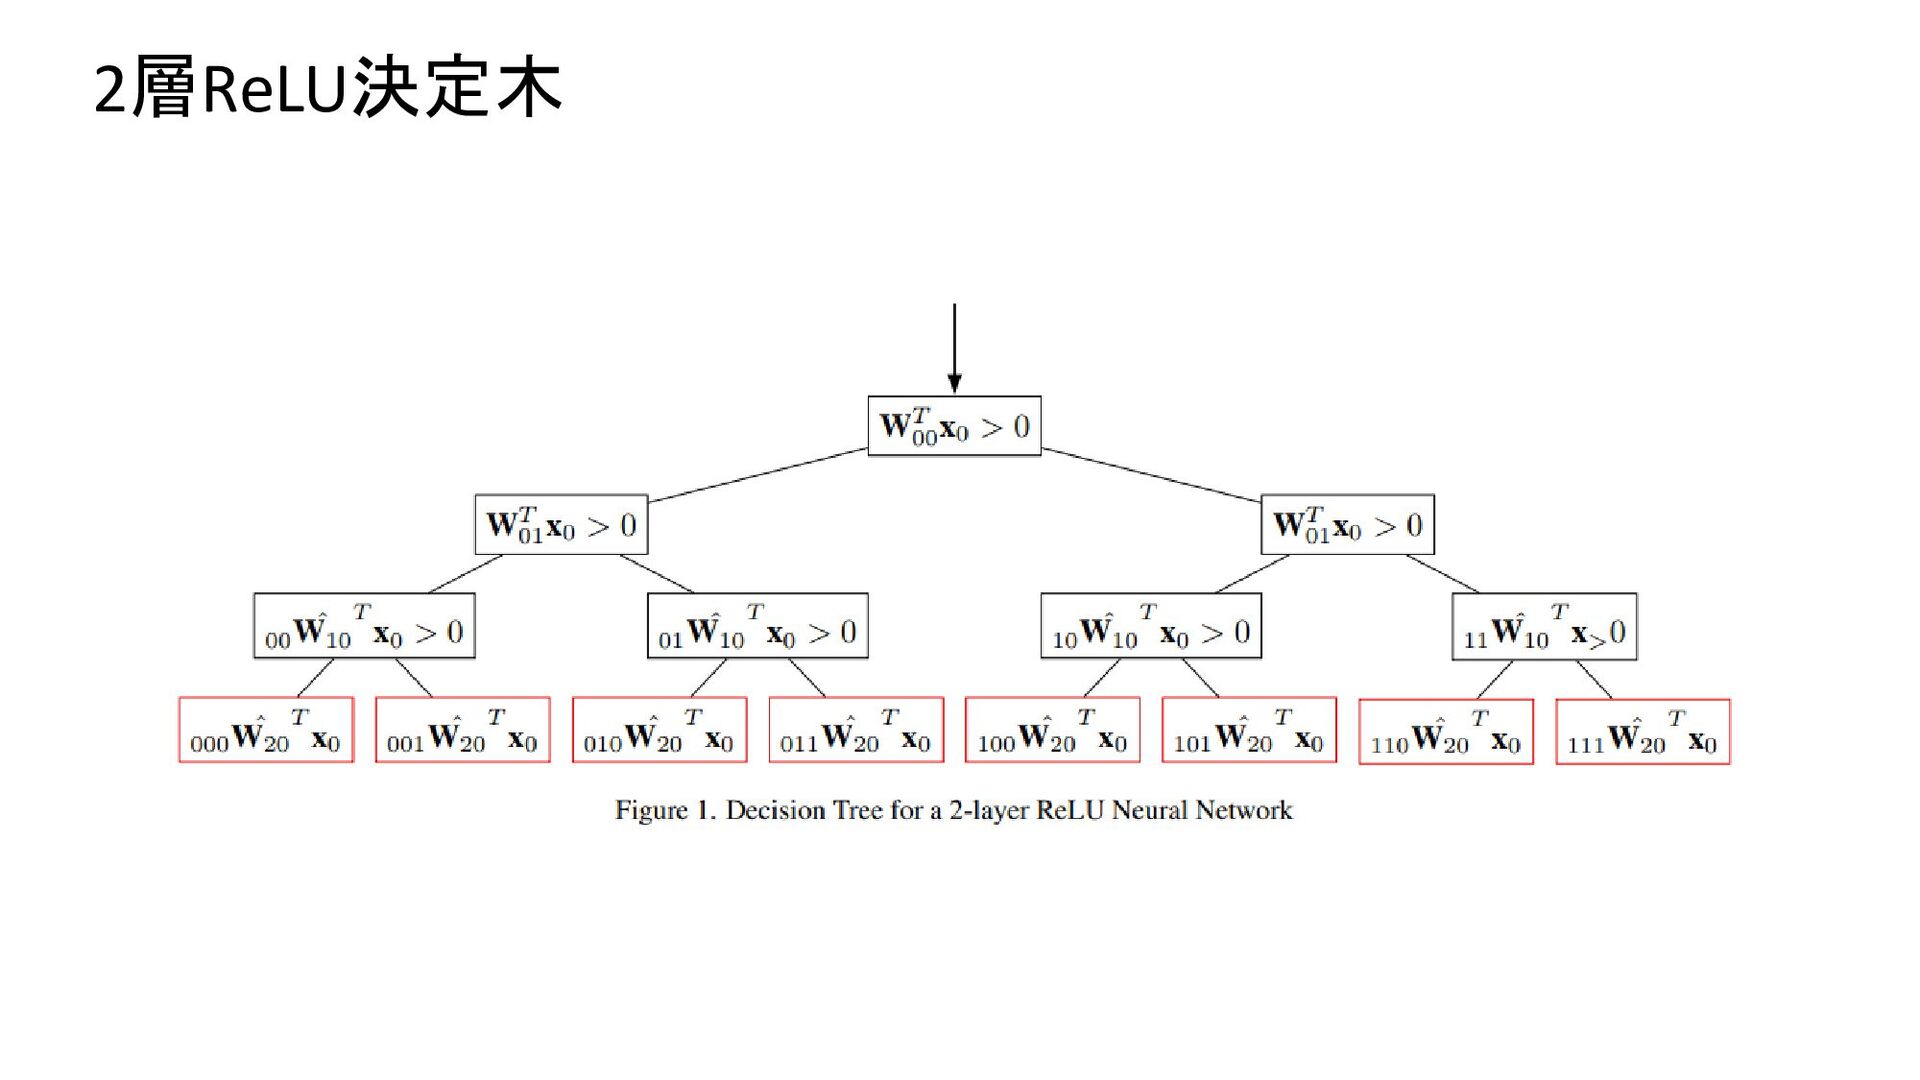
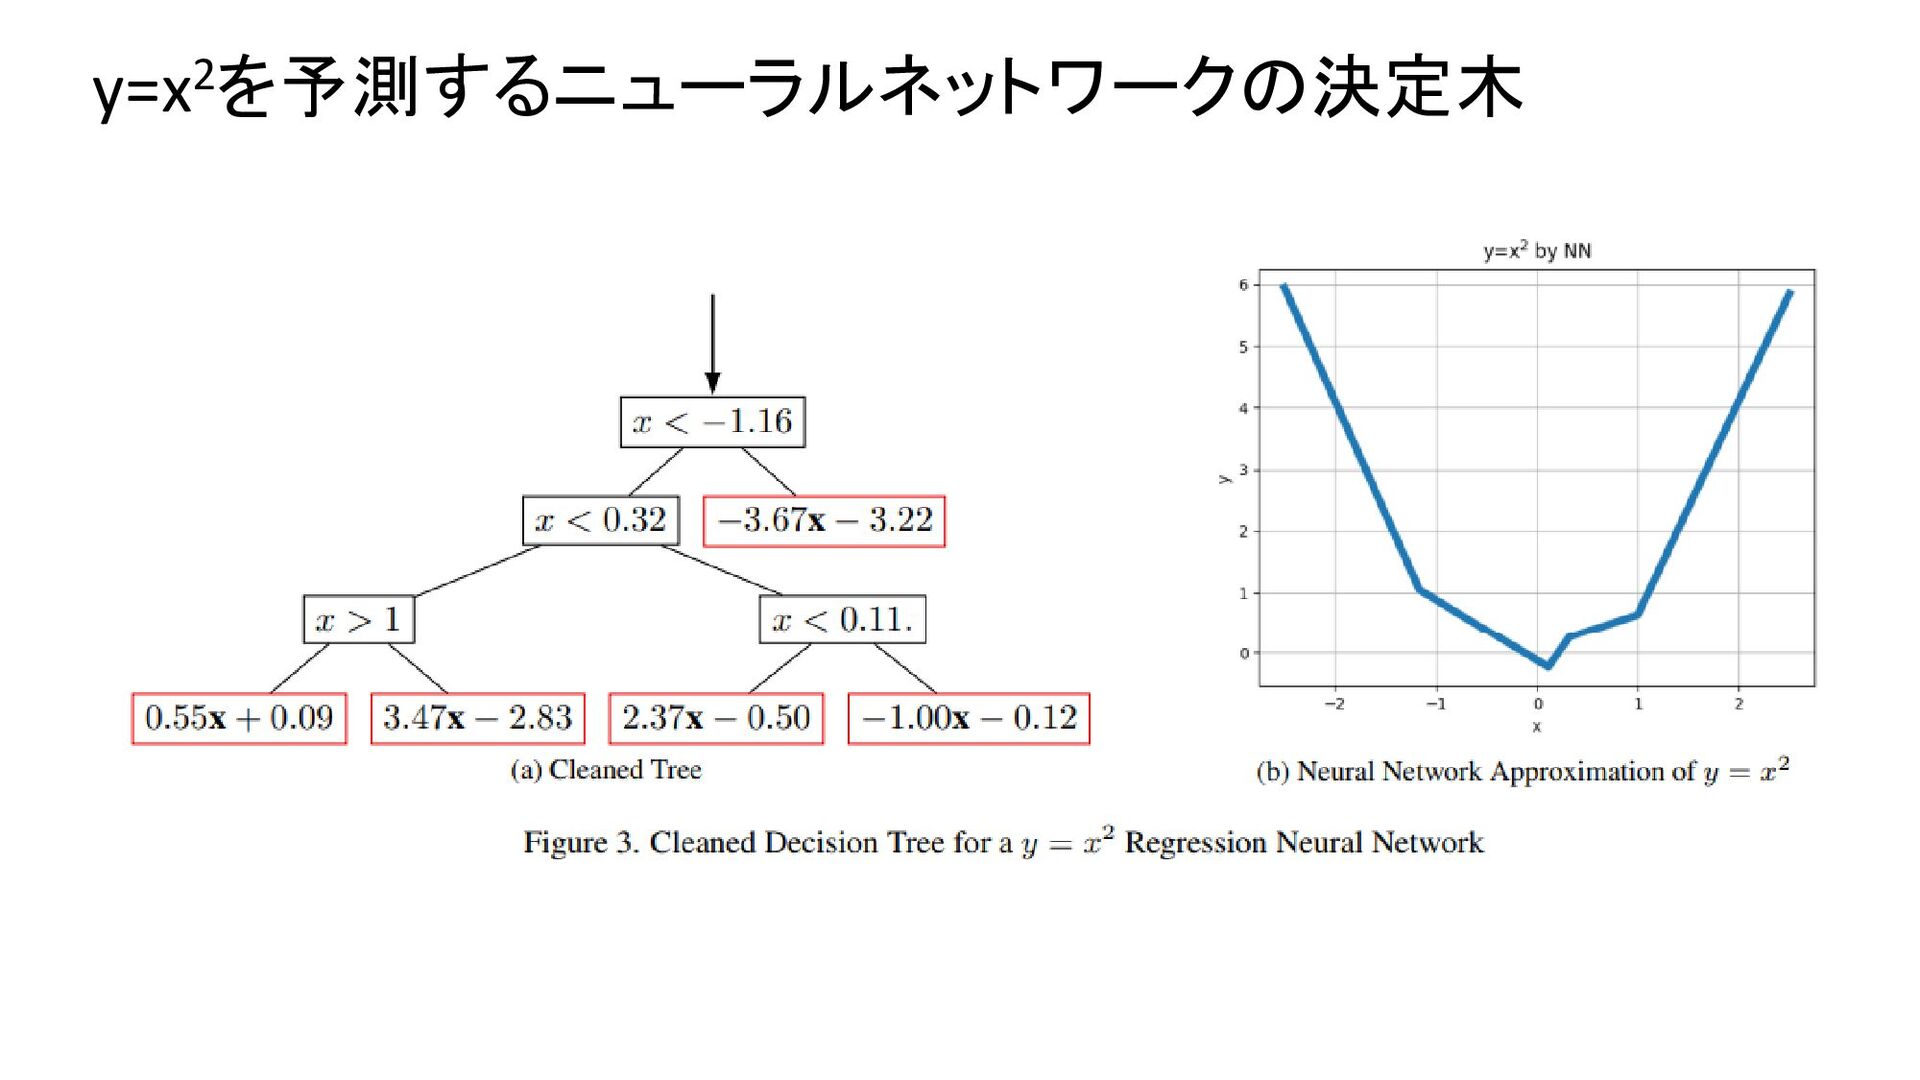
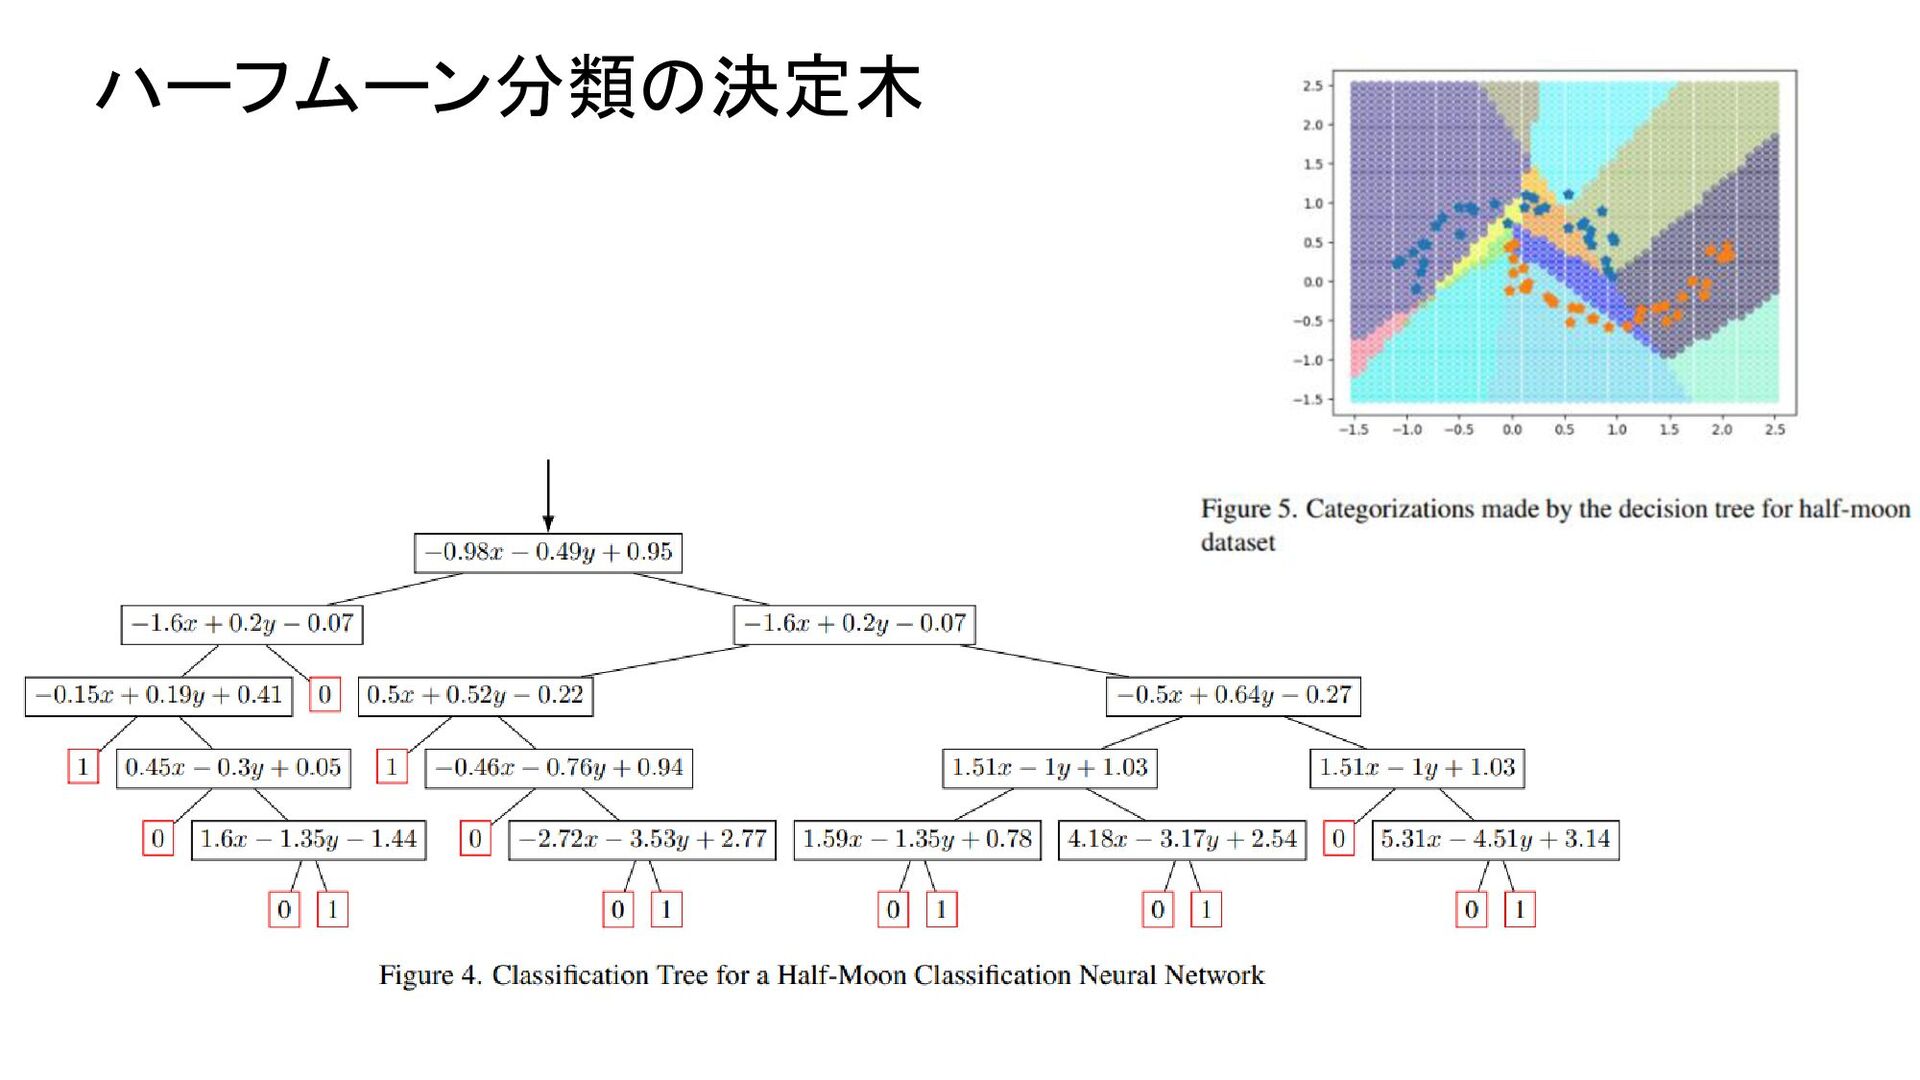
1. ニューラルネットワークは決定木 (原文: Neural Networks are Decision Trees) この原稿では、区分線形活性化関数を持つ任意のフィードフォワードニューラルネットワークが決定木として表現できること を示す。この表現は近似ではなく等価であるため、ニューラルネットワークの精度をそっくりそのまま保つことができる。この
成果は、ニューラルネットワークのブラックボックス的な性質に取り組む道を開くものだと考えています。我々は、いくつかの ニューラルネットワークの等価木を共有し、解釈可能性を提供する以外に、木表現がいくつかの計算上の利点を達成する ことができることを示す。この解析は、完全連結ネットワークと畳み込みネットワークの両方に対して行われ、これらのネット ワークはスキップ連結や正規化を含んでいても含んでいなくてもよい。 https://arxiv.org/abs/2210.05189v2 目的:ニューラルネットワークはそれと等価な決定木に変換できることを示す 成果:ニューラルネットワークのブラックボックス的性質に取り組む道をひらく 方法:ニューラルネットワークを決定木に変換する方法を提案 固有名: - 著者所属: ACC Technologies -
2. COVID-19パンデミック時の共和党と民主党の過剰死亡率 (原文: Excess death rates for Republicans and Democrats
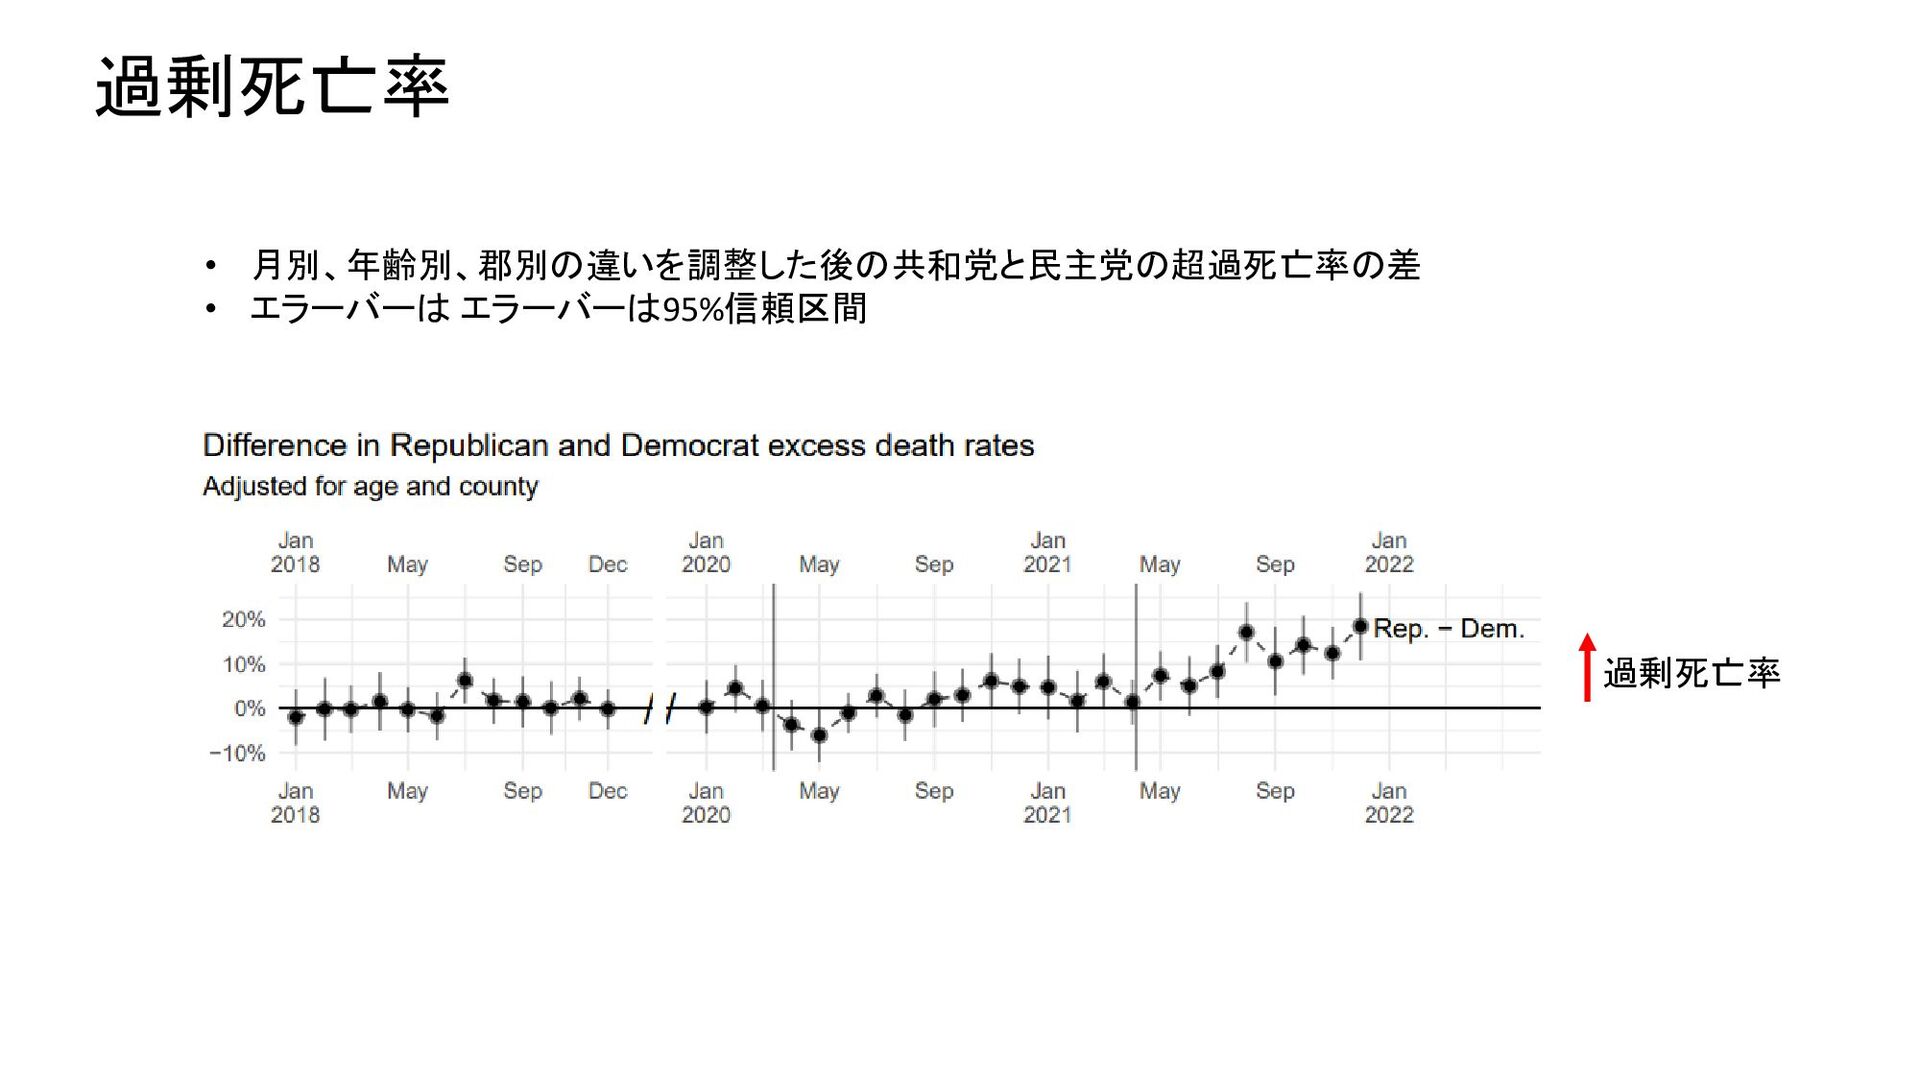
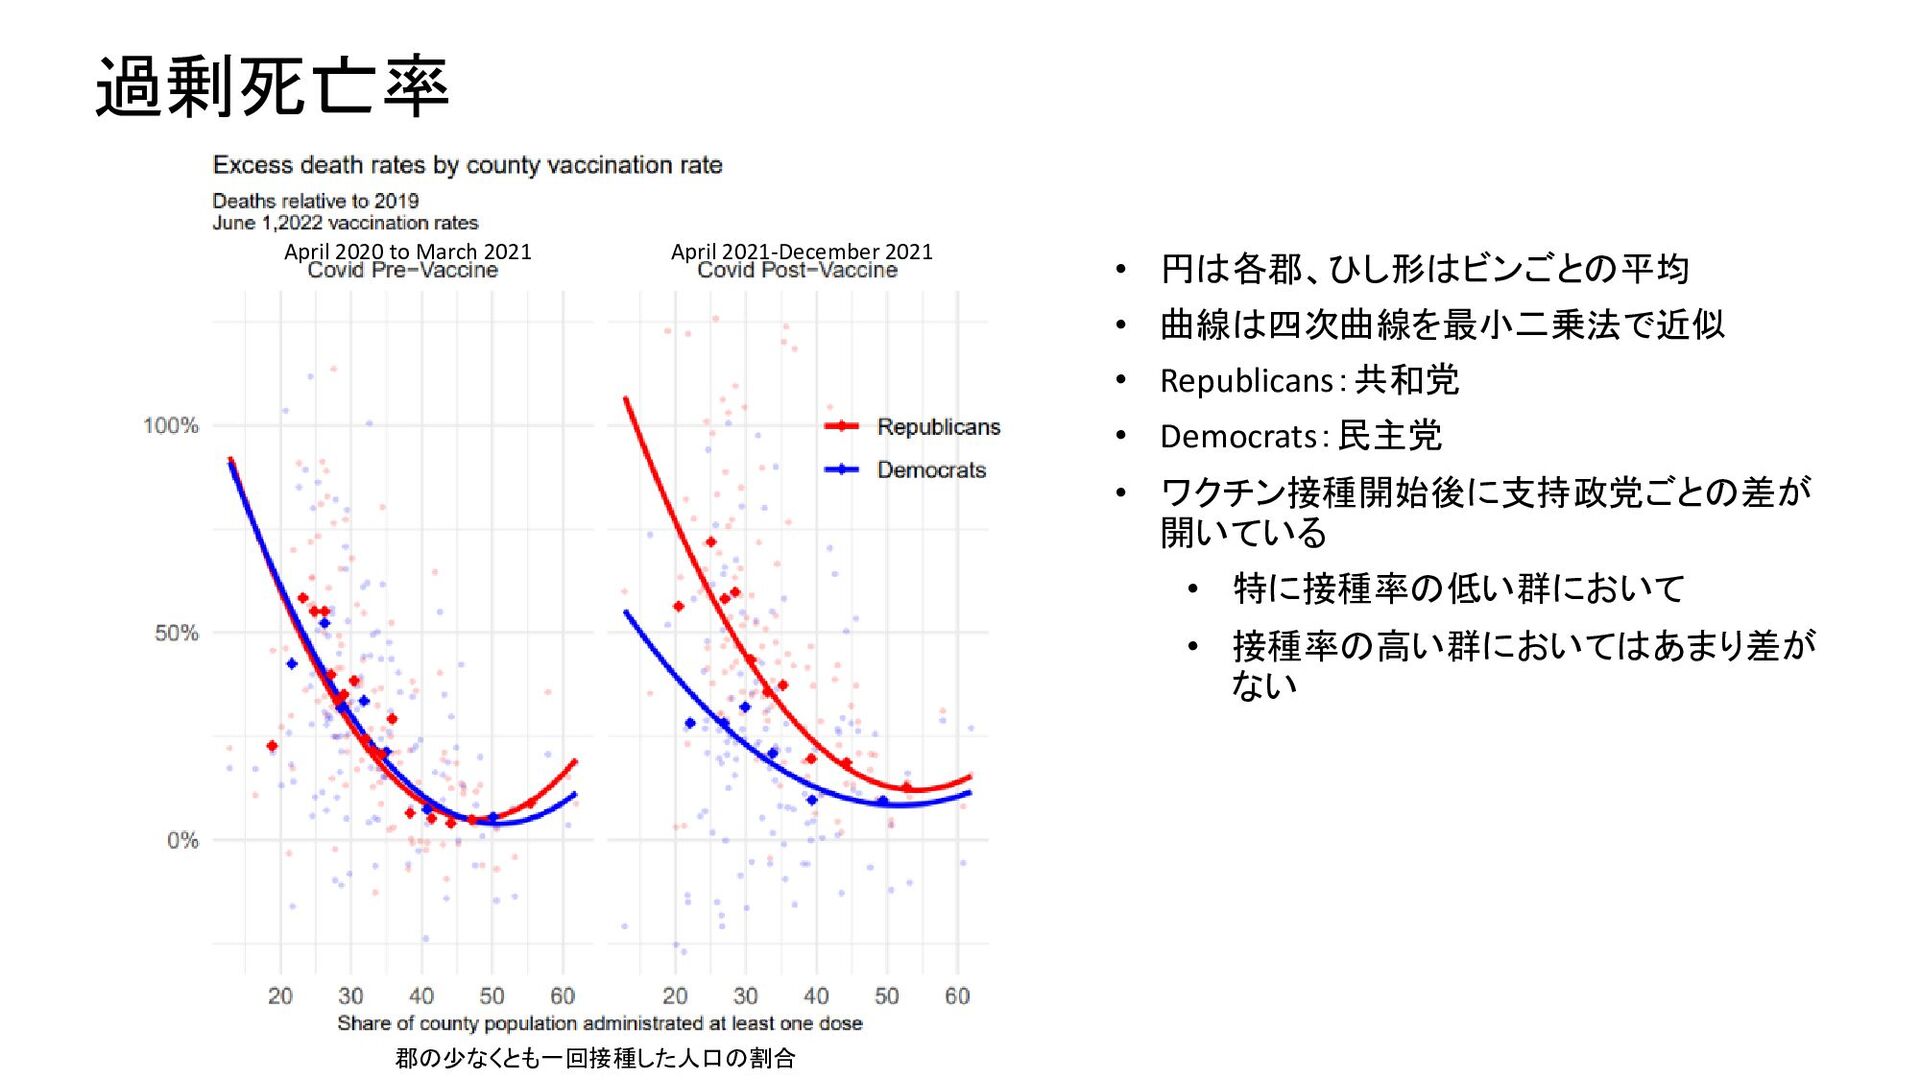
during the COVID-19 pandemic) 共和党寄りの郡が民主党寄りの郡よりもCOVID-19の死亡率が高かったという証拠や、所属政党とワクチン接種の見解の 間のリンクの証拠がある中で、政治的所属はCOVID-19の潜在的なリスク要因として浮上している。本研究では、オハイオ 州とフロリダ州の2017年の有権者登録と2018年から2021年の死亡率データのリンケージを介して、COVID-19パンデミック 時の政治的所属と過剰死亡率との個人レベルのデータセットを構築しています。我々は、登録された共和党員の過剰死亡 率が登録された民主党員と比較して大幅に高く、その差のほぼすべてが調査対象州でワクチンが広く利用できるように なった後の期間に集中していると推定している。全体として、共和党員の過剰死亡率は、民主党員の過剰死亡率よりも5.4 ポイント(pp)、つまり76%高かった。ワクチン接種後、共和党と民主党の過剰死亡率の差は1.6pp(民主党の過剰死亡率の 22%)から10.4pp(民主党の過剰死亡率の153%)に拡大した。共和党と民主党の超過死亡率の差は、ワクチン接種率の 低い郡に集中しており、ワクチンが広く普及した後にのみ顕在化する。 https://arxiv.org/abs/2209.10751v2 目的:政治的帰属とCOVID-19死亡率の関係を調査する 成果:共和党員の過剰死亡率が大幅に高い 方法: オハイオ州とフロリダ州の2017年の有権者登録と2018年から2021年の死亡率データの関係を調査 固有名: - 著者所属:イエール大学 -
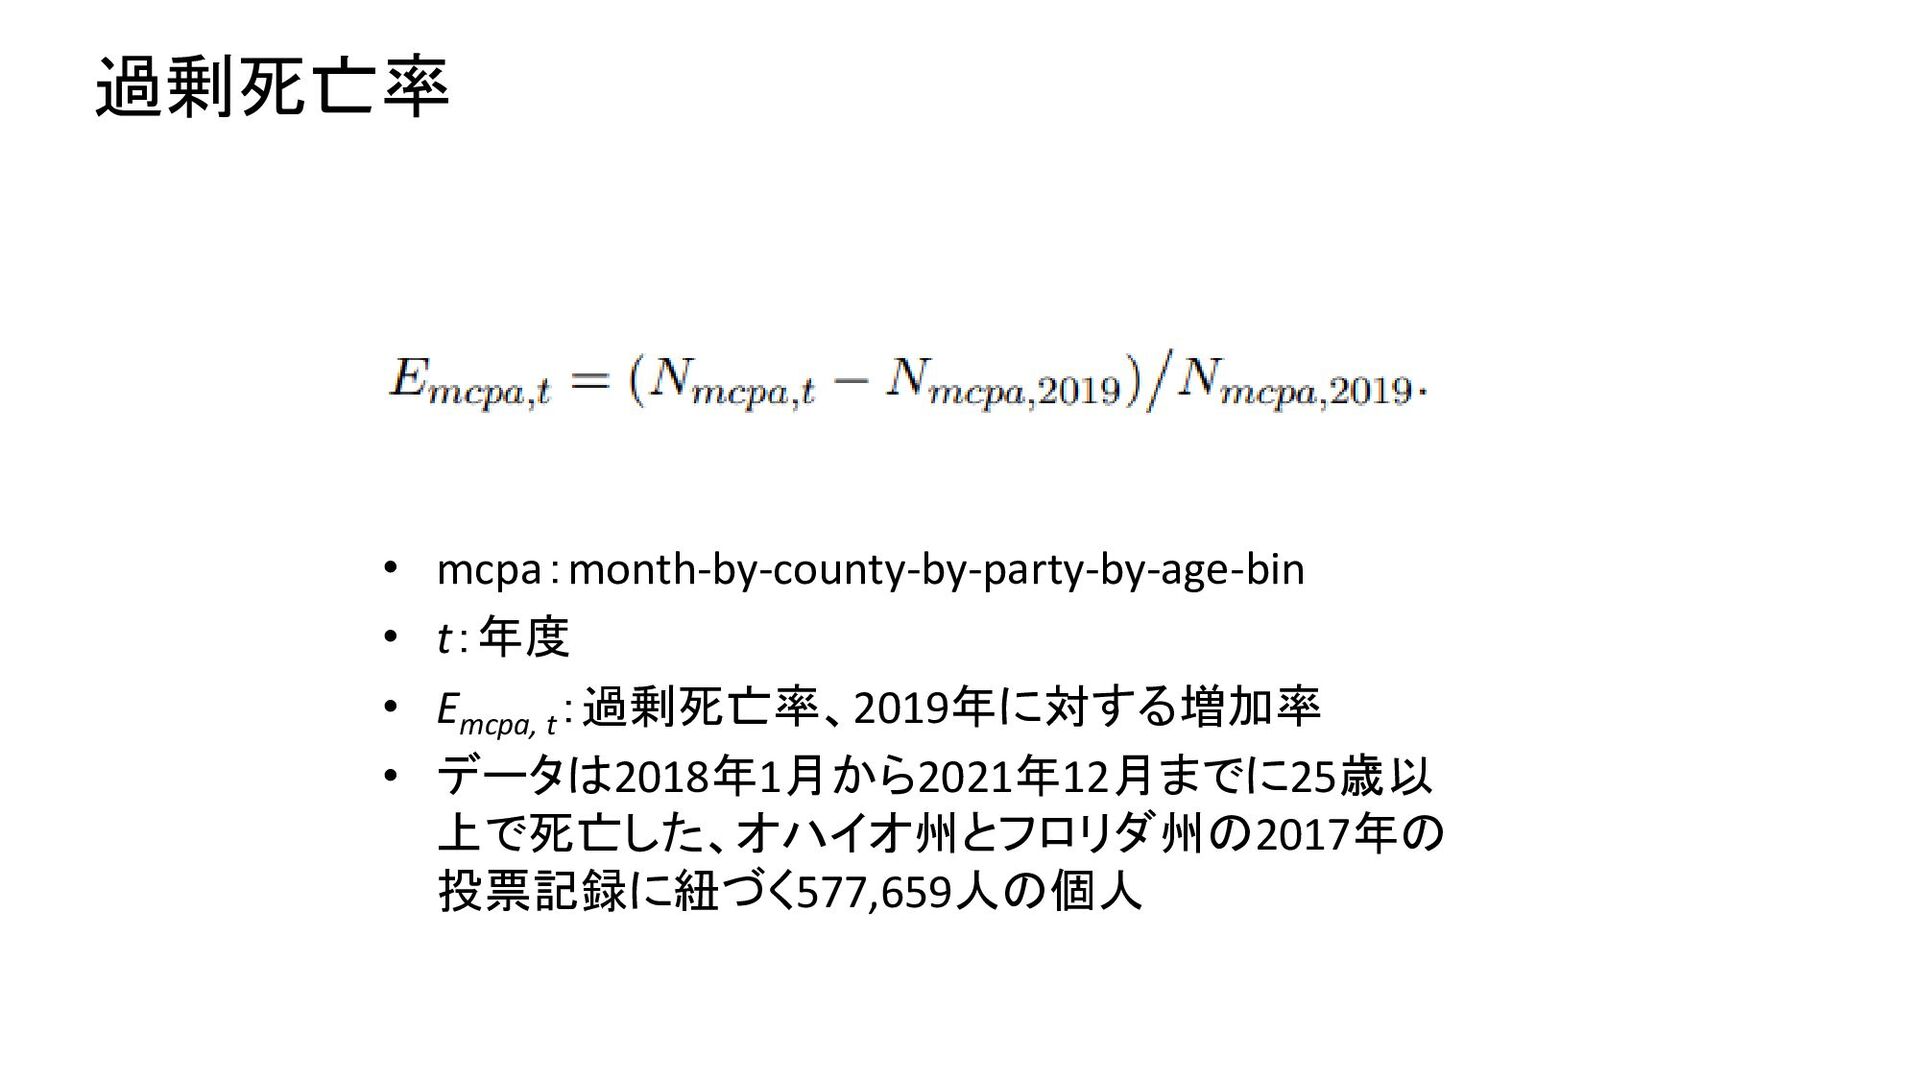
過剰死亡率 • mcpa:month-by-county-by-party-by-age-bin • t:年度 • Emcpa, t :過剰死亡率、2019年に対する増加率 •
データは2018年1月から2021年12月までに25歳以 上で死亡した、オハイオ州とフロリダ州の2017年の 投票記録に紐づく577,659人の個人 -
過剰死亡率 April 2020 to March 2021 April 2021-December 2021 •
円は各郡、ひし形はビンごとの平均 • 曲線は四次曲線を最小二乗法で近似 • Republicans:共和党 • Democrats:民主党 • ワクチン接種開始後に支持政党ごとの差が 開いている • 特に接種率の低い群において • 接種率の高い群においてはあまり差が ない 郡の少なくとも一回接種した人口の割合 -
3. AIで未来を予測する:指数関数的に成長する知識ネットワークにおける高品質なリンク予測 (原文: Predicting the Future of AI with AI:
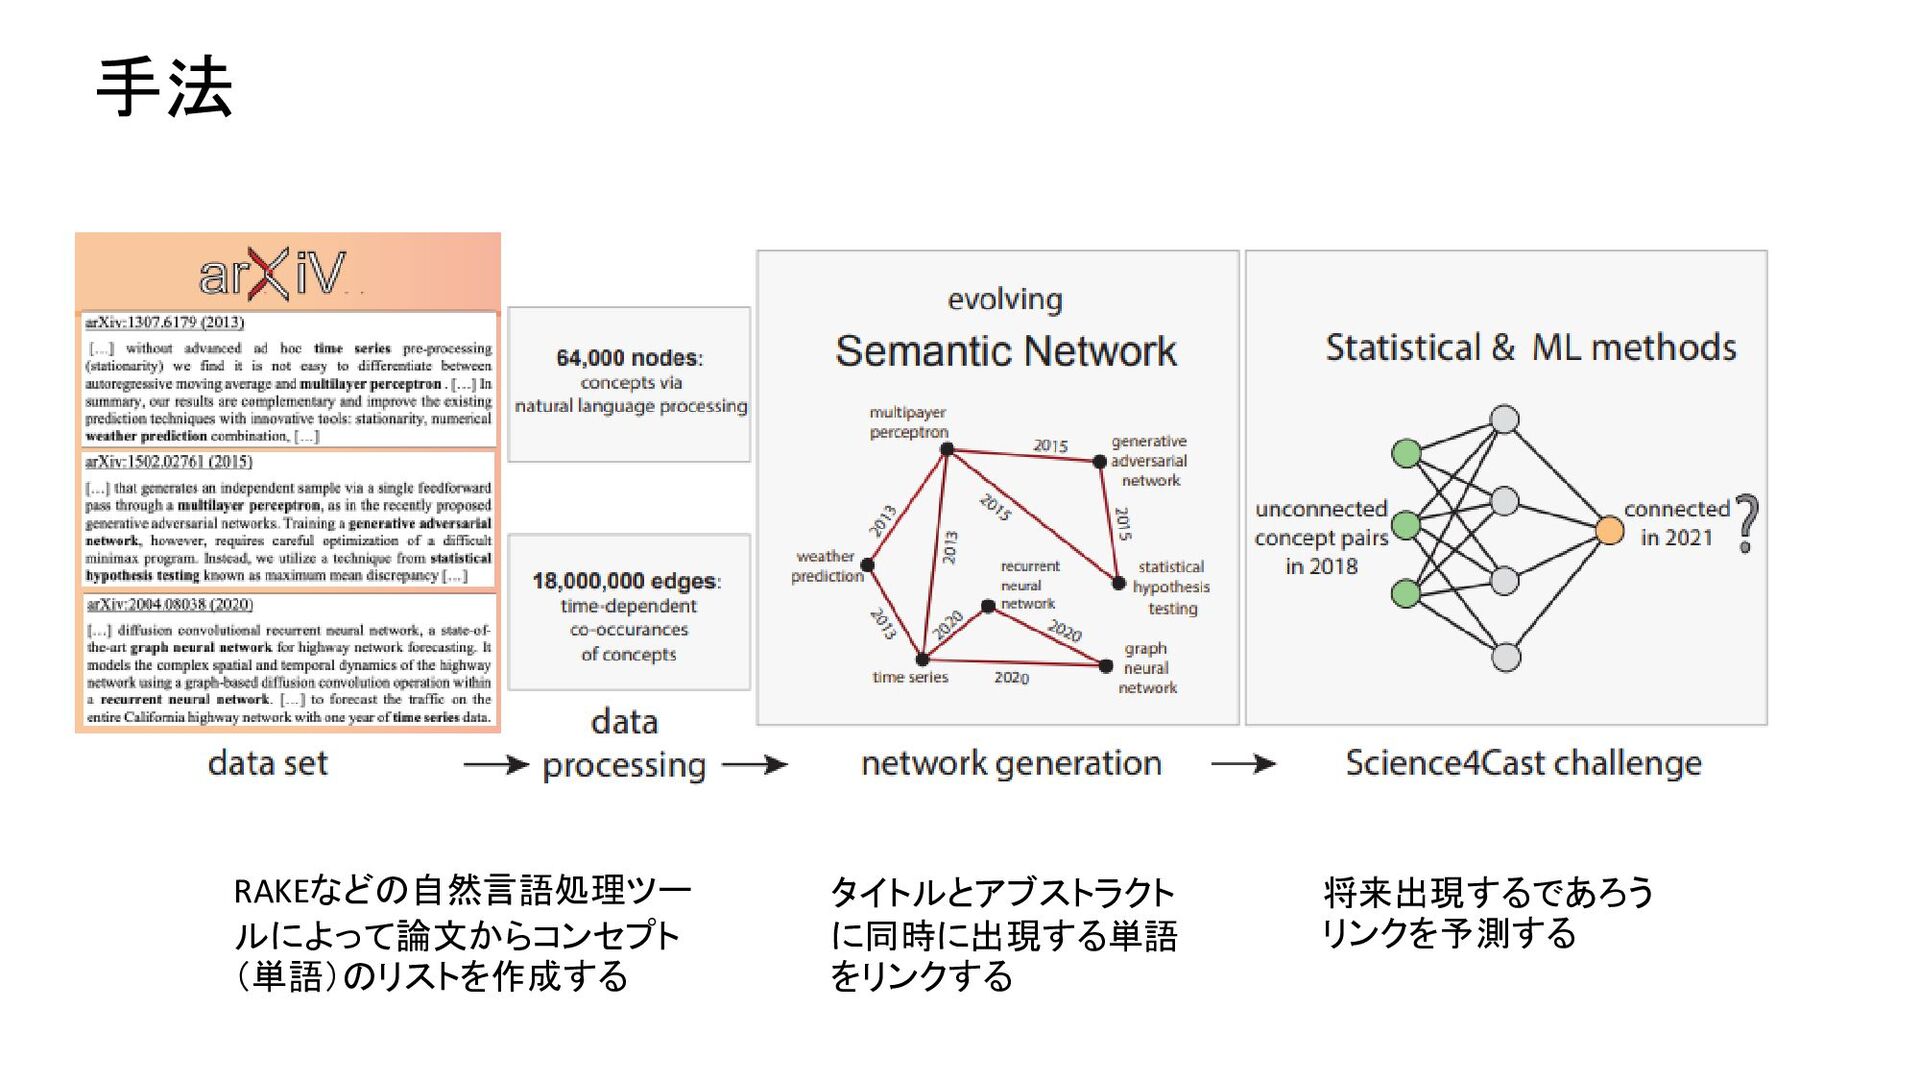
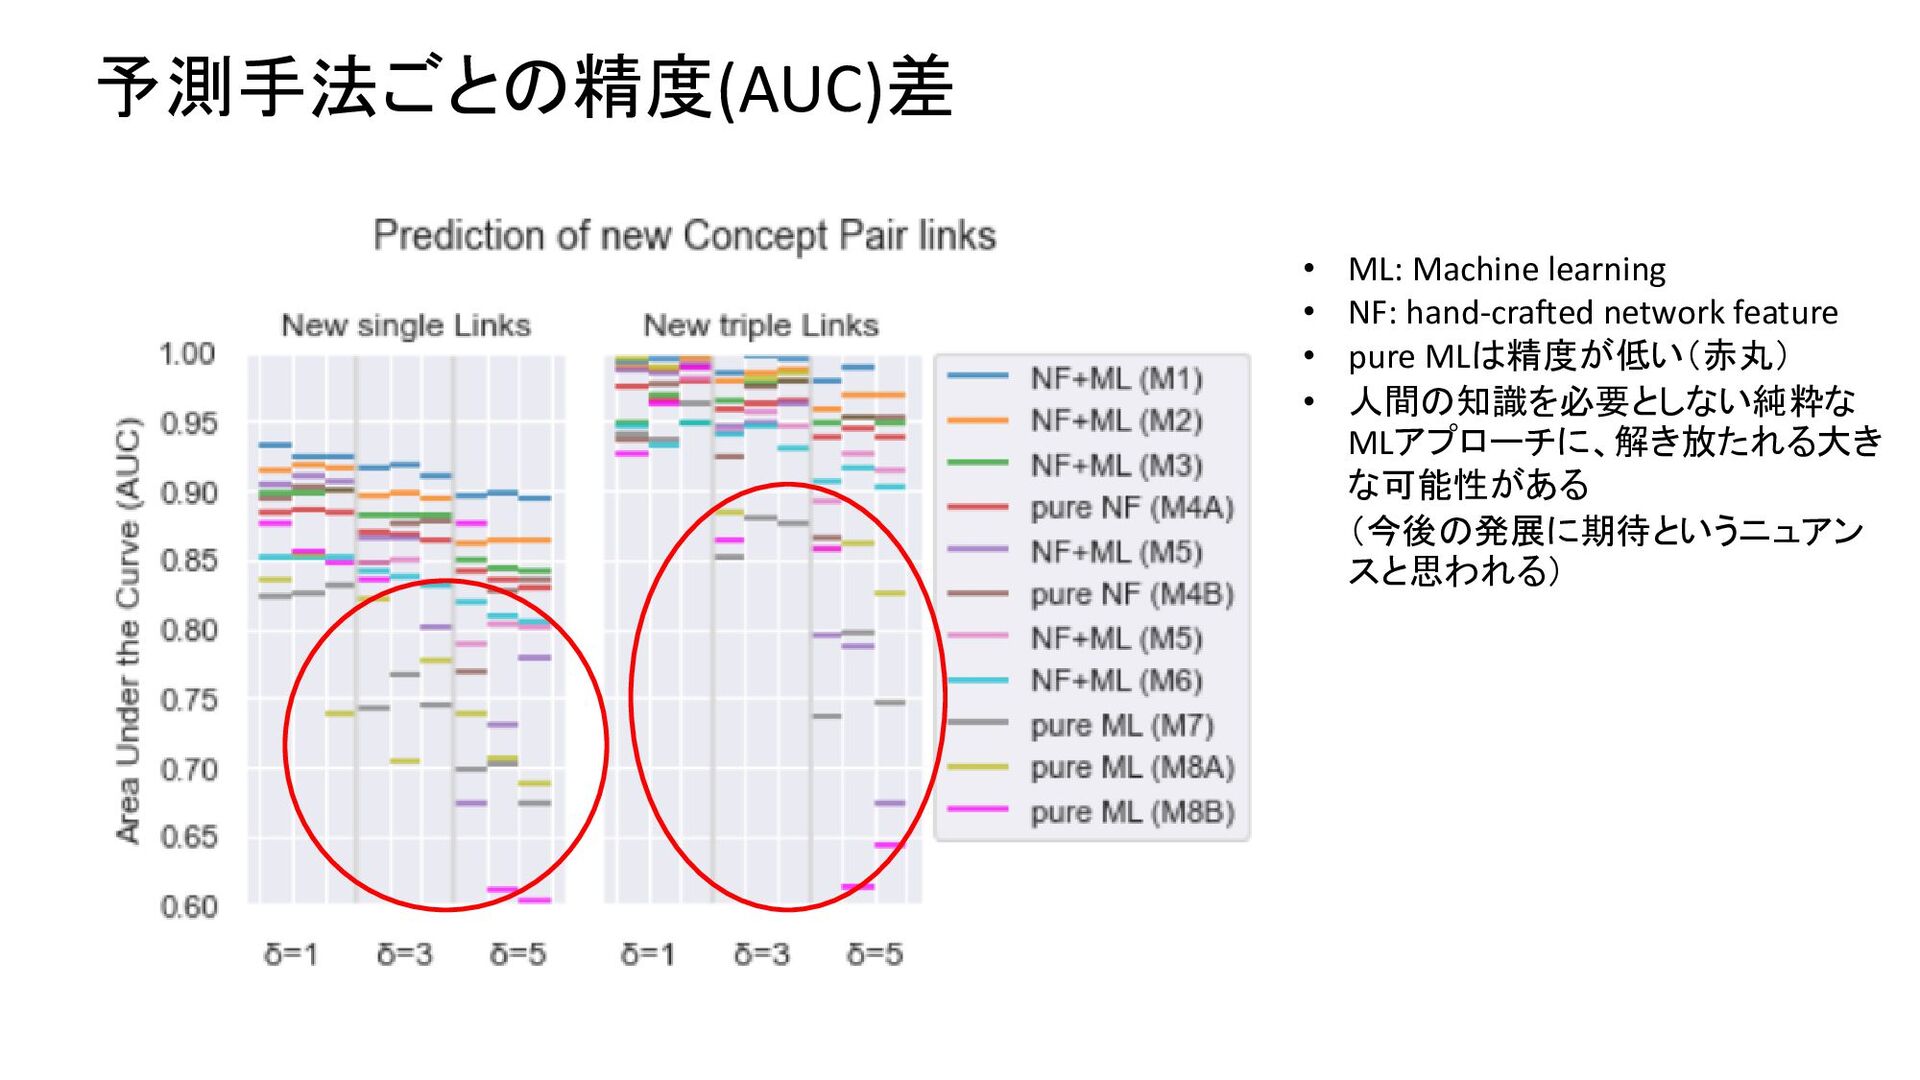
High-quality link prediction in an exponentially growing knowledge network) 科学文献から洞察を得て、新しいパーソナライズされた研究の方向性やアイデアを提案できるツールは、科学の進歩を著 しく加速させる可能性があります。このようなアプローチから恩恵を受ける可能性がある分野は、人工知能(AI)研究である。 人工知能研究では、科学論文の数がここ数年で指数関数的に増加しており、人間の研究者がその進捗を追跡することは 困難になっている。ここでは、AI技術を利用して、AI自体の将来の研究の方向性を予測する。我々は、実世界のデータに基 づく新しいグラフベースのベンチマーク、Science4Castベンチマークを開発し、進化するAIのセマンティックネットワークの将 来の状態を予測することを目的とする。そのために、10万以上の研究論文を用い、64,000以上のコンセプトノードからなる 知識ネットワークを構築する。そして、この課題に取り組むために、純粋な統計的手法から純粋な学習手法まで、10種類の 多様な手法を紹介する。驚くべきことに、最も強力な方法は、エンドツーエンドのAIアプローチではなく、ネットワークの特徴 を注意深く精選したセットを使用している。これは、人間の知識を必要としない純粋なMLアプローチに、解き放たれる大きな 可能性があることを示している。最終的には、将来の新しい研究の方向性をより良く予測することが、より高度な研究提案 ツールの重要な構成要素となるだろう。 https://arxiv.org/abs/2210.00881v1 目的:AI技術を利用して、AI自体の将来の研究の方向性を予測する 成果:ベンチマークの公開 方法:研究論文から知識ネットワークを構築する。構築手法は10種類の方法を紹介。 固有名: Science4Castベンチマーク 著者所属:マックスプランク協会、テレコム研究所、トロント大学、カリフォルニア大学、他8研究所 -
予測手法ごとの精度(AUC)差 • ML: Machine learning • NF: hand-crafted network feature
• pure MLは精度が低い(赤丸) • 人間の知識を必要としない純粋な MLアプローチに、解き放たれる大き な可能性がある (今後の発展に期待というニュアン スと思われる) -
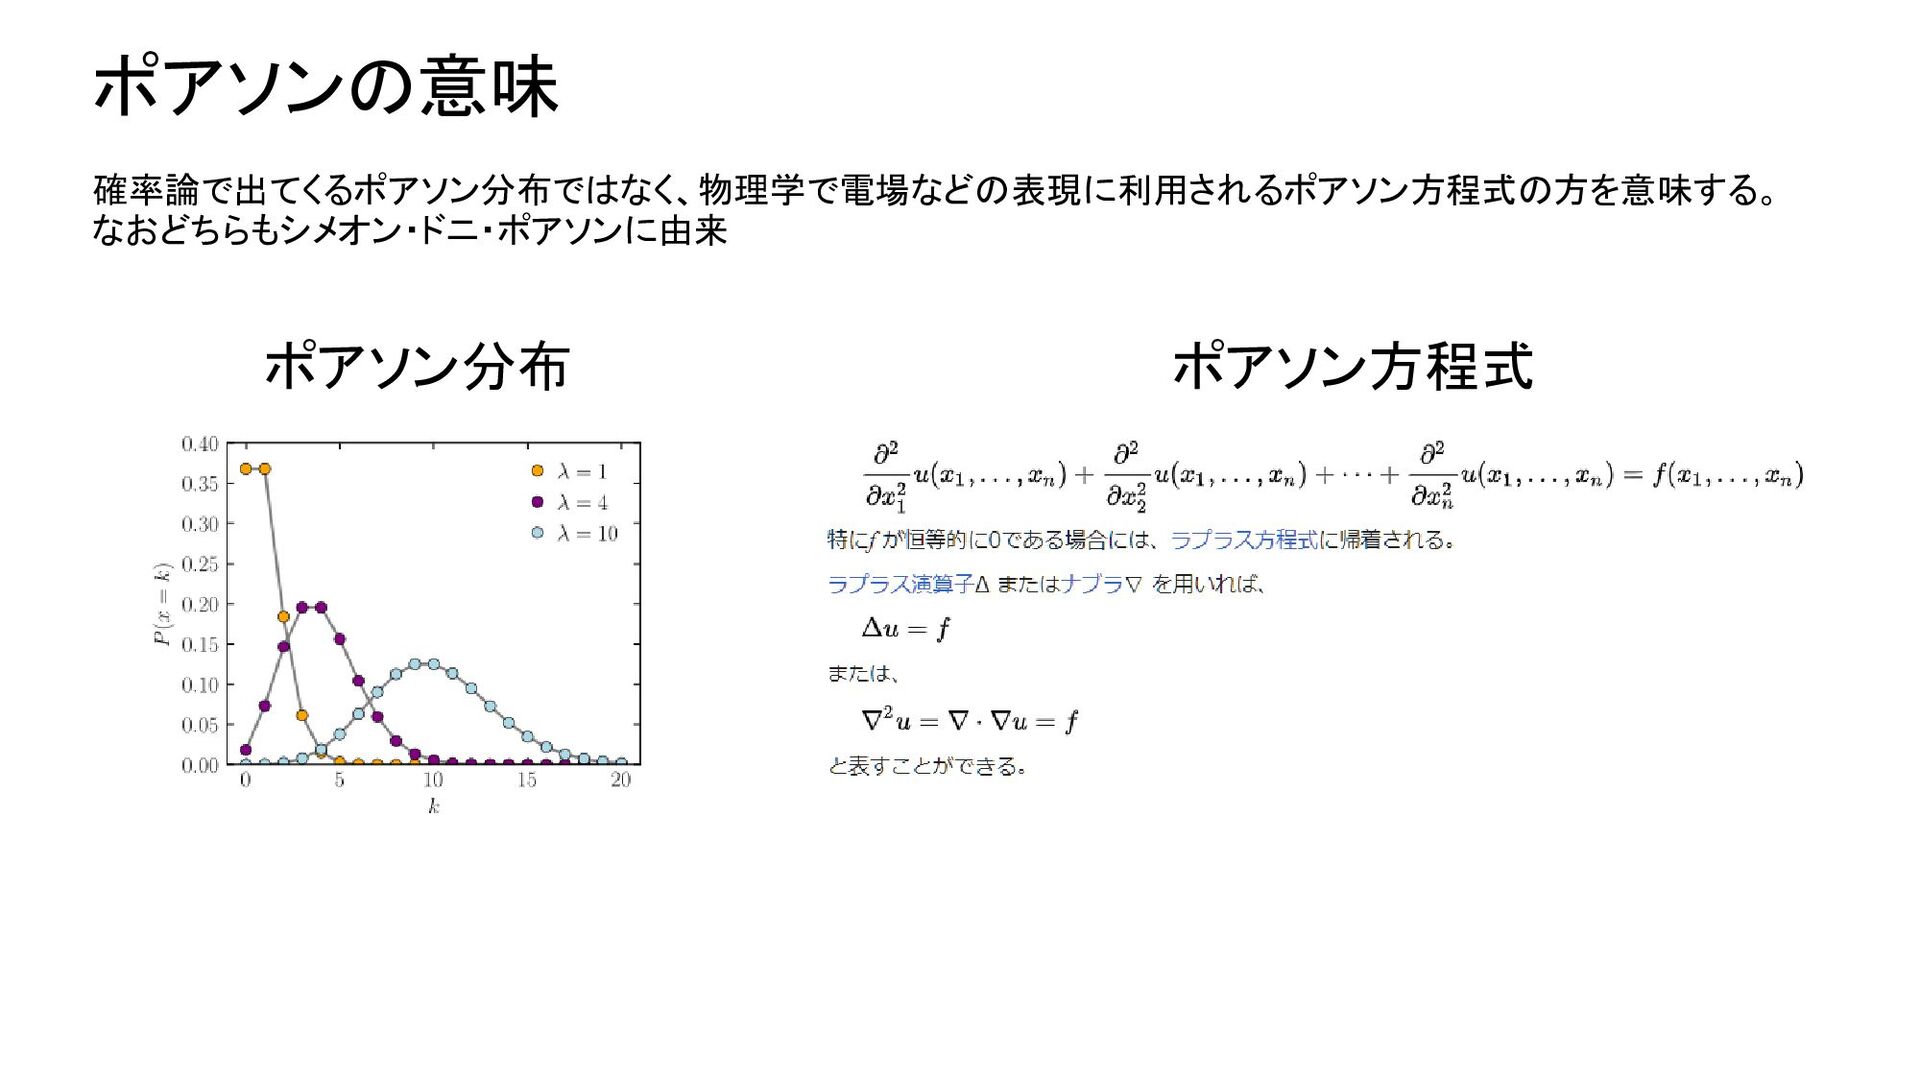
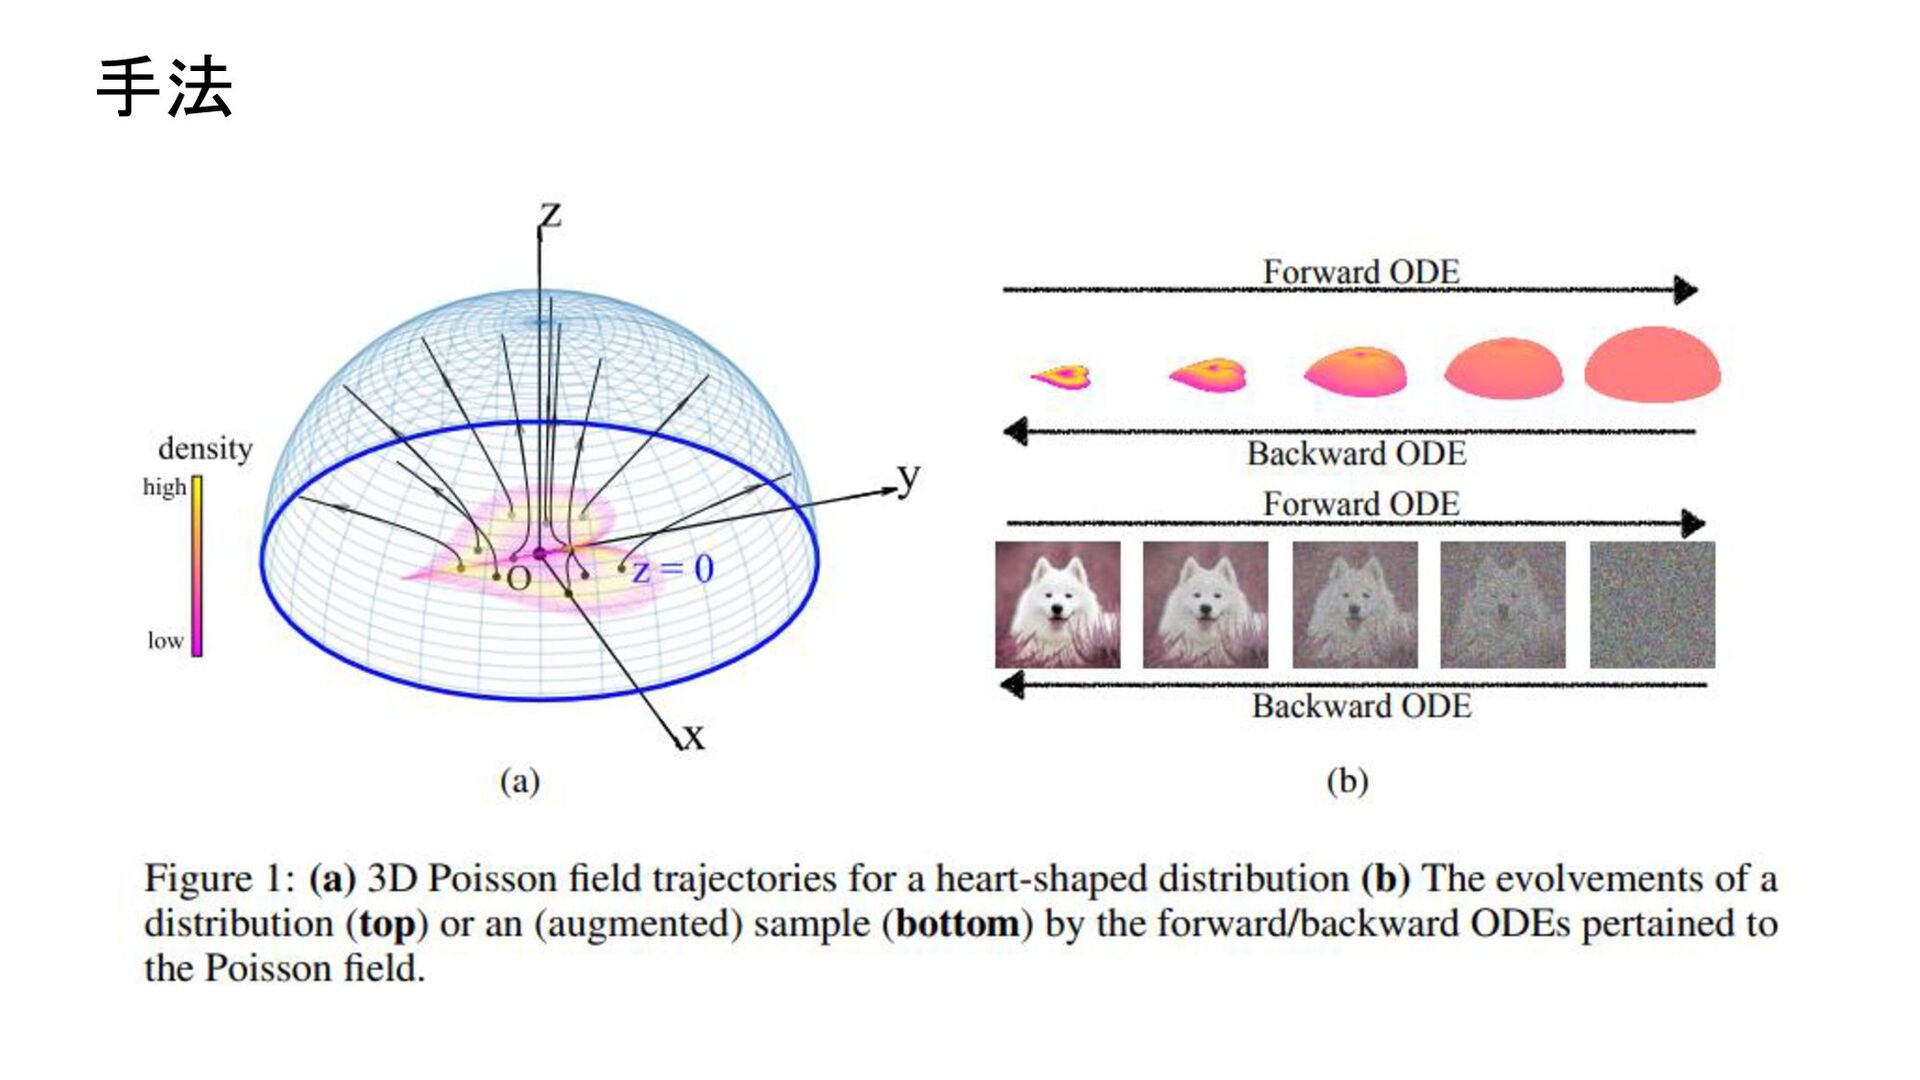
4. ポアソンフロー生成モデル (原文: Poisson Flow Generative Models) 高次元半球上の一様分布を任意のデータ分布に写像する、新しい「ポアソン流」生成モデル(PFGM)を提案する。データ点 を、高次元電界(ポアソン方程式の解の勾配)を生成する、追加次元$z$で拡張された空間における$z=0$超平面上の電荷 として解釈する。これらの電荷が電界線に沿って上方に流れると、$z=0$平面上の初期分布は半径$r$の半球上の分布に
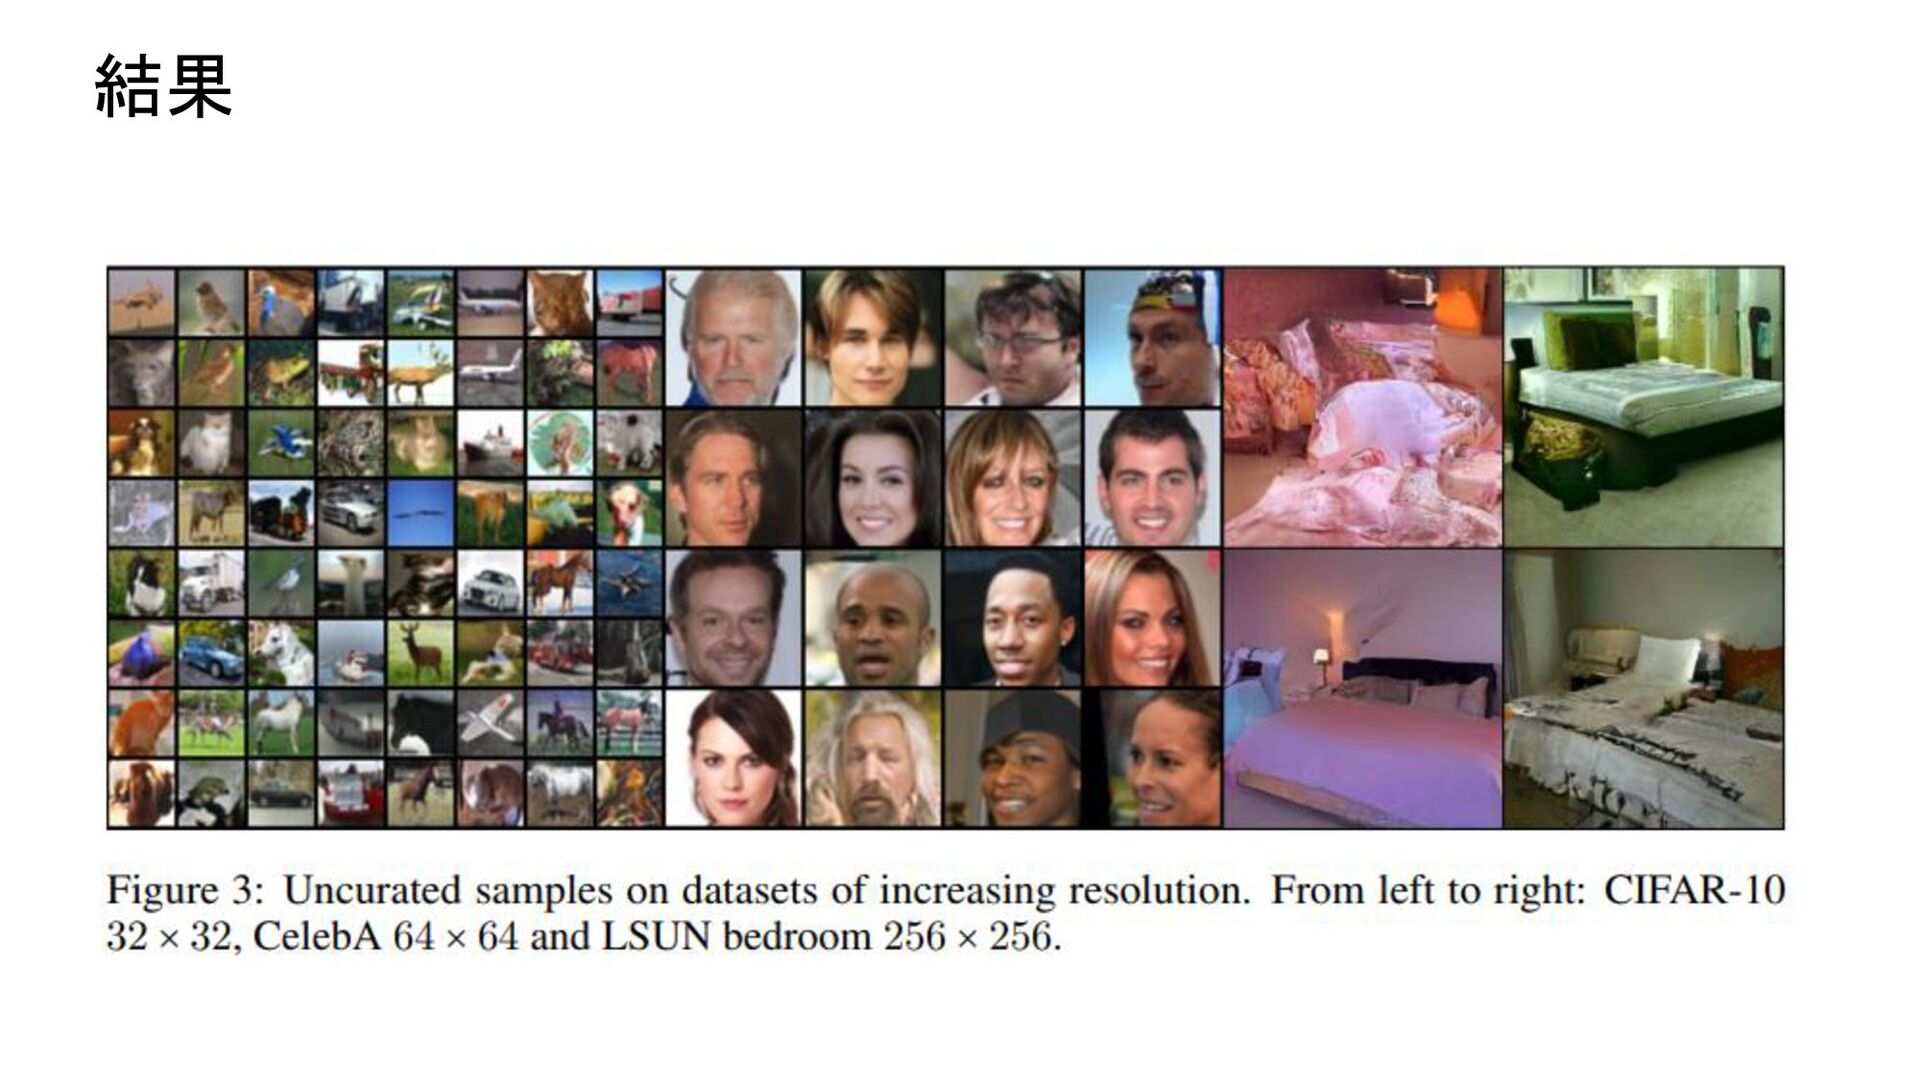
変換され、$r ¥toinfty$ 極限で一様になることを証明する。この両対称変換を学習するために、拡張空間における正規化場 を推定する。サンプリングのために、物理的に意味のある追加次元によって固定された逆向きのODEを考案する:$z$がゼ ロになったとき、サンプルは拡張されていないデータ多様体にぶつかる。実験的に、PFGMはCIFAR-10における正規化フ ローモデルの中で、Inceptionスコア$9.68$、FIDスコア$2.35$という現在の最新鋭の性能を達成することができた。また、画 像生成タスクにおいて、$10times$から$20 ¥times$ の高速化を実現しながら、最新のSDEアプローチと同程度の性能を発 揮している。さらに、PFGMは弱いネットワークアーキテクチャでの推定誤差に強く、オイラー法のステップサイズに頑健であ る。コードは https://github.com/Newbeeer/poisson_flow で入手可能である。 目的:新たな正規化フローモデルの提案 成果:画像生成において10倍から20倍の高速化を行いつつ、最新手法と同等の性能 方法:元のデータ次元より一つ高い次元での半球とつなぐフローを学習する 固有名: “Poisson flow” generative model (PFGM) 著者所属:マサチューセッツ大学 https://arxiv.org/abs/2209.11178v4 -
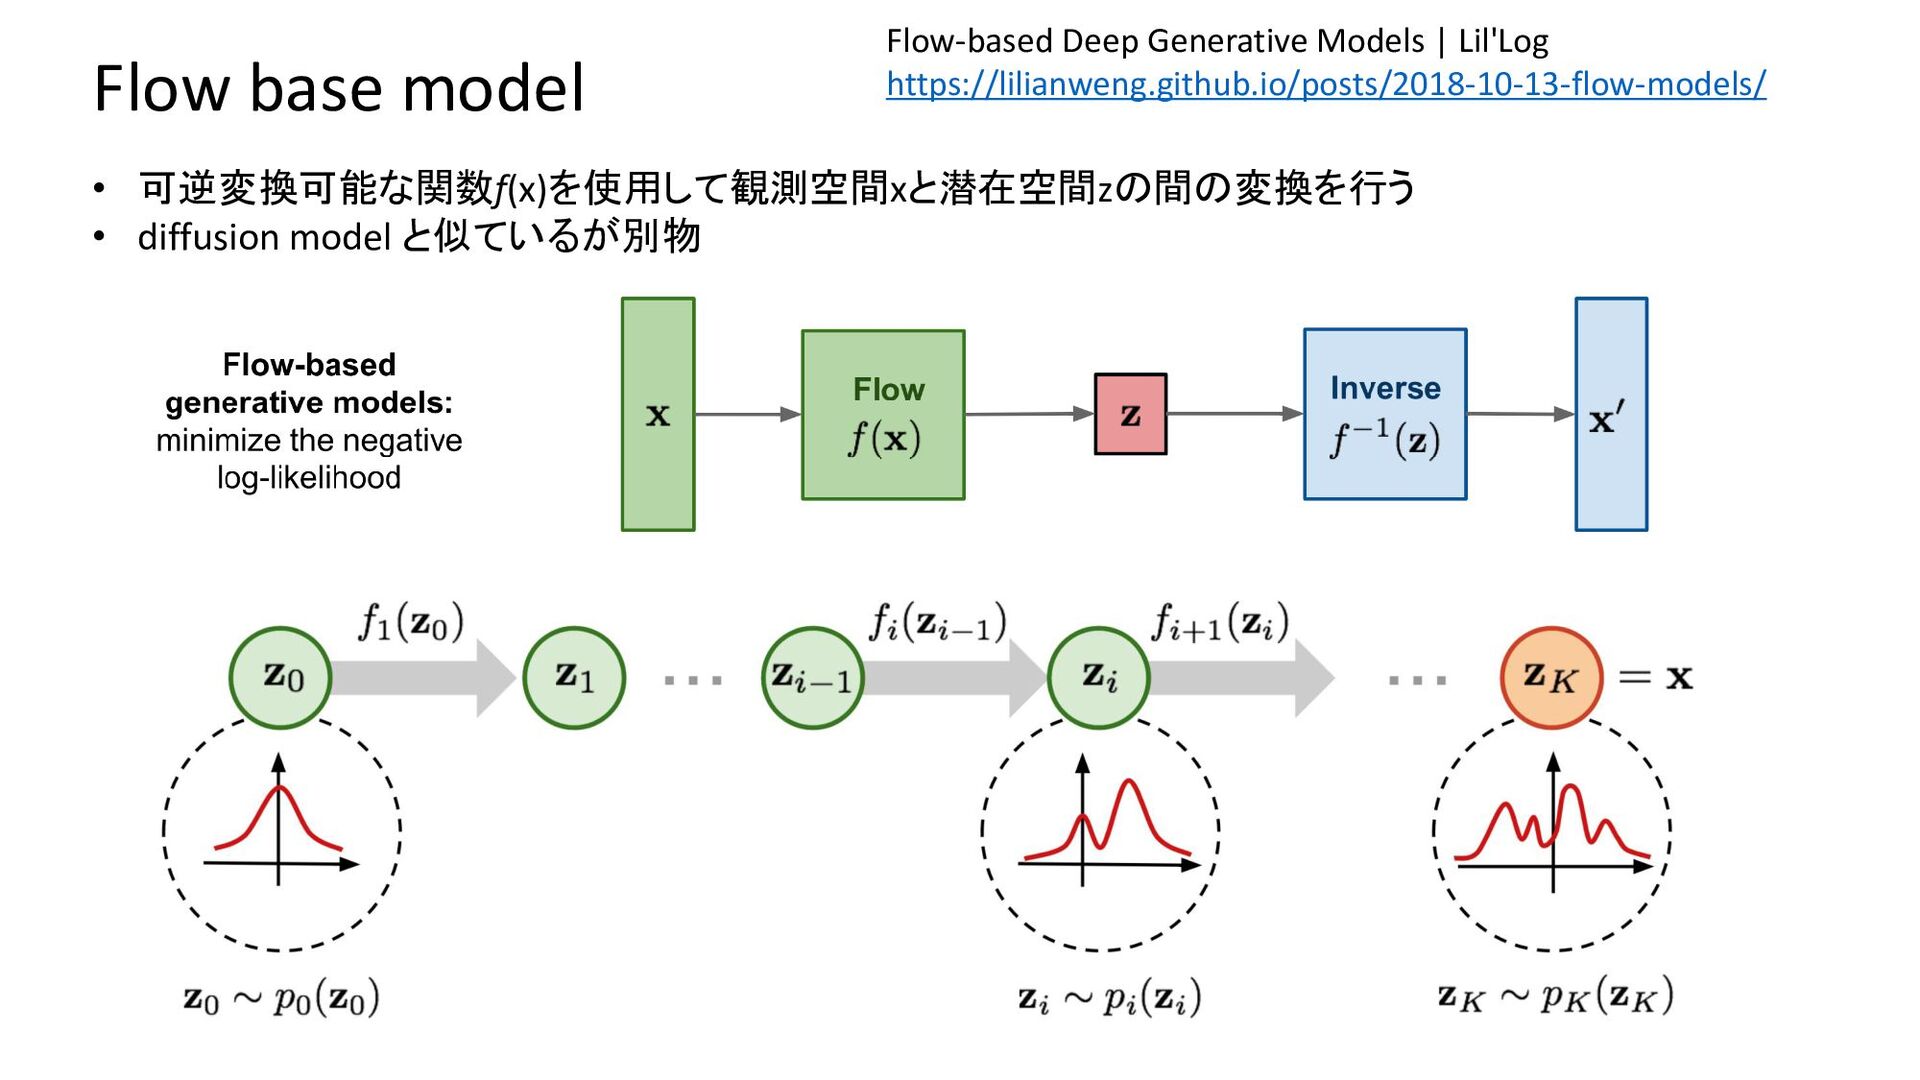
Flow base model Flow-based Deep Generative Models | Lil'Log https://lilianweng.github.io/posts/2018-10-13-flow-models/
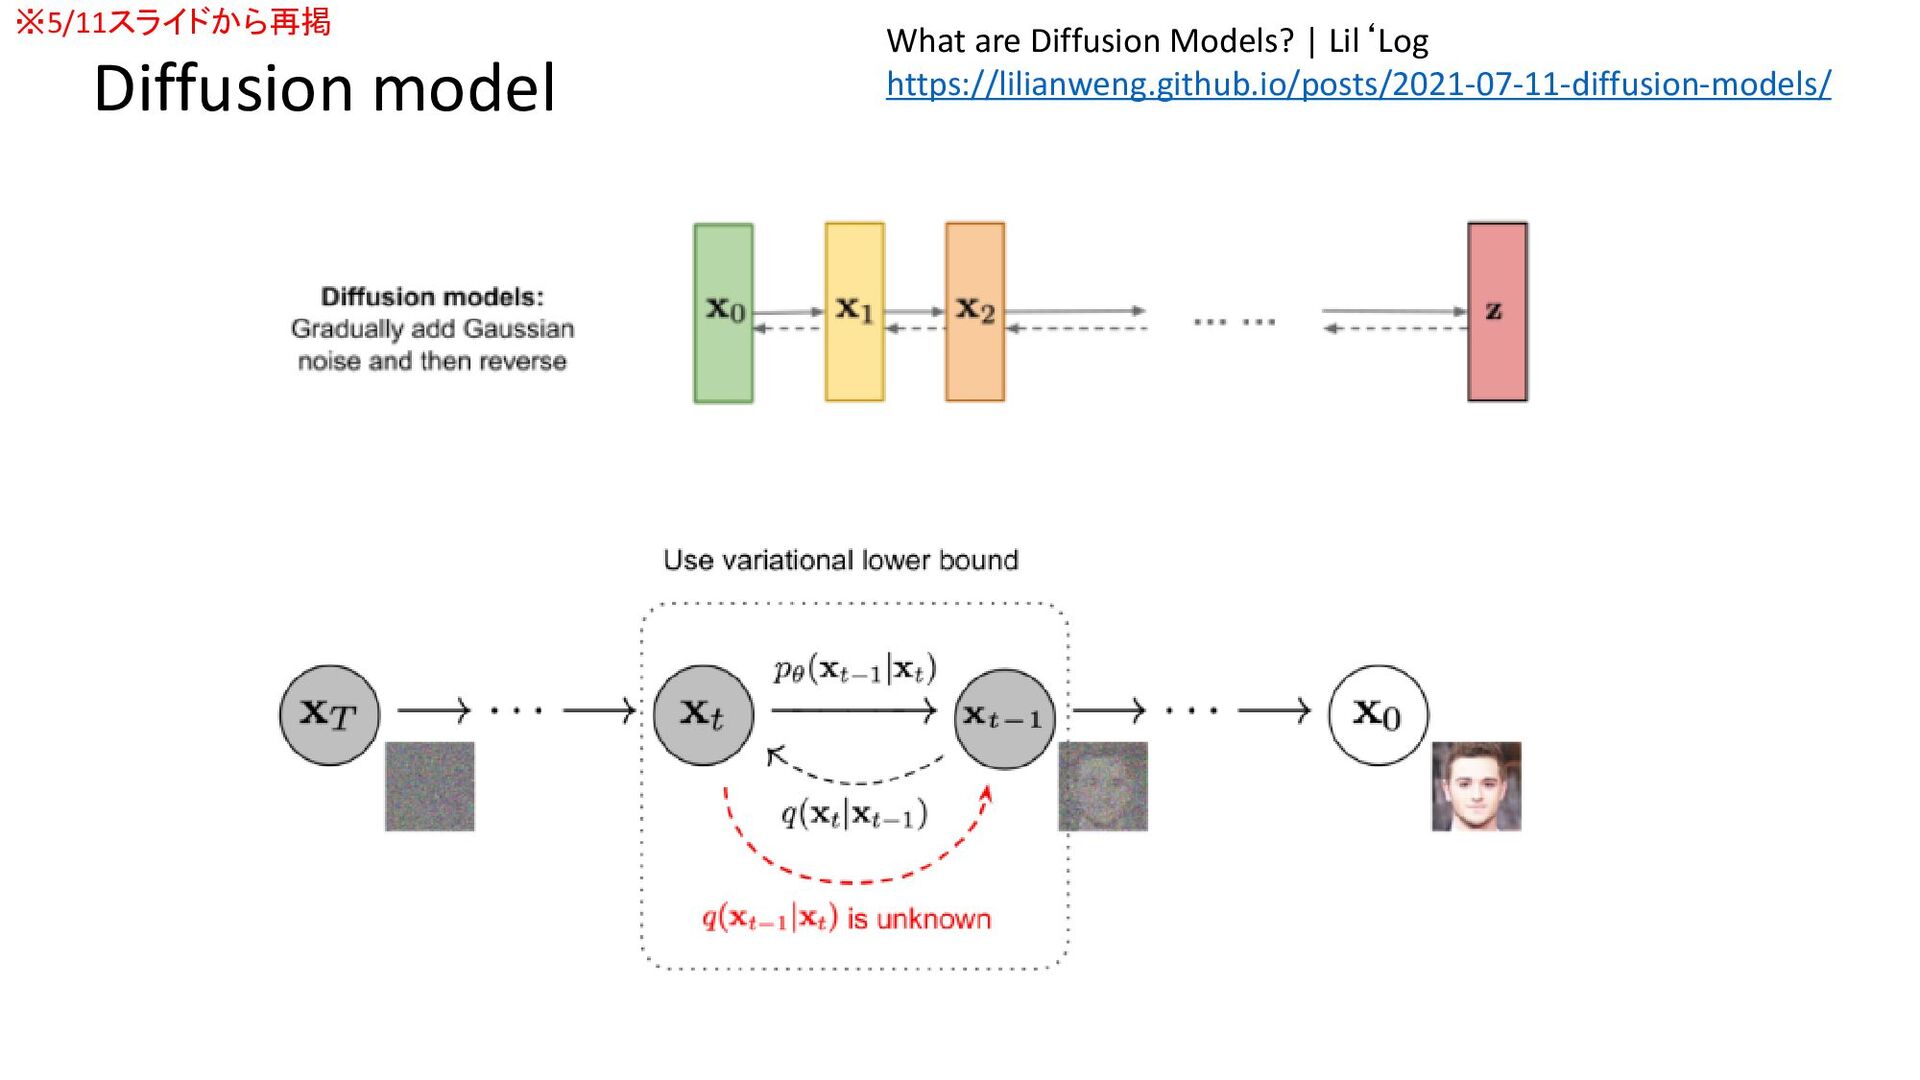
• 可逆変換可能な関数f(x)を使用して観測空間xと潜在空間zの間の変換を行う • diffusion model と似ているが別物 -
5. 人間の規則的な強化学習とプランニングによって、ノープレス外交ゲームをマスターする (原文: Mastering the Game of No-Press Diplomacy via
Human-Regularized Reinforcement Learning and Planning) ノープレス外交は、協力と競争の両方を含む複雑な戦略ゲームであり、マルチエージェントAI研究のベンチマークとして利 用されてきた。チェス、囲碁、ポーカーなどの純粋な敵対ゲームでは自己再生強化学習が多くの成功を収めているが、人 間との協力が必要な領域では自己再生だけでは最適な性能を達成することができない。我々はこの欠点に対処するため、 まずDiL-piKLと呼ぶ計画アルゴリズムを導入し、報酬最大化政策を人間の模倣学習された政策に向けて正則化する。この アルゴリズムは、修正された効用関数の下で、後悔しない学習アルゴリズムであることを証明する。さらに、DiL-piKLをRL- DiL-piKLと呼ぶ自己再生強化学習アルゴリズムに拡張し、人間の遊びのモデルを提供すると同時に、この人間モデルによく 反応するエージェントを学習させることができることを示す。我々は RL-DiL-piKL を用いて、Diplodocus と名付けたエージェン トを学習させた。初級者から上級者まで62人の人間が参加した200ゲームのノープレス外交トーナメントにおいて、2人の Diplodocusエージェントは、2ゲーム以上プレイした他の参加者よりも高い平均スコアを達成し、Eloレーティングモデルによ ると1位と3位にランクされた。 目的:人との協力が必要な状況における学習アルゴリズム 成果:Eloレーティングモデルにより1位と3位にランク 方法: 報酬最大化と人間の模倣のバランスを取った学習 固有名:DiL-piKLアルゴリズム、 Diplodocusモデル 著者所属:Meta AI https://arxiv.org/abs/2210.05492v1 -
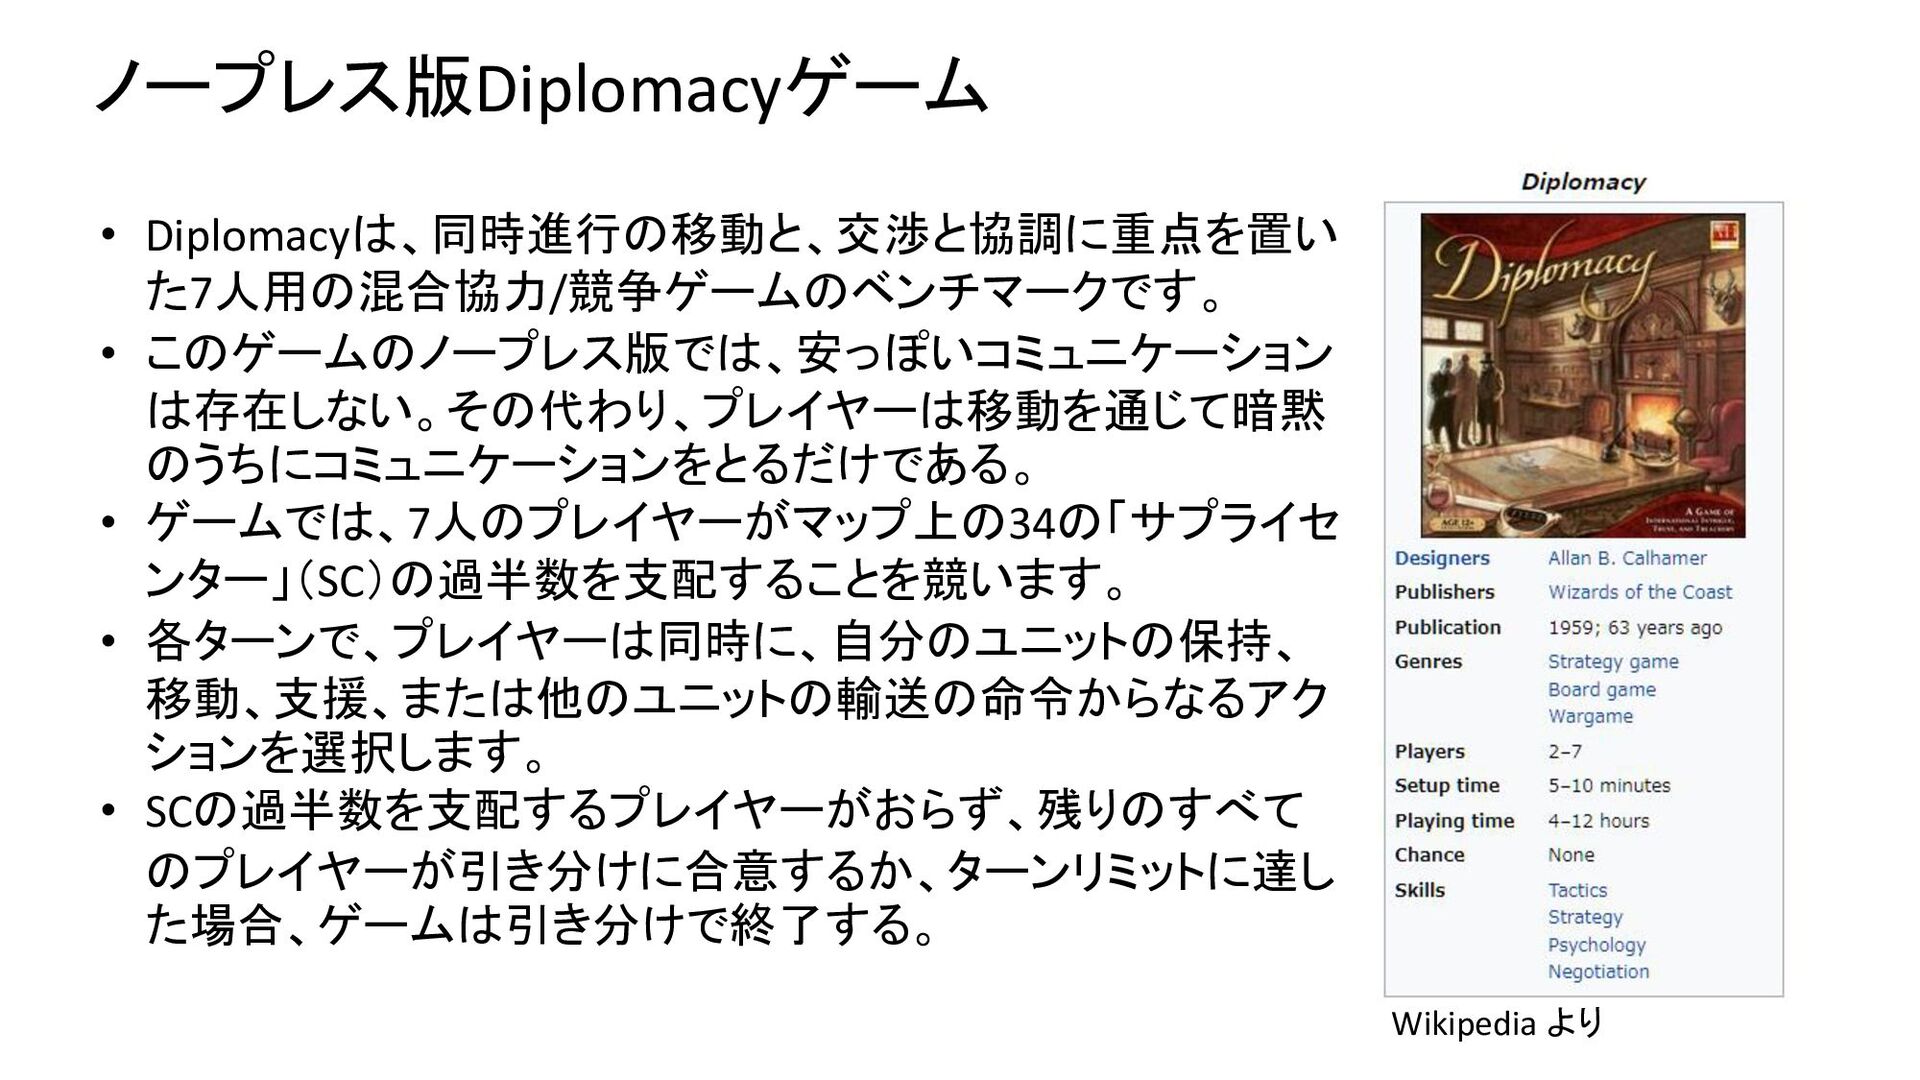
ノープレス版Diplomacyゲーム • Diplomacyは、同時進行の移動と、交渉と協調に重点を置い た7人用の混合協力/競争ゲームのベンチマークです。 • このゲームのノープレス版では、安っぽいコミュニケーション は存在しない。その代わり、プレイヤーは移動を通じて暗黙 のうちにコミュニケーションをとるだけである。 • ゲームでは、7人のプレイヤーがマップ上の34の「サプライセ
ンター」(SC)の過半数を支配することを競います。 • 各ターンで、プレイヤーは同時に、自分のユニットの保持、 移動、支援、または他のユニットの輸送の命令からなるアク ションを選択します。 • SCの過半数を支配するプレイヤーがおらず、残りのすべて のプレイヤーが引き分けに合意するか、ターンリミットに達し た場合、ゲームは引き分けで終了する。 Wikipedia より -
Background • このような「無報酬外交」においては、人間のゲームのコーパスがあれば、人間の行動を模倣するため にディープラーニングを用いることができる。 • 深層模倣学習を活用した最初のDiplomacyエージェントはPaquetteら(2019)である • Grayら(2020)は,一辺探索により改善された政策を行うエージェントを提案した.このエージェントは,人 間のデータで学習した政策と価値関数を用いて,後悔最小化を用いて探索を行う. •
Paquetteら(2019)はアクター・クリティックのアプローチを適用し,このエージェントは他のセルフプレイ エージェントの集団では強くプレイするが,人間を模倣したエージェントの集団に対してはより悪くプレイ することを発見した • Anthonyら(2020)は、人間の慣習からのドリフトを減らすために、架空のプレイの修正に基づく自己プレ イアプローチを使用した。その結果,1vs6 と 6vs1 の両設定において,純粋な模倣学習よりも強いが,探 索を用いるエージェントよりも弱い政策が得られた. • Bakhtinら(2021)はDORA と呼ばれるエージェントを作成した。DORAは人間データなしの2p0s版 Diplomacyでは超人的な性能を達成したが、7人対戦のフルゲームでは自分以外のエージェントとはうま くいかない。 • Jacobら(2022)は、正則化推論時間探索技術により、強いだけでなく、人間の行動をよくモデル化するこ とができるエージェントを生成できることを示した。彼らはノープレス外交の領域において、人間の模倣 学習方針に向けてKL-ダイバージェンス・ペナルティでヘッジ(平衡探索アルゴリズム)を正則化すること で、模倣学習の人間の行動予測精度と同等かそれ以上の強さを持ちながら、実質的に強くなることを 示している。 -
方策のモデル化 効用関数 模倣方策との差 重み付け piKL(Jcobらの方法)では固定 DiLpiKL(提案法)では可変 iはプレイヤー引数 piKL:おそらくπ(方策) + KLダイバージェンス
DiLpiKL:Distributional lambda piKL アンカーポリシー 学習される方策 -
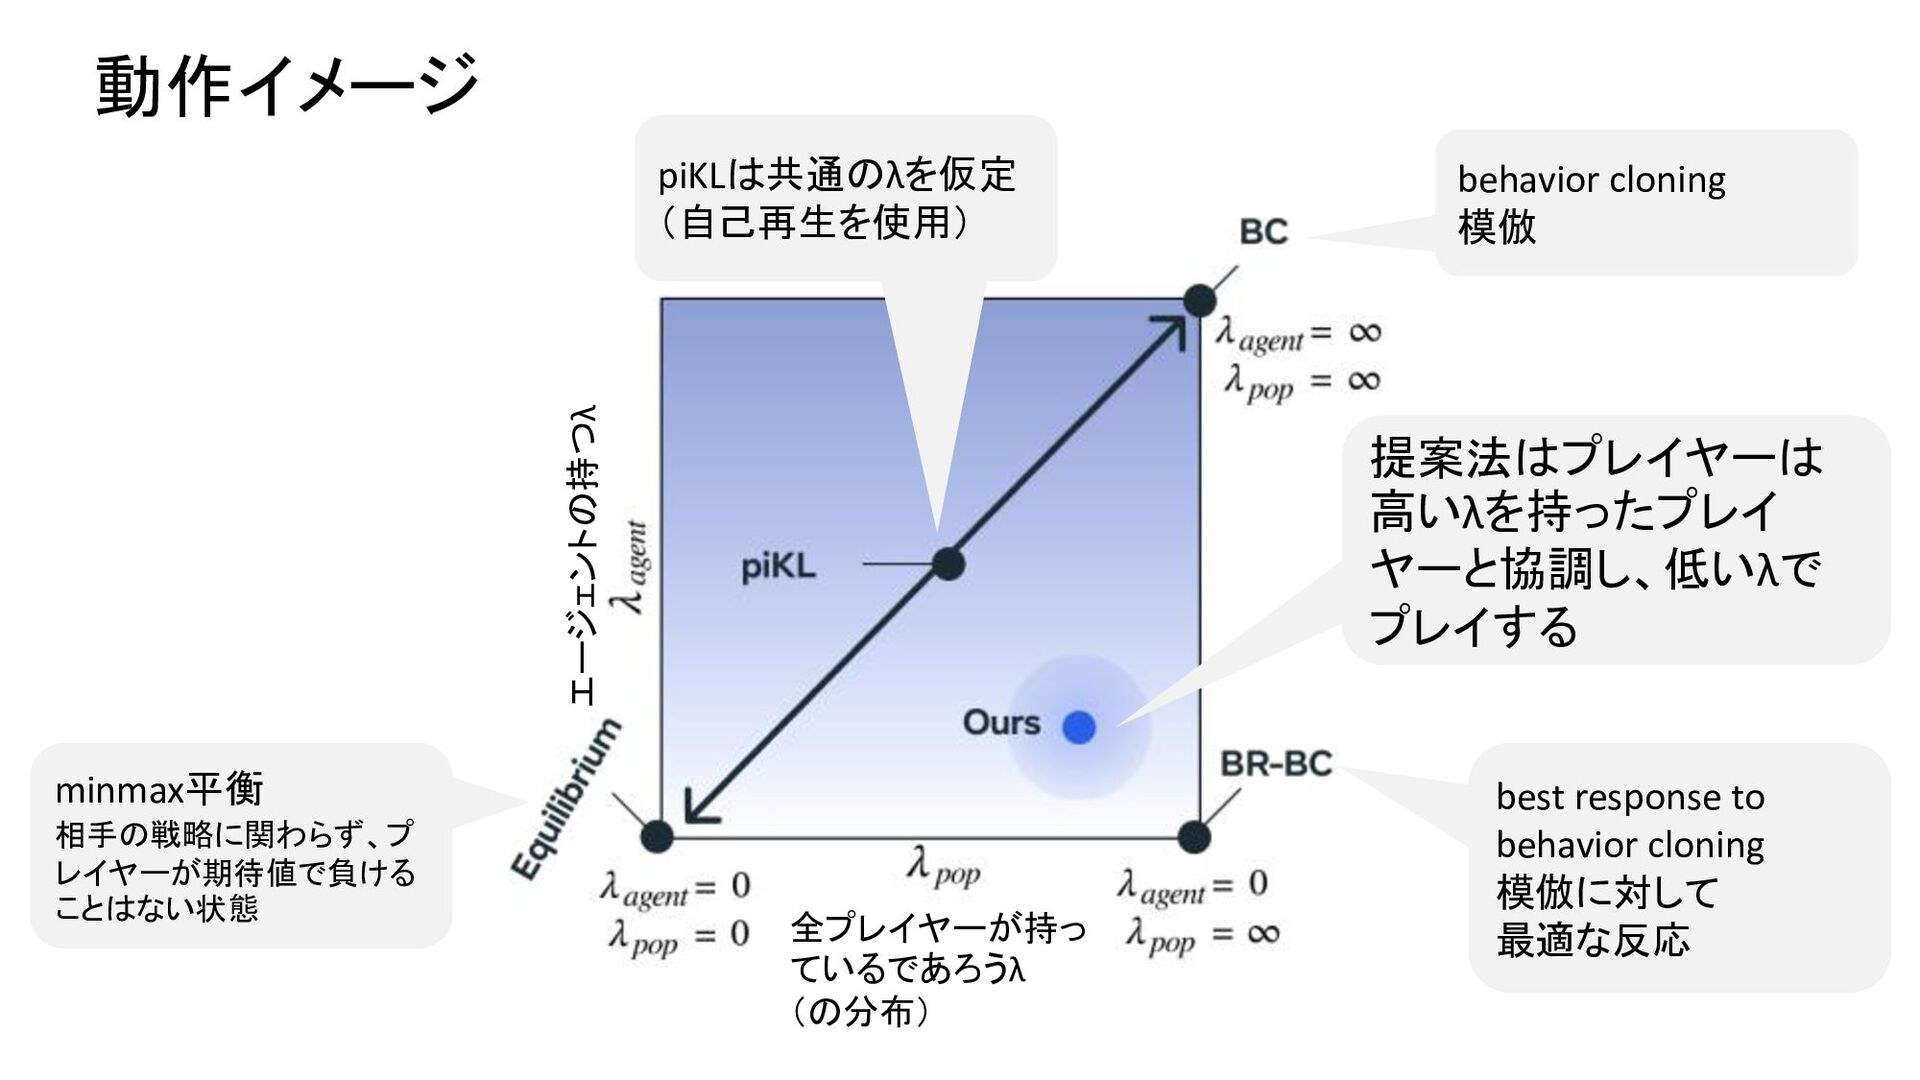
動作イメージ エージェントの持つλ 全プレイヤーが持っ ているであろうλ (の分布) behavior cloning 模倣 best response
to behavior cloning 模倣に対して 最適な反応 minmax平衡 相手の戦略に関わらず、プ レイヤーが期待値で負ける ことはない状態 piKLは共通のλを仮定 (自己再生を使用) 提案法はプレイヤーは 高いλを持ったプレイ ヤーと協調し、低いλで プレイする -
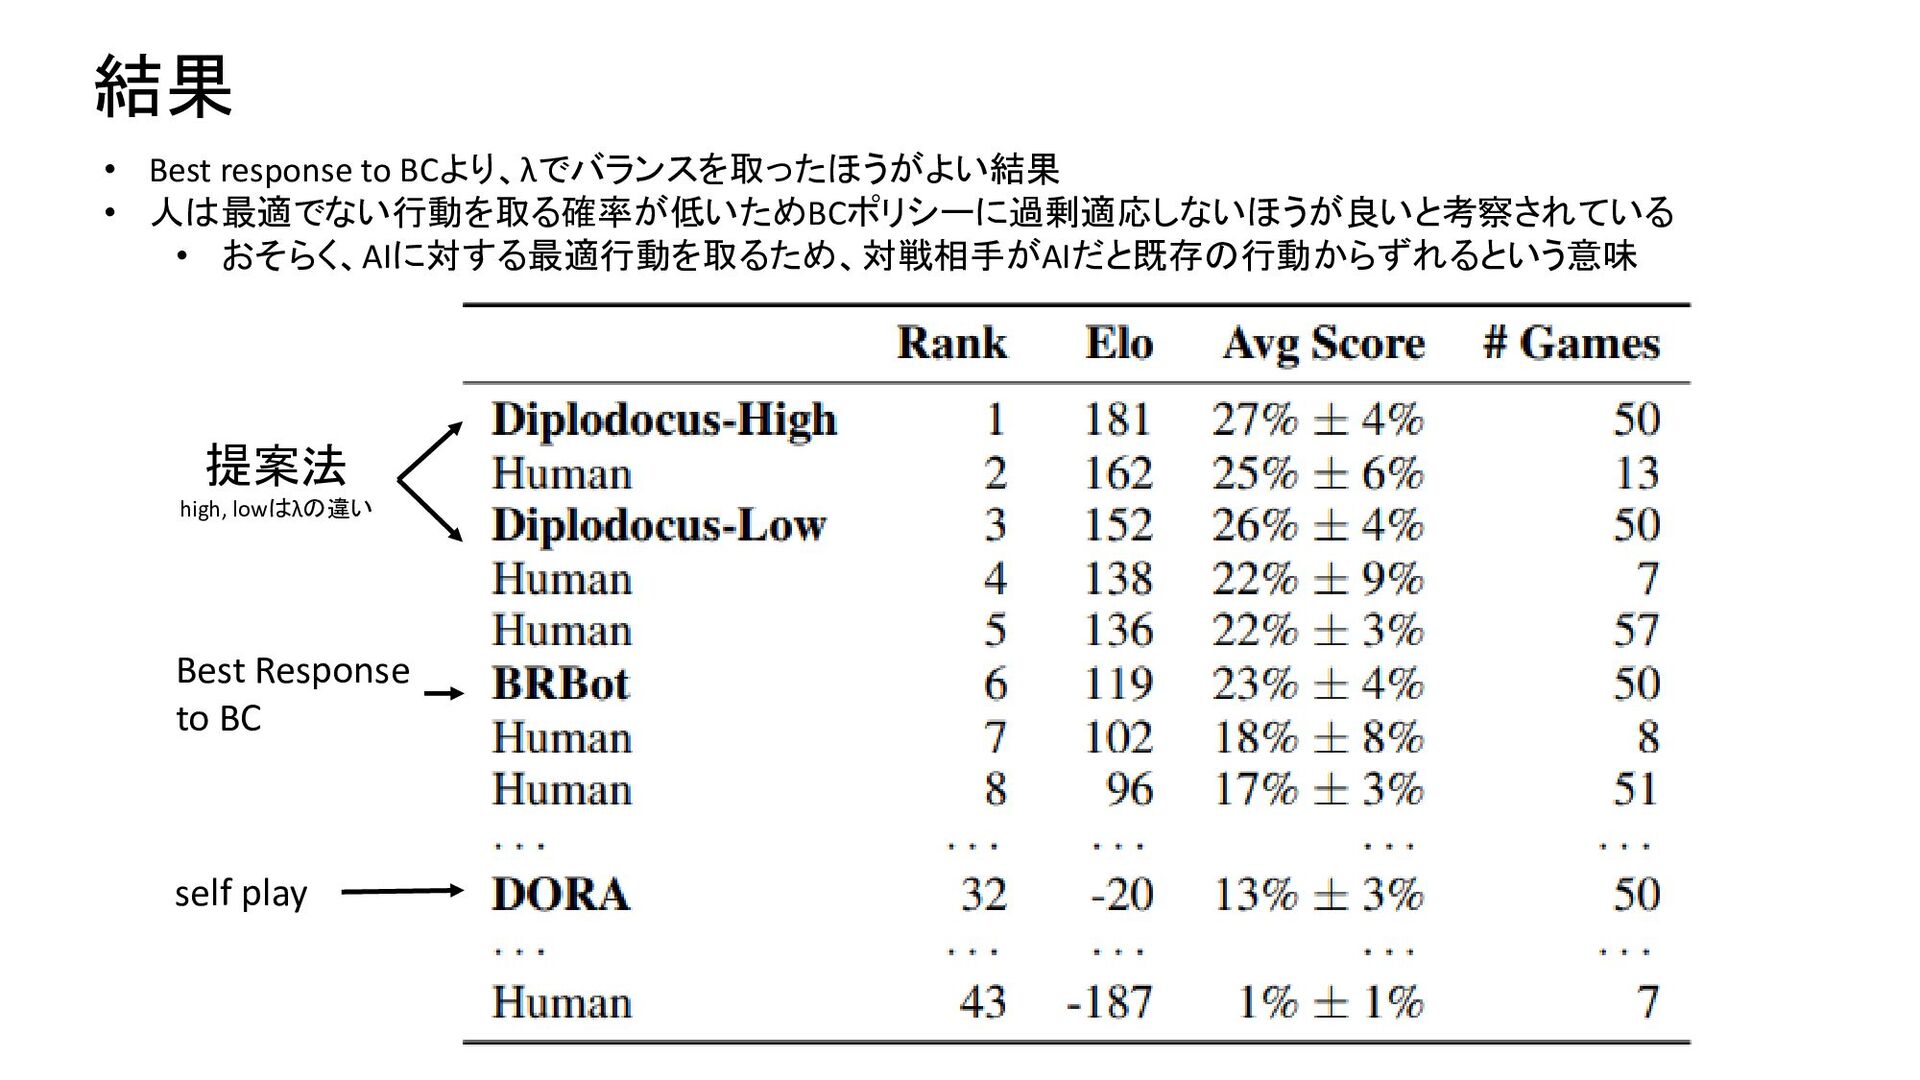
結果 提案法 high, lowはλの違い Best Response to BC • Best
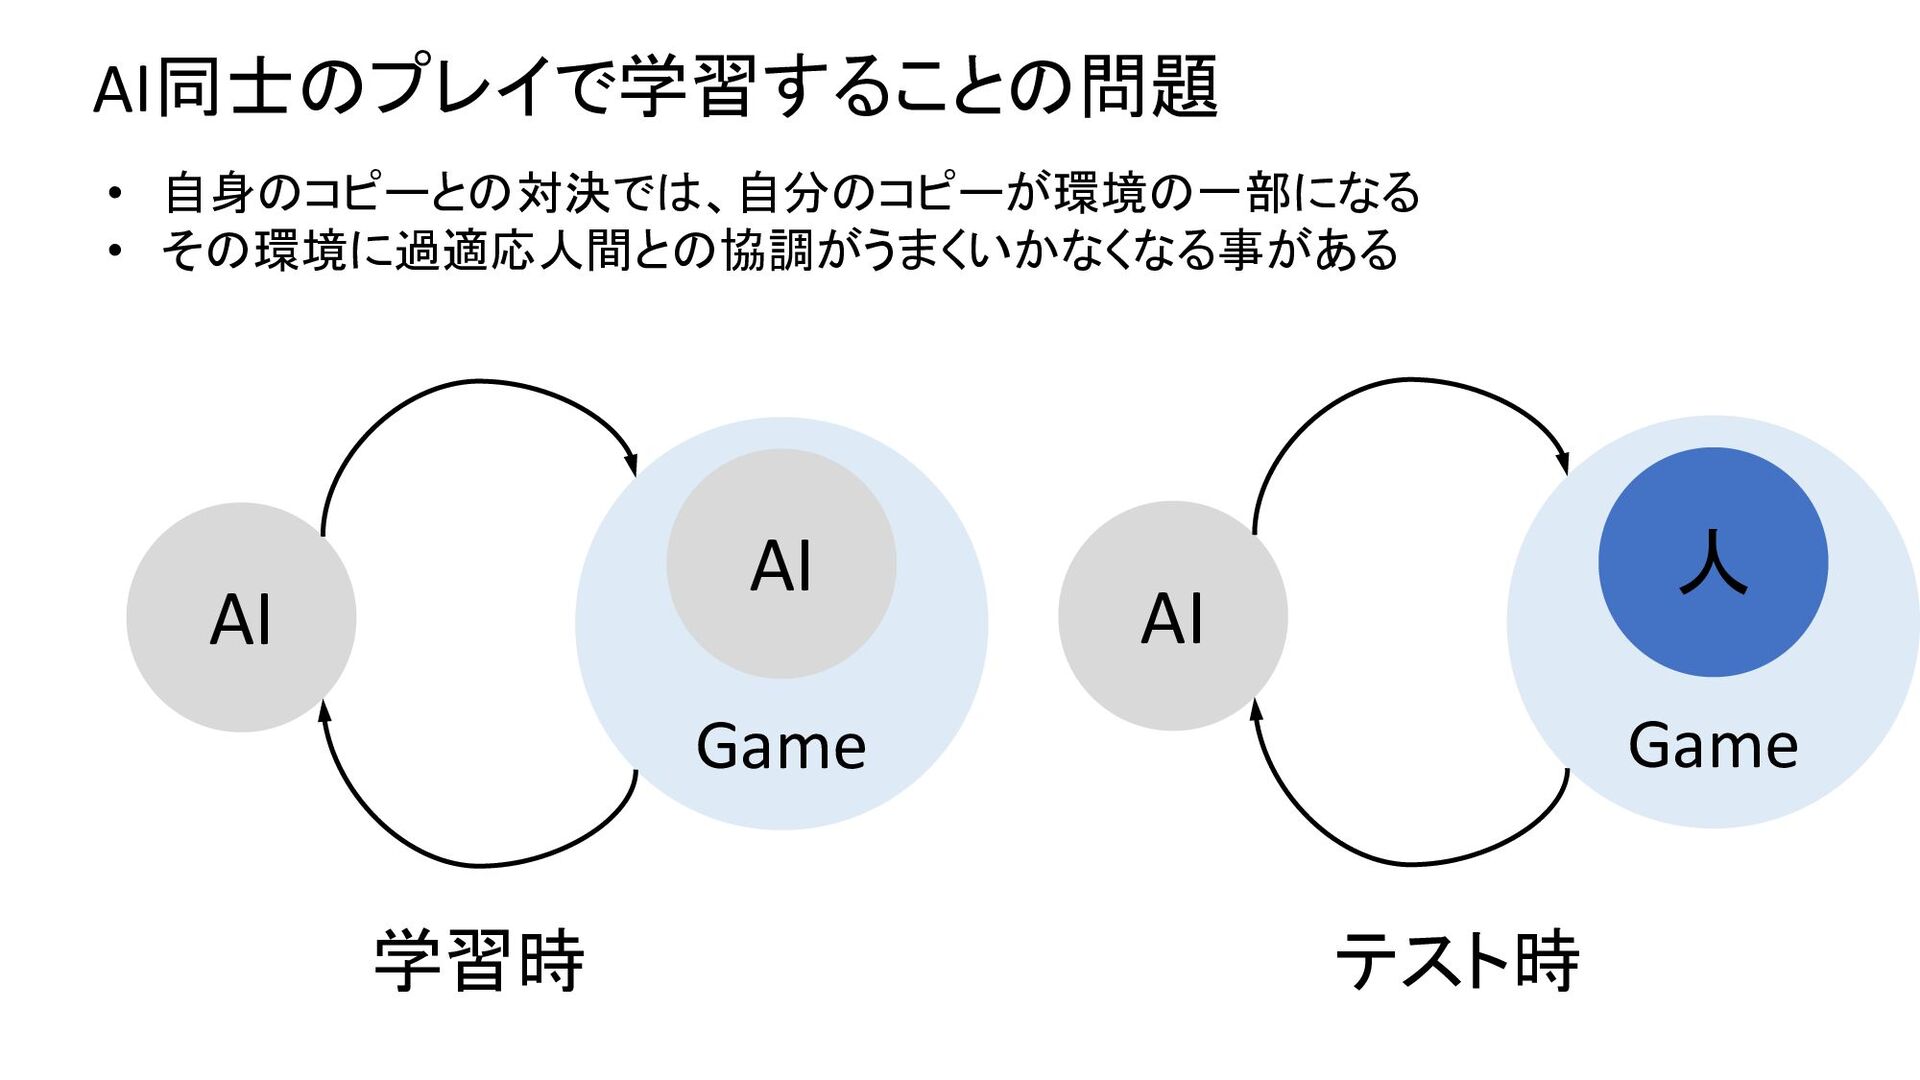
response to BCより、λでバランスを取ったほうがよい結果 • 人は最適でない行動を取る確率が低いためBCポリシーに過剰適応しないほうが良いと考察されている • おそらく、AIに対する最適行動を取るため、対戦相手がAIだと既存の行動からずれるという意味 self play -
6. 人間の規則的な探索と学習による人間とAIの協調 (原文: Human-AI Coordination via Human-Regularized Search and Learning)
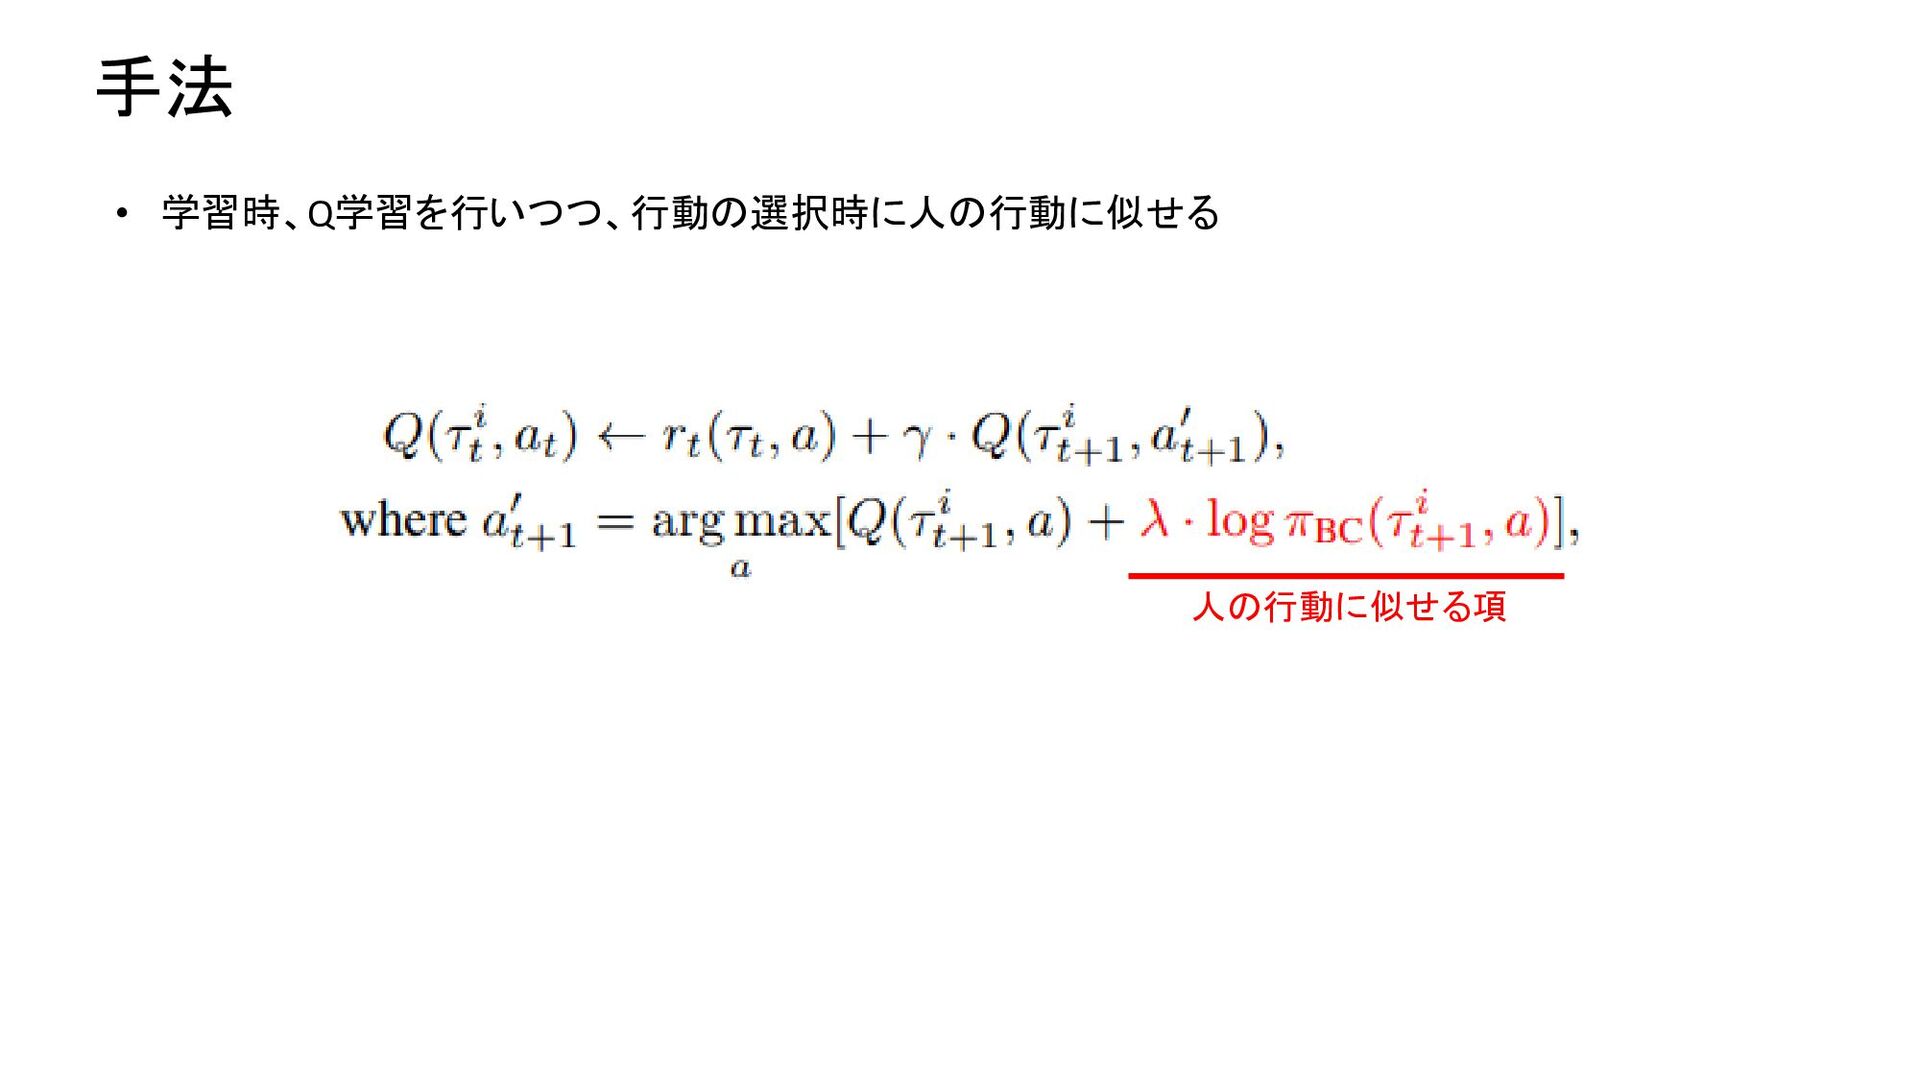
我々は、人間の行動のデータセットが与えられ、部分的に観測可能な完全協調環境において、人間とうまく協調するAIエー ジェントを作る問題を考える。我々は、人間データの正則化探索手法であるpiKLにインスパイアされ、行動クローニングポリ シーから大きく離れることなく改善する3ステップのアルゴリズムを開発し、Hanabiベンチマークにおいて実際の人間との協 調で高い性能を達成する。まず、正則化探索アルゴリズムと行動クローニングを用いて、多様なスキルレベルを捉えたより 良い人間モデルを生成する。次に、政策の正則化の考え方を強化学習に統合し、人間モデルの人間らしい最良応答を学 習させる。最後に、テスト時に最良応答ポリシーの上に正則化探索を適用し、人間と遊ぶ際の分布外の課題を処理する。 我々は、人間を用いた2つの大規模実験で本手法を評価する。まず、多様な人間のプレイヤーからなるアドホックチームと 対戦した場合、我々の手法が専門家よりも優れていることを示す。第二に、本手法は、専門家に2つのエージェントで繰り 返しプレイさせることにより、行動クローニングベースラインに対するバニラ最良応答より優れていることを示す。 目的:人の模倣と方策の改善を両立する 成果:Hanabiベンチマークにおいて実際の人間との協調で高い性能を達成 方法: 強化学習を人の行動で補正する 固有名:piKL-IL(Imitation learning)、piKL-BR(best response) 著者所属:Meta AI https://arxiv.org/abs/2210.05125v1 -
プレイするゲーム GitHub - Hanabi-Live/hanabi-live: A web server that allows people
to play Hanab, a cooperative card game of logic and reasoning. https://github.com/Hanabi-Live/hanabi-live • Hanabiはテーブルの上にカードを順番に並べ、完璧な花火を作り上げる協力なゲーム(日本語の花火に由来) • 実験ではHANAB LIVEを使用 • HANAB LIVEはオンラインで協力的なカードゲームをプレイすることができるサイト • GitHub上でコードが公開されている -
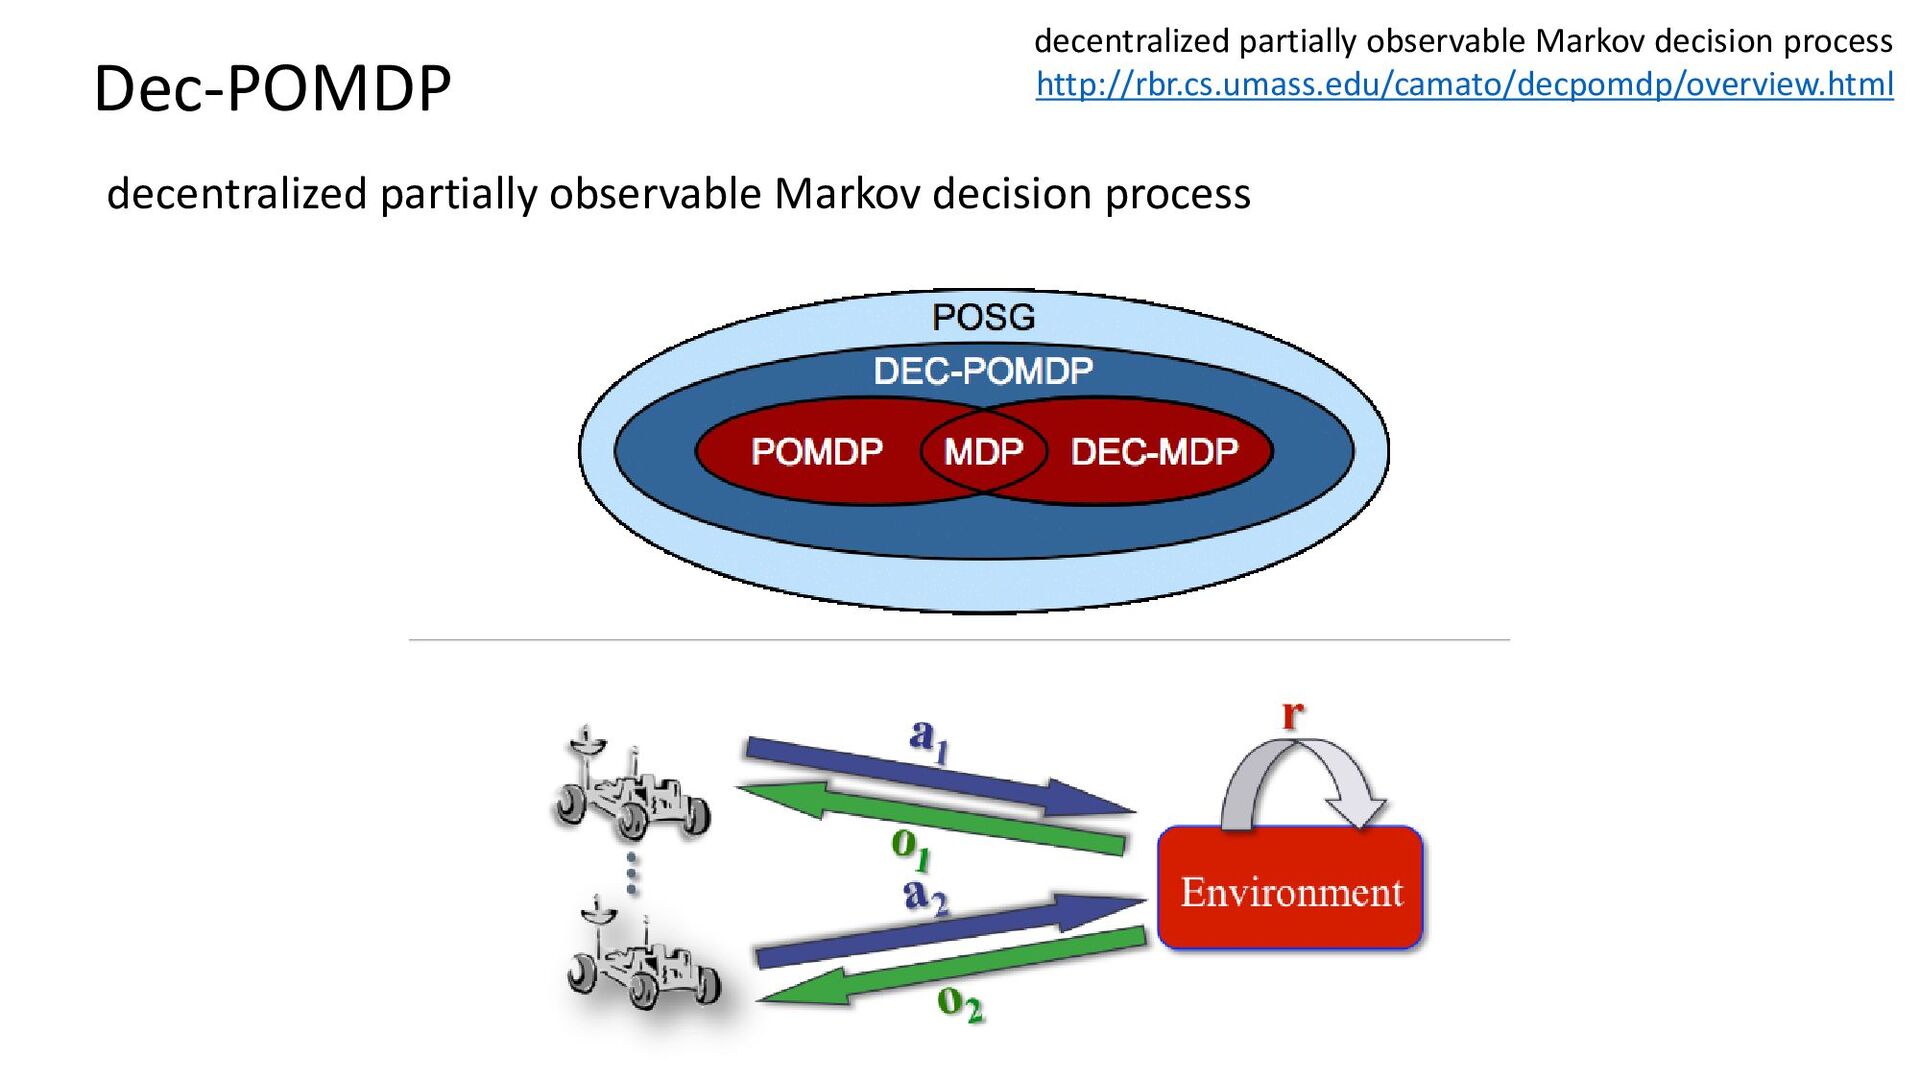
Dec-POMDP decentralized partially observable Markov decision process decentralized partially observable
Markov decision process http://rbr.cs.umass.edu/camato/decpomdp/overview.html -
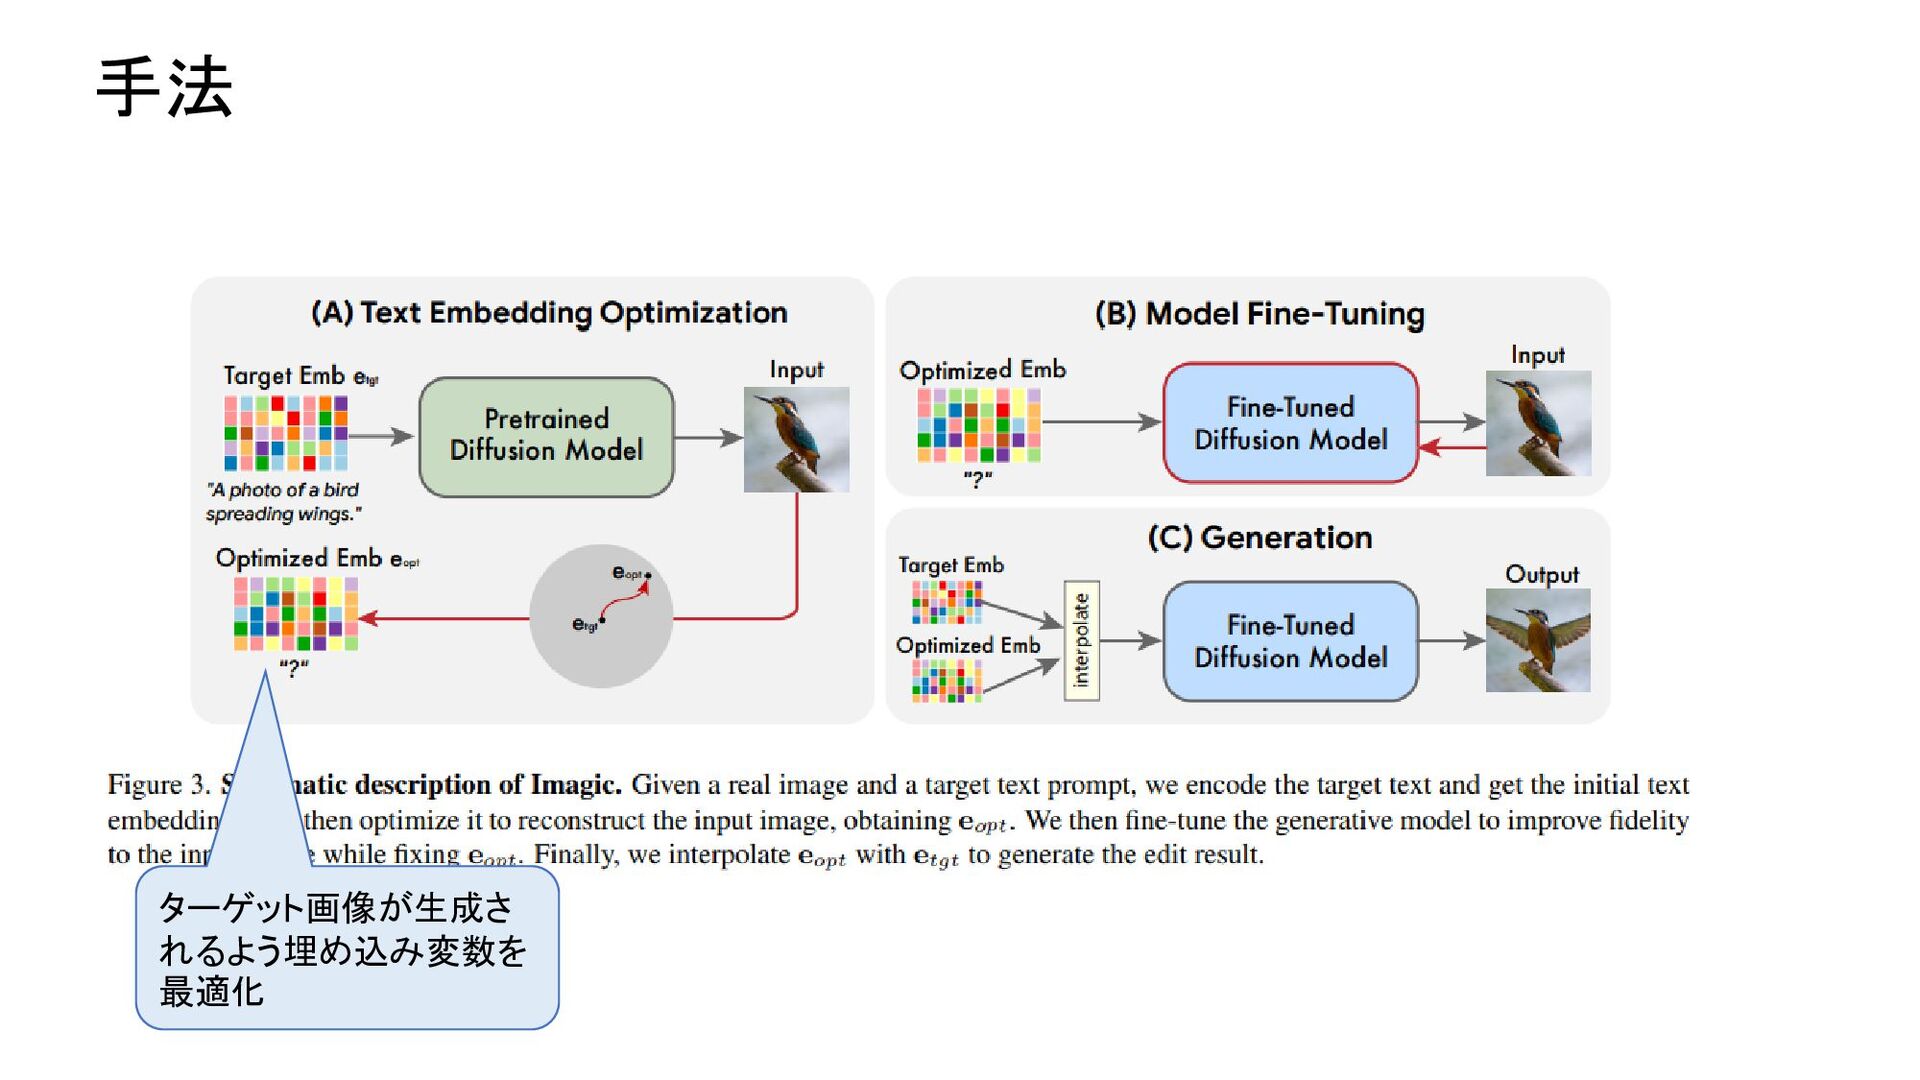
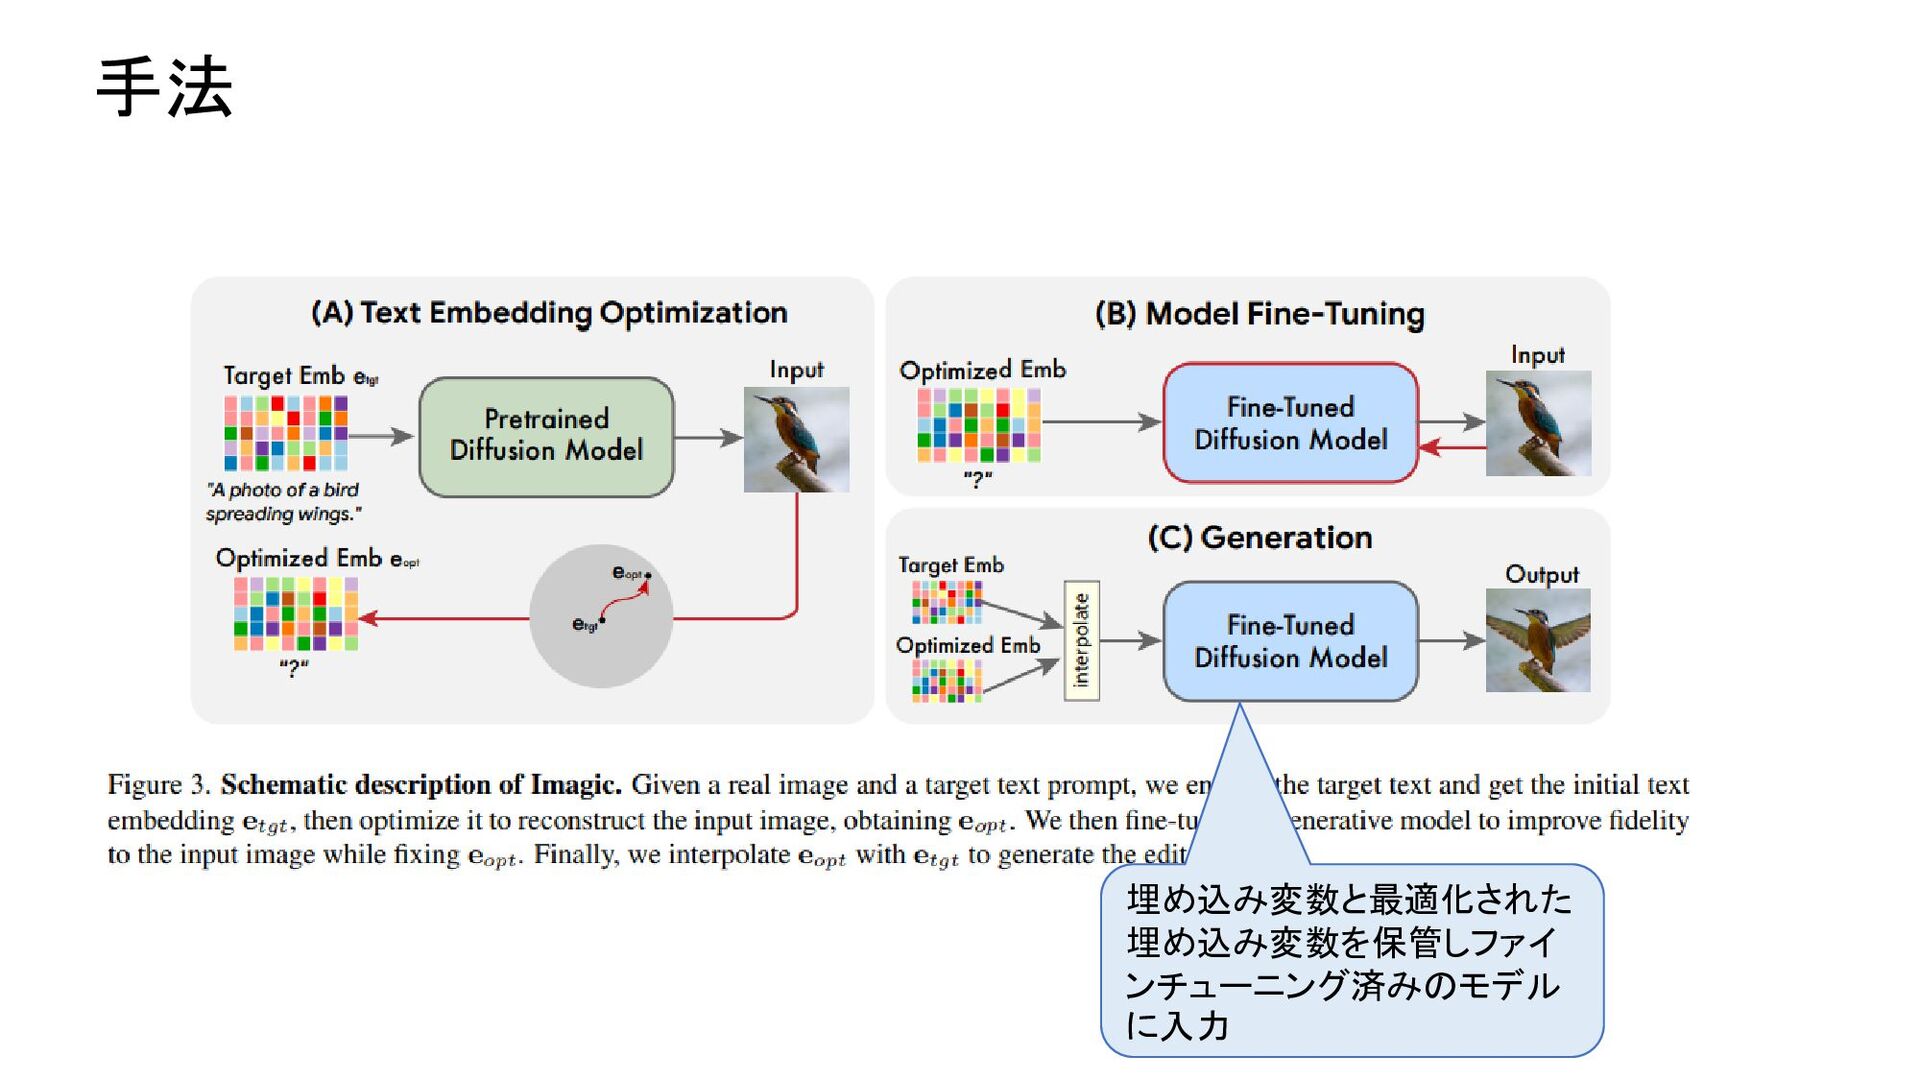
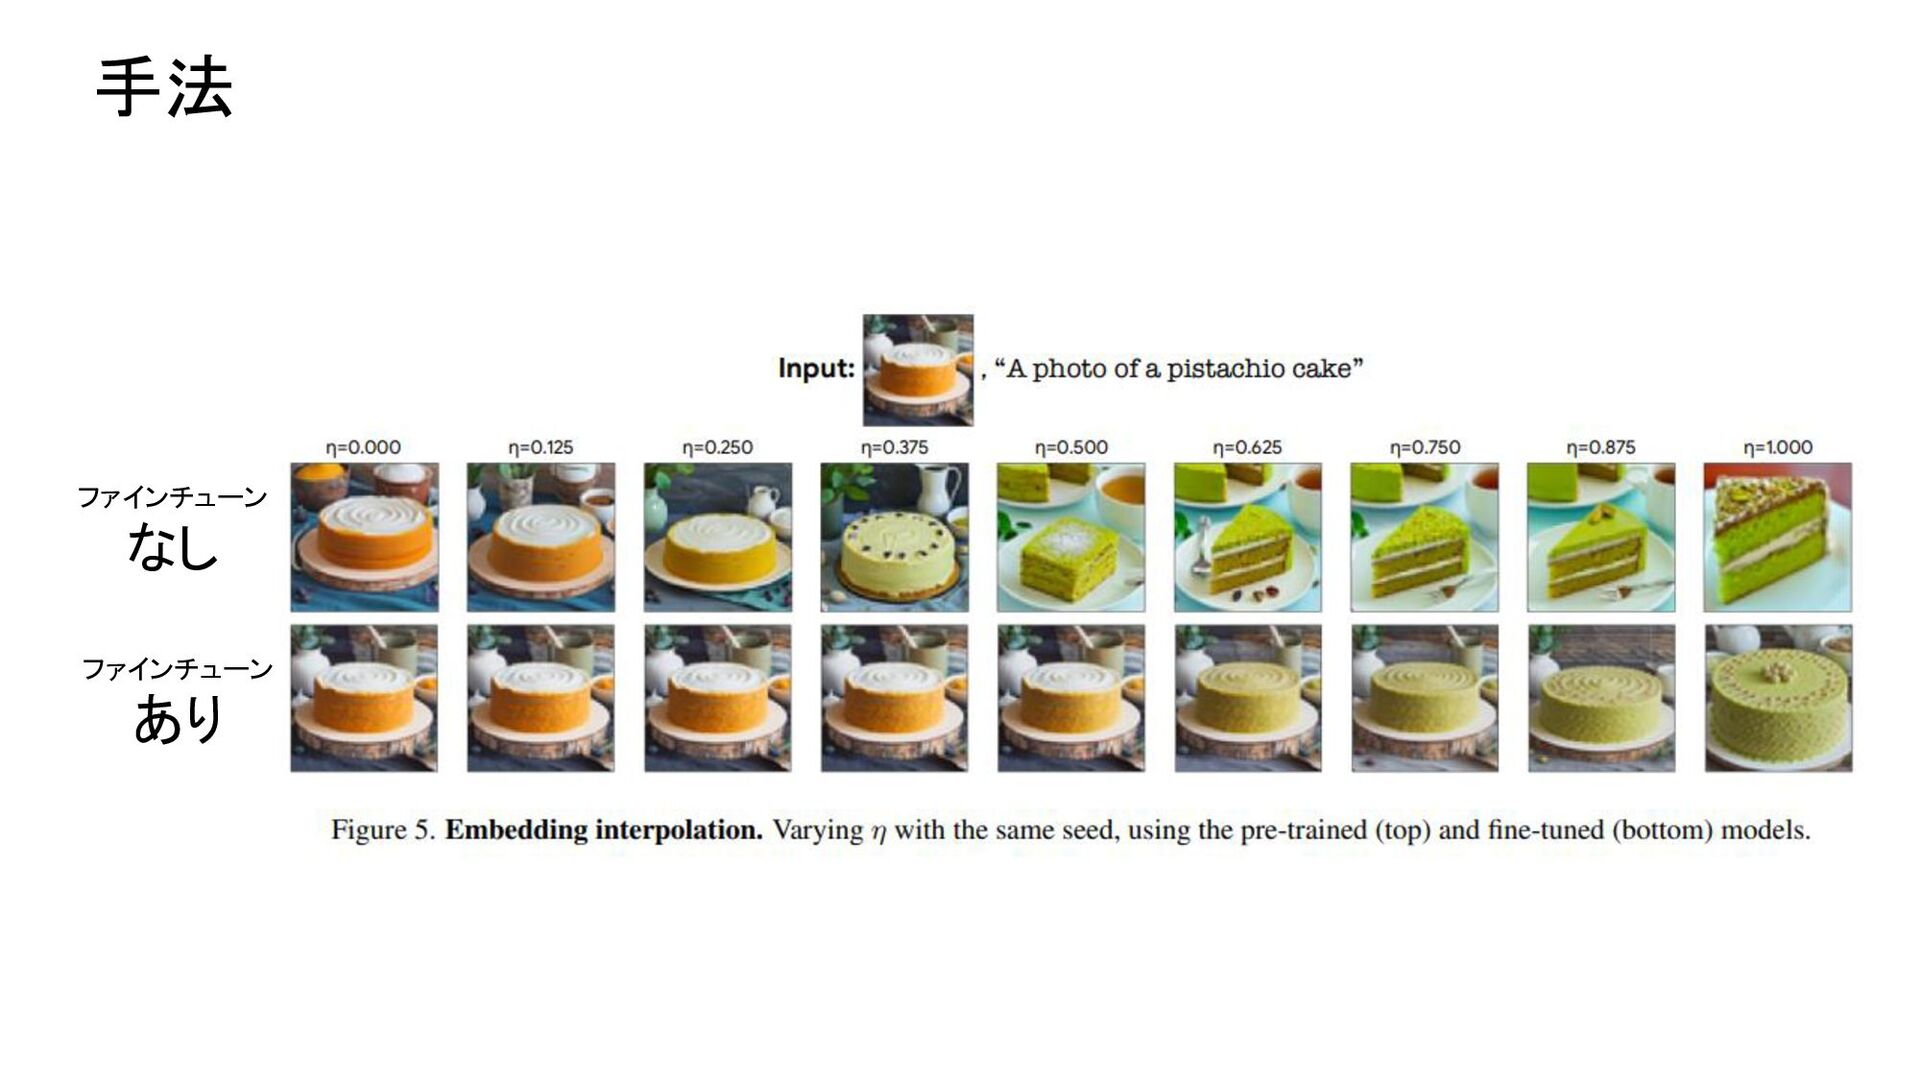
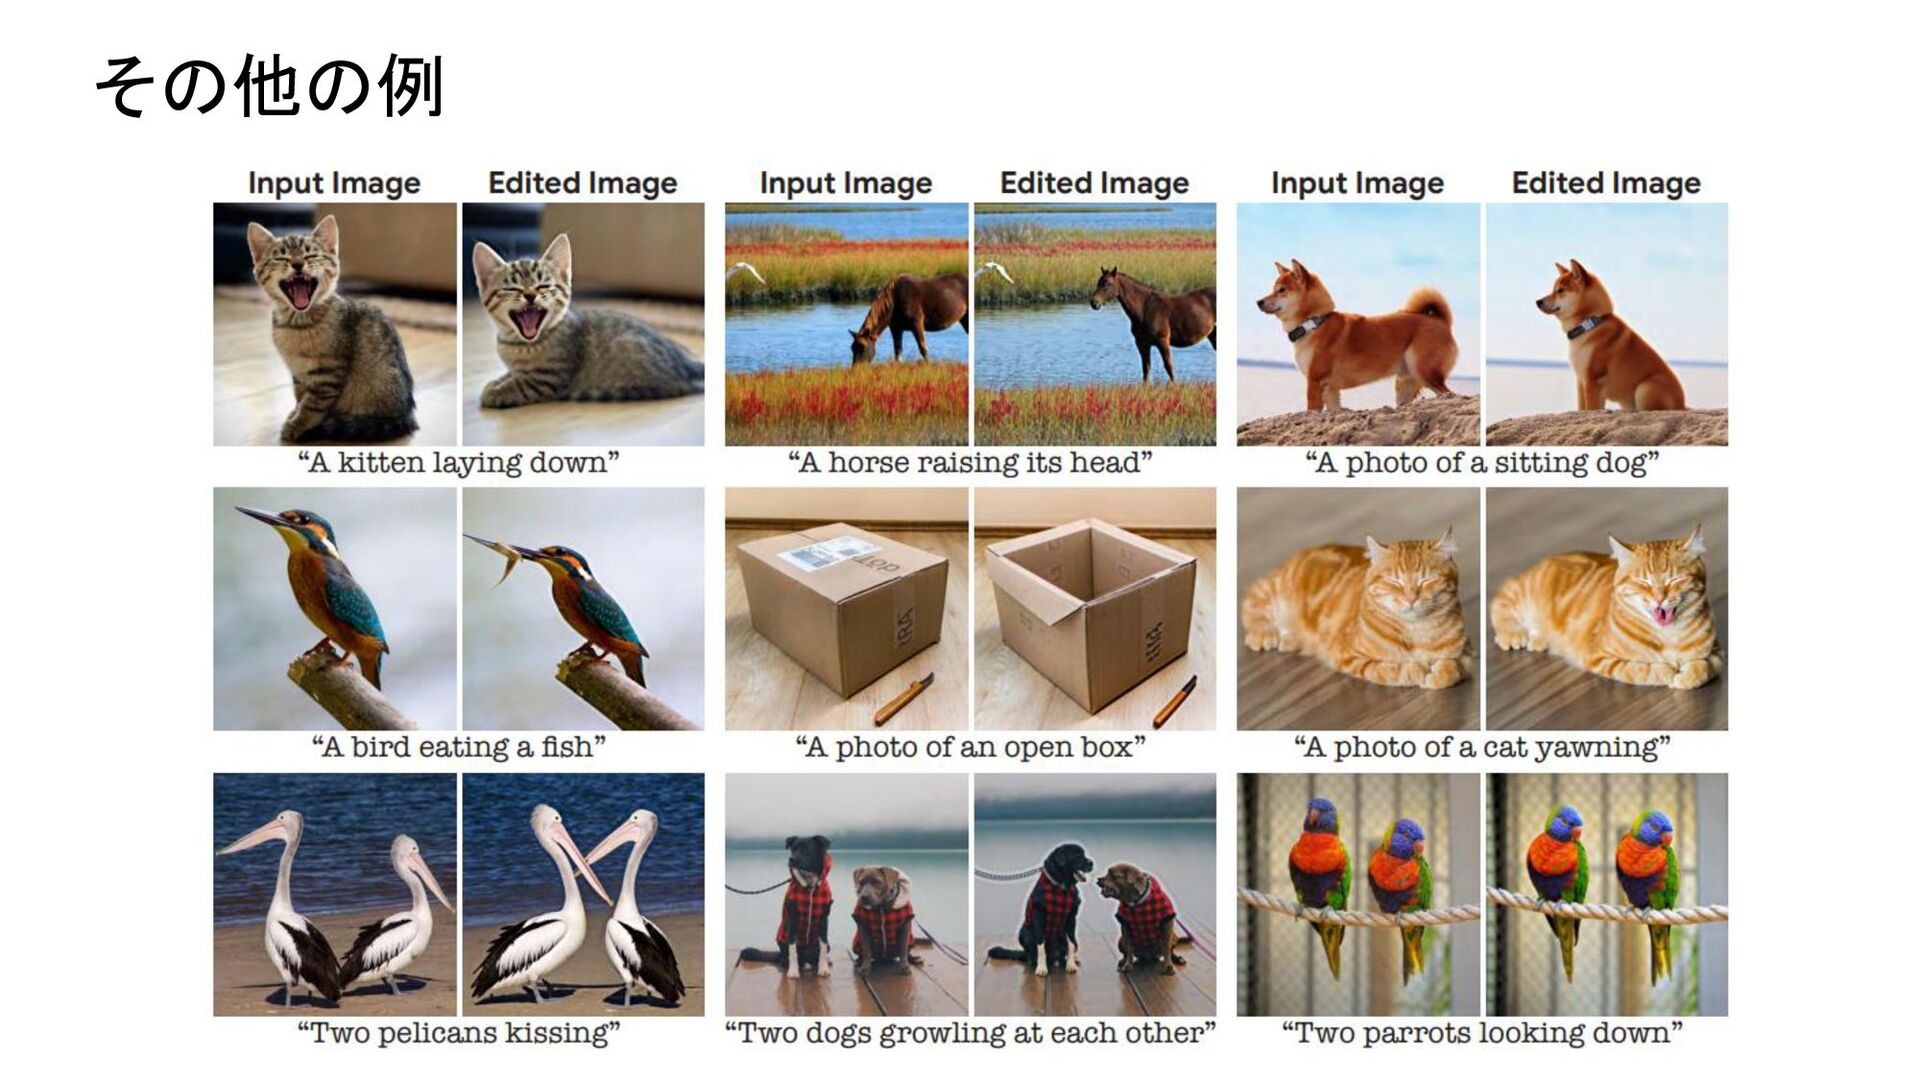
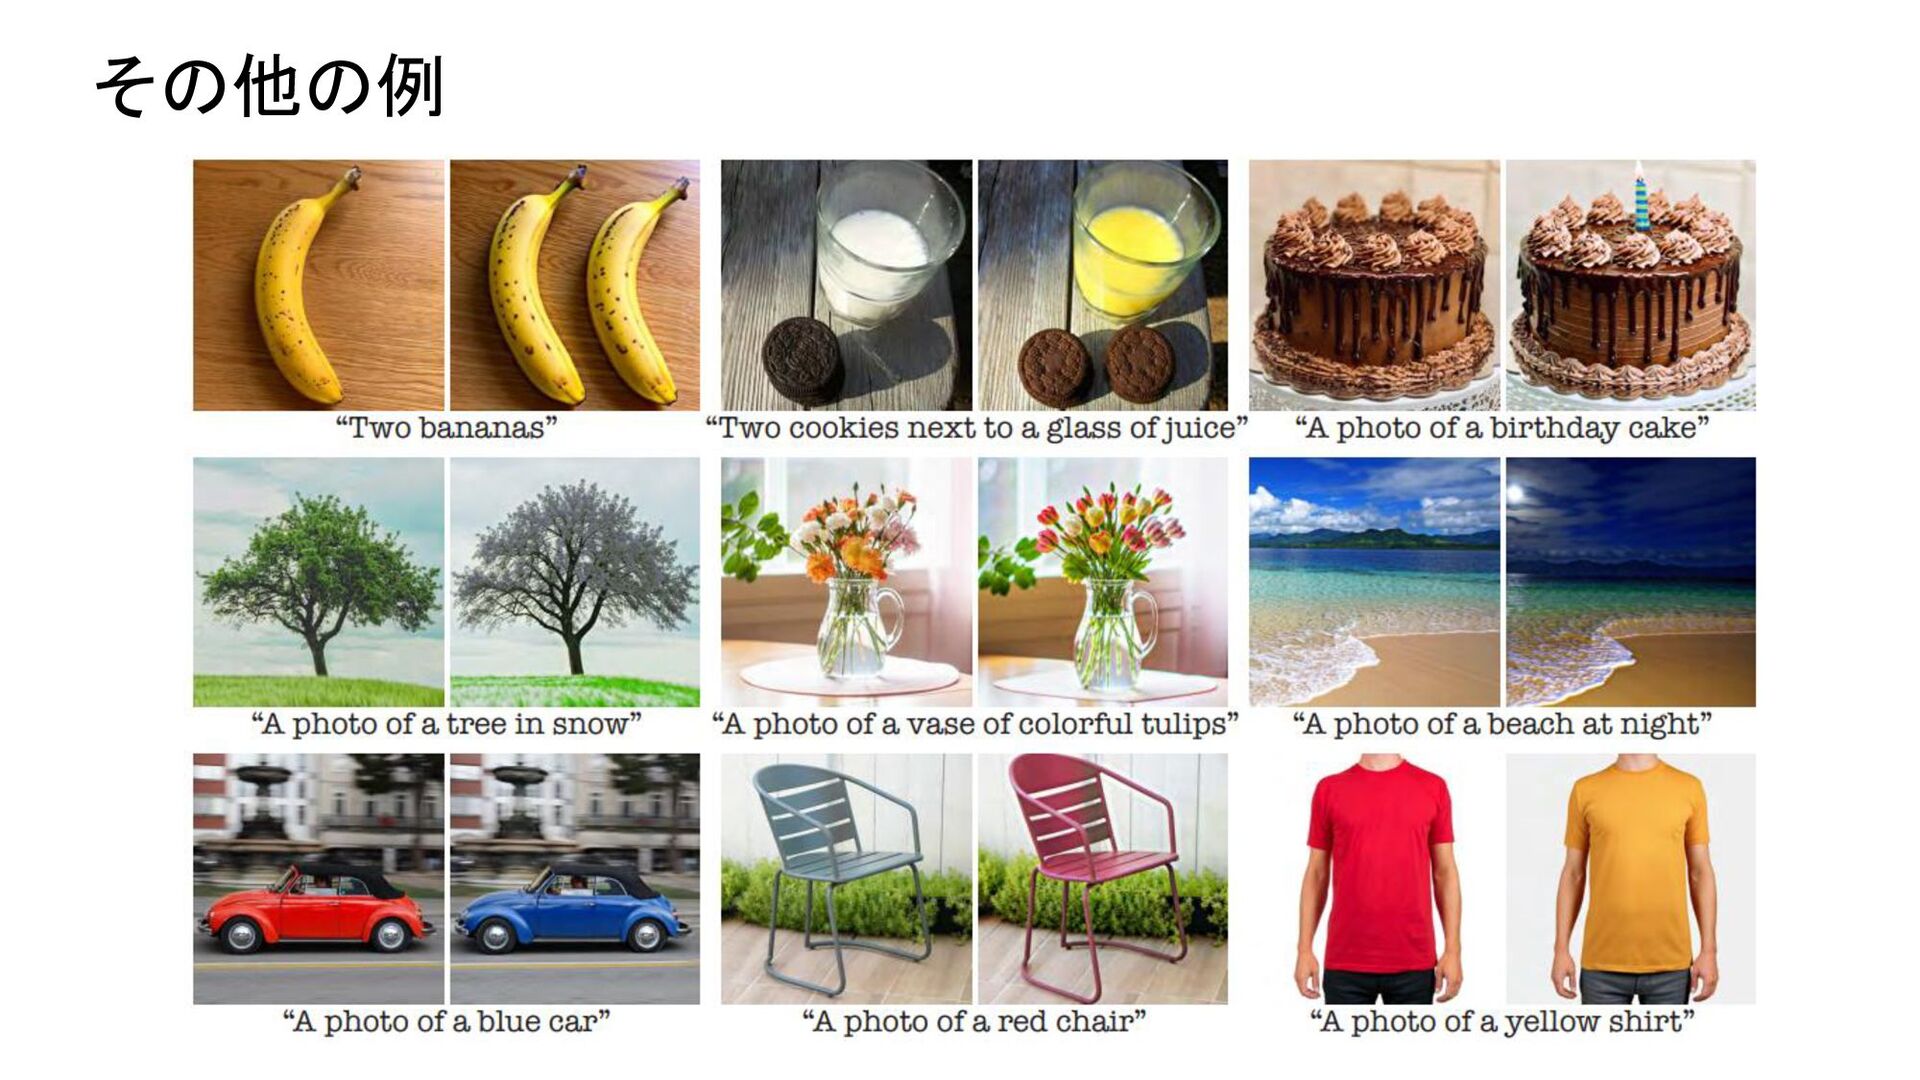
7. Imagic: 拡散モデルによるテキストベースの実画像編集 (原文: Imagic: Text-Based Real Image Editing with
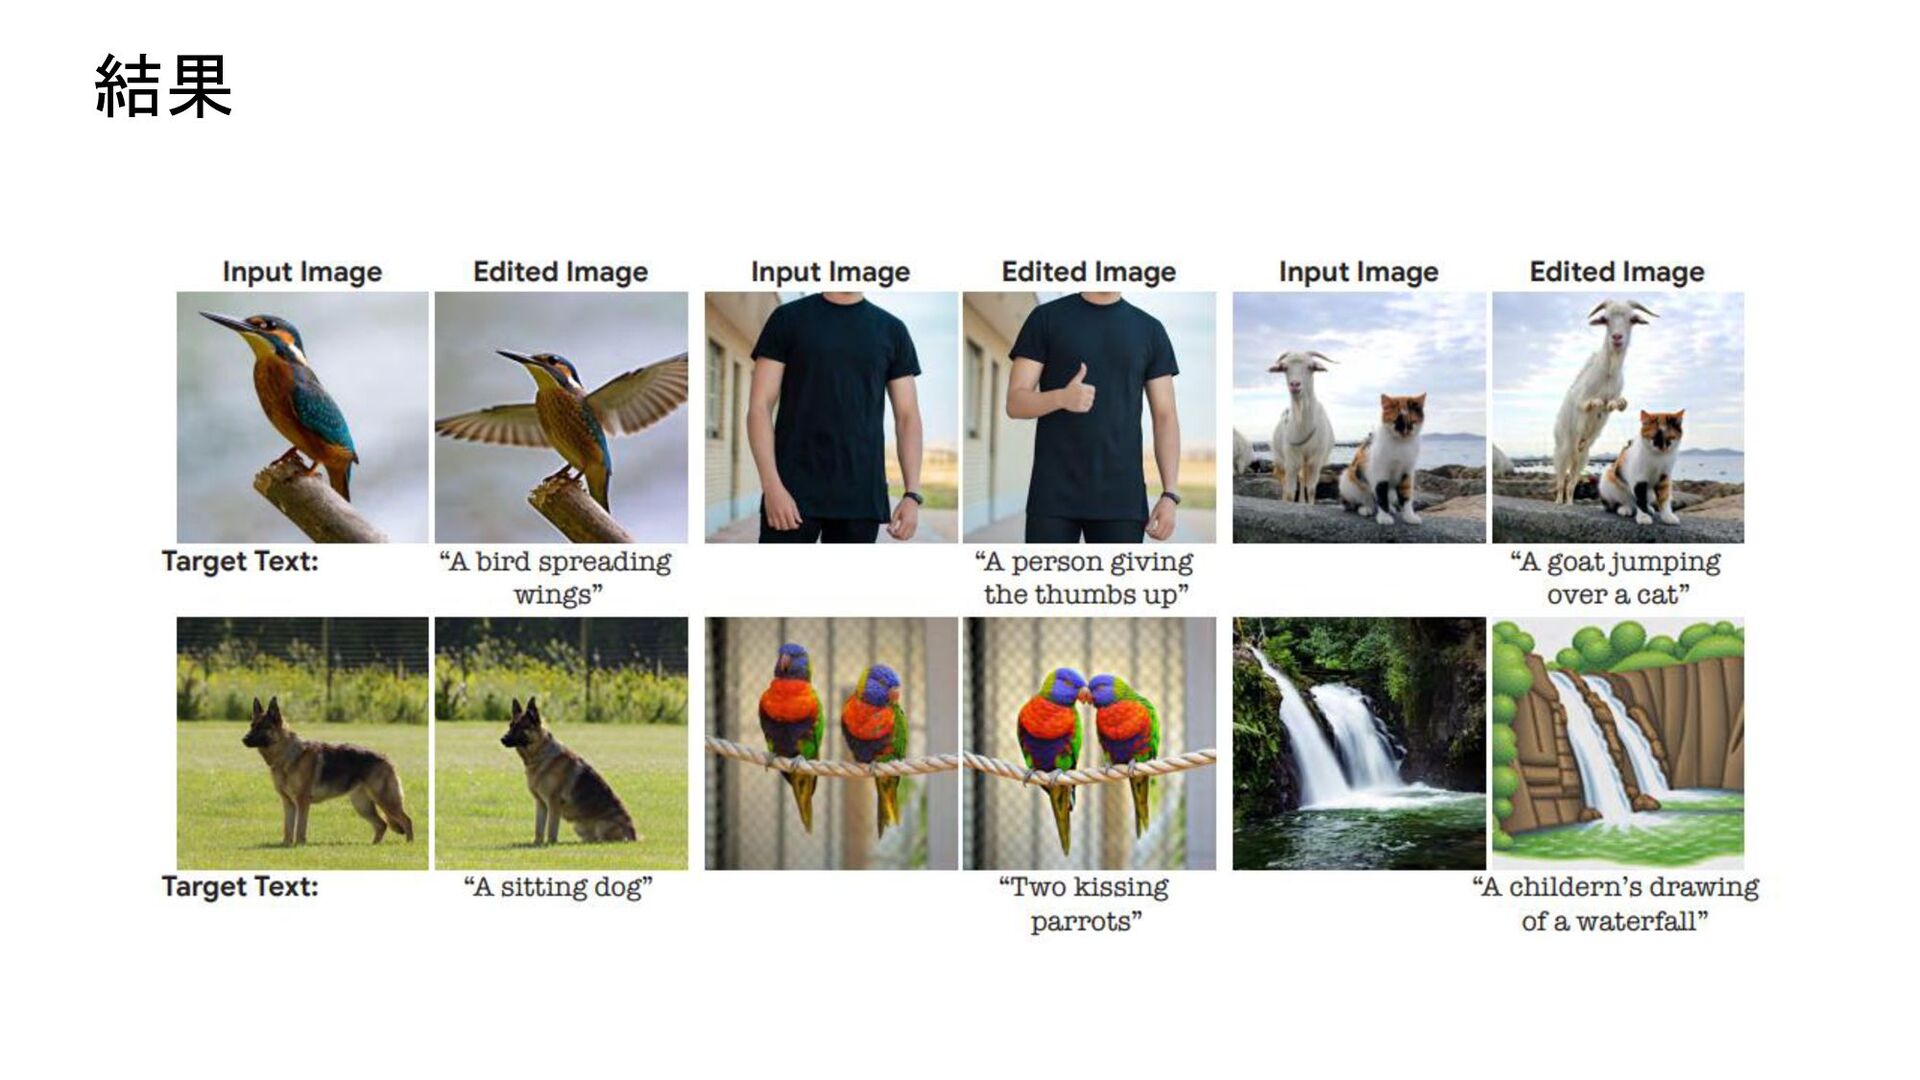
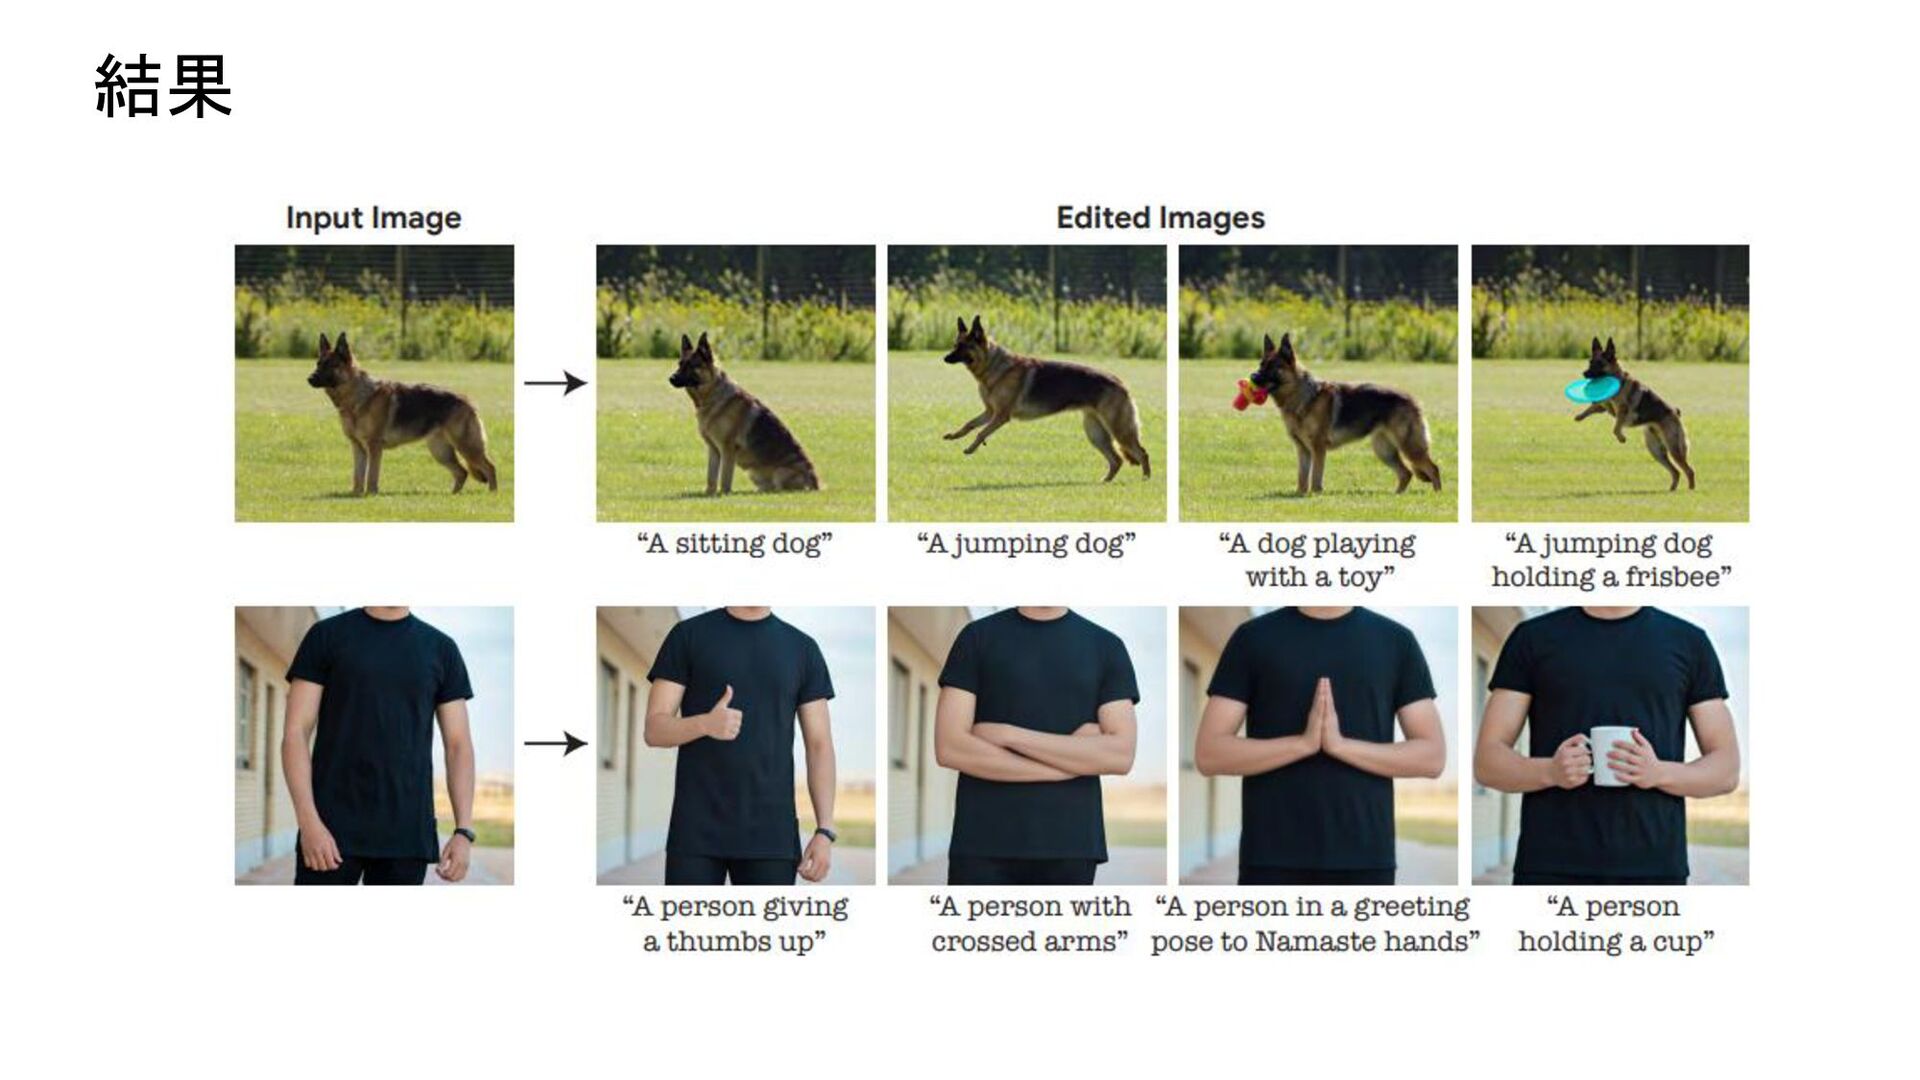
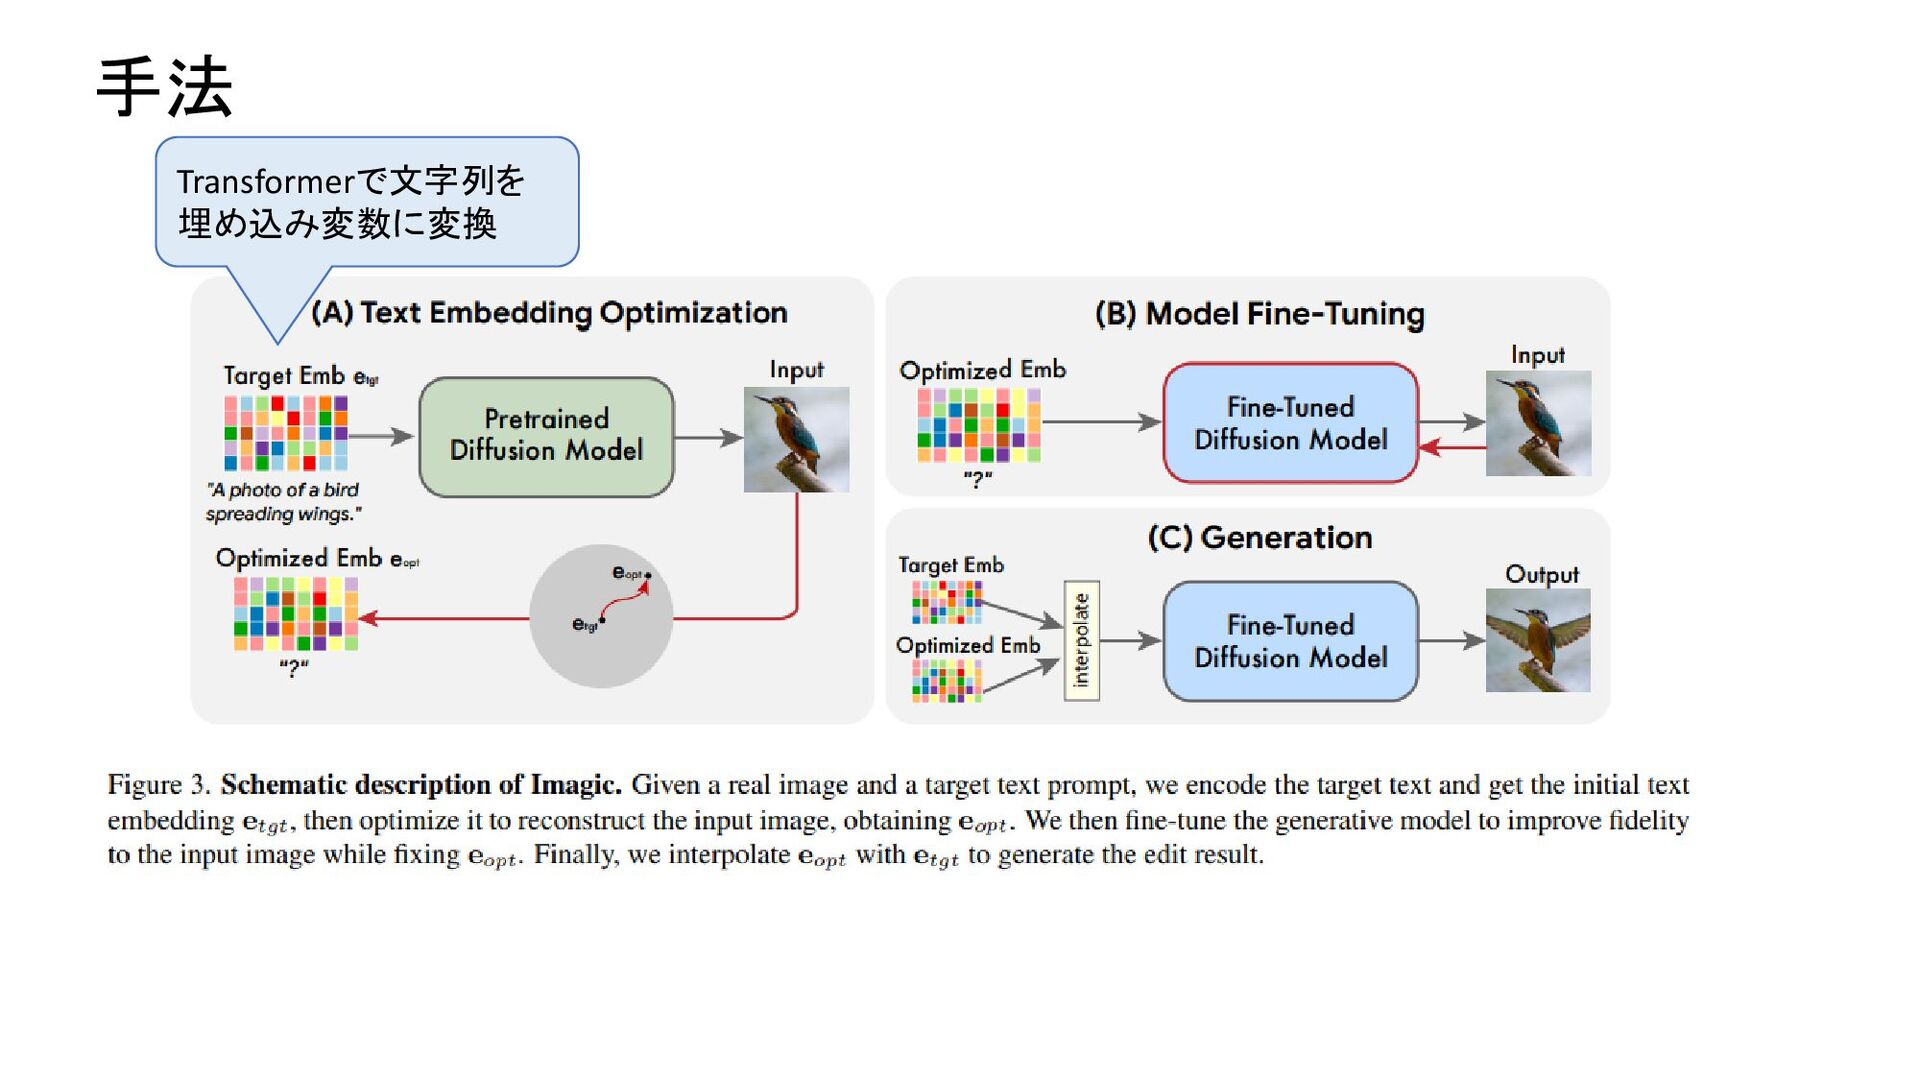
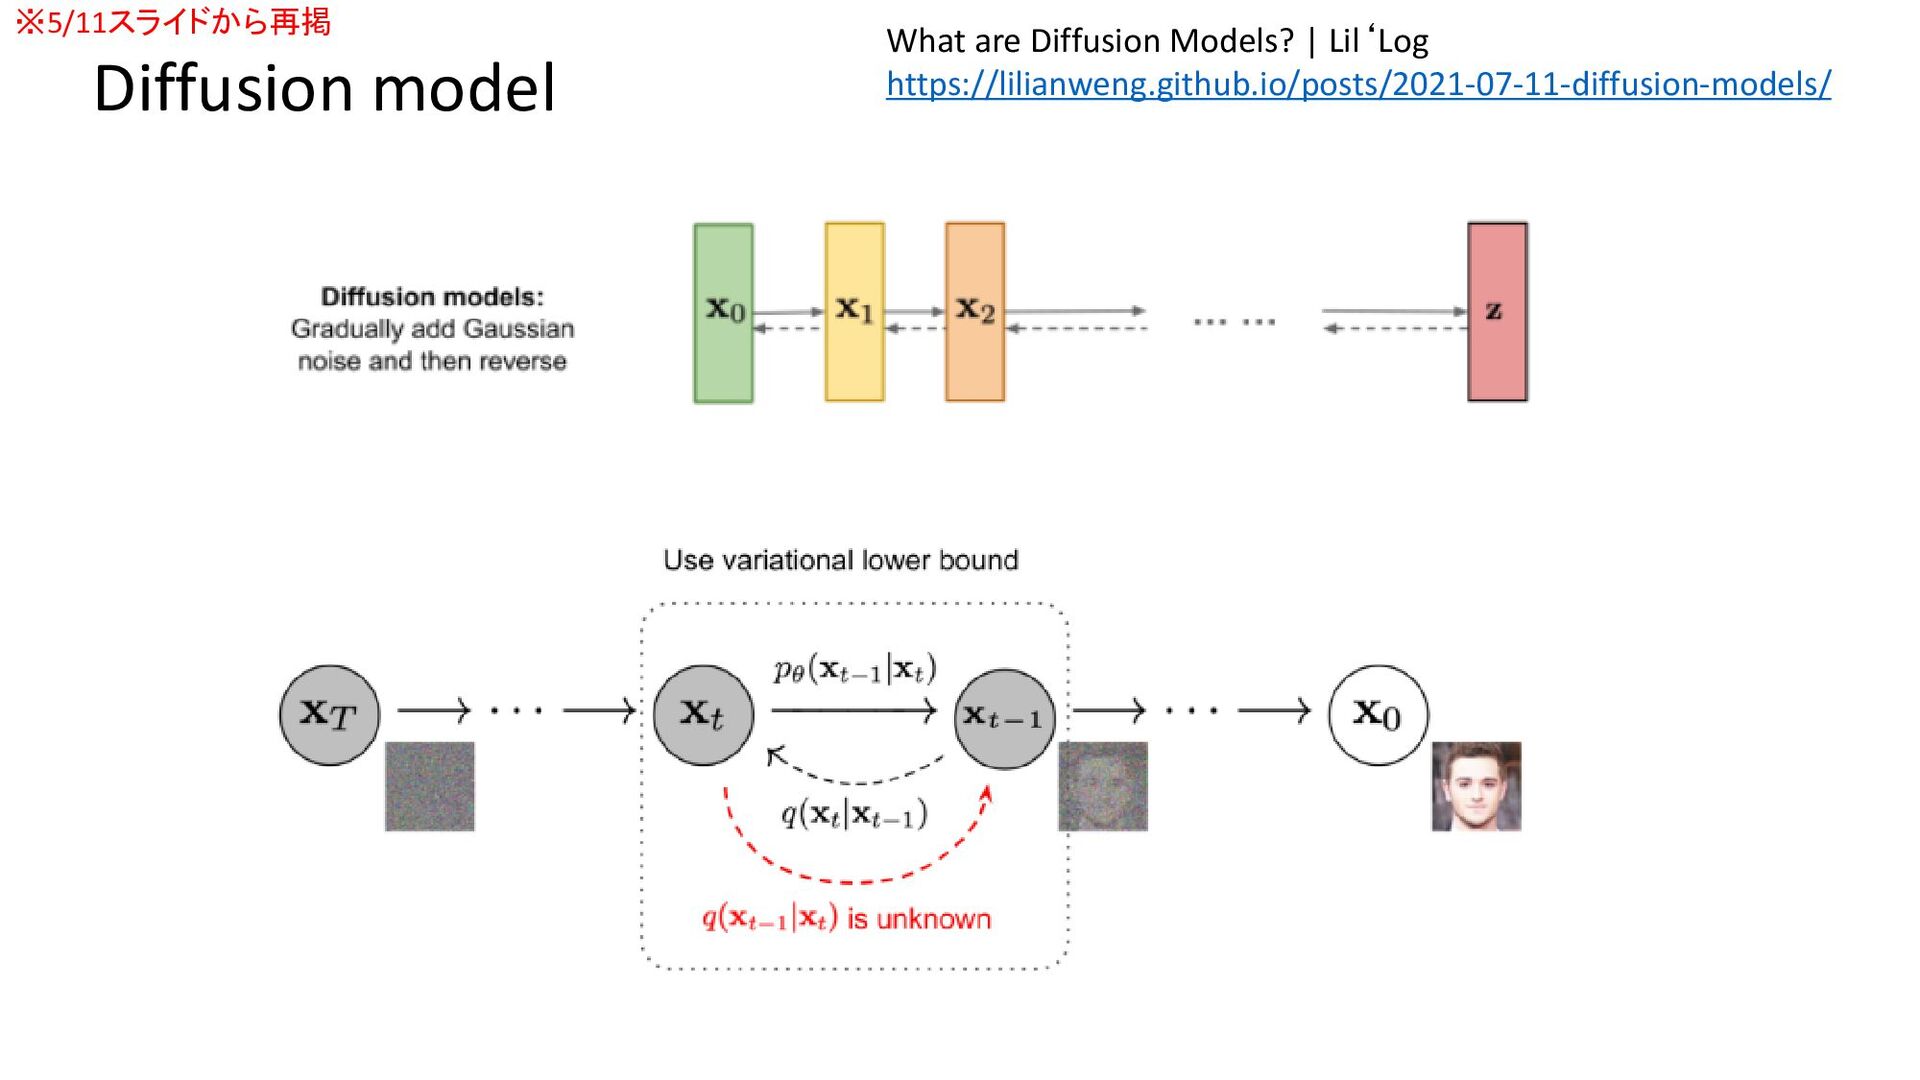
Diffusion Models) 近年、テキストを用いた画像編集が注目されている。しかし、ほとんどの手法は、特定の編集タイプ(例えば、オブジェクト のオーバーレイ、スタイル転送)に限定されているか、合成的に生成された画像に適用されているか、共通のオブジェクト の複数の入力画像を必要とするのが現状である。本論文では、複雑な(例えば、非剛体の)テキストガイド付き意味編集を 単一の実画像に適用する能力を、初めて実証する。例えば、画像内の1つまたは複数のオブジェクトの姿勢や構図を、元 の特徴を維持したまま変更することが可能である。例えば、立っている犬を座らせたり、ジャンプさせたり、鳥を羽ばたかせ たりすることができます。-- 本手法は、ユーザから提供された高解像度の自然画像内にある、1つまたは複数の物体の姿 勢や構図を、元の特徴を維持したまま変化させることができる。本手法は、従来とは異なり、1枚の入力画像と目的のテキ スト(編集したい内容)のみを必要とします。また、実画像上で動作するため、画像マスクやオブジェクトの追加ビューなどの 追加入力を必要としない。Imagic "と呼ぶこの手法は、事前に学習させたテキスト-画像拡散モデルを利用して、このタスク を実行します。Imagicは、画像特有の外観を捉えるために拡散モデルを微調整しながら、入力画像とターゲットテキストの 両方に一致するテキスト埋め込みを生成する。我々は、様々なドメインからの多数の入力に対して、本手法の品質と汎用 性を実証し、単一の統一されたフレームワーク内で、高品質の複雑な意味的画像編集の数々を紹介する。 目的:複雑な(例えば非剛体変換)テキストガイド付き意味編集 成果:例えば、立っている犬を座らせたり、ジャンプさせたり、鳥を羽ばたかせたりすることができる 方法: Diffusion Model 固有名:Imagic 著者所属:Google Research https://arxiv.org/abs/2210.09276v1 -
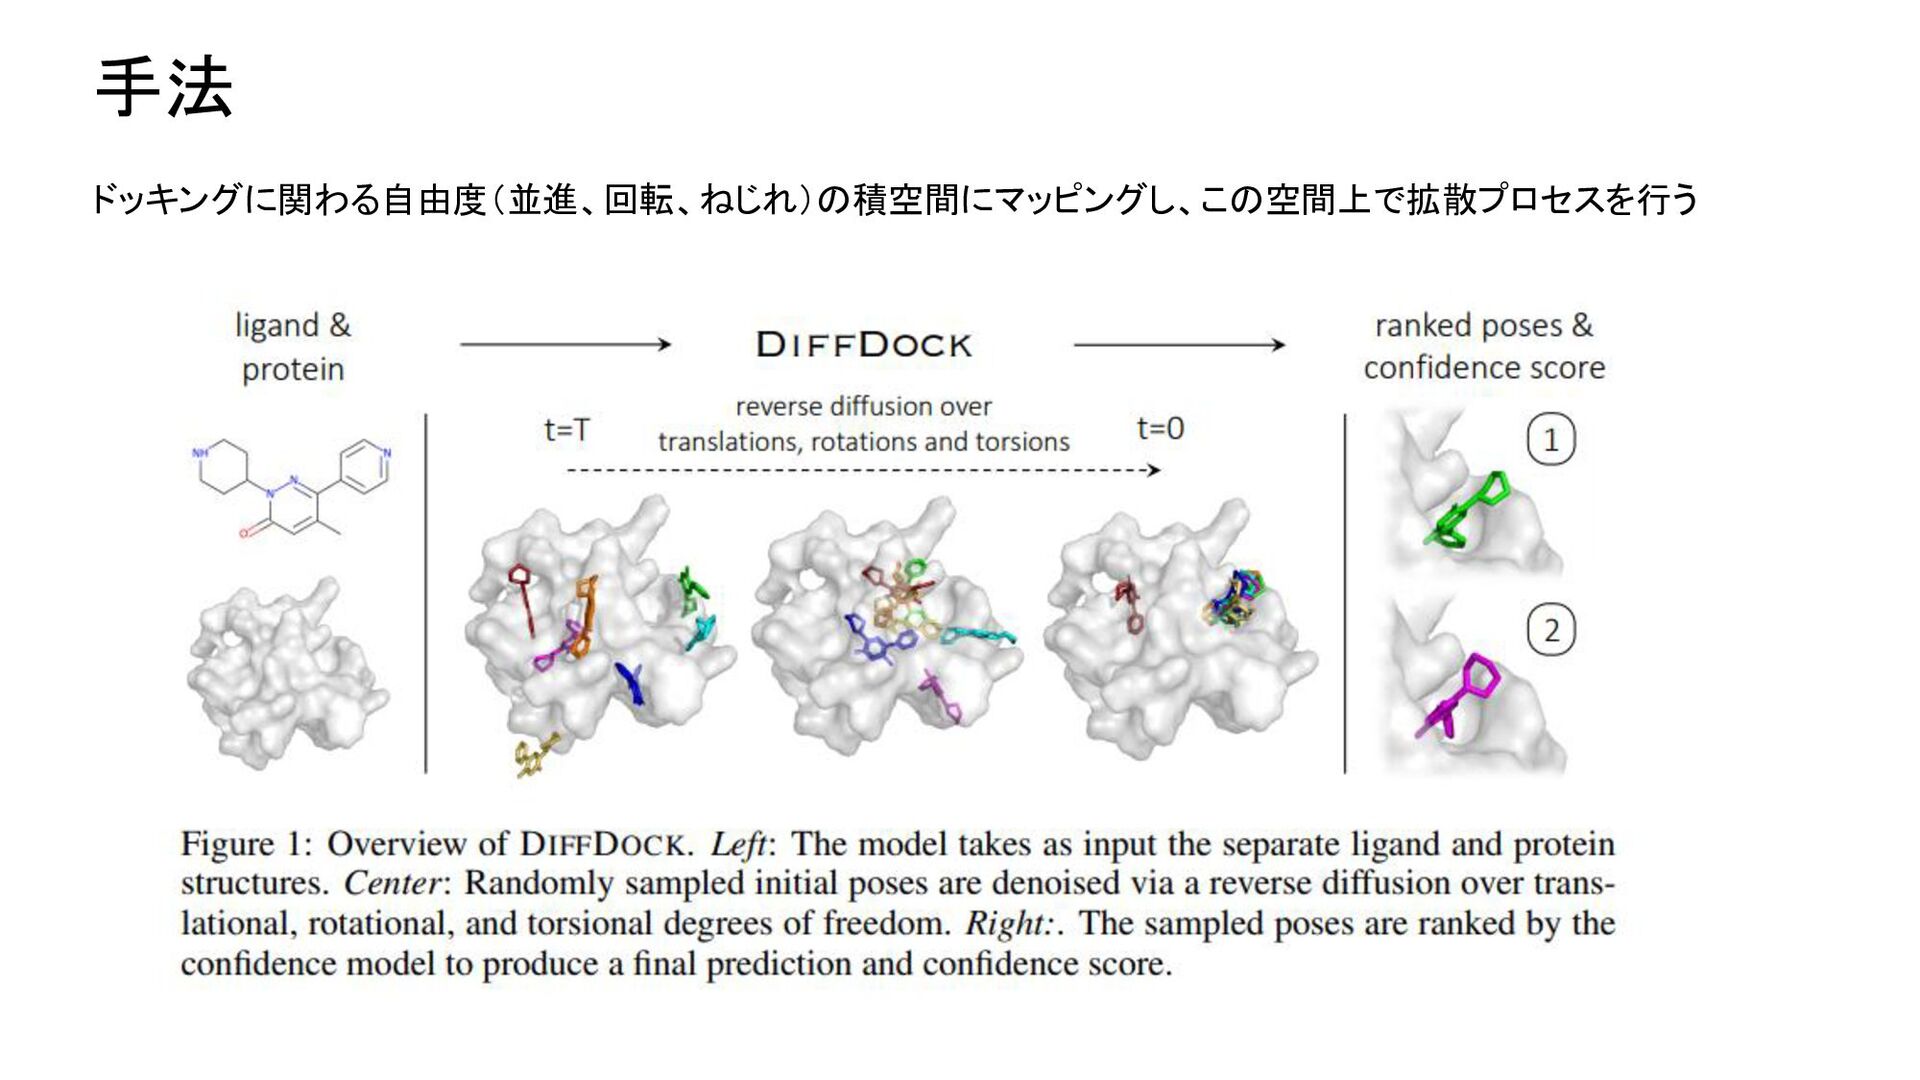
8. DiffDock:分子ドッキングのための拡散ステップ、ツイスト、そしてターン (原文: DiffDock: Diffusion Steps, Twists, and Turns for
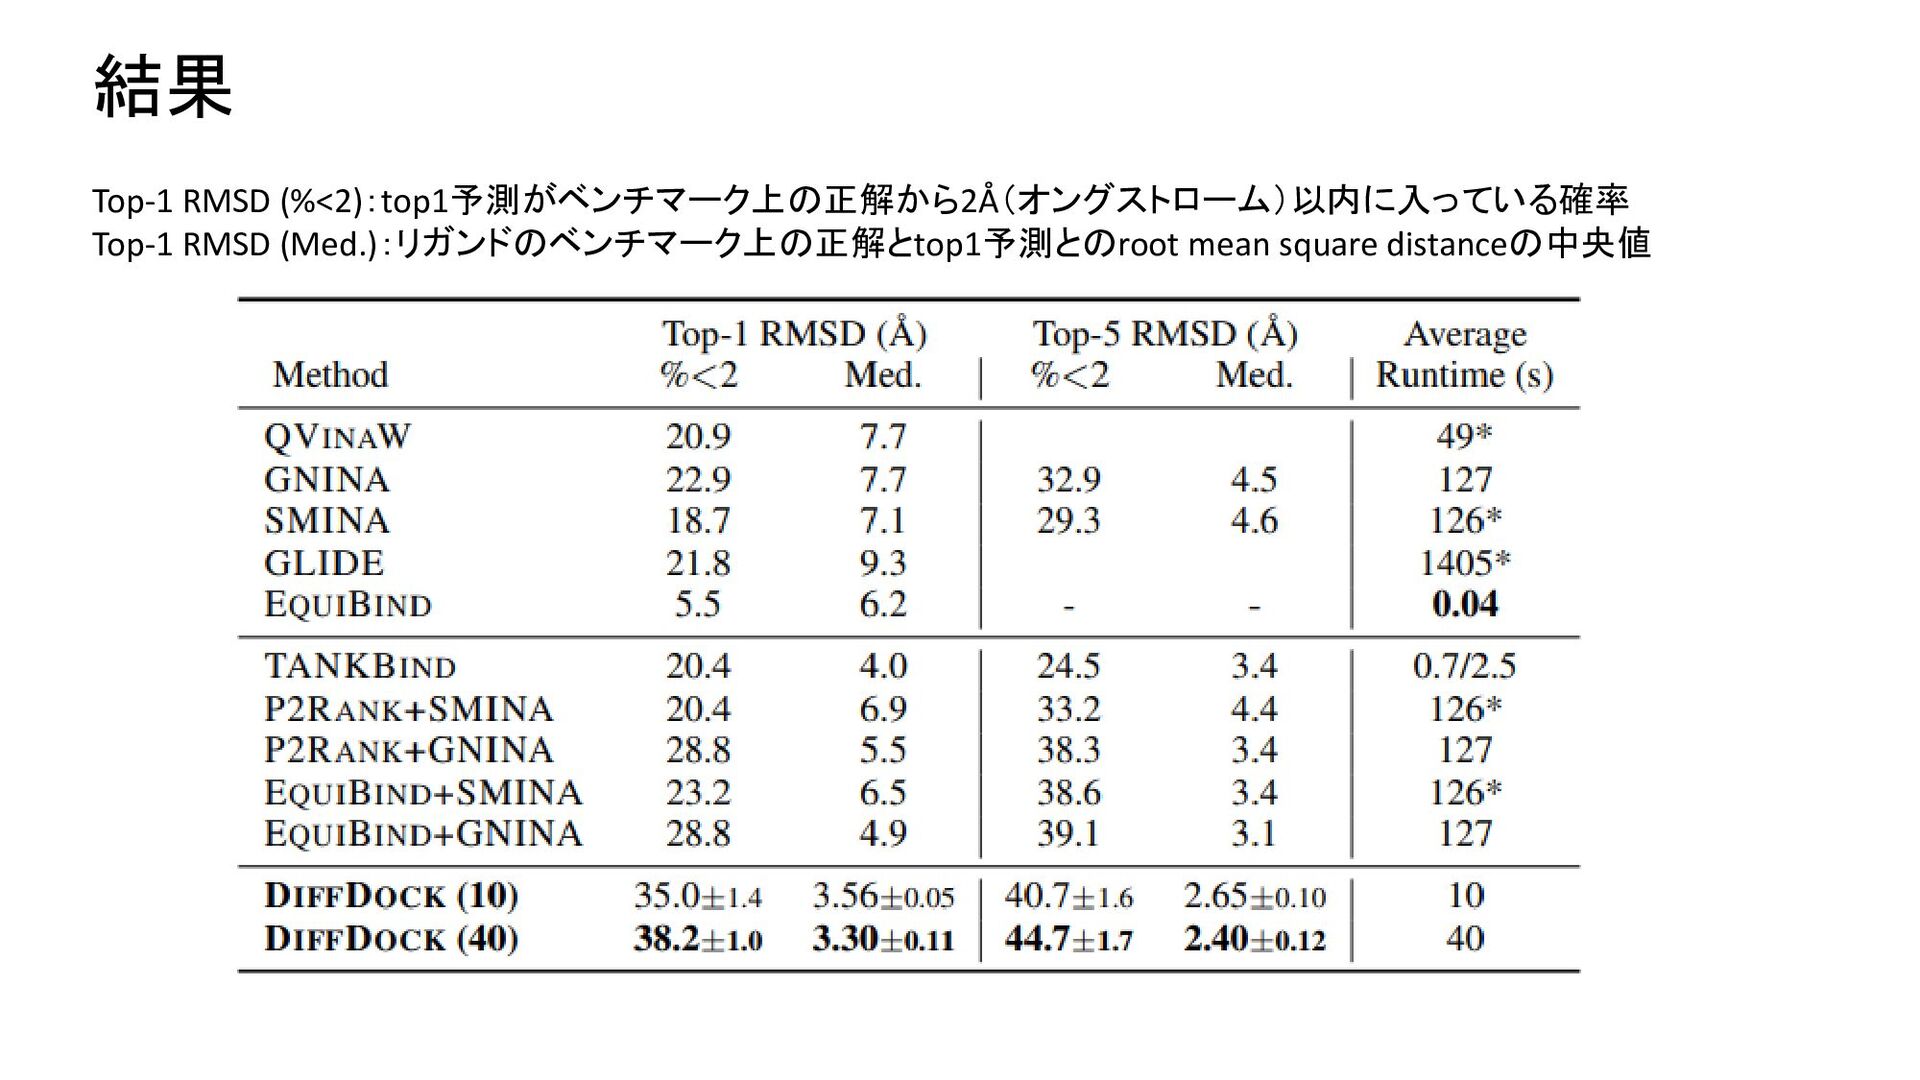
Molecular Docking) 低分子リガンドとタンパク質の結合構造を予測すること--分子ドッキングとして知られる作業--は、創薬に不可欠である。ドッ キングを回帰問題として扱う最近のディープラーニング手法は、従来の探索ベースの手法に比べて実行時間が短縮されま したが、精度の大幅な向上には至っていません。我々は、分子ドッキングを生成モデリング問題として捉え、リガンドポーズ の非ユークリッド多様体上の拡散生成モデルであるDiffDockを開発しました。そのために、この多様体をドッキングに関わ る自由度(並進、回転、ねじれ)の積空間にマッピングし、この空間上で効率的な拡散プロセスを開発しました。経験的に、 DiffDockはPDBBindにおいて38%のトップ1成功率(RMSD<2A)を獲得し、従来のドッキング手法(23%)やディープラーニング 手法(20%)といった従来の最先端手法を大幅に上回る結果を得ました。さらに、DiffDockは推論時間が速く、高い選択精度 で信頼性推定値を提供します。 目的:分子とタンパク質の結合構造を予測すること 成果:DiffDockはPDBBindにおいて38%のトップ1成功率(RMSD<2A)を獲得し、従来の最先端手法を大幅に上回る結果を得た 方法:分子結合を生成問題としてとらえ拡散生成モデルで推定 固有名:DiffDock 著者所属:マサチューセッツ工科大学 https://arxiv.org/abs/2210.01776v1 -
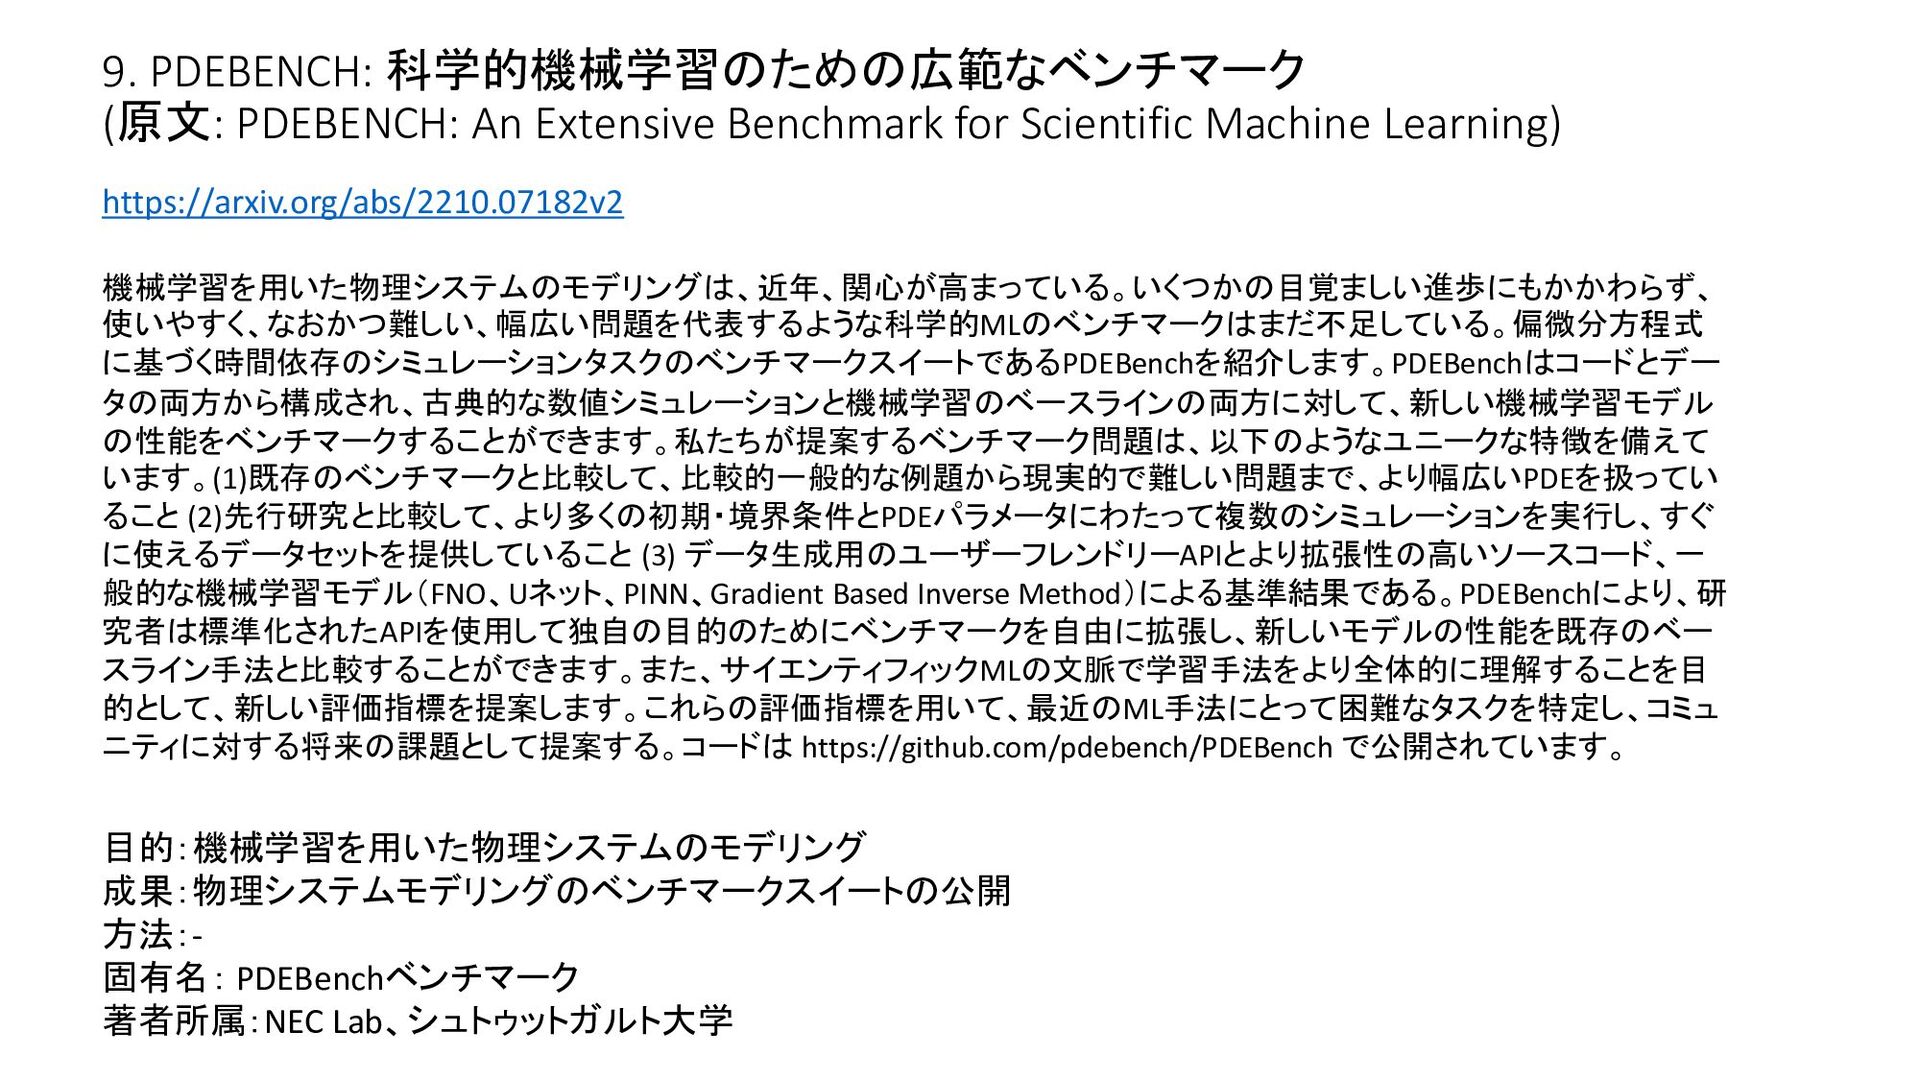
9. PDEBENCH: 科学的機械学習のための広範なベンチマーク (原文: PDEBENCH: An Extensive Benchmark for Scientific
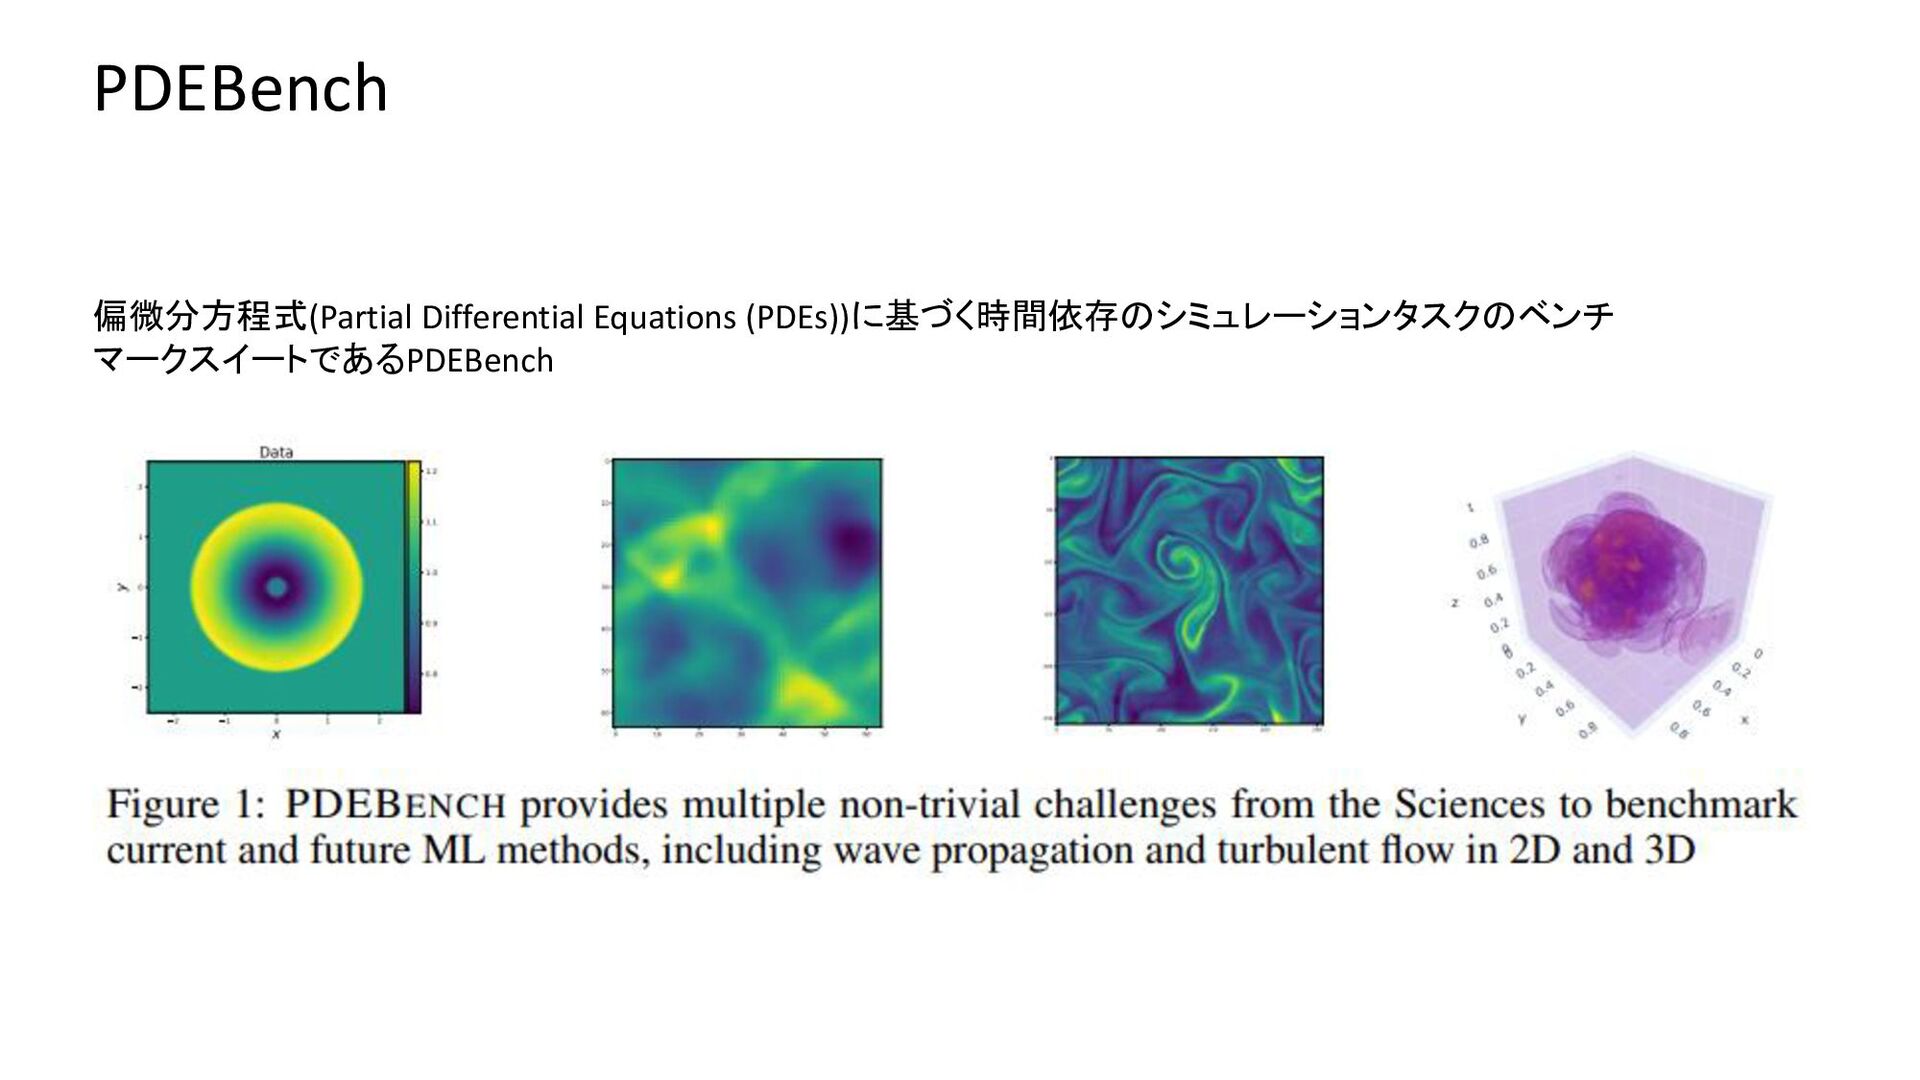
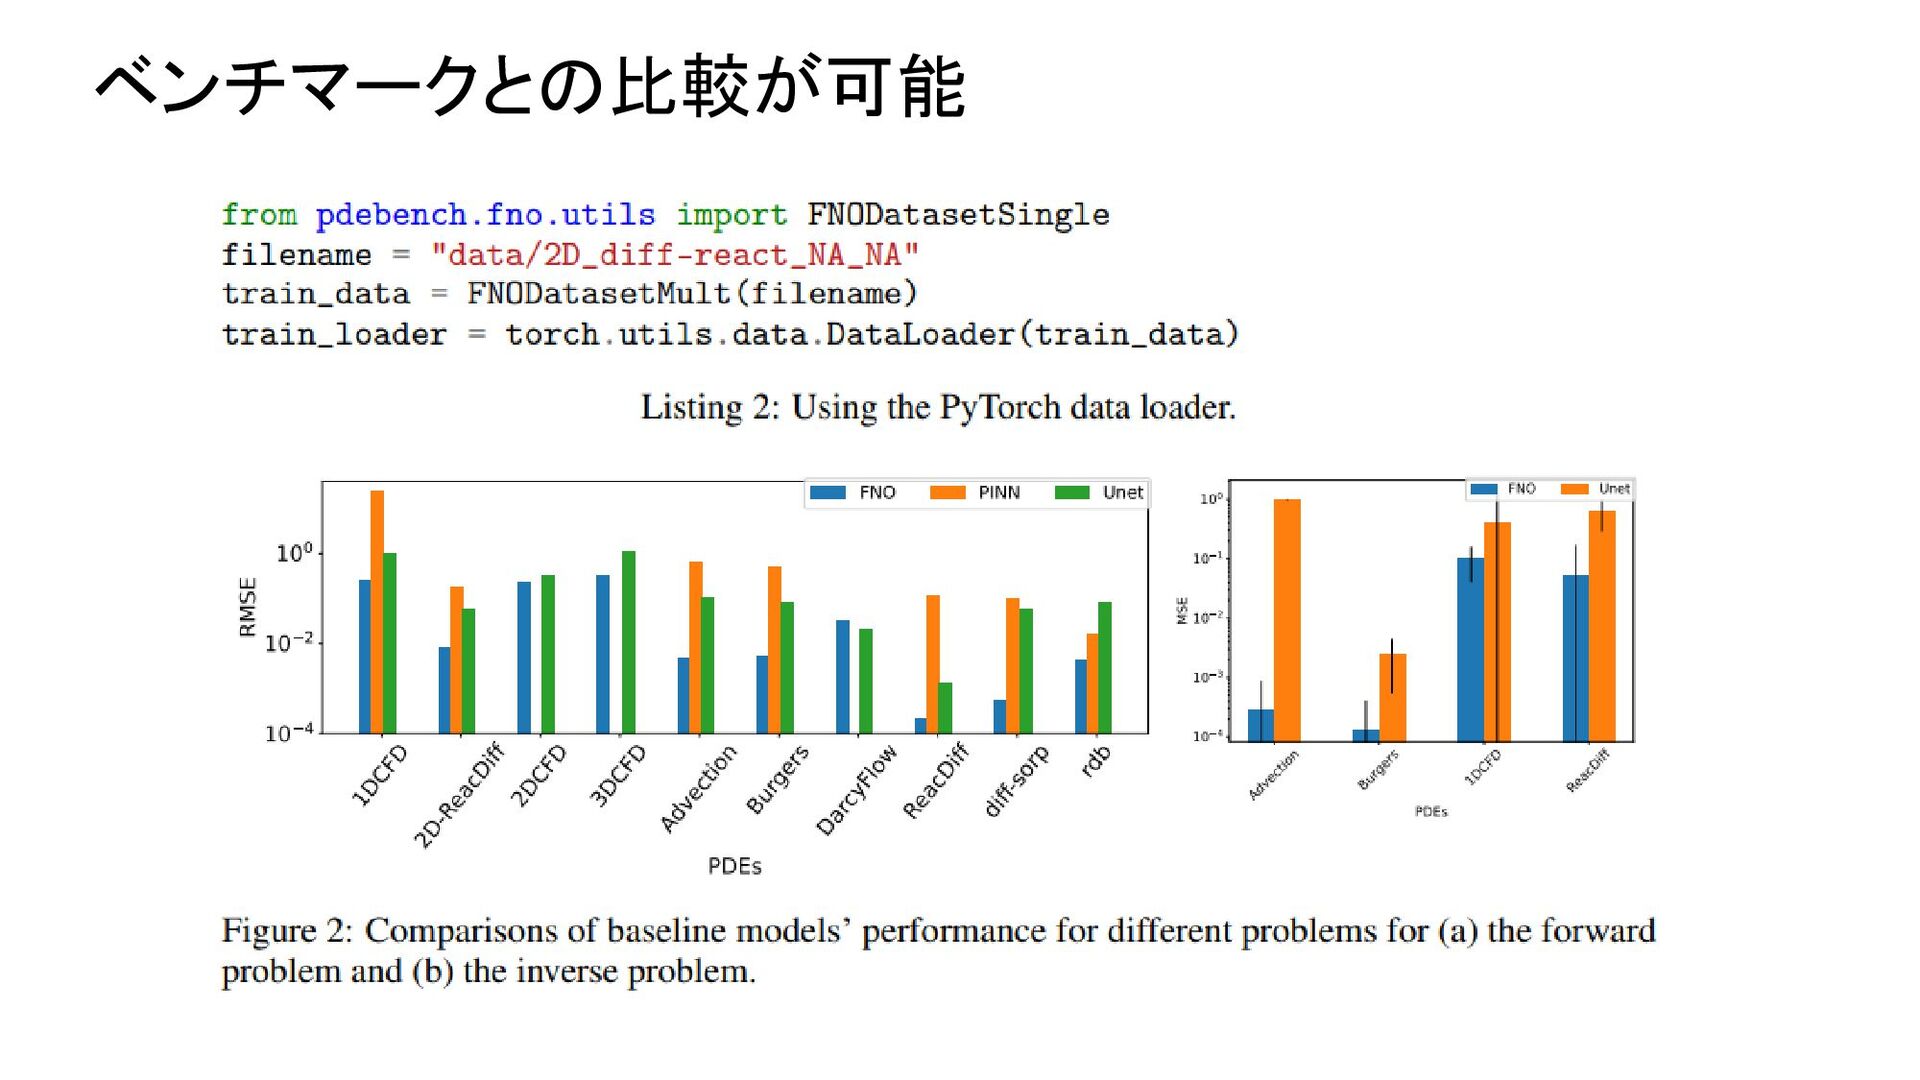
Machine Learning) 機械学習を用いた物理システムのモデリングは、近年、関心が高まっている。いくつかの目覚ましい進歩にもかかわらず、 使いやすく、なおかつ難しい、幅広い問題を代表するような科学的MLのベンチマークはまだ不足している。偏微分方程式 に基づく時間依存のシミュレーションタスクのベンチマークスイートであるPDEBenchを紹介します。PDEBenchはコードとデー タの両方から構成され、古典的な数値シミュレーションと機械学習のベースラインの両方に対して、新しい機械学習モデル の性能をベンチマークすることができます。私たちが提案するベンチマーク問題は、以下のようなユニークな特徴を備えて います。(1)既存のベンチマークと比較して、比較的一般的な例題から現実的で難しい問題まで、より幅広いPDEを扱ってい ること (2)先行研究と比較して、より多くの初期・境界条件とPDEパラメータにわたって複数のシミュレーションを実行し、すぐ に使えるデータセットを提供していること (3) データ生成用のユーザーフレンドリーAPIとより拡張性の高いソースコード、一 般的な機械学習モデル(FNO、Uネット、PINN、Gradient Based Inverse Method)による基準結果である。PDEBenchにより、研 究者は標準化されたAPIを使用して独自の目的のためにベンチマークを自由に拡張し、新しいモデルの性能を既存のベー スライン手法と比較することができます。また、サイエンティフィックMLの文脈で学習手法をより全体的に理解することを目 的として、新しい評価指標を提案します。これらの評価指標を用いて、最近のML手法にとって困難なタスクを特定し、コミュ ニティに対する将来の課題として提案する。コードは https://github.com/pdebench/PDEBench で公開されています。 目的:機械学習を用いた物理システムのモデリング 成果:物理システムモデリングのベンチマークスイートの公開 方法:- 固有名: PDEBenchベンチマーク 著者所属:NEC Lab、シュトゥットガルト大学 https://arxiv.org/abs/2210.07182v2 -
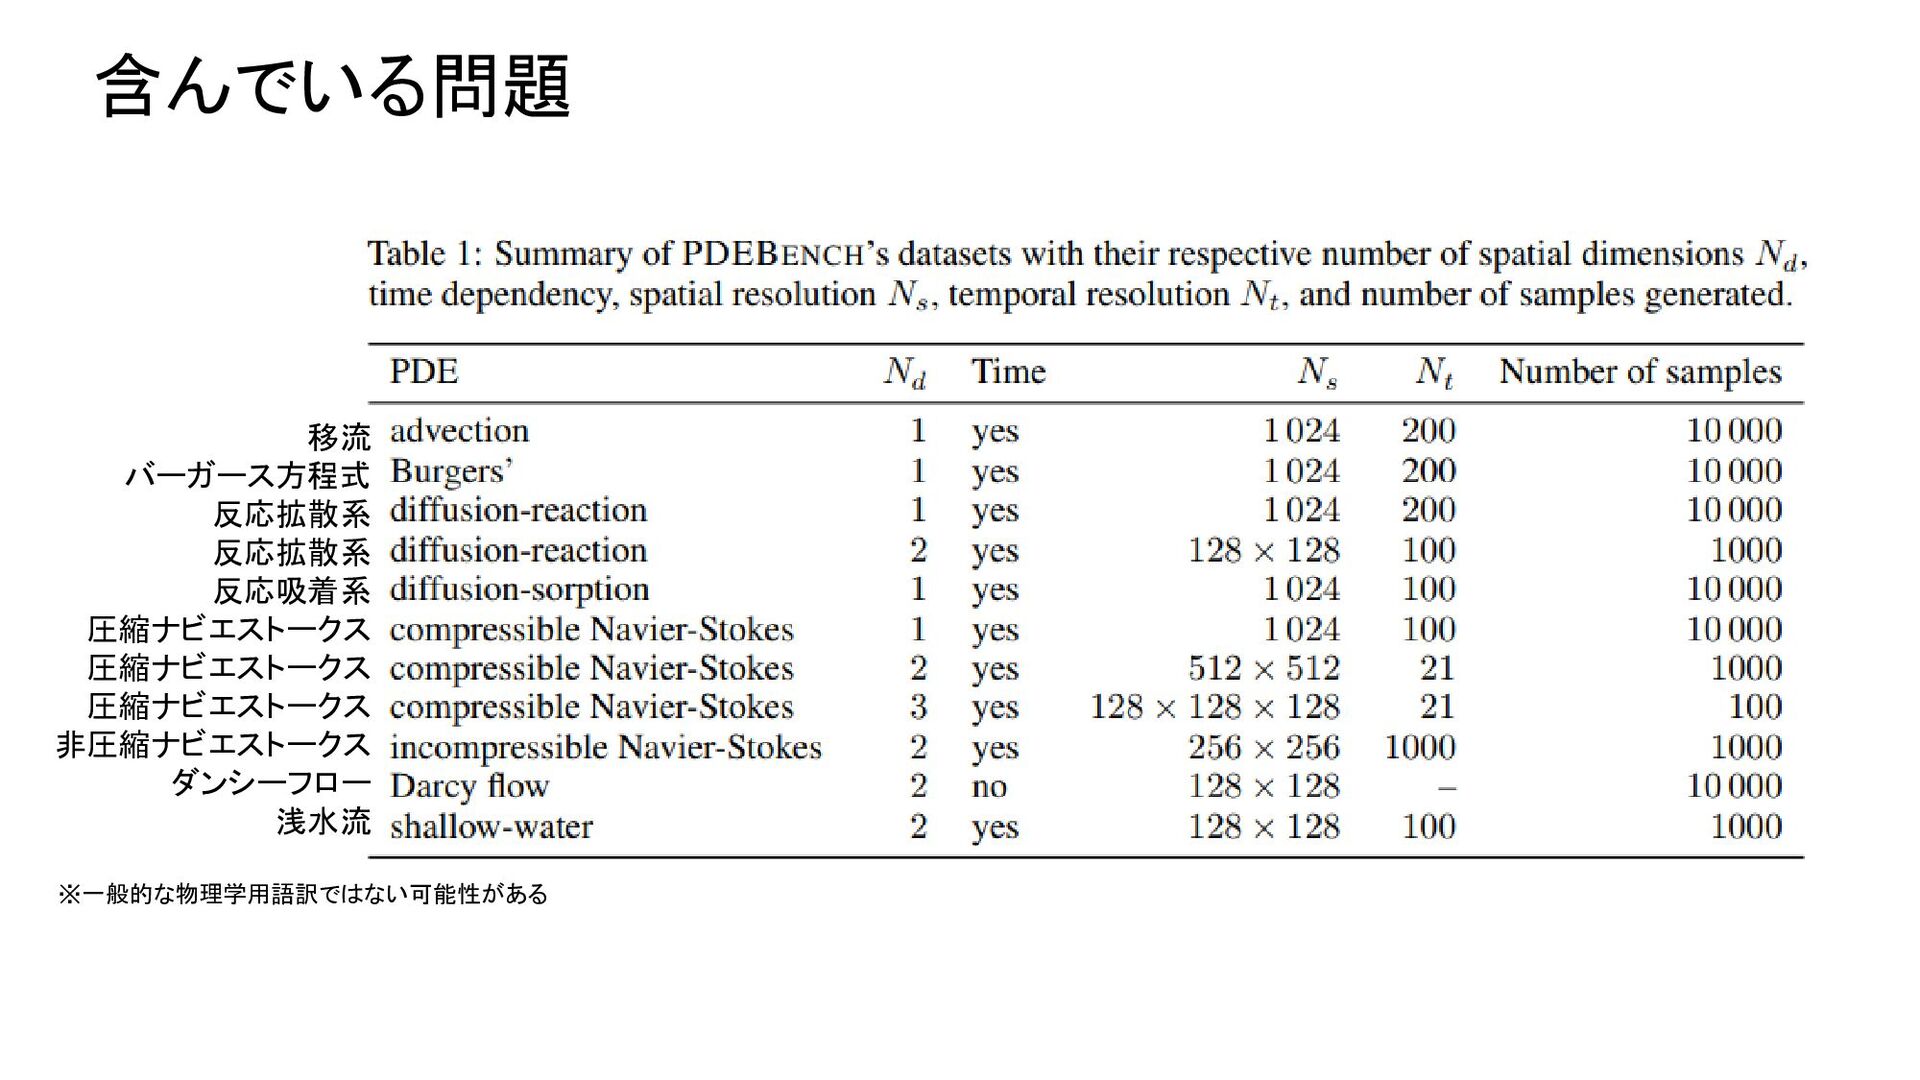
含んでいる問題 移流 バーガース方程式 反応拡散系 反応拡散系 反応吸着系 圧縮ナビエストークス 圧縮ナビエストークス 圧縮ナビエストークス 非圧縮ナビエストークス
ダンシーフロー 浅水流 ※一般的な物理学用語訳ではない可能性がある -
10. フォールディング拡散による蛋白質構造生成 (原文: Protein structure generation via folding diffusion) 新規かつ物理的に折り畳み可能なタンパク質構造を計算機で生成することができれば、新たな生物学的発見や、未だ克
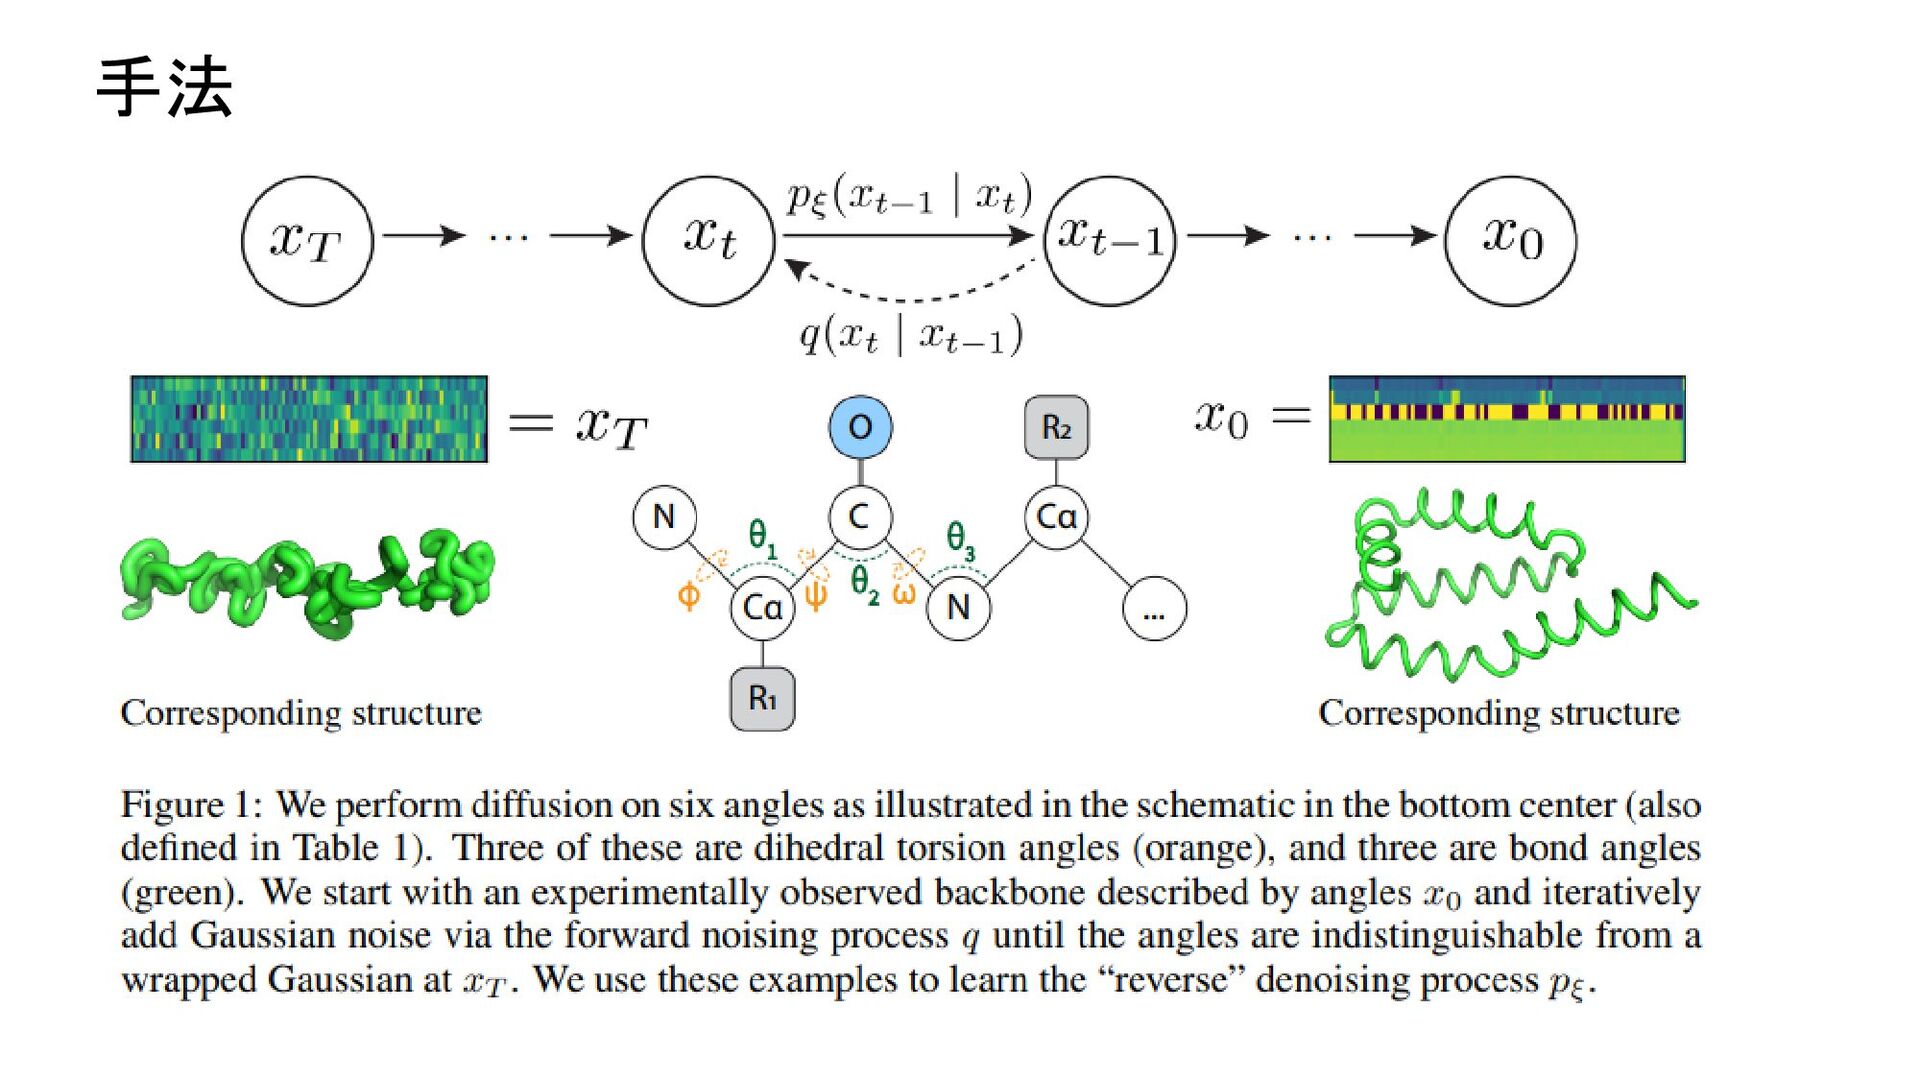
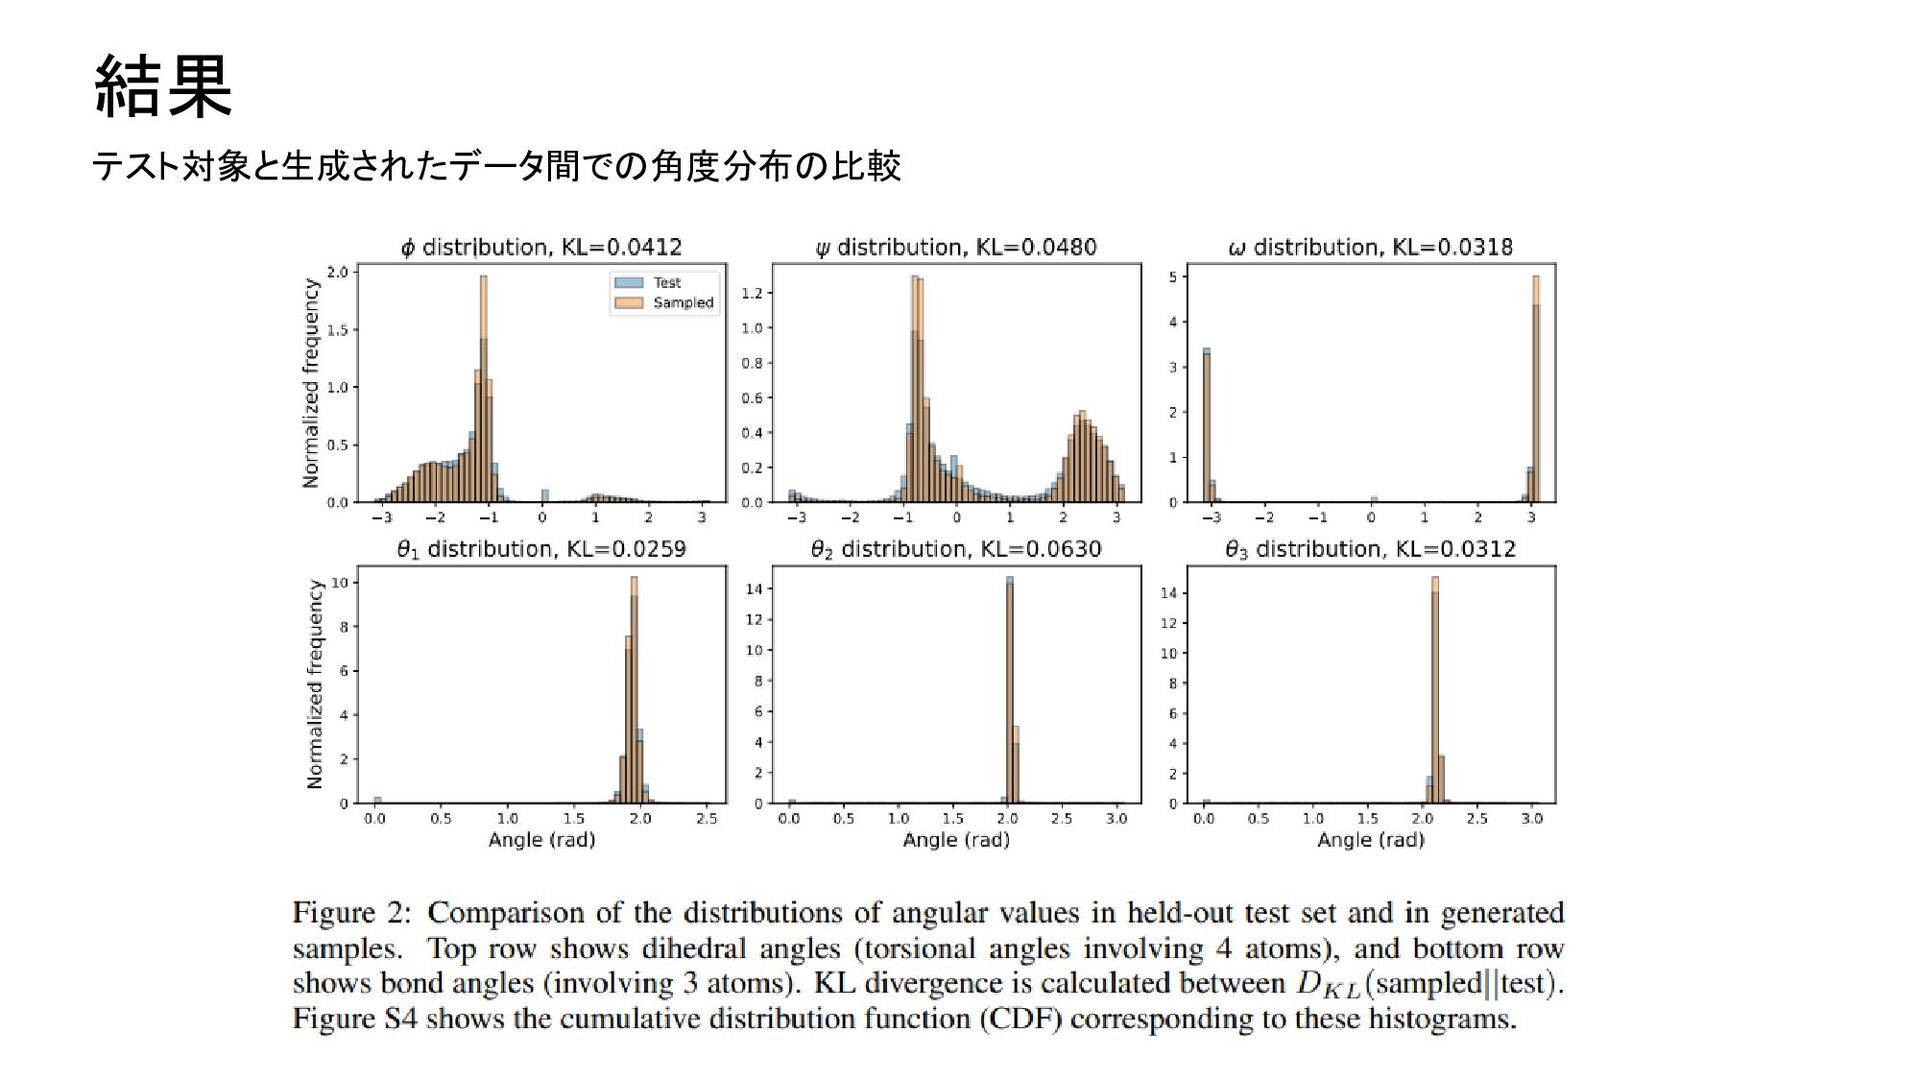
服されていない疾患をターゲットとした新たな治療法につながることが期待されます。しかし、近年のタンパク質構造予測技 術の進歩にもかかわらず、ニューラルネットワークから多様で新規なタンパク質構造を直接生成することは依然として困難 である。本研究では、タンパク質の折り畳み過程を反映した手順でタンパク質の骨格構造を設計する、拡散に基づく新しい 生成モデルを提案する。タンパク質の骨格構造を、構成するアミノ酸残基の相対的な向きを表す連続した角度で表現し、ラ ンダムに展開された状態から安定した折りたたみ構造に向かってノイズを除去しながら、新しい構造を生成する。これは、 タンパク質が生物学的にどのようにエネルギー的に有利なコンフォメーションに変化するかを反映しているだけでなく、この 表現に固有のシフトと回転の不変性により、複雑な等変量ネットワークの必要性を大幅に軽減している。我々は、単純なト ランスフォーマーバックボーンを用いたノイズ除去拡散確率モデルを訓練し、その結果得られたモデルが、天然に存在する タンパク質に類似した複雑さと構造パターンを持つ非常にリアルなタンパク質構造を無条件で生成することを実証する。ま た、タンパク質構造拡散のためのコードベースと学習済みモデルを初めてオープンソースで公開する。 目的:タンパク質折りたたみ構造の生成 成果:天然に存在するタンパク質に類似した複雑さと構造パターンを持つタンパク質構造を無条件で生成 方法:拡散生成モデルで折りたたみ構造を生成 固有名:- 著者所属:スタンフォード大学、マイクロソフト・リサーチ https://arxiv.org/abs/2209.15611v1
 ailaboocu
 ktanishima
 pman0214
 ayatokanada
 takehaya
 institutdelelevage
 kogoro
 hirachan
 imai448
 takasehideki
 ifri
 yukiar
 xspa2012
 uxyall
 cassininazir
 portentint
 jct
 aleyda
 jeffersonlam
 colly
 ipullrank
 mayatellez
 bkeepers