Share
Embed
Azure Reliability v0.2.21.0630
残念ながら現代のクラウドサービスでは障害が発生します。
一般向けに公開されたパブリッククラウドは多くの場合、特定の一社が保有するデータセンターよりもはるかに規模が大きく、また社会的な影響も大きいため、その障害はニュースとして大きく取りざたされます。ただクラウドは魔法でも未来の技術でもなく、基礎となる技術は皆様が所有する IT 設備と何ら変わりがないのです。障害は不可避なものと考えましょう。
またクラウドはオンプレミスとは異なりメンテナンスもその利用料金に含まれ、利用者の手を煩わせないようになっています。ただ利用者から見ればその影響は無視できるものではないでしょう。障害もメンテナンスも、サービスの停止に繋がりうるという意味では同じかもしれません。
Azure のような IaaS や PaaS は利用者のアプリケーションが搭載され、初めてエンドユーザーに対して「サービス」が提供されます。Azure の「利用者」は「サービスの事業者」でもあります。その「サービス」によって品質要求はまちまちです。可用性は突き詰めればキリがありませんので、どこかで妥協が必要です。絶対に落ちてはならないサービスもあれば、多少落ちてもいいからとにかく安ければいいというサービスもあるでしょうから、サービス特性に合わせた必要十分な障害とメンテナンス対策が必要です。それを決定するのはクラウドサービスの利用者であり、クラウドそのものに対する理解が重要です。
本資料がこれから Azure を利用する方に、あるいは既にご利用いただいている方の参考になれば幸いです。
Ayumu Inaba
March 14, 2022
Transcript
70 slides
-
優れたアーキテクチャの必要性 クラウド活用のメリットを最大化するためには、対象クラウドを 理解して使いこなすことが重要 4 高いコスト効率 優れた弾力性 IT管理の簡略化 組み込まれた フォールトトレラン ス
迅速&グローバル な展開 クラウドサービスの特徴と設計原則 クラウドサービスの種類と共同責任モデル -
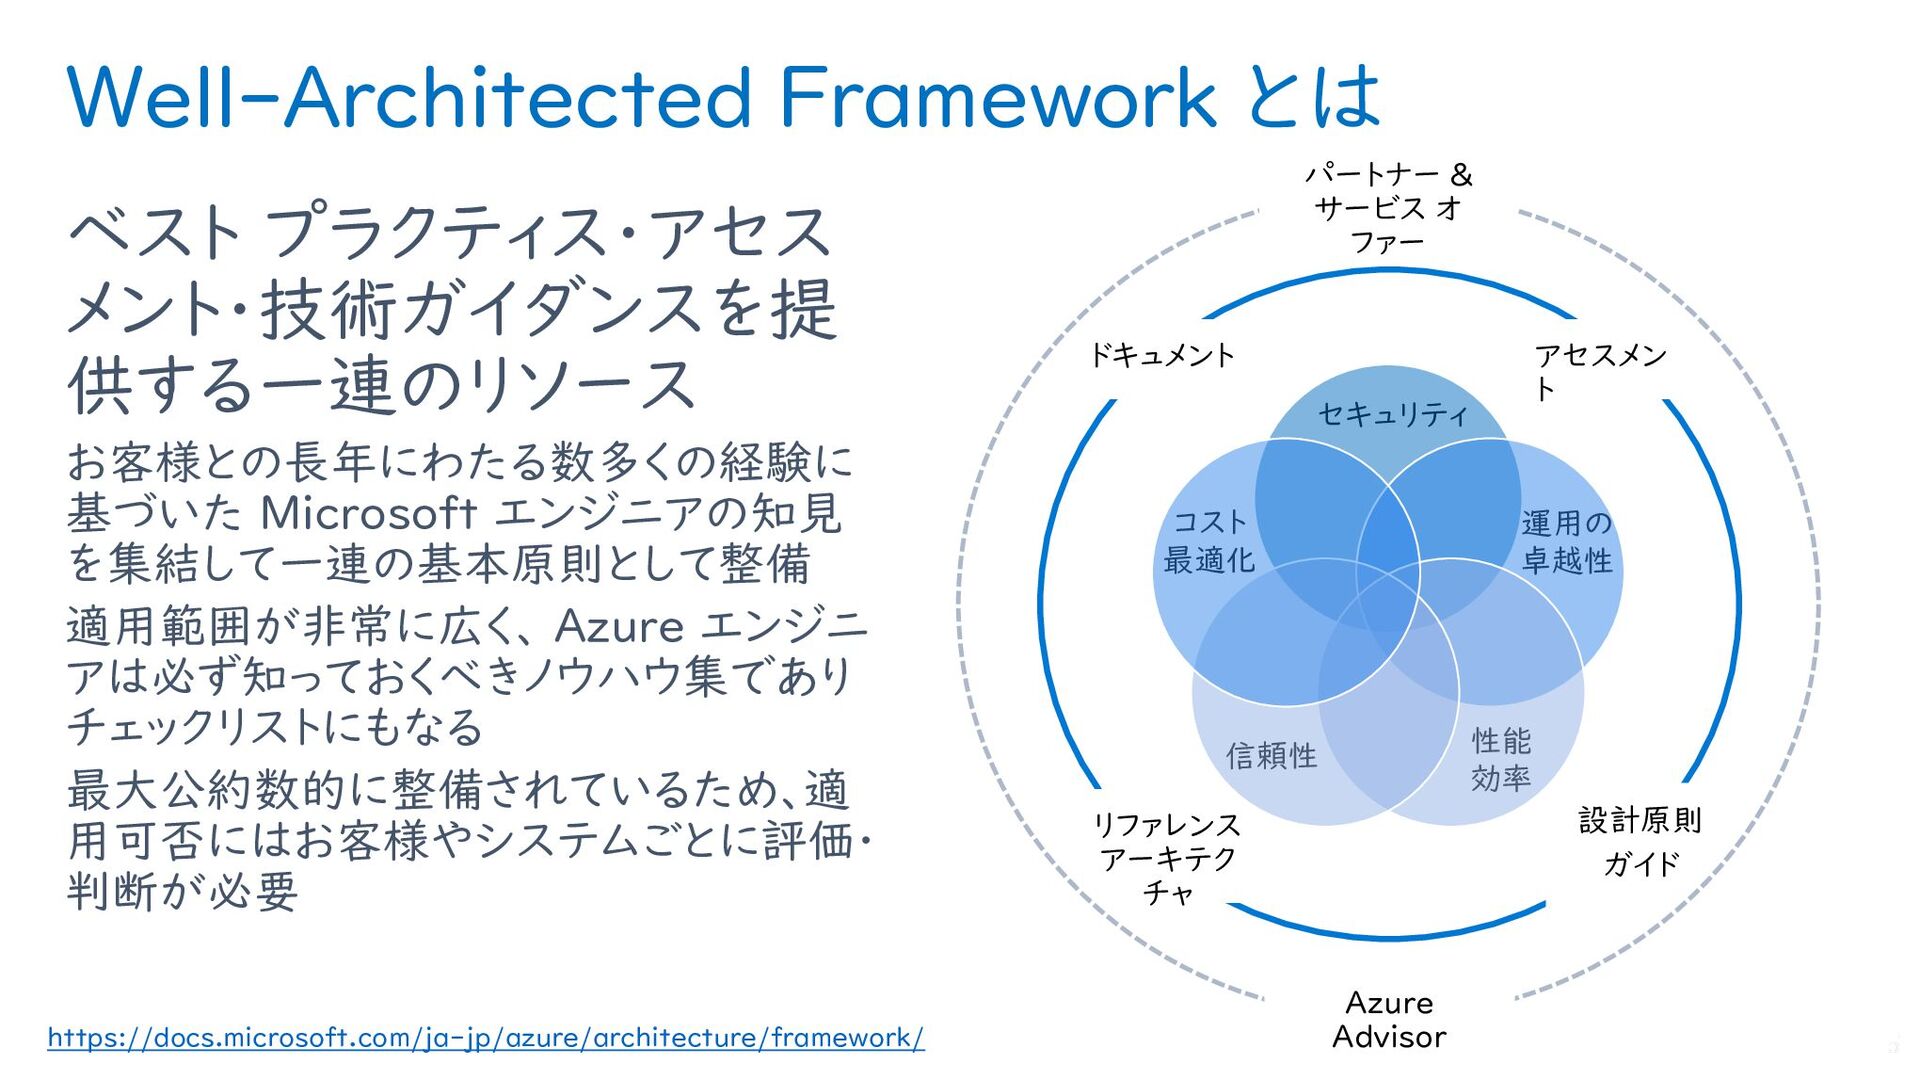
5 コスト 最適化 運用の 卓越性 性能 効率 信頼性 セキュリティ アセスメン
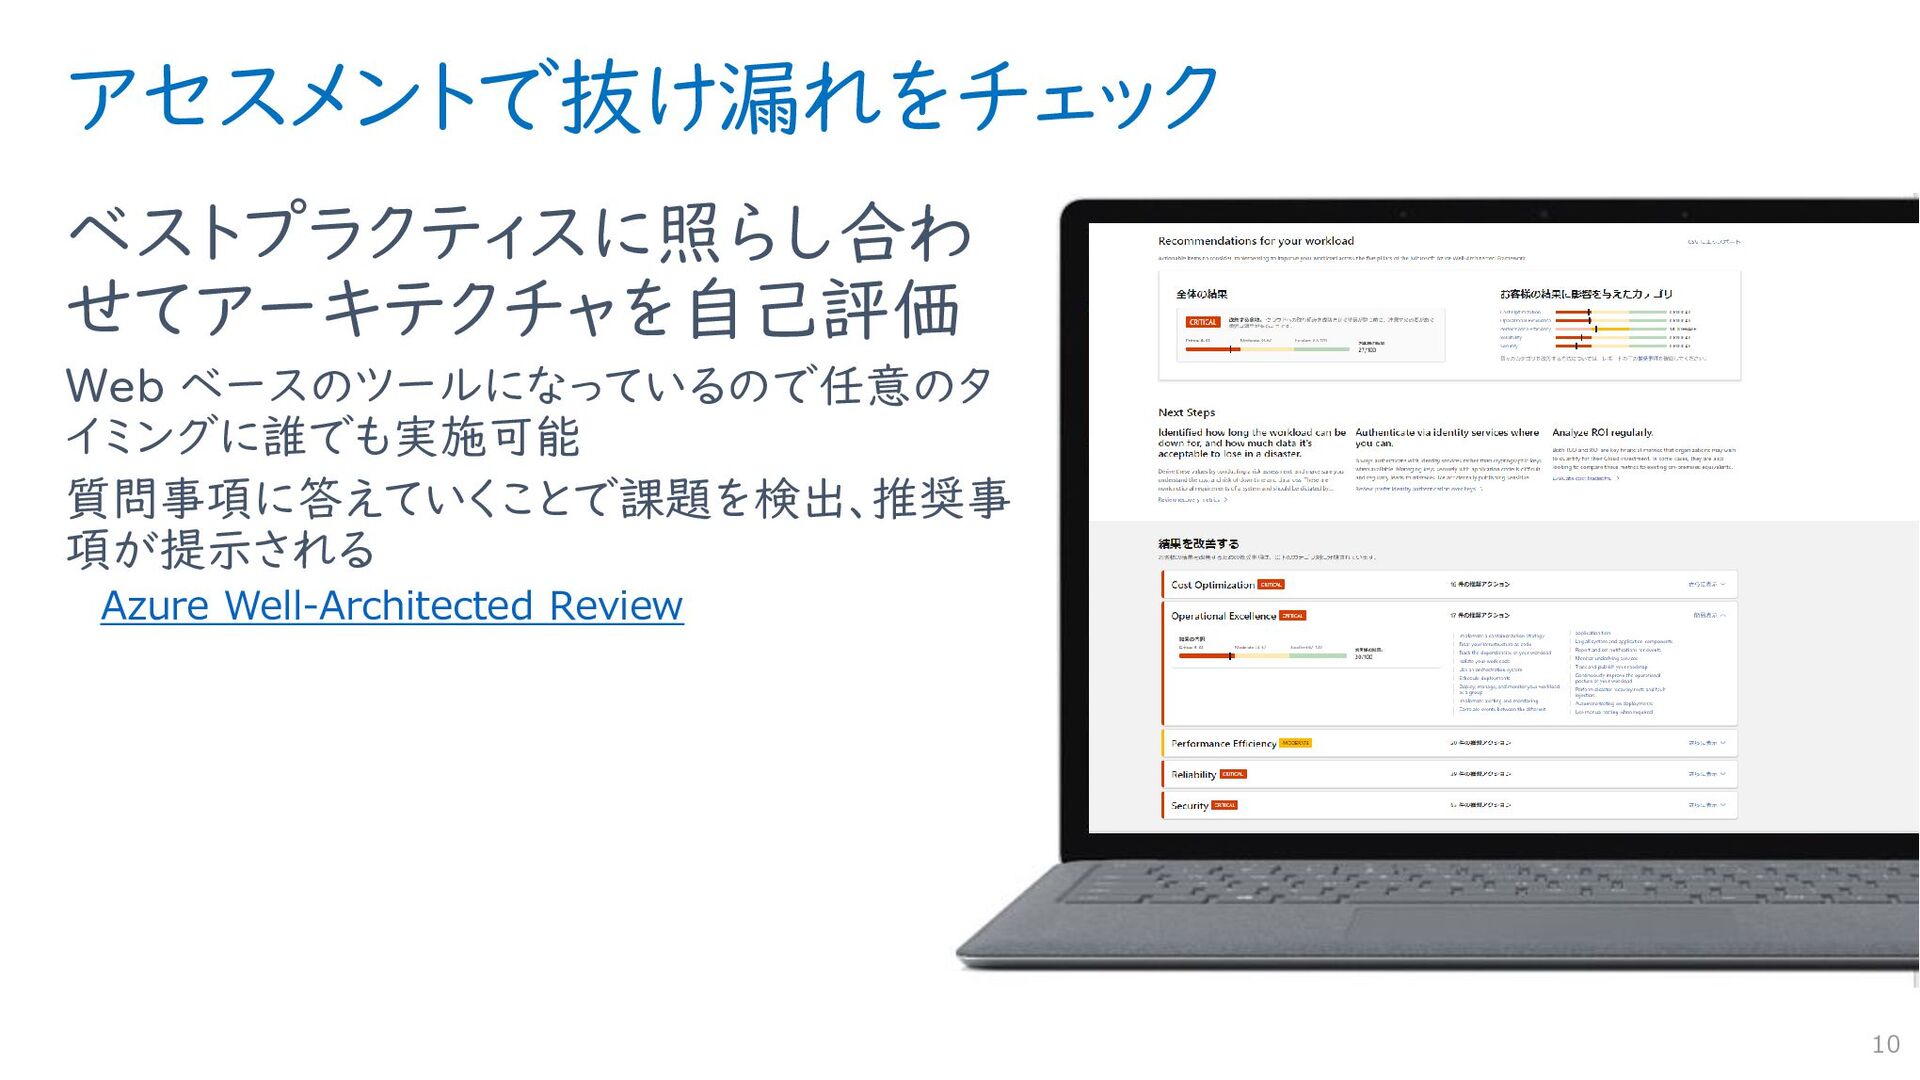
ト ドキュメント リファレンス アーキテク チャ 設計原則 ガイド Azure Advisor パートナー & サービス オ ファー Well-Architected Framework とは ベスト プラクティス・アセス メント・技術ガイダンスを提 供する一連のリソース お客様との長年にわたる数多くの経験に 基づいた Microsoft エンジニアの知見 を集結して一連の基本原則として整備 適用範囲が非常に広く、 Azure エンジニ アは必ず知っておくべきノウハウ集であり チェックリストにもなる 最大公約数的に整備されているため、適 用可否にはお客様やシステムごとに評価・ 判断が必要 5 https://docs.microsoft.com/ja-jp/azure/architecture/framework/ -
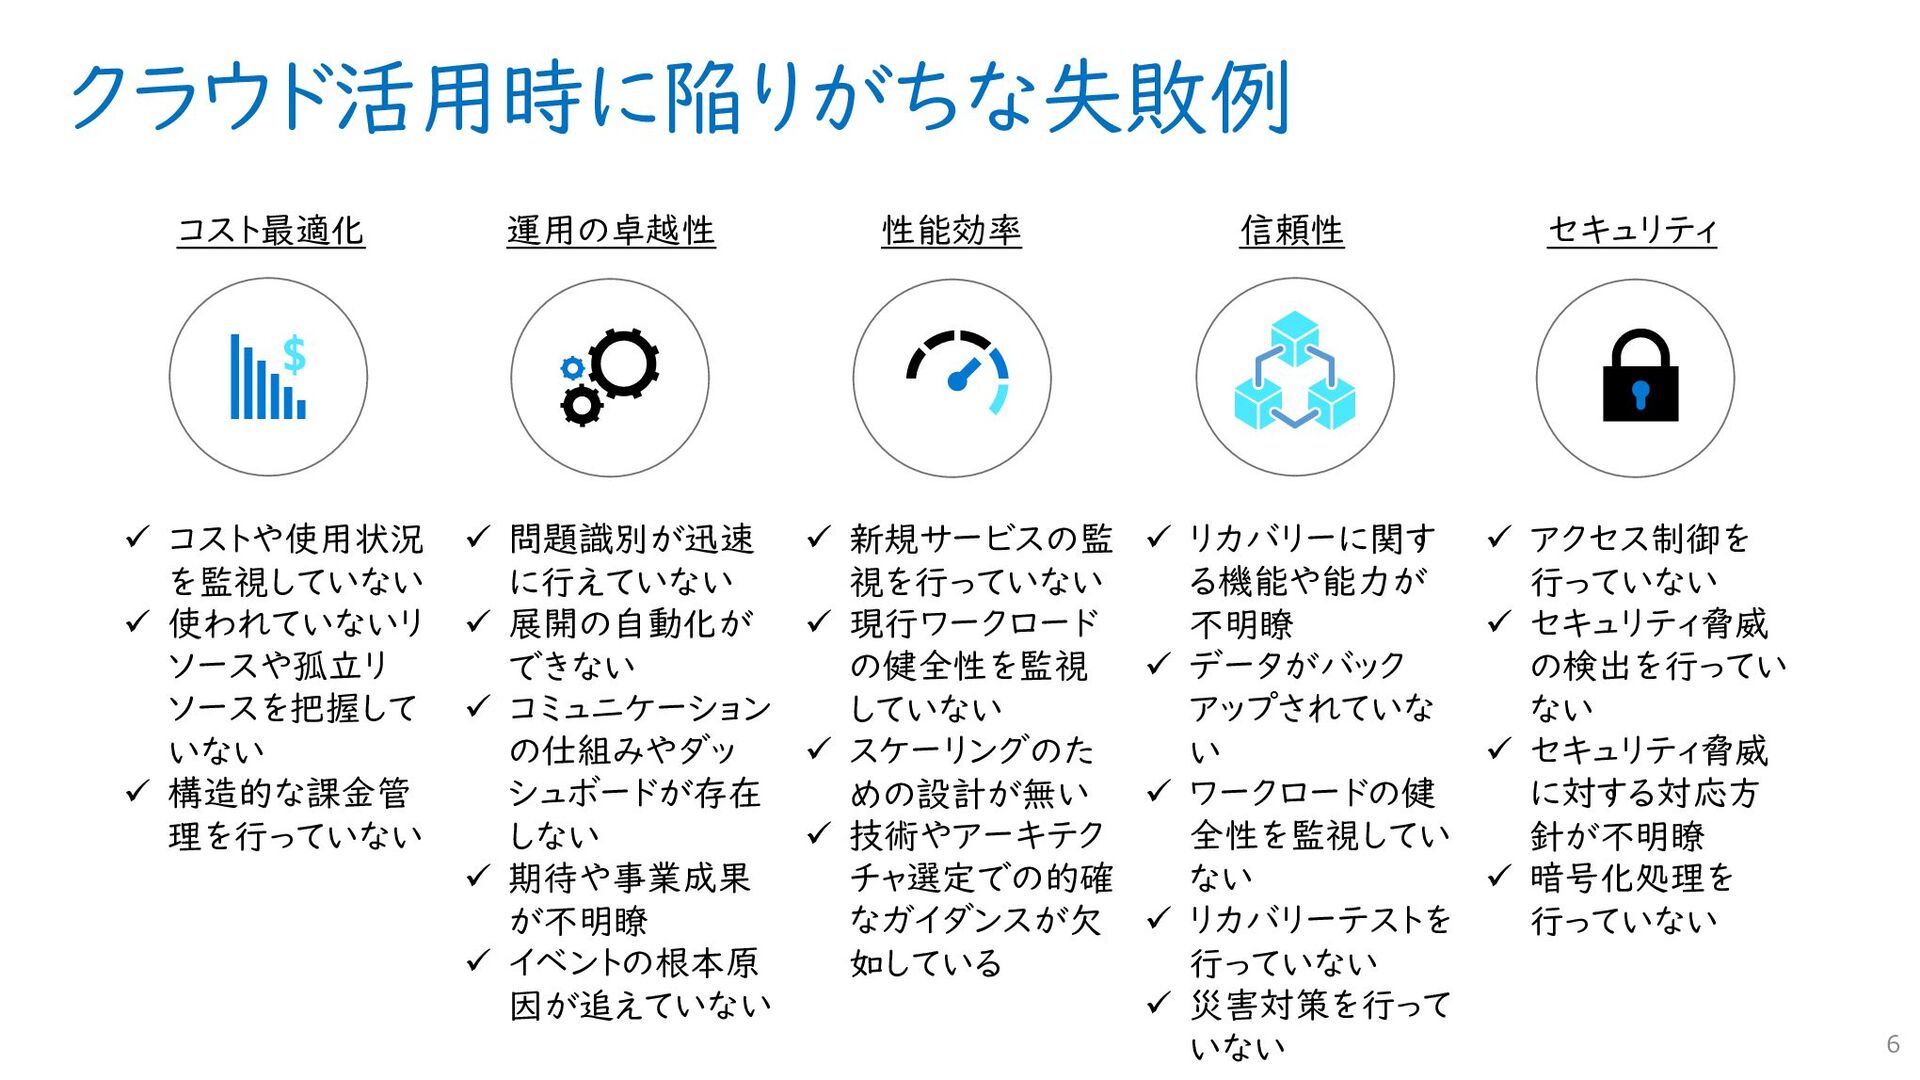
クラウド活用時に陥りがちな失敗例 6 ✓ コストや使用状況 を監視していない ✓ 使われていないリ ソースや孤立リ ソースを把握して いない
✓ 構造的な課金管 理を行っていない ✓ 問題識別が迅速 に行えていない ✓ 展開の自動化が できない ✓ コミュニケーション の仕組みやダッ シュボードが存在 しない ✓ 期待や事業成果 が不明瞭 ✓ イベントの根本原 因が追えていない ✓ 新規サービスの監 視を行っていない ✓ 現行ワークロード の健全性を監視 していない ✓ スケーリングのた めの設計が無い ✓ 技術やアーキテク チャ選定での的確 なガイダンスが欠 如している ✓ リカバリーに関す る機能や能力が 不明瞭 ✓ データがバック アップされていな い ✓ ワークロードの健 全性を監視してい ない ✓ リカバリーテストを 行っていない ✓ 災害対策を行って いない ✓ アクセス制御を 行っていない ✓ セキュリティ脅威 の検出を行ってい ない ✓ セキュリティ脅威 に対する対応方 針が不明瞭 ✓ 暗号化処理を 行っていない コスト最適化 運用の卓越性 性能効率 信頼性 セキュリティ -
Well-Architected Framework の使い方 5つの観点から整備されたベストプラクティスに基づき、アセス メントと改善を行う 7 ✓ 運用・開発の両面 でコスト効率に優 れたクラウド環境
を設計 ✓ 非効率的で無駄 なクラウド支出を 可視化 ✓ DevOps や自動 化により開発と展 開のサイクルを高 速化 ✓ 優れた監視アーキ テクチャを整備し 障害を予兆検知 ✓ 変動する需要に 応じた柔軟なス ケーリングに対応 したアーキテク チャを設計 ✓ 性能とスケーラビ リティを念頭にコ スト効率を維持 ✓ 様々なレベルでの 障害から適切にリ カバリーするため の設計 ✓ 利害関係者や顧 客が要求する時 間内に、障害から 復旧できる設計 ✓ 設計と実装から展 開と運用まで一貫 したセキュリティを 確保 ✓ アプリケーション、 プロセス、組織の 文化にセキュリ ティを組み込む コスト最適化 運用の卓越性 性能効率 信頼性 セキュリティ -
WAF の適用は継続的な改善のプロセス 設計フェーズ 最新のベストプラクティスを盛り込むことで、リスクを抑え 高品質なアーキテクチャを設計する Ex. 広域災害発生時の業務を支える高可用性アーキテクチャ 構築フェーズ 実装やテストに応じて変化していくアーキテクチャを、定期 的にアセスメントすることで抜け漏れを防ぐ
Ex. システムが具体化するにつれて見えてくる運用と保守の課題 運用フェーズ ビジネス状況の変化や Azure サービスの進化に合わせ て継続的なシステムの見直しを行っていく Ex. 実稼働後に発生するコストの変動や性能の見直し 8 設計 構築 運用 -
まずは基礎知識を理解する 9 どのフェーズにおいても基礎知 識が非常に重要 各サービスの知識とあわせて設計パターンやガ イダンスを理解しておく Azure Architecture Center Well-Architected
Framework もこの中の1トピック 全トピックを網羅的にカバーするのは効率が悪 いので、WAF の5つの柱に沿って個々のシステ ム単位で深堀りするとよい MS Learn にも独習コンテンツが提供されている Microsoft Azure Well-Architected Framework の概要 - Learn | Microsoft Docs -
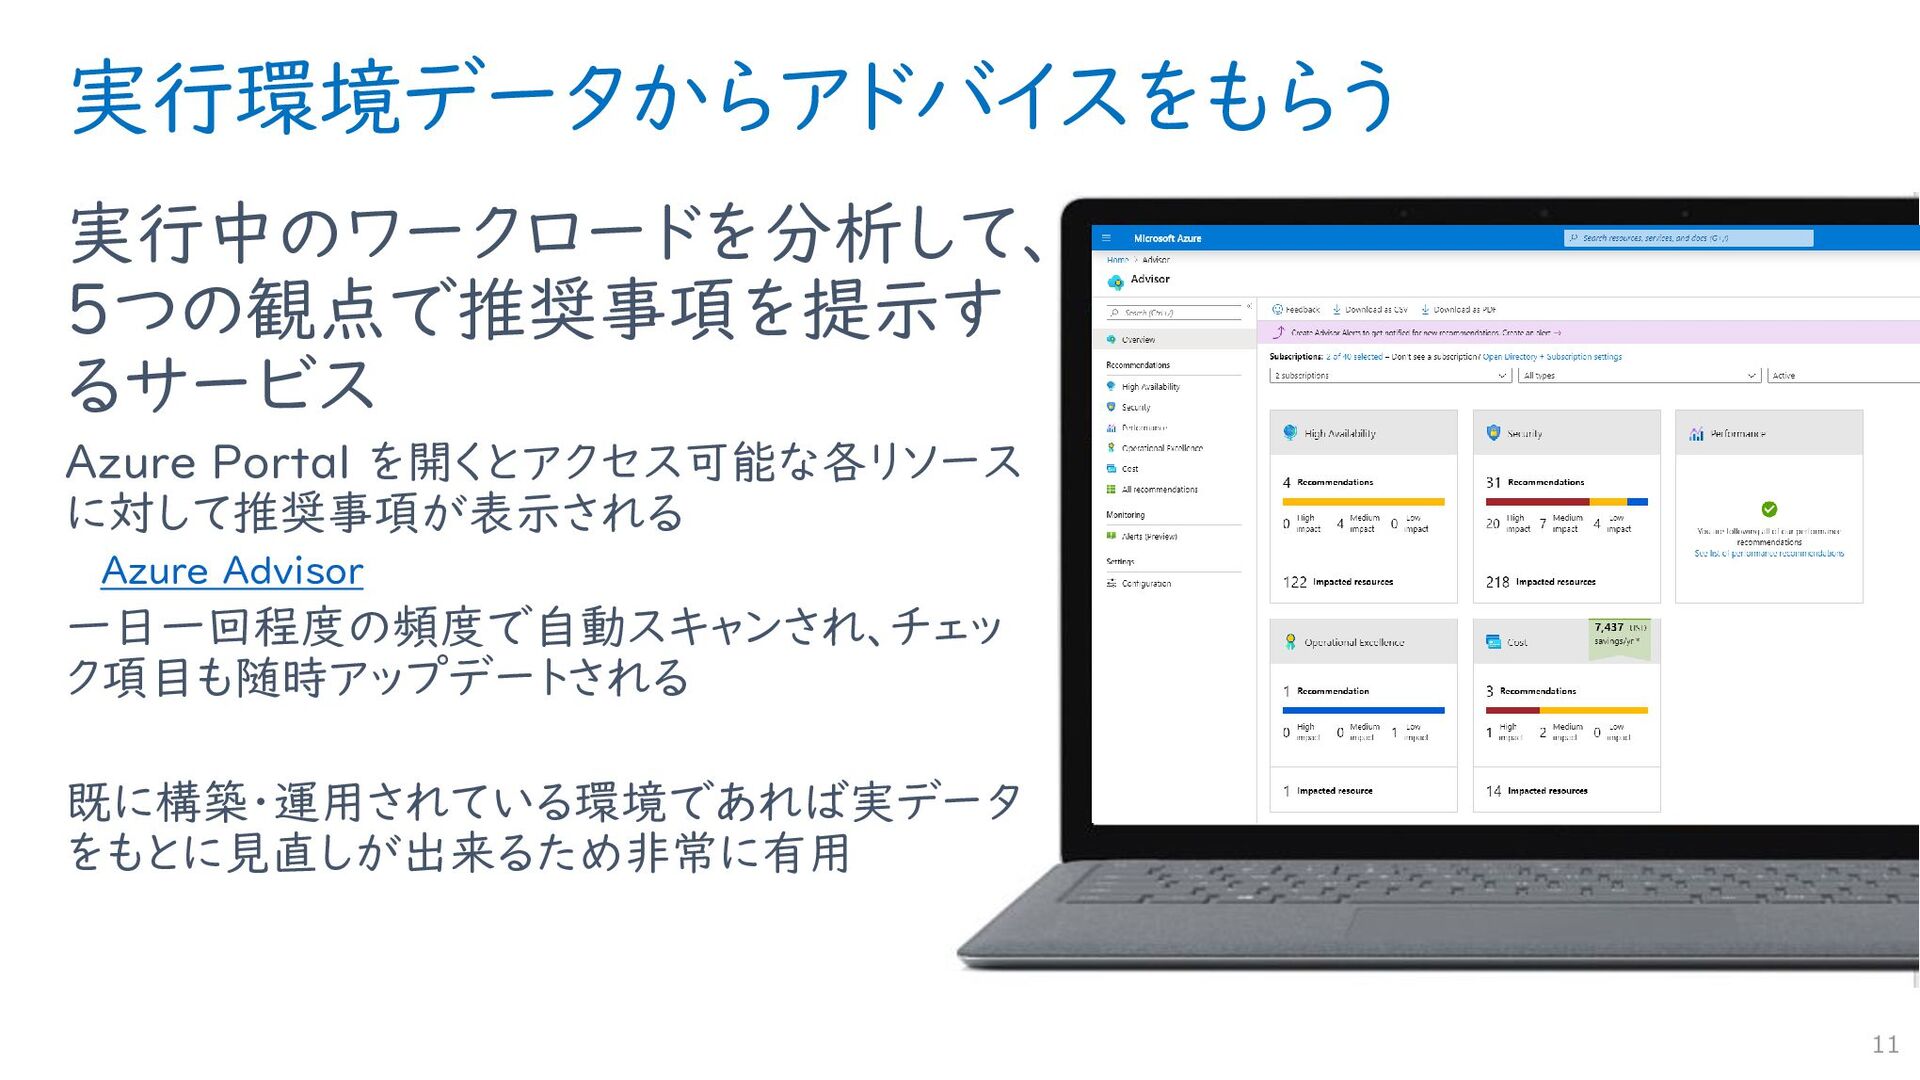
実行環境データからアドバイスをもらう 11 実行中のワークロードを分析して、 5つの観点で推奨事項を提示す るサービス Azure Portal を開くとアクセス可能な各リソース に対して推奨事項が表示される Azure
Advisor 一日一回程度の頻度で自動スキャンされ、チェッ ク項目も随時アップデートされる 既に構築・運用されている環境であれば実データ をもとに見直しが出来るため非常に有用 -
Workshop 判明したリスクや改善点に 対して、ビジネス判断に基 づき優先付け アセスメントや Advisor による評価結果 をもとに改善策を整理 アーキテクチャドキュメントなどを整理しか 関係者を集めて実施する
各改善策を実施することによるインパクト を評価 優先度を設定し実施の可否を判断し開 発・保守計画に盛り込む 推奨事項すべてに対処する ことが目的ではない 12 -
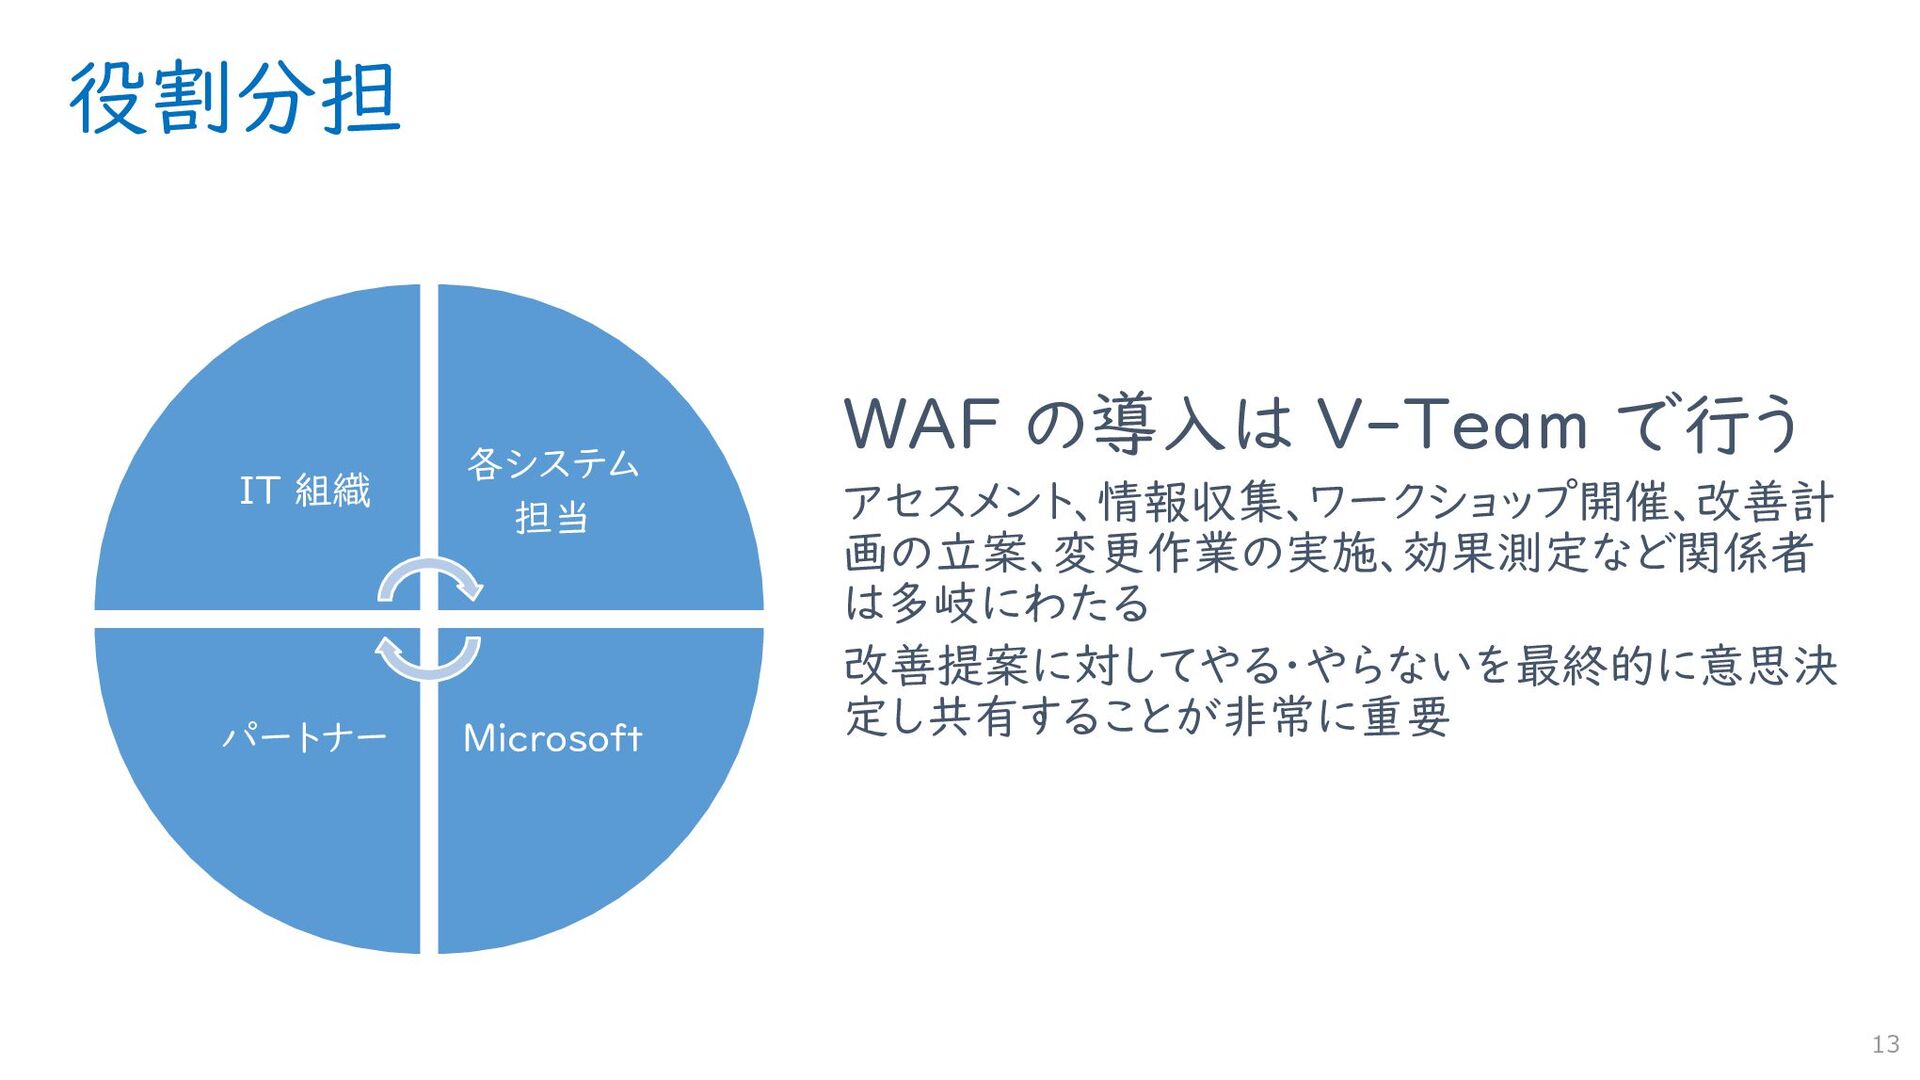
役割分担 WAF の導入は V-Team で行う アセスメント、情報収集、ワークショップ開催、改善計 画の立案、変更作業の実施、効果測定など関係者 は多岐にわたる 改善提案に対してやる・やらないを最終的に意思決 定し共有することが非常に重要
13 IT 組織 各システム 担当 Microsoft パートナー -
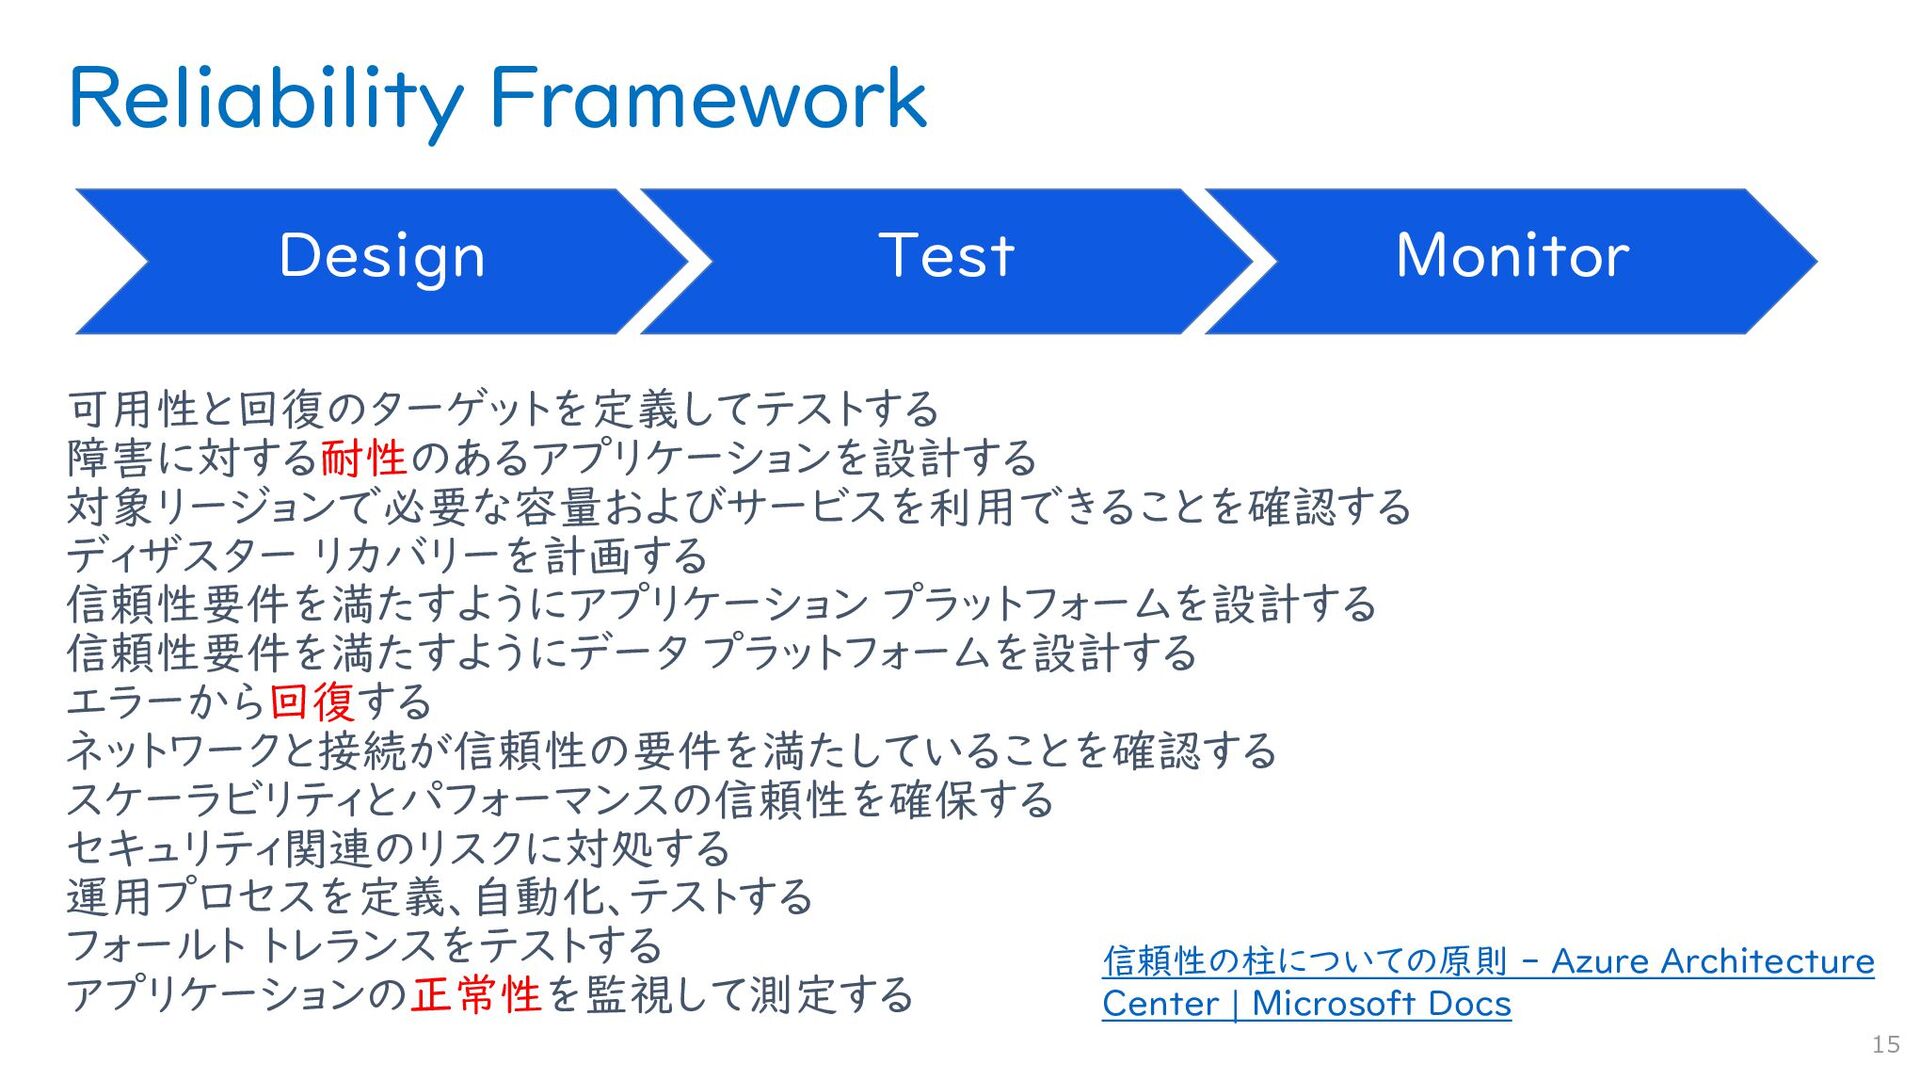
Reliability Framework 15 Design Test Monitor 可用性と回復のターゲットを定義してテストする 障害に対する耐性のあるアプリケーションを設計する 対象リージョンで必要な容量およびサービスを利用できることを確認する ディザスター
リカバリーを計画する 信頼性要件を満たすようにアプリケーション プラットフォームを設計する 信頼性要件を満たすようにデータ プラットフォームを設計する エラーから回復する ネットワークと接続が信頼性の要件を満たしていることを確認する スケーラビリティとパフォーマンスの信頼性を確保する セキュリティ関連のリスクに対処する 運用プロセスを定義、自動化、テストする フォールト トレランスをテストする アプリケーションの正常性を監視して測定する 信頼性の柱についての原則 - Azure Architecture Center | Microsoft Docs -
Design for Failure and Resilience 障害を避けるだけでなく、障害が発生した時 に対応するための仕組みが重要 Data Backup データの破損や削除に備えて、以前の正常な状態に復旧する
High Availability 障害時にもダウンタイムを極小化し、システムが健全な状態で継続 稼働することを目的とする Disaster Recovery 広域災害においても迅速なシステムを復旧し、業務継続・サービス 提供することを目的とする 17 Original Backup Primary site Secondary site Primary site -
システム影響のある変更は いつでも発生しうる 新たなインスタンスが追加、変更、削 除が24/7で行われる 変更管理は常に自動制御され必要 なタイミングで行われる ワークロードは負荷に応じて自動、或 いは事前予測に基づいてスケールア ウト、スケールインを行う 世界中で新規サービス、ソフトウェア
が適用される 各リージョンでキャパシティ増強の要 求に合わせて常に通信制御を行いな がら資源追加が行われている -
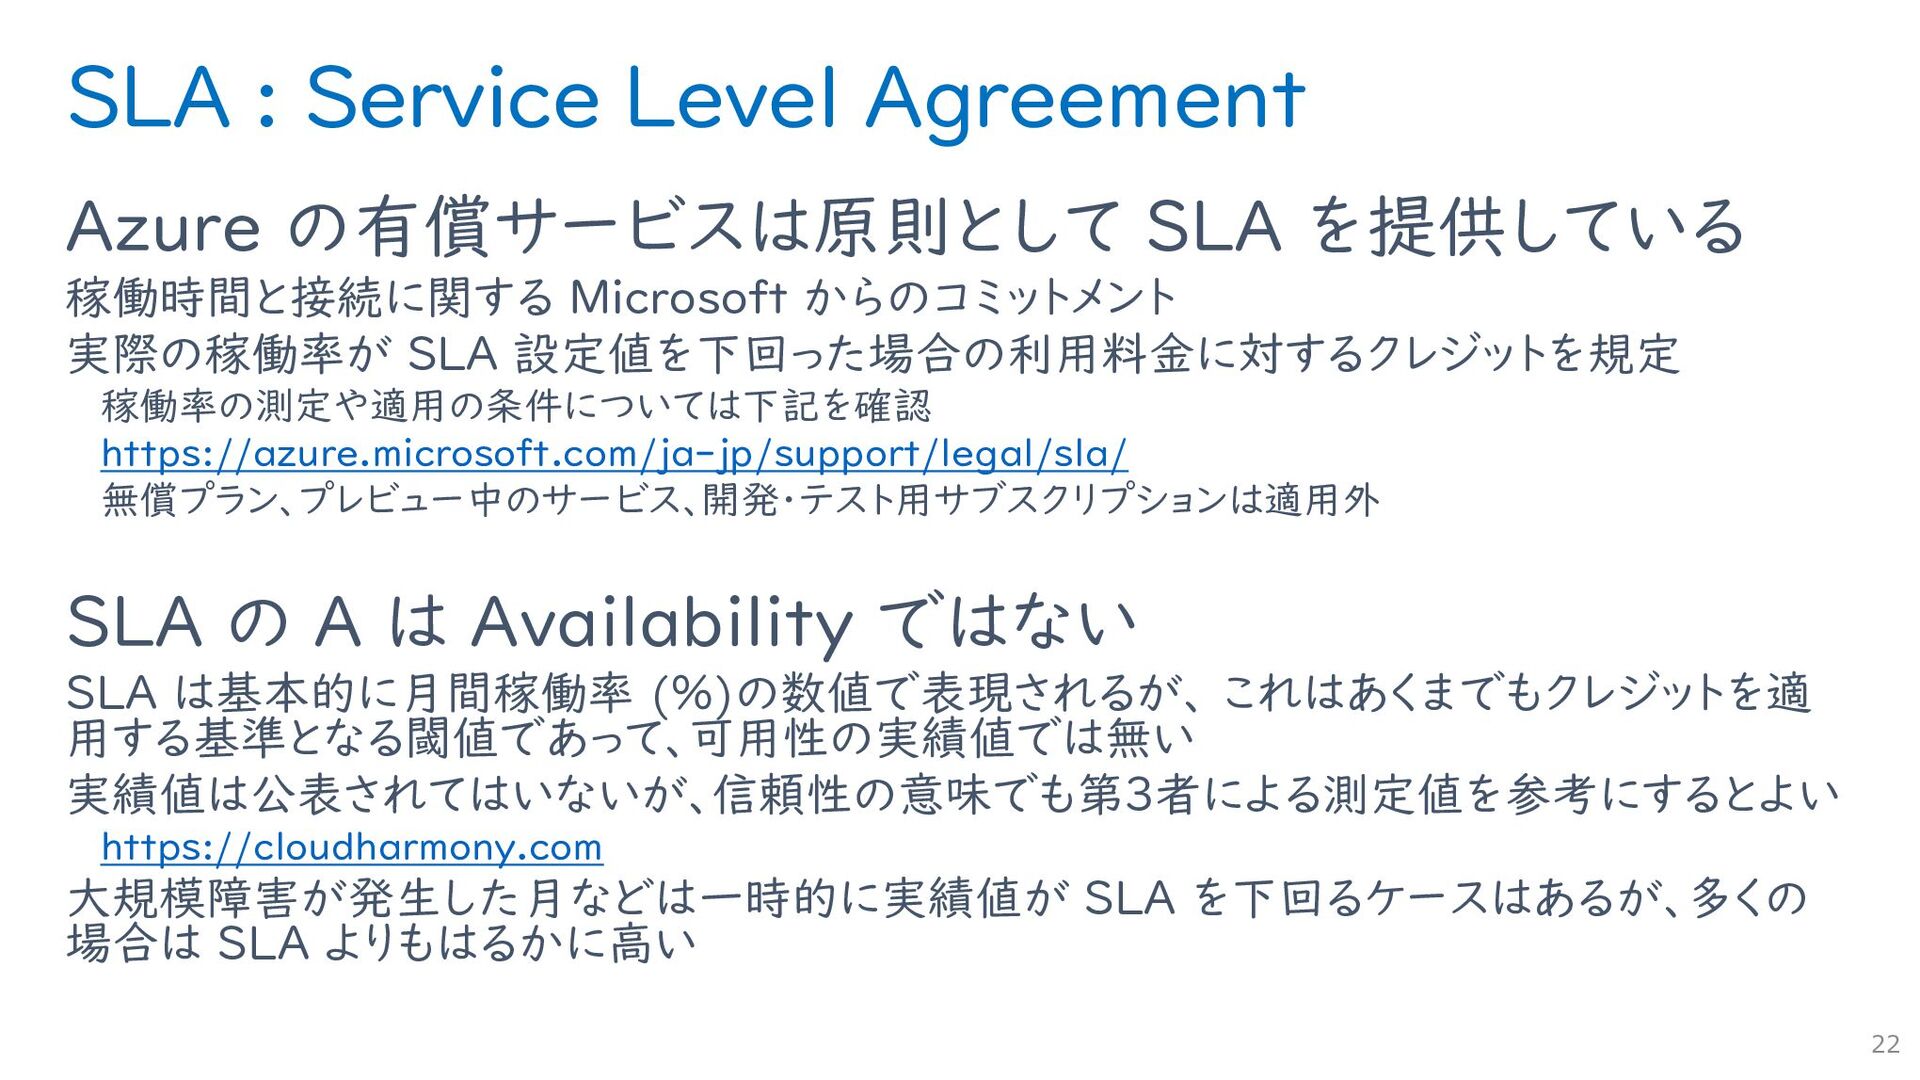
SLA : Service Level Agreement Azure の有償サービスは原則として SLA を提供している 稼働時間と接続に関する
Microsoft からのコミットメント 実際の稼働率が SLA 設定値を下回った場合の利用料金に対するクレジットを規定 稼働率の測定や適用の条件については下記を確認 https://azure.microsoft.com/ja-jp/support/legal/sla/ 無償プラン、プレビュー中のサービス、開発・テスト用サブスクリプションは適用外 SLA の A は Availability ではない SLA は基本的に月間稼働率 (%)の数値で表現されるが、 これはあくまでもクレジットを適 用する基準となる閾値であって、可用性の実績値では無い 実績値は公表されてはいないが、信頼性の意味でも第3者による測定値を参考にするとよい https://cloudharmony.com 大規模障害が発生した月などは一時的に実績値が SLA を下回るケースはあるが、多くの 場合は SLA よりもはるかに高い 22 -
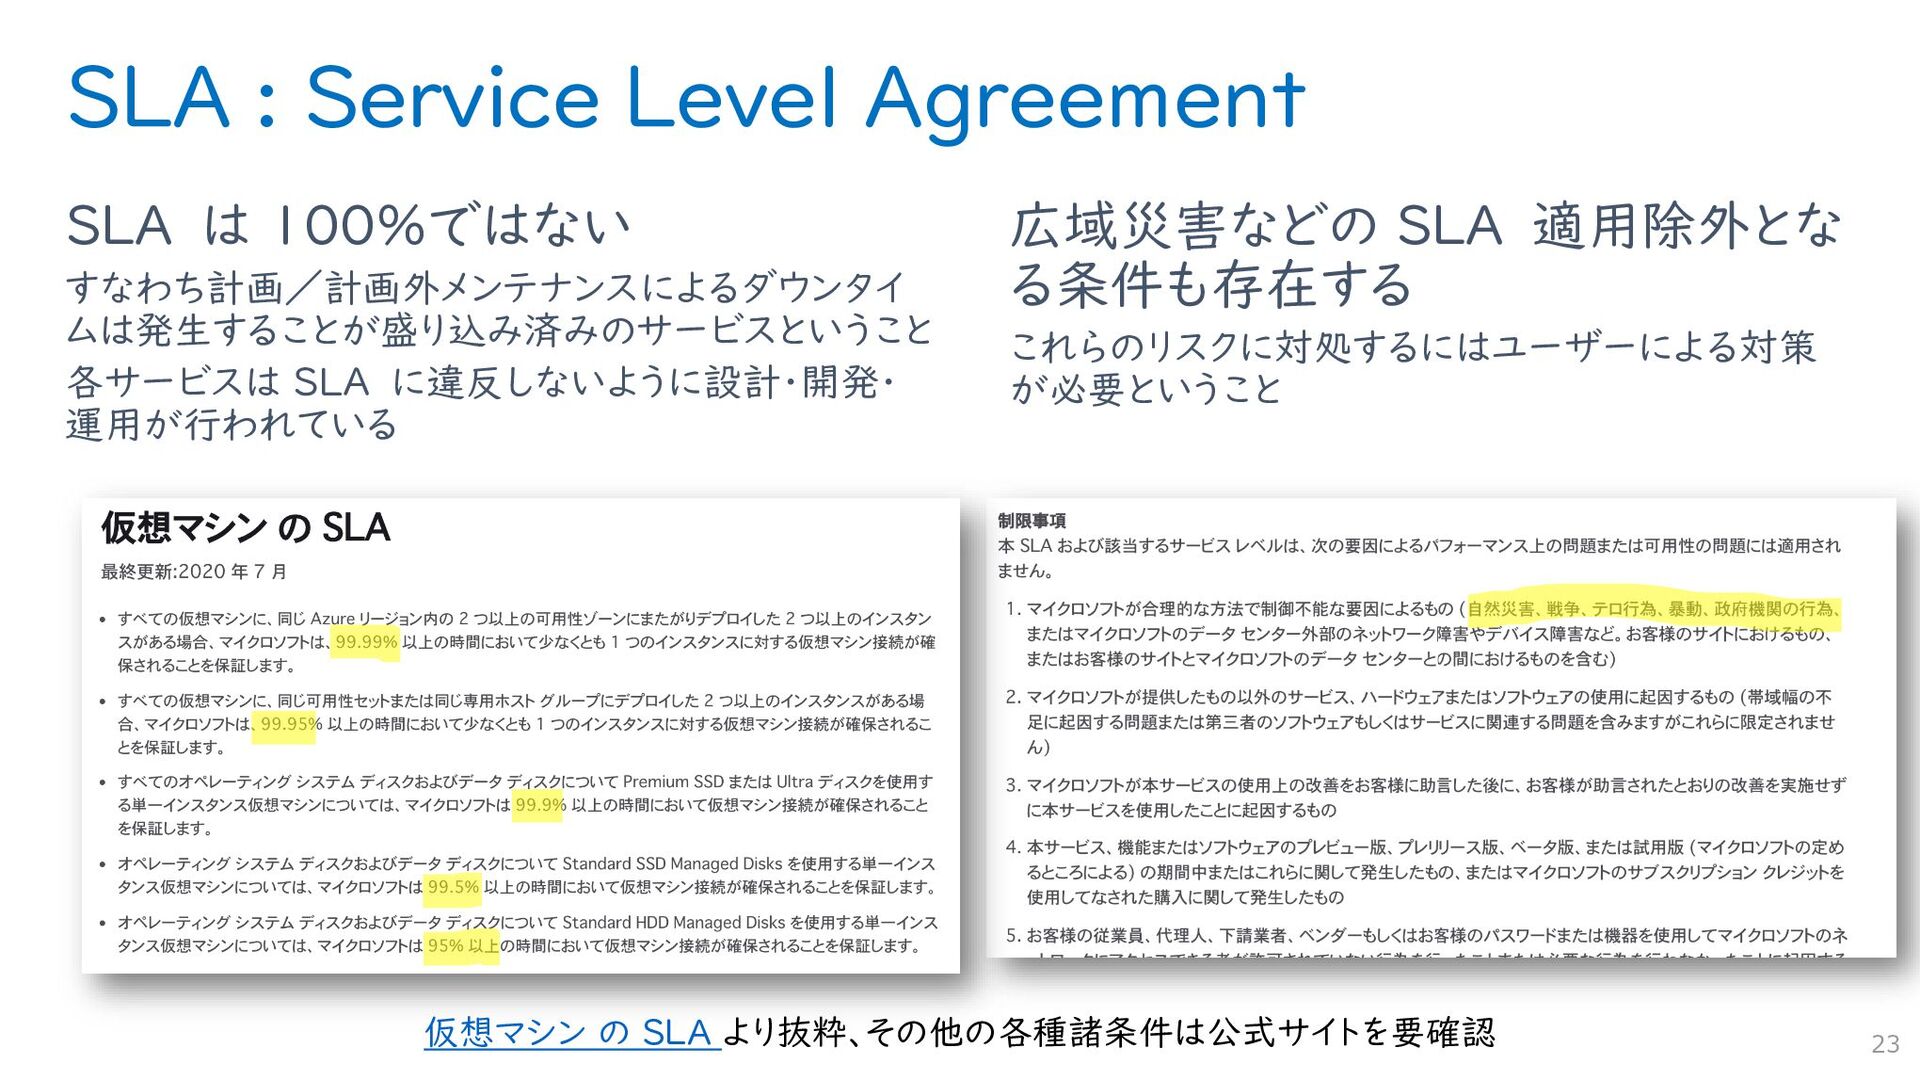
SLA : Service Level Agreement SLA は 100%ではない すなわち計画/計画外メンテナンスによるダウンタイ ムは発生することが盛り込み済みのサービスということ
各サービスは SLA に違反しないように設計・開発・ 運用が行われている 広域災害などの SLA 適用除外とな る条件も存在する これらのリスクに対処するにはユーザーによる対策 が必要ということ 23 仮想マシン の SLA より抜粋、その他の各種諸条件は公式サイトを要確認 -
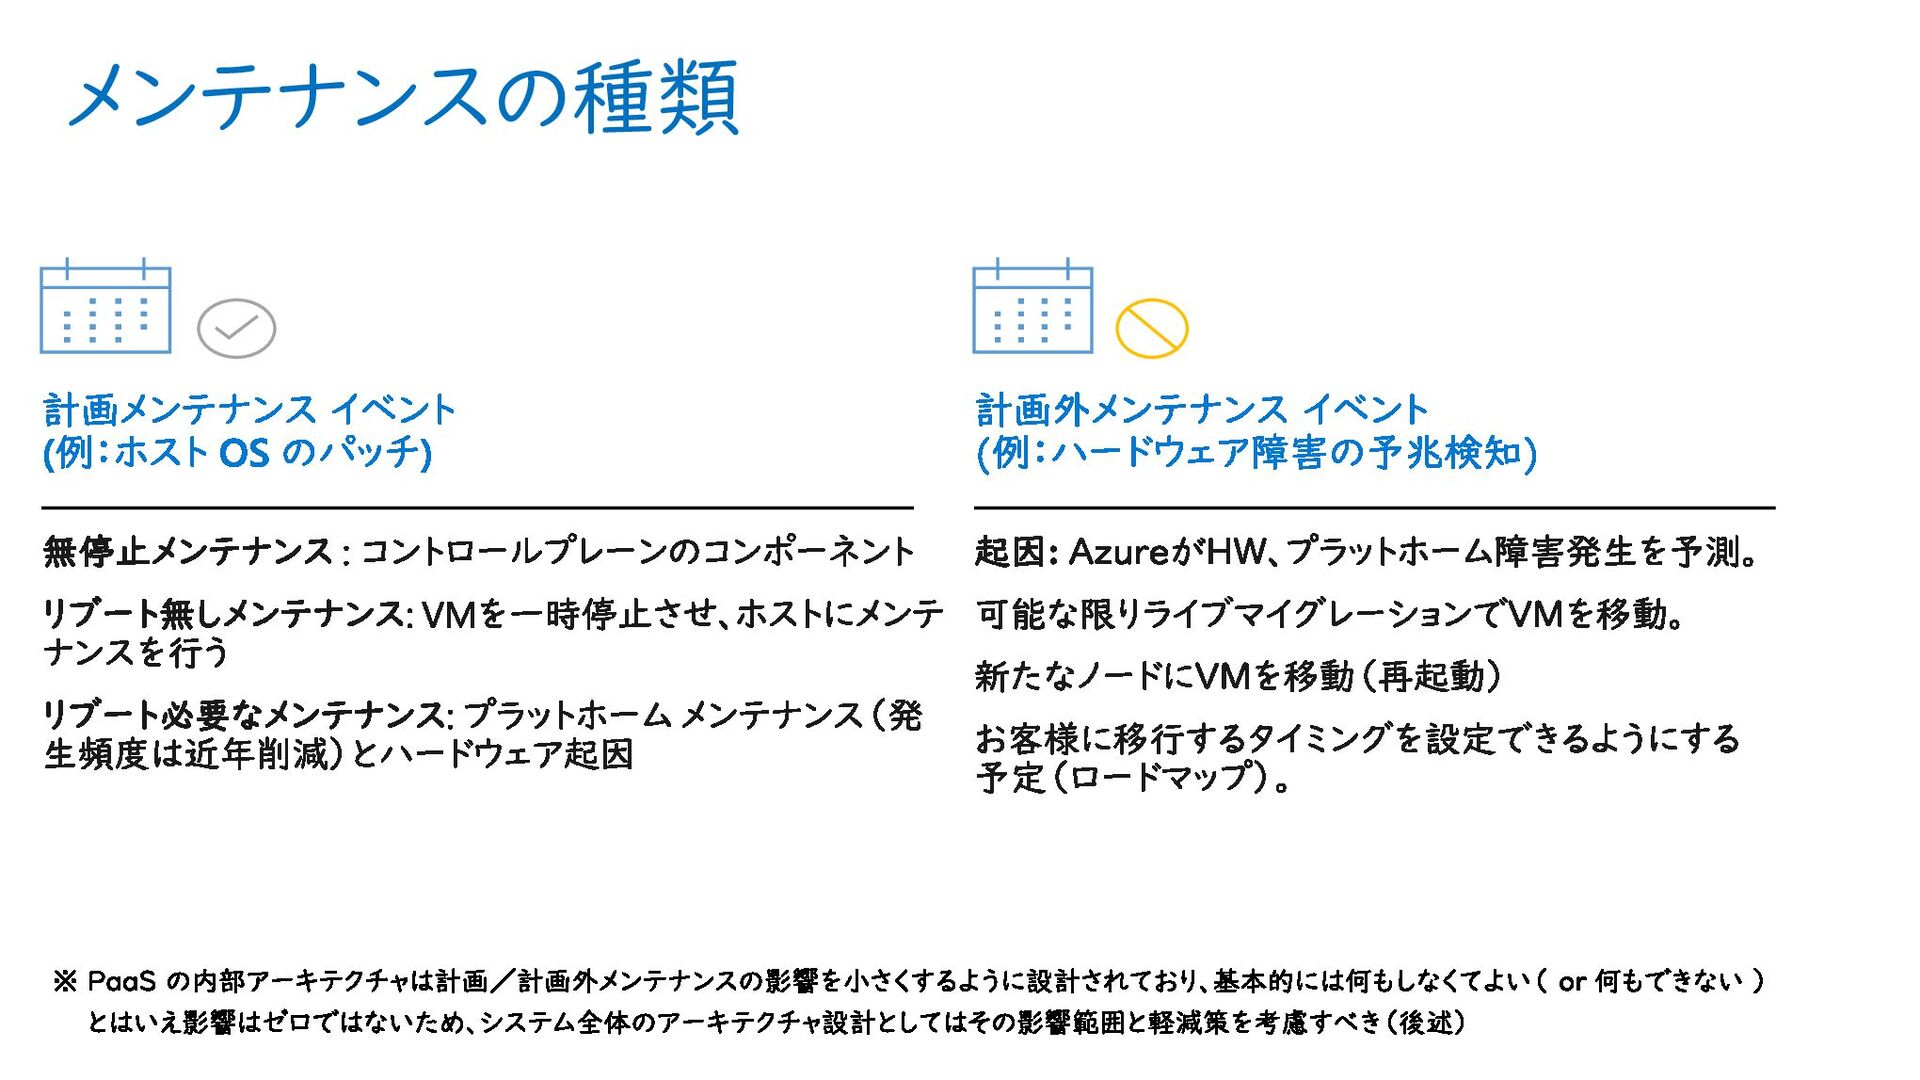
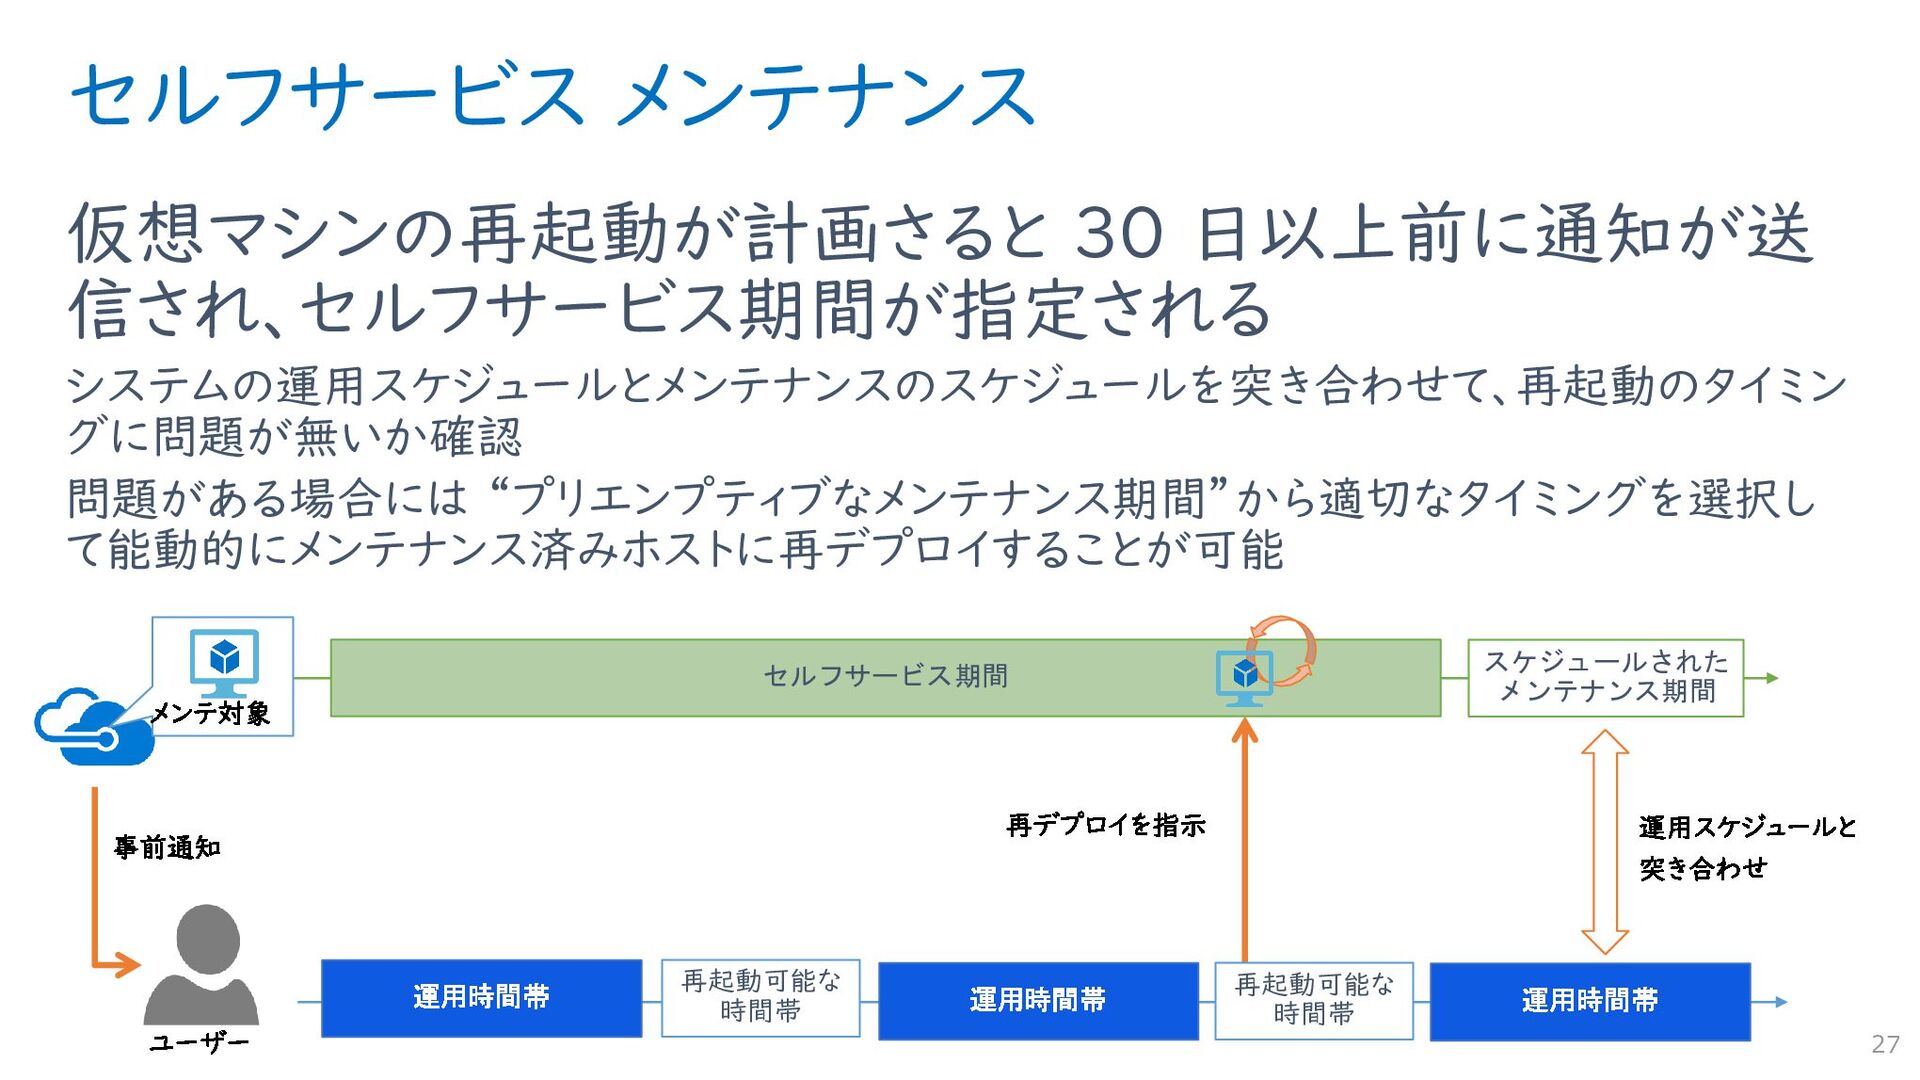
セルフサービス メンテナンス 仮想マシンの再起動が計画さると 30 日以上前に通知が送 信され、セルフサービス期間が指定される システムの運用スケジュールとメンテナンスのスケジュールを突き合わせて、再起動のタイミン グに問題が無いか確認 問題がある場合には “プリエンプティブなメンテナンス期間”から適切なタイミングを選択し
て能動的にメンテナンス済みホストに再デプロイすることが可能 27 スケジュールされた メンテナンス期間 セルフサービス期間 再起動可能な 時間帯 再起動可能な 時間帯 -
SQL Database の予測可能なメンテナンス期間 SQL Database および Managed Instance では計画メ ンテナンスが行われる時間帯を指定することができる
既定では月曜日から日曜日の現地時刻で午後 5 時から午前 8 時に行われている ほとんどの更新はホットパッチ等により可用性影響はないが、一部は短期間の中断が必要になる この場合メンテナンス中に平均 1.7 回程度のフェイルオーバーと、それに伴う平均8秒程度の中断が発生 運用スケジュールとして問題がある場合には以下を選択できる 平日期間、月曜日から木曜日の現地時刻で午後 10 時から午前 6 時 週末期間、金曜日から日曜日の現地時刻で午後 10 時から午前 6 時 29 * 仮想マシンの様に特定のタイミングでメンテナンスを行う機能ではない * プロキシ接続の場合はゲートウェイメンテナンスの影響は別途発生 メンテナンス期間の 適用対象 -
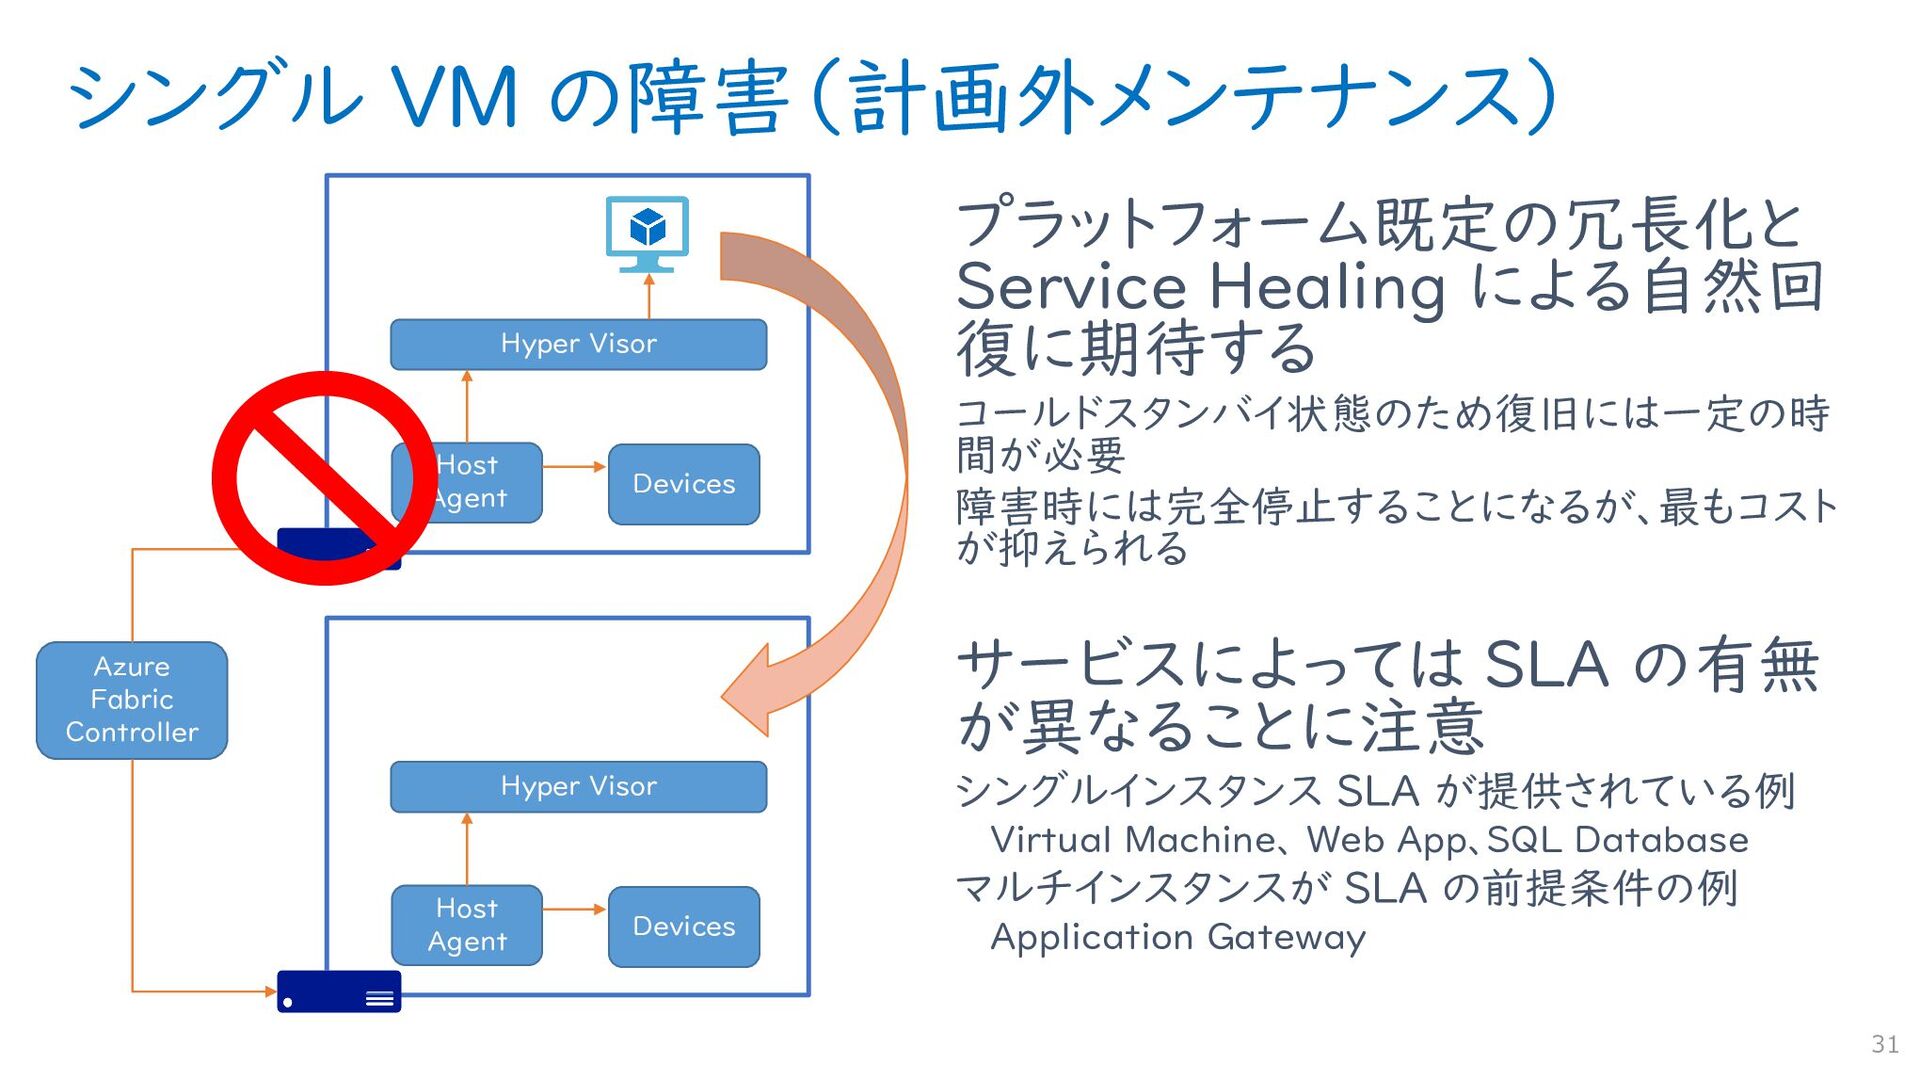
シングル VM の障害(計画外メンテナンス) プラットフォーム既定の冗長化と Service Healing による自然回 復に期待する コールドスタンバイ状態のため復旧には一定の時 間が必要
障害時には完全停止することになるが、最もコスト が抑えられる サービスによっては SLA の有無 が異なることに注意 シングルインスタンス SLA が提供されている例 Virtual Machine、 Web App、SQL Database マルチインスタンスが SLA の前提条件の例 Application Gateway 31 Azure Fabric Controller Hyper Visor Host Agent Devices Hyper Visor Host Agent Devices -
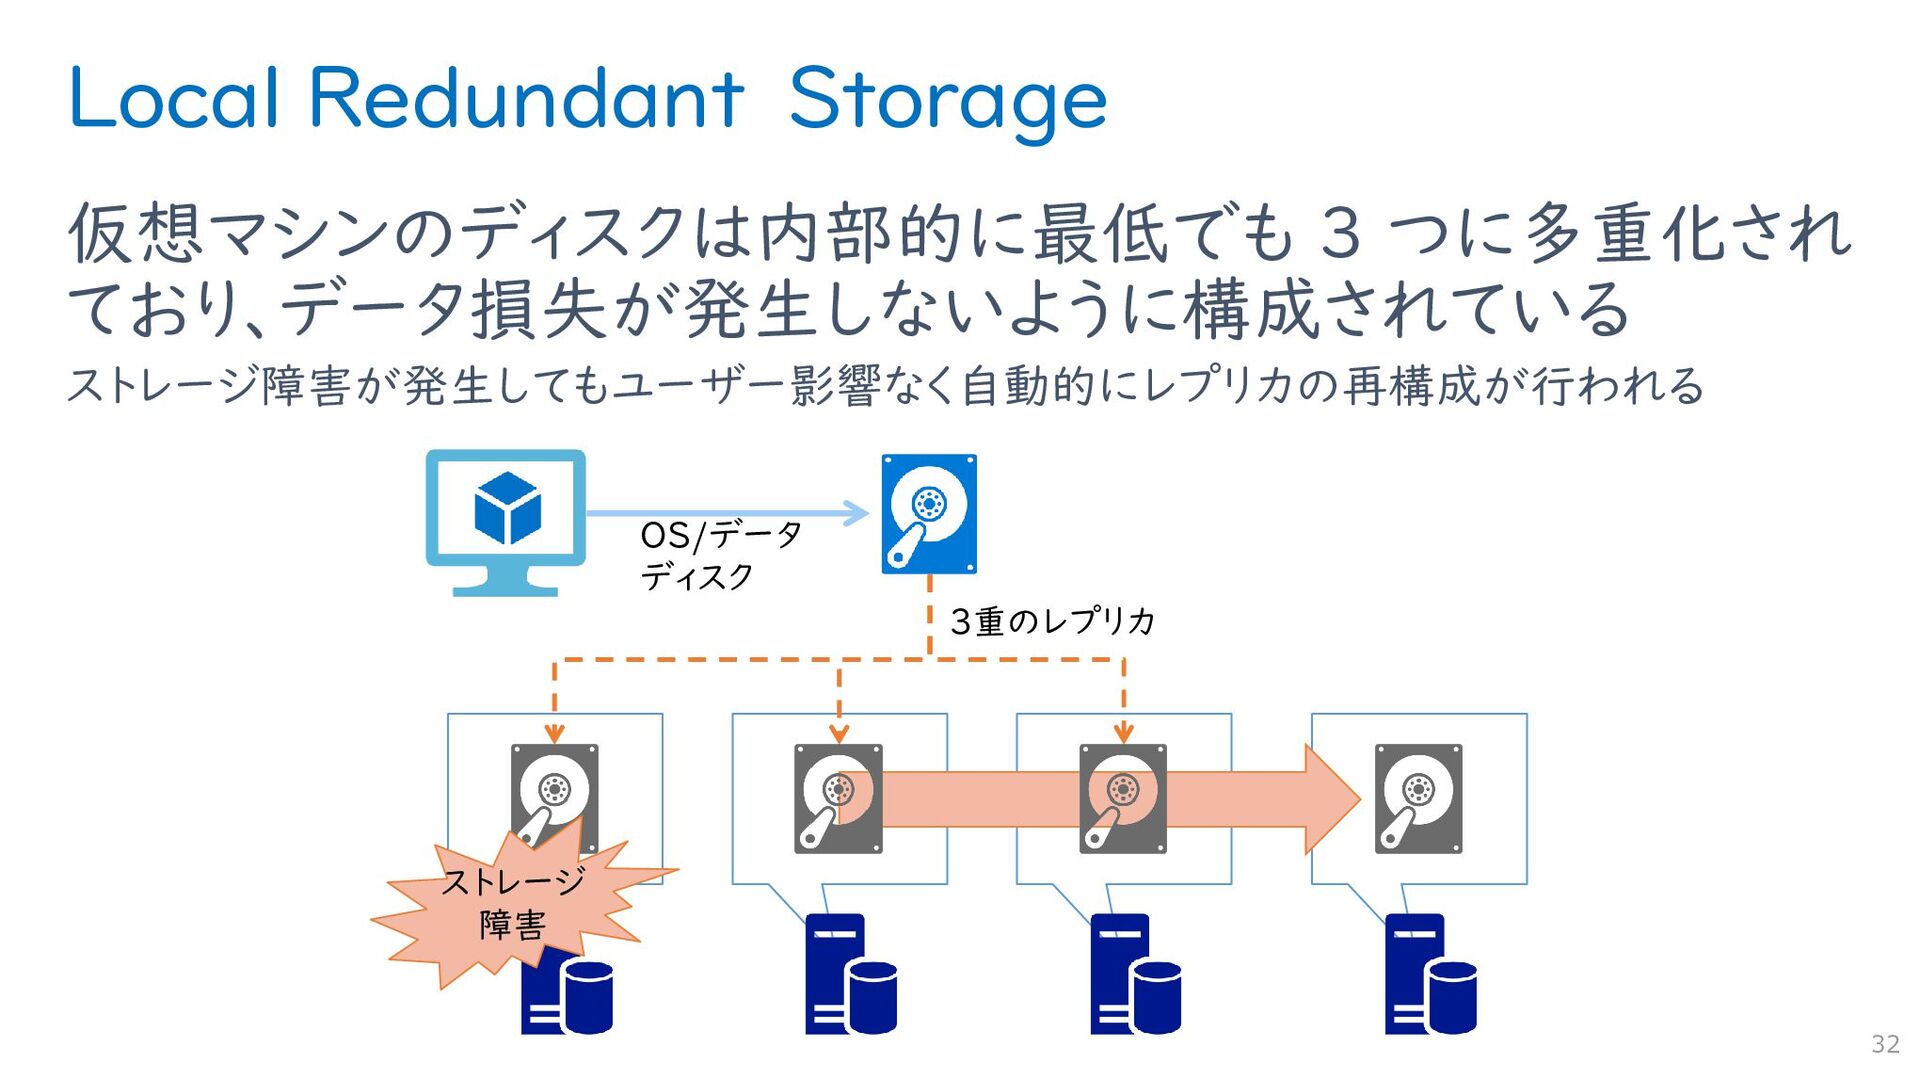
ホスト 障害 再デプロイ OS ディスク データディスク 一時ディスク 一時ディスク 仮想マシンに期待できる最低限の回復性 ホスト障害時があっても仮想マシンはデータ損失なく再起動
前述の Service Healing や Local Redundant Storage を組み合わせて実現 さらに高い可用性や回復性が必要な場合、利用者が自身で仕組みを設計・構築する必要がある そのベストプラクティスがビルトインされたものが PaaS (Managed Service) -
可用性、足りてますか? ここまでは Azure で基本的に備わった可用性の仕組みで、 サービスに組み込まれる形で提供されている さらに高度な要求を満たすためには利用者による設計と実装 が必要になってくる 特に IaaS の場合は
Azure の特性を踏まえた独自の可用性設計が必要になってくる PaaS の場合は内包された可用性の仕組みを理解して活用していく方針となる 34 -
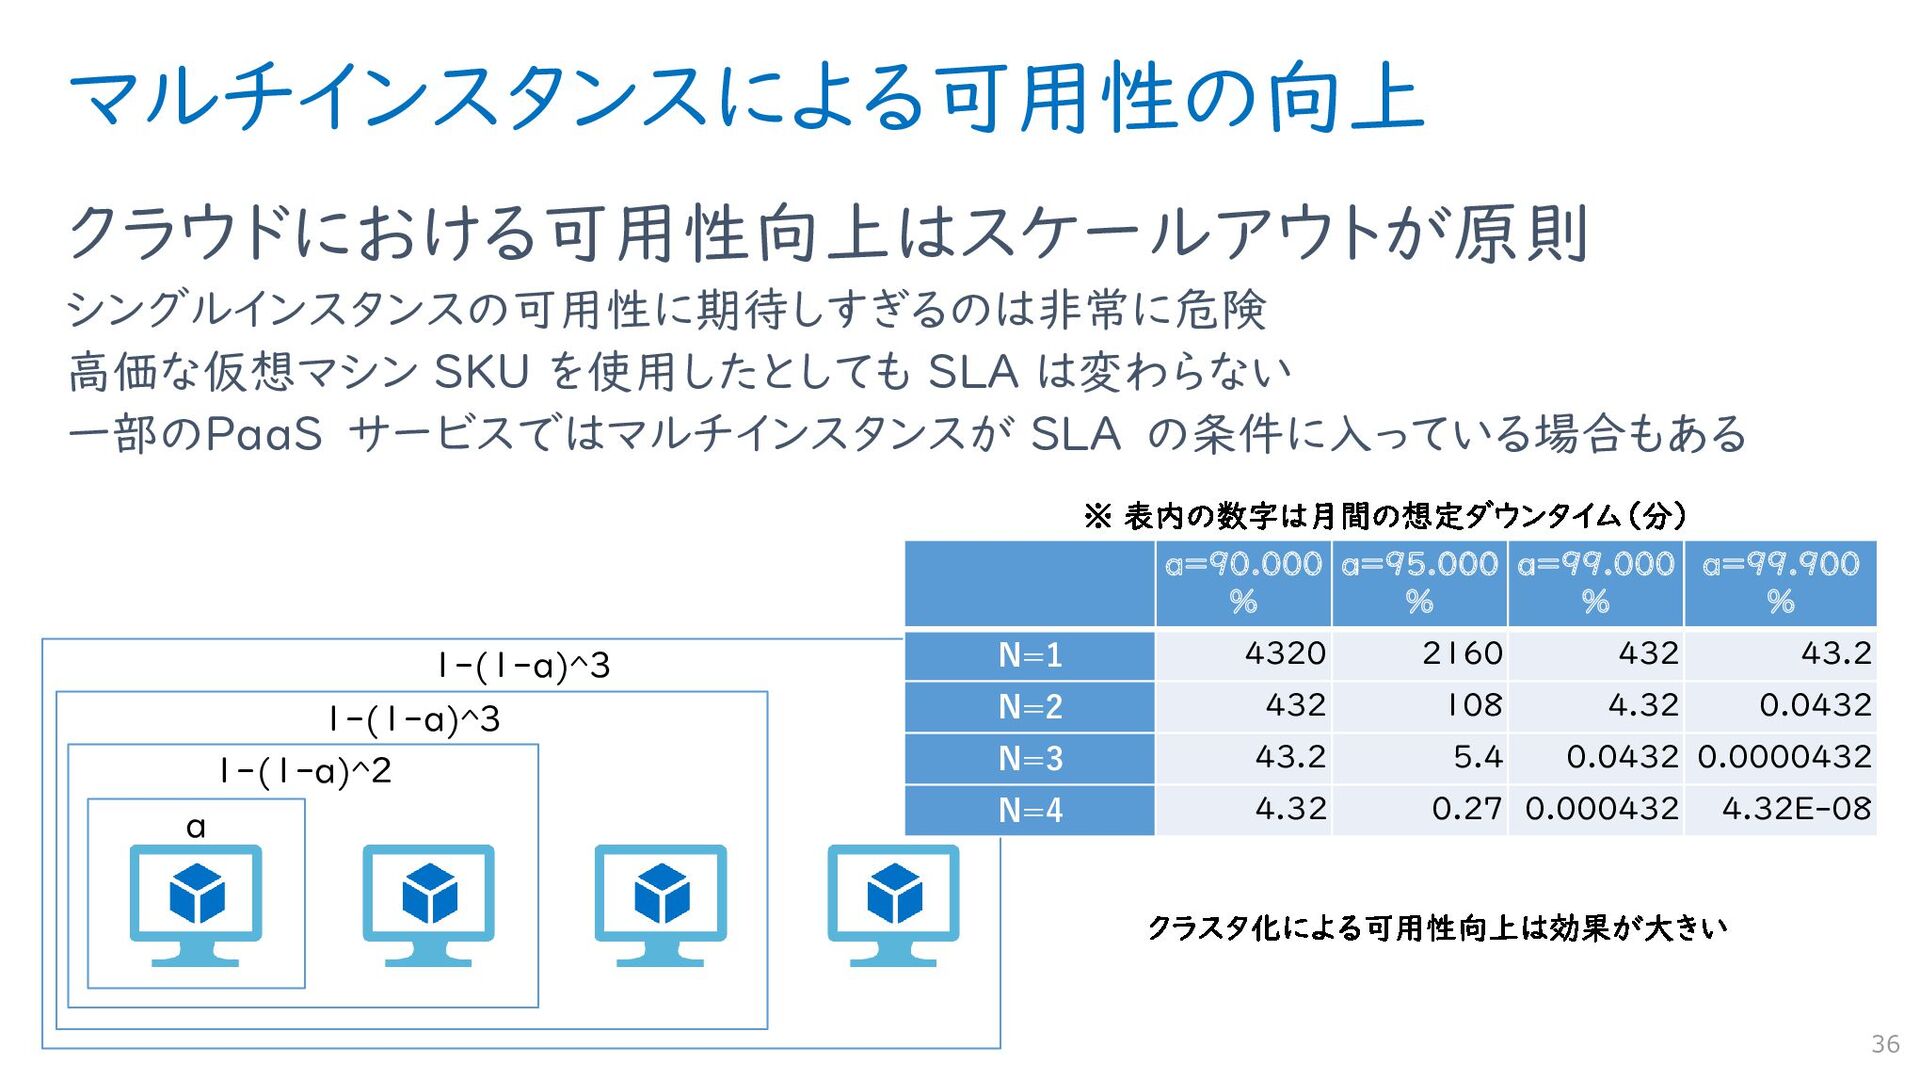
マルチインスタンスによる可用性の向上 クラウドにおける可用性向上はスケールアウトが原則 シングルインスタンスの可用性に期待しすぎるのは非常に危険 高価な仮想マシン SKU を使用したとしても SLA は変わらない 一部のPaaS サービスではマルチインスタンスが
SLA の条件に入っている場合もある 36 a 1-(1-a)^2 1-(1-a)^3 1-(1-a)^3 a=90.000 % a=95.000 % a=99.000 % a=99.900 % N=1 4320 2160 432 43.2 N=2 432 108 4.32 0.0432 N=3 43.2 5.4 0.0432 0.0000432 N=4 4.32 0.27 0.000432 4.32E-08 -
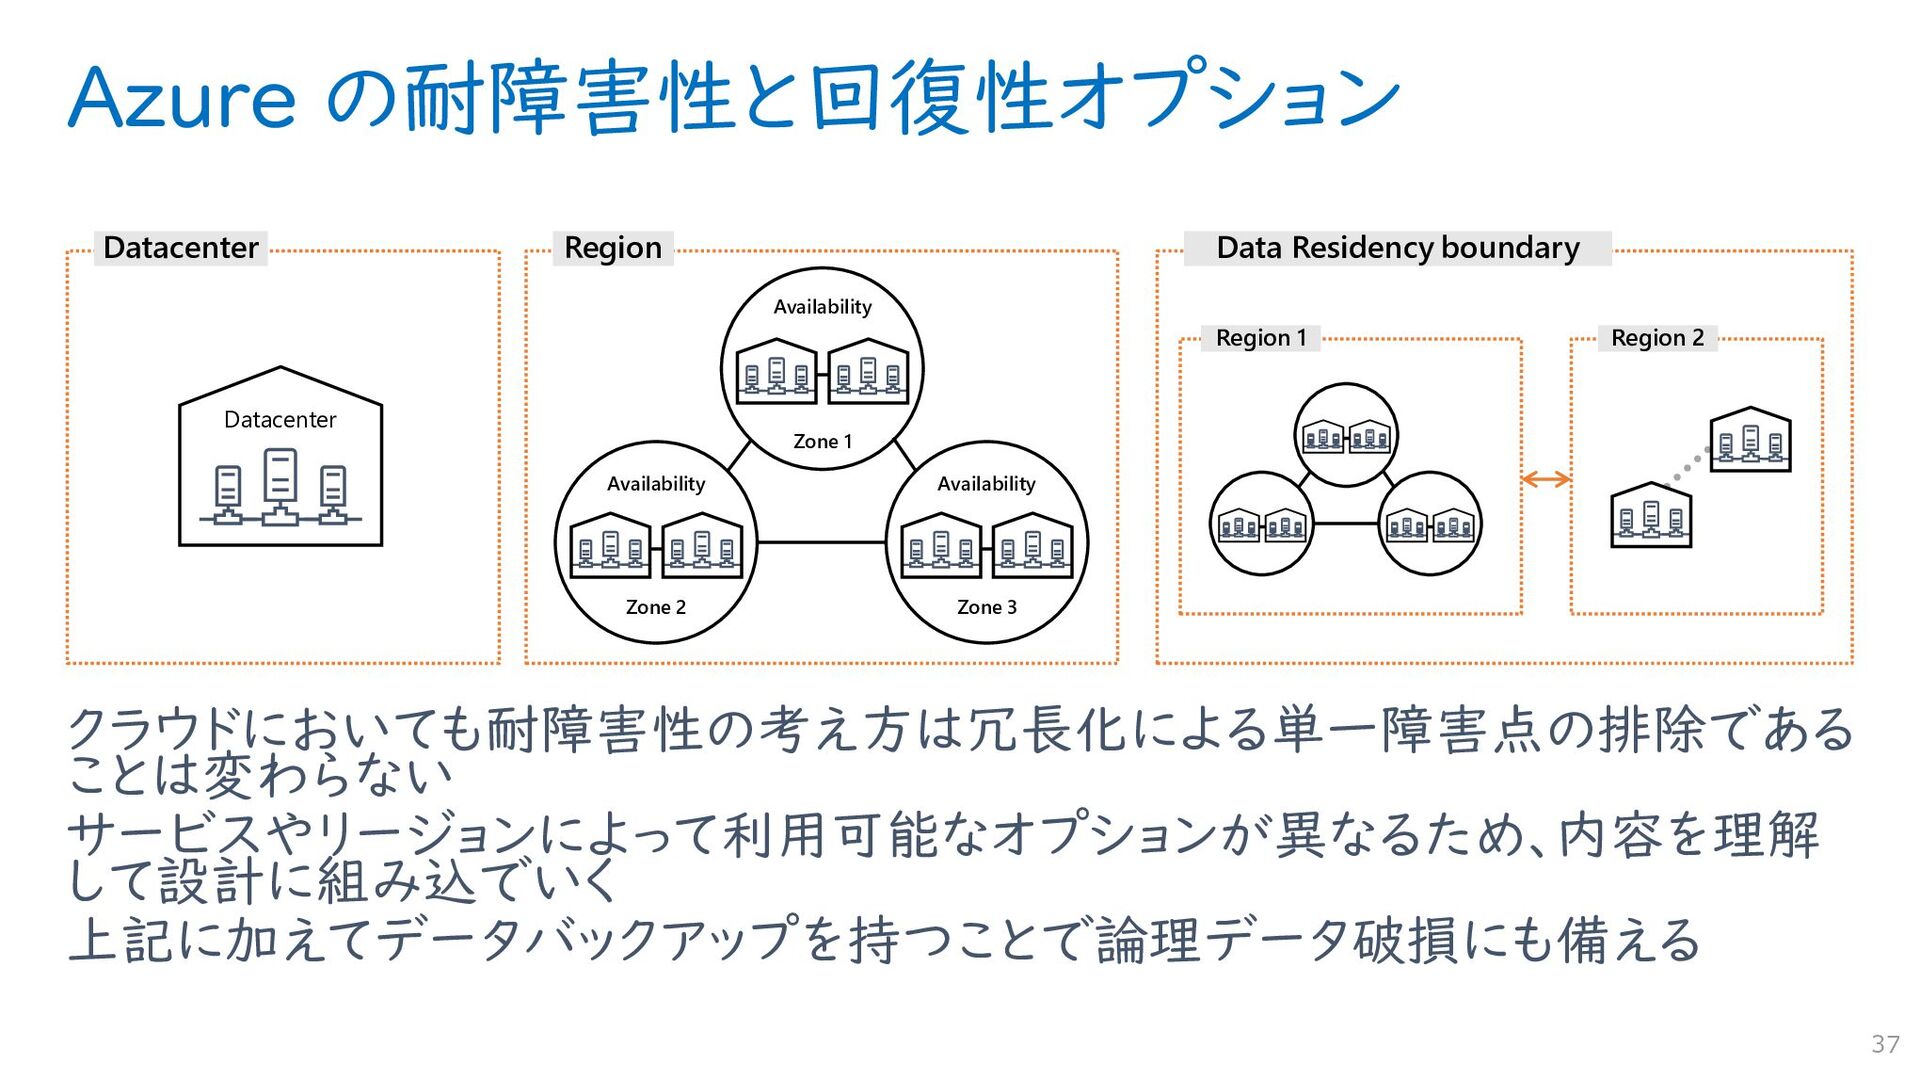
Azure の耐障害性と回復性オプション クラウドにおいても耐障害性の考え方は冗長化による単一障害点の排除である ことは変わらない サービスやリージョンによって利用可能なオプションが異なるため、内容を理解 して設計に組み込でいく 上記に加えてデータバックアップを持つことで論理データ破損にも備える 37 Region Zone
2 Zone 3 Zone 1 Availability Availability Availability Datacenter Datacenter Data Residency boundary Region 1 Region 2 -
可用性セット : データセンターレベルの回復性 複数の仮想マシンをデータセン ター内で分散配置して全面停 止を回避する FD : 障害ドメイン ラックレベルでの分散配置、ネットワークや電源系統が
独立することで同時障害のリスクを軽減 UD : 更新ドメイン ホストマシンレベルでの分散配置、ホスト OS メンテナン スによる同時停止や再起動リスクを軽減 仮想マシンの場合は作成時に 可用性セットを指定して構成 PaaS では内部的にこの可用性セットか後述の ゾーン冗長化が行われている 38 FD0 FD1 FD2 Datacenter -
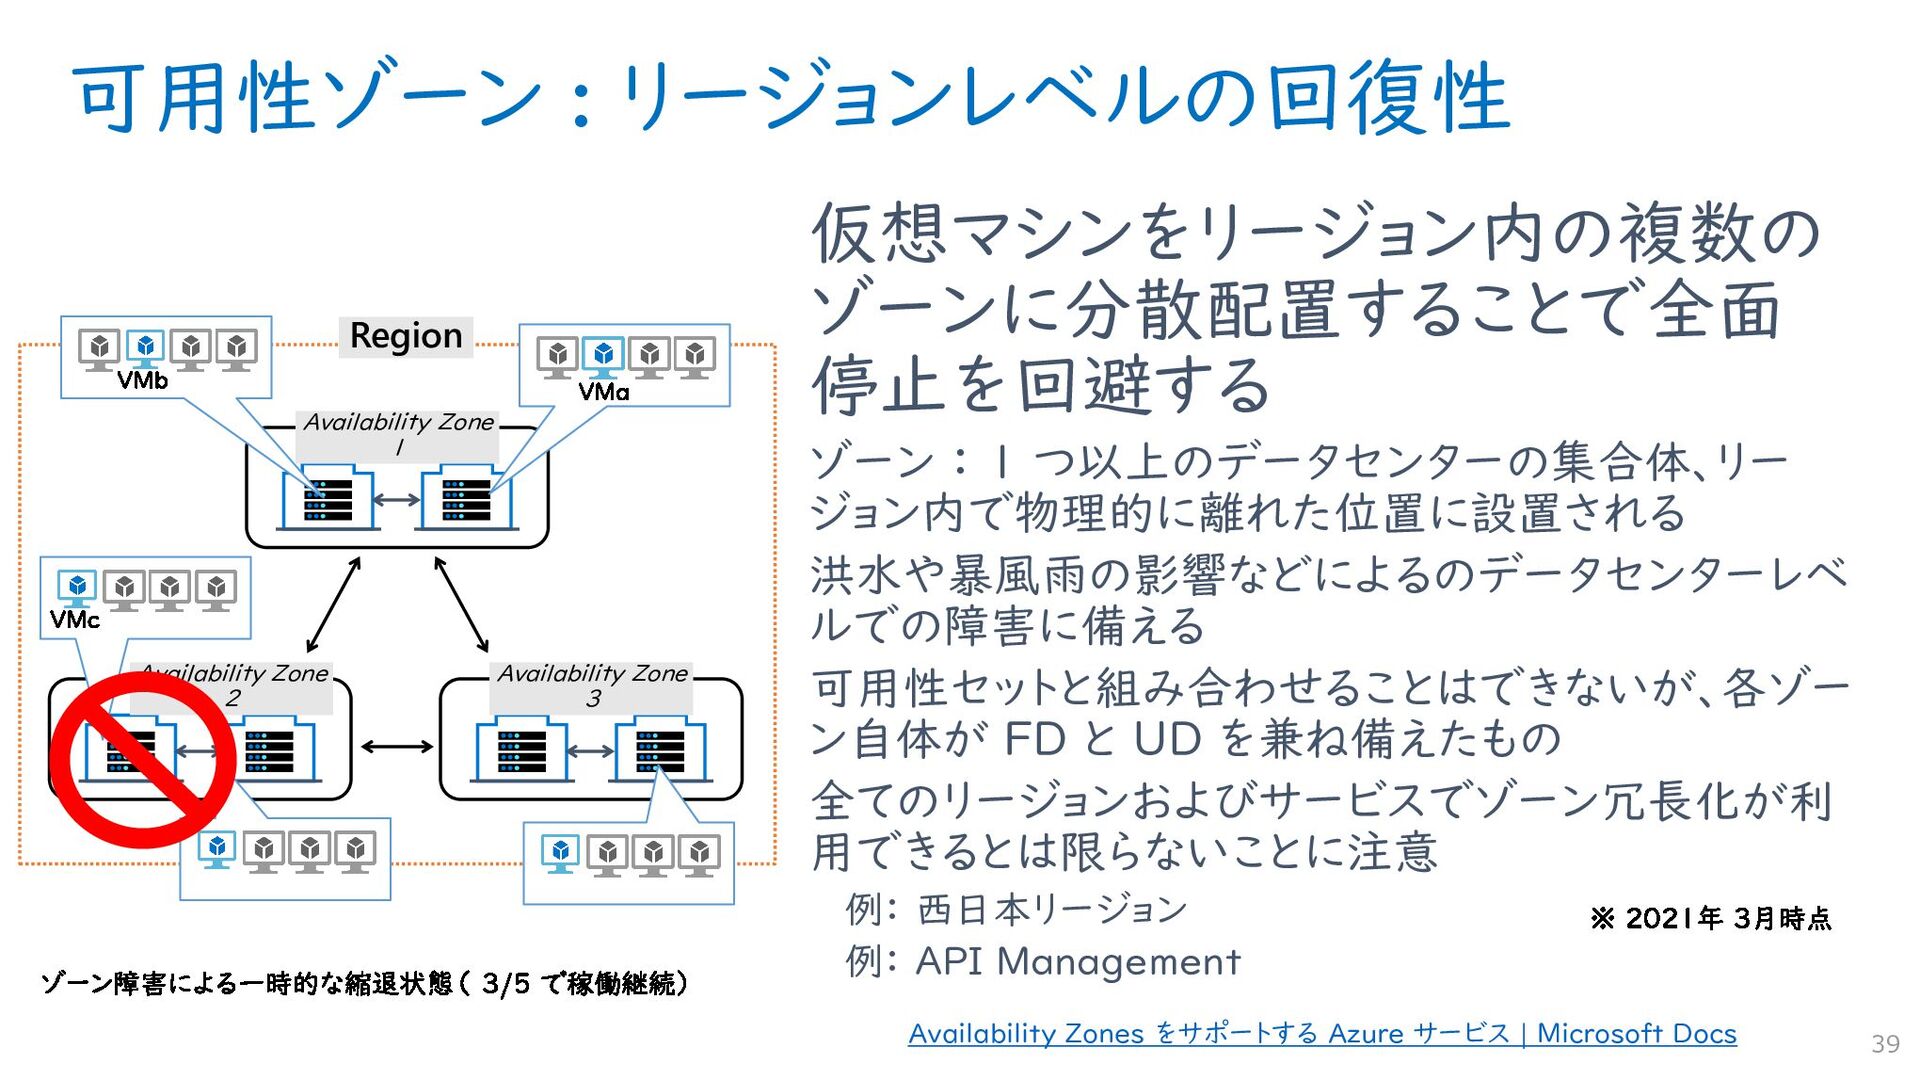
可用性ゾーン : リージョンレベルの回復性 仮想マシンをリージョン内の複数の ゾーンに分散配置することで全面 停止を回避する ゾーン : 1 つ以上のデータセンターの集合体、リー
ジョン内で物理的に離れた位置に設置される 洪水や暴風雨の影響などによるのデータセンターレベ ルでの障害に備える 可用性セットと組み合わせることはできないが、各ゾー ン自体が FD と UD を兼ね備えたもの 全てのリージョンおよびサービスでゾーン冗長化が利 用できるとは限らないことに注意 例: 西日本リージョン 例: API Management 39 Region Availability Zone 1 Availability Zone 2 Availability Zone 3 Availability Zones をサポートする Azure サービス | Microsoft Docs -
AZ1 可用性ゾーンを利用した冗長化カテゴリ ゾーン : Zonal インスタンス作成時に配置先のゾーンを明示的に 指定する(ピン止め)ことが出来るサービス 利用者は複数インスタンスを異なるゾーンに配置 例: Virtual
Machine, Managed Disk (LRS), ILB ASE, Etc… ゾーン冗長化: Zone Redundant 内部的に複数ゾーン横断して配置されるサービス デフォルト設定ではない場合は利用者が明示的にゾーン 冗長化を有効にする 例: Storage Account, SQL Database, Standard Load Balancer, Etc.. 40 AZ2 AZ3 Scale Scale Scale Replicate Replicate Failover -
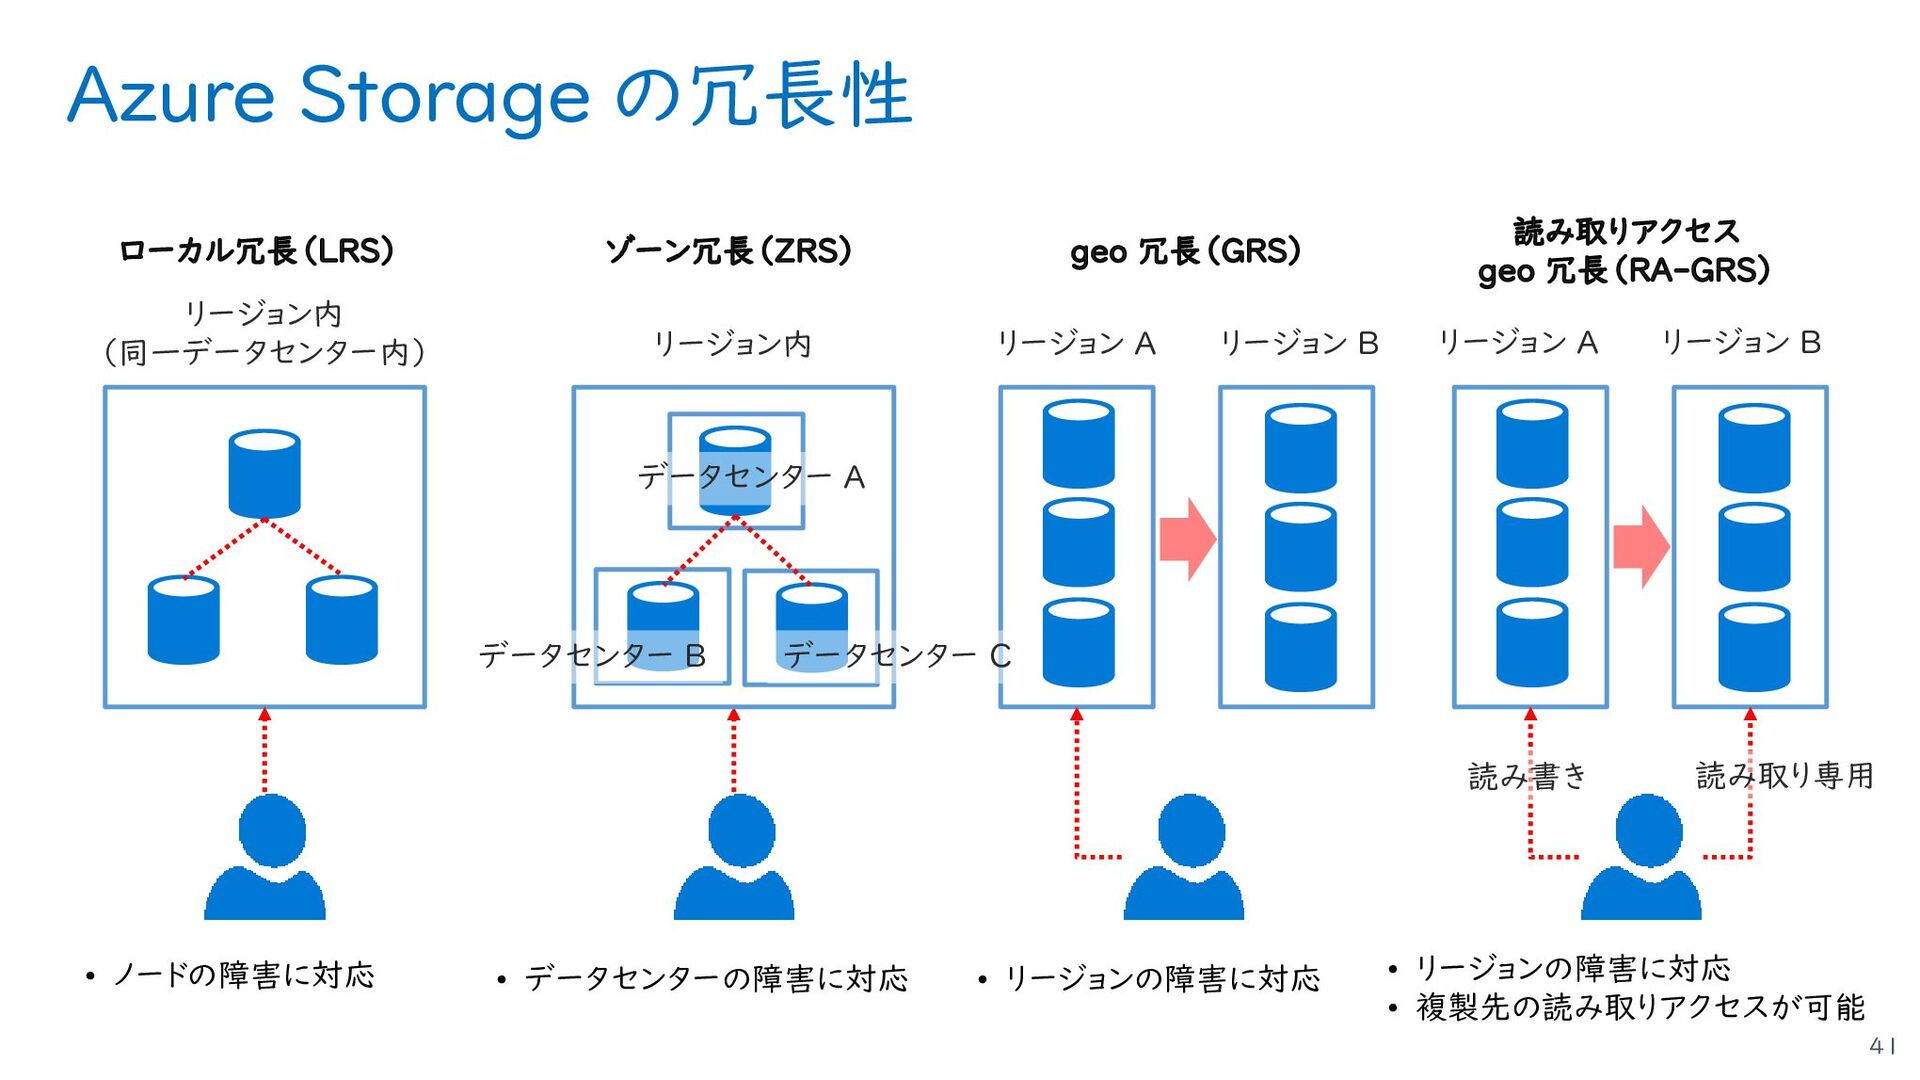
Azure Storage の冗長性 41 読み書き 読み取り専用 リージョン A リージョン B
リージョン A リージョン B リージョン内 リージョン内 (同一データセンター内) データセンター A データセンター B データセンター C • ノードの障害に対応 • データセンターの障害に対応 • リージョンの障害に対応 • リージョンの障害に対応 • 複製先の読み取りアクセスが可能 -
ペアリージョン : 地理的なレベルでの回復性 仮想マシンをペアとなるリージョン に分散配置することで全面停止を 回避する ペアは任意の組み合わせではなく事前に決まってい るもの(通常は同一国内だが例外アリ) リージョン間は 300
mile 以上の距離を話して配置 するため、広域災害によるリージョンレベルでの障害 に対しても全面停止を回避 ペアリージョンは同時にメンテナンスが行われない (非ペアリージョンは同時メンテがあり得る) ペアリージョンが同時に被災した場合は片方を優先 して復旧する 42 Data Residency boundary Region 1 Region 2 Azure のペアになっているリージョンを使用したビジネス継続性とディザスター リカバリー | Microsoft Docs -
Region1 マルチリージョン : Geo 冗長オプション 一部のサービスはリージョンを横断した冗長化オプションを提供し ている クロスリージョンのレプリケーションとフェイルオーバーをセットで提供することで RTO を短縮
ただし非同期レプリケーションであるためデータ損失は発生しうる(RPO > 0) 43 Region2 Region3 RegionN Region1 Region2 -
日本ジオの例 日本国内では広域災害対策・負荷分散のために東日本・西 日本のペアリージョンを使用することができる ただし必ずしも完全に同一の構成が取れるわけではないことに注意 西日本リージョン 東日本リージョン Availability ゾーン 1 Availability
ゾーン 2 Availability ゾーン 3 データ回復性境界 - リージョン別の Azure 製品 | Microsoft Azure - Availability Zones をサポートする Azure サービス | Microsoft Docs -
仮想マシンの可用性における考慮事項 クラスタレベルでの「サービスとしての可用性」を実現するためには、複数の仮想マシン上に 配備されることを意識したソフトウェア構成が必要になる 46 クラスタ 全体の 可用性 Microsoftの 責任範囲 Virtualization
Compute Storage Network 利用者の 責任範囲 Operating System Middleware Application Virtualization Compute Storage Network Operating System Middleware Application -
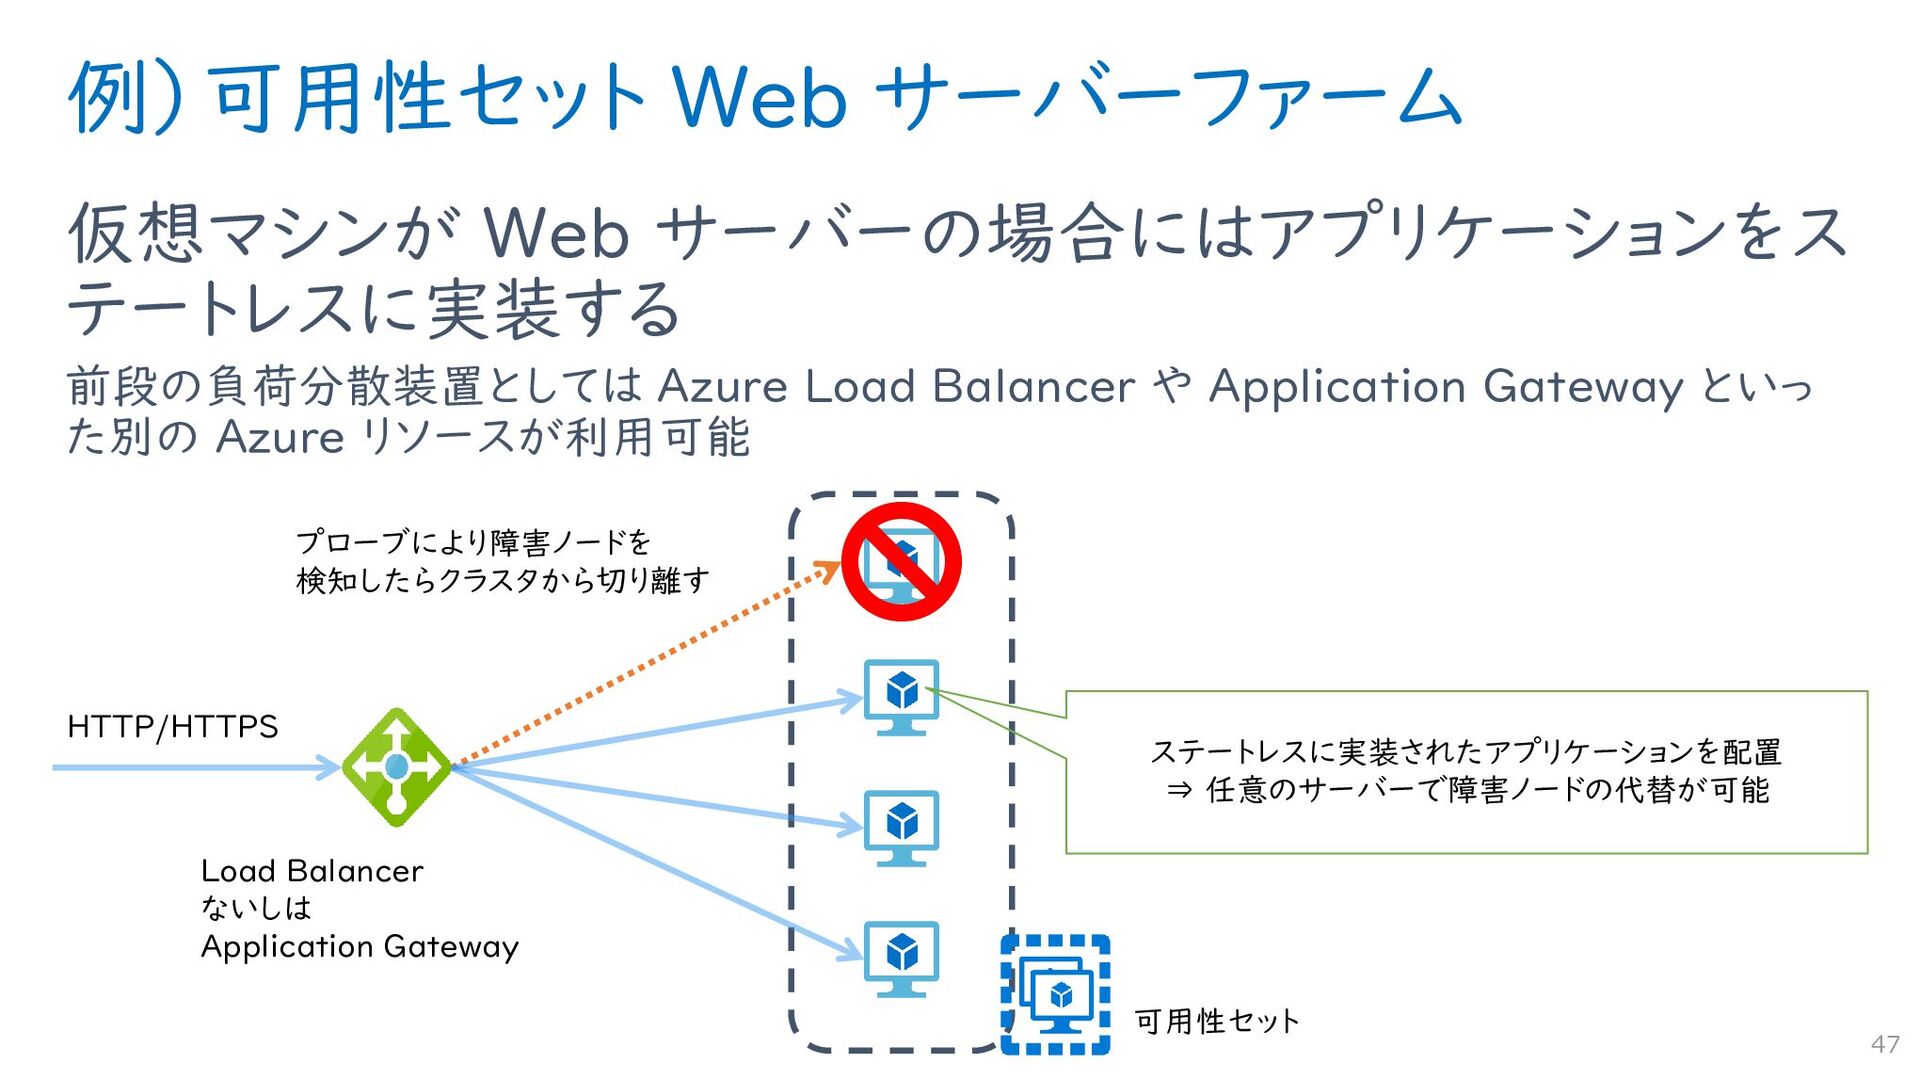
例)可用性セット Web サーバーファーム 仮想マシンが Web サーバーの場合にはアプリケーションをス テートレスに実装する 前段の負荷分散装置としては Azure Load
Balancer や Application Gateway といっ た別の Azure リソースが利用可能 47 Load Balancer ないしは Application Gateway HTTP/HTTPS 可用性セット ステートレスに実装されたアプリケーションを配置 ⇒ 任意のサーバーで障害ノードの代替が可能 プローブにより障害ノードを 検知したらクラスタから切り離す -
例)可用性セット DB サーバクラスタ 仮想マシンの役割が DB サーバーの場合は、対応したクラス タ用ミドルウェアが必要になることが多い SQL Server の場合には
Always On Availability Group および Windows Server Failover Cluster などを利用 複数の DB サーバー間でデータ同期を取りつつ、Load Balancer の NAT 機能を利用して 主系への透過的な接続を実現 48 Load Balancer TDS 可用性セット Active Stand-by 主系で永続化されたデータを Always-on の機能によって 同期レプリケーション -
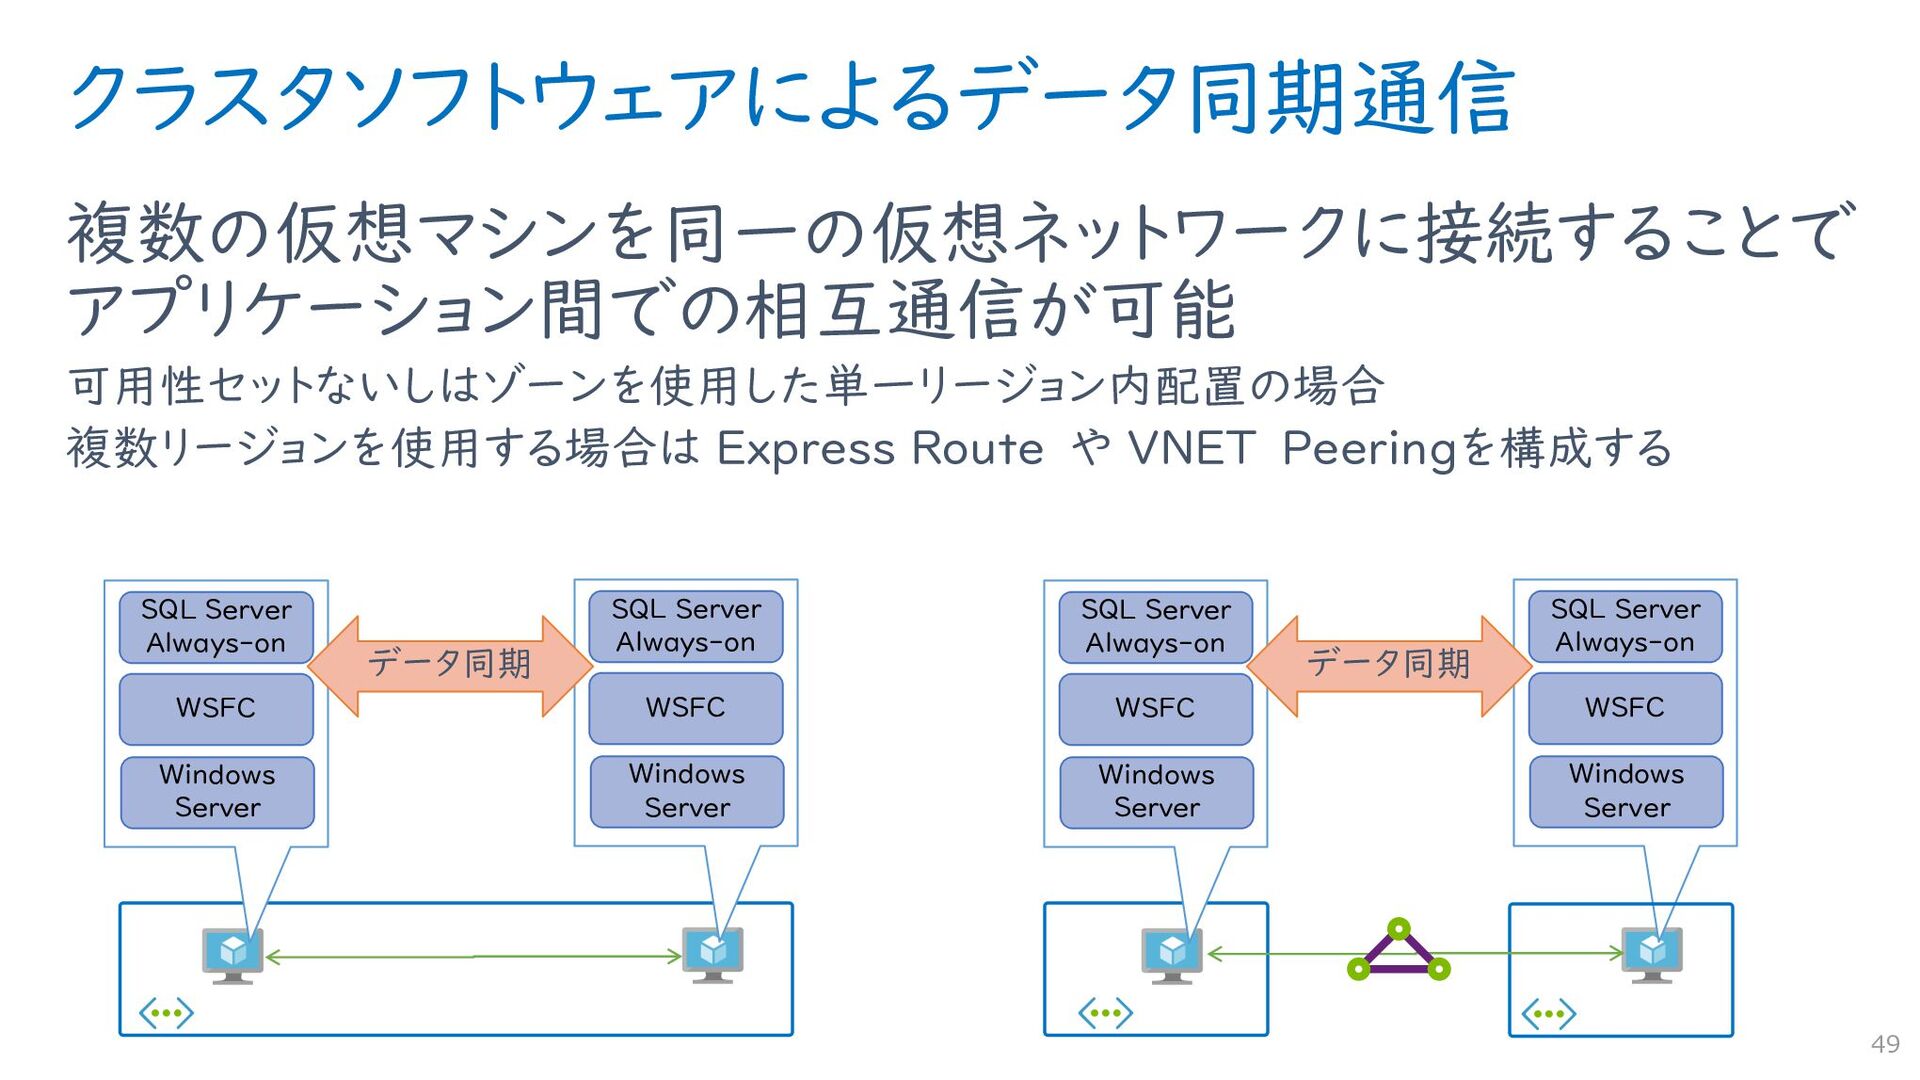
クラスタソフトウェアによるデータ同期通信 複数の仮想マシンを同一の仮想ネットワークに接続することで アプリケーション間での相互通信が可能 可用性セットないしはゾーンを使用した単一リージョン内配置の場合 複数リージョンを使用する場合は Express Route や VNET Peeringを構成する
49 WSFC SQL Server Always-on Windows Server WSFC SQL Server Always-on Windows Server データ同期 WSFC SQL Server Always-on Windows Server WSFC SQL Server Always-on Windows Server データ同期 -
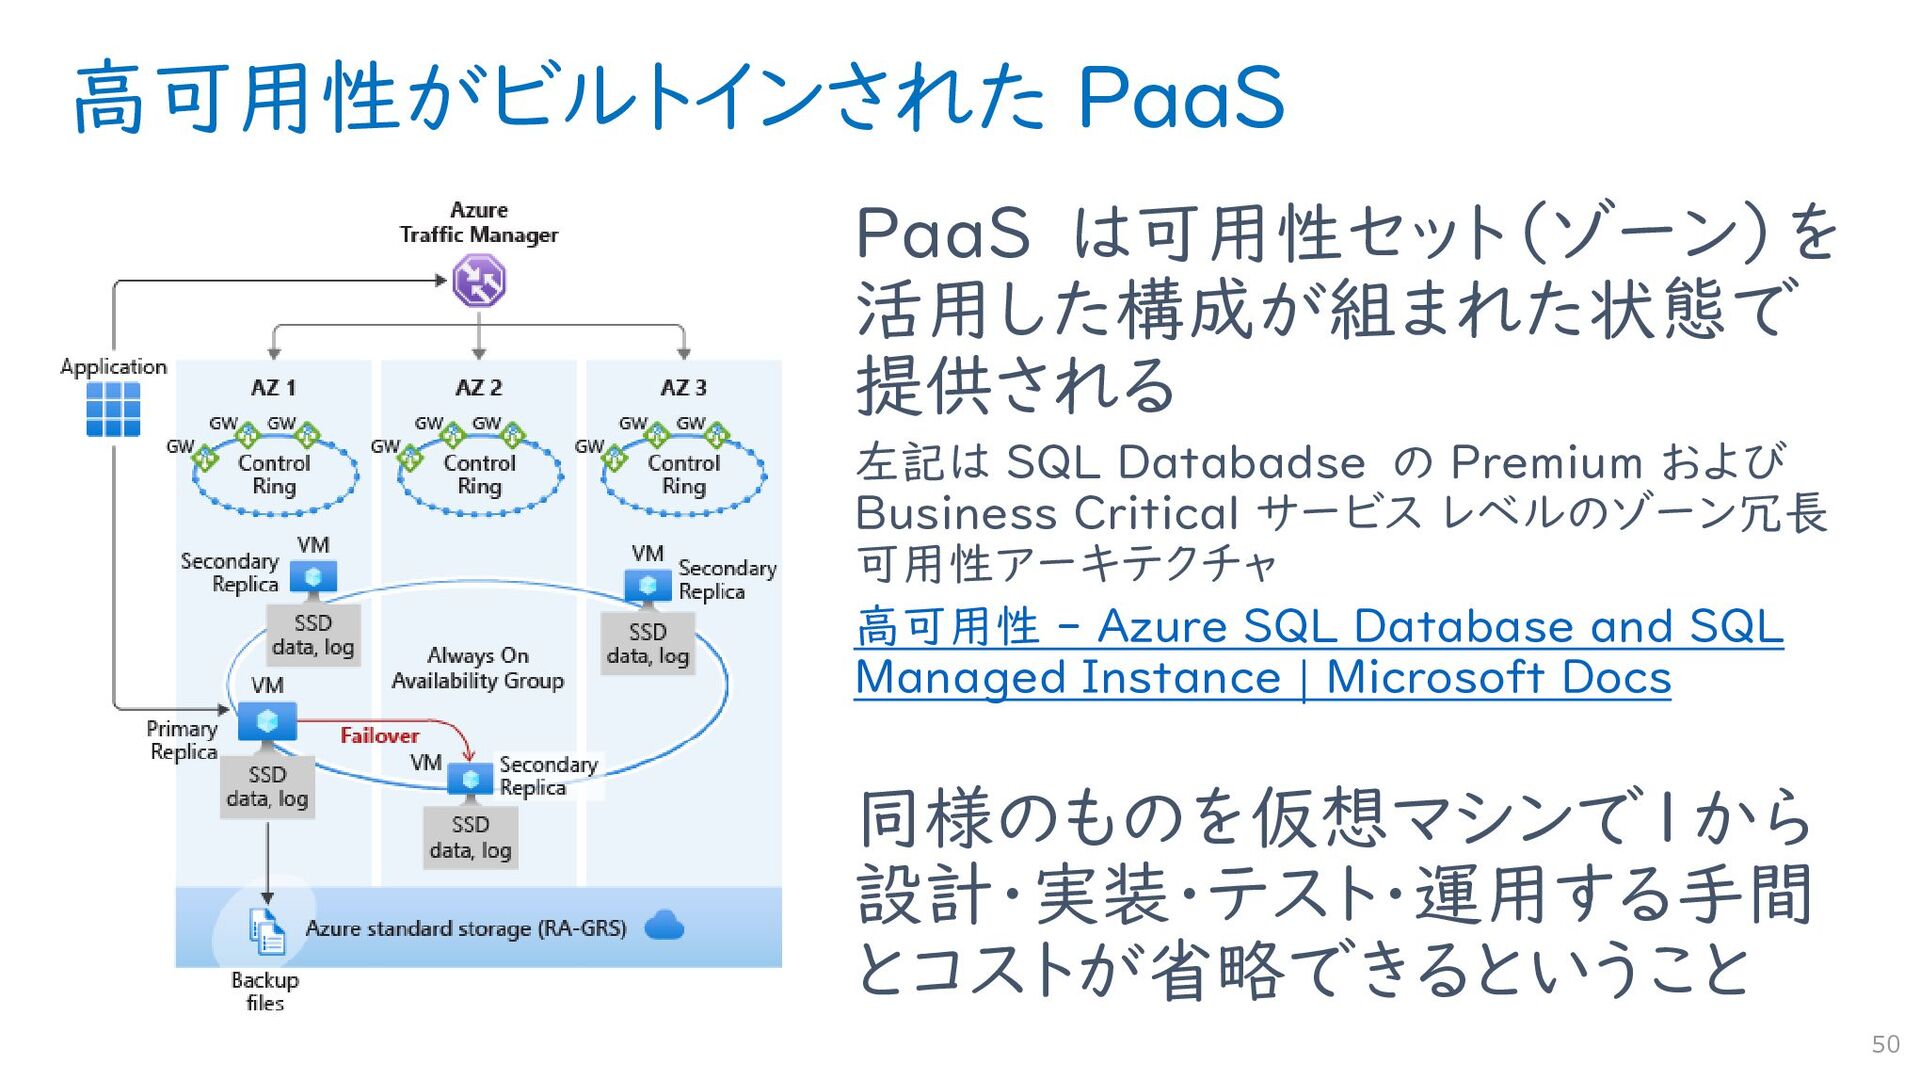
高可用性がビルトインされた PaaS PaaS は可用性セット(ゾーン)を 活用した構成が組まれた状態で 提供される 左記は SQL Databadse の
Premium および Business Critical サービス レベルのゾーン冗長 可用性アーキテクチャ 高可用性 - Azure SQL Database and SQL Managed Instance | Microsoft Docs 同様のものを仮想マシンで1から 設計・実装・テスト・運用する手間 とコストが省略できるということ 50 -
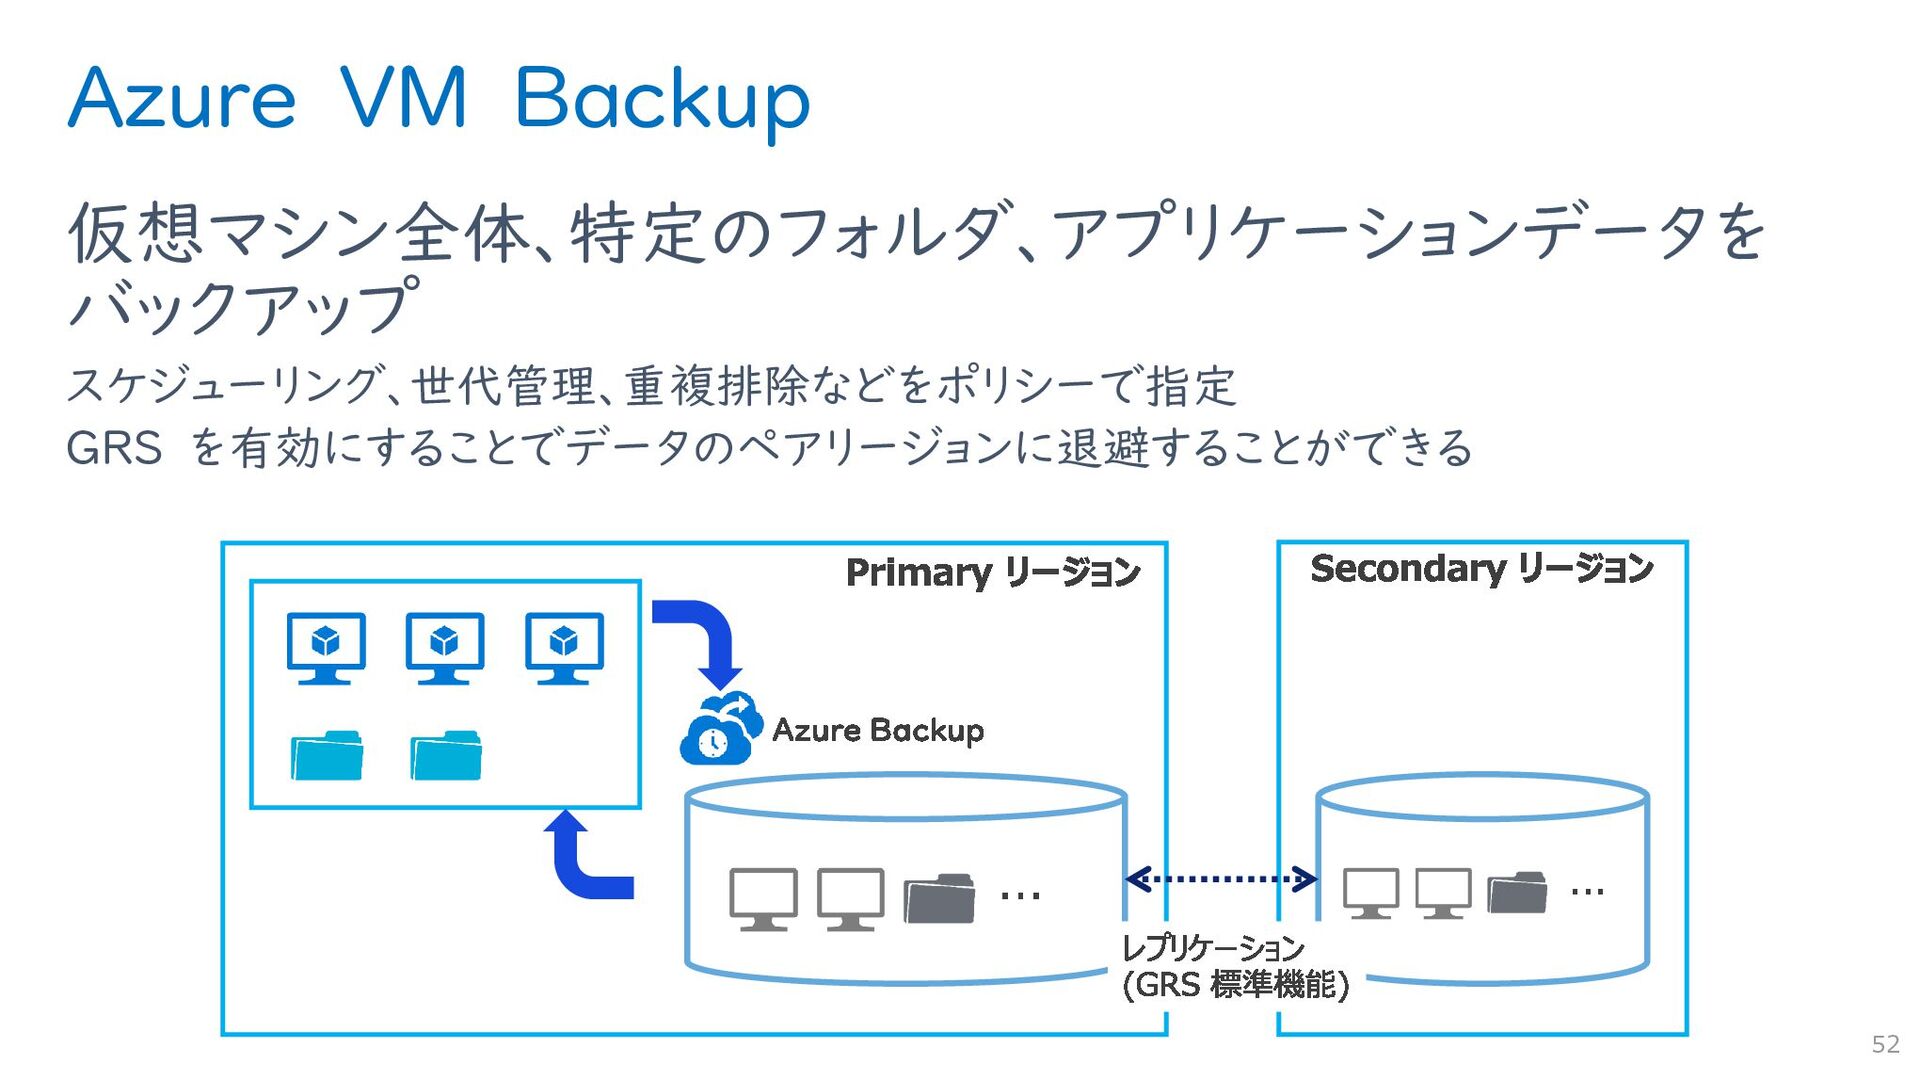
[参考] Azure Backup と Site Recovery Azure 東日本リージョン Recovery Service
コンテナ 保護対象 VM 内部ストレージ Backup / Restore GRS Azure 西日本 内部ストレージ (アクセス不可レプリカ) Azure 東日本リージョン Recovery Service コンテナ 保護対象 VM Azure 西日本 キャッシュ用ストレージ レプリカディスク レプリケーション テストフェイルオーバー /フェイルオーバー / 移行 -
Replication ≠ Backup Storage アカウント等で実装されているレプリケーションは論 理データ破損に対しては無力 レプリケーションはストレージ装置な破損等によるデータ喪失リスクを軽減することが目的 ミスオペレーションやバグに起因するデータ破壊操作は、ストレージ上は正常なトランザクショ ンとして記録され、レプリカに対してもコミットされる バックアップによって過去の正常なデータに巻き戻せる(リストア)ことが重要
55 3重のレプリカ 不正なデータ 書き込み 不正データが永続化される 時系列 v1 v2 v3(不正) v4 (=v2) v1 v2 バックアップ リストア -
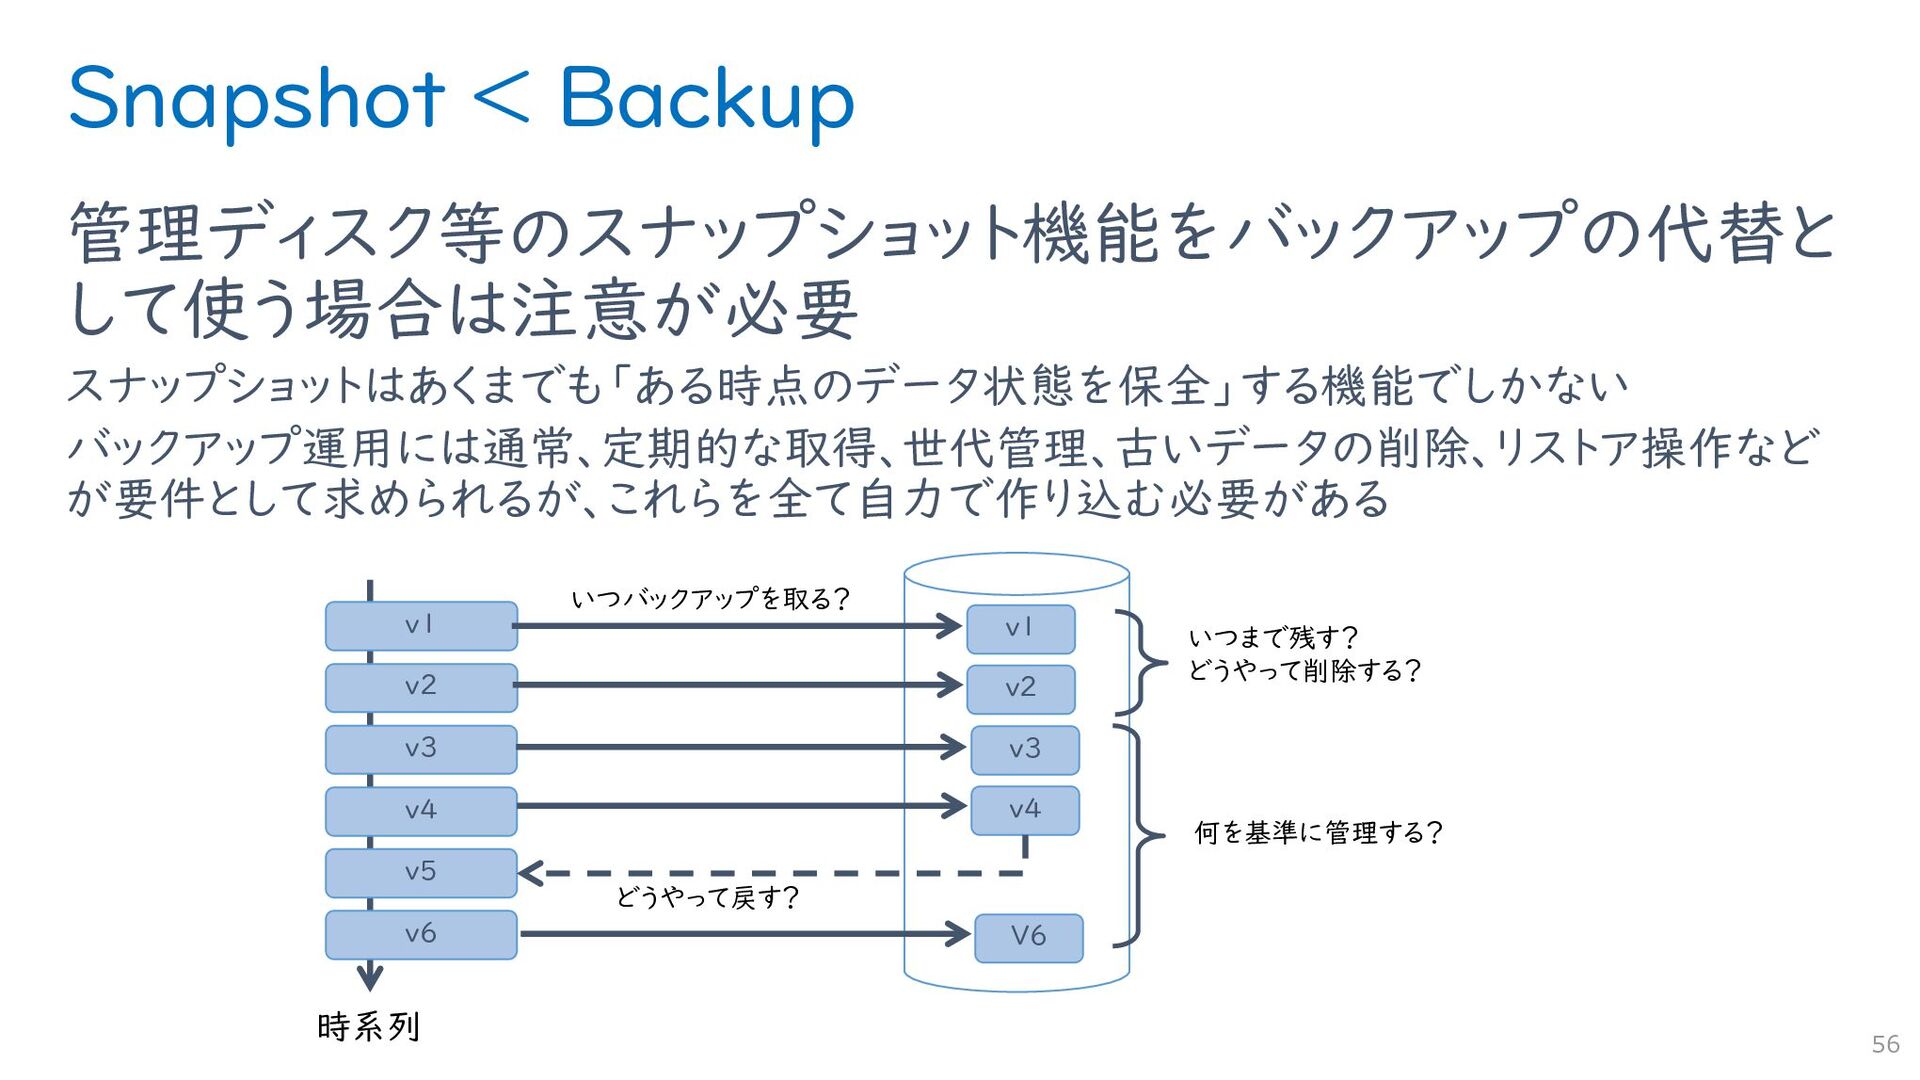
Snapshot < Backup 管理ディスク等のスナップショット機能をバックアップの代替と して使う場合は注意が必要 スナップショットはあくまでも「ある時点のデータ状態を保全」する機能でしかない バックアップ運用には通常、定期的な取得、世代管理、古いデータの削除、リストア操作など が要件として求められるが、これらを全て自力で作り込む必要がある 56 時系列
v1 v2 v4 v1 v2 いつバックアップを取る? どうやって戻す? v3 v5 v6 v3 v4 V6 いつまで残す? どうやって削除する? 何を基準に管理する? -
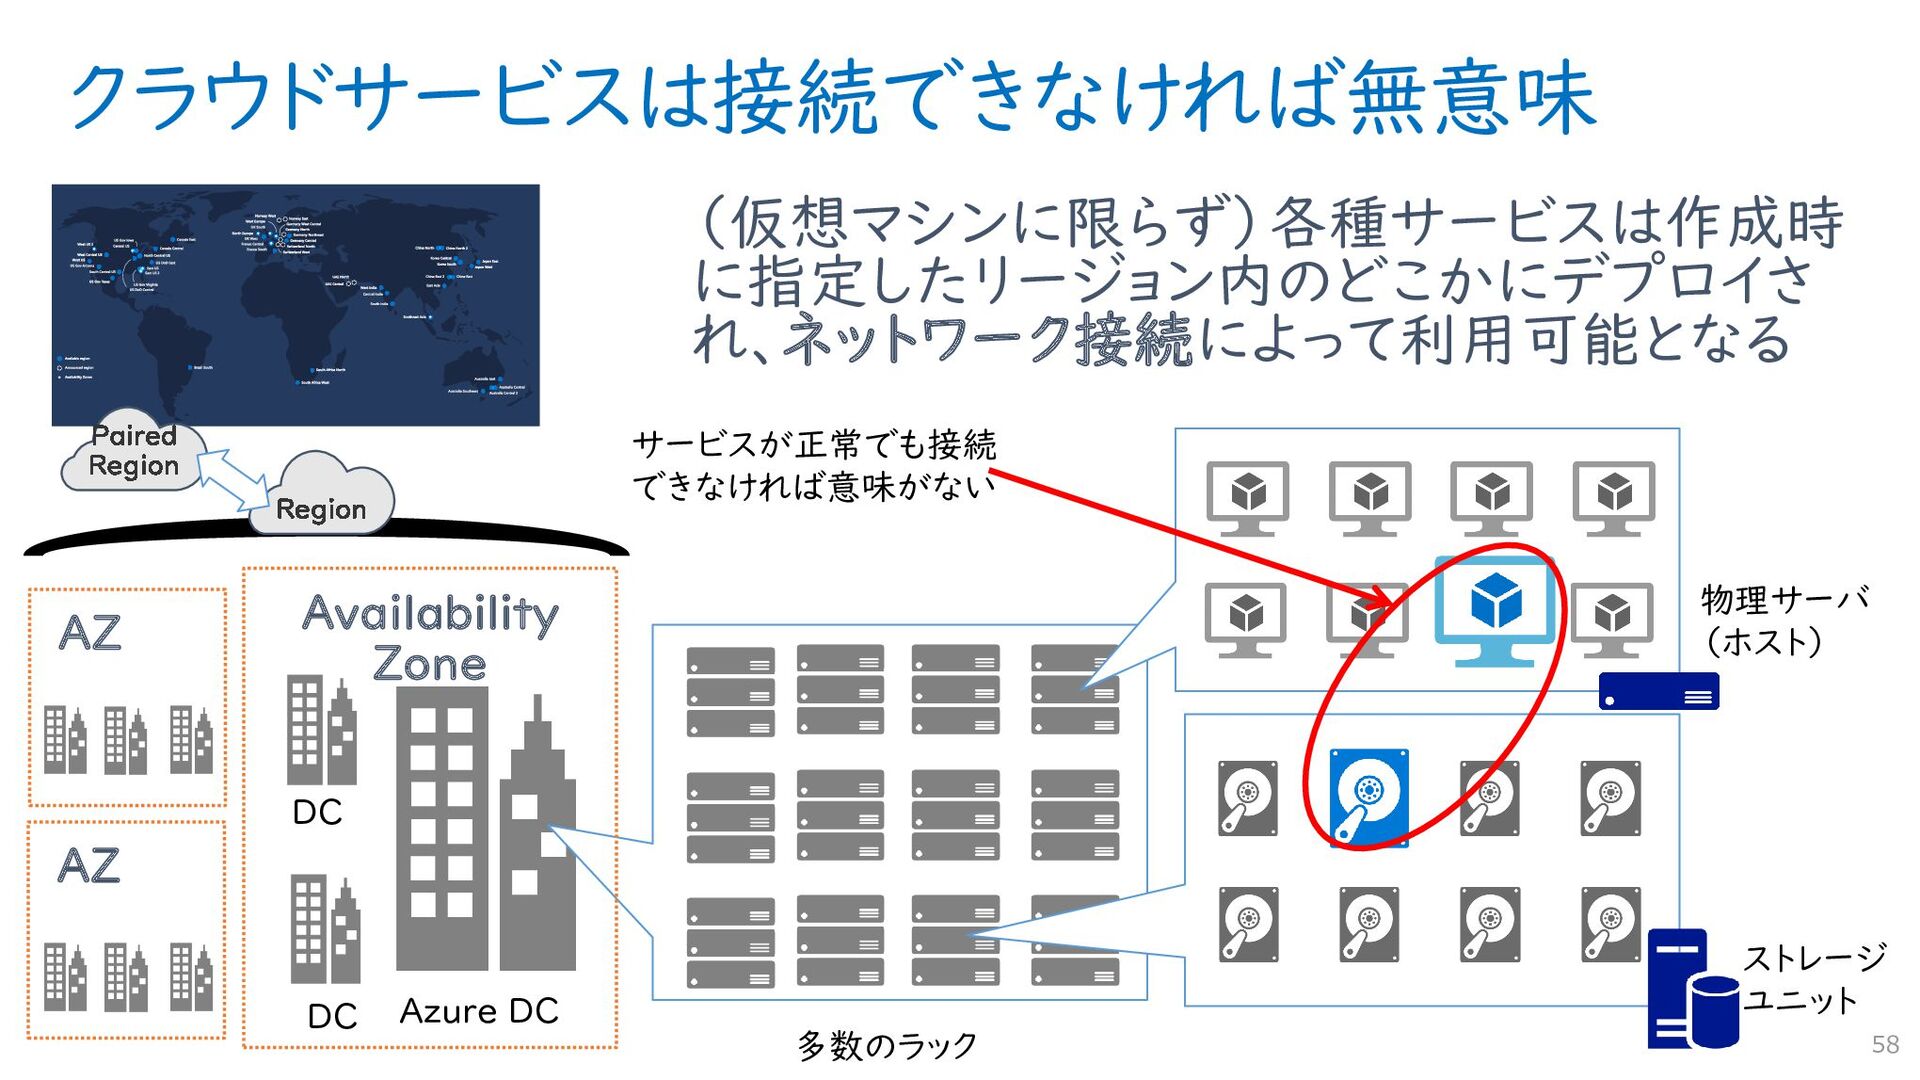
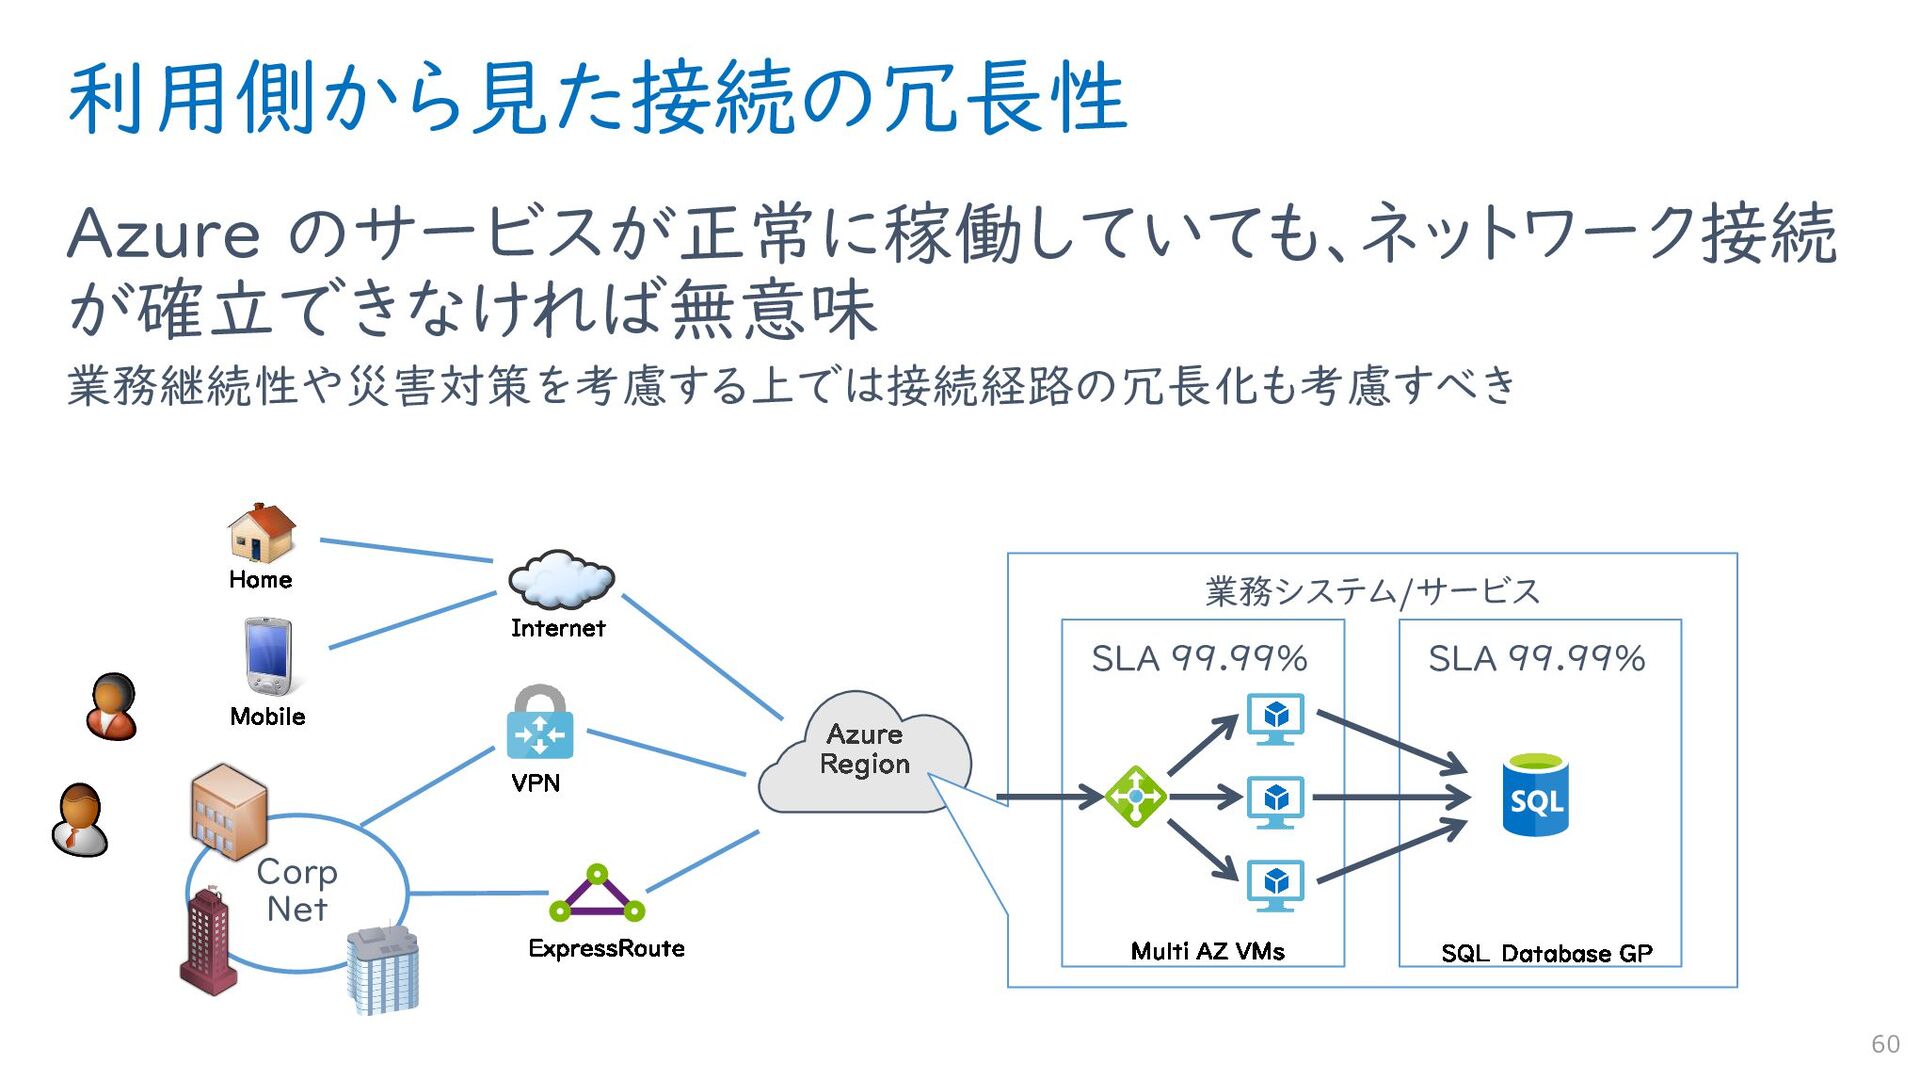
クラウドサービスは接続できなければ無意味 58 Azure DC 多数のラック 物理サーバ (ホスト) ストレージ ユニット サービスが正常でも接続
できなければ意味がない (仮想マシンに限らず)各種サービスは作成時 に指定したリージョン内のどこかにデプロイさ れ、ネットワーク接続によって利用可能となる Availability Zone DC DC AZ AZ -
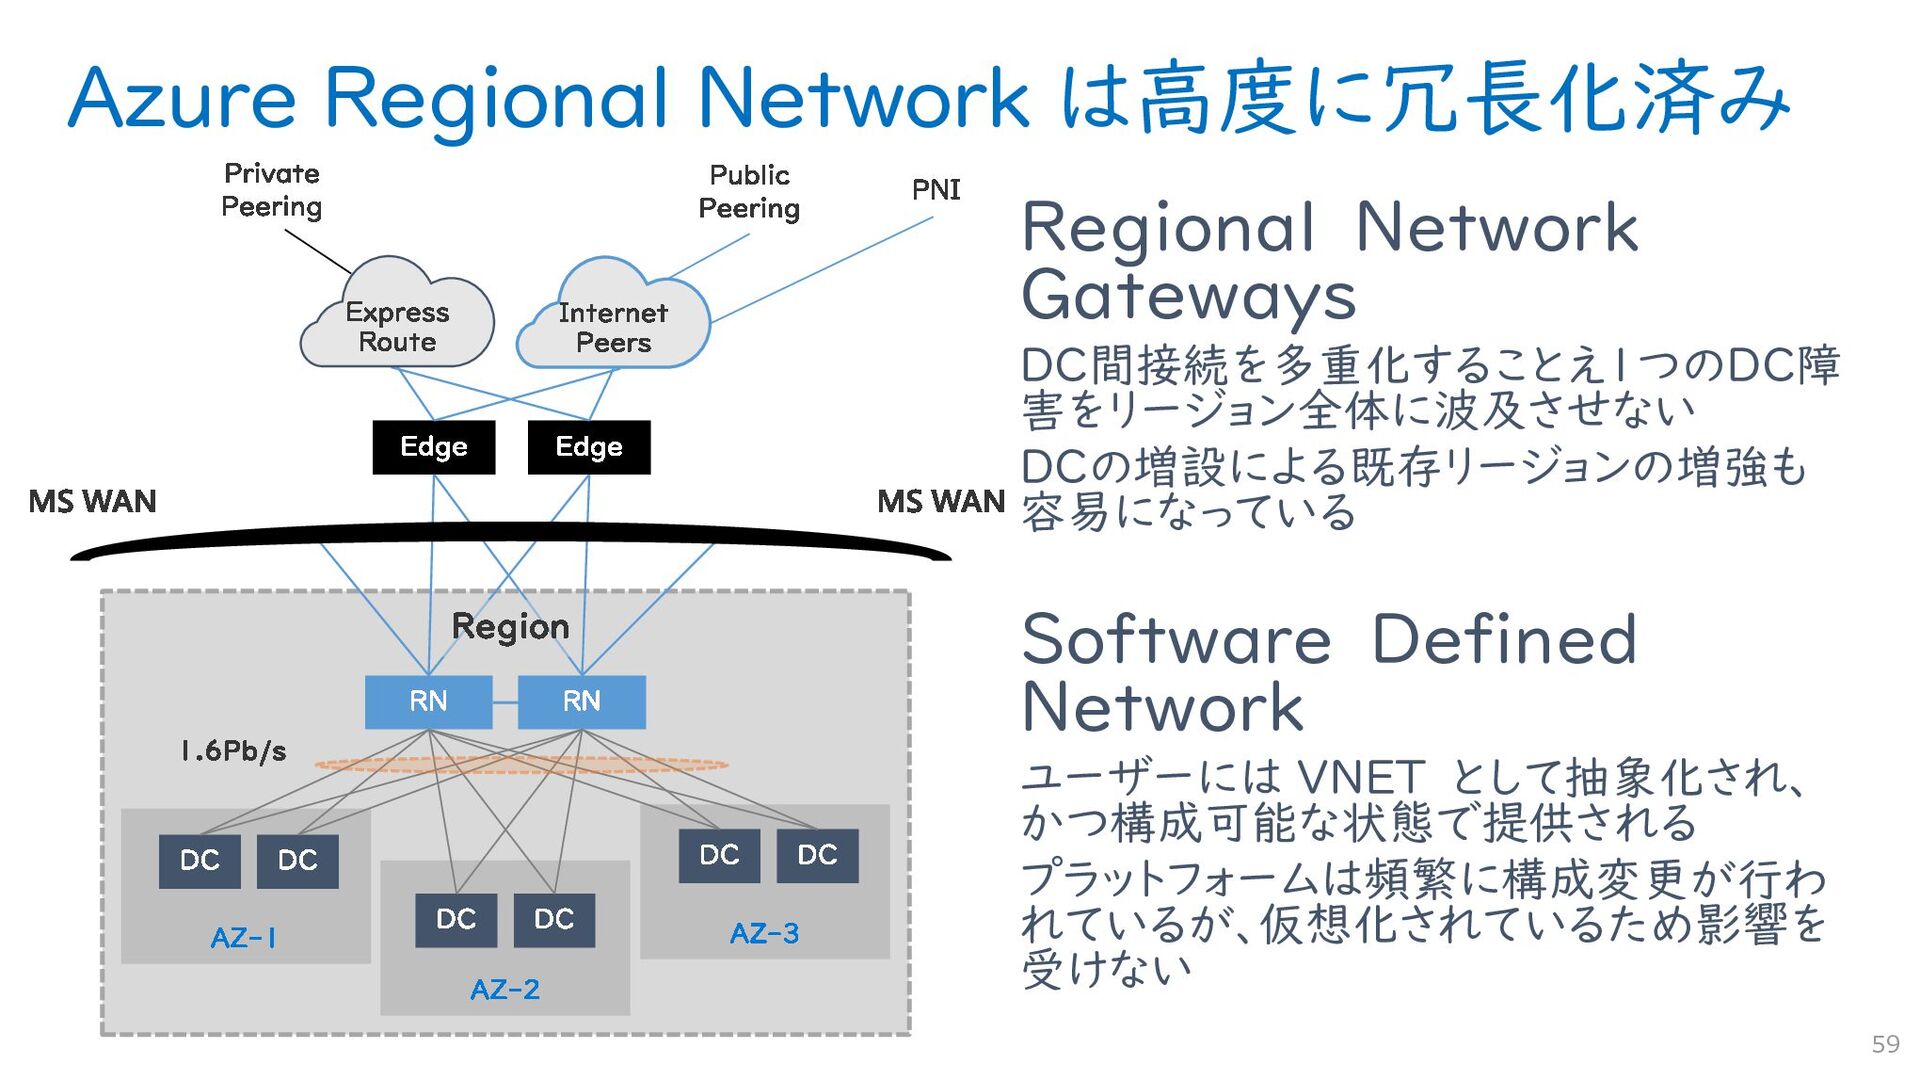
Azure Regional Network は高度に冗長化済み Regional Network Gateways DC間接続を多重化することえ1つのDC障 害をリージョン全体に波及させない DCの増設による既存リージョンの増強も
容易になっている Software Defined Network ユーザーには VNET として抽象化され、 かつ構成可能な状態で提供される プラットフォームは頻繁に構成変更が行わ れているが、仮想化されているため影響を 受けない 59 -
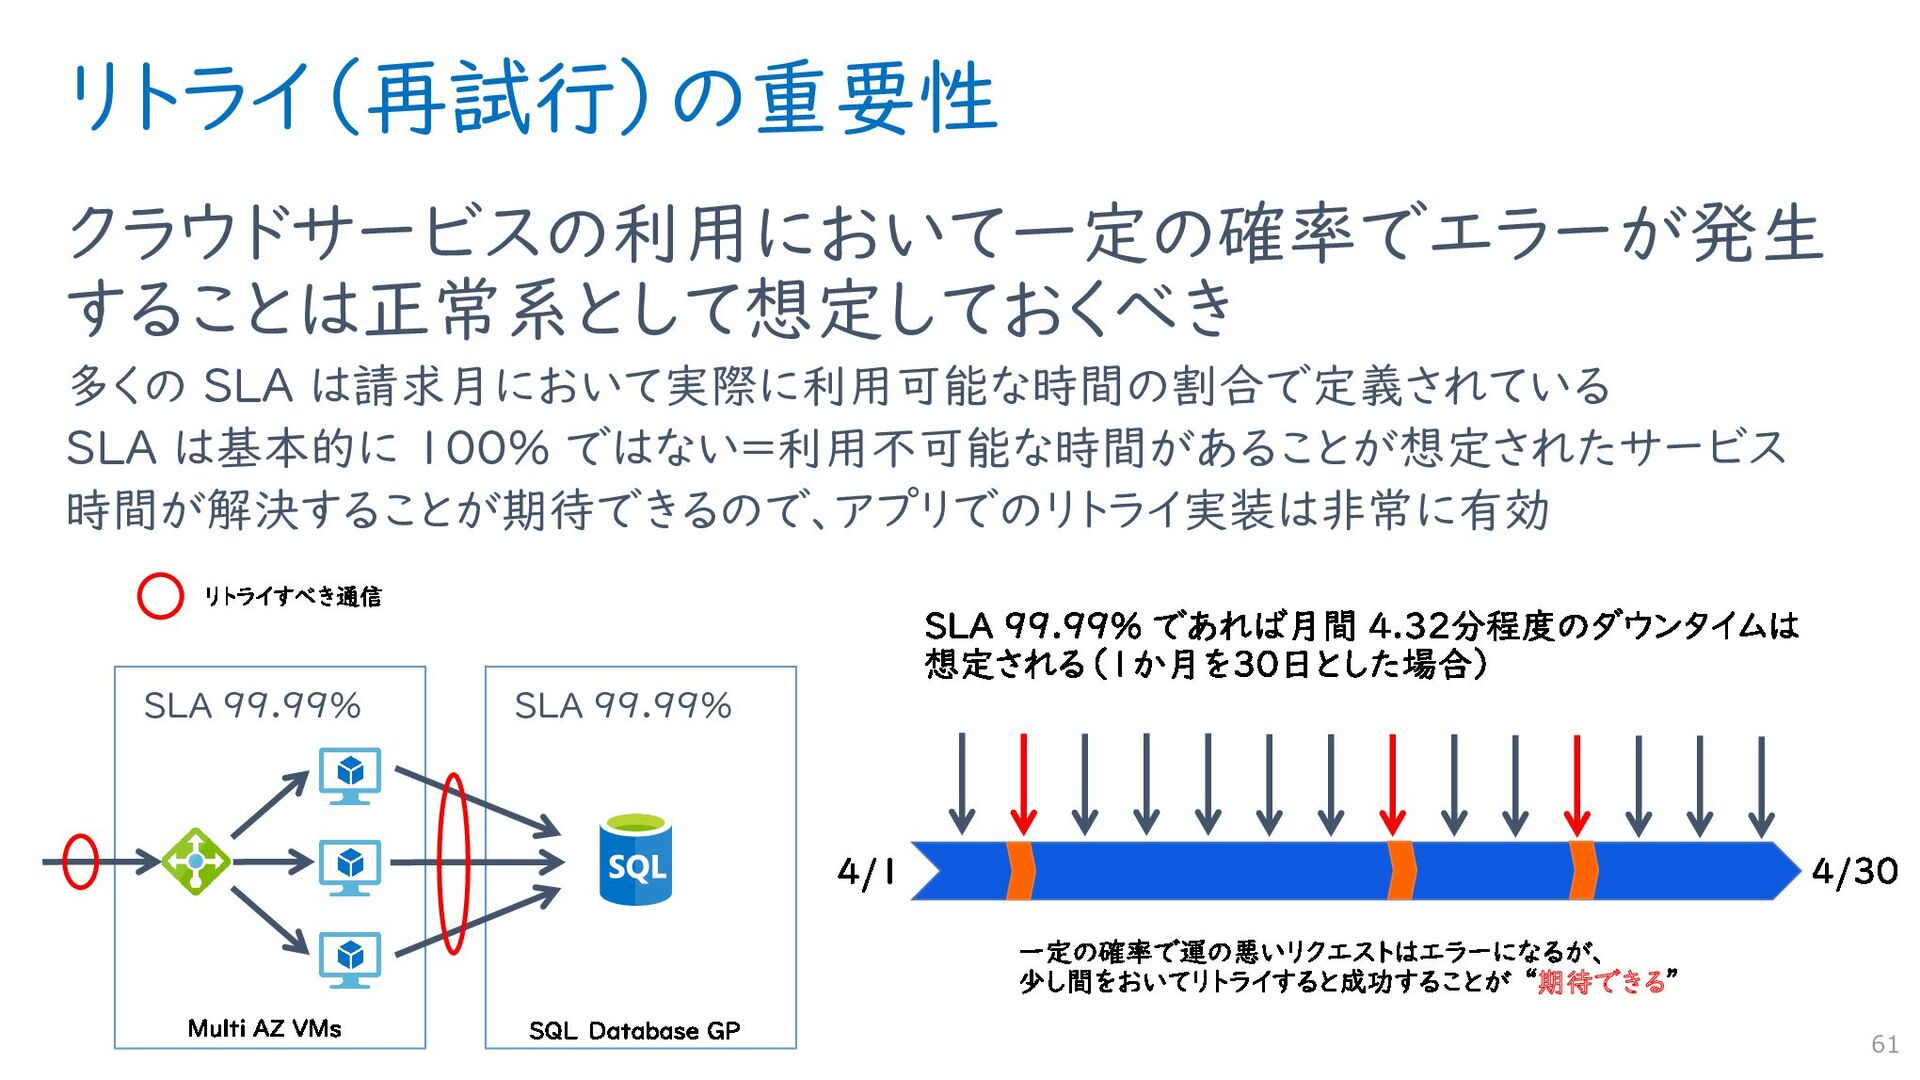
SLA 99.99% SLA 99.99% リトライ(再試行)の重要性 クラウドサービスの利用において一定の確率でエラーが発生 することは正常系として想定しておくべき 多くの SLA は請求月において実際に利用可能な時間の割合で定義されている
SLA は基本的に 100% ではない=利用不可能な時間があることが想定されたサービス 時間が解決することが期待できるので、アプリでのリトライ実装は非常に有効 61 期待できる -
SLA で定義された稼働率の例 代表的な SLA の値とエラーバジェット(月間許容ダウンタイ ム)を整理すると以下のようになる 62 稼働率 月間ダウンタイム SLAの例
95.000 % 2160 分 Standard HDD Managed Disks を使用する単一インスタンス仮想マシン 99.000 % 432 分 LRS/ZRS/GRS ストレージアカウント Cool アクセスレベルに対する読み取りと 書き込み 99.500 % 216 分 Standard SSD Managed Disks を使用する単一インスタンス仮想マシン 99.900 % 43.2分 Premium SSD Managed Disks を使用する単一インスタンス仮想マシン LRS/ZRS/GRS ストレージアカウント 非 Cool アクセスレベルに対する読み取り と書き込み 99.950 % 21.6 分 Free または Shared レベルの Apps を除くすべての App Service 99.990 % 4.32 分 同じ Azure リージョン内の 2 つ以上の可用性ゾーンにまたがりデプロイした 2 つ以上のインスタンスがある仮想マシン 99.995 % 2.16 分 ゾーン冗長デプロイとして構成されている Business Critical または Premium 層の SQL Database -
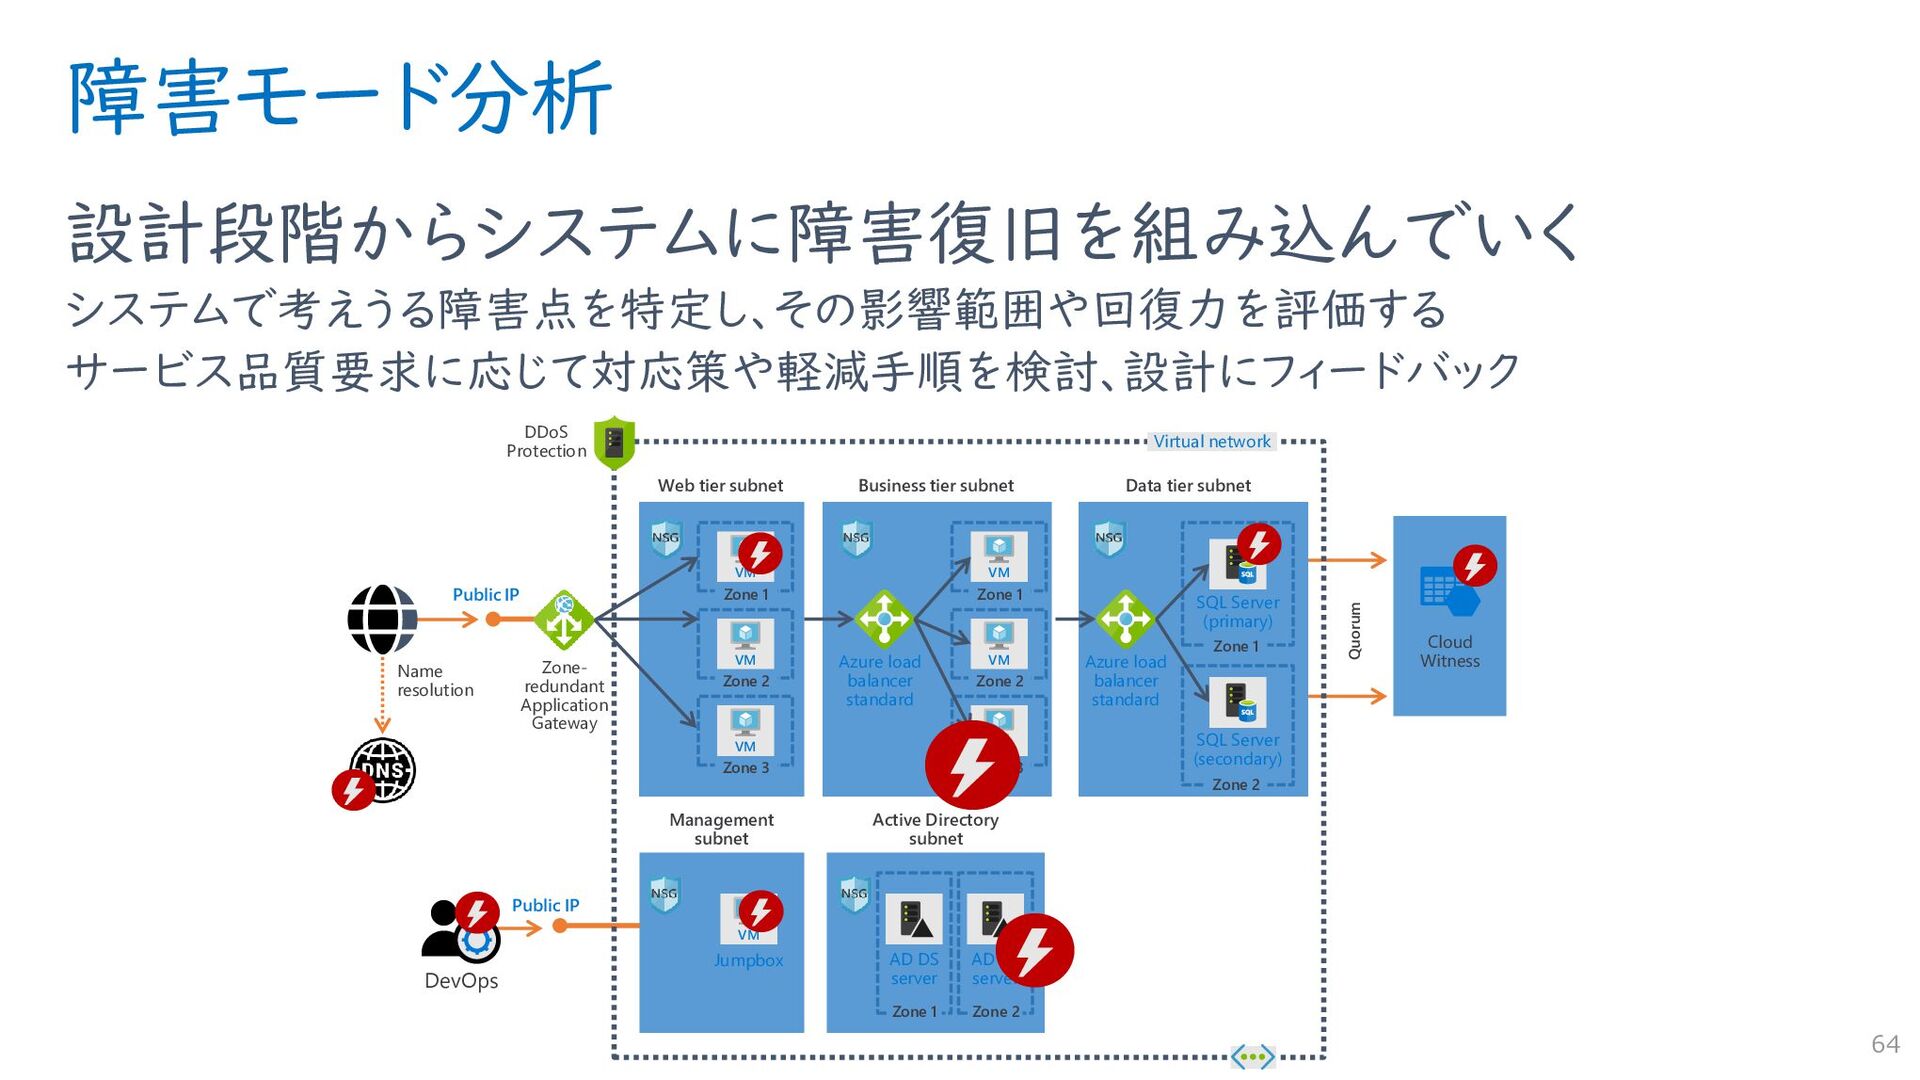
障害モード分析 設計段階からシステムに障害復旧を組み込んでいく システムで考えうる障害点を特定し、その影響範囲や回復力を評価する サービス品質要求に応じて対応策や軽減手順を検討、設計にフィードバック 64 Name resolution Cloud Witness Quorum
Public IP Public IP Zone- redundant Application Gateway DevOps Web tier subnet Business tier subnet Data tier subnet Management subnet Active Directory subnet Azure load balancer standard Azure load balancer standard Virtual network DDoS Protection AD DS server AD DS server VM Jumpbox VM Zone 1 VM Zone 2 VM Zone 3 VM Zone 1 VM Zone 2 VM Zone 3 SQL Server (primary) SQL Server (secondary) Zone 1 Zone 2 Zone 1 Zone 2 -
障害モード分析 リージョン規模、あるいは複合的な大規模障害や広域災害に 対応するにはマルチリージョン構成を検討 65 Web tier subnet Business tier subnet
Data tier subnet Management subnet Active Directory subnet Azure load balancer standard Azure load balancer standard Virtual Network DDoS Protection AD DS server AD DS server VM Jumpbox VM Zone 1 VM Zone 2 VM Zone 3 VM Zone 1 VM Zone 2 VM Zone 3 SQL Server (primary) SQL Server (secondary) Zone 1 Zone 2 Zone 1 Zone 2 Failover Internet Traffic manager Region 1 Region 2 Web tier subnet Business tier subnet Data tier subnet Management subnet Active Directory subnet Azure load balancer standard Azure load balancer standard Virtual network DDoS Protection AD DS server AD DS server VM Jumpbox VM Zone 1 VM Zone 2 VM Zone 3 VM Zone 1 VM Zone 2 VM Zone 3 SQL Server (primary) SQL Server (secondary) Zone 1 Zone 2 Zone 1 Zone 2 -
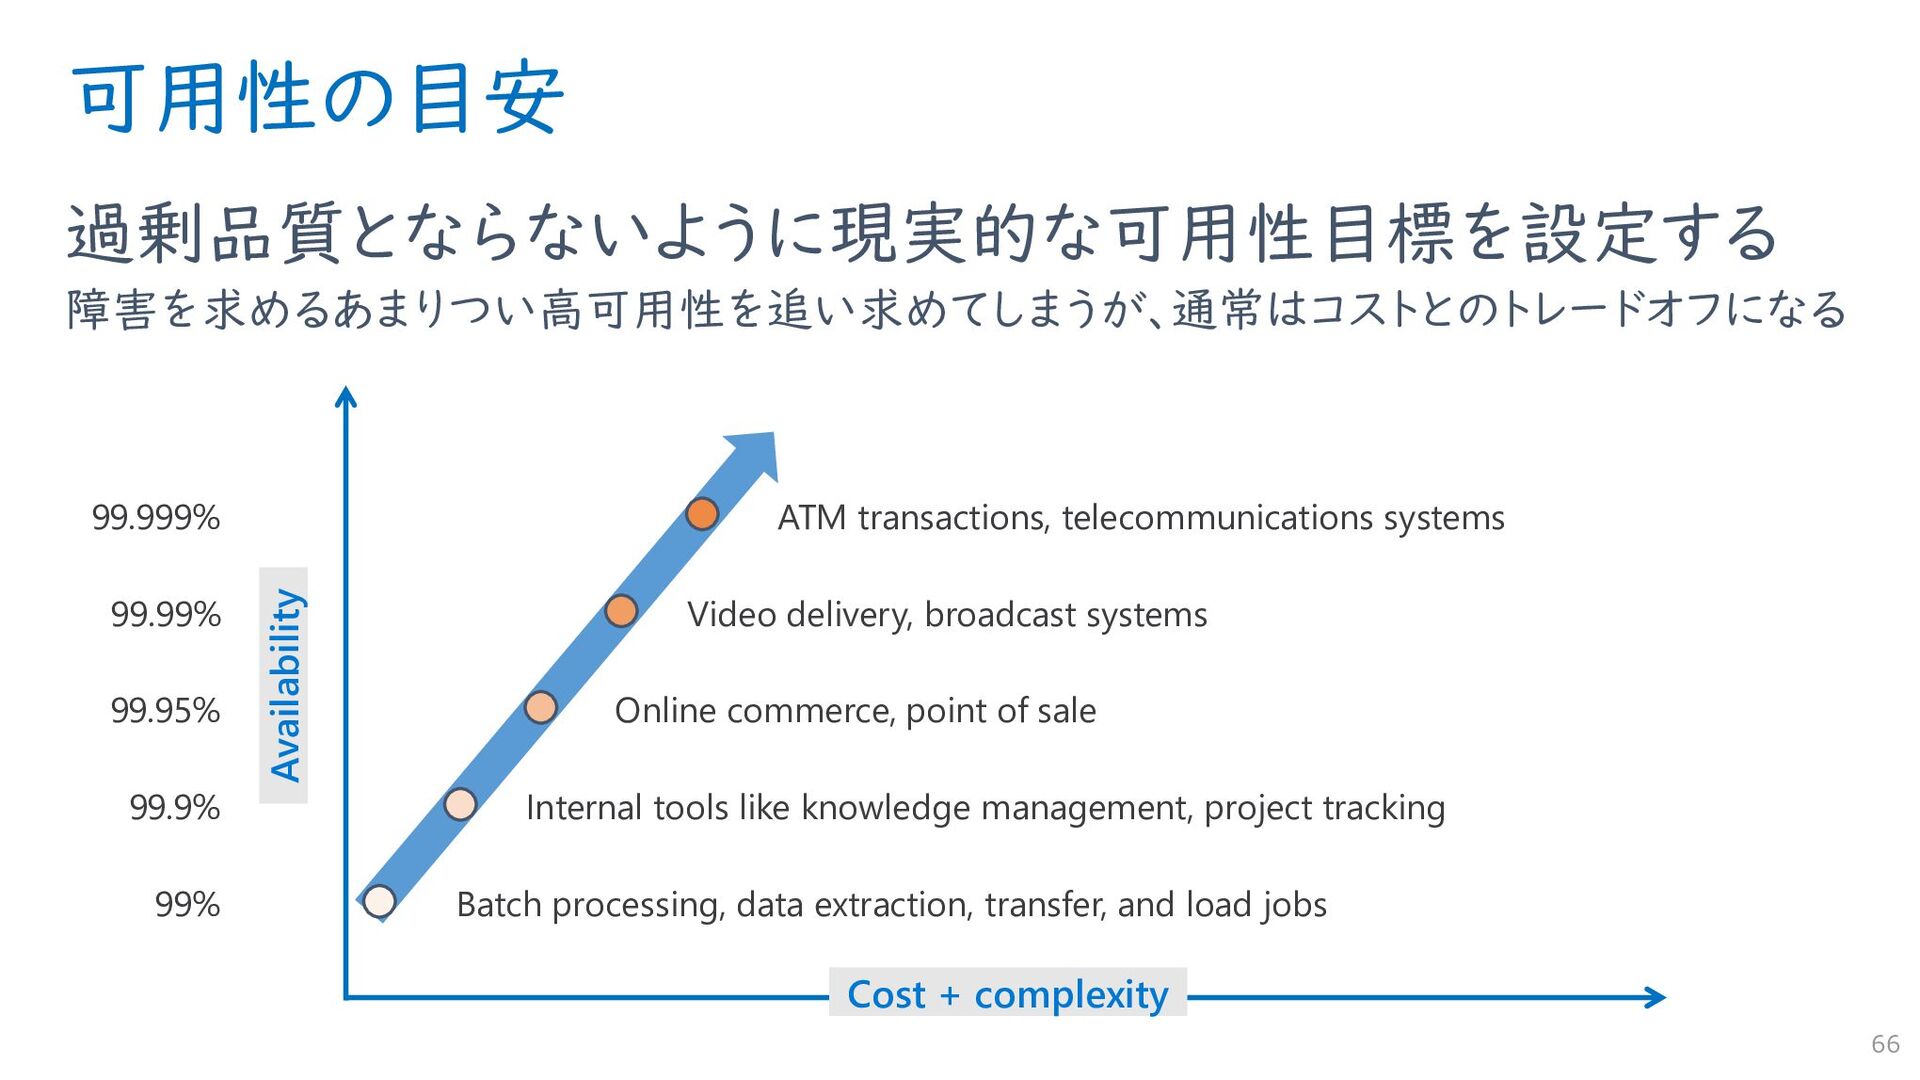
可用性の目安 過剰品質とならないように現実的な可用性目標を設定する 障害を求めるあまりつい高可用性を追い求めてしまうが、通常はコストとのトレードオフになる 66 Cost + complexity Availability Video delivery,
broadcast systems ATM transactions, telecommunications systems Batch processing, data extraction, transfer, and load jobs Internal tools like knowledge management, project tracking Online commerce, point of sale 99% 99.9% 99.95% 99.99% 99.999% -
[参考] 災害対策例の RPO/RTO の目安 種別 方式 RPO/RTO 備考 Web サーバー
Azure Backup/復元 RPO 1日 RTO > 1時間 Azure Backup にてリージョンをまたがる復元の設定(CRR: Cross Region Restore)を実施し、ペアリージョンに て復元。RTO は目安。 Azure Site Recovery RPO < 60分 RTO < 2時間 アプリケーション整合性で最小60分のストレージの差分同期を行い、フェールオーバー時は、ASR の機能にてフェー ルオーバー。RTO は SLA。 データベー ス データベースのバックアップ/復 元 RPO 1日 RTO > 12時間 データベースの機能のバックアップ及び復元。RTO はソフトウェアのインストールも含めた目安。 Azure Backup/復元 RPO 1日 RTO > 1時間 Azure Backup にてリージョンをまたがる復元の設定(CRR: Cross Region Restore)を実施し、ペアリージョンに て復元。RTO は目安。 Azure Site Recovery RPO < 60分 RTO < 2時間 アプリケーション整合性で最小60分のストレージの差分同期を行い、フェールオーバー時は、ASR の機能にてフェー ルオーバー。RTO は SLA。 SQL Server Always On or ミ ラーリング(同期) RPO > 0秒 RTO > 数秒 SQL Server のクラスタ機能(同期コミット:自動フェールオーバー) SQL Server Always On or ミ ラーリング(非同期) RPO > 数秒 RTO > 数分 SQL Server のクラスタ機能(非同期コミット:手動フェールオーバー) SQL Database の自動フェイ ルオーバーグループ RPO < 5秒 RTO < 1時間 自動フェイルオーバーグループでのフェイルオーバー 〇リージョン全体でのサービスの中断から復旧する https://docs.microsoft.com/ja-jp/azure/architecture/resiliency/recovery-loss-azure-region 〇SQL Server のためにディザスター リカバリーを設定する https://docs.microsoft.com/ja-jp/azure/site-recovery/site-recovery-sql -
[参考] 3rd Party Solution 69 Partner Product Solution Key Workloads
CommVault Backup and DR, Workload and Data Migration, Endpoint Data Protection Veritas NetBackup Veritas BackupExec Backup and DR, Workload and Data Migration, Endpoint Data Protection HPE Data Protector HPE VM Explorer StoreOnce CloudBank Backup and DR NetApp ONTAP Cloud NetApp AltaVault Cloud-Based Appliance Backup and DR, Migration, DevTest Data Domain Cloud Tier EMC Avamar Virtual Edition EMC Data Protection Suite CloudBoost Backup and DR Long-Term Retention Veeam® Cloud Connect™ for the Enterprise Veeam® Cloud Connect™ for Service Providers Veeam® Direct Restore to Azure Backup and DR, Workload and Data Migration, Endpoint Data Protection Quest Rapid Recovery Backup and DR, Archiving Carbonite Endpoint Protection Endpoint Data Protection Spectrum Protect Backup and DR for Windows, Linux, and Unix Actifio Sky Backup and DR, Data Migration, DevTest Rubrik Backup and DR, Workload and Data Migration, Archival, Search Cohesity CloudArchive, CloudTier, CloudReplicate Innovative secondary storage consolidation platform with comprehensive integration with Azure Disks and Blobs -
Microsoft Confidential ◼ 本資料は情報提供のみを目的としており、本資料に記載されている情報は、本資料作成時点でのマイクロソフトの見解を示したものです。状況等の変化により、内容は変更される場合があります。本資料 に特別条件等が提示されている場合、かかる条件等は、貴社との有効な契約を通じて決定されます。それまでは、正式に確定するものではありません。従って、本資料の記載内容とは異なる場合がありま す。また、本資料に記載されている価格はいずれも、別段の表記がない限り、参考価格となります。貴社の最終的な購入価格は、貴社のリセラー様により決定されます。マイクロソフトは、本資料の情報に対 して明示的、黙示的または法的な、いかなる保証も行いません。 © 2020 Microsoft
Corporation. All rights reserved. Microsoft, Windows, その他本文中に登場した各製品名は、Microsoft Corporation の米国およびその他の国における登録商標または商標です。 その他、記載されている会社名および製品名は、一般に各社の商標です。 70