Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Kubernetesで作るLLM推論基盤(OCHaCafe Season 12 #1)
Search
oracle4engineer
PRO
October 14, 2026
6
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Kubernetesで作るLLM推論基盤(OCHaCafe Season 12 #1)
oracle4engineer
PRO
October 14, 2026
More Decks by oracle4engineer
See All by oracle4engineer
【Oracle AI Spotlight ウェビナー】AI活用を支えるデータ基盤とは ― いま押さえておきたい Oracle AI Database 26ai の注目機能
oracle4engineer
PRO
1
46
Deep Data Security 機能解説
oracle4engineer
PRO
2
760
kagent で Kubernetes 運用を考える
oracle4engineer
PRO
1
430
Oracle Base Database Service 技術詳細
oracle4engineer
PRO
17
120k
Oracle Cloud Infrastructure:2026年9月度サービス・アップデート
oracle4engineer
PRO
1
290
[2026 Oracle Technical Deep Dive] Apache Iceberg × Oracle AI Database -Oracle Autonomous AI Lakehouseが実現するAI時代のデータ基盤- (2026年9月17日開催)
oracle4engineer
PRO
0
140
[2026 Oracle Technical Deep Dive] エンタープライズAIエージェントを支えるOCIソリューション。ラインナップと特徴を理解しよう! (2026年9月17日開催)
oracle4engineer
PRO
0
690
[2026 Oracle Technical Deep Dive] AI時代のデータベース基盤をどう選ぶ? Exadata Database Serviceの選択肢と使い分け (2026年9月17日開催)
oracle4engineer
PRO
0
250
[2026 Oracle Technical Deep Dive] オンプレミスDBのCloud移行アプローチ:移行計画に基づくメソッドとツールの選択 (2026年9月17日開催)
oracle4engineer
PRO
0
170
Featured
See All Featured
Lessons Learnt from Crawling 1000+ Websites
charlesmeaden
PRO
1
1.6k
The Psychology of Web Performance [Beyond Tellerrand 2023]
tammyeverts
49
3.6k
Making Projects Easy
brettharned
120
6.8k
HDC tutorial
michielstock
2
950
Building a Scalable Design System with Sketch
lauravandoore
464
34k
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.4k
Dealing with People You Can't Stand - Big Design 2015
cassininazir
367
27k
From π to Pie charts
rasagy
1
390
Designing Dashboards & Data Visualisations in Web Apps
destraynor
232
55k
Context Engineering - Making Every Token Count
addyosmani
9
1.2k
Utilizing Notion as your number one productivity tool
mfonobong
4
610
The Straight Up "How To Draw Better" Workshop
denniskardys
239
140k
Transcript
Kubernetesで実現する LLM推論基盤 Yuki Sogawa ⽇本オラクル
⾃⼰紹介 バックグラウンド ⼤阪⼤学でデータセンターの省電⼒化の研究をしていました 趣味 ギター、バイク、ゲームなど 曽川 宥輝 ⽇本オラクル CloudNative/AI,ML クラウドエンジニア
Copyright © 2026, Oracle and/or its affiliates 2
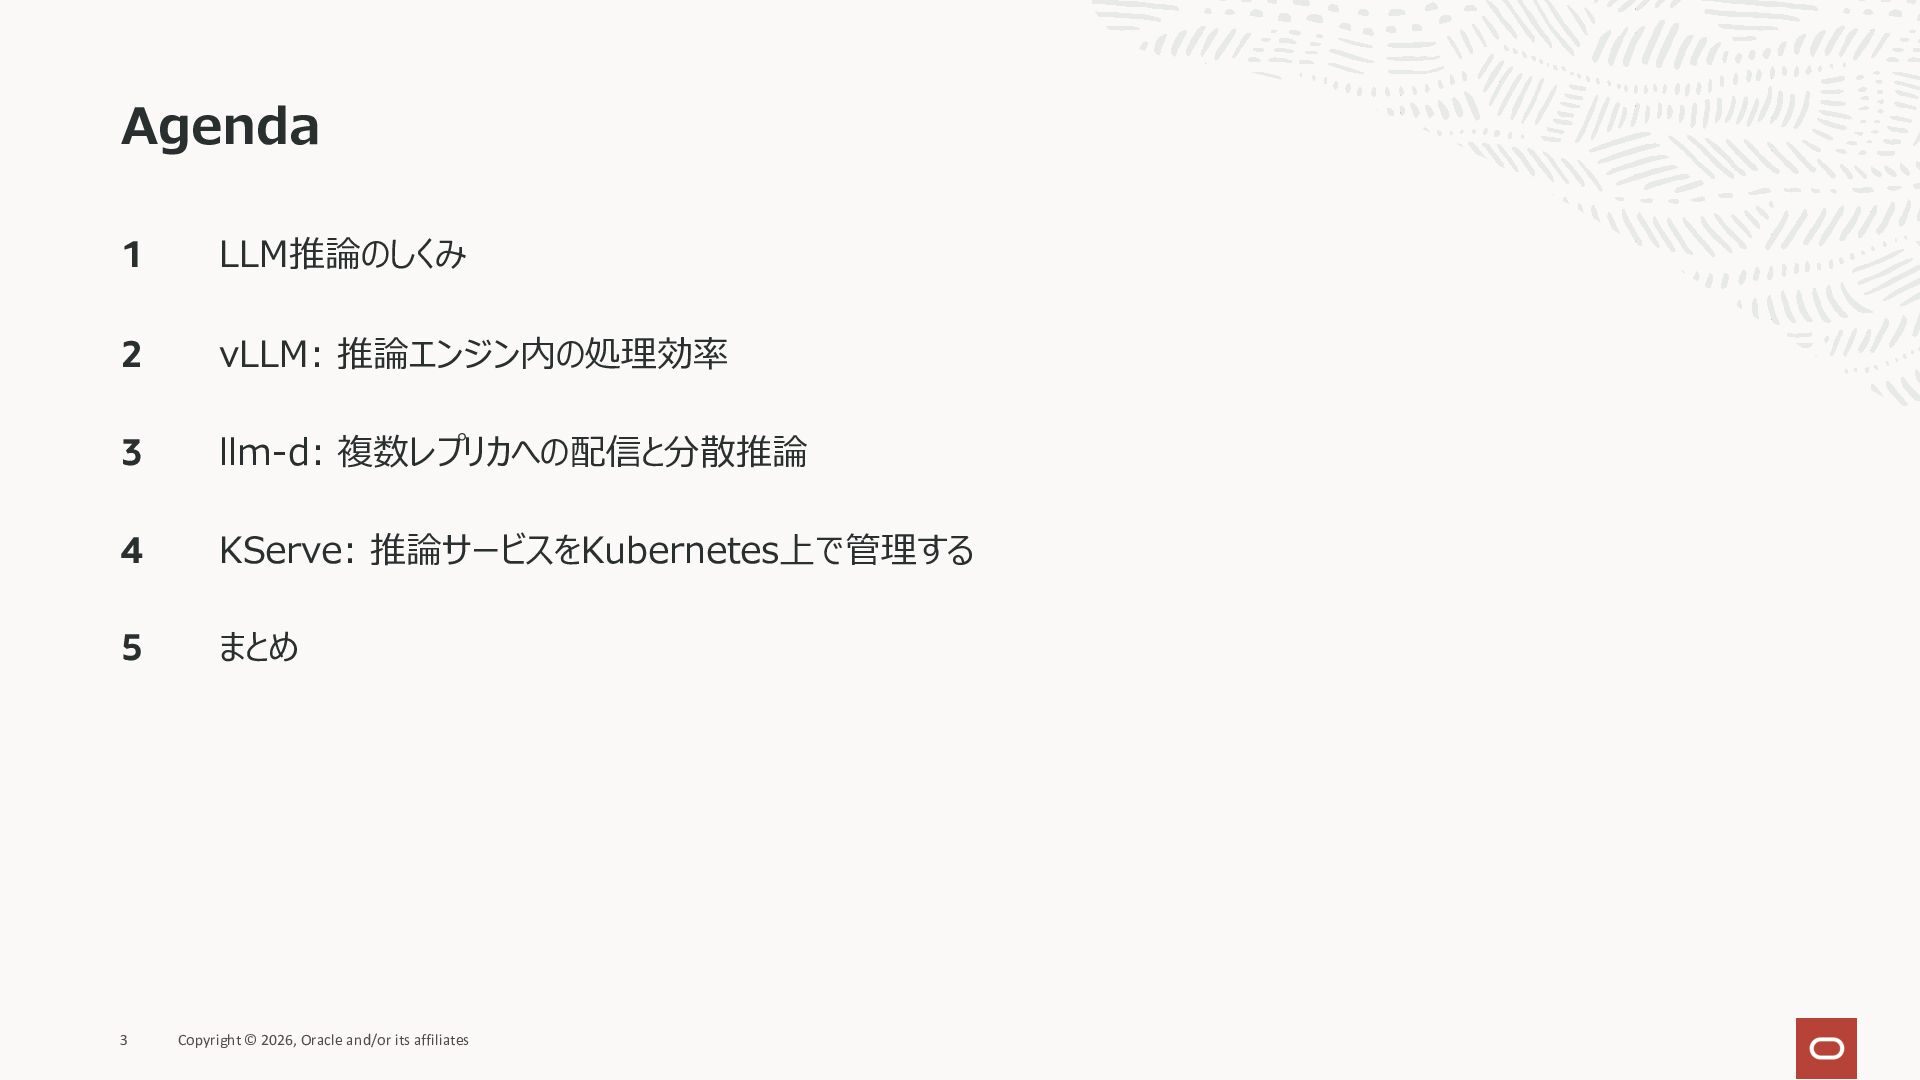
Agenda 1 LLM推論のしくみ 2 vLLM: 推論エンジン内の処理効率 3 llm-d: 複数レプリカへの配信と分散推論 4
KServe: 推論サービスをKubernetes上で管理する 5 まとめ 3 Copyright © 2026, Oracle and/or its affiliates
LLM推論の仕組み
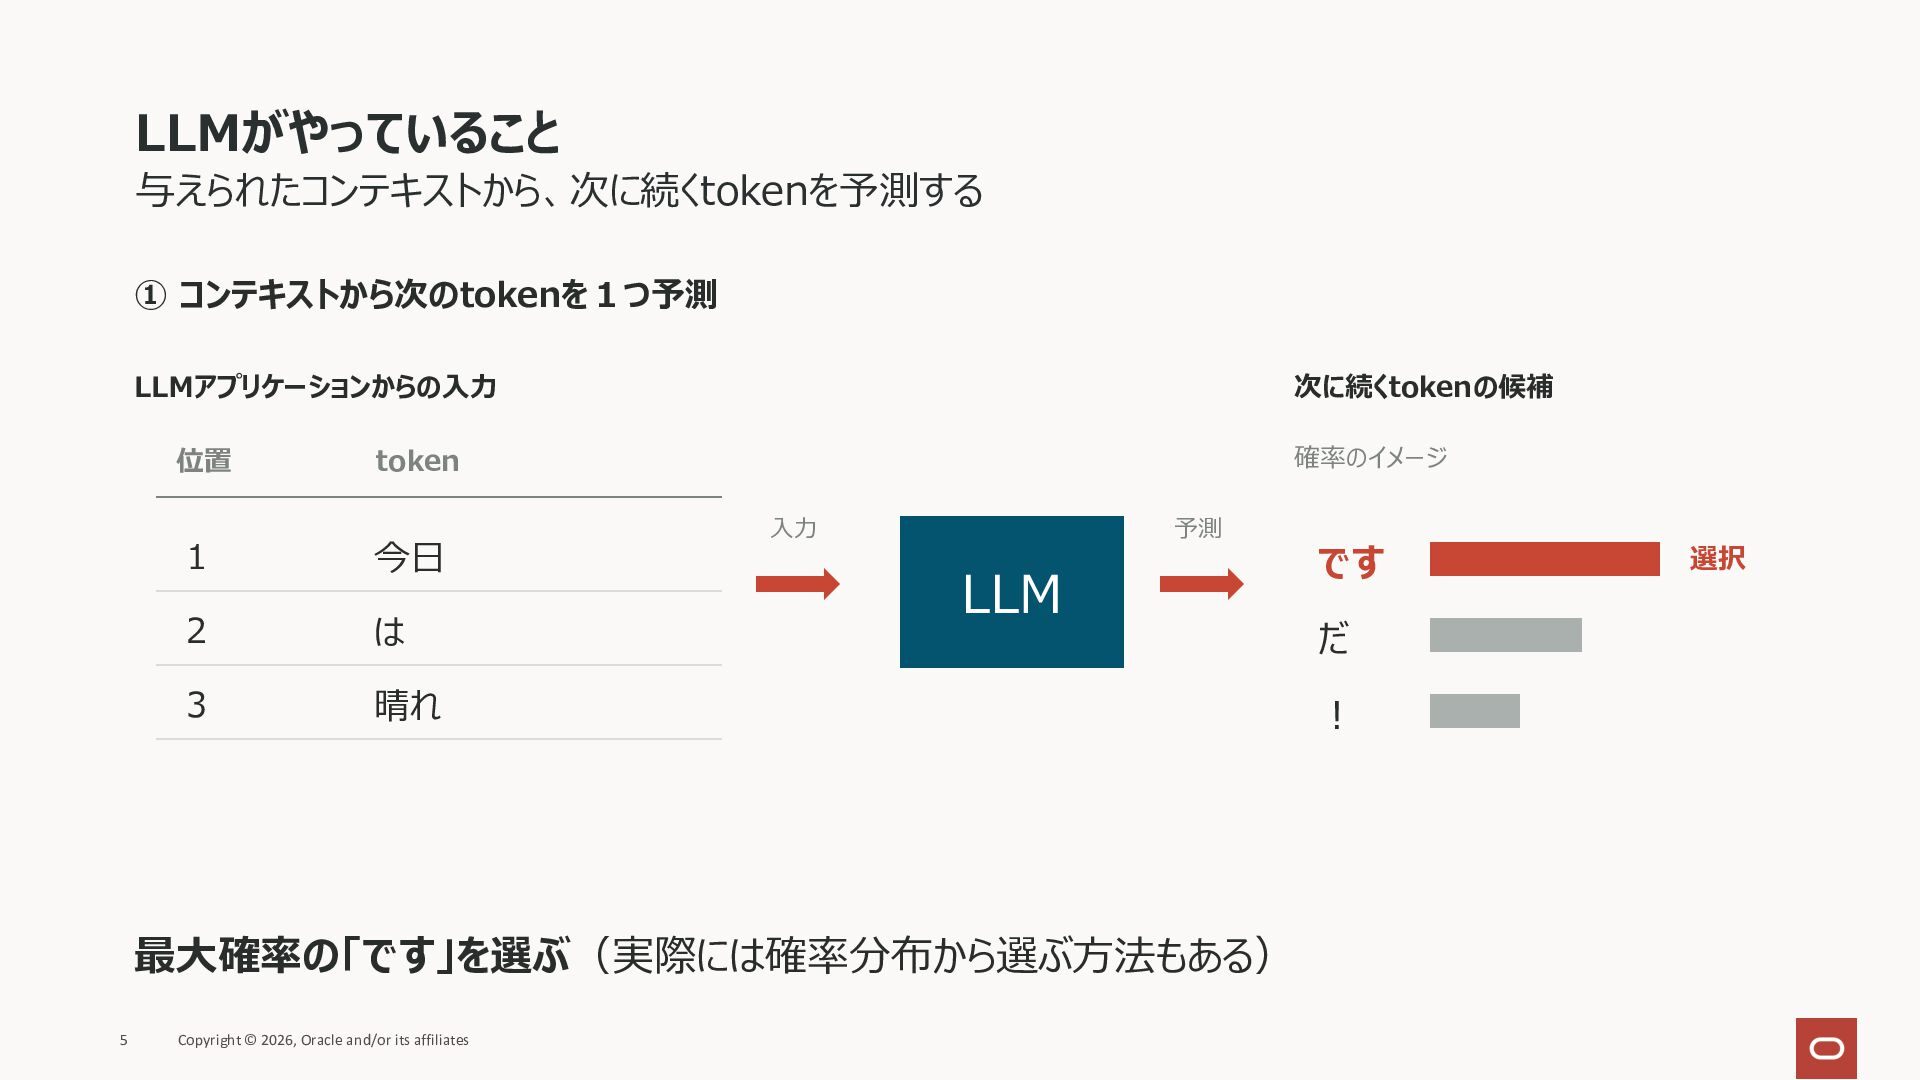
LLMがやっていること 与えられたコンテキストから、次に続くtokenを予測する ① コンテキストから次のtokenを1つ予測 LLMアプリケーションからの⼊⼒ 位置 次に続くtokenの候補 確率のイメージ token 1
今⽇ 2 は 3 晴れ ⼊⼒ 予測 LLM 最⼤確率の「です」を選ぶ(実際には確率分布から選ぶ⽅法もある) 5 Copyright © 2026, Oracle and/or its affiliates です だ ︕ 選択
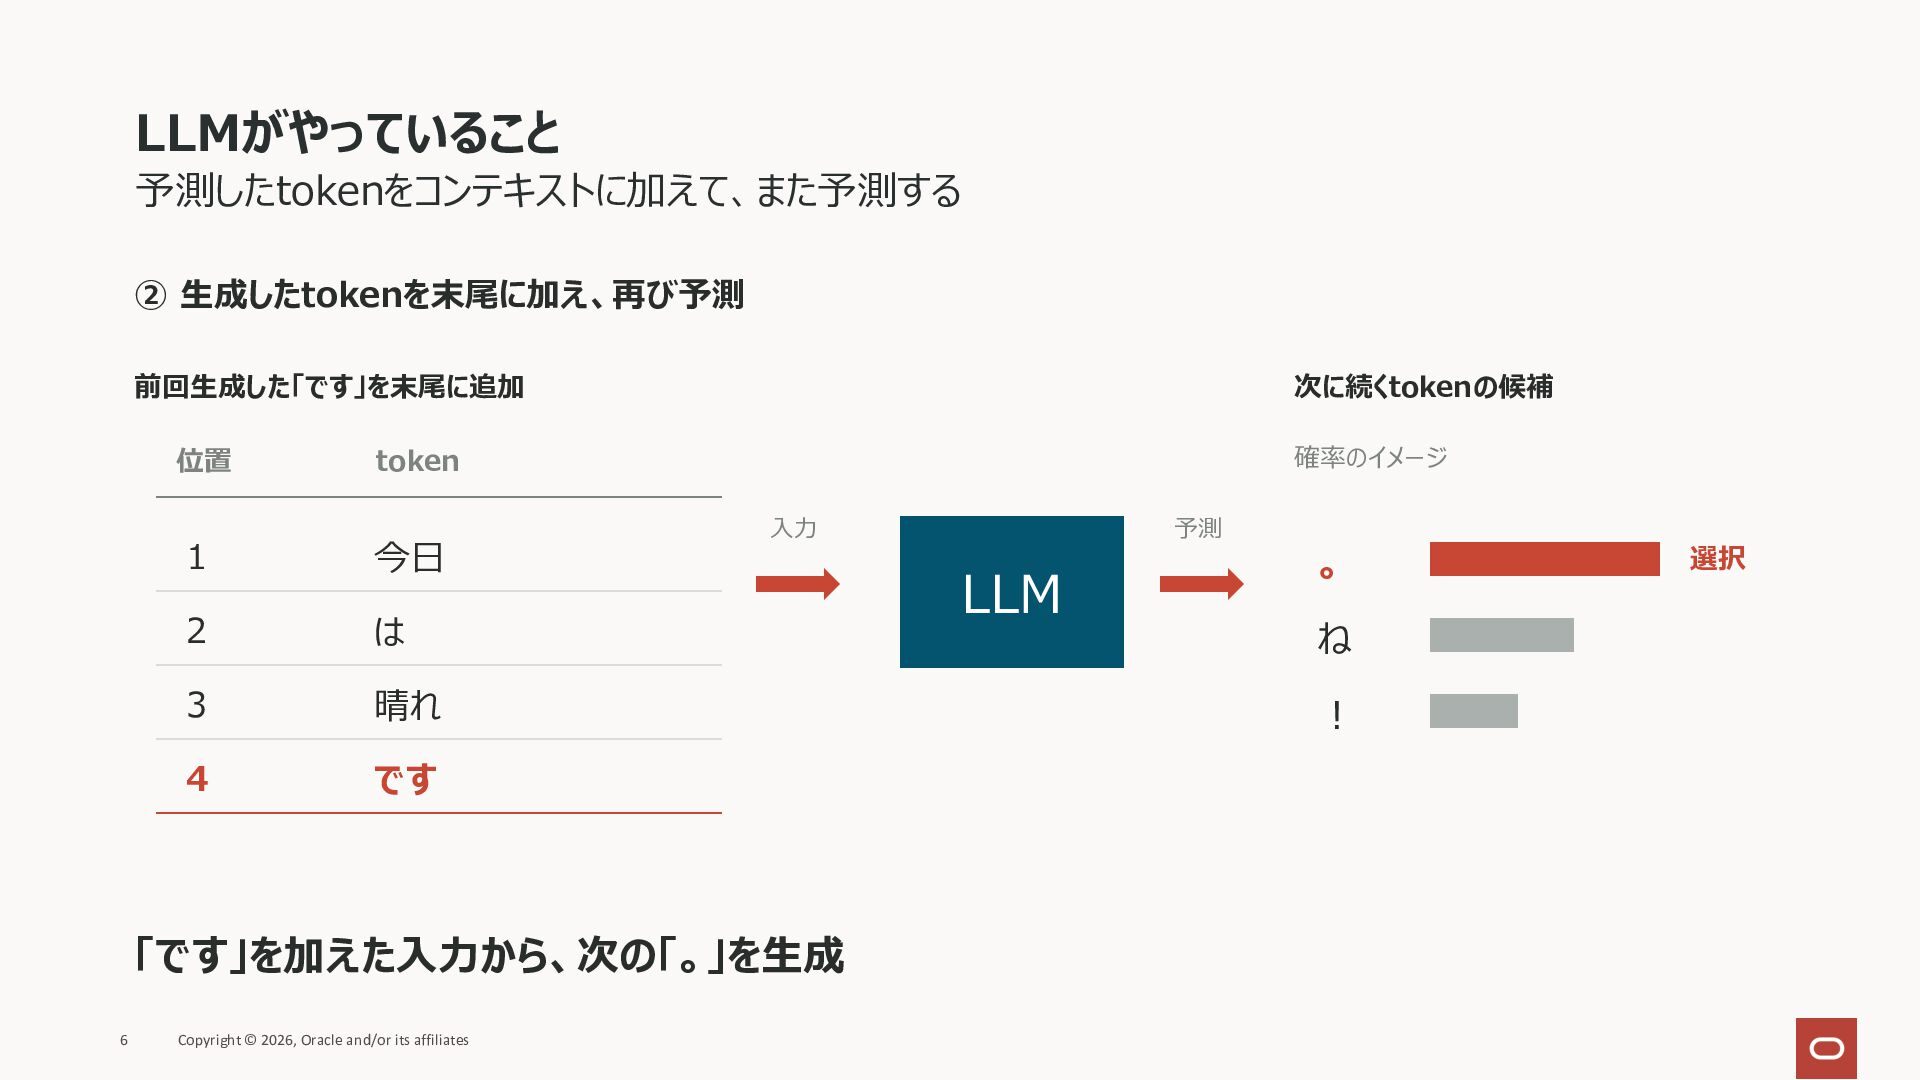
LLMがやっていること 予測したtokenをコンテキストに加えて、また予測する ② ⽣成したtokenを末尾に加え、再び予測 前回⽣成した「です」を末尾に追加 位置 次に続くtokenの候補 確率のイメージ token 1
今⽇ 2 は 3 晴れ 4 です ⼊⼒ 「です」を加えた⼊⼒から、次の「。」を⽣成 6 Copyright © 2026, Oracle and/or its affiliates 予測 LLM 。 ね ︕ 選択
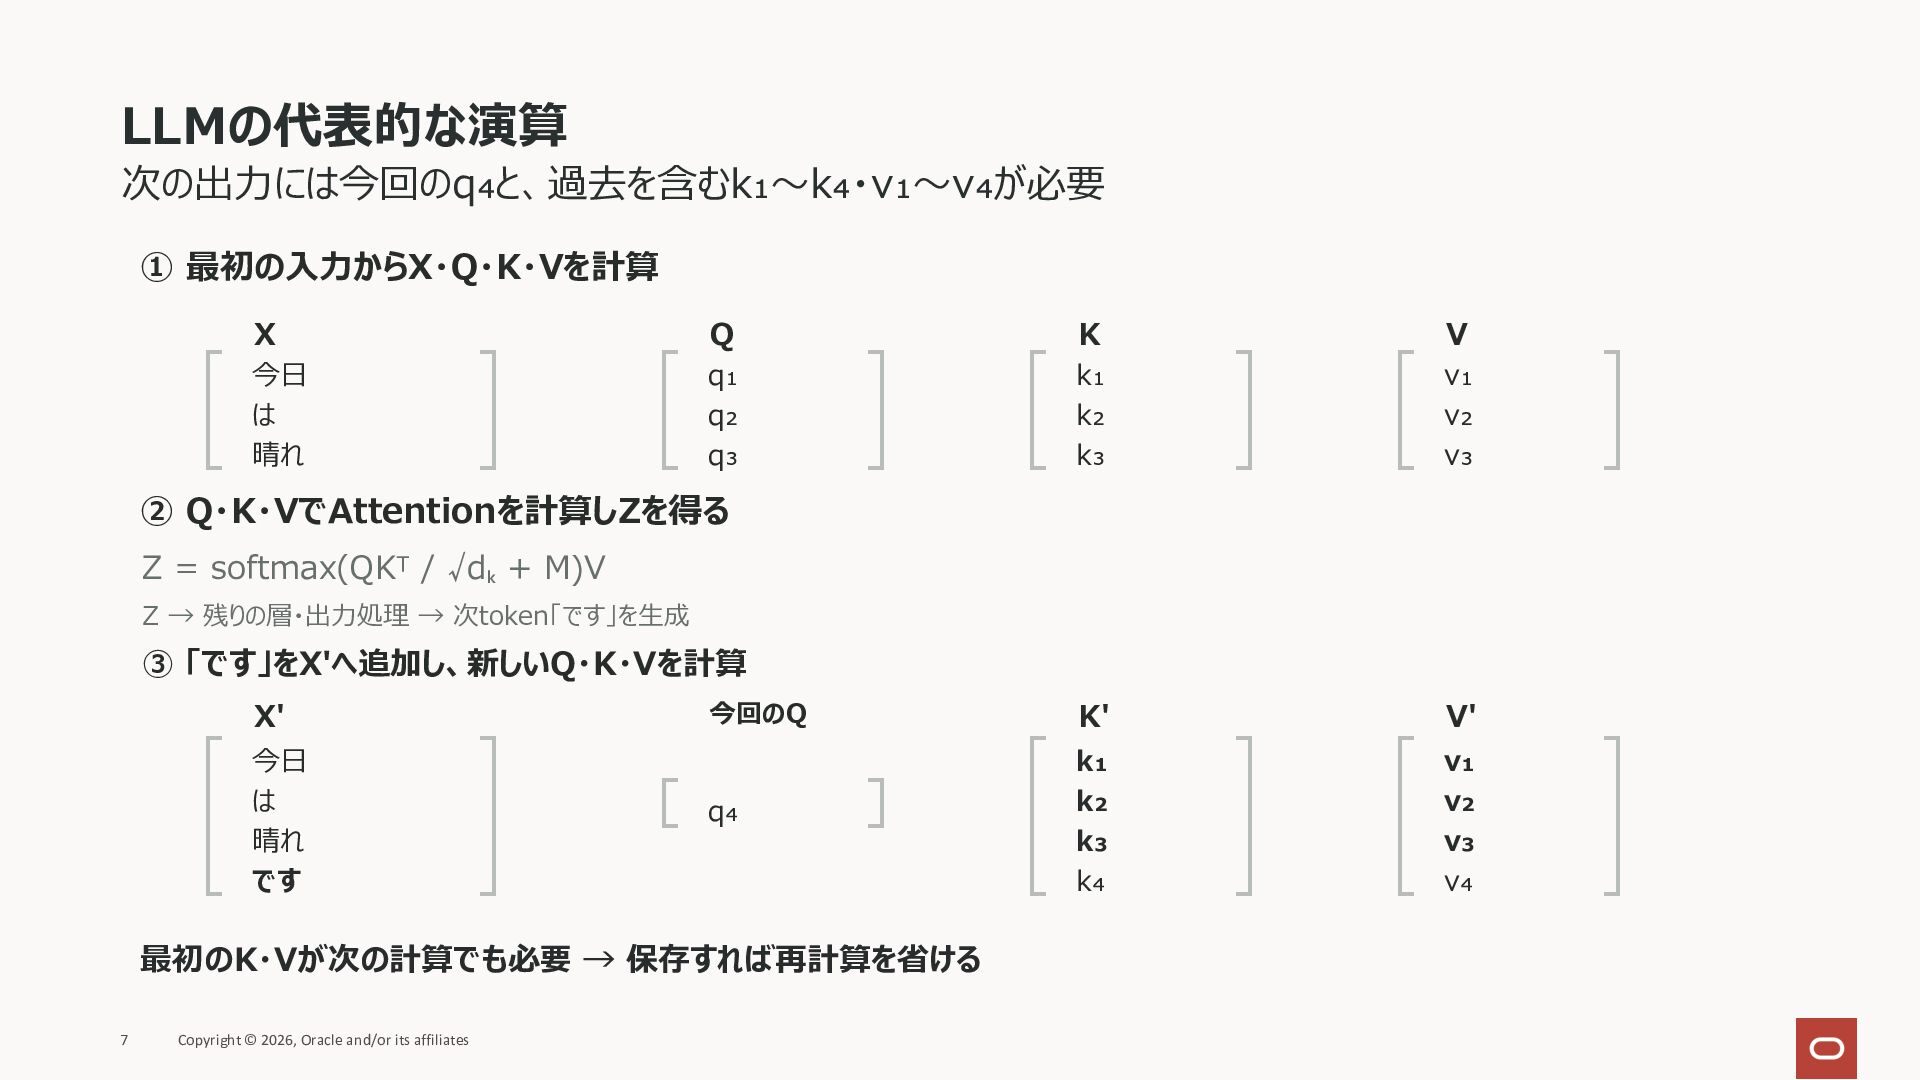
LLMの代表的な演算 次の出⼒には今回のq₄と、過去を含むk₁〜k₄・v₁〜v₄が必要 ① 最初の⼊⼒からX・Q・K・Vを計算 X Q K V 今⽇ は
晴れ q₁ q₂ q₃ k₁ k₂ k₃ v₁ v₂ v₃ 今回のQ K′ V′ q₄ k₁ k₂ k₃ k₄ v₁ v₂ v₃ v₄ ② Q・K・VでAttentionを計算しZを得る Z = softmax(QKᵀ / √dₖ + M)V Z → 残りの層・出⼒処理 → 次token「です」を⽣成 ③ 「です」をX′へ追加し、新しいQ・K・Vを計算 X′ 今⽇ は 晴れ です 最初のK・Vが次の計算でも必要 → 保存すれば再計算を省ける 7 Copyright © 2026, Oracle and/or its affiliates
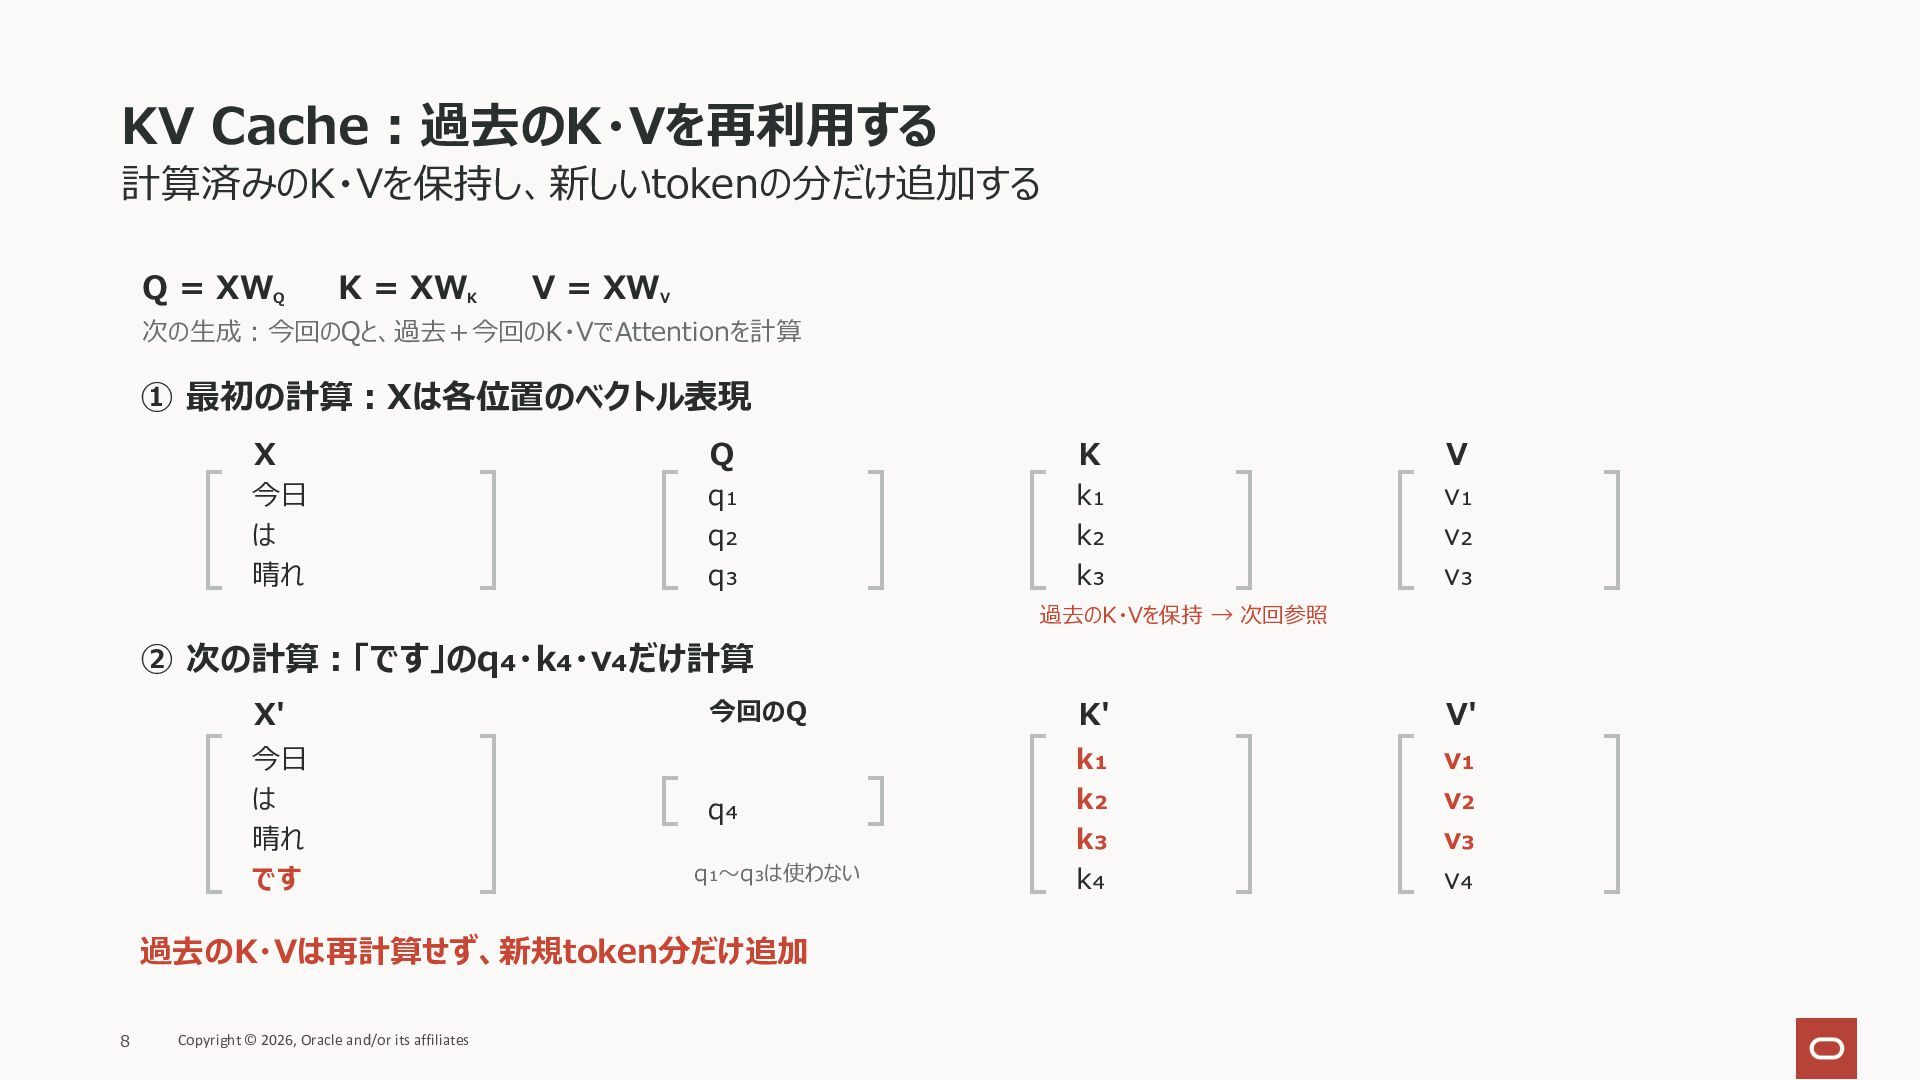
KV Cache︓過去のK・Vを再利⽤する 計算済みのK・Vを保持し、新しいtokenの分だけ追加する Q = XWQ K = XWK V
= XWV 次の⽣成︓今回のQと、過去+今回のK・VでAttentionを計算 ① 最初の計算︓Xは各位置のベクトル表現 X Q K V 今⽇ は 晴れ q₁ q₂ q₃ k₁ k₂ k₃ v₁ v₂ v₃ 過去のK・Vを保持 → 次回参照 ② 次の計算︓「です」のq₄・k₄・v₄だけ計算 X′ 今⽇ は 晴れ です 今回のQ K′ V′ q₄ k₁ k₂ k₃ k₄ v₁ v₂ v₃ v₄ q₁〜q₃は使わない 過去のK・Vは再計算せず、新規token分だけ追加 8 Copyright © 2026, Oracle and/or its affiliates
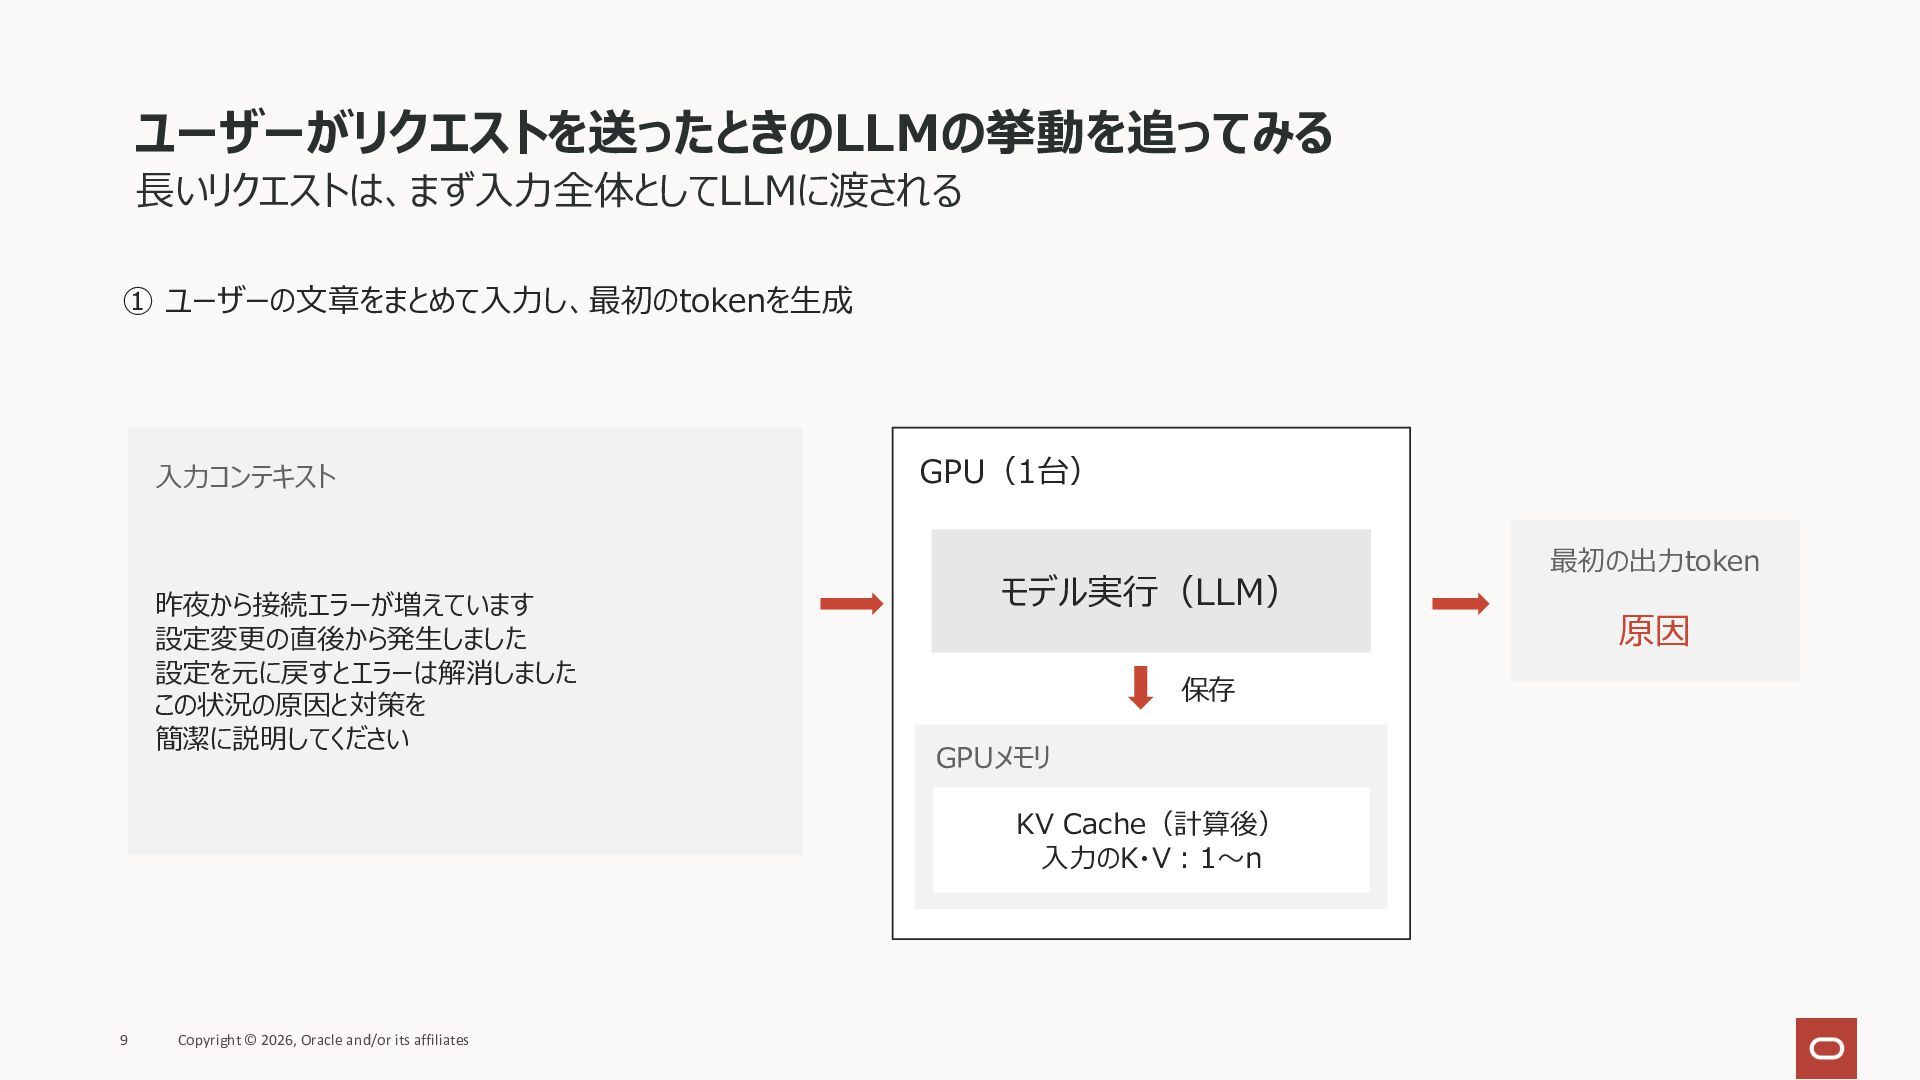
ユーザーがリクエストを送ったときのLLMの挙動を追ってみる ⻑いリクエストは、まず⼊⼒全体としてLLMに渡される ① ユーザーの⽂章をまとめて⼊⼒し、最初のtokenを⽣成 ⼊⼒コンテキスト 昨夜から接続エラーが増えています 設定変更の直後から発⽣しました 設定を元に戻すとエラーは解消しました この状況の原因と対策を 簡潔に説明してください
GPU(1台) モデル実⾏(LLM) 保存 GPUメモリ KV Cache(計算後) ⼊⼒のK・V︓1〜n 9 Copyright © 2026, Oracle and/or its affiliates 最初の出⼒token 原因
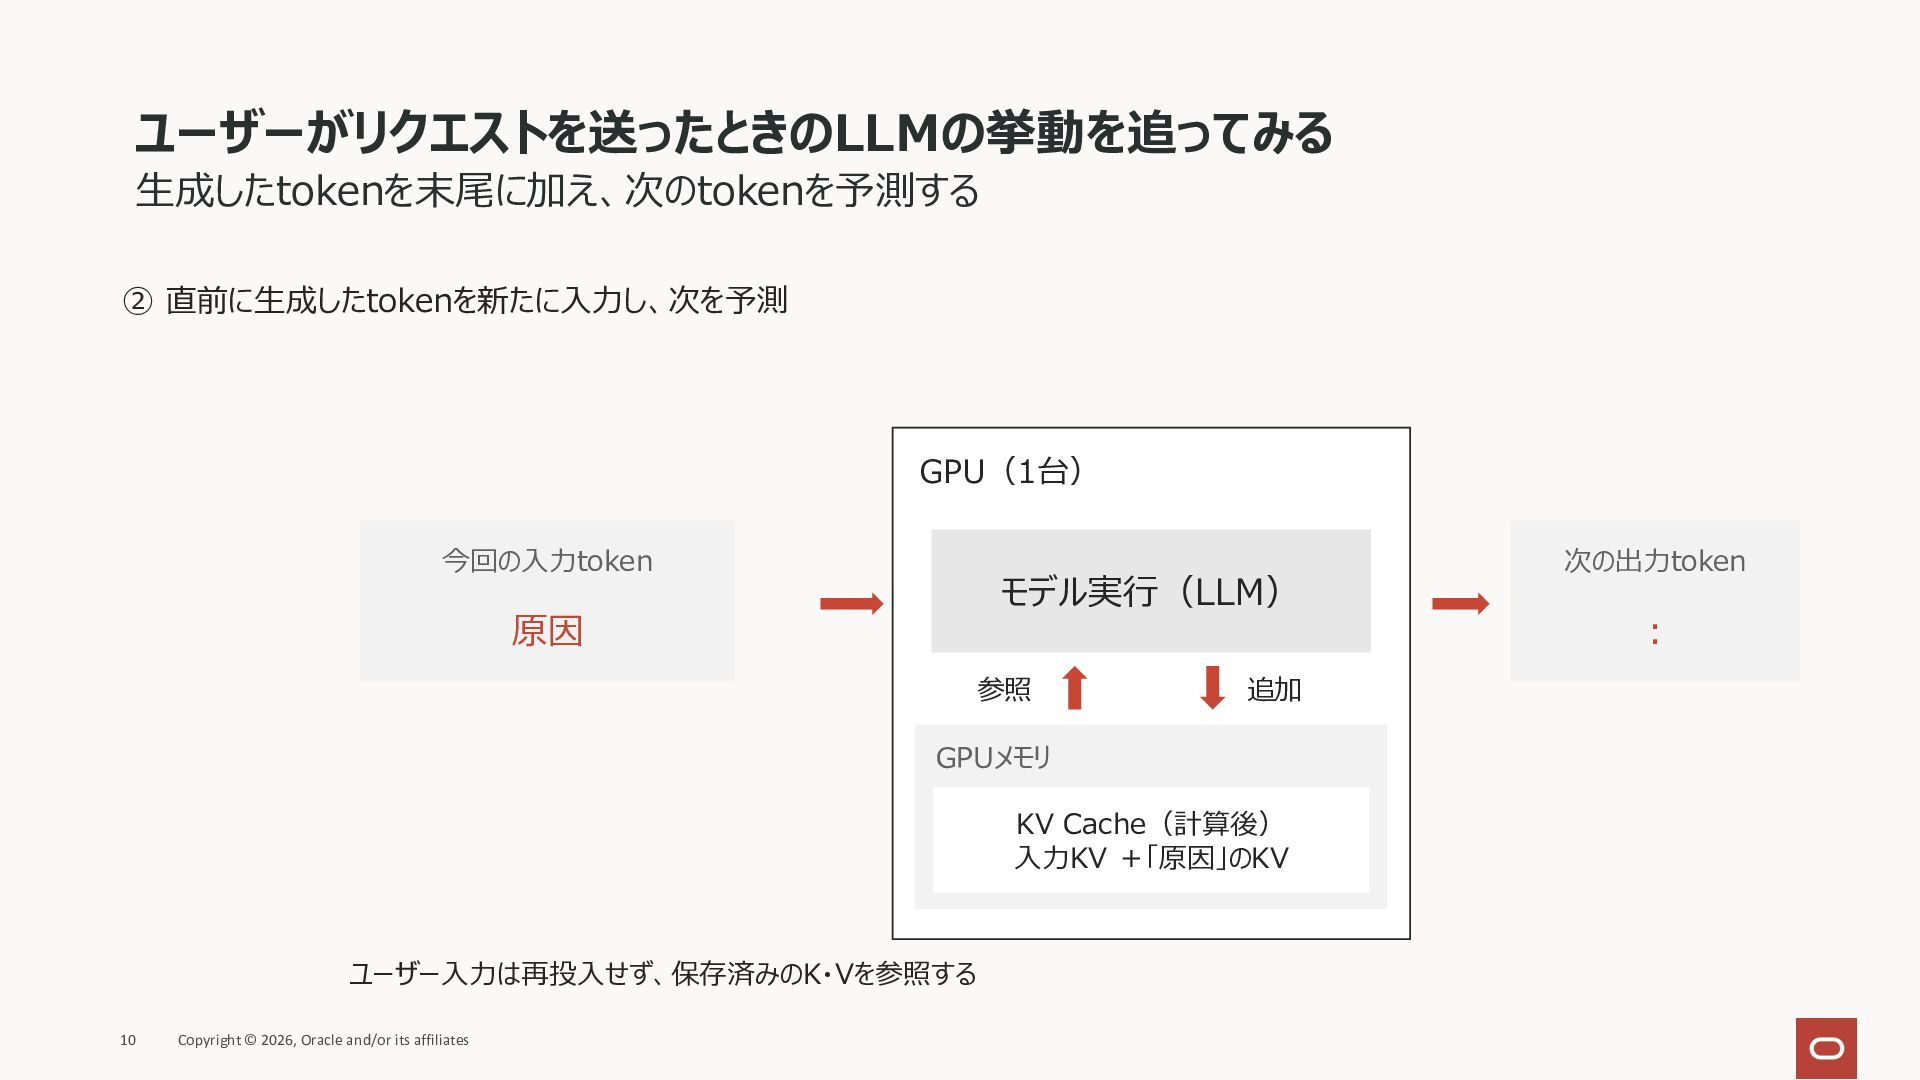
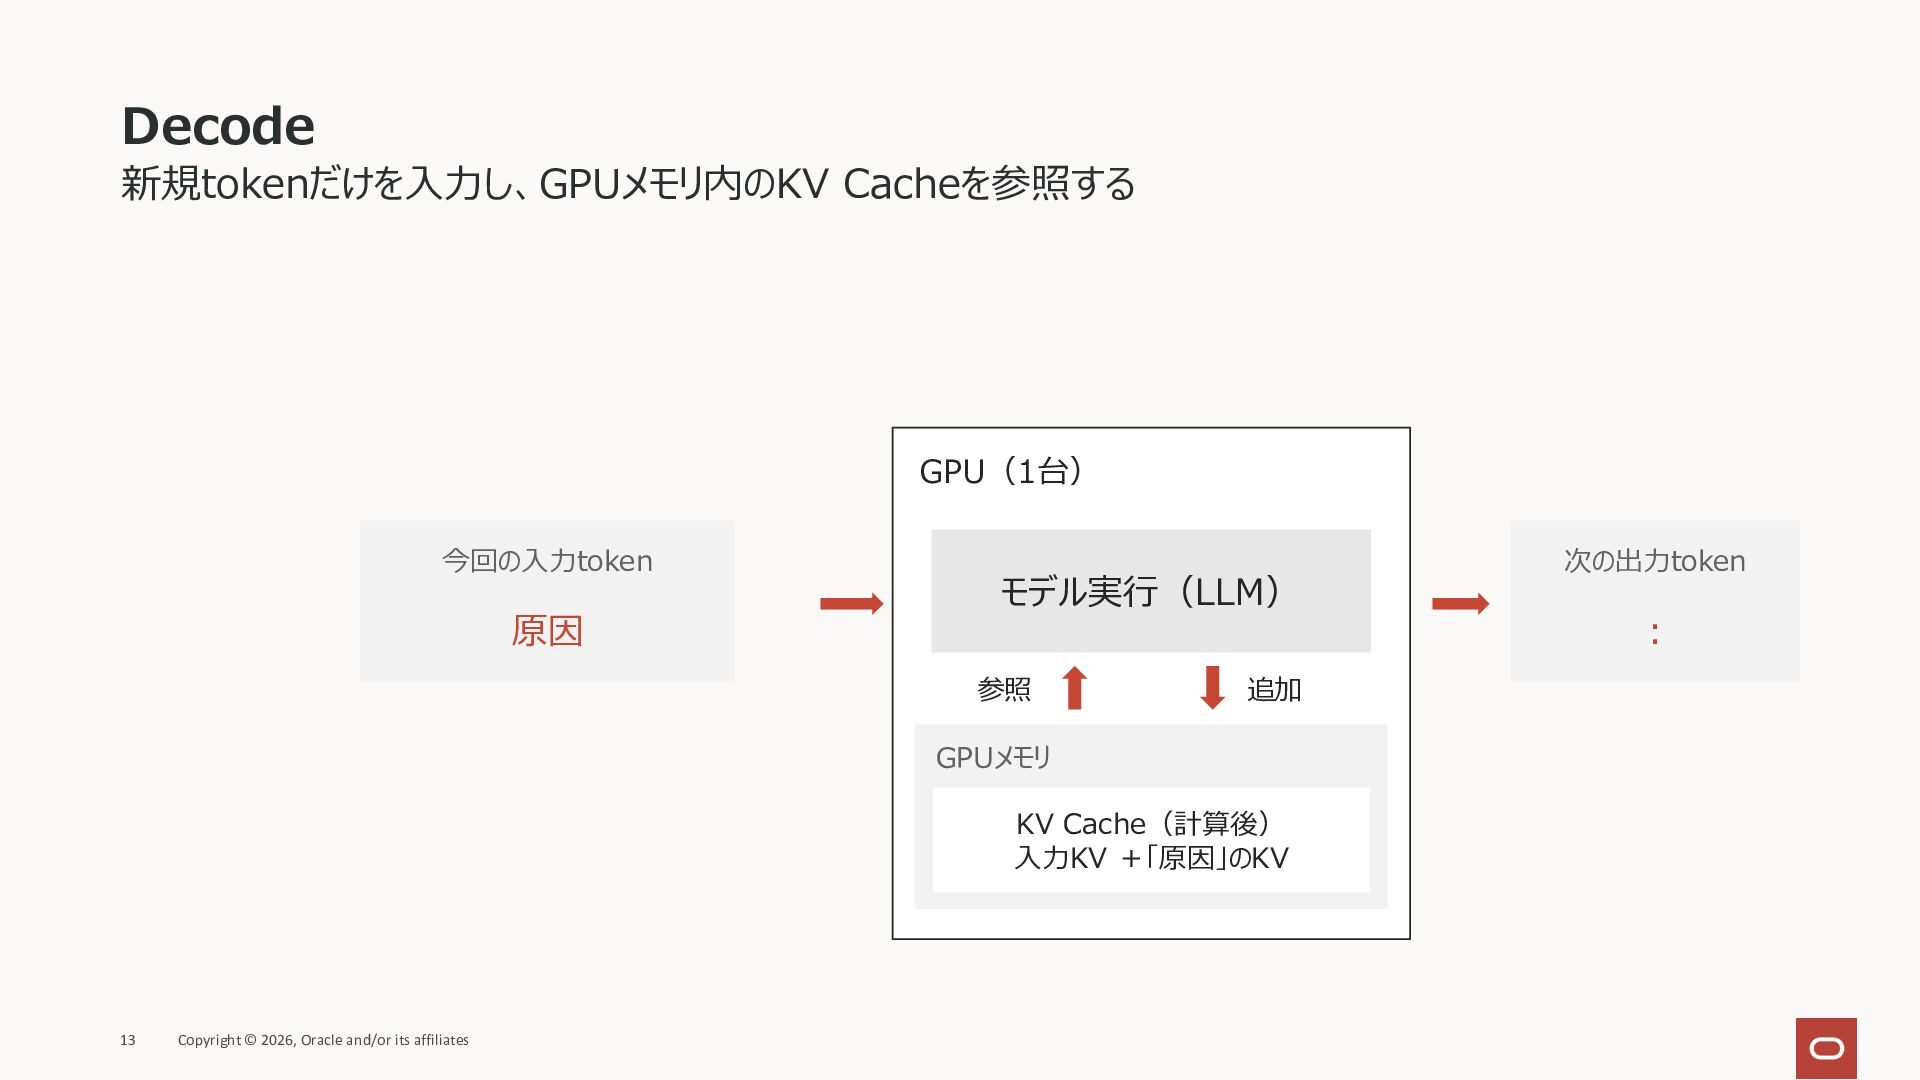
ユーザーがリクエストを送ったときのLLMの挙動を追ってみる ⽣成したtokenを末尾に加え、次のtokenを予測する ② 直前に⽣成したtokenを新たに⼊⼒し、次を予測 GPU(1台) 今回の⼊⼒token モデル実⾏(LLM) 原因 参照 追加
GPUメモリ KV Cache(計算後) ⼊⼒KV +「原因」のKV ユーザー⼊⼒は再投⼊せず、保存済みのK・Vを参照する 10 Copyright © 2026, Oracle and/or its affiliates 次の出⼒token ︓
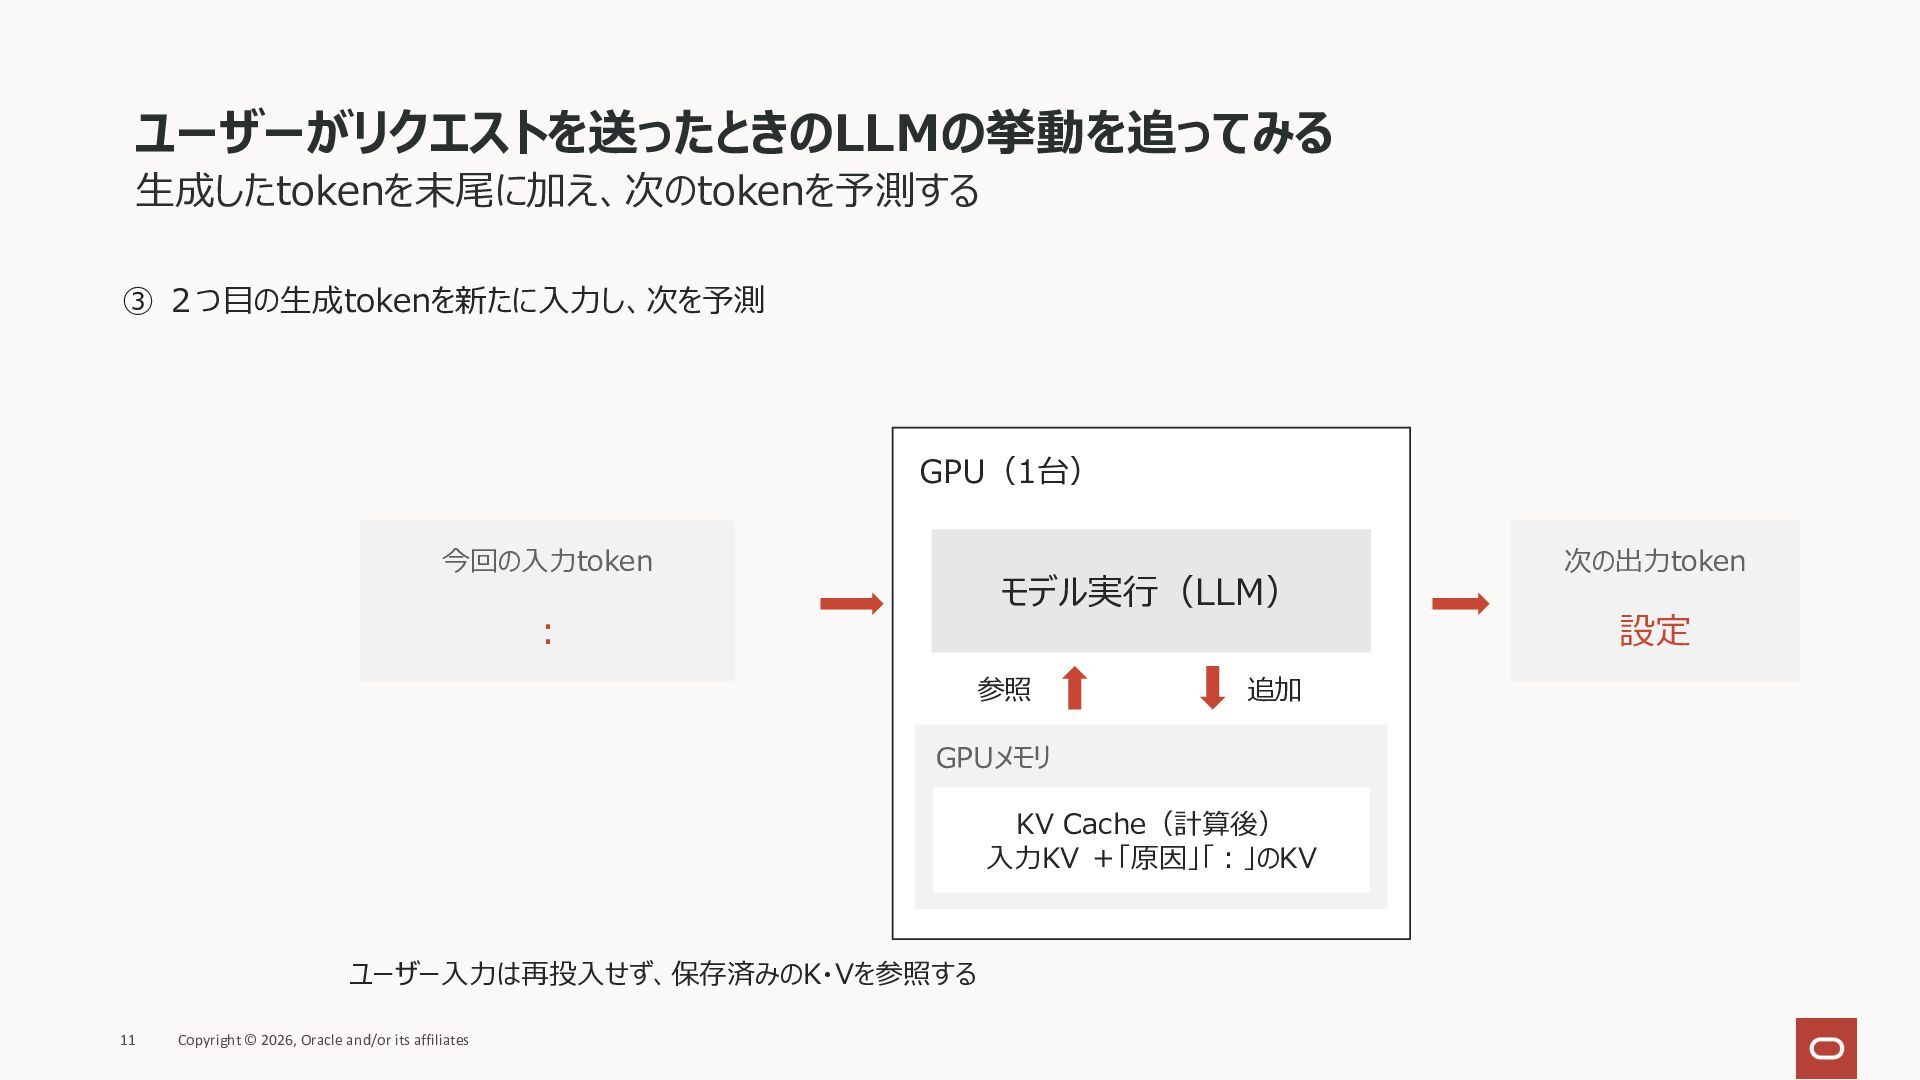
ユーザーがリクエストを送ったときのLLMの挙動を追ってみる ⽣成したtokenを末尾に加え、次のtokenを予測する ③ 2つ⽬の⽣成tokenを新たに⼊⼒し、次を予測 GPU(1台) 今回の⼊⼒token モデル実⾏(LLM) ︓ 参照 追加
GPUメモリ KV Cache(計算後) ⼊⼒KV +「原因」「︓」のKV ユーザー⼊⼒は再投⼊せず、保存済みのK・Vを参照する 11 Copyright © 2026, Oracle and/or its affiliates 次の出⼒token 設定
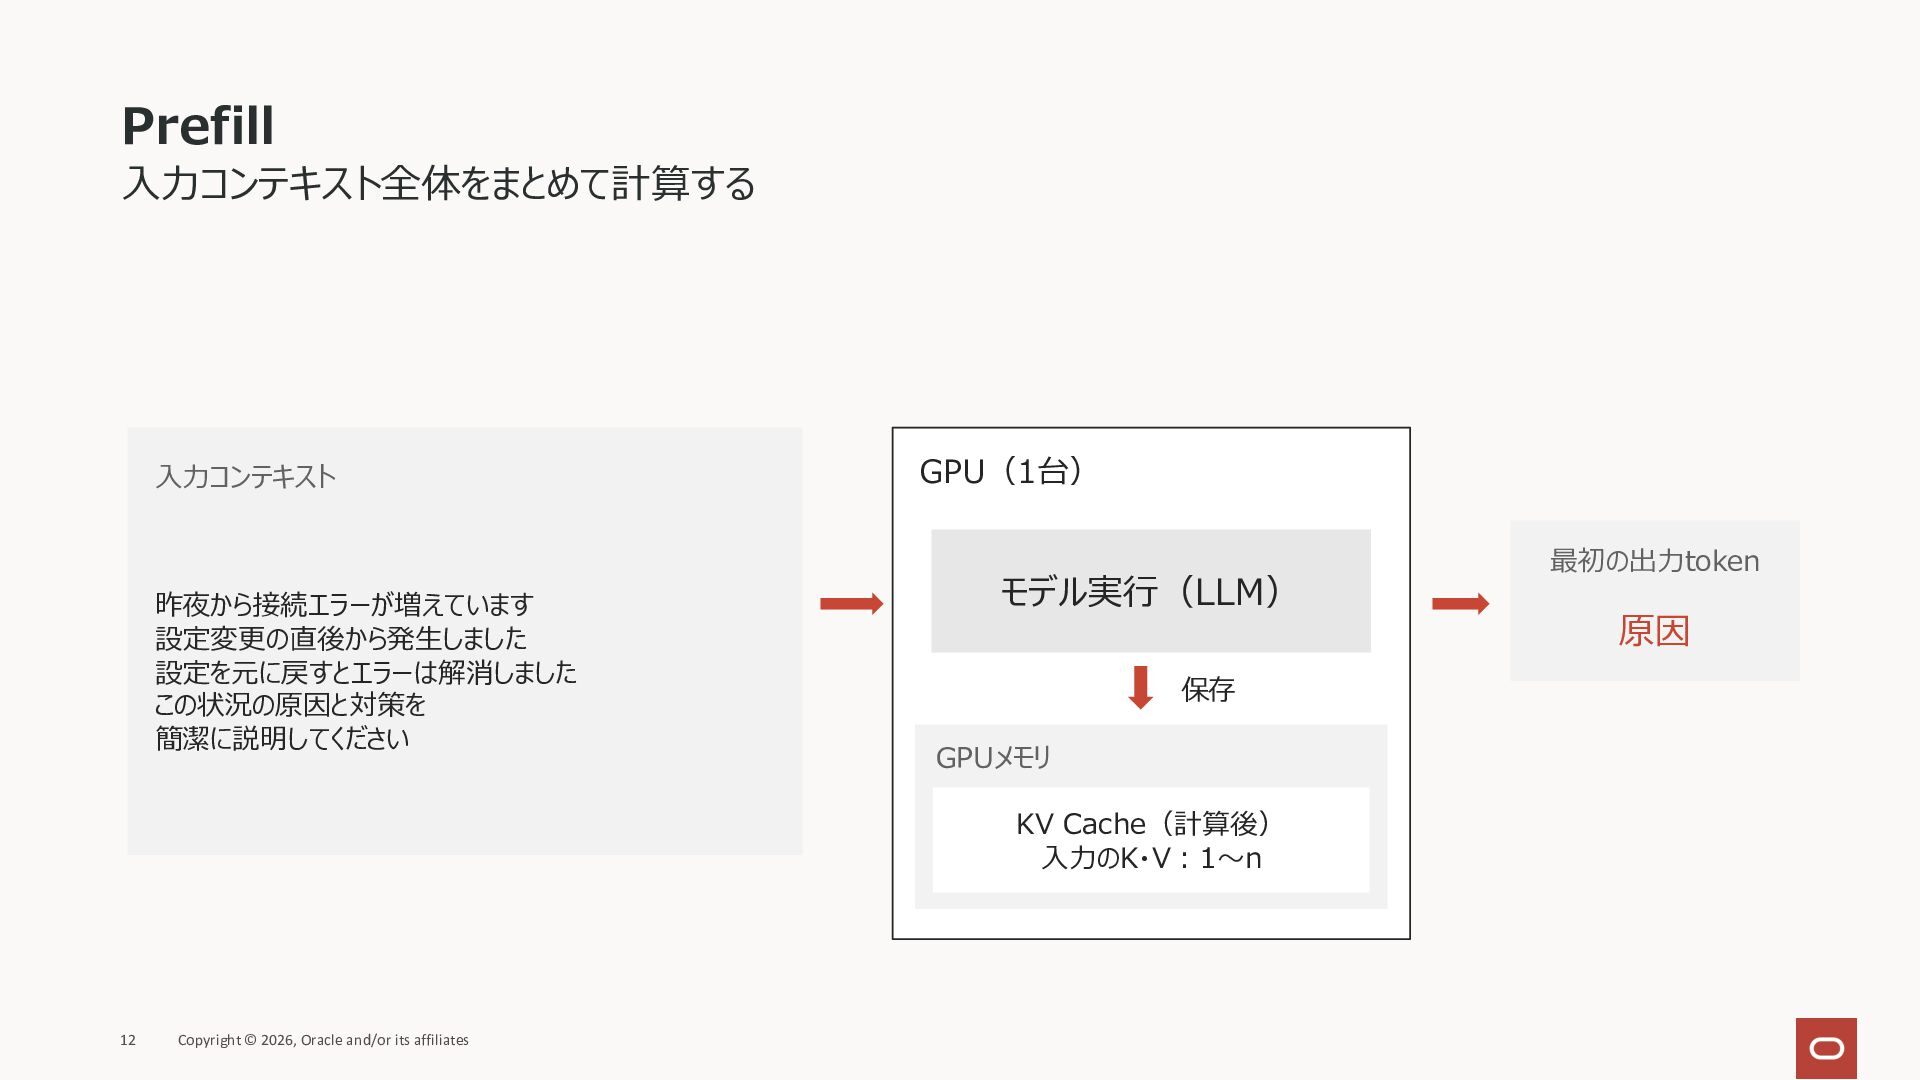
Prefill ⼊⼒コンテキスト全体をまとめて計算する ⼊⼒コンテキスト 昨夜から接続エラーが増えています 設定変更の直後から発⽣しました 設定を元に戻すとエラーは解消しました この状況の原因と対策を 簡潔に説明してください GPU(1台) モデル実⾏(LLM)
保存 GPUメモリ KV Cache(計算後) ⼊⼒のK・V︓1〜n 12 Copyright © 2026, Oracle and/or its affiliates 最初の出⼒token 原因
Decode 新規tokenだけを⼊⼒し、GPUメモリ内のKV Cacheを参照する GPU(1台) 今回の⼊⼒token 原因 モデル実⾏(LLM) 参照 追加 GPUメモリ
KV Cache(計算後) ⼊⼒KV +「原因」のKV 13 Copyright © 2026, Oracle and/or its affiliates 次の出⼒token ︓
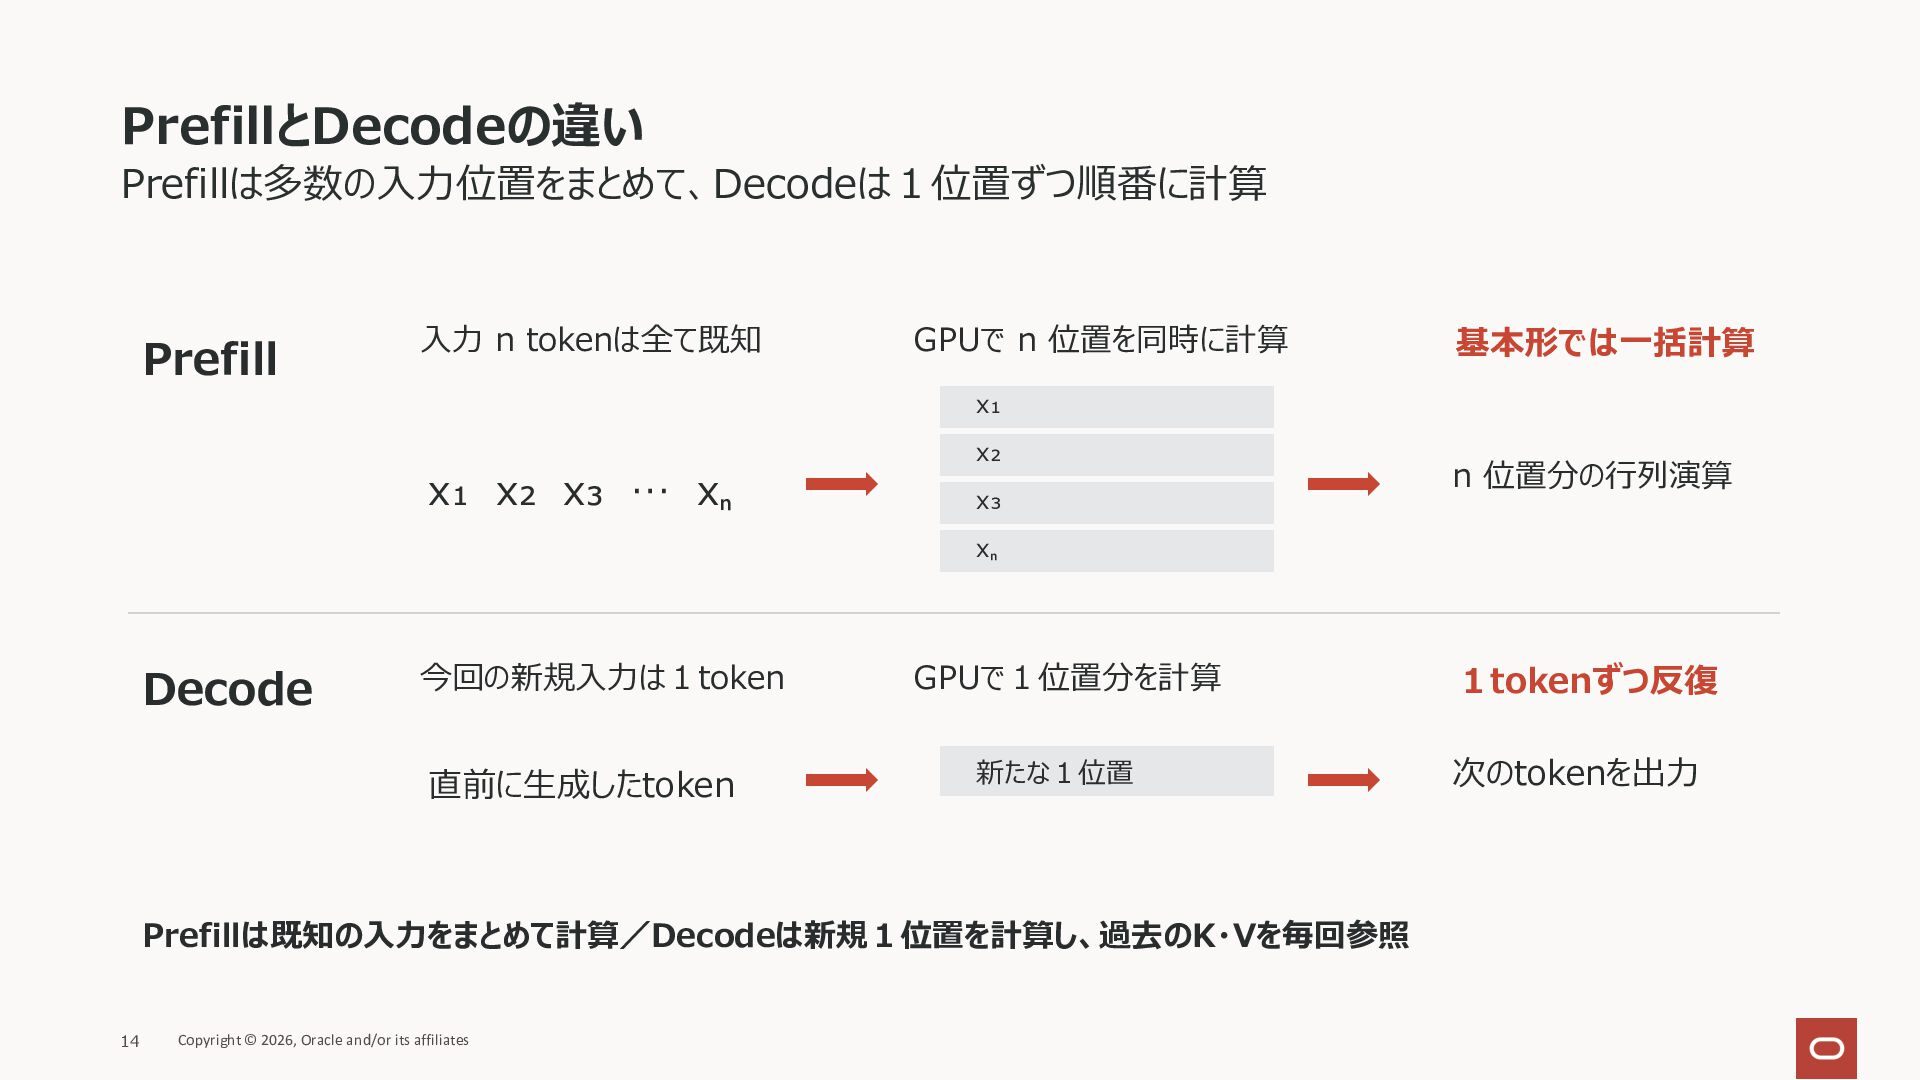
PrefillとDecodeの違い Prefillは多数の⼊⼒位置をまとめて、Decodeは1位置ずつ順番に計算 Prefill ⼊⼒ n tokenは全て既知 GPUで n 位置を同時に計算 基本形では⼀括計算
x₁ x₁ x₂ x₃ … xₙ x₂ x₃ n 位置分の⾏列演算 xₙ Decode 今回の新規⼊⼒は1token 直前に⽣成したtoken GPUで1位置分を計算 1tokenずつ反復 新たな1位置 次のtokenを出⼒ Prefillは既知の⼊⼒をまとめて計算/Decodeは新規1位置を計算し、過去のK・Vを毎回参照 14 Copyright © 2026, Oracle and/or its affiliates
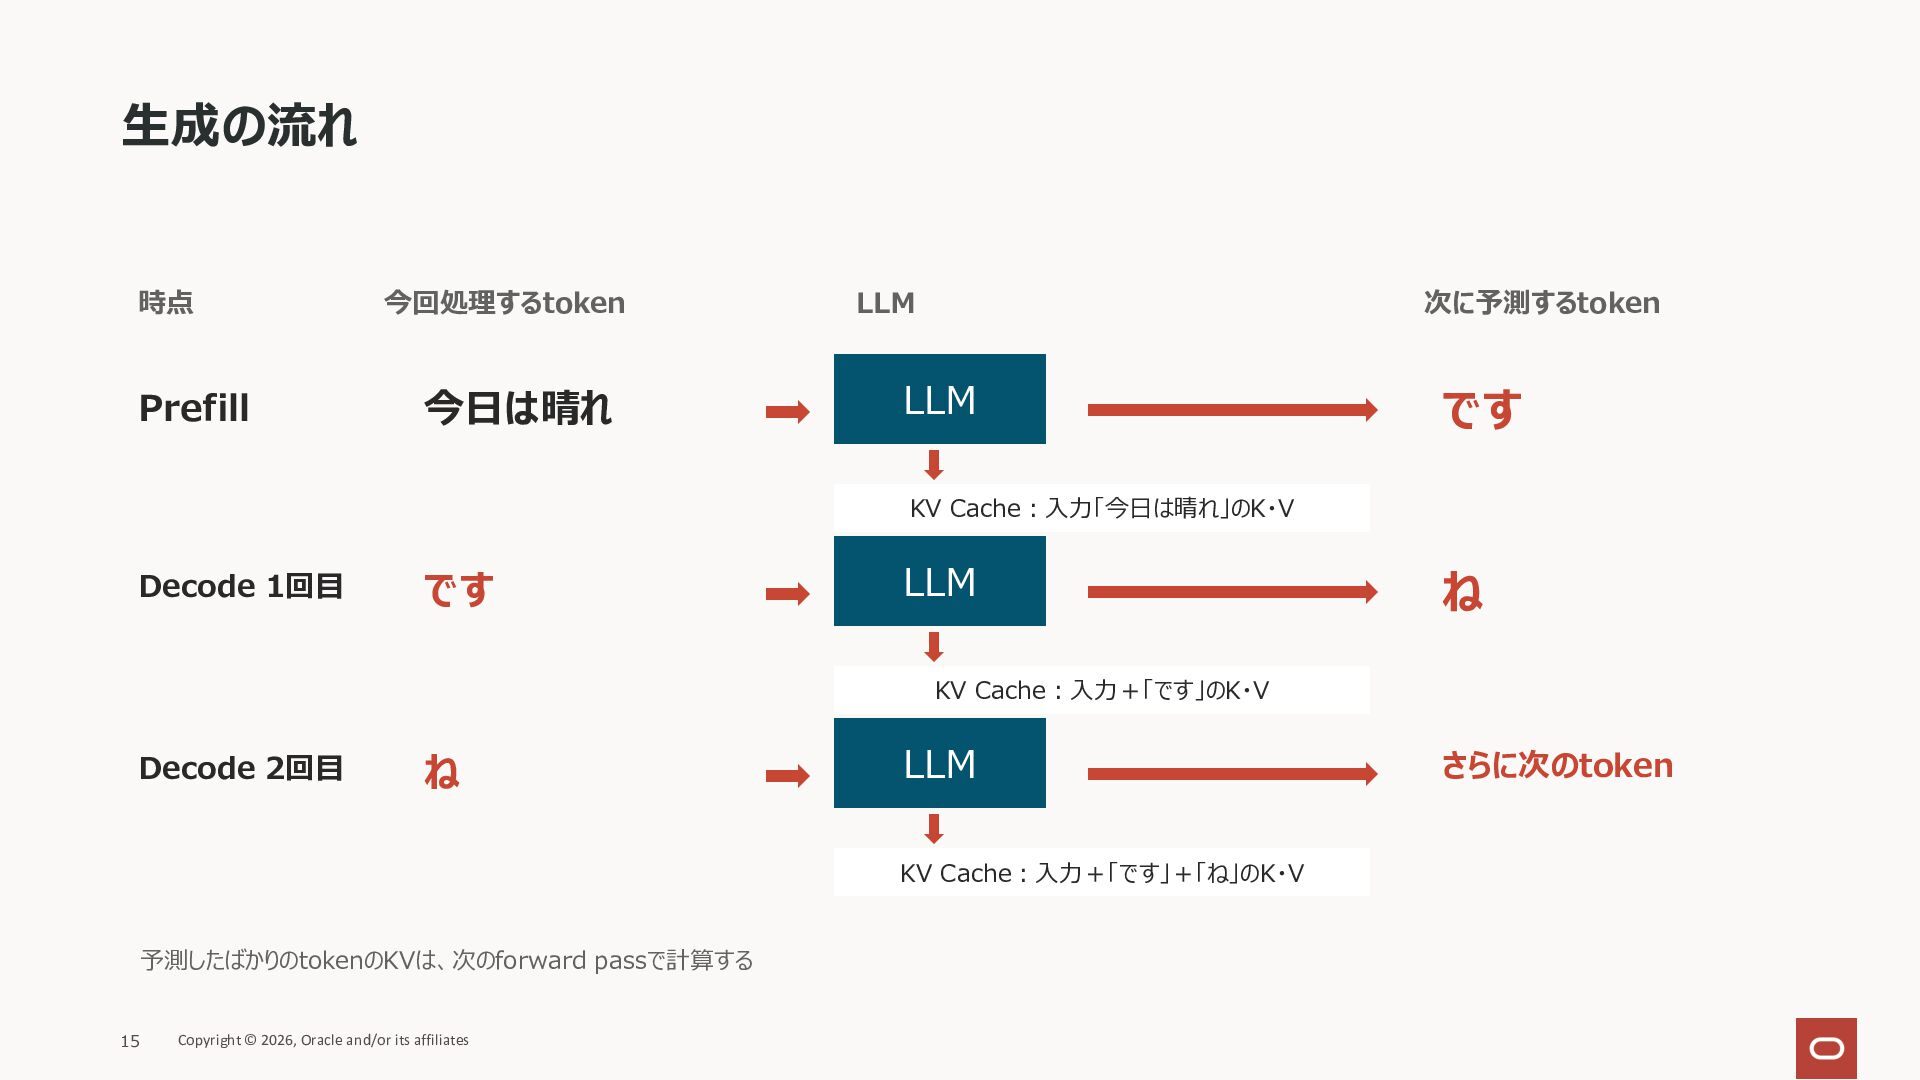
⽣成の流れ 時点 Prefill 今回処理するtoken 今⽇は晴れ LLM 次に予測するtoken LLM です KV
Cache︓⼊⼒「今⽇は晴れ」のK・V Decode 1回⽬ です LLM ね KV Cache︓⼊⼒+「です」のK・V Decode 2回⽬ ね LLM KV Cache︓⼊⼒+「です」+「ね」のK・V 予測したばかりのtokenのKVは、次のforward passで計算する 15 Copyright © 2026, Oracle and/or its affiliates さらに次のtoken
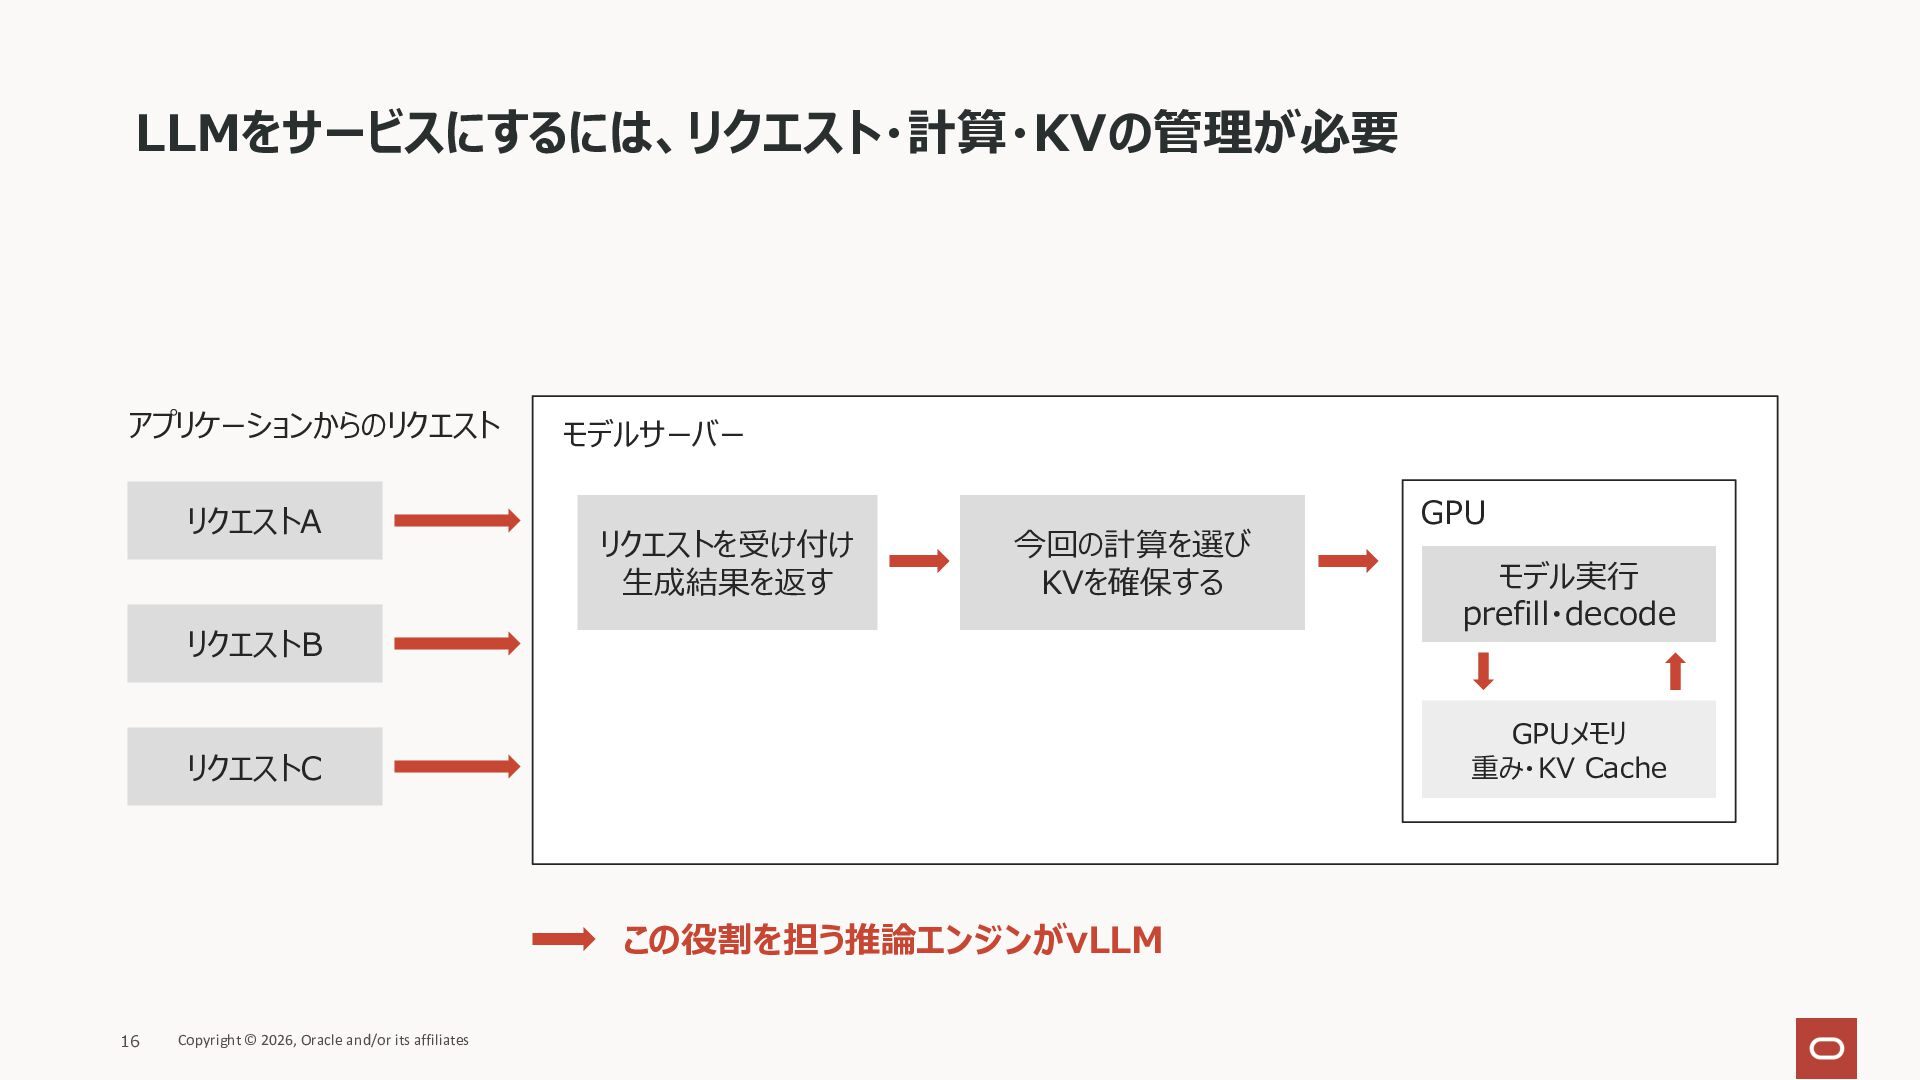
LLMをサービスにするには、リクエスト・計算・KVの管理が必要 アプリケーションからのリクエスト リクエストA モデルサーバー リクエストを受け付け ⽣成結果を返す 今回の計算を選び KVを確保する リクエストB この役割を担う推論エンジンがvLLM
Copyright © 2026, Oracle and/or its affiliates モデル実⾏ prefill・decode GPUメモリ 重み・KV Cache リクエストC 16 GPU
vLLM 推論エンジン内の処理効率を⾼める
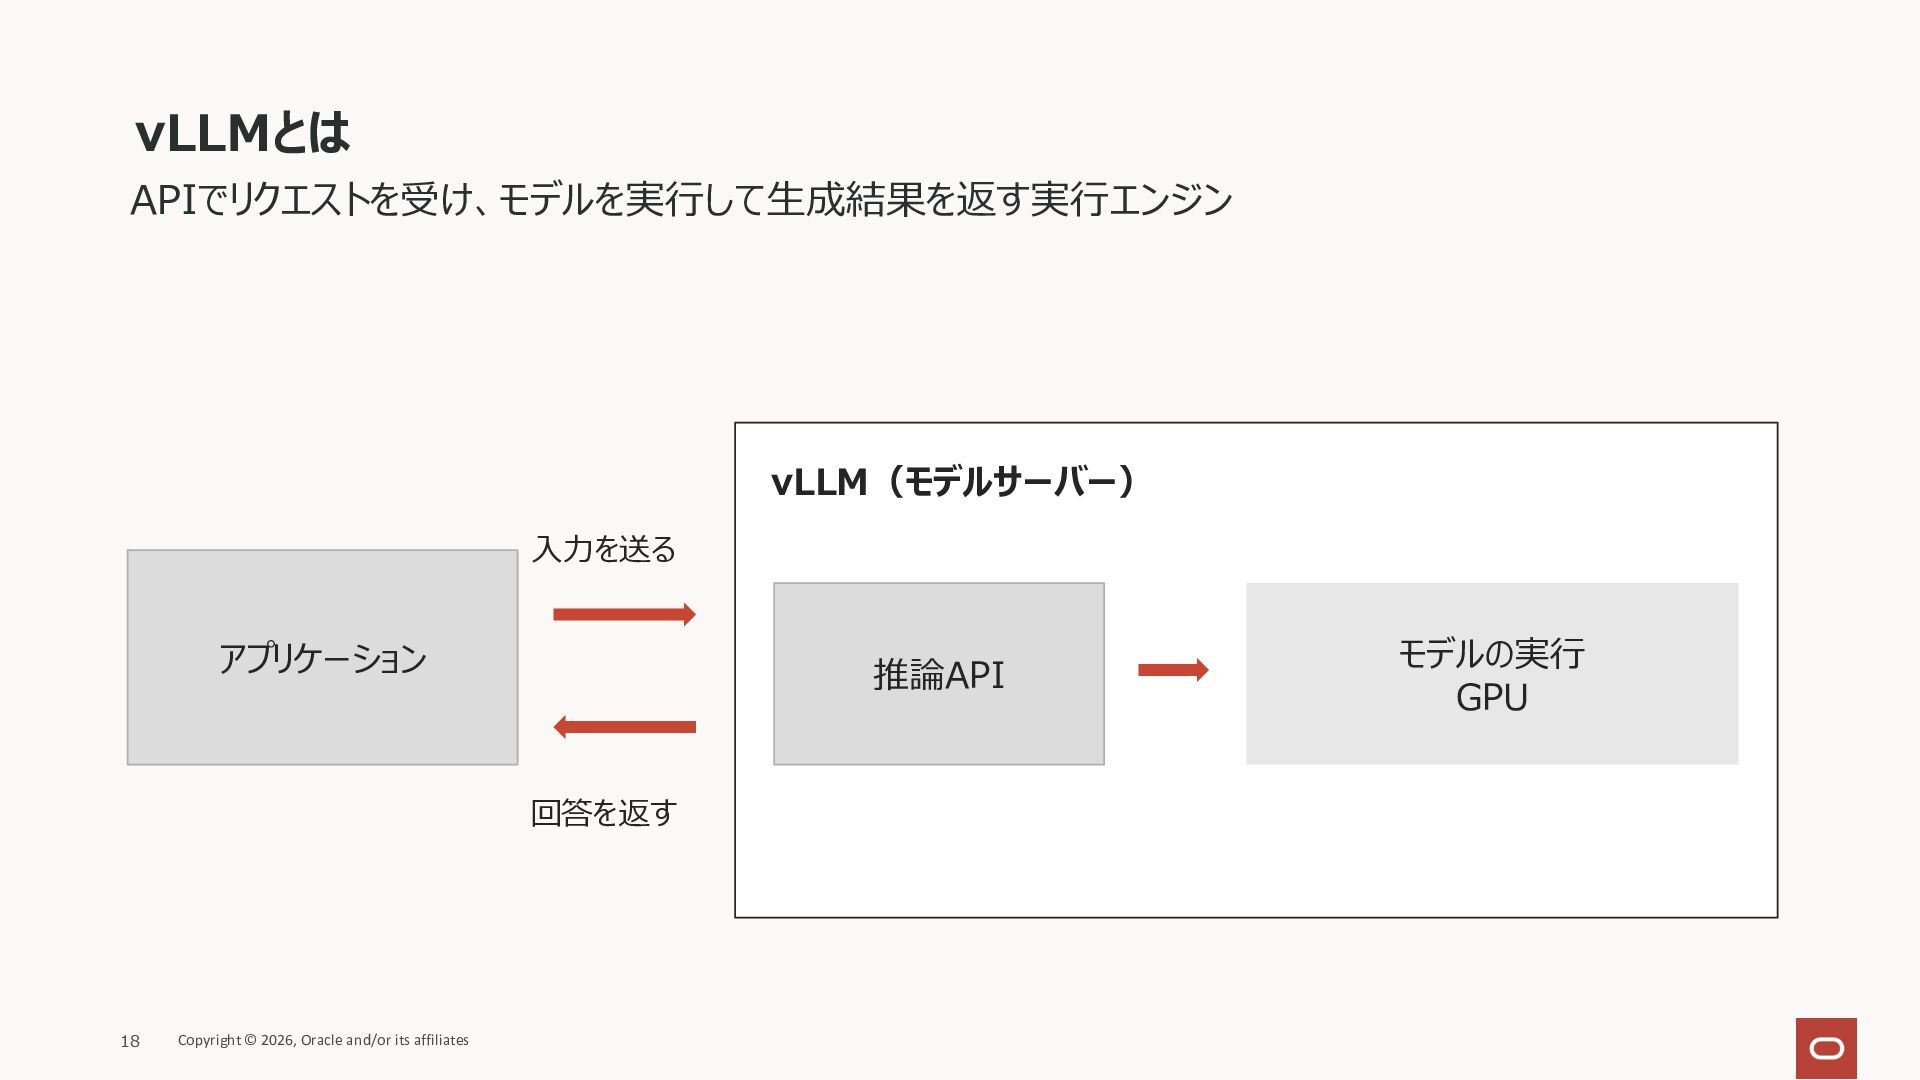
vLLMとは APIでリクエストを受け、モデルを実⾏して⽣成結果を返す実⾏エンジン vLLM(モデルサーバー) ⼊⼒を送る アプリケーション 推論API 回答を返す 18 Copyright ©
2026, Oracle and/or its affiliates モデルの実⾏ GPU
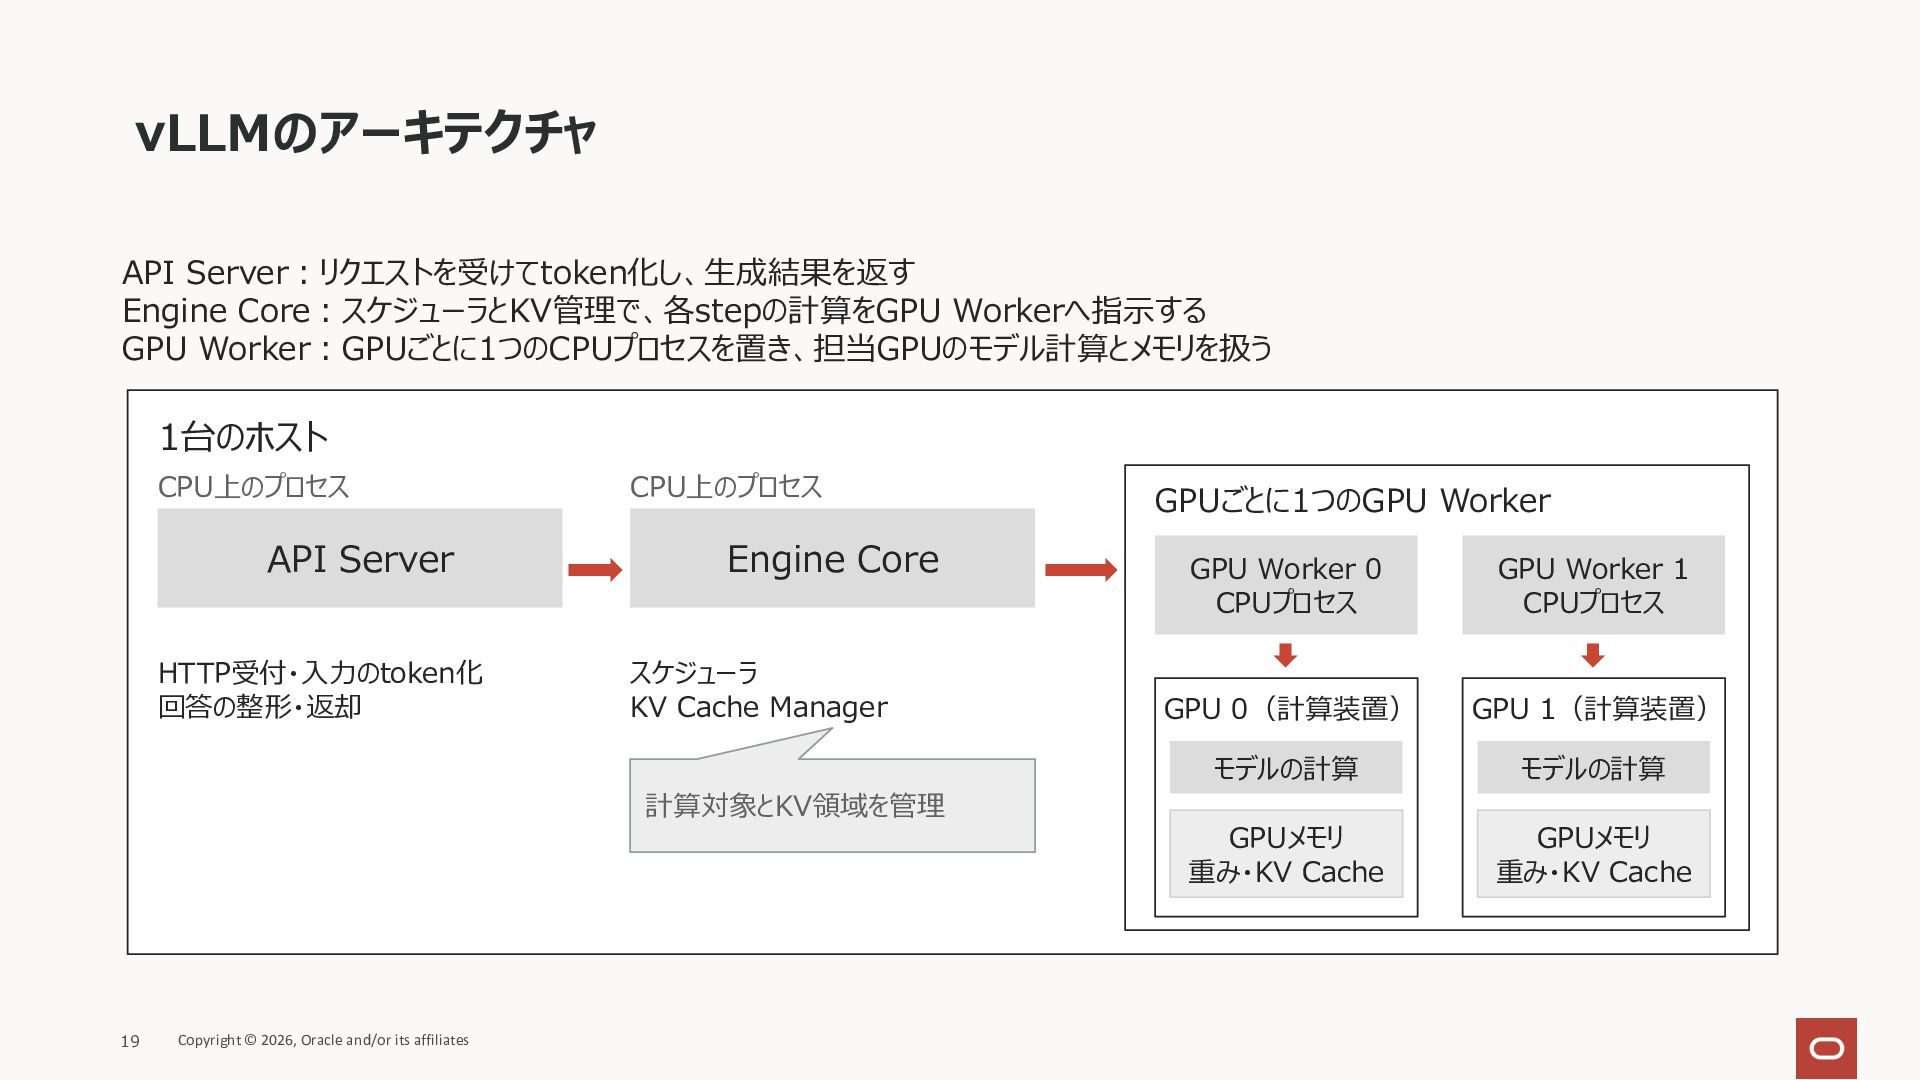
vLLMのアーキテクチャ API Server︓リクエストを受けてtoken化し、⽣成結果を返す Engine Core︓スケジューラとKV管理で、各stepの計算をGPU Workerへ指⽰する GPU Worker︓GPUごとに1つのCPUプロセスを置き、担当GPUのモデル計算とメモリを扱う 1台のホスト CPU上のプロセス
API Server HTTP受付・⼊⼒のtoken化 回答の整形・返却 CPU上のプロセス Engine Core スケジューラ KV Cache Manager 計算対象とKV領域を管理 19 Copyright © 2026, Oracle and/or its affiliates GPUごとに1つのGPU Worker GPU Worker 0 CPUプロセス GPU Worker 1 CPUプロセス GPU 0(計算装置) GPU 1(計算装置) モデルの計算 モデルの計算 GPUメモリ 重み・KV Cache GPUメモリ 重み・KV Cache
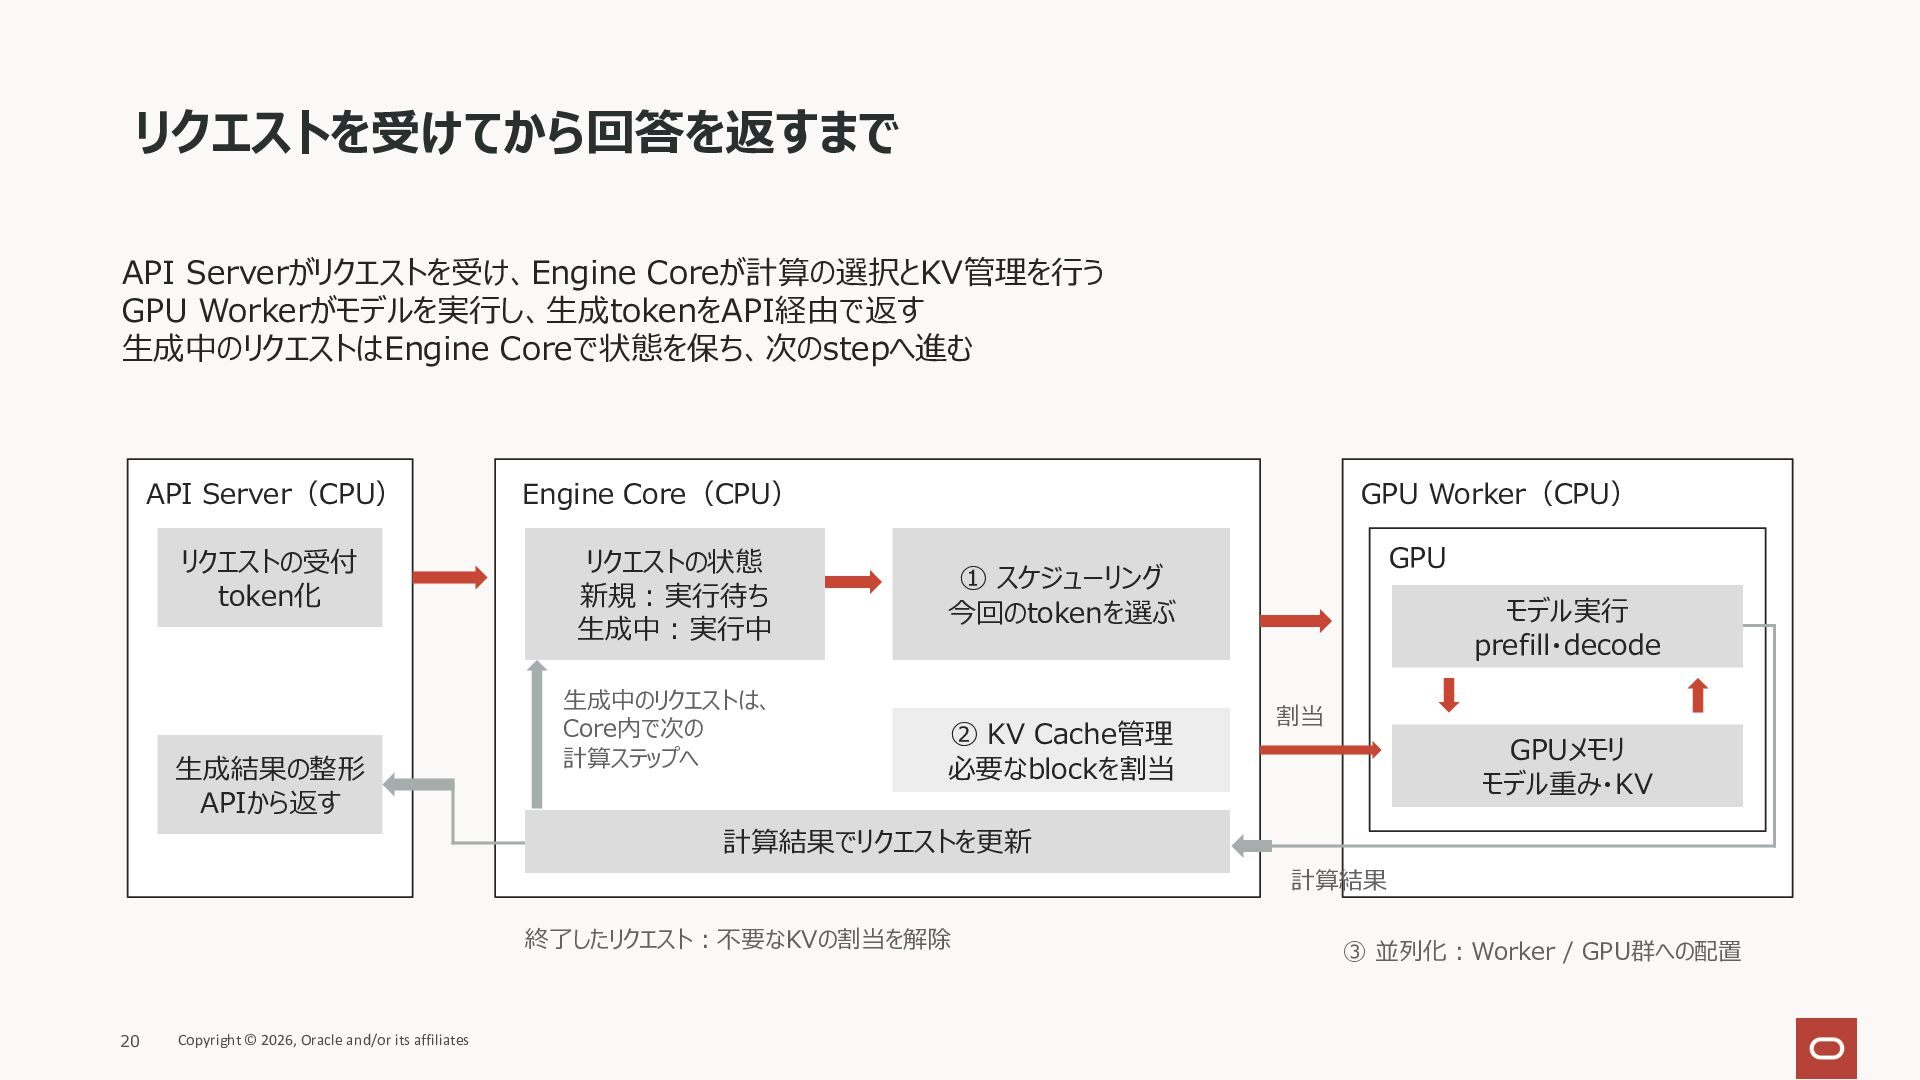
リクエストを受けてから回答を返すまで API Serverがリクエストを受け、Engine Coreが計算の選択とKV管理を⾏う GPU Workerがモデルを実⾏し、⽣成tokenをAPI経由で返す ⽣成中のリクエストはEngine Coreで状態を保ち、次のstepへ進む API Server(CPU)
Engine Core(CPU) リクエストの受付 token化 リクエストの状態 新規︓実⾏待ち ⽣成中︓実⾏中 ⽣成結果の整形 APIから返す ⽣成中のリクエストは、 Core内で次の 計算ステップへ GPU Worker(CPU) GPU ① スケジューリング 今回のtokenを選ぶ ② KV Cache管理 必要なblockを割当 モデル実⾏ prefill・decode 割当 GPUメモリ モデル重み・KV 計算結果でリクエストを更新 計算結果 終了したリクエスト︓不要なKVの割当を解除 20 Copyright © 2026, Oracle and/or its affiliates ③ 並列化︓Worker / GPU群への配置
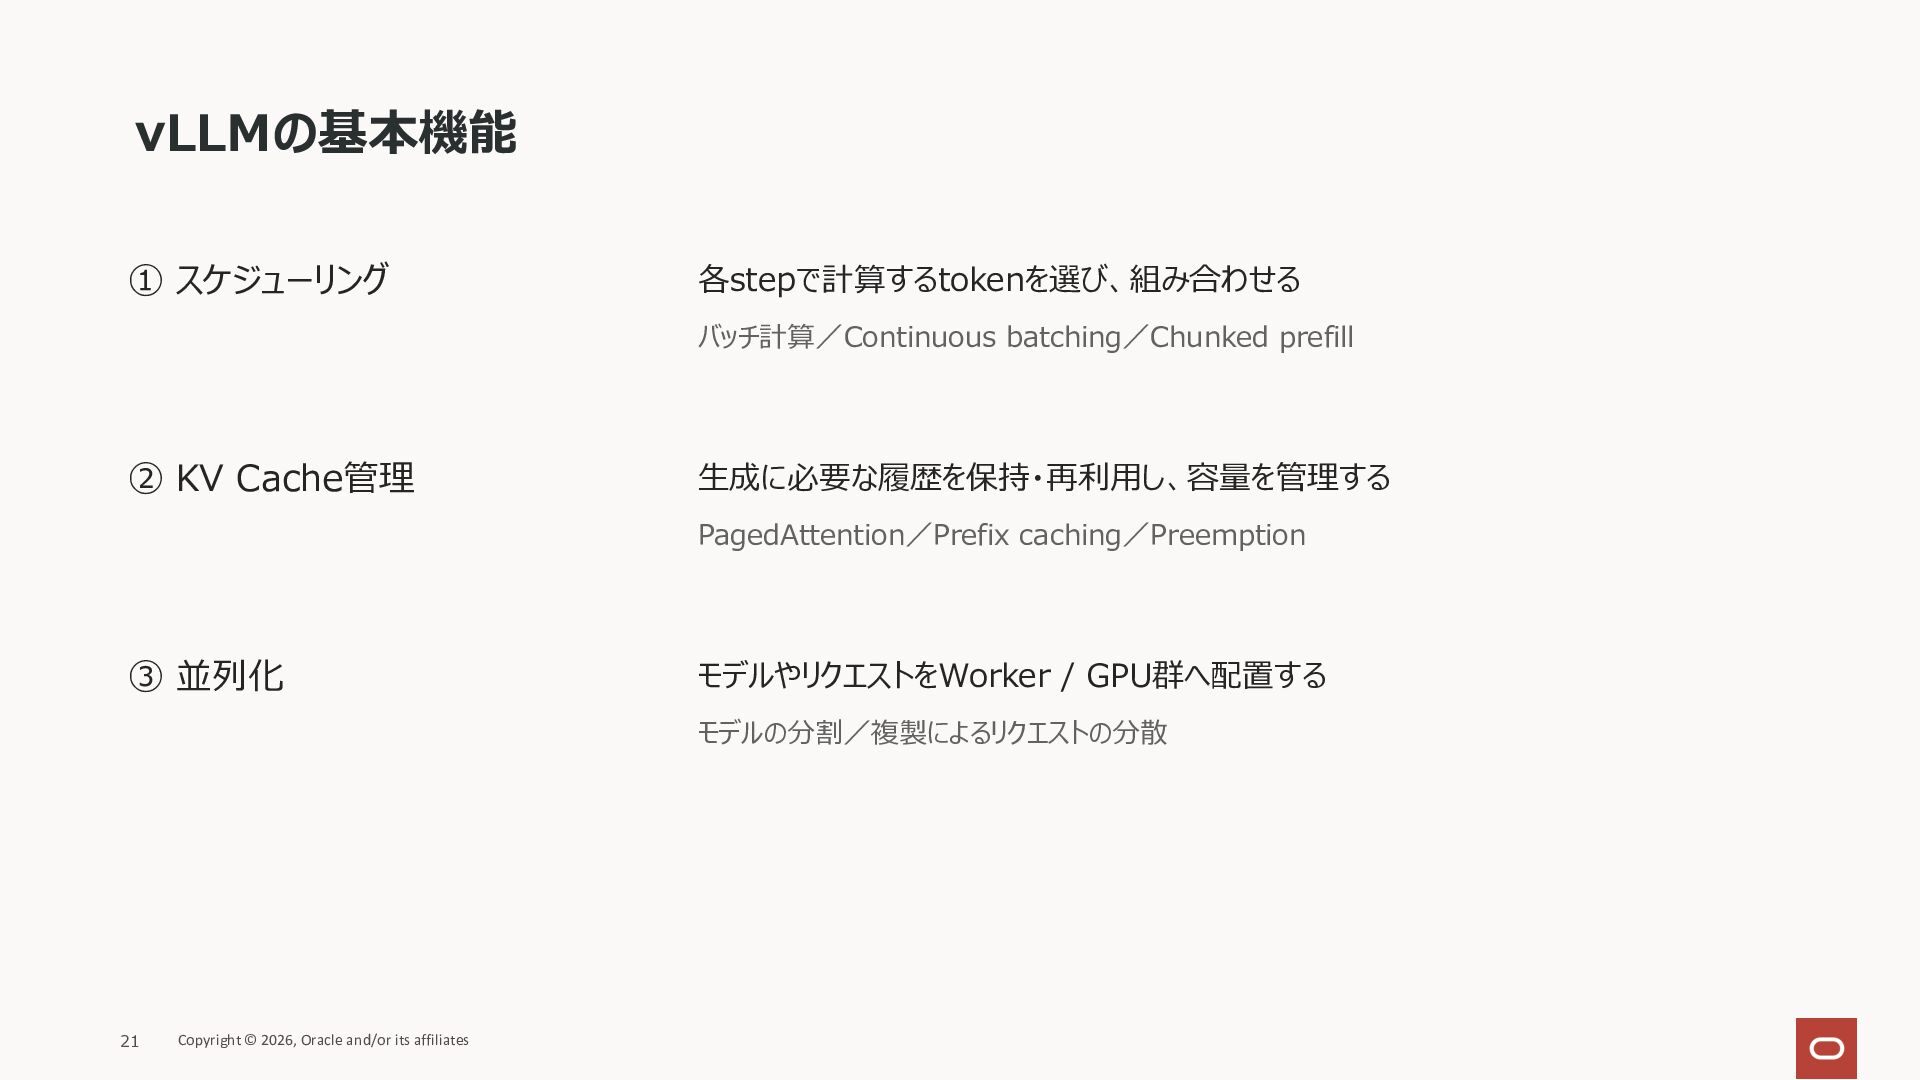
vLLMの基本機能 ① スケジューリング 各stepで計算するtokenを選び、組み合わせる バッチ計算/Continuous batching/Chunked prefill ② KV Cache管理
⽣成に必要な履歴を保持・再利⽤し、容量を管理する PagedAttention/Prefix caching/Preemption ③ 並列化 モデルやリクエストをWorker / GPU群へ配置する モデルの分割/複製によるリクエストの分散 21 Copyright © 2026, Oracle and/or its affiliates
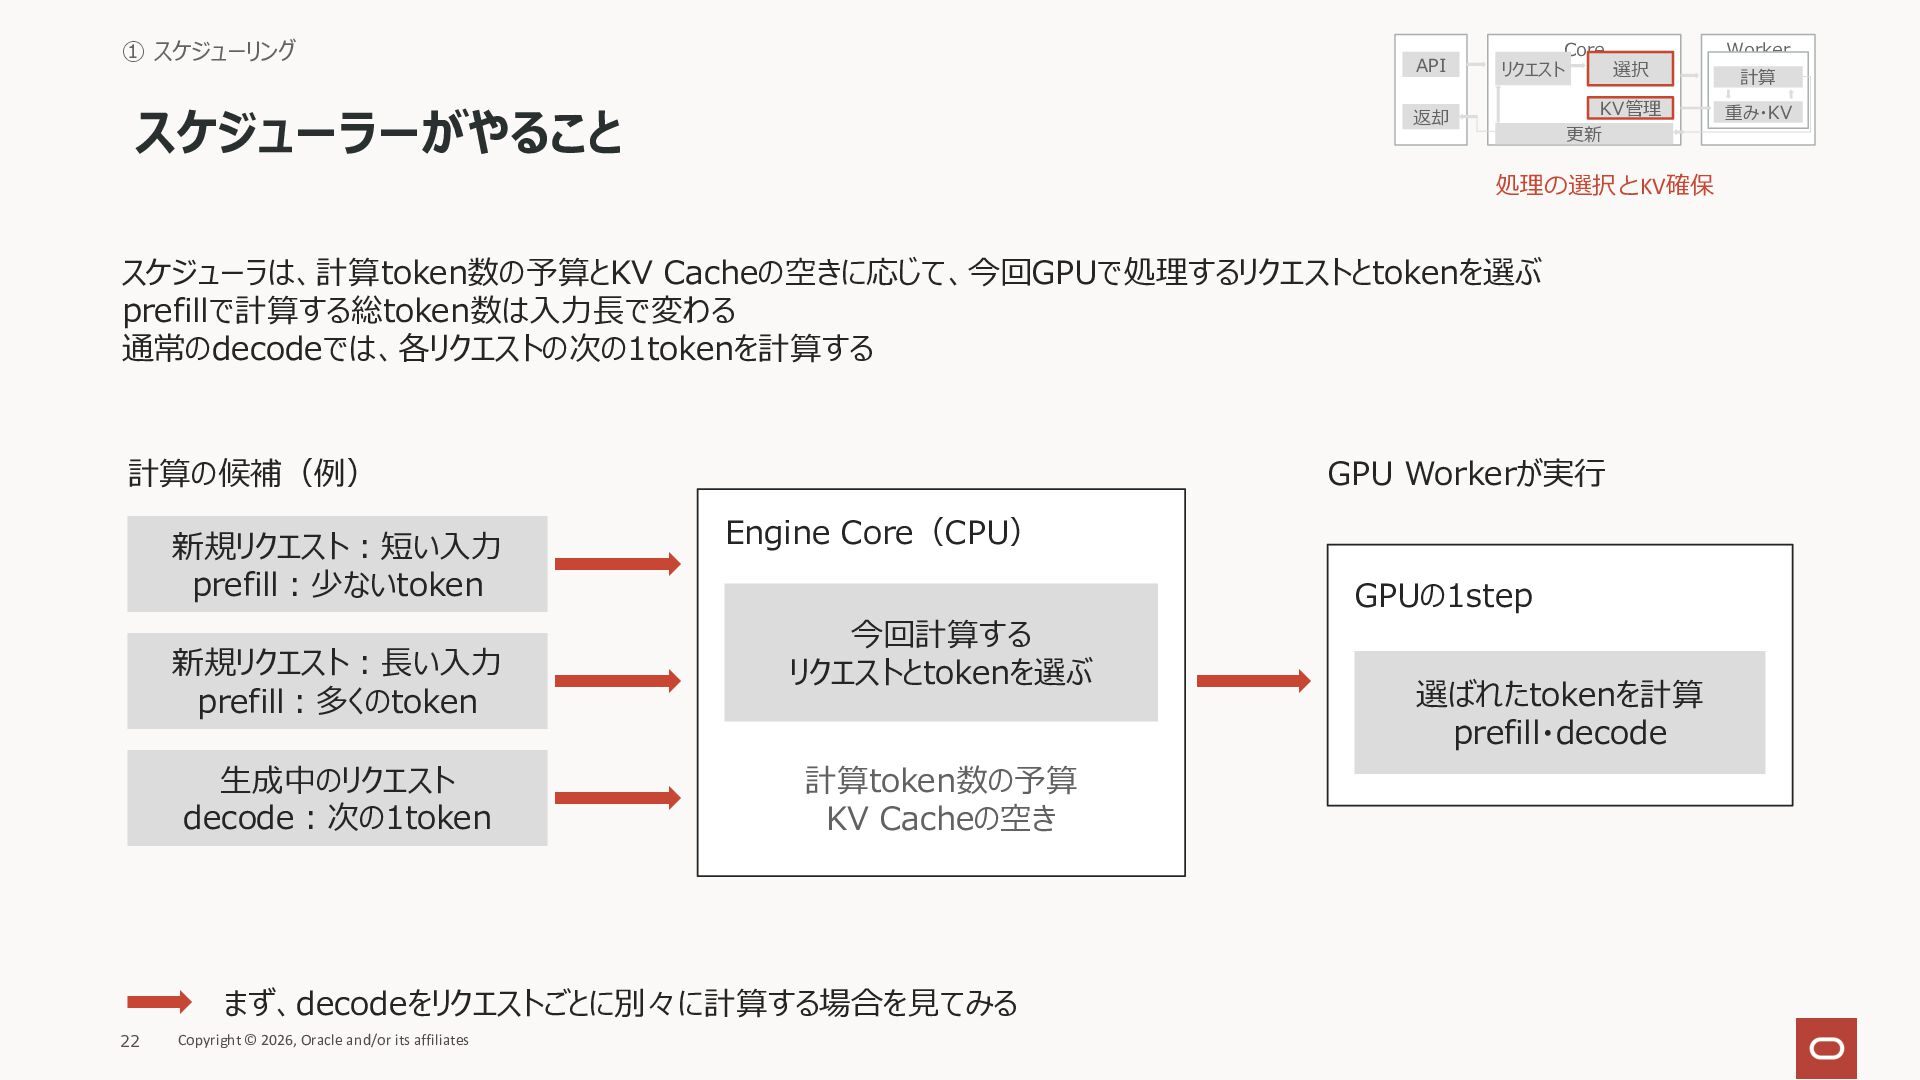
① スケジューリング スケジューラーがやること API Core リクエスト 選択 Worker 返却 KV管理
更新 重み・KV 処理の選択とKV確保 スケジューラは、計算token数の予算とKV Cacheの空きに応じて、今回GPUで処理するリクエストとtokenを選ぶ prefillで計算する総token数は⼊⼒⻑で変わる 通常のdecodeでは、各リクエストの次の1tokenを計算する 計算の候補(例) 新規リクエスト︓短い⼊⼒ prefill︓少ないtoken 新規リクエスト︓⻑い⼊⼒ prefill︓多くのtoken ⽣成中のリクエスト decode︓次の1token GPU Workerが実⾏ Engine Core(CPU) 今回計算する リクエストとtokenを選ぶ 計算token数の予算 KV Cacheの空き まず、decodeをリクエストごとに別々に計算する場合を⾒てみる 22 Copyright © 2026, Oracle and/or its affiliates GPUの1step 選ばれたtokenを計算 prefill・decode 計算
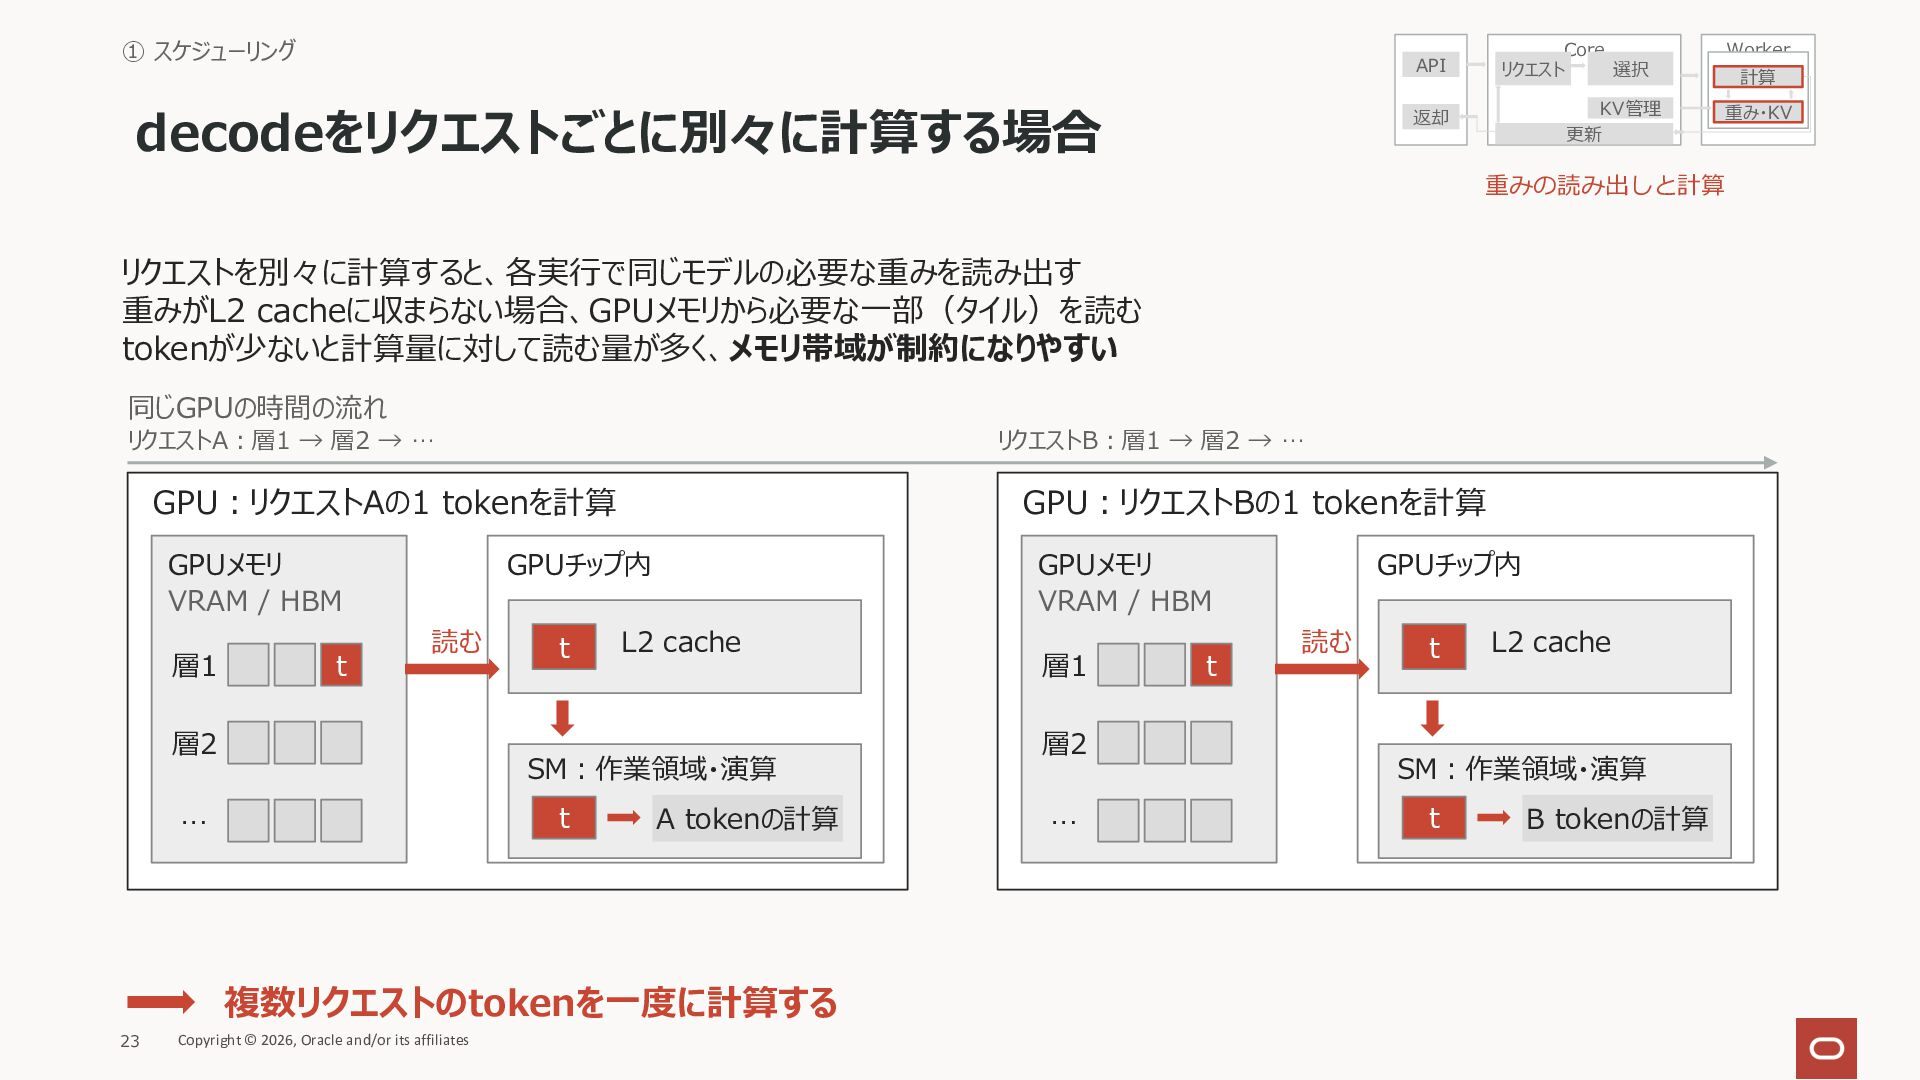
① スケジューリング decodeをリクエストごとに別々に計算する場合 API Core リクエスト 選択 Worker 返却 KV管理
更新 重み・KV 計算 重みの読み出しと計算 リクエストを別々に計算すると、各実⾏で同じモデルの必要な重みを読み出す 重みがL2 cacheに収まらない場合、GPUメモリから必要な⼀部(タイル)を読む tokenが少ないと計算量に対して読む量が多く、メモリ帯域が制約になりやすい 同じGPUの時間の流れ リクエストA︓層1 → 層2 → … リクエストB︓層1 → 層2 → … GPU︓リクエストAの1 tokenを計算 GPU︓リクエストBの1 tokenを計算 GPUメモリ VRAM / HBM GPUメモリ VRAM / HBM 層1 t GPUチップ内 読む 層2 t L2 cache SM︓作業領域・演算 t … A tokenの計算 複数リクエストのtokenを⼀度に計算する 23 Copyright © 2026, Oracle and/or its affiliates 層1 層2 … t GPUチップ内 読む t L2 cache SM︓作業領域・演算 t B tokenの計算
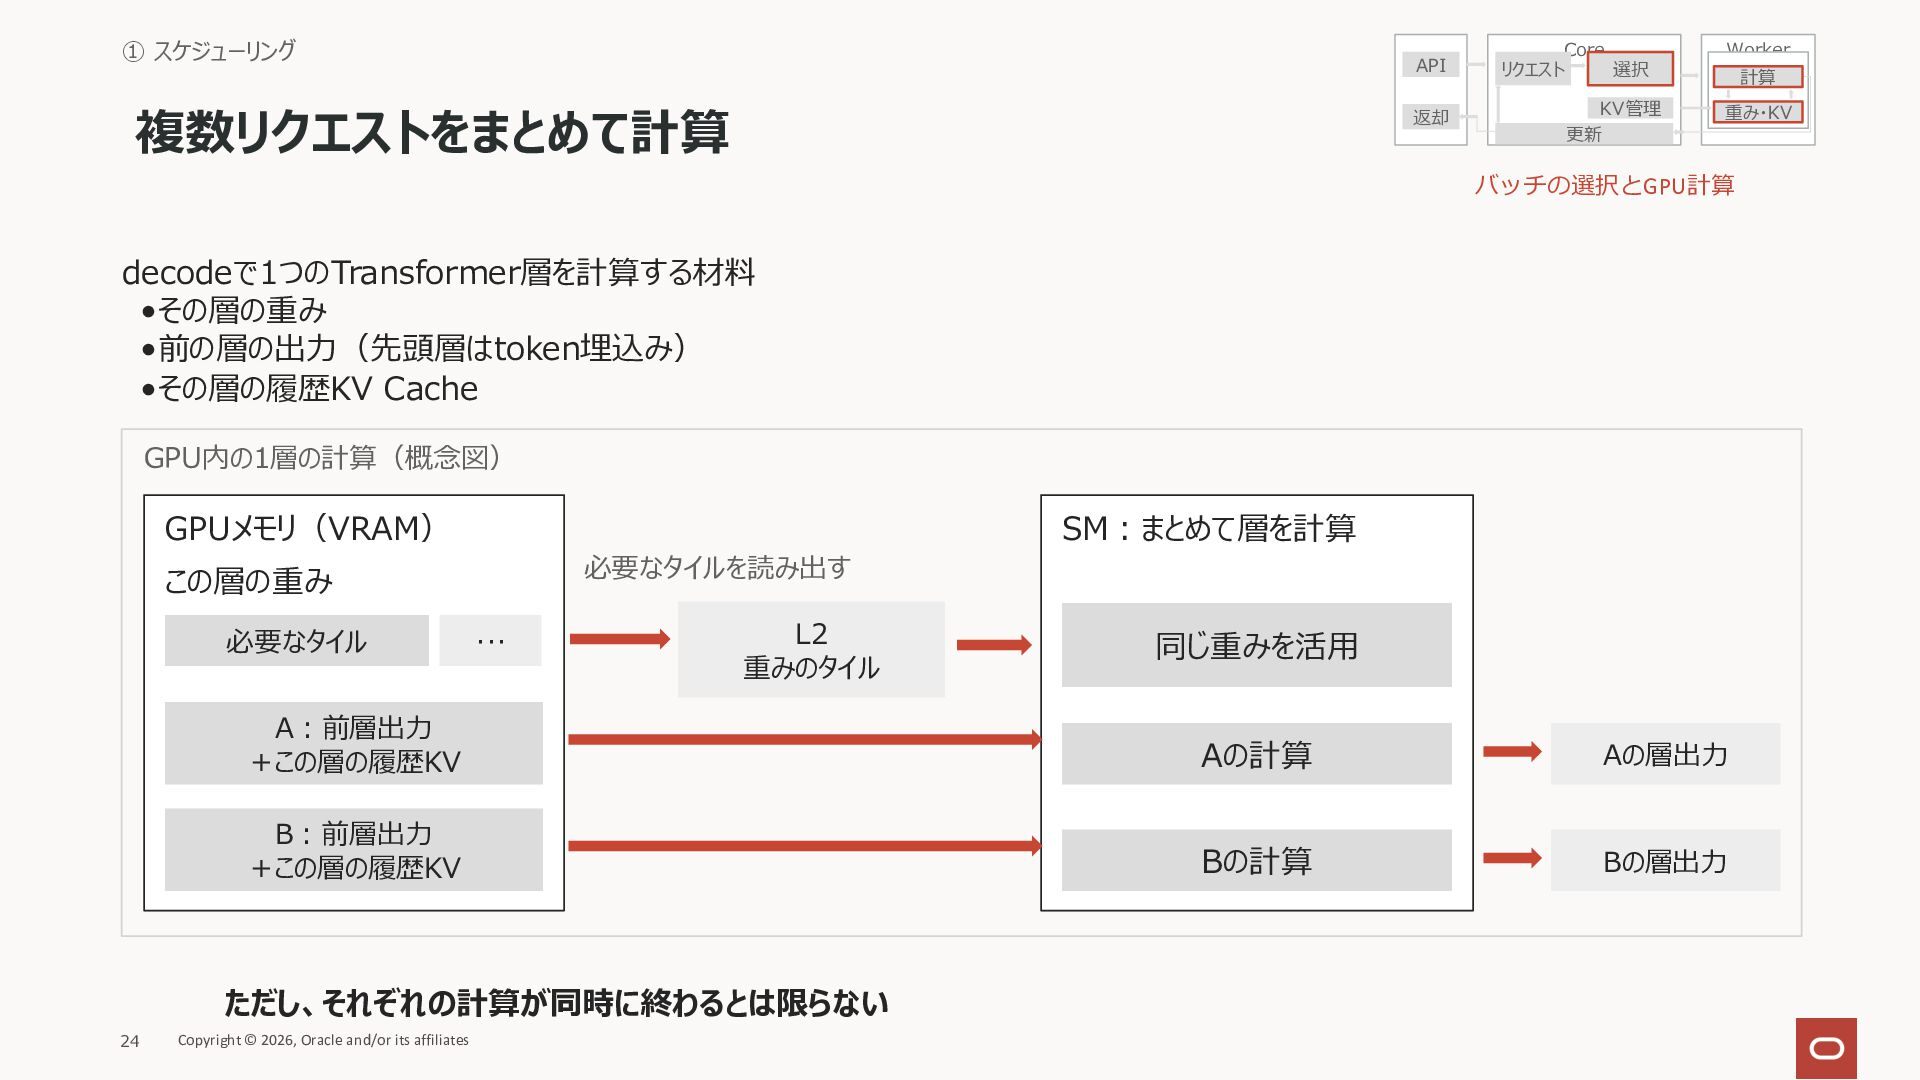
① スケジューリング 複数リクエストをまとめて計算 API Core リクエスト 選択 Worker 返却 KV管理
更新 重み・KV 計算 バッチの選択とGPU計算 decodeで1つのTransformer層を計算する材料 •その層の重み •前の層の出⼒(先頭層はtoken埋込み) •その層の履歴KV Cache GPU内の1層の計算(概念図) GPUメモリ(VRAM) SM︓まとめて層を計算 必要なタイルを読み出す この層の重み 必要なタイル … L2 重みのタイル A︓前層出⼒ +この層の履歴KV Aの計算 Aの層出⼒ B︓前層出⼒ +この層の履歴KV Bの計算 Bの層出⼒ ただし、それぞれの計算が同時に終わるとは限らない 24 同じ重みを活⽤ Copyright © 2026, Oracle and/or its affiliates
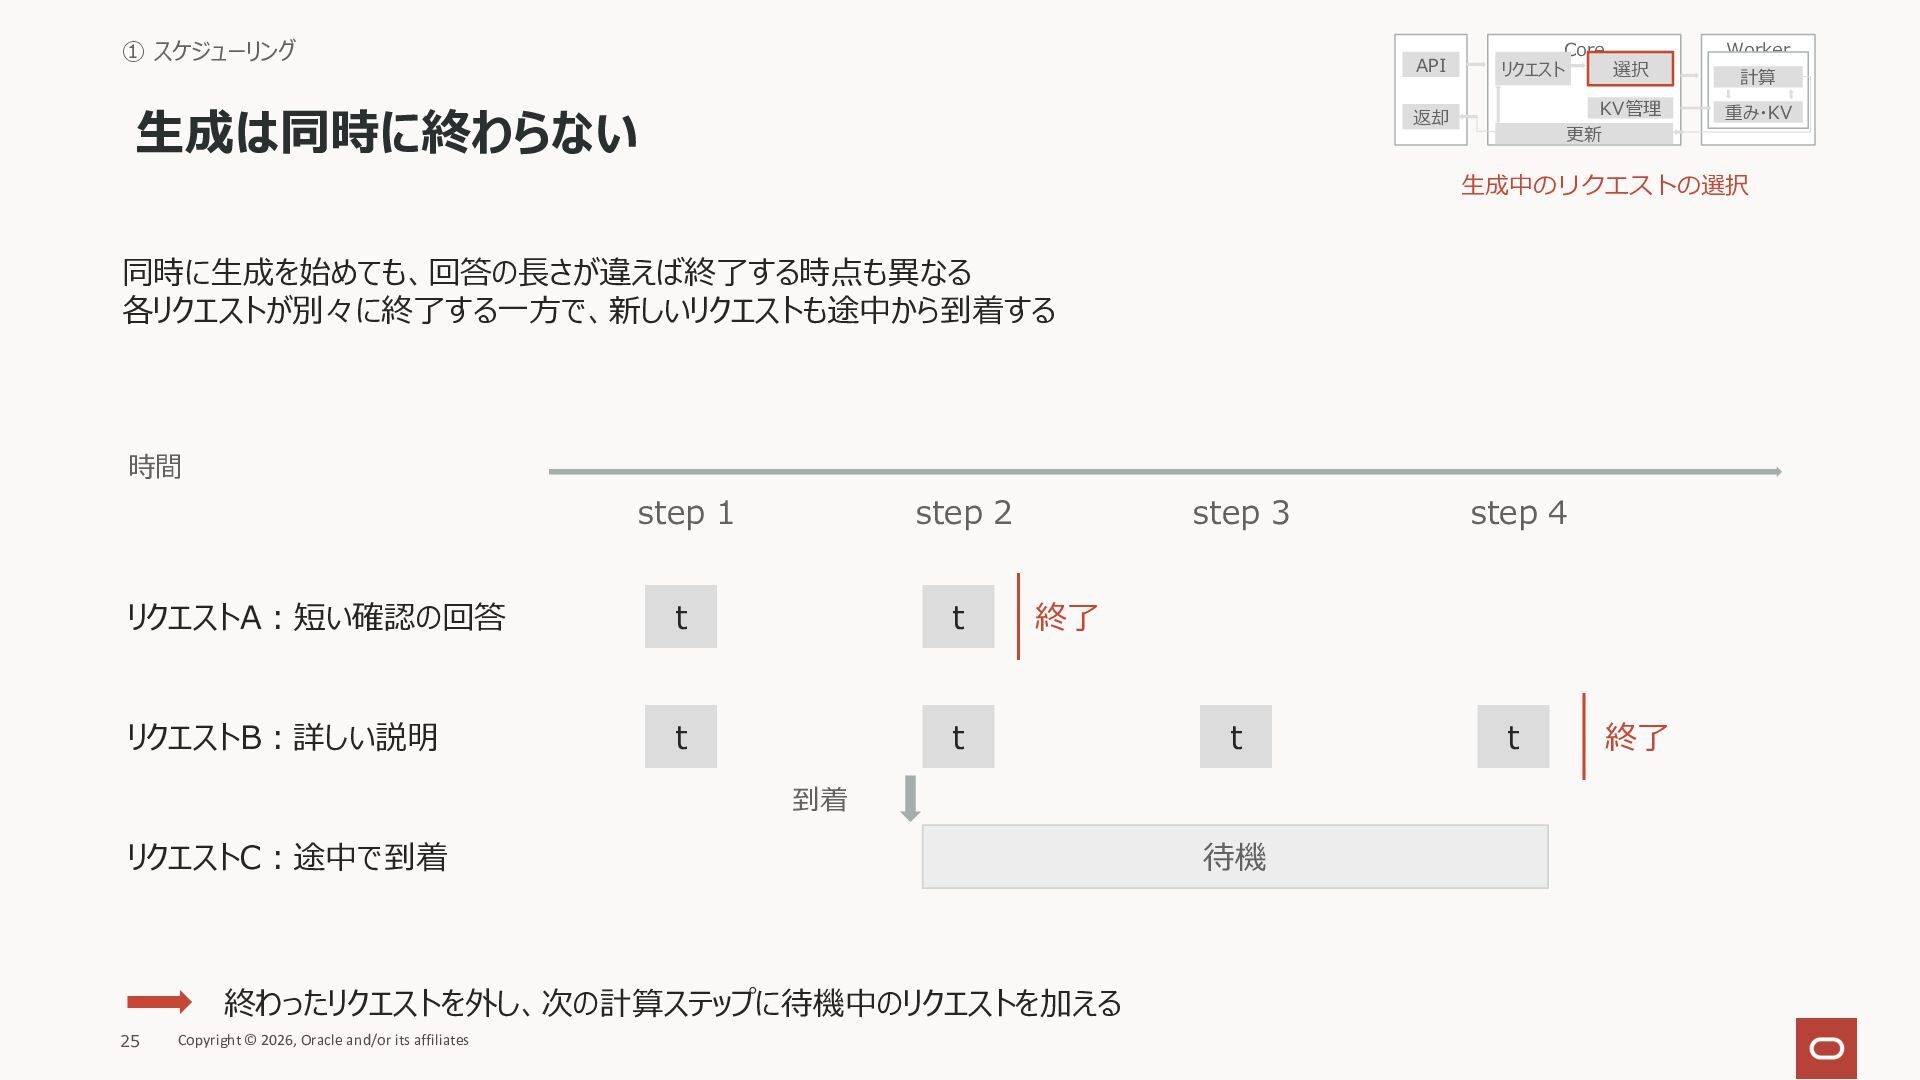
① スケジューリング ⽣成は同時に終わらない API Core リクエスト 選択 Worker 返却 KV管理
更新 重み・KV 計算 ⽣成中のリクエストの選択 同時に⽣成を始めても、回答の⻑さが違えば終了する時点も異なる 各リクエストが別々に終了する⼀⽅で、新しいリクエストも途中から到着する 時間 step 1 step 2 リクエストA︓短い確認の回答 t t リクエストB︓詳しい説明 t t step 3 step 4 t t 終了 到着 リクエストC︓途中で到着 終わったリクエストを外し、次の計算ステップに待機中のリクエストを加える 25 Copyright © 2026, Oracle and/or its affiliates 待機 終了
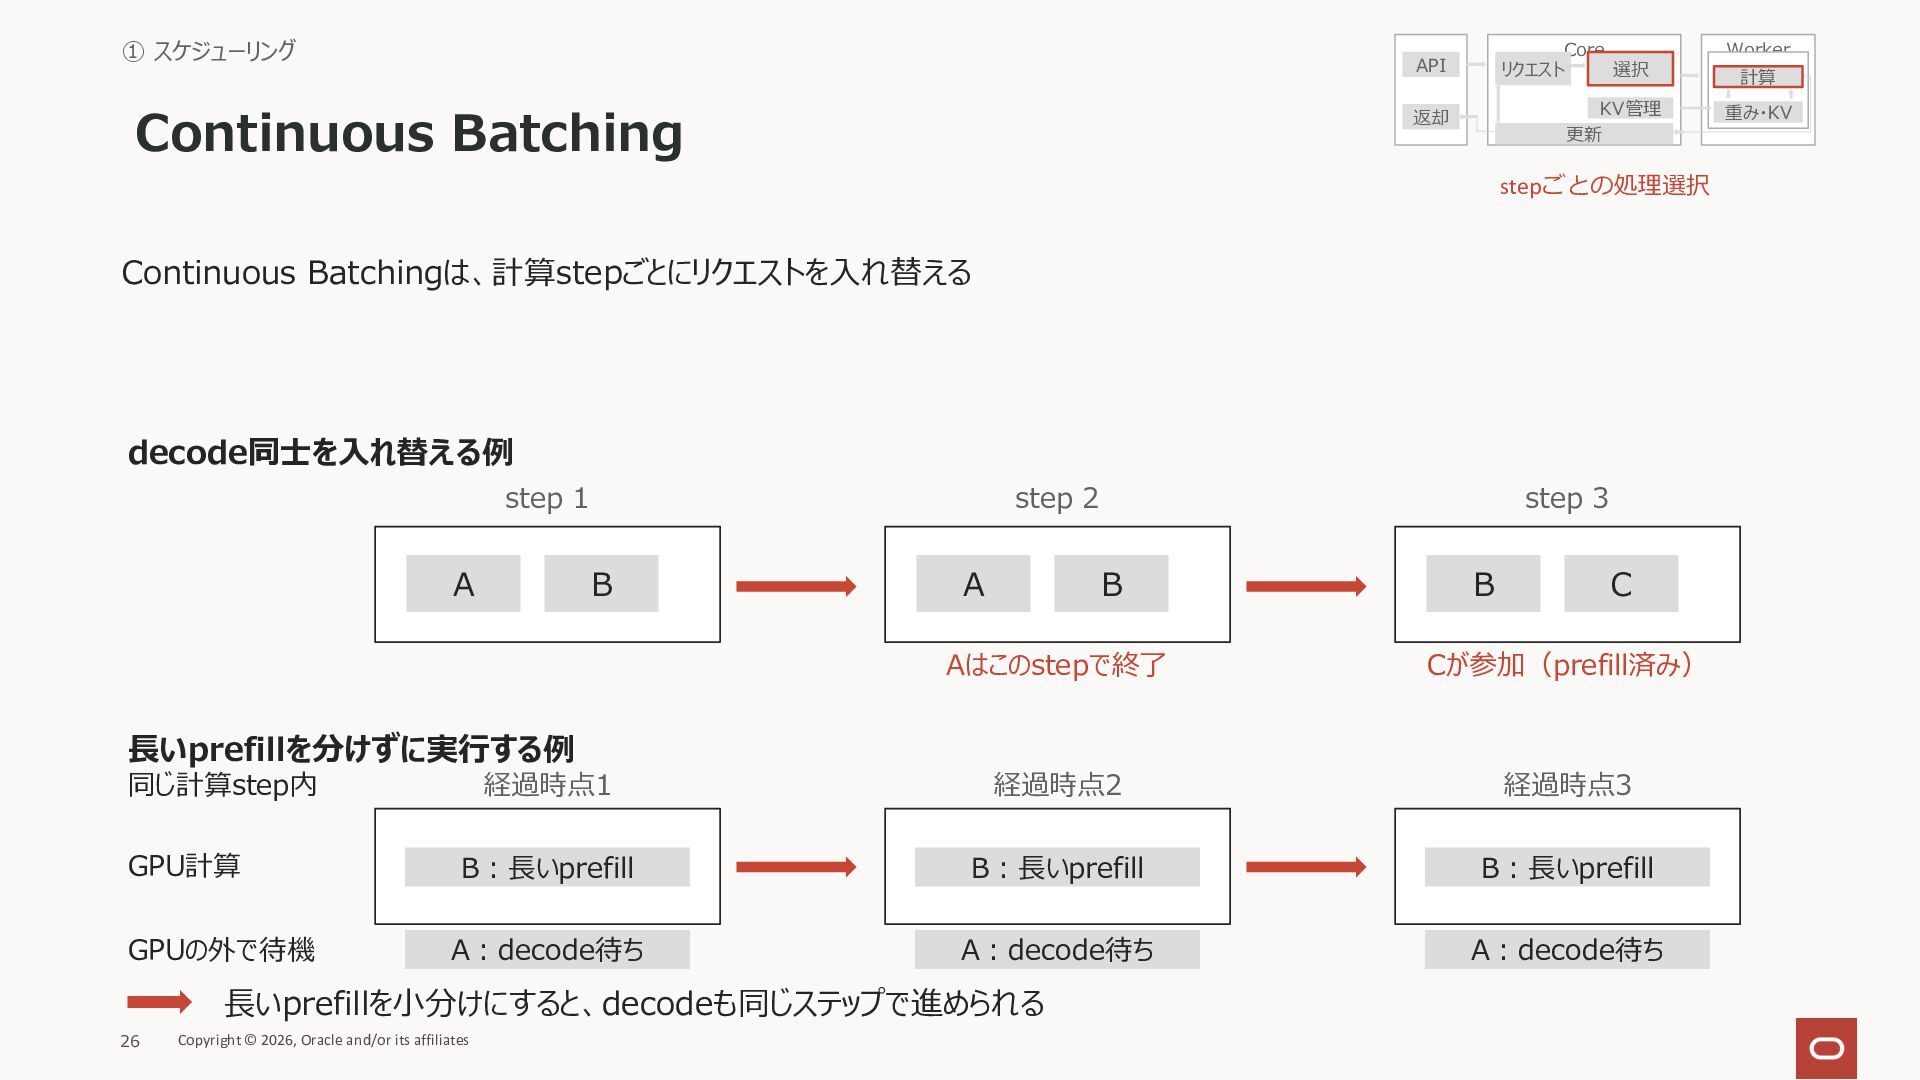
① スケジューリング Continuous Batching API Core リクエスト 選択 Worker 返却
KV管理 更新 重み・KV stepごとの処理選択 Continuous Batchingは、計算stepごとにリクエストを⼊れ替える decode同⼠を⼊れ替える例 step 1 A step 2 B A step 3 B B C Aはこのstepで終了 Cが参加(prefill済み) 経過時点1 経過時点2 経過時点3 GPU計算 B︓⻑いprefill B︓⻑いprefill B︓⻑いprefill GPUの外で待機 A︓decode待ち A︓decode待ち A︓decode待ち ⻑いprefillを分けずに実⾏する例 同じ計算step内 ⻑いprefillを⼩分けにすると、decodeも同じステップで進められる 26 Copyright © 2026, Oracle and/or its affiliates 計算
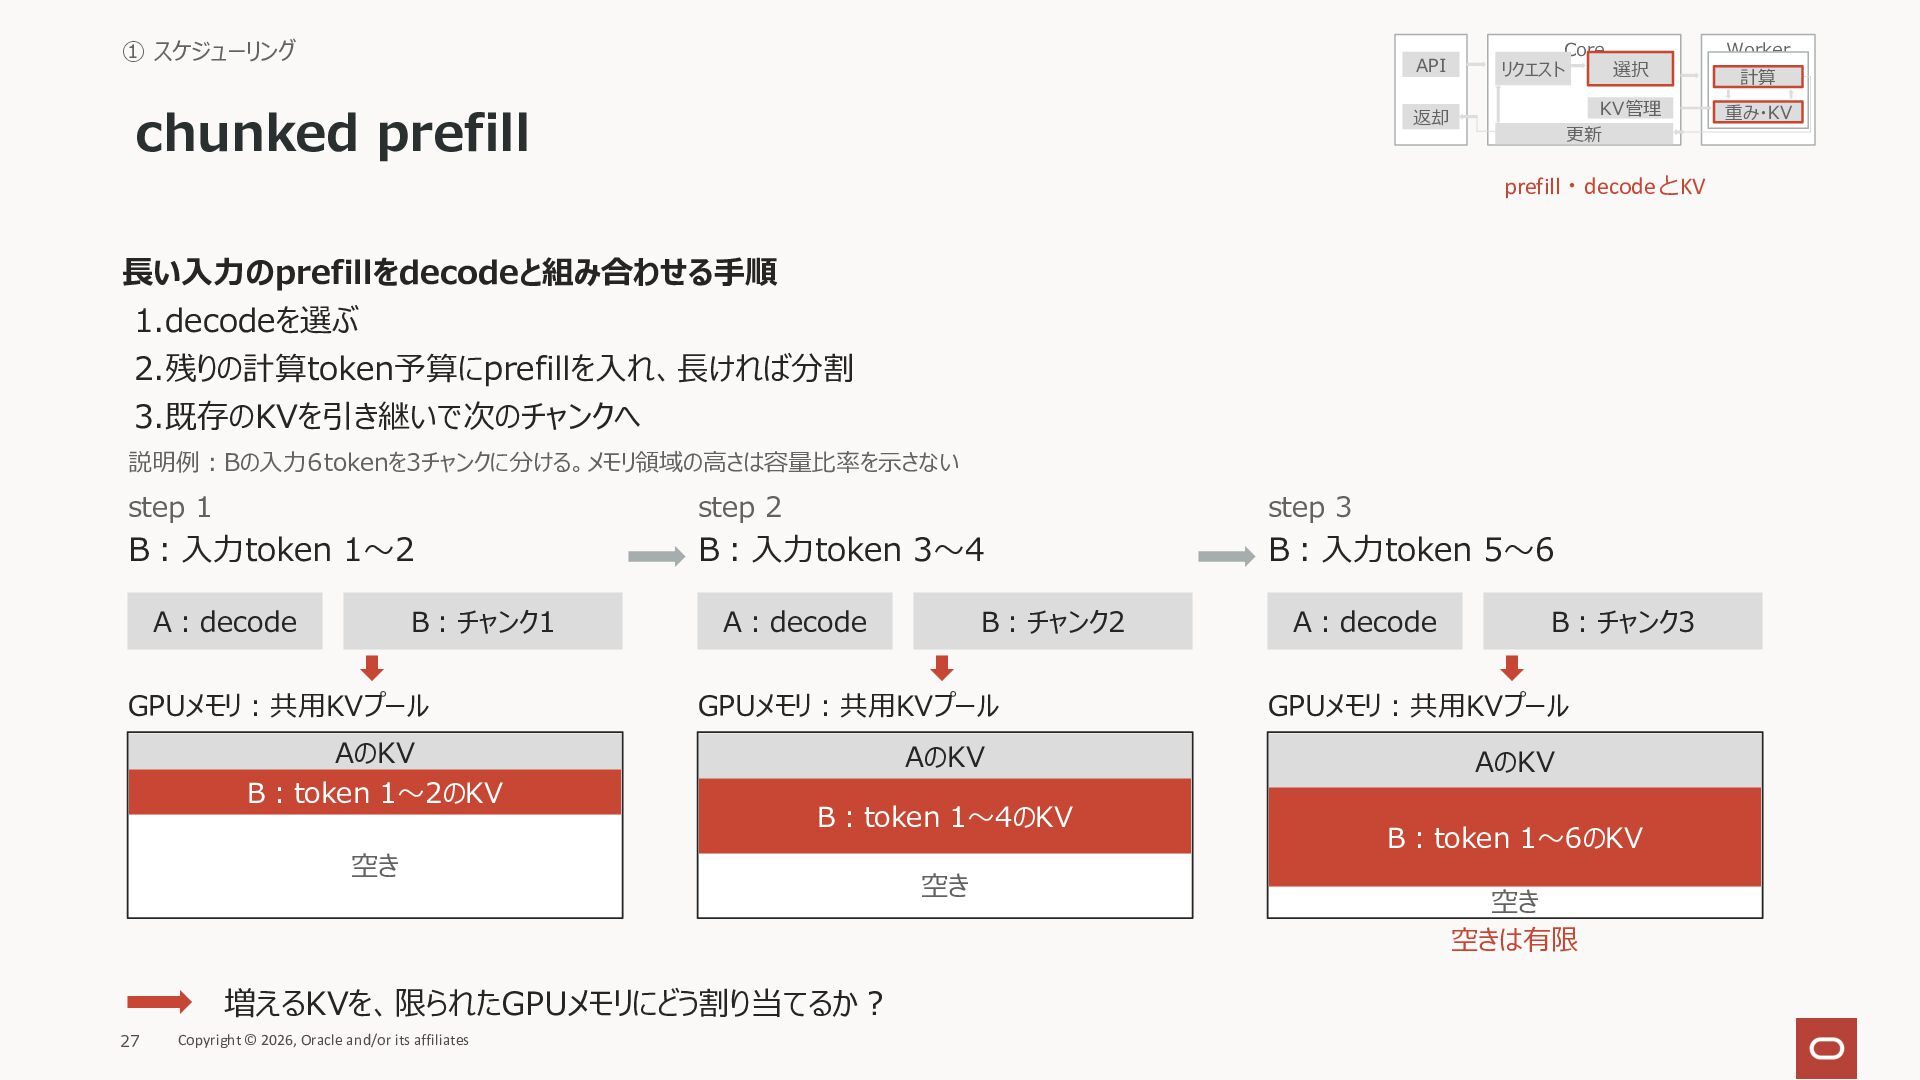
① スケジューリング chunked prefill API Core リクエスト 選択 Worker 返却
KV管理 更新 重み・KV prefill・decodeとKV ⻑い⼊⼒のprefillをdecodeと組み合わせる⼿順 1.decodeを選ぶ 2.残りの計算token予算にprefillを⼊れ、⻑ければ分割 3.既存のKVを引き継いで次のチャンクへ 説明例︓Bの⼊⼒6tokenを3チャンクに分ける。メモリ領域の⾼さは容量⽐率を⽰さない step 1 step 2 step 3 B︓⼊⼒token 1〜2 B︓⼊⼒token 3〜4 B︓⼊⼒token 5〜6 A︓decode B︓チャンク1 GPUメモリ︓共⽤KVプール AのKV B︓token 1〜2のKV A︓decode B︓チャンク3 GPUメモリ︓共⽤KVプール AのKV AのKV B︓token 1〜4のKV 増えるKVを、限られたGPUメモリにどう割り当てるか︖ Copyright © 2026, Oracle and/or its affiliates A︓decode GPUメモリ︓共⽤KVプール 空き 27 B︓チャンク2 空き B︓token 1〜6のKV 空き 空きは有限 計算
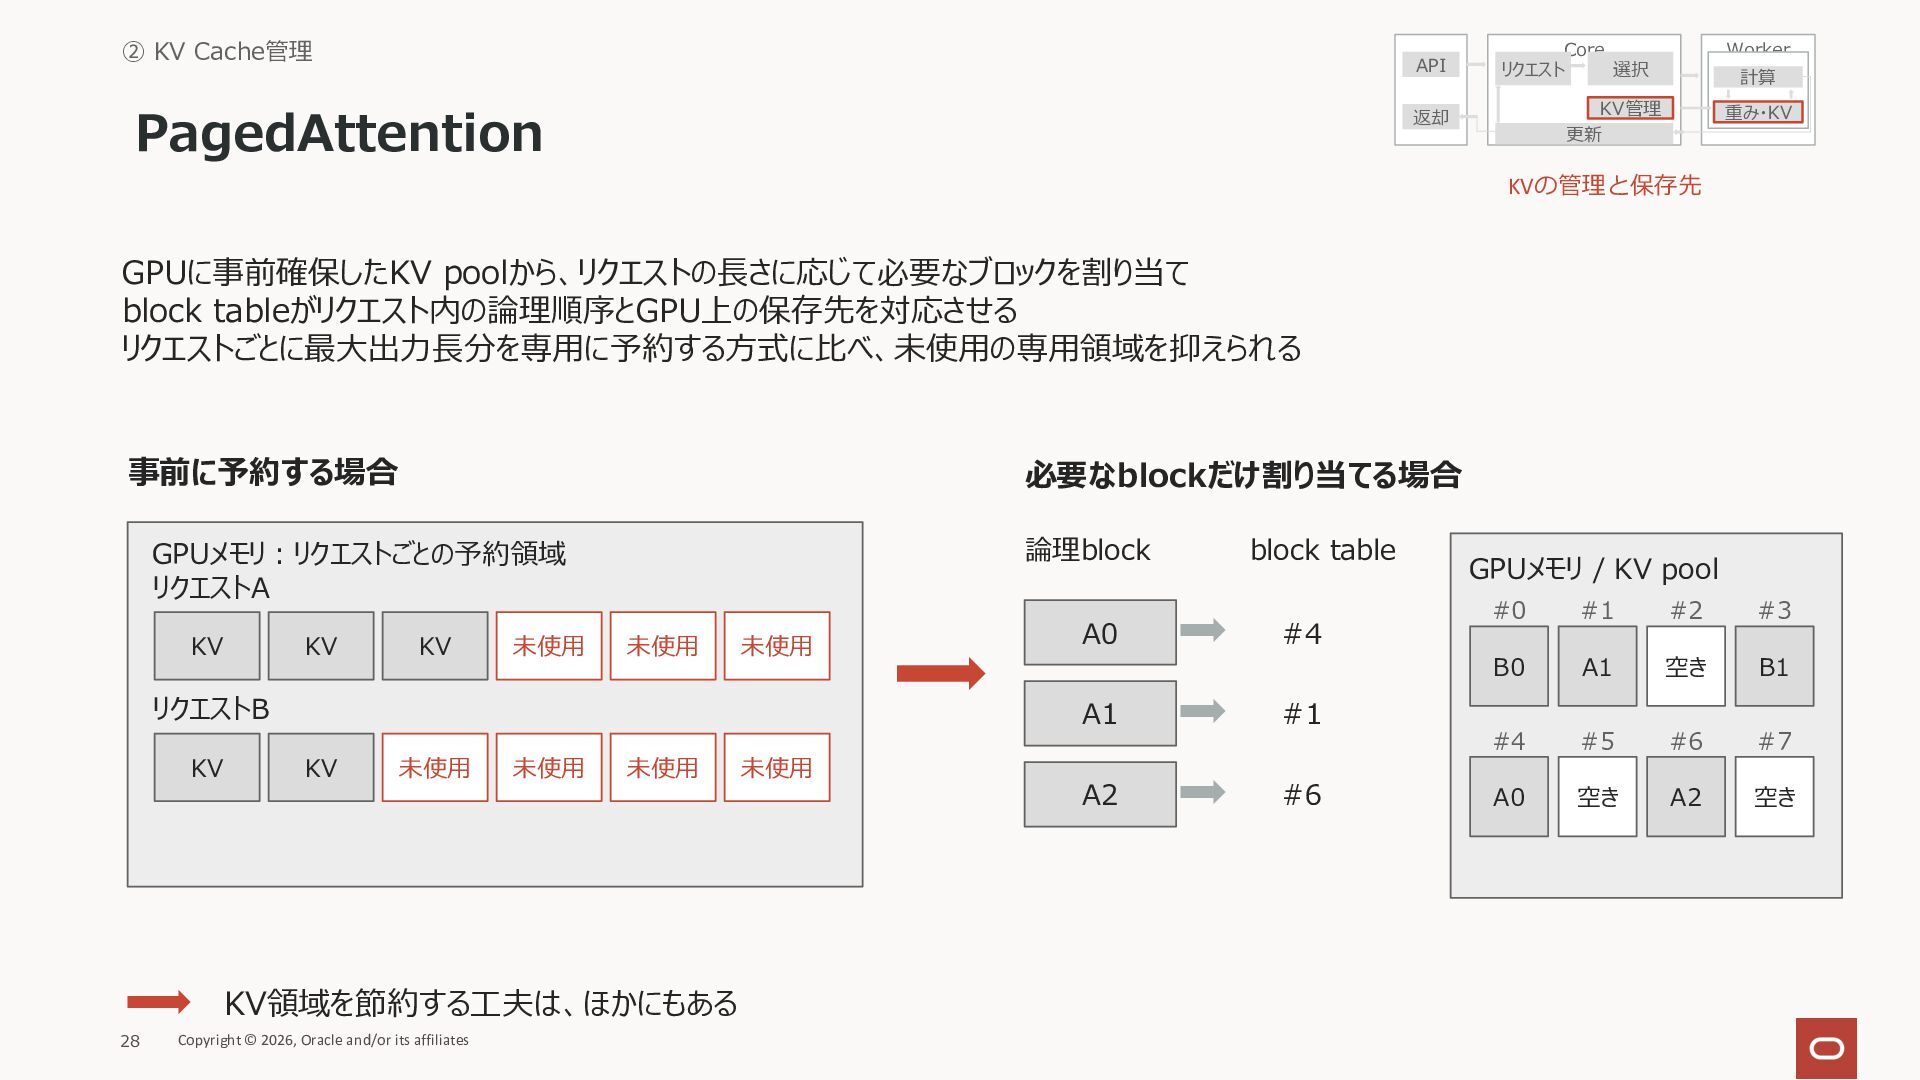
② KV Cache管理 PagedAttention API Core リクエスト 選択 Worker 返却
KV管理 更新 重み・KV 計算 KVの管理と保存先 GPUに事前確保したKV poolから、リクエストの⻑さに応じて必要なブロックを割り当て block tableがリクエスト内の論理順序とGPU上の保存先を対応させる リクエストごとに最⼤出⼒⻑分を専⽤に予約する⽅式に⽐べ、未使⽤の専⽤領域を抑えられる 事前に予約する場合 必要なblockだけ割り当てる場合 論理block GPUメモリ︓リクエストごとの予約領域 リクエストA KV KV KV 未使⽤ 未使⽤ 未使⽤ リクエストB KV KV 未使⽤ 未使⽤ 未使⽤ KV領域を節約する⼯夫は、ほかにもある 28 Copyright © 2026, Oracle and/or its affiliates 未使⽤ A0 block table #4 A1 #1 A2 #6 GPUメモリ / KV pool #0 #1 #2 #3 B0 A1 空き B1 #4 #5 #6 #7 A0 空き A2 空き
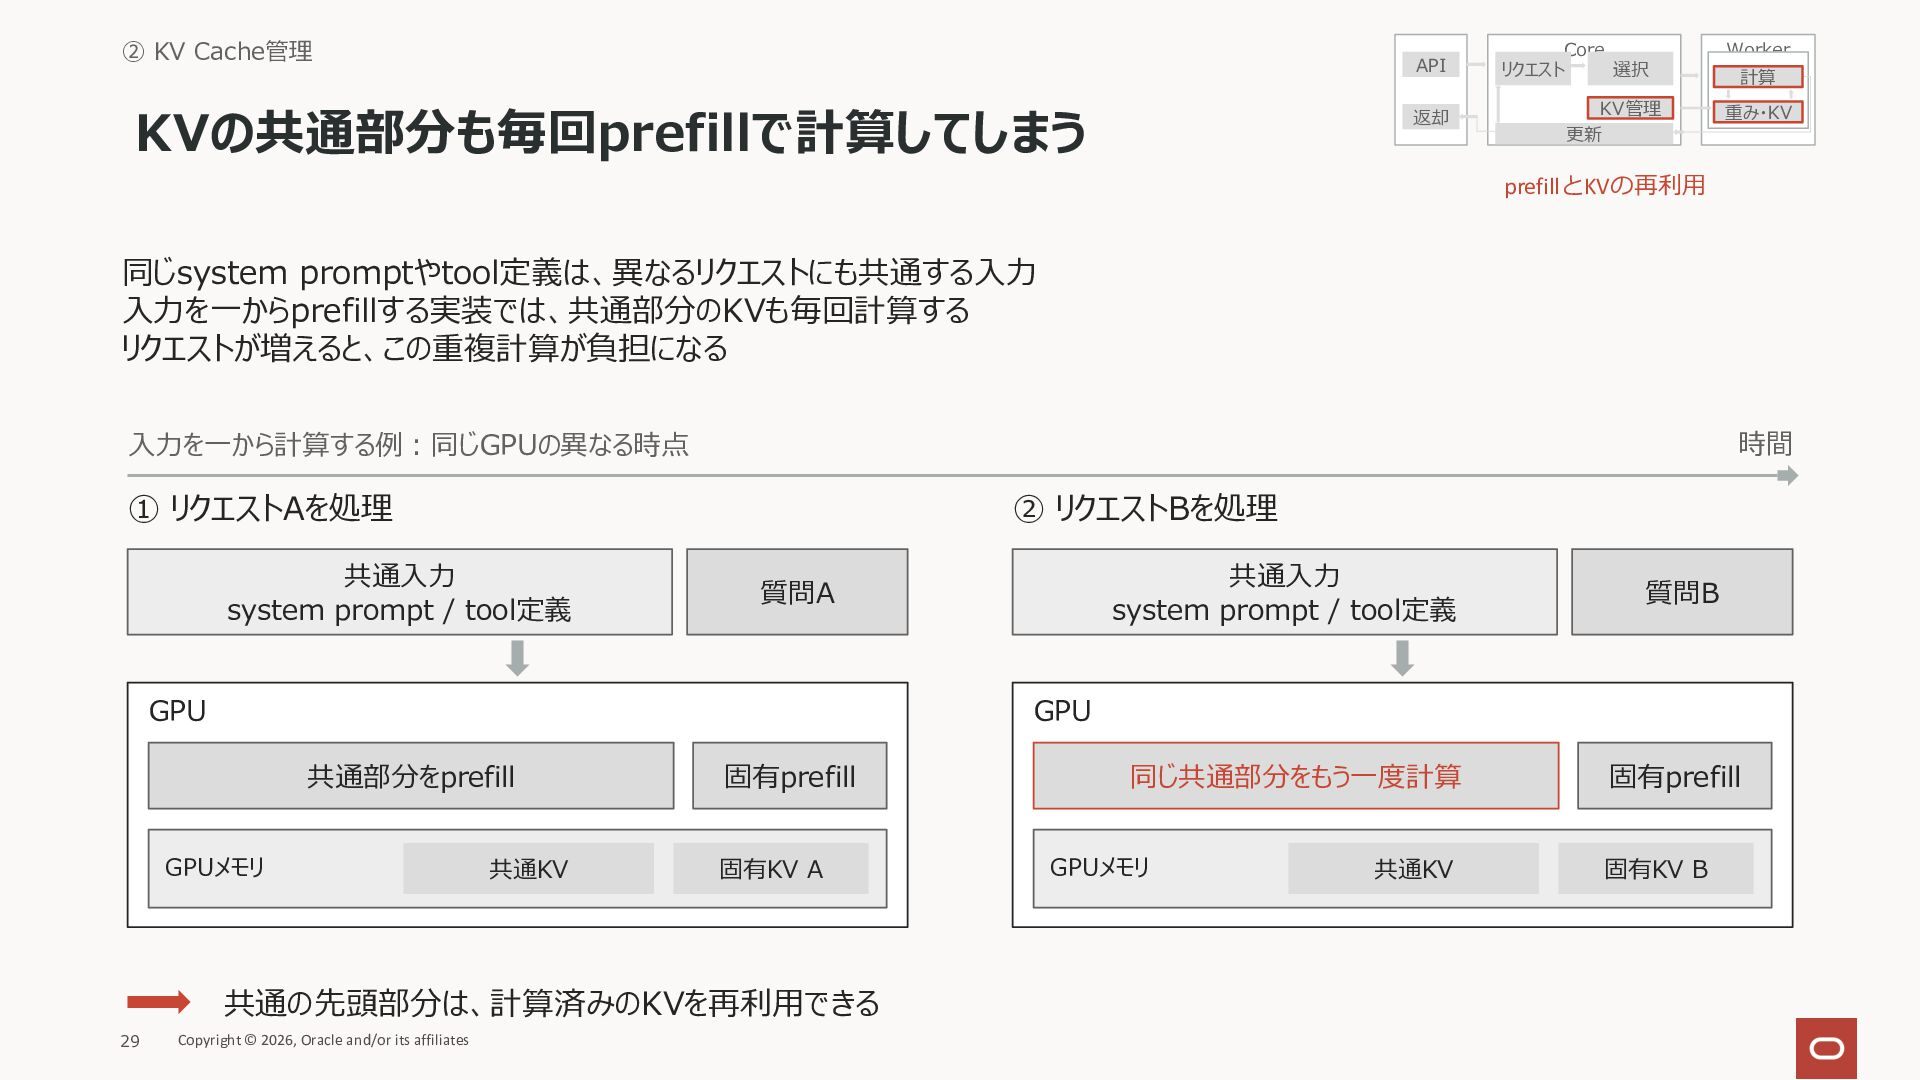
② KV Cache管理 KVの共通部分も毎回prefillで計算してしまう API Core リクエスト 選択 Worker 返却
KV管理 更新 重み・KV 計算 prefillとKVの再利⽤ 同じsystem promptやtool定義は、異なるリクエストにも共通する⼊⼒ ⼊⼒を⼀からprefillする実装では、共通部分のKVも毎回計算する リクエストが増えると、この重複計算が負担になる 時間 ⼊⼒を⼀から計算する例︓同じGPUの異なる時点 ① リクエストAを処理 ② リクエストBを処理 共通⼊⼒ system prompt / tool定義 質問A GPU 質問B 同じ共通部分をもう⼀度計算 固有prefill GPU 共通部分をprefill GPUメモリ 共通KV 固有prefill 固有KV A 共通の先頭部分は、計算済みのKVを再利⽤できる 29 共通⼊⼒ system prompt / tool定義 Copyright © 2026, Oracle and/or its affiliates GPUメモリ 共通KV 固有KV B
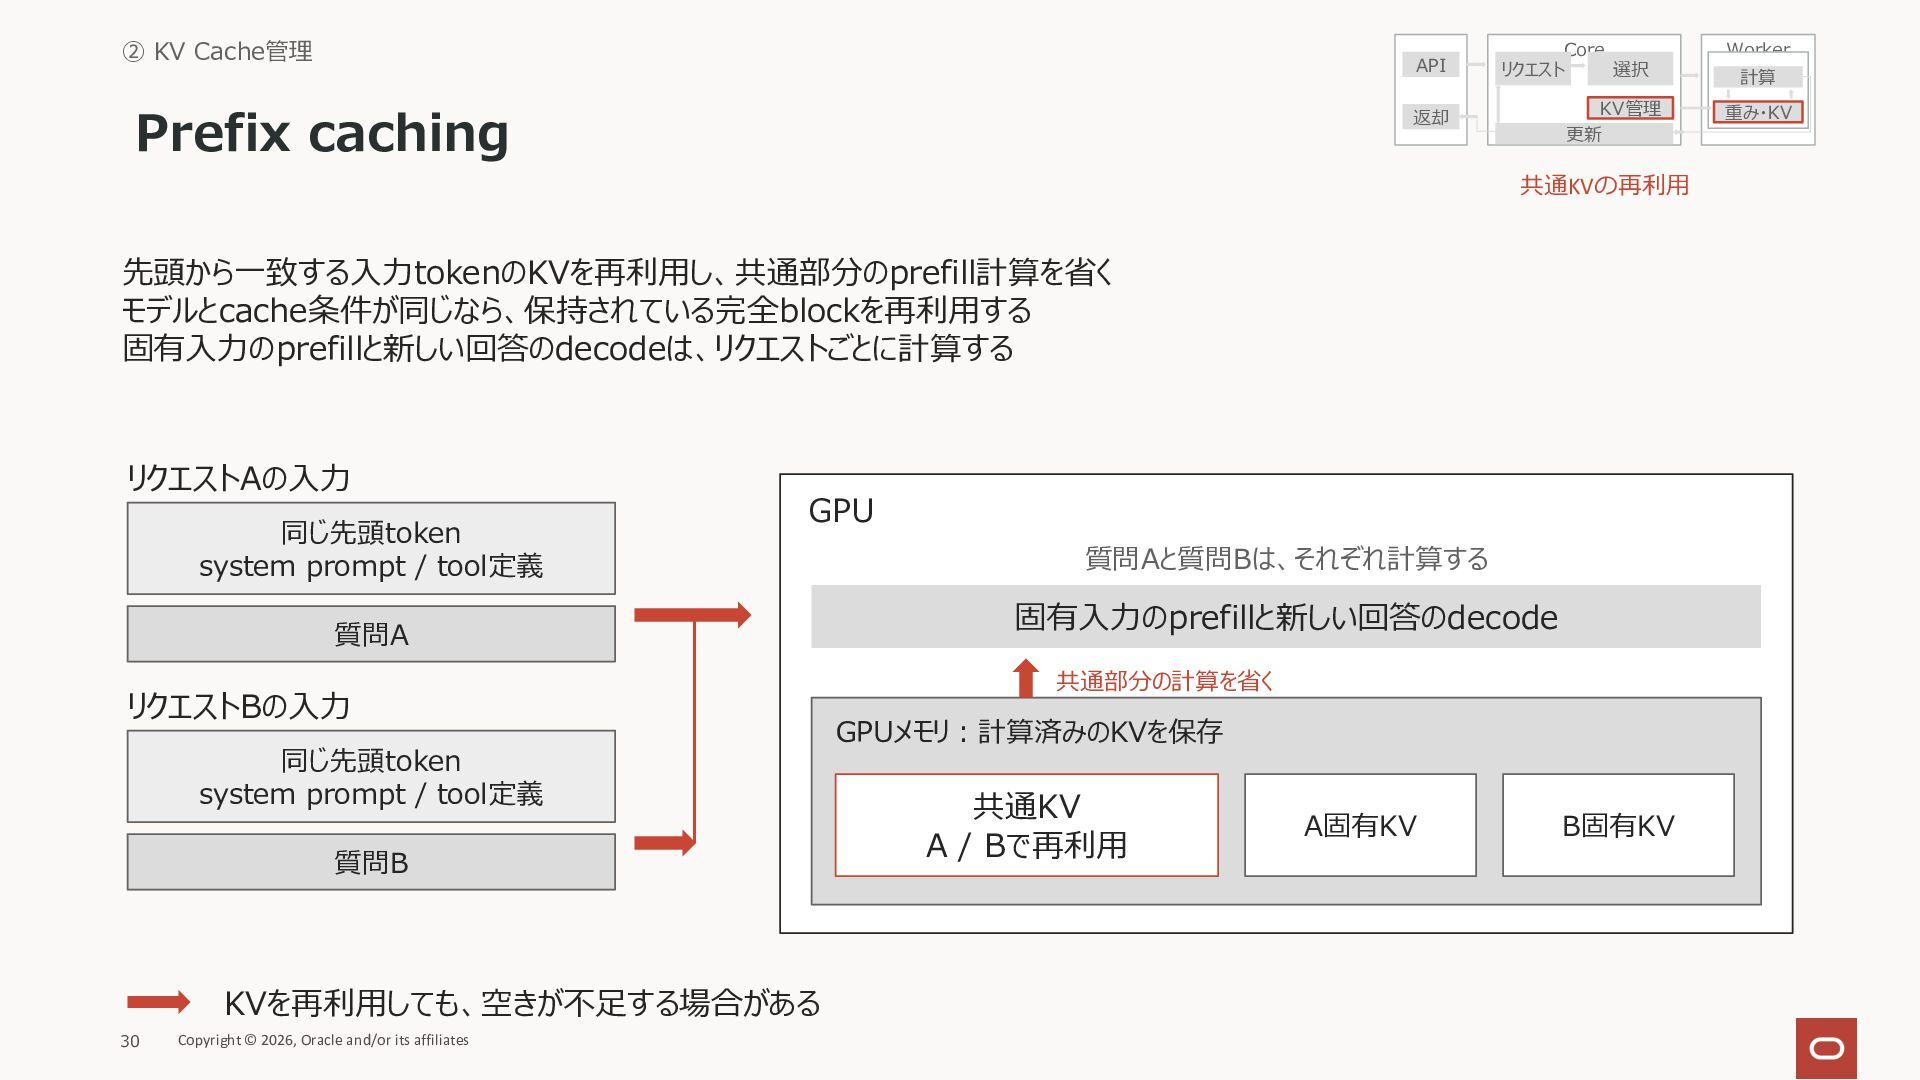
② KV Cache管理 Prefix caching API Core リクエスト 選択 Worker
返却 KV管理 更新 重み・KV 共通KVの再利⽤ 先頭から⼀致する⼊⼒tokenのKVを再利⽤し、共通部分のprefill計算を省く モデルとcache条件が同じなら、保持されている完全blockを再利⽤する 固有⼊⼒のprefillと新しい回答のdecodeは、リクエストごとに計算する リクエストAの⼊⼒ 同じ先頭token system prompt / tool定義 GPU 質問A リクエストBの⼊⼒ 同じ先頭token system prompt / tool定義 質問B KVを再利⽤しても、空きが不⾜する場合がある 30 Copyright © 2026, Oracle and/or its affiliates 質問Aと質問Bは、それぞれ計算する 固有⼊⼒のprefillと新しい回答のdecode 共通部分の計算を省く GPUメモリ︓計算済みのKVを保存 共通KV A / Bで再利⽤ A固有KV B固有KV 計算
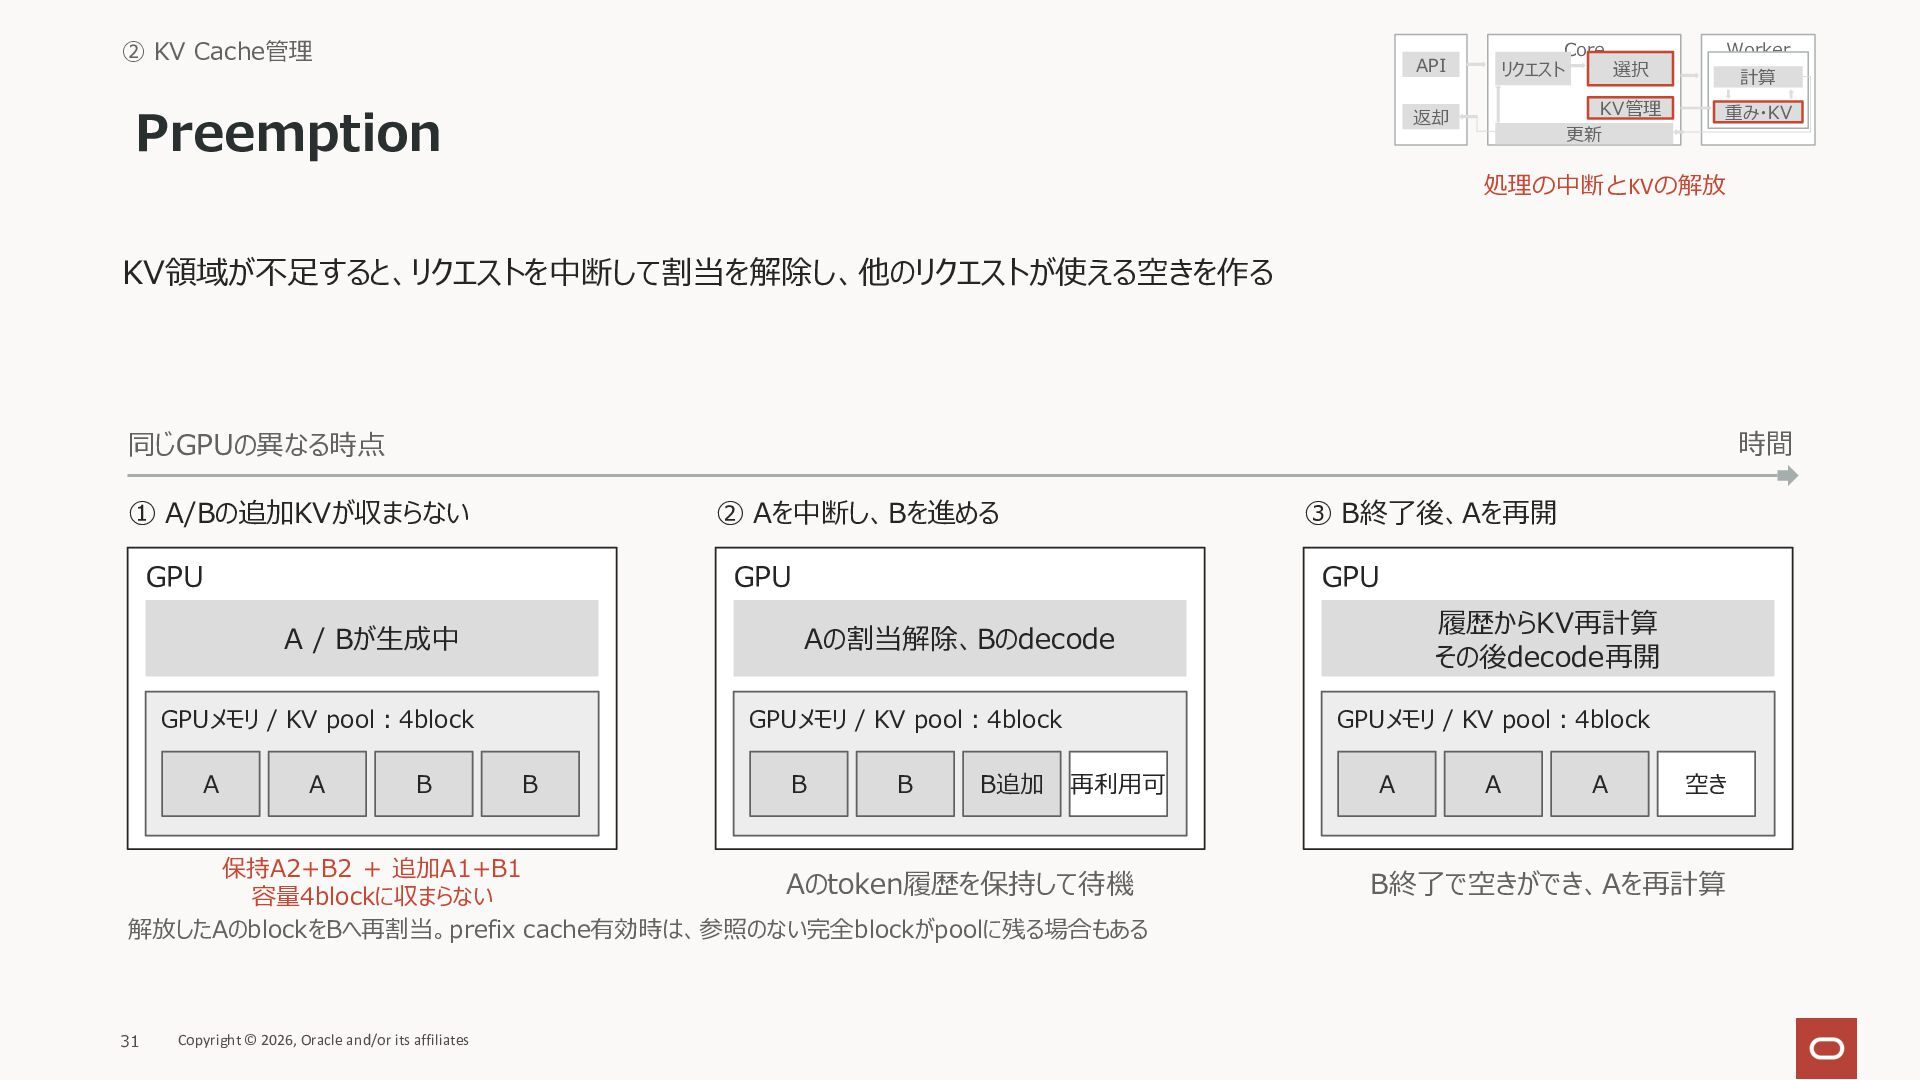
② KV Cache管理 Preemption API Core リクエスト 選択 Worker 返却
KV管理 更新 重み・KV 計算 処理の中断とKVの解放 KV領域が不⾜すると、リクエストを中断して割当を解除し、他のリクエストが使える空きを作る 時間 同じGPUの異なる時点 ① A/Bの追加KVが収まらない ② Aを中断し、Bを進める ③ B終了後、Aを再開 GPU GPU GPU A / Bが⽣成中 GPUメモリ / KV pool︓4block A A B GPUメモリ / KV pool︓4block B B B B追加 GPUメモリ / KV pool︓4block 再利⽤可 保持A2+B2 + 追加A1+B1 Aのtoken履歴を保持して待機 容量4blockに収まらない 解放したAのblockをBへ再割当。prefix cache有効時は、参照のない完全blockがpoolに残る場合もある 31 Copyright © 2026, Oracle and/or its affiliates 履歴からKV再計算 その後decode再開 Aの割当解除、Bのdecode A A A 空き B終了で空きができ、Aを再計算
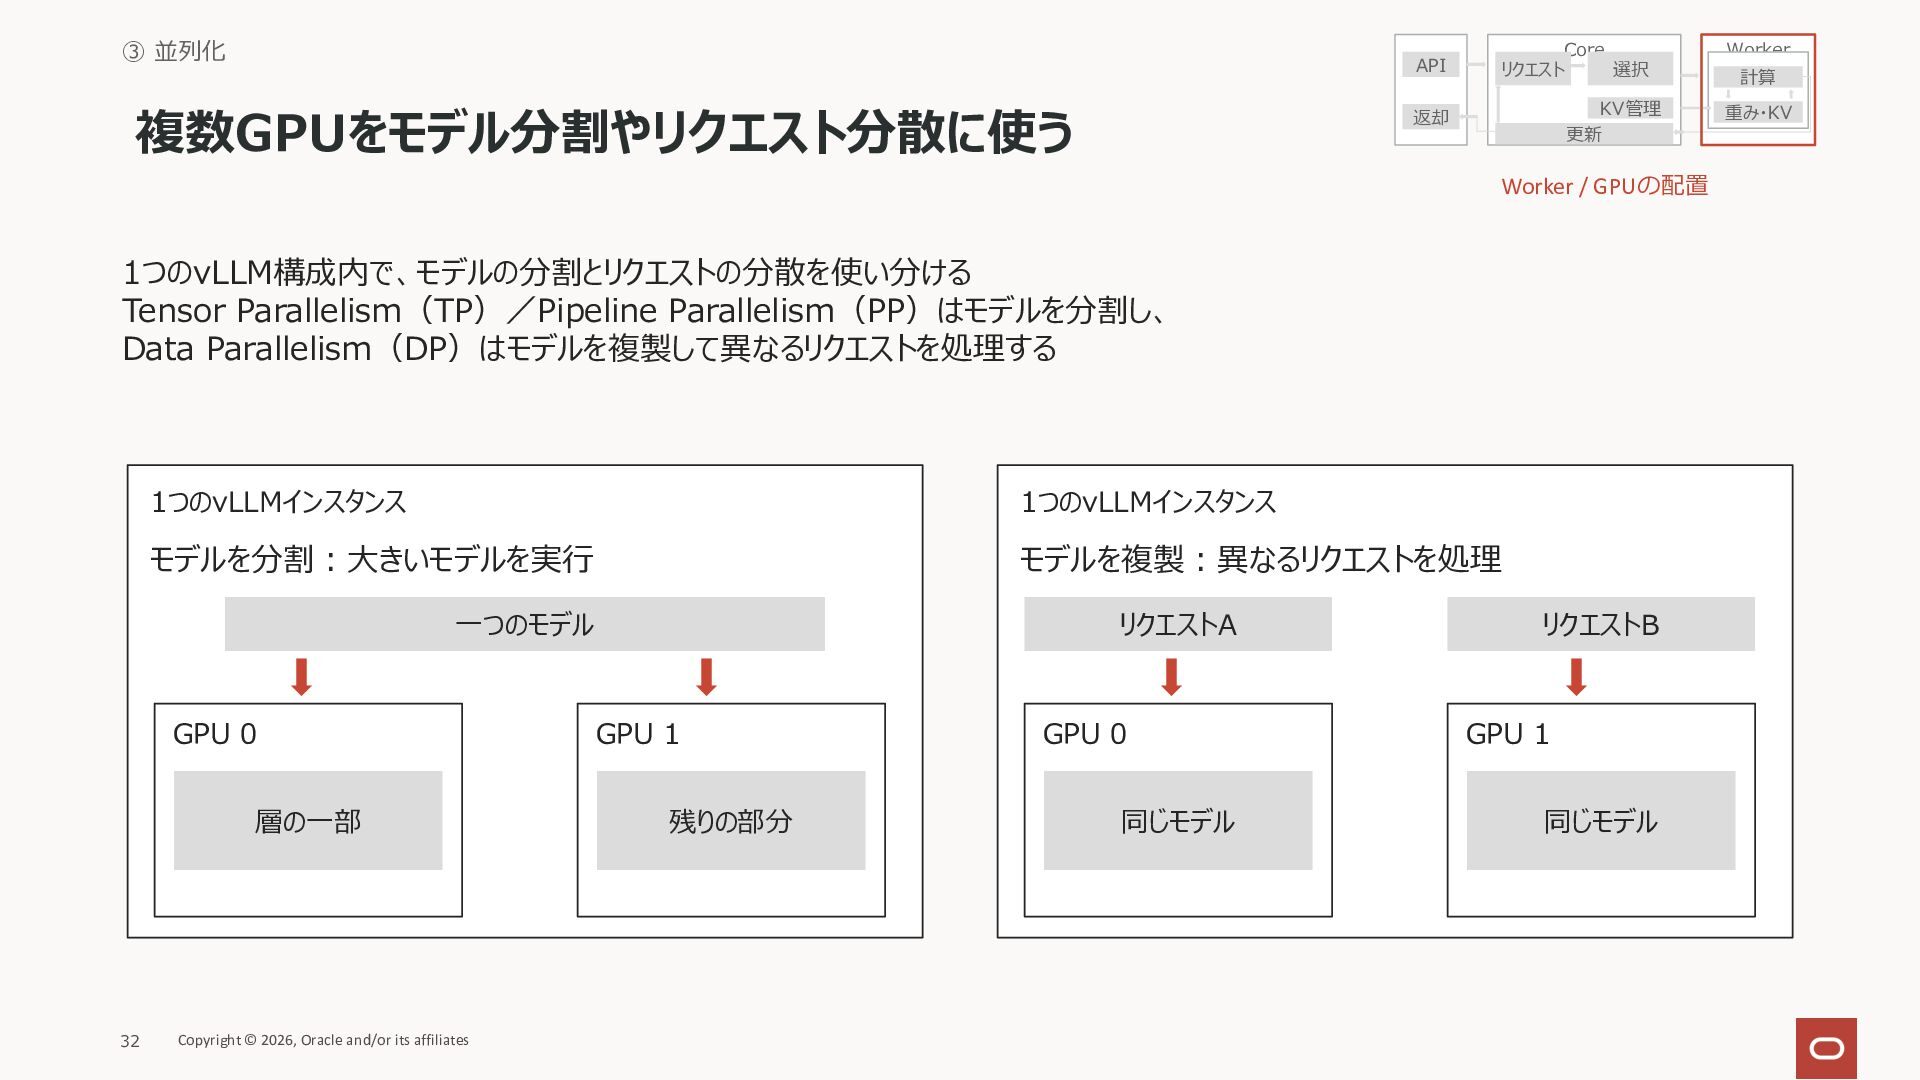
③ 並列化 複数GPUをモデル分割やリクエスト分散に使う API Core リクエスト 選択 Worker 返却 KV管理
更新 重み・KV Worker / GPUの配置 1つのvLLM構成内で、モデルの分割とリクエストの分散を使い分ける Tensor Parallelism(TP)/Pipeline Parallelism(PP)はモデルを分割し、 Data Parallelism(DP)はモデルを複製して異なるリクエストを処理する 1つのvLLMインスタンス 1つのvLLMインスタンス モデルを分割︓⼤きいモデルを実⾏ モデルを複製︓異なるリクエストを処理 ⼀つのモデル GPU 0 層の⼀部 32 Copyright © 2026, Oracle and/or its affiliates リクエストA GPU 1 残りの部分 GPU 0 同じモデル リクエストB GPU 1 同じモデル 計算
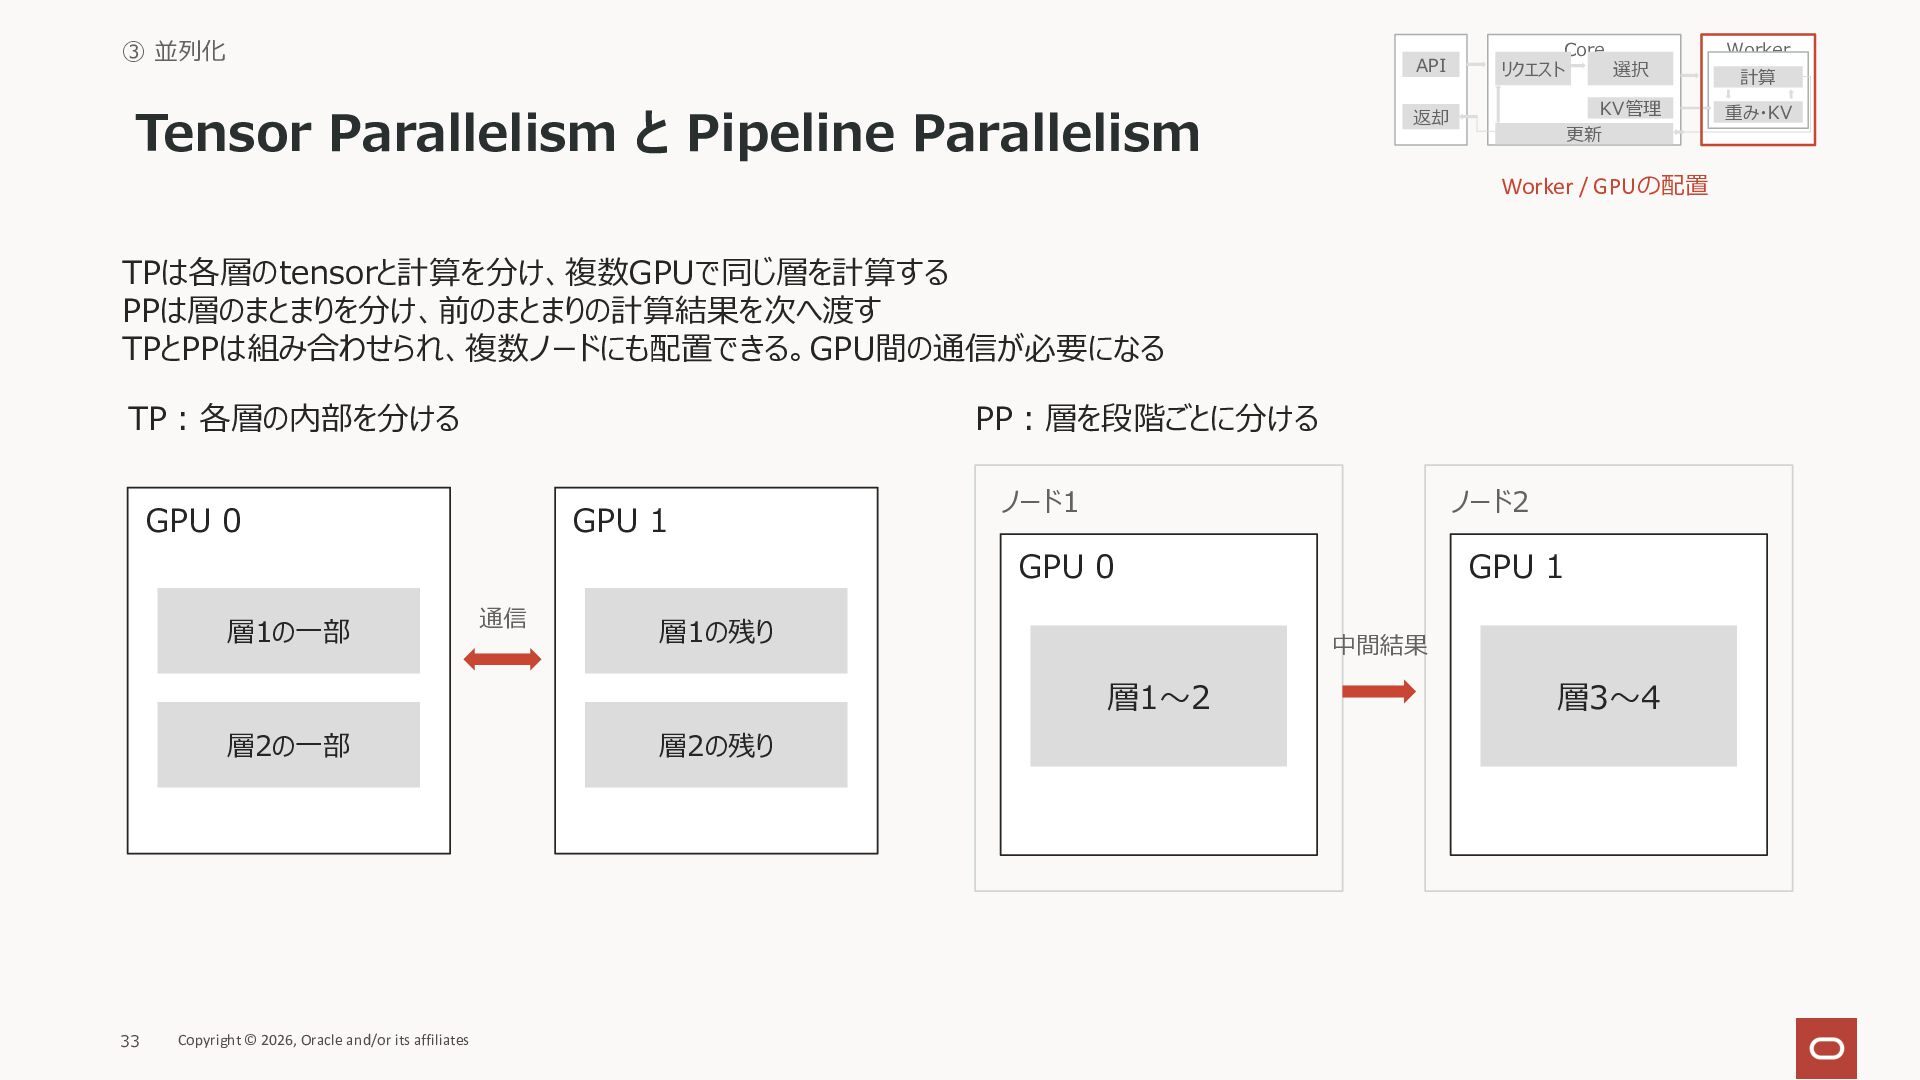
③ 並列化 Tensor Parallelism と Pipeline Parallelism API Core リクエスト
選択 Worker 返却 KV管理 更新 重み・KV Worker / GPUの配置 TPは各層のtensorと計算を分け、複数GPUで同じ層を計算する PPは層のまとまりを分け、前のまとまりの計算結果を次へ渡す TPとPPは組み合わせられ、複数ノードにも配置できる。GPU間の通信が必要になる TP︓各層の内部を分ける PP︓層を段階ごとに分ける GPU 0 層1の⼀部 GPU 1 通信 ノード1 ノード2 GPU 0 GPU 1 層1の残り 中間結果 層1〜2 層2の⼀部 33 Copyright © 2026, Oracle and/or its affiliates 層2の残り 層3〜4 計算
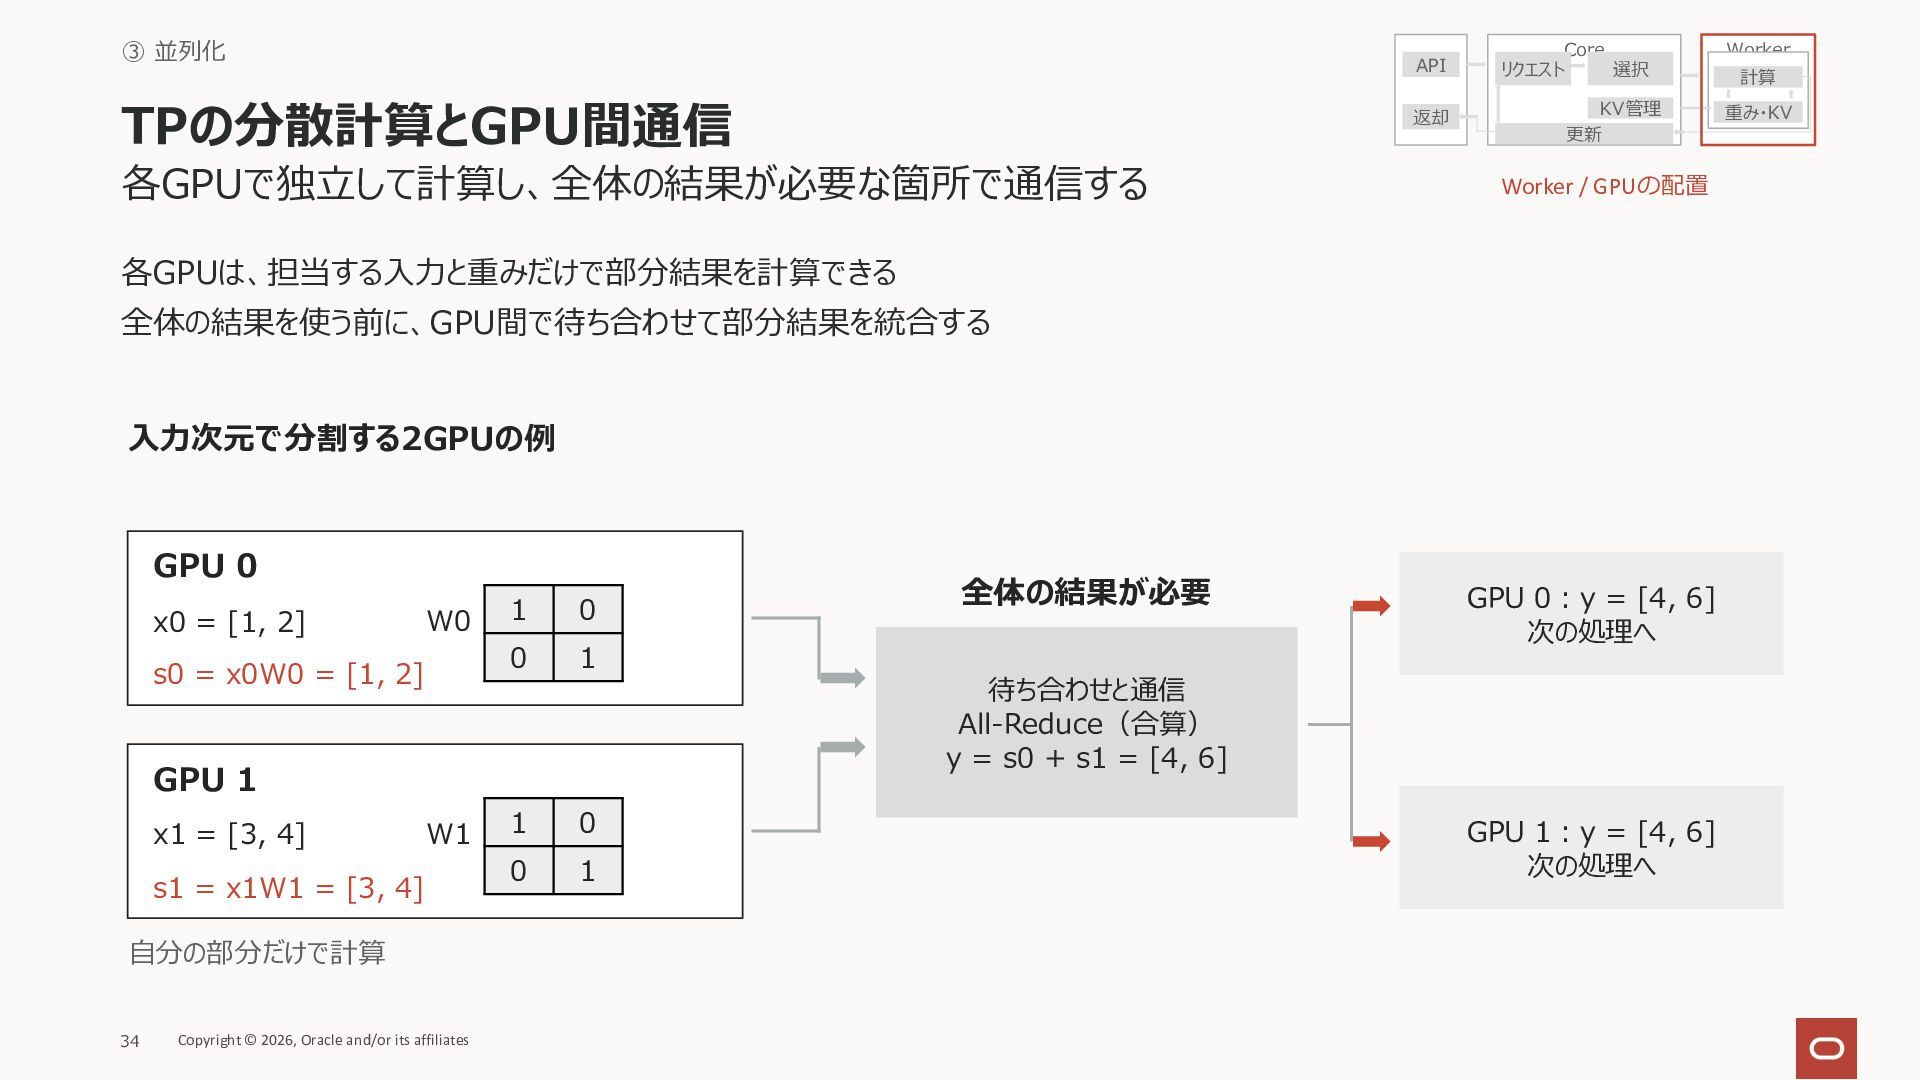
③ 並列化 TPの分散計算とGPU間通信 各GPUで独⽴して計算し、全体の結果が必要な箇所で通信する API Core リクエスト 選択 Worker 返却
KV管理 更新 重み・KV Worker / GPUの配置 各GPUは、担当する⼊⼒と重みだけで部分結果を計算できる 全体の結果を使う前に、GPU間で待ち合わせて部分結果を統合する ⼊⼒次元で分割する2GPUの例 GPU 0 x0 = [1, 2] W0 s0 = x0W0 = [1, 2] 1 0 0 1 1 0 0 1 GPU 1 x1 = [3, 4] W1 s1 = x1W1 = [3, 4] ⾃分の部分だけで計算 34 Copyright © 2026, Oracle and/or its affiliates 全体の結果が必要 GPU 0︓y = [4, 6] 次の処理へ 待ち合わせと通信 All-Reduce(合算) y = s0 + s1 = [4, 6] GPU 1︓y = [4, 6] 次の処理へ 計算
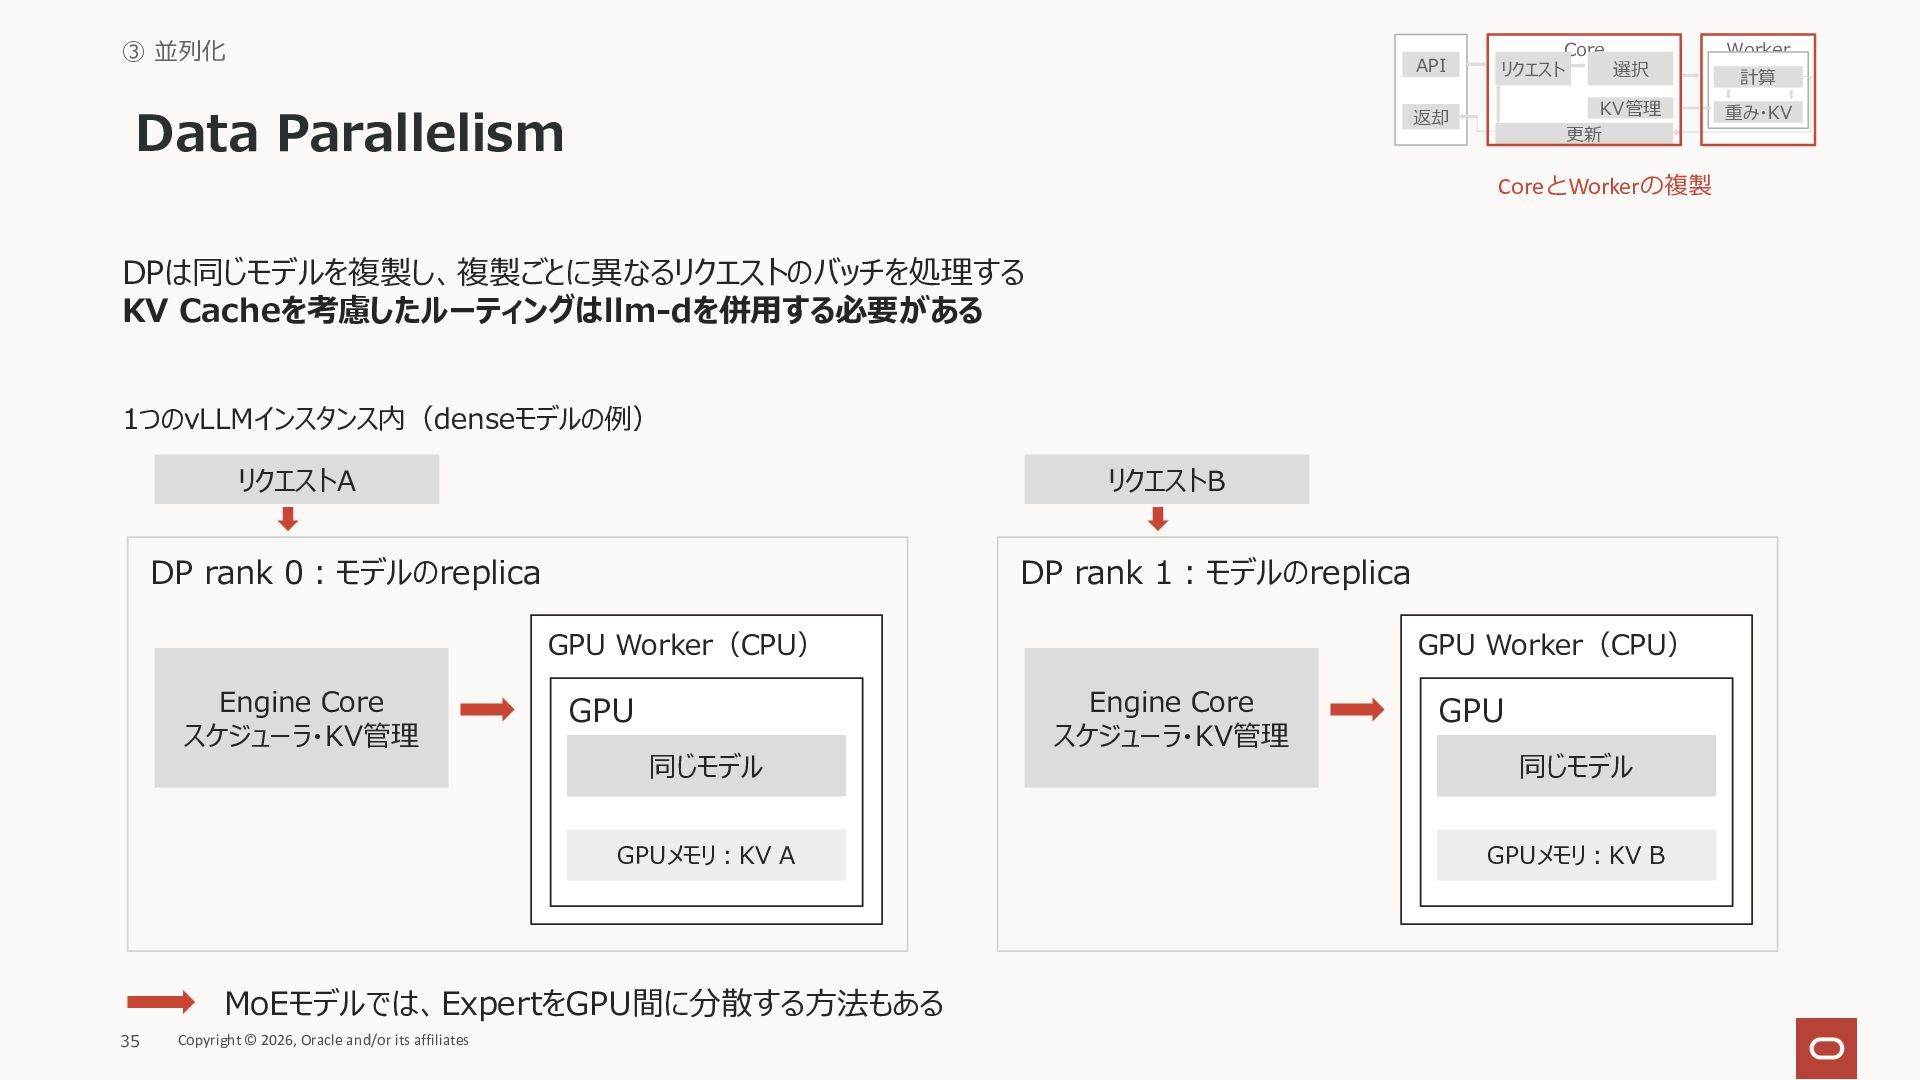
③ 並列化 Data Parallelism API Core リクエスト 選択 Worker 返却
KV管理 更新 重み・KV CoreとWorkerの複製 DPは同じモデルを複製し、複製ごとに異なるリクエストのバッチを処理する KV Cacheを考慮したルーティングはllm-dを併⽤する必要がある 1つのvLLMインスタンス内(denseモデルの例) リクエストA リクエストB DP rank 0︓モデルのreplica DP rank 1︓モデルのreplica GPU Worker(CPU) Engine Core スケジューラ・KV管理 GPU 同じモデル GPUメモリ︓KV A MoEモデルでは、ExpertをGPU間に分散する⽅法もある 35 Copyright © 2026, Oracle and/or its affiliates GPU Worker(CPU) Engine Core スケジューラ・KV管理 GPU 同じモデル GPUメモリ︓KV B 計算
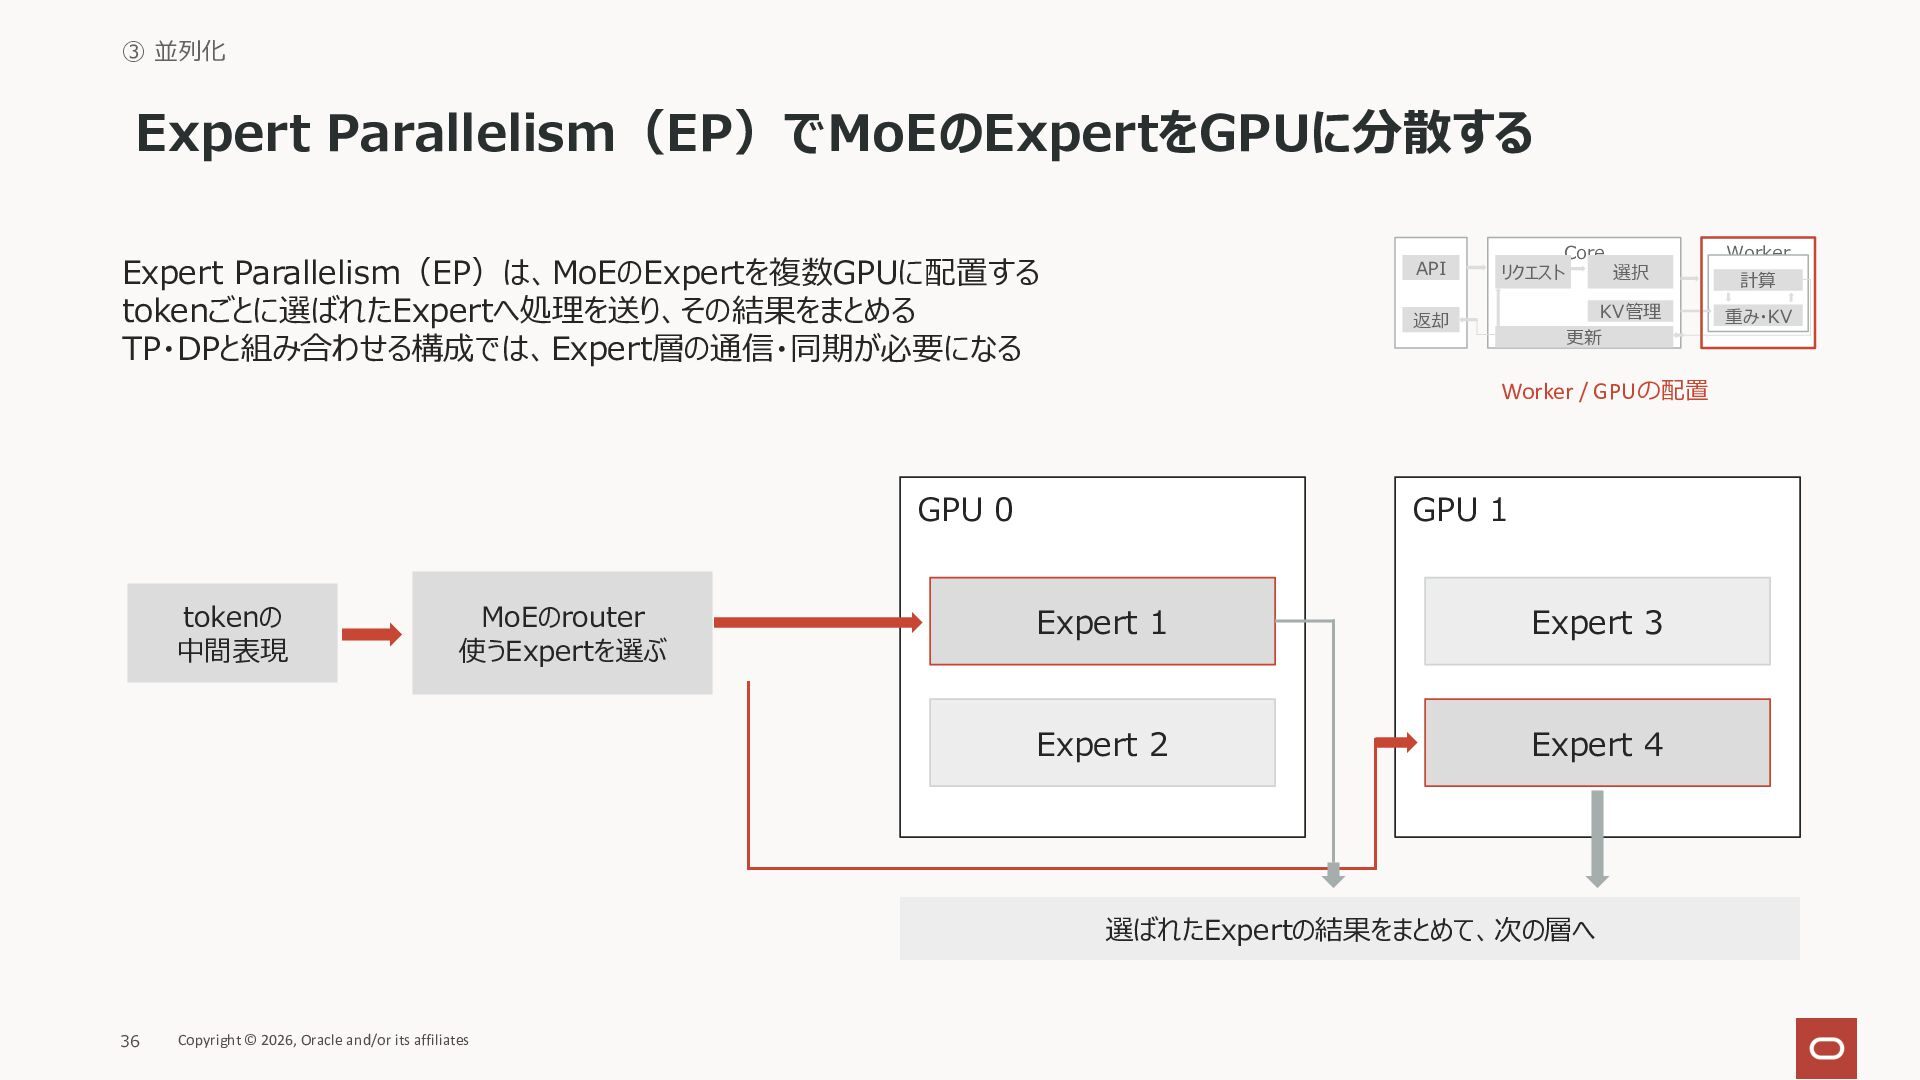
③ 並列化 Expert Parallelism(EP)でMoEのExpertをGPUに分散する Expert Parallelism(EP)は、MoEのExpertを複数GPUに配置する tokenごとに選ばれたExpertへ処理を送り、その結果をまとめる TP・DPと組み合わせる構成では、Expert層の通信・同期が必要になる API Core
リクエスト 選択 Worker 返却 KV管理 更新 重み・KV Worker / GPUの配置 GPU 0 tokenの 中間表現 MoEのrouter 使うExpertを選ぶ GPU 1 Expert 1 Expert 3 Expert 2 Expert 4 選ばれたExpertの結果をまとめて、次の層へ 36 Copyright © 2026, Oracle and/or its affiliates 計算
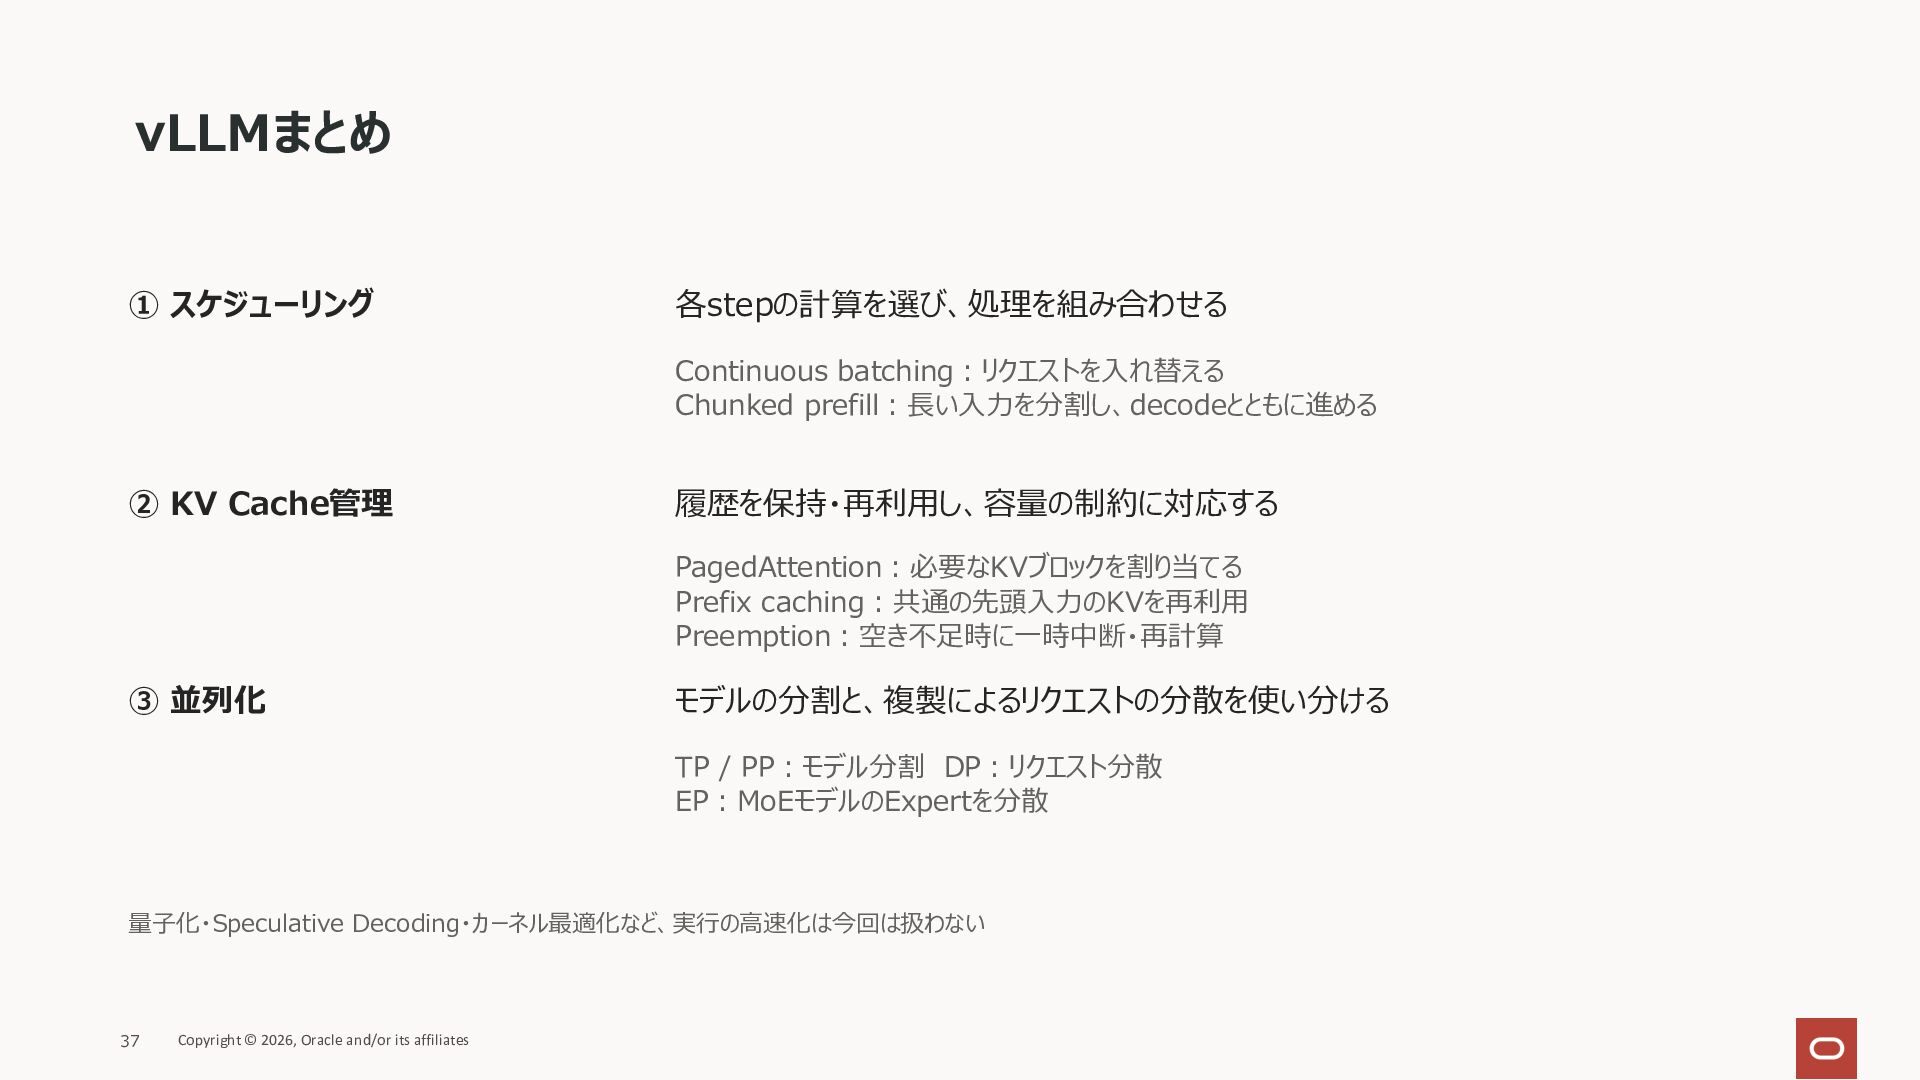
vLLMまとめ ① スケジューリング 各stepの計算を選び、処理を組み合わせる Continuous batching︓リクエストを⼊れ替える Chunked prefill︓⻑い⼊⼒を分割し、decodeとともに進める ② KV
Cache管理 履歴を保持・再利⽤し、容量の制約に対応する PagedAttention︓必要なKVブロックを割り当てる Prefix caching︓共通の先頭⼊⼒のKVを再利⽤ Preemption︓空き不⾜時に⼀時中断・再計算 ③ 並列化 モデルの分割と、複製によるリクエストの分散を使い分ける TP / PP︓モデル分割 DP︓リクエスト分散 EP︓MoEモデルのExpertを分散 量⼦化・Speculative Decoding・カーネル最適化など、実⾏の⾼速化は今回は扱わない 37 Copyright © 2026, Oracle and/or its affiliates
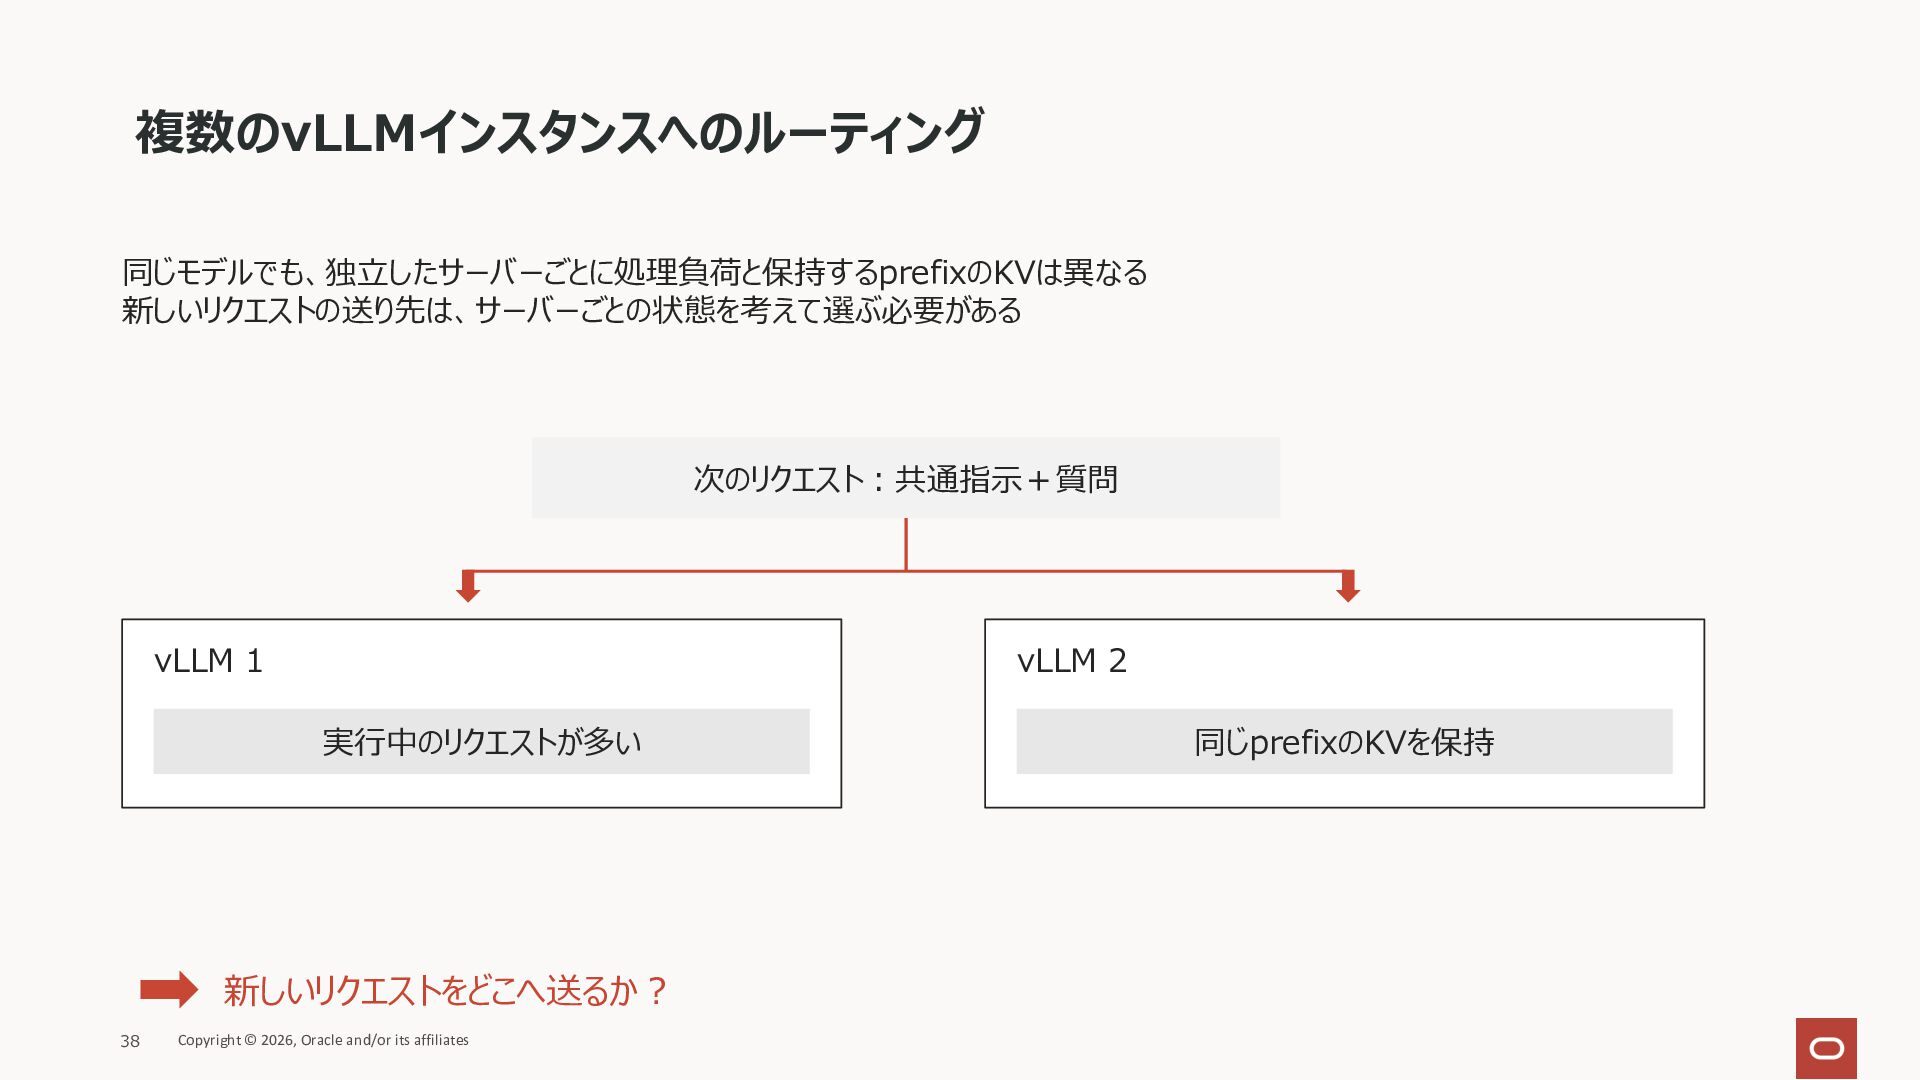
複数のvLLMインスタンスへのルーティング 同じモデルでも、独⽴したサーバーごとに処理負荷と保持するprefixのKVは異なる 新しいリクエストの送り先は、サーバーごとの状態を考えて選ぶ必要がある 次のリクエスト︓共通指⽰+質問 vLLM 1 vLLM 2 実⾏中のリクエストが多い 新しいリクエストをどこへ送るか︖
38 Copyright © 2026, Oracle and/or its affiliates 同じprefixのKVを保持
llm-d 複数の推論レプリカへの配信と分散推論
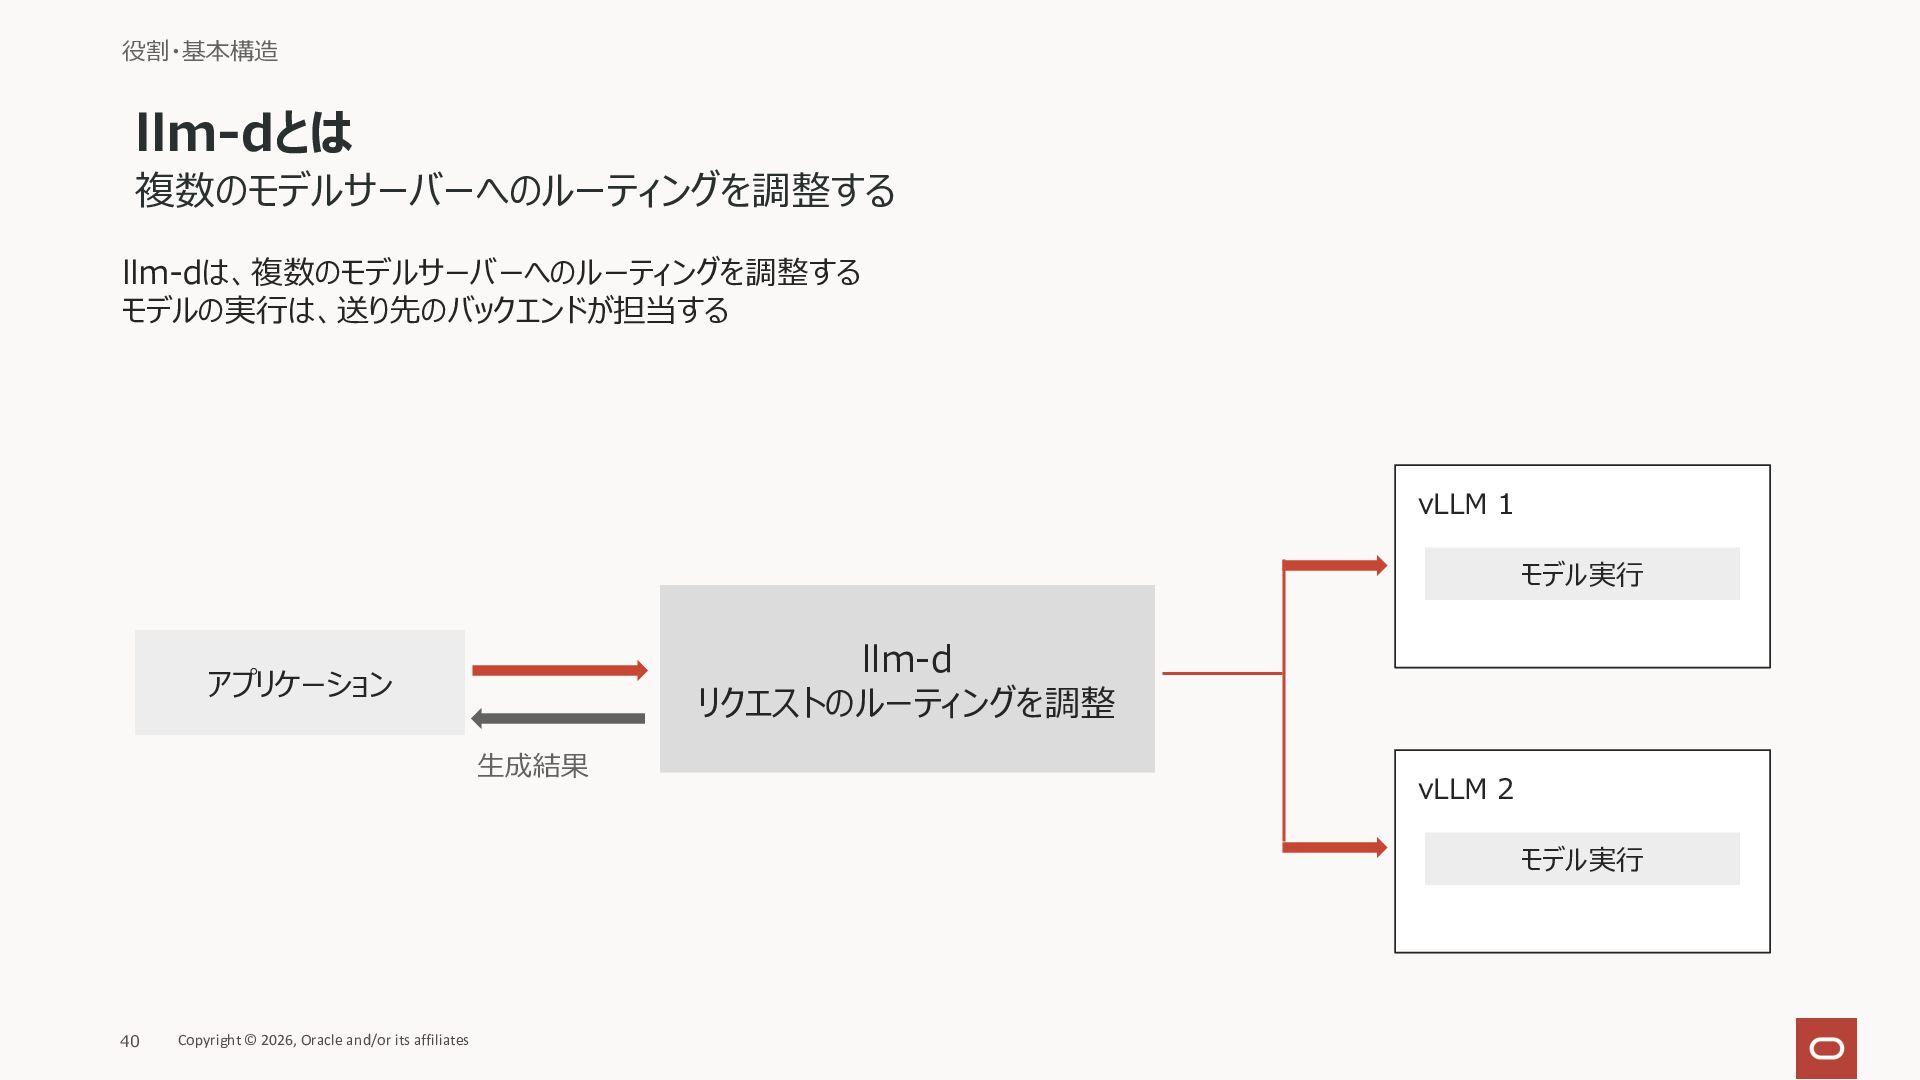
役割・基本構造 llm-dとは 複数のモデルサーバーへのルーティングを調整する llm-dは、複数のモデルサーバーへのルーティングを調整する モデルの実⾏は、送り先のバックエンドが担当する vLLM 1 モデル実⾏ llm-d リクエストのルーティングを調整
アプリケーション ⽣成結果 vLLM 2 モデル実⾏ 40 Copyright © 2026, Oracle and/or its affiliates
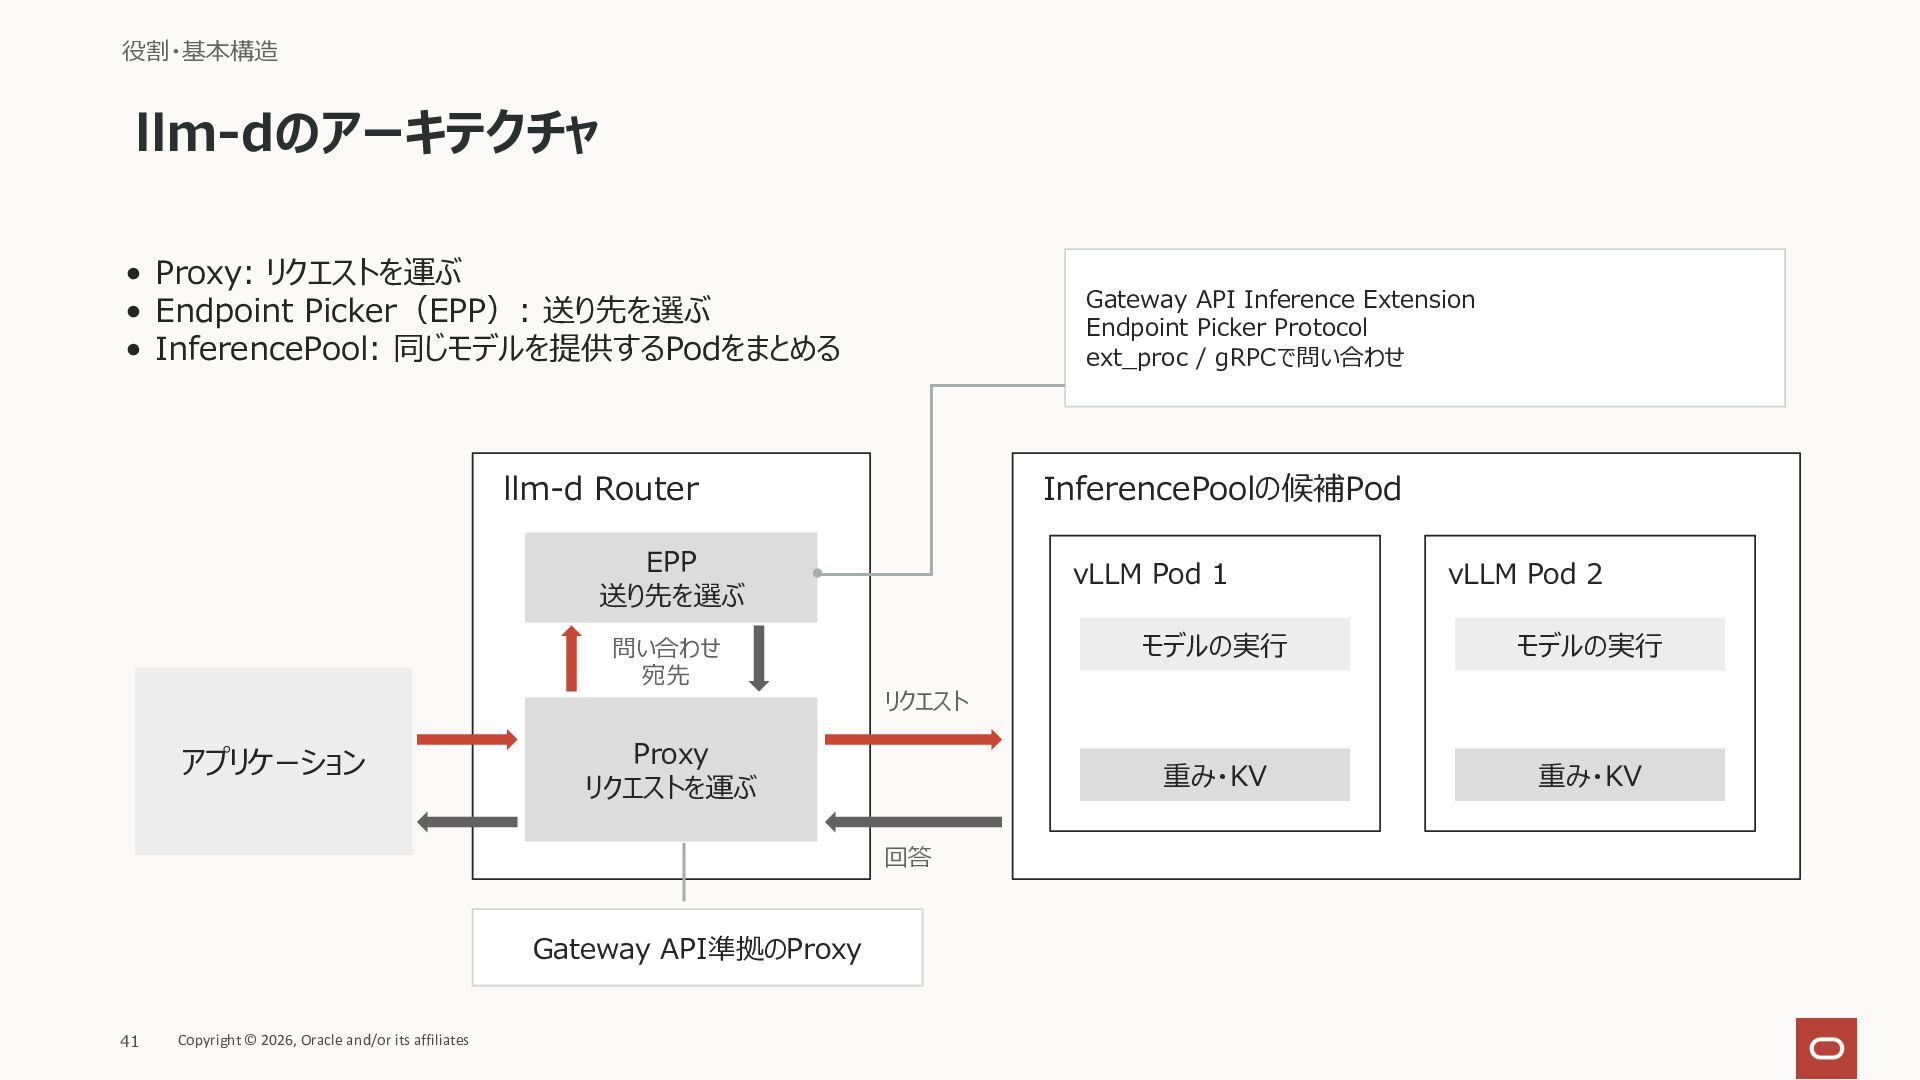
役割・基本構造 llm-dのアーキテクチャ • Proxy: リクエストを運ぶ • Endpoint Picker(EPP): 送り先を選ぶ •
InferencePool: 同じモデルを提供するPodをまとめる Gateway API Inference Extension Endpoint Picker Protocol ext_proc / gRPCで問い合わせ llm-d Router InferencePoolの候補Pod EPP 送り先を選ぶ 問い合わせ 宛先 アプリケーション vLLM Pod 1 回答 41 Copyright © 2026, Oracle and/or its affiliates モデルの実⾏ モデルの実⾏ 重み・KV 重み・KV リクエスト Proxy リクエストを運ぶ Gateway API準拠のProxy vLLM Pod 2
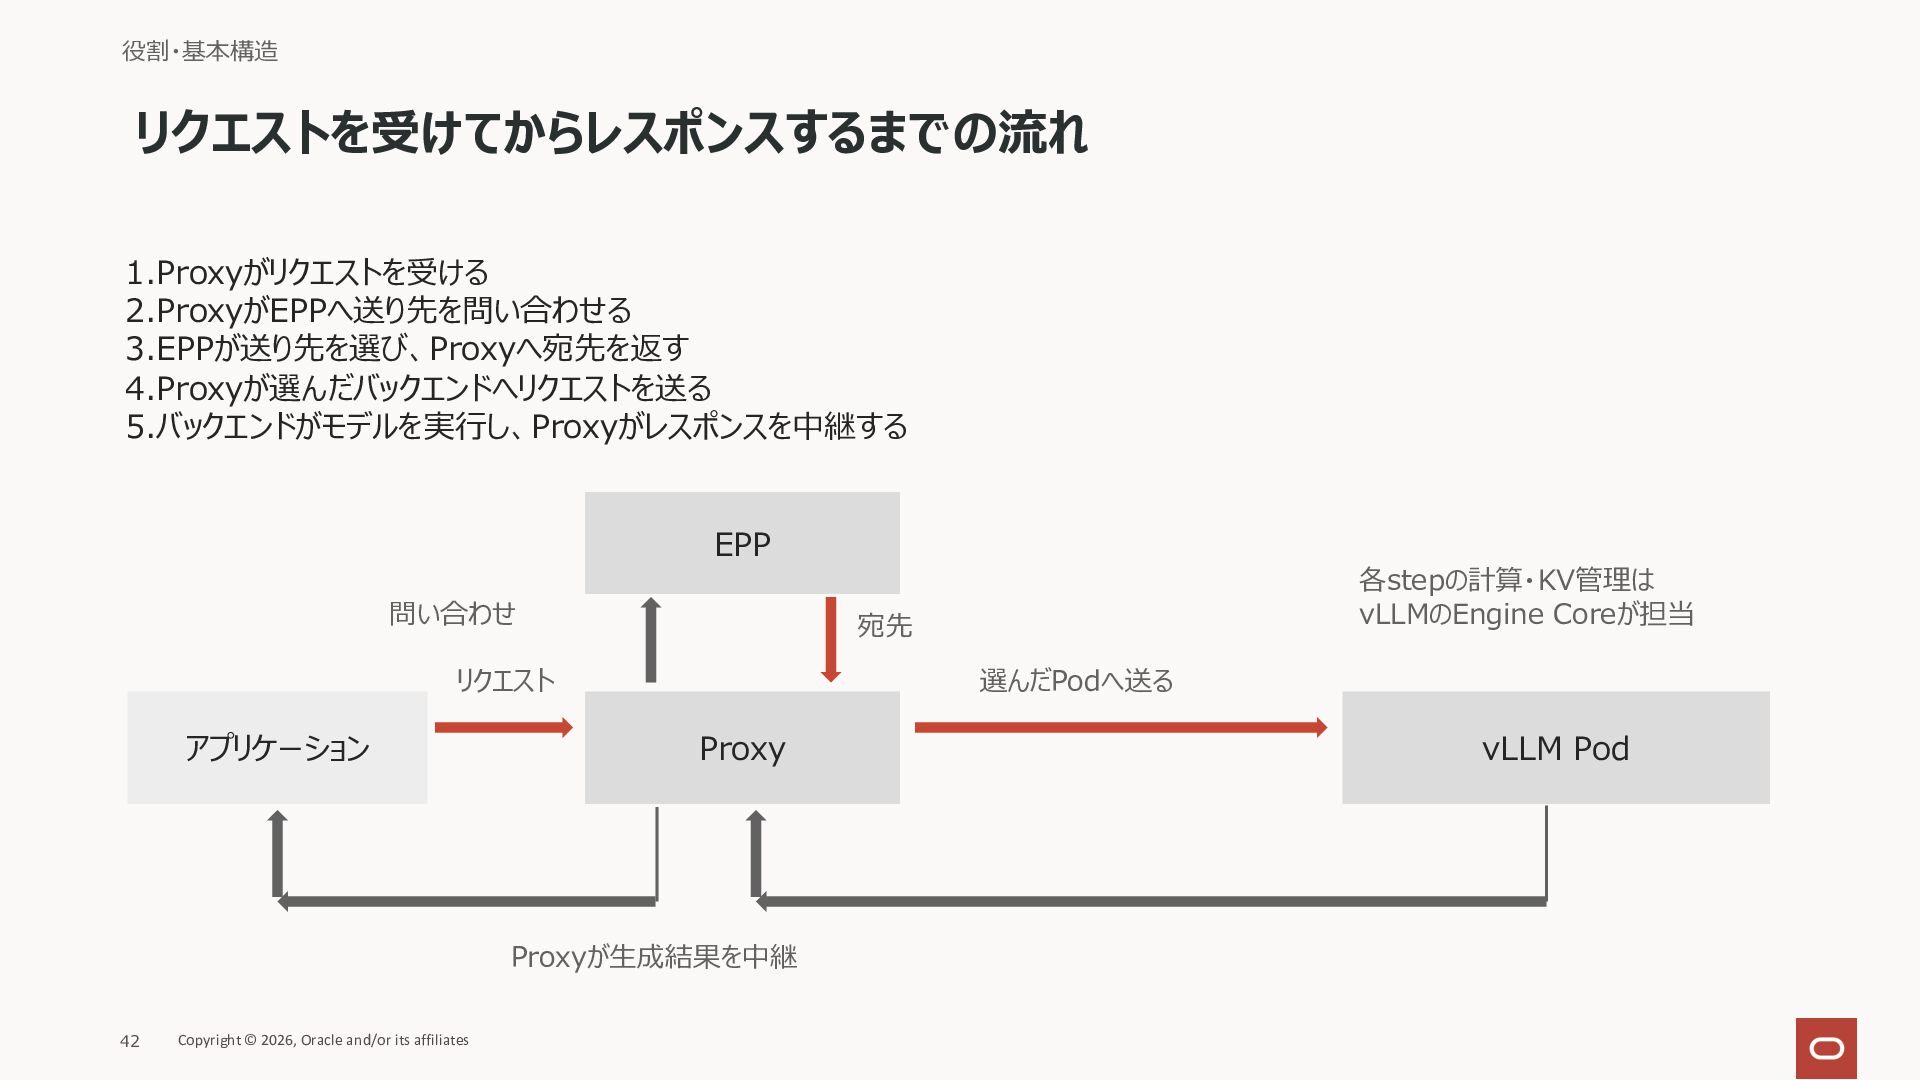
役割・基本構造 リクエストを受けてからレスポンスするまでの流れ 1.Proxyがリクエストを受ける 2.ProxyがEPPへ送り先を問い合わせる 3.EPPが送り先を選び、Proxyへ宛先を返す 4.Proxyが選んだバックエンドへリクエストを送る 5.バックエンドがモデルを実⾏し、Proxyがレスポンスを中継する EPP 問い合わせ 宛先
リクエスト アプリケーション 選んだPodへ送る Proxy Proxyが⽣成結果を中継 42 Copyright © 2026, Oracle and/or its affiliates 各stepの計算・KV管理は vLLMのEngine Coreが担当 vLLM Pod
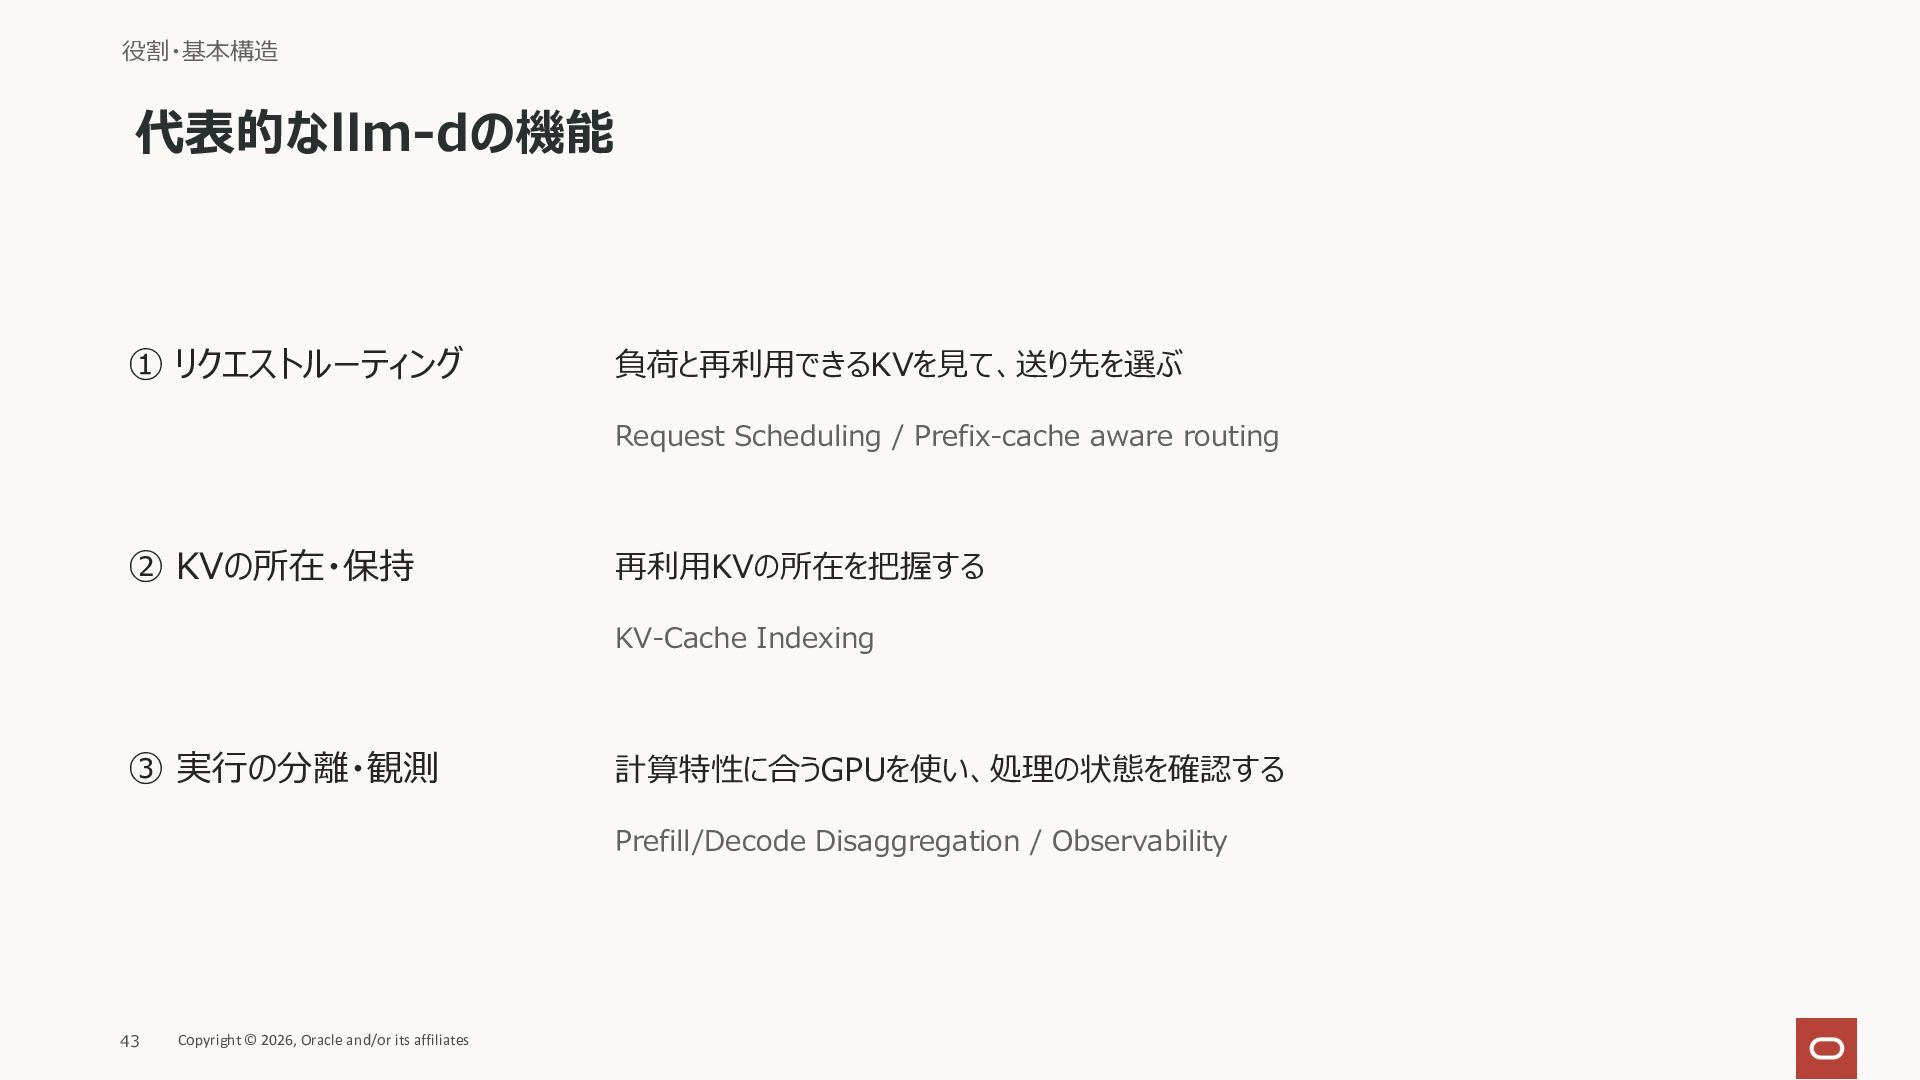
役割・基本構造 代表的なllm-dの機能 ① リクエストルーティング 負荷と再利⽤できるKVを⾒て、送り先を選ぶ Request Scheduling / Prefix-cache aware
routing ② KVの所在・保持 再利⽤KVの所在を把握する KV-Cache Indexing ③ 実⾏の分離・観測 計算特性に合うGPUを使い、処理の状態を確認する Prefill/Decode Disaggregation / Observability 43 Copyright © 2026, Oracle and/or its affiliates
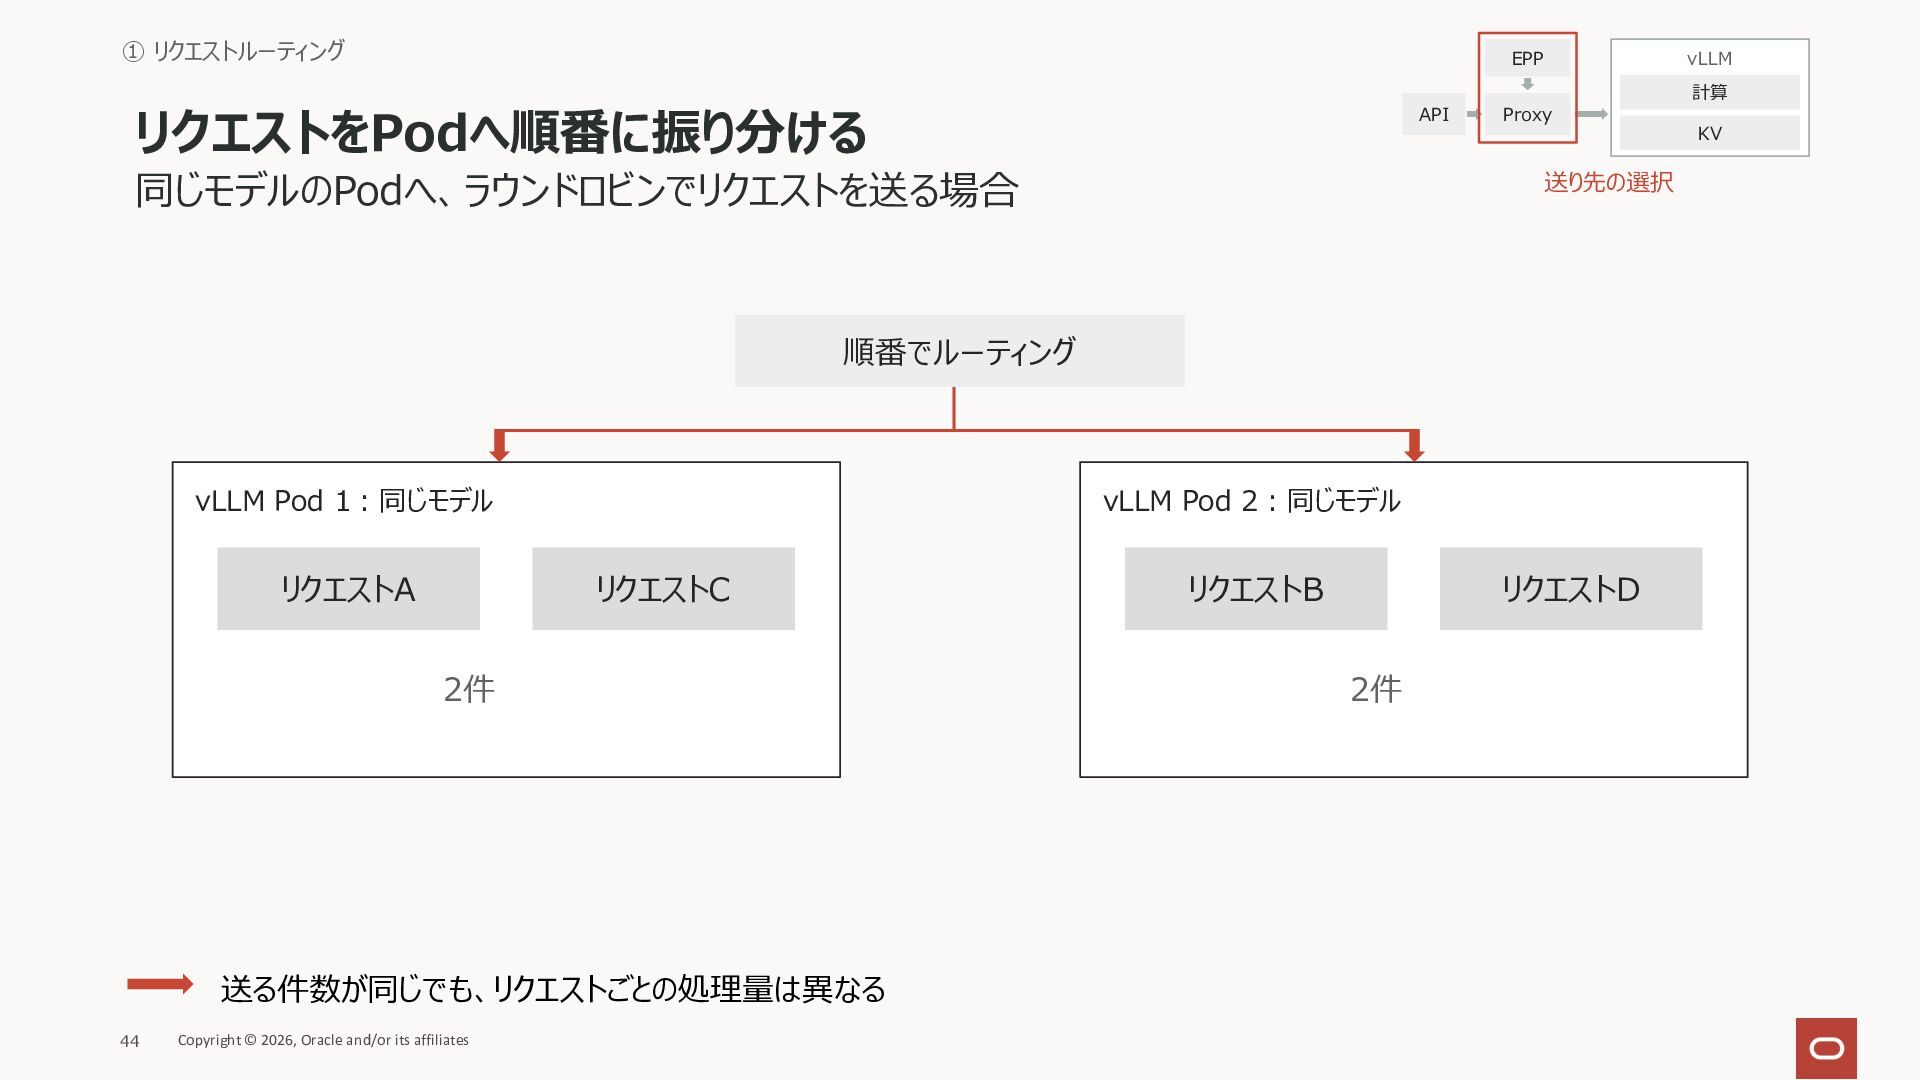
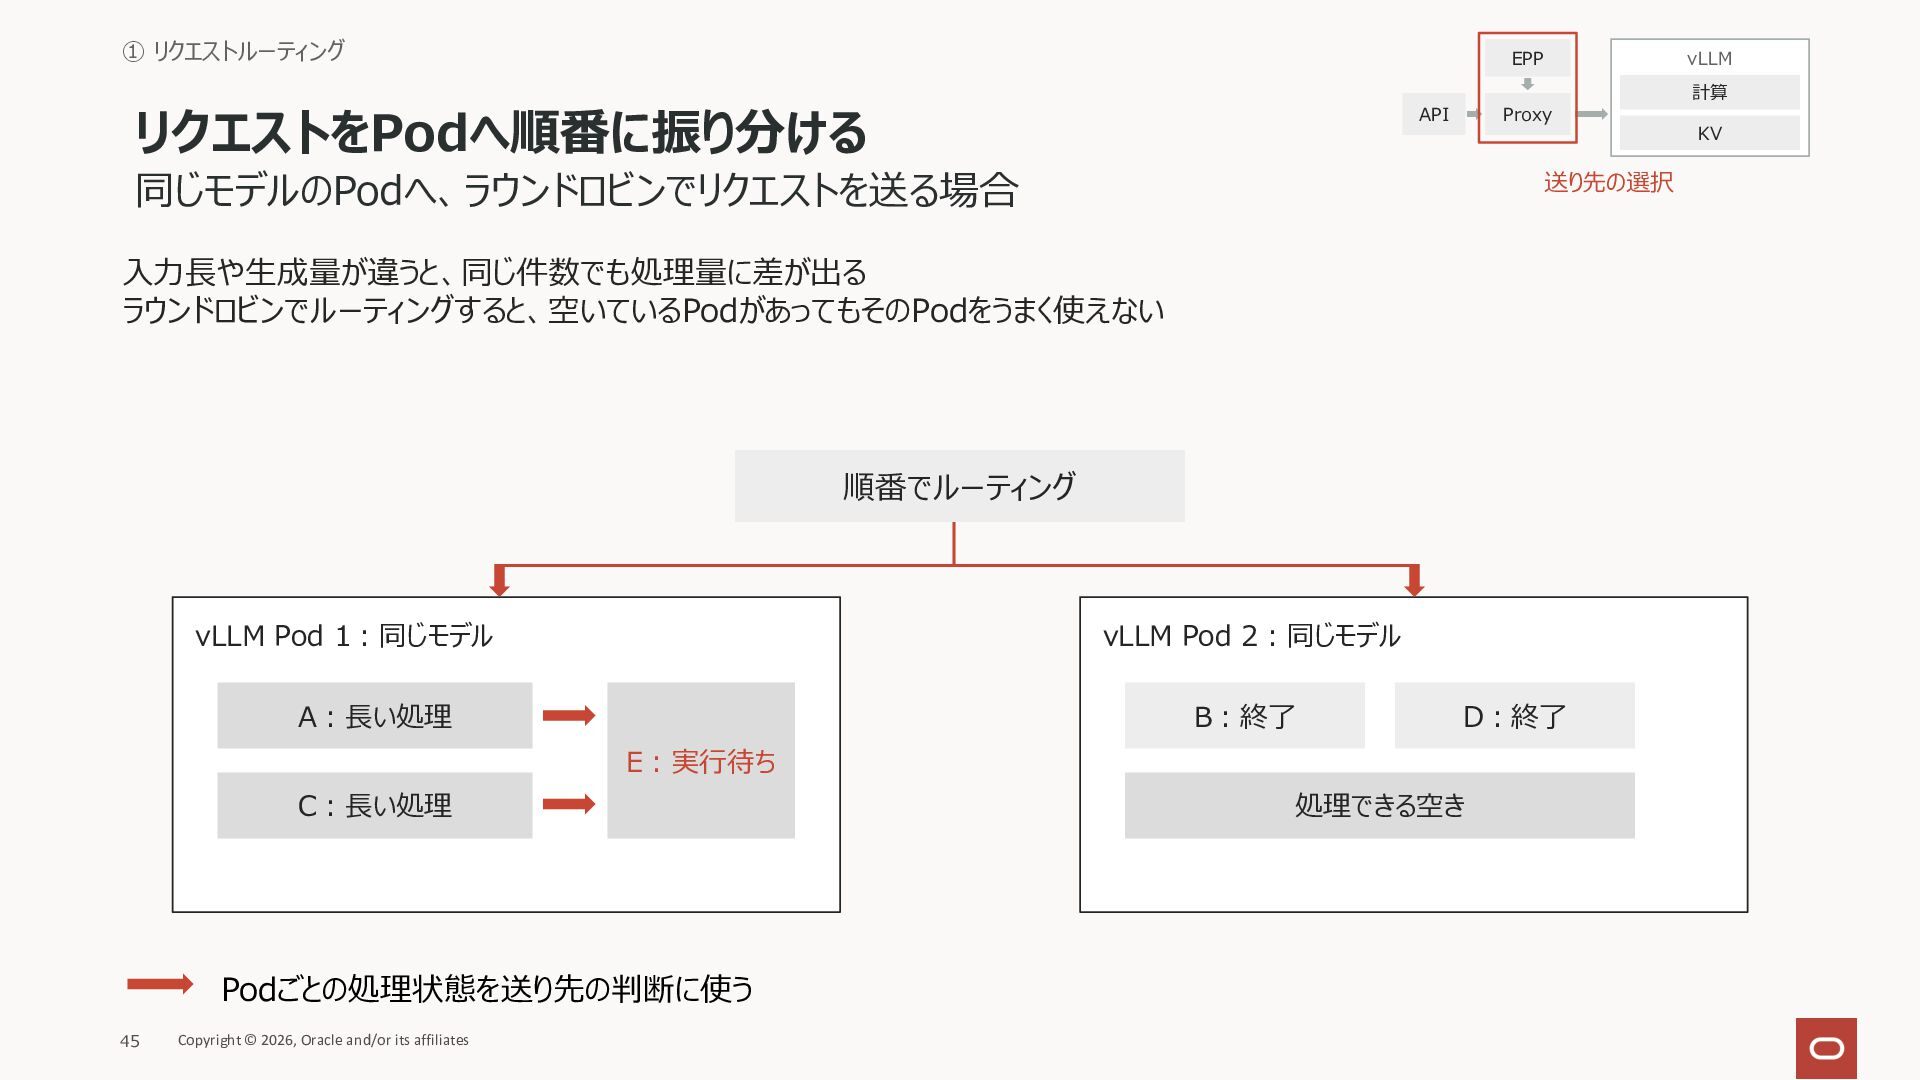
① リクエストルーティング EPP リクエストをPodへ順番に振り分ける API 同じモデルのPodへ、ラウンドロビンでリクエストを送る場合 Proxy 送り先の選択 順番でルーティング vLLM
Pod 1︓同じモデル リクエストA vLLM Pod 2︓同じモデル リクエストC 2件 送る件数が同じでも、リクエストごとの処理量は異なる 44 Copyright © 2026, Oracle and/or its affiliates リクエストB リクエストD 2件 vLLM 計算 KV
① リクエストルーティング EPP リクエストをPodへ順番に振り分ける API Proxy 同じモデルのPodへ、ラウンドロビンでリクエストを送る場合 送り先の選択 ⼊⼒⻑や⽣成量が違うと、同じ件数でも処理量に差が出る ラウンドロビンでルーティングすると、空いているPodがあってもそのPodをうまく使えない
順番でルーティング vLLM Pod 1︓同じモデル vLLM Pod 2︓同じモデル A︓⻑い処理 B︓終了 D︓終了 E︓実⾏待ち C︓⻑い処理 Podごとの処理状態を送り先の判断に使う 45 Copyright © 2026, Oracle and/or its affiliates 処理できる空き vLLM 計算 KV
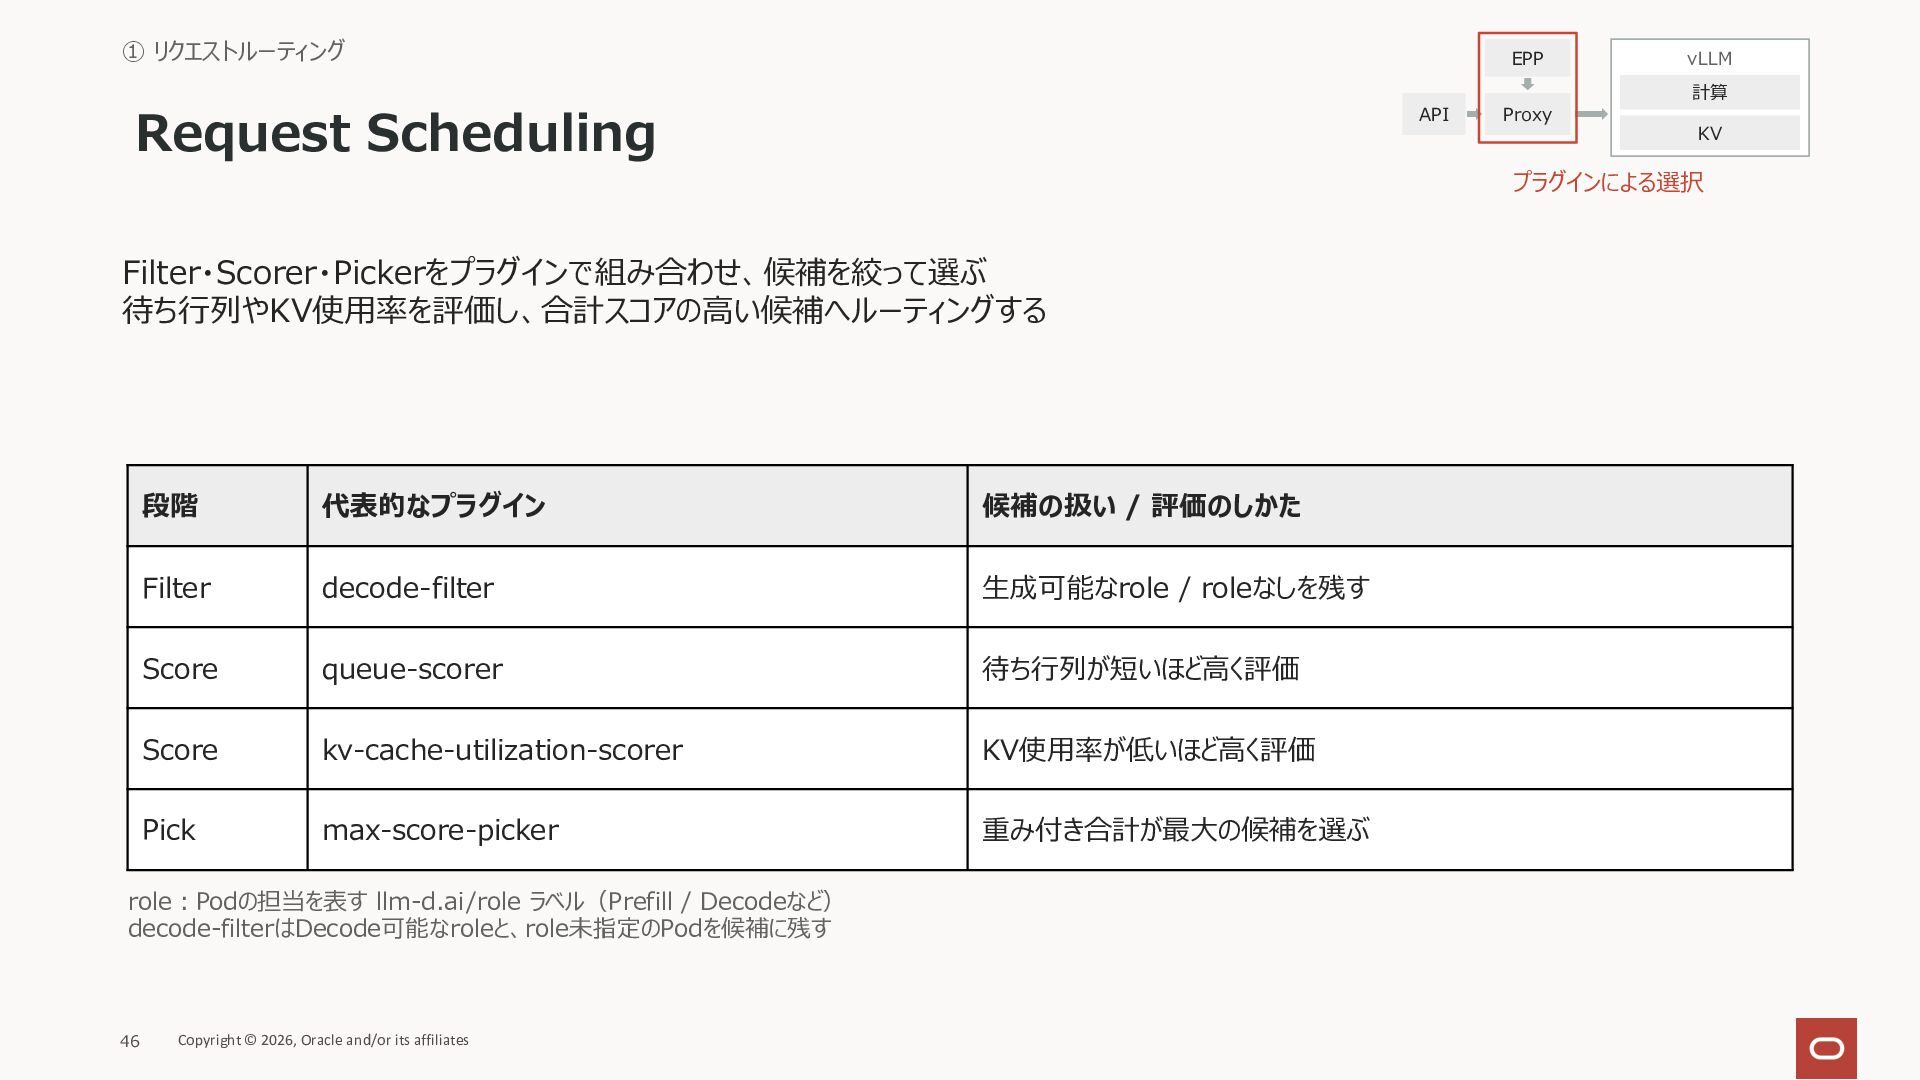
① リクエストルーティング EPP Request Scheduling API Proxy vLLM 計算 KV
プラグインによる選択 Filter・Scorer・Pickerをプラグインで組み合わせ、候補を絞って選ぶ 待ち⾏列やKV使⽤率を評価し、合計スコアの⾼い候補へルーティングする 段階 代表的なプラグイン 候補の扱い / 評価のしかた Filter decode-filter ⽣成可能なrole / roleなしを残す Score queue-scorer 待ち⾏列が短いほど⾼く評価 Score kv-cache-utilization-scorer KV使⽤率が低いほど⾼く評価 Pick max-score-picker 重み付き合計が最⼤の候補を選ぶ role︓Podの担当を表す llm-d.ai/role ラベル(Prefill / Decodeなど) decode-filterはDecode可能なroleと、role未指定のPodを候補に残す 46 Copyright © 2026, Oracle and/or its affiliates
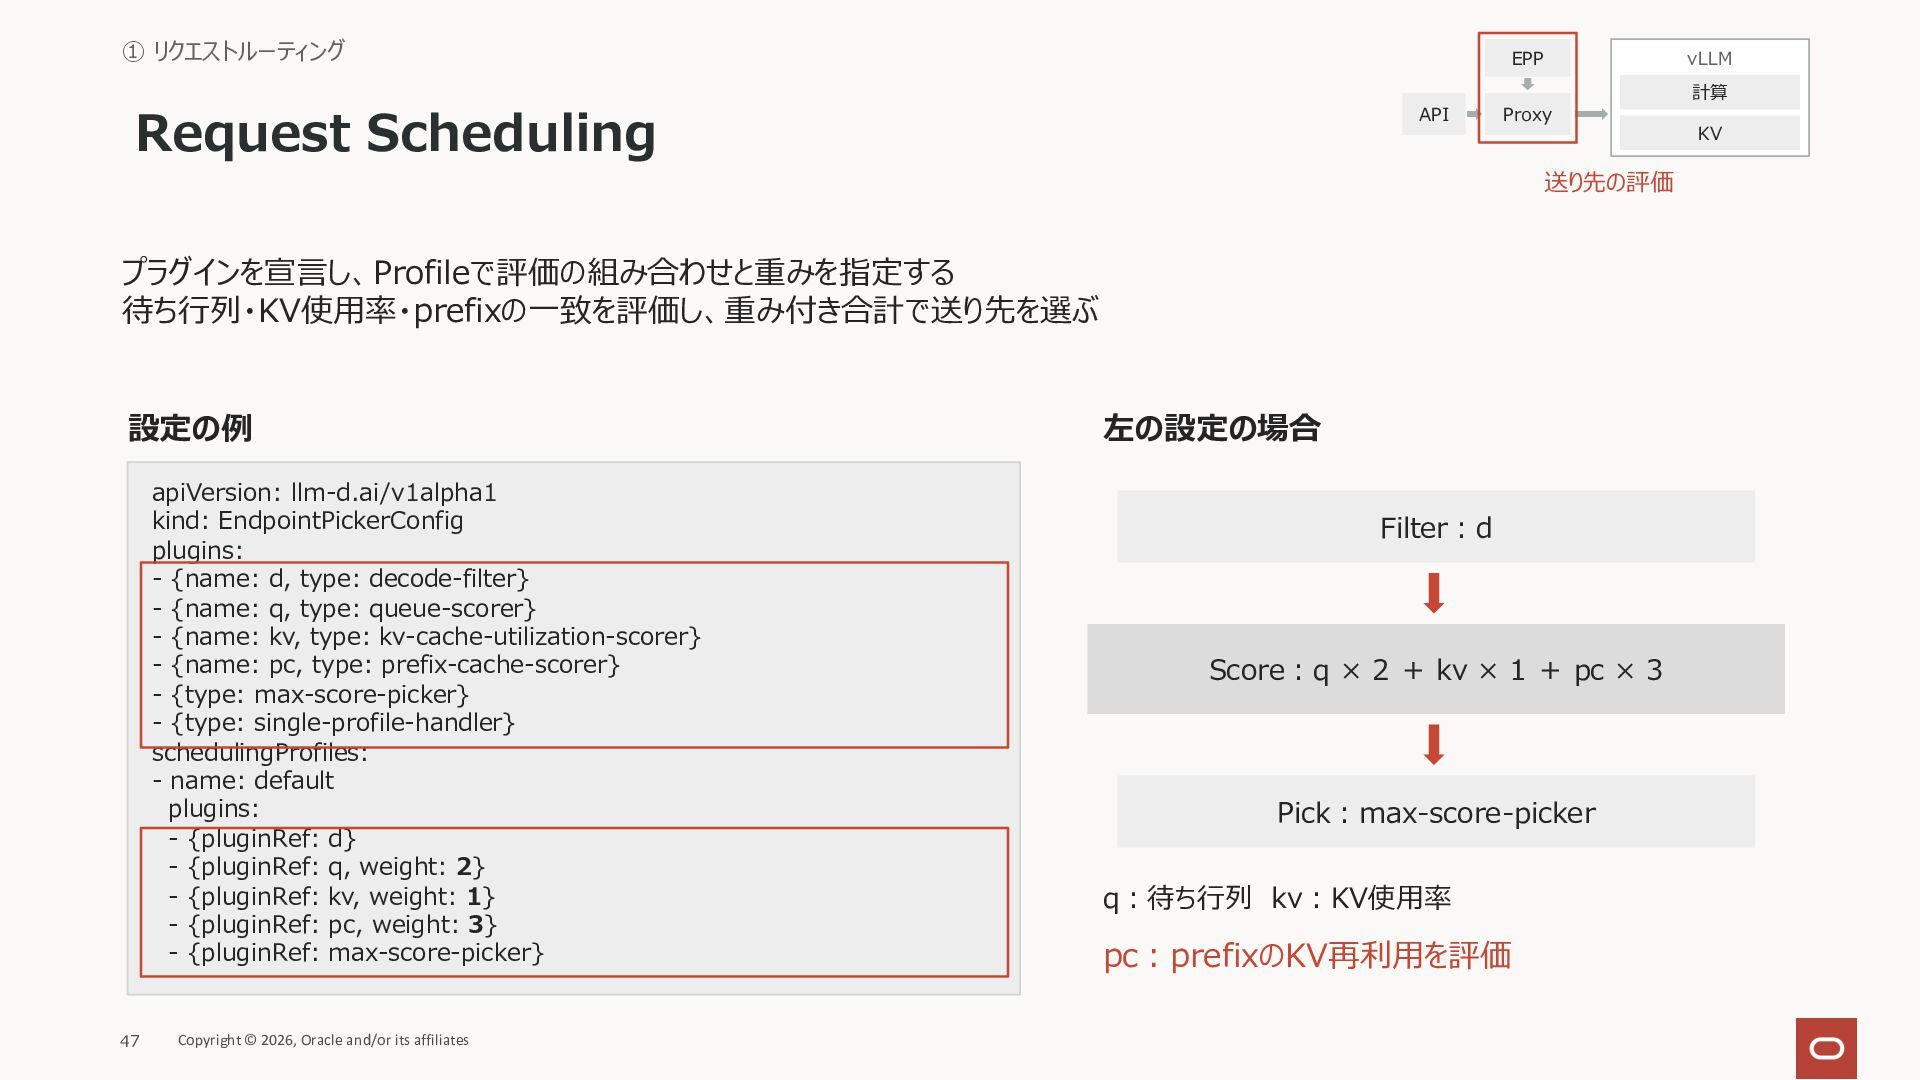
① リクエストルーティング EPP Request Scheduling API Proxy 送り先の評価 プラグインを宣⾔し、Profileで評価の組み合わせと重みを指定する 待ち⾏列・KV使⽤率・prefixの⼀致を評価し、重み付き合計で送り先を選ぶ
設定の例 apiVersion: llm-d.ai/v1alpha1 kind: EndpointPickerConfig plugins: - {name: d, type: decode-filter} - {name: q, type: queue-scorer} - {name: kv, type: kv-cache-utilization-scorer} - {name: pc, type: prefix-cache-scorer} - {type: max-score-picker} - {type: single-profile-handler} schedulingProfiles: - name: default plugins: - {pluginRef: d} - {pluginRef: q, weight: 2} - {pluginRef: kv, weight: 1} - {pluginRef: pc, weight: 3} - {pluginRef: max-score-picker} 47 Copyright © 2026, Oracle and/or its affiliates 左の設定の場合 Filter︓d Score︓q × 2 + kv × 1 + pc × 3 Pick︓max-score-picker q︓待ち⾏列 kv︓KV使⽤率 pc︓prefixのKV再利⽤を評価 vLLM 計算 KV
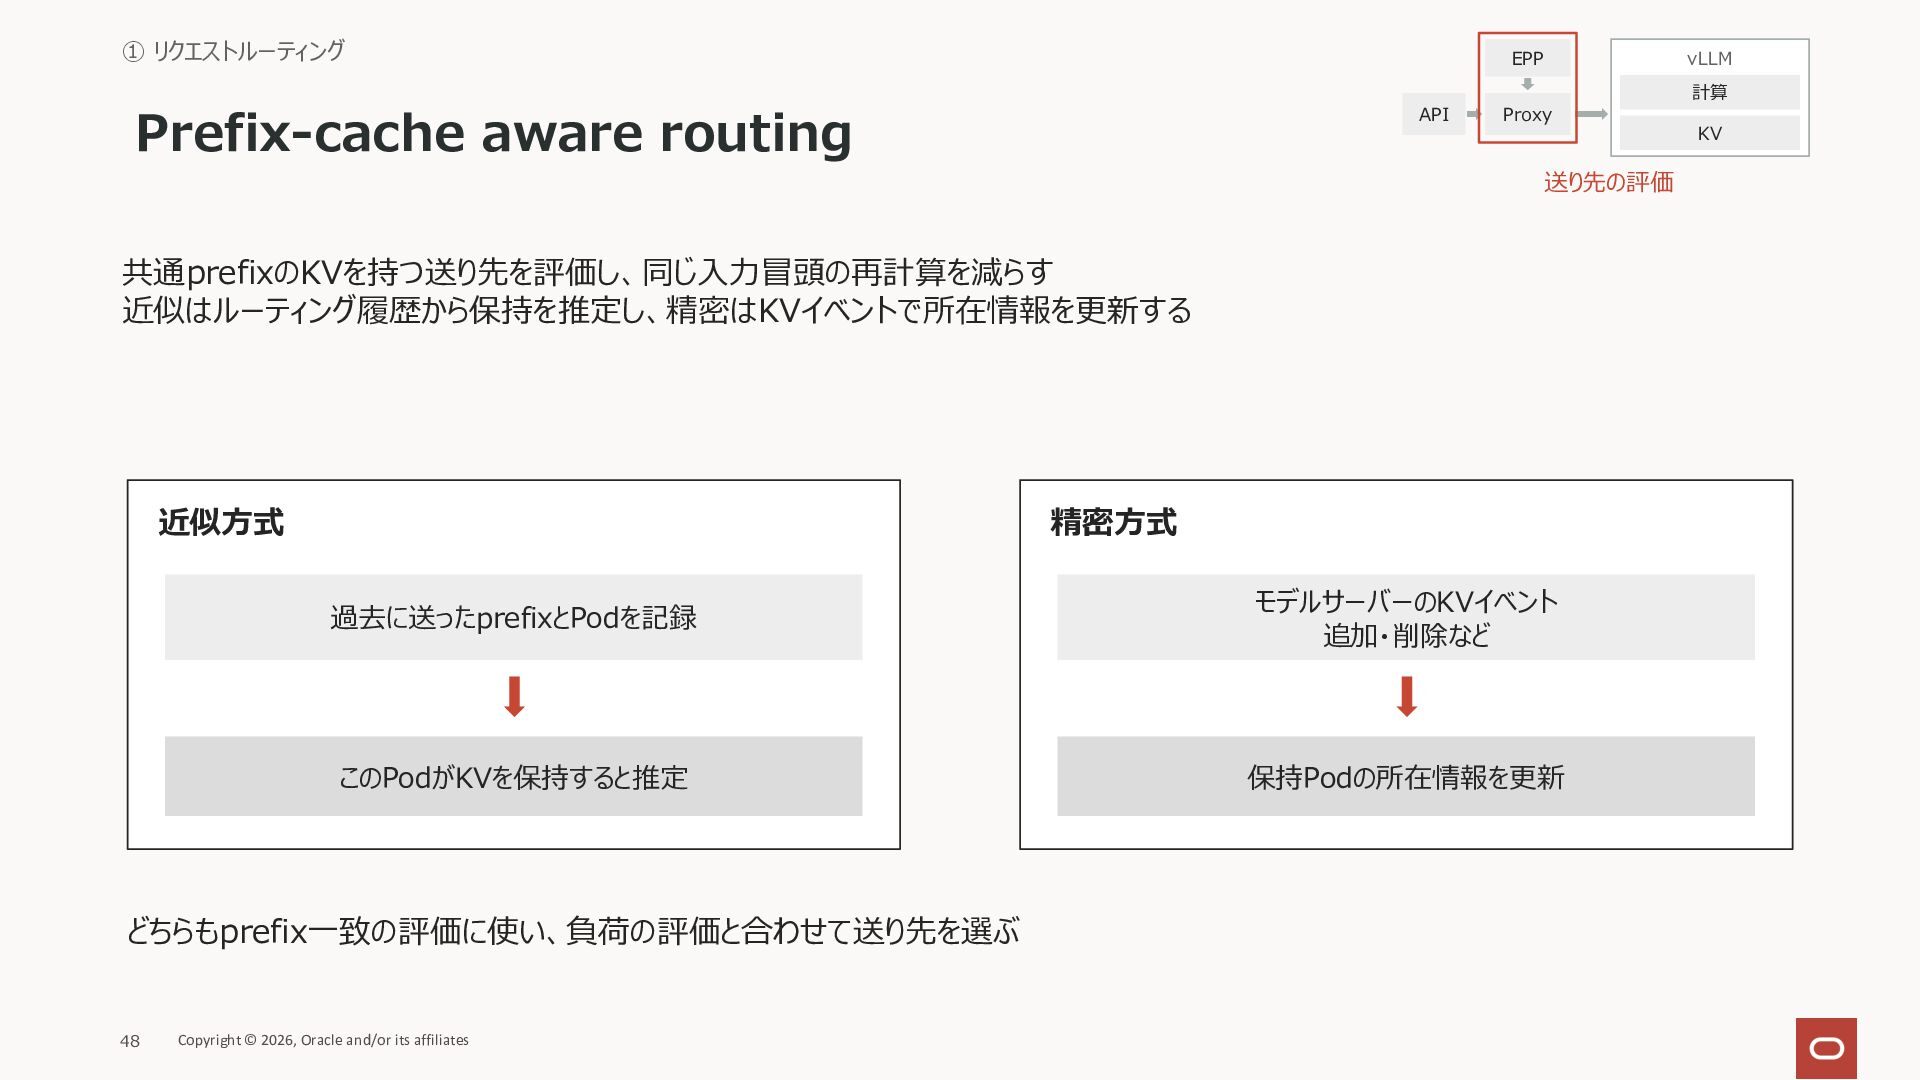
① リクエストルーティング EPP Prefix-cache aware routing API Proxy 送り先の評価 共通prefixのKVを持つ送り先を評価し、同じ⼊⼒冒頭の再計算を減らす
近似はルーティング履歴から保持を推定し、精密はKVイベントで所在情報を更新する 近似⽅式 精密⽅式 過去に送ったprefixとPodを記録 モデルサーバーのKVイベント 追加・削除など このPodがKVを保持すると推定 保持Podの所在情報を更新 どちらもprefix⼀致の評価に使い、負荷の評価と合わせて送り先を選ぶ 48 Copyright © 2026, Oracle and/or its affiliates vLLM 計算 KV
① リクエストルーティング EPP Prefix-cache aware routing API 近似⽅式 Proxy KVの所在情報
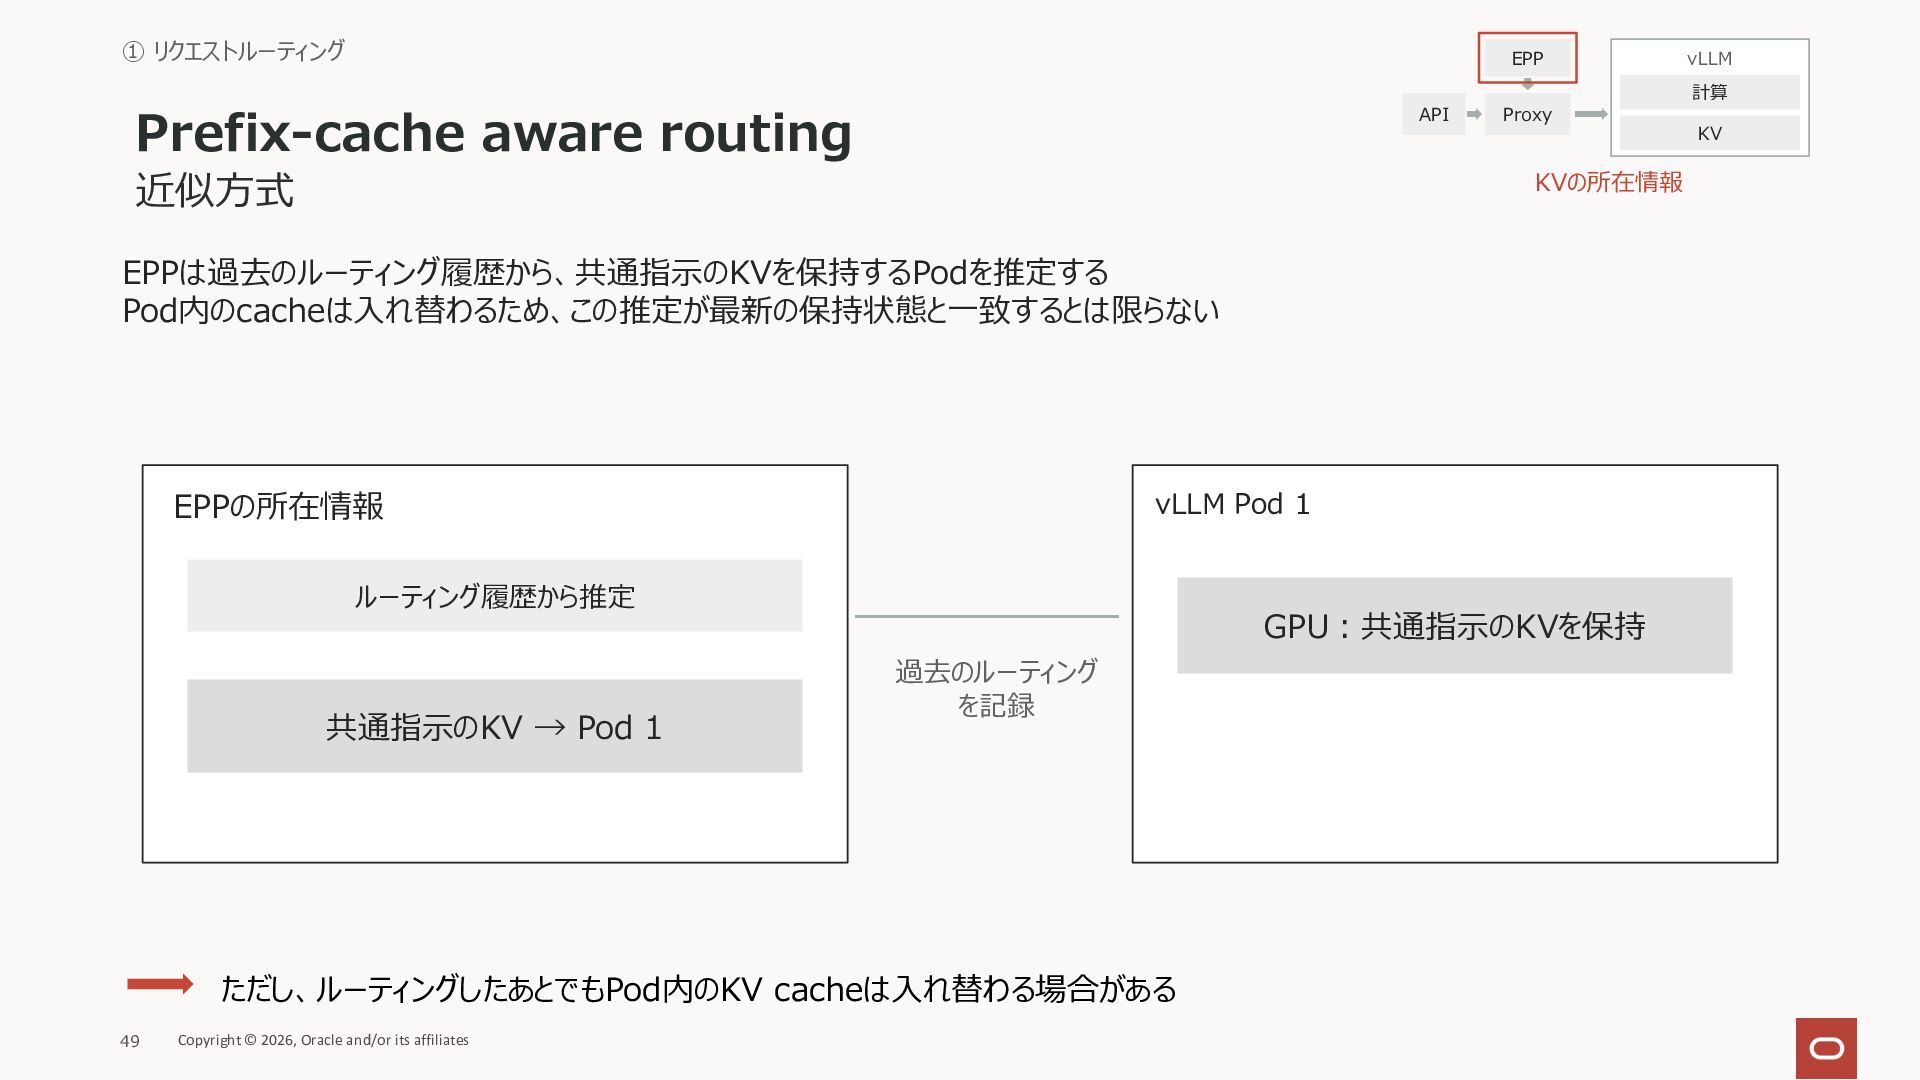
EPPは過去のルーティング履歴から、共通指⽰のKVを保持するPodを推定する Pod内のcacheは⼊れ替わるため、この推定が最新の保持状態と⼀致するとは限らない vLLM Pod 1 EPPの所在情報 ルーティング履歴から推定 共通指⽰のKV → Pod 1 GPU︓共通指⽰のKVを保持 過去のルーティング を記録 ただし、ルーティングしたあとでもPod内のKV cacheは⼊れ替わる場合がある 49 Copyright © 2026, Oracle and/or its affiliates vLLM 計算 KV
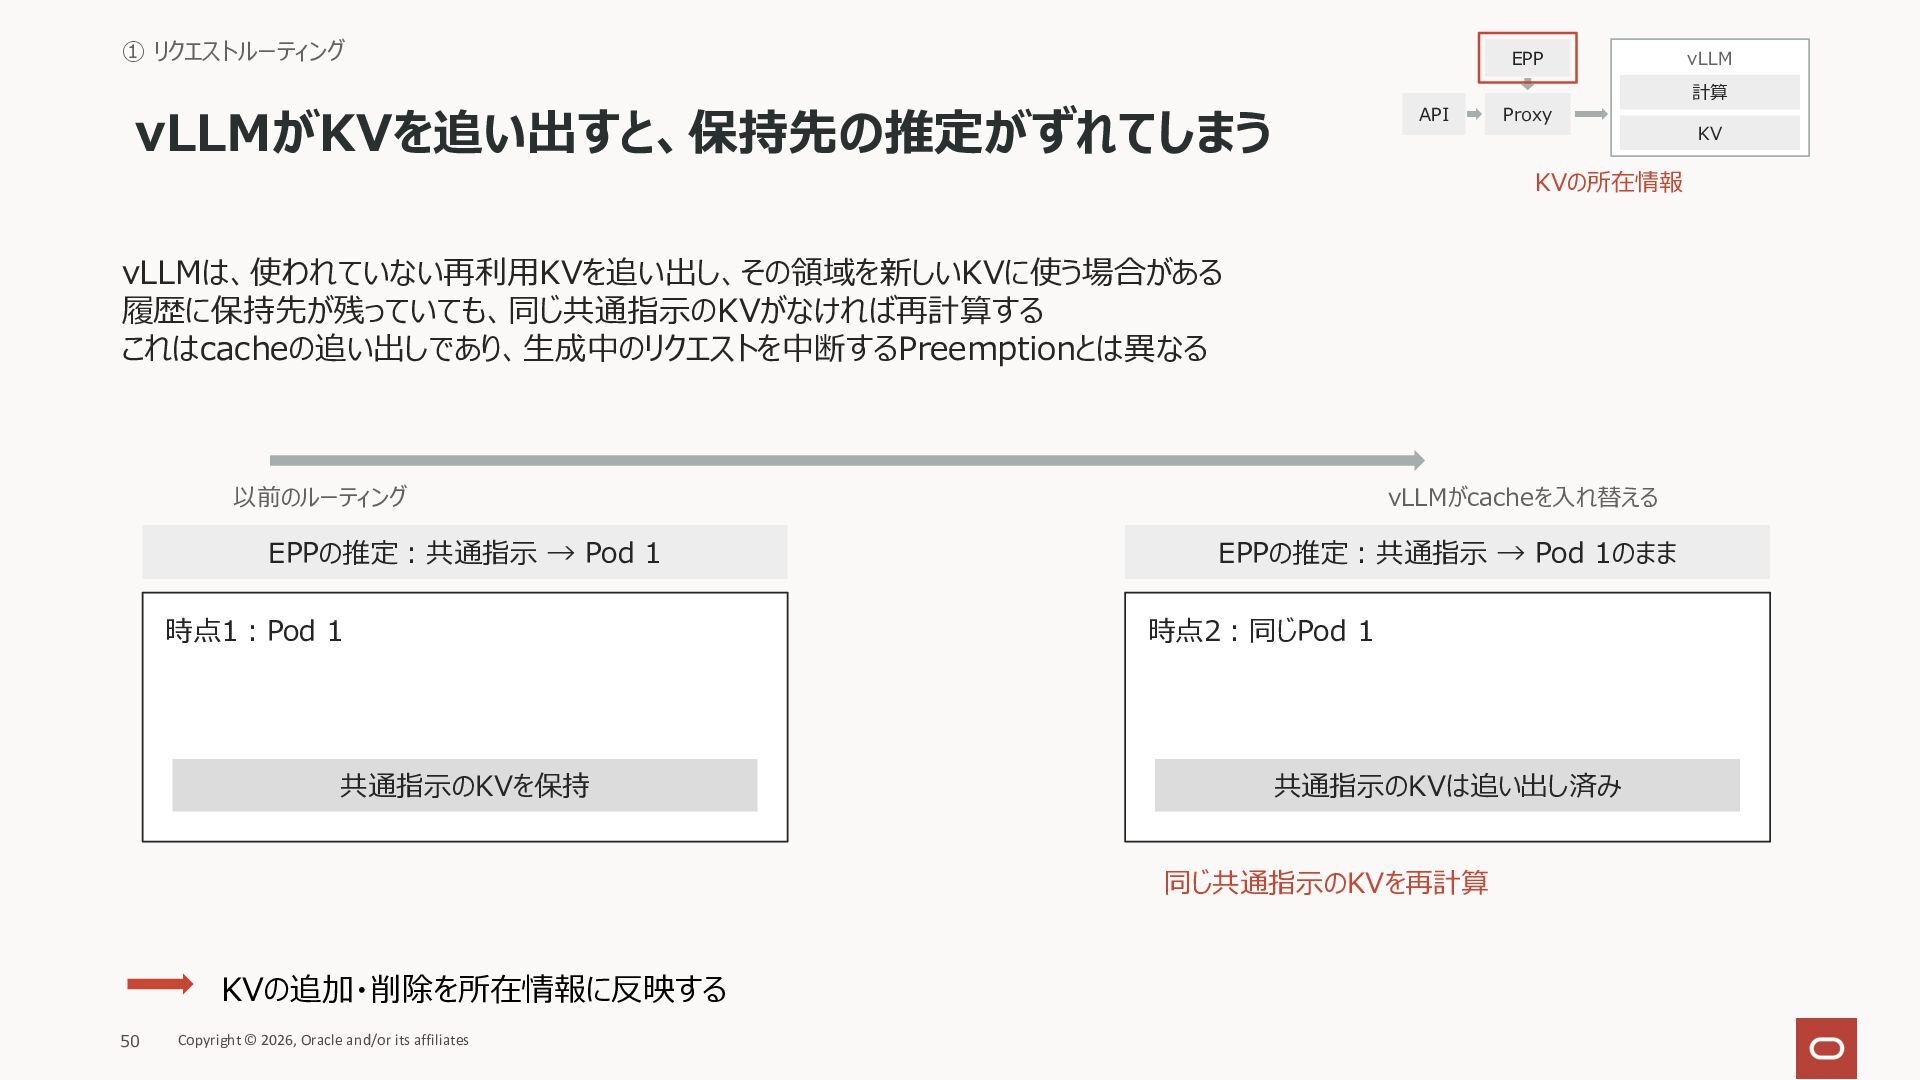
① リクエストルーティング EPP vLLMがKVを追い出すと、保持先の推定がずれてしまう API Proxy KVの所在情報 vLLMは、使われていない再利⽤KVを追い出し、その領域を新しいKVに使う場合がある 履歴に保持先が残っていても、同じ共通指⽰のKVがなければ再計算する これはcacheの追い出しであり、⽣成中のリクエストを中断するPreemptionとは異なる
以前のルーティング EPPの推定︓共通指⽰ → Pod 1 時点1︓Pod 1 共通指⽰のKVを保持 vLLMがcacheを⼊れ替える EPPの推定︓共通指⽰ → Pod 1のまま 時点2︓同じPod 1 共通指⽰のKVは追い出し済み 同じ共通指⽰のKVを再計算 KVの追加・削除を所在情報に反映する 50 Copyright © 2026, Oracle and/or its affiliates vLLM 計算 KV
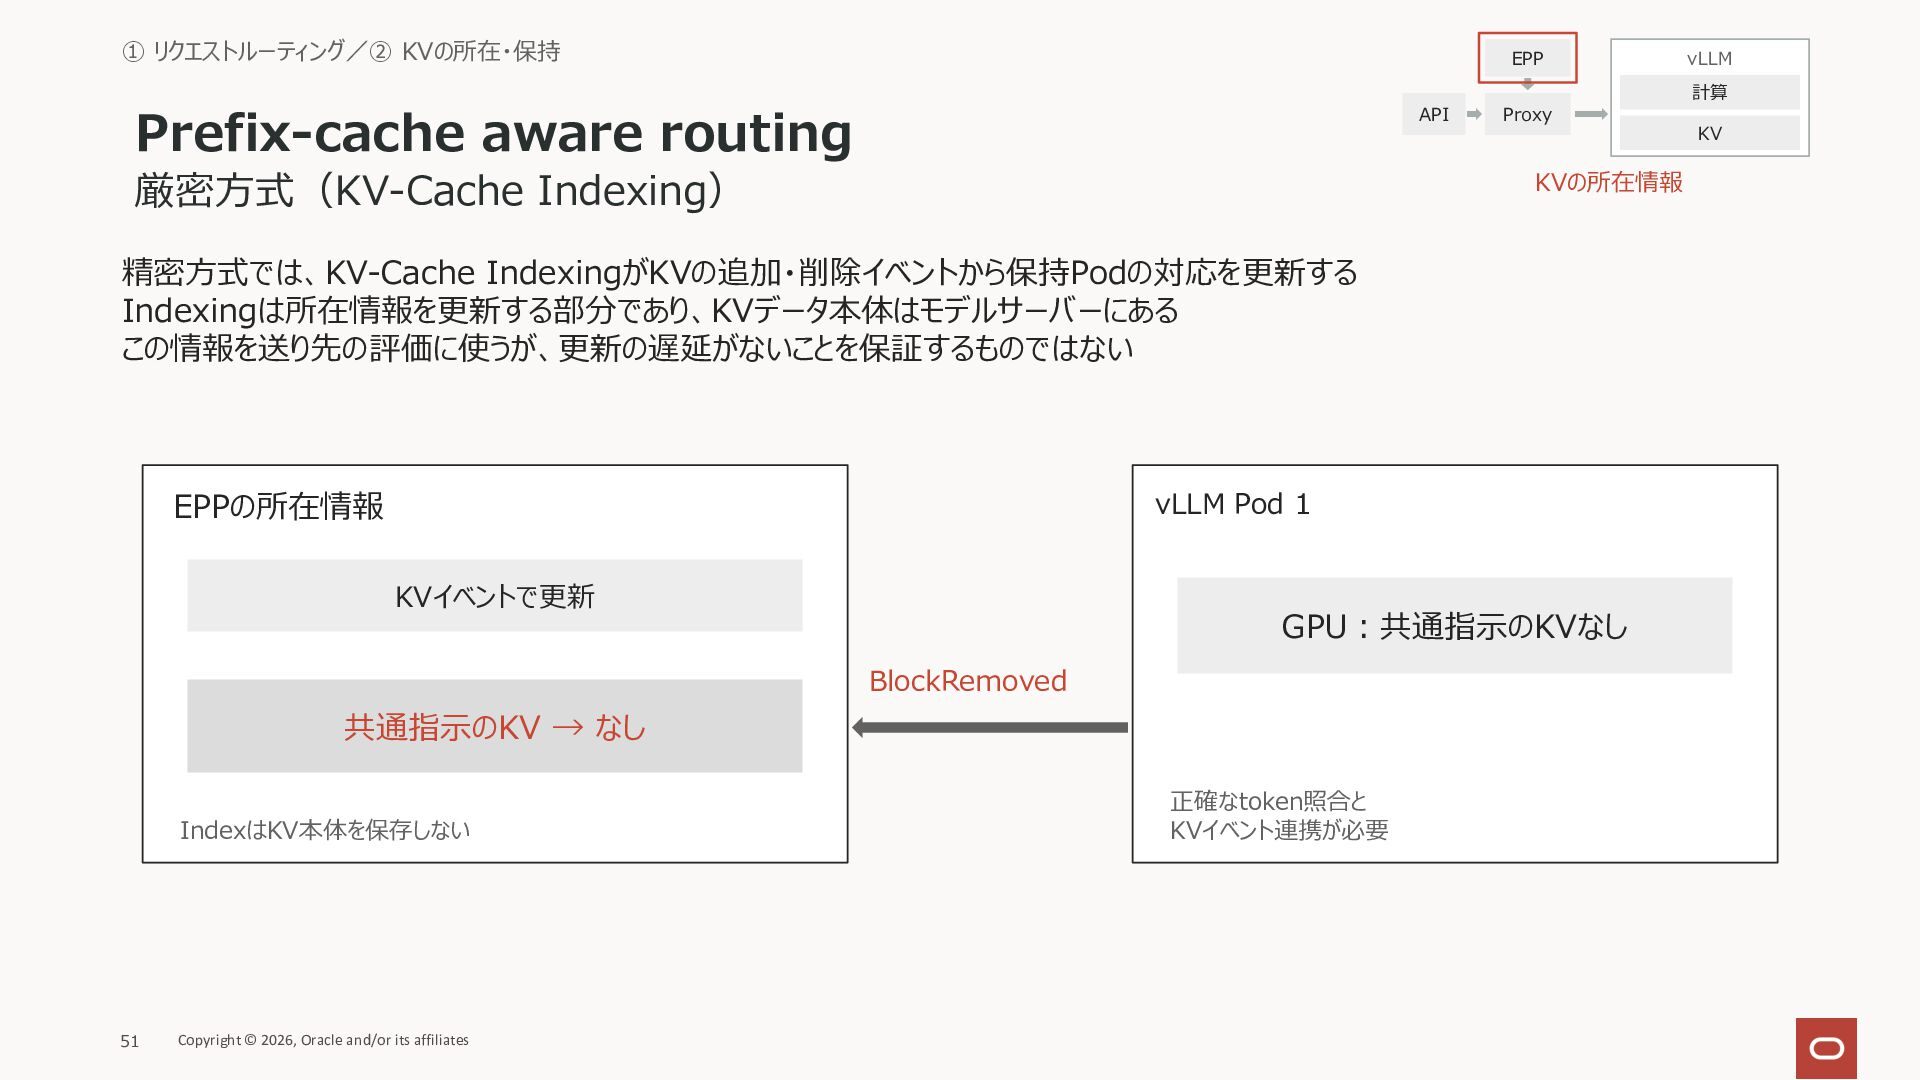
① リクエストルーティング/② KVの所在・保持 EPP Prefix-cache aware routing API 厳密⽅式(KV-Cache Indexing)
Proxy KVの所在情報 精密⽅式では、KV-Cache IndexingがKVの追加・削除イベントから保持Podの対応を更新する Indexingは所在情報を更新する部分であり、KVデータ本体はモデルサーバーにある この情報を送り先の評価に使うが、更新の遅延がないことを保証するものではない vLLM Pod 1 EPPの所在情報 KVイベントで更新 GPU︓共通指⽰のKVなし BlockRemoved 共通指⽰のKV → なし IndexはKV本体を保存しない 51 Copyright © 2026, Oracle and/or its affiliates 正確なtoken照合と KVイベント連携が必要 vLLM 計算 KV
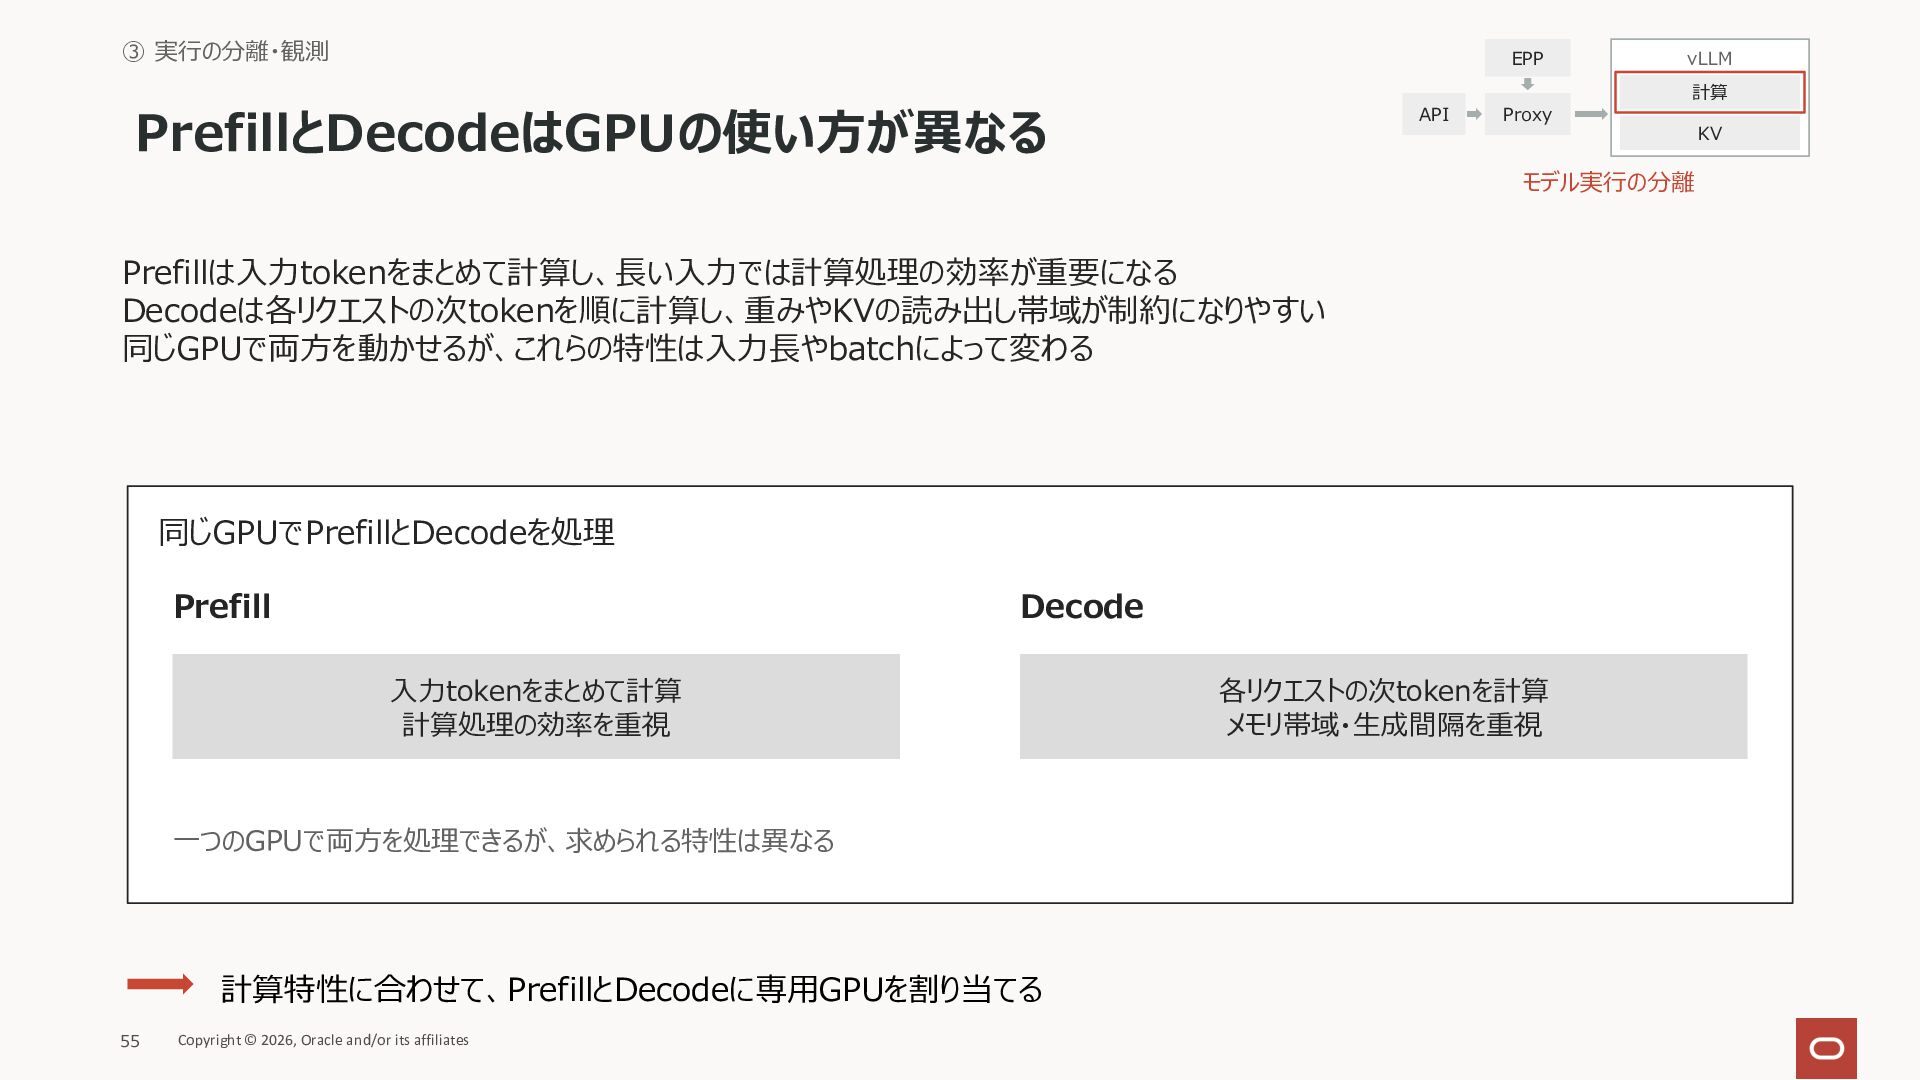
③ 実⾏の分離・観測 EPP PrefillとDecodeはGPUの使い⽅が異なる API Proxy vLLM 計算 モデル実⾏の分離 Prefillは⼊⼒tokenをまとめて計算し、⻑い⼊⼒では計算処理の効率が重要になる
Decodeは各リクエストの次tokenを順に計算し、重みやKVの読み出し帯域が制約になりやすい 同じGPUで両⽅を動かせるが、これらの特性は⼊⼒⻑やbatchによって変わる 同じGPUでPrefillとDecodeを処理 Prefill Decode ⼊⼒tokenをまとめて計算 計算処理の効率を重視 ⼀つのGPUで両⽅を処理できるが、求められる特性は異なる 計算特性に合わせて、PrefillとDecodeに専⽤GPUを割り当てる 55 Copyright © 2026, Oracle and/or its affiliates 各リクエストの次tokenを計算 メモリ帯域・⽣成間隔を重視 KV
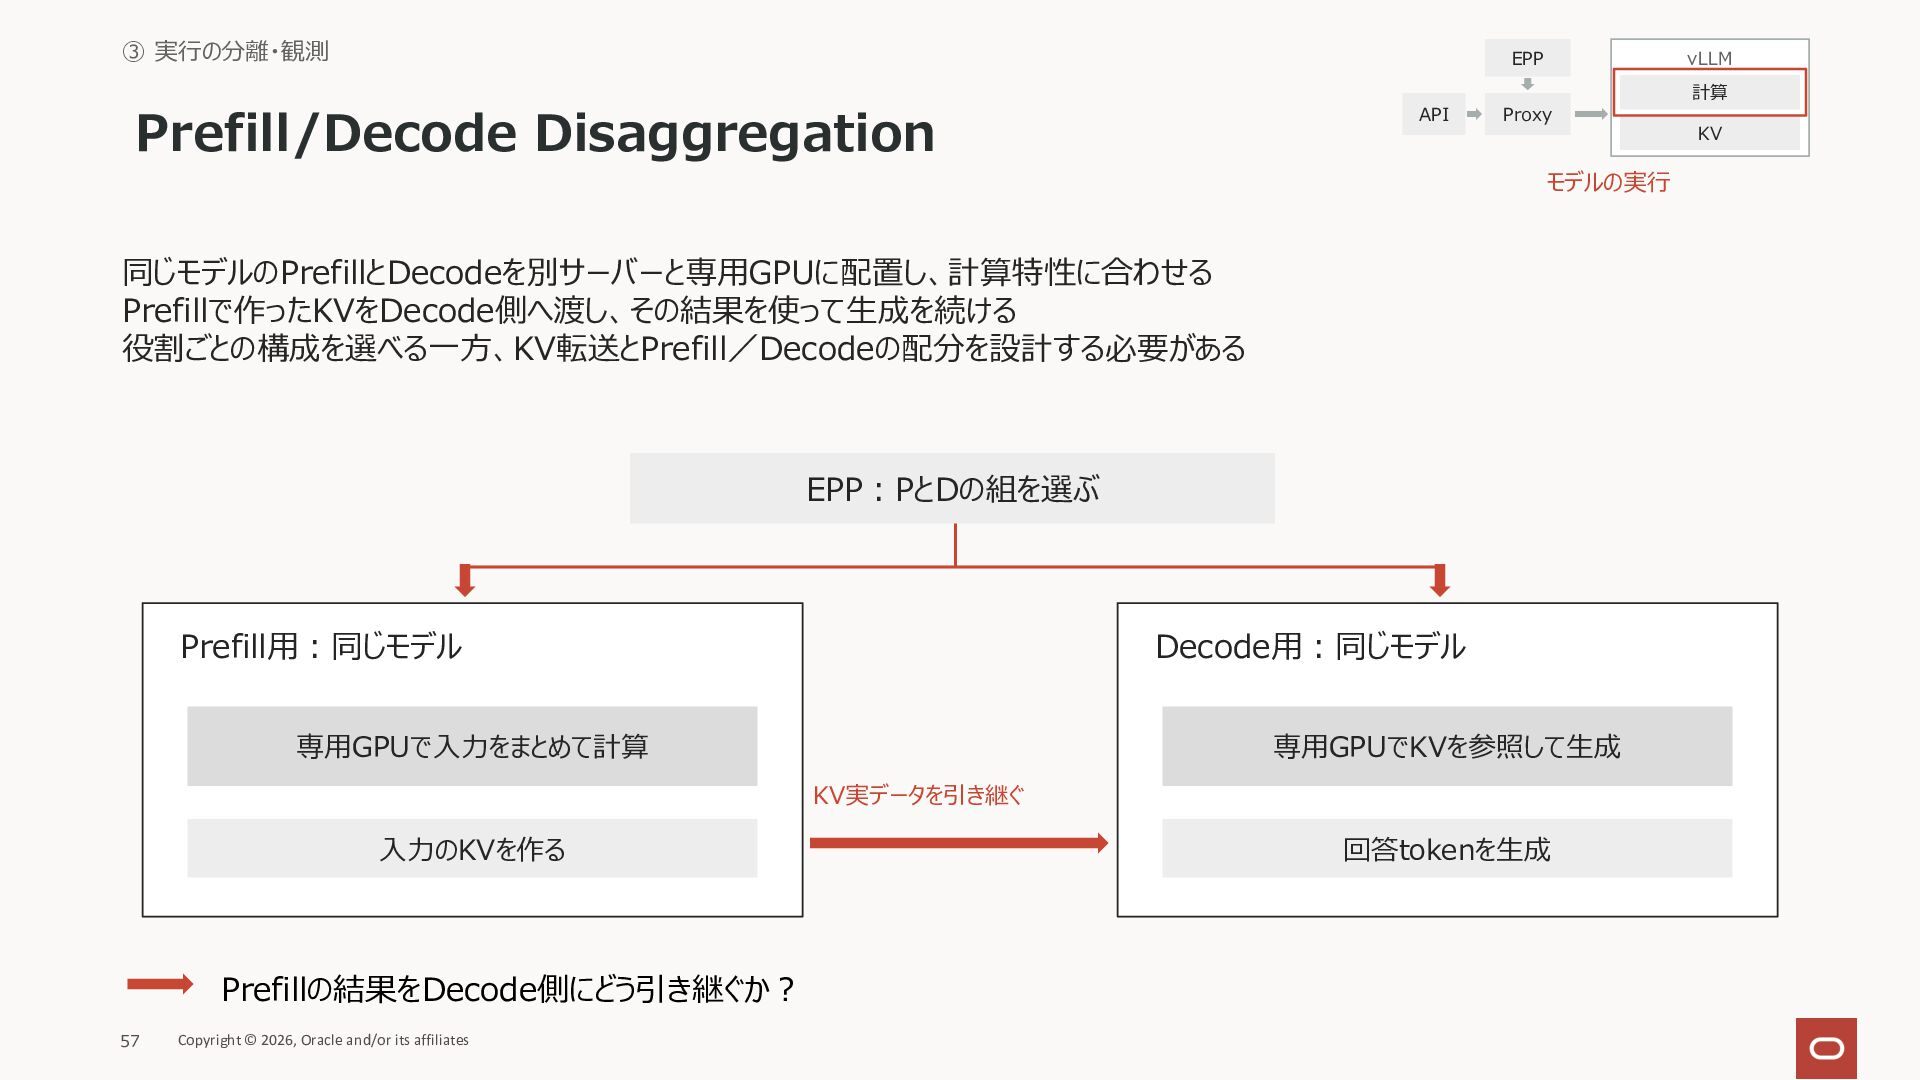
③ 実⾏の分離・観測 EPP Prefill/Decode Disaggregation API vLLM Proxy モデルの実⾏ 同じモデルのPrefillとDecodeを別サーバーと専⽤GPUに配置し、計算特性に合わせる
Prefillで作ったKVをDecode側へ渡し、その結果を使って⽣成を続ける 役割ごとの構成を選べる⼀⽅、KV転送とPrefill/Decodeの配分を設計する必要がある EPP︓PとDの組を選ぶ Prefill⽤︓同じモデル Decode⽤︓同じモデル 専⽤GPUで⼊⼒をまとめて計算 専⽤GPUでKVを参照して⽣成 KV実データを引き継ぐ ⼊⼒のKVを作る Prefillの結果をDecode側にどう引き継ぐか︖ 57 Copyright © 2026, Oracle and/or its affiliates 回答tokenを⽣成 計算 KV
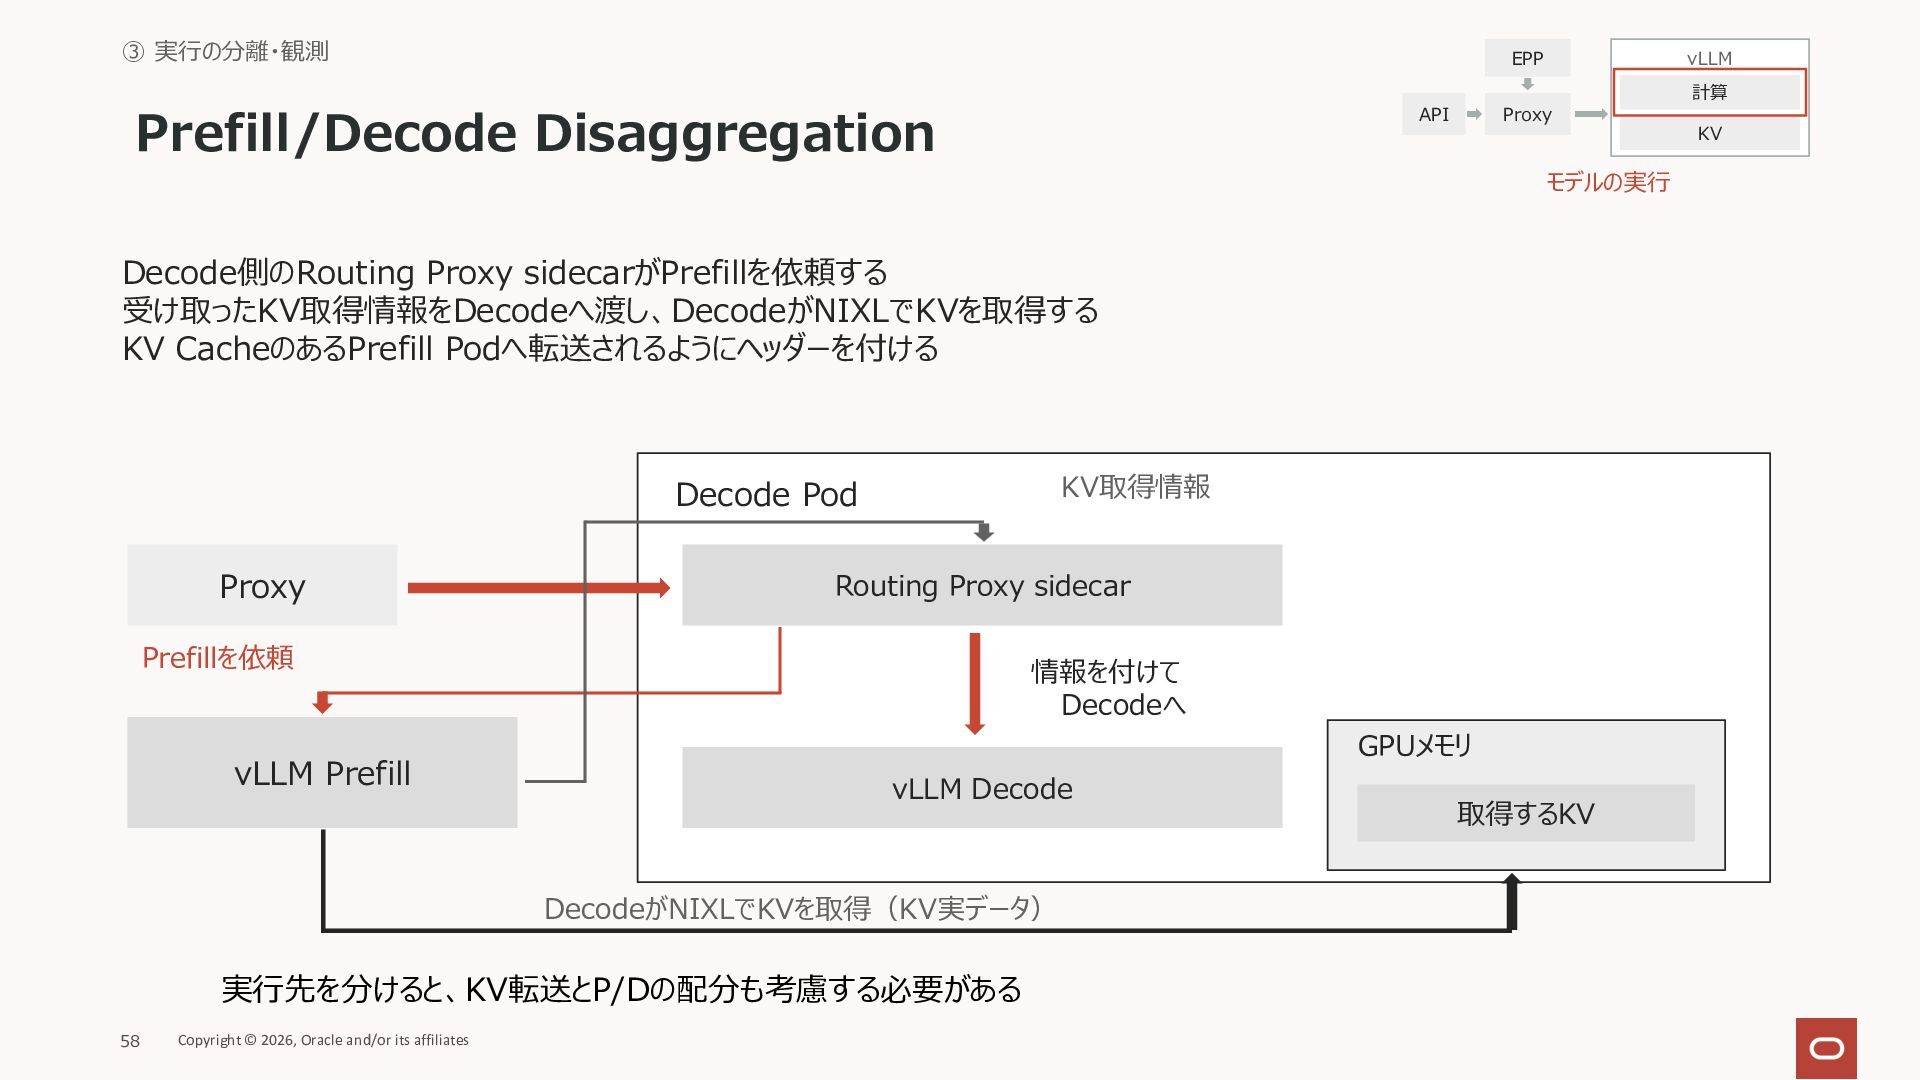
③ 実⾏の分離・観測 EPP Prefill/Decode Disaggregation API vLLM Proxy モデルの実⾏ Decode側のRouting
Proxy sidecarがPrefillを依頼する 受け取ったKV取得情報をDecodeへ渡し、DecodeがNIXLでKVを取得する KV CacheのあるPrefill Podへ転送されるようにヘッダーを付ける KV取得情報 Decode Pod Proxy Routing Proxy sidecar Prefillを依頼 vLLM Prefill 情報を付けて Decodeへ GPUメモリ vLLM Decode DecodeがNIXLでKVを取得(KV実データ) 実⾏先を分けると、KV転送とP/Dの配分も考慮する必要がある 58 Copyright © 2026, Oracle and/or its affiliates 取得するKV 計算 KV
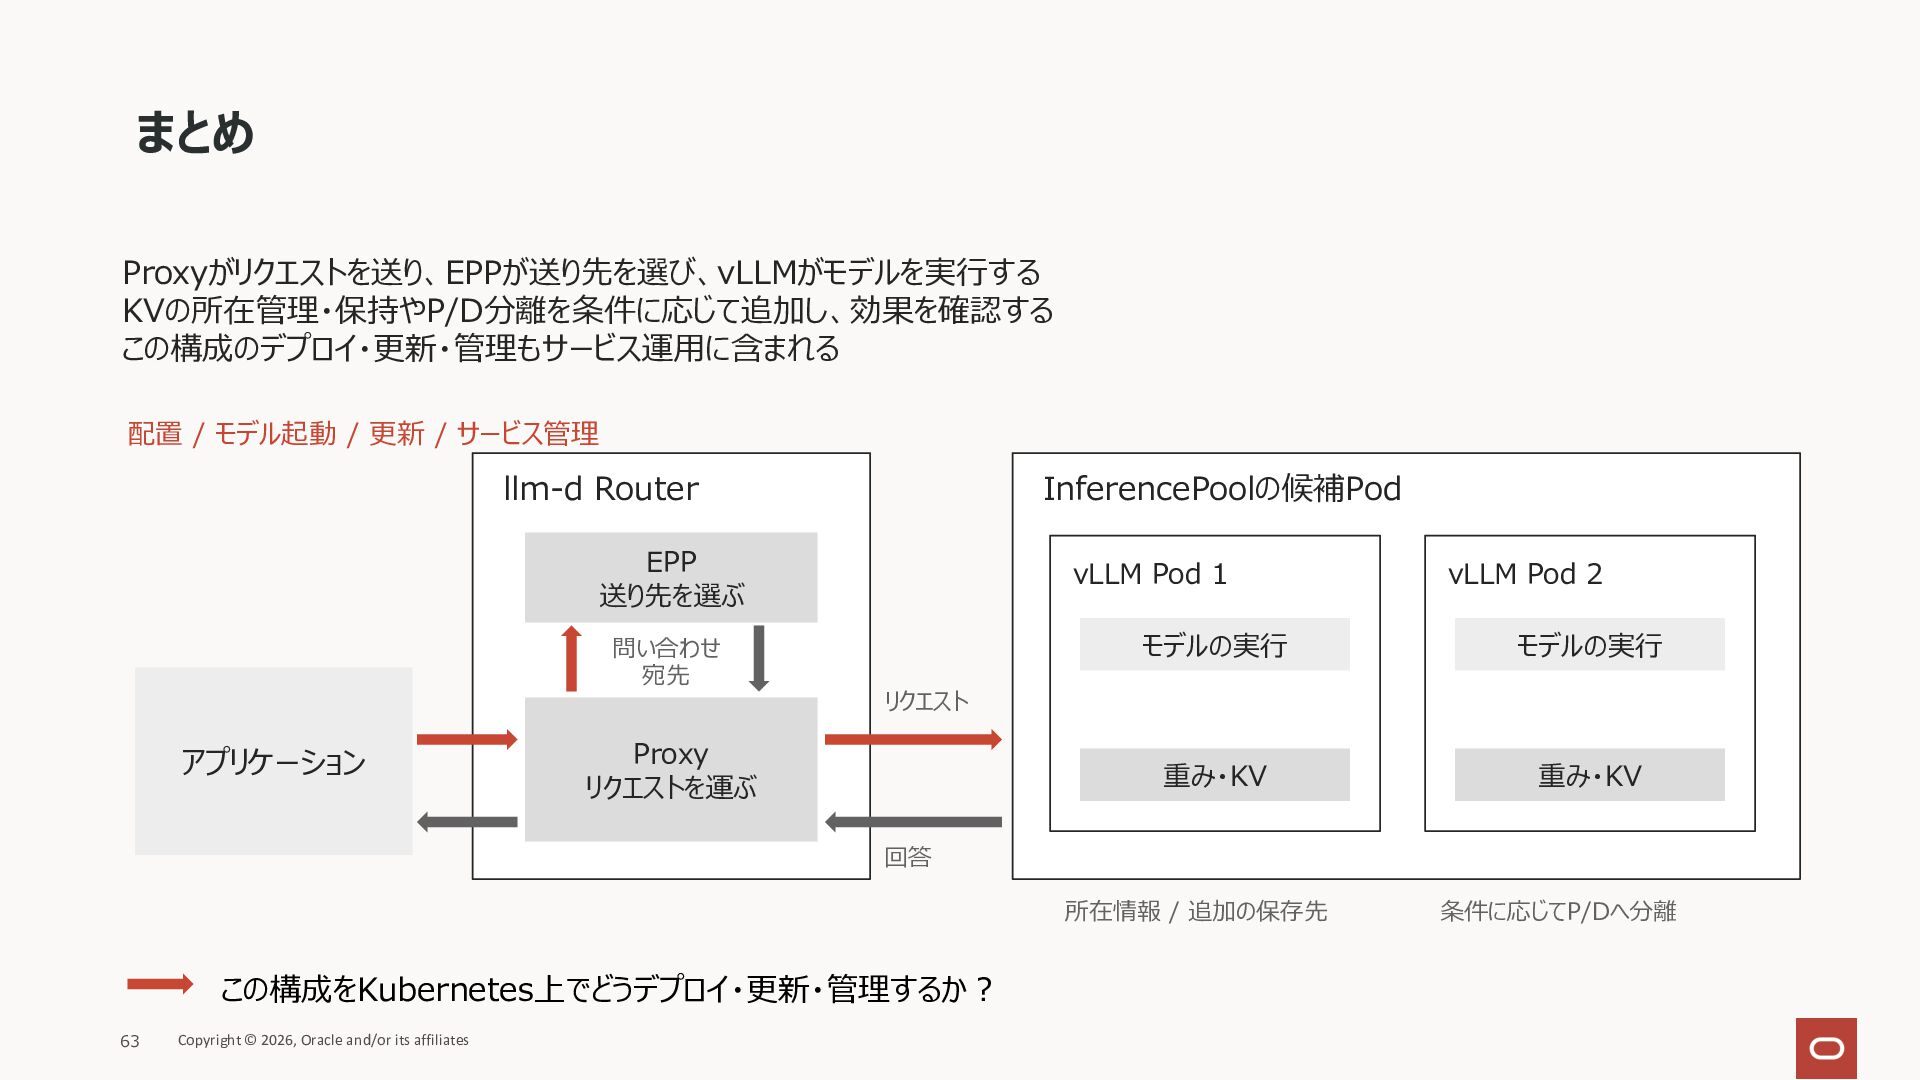
まとめ Proxyがリクエストを送り、EPPが送り先を選び、vLLMがモデルを実⾏する KVの所在管理・保持やP/D分離を条件に応じて追加し、効果を確認する この構成のデプロイ・更新・管理もサービス運⽤に含まれる 配置 / モデル起動 / 更新 /
サービス管理 llm-d Router InferencePoolの候補Pod EPP 送り先を選ぶ 問い合わせ 宛先 アプリケーション vLLM Pod 1 vLLM Pod 2 モデルの実⾏ モデルの実⾏ 重み・KV 重み・KV リクエスト Proxy リクエストを運ぶ 回答 所在情報 / 追加の保存先 この構成をKubernetes上でどうデプロイ・更新・管理するか︖ 63 Copyright © 2026, Oracle and/or its affiliates 条件に応じてP/Dへ分離
KServe 推論サービスをKubernetes上で管理する
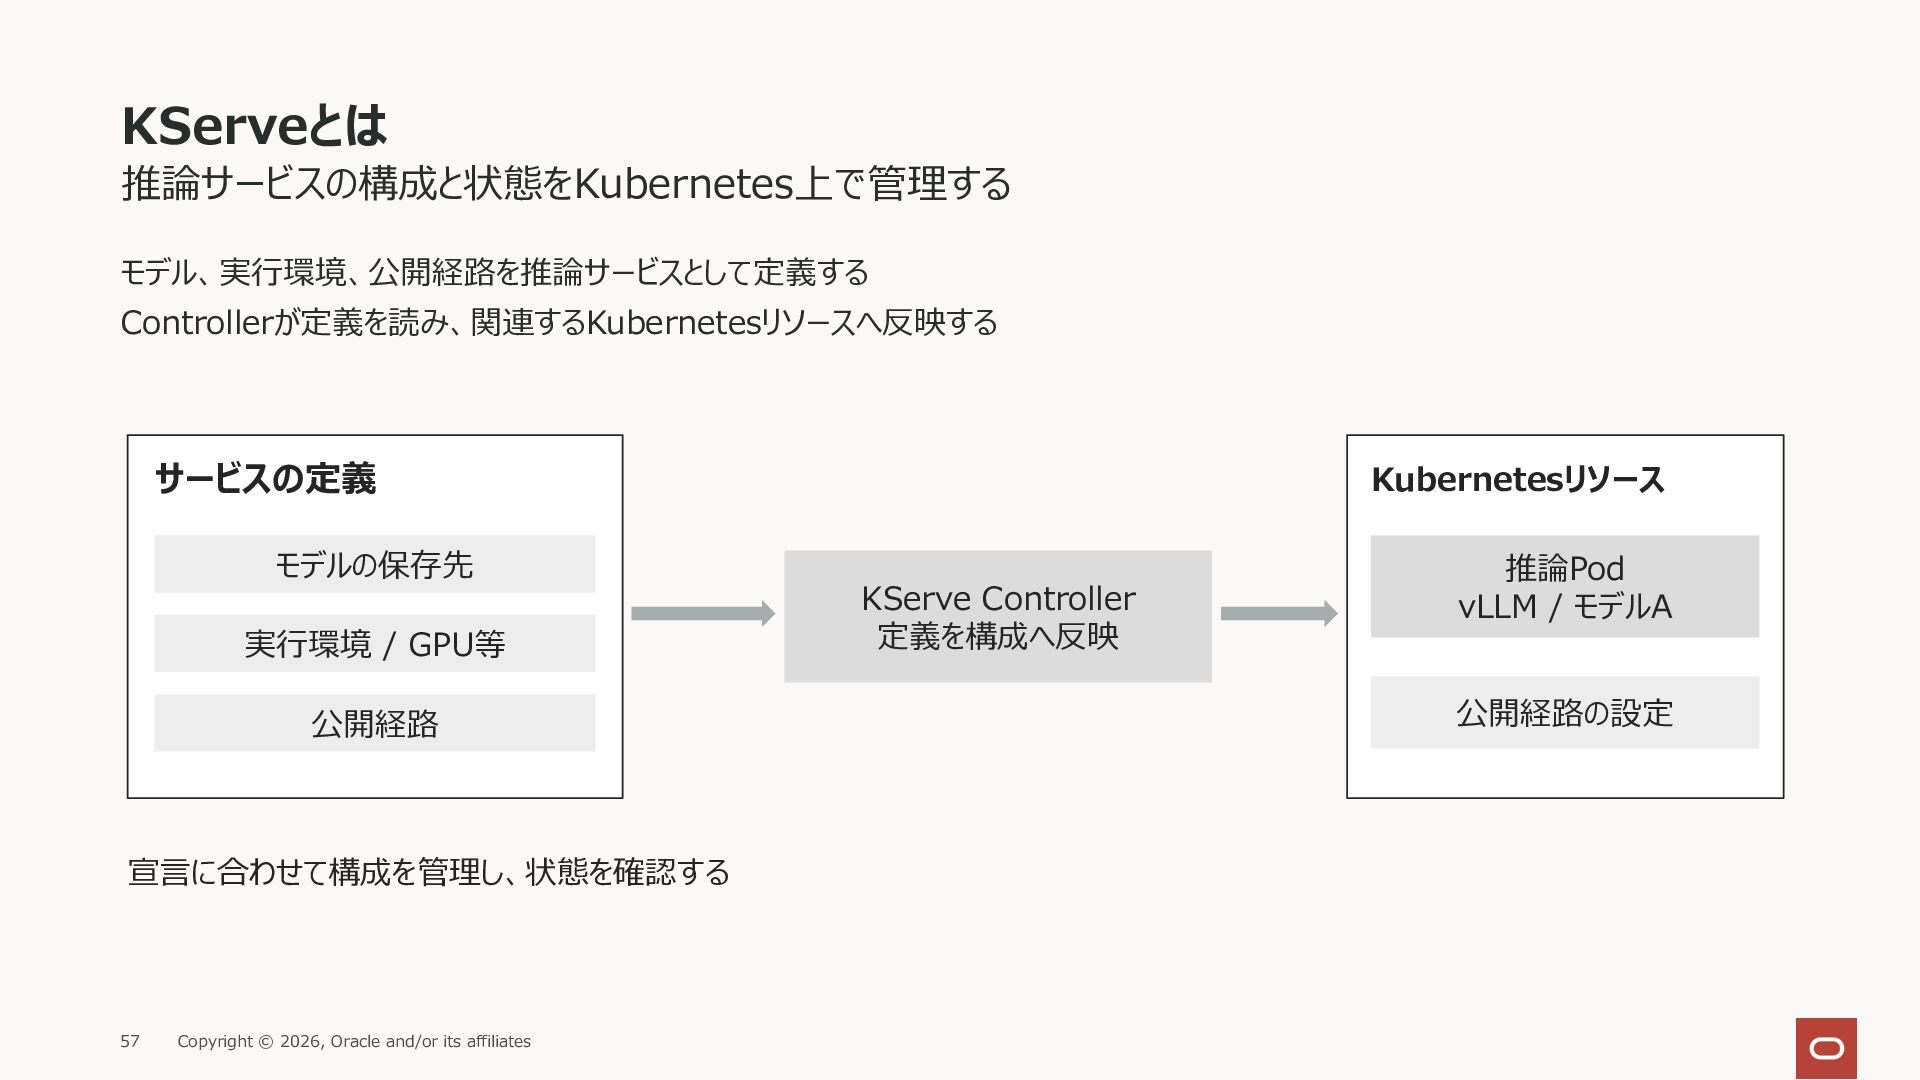
KServeとは 推論サービスの構成と状態をKubernetes上で管理する モデル、実⾏環境、公開経路を推論サービスとして定義する Controllerが定義を読み、関連するKubernetesリソースへ反映する サービスの定義 モデルの保存先 実⾏環境 / GPU等 公開経路
宣⾔に合わせて構成を管理し、状態を確認する 57 Copyright © 2026, Oracle and/or its affiliates Kubernetesリソース KServe Controller 定義を構成へ反映 推論Pod vLLM / モデルA 公開経路の設定
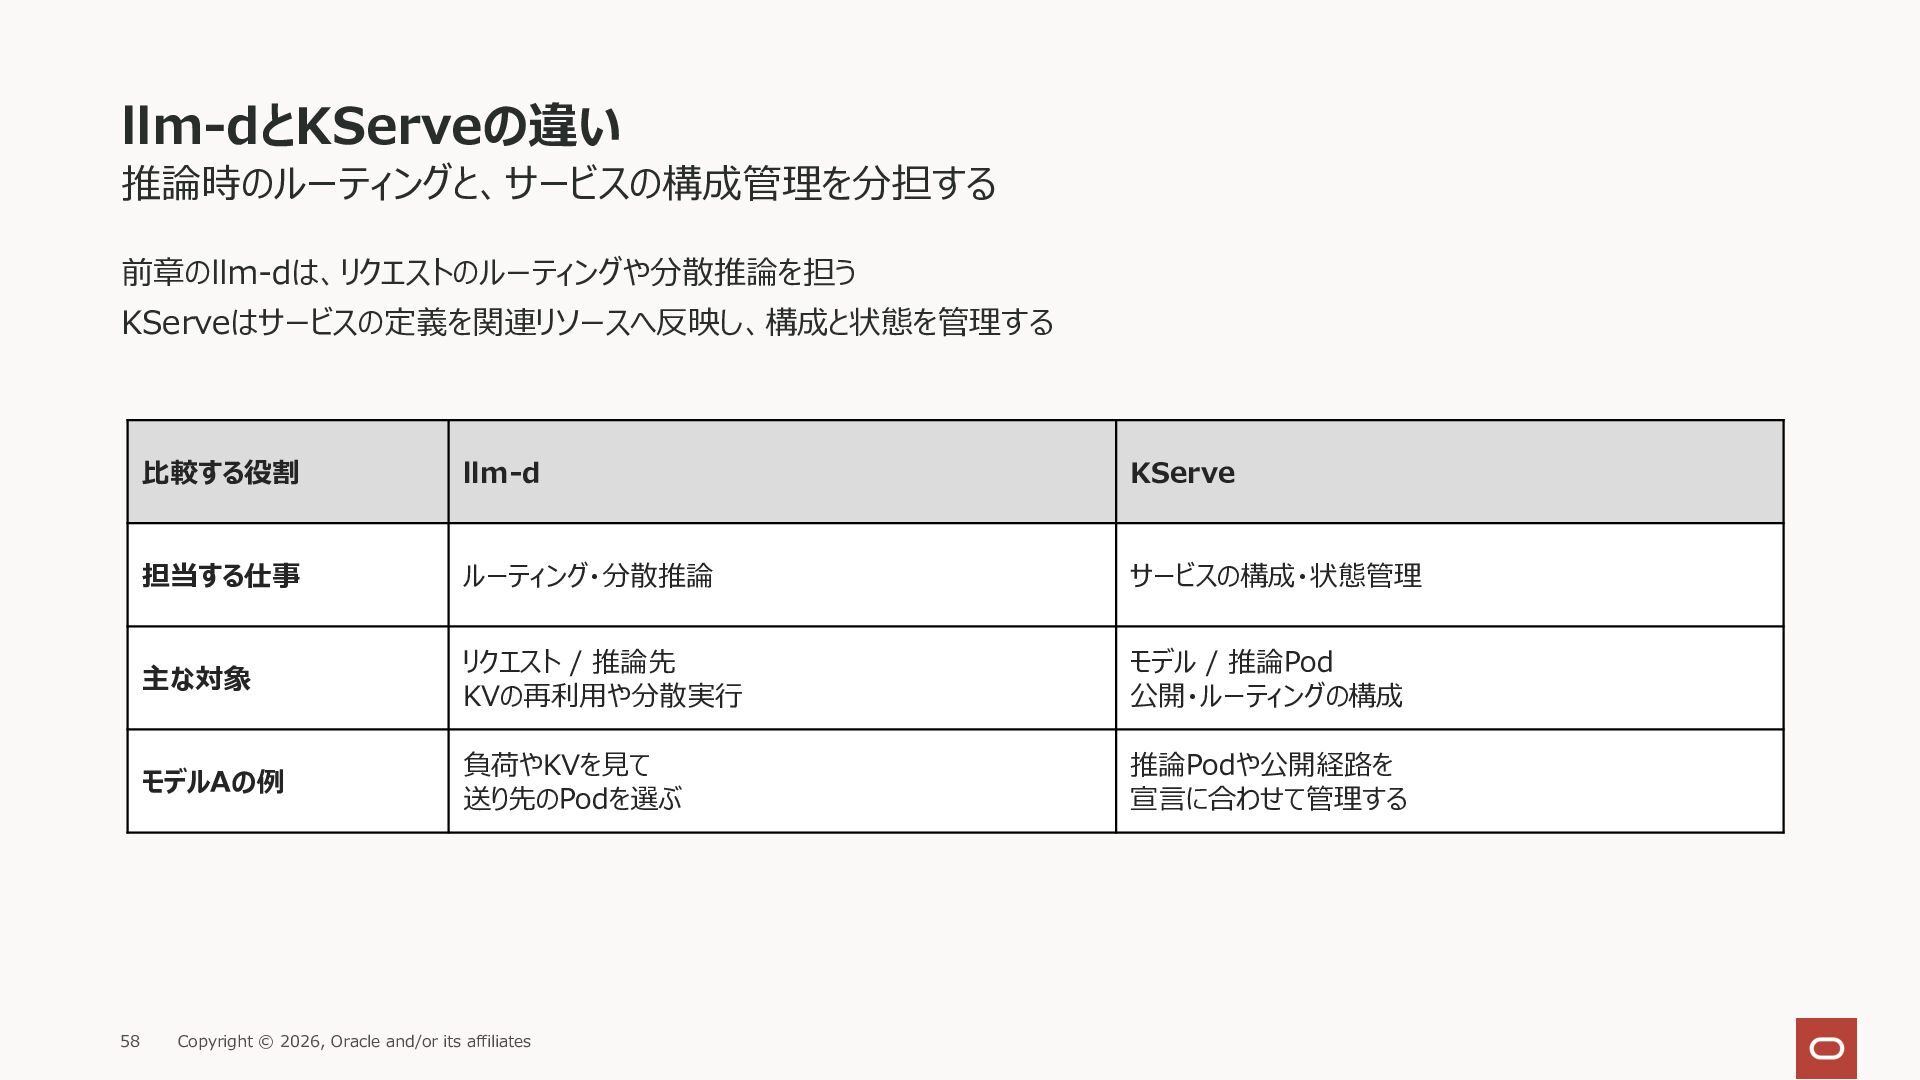
llm-dとKServeの違い 推論時のルーティングと、サービスの構成管理を分担する 前章のllm-dは、リクエストのルーティングや分散推論を担う KServeはサービスの定義を関連リソースへ反映し、構成と状態を管理する 58 ⽐較する役割 llm-d KServe 担当する仕事 ルーティング・分散推論
サービスの構成・状態管理 主な対象 リクエスト / 推論先 KVの再利⽤や分散実⾏ モデル / 推論Pod 公開・ルーティングの構成 モデルAの例 負荷やKVを⾒て 送り先のPodを選ぶ 推論Podや公開経路を 宣⾔に合わせて管理する Copyright © 2026, Oracle and/or its affiliates
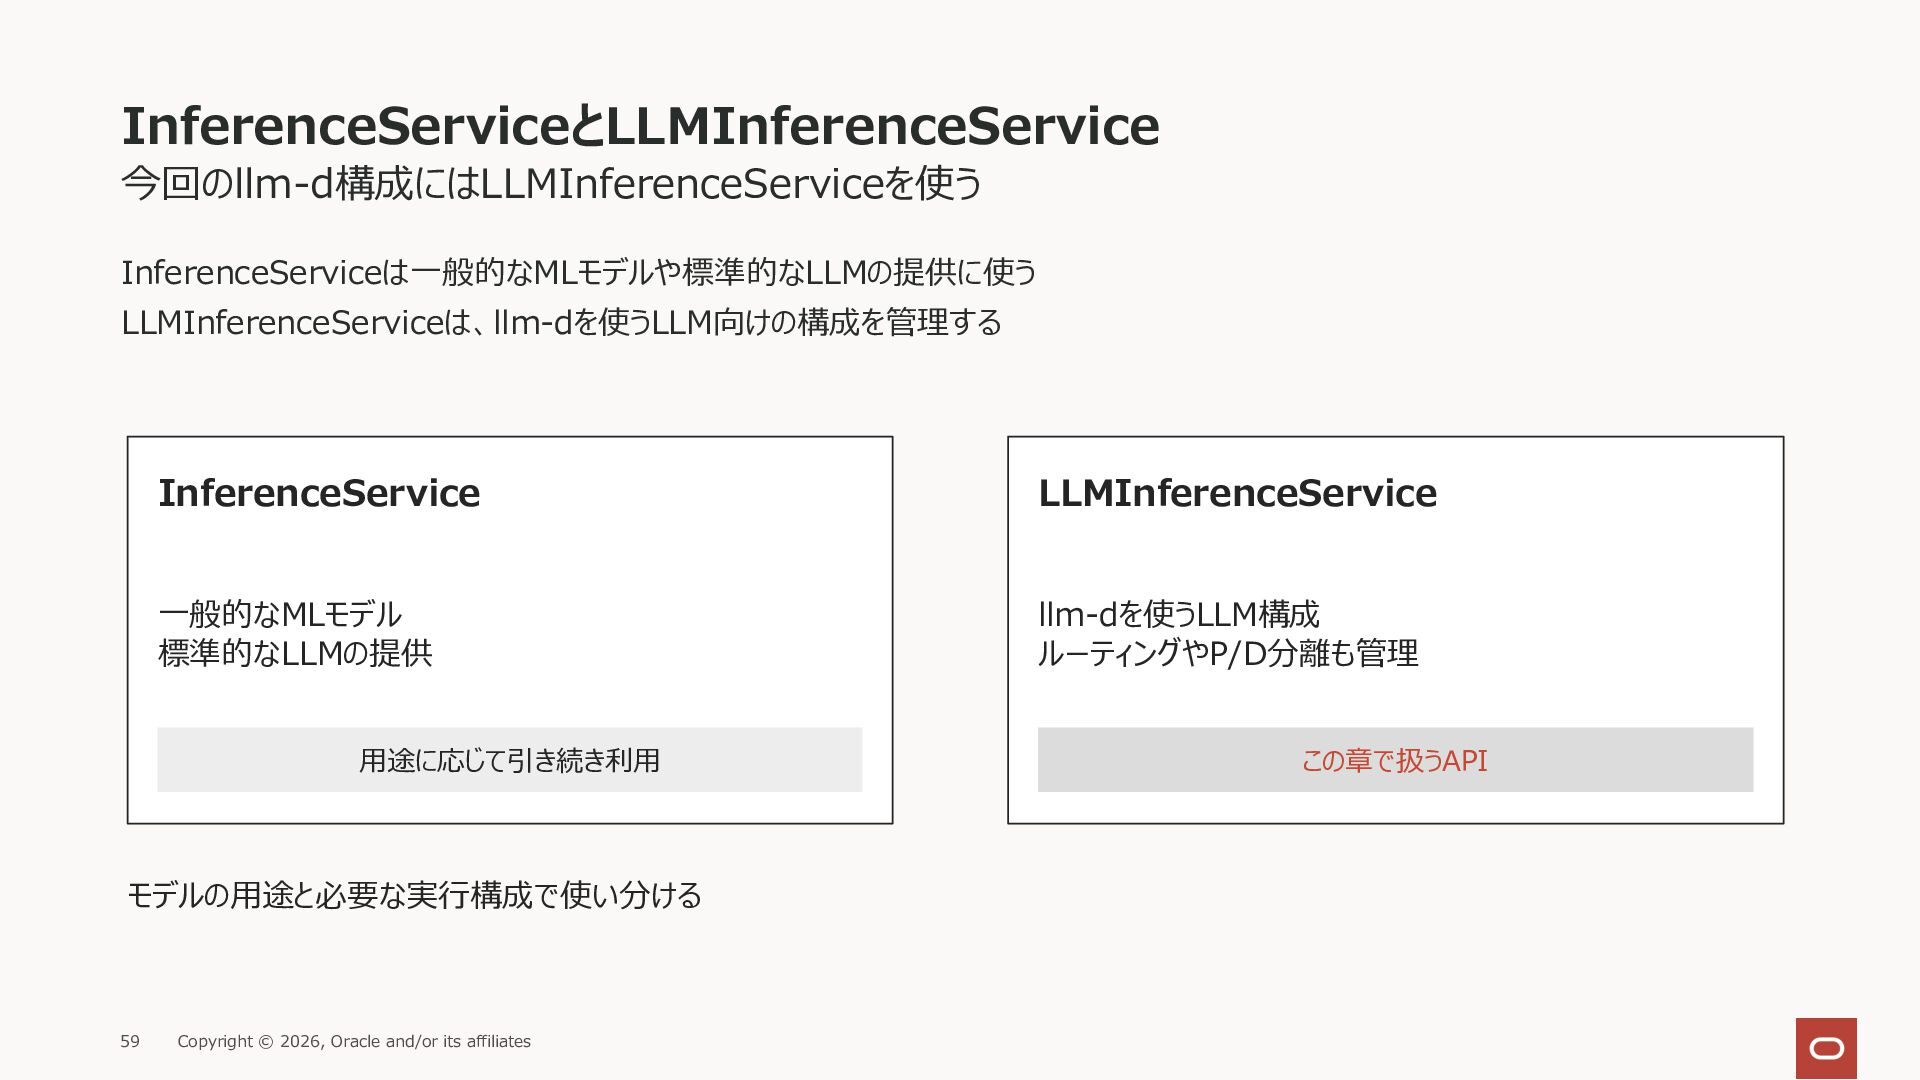
InferenceServiceとLLMInferenceService 今回のllm-d構成にはLLMInferenceServiceを使う InferenceServiceは⼀般的なMLモデルや標準的なLLMの提供に使う LLMInferenceServiceは、llm-dを使うLLM向けの構成を管理する InferenceService LLMInferenceService ⼀般的なMLモデル 標準的なLLMの提供 llm-dを使うLLM構成 ルーティングやP/D分離も管理
⽤途に応じて引き続き利⽤ モデルの⽤途と必要な実⾏構成で使い分ける 59 Copyright © 2026, Oracle and/or its affiliates この章で扱うAPI
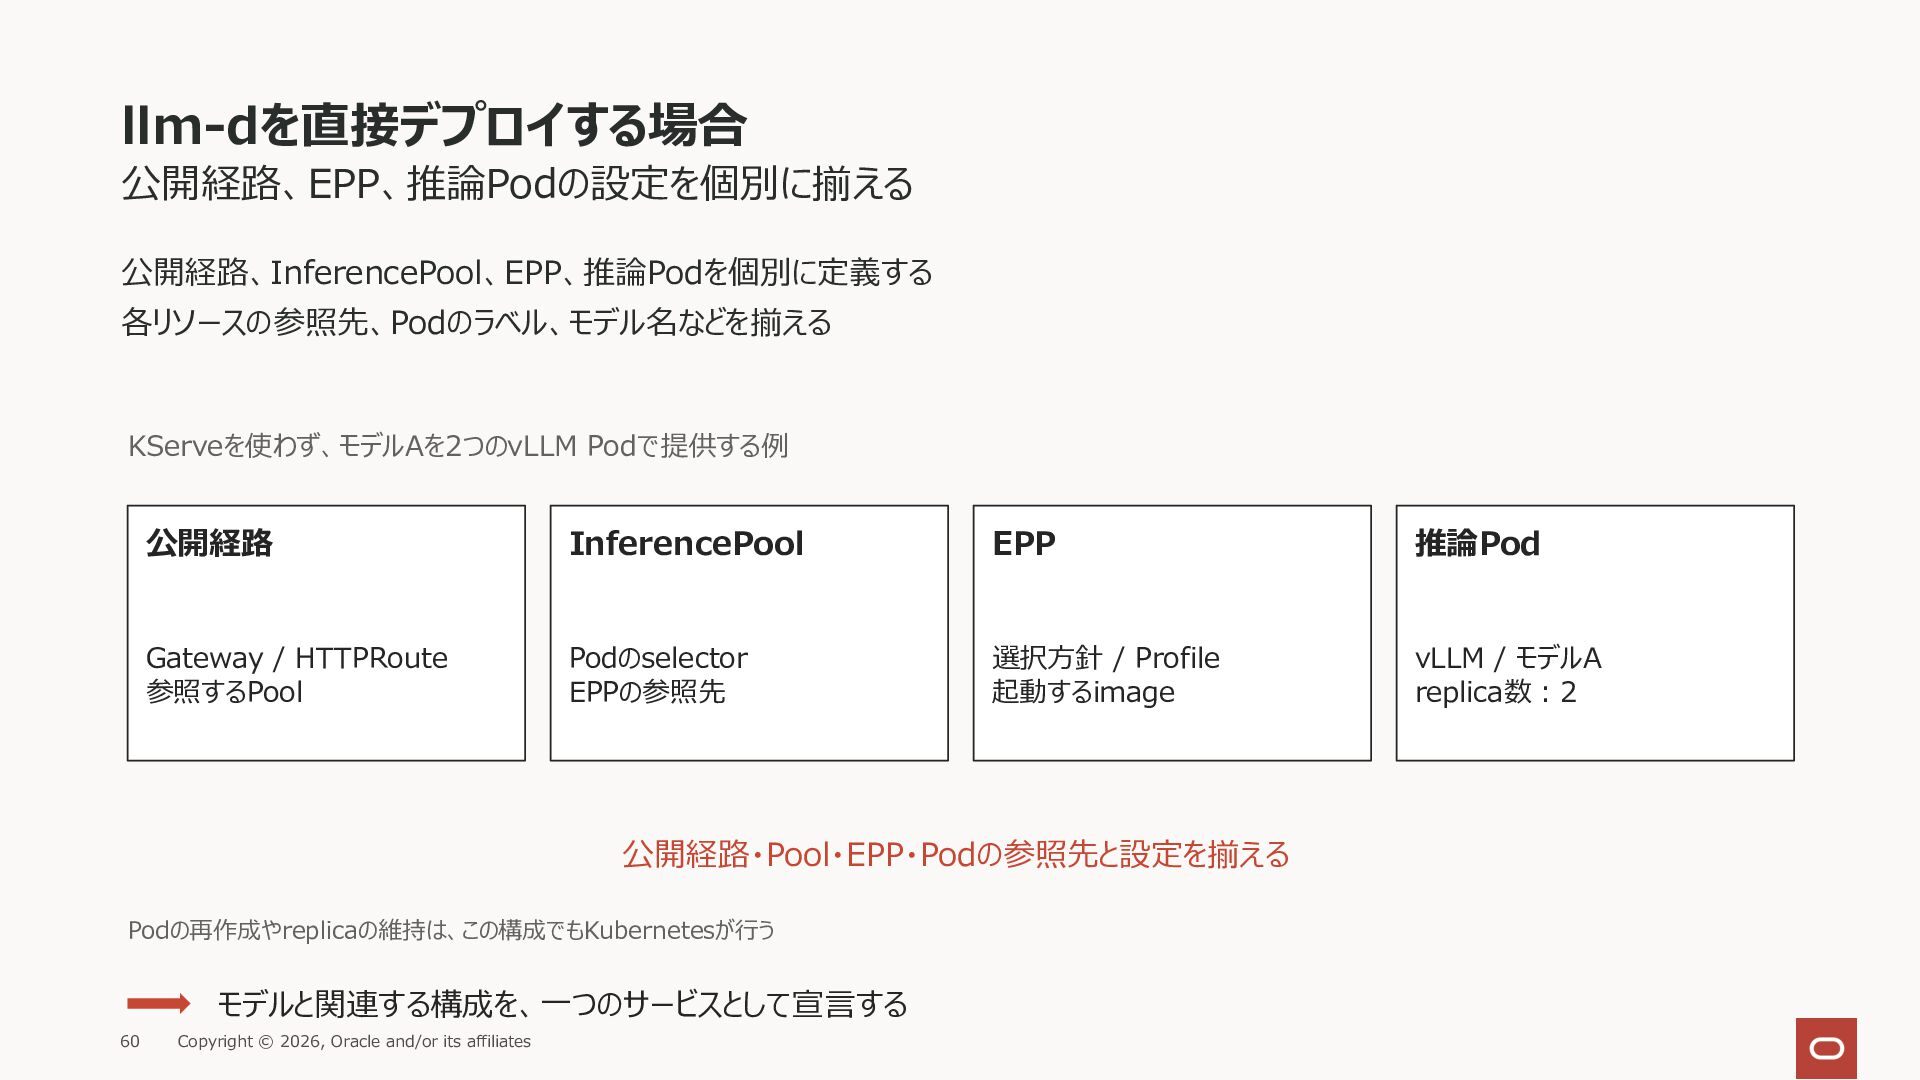
llm-dを直接デプロイする場合 公開経路、EPP、推論Podの設定を個別に揃える 公開経路、InferencePool、EPP、推論Podを個別に定義する 各リソースの参照先、Podのラベル、モデル名などを揃える KServeを使わず、モデルAを2つのvLLM Podで提供する例 公開経路 InferencePool EPP 推論Pod
Gateway / HTTPRoute 参照するPool Podのselector EPPの参照先 選択⽅針 / Profile 起動するimage vLLM / モデルA replica数︓2 公開経路・Pool・EPP・Podの参照先と設定を揃える Podの再作成やreplicaの維持は、この構成でもKubernetesが⾏う モデルと関連する構成を、⼀つのサービスとして宣⾔する 60 Copyright © 2026, Oracle and/or its affiliates
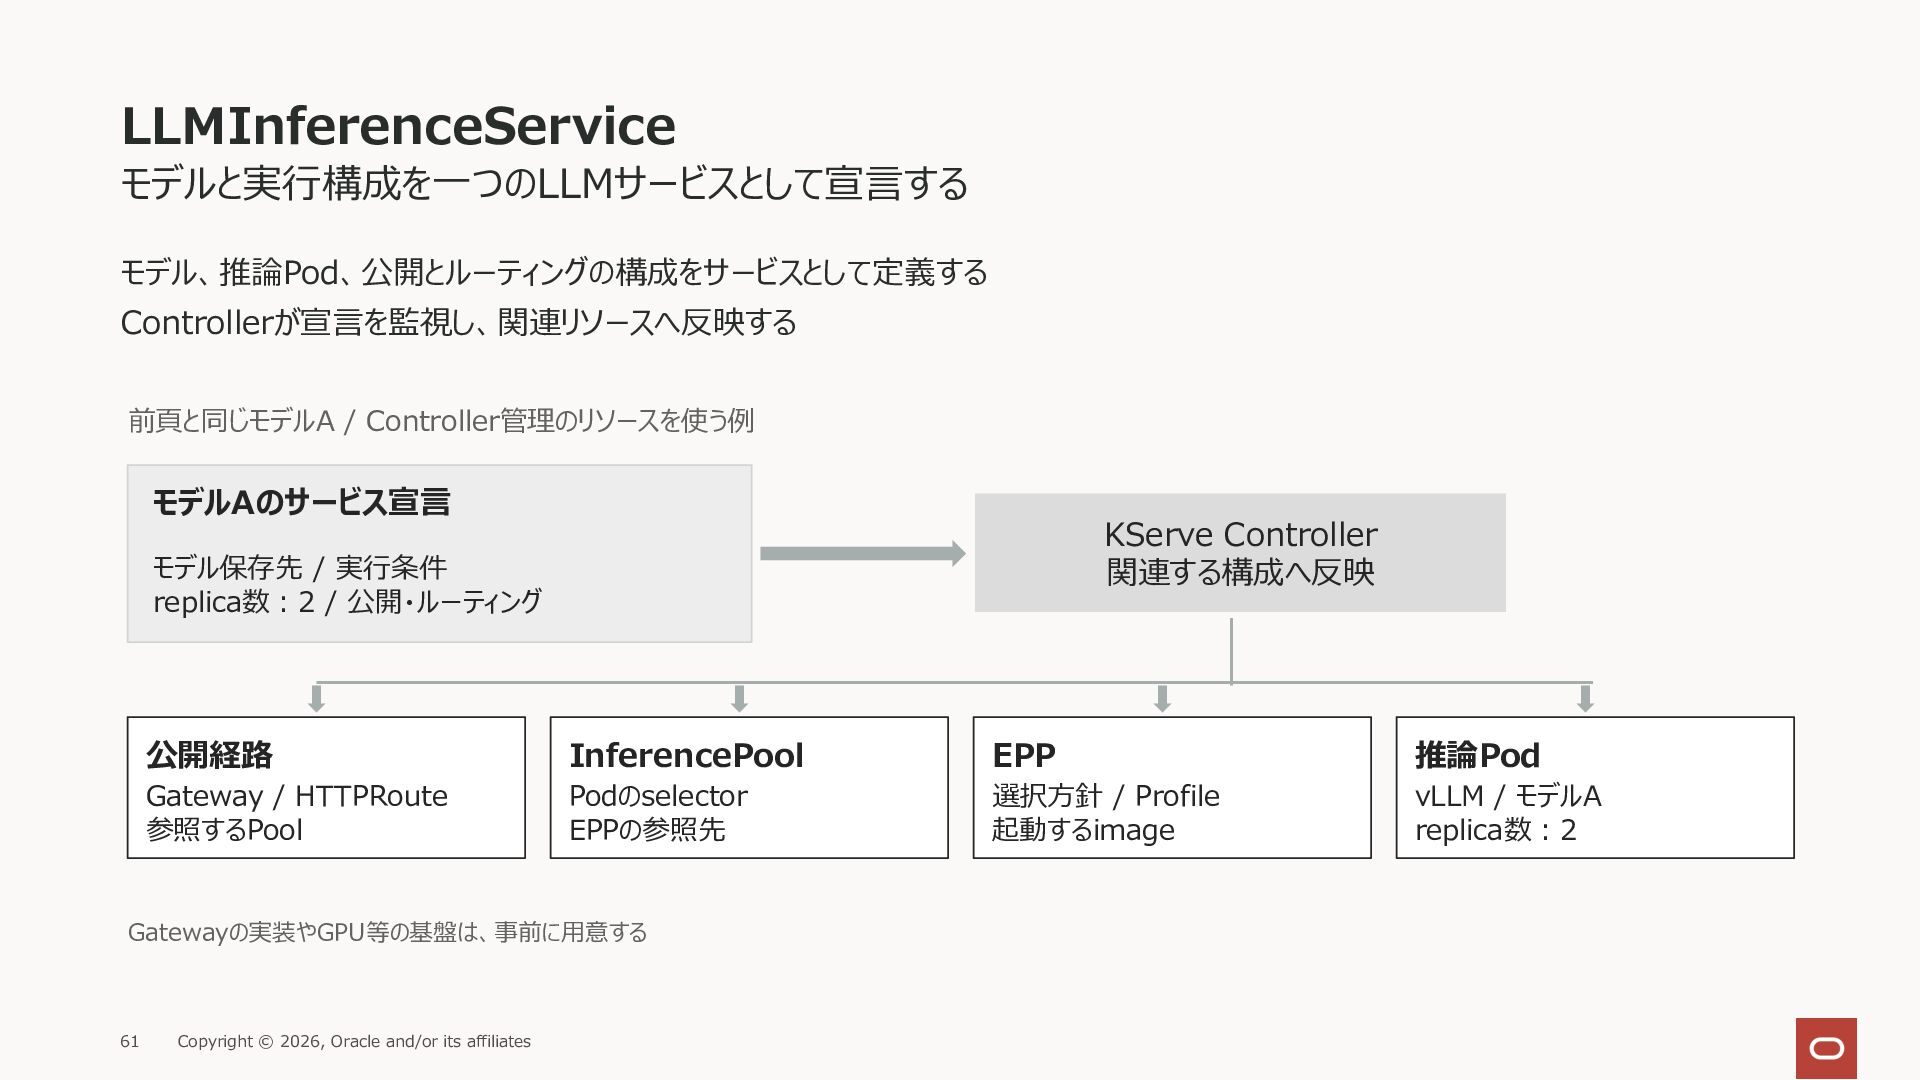
LLMInferenceService モデルと実⾏構成を⼀つのLLMサービスとして宣⾔する モデル、推論Pod、公開とルーティングの構成をサービスとして定義する Controllerが宣⾔を監視し、関連リソースへ反映する 前⾴と同じモデルA / Controller管理のリソースを使う例 モデルAのサービス宣⾔ KServe Controller
関連する構成へ反映 モデル保存先 / 実⾏条件 replica数︓2 / 公開・ルーティング 公開経路 InferencePool EPP 推論Pod Gateway / HTTPRoute 参照するPool Podのselector EPPの参照先 選択⽅針 / Profile 起動するimage vLLM / モデルA replica数︓2 Gatewayの実装やGPU等の基盤は、事前に⽤意する 61 Copyright © 2026, Oracle and/or its affiliates
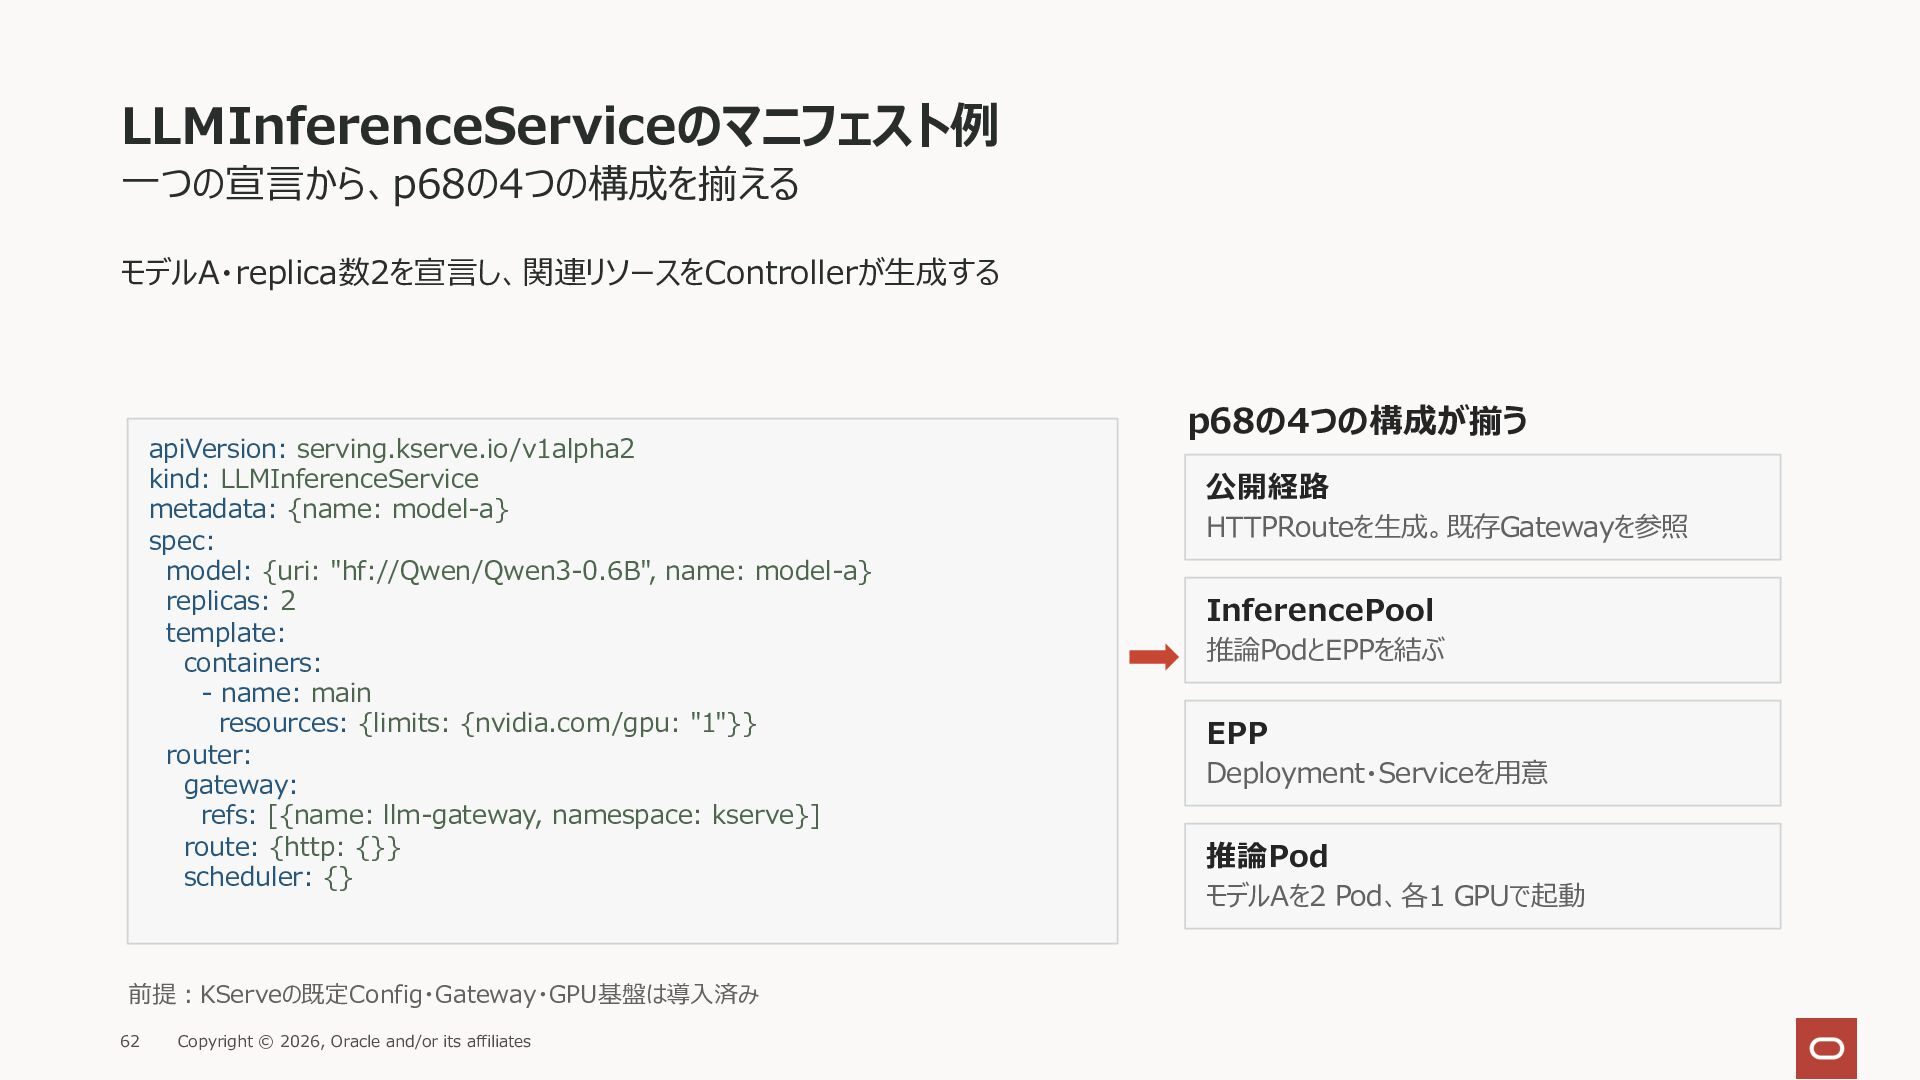
LLMInferenceServiceのマニフェスト例 ⼀つの宣⾔から、p68の4つの構成を揃える モデルA・replica数2を宣⾔し、関連リソースをControllerが⽣成する apiVersion: serving.kserve.io/v1alpha2 kind: LLMInferenceService metadata: {name: model-a}
spec: model: {uri: "hf://Qwen/Qwen3-0.6B", name: model-a} replicas: 2 template: containers: - name: main resources: {limits: {nvidia.com/gpu: "1"}} router: gateway: refs: [{name: llm-gateway, namespace: kserve}] route: {http: {}} scheduler: {} 前提︓KServeの既定Config・Gateway・GPU基盤は導⼊済み 62 Copyright © 2026, Oracle and/or its affiliates p68の4つの構成が揃う 公開経路 HTTPRouteを⽣成。既存Gatewayを参照 InferencePool 推論PodとEPPを結ぶ EPP Deployment・Serviceを⽤意 推論Pod モデルAを2 Pod、各1 GPUで起動
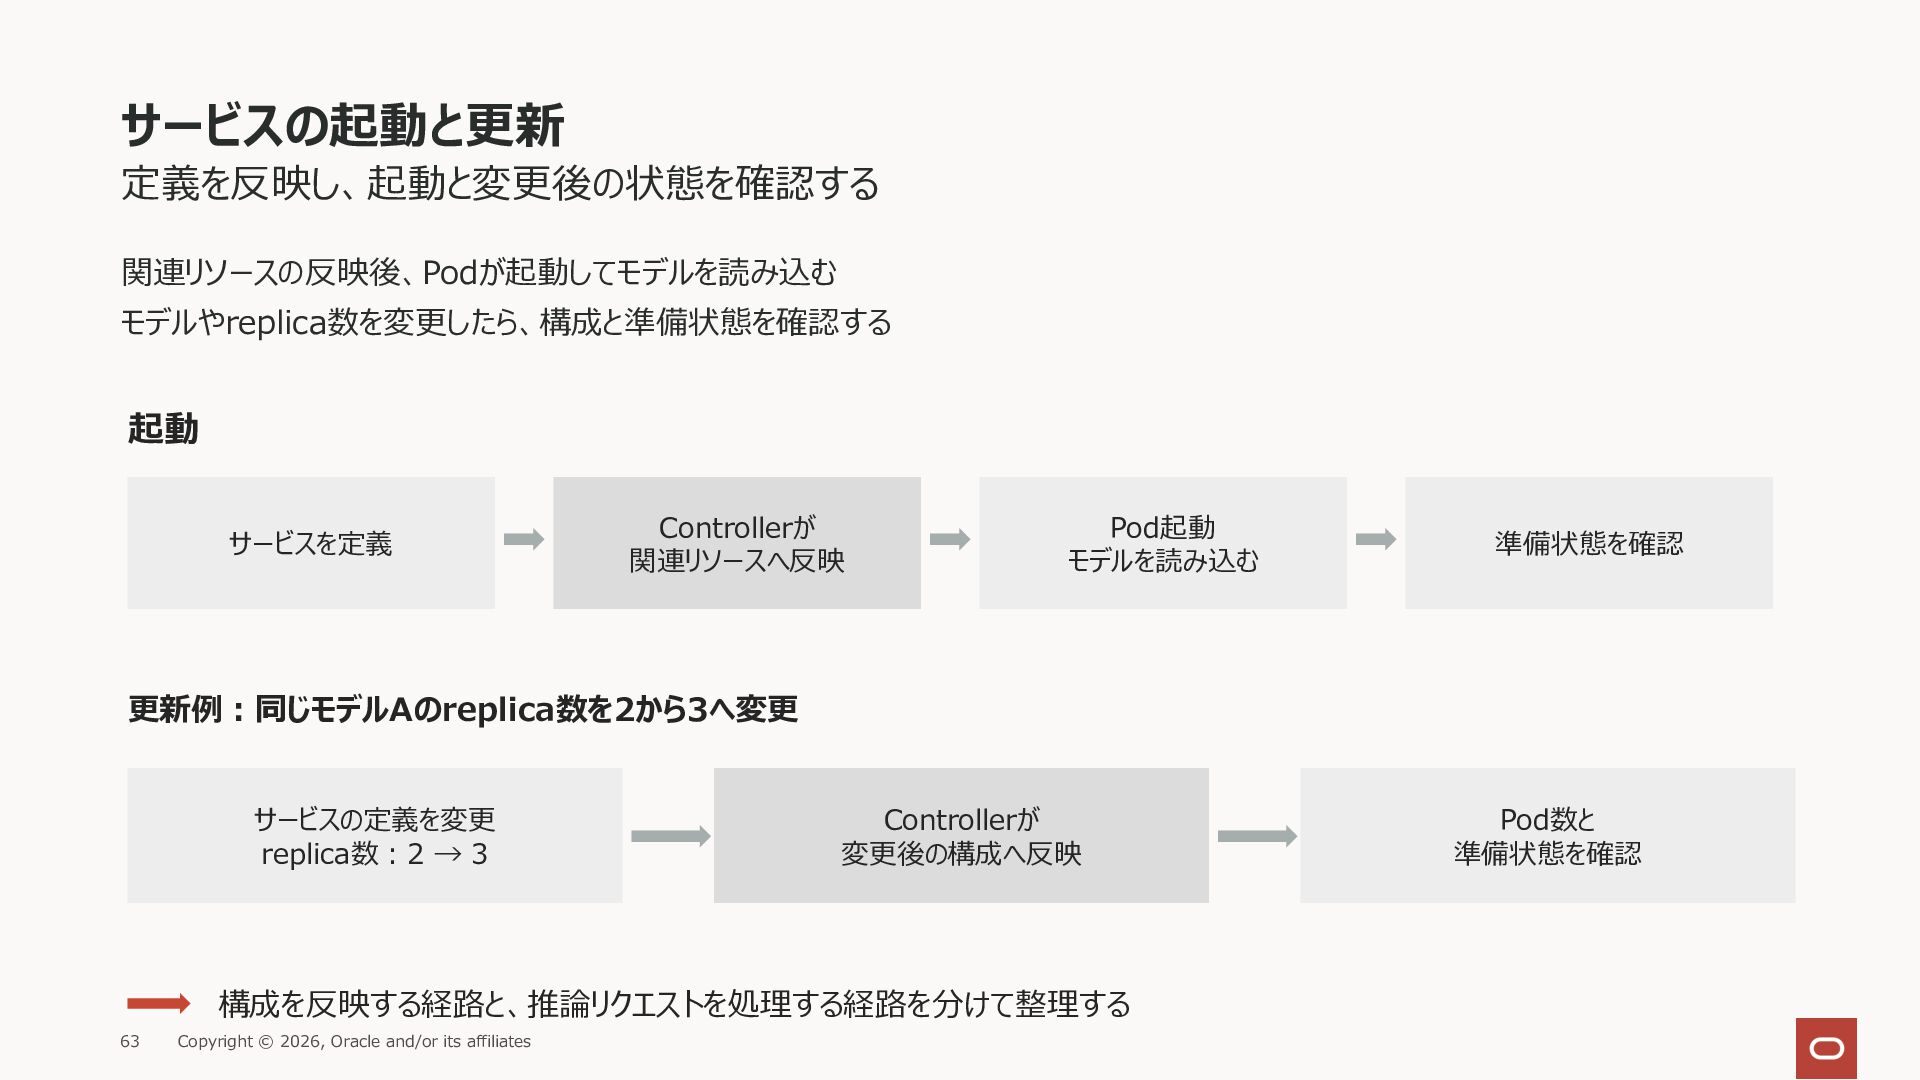
サービスの起動と更新 定義を反映し、起動と変更後の状態を確認する 関連リソースの反映後、Podが起動してモデルを読み込む モデルやreplica数を変更したら、構成と準備状態を確認する 起動 サービスを定義 Controllerが 関連リソースへ反映 Pod起動 モデルを読み込む
準備状態を確認 更新例︓同じモデルAのreplica数を2から3へ変更 サービスの定義を変更 replica数︓2 → 3 Controllerが 変更後の構成へ反映 構成を反映する経路と、推論リクエストを処理する経路を分けて整理する 63 Copyright © 2026, Oracle and/or its affiliates Pod数と 準備状態を確認
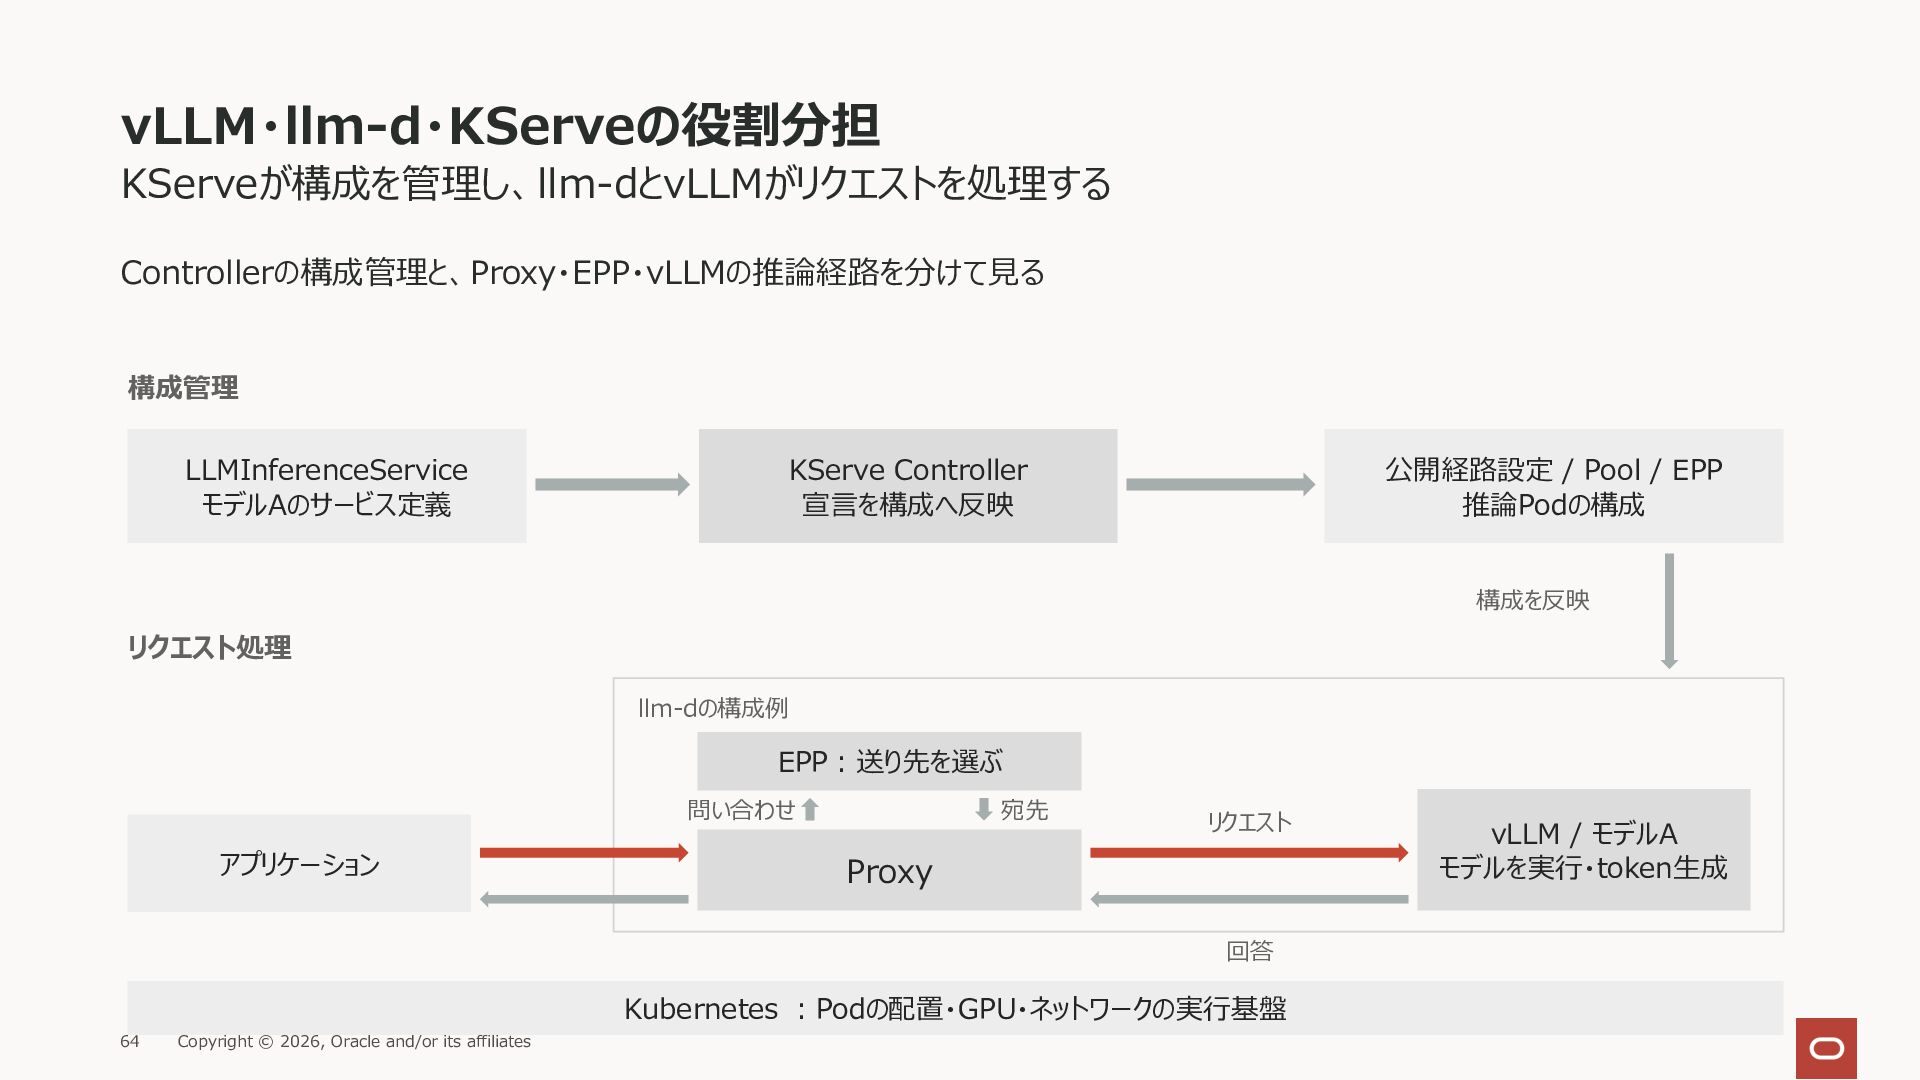
vLLM・llm-d・KServeの役割分担 KServeが構成を管理し、llm-dとvLLMがリクエストを処理する Controllerの構成管理と、Proxy・EPP・vLLMの推論経路を分けて⾒る 構成管理 LLMInferenceService モデルAのサービス定義 KServe Controller 宣⾔を構成へ反映 公開経路設定
/ Pool / EPP 推論Podの構成 構成を反映 リクエスト処理 llm-dの構成例 EPP︓送り先を選ぶ 問い合わせ アプリケーション 宛先 リクエスト Proxy 回答 Kubernetes ︓Podの配置・GPU・ネットワークの実⾏基盤 64 Copyright © 2026, Oracle and/or its affiliates vLLM / モデルA モデルを実⾏・token⽣成
まとめ
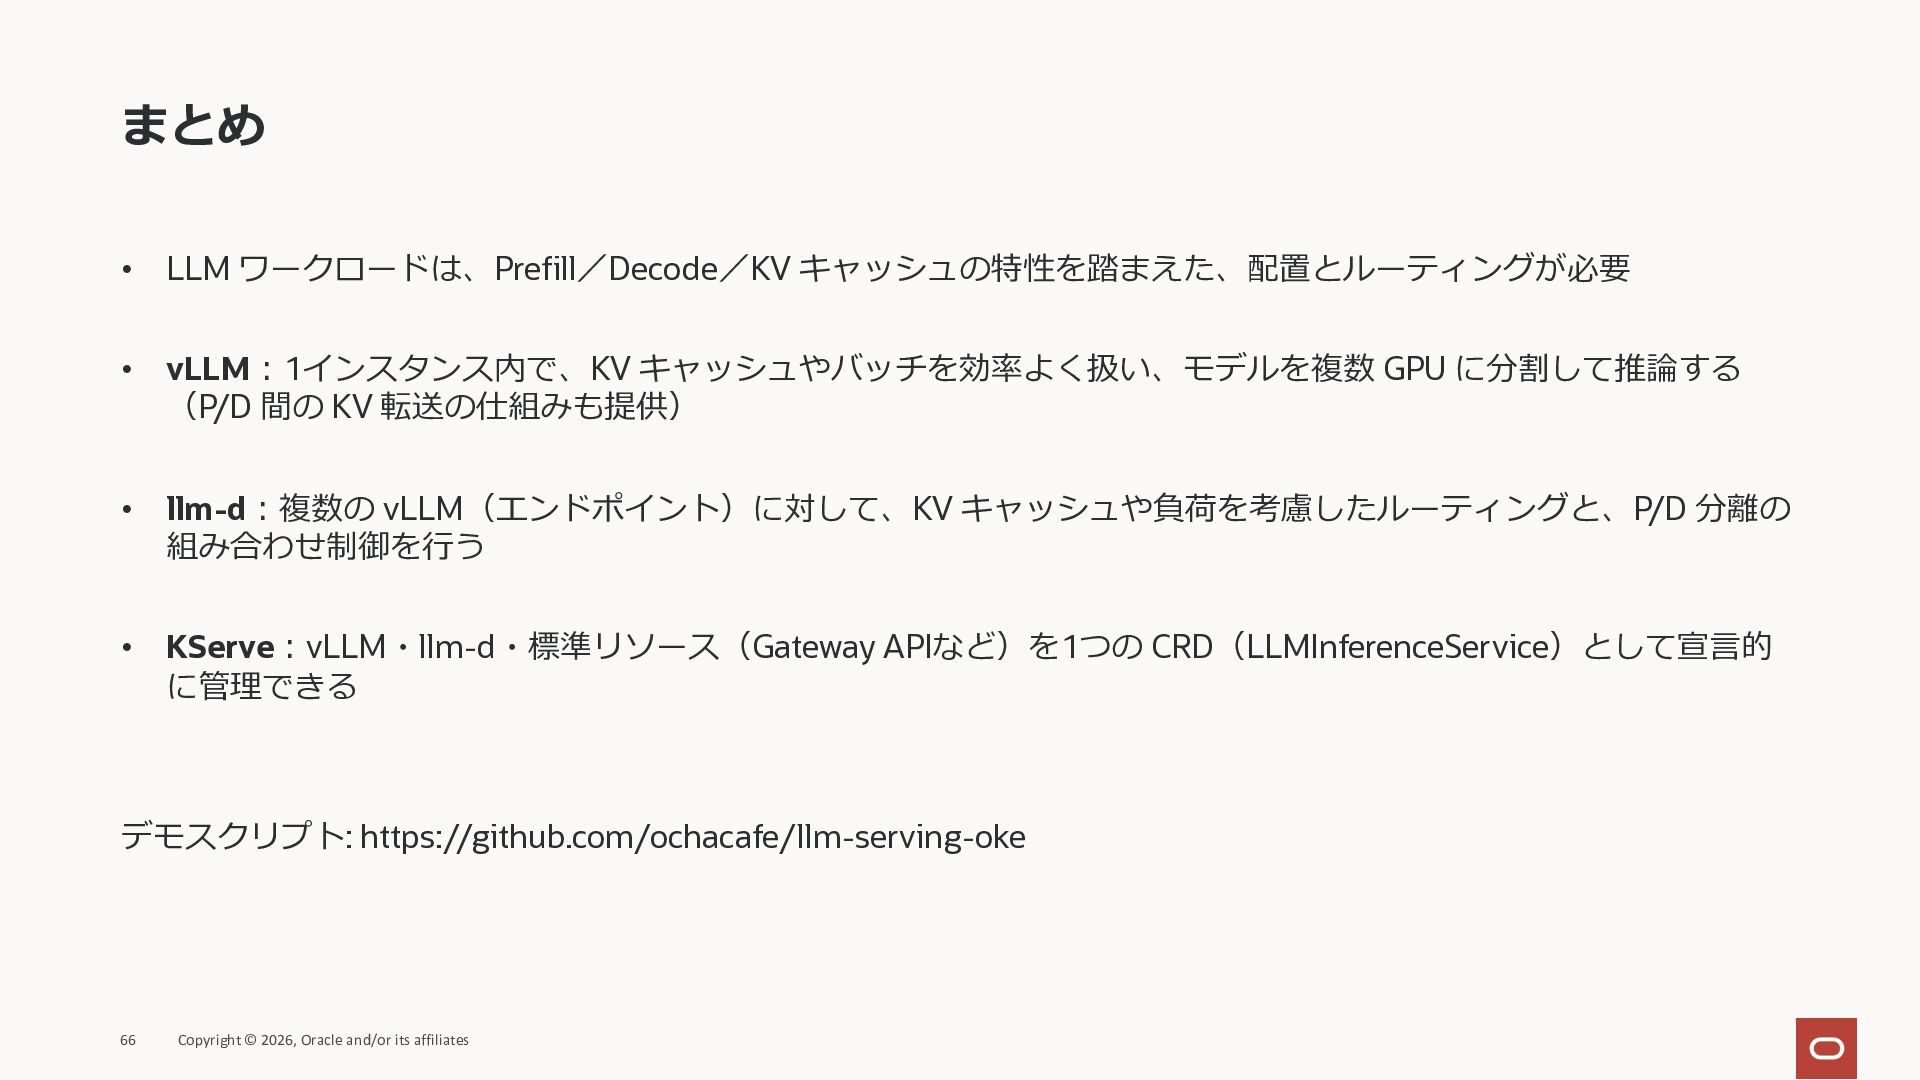
まとめ • LLM ワークロードは、Prefill/Decode/KV キャッシュの特性を踏まえた、配置とルーティングが必要 • vLLM︓1インスタンス内で、KV キャッシュやバッチを効率よく扱い、モデルを複数 GPU に分割して推論する
(P/D 間の KV 転送の仕組みも提供) • llm-d︓複数の vLLM(エンドポイント)に対して、KV キャッシュや負荷を考慮したルーティングと、P/D 分離の 組み合わせ制御を⾏う • KServe︓vLLM・llm-d・標準リソース(Gateway APIなど)を1つの CRD(LLMInferenceService)として宣⾔的 に管理できる デモスクリプト: https://github.com/ochacafe/llm-serving-oke 66 Copyright © 2026, Oracle and/or its affiliates
None


 oracle4engineer
 charlesmeaden
 tammyeverts
 brettharned
 michielstock
 lauravandoore
 addyosmani
 cassininazir
 rasagy
 destraynor
 mfonobong
 denniskardys