Upgrade to Pro — share decks privately, control downloads, hide ads and more …

社内AIエージェント「Askワンバン」における コストチューニングの取り組み

t0yohei
October 29, 2026

社内AIエージェント「Askワンバン」における コストチューニングの取り組み

AI活用 LT祭り ─ あの人・あの会社のAI活用事例 (2026/10/29)の登壇資料です。
https://supporterz-seminar.connpass.com/event/406206/

t0yohei

October 29, 2026

Transcript

43 slides
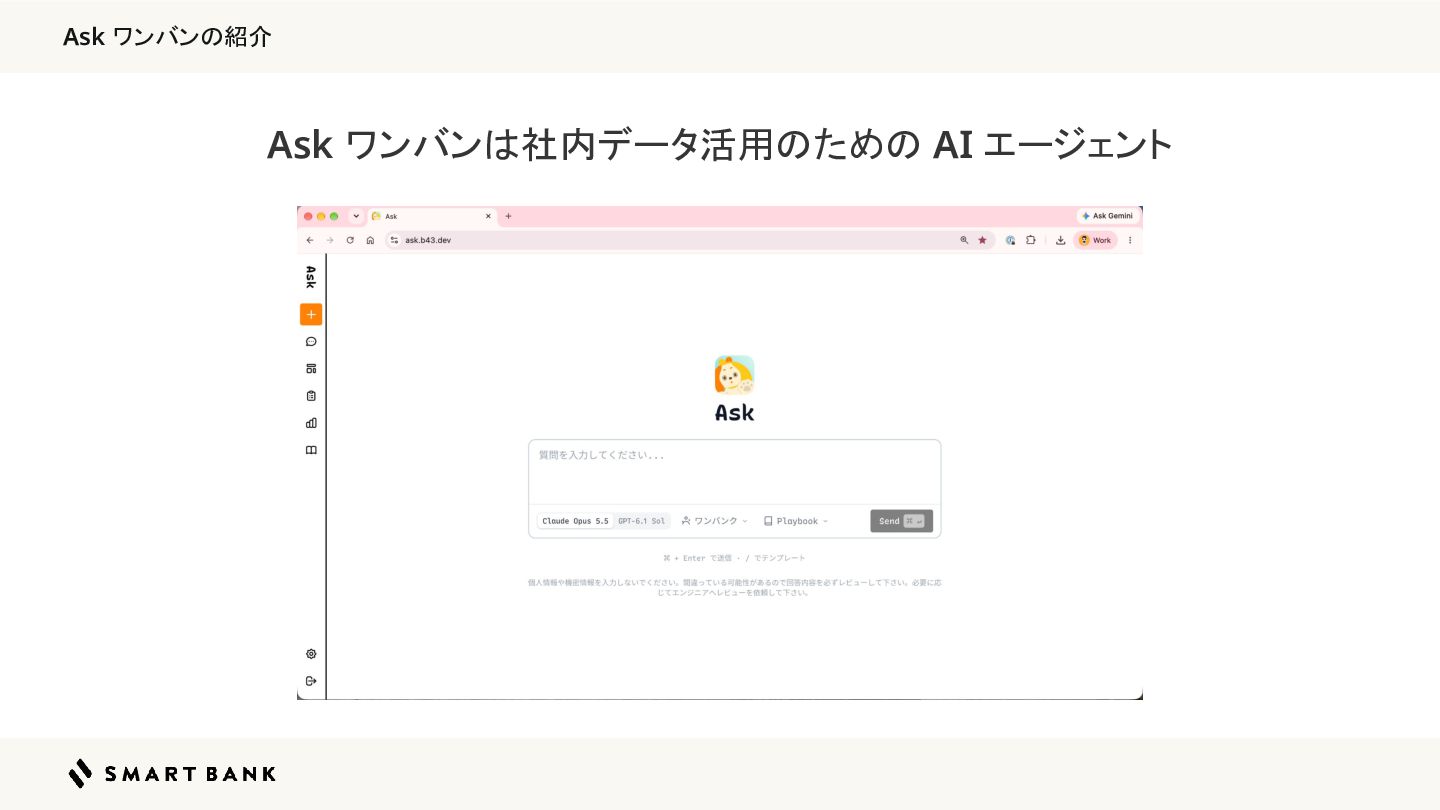
  1. 話す内容 1. Ask ワンバンの紹介 2. コストチューニング前の Ask ワンバン 3. Ask

    ワンバンで実施したコストチューニング 4. 取り組みからの学び
  2. 6

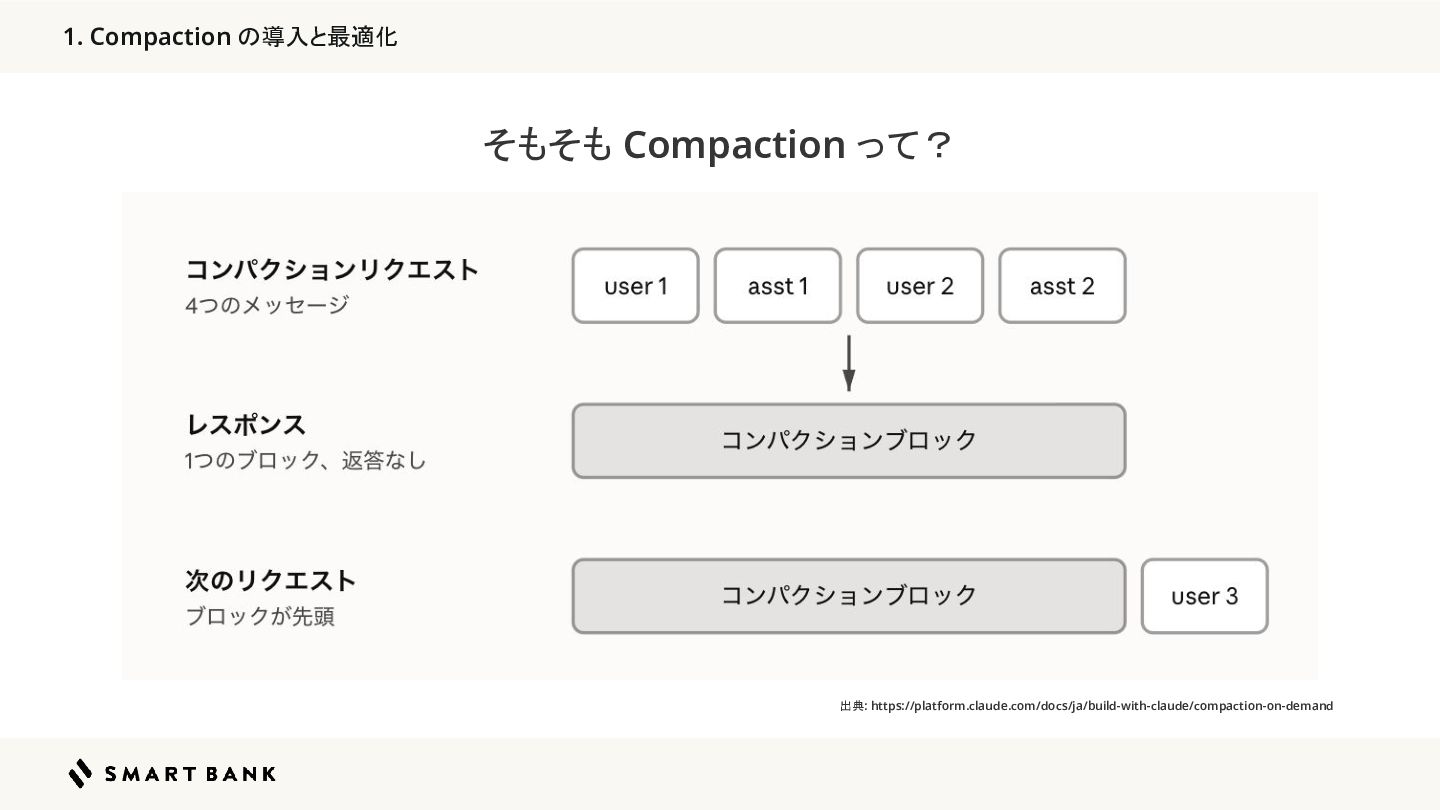
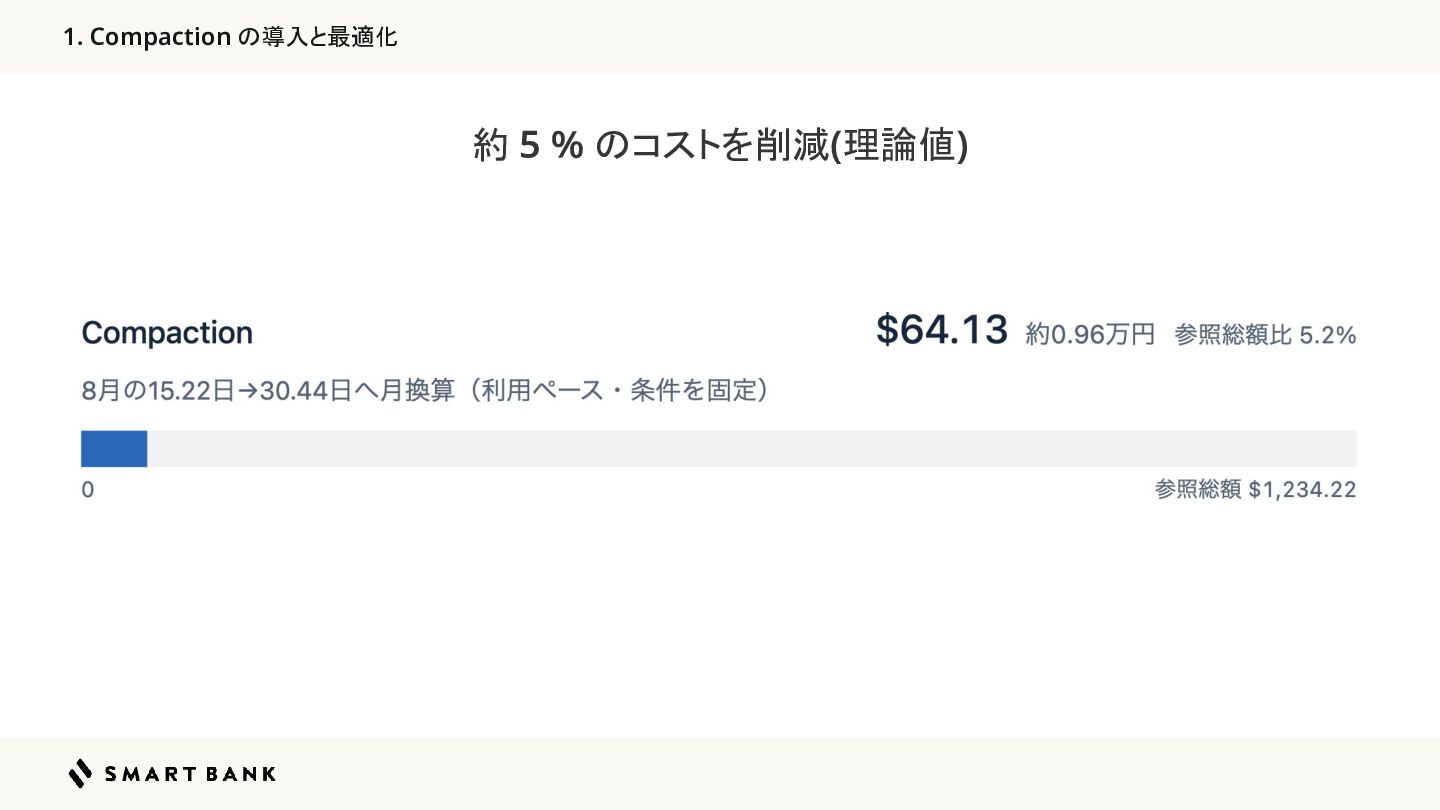
  3. 1. Compaction の導入と最適化 • Opus (4.6 〜 5.5) の context

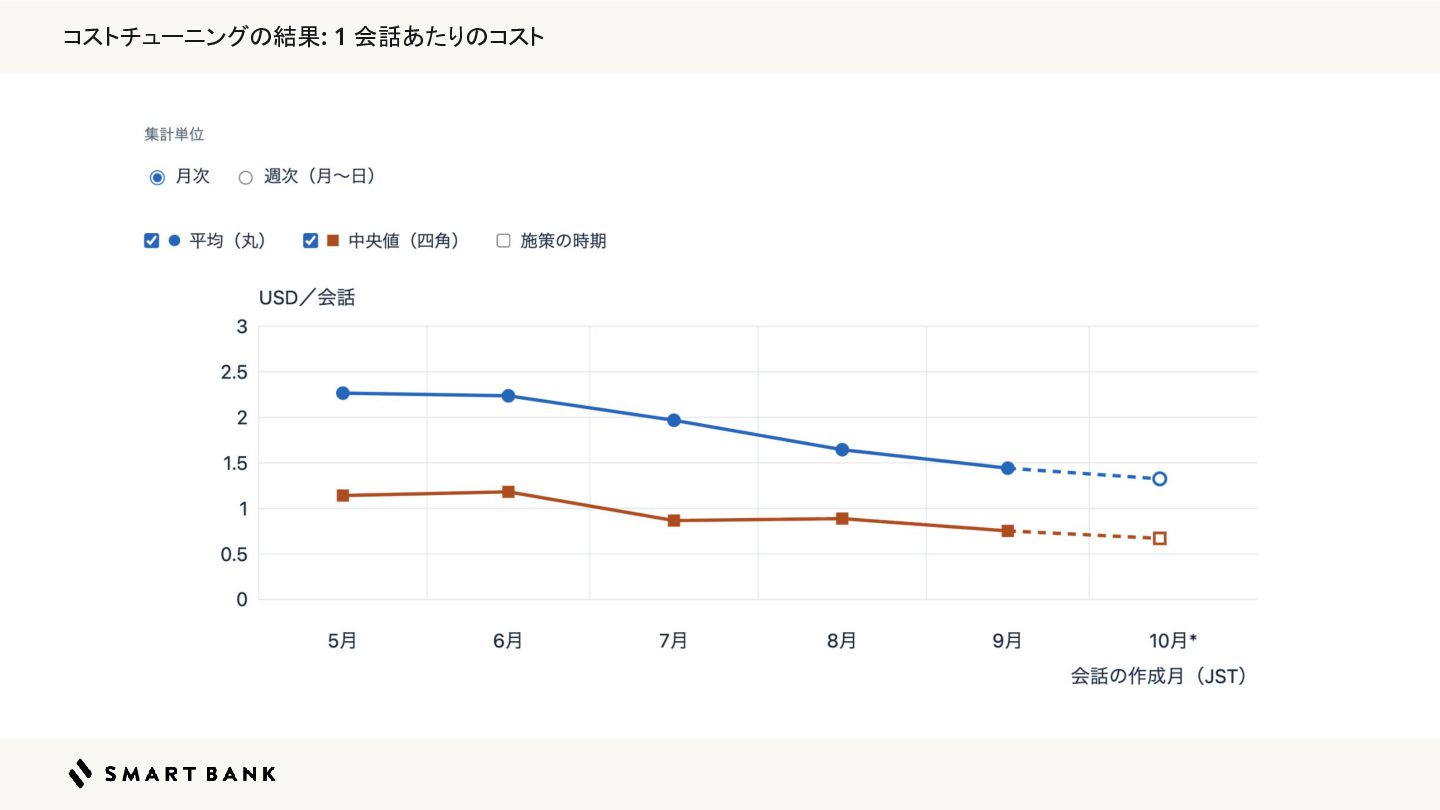
    window は 1,000,000 token ◦ • • 会話が長く続くとその分費用がかさむ Compaction はやればやるだけいいってものではない ◦ Compaction 時の context の喪失による会話品質劣化 ◦ Compaction block の生成にも費用が発生 閾値は 400,000 token から始めて計測しつつ 300,000 token に調整
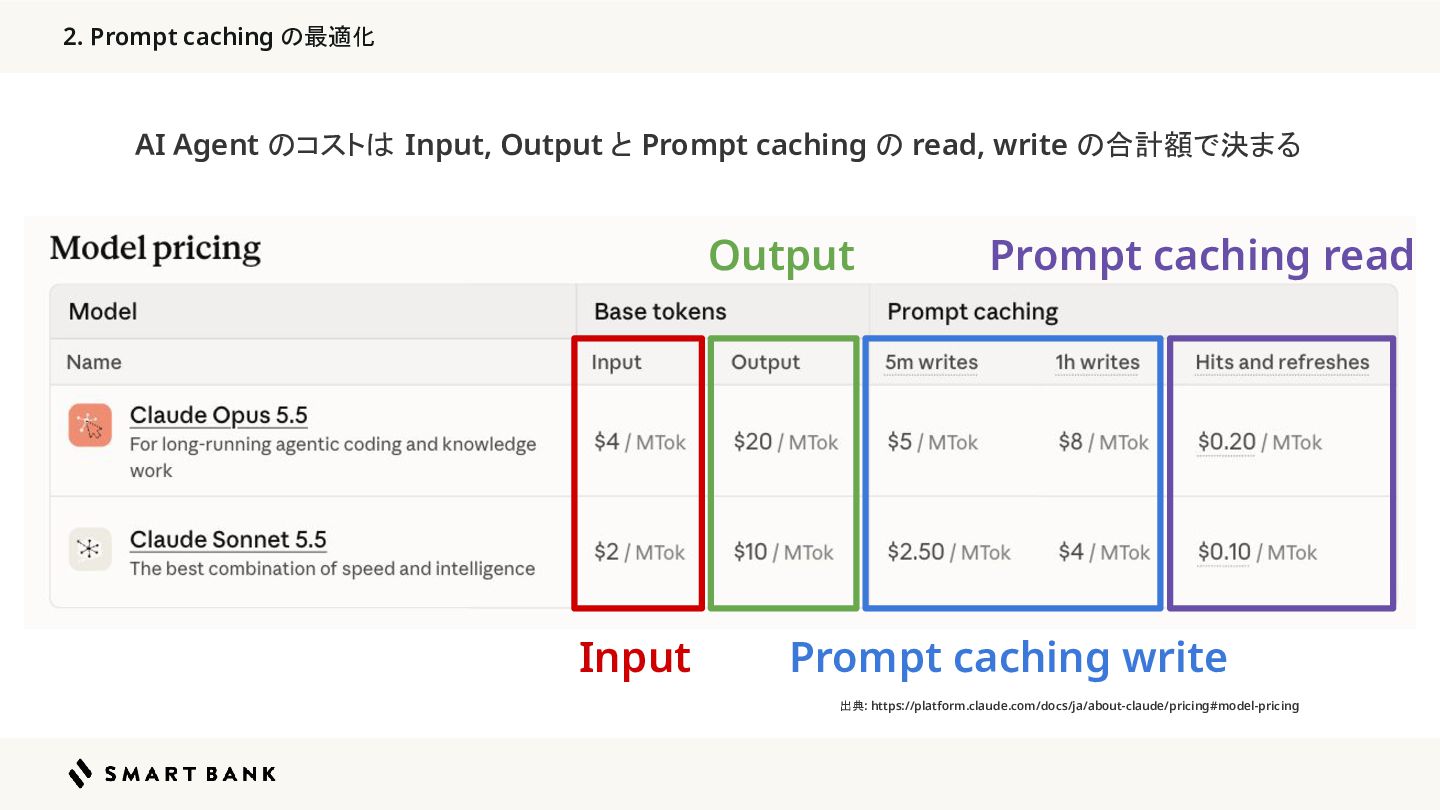
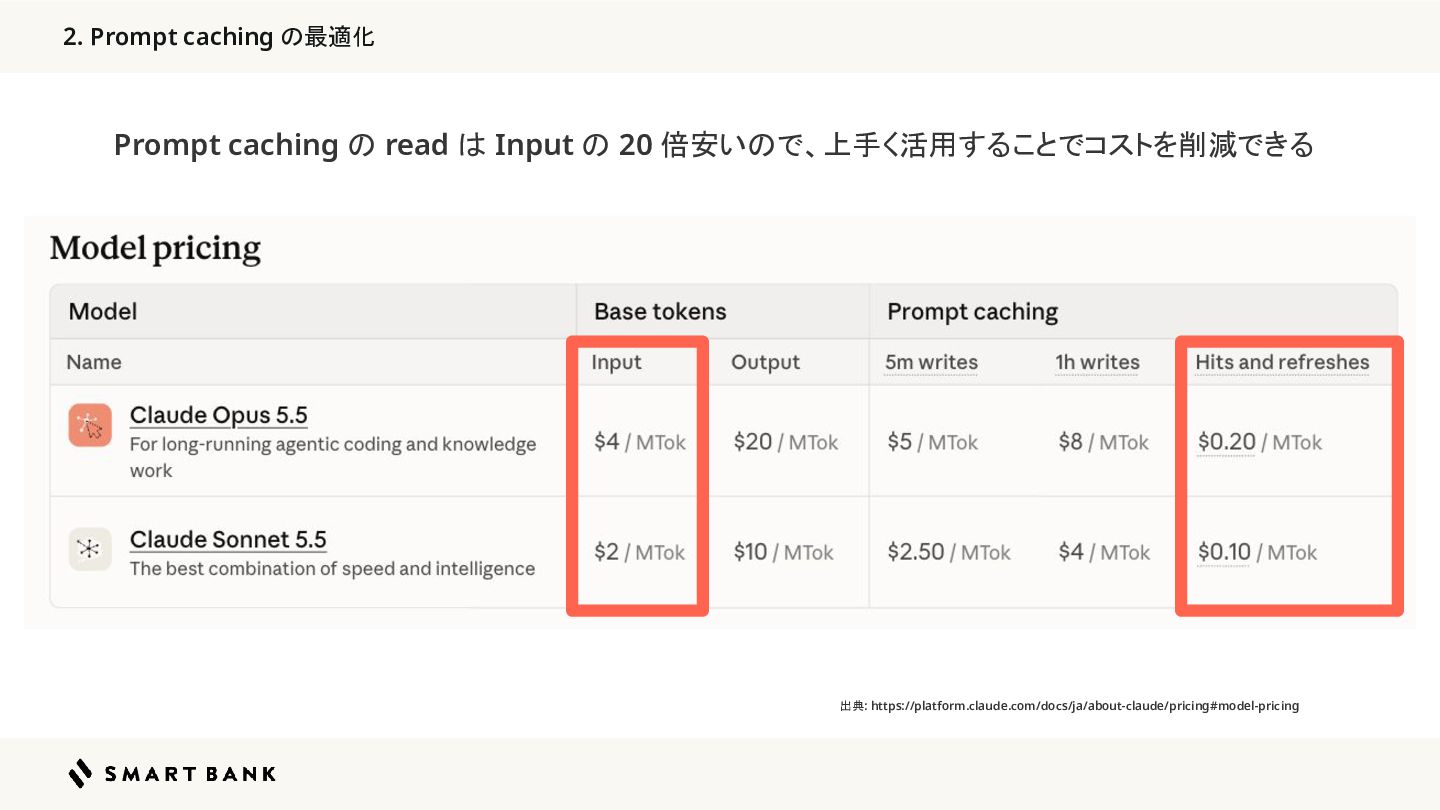
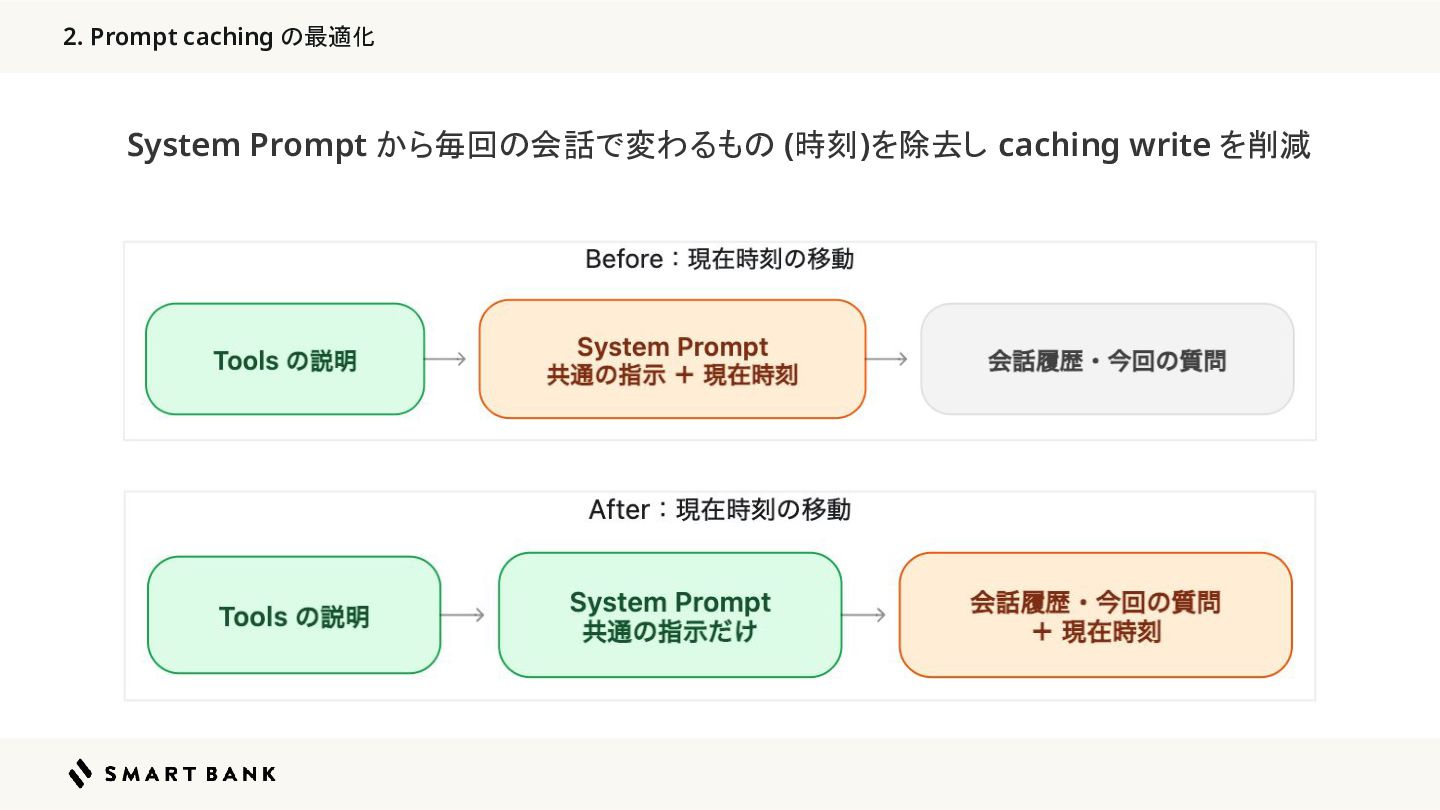
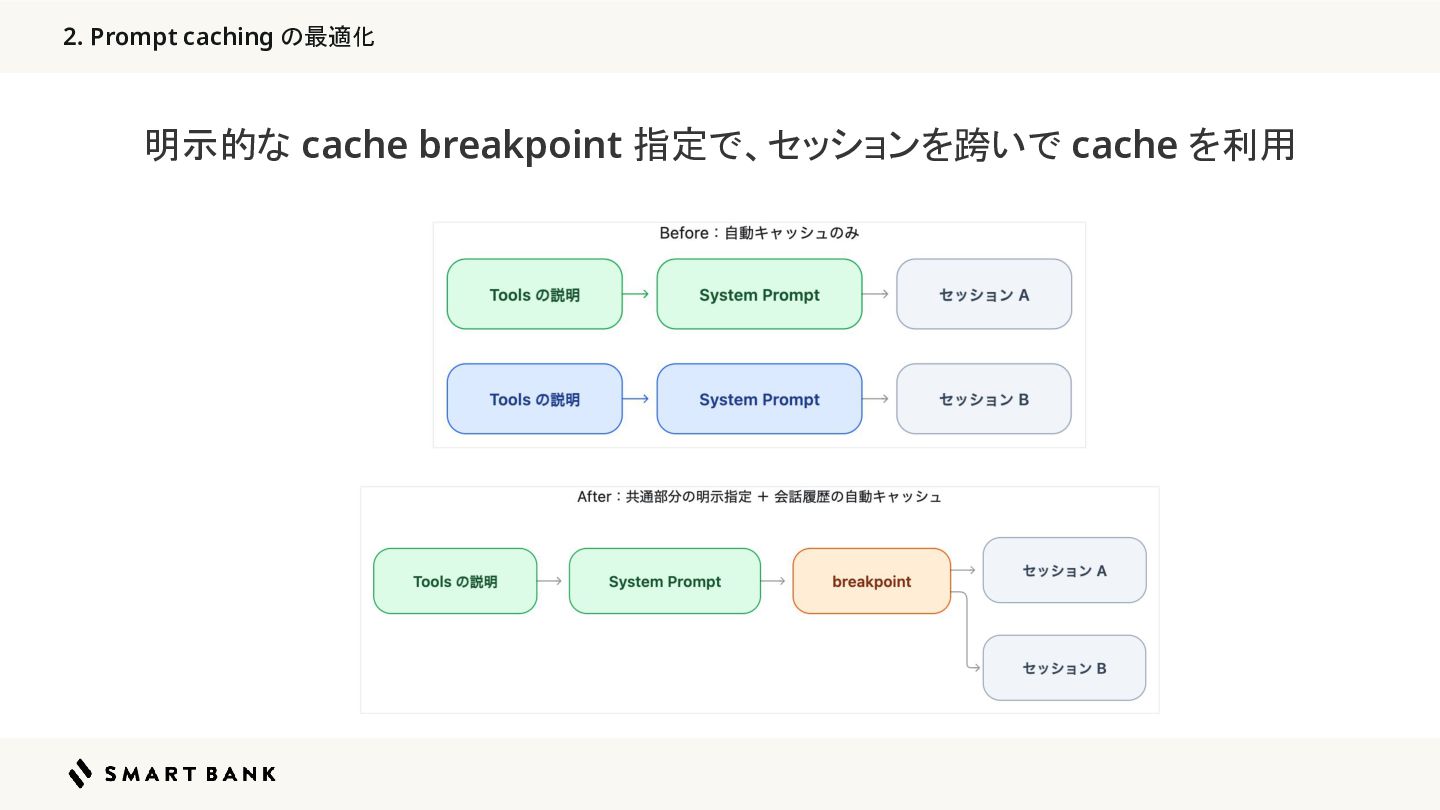
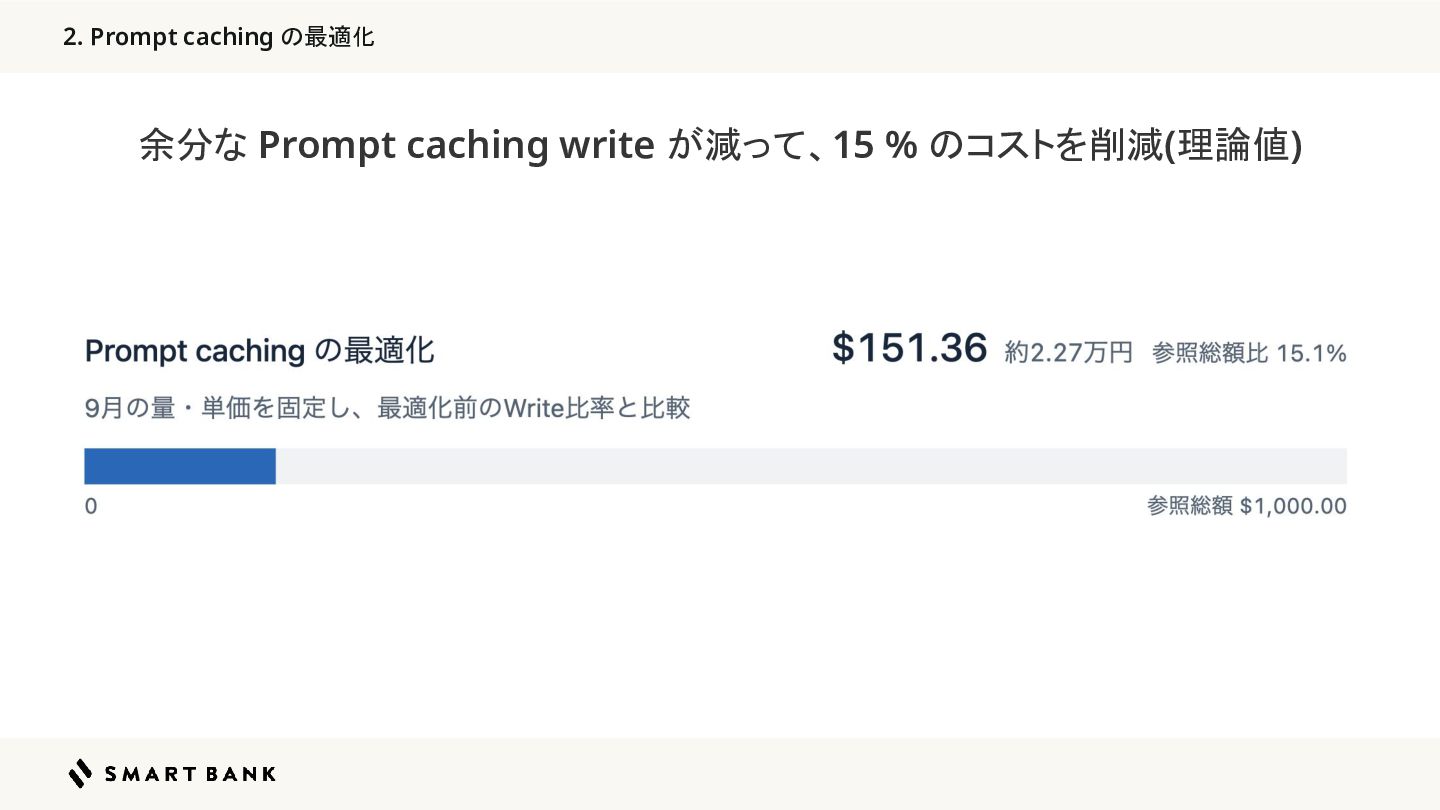
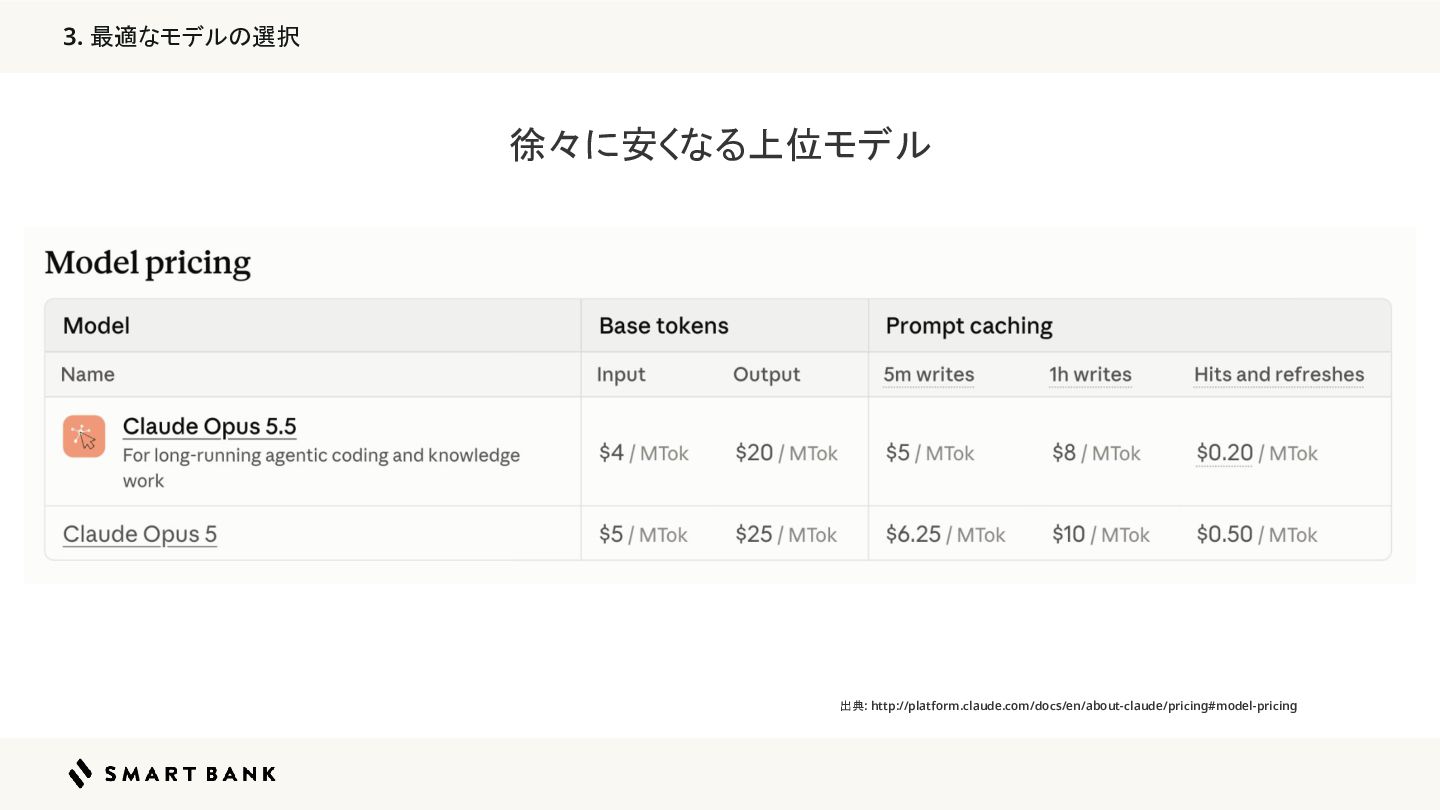
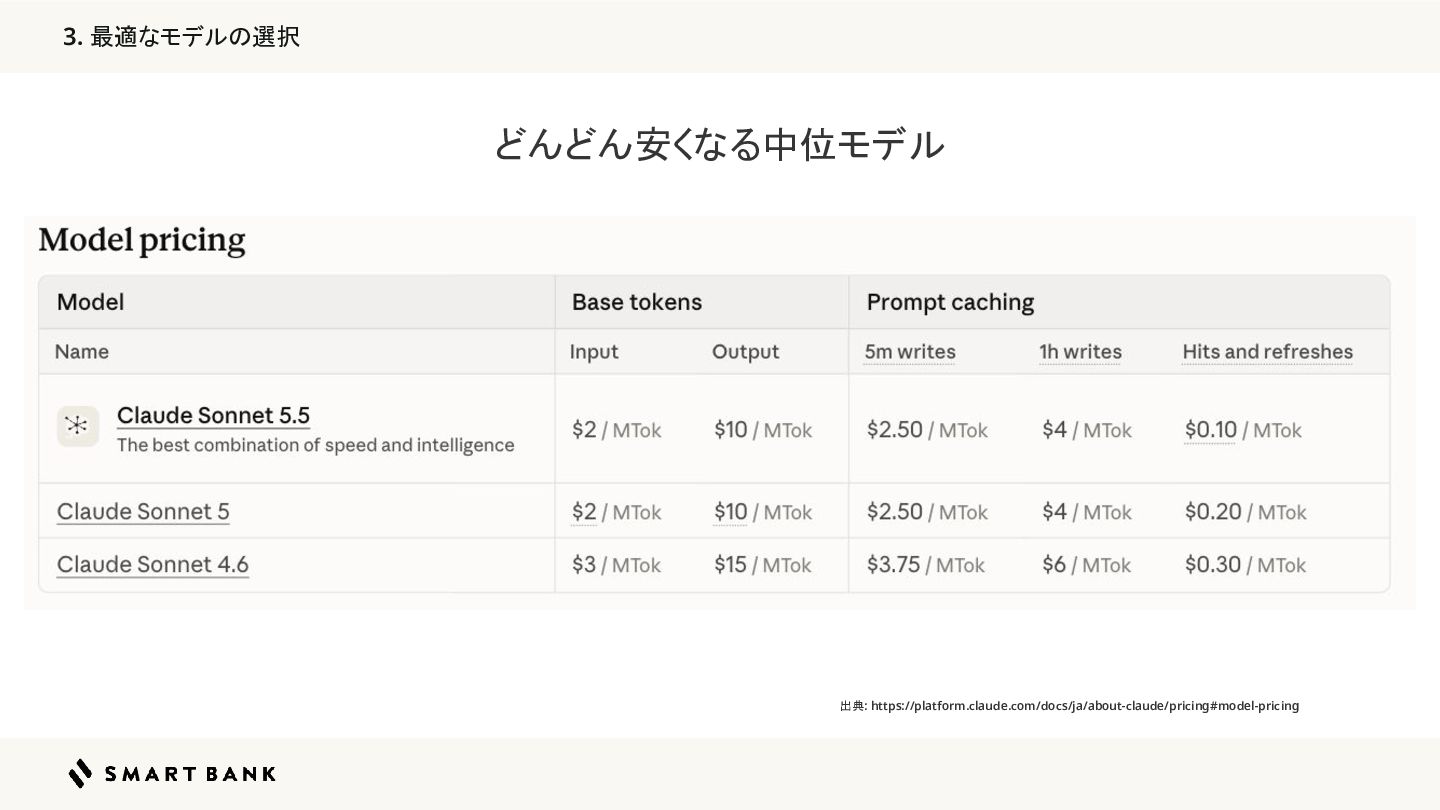
  4. 2. Prompt caching の最適化 AI Agent のコストは Input, Output と

    Prompt caching の read, write の合計額で決まる Output Input Prompt caching read Prompt caching write 出典: https://platform.claude.com/docs/ja/about-claude/pricing#model-pricing
  5. 2. Prompt caching の最適化 Prompt caching の read は Input

    の 20 倍安いので、上手く活用することでコストを削減できる 出典: https://platform.claude.com/docs/ja/about-claude/pricing#model-pricing
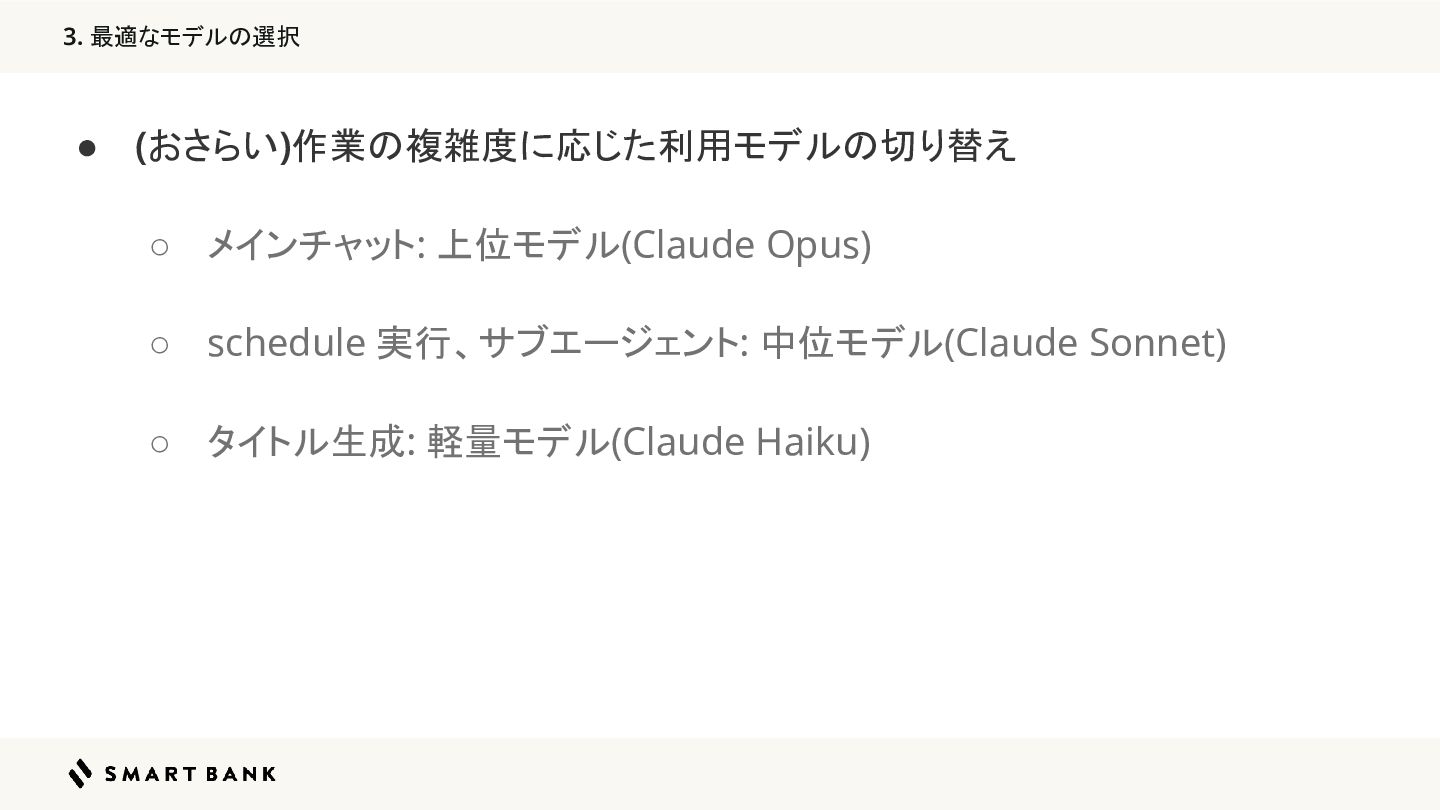
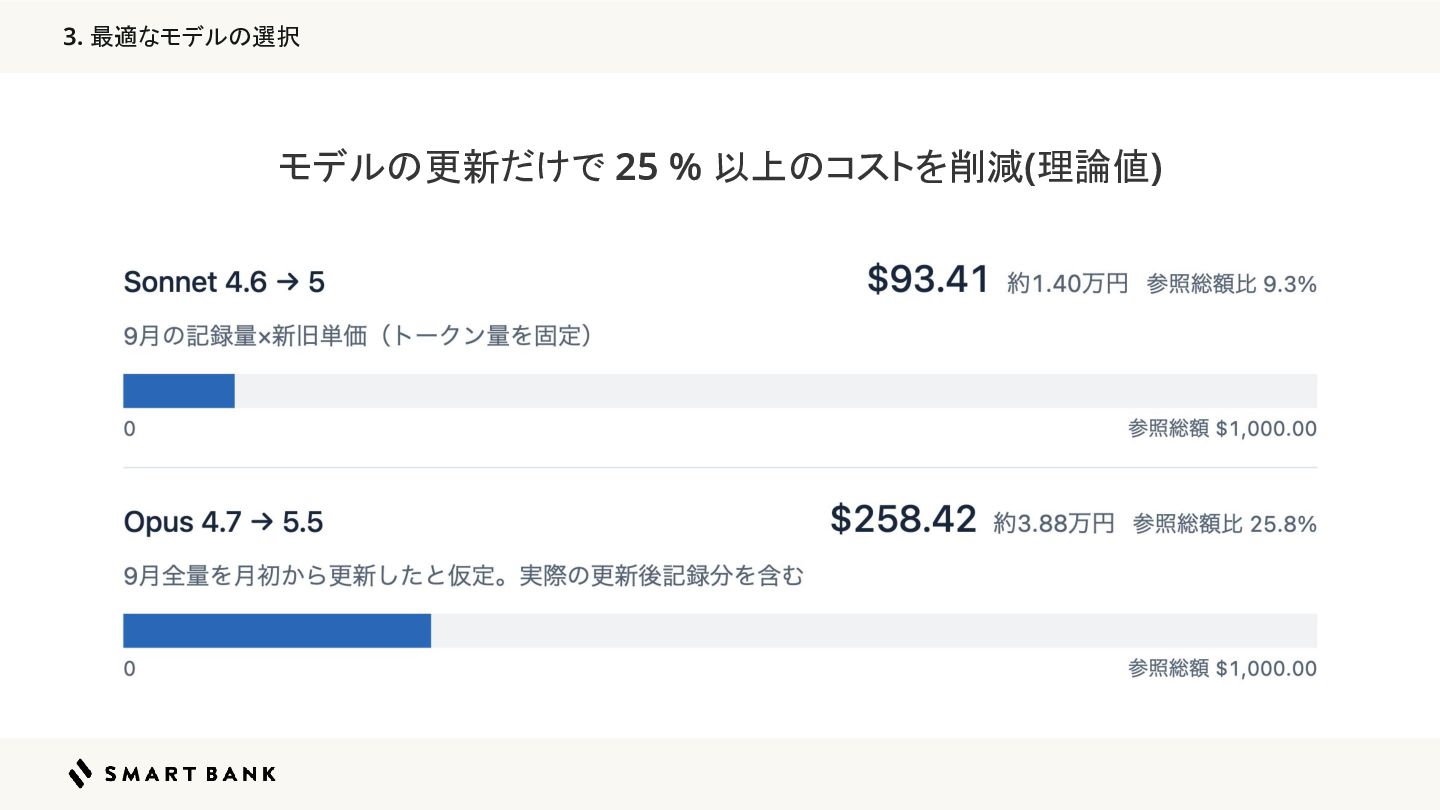
  6. 3. 最適なモデルの選択 • (おさらい)作業の複雑度に応じた利用モデルの切り替え ◦ メインチャット: 上位モデル(Claude Opus) ◦ schedule

    実行、サブエージェント: 中位モデル(Claude Sonnet) ◦ タイトル生成: 軽量モデル(Claude Haiku)
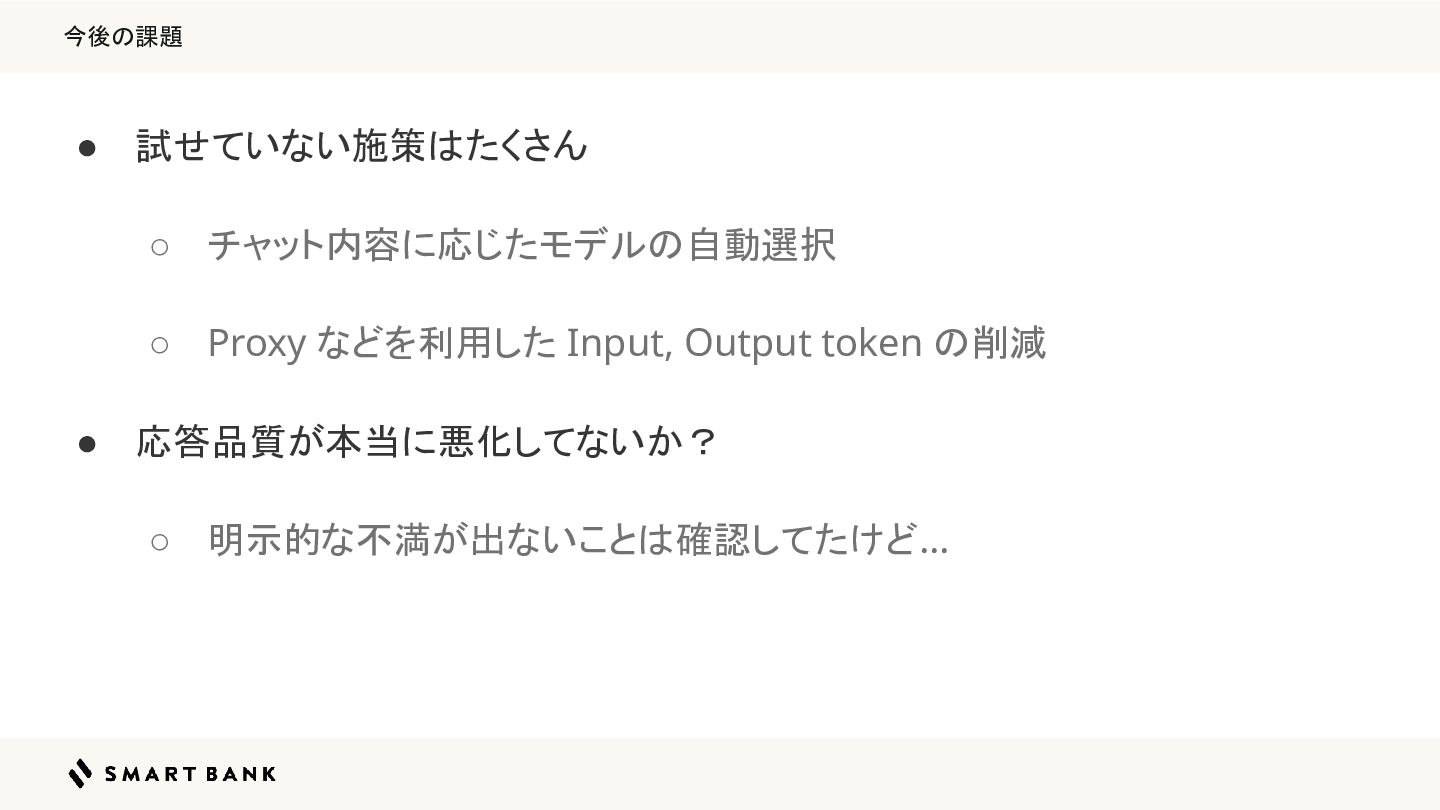
  7. 今後の課題 • 試せていない施策はたくさん ◦ チャット内容に応じたモデルの自動選択 ◦ Proxy などを利用した Input, Output

    token の削減 • 応答品質が本当に悪化してないか? ◦ 明示的な不満が出ないことは確認してたけど...
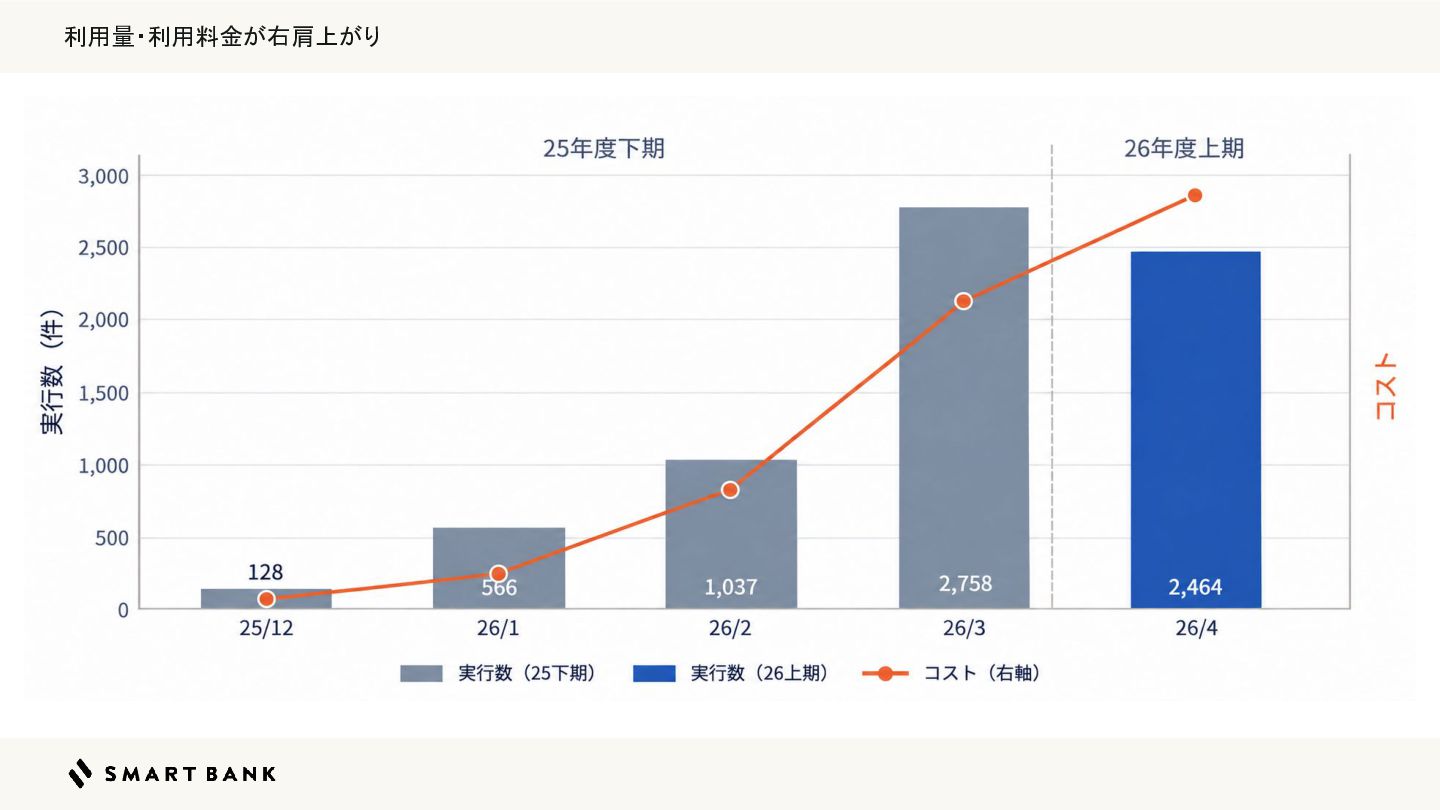
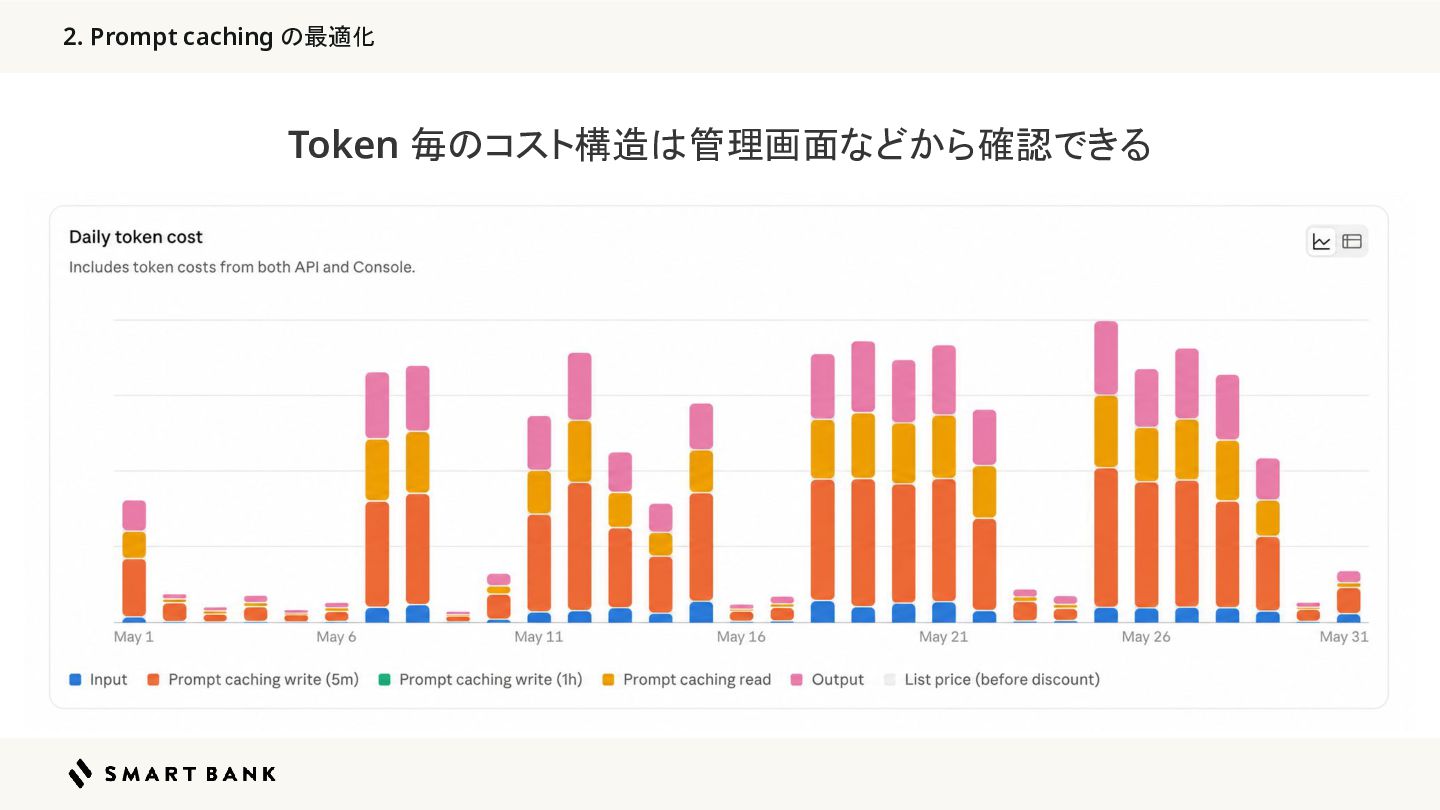
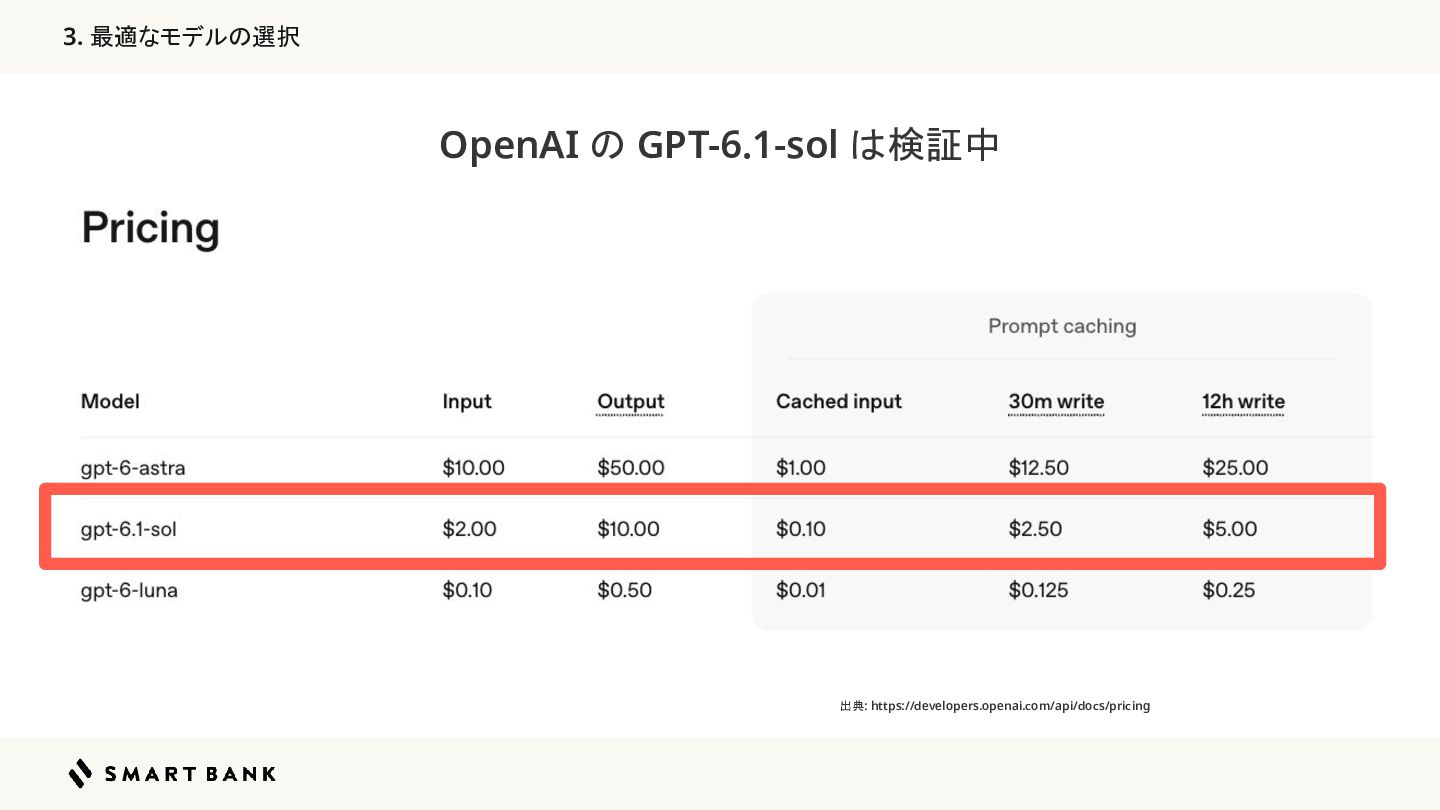
  8. ボトルネックの特定が大事 • 実は最初の 3 ヶ月は何の成果も得られなかった ◦ • OpenAI の Model

    への切り替えを進めたけど... Token 利用量(Input, Output, Prompt caching の read, write) をきちんと記録し始めると改善が進んだ ◦ • 調査の効率化、優先順位付け パフォーマンスチューニングと同じ!
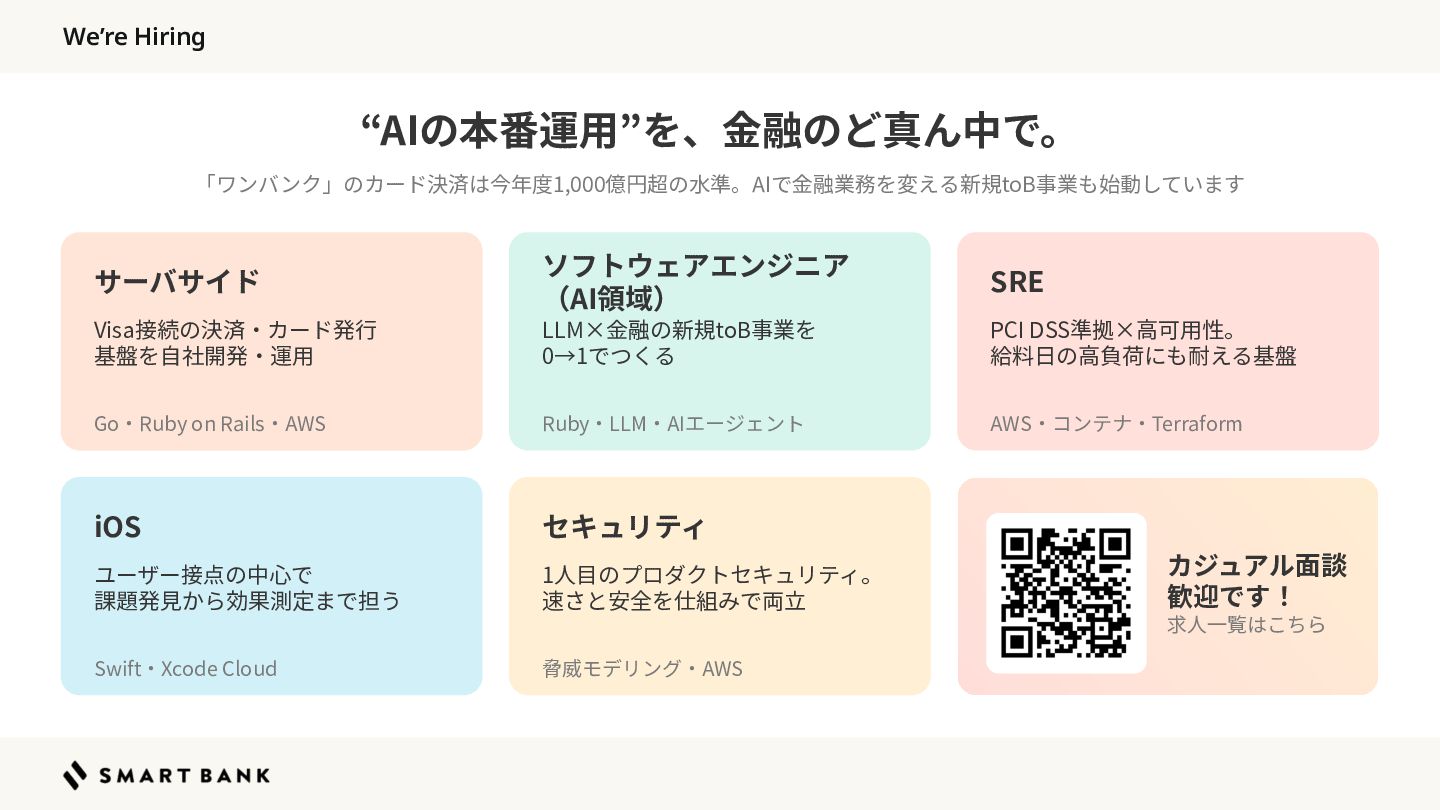
  9. We’re Hiring “AIの本番運⽤”を、⾦融のど真ん中で。 「ワンバンク」のカード決済は今年度1,000億円超の⽔準。AIで⾦融業務を変える新規toB事業も始動しています サーバサイド ソフトウェアエンジニア (AI領域) SRE Visa接続の決済‧カード発⾏ 基盤を⾃社開発‧運⽤

    LLM×⾦融の新規toB事業を 0→1でつくる PCI DSS準拠×⾼可⽤性。 給料⽇の⾼負荷にも耐える基盤 Go‧Ruby on Rails‧AWS Ruby‧LLM‧AIエージェント AWS‧コンテナ‧Terraform iOS セキュリティ ユーザー接点の中⼼で 課題発⾒から効果測定まで担う 1⼈⽬のプロダクトセキュリティ。 速さと安全を仕組みで両⽴ カジュアル⾯談 歓迎です! 求⼈⼀覧はこちら Swift‧Xcode Cloud 脅威モデリング‧AWS

More Decks by t0yohei
Other Decks in Programming