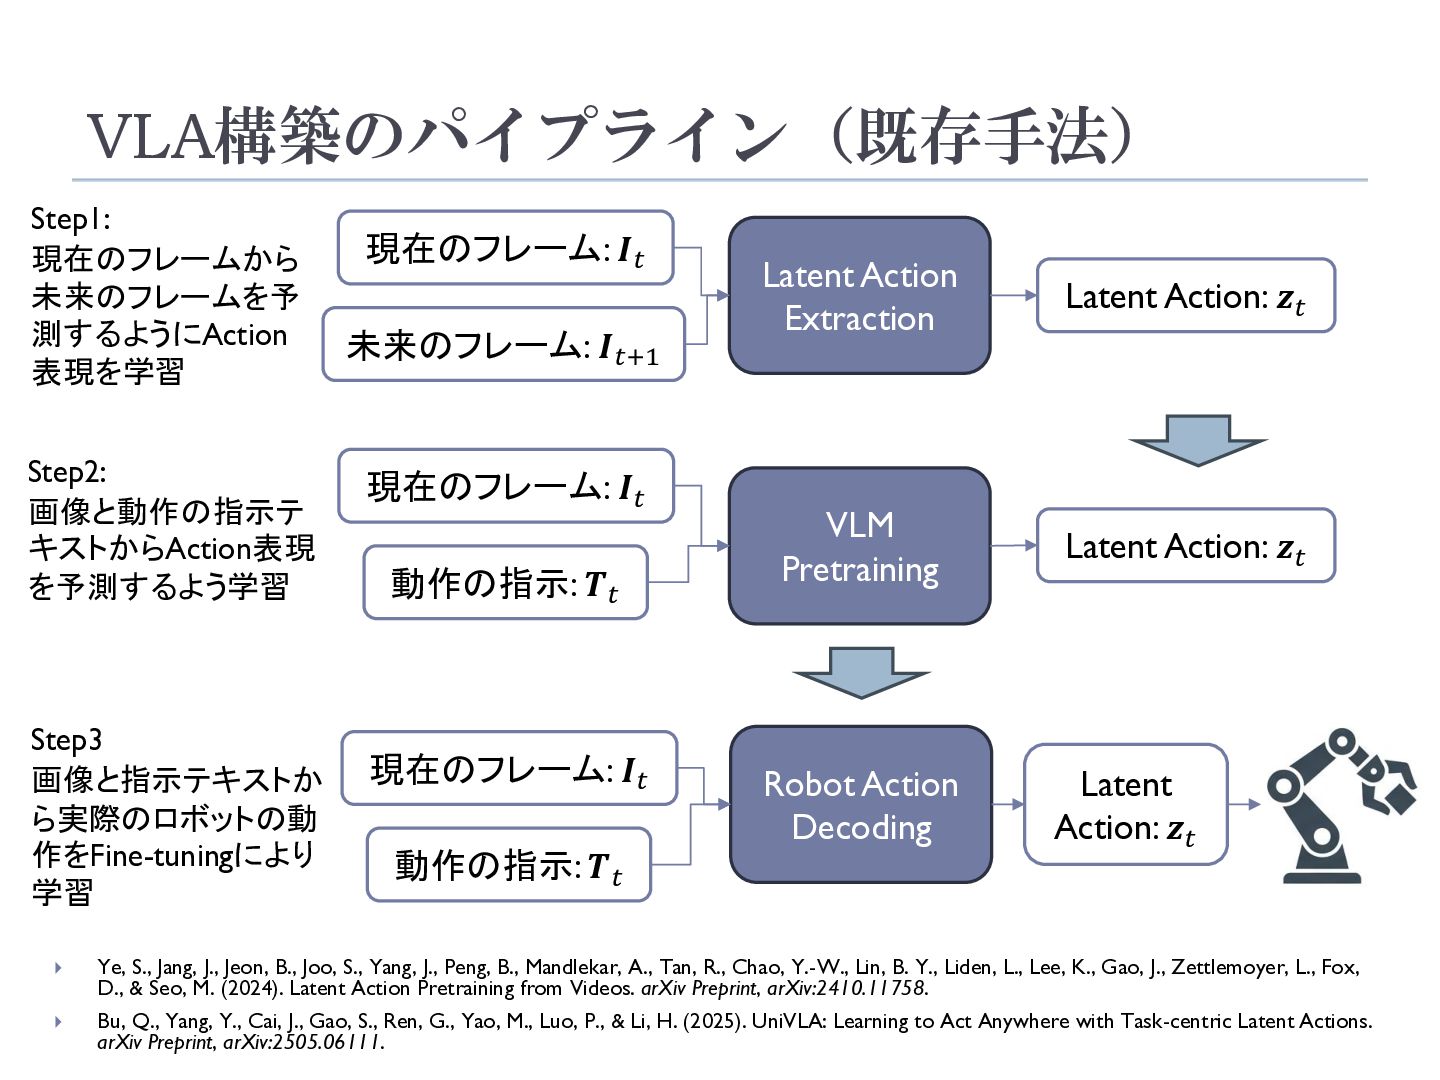
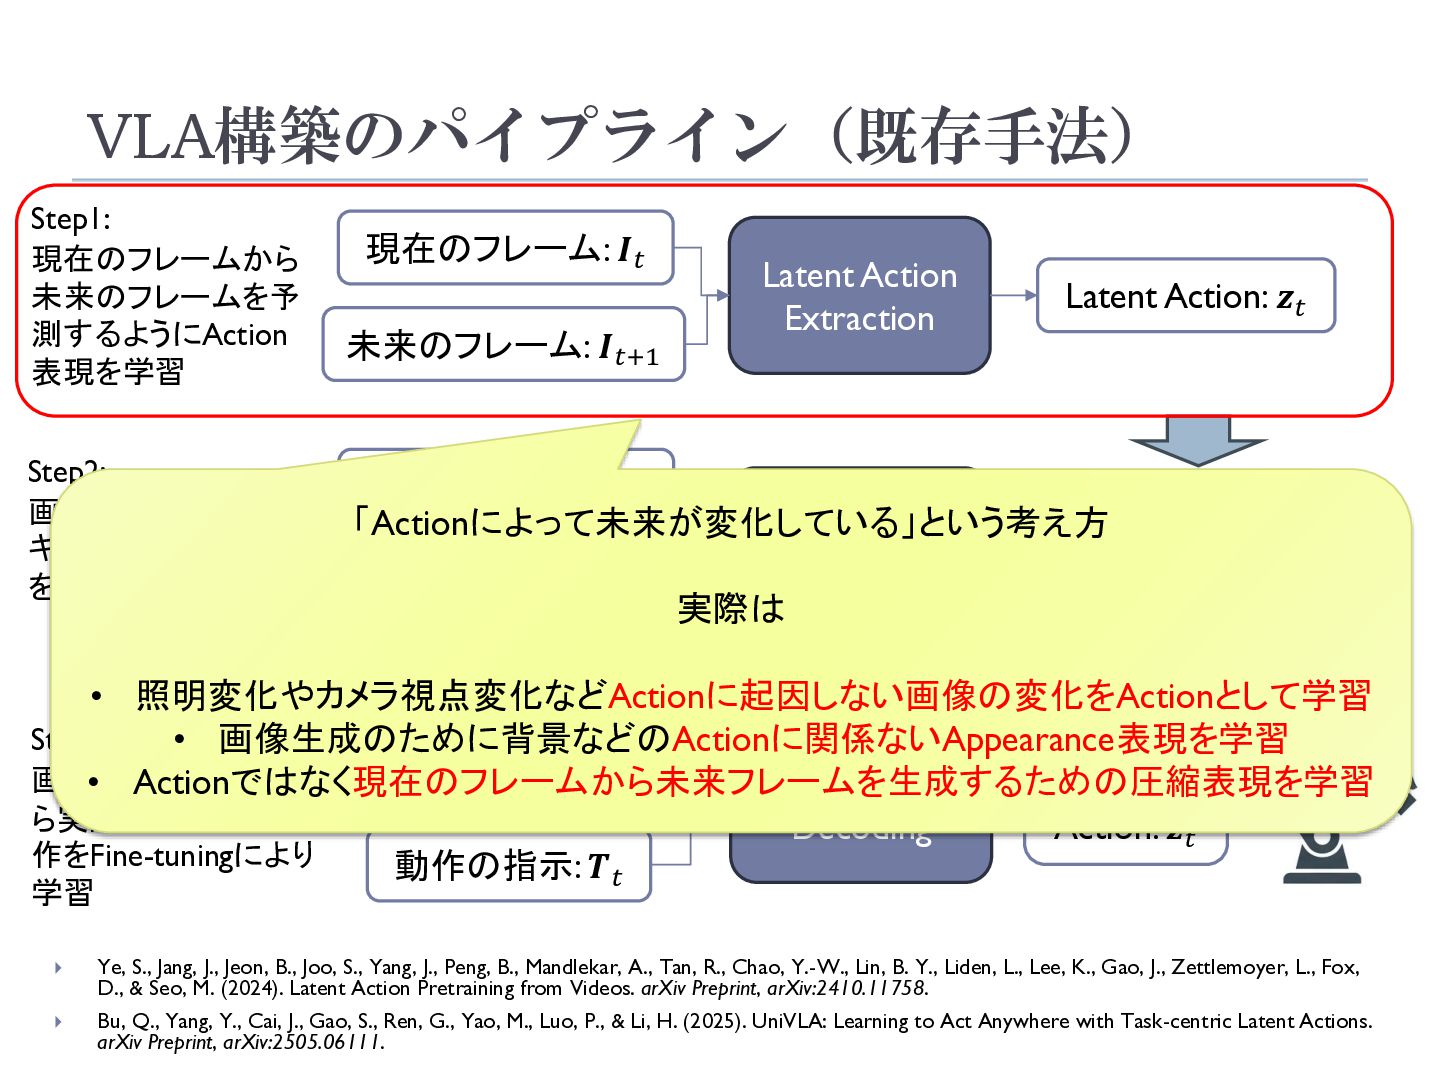
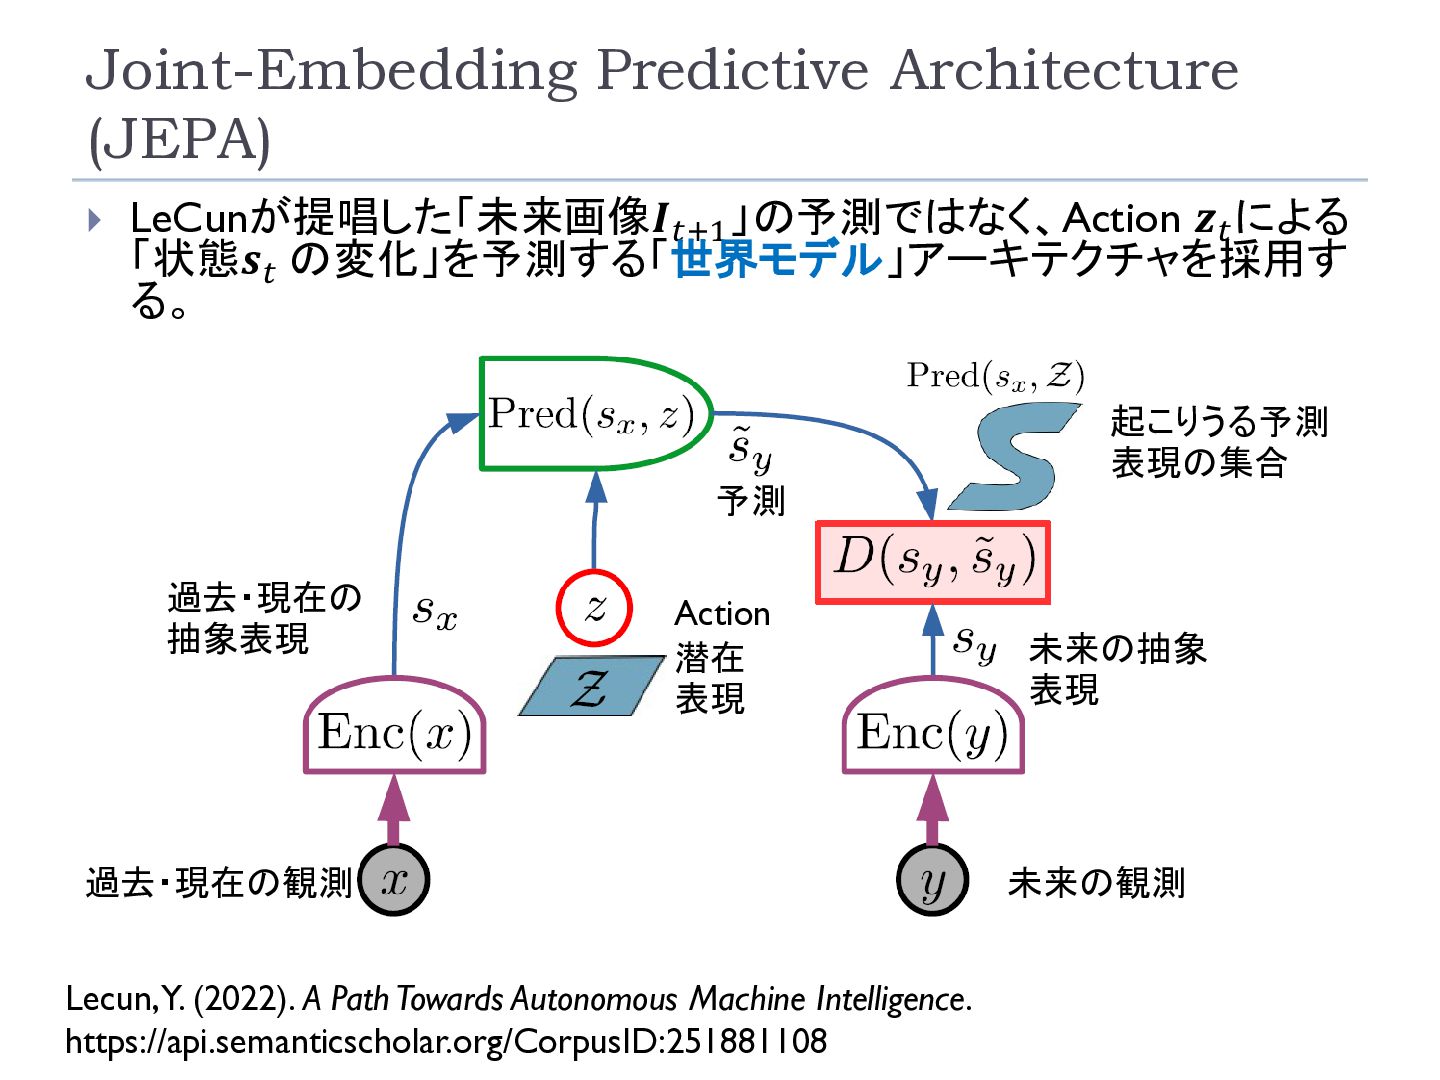
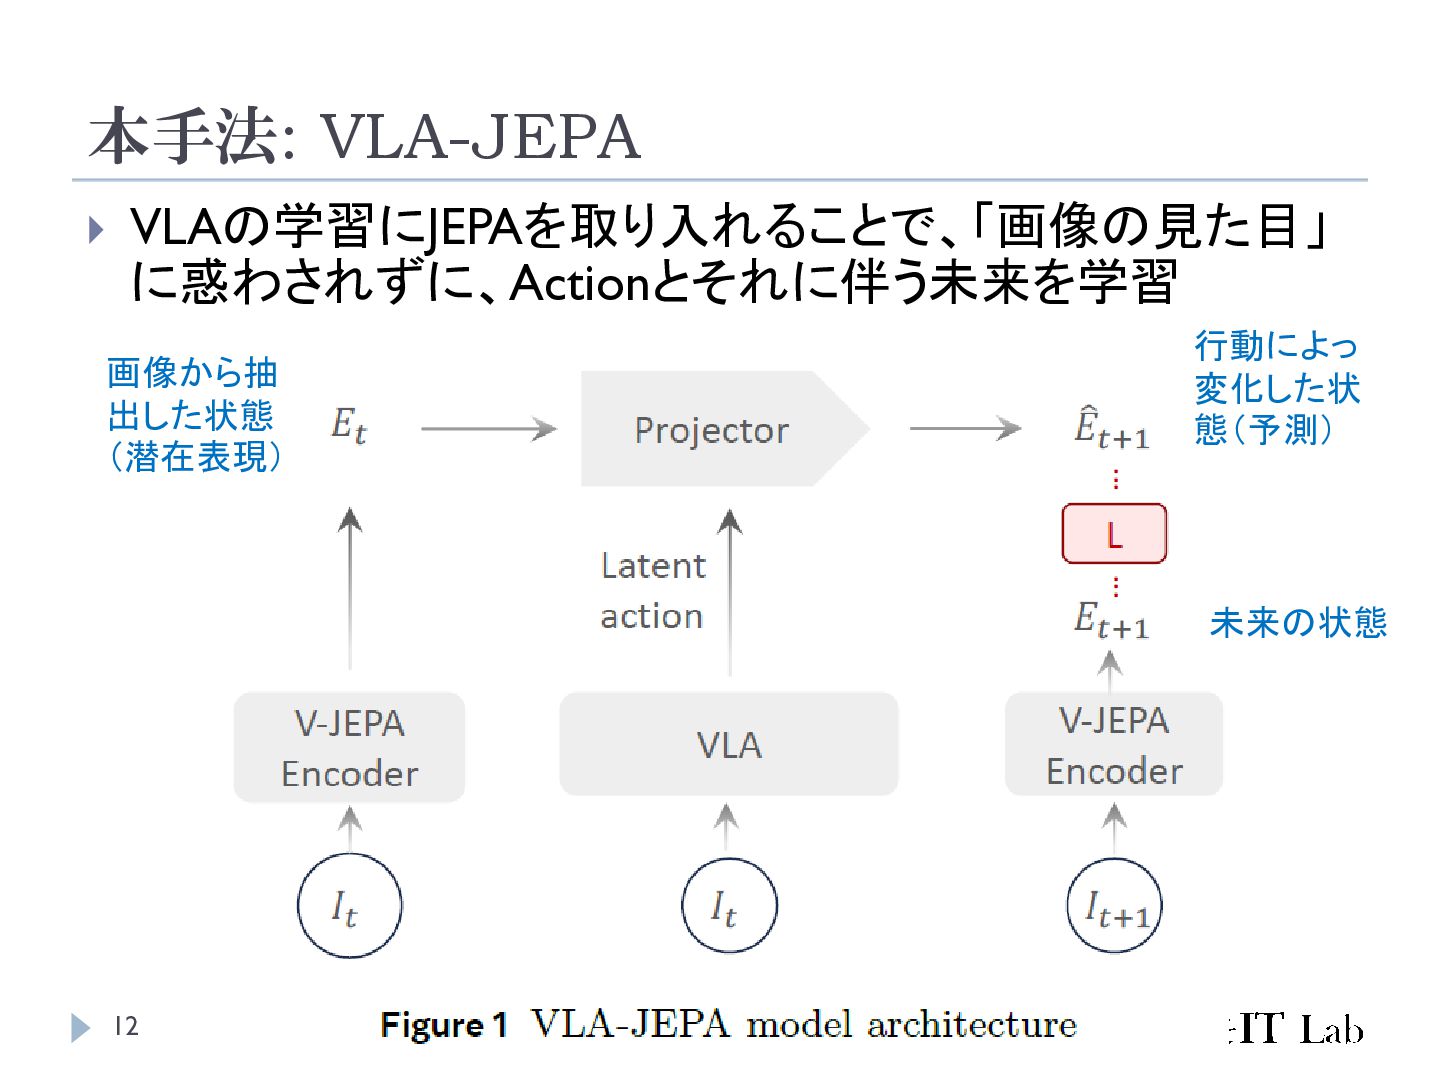
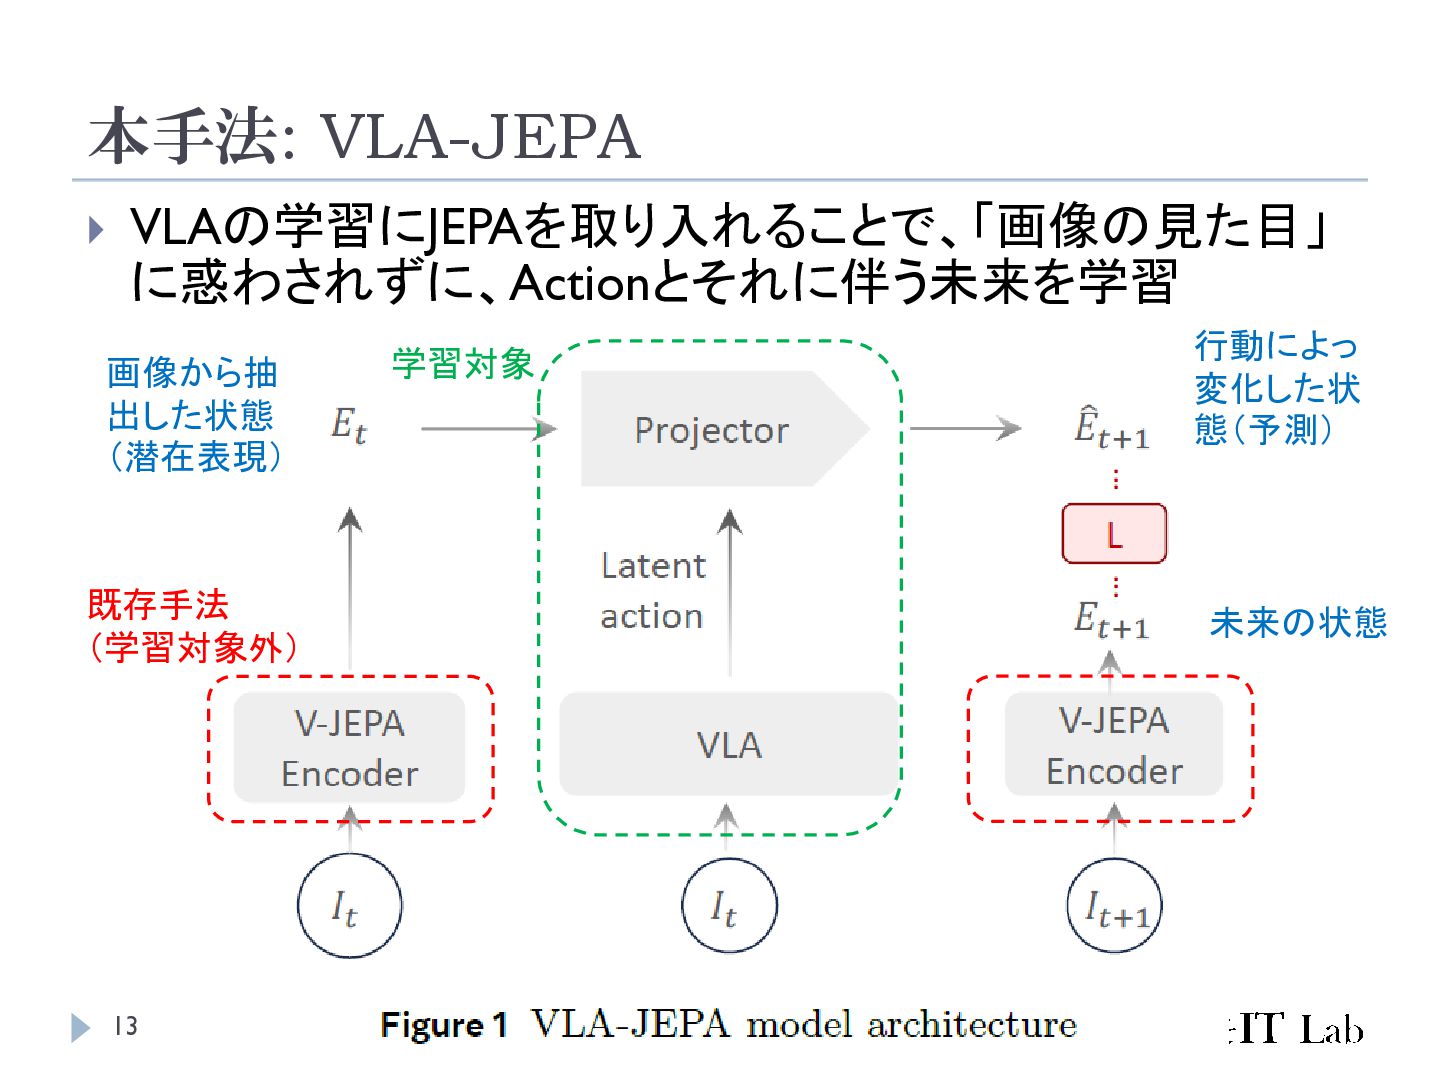
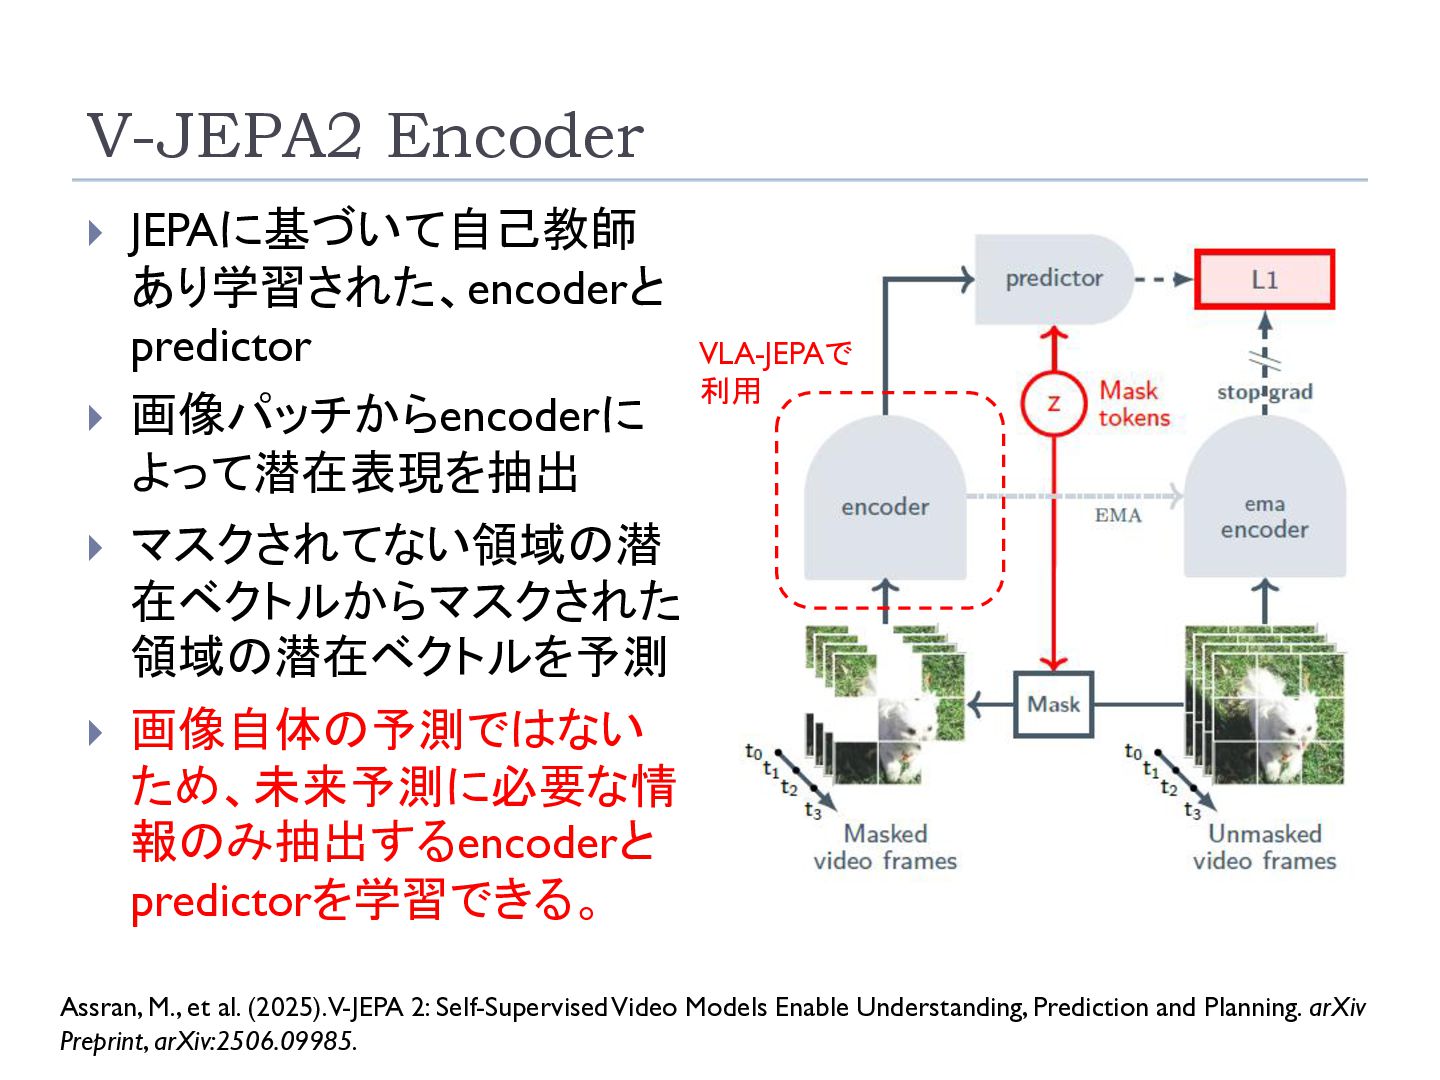
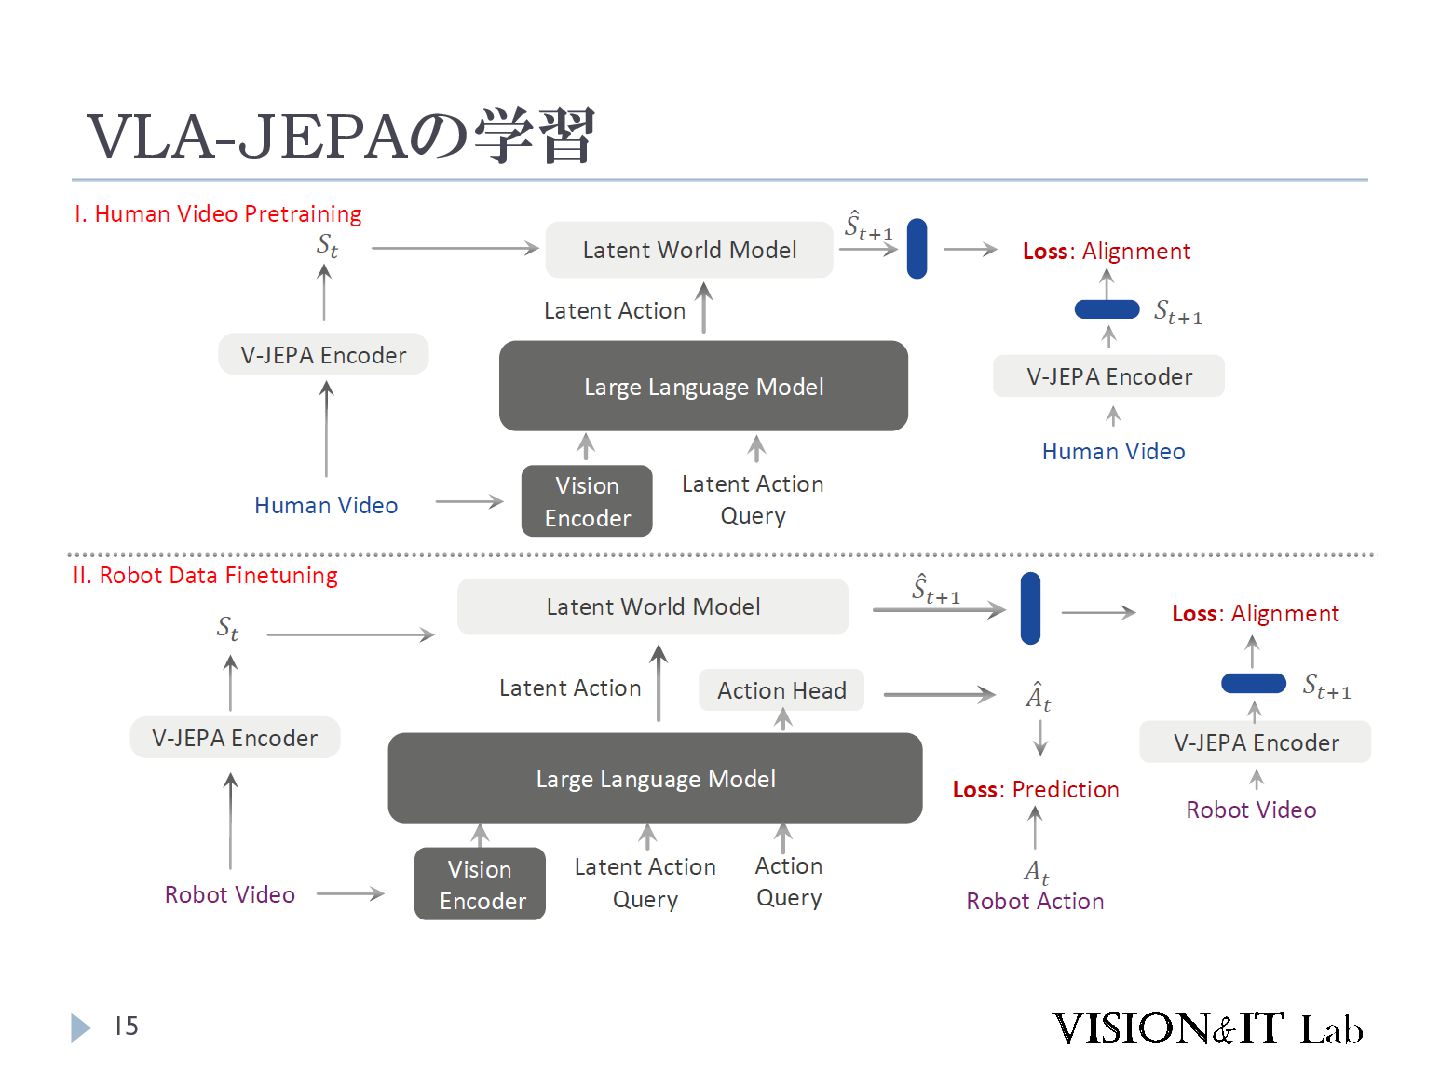
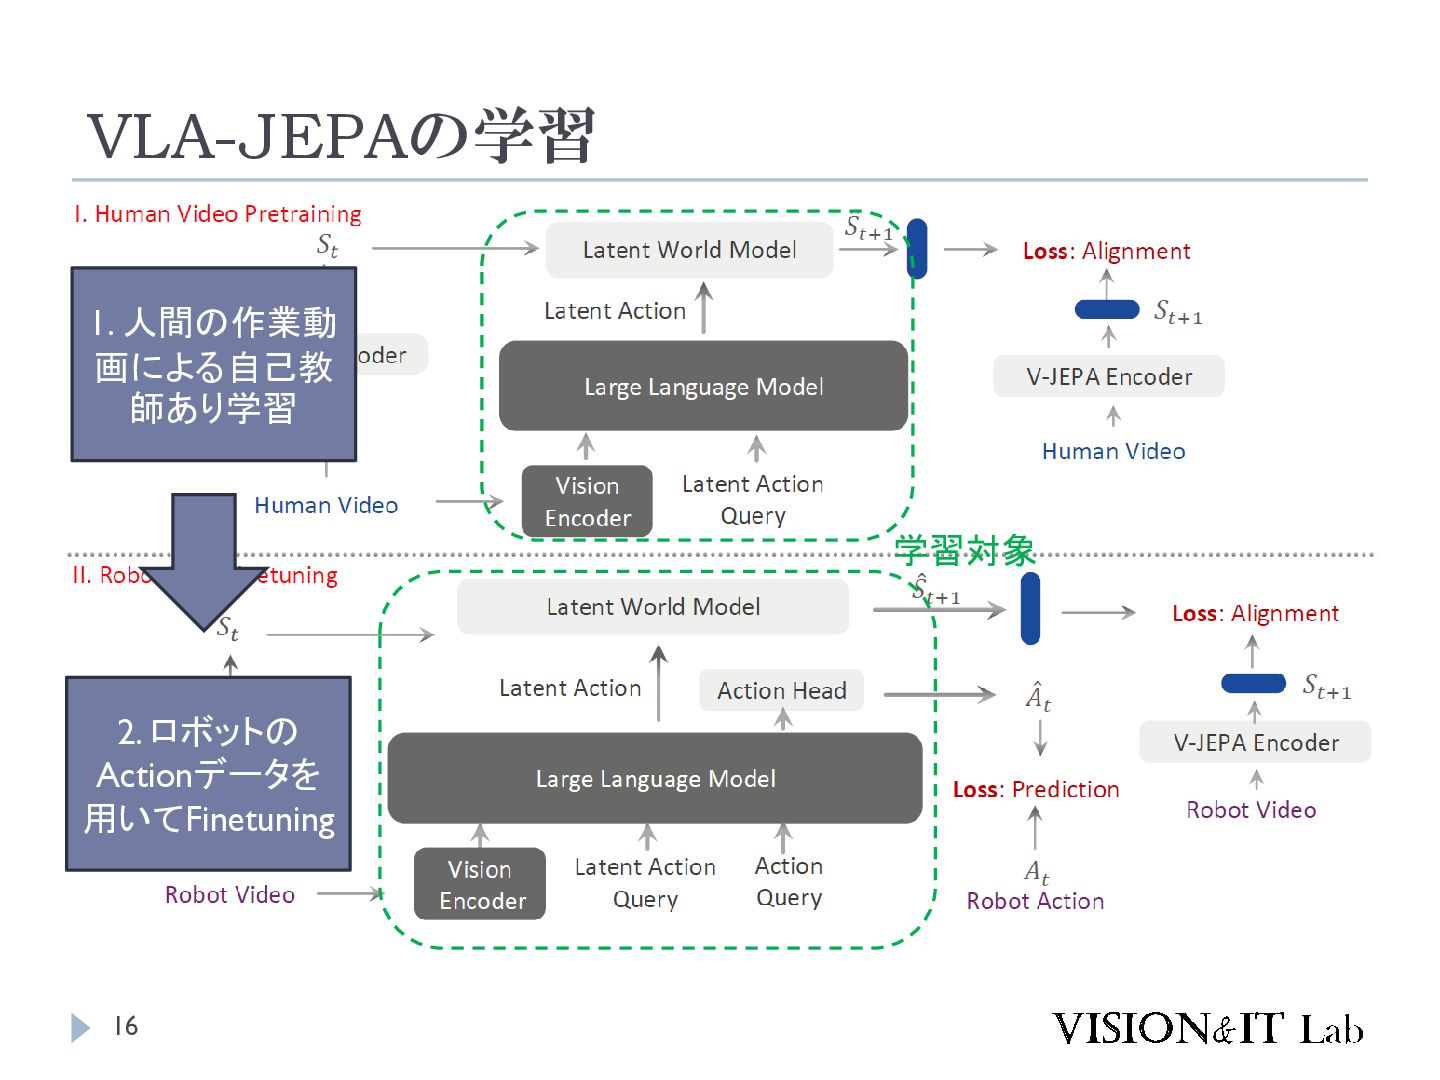
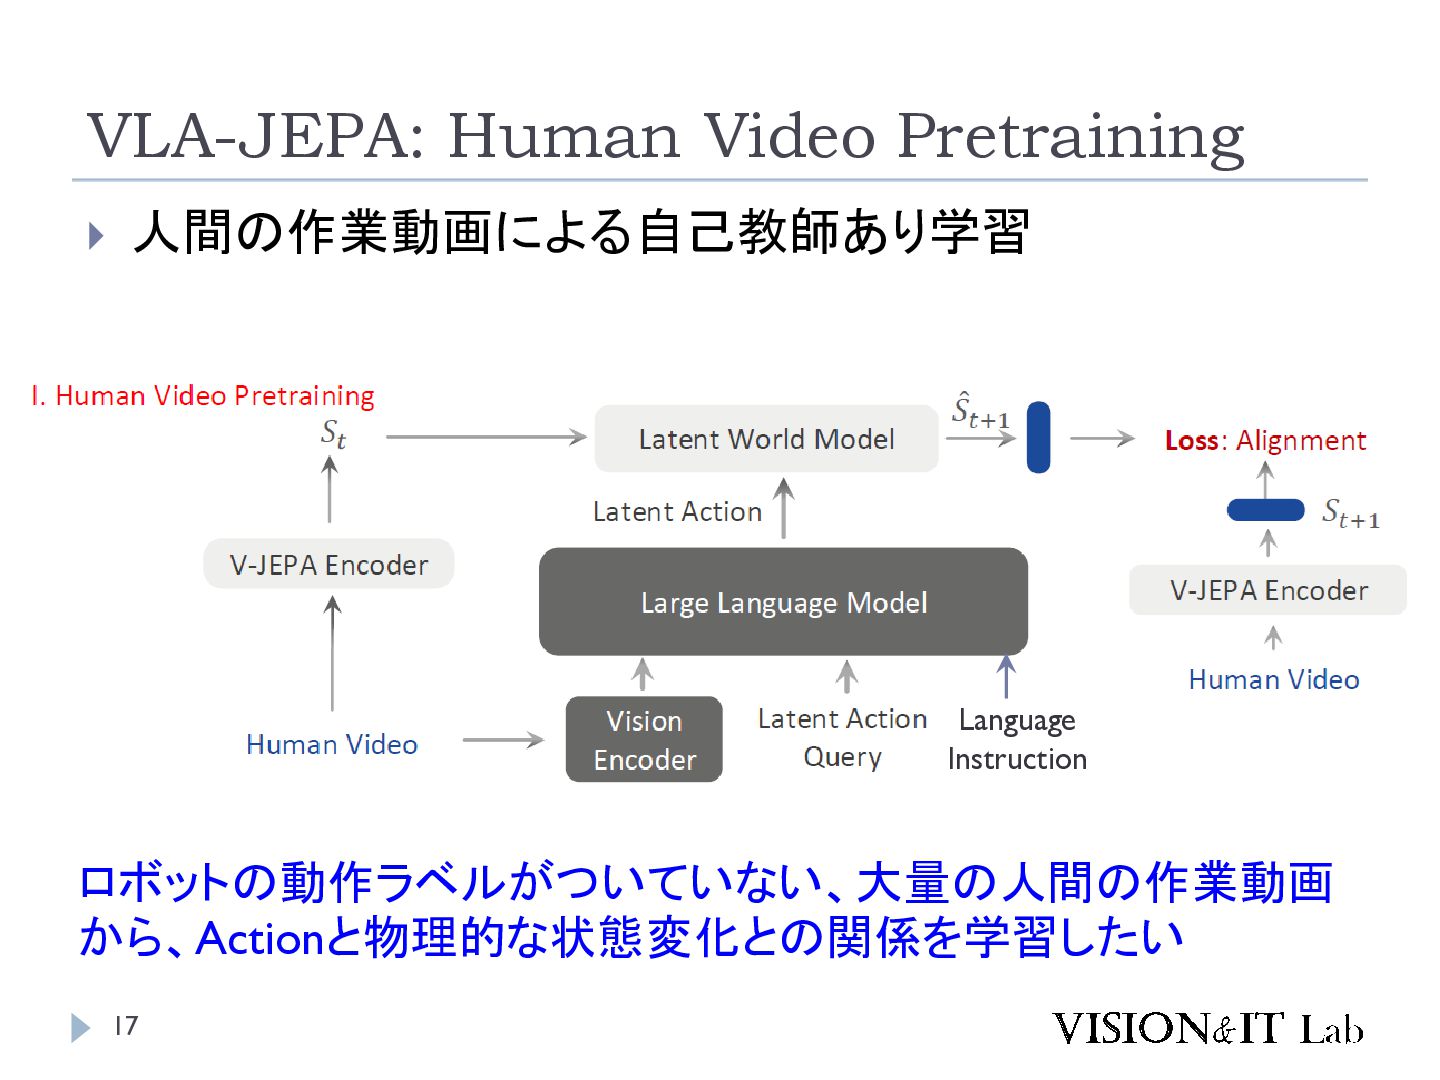
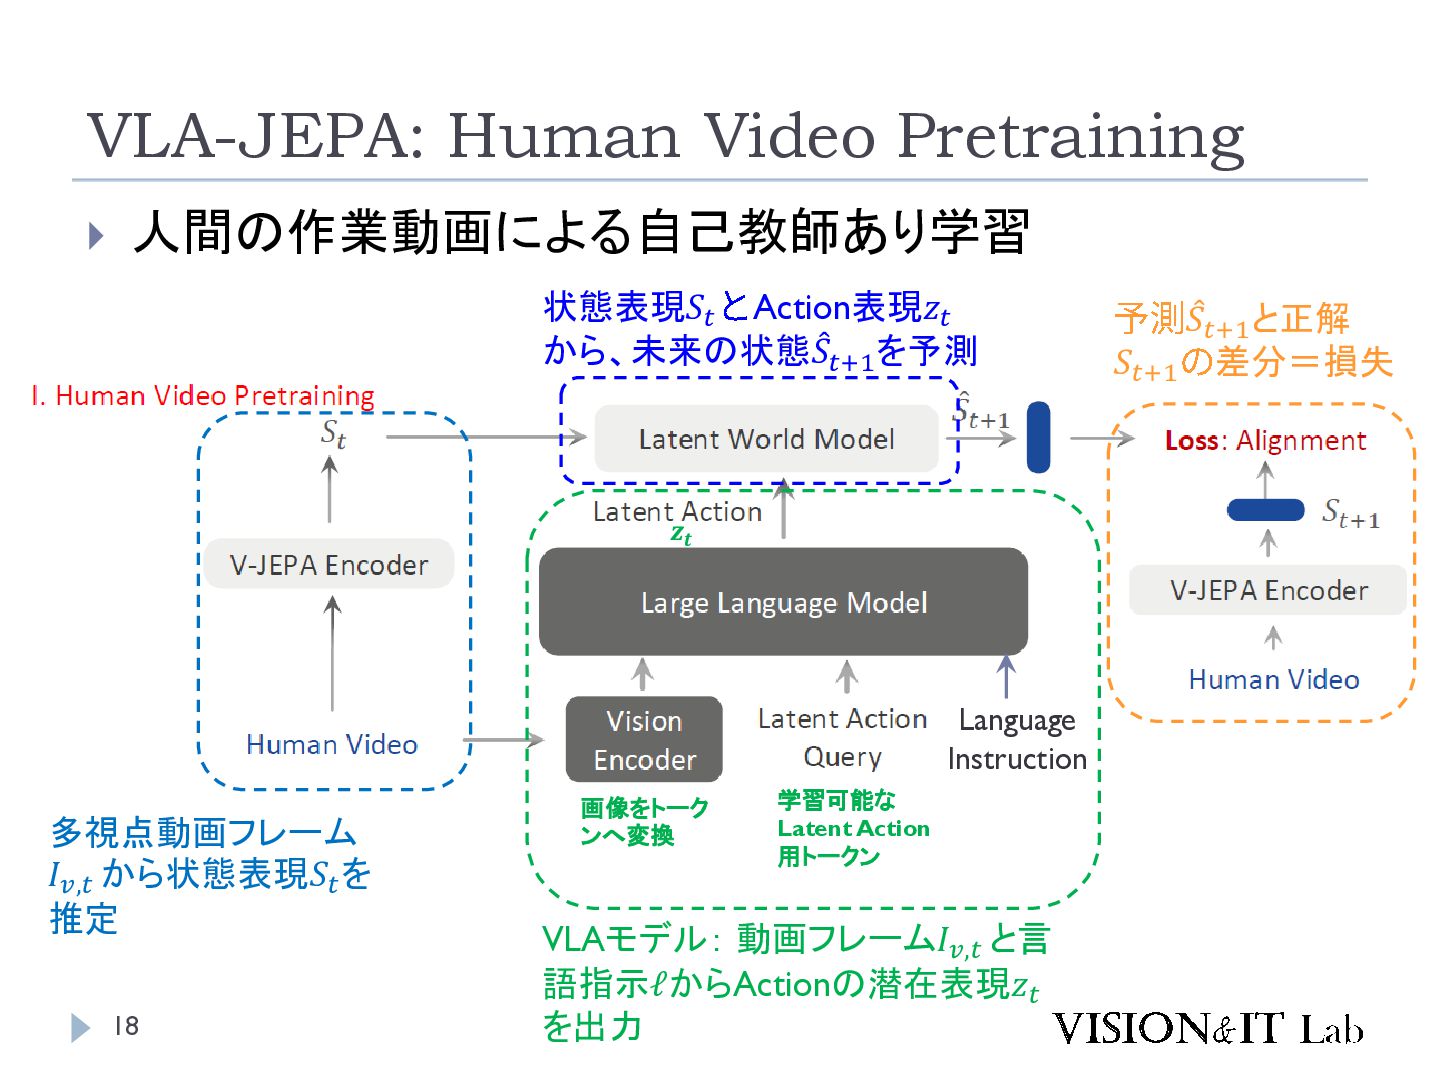
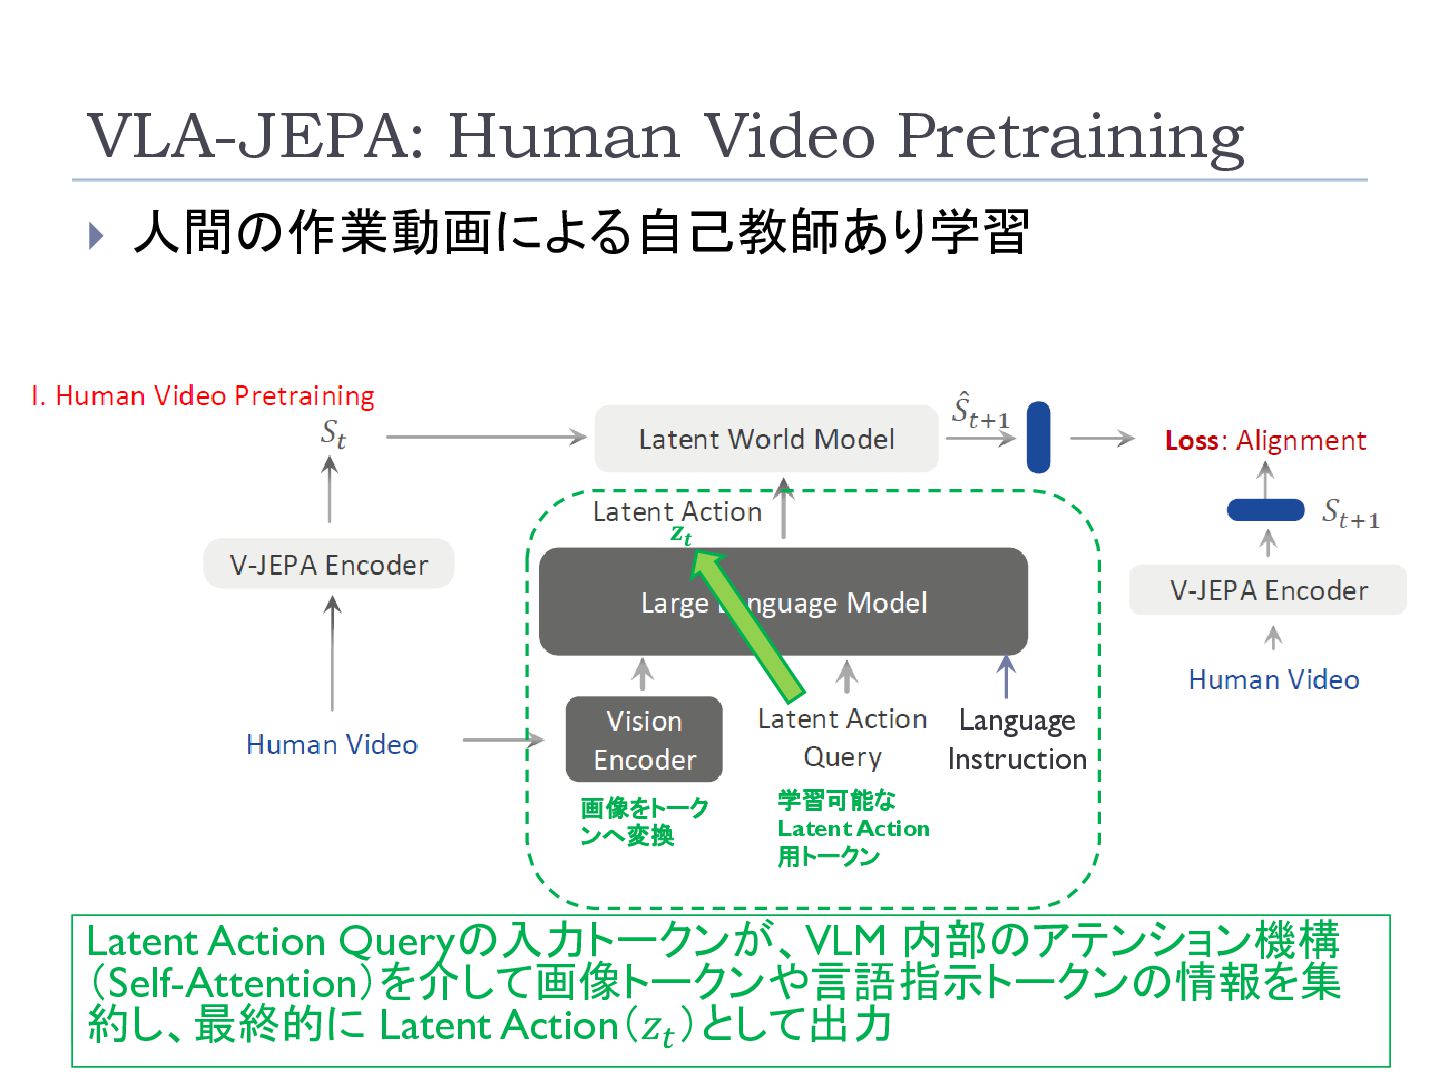
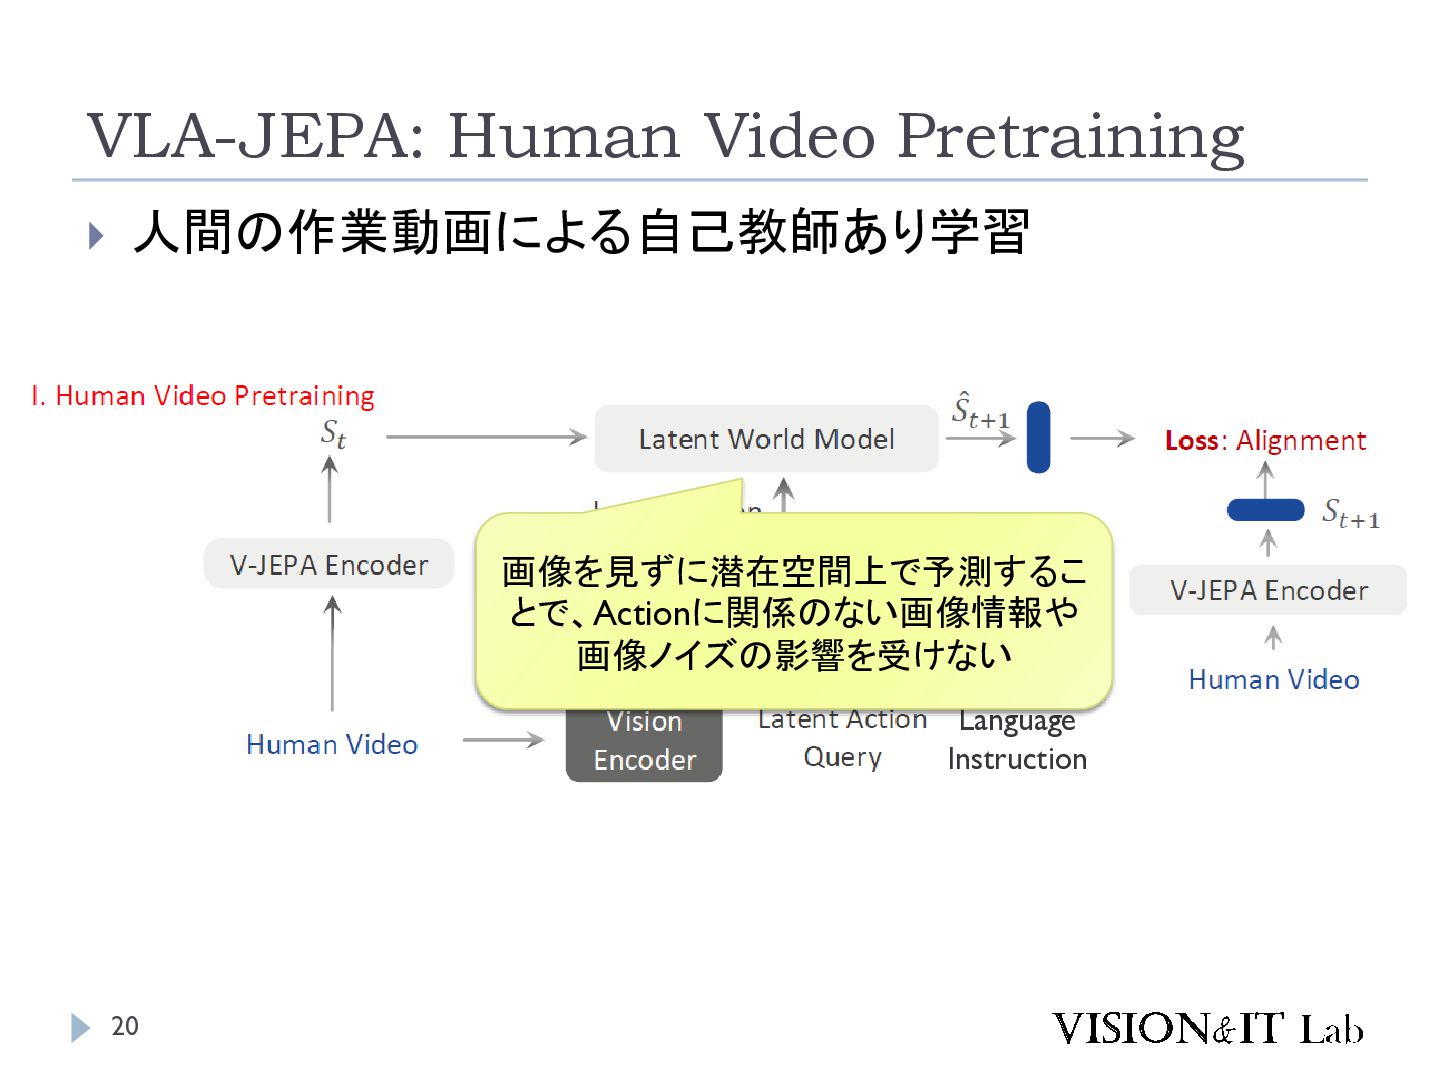
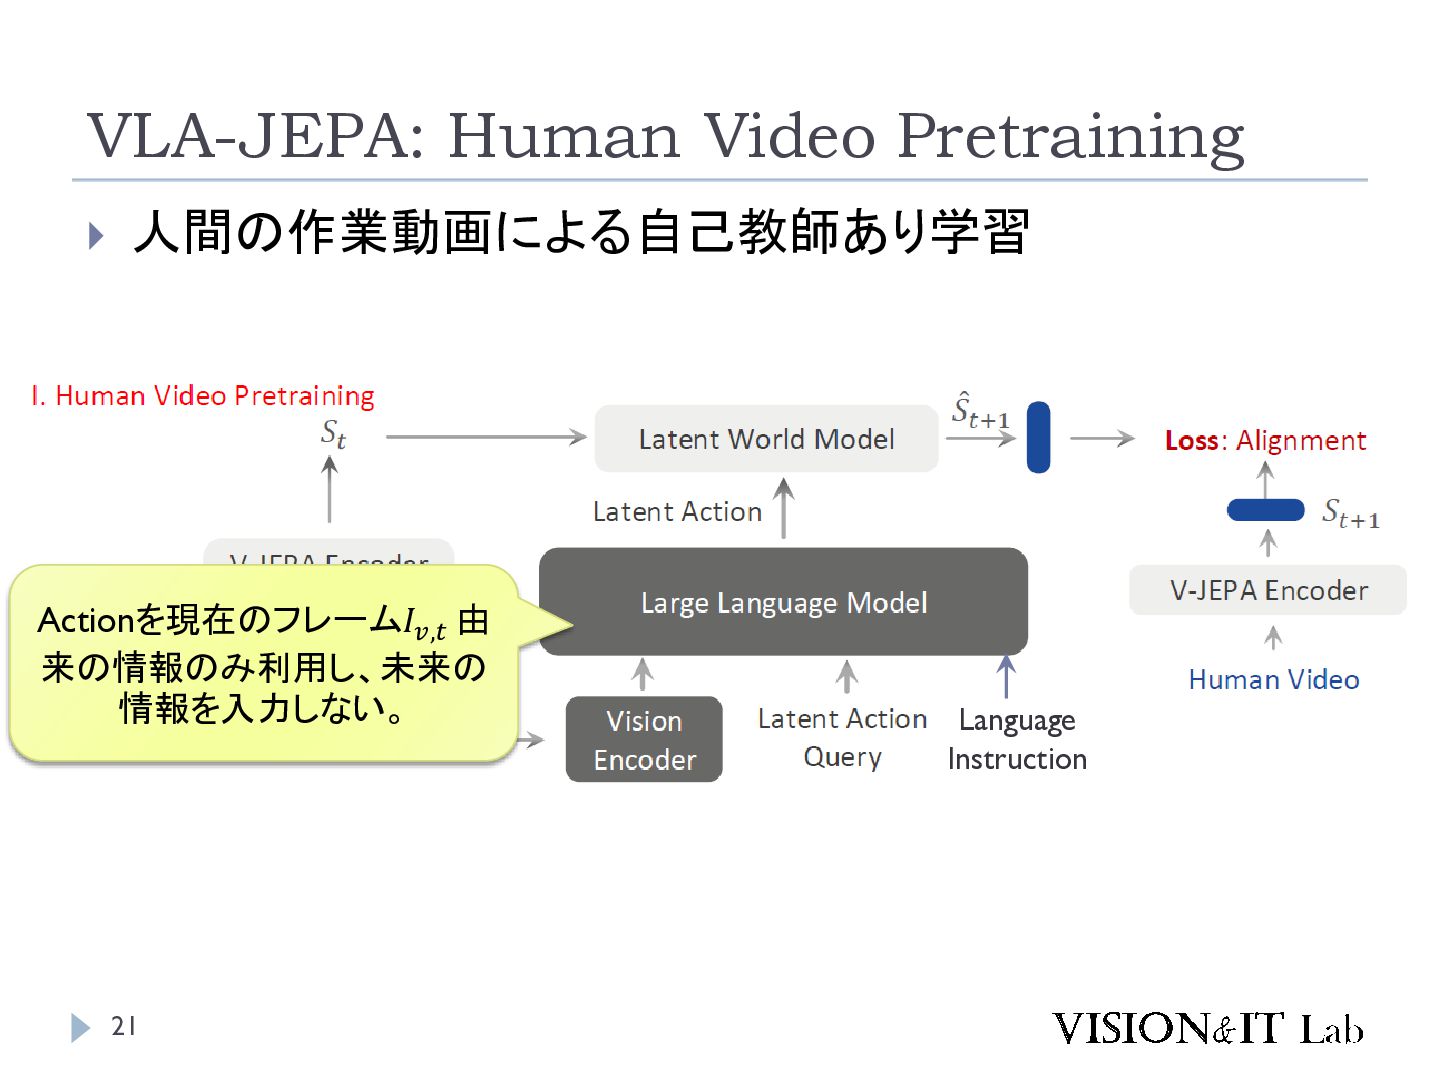
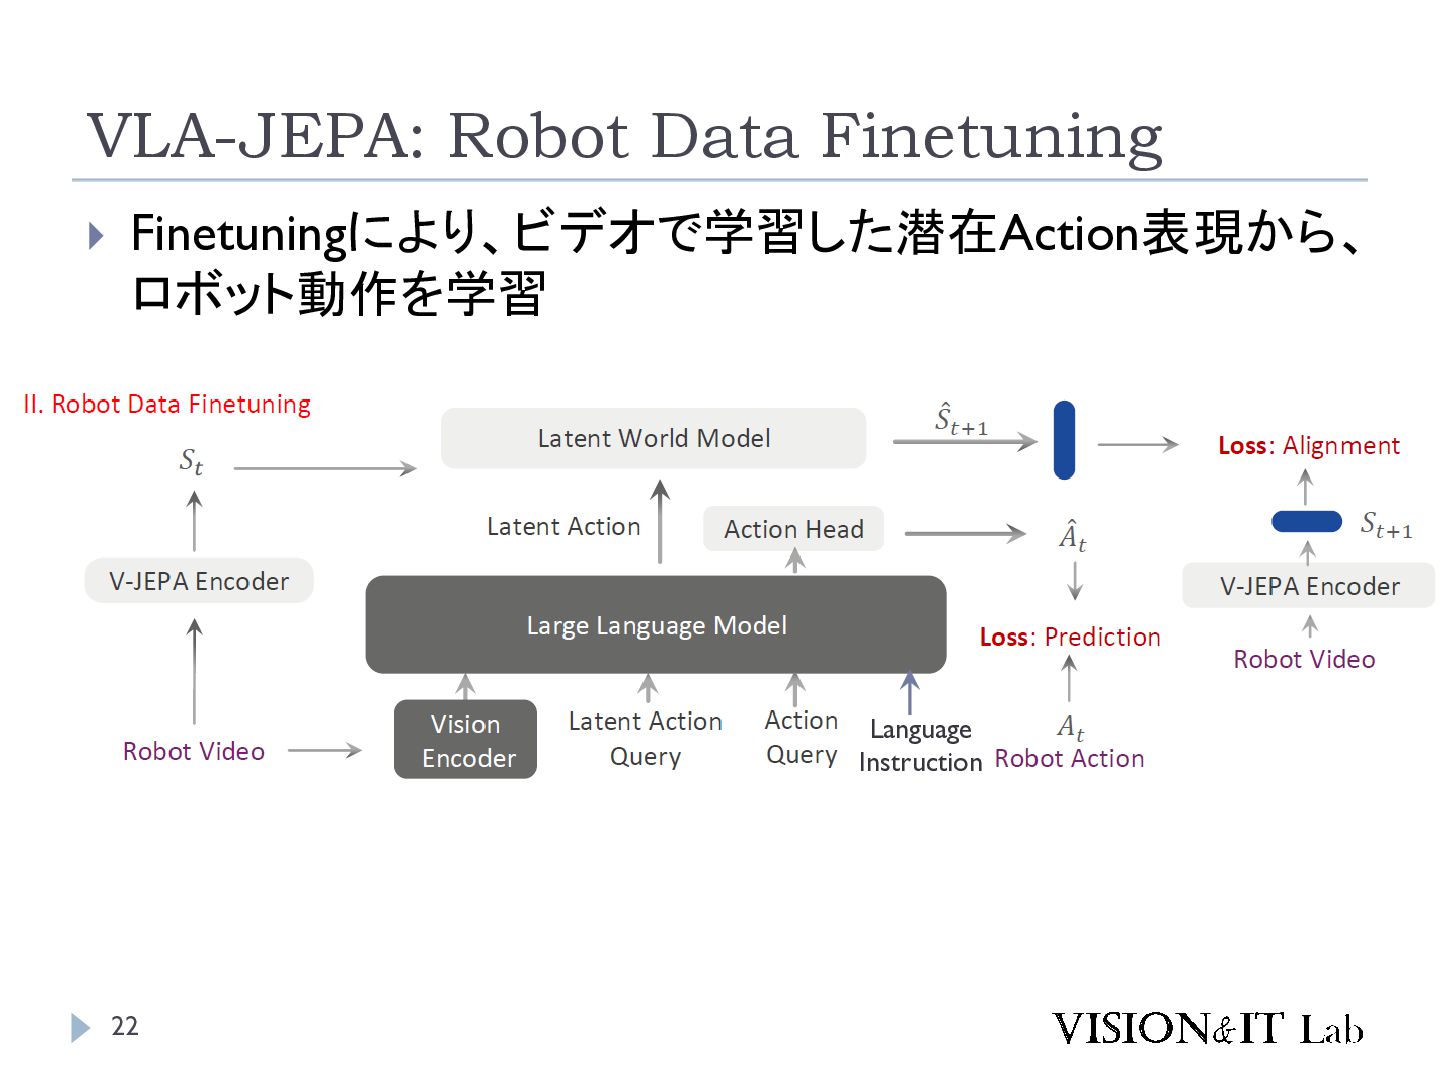
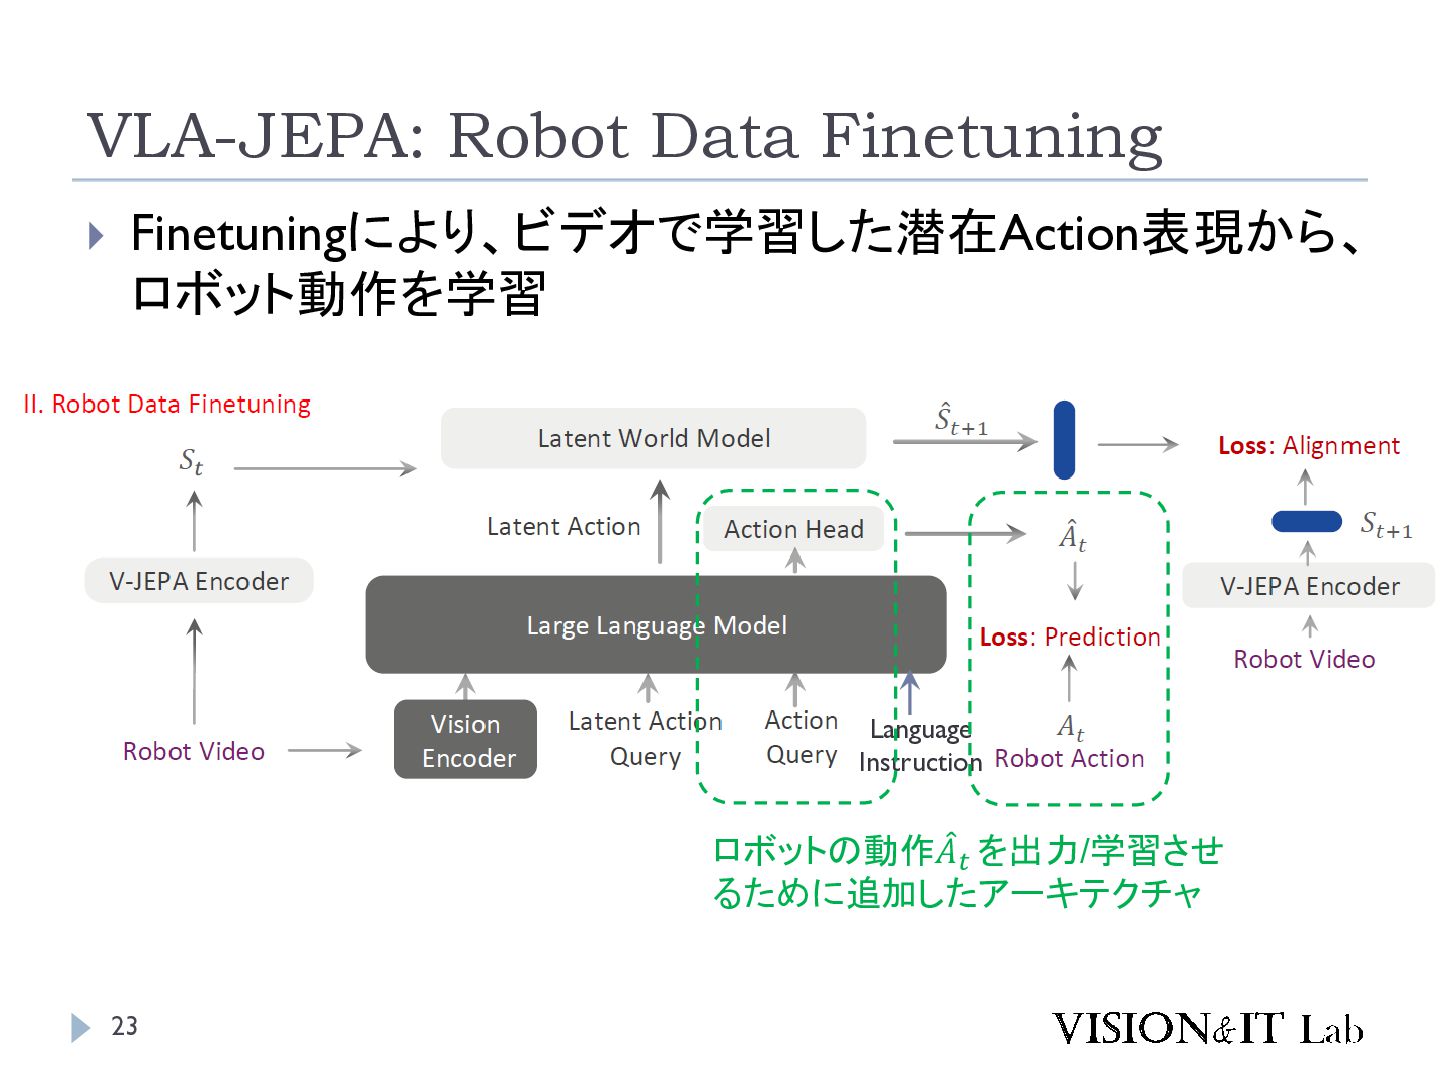
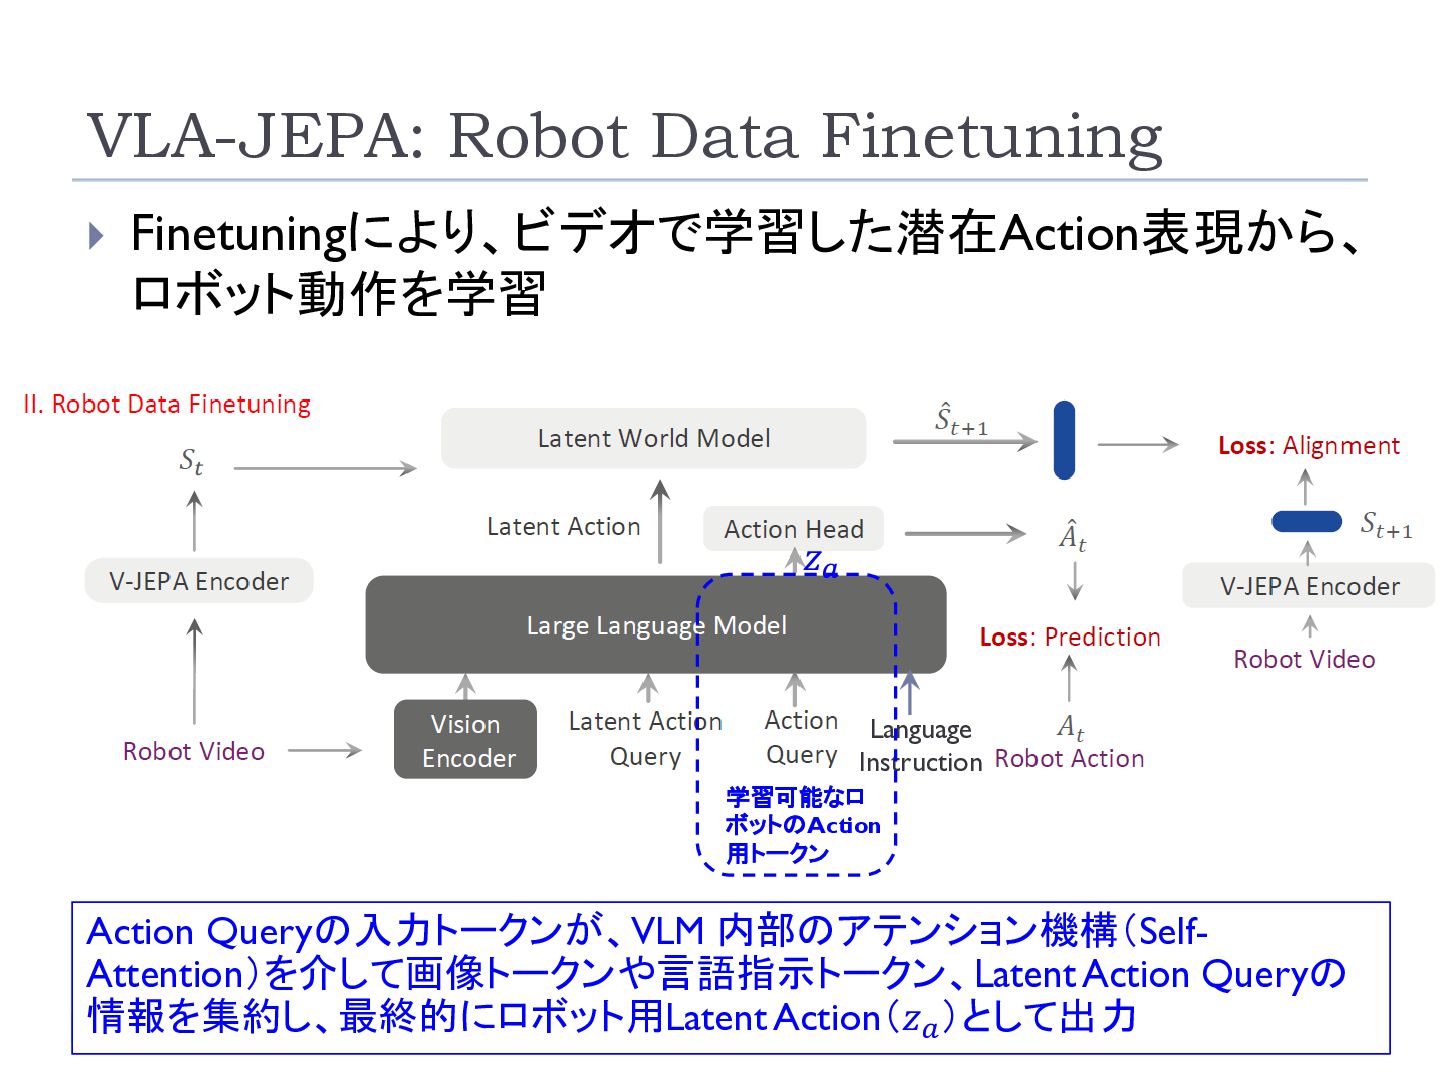
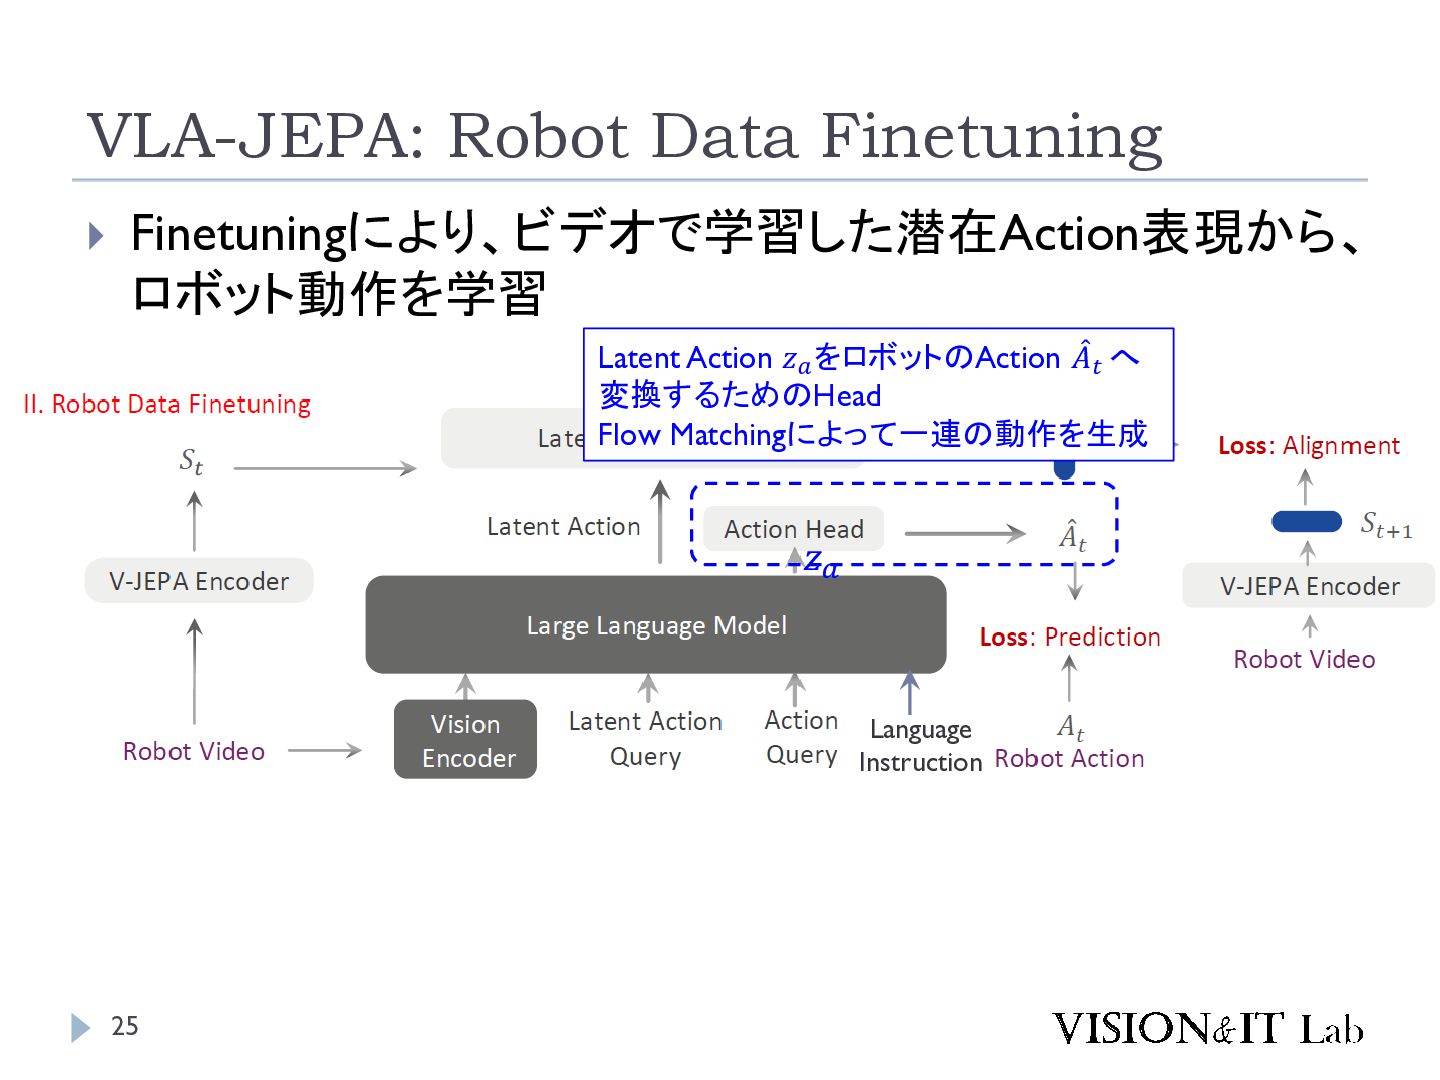
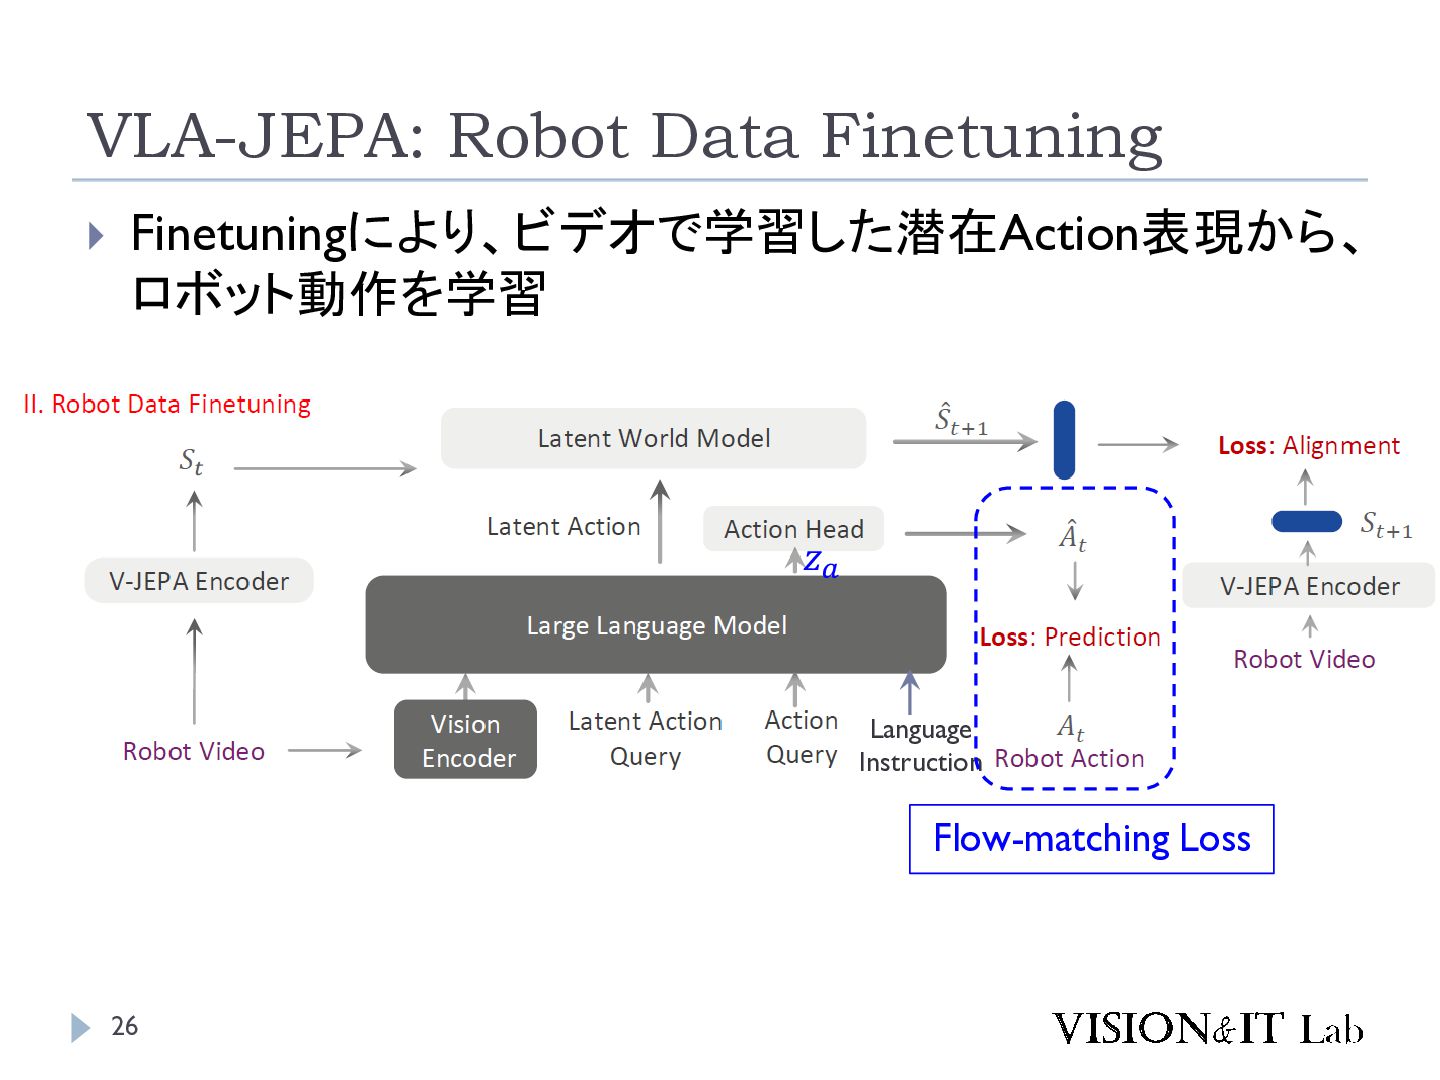
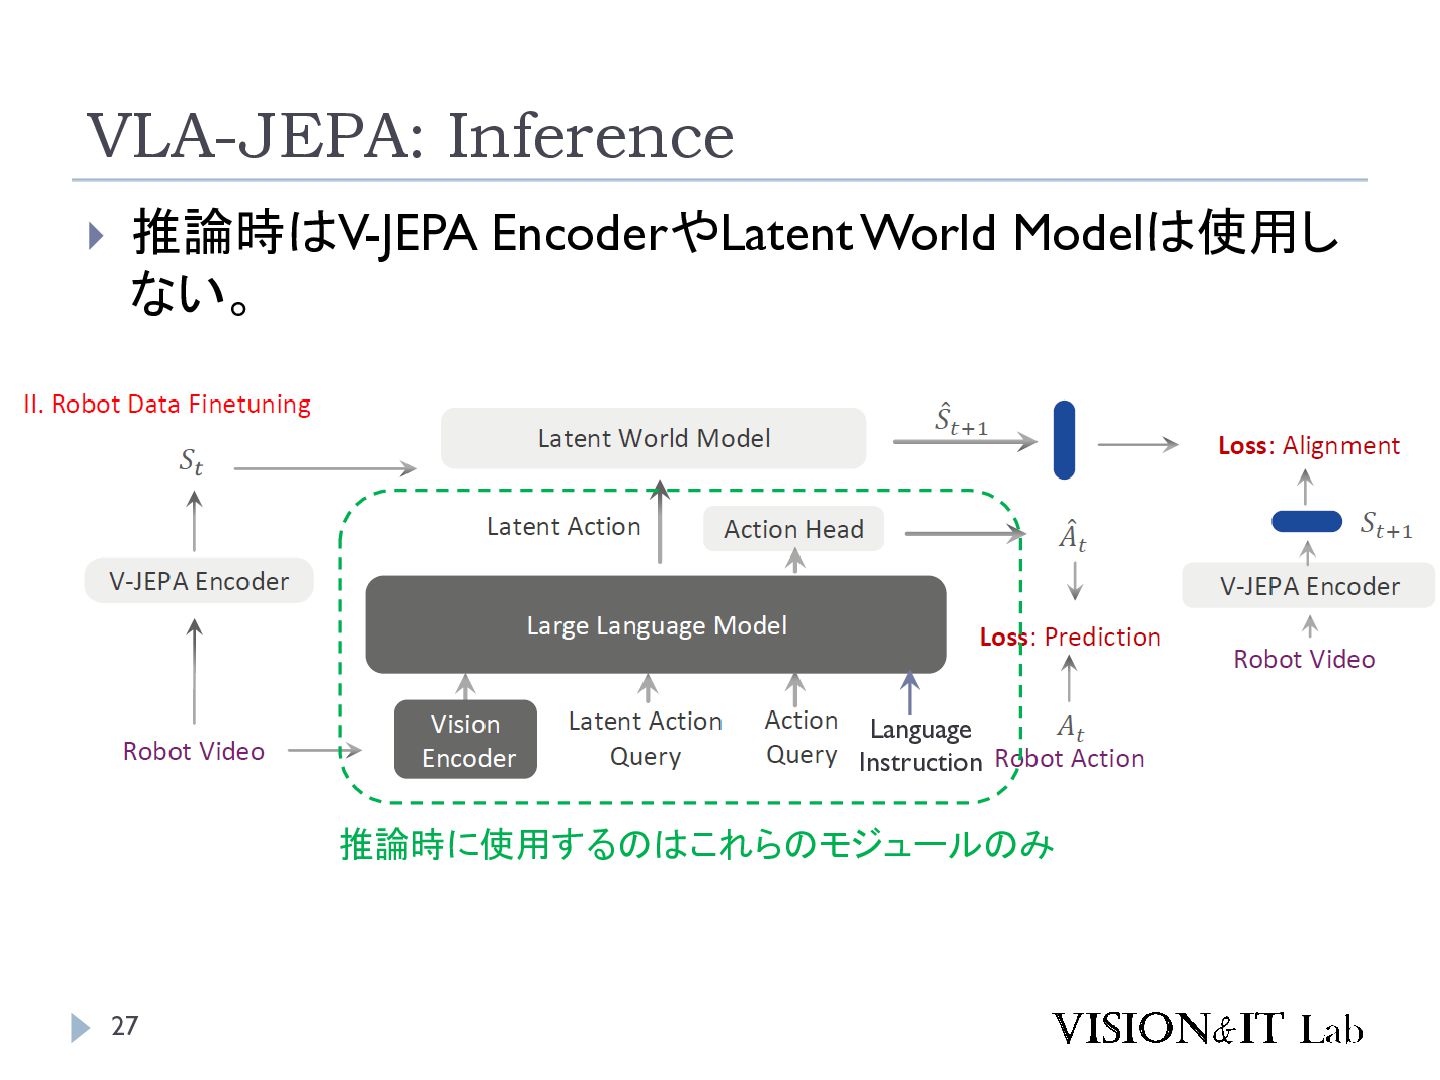
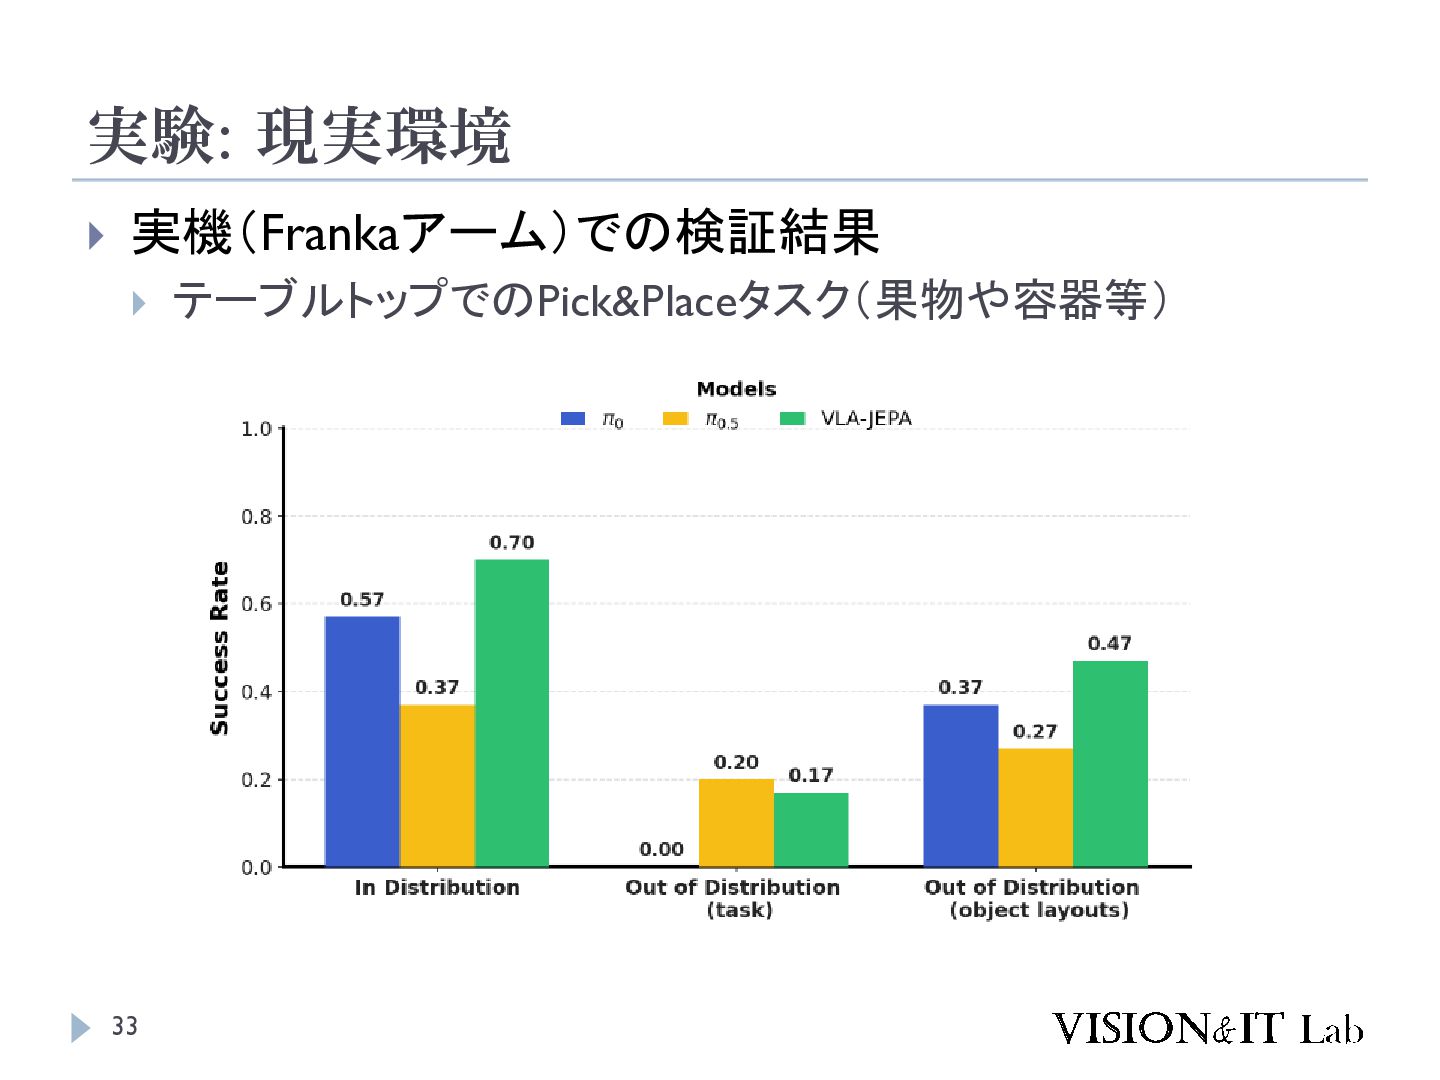
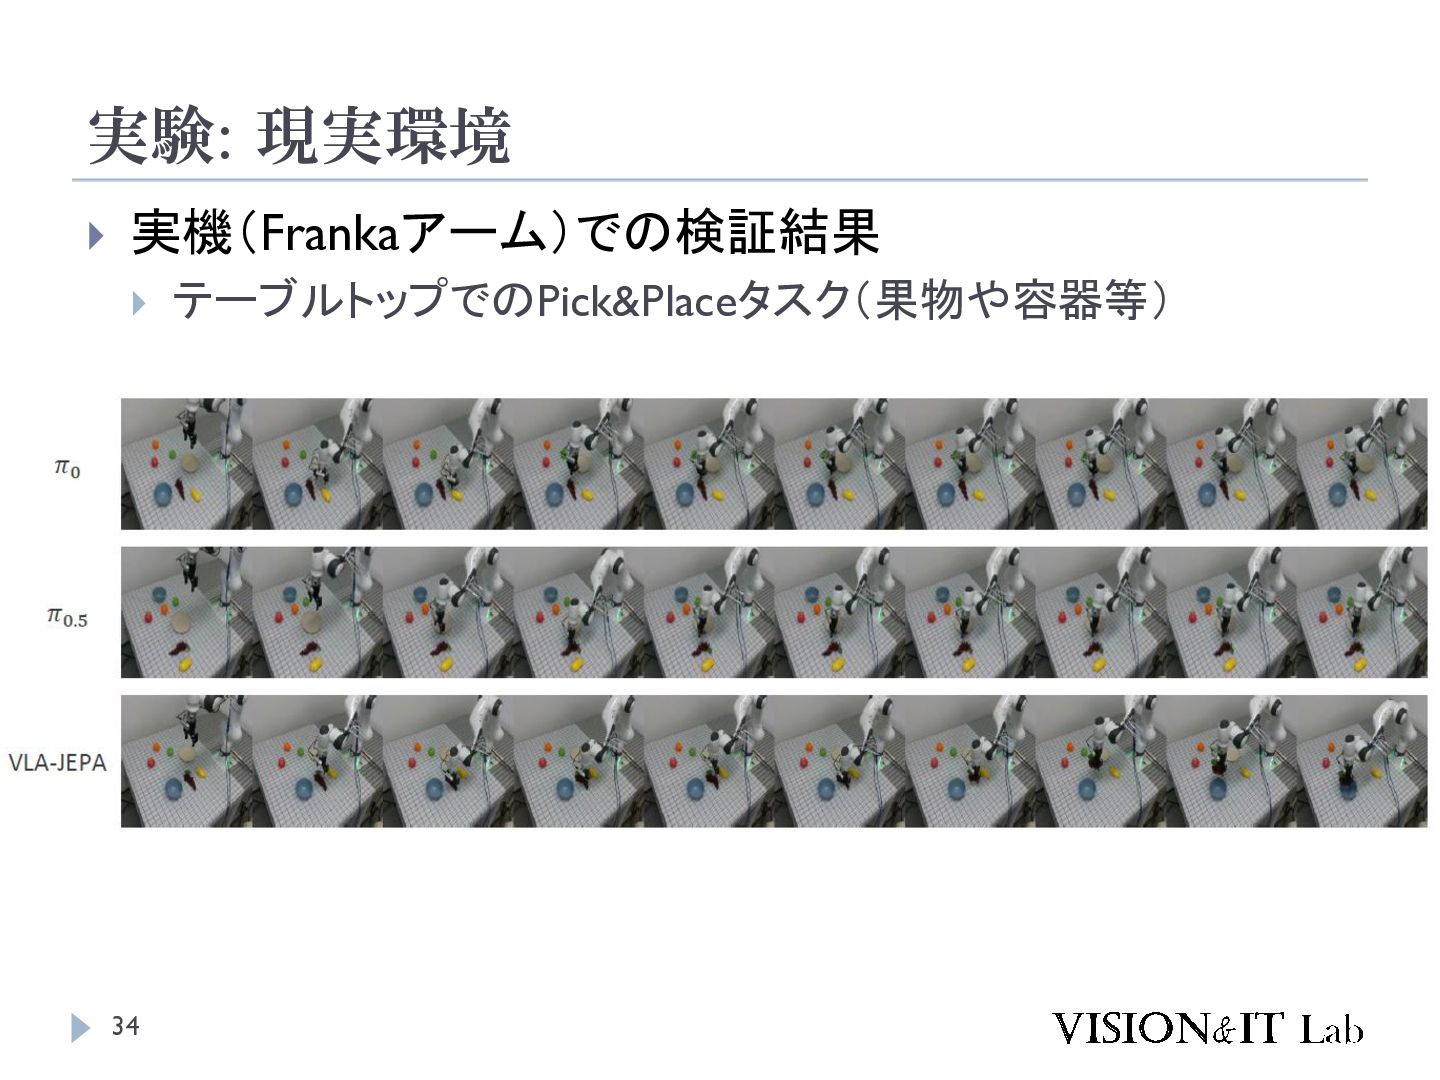
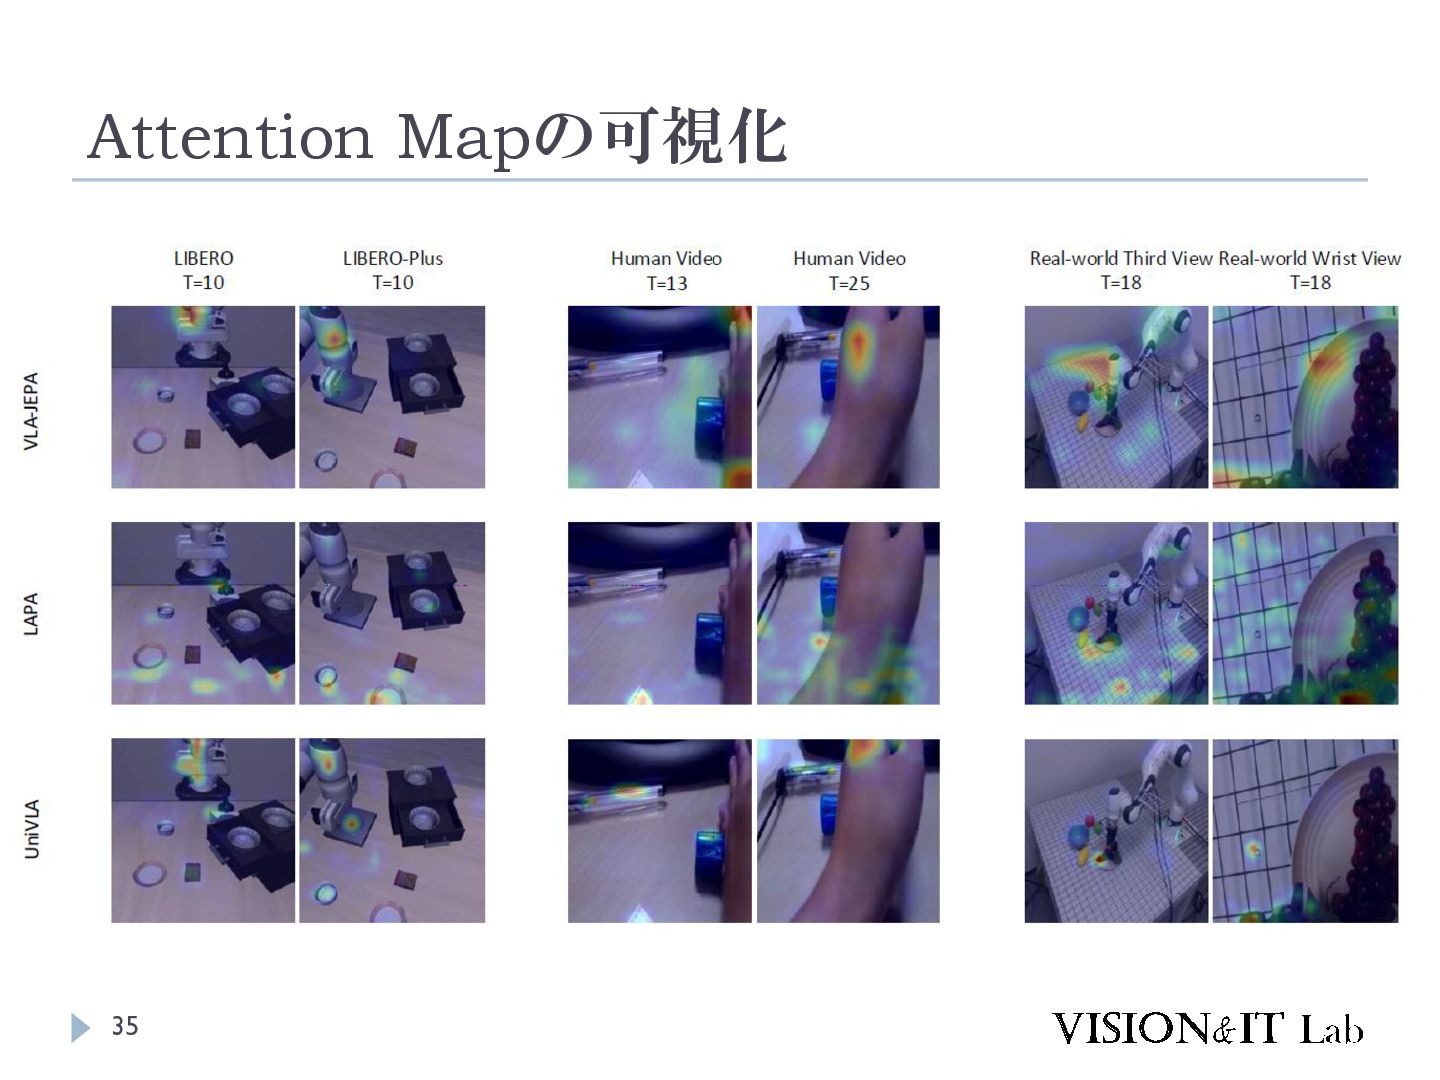
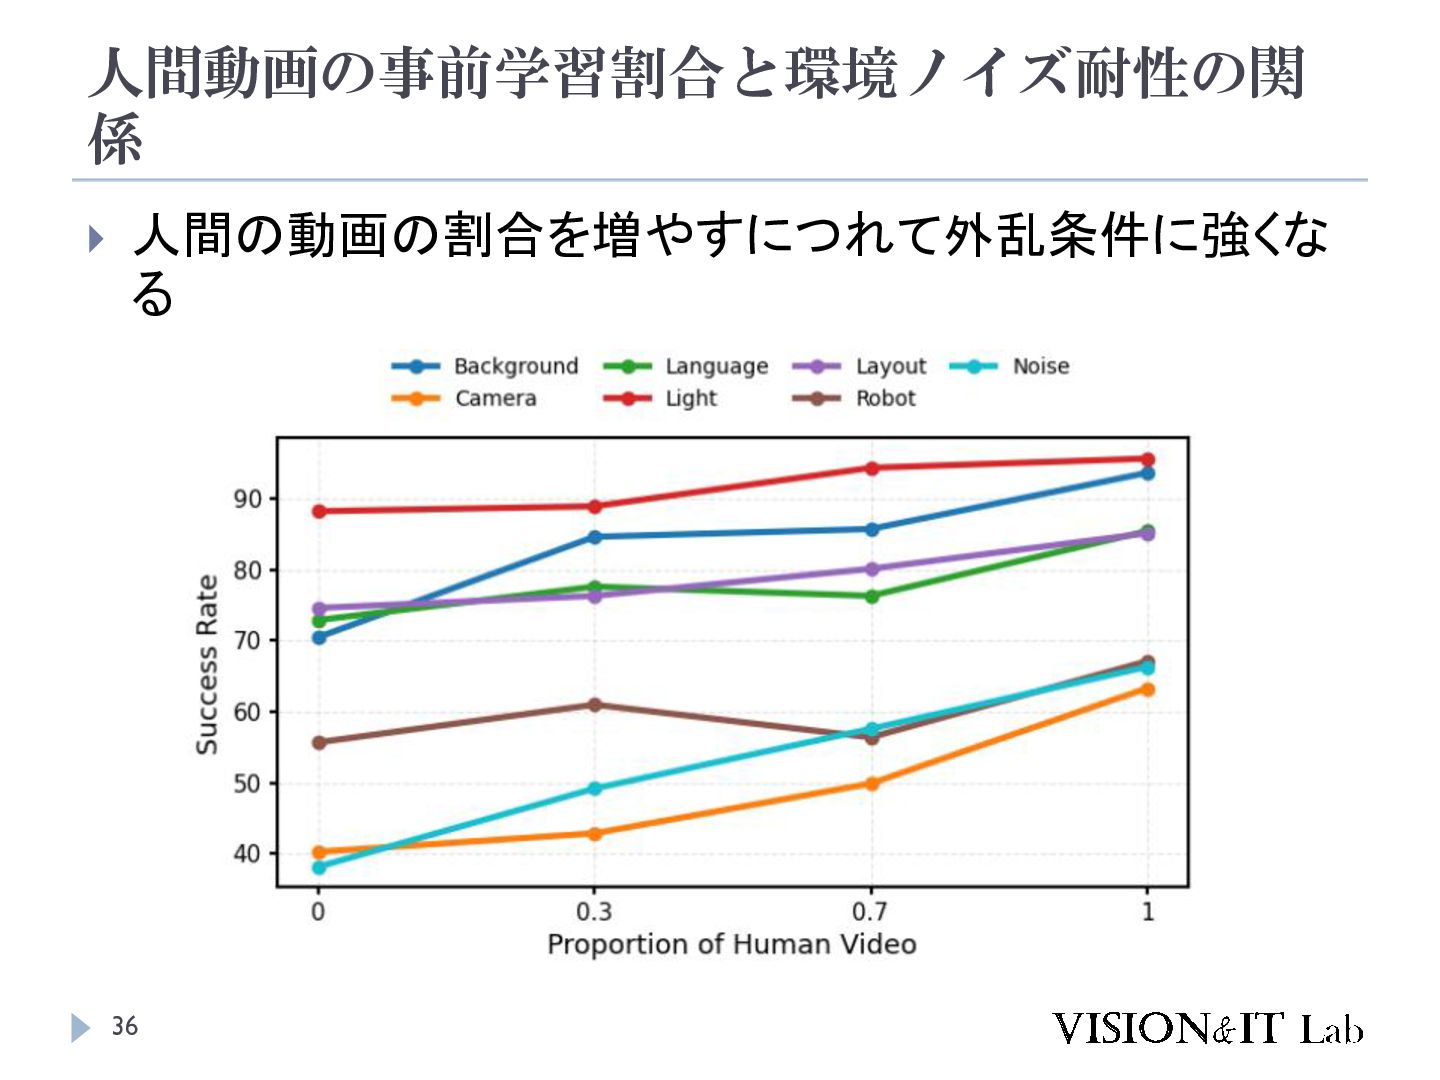
現在のフレーム: 𝑰𝑡 未来のフレーム: 𝑰𝑡+1 Latent Action Extraction Latent Action: 𝒛𝑡 現在のフレーム: 𝑰𝑡 「Actionによって未来が変化している」という考え方 VLM Latent Action: 𝒛𝑡 Pretraining 動作の指示: 𝑻𝑡 実際は • 照明変化やカメラ視点変化などActionに起因しない画像の変化をActionとして学習 Step3 • 画像生成のために背景などのActionに関係ないAppearance表現を学習 現在のフレーム: 𝑰𝑡 画像と指示テキストか • Actionではなく現在のフレームから未来フレームを生成するための圧縮表現を学習 Robot Action Latent ら実際のロボットの動 Decoding Action: 𝒛𝑡 作をFine-tuningにより 動作の指示: 𝑻𝑡 学習 Ye, S., Jang, J., Jeon, B., Joo, S., Yang, J., Peng, B., Mandlekar, A., Tan, R., Chao, Y.-W., Lin, B. Y., Liden, L., Lee, K., Gao, J., Zettlemoyer, L., Fox, D., & Seo, M. (2024). Latent Action Pretraining from Videos. arXiv Preprint, arXiv:2410.11758. Bu, 10Q., Yang, Y., Cai, J., Gao, S., Ren, G., Yao, M., Luo, P., & Li, H. (2025). UniVLA: Learning to Act Anywhere with Task-centric Latent Actions. arXiv Preprint, arXiv:2505.06111.


 takmin
 greenmidori
 daidaidai
 kentarofujii
 mhlyc
 taketakekaho
 yamaguchitk333
 kenichinakamura
 yazm
 syuchimu
 gree_tech
 yahonda
 x5gtrn
 kimpetersen
 keavy
 zakiyama
 quramy
 mkilby
 bermonpainter
 rabernat
 jdejongh
 akosma
 kastner
 cassininazir
 codingconduct