Share
Embed
[論文サーベイ] Survey on Google DeepMind’s Game AI 2
[論文サーベイ] Survey on Google DeepMind’s Game AI 2
PDFファイルをダウンロードすると,スライド内のリンクを見ることができます.
1.Training Agents Inside of Scalable World Models,
Danijar Hafner et al. (Google DeepMind et al.)
[arXiv'2509] (Cited by: 11 )
2.SIMA 2: A Generalist Embodied Agent for Virtual Worlds,
Adrian Bolton et al. (Google DeepMind et al.)
[arXiv'2512] (Cited by: - )
tt1717
January 06, 2026
Transcript
21 slides
-
1/21 Survey on Google DeepMind’s Game AI 2 タイトル 学会
著者/所属 引用数 Training Agents Inside of Scalable World Models [arXiv'2509] Danijar Hafner et al. (Google DeepMind et al.) 11 SIMA 2: A Generalist Embodied Agent for Virtual Worlds [arXiv'2512] Adrian Bolton et al. (Google DeepMind et al.) - 2026/01/07 -
2/21 Prior Research SIMA [arXiv’2404] SIMA2 [arXiv’2512] Dreamer [ICLR’20] DreamerV2
[ICLR’21] DreamerV3 [Nature’25] DreamerV4 [arXiv’2509] -
3/21 Prior Research SIMA [arXiv’2404] 言語指示で多様な3Dゲームを プレイする汎用エージェント SIMA2 [arXiv’2512] 対話を通じた柔軟なタスク遂行と,未知
環境への適応を実現したエージェント Dreamer [ICLR’20] 画像入力のみによる DeepMind Control Suite での高スコア達成 DreamerV2 [ICLR’21] 離散的な世界モデルによる Atariでの人間レベル達成 DreamerV3 [Nature’25] オンライン相互作用による ダイヤモンドタスクの達成 DreamerV4 [arXiv’2509] オフラインデータによるダイ ヤモンドタスクの達成 -
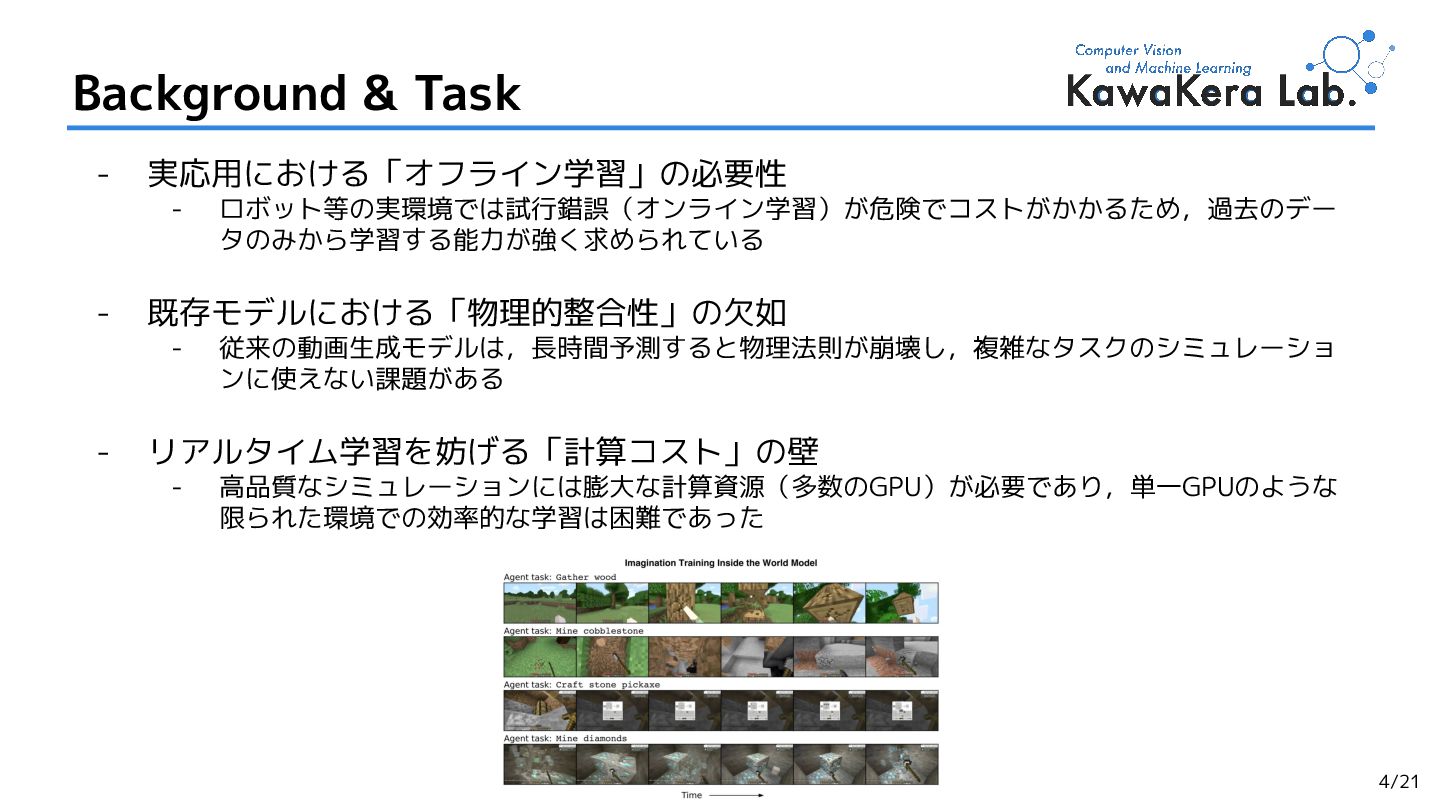
- 実応用における「オフライン学習」の必要性 - ロボット等の実環境では試行錯誤(オンライン学習)が危険でコストがかかるため,過去のデー タのみから学習する能力が強く求められている - 既存モデルにおける「物理的整合性」の欠如 - 従来の動画生成モデルは,長時間予測すると物理法則が崩壊し,複雑なタスクのシミュレーショ ンに使えない課題がある
- リアルタイム学習を妨げる「計算コスト」の壁 - 高品質なシミュレーションには膨大な計算資源(多数のGPU)が必要であり,単一GPUのような 限られた環境での効率的な学習は困難であった 4/21 Background & Task -
- 初めてオフラインデータのみで「ダイヤモンド取得」を達成 - DreamerV4により,環境との相互作用を一切行わずに難関タスクを解決 - 従来のVPT [NeurIPS’22]と比較して1/100のデータ量で上回る性能を実証 - ショートカット・フォーシングによる「正確な物理再現」 -
新たな目的関数とアーキテクチャを導入し,複雑なゲームメカニクスや物体インタラクションを 正確かつ長期的に維持できる世界モデルを実現 - 「単一GPU」でのリアルタイムな学習・推論を実現 - モデルの効率化により計算コストを劇的に削減 - 単一GPU上で20FPS以上の高速動作を実現し,手軽な環境でのイマジネーション学習が可能 5/21 Contributions -
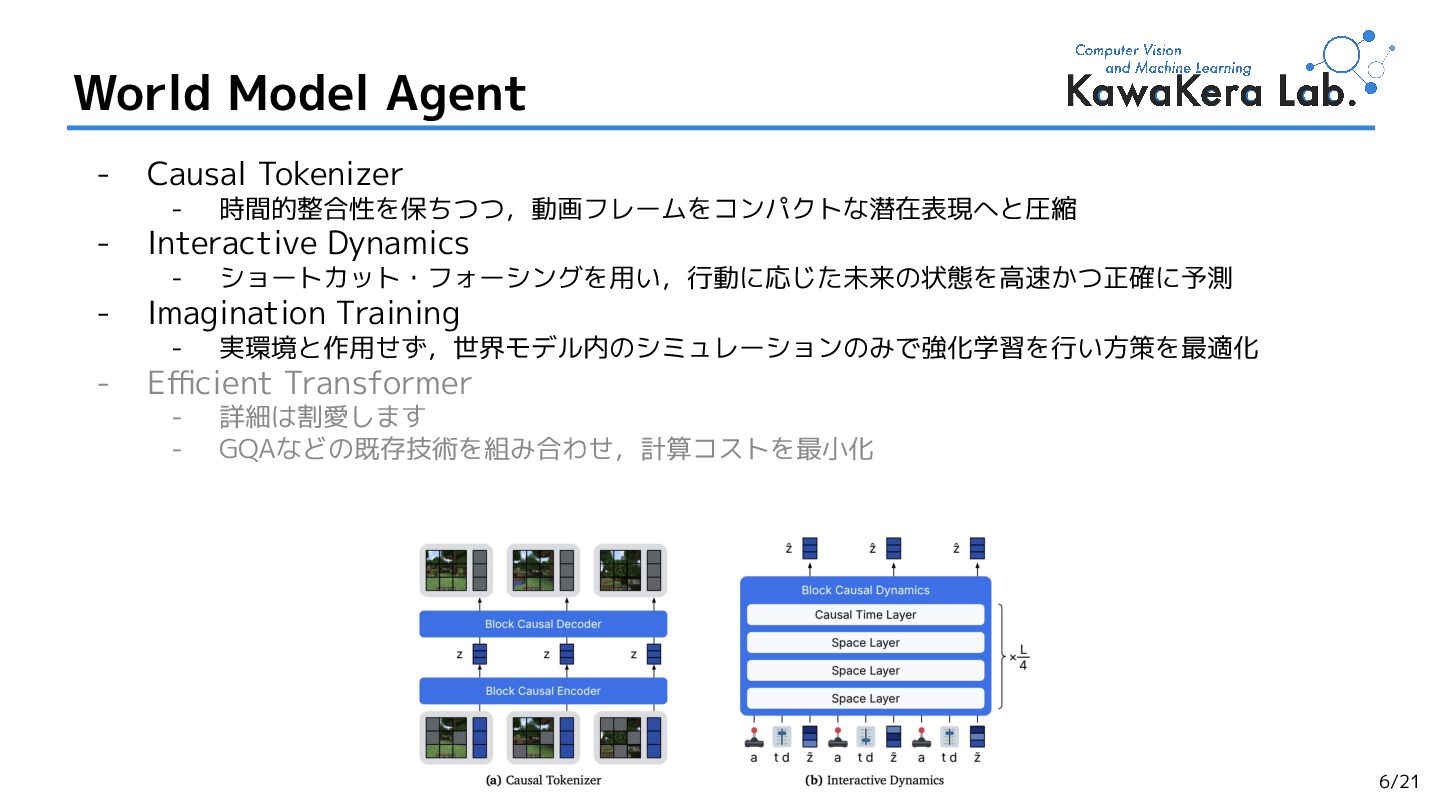
6/21 World Model Agent - Causal Tokenizer - 時間的整合性を保ちつつ,動画フレームをコンパクトな潜在表現へと圧縮 -
Interactive Dynamics - ショートカット・フォーシングを用い,行動に応じた未来の状態を高速かつ正確に予測 - Imagination Training - 実環境と作用せず,世界モデル内のシミュレーションのみで強化学習を行い方策を最適化 - Efficient Transformer - 詳細は割愛します - GQAなどの既存技術を組み合わせ,計算コストを最小化 -
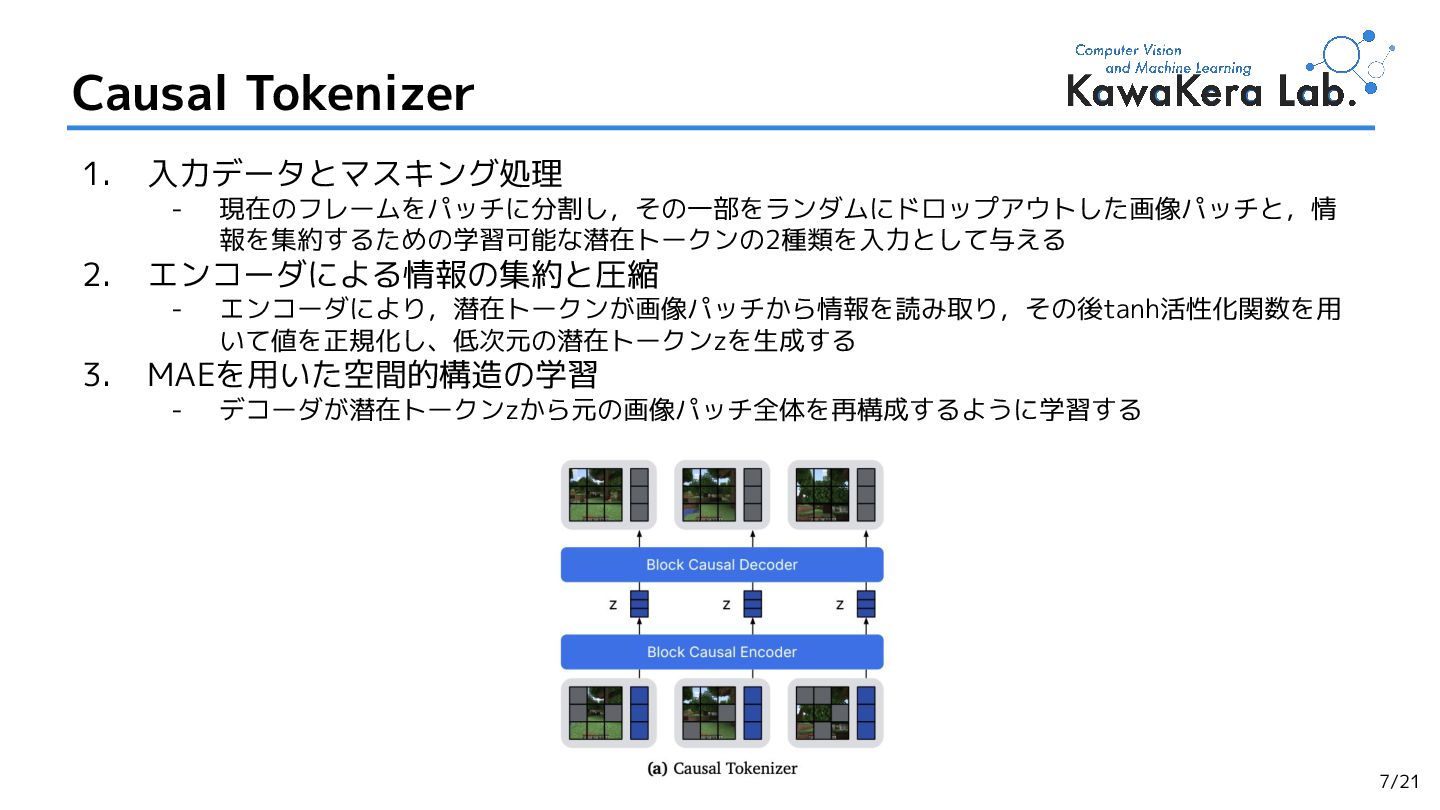
7/21 Causal Tokenizer 1. 入力データとマスキング処理 - 現在のフレームをパッチに分割し,その一部をランダムにドロップアウトした画像パッチと,情 報を集約するための学習可能な潜在トークンの2種類を入力として与える 2. エンコーダによる情報の集約と圧縮
- エンコーダにより,潜在トークンが画像パッチから情報を読み取り,その後tanh活性化関数を用 いて値を正規化し、低次元の潜在トークンzを生成する 3. MAEを用いた空間的構造の学習 - デコーダが潜在トークンzから元の画像パッチ全体を再構成するように学習する -
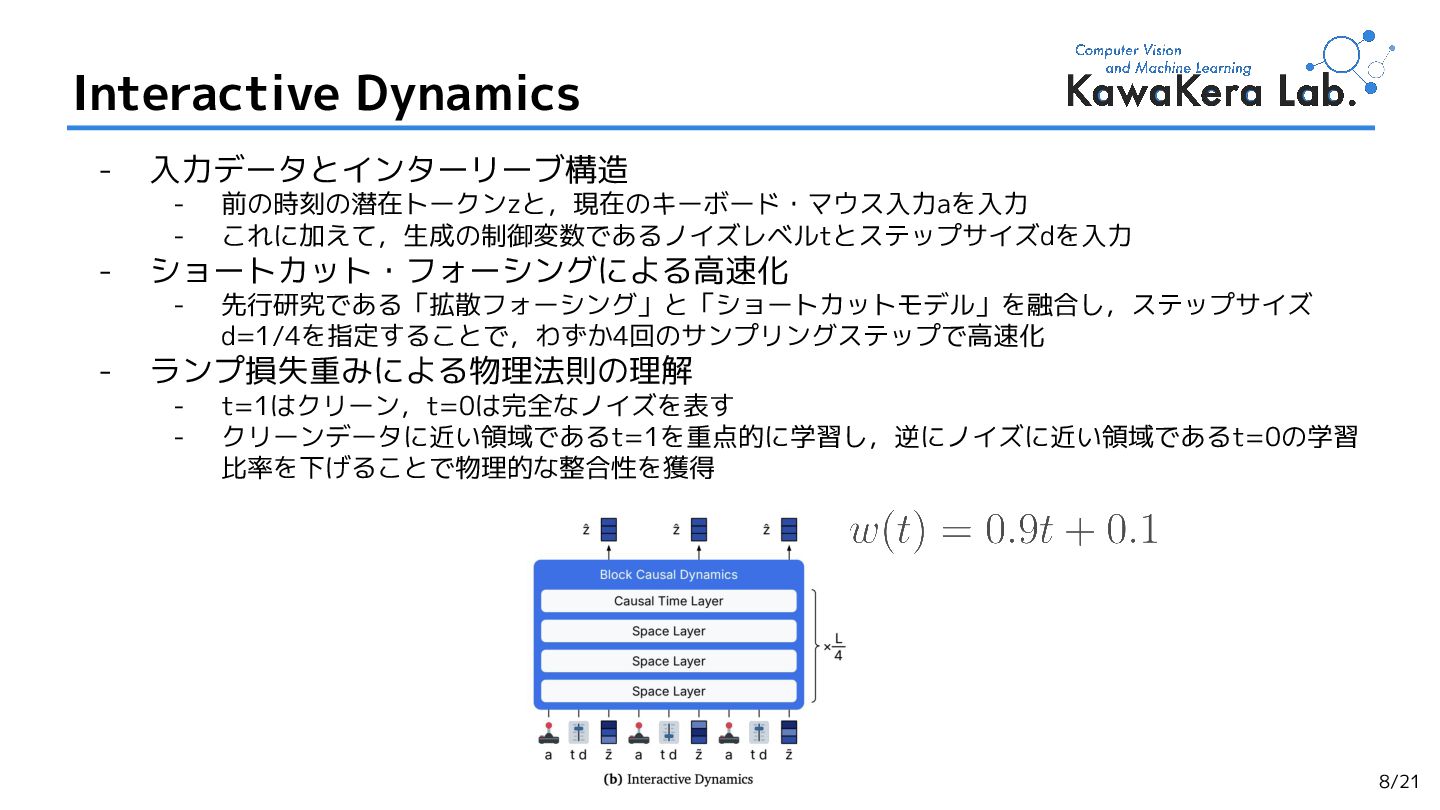
8/21 Interactive Dynamics - 入力データとインターリーブ構造 - 前の時刻の潜在トークンzと,現在のキーボード・マウス入力aを入力 - これに加えて,生成の制御変数であるノイズレベルtとステップサイズdを入力 -
ショートカット・フォーシングによる高速化 - 先行研究である「拡散フォーシング」と「ショートカットモデル」を融合し,ステップサイズ d=1/4を指定することで,わずか4回のサンプリングステップで高速化 - ランプ損失重みによる物理法則の理解 - t=1はクリーン,t=0は完全なノイズを表す - クリーンデータに近い領域であるt=1を重点的に学習し,逆にノイズに近い領域であるt=0の学習 比率を下げることで物理的な整合性を獲得 -
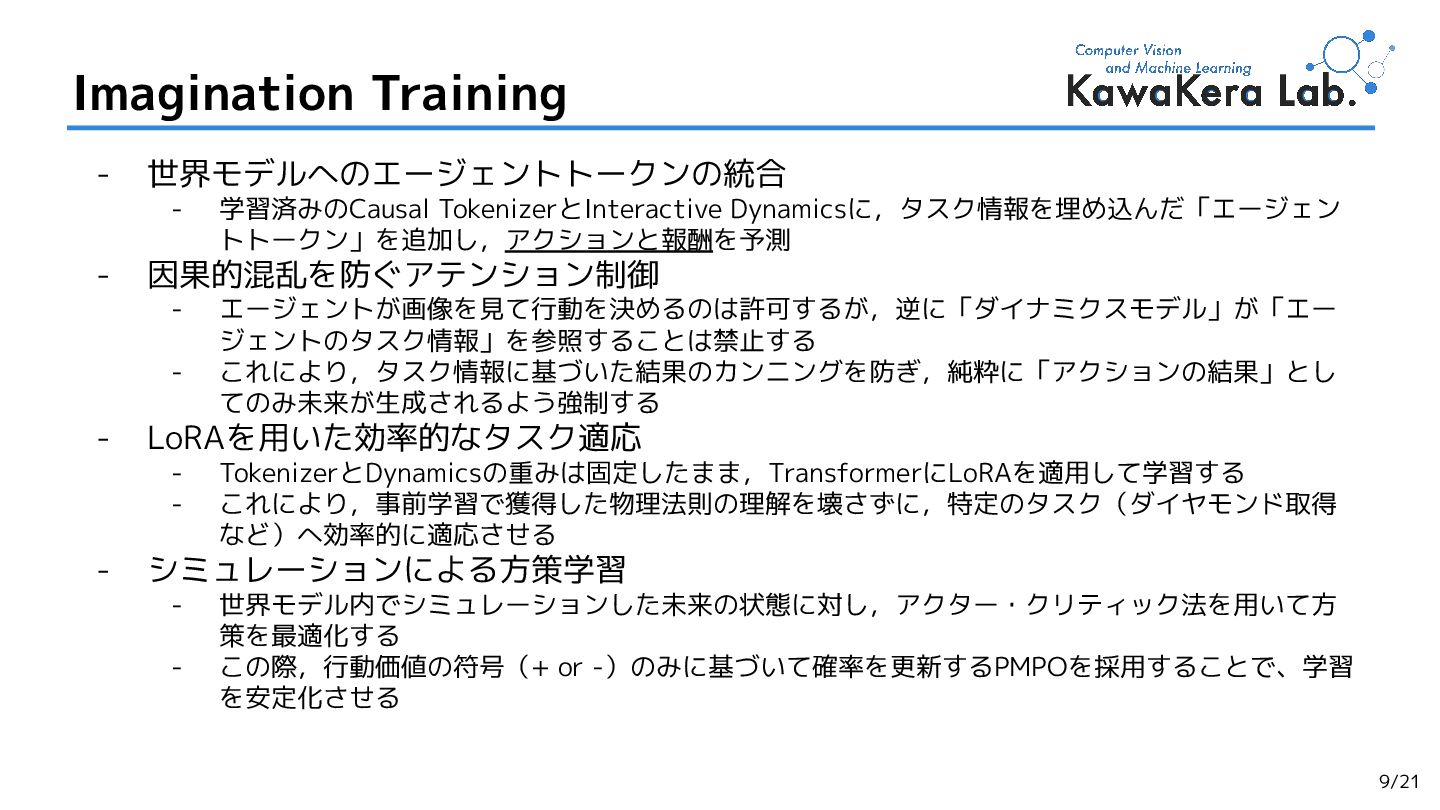
9/21 Imagination Training - 世界モデルへのエージェントトークンの統合 - 学習済みのCausal TokenizerとInteractive Dynamicsに,タスク情報を埋め込んだ「エージェン トトークン」を追加し,アクションと報酬を予測
- 因果的混乱を防ぐアテンション制御 - エージェントが画像を見て行動を決めるのは許可するが,逆に「ダイナミクスモデル」が「エー ジェントのタスク情報」を参照することは禁止する - これにより,タスク情報に基づいた結果のカンニングを防ぎ,純粋に「アクションの結果」とし てのみ未来が生成されるよう強制する - LoRAを用いた効率的なタスク適応 - TokenizerとDynamicsの重みは固定したまま,TransformerにLoRAを適用して学習する - これにより,事前学習で獲得した物理法則の理解を壊さずに,特定のタスク(ダイヤモンド取得 など)へ効率的に適応させる - シミュレーションによる方策学習 - 世界モデル内でシミュレーションした未来の状態に対し,アクター・クリティック法を用いて方 策を最適化する - この際,行動価値の符号(+ or -)のみに基づいて確率を更新するPMPOを採用することで、学習 を安定化させる -
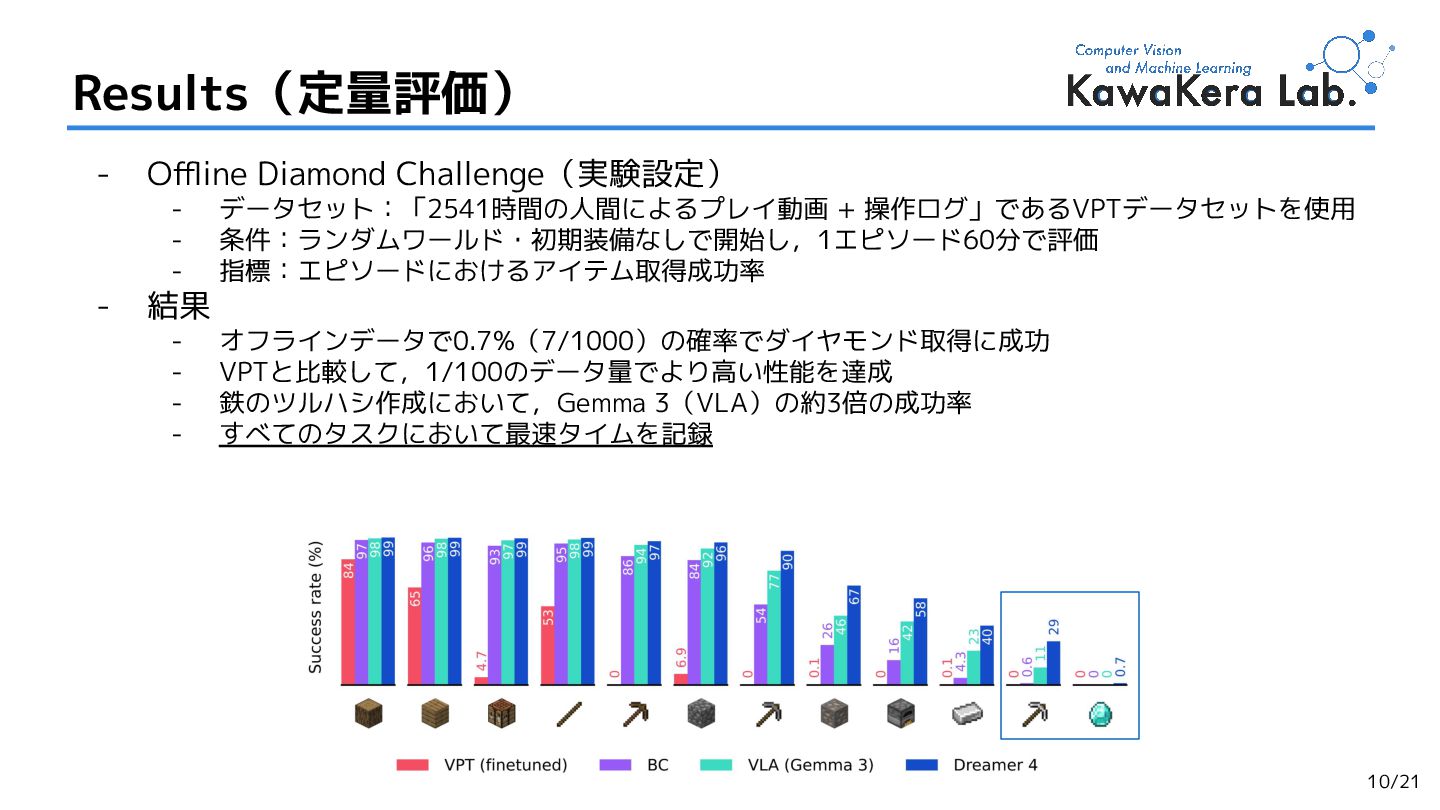
10/21 Results(定量評価) - Offline Diamond Challenge(実験設定) - データセット:「2541時間の人間によるプレイ動画 + 操作ログ」であるVPTデータセットを使用
- 条件:ランダムワールド・初期装備なしで開始し,1エピソード60分で評価 - 指標:エピソードにおけるアイテム取得成功率 - 結果 - オフラインデータで0.7%(7/1000)の確率でダイヤモンド取得に成功 - VPTと比較して,1/100のデータ量でより高い性能を達成 - 鉄のツルハシ作成において,Gemma 3(VLA)の約3倍の成功率 - すべてのタスクにおいて最速タイムを記録 -
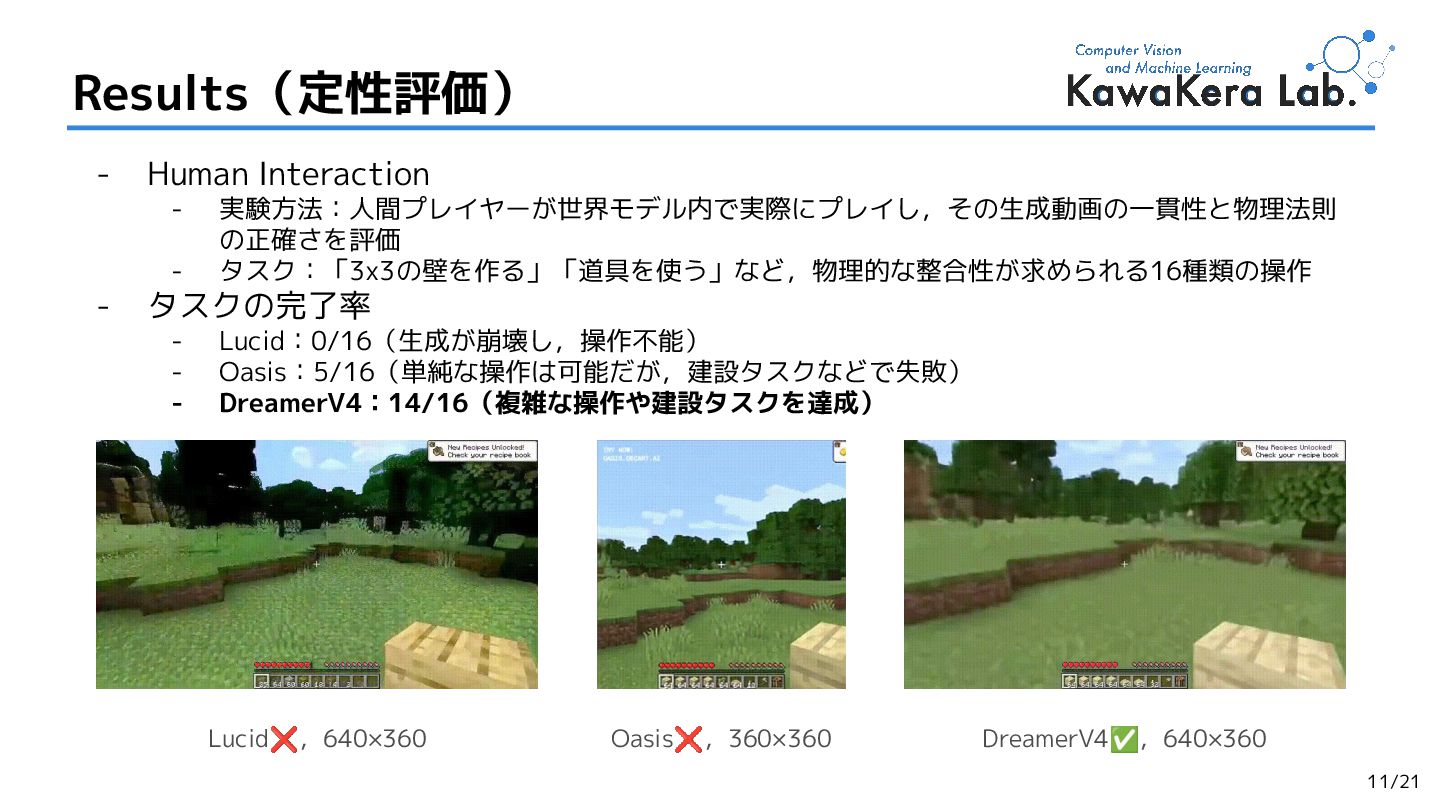
11/21 Results(定性評価) - Human Interaction - 実験方法:人間プレイヤーが世界モデル内で実際にプレイし,その生成動画の一貫性と物理法則 の正確さを評価 - タスク:「3x3の壁を作る」「道具を使う」など,物理的な整合性が求められる16種類の操作
- タスクの完了率 - Lucid:0/16(生成が崩壊し,操作不能) - Oasis:5/16(単純な操作は可能だが,建設タスクなどで失敗) - DreamerV4:14/16(複雑な操作や建設タスクを達成) Lucid❌,640×360 Oasis❌,360×360 DreamerV4✅,640×360 -
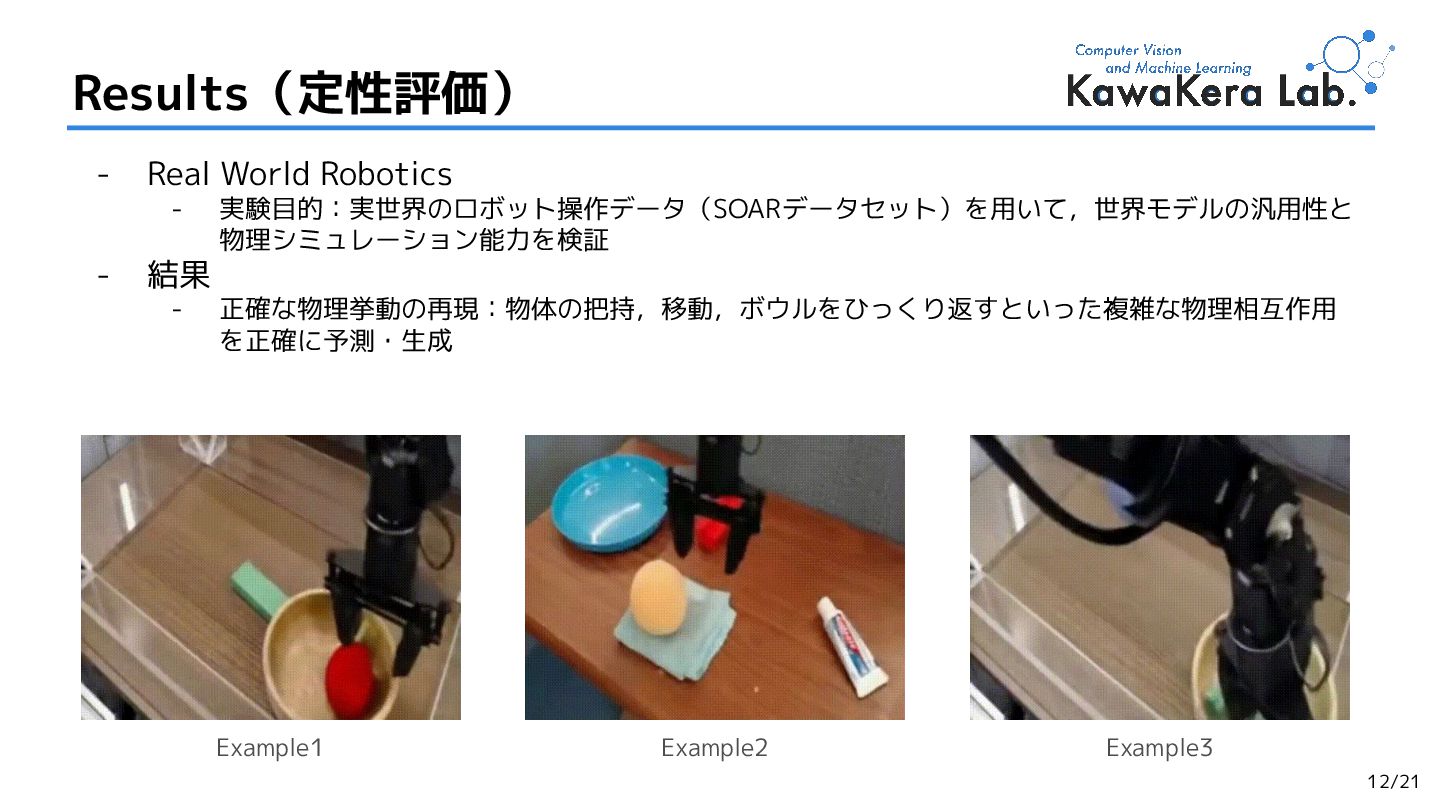
12/21 Results(定性評価) - Real World Robotics - 実験目的:実世界のロボット操作データ(SOARデータセット)を用いて,世界モデルの汎用性と 物理シミュレーション能力を検証 -
結果 - 正確な物理挙動の再現:物体の把持,移動,ボウルをひっくり返すといった複雑な物理相互作用 を正確に予測・生成 Example1 Example2 Example3 -
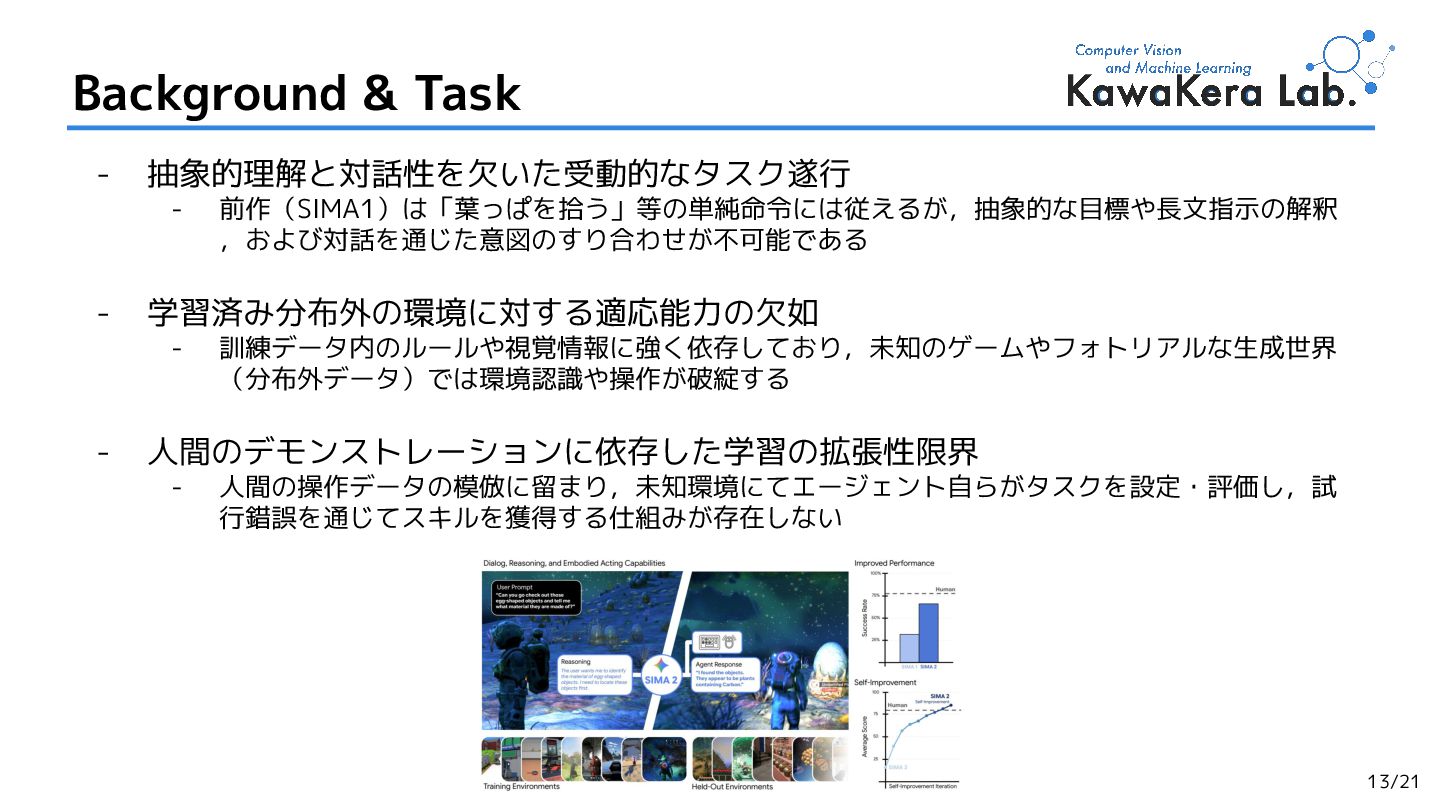
- 抽象的理解と対話性を欠いた受動的なタスク遂行 - 前作(SIMA1)は「葉っぱを拾う」等の単純命令には従えるが,抽象的な目標や長文指示の解釈 ,および対話を通じた意図のすり合わせが不可能である - 学習済み分布外の環境に対する適応能力の欠如 - 訓練データ内のルールや視覚情報に強く依存しており,未知のゲームやフォトリアルな生成世界 (分布外データ)では環境認識や操作が破綻する
- 人間のデモンストレーションに依存した学習の拡張性限界 - 人間の操作データの模倣に留まり,未知環境にてエージェント自らがタスクを設定・評価し,試 行錯誤を通じてスキルを獲得する仕組みが存在しない 13/21 Background & Task -
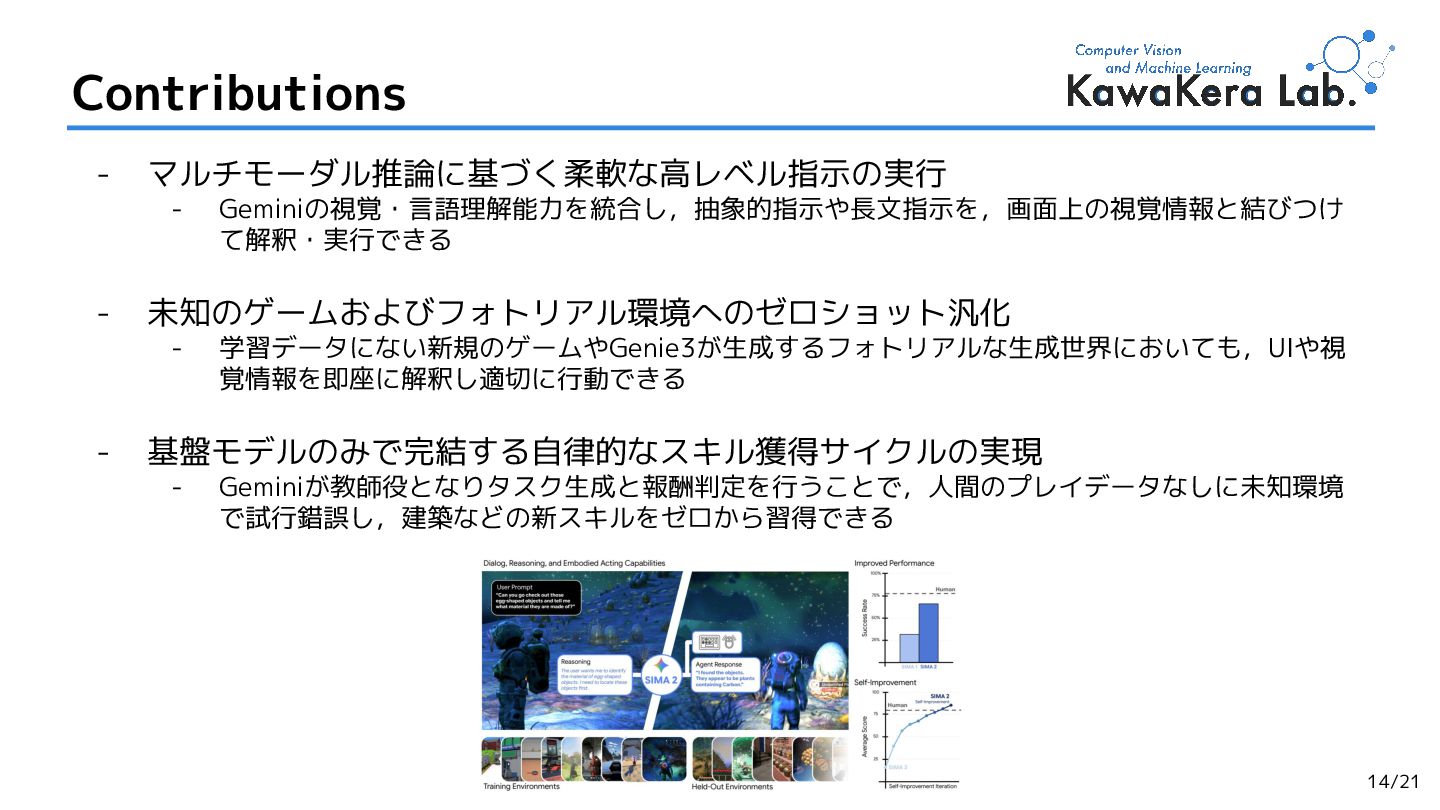
- マルチモーダル推論に基づく柔軟な高レベル指示の実行 - Geminiの視覚・言語理解能力を統合し,抽象的指示や長文指示を,画面上の視覚情報と結びつけ て解釈・実行できる - 未知のゲームおよびフォトリアル環境へのゼロショット汎化 - 学習データにない新規のゲームやGenie3が生成するフォトリアルな生成世界においても,UIや視 覚情報を即座に解釈し適切に行動できる
- 基盤モデルのみで完結する自律的なスキル獲得サイクルの実現 - Geminiが教師役となりタスク生成と報酬判定を行うことで,人間のプレイデータなしに未知環境 で試行錯誤し,建築などの新スキルをゼロから習得できる 14/21 Contributions -
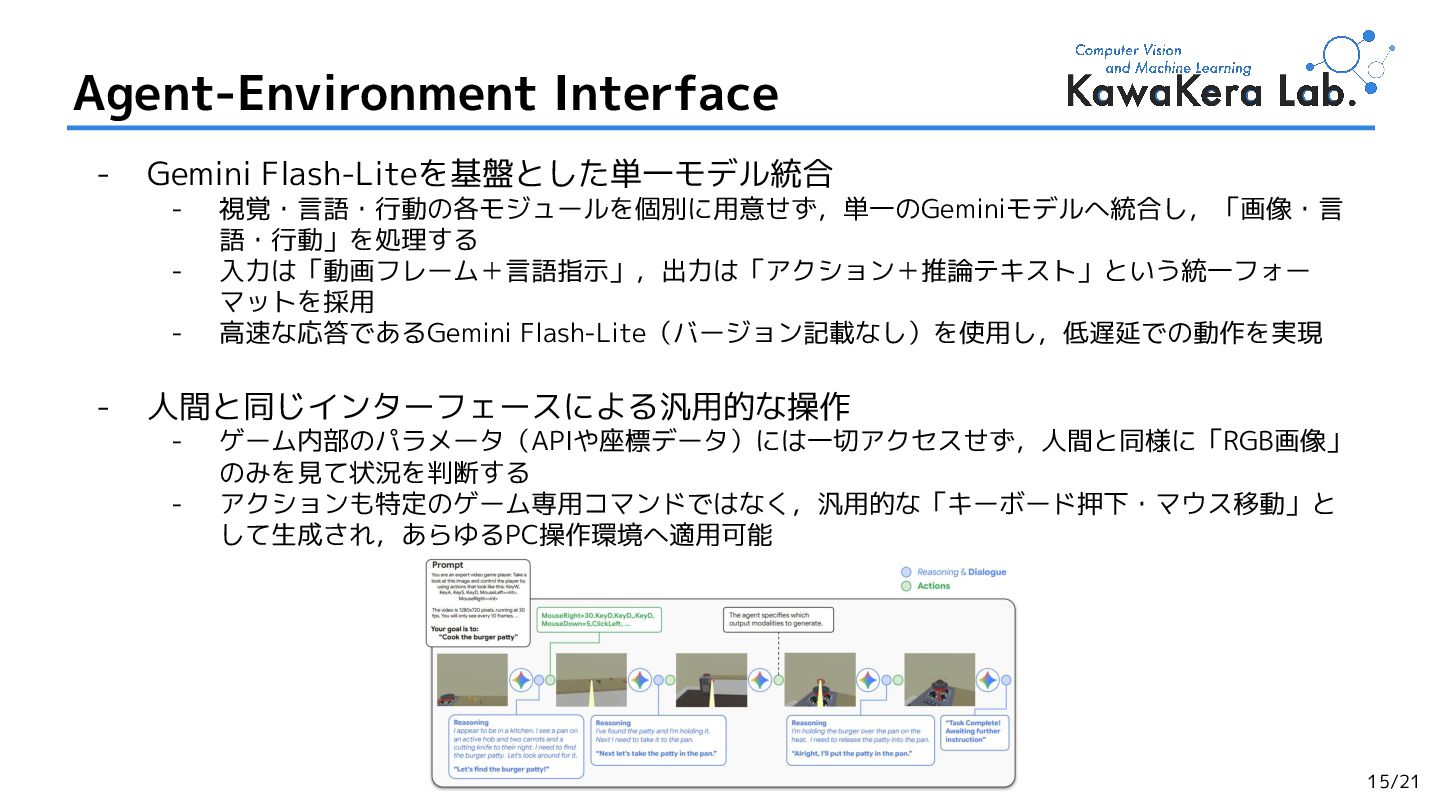
15/21 Agent-Environment Interface - Gemini Flash-Liteを基盤とした単一モデル統合 - 視覚・言語・行動の各モジュールを個別に用意せず,単一のGeminiモデルへ統合し,「画像・言 語・行動」を処理する -
入力は「動画フレーム+言語指示」,出力は「アクション+推論テキスト」という統一フォー マットを採用 - 高速な応答であるGemini Flash-Lite(バージョン記載なし)を使用し,低遅延での動作を実現 - 人間と同じインターフェースによる汎用的な操作 - ゲーム内部のパラメータ(APIや座標データ)には一切アクセスせず,人間と同様に「RGB画像」 のみを見て状況を判断する - アクションも特定のゲーム専用コマンドではなく,汎用的な「キーボード押下・マウス移動」と して生成され,あらゆるPC操作環境へ適用可能 -
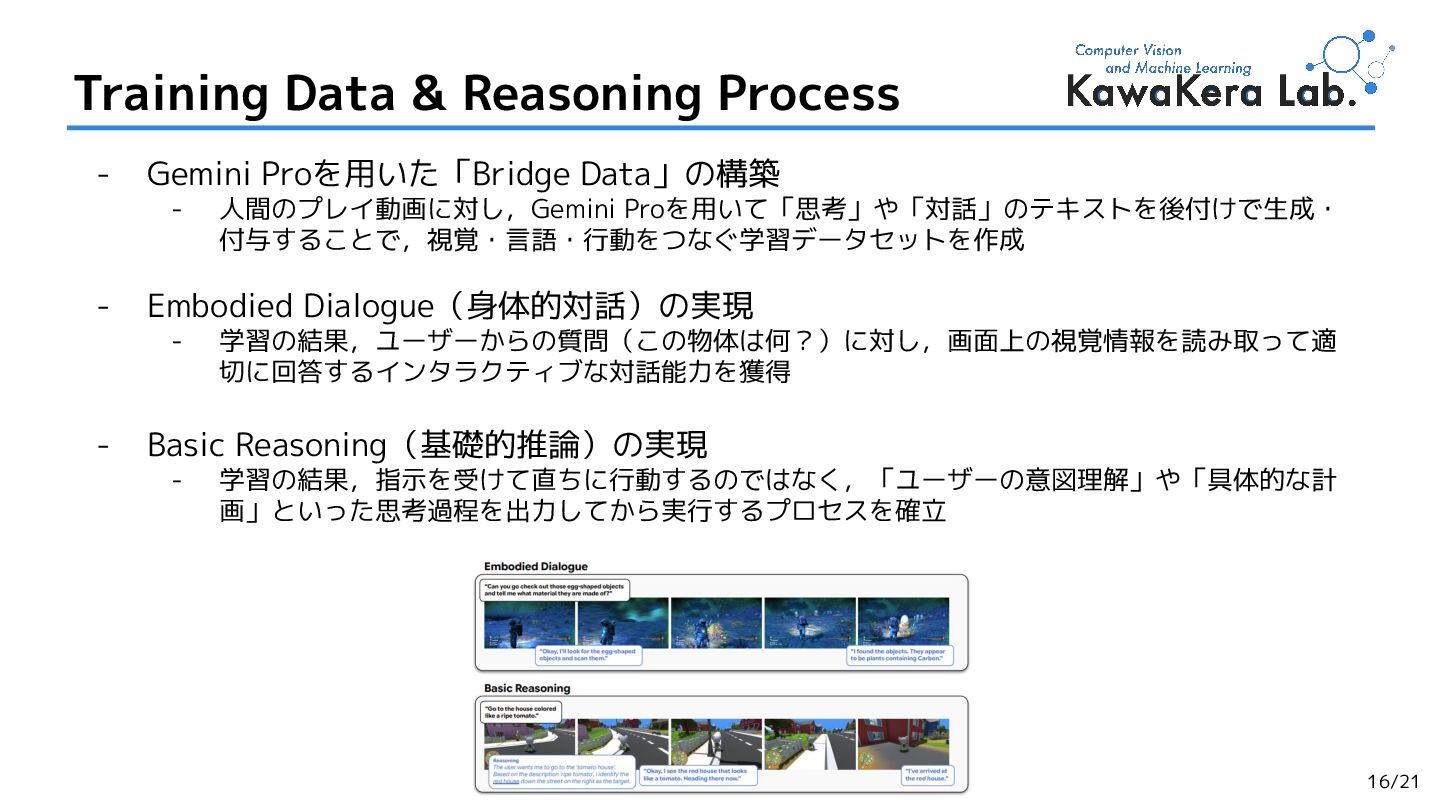
16/21 Training Data & Reasoning Process - Gemini Proを用いた「Bridge Data」の構築
- 人間のプレイ動画に対し,Gemini Proを用いて「思考」や「対話」のテキストを後付けで生成・ 付与することで,視覚・言語・行動をつなぐ学習データセットを作成 - Embodied Dialogue(身体的対話)の実現 - 学習の結果,ユーザーからの質問(この物体は何?)に対し,画面上の視覚情報を読み取って適 切に回答するインタラクティブな対話能力を獲得 - Basic Reasoning(基礎的推論)の実現 - 学習の結果,指示を受けて直ちに行動するのではなく,「ユーザーの意図理解」や「具体的な計 画」といった思考過程を出力してから実行するプロセスを確立 -
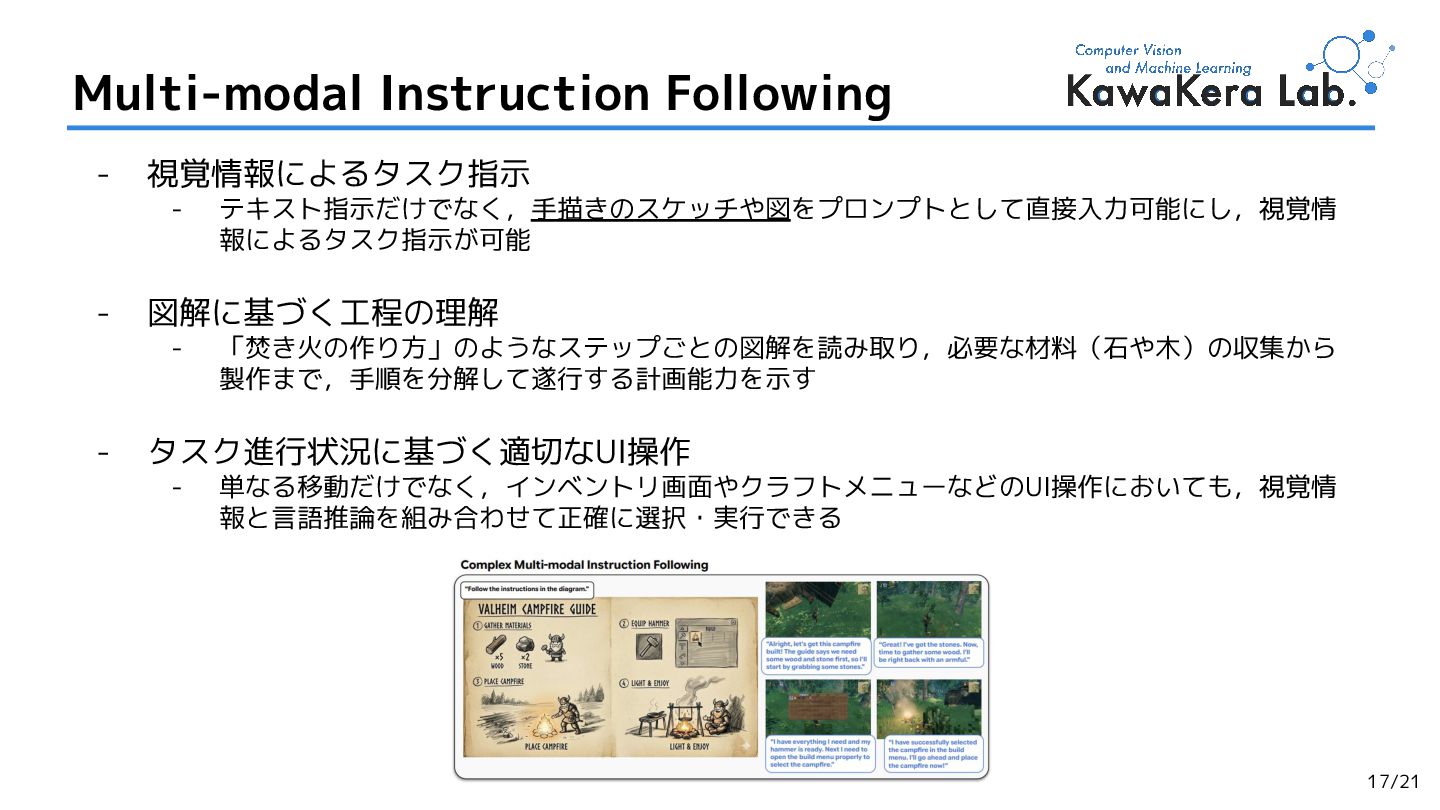
17/21 Multi-modal Instruction Following - 視覚情報によるタスク指示 - テキスト指示だけでなく,手描きのスケッチや図をプロンプトとして直接入力可能にし,視覚情 報によるタスク指示が可能 -
図解に基づく工程の理解 - 「焚き火の作り方」のようなステップごとの図解を読み取り,必要な材料(石や木)の収集から 製作まで,手順を分解して遂行する計画能力を示す - タスク進行状況に基づく適切なUI操作 - 単なる移動だけでなく,インベントリ画面やクラフトメニューなどのUI操作においても,視覚情 報と言語推論を組み合わせて正確に選択・実行できる -
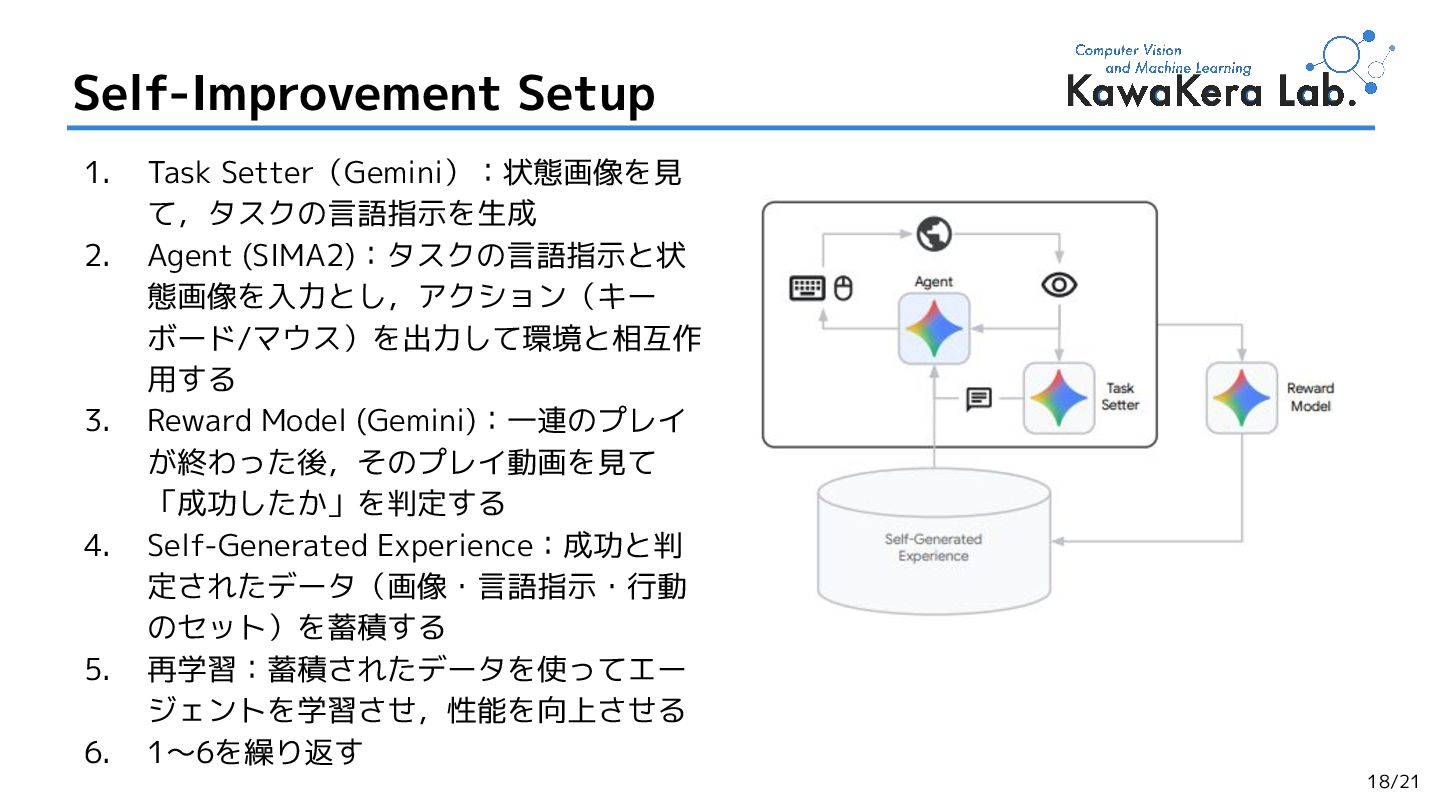
18/21 Self-Improvement Setup 1. Task Setter(Gemini):状態画像を見 て,タスクの言語指示を生成 2. Agent (SIMA2):タスクの言語指示と状
態画像を入力とし,アクション(キー ボード/マウス)を出力して環境と相互作 用する 3. Reward Model (Gemini):一連のプレイ が終わった後,そのプレイ動画を見て 「成功したか」を判定する 4. Self-Generated Experience:成功と判 定されたデータ(画像・言語指示・行動 のセット)を蓄積する 5. 再学習:蓄積されたデータを使ってエー ジェントを学習させ,性能を向上させる 6. 1〜6を繰り返す -
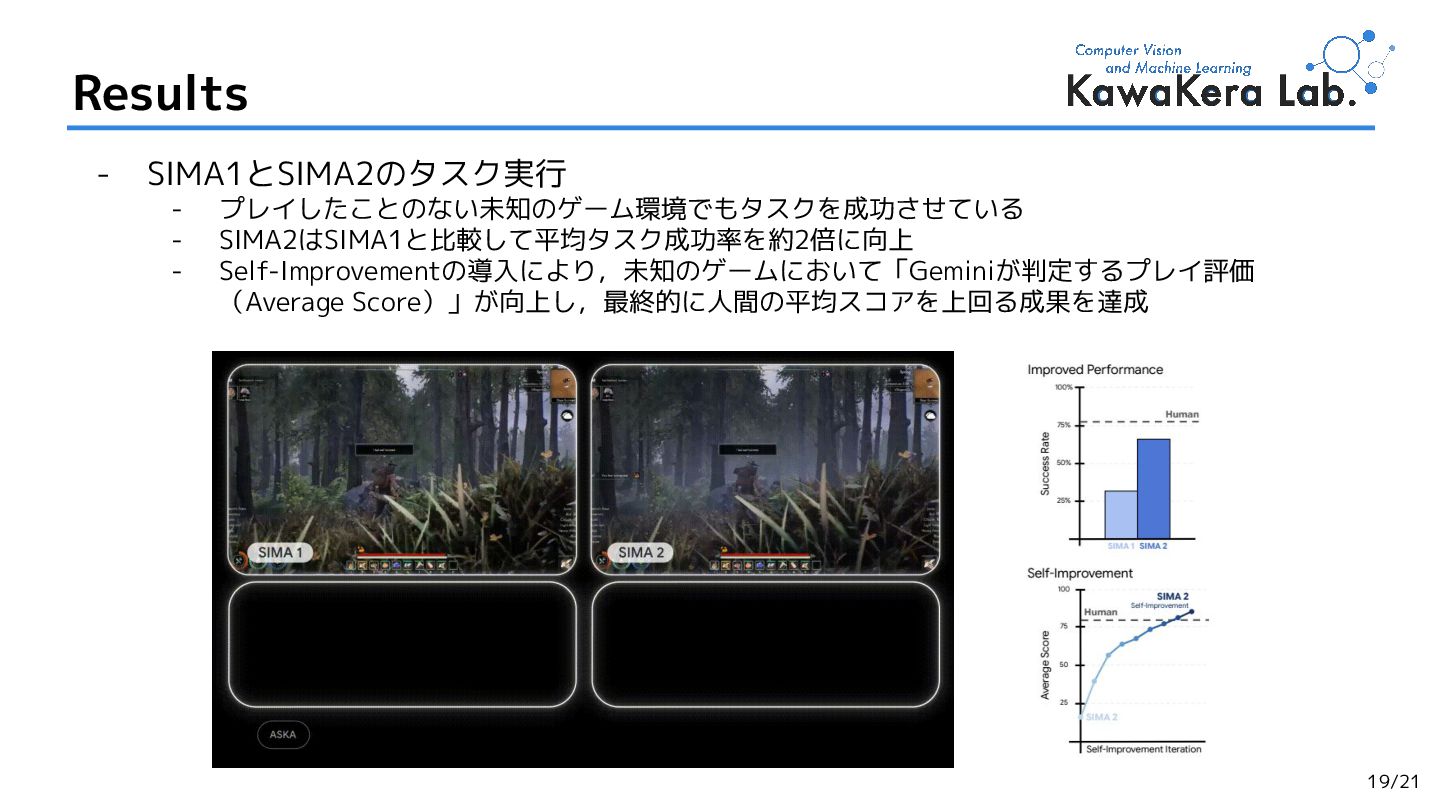
19/21 Results - SIMA1とSIMA2のタスク実行 - プレイしたことのない未知のゲーム環境でもタスクを成功させている - SIMA2はSIMA1と比較して平均タスク成功率を約2倍に向上 - Self-Improvementの導入により,未知のゲームにおいて「Geminiが判定するプレイ評価
(Average Score)」が向上し,最終的に人間の平均スコアを上回る成果を達成 -
20/21 DreamerV4: - オフラインデータによるダイヤモンドタスクの達成 Conclusion SIMA2: - 対話を通じた柔軟なタスク遂行と,未知環境への適応を実現したエー ジェント ❖
傾向と今後 ➢ 世界モデルでのシミュレーションがロボットへ応用されている [arXiv’2512] ➢ 「世界モデルの高いサンプル効率」と「言語指示による操作能力」の統合が進 み,複雑なロボットタスクの解決と実社会への展開が加速する