Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Generative Spoken Dialogue Language Modeling [対...
Search
Sloth
December 14, 2023
Research
530
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Generative Spoken Dialogue Language Modeling [対話論文読み会@電通大]
TACL'23でMeta AI Researchから発表された"Generative Spoken Dialogue Language Modeling"の輪読資料です.
Sloth
December 14, 2023
More Decks by Sloth
See All by Sloth
AVSRの世界と日本語特化モデル開発の裏側.pdf
yuta0306
1
750
Core Audio tapを使ったリアルタイム音声処理のお話
yuta0306
0
460
Other Decks in Research
See All in Research
[最先端NLP勉強会2026] Checklists Are Better Than Reward Models For Aligning Language Models
nzw0301
1
340
フィジカルAIの社会実装に向けて -AIエージェントからAgentic Roboticsへ-
hf149
1
2.6k
オンライン凸最適化の基礎とゲーム理論への応用 (IBIS 2026 チュートリアル)
taira_tsuchiya
2
1.2k
[最先端NLP勉強会2026] Agentic Rubrics as Contextual Verifiers for SWE Agents
rfujii
1
400
最先端NLP勉強会2026 論文紹介:Reasoning with Sampling: Your Base Model is Smarter Than You Think (ICLR 2026 paper)
kogoro
4
900
Easy to Guess, Hard to Verify: Lessons from AIMO 3 for Olympiad-Level AI Mathematics
corochann
0
140
SLAMはどこまで解決されたのか?
tomonom
0
1.6k
超効率化への挑戦:1bit LLMの現状と展望
yumaichikawa
0
940
論文読み会 SNLP2026 Tau2-Bench: Evaluating Conversational Agents in a Dual-Control Environment
s_mizuki_nlp
0
320
ros2-perf-multihost: 分散システムにおける客観的なアーキテクチャ評価フレームワーク
takasehideki
0
320
Local Development Companies Network - National Conference 2026
ldcn
0
150
[IEICE-Soceity-Conf2026] セマンティック通信を見据えたマルチスケールセンシングと 学習の融合によるデジタルツイン基盤 / Digital Twin Infrastructure via the Fusion of Multi-Scale Sensing and Learning toward Semantic Communications
pman0214
0
130
Featured
See All Featured
Bash Introduction
62gerente
615
220k
Raft: Consensus for Rubyists
vanstee
143
7.8k
Are puppies a ranking factor?
jonoalderson
2
4.1k
Avoiding the “Bad Training, Faster” Trap in the Age of AI
tmiket
0
290
The Curious Case for Waylosing
cassininazir
1
590
A better future with KSS
kneath
240
18k
Building AI with AI
inesmontani
PRO
1
1.3k
The Invisible Side of Design
smashingmag
301
52k
My Coaching Mixtape
mlcsv
0
370
Faster Mobile Websites
deanohume
310
32k
Statistics for Hackers
jakevdp
799
230k
職位にかかわらず全員がリーダーシップを発揮するチーム作り / Building a team where everyone can demonstrate leadership regardless of position
madoxten
70
68k
Transcript
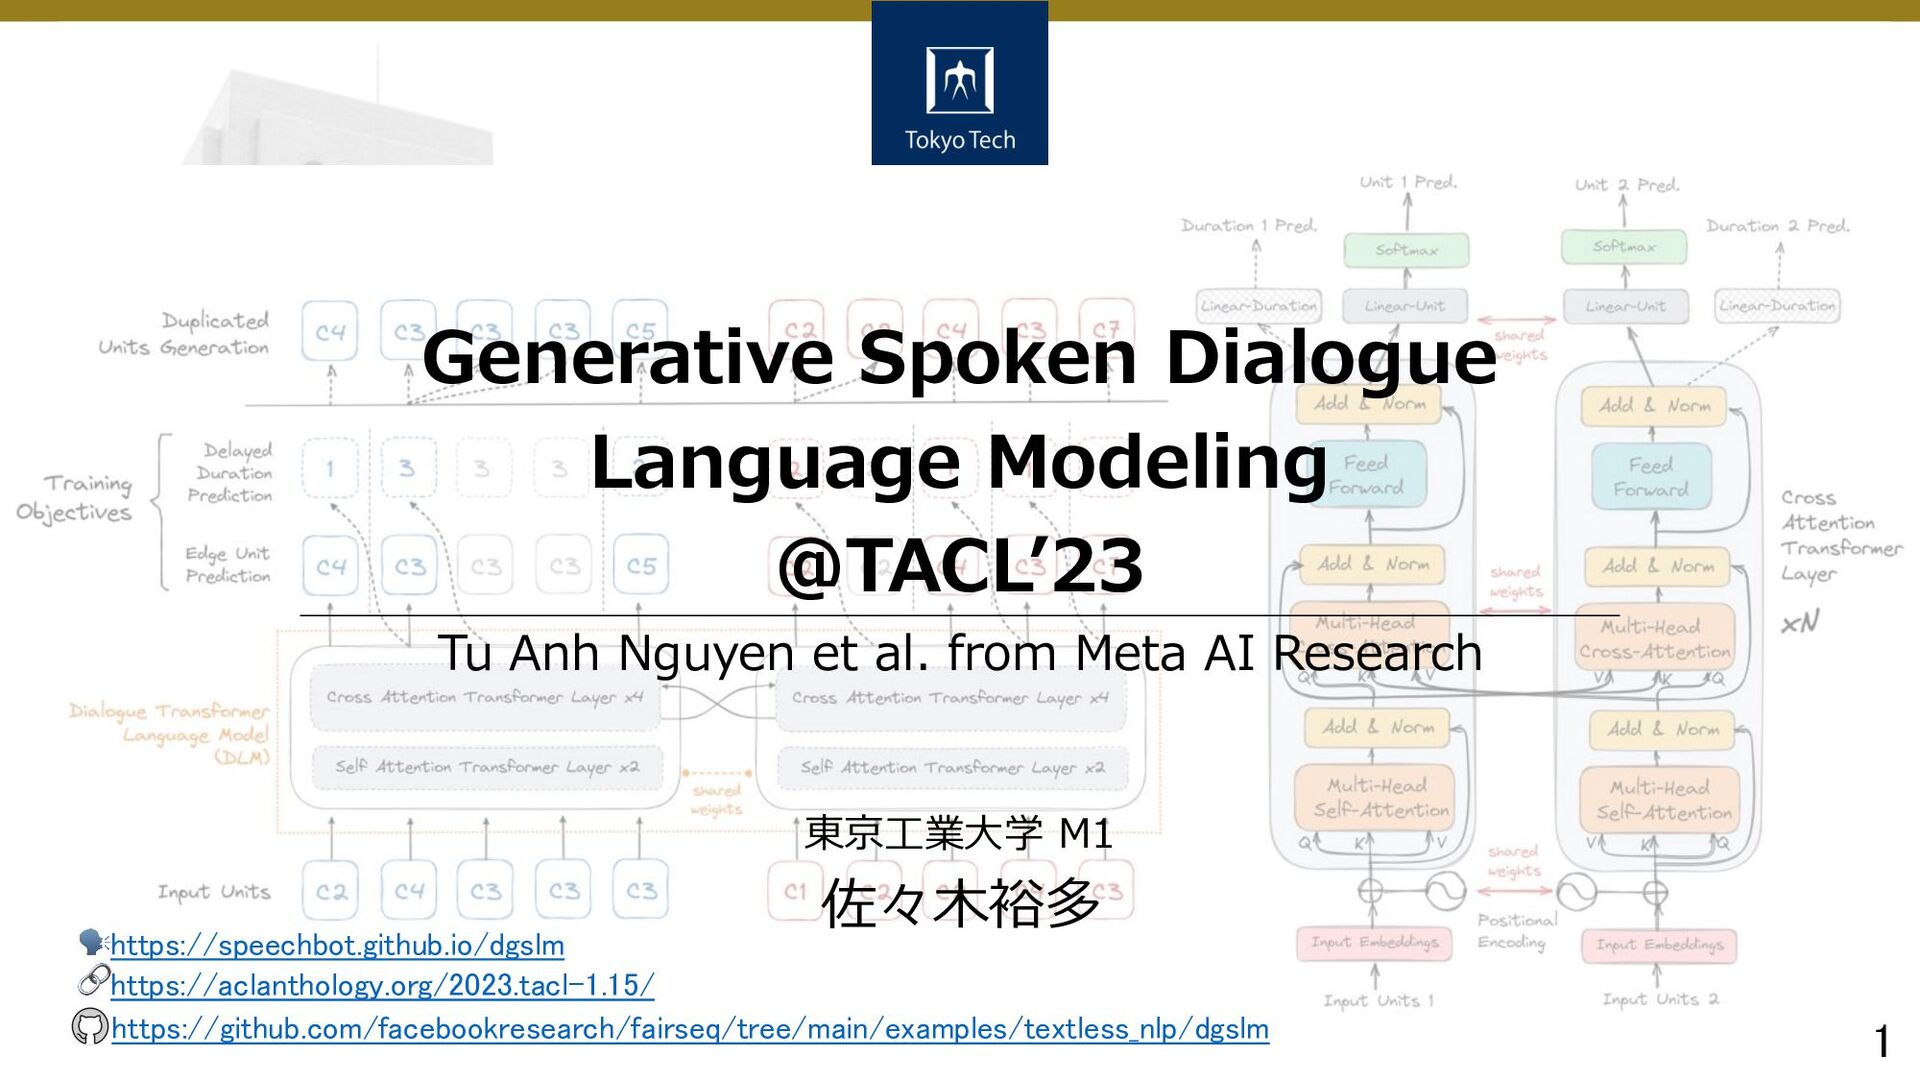
1 Generative Spoken Dialogue Language Modeling @TACLʼ23 佐々⽊裕多 東京⼯業⼤学 M1
Tu Anh Nguyen et al. from Meta AI Research 🔗https://aclanthology.org/2023.tacl-1.15/ https://github.com/facebookresearch/fairseq/tree/main/examples/textless_nlp/dgslm 🗣https://speechbot.github.io/dgslm
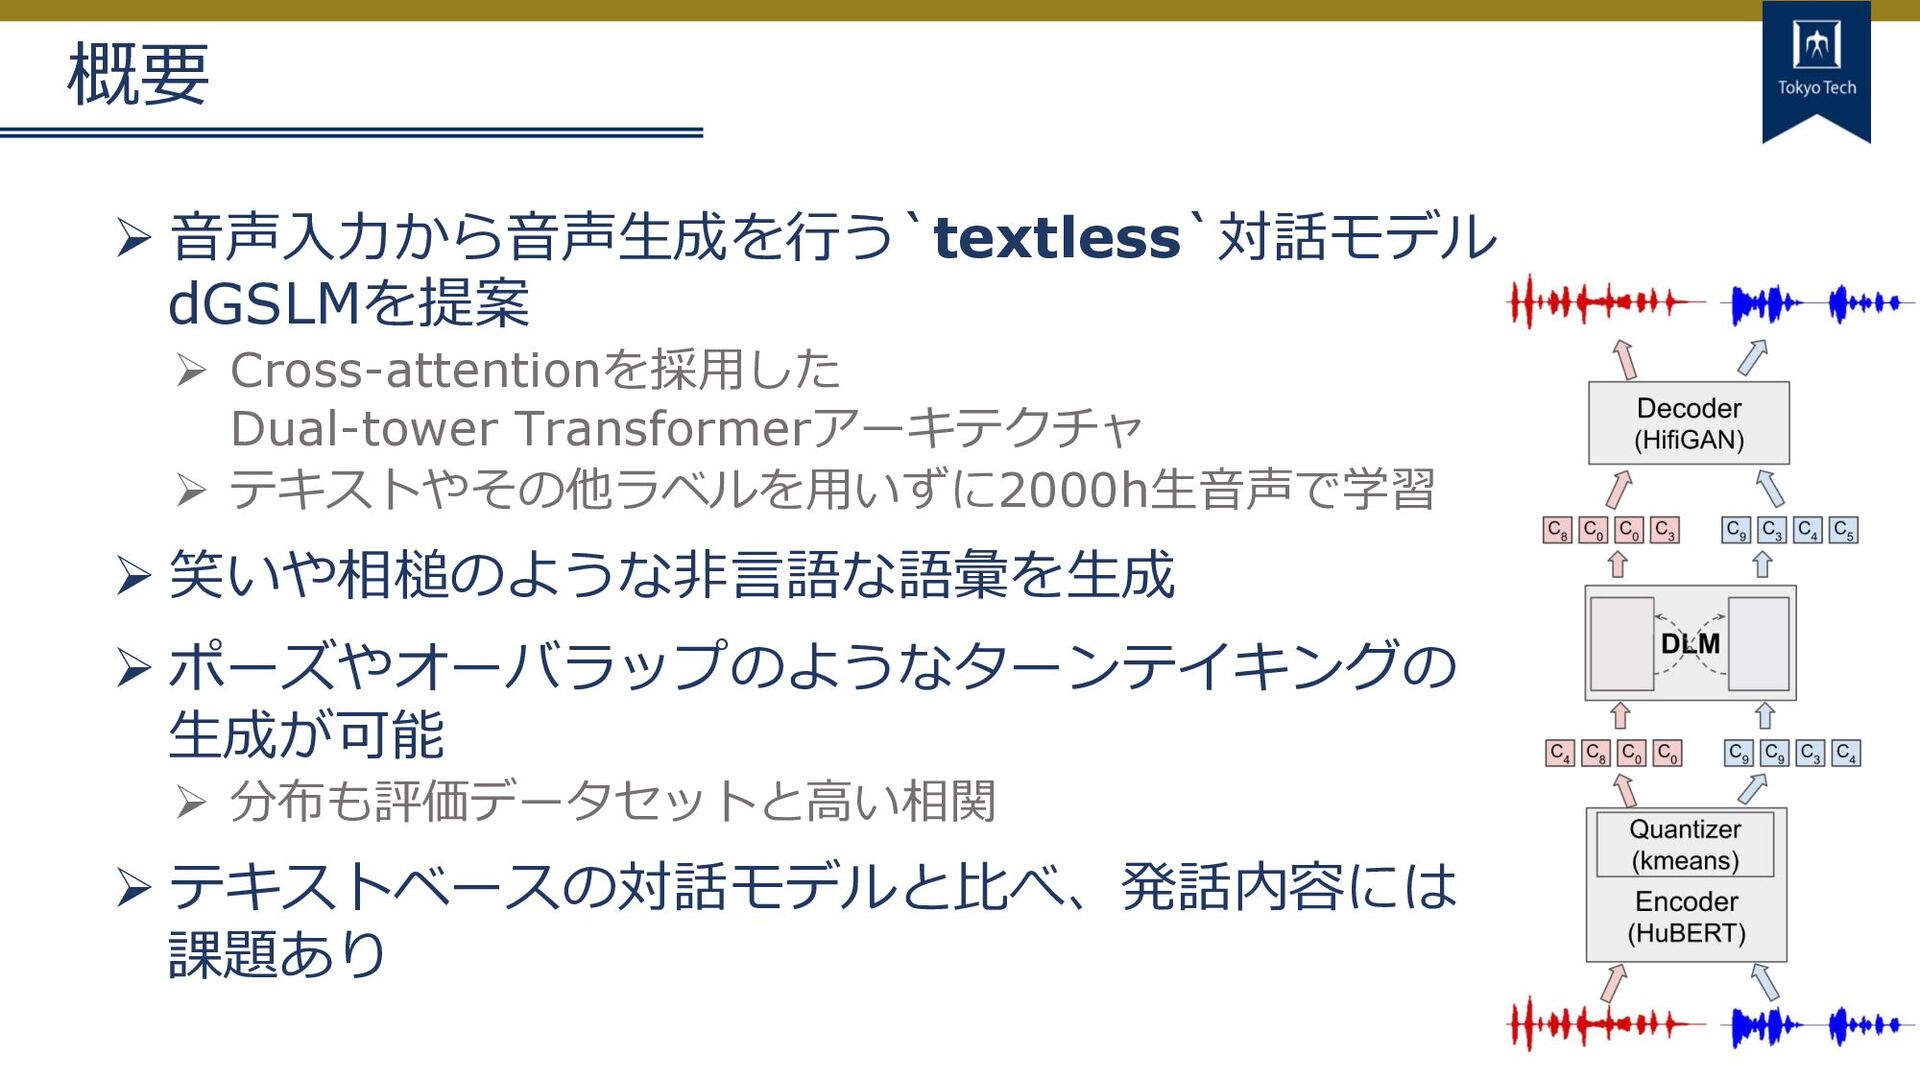
2 概要 Ø ⾳声⼊⼒から⾳声⽣成を⾏う`textless`対話モデル dGSLMを提案 Ø Cross-attentionを採⽤した Dual-tower Transformerアーキテクチャ Ø
テキストやその他ラベルを⽤いずに2000h⽣⾳声で学習 Ø 笑いや相槌のような⾮⾔語な語彙を⽣成 Ø ポーズやオーバラップのようなターンテイキングの ⽣成が可能 Ø 分布も評価データセットと⾼い相関 Ø テキストベースの対話モデルと⽐べ、発話内容には 課題あり
3 対話システムの現状 Ø 会話は流れるようなターンの連続 ❌ 多すぎるオーバラップ ❌ ⻑い沈黙 Ø オーバラップや沈黙は起きるが、重要な情報を伝える
Ø Content-neutralな⾔語情報 Ø E.g., “hmm”, “yeah” Ø ⾮⾔語な語彙 Ø E.g., 笑い Ø 聞き⼿の態度 Ø E.g., 相槌 テキストベースのインターフェースでの対話研究が多いため、 ターンテイキングの調整に難しさ
4 本研究の⽴ち位置 Ø テキストやASRを介さず、⽣⾳声から⾳声対話モデルを学習す る実現可能性を検証 Ø ASRを通すとユーザからの⼊⼒を待つ必要性 Ø ⾃⼰教師あり学習やtextlessな⾳声処理が発展中 Ø
対話モデルを⾮⾔語的な特徴でも評価 Ø 提案モデルdGSLMが、会話の表⾯上の特徴であるターンテイキ ングや相槌を⾼精度で模倣できていることを⽰す Ø テキストベースのカスケードな対話モデルのような意味的な情報を明⽰ 的には学習しないが…
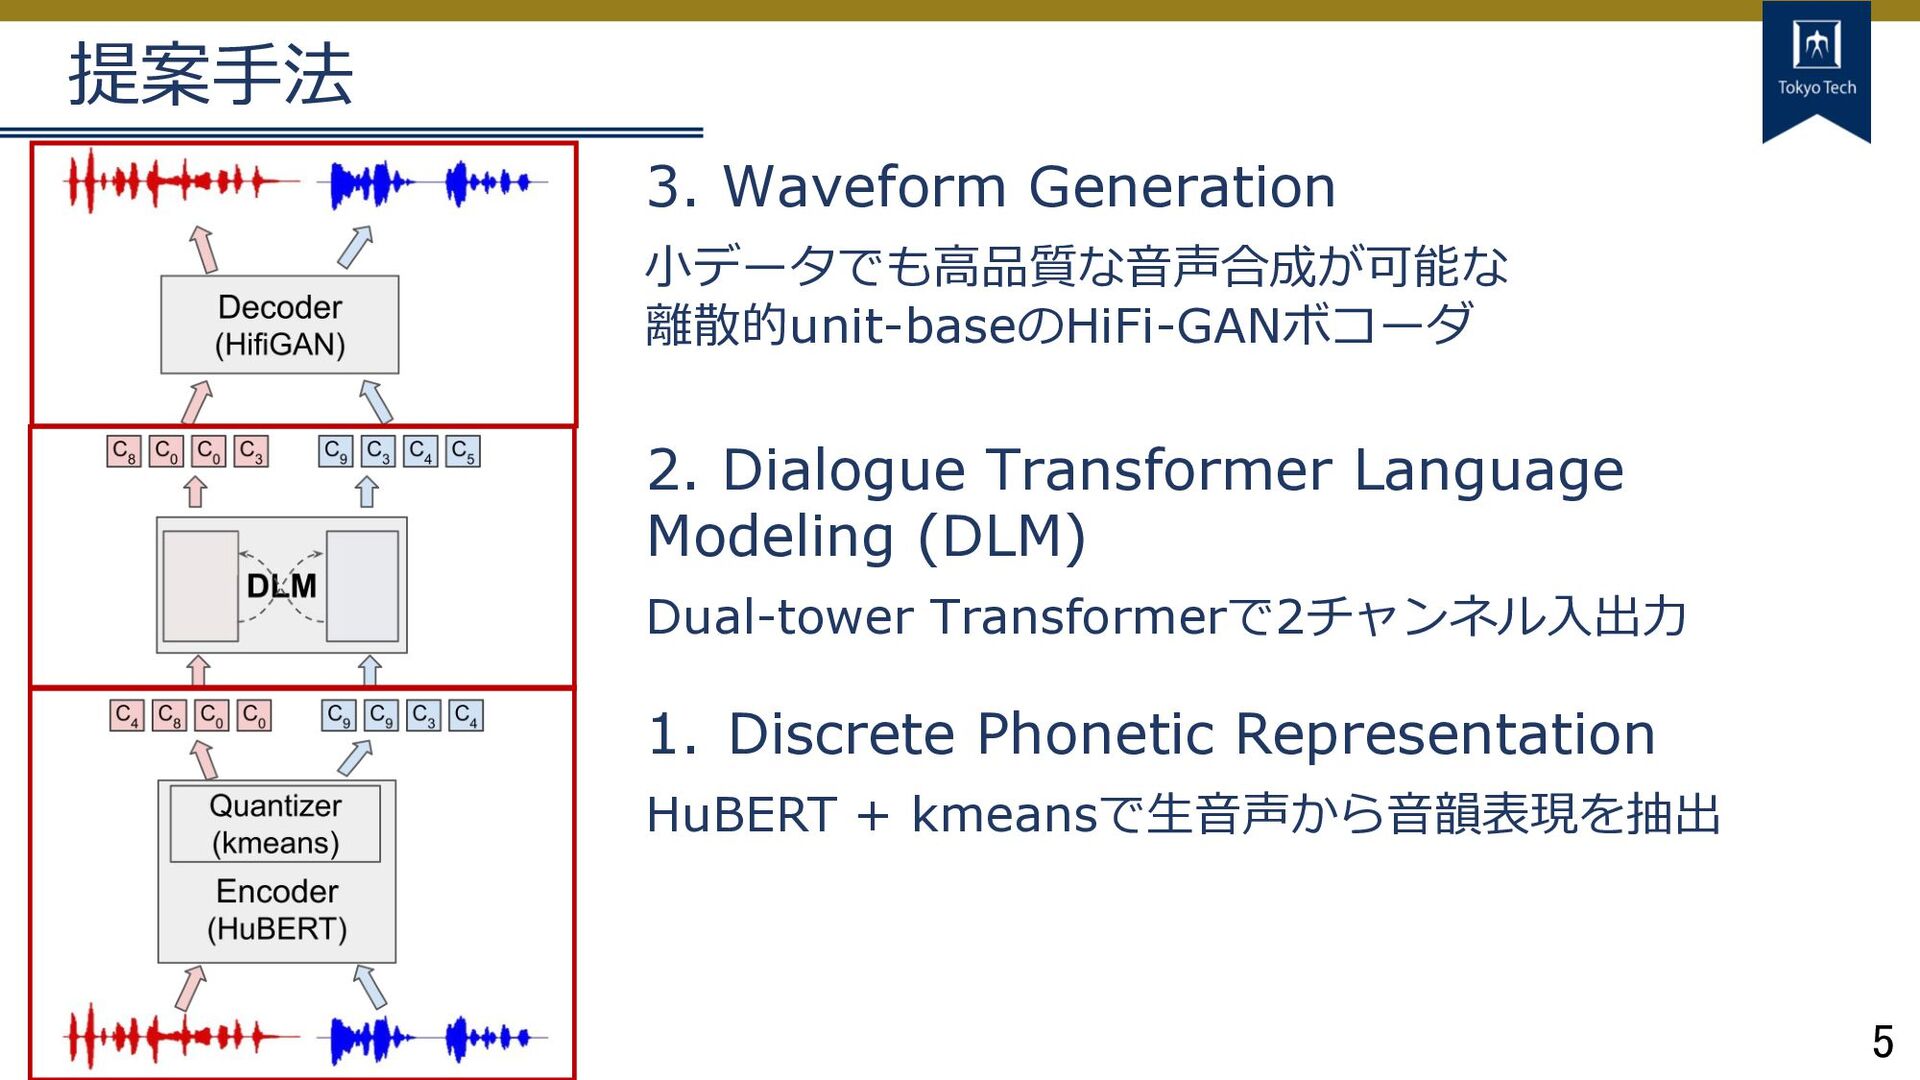
5 提案⼿法 2. Dialogue Transformer Language Modeling (DLM) Dual-tower Transformerで2チャンネル⼊出⼒
1. Discrete Phonetic Representation HuBERT + kmeansで⽣⾳声から⾳韻表現を抽出 3. Waveform Generation ⼩データでも⾼品質な⾳声合成が可能な 離散的unit-baseのHiFi-GANボコーダ
6 1. Discrete Phonetic Representation HuBERT: Self-Supervised Speech Representation Learning
by Masked Prediction of Hidden Units Ø 会話には “hmm”のようなカジュアル表現や 笑いのような⾮⾔語⾳声含まれる Ø ドメインに適切な⾳韻表現を獲得するため HuBERTを採⽤ Ø HuBERTの出⼒をkmeansでクラスタリング Ø 離散的な⾳韻unitを獲得 Ø 最終的な離散的⾳韻unitのコードブックは500 Ø 様々な⾳韻クラスをモデル化 ※HuBERTの⾃⼰教師あり学習は⾯⽩いので 興味があれば論⽂を参照してください
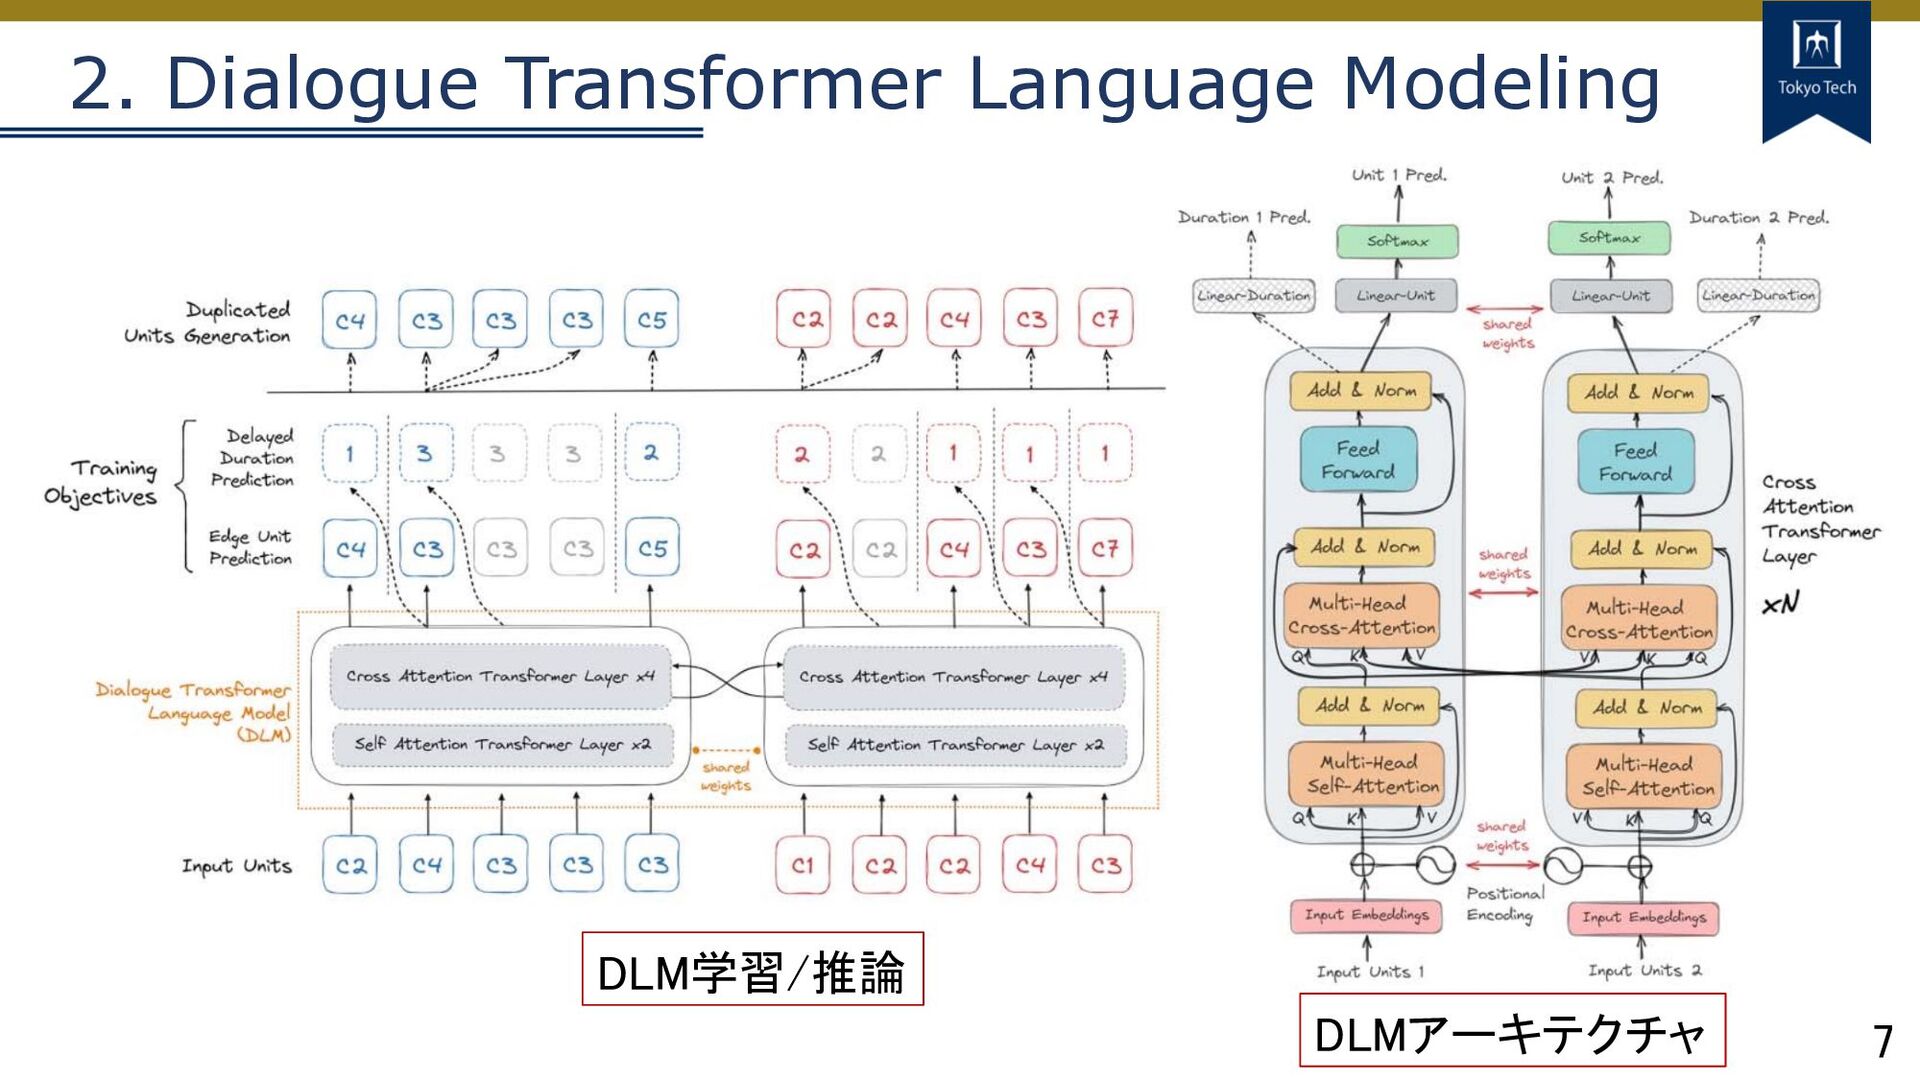
7 2. Dialogue Transformer Language Modeling DLMアーキテクチャ DLM学習/推論
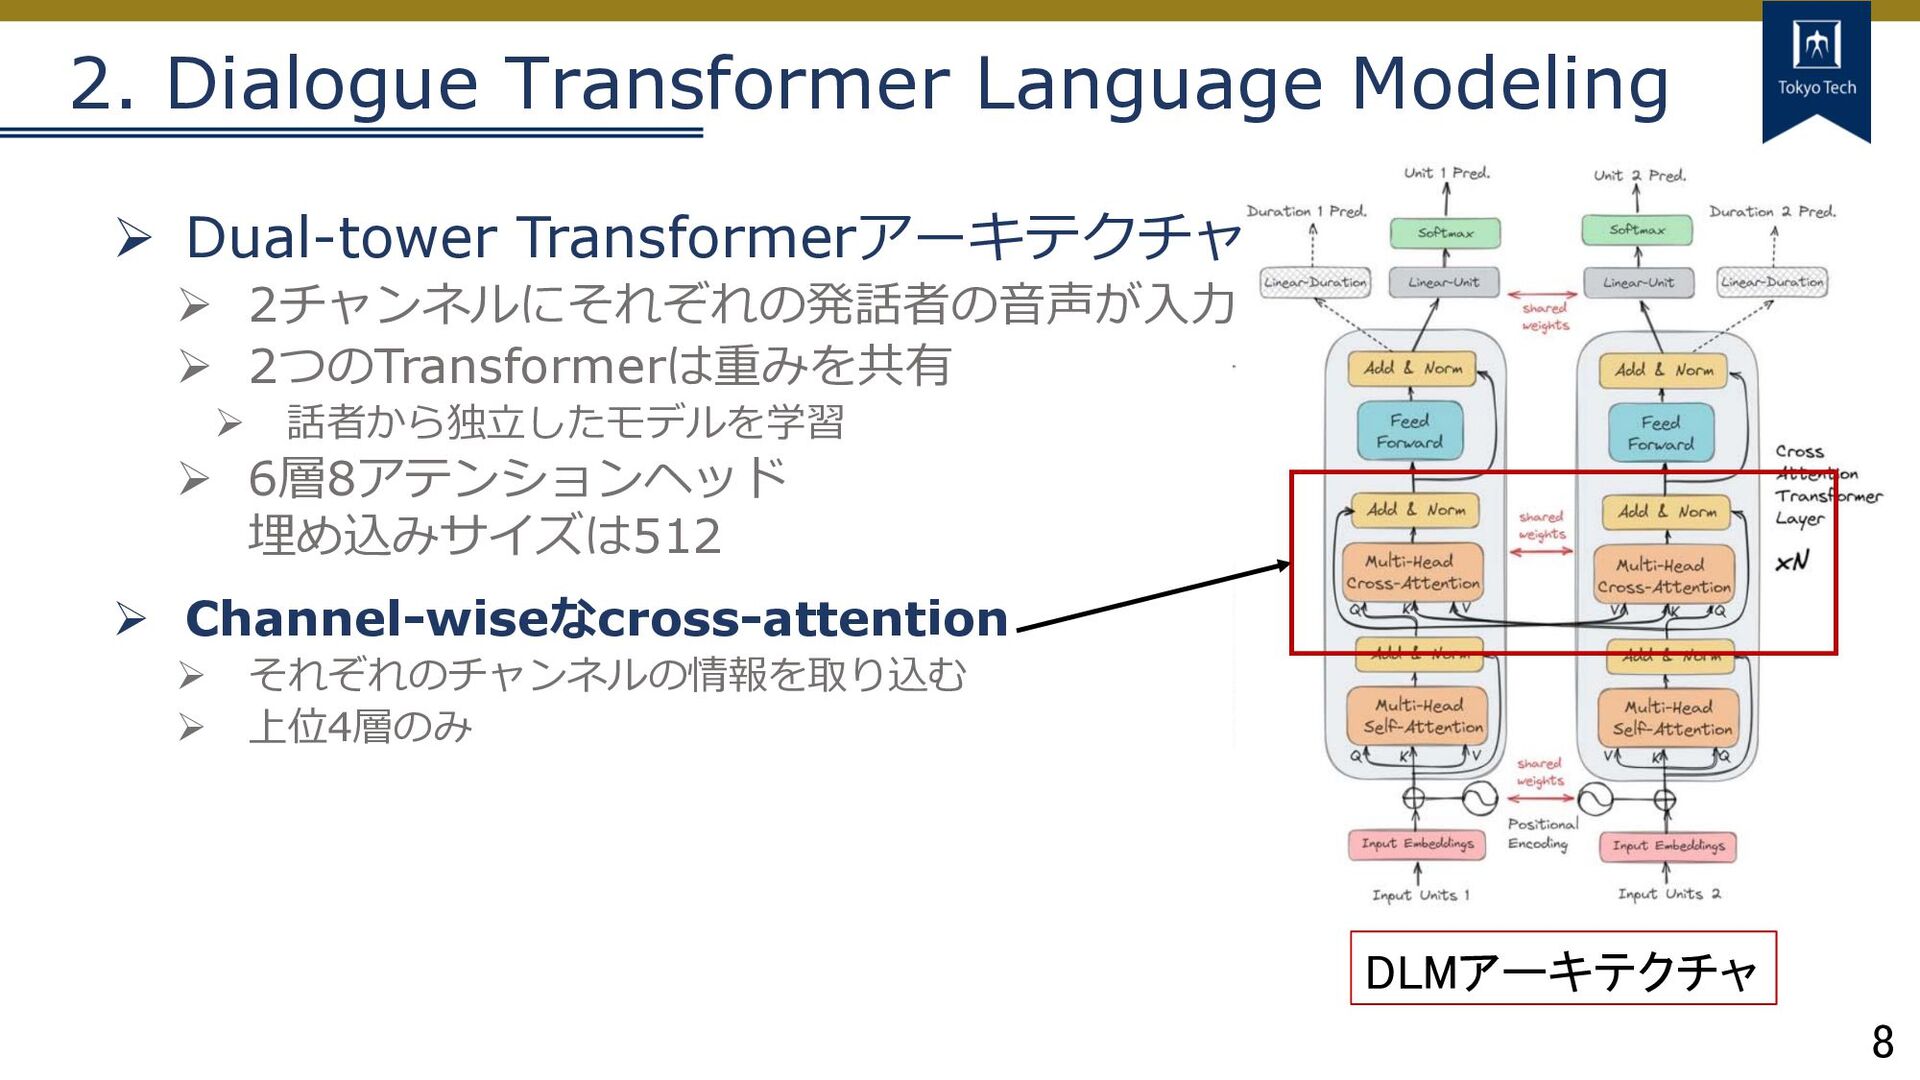
8 2. Dialogue Transformer Language Modeling DLMアーキテクチャ Ø Dual-tower Transformerアーキテクチャ
Ø 2チャンネルにそれぞれの発話者の⾳声が⼊⼒ Ø 2つのTransformerは重みを共有 Ø 話者から独⽴したモデルを学習 Ø 6層8アテンションヘッド 埋め込みサイズは512 Ø Channel-wiseなcross-attention Ø それぞれのチャンネルの情報を取り込む Ø 上位4層のみ
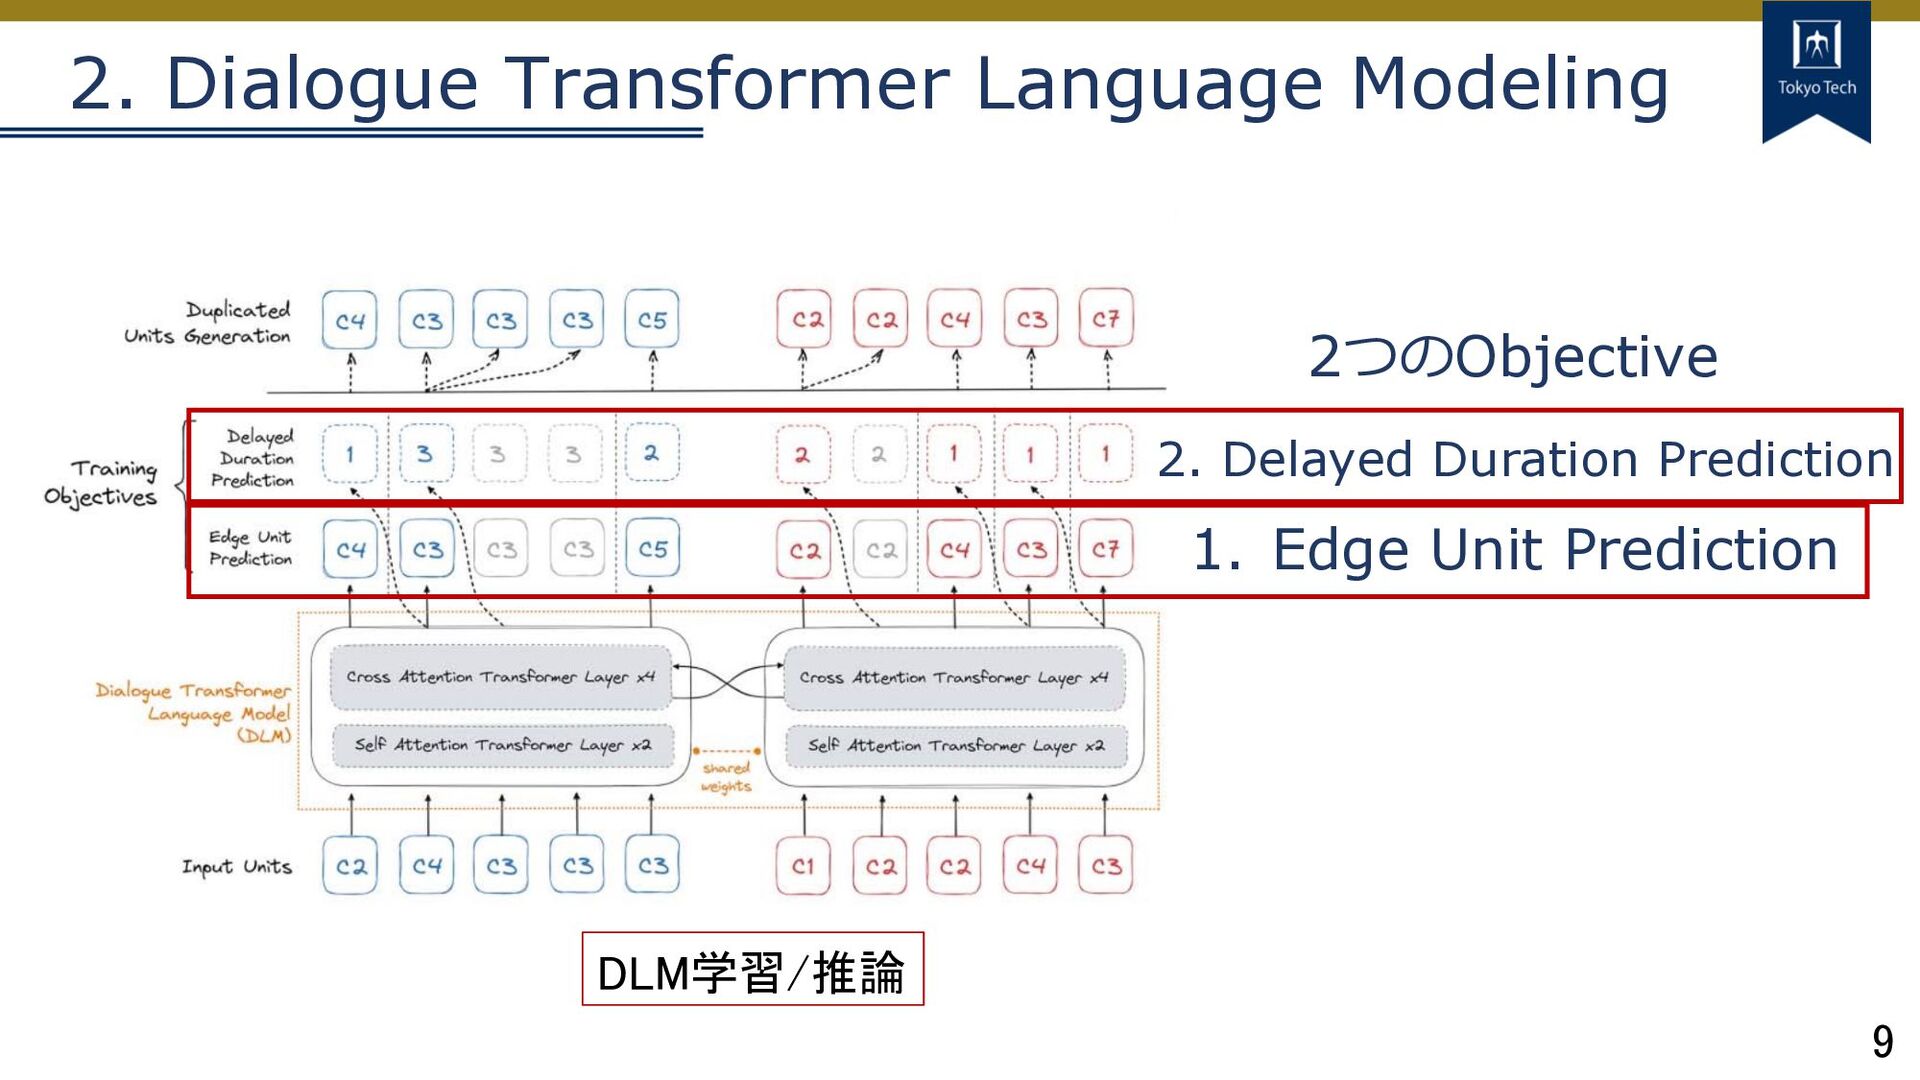
9 2. Dialogue Transformer Language Modeling DLM学習/推論 1. Edge Unit
Prediction 2. Delayed Duration Prediction 2つのObjective
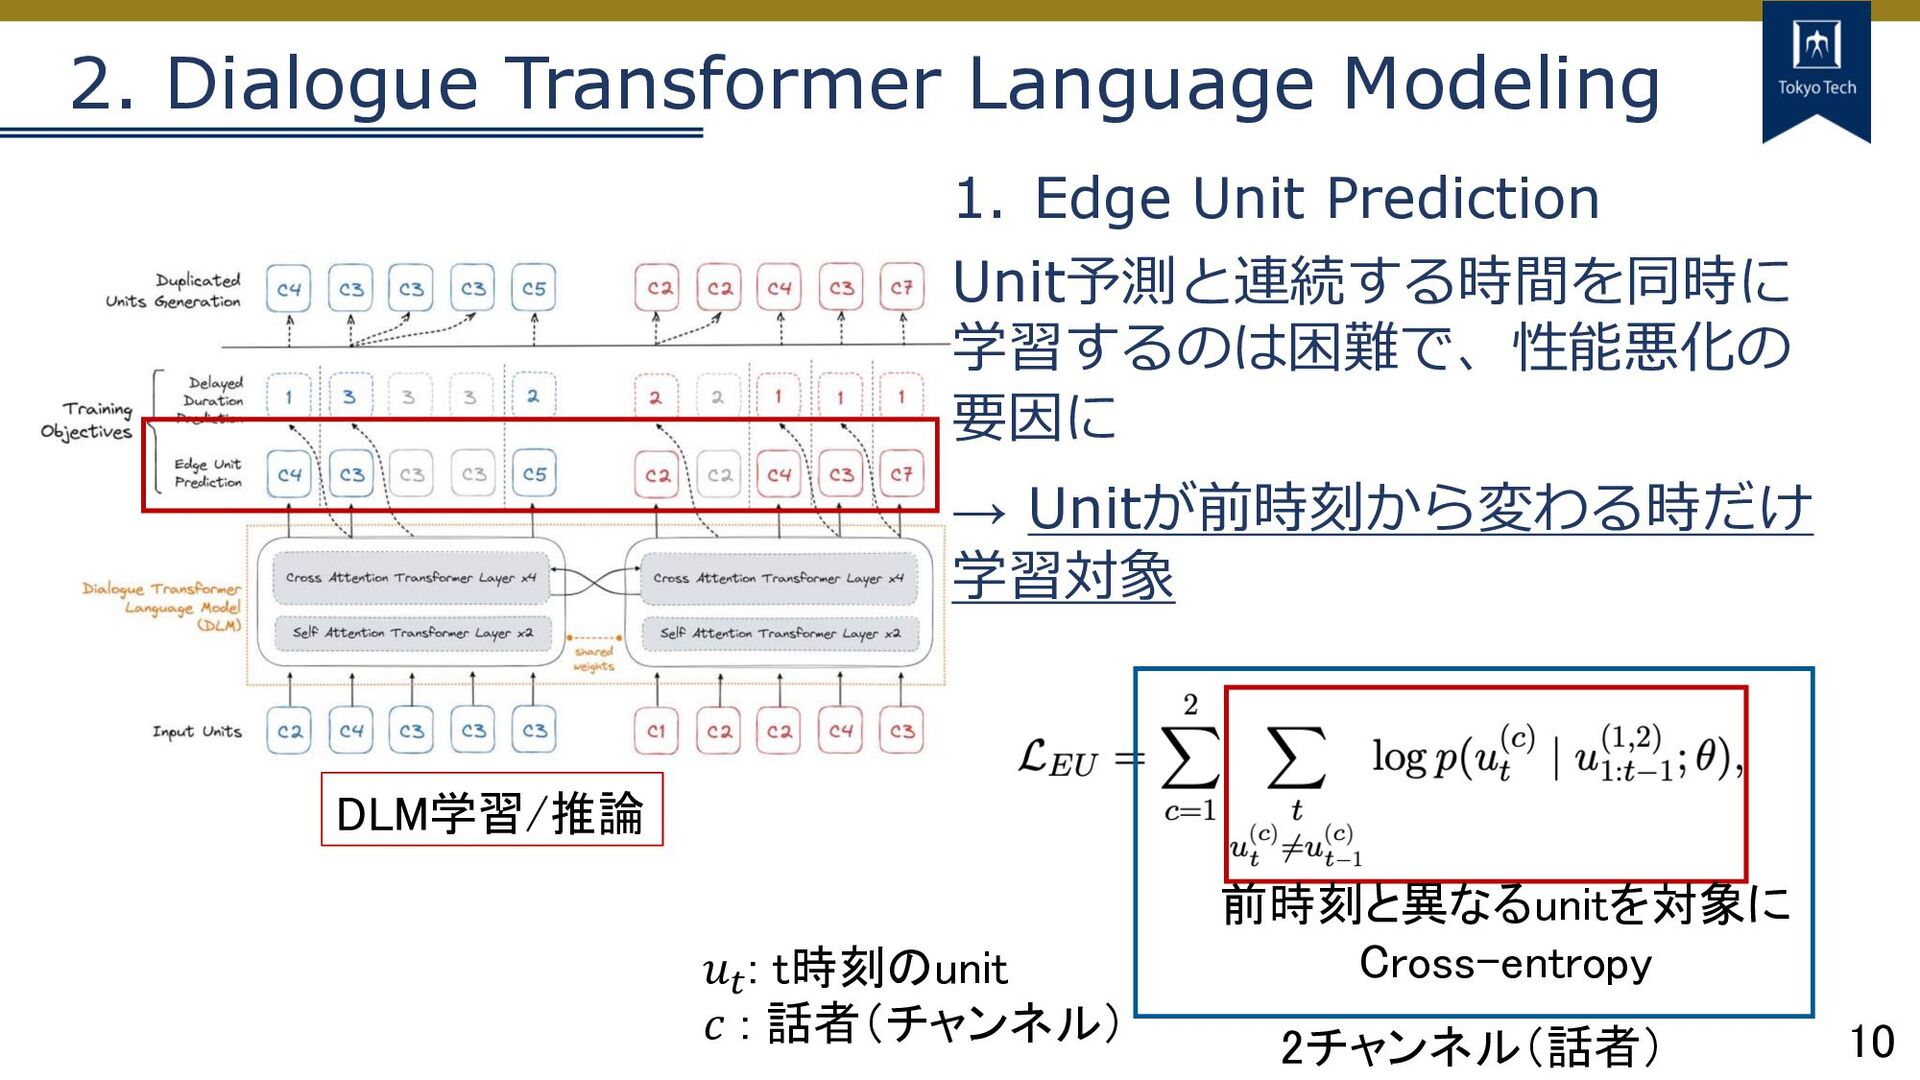
10 2. Dialogue Transformer Language Modeling DLM学習/推論 1. Edge Unit
Prediction Unit予測と連続する時間を同時に 学習するのは困難で、性能悪化の 要因に → Unitが前時刻から変わる時だけ 学習対象 前時刻と異なるunitを対象に Cross-entropy 2チャンネル(話者) 𝑢! : t時刻のunit 𝑐 : 話者(チャンネル)
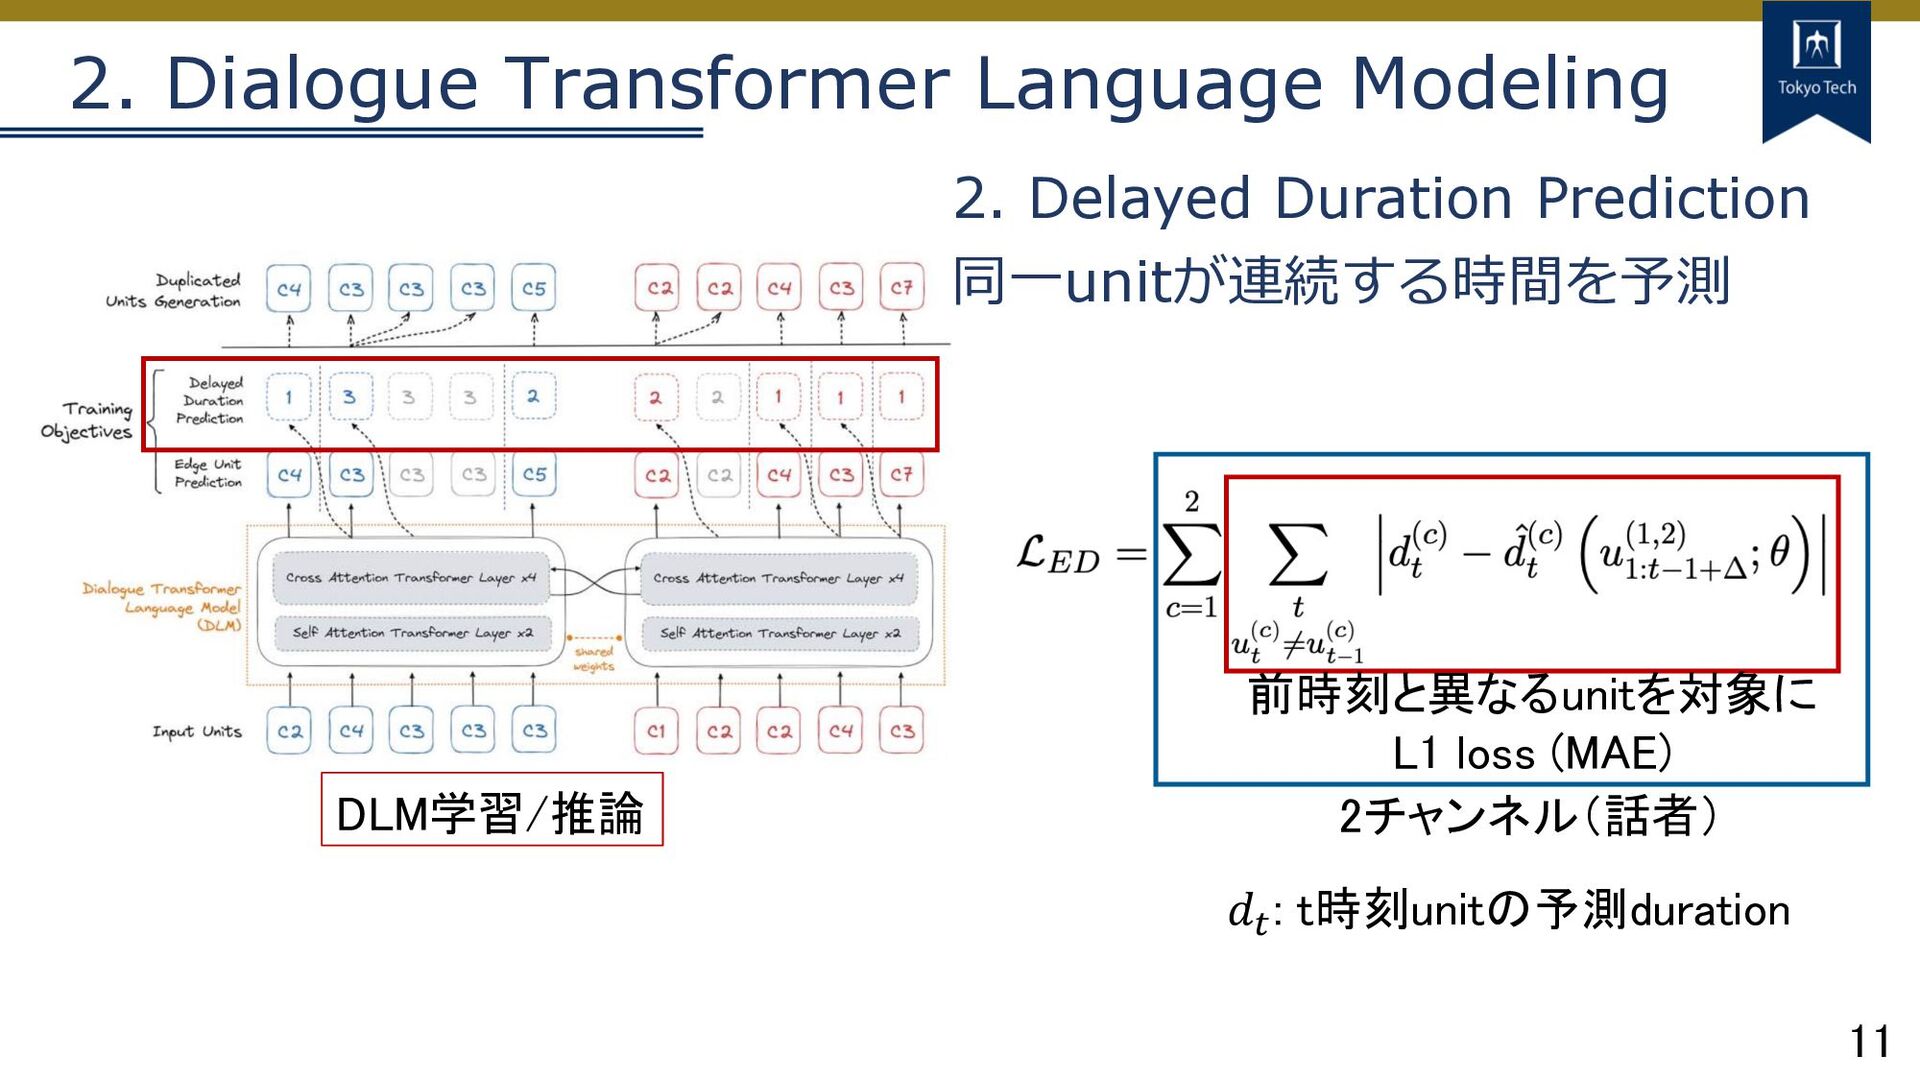
11 2. Dialogue Transformer Language Modeling DLM学習/推論 2. Delayed Duration
Prediction 同⼀unitが連続する時間を予測 前時刻と異なるunitを対象に L1 loss (MAE) 2チャンネル(話者) 𝑑! : t時刻unitの予測duration
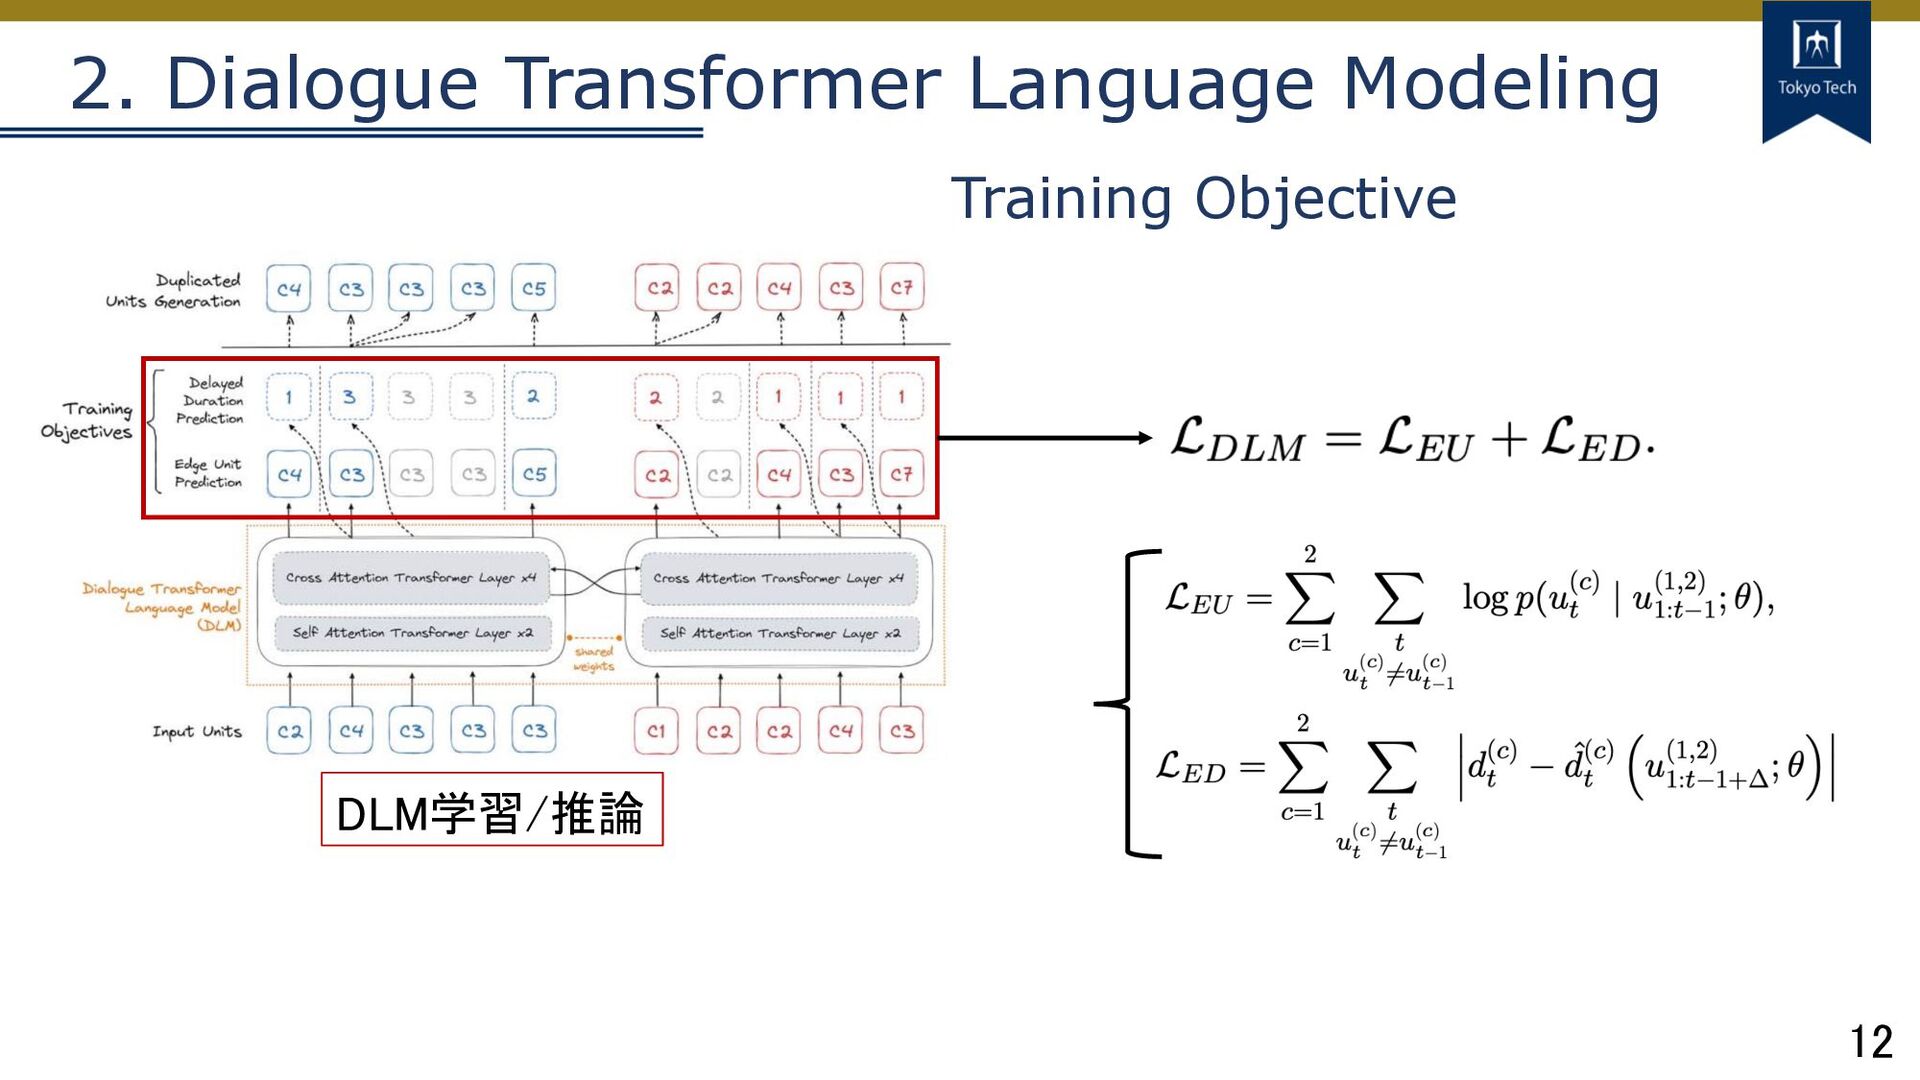
12 2. Dialogue Transformer Language Modeling DLM学習/推論 Training Objective
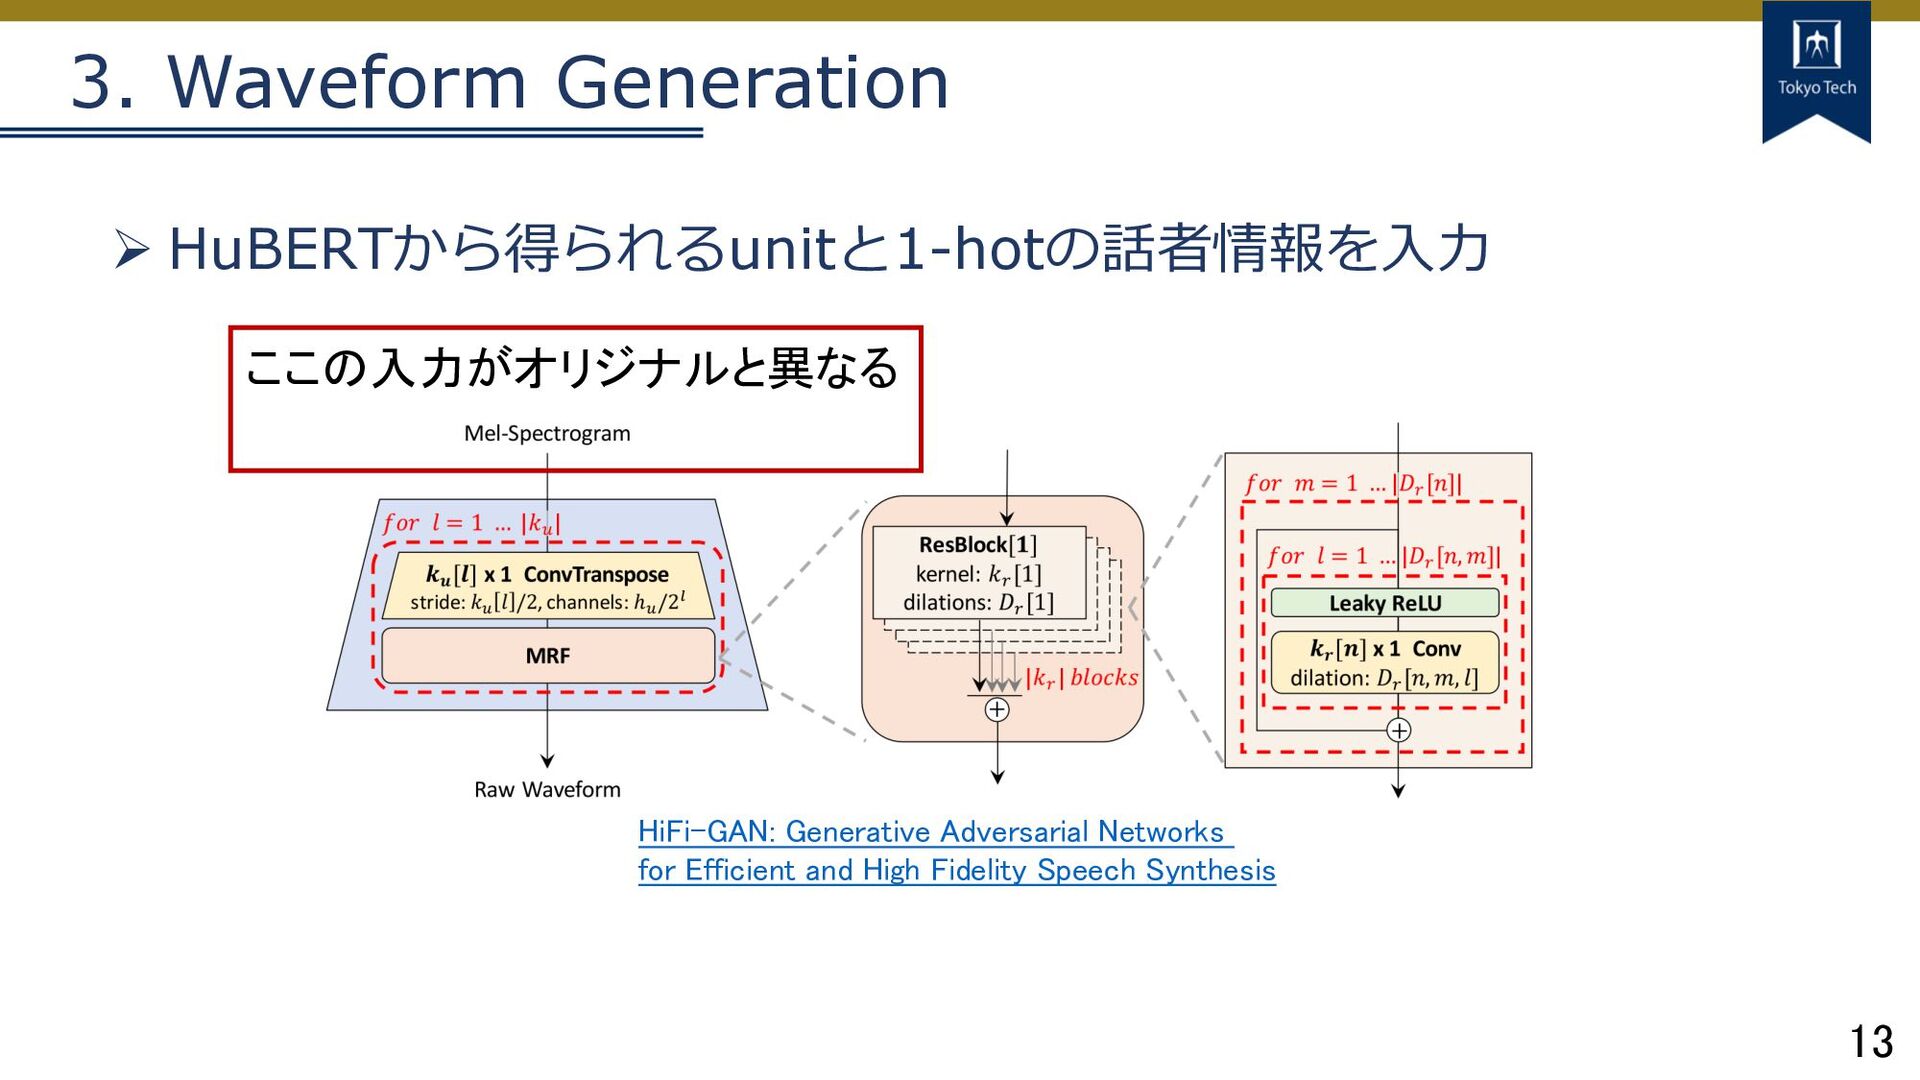
13 3. Waveform Generation Ø HuBERTから得られるunitと1-hotの話者情報を⼊⼒ HiFi-GAN: Generative Adversarial Networks
for Efficient and High Fidelity Speech Synthesis ここの入力がオリジナルと異なる
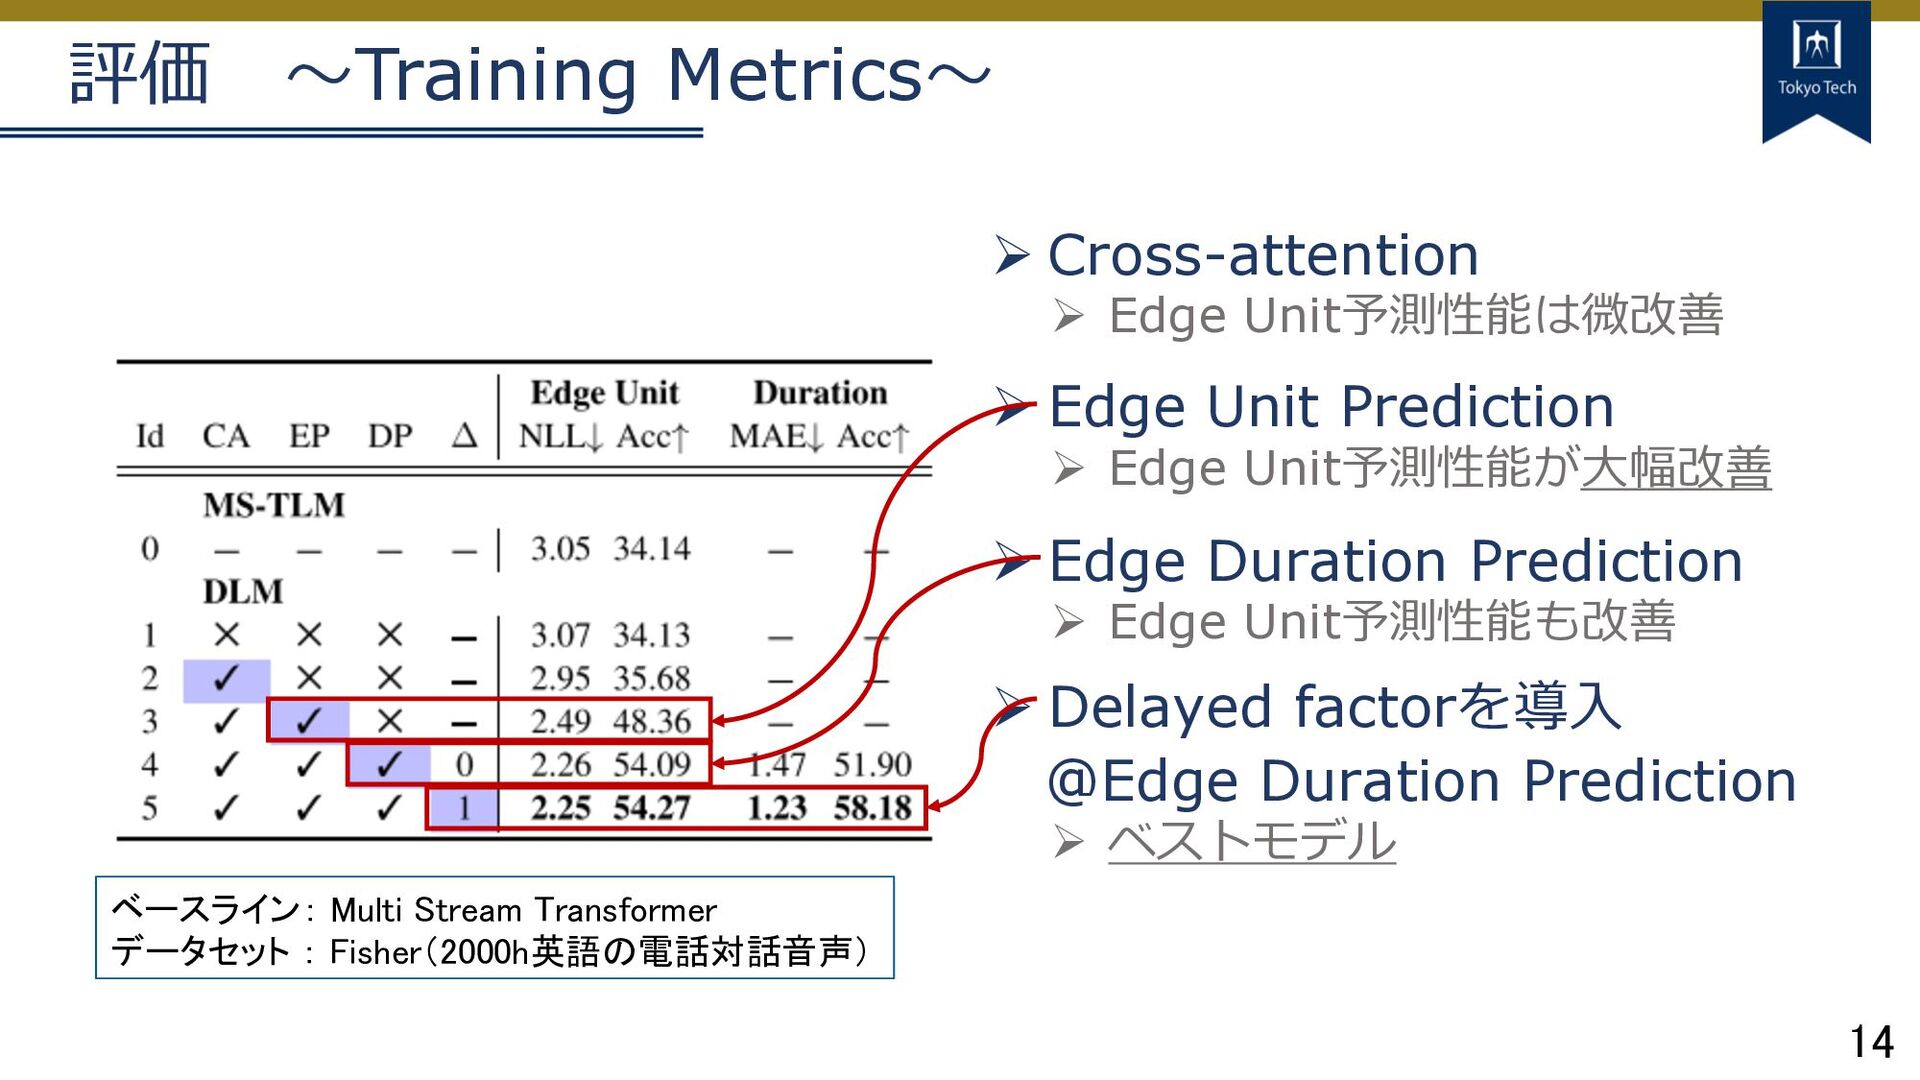
14 評価 〜Training Metrics〜 Ø Cross-attention Ø Edge Unit予測性能は微改善 Ø
Edge Unit Prediction Ø Edge Unit予測性能が⼤幅改善 Ø Edge Duration Prediction Ø Edge Unit予測性能も改善 Ø Delayed factorを導⼊ @Edge Duration Prediction Ø ベストモデル ベースライン: Multi Stream Transformer データセット : Fisher(2000h英語の電話対話音声)
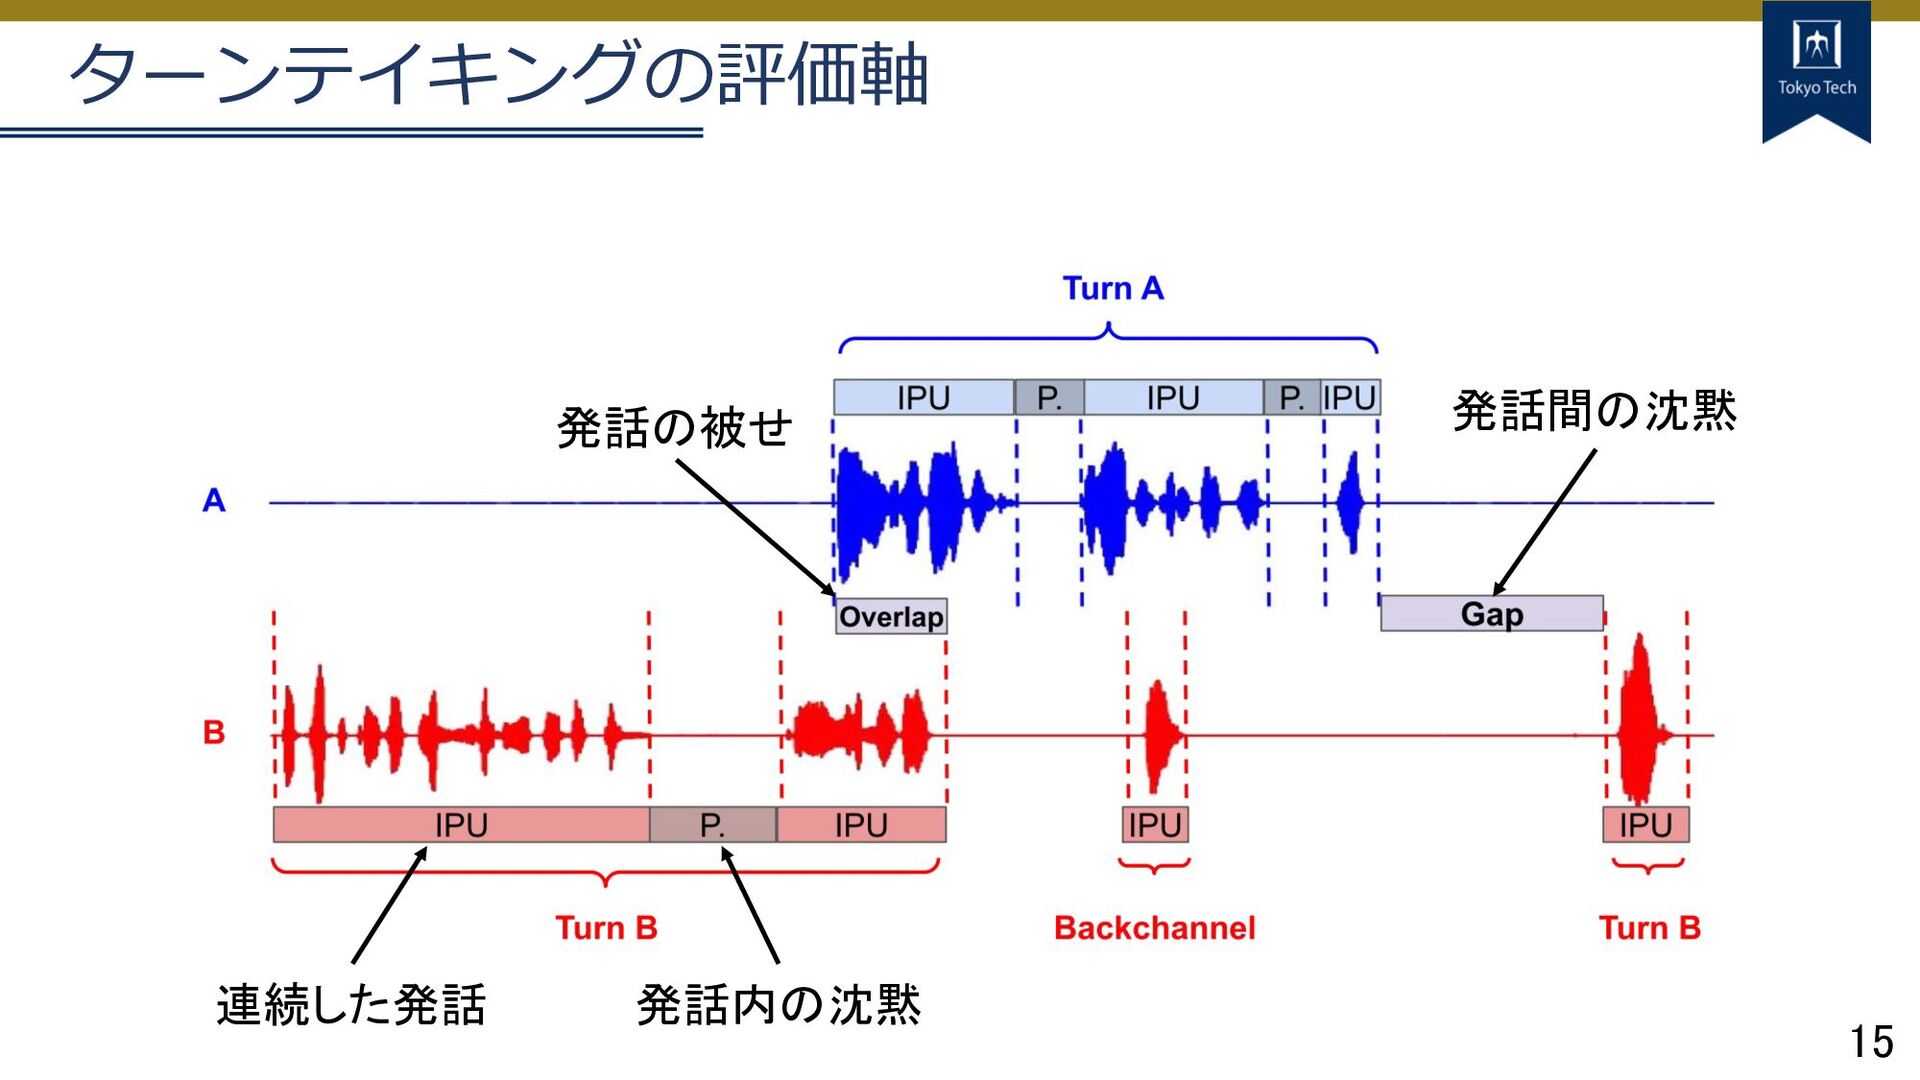
15 ターンテイキングの評価軸 連続した発話 発話内の沈黙 発話の被せ 発話間の沈黙
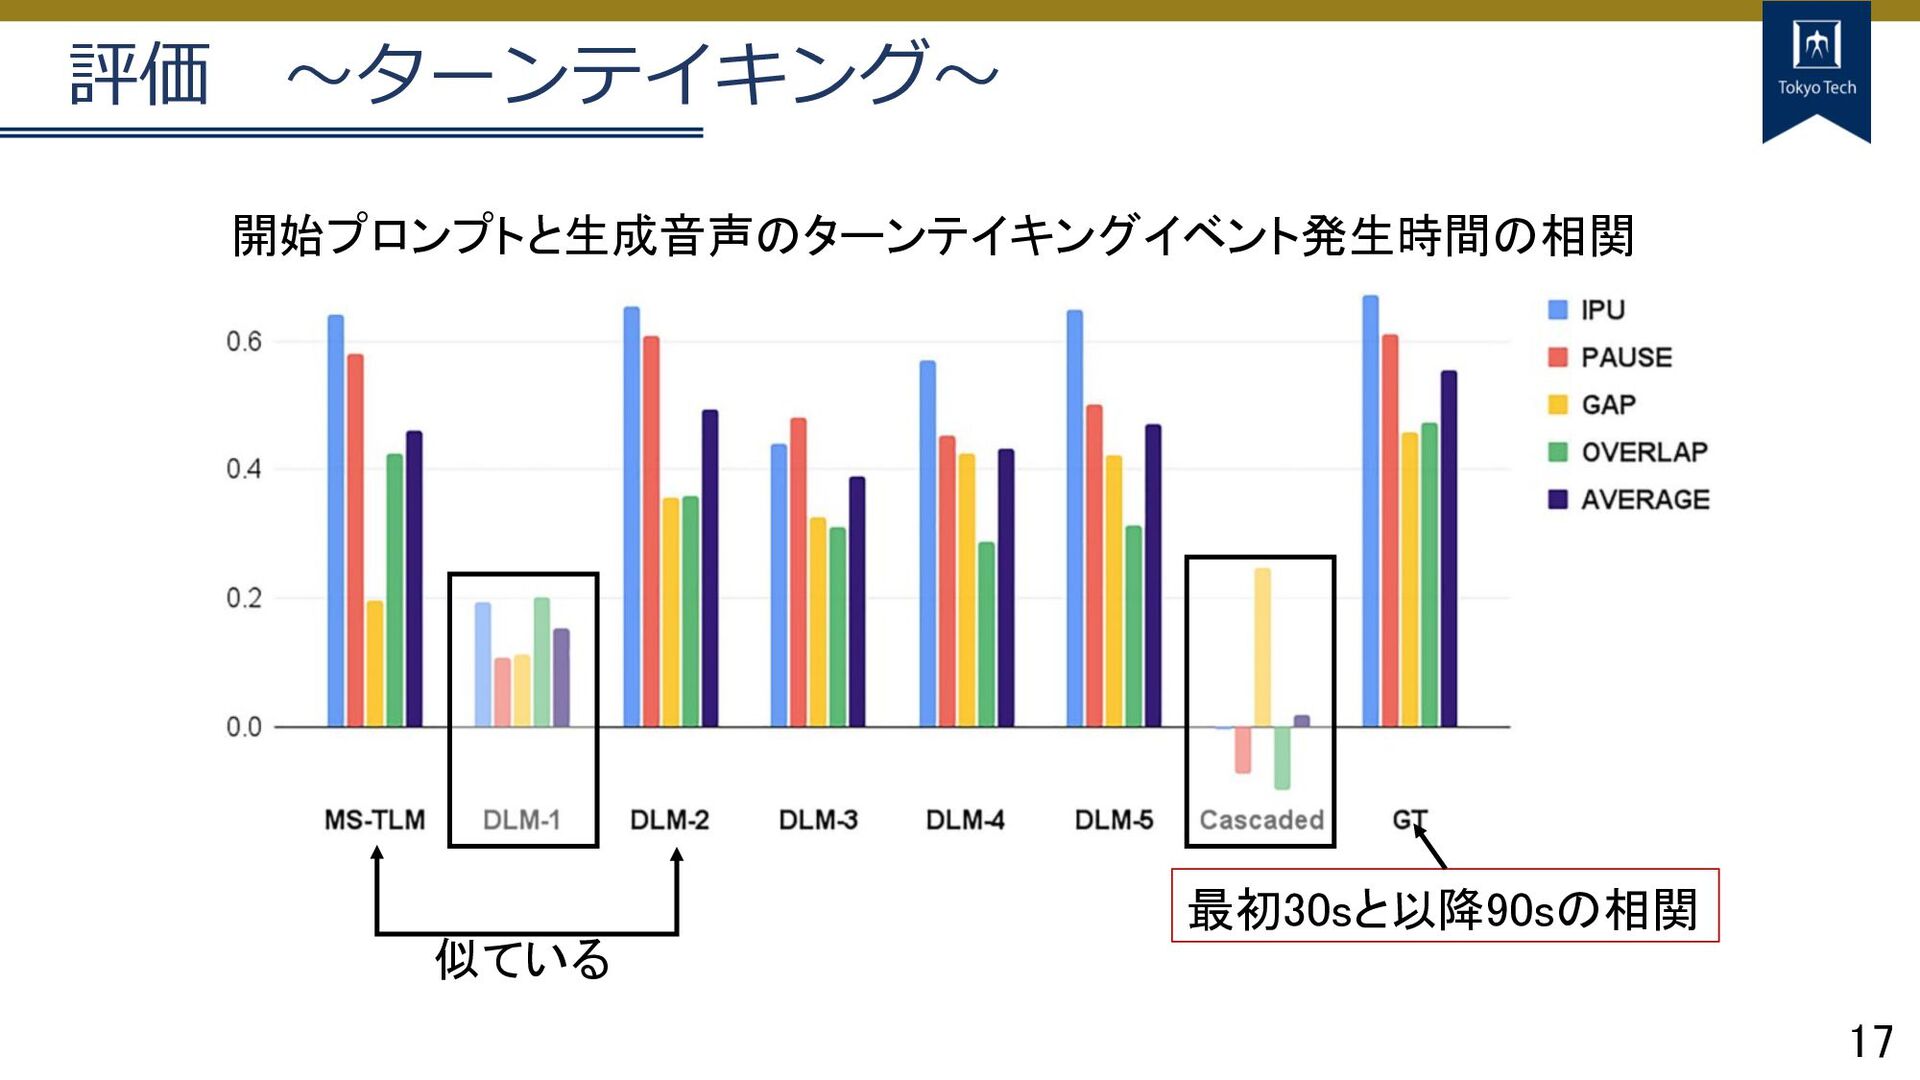
16 評価 〜ターンテイキング〜 DLM-1は IPU以外長い DLM-2はオーバーラップ短め ポーズ/ギャップ長め DLM-3-5はオーバーラップ長め ポーズ/ギャップ短め
17 評価 〜ターンテイキング〜 最初30sと以降90sの相関 開始プロンプトと生成音声のターンテイキングイベント発生時間の相関 似ている
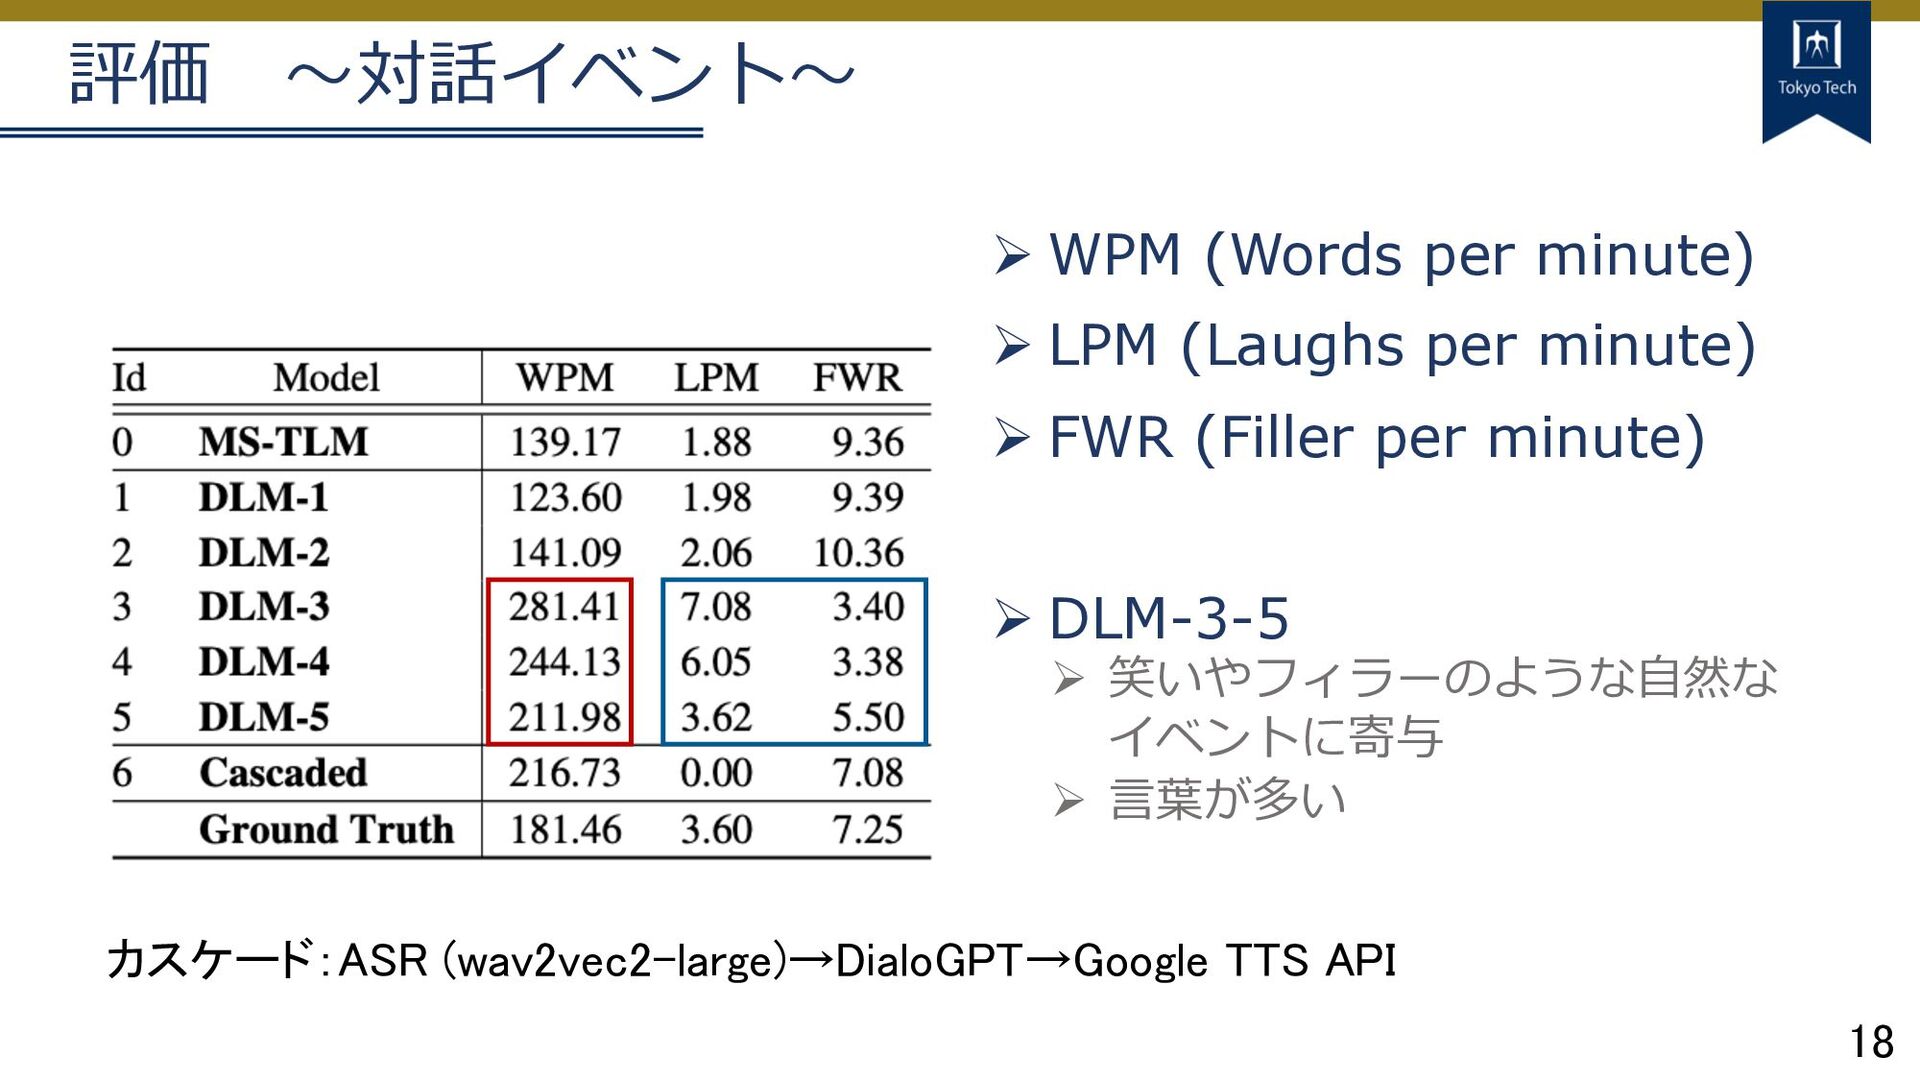
18 評価 〜対話イベント〜 Ø WPM (Words per minute) Ø LPM
(Laughs per minute) Ø FWR (Filler per minute) Ø DLM-3-5 Ø 笑いやフィラーのような⾃然な イベントに寄与 Ø ⾔葉が多い カスケード:ASR (wav2vec2-large)→DialoGPT→Google TTS API
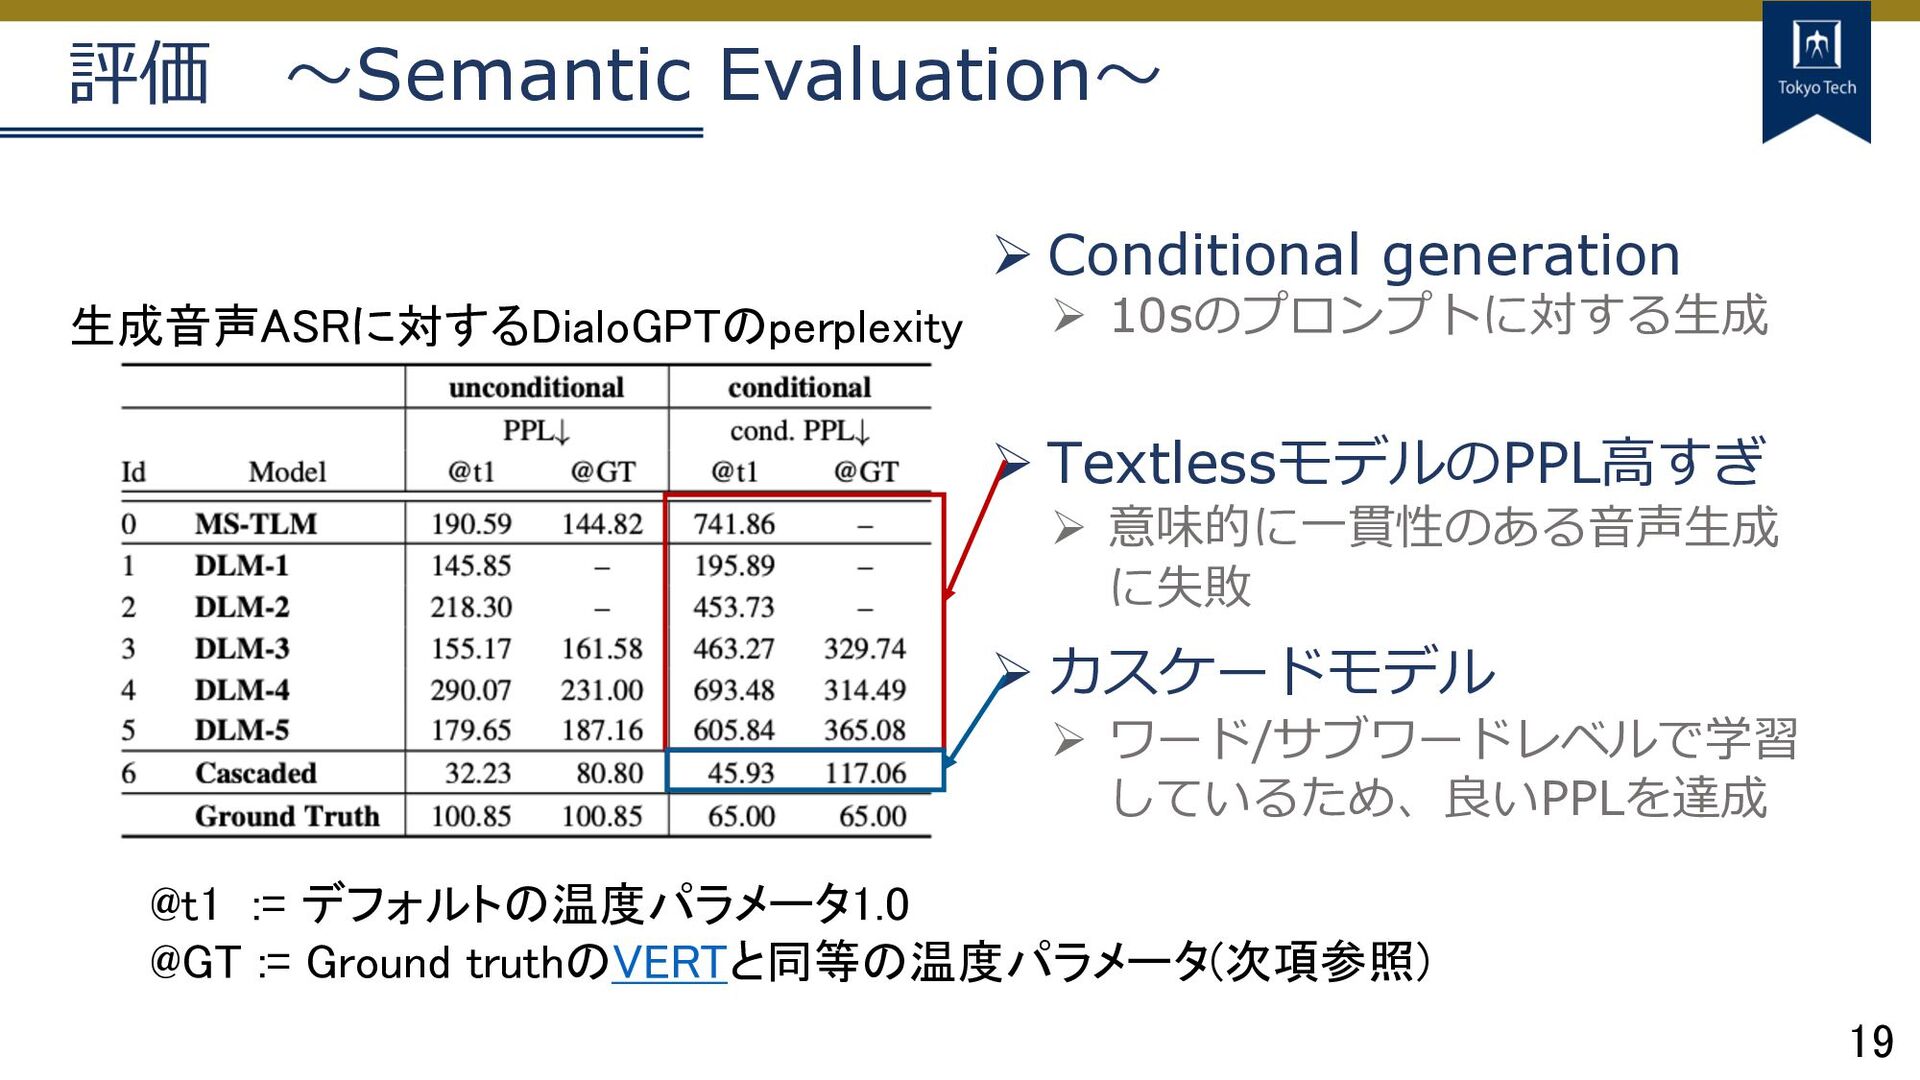
19 評価 〜Semantic Evaluation〜 Ø Conditional generation Ø 10sのプロンプトに対する⽣成 Ø
TextlessモデルのPPL⾼すぎ Ø 意味的に⼀貫性のある⾳声⽣成 に失敗 Ø カスケードモデル Ø ワード/サブワードレベルで学習 しているため、良いPPLを達成 生成音声ASRに対するDialoGPTのperplexity @t1 := デフォルトの温度パラメータ1.0 @GT := Ground truthのVERTと同等の温度パラメータ(次項参照)
20 評価 〜Semantic Evaluation〜 温度パラメータ [0.3, 2.0]に対するDialoGPTのPPLの摂動
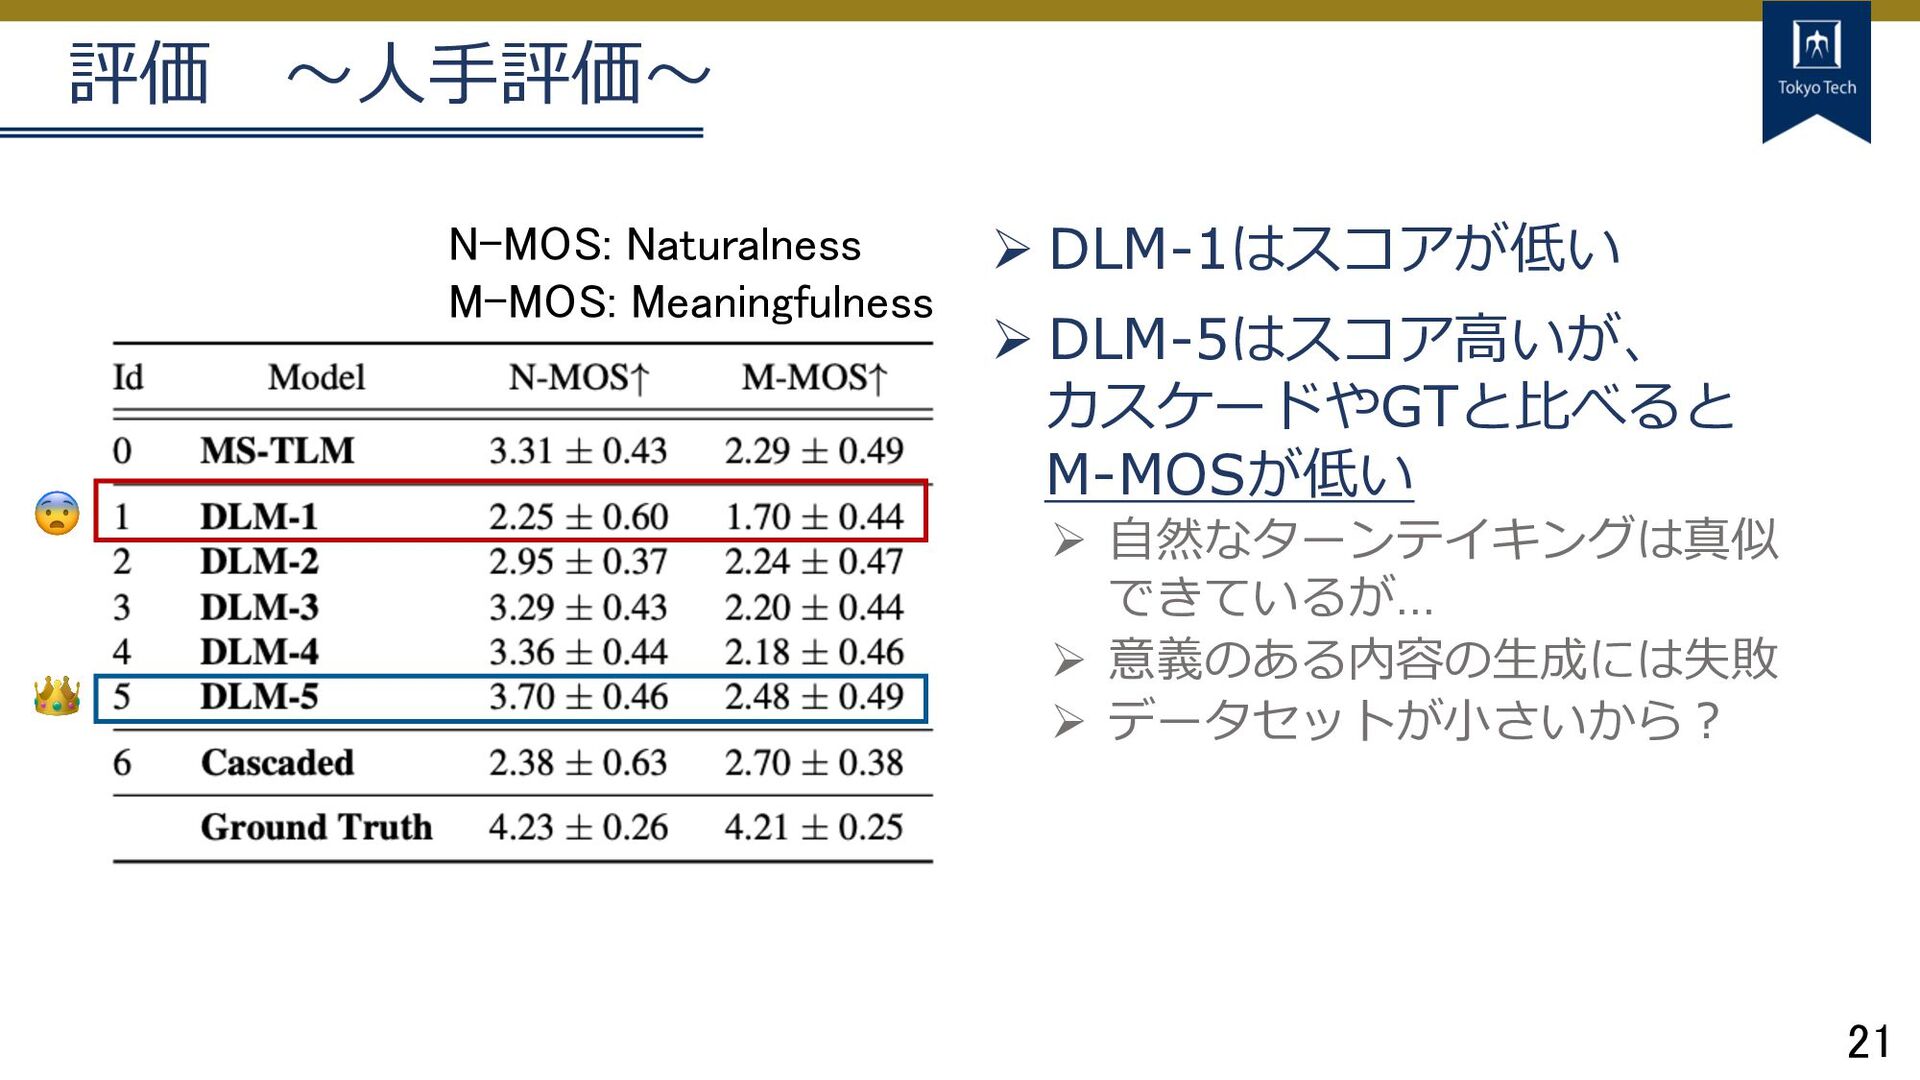
21 評価 〜⼈⼿評価〜 Ø DLM-1はスコアが低い Ø DLM-5はスコア⾼いが、 カスケードやGTと⽐べると M-MOSが低い Ø
⾃然なターンテイキングは真似 できているが… Ø 意義のある内容の⽣成には失敗 Ø データセットが⼩さいから︖ 👑 😨 N-MOS: Naturalness M-MOS: Meaningfulness
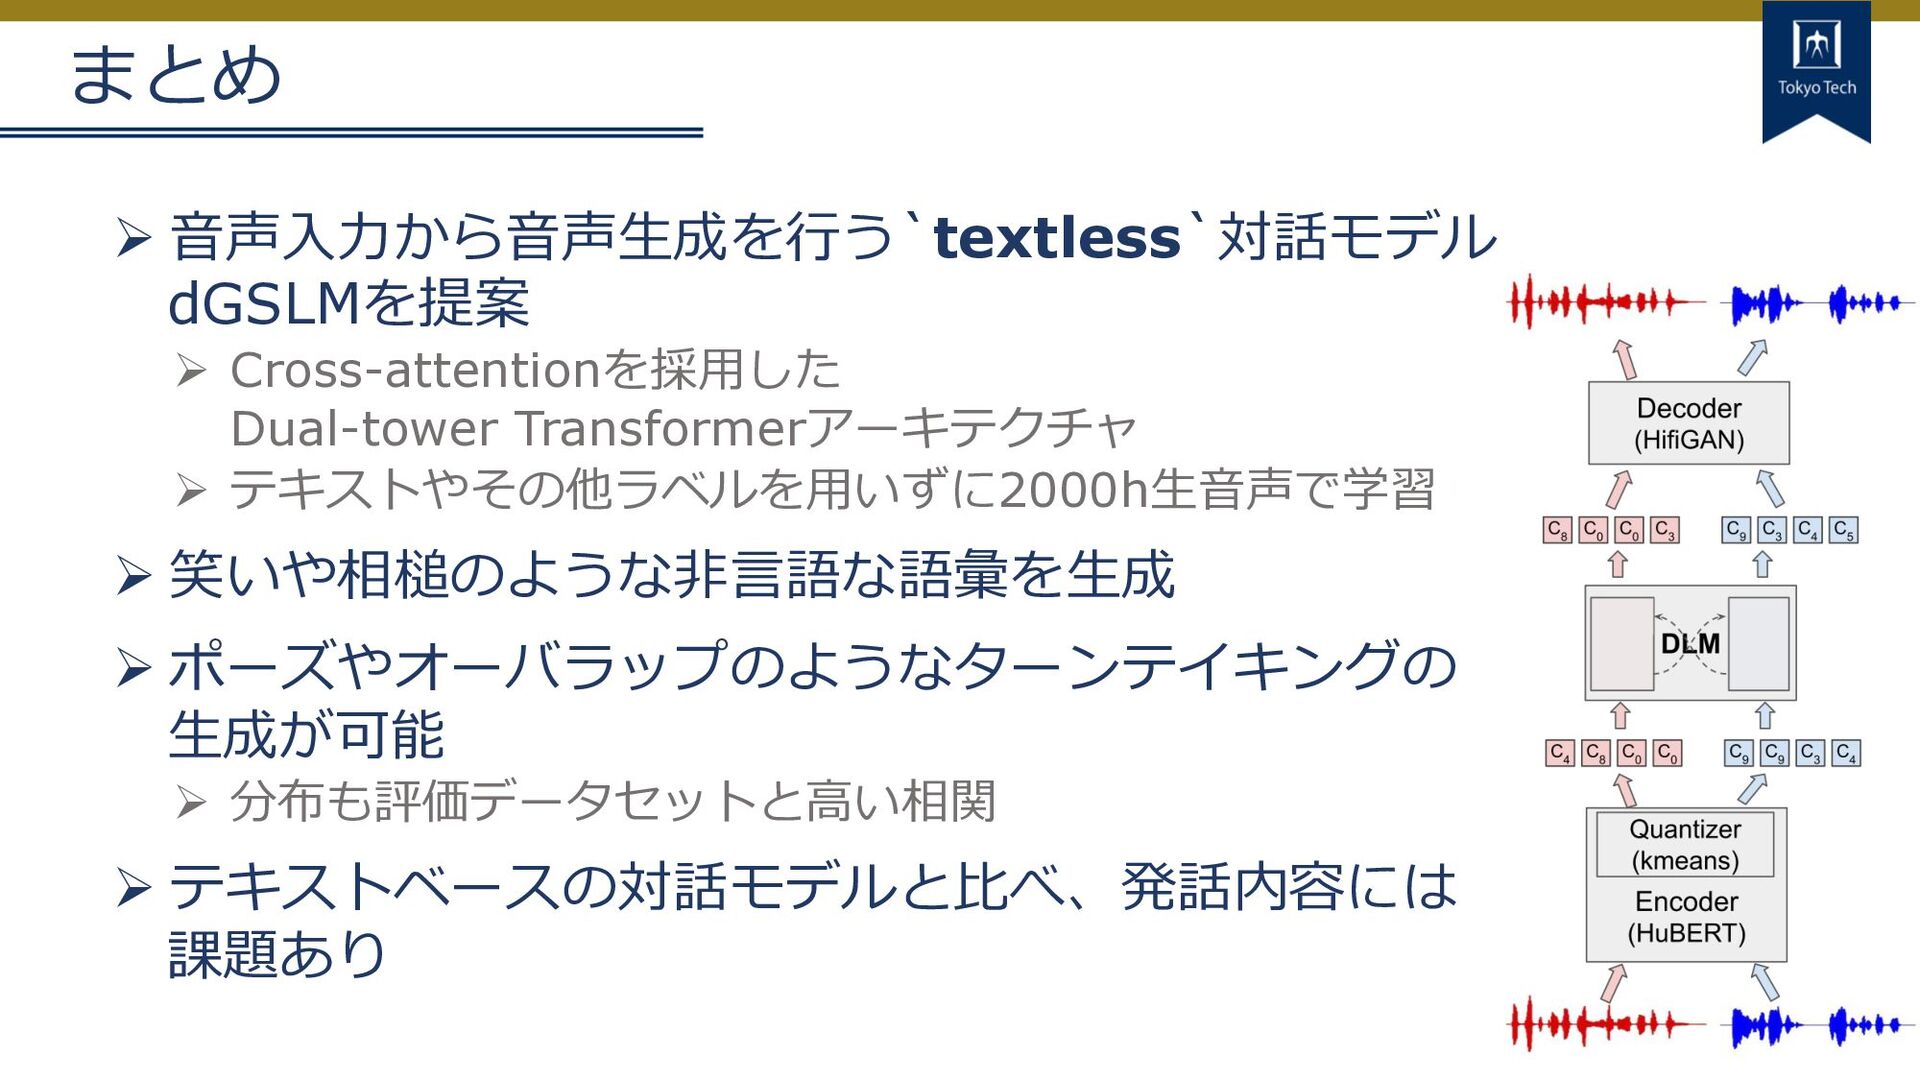
22 まとめ Ø ⾳声⼊⼒から⾳声⽣成を⾏う`textless`対話モデル dGSLMを提案 Ø Cross-attentionを採⽤した Dual-tower Transformerアーキテクチャ Ø
テキストやその他ラベルを⽤いずに2000h⽣⾳声で学習 Ø 笑いや相槌のような⾮⾔語な語彙を⽣成 Ø ポーズやオーバラップのようなターンテイキングの ⽣成が可能 Ø 分布も評価データセットと⾼い相関 Ø テキストベースの対話モデルと⽐べ、発話内容には 課題あり


 yuta0306
 nzw0301
 hf149
 taira_tsuchiya
 rfujii
 kogoro
 corochann
 tomonom
 yumaichikawa
 s_mizuki_nlp
 takasehideki
 ldcn
 pman0214
 62gerente
 vanstee
 jonoalderson
 tmiket
 cassininazir
 kneath
 inesmontani
 smashingmag
 mlcsv
 deanohume
 jakevdp
 madoxten