Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
言語処理学会2024-継続事前学習による日本語に強い大規模言語モデルの構築
Search
Kazuki Fujii
December 14, 2025
Research
110
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
言語処理学会2024-継続事前学習による日本語に強い大規模言語モデルの構築
Kazuki Fujii
December 14, 2025
More Decks by Kazuki Fujii
See All by Kazuki Fujii
IHPCSS2025-Kazuki-Fujii
fujiikazuki2000
0
57
2024-02-Tokyo-Tech-大規模言語モデルの事前学習知見
fujiikazuki2000
0
52
情報処理学会-全国大会2024-大規模言語モデルの分散並列学習
fujiikazuki2000
0
51
AWS Summit Japan 2025 Amazon SageMaker HyperPodを利用した日本語LLM(Swallow)の構築 (CUS-02)
fujiikazuki2000
0
77
合成データパイプラインを利用したSwallowProjectに おけるLLM性能向上
fujiikazuki2000
1
330
論文では語られないLLM開発において重要なこと Swallow Projectを通して
fujiikazuki2000
8
2.1k
大規模言語モデルの学習知見
fujiikazuki2000
0
250
自然言語処理のための分散並列学習
fujiikazuki2000
1
790
Other Decks in Research
See All in Research
ros2-perf-multihost: 分散システムにおける客観的なアーキテクチャ評価フレームワーク
takasehideki
0
320
Evaluation génomique des femelles laitières croisées : comprendre la méthode pour accompagner les éleveurs à son utilisation
institutdelelevage
PRO
0
200
TESSERA: Temporal Embeddings of Surface Spectra for Earth Representation and Analysis
satai
3
120
XDPerf: A High-Performance Traffic Generator Built with WASM and eBPF
takehaya
1
370
[UAI2026, Tutorial Talk] Tensor Networks for Density Estimation: The merits of low-rank structures, tractable inference, and uncertainty quantification
gkazunii
0
110
[最先端NLP勉強会2026] Agentic Rubrics as Contextual Verifiers for SWE Agents
rfujii
1
410
SPACE 2026 - Renforcer l’attractivité des métiers des productions animales dans les établissements d'enseignement agricole
institutdelelevage
PRO
0
110
就労支援の現場での生成AI活用
enochan
0
180
幾何学的深層学習入門 ~3次元構造と対称性を学習するニューラルネットワーク~
taniai
3
960
超効率化への挑戦:1bit LLMの現状と展望
yumaichikawa
0
950
Détecter les vulnérabilités dans un environnement souverain
hellosct1
0
120
JICA QUEST 共創×革新プログラム Impact Report(海ノ向こうコーヒー)
ontheslope
0
950
Featured
See All Featured
Product Roadmaps are Hard
iamctodd
55
13k
Exploring the relationship between traditional SERPs and Gen AI search
raygrieselhuber
PRO
4
4.4k
Building Applications with DynamoDB
mza
96
7.3k
Claude Code のすすめ
schroneko
67
230k
The Straight Up "How To Draw Better" Workshop
denniskardys
239
140k
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
550
Docker and Python
trallard
47
4.2k
brightonSEO & MeasureFest 2025 - Winning Strategies for Black Friday CRO & PPC - Christian Goodrich
cargoodrich
3
890
sira's awesome portfolio website redesign presentation
elsirapls
0
480
Intergalactic Javascript Robots from Outer Space
tanoku
273
28k
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
[RailsConf 2023 Opening Keynote] The Magic of Rails
eileencodes
31
10k
Transcript
継続事前学習による日本語に強い 大規模言語モデルの構築 東京工業大学 藤井一喜 中村泰士 Mengsay Loem 飯田大貴 大井聖也 服部翔 平井翔太 水木栄 横田理央 岡崎直観 A8-5
2 概要 • Llama 2をベースに日本語コーパスで継続事前学習 • 7B, 13B, 70B のモデル規模にて効果を確認
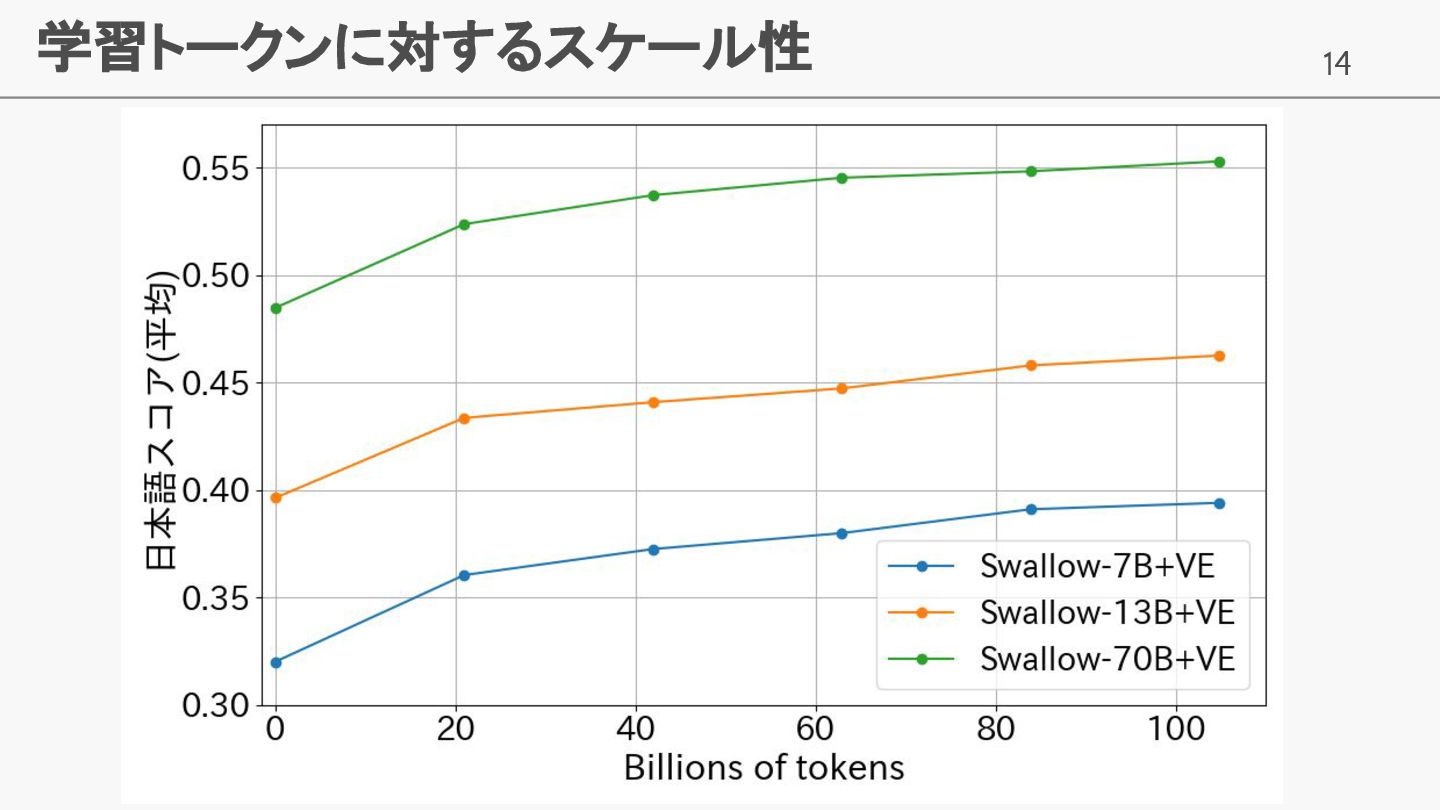
• 学習データ量の増加に伴い日本語性能が向上することを確 認
3 発表構成 • 背景、貢献 • モデルの学習 • モデルの評価
4 背景 • 英語言語資源 >> 日本語言語資源 • Common Crawlでは推定 英語:日本語
= 9:1 • from scratchからの事前学習には膨大な計算資源が必要 • 仮に本実験をfrom scratchから行うと約 20倍の計算資源が必要 → 英語LLM (Llama 2)から継続事前学習を行う 能力や知識を日本語に転移することを狙う
5 貢献 • 継続事前学習の有効性検証 • 7B, 13B, 70Bのモデルサイズ • フルスクラッチ日本語LLMとの比較
• 学習データ量のスケール性の確認 • 20B, 40B, 60B, 80B, 100B Token学習した際の日本語スコアにて検証 • Swallow 7B, 13B, 70Bを公開 • 語彙拡張版: Swallow 7B, 13B, 70B • 語彙拡張なし: Swallow 7B NVE, 13B NVE, 70B NVE
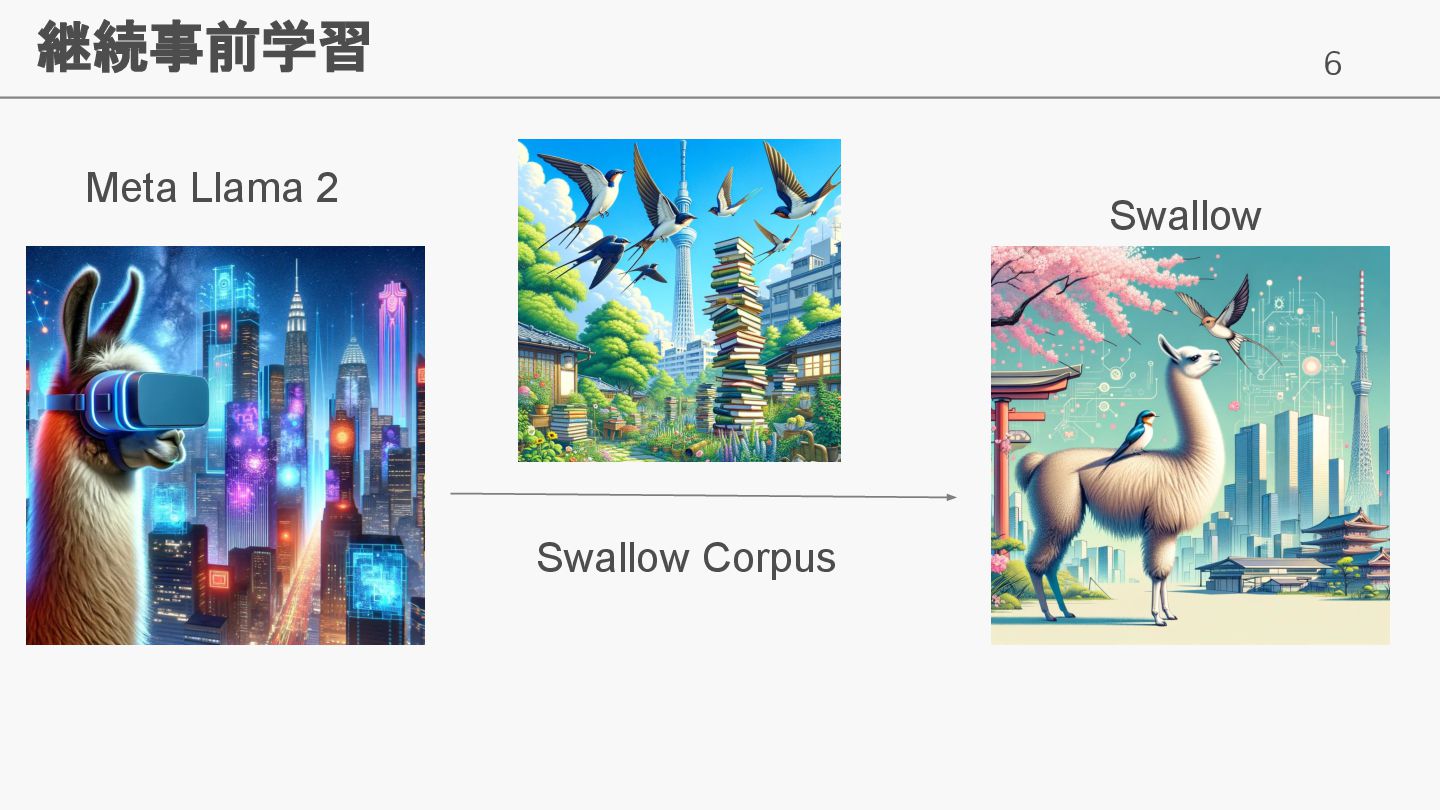
6 継続事前学習 Meta Llama 2 Swallow Swallow Corpus
7 学習設定 • モデルアーキテクチャ • Llama 2アーキテクチャから変更なし(継続事前学習の特性上) • context size=4096(事前学習時と同様)
• 学習率 • re-warmup方式を採用 • 7B, 13B LR=1.0E-4、70B LR=5.0E-5 (予備実験にて調査) • バッチサイズ • global batch size = 1024 • Llama 2の事前学習時には、4M Tokenなので 4M/4096から算出
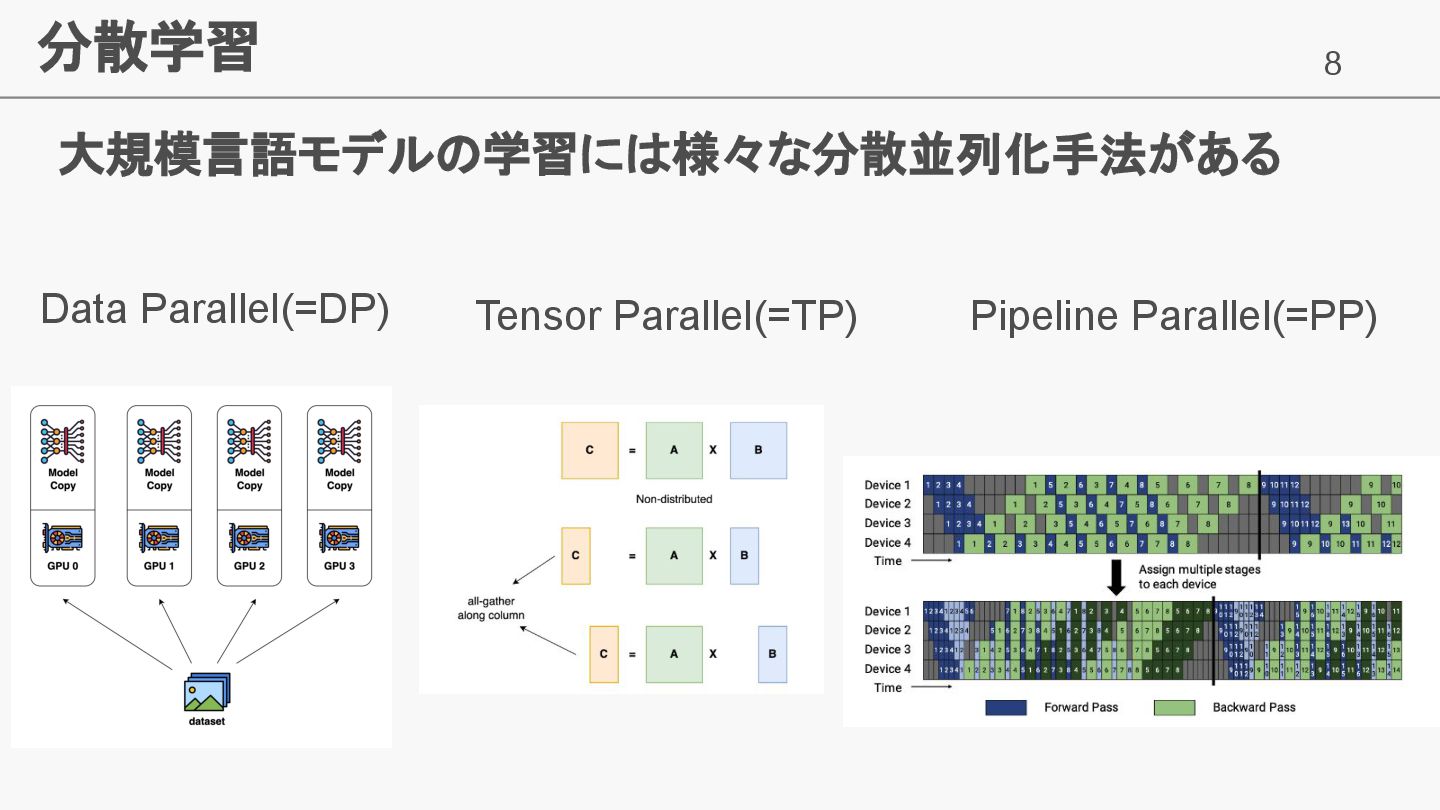
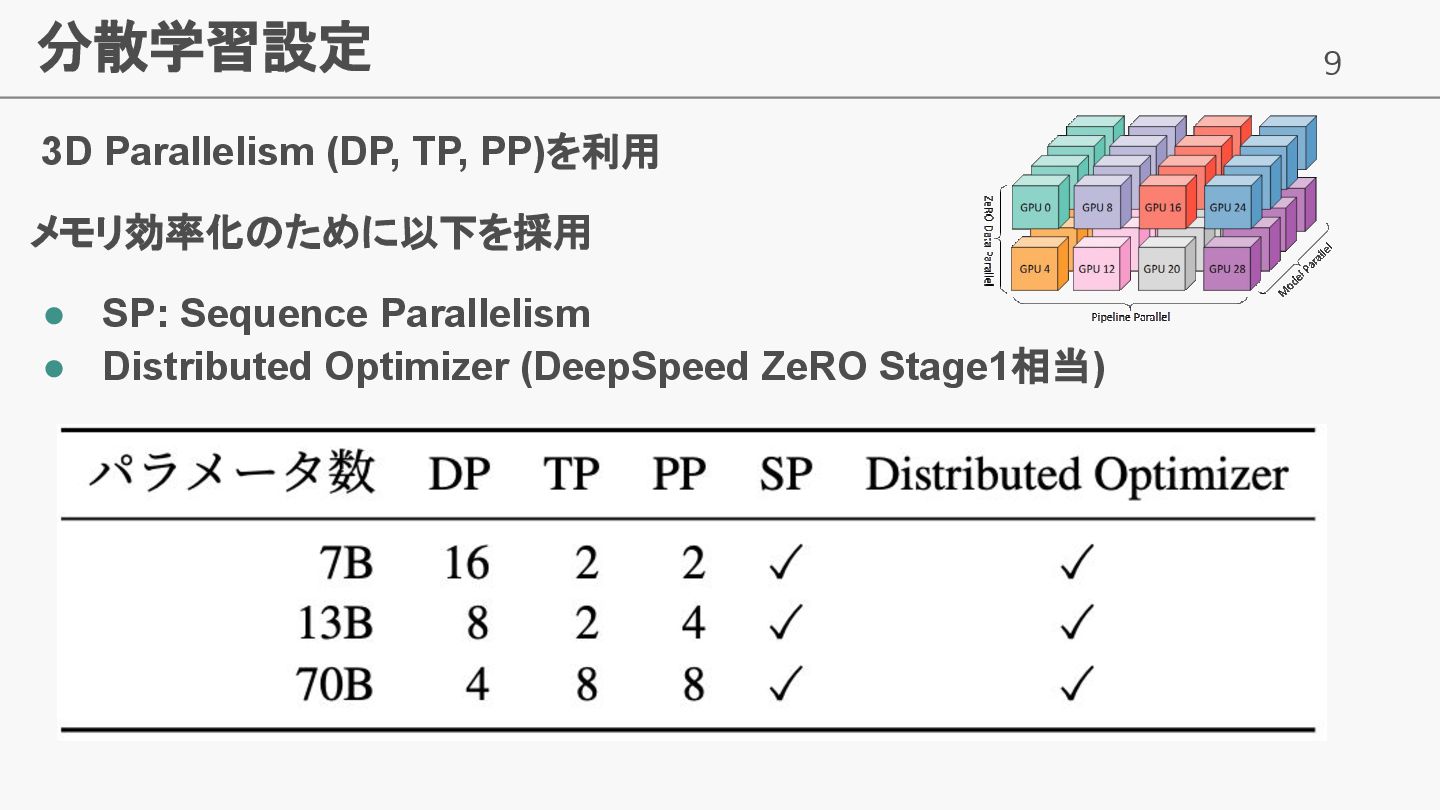
8 分散学習 大規模言語モデルの学習には様々な分散並列化手法がある Data Parallel(=DP) Tensor Parallel(=TP) Pipeline Parallel(=PP)
9 分散学習設定 3D Parallelism (DP, TP, PP)を利用 メモリ効率化のために以下を採用 • SP:
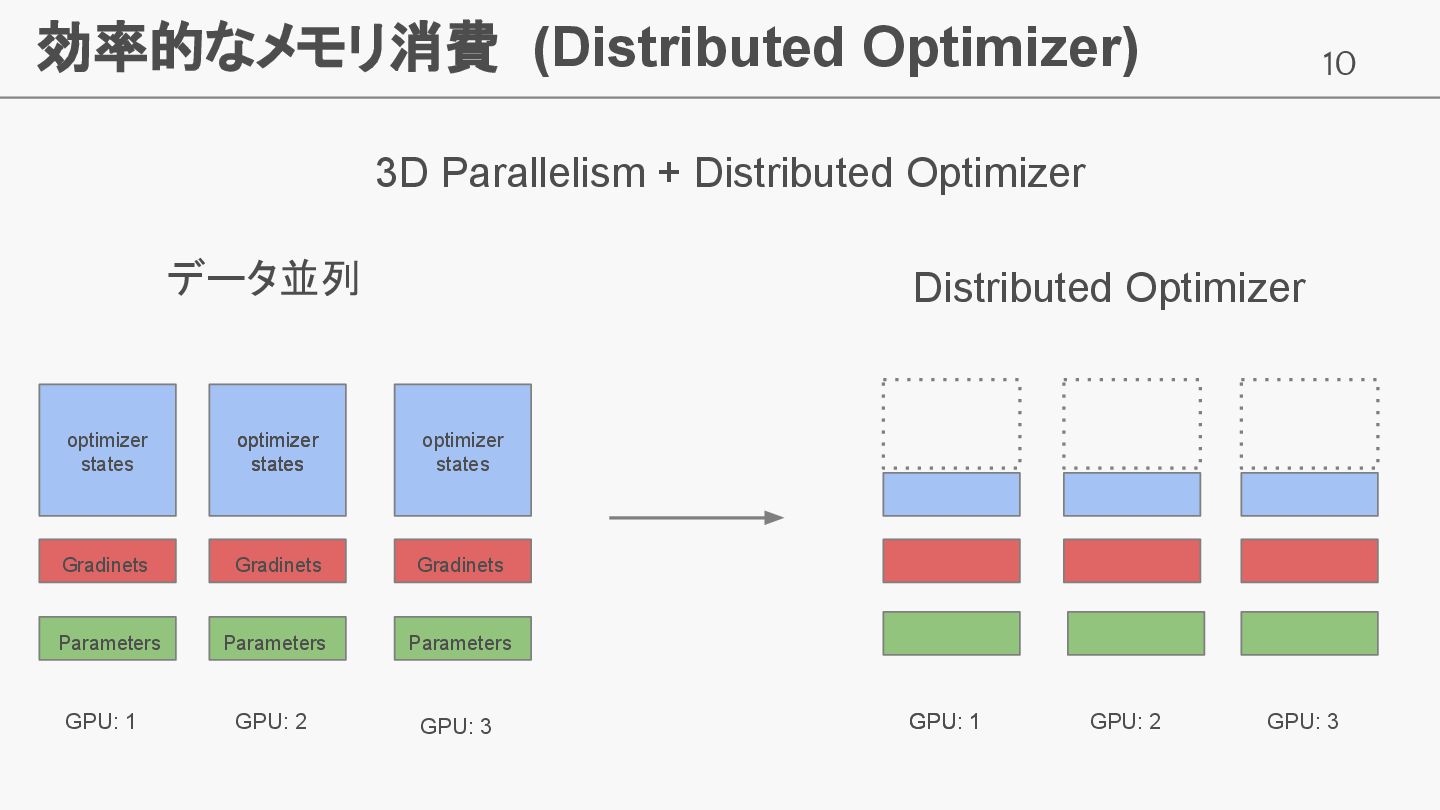
Sequence Parallelism • Distributed Optimizer (DeepSpeed ZeRO Stage1相当)
10 効率的なメモリ消費 (Distributed Optimizer) データ並列 Distributed Optimizer GPU: 1 GPU:
2 GPU: 3 GPU: 1 GPU: 1 GPU: 2 GPU: 3 3D Parallelism + Distributed Optimizer optimizer states optimizer states optimizer states Gradinets optimizer states Gradinets Gradinets Parameters Parameters Parameters
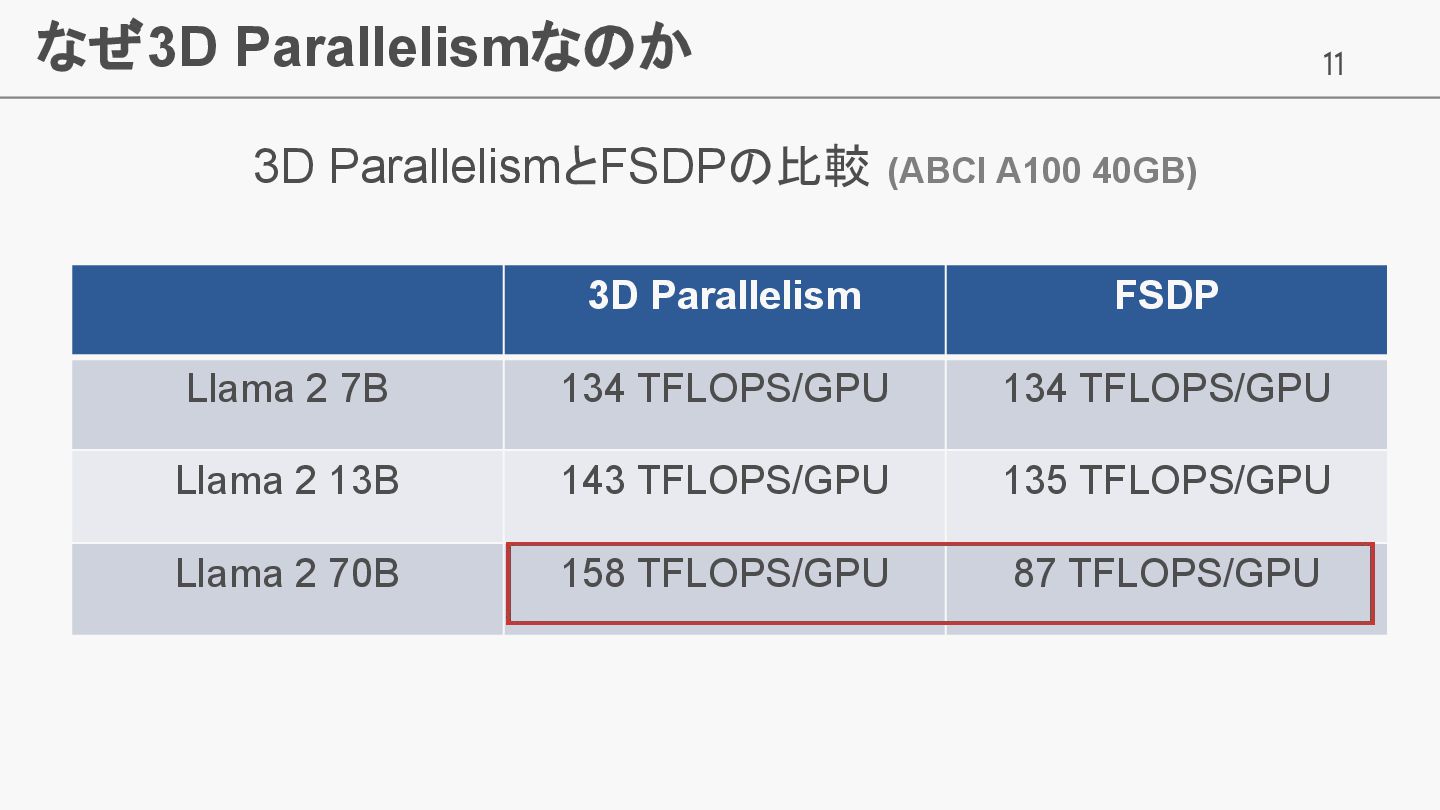
11 なぜ3D Parallelismなのか 3D ParallelismとFSDPの比較 (ABCI A100 40GB) 3D Parallelism
FSDP Llama 2 7B 134 TFLOPS/GPU 134 TFLOPS/GPU Llama 2 13B 143 TFLOPS/GPU 135 TFLOPS/GPU Llama 2 70B 158 TFLOPS/GPU 87 TFLOPS/GPU
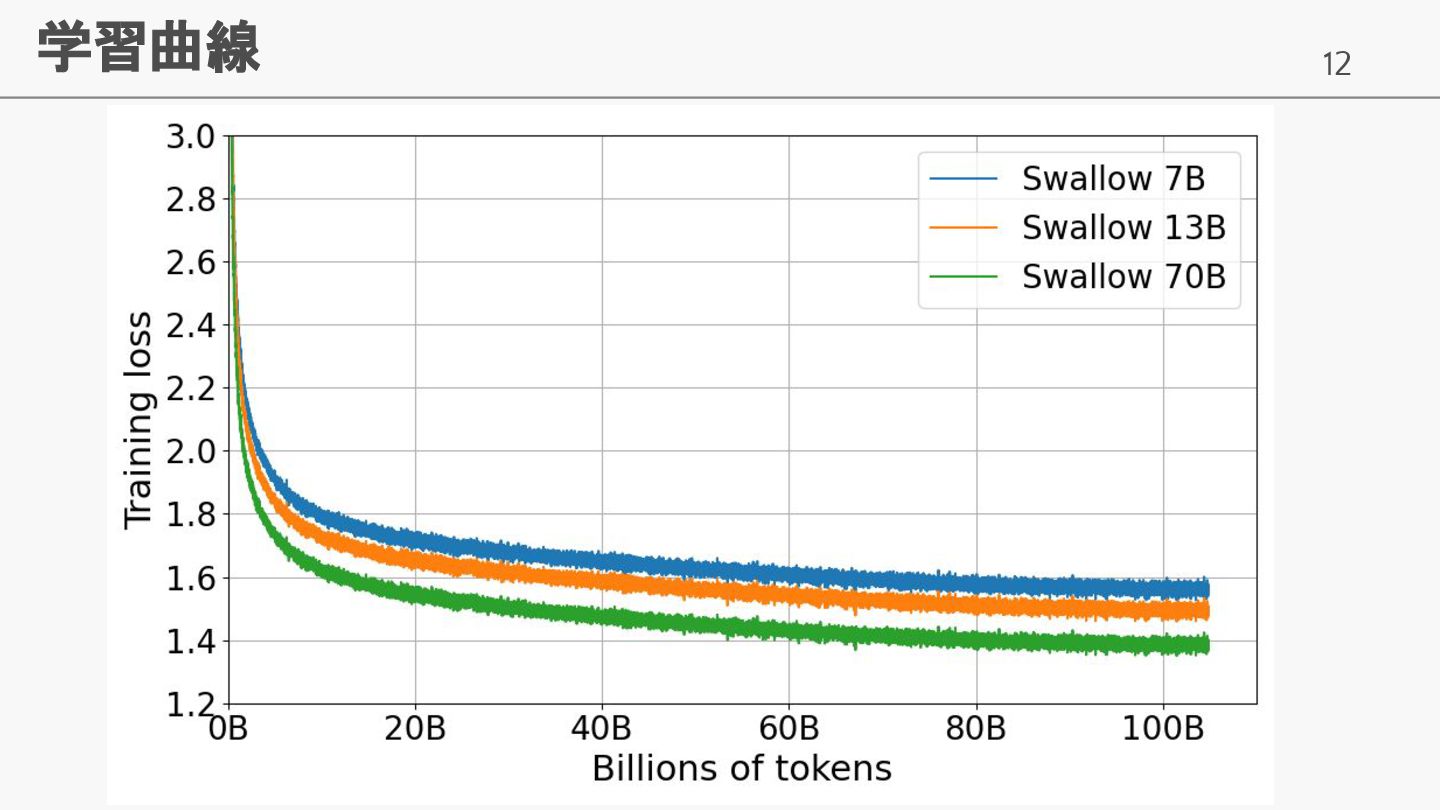
12 学習曲線
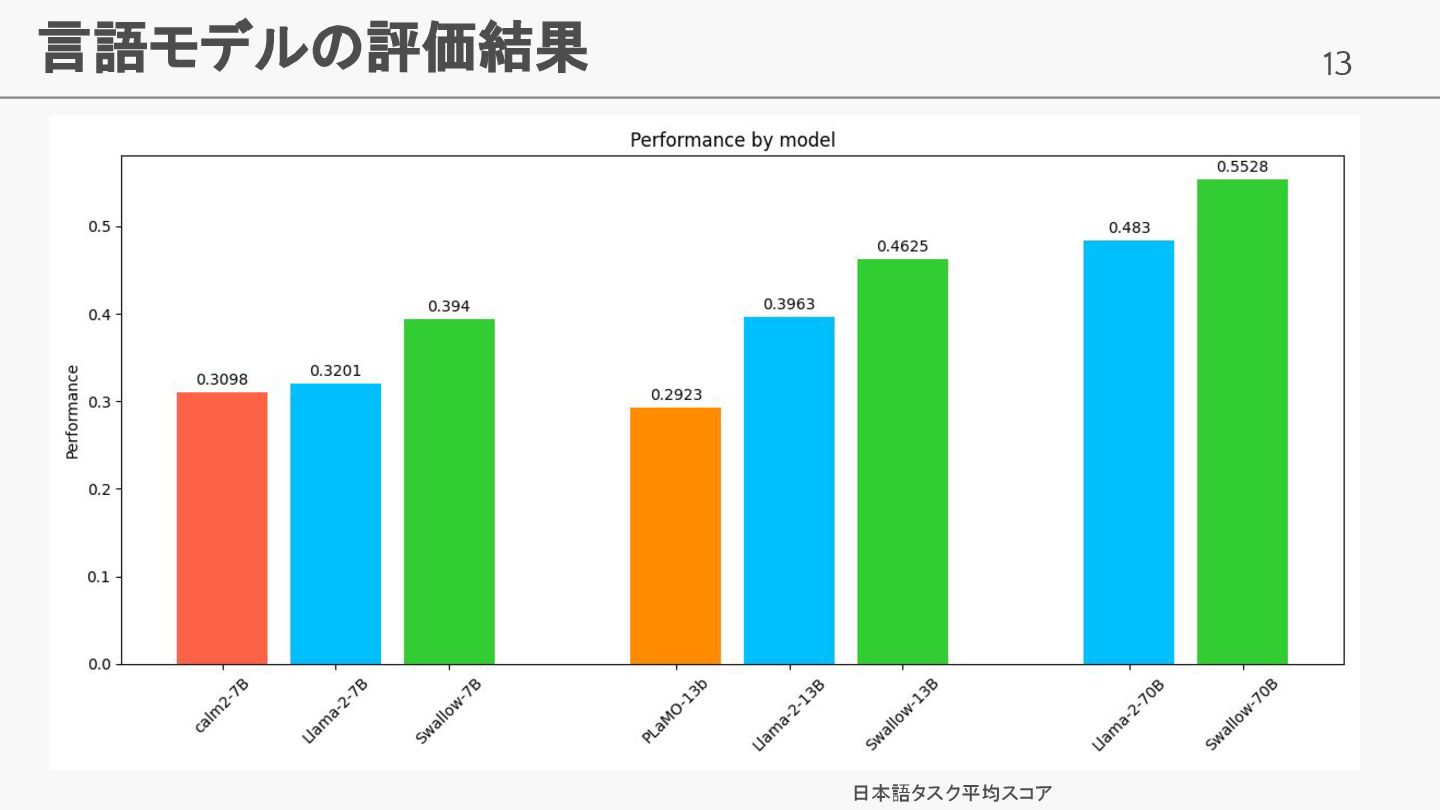
13 言語モデルの評価結果 日本語タスク平均スコア
14 学習トークンに対するスケール性
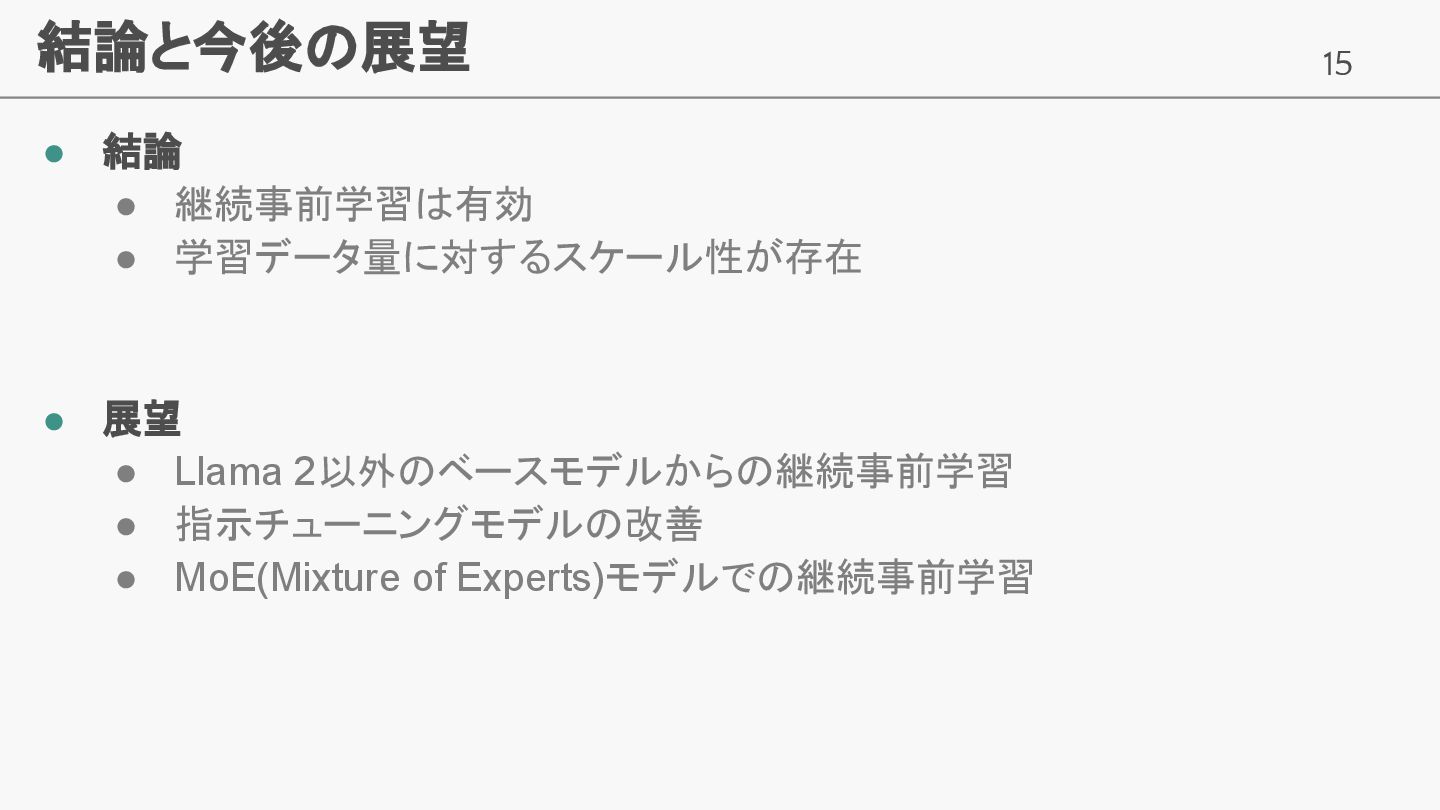
15 結論と今後の展望 • 結論 • 継続事前学習は有効 • 学習データ量に対するスケール性が存在 • 展望
• Llama 2以外のベースモデルからの継続事前学習 • 指示チューニングモデルの改善 • MoE(Mixture of Experts)モデルでの継続事前学習
補足資料
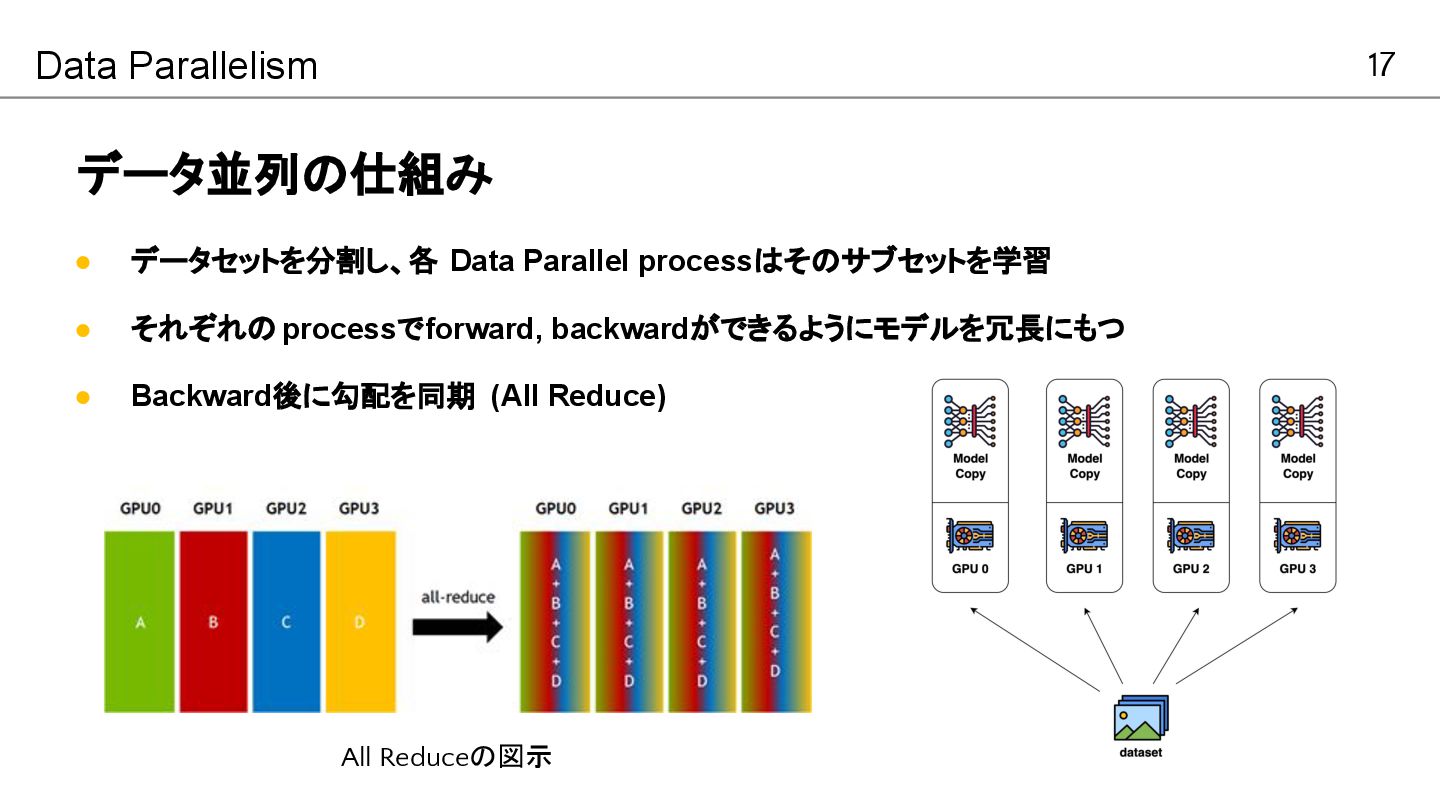
17 データ並列の仕組み Data Parallelism • データセットを分割し、各 Data Parallel processはそのサブセットを学習 •
それぞれの processでforward, backwardができるようにモデルを冗長にもつ • Backward後に勾配を同期 (All Reduce) All Reduceの図示
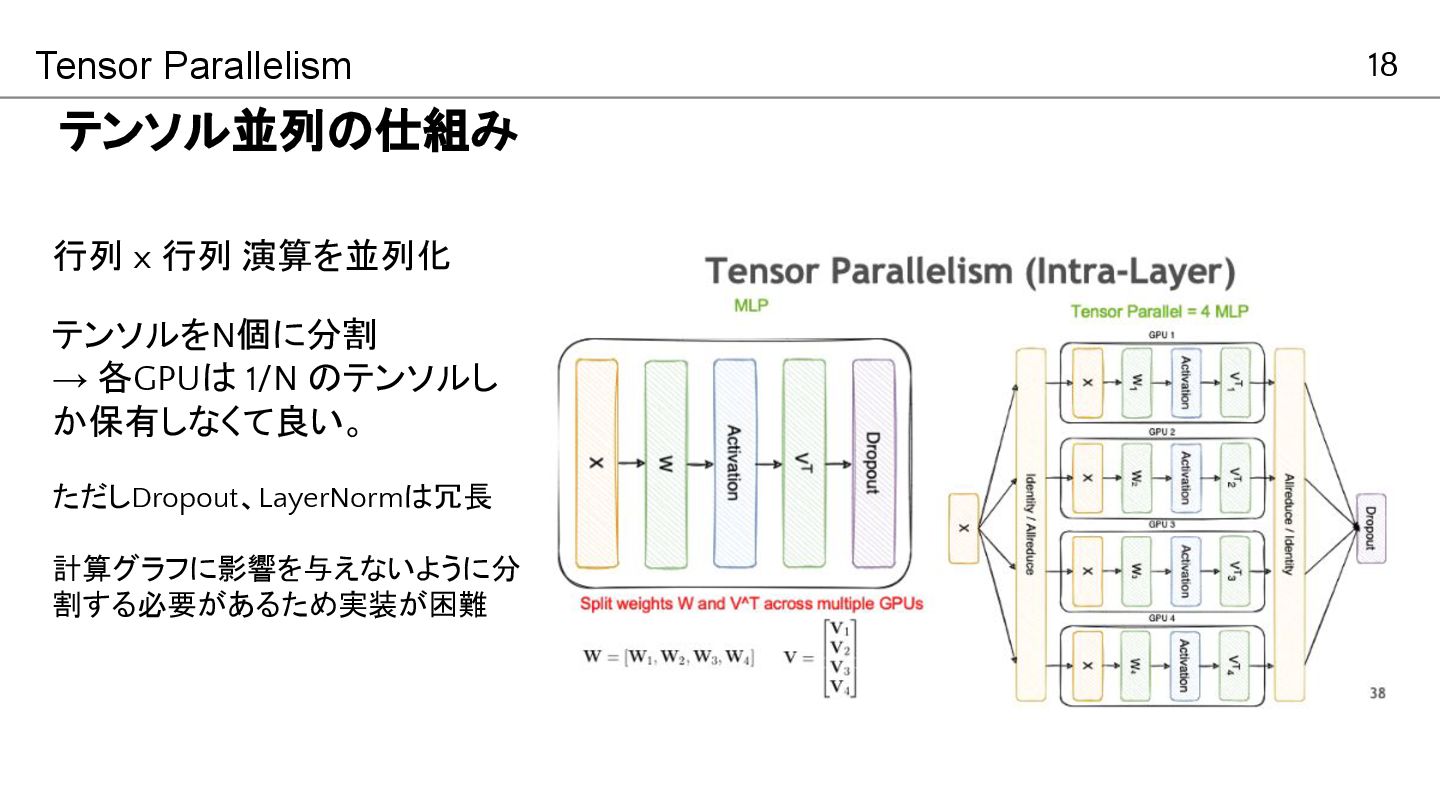
18 テンソル並列の仕組み Tensor Parallelism Dosovitskiy et al, ICLR2021, “An Image
is Worth 16x16 Words: Transformers for Image Recognition at Scale” 行列 x 行列 演算を並列化 テンソルをN個に分割 → 各GPUは 1/N のテンソルし か保有しなくて良い。 ただしDropout、LayerNormは冗長 計算グラフに影響を与えないように分 割する必要があるため実装が困難
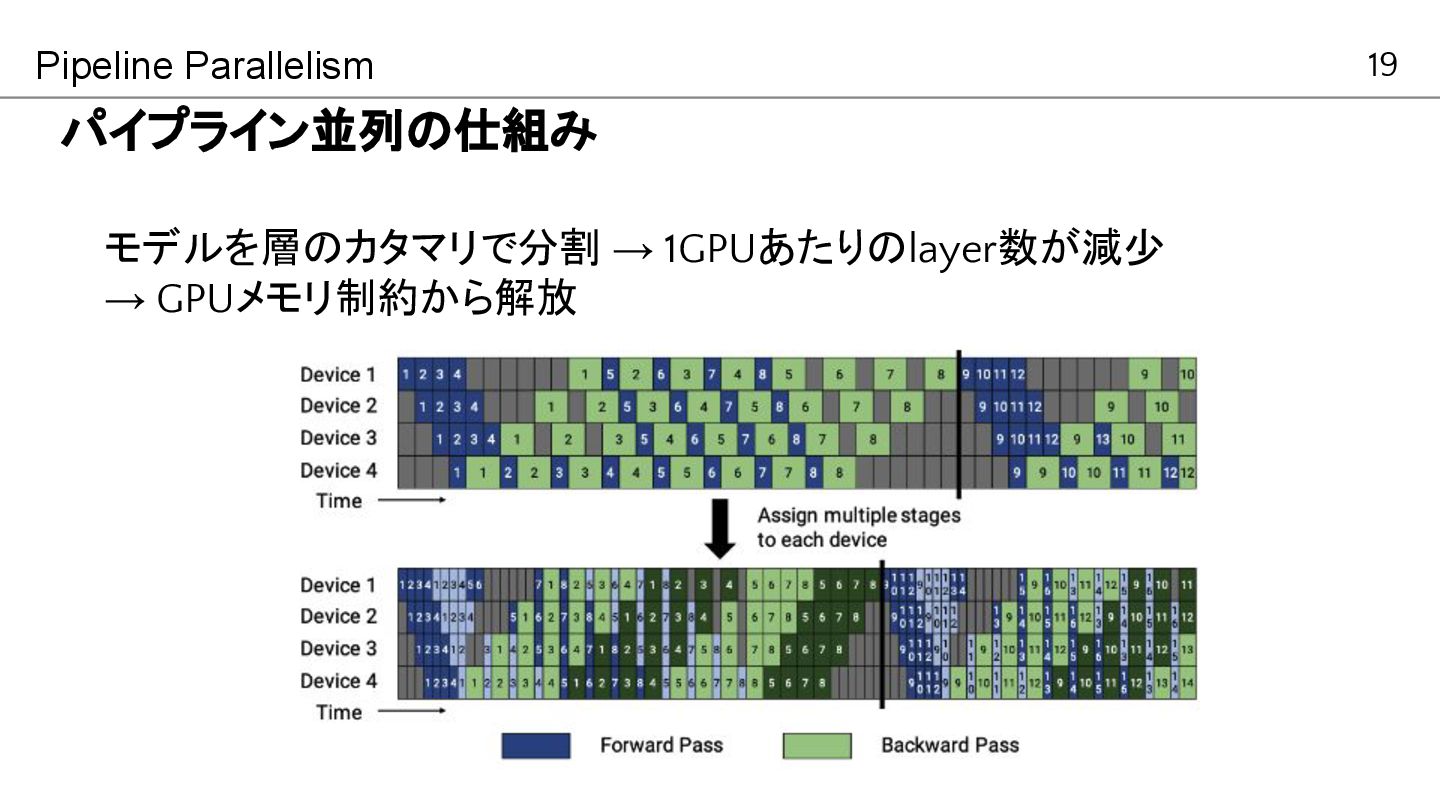
19 パイプライン並列の仕組み Pipeline Parallelism Dosovitskiy et al, ICLR2021, “An Image
is Worth 16x16 Words: Transformers for Image Recognition at Scale” モデルを層のカタマリで分割 → 1GPUあたりのlayer数が減少 → GPUメモリ制約から解放
20 学習コーパス Swallow Corpus 継続事前学習データ 日:英=9:1 日本語データ (90%) • Swallow
Corpus • 日本語Wikipedia 英語データ (10%) • RefinedWeb • The Pile arXiv Swallow Corpusについては、JNLP2024 「Swallow コーパス: 日本語大規模ウェブコーパス」 を参照のこと
21 学習ライブラリ 1. 3D Parallelism をサポート 2. Llamaアーキテクチャに対応 3. HF
→ Megatron 変換コードあり 詳細 ↓
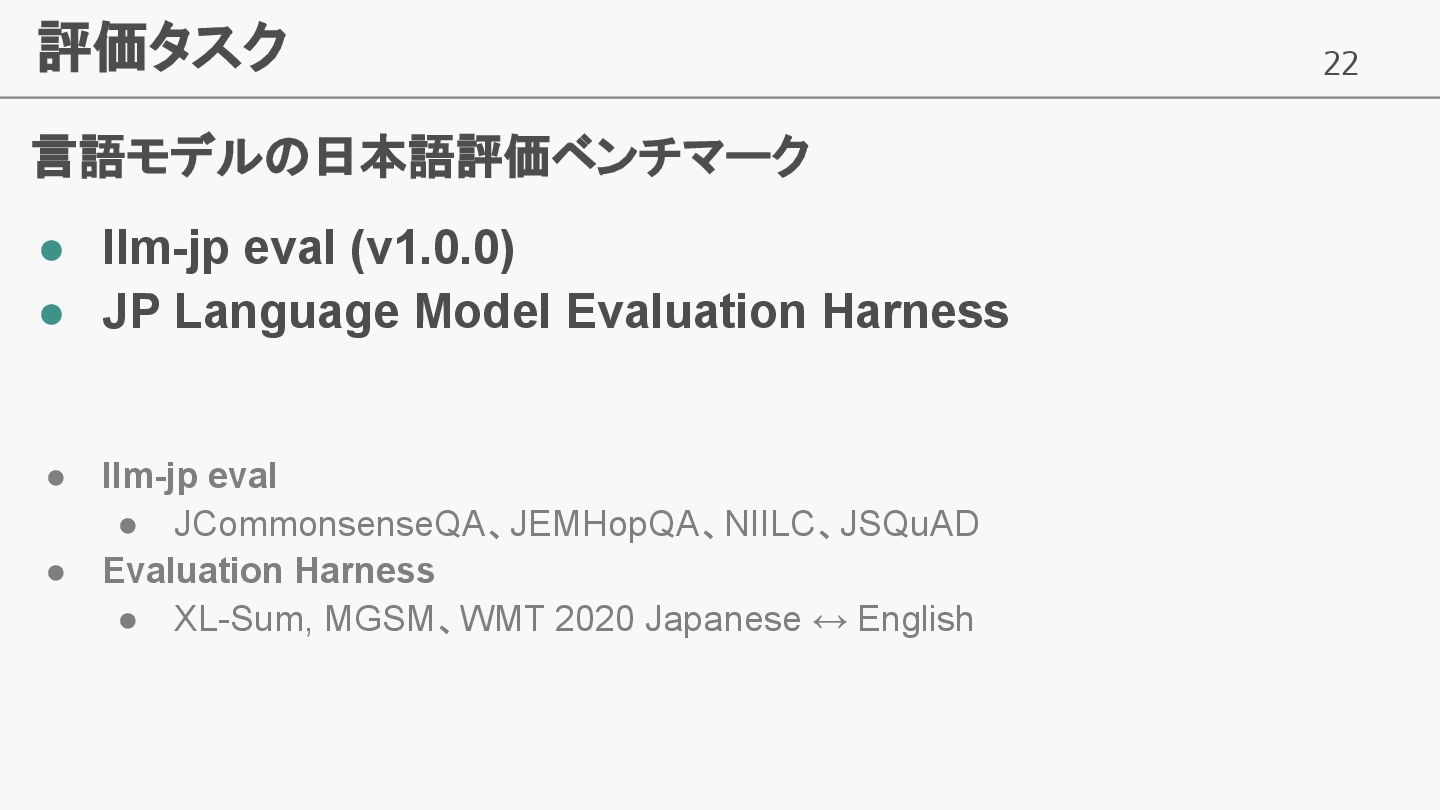
22 評価タスク 言語モデルの日本語評価ベンチマーク • llm-jp eval (v1.0.0) • JP Language
Model Evaluation Harness • llm-jp eval • JCommonsenseQA、JEMHopQA、NIILC、JSQuAD • Evaluation Harness • XL-Sum, MGSM、WMT 2020 Japanese ↔ English
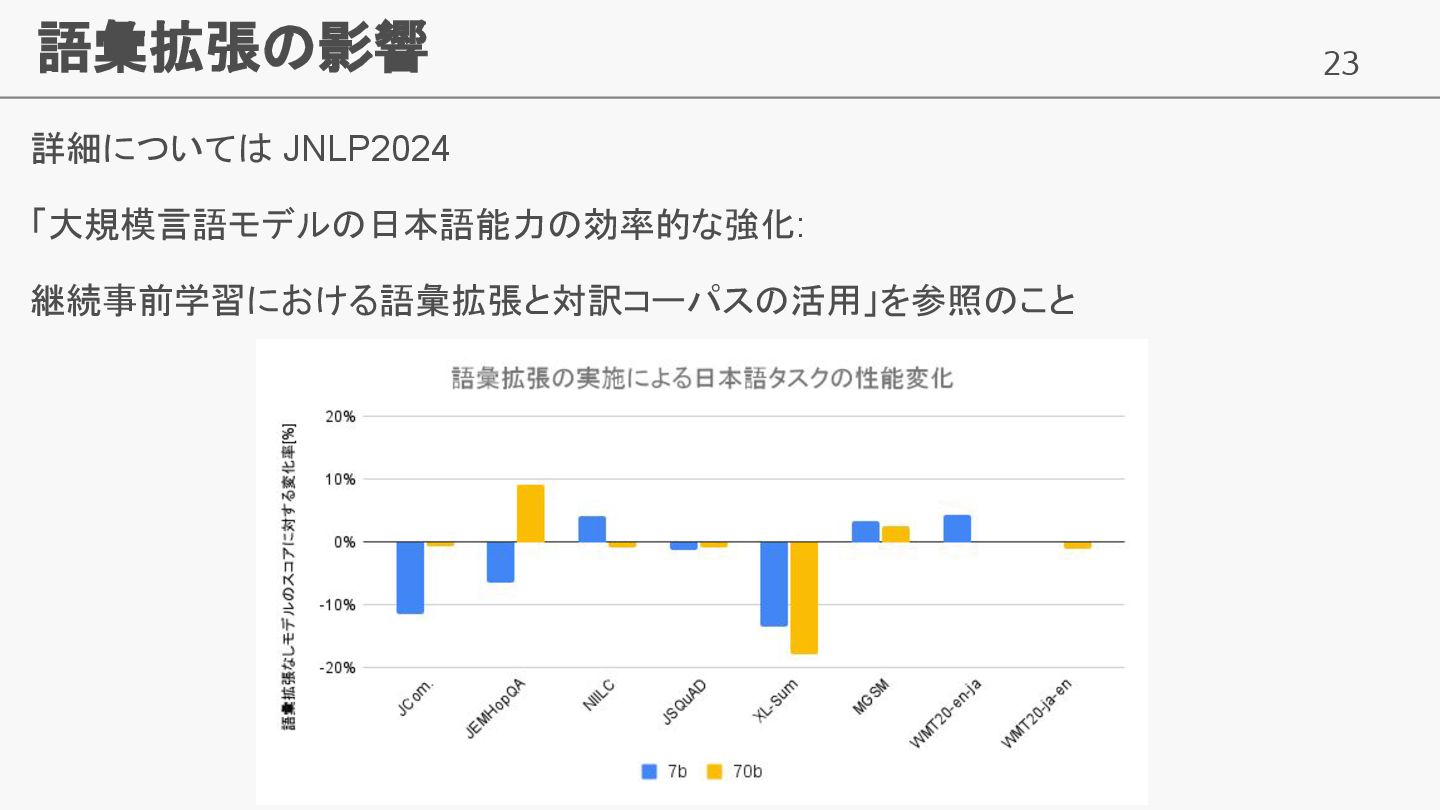
23 語彙拡張の影響 詳細については JNLP2024 「大規模言語モデルの日本語能力の効率的な強化: 継続事前学習における語彙拡張と対訳コーパスの活用」を参照のこと


 fujiikazuki2000
 takasehideki
 institutdelelevage
 satai
 takehaya
 gkazunii
 rfujii
 enochan
 taniai
 yumaichikawa
 hellosct1
 ontheslope
 iamctodd
 raygrieselhuber
 mza
 schroneko
 denniskardys
 jct
 trallard
 cargoodrich
 elsirapls
 tanoku
 aleyda
 eileencodes