Share
Embed
Transcript
42 slides
-
⾃⼰紹介 板垣 正敏(いたがき まさとし) 1955年新潟県村上市⽣まれ 株式会社BSNアイネット 技術顧問
中⼩企業診断⼠ NPO法⼈ 新潟オープンソース協会 理事 ⽇本Rubyの会 会員 Python機械学習勉強会 in 新潟 世話⼈ -
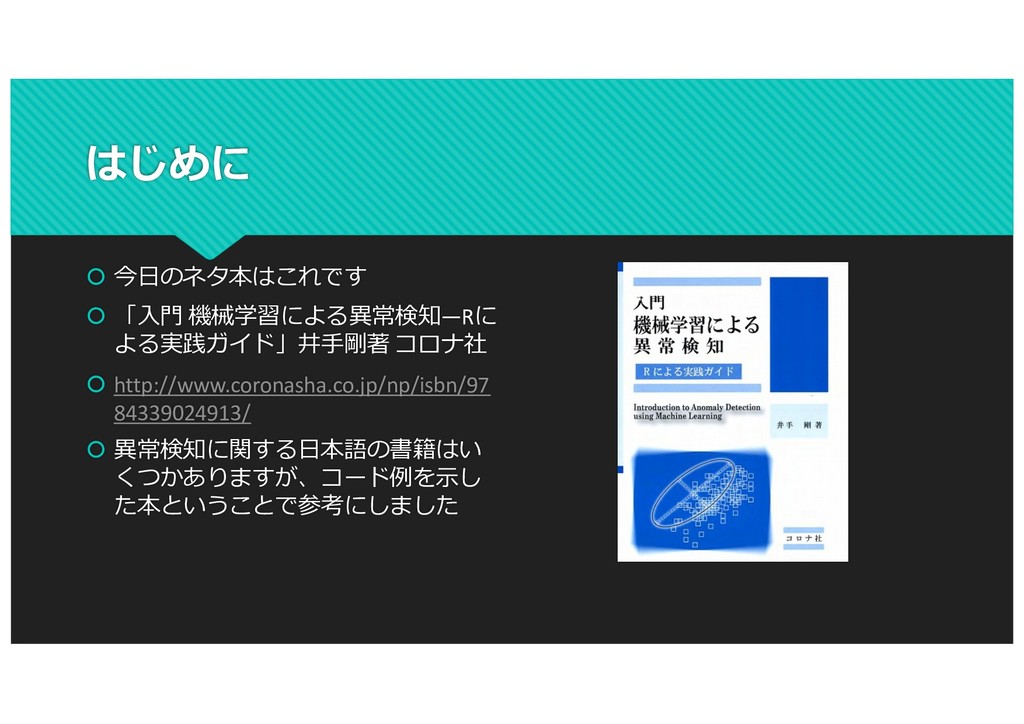
はじめに 今⽇のネタ本はこれです 「⼊⾨ 機械学習による異常検知―Rに よる実践ガイド」井⼿剛著 コロナ社 http://www.coronasha.co.jp/np/isbn/97
84339024913/ 異常検知に関する⽇本語の書籍はい くつかありますが、コード例を⽰し た本ということで参考にしました -
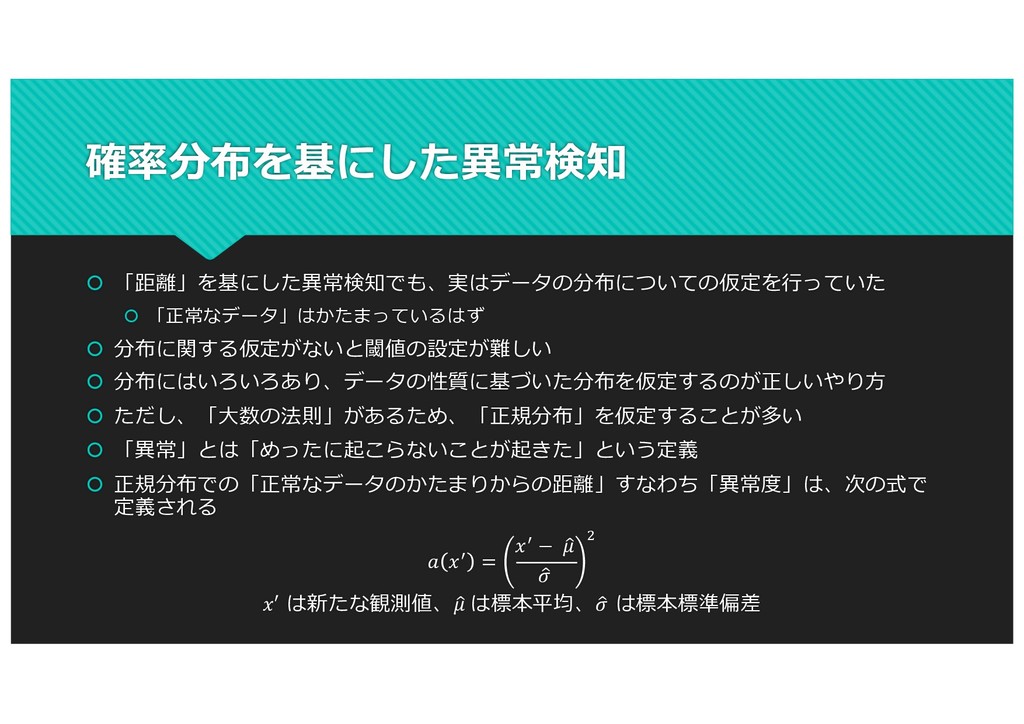
確率分布を基にした異常検知 「距離」を基にした異常検知でも、実はデータの分布についての仮定を⾏っていた 「正常なデータ」はかたまっているはず 分布に関する仮定がないと閾値の設定が難しい 分布にはいろいろあり、データの性質に基づいた分布を仮定するのが正しいやり⽅
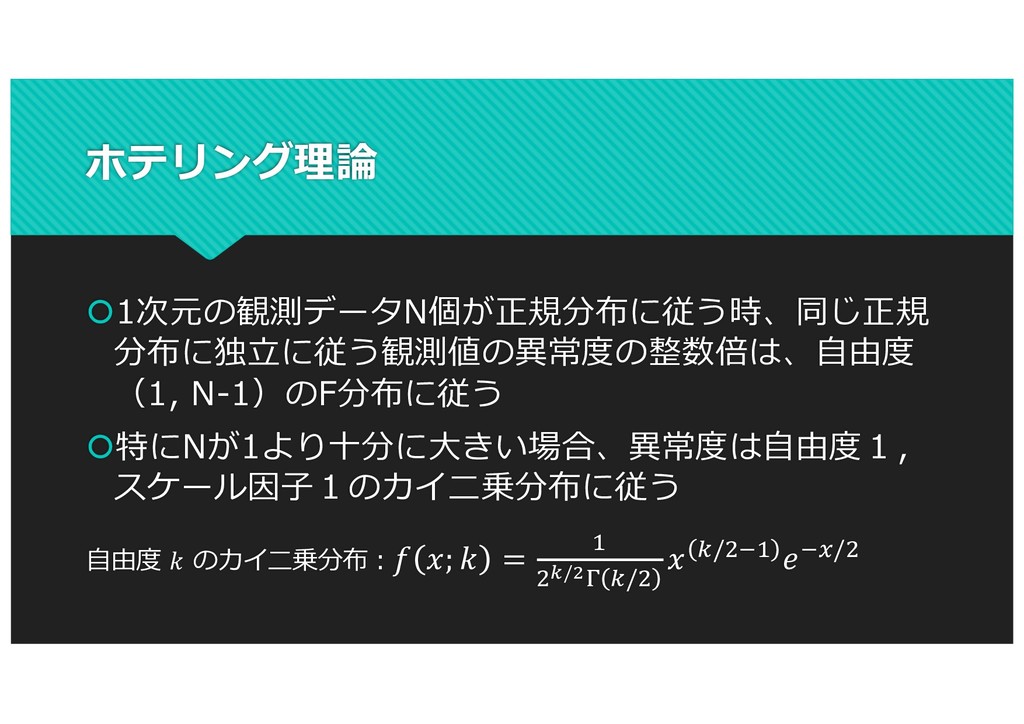
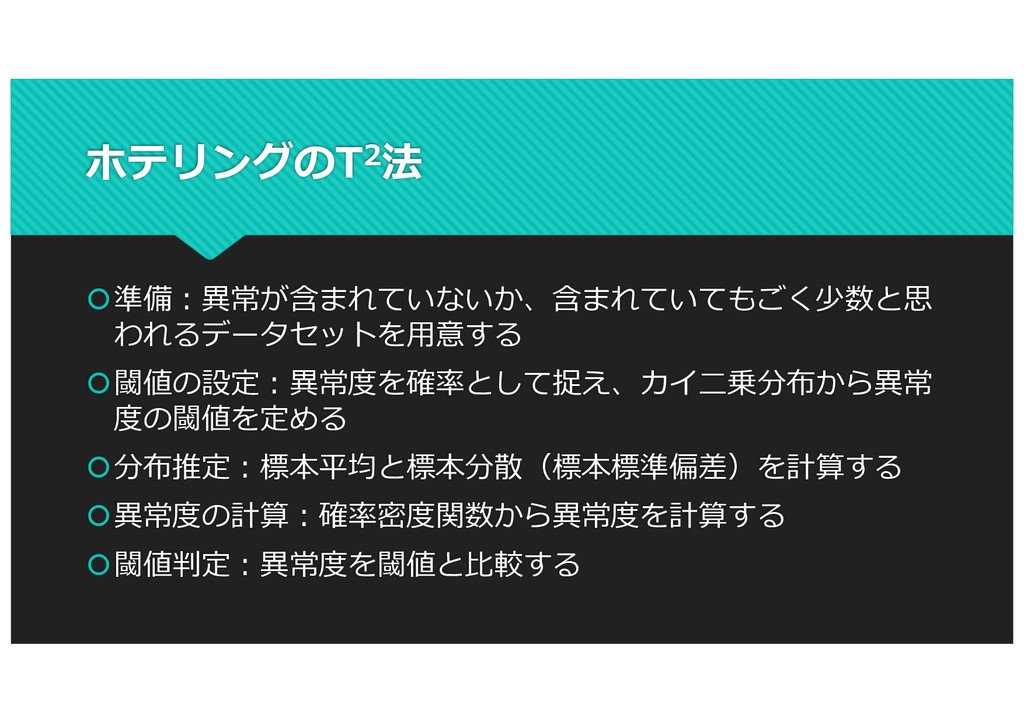
ただし、「⼤数の法則」があるため、「正規分布」を仮定することが多い 「異常」とは「めったに起こらないことが起きた」という定義 正規分布での「正常なデータのかたまりからの距離」すなわち「異常度」は、次の式で 定義される 1 = 1 − 2 2 . ′ は新たな観測値、 2 は標本平均、 2 は標本標準偏差 -
正規分布の異常度と確率 全スライドの異常度は「分散で 調整された平均からの距離の2 乗」 平均からどれくらい離れたら異 常とするかの「閾値」は、「ど れくらい稀なことなのか」とい う確率から求める「信頼区間」
から決める scipy.stats.norm.interval(alpha, loc=0, scale=1) -
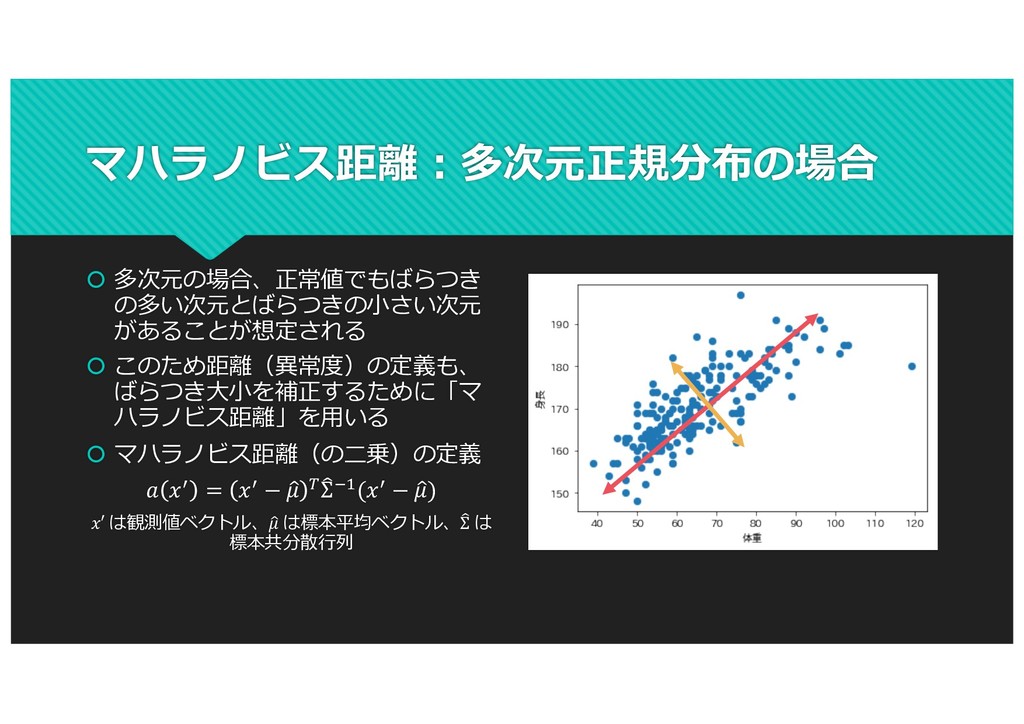
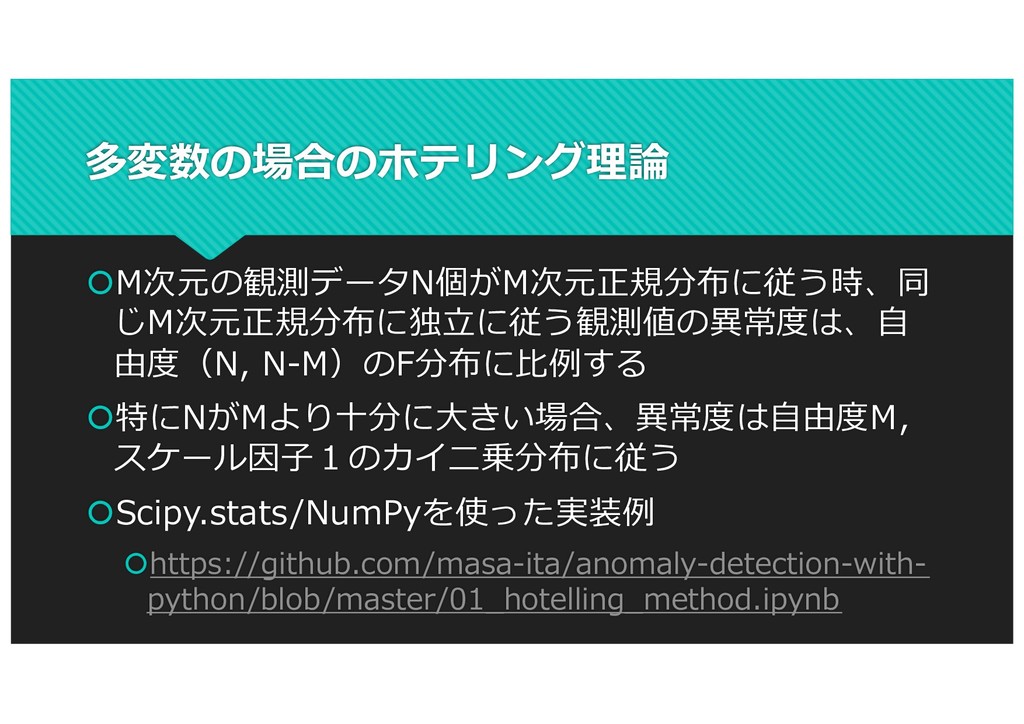
マハラノビス距離︓多次元正規分布の場合 多次元の場合、正常値でもばらつき の多い次元とばらつきの⼩さい次元 があることが想定される このため距離(異常度)の定義も、 ばらつき⼤⼩を補正するために「マ ハラノビス距離」を⽤いる
マハラノビス距離(の⼆乗)の定義 1 = 1 − 2 A B Σ>)(1 − 2 ) ′ は観測値ベクトル、2 は標本平均ベクトル、B Σ は 標本共分散⾏列 -
ガンマ分布による異常検知 「ひと⼭」ではあるが「正の値しかとらない」「左右対称でない」分 布を持つデータに対しての異常検知 Ex. 体重など ガンマ分布のパラメータ推定法にはモーメント法や最尤法が使われる 異常度の定義は負の対数尤度を使うが、分布は容易に求めることがで
きないため、閾値は分位点で定めるのが現実的 Scipy.stats/NumPyによる実装例 https://github.com/masa-ita/anomaly-detection-with- python/blob/master/03_gamma_dist.ipynb -
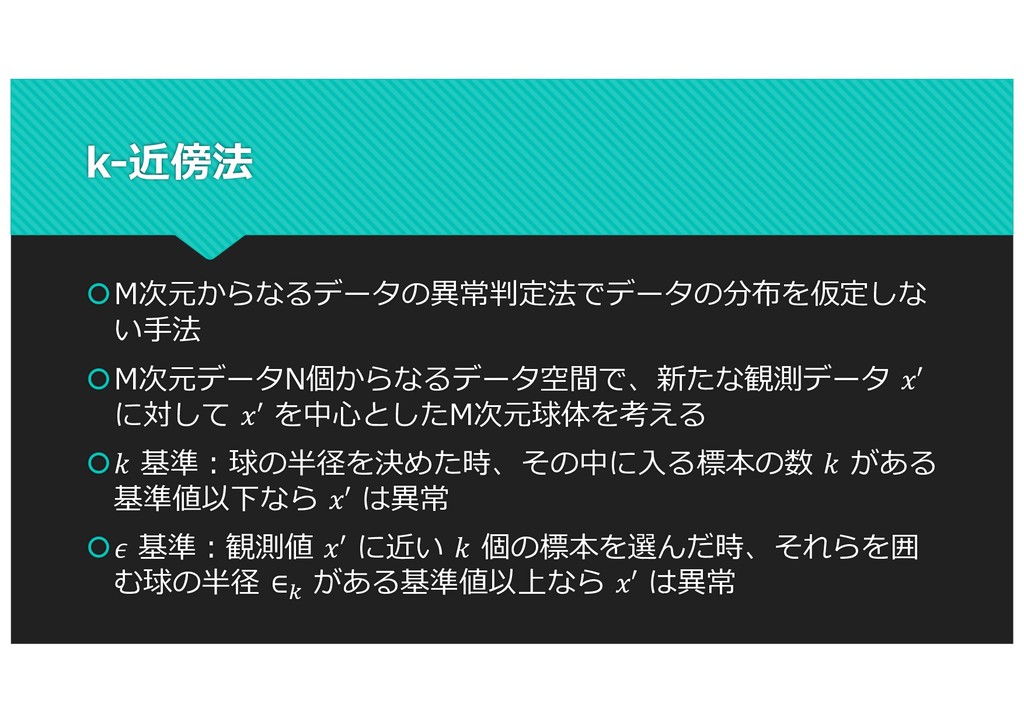
k-近傍法 M次元からなるデータの異常判定法でデータの分布を仮定しな い⼿法 M次元データN個からなるデータ空間で、新たな観測データ ′ に対して ′ を中⼼としたM次元球体を考える 基準︓球の半径を決めた時、その中に⼊る標本の数
がある 基準値以下なら ′ は異常 基準︓観測値 ′ に近い 個の標本を選んだ時、それらを囲 む球の半径 ∈= がある基準値以上なら ′ は異常 -
クラスタリングによる⽅法 データをクラスタリングによって「塊(クラスター)の集合」ととらえ、どの 塊にも属さないデータを異常と考える⼿法 クラスタリングの⼿法として次のようなものが使われる k-means法 クラスターの中⼼からの距離を使って、あるデータ点がどのクラスターに属するかを決
め、中⼼を更新しながら繰り返す⼿法 混合正規分布モデル クラスターを正規分布と仮定して、データ点を最も所属する確率の⾼いクラスターに分 類していく⼿法 scikit-learnによる実装例 https://github.com/masa-ita/anomaly-detection-with- python/blob/master/05_gaussian_mixture.ipynb -
時系列ではないデータの異常検知⼿法 分布 ⼀⼭ 正規分布 ホテリングT2法 マハラノビスタグチ法 ⾮対称 ガンマ分布を利⽤ 異常データ混⼊ 線型結合モデル
複数の⼭ 近傍距離 k -近傍法 カーネル密度推定 クラスタリング k-means法 混合正規分布 -
One-Class Support Vector Machine データのほぼ全体を囲む球を考え、その球に⼊り切らなかったもの を異常と考える 異常度(距離)の計算において、線形計算である内積を⾮線形計算 に置換する⼿法(カーネル法)の採⽤により、⾮線形データについ
ても扱うことが可能となる scikit-learnによる実装例 https://github.com/masa-ita/anomaly-detection-with- python/blob/master/06_one_class_svm.ipynb -
次元削減による異常検知︓主成分分析 多変量データで変数間に関係がある場合、逆⾏列計算を前提とする ホテリング理論のような⼿法は使えなくなる 逆⾏列が求められない「特異⾏列」になりやすい M次元のデータをM>NとなるN次元に写像し、その中でデータの分 布する「正常部分空間」を求め、そこからどれくらい離れているか で異常か正常かを判定する
確率的主成分分析や、⾮線形変換を伴うカーネル主成分分析などの ⼿法もある pyod PCA による実装例 https://github.com/masa-ita/anomaly-detection-with- python/blob/master/07_pca.ipynb -
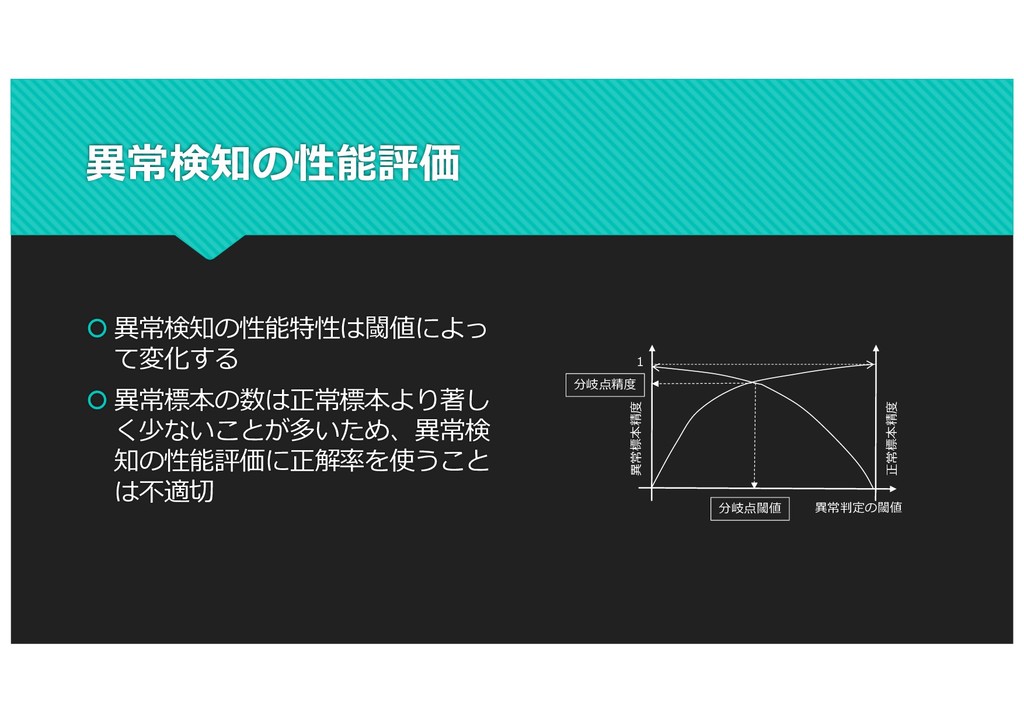
異常検知の性能評価 異常検知の性能特性は閾値によっ て変化する 異常標本の数は正常標本より著し く少ないことが多いため、異常検 知の性能評価に正解率を使うこと は不適切 異常判定の閾値
異常標本精度 正常標本精度 1 分岐点閾値 分岐点精度 -
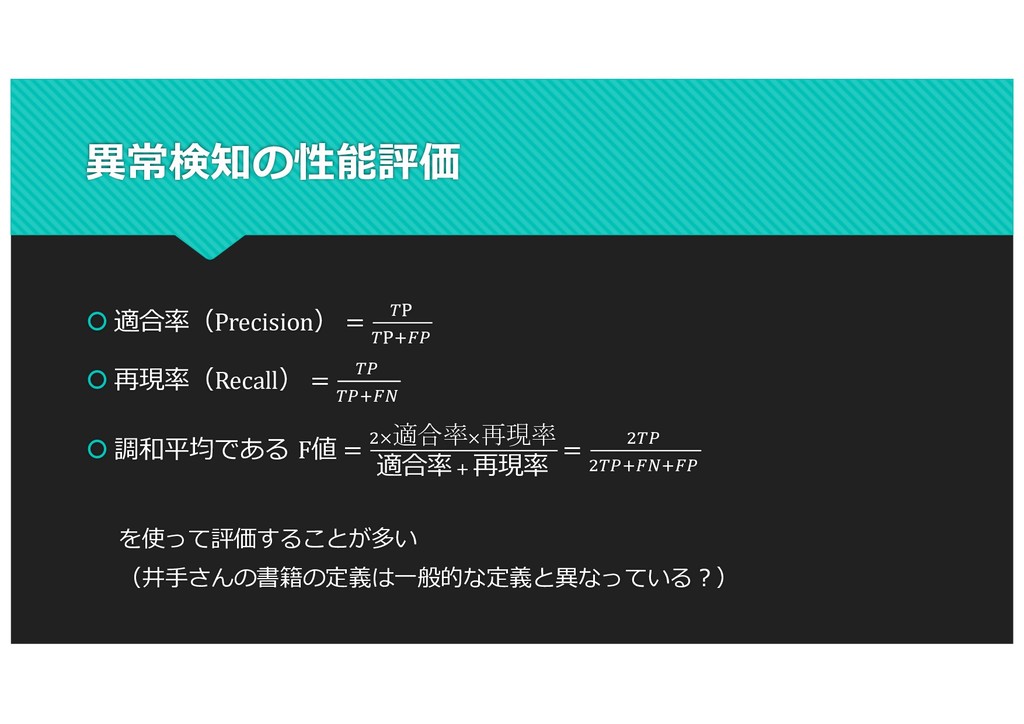
異常検知の性能評価 適合率(Precision) = AN ANOPQ 再現率(Recall) = AQ
AQOPU 調和平均である F値 = .×適合率×再現率 適合率O 再現率 = .AQ .AQOPUOPQ を使って評価することが多い (井⼿さんの書籍の定義は⼀般的な定義と異なっている︖) -
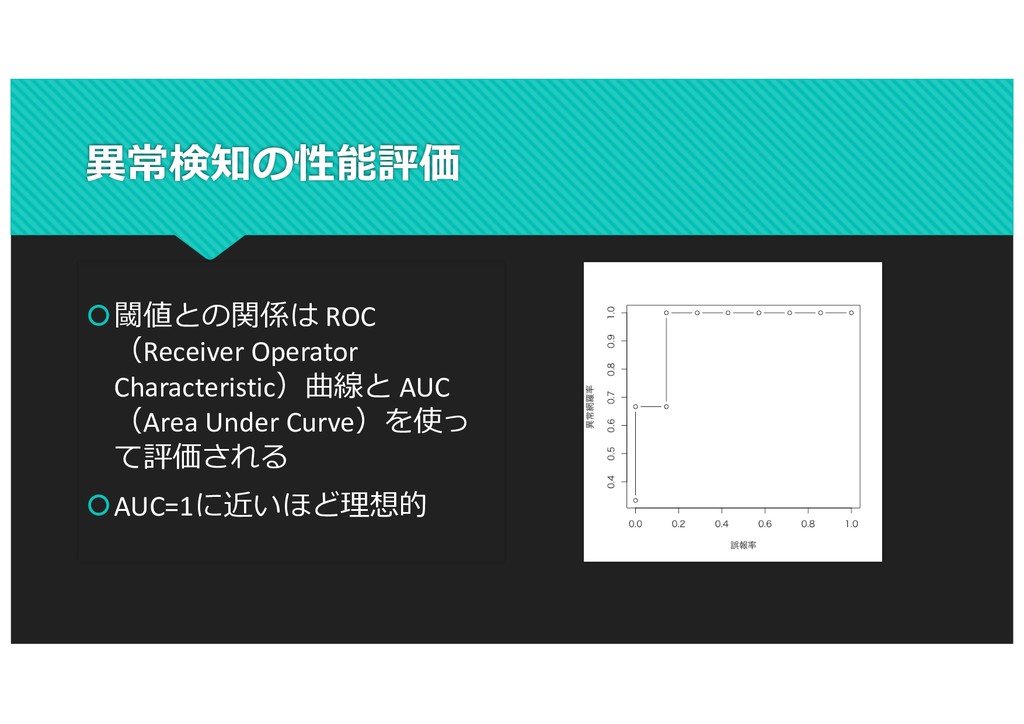
異常検知の性能評価 閾値との関係は ROC (Receiver Operator Characteristic)曲線と AUC (Area Under Curve)を使っ
て評価される AUC=1に近いほど理想的 -
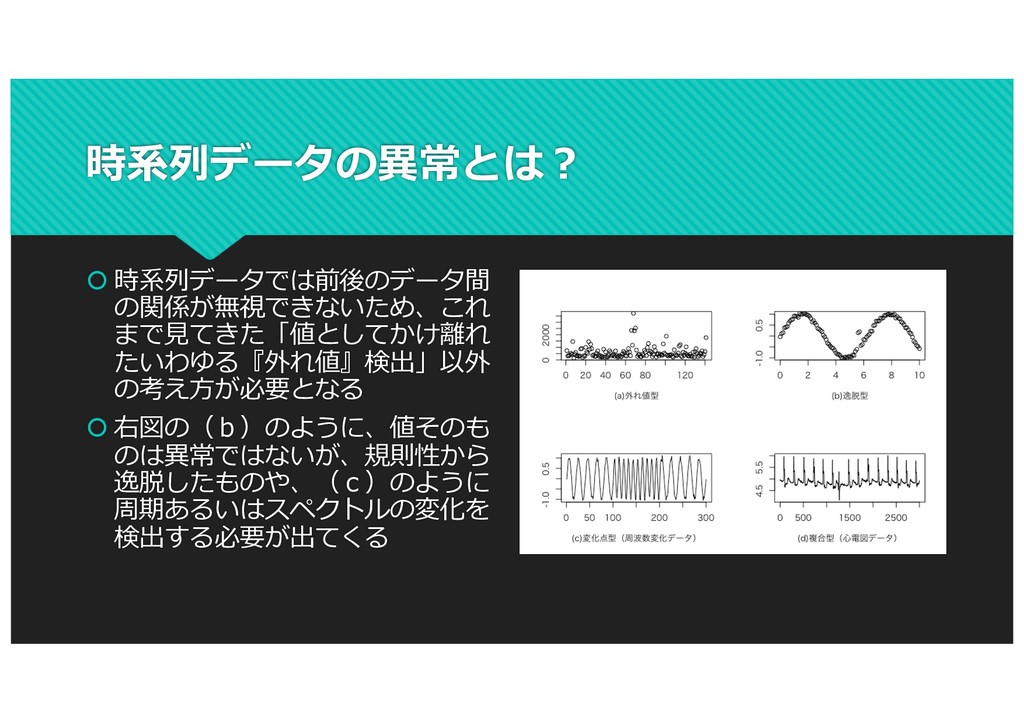
時系列データの異常とは︖ 時系列データでは前後のデータ間 の関係が無視できないため、これ まで⾒てきた「値としてかけ離れ たいわゆる『外れ値』検出」以外 の考え⽅が必要となる 右図の(b)のように、値そのも のは異常ではないが、規則性から
逸脱したものや、(c)のように 周期あるいはスペクトルの変化を 検出する必要が出てくる -
スライディングウィンドウと異常部位検出 スライディングウィンドウ法 時系列データについて、ある⼀定の⻑さの「窓」を想定し、窓をスラ イドしながら、窓から⾒える複数の観測値(部分時系列)をベクトル として取り出す⽅法 異常部位検出 スライディングウィンドウ法で得られた部分時系列の集合をベクトル データセットとして扱い、異常な部分時系列を検出する
部分時系列どうしの「距離」や「類似度」を使って判定する pyod KNN を使った実装例 https://github.com/masa-ita/anomaly-detection-with- python/blob/master/09_knn_pyod.ipynb -
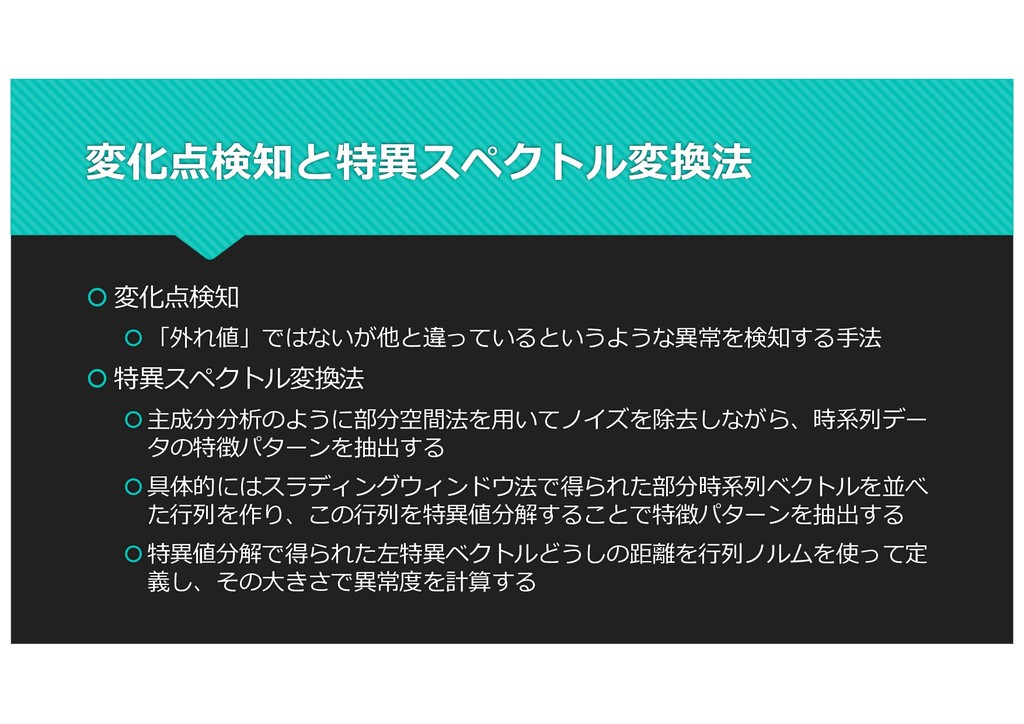
変化点検知と特異スペクトル変換法 変化点検知 「外れ値」ではないが他と違っているというような異常を検知する⼿法 特異スペクトル変換法 主成分分析のように部分空間法を⽤いてノイズを除去しながら、時系列デー タの特徴パターンを抽出する 具体的にはスラディングウィンドウ法で得られた部分時系列ベクトルを並べ た⾏列を作り、この⾏列を特異値分解することで特徴パターンを抽出する
特異値分解で得られた左特異ベクトルどうしの距離を⾏列ノルムを使って定 義し、その⼤きさで異常度を計算する -
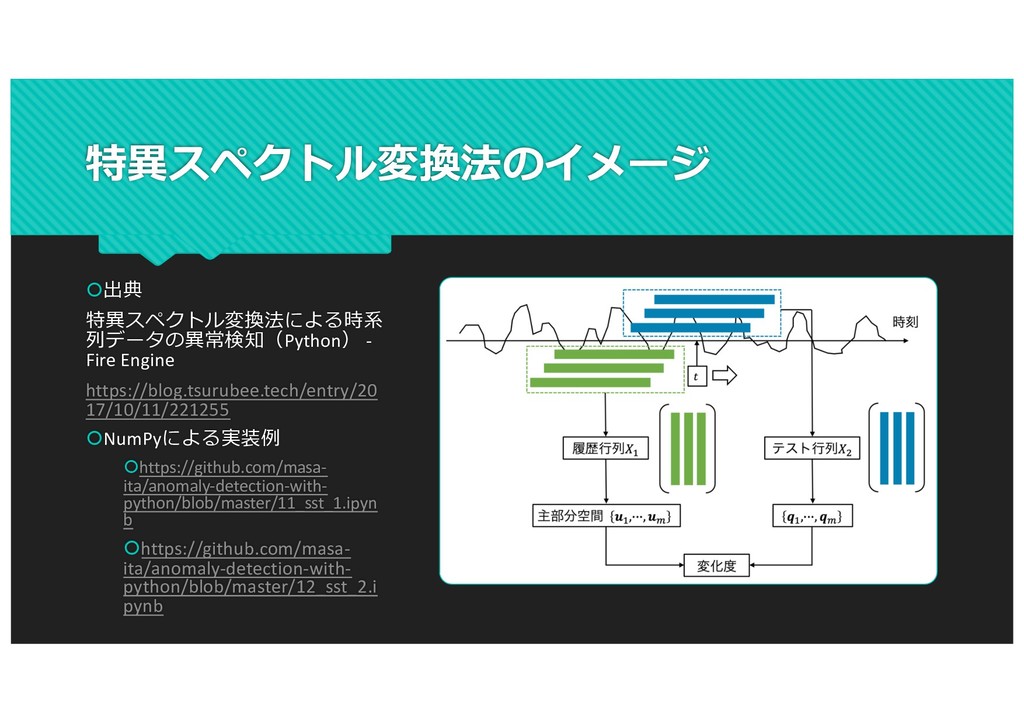
特異スペクトル変換法のイメージ 出典 特異スペクトル変換法による時系 列データの異常検知(Python) - Fire Engine https://blog.tsurubee.tech/entry/20 17/10/11/221255 NumPyによる実装例
https://github.com/masa- ita/anomaly-detection-with- python/blob/master/11_sst_1.ipyn b https://github.com/masa- ita/anomaly-detection-with- python/blob/master/12_sst_2.i pynb -
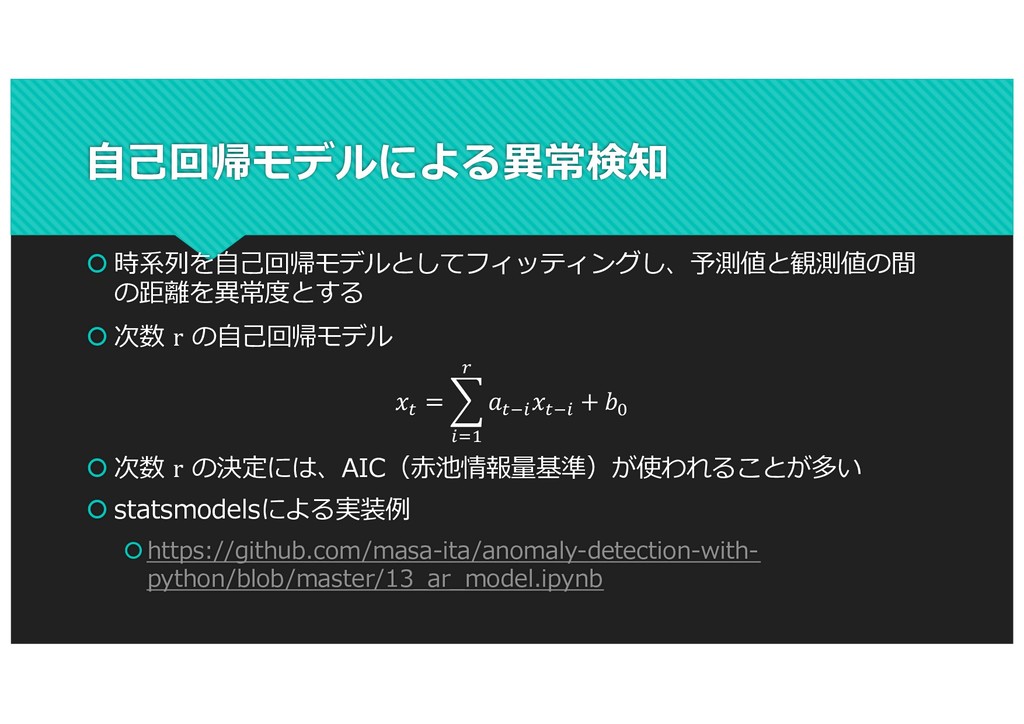
⾃⼰回帰モデルによる異常検知 時系列を⾃⼰回帰モデルとしてフィッティングし、予測値と観測値の間 の距離を異常度とする 次数 r の⾃⼰回帰モデル X =
& '() Y X>' X>' + \ 次数 r の決定には、AIC(⾚池情報量基準)が使われることが多い statsmodelsによる実装例 https://github.com/masa-ita/anomaly-detection-with- python/blob/master/13_ar_model.ipynb -
⾃⼰回帰型モデルのバリエーション AR(Autoregressive model︓⾃⼰回帰モデル) 基本となる⾃⼰回帰モデル ARMA(Autoregressive and Moving
Average model︓⾃⼰回帰移動平均モデル) ARモデルに過去の変動の影響を加えたモデル ARIMA(Autoregressive, Integrated and Moving Average model︓⾃⼰回帰和分移動平均モ デル) ARMAモデルに和分要素(トレンド)を加えた⾮定常モデル SARIMA(Seasonal, Autoregressive, Integrated and Moving Average model︓季節変動⾃⼰ 回帰和分移動平均モデル) ARIMAモデルに季節変動要素を加えたモデル -
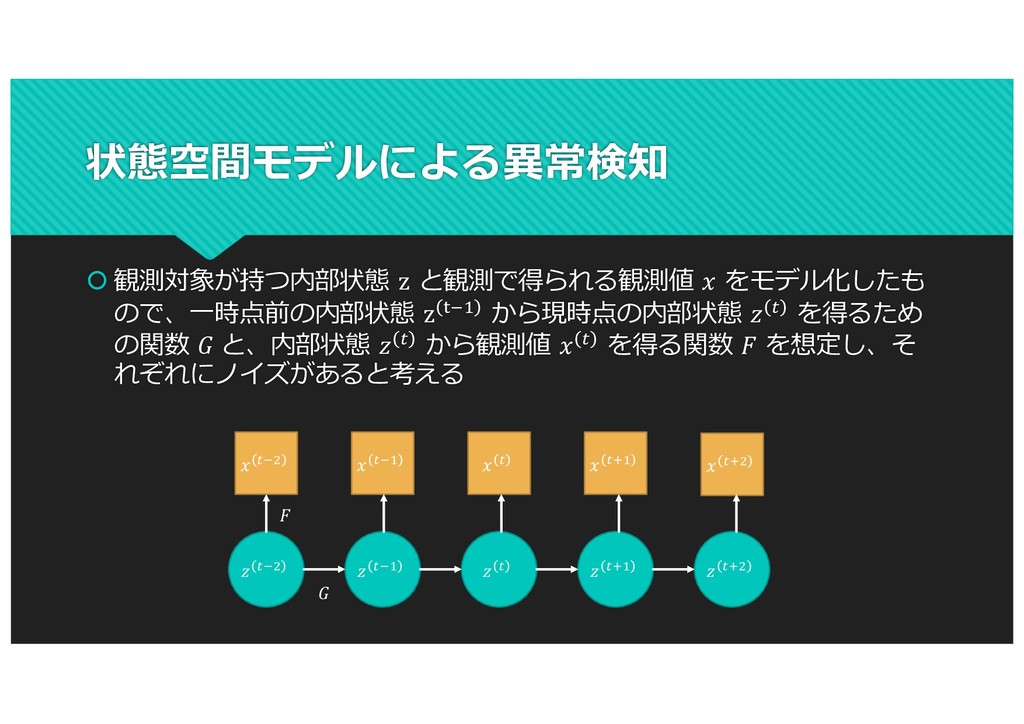
状態空間モデルによる異常検知 観測対象が持つ内部状態 z と観測で得られる観測値 をモデル化したも ので、⼀時点前の内部状態 z ^>) から現時点の内部状態
X を得るため の関数 と、内部状態 X から観測値 X を得る関数 を想定し、そ れぞれにノイズがあると考える X>. X>) X XO) XO. X>. X>) X XO) XO. -
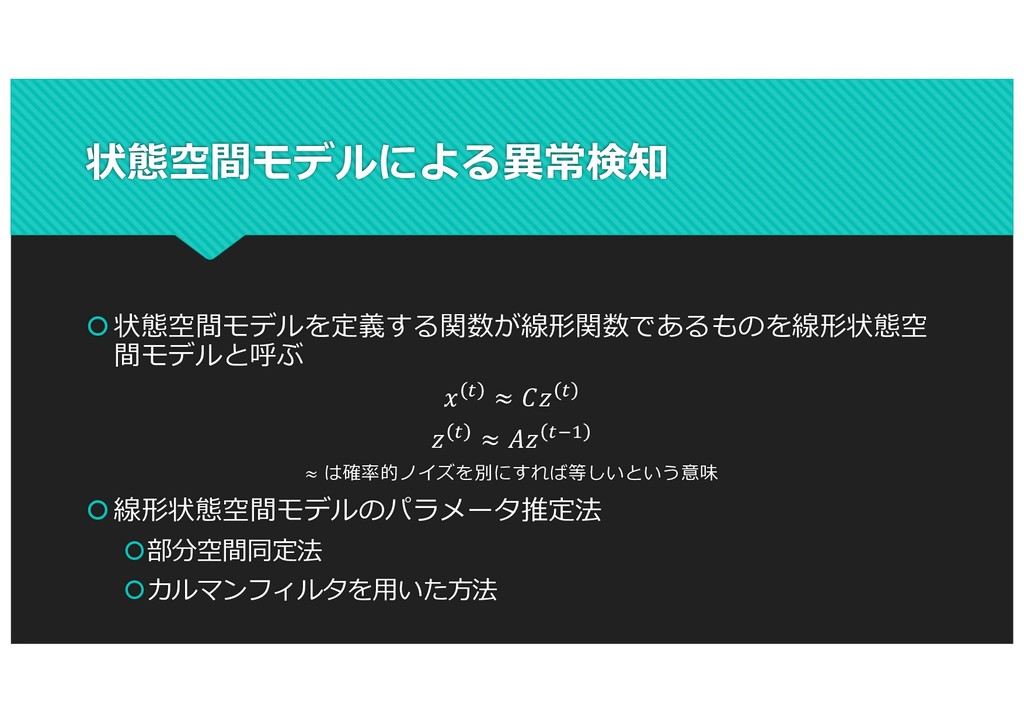
状態空間モデルによる異常検知 状態空間モデルを定義する関数が線形関数であるものを線形状態空 間モデルと呼ぶ X ≈ X X ≈ X>)
≈ は確率的ノイズを別にすれば等しいという意味 線形状態空間モデルのパラメータ推定法 部分空間同定法 カルマンフィルタを⽤いた⽅法 -
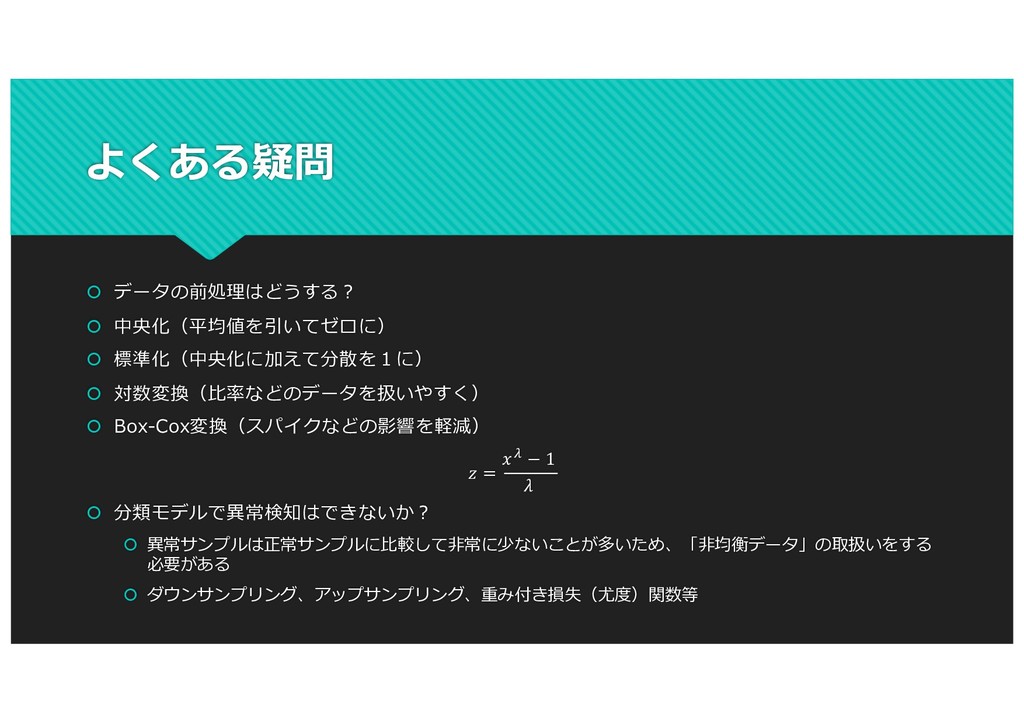
よくある疑問 データの前処理はどうする︖ 中央化(平均値を引いてゼロに) 標準化(中央化に加えて分散を1に) 対数変換(⽐率などのデータを扱いやすく)
Box-Cox変換(スパイクなどの影響を軽減) = e − 1 分類モデルで異常検知はできないか︖ 異常サンプルは正常サンプルに⽐較して⾮常に少ないことが多いため、「⾮均衡データ」の取扱いをする 必要がある ダウンサンプリング、アップサンプリング、重み付き損失(尤度)関数等 -
まとめ 異常検知には、対象となるデータによって異なる⼿法が必要 対象となるデータが同じでも、異なる⼿法による検知があり得る 異常検知に使われるRのライブラリの代替となるPythonのライブラリは だいたいある 様々な⼿法の異常検知を同⼀のAPIでラッピングしたPyODは便利かもし
れない 異常検知には「⼀般解」はない︖ 背景となる統計モデルや数式の導出に興味のある⽅は、本を読んでくだ さい -
参考ページ 教師なし学習による異常値検知: マハラノビス距離 (実装編) https://qiita.com/shopetan/items/30f6e0932485c976a946 Robust covariance
estimation and Mahalanobis distances relevance https://scikit-learn.org/stable/auto_examples/covariance/plot_mahalanobis_distances.html Pythonとカーネル密度推定(KDE)について調べたまとめ https://vaaaaaanquish.hatenablog.com/entry/2017/10/29/181949 Kernel Density Estimation in Python https://jakevdp.github.io/blog/2013/12/01/kernel-density-estimation/ Rで計量時系列分析︓AR, MA, ARMA, ARIMAモデル, 予測 https://tjo.hatenablog.com/entry/2013/07/12/184704 -
参考ページ Pythonによる時系列データの異常検知 https://blog.brains-tech.co.jp/entry/2017/10/17/170140 Time Series Analysis by
State Space Methods https://www.statsmodels.org/stable/statespace.html#module- statsmodels.tsa.statespace Understanding Kalman Filters https://www.youtube.com/playlist?list=PLn8PRpmsu08pzi6EMiYnR-076Mh-q3tWr PyOD https://github.com/yzhao062/pyod