Share
Embed
A Gentle Introduction to Transformers
2026/3/5 SQAI招待講演資料
Semantic Machine Intelligence Lab., Keio Univ. PRO
March 04, 2026
Transcript
87 slides
-
コンセプト: 基礎からトランスフォーマーまでを 1.5時間に詰め込む - - 2 前提: 理工系B2-B3の知識 1. ニューラルネットの基礎
基礎的概念 2. 再帰型ニューラルネット LSTMとの違いおよびエンコーダ・デ コーダモデル 3. 汎化と過学習 トランスフォーマ層内のレイヤー正規化 4. 注意機構 基幹部分のQKV注意 5. トランスフォーマー 数式的には内積と行列と指数関数がわかればOK! -
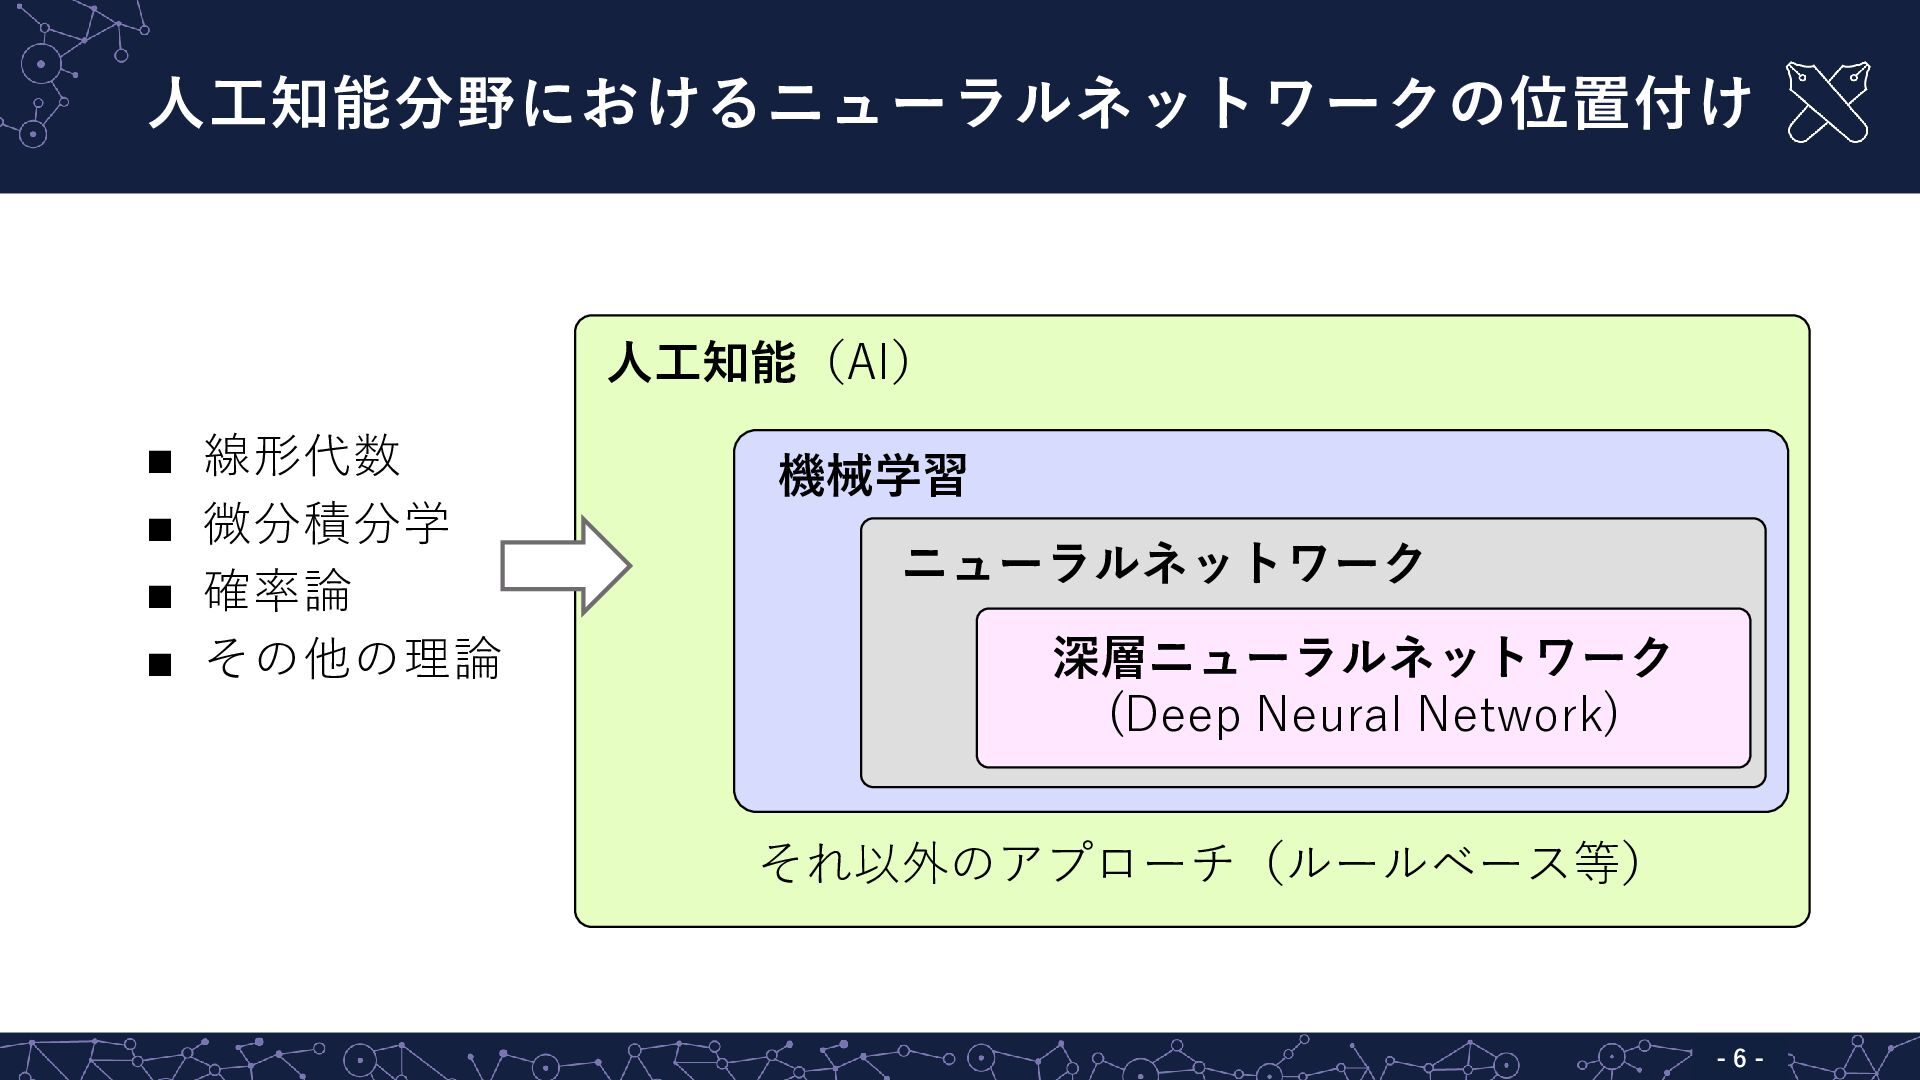
人工知能分野におけるニューラルネットワークの位置付け - - 6 深層ニューラルネットワーク (Deep Neural Network) 人工知能(AI) 機械学習
ニューラルネットワーク それ以外のアプローチ(ルールベース等) ▪ 線形代数 ▪ 微分積分学 ▪ 確率論 ▪ その他の理論 -
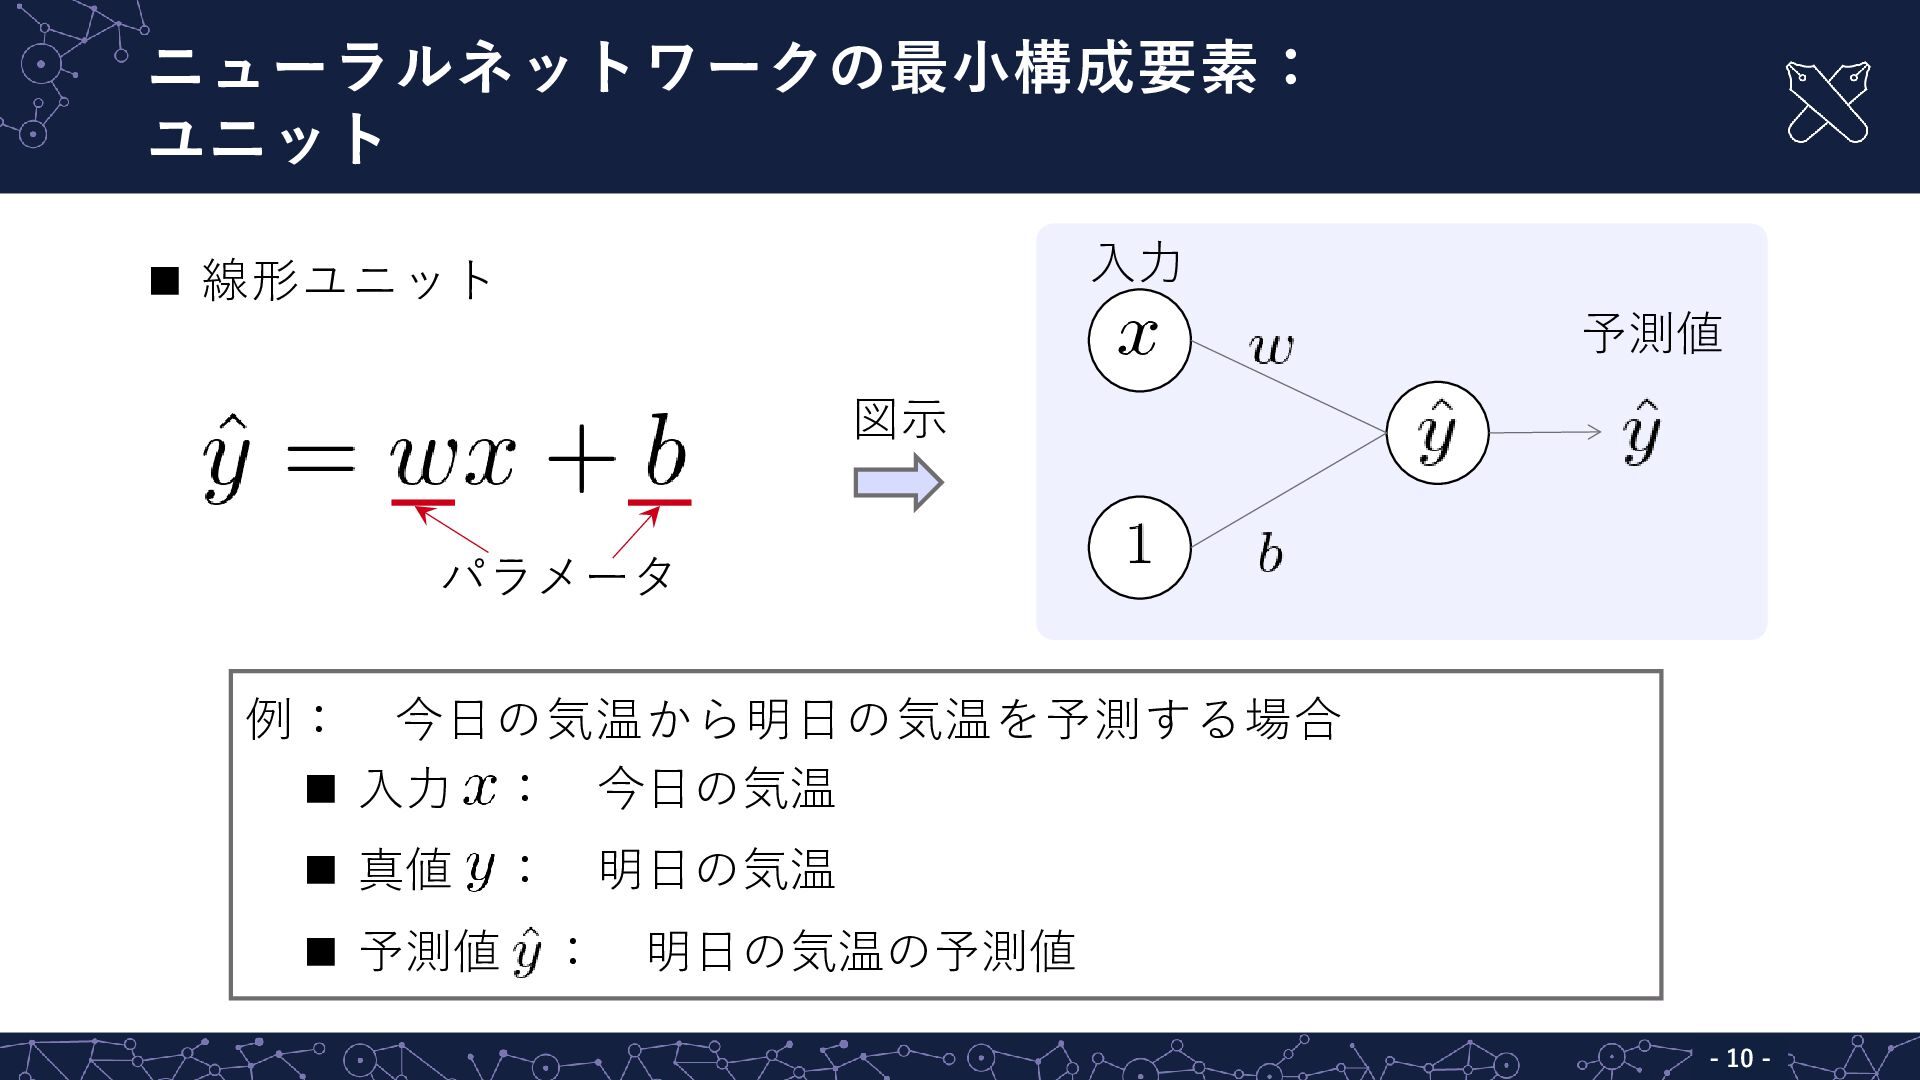
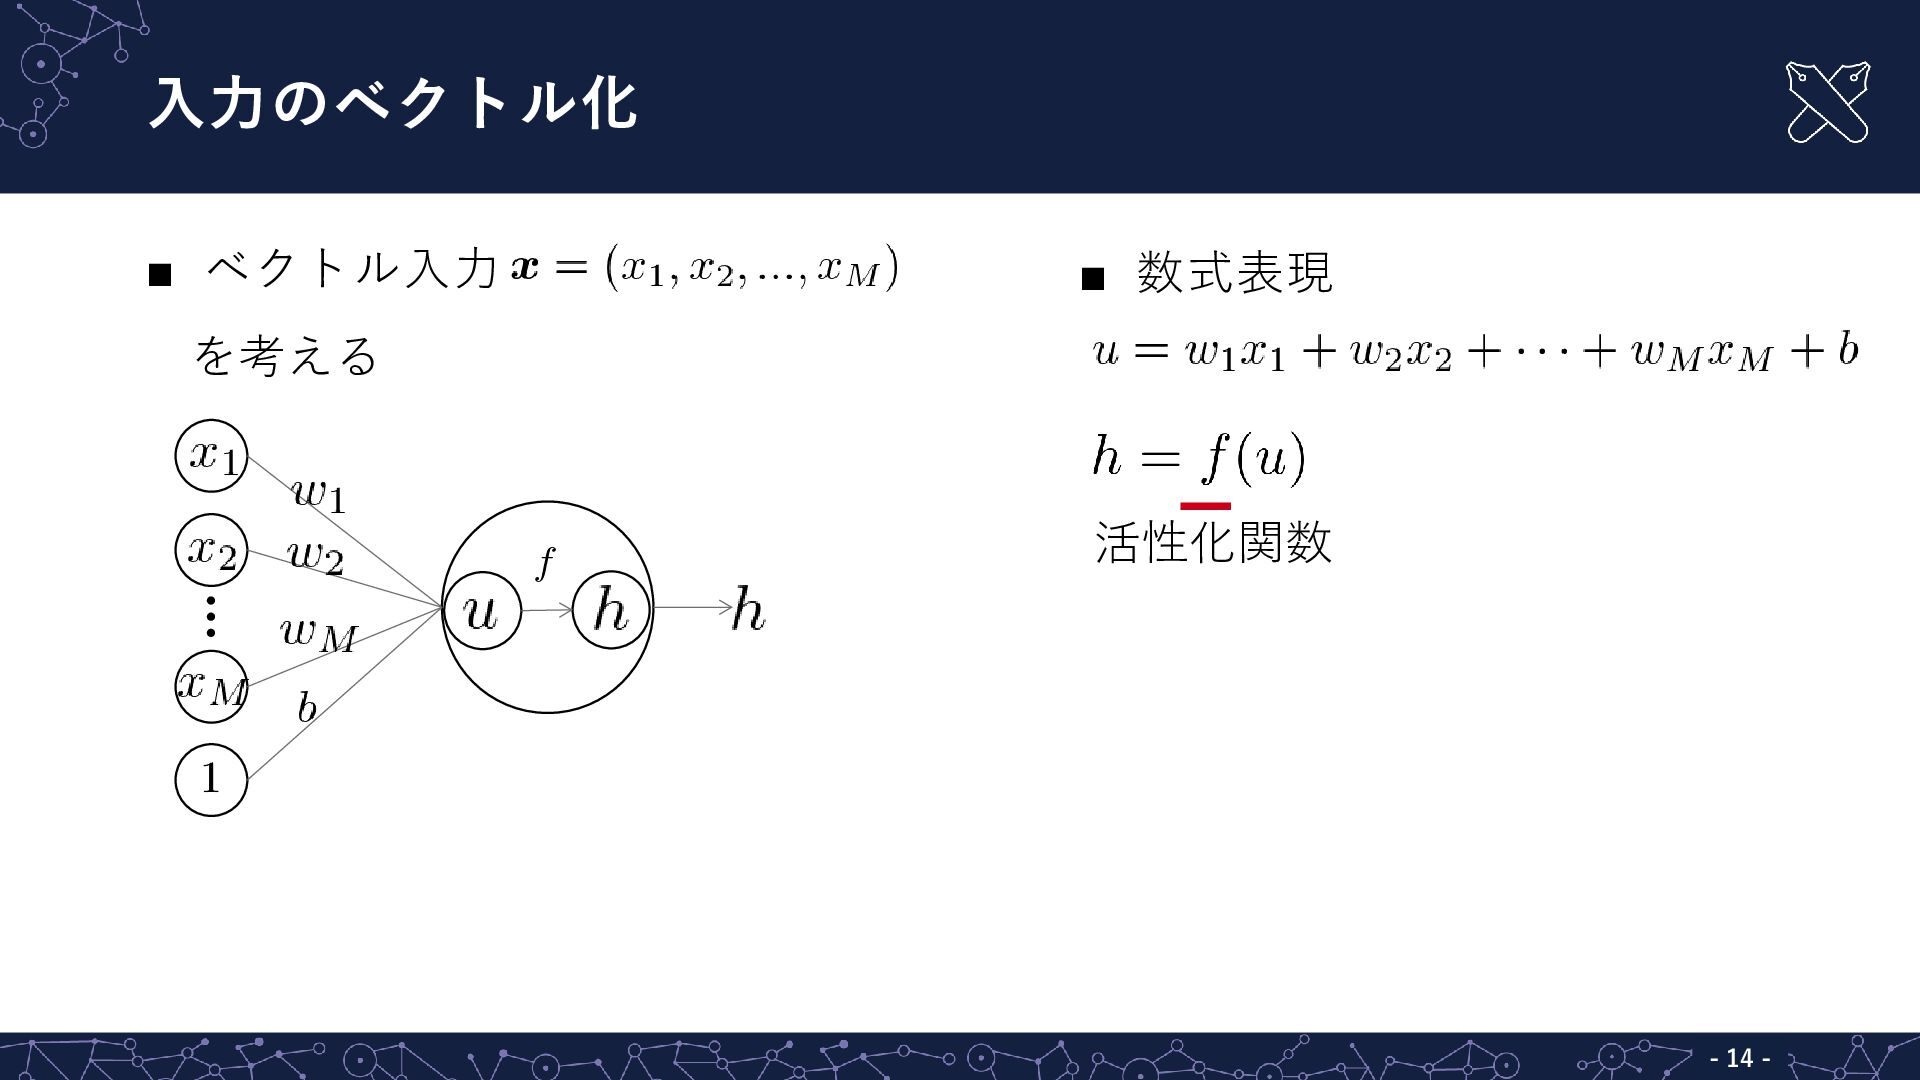
ニューラルネットワークの最小構成要素: ユニット - - 10 線形ユニット パラメータ 入力
: 今日の気温 真値 : 明日の気温 予測値 : 明日の気温の予測値 例: 今日の気温から明日の気温を予測する場合 予測値 入力 図示 -
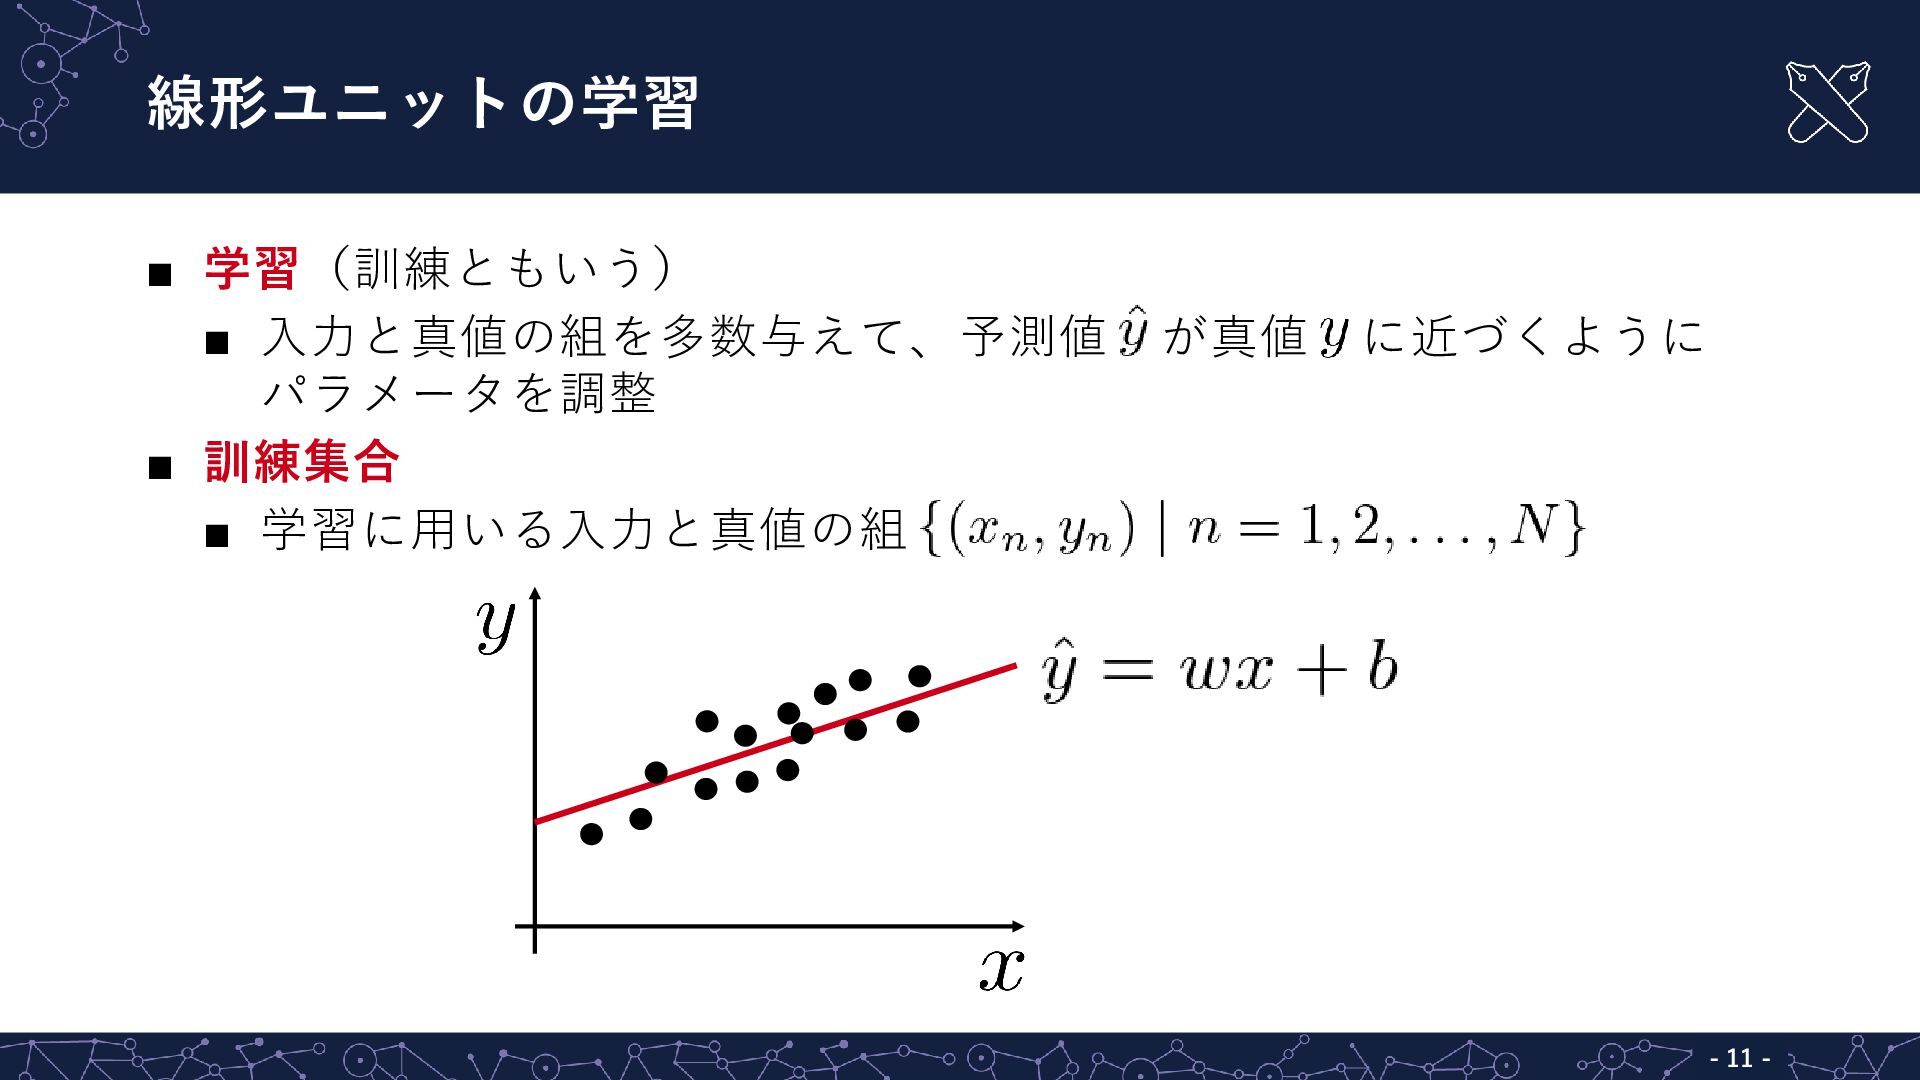
線形ユニットの学習 - - 11 ▪ 学習(訓練ともいう) ▪ 入力と真値の組を多数与えて、予測値 が真値 に近づくように
パラメータを調整 ▪ 訓練集合 ▪ 学習に用いる入力と真値の組 -
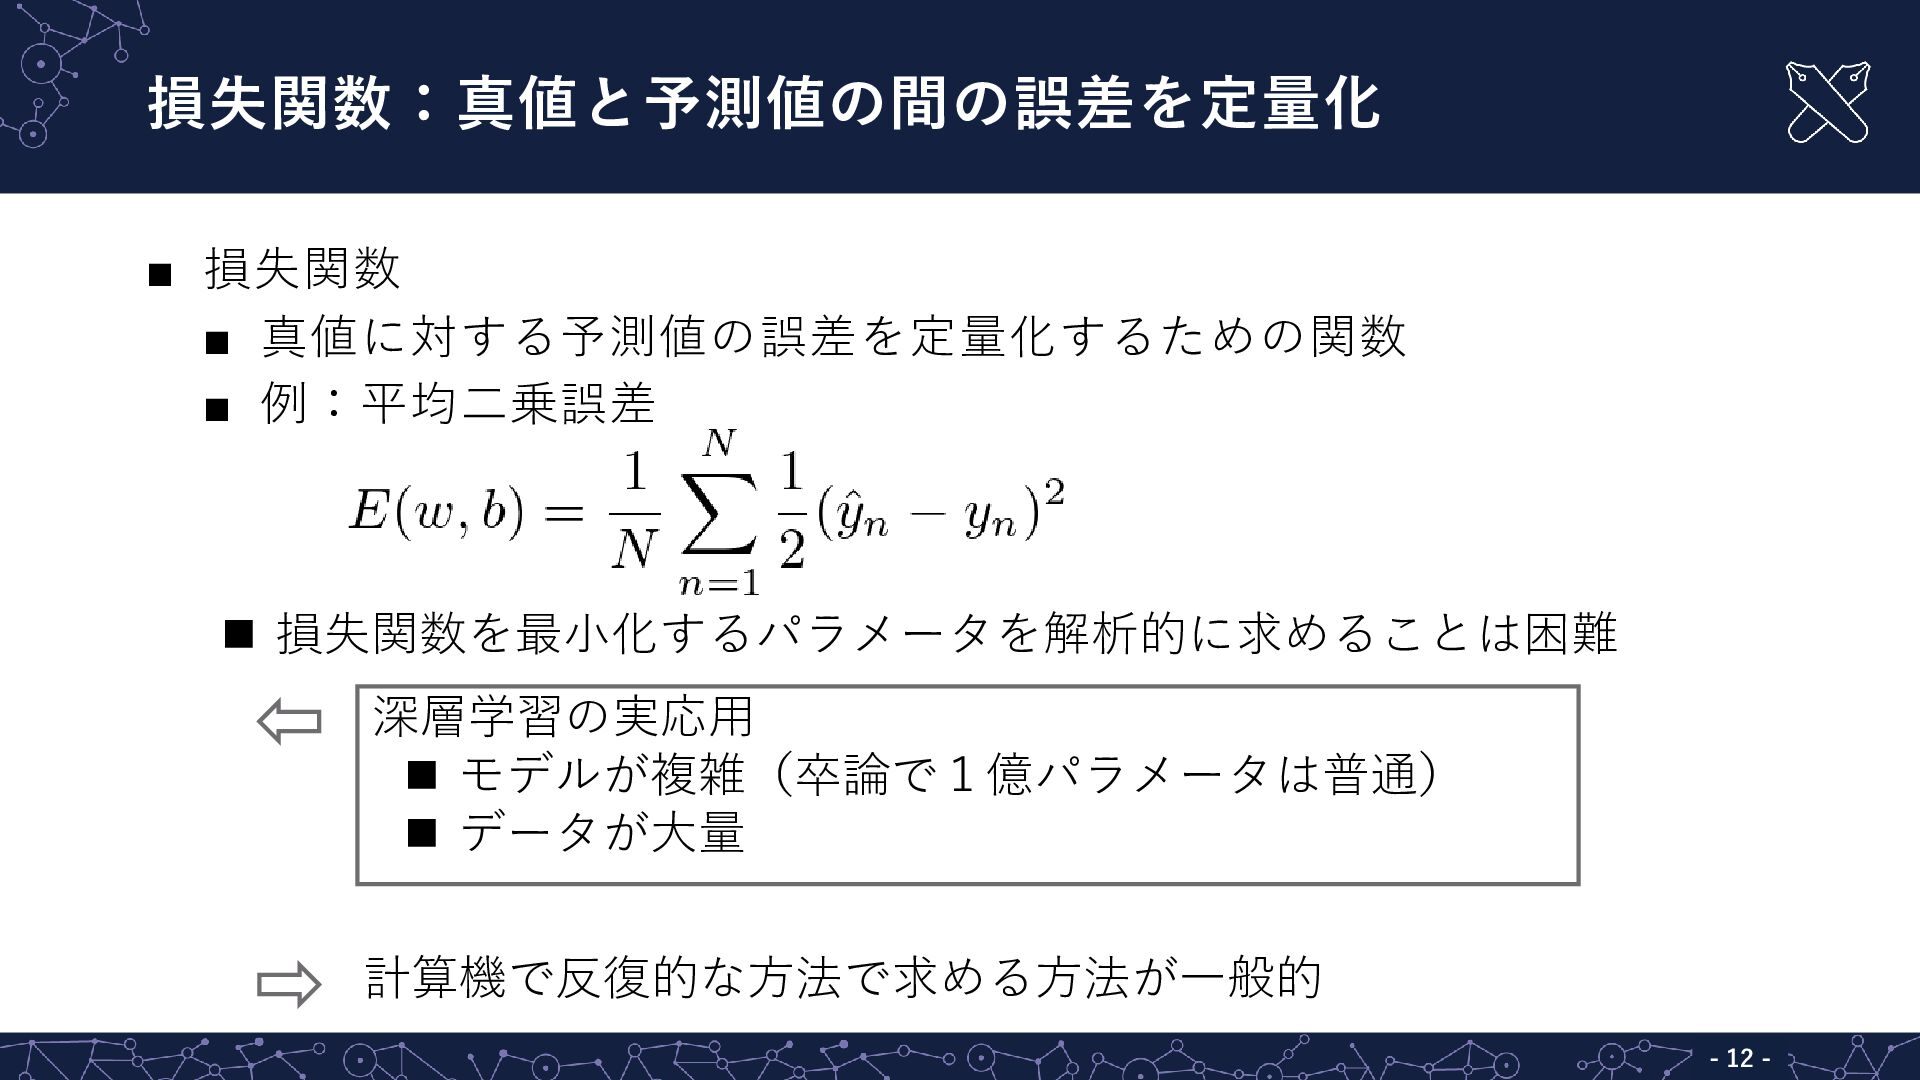
▪ 損失関数 ▪ 真値に対する予測値の誤差を定量化するための関数 ▪ 例:平均二乗誤差 損失関数:真値と予測値の間の誤差を定量化 - - 12
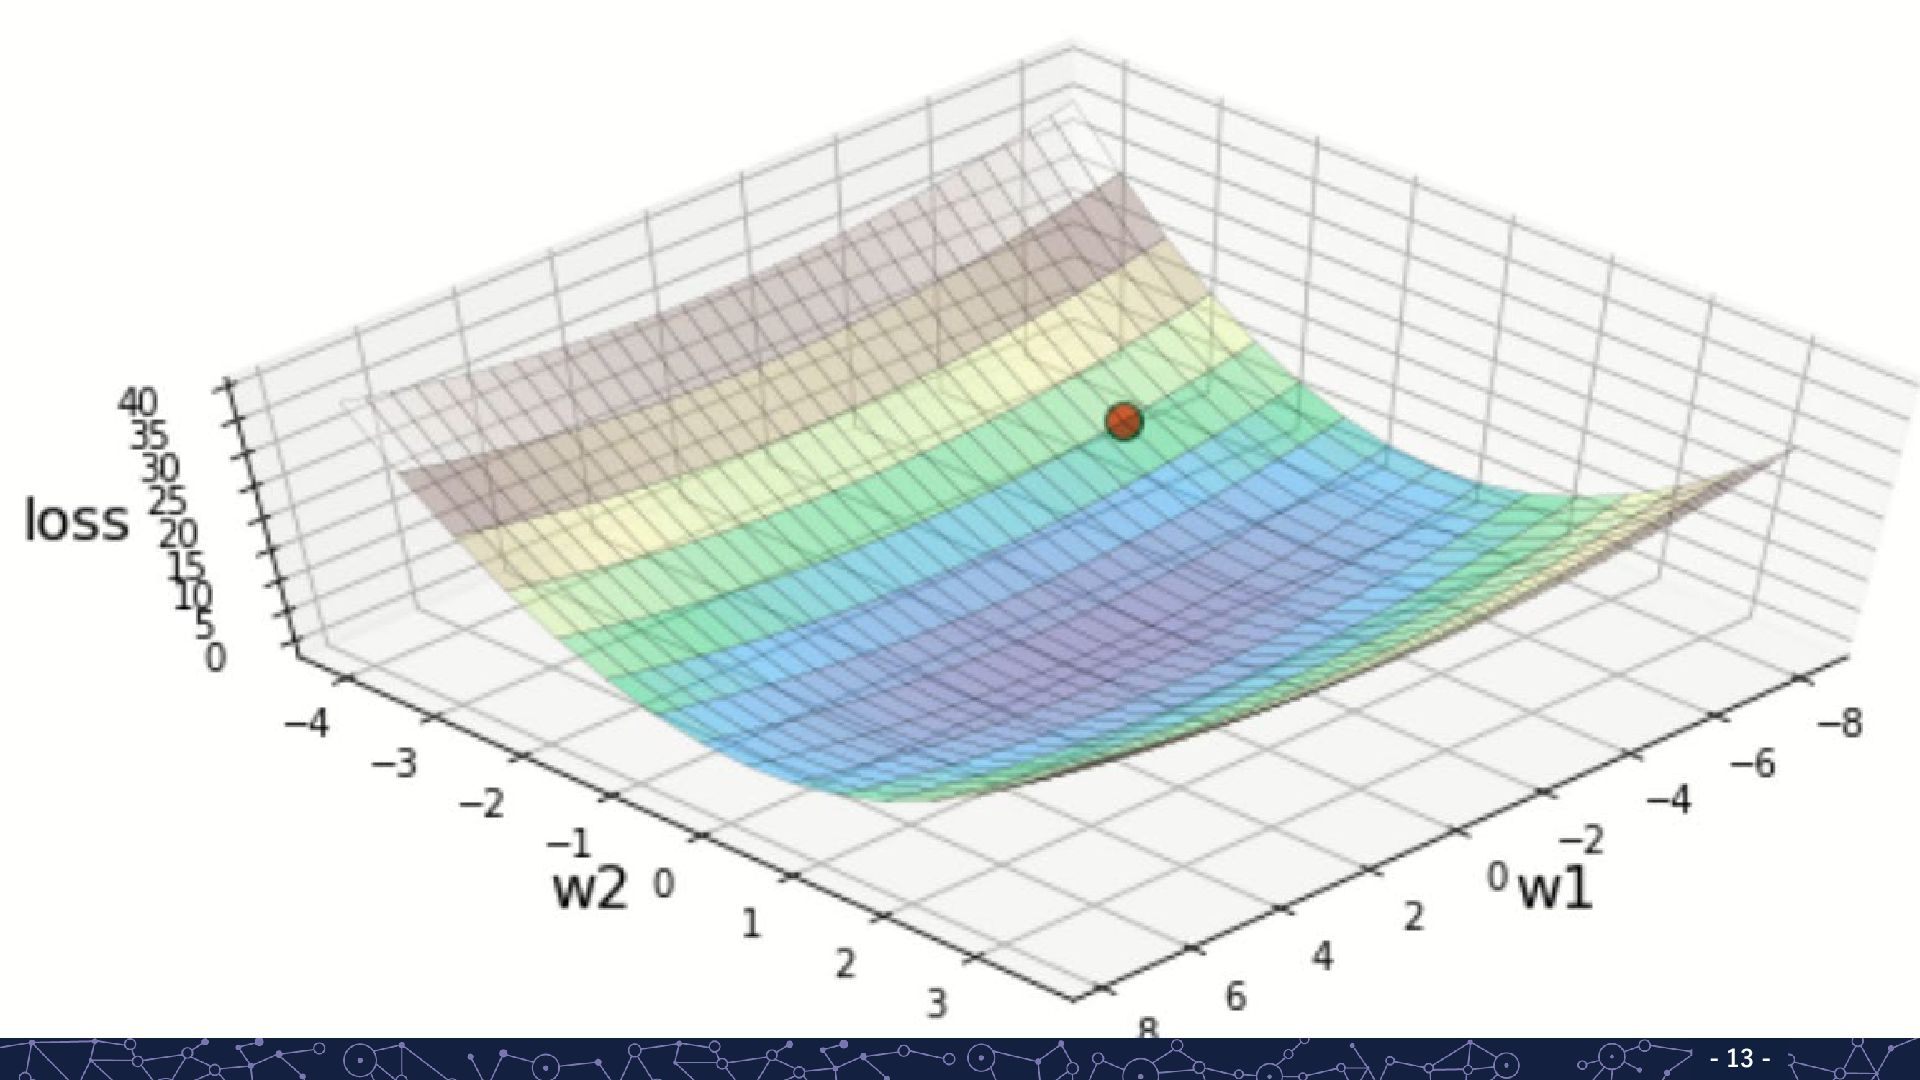
損失関数を最小化するパラメータを解析的に求めることは困難 モデルが複雑(卒論で1億パラメータは普通) データが大量 深層学習の実応用 計算機で反復的な方法で求める方法が一般的 -
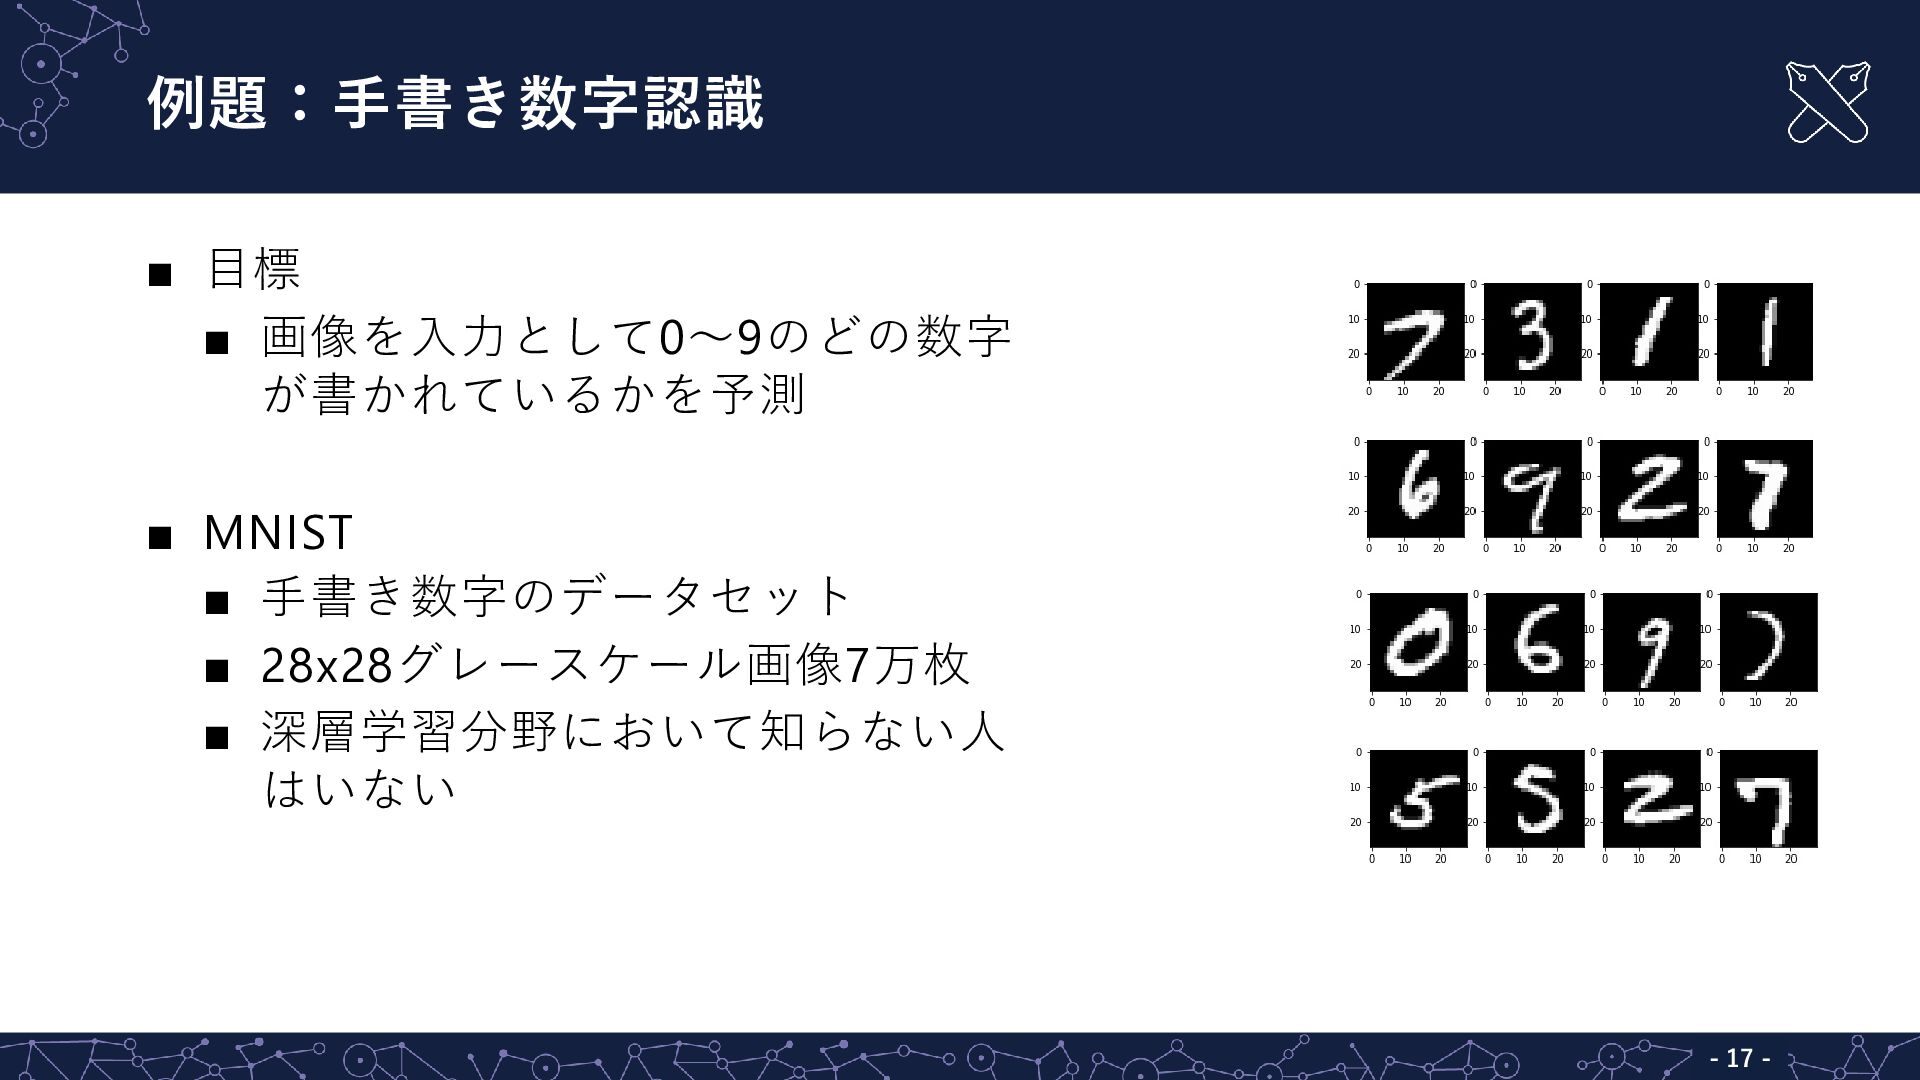
例題:手書き数字認識 - - 17 ▪ 目標 ▪ 画像を入力として0~9のどの数字 が書かれているかを予測 ▪
MNIST ▪ 手書き数字のデータセット ▪ 28x28グレースケール画像7万枚 ▪ 深層学習分野において知らない人 はいない -
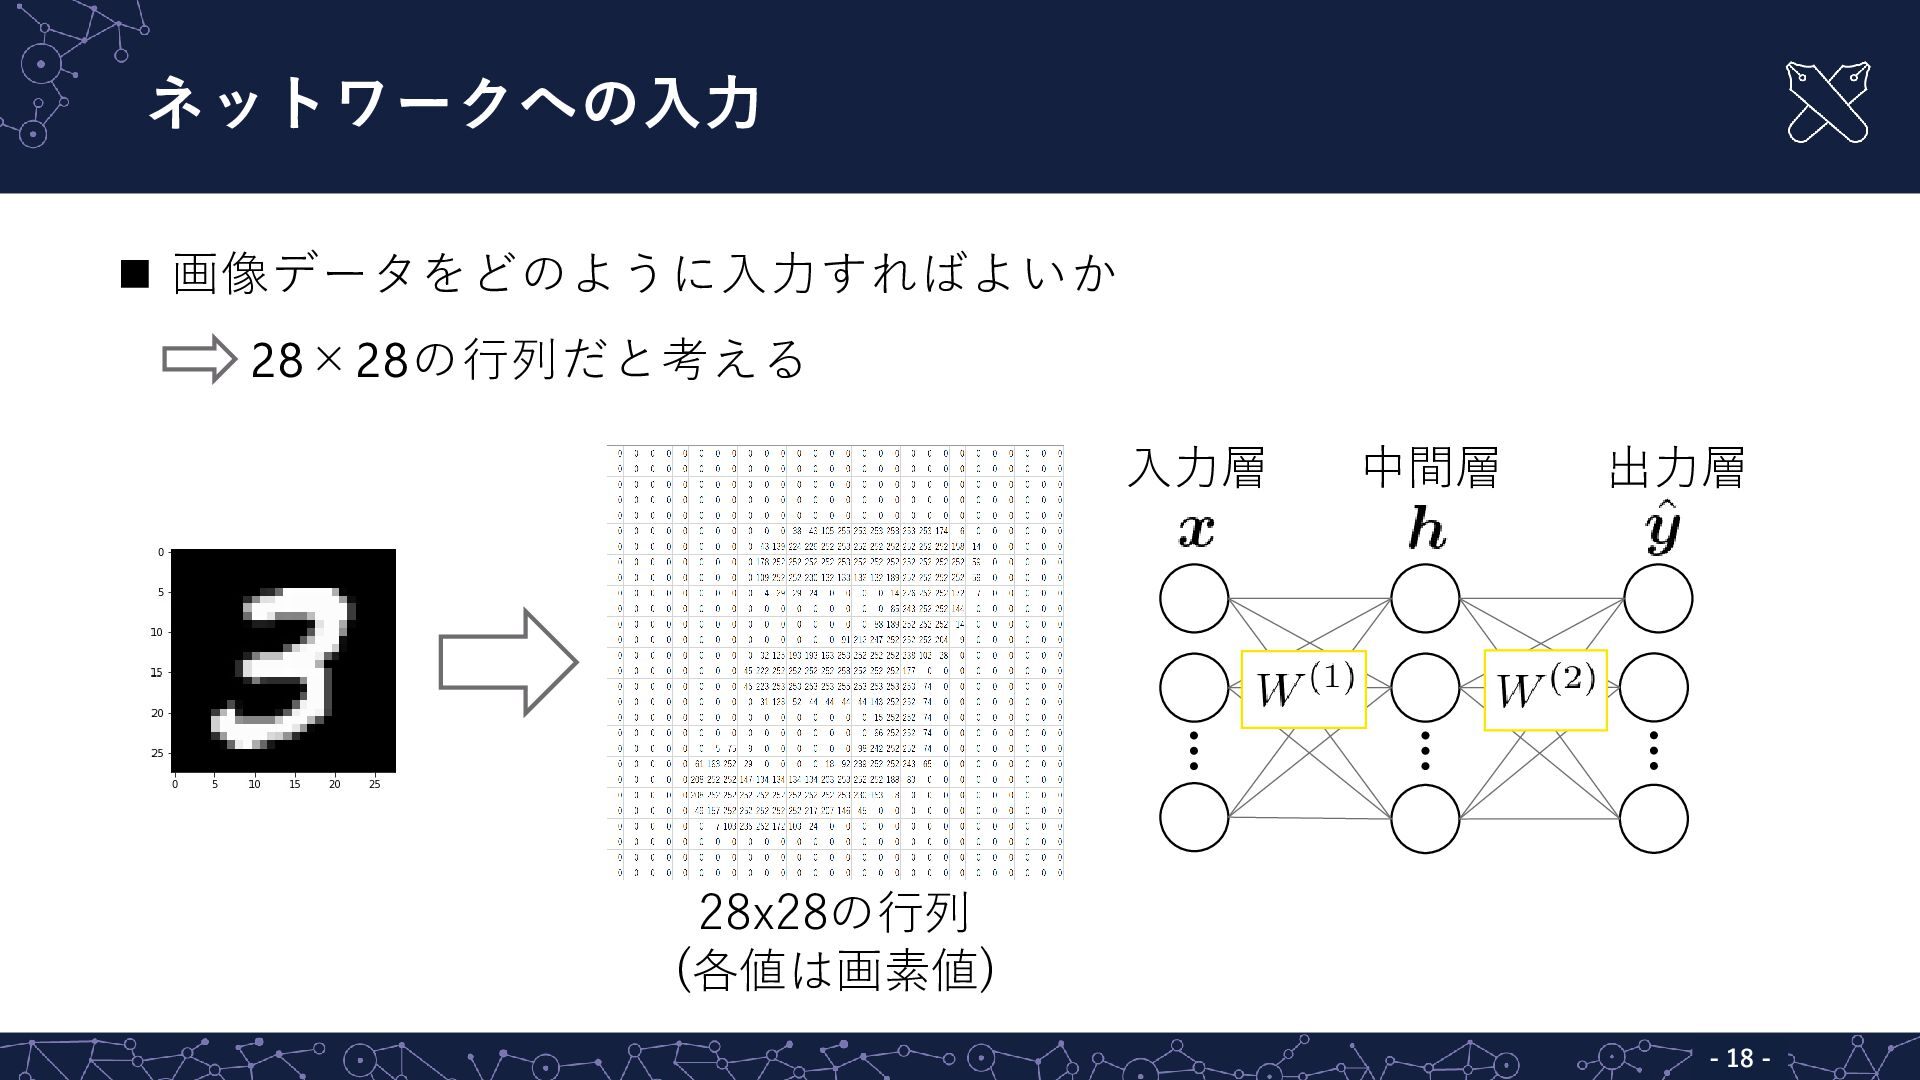
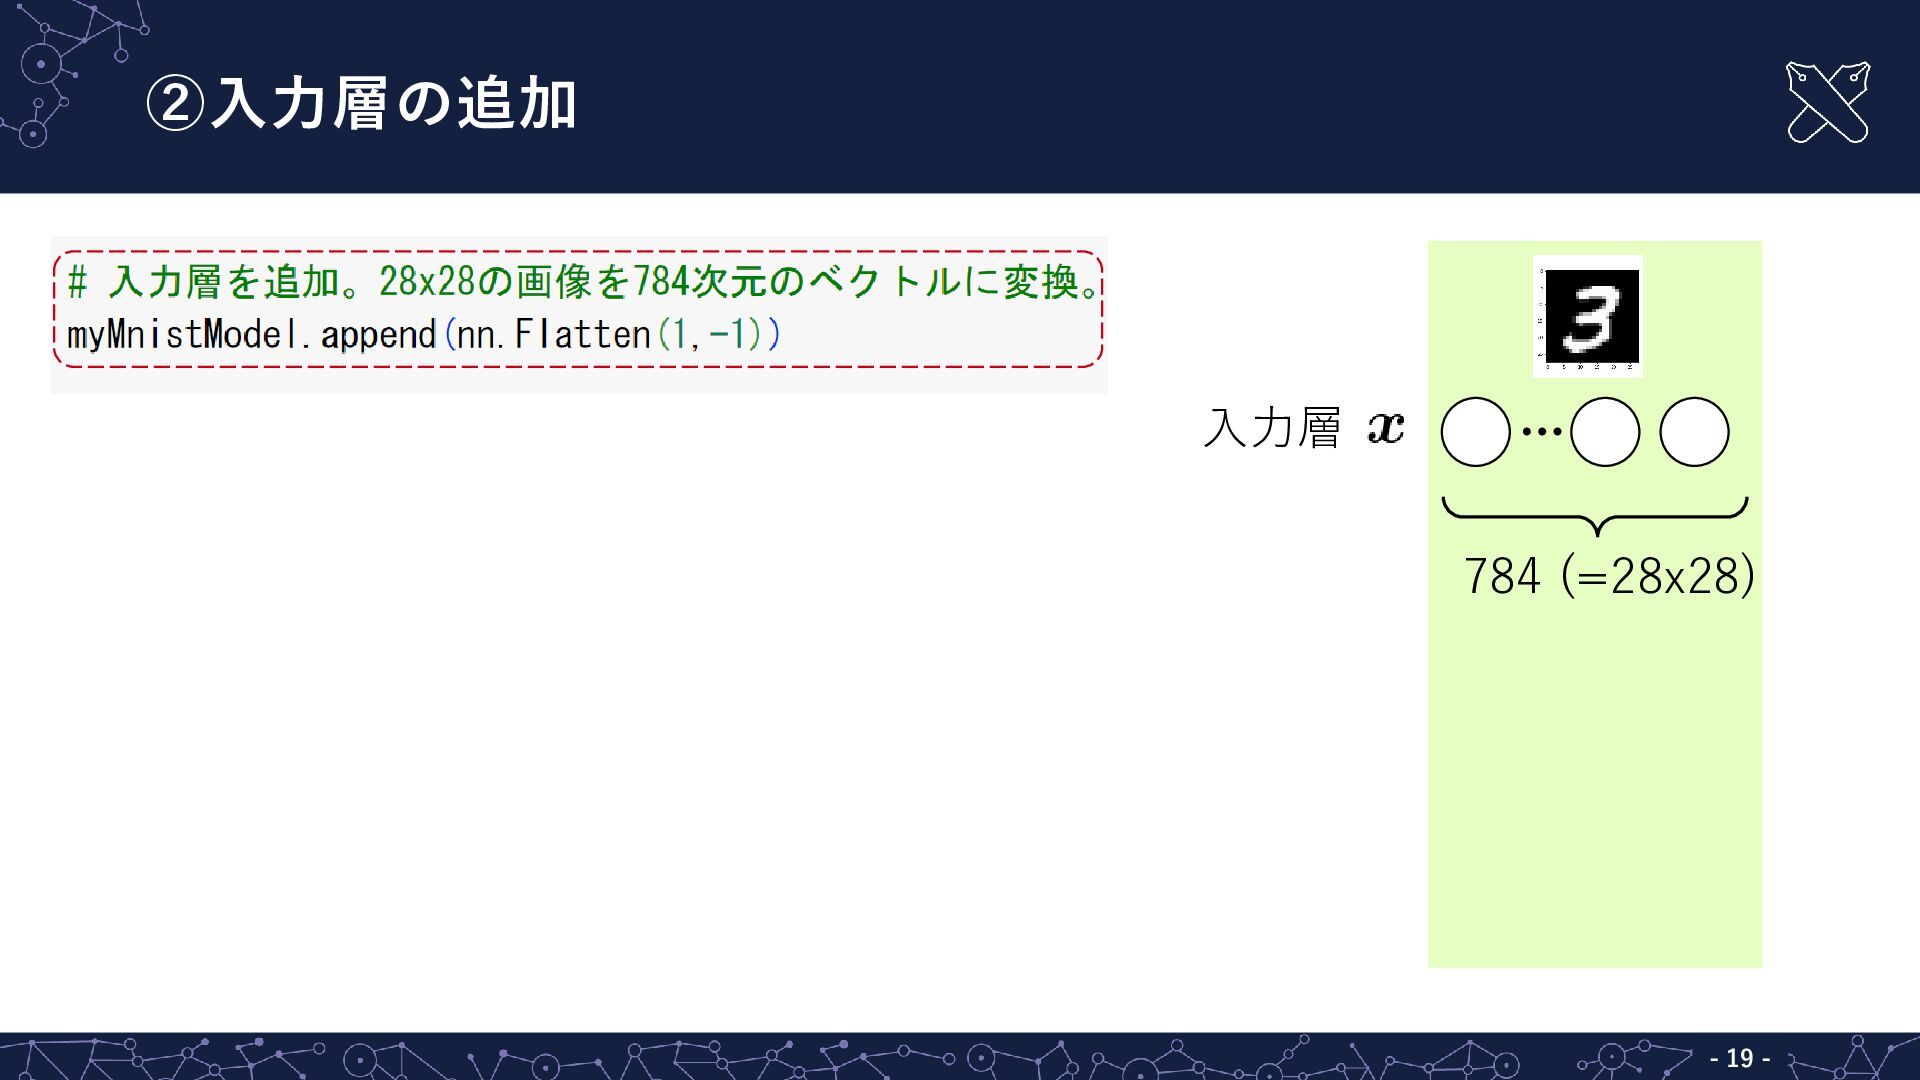
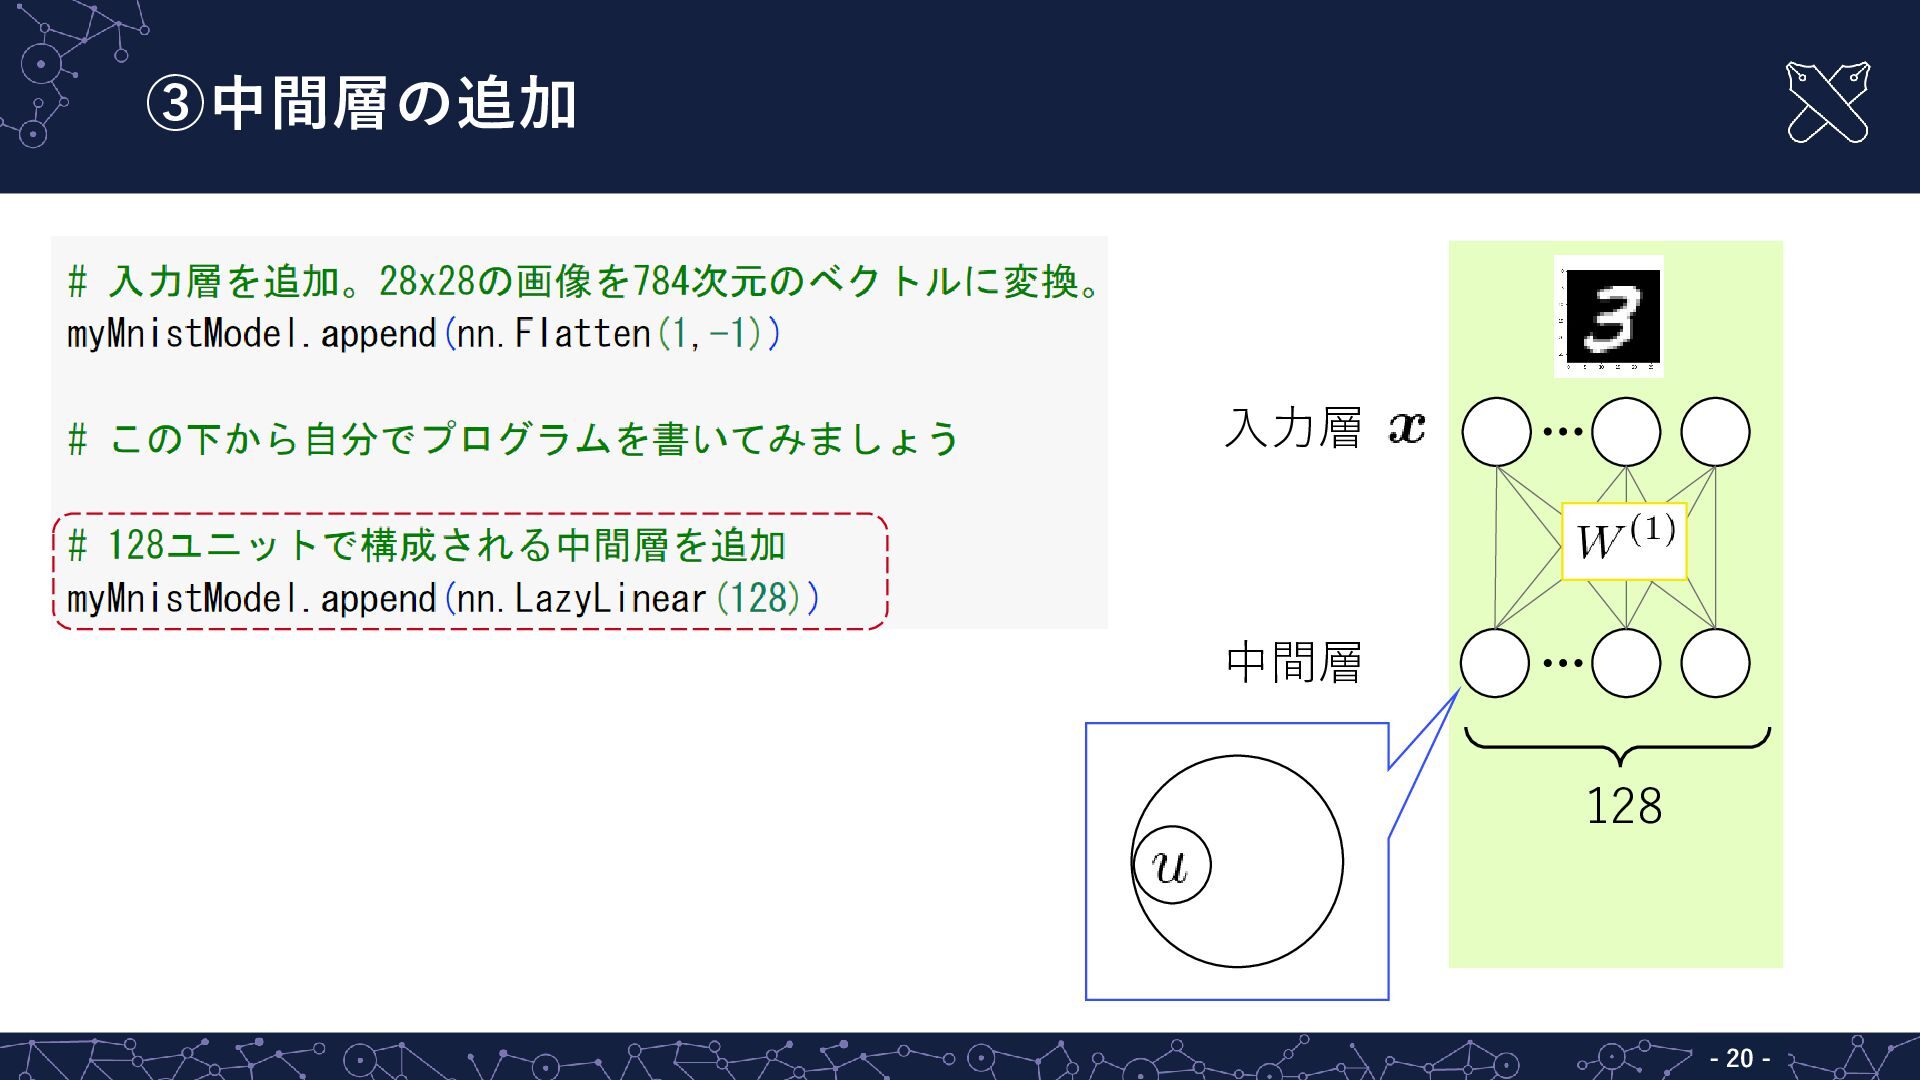
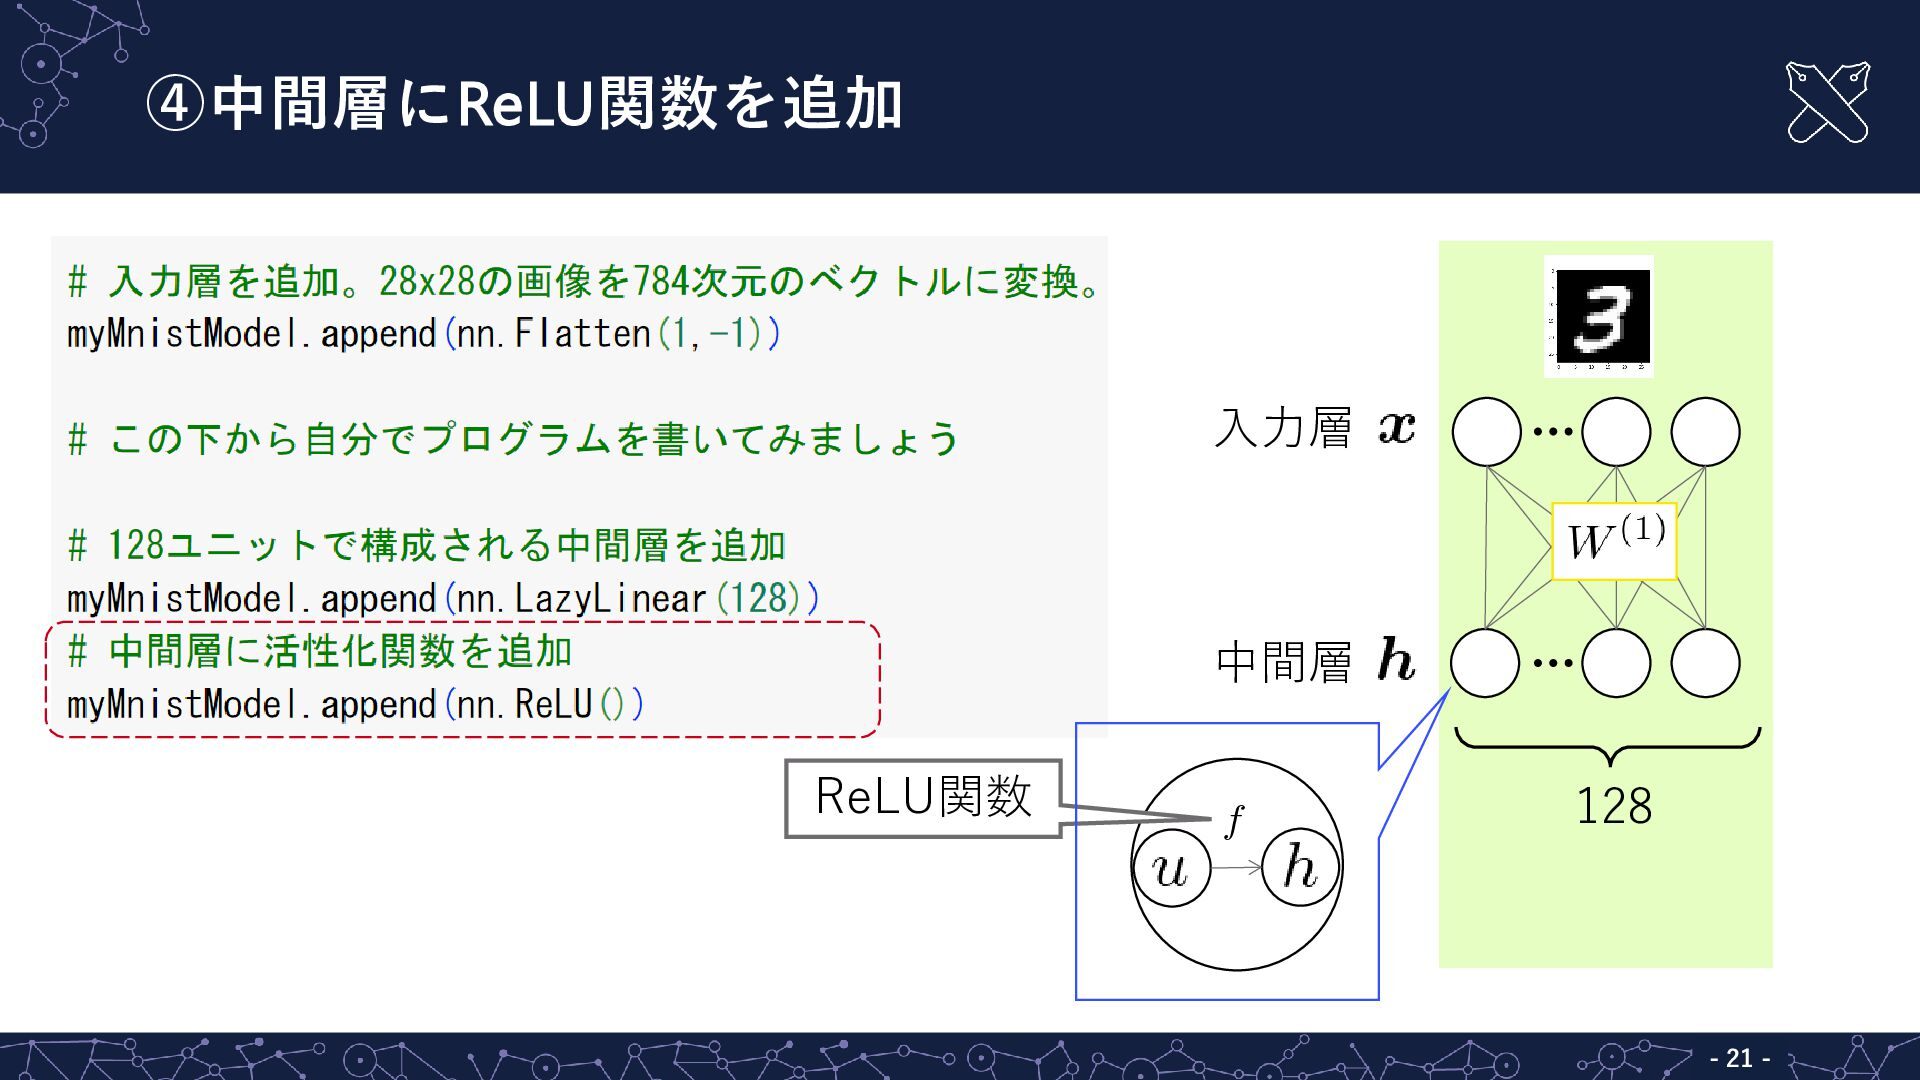
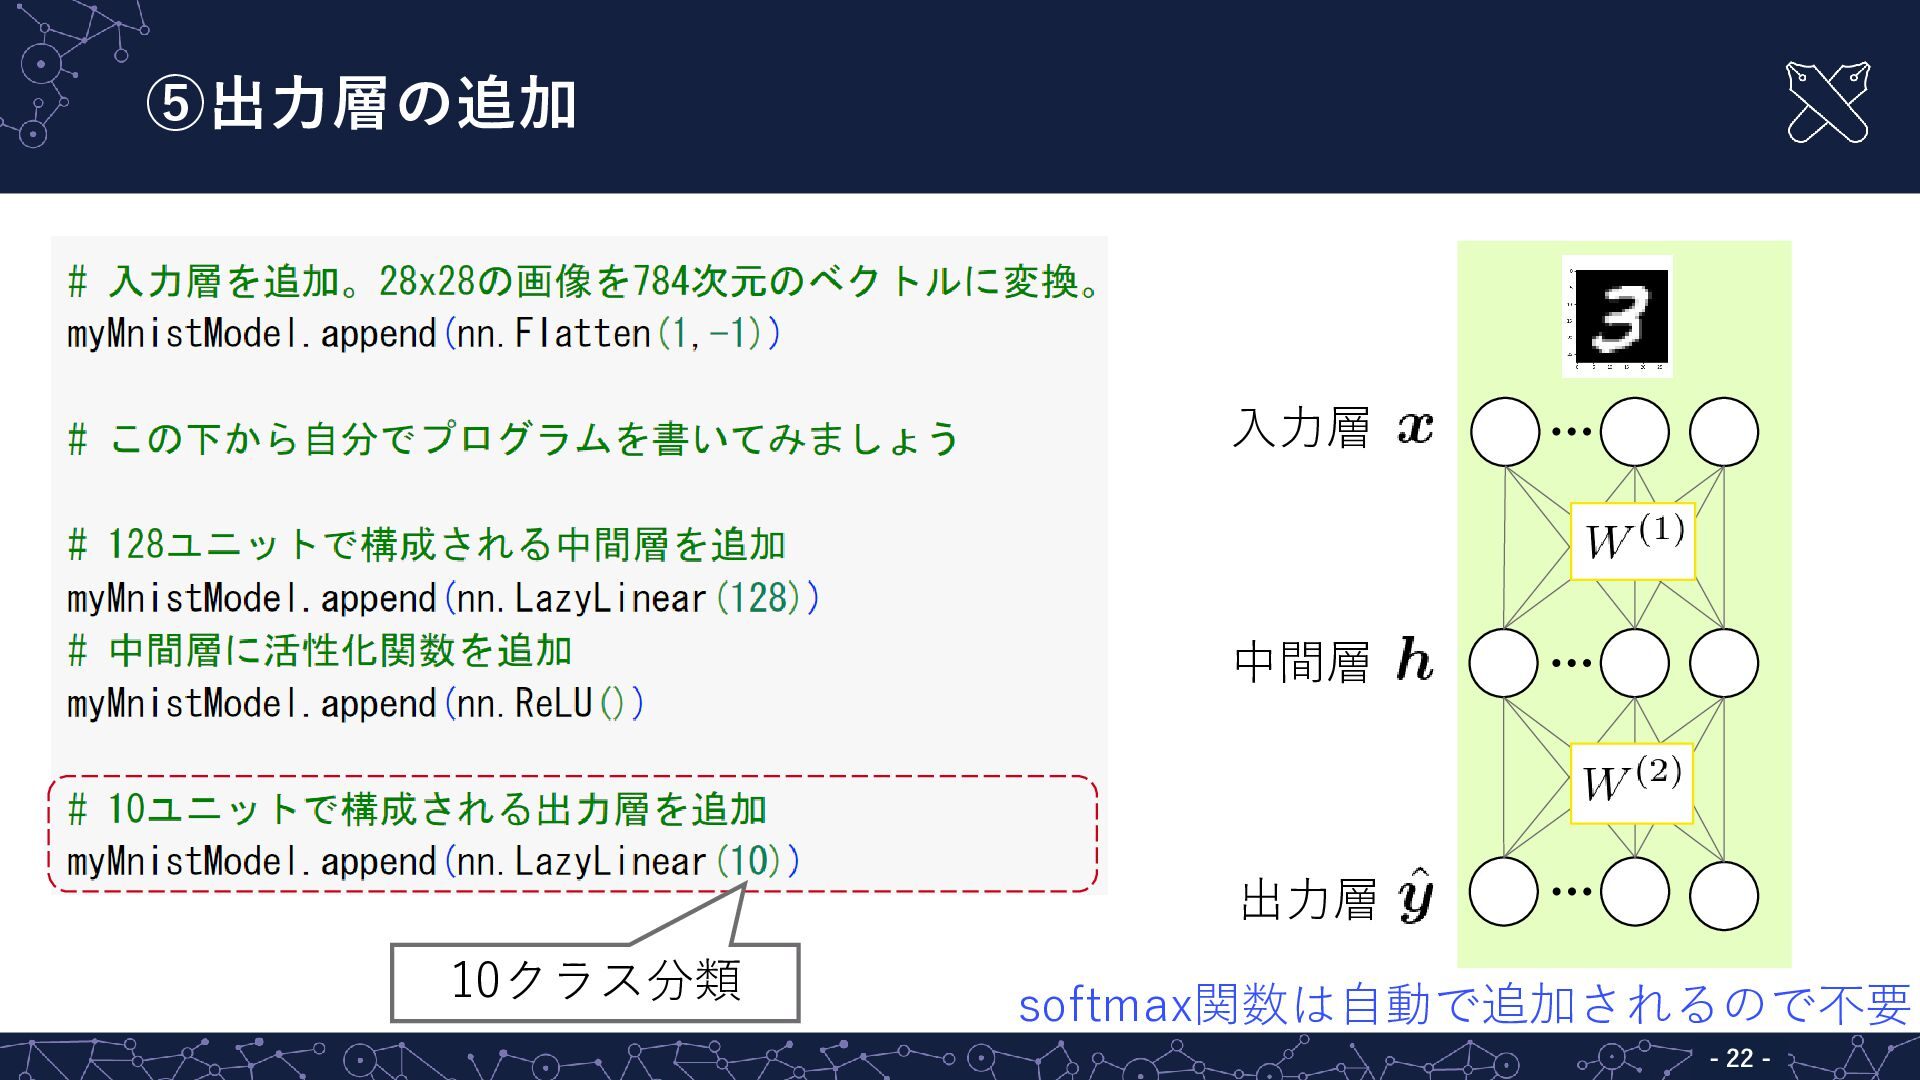
ネットワークへの入力 - - 18 画像データをどのように入力すればよいか 入力層 出力層 中間層 28x28の行列
(各値は画素値) 28×28の行列だと考える -
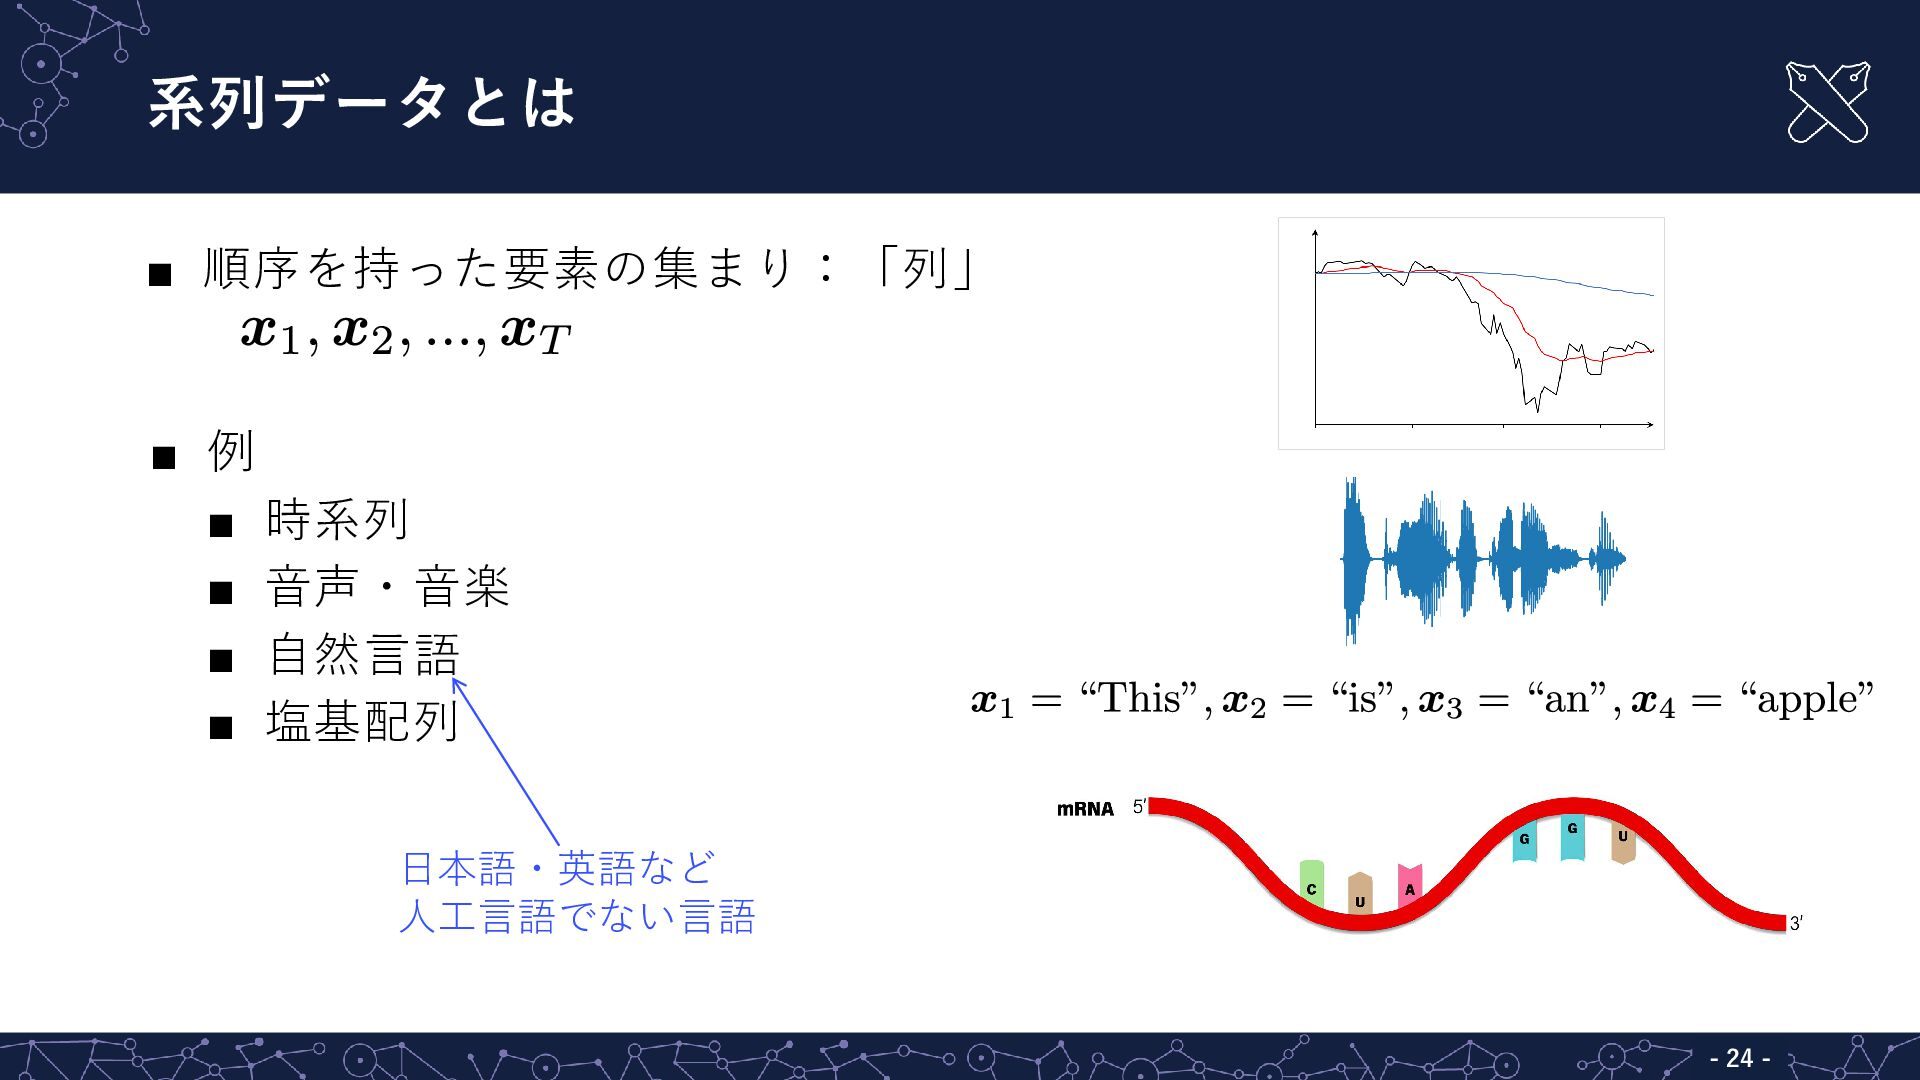
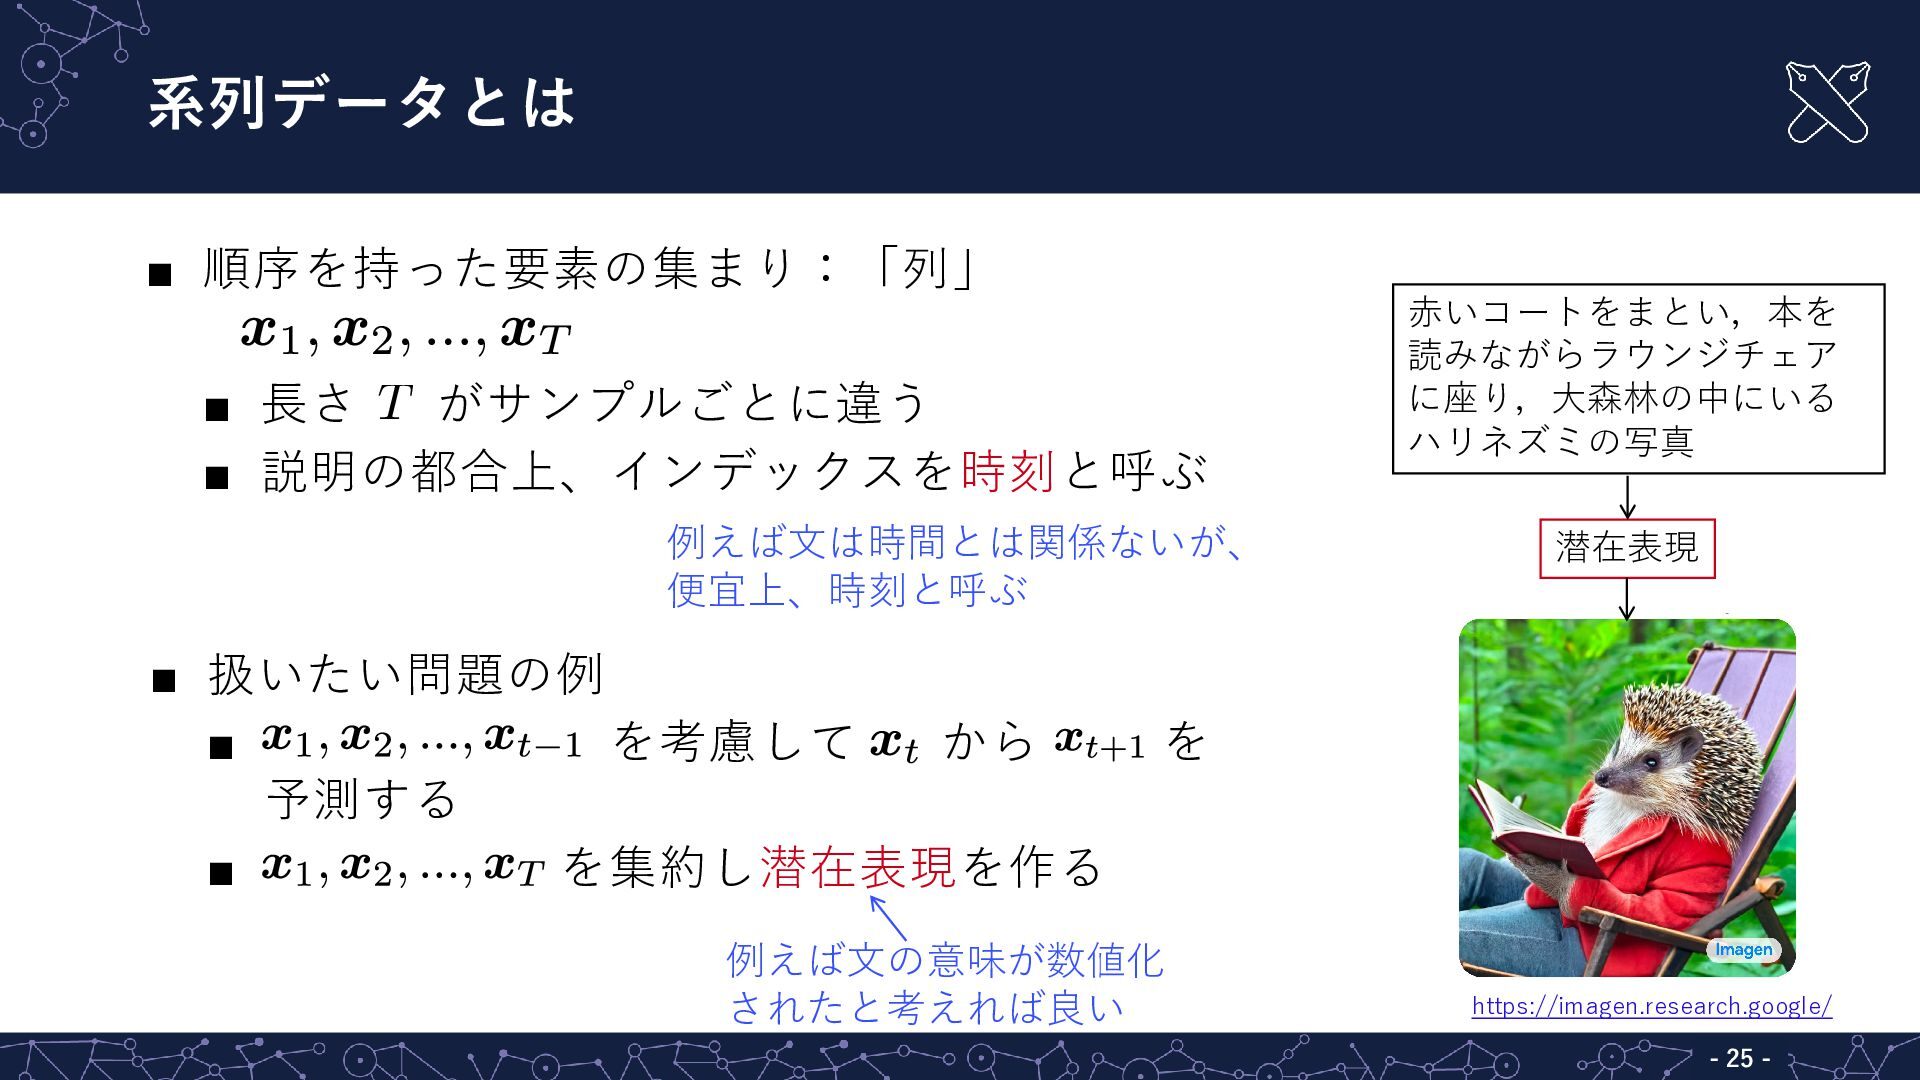
系列データとは ▪ 順序を持った要素の集まり:「列」 ▪ 例 ▪ 時系列 ▪ 音声・音楽 ▪
自然言語 ▪ 塩基配列 - - 24 日本語・英語など 人工言語でない言語 -
系列データとは ▪ 順序を持った要素の集まり:「列」 ▪ 長さ がサンプルごとに違う ▪ 説明の都合上、インデックスを時刻と呼ぶ ▪ 扱いたい問題の例
▪ を考慮して から を 予測する ▪ を集約し潜在表現を作る - - 25 https://imagen.research.google/ 赤いコートをまとい,本を 読みながらラウンジチェア に座り,大森林の中にいる ハリネズミの写真 例えば文は時間とは関係ないが、 便宜上、時刻と呼ぶ 潜在表現 例えば文の意味が数値化 されたと考えれば良い -
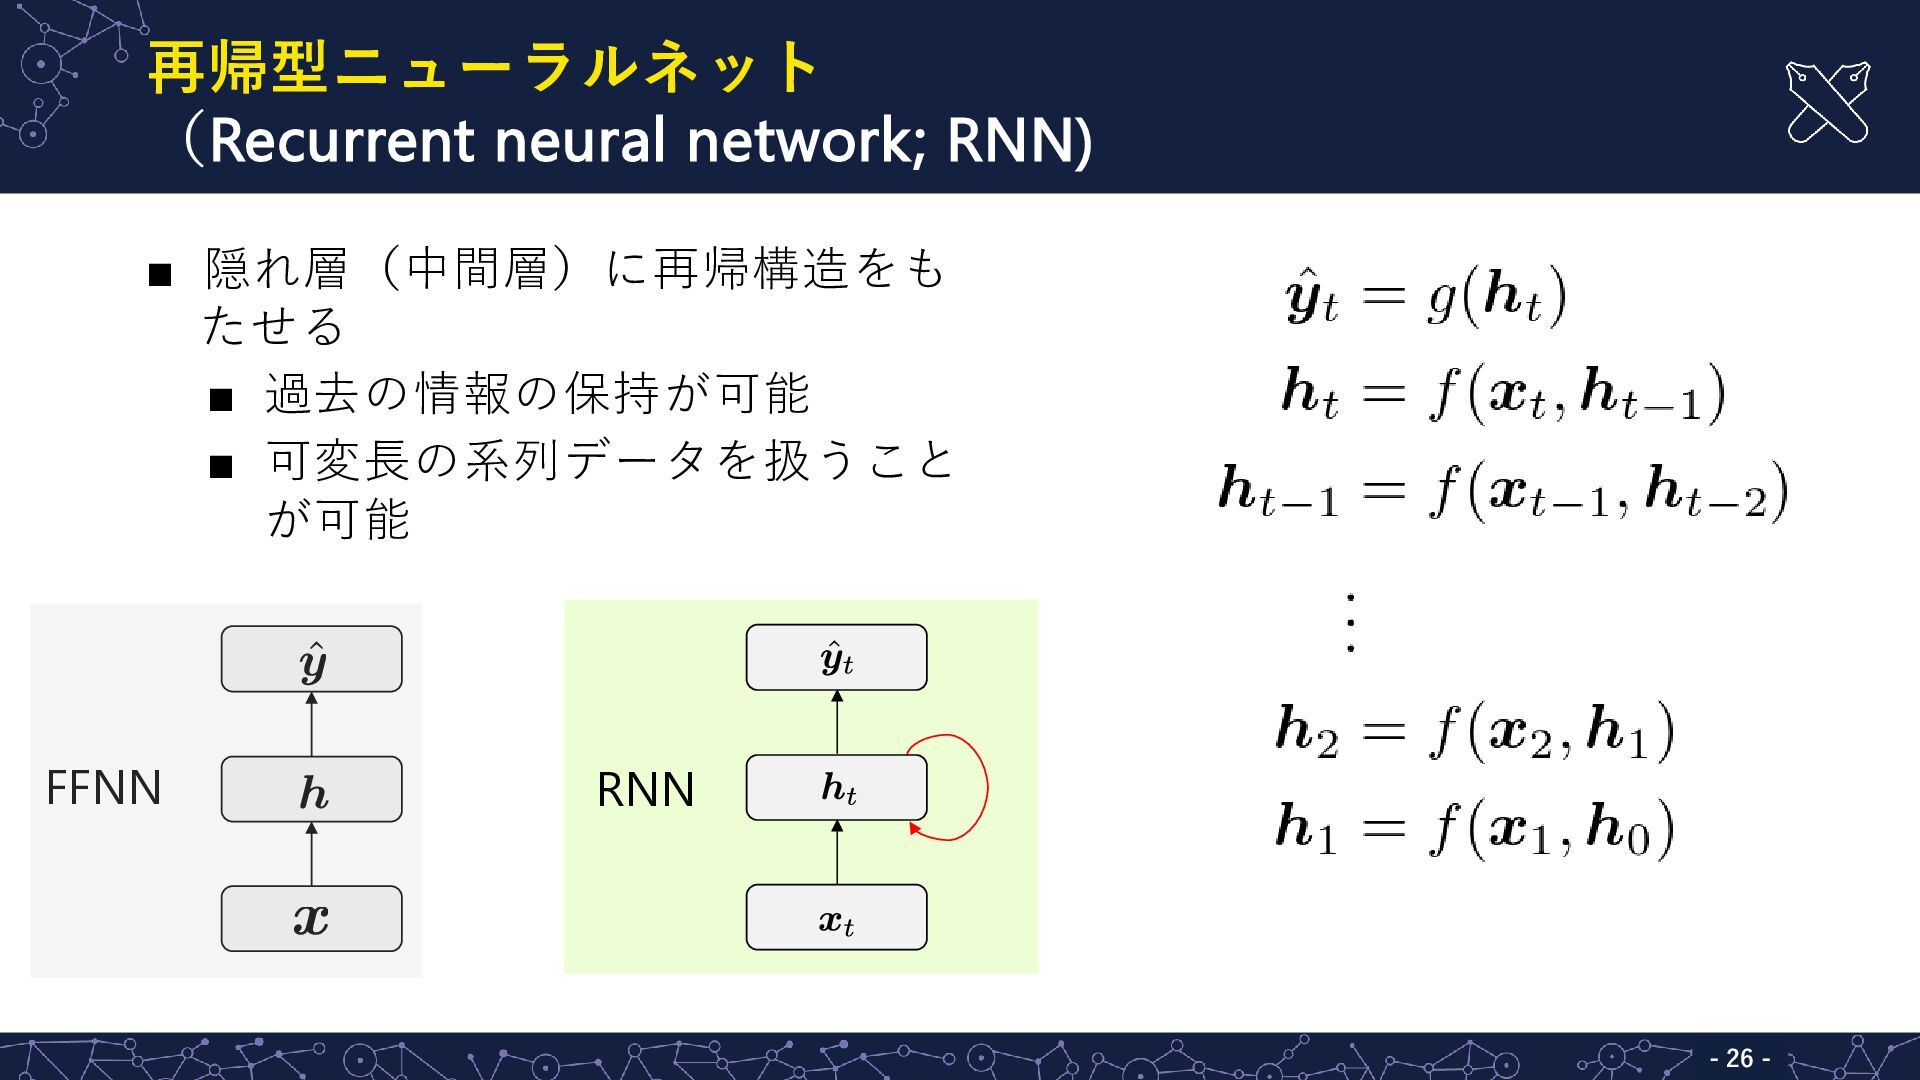
再帰型ニューラルネット (Recurrent neural network; RNN) ▪ 隠れ層(中間層)に再帰構造をも たせる ▪ 過去の情報の保持が可能
▪ 可変長の系列データを扱うこと が可能 - - 26 RNN FFNN -
LSTM (long short-term memory, 長・短期記憶) [Hochreiter+ 1997] - - 27
▪ DNN時代より前に提案され、DNN時代に再注目された ▪ 短期と長期の記憶のバランスを調整可能 RNNの弱点を克服 ▪ 構造の特徴 ▪ メモリーセル:RNNの中間層のユニットの代わり ▪ ゲート機構 -
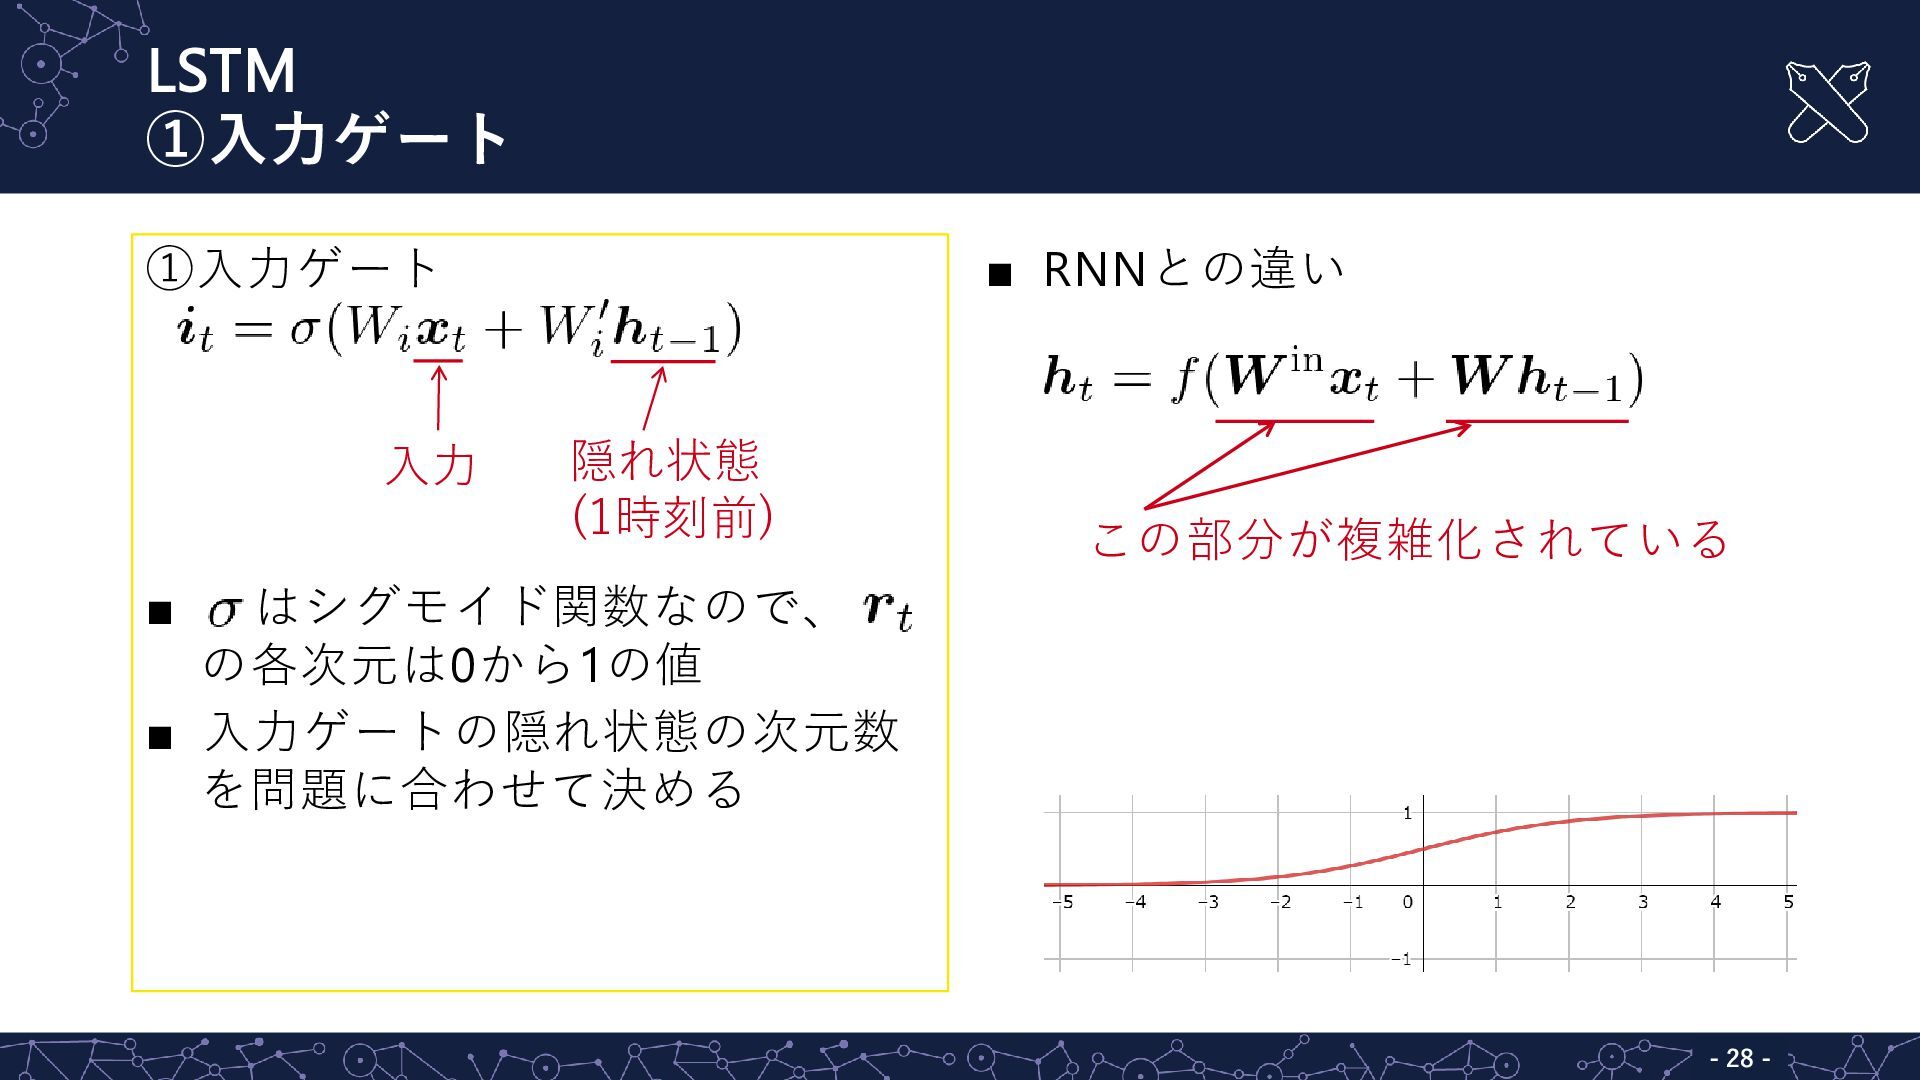
LSTM ①入力ゲート - - 28 ①入力ゲート ▪ はシグモイド関数なので、 の各次元は0から1の値 ▪
入力ゲートの隠れ状態の次元数 を問題に合わせて決める ▪ RNNとの違い この部分が複雑化されている 入力 隠れ状態 (1時刻前) -
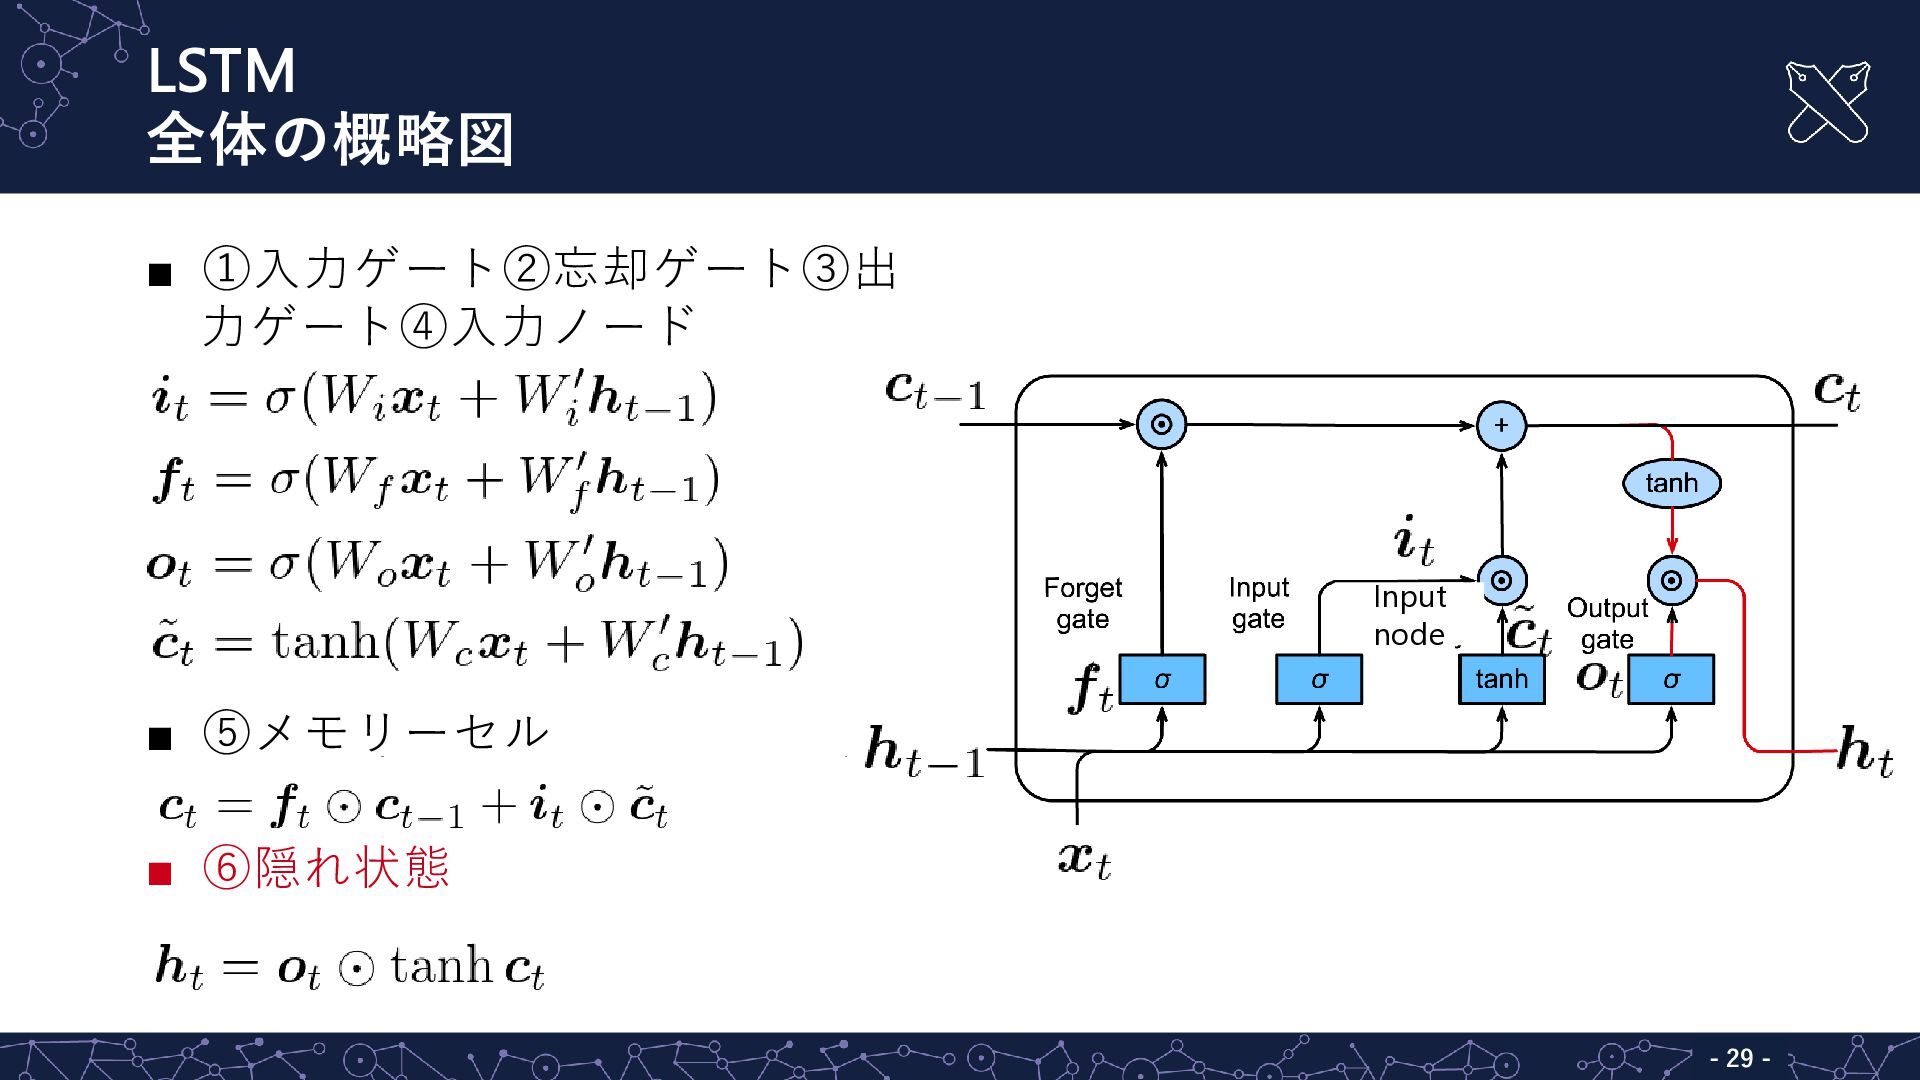
LSTM 全体の概略図 - - 29 ▪ ①入力ゲート②忘却ゲート③出 力ゲート④入力ノード ▪ ⑤メモリーセル
▪ ⑥隠れ状態 Input node -
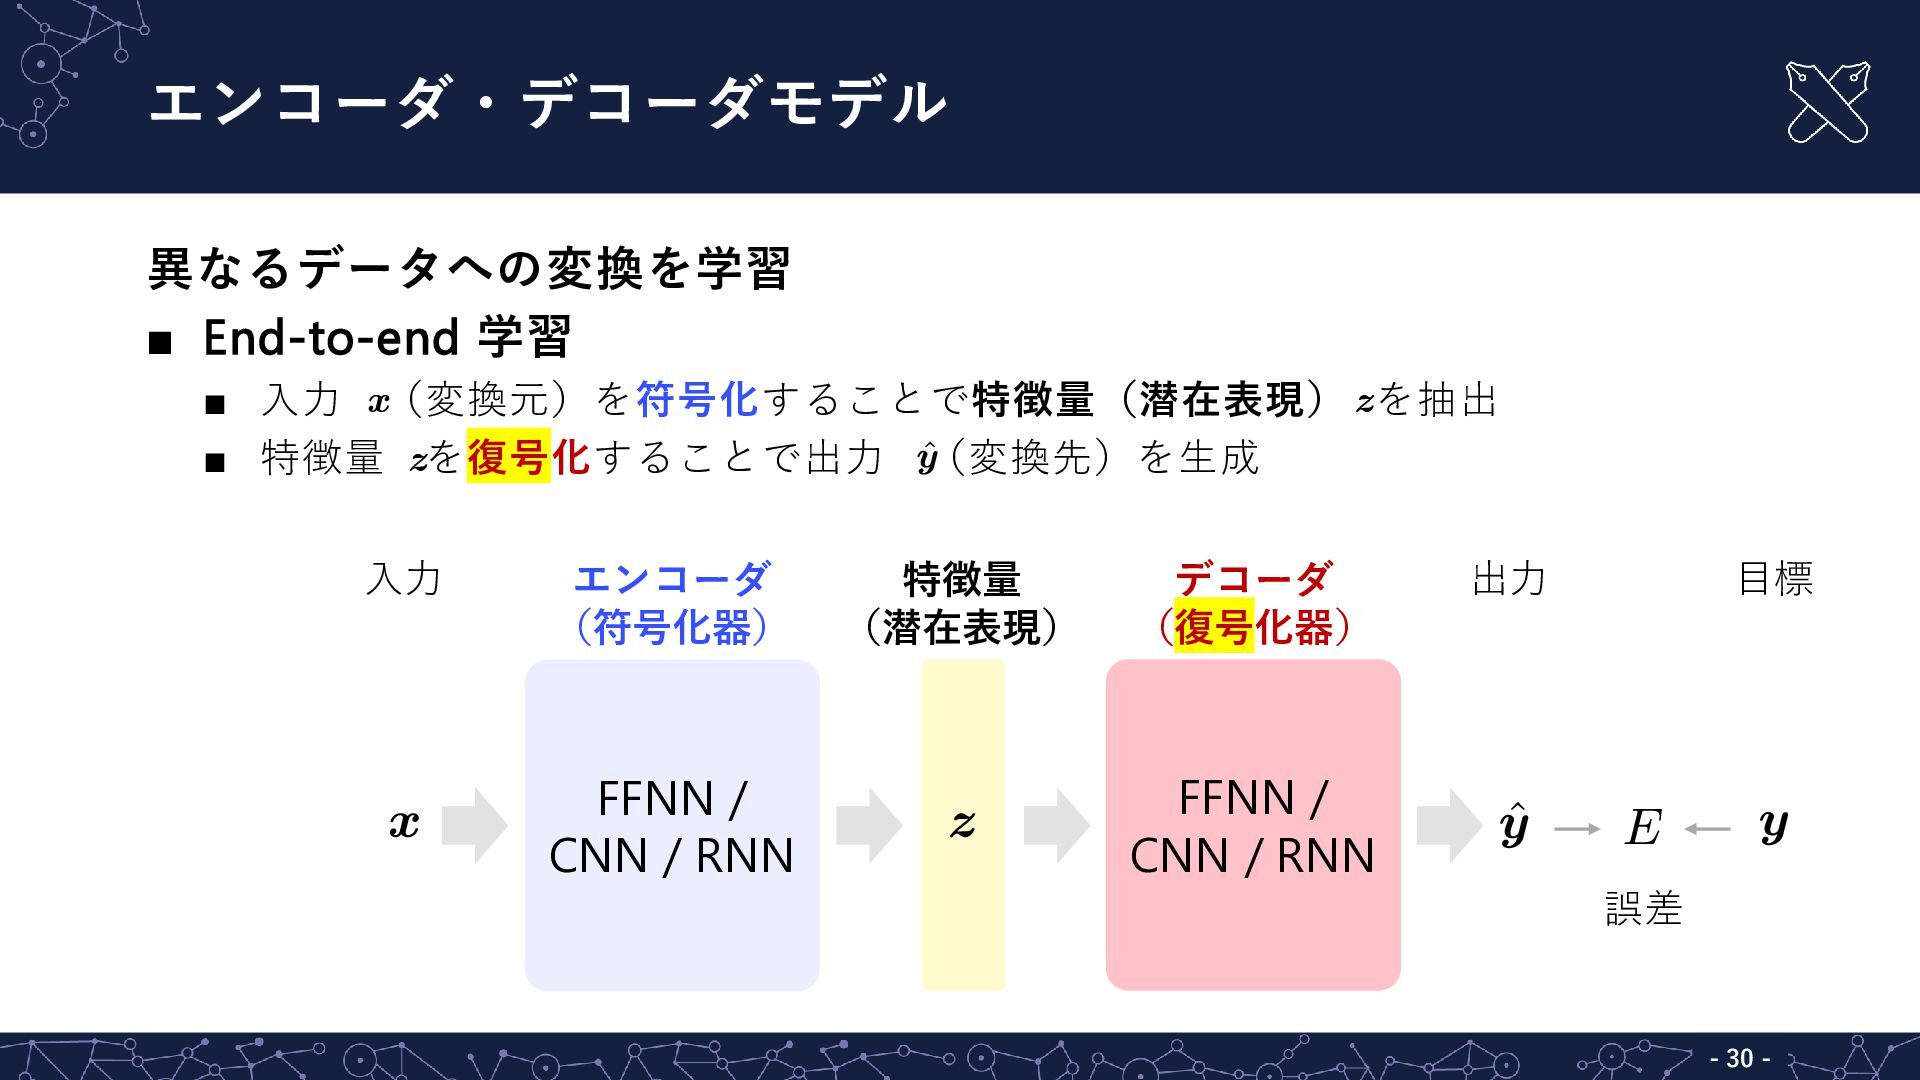
エンコーダ・デコーダモデル - - 30 異なるデータへの変換を学習 ▪ End-to-end 学習 ▪ 入力
(変換元)を符号化することで特徴量(潜在表現) を抽出 ▪ 特徴量 を復号化することで出力 (変換先)を生成 入力 出力 FFNN / CNN / RNN FFNN / CNN / RNN 目標 誤差 エンコーダ (符号化器) デコーダ (復号化器) 特徴量 (潜在表現) -
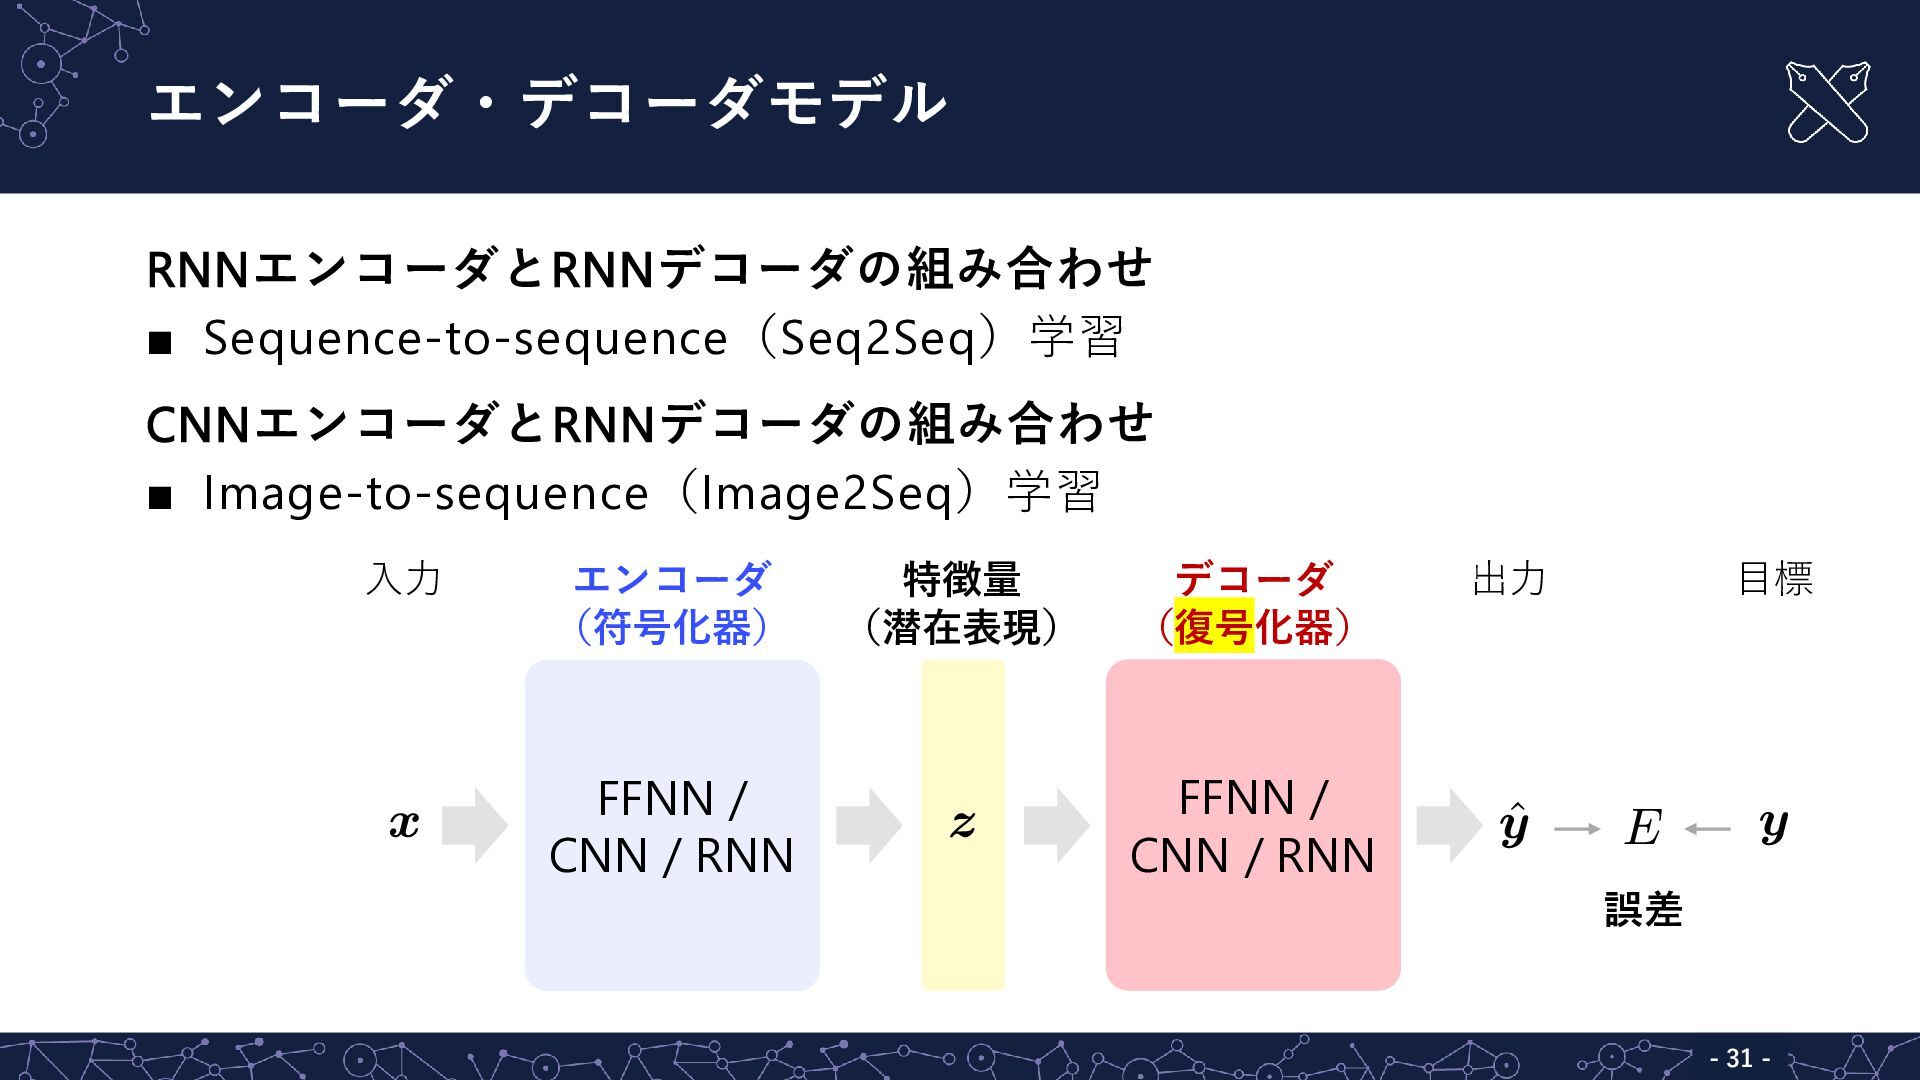
エンコーダ・デコーダモデル - - 31 RNNエンコーダとRNNデコーダの組み合わせ ▪ Sequence-to-sequence(Seq2Seq)学習 CNNエンコーダとRNNデコーダの組み合わせ ▪ Image-to-sequence(Image2Seq)学習
入力 出力 FFNN / CNN / RNN FFNN / CNN / RNN 目標 誤差 エンコーダ (符号化器) デコーダ (復号化器) 特徴量 (潜在表現) -
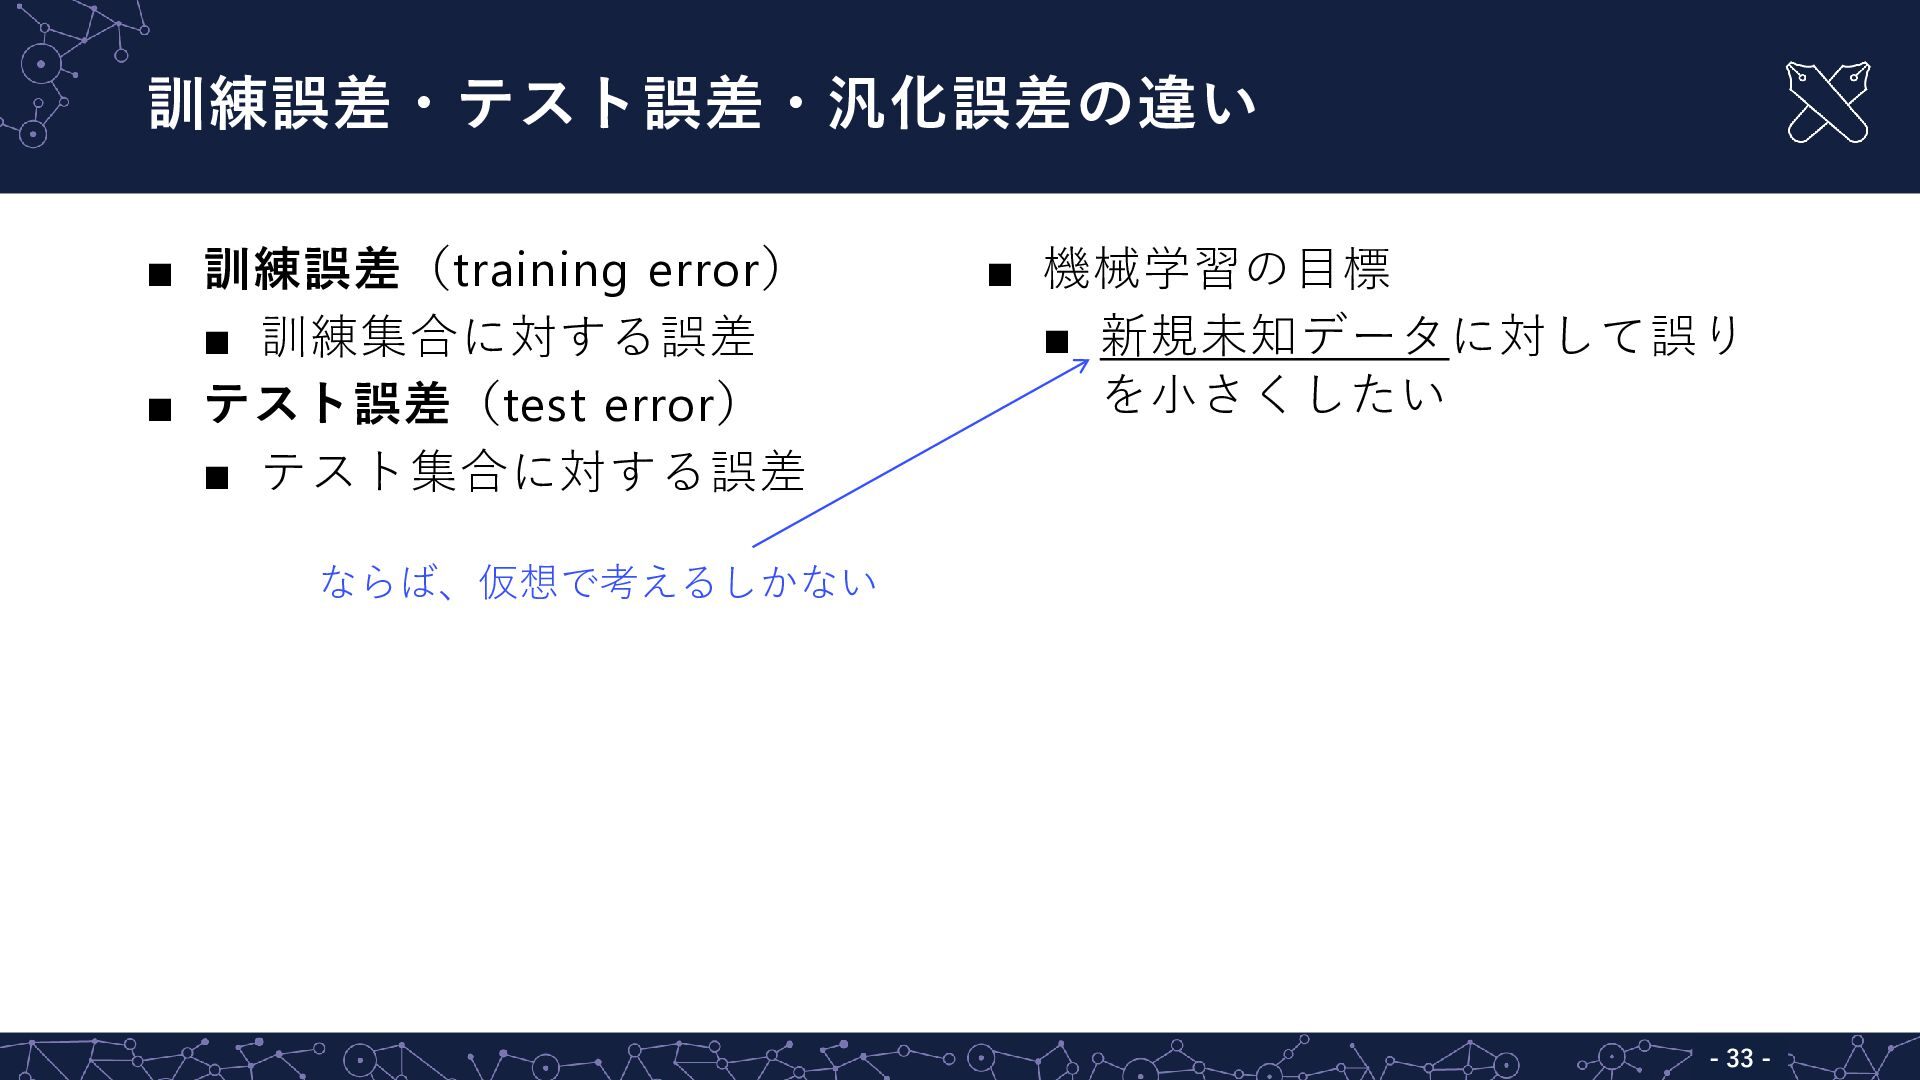
訓練誤差・テスト誤差・汎化誤差の違い - - 33 ▪ 訓練誤差(training error) ▪ 訓練集合に対する誤差 ▪
テスト誤差(test error) ▪ テスト集合に対する誤差 ▪ 機械学習の目標 ▪ 新規未知データに対して誤り を小さくしたい ならば、仮想で考えるしかない -
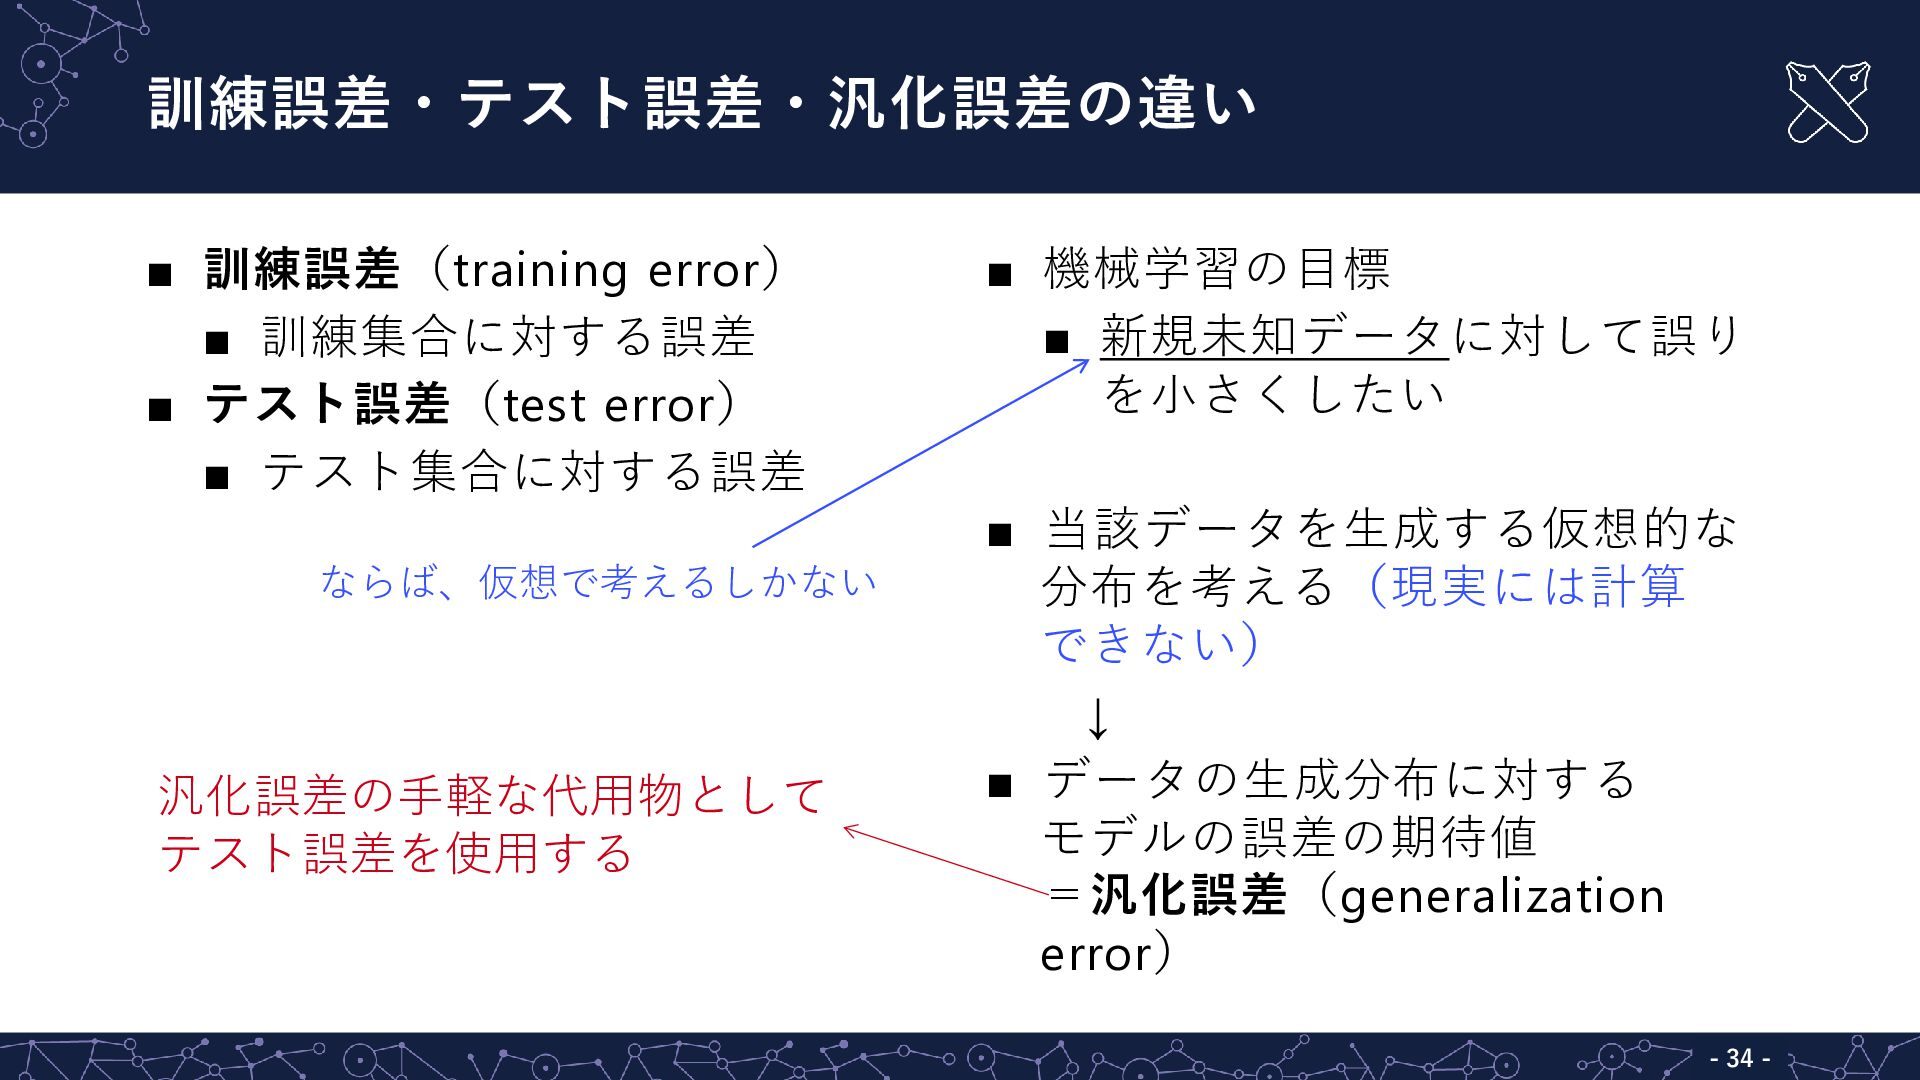
訓練誤差・テスト誤差・汎化誤差の違い - - 34 ▪ 訓練誤差(training error) ▪ 訓練集合に対する誤差 ▪
テスト誤差(test error) ▪ テスト集合に対する誤差 ▪ 機械学習の目標 ▪ 新規未知データに対して誤り を小さくしたい ▪ 当該データを生成する仮想的な 分布を考える(現実には計算 できない) ↓ ▪ データの生成分布に対する モデルの誤差の期待値 =汎化誤差(generalization error) 汎化誤差の手軽な代用物として テスト誤差を使用する ならば、仮想で考えるしかない -
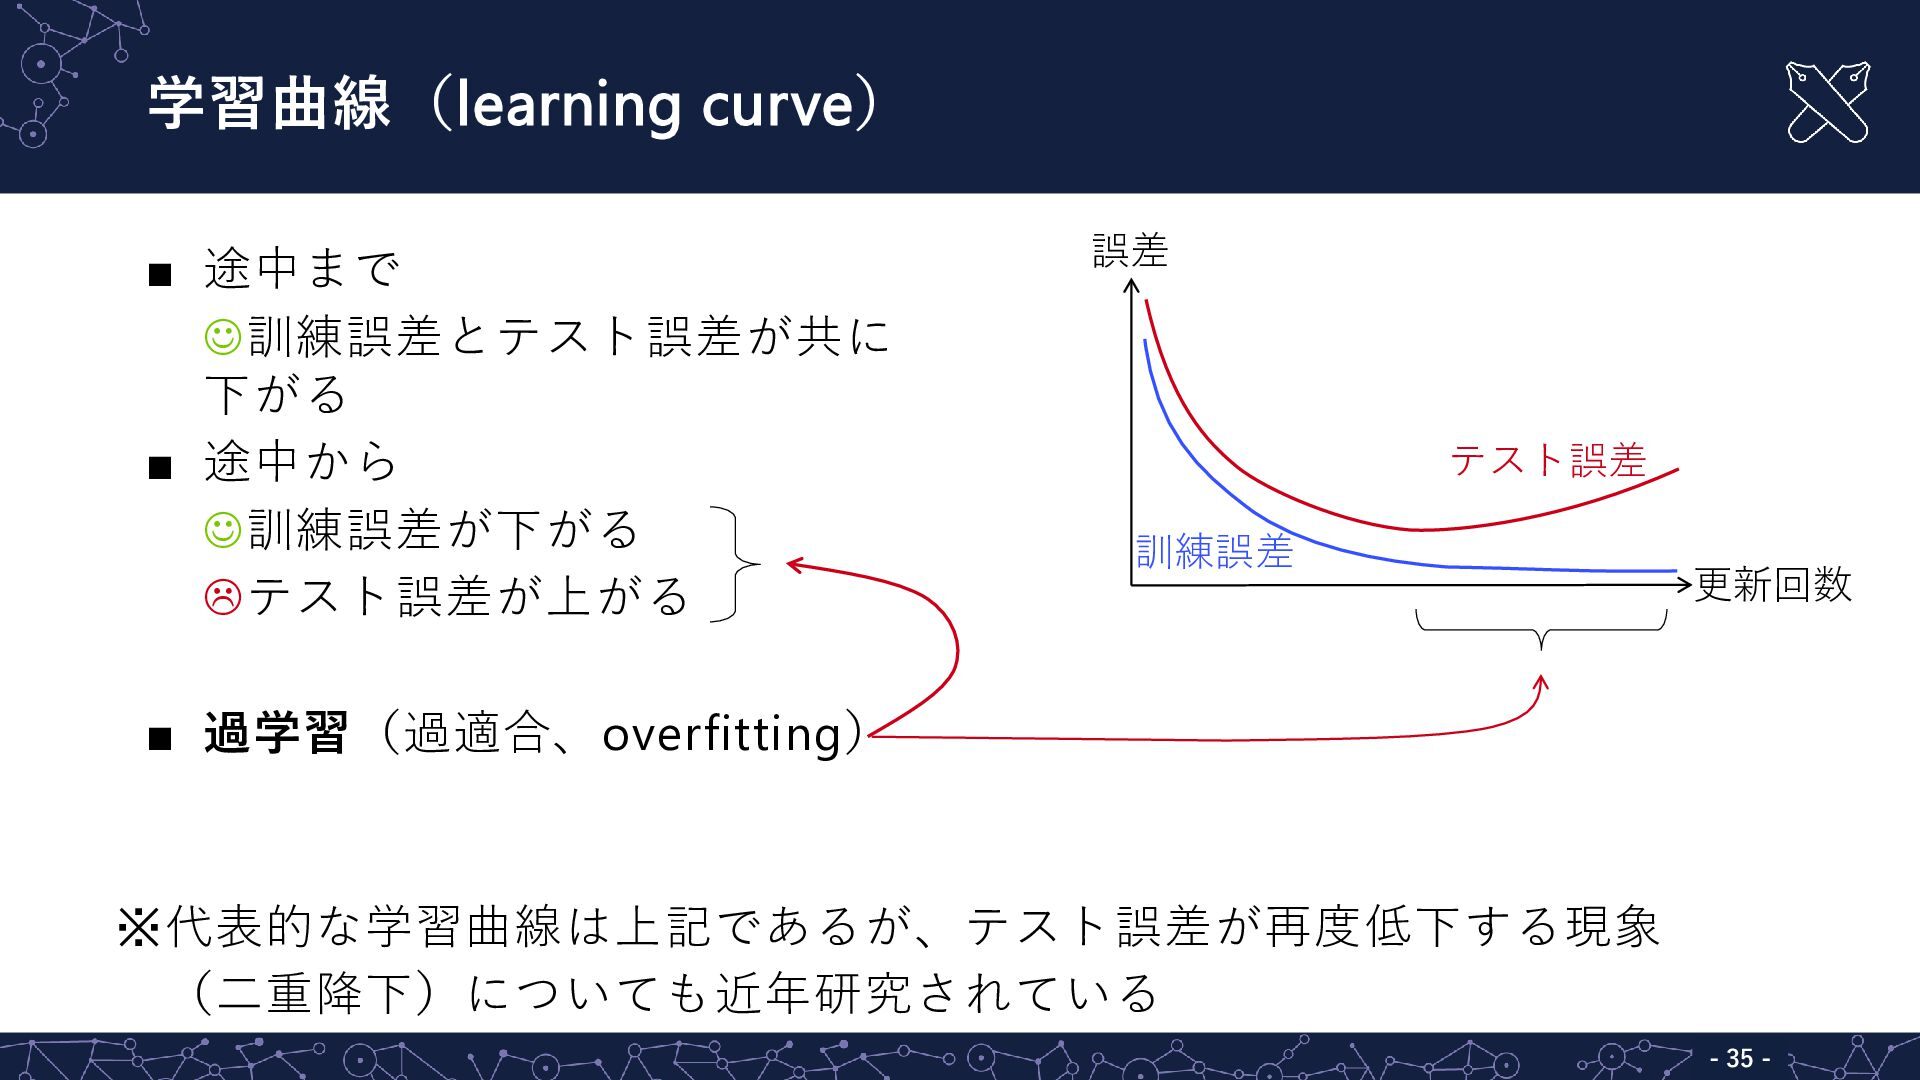
学習曲線(learning curve) - - 35 ▪ 途中まで 訓練誤差とテスト誤差が共に 下がる ▪
途中から 訓練誤差が下がる テスト誤差が上がる ▪ 過学習(過適合、overfitting) ※代表的な学習曲線は上記であるが、テスト誤差が再度低下する現象 (二重降下)についても近年研究されている 更新回数 誤差 テスト誤差 訓練誤差 -
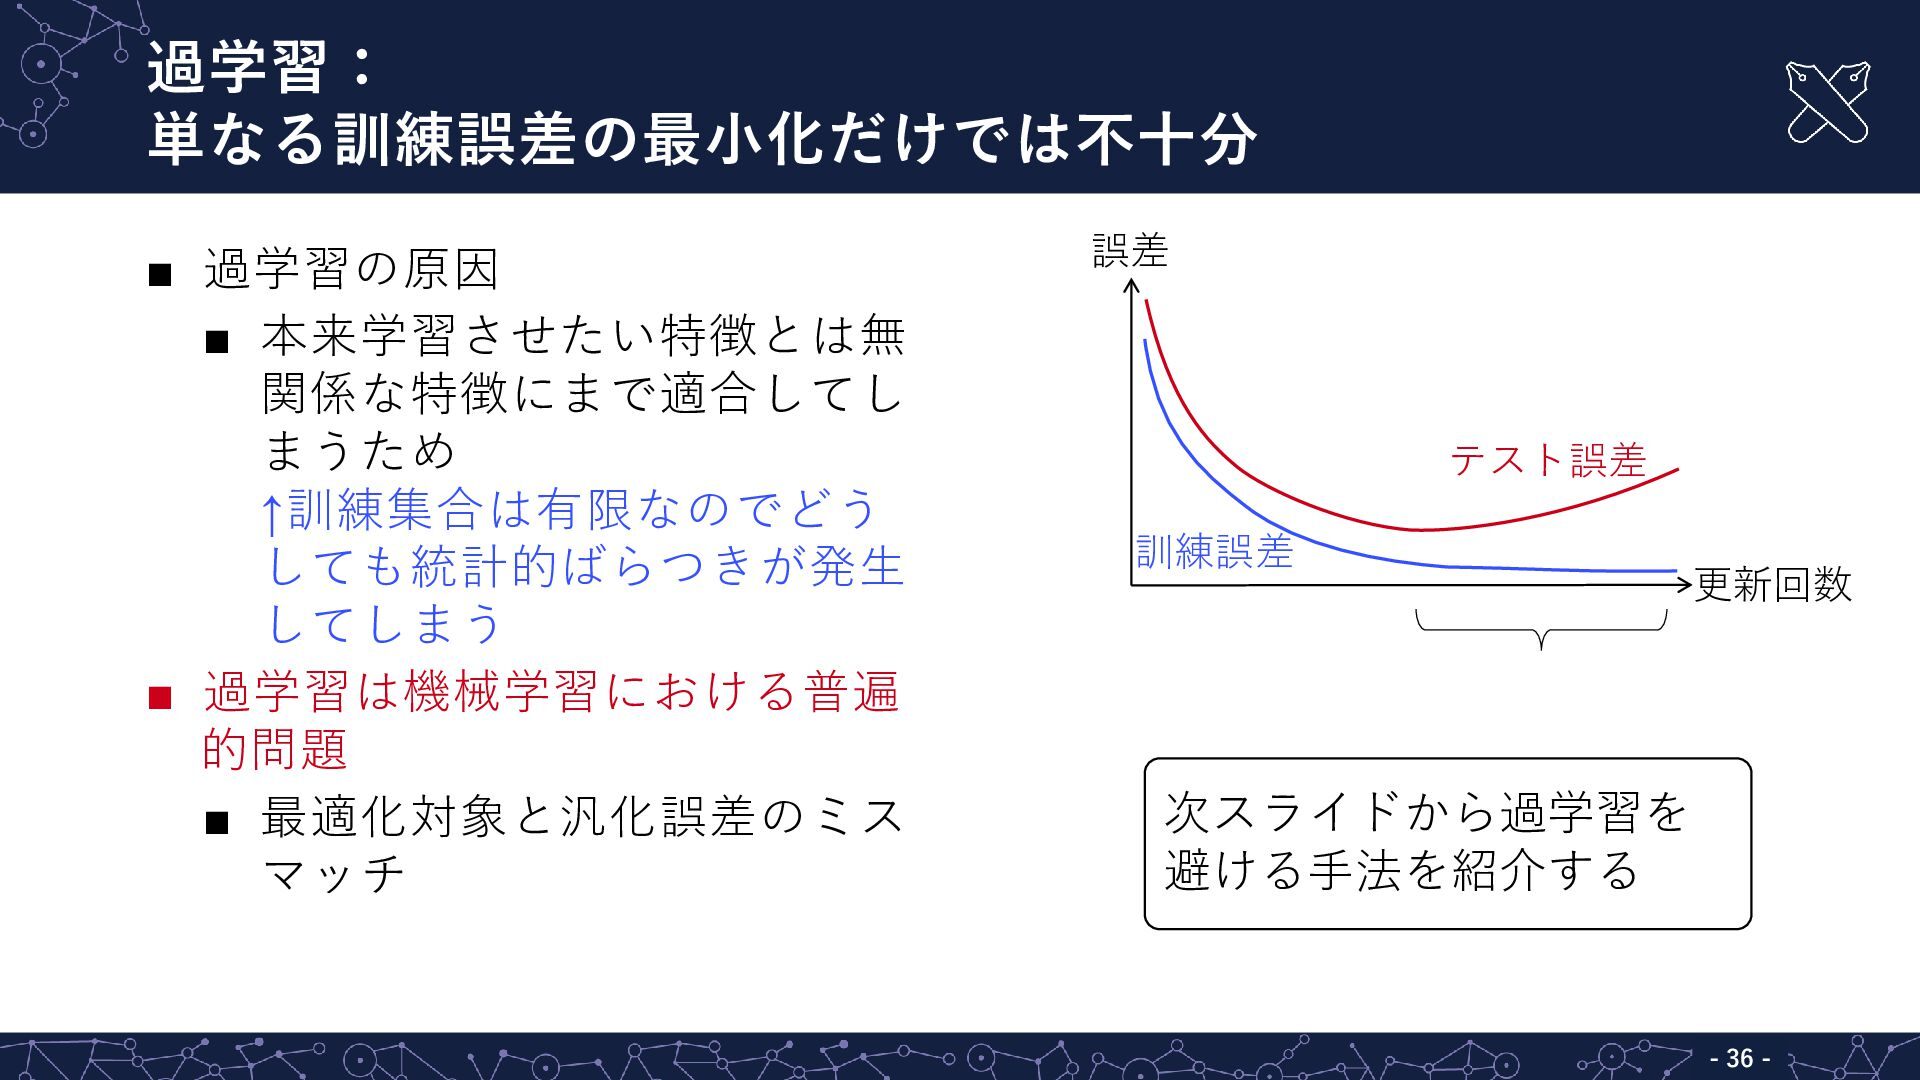
過学習: 単なる訓練誤差の最小化だけでは不十分 - - 36 ▪ 過学習の原因 ▪ 本来学習させたい特徴とは無 関係な特徴にまで適合してし
まうため ↑訓練集合は有限なのでどう しても統計的ばらつきが発生 してしまう ▪ 過学習は機械学習における普遍 的問題 ▪ 最適化対象と汎化誤差のミス マッチ 更新回数 誤差 テスト誤差 訓練誤差 次スライドから過学習を 避ける手法を紹介する -
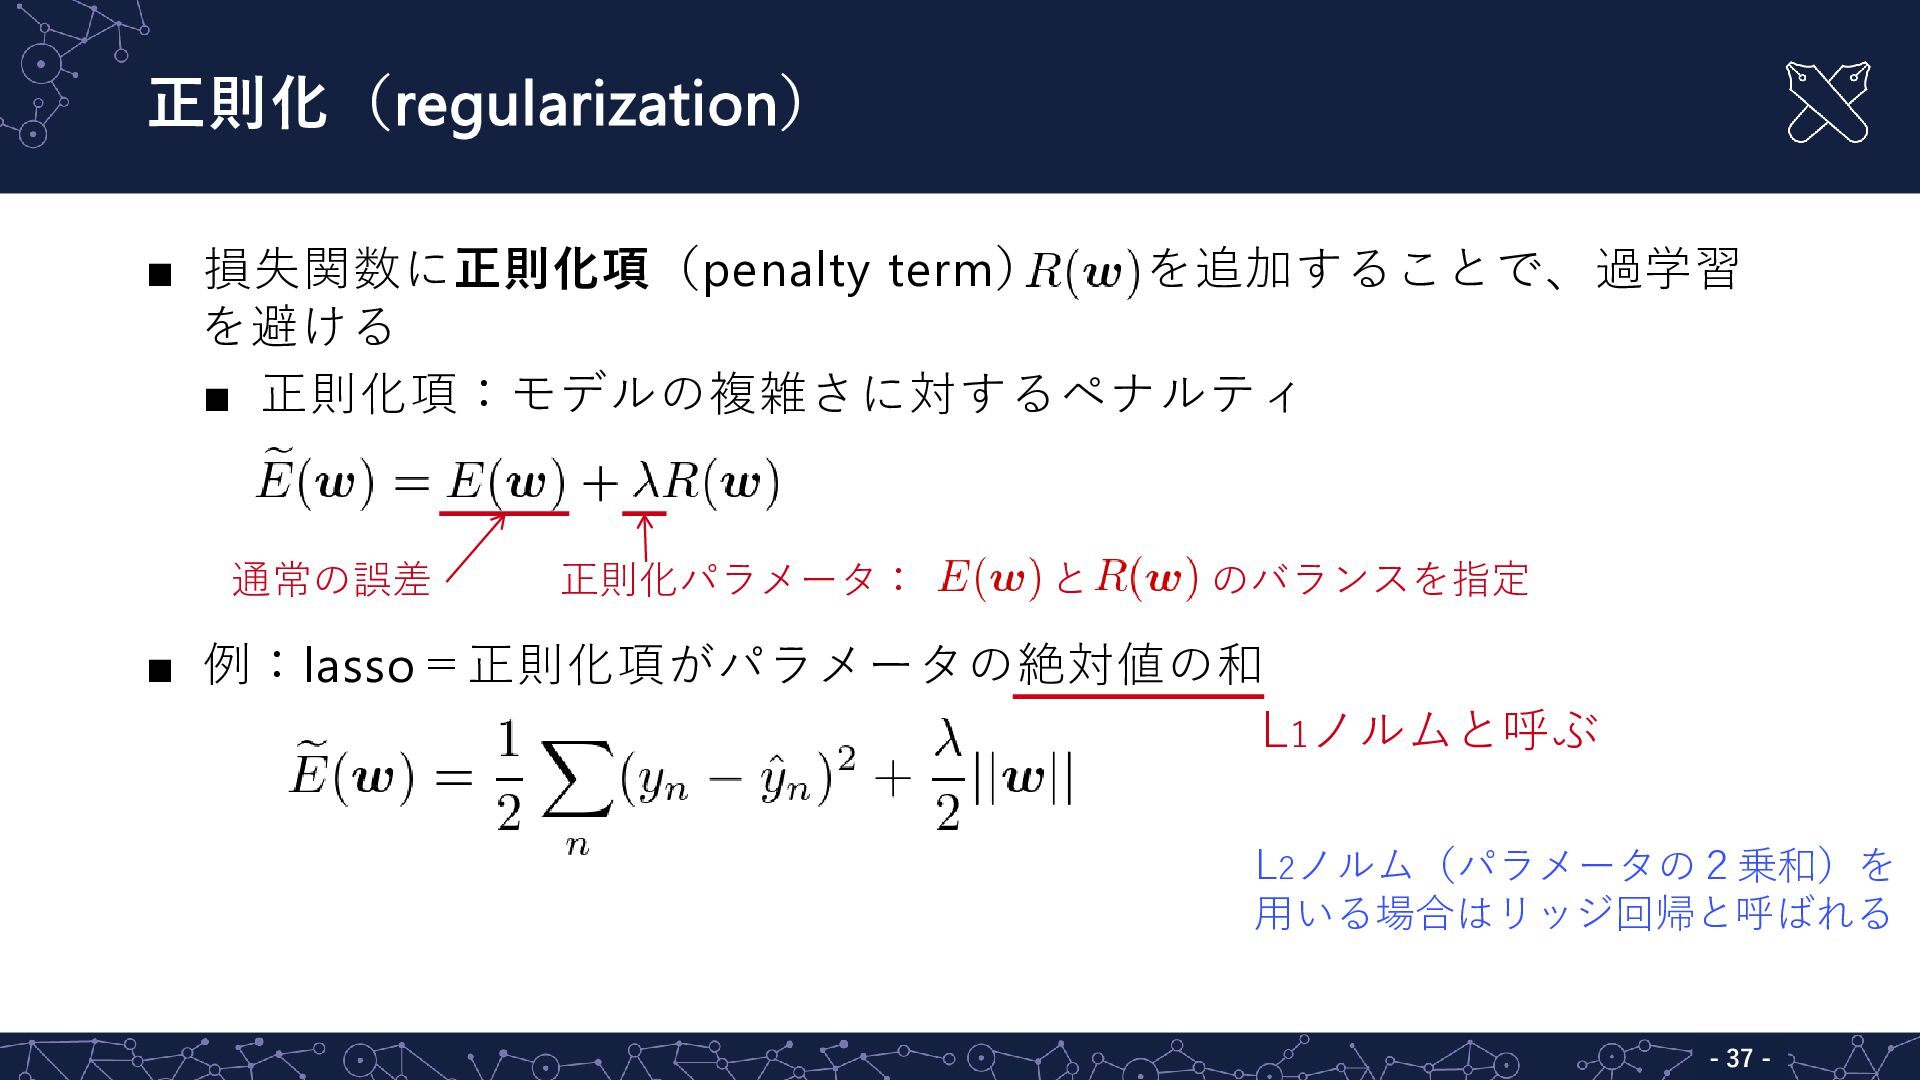
正則化(regularization) - - 37 ▪ 損失関数に正則化項(penalty term) を追加することで、過学習 を避ける ▪
正則化項:モデルの複雑さに対するペナルティ ▪ 例:lasso=正則化項がパラメータの絶対値の和 通常の誤差 正則化パラメータ: と のバランスを指定 L1ノルムと呼ぶ L2ノルム(パラメータの2乗和)を 用いる場合はリッジ回帰と呼ばれる -
★バッチ正規化(batch normalization) [Ioffe+ 2015] - - 38 ▪ 効果: 学習を安定化させる
↑バッチ正規化発明以前: 鋭い極小値の影響が強いため学習率を 小さくしなければならなかった ▪ 現代的なDNNではバッチ正規化(とその後継)を多用 ▪ ドロップアウトを一部代替 https://blog.google/products/search/search-language-understanding-bert/ https://www.whichfaceisreal.com/ GAN Transformer 「USA to ブラジル」 が検索上位に 「ブラジル to USA 」 が検索上位に -
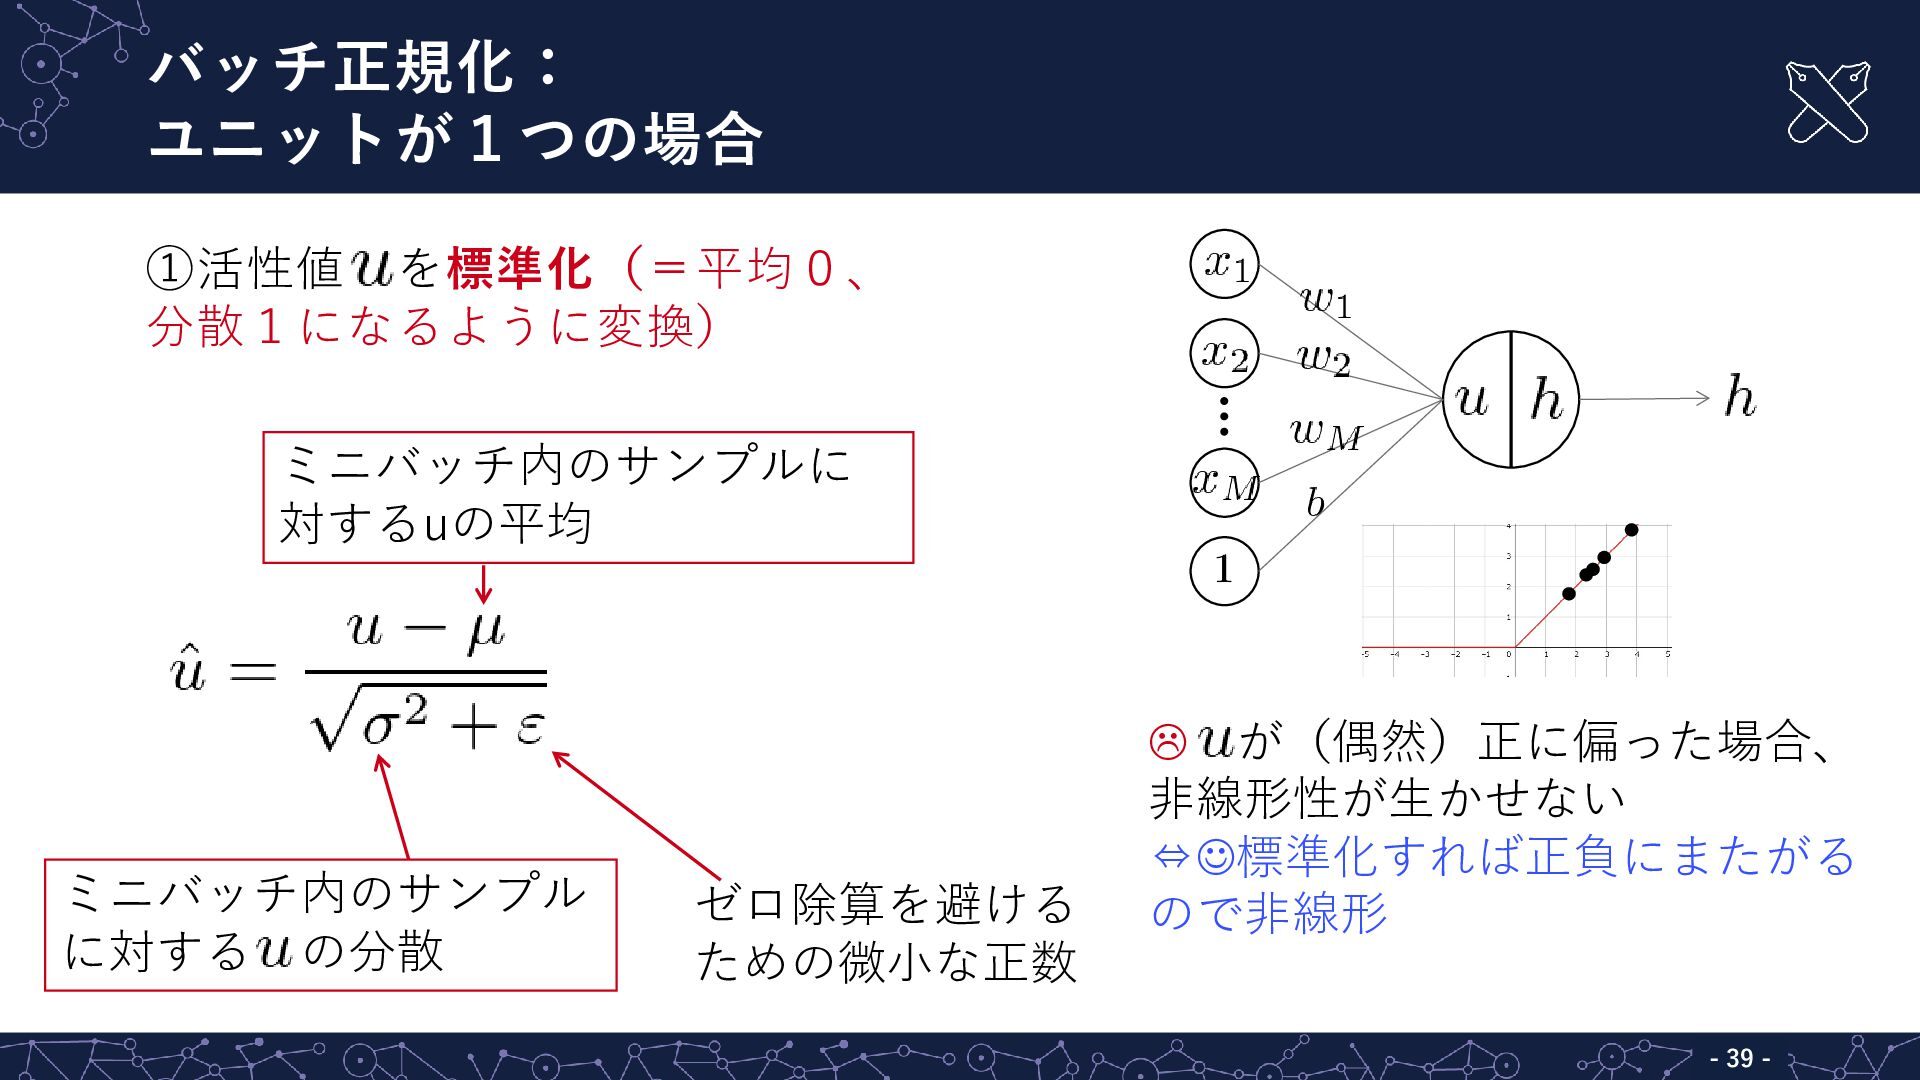
バッチ正規化: ユニットが1つの場合 - - 39 ①活性値 を標準化(=平均0、 分散1になるように変換) ゼロ除算を避ける ための微小な正数
ミニバッチ内のサンプルに 対するuの平均 ミニバッチ内のサンプル に対する の分散 が(偶然)正に偏った場合、 非線形性が生かせない ⇔標準化すれば正負にまたがる ので非線形 -
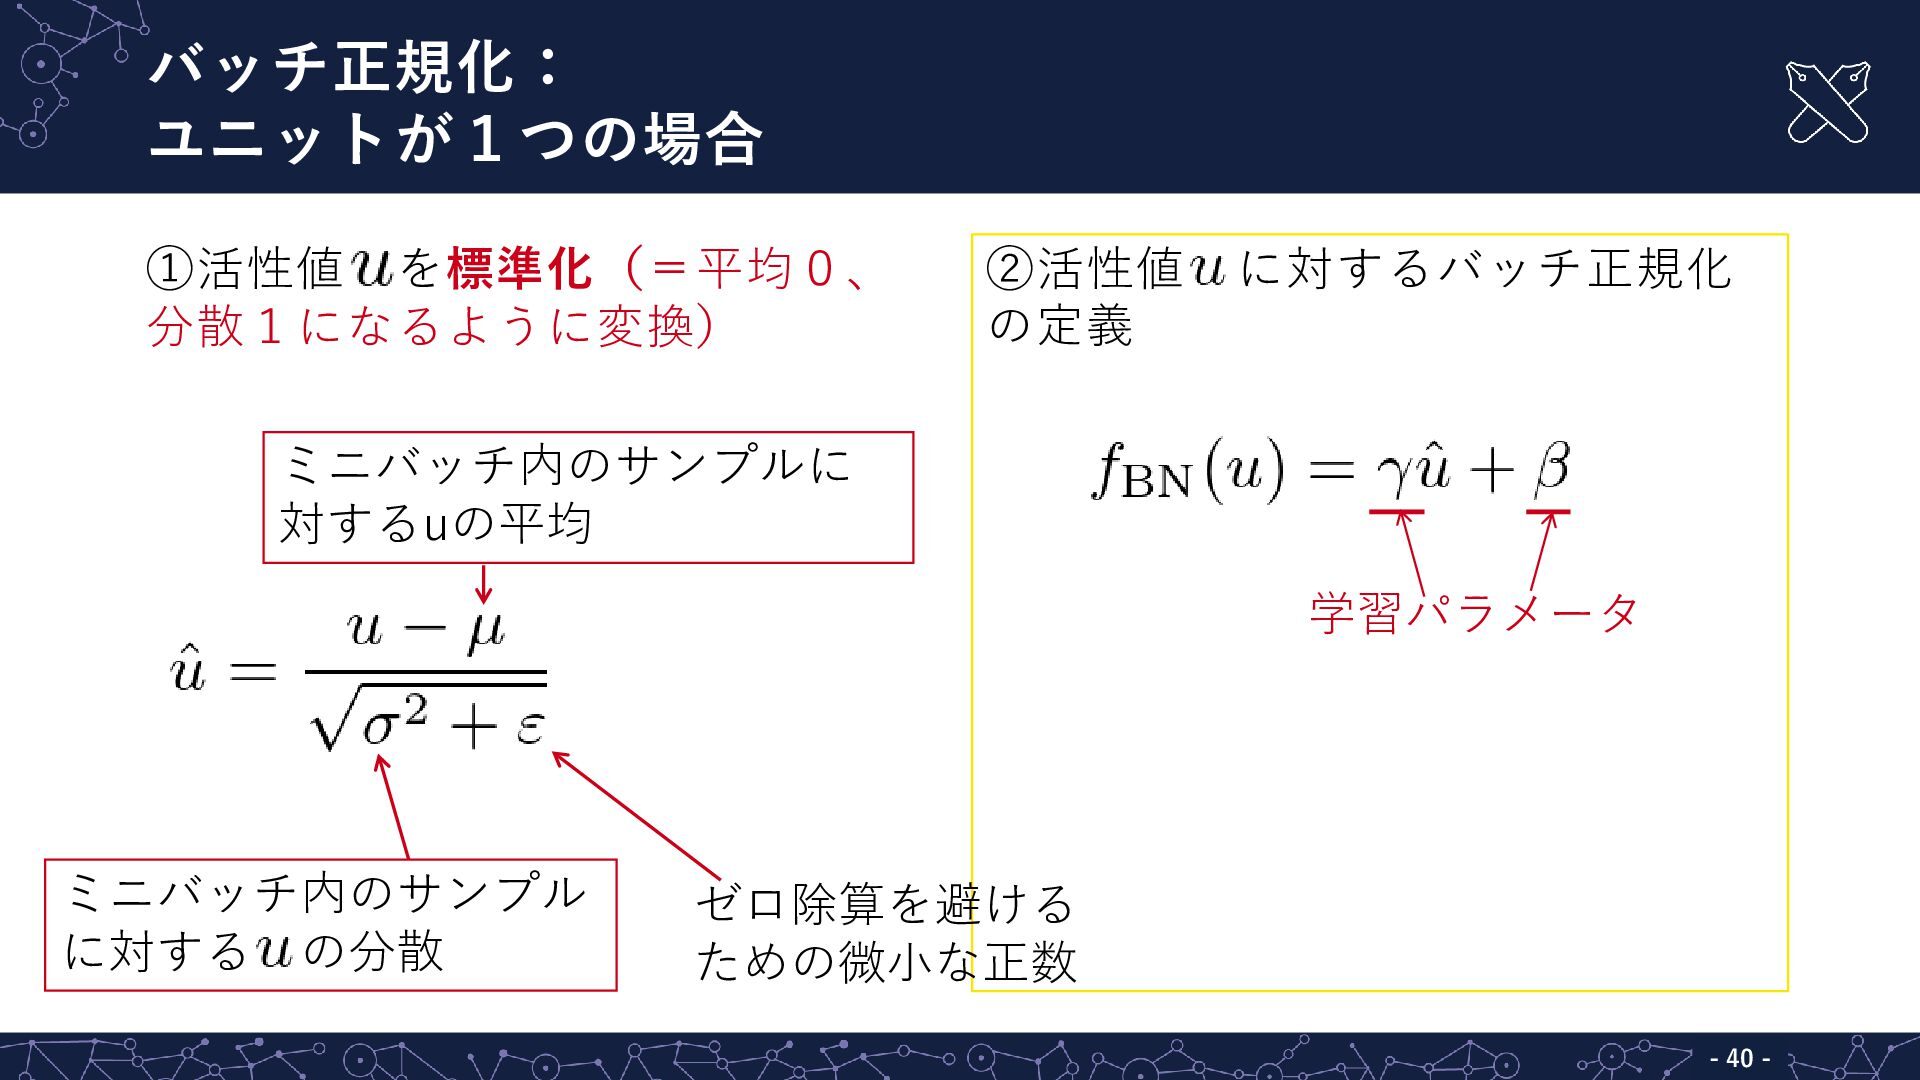
バッチ正規化: ユニットが1つの場合 - - 40 ①活性値 を標準化(=平均0、 分散1になるように変換) ②活性値 に対するバッチ正規化
の定義 学習パラメータ ゼロ除算を避ける ための微小な正数 ミニバッチ内のサンプルに 対するuの平均 ミニバッチ内のサンプル に対する の分散 -
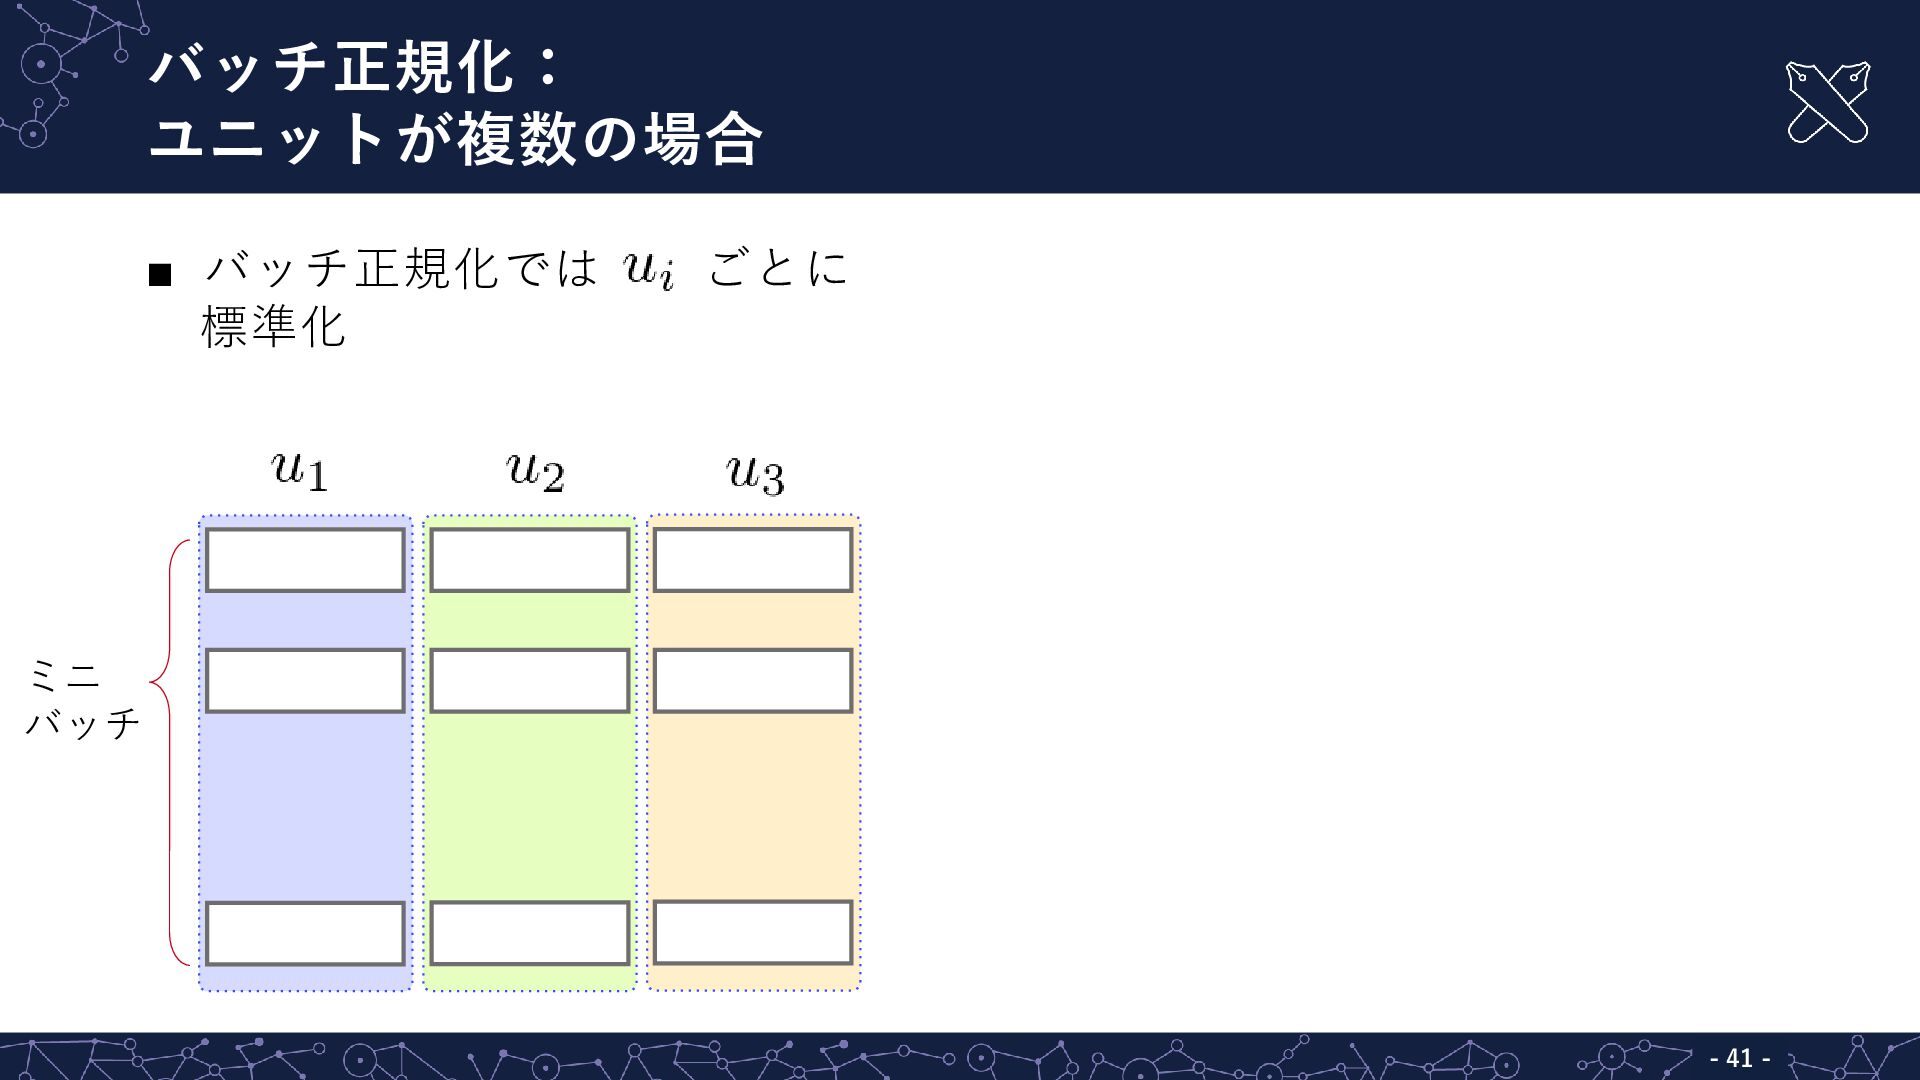
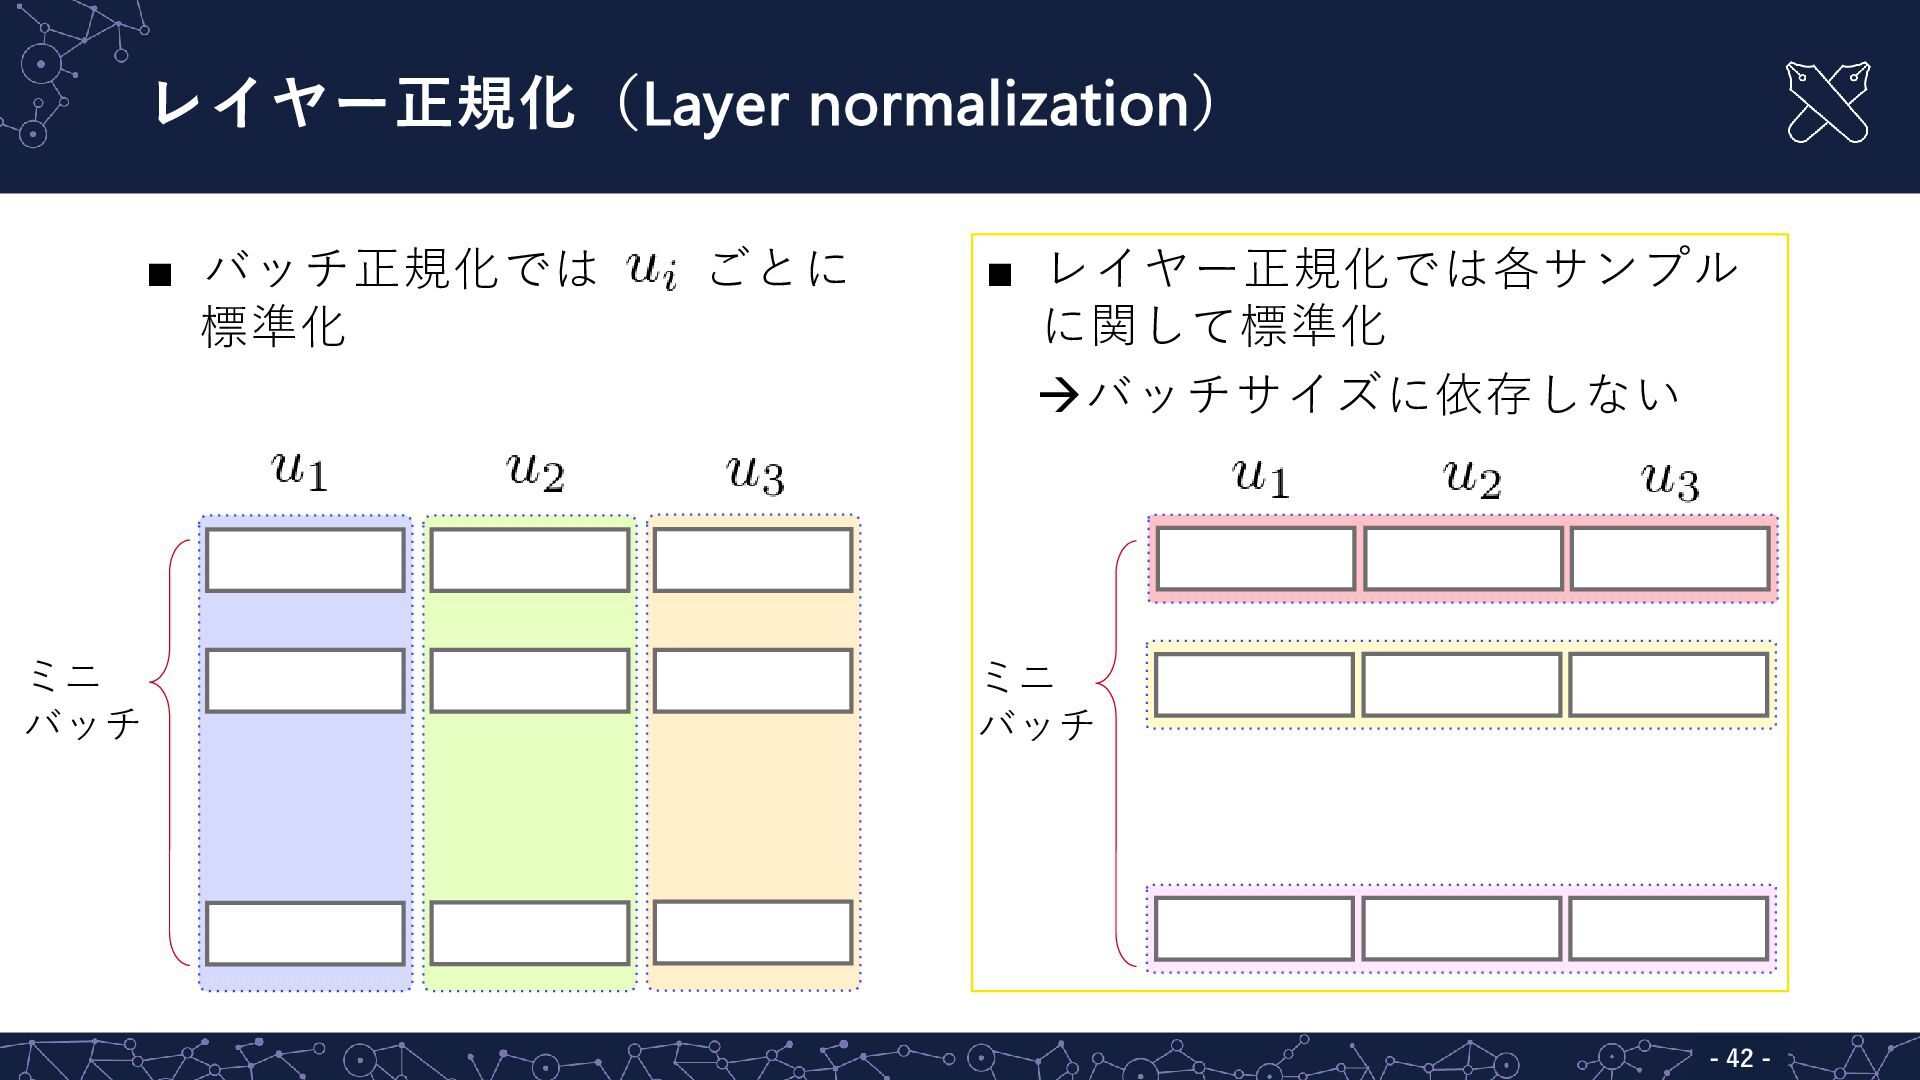
レイヤー正規化(Layer normalization) - - 42 ▪ バッチ正規化では ごとに 標準化 ▪
レイヤー正規化では各サンプル に関して標準化 バッチサイズに依存しない ミニ バッチ ミニ バッチ -
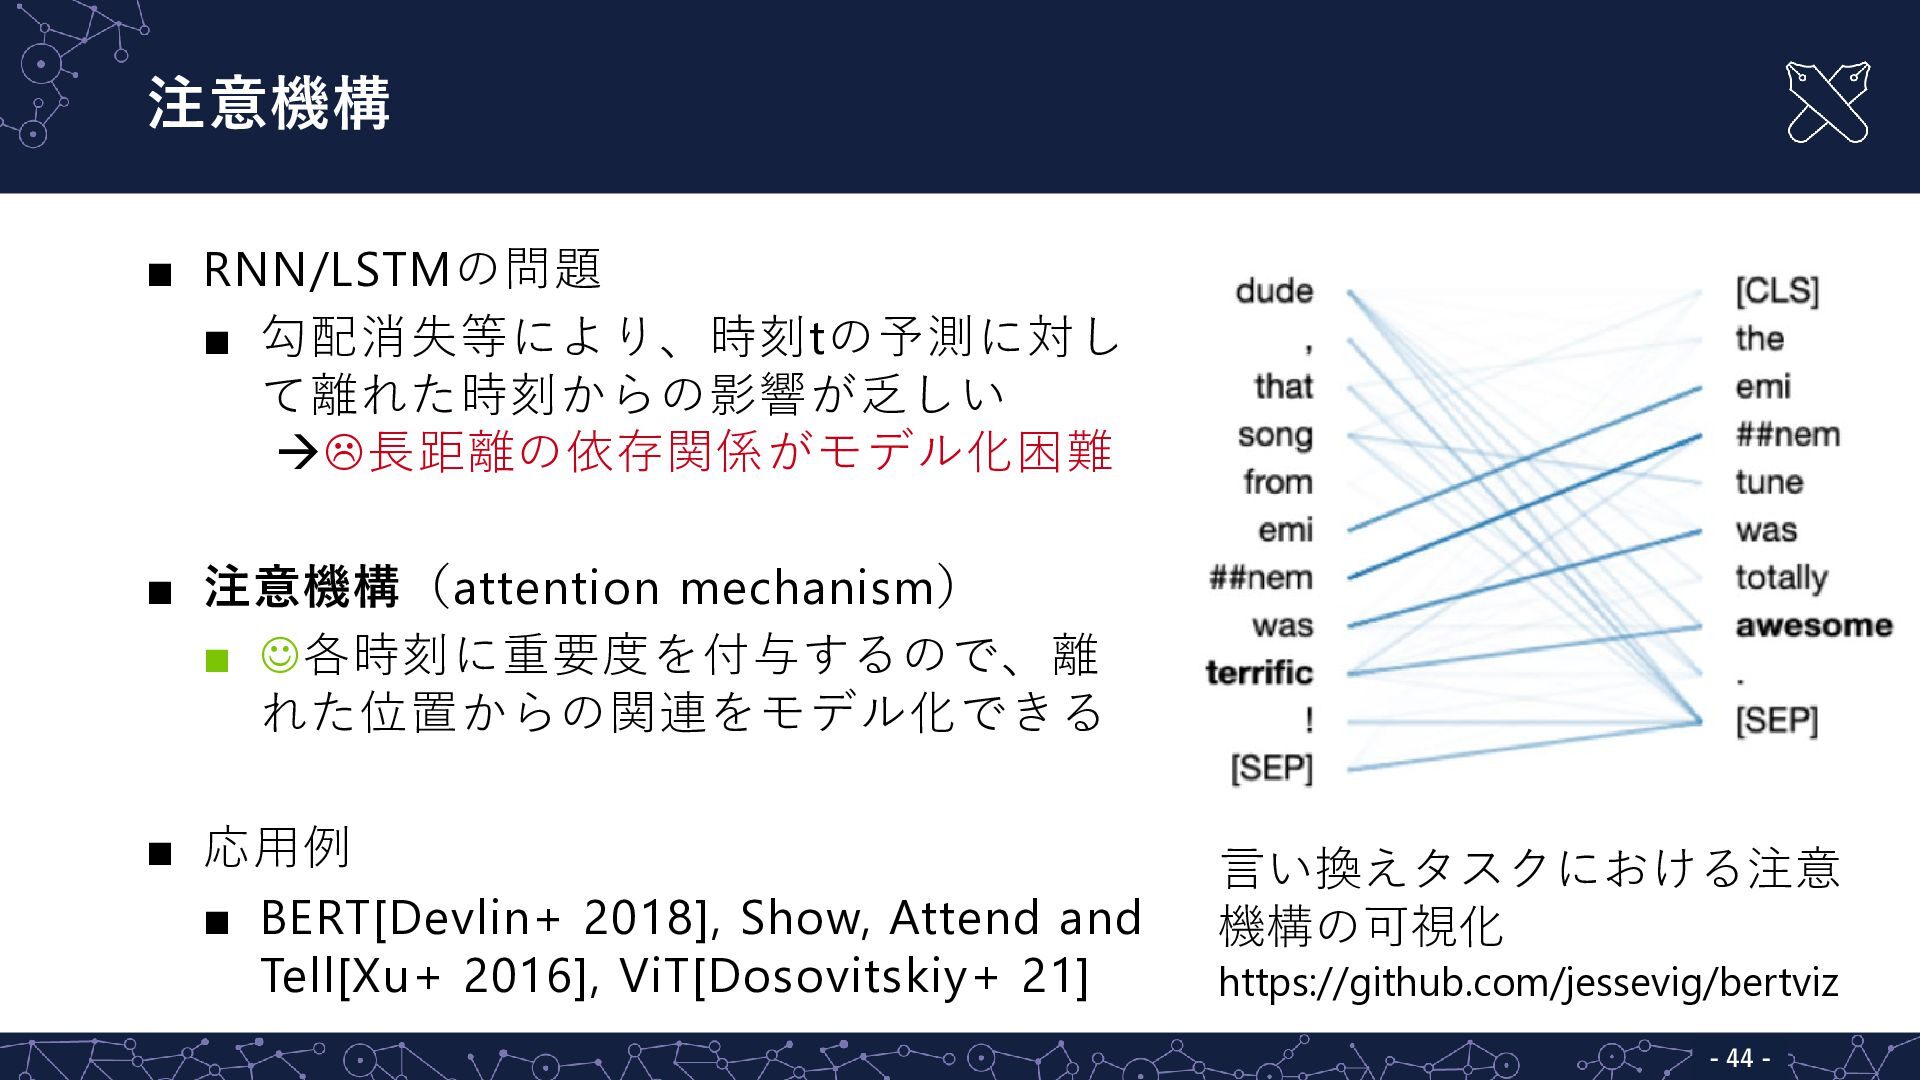
注意機構 - - 44 ▪ RNN/LSTMの問題 ▪ 勾配消失等により、時刻tの予測に対し て離れた時刻からの影響が乏しい 長距離の依存関係がモデル化困難
▪ 注意機構(attention mechanism) ▪ 各時刻に重要度を付与するので、離 れた位置からの関連をモデル化できる ▪ 応用例 ▪ BERT[Devlin+ 2018], Show, Attend and Tell[Xu+ 2016], ViT[Dosovitskiy+ 21] 言い換えタスクにおける注意 機構の可視化 https://github.com/jessevig/bertviz -
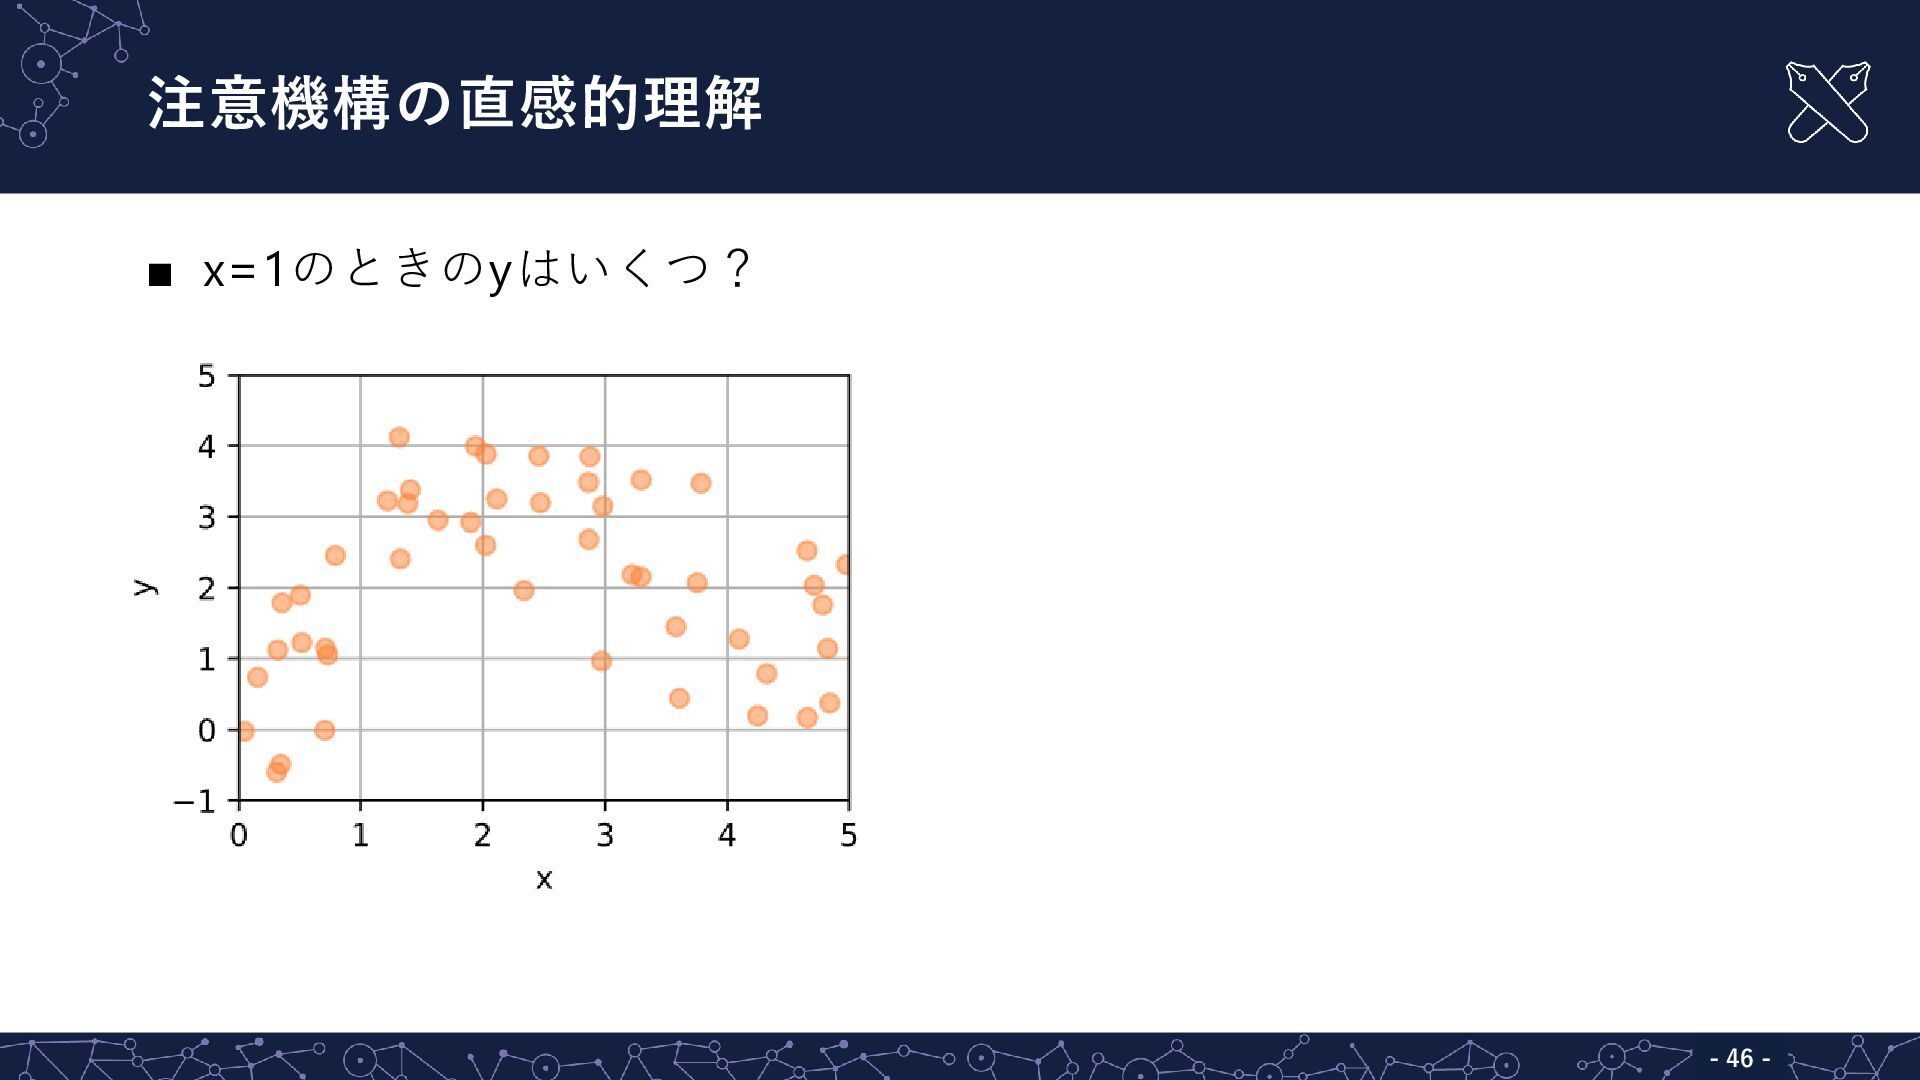
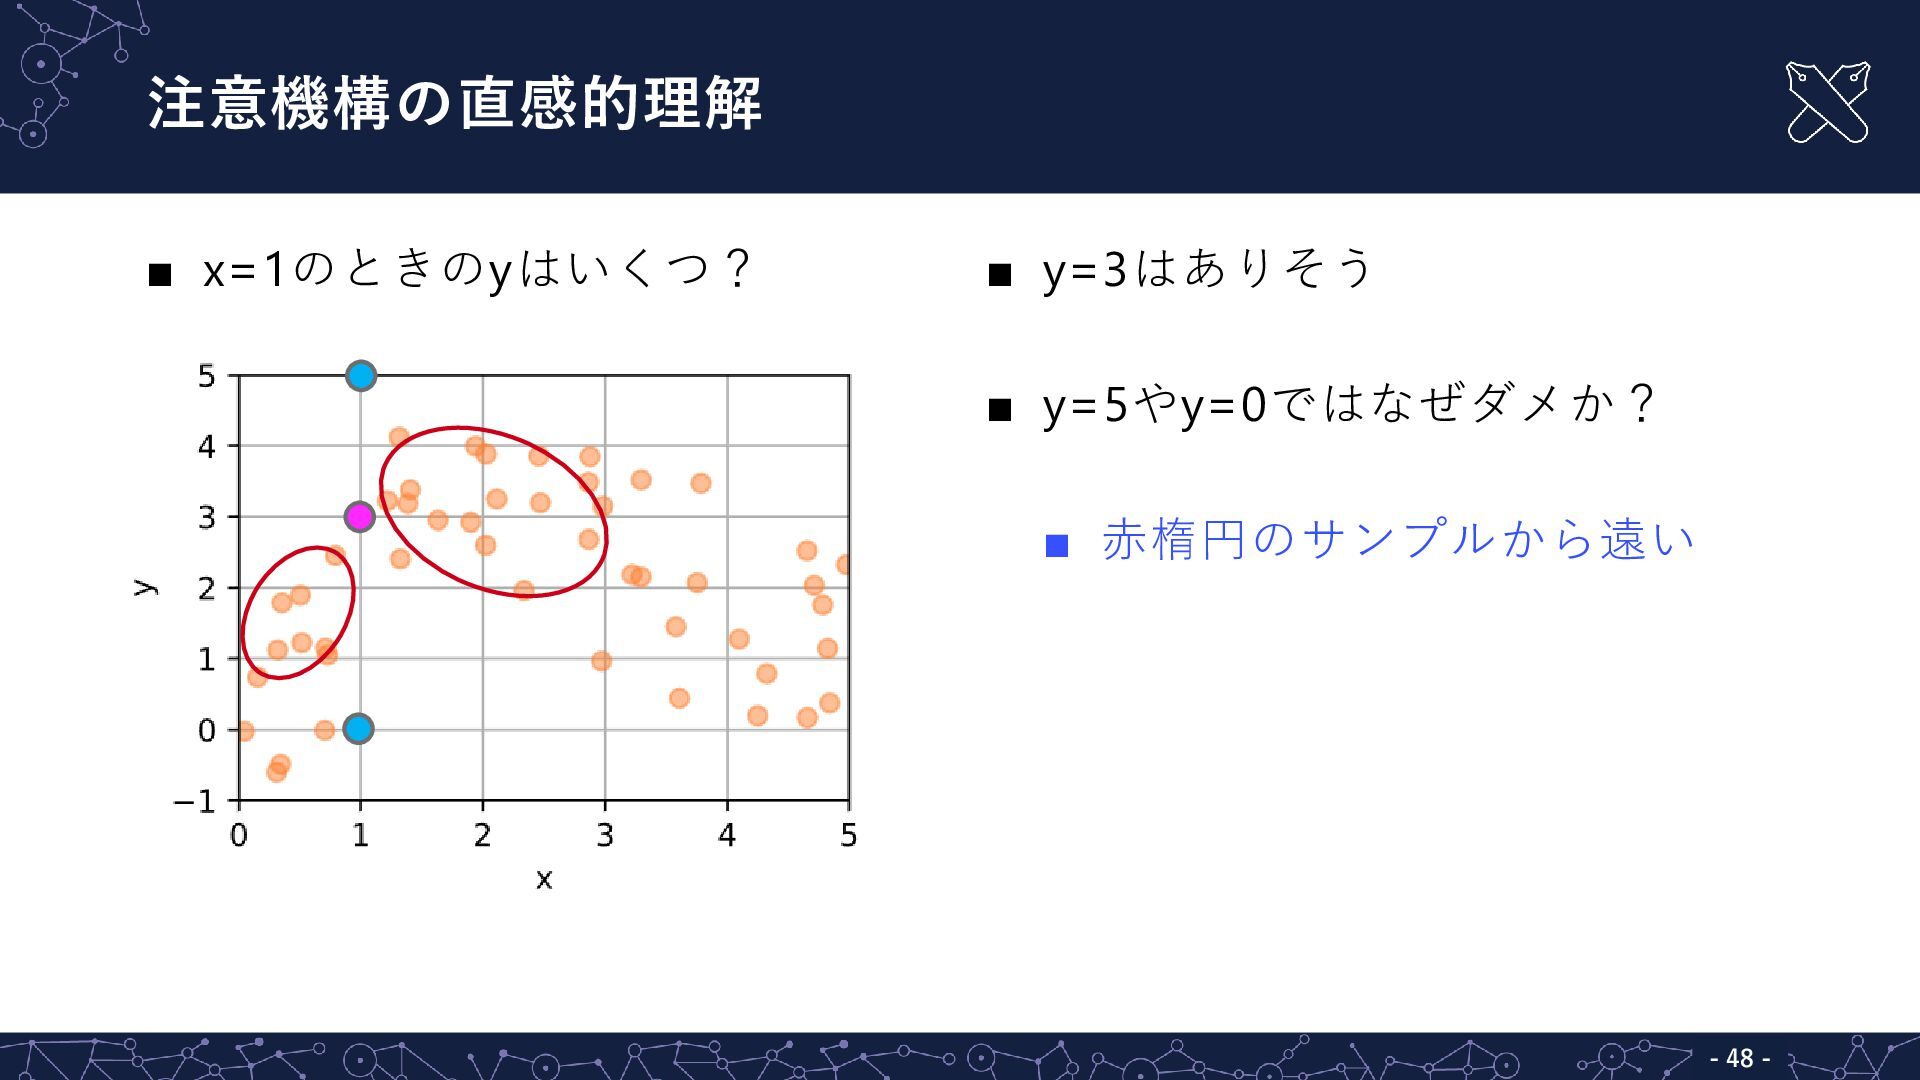
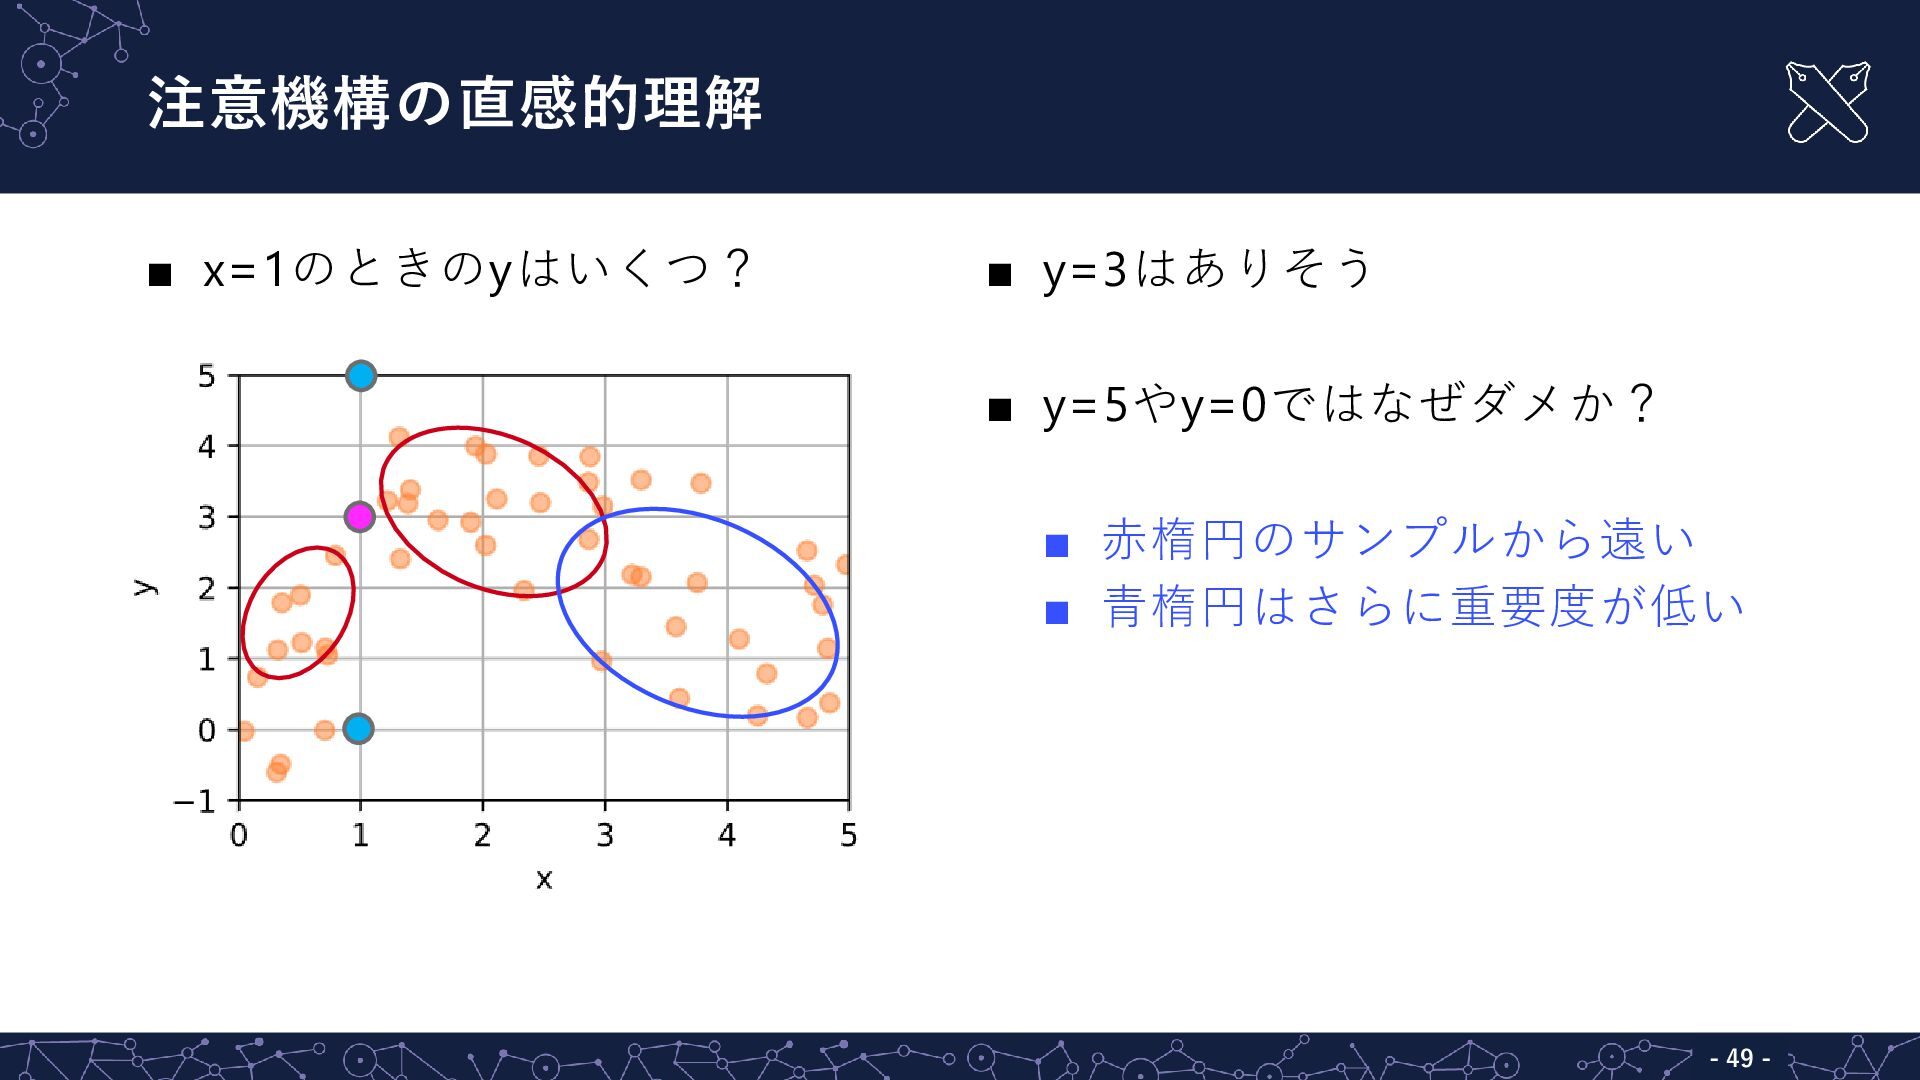
注意機構の直感的理解 - - 49 ▪ x=1のときのyはいくつ? ▪ y=3はありそう ▪ y=5やy=0ではなぜダメか?
▪ 赤楕円のサンプルから遠い ▪ 青楕円はさらに重要度が低い -
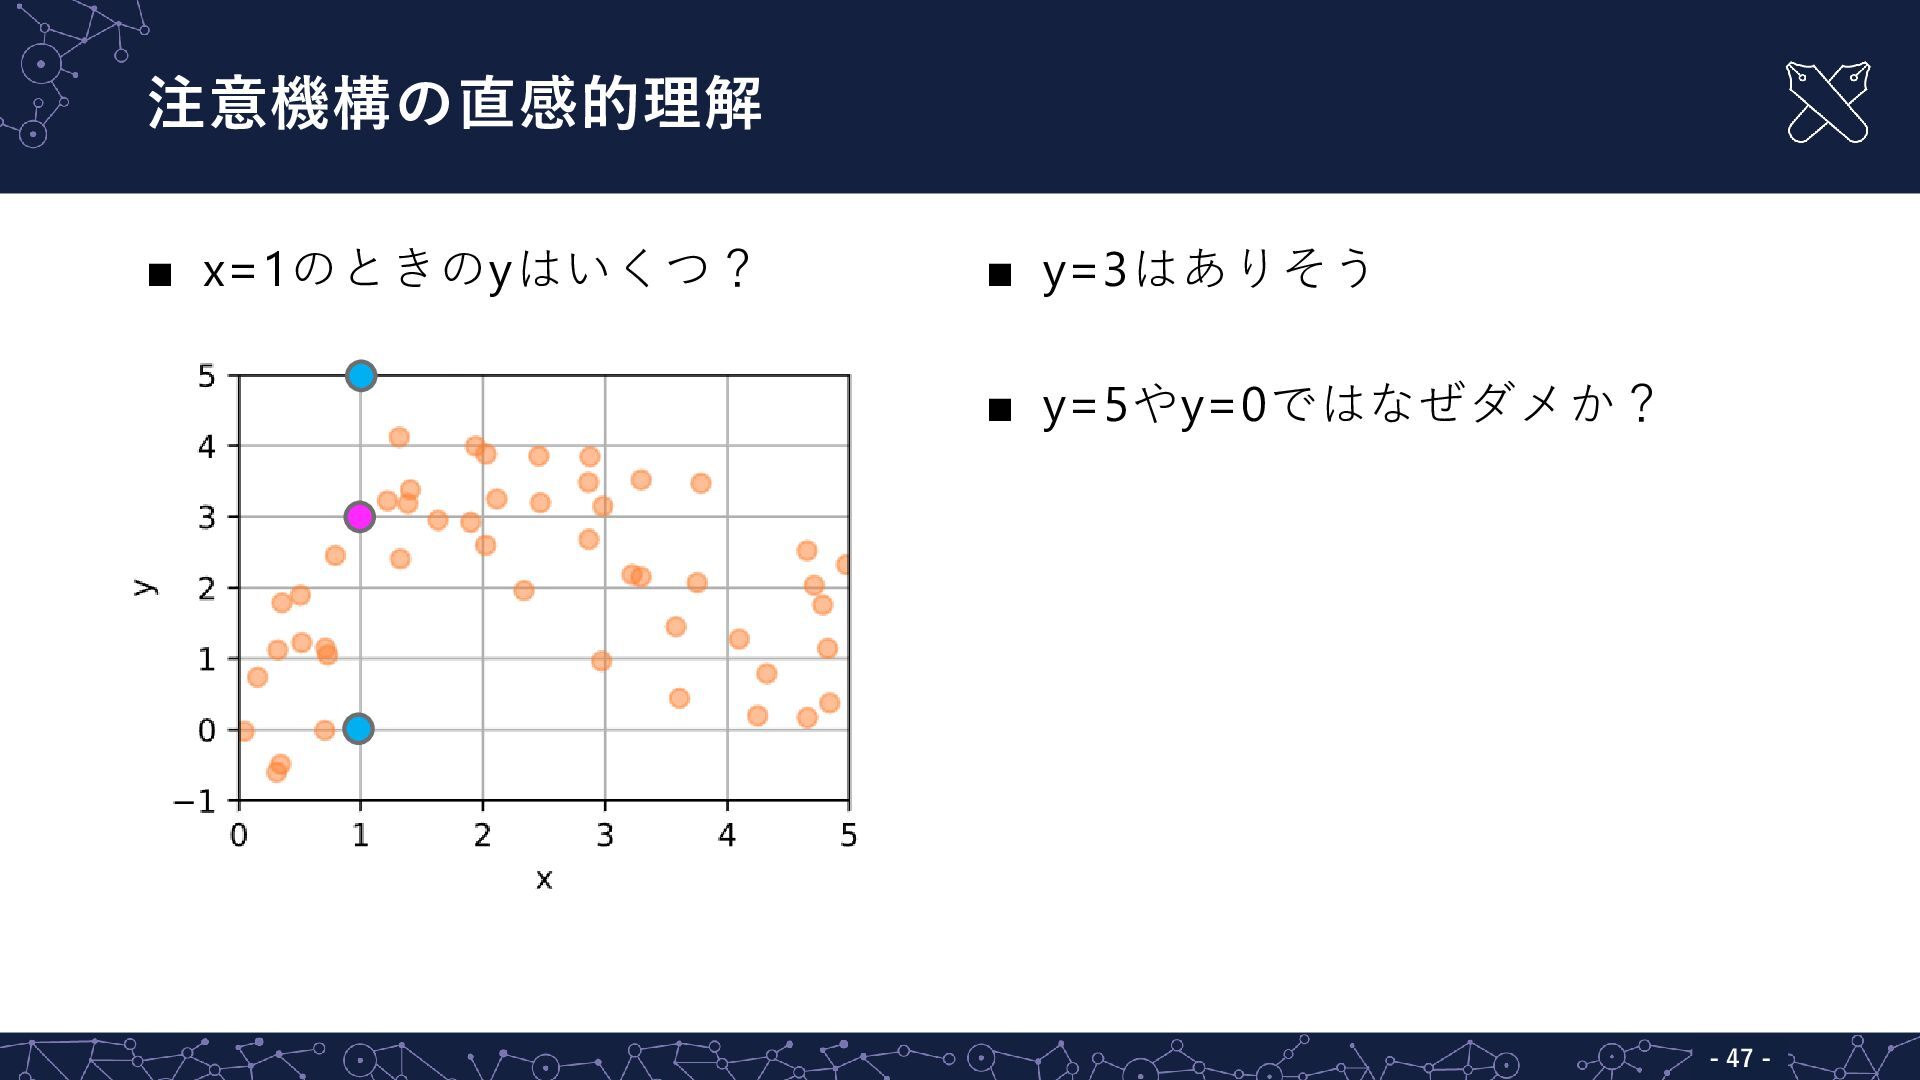
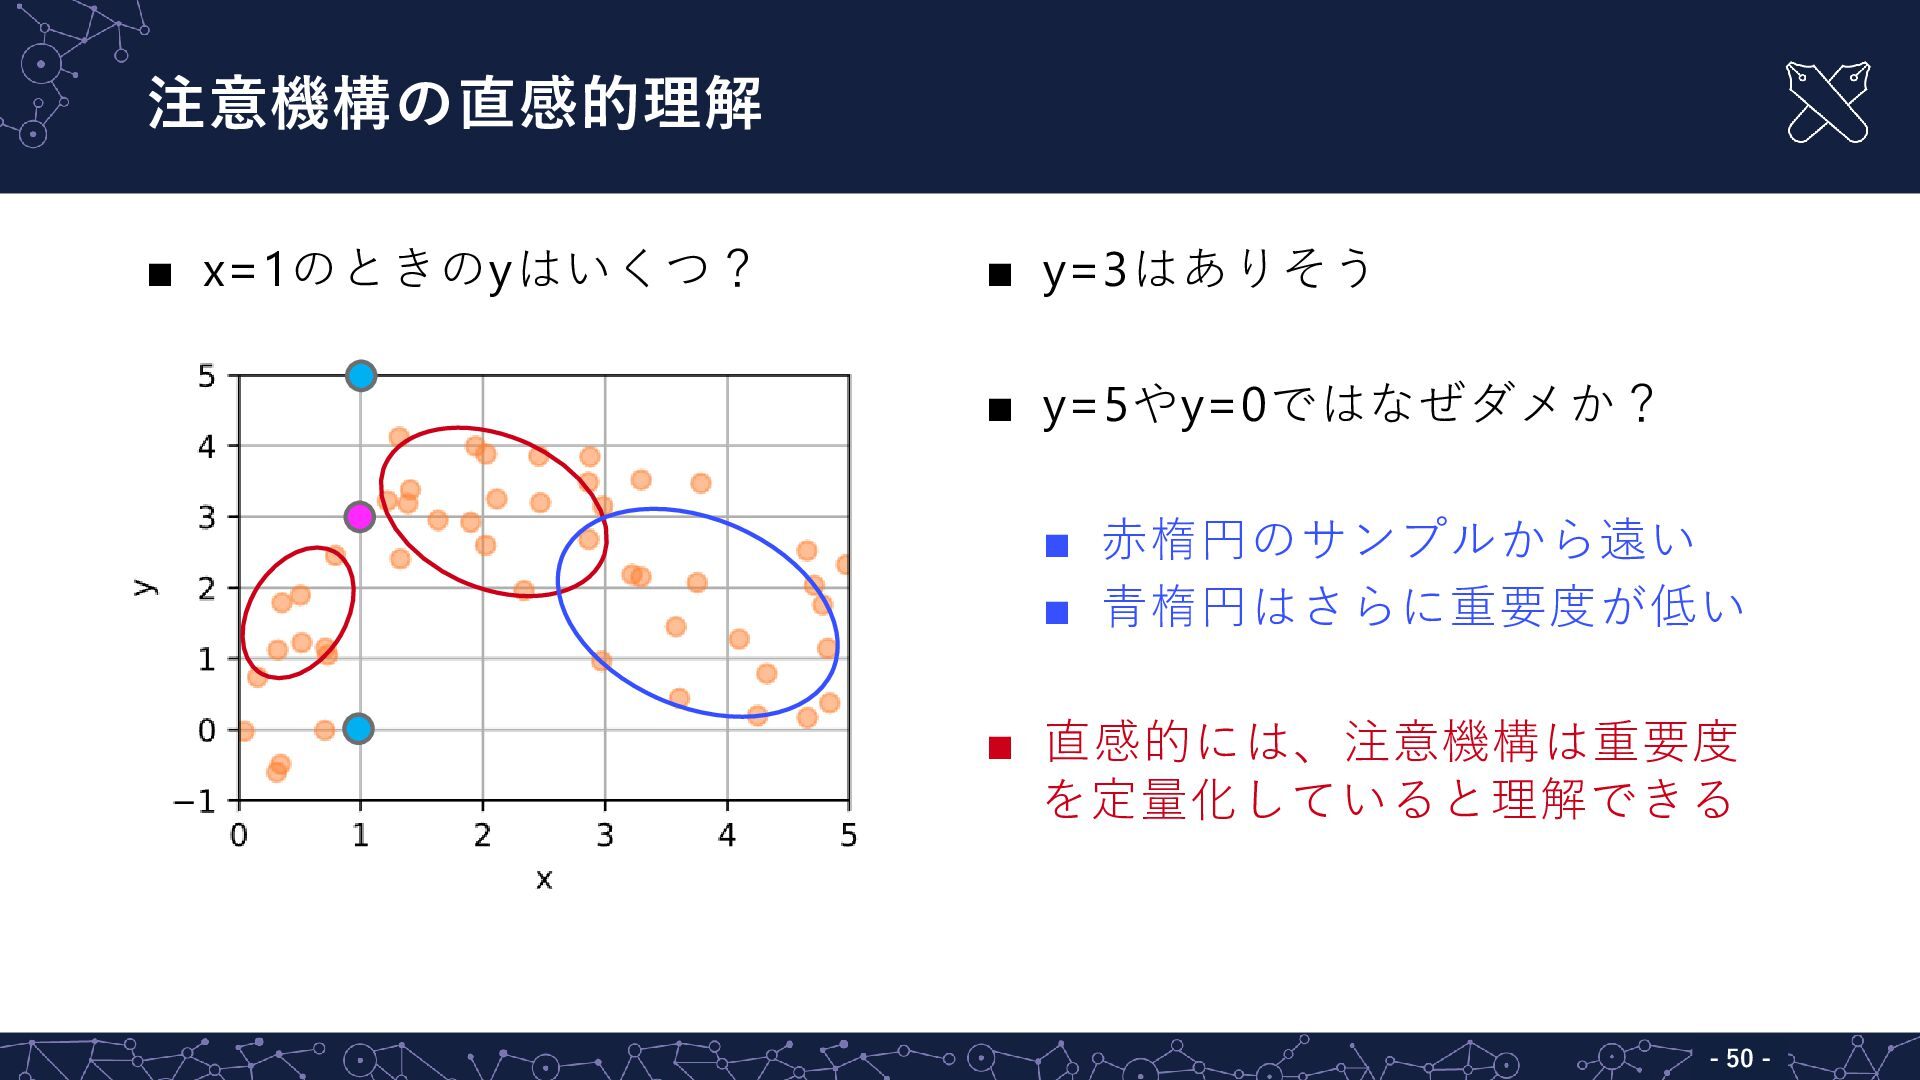
注意機構の直感的理解 - - 50 ▪ x=1のときのyはいくつ? ▪ y=3はありそう ▪ y=5やy=0ではなぜダメか?
▪ 赤楕円のサンプルから遠い ▪ 青楕円はさらに重要度が低い ▪ 直感的には、注意機構は重要度 を定量化していると理解できる -
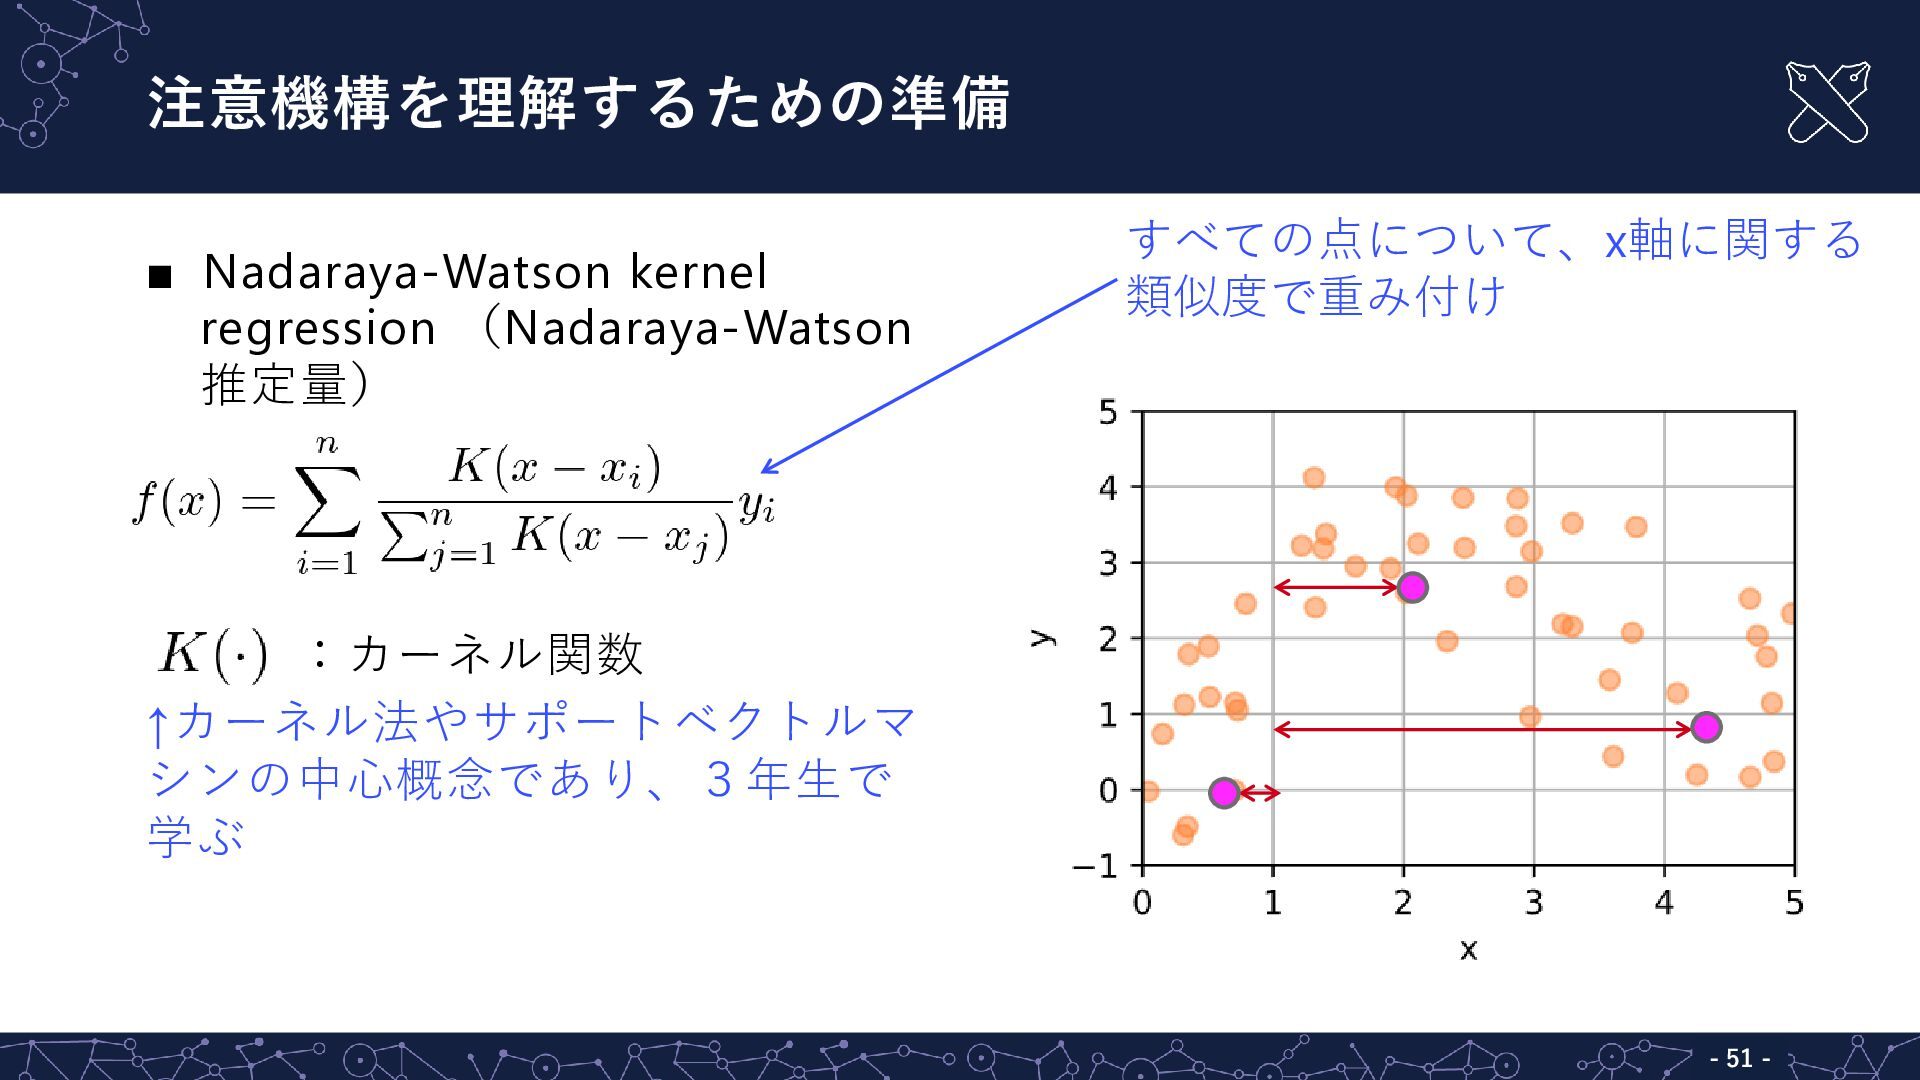
注意機構を理解するための準備 - - 51 ▪ Nadaraya-Watson kernel regression (Nadaraya-Watson 推定量)
:カーネル関数 ↑カーネル法やサポートベクトルマ シンの中心概念であり、3年生で 学ぶ すべての点について、x軸に関する 類似度で重み付け -
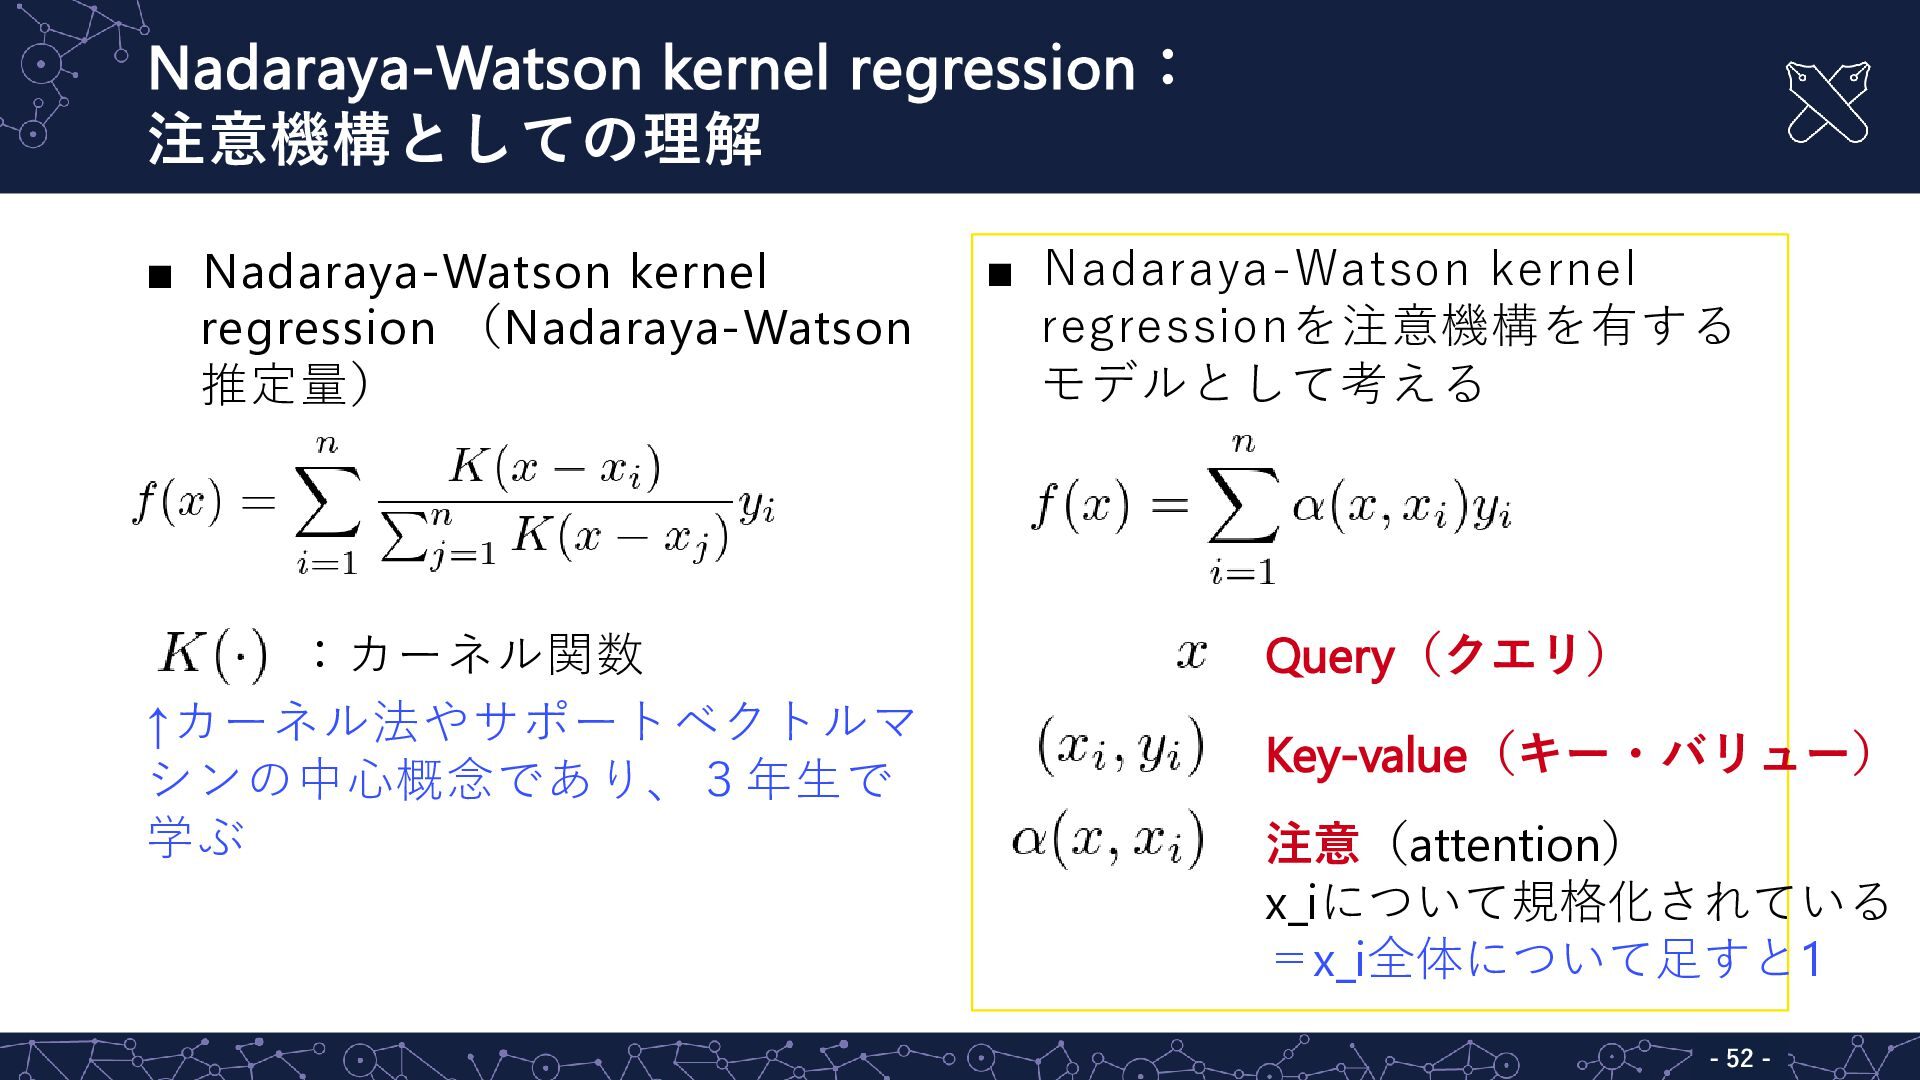
Nadaraya-Watson kernel regression: 注意機構としての理解 - - 52 ▪ Nadaraya-Watson kernel
regression (Nadaraya-Watson 推定量) :カーネル関数 ↑カーネル法やサポートベクトルマ シンの中心概念であり、3年生で 学ぶ ▪ Nadaraya-Watson kernel regressionを注意機構を有する モデルとして考える Query(クエリ) Key-value(キー・バリュー) 注意(attention) x_iについて規格化されている =x_i全体について足すと1 -
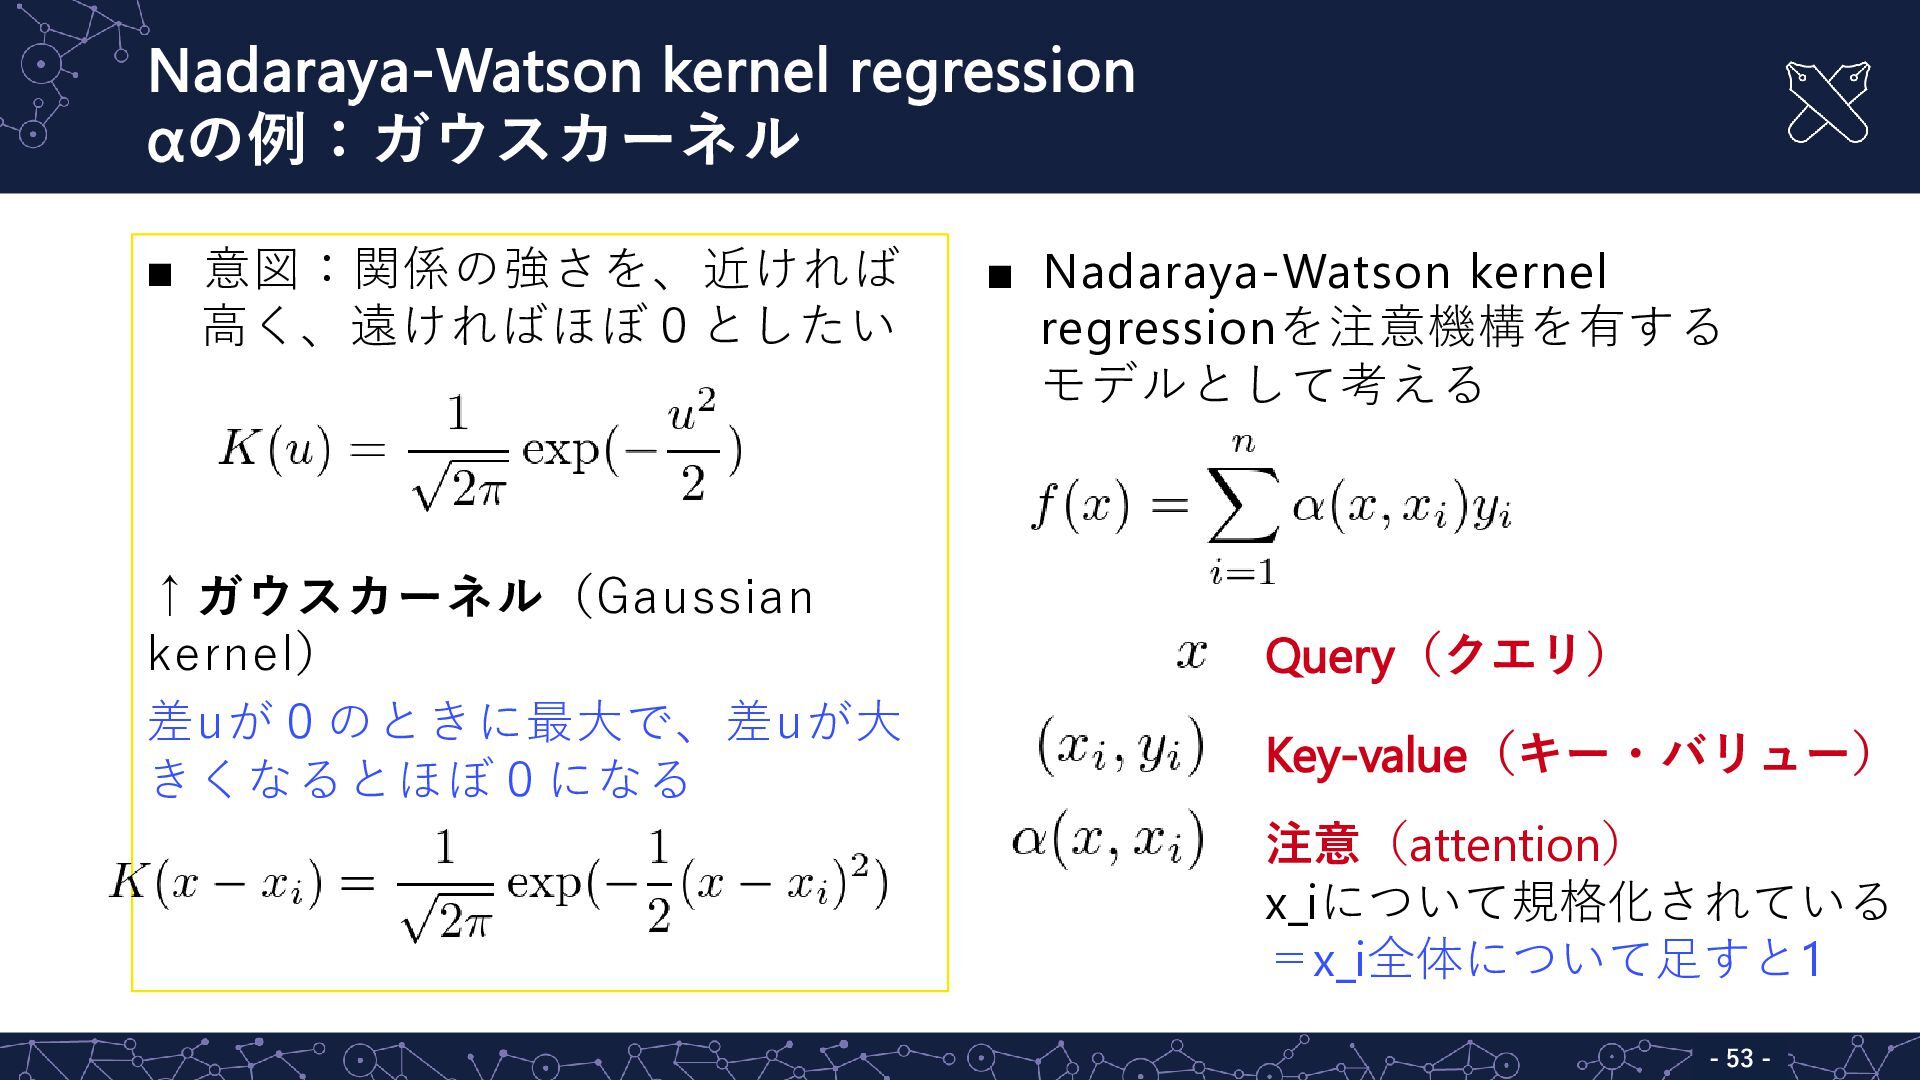
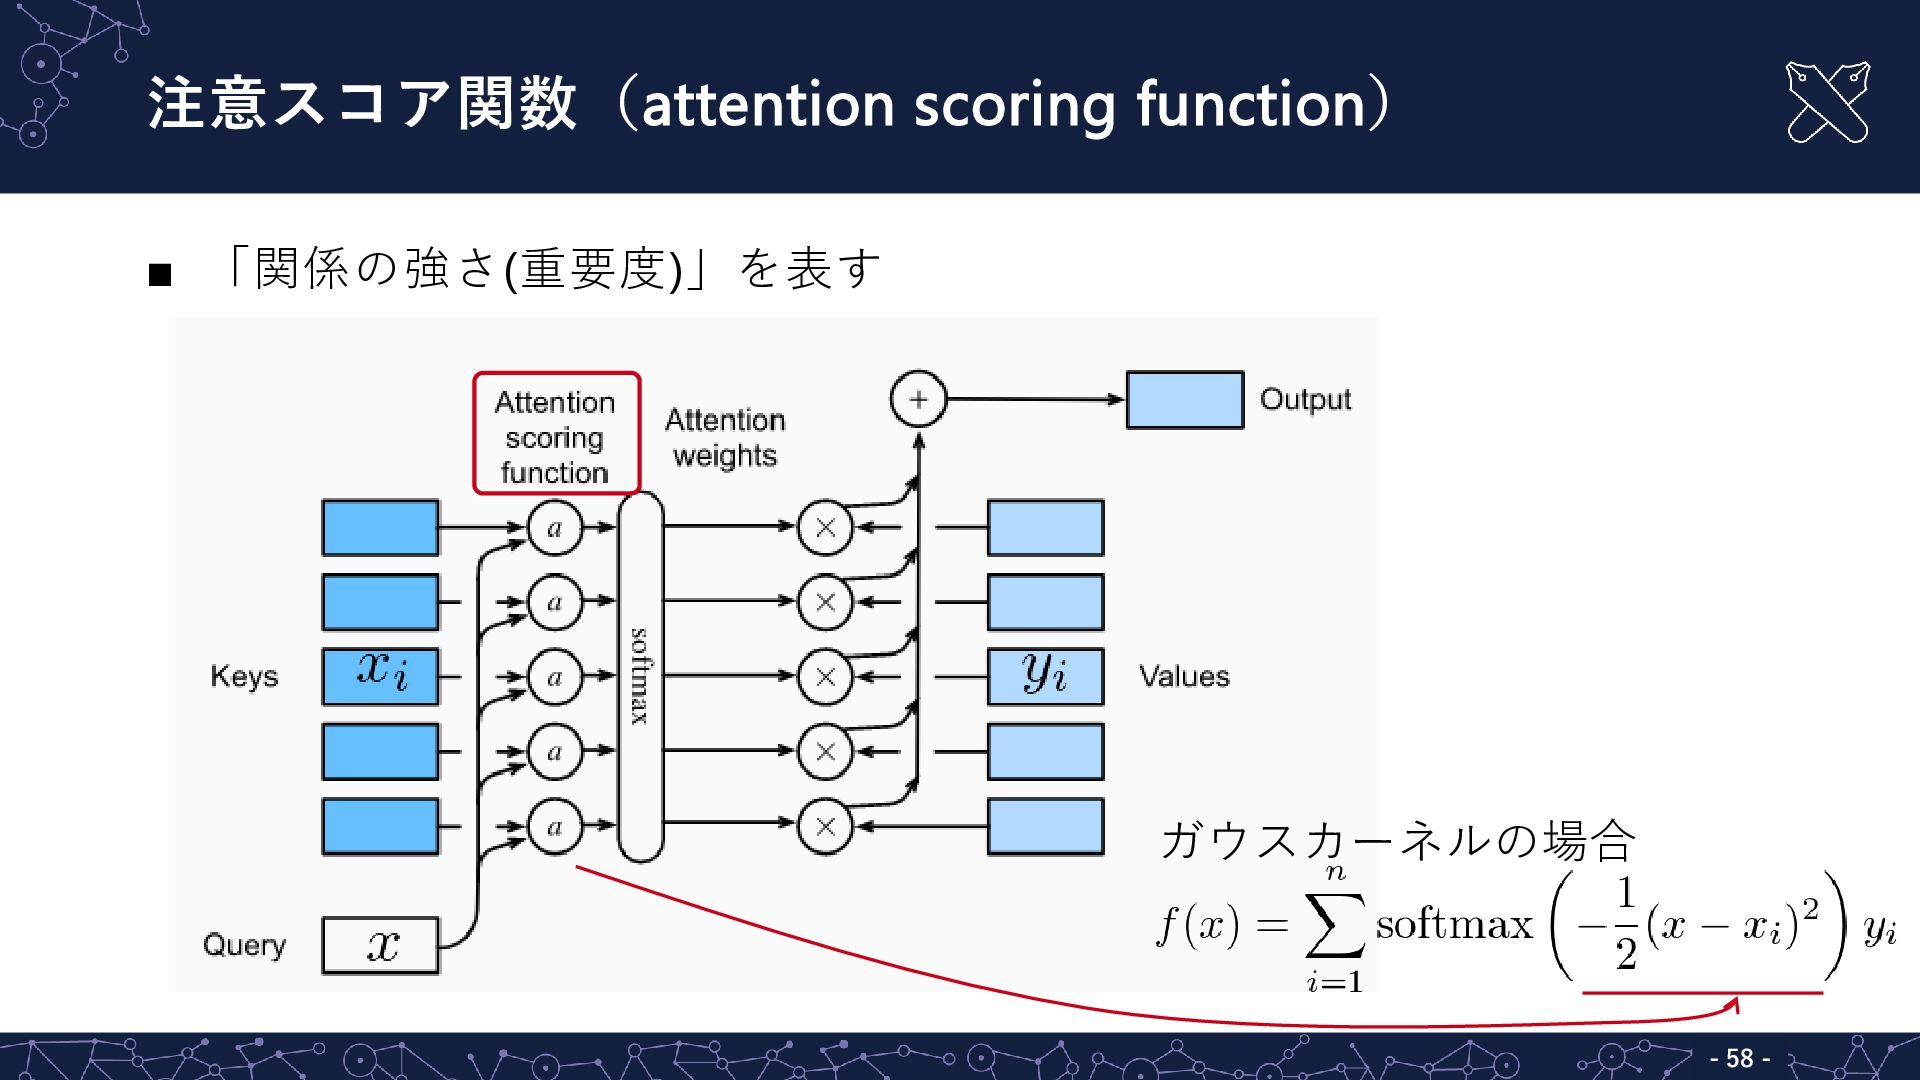
Nadaraya-Watson kernel regression αの例:ガウスカーネル - - 53 ▪ 意図:関係の強さを、近ければ 高く、遠ければほぼ0としたい
↑ガウスカーネル(Gaussian kernel) 差uが0のときに最大で、差uが大 きくなるとほぼ0になる ▪ Nadaraya-Watson kernel regressionを注意機構を有する モデルとして考える Query(クエリ) Key-value(キー・バリュー) 注意(attention) x_iについて規格化されている =x_i全体について足すと1 -
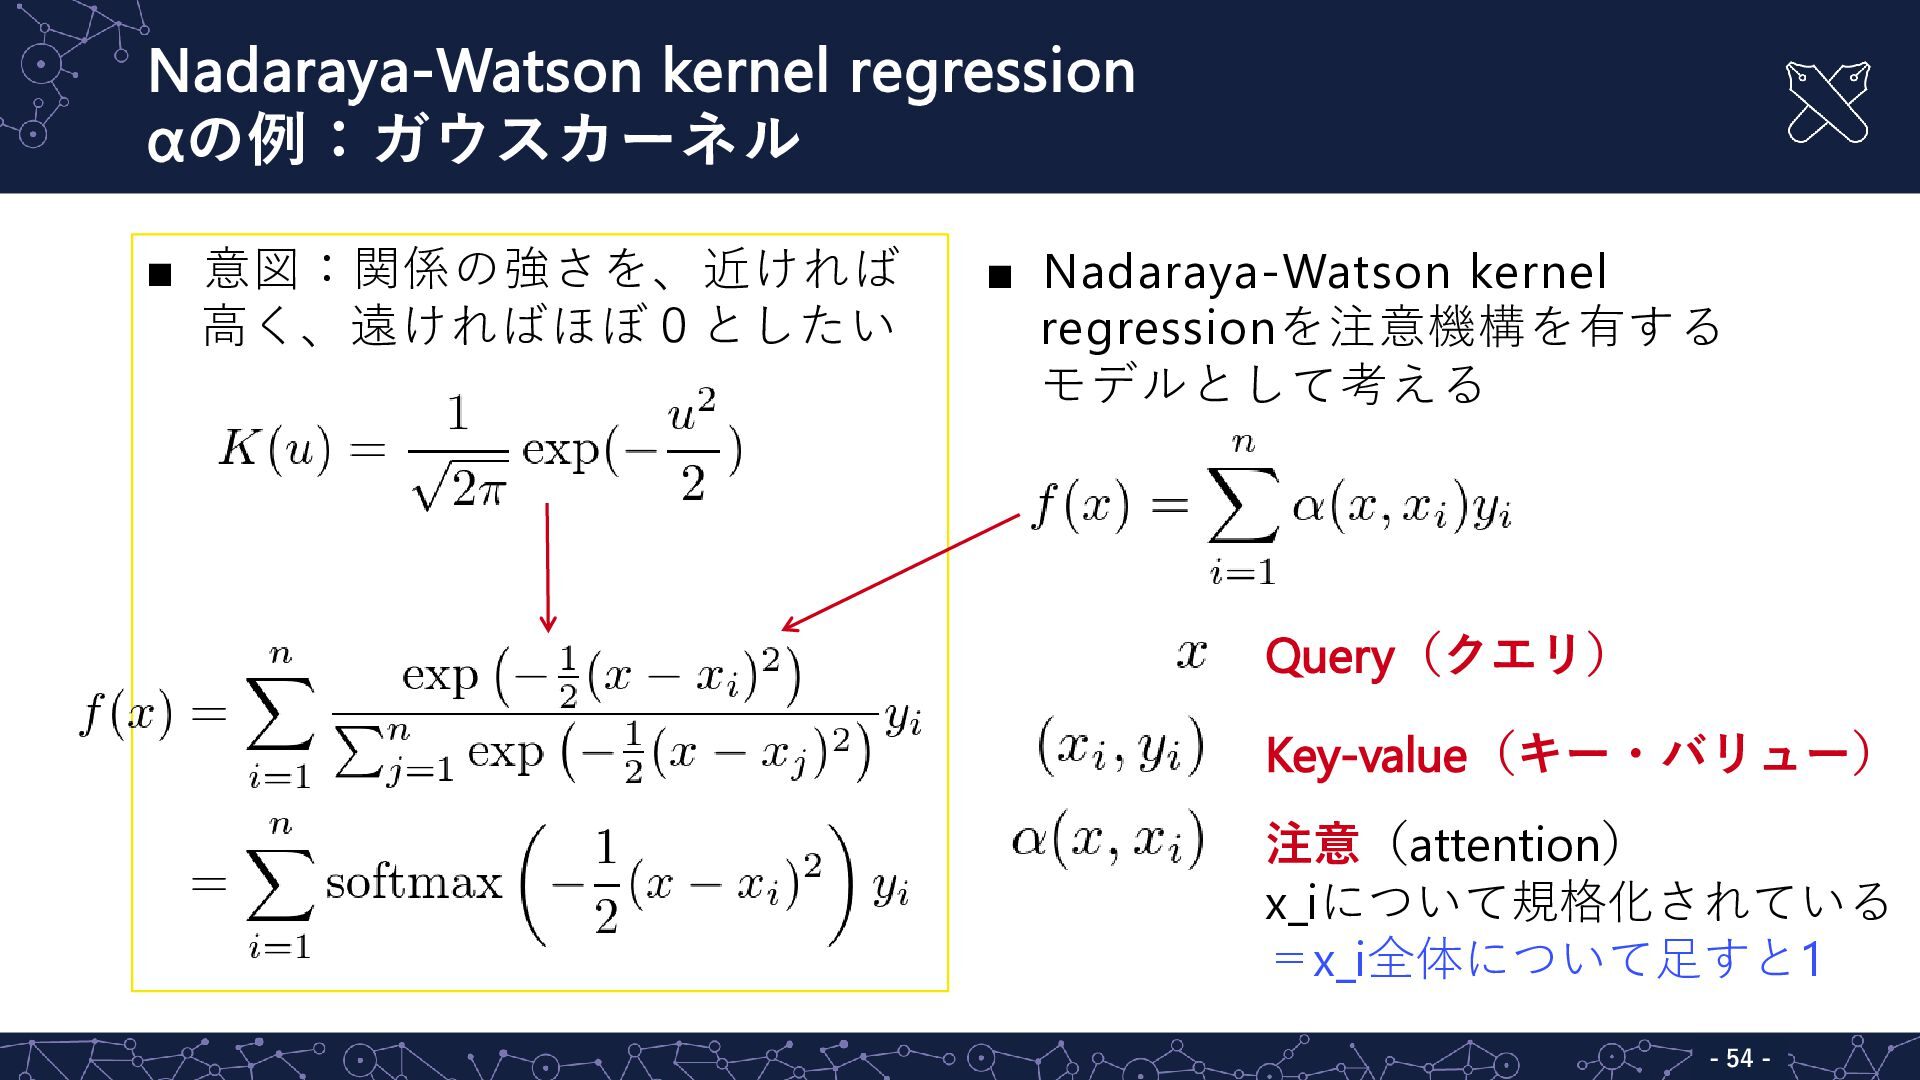
Nadaraya-Watson kernel regression αの例:ガウスカーネル - - 54 ▪ 意図:関係の強さを、近ければ 高く、遠ければほぼ0としたい
▪ Nadaraya-Watson kernel regressionを注意機構を有する モデルとして考える Query(クエリ) Key-value(キー・バリュー) 注意(attention) x_iについて規格化されている =x_i全体について足すと1 -
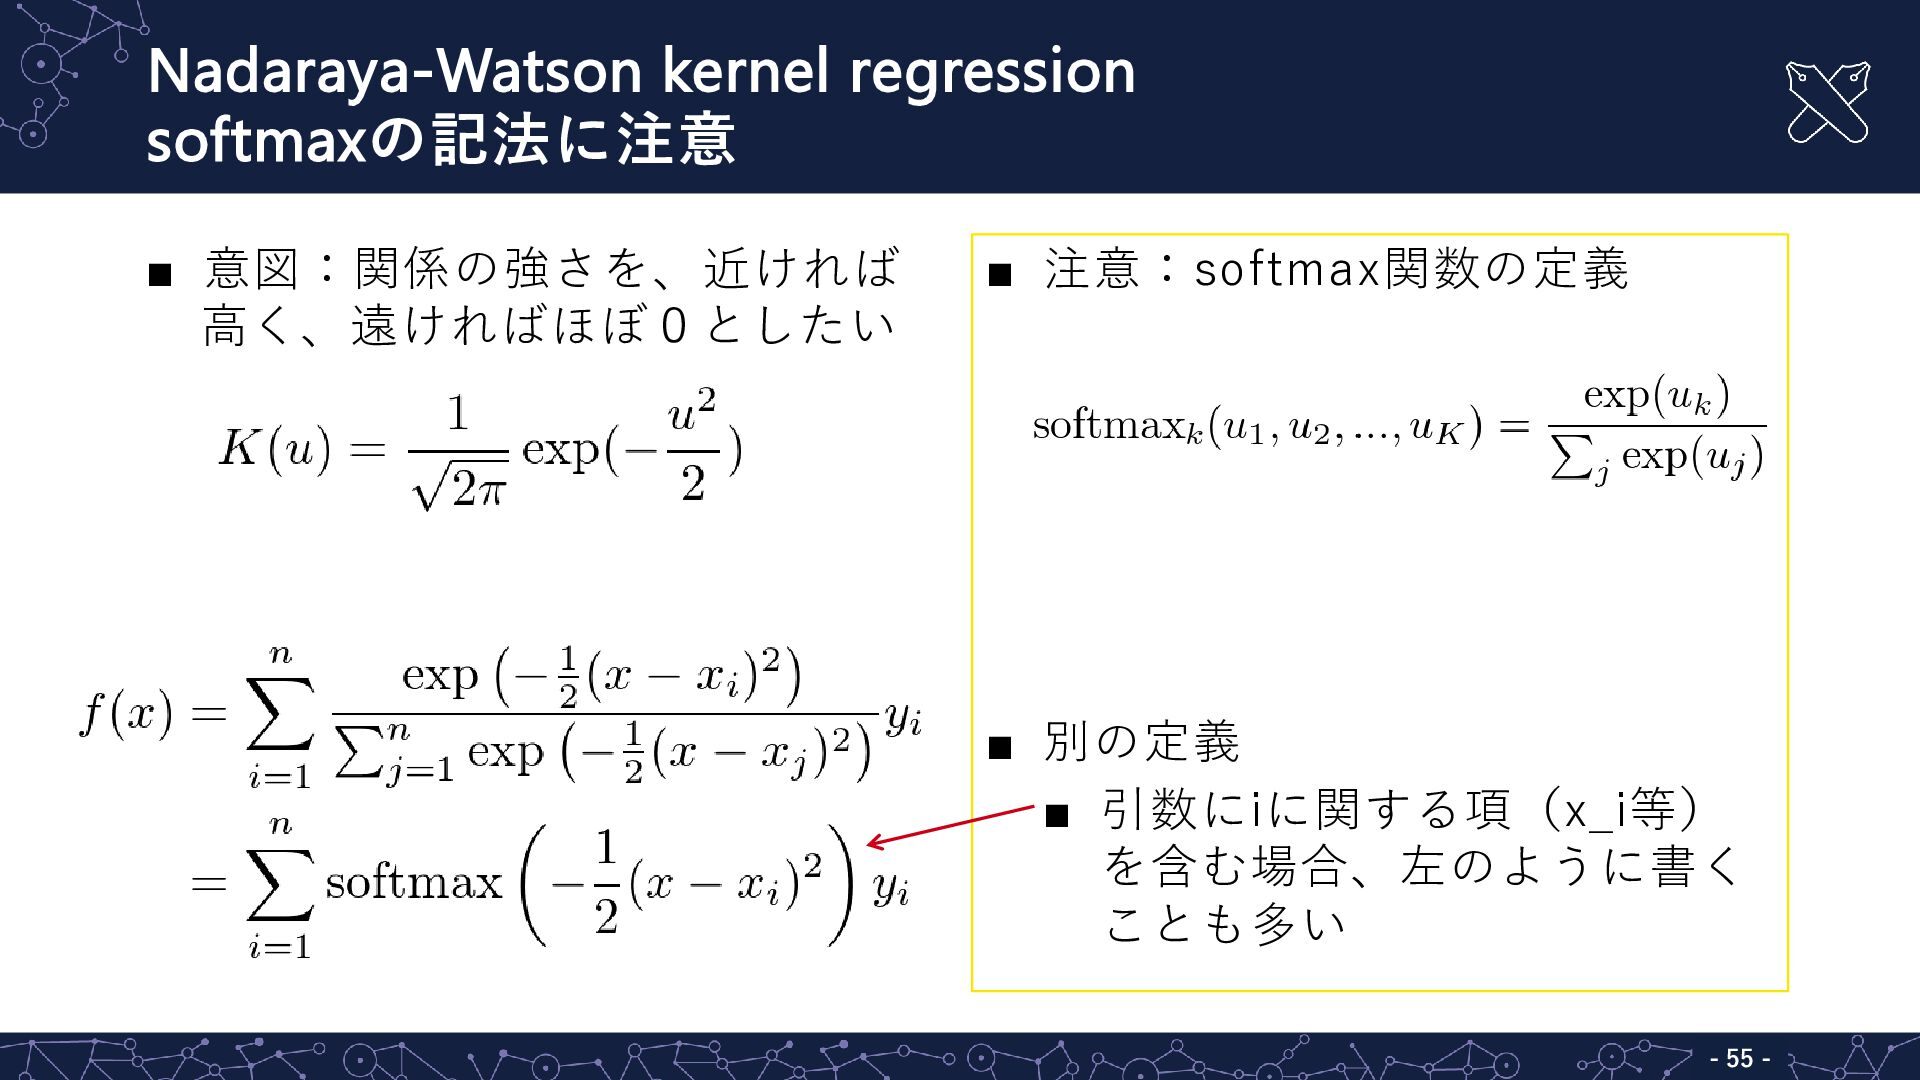
Nadaraya-Watson kernel regression softmaxの記法に注意 - - 55 ▪ 意図:関係の強さを、近ければ 高く、遠ければほぼ0としたい
▪ 注意:softmax関数の定義 ▪ 別の定義 ▪ 引数にiに関する項(x_i等) を含む場合、左のように書く ことも多い -
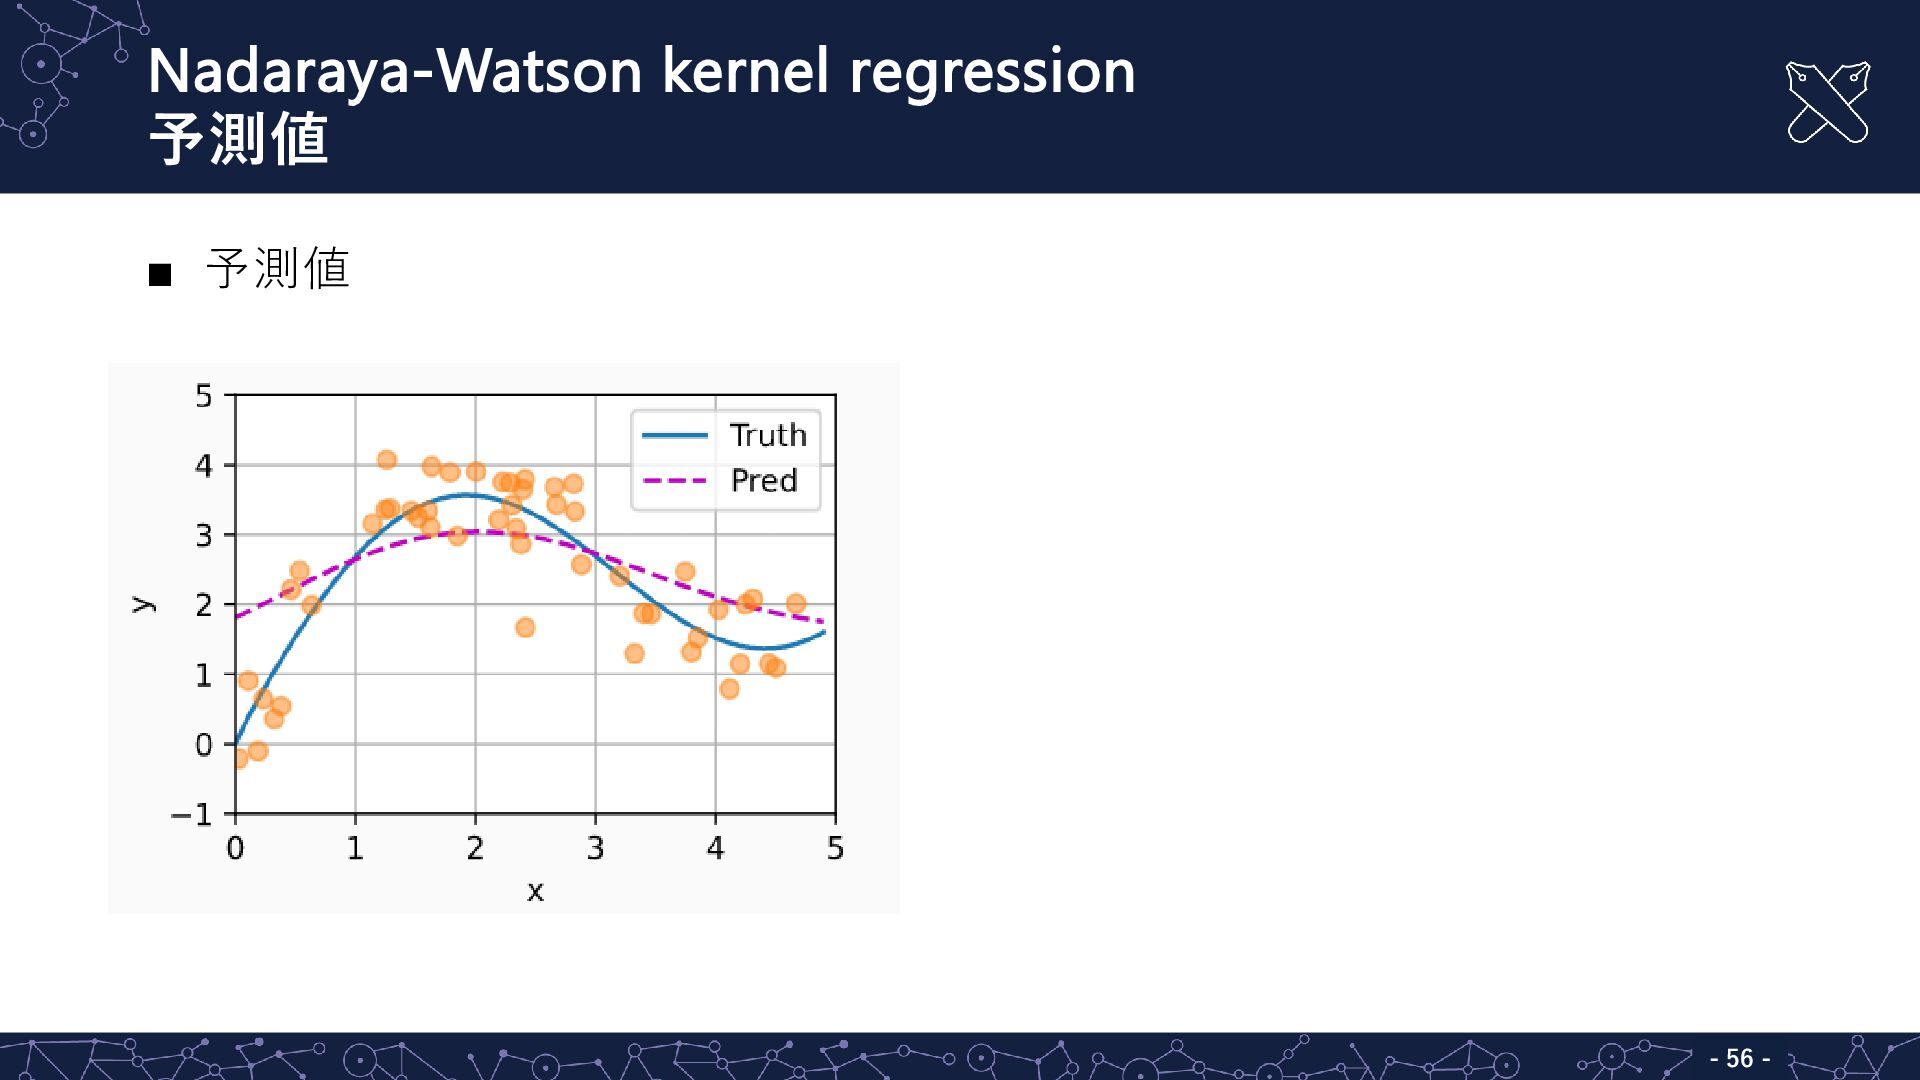
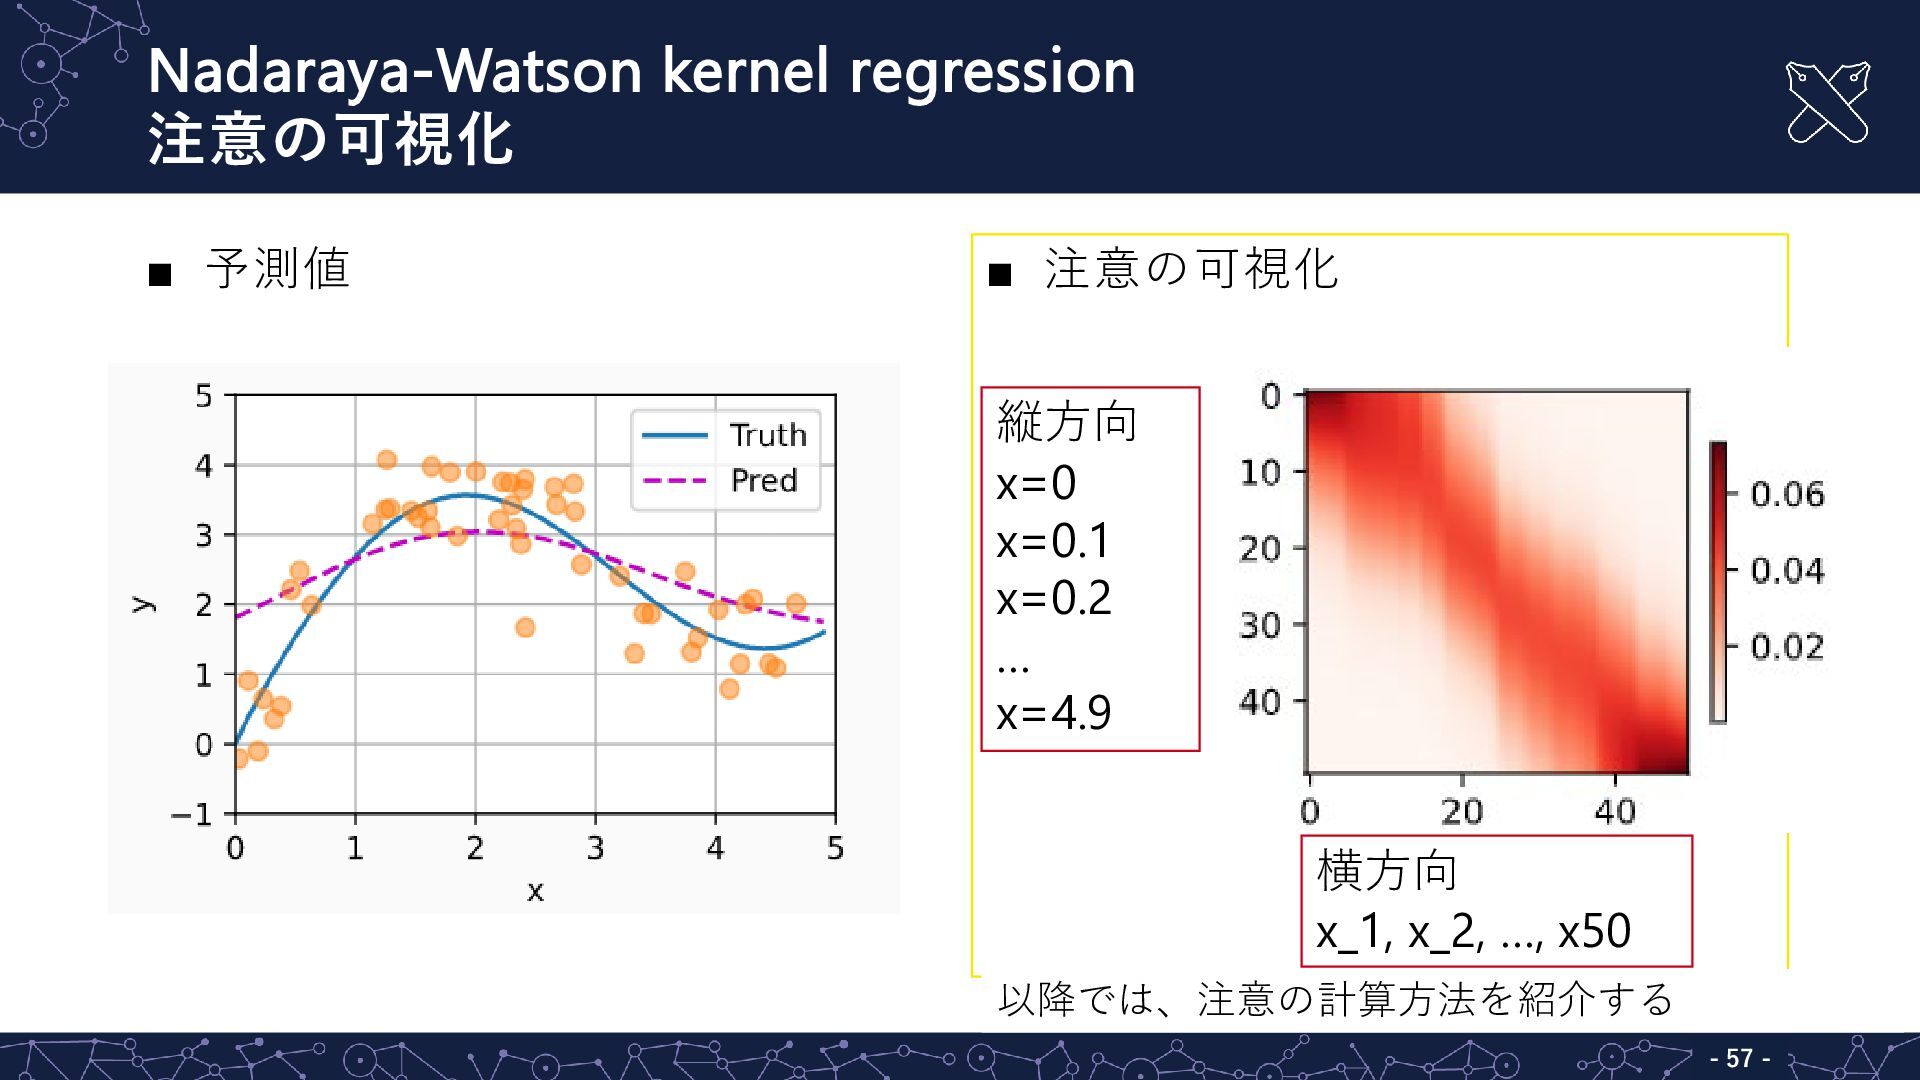
Nadaraya-Watson kernel regression 注意の可視化 - - 57 ▪ 予測値 ▪
注意の可視化 縦方向 x=0 x=0.1 x=0.2 … x=4.9 横方向 x_1, x_2, …, x50 以降では、注意の計算方法を紹介する -
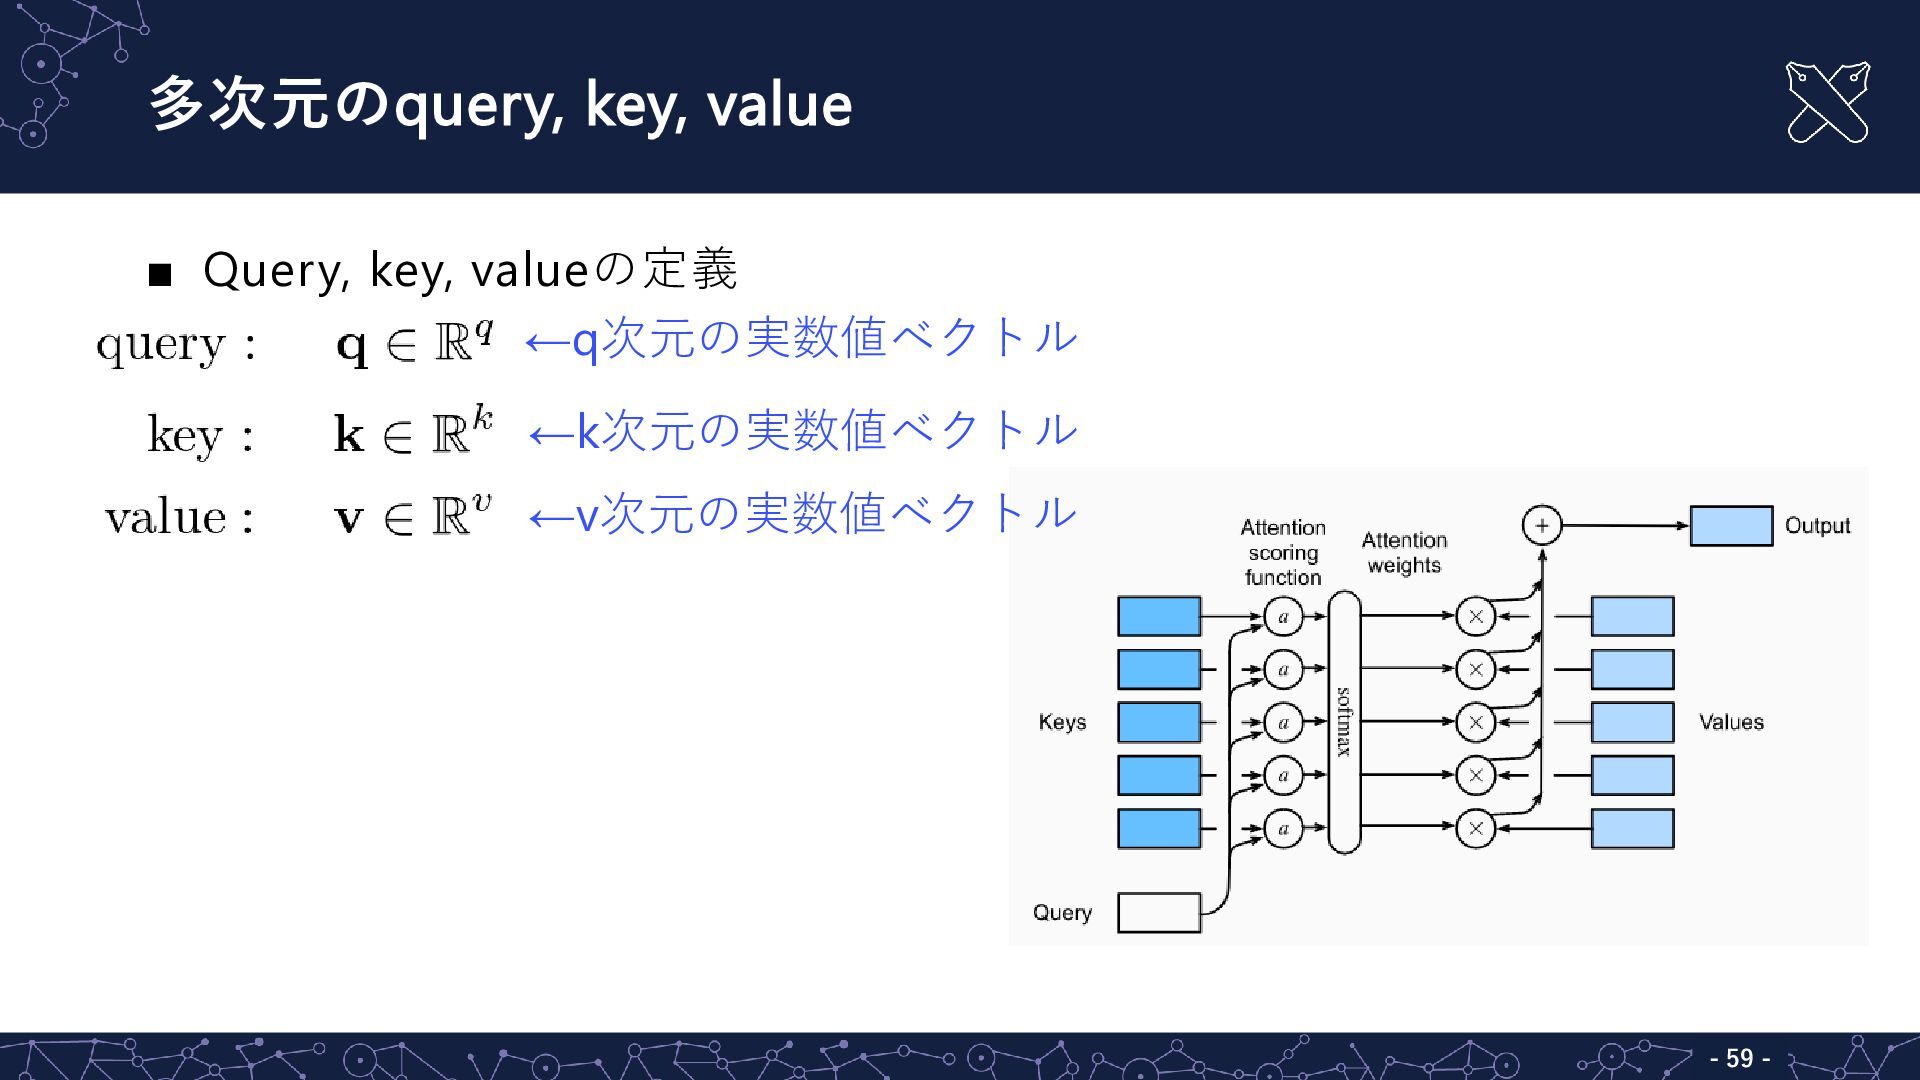
多次元のquery, key, value - - 59 ▪ Query, key, valueの定義
←q次元の実数値ベクトル ←k次元の実数値ベクトル ←v次元の実数値ベクトル -
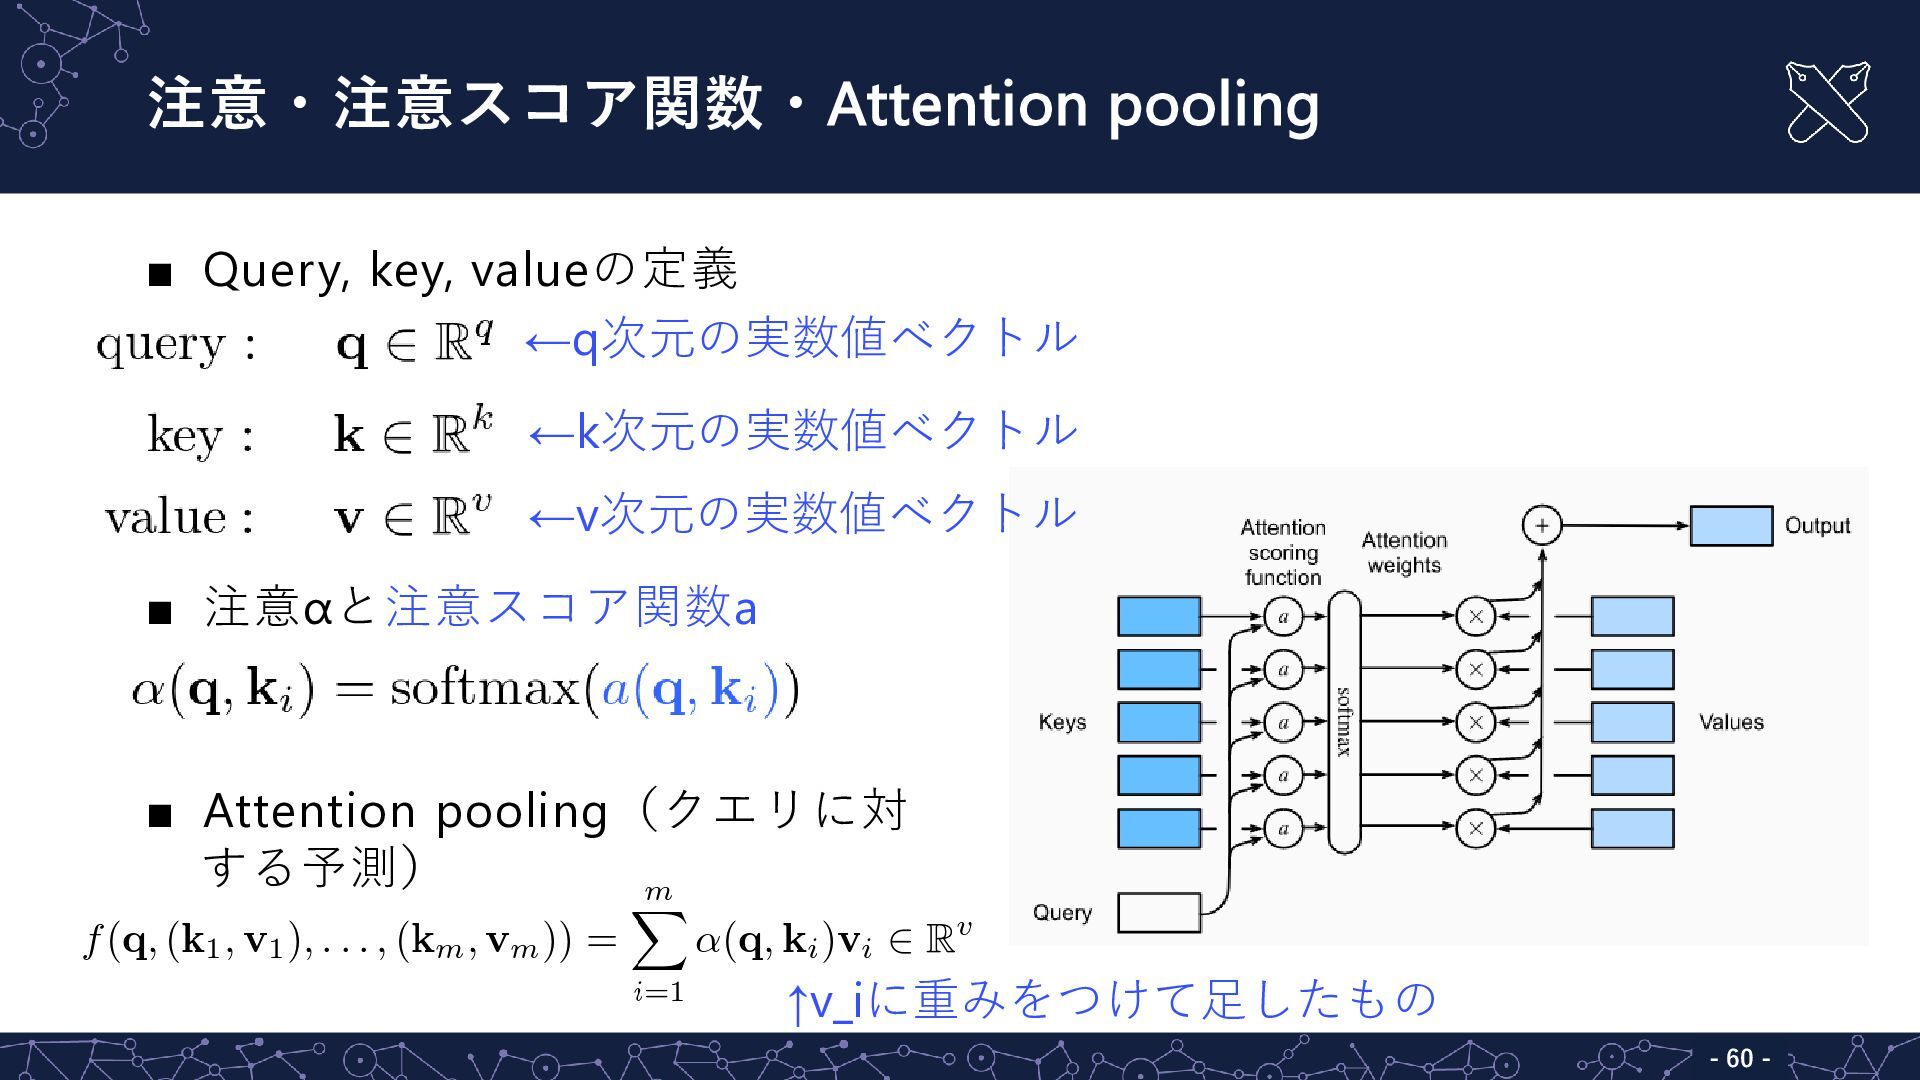
注意・注意スコア関数・Attention pooling - - 60 ▪ Query, key, valueの定義 ▪
注意αと注意スコア関数a ▪ Attention pooling(クエリに対 する予測) ←q次元の実数値ベクトル ←k次元の実数値ベクトル ←v次元の実数値ベクトル ↑v_iに重みをつけて足したもの -
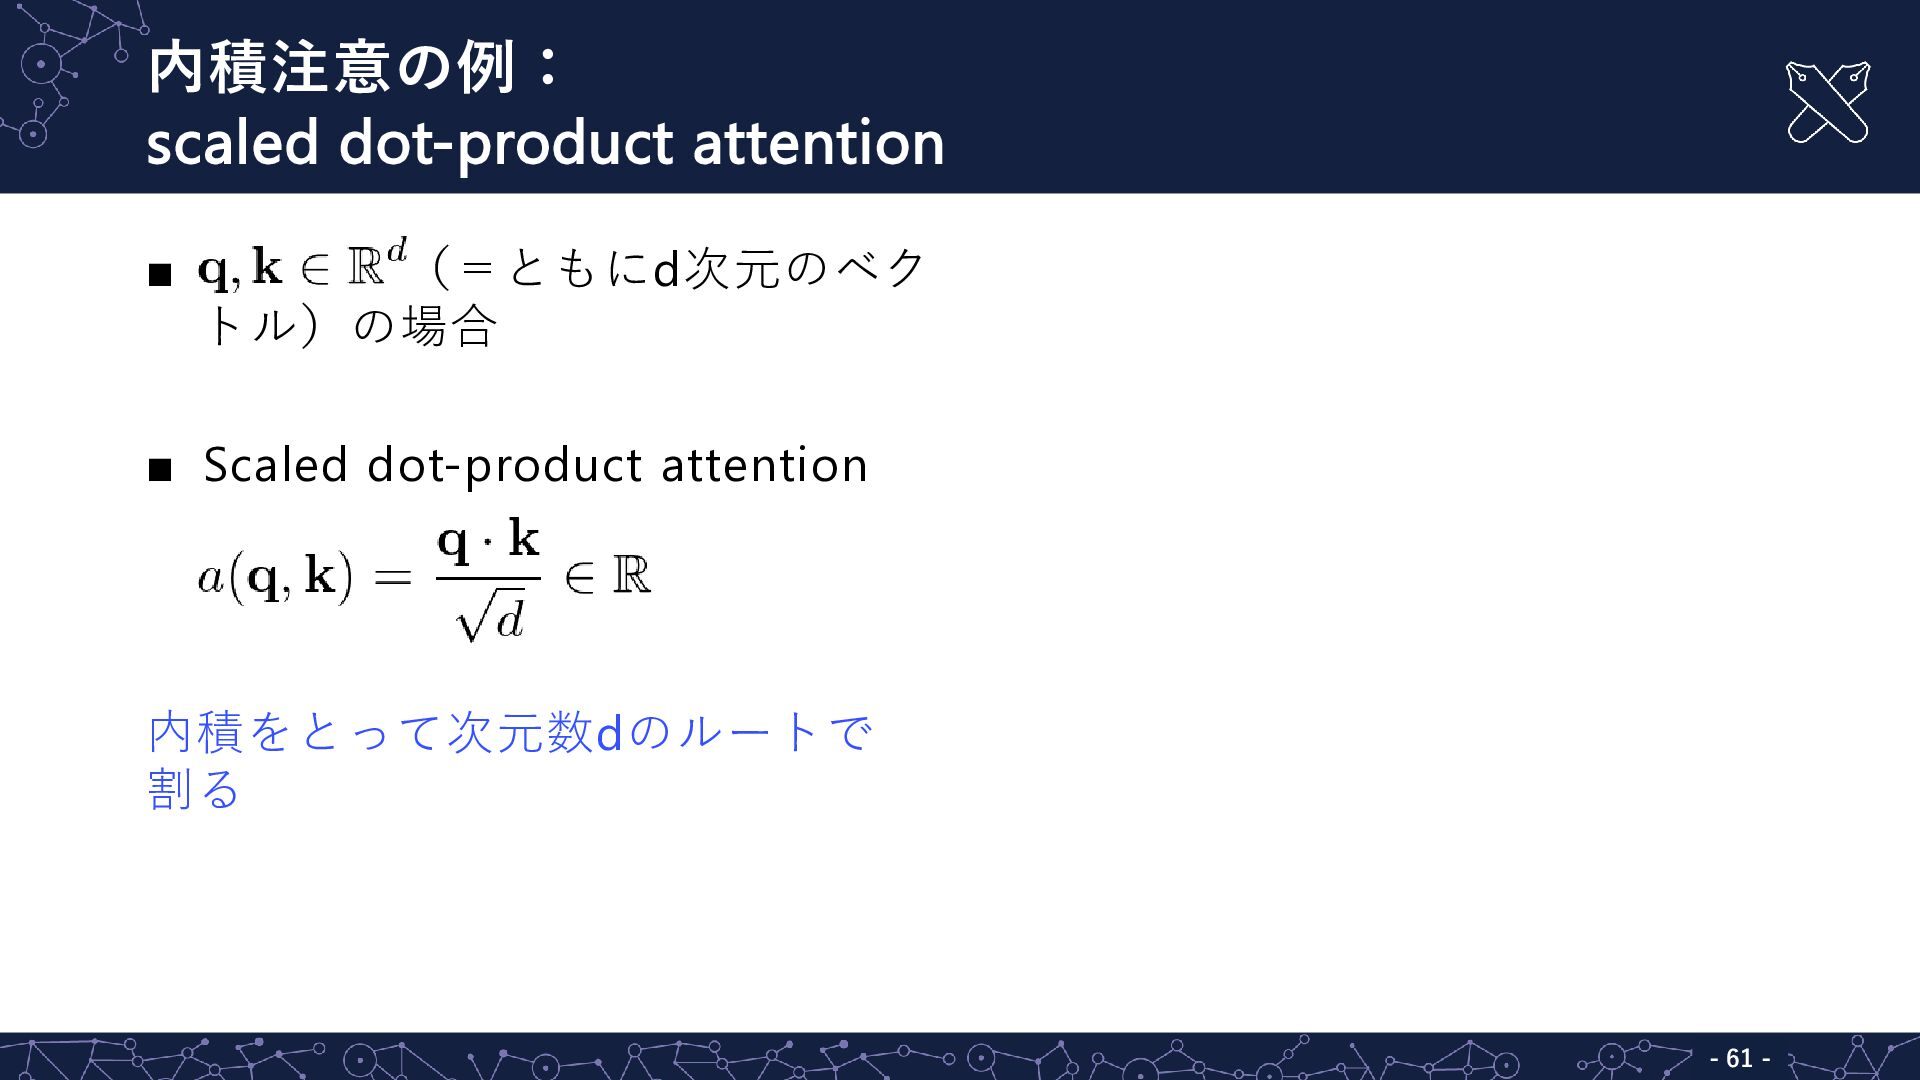
内積注意の例: scaled dot-product attention - - 61 ▪ (=ともにd次元のベク トル)の場合
▪ Scaled dot-product attention 内積をとって次元数dのルートで 割る -
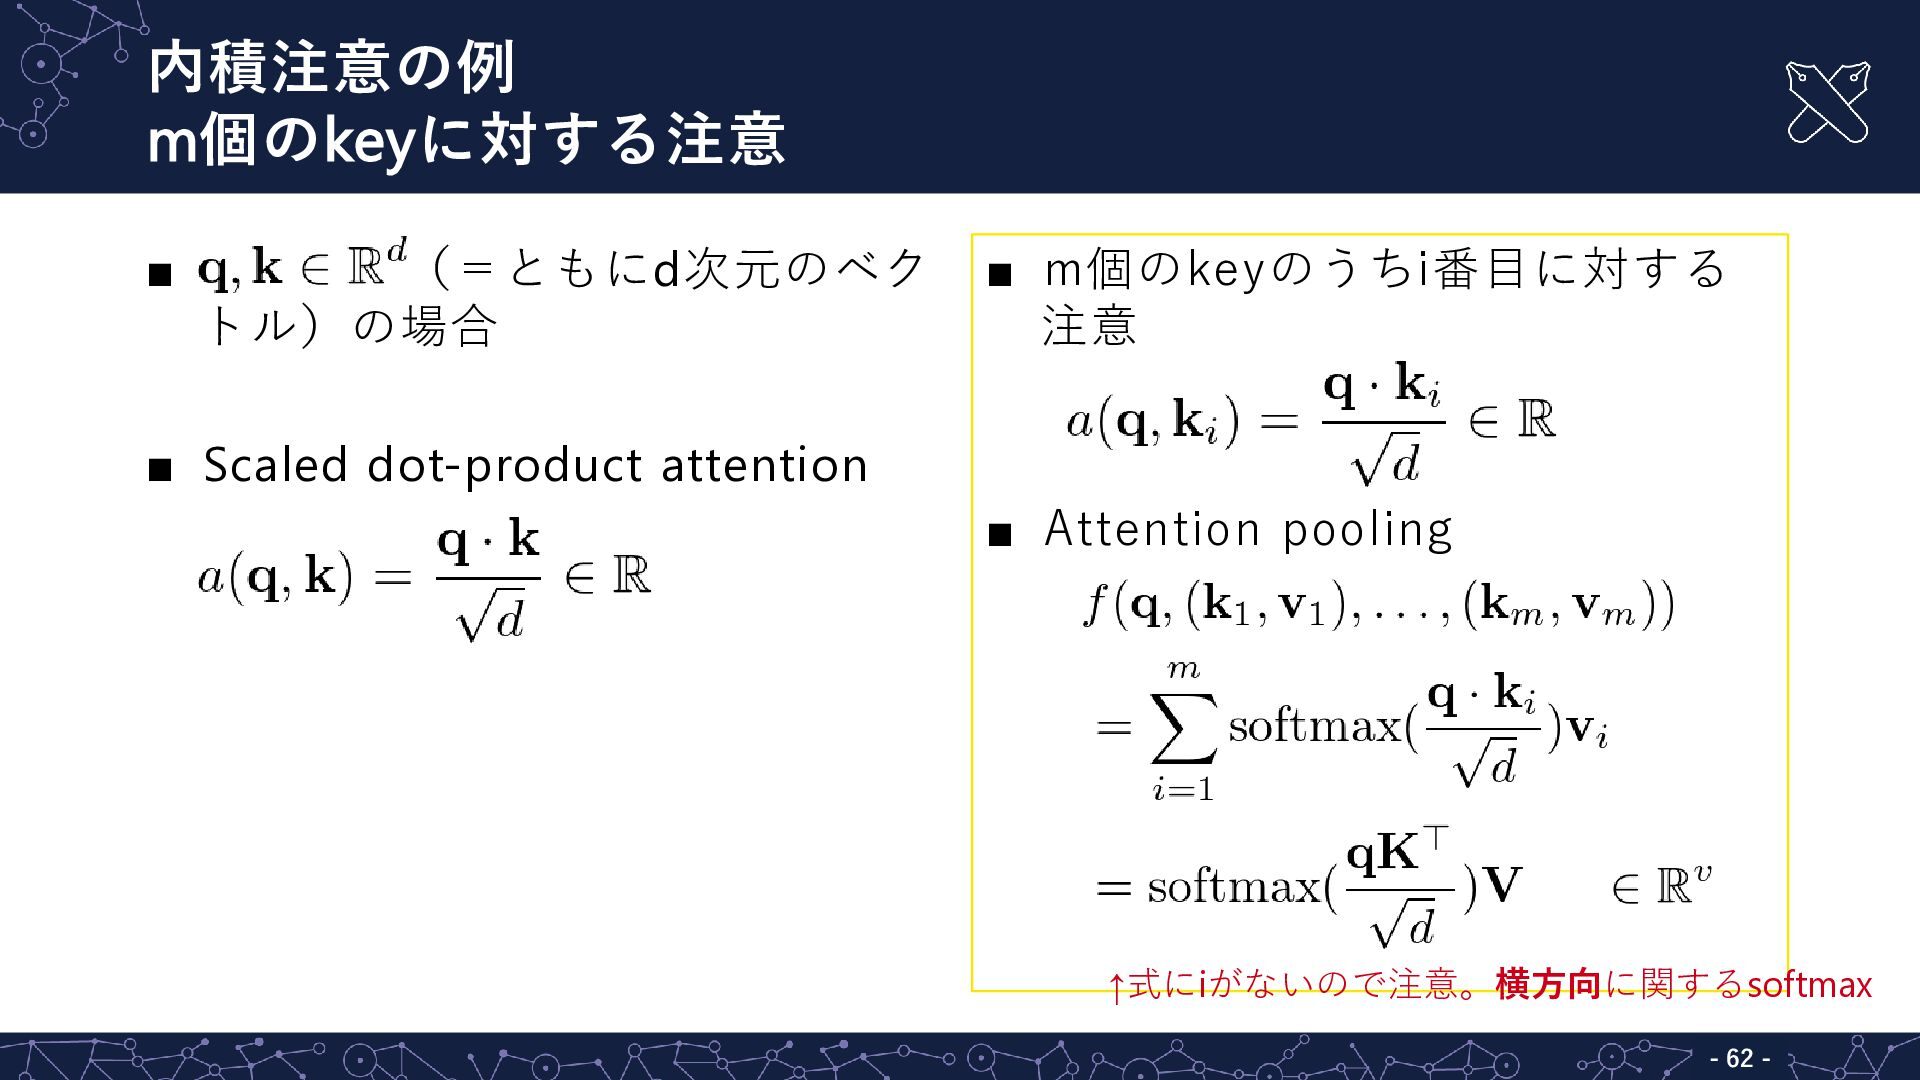
内積注意の例 m個のkeyに対する注意 - - 62 ▪ (=ともにd次元のベク トル)の場合 ▪ Scaled
dot-product attention ▪ m個のkeyのうちi番目に対する 注意 ▪ Attention pooling ↑式にiがないので注意。横方向に関するsoftmax -
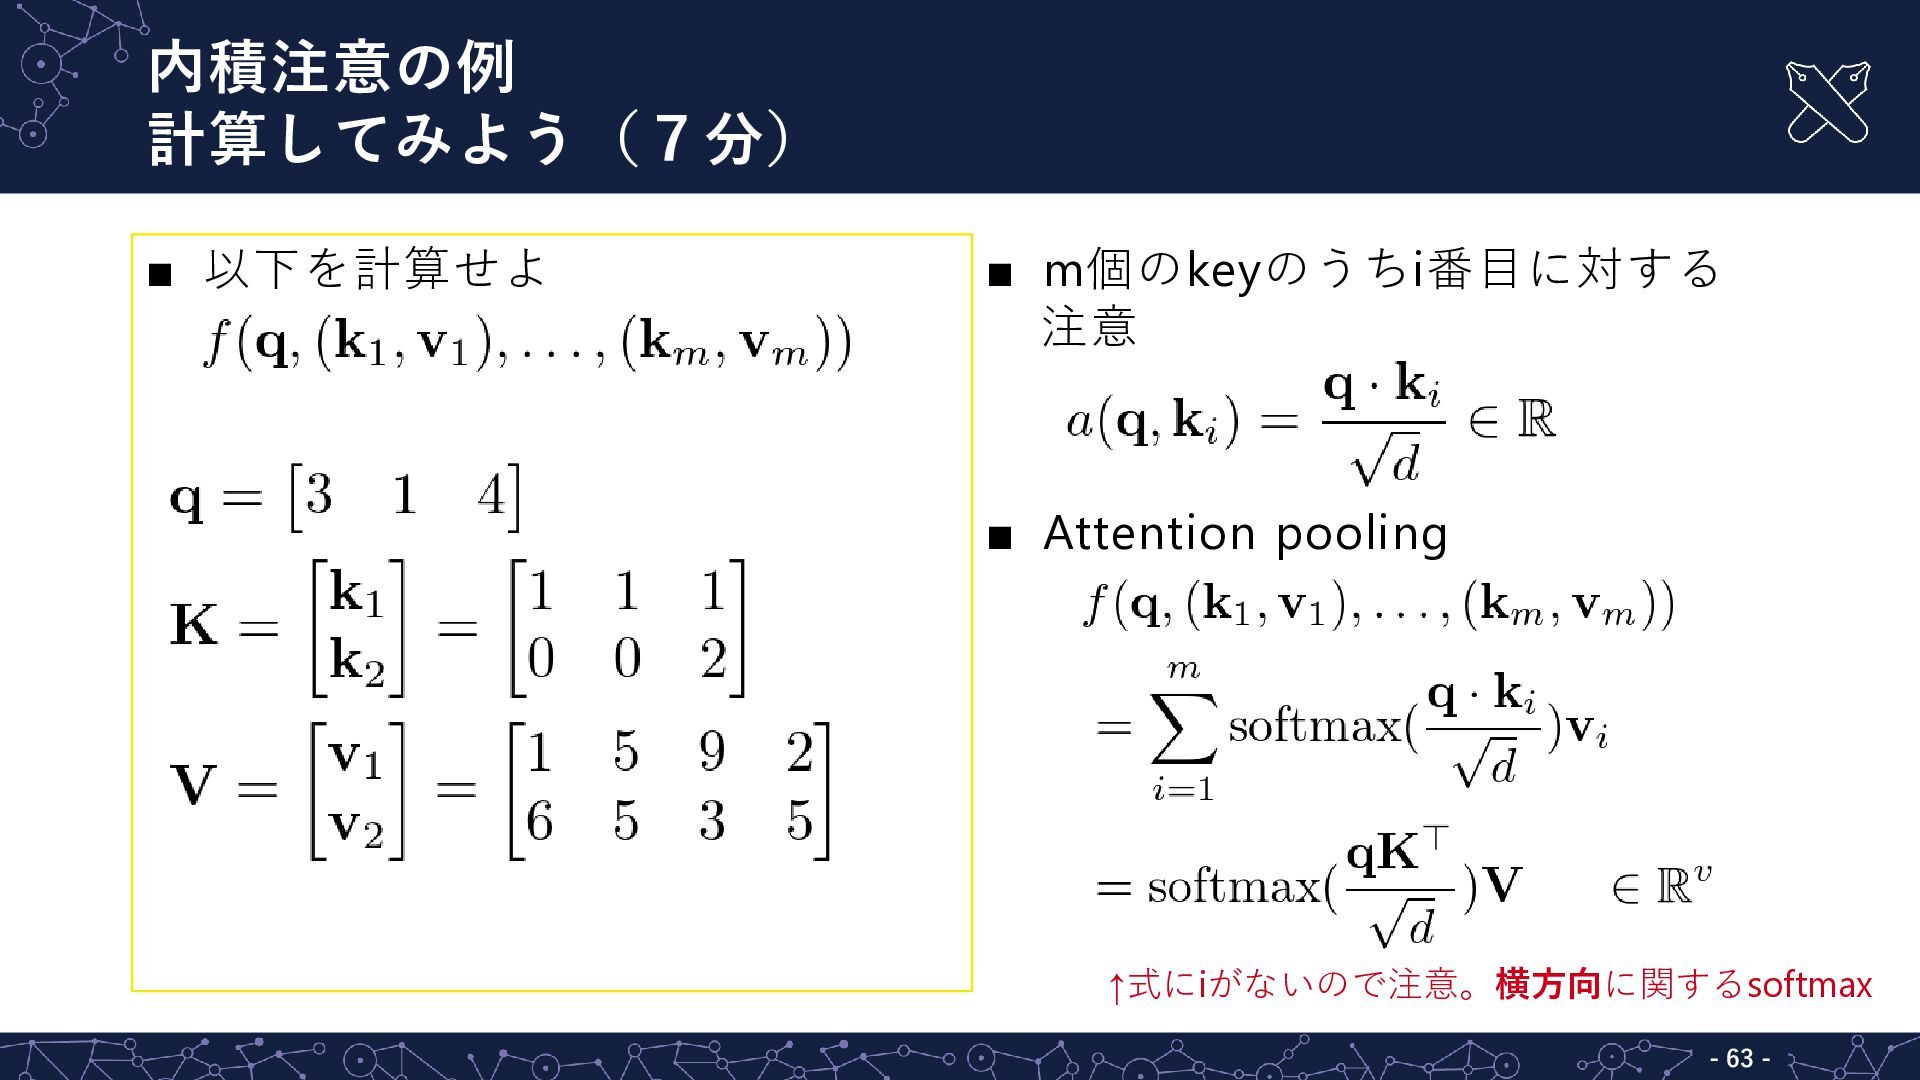
内積注意の例 計算してみよう(7分) - - 63 ▪ 以下を計算せよ ▪ m個のkeyのうちi番目に対する 注意
▪ Attention pooling ↑式にiがないので注意。横方向に関するsoftmax -
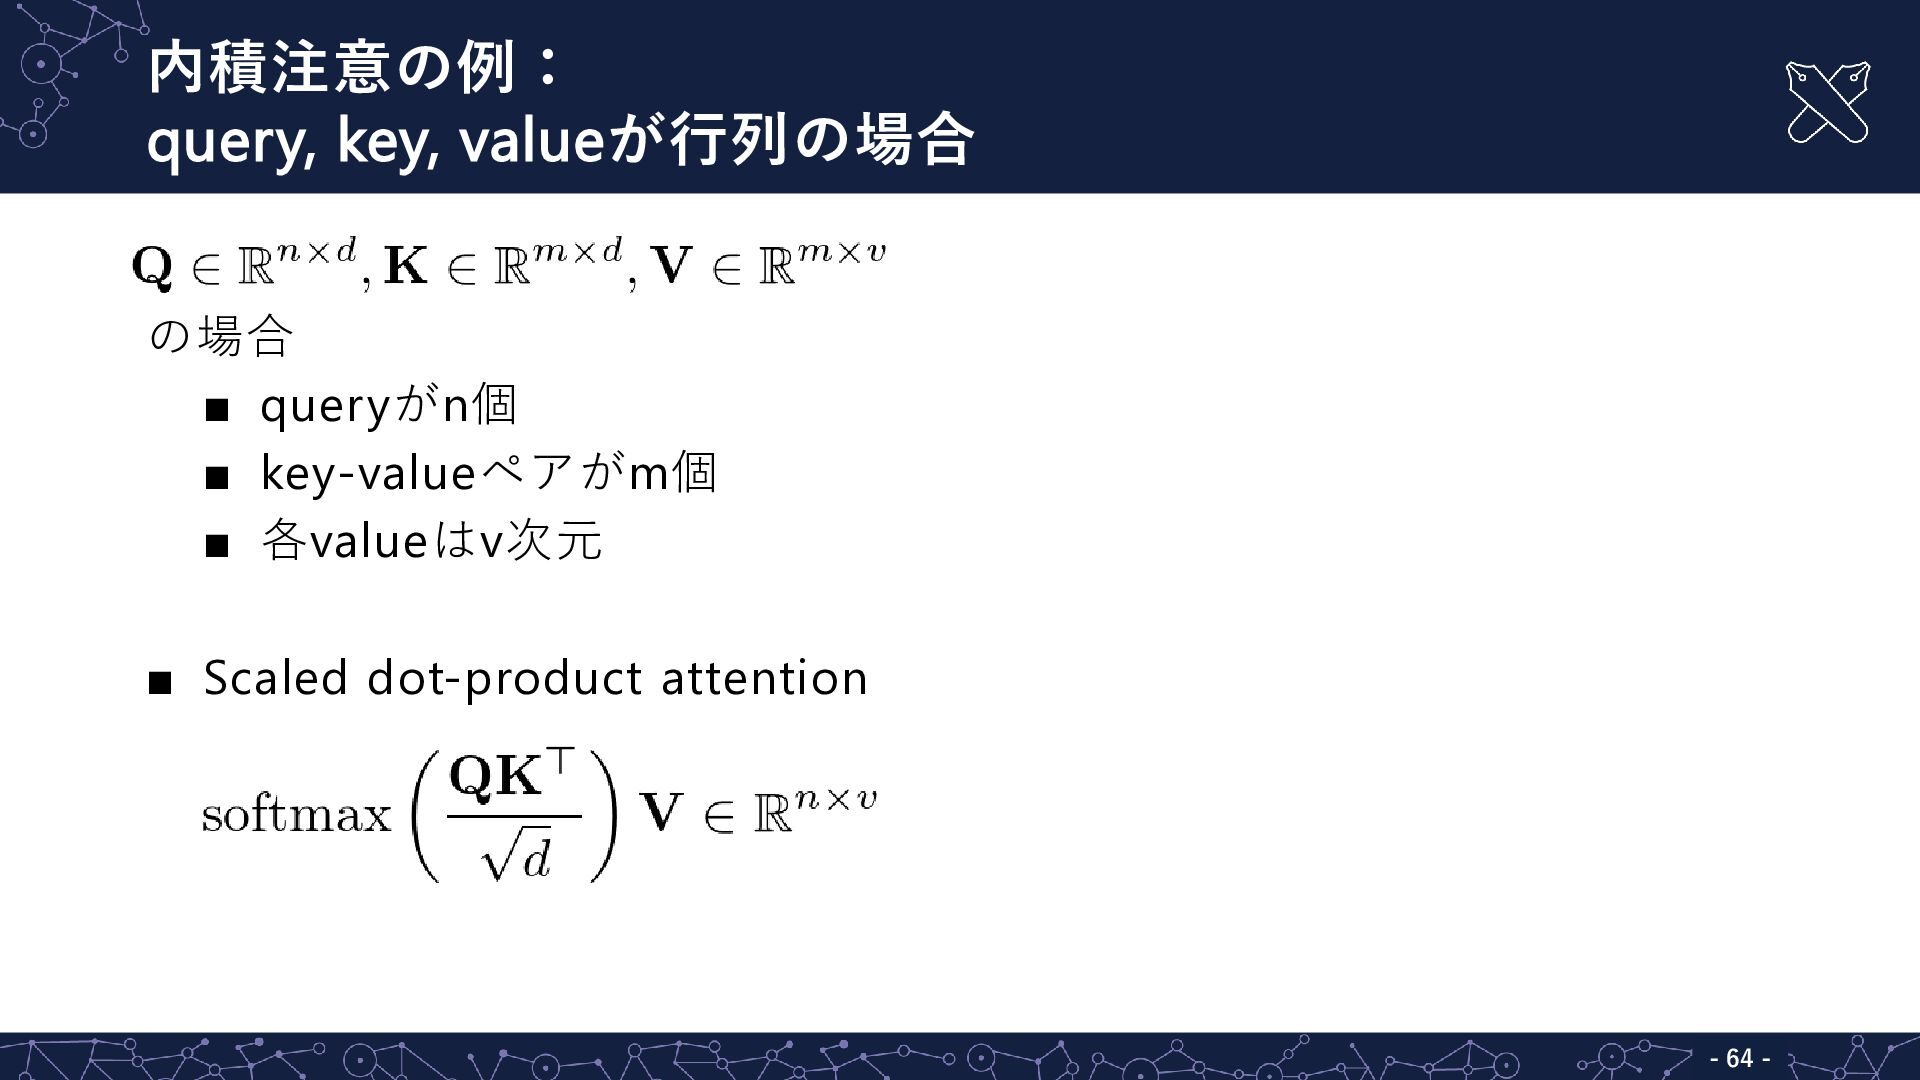
内積注意の例: query, key, valueが行列の場合 - - 64 の場合 ▪ queryがn個
▪ key-valueペアがm個 ▪ 各valueはv次元 ▪ Scaled dot-product attention -
トランスフォーマー - - 66 トランスフォーマー(transformer)[Vaswani+ 2017] ▪ 機械翻訳用のニューラルネットとして提案 ▪ 自然言語処理タスクの多くで主流
▪ BERT, GPT-3/4等 ▪ 画像処理、マルチモーダル言語処理、時系列予測等 へ現在も爆発的に拡大中 トランスフォーマーを使いこなせれば、種々のタスク に実用レベルで対応できる [Vaswani+ 2017] -
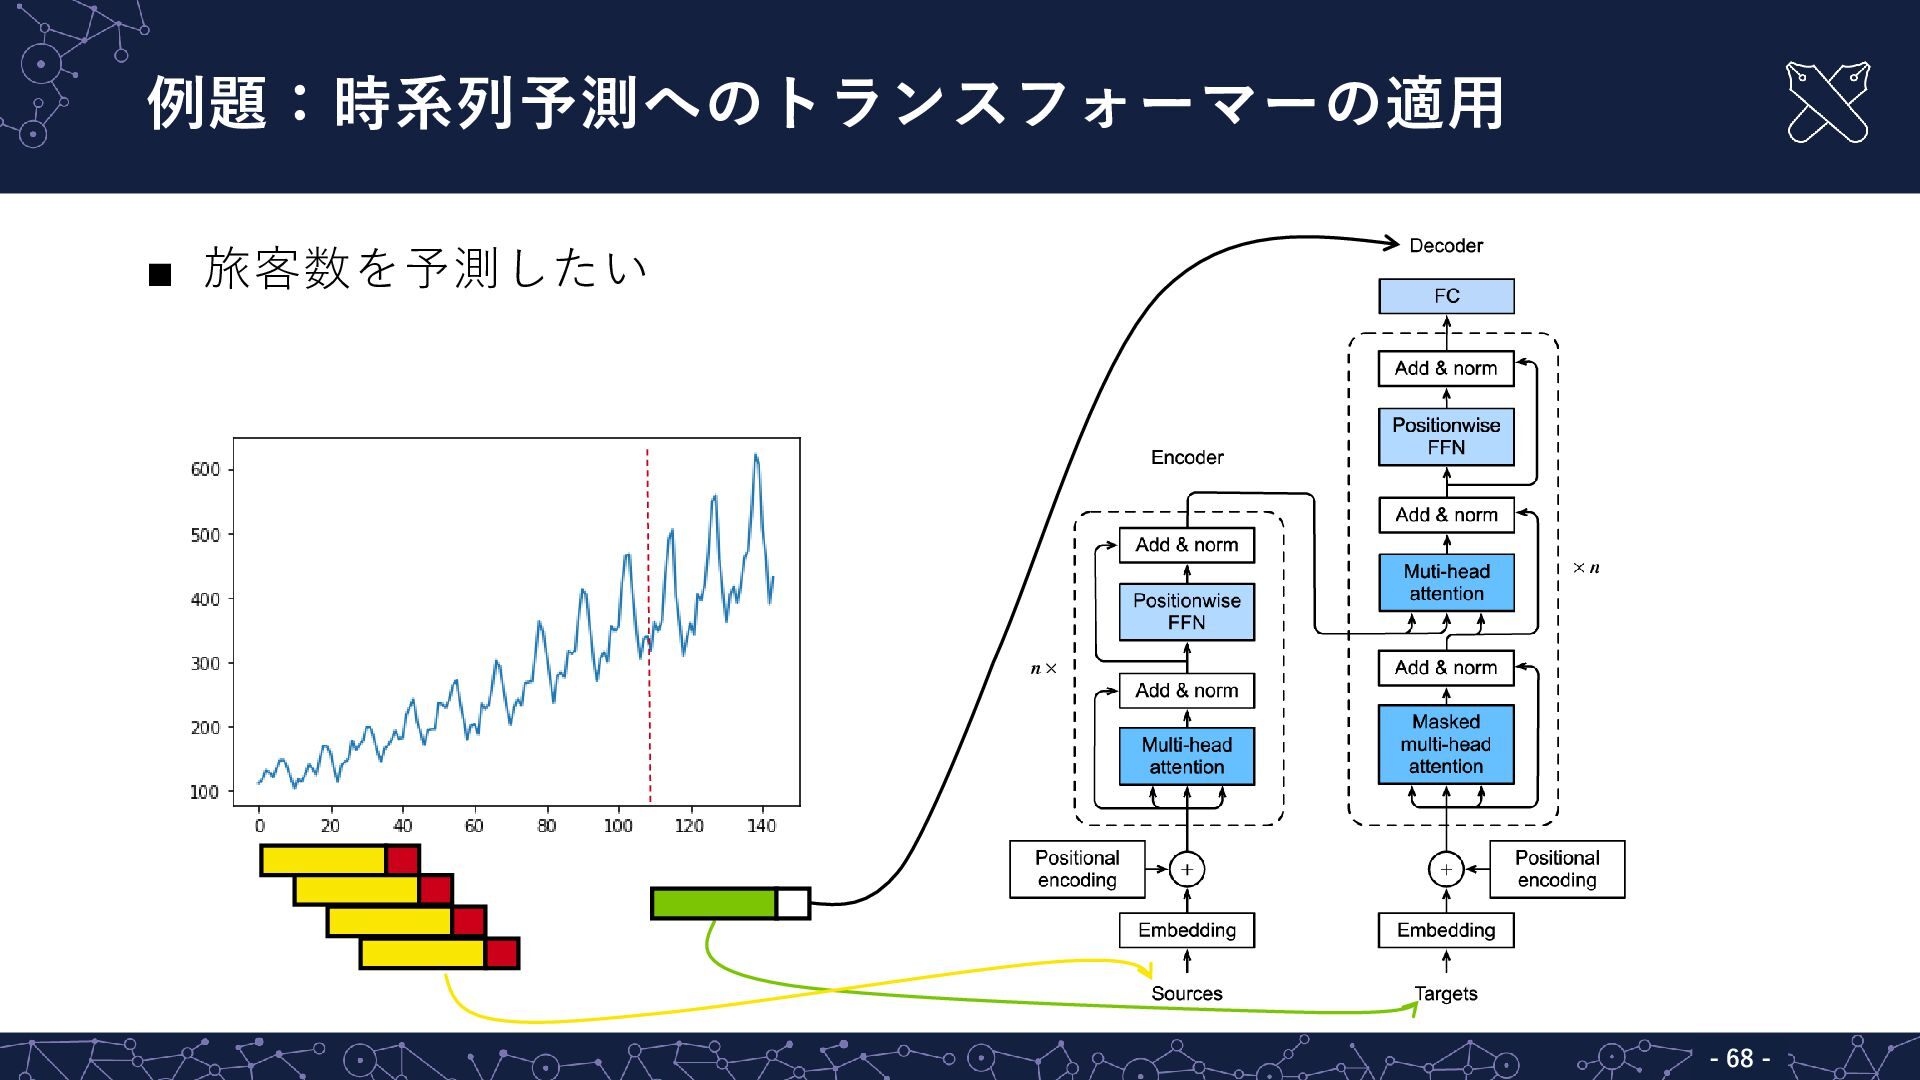
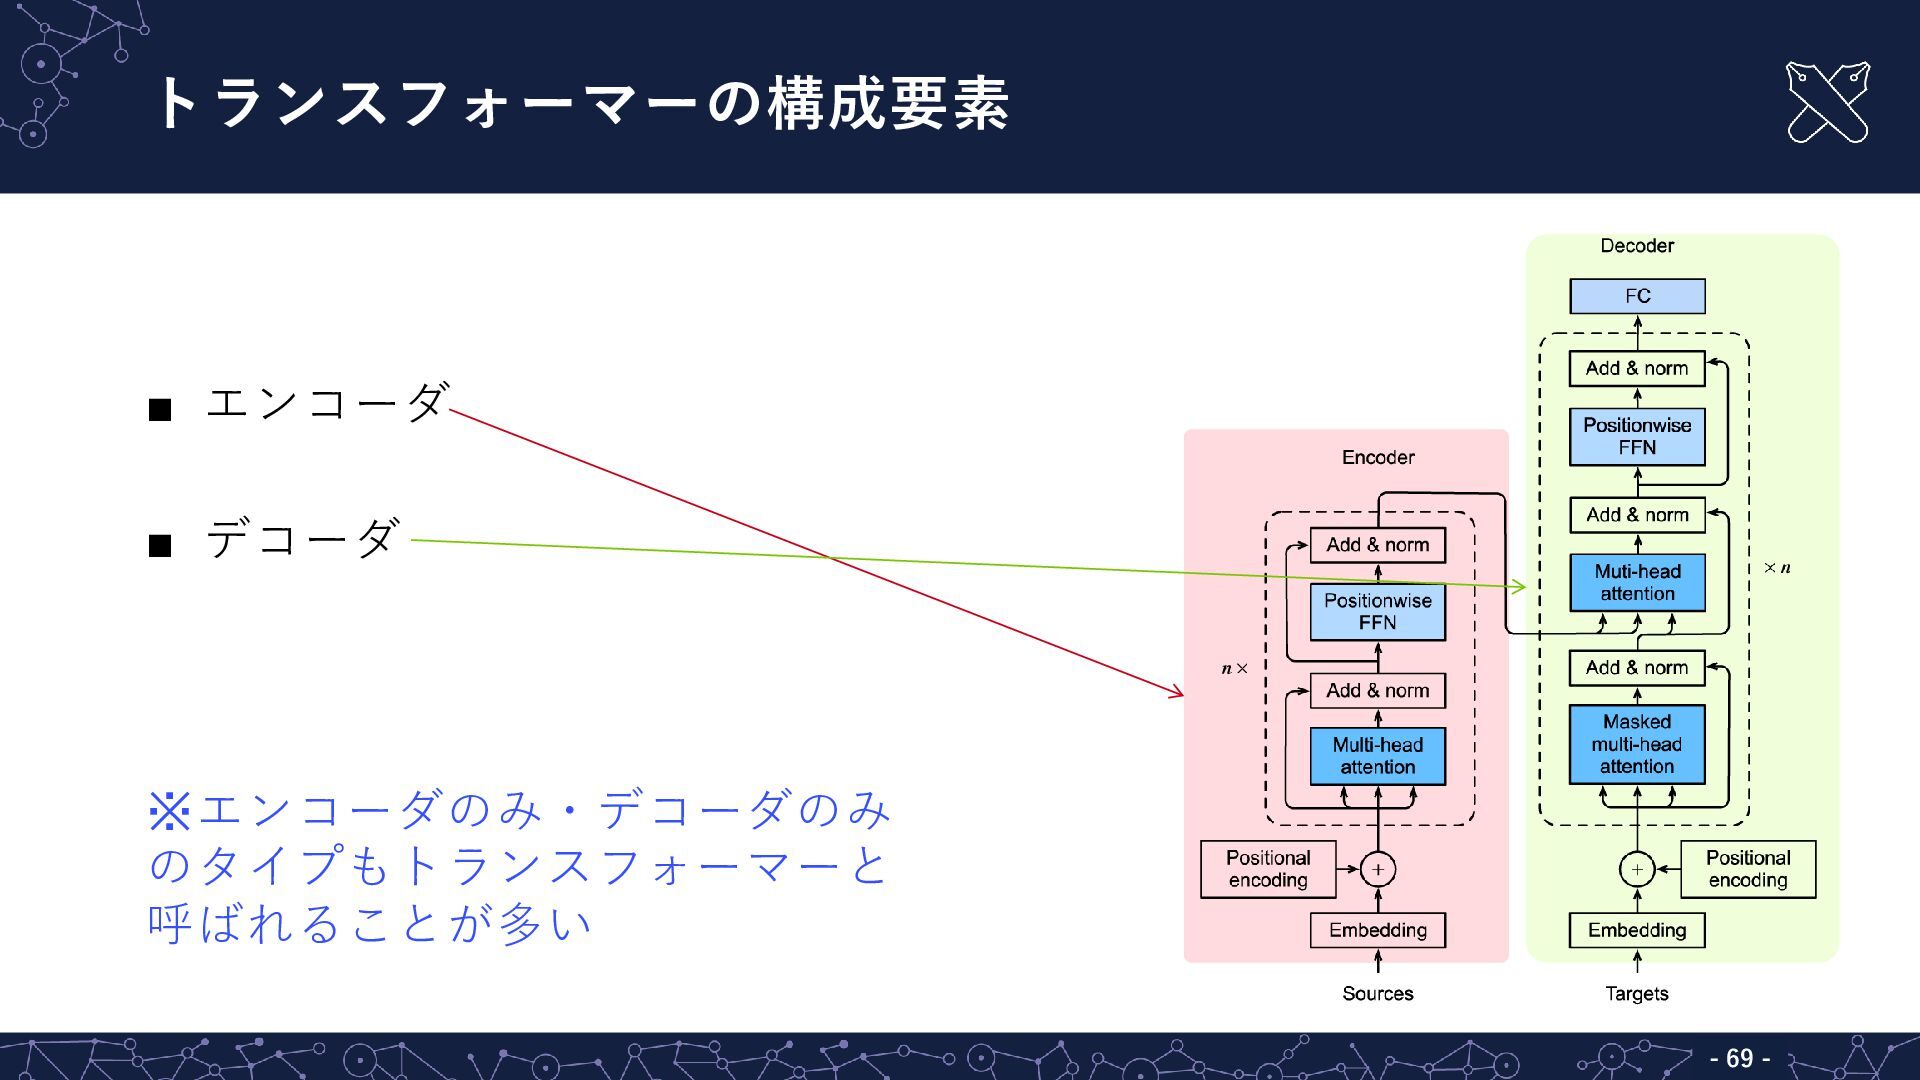
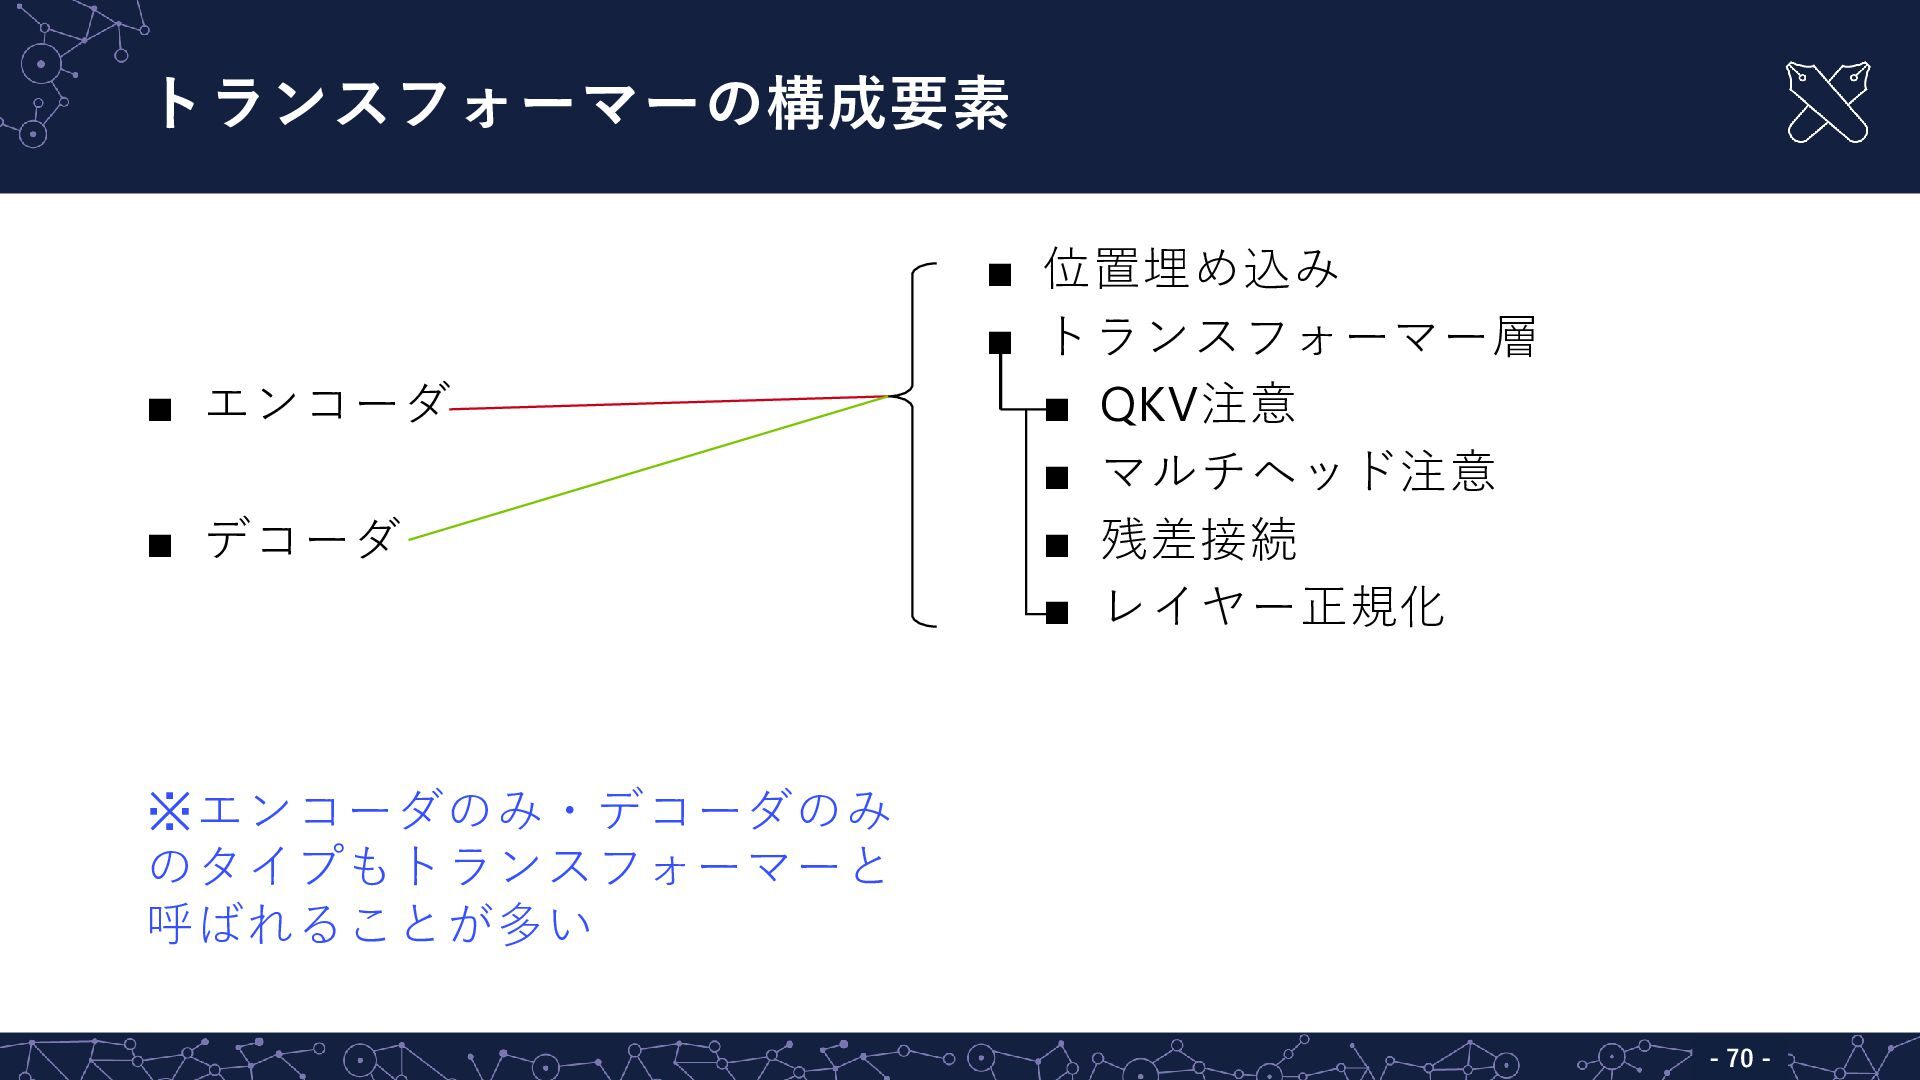
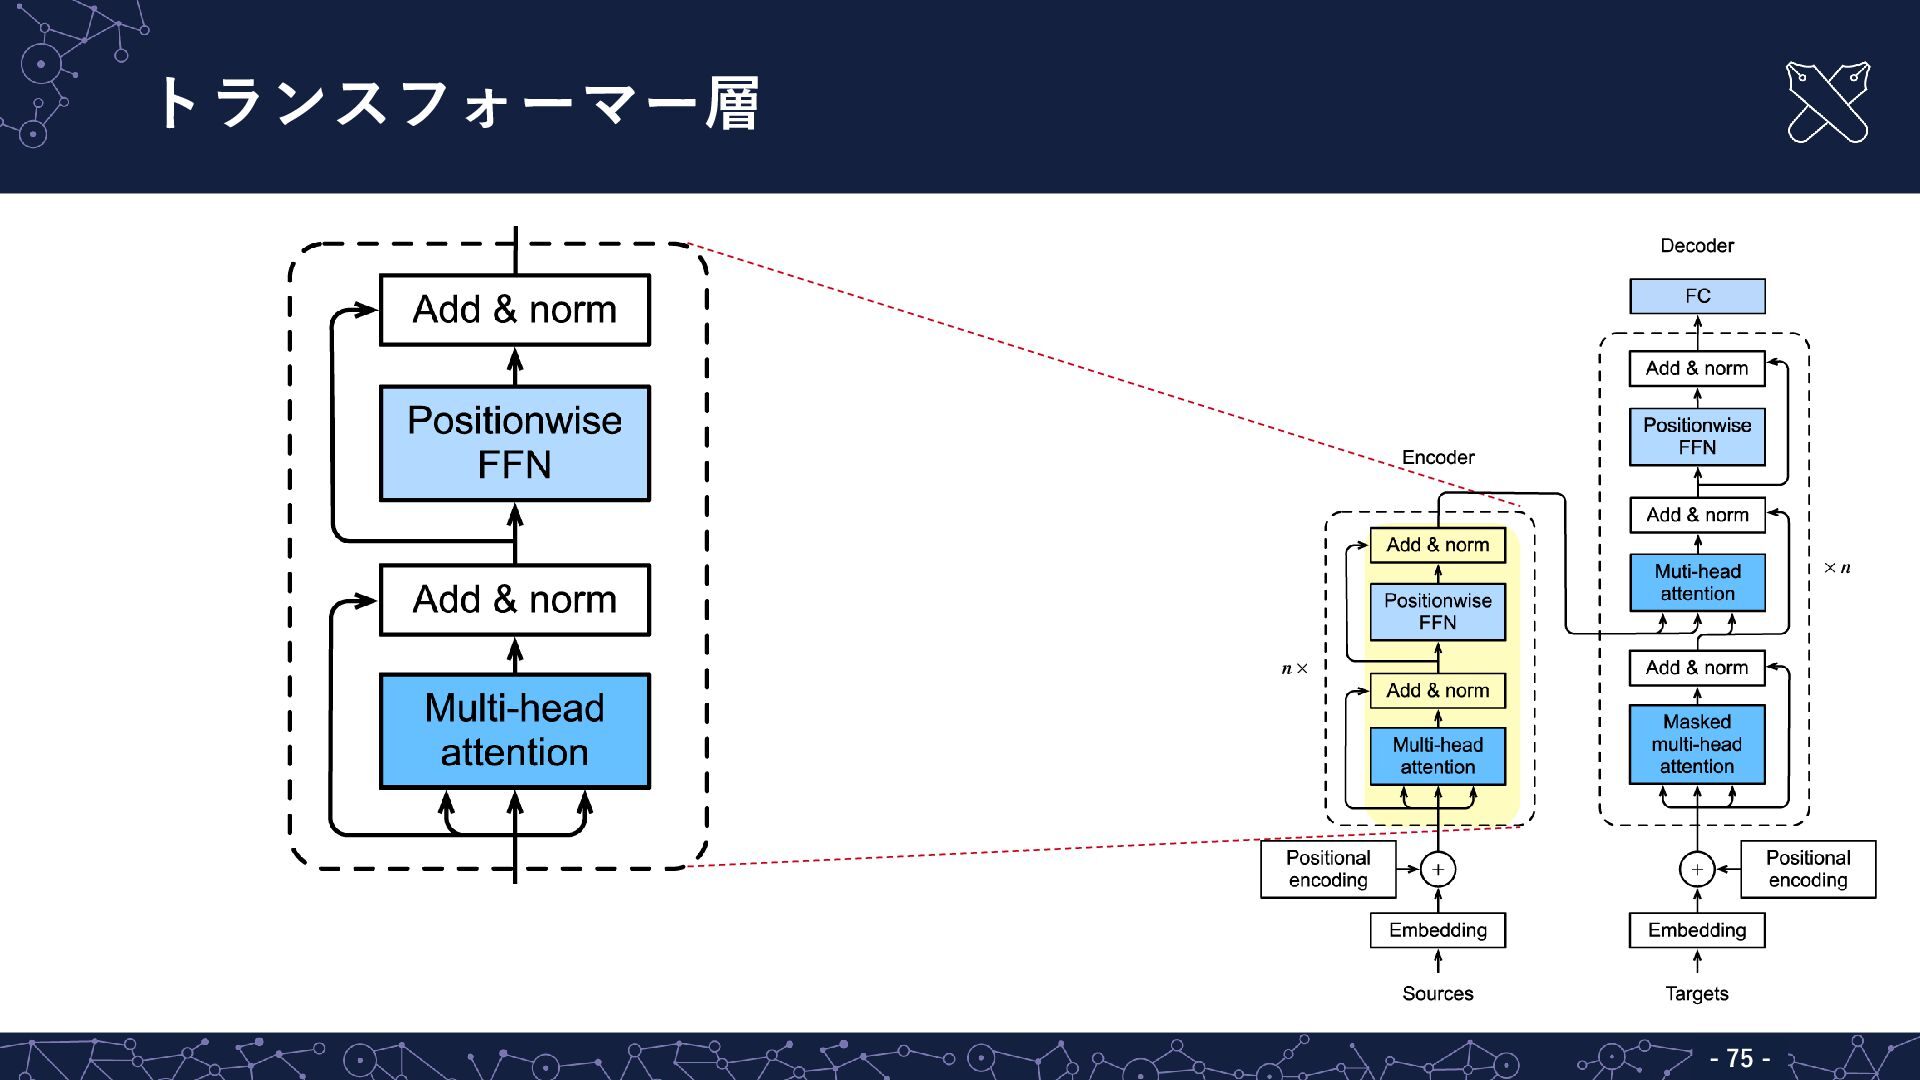
トランスフォーマーの構成要素 - - 70 ▪ エンコーダ ▪ デコーダ ※エンコーダのみ・デコーダのみ のタイプもトランスフォーマーと
呼ばれることが多い ▪ 位置埋め込み ▪ トランスフォーマー層 ▪ QKV注意 ▪ マルチヘッド注意 ▪ 残差接続 ▪ レイヤー正規化 -
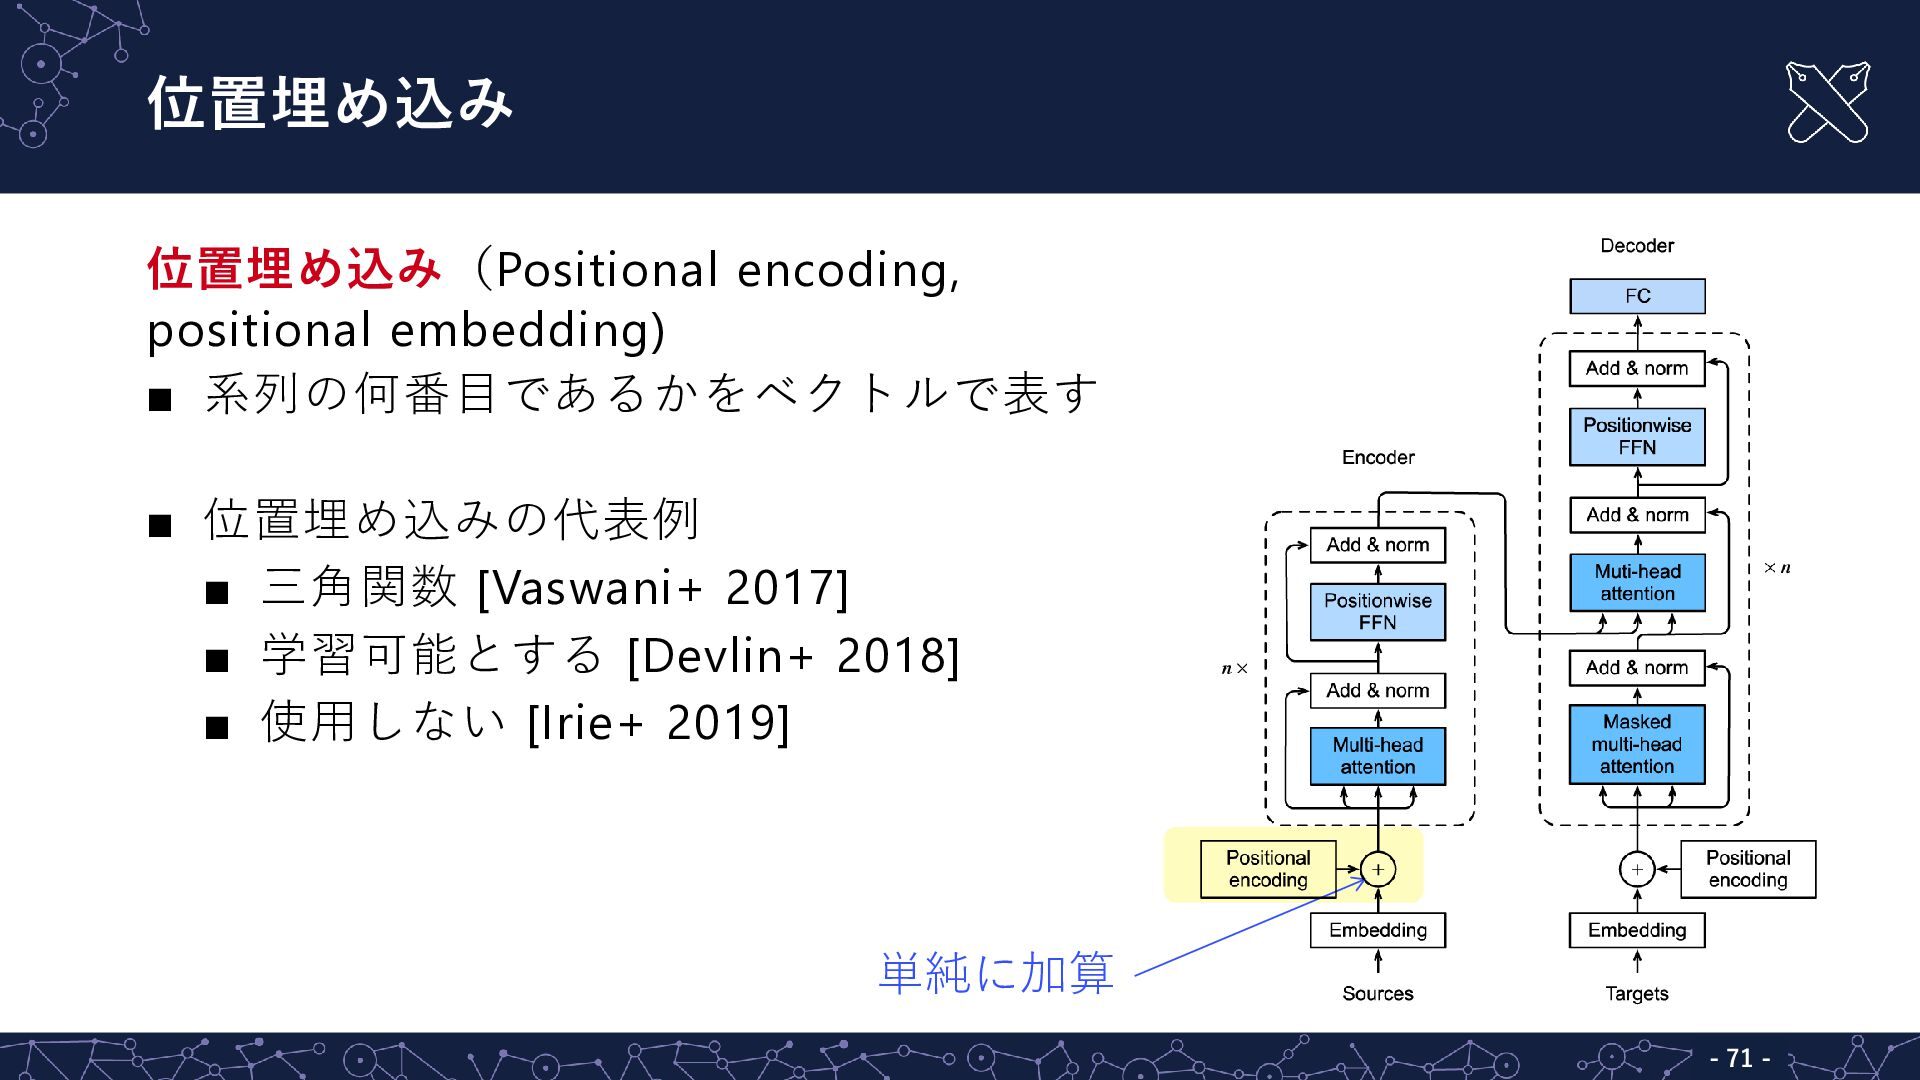
位置埋め込み - - 71 位置埋め込み(Positional encoding, positional embedding) ▪ 系列の何番目であるかをベクトルで表す
▪ 位置埋め込みの代表例 ▪ 三角関数 [Vaswani+ 2017] ▪ 学習可能とする [Devlin+ 2018] ▪ 使用しない [Irie+ 2019] 単純に加算 -
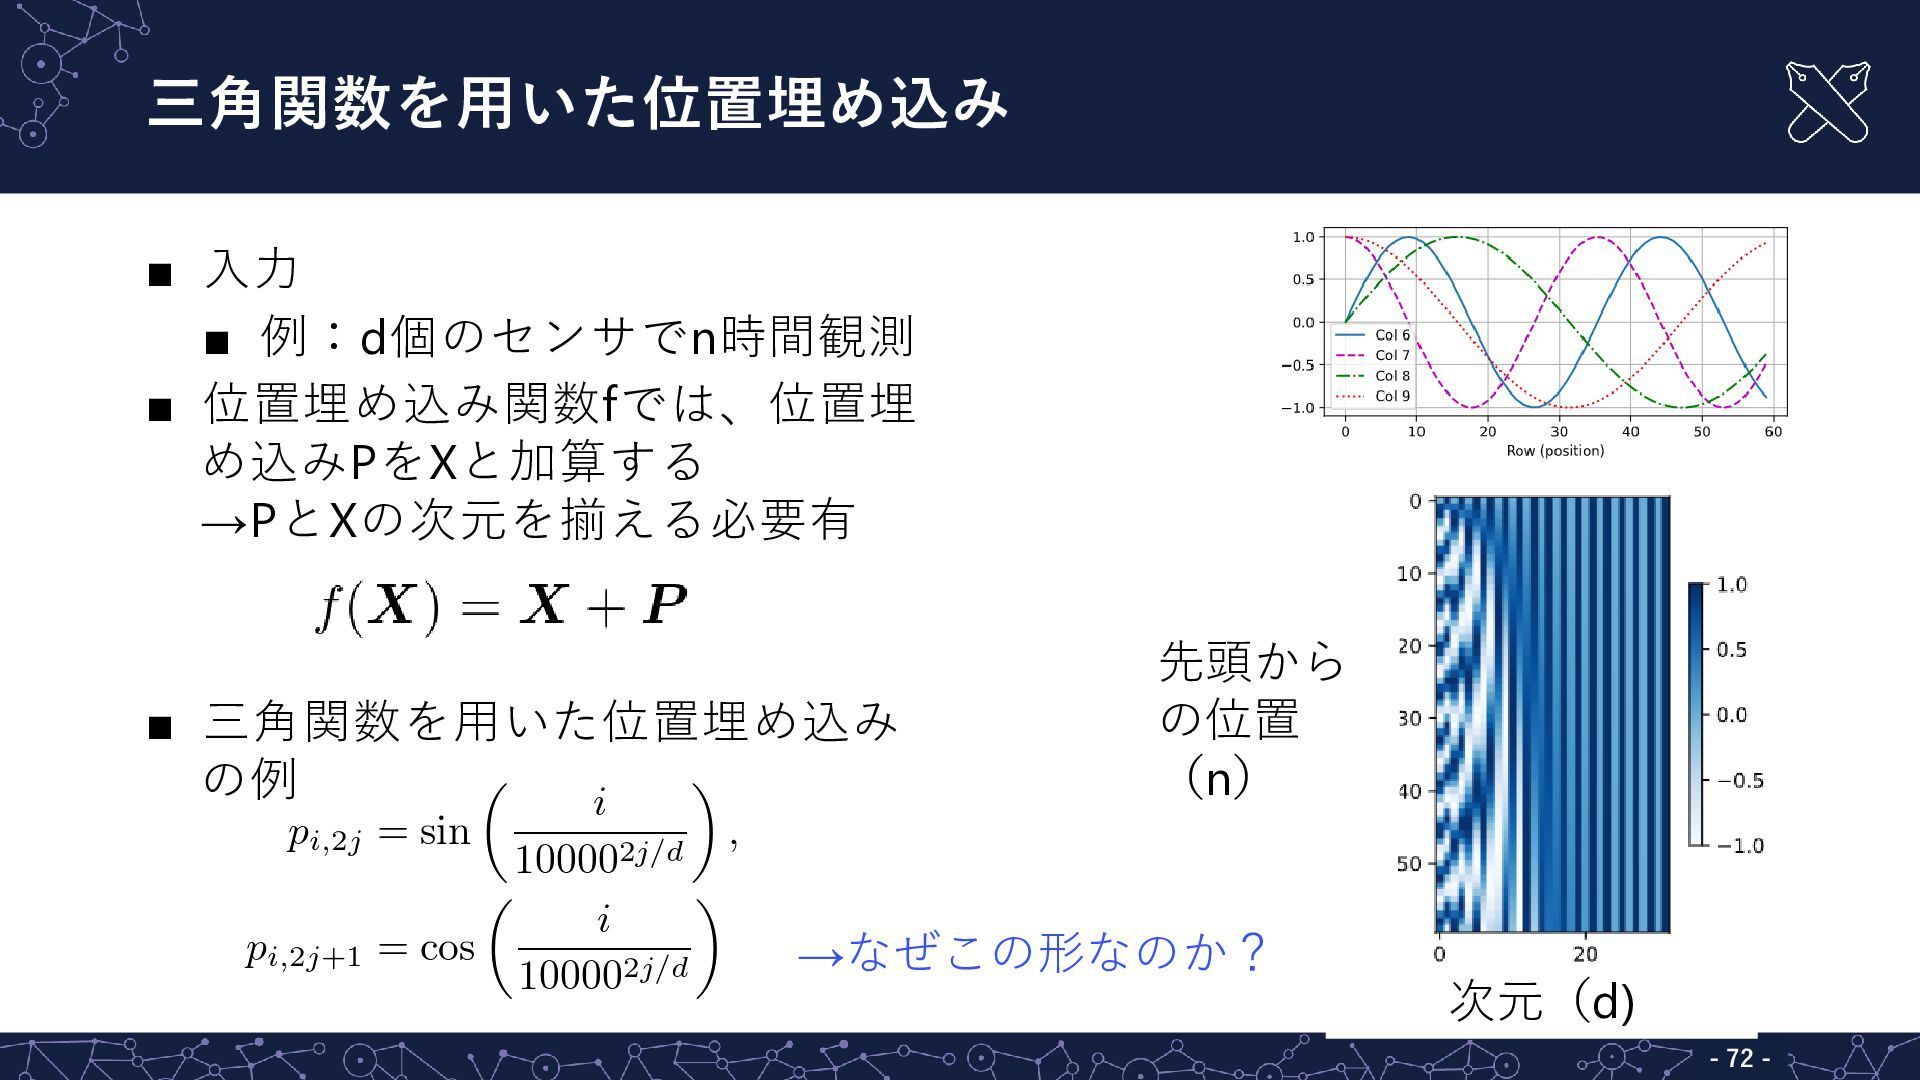
三角関数を用いた位置埋め込み - - 72 ▪ 入力 ▪ 例:d個のセンサでn時間観測 ▪ 位置埋め込み関数fでは、位置埋
め込みPをXと加算する →PとXの次元を揃える必要有 ▪ 三角関数を用いた位置埋め込み の例 →なぜこの形なのか? 先頭から の位置 (n) 次元(d) -
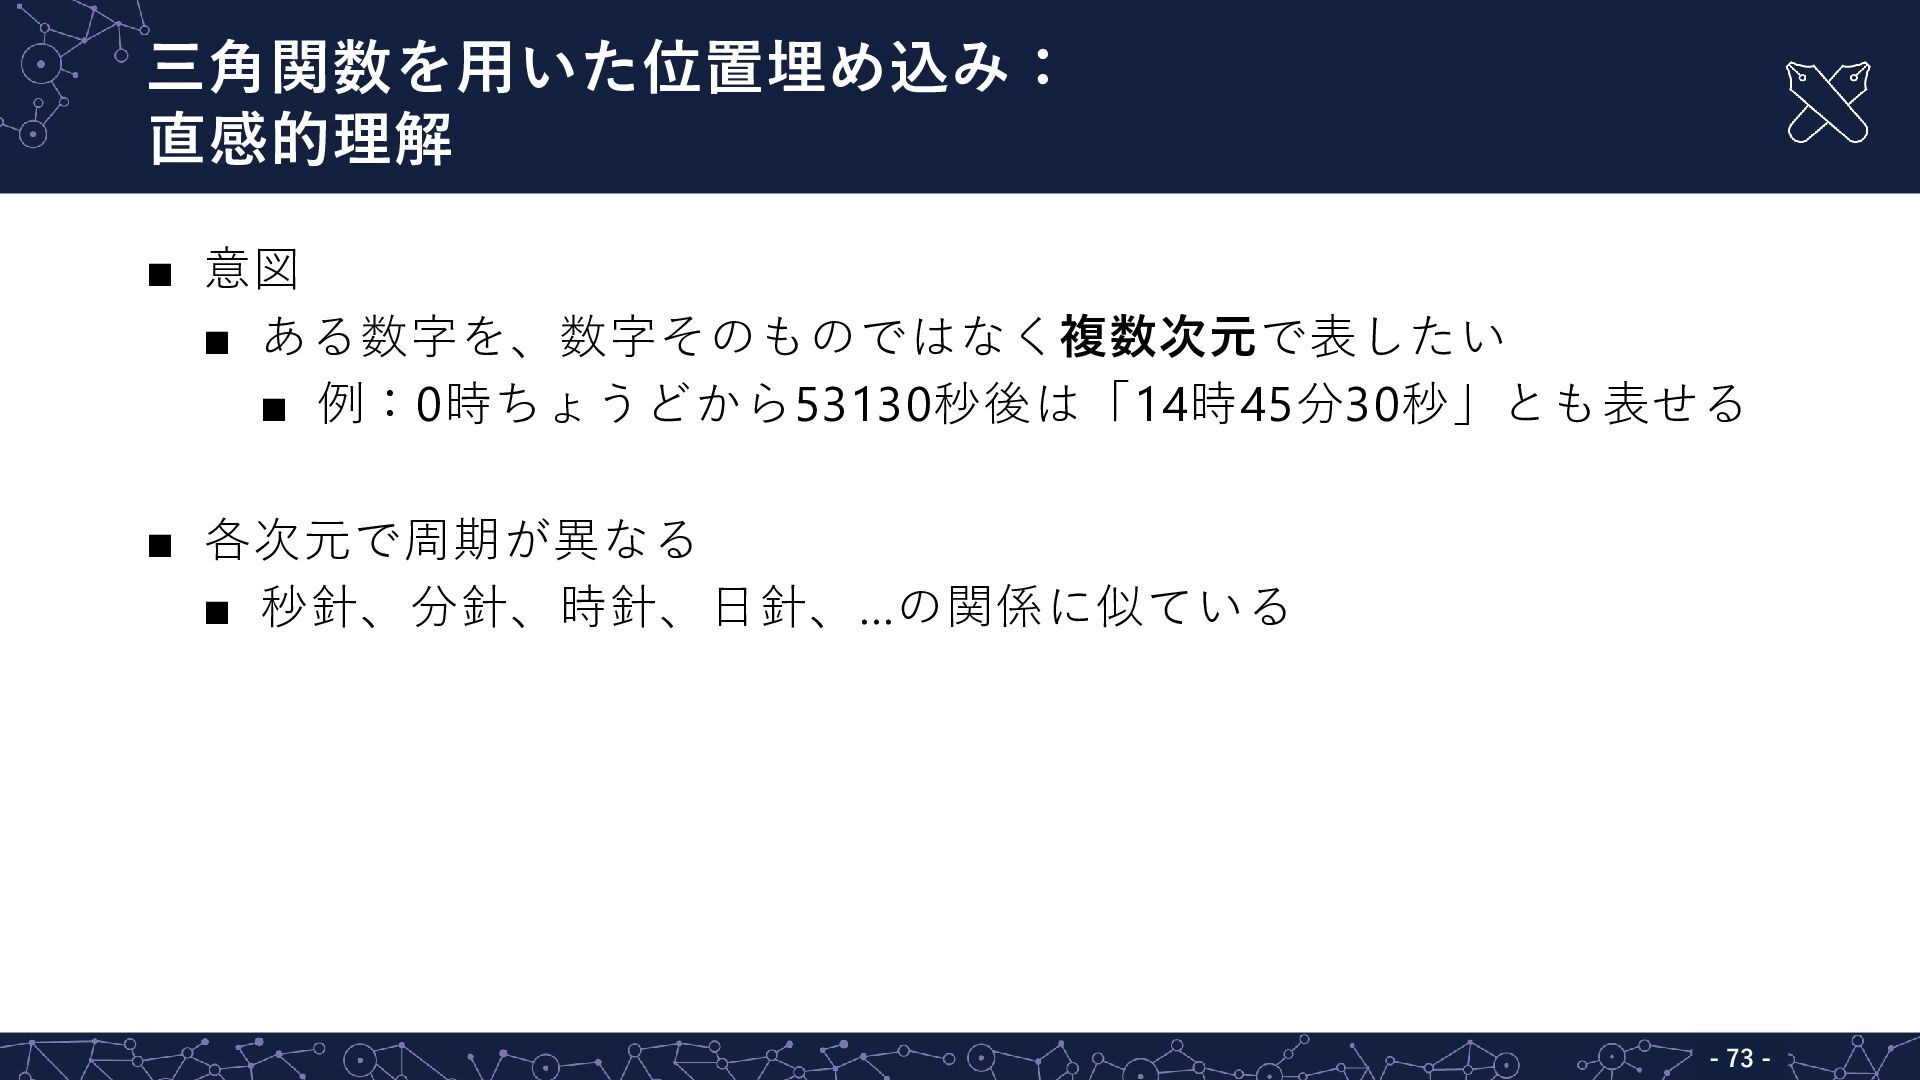
三角関数を用いた位置埋め込み: 直感的理解 - - 73 ▪ 意図 ▪ ある数字を、数字そのものではなく複数次元で表したい ▪
例:0時ちょうどから53130秒後は「14時45分30秒」とも表せる ▪ 各次元で周期が異なる ▪ 秒針、分針、時針、日針、…の関係に似ている -
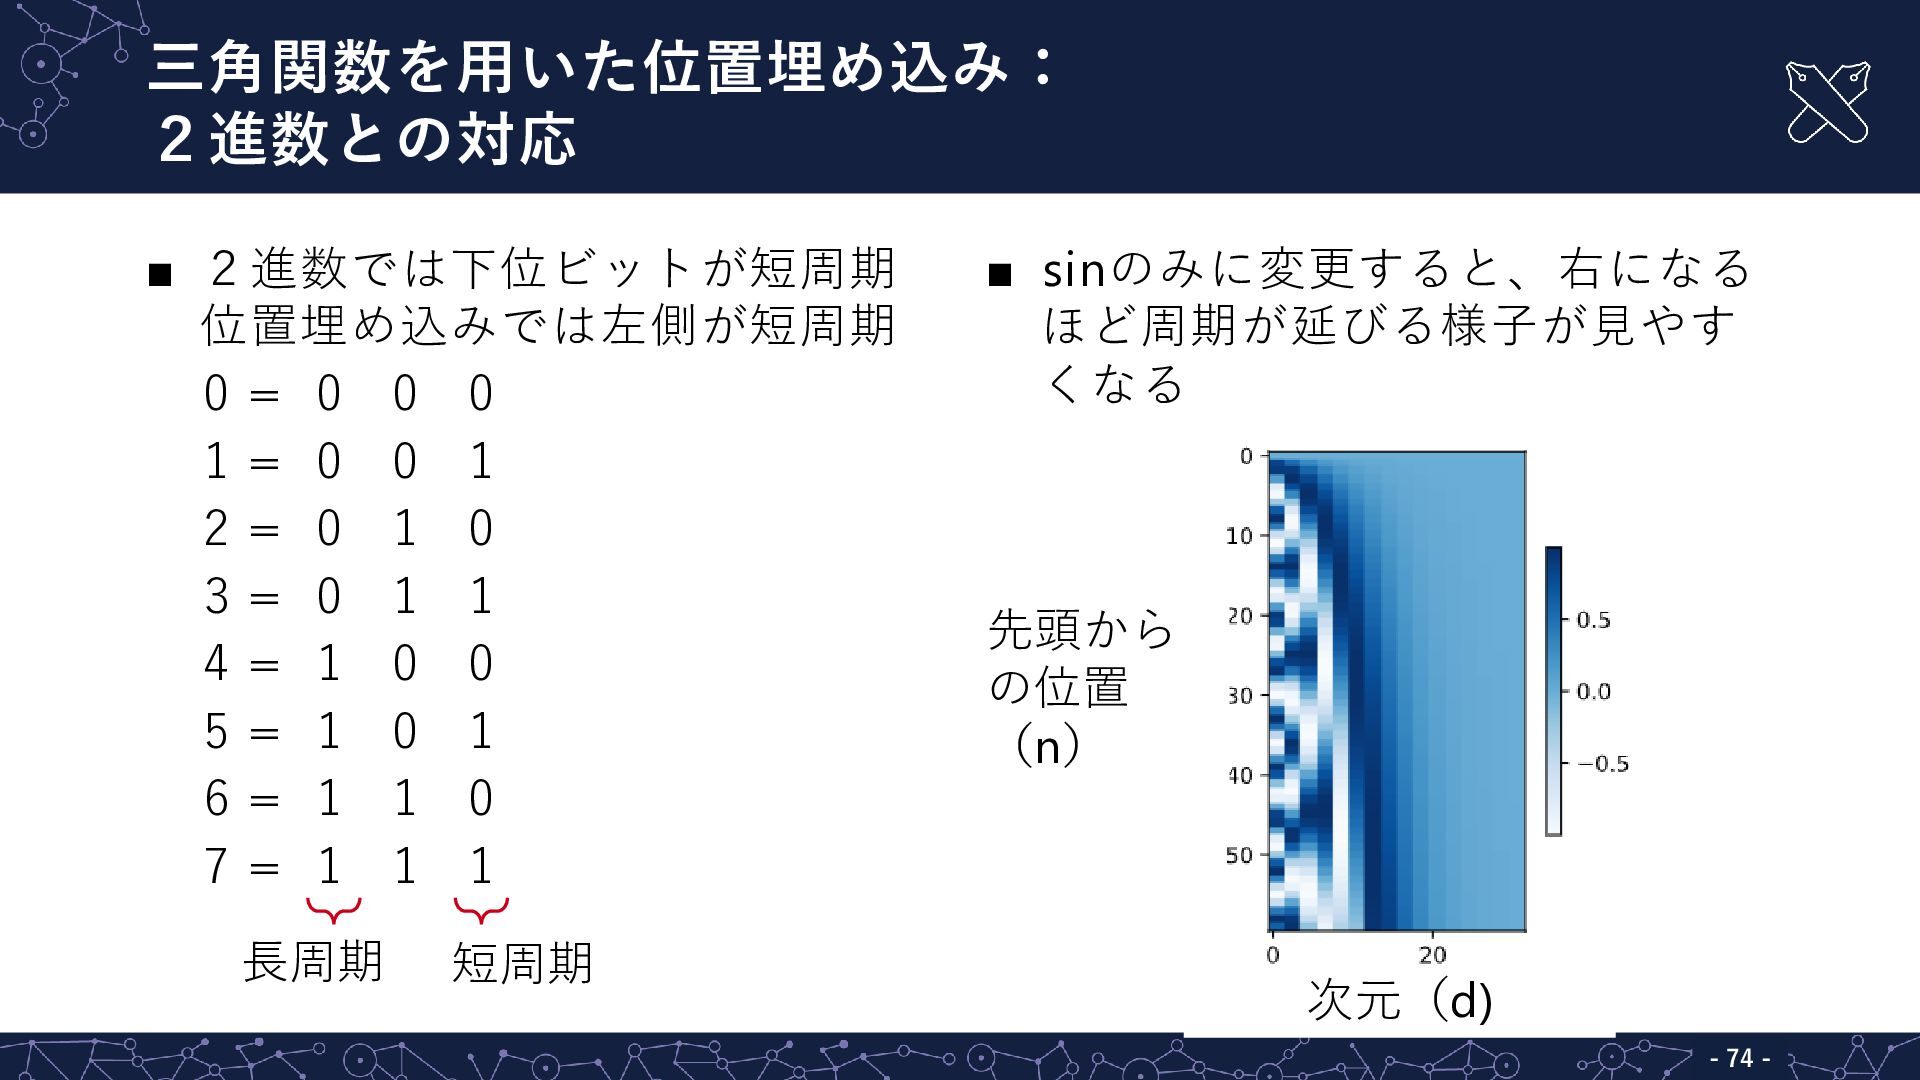
三角関数を用いた位置埋め込み: 2進数との対応 - - 74 ▪ 2進数では下位ビットが短周期 位置埋め込みでは左側が短周期 0 =
0 0 0 1 = 0 0 1 2 = 0 1 0 3 = 0 1 1 4 = 1 0 0 5 = 1 0 1 6 = 1 1 0 7 = 1 1 1 ▪ sinのみに変更すると、右になる ほど周期が延びる様子が見やす くなる 長周期 短周期 先頭から の位置 (n) 次元(d) -
QKV注意 [Vaswani+ 2017] - - 76 ▪ 前述の内積注意(scaled dot-product attention)を利用して
を得る ▪ 自己注意(self-attention) Query, key, valueが同じ入力から計算される 場合 ▪ クロス注意(cross-attention) Query, key, valueが異なる入力から計算され る場合 Q K V -
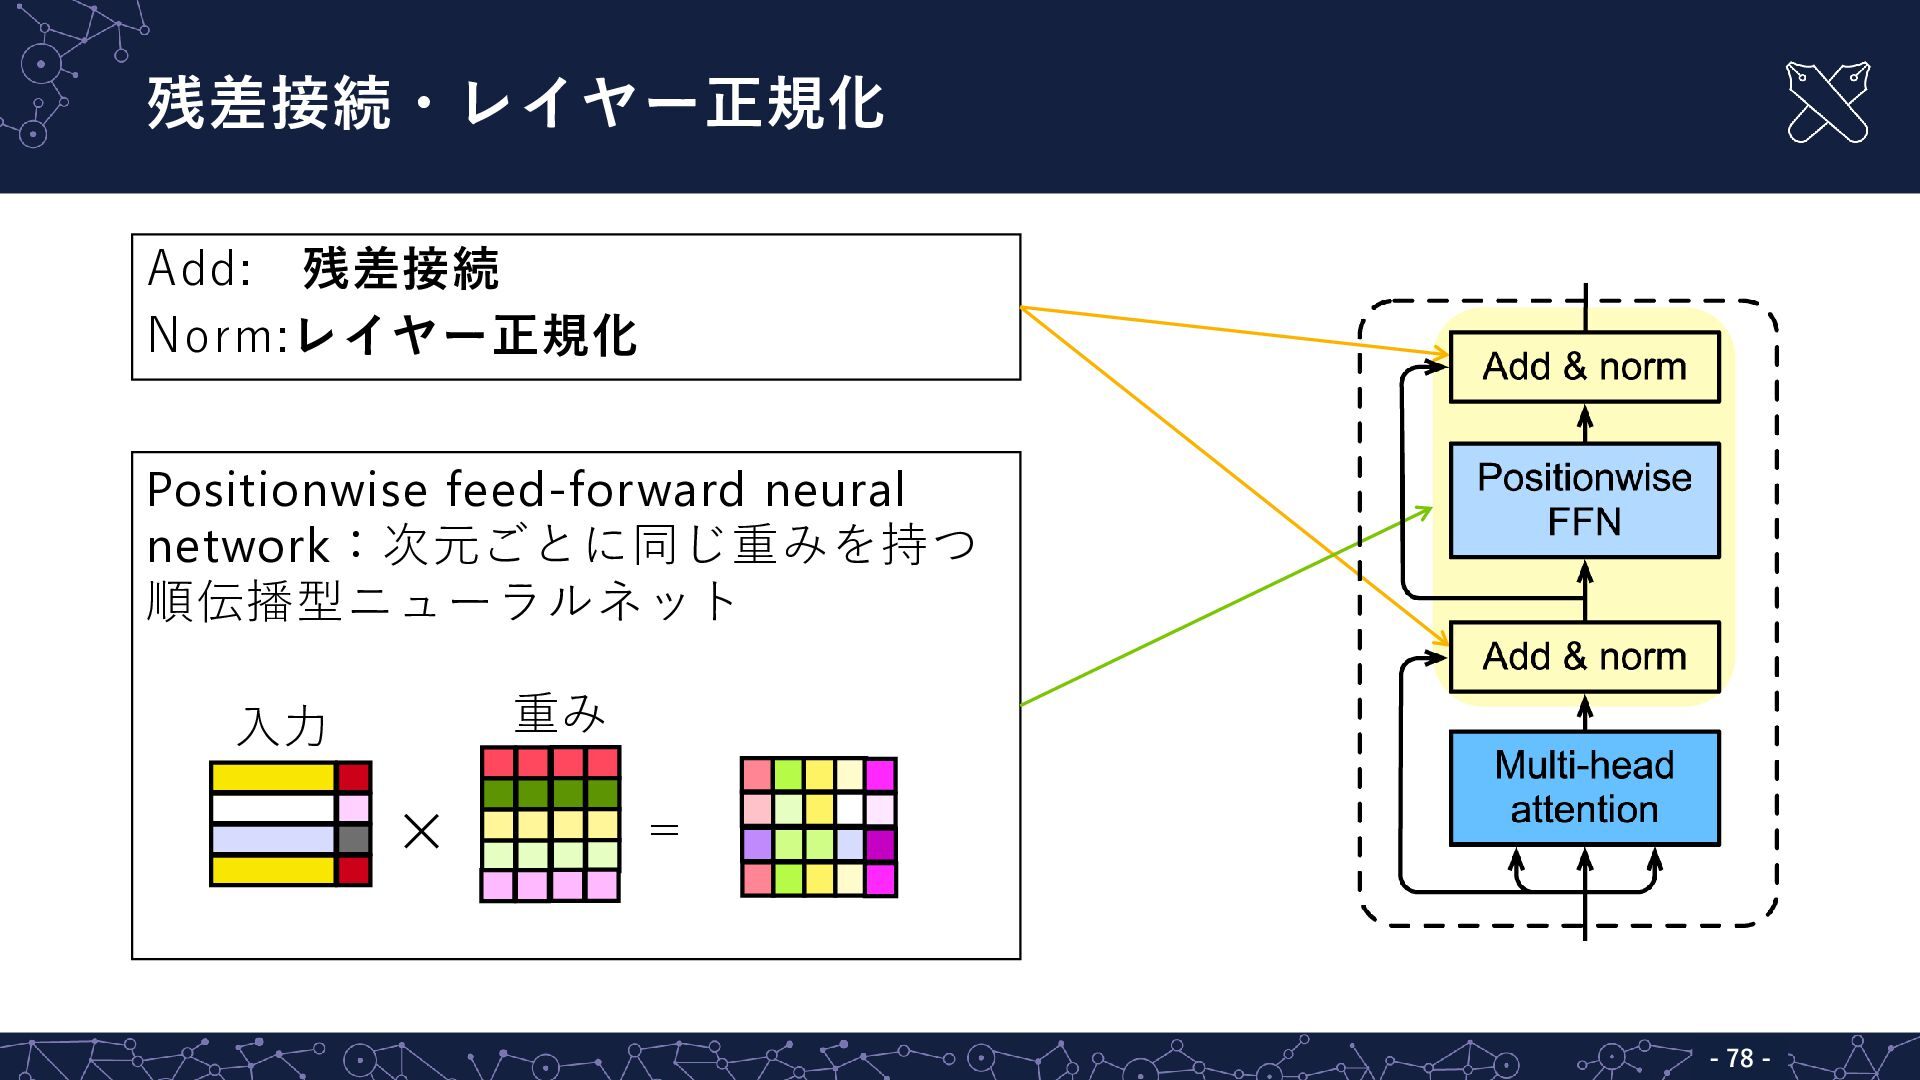
Positionwise feed-forward neural network:次元ごとに同じ重みを持つ 順伝播型ニューラルネット 残差接続・レイヤー正規化 - - 78 Add:
残差接続 Norm:レイヤー正規化 重み 入力 ✕ = -
★残差接続(residual connection)[He+ 2016] - - 79 ▪ 層を迂回する近道を設ける接続方法 ▪ 効果:
深層化を可能にした ↑迂回された層が不要なら、ゼロになるよう学習されれば良い ▪ 迂回された層の役割: 残差 の予測 スキップ接続(skip connection) 残差ブロック(residual block) -
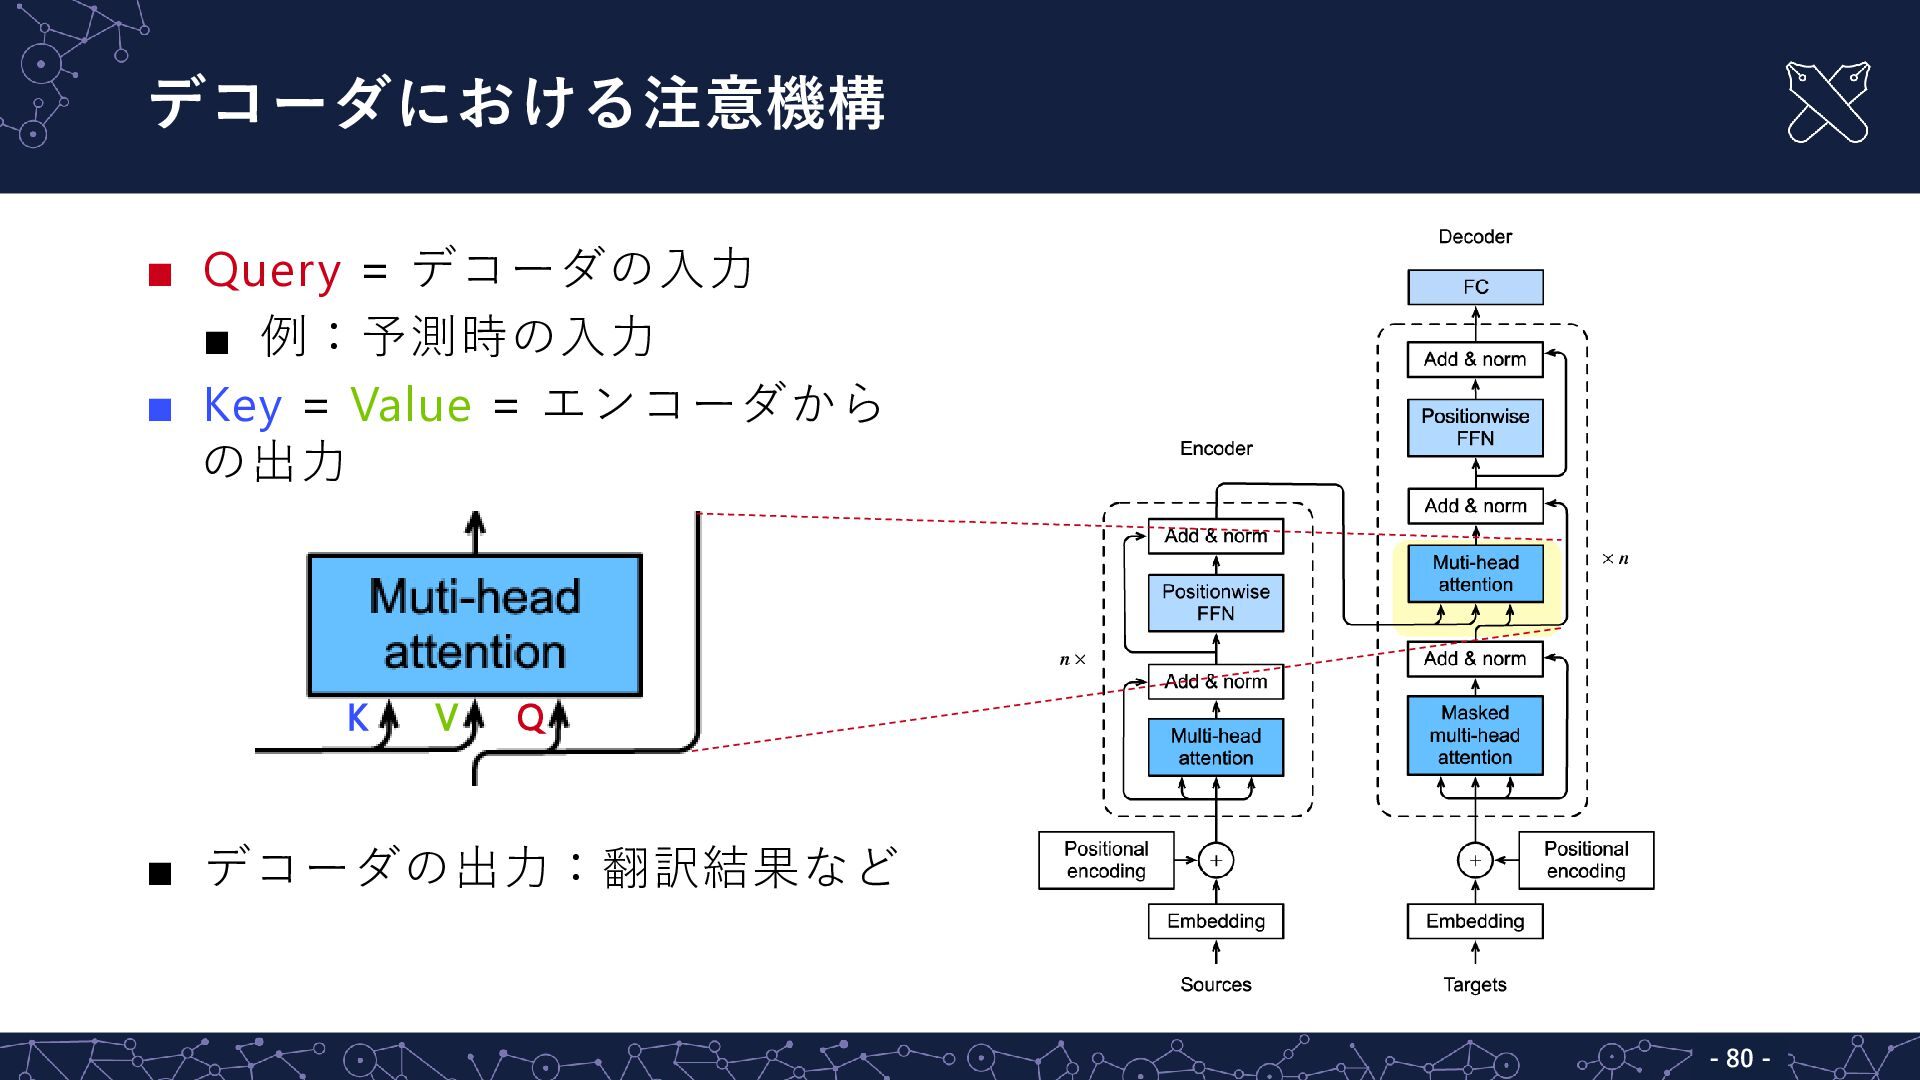
デコーダにおける注意機構 - - 81 ▪ Query = デコーダの入力 ▪ 例:予測時の入力
▪ Key = Value = エンコーダから の出力 ▪ デコーダの出力:翻訳結果など K V Q -
まとめ - - 83 1. 導入 2. ニューラルネットの基礎 3. 再帰型ニューラルネット
4. 汎化と過学習 5. 注意機構 6. トランスフォーマー -
本講義全体の参考図書 - - 86 ▪ ★機械学習スタートアップシリーズ これならわかる深層学習入門 瀧雅人著 講談 社(本講義では、異なる表記を用いることがあるので注意)
▪ ★Dive into Deep Learning (https://d2l.ai/) ▪ 深層学習 改訂第2版 (機械学習プロフェッショナルシリーズ) 岡谷貴之著 講談社 ▪ ディープラーニングを支える技術 岡野原大輔著 技術評論社 ▪ 画像認識 (機械学習プロフェッショナルシリーズ) 原田達也著 講談社 ▪ 深層学習による自然言語処理 (機械学習プロフェッショナルシリーズ) 坪井祐太、 海野裕也、鈴木潤 著、講談社 ▪ IT Text 自然言語処理の基礎 岡﨑直観、荒瀬由紀、鈴木潤、鶴岡慶雅、宮尾祐介 著、オーム社 ▪ 東京大学工学教程 情報工学 機械学習 中川 裕志著、東京大学工学教程編纂委員会 編 丸善出版 ▪ パターン認識と機械学習 上・下 C.M. ビショップ著 丸善出版 -
参考文献 - - 87 1. Nadaraya, E. A. (1964). On
estimating regression. Theory of Probability & Its Applications, 9(1), 141–142. 2. Watson, G. S. (1964). Smooth regression analysis. Sankhyā: The Indian Journal of Statistics, Series A, pp. 359–372. 3. Dosovitskiy, A., Beyer, L., Kolesnikov, A., Weissenborn, D., Zhai, X., Unterthiner, T., ... & Houlsby, N. (2020). An image is worth 16x16 words: Transformers for image recognition at scale. arXiv preprint arXiv:2010.11929. 4. Fukui, H., Hirakawa, T., Yamashita, T., & Fujiyoshi, H. (2019). Attention branch network: Learning of attention mechanism for visual explanation. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 10705-10714). 5. Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., ... & Polosukhin, I. (2017). Attention is all you need. In Advances in neural information processing systems (pp. 5998-6008).