Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
[RSJ26] AnoleVLA: Lightweight Vision-Language-A...
Search
Semantic Machine Intelligence Lab., Keio Univ.
PRO
August 29, 2026
Technology
160
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
[RSJ26] AnoleVLA: Lightweight Vision-Language-Action Model with Deep State Space Models for Mobile Manipulation
Semantic Machine Intelligence Lab., Keio Univ.
PRO
August 29, 2026
More Decks by Semantic Machine Intelligence Lab., Keio Univ.
See All by Semantic Machine Intelligence Lab., Keio Univ.
[RSJ26] Building a VLA Model Based on Self-Distilled Classification
keio_smilab
PRO
0
200
[RSJ26] NarrativeFlow: Flow-Based Vision-Language-Action Model Using Robot Velocity Fields
keio_smilab
PRO
0
230
[RSJ26] Flow as Flow: Modeling Robot Velocity Fields as Probability Velocity Fields
keio_smilab
PRO
1
230
[RSJ26] Hierarchy-Aware Multimodal Retrieval-Augmented Generation for Embodied Question Answering
keio_smilab
PRO
1
190
[MIRU26] Open-Vocabulary Intention-Guided Object Detection in Diverse Scenes
keio_smilab
PRO
0
230
[Journal club] Evo-1: Lightweight Vision-Language-Action Model with Preserved Semantic Alignment
keio_smilab
PRO
0
56
[MIRU26] To What Extent Does MLLM-as-a-Judge Exhibit Cross-Model Preference Bias?
keio_smilab
PRO
0
320
[Journal club] FlashVID: Efficient Video Large Language Models via Training-free Tree-based Spatiotemporal Token Merging
keio_smilab
PRO
0
49
[Journal club] DyCoke: Dynamic Compression of Tokens for Fast Video Large Language Models
keio_smilab
PRO
1
82
Other Decks in Technology
See All in Technology
[2026-09-30]ロックンロールは鳴り止まないっ - 信頼性かまってちゃん - 「データ駆動を投げ捨ててまで。」追いかける信頼性改善に向けた取り組みの話
tosite
0
180
1人アドミンな私は AWSアカウント申請をSlackで完結したい!
ysuzuki
0
110
BedrockとLambdaで作る リアルタイム進行型推理ゲーム
kawametho
0
160
MCPゲートウェイを作って運用してわかったこと — Agent時代の権限管理の現在地
mtpooh
10
2.9k
組み立てて楽しむ AWS Blocks 入門
kmiya84377
0
140
TiDBファミリーにDWHが新登場!! TiDB最新情報 / TiDB update 202609
yoshiakiyamasaki
0
190
DAMOS - The Smart Cruise Control for RAM
ennael
PRO
1
100
高負荷プロダクション環境におけるAWS Lambdaのリアル 〜スケールとコストを左右する実行ライフサイクルの技術仕様〜
maimyyym
2
850
行動するAIのためのオントロジー | DevRev — Encraft #26.pdf
dvrv_tknrszk
2
670
HolmesGPTで始めるSREエージェント入門!プラットフォームの障害調査はAIにお任せ 〜
leveragestech
PRO
0
140
雪かき部 #7 もう怖くない!SELECT文!
foursue
0
270
spanner-autoscalerに学ぶ CRD設計パターン 〜自動化と緊急時対応を両立する Kubernetesコントローラーの作り方〜
tkuchiki
0
220
Featured
See All Featured
We Are The Robots
honzajavorek
0
380
Build your cross-platform service in a week with App Engine
jlugia
234
19k
I Don’t Have Time: Getting Over the Fear to Launch Your Podcast
jcasabona
35
2.9k
B2B Lead Gen: Tactics, Traps & Triumph
marketingsoph
0
260
技術選定の審美眼(2025年版) / Understanding the Spiral of Technologies 2025 edition
twada
PRO
120
120k
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
240
The Pragmatic Product Professional
lauravandoore
37
7.5k
RailsConf & Balkan Ruby 2019: The Past, Present, and Future of Rails at GitHub
eileencodes
141
35k
Conquering PDFs: document understanding beyond plain text
inesmontani
PRO
4
3.1k
Abbi's Birthday
coloredviolet
4
10k
Put a Button on it: Removing Barriers to Going Fast.
kastner
60
4.6k
Transcript
深層状態空間モデルに基づく 軽量VLAによる物体操作 慶應義塾大学 髙木裕輔 神原元就 八島大地 妹尾幸樹 戸倉健登 杉浦孔明
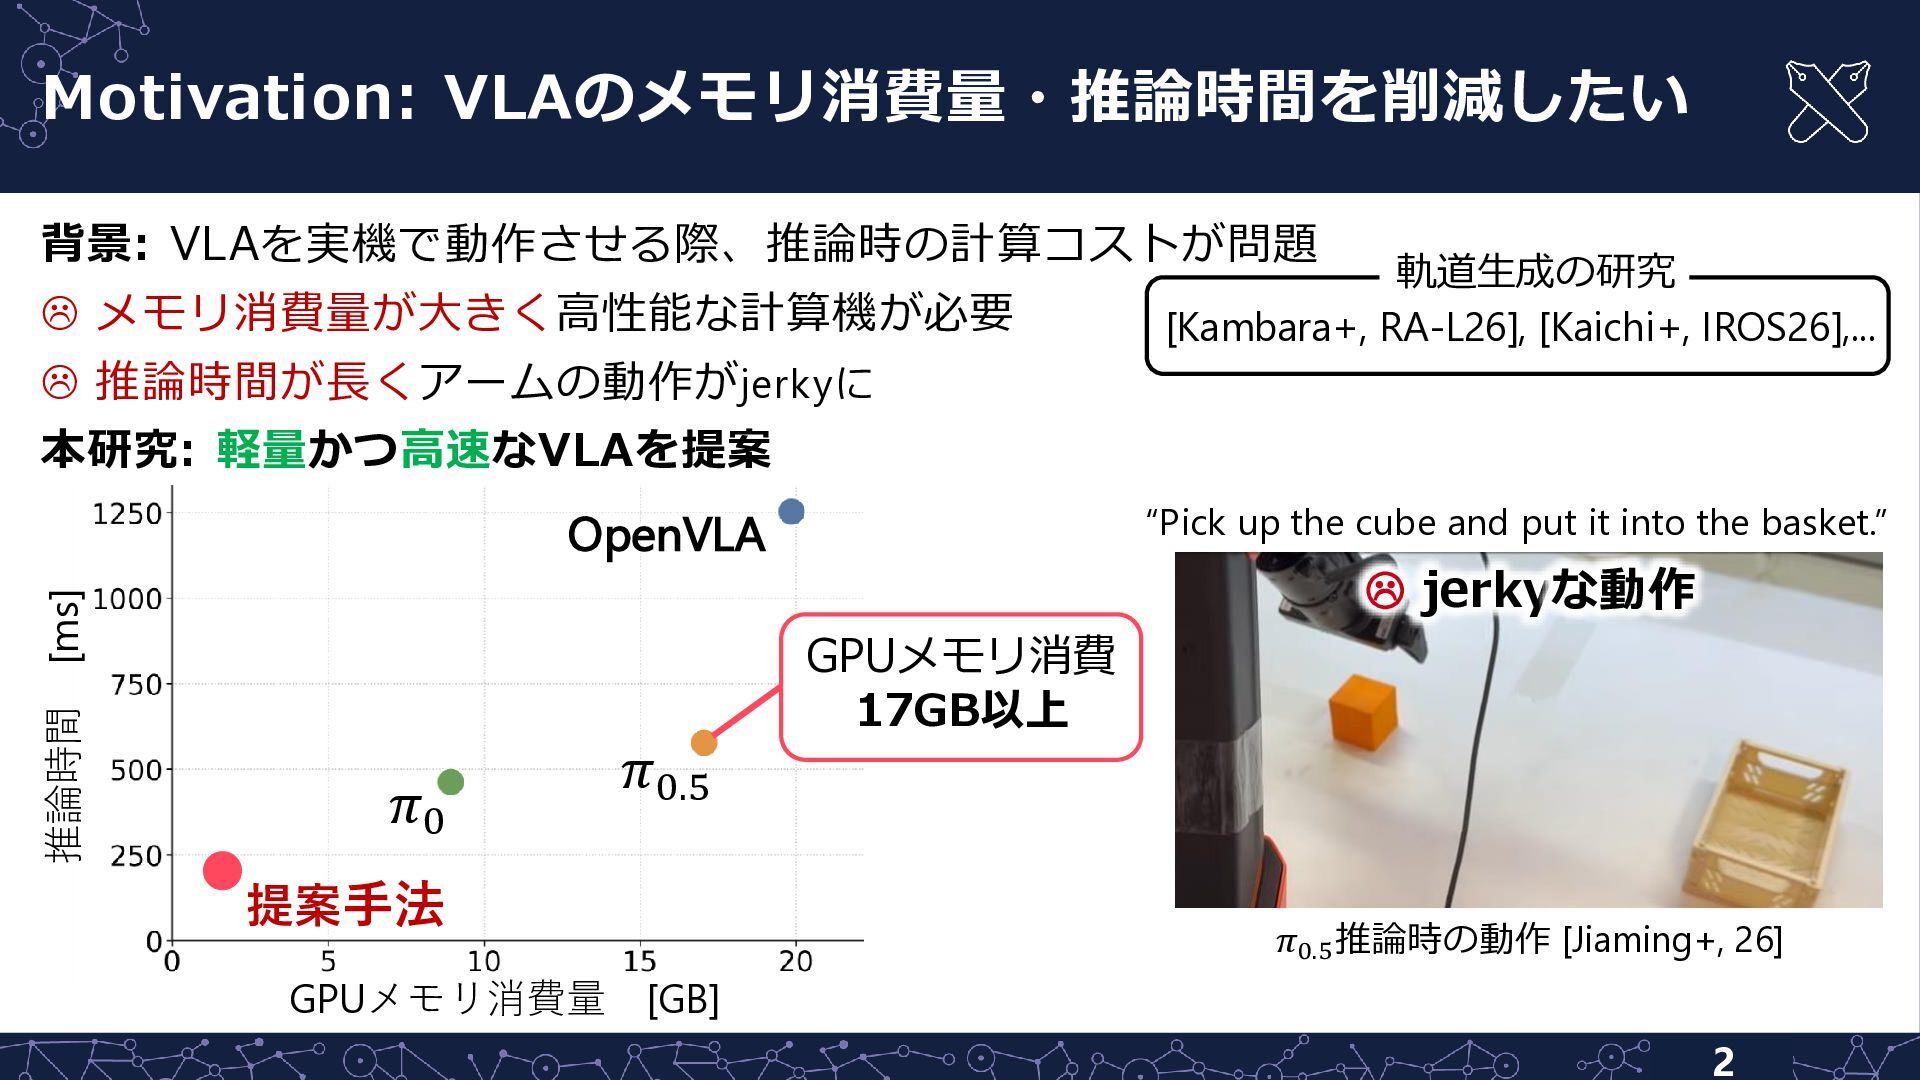
Motivation: VLAのメモリ消費量・推論時間を削減したい 背景: VLAを実機で動作させる際、推論時の計算コストが問題 メモリ消費量が大きく高性能な計算機が必要 軌道生成の研究 [Kambara+, RA-L26], [Kaichi+,
IROS26],... 推論時間が長くアームの動作がjerkyに 本研究: 軽量かつ高速なVLAを提案 “Pick up the cube and put it into the basket.” 推論時間 [ms] OpenVLA jerkyな動作 GPUメモリ消費 17GB以上 𝜋0 𝜋0.5 提案手法 𝜋0.5 推論時の動作 [Jiaming+, 26] GPUメモリ消費量 [GB] 2
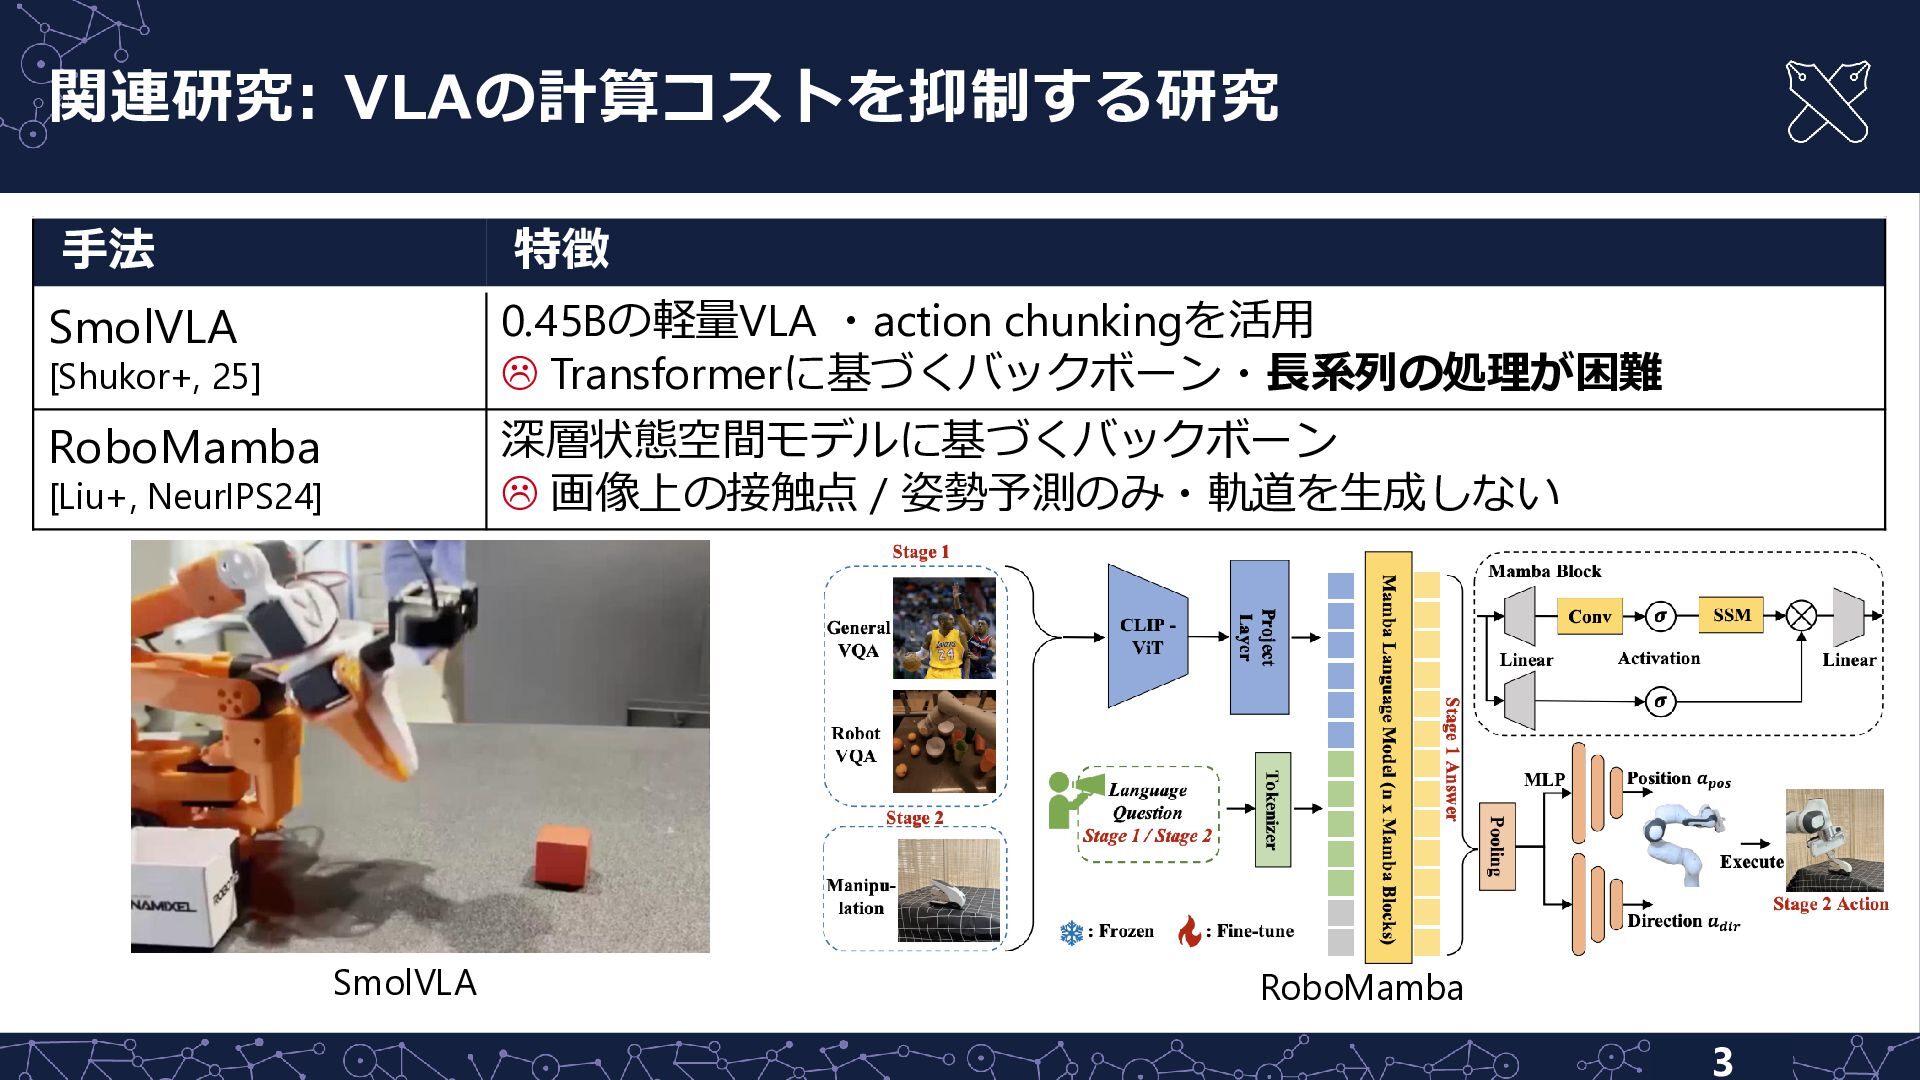
関連研究: VLAの計算コストを抑制する研究 手法 特徴 SmolVLA 0.45Bの軽量VLA ・action chunkingを活用 Transformerに基づくバックボーン・長系列の処理が困難
深層状態空間モデルに基づくバックボーン 画像上の接触点 / 姿勢予測のみ・軌道を生成しない [Shukor+, 25] RoboMamba [Liu+, NeurIPS24] SmolVLA RoboMamba 3
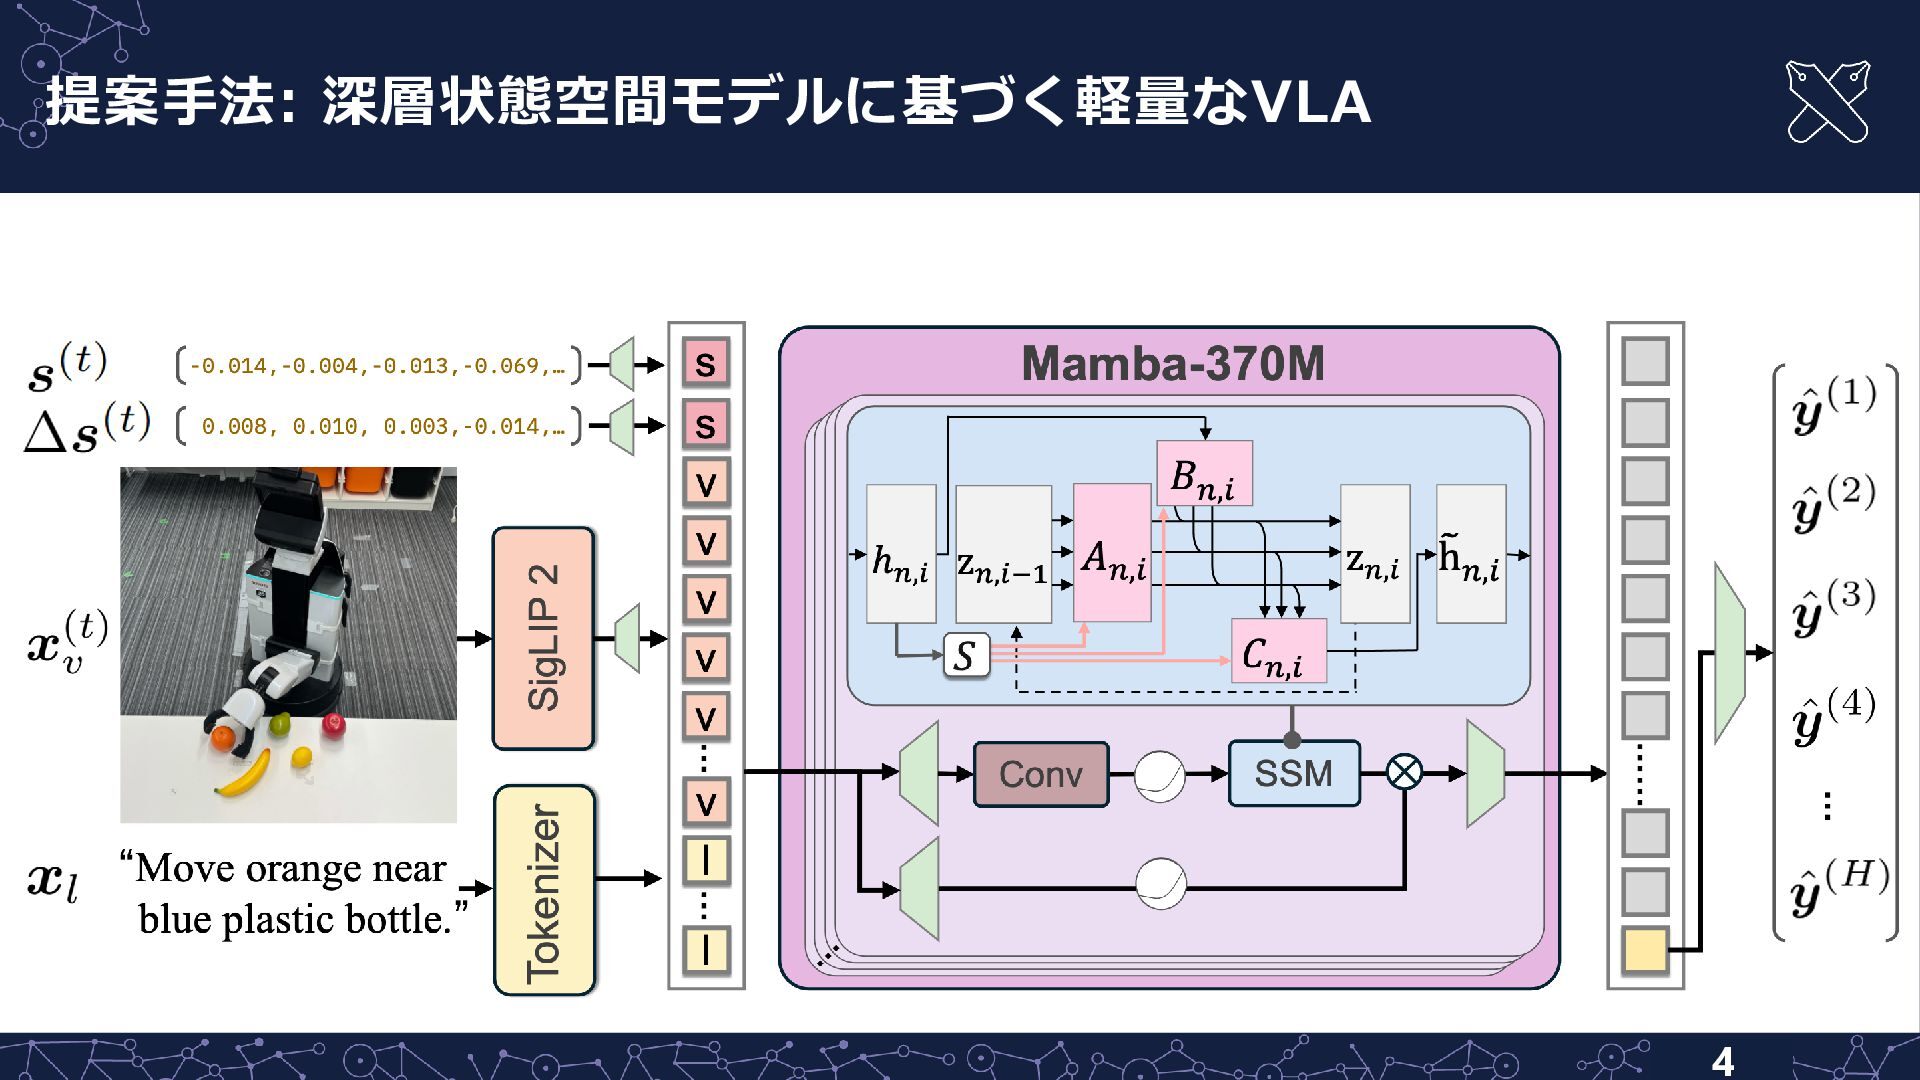
提案手法: 深層状態空間モデルに基づく軽量なVLA 4
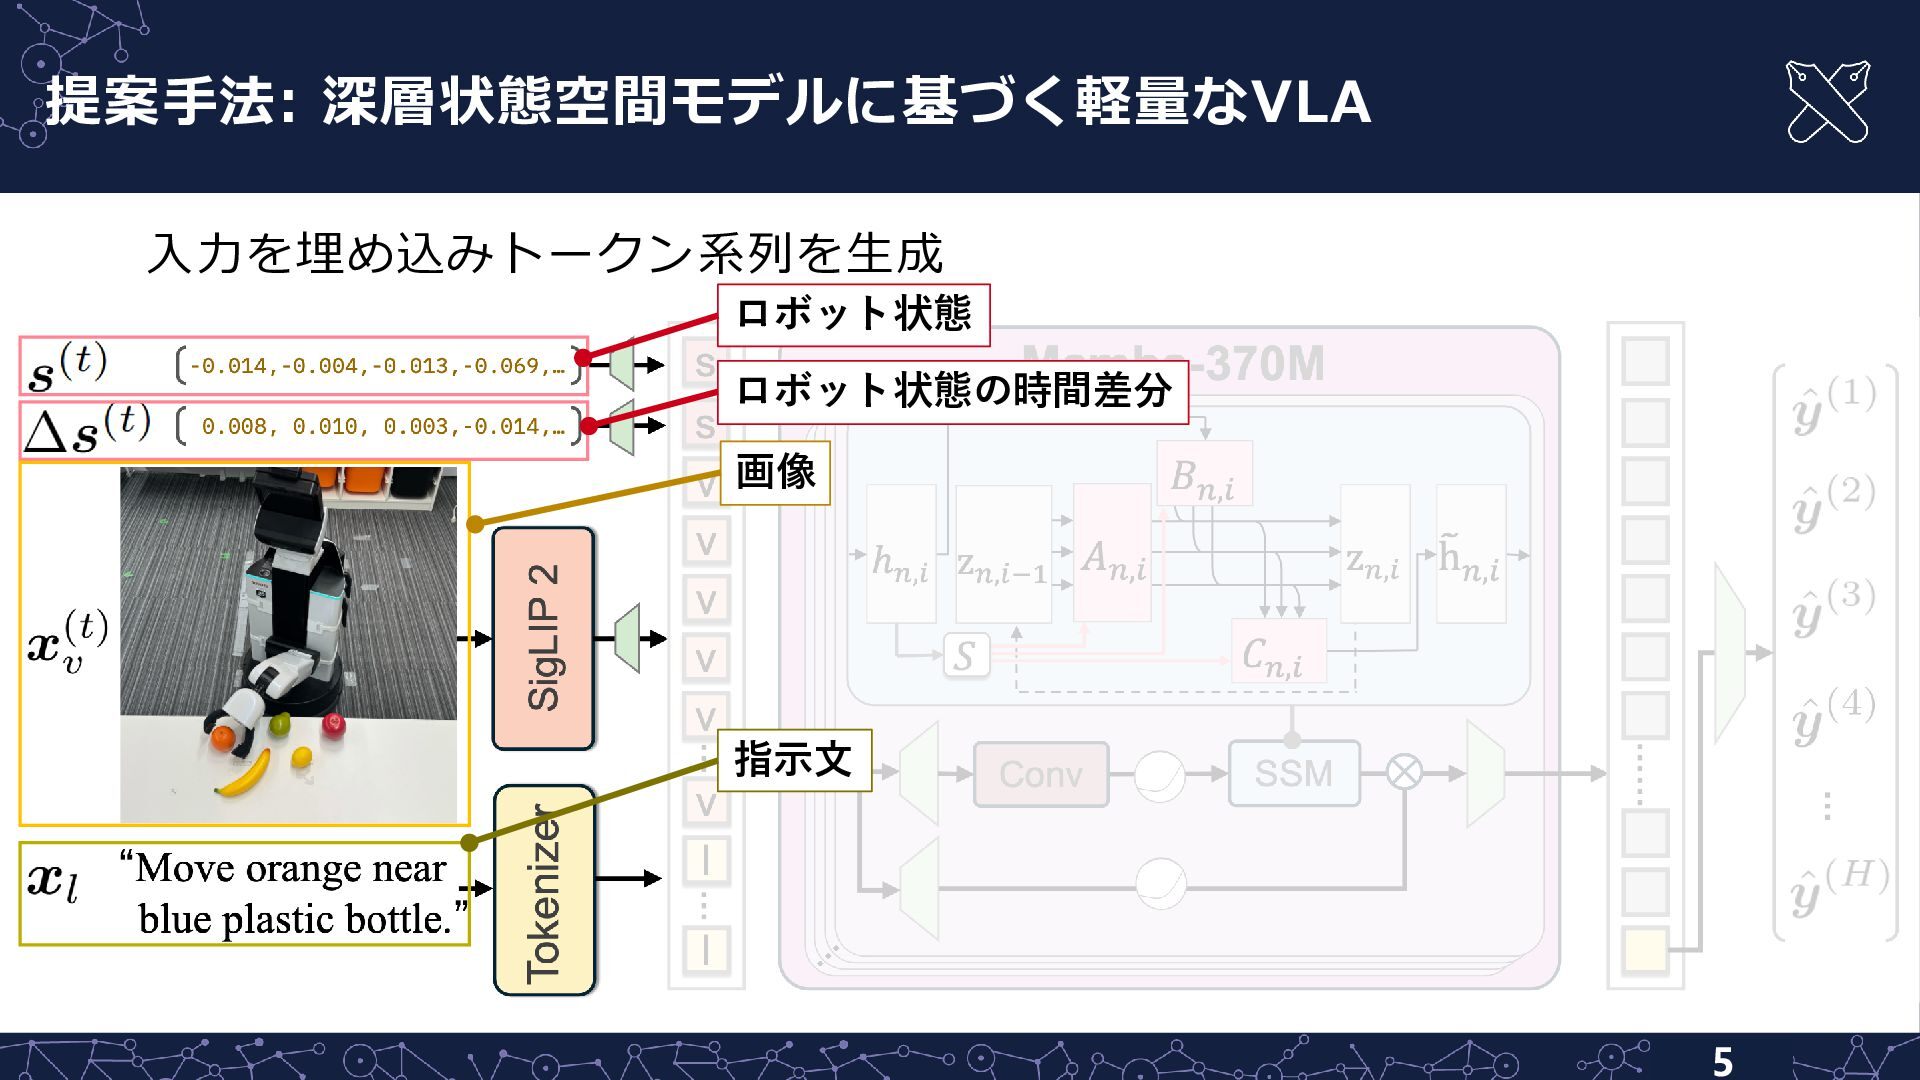
提案手法: 深層状態空間モデルに基づく軽量なVLA 入力を埋め込みトークン系列を生成 ロボット状態 ロボット状態の時間差分 画像 指示文 5
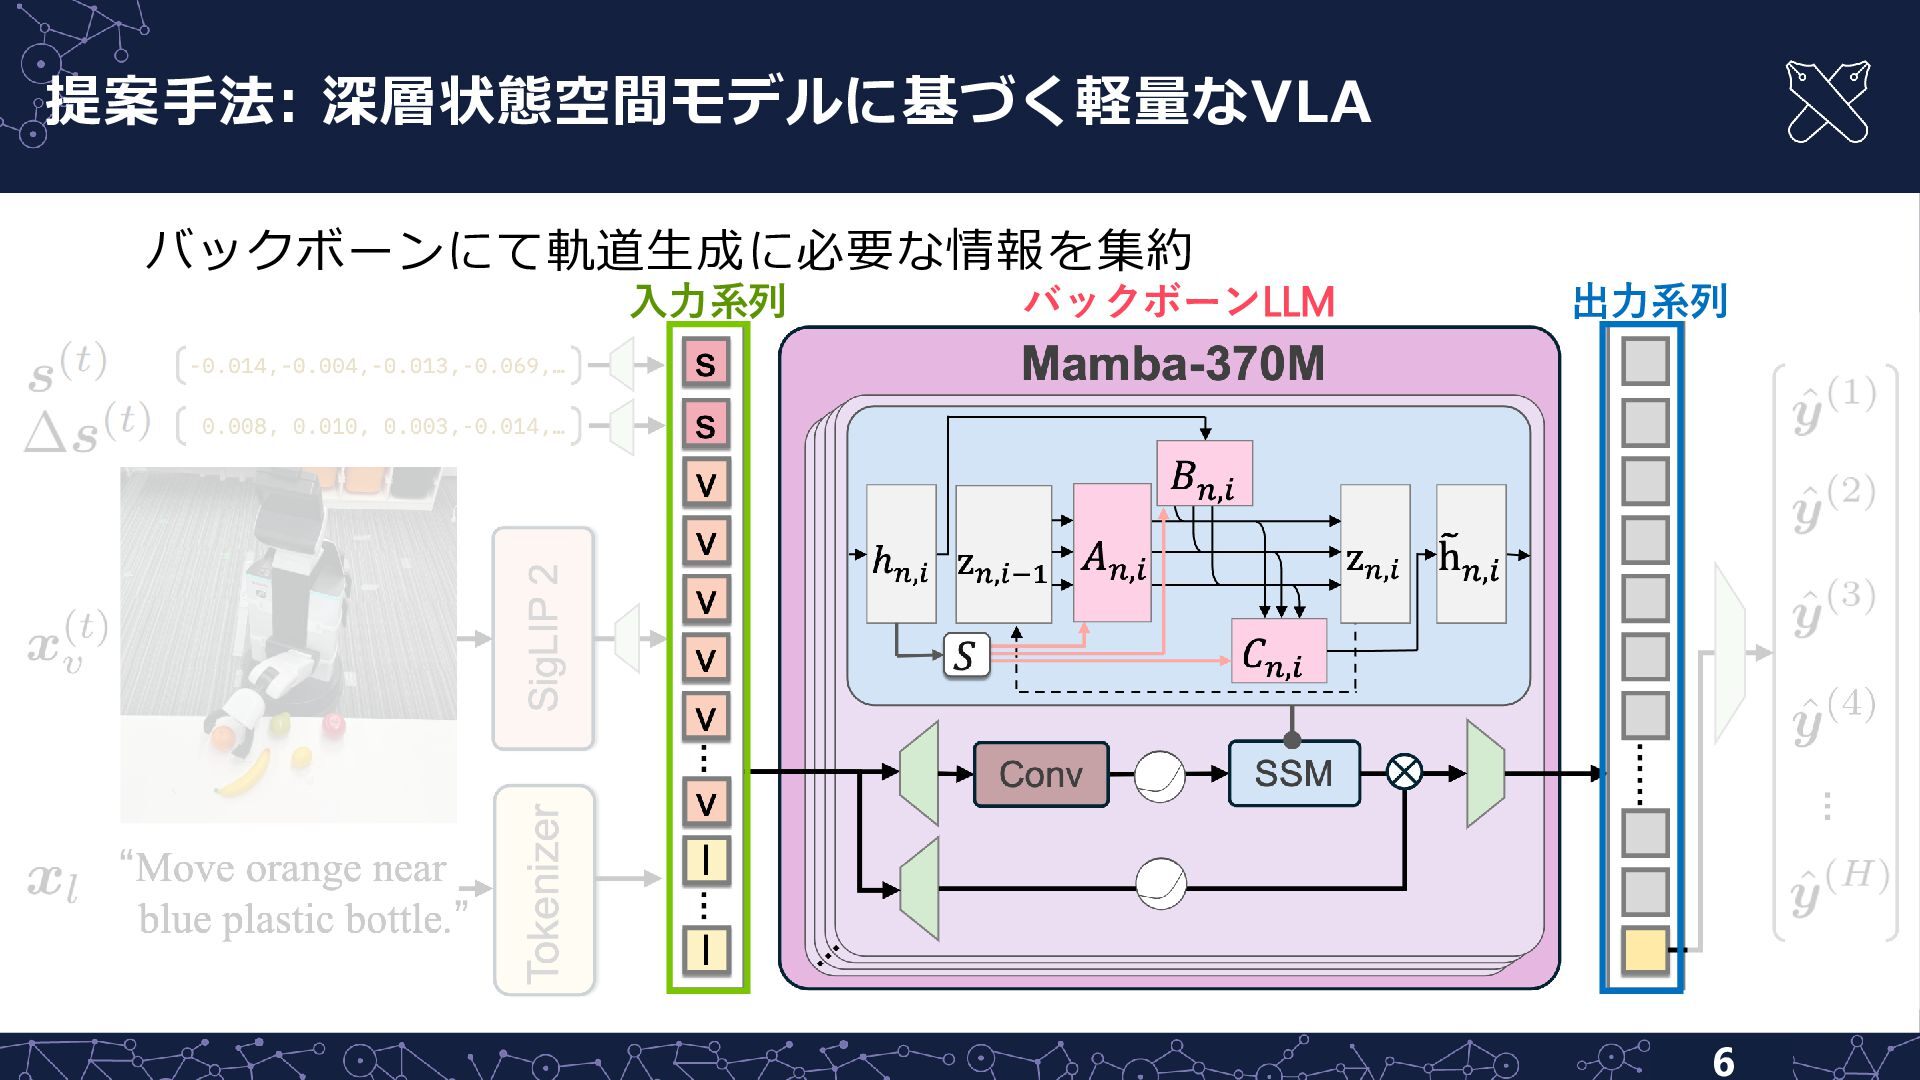
提案手法: 深層状態空間モデルに基づく軽量なVLA バックボーンにて軌道生成に必要な情報を集約 入力系列 バックボーンLLM 出力系列 6
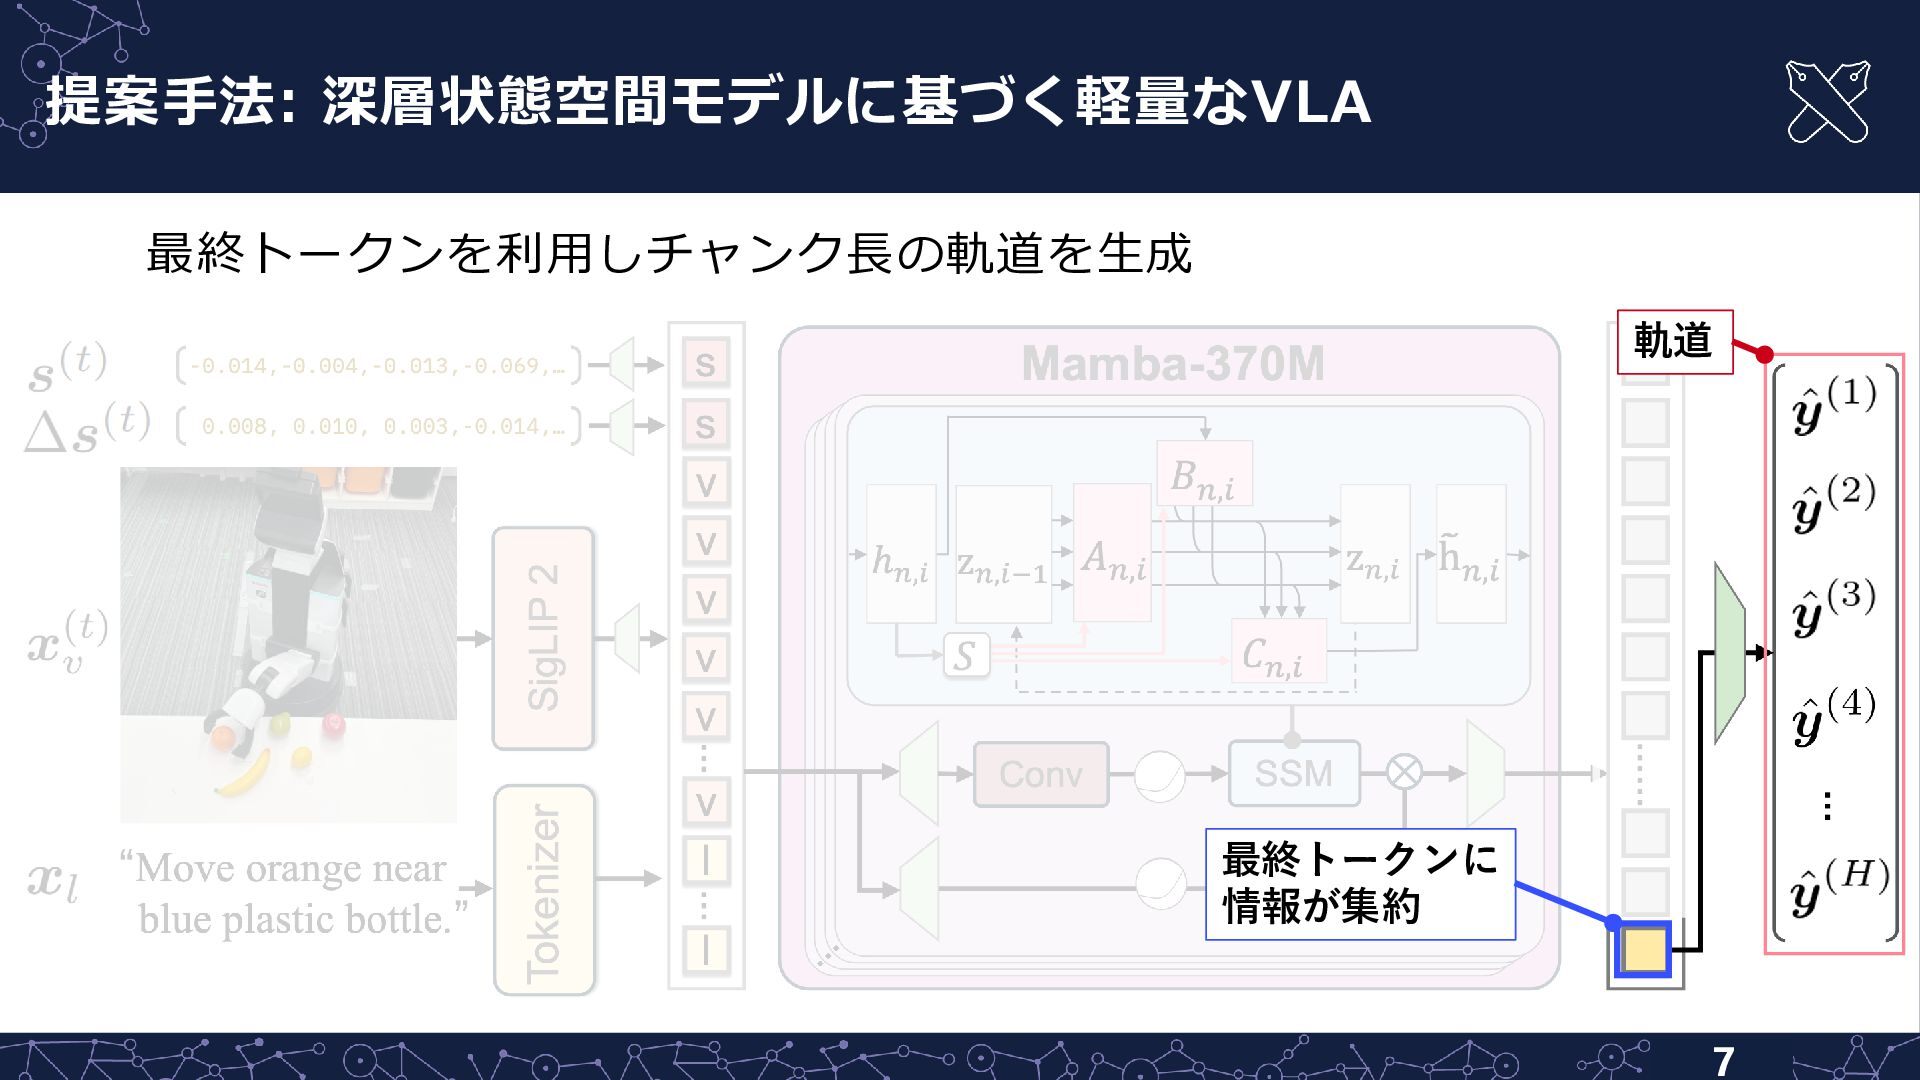
提案手法: 深層状態空間モデルに基づく軽量なVLA 最終トークンを利用しチャンク長の軌道を生成 軌道 最終トークンに 情報が集約 7
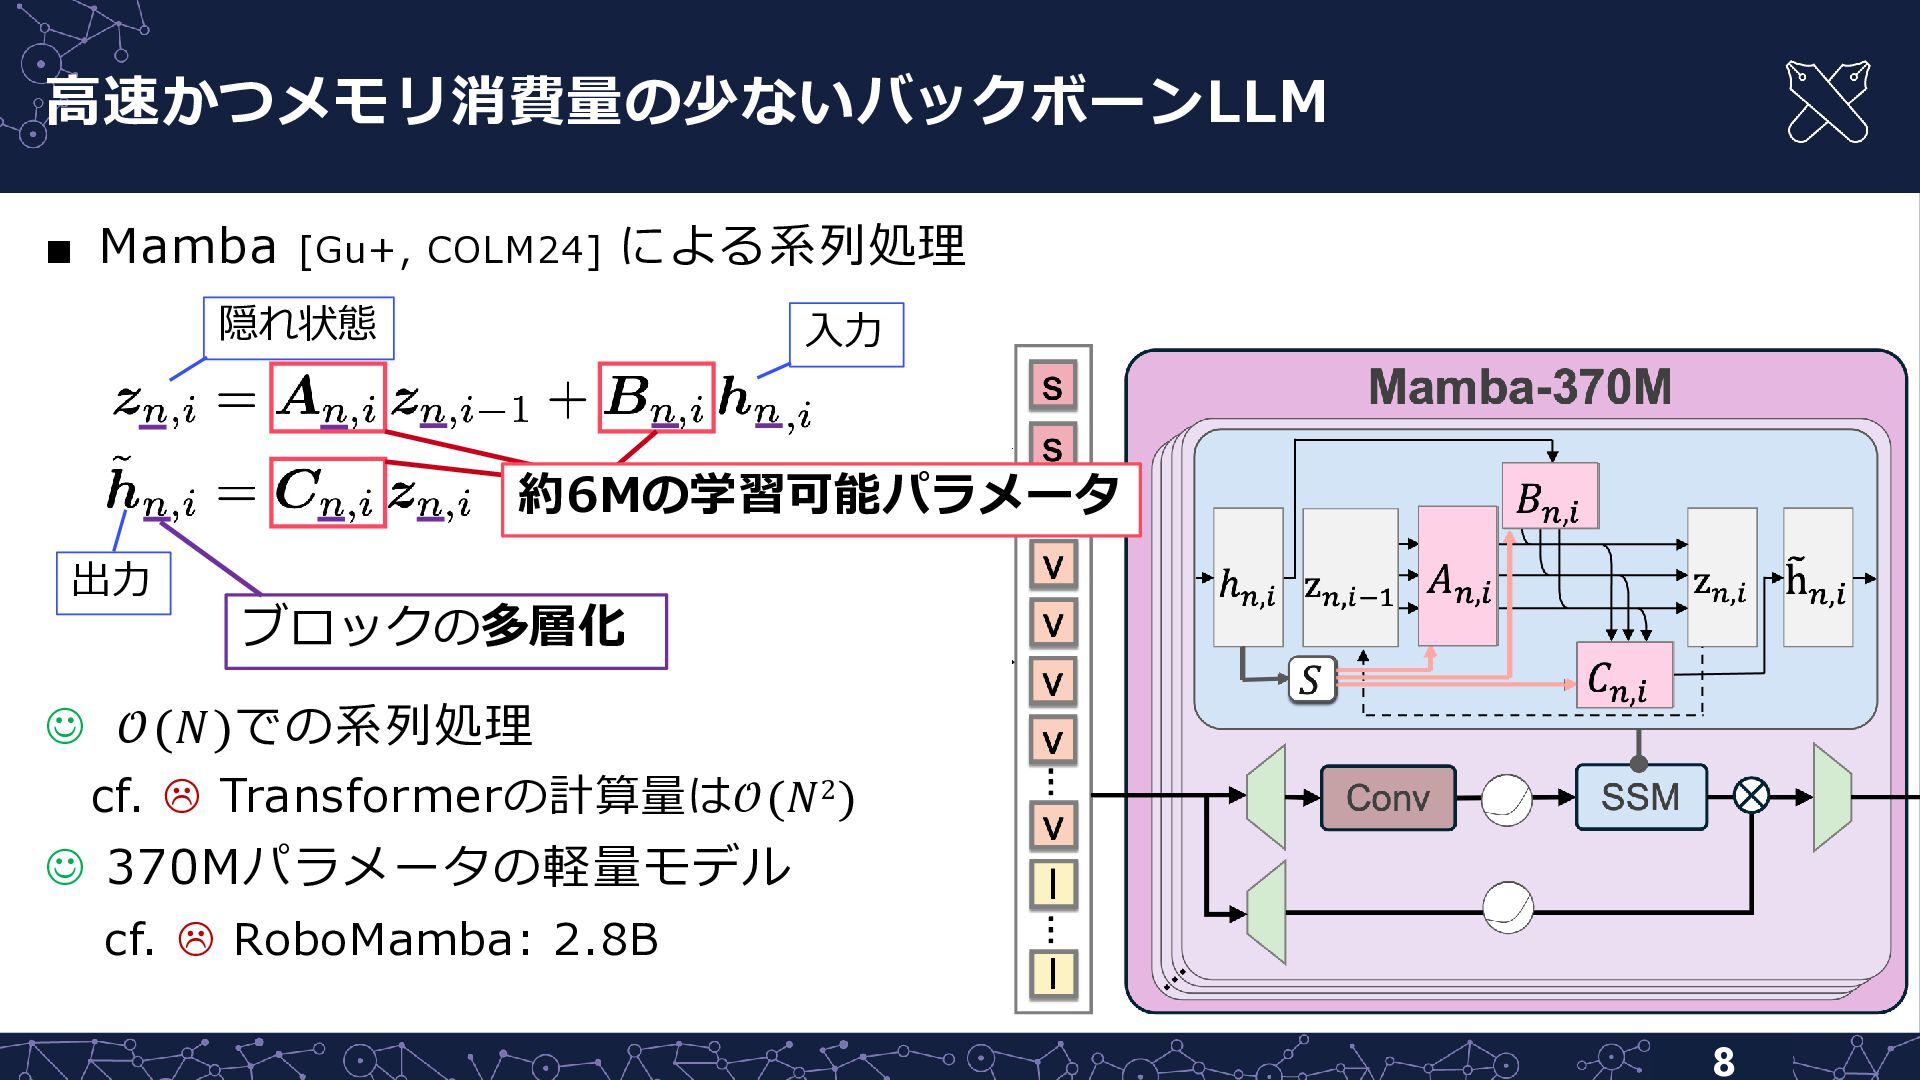
高速かつメモリ消費量の少ないバックボーンLLM ▪ Mamba [Gu+, COLM24] による系列処理 隠れ状態 入力 約6Mの学習可能パラメータ 出力
ブロックの多層化 ☺ 𝒪(𝑁)での系列処理 cf. Transformerの計算量は𝒪(𝑁 2 ) ☺ 370Mパラメータの軽量モデル cf. RoboMamba: 2.8B 8
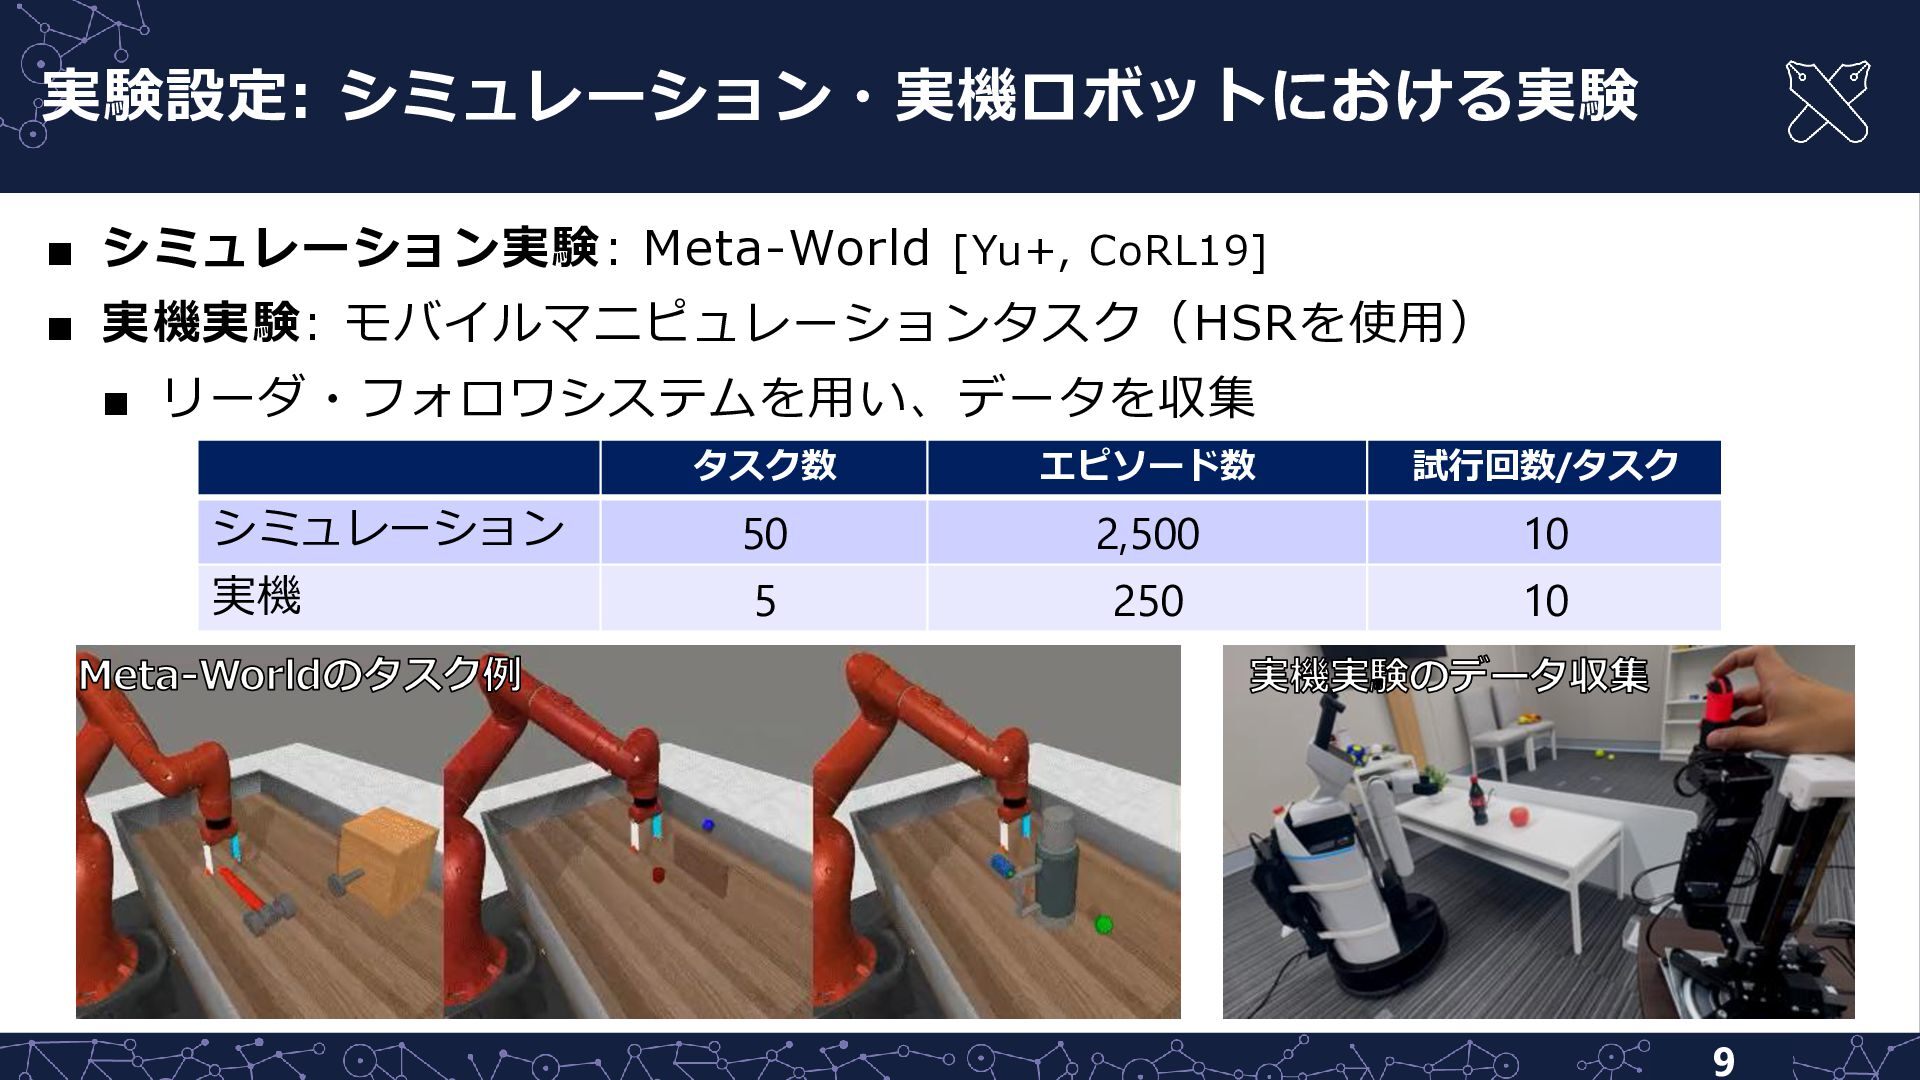
実験設定: シミュレーション・実機ロボットにおける実験 ▪ シミュレーション実験: Meta-World [Yu+, CoRL19] ▪ 実機実験: モバイルマニピュレーションタスク(HSRを使用)
▪ リーダ・フォロワシステムを用い、データを収集 タスク数 エピソード数 試行回数/タスク シミュレーション 50 2,500 10 実機 5 250 10 Meta-Worldのタスク例 実機実験のデータ収集 9
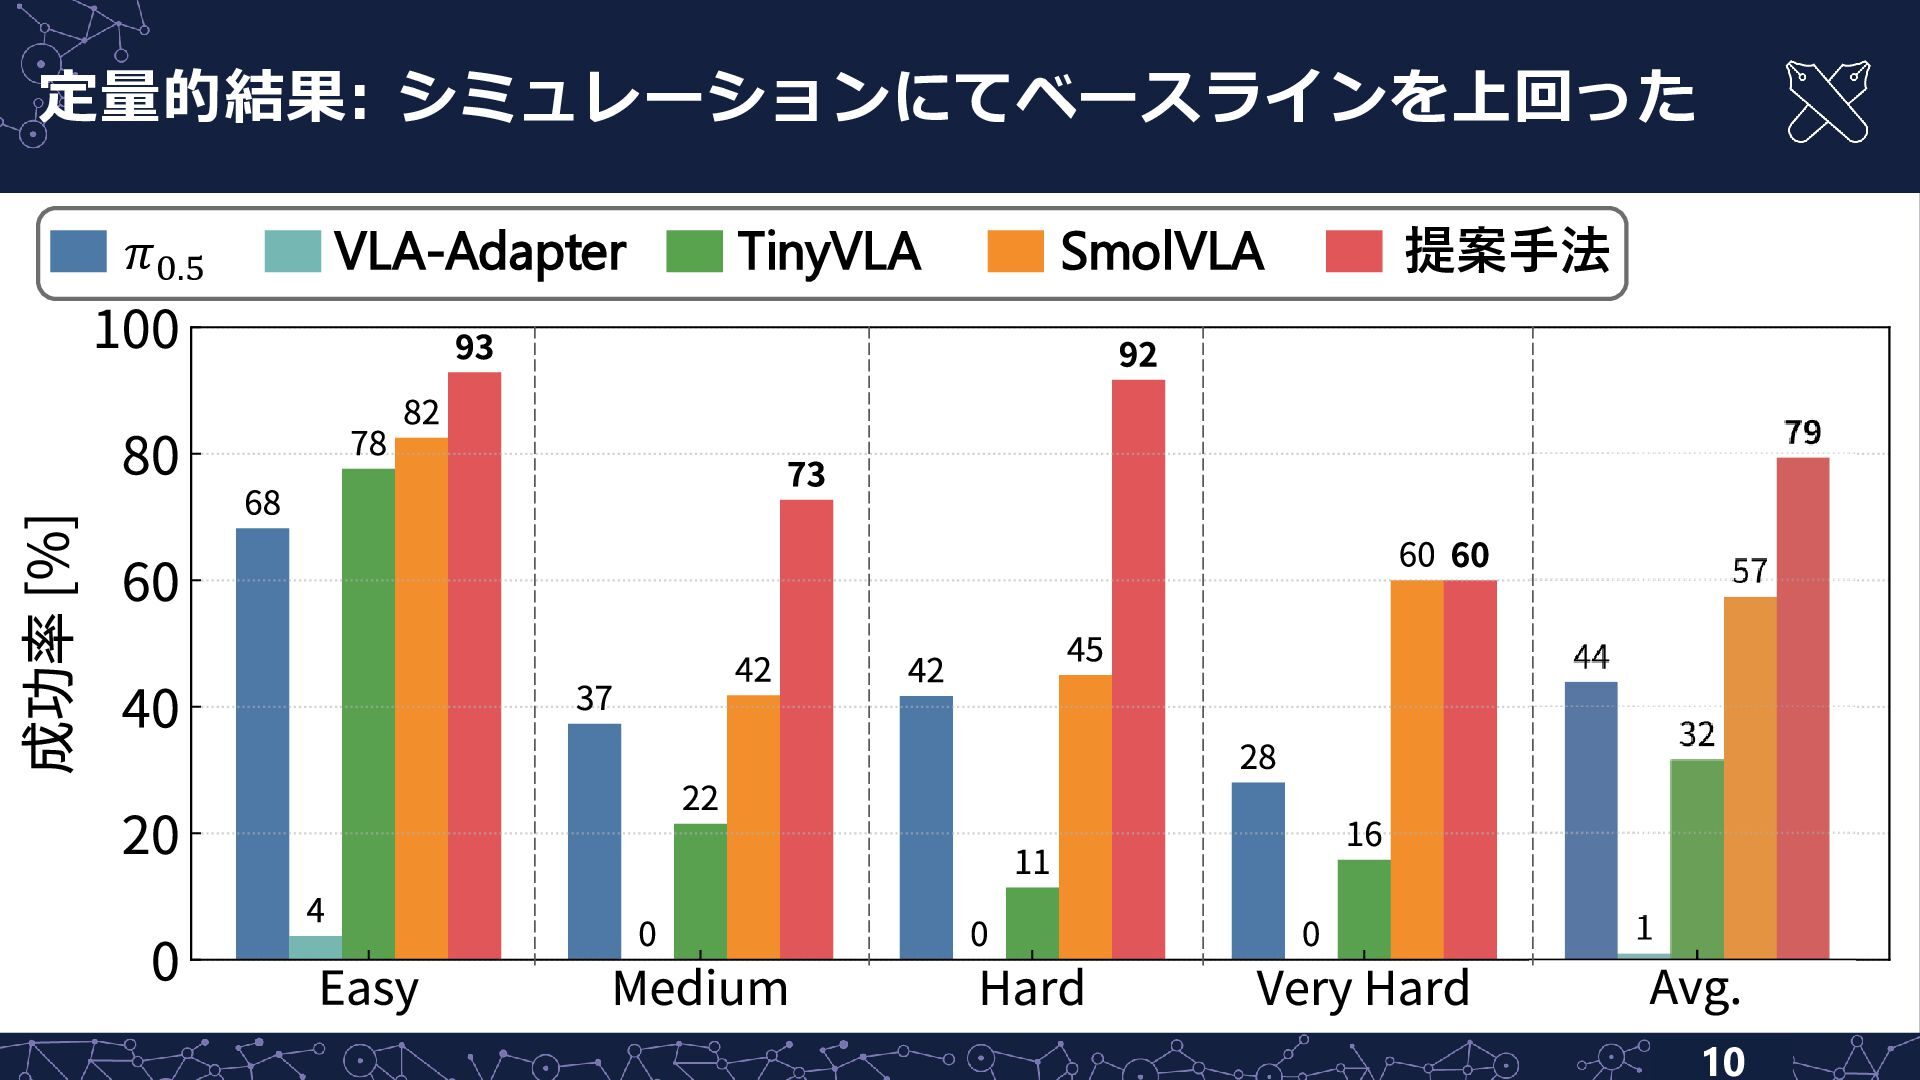
定量的結果: シミュレーションにてベースラインを上回った 𝜋0.5 VLA-Adapter TinyVLA SmolVLA 提案手法 10
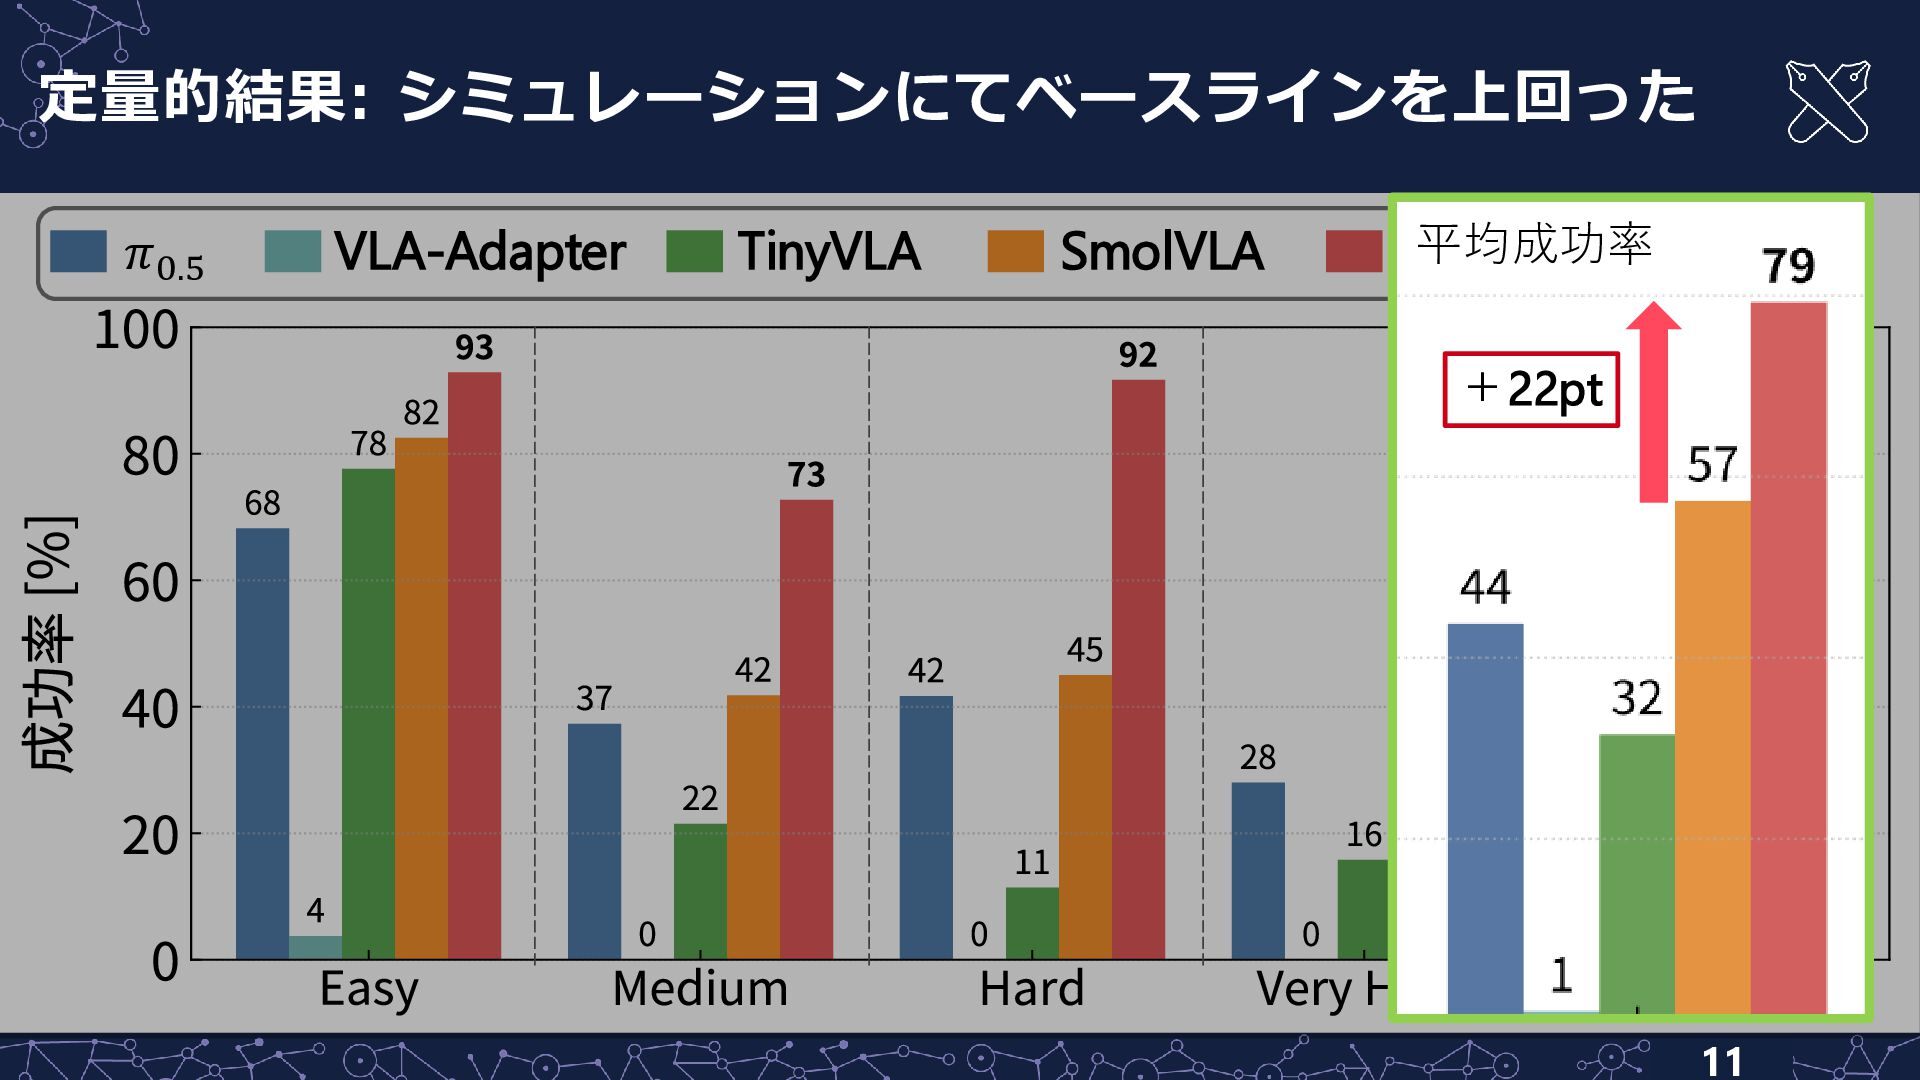
定量的結果: シミュレーションにてベースラインを上回った 𝜋0.5 VLA-Adapter TinyVLA SmolVLA 平均成功率 提案手法 +22pt 11
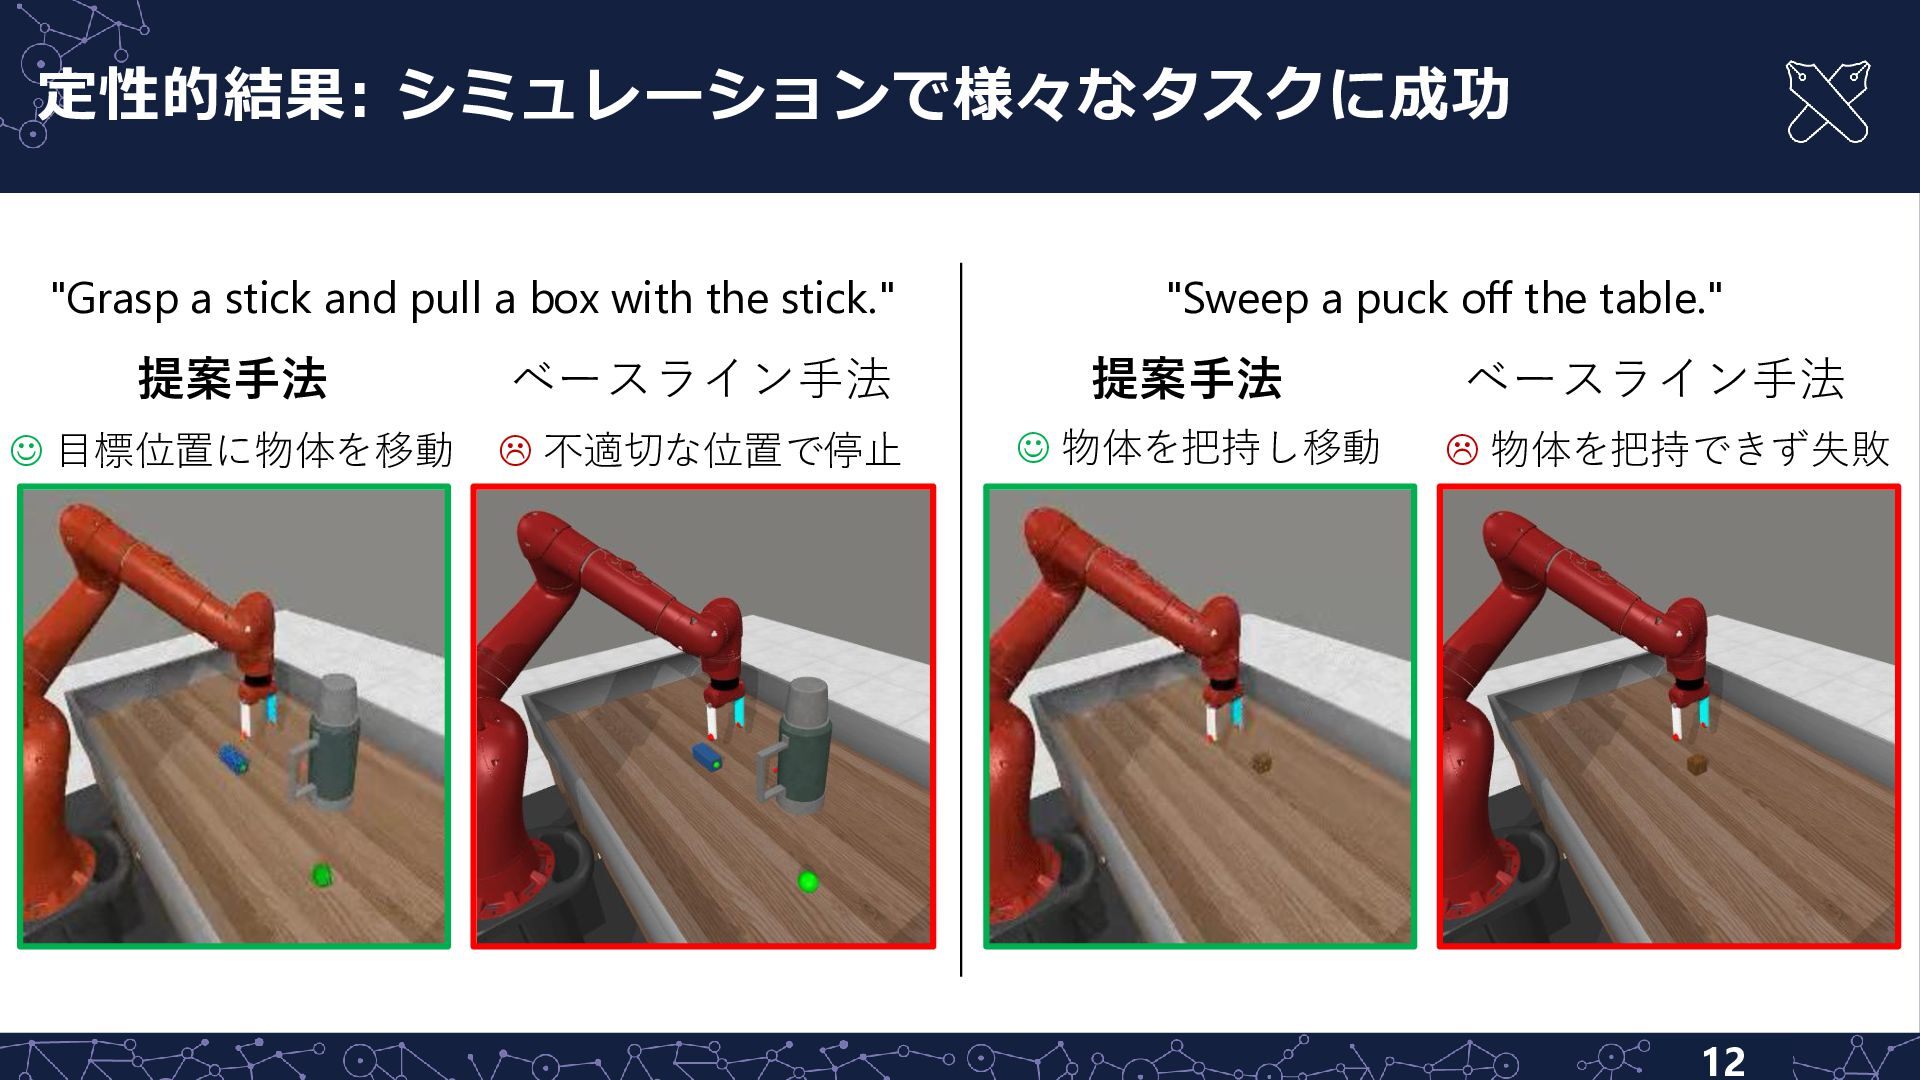
定性的結果: シミュレーションで様々なタスクに成功 "Grasp a stick and pull a box with
the stick." "Sweep a puck off the table." 提案手法 ベースライン手法 提案手法 ベースライン手法 ☺ 目標位置に物体を移動 不適切な位置で停止 ☺ 物体を把持し移動 物体を把持できず失敗 12
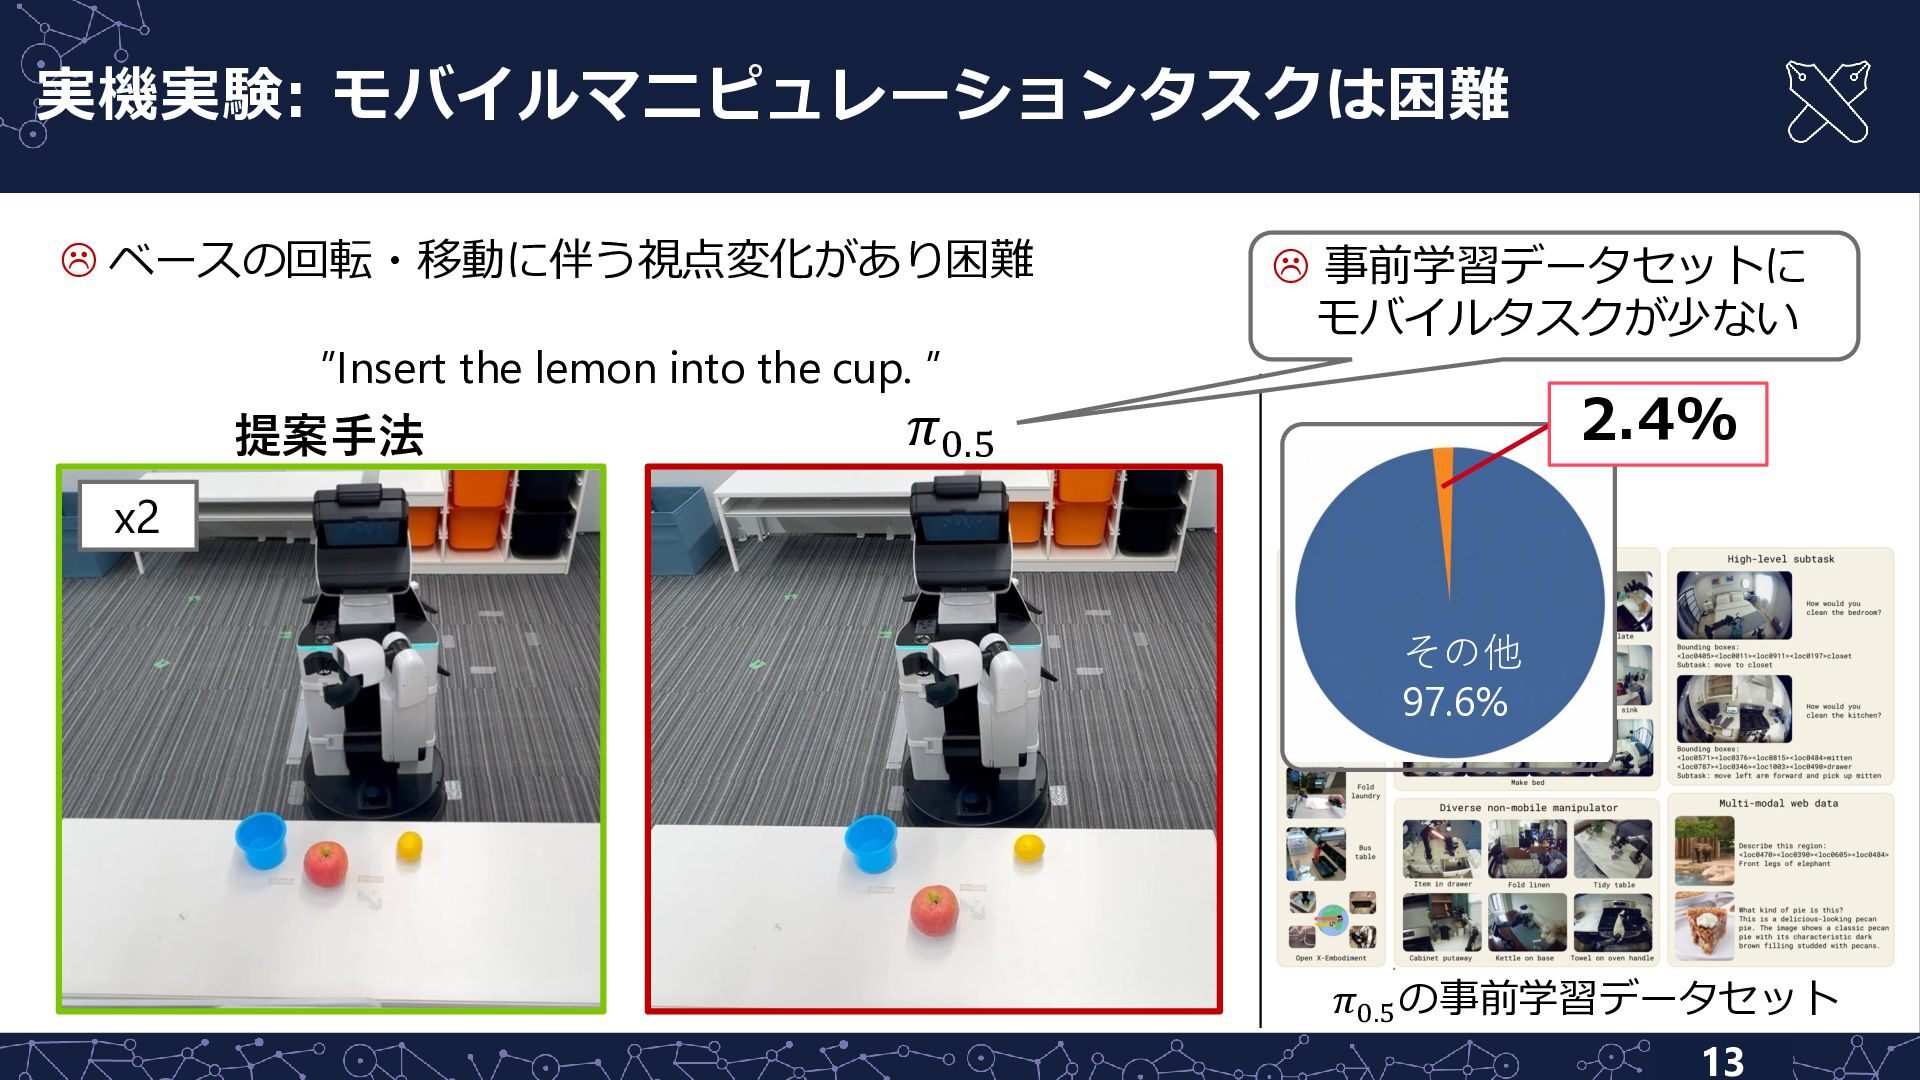
実機実験: モバイルマニピュレーションタスクは困難 ベースの回転・移動に伴う視点変化があり困難 ”Insert the lemon into the cup.
” 提案手法 事前学習データセットに モバイルタスクが少ない 2.4% 𝜋0.5 x2 その他 97.6% 𝜋0.5 の事前学習データセット 13
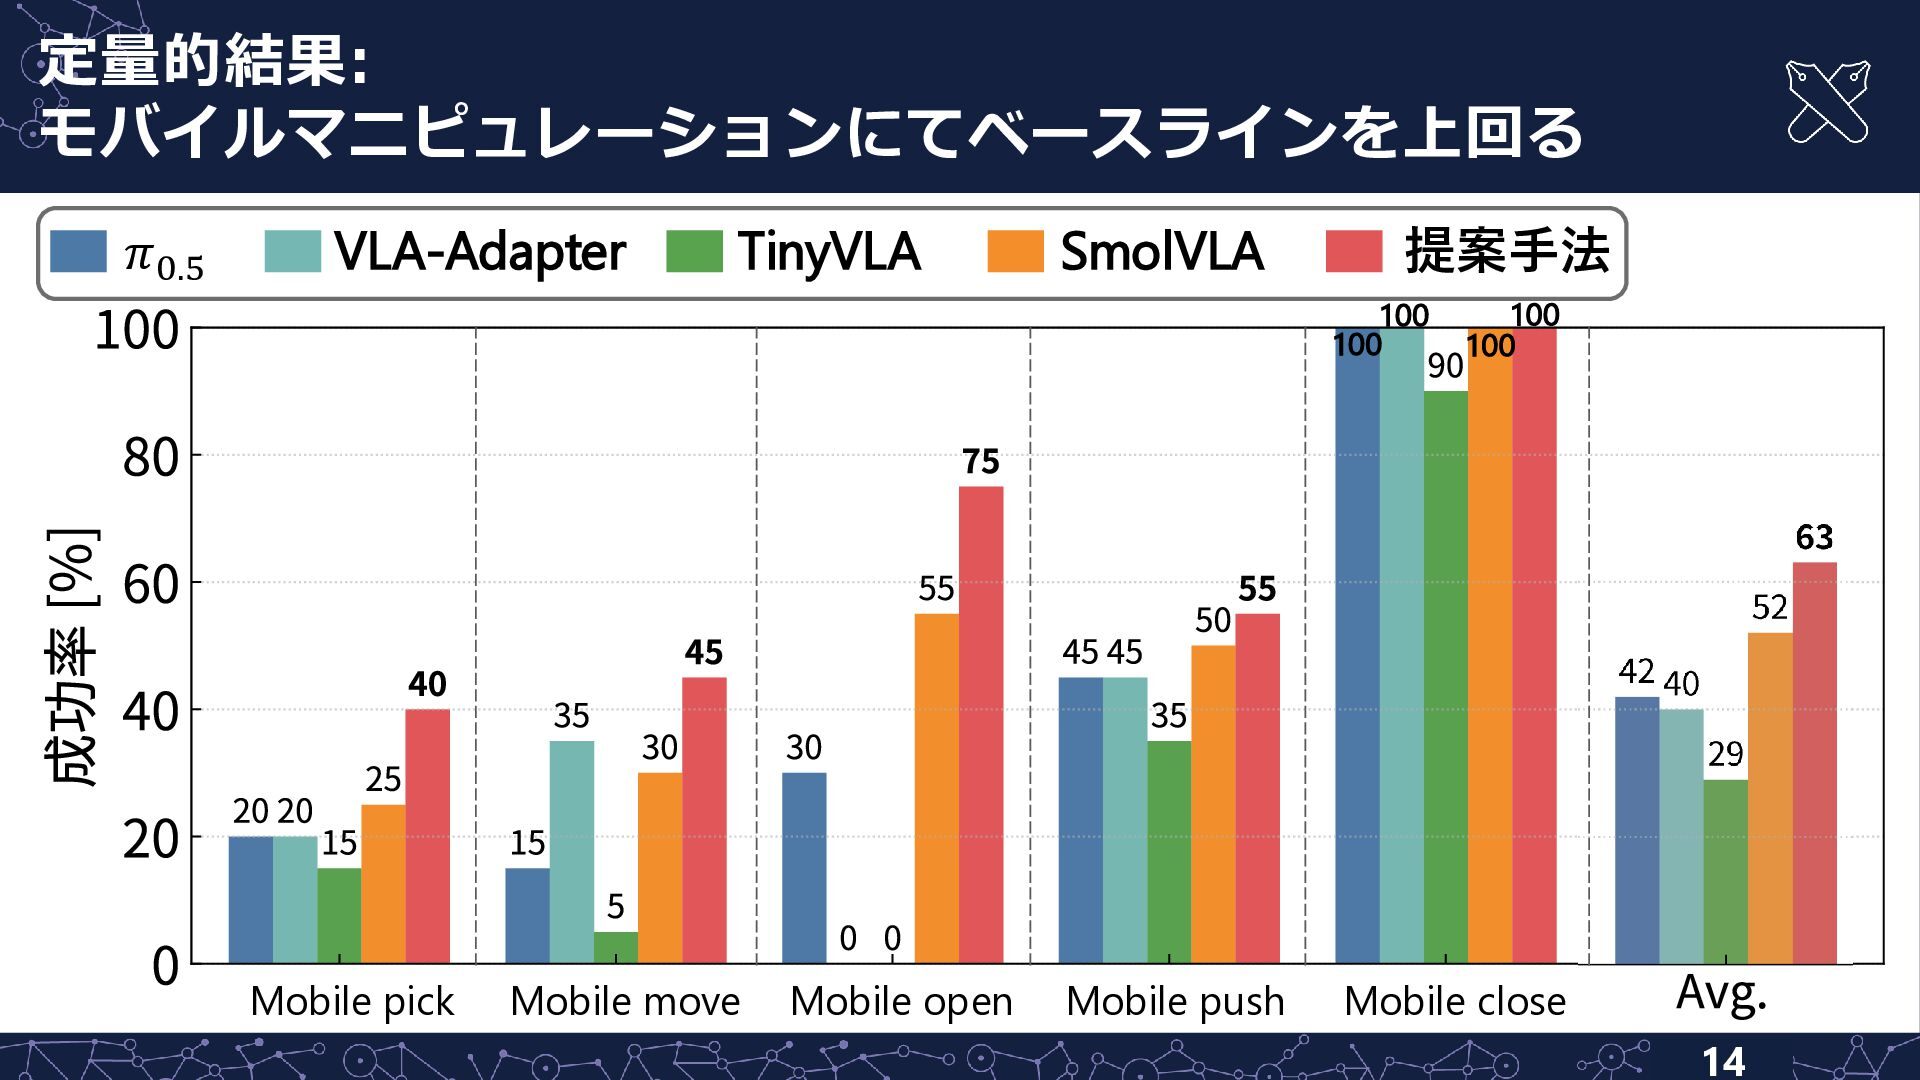
定量的結果: モバイルマニピュレーションにてベースラインを上回る 𝜋0.5 VLA-Adapter TinyVLA SmolVLA 提案手法 100 100 Mobile
pick Mobile move Mobile open Mobile push 100 100 Mobile close 14
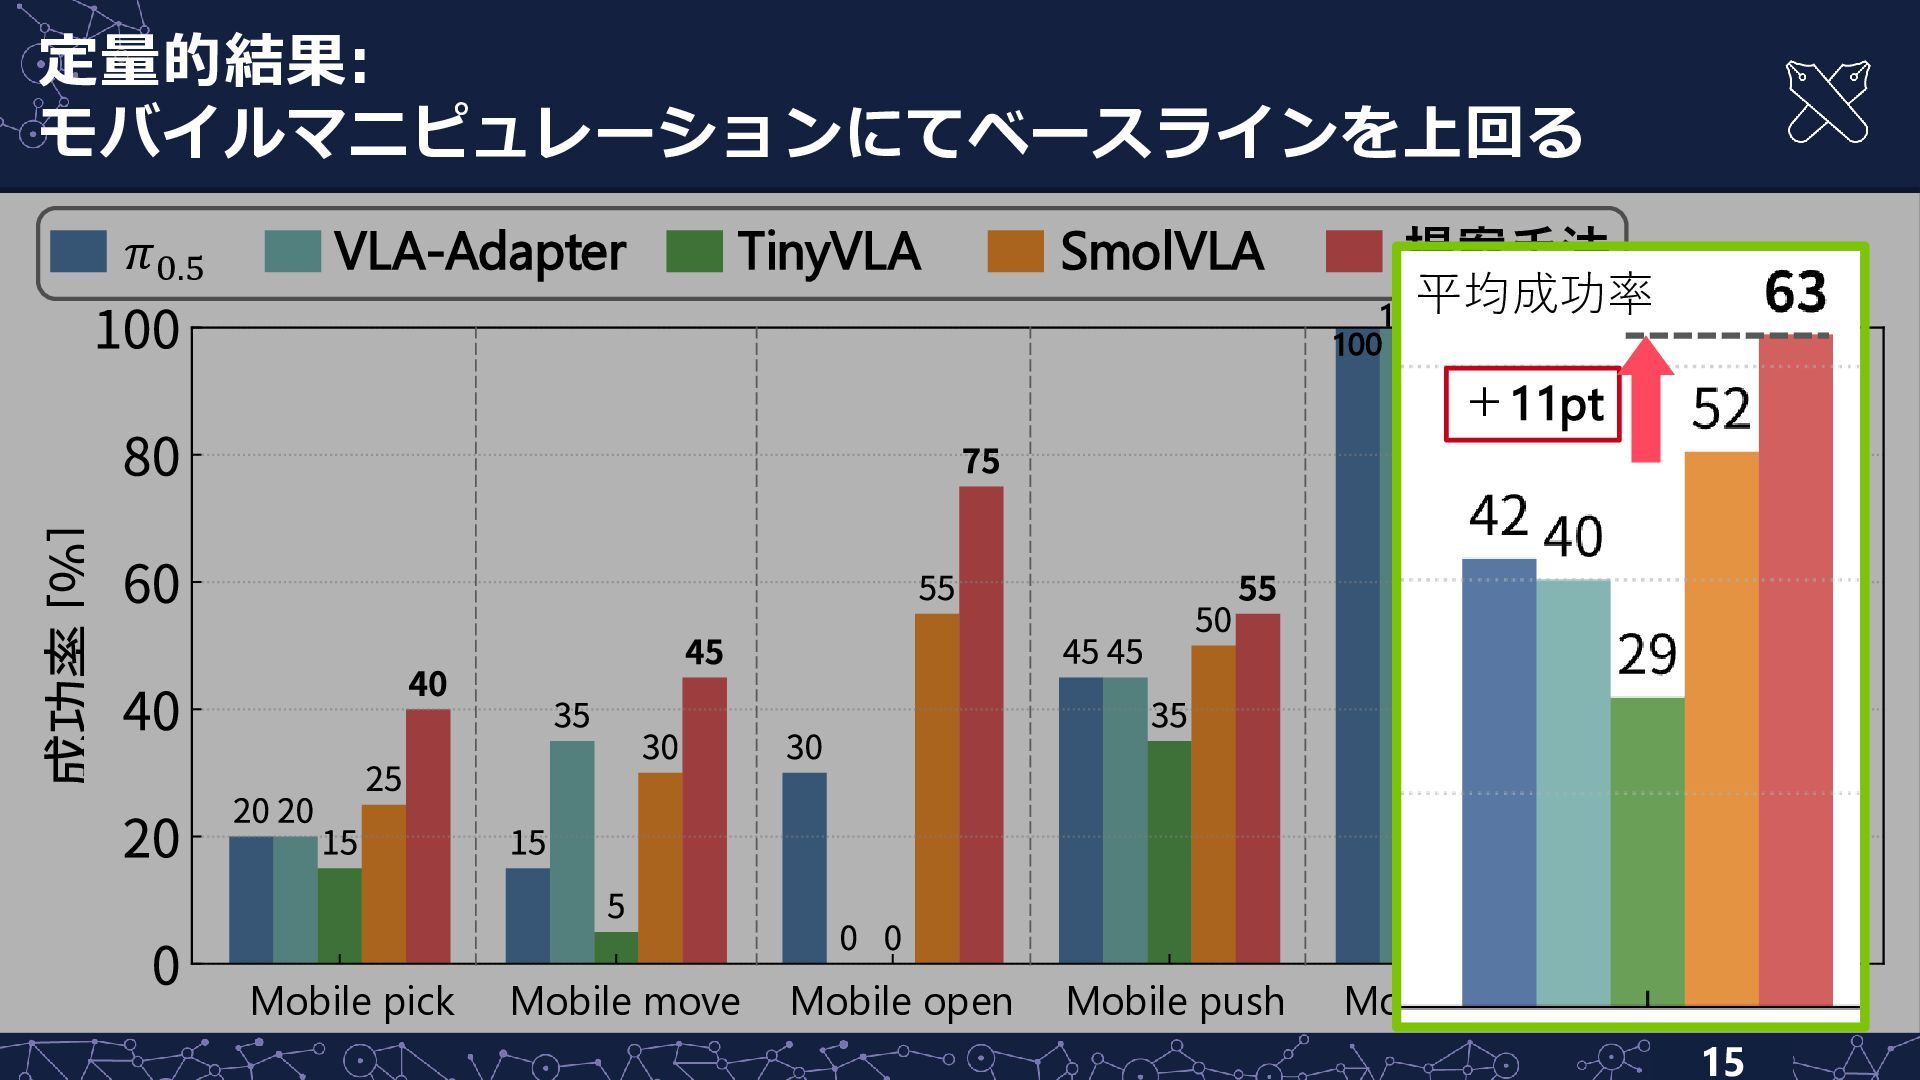
定量的結果: モバイルマニピュレーションにてベースラインを上回る 𝜋0.5 VLA-Adapter TinyVLA SmolVLA 提案手法 100 100平均成功率 100
100 +11pt Mobile pick Mobile move Mobile open Mobile push Mobile close 15
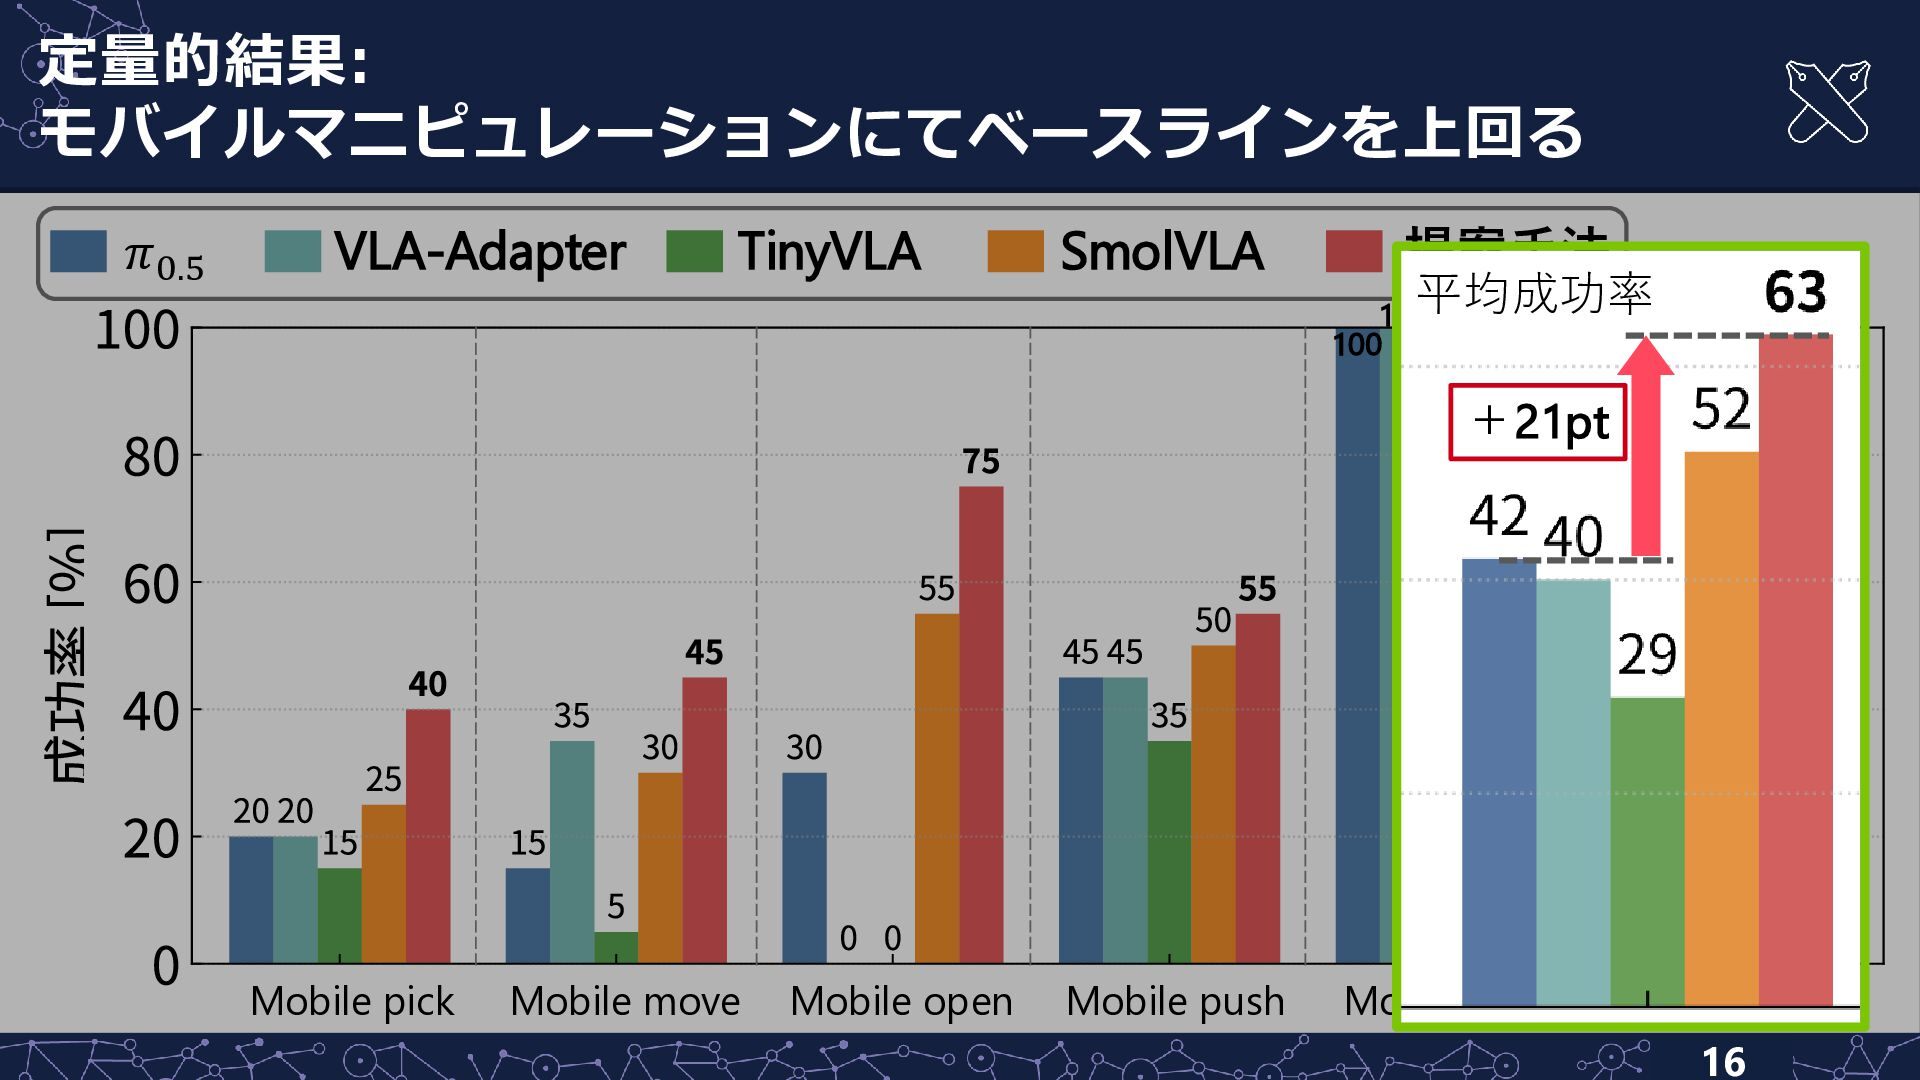
定量的結果: モバイルマニピュレーションにてベースラインを上回る 𝜋0.5 VLA-Adapter TinyVLA SmolVLA 提案手法 100 100平均成功率 100
100 +21pt Mobile pick Mobile move Mobile open Mobile push Mobile close 16
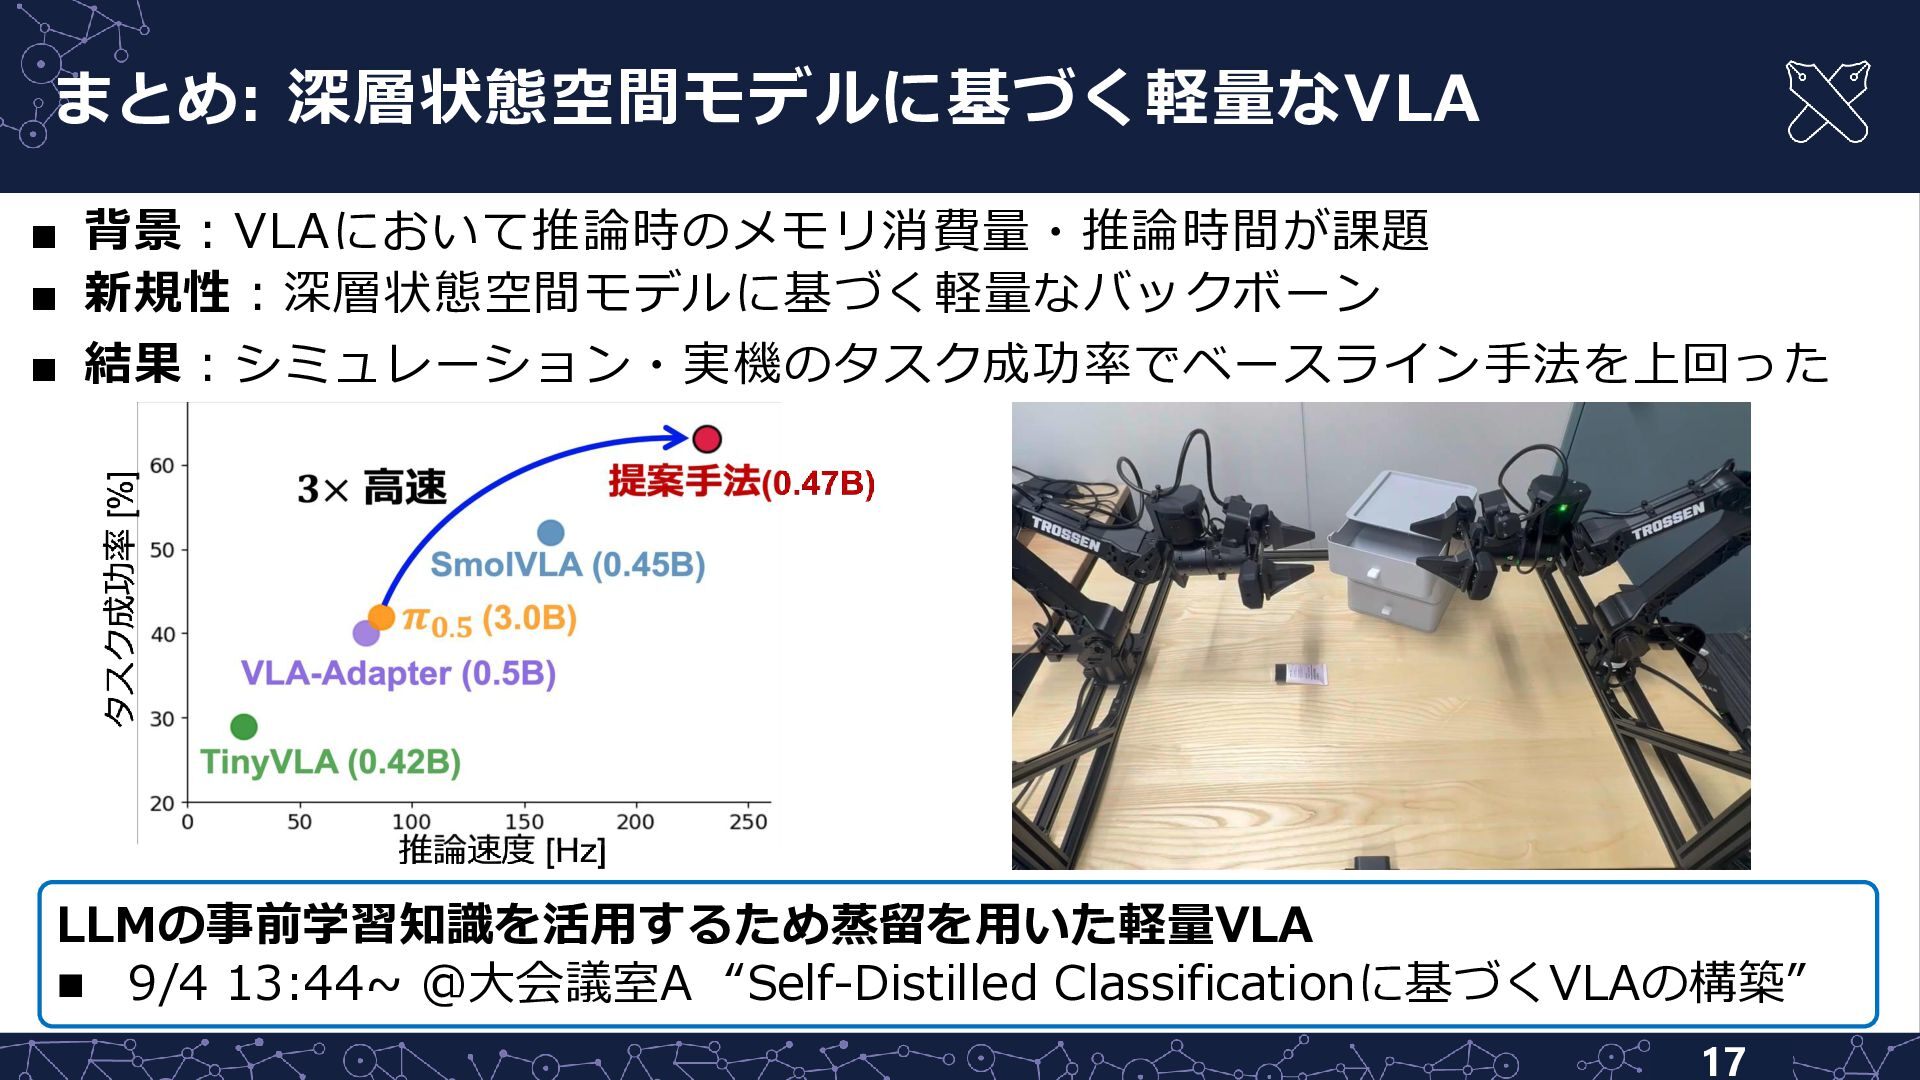
まとめ: 深層状態空間モデルに基づく軽量なVLA ▪ 背景:VLAにおいて推論時のメモリ消費量・推論時間が課題 ▪ 新規性:深層状態空間モデルに基づく軽量なバックボーン ▪ 結果:シミュレーション・実機のタスク成功率でベースライン手法を上回った LLMの事前学習知識を活用するため蒸留を用いた軽量VLA ◼
9/4 13:44~ @大会議室A “Self-Distilled Classificationに基づくVLAの構築” 17
Appendix
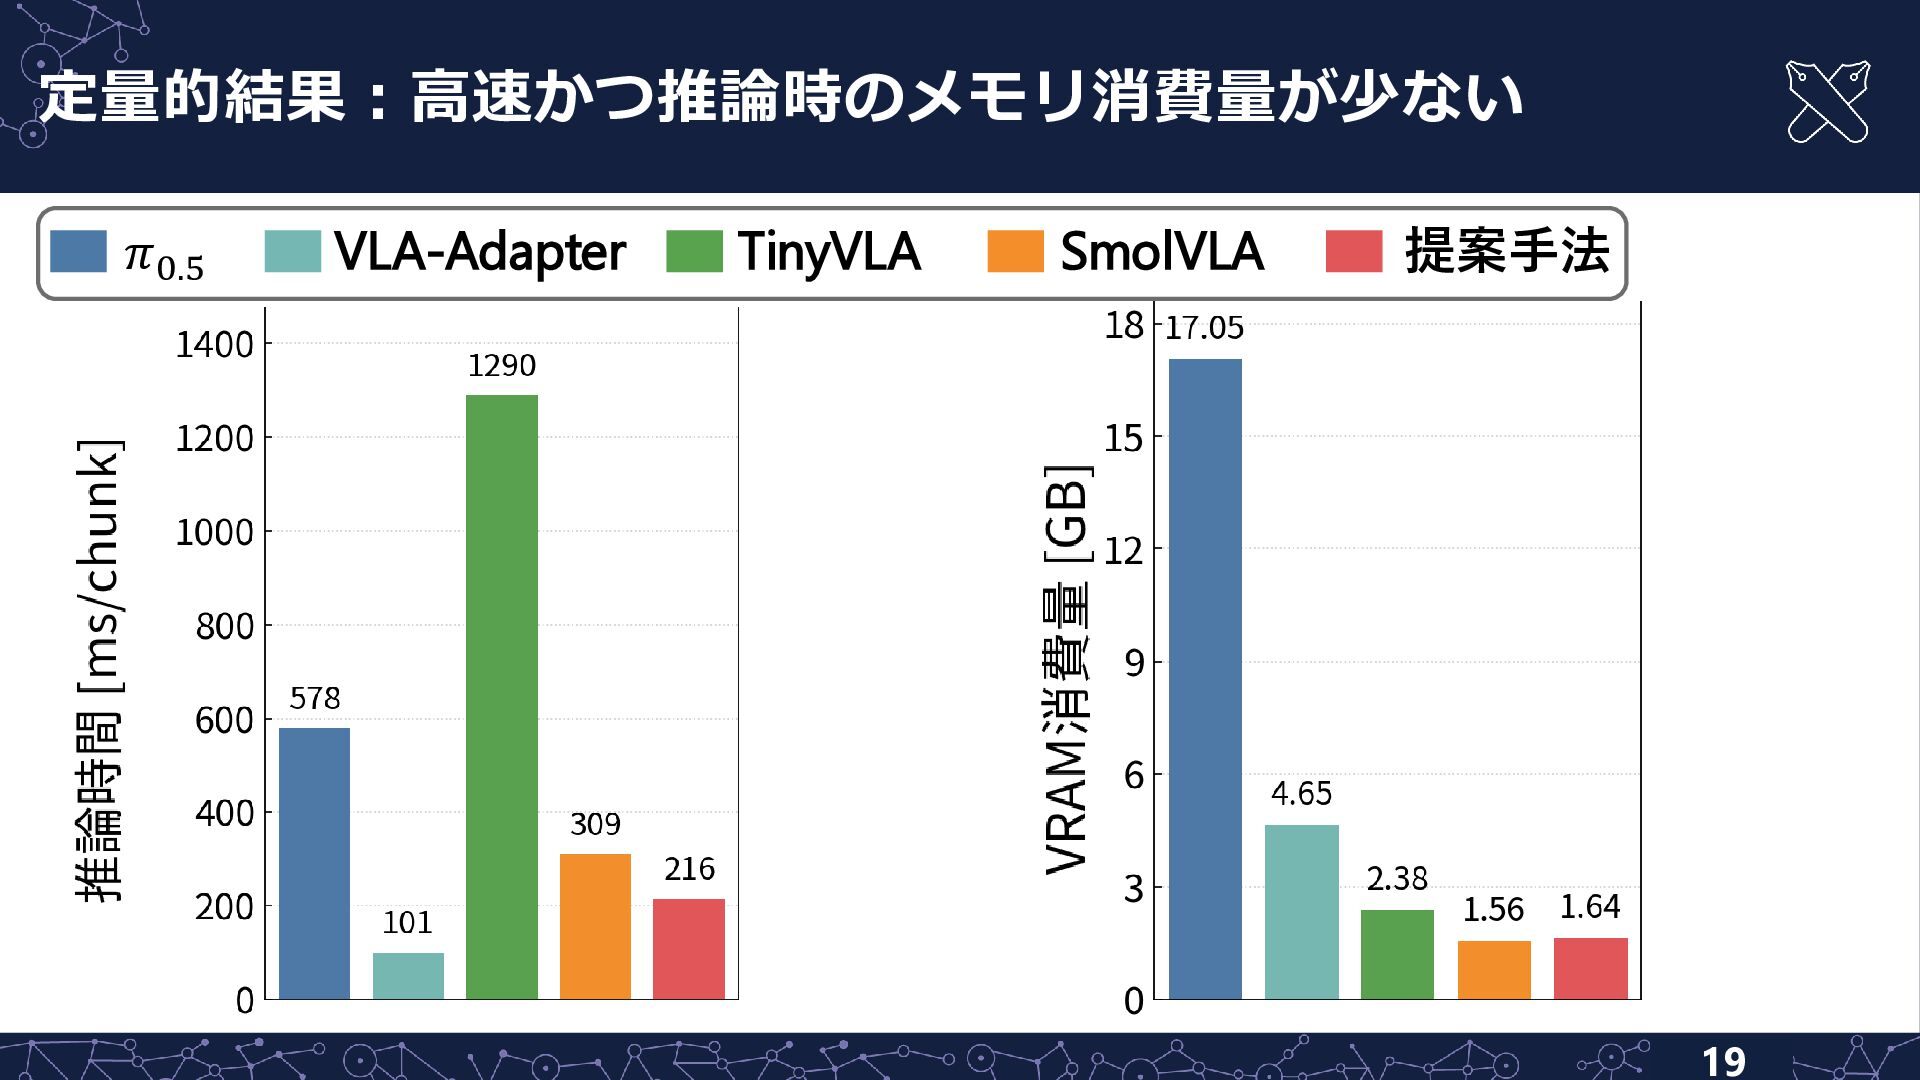
定量的結果:高速かつ推論時のメモリ消費量が少ない 𝜋0.5 VLA-Adapter TinyVLA SmolVLA 提案手法 19
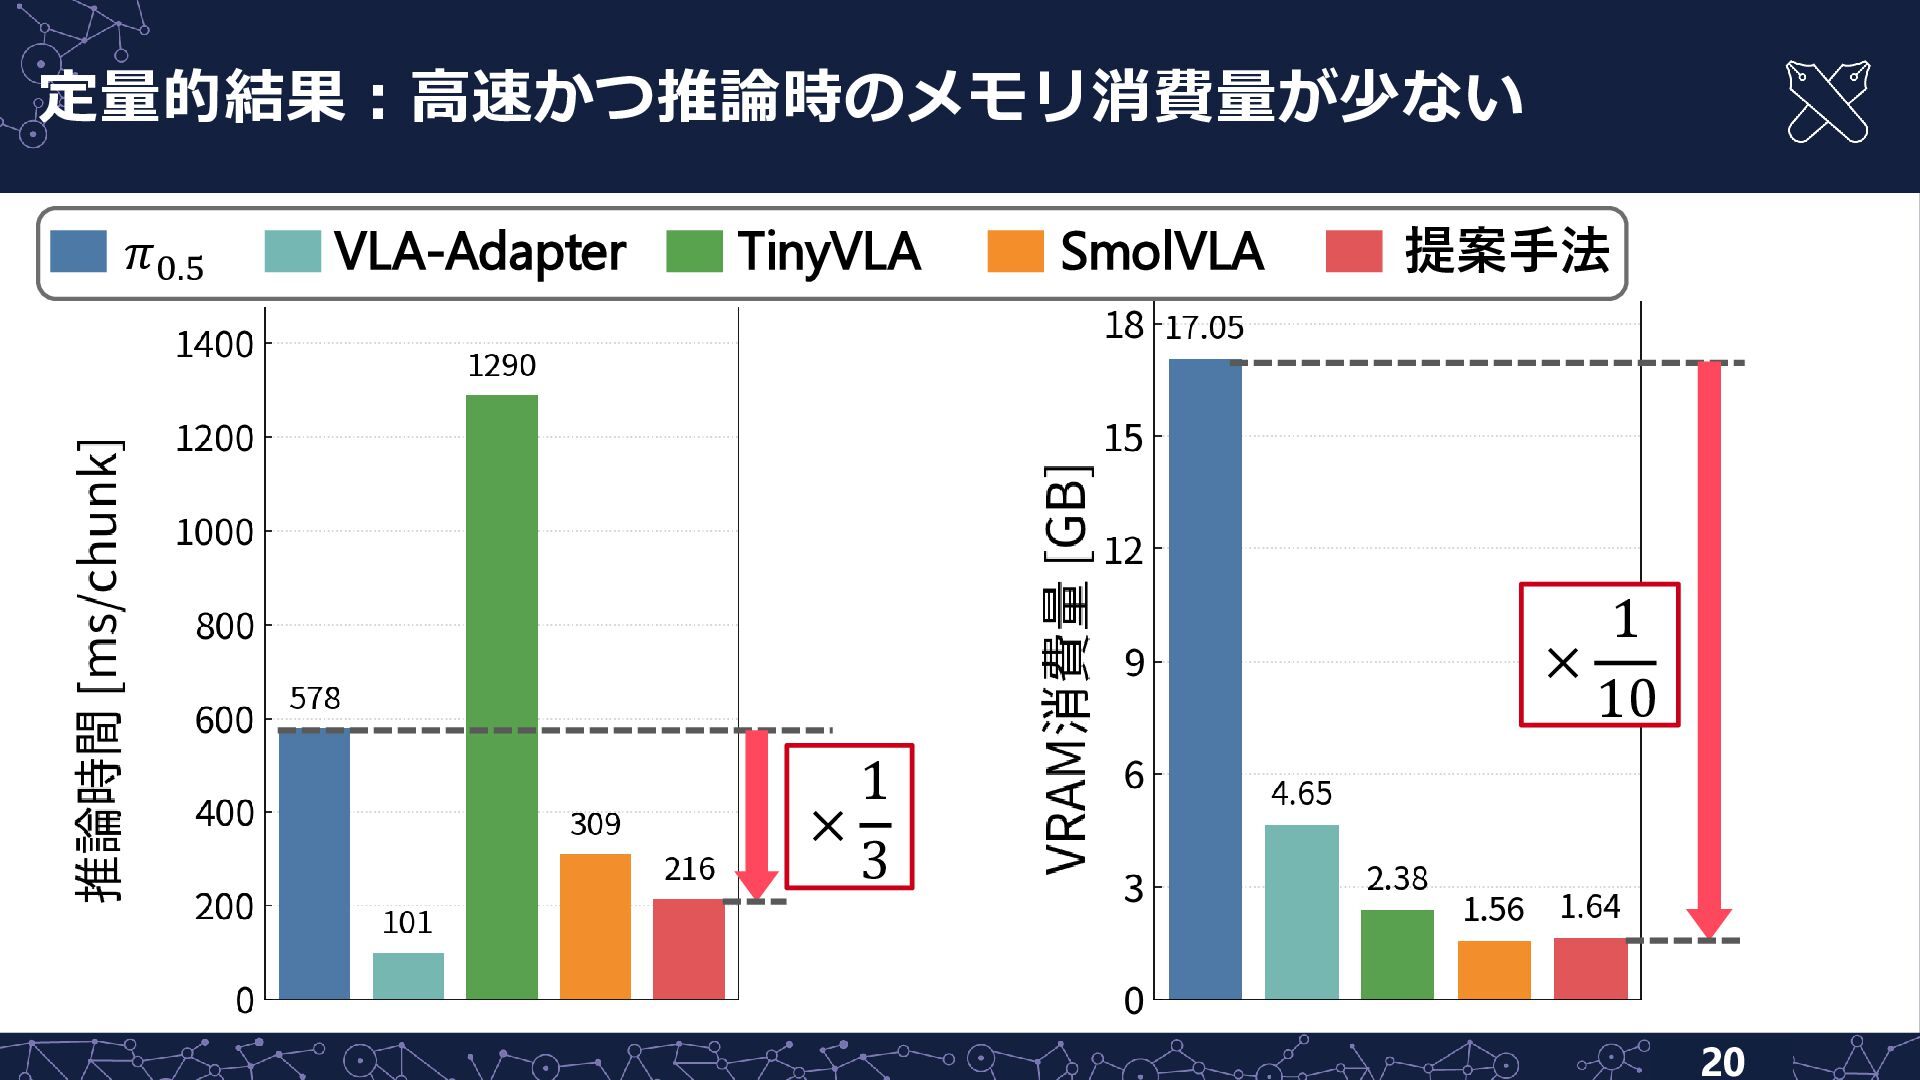
定量的結果:高速かつ推論時のメモリ消費量が少ない 𝜋0.5 VLA-Adapter TinyVLA SmolVLA 提案手法 1 × 10 1
× 3 20
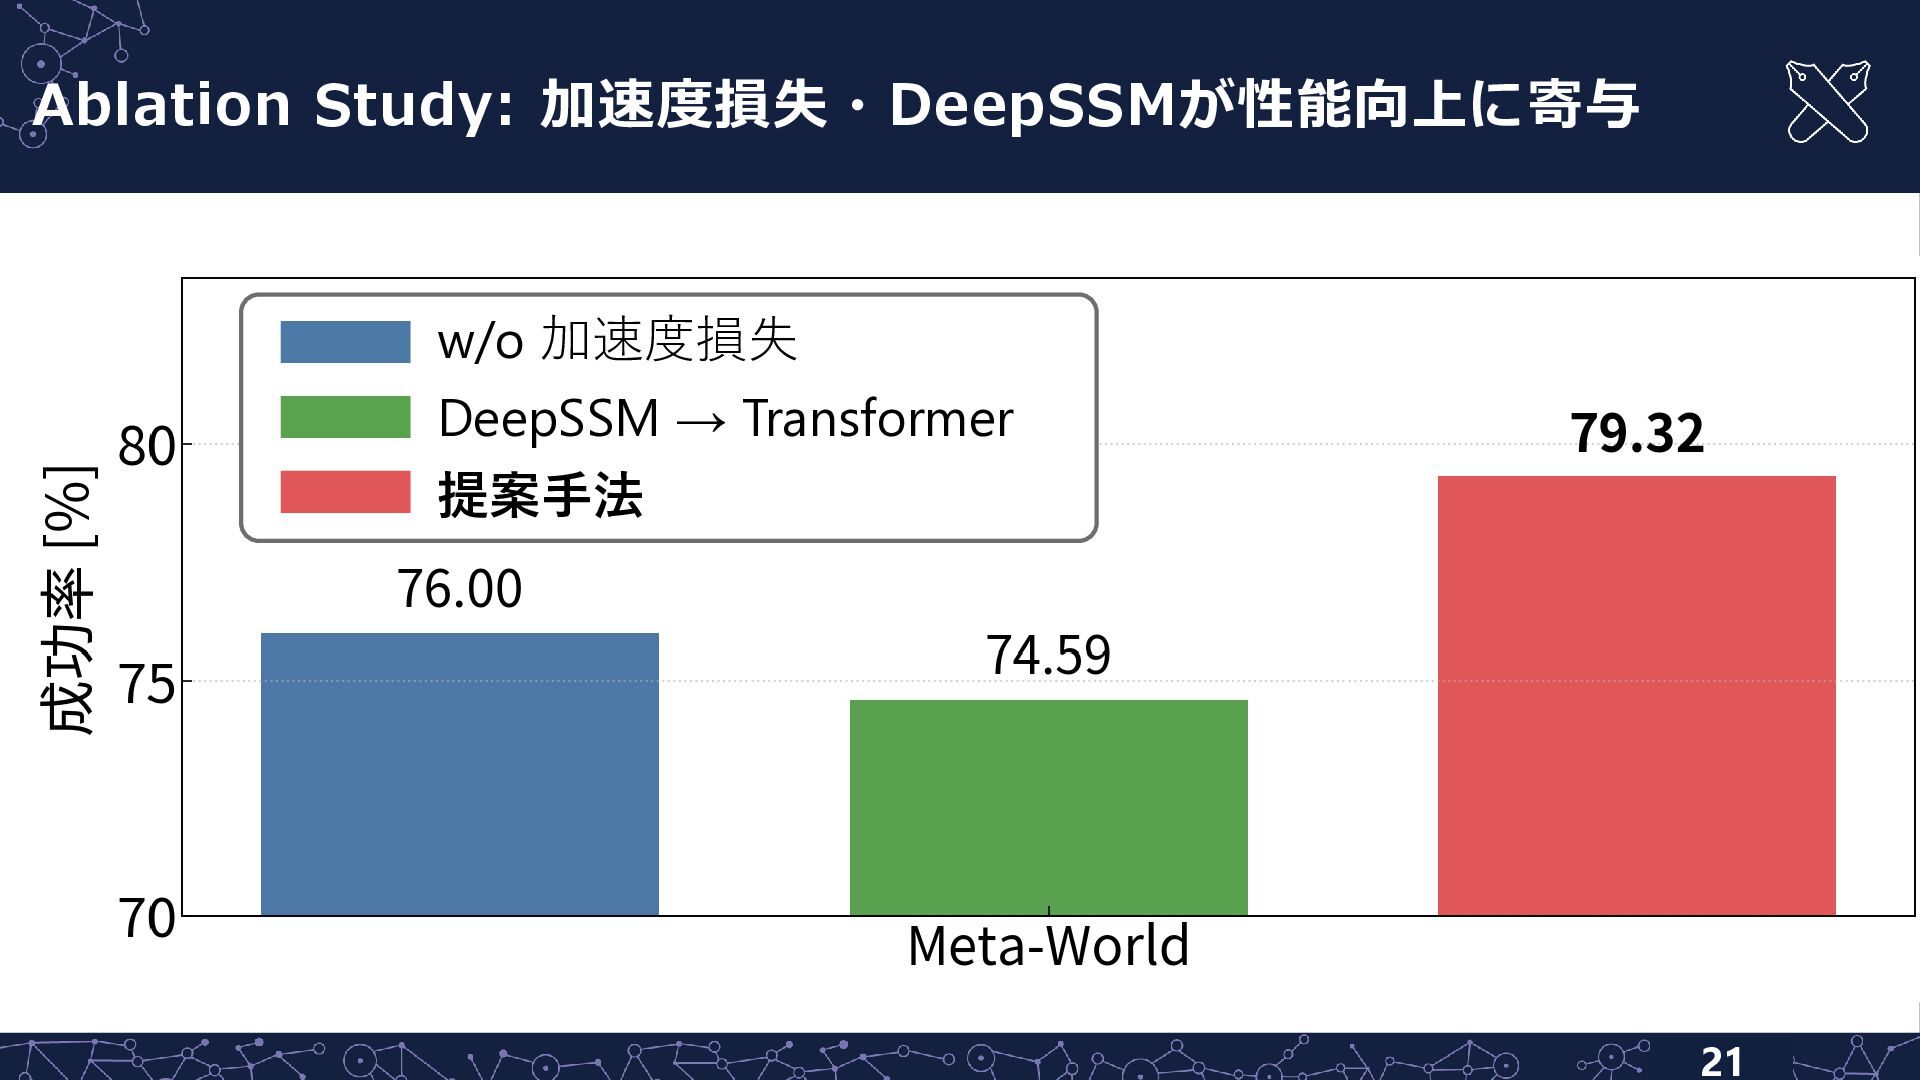
Ablation Study: 加速度損失・DeepSSMが性能向上に寄与 w/o 加速度損失 DeepSSM → Transformer 提案手法 21
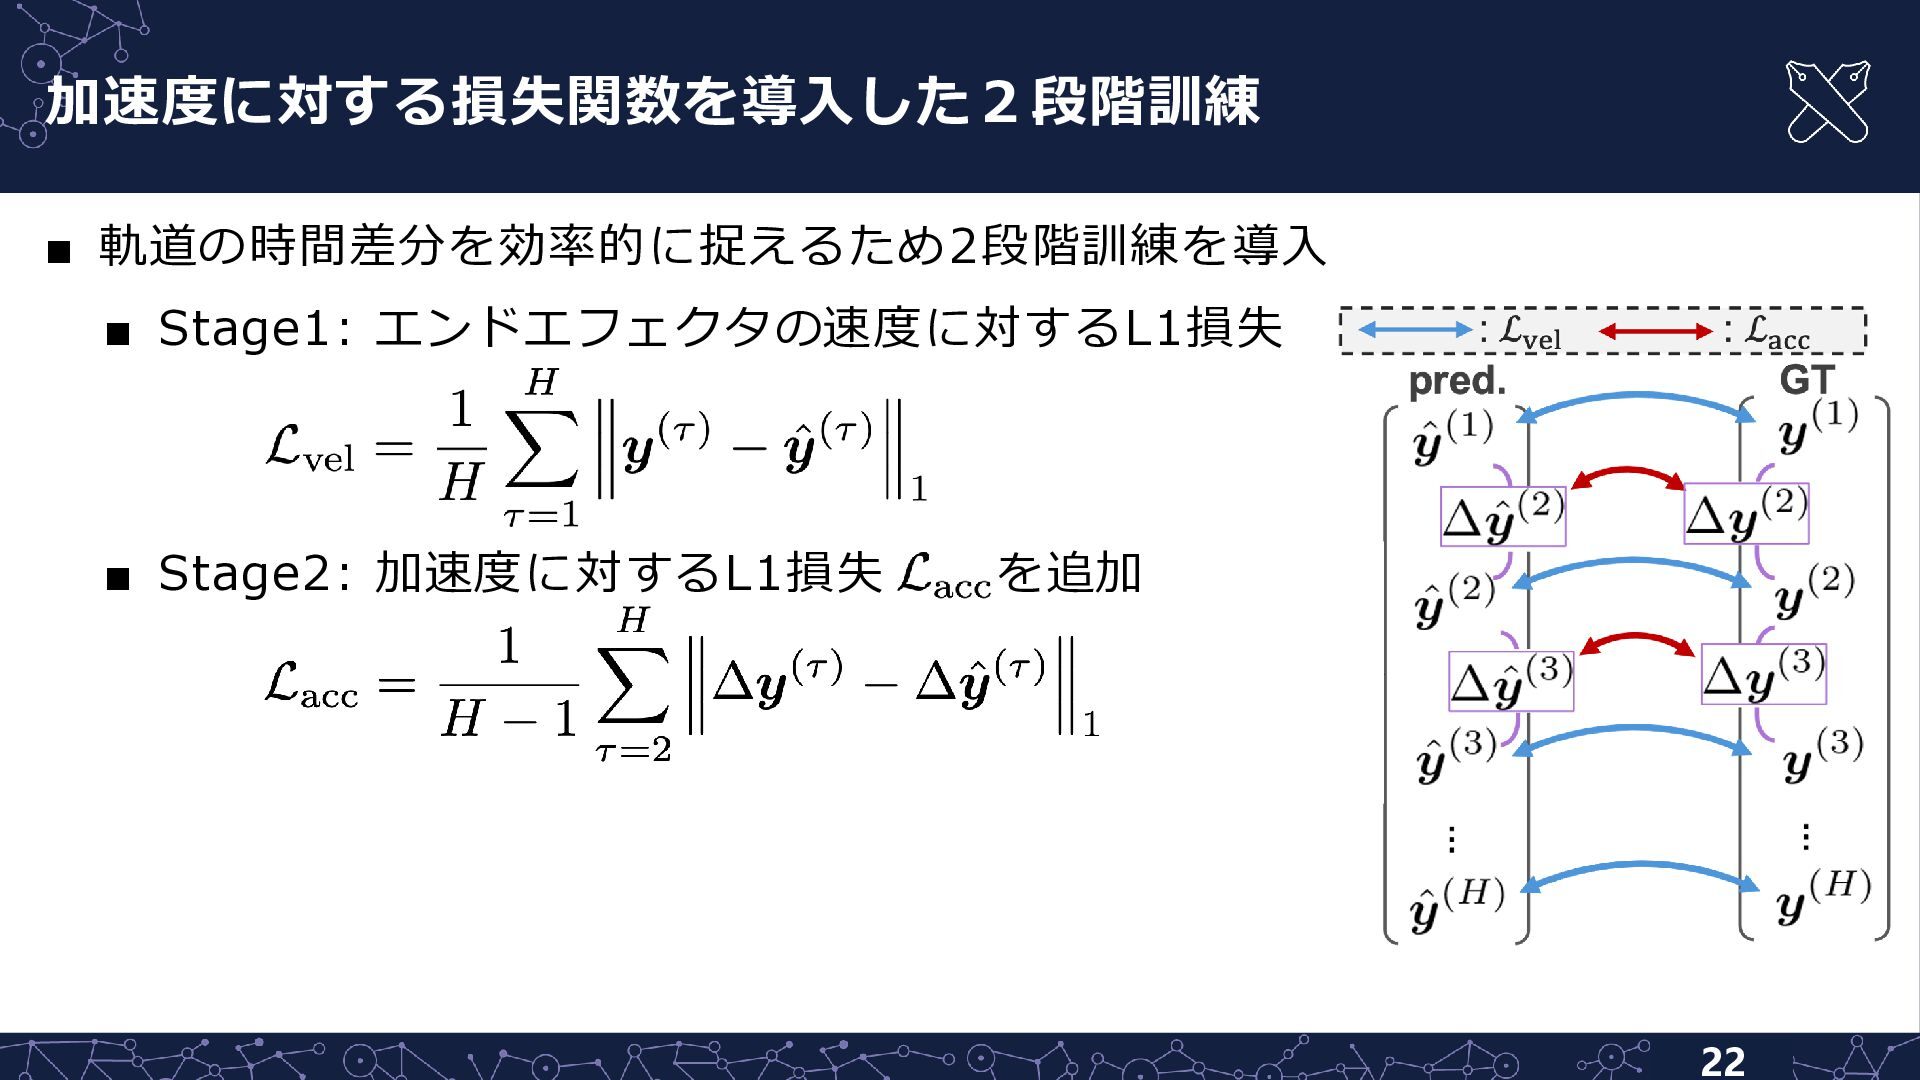
加速度に対する損失関数を導入した2段階訓練 ▪ 軌道の時間差分を効率的に捉えるため2段階訓練を導入 ▪ Stage1: エンドエフェクタの速度に対するL1損失 ▪ Stage2: 加速度に対するL1損失. .
を追加 22
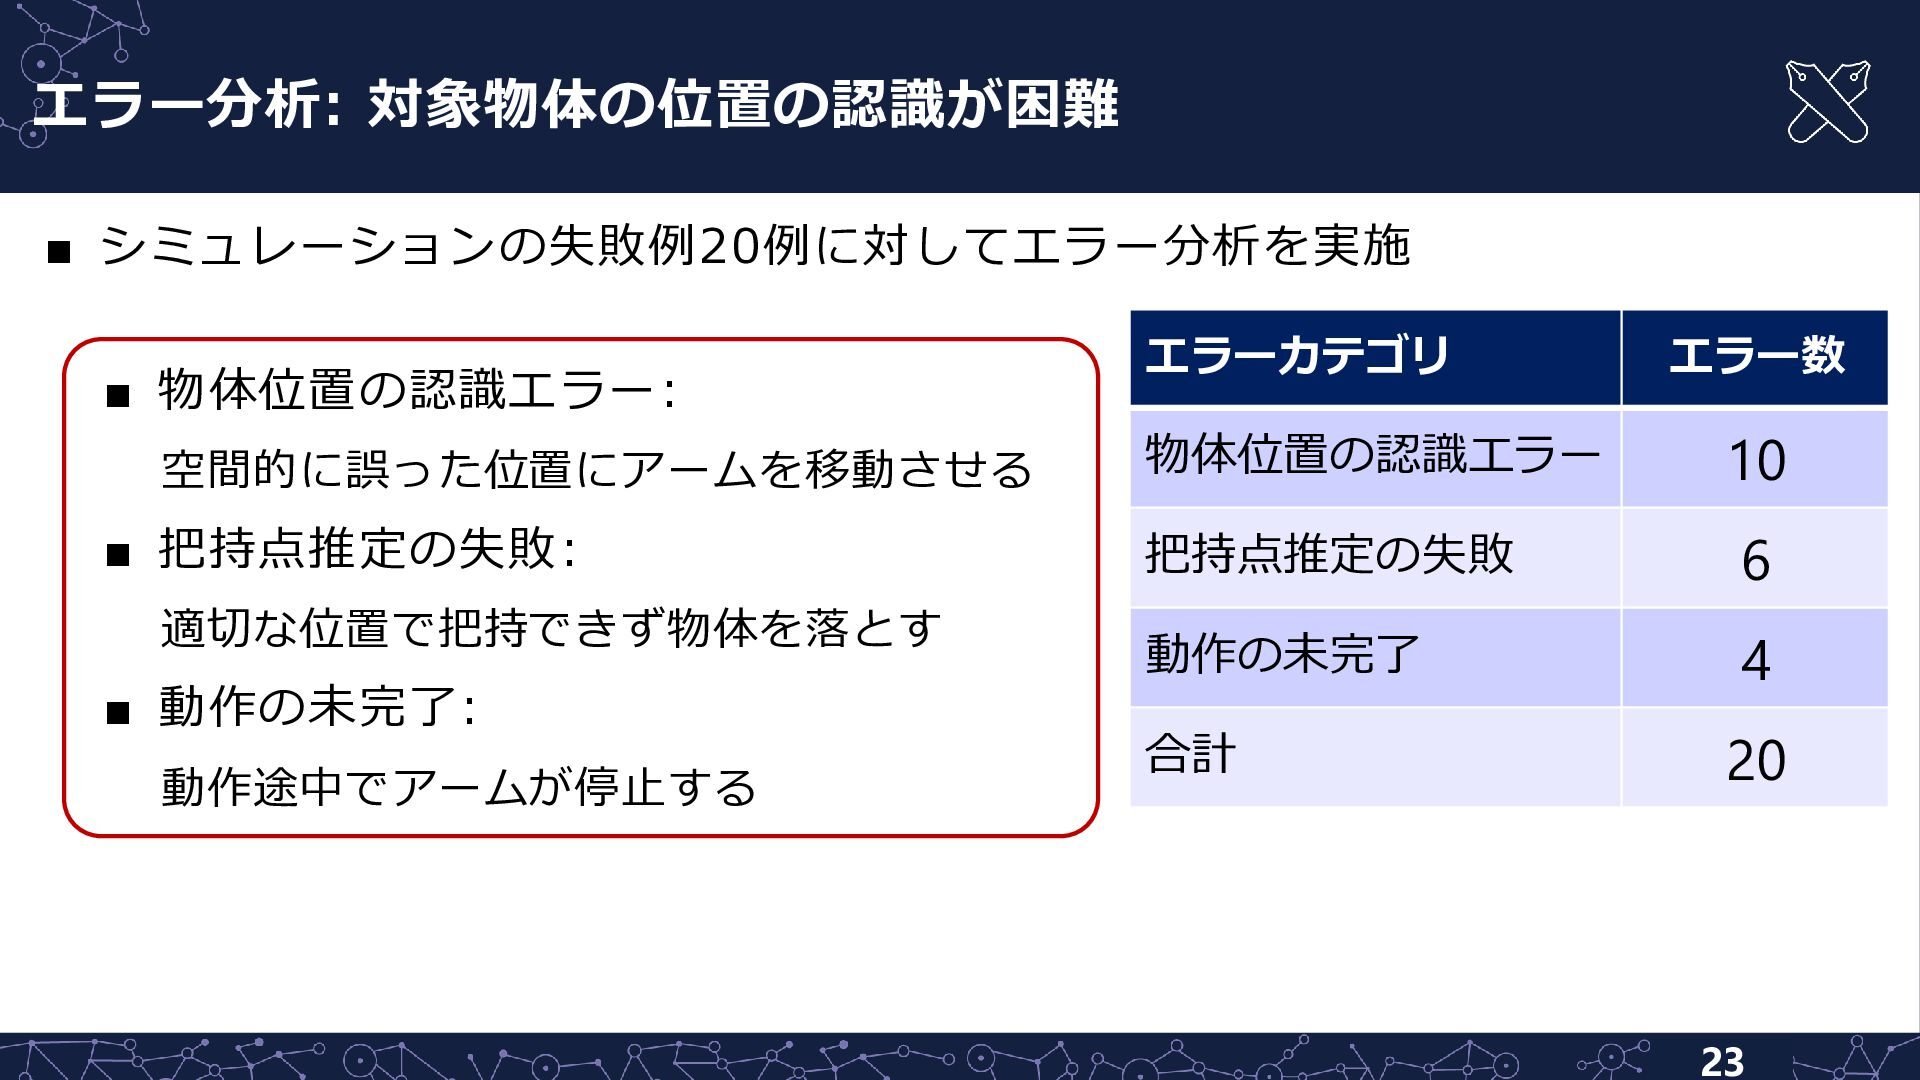
エラー分析: 対象物体の位置の認識が困難 ▪ シミュレーションの失敗例20例に対してエラー分析を実施 ▪ 物体位置の認識エラー: 空間的に誤った位置にアームを移動させる ▪ 把持点推定の失敗: 適切な位置で把持できず物体を落とす
▪ 動作の未完了: 動作途中でアームが停止する エラーカテゴリ エラー数 物体位置の認識エラー 10 把持点推定の失敗 6 動作の未完了 4 合計 20 23
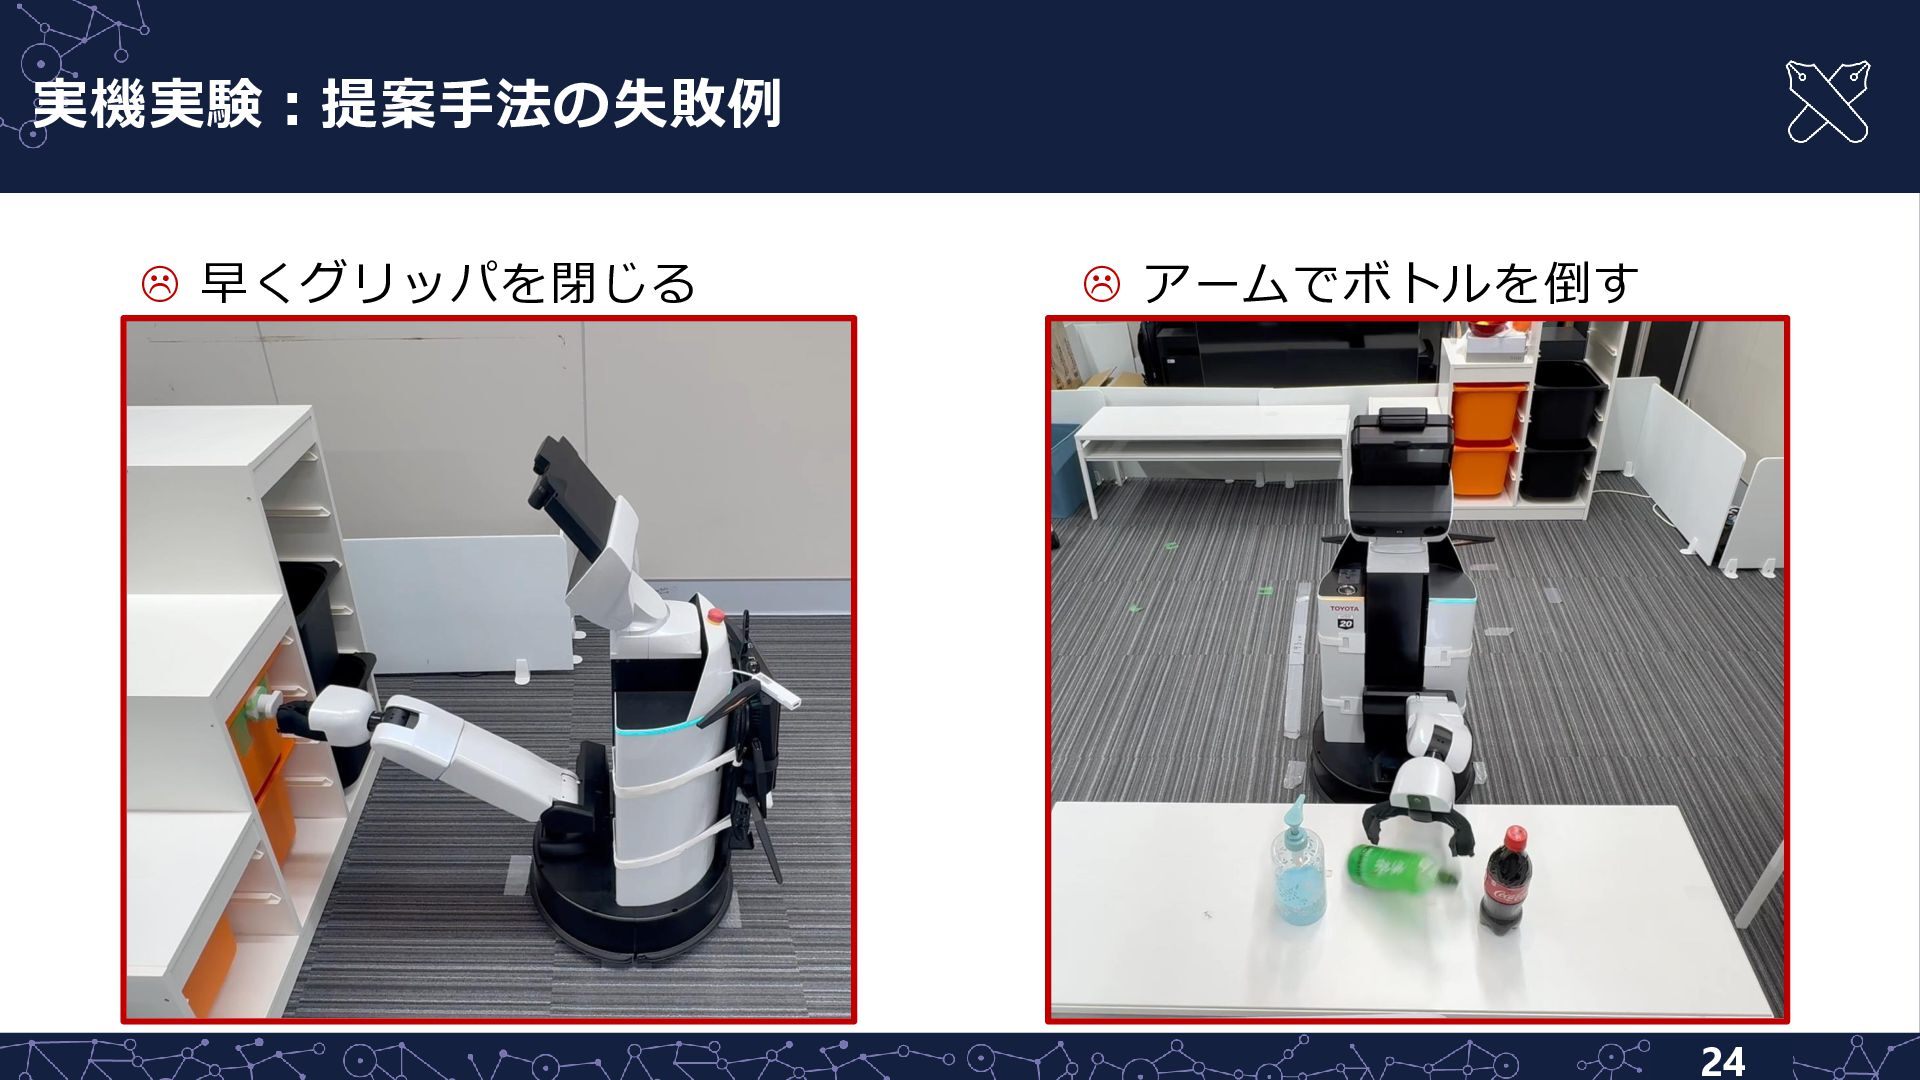
実機実験:提案手法の失敗例 早くグリッパを閉じる アームでボトルを倒す 24


 keio_smilab
 tosite
 ysuzuki
 kawametho
 mtpooh
 kmiya84377
 yoshiakiyamasaki
 ennael
 maimyyym
 dvrv_tknrszk
 leveragestech
 foursue
 tkuchiki
 honzajavorek
 jlugia
 jcasabona
 marketingsoph
 twada
 danielanewman
 stuffmc
 lauravandoore
 eileencodes
 inesmontani
 coloredviolet
 kastner