Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
ローカルLLMでどこまでコードが書けるか / How much code can be wri...
Search
Naoki Kishida
May 13, 2026
Programming
670
2
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
ローカルLLMでどこまでコードが書けるか / How much code can be written on a local LLM
2026/5/13のイベントでの登壇資料です
https://levtechlab.connpass.com/event/389511/
Naoki Kishida
May 13, 2026
More Decks by Naoki Kishida
See All by Naoki Kishida
コードで差別化できない時代の ソフトウェアエンジニアリング / Software Engineering in an Era Where Code Doesn’t Differentiate
kishida
2
180
GemmaをJevのように使ってみる / Use Gemma like Jev
kishida
5
820
Java 27新機能 / Java 27 new features
kishida
2
240
ローカルLLMでどこまでコードが書けるか -LLM基礎知識 / How much code can be written on a local LLM - fundamental knowledge
kishida
10
11k
ソフトウェアエンジニアにとっての生成AI - 特性を知って使い倒す / generative ai for software enginner
kishida
7
2.5k
ローカルLLMでどこまでコードが書けるか -縮小版 / How much code can be written on a local LLM Shortened
kishida
2
430
ローカルLLMでどこまでコードが書けるか -拡張版 / How much code can be written on a local LLM Extended
kishida
12
5.7k
Javaの型とAI時代に型が大事な理由 / java types and type in AI era
kishida
2
290
ローカルLLM基礎知識 / local LLM basics 2025
kishida
30
18k
Other Decks in Programming
See All in Programming
SalesForceを内製化!? ~ HR事業を支える顧客管理基盤のインフラを大公開 ~
oku053
0
190
残高管理から台帳サービスへの進化
artoy
1
210
Verilogで学ぶCPU自作入門
uyuki234
8
4.2k
[Dev Group Paris Octobre 26] Agentforce, SIforce, Claudeforce, Slackbot… on s'y retrouve ?
nabondance
0
120
dotNET_vulnclicker_intro.pdf
deka_morita
0
150
エージェントを使い続けるためのメタワーク / Meta-work for keeping using the agent
rkaga
4
1.4k
phperだってパンチカードでコーディングしたい
o0h
PRO
0
370
PumaからFalconに移行したRailsアプリケーションでの実践
falcon8823
0
190
No More NoSuchMethodError
exoego
1
110
月間100万人のサービス刷新で、 技術選定をHonoに振り切った話
yutobara
8
6.8k
機械に任せるテスト、人が見るテスト ⽣成AIで引き直した、運⽤保守フェーズの線引き
dske104
0
200
ジョジョの世界をXRで再現する
mofurune
0
180
Featured
See All Featured
Breaking role norms: Why Content Design is so much more than writing copy - Taylor Woolridge
uxyall
1
450
From π to Pie charts
rasagy
1
400
Typedesign – Prime Four
hannesfritz
42
3.2k
New Earth Scene 8
popppiees
4
2.7k
GitHub's CSS Performance
jonrohan
1033
470k
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
Fashionably flexible responsive web design (full day workshop)
malarkey
409
67k
How to audit for AI Accessibility on your Front & Back End
davetheseo
0
610
Leadership Guide Workshop - DevTernity 2021
reverentgeek
1
400
The Power of CSS Pseudo Elements
geoffreycrofte
82
6.6k
Building Flexible Design Systems
yeseniaperezcruz
330
41k
4 Signs Your Business is Dying
shpigford
187
23k
Transcript
ローカルLLMでどこまでコードが書けるのか 2026-05-13 レバテックLAB 「ローカルLLM 組織での“実運用”の可能性」 きしだ なおき
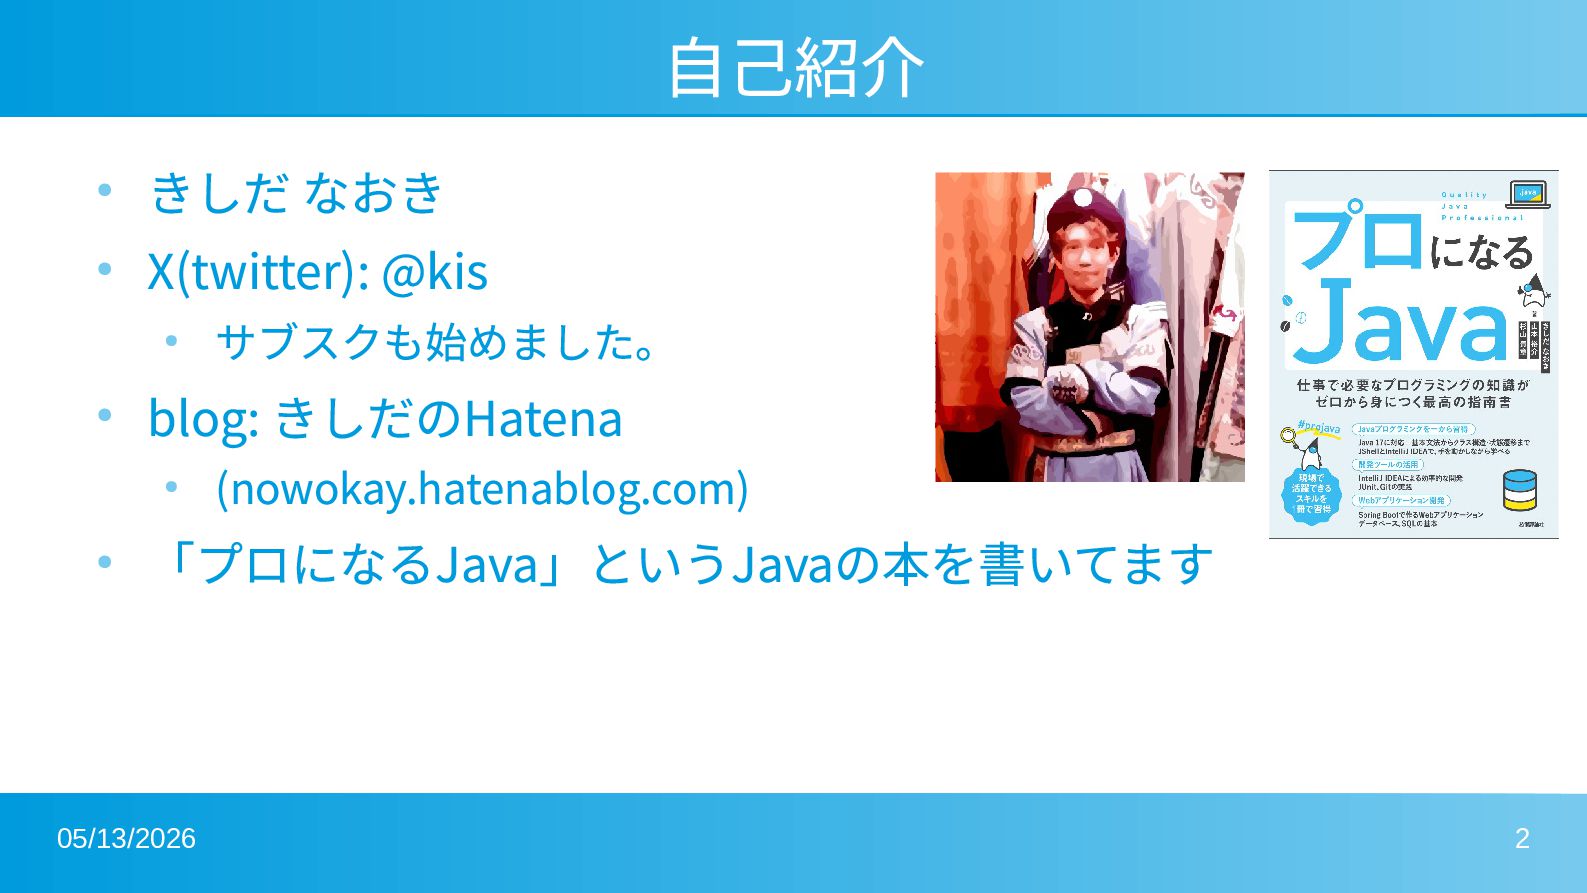
05/13/2026 2 自己紹介 • きしだ なおき • X(twitter): @kis •
サブスクも始めました。 • blog: きしだのHatena • (nowokay.hatenablog.com) • 「プロになるJava」というJavaの本を書いてます
3 2023年からの3年で おうちで動くLLMはどう変わったか
2023 「動いて偉い!」 • チャットのできるモデルが出始める • 日本語を学習させないと 日本語は話せない • 「対話できてえらい」 「聞いたことに答えてくれて
偉い」
2024「まともに動く!」 • まともな意味のある長文を出す • 特別に学習しなくても日本語で答える
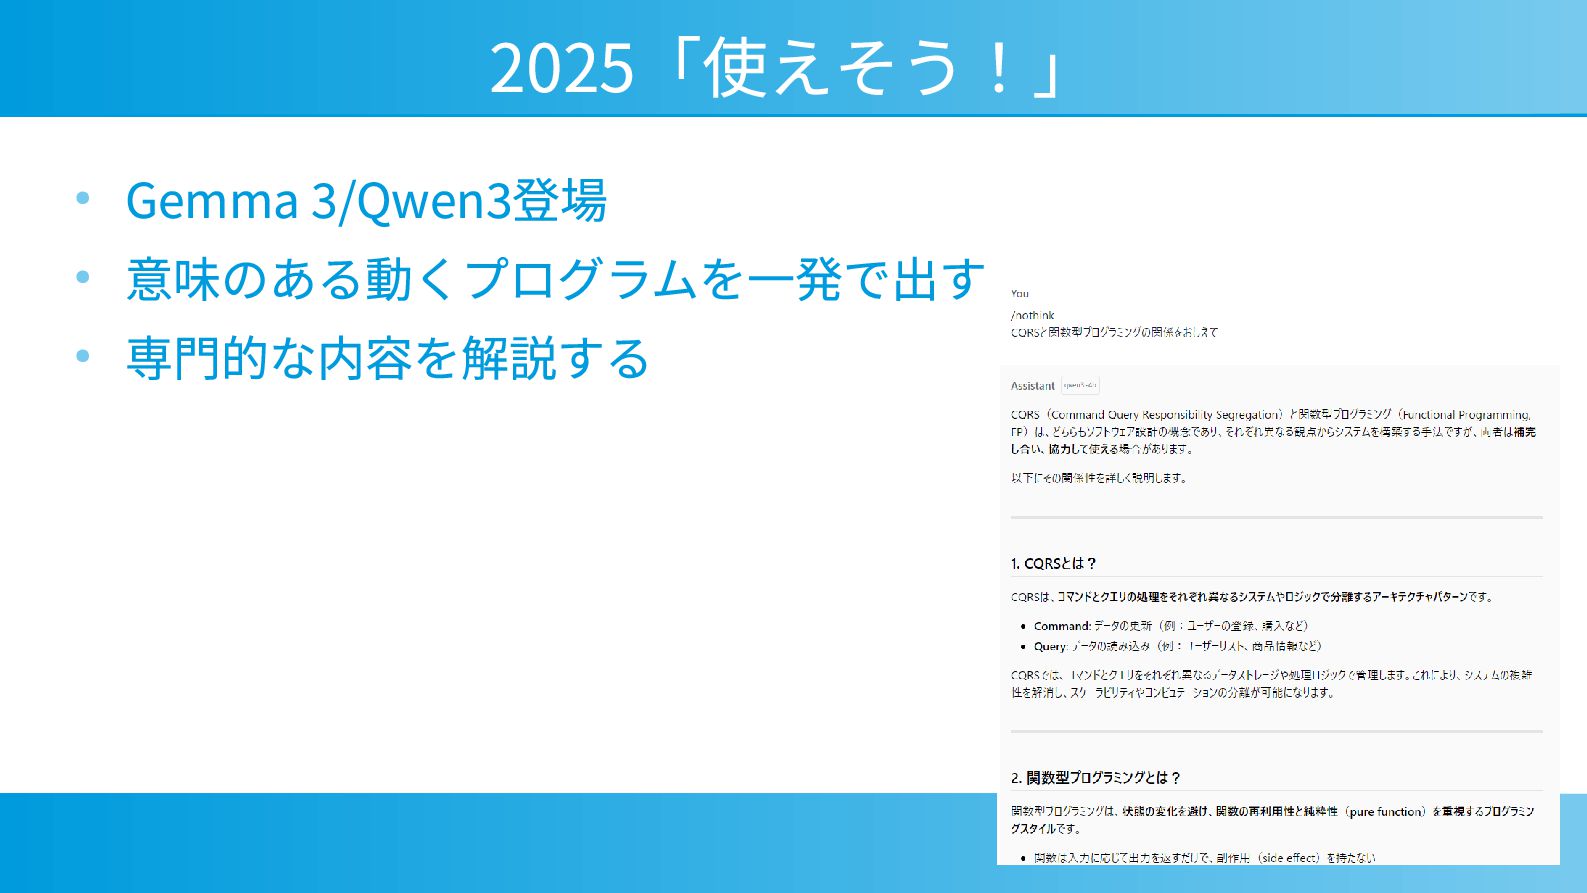
2025「使えそう!」 • Gemma 3/Qwen3登場 • 意味のある動くプログラムを一発で出す • 専門的な内容を解説する
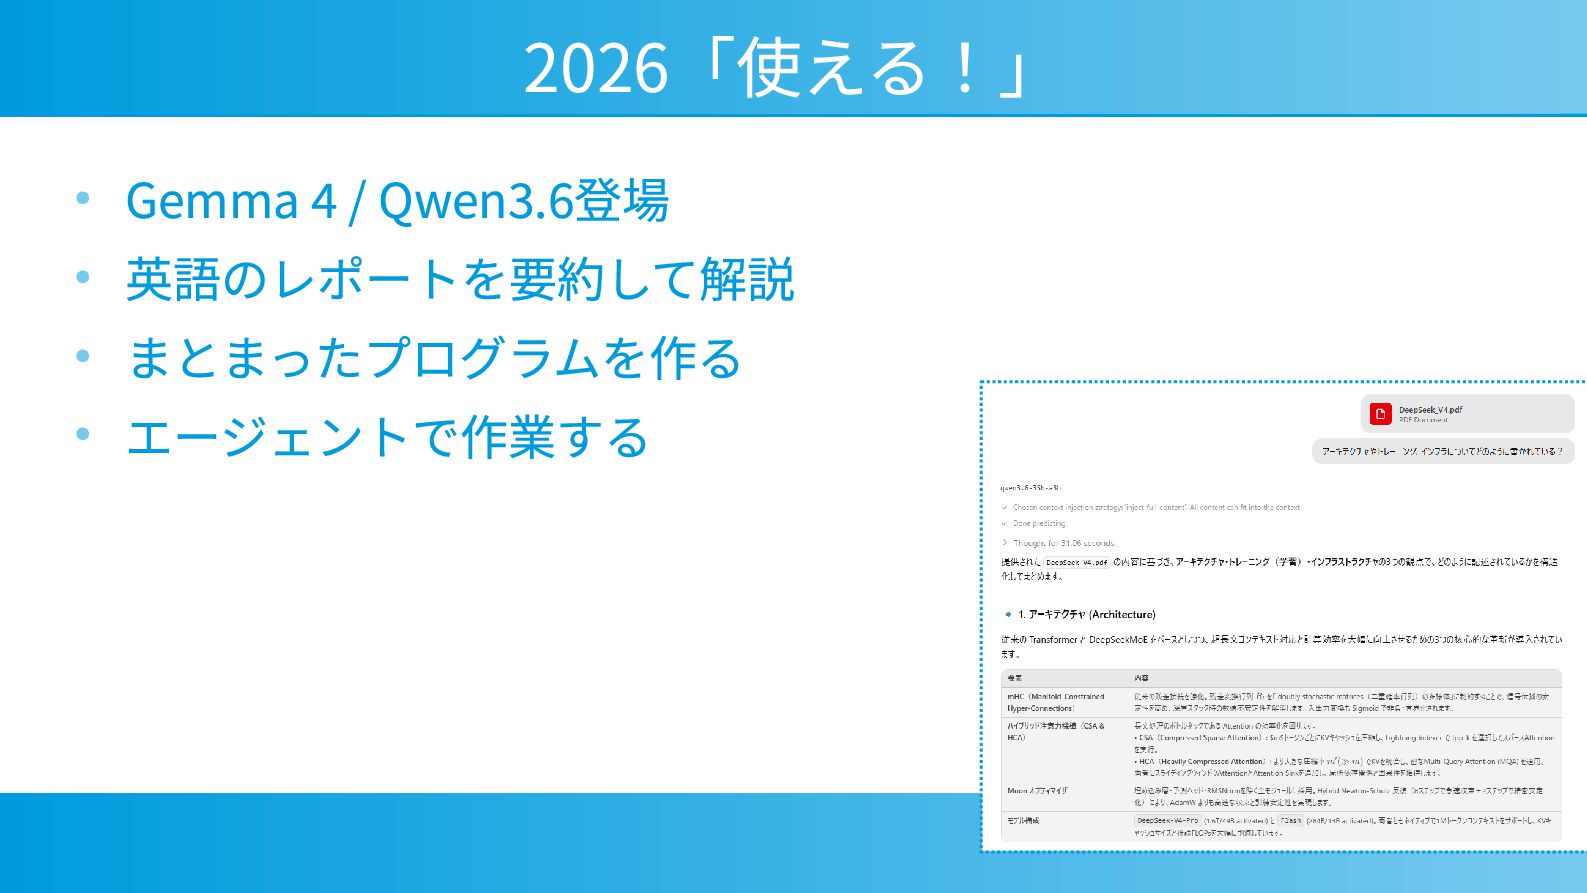
2026「使える!」 • Gemma 4 / Qwen3.6登場 • 英語のレポートを要約して解説 • まとまったプログラムを作る
• エージェントで作業する
現在の状況(モデル) • 30Bくらいのモデル • 1往復でおわるチャットには十分 • 要約、翻訳、簡単な質問 • 最初のコーディングなら十分 •
デバッグには ハマることがある • 500B以上のモデル • 高度なこと以外には十分 • メモリ高騰が残念
現在の状況(ビジネス的) • コーディングエージェント使い放題はコストがかさむ • プロプラモデルは制限がきびしい • プロプラモデルは値上がりする • サーバーが足りてない •
新しい高性能モデルは高くなっていってる
今日の話 • 手元のマシンでコーディング作業を行う • 32GB-64GBの統合メモリでQwen3.6 / Gemma 4を動かす • 将来的には192GB-256GBで250B程度を動かす
• 15万トークン以内の作業 • LLM用サーバーで共有はおすすめしない • コーディングの高負荷でサーバーを運用するのは大変 • ある程度をQwen3.6 / Gemma 4でまかなうならコスト回収も大変 • オープンモデルでもAPIを使ったほうがいい • 単にモデル選択と利用料金の問題になる
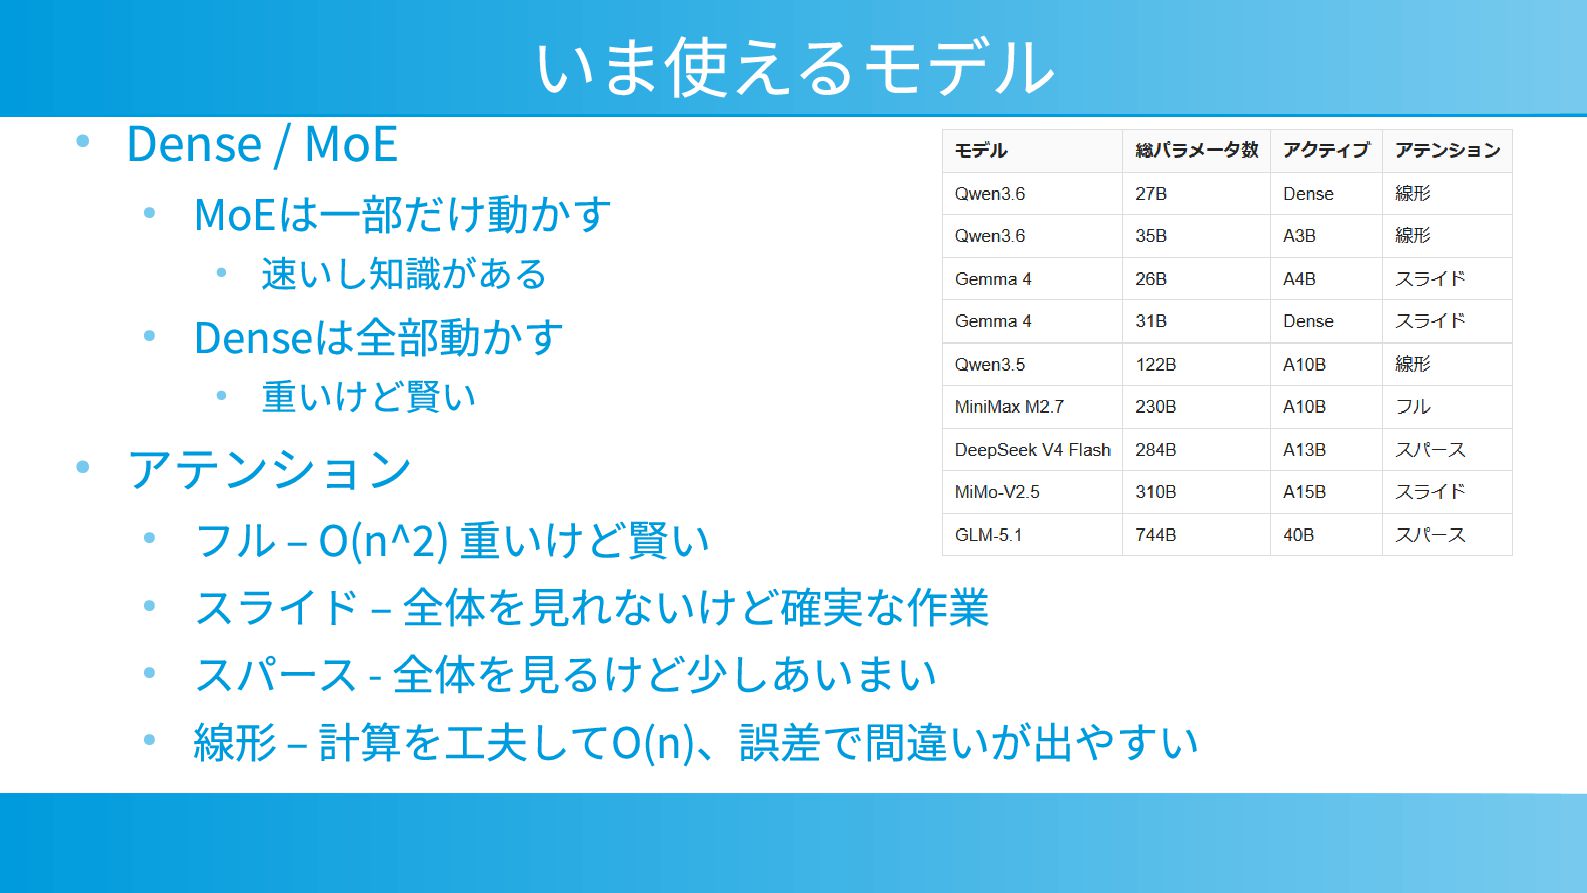
いま使えるモデル • Dense / MoE • MoEは一部だけ動かす • 速いし知識がある •
Denseは全部動かす • 重いけど賢い • アテンション • フル – O(n^2) 重いけど賢い • スライド – 全体を見れないけど確実な作業 • スパース - 全体を見るけど少しあいまい • 線形 – 計算を工夫してO(n)、誤差で間違いが出やすい
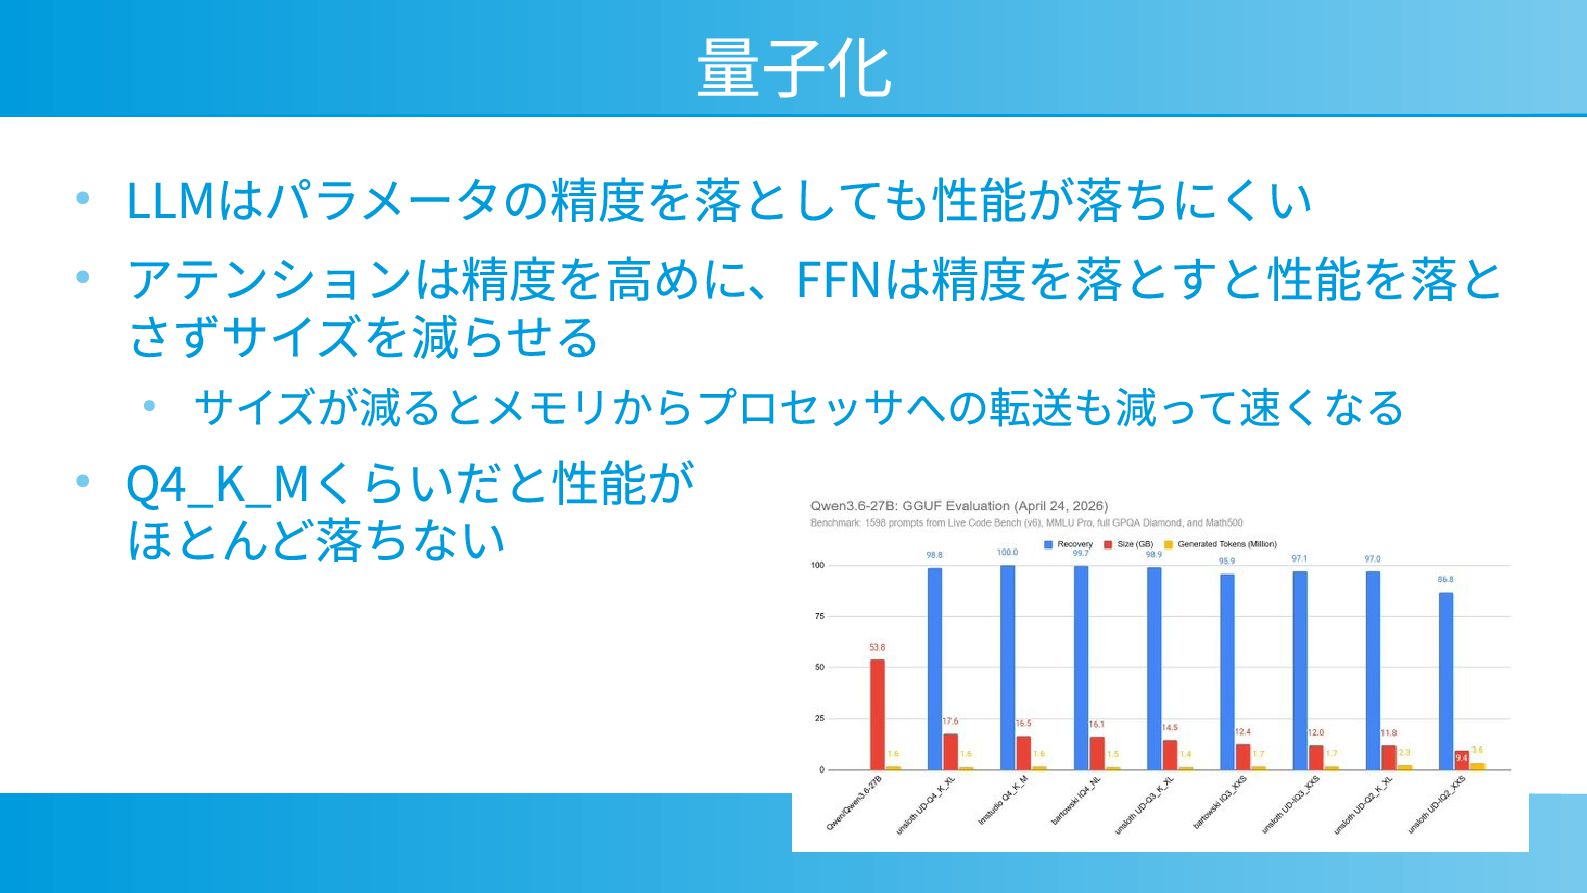
量子化 • LLMはパラメータの精度を落としても性能が落ちにくい • アテンションは精度を高めに、FFNは精度を落とすと性能を落と さずサイズを減らせる • サイズが減るとメモリからプロセッサへの転送も減って速くなる • Q4_K_Mくらいだと性能が
ほとんど落ちない
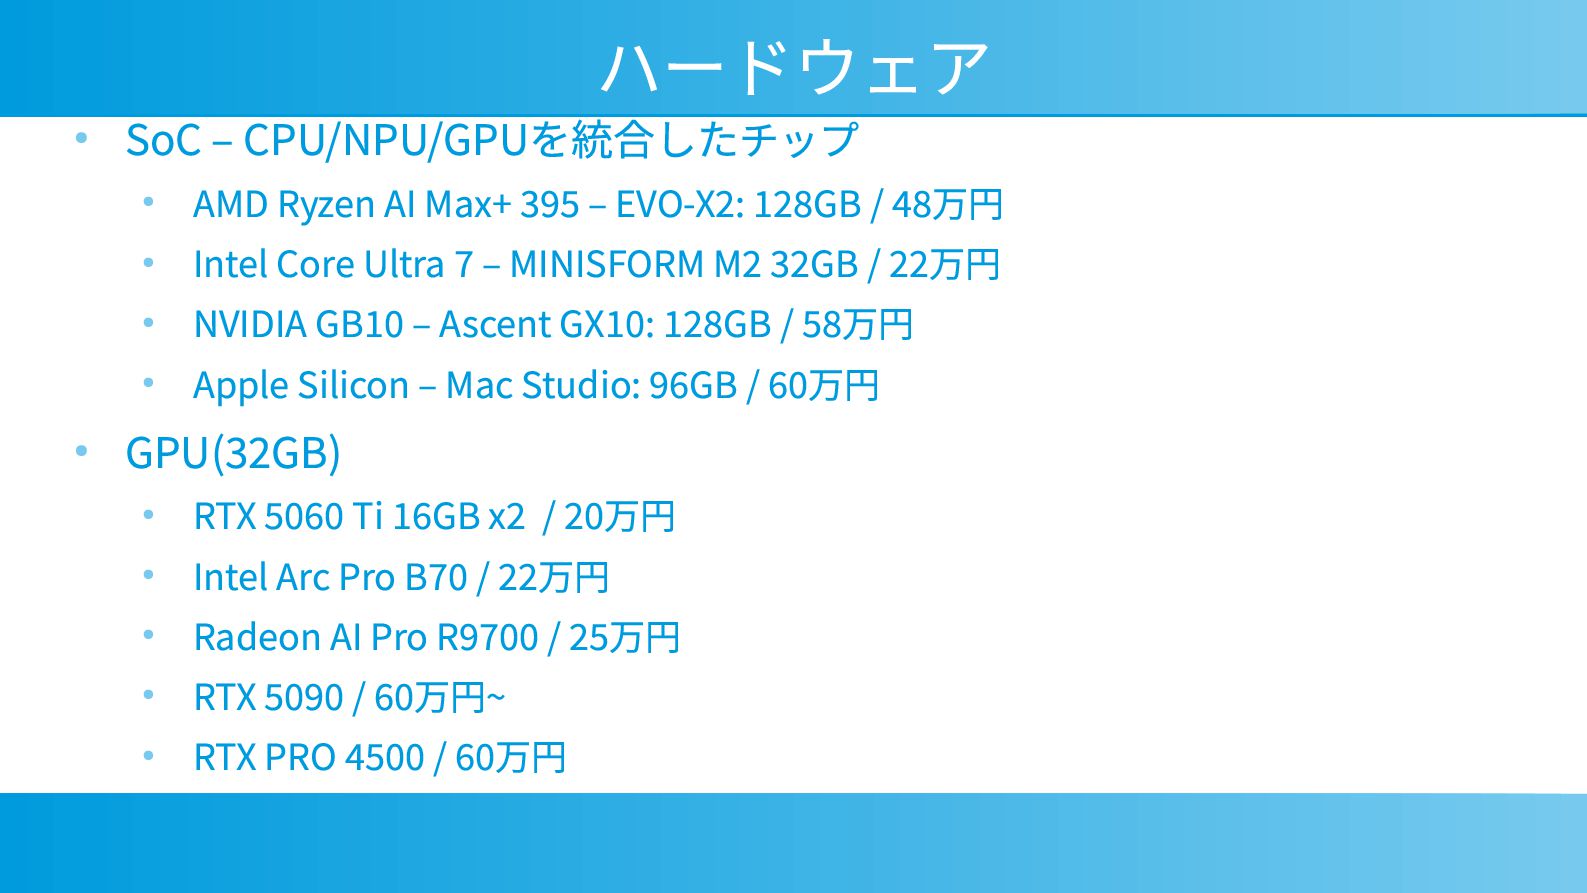
ハードウェア • SoC – CPU/NPU/GPUを統合したチップ • AMD Ryzen AI Max+
395 – EVO-X2: 128GB / 48万円 • Intel Core Ultra 7 – MINISFORM M2 32GB / 22万円 • NVIDIA GB10 – Ascent GX10: 128GB / 58万円 • Apple Silicon – Mac Studio: 96GB / 60万円 • GPU(32GB) • RTX 5060 Ti 16GB x2 / 20万円 • Intel Arc Pro B70 / 22万円 • Radeon AI Pro R9700 / 25万円 • RTX 5090 / 60万円~ • RTX PRO 4500 / 60万円
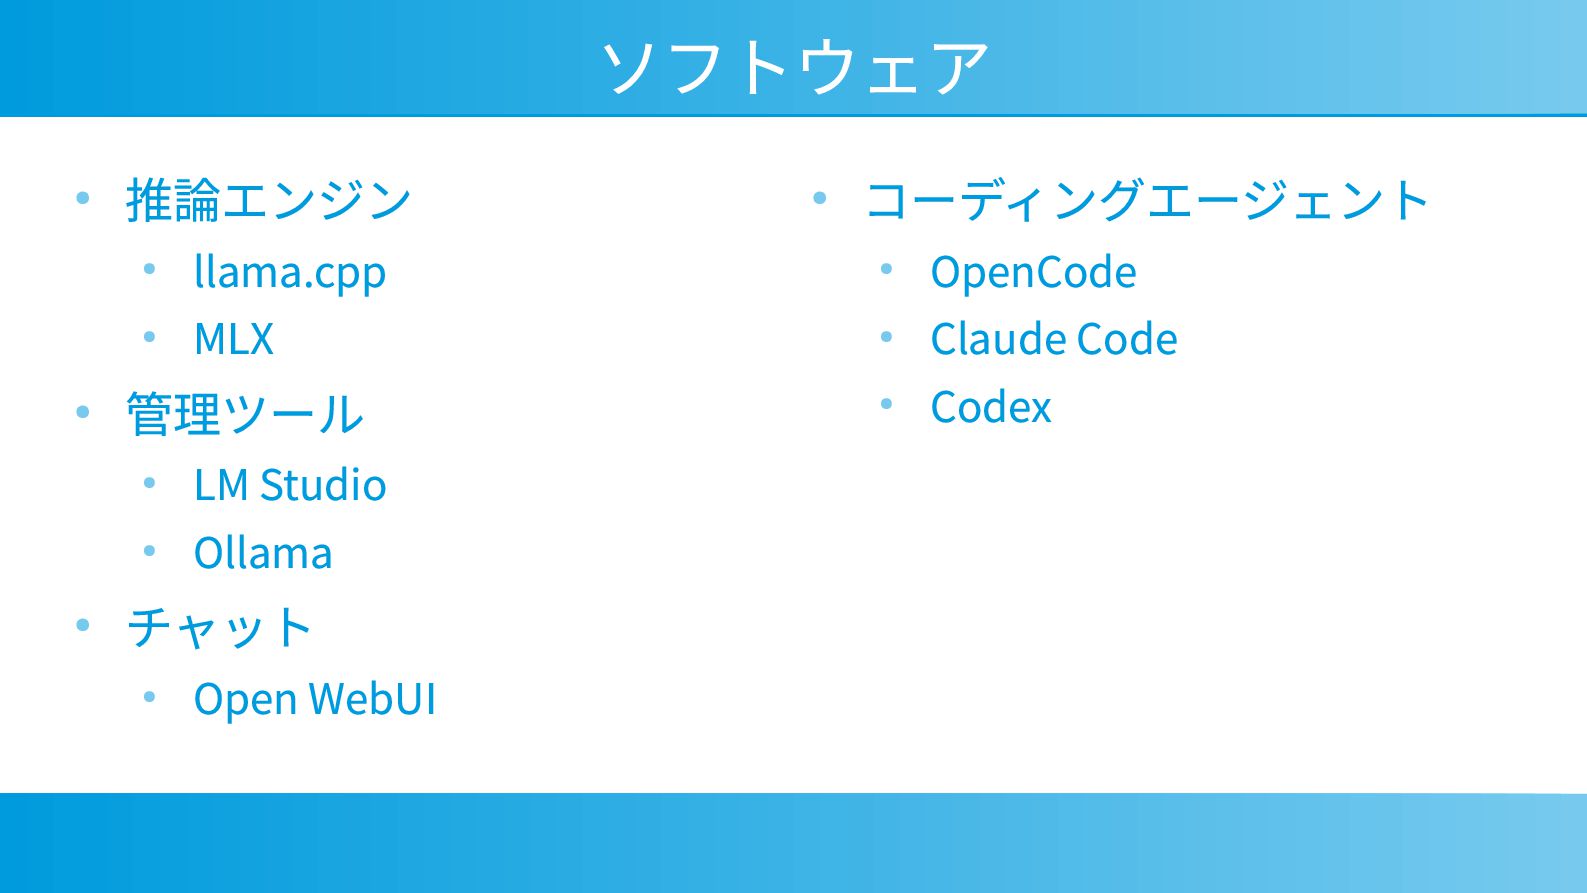
ソフトウェア • 推論エンジン • llama.cpp • MLX • 管理ツール •
LM Studio • Ollama • チャット • Open WebUI • コーディングエージェント • OpenCode • Claude Code • Codex
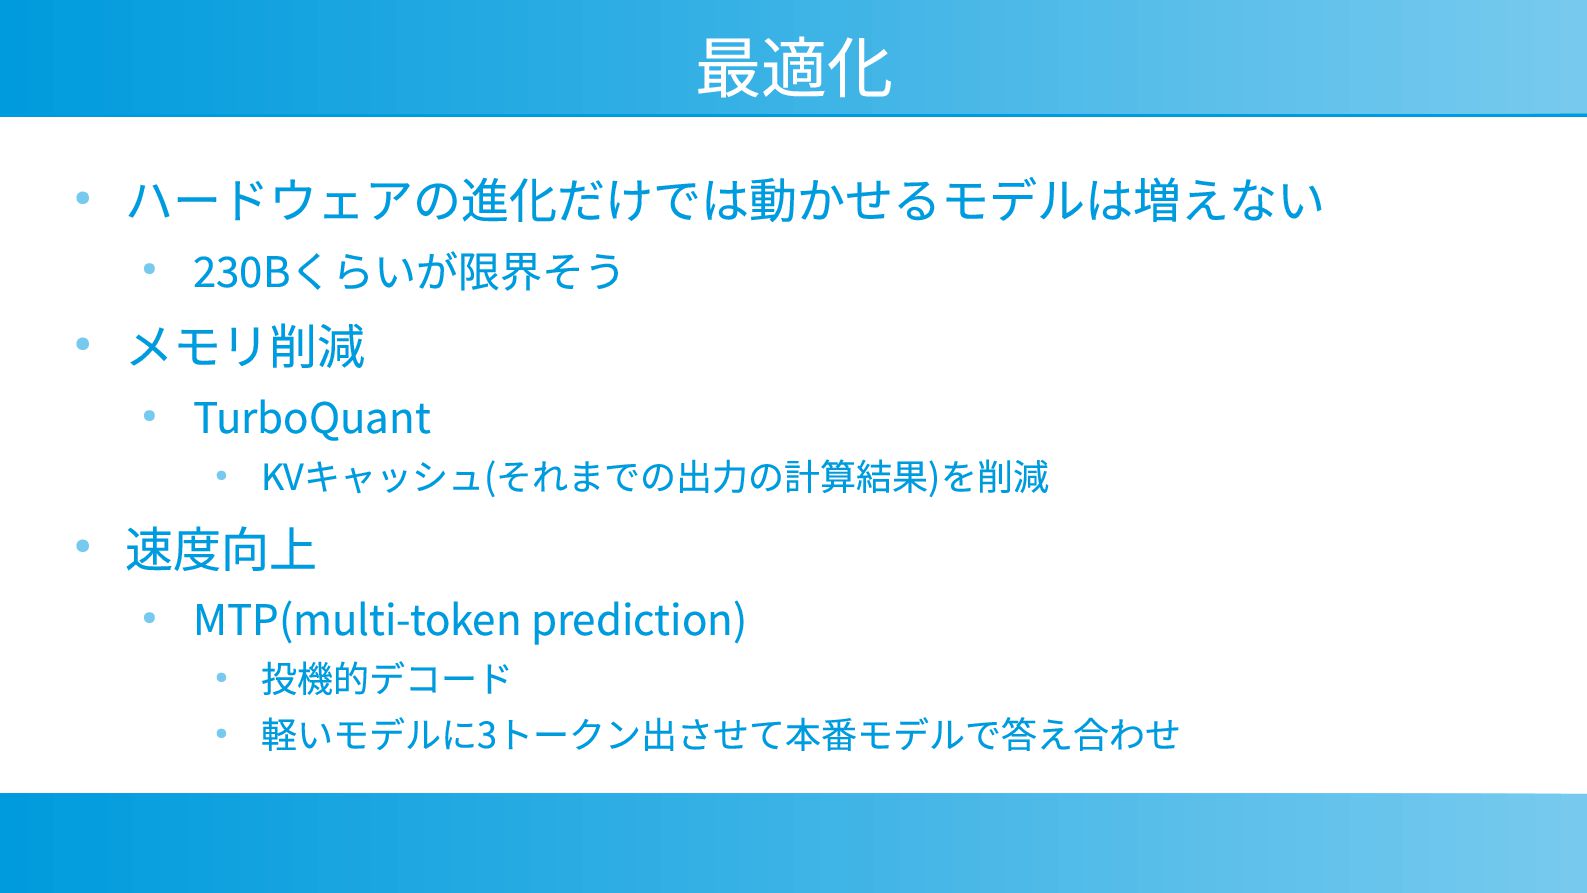
最適化 • ハードウェアの進化だけでは動かせるモデルは増えない • 230Bくらいが限界そう • メモリ削減 • TurboQuant •
KVキャッシュ(それまでの出力の計算結果)を削減 • 速度向上 • MTP(multi-token prediction) • 投機的デコード • 軽いモデルに3トークン出させて本番モデルで答え合わせ
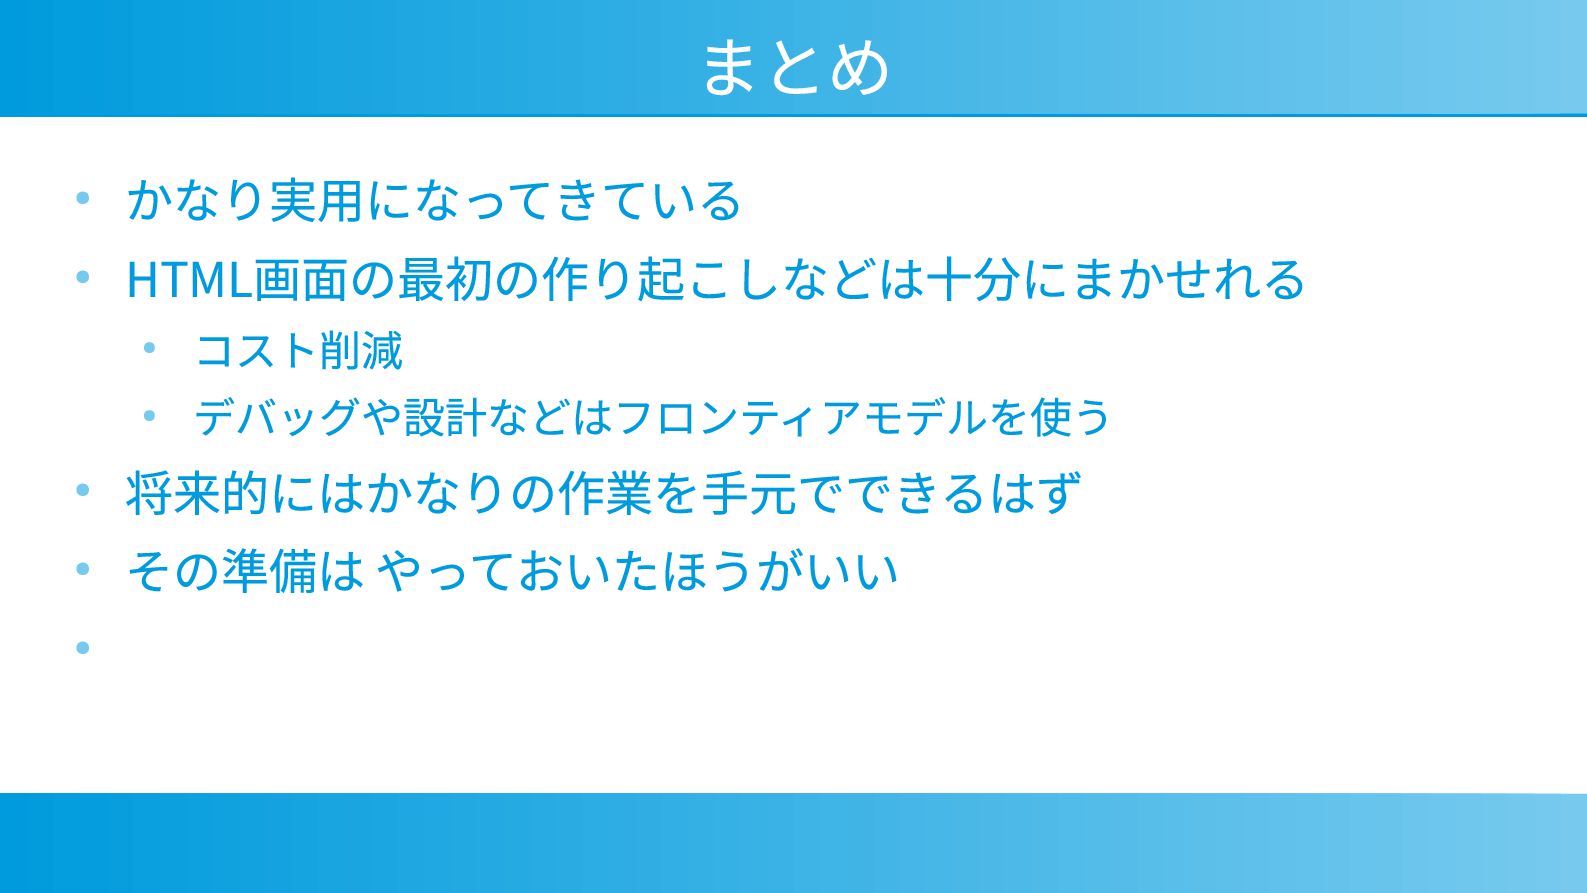
まとめ • かなり実用になってきている • HTML画面の最初の作り起こしなどは十分にまかせれる • コスト削減 • デバッグや設計などはフロンティアモデルを使う •
将来的にはかなりの作業を手元でできるはず • その準備は やっておいたほうがいい •


 kishida
 oku053
 artoy
 uyuki234
 nabondance
 deka_morita
 rkaga
 o0h
 falcon8823
 exoego
 yutobara
 dske104
 mofurune
 uxyall
 rasagy
 hannesfritz
 popppiees
 jonrohan
 jeffersonlam
 malarkey
 davetheseo
 reverentgeek
 geoffreycrofte
 yeseniaperezcruz
 shpigford