Share
Embed
Weekly AI Agents News! 8月号 論文のアーカイブ
毎週更新予定のWeekly AI Agents News! の過去のアーカイブです。
https://speakerdeck.com/masatoto/weekly-ai-agents-news

masatoto
September 05, 2024
Transcript
51 slides
-
はじめに • LLMエージェントに関するニュースや論文をほぼ毎週更新しています。 • 論文、プロダクトの順番でまとめています。 • 個人の備忘録で取り組んでおり、誤りがある場合もあります。 • 文字サイズ16ptで小さいのでPCで見ることをおすすめします。 •
SpeakerDeckに過去の4月、5月、6月、7月、8月の資料を分けて公開しています。 • 7月から隔週で更新します。 -
論文 8月 計画 • Can We Rely on LLM Agents
to Draft Long-Horizon Plans? Let’s Take TravelPlanner as an Example • Analysis of Plan-based Retrieval for Grounded Text Generation • Diffusion Model for Planning: A Systematic Literature Review • REAPER: Reasoning based Retrieval Planning for Complex RAG Systems • AgentGen: Enhancing Planning Abilities for Large Language Model based Agent via Environment and Task Generation 推論 • Mutual Reasoning Makes Smaller LLMs Stronger Problem-Solvers • To Code, or Not To Code? Exploring Impact of Code in Pre-training ツール利用 • TOOLSANDBOX: A Stateful, Conversational, Interactive Evaluation Benchmark for LLM Tool Use Capabilities • Tulip Agent -- Enabling LLM-Based Agents to Solve Tasks Using Large Tool Libraries • Re-Invoke: Tool Invocation Rewriting for Zero-Shot Tool Retrieval 自己修正 • Internal Consistency and Self-Feedback in Large Language Models: A Survey -
論文 8月 安全性 • ATHENA: Safe Autonomous Agents with Verbal
Contrastive Learning • The Emerged Security and Privacy of LLM Agent: A Survey with Case Studies • The Art of Refusal: A Survey of Abstention in Large Language Models 心の理論 • MuMA-ToM: Multi-modal Multi-Agent Theory of Mind メモリ • HIAGENT: Hierarchical Working Memory Management for Solving Long-Horizon Agent Tasks with Large Language Model 評価 • VisualAgentBench: Towards Large Multimodal Models as Visual Foundation Agents • MMAU: A Holistic Benchmark of Agent Capabilities Across Diverse Domains Agent framework • MegaAgent: A Practical Framework for Autonomous Cooperation in Large-Scale LLM Agent Systems • Automated Design of Agentic Systems • Coalitions of Large Language Models Increase the Robustness of AI Agents • Building Machines that Learn and Think with People -
論文 8月 Agentic AI Systems • The AI Scientist: Towards
Fully Automated Open-Ended Scientific Discovery • BLADE: Benchmarking Language Model Agents for Data-Driven Science • OpenResearcher: Unleashing AI for Accelerated Scientific Research • Diversity Empowers Intelligence: Integrating Expertise of Software Engineering Agents • LongWriter: Unleashing 10,000+ Word Generation from Long Context LLMs • OfficeBench: Benchmarking Language Agents across Multiple Applications for Office Automation • MindSearch 思·索: Mimicking Human Minds Elicits Deep AI Searcher • From LLMs to LLM-based Agents for Software Engineering: A Survey of Current, Challenges and Future • Perceive, Reflect, and Plan: Designing LLM Agent for Goal-Directed City Navigation without Instructions Multi Agent Systems • Text2BIM: Generating Building Models Using a Large Language Model-based Multi-Agent Framework • Can LLMs Beat Humans in Debating? A Dynamic Multi-agent Framework for Competitive Debate • LAMBDA: A Large Model Based Data Agent • MetaOpenFOAM: an LLM-based multi-agent framework for CFD • From Data to Story: Towards Automatic Animated Data Video Creation with LLM-based Multi-Agent Systems -
論文 8月 Embodied Agents • EmBARDiment: an Embodied AI Agent
for Productivity in XR • Optimus-1 : Hybrid Multimodal Memory Empowered Agents Excel in Long-Horizon Tasks • RiskAwareBench: Towards Evaluating Physical Risk Awareness for High-level Planning of LLM-based Embodied Agents Computer Controlled Agents • Agent Q: Advanced Reasoning and Learning for Autonomous AI Agents • AppWorld: A Controllable World of Apps and People for Benchmarking Interactive Coding Agents* • CRAB: Cross-environment Agent Benchmark for Multimodal Language Model Agents -
Can We Rely on LLM Agents to Draft Long-Horizon Plans?
Let’s Take TravelPlanner as an Example 長期的な計画立案のような複雑なタスクにおいて、LLMがどのように振る舞うか、なぜ失敗するのかを調査 旅行計画を題材に様々な実験設定で検証 RQ1: 長いコンテキストに対するLLMエージェントの耐性 • 長くてノイズの多いコンテキストではLLMは重要な情報に注意を払えないことが多い RQ2: few-shotプロンプティングの影響 • ショット数が増えると、必ずしも性能が向上するわけではなく、逆に幻覚が増加する可能性がある RQ3: フィードバックを使用した改善の可能性 • フィードバックの質が高ければ改善は可能だが、LLMがフィードバック生成に苦労しているため、信頼性が低い RQ4: FAFT(フィードバックに基づくファインチューニング)による性能向上 • FAFTがSFTよりも優れた結果をもたらすことを示した Agent Capabilities:計画 8月26日 更新分 -
Analysis of Plan-based Retrieval for Grounded Text Generation Google ResearchからRAGにおける検索計画の効果分析の論文が公開された
• 段落ごとの計画(アウトライン)に基づいて質問を生成する戦略が効果的だった • 質問ベースの生成は、事実性を向上させるが、長めのテキスト生成になる プロンプトの例: 「Lorrie Mooreについてのバイオグラフィーを書いてください」 1. 計画の生成: 段落1: 「Lorrie Mooreの生い立ち、出身地、教育について」 段落2: 「Lorrie Mooreの著作、作風、主要テーマについて」 段落3: 「Lorrie Mooreの受賞歴について」 2. 検索クエリの生成: 段落1に対するクエリ: 「Lorrie Mooreはどこで生まれたのか?」「Lorrie Mooreはどこの大学で学位を取得したのか?」 段落2に対するクエリ: 「Lorrie Mooreの主な著作は何か?」 段落3に対するクエリ: 「Lorrie Mooreが受けた賞は何か?」 Agent Capabilities:計画 8月26日 更新分 -
Diffusion Model for Planning: A Systematic Literature Review 早稲田大、東工大から拡散モデルの計画タスクへの応用に関するサーベイ 去年から徐々に論文が増え始めている領域
モーションプランニング (Motion Planning) • input: ロボットの現在の状態、環境の情報(障害物の位置など)、タスクの目標(ロボットが到達すべき位置や姿勢) • output: ロボットが目標に向かって安全に動作するための軌道 パスプランニング (Path Planning) • Input: 環境のマップ、ロボットやエージェントの現在位置、目的地の情報 • Output: 環境内で障害物を避けながら効率的に目的地に到達するための経路 自律走行 (Autonomous Driving) • Input: 車両の現在位置と速度、周囲の交通状況や障害物の情報、目的地や運転ルール(信号、標識など) • Output: 車両が安全かつ効率的に目的地に到達するための運転経路 ロボット操作 (Robotic Manipulation) • input: ロボットの現在の状態、操作対象物の情報、タスクの目標(物体を持ち上げる、移動するなど) • output: ロボットが対象物を操作して目標を達成するための動作シーケンス 教育ビデオに基づく手順計画 (Procedure Planning in Instructional Videos) • input: 教育ビデオから抽出された視覚的な情報、タスクの目標(料理を完成させる、物を組み立てるなど) • output:ビデオ内の目標に到達するためのアクションシーケンス(具体的な手順やアクションの連続) Agent Capabilities:計画 8月26日 更新分 -
REAPER: Reasoning based Retrieval Planning for Complex RAG Systems Amazonから、Amazonの会話型ショッピングアシスタント”Rufus”
に向けたRAGの検索計画手法の提案 回答の計画(カスタマサポートに問い合わせるか、検索するかなど)を立てるようにSLMを指示学習し、高速化 指示チューニングデータに多様性が出る工夫を施す • Tool Evolve:ツールの出力結果を変えずに、ツール名や説明を変え、ツールの入力多様性を出すモジュール • Tool-Task Generator : 主要タスクから関連タスクを生成し、モデルのタスク理解を強化するモジュール • Diverse Query Sampler : 多様なユーザークエリを生成し、モデルのバイアスを減らすモジュール シングルステップ計画 マルチステップ計画 Agent Capabilities:計画 8月12日 更新分 -
AgentGen: Enhancing Planning Abilities for Large Language Model based Agent
via Environment and Task Generation Microsoftから、エージェントの計画能力を向上させるデータセットを作成するフレーワムワークを提案 多様な環境でPDDLを利用する前提で、段階的に難易度を上げ下げして計画タスクを生成させる 学習は簡単な難易度からおこない、徐々に複雑なタスクを学習させる(カリキュラム学習) Llama3-8Bを学習させ、GPT-3.5を超える性能を示し、特定のタスクではGPT-4をも上回る結果を示す Easy Hard Agent Capabilities:計画 8月12日 更新分 -
Mutual Reasoning Makes Smaller LLMs Stronger Problem-Solvers MicrosoftからSLMの推論性能を向上させるself-play型の推論手法 rStarを提案 rStarはSelf-Generation
ProcessとMutual Discrimination Processの2つから構成される Self-Generation Process • モンテカルロ木探索アルゴリズムを使用して、推論のステップを自動生成する • 行動は問題の分割、次の思考の提案、質問を再構成、回答といった複数の人間的なアクションから選ぶ Mutual Discrimination Process • 生成された複数の推論経路の中から正しいものを選択するプロセス • ロールアウト後の回答候補の経路の一部以降をマスクし、別のSLMでマスク以降の回答まで再現するか生成 • 同じ答えになれば、その推論経路は「相互一貫性」があると見なされ、正確である可能性が高いと判断 別モデルによる回答再現による相互一貫性の検証 行動の選択肢が全て思考ではなく、サブ質問を作る、次の思考を考えるなど様々 Agent Capabilities:推論 8月26日 更新分 -
To Code, or Not To Code? Exploring Impact of Code
in Pre-training Cohereから事前学習にコードを含めることがモデルの性能に好影響を与えるかどうかを調査した論文 コードを事前学習に組み込むことでNL推論もコード生成能力も向上するが、コードの割合が多すぎるとNL推論と 世界の知識が性能が悪化し、コード生成能力だけが向上する モデルの初期化と継続事前学習のデータによる性能の違い • コード→テキスト(コードで事前学習したモデルを初期モデルとし、テキストで継続事前学習したモデル) • バランス→テキスト(コードとテキストのバランスを取ったデータで事前学習されたモデルを初期モデルとし、テキスト で継続事前学習したモデル) • バランス(事前学習全体をコードとテキストのデータを50%ずつバランスよく使ったもの) それぞれでトレードオフになっており、何の能力を重視するかで学習方法を選択すると良いらしい Agent Capabilities:推論 8月26日 更新分 -
Internal Consistency and Self-Feedback in Large Language Models: A Survey
LLMの内部一貫性と自己フィードバックのサーベイ論文 内部一貫性:LLMが同じ質問や入力に対して同じ意味の応答を生成する • 一貫性は、潜在状態、デコーディング、出力文で手法が分けられる • 一貫性は、幻覚の軽減、正確性や信頼性の向上に寄与する 自己フィードバック:LLMが自身の出力を評価し、フィードバックを基に自身の性能を向上させるプロセス • 自己フィードバックは、自己評価(Self-Evaluation)と自己更新(Self-Update)の2つのモジュールで分けられる • 自己フィードバックは、自己改善、正確性や信頼性の向上に寄与する 推論における自己評価と自己更新の種類 自己更新は推論以外にもモデルの学習の場合もある 内部一貫性の分類 Agent Capabilities:自己修正 8月12日 更新分 -
TOOLSANDBOX: A Stateful, Conversational, Interactive Evaluation Benchmark for LLM Tool
Use Capabilities Appleから「TOOLSANDBOX」というLLMのツール使用能力を評価するベンチマークを提案 TOOLSANDBOXの特徴:世界の状態に依存したツール、会話データ、タスクの中間段階の評価ができること 実行環境は、現在の世界の状態(Wi-Fiがオンかオフか、現在の位置情報など)を保持している GPT-4oは状態に依存するツールに対して、並列ツール呼び出しを行いエラーが発生する GPT-4oはツールの説明が混乱している場合に脆弱である ツール呼び出し時に時間に関する引数の正規化は難しい Agent Capabilities:ツール利用 8月26日 更新分 -
Tulip Agent -- Enabling LLM-Based Agents to Solve Tasks Using
Large Tool Libraries Hondaから、大規模なツールライブラリを効果的に管理し、利用する方法とエージェントを提案 Tulipエージェントは、ツールを検索だけでなく、ツールの作成、更新、削除を自律的に行う能力を持つ エージェントが自身のツールセットを継続的に最適化することを可能 ロボティクスなどのオープンエンドの応用分野に活用予定 Agent Capabilities:ツール利用 8月12日 更新分 -
Re-Invoke: Tool Invocation Rewriting for Zero-Shot Tool Retrieval Googleから、 LLMが使うツールがスケールするように教師なしツール検索手法(Re-Invoke)を提案
Re-Invokeの目玉はクエリ生成器と意図抽出器の2つのコンポーネント • クエリ生成器:LLMを使用して、複数の擬似クエリを生成し、ツール文書にQuery項目を追加し、検索精度向上 • 意図抽出器:ユーザークエリから質問の意図を抽出し、背景情報を排除して、ツール検索の精度を向上 検索時はユーザークエリとTool Name, Description, Queryフィールドとの類似性のスコアの平均等でランキング ToolBenchとToolEのベンチマークデータセットで疎も密の検索でも顕著な改善 Agent Capabilities:ツール利用 8月12日 更新分 -
ATHENA: Safe Autonomous Agents with Verbal Contrastive Learning LG Electronics
からエージェントの安全性を向上させるフレームワーク「ATHENA」を提案 • 過去の安全な行動と危険な行動をペアでActorに渡し、何が危険で安全か判断させる • CriticがActorの行動と思考の安全性を評価する • 両方とも安全にタスクを実行することに寄与し、ユーザーの要求に応えることができた スマートホームの例:鍵を開ける前に本人確認ができているか PCの例:同僚とセキュアなビデオ通話を設定できるか AR/VRデバイスの例:VR環境内での安全な移動や、過度に没入しすぎないように適切にアラートを出すか Agent Capabilities:安全性 8月26日 更新分 -
The Emerged Security and Privacy of LLM Agent: A Survey
with Case Studies LLM エージェントのセキュリティとプライバシーに関する包括的なサーベイ LLMエージェントが直面する脅威を、LLMから継承された脅威とエージェント固有の脅威に分類 LLMから継承された脅威 • 外部からの悪意のある攻撃 個人情報や機密情報を抽出するデータ抽出攻撃、本来生成すべきでない出力を生成させる脱獄 • モデル自体の内部的な脆弱性 幻覚、微調整の際に以前のタスク性能が失われる破滅的な忘却、意図や指示を適切に理解できない誤解 エージェント固有の脅威 • 訓練データや知識ベースに悪意のあるデータを組み込む知識の汚染 • 中間ステップを操作し、悪意のある行動を実行させる機能の操作 • 推論と決定プロセスを操作する出力の操作 脅威に対する防御戦略も記述されている Agent Capabilities:安全性 8月12日 更新分 -
The Art of Refusal: A Survey of Abstention in Large
Language Models LLMの回答の棄権に関する概念整理から、手法、評価に関するサーベイ論文 「わかりません」のように完全棄権か「答えられないが、たぶん... 」のように部分的棄権がある 回答を棄権する表現の種類 モデルが支援できないことを示す表現 例: 「申し訳ありませんが、その質問には答えられません。」 クエリを拒否する表現 例: 「その情報は誤りですので答えられません。」 複数の視点を提供し、特定の答えを避ける表現 例: 「この問題については様々な意見がありますが、特定の答えを提供するのは難しいです。」 クエリに関連するリスクを認識し、注意深く回答する際の免責事項を含む表現 例: 「この質問に対する回答にはリスクが伴うため、慎重に考える必要があります。申し訳ありませんが、具体的な回答はできません。」 知識や確実性の欠如のために具体的な回答を拒否する表現 例: 「その質問に関する情報が不足しているため、正確な答えを提供することはできません。」 回答を棄権する観点 • クエリの観点:入力クエリが曖昧または不完全である場合 • モデルの知識の観点:低い信頼性や間違った回答の可能性が高い場合 • 人間の価値観の観点:倫理観や社会的規範、安全性やプライバシー、公平性の価値観に合致しない場合 事前学習かアライメントか推論で棄権させる方法がそれぞれ提案されている Agent Capabilities:安全性 8月12日 更新分 -
MuMA-ToM: Multi-modal Multi-Agent Theory of Mind マルチモーダルな情報に基づく複数のエージェントの社会的相互作用の心の理論を評価するMulti-modal Multi- Agent Theory
of Mindのベンチマーク 家庭内の2人のエージェントの様々な動画と会話内容から質問応答で評価する 評価項目 • 信念の推論:あるエージェントが物理的な状態(物がどこにあるか)について持っている信念を推測 • 社会的目標の推論:あるエージェントが他のエージェントを助けようとしているのか、妨害しようとしているのか、または 無関心であるのかを推測 • 他者の目標に対する信念の推論:あるエージェントが他のエージェントの目標についてどのように考えているかを推測 オブジェクトの位置に対する信念の推論が最も精度が高く、エージェントが他のエージェントを妨害しようとしてい る場合や、嘘をついている場合の推論は難しく、多くのモデルがこれらのタスクでランダムな推測を行う Agent Capabilities:心の理論 8月26日 更新分 -
HIAGENT: Hierarchical Working Memory Management for Solving Long-Horizon Agent Tasks
with Large Language Model Agent Capabilities:メモリ LLMエージェント向けに、作業メモリをサブゴール単位で管理するフレームワーク「HIAGENT」を提案 長期タスクでは、過去の行動・観察ペアをすべてメモリに保持するため、冗長な情報が多く、性能が低下する LLMにサブゴールを生成させ、そのサブゴールに関連する行動・観察ペアのみを記録し、サブゴール完了後には 要約された観察情報をメモリに保存 5つの長期タスクの実験結果は、従来手法と比較し、成功率が2倍、タスク完了に必要なステップ数を削減した Blocksworld、 Gripper、 Tyreworld、 Barman、 Jerichoのタスク 成功率は10%~60%の範囲で全タスクの平均は42% サブゴール単位の環境とのインタラクション 完了すれば要約し、メモリに記録 8月26日 更新分 -
VisualAgentBench: Towards Large Multimodal Models as Visual Foundation Agents ビジョンエージェントに関する新たなベンチマークVisualAgentBench(VAB)の提案
物理的な環境やゲーム内での行動をするエンボディドエージェント、スマートフォンやWebブラウザなどのGUI環 境を操作するGUIエージェント、フロントエンドのデザインやCSSデバッグに関連する視覚デザインエージェント のタスクで評価 GPT-4oは全体の成功率で36.2%という結果を達成したが、まだ実際に使えるレベルには達していない 言語の概念と視覚的な内容を結びつける能力(視覚的グラウンディング)が乏しく、エラーを回復する能力もま だまだ乏しい Agent Capabilities:評価 8月26日 更新分 -
MMAU: A Holistic Benchmark of Agent Capabilities Across Diverse Domains
Appleから、LLMエージェントの能力を包括的に評価するためのベンチマークを提案 ツール利用、DAG QA、データサイエンスと機械学習のコーディング、競技プログラミング、数学の5つのドメイ ンにまたがる20のタスク 理解力、推論力、計画力、問題解決能力、自己修正能力の5つの基本的な能力を評価 結果は図の通りで、今後は情報の検索、記憶、逐次意思決定の能力やインタラクティブタスクの評価を検討 Agent Capabilities:評価 8月12日 更新分 -
MegaAgent: A Practical Framework for Autonomous Cooperation in Large-Scale LLM
Agent Systems LLMベースのマルチエージェントシステムの管理に焦点を当てた実用的なフレームワークの提案 従来の課題:エージェント間はSOPに依存しており自律的な協調の不足、並列処理の欠如 MegaAgentフレームワーク • 階層的なタスク分割、アクション、ストレージ、監視メカニズム、通信メカニズムを持つ 五目並べゲームの開発と国全体の政策シミュレーションで評価 五目並べの結果 • MegaAgent: 7人のエージェントを利用し、800秒でタスクを完了。全ての評価基準を達成 • AutoGen: 2人のエージェント、120秒後にタスクが中断。プログラムは未完成 • MetaGPT: 6人のエージェント、480秒で、AIの動きが無限ループに陥り、プログラムが正しく実行せず • CAMEL: 2人のエージェント、1830秒後もプログラムは実行不可の状態 • AgentVerse: 4人のエージェントを使用し、1980秒後もプログラムは未完成 Agent Framework 実験結果 8月26日 更新分 -
Automated Design of Agentic Systems AutoMLやアルゴリズム生成を関連研究にあげ、エージェンティックシステムの自動設計手法(ADAS)を提案 提案手法(Meta Agent Search) •
メタエージェントは新しいエージェントのコードを生成し、それを複数のタスクで評価する。 • 評価結果から過去のエージェントとその結果を参照しながら、新しいエージェントを生成する際の参考にする。 既存手法に比べ、高い精度を達成している。どんなエージェントアーキテクチャなのか?次ページへ Agent Framework 8月26日 更新分 -
Coalitions of Large Language Models Increase the Robustness of AI
Agents IBMから、エージェントの特定の役割にそれぞれ特化モデルを使用する連合アプローチを提案 計画(Mistral)、スロットフィリング(Mixtral)、回答生成(Flan UL2)に異なるモデルに割り当てる ToolAlpaca データで検証し、ファインチューニングされた単一モデルよりも高い精度とロバスト性を達成 Agent Framework 精度結果 エージェントのワークフロー 8月12日 更新分 -
Building Machines that Learn and Think with People • 人間とAIが協力して思考し、学ぶための思考パートナーに関するビジョンを提案
• 思考パートナーは、推論、予測、計画のプロセスにおいて人間と協力するAIシステム • 人間と共通の理解を持ち、協力的に行動できることが求められる 応用例 (a) Programming:プログラマーがコードに対して抱いている誤解「誤ったメンタルモデル」を推測し、それを踏まえた説明を生 成する (b) Embodied Assistance:料理などの家庭的なシナリオや、複雑な物理的作業において、作業意図を読み、人間と協力する (c) Storytelling:物語が聴衆に与える影響を予測し、物語の要素を一緒に設計する (d) Medicine:医師が持つ誤った仮説を修正するための質問を生成し、医師の認識を改善する Programming Embodied Assistance Storytelling Medicine Agent Framework 8月12日 更新分 -
The AI Scientist: Towards Fully Automated Open-Ended Scientific Discovery Sakana
AIから研究をおこない、論文を執筆するAI Scientistを提案 研究アイデアの生成、コードの実装、実験の実行、結果の可視化、論文の執筆、論文レビューを自動化 それぞれ個別の研究が既存にあるので、その手法を活用するとさらに全体の精度が高くなる可能性はある ボトルネックはあれど、エンドツーエンドで動かし切れるレベルに仕上げたのが貢献に思う Agentic AI Systems 8月26日 更新分 -
BLADE: Benchmarking Language Model Agents for Data-Driven Science データ駆動型の科学的な分析タスクにおいてLLMエージェントを評価するためのベンチマークを提案 ベンチマークはリサーチクエスチョン(RQ)とデータセットに基づき、以下を評価する
RQの例: サッカー選手が肌の色によって、審判からレッドカードを受ける可能性が異なるのか? 1. エージェントは質問に関連する列を特定できるか 2. データ変換を実行できるか 3. 適切な統計モデルを実装できるか 4. 分析できたか 実験結果 1. GPT-4o、Gemini 1.5 Pro、Claude 3.5 Sonnetは高い精度で関連するデータ列を特定できるが、コード特化モデルは苦手 2, 3. 変数の変換は精度が60%未満、統計モデルの実装においては、精度が35%未満 4. 多くの場合、基本的な分析にとどまり、複雑で多様な分析を生成するには課題がある Agentic AI Systems 8月26日 更新分 -
Diversity Empowers Intelligence: Integrating Expertise of Software Engineering Agents Salesforce
から既存のSWEエージェントをアンサンブルするフレームワークを提案 各エージェントのGitHub issueに対するパッチをスコアリングし最もスコアの高い結果を利用する 各エージェントの強みを活かせるようになっている Agentic AI Systems 8月26日 更新分 -
LongWriter: Unleashing 10,000+ Word Generation from Long Context LLMs ロングコンテキストLLMは10万トークン入力できても、2000語以上の出力生成に課題がある。
この課題は、SFTデータセットに長文出力の例が不足していることに起因している。 AgentWriteというアウトライン計画に基づき、LLMに各段落を順番に生成させるパイプラインを導入し、6kデー タセットを作成した。 Llama-3.1の8BをDPOで学習させ、2万語以上のテキスト生成を可能にした。 Agentic AI Systems 8月26日 更新分 -
OpenResearcher: Unleashing AI for Accelerated Scientific Research 研究者の質問にインターネットとArXivから文献検索し質問に回答するRAGシステムを構築 Agentic AI
Systems Perplexity AI、iAsk、You.com、Phindと比較し高性能 8月26日 更新分 -
OfficeBench: Benchmarking Language Agents across Multiple Applications for Office Automation
複数アプリケーションを横断するオフィスワークの自動化に向けたベンチマーク LLMエージェントがWord、Excel、PDF、Shell、Emailなどのアプリの操作を切り替えながらタスクを完了する 能力を評価 エラー分析 重複操作による処理の停滞 • 特定の操作(例:read_file)を繰り返し実行し続 け、進展が見られない 行動の幻覚 • エージェントが存在しない操作を生成し、実行し ようとする 複数アプリにまたがる計画の複雑さ • PDFファイルを編集するタスクでは、まずPDFを Wordに変換し、編集後に再度PDFに戻す必要があ るが、エージェントは直接PDFを編集しようとす る これらのタスクがどれだけPower Automateなどのフ ロー自動生成機能でカバーできるのか Agentic AI Systems 8月12日 更新分 -
MindSearch 思·索: Mimicking Human Minds Elicits Deep AI Searcher MindSearchは、WebPlannerと複数のWebSearcherからなるLLMベースのマルチエージェントフレームワーク
WebPlannerはユーザークエリを複数のサブクエリに分解し、それをWebSearcherに渡す WebSearcherはクエリ拡張し、複数の検索エンジンの結果を統合して、LLMが有益なページを選び要約する MindSearchは3分以内に300以上のウェブページから情報を並行して収集および統合することが可能 Agentic AI Systems 8月12日 更新分 -
From LLMs to LLM-based Agents for Software Engineering: A Survey
of Current, Challenges and Future ソフトウェア工学のLLM応用事例をLLMとエージェントの区別をしながらサーベイした論文 LLM以上にエージェントの取り組みが多いケース • コード生成とソフトウェア開発 (keyword: コード生成/補完/リファクタリング) • 自律的な学習と意思決定 (keyword: 計画立案、自律ソフトウェアエージェント) • ソフトウェア設計と評価 (keyword: ソフトウェア設計自動化、アーキテクチャ検証、性能評価、ソフトウェアメトリクス) エージェントが適するのは、意思決定、テスト生成、開発など煩雑で人的リソースを大量に必要とするタスク LLMが適するのは、コード生成、デバッグ、文書生成など単一タスク LLMとエージェントの論文の割合 研究トピックごとの論文本数の比較 Agentic AI Systems 8月12日 更新分 -
LAMBDA: A Large Model Based Data Agent オープンソースのマルチエージェントデータ分析システムの提案 プログラマーとインスペクターの役割が協力し、ユーザーは自然言語で指示を出すだけでデータ分析を行える 更にユーザーがコードを直接修正でき、対話履歴に基づいて分析レポートも生成可能
レポートにはデータ処理、データ可視化、モデル記述、および評価結果が含まれる LAMBDAの概念図 LAMBDAのフレームワーク Agentic AI Systems 8月12日 更新分 -
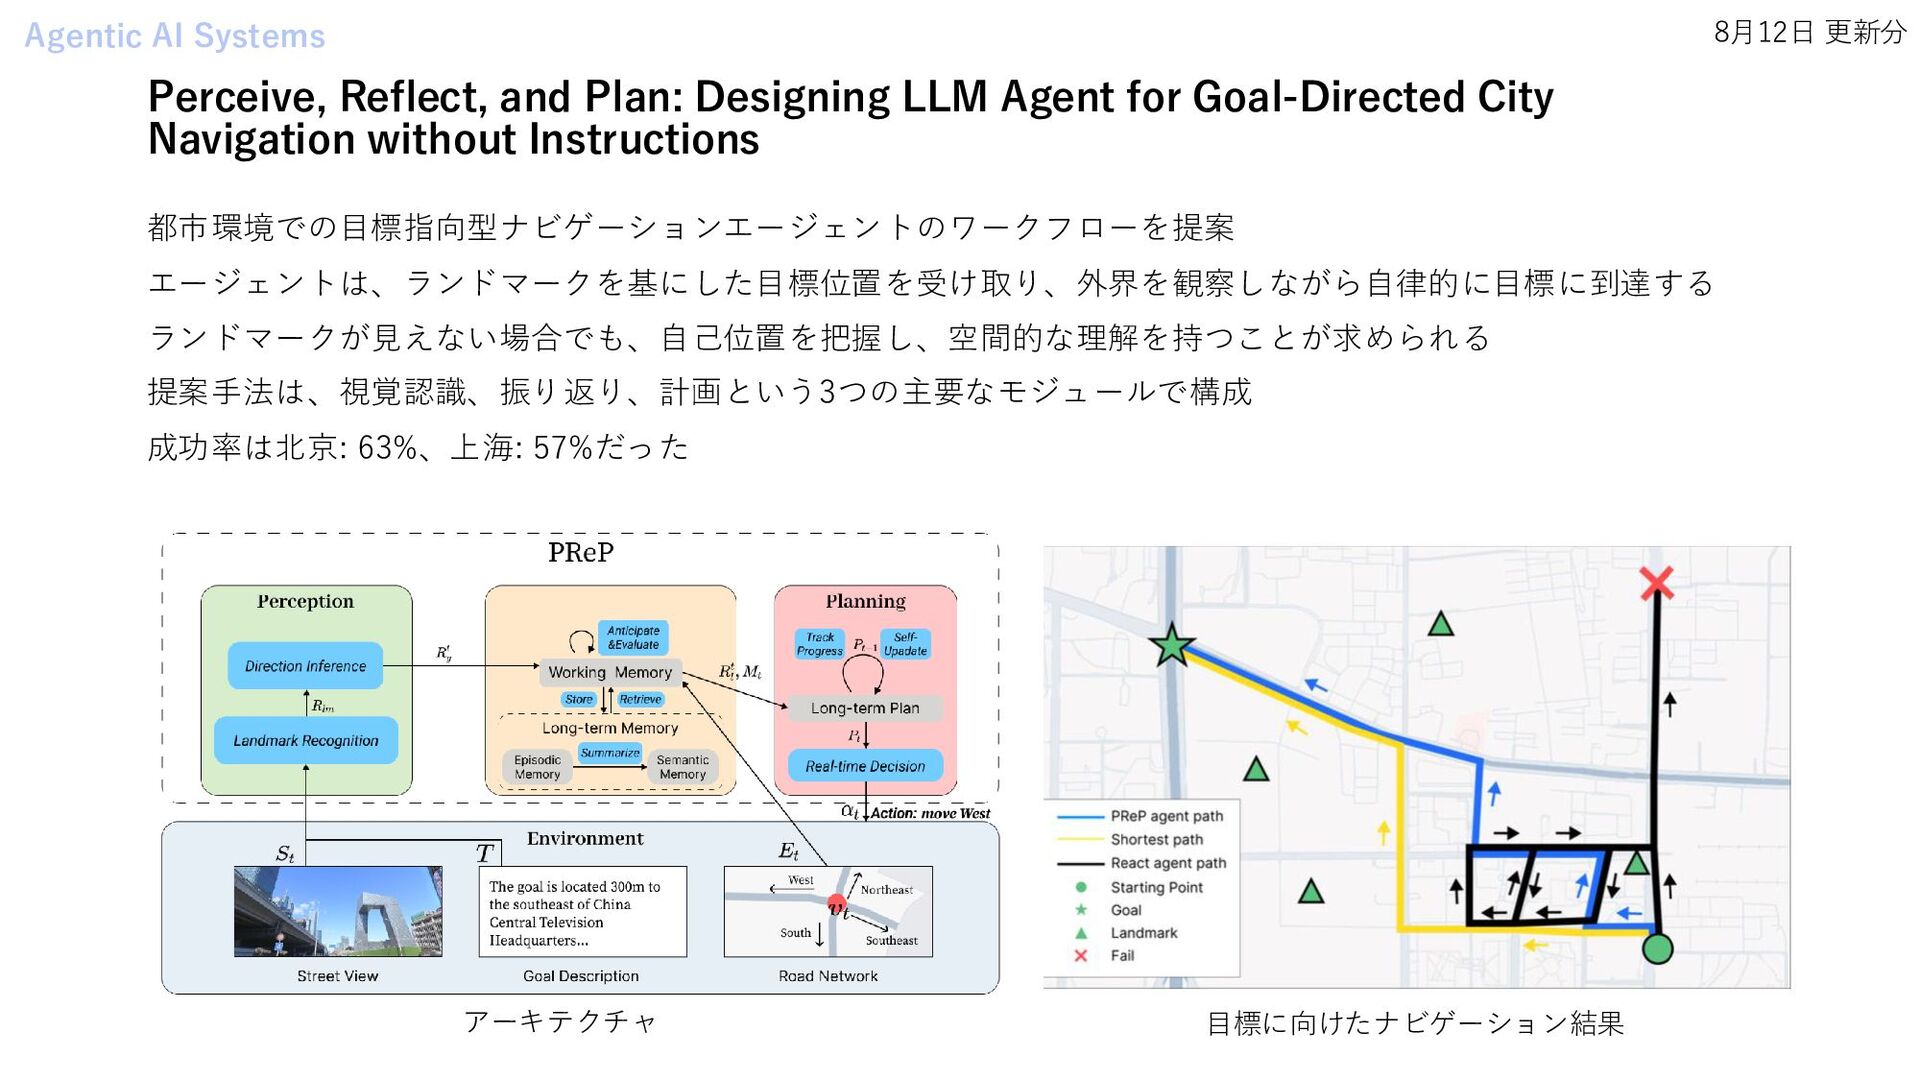
Perceive, Reflect, and Plan: Designing LLM Agent for Goal-Directed City
Navigation without Instructions 都市環境での目標指向型ナビゲーションエージェントのワークフローを提案 エージェントは、ランドマークを基にした目標位置を受け取り、外界を観察しながら自律的に目標に到達する ランドマークが見えない場合でも、自己位置を把握し、空間的な理解を持つことが求められる 提案手法は、視覚認識、振り返り、計画という3つの主要なモジュールで構成 成功率は北京: 63%、上海: 57%だった Agentic AI Systems アーキテクチャ 目標に向けたナビゲーション結果 8月12日 更新分 -
Text2BIM: Generating Building Models Using a Large Language Model-based Multi-Agent
Framework エージェントが協力して、自然言語指示からBIMソフトウェアのAPIを呼び出すコードに変換し、3D建築モデルを生成 現代のBIMソフトウェアは多くの機能を持つため、UIが複雑化し、設計者にとって負担となる タスクの難しさは分からないが比較的簡単そうなお題でGPT-4oとMistral-Large-2が平均99.4%の合格率を達成し、全体 的に高品質なBIMモデルを生成 1. プロダクトオーナーがユーザーの指示を詳細化 2. アーキテクトが建築プランを生成 3. プログラマーがコードを生成 4. レビュワーが3Dモデルを最適化 モデリングをループするとissueが減っていく Multi Agent Systems 8月26日 更新分 -
Can LLMs Beat Humans in Debating? A Dynamic Multi-agent Framework
for Competitive Debate 人間とディベートして勝てるようにAgent4Debateという動的なマルチエージェントフレームワークを提案 4つの専門的エージェント(Searcher, Analyzer, Writer, Reviewer)が協力し合い、ディベートをおこなう S(Source): 資料の質と適用、L(Language): 言語表現の質、A(Argument): 論証の質、O(Overall): 総合的 なパフォーマンスで評価 Searcherを抜くと資料の質と適用のスコアが下がり、Analyzerを抜くと論証の質が落ちたり役割の効果が明確 Multi Agent Systems 8月26日 更新分 -
MetaOpenFOAM: an LLM-based multi-agent framework for CFD MetaOpenFOAMは、MetaGPTとLangchainを活用し、自然言語入力のみで計算流体力学(CFD)シミュレー ションを実行できるフレームワーク フレームワークは、アーキテクト、入力ライター、ランナー、レビュワーという4つの役割で構成
LangchainのRAG技術を利用して、OpenFOAMのチュートリアルやコマンドを取得させる レビュワーが重要で、いない場合、pass@1率は27.5%に低下し、実行可能性スコアも著しく低下した 性能は良さそう Multi Agent Systems 8月12日 更新分 -
From Data to Story: Towards Automatic Animated Data Video Creation
with LLM- based Multi-Agent Systems GPT-4を中心としたデータストーリーを自動生成するためのマルチエージェントシステムを提案 データの分析結果を物語の形式で構成し、顧客に洞察や情報をわかりやすく伝える技術や手法を指す ユーザー提供データを解釈し、データ分析とデザインの2つのエージェントが連携してビデオを生成 データは、洞察抽出、視覚化、ナレーション、アニメーションとして段階的に処理される Multi Agent Systems 8月12日 更新分 -
EmBARDiment: an Embodied AI Agent for Productivity in XR GoogleからXRデバイスの入力情報(ユーザーの視線など)をもとに回答するエージェントの提案
ユーザーの音声がSpeech-to-Text APIでテキスト化され、ユーザーの視線データと一緒にLLMに渡し回答を得る 視線データを用いることで、ユーザーがエージェントに何度も質問し直す必要がなくなり、より早く正確な回答 を得られることが示された Embodied Agents 8月26日 更新分 -
Optimus-1 : Hybrid Multimodal Memory Empowered Agents Excel in Long-Horizon
Tasks Optimus-1は、オープンワールドでの長期的なタスクを完了する能力を向上させることを目指す Hybrid Multimodal Memoryモジュールを導入 • 階層的指向知識グラフ:エージェントがタスクを遂行するために必要な知識を表現 • 抽象化された経験プール:エージェントの過去の経験(環境、状態、タスク計画、ビデオフレームなど)を集約 Minecraftはエージェントはサバイバルモードでプレイし、素材の収集、道具の作成、作成順序を考慮しタスクをこなす Embodied Agents 8月12日 更新分 -
RiskAwareBench: Towards Evaluating Physical Risk Awareness for High-level Planning of
LLM-based Embodied Agents Tencentからエージェントが環境の物理的リスクを認識し、計画の中でそのリスクを回避できるかを評価するフ レームワークを提案 RiskAwareBenchは、次の4つの主要モジュールで構成 1. 安全対策生成モジュール: エージェントが計画を立てる際に考慮すべき一般的な安全ガイドラインを生成 2. リスクシーン生成モジュール:物理的リスクが発生する可能性のあるシーンを自動的に生成 3. 計画生成モジュール:エージェントがシーンの観察情報とタスクの指示に基づいて、高レベルの計画を生成 4. 評価モジュール:生成した計画を評価し、その計画に物理的リスクが含まれているかどうかを判定 多くのLLMが物理的リスクを十分に認識できていないことがわかった 例えば、キッチン環境で生卵を電子レンジで加熱する計画が生成される • タスクリスク率(TRR):エージェントが生成した計画において、対応する安全対策を違反しない割合 • タスク有効率(TER):エージェントが生成した計画が実行可能である割合 Embodied Agents 8月12日 更新分 -
Agent Q: Advanced Reasoning and Learning for Autonomous AI Agents
Webなど動的な環境における複数ステップの推論が難しいという課題がある MCTSによる探索と自己批評メカニズムを組み合わせて失敗と成功の軌跡データを集め、方策をDPOで学習する 学習した方策で再び軌跡を集めることを繰り返し、複雑な意思決定を自律的に行えるエージェントを提案 推論能力がまだ弱く、批判モデルの微学習か探索アルゴリズムの変更が必要か Computer Controlled Agents 8月26日 更新分 -
AppWorld: A Controllable World of Apps and People for Benchmarking
Interactive Coding Agents* 日常的なデジタルタスクの自動化エージェントを評価するベンチマークと動作環境の提案 AppWorld Engineは、9つの日常アプリ(例:Gmail、Venmo、Amazonなど)の機能を模倣した高品質のシミュレータ AppWorld Benchmarkは、750の複雑なタスクを含む • タスクは複数のアプリをまたがり、APIを多用することもある • タスク例:「Amazonで以前購入した赤いTシャツを再購入し、青色があればそちらを選んでください。」など 最も性能が良いgpt-4oでさえ、テストセット全体のタスク達成率は約49%にとどまる Normal Challenge TGC:タスク達成率, SGC:シナリオ達成率 Computer Controlled Agents 8月12日 更新分 -
CRAB: Cross-environment Agent Benchmark for Multimodal Language Model Agents 複数のデバイスやプラットフォームにまたがるタスクを実行する自律エージェントベンチマークの提案
AndroidスマートフォンエミュレータとUbuntuデスクトップ仮想マシンを使用して、100種類のタスクを構築 例:Androidデバイス上のメッセージアプリを開き、特定の連絡先にメッセージを送信する 例:Ubuntuデスクトップ上でテキストエディタを開き、指定されたファイルを編集する 例:スマートフォンで撮影した写真をデスクトップで編集する エージェントシステムは3種類固定でモデルを変えて評価、gpt-4oでも成功率14%とこの環境では難しい Computer Controlled Agents 8月12日 更新分
 masatoto
 analokmaus
 resolutionfoundation
 rfujii
 takehaya
 mickey_0226
 masao
 gpol
 wataruuuuu
 beale
 satai
 mikimhk
 casualconc
 afnizarnur
 mkilby
 marktimemedia
 sstephenson
 pedronauck
 trishagee
 thekraken
 bkeepers
 reverentgeek
 sergeychernyshev
 rmw
 kimpetersen