Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
理解してほしいVision Transformer / plz-understand-ViT
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
shun74
June 23, 2022
Programming
870
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
理解してほしいVision Transformer / plz-understand-ViT
Easy to understand explanation form NN to ViT.
shun74
June 23, 2022
Transcript
15 slides
理解してほしい VisionTransformer B4 佐藤 駿
はじめに • 機械学習を全く知らない人でも理解できるように解説します 目次 • 機械学習 • ニューラルネット • 畳み込みニューラルネット
(CNN) • Vision Transformer (ViT) • Attention • CNN vs ViT • ViTとCNNのいいとこどり例
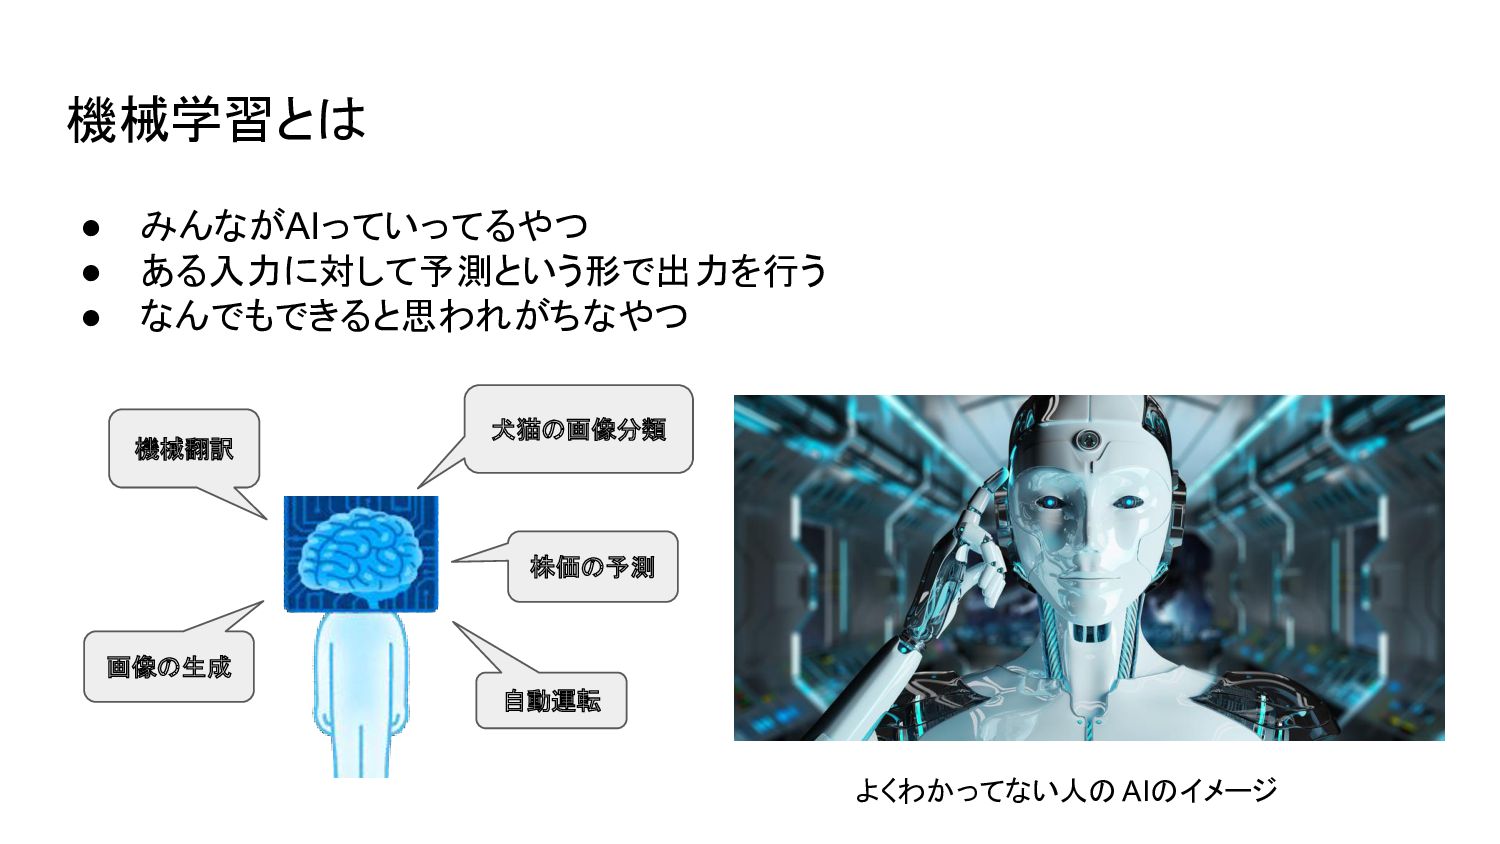
機械学習とは • みんながAIっていってるやつ • ある入力に対して予測という形で出力を行う • なんでもできると思われがちなやつ 犬猫の画像分類 株価の予測 機械翻訳
画像の生成 自動運転 よくわかってない人の AIのイメージ
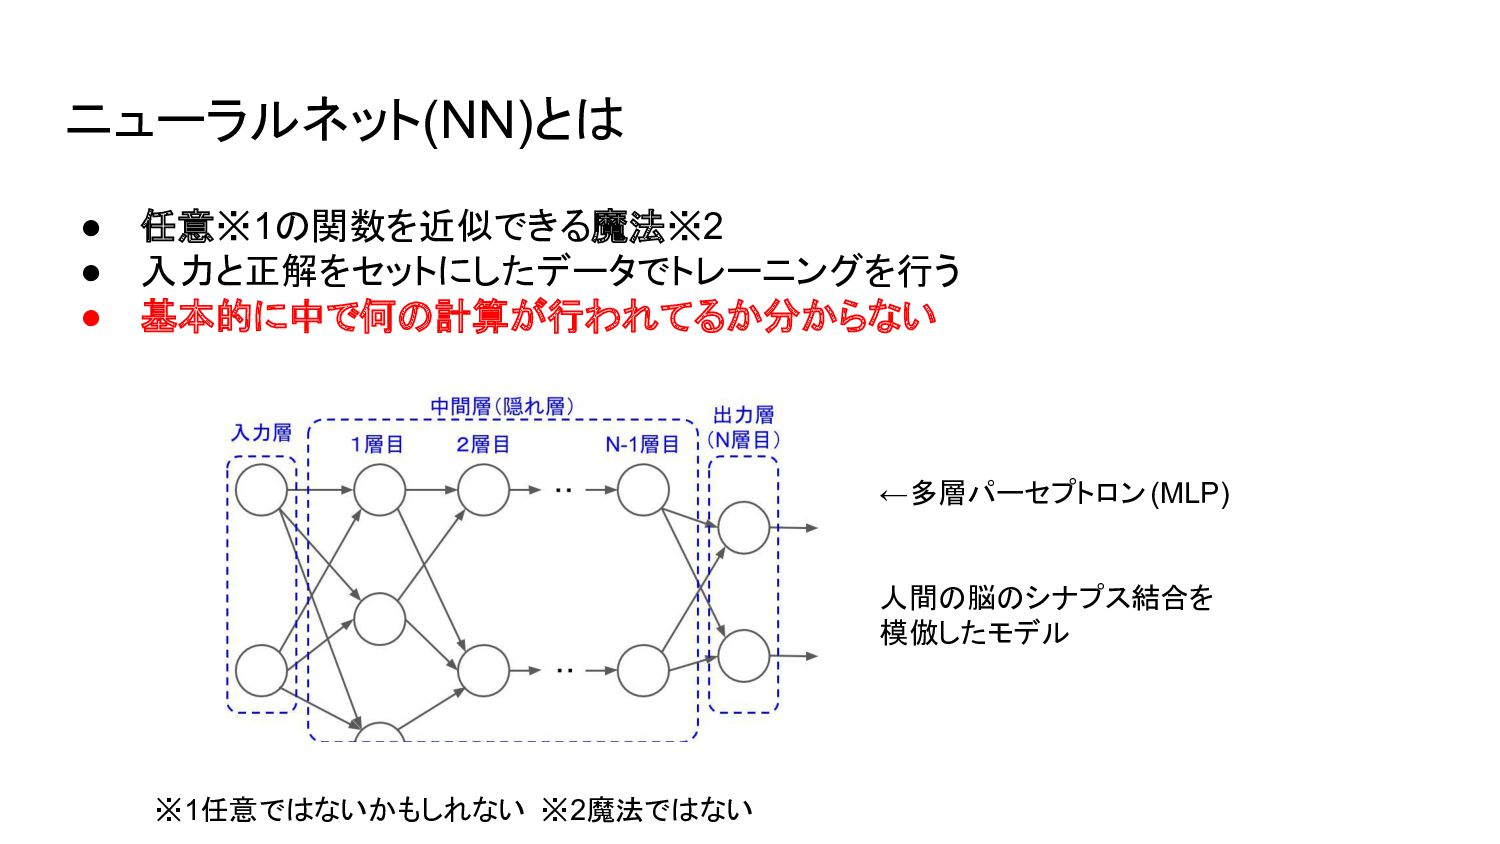
ニューラルネット(NN)とは • 任意※1の関数を近似できる魔法※2 • 入力と正解をセットにしたデータでトレーニングを行う • 基本的に中で何の計算が行われてるか分からない ※1任意ではないかもしれない ※2魔法ではない ←多層パーセプトロン(MLP)
人間の脳のシナプス結合を 模倣したモデル
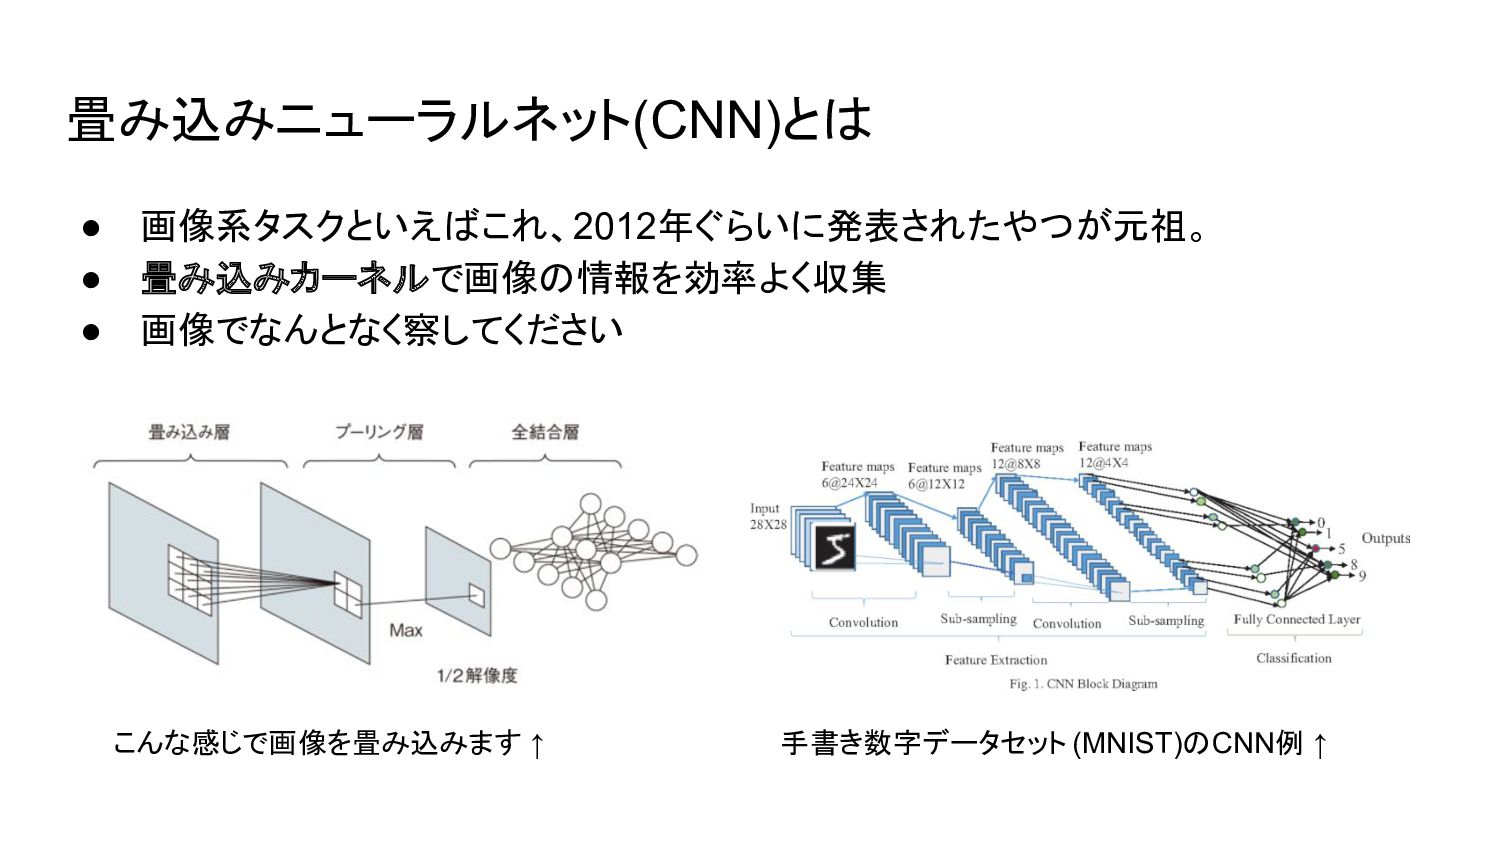
畳み込みニューラルネット(CNN)とは • 画像系タスクといえばこれ、2012年ぐらいに発表されたやつが元祖。 • 畳み込みカーネルで画像の情報を効率よく収集 • 画像でなんとなく察してください 手書き数字データセット (MNIST)のCNN例 ↑
こんな感じで画像を畳み込みます ↑
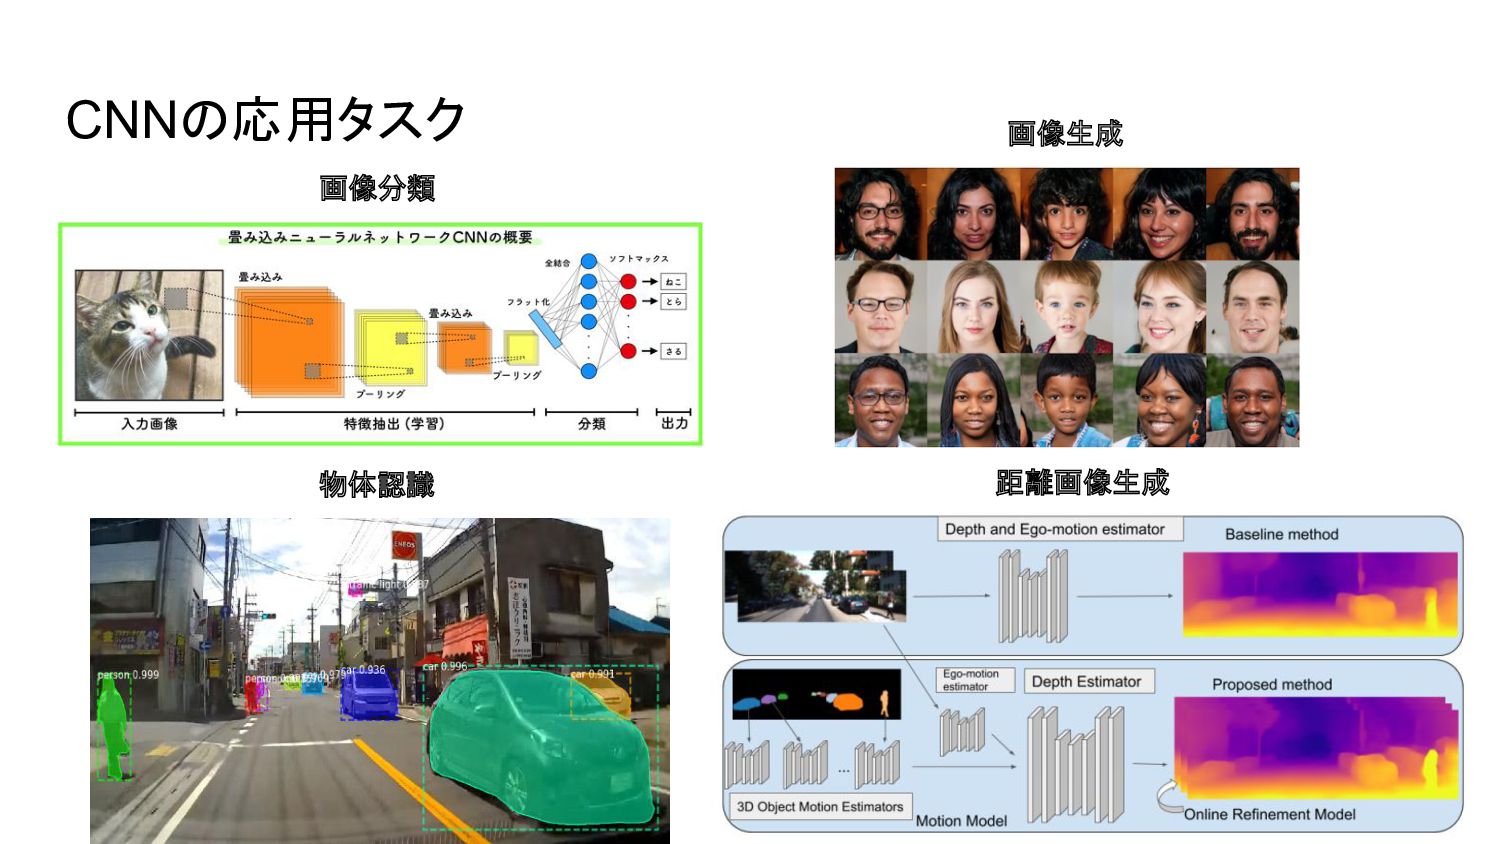
CNNの応用タスク 画像分類 画像生成 物体認識 距離画像生成
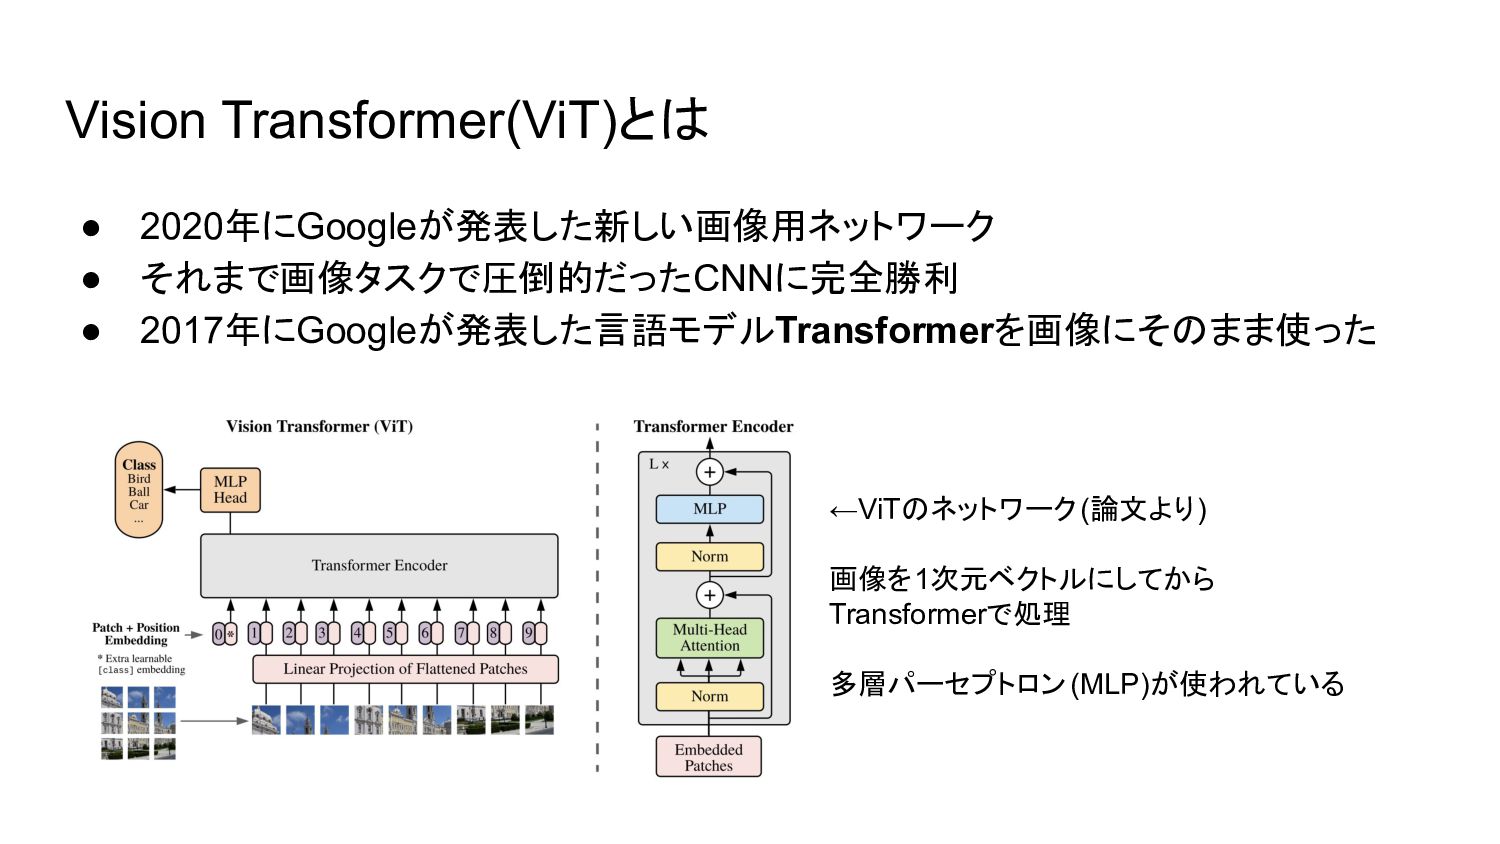
Vision Transformer(ViT)とは • 2020年にGoogleが発表した新しい画像用ネットワーク • それまで画像タスクで圧倒的だったCNNに完全勝利 • 2017年にGoogleが発表した言語モデルTransformerを画像にそのまま使った ←ViTのネットワーク(論文より) 画像を1次元ベクトルにしてから
Transformerで処理 多層パーセプトロン(MLP)が使われている
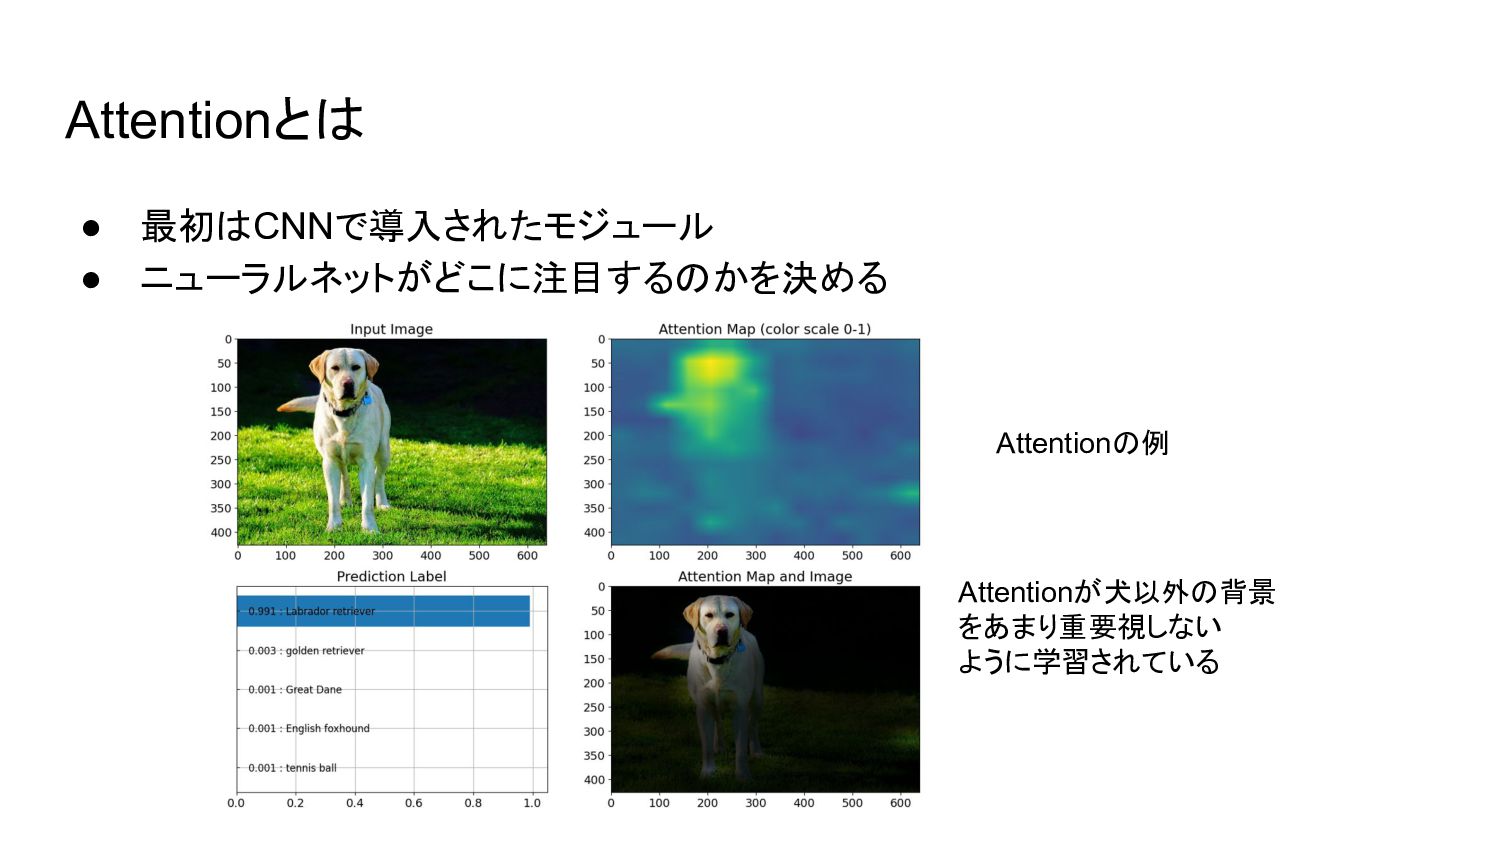
Attentionとは • 最初はCNNで導入されたモジュール • ニューラルネットがどこに注目するのかを決める Attentionの例 Attentionが犬以外の背景 をあまり重要視しない ように学習されている
Scaled Dot-Product Attentionの解説 Query, Key, Valueを用意して計算 1. Query, Keyの行列積を計算 2.
SoftMaxを使ってAttentionMapを生成 3. ValueにMaskを適用して完成 • ViTで使われているのはMulti-Head Attention • Scaled Dot-Product Attentionを複数使う • より多くのパターンを作ることで情報量UP
Vision Transformerのアーキテクチャ1 入力 画像をパッチに分割して1次元ベクトル化 (xy座標情報は捨てる) パッチごとにPosition Embeddingも追加 ViTでは16*16単位で画像をパッチ化 パッチ化した画像を平坦化して入力!
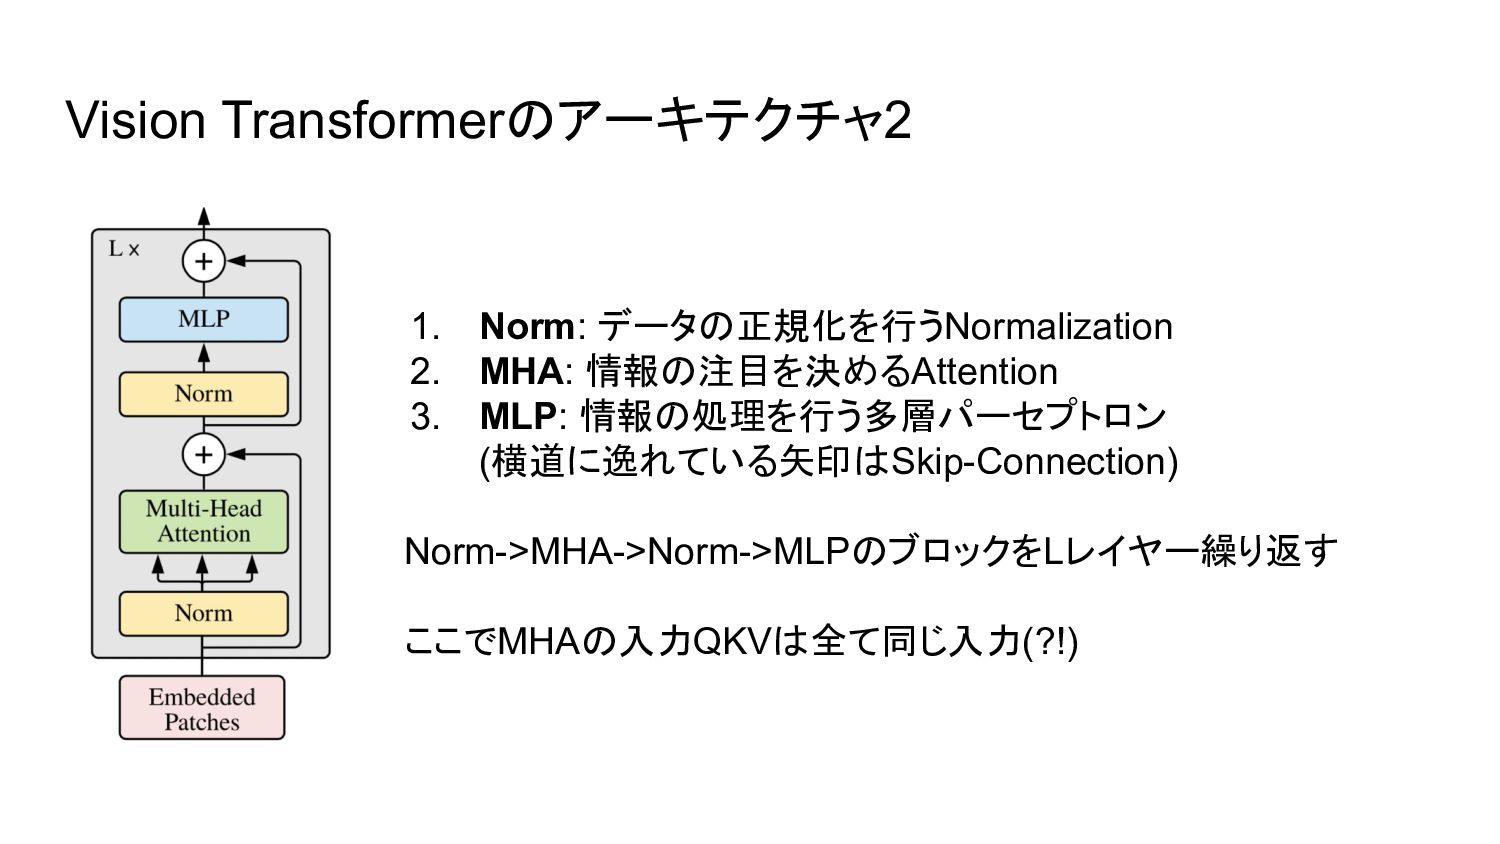
Vision Transformerのアーキテクチャ2 1. Norm: データの正規化を行うNormalization 2. MHA: 情報の注目を決めるAttention 3. MLP:
情報の処理を行う多層パーセプトロン (横道に逸れている矢印はSkip-Connection) Norm->MHA->Norm->MLPのブロックをLレイヤー繰り返す ここでMHAの入力QKVは全て同じ入力(?!)
CNN vs ViT Q. なぜViTがCNNに圧勝したのか A. タスクがちょうど良かったから ViT : Attentionで全体(Global)の特徴量をまとめる
CNN: 畳み込みで局所(Local)の特徴量を捉える • 比較が画像分類タスクだったためViTが圧勝した • 画像分類は画像の中に何が映っているか何となく分かればいい ViTとResNet(CNN)の 内部表現の類似性の比較 ViTの方が安定した表現を 獲得している (?)
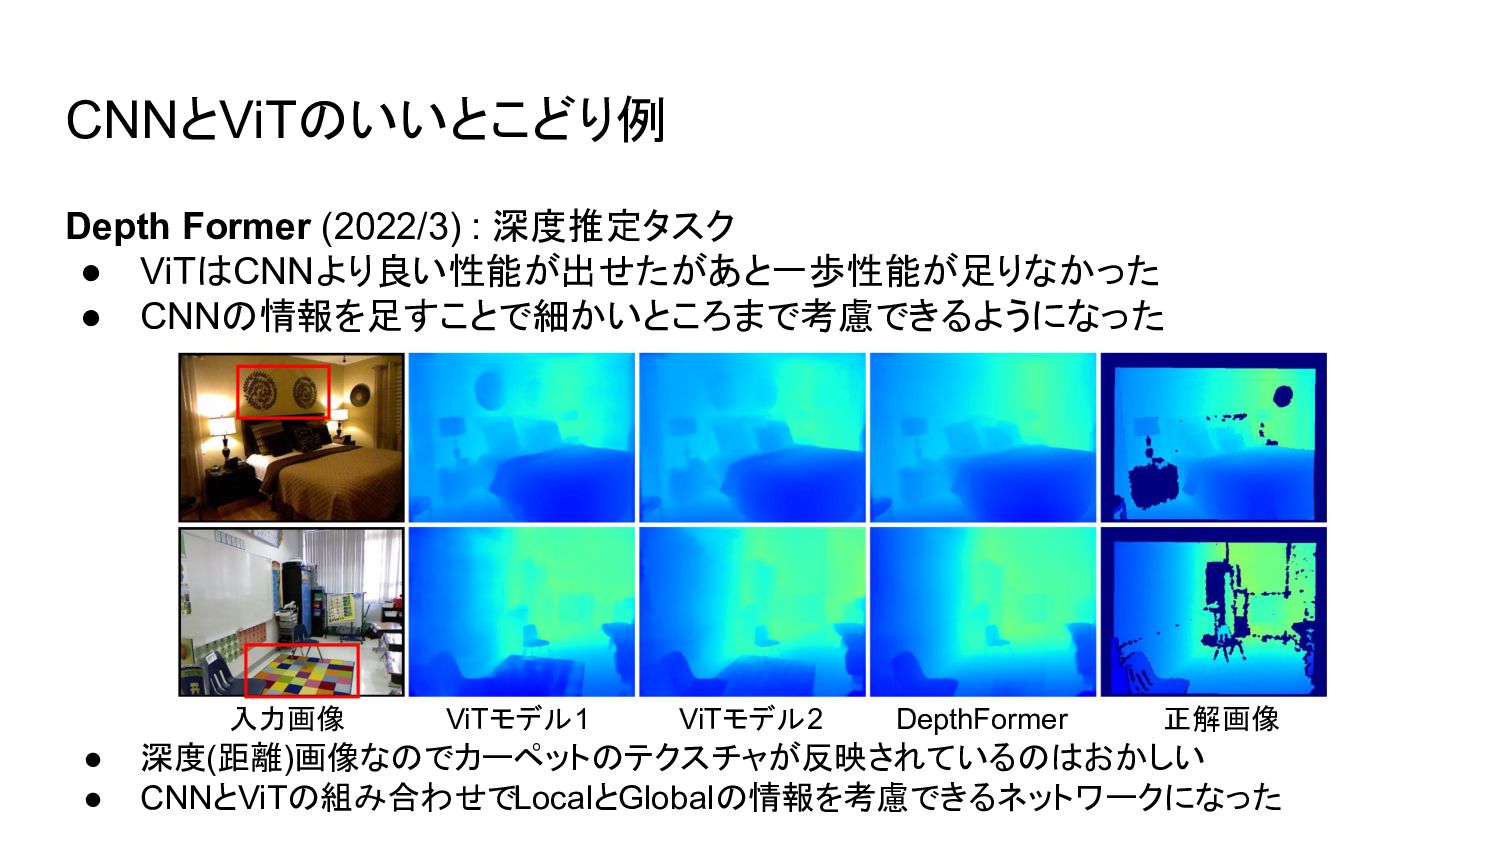
CNNとViTのいいとこどり例 Depth Former (2022/3) : 深度推定タスク • ViTはCNNより良い性能が出せたがあと一歩性能が足りなかった • CNNの情報を足すことで細かいところまで考慮できるようになった
• 深度(距離)画像なのでカーペットのテクスチャが反映されているのはおかしい • CNNとViTの組み合わせでLocalとGlobalの情報を考慮できるネットワークになった 入力画像 ViTモデル1 ViTモデル2 DepthFormer 正解画像
さいごに • 現在多くの画像タスクでBackboneとしてViTが使われている • ViT自体も様々なモデルの開発競争が行われている • ViT以外にもCNNだけのモデルやMLPのモデルも研究されている • みんなもViTを実装して最新のAIモデルを作ろう! •
画像系AIの相談があれば@shun74まで
参考 1. ニューラルネット: https://ledge.ai/neural-network/ 2. CNN: https://leadinge.co.jp/rd/2021/06/07/863/ 3. ViT: https://qiita.com/omiita/items/0049ade809c4817670d7
(最強資料) 4. ViT vs CNN: https://ai-scholar.tech/articles/transformer/transformer-vs-cnn 5. DepthFormer: https://arxiv.org/abs/2203.14211
More Decks by shun74
See All by shun74
深度推定モデルの自己教師あり学習/self-supervised-depth
shun74
0
590
GPUでステレオマッチング / Stereo-matching with GPU
shun74
0
1.3k
卒業研究の進め方 / How to preceed with the research
shun74
1
670
Barcode Recognition / pharmacode-decoder
shun74
0
1.2k
Vision Transformer講座 / Vision Transformer Presentation
shun74
1
870
ニューラルネットの1bit化 / 1bit-neural-network
shun74
0
1.1k
Defocus Map Estimation From a Single Image Based on Two-Parameter Defocus Model / two-parameter-defocus-model
shun74
0
440
Other Decks in Programming
See All in Programming
Modernizing iOS Apps
seyfoyun
0
150
オーケストレーション記述言語 Katari
yukikurage
0
260
조합이폭발하는디자인시스템이걸눈으로도테스트하라고요
giljongyu
0
750
GraphQL の onError と Nullability のこれから
quramy
0
220
Snowflake Openflow Connector利用の勘所 / 20261024developersio2026tokyo-snowflake-openflow
kasacchiful
PRO
0
340
Apple Intelligenceとオンデバイス時代の到来
yahir0
0
240
Augmenting AI with the Power of Jakarta EE
ivargrimstad
0
300
AIで開発が速くなった先で、開発チームは何を目指すか
shihochan
1
2k
私なりのハーネスエンジニアリング ~独自の言語処理系の開発を通して~
seosoft
0
200
LLM 101: Exploring LLMs, Starting with Tokens.
dalinaum
0
110
TanStack Vue Query と Pinia Colada から学ぶ非同期状態の型設計
aoshi
0
670
自作Discord音声botをLambda MicroVMsに移行した話 / Migrating My Discord Voice Bot to Lambda MicroVMs
akihisaikeda
1
320
Featured
See All Featured
Color Theory Basics | Prateek | Gurzu
gurzu
1
520
Reflections from 52 weeks, 52 projects
jeffersonlam
356
22k
Optimizing for Happiness
mojombo
378
71k
Learning to Love Humans: Emotional Interface Design
aarron
275
41k
Applied NLP in the Age of Generative AI
inesmontani
PRO
4
2.6k
Side Projects
sachag
456
43k
The Power of CSS Pseudo Elements
geoffreycrofte
82
6.6k
Paper Plane (Part 1)
katiecoart
PRO
3
12k
Ten Tips & Tricks for a 🌱 transition
stuffmc
1
280
AI in Enterprises - Java and Open Source to the Rescue
ivargrimstad
0
1.6k
The untapped power of vector embeddings
frankvandijk
2
2k
Gemini Prompt Engineering: Practical Techniques for Tangible AI Outcomes
mfonobong
2
630


 shun74
 seyfoyun
 yukikurage
 giljongyu
 quramy
 kasacchiful
 yahir0
 ivargrimstad
 shihochan
 seosoft
 dalinaum
 aoshi
 akihisaikeda
 gurzu
 jeffersonlam
 mojombo
 aarron
 inesmontani
 sachag
 geoffreycrofte
 katiecoart
 stuffmc
 frankvandijk
 mfonobong