Share
Embed
Vision Transformer講座 / Vision Transformer Presentation
Vision Transformer講座です。
Vision Transformerについて解説しました。
shun74
November 09, 2022
Transcript
33 slides
-
目次 • Vision Transformerとは • Vision Transformerのアーキテクチャ • Multi-Head Self
Attentionについて • Vision Transformerの分析 • Vision Transformerの派生研究 -
Vision Transformerとは An Image is Worth 16x16 Words: Transformers for
Image Recognition at Scale. Alexey Dosovitskiy他. ICLR 2021. (https://openreview.net/forum?id=YicbFdNTTy) • Googleの研究者グループが発表した最新の画像分類モデル • 言語モデルのTransformer(NIPS 2017)をほぼそのまま画像タスクに転用した • CNNなどの既存の画像分類モデルを上回る精度を達成 • 従来の画像系モデルの常識を大きく変えた -
Vision Transformerとは • 画像を時系列データのように処理 • 畳み込みなしで画像から情報を抽出 • Multi-Head Self Attentionという特徴的なモジュール
• Vision Transformerの概要(論文より) • 画像のベクトル化と全結合層で情報を 取り出す -
Visnion Transformerのアーキテクチャ • Vision Transformerは以下の順番で画像を処理 1. 画像のベクトル(トークン)化 ⇢ Embedding 2.
ベクトルの情報抽出&集約 ⇢ Encoder 3. 特徴量からクラス分類 ⇢ Head -
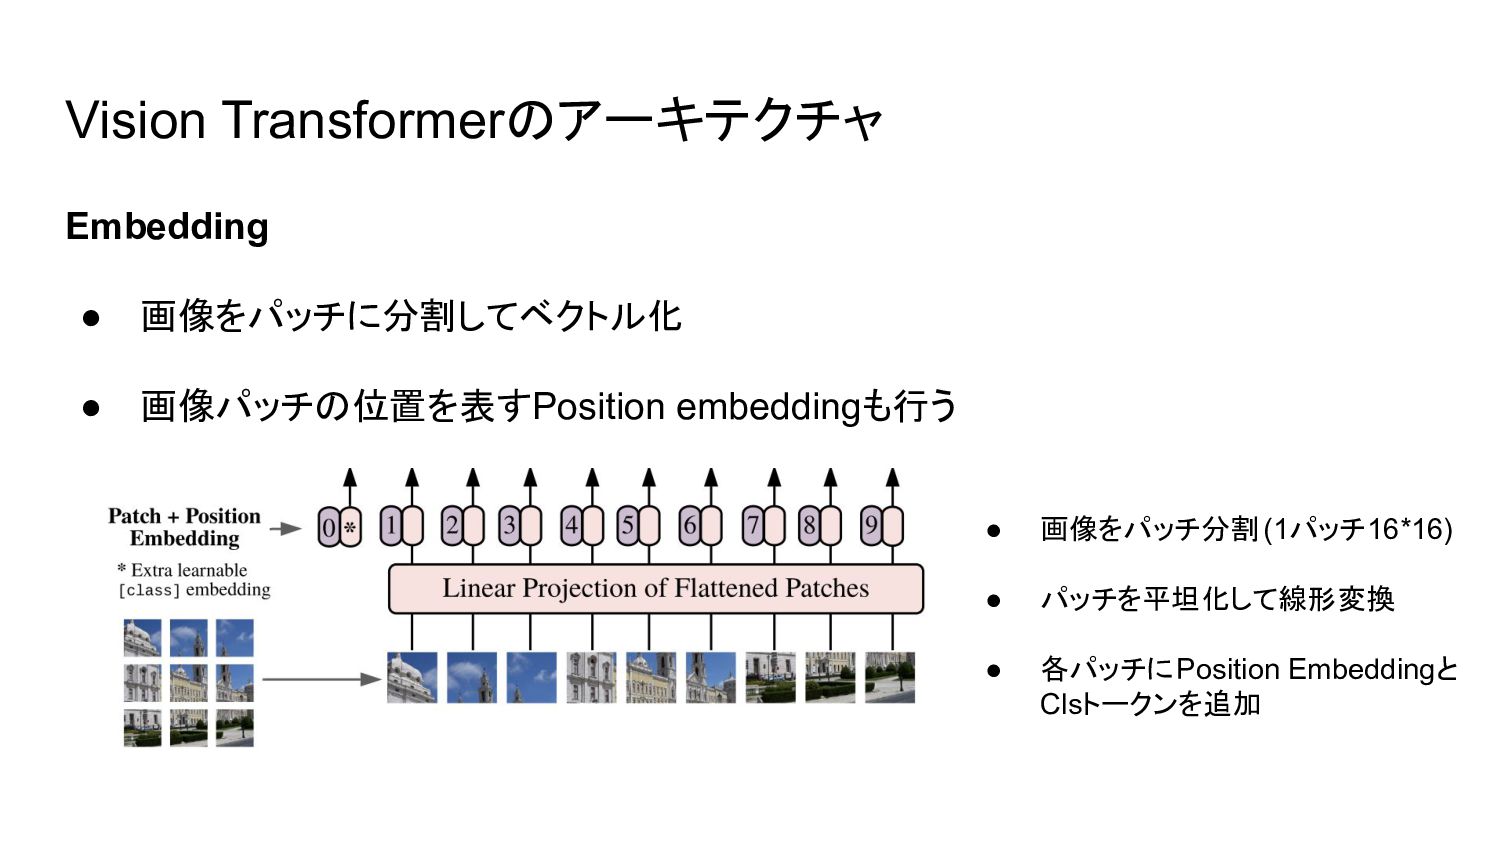
Vision Transformerのアーキテクチャ Embedding • 画像をパッチに分割してベクトル化 • 画像パッチの位置を表すPosition embeddingも行う • 画像をパッチ分割(1パッチ16*16)
• パッチを平坦化して線形変換 • 各パッチにPosition Embeddingと Clsトークンを追加 -
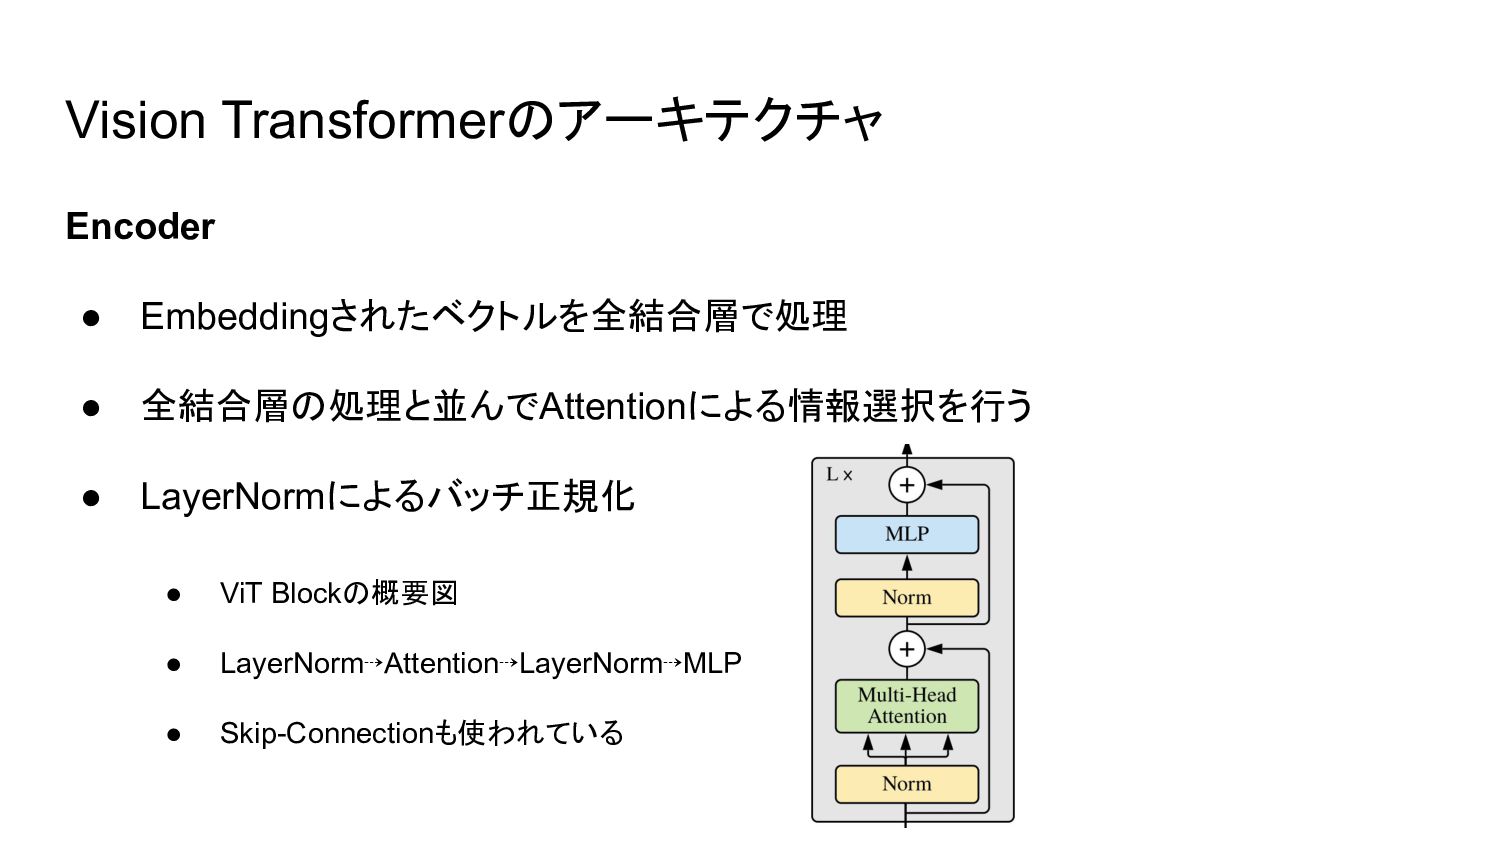
Vision Transformerのアーキテクチャ Encoder • Embeddingされたベクトルを全結合層で処理 • 全結合層の処理と並んでAttentionによる情報選択を行う • LayerNormによるバッチ正規化 •
ViT Blockの概要図 • LayerNorm⇢Attention⇢LayerNorm⇢MLP • Skip-Connectionも使われている -
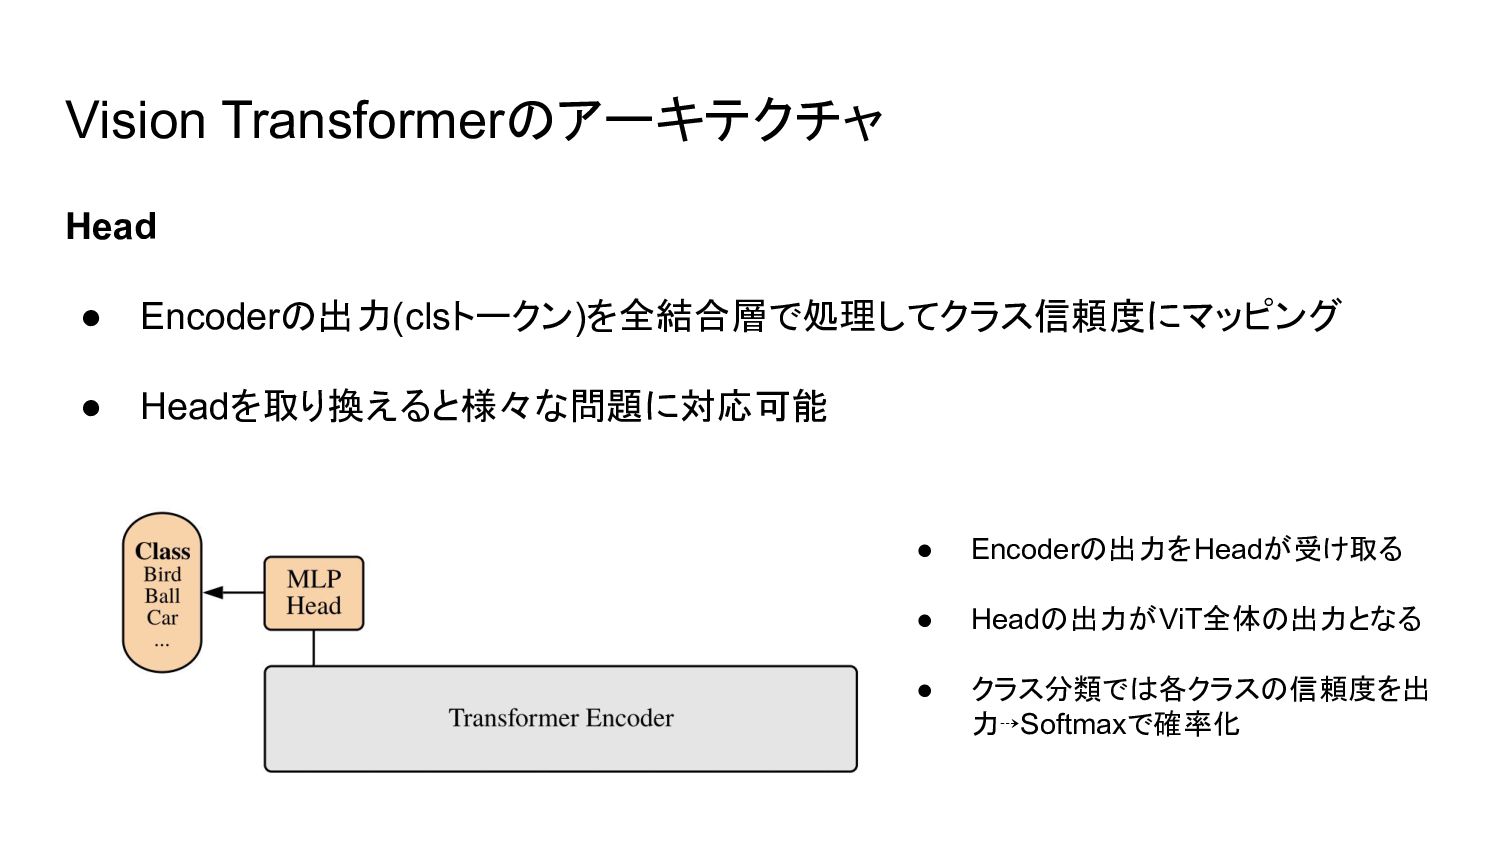
Vision Transformerのアーキテクチャ Head • Encoderの出力(clsトークン)を全結合層で処理してクラス信頼度にマッピング • Headを取り換えると様々な問題に対応可能 • Encoderの出力をHeadが受け取る •
Headの出力がViT全体の出力となる • クラス分類では各クラスの信頼度を出 力⇢Softmaxで確率化 -
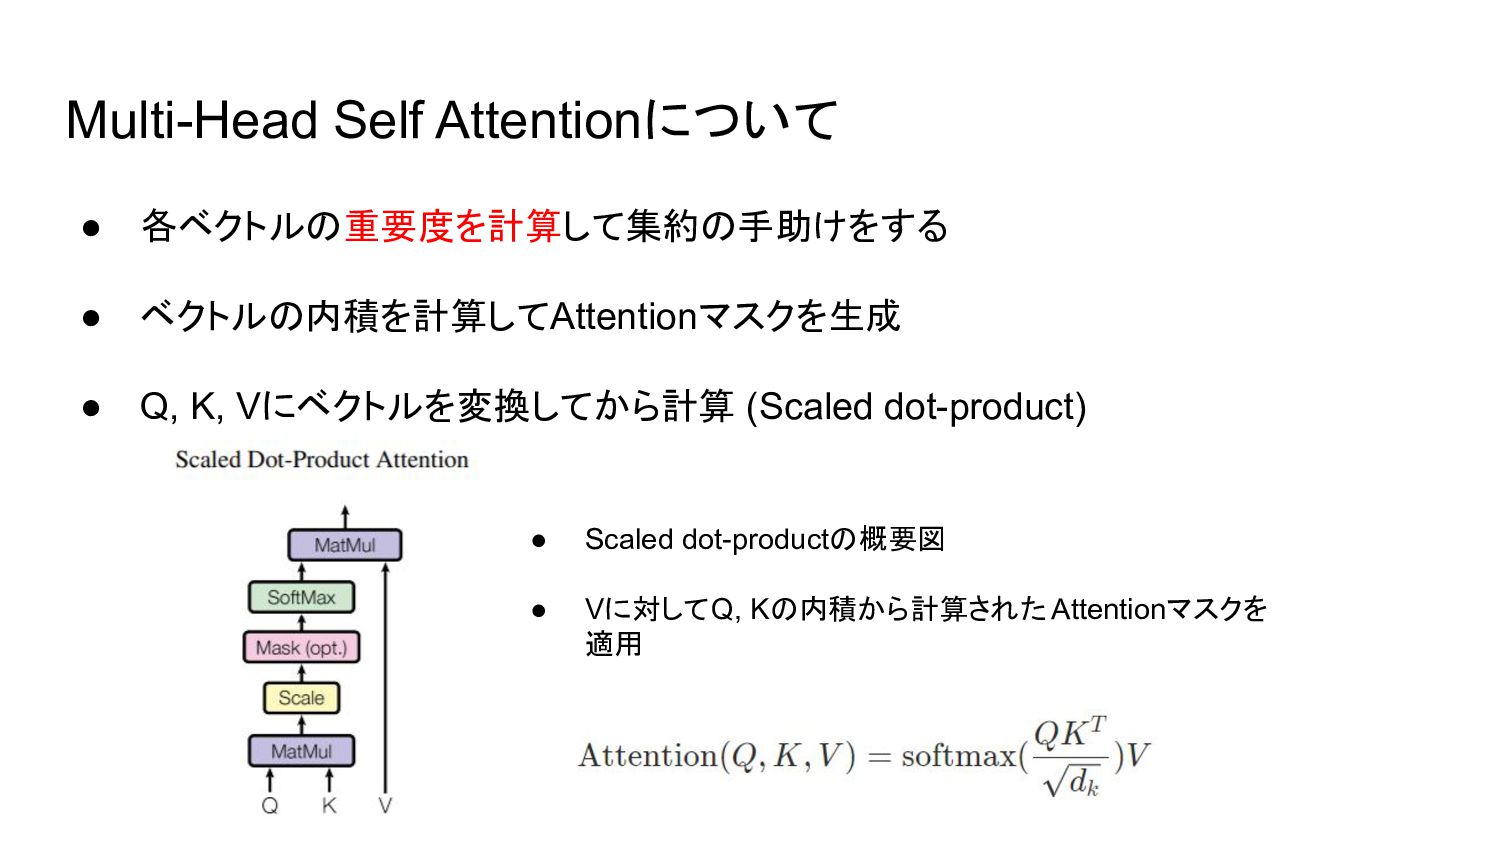
Multi-Head Self Attentionについて • 各ベクトルの重要度を計算して集約の手助けをする • ベクトルの内積を計算してAttentionマスクを生成 • Q, K,
Vにベクトルを変換してから計算 (Scaled dot-product) • Scaled dot-productの概要図 • Vに対してQ, Kの内積から計算された Attentionマスクを 適用 -
Multi-Head Self Attentionについて Scaled dot-product • Q, K, Vから計算を行う 1.
Q, K, Vはそれぞれ同じ入力に異なる全結合層を適用して生成 2. QとKのそれぞれのベクトル積(内積)を計算 3. Q,Kの内積をベクトル長で割ったものをSoftmaxで正規化(Attentionマスク) 4. VにAttentionマスクを適用して全結合層を適用 -
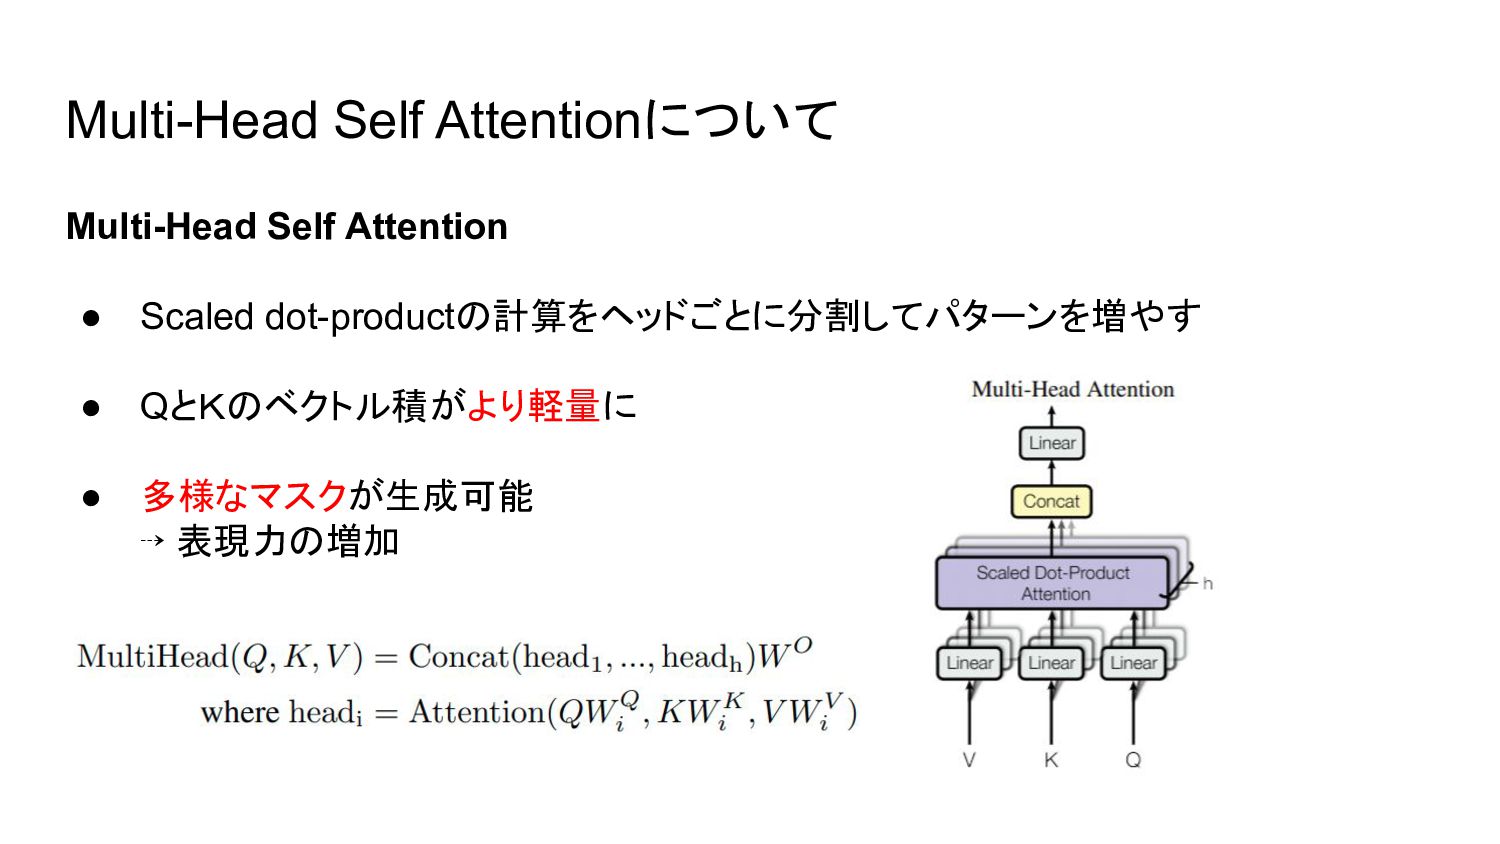
Multi-Head Self Attentionについて Multi-Head Self Attention • Scaled dot-productの計算をヘッドごとに分割してパターンを増やす •
QとKのベクトル積がより軽量に • 多様なマスクが生成可能 ⇢ 表現力の増加 -
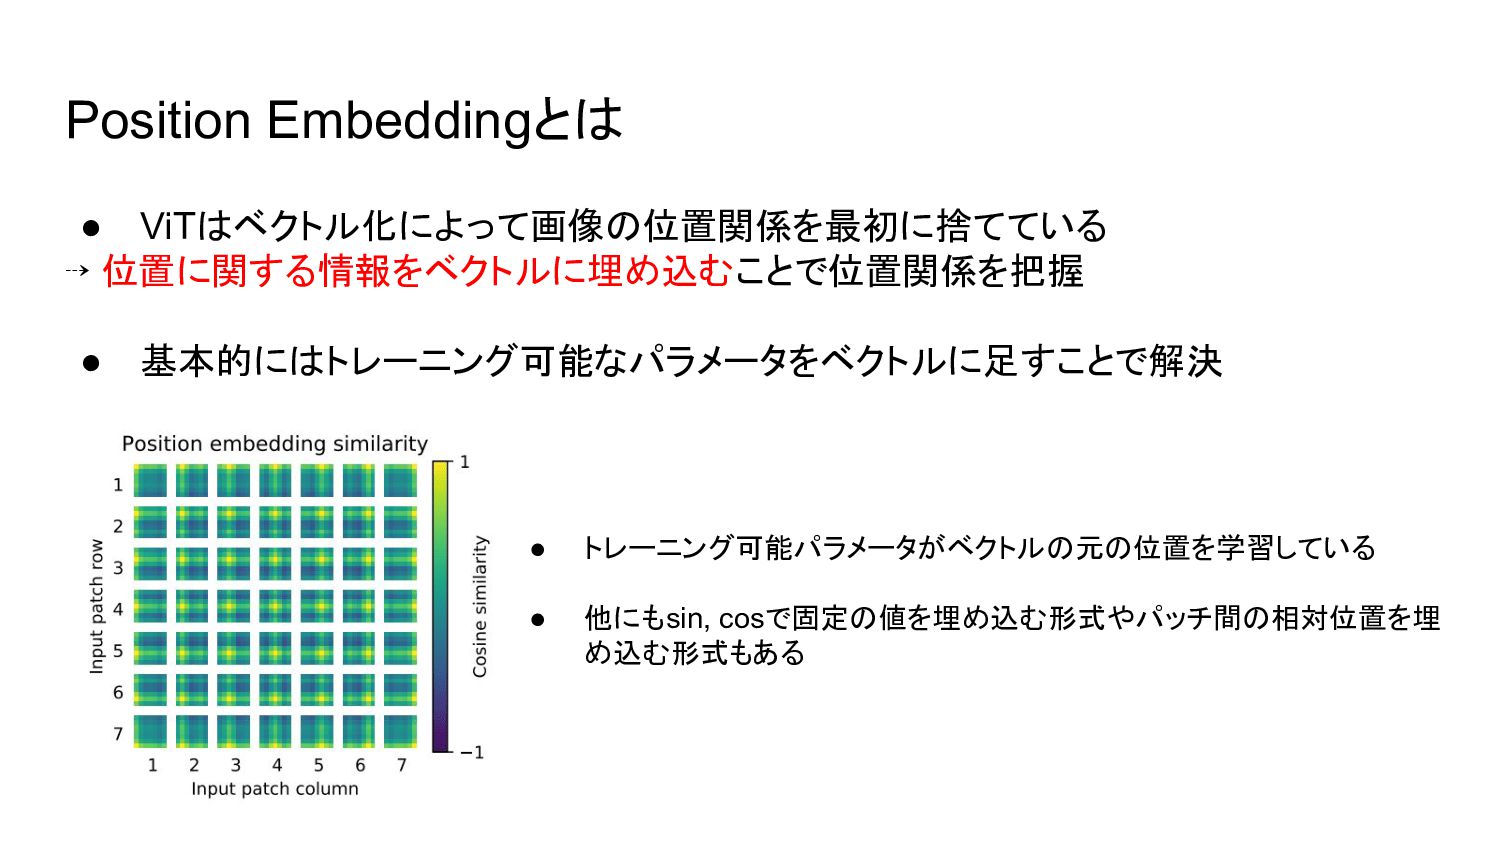
Position Embeddingとは • ViTはベクトル化によって画像の位置関係を最初に捨てている ⇢ 位置に関する情報をベクトルに埋め込むことで位置関係を把握 • 基本的にはトレーニング可能なパラメータをベクトルに足すことで解決 • トレーニング可能パラメータがベクトルの元の位置を学習している
• 他にもsin, cosで固定の値を埋め込む形式やパッチ間の相対位置を埋 め込む形式もある -
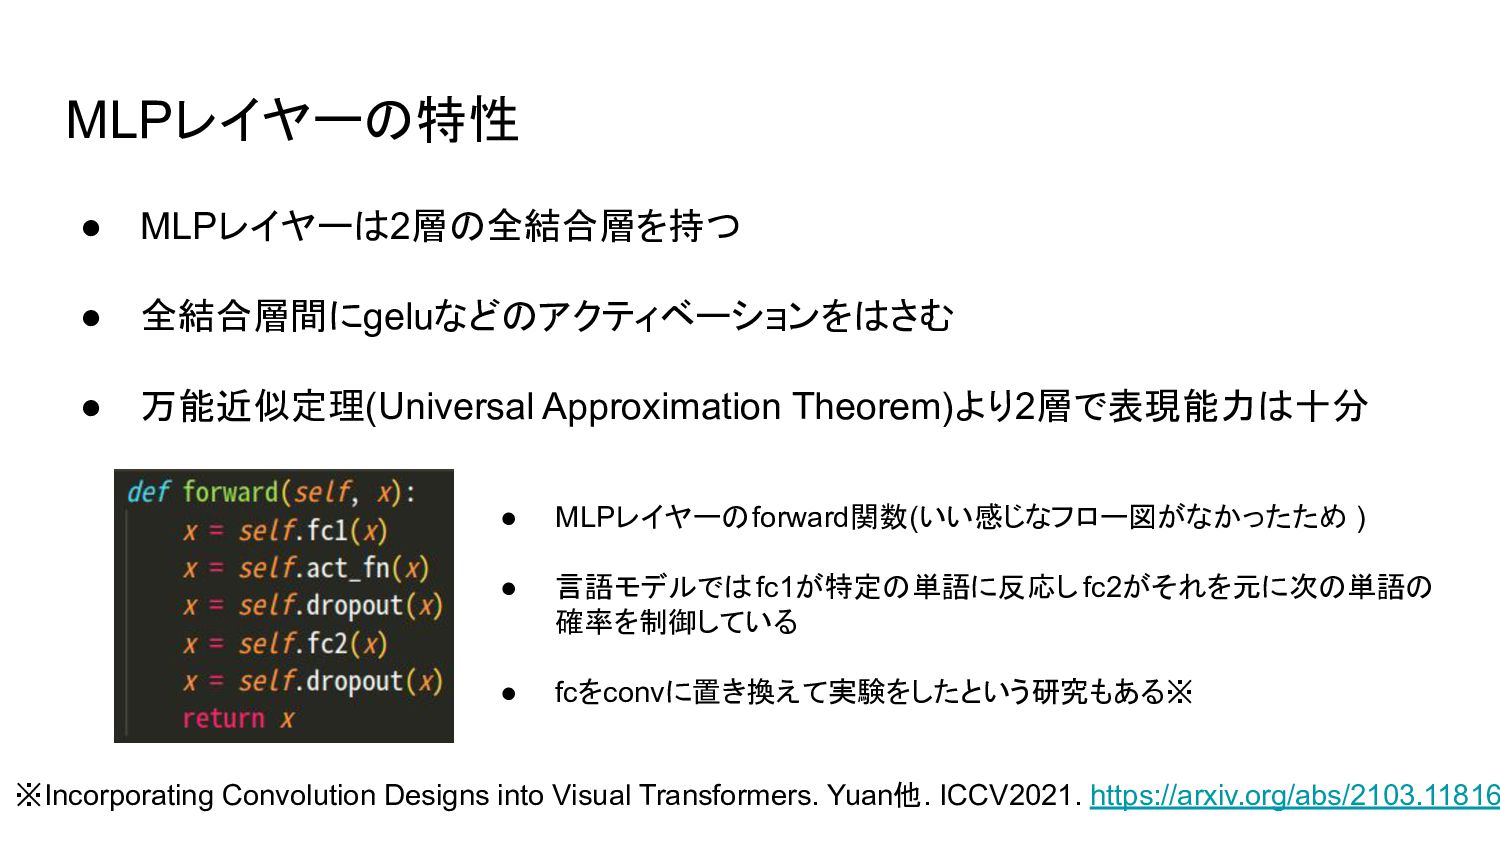
MLPレイヤーの特性 • MLPレイヤーは2層の全結合層を持つ • 全結合層間にgeluなどのアクティベーションをはさむ • 万能近似定理(Universal Approximation Theorem)より2層で表現能力は十分 •
MLPレイヤーのforward関数(いい感じなフロー図がなかったため ) • 言語モデルではfc1が特定の単語に反応し fc2がそれを元に次の単語の 確率を制御している • fcをconvに置き換えて実験をしたという研究もある※ ※Incorporating Convolution Designs into Visual Transformers. Yuan他. ICCV2021. https://arxiv.org/abs/2103.11816 -
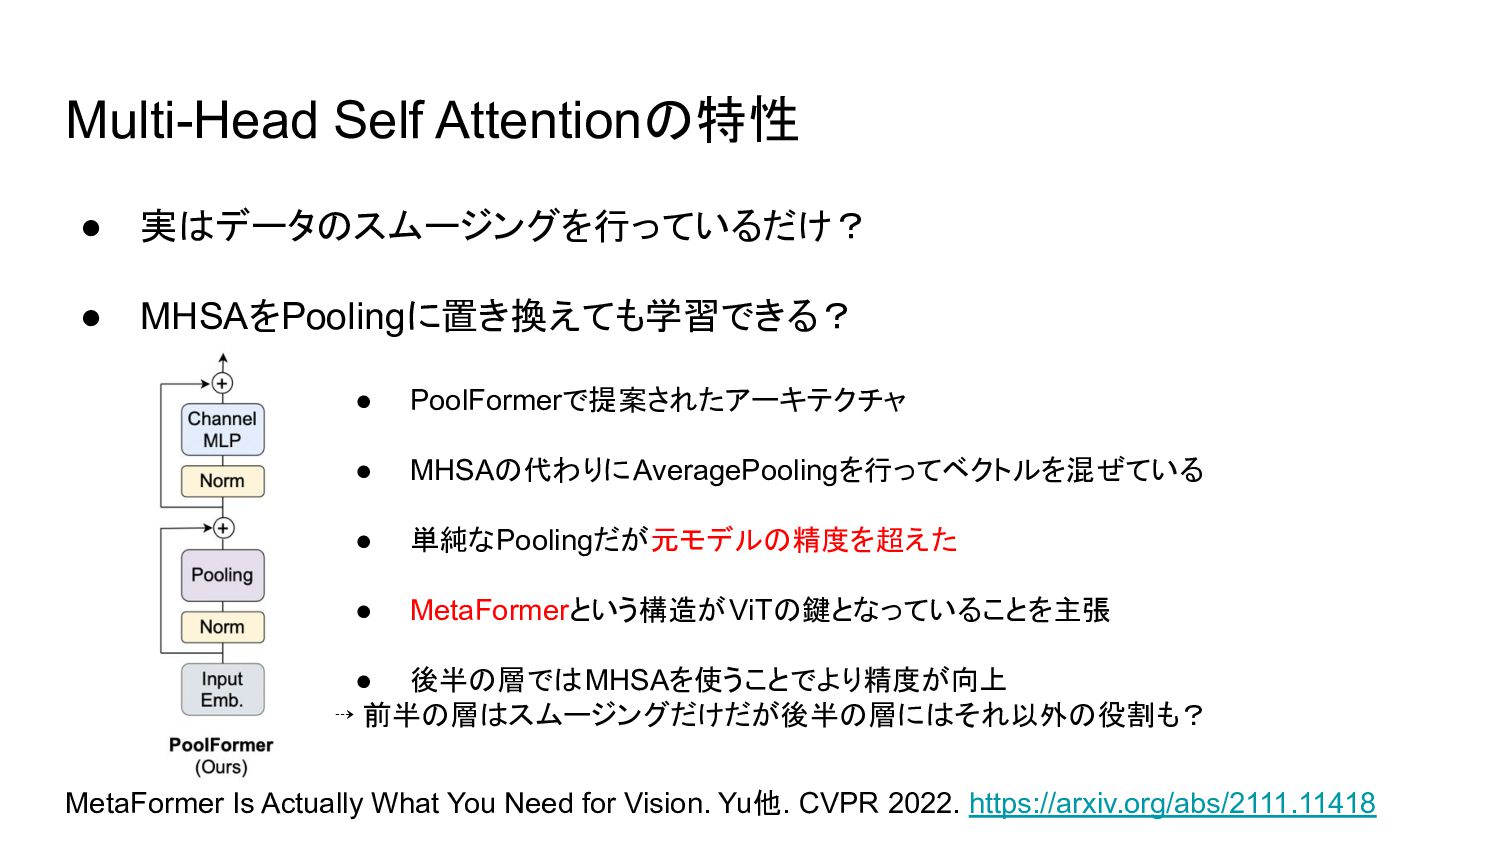
Multi-Head Self Attentionの特性 • 実はデータのスムージングを行っているだけ? • MHSAをPoolingに置き換えても学習できる? • PoolFormerで提案されたアーキテクチャ •
MHSAの代わりにAveragePoolingを行ってベクトルを混ぜている • 単純なPoolingだが元モデルの精度を超えた • MetaFormerという構造がViTの鍵となっていることを主張 • 後半の層ではMHSAを使うことでより精度が向上 ⇢ 前半の層はスムージングだけだが後半の層にはそれ以外の役割も? MetaFormer Is Actually What You Need for Vision. Yu他. CVPR 2022. https://arxiv.org/abs/2111.11418 -
LayerNorm vs BatchNorm • ViTではTransformerを継いでLayerNormが使われている • LayerNormは平均分散を入力ごとに計算するためベクトル長の変化に強い • BatchNormはあらかじめ平均分散を用意してから計算するため高速 ⇢
入力のサイズが一定の画像モデルならBatchNormでもいいのでは? LayerNormをBatchNormに置き換えて実験を行った研究※ • そのまま置き換えると学習中に勾配が爆発して学習不可(MLPのスケール問題) ⇢ しかしMLPのfc間にBatchNormを入れればLayerNormの時と同様に学習ができた ※Leveraging Batch Normalization for Vision Transformers. Yao他. ICCVW 2021. https://patrick-llgc.github.io/Learning-Deep-Learning/paper_notes/bn_ffn_bn.html -
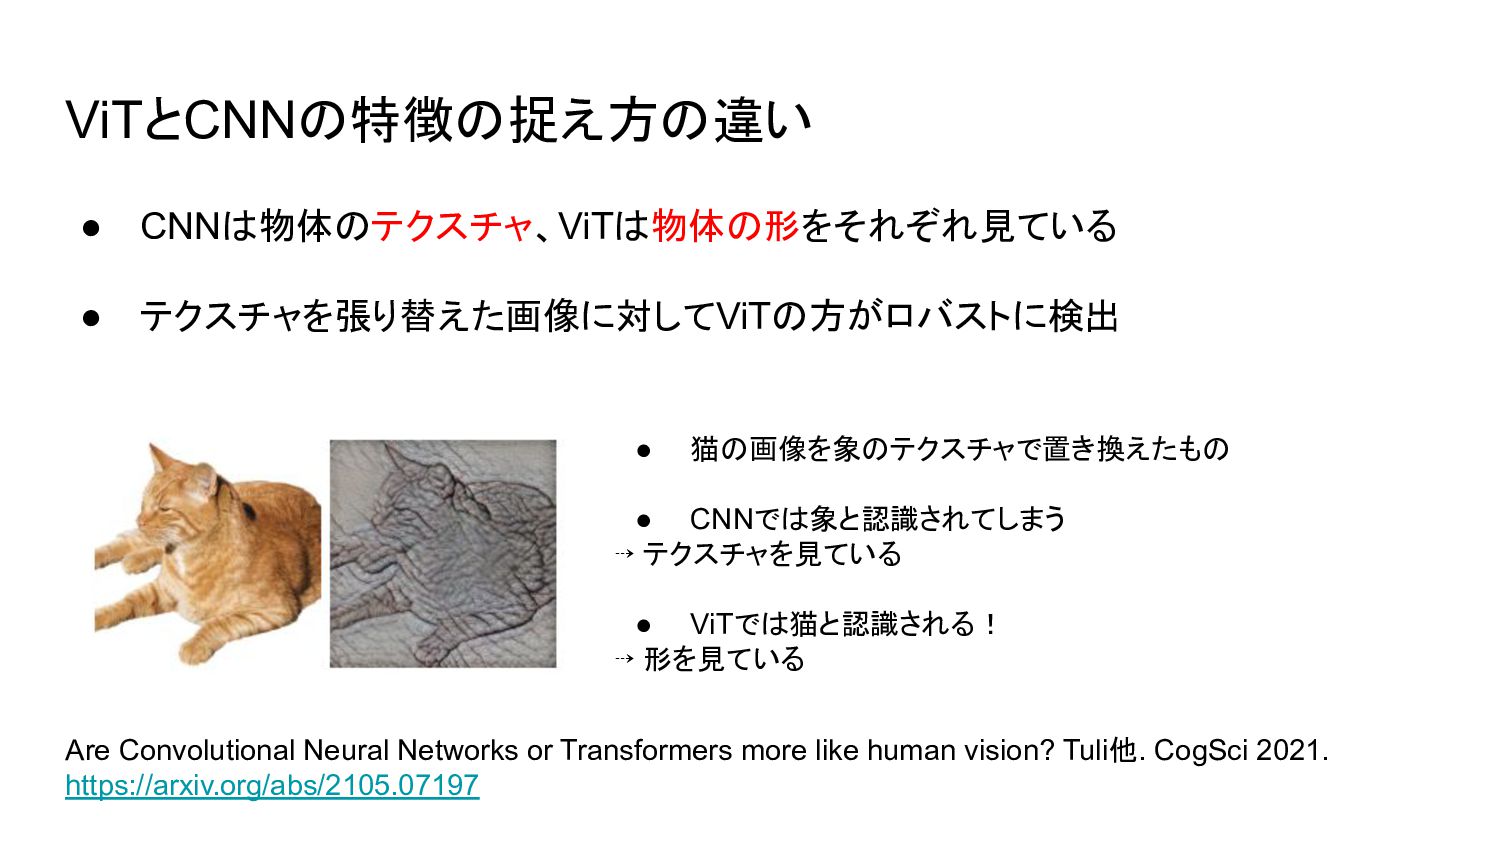
ViTとCNNの特徴の捉え方の違い • CNNは物体のテクスチャ、ViTは物体の形をそれぞれ見ている • テクスチャを張り替えた画像に対してViTの方がロバストに検出 • 猫の画像を象のテクスチャで置き換えたもの • CNNでは象と認識されてしまう ⇢
テクスチャを見ている • ViTでは猫と認識される! ⇢ 形を見ている Are Convolutional Neural Networks or Transformers more like human vision? Tuli他. CogSci 2021. https://arxiv.org/abs/2105.07197 -
ViTのグローバル情報処理能力 • ViTはCNNに比べて手前の層からグローバル情報を保持している • 層の表現の類似度をCKAという方式で計算して可視化したもの • ViTの方がCNNよりも層全体の表現に類似度がある • ネットワークの層の途中で表現を抽出したところViTの方がCNNより精度よく分類 ができた⇢CNNには受容野という制約がある
Do Vision Transformers See Like Convolutional Neural Networks? Raghu他. https://arxiv.org/abs/2108.08810 -
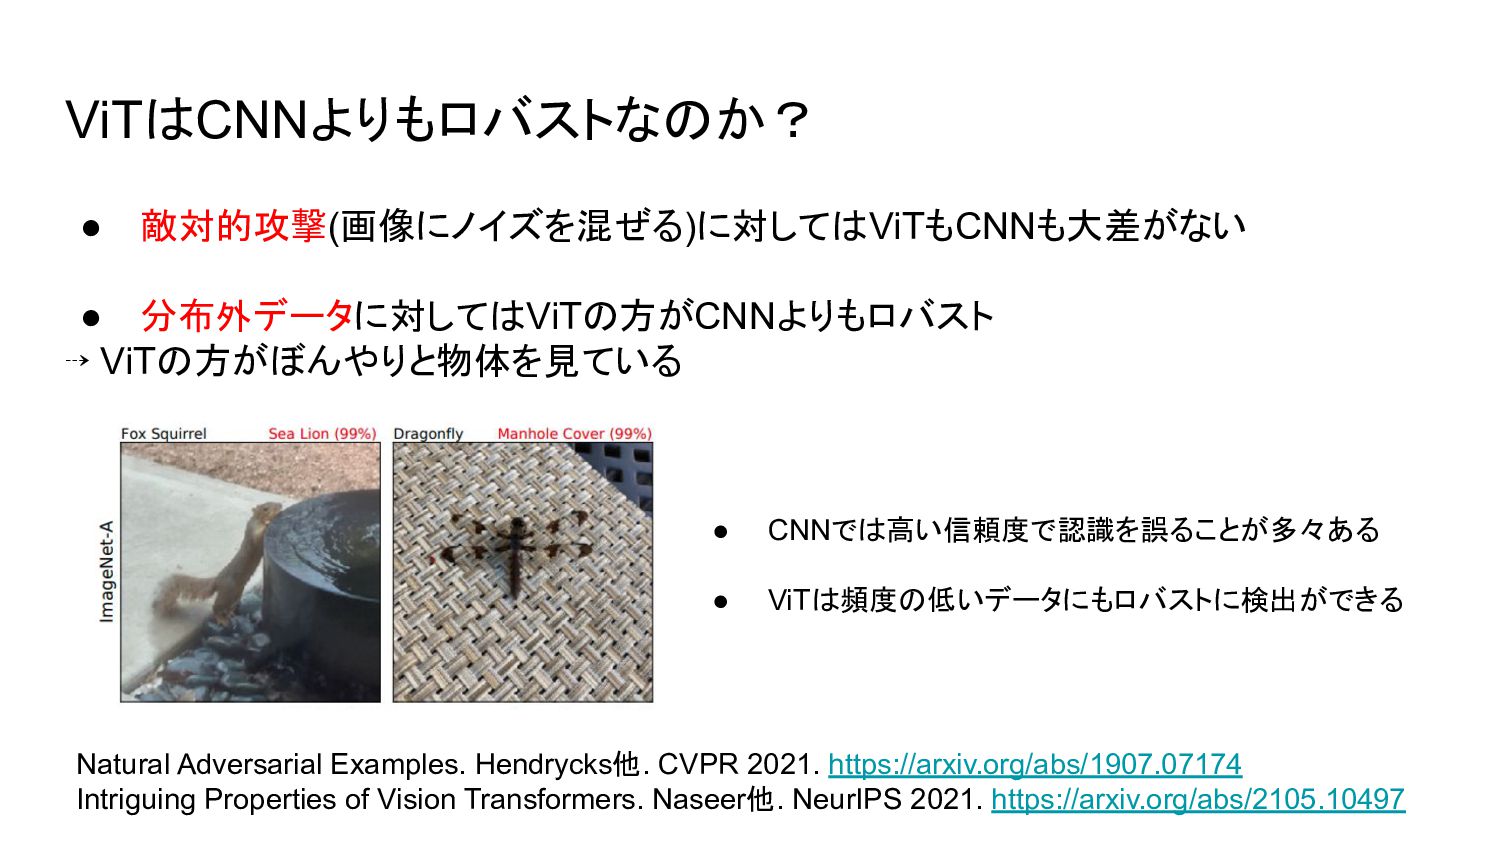
ViTはCNNよりもロバストなのか? • 敵対的攻撃(画像にノイズを混ぜる)に対してはViTもCNNも大差がない • 分布外データに対してはViTの方がCNNよりもロバスト ⇢ ViTの方がぼんやりと物体を見ている • CNNでは高い信頼度で認識を誤ることが多々ある •
ViTは頻度の低いデータにもロバストに検出ができる Natural Adversarial Examples. Hendrycks他. CVPR 2021. https://arxiv.org/abs/1907.07174 Intriguing Properties of Vision Transformers. Naseer他. NeurIPS 2021. https://arxiv.org/abs/2105.10497 -
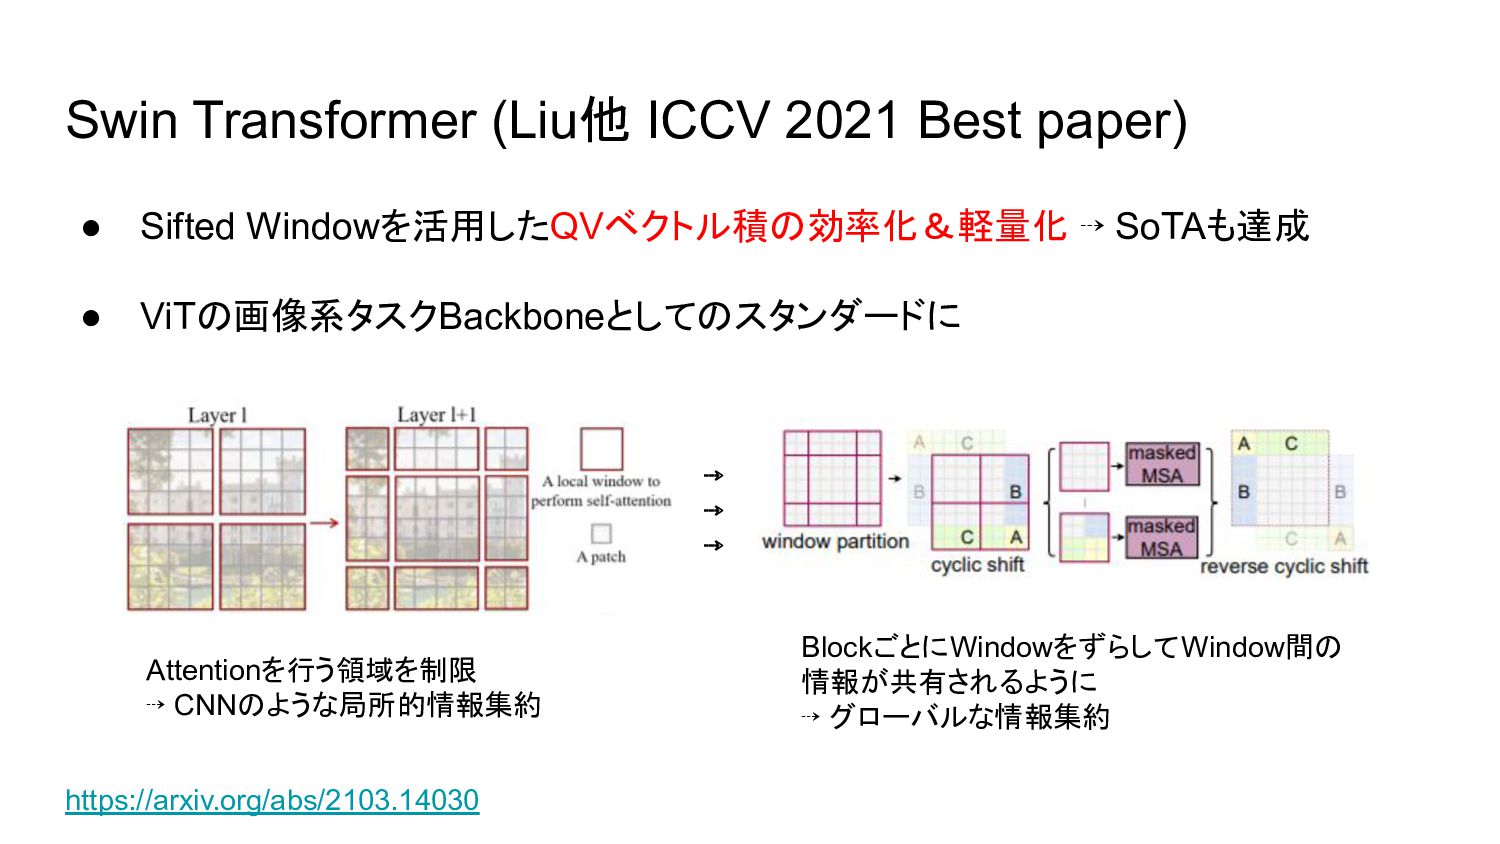
Swin Transformer (Liu他 ICCV 2021 Best paper) • Sifted Windowを活用したQVベクトル積の効率化&軽量化
⇢ SoTAも達成 • ViTの画像系タスクBackboneとしてのスタンダードに Attentionを行う領域を制限 ⇢ CNNのような局所的情報集約 BlockごとにWindowをずらしてWindow間の 情報が共有されるように ⇢ グローバルな情報集約 ⇢ ⇢ ⇢ https://arxiv.org/abs/2103.14030 -
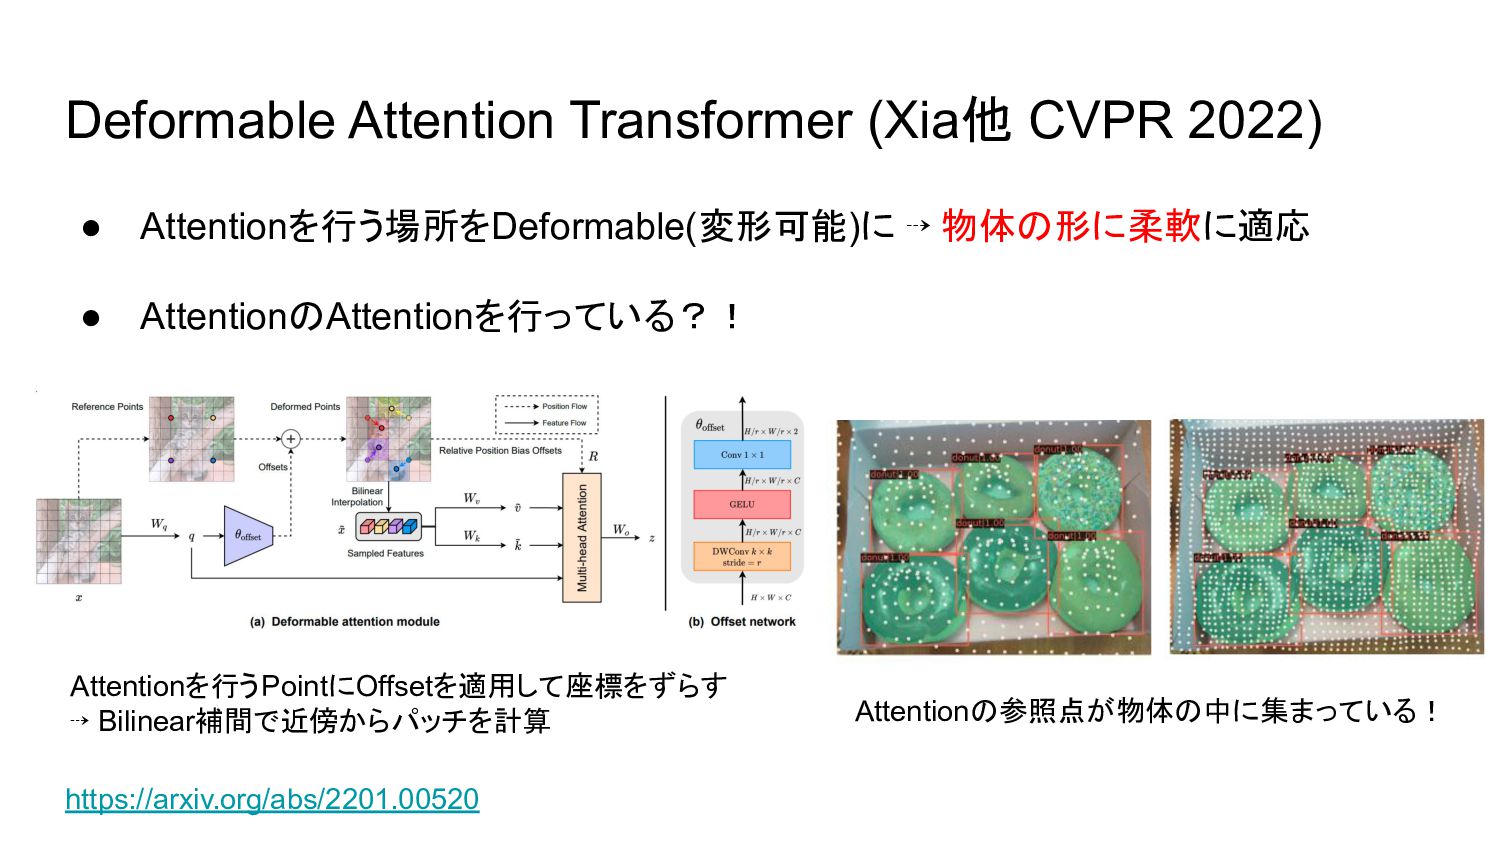
Deformable Attention Transformer (Xia他 CVPR 2022) • Attentionを行う場所をDeformable(変形可能)に ⇢ 物体の形に柔軟に適応
• AttentionのAttentionを行っている?! Attentionを行うPointにOffsetを適用して座標をずらす ⇢ Bilinear補間で近傍からパッチを計算 Attentionの参照点が物体の中に集まっている! https://arxiv.org/abs/2201.00520 -
Depth Former (Li他 Arxiv 2022) • 単眼深度推定タスクでViTとCNNをうまく組み合わせた ⇢ ViTだけでは解決が難しかった問題を解決! •
ViTとCNNの強みを発揮 Depth Formerのアーキテクチャ HAHI ModuleがViTとCNNを結合する重要な部分 (Deformable Attentionを使用) https://arxiv.org/abs/2203.14211 -
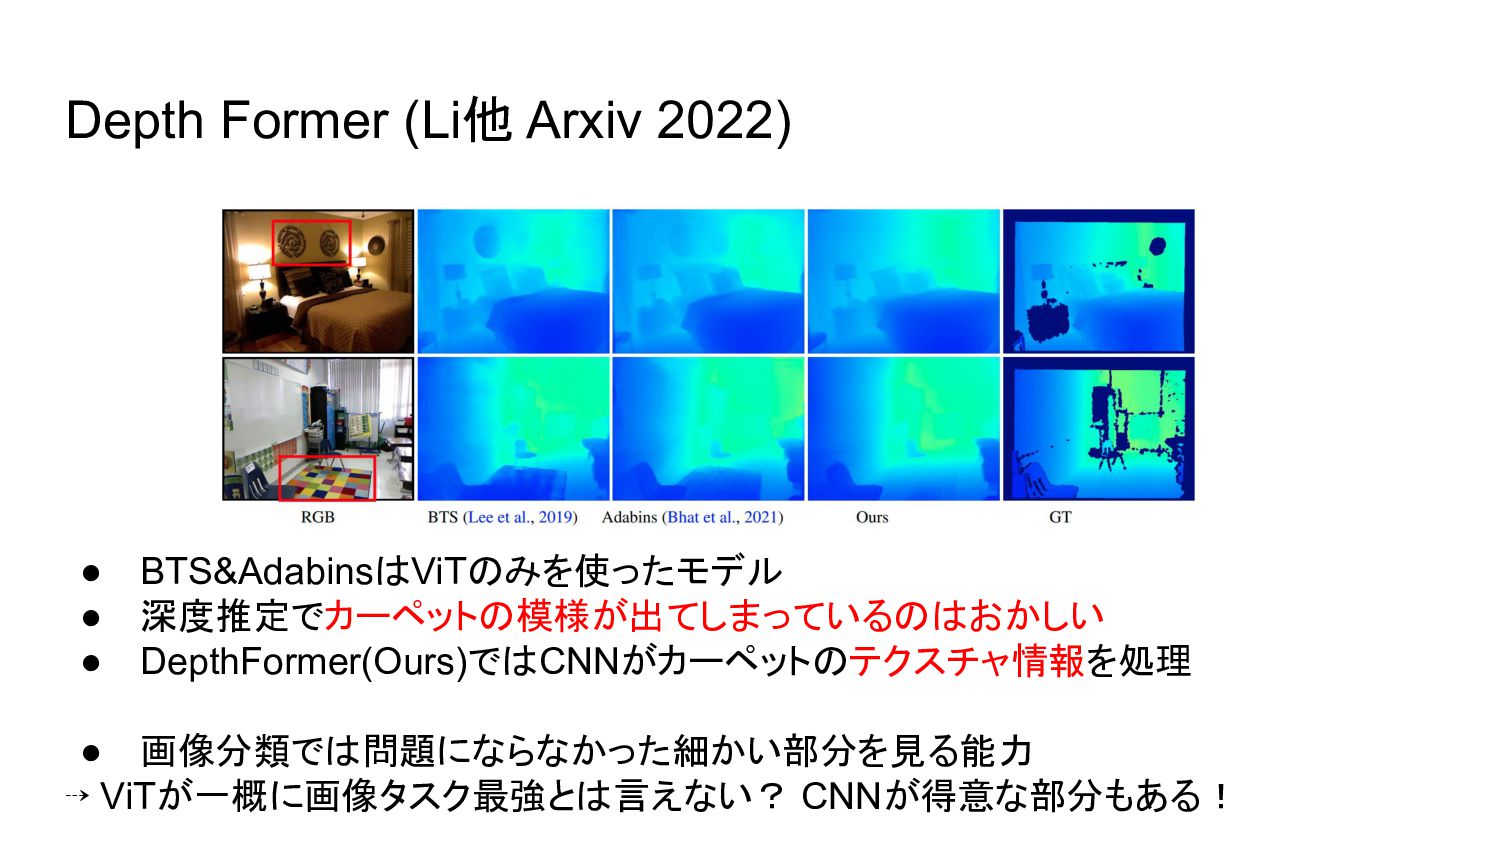
Depth Former (Li他 Arxiv 2022) • BTS&AdabinsはViTのみを使ったモデル • 深度推定でカーペットの模様が出てしまっているのはおかしい •
DepthFormer(Ours)ではCNNがカーペットのテクスチャ情報を処理 • 画像分類では問題にならなかった細かい部分を見る能力 ⇢ ViTが一概に画像タスク最強とは言えない? CNNが得意な部分もある! -
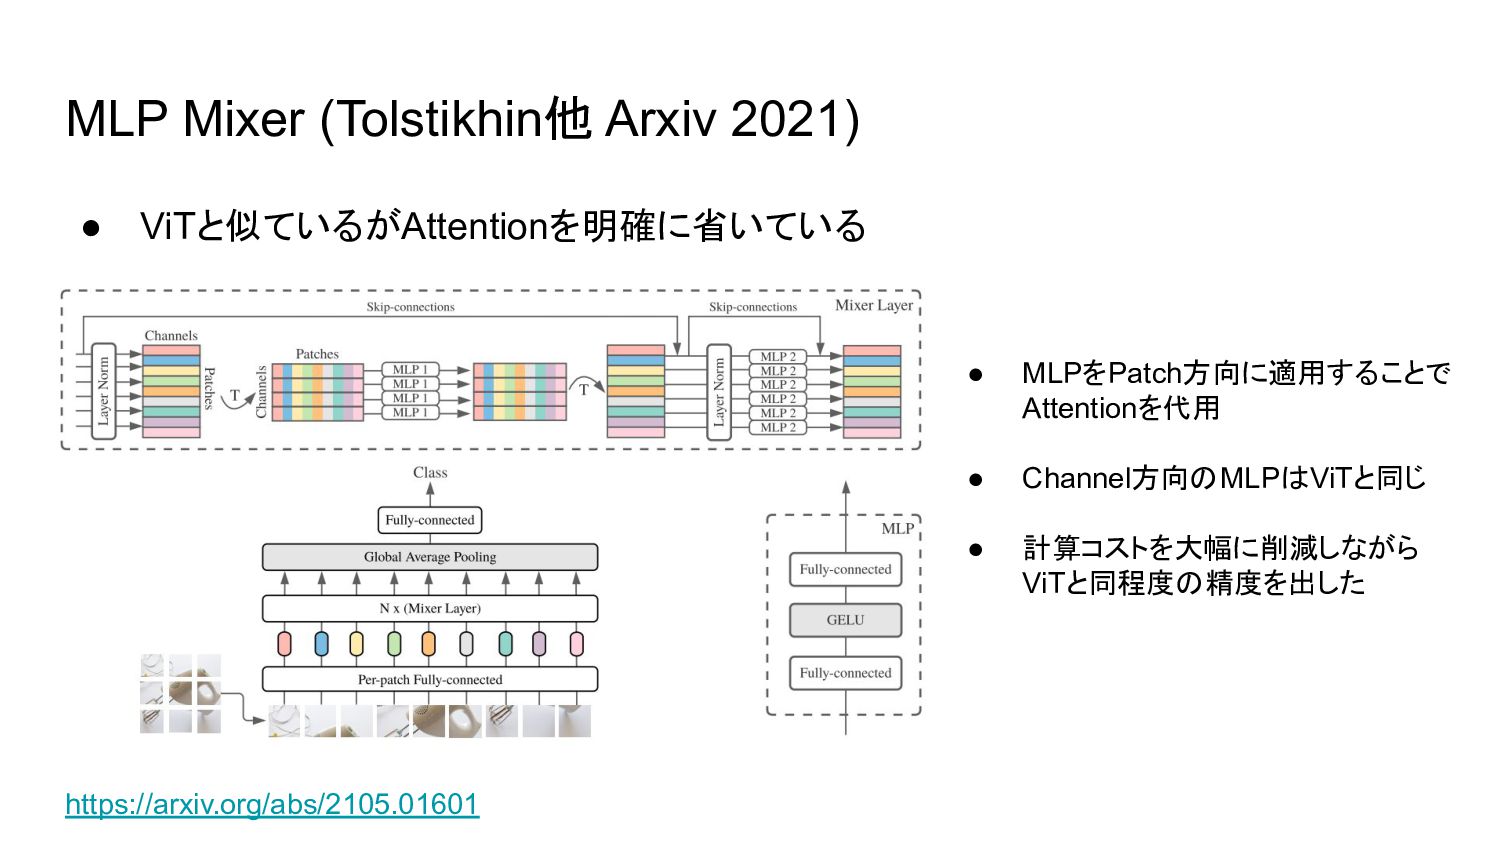
MLP Mixer (Tolstikhin他 Arxiv 2021) • ViTと似ているがAttentionを明確に省いている https://arxiv.org/abs/2105.01601 • MLPをPatch方向に適用することで
Attentionを代用 • Channel方向のMLPはViTと同じ • 計算コストを大幅に削減しながら ViTと同程度の精度を出した