Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
論文読み会 / GLAZE: Protecting Artists from Style Mi...
Search
chck
April 14, 2023
Research
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
論文読み会 / GLAZE: Protecting Artists from Style Mimicry by Text-to-Image Models
社内論文読み会、PaperFridayでの発表資料です
chck
April 14, 2023
More Decks by chck
See All by chck
Research Engineerという仕事 / Research Engineering: Bridging Research and Business
chck
1
370
CyberAgent AI Lab研修 / Social Implementation Anti-Patterns in AI Lab
chck
7
5.1k
CyberAgent AI Lab研修 / Container for Research
chck
1
2.4k
CyberAgent AI Lab研修 / Code Review in a Team
chck
3
2.6k
論文読み会 / Socio-Technical Anti-Patterns in Building ML-Enabled Software: Insights from Leaders on the Forefront
chck
0
170
CyberAgent AI事業本部MLOps研修Container編 / Container for MLOps
chck
3
6.3k
論文読み会 / On the Factory Floor: ML Engineering for Industrial-Scale Ads Recommendation Models
chck
0
96
論文読み会 / GUIGAN: Learning to Generate GUI Designs Using Generative Adversarial Networks
chck
0
84
機械学習開発のためのコンテナ入門 / Container for ML
chck
0
1k
Other Decks in Research
See All in Research
学術バーQ AI研究最前線:自己教師あり学習による画像モデルの事前学習
naok615
0
160
量子サマースクール2026「量子計算機アーキテクチャ分野の概観」
youten622
1
970
Karkada さんの論文 × 2 の紹介: (1) Closed-Form Training Dynamics Reveal Learned Features and Linear Structure in Word2Vec-like Models, (2) Symmetry in language statistics shapes the geometry of model representations
eumesy
PRO
1
840
MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing
satai
3
150
第64回CV・PRML勉強会 論文紹介:Linguistic Priors for Visual Decoupling: Towards Symmetric Vision-Brain Alignment
sokikatayama
0
250
実例から見るLLMのマンガ理解:実務VQAタスクによる長期的文脈と視覚情報の定性評価
kzmssk
0
190
Evaluation génomique des femelles laitières croisées : comprendre la méthode pour accompagner les éleveurs à son utilisation
institutdelelevage
PRO
0
170
最先端NLP勉強会2026 論文紹介:Reasoning with Sampling: Your Base Model is Smarter Than You Think (ICLR 2026 paper)
kogoro
4
700
完全自律LLMエージェントでDIVER OSINT CTF 2026に挑戦してみた
analokmaus
0
760
Bilan travail en élevage : première restitution des enquêtes 2025-2026
institutdelelevage
PRO
0
190
論文読み会 SNLP2026 Tau2-Bench: Evaluating Conversational Agents in a Dual-Control Environment
s_mizuki_nlp
0
300
Hitting the buffers
beale
0
220
Featured
See All Featured
Evolution of real-time – Irina Nazarova, EuRuKo, 2024
irinanazarova
9
1.6k
We Have a Design System, Now What?
morganepeng
55
8.4k
The Pragmatic Product Professional
lauravandoore
37
7.5k
The Web Performance Landscape in 2024 [PerfNow 2024]
tammyeverts
12
1.3k
Efficient Content Optimization with Google Search Console & Apps Script
katarinadahlin
PRO
1
920
HU Berlin: Industrial-Strength Natural Language Processing with spaCy and Prodigy
inesmontani
PRO
0
750
StorybookのUI Testing Handbookを読んだ
zakiyama
31
7k
30 Presentation Tips
portentint
PRO
1
430
Heart Work Chapter 1 - Part 1
lfama
PRO
10
37k
From π to Pie charts
rasagy
1
400
The browser strikes back
jonoalderson
0
1.8k
What’s in a name? Adding method to the madness
productmarketing
PRO
24
4.2k
Transcript
GLAZE: Protecting Artists from Style Mimicry by Text-to-Image Models 23/04/14
PaperFriday, Yuki Iwazaki@AI Lab
2 Point: 画像生成モデルのスタイル模倣をミスリードさせる ノイズ合成ツールを絵描き向けに公開 arXiv preprint, 2023 Feb Authors: Shawn
Shan, Jenna Cryan, Emily Wenger, Haitao Zheng, Rana Hanocka, Ben Y. Zhao Reason: - Diffusion modelが流行っているのでそのキャッチアップ - 生成モデルの芸術界への影響
Introduction 3
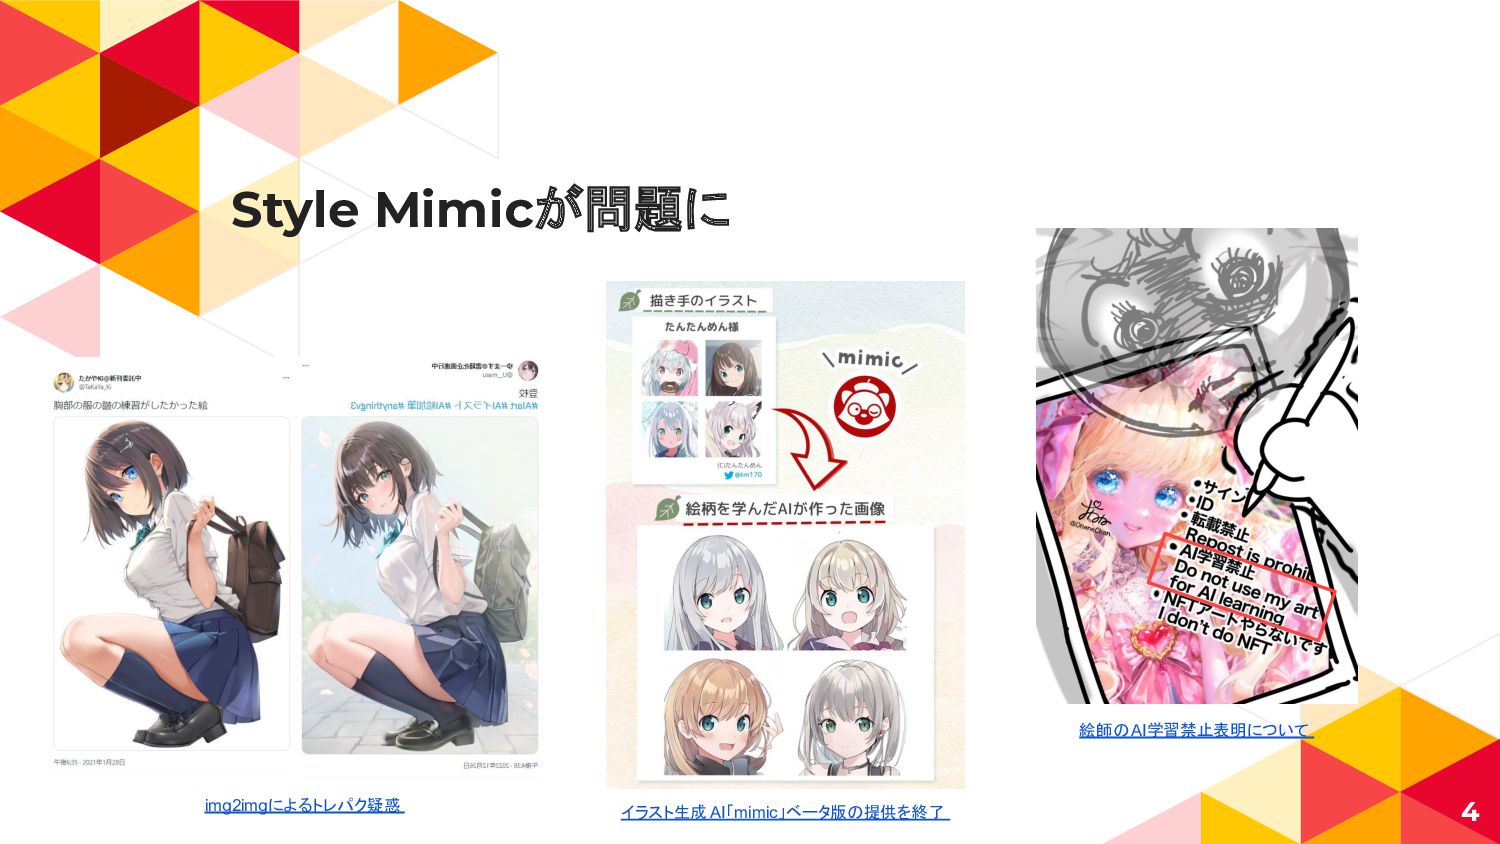
Style Mimicが問題に 4 イラスト生成 AI「mimic」ベータ版の提供を終了 img2imgによるトレパク疑惑 絵師のAI学習禁止表明について
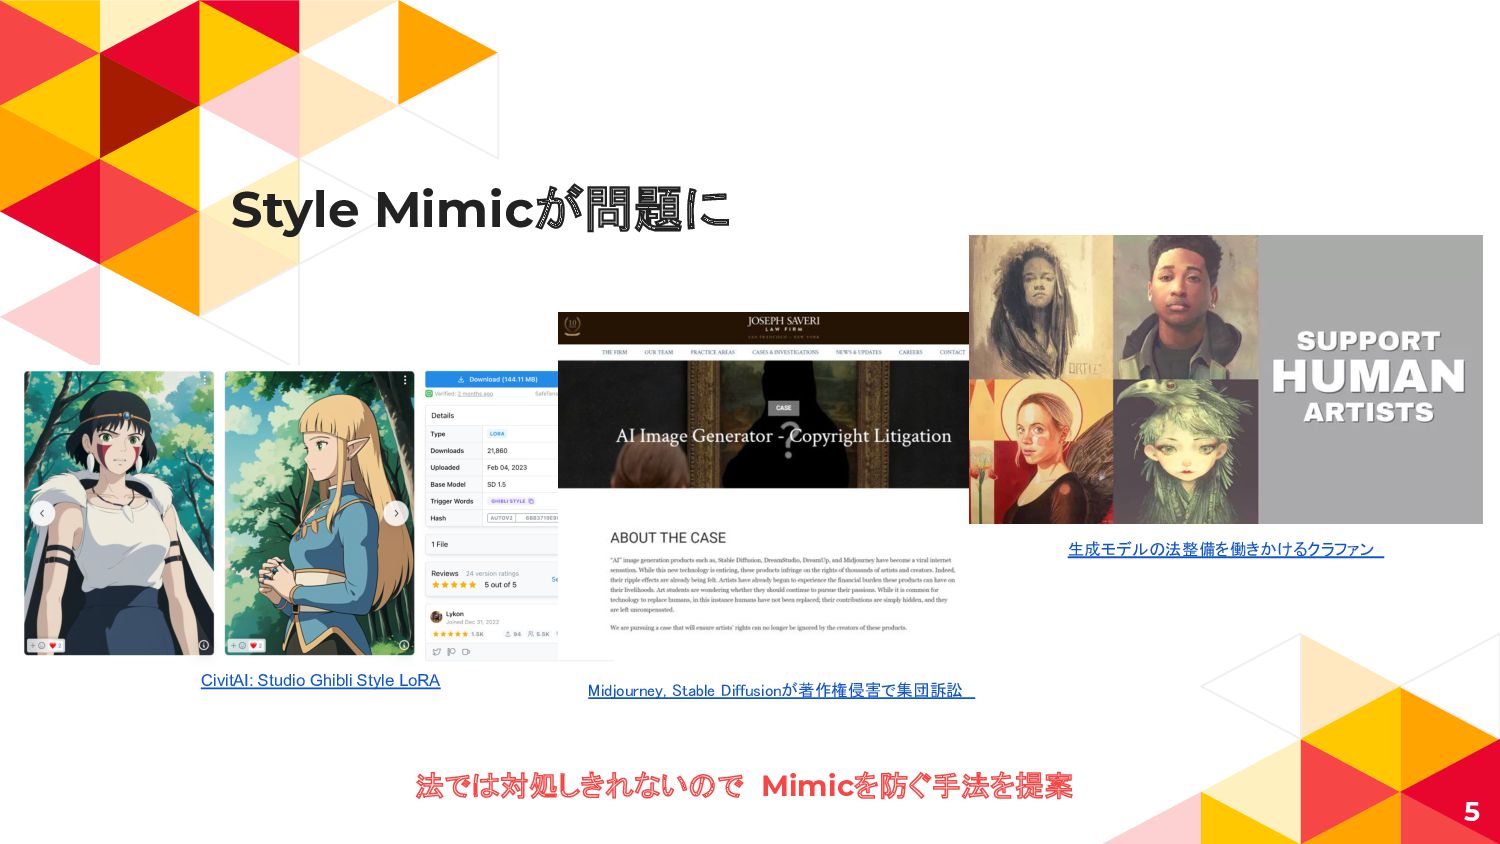
Style Mimicが問題に 5 CivitAI: Studio Ghibli Style LoRA Midjourney, Stable
Diffusionが著作権侵害で集団訴訟 生成モデルの法整備を働きかけるクラファン 法では対処しきれないので Mimicを防ぐ手法を提案
Recent Work 6
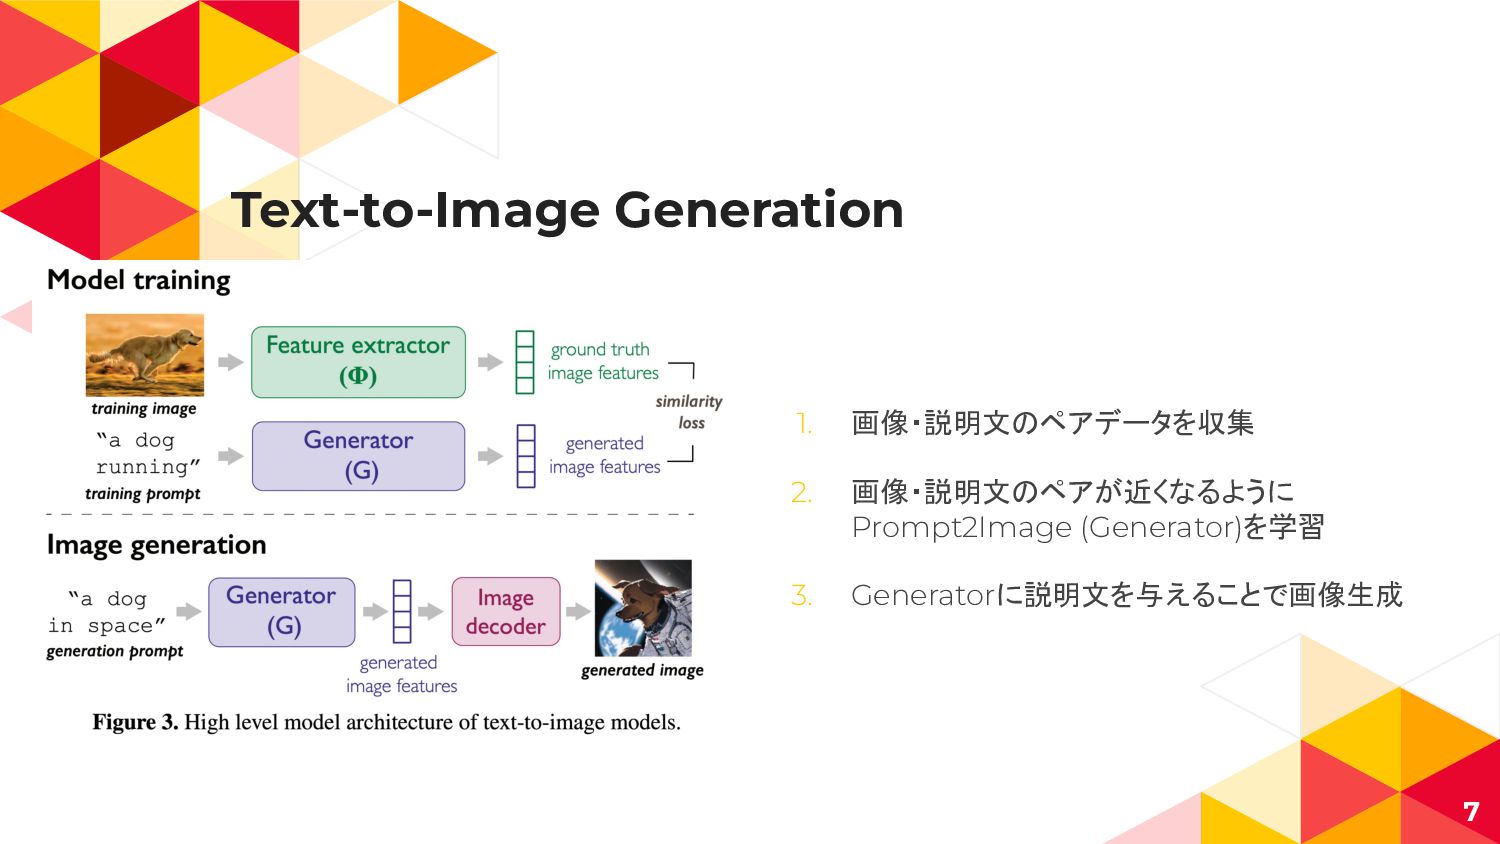
Text-to-Image Generation 7 1. 画像・説明文のペアデータを収集 2. 画像・説明文のペアが近くなるように Prompt2Image (Generator)を学習 3.
Generatorに説明文を与えることで画像生成
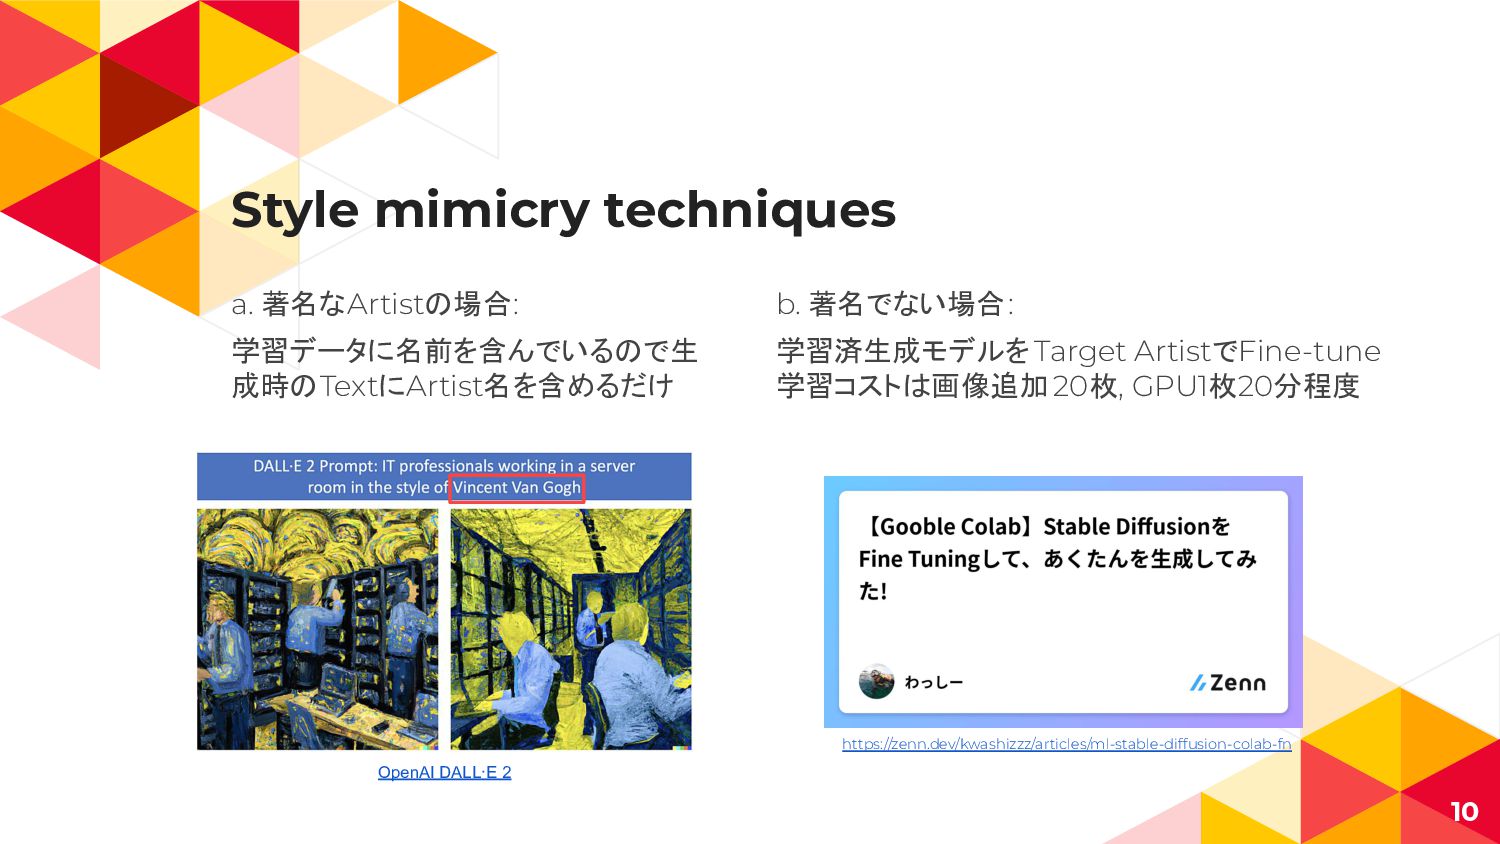
Style mimicry techniques a. 著名なArtistの場合: 学習データに名前を含んでいるので生 成時のTextにArtist名を含めるだけ b. 著名でない場合: 学習済生成モデルを
Target ArtistでFine-tune 学習コストは画像追加 20枚, GPU1枚20分程度 10 OpenAI DALL·E 2 https://zenn.dev/kwashizzz/articles/ml-stable-diffusion-colab-fn
Proposed Method 11
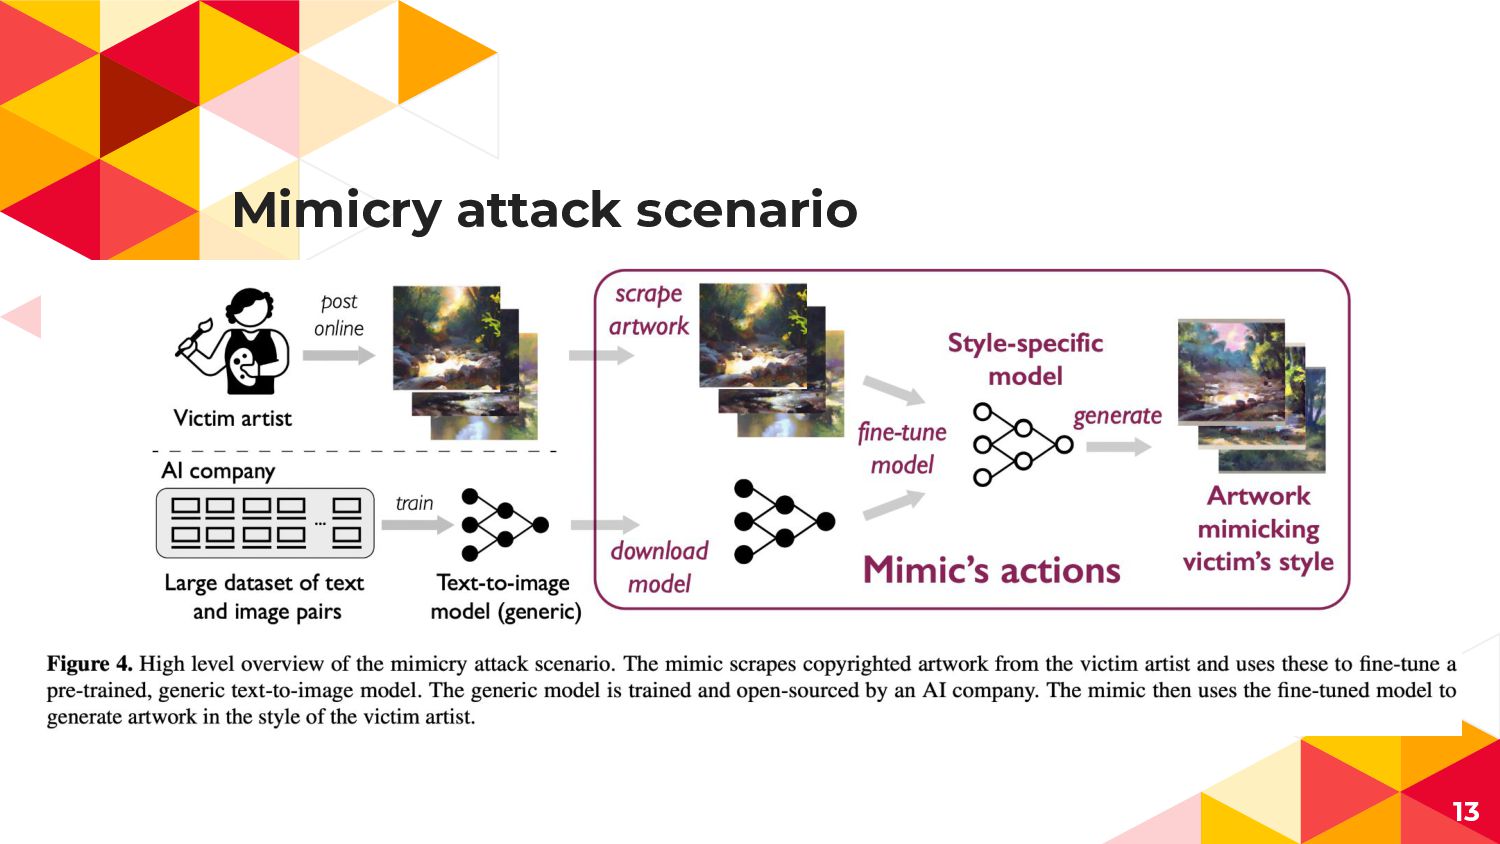
Mimicry attack scenario 13
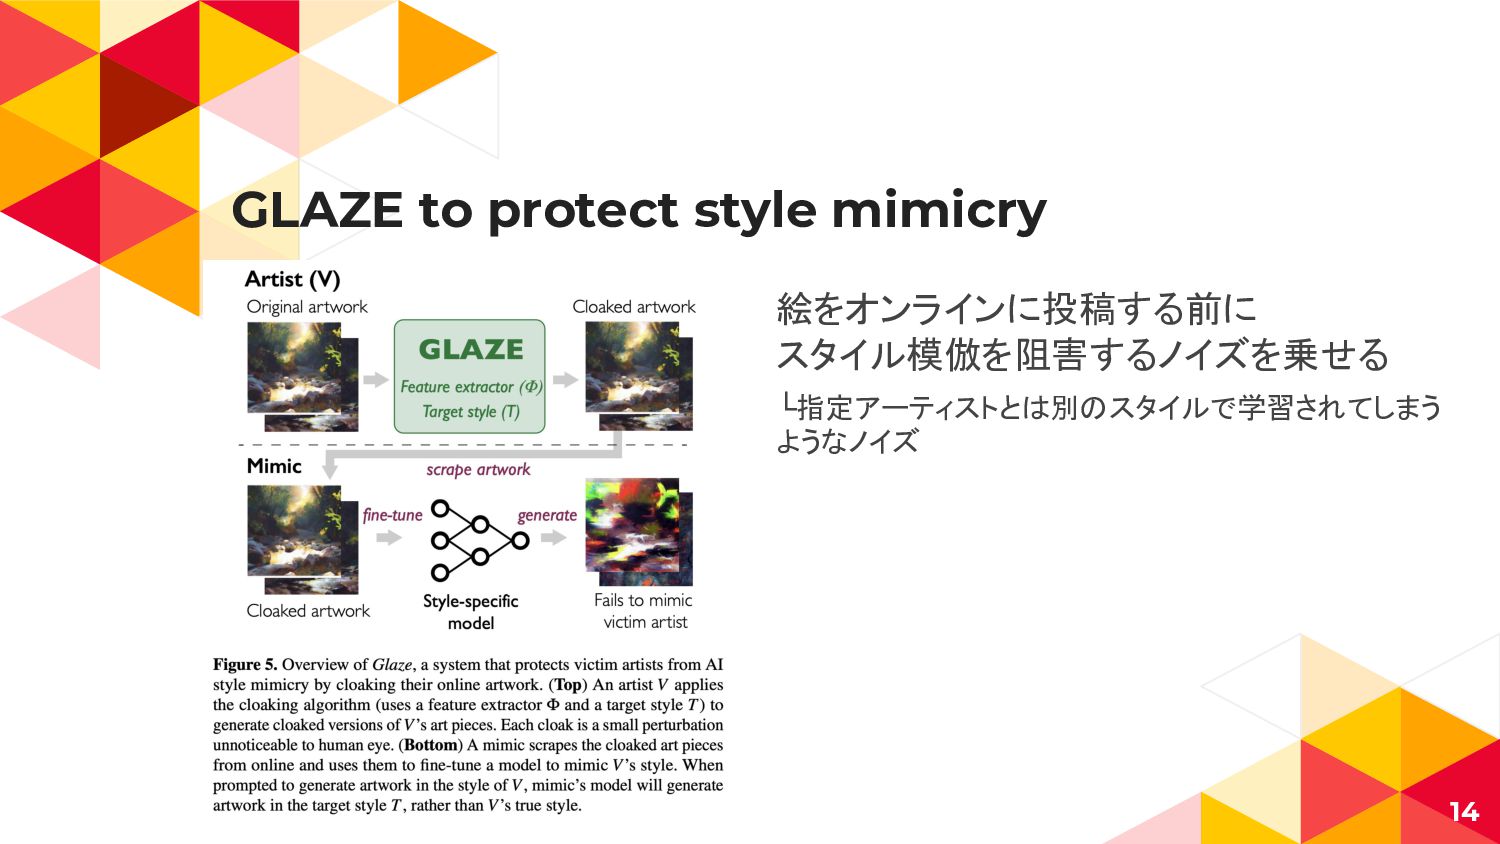
GLAZE to protect style mimicry 絵をオンラインに投稿する前に スタイル模倣を阻害するノイズを乗せる └指定アーティストとは別のスタイルで学習されてしまう ようなノイズ 14
Design Intuition 15 画風の定義は難しいので Style transferに着目 模倣されてもいい特徴( Objectや位置関係)を分離
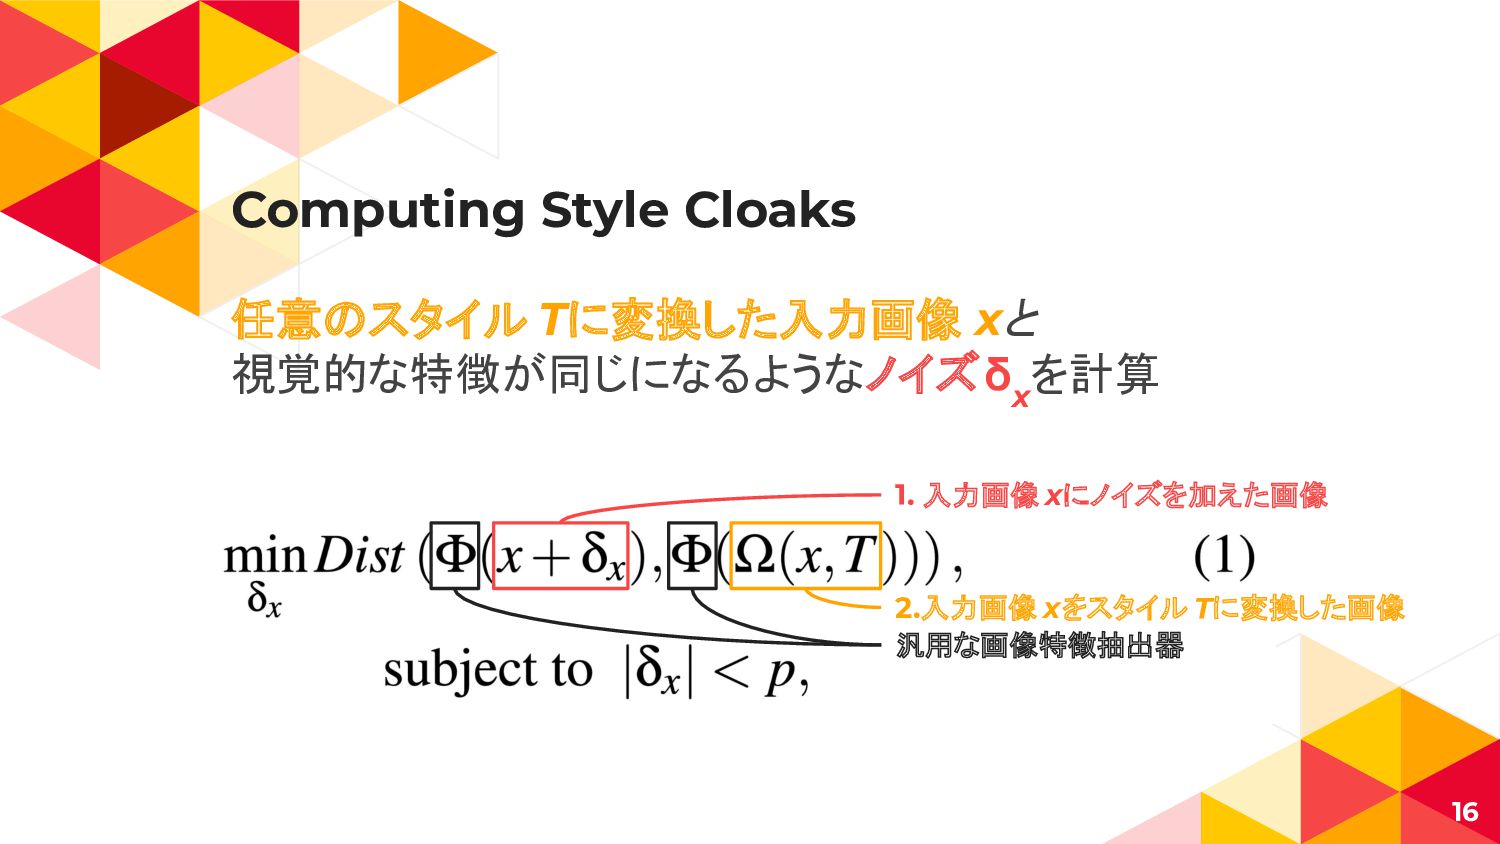
Computing Style Cloaks 任意のスタイル Tに変換した入力画像 xと 視覚的な特徴が同じになるようなノイズδ x を計算 16
2.入力画像 xをスタイル Tに変換した画像 汎用な画像特徴抽出器 1. 入力画像 xにノイズを加えた画像
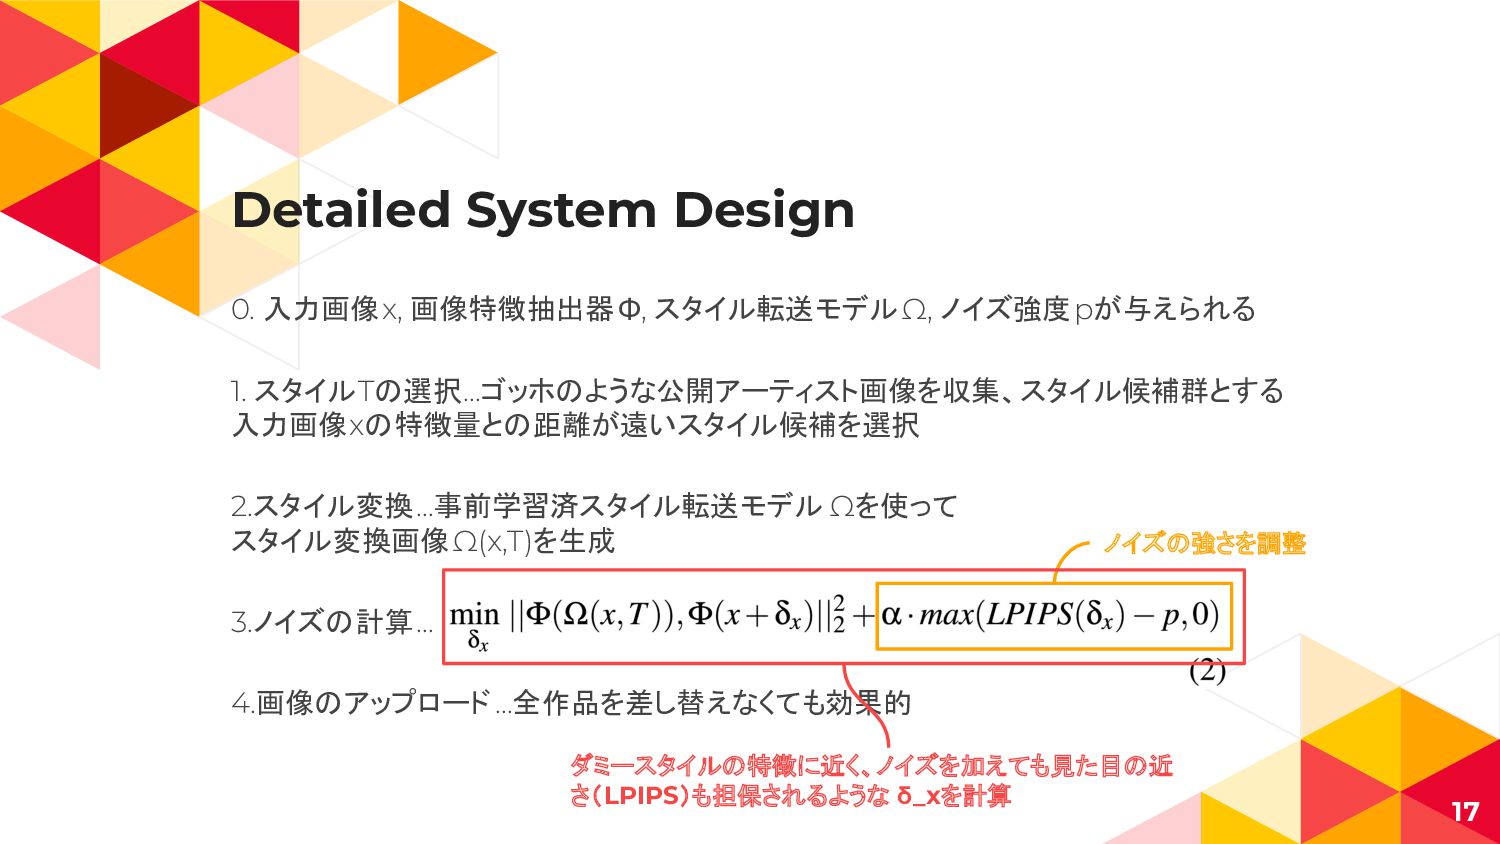
Detailed System Design 0. 入力画像x, 画像特徴抽出器Φ, スタイル転送モデル Ω, ノイズ強度pが与えられる 1.
スタイルTの選択...ゴッホのような公開アーティスト画像を収集、スタイル候補群とする 入力画像xの特徴量との距離が遠いスタイル候補を選択 2.スタイル変換...事前学習済スタイル転送モデル Ωを使って スタイル変換画像Ω(x,T)を生成 3.ノイズの計算... 4.画像のアップロード...全作品を差し替えなくても効果的 17 ノイズの強さを調整 ダミースタイルの特徴に近く、ノイズを加えても見た目の近 さ(LPIPS)も担保されるような δ_xを計算
Evaluation 18
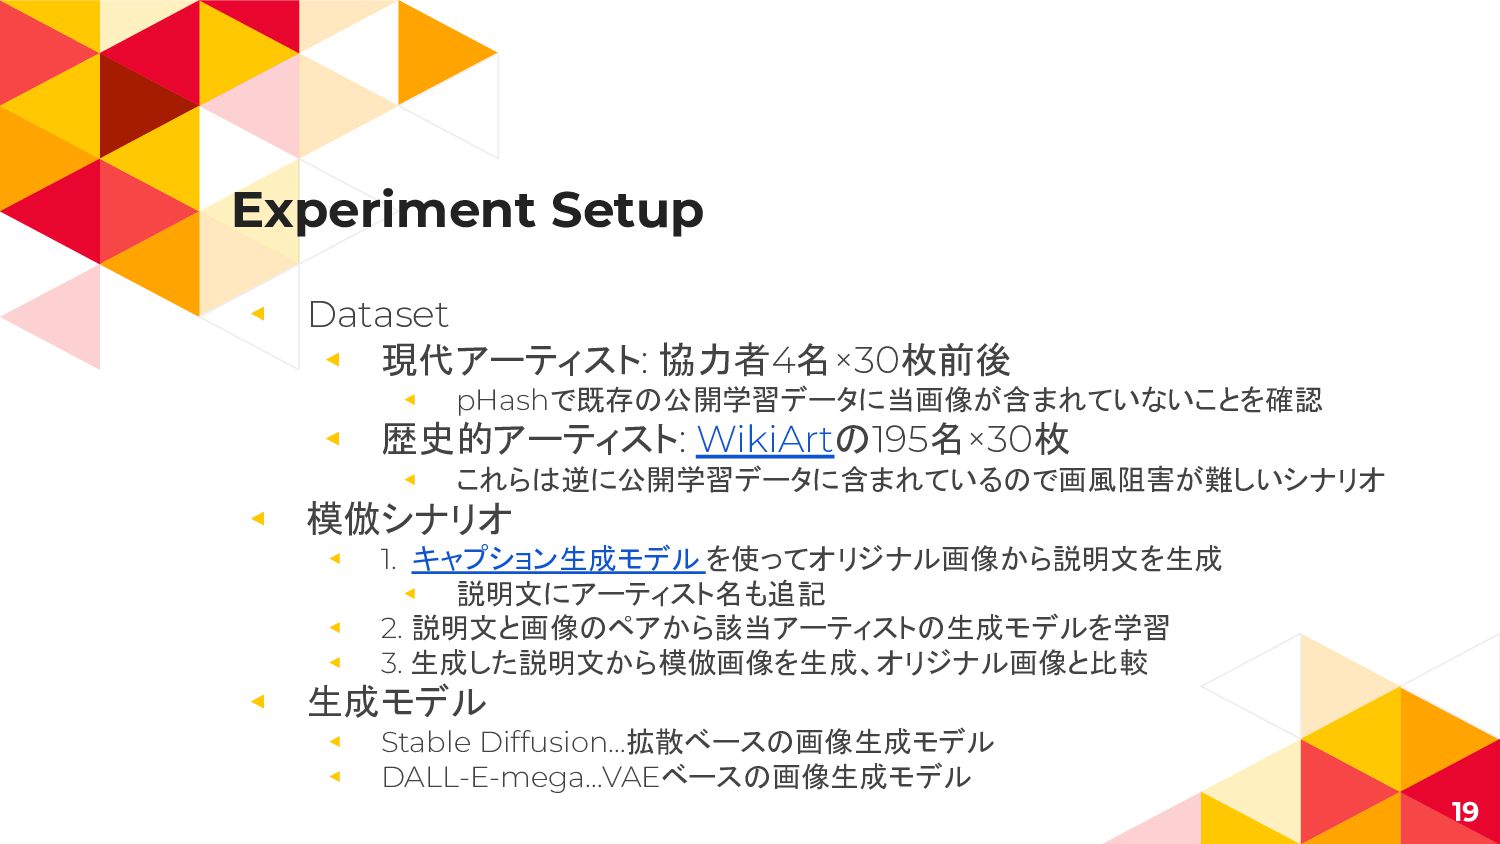
Experiment Setup ◂ Dataset ◂ 現代アーティスト: 協力者4名×30枚前後 ◂ pHashで既存の公開学習データに当画像が含まれていないことを確認 ◂
歴史的アーティスト: WikiArtの195名×30枚 ◂ これらは逆に公開学習データに含まれているので画風阻害が難しいシナリオ ◂ 模倣シナリオ ◂ 1. キャプション生成モデル を使ってオリジナル画像から説明文を生成 ◂ 説明文にアーティスト名も追記 ◂ 2. 説明文と画像のペアから該当アーティストの生成モデルを学習 ◂ 3. 生成した説明文から模倣画像を生成、オリジナル画像と比較 ◂ 生成モデル ◂ Stable Diffusion…拡散ベースの画像生成モデル ◂ DALL-E-mega…VAEベースの画像生成モデル 19
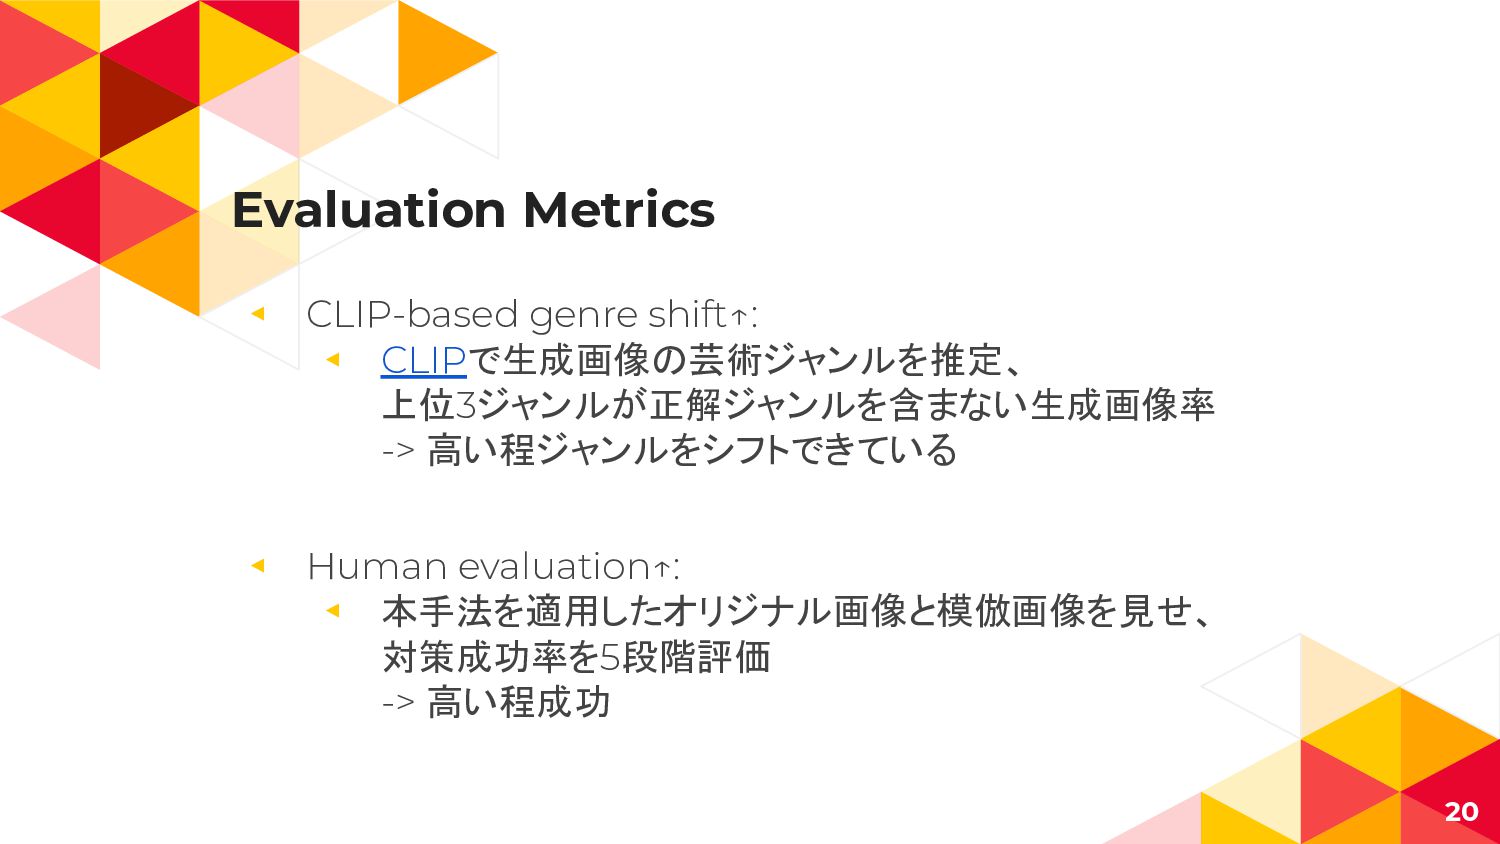
Evaluation Metrics ◂ CLIP-based genre shift↑: ◂ CLIPで生成画像の芸術ジャンルを推定、 上位3ジャンルが正解ジャンルを含まない生成画像率 ->
高い程ジャンルをシフトできている ◂ Human evaluation↑: ◂ 本手法を適用したオリジナル画像と模倣画像を見せ、 対策成功率を5段階評価 -> 高い程成功 20
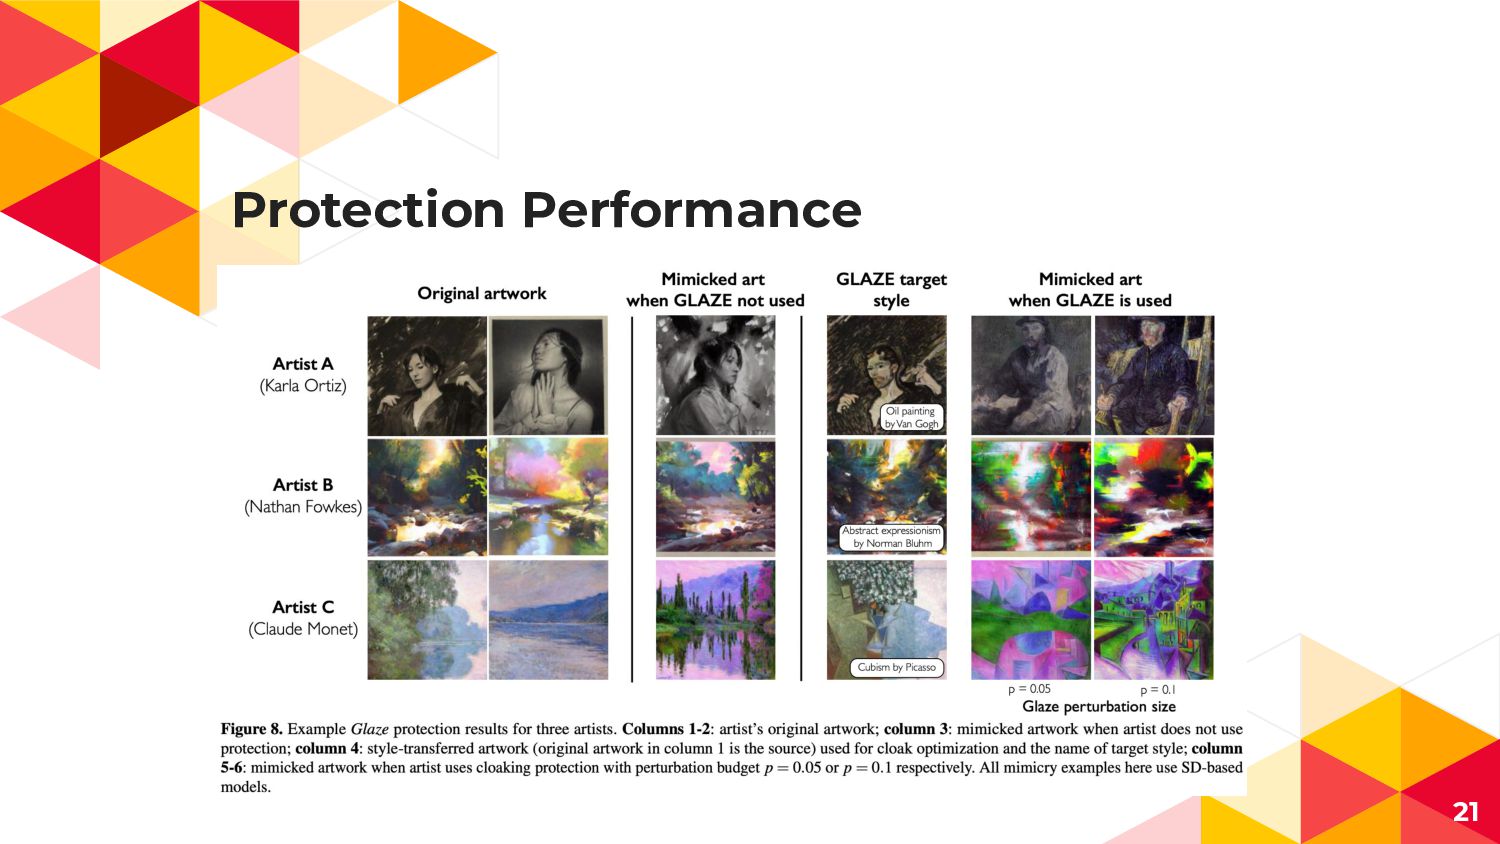
Protection Performance 21
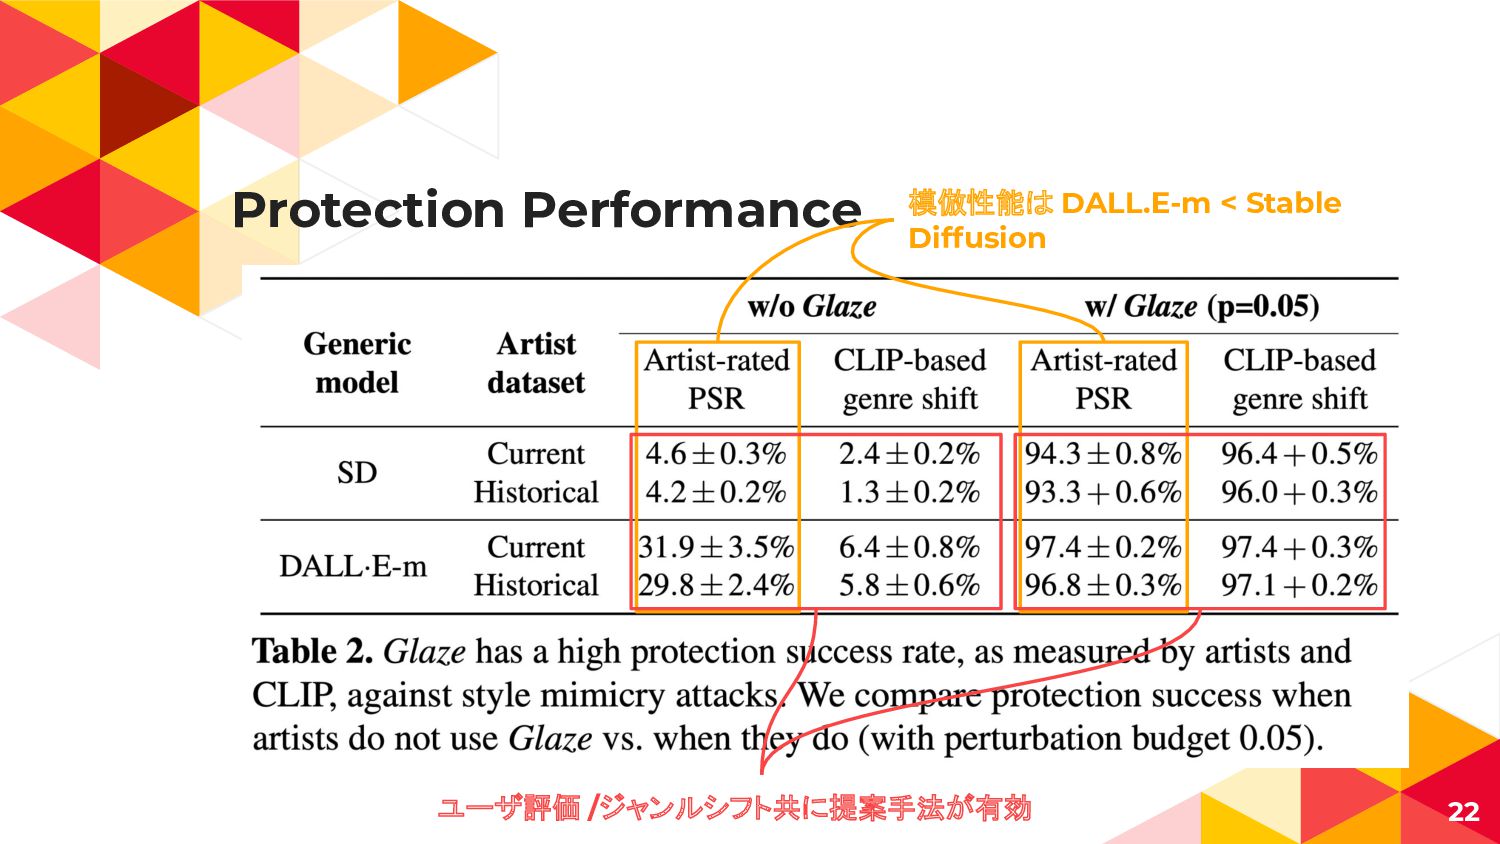
Protection Performance 22 模倣性能は DALL.E-m < Stable Diffusion ユーザ評価 /ジャンルシフト共に提案手法が有効
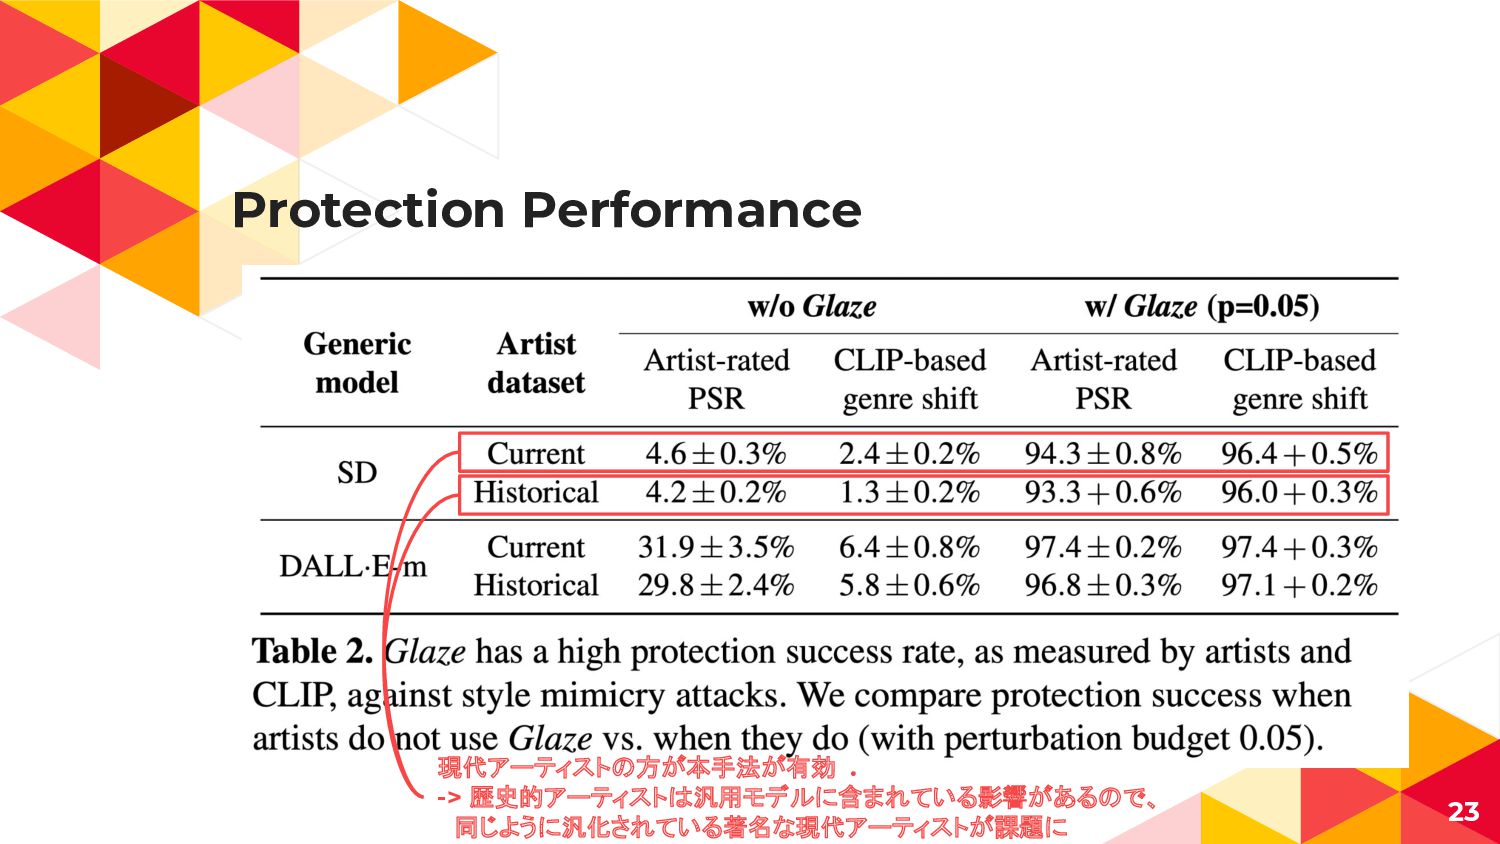
Protection Performance 23 現代アーティストの方が本手法が有効 . -> 歴史的アーティストは汎用モデルに含まれている影響があるので、 同じように汎化されている著名な現代アーティストが課題に
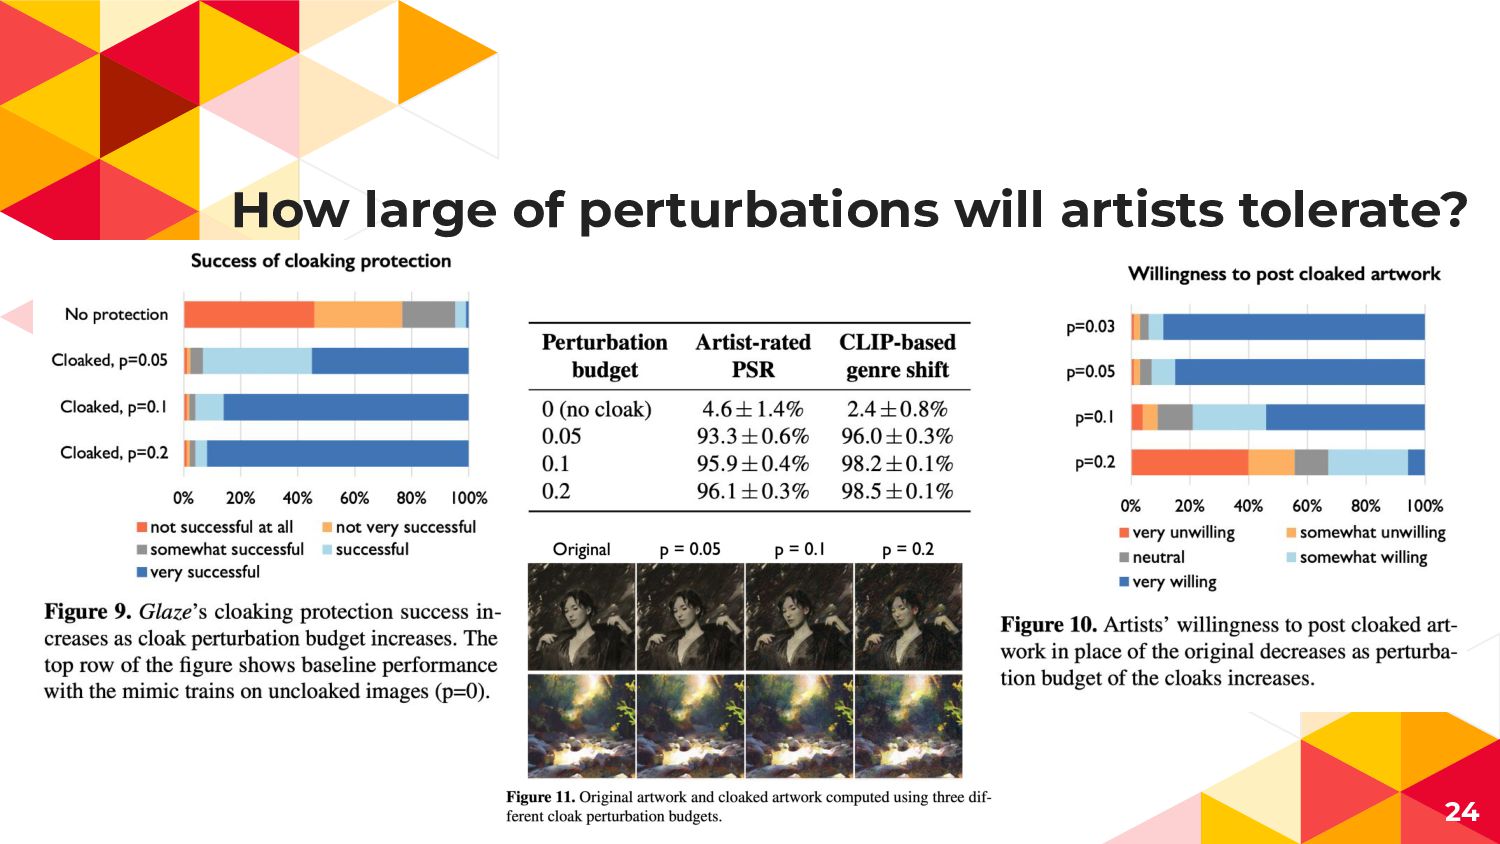
How large of perturbations will artists tolerate? 24
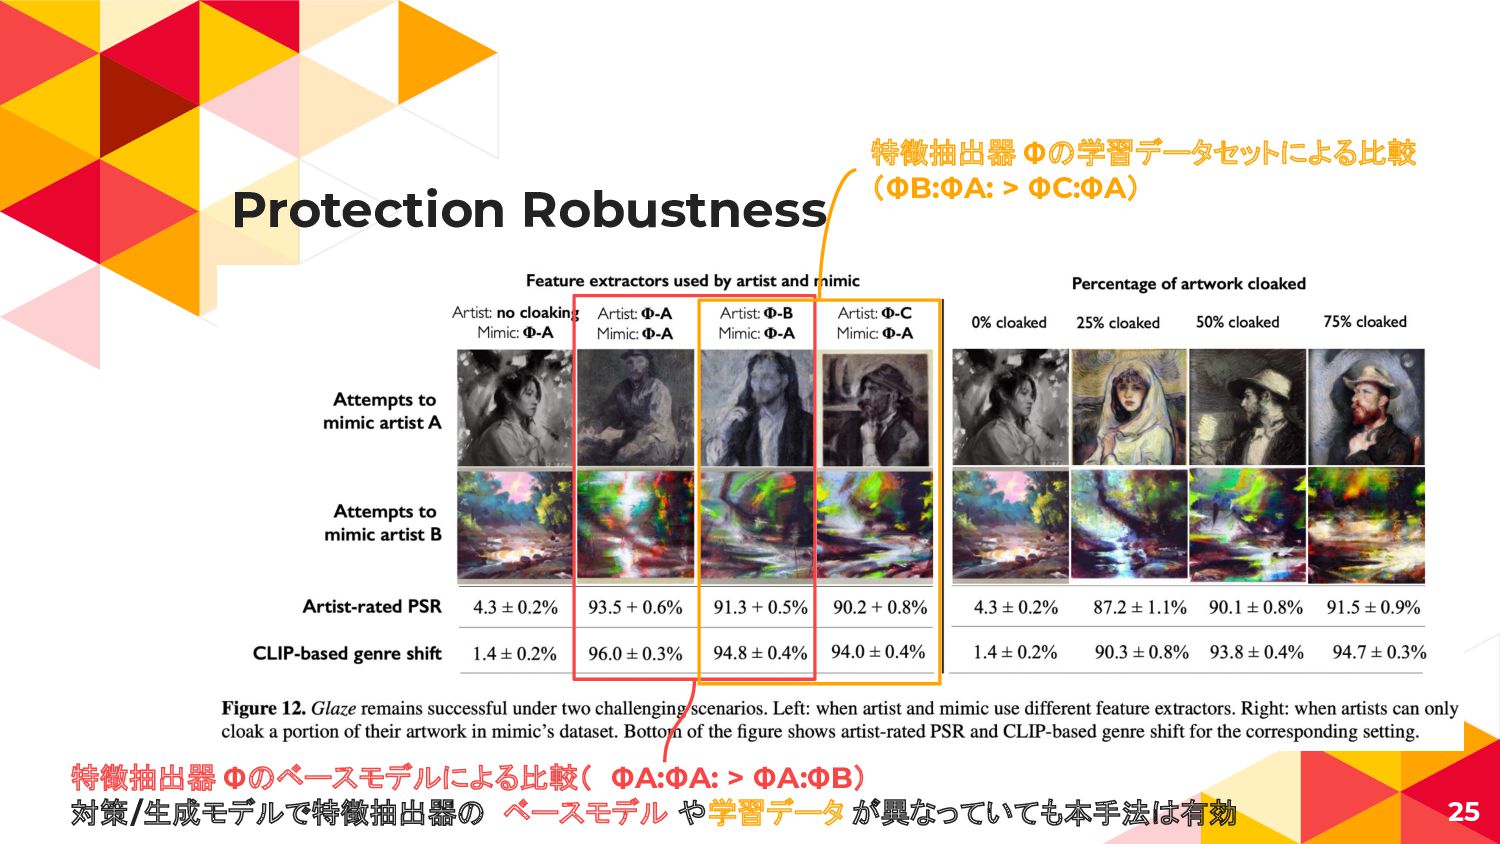
Protection Robustness 25 特徴抽出器 Φのベースモデルによる比較( ΦA:ΦA: > ΦA:ΦB) 対策/生成モデルで特徴抽出器の ベースモデル
や学習データ が異なっていても本手法は有効 特徴抽出器 Φの学習データセットによる比較 (ΦB:ΦA: > ΦC:ΦA)
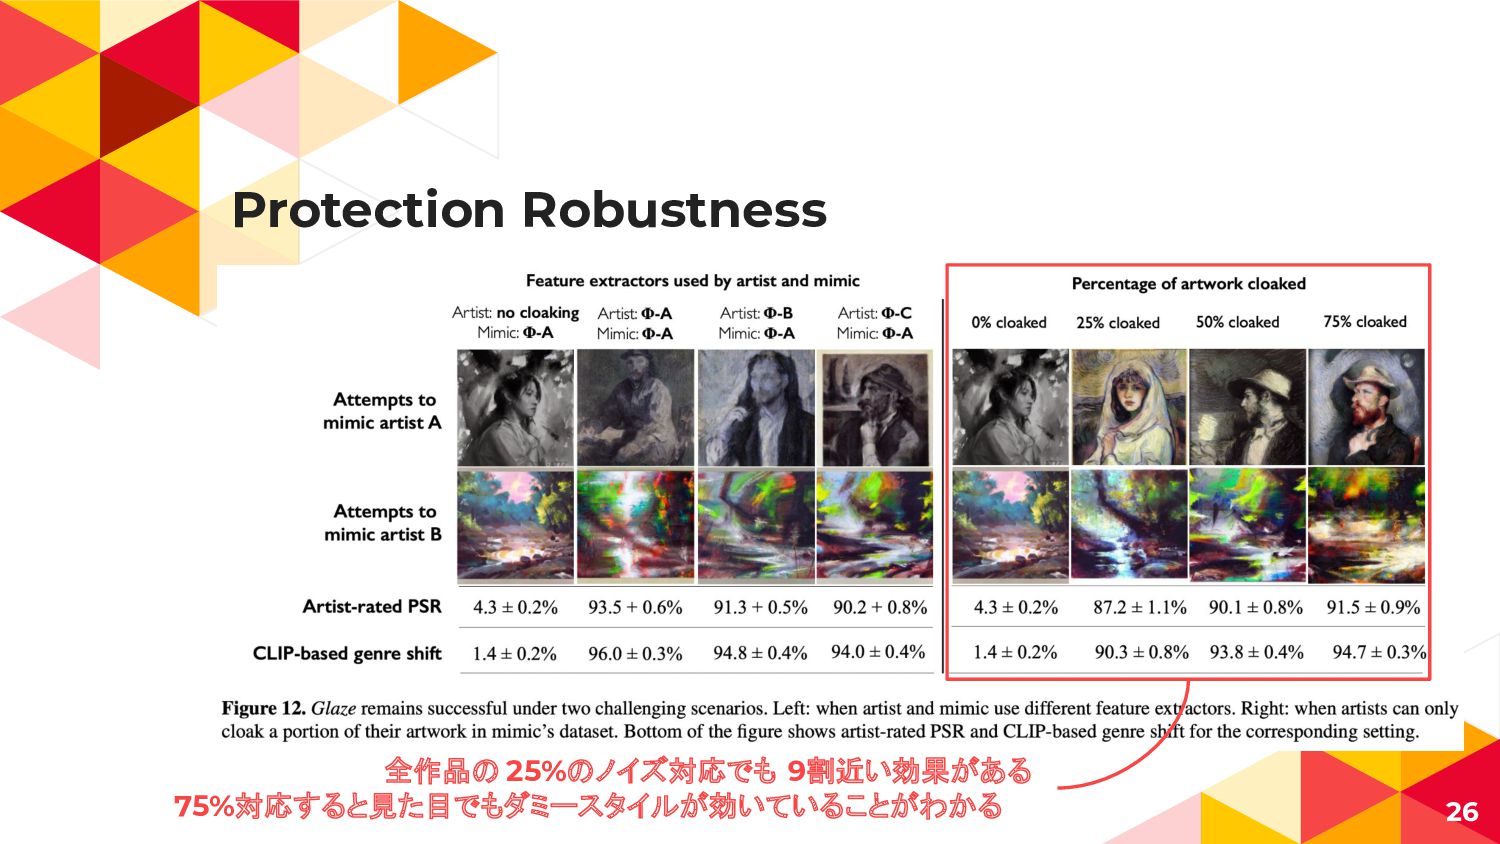
Protection Robustness 26 全作品の 25%のノイズ対応でも 9割近い効果がある 75%対応すると見た目でもダミースタイルが効いていることがわかる
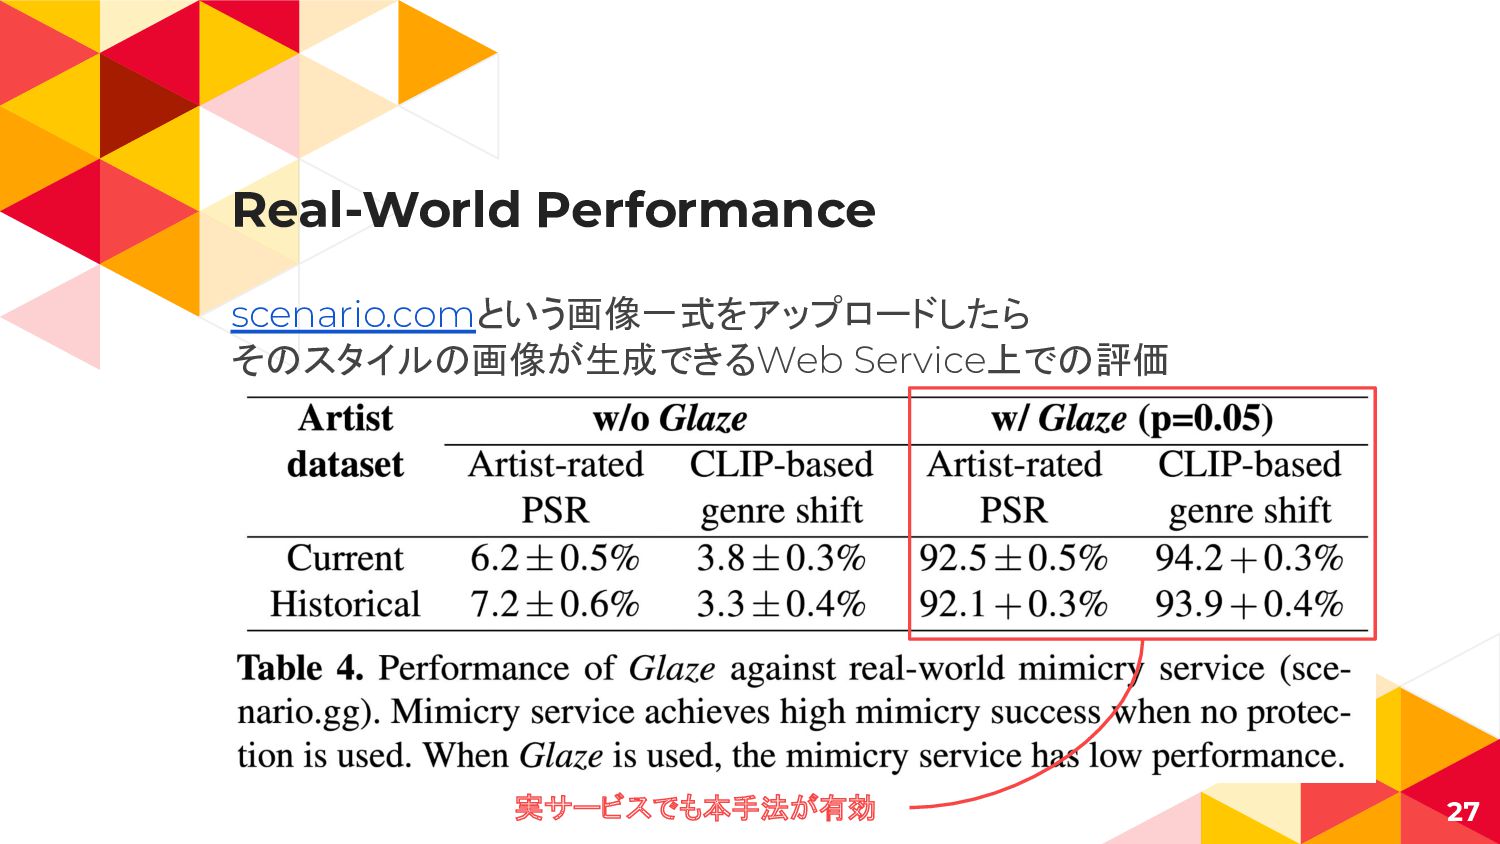
Real-World Performance scenario.comという画像一式をアップロードしたら そのスタイルの画像が生成できるWeb Service上での評価 27 実サービスでも本手法が有効
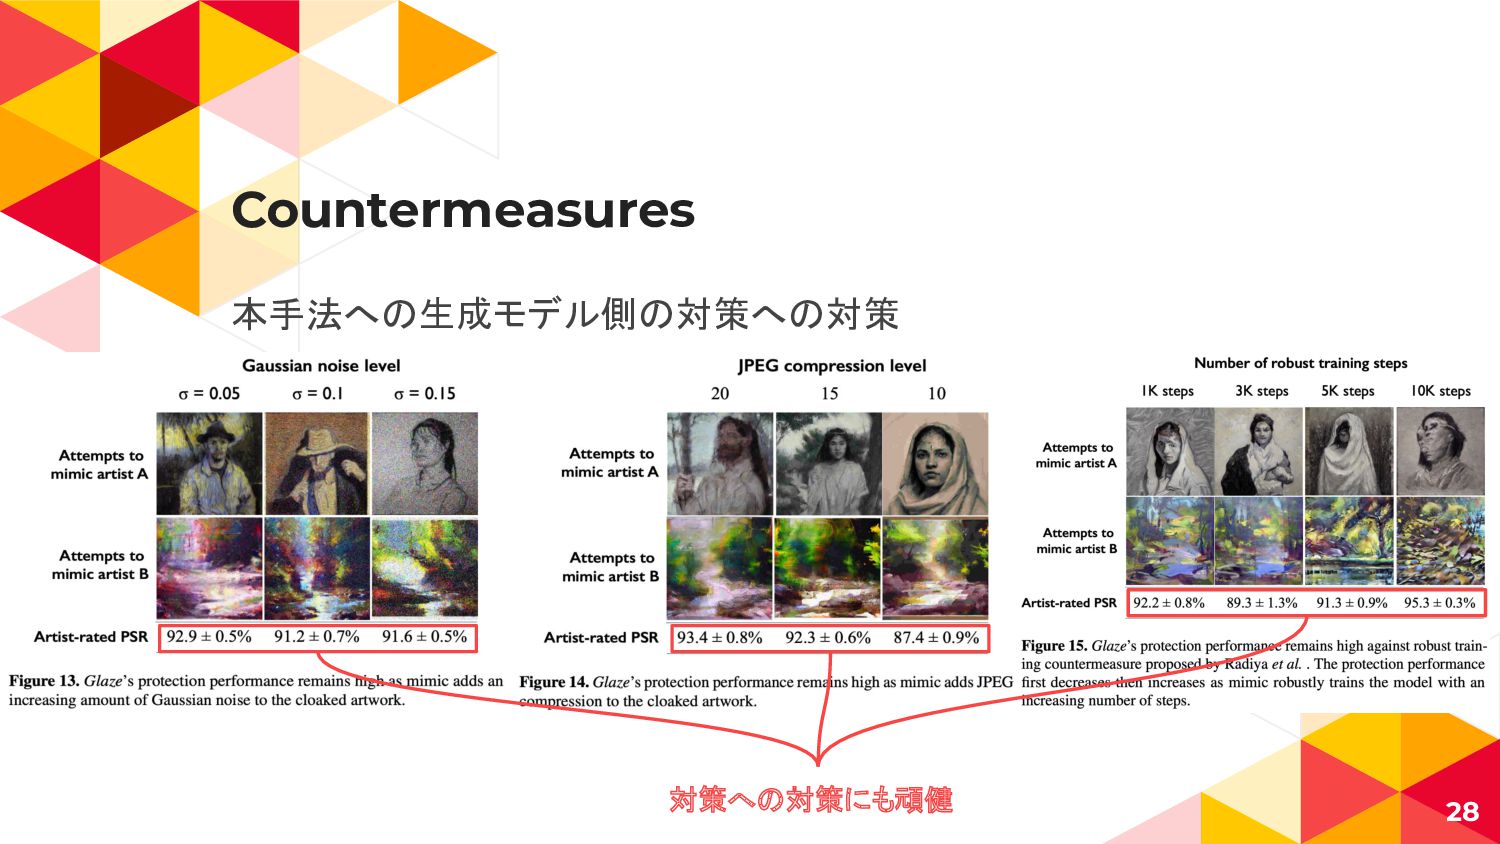
Countermeasures 本手法への生成モデル側の対策への対策 28 対策への対策にも頑健
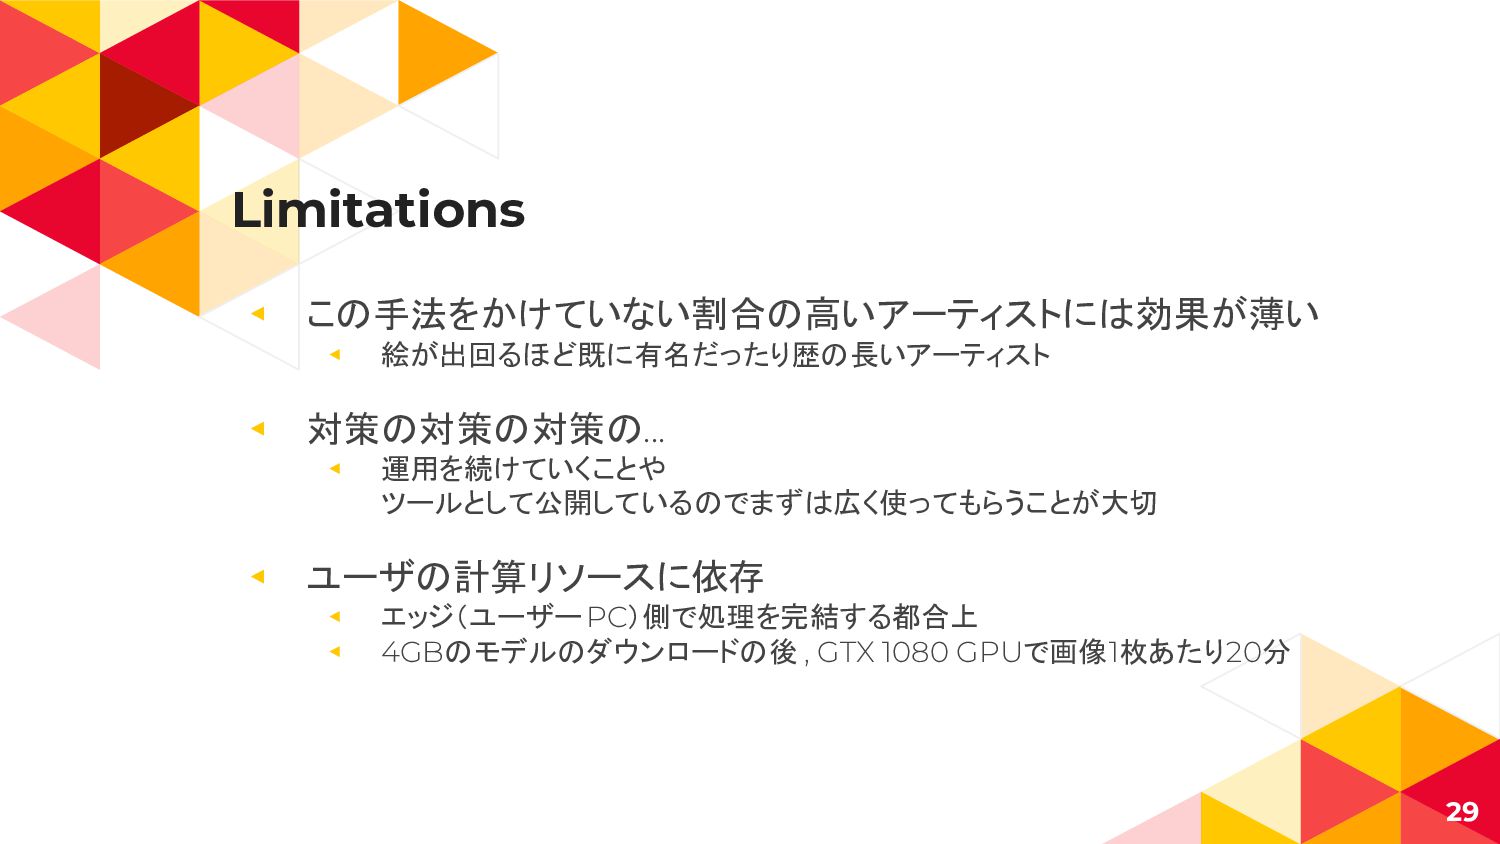
Limitations ◂ この手法をかけていない割合の高いアーティストには効果が薄い ◂ 絵が出回るほど既に有名だったり歴の長いアーティスト ◂ 対策の対策の対策の... ◂ 運用を続けていくことや ツールとして公開しているのでまずは広く使ってもらうことが大切
◂ ユーザの計算リソースに依存 ◂ エッジ(ユーザーPC)側で処理を完結する都合上 ◂ 4GBのモデルのダウンロードの後 , GTX 1080 GPUで画像1枚あたり20分 29
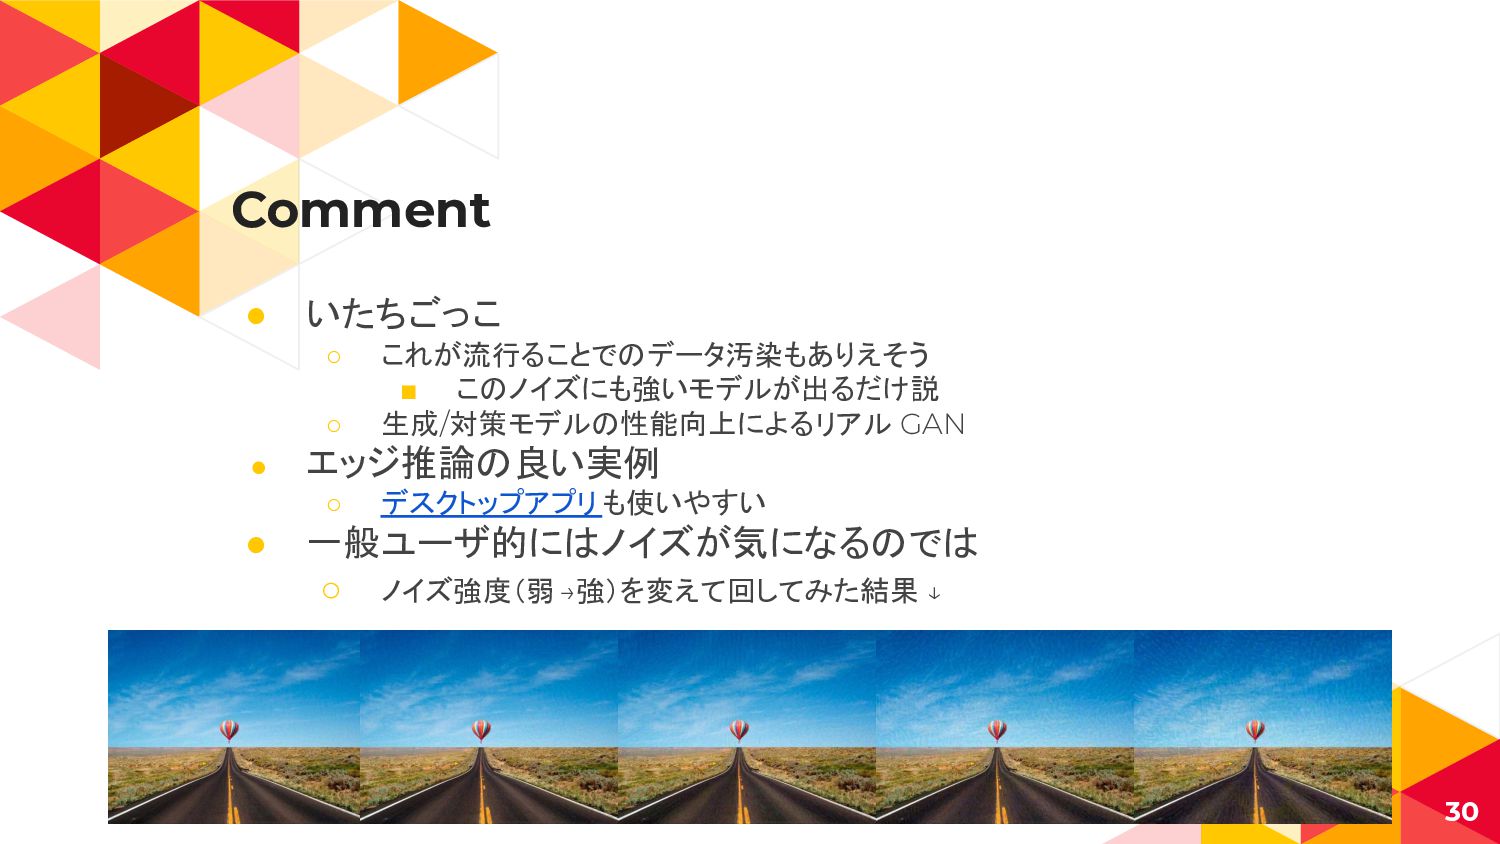
Comment • いたちごっこ ◦ これが流行ることでのデータ汚染もありえそう ▪ このノイズにも強いモデルが出るだけ説 ◦ 生成/対策モデルの性能向上によるリアル GAN
• エッジ推論の良い実例 ◦ デスクトップアプリも使いやすい • 一般ユーザ的にはノイズが気になるのでは ◦ ノイズ強度(弱→強)を変えて回してみた結果 ↓ 30


 chck
 naok615
 youten622
 eumesy
 satai
 sokikatayama
 kzmssk
 institutdelelevage
 kogoro
 analokmaus
 s_mizuki_nlp
 beale
 irinanazarova
 morganepeng
 lauravandoore
 tammyeverts
 katarinadahlin
 inesmontani
 zakiyama
 portentint
 lfama
 rasagy
 jonoalderson
 productmarketing