インフラコストとセキュリティ課題解決のためのリアーキテクチャリング / srekaigi2025

Share
Embed
インフラコストとセキュリティ課題解決のためのリアーキテクチャリング / srekaigi2025
サービス信頼性向上の為のボトルネックは、サービスのアーキテクチャ自体の見直しなくしては解消できないことがあります。
品質保証エンジニアリングプラットフォームAutifyのSREチームは、プロダクトのコアに手を入れなくても最適化できるコスト効率化を終えた後、コスト効率化・潜在的なセキュリティ課題解消のため、Kubernetesへの移行、Karpenterの導入、MLワークロードが稼働するGKEクラスターの運用改善、そして、SPOFを解消するリアーキテクチャリングに取り組みました。
テスト自動化ツールのインフラストラクチャは典型的なWEBサービスとはトラフィックやスケーリング要件が異なるため、教科書通りのクラウドネイティブ技術の適用では収まらない面白みがあります。本セッションで紹介される事例は、独自性のある事例であるともに、様々なサービス開発現場で再利用可能なナレッジとなるでしょう。

Kazuki Higashiguchi
January 24, 2025
Transcript
90 slides
-
インフラコストと セキュリティ課題解決のための リアーキテクチャリング 2025/01/26, SRE Kaigi 2025 Senior Site Reliability
Engineer 東口 和暉 @hgsgtk -
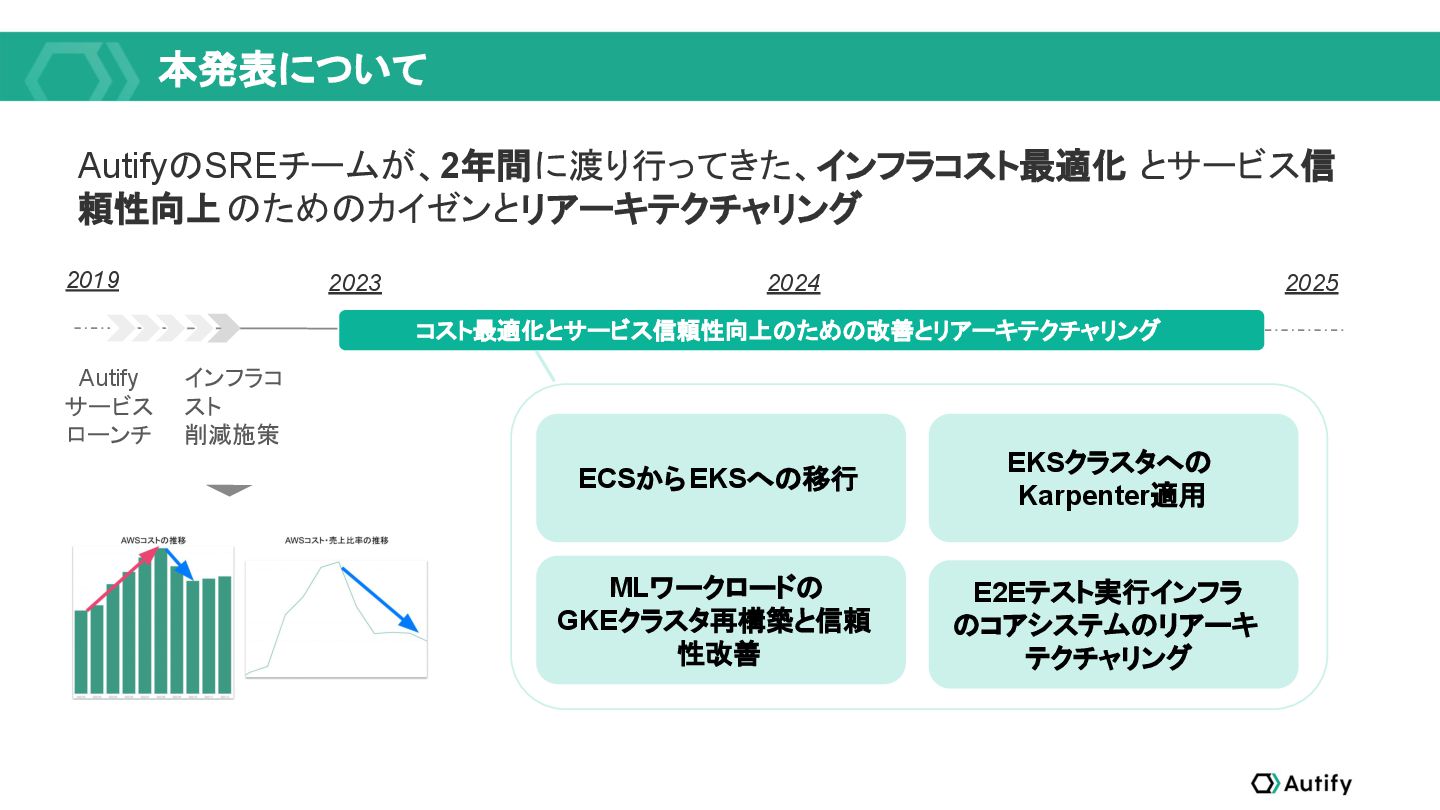
本発表について AutifyのSREチームが、2年間に渡り行ってきた、インフラコスト最適化 とサービス信 頼性向上のためのカイゼンとリアーキテクチャリング Autify サービス ローンチ 2019 インフラコ スト
削減施策 2023 2024 コスト最適化とサービス信頼性向上のための改善とリアーキテクチャリング 2025 ECSからEKSへの移行 EKSクラスタへの Karpenter適用 MLワークロードの GKEクラスタ再構築と信頼 性改善 E2Eテスト実行インフラ のコアシステムのリアーキ テクチャリング -
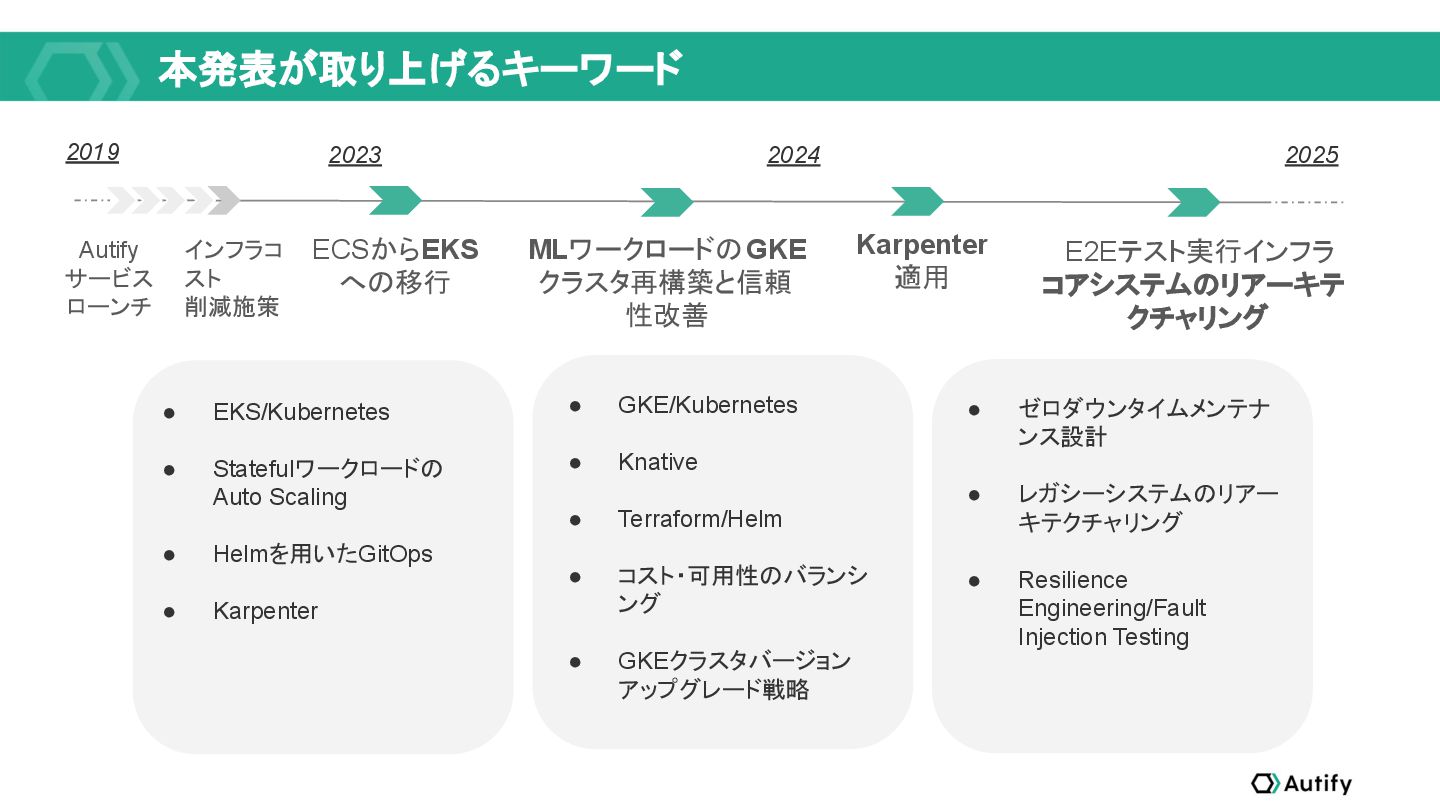
本発表が取り上げるキーワード • EKS/Kubernetes • Statefulワークロードの Auto Scaling • Helmを用いたGitOps •
Karpenter 2019 2023 2024 2025 ECSからEKS への移行 MLワークロードのGKE クラスタ再構築と信頼 性改善 Karpenter 適用 E2Eテスト実行インフラ コアシステムのリアーキテ クチャリング Autify サービス ローンチ インフラコ スト 削減施策 • GKE/Kubernetes • Knative • Terraform/Helm • コスト・可用性のバランシ ング • GKEクラスタバージョン アップグレード戦略 • ゼロダウンタイムメンテナ ンス設計 • レガシーシステムのリアー キテクチャリング • Resilience Engineering/Fault Injection Testing -
タイトルタイトルタイトルタイトルタ イトルタイトルタイトル 小見出し小見出し小見出し小見出し 東口 和暉 (Kazuki Higashiguchi) Senior SRE @
Autify, Inc. (2022~) SWE, Tech Lead, EM @ BASE, Inc. (2017~) Project Manager @ S-cubism inc. (2016~) Special thanks: Autify SREs Dmitry Ponkin, Matt Hopkins, Maxim Gashkov @hgsgtk SRECon 2022 APAC セッションスピーカー 技術評論社 ”Software Design 2020年12月号” 寄稿 -
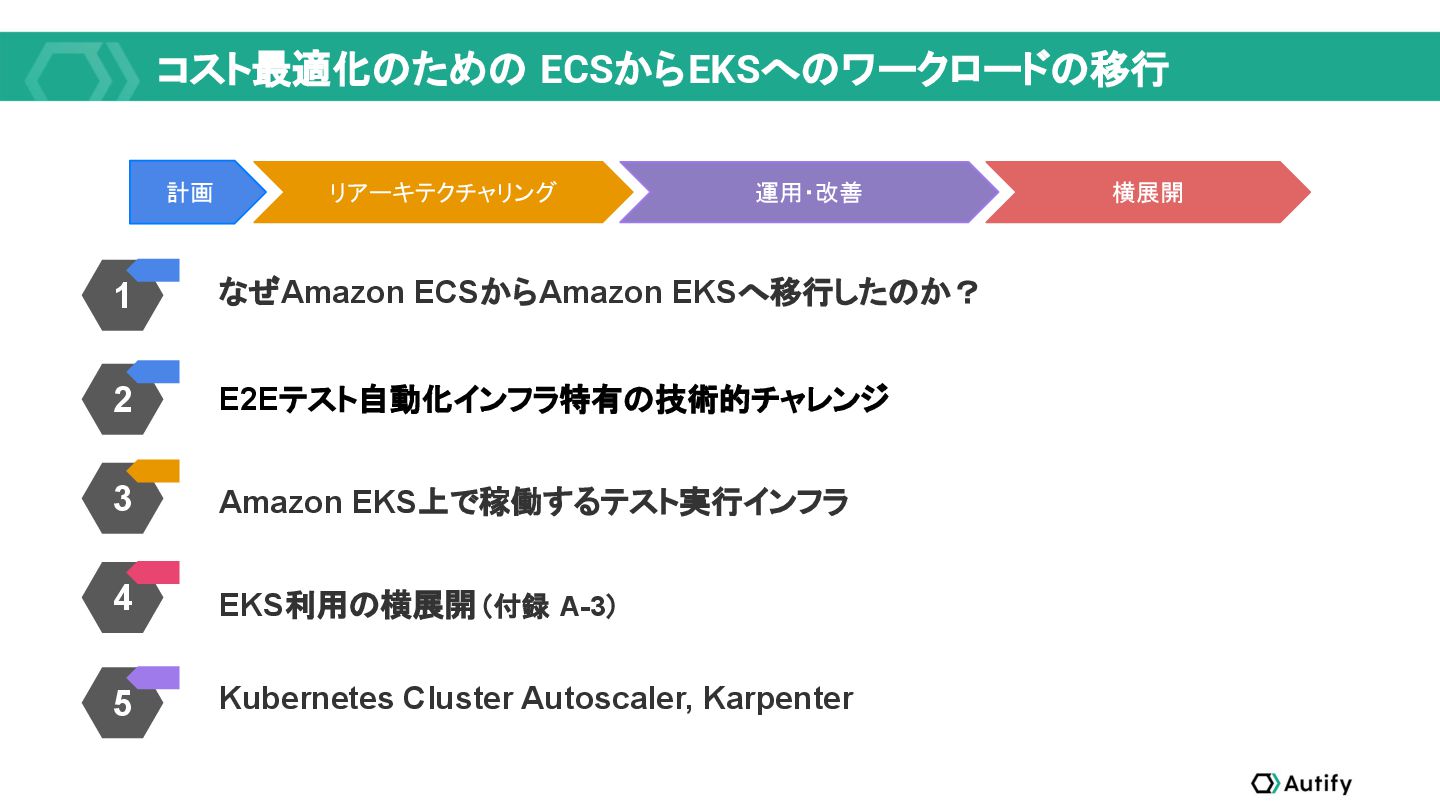
コスト最適化のための ECSからEKSへのワークロードの移行 なぜAmazon ECSからAmazon EKSへ移行したのか? 1 2 3 Amazon EKS上で稼働するテスト実行インフラ
E2Eテスト自動化インフラ特有の技術的チャレンジ 計画 リアーキテクチャリング 運用・改善 横展開 4 EKS利用の横展開(付録 A-3) 5 Kubernetes Cluster Autoscaler, Karpenter -
コスト最適化のための Amazon ECSから Amazon EKSへのワークロードの移行 なぜAmazon ECSから Amazon EKSへ移行したのか? 計画
リアーキテクチャリング 運用・改善 横展開 -
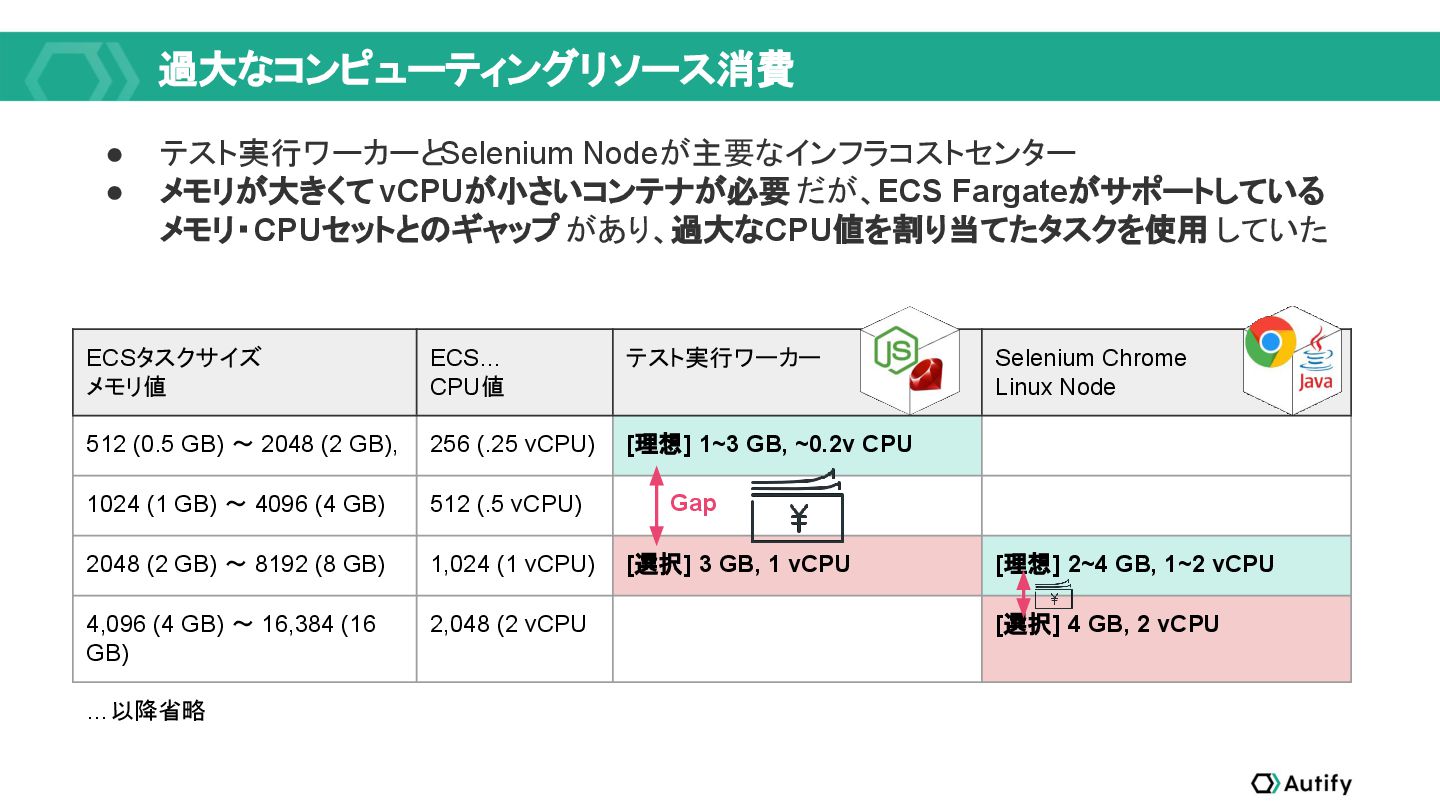
過大なコンピューティングリソース消費 • テスト実行ワーカーとSelenium Nodeが主要なインフラコストセンター • メモリが大きくてvCPUが小さいコンテナが必要 だが、ECS Fargateがサポートしている メモリ・CPUセットとのギャップ があり、過大なCPU値を割り当てたタスクを使用
していた ECSタスクサイズ メモリ値 ECS… CPU値 テスト実行ワーカー Selenium Chrome Linux Node 512 (0.5 GB) ~ 2048 (2 GB), 256 (.25 vCPU) [理想] 1~3 GB, ~0.2v CPU 1024 (1 GB) ~ 4096 (4 GB) 512 (.5 vCPU) 2048 (2 GB) ~ 8192 (8 GB) 1,024 (1 vCPU) [選択] 3 GB, 1 vCPU [理想] 2~4 GB, 1~2 vCPU 4,096 (4 GB) ~ 16,384 (16 GB) 2,048 (2 vCPU [選択] 4 GB, 2 vCPU Gap …以降省略 -
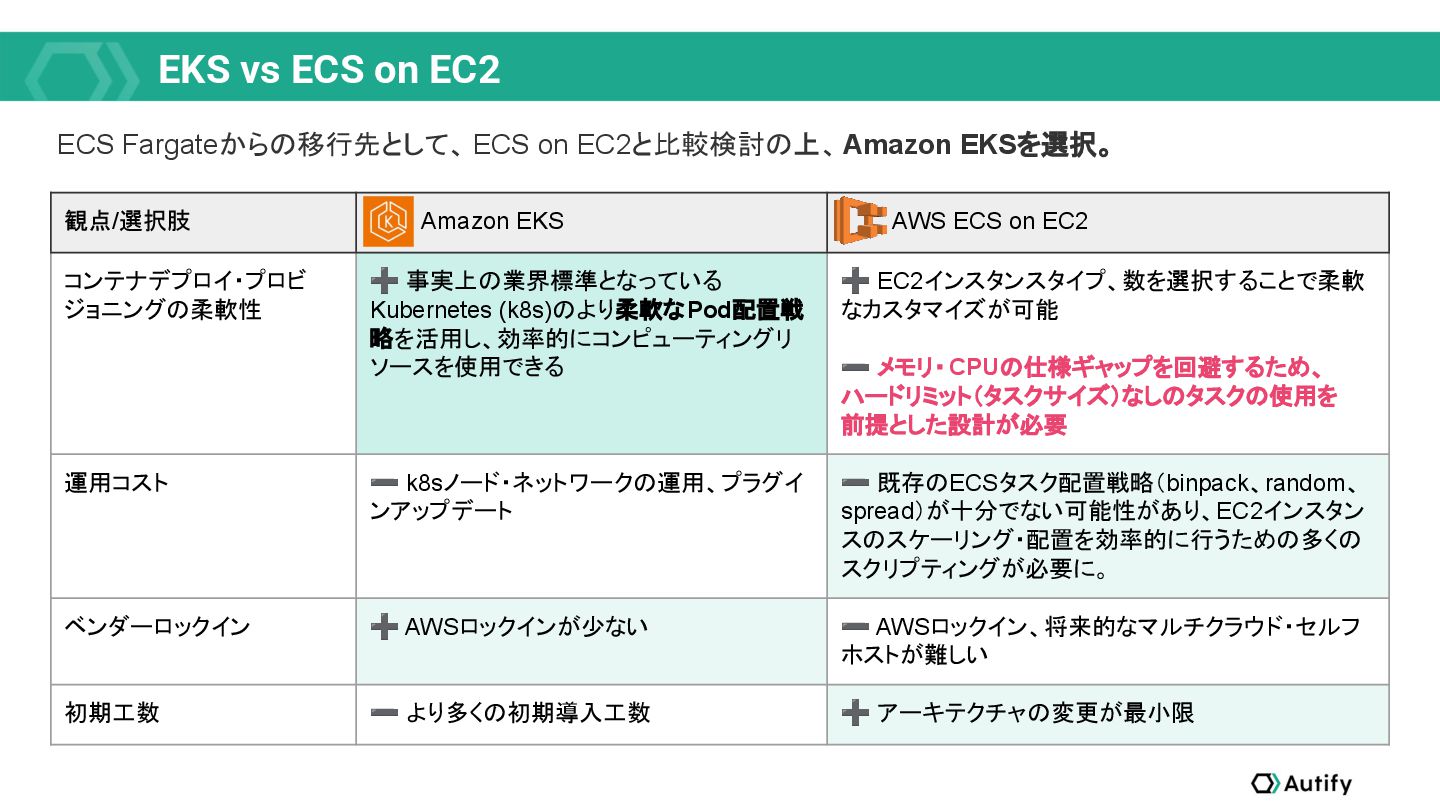
観点/選択肢 Amazon EKS AWS ECS on EC2 コンテナデプロイ・プロビ ジョニングの柔軟性 ➕
事実上の業界標準となっている Kubernetes (k8s)のより柔軟なPod配置戦 略を活用し、効率的にコンピューティングリ ソースを使用できる ➕ EC2インスタンスタイプ、数を選択することで柔軟 なカスタマイズが可能 ➖ メモリ・CPUの仕様ギャップを回避するため、 ハードリミット(タスクサイズ)なしのタスクの使用を 前提とした設計が必要 運用コスト ➖ k8sノード・ネットワークの運用、プラグイ ンアップデート ➖ 既存のECSタスク配置戦略(binpack、random、 spread)が十分でない可能性があり、EC2インスタン スのスケーリング・配置を効率的に行うための多くの スクリプティングが必要に。 ベンダーロックイン ➕ AWSロックインが少ない ➖ AWSロックイン、将来的なマルチクラウド・セルフ ホストが難しい 初期工数 ➖ より多くの初期導入工数 ➕ アーキテクチャの変更が最小限 EKS vs ECS on EC2 ECS Fargateからの移行先として、 ECS on EC2と比較検討の上、Amazon EKSを選択。 -
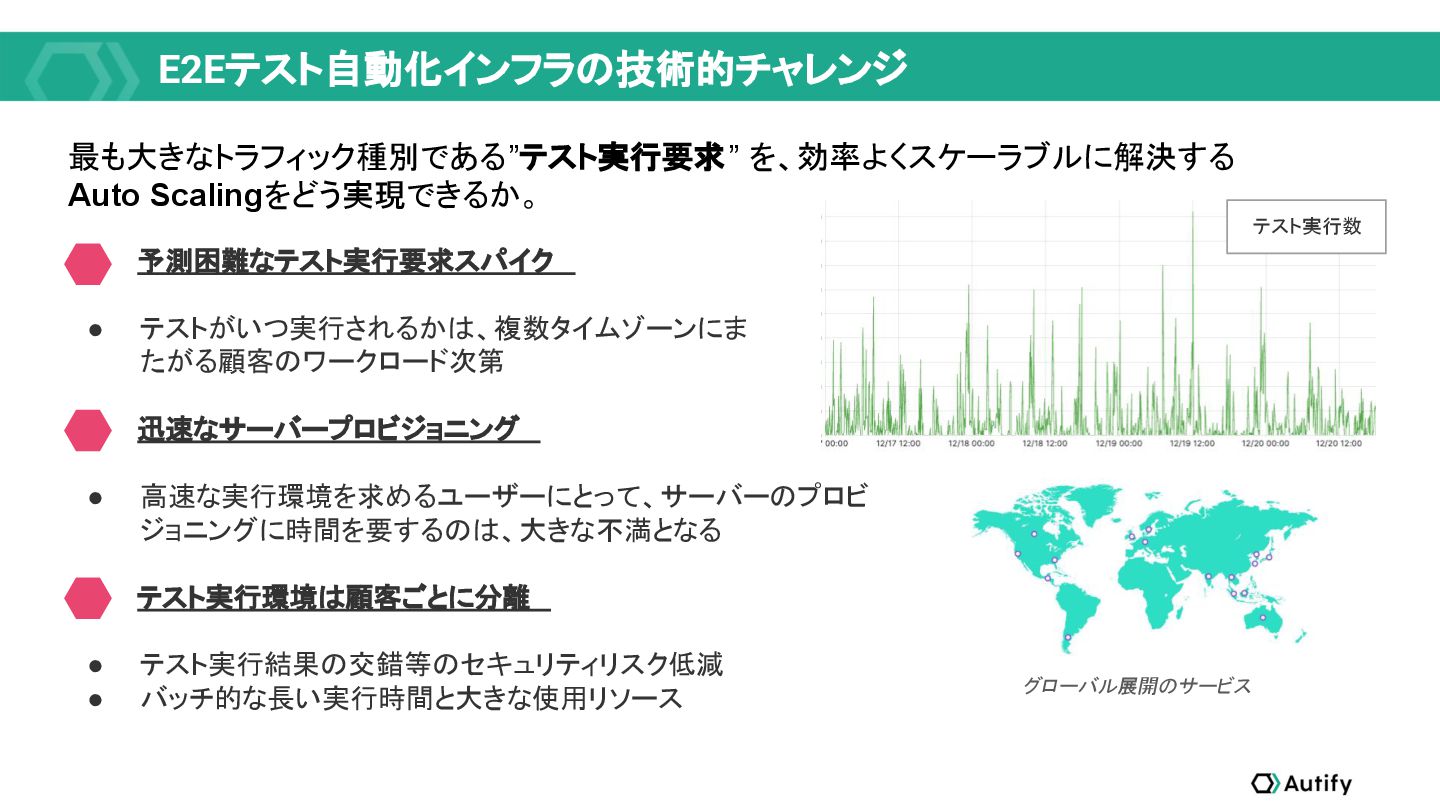
E2Eテスト自動化インフラの技術的チャレンジ 予測困難なテスト実行要求スパイク • テストがいつ実行されるかは、複数タイムゾーンにま たがる顧客のワークロード次第 テスト実行環境は顧客ごとに分離 迅速なサーバープロビジョニング • 高速な実行環境を求めるユーザーにとって、サーバーのプロビ ジョニングに時間を要するのは、大きな不満となる
最も大きなトラフィック種別である ”テスト実行要求” を、効率よくスケーラブルに解決する Auto Scalingをどう実現できるか。 テスト実行数 グローバル展開のサービス • テスト実行結果の交錯等のセキュリティリスク低減 • バッチ的な長い実行時間と大きな使用リソース -
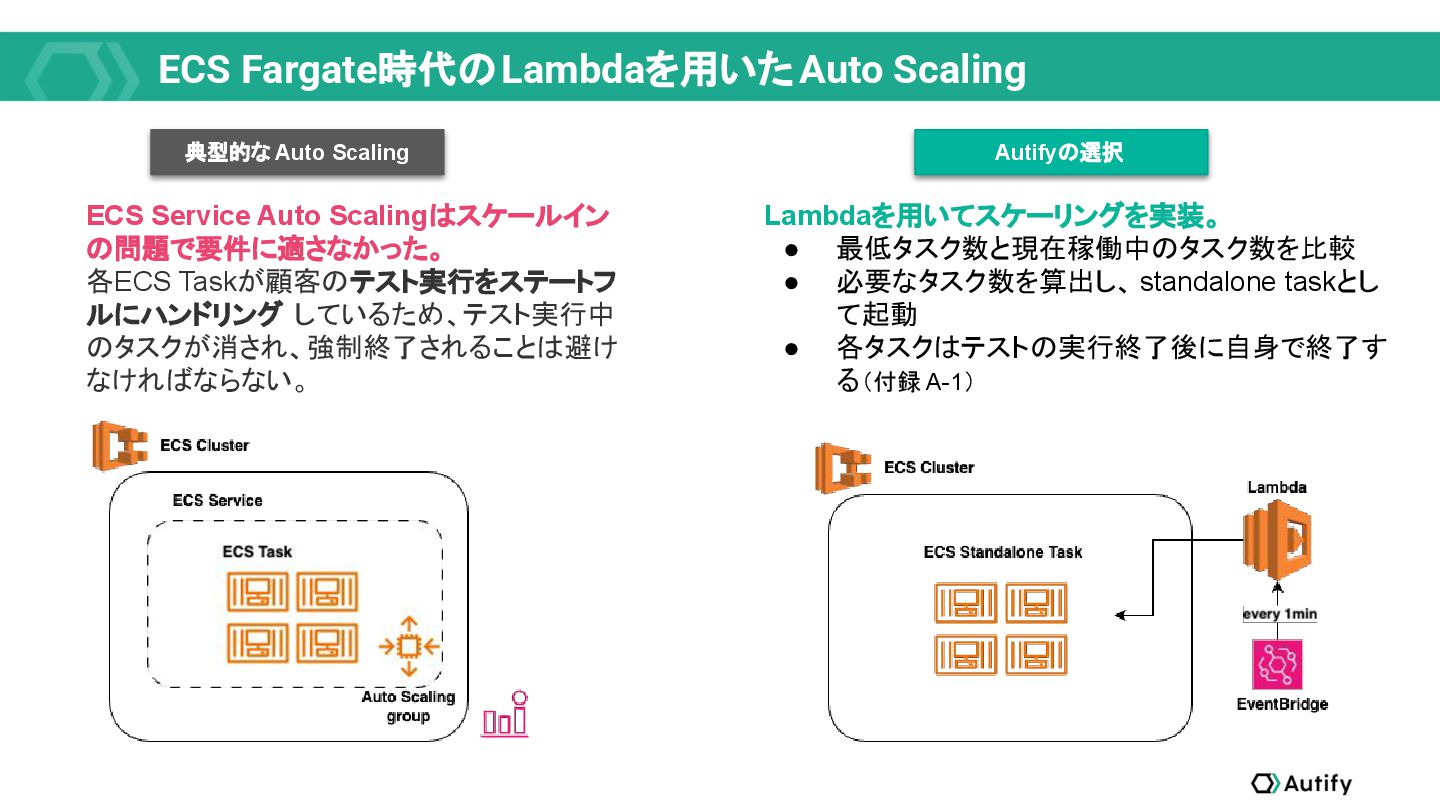
ECS Fargate時代のLambdaを用いたAuto Scaling ECS Service Auto Scalingはスケールイン の問題で要件に適さなかった。 各ECS Taskが顧客のテスト実行をステートフ
ルにハンドリング しているため、テスト実行中 のタスクが消され、強制終了されることは避け なければならない。 Lambdaを用いてスケーリングを実装。 • 最低タスク数と現在稼働中のタスク数を比較 • 必要なタスク数を算出し、 standalone taskとし て起動 • 各タスクはテストの実行終了後に自身で終了す る(付録 A-1) 典型的な Auto Scaling Autifyの選択 -
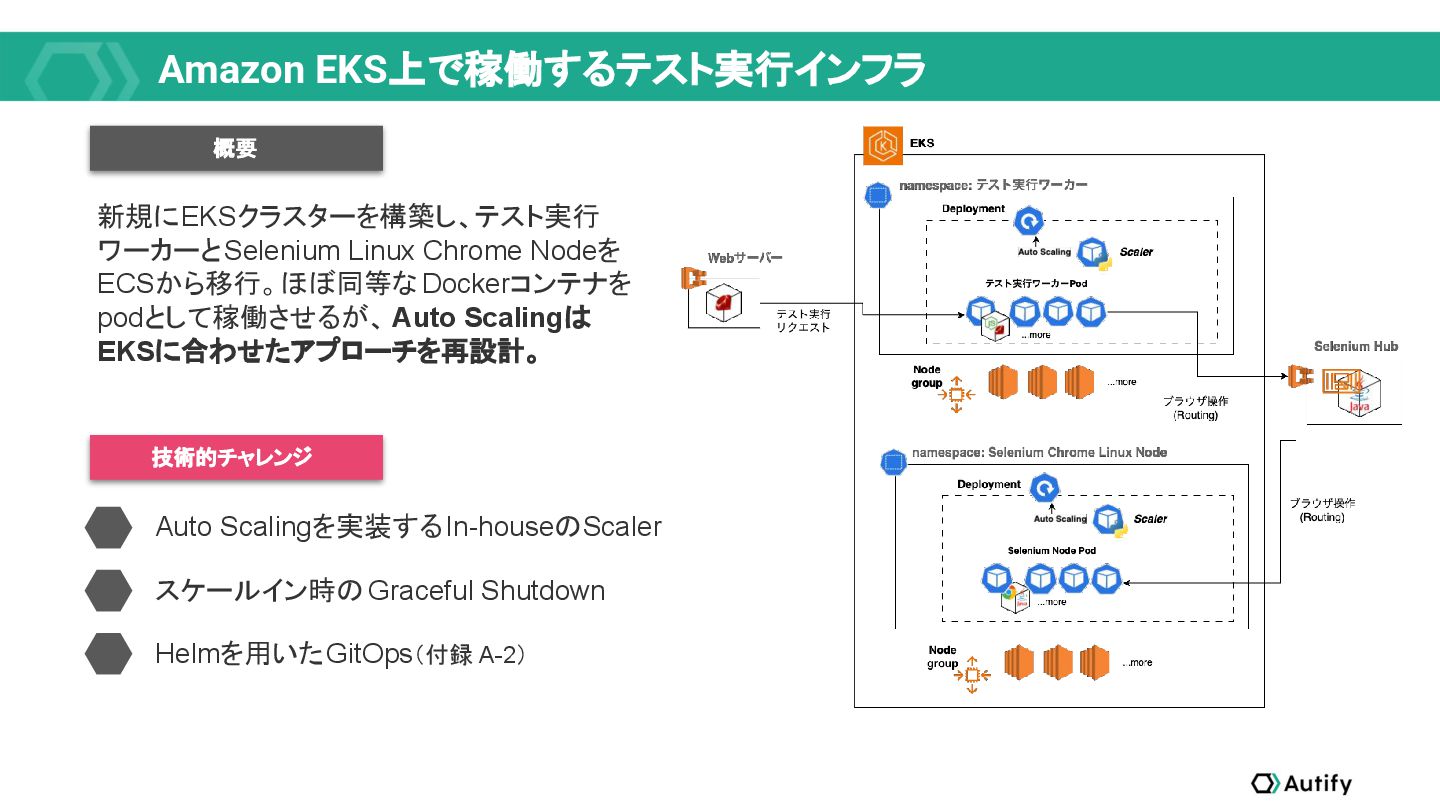
Amazon EKS上で稼働するテスト実行インフラ 新規にEKSクラスターを構築し、テスト実行 ワーカーとSelenium Linux Chrome Nodeを ECSから移行。ほぼ同等な Dockerコンテナを podとして稼働させるが、
Auto Scalingは EKSに合わせたアプローチを再設計。 Auto Scalingを実装するIn-houseのScaler 技術的チャレンジ 概要 スケールイン時のGraceful Shutdown Helmを用いたGitOps(付録 A-2) -
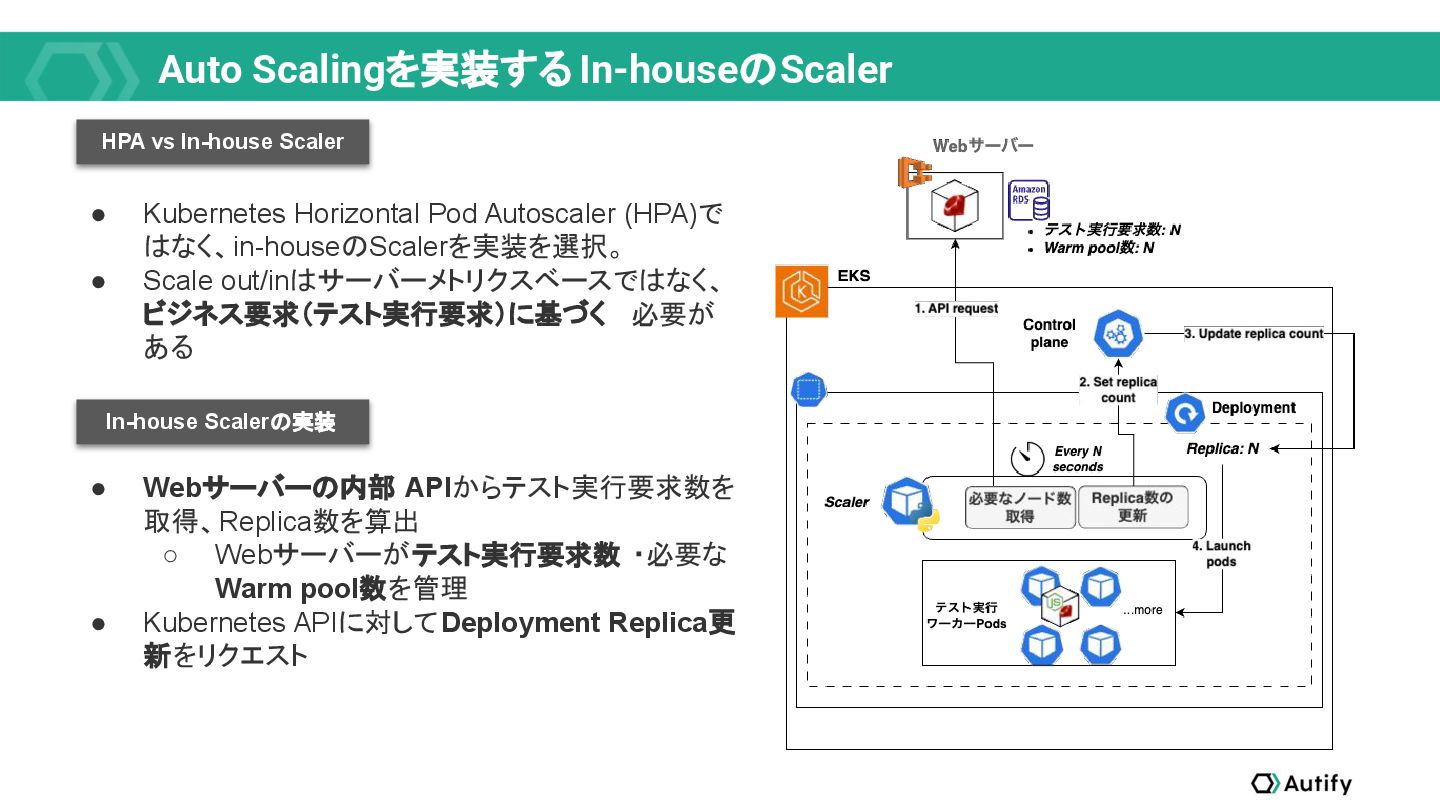
Auto Scalingを実装する In-houseのScaler • Kubernetes Horizontal Pod Autoscaler (HPA)で はなく、in-houseのScalerを実装を選択。
• Scale out/inはサーバーメトリクスベースではなく、 ビジネス要求(テスト実行要求)に基づく 必要が ある • Webサーバーの内部 APIからテスト実行要求数を 取得、Replica数を算出 ◦ Webサーバーがテスト実行要求数 ・必要な Warm pool数を管理 • Kubernetes APIに対してDeployment Replica更 新をリクエスト In-house Scalerの実装 HPA vs In-house Scaler -
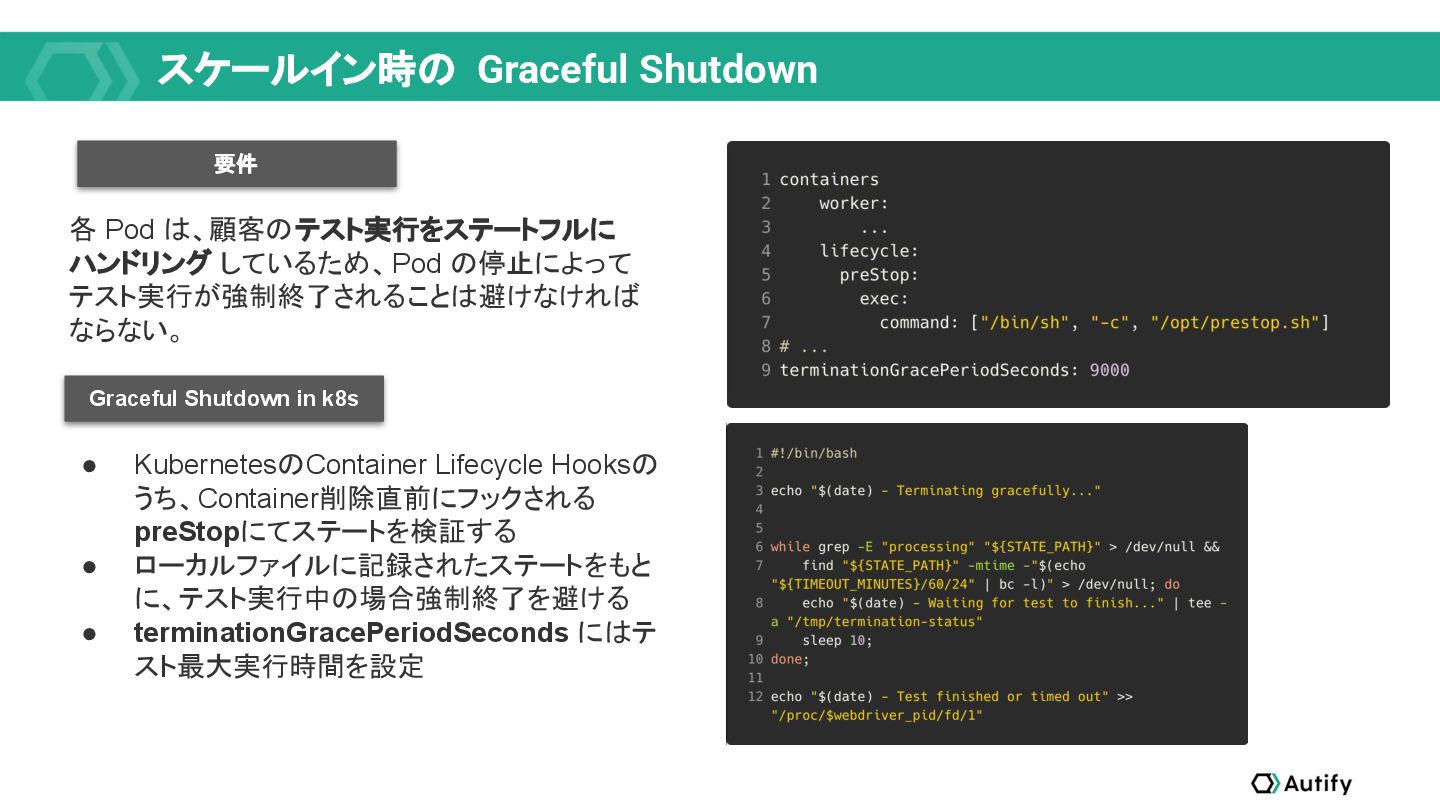
スケールイン時の Graceful Shutdown 要件 各 Pod は、顧客のテスト実行をステートフルに ハンドリング しているため、Pod の停止によって
テスト実行が強制終了されることは避けなければ ならない。 Graceful Shutdown in k8s • KubernetesのContainer Lifecycle Hooksの うち、Container削除直前にフックされる preStopにてステートを検証する • ローカルファイルに記録されたステートをもと に、テスト実行中の場合強制終了を避ける • terminationGracePeriodSeconds にはテ スト最大実行時間を設定 -
EKS移行による効果 テスト実行ワーカー Selenium Chrome Linux Node [w/EKS] 1~3 GB, ~0.2v
CPU [w/Fargate] 3 GB, 1 vCPU [w/EKS] 2~4 GB, 1~2 vCPU [w/Fargate] 4 GB, 2 vCPU • 各ワークロードの要件に合致した Resource RequestsとLimitsを設定し、当初 のコスト課題の要因が解消 • レイテンシーなどユーザー体験を損なうことなく、ワークロードにかかっていた平均 コンピューティングコストが約半分に -
コスト最適化のための Amazon ECSから Amazon EKSへのワークロードの移行 Kubernetes Cluster Autoscaler Karpenter 計画
リアーキテクチャリング 運用・改善 横展開 -
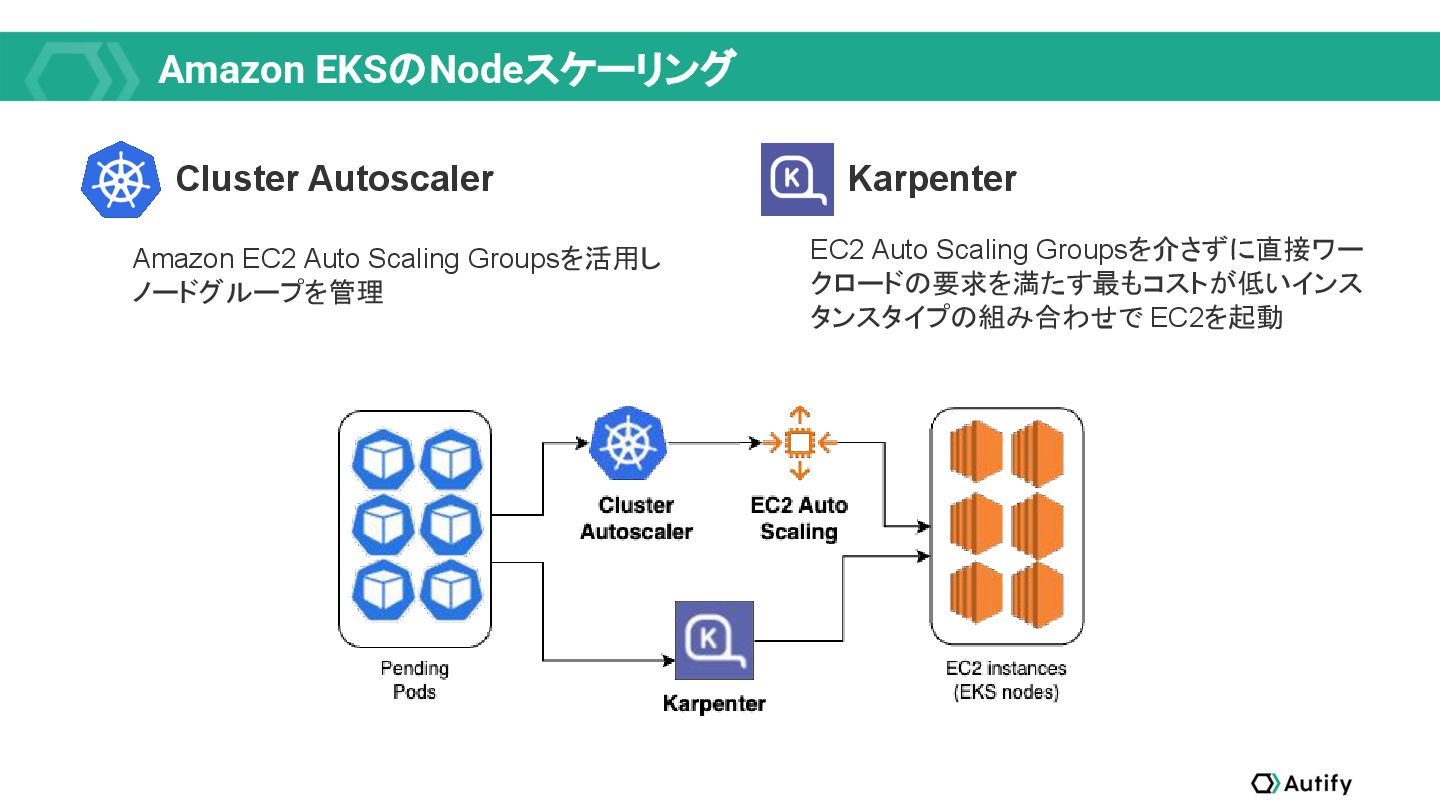
Amazon EKSのNodeスケーリング Cluster Autoscaler Karpenter Amazon EC2 Auto Scaling Groupsを活用し
ノードグループを管理 EC2 Auto Scaling Groupsを介さずに直接ワー クロードの要求を満たす最もコストが低いインス タンスタイプの組み合わせで EC2を起動 -
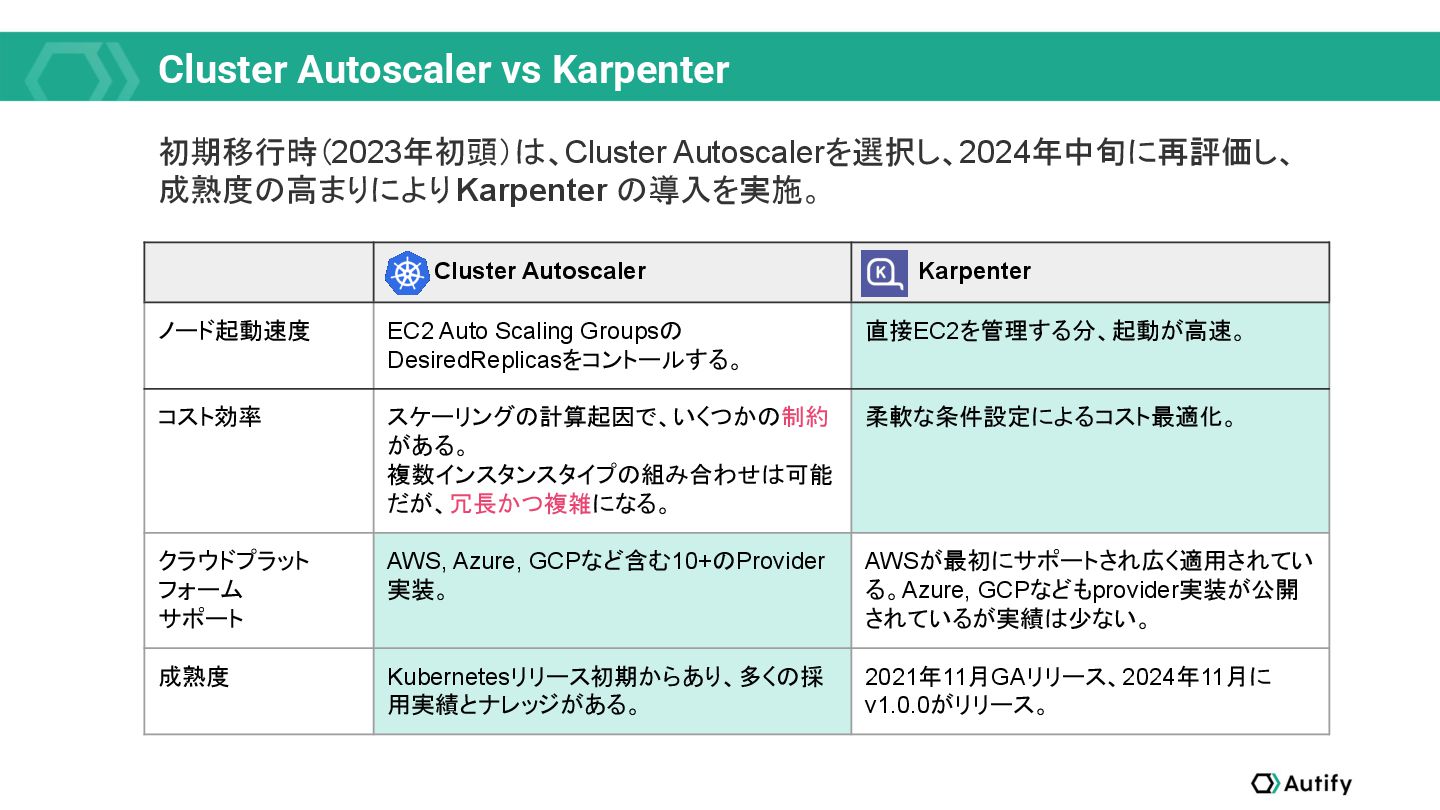
Cluster Autoscaler vs Karpenter Cluster Autoscaler Karpenter ノード起動速度 EC2 Auto
Scaling Groupsの DesiredReplicasをコントールする。 直接EC2を管理する分、起動が高速。 コスト効率 スケーリングの計算起因で、いくつかの制約 がある。 複数インスタンスタイプの組み合わせは可能 だが、冗長かつ複雑になる。 柔軟な条件設定によるコスト最適化。 クラウドプラット フォーム サポート AWS, Azure, GCPなど含む10+のProvider 実装。 AWSが最初にサポートされ広く適用されてい る。Azure, GCPなどもprovider実装が公開 されているが実績は少ない。 成熟度 Kubernetesリリース初期からあり、多くの採 用実績とナレッジがある。 2021年11月GAリリース、2024年11月に v1.0.0がリリース。 初期移行時(2023年初頭)は、Cluster Autoscalerを選択し、2024年中旬に再評価し、 成熟度の高まりにより Karpenter の導入を実施。 -
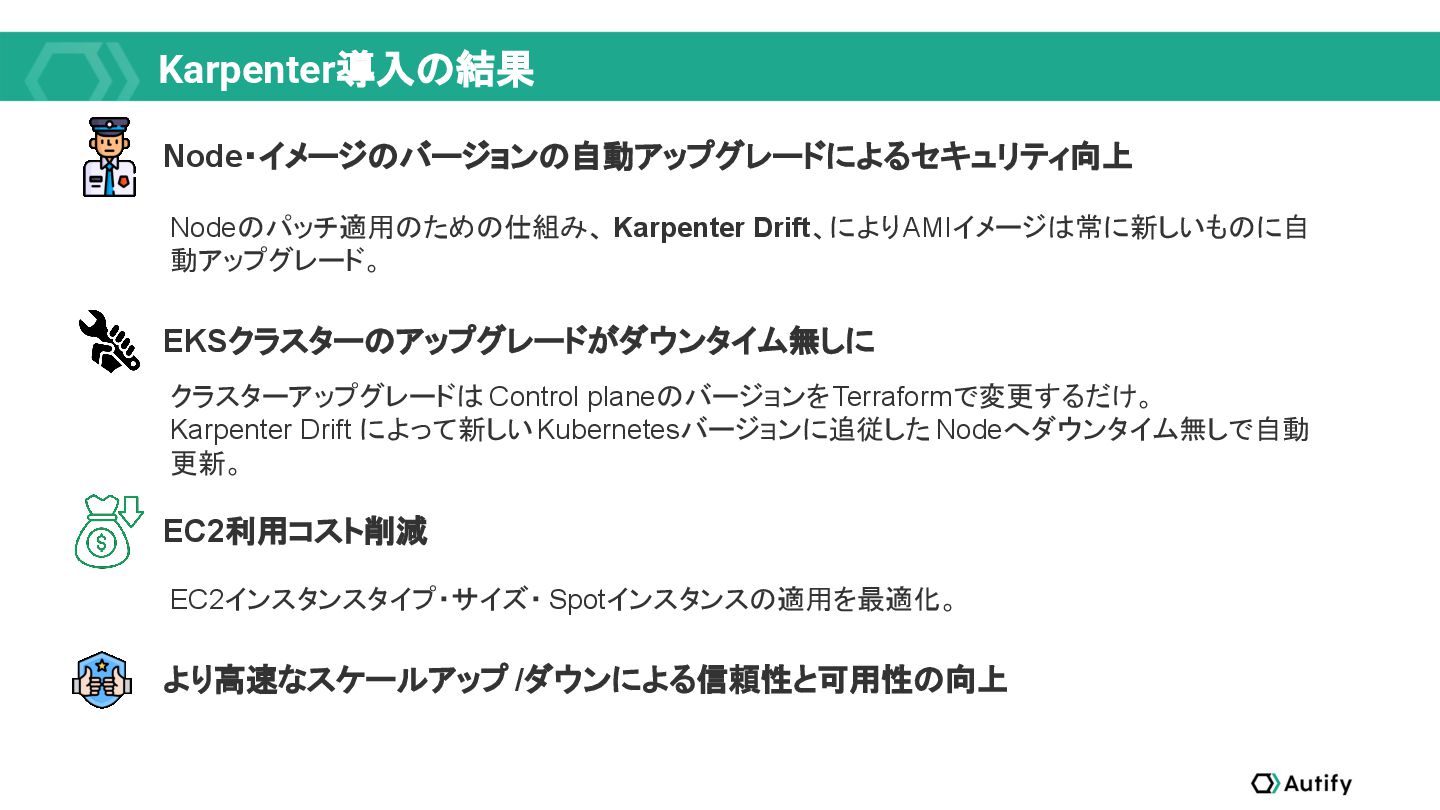
Karpenter導入の結果 EC2利用コスト削減 より高速なスケールアップ /ダウンによる信頼性と可用性の向上 Node・イメージのバージョンの自動アップグレードによるセキュリティ向上 EKSクラスターのアップグレードがダウンタイム無しに EC2インスタンスタイプ・サイズ・ Spotインスタンスの適用を最適化。 Nodeのパッチ適用のための仕組み、 Karpenter
Drift、によりAMIイメージは常に新しいものに自 動アップグレード。 クラスターアップグレードは Control planeのバージョンをTerraformで変更するだけ。 Karpenter Drift によって新しいKubernetesバージョンに追従した Nodeへダウンタイム無しで自動 更新。 -
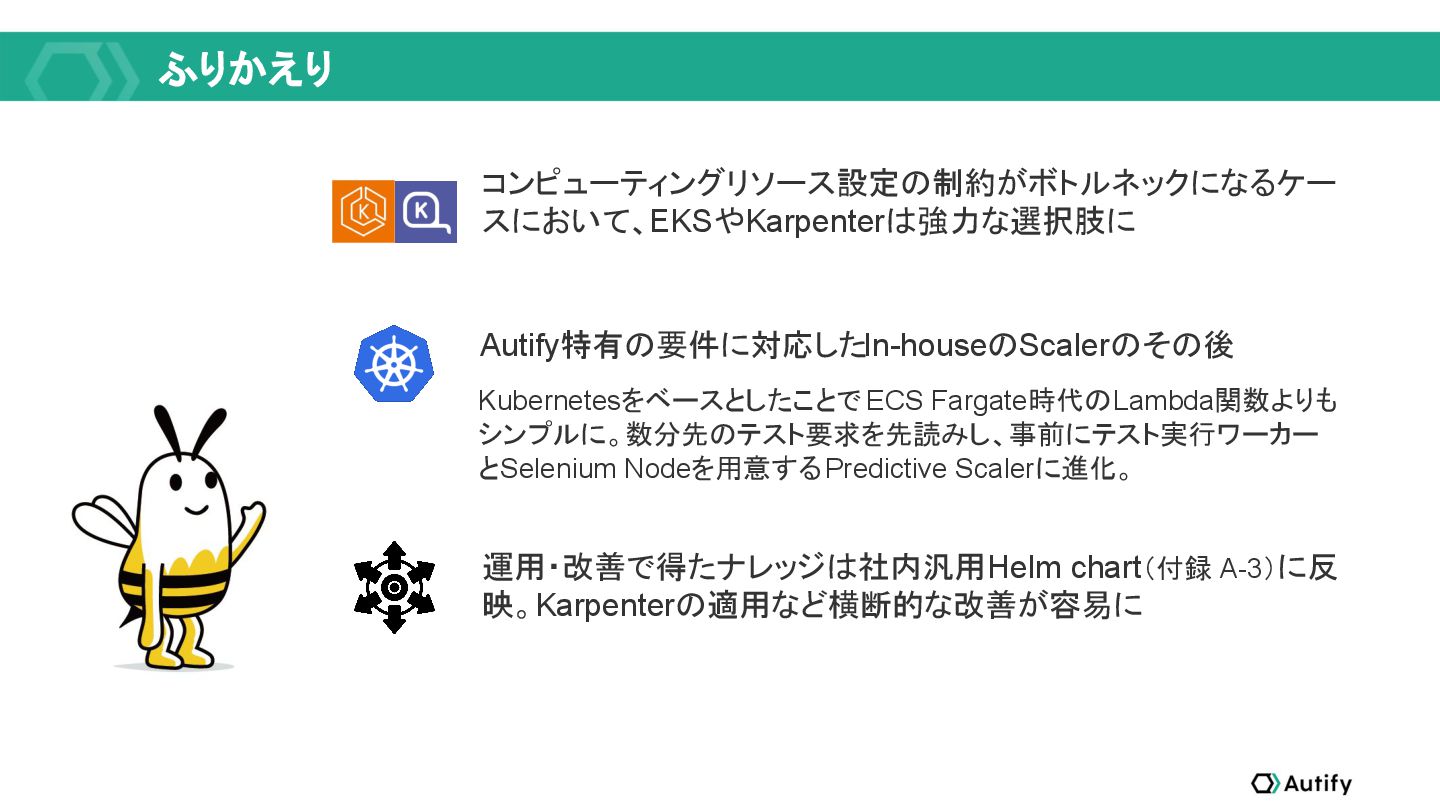
ふりかえり Autify特有の要件に対応したIn-houseのScalerのその後 Kubernetesをベースとしたことで ECS Fargate時代のLambda関数よりも シンプルに。数分先のテスト要求を先読みし、事前にテスト実行ワーカー とSelenium Nodeを用意するPredictive Scalerに進化。 運用・改善で得たナレッジは社内汎用
Helm chart(付録 A-3)に反 映。Karpenterの適用など横断的な改善が容易に コンピューティングリソース設定の制約がボトルネックになるケー スにおいて、EKSやKarpenterは強力な選択肢に -
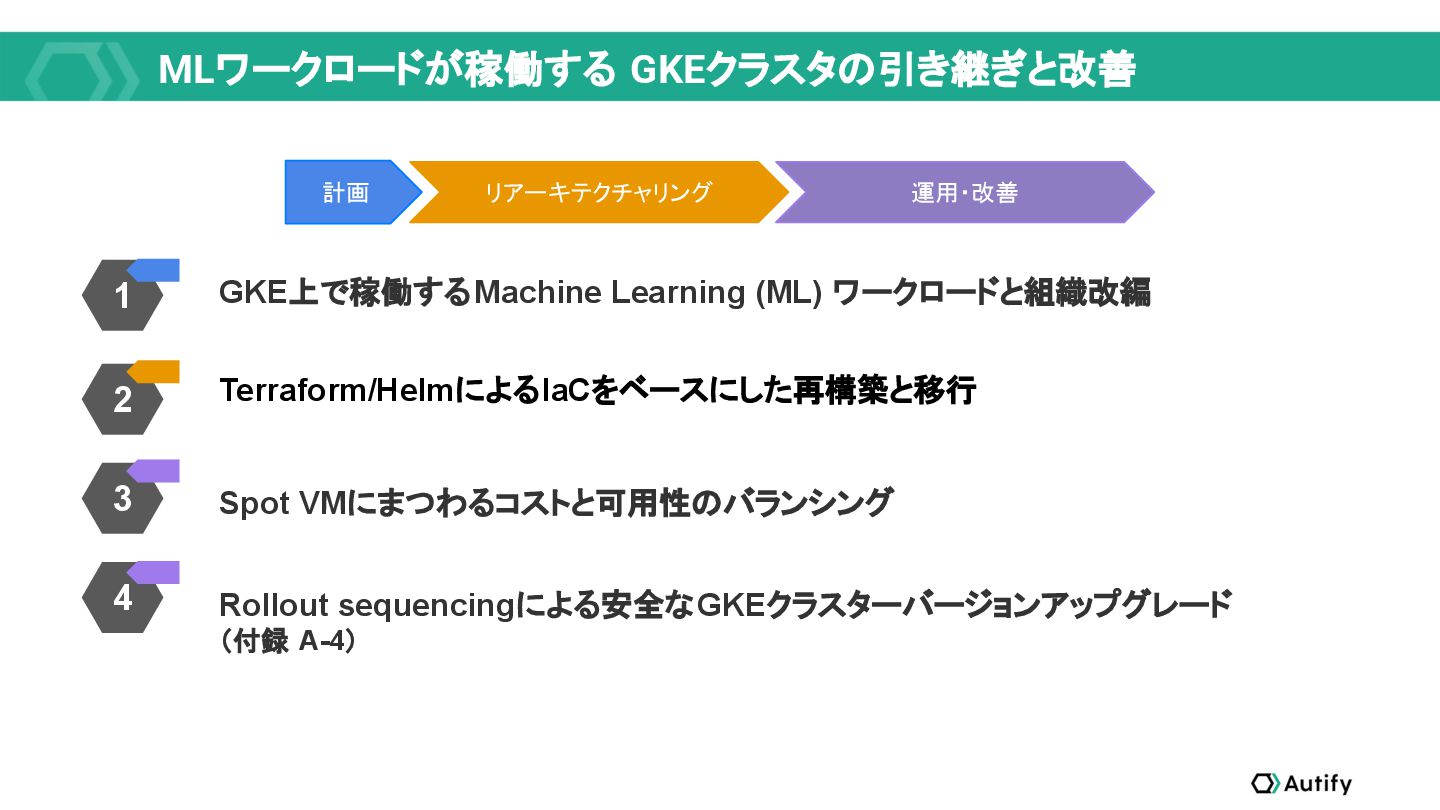
MLワークロードが稼働する GKEクラスタの引き継ぎと改善 GKE上で稼働するMachine Learning (ML) ワークロードと組織改編 1 2 3 Spot
VMにまつわるコストと可用性のバランシング Terraform/HelmによるIaCをベースにした再構築と移行 計画 リアーキテクチャリング 運用・改善 4 Rollout sequencingによる安全なGKEクラスターバージョンアップグレード (付録 A-4) -
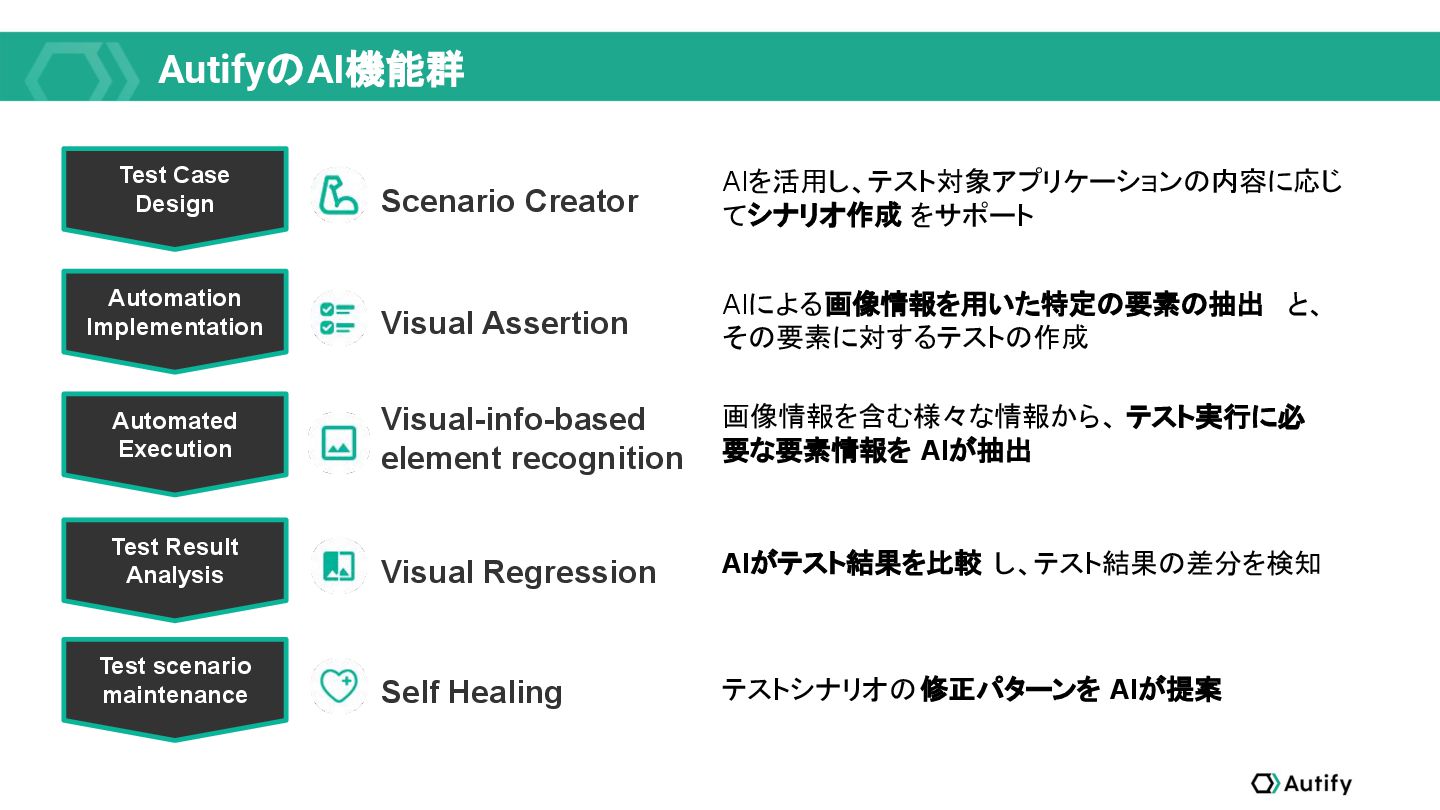
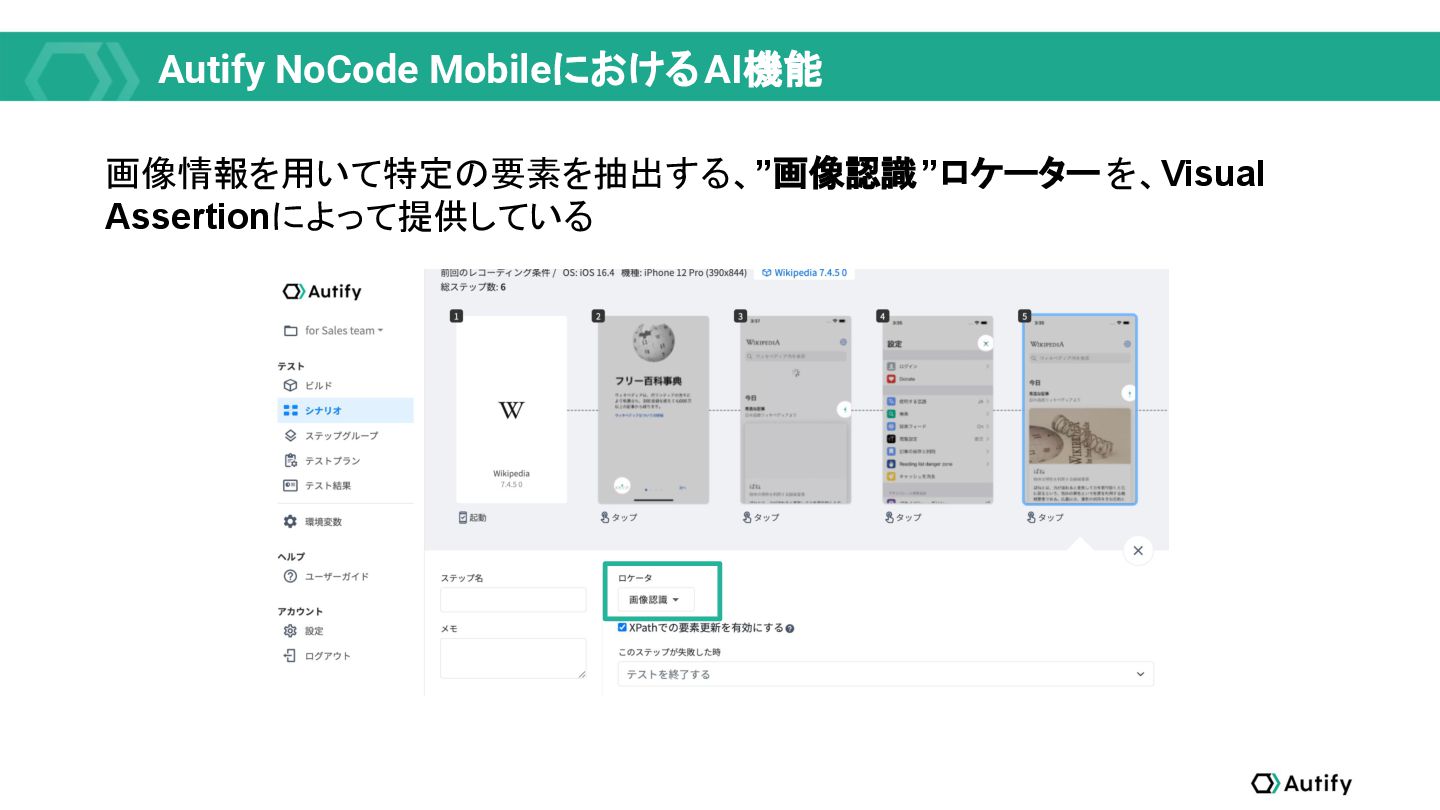
AutifyのAI機能群 Test Case Design Automation Implementation Automated Execution Test Result
Analysis Test scenario maintenance Scenario Creator Visual Assertion Visual-info-based element recognition Visual Regression Self Healing AIを活用し、テスト対象アプリケーションの内容に応じ てシナリオ作成 をサポート AIによる画像情報を用いた特定の要素の抽出 と、 その要素に対するテストの作成 画像情報を含む様々な情報から、 テスト実行に必 要な要素情報を AIが抽出 AIがテスト結果を比較 し、テスト結果の差分を検知 テストシナリオの修正パターンを AIが提案 -
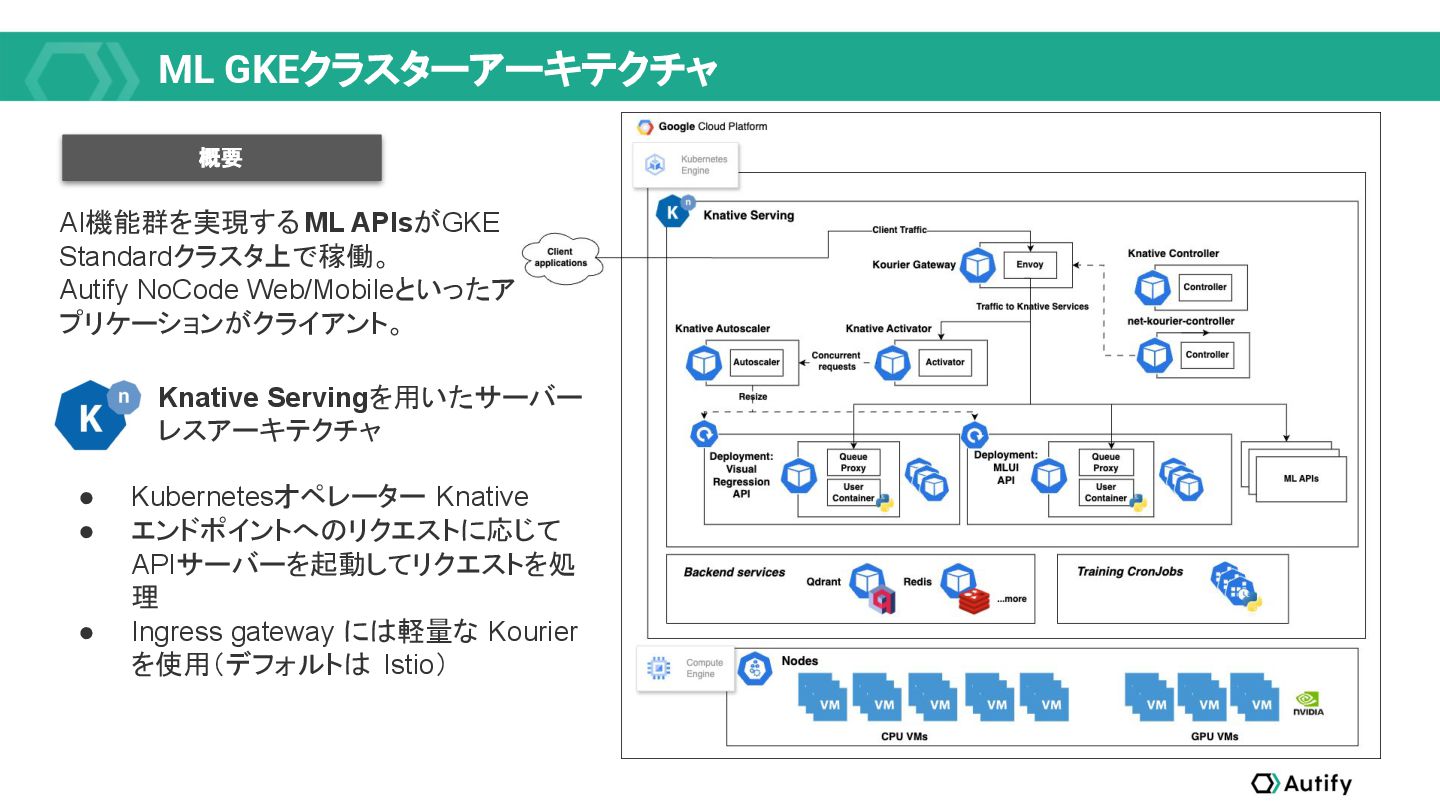
ML GKEクラスターアーキテクチャ AI機能群を実現するML APIsがGKE Standardクラスタ上で稼働。 Autify NoCode Web/Mobileといったア プリケーションがクライアント。 •
Kubernetesオペレーター Knative • エンドポイントへのリクエストに応じて APIサーバーを起動してリクエストを処 理 • Ingress gateway には軽量な Kourier を使用(デフォルトは Istio) 概要 Knative Servingを用いたサーバー レスアーキテクチャ -
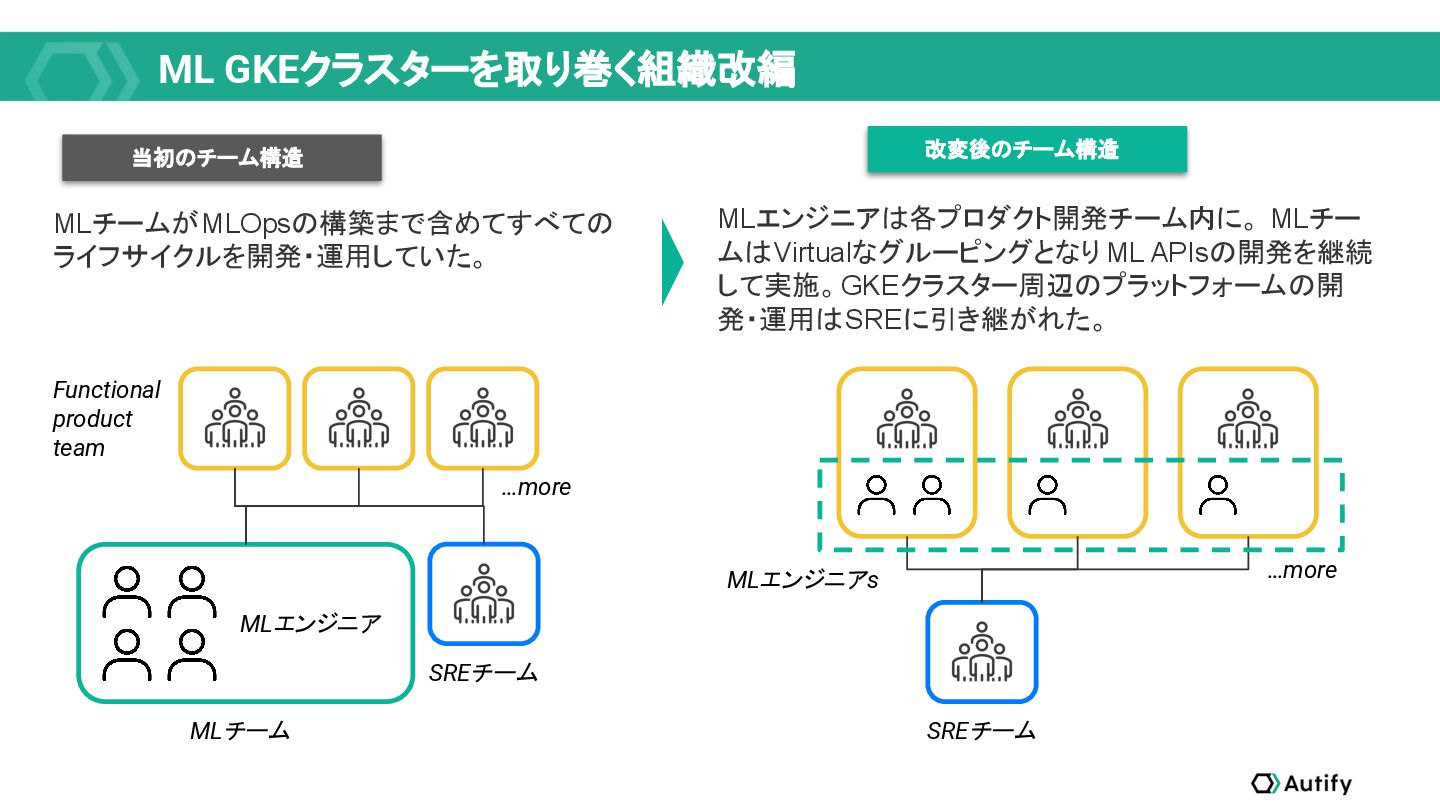
ML GKEクラスターを取り巻く組織改編 MLチーム SREチーム Functional product team …more 当初のチーム構造 改変後のチーム構造
SREチーム …more MLエンジニア MLチームがMLOpsの構築まで含めてすべての ライフサイクルを開発・運用していた。 MLエンジニアs MLエンジニアは各プロダクト開発チーム内に。 MLチー ムはVirtualなグルーピングとなり ML APIsの開発を継続 して実施。GKEクラスター周辺のプラットフォームの開 発・運用はSREに引き継がれた。 -
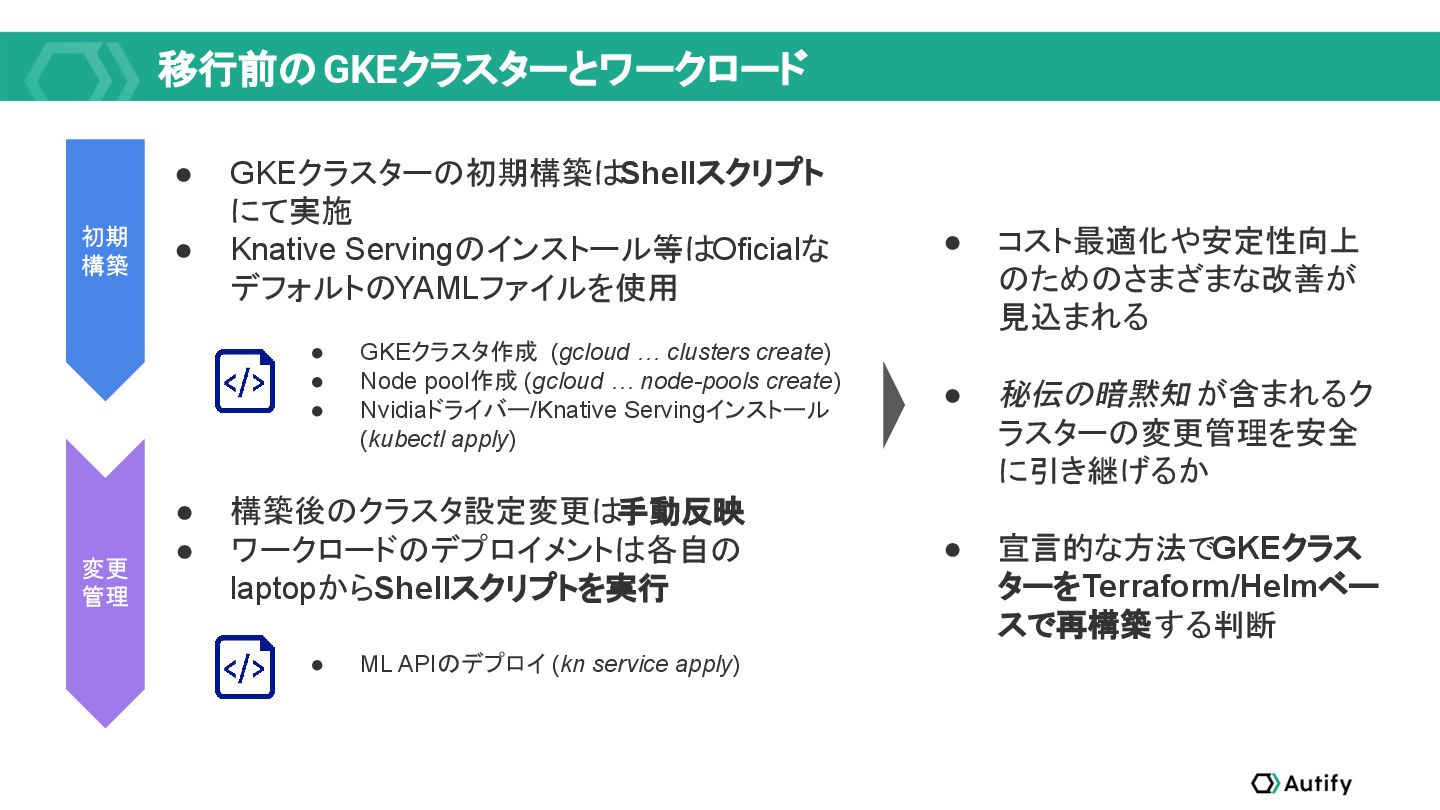
移行前のGKEクラスターとワークロード • 構築後のクラスタ設定変更は手動反映 • ワークロードのデプロイメントは各自の laptopからShellスクリプトを実行 • GKEクラスタ作成 (gcloud …
clusters create) • Node pool作成 (gcloud … node-pools create) • Nvidiaドライバー/Knative Servingインストール (kubectl apply) • ML APIのデプロイ (kn service apply) • コスト最適化や安定性向上 のためのさまざまな改善が 見込まれる • 秘伝の暗黙知 が含まれるク ラスターの変更管理を安全 に引き継げるか • 宣言的な方法でGKEクラス ターをTerraform/Helmベー スで再構築する判断 変更 管理 初期 構築 • GKEクラスターの初期構築はShellスクリプト にて実施 • Knative Servingのインストール等はOficialな デフォルトのYAMLファイルを使用 -
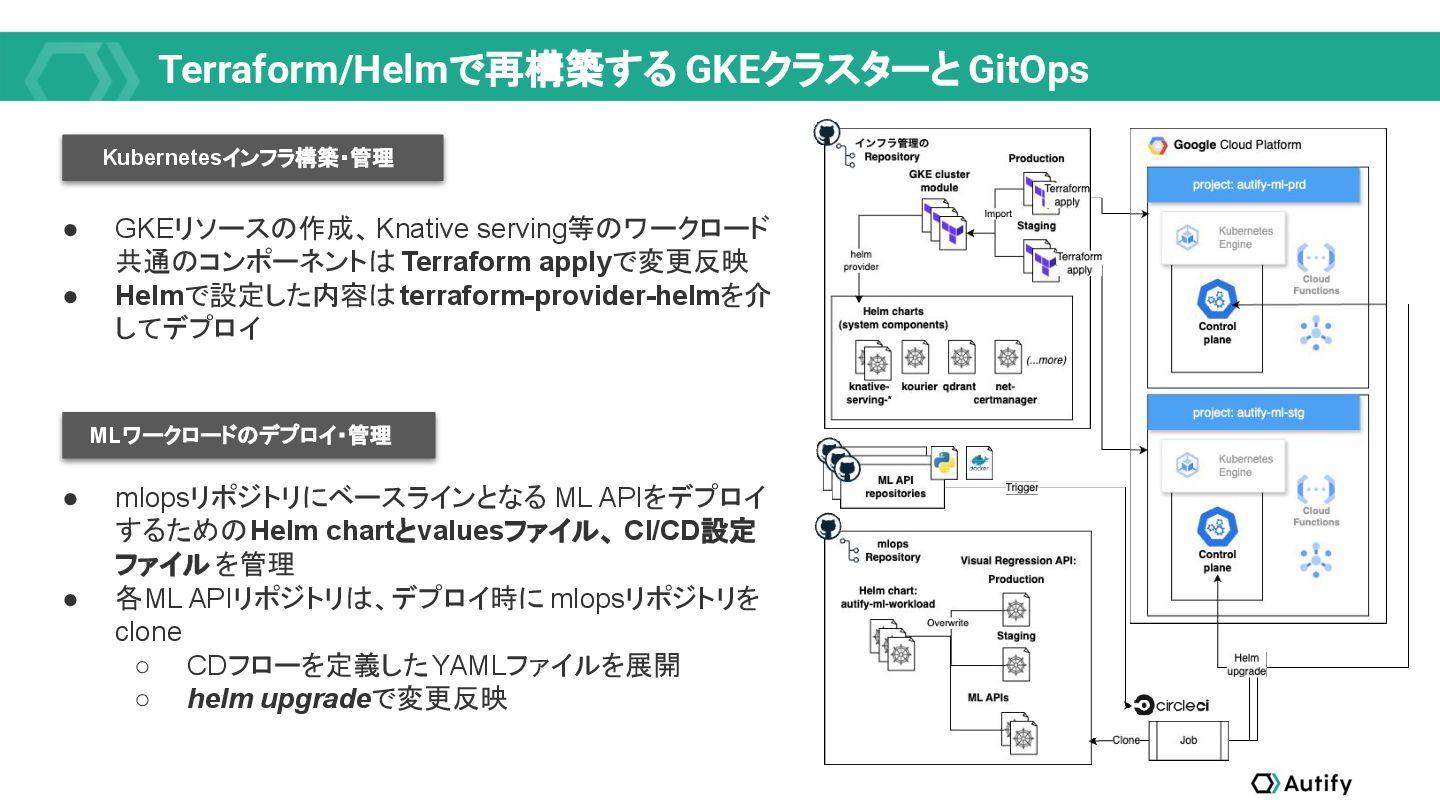
Terraform/Helmで再構築する GKEクラスターと GitOps MLワークロードのデプロイ・管理 Kubernetesインフラ構築・管理 • GKEリソースの作成、Knative serving等のワークロード 共通のコンポーネントは Terraform
applyで変更反映 • Helmで設定した内容はterraform-provider-helmを介 してデプロイ • mlopsリポジトリにベースラインとなる ML APIをデプロイ するためのHelm chartとvaluesファイル、 CI/CD設定 ファイル を管理 • 各ML APIリポジトリは、デプロイ時に mlopsリポジトリを clone ◦ CDフローを定義したYAMLファイルを展開 ◦ helm upgradeで変更反映 -
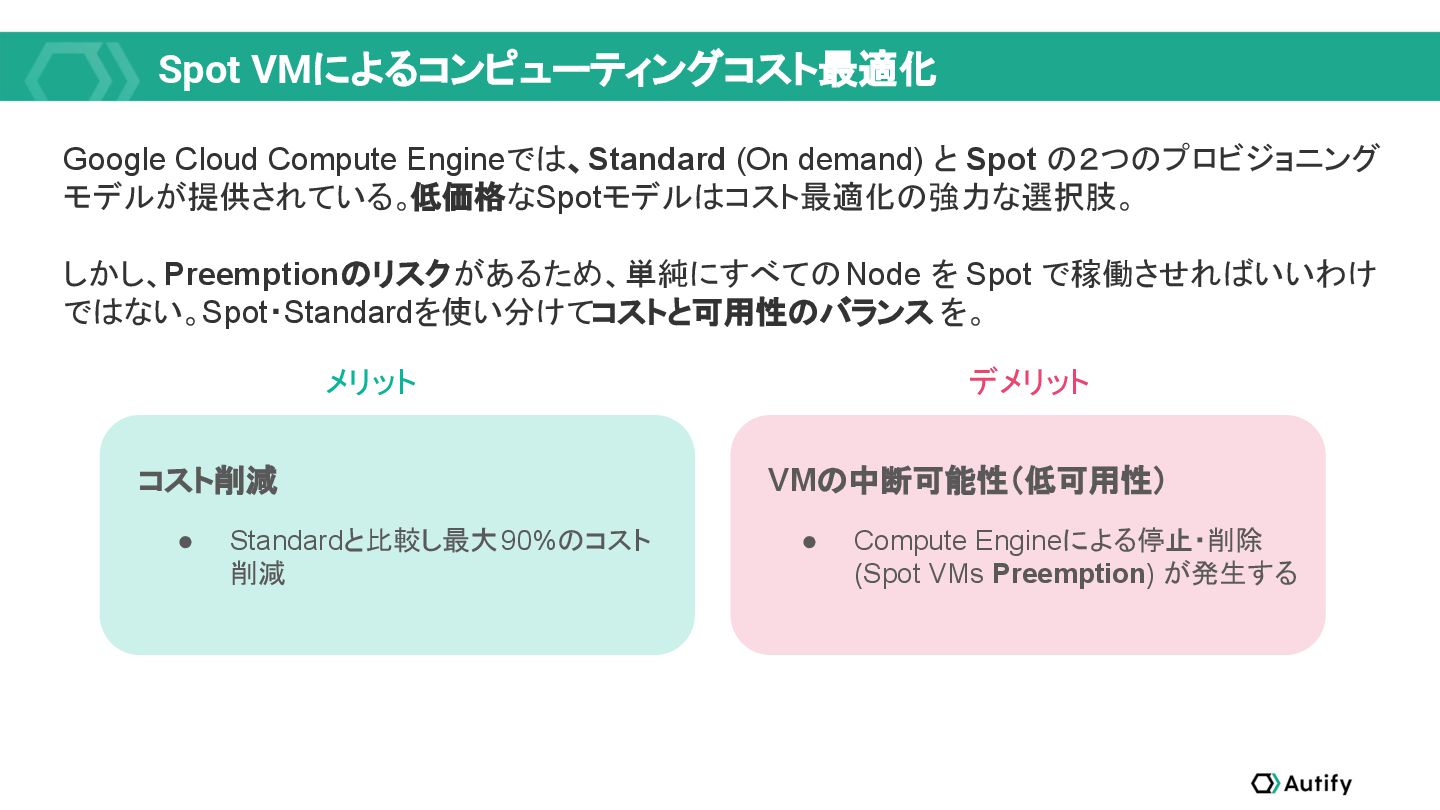
Spot VMによるコンピューティングコスト最適化 Google Cloud Compute Engineでは、Standard (On demand) と Spot
の2つのプロビジョニング モデルが提供されている。低価格なSpotモデルはコスト最適化の強力な選択肢。 しかし、Preemptionのリスクがあるため、単純にすべての Node を Spot で稼働させればいいわけ ではない。Spot・Standardを使い分けてコストと可用性のバランス を。 メリット デメリット コスト削減 VMの中断可能性(低可用性) • Compute Engineによる停止・削除 (Spot VMs Preemption) が発生する • Standardと比較し最大90%のコスト 削減 -
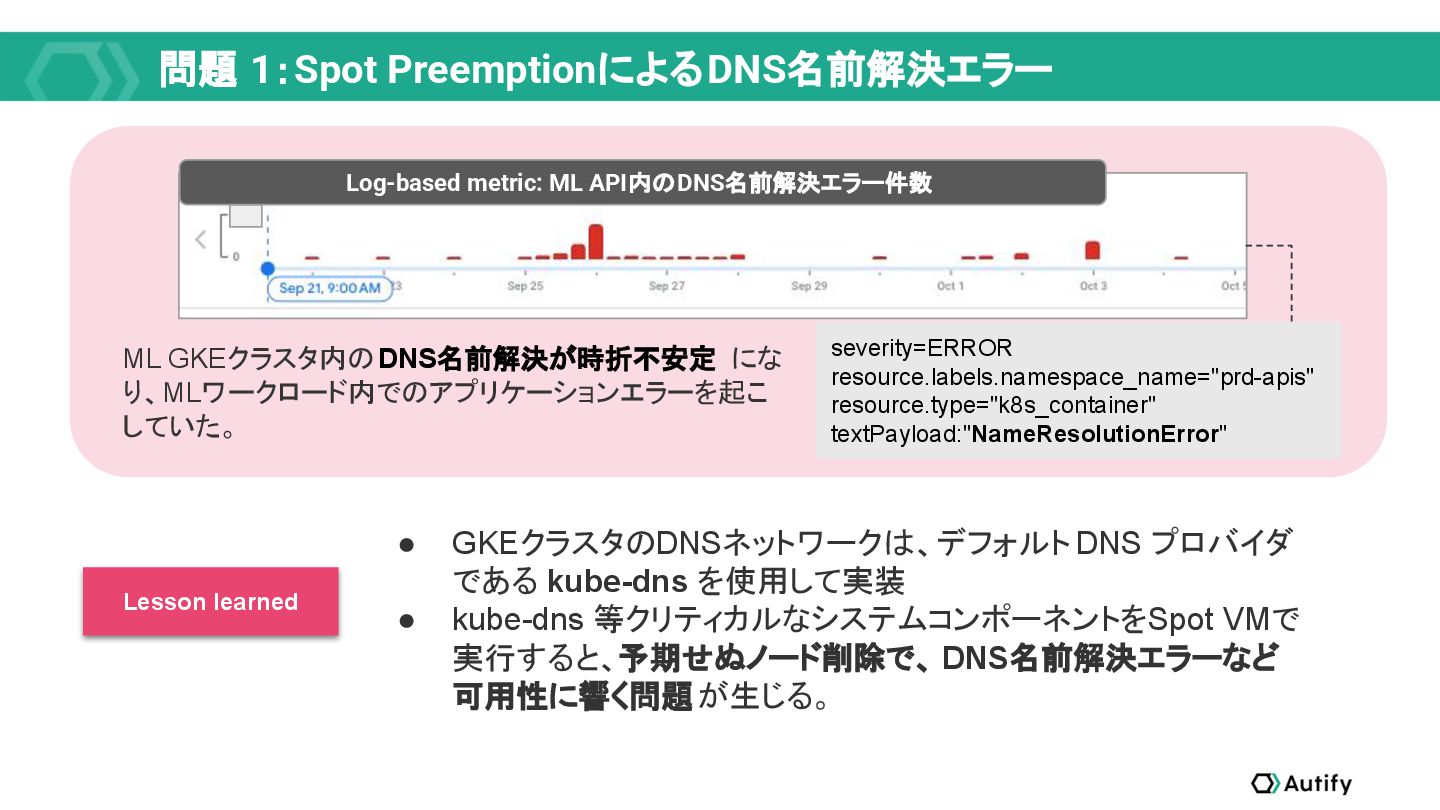
問題 1:Spot PreemptionによるDNS名前解決エラー ML GKEクラスタ内のDNS名前解決が時折不安定 にな り、MLワークロード内でのアプリケーションエラーを起こ していた。 Log-based metric:
ML API内のDNS名前解決エラー件数 severity=ERROR resource.labels.namespace_name="prd-apis" resource.type="k8s_container" textPayload:"NameResolutionError" • GKEクラスタのDNSネットワークは、デフォルト DNS プロバイダ である kube-dns を使用して実装 • kube-dns 等クリティカルなシステムコンポーネントを Spot VMで 実行すると、予期せぬノード削除で、 DNS名前解決エラーなど 可用性に響く問題が生じる。 Lesson learned -
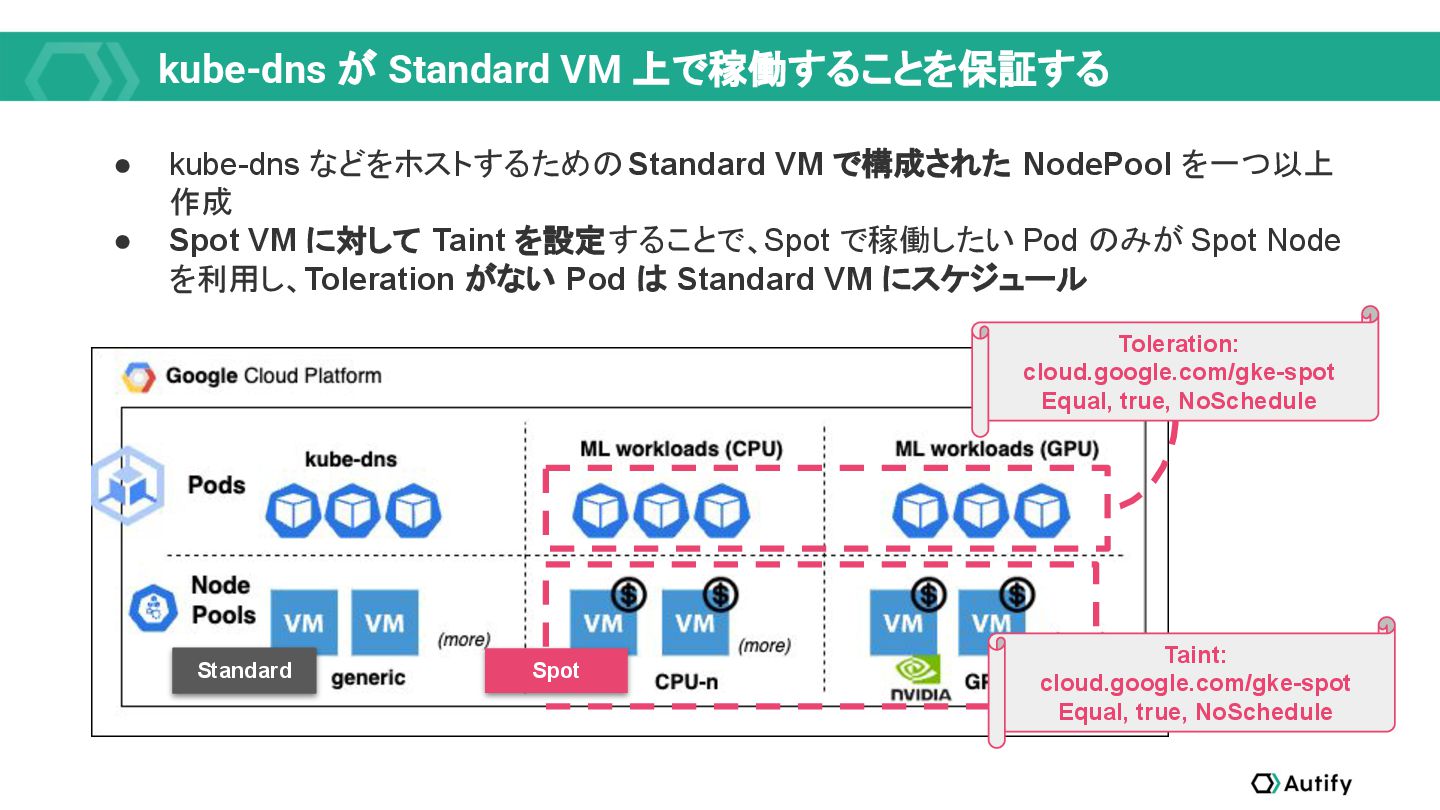
kube-dns が Standard VM 上で稼働することを保証する Toleration: cloud.google.com/gke-spot Equal, true, NoSchedule
Taint: cloud.google.com/gke-spot Equal, true, NoSchedule Standard Spot • kube-dns などをホストするための Standard VM で構成された NodePool を一つ以上 作成 • Spot VM に対して Taint を設定することで、Spot で稼働したい Pod のみが Spot Node を利用し、Toleration がない Pod は Standard VM にスケジュール -
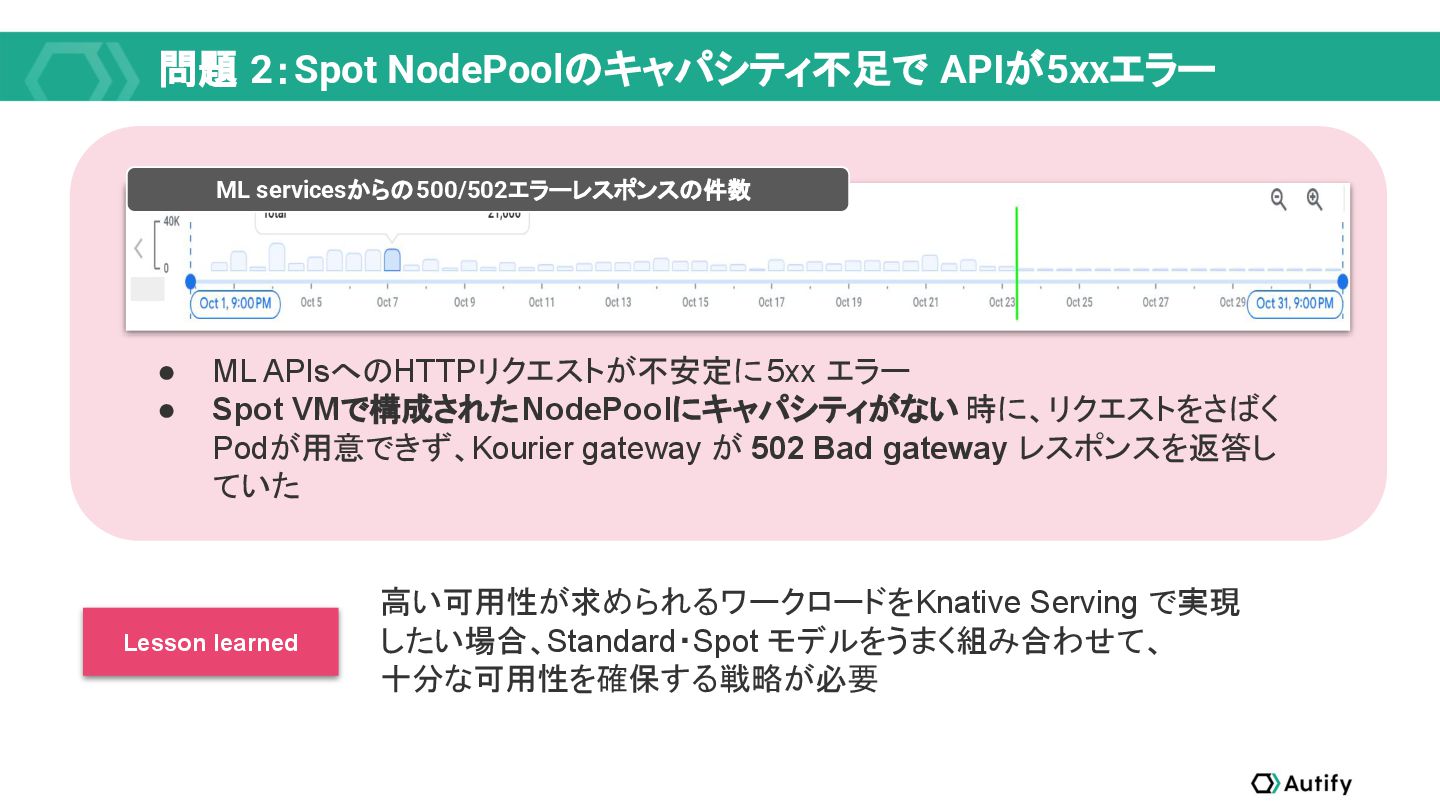
問題 2:Spot NodePoolのキャパシティ不足で APIが5xxエラー ML servicesからの500/502エラーレスポンスの件数 • ML APIsへのHTTPリクエストが不安定に 5xx
エラー • Spot VMで構成されたNodePoolにキャパシティがない 時に、リクエストをさばく Podが用意できず、Kourier gateway が 502 Bad gateway レスポンスを返答し ていた 高い可用性が求められるワークロードを Knative Serving で実現 したい場合、Standard・Spot モデルをうまく組み合わせて、 十分な可用性を確保する戦略が必要 Lesson learned -
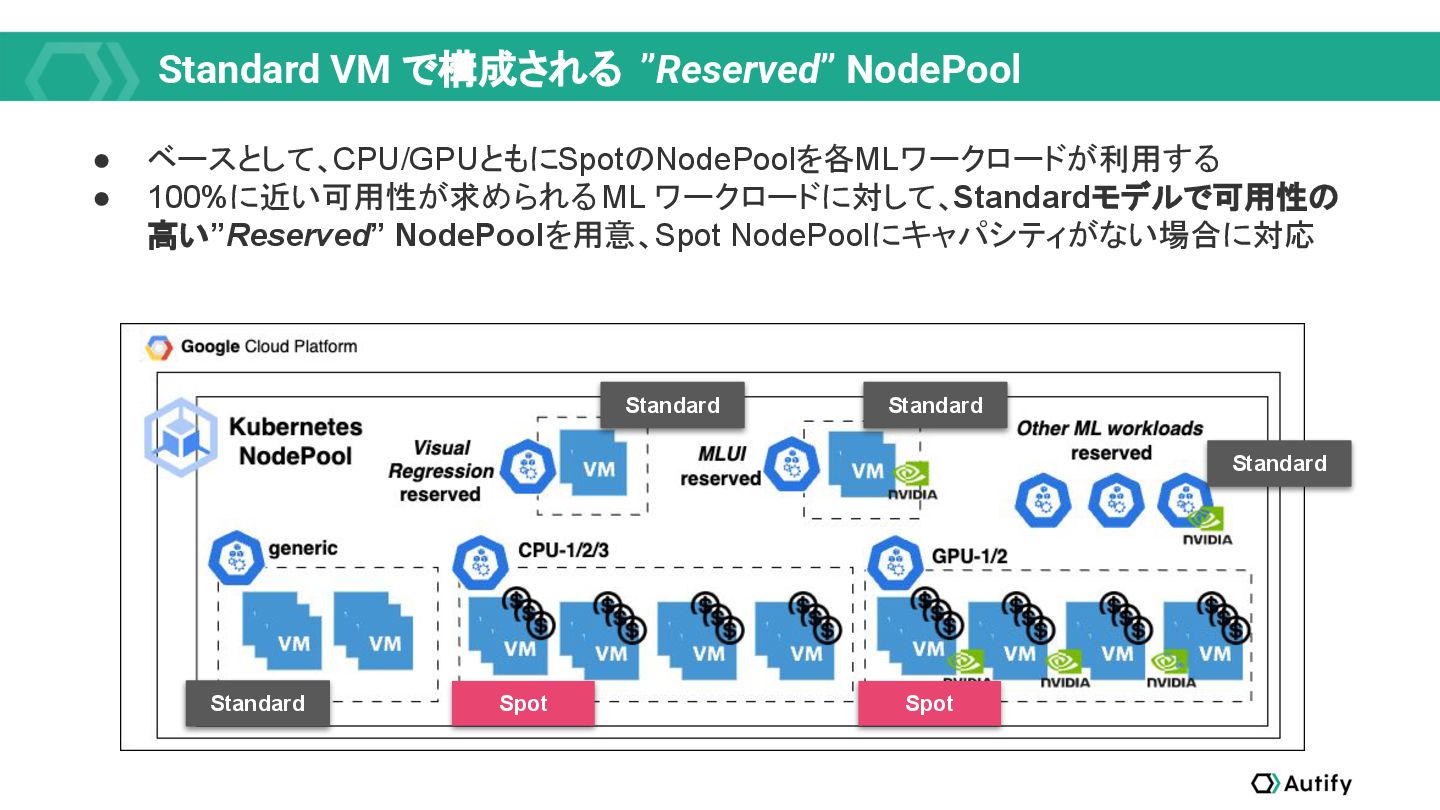
Standard VM で構成される ”Reserved” NodePool • ベースとして、CPU/GPUともにSpotのNodePoolを各MLワークロードが利用する • 100%に近い可用性が求められる ML
ワークロードに対して、Standardモデルで可用性の 高い”Reserved” NodePoolを用意、Spot NodePoolにキャパシティがない場合に対応 Standard Spot Spot Standard Standard Standard -
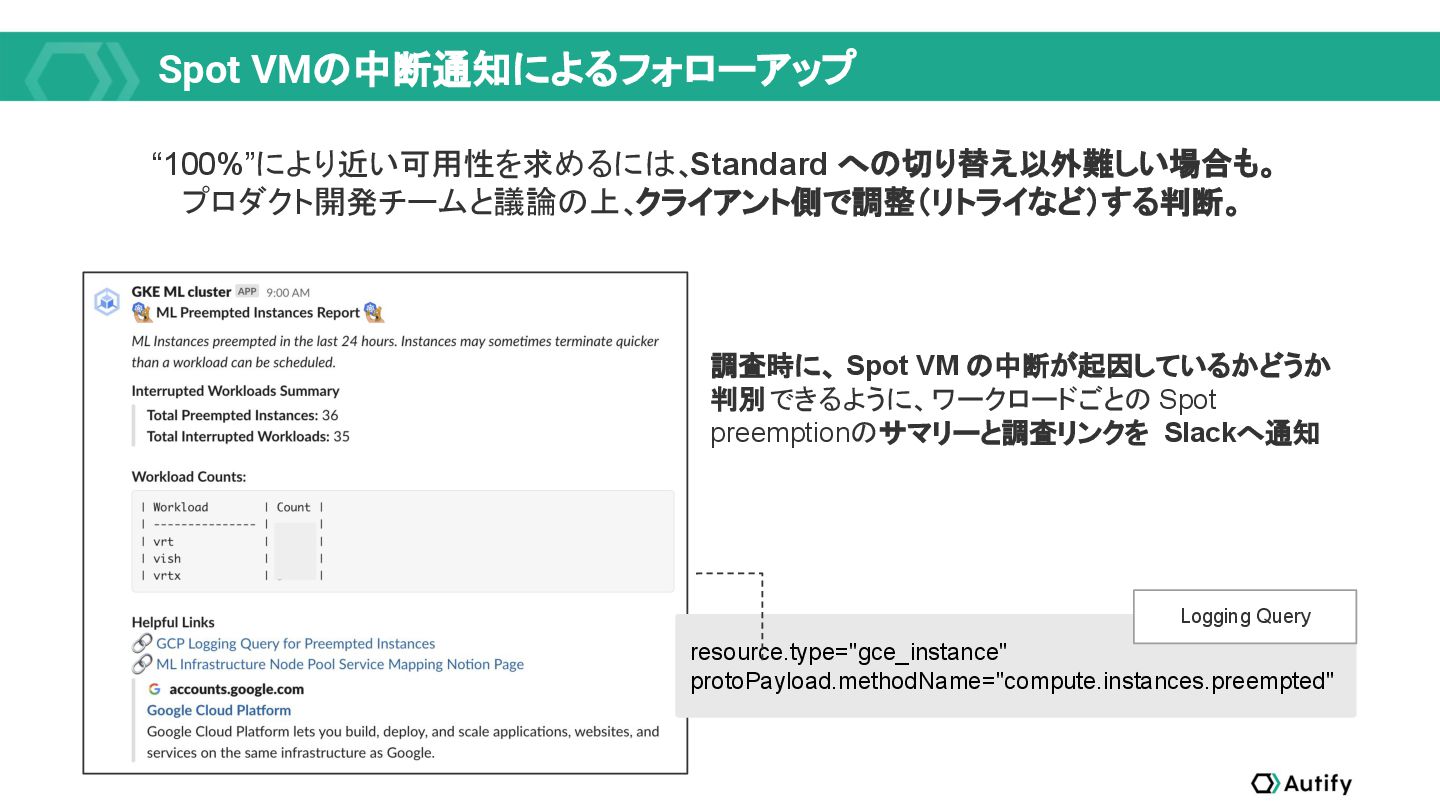
Spot VMの中断通知によるフォローアップ “100%”により近い可用性を求めるには、 Standard への切り替え以外難しい場合も。 プロダクト開発チームと議論の上、 クライアント側で調整(リトライなど)する判断。 調査時に、 Spot VM
の中断が起因しているかどうか 判別できるように、ワークロードごとの Spot preemptionのサマリーと調査リンクを Slackへ通知 resource.type="gce_instance" protoPayload.methodName="compute.instances.preempted" Logging Query -
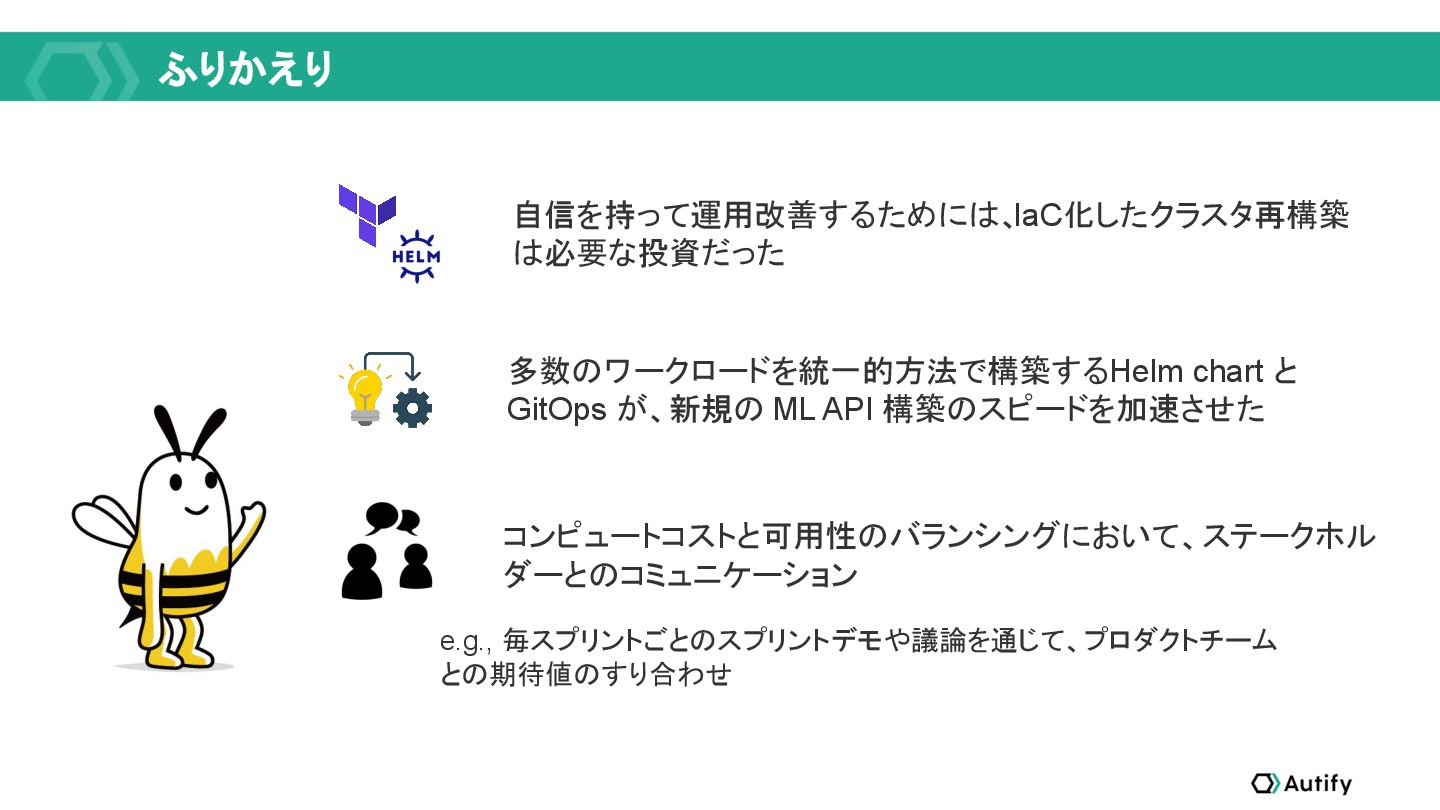
ふりかえり コンピュートコストと可用性のバランシングにおいて、ステークホル ダーとのコミュニケーション 自信を持って運用改善するためには、 IaC化したクラスタ再構築 は必要な投資だった 多数のワークロードを統一的方法で構築する Helm chart と
GitOps が、新規の ML API 構築のスピードを加速させた e.g., 毎スプリントごとのスプリントデモや議論を通じて、プロダクトチーム との期待値のすり合わせ -
テスト実行インフラの潜在的なセキュリティ課題 セキュリティ課題を解消するテスト実行インフラリアーキテクチャ 1 2 3 Selenium HubからIn-houseのノード管理システムへ ステートフルでSPOFなSelenium Hubの ゼロダウンタイムメンテナンス
(付録 A-5) 計画 運用・改善 リアーキテクチャリング 4 Resilience Testing -
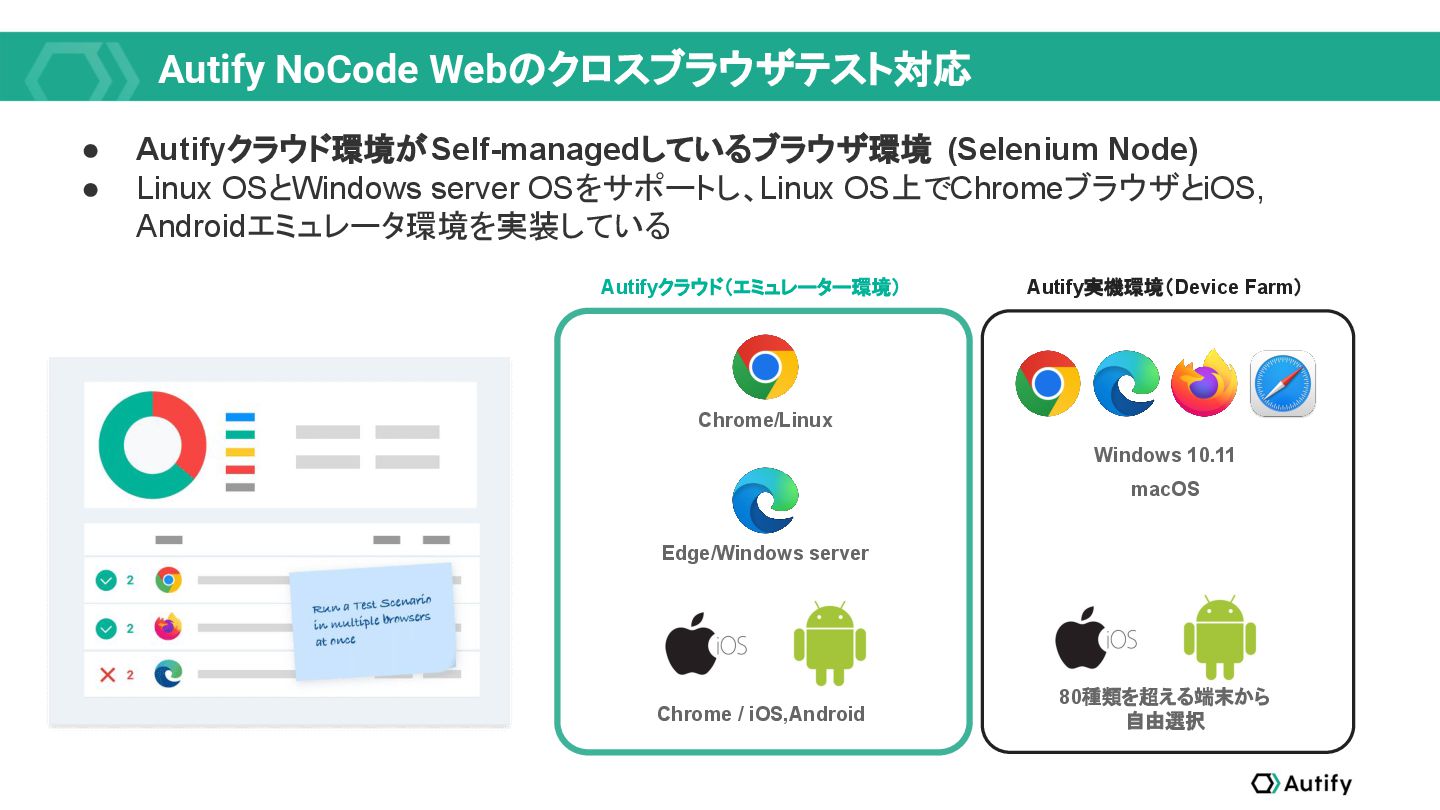
Autify NoCode Webのクロスブラウザテスト対応 Autifyクラウド(エミュレーター環境) Autify実機環境(Device Farm) Windows 10.11 macOS 80種類を超える端末から
自由選択 Edge/Windows server Chrome/Linux Chrome / iOS,Android • Autifyクラウド環境がSelf-managedしているブラウザ環境 (Selenium Node) • Linux OSとWindows server OSをサポートし、Linux OS上でChromeブラウザとiOS, Androidエミュレータ環境を実装している -
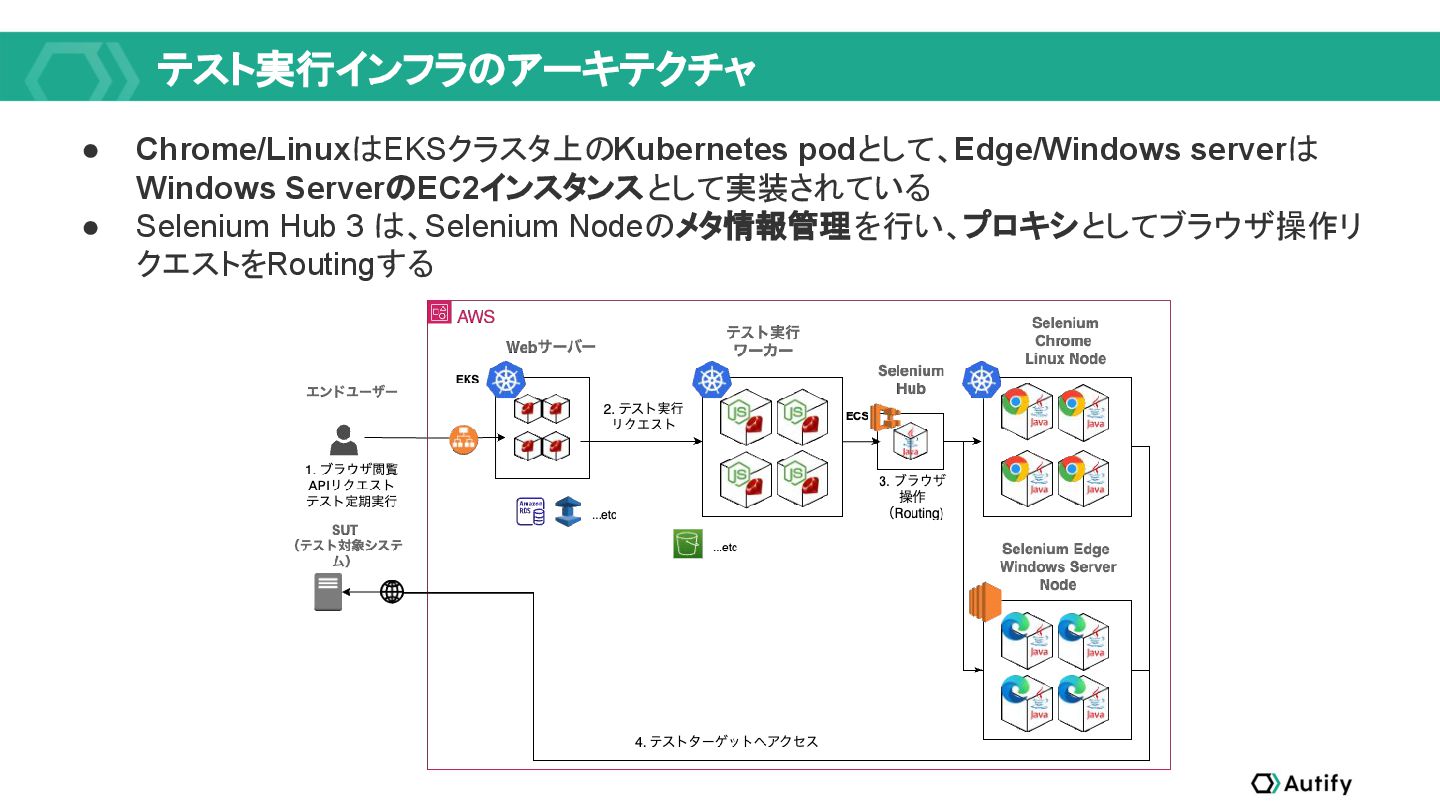
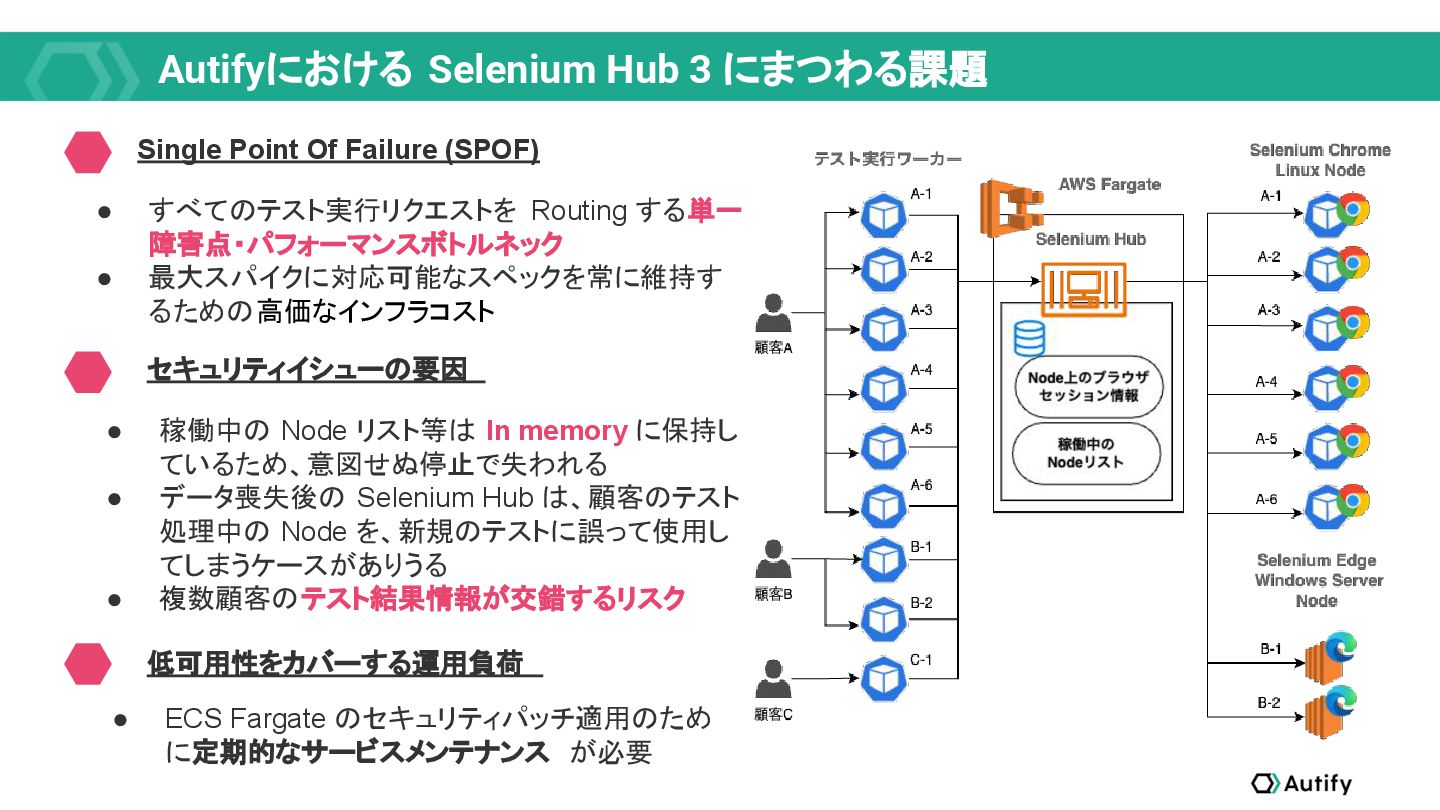
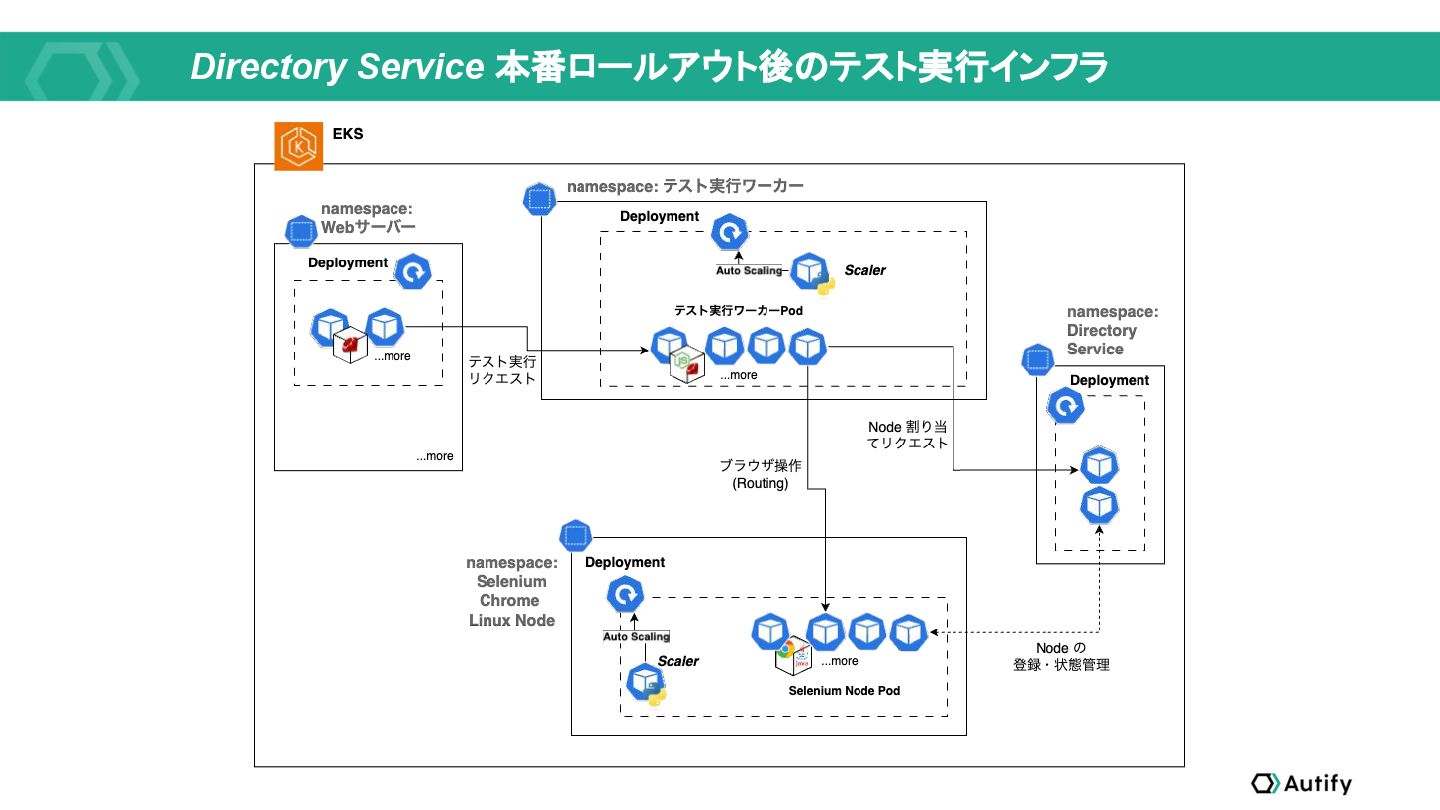
テスト実行インフラのアーキテクチャ • Chrome/LinuxはEKSクラスタ上のKubernetes podとして、Edge/Windows serverは Windows ServerのEC2インスタンスとして実装されている • Selenium Hub
3 は、Selenium Nodeのメタ情報管理を行い、プロキシとしてブラウザ操作リ クエストをRoutingする -
Autifyにおける Selenium Hub 3 にまつわる課題 • すべてのテスト実行リクエストを Routing する単一 障害点・パフォーマンスボトルネック
• 最大スパイクに対応可能なスペックを常に維持す るための高価なインフラコスト • 稼働中の Node リスト等は In memory に保持し ているため、意図せぬ停止で失われる • データ喪失後の Selenium Hub は、顧客のテスト 処理中の Node を、新規のテストに誤って使用し てしまうケースがありうる • 複数顧客のテスト結果情報が交錯するリスク • ECS Fargate のセキュリティパッチ適用のため に定期的なサービスメンテナンス が必要 Single Point Of Failure (SPOF) セキュリティイシューの要因 低可用性をカバーする運用負荷 -
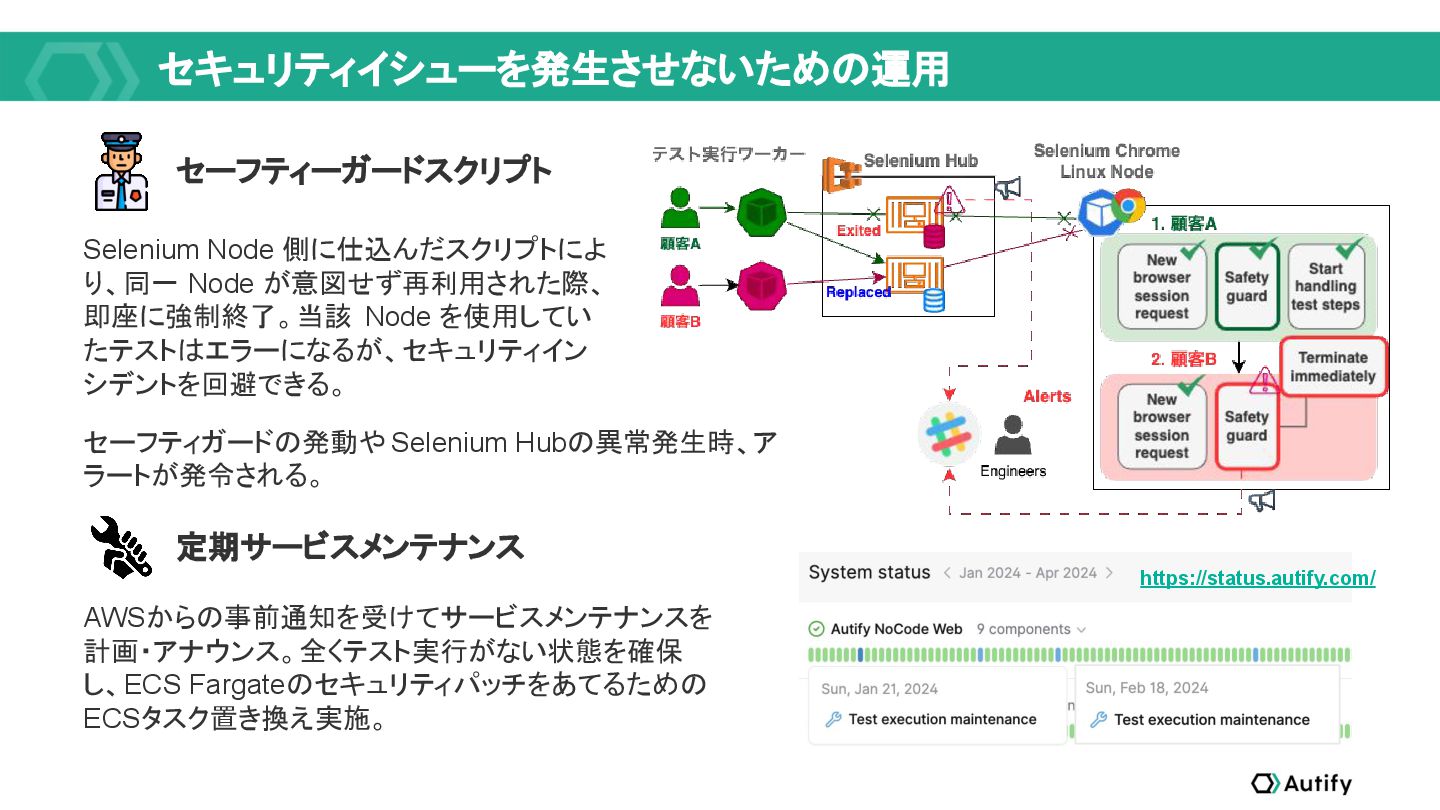
セキュリティイシューを発生させないための運用 セーフティーガードスクリプト https://status.autify.com/ 定期サービスメンテナンス AWSからの事前通知を受けてサービスメンテナンスを 計画・アナウンス。全くテスト実行がない状態を確保 し、ECS Fargateのセキュリティパッチをあてるための ECSタスク置き換え実施。 Selenium
Node 側に仕込んだスクリプトによ り、同一 Node が意図せず再利用された際、 即座に強制終了。当該 Node を使用してい たテストはエラーになるが、セキュリティイン シデントを回避できる。 セーフティガードの発動や Selenium Hubの異常発生時、ア ラートが発令される。 -
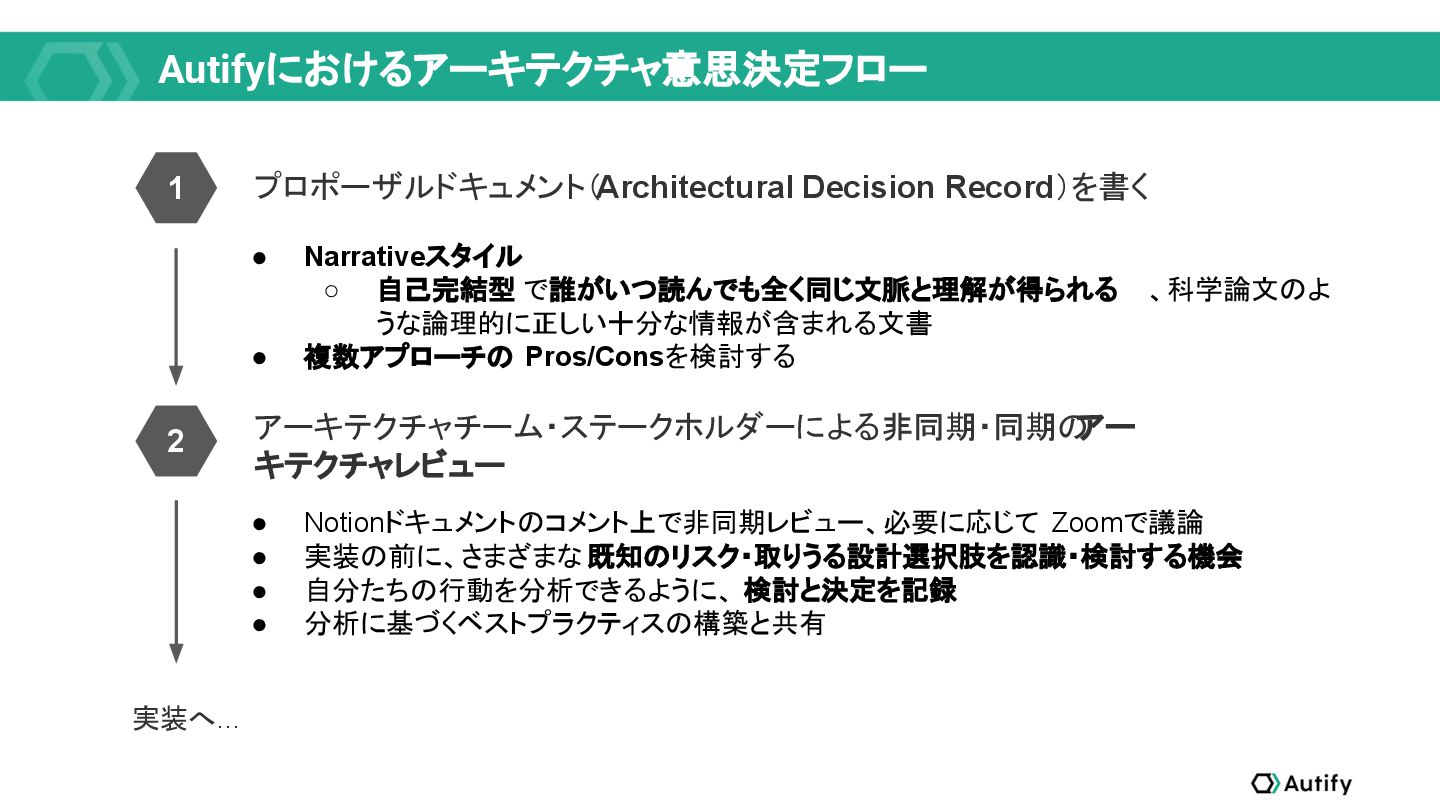
Autifyにおけるアーキテクチャ意思決定フロー 1 プロポーザルドキュメント(Architectural Decision Record)を書く 2 アーキテクチャチーム・ステークホルダーによる非同期・同期の アー キテクチャレビュー •
Notionドキュメントのコメント上で非同期レビュー、必要に応じて Zoomで議論 • 実装の前に、さまざまな 既知のリスク・取りうる設計選択肢を認識・検討する機会 • 自分たちの行動を分析できるように、 検討と決定を記録 • 分析に基づくベストプラクティスの構築と共有 実装へ... • Narrativeスタイル ◦ 自己完結型 で誰がいつ読んでも全く同じ文脈と理解が得られる 、科学論文のよ うな論理的に正しい十分な情報が含まれる文書 • 複数アプローチの Pros/Consを検討する -
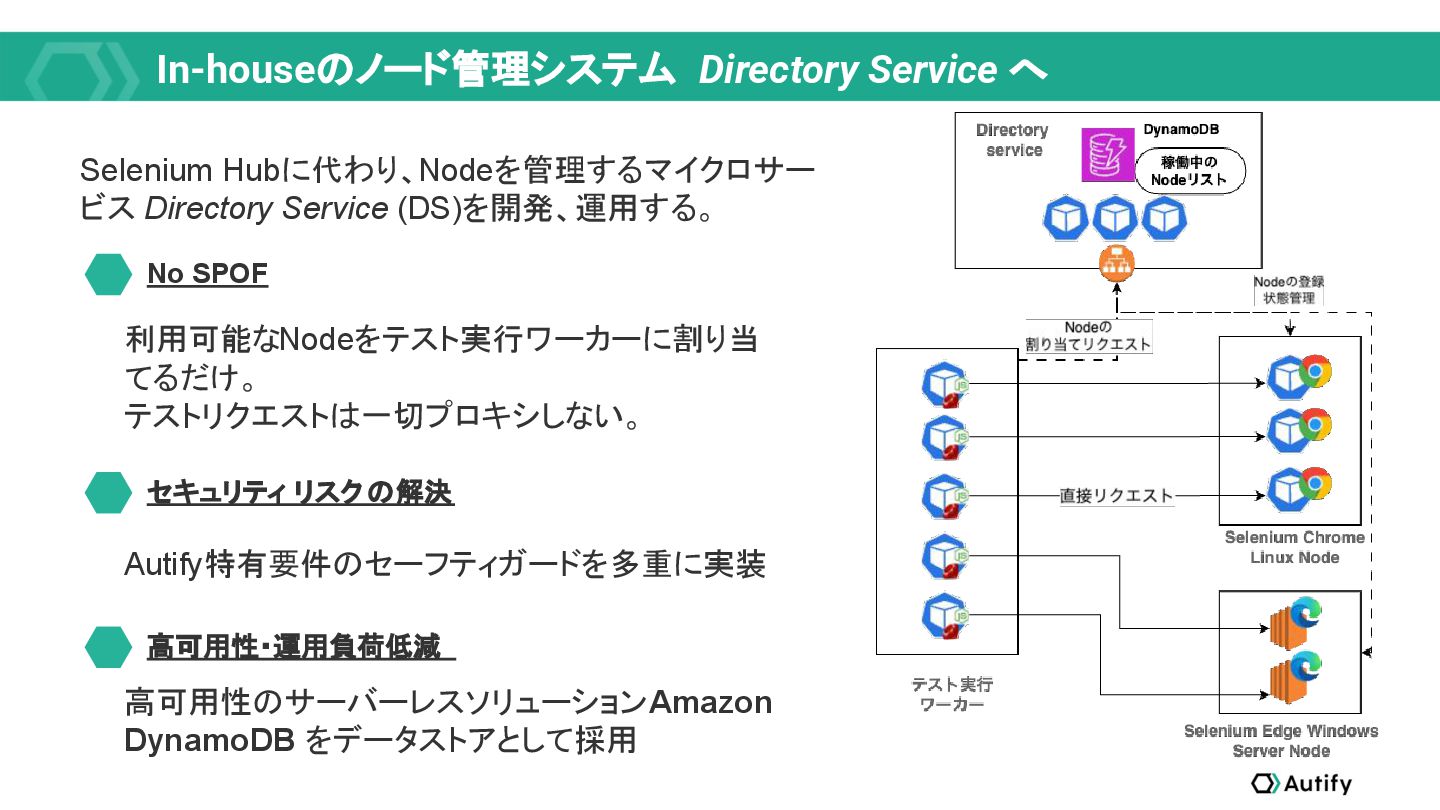
In-houseのノード管理システム Directory Service へ Selenium Hubに代わり、Nodeを管理するマイクロサー ビス Directory Service (DS)を開発、運用する。
Autify特有要件のセーフティガードを多重に実装 No SPOF 利用可能なNodeをテスト実行ワーカーに割り当 てるだけ。 テストリクエストは一切プロキシしない。 セキュリティ リスクの解決 高可用性のサーバーレスソリューション Amazon DynamoDB をデータストアとして採用 高可用性・運用負荷低減 -
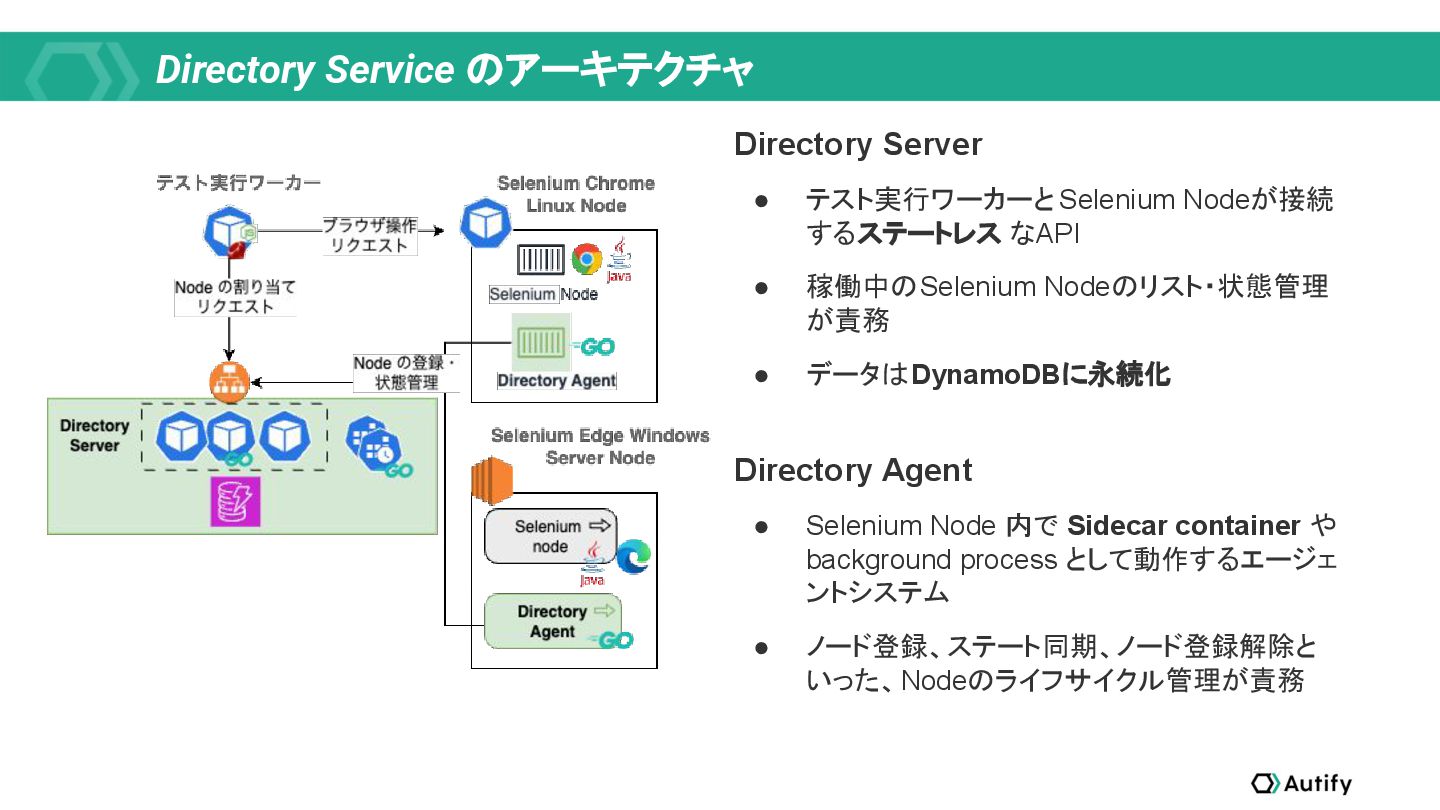
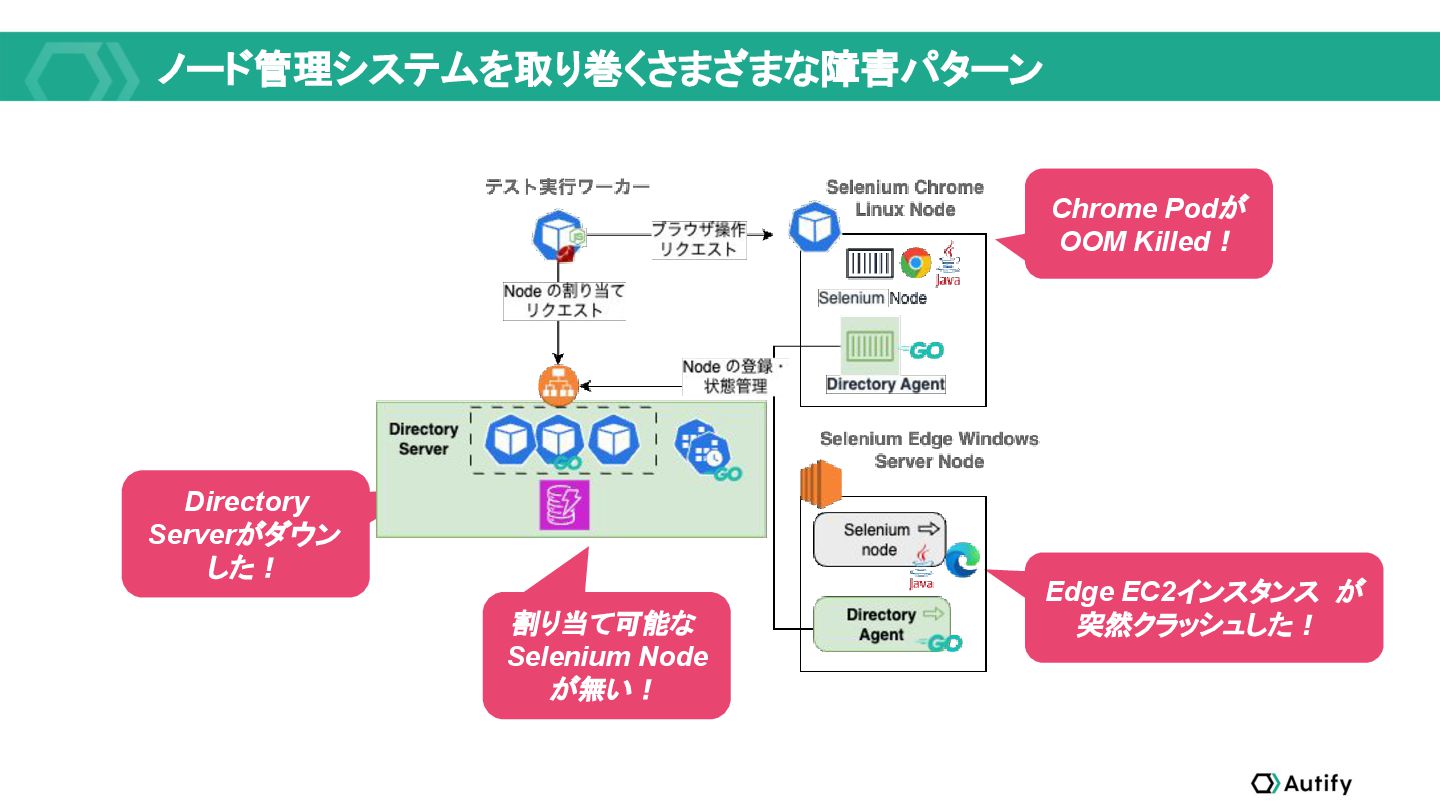
Directory Service のアーキテクチャ Directory Server • テスト実行ワーカーと Selenium Nodeが接続 するステートレス
なAPI • 稼働中のSelenium Nodeのリスト・状態管理 が責務 • データはDynamoDBに永続化 Directory Agent • Selenium Node 内で Sidecar container や background process として動作するエージェ ントシステム • ノード登録、ステート同期、ノード登録解除と いった、Nodeのライフサイクル管理が責務 -
ノード管理システムを取り巻くさまざまな障害パターン Edge EC2インスタンス が 突然クラッシュした! Directory Serverがダウン した! Chrome Podが
OOM Killed! 割り当て可能な Selenium Node が無い! -
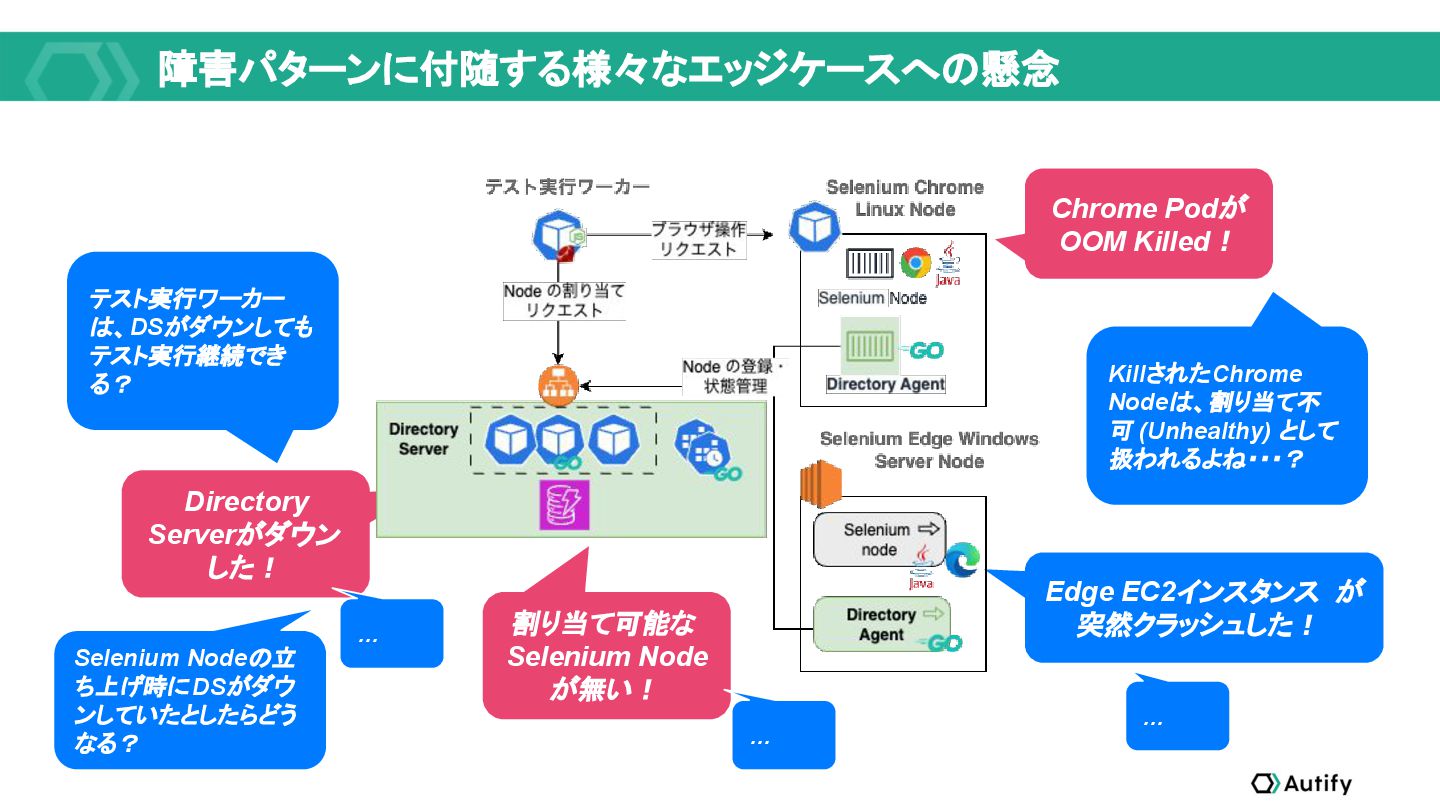
障害パターンに付随する様々なエッジケースへの懸念 Edge EC2インスタンス が 突然クラッシュした! Directory Serverがダウン した! Chrome Podが
OOM Killed! 割り当て可能な Selenium Node が無い! テスト実行ワーカー は、DSがダウンしても テスト実行継続でき る? KillされたChrome Nodeは、割り当て不 可 (Unhealthy) として 扱われるよね・・・? Selenium Nodeの立 ち上げ時に DSがダウ ンしていたとしたらどう なる? … … … -
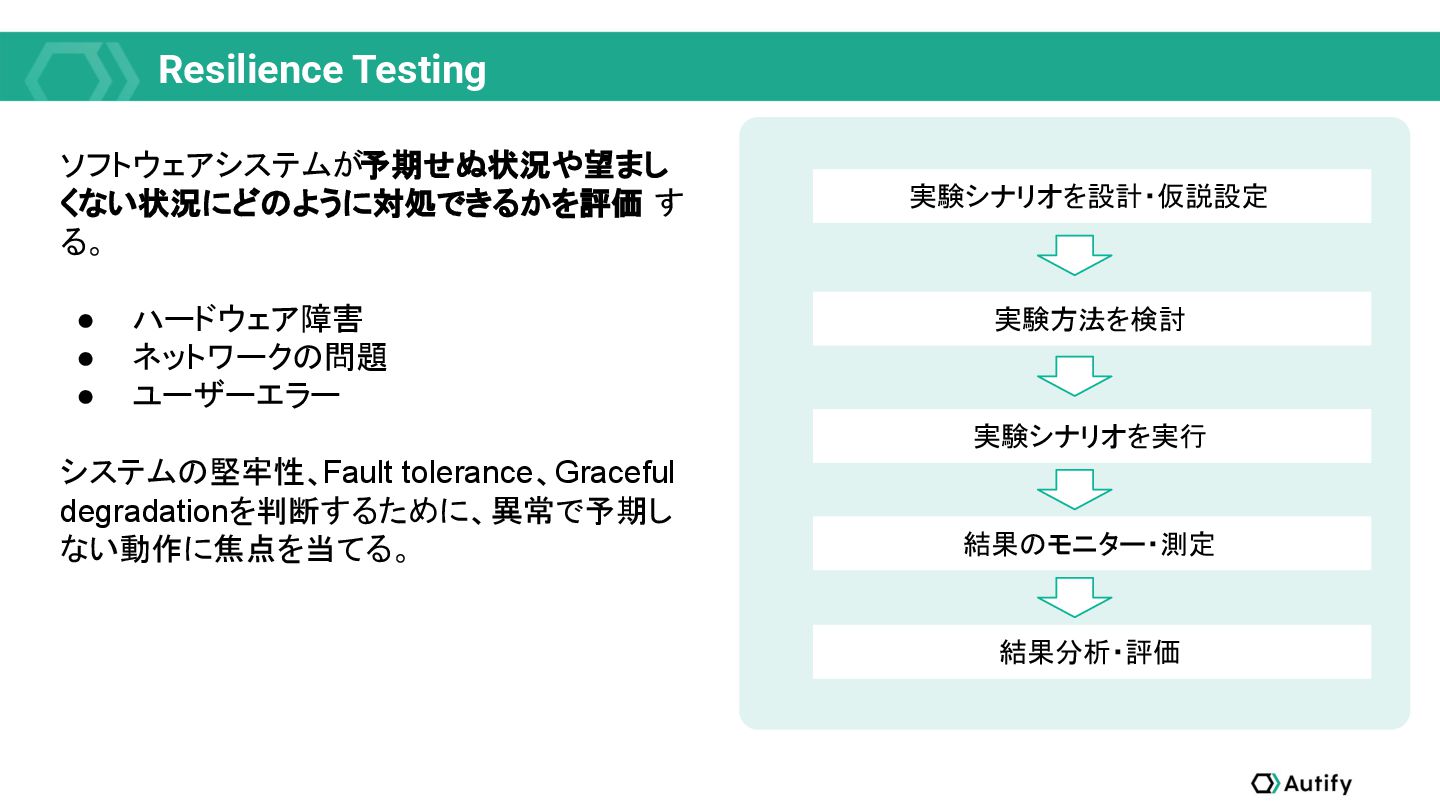
Resilience Testing 実験シナリオを設計・仮説設定 実験方法を検討 実験シナリオを実行 結果のモニター・測定 結果分析・評価 ソフトウェアシステムが予期せぬ状況や望まし くない状況にどのように対処できるかを評価 す
る。 • ハードウェア障害 • ネットワークの問題 • ユーザーエラー システムの堅牢性、Fault tolerance、Graceful degradationを判断するために、異常で予期し ない動作に焦点を当てる。 -
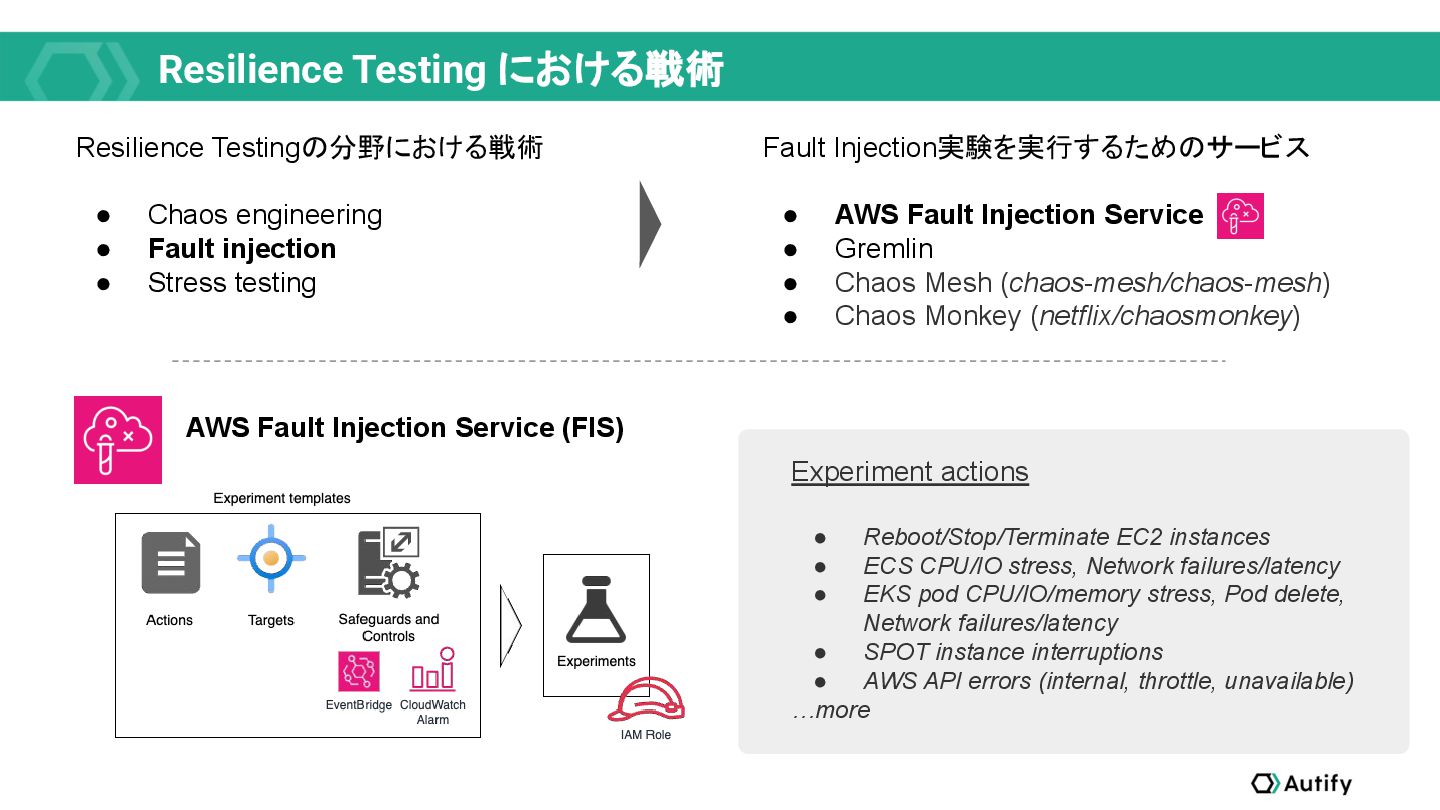
Resilience Testing における戦術 Experiment actions • Reboot/Stop/Terminate EC2 instances •
ECS CPU/IO stress, Network failures/latency • EKS pod CPU/IO/memory stress, Pod delete, Network failures/latency • SPOT instance interruptions • AWS API errors (internal, throttle, unavailable) …more Resilience Testingの分野における戦術 • Chaos engineering • Fault injection • Stress testing Fault Injection実験を実行するためのサービス • AWS Fault Injection Service • Gremlin • Chaos Mesh (chaos-mesh/chaos-mesh) • Chaos Monkey (netflix/chaosmonkey) AWS Fault Injection Service (FIS) -
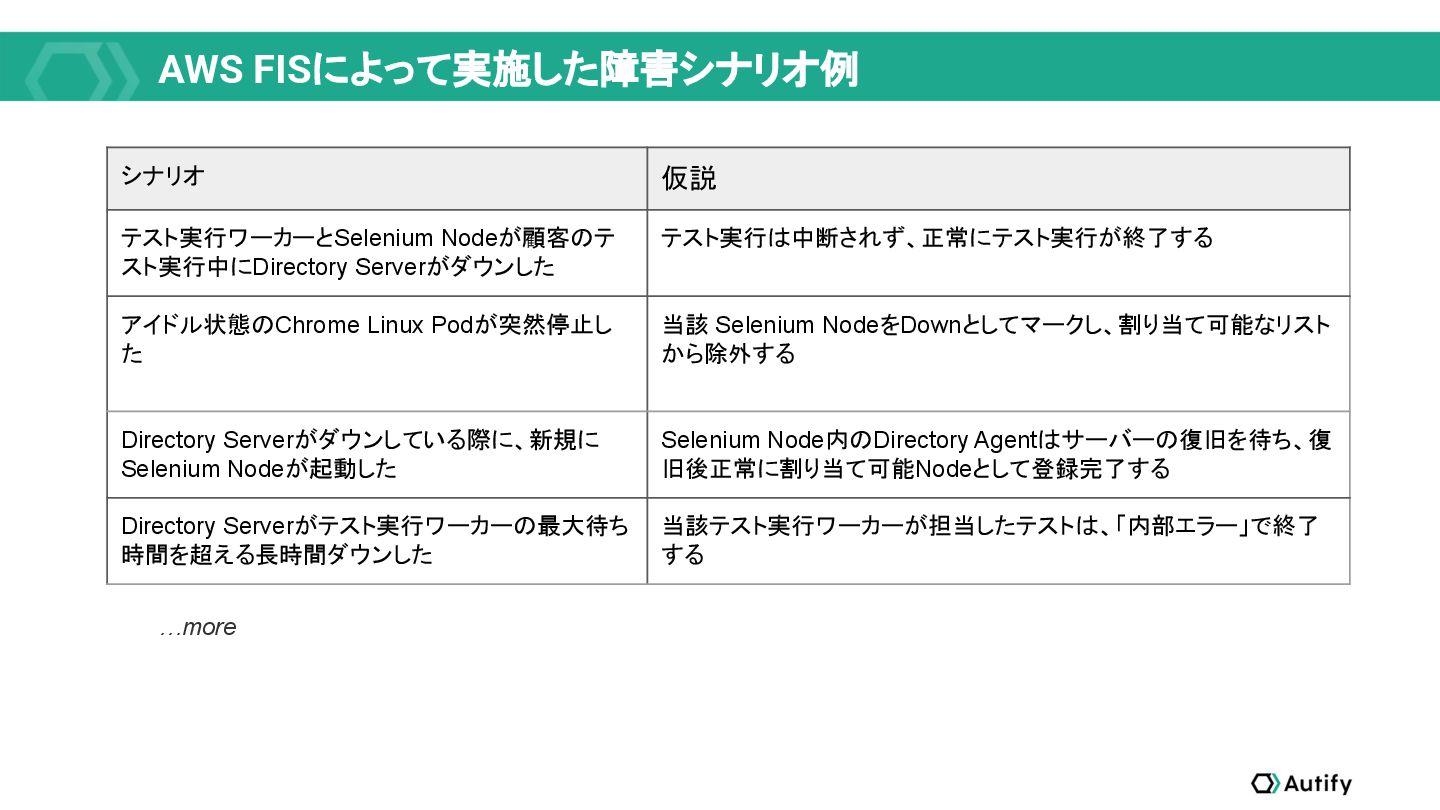
AWS FISによって実施した障害シナリオ例 シナリオ 仮説 テスト実行ワーカーとSelenium Nodeが顧客のテ スト実行中にDirectory Serverがダウンした テスト実行は中断されず、正常にテスト実行が終了する アイドル状態のChrome
Linux Podが突然停止し た 当該 Selenium NodeをDownとしてマークし、割り当て可能なリスト から除外する Directory Serverがダウンしている際に、新規に Selenium Nodeが起動した Selenium Node内のDirectory Agentはサーバーの復旧を待ち、復 旧後正常に割り当て可能Nodeとして登録完了する Directory Serverがテスト実行ワーカーの最大待ち 時間を超える長時間ダウンした 当該テスト実行ワーカーが担当したテストは、「内部エラー」で終了 する …more -
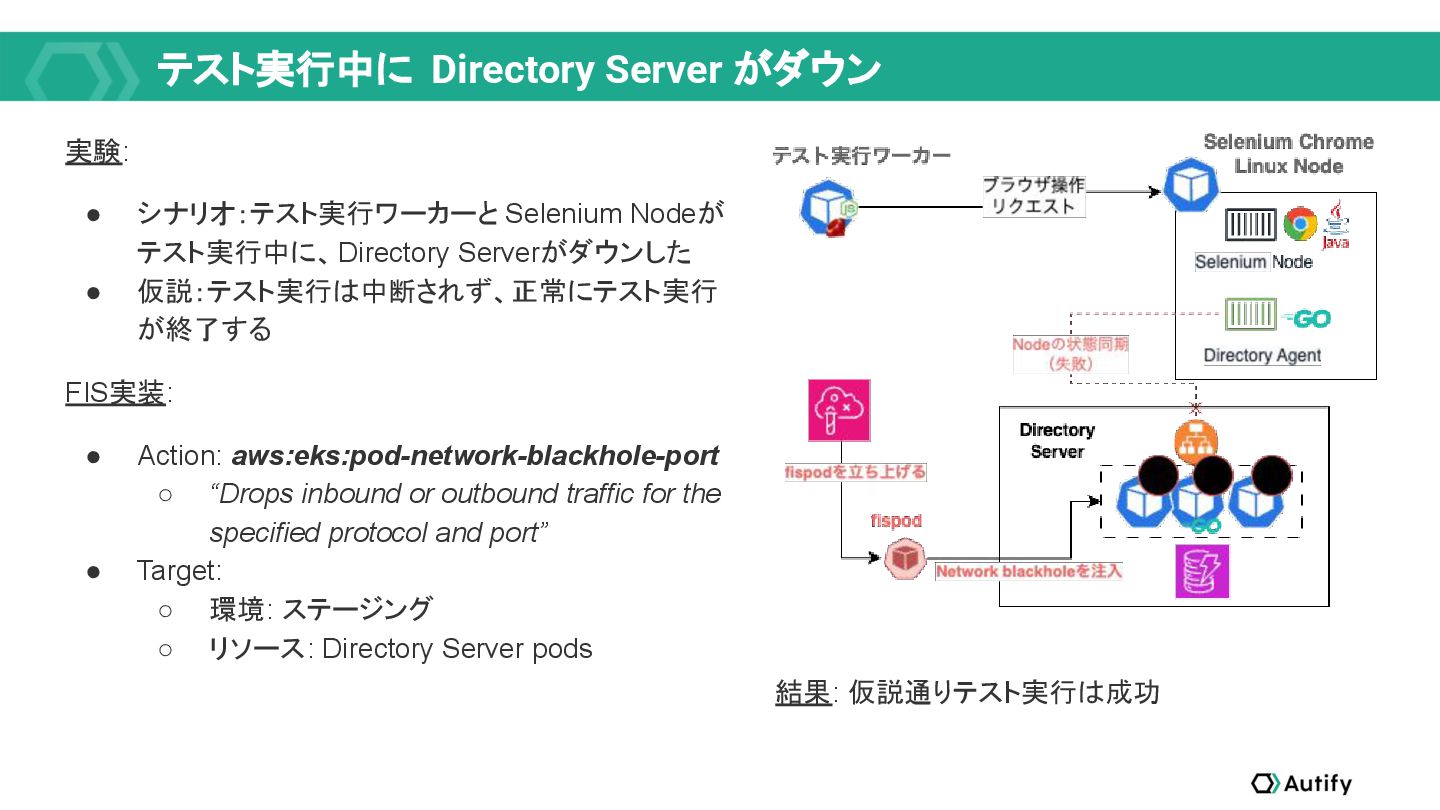
テスト実行中に Directory Server がダウン 実験: • シナリオ:テスト実行ワーカーと Selenium Nodeが テスト実行中に、Directory
Serverがダウンした • 仮説:テスト実行は中断されず、正常にテスト実行 が終了する FIS実装: • Action: aws:eks:pod-network-blackhole-port ◦ “Drops inbound or outbound traffic for the specified protocol and port” • Target: ◦ 環境: ステージング ◦ リソース: Directory Server pods 結果: 仮説通りテスト実行は成功 -
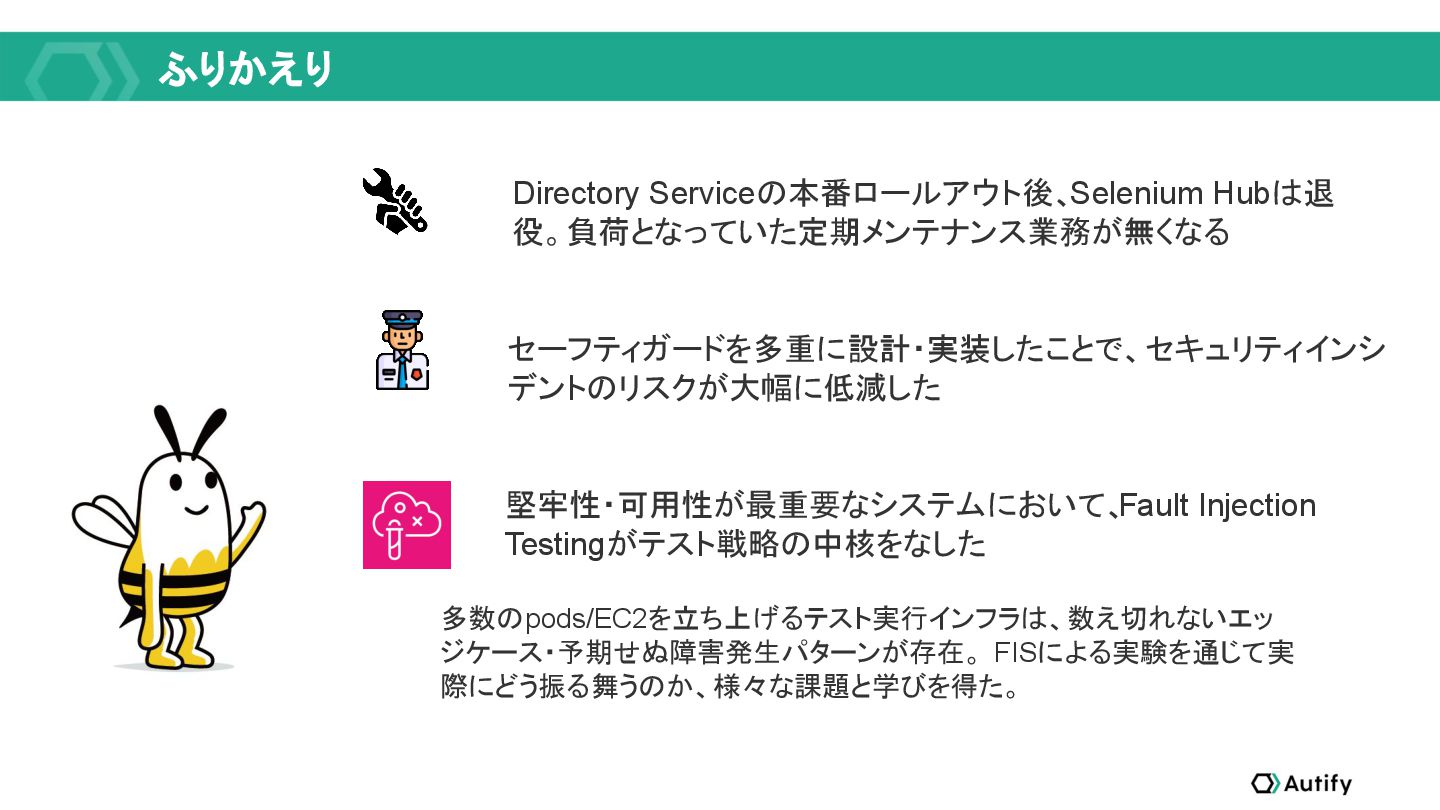
ふりかえり 堅牢性・可用性が最重要なシステムにおいて、 Fault Injection Testingがテスト戦略の中核をなした Directory Serviceの本番ロールアウト後、Selenium Hubは退 役。負荷となっていた定期メンテナンス業務が無くなる セーフティガードを多重に設計・実装したことで、セキュリティインシ
デントのリスクが大幅に低減した 多数のpods/EC2を立ち上げるテスト実行インフラは、数え切れないエッ ジケース・予期せぬ障害発生パターンが存在。 FISによる実験を通じて実 際にどう振る舞うのか、様々な課題と学びを得た。 -
タイトルタイトルタイトルタイトルタ イトルタイトルタイトル 小見出し小見出し小見出し小見出し 質問・コメント・深堀りリクエスト・フィードバック お待ちしております! Ask the Speaker 1F スポンサーブースルーム
懇親会 #srekaigi, #srekaigi_a, @hgsgtk -
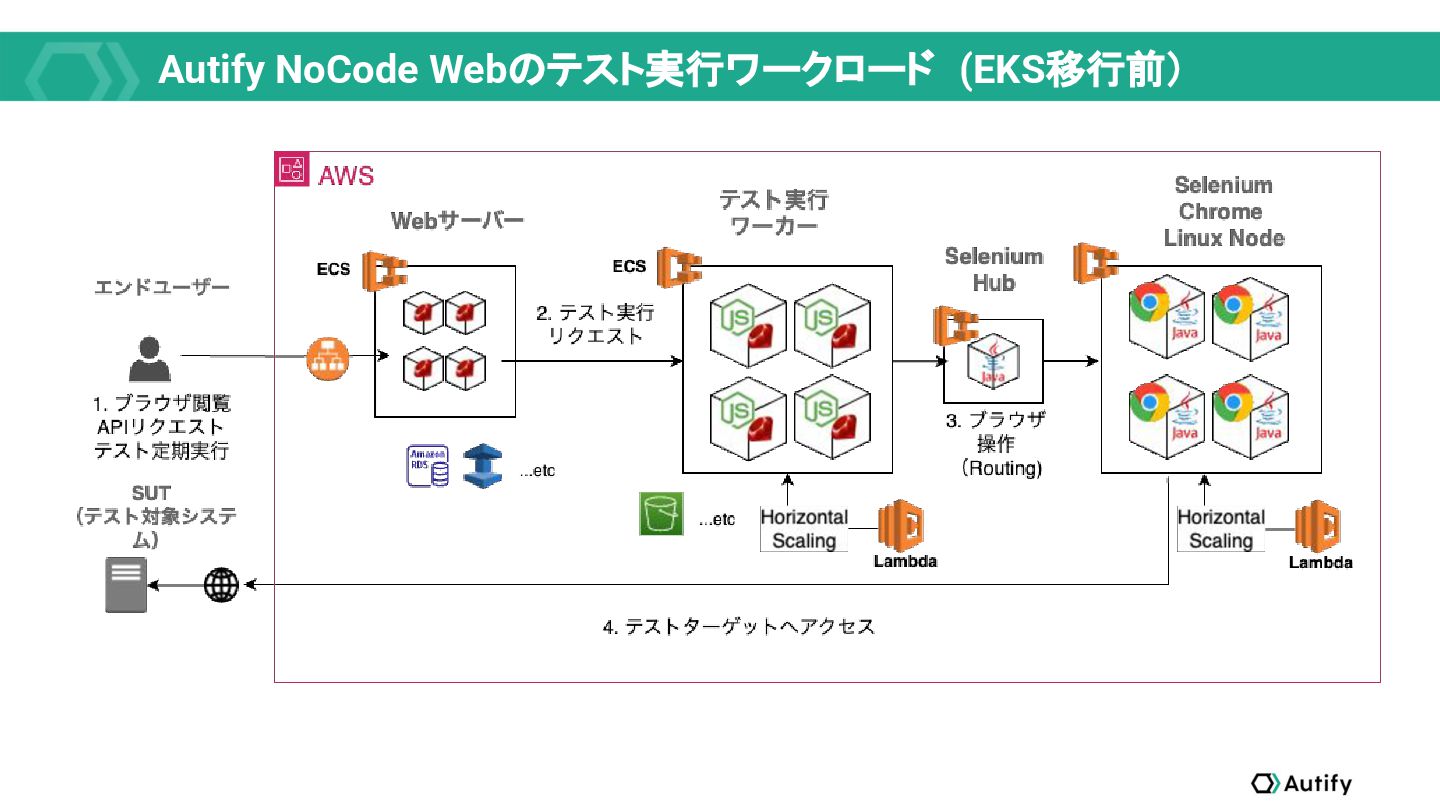
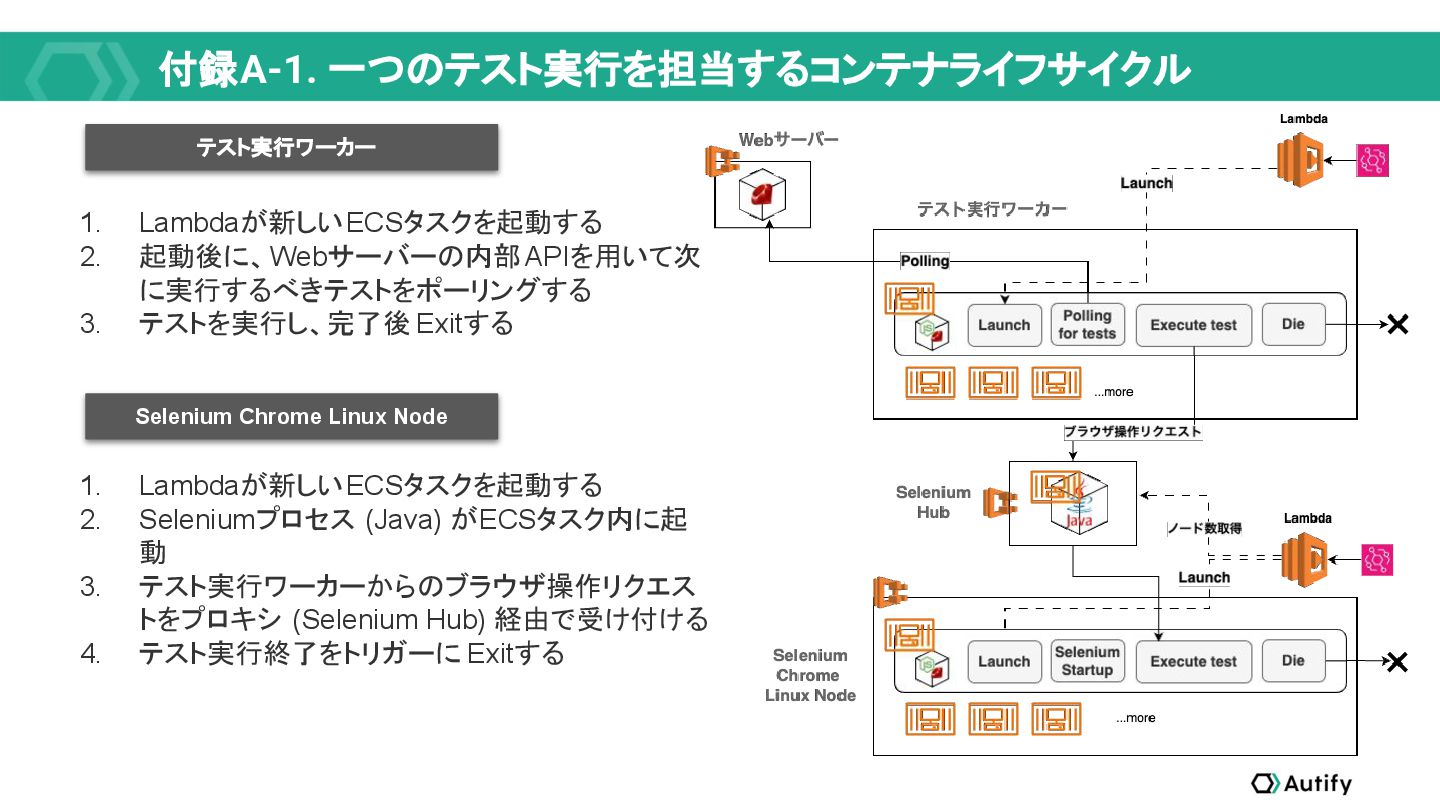
付録A-1. 一つのテスト実行を担当するコンテナライフサイクル 1. Lambdaが新しいECSタスクを起動する 2. 起動後に、Webサーバーの内部APIを用いて次 に実行するべきテストをポーリングする 3. テストを実行し、完了後 Exitする
テスト実行ワーカー Selenium Chrome Linux Node 1. Lambdaが新しいECSタスクを起動する 2. Seleniumプロセス (Java) がECSタスク内に起 動 3. テスト実行ワーカーからのブラウザ操作リクエス トをプロキシ (Selenium Hub) 経由で受け付ける 4. テスト実行終了をトリガーに Exitする -
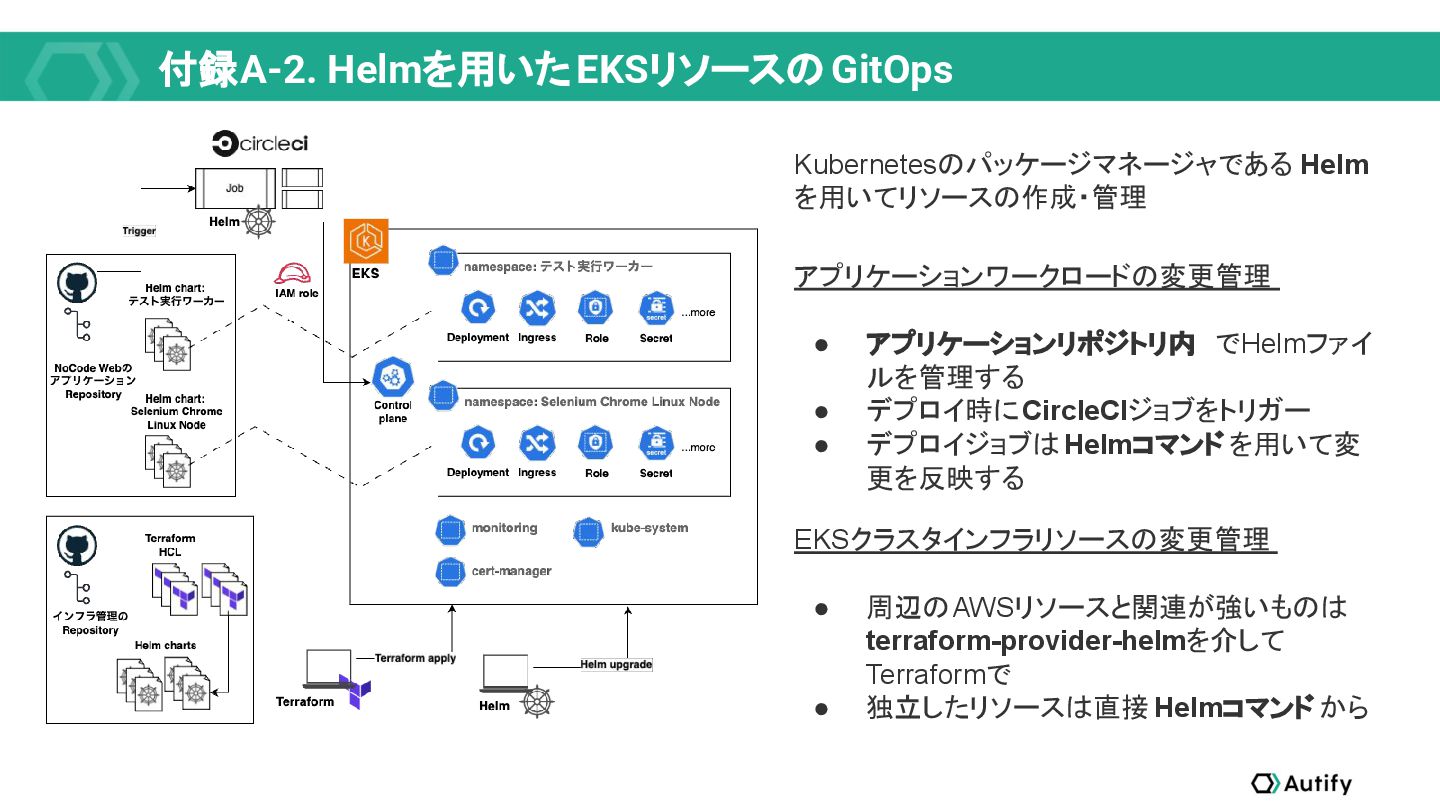
付録A-2. Helmを用いたEKSリソースの GitOps アプリケーションワークロードの変更管理 • アプリケーションリポジトリ内 でHelmファイ ルを管理する • デプロイ時にCircleCIジョブをトリガー
• デプロイジョブはHelmコマンド を用いて変 更を反映する EKSクラスタインフラリソースの変更管理 • 周辺のAWSリソースと関連が強いものは terraform-provider-helmを介して Terraformで • 独立したリソースは直接 Helmコマンド から Kubernetesのパッケージマネージャである Helm を用いてリソースの作成・管理 -
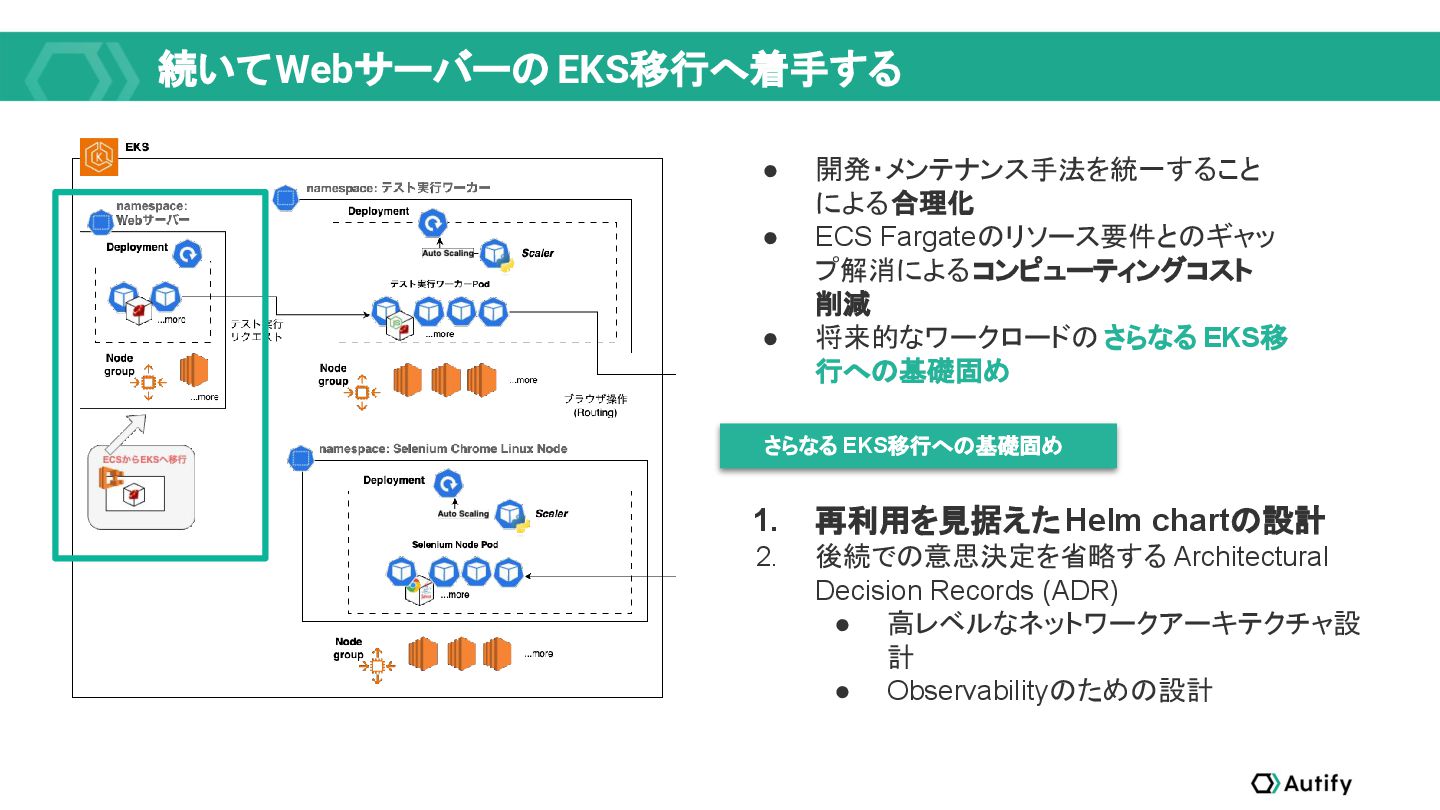
続いてWebサーバーの EKS移行へ着手する • 開発・メンテナンス手法を統一すること による合理化 • ECS Fargateのリソース要件とのギャッ プ解消によるコンピューティングコスト 削減
• 将来的なワークロードの さらなる EKS移 行への基礎固め 1. 再利用を見据えたHelm chartの設計 2. 後続での意思決定を省略する Architectural Decision Records (ADR) • 高レベルなネットワークアーキテクチャ設 計 • Observabilityのための設計 さらなる EKS移行への基礎固め -
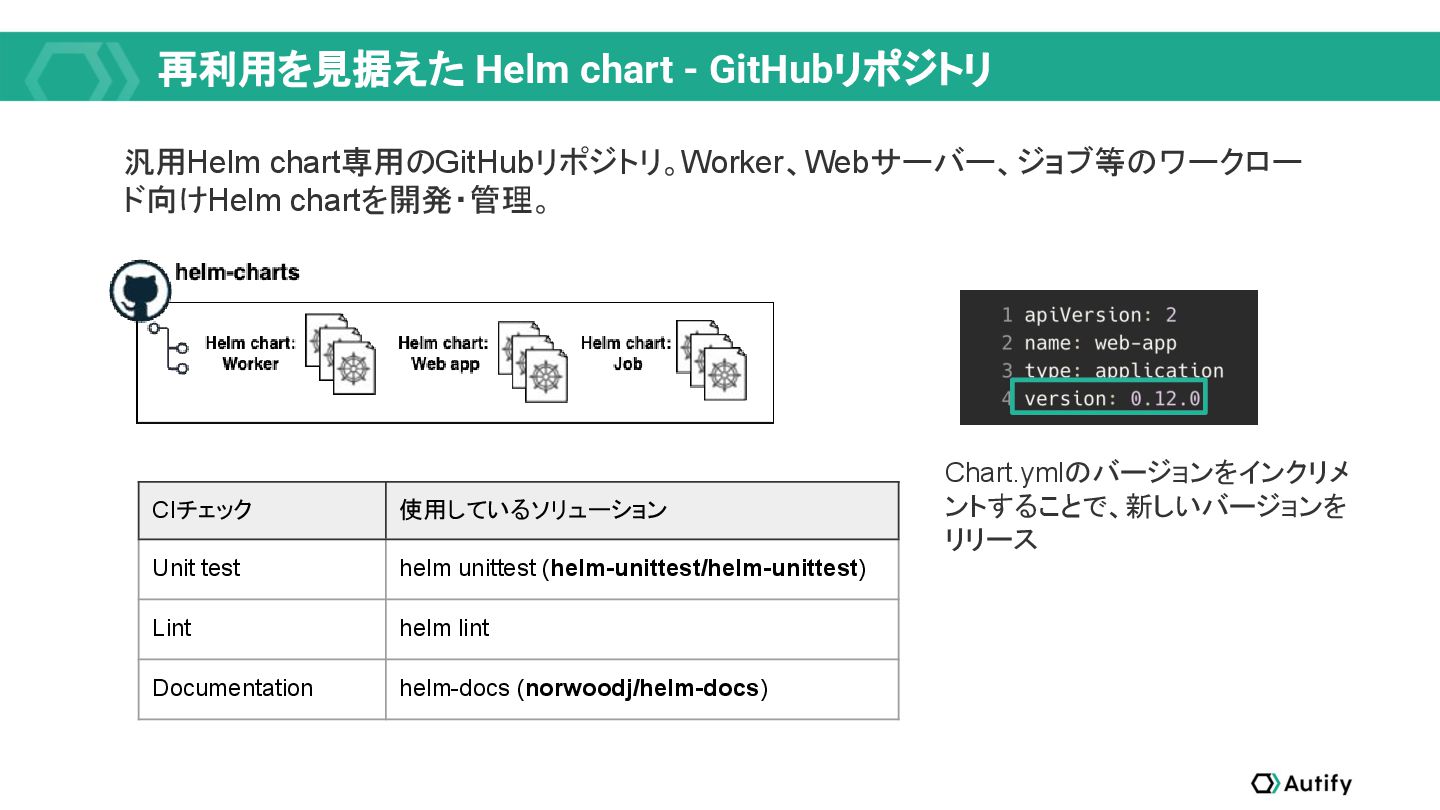
再利用を見据えた Helm chart - GitHubリポジトリ 汎用Helm chart専用のGitHubリポジトリ。Worker、Webサーバー、ジョブ等のワークロー ド向けHelm chartを開発・管理。 CIチェック
使用しているソリューション Unit test helm unittest (helm-unittest/helm-unittest) Lint helm lint Documentation helm-docs (norwoodj/helm-docs) Chart.ymlのバージョンをインクリメ ントすることで、新しいバージョンを リリース -
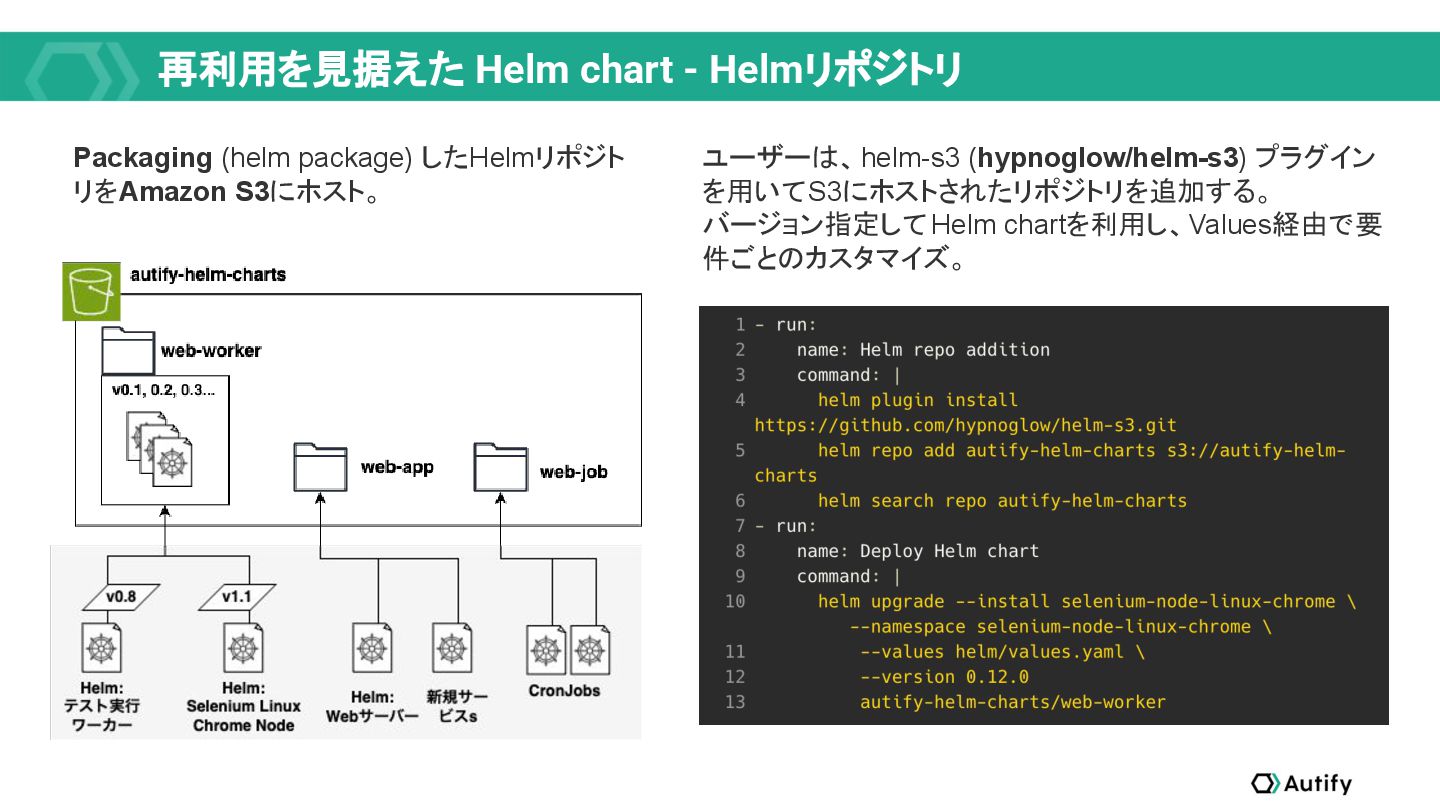
再利用を見据えた Helm chart - Helmリポジトリ ユーザーは、helm-s3 (hypnoglow/helm-s3) プラグイン を用いてS3にホストされたリポジトリを追加する。 バージョン指定してHelm
chartを利用し、Values経由で要 件ごとのカスタマイズ。 Packaging (helm package) したHelmリポジト リをAmazon S3にホスト。 -
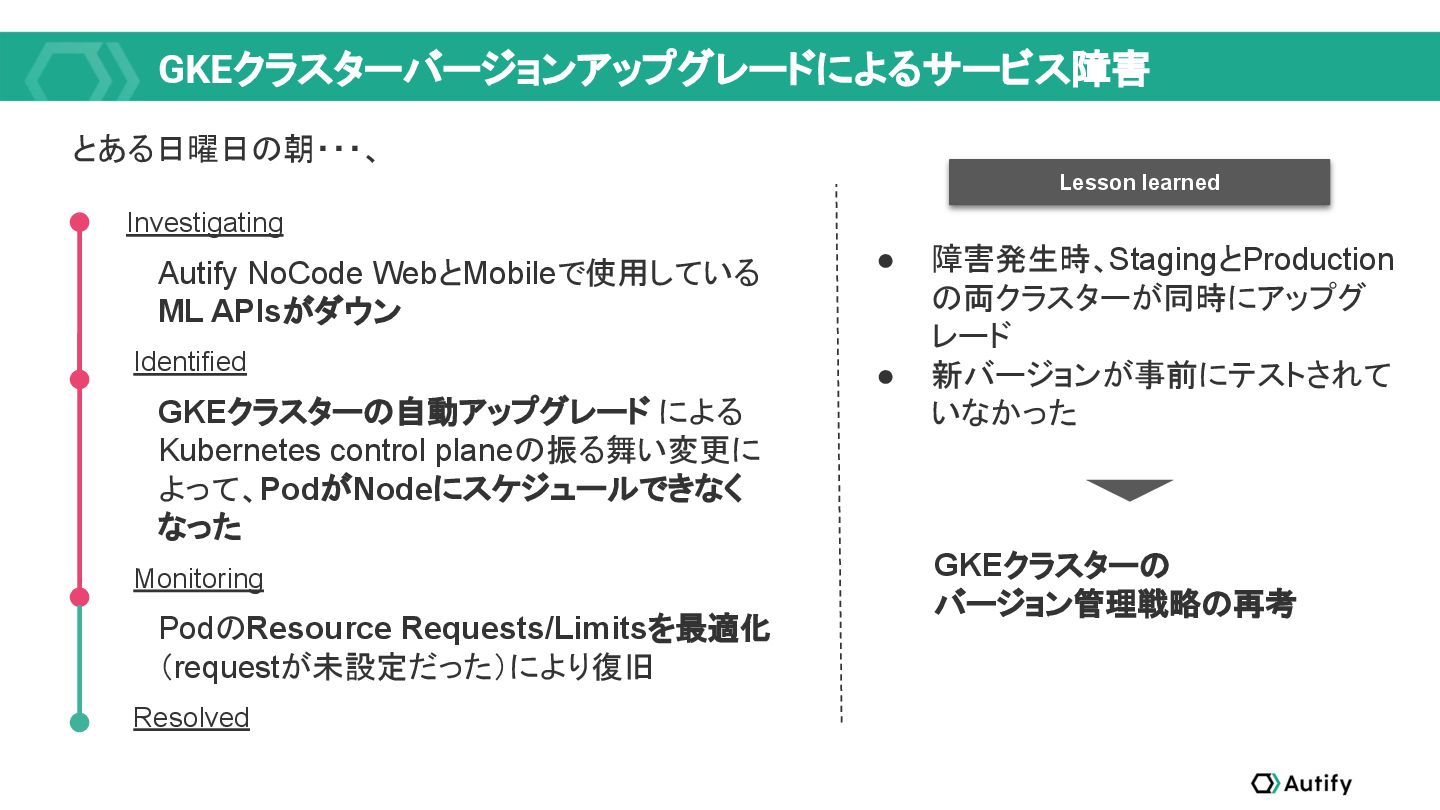
GKEクラスターバージョンアップグレードによるサービス障害 Investigating Identified Monitoring Resolved Autify NoCode WebとMobileで使用している ML APIsがダウン
GKEクラスターの自動アップグレード による Kubernetes control planeの振る舞い変更に よって、PodがNodeにスケジュールできなく なった PodのResource Requests/Limitsを最適化 (requestが未設定だった)により復旧 とある日曜日の朝・・・、 Lesson learned • 障害発生時、StagingとProduction の両クラスターが同時にアップグ レード • 新バージョンが事前にテストされて いなかった GKEクラスターの バージョン管理戦略の再考 -
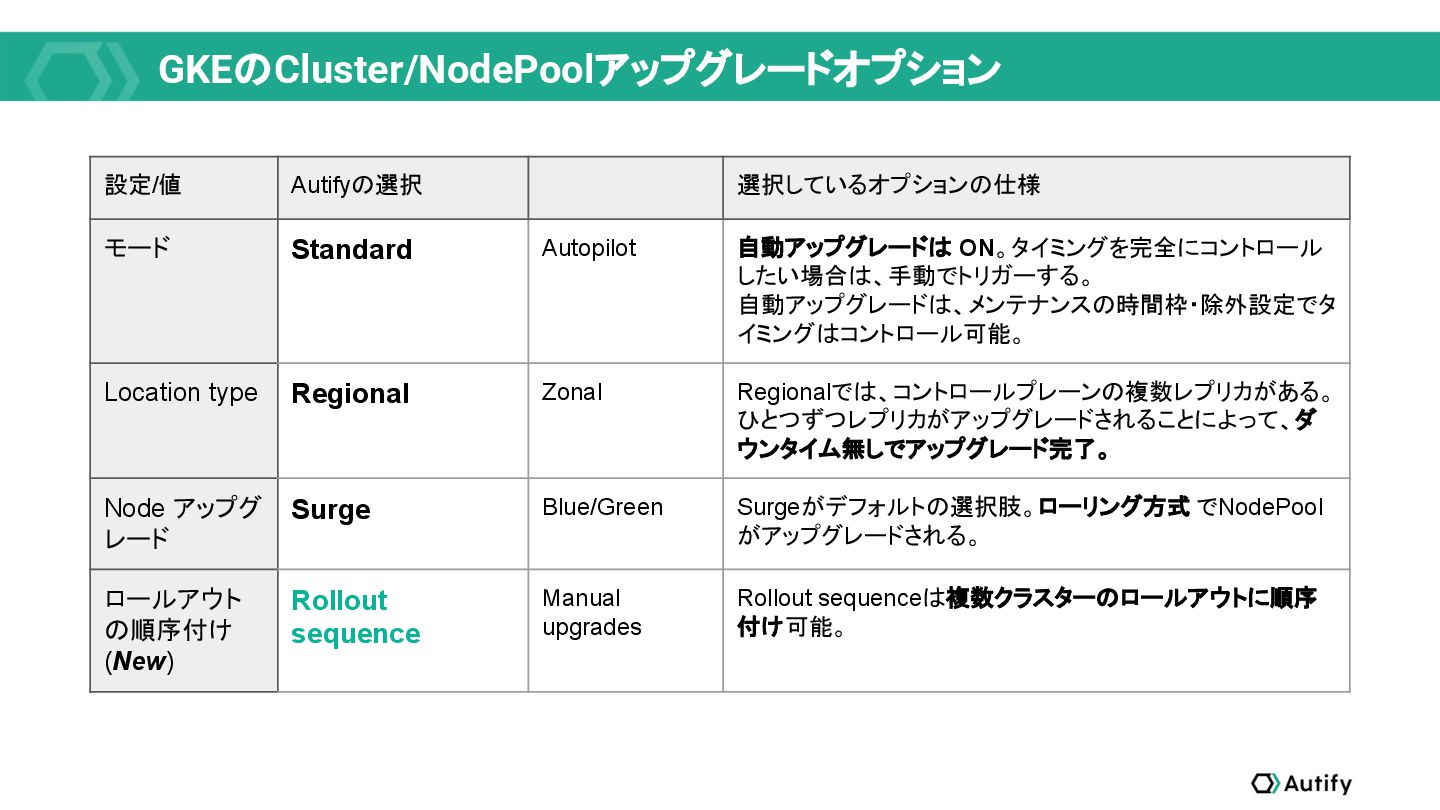
GKEのCluster/NodePoolアップグレードオプション 設定/値 Autifyの選択 選択しているオプションの仕様 モード Standard Autopilot 自動アップグレードは ON。タイミングを完全にコントロール したい場合は、手動でトリガーする。
自動アップグレードは、メンテナンスの時間枠・除外設定でタ イミングはコントロール可能。 Location type Regional Zonal Regionalでは、コントロールプレーンの複数レプリカがある。 ひとつずつレプリカがアップグレードされることによって、ダ ウンタイム無しでアップグレード完了。 Node アップグ レード Surge Blue/Green Surgeがデフォルトの選択肢。ローリング方式 でNodePool がアップグレードされる。 ロールアウト の順序付け (New) Rollout sequence Manual upgrades Rollout sequenceは複数クラスターのロールアウトに順序 付け可能。 -
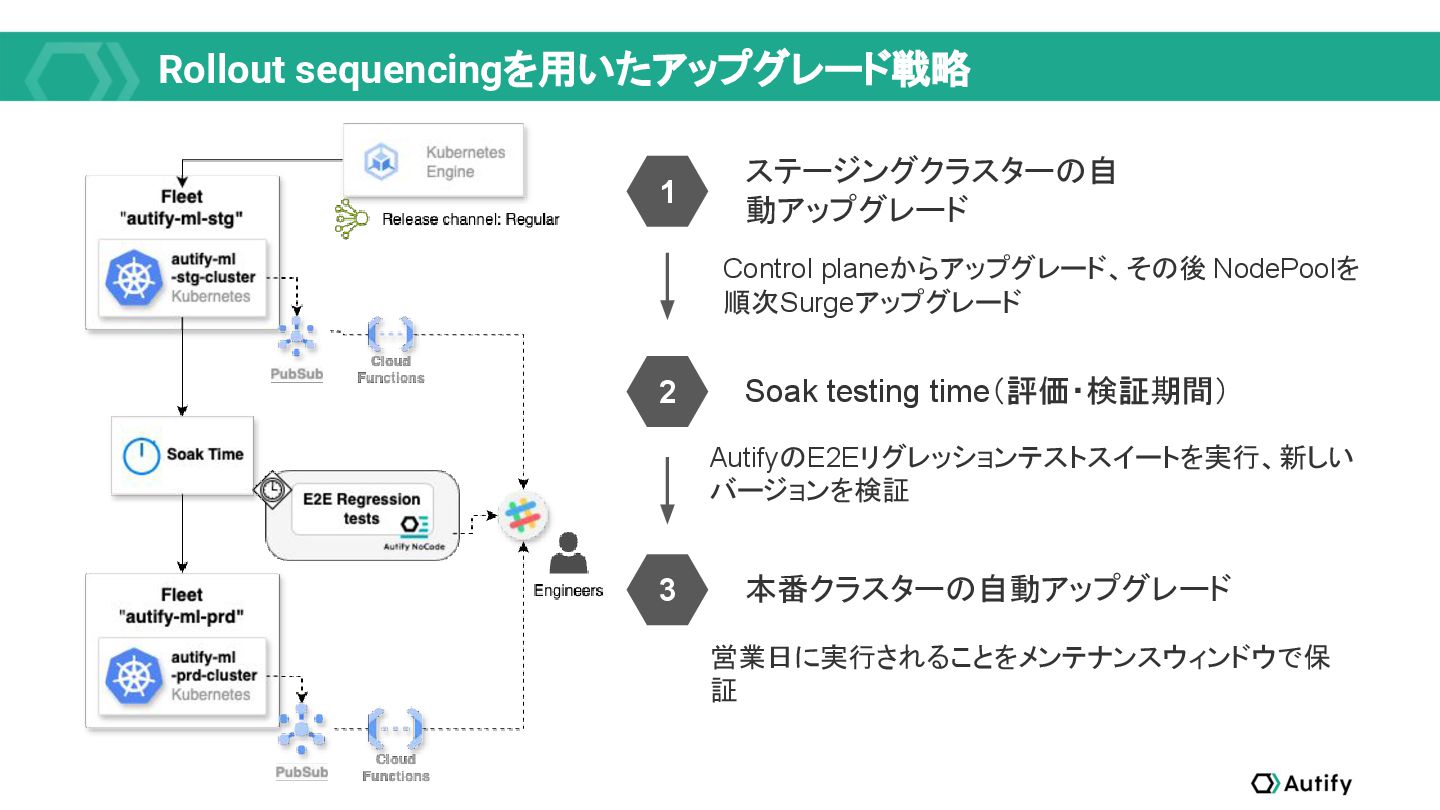
Rollout sequencingを用いたアップグレード戦略 本番クラスターの自動アップグレード 1 ステージングクラスターの自 動アップグレード 2 Soak testing time(評価・検証期間)
3 AutifyのE2Eリグレッションテストスイートを実行、新しい バージョンを検証 営業日に実行されることをメンテナンスウィンドウで保 証 Control planeからアップグレード、その後 NodePoolを 順次Surgeアップグレード -
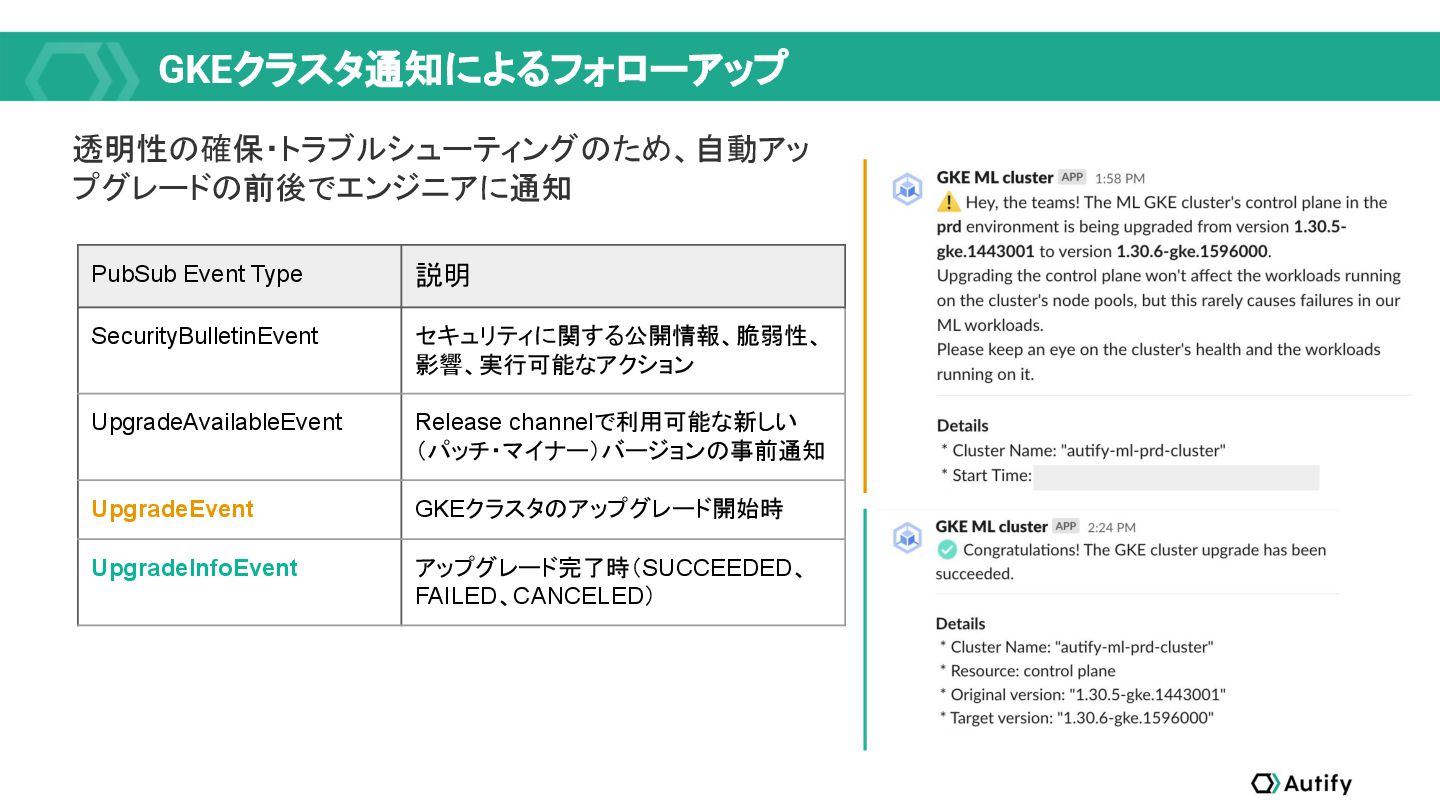
GKEクラスタ通知によるフォローアップ PubSub Event Type 説明 SecurityBulletinEvent セキュリティに関する公開情報、脆弱性、 影響、実行可能なアクション UpgradeAvailableEvent Release
channelで利用可能な新しい (パッチ・マイナー)バージョンの事前通知 UpgradeEvent GKEクラスタのアップグレード開始時 UpgradeInfoEvent アップグレード完了時(SUCCEEDED、 FAILED、CANCELED) 透明性の確保・トラブルシューティングのため、自動アッ プグレードの前後でエンジニアに通知 -
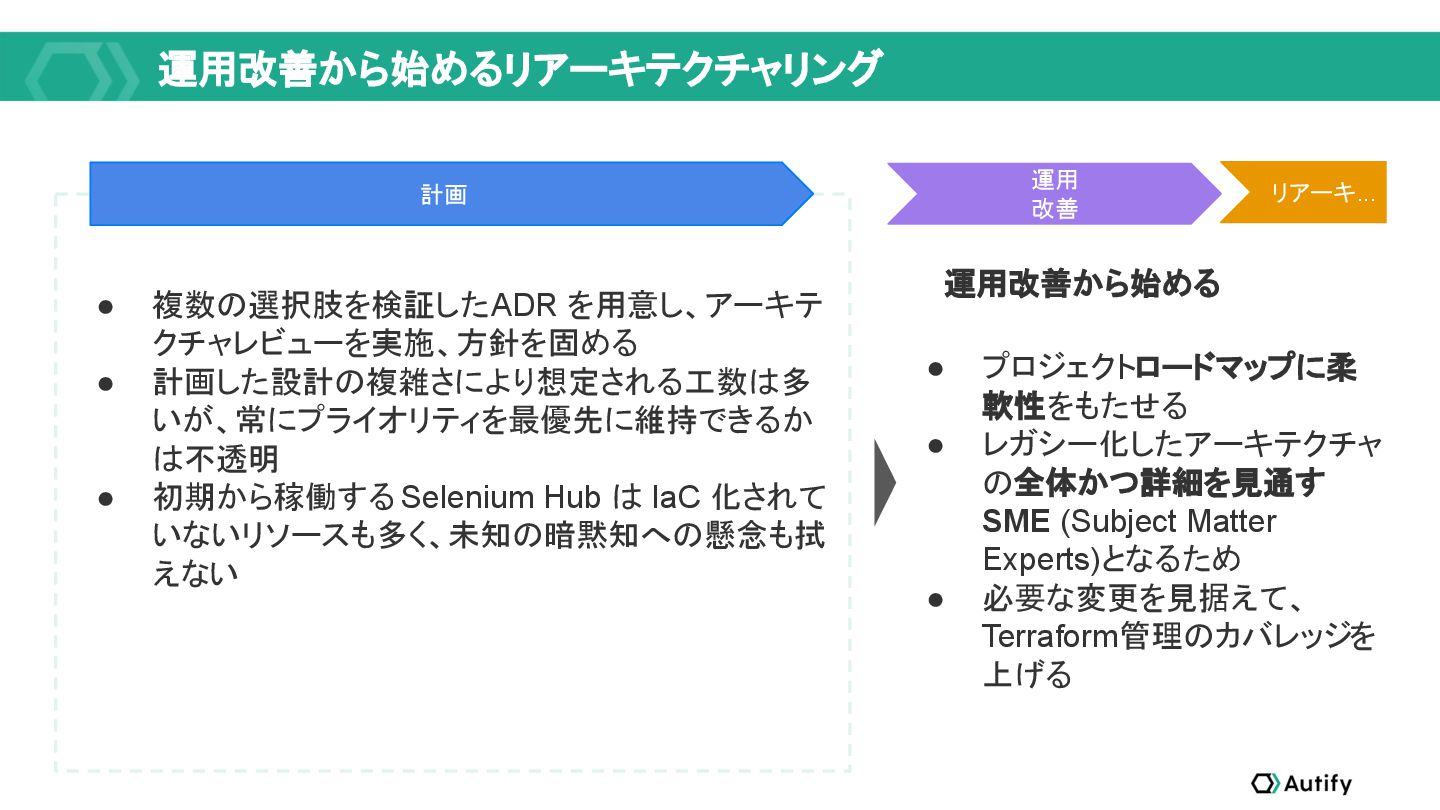
運用改善から始めるリアーキテクチャリング 計画 運用 改善 リアーキ... • 複数の選択肢を検証した ADR を用意し、アーキテ クチャレビューを実施、方針を固める
• 計画した設計の複雑さにより想定される工数は多 いが、常にプライオリティを最優先に維持できるか は不透明 • 初期から稼働する Selenium Hub は IaC 化されて いないリソースも多く、未知の暗黙知への懸念も拭 えない 運用改善から始める • プロジェクトロードマップに柔 軟性をもたせる • レガシー化したアーキテクチャ の全体かつ詳細を見通す SME (Subject Matter Experts)となるため • 必要な変更を見据えて、 Terraform管理のカバレッジを 上げる -
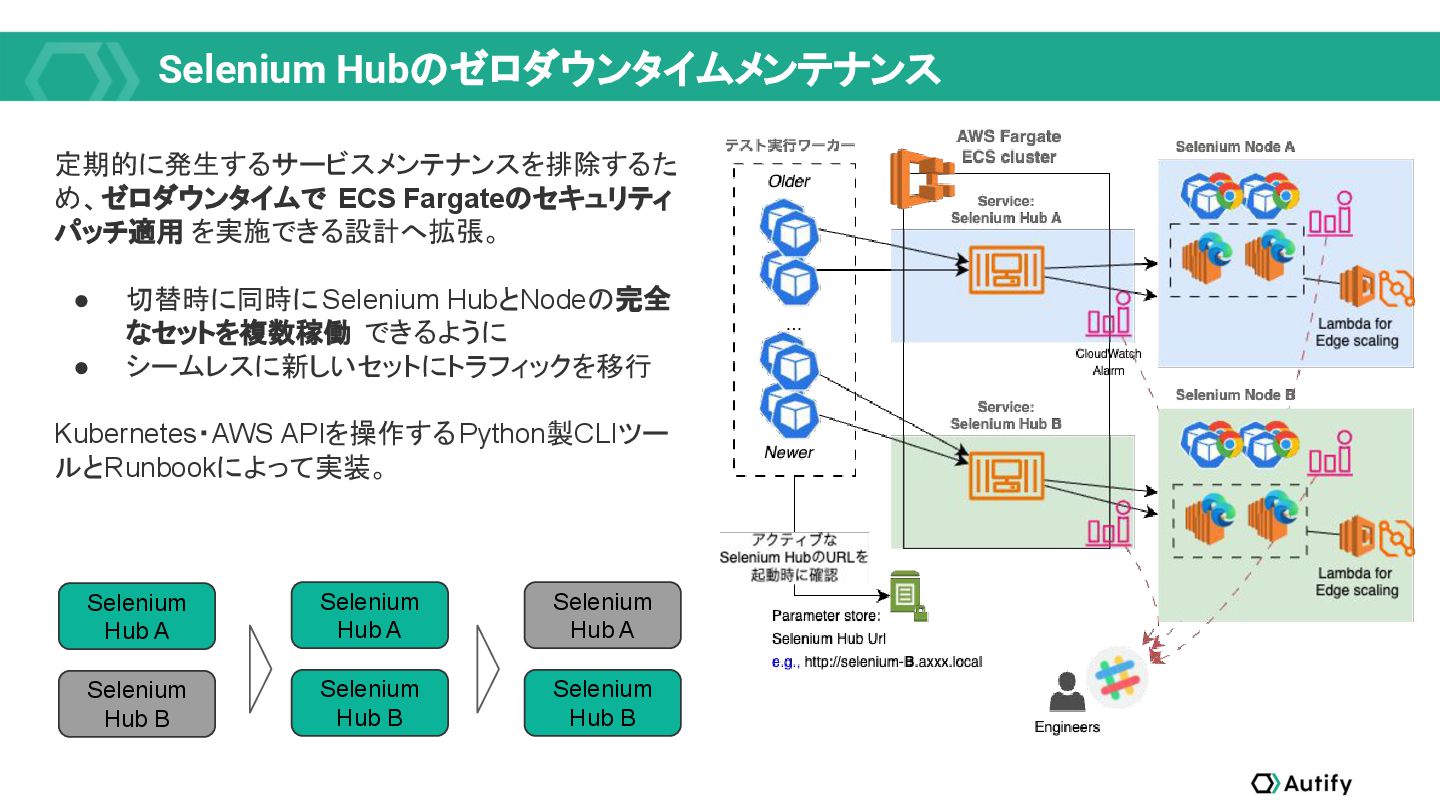
Selenium Hubのゼロダウンタイムメンテナンス Selenium Hub A Selenium Hub A Selenium Hub
B Selenium Hub B Selenium Hub A Selenium Hub B 定期的に発生するサービスメンテナンスを排除するた め、ゼロダウンタイムで ECS Fargateのセキュリティ パッチ適用 を実施できる設計へ拡張。 • 切替時に同時にSelenium HubとNodeの完全 なセットを複数稼働 できるように • シームレスに新しいセットにトラフィックを移行 Kubernetes・AWS APIを操作するPython製CLIツー ルとRunbookによって実装。 -
参考文献 • Matt Hopkins. “Leveraging Amazon S3 with Athena for
Cost Effective Log Management”. https://nocode.autify.com/blog/optimizing-cloud-application-log-management, (Posted on 2023/12/8) • 松浦隼人. “AWSコスト削減事例祭り”. https://speakerdeck.com/autifyhq/awskosutoxue-jian-shi-li-ji-ri, (Posted on 2023/2/22) • 東口 和暉. “A Better Way to Manage Stateful Systems: Design for Observability and Robust Deployment”. https://www.usenix.org/conference/srecon22apac/presentation/higashiguchi, (Posted on 2022/12/8) • Matt Hopkins. “Solutions for Cost-Effective EKS Control Plane Logging”. https://nocode.autify.com/blog/solutions-for-cost-effective-eks-control-plane-logging, (Posted on 2020/10/3) • 松浦隼人. “FargateとLambdaで作るスケーラブルな E2Eテスト実行基盤”. https://speakerdeck.com/doublemarket/building-a-scalable-e2e-test-execution-platform-with-aws-fargat e-and-lambda, (Posted on 2020/3/28) -
参考文献 • AWS re:Invent 2023. “Improve application resilience with AWS
Fault Injection Service (ARC317)”. https://www.youtube.com/watch?v=N0aZZVVZiUw, (Posted on 2023/12/5) • AWS Fault Injection Service. “AWS FIS Actions reference”. https://docs.aws.amazon.com/fis/latest/userguide/fis-actions-reference.html, (Referred on 2025/1/16) • Amazon ECS Developer Guide. “Amazon ECS task definition parameters”. https://docs.aws.amazon.com/AmazonECS/latest/developerguide/task_definition_parameters.html, (Referred on 2024/12/23) • Amazon ECS Developer Guide. “Automatically scale your Amazon ECS service”. https://docs.aws.amazon.com/AmazonECS/latest/developerguide/service-auto-scaling.html, (Referred on 2024/12/24) • Amazon EKS User Guide. “Cluster Autoscaler”. https://docs.aws.amazon.com/eks/latest/best-practices/cas.html, (Referred on 2025/1/15) • kubernetes/autoscaler. “Cluster Autoscaler on AWS”. https://github.com/kubernetes/autoscaler/blob/master/cluster-autoscaler/cloudprovider/aws/README. md#using-mixed-instances-policies-and-spot-instances, (Referred on 2025/1/15) -
参考文献 • Architectural Decision Records. “Motivation and Definitions”. https://adr.github.io/, (Referred
on 2025/1/20) • AWS Blog. “How to upgrade Amazon EKS worker nodes with Karpenter Drift”. https://aws.amazon.com/blogs/containers/how-to-upgrade-amazon-eks-worker-nodes-with-karpenter-d rift/, (Referred on 2025/1/15) • AWS re:Invent 2023. “Harness the power of Karpenter to scale, optimize & upgrade Kubernetes (CON331)”. https://www.youtube.com/watch?v=lkg_9ETHeks, (Posted on 2023/12/5) • Amazon EKS User Guide. “Scale cluster compute with Karpenter and Cluster Autoscaler”. https://docs.aws.amazon.com/eks/latest/userguide/autoscaling.html, (Referred on 2025/1/15) • Cloud Native Computing Foundation. “What Karpenter v1.0.0 means for Kubernetes autoscaling”. https://www.cncf.io/blog/2024/11/06/karpenter-v1-0-0-beta/, (Referred on 2025/1/15) -
参考文献 • Knative. “Knative Serving Architecture”. https://knative.dev/docs/serving/architecture/, (Referred on 2025/1/7)
• Knative. “HTTP Request Flows”. https://knative.dev/docs/serving/request-flow/, (Referred on 2025/1/7) • Red Hat Developer. “Kourier: A lightweight Knative Serving ingress”. https://developers.redhat.com/blog/2020/06/30/kourier-a-lightweight-knative-serving-ingress, (Referred on 2025/1/7) • kubernetes. “Horizontal Pod Autoscaling”. https://kubernetes.io/docs/tasks/run-application/horizontal-pod-autoscale/, (Referred on 2024/12/26) • kubernetes. “Container Lifecycle Hooks”. https://kubernetes.io/docs/concepts/containers/container-lifecycle-hooks/, (Referred on 2024/12/26) • kubernetes. “Pod Lifecycle#Termination of Pods”. https://kubernetes.io/docs/concepts/workloads/pods/pod-lifecycle/#pod-termination, (Referred on 2024/12/26) • kubernetes. “Resource Management for Pods and Containers”. https://kubernetes.io/docs/concepts/configuration/manage-resources-containers/, (Referred on 2025/1/14) -
参考文献 • Google Cloud Compute Engine. “Spot VMs”. https://cloud.google.com/compute/docs/instances/spot, (Referred
on 2025/1/9) • Google Kubernetes Engine. “Using kube-dns”. https://cloud.google.com/kubernetes-engine/docs/how-to/kube-dns, (Referred on 2025/1/9) • Google Kubernetes Engine. “Run fault-tolerant workloads at lower costs with Spot VMs”. https://cloud.google.com/kubernetes-engine/docs/how-to/spot-vms, (Referred on 2025/1/9) • Google Kubernetes Engine. “Standard cluster upgrades”. https://cloud.google.com/kubernetes-engine/docs/concepts/cluster-upgrades, (Referred on 2025/1/14) • Google Kubernetes Engine. “About cluster upgrades with rollout sequencing”. https://cloud.google.com/kubernetes-engine/docs/concepts/about-rollout-sequencing, (Referred on 2025/1/14) • Google Kubernetes Engine. “Cluster notifications”. https://cloud.google.com/kubernetes-engine/docs/concepts/cluster-notifications, (Referred on 2025/1/14)
 hgsgtk
 smt7174
 sansantech
 keitah
 butadora
 harutiro
 ginjihayashi
 a_suenami
 oracle4engineer
 comi190327
 rist
 jirtosterone
 pauli
 marketingsoph
 tanoku
 moore
 jdejongh
 brad_frost
 khoart
 62gerente
 thirion
 jacobian
 lara
 dougneiner
 jnunemaker