Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Kubeflowで作る共通データ基盤 (道半ば編)
Search
Sponsored
·
Your Podcast. Everywhere. Effortlessly.
Share. Educate. Inspire. Entertain. You do you. We'll handle the rest.
→
JDSC
August 19, 2021
Technology
320
1
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Kubeflowで作る共通データ基盤 (道半ば編)
合同勉強会での資料です。
JDSC
August 19, 2021
More Decks by JDSC
See All by JDSC
会社説明資料2027上期
jdsc
1
32k
JDSC採用ページⅡ
jdsc
0
4.5k
JDSC採用ページ
jdsc
1
120k
Data Meshと私
jdsc
0
310
家電製品の異常検知 (Case Study)
jdsc
0
630
鉄道省エネに向けた車上データ活用事例の紹介
jdsc
0
880
InterpretMLと Explainable Boosting Machineのススメ
jdsc
1
3.4k
Google Cloud Build とAI Platformではじめる軽量MLOps pipelineとAlphaSQL
jdsc
0
540
JDSCの事業・技術
jdsc
0
19k
Other Decks in Technology
See All in Technology
CTO Night|NotionのAIエージェントとFDE
kzkhykw1991
0
320
プロダクトが成長すると、 プロダクトマネージャーの仕事はどう変わるのか - 「まず作る」から「小さく学び、確かめながら進む」へ
sansantech
PRO
1
370
日本AIベンチャーレポート2026
kentarofujii
0
240
DevelopersIO2026 -バックアップは“消されないこと”が9割-
yoshida0129
0
410
Codex を使った障害対応机上演習の実際
orgachem
PRO
0
360
VLA-JEPA: Enhancing Vision-Language-Action Models with Latent World Models
takmin
0
330
構造で守らせる データ・法務・セキュリティ・開発チームとつくる AI時代のデータガバナンスとデータ基盤のリアル
legalontechnologies
PRO
1
520
契約で守るコンパウンドプロダクトのデザインシステム
yug1224
1
1.4k
Autonomous AI Lakehouse - Live AI Hubから始めるセキュアなAIデータ活用 -
oracle4engineer
PRO
2
150
生成AI時代、PMは事業責任者に進化するともっと面白い〜PMだからこそ事業構造を動かせる時代に〜
kakehashi
PRO
0
870
BacklogのRAG 今ならこう作る - S3 Vectorsと自前パイプラインの勘所
revsystem
0
140
Obsidian Vault Architectures
x5gtrn
PRO
0
160
Featured
See All Featured
Color Theory Basics | Prateek | Gurzu
gurzu
1
500
Chrome DevTools: State of the Union 2024 - Debugging React & Beyond
addyosmani
10
1.4k
Thoughts on Productivity
jonyablonski
76
5.4k
Lightning talk: Run Django tests with GitHub Actions
sabderemane
0
300
Navigating the moral maze — ethical principles for Al-driven product design
skipperchong
2
650
Winning Ecommerce Organic Search in an AI Era - #searchnstuff2025
aleyda
2
2.2k
The Curious Case for Waylosing
cassininazir
1
580
AI Search: Implications for SEO and How to Move Forward - #ShenzhenSEOConference
aleyda
1
1.4k
How to Create Impact in a Changing Tech Landscape [PerfNow 2023]
tammyeverts
56
3.5k
The Invisible Side of Design
smashingmag
301
52k
Visualizing Your Data: Incorporating Mongo into Loggly Infrastructure
mongodb
50
10k
Mind Mapping
helmedeiros
1
410
Transcript
Kubeflowで作る共通データ基盤 (道半ば編)
自己紹介 - 石井 正浩 - SIerとか携帯屋さんとかを経て現職 - 朝起きたら”ものもらい”ができてて左目が あかない
今日話すこと - データ基盤開発の課題 - Kubeflow on GKEやってみた
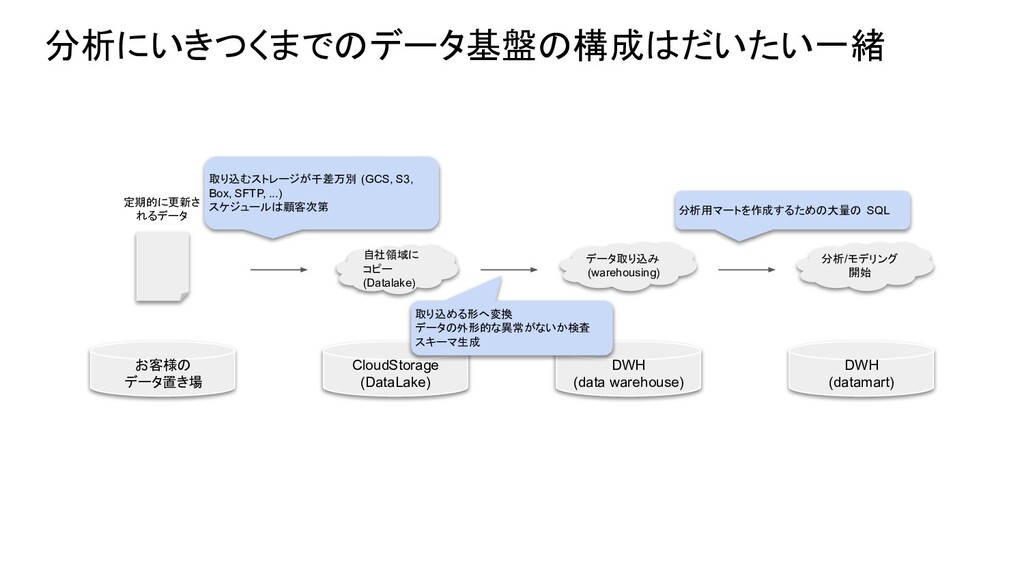
CloudStorage (DataLake) 分析にいきつくまでのデータ基盤の構成はだいたい一緒 お客様の データ置き場 定期的に更新さ れるデータ 自社領域に コピー (Datalake)
DWH (data warehouse) データ取り込み (warehousing) 分析/モデリング 開始 DWH (datamart) 取り込むストレージが千差万別 (GCS, S3, Box, SFTP, ...) スケジュールは顧客次第 取り込める形へ変換 データの外形的な異常がないか検査 スキーマ生成 分析用マートを作成するための大量の SQL
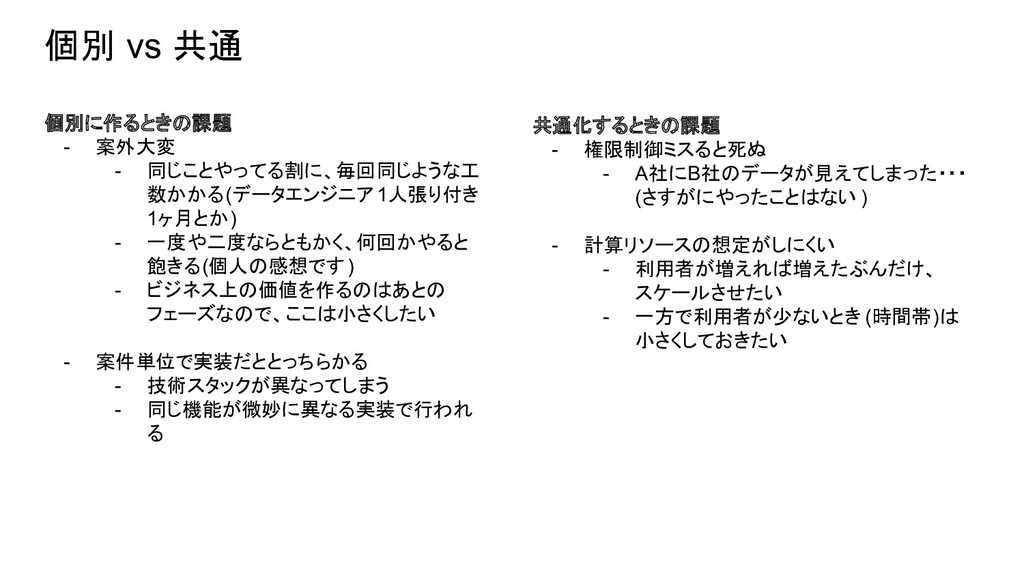
個別 vs 共通 個別に作るときの課題 - 案外大変 - 同じことやってる割に、毎回同じような工 数かかる(データエンジニア1人張り付き 1ヶ月とか)
- 一度や二度ならともかく、何回かやると 飽きる(個人の感想です) - ビジネス上の価値を作るのはあとの フェーズなので、ここは小さくしたい - 案件単位で実装だととっちらかる - 技術スタックが異なってしまう - 同じ機能が微妙に異なる実装で行われ る 共通化するときの課題 - 権限制御ミスると死ぬ - A社にB社のデータが見えてしまった・・・ (さすがにやったことはない ) - 計算リソースの想定がしにくい - 利用者が増えれば増えたぶんだけ、 スケールさせたい - 一方で利用者が少ないとき (時間帯)は 小さくしておきたい
Kubeflow on GKE
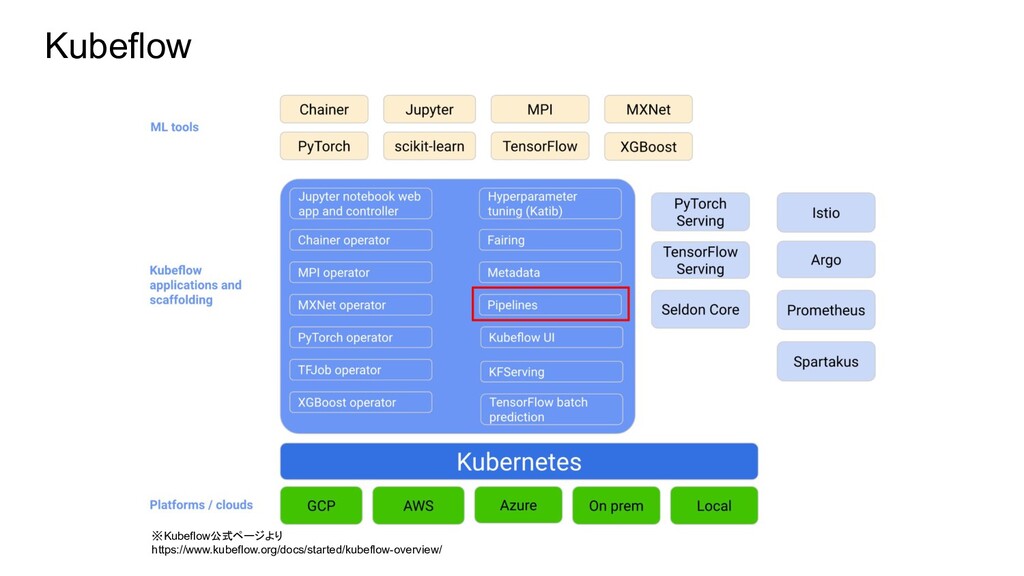
Kubeflow ※Kubeflow公式ページより https://www.kubeflow.org/docs/started/kubeflow-overview/
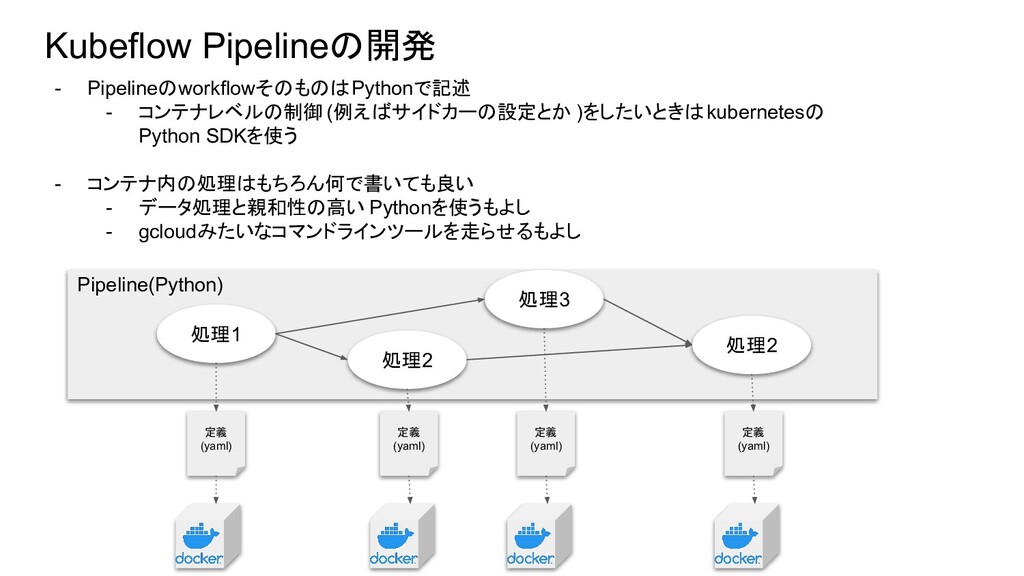
Kubeflow Pipelineの開発 - PipelineのworkflowそのものはPythonで記述 - コンテナレベルの制御 (例えばサイドカーの設定とか )をしたいときはkubernetesの Python SDKを使う
- コンテナ内の処理はもちろん何で書いても良い - データ処理と親和性の高い Pythonを使うもよし - gcloudみたいなコマンドラインツールを走らせるもよし Pipeline(Python) 処理1 処理2 定義 (yaml) 定義 (yaml) 処理3 処理2 定義 (yaml) 定義 (yaml)
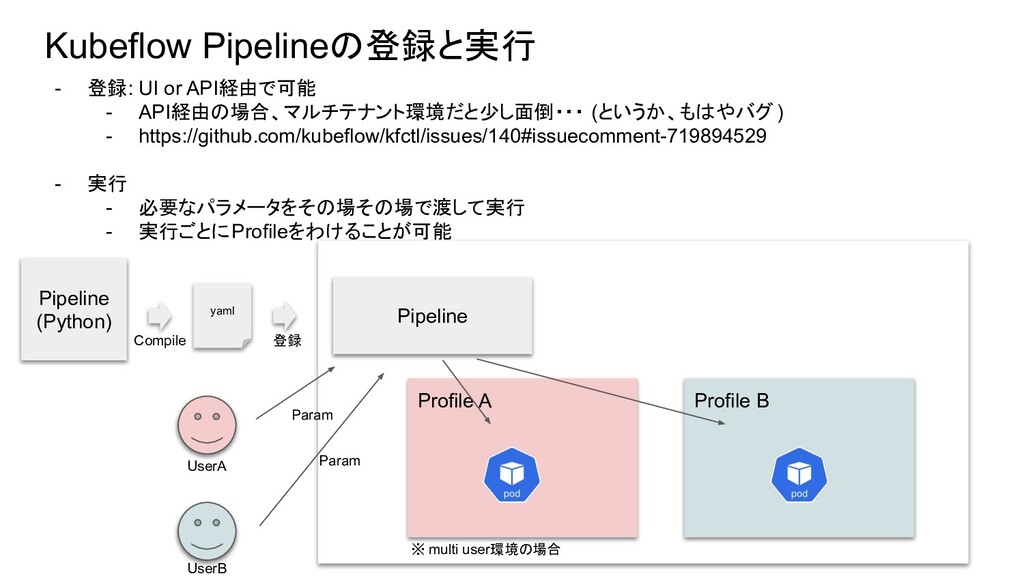
Kubeflow Pipelineの登録と実行 - 登録: UI or API経由で可能 - API経由の場合、マルチテナント環境だと少し面倒・・・ (というか、もはやバグ
) - https://github.com/kubeflow/kfctl/issues/140#issuecomment-719894529 - 実行 - 必要なパラメータをその場その場で渡して実行 - 実行ごとにProfileをわけることが可能 Pipeline (Python) yaml Compile 登録 Pipeline UserA UserB Profile A Profile B ※ multi user環境の場合 Param Param
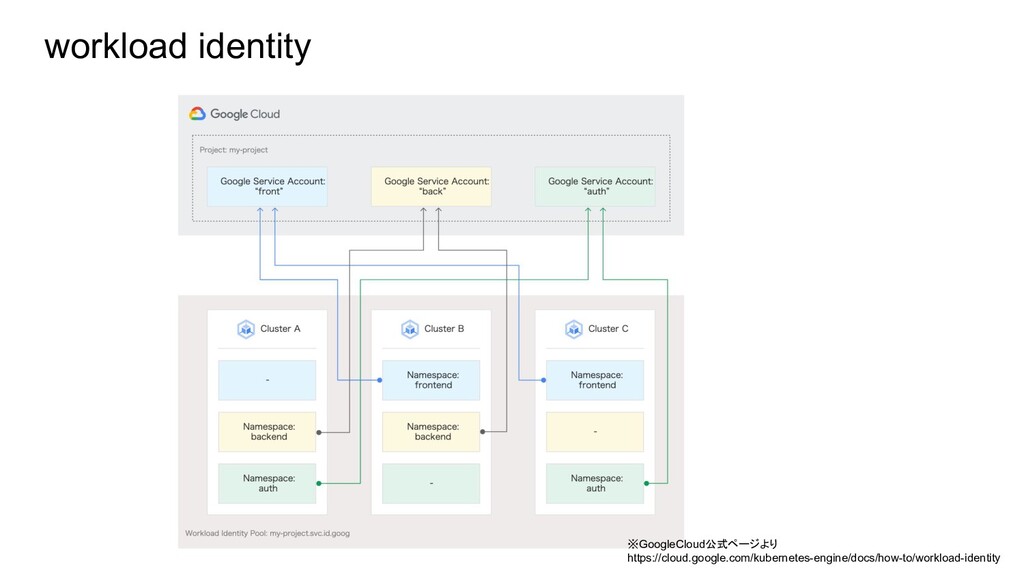
workload identity ※GoogleCloud公式ページより https://cloud.google.com/kubernetes-engine/docs/how-to/workload-identity
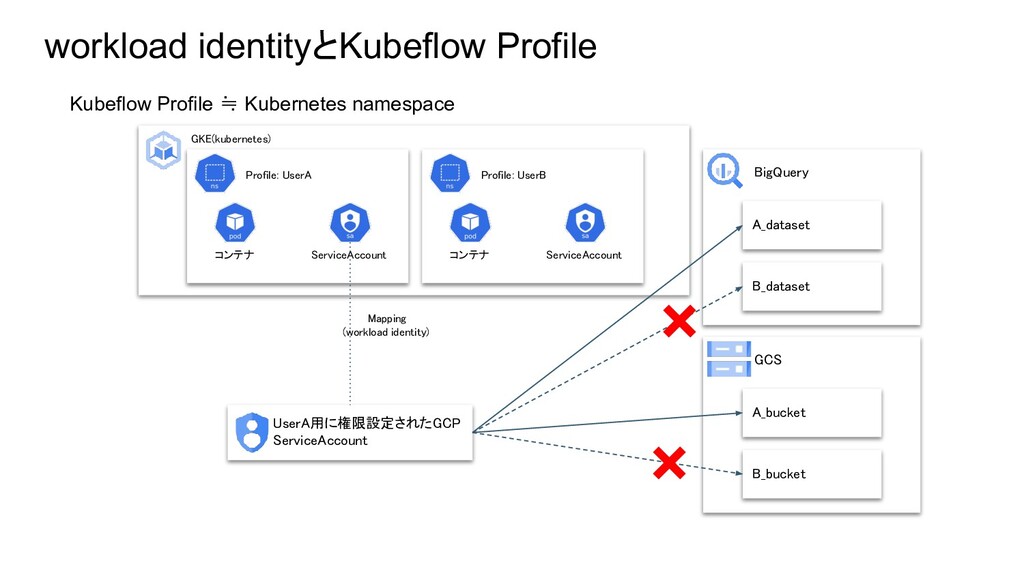
workload identityとKubeflow Profile Kubeflow Profile ≒ Kubernetes namespace UserA用に権限設定されたGCP ServiceAccount
BigQuery A_dataset ServiceAccount Profile: UserA コンテナ B_dataset Mapping (workload identity) GCS A_bucket B_bucket GKE(kubernetes) ServiceAccount Profile: UserB コンテナ
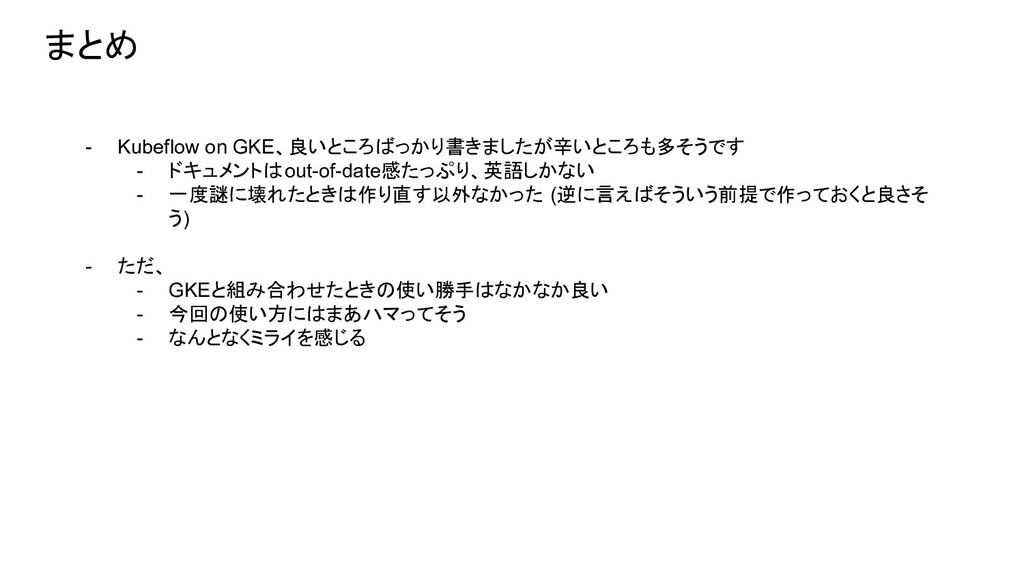
まとめ - Kubeflow on GKE、良いところばっかり書きましたが辛いところも多そうです - ドキュメントはout-of-date感たっぷり、英語しかない - 一度謎に壊れたときは作り直す以外なかった (逆に言えばそういう前提で作っておくと良さそ
う) - ただ、 - GKEと組み合わせたときの使い勝手はなかなか良い - 今回の使い方にはまあハマってそう - なんとなくミライを感じる


 jdsc
 kzkhykw1991
 sansantech
 kentarofujii
 yoshida0129
 orgachem
 takmin
 legalontechnologies
 yug1224
 oracle4engineer
 kakehashi
 revsystem
 x5gtrn
 gurzu
 addyosmani
 jonyablonski
 sabderemane
 skipperchong
 aleyda
 cassininazir
 tammyeverts
 smashingmag
 mongodb
 helmedeiros