Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
JAWS-UG クラウド女子会×初心者支部 コラボ会 ~子連れ参加ウェルカム勉強会!
Search
ShigeruOda
February 08, 2026
Technology
120
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
JAWS-UG クラウド女子会×初心者支部 コラボ会 ~子連れ参加ウェルカム勉強会!
JAWS-UG クラウド女子会×初心者支部 コラボ会 ~子連れ参加ウェルカム勉強会!
ShigeruOda
February 08, 2026
More Decks by ShigeruOda
See All by ShigeruOda
Amazon S3 Tablesに全部任せてみた結果——コンパクション/スナップショット管理は本当に手放せるか
shigeruoda
1
770
AWS re:Invent 2025 Apache Iceberg Recap
shigeruoda
1
120
Amazon Athena で JSON・Parquet・Iceberg のデータを検索し、性能を比較してみた
shigeruoda
1
650
Amazon S3標準/ S3 Tables/S3 Express One Zoneを使ったログ分析
shigeruoda
6
1k
CFP選定とタイムテーブル決めについて
shigeruoda
0
220
今年前半のAWSアップデートを振り返り
shigeruoda
0
160
#31 JAWS-UG主催 週刊AWSキャッチアップ (2024/5/6週)
shigeruoda
0
250
#30 JAWS-UG主催 週刊AWSキャッチアップ(2024/4/29週)
shigeruoda
0
200
#28 JAWS-UG主催 週刊AWSキャッチアップ(2024/4/15週)
shigeruoda
0
230
Other Decks in Technology
See All in Technology
ログラスのマルチプロダクトを 支える認証基盤 〜テナントごとに異なる統制とどう向き合うか〜
dada4386
3
400
生成AIを使って「人が」考える技術 ― AI時代の人機共想と実践ノウハウ|UNITT AC2026
ishiirikie
0
550
Meet AgentCore Identity Consent Portal
hironobuiga
3
190
React Nativeでの OTA Updateって、 どう説明する?
ichiki1023
0
150
ミイダス株式会社 テックチームのご紹介 / MIIDAS Tech Team
miidas
0
150
おそらく日本で唯一のDevRelインターン生として
husengs7
0
170
BedrockとLambdaで作る リアルタイム進行型推理ゲーム
kawametho
0
190
あなたの知らないAmazon VPC Route Server/Amazon VPC Route Server you don't know about
masakiokuda
2
220
私の推しは「聞いてから進む」AIです -AI-DLCに一人でアプリを作らせた話
yama3133
1
170
Snowflake Horizon Catalog と Apache Iceberg で作る オープンなデータ基盤
kitagawaz
0
440
事業活動を AI Ready にする攻めと守りのデータエンジニアリング / data-engineering-for-ai-ready-business
pei0804
1
180
転んだ話が背中を預ける理由になる / A_story_about_falling_down_gives_you_a_reason_to_watch_each_other_s_backs.pdf
pauli
3
220
Featured
See All Featured
Fight the Zombie Pattern Library - RWD Summit 2016
marcelosomers
234
18k
Conquering PDFs: document understanding beyond plain text
inesmontani
PRO
4
3.2k
Optimising Largest Contentful Paint
csswizardry
37
4k
Bridging the Design Gap: How Collaborative Modelling removes blockers to flow between stakeholders and teams @FastFlow conf
baasie
0
710
Agile Actions for Facilitating Distributed Teams - ADO2019
mkilby
0
300
The Pragmatic Product Professional
lauravandoore
37
7.5k
ピンチをチャンスに:未来をつくるプロダクトロードマップ #pmconf2020
aki_iinuma
128
56k
Max Prin - Stacking Signals: How International SEO Comes Together (And Falls Apart)
techseoconnect
PRO
0
480
Leo the Paperboy
mayatellez
10
2.3k
Improving Core Web Vitals using Speculation Rules API
sergeychernyshev
21
1.7k
Deep Space Network (abreviated)
tonyrice
0
350
Typedesign – Prime Four
hannesfritz
42
3.2k
Transcript
AWS re:Invent 2025 Apache Iceberg Recap JAWS-UG クラウド女子会×初心者支部 コラボ会 ~子連れ参加ウェルカム勉強会!
2025.02.08 1
自己紹介 Name Shigeru Oda Community Japan AWS User Group Beginner's
Branch AWS Community Hero Role Product Infrastructure Technical Lead at Sansan, Inc. 2
お伝えすること Apache Iceberg の基礎 AWS re:Invent 2025 で発表された Apache Iceberg
関連アップデート 3
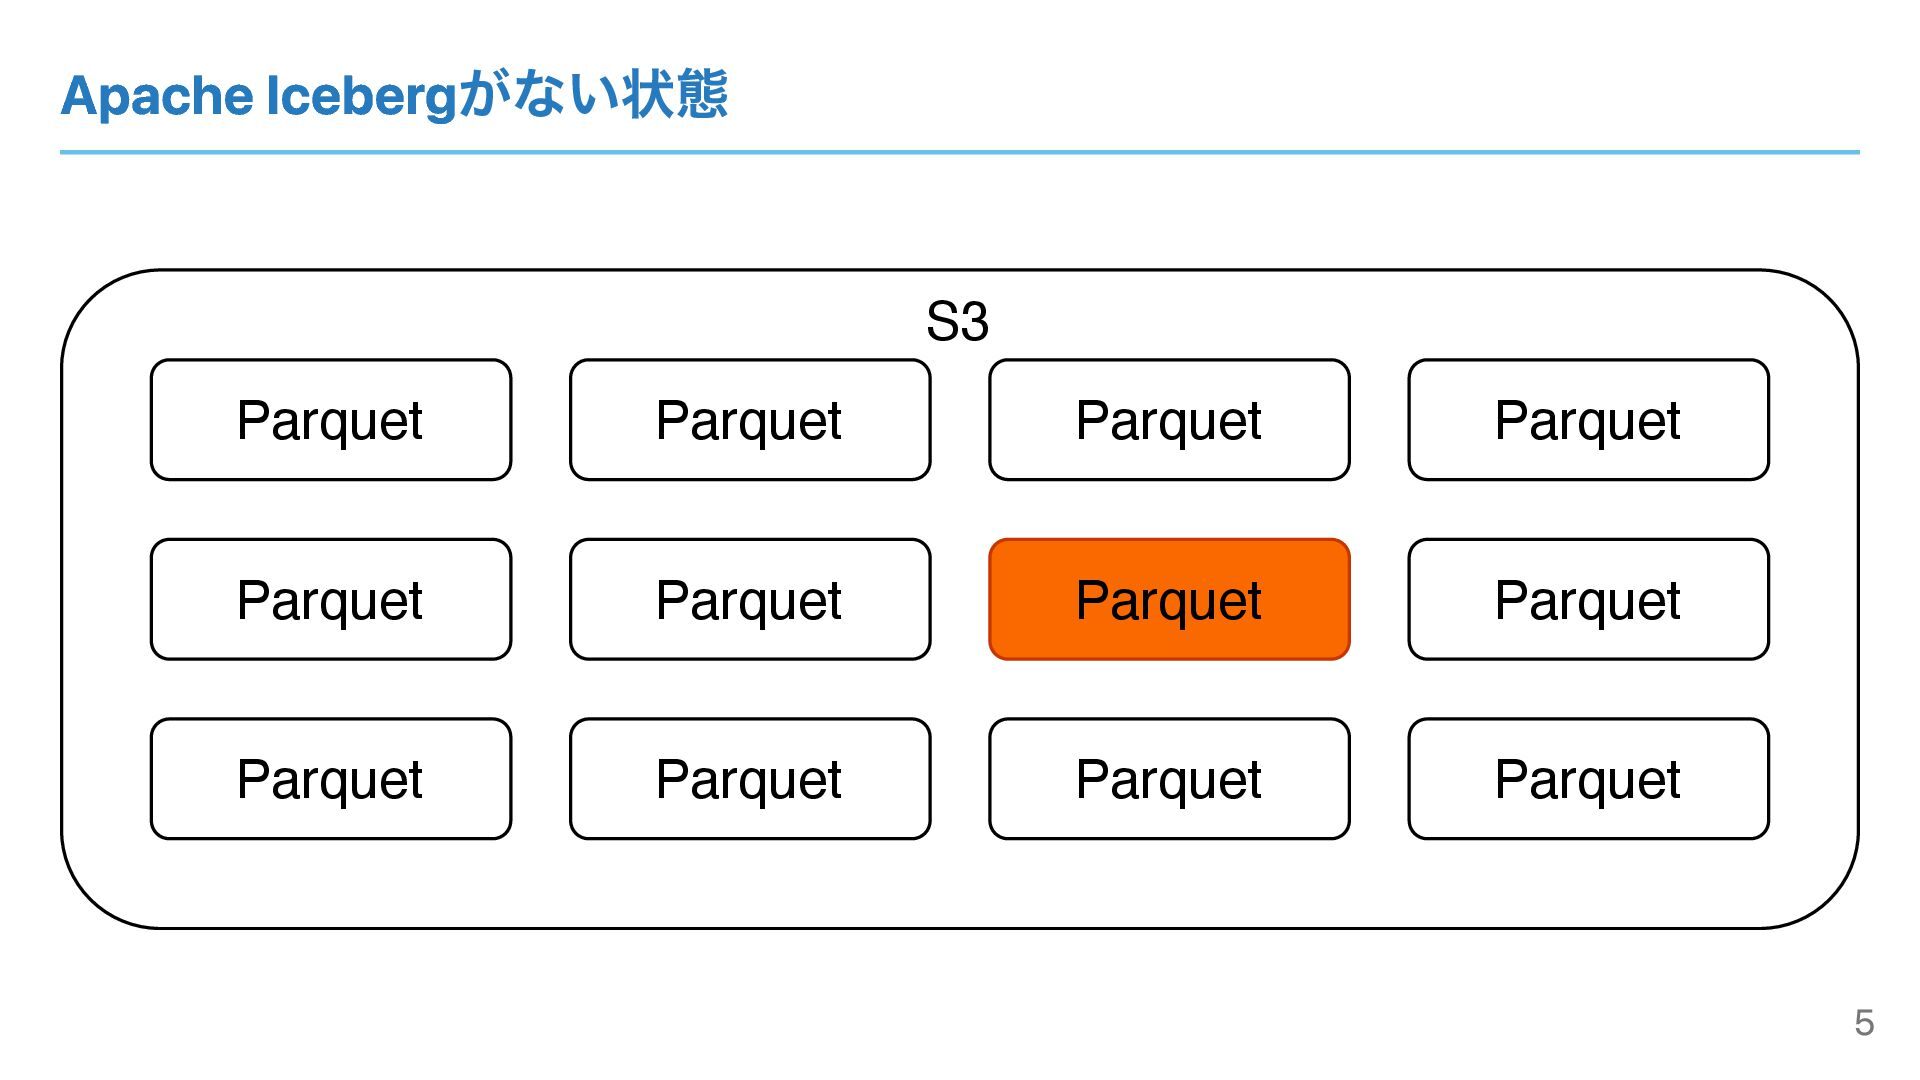
Apache Iceberg ってなに? Apache Iceberg は「データレイク用のテーブルフォーマット」 S3などのオブジェクトストレージで構成される巨大かつ複雑なテーブルを分散エンジン (Spark、Trino、Flink、Hiveなどから効率良く扱える仕組みを提供します 具体的な機能としては ▪
ACID 保証: トランザクション制御 ▪ スキーマ進化: カラム追加・変更が安全 ▪ タイムトラベル: 過去の状態に遡れる ▪ 高速なメタデータ操作: パーティション管理が効率的 4
Apache Icebergがない状態 S3 Parquet Parquet Parquet Parquet Parquet Parquet Parquet
Parquet Parquet Parquet Parquet Parquet 5
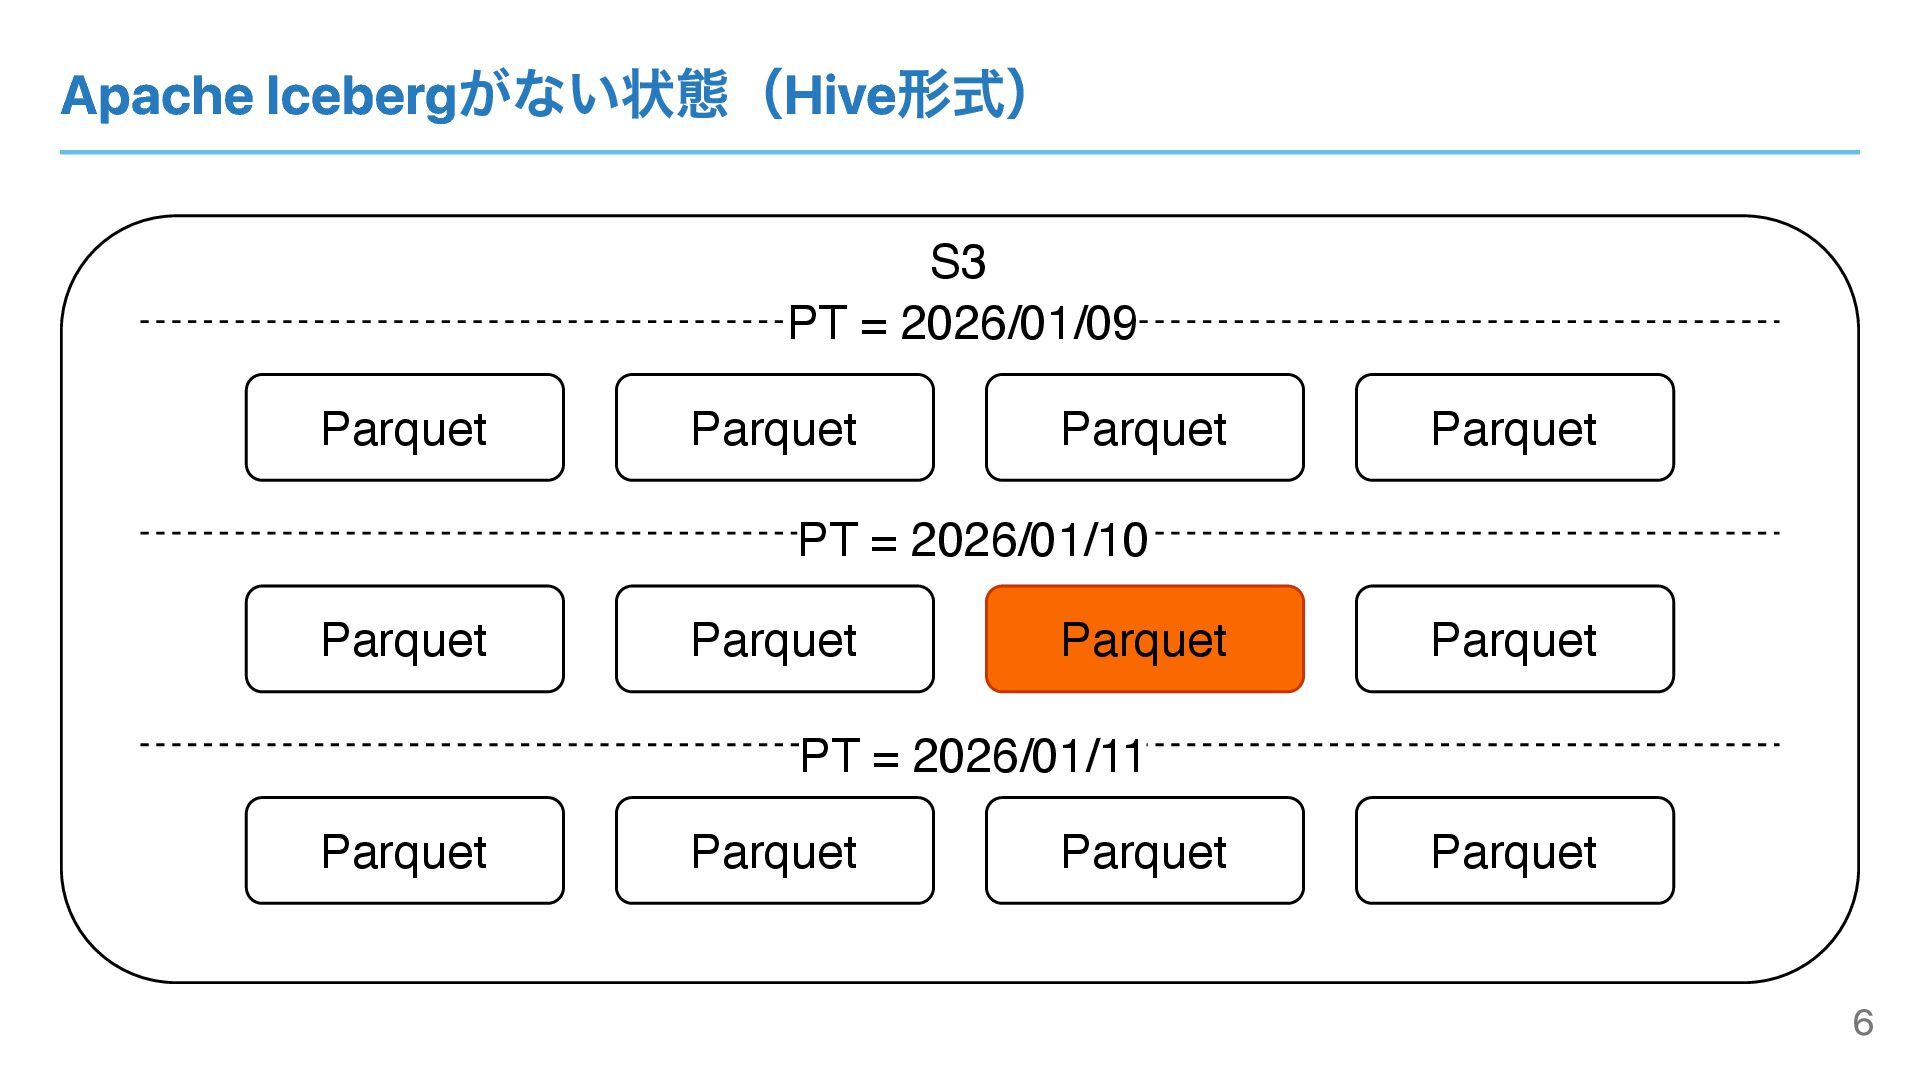
Apache Icebergがない状態(Hive形式) S3 Parquet Parquet Parquet Parquet Parquet Parquet Parquet
Parquet Parquet Parquet Parquet Parquet PT = 2026/01/10 PT = 2026/01/11 PT = 2026/01/09 6
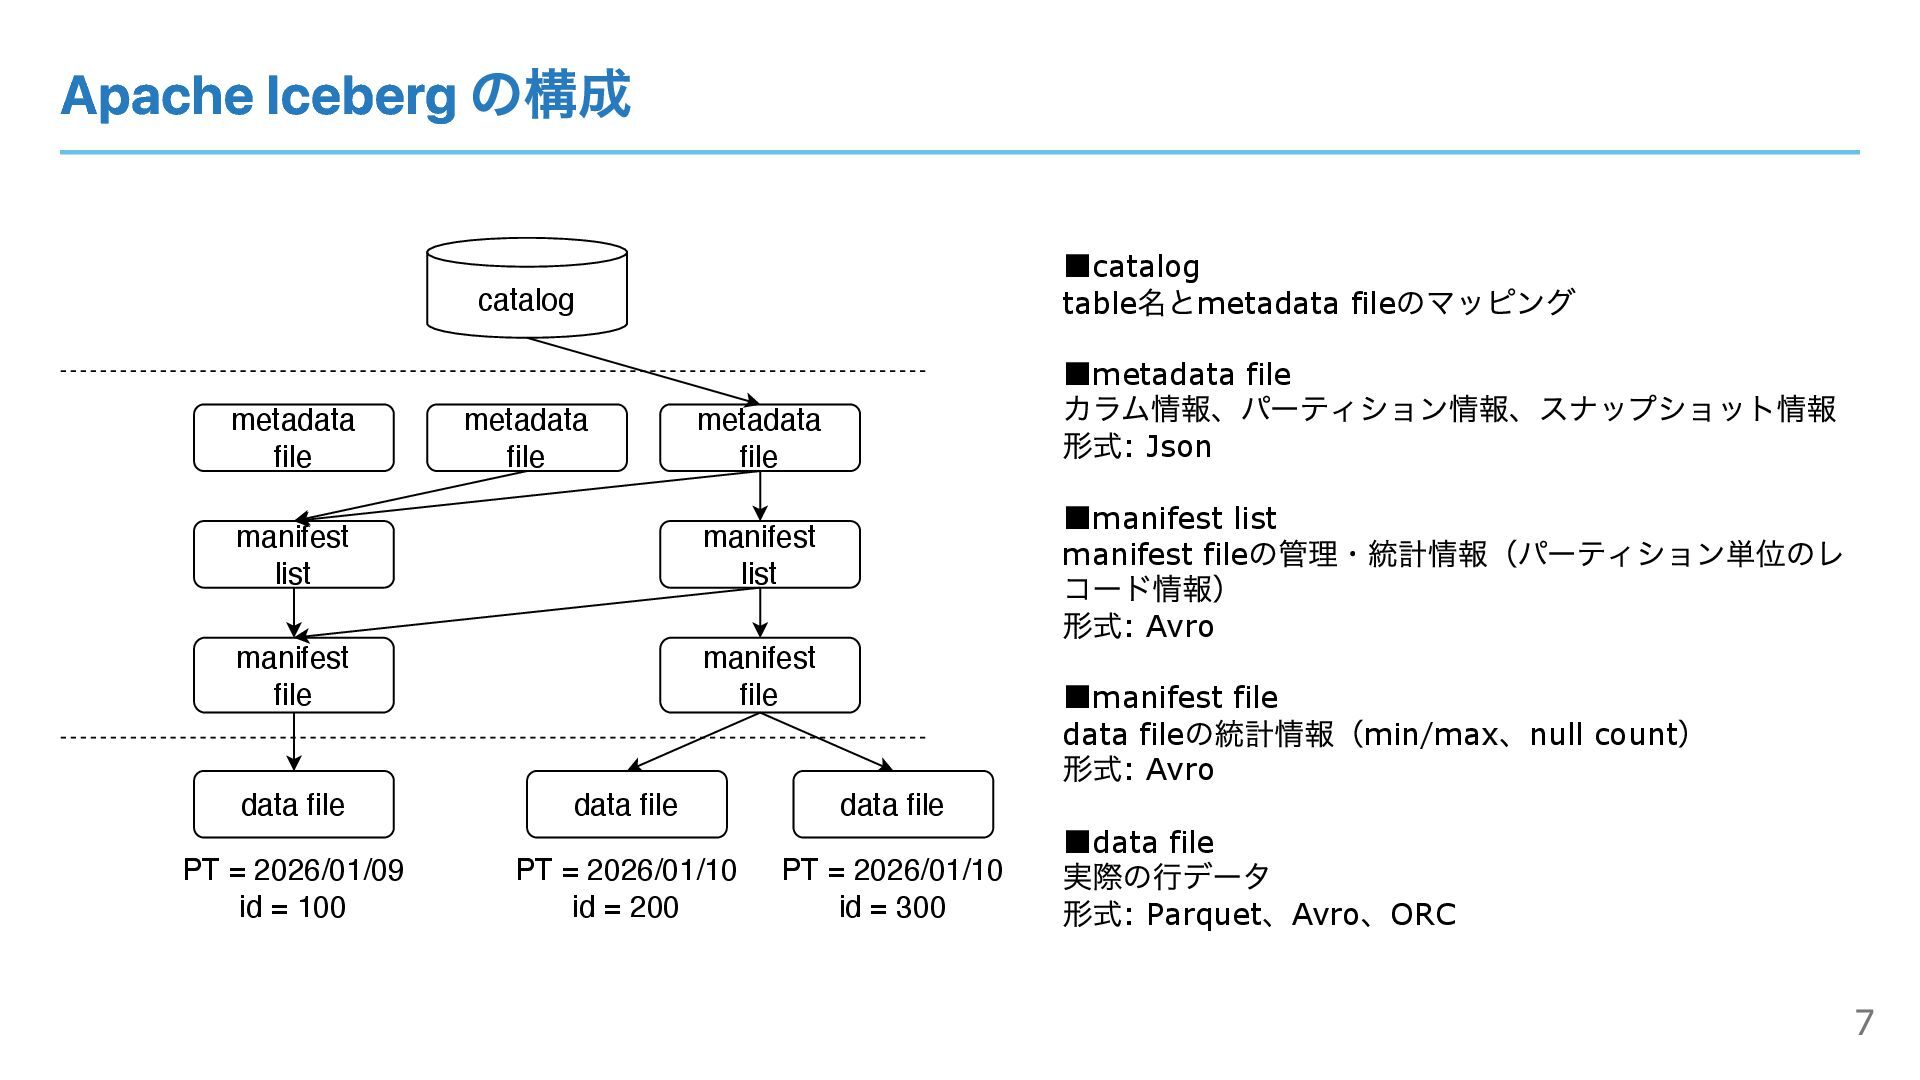
Apache Iceberg の構成 catalog metadata file manifest list manifest file
data file ▪catalog table 名とmetadata file のマッピング ▪metadata file カラム情報、パーティション情報、スナップショット情報 形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC data file manifest file data file manifest list metadata file PT = 2026/01/09 id = 100 PT = 2026/01/10 id = 200 PT = 2026/01/10 id = 300 metadata file 7
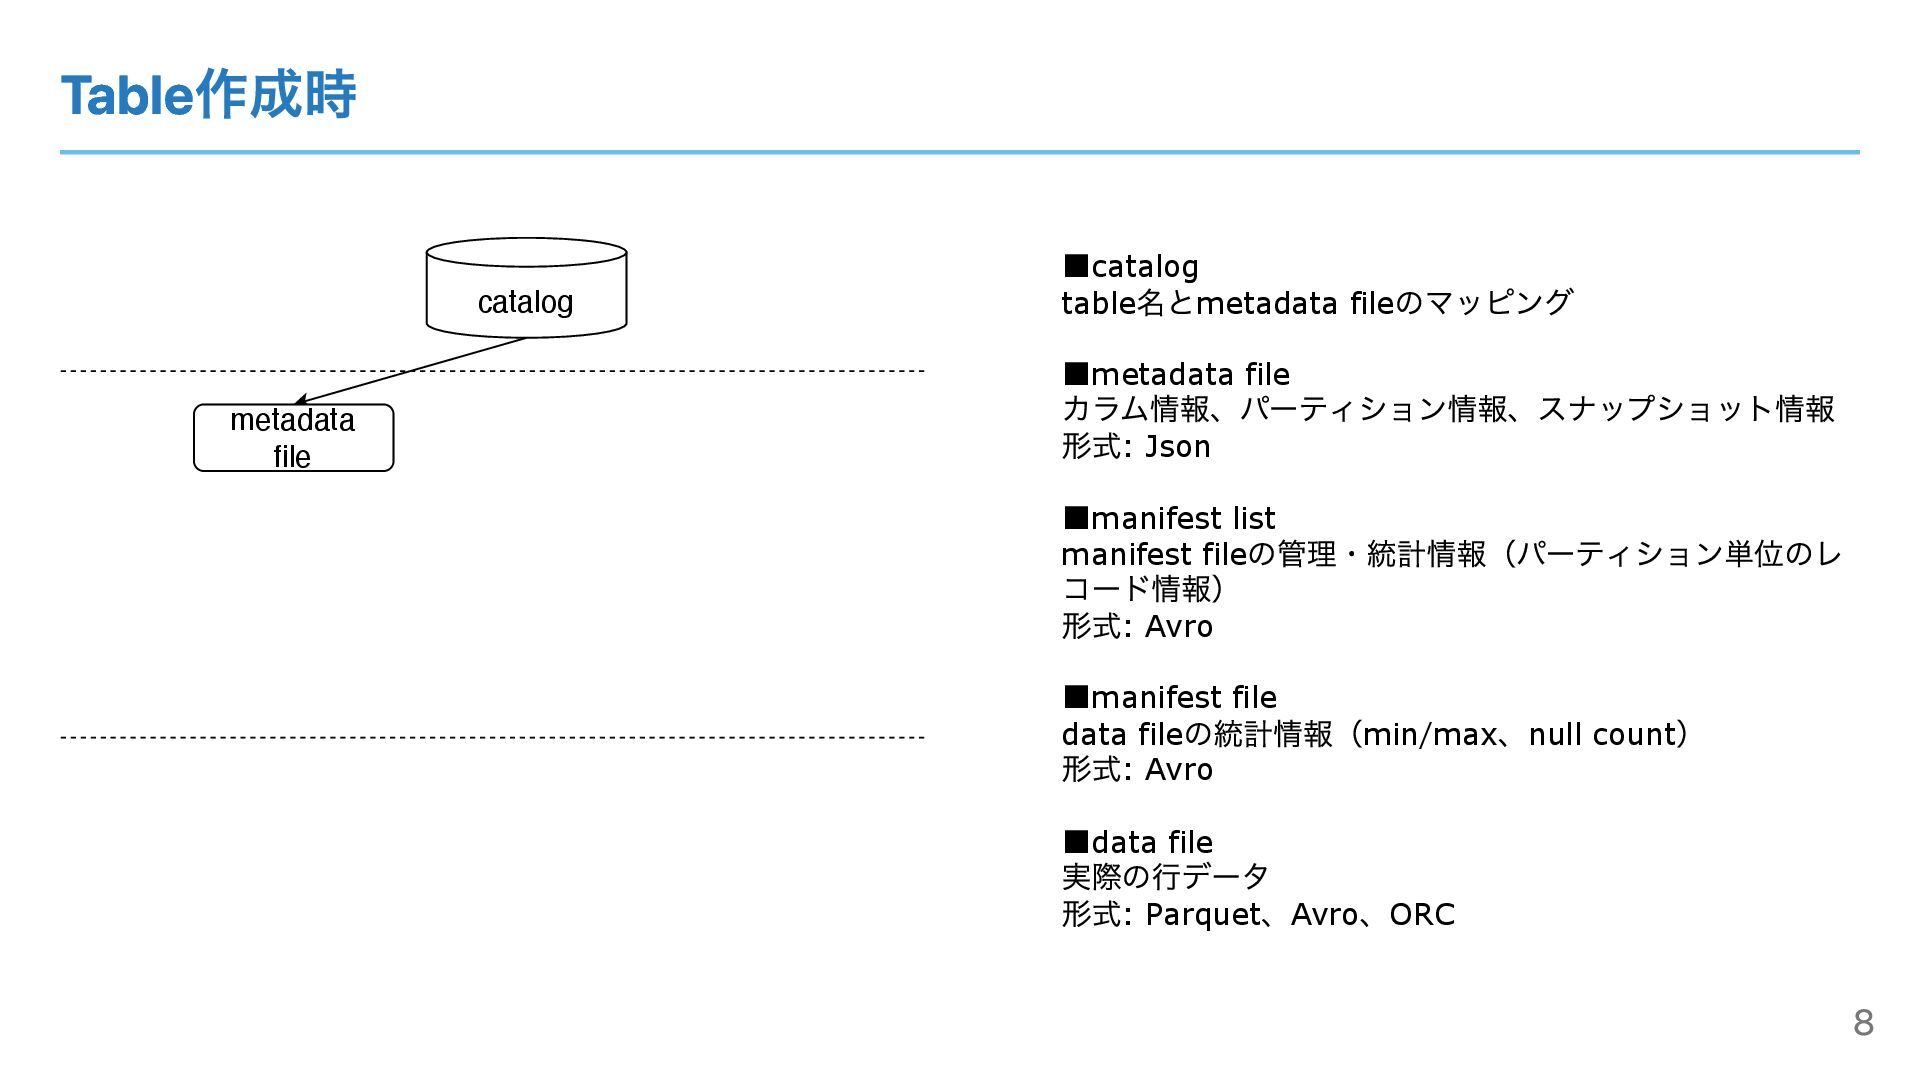
Table作成時 catalog ▪catalog table 名とmetadata file のマッピング ▪metadata file カラム情報、パーティション情報、スナップショット情報
形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC metadata file 8
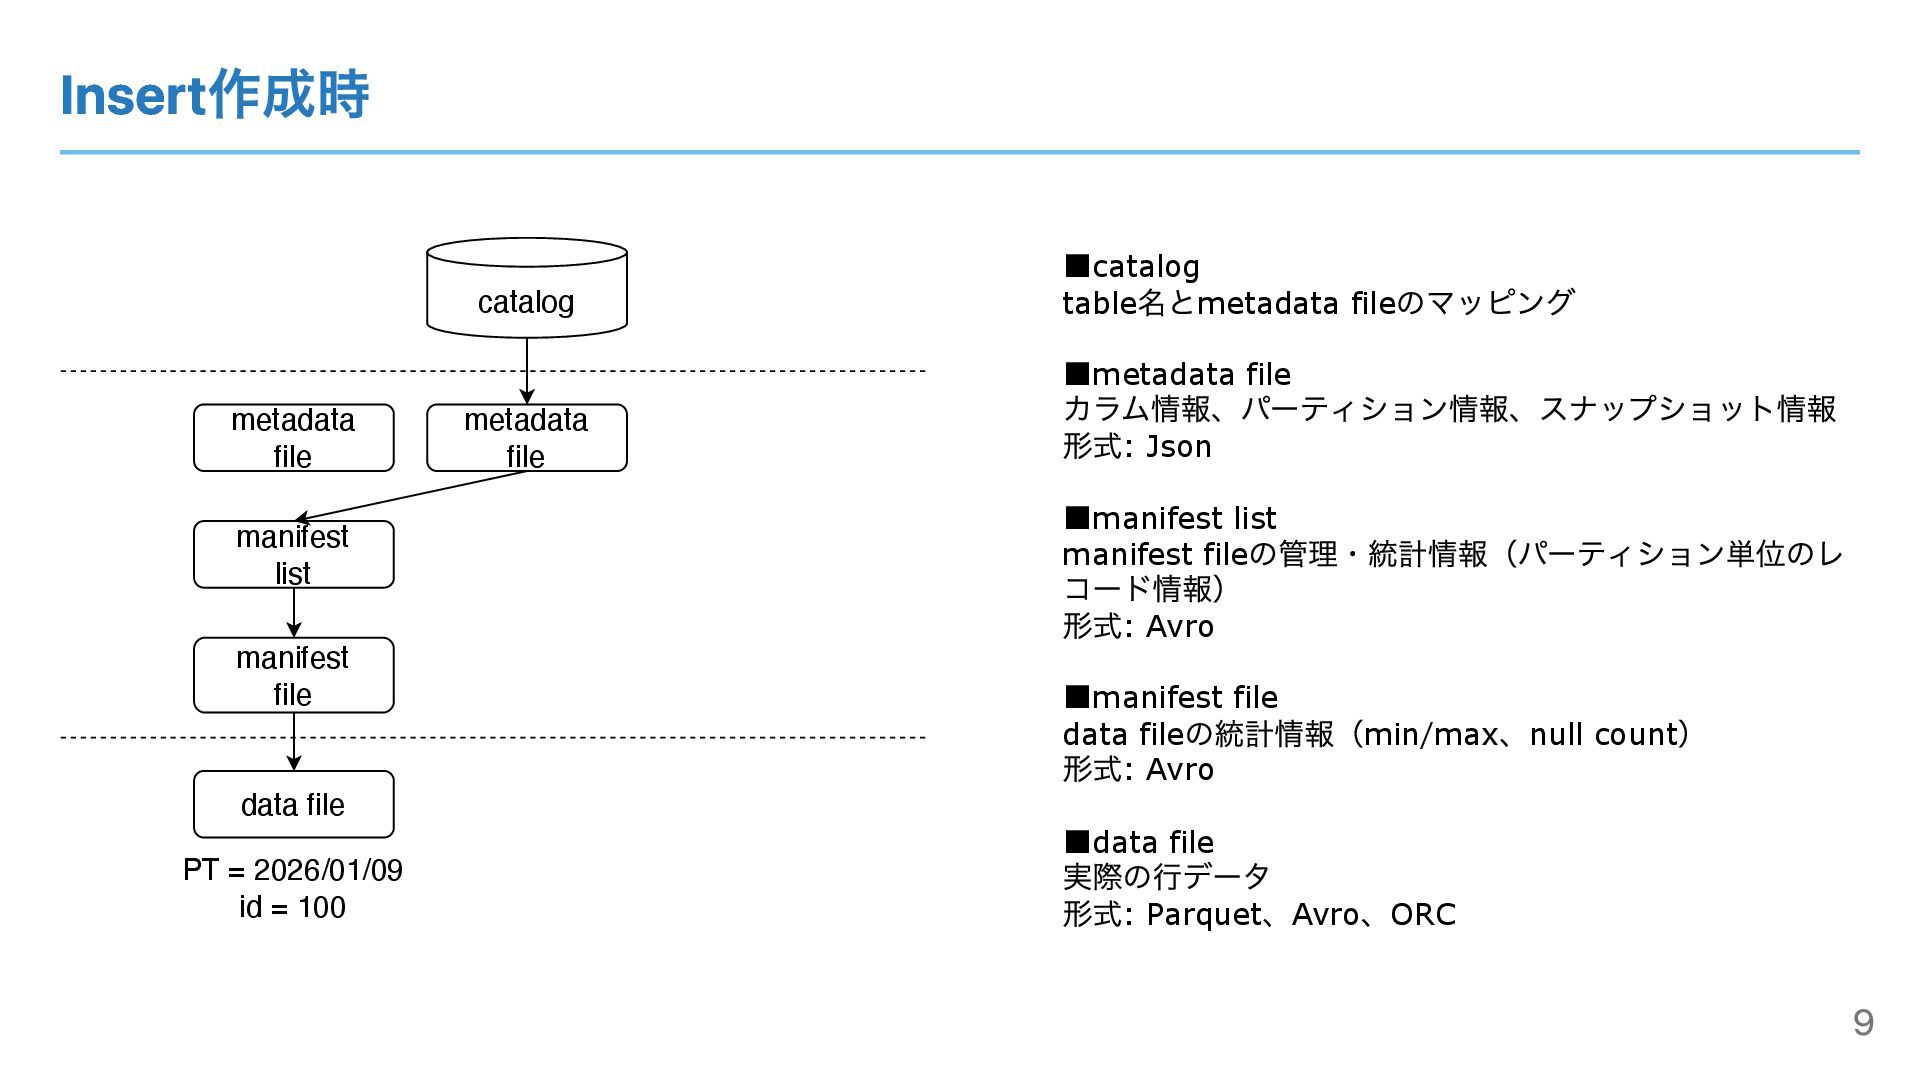
Insert作成時 catalog metadata file ▪catalog table 名とmetadata file のマッピング ▪metadata
file カラム情報、パーティション情報、スナップショット情報 形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC manifest file data file manifest list metadata file PT = 2026/01/09 id = 100 9
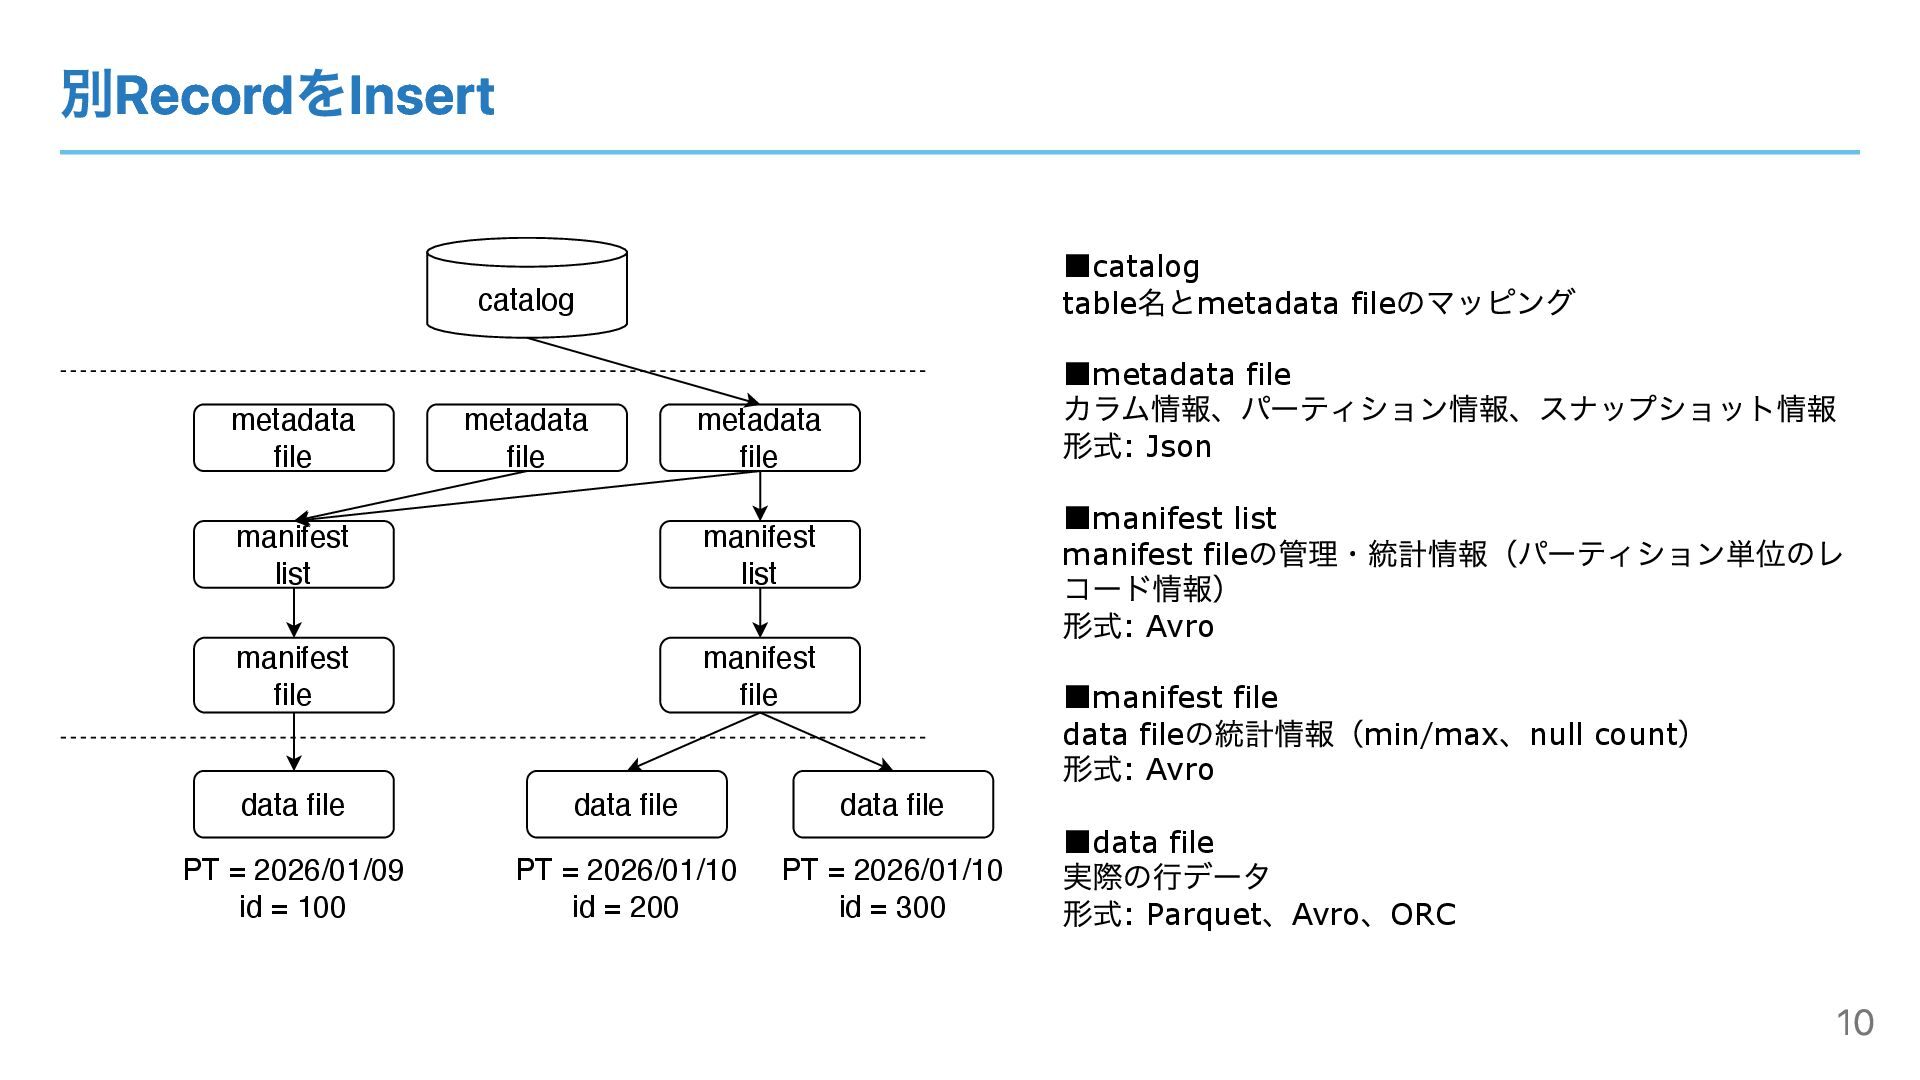
別RecordをInsert catalog metadata file manifest list manifest file data file
▪catalog table 名とmetadata file のマッピング ▪metadata file カラム情報、パーティション情報、スナップショット情報 形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC data file manifest file data file manifest list metadata file PT = 2026/01/09 id = 100 PT = 2026/01/10 id = 200 metadata file PT = 2026/01/10 id = 300 10
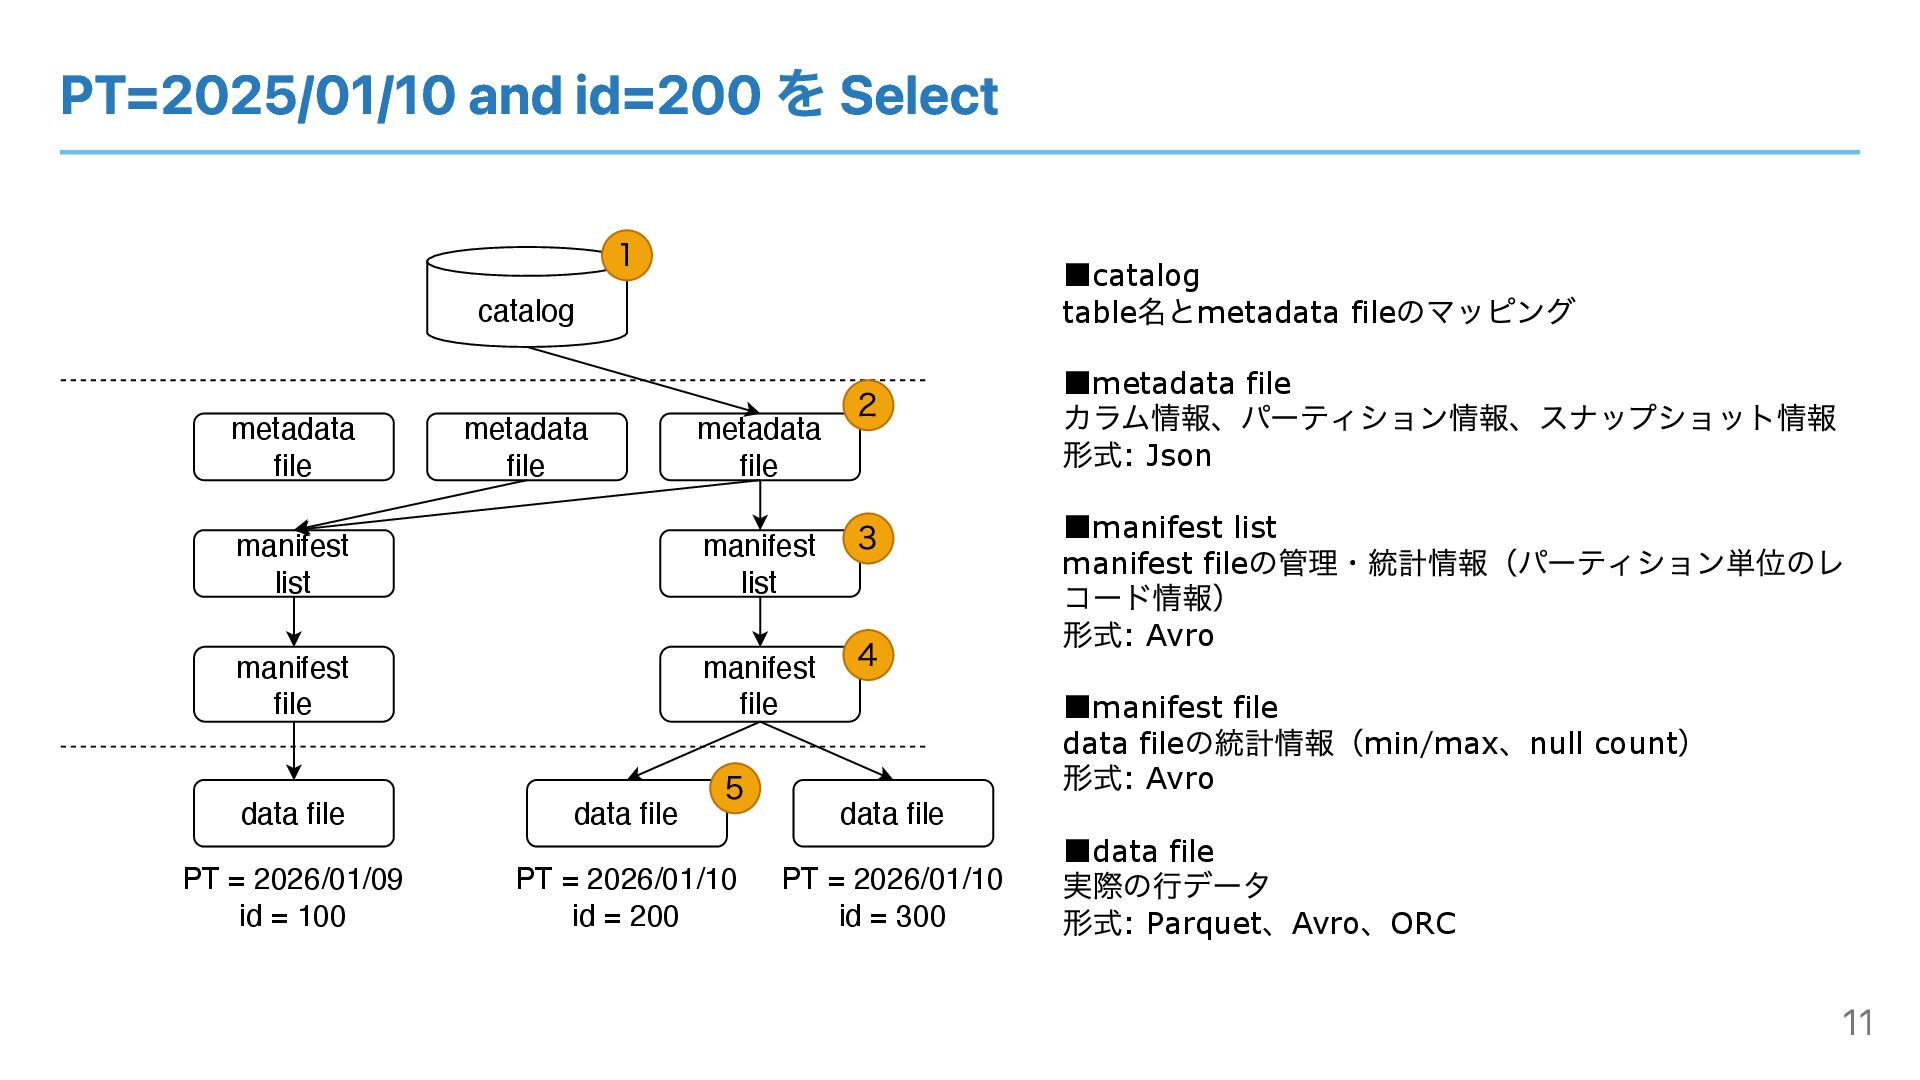
PT=2025/01/10 and id=200 を Select catalog metadata file manifest list
manifest file data file ▪catalog table 名とmetadata file のマッピング ▪metadata file カラム情報、パーティション情報、スナップショット情報 形式: Json ▪manifest list manifest file の管理・統計情報(パーティション単位のレ コード情報) 形式: Avro ▪manifest file data file の統計情報(min/max 、null count ) 形式: Avro ▪data file 実際の⾏データ 形式: Parquet 、Avro 、ORC data file manifest file data file manifest list metadata file PT = 2026/01/09 id = 100 PT = 2026/01/10 id = 200 PT = 2026/01/10 id = 300 metadata file 1 2 3 4 5 11
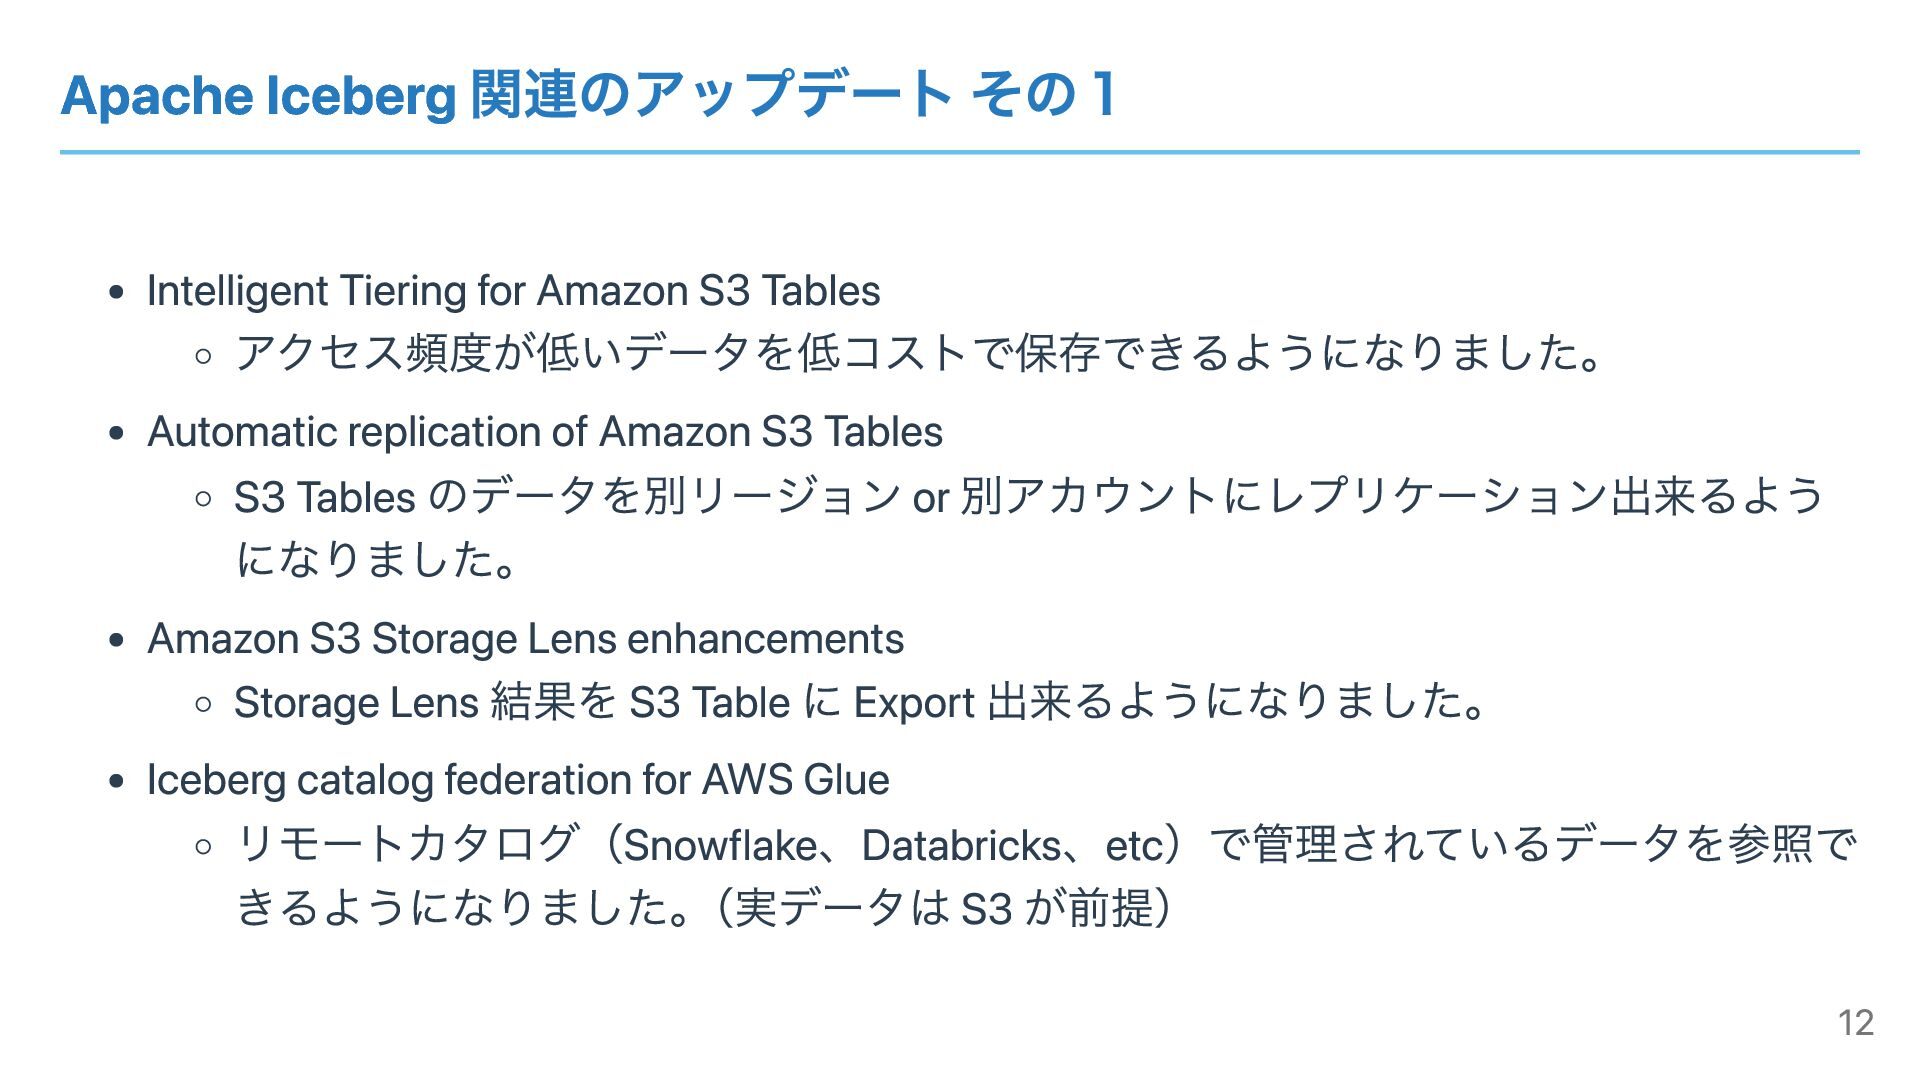
Apache Iceberg 関連のアップデート その1 Intelligent Tiering for Amazon S3 Tables
アクセス頻度が低いデータを低コストで保存できるようになりました。 Automatic replication of Amazon S3 Tables S3 Tables のデータを別リージョン or 別アカウントにレプリケーション出来るよう になりました。 Amazon S3 Storage Lens enhancements Storage Lens 結果を S3 Table に Export 出来るようになりました。 Iceberg catalog federation for AWS Glue リモートカタログ(Snowflake、Databricks、etc)で管理されているデータを参照で きるようになりました。 (実データは S3 が前提) 12
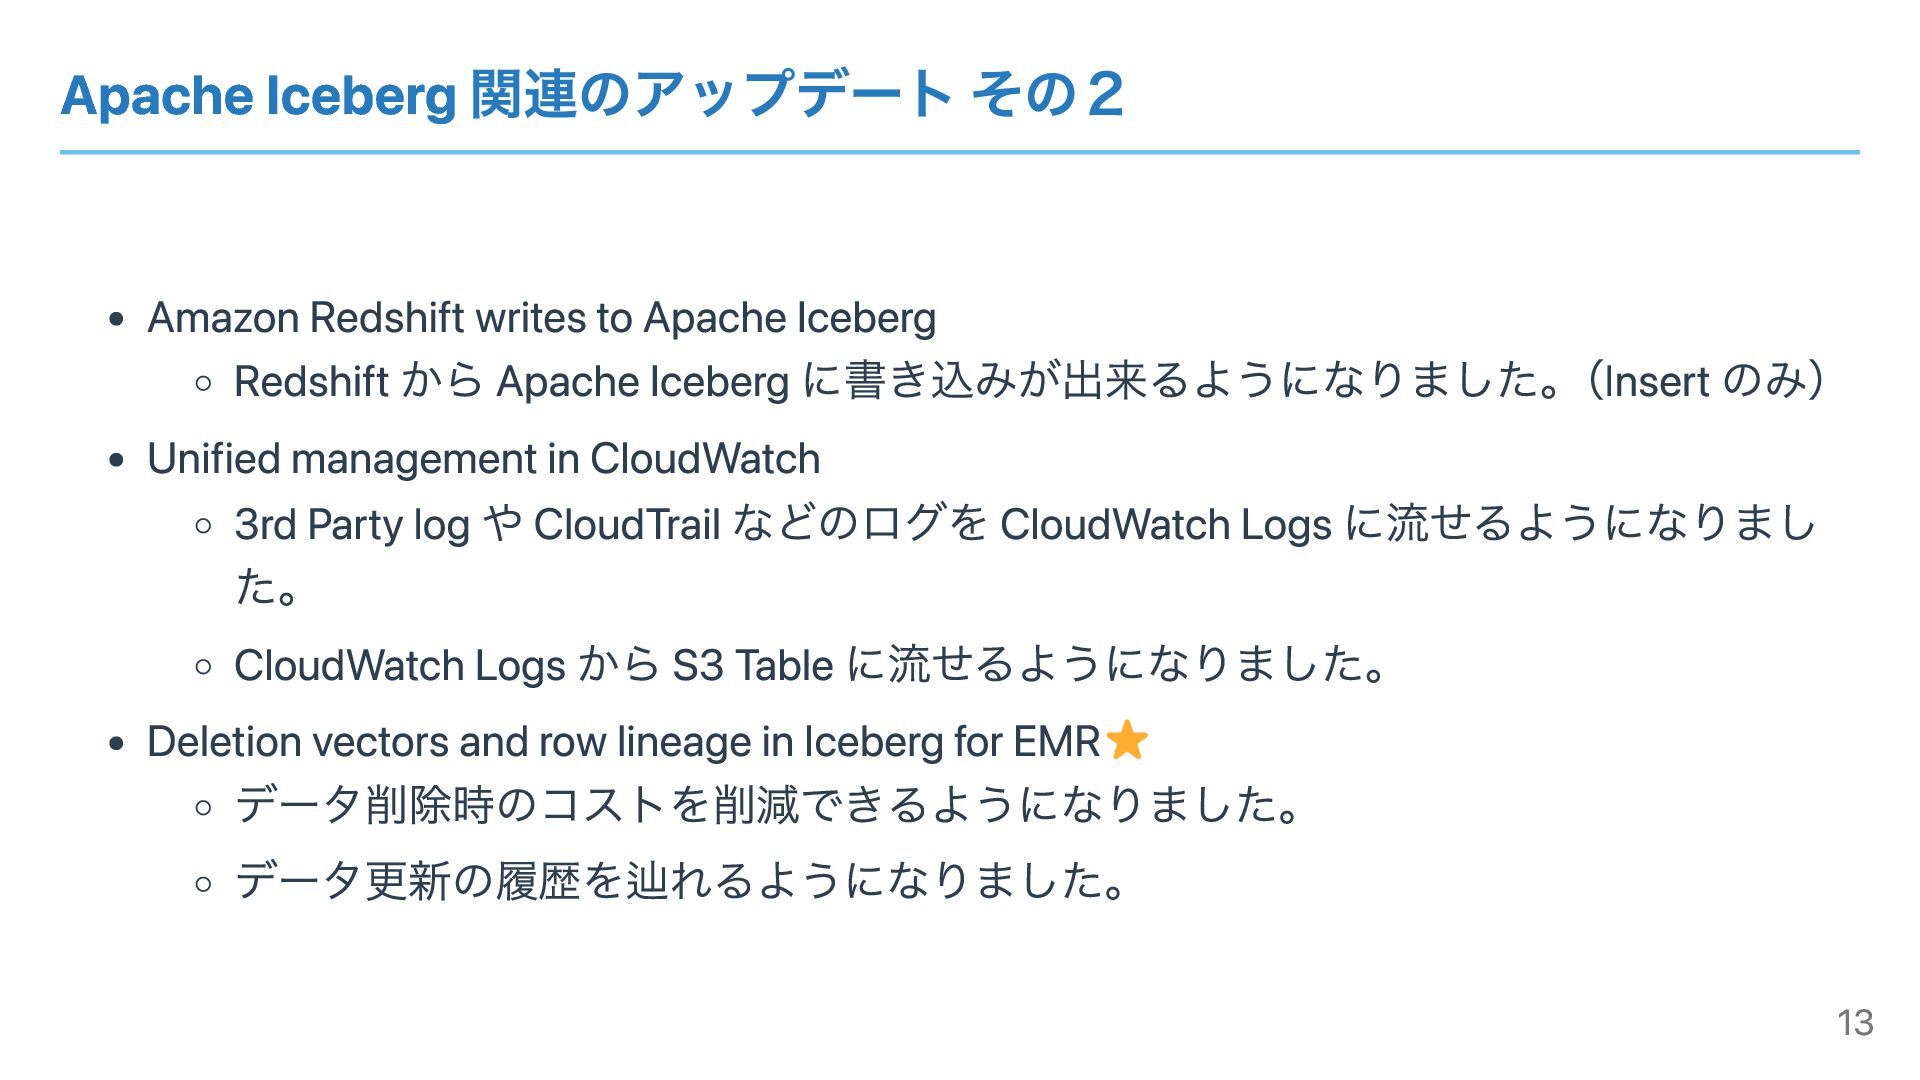
Apache Iceberg 関連のアップデート その2 Amazon Redshift writes to Apache Iceberg
Redshift から Apache Iceberg に書き込みが出来るようになりました。 (Insert のみ) Unified management in CloudWatch 3rd Party log や CloudTrail などのログを CloudWatch Logs に流せるようになりまし た。 CloudWatch Logs から S3 Table に流せるようになりました。 Deletion vectors and row lineage in Iceberg for EMR データ削除時のコストを削減できるようになりました。 データ更新の履歴を辿れるようになりました。 13
deletion vectors 削除ベクトル 14
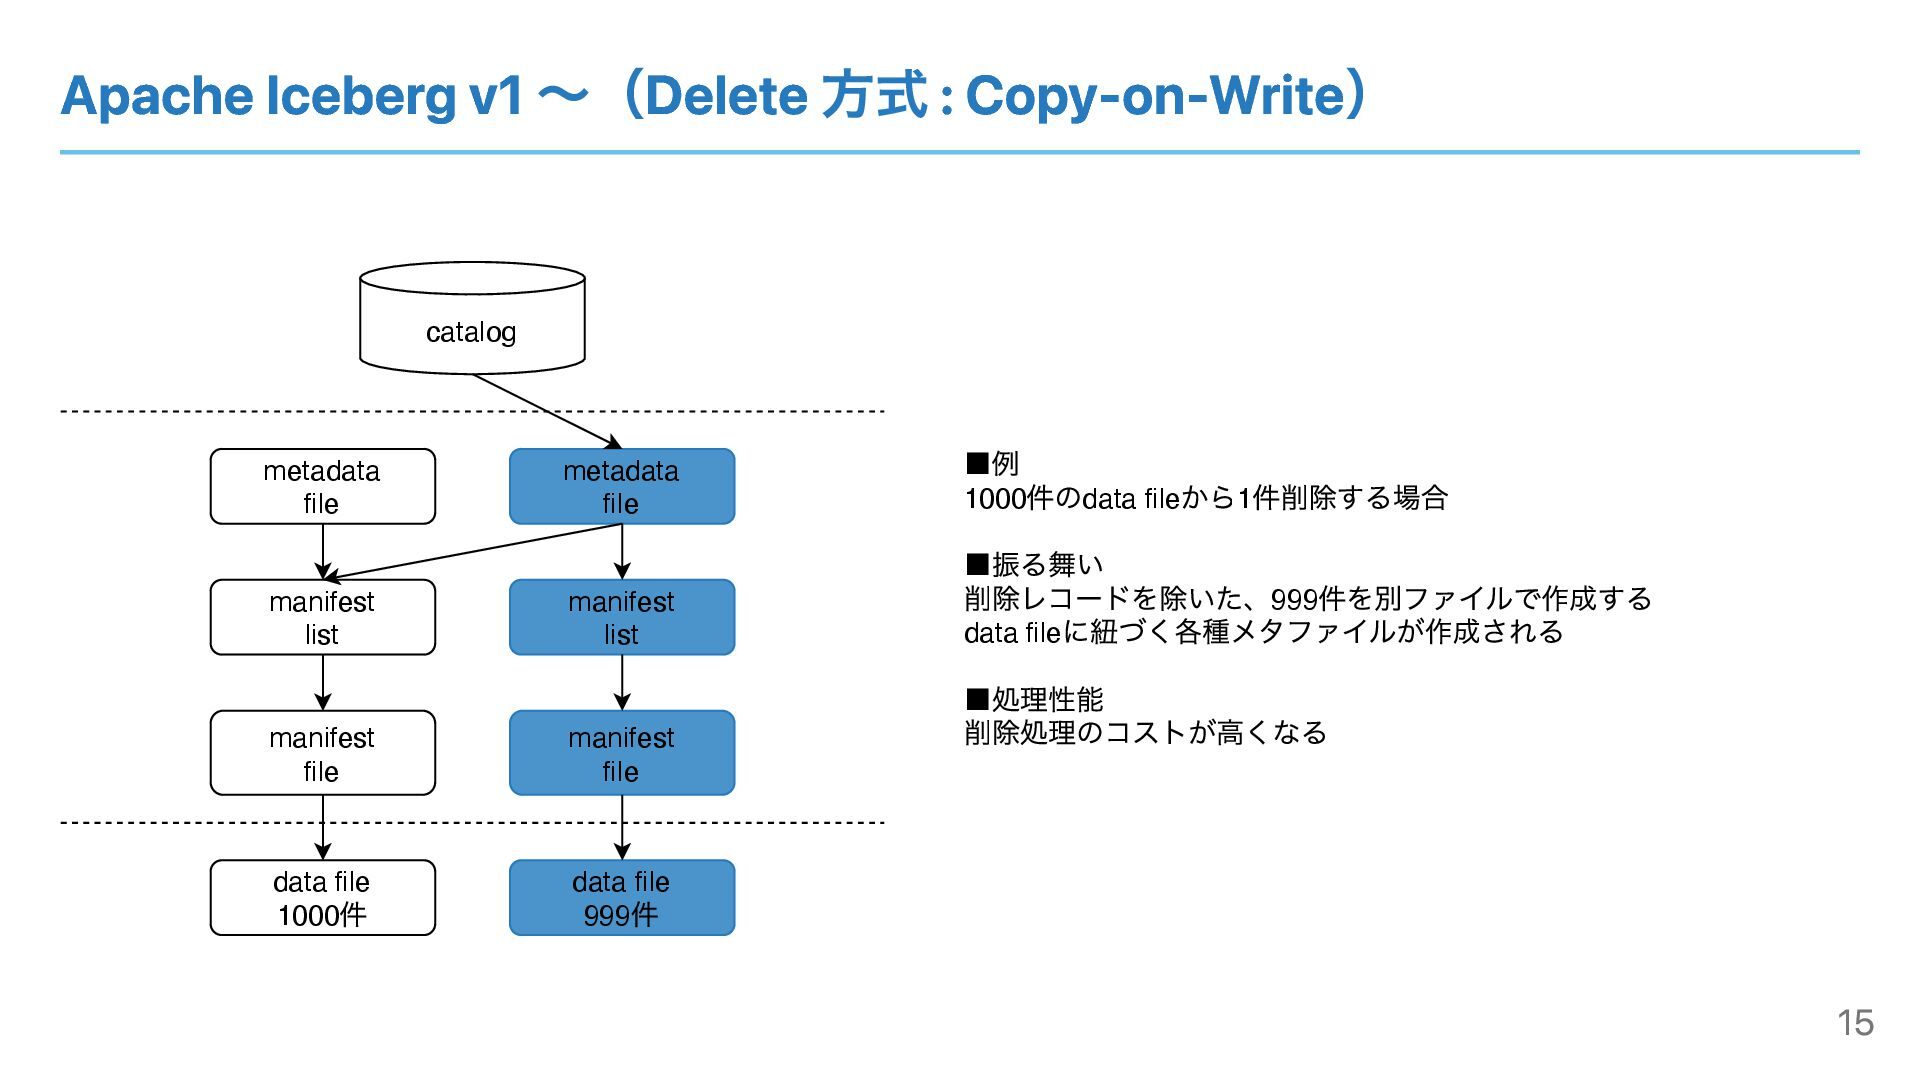
Apache Iceberg v1 〜(Delete 方式 : Copy-on-Write) catalog metadata file
manifest list manifest file data file 1000 件 ▪例 1000 件のdata file から1 件削除する場合 ▪振る舞い 削除レコードを除いた、999 件を別ファイルで作成する data file に紐づく各種メタファイルが作成される ▪処理性能 削除処理のコストが⾼くなる data file 999 件 metadata file manifest list manifest file 15
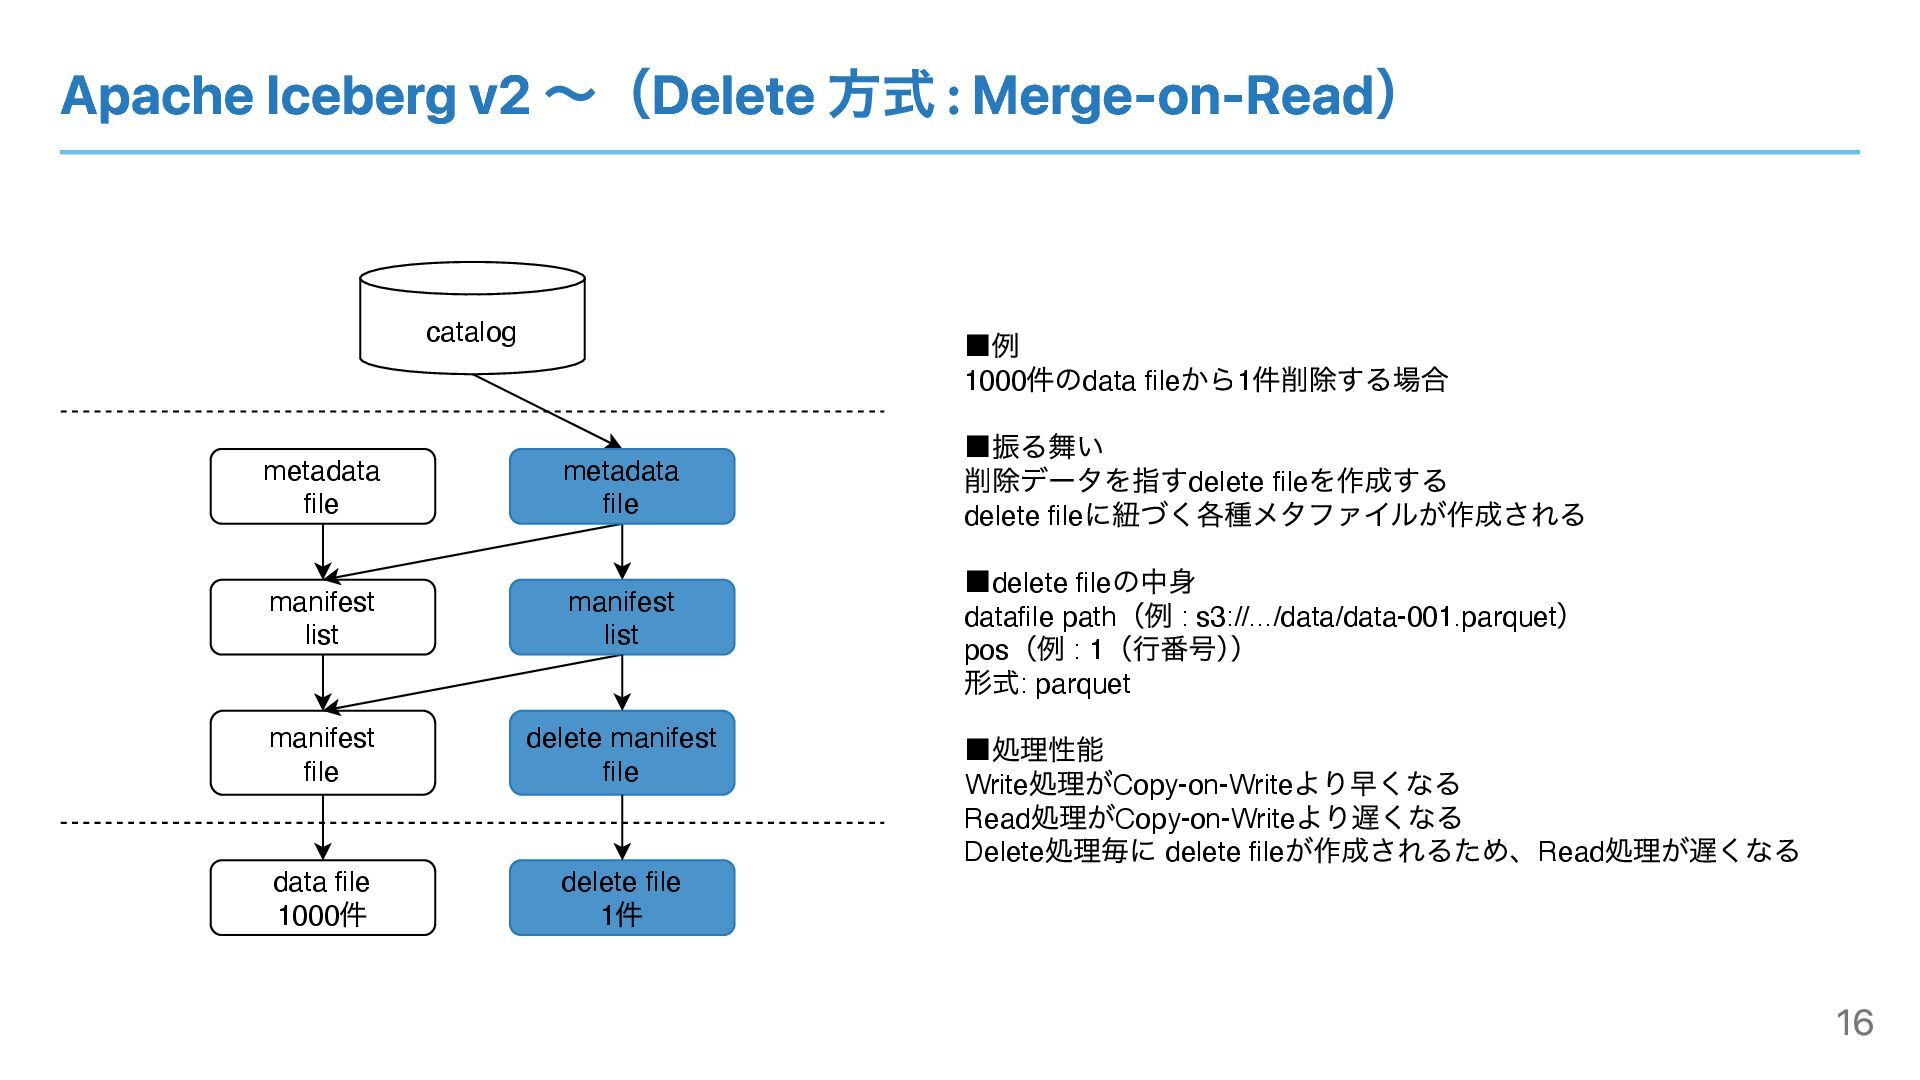
Apache Iceberg v2 〜(Delete 方式 : Merge-on-Read) catalog metadata file
manifest list manifest file data file 1000 件 ▪例 1000 件のdata file から1 件削除する場合 ▪振る舞い 削除データを指すdelete file を作成する delete file に紐づく各種メタファイルが作成される ▪delete file の中⾝ datafile path (例 : s3://.../data/data-001.parquet ) pos (例 : 1 (⾏番号) ) 形式: parquet ▪処理性能 Write 処理がCopy-on-Write より早くなる Read 処理がCopy-on-Write より遅くなる Delete 処理毎に delete file が作成されるため、Read 処理が遅くなる delete file 1 件 metadata file manifest list delete manifest file 16
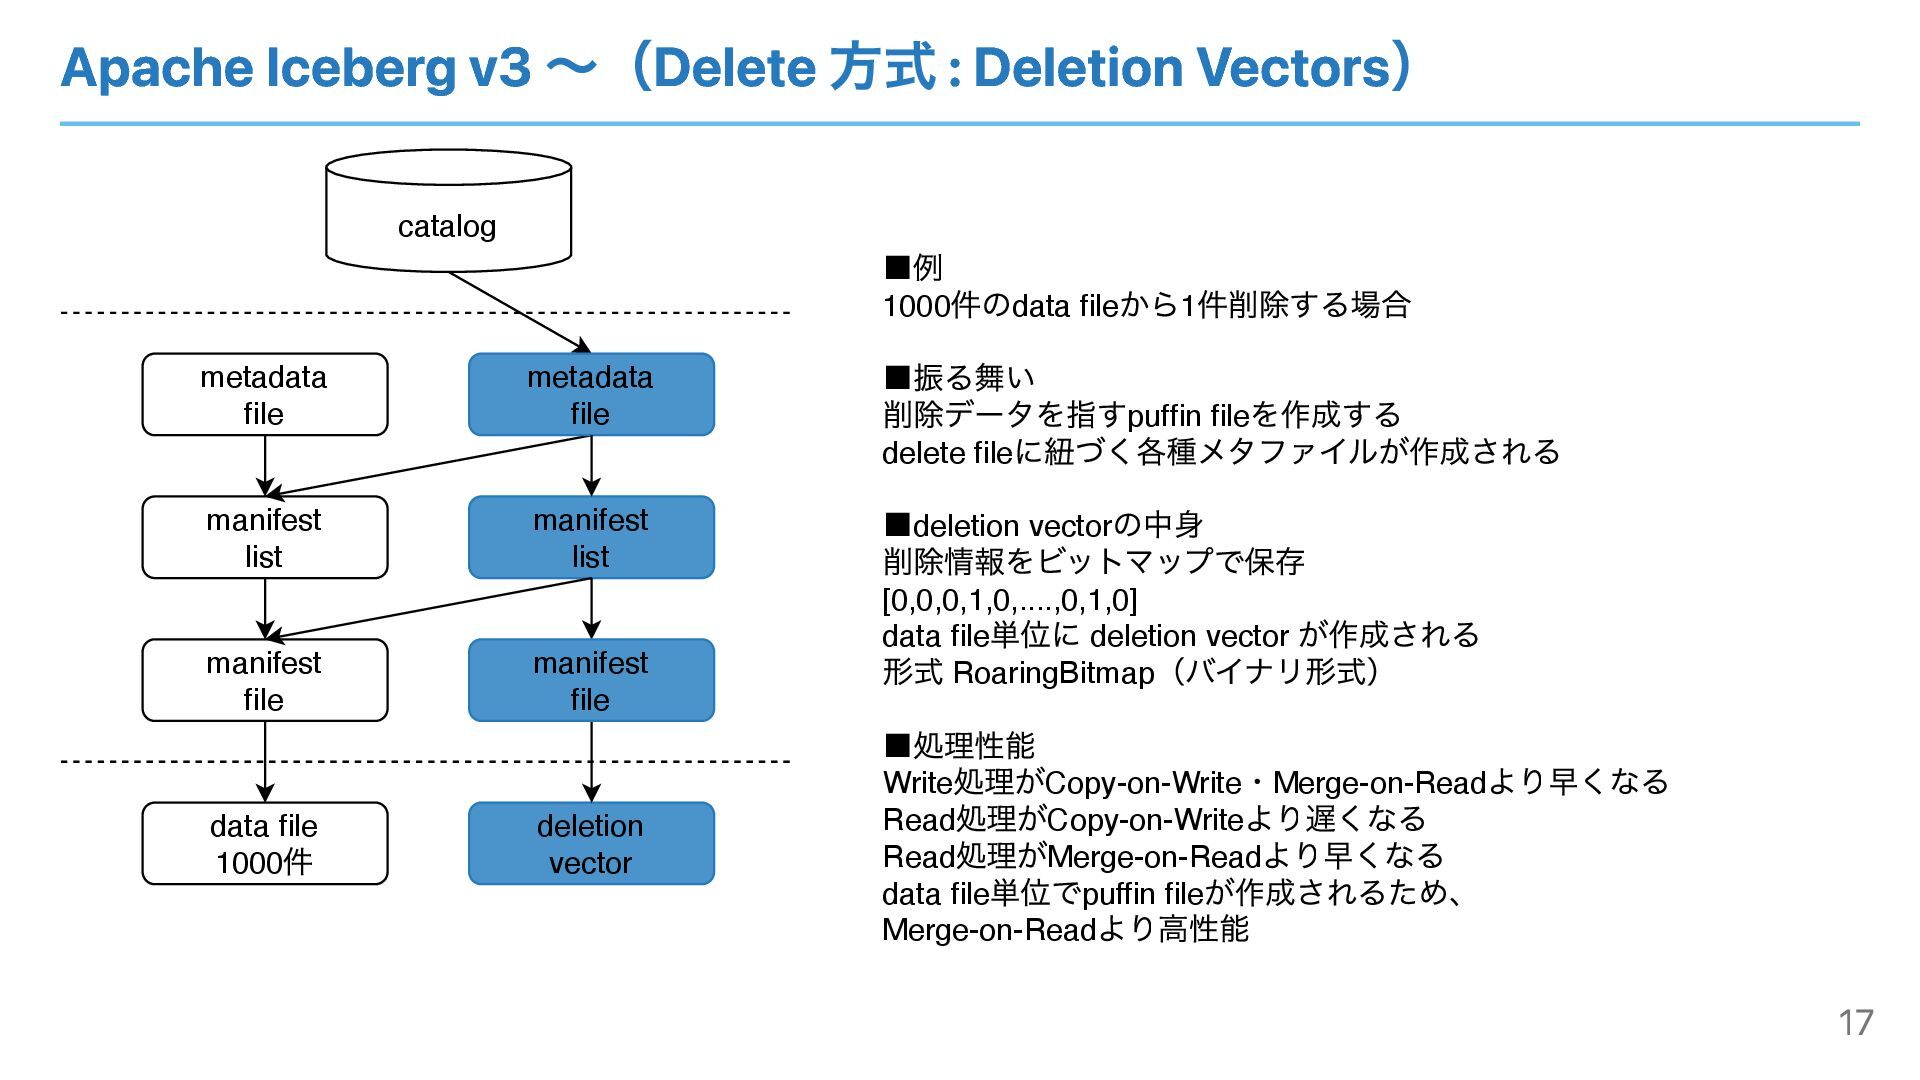
Apache Iceberg v3 〜(Delete 方式 : Deletion Vectors) catalog metadata
file manifest list manifest file data file 1000 件 deletion vector metadata file manifest list ▪例 1000 件のdata file から1 件削除する場合 ▪振る舞い 削除データを指すpuffin file を作成する delete file に紐づく各種メタファイルが作成される ▪deletion vector の中⾝ 削除情報をビットマップで保存 [0,0,0,1,0,....,0,1,0] data file 単位に deletion vector が作成される 形式 RoaringBitmap (バイナリ形式) ▪処理性能 Write 処理がCopy-on-Write ・Merge-on-Read より早くなる Read 処理がCopy-on-Write より遅くなる Read 処理がMerge-on-Read より早くなる data file 単位でpuffin file が作成されるため、 Merge-on-Read より⾼性能 manifest file 17
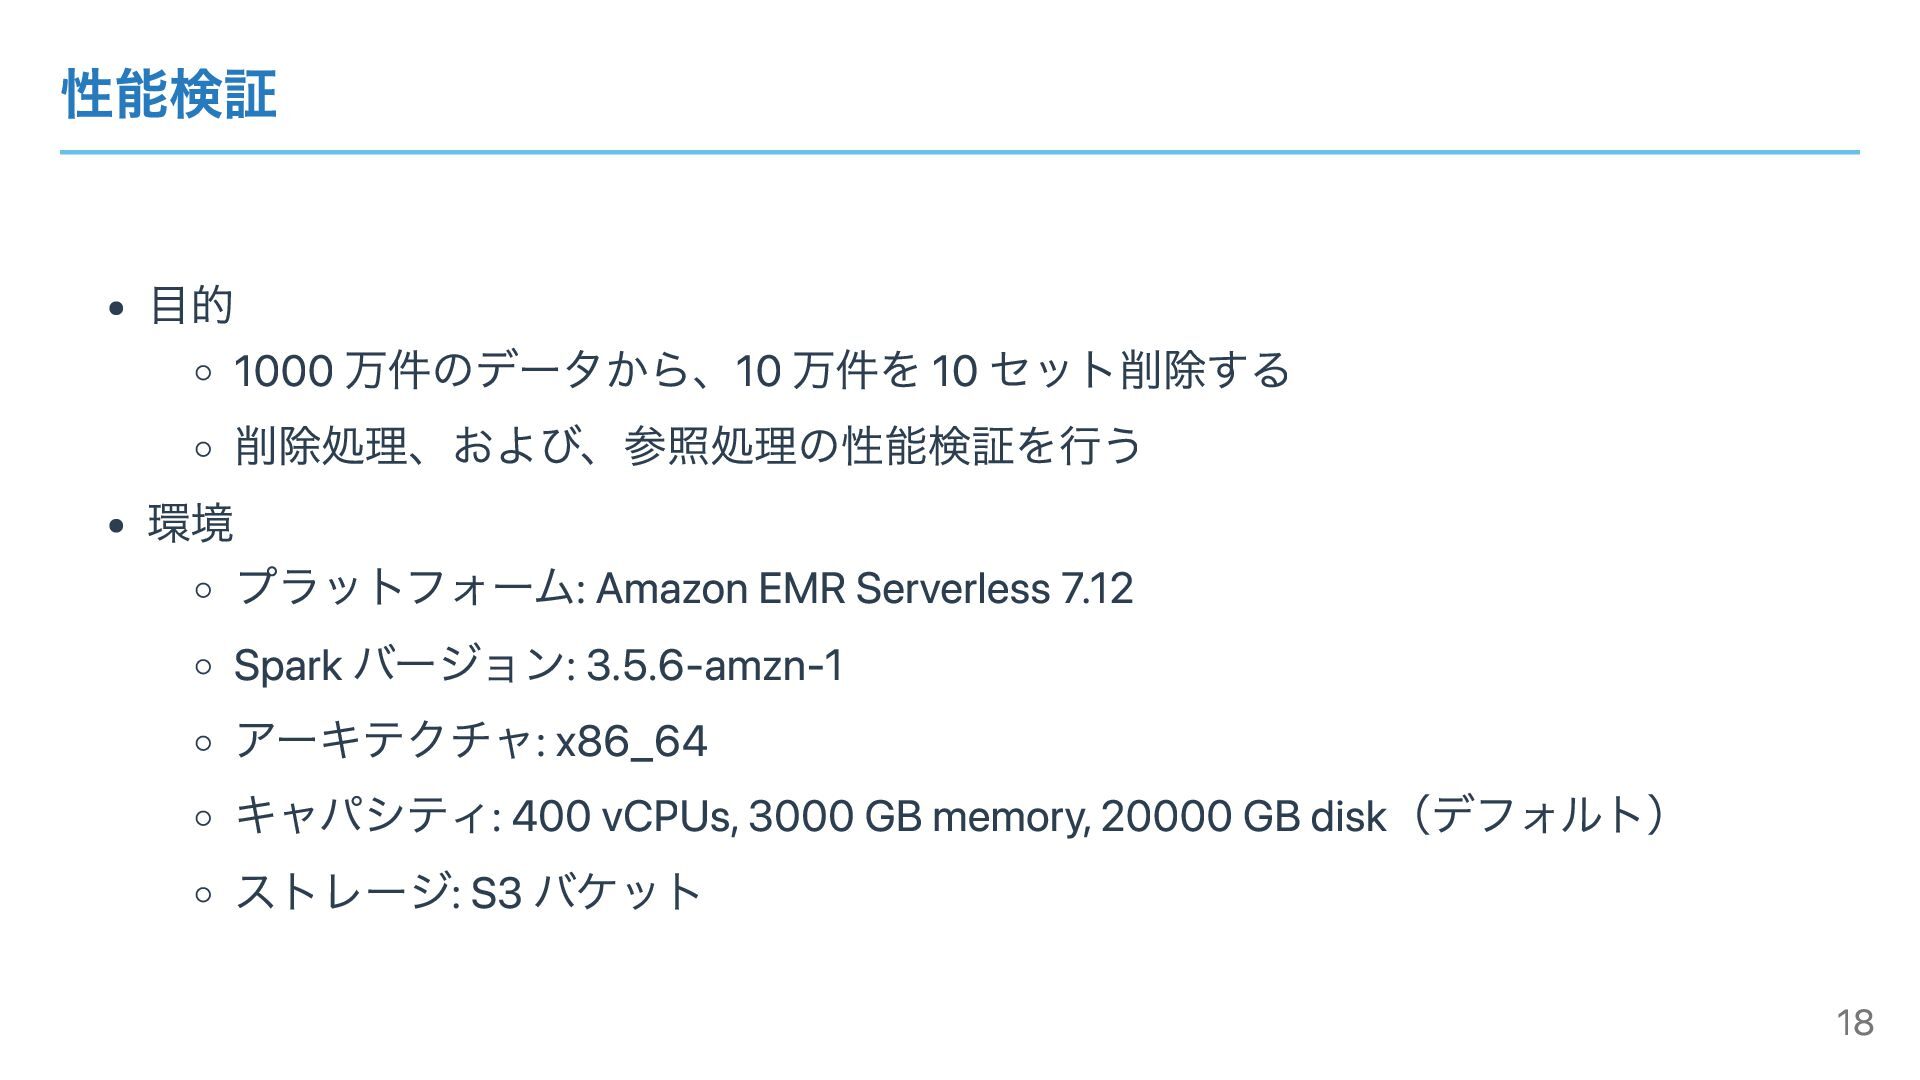
性能検証 目的 1000 万件のデータから、10 万件を 10 セット削除する 削除処理、および、参照処理の性能検証を行う 環境 プラットフォーム:
Amazon EMR Serverless 7.12 Spark バージョン: 3.5.6-amzn-1 アーキテクチャ: x86_64 キャパシティ: 400 vCPUs, 3000 GB memory, 20000 GB disk(デフォルト) ストレージ: S3 バケット 18
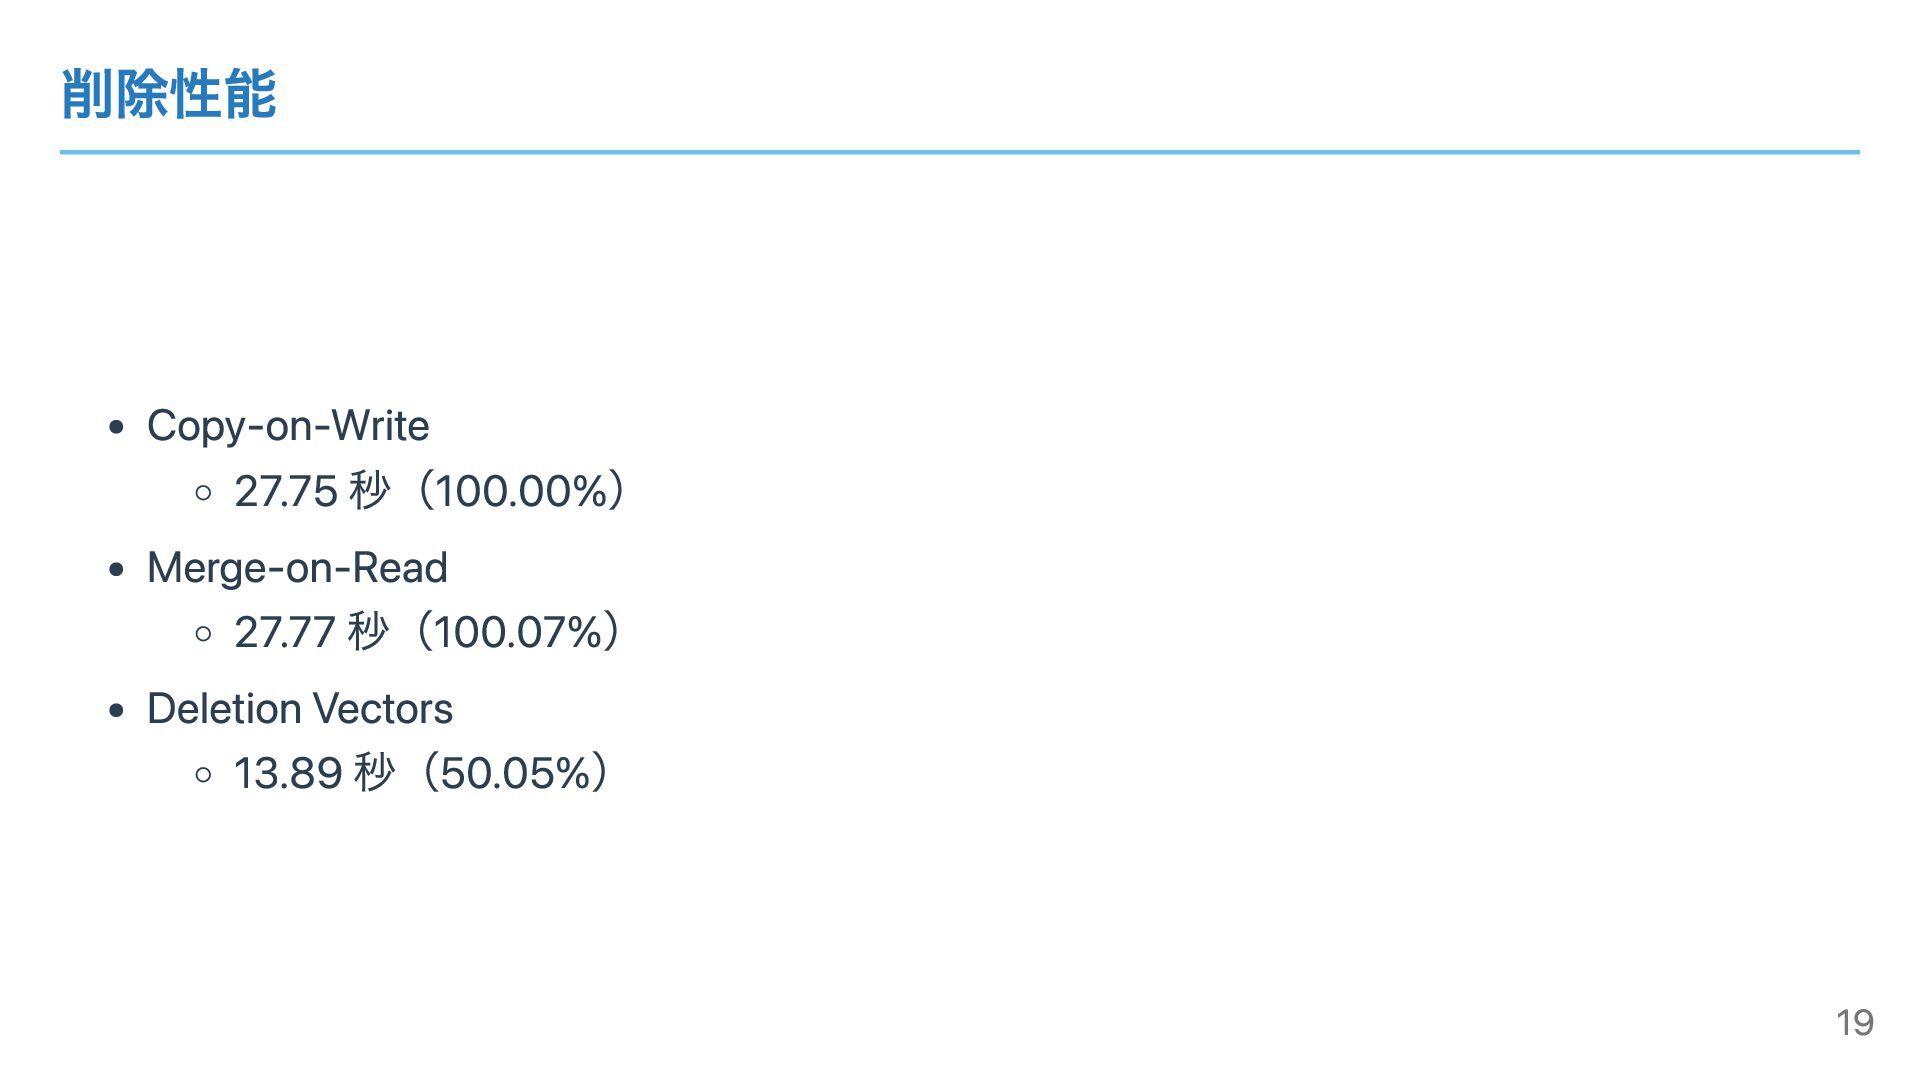
削除性能 Copy-on-Write 27.75 秒(100.00%) Merge-on-Read 27.77 秒(100.07%) Deletion Vectors 13.89
秒(50.05%) 19
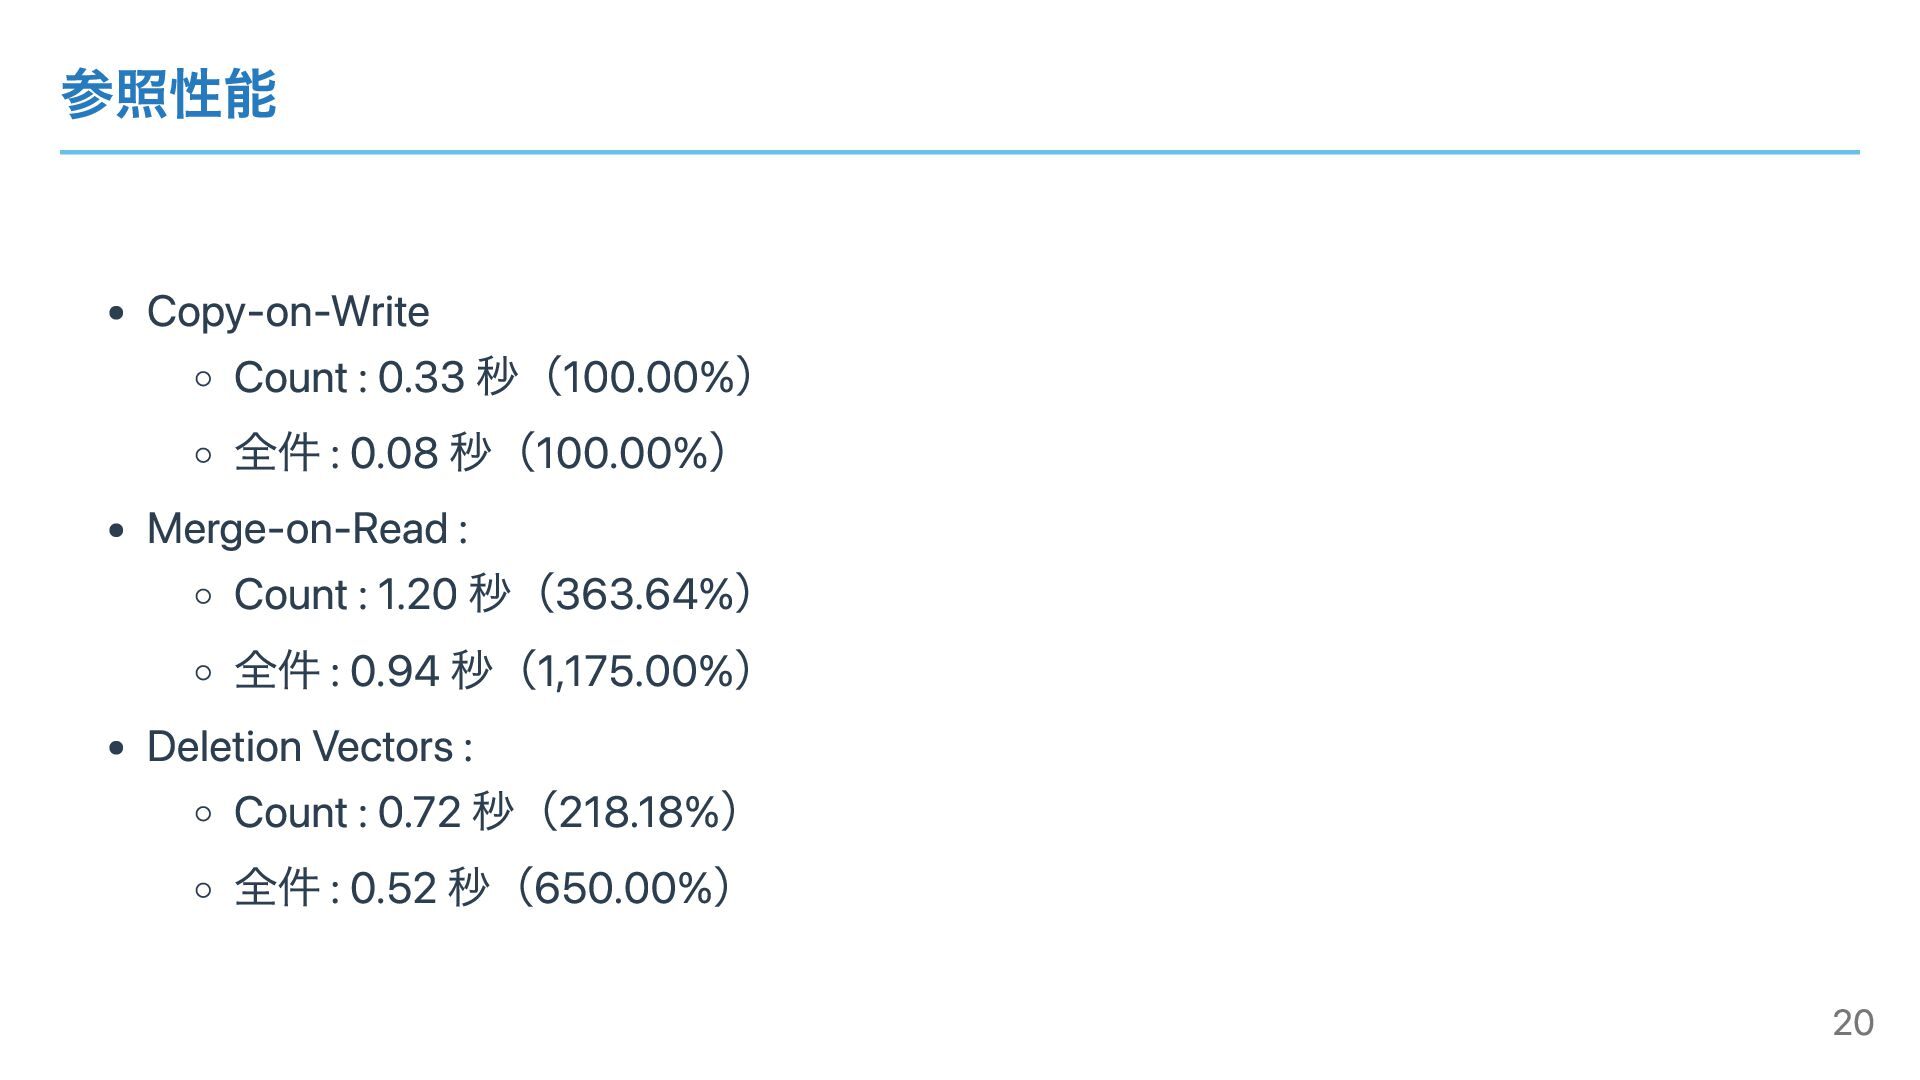
参照性能 Copy-on-Write Count : 0.33 秒(100.00%) 全件 : 0.08 秒(100.00%)
Merge-on-Read : Count : 1.20 秒(363.64%) 全件 : 0.94 秒(1,175.00%) Deletion Vectors : Count : 0.72 秒(218.18%) 全件 : 0.52 秒(650.00%) 20
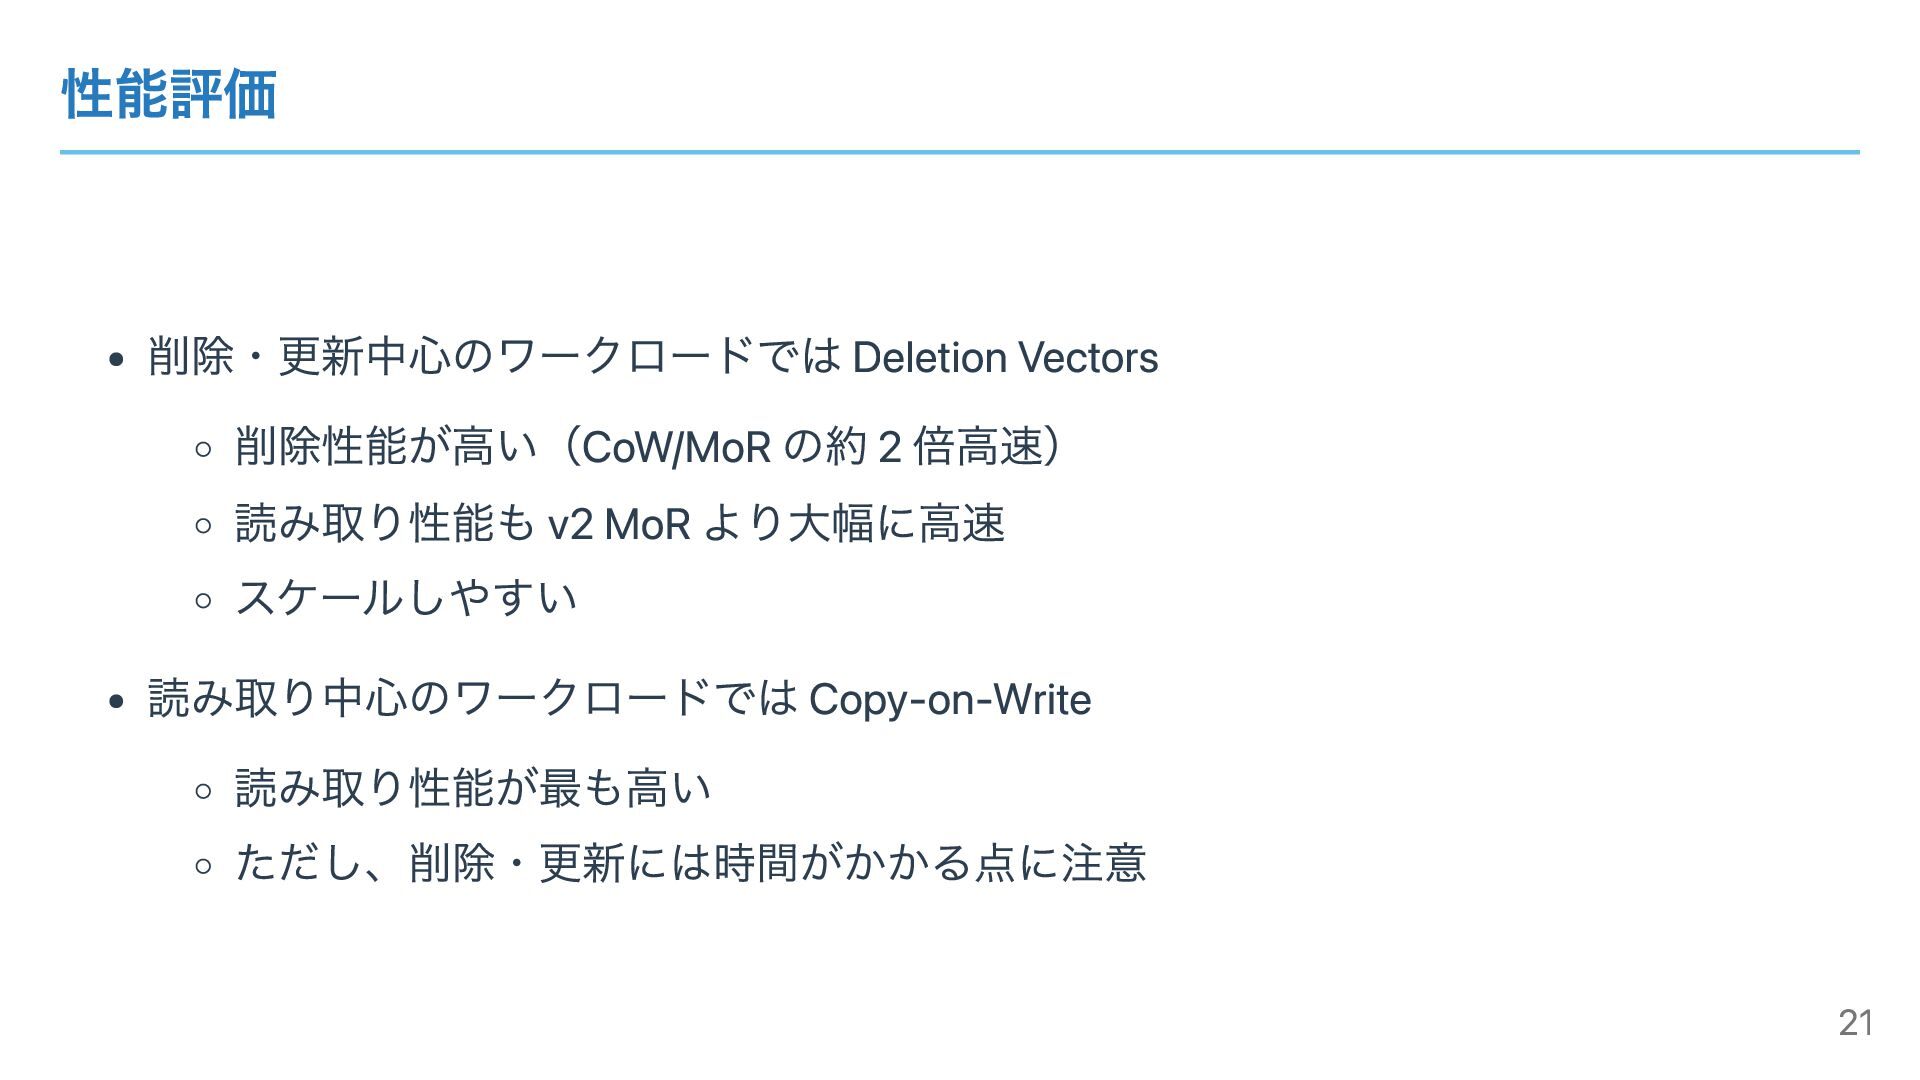
性能評価 削除・更新中心のワークロードでは Deletion Vectors 削除性能が高い(CoW/MoR の約 2 倍高速) 読み取り性能も v2
MoR より大幅に高速 スケールしやすい 読み取り中心のワークロードでは Copy-on-Write 読み取り性能が最も高い ただし、削除・更新には時間がかかる点に注意 21
最後に 今後も Apache Iceberg を中心とした Data Lake 整備が進んで行くと考えています。 データ整備の1案としてご利用ください 22


 shigeruoda
 dada4386
 ishiirikie
 hironobuiga
 ichiki1023
 miidas
 husengs7
 kawametho
 masakiokuda
 yama3133
 kitagawaz
 pei0804
 pauli
 marcelosomers
 inesmontani
 csswizardry
 baasie
 mkilby
 lauravandoore
 aki_iinuma
 techseoconnect
 mayatellez
 sergeychernyshev
 tonyrice
 hannesfritz