「原因不明なナゾの障害」で終わらないための Kubernetes のログの徹底活用
Sponsored
·
 Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→
Ship Features Fearlessly
Turn features on and off without deploys. Used by thousands of Ruby developers.
→

Share
Embed
「原因不明なナゾの障害」で終わらないための Kubernetes のログの徹底活用

GoogleCloudPlatformJapan
October 14, 2025
Transcript
34 slides
-
「原因不明なナゾの障害」 で終わらないための Kubernetes のログの徹底活用 Kakeru Ishii / Ryunosuke Suzuki Cloud
Native Days Winter 2025 - プレイベント -
Kakeru Ishii Google Cloud Technical Solutions Engineer Ryunosuke Suzuki Google
Cloud Technical Solutions Engineer Speakers @RyuSA @kyasbal_k -
04 なぜ今日のテーマを私たちが話すの ? 我々 TSE のお仕事は 「お問い合わせを受けて、実際にテレメトリを調査しお客様への質問に答えること」 Google Cloud には
Kubernetes に関連する製品が多数存在する • Google Kubernetes Engine (GKE) や Google Distributed Cloud (GDC) などの Kubernetes クラスタを構築・管理する製品 • その他多数の GKE 上で動作している製品 TSE は問い合わせを受けて初めてお客様のクラスタの設定やログを見ます。 今まで見たことがなく、何のワークロードが稼働しているかも基本的に知らない Kubernetes クラスタの過去の状態を推測、 調査の依頼を受けた問題の原因究明を行います。また、場合によっては問い合わせ時にはクラスタはすでに削除されていることもあります。 -
05 なぜ今日のテーマを私たちが話すの ? 我々 TSE のお仕事は 「お問い合わせを受けて、実際にテレメトリを調査しお客様への質問に答えること」 Google Cloud には
Kubernetes に関連する製品が多数存在する • Google Kubernetes Engine (GKE) や Google Distributed Cloud (GDC) などの Kubernetes クラスタを構築・管理する製品 • その他多数の GKE 上で動作している製品 TSE は問い合わせを受けて初めてお客様のクラスタの設定やログを見ます。 今まで見たことがなく、何のワークロードが稼働しているかも基本的に知らない Kubernetes クラスタの過去の状態を推測、 調査の依頼を受けた問題の原因究明を行います。また、場合によっては問い合わせ時にはクラスタはすでに削除されていることもあります。 つまり、多分 Kubernetes のログにとても詳しいんです。 -
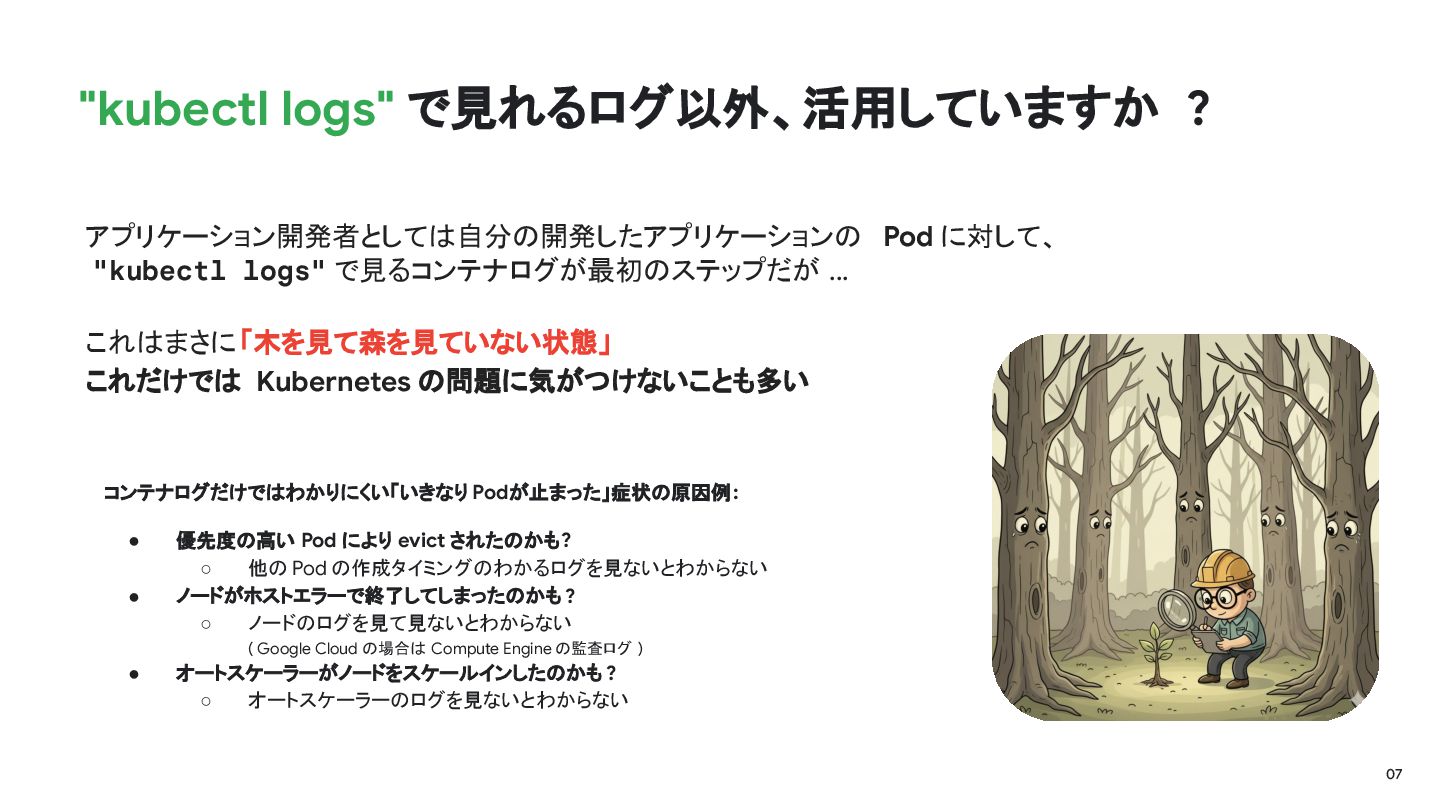
07 アプリケーション開発者としては自分の開発したアプリケーションの Pod に対して、 "kubectl logs" で見るコンテナログが最初のステップだが ... これはまさに「木を見て森を見ていない状態」 これだけでは
Kubernetes の問題に気がつけないことも多い "kubectl logs" で見れるログ以外、活用していますか ? コンテナログだけではわかりにくい「いきなり Podが止まった」症状の原因例: • 優先度の高い Pod により evict されたのかも? ◦ 他の Pod の作成タイミングのわかるログを見ないとわからない • ノードがホストエラーで終了してしまったのかも ? ◦ ノードのログを見て見ないとわからない ( Google Cloud の場合は Compute Engine の監査ログ ) • オートスケーラーがノードをスケールインしたのかも ? ◦ オートスケーラーのログを見ないとわからない -
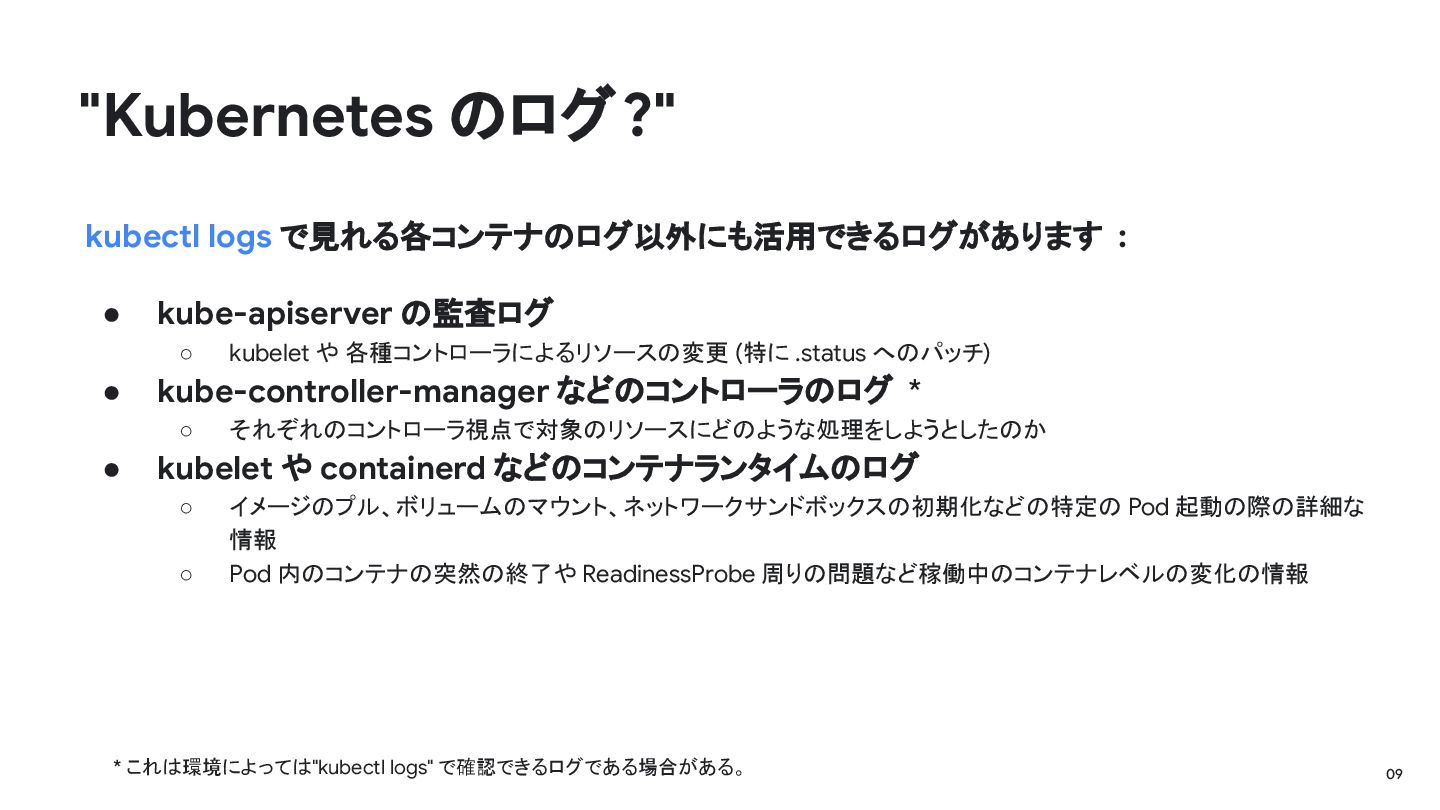
08 "Kubernetes のログ?" kubectl logs で見れる各コンテナのログ以外にも活用できるログがあります : • kube-apiserver の監査ログ
• kube-controller-manager などのコントローラのログ * • kubelet や containerd などのコンテナランタイムのログ * これは環境によっては "kubectl logs" で確認できるログである場合がある。 -
09 "Kubernetes のログ?" kubectl logs で見れる各コンテナのログ以外にも活用できるログがあります : • kube-apiserver の監査ログ
◦ kubelet や 各種コントローラによるリソースの変更 (特に .status へのパッチ) • kube-controller-manager などのコントローラのログ * ◦ それぞれのコントローラ視点で対象のリソースにどのような処理をしようとしたのか • kubelet や containerd などのコンテナランタイムのログ ◦ イメージのプル、ボリュームのマウント、ネットワークサンドボックスの初期化などの特定の Pod 起動の際の詳細な 情報 ◦ Pod 内のコンテナの突然の終了や ReadinessProbe 周りの問題など稼働中のコンテナレベルの変化の情報 * これは環境によっては "kubectl logs" で確認できるログである場合がある。 -
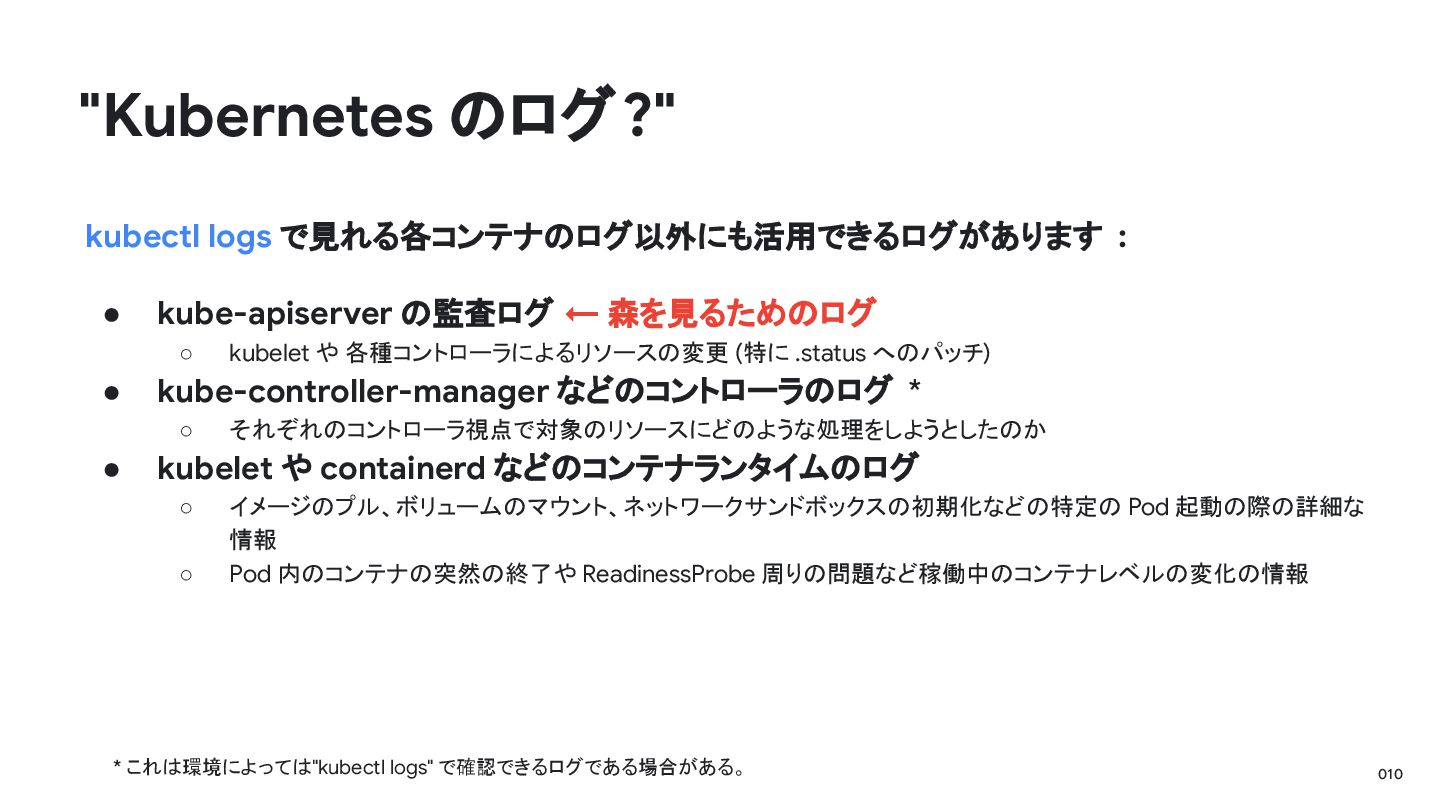
010 "Kubernetes のログ?" kubectl logs で見れる各コンテナのログ以外にも活用できるログがあります : • kube-apiserver の監査ログ
← 森を見るためのログ ◦ kubelet や 各種コントローラによるリソースの変更 (特に .status へのパッチ) • kube-controller-manager などのコントローラのログ * ◦ それぞれのコントローラ視点で対象のリソースにどのような処理をしようとしたのか • kubelet や containerd などのコンテナランタイムのログ ◦ イメージのプル、ボリュームのマウント、ネットワークサンドボックスの初期化などの特定の Pod 起動の際の詳細な 情報 ◦ Pod 内のコンテナの突然の終了や ReadinessProbe 周りの問題など稼働中のコンテナレベルの変化の情報 * これは環境によっては "kubectl logs" で確認できるログである場合がある。 -
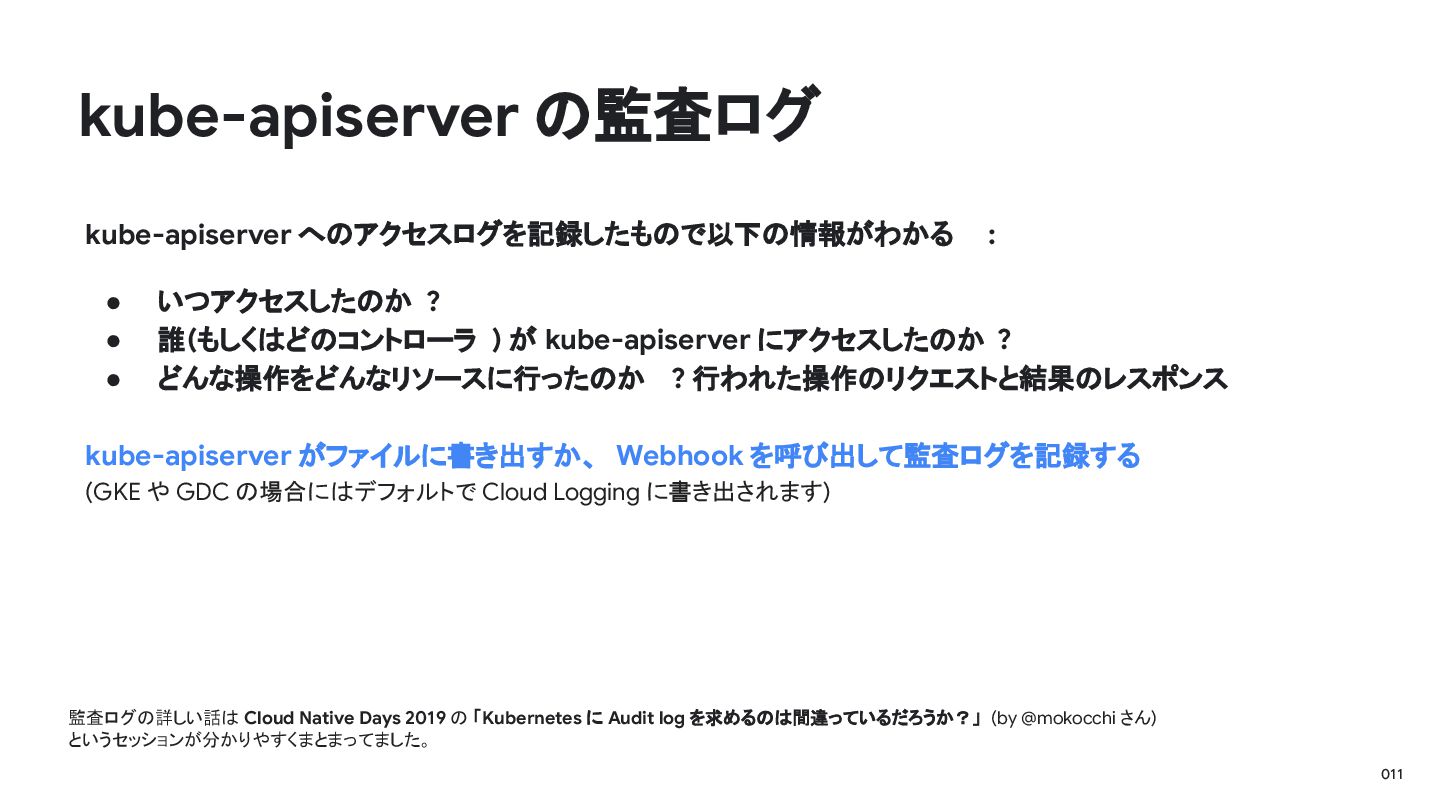
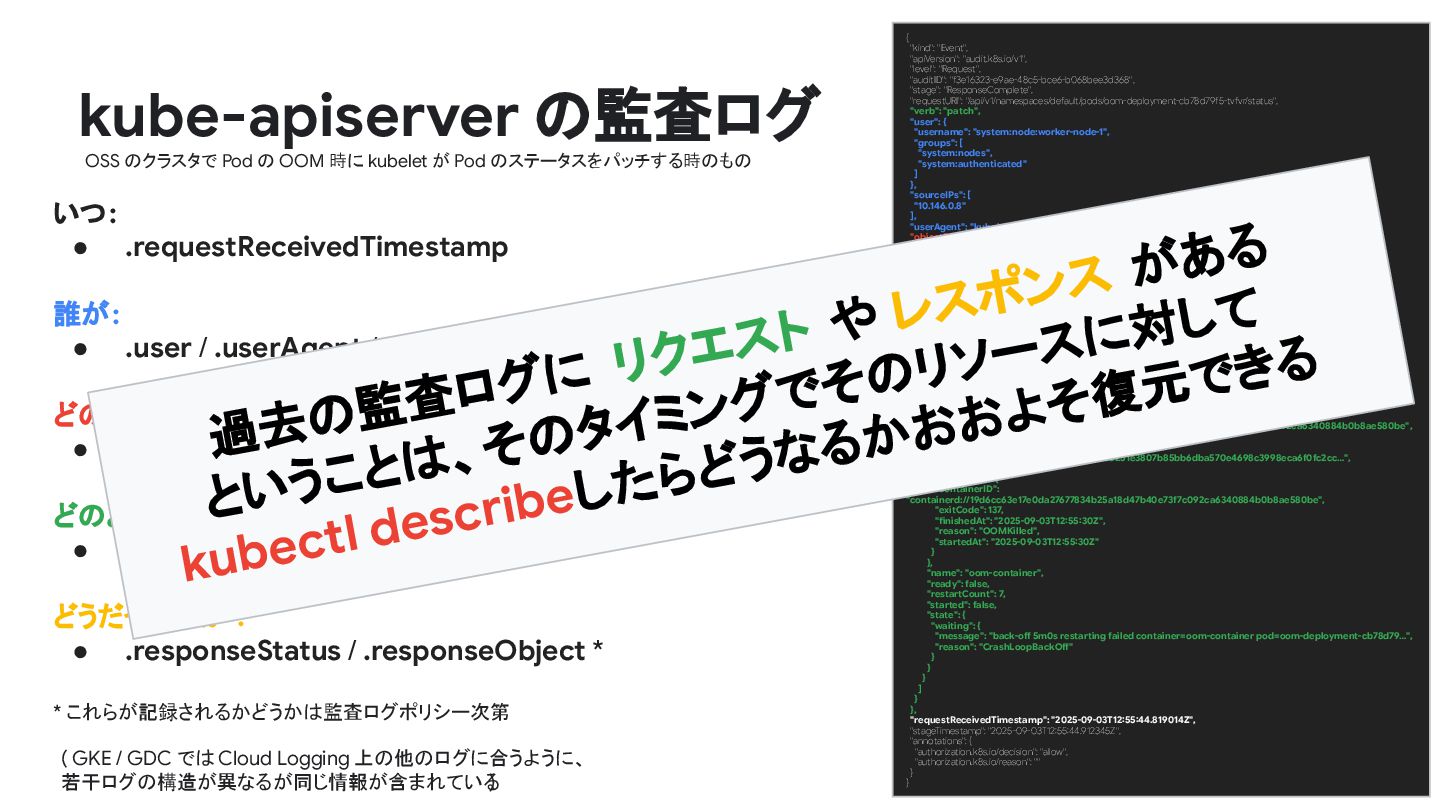
011 kube-apiserver の監査ログ kube-apiserver へのアクセスログを記録したもので以下の情報がわかる : • いつアクセスしたのか ? •
誰(もしくはどのコントローラ ) が kube-apiserver にアクセスしたのか ? • どんな操作をどんなリソースに行ったのか ? 行われた操作のリクエストと結果のレスポンス kube-apiserver がファイルに書き出すか、 Webhook を呼び出して監査ログを記録する (GKE や GDC の場合にはデフォルトで Cloud Logging に書き出されます) 監査ログの詳しい話は Cloud Native Days 2019 の 「Kubernetes に Audit log を求めるのは間違っているだろうか?」 (by @mokocchi さん) というセッションが分かりやすくまとまってました。 -
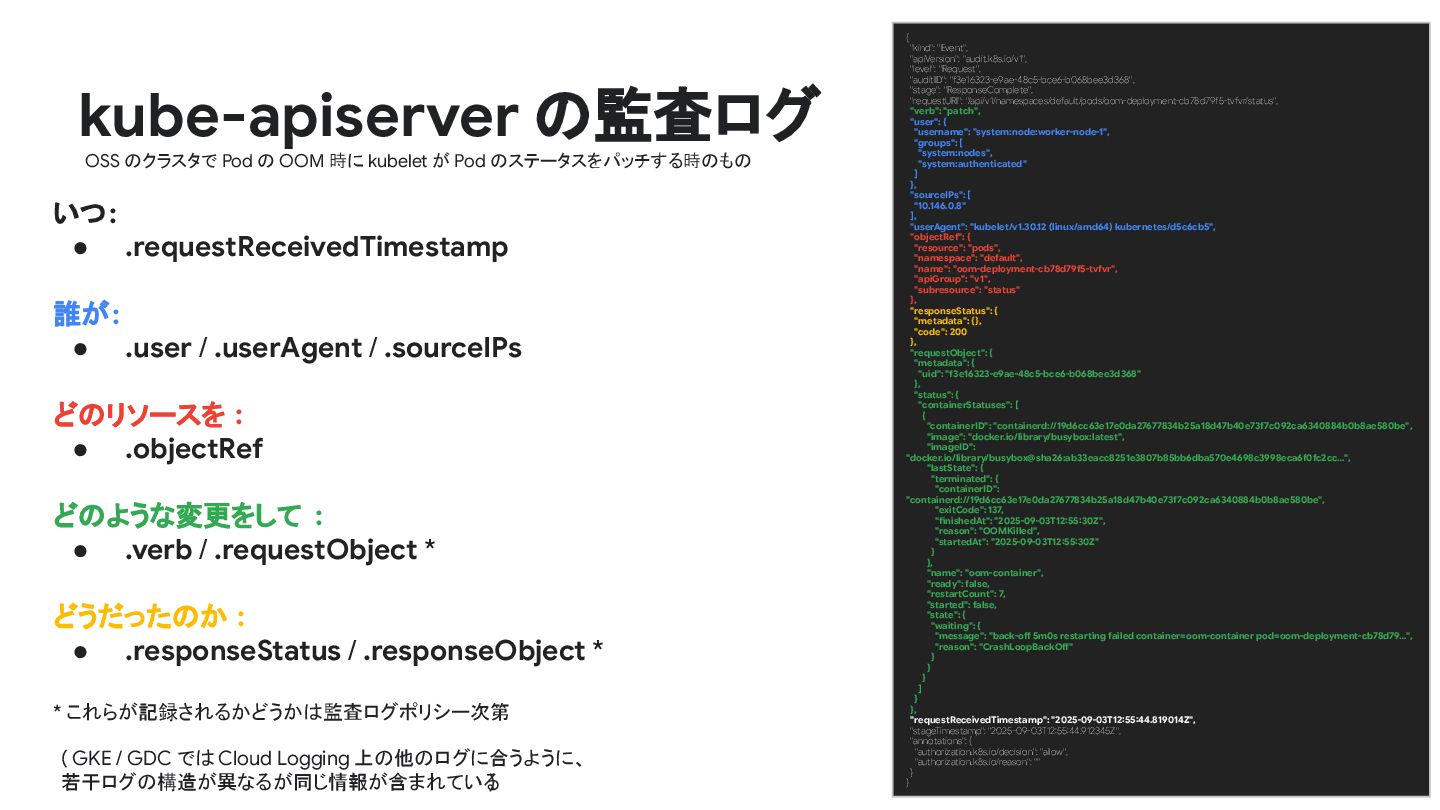
012 kube-apiserver の監査ログ { "kind": "Event", "apiVersion": "audit.k8s.io/v1", "level": "Request",
"auditID": "f3e16323-e9ae-48c5-bce6-b068bee3d368", "stage": "ResponseComplete", "requestURI": "/api/v1/namespaces/default/pods/oom-deployment-cb78d79f5-tvfvr/status", "verb": "patch", "user": { "username": "system:node:worker-node-1", "groups": [ "system:nodes", "system:authenticated" ] }, "sourceIPs": [ "10.146.0.8" ], "userAgent": "kubelet/v1.30.12 (linux/amd64) kubernetes/d5c6cb5", "objectRef": { "resource": "pods", "namespace": "default", "name": "oom-deployment-cb78d79f5-tvfvr", "apiGroup": "v1", "subresource": "status" }, "responseStatus": { "metadata": {}, "code": 200 }, "requestObject": { "metadata": { "uid": "f3e16323-e9ae-48c5-bce6-b068bee3d368" }, "status": { "containerStatuses": [ { "containerID": "containerd://19d6cc63e17e0da27677834b25a18d47b40e73f7c092ca6340884b0b8ae580be", "image": "docker.io/library/busybox:latest", "imageID": "docker.io/library/busybox@sha26:ab33eacc8251e3807b85bb6dba570e4698c3998eca6f0fc2cc…", "lastState": { "terminated": { "containerID": "containerd://19d6cc63e17e0da27677834b25a18d47b40e73f7c092ca6340884b0b8ae580be", "exitCode": 137, "finishedAt": "2025-09-03T12:55:30Z", "reason": "OOMKilled", "startedAt": "2025-09-03T12:55:30Z" } }, "name": "oom-container", "ready": false, "restartCount": 7, "started": false, "state": { "waiting": { "message": "back-off 5m0s restarting failed container=oom-container pod=oom-deployment-cb78d79…", "reason": "CrashLoopBackOff" } } } ] } }, "requestReceivedTimestamp": "2025-09-03T12:55:44.819014Z", "stageTimestamp": "2025-09-03T12:55:44.912345Z", "annotations": { "authorization.k8s.io/decision": "allow", "authorization.k8s.io/reason": "" } } いつ: • .requestReceivedTimestamp 誰が: • .user / .userAgent / .sourceIPs どのリソースを : • .objectRef どのような変更をして : • .verb / .requestObject * どうだったのか : • .responseStatus / .responseObject * * これらが記録されるかどうかは監査ログポリシー次第 ( GKE / GDC では Cloud Logging 上の他のログに合うように、 若干ログの構造が異なるが同じ情報が含まれている ) OSS のクラスタで Pod の OOM 時に kubelet が Pod のステータスをパッチする時のもの -
013 kube-apiserver の監査ログ { "kind": "Event", "apiVersion": "audit.k8s.io/v1", "level": "Request",
"auditID": "f3e16323-e9ae-48c5-bce6-b068bee3d368", "stage": "ResponseComplete", "requestURI": "/api/v1/namespaces/default/pods/oom-deployment-cb78d79f5-tvfvr/status", "verb": "patch", "user": { "username": "system:node:worker-node-1", "groups": [ "system:nodes", "system:authenticated" ] }, "sourceIPs": [ "10.146.0.8" ], "userAgent": "kubelet/v1.30.12 (linux/amd64) kubernetes/d5c6cb5", "objectRef": { "resource": "pods", "namespace": "default", "name": "oom-deployment-cb78d79f5-tvfvr", "apiGroup": "v1", "subresource": "status" }, "responseStatus": { "metadata": {}, "code": 200 }, "requestObject": { "metadata": { "uid": "f3e16323-e9ae-48c5-bce6-b068bee3d368" }, "status": { "containerStatuses": [ { "containerID": "containerd://19d6cc63e17e0da27677834b25a18d47b40e73f7c092ca6340884b0b8ae580be", "image": "docker.io/library/busybox:latest", "imageID": "docker.io/library/busybox@sha26:ab33eacc8251e3807b85bb6dba570e4698c3998eca6f0fc2cc…", "lastState": { "terminated": { "containerID": "containerd://19d6cc63e17e0da27677834b25a18d47b40e73f7c092ca6340884b0b8ae580be", "exitCode": 137, "finishedAt": "2025-09-03T12:55:30Z", "reason": "OOMKilled", "startedAt": "2025-09-03T12:55:30Z" } }, "name": "oom-container", "ready": false, "restartCount": 7, "started": false, "state": { "waiting": { "message": "back-off 5m0s restarting failed container=oom-container pod=oom-deployment-cb78d79…", "reason": "CrashLoopBackOff" } } } ] } }, "requestReceivedTimestamp": "2025-09-03T12:55:44.819014Z", "stageTimestamp": "2025-09-03T12:55:44.912345Z", "annotations": { "authorization.k8s.io/decision": "allow", "authorization.k8s.io/reason": "" } } いつ: • .requestReceivedTimestamp 誰が: • .user / .userAgent / .sourceIPs どのリソースを : • .objectRef どのような変更をして : • .verb / .requestObject * どうだったのか : • .responseStatus / .responseObject * * これらが記録されるかどうかは監査ログポリシー次第 ( GKE / GDC では Cloud Logging 上の他のログに合うように、 若干ログの構造が異なるが同じ情報が含まれている ) OSS のクラスタで Pod の OOM 時に kubelet が Pod のステータスをパッチする時のもの 過去の監査ログに リクエスト や レスポンス がある ということは、そのタイミングでそのリソースに対して kubectl describeしたらどうなるかおおよそ復元できる -
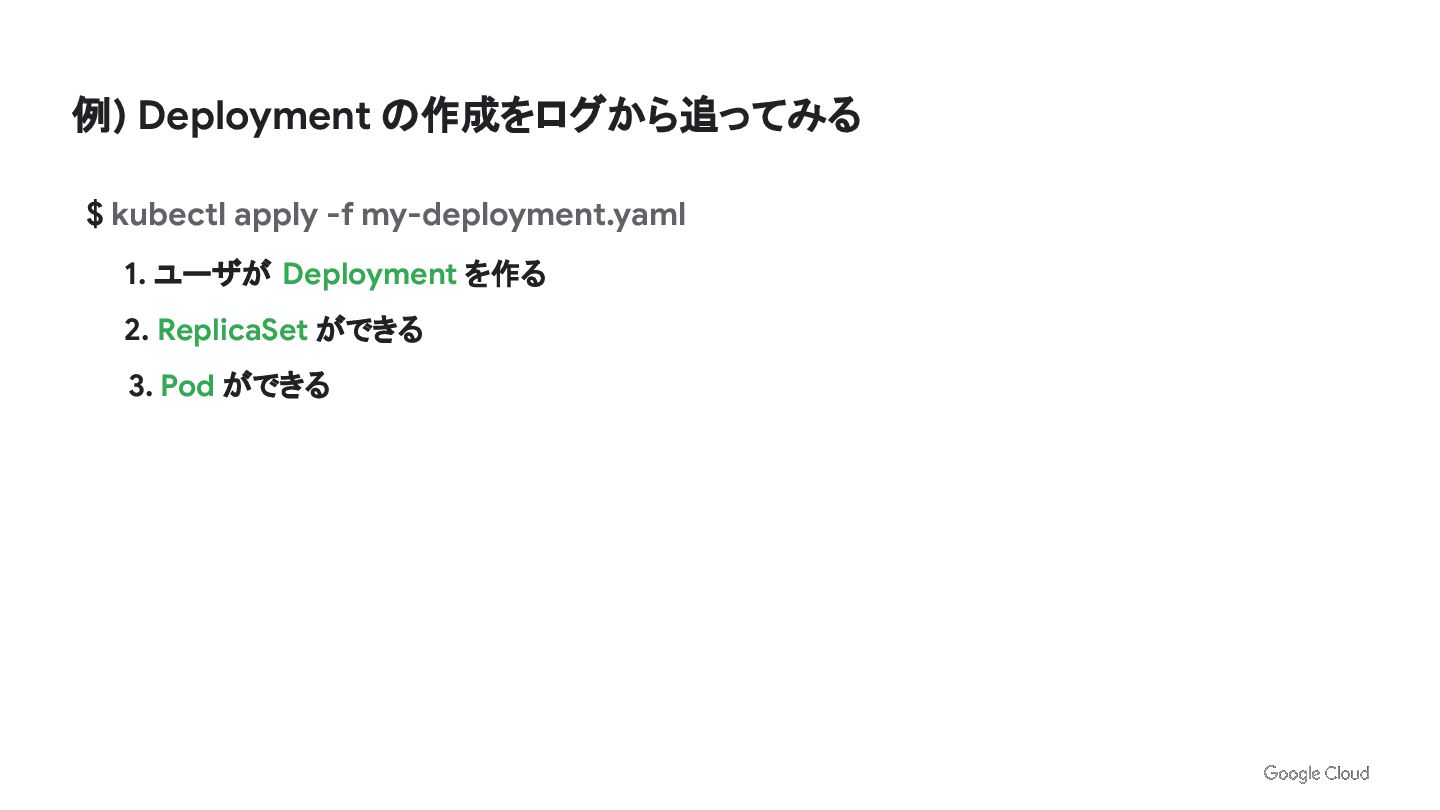
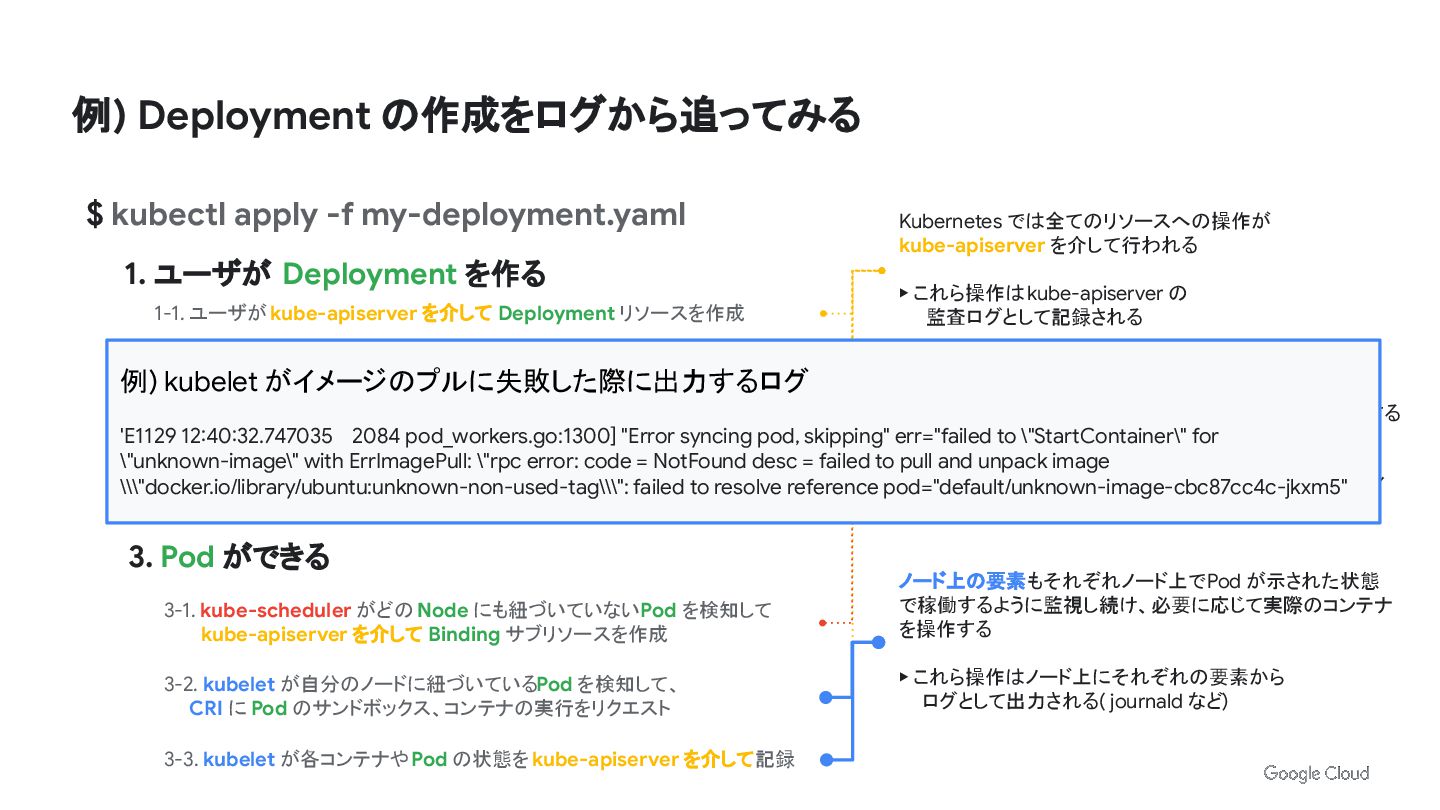
例) Deployment の作成をログから追ってみる 1. ユーザが Deployment を作る 2. ReplicaSet ができる
3. Pod ができる $ kubectl apply -f my-deployment.yaml -
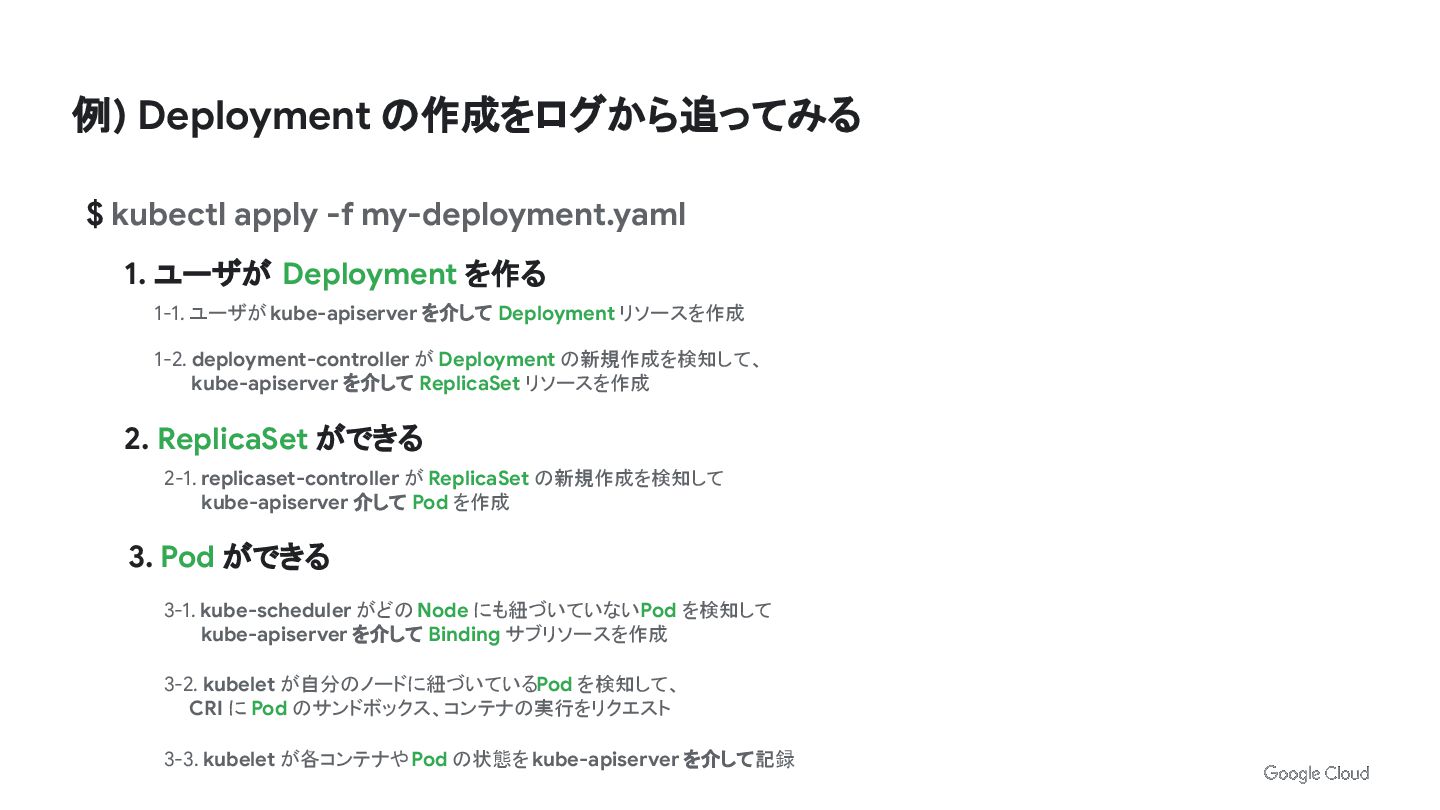
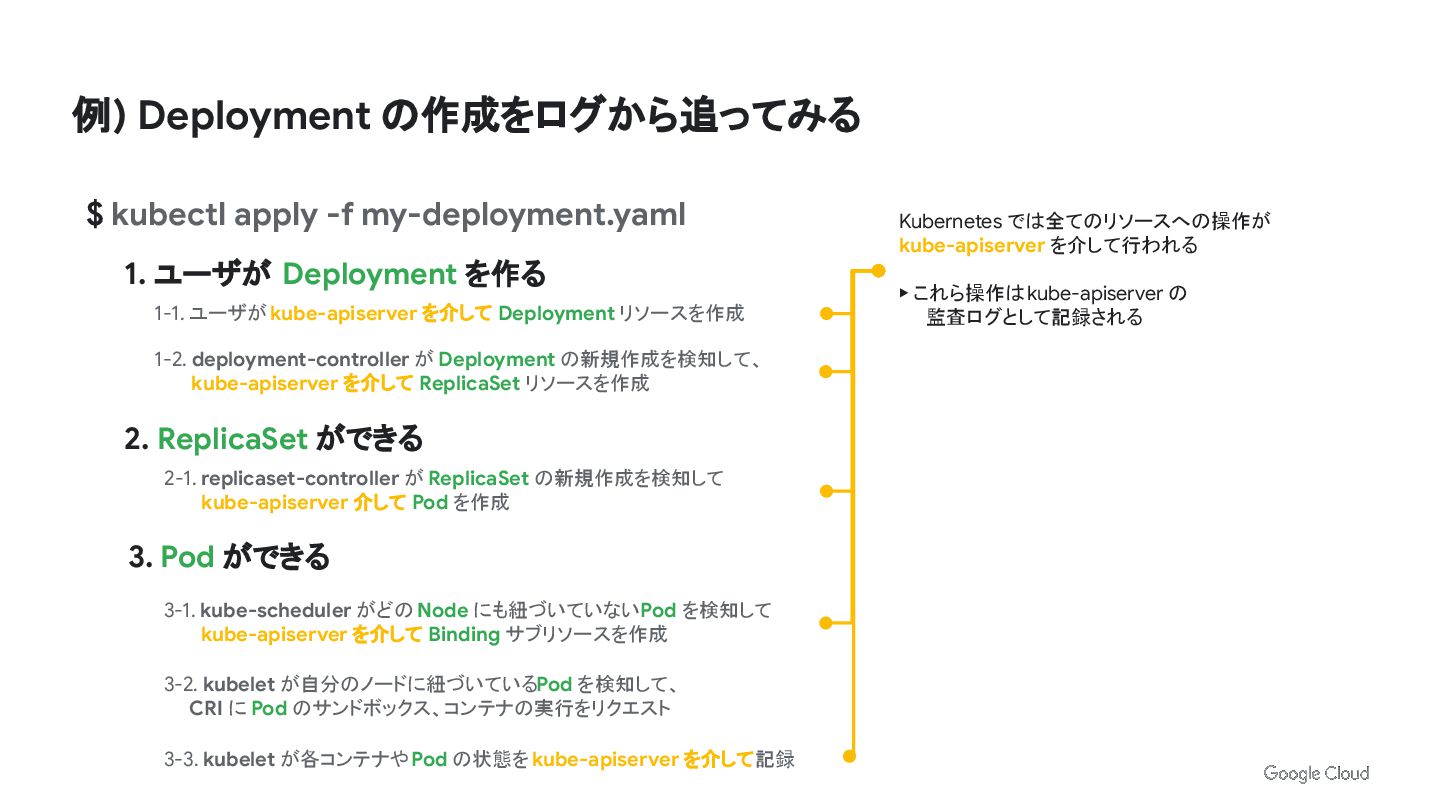
例) Deployment の作成をログから追ってみる 1. ユーザが Deployment を作る 2. ReplicaSet ができる
3. Pod ができる 1-1. ユーザが kube-apiserver を介して Deployment リソースを作成 1-2. deployment-controller が Deployment の新規作成を検知して、 kube-apiserver を介して ReplicaSet リソースを作成 2-1. replicaset-controller が ReplicaSet の新規作成を検知して kube-apiserver 介して Pod を作成 3-1. kube-scheduler がどの Node にも紐づいていない Pod を検知して kube-apiserver を介して Binding サブリソースを作成 3-2. kubelet が自分のノードに紐づいている Pod を検知して、 CRI に Pod のサンドボックス、コンテナの実行をリクエスト 3-3. kubelet が各コンテナや Pod の状態を kube-apiserver を介して記録 $ kubectl apply -f my-deployment.yaml -
例) Deployment の作成をログから追ってみる 1. ユーザが Deployment を作る 2. ReplicaSet ができる
3. Pod ができる 1-1. ユーザが kube-apiserver を介して Deployment リソースを作成 1-2. deployment-controller が Deployment の新規作成を検知して、 kube-apiserver を介して ReplicaSet リソースを作成 2-1. replicaset-controller が ReplicaSet の新規作成を検知して kube-apiserver 介して Pod を作成 3-1. kube-scheduler がどの Node にも紐づいていない Pod を検知して kube-apiserver を介して Binding サブリソースを作成 3-2. kubelet が自分のノードに紐づいている Pod を検知して、 CRI に Pod のサンドボックス、コンテナの実行をリクエスト 3-3. kubelet が各コンテナや Pod の状態を kube-apiserver を介して記録 $ kubectl apply -f my-deployment.yaml Kubernetes では全てのリソースへの操作が kube-apiserver を介して行われる ▶ これら操作は kube-apiserver の 監査ログとして記録される -
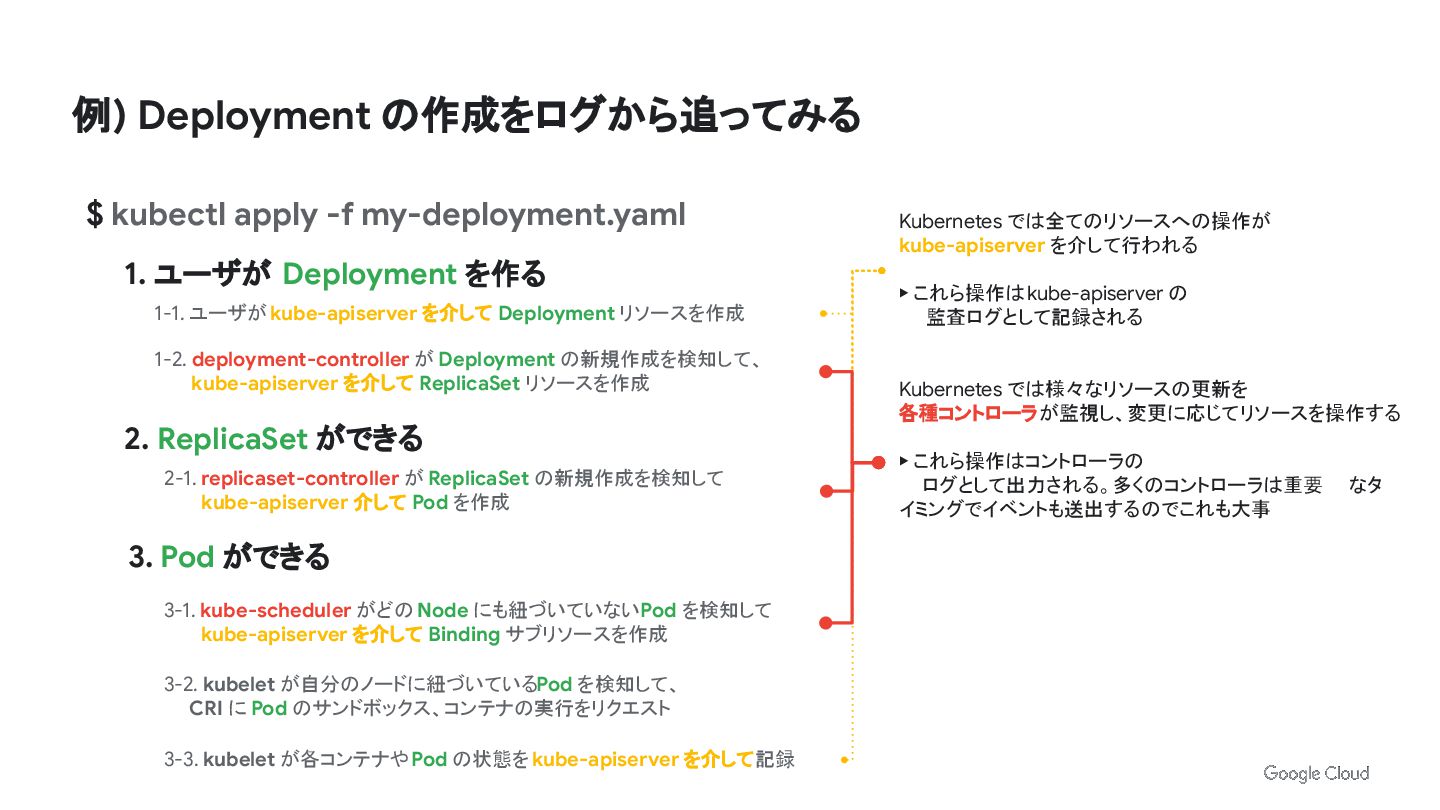
例) Deployment の作成をログから追ってみる 1. ユーザが Deployment を作る 2. ReplicaSet ができる
3. Pod ができる 1-1. ユーザが kube-apiserver を介して Deployment リソースを作成 1-2. deployment-controller が Deployment の新規作成を検知して、 kube-apiserver を介して ReplicaSet リソースを作成 2-1. replicaset-controller が ReplicaSet の新規作成を検知して kube-apiserver 介して Pod を作成 3-1. kube-scheduler がどの Node にも紐づいていない Pod を検知して kube-apiserver を介して Binding サブリソースを作成 3-2. kubelet が自分のノードに紐づいている Pod を検知して、 CRI に Pod のサンドボックス、コンテナの実行をリクエスト 3-3. kubelet が各コンテナや Pod の状態を kube-apiserver を介して記録 $ kubectl apply -f my-deployment.yaml Kubernetes では全てのリソースへの操作が kube-apiserver を介して行われる ▶ これら操作は kube-apiserver の 監査ログとして記録される Kubernetes では様々なリソースの更新を 各種コントローラが監視し、変更に応じてリソースを操作する ▶ これら操作はコントローラの ログとして出力される。多くのコントローラは重要 なタ イミングでイベントも送出するのでこれも大事 -
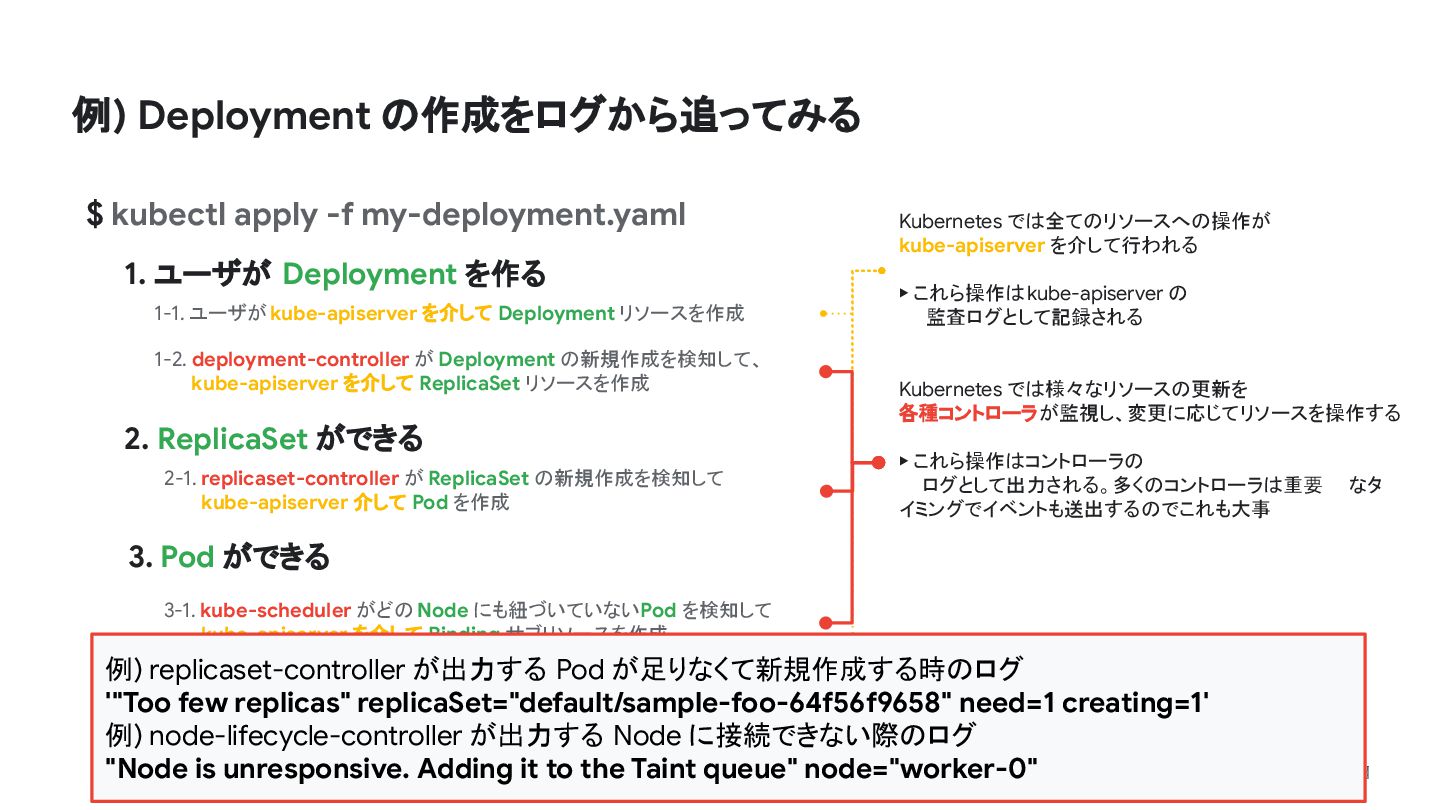
例) Deployment の作成をログから追ってみる 1. ユーザが Deployment を作る 2. ReplicaSet ができる
3. Pod ができる 1-1. ユーザが kube-apiserver を介して Deployment リソースを作成 1-2. deployment-controller が Deployment の新規作成を検知して、 kube-apiserver を介して ReplicaSet リソースを作成 2-1. replicaset-controller が ReplicaSet の新規作成を検知して kube-apiserver 介して Pod を作成 3-1. kube-scheduler がどの Node にも紐づいていない Pod を検知して kube-apiserver を介して Binding サブリソースを作成 3-2. kubelet が自分のノードに紐づいている Pod を検知して、 CRI に Pod のサンドボックス、コンテナの実行をリクエスト 3-3. kubelet が各コンテナや Pod の状態を kube-apiserver を介して記録 $ kubectl apply -f my-deployment.yaml Kubernetes では全てのリソースへの操作が kube-apiserver を介して行われる ▶ これら操作は kube-apiserver の 監査ログとして記録される Kubernetes では様々なリソースの更新を 各種コントローラが監視し、変更に応じてリソースを操作する ▶ これら操作はコントローラの ログとして出力される。多くのコントローラは重要 なタ イミングでイベントも送出するのでこれも大事 例) replicaset-controller が出力する Pod が足りなくて新規作成する時のログ '"Too few replicas" replicaSet="default/sample-foo-64f56f9658" need=1 creating=1' 例) node-lifecycle-controller が出力する Node に接続できない際のログ "Node is unresponsive. Adding it to the Taint queue" node="worker-0" -
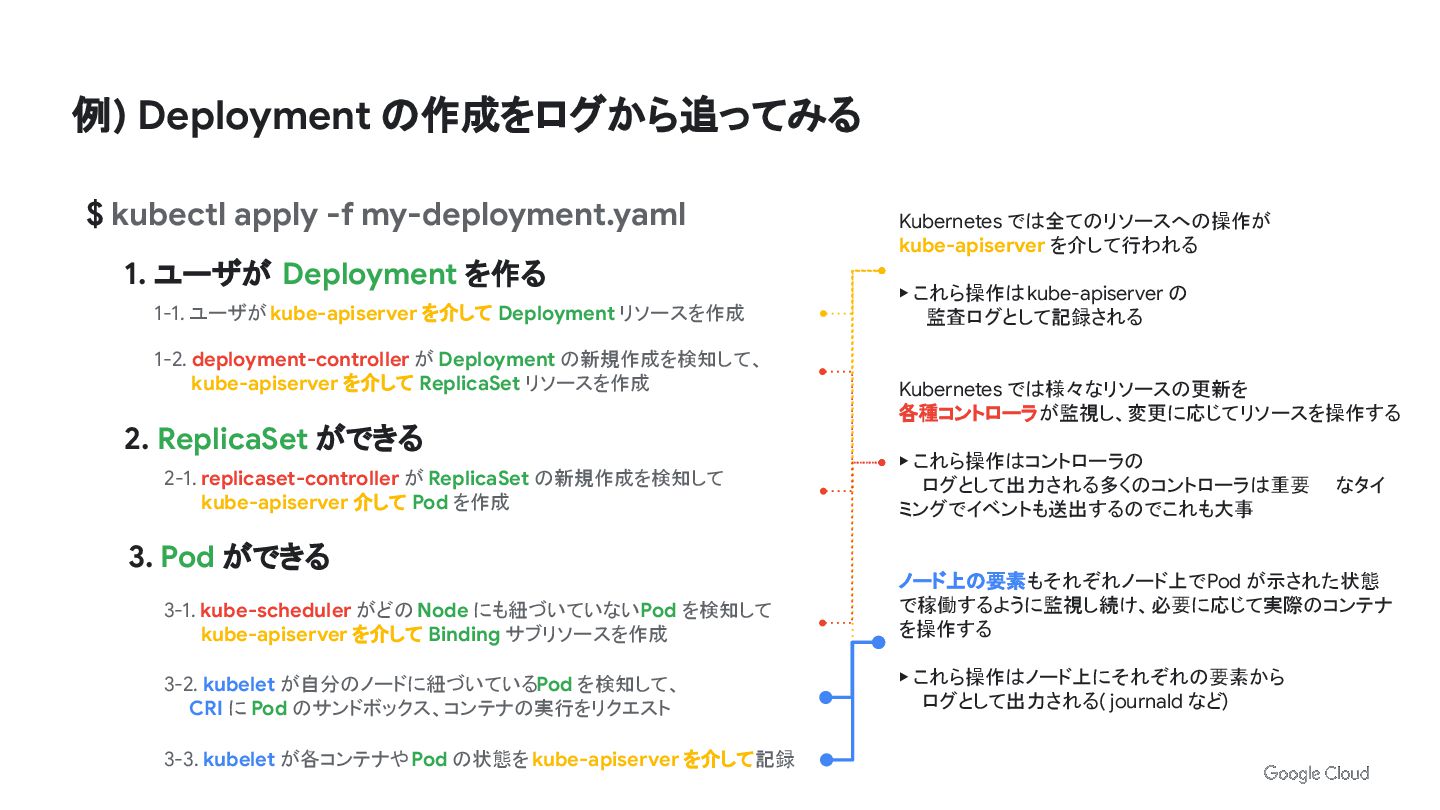
例) Deployment の作成をログから追ってみる 1. ユーザが Deployment を作る 2. ReplicaSet ができる
3. Pod ができる 1-1. ユーザが kube-apiserver を介して Deployment リソースを作成 1-2. deployment-controller が Deployment の新規作成を検知して、 kube-apiserver を介して ReplicaSet リソースを作成 2-1. replicaset-controller が ReplicaSet の新規作成を検知して kube-apiserver 介して Pod を作成 3-1. kube-scheduler がどの Node にも紐づいていない Pod を検知して kube-apiserver を介して Binding サブリソースを作成 3-2. kubelet が自分のノードに紐づいている Pod を検知して、 CRI に Pod のサンドボックス、コンテナの実行をリクエスト 3-3. kubelet が各コンテナや Pod の状態を kube-apiserver を介して記録 $ kubectl apply -f my-deployment.yaml Kubernetes では全てのリソースへの操作が kube-apiserver を介して行われる ▶ これら操作は kube-apiserver の 監査ログとして記録される Kubernetes では様々なリソースの更新を 各種コントローラが監視し、変更に応じてリソースを操作する ▶ これら操作はコントローラの ログとして出力される多くのコントローラは重要 なタイ ミングでイベントも送出するのでこれも大事 ノード上の要素もそれぞれノード上で Pod が示された状態 で稼働するように監視し続け、必要に応じて実際のコンテナ を操作する ▶ これら操作はノード上にそれぞれの要素から ログとして出力される ( journald など) -
例) Deployment の作成をログから追ってみる 1. ユーザが Deployment を作る 2. ReplicaSet ができる
3. Pod ができる 1-1. ユーザが kube-apiserver を介して Deployment リソースを作成 1-2. deployment-controller が Deployment の新規作成を検知して、 kube-apiserver を介して ReplicaSet リソースを作成 2-1. replicaset-controller が ReplicaSet の新規作成を検知して kube-apiserver 介して Pod を作成 3-1. kube-scheduler がどの Node にも紐づいていない Pod を検知して kube-apiserver を介して Binding サブリソースを作成 3-2. kubelet が自分のノードに紐づいている Pod を検知して、 CRI に Pod のサンドボックス、コンテナの実行をリクエスト 3-3. kubelet が各コンテナや Pod の状態を kube-apiserver を介して記録 $ kubectl apply -f my-deployment.yaml Kubernetes では全てのリソースへの操作が kube-apiserver を介して行われる ▶ これら操作は kube-apiserver の 監査ログとして記録される Kubernetes では様々なリソースの更新を 各種コントローラが監視し、変更に応じてリソースを操作する ▶ これら操作はコントローラの ログとして出力される多くのコントローラは重要 なタイ ミングでイベントも送出するのでこれも大事 ノード上の要素もそれぞれノード上で Pod が示された状態 で稼働するように監視し続け、必要に応じて実際のコンテナ を操作する ▶ これら操作はノード上にそれぞれの要素から ログとして出力される ( journald など) 例) kubelet がイメージのプルに失敗した際に出力するログ 'E1129 12:40:32.747035 2084 pod_workers.go:1300] "Error syncing pod, skipping" err="failed to \"StartContainer\" for \"unknown-image\" with ErrImagePull: \"rpc error: code = NotFound desc = failed to pull and unpack image \\\"docker.io/library/ubuntu:unknown-non-used-tag\\\": failed to resolve reference pod="default/unknown-image-cbc87cc4c-jkxm5" -
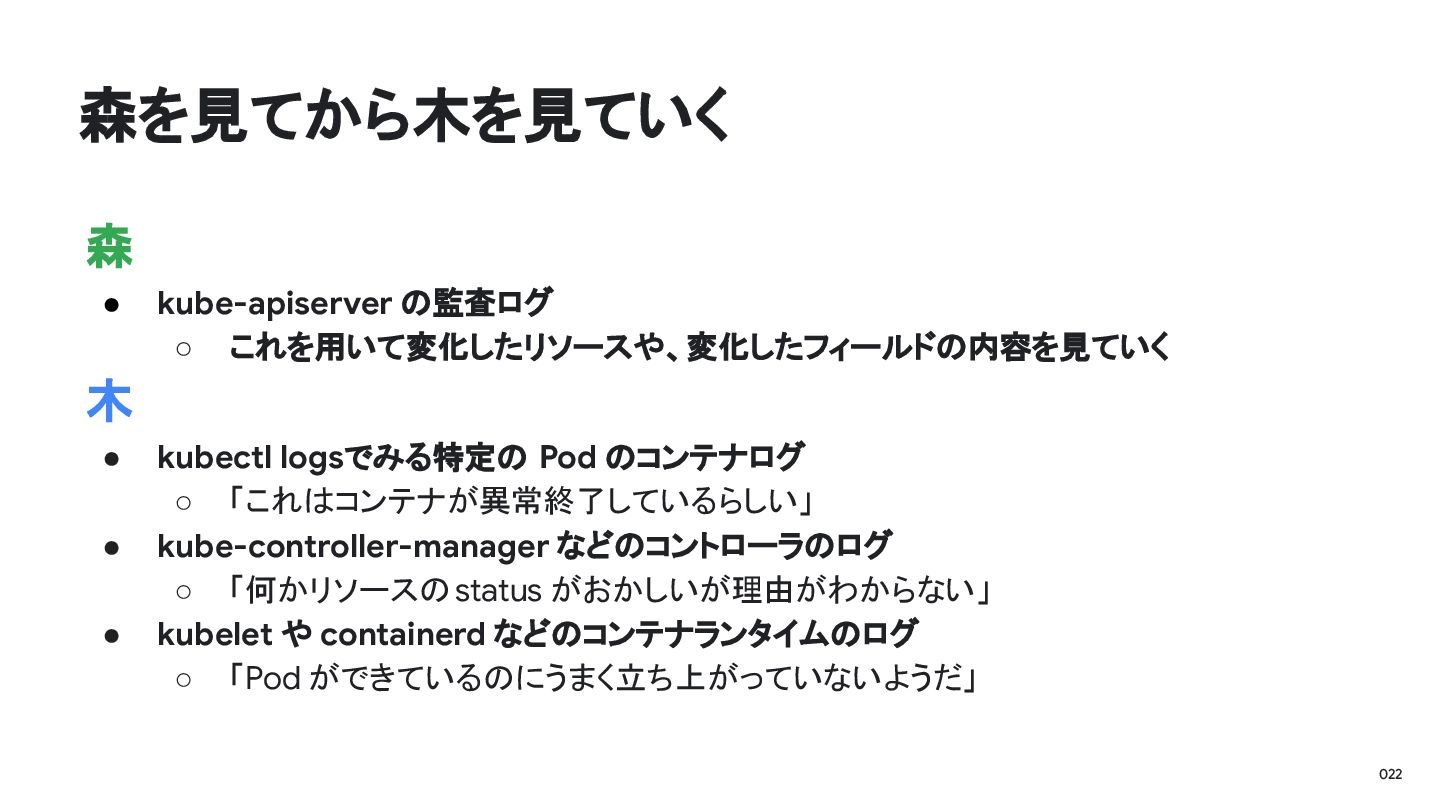
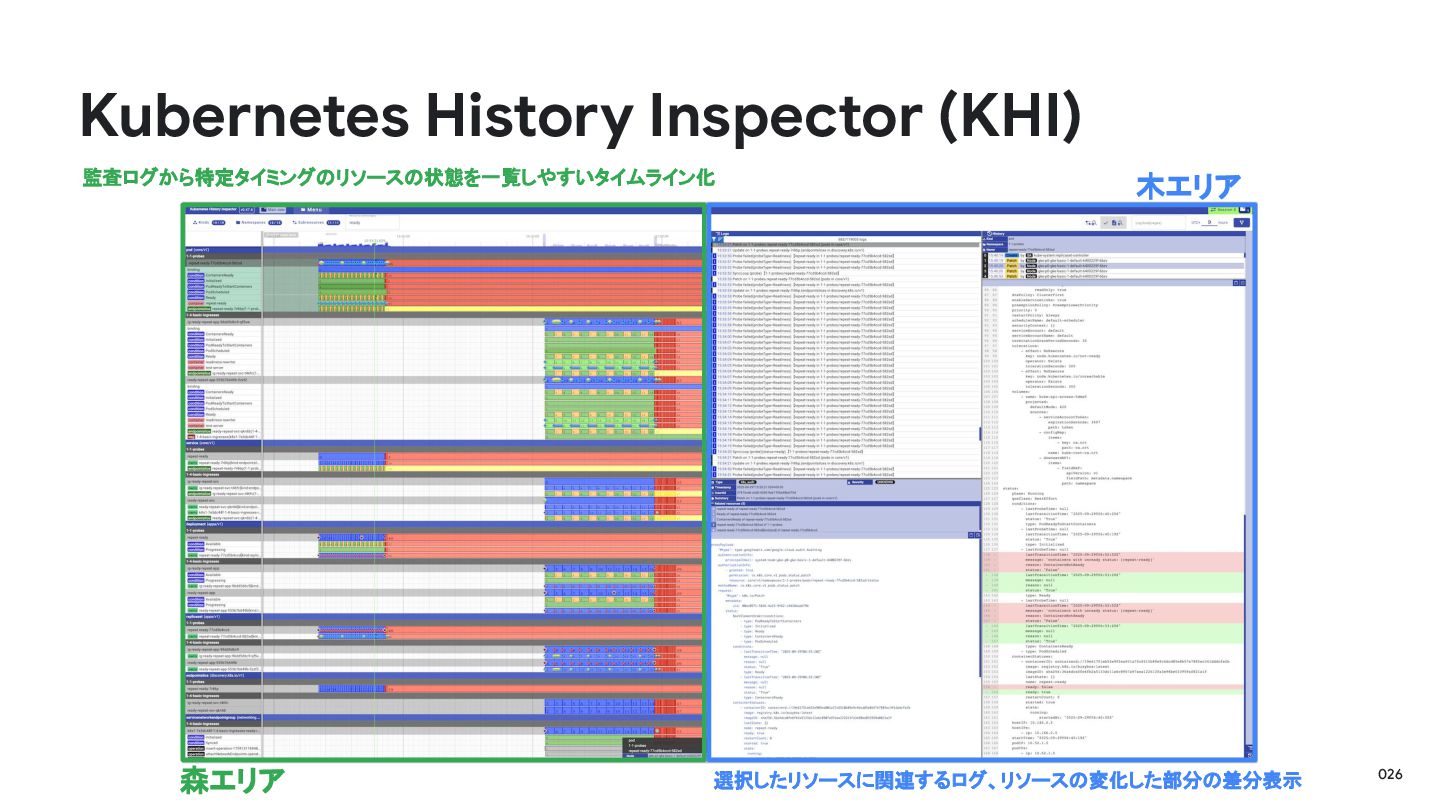
022 森を見てから木を見ていく 森 • kube-apiserver の監査ログ ◦ これを用いて変化したリソースや、変化したフィールドの内容を見ていく 木 •
kubectl logsでみる特定の Pod のコンテナログ ◦ 「これはコンテナが異常終了しているらしい」 • kube-controller-manager などのコントローラのログ ◦ 「何かリソースの status がおかしいが理由がわからない」 • kubelet や containerd などのコンテナランタイムのログ ◦ 「Pod ができているのにうまく立ち上がっていないようだ」 -
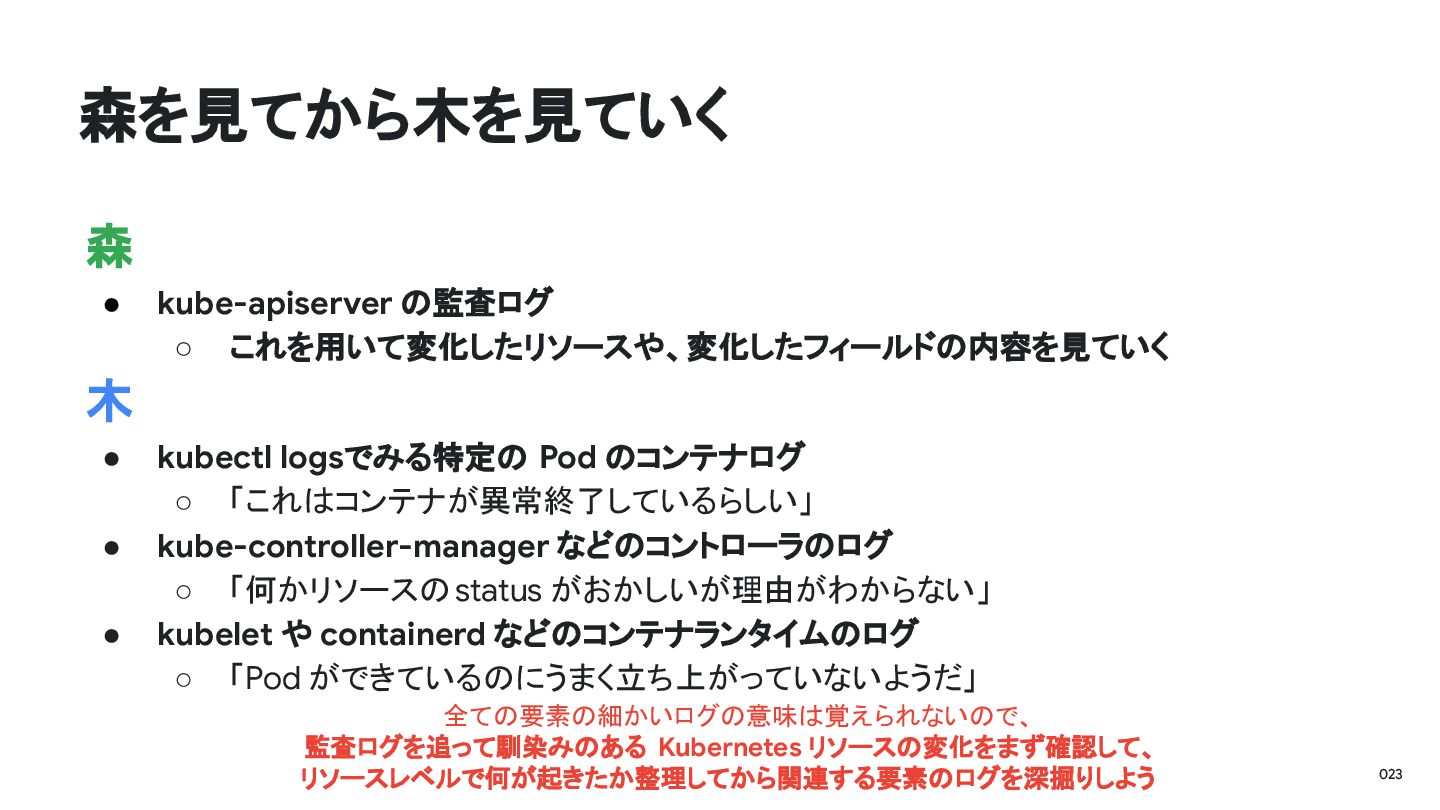
023 森を見てから木を見ていく 森 • kube-apiserver の監査ログ ◦ これを用いて変化したリソースや、変化したフィールドの内容を見ていく 木 •
kubectl logsでみる特定の Pod のコンテナログ ◦ 「これはコンテナが異常終了しているらしい」 • kube-controller-manager などのコントローラのログ ◦ 「何かリソースの status がおかしいが理由がわからない」 • kubelet や containerd などのコンテナランタイムのログ ◦ 「Pod ができているのにうまく立ち上がっていないようだ」 全ての要素の細かいログの意味は覚えられないので、 監査ログを追って馴染みのある Kubernetes リソースの変化をまず確認して、 リソースレベルで何が起きたか整理してから関連する要素のログを深掘りしよう -
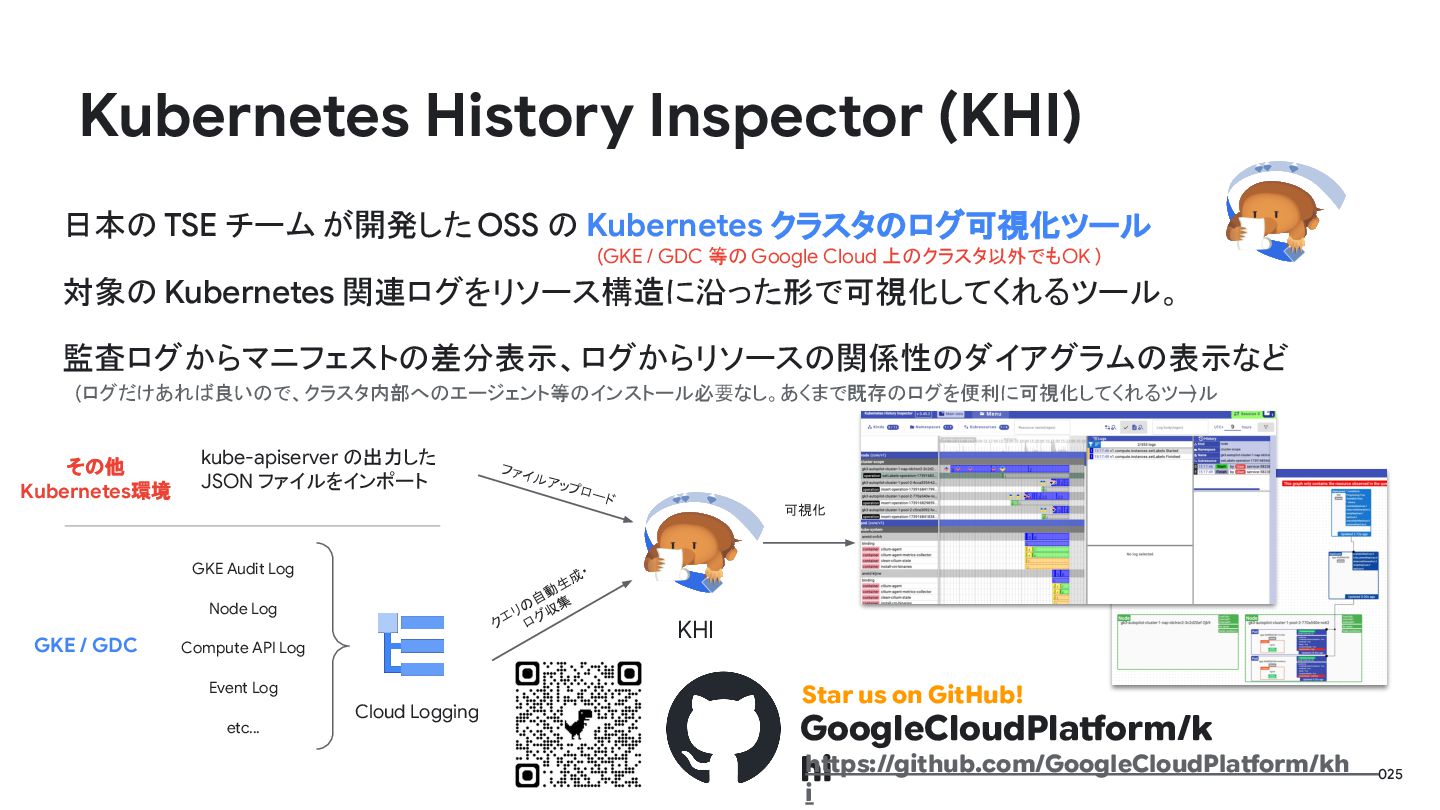
025 Kubernetes History Inspector (KHI) 日本の TSE チーム が開発した OSS
の Kubernetes クラスタのログ可視化ツール 対象の Kubernetes 関連ログをリソース構造に沿った形で可視化してくれるツール。 監査ログからマニフェストの差分表示、ログからリソースの関係性のダイアグラムの表示など GKE Audit Log Node Log Compute API Log Event Log etc... KHI Cloud Logging クエリの 自 動 生 成 ・ ログ収 集 可視化 GoogleCloudPlatform/k hi https://github.com/GoogleCloudPlatform/kh i Star us on GitHub! GKE / GDC その他 Kubernetes環境 kube-apiserver の出力した JSON ファイルをインポート ファイルアップロード (GKE / GDC 等の Google Cloud 上のクラスタ以外でも OK ) (ログだけあれば良いので、クラスタ内部へのエージェント等のインストール必要なし。あくまで既存のログを便利に可視化してくれるツール ) -
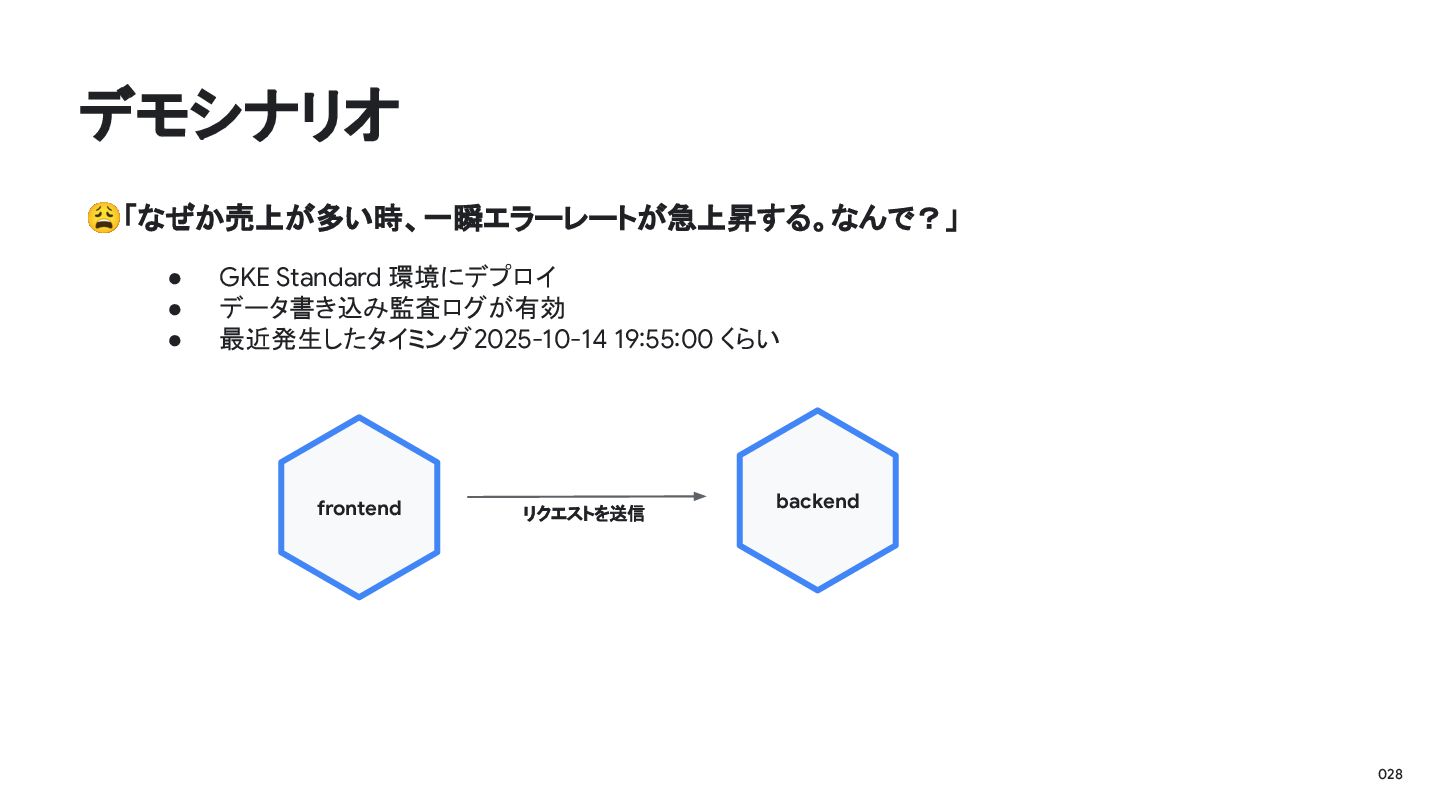
028 デモシナリオ frontend backend リクエストを送信 😩「なぜか売上が多い時、一瞬エラーレートが急上昇する。なんで?」 • GKE Standard 環境にデプロイ
• データ書き込み監査ログが有効 • 最近発生したタイミング 2025-10-14 19:55:00 くらい -
029 デモシナリオ frontend backend リクエストを送信 😩「なぜか売上が多い時、一瞬エラーレートが急上昇する。なんで?」 • GKE Standard 環境にデプロイ
• データ書き込み監査ログが有効 • 最近発生したタイミング 2025-10-14 10:30:00 くらい KHI で実際に見てみよう -
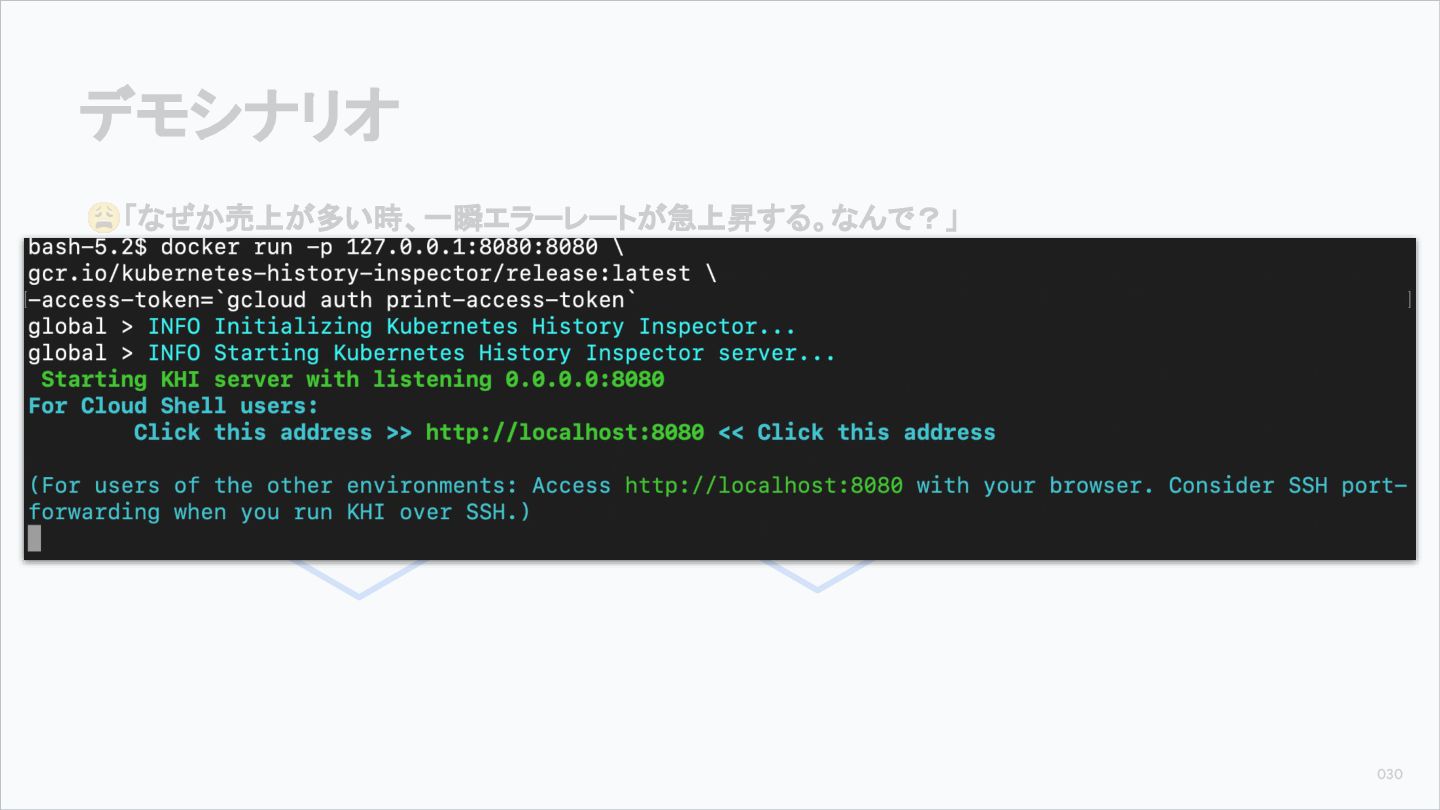
030 デモシナリオ frontend backend リクエストを送信 😩「なぜか売上が多い時、一瞬エラーレートが急上昇する。なんで?」 • GKE Standard 環境にデプロイ
• データ書き込み監査ログが有効 • 最近発生したタイミング 2025-10-14 10:30:00 くらい -
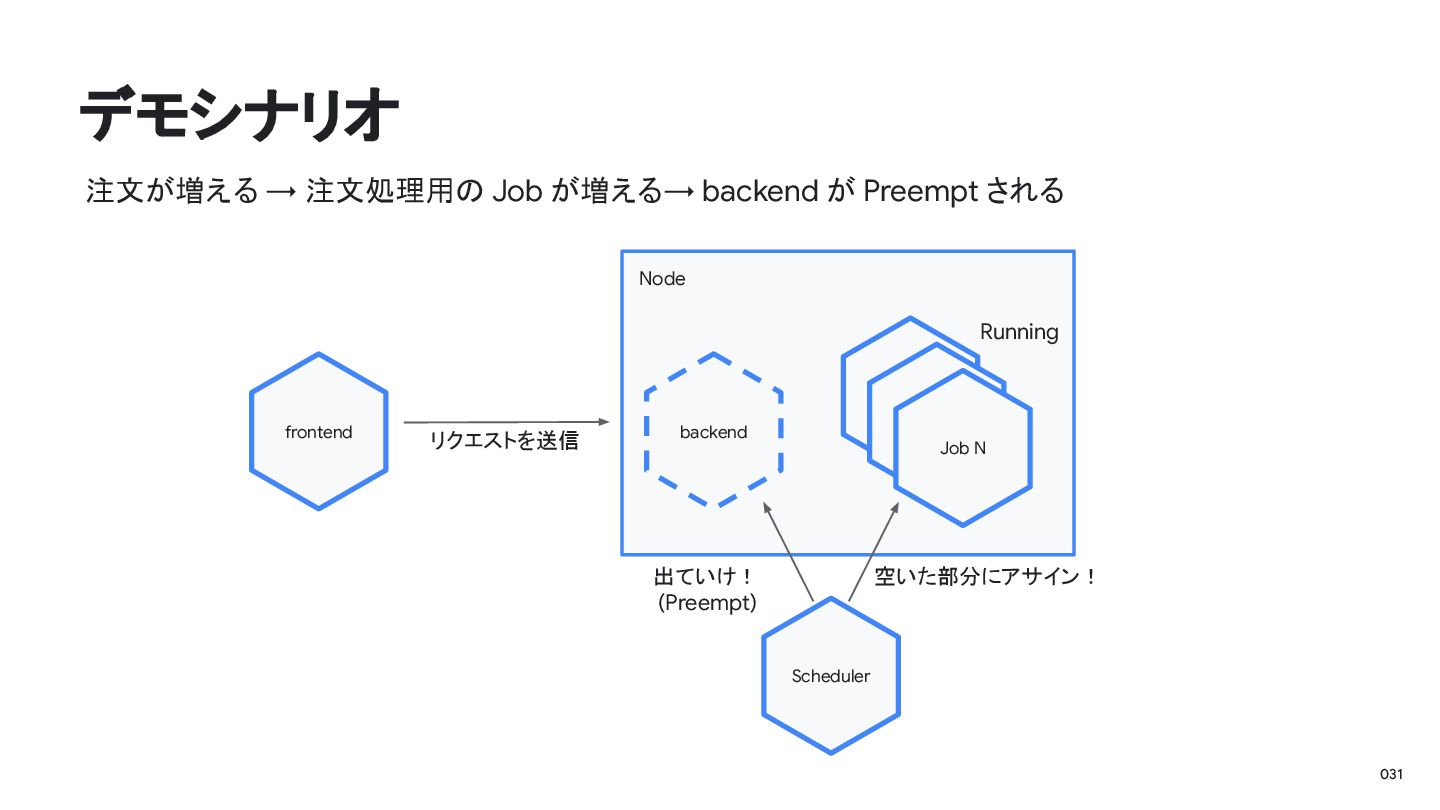
031 Node デモシナリオ frontend backend リクエストを送信 Job - 1 Job
- 1 Job N Scheduler Running 注文が増える → 注文処理用の Job が増える→ backend が Preempt される 出ていけ! (Preempt) 空いた部分にアサイン! -
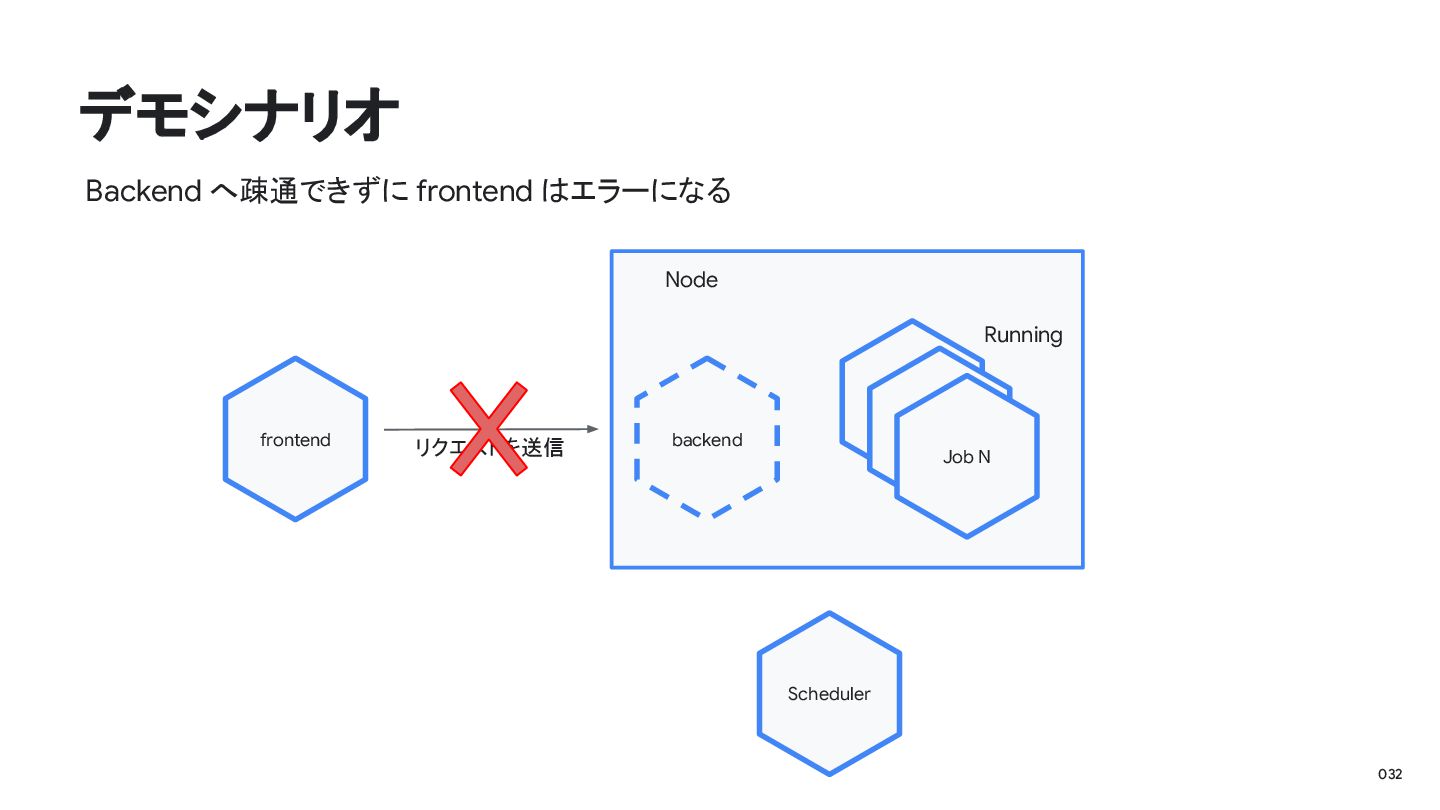
032 Node デモシナリオ frontend backend リクエストを送信 Job - 1 Job
- 1 Job N Scheduler Running Backend へ疎通できずに frontend はエラーになる -
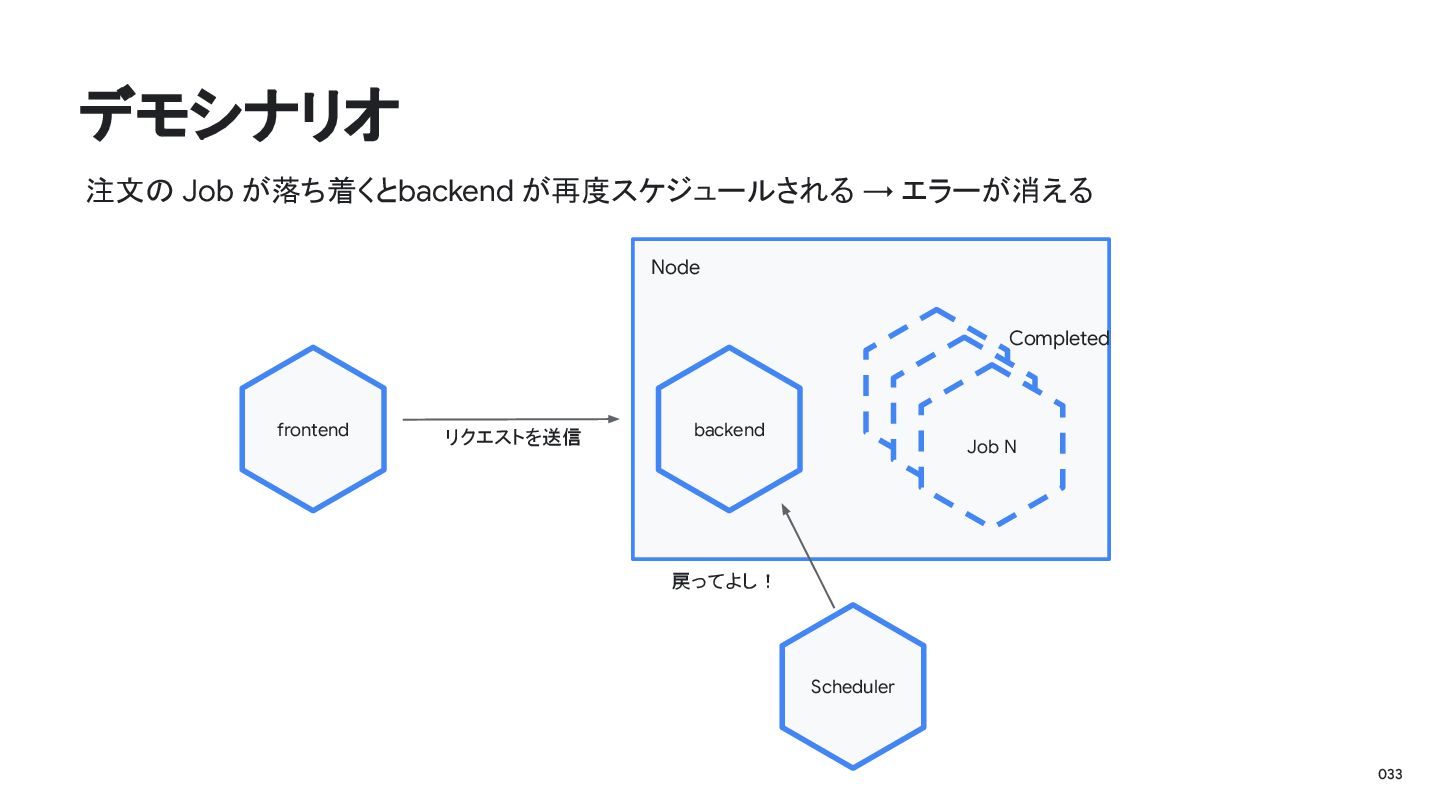
033 Node デモシナリオ frontend backend リクエストを送信 注文の Job が落ち着くとbackend が再度スケジュールされる
→ エラーが消える Job - 1 Job - 1 Job N Scheduler Completed 戻ってよし! -
034 まとめ + 質疑応答タイム GoogleCloudPlatform/k hi https://github.com/GoogleCloudPlatform/kh i Star us
on GitHub! • Kubernetes 上の障害を理解するためには「森を見てから木を見る」 ◦ kube-apiserver の監査ログを用いてリソースレベルでの大まかな振る舞いを把握する → 森を見る ◦ 対象のリソースに関連するコントローラのログ、コンテナのログなど、 問題の疑われる領域の細かいログを見ていく →木を見る • 今回触れたトラブルシューティングのデモ ◦ シナリオ: Job の数が増えて意図せずサーバの Pod をプリエンプトとしてしまった ◦ 複数のリソースが関連する障害では、監査ログからリソースの振る舞いを読み解いていくと良い • Kubernetes 関連の多量のログを可視化するのに Kubernetes History Inspector(KHI)が便利 ◦ 単なるログビューアなので クラスタ内に何も入れる必要がない ◦ GKE /GDC などの Google Cloud の Kubernetes クラスタでなくても利用可能
 googlecloudjapan
 ymk1102
 sasakendayo
 loglass2019
 chibah
 nazoru
 progmat
 arm0020
 smartgate
 stuartwintertear
 asiaquest
 circulation
 mirygoaround
 vanstee
 ks91
 inesmontani
 techseoconnect
 stephaniewalter
 gurzu
 thekraken
 pauljervisheath
 smashingmag
 akademiya2063
 maltzj
 tammyeverts