Share
Embed
rtrec@dbem6
Database Engineering Meetup #6: Data + AI
https://scalar.connpass.com/event/345819/
で @myui が発表した
「おすすめが止まらない:秒単位で即応するリアルタイム推薦技術」のスライドです。
リアルタイムの推薦ライブラリ
https://github.com/myui/rtrec
を紹介しました。
Makoto Yui
March 17, 2025
Transcript
56 slides
-
おすすめが⽌まらない: 秒単位で即応するリアルタイム推薦技術 Real-Time Recommendation Technology evolving at the Speed of
Seconds Senior Principal Engineer Makoto Yui @myui -
⾃⼰紹介 @myui 2 2009年 NAIST博⼠後期課程修了。博⼠(⼯学) ロックフリーDB、並列分散DB、XMLネイティブデータベースを研究 学振PD、CWI客員研究員、産総研主任研究員を経て、2015年トレ ジャーデータ⼊社。 Research Engineer→ワークフローteam→ML
team tech lead→CTO室所属 Apache Hivemallの開発やTreasure AutoMLのサービス化をリード XMLデータベースの開発で第1期IPA未踏ユーススーパクリエイタ -
7 従来の推薦システム • オフラインで⽣成されたバッチ推薦 ◦ モデルの更新は頻繁に出来ない(毎⽇または毎週) • オンラインのモデル更新に対応したOSSの推薦ライブラリが存在しない ◦ Implicit、LightFMとそのwrapperのRectoolsは割とよくできているが、逐次更新には
対応できない ◦ 最初はContextual Banditsを検討したが、線形モデル(arm)をアイテムごとに作るので予測がスケールし ない(オンライン更新に対応したapprox NN検索ライブラリがない) Argmax dot productを近似NNで⾼速化 https://www.benfrederickson.com/approximate-nearest-neighbours-for-recommender-systems/ Why Realtime Recommendation? -
従来の推薦システムの制限事項 8 • ユーザーの⾏動にリアルタイムで対応できない ◦ 既に購⼊済みのアイテムに関連したアイテムが表⽰される ▪ ヒューリスティックなロジックで後処理する必要がある ◦ レコメンドしたアイテムに反応がなくてもレコメンド内容に反映されない
• コンテキストに応じた推薦ができない ◦ ⼦供と⼀緒の時と⼀⼈では観る番組が異なる ◦ 時間帯によって興味が異なる(通勤中、リラックスした時間) • 推薦された商品に興味がないのにクリックしていないのに 推薦リストが更新されない ◦ 否定的または肯定的なリアルタイムのフィードバックが 即時反映されない -
Why Realtime Recommendation? 9 リアルタイム推薦システム • ユーザーのインタラクションに動的に適応し、コンテキストに応じた 推薦を⾏う • 技術課題
◦ モデルを動的に更新するにはオンライン学習が必要だが、巷にある推薦 ライブラリはオンライン学習に⾮対応 ◦ 蓄積済みバッチ的な学習と差分学習の両⽴ ▪ オンライン学習(1 epoch)だけだと精度⾯やスループットの問題が ある • ある程度データ量がないと良いモデルが作れない • 新規のデータに対して追加学習できることが重要 -
13 リアルタイム処理のコストに⾒合わない状況 • コンテンツやユーザー嗜好の変化が緩やか → オフラインやバッチ処理で⼗分な精度が得られる場合 • システムコストと複雑性の増⼤ → リアルタイム処理のインフラ投資や運⽤コストが過剰な場合
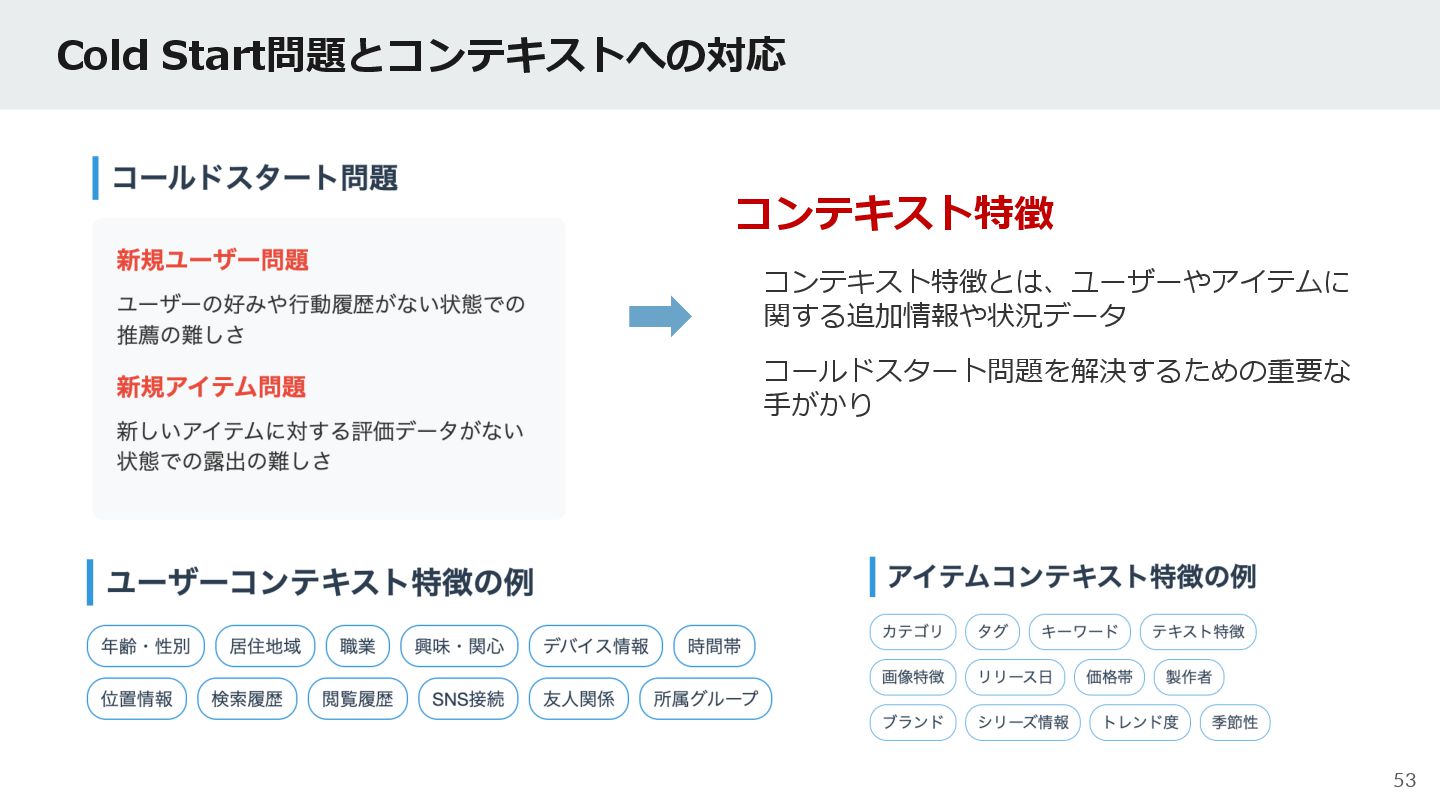
• コールドスタート問題 → 初期データが不⾜しているユーザーには適⽤が難しい When not to use real-time recommendations? Disclaimer: リアルタイムが常に必要とは限りません バッチレコメンデーションで十分なケースも多く存在します -
When to use real-time recommendations? 14 リアルタイムレコメンデーションが効果的な状況 • ユーザー⾏動の急速な変化 例:
閲覧、クリック、購⼊などの直近のアクションに基づく推薦 • 動的なコンテキスト 例: 季節性、トレンド、イベント等、時間依存の要素が強い場合 • 即時性が求められるアプリケーション 例: ニュース、ソーシャルメディア、フラッシュセールなど -
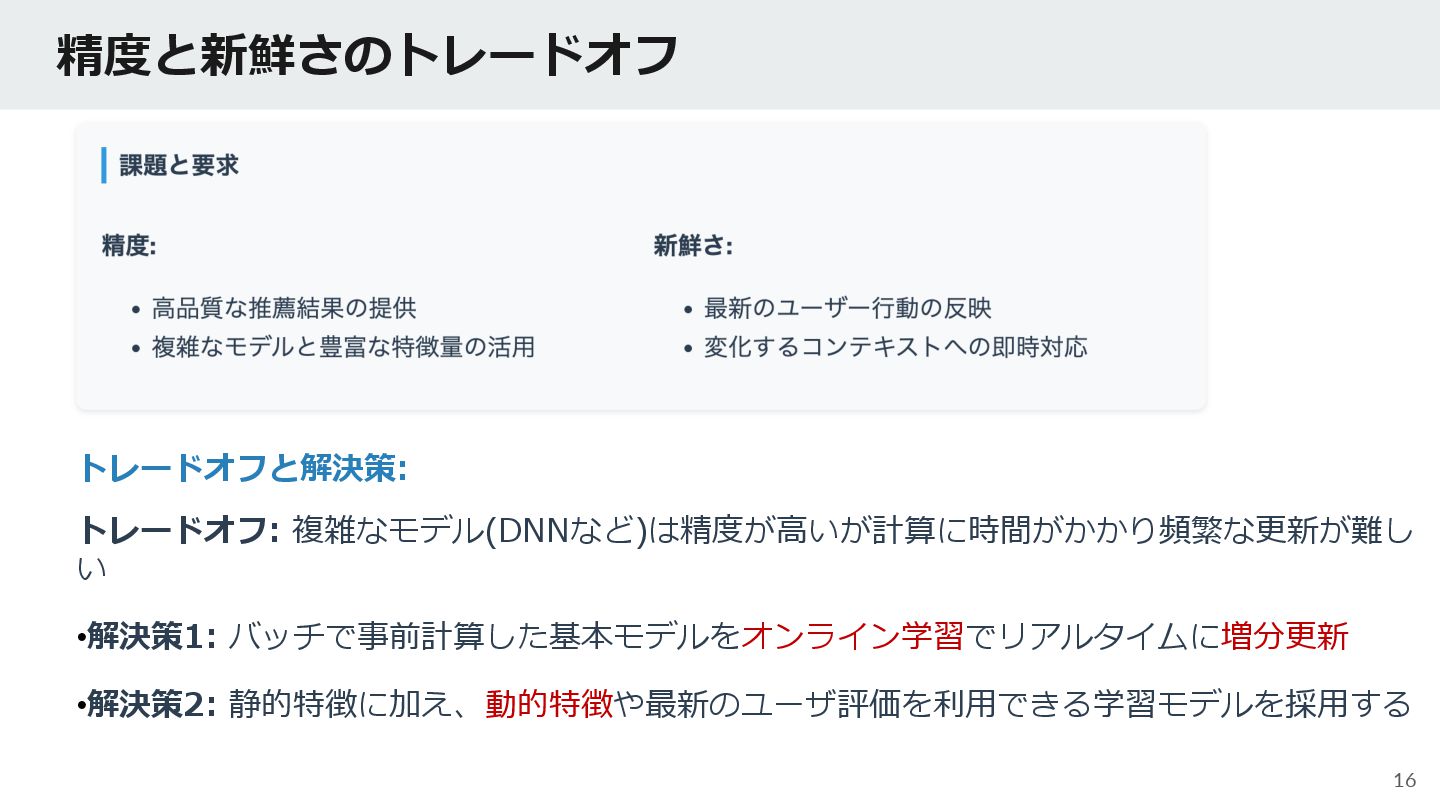
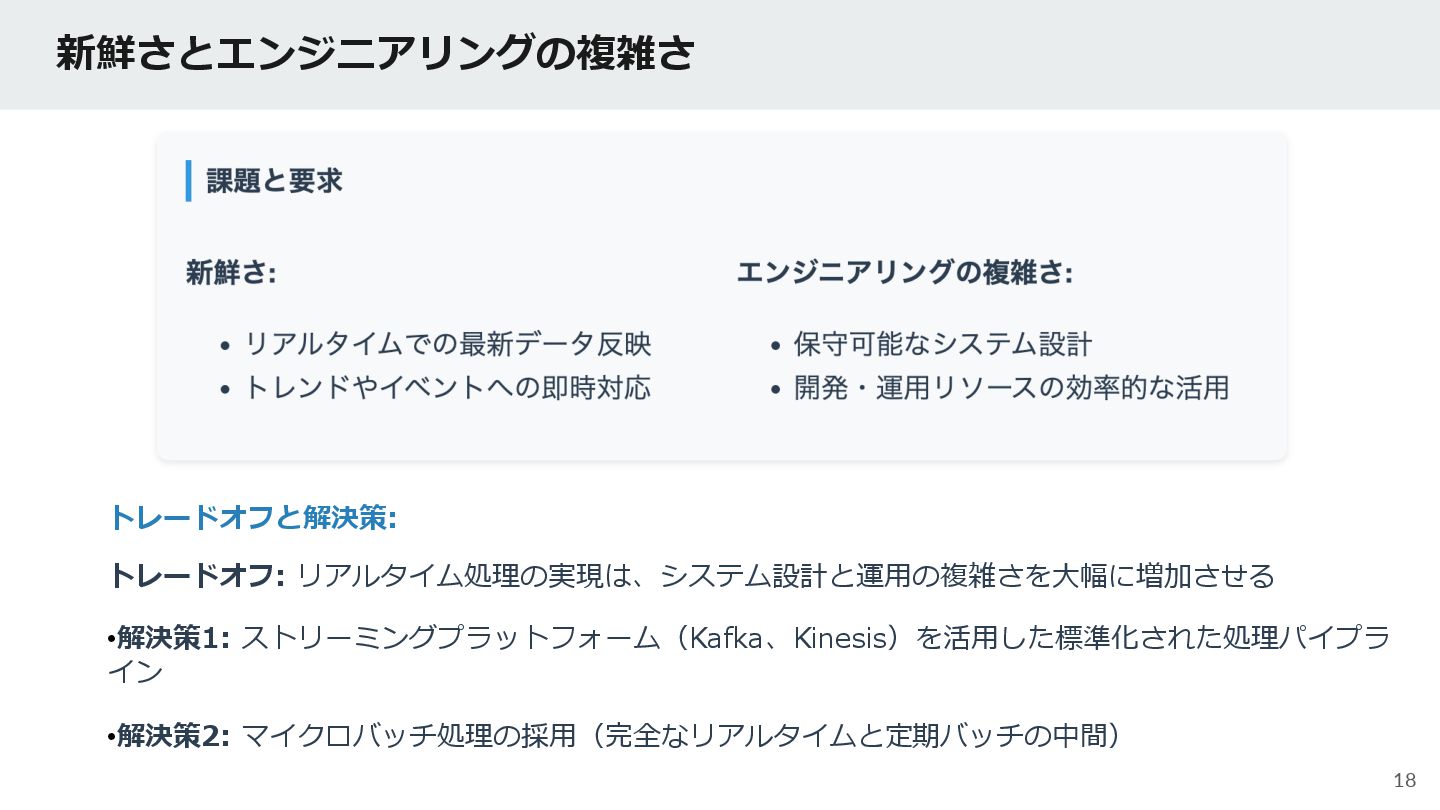
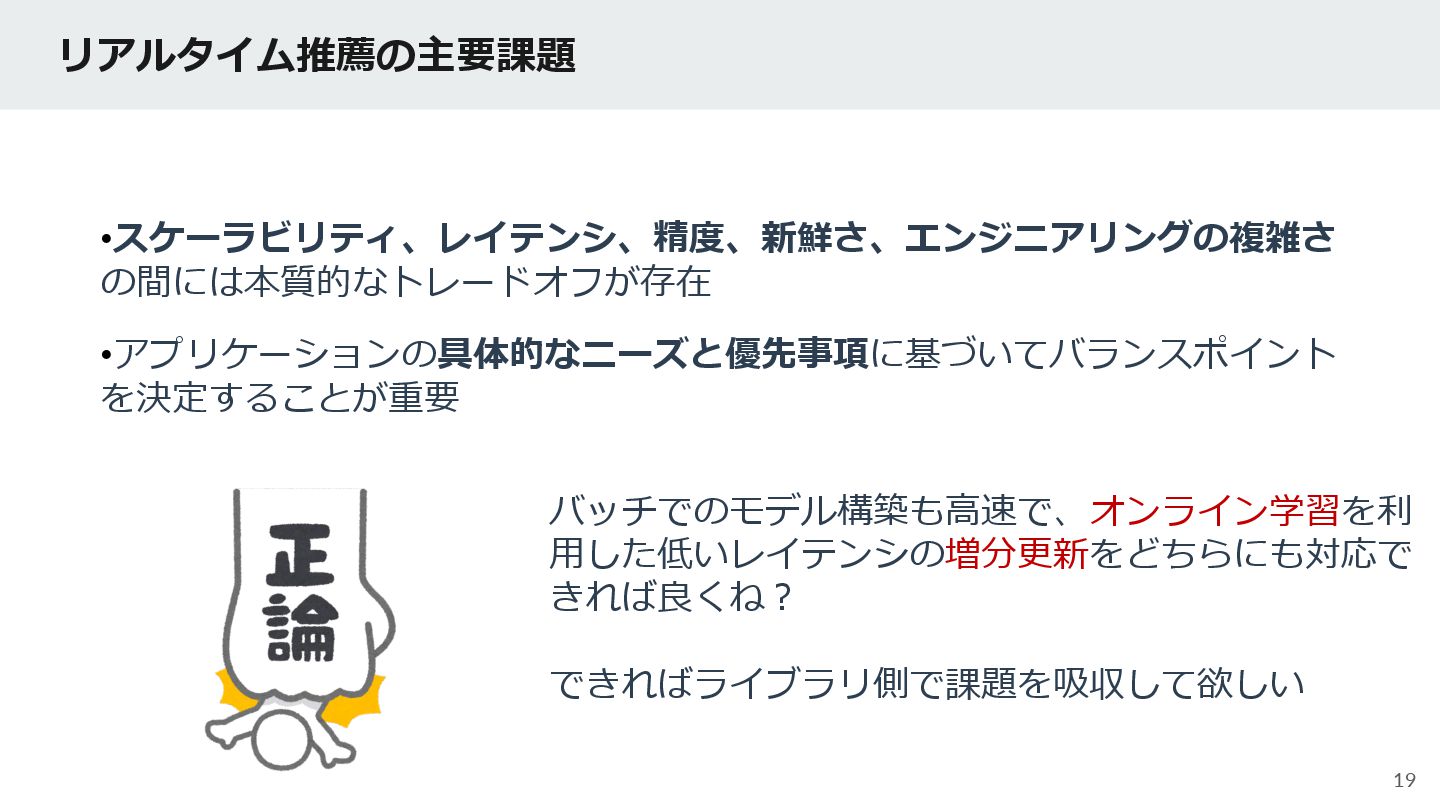
リアルタイム推薦の主要課題 15 1. スケーラビリティ: ⼤量のデータとトラフィックの処理 2. レイテンシ: ミリ秒単位での推薦⽣成 3. 精度:
スピード要件にもかかわらず推薦の質を維持 4. 新鮮さ: 推薦が最新のユーザー⾏動を反映していることを 保証 5. エンジニアリングの複雑さ: モデルをストリーミングシス テムと統合 これらの課題は互いに密接に関連しており、⼀つの課題を最適化すると他の課題に影響を与える トレードオフの関係 → リアルタイム推薦システムはこれらのバランスを考慮する必要がある -
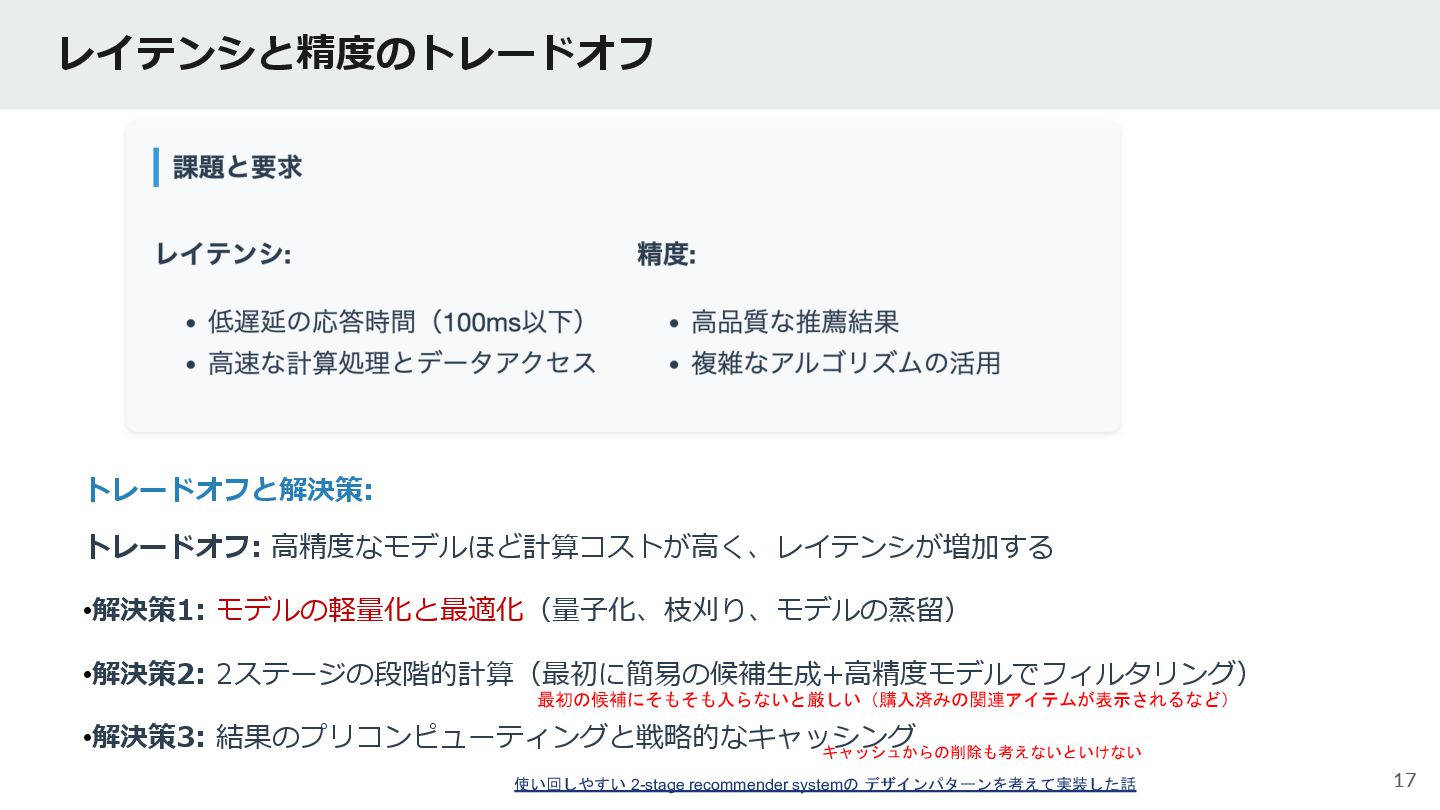
レイテンシと精度のトレードオフ 17 トレードオフと解決策: トレードオフ: ⾼精度なモデルほど計算コストが⾼く、レイテンシが増加する •解決策1: モデルの軽量化と最適化(量⼦化、枝刈り、モデルの蒸留) •解決策2: 2ステージの段階的計算(最初に簡易の候補⽣成+⾼精度モデルでフィルタリング) •解決策3:
結果のプリコンピューティングと戦略的なキャッシング 使い回しやすい 2-stage recommender systemの デザインパターンを考えて実装した話 最初の候補にそもそも入らないと厳しい(購入済みの関連アイテムが表示されるなど) キャッシュからの削除も考えないといけない -
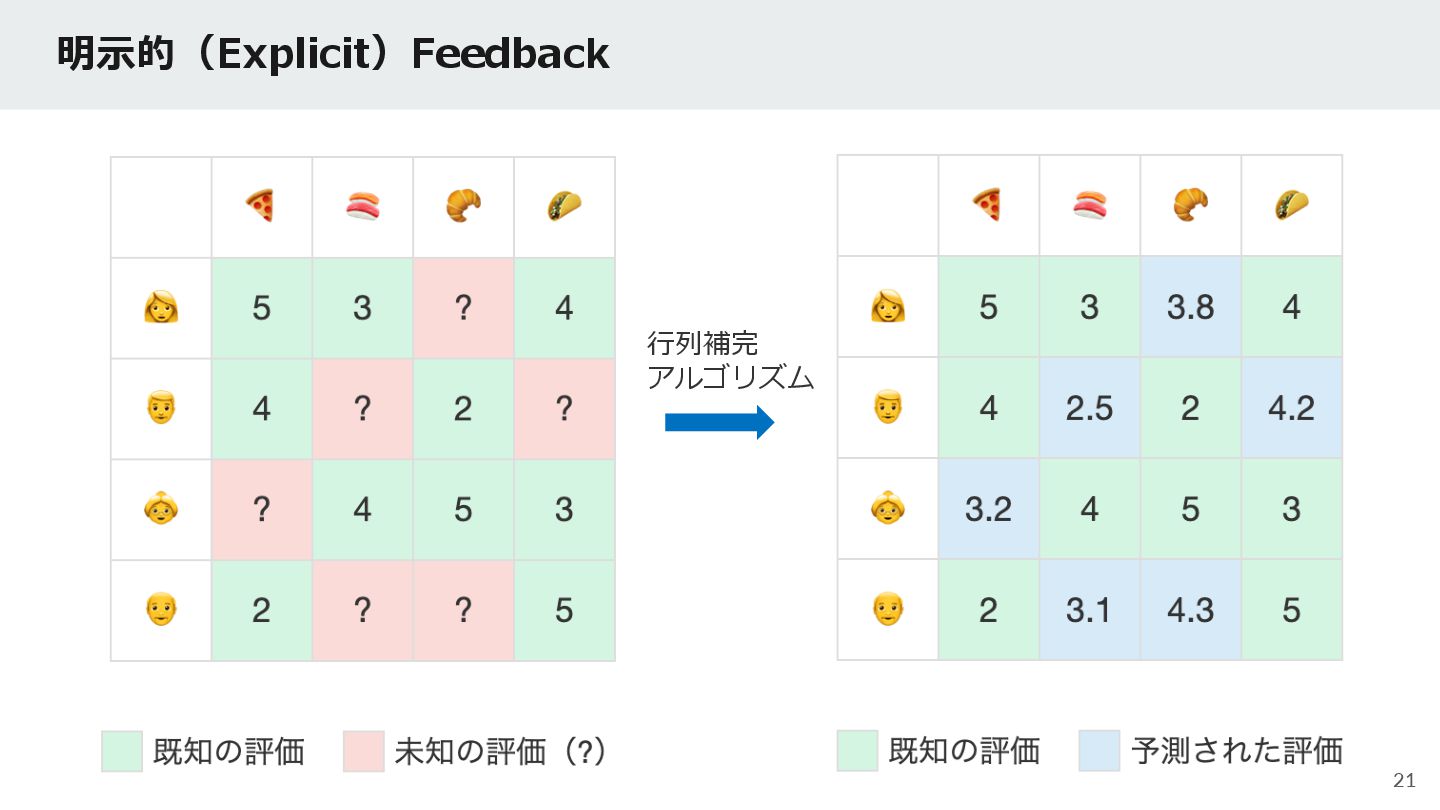
Matrix Factorization (FunkSVD) 22 R ≈ P × Q^T R:
評価⾏列(⽋損値を含む) P: ユーザー潜在特徴⾏列 Q^T: アイテム潜在特徴⾏列の転置 Netflix Prizeで Simon Funk によって提案された推薦システム向けの ⾏列分解⼿法(低ランク⾏列で近似) -
23 実⽤例 Netflix: Netflix Prizeで広く使われ、推薦システムの基盤技術となった Amazon: 商品推薦エンジンに類似⼿法を採⽤ Spotify: ⾳楽推薦に⾏列分解ベースの⼿法を利⽤ YouTube:
動画推薦に広く活⽤ Matrix Factorization (FunkSVD) Netflix Prizeで Simon Funk によって提案された推薦システム向けの ⾏列分解⼿法(低ランク⾏列で近似) -
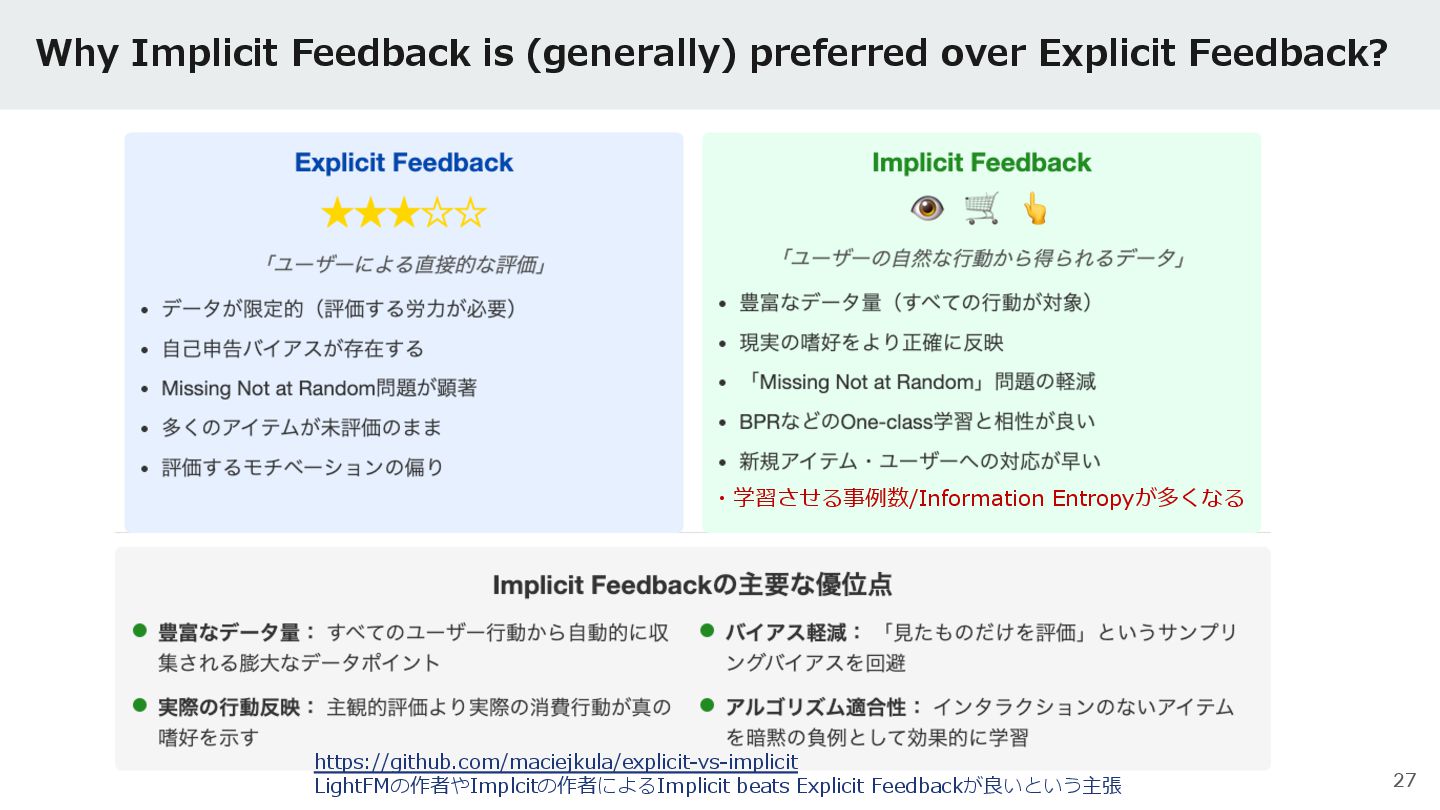
Why Implicit Feedback is (generally) preferred over Explicit Feedback? 27
https://github.com/maciejkula/explicit-vs-implicit LightFMの作者やImplcitの作者によるImplicit beats Explicit Feedbackが良いという主張 ・学習させる事例数/Information Entropyが多くなる -
Bayesian Personalized Ranking (BPR) 28 暗黙的Feedbackのためのペアワイズ⽐較に基づく確率的ランキング⼿法 基本概念 • ユーザは観測されたインタラクションしたアイテムi(+1)は未観測のものよりアイテムj(-1)より好む と仮定
• ユーザーの選好関係の順序(i > j)を直接モデル化 i(+1) j(-1) • 𝑃 𝑖 <! 𝑗 : ユーザ𝑢がアイテム𝑖よりアイテム𝑗を好む確率 • ' 𝑋!", ' 𝑋!# : ユーザ𝑢に対するアイテム𝑖, 𝑗の予測スコア 定式化 𝑃 𝑖 <! 𝑗 = 𝜎 ' 𝑋!"# = 𝜎 ' 𝑋!" − ' 𝑋!# > 0.5 ⽬的関数 -
Negative samplingに対する疑問 31 新規アイテムが時間経過と 共に増えていく 新規ユーザも時間経過と 共に増えていく 新規追加されるアイテムよりも 既存アイテムの⽅が、⾼い確率 で選ばれ、偏ったサンプリング
がされてしまう😢 リアルタイムフィードバックを考慮すると… -
iALS (Implicit Alternating Least Squares) 32 • 交互最⼩⼆乗法(Alternating Least Squares)を暗黙的Feedbackに適⽤する⼿法
◦ 共役勾配法(Conjugate Gradient)を利⽤した効率的な計算が可能(OSSのimplicitが代表 的な実装) • 近年Stefan Rendel(BPR/FM論⽂の著者)らのGoogle研究チームによって、重要な指摘がなされ、 Deep系のモデルに匹敵する結果であると報告されている[1] S. Rendel et.al., Revisiting the Performance of iALS on item Recommendation Benchmarks, Proc. RecSysʼ22 ML20Mでは、iALSはMult-VAEと同等のパ フォーマンス EASE/SLIMも健闘 MSDでは、iALSはEASEに次ぐ2番⽬に優 れた⼿法 • Visinalエンジニアの記事 • GMOエンジニアの記事 • CyberAgentエンジニアの記事 -
33 iALSの着眼点: • 接触が実際にあるユーザー・アイテムの組み合わせについては、確かにそのユーザーはアイテムに何かしら の興味があったと⾔える • しかし、接触がなかった組み合わせについては、必ずしも興味がなかったのではなく、ユーザーがアイテム のことを知り得なかった場合など、さまざまな事情がありえる → よって、この場合はそれほど⾃信を持って
𝑈" ・𝑉 # が 0 に近いとは⾔えない iALS (Implicit Alternating Least Squares) Revisiting iALS論⽂の損失関数 S. Rendel et.al., Revisiting the Performance of iALS on item Recommendation Benchmarks, Proc. RecSysʼ22 オリジナルとは若干異なるがこっちの方が真にimplicit -
確信度を利⽤しImplicitフィードバックをExplicit化 34 明⽰的な評価がない状況でも、⾏動の頻度から選好に対する確信度を導出し、重みとして利⽤ benfred/implicitはこのアプローチ iALSのオリジナル論⽂ Collaborative Filtering for Implicit Feedback
Datasets. Proc. ICDM 2008. 「暗黙的フィードバックはbinary値、明示的フィードバックはそれ以外」といった理解は正しくないとのこと -
深層学習推薦システムの再現性問題 35 RecSysʼ19のBest Paper 「Are We Really Making Much Progress?
A Worrying Analysis of Recent Neural Recommendation Approaches」の主張 • トップ会議(KDD, SIGIR, WWW, RecSys)で発表されたDNN関連の推薦シ ステム研究18本を追試 • 実装の再現に現実的な努⼒を⾏った上で再現できたのはわずか7本(39%) • 再現できた7本のうち6本が単純なkNNベースの⼿法+ハイパーパラメータ最適 化に性能で劣る • 残り1本も単純な線形⼿法(調整済み)に負ける場合 があることが判明 • 評価できるのは、Mult-VAEぐらい RecSys 2019 ベストペーパーを読んだメモ@Qiita -
SLIM (Sparse LInear Method) 36 Ning & Karypis, SLIM: Sparse
Linear Methods for Top-N Recommender Systems, Proc. ICDM 2011 -
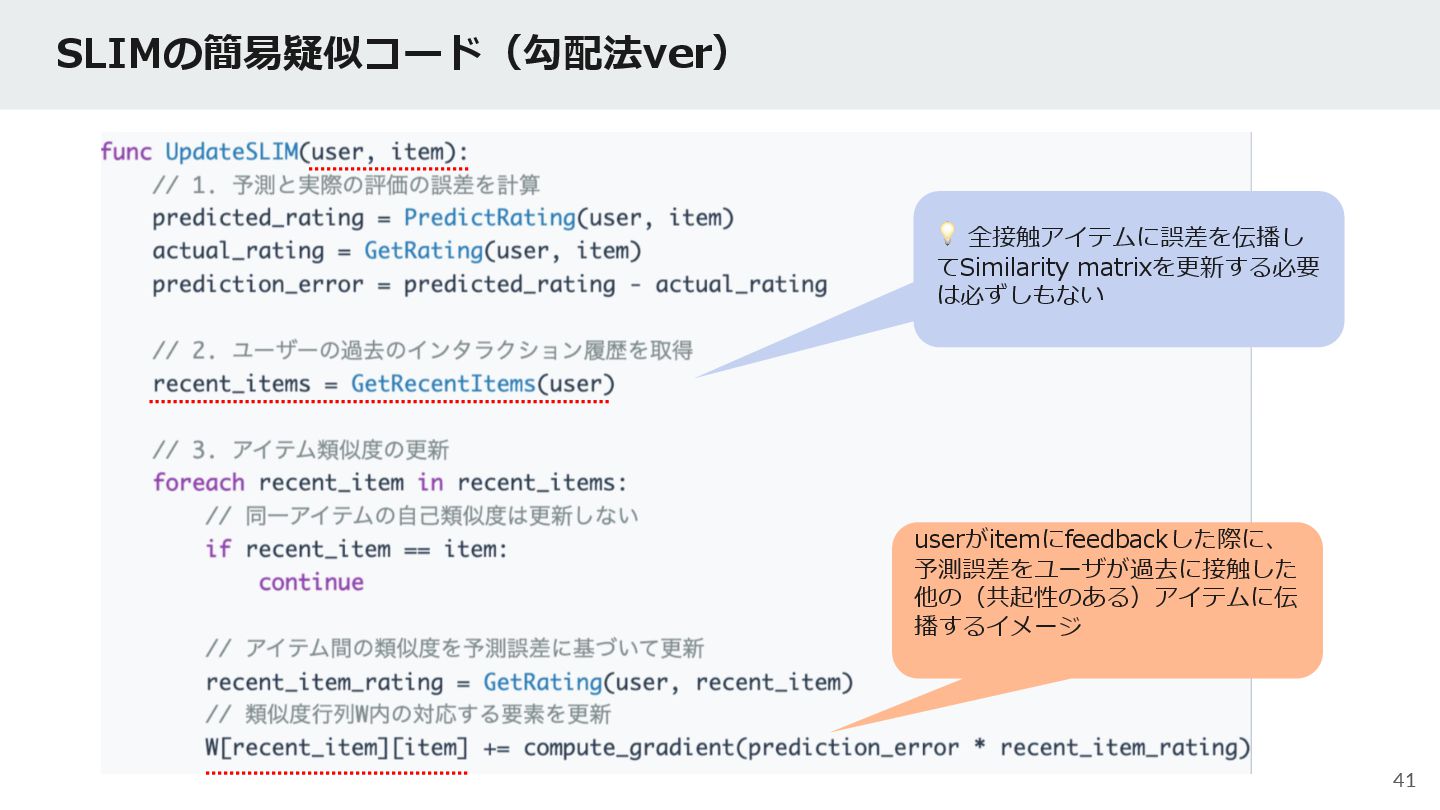
SLIM (Sparse LInear Method) 37 アイテム間のSimilarityを重みとして学習し、評価⾏列を再構成 . 𝑟! = 𝑟!
𝑊で予測し、ユーザーがまだ評価していないアイテムを⾼スコア順に推薦 アイテムベースの協調フィルタリングの安定性 𝑊はスパースであることに注意 ユーザの過去のアイテムRatingが 𝑅!" の予測に利⽤される ユーザの評価⾏列もスパース -
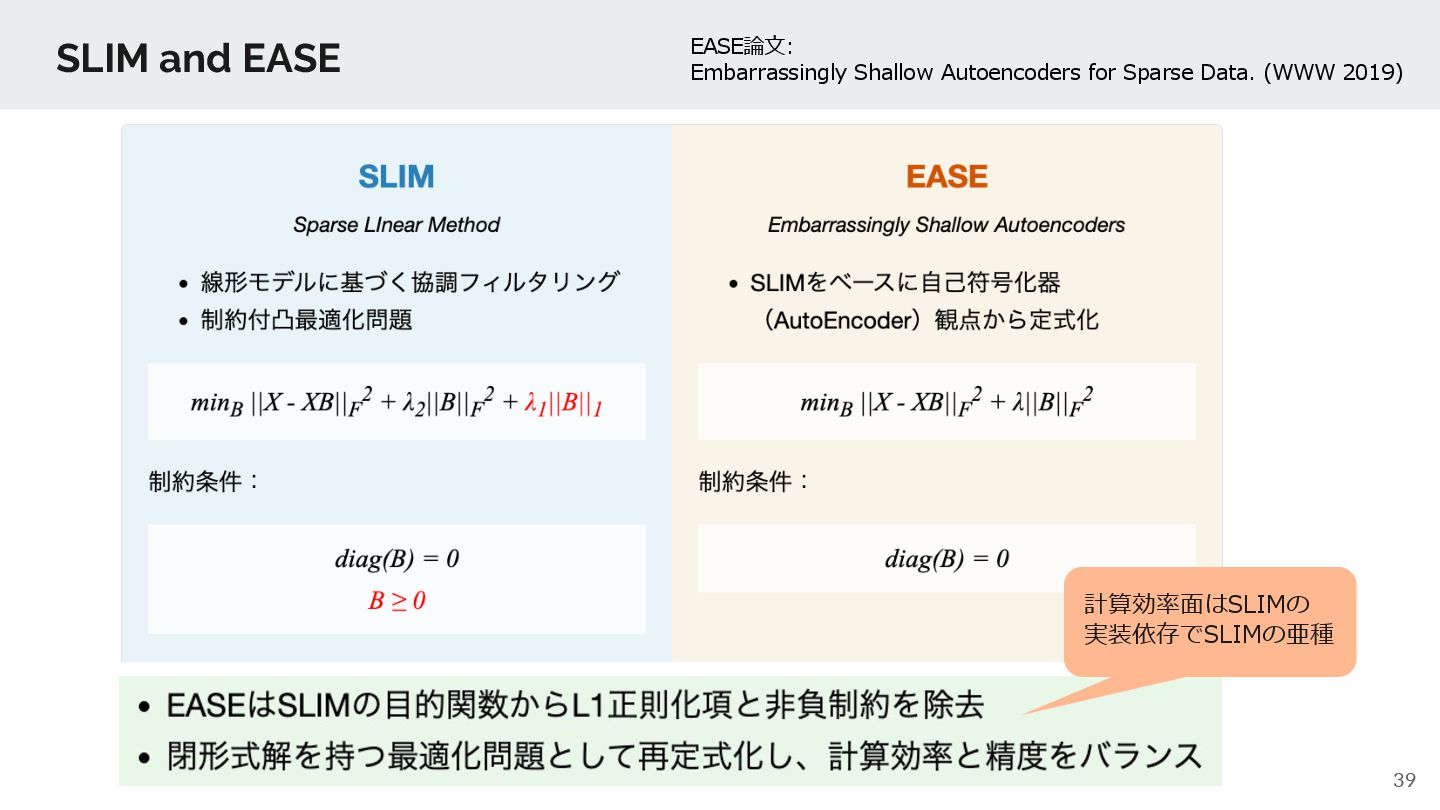
SLIM and EASE 39 EASE論⽂: Embarrassingly Shallow Autoencoders for Sparse
Data. (WWW 2019) 計算効率⾯はSLIMの 実装依存でSLIMの亜種 -
SLIMとMFの⽐較 40 MF SLIM URM(User Rating Matrix)を予測に⽤いる( - 𝑟! =
𝑟! 𝑊 )のが特徴 → 最新のフィードバックを利⽤できる 学習済みの潜在ベクトルの内積で予測 学習 New interaction New interaction 𝑚𝑜𝑑𝑒𝑙. 𝑓𝑖𝑡(𝑅′, 𝑟 # ) 𝑊 # = 𝑚𝑜𝑑𝑒𝑙. 𝑐𝑜𝑒𝑓_ -
From SLIM to Regression 42 💡 Cordinate Descent(座標降下法)を ⽤いたElasticNetで⾼速かつ精度良く解ける from
sklearn.linear_model import ElasticNet -
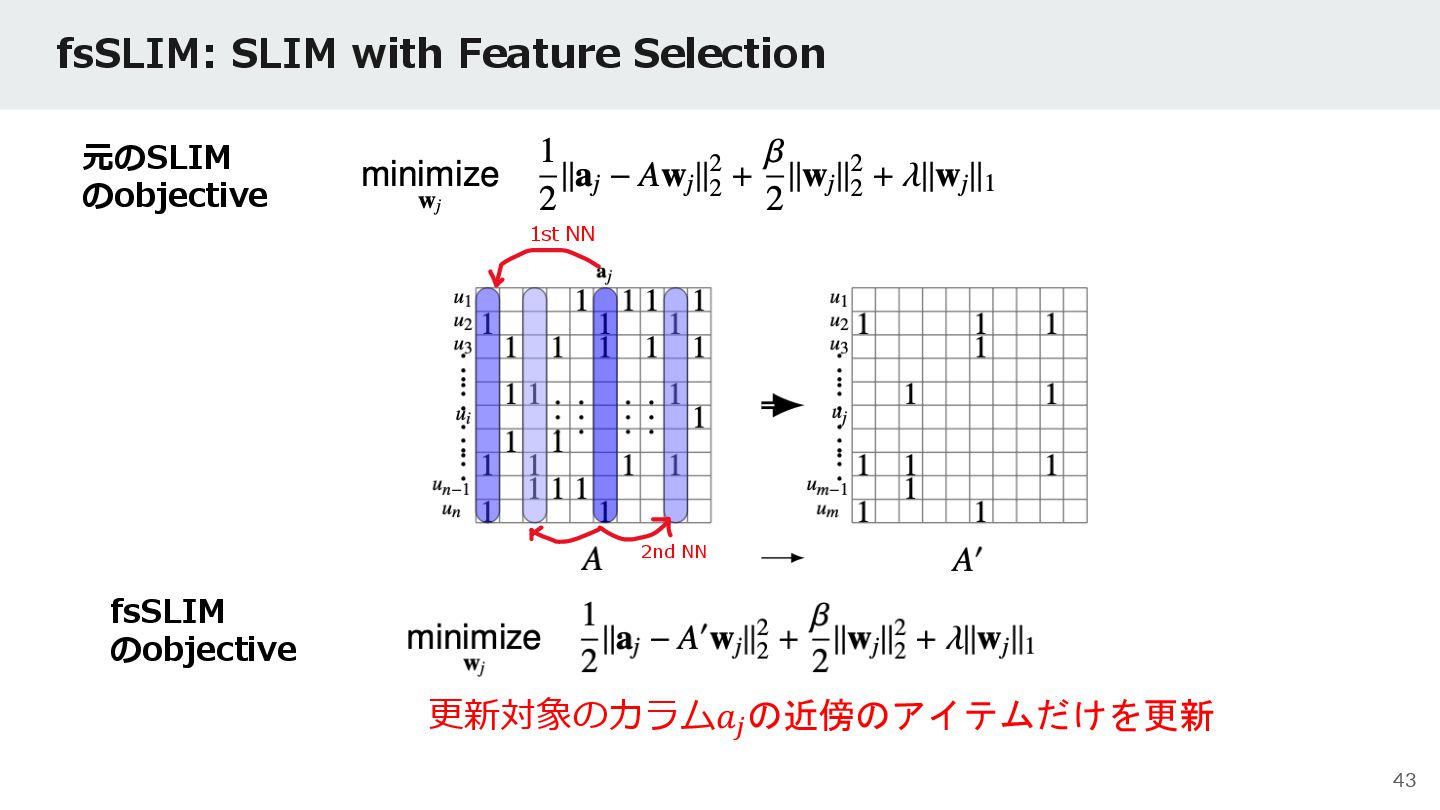
fsSLIM: SLIM with Feature Selection 43 元のSLIM のobjective fsSLIM のobjective
1st NN 2nd NN 更新対象のカラム𝑎! の近傍のアイテムだけを更新 -
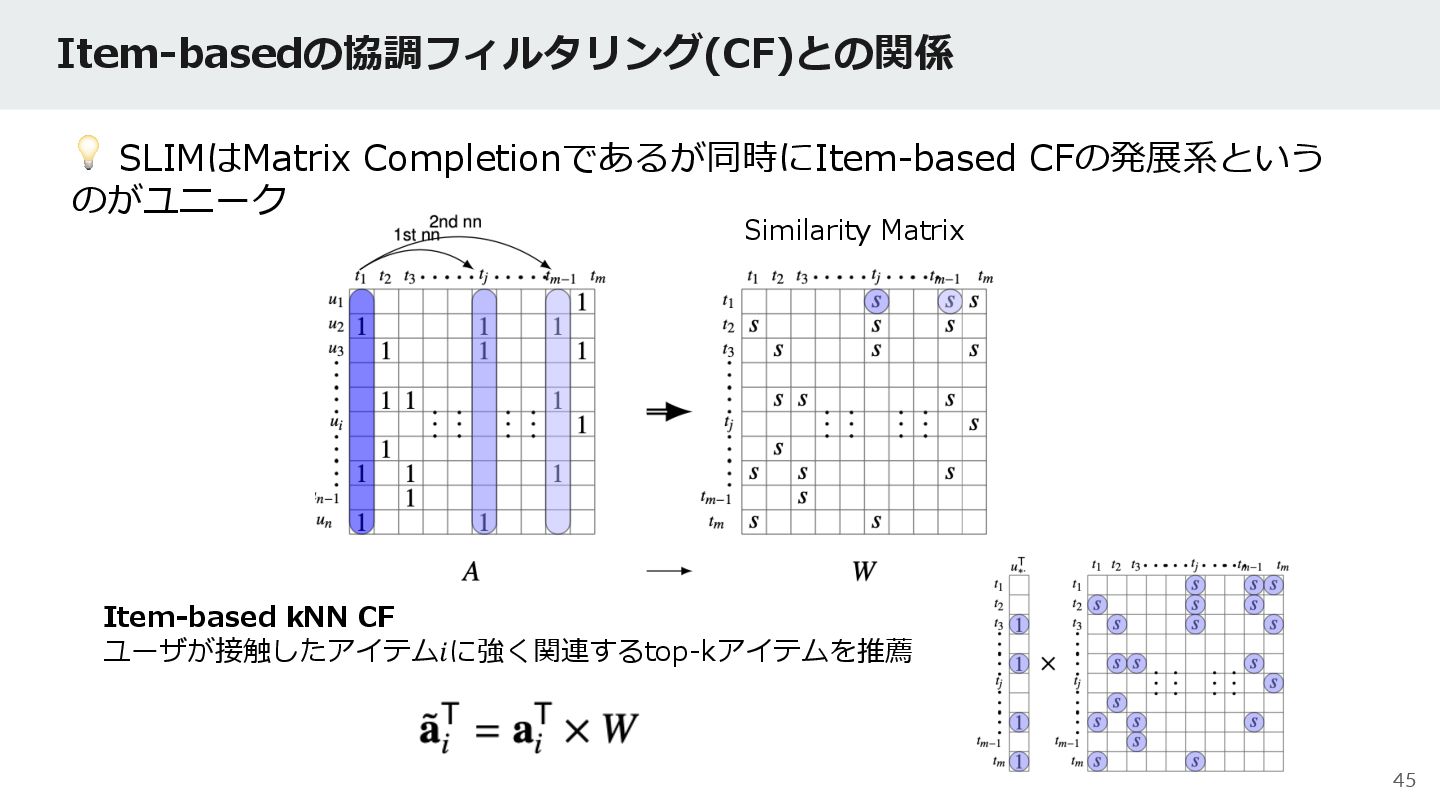
Item-basedの協調フィルタリング(CF)との関係 45 💡 SLIMはMatrix Completionであるが同時にItem-based CFの発展系という のがユニーク Similarity Matrix Item-based
kNN CF ユーザが接触したアイテム𝑖に強く関連するtop-kアイテムを推薦 -
SLIM with Feature Selectionによって得られる性能向上 46 Ning & Karypis, SLIM: Sparse
Linear Methods for Top-N Recommender Systems, Proc. ICDM 2011 -
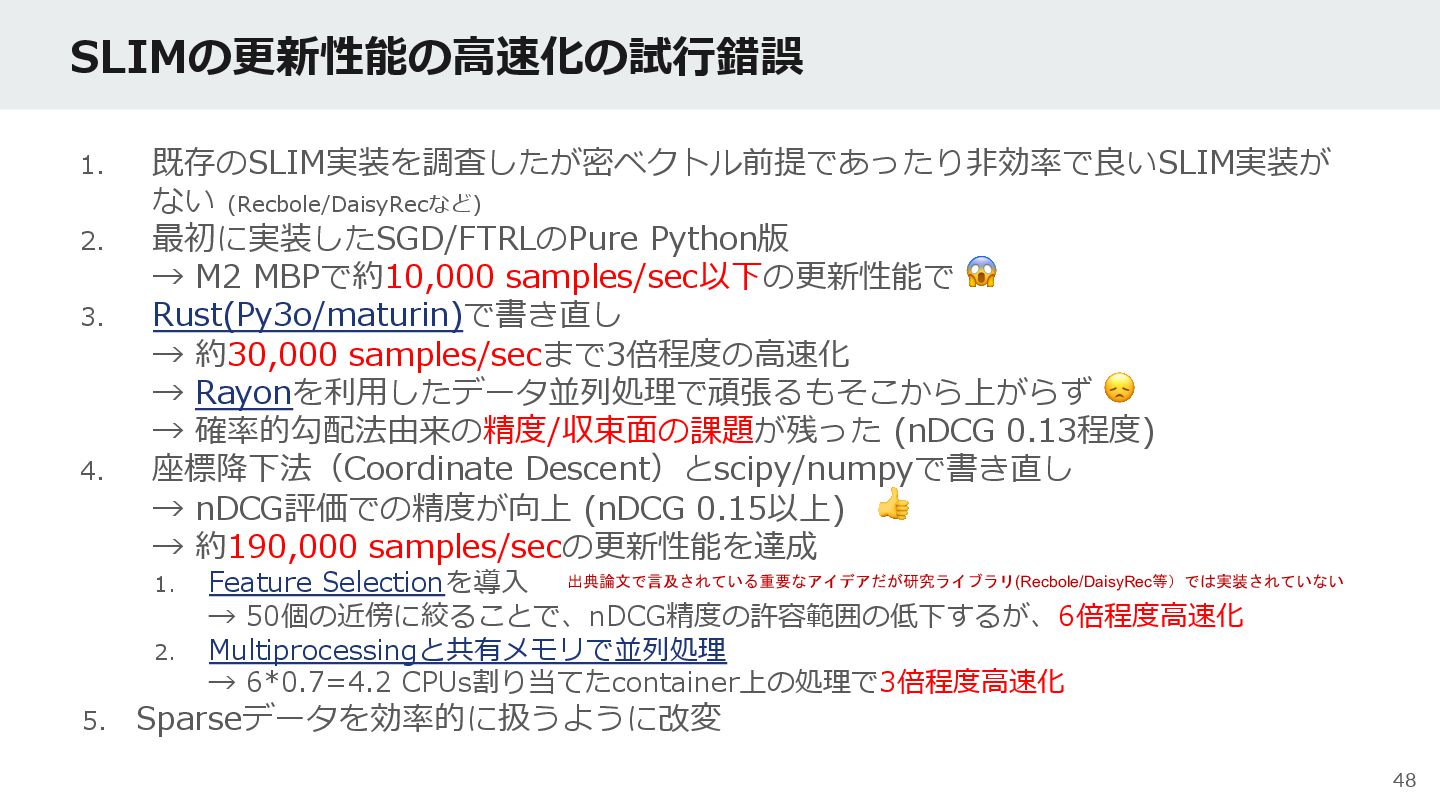
SLIMの更新性能の⾼速化の試⾏錯誤 48 1. 既存のSLIM実装を調査したが密ベクトル前提であったり⾮効率で良いSLIM実装が ない (Recbole/DaisyRecなど) 2. 最初に実装したSGD/FTRLのPure Python版 →
M2 MBPで約10,000 samples/sec以下の更新性能で 😱 3. Rust(Py3o/maturin)で書き直し → 約30,000 samples/secまで3倍程度の⾼速化 → Rayonを利⽤したデータ並列処理で頑張るもそこから上がらず 😞 → 確率的勾配法由来の精度/収束⾯の課題が残った (nDCG 0.13程度) 4. 座標降下法(Coordinate Descent)とscipy/numpyで書き直し → nDCG評価での精度が向上 (nDCG 0.15以上) 👍 → 約190,000 samples/secの更新性能を達成 1. Feature Selectionを導⼊ → 50個の近傍に絞ることで、nDCG精度の許容範囲の低下するが、6倍程度⾼速化 2. Multiprocessingと共有メモリで並列処理 → 6*0.7=4.2 CPUs割り当てたcontainer上の処理で3倍程度⾼速化 5. Sparseデータを効率的に扱うように改変 出典論文で言及されている重要なアイデアだが研究ライブラリ(Recbole/DaisyRec等)では実装されていない -
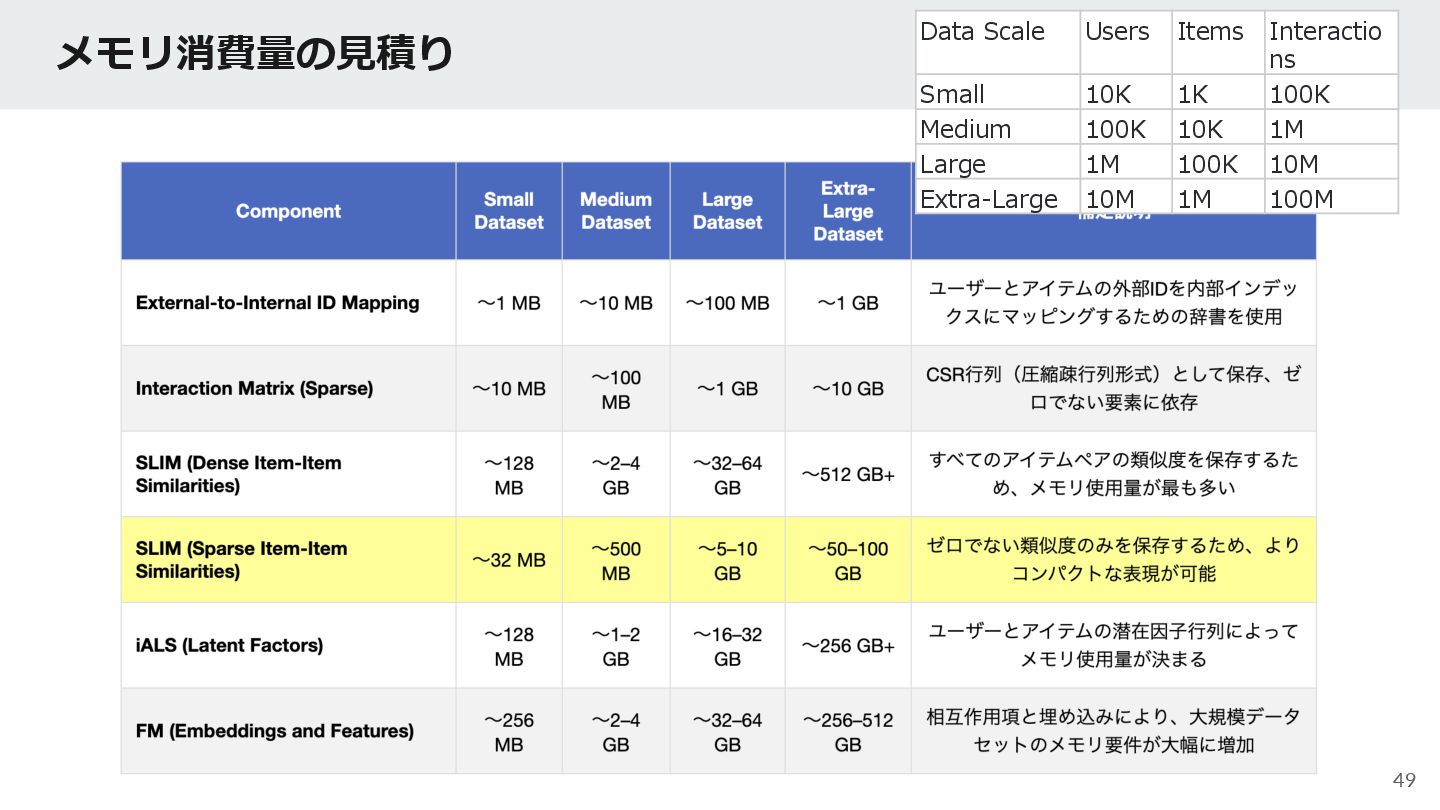
メモリ消費量の⾒積り 49 Data Scale Users Items Interactio ns Small 10K
1K 100K Medium 100K 10K 1M Large 1M 100K 10M Extra-Large 10M 1M 100M -
ユーザ評価⾏列(URM)へのTime Decay(半減期)の導⼊ 50 ユーザーの興味や好みは、時間の経過とともに変動する 「 Time weight collaborative filtering 」論⽂の時間の経過とともにユーザーのインタラ
クションの重要度を変化させる⼿法を導⼊ → 遅延実⾏でユーザ評価⾏列の参照時にTime decayを適⽤ Time weight collaborative filtering (CIKM’05) Time Decay導⼊効果 👍 ユーザーの最新のfeedbackをより 強調することで、推薦内容が最新の嗜 好変化に即応 👍 古いインタラクションが推薦に与え る影響を低減することで、興味が薄れ たアイテムが推薦されるリスクを軽減 -
Incremental Feedbackのユーザ評価⾏列(URM)への反映 51 暗黙的Feedbackの⼊⼒となるURMは0/1のみで以下のようなリアルタイムのFeedbackに適さない また、Explicit FeedbackもURMが集計されていることを基本的に前提としている → URMを予測に使うSLIMの特徴を利⽤ → リアルタイムのフィードバックを受け付けるオンライン学習⽤に指定のレンジ内でURMを
delta更新するような⼊⼒設計 new_value = clip_range( apply_decay(current) + delta) ) -
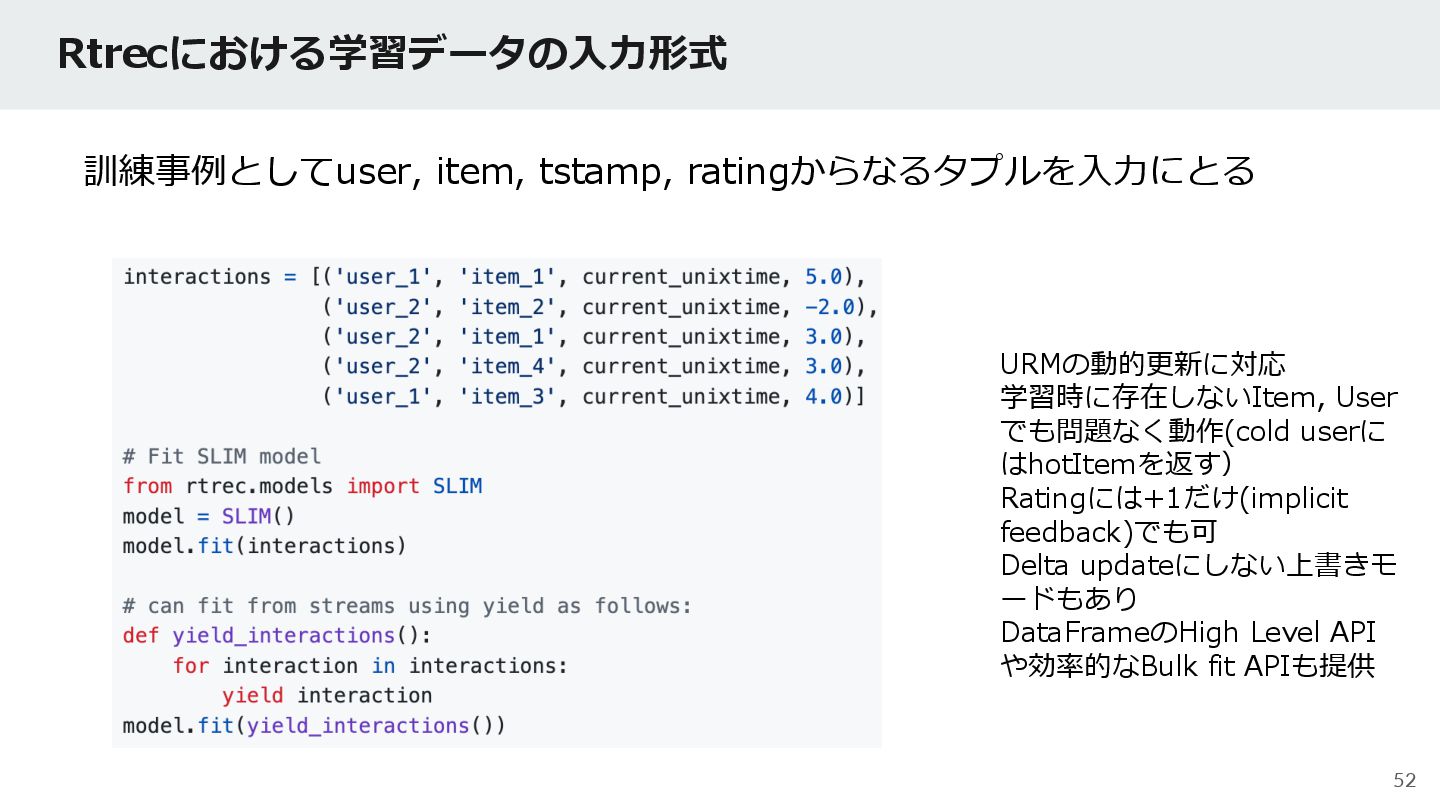
Rtrecにおける学習データの⼊⼒形式 52 訓練事例としてuser, item, tstamp, ratingからなるタプルを⼊⼒にとる URMの動的更新に対応 学習時に存在しないItem, User でも問題なく動作(cold
userに はhotItemを返す) Ratingには+1だけ(implicit feedback)でも可 Delta updateにしない上書きモ ードもあり DataFrameのHigh Level API や効率的なBulk fit APIも提供 -
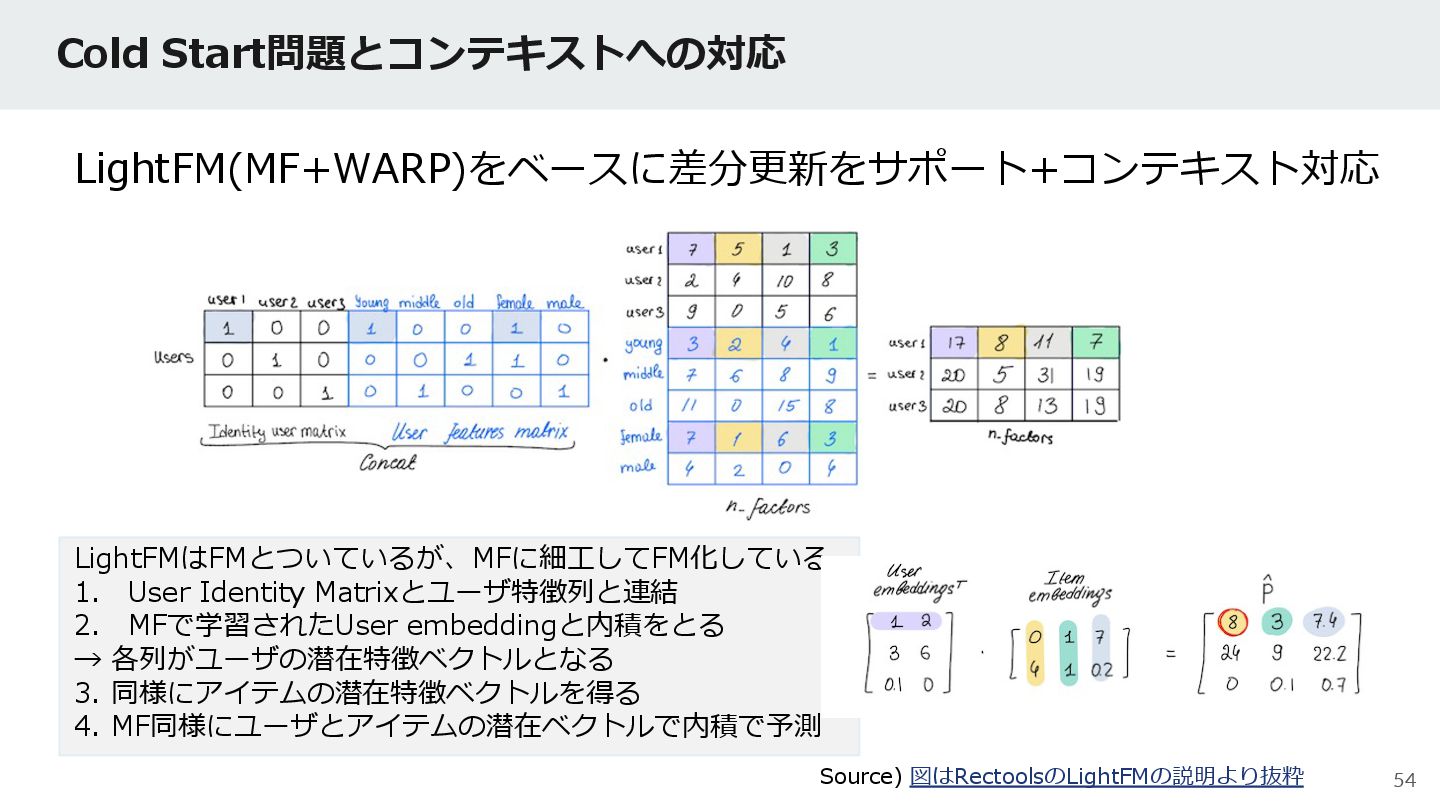
Cold Start問題とコンテキストへの対応 54 LightFM(MF+WARP)をベースに差分更新をサポート+コンテキスト対応 Source) 図はRectoolsのLightFMの説明より抜粋 LightFMはFMとついているが、MFに細⼯してFM化している 1. User Identity
Matrixとユーザ特徴列と連結 2. MFで学習されたUser embeddingと内積をとる → 各列がユーザの潜在特徴ベクトルとなる 3. 同様にアイテムの潜在特徴ベクトルを得る 4. MF同様にユーザとアイテムの潜在ベクトルで内積で予測 -
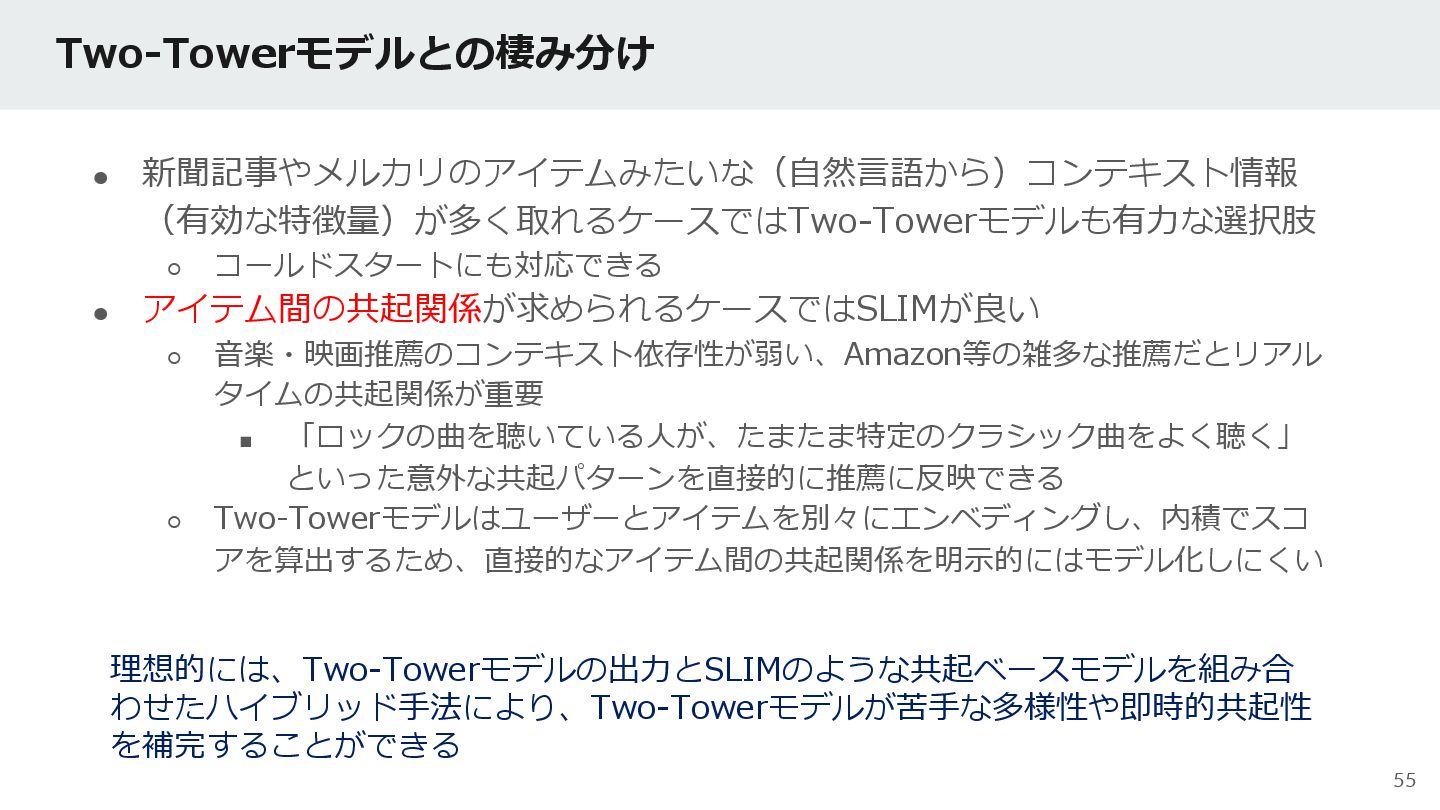
Two-Towerモデルとの棲み分け 55 • 新聞記事やメルカリのアイテムみたいな(⾃然⾔語から)コンテキスト情報 (有効な特徴量)が多く取れるケースではTwo-Towerモデルも有⼒な選択肢 ◦ コールドスタートにも対応できる • アイテム間の共起関係が求められるケースではSLIMが良い ◦
⾳楽・映画推薦のコンテキスト依存性が弱い、Amazon等の雑多な推薦だとリアル タイムの共起関係が重要 ▪ 「ロックの曲を聴いている⼈が、たまたま特定のクラシック曲をよく聴く」 といった意外な共起パターンを直接的に推薦に反映できる ◦ Two-Towerモデルはユーザーとアイテムを別々にエンベディングし、内積でスコ アを算出するため、直接的なアイテム間の共起関係を明⽰的にはモデル化しにくい 理想的には、Two-Towerモデルの出⼒とSLIMのような共起ベースモデルを組み合 わせたハイブリッド⼿法により、Two-Towerモデルが苦⼿な多様性や即時的共起性 を補完することができる -
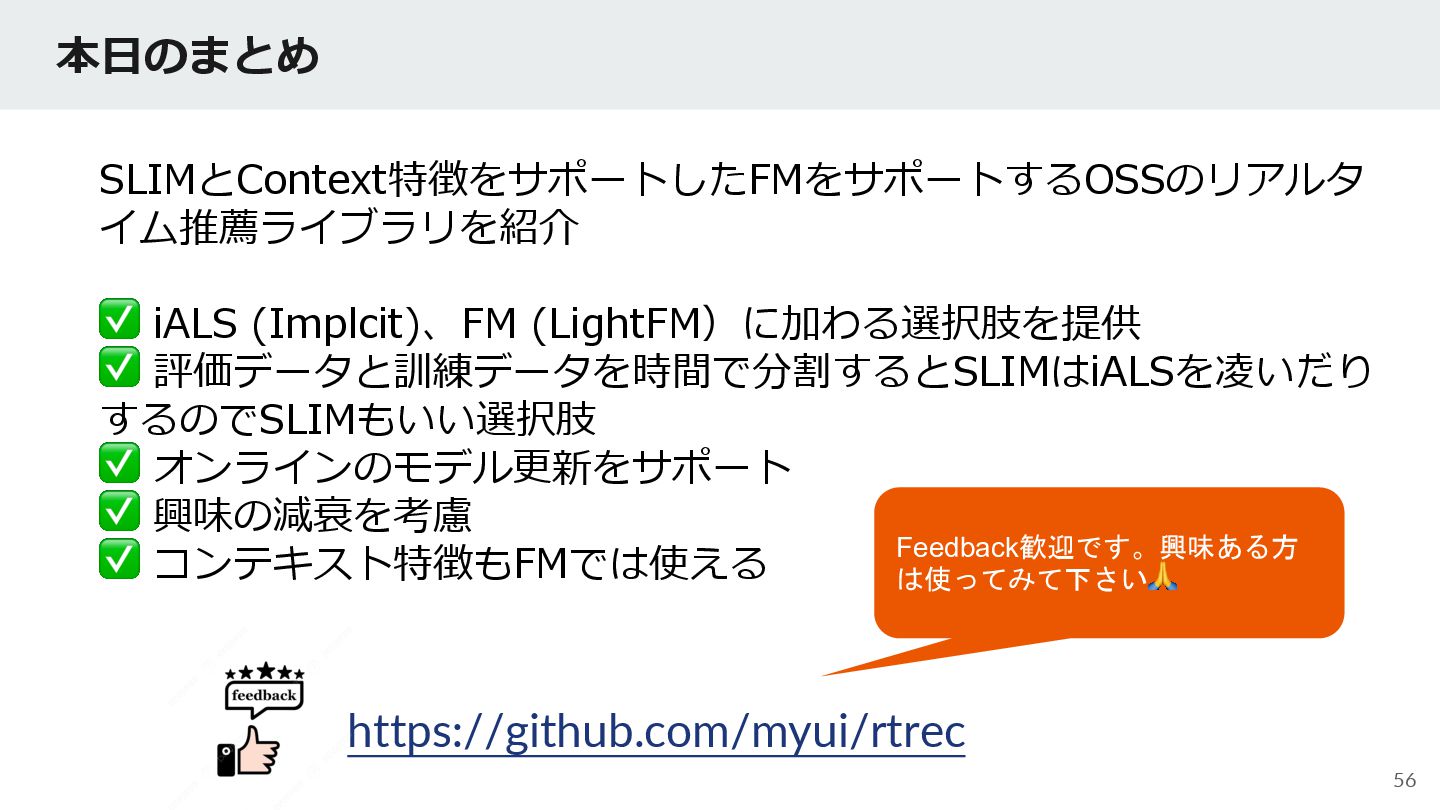
本⽇のまとめ 56 https://github.com/myui/rtrec Feedback歓迎です。興味ある方 は使ってみて下さい🙏 SLIMとContext特徴をサポートしたFMをサポートするOSSのリアルタ イム推薦ライブラリを紹介 ✅ iALS (Implcit)、FM
(LightFM)に加わる選択肢を提供 ✅ 評価データと訓練データを時間で分割するとSLIMはiALSを凌いだり するのでSLIMもいい選択肢 ✅ オンラインのモデル更新をサポート ✅ 興味の減衰を考慮 ✅ コンテキスト特徴もFMでは使える