Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
exists?で起きるN+1問題にSetで対処する
Search
patorash
July 21, 2021
Technology
870
0
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
exists?で起きるN+1問題にSetで対処する
Ruby on Railsでよく発生するN+1問題の解決方法として、exists?の場合は標準ライブラリのSetを使うといいかもしれない、という話です。
patorash
July 21, 2021
More Decks by patorash
See All by patorash
中間管理職はそこそこ楽しい
patorash
0
60
情報共有戦略と戦術
patorash
1
1.4k
DBのメタデータを管理する文化を作る
patorash
0
720
Stimulusのススメ
patorash
0
100
ActiveRecordの速度改善Tips2020冬
patorash
0
100
わかった気になる!OpenID Connect
patorash
2
2.2k
Indexの種類
patorash
1
850
Start-SQLの紹介
patorash
0
790
RailsアプリにGraphQLを導入してみた話
patorash
1
710
Other Decks in Technology
See All in Technology
1万名の社員が使う認証基盤で どう信頼性を担保するか?
kairim0
0
210
AIアプリを使い分けるための共通ツール基盤を考えてみる#devio2026
osawa
0
250
Execution in the Kingdom of Agents: Reflections on Abstraction and Complexity
bcantrill
0
840
カンファレンスに参加した後の浮遊感とセルフケア
pauli
0
310
KanaAI
shreyas1009
0
150
AI時代に必要な脅威モデリング― 変化の速度に負けない理解とリスク判断
masakane55
4
980
OpenSharing について熱く語る 〜AI アセットの共有について〜
kameitomohiro
0
230
Datadog の学び方 - あるいは、オブザーバビリティを学ぶとは何か
mananyuki
1
450
[2026-09-30]ロックンロールは鳴り止まないっ - 信頼性かまってちゃん - 「データ駆動を投げ捨ててまで。」追いかける信頼性改善に向けた取り組みの話
tosite
0
200
Snowflake Horizon Catalog と Apache Iceberg で作る オープンなデータ基盤
kitagawaz
0
440
[2026 Oracle Technical Deep Dive] OCI AI Resilience -OCIのセキュリティ対策機能をきちんと使いこなす- (2026年9月17日開催)
oracle4engineer
PRO
0
130
The seven pitfalls of AI (revised version)
ufried
0
260
Featured
See All Featured
Joys of Absence: A Defence of Solitary Play
codingconduct
1
530
Why Your Marketing Sucks and What You Can Do About It - Sophie Logan
marketingsoph
0
420
Six Lessons from altMBA
skipperchong
29
4.5k
Making Projects Easy
brettharned
120
6.8k
What does AI have to do with Human Rights?
axbom
PRO
1
2.4k
The agentic SEO stack - context over prompts
schlessera
0
960
How To Stay Up To Date on Web Technology
chriscoyier
790
250k
Raft: Consensus for Rubyists
vanstee
142
7.7k
Faster Mobile Websites
deanohume
310
32k
[RailsConf 2023] Rails as a piece of cake
palkan
59
7.1k
"I'm Feeling Lucky" - Building Great Search Experiences for Today's Users (#IAC19)
danielanewman
230
23k
Writing Fast Ruby
sferik
630
63k
Transcript
exists?で起きるN+1問 題にSetで対処する 2021-07-21 株式会社リゾーム 社内勉強会 @patorash
稀によくあるコード # CSVファイルの行数だけUser.exists?が実行されるやーつ csv.foreach do |row| name = row['名前'] age
= row['年齢'] hobby = row['趣味'] # User.find_or_create_by!とか言わないで… unless User.exists?(name: name, age: age, hobby: hobby) User.create!(name: name, age: age, hobby: hobby) end end
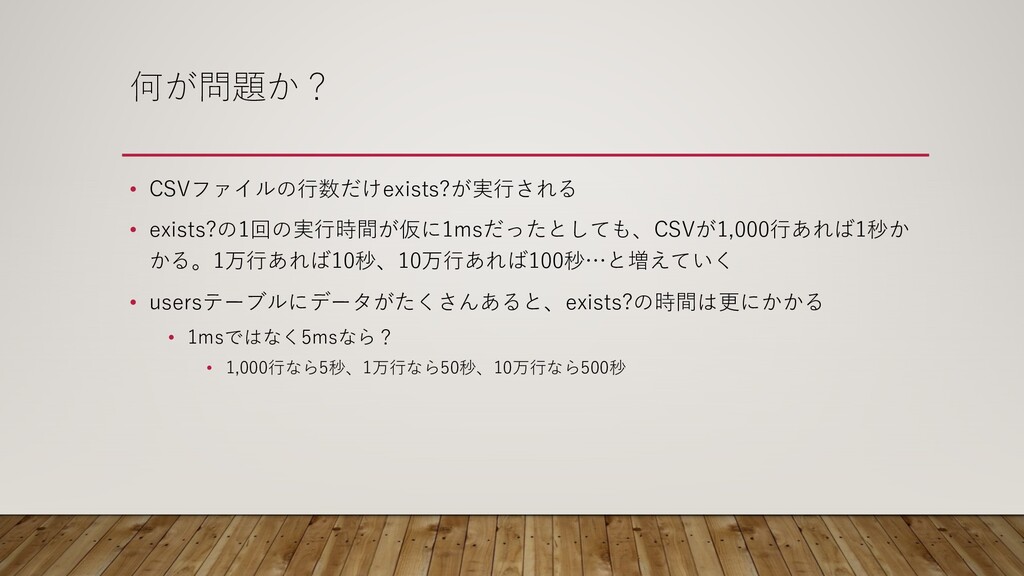
何が問題か? • CSVファイルの⾏数だけexists?が実⾏される • exists?の1回の実⾏時間が仮に1msだったとしても、CSVが1,000⾏あれば1秒か かる。1万⾏あれば10秒、10万⾏あれば100秒…と増えていく • usersテーブルにデータがたくさんあると、exists?の時間は更にかかる • 1msではなく5msなら?
• 1,000⾏なら5秒、1万⾏なら50秒、10万⾏なら500秒
どうしてこんなことに… • 重複データを検知したいから
どうすれば… • とはいえ、重複しているかどうかは DBに問い合わせしなければわからな いじゃないか! • N回のクエリが発⽣するのも⽌むを 得ない!
そう考えていた頃が私にもありました
標準ライブラリSetを使え! • Setは、数学の集合を扱うクラス • 集合とは、重複のないオブジェクトの集まりです。Arrayの持つ演算機能とHash の⾼速な検索機能を合わせ持ちます。 Setは内部記憶としてHashを使うため、集合要素の等価性はObject.eql?と Object#hashを⽤いて判断されます。したがって、集合の各要素には、これらの メソッドが適切に定義されている必要があります。 集合の順序は保証されません。
(Ruby リファレンスマニュアルより)
どういうこと? • Setを使うと、配列の要素毎にhash関数が呼ばれて、それがkeyに設定された Hashを持つことになる。(内部的に) # これはつまり… set = Set.new(["a", "b"])
# 内部としてはこういう感じになっている hash = ["a", "b"].each_with_object({}) {|v, o| o[v.hash] = v } # => {690777552598146486=>"a", -2489798041940868951=>"b"} # これはつまり… set.include?("a") # => true # こういうこと。総当りせず、hash値がキーとヒットするかを調べるので速い hash.keys.include?("a".hash) # => true
つまり… • usersテーブルの内容を全て持ってきてSetに⼊れてしまえばN回発⾏される クエリは必要ない!(富豪的発想) • なぜ富豪的? • メモリにusersテーブルの全データを載せるから
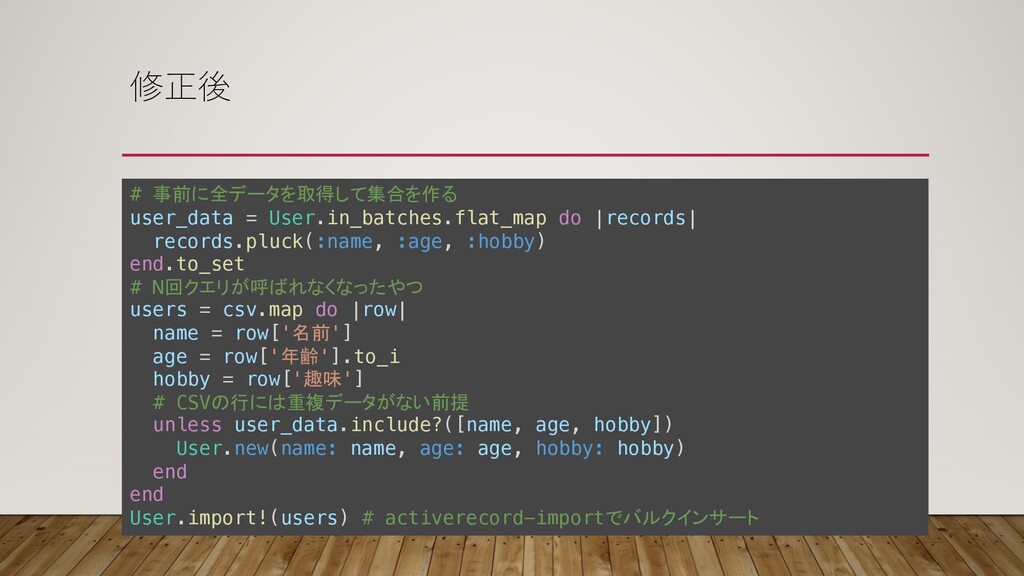
修正後 # 事前に全データを取得して集合を作る user_data = User.in_batches.flat_map do |records| records.pluck(:name, :age,
:hobby) end.to_set # N回クエリが呼ばれなくなったやつ users = csv.map do |row| name = row['名前'] age = row['年齢'].to_i hobby = row['趣味'] # CSVの行には重複データがない前提 unless user_data.include?([name, age, hobby]) User.new(name: name, age: age, hobby: hobby) end end User.import!(users) # activerecord-importでバルクインサート
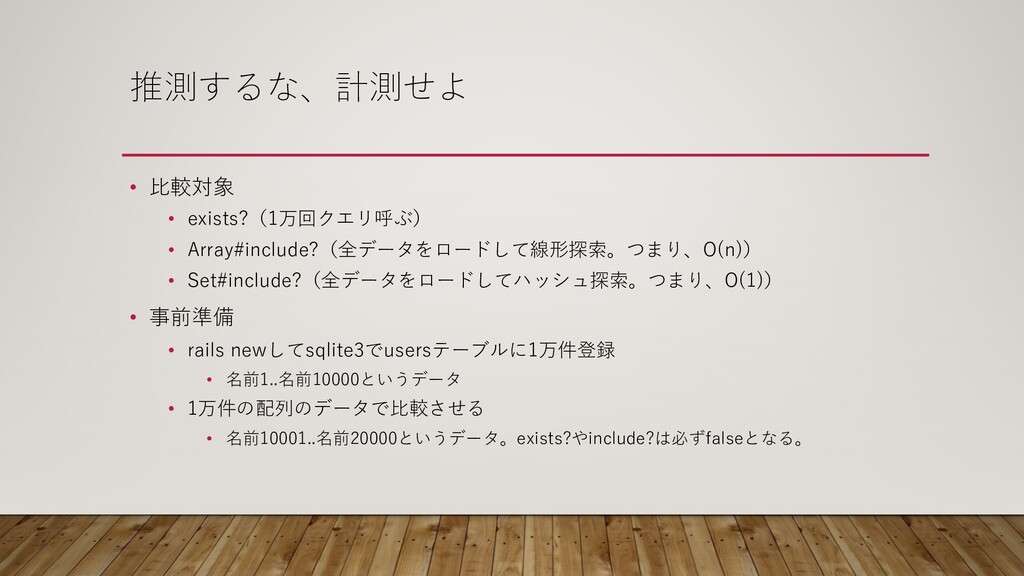
推測するな、計測せよ • ⽐較対象 • exists?(1万回クエリ呼ぶ) • Array#include?(全データをロードして線形探索。つまり、O(n)) • Set#include?(全データをロードしてハッシュ探索。つまり、O(1)) •
事前準備 • rails newしてsqlite3でusersテーブルに1万件登録 • 名前1..名前10000というデータ • 1万件の配列のデータで⽐較させる • 名前10001..名前20000というデータ。exists?やinclude?は必ずfalseとなる。
推測するな、計測せよ(結果) bin/rails runner script/benchmark.rb Warming up -------------------------------------- exists? 1.000 i/100ms
Array#include? 1.000 i/100ms Set#include? 1.000 i/100ms Calculating ------------------------------------- exists? 0.085 (± 0.0%) i/s - 1.000 in 11.734614s Array#include? 0.059 (± 0.0%) i/s - 1.000 in 17.012424s Set#include? 8.503 (± 0.0%) i/s - 43.000 in 5.064850s Comparison: Set#include?: 8.5 i/s exists?: 0.1 i/s - 99.78x (± 0.00) slower Array#include?: 0.1 i/s - 144.66x (± 0.00) slower
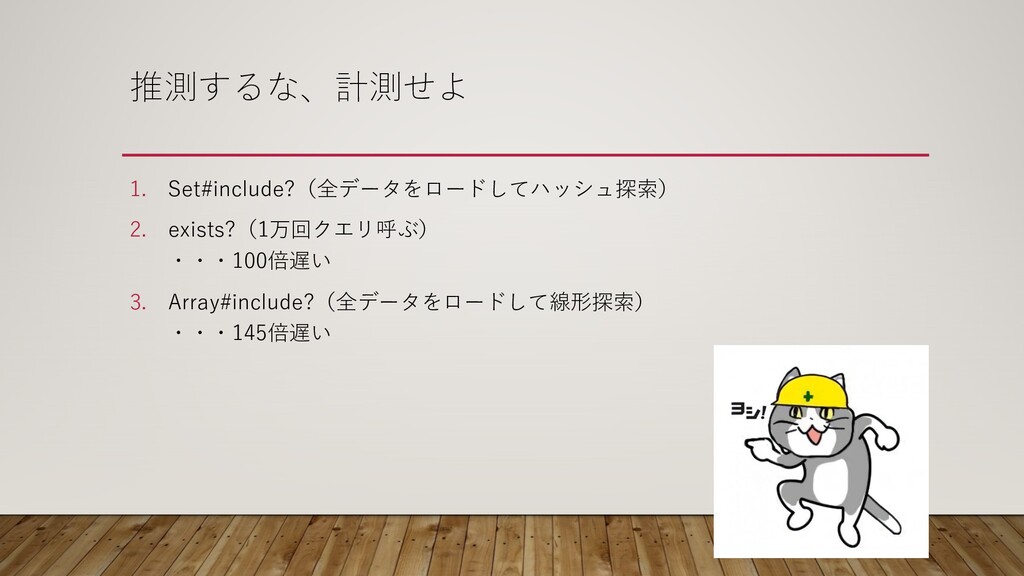
推測するな、計測せよ 1. Set#include?(全データをロードしてハッシュ探索) 2. exists?(1万回クエリ呼ぶ) ・・・100倍遅い 3. Array#include?(全データをロードして線形探索) ・・・145倍遅い
ご清聴ありがとうございました


 patorash
 kairim0
 osawa
 bcantrill
 pauli
 shreyas1009
 masakane55
 kameitomohiro
 mananyuki
 tosite
 kitagawaz
 oracle4engineer
 ufried
 codingconduct
 marketingsoph
 skipperchong
 brettharned
 axbom
 schlessera
 chriscoyier
 vanstee
 deanohume
 palkan
 danielanewman
 sferik