Share
Embed
Describe data analysis workflow with workflow languages
ワークフロー言語でデータ解析ワークフローを記述する @ 希少疾患インフォマティクス2 https://misshie.github.io/rdinfo2020/
Tazro Inutano Ohta
February 17, 2020
Transcript
45 slides
-
⾃⼰紹介 ⼤⽥達郎, 特任助教 @ DBCLS twitter, github: @inutano 遺伝学研究所 (静岡県三島市)
勤務 DDBJ のお隣さん 最近のお仕事 RDFによるNGSデータやサンプル情報の統合 Common Workflow Language を⽤いた解析パイプライン構築 ⽉例技術者交流会 Pitagora Meetup のホスト 関連: Workflow Meetup -
0. ⾊々のツールを⾃分のマシンにインストールしては試す 1. 本命のツールが固まったので [好きな⾔語] でワークフローを組む 2. ⾃分の使っているクラスタで分散処理できるようバッチ処理を組む 3. ⼤量のデータを流してはせっせと結果をこしらえる
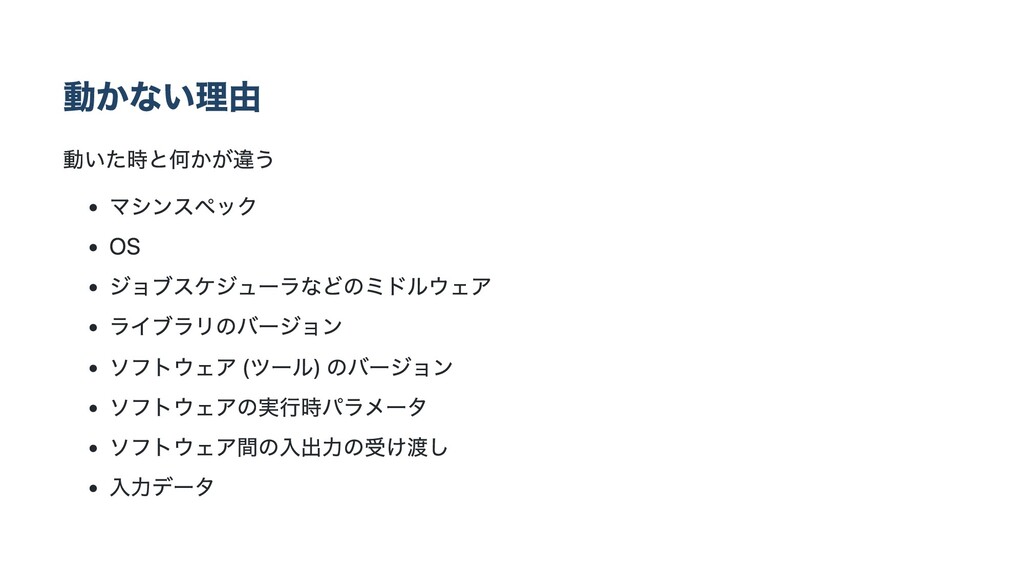
4. 数年が経つ 5. ⾔語やフレームワークのバージョン、使っているマシンのOSが変わる 6. ある⽇突然もう⼀度同じ処理をする必要が発⽣する 7. 昔作ったワークフローを動かしてみるが動かない 8. 直しても直してもエラーが出る 9. 書き直した⽅が早いんじゃないかと思い始める頃には何⽇も経っている -
0. ⾊々のツールを⾃分のマシンにインストールしては試す 1. 本命のツールが固まったので [好きな⾔語] でワークフローを組む 2. ⾃分の使っているクラスタで分散処理できるようバッチ処理を組む 3. ⼤量のデータを流してはせっせと結果をこしらえる
4. ある⽇ (同僚|共同研究者|論⽂を読んだ知らない誰か) からWFをくれと頼まれる 5. スクリプト群を渡して使い⽅を説明する 6. 少しすると「"....." というエラーが出て進まない」と問い合わせがくる 7. ⾃分のところではそんなエラーは出ない。多分これかな?と指⽰を出す 8. 「今度は "....." というエラーが出て進まない」と問い合わせがくる 9. 以下 7-8 をうんざりするまで繰り返す、時間が奪われる、進捗が失われる -
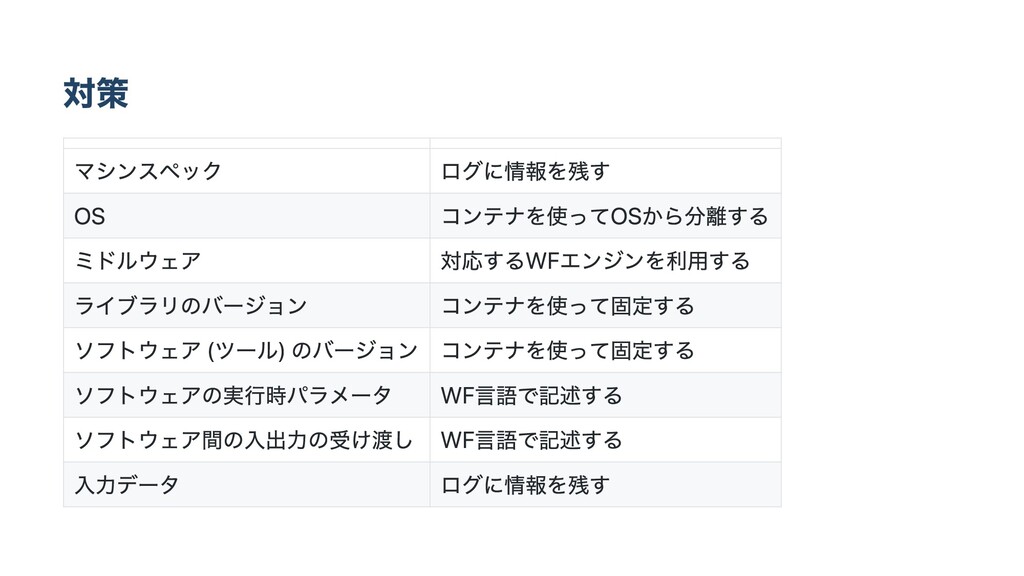
対策 マシンスペック ログに情報を残す OS コンテナを使ってOSから分離する ミドルウェア 対応するWFエンジンを利⽤する ライブラリのバージョン コンテナを使って固定する ソフトウェア
(ツール) のバージョン コンテナを使って固定する ソフトウェアの実⾏時パラメータ WF⾔語で記述する ソフトウェア間の⼊出⼒の受け渡し WF⾔語で記述する ⼊⼒データ ログに情報を残す -
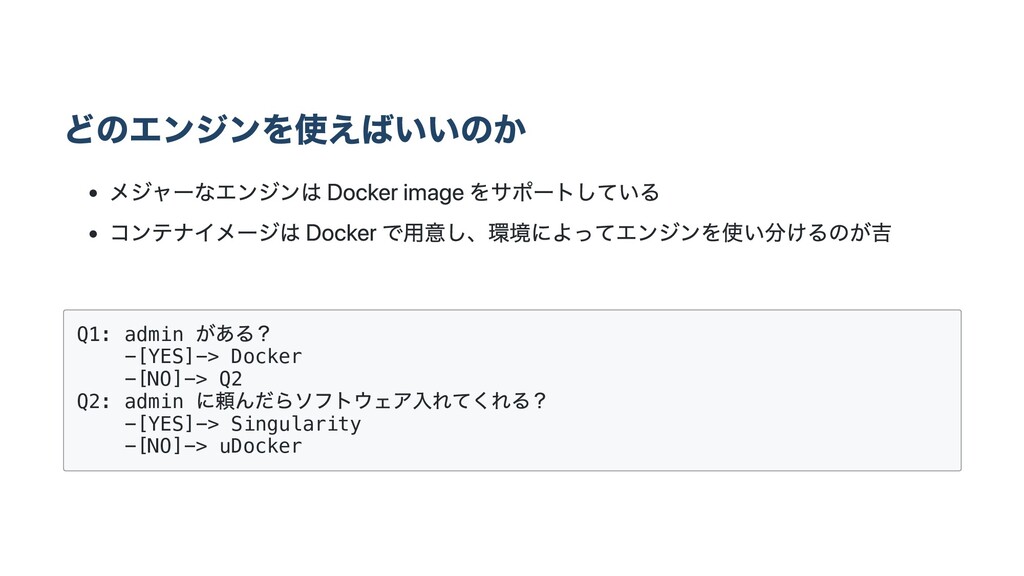
どのエンジンを使えばいいのか メジャーなエンジンは Docker image をサポートしている コンテナイメージは Docker で⽤意し、環境によってエンジンを使い分けるのが吉 Q1: admin
がある? -[YES]-> Docker -[NO]-> Q2 Q2: admin に頼んだらソフトウェア⼊れてくれる? -[YES]-> Singularity -[NO]-> uDocker -
⾃作スクリプト ローカルにあるスクリプトファイルを COPY するのはやめよう Dockerfile だけあればビルドできる⽅がよりポータブルで管理が楽 「Dockerfile と同じ場所にあるスクリプトを名前で指定」という仕様が危険 ここで意図しない挙動が起きるとデバッグ時に気付けない GitHub
でスクリプトをきちんとバージョン管理、タグを打っておく GitHub で Release を作って ADD で取ってくるのがよい (by @suecharo) スクリプト間で利⽤するライブラリの衝突の⼼配がなければマイスクリプト全部⼊りユー ティリティコンテナを作っても 理想はバラバラのスクリプトよりは1つのコマンドラインツール、複数のサブコマン ドとして実装したい -
なるべく軽いイメージを サイズが⼤きいと取り回しが⼤変 テストや開発時にビルドを繰り返す場合に負担 サイズの⼩さいベースイメージを使う e.g. debian, alpine 不要なライブラリは⼊れない、ビルド時にのみ必要なライブラリは構築後に削る パッケージマネージャの機能を使う alpine
の apk add --virtual とか (参考) マルチステージビルドを活⽤する (参考) -
コンテナのバージョン管理 ⼿動はしんどいので⾃動化しましょう Dockerfile を書いて GitHub に置く タグとリリースを適切に付与してバージョン管理する Docker Hub もしくは
Quay を使って Automated build でイメージを作る イメージタグをGitHubのタグに連携してつける latest はデバッグで死ぬので絶対に使ってはいけない -
シェアウェアの闇 有償、ユーザ登録が必要、再配布が禁⽌されているツールは上の⽅法が使えない Dockerfile だけを公開しておき、イメージは⼿元でビルドしてもらう ツールはユーザにダウンロードしてもらい、コンテナは各⾃でビルド ツールのバージョンがコントロールできないなど問題が多い ビルドしたイメージをパーソナルコミュニケーションのレベルで配布する 再配布禁⽌に引っかかるのでツールによっては違反 いっそコンテナ化しない インストールの⼿間がそこまででもなければ、コンテナ化しなくていいかも
同等の機能を持つ他の選択肢があればこのようなツールは出来るだけ避ける もしそういう開発をやっている⼈間がいたら使いにくいからやめろと説得する MIT や Apache 2.0 などの緩いOSSを勧めよう -
BOSC 2019 で⼀定のユーザが確認できたもの BOSC: Bioinformatics Open Source Conference https://www.open-bio.org/events/bosc/ Galaxy
workflow specification (-2007) Workflow description language (WDL) (2012-) snakemake (2012-) nextflow (2013-) common workflow language (CWL) (2014-) -
ワークフロー⾔語の分類 シンタックスによる分類 Domain Specific Language (DSL) 型 データ型 (マークアップ型) 実⾏エンジンとの結合度合いによる分類
エンジンが選択可能 エンジンが選択不可 (密結合) 開発元による分類 個⼈ 研究所単位でのバックアップ コミュニティによる運営 -
Pros (and Cons) DSL vs Data DSL: ⼀度覚えたら書きやすい, 柔軟性が⾼い Data:
パースしやすいので変換が容易, ⽂法がプレーン 実⾏エンジン 固定: 開発リソースが分散しないので多機能、⾼機能に 複数: ⾃分の環境やニーズに合ったエンジンを選択できる 開発元 組織: 組織の信頼性や安定性が開発の品質に繋がりやすい 個⼈: ⾝軽だが継続性にリスクがある OSS: 組織と個⼈の中間, 品質や継続性はコミュニティのメンバーに依存する -
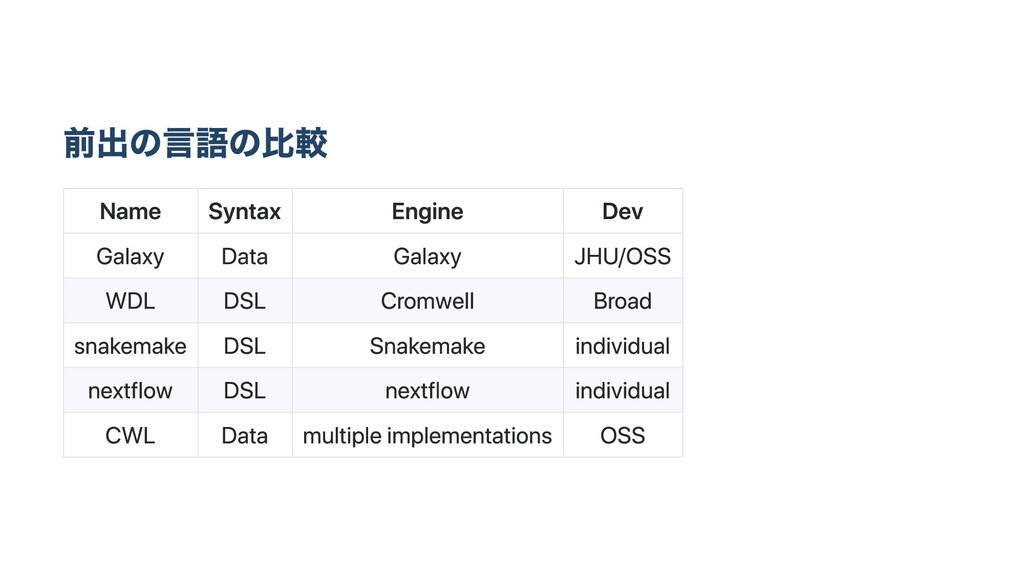
前出の⾔語の⽐較 Name Syntax Engine Dev Galaxy Data Galaxy JHU/OSS WDL
DSL Cromwell Broad snakemake DSL Snakemake individual nextflow DSL nextflow individual CWL Data multiple implementations OSS -
nextflow を選ぶ理由 柔軟な記法 コマンドラインを埋め込むような感覚で書ける パワフルなエンジン ⼤概のジョブスケジューラに対応、クラウドにも対応 コミュニティの勢い nf.core などのリソースも多い 少⼈数の同じくらいのスキルのチームで⽣産性を上げるなら現状はnextflowがベスト
BroadのGATK WFがWDLなのでこれらを再利⽤できるWDLもGood -
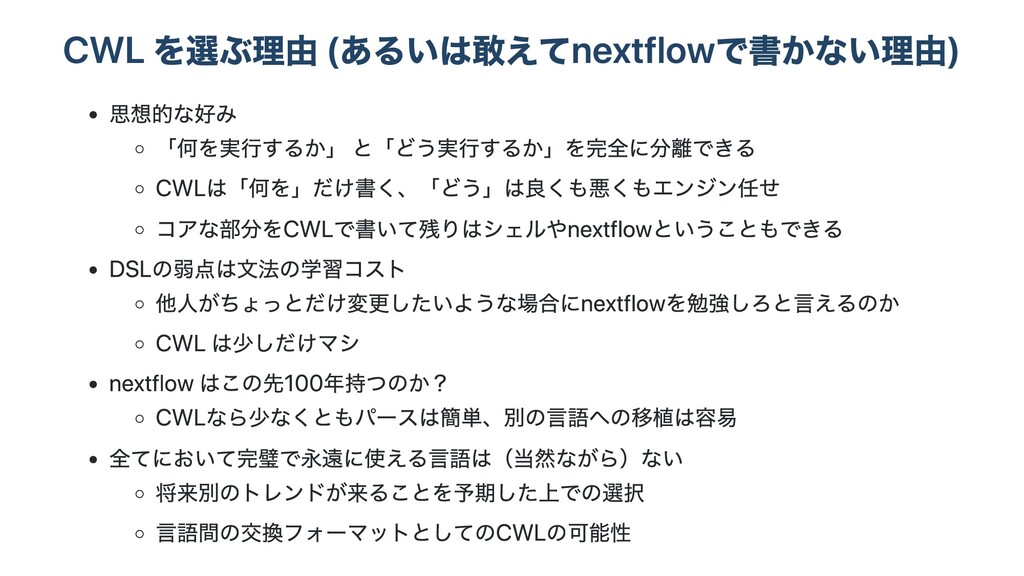
CWL を選ぶ理由 (あるいは敢えてnextflowで書かない理由) 思想的な好み 「何を実⾏するか」 と「どう実⾏するか」を完全に分離できる CWLは「何を」だけ書く、「どう」は良くも悪くもエンジン任せ コアな部分をCWLで書いて残りはシェルやnextflowということもできる DSLの弱点は⽂法の学習コスト 他⼈がちょっとだけ変更したいような場合にnextflowを勉強しろと⾔えるのか
CWL は少しだけマシ nextflow はこの先100年持つのか? CWLなら少なくともパースは簡単、別の⾔語への移植は容易 全てにおいて完璧で永遠に使える⾔語は(当然ながら)ない 将来別のトレンドが来ることを予期した上での選択 ⾔語間の交換フォーマットとしてのCWLの可能性 -
Common Workflow Language (CWL) BOSC⽣まれ、GitHub育ちの完全OSSプロジ ェクト 規約 (specification) と標準実装 (reference
implementation) YAMLベースで input/command/output を記 述する Bioinfo に限らない, 物理学分野などでも使っ ている⼈がいる ⽇本にも5⼈のコミッタがいる -
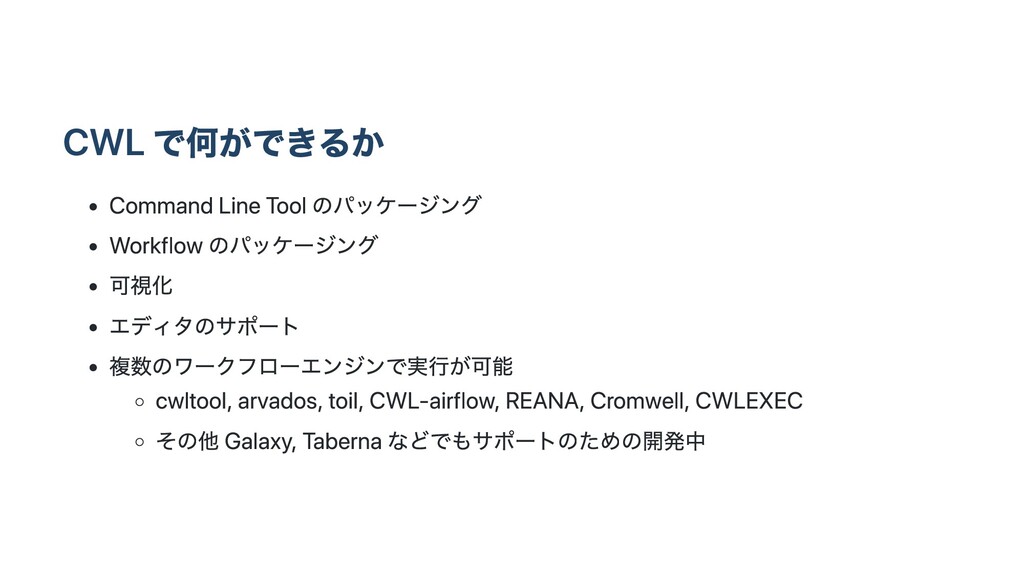
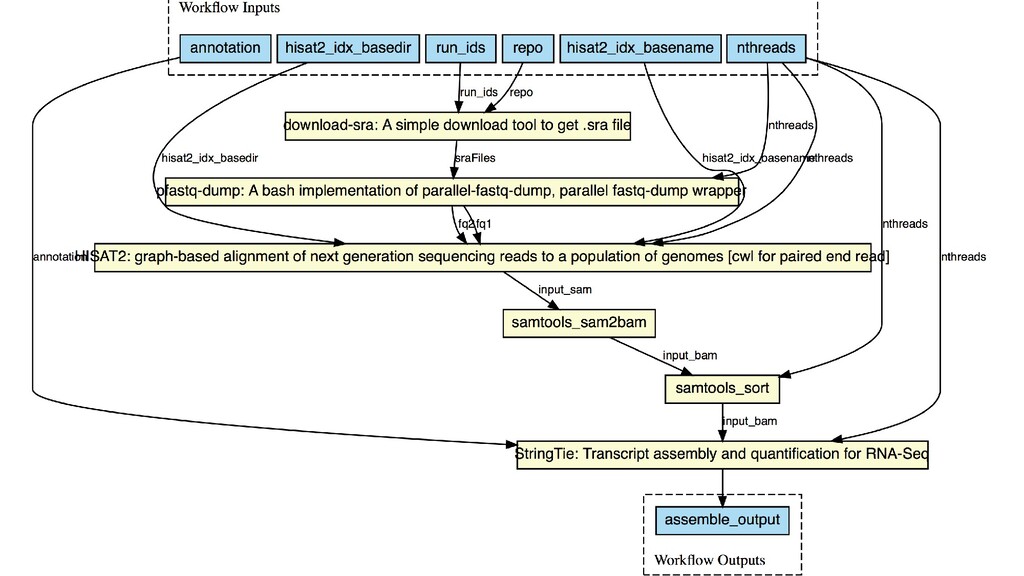
CWL で何ができるか Command Line Tool のパッケージング Workflow のパッケージング 可視化 エディタのサポート
複数のワークフローエンジンで実⾏が可能 cwltool, arvados, toil, CWL-airflow, REANA, Cromwell, CWLEXEC その他 Galaxy, Taberna などでもサポートのための開発中 -
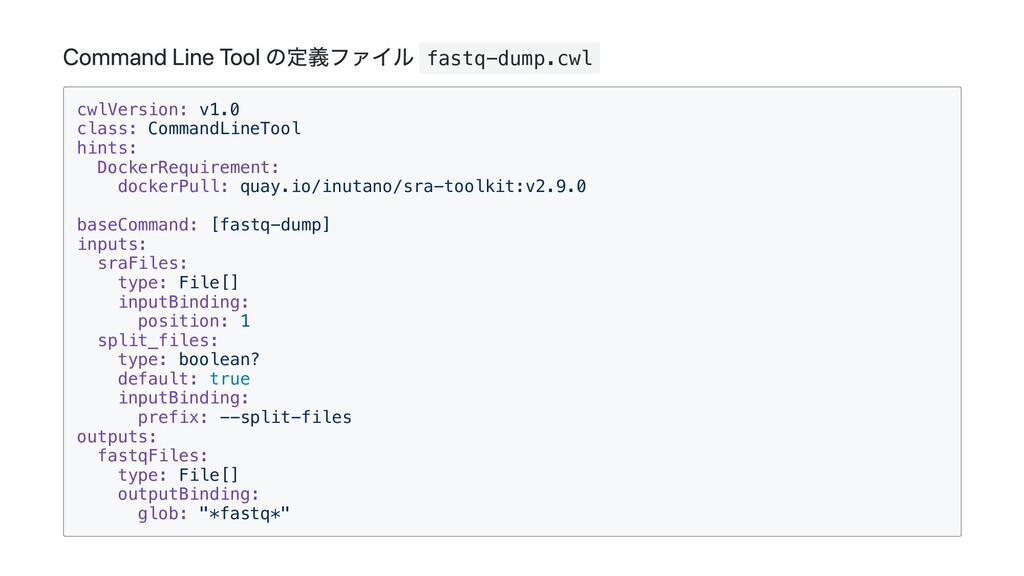
Command Line Tool の定義ファイル fastq-dump.cwl cwlVersion: v1.0 class: CommandLineTool hints:
DockerRequirement: dockerPull: quay.io/inutano/sra-toolkit:v2.9.0 baseCommand: [fastq-dump] inputs: sraFiles: type: File[] inputBinding: position: 1 split_files: type: boolean? default: true inputBinding: prefix: --split-files outputs: fastqFiles: type: File[] outputBinding: glob: "*fastq*" -
Workflow の定義ファイル fastqc_wf.cwl cwlVersion: v1.0 class: Workflow inputs: sra_files: File[]
outputs: fastqc_result: type: File[] outputSource: fastqc/fastqc_result steps: pfastq_dump: run: pfastq-dump.cwl in: sraFiles: sra_files out: [fastqFiles] fastqc: run: fastqc.cwl in: seqfile: pfastq_dump/fastqFiles out: [fastqc_result] -
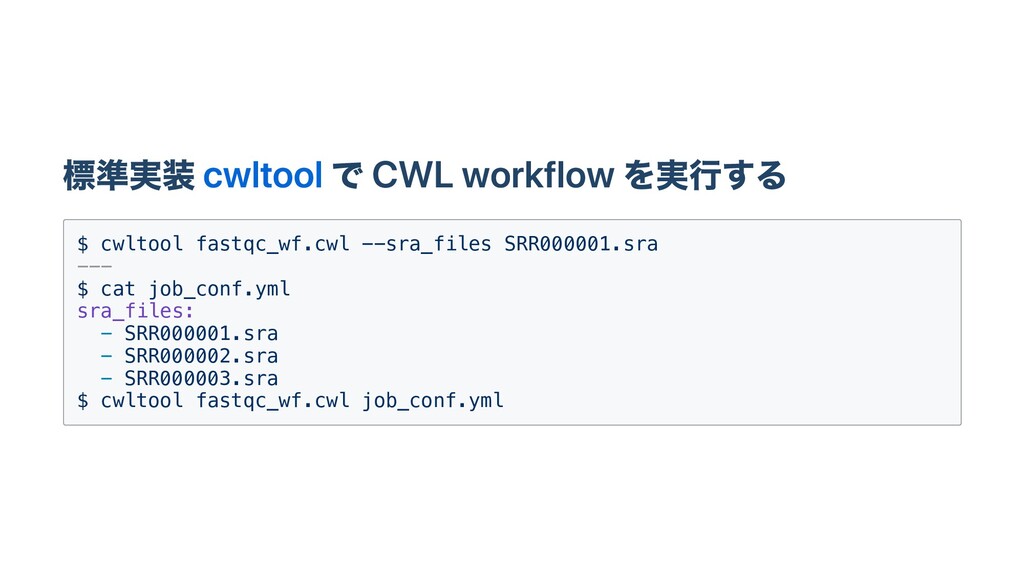
標準実装 cwltool で CWL workflow を実⾏する $ cwltool fastqc_wf.cwl --sra_files
SRR000001.sra --- $ cat job_conf.yml sra_files: - SRR000001.sra - SRR000002.sra - SRR000003.sra $ cwltool fastqc_wf.cwl job_conf.yml -
Implementations Name Platform cwltool Linux, OS X, Windows, local execution
only Arvados AWS, GCP, Azure, Slurm Toil AWS, Azure, GCP, Grid Engine, OpenStack, Slurm, etc. CWL-Airflow Linux, OS X REANA Kubernetes, CERN OpenStack (OpenStack Magnum) Cromwell Google, HTCondor, Local, LSF, PBS/Torque, SGE, Slurm, TES CWLEXEC IBM Spectrum LSF 10.1.0.3+ -
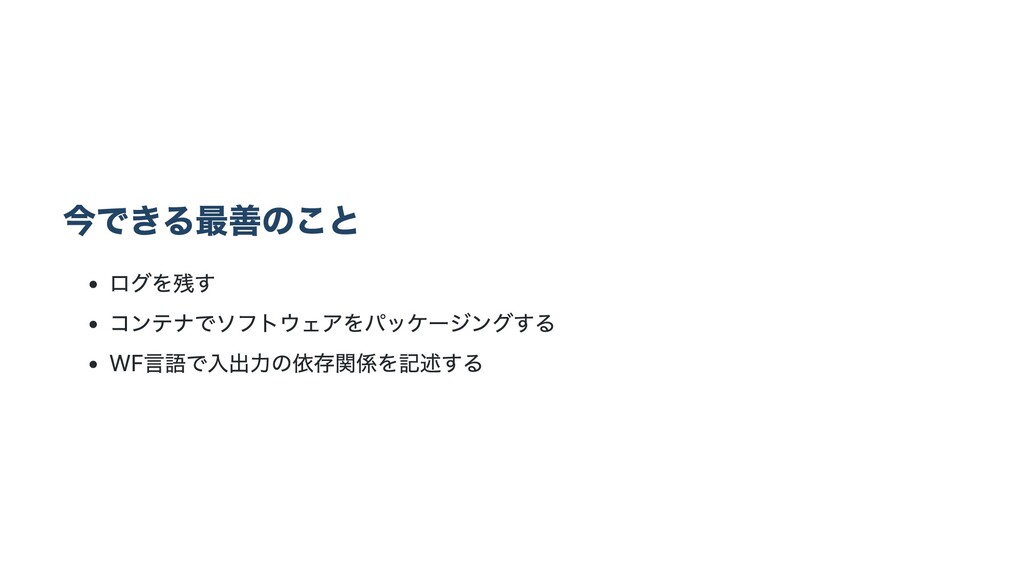
詳細なログを残すことの重要性 残すべき情報 コンテナ、WF⾔語で分離したもの「以外」 e.g. マシン、OS、ミドルウェア、⼊⼒データ WFエンジンのログ情報を利⽤ cwltool --debug ResearchObject というハードコアな⼿段もある
cwltool --provenance マシンスペックと消費リソースを記録するユーティリティツール cwl-metrics github.com/inutano/cwl-metrics -
番外編: Notebook Notebookは最⾼ 前述の通り試⾏錯誤はWF⾔語ではなくnotebookでやるべき R, python, Julia による統計解析と可視化は notebook 以外あり得ない
notebook である程度固まってからWF⾔語に落とし込むというフローがベスト NGSの⽂脈で⾔うと以下のような役割分担 配列データ - (WF⾔語) -> vcfなどのテーブルデータ - (notebook) -> 統計値や図 Notebook もコンテナで: hub.docker.com/u/jupyter -
追記: 当⽇の質疑の⼀部 再配布不可のツールの現状のコンテナ化ベストプラクティスは ツールは各⾃でインストールしてもらい、インストールされているツールが正しい バージョンかどうかを確かめるステップをWFに⼊れるのがよい blastのdbファイルなどはどのように扱うのがよいか? コンテナには含めずオブジェクトストレージなどに置いておきそれをワークフロー の⼊⼒として取りに⾏くのがよいが、サイズやデータの消費期限次第。 DSL vs
Data, ⼊出⼒のハンドリングが柔軟なのは? ⼤量の⼊出⼒の処理などはDSLの⽅が得意。Dataでも書けるが冗⻑になりがち KNIMEのような統合環境はないか? 強いて⾔えば Galaxy か。Rabix Composer も近い 配列解析はツールのバリエーションが多い、ライフサイクルが⽐較的短いため CLI が好まれがちだと思われる