Upgrade to Pro
— share decks privately, control downloads, hide ads and more …
Speaker Deck
Sign up for free
Menu
Search
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Features
All features
Private URLs
Password Protection
Custom URLS
Scheduled publishing
Remove Branding
Restrict embedding
Deck Collections
Notes
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Explore
Featured decks
Featured speakers
Programming
Technology
Storyboards
Pricing
Search
Sign in
Sign up for free
Monocular 3D Object Detection Survey
Search
Hata Ryosuke
January 22, 2020
Research
520
3
Share
Embed
Copy iframe code
Copy JS code
Copy link
Start on current slide
Monocular 3D Object Detection Survey
Survey for a kaggle competition: Peking University/Baidu - Autonomous Driving
Hata Ryosuke
January 22, 2020
More Decks by Hata Ryosuke
See All by Hata Ryosuke
関西Kaggler会 発表スライド
ryosukehata
1
1.3k
pytorchで機械学習しない
ryosukehata
3
1.1k
量子情報勉強会,量子ゲートについて
ryosukehata
0
260
Other Decks in Research
See All in Research
MM-OVSeg: Multimodal Optical–SAR Fusion for Open-Vocabulary Segmentation in Remote Sensing
satai
3
130
J-STAGEの現況と全文XML登載必須化について
xspa2012
0
220
LA-Bench 2025:実験指示から 実行可能手順を生成するためのデータセット/LA-Bench 2025: A Dataset for Generating Executable Experimental Procedures from Experimental Instructions
stktu
0
150
最先端NLP 2026 論文紹介: Wait, Wait, Wait... Why Do Reasoning Models Loop? / SNLP Paper Review: Wait, Wait, Wait... Why Do Reasoning Models Loop?
tkng
0
220
ハードウェア研究で国際トップ会議を目指す!IROS 2027での論文採択を目指して
ayatokanada
6
3.7k
2025年度秋葉原ウォーカブルプロジェクト調査報告 「アキバらしいウォーカブル」とは何か
izumiyama_lab
1
220
2026年度 生成AI を活用した論文執筆ガイド/ワークショップ / 2026 Academic Year Guide to Writing Papers Using Generative AI - Workshop
ks91
PRO
0
230
MIRU2026 チュートリアル講演2:三次元データ処理の動向
nnchiba
6
4.8k
高性能計算機クラスタを用いた大規模点群処理による森林の単木抽出と構造解析
kentaitakura
1
130
[Fishers] DIVER OSINT CTF 2026 特化AIエージェントハーネスで挑戦するOSINT CTF
analokmaus
0
560
VLMの推論を高速化する視覚トークン削減の仕組み
tattaka
2
310
Apache Gravitinoで実現する Icebergカタログ統合とアクセスの一元化
matsumooon
0
500
Featured
See All Featured
Reflections from 52 weeks, 52 projects
jeffersonlam
356
21k
Evolving SEO for Evolving Search Engines
ryanjones
0
280
A brief & incomplete history of UX Design for the World Wide Web: 1989–2019
jct
2
500
Heart Work Chapter 1 - Part 1
lfama
PRO
9
36k
Hiding What from Whom? A Critical Review of the History of Programming languages for Music
tomoyanonymous
3
1.2k
Building Adaptive Systems
keathley
44
3.2k
Public Speaking Without Barfing On Your Shoes - THAT 2023
reverentgeek
1
560
Documentation Writing (for coders)
carmenintech
77
5.5k
A Modern Web Designer's Workflow
chriscoyier
699
190k
Conquering PDFs: document understanding beyond plain text
inesmontani
PRO
4
3k
How to Talk to Developers About Accessibility
jct
2
540
Effective software design: The role of men in debugging patriarchy in IT @ Voxxed Days AMS
baasie
0
510
Transcript
Monocular 3D Object Detection Survey 畑 遼介
Summary ・CAD modelを使わないもの[1, 2] End to Endで学習が可能。(OFTNet) ・CAD modelを使う[3, 4,
5, 6, 7] 1 Stage: Mask-RCNN, RoIを作成 2 Stage: RoIから三次元情報を作成 論文中よく使われているのはFaster R-CNNだが, ここから最後までやるのはつらそう。
[1] Orthographic Feature Transform for Monocular 3D Object Detection 2018/11
https://arxiv.org/abs/1811.08188
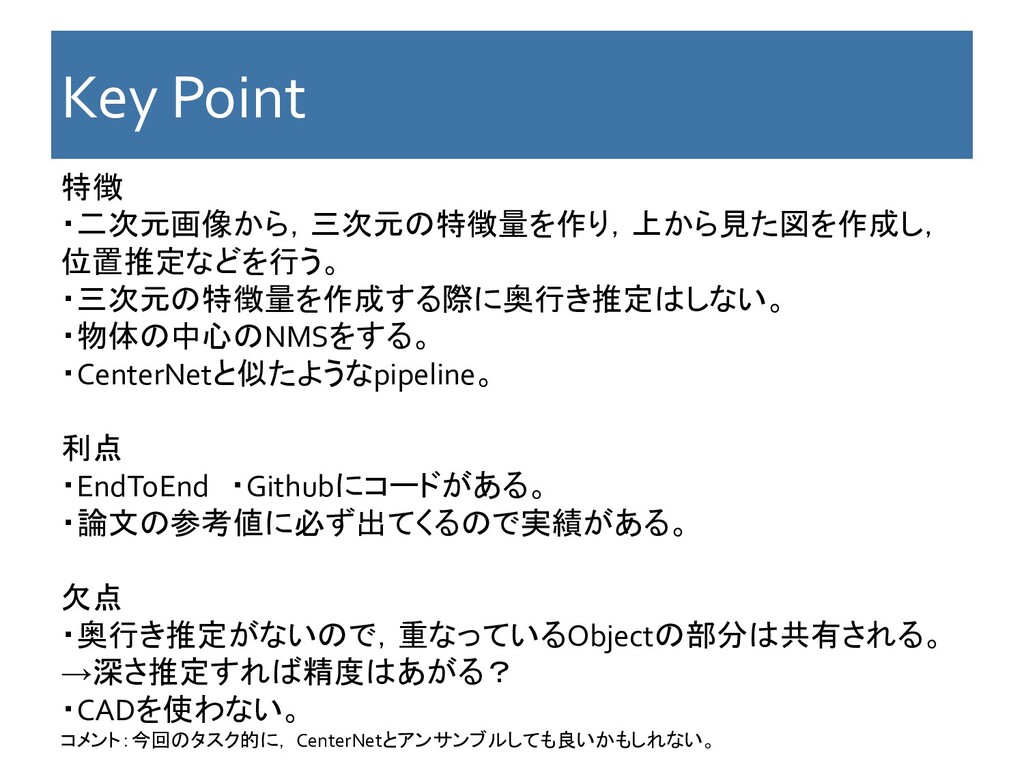
Key Point 特徴 ・二次元画像から,三次元の特徴量を作り,上から見た図を作成し, 位置推定などを行う。 ・三次元の特徴量を作成する際に奥行き推定はしない。 ・物体の中心のNMSをする。 ・CenterNetと似たようなpipeline。 利点 ・EndToEnd ・Githubにコードがある。
・論文の参考値に必ず出てくるので実績がある。 欠点 ・奥行き推定がないので,重なっているObjectの部分は共有される。 →深さ推定すれば精度はあがる? ・CADを使わない。 コメント:今回のタスク的に, CenterNetとアンサンブルしても良いかもしれない。
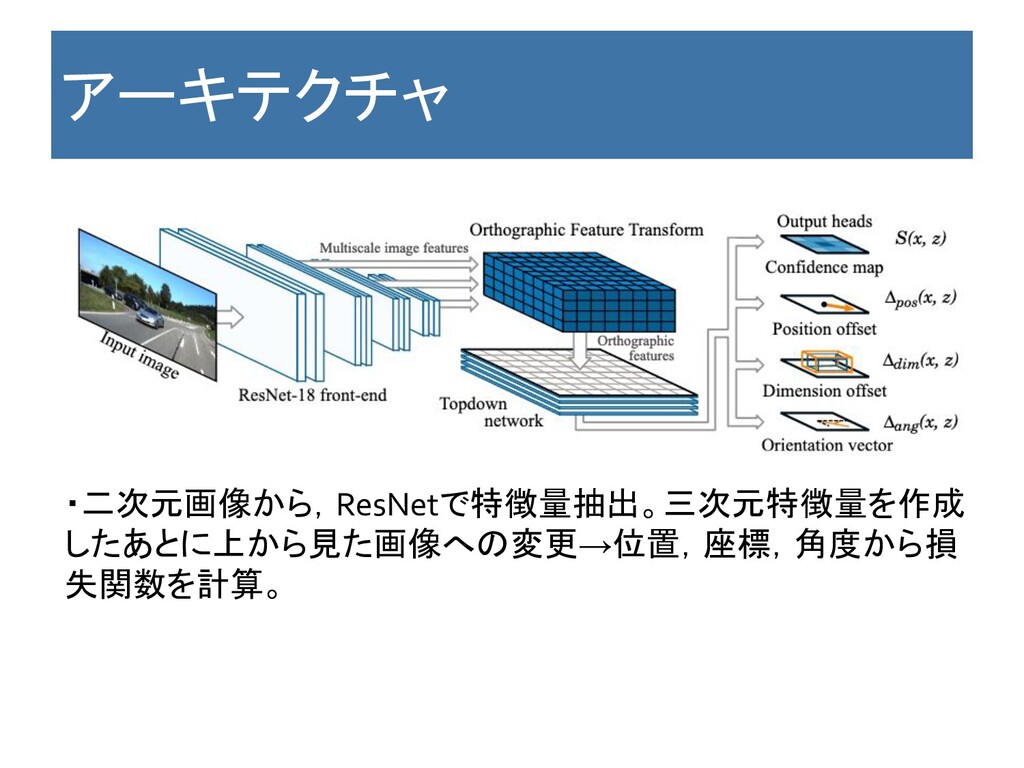
アーキテクチャ ・二次元画像から,ResNetで特徴量抽出。三次元特徴量を作成 したあとに上から見た画像への変更→位置,座標,角度から損 失関数を計算。
[2] SHIFT R-CNN: DEEP MONOCULAR 3D OBJECT DETECTION WITH CLOSED-FROM
GEOMETRIC CONSTRAINTS 2019/03 https://arxiv.org/abs/1905.09970
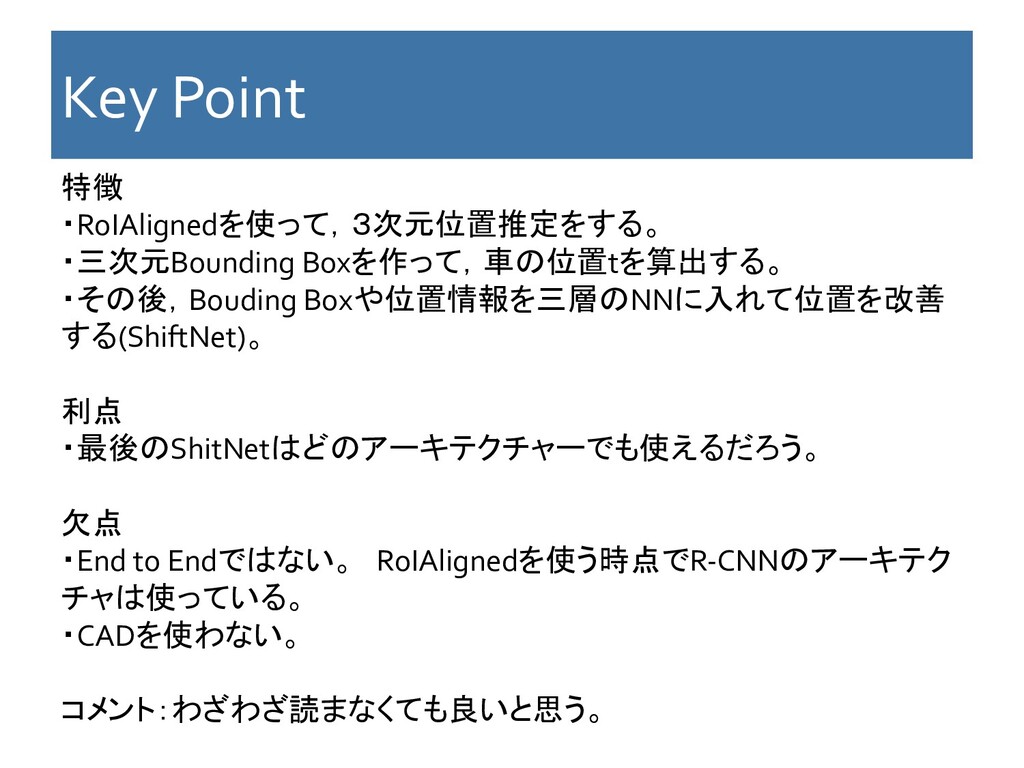
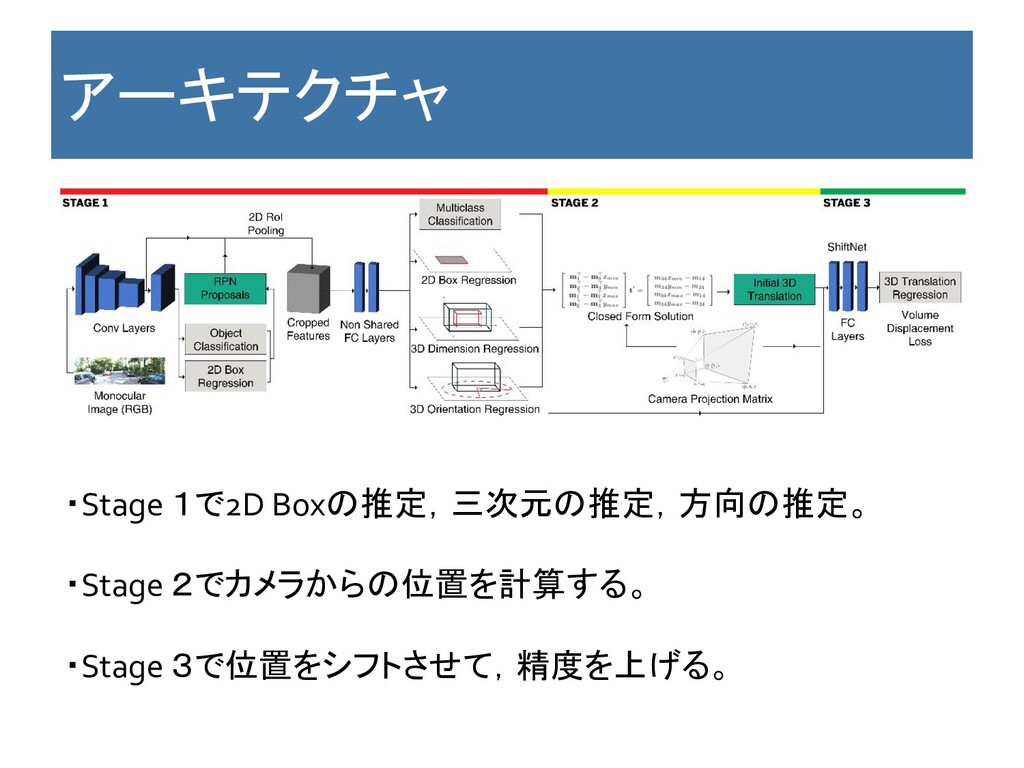
Key Point 特徴 ・RoIAlignedを使って,3次元位置推定をする。 ・三次元Bounding Boxを作って,車の位置tを算出する。 ・その後,Bouding Boxや位置情報を三層のNNに入れて位置を改善 する(ShiftNet)。 利点
・最後のShitNetはどのアーキテクチャーでも使えるだろう。 欠点 ・End to Endではない。 RoIAlignedを使う時点でR-CNNのアーキテク チャは使っている。 ・CADを使わない。 コメント:わざわざ読まなくても良いと思う。
アーキテクチャ ・Stage 1で2D Boxの推定,三次元の推定,方向の推定。 ・Stage 2でカメラからの位置を計算する。 ・Stage 3で位置をシフトさせて,精度を上げる。
[3] Deep MANT: A Coarse-to-fine Many-Task Network for joint 2D
and 3D vehicle analysis from monocular image 2017/3 https://arxiv.org/abs/1703.07570
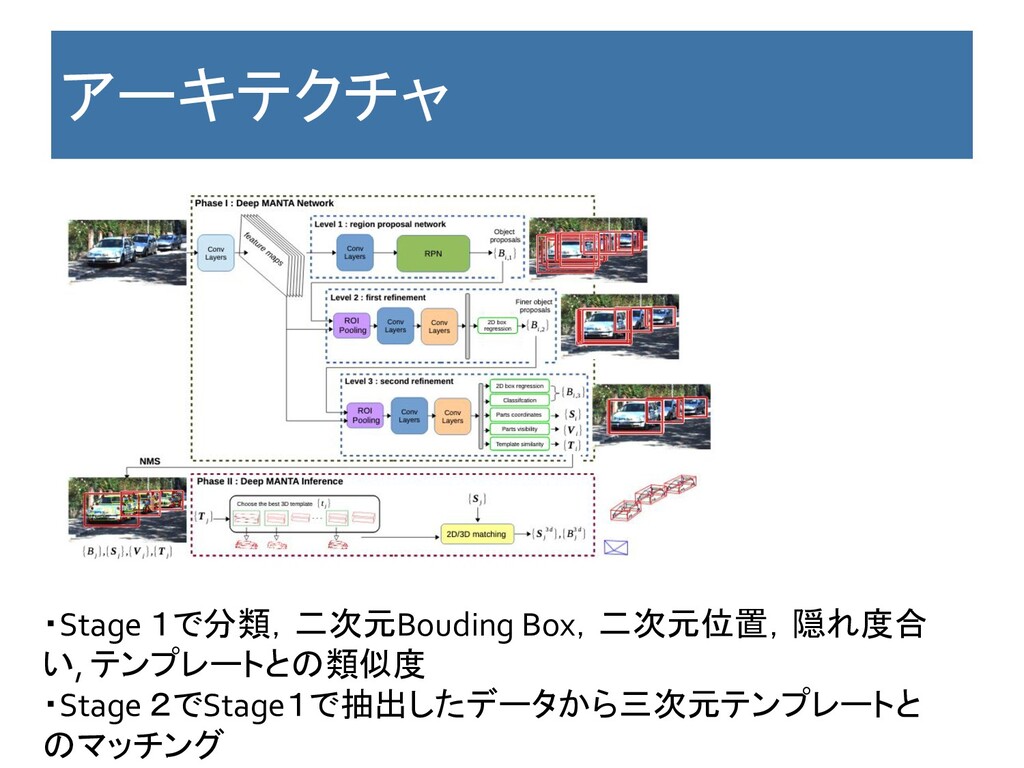
Key Point 特徴 ・二次元データから特徴点を抽出して三次元データとマッチさせるは じめの論文。 ・車は特徴的な形状をしているので,三次元データへと再現ができる と提言している。 利点 ・CADを使う。 欠点
・End to Endではない。Cascaded R-CNNのアーキテクチャを使って二 次元特徴量を出している。 ・三次元のテンプレートマッチングのやり方が不明。 コメント:精度はそこまで出ているわけではないので読まなくてもいい と思う。
アーキテクチャ ・Stage 1で分類,二次元Bouding Box,二次元位置,隠れ度合 い, テンプレートとの類似度 ・Stage 2でStage1で抽出したデータから三次元テンプレートと のマッチング
[4] 3D-RCNN: Instance-level 3D Object Reconstruction via Render-and-Compose 2018 http://abhijitkundu.info/projects/3D-RCNN/
CVPR 2018
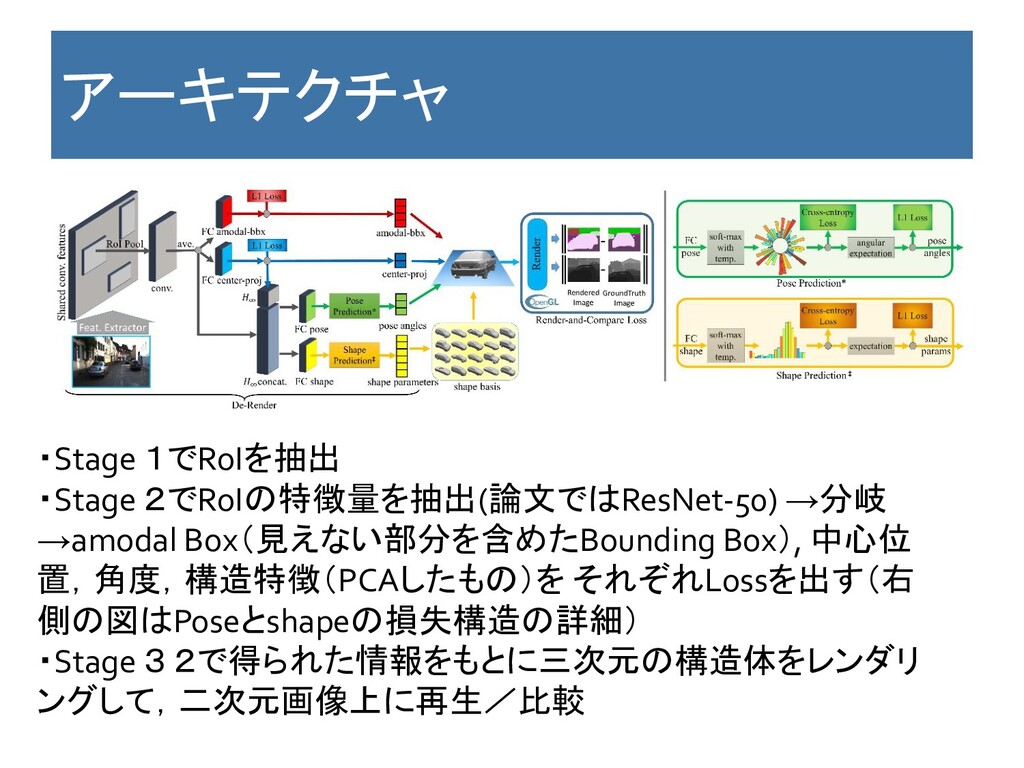
Key Point 特徴 ・RoIから特徴量抽出→分岐させてregression ・分岐の中身はamodal Box(見えない部分を含めたBounding Box), 中心位置,角度 ,3D CADをPCAで10次元に圧縮したもの。
・上の情報を使って三次元画像をレンダリング,二次元上に再生して,マスターと比 較。 利点 ・CADを使う。精度は出そう。 欠点 ・End to Endではない。 ・pipelineをすべて動かそうと思うと,R−CNNスタートで間にOpenGLを 使うことがあるので,手間がすごそう。 コメント:3D CADをPCAするアイデアは使えそう。 ただし,すべてのpipelineを通すとなると辛そう。
アーキテクチャ ・Stage 1でRoIを抽出 ・Stage 2でRoIの特徴量を抽出(論文ではResNet-50) →分岐 →amodal Box(見えない部分を含めたBounding Box),
中心位 置,角度,構造特徴(PCAしたもの)を それぞれLossを出す(右 側の図はPoseとshapeの損失構造の詳細) ・Stage 3 2で得られた情報をもとに三次元の構造体をレンダリ ングして,二次元画像上に再生/比較
[5] Mono3D++: Monocular 3D Vehicle Detection with Two-Scale 3D Hypotheses
and Task Priors 2019/1 https://arxiv.org/abs/1901.03446
Key Point 特徴 ・SSDの特徴量から2次元擬推定,3次元Bounding Box, WireFrameに よる推定によるJointで最終的にrobostな3次元位置推定。(別の車に 隠れている車があるので,より頑健にしたい) ・Loss function周りや,3次元推定の数式の説明が丁寧。
利点 ・SSDでやってるので,理屈の上ではEnd to End 欠点 ・実験は2次元Bounding Boxを出すのに一週間,その後の処理が2 時間とか書かれているので,End to Endとは言い難い。 ・数式を追うのが結構しんどい。 コメント:数式を読んで実装することを考えると参考にはならなさそう。 精読するならば読み応えありそう。
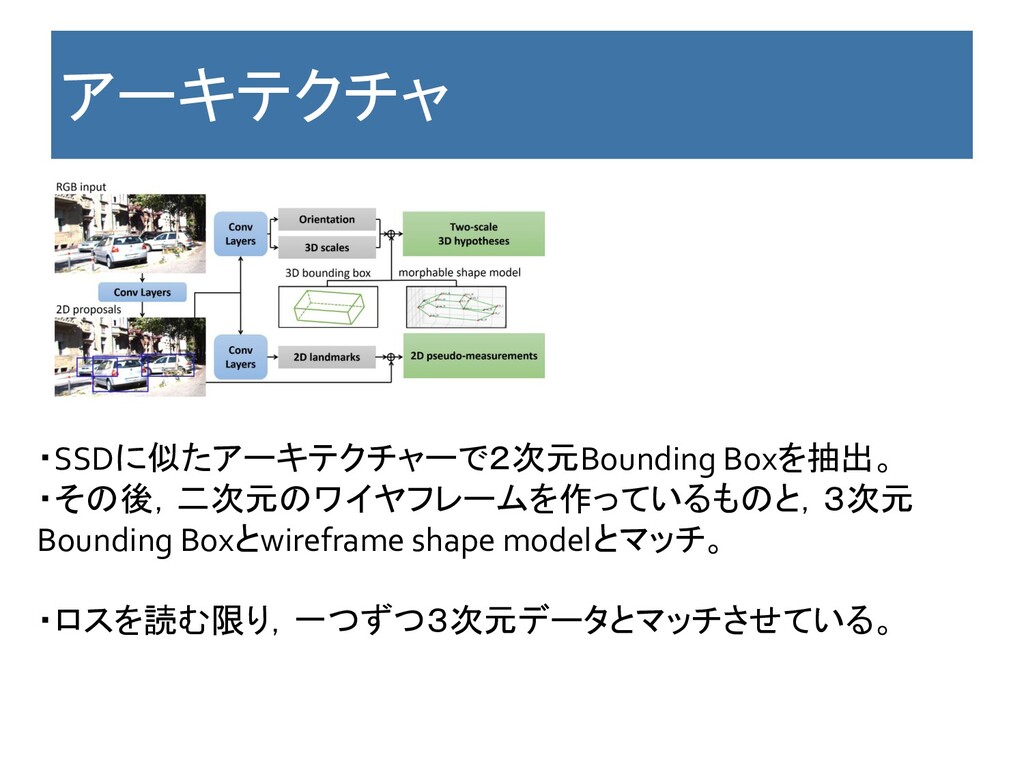
アーキテクチャ ・SSDに似たアーキテクチャーで2次元Bounding Boxを抽出。 ・その後,二次元のワイヤフレームを作っているものと,3次元 Bounding Boxとwireframe shape modelとマッチ。 ・ロスを読む限り,一つずつ3次元データとマッチさせている。
[6] Monocular 3D Object Detection via Geometric Reasoning on Keypoints
2019/5 https://arxiv.org/abs/1905.05618
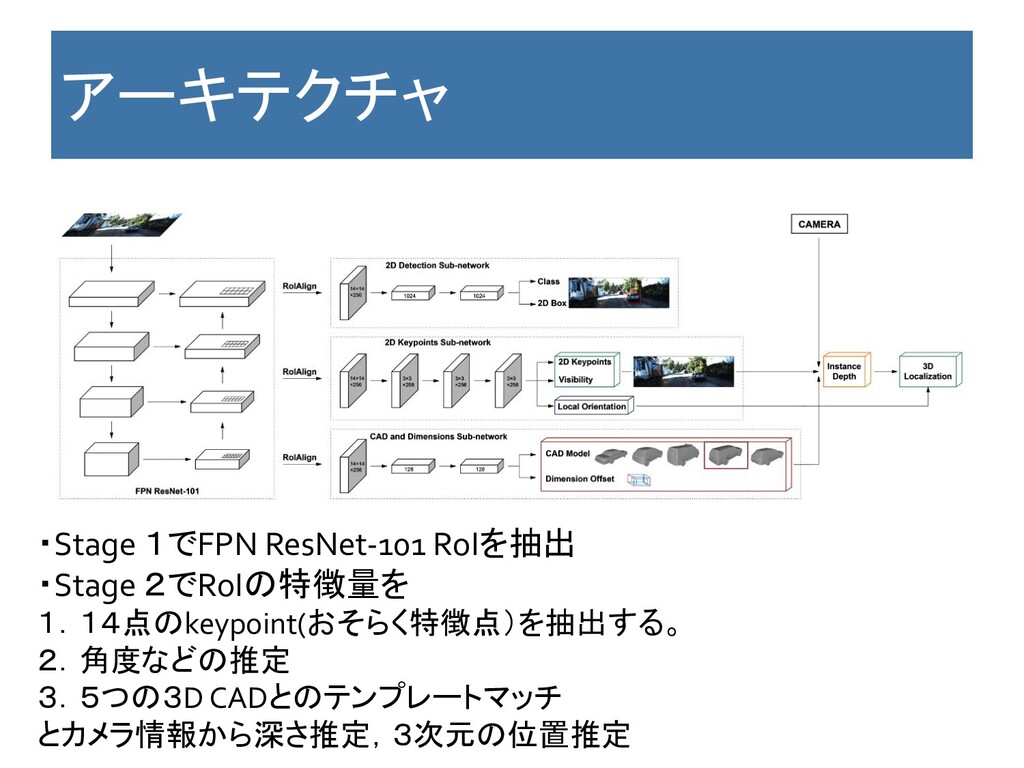
Key Point 特徴 ・Mask R-CNNを通したあとの2次元Bounding Boxの特徴量から1. 14点のkeypoint(おそらく特徴点)を抽出 2.角度などの推定 3.5つの3D CADとのテンプレートマッチ
する。 ・1➖3の特徴量から深さ推定して,位置を特定する。 利点 ・CADの一部を使う。 欠点 ・多分。End to Endではない コメント:使っているCADがセダンやミニバンなどの特徴的な車の5種 だったので途中で読むのをやめた。あまり有用ではないと思う。
アーキテクチャ ・Stage 1でFPN ResNet-101 RoIを抽出 ・Stage 2でRoIの特徴量を 1.14点のkeypoint(おそらく特徴点)を抽出する。 2.角度などの推定 3.5つの3D
CADとのテンプレートマッチ とカメラ情報から深さ推定,3次元の位置推定
[7] Monocular 3D Object Detection Leveraging Accurate Proposals and Shape
Reconstruction 2019/4 https://arxiv.org/abs/1904.01690 CVPR 2019
Key Point 特徴 ・2次元画像だけから,3次元位置を含んだ絵を作成することを目的 にした論文。 ・その過程で位置推定を行っている。 利点 ・実用上CADデータがない場合もあるので,そのときにも使える。 欠点 ・コンペ的にはCADは与えられているので,使わないことは欠点
コメント:Feature Mapの作り方は参考になりそうだが,研究内容が現 在のコンペの目的を超えているためすべての実装はいらない。技術 的には面白そう。
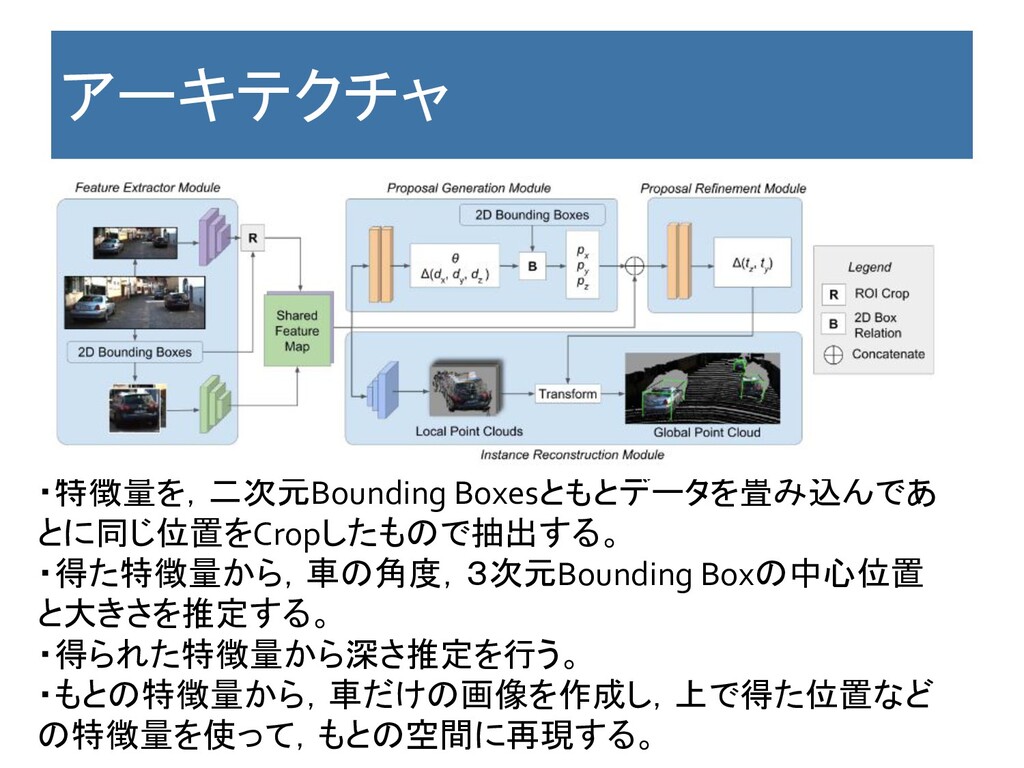
アーキテクチャ ・特徴量を,二次元Bounding Boxesともとデータを畳み込んであ とに同じ位置をCropしたもので抽出する。 ・得た特徴量から,車の角度,3次元Bounding Boxの中心位置 と大きさを推定する。 ・得られた特徴量から深さ推定を行う。 ・もとの特徴量から,車だけの画像を作成し,上で得た位置など の特徴量を使って,もとの空間に再現する。


 ryosukehata
 satai
 xspa2012
 stktu
 tkng
 ayatokanada
 izumiyama_lab
 ks91
 nnchiba
 kentaitakura
 analokmaus
 tattaka
 matsumooon
 jeffersonlam
 ryanjones
 jct
 lfama
 tomoyanonymous
 keathley
 reverentgeek
 carmenintech
 chriscoyier
 inesmontani
 baasie